1. Einführung
In diesem Codelab erfahren Sie, wie Sie mit Workflows und Diagrammen im Agent Development Kit (ADK) Agentensysteme der nächsten Generation erstellen. Sie implementieren gängige Architekturmuster, orchestrieren Human-in-the-Loop-Interaktionen (HITL) und verwalten asynchrone Ausführungen mit langer Laufzeit. Außerdem lernen Sie, unternehmenseigene Wissensdatenbanken und persistenten Speicher zu integrieren, um das Verhalten von KI-Agenten anzupassen und weiterzuentwickeln. Abschließend verbinden Sie diese Funktionen, um eine automatisierte Pipeline zur Videogenerierung zu erstellen.
Szenario
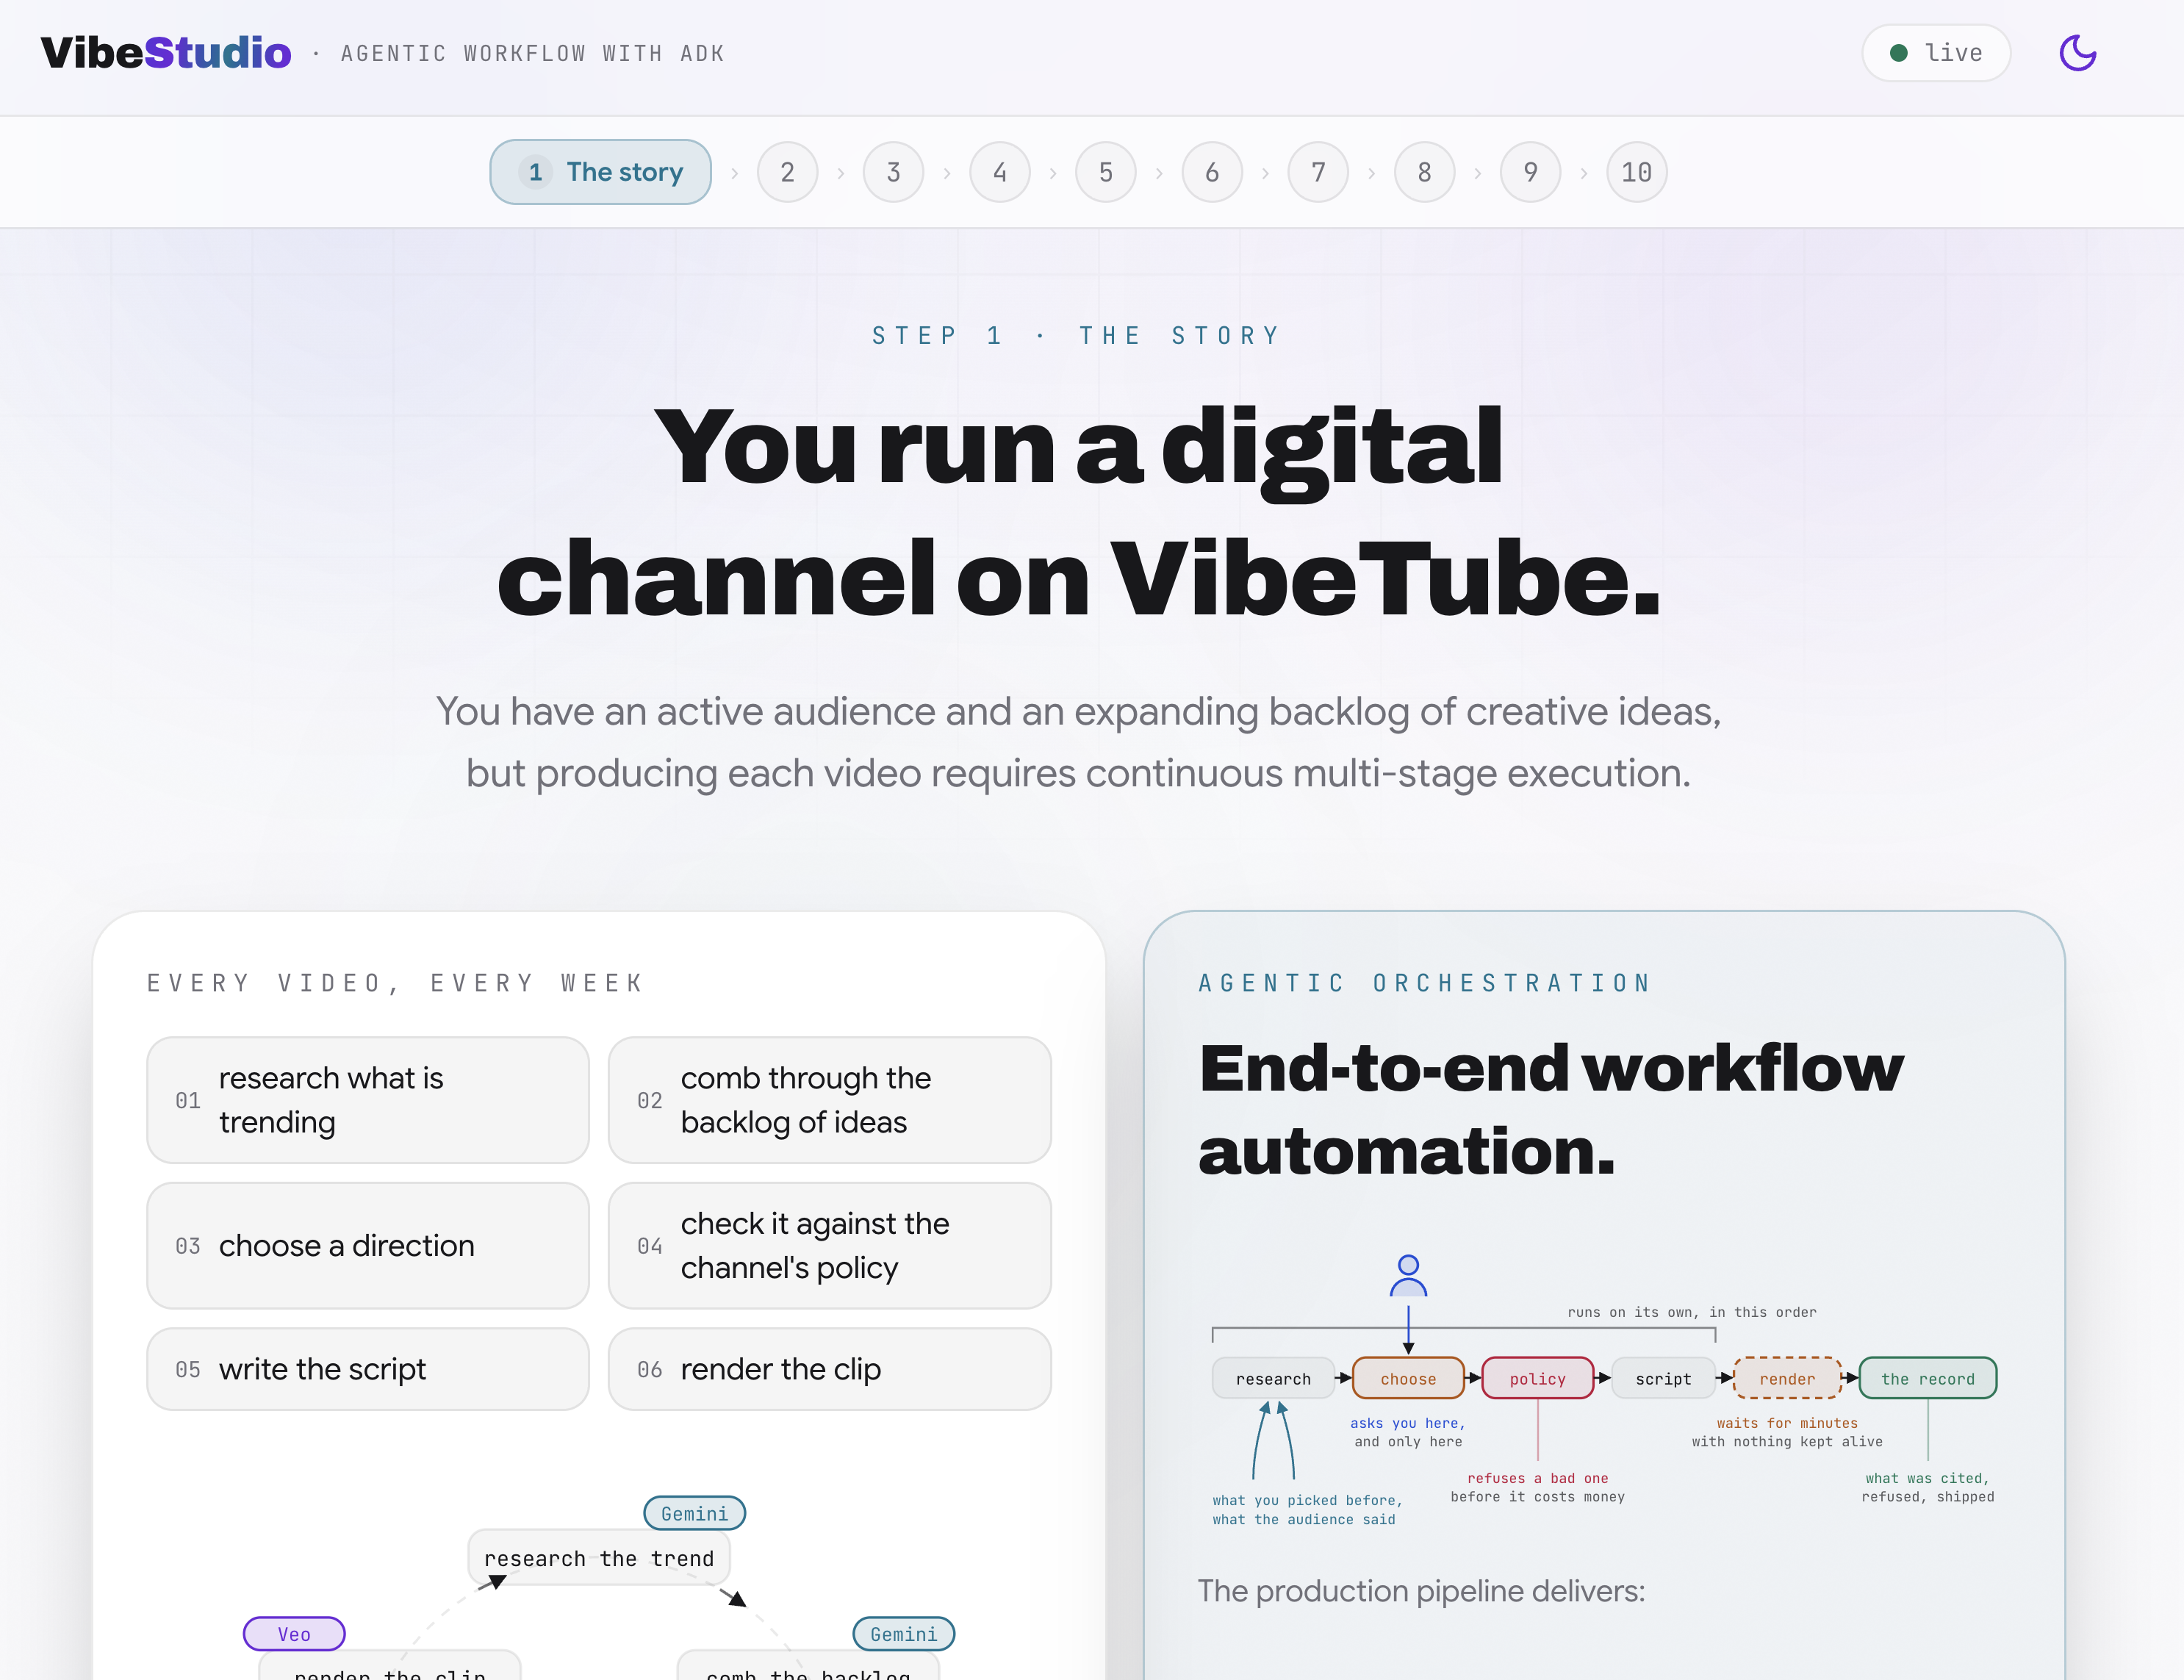
Du betreibst einen digitalen Kanal auf VibeTube mit einer aktiven Zielgruppe und einem wachsenden Fundus an kreativen Ideen. Für die Produktion jedes Videos sind mehrere Phasen erforderlich: Recherche nach aktuellen Formaten, Berücksichtigung von Zuschauerfeedback, Entwicklung von Skripten, Überprüfung der Richtlinienkonformität und Generierung von Videoclips. Generative Modelle können einzelne Assets entwerfen, aber für konsistente Releases ist eine orchestrierte KI-Agentenarchitektur erforderlich.
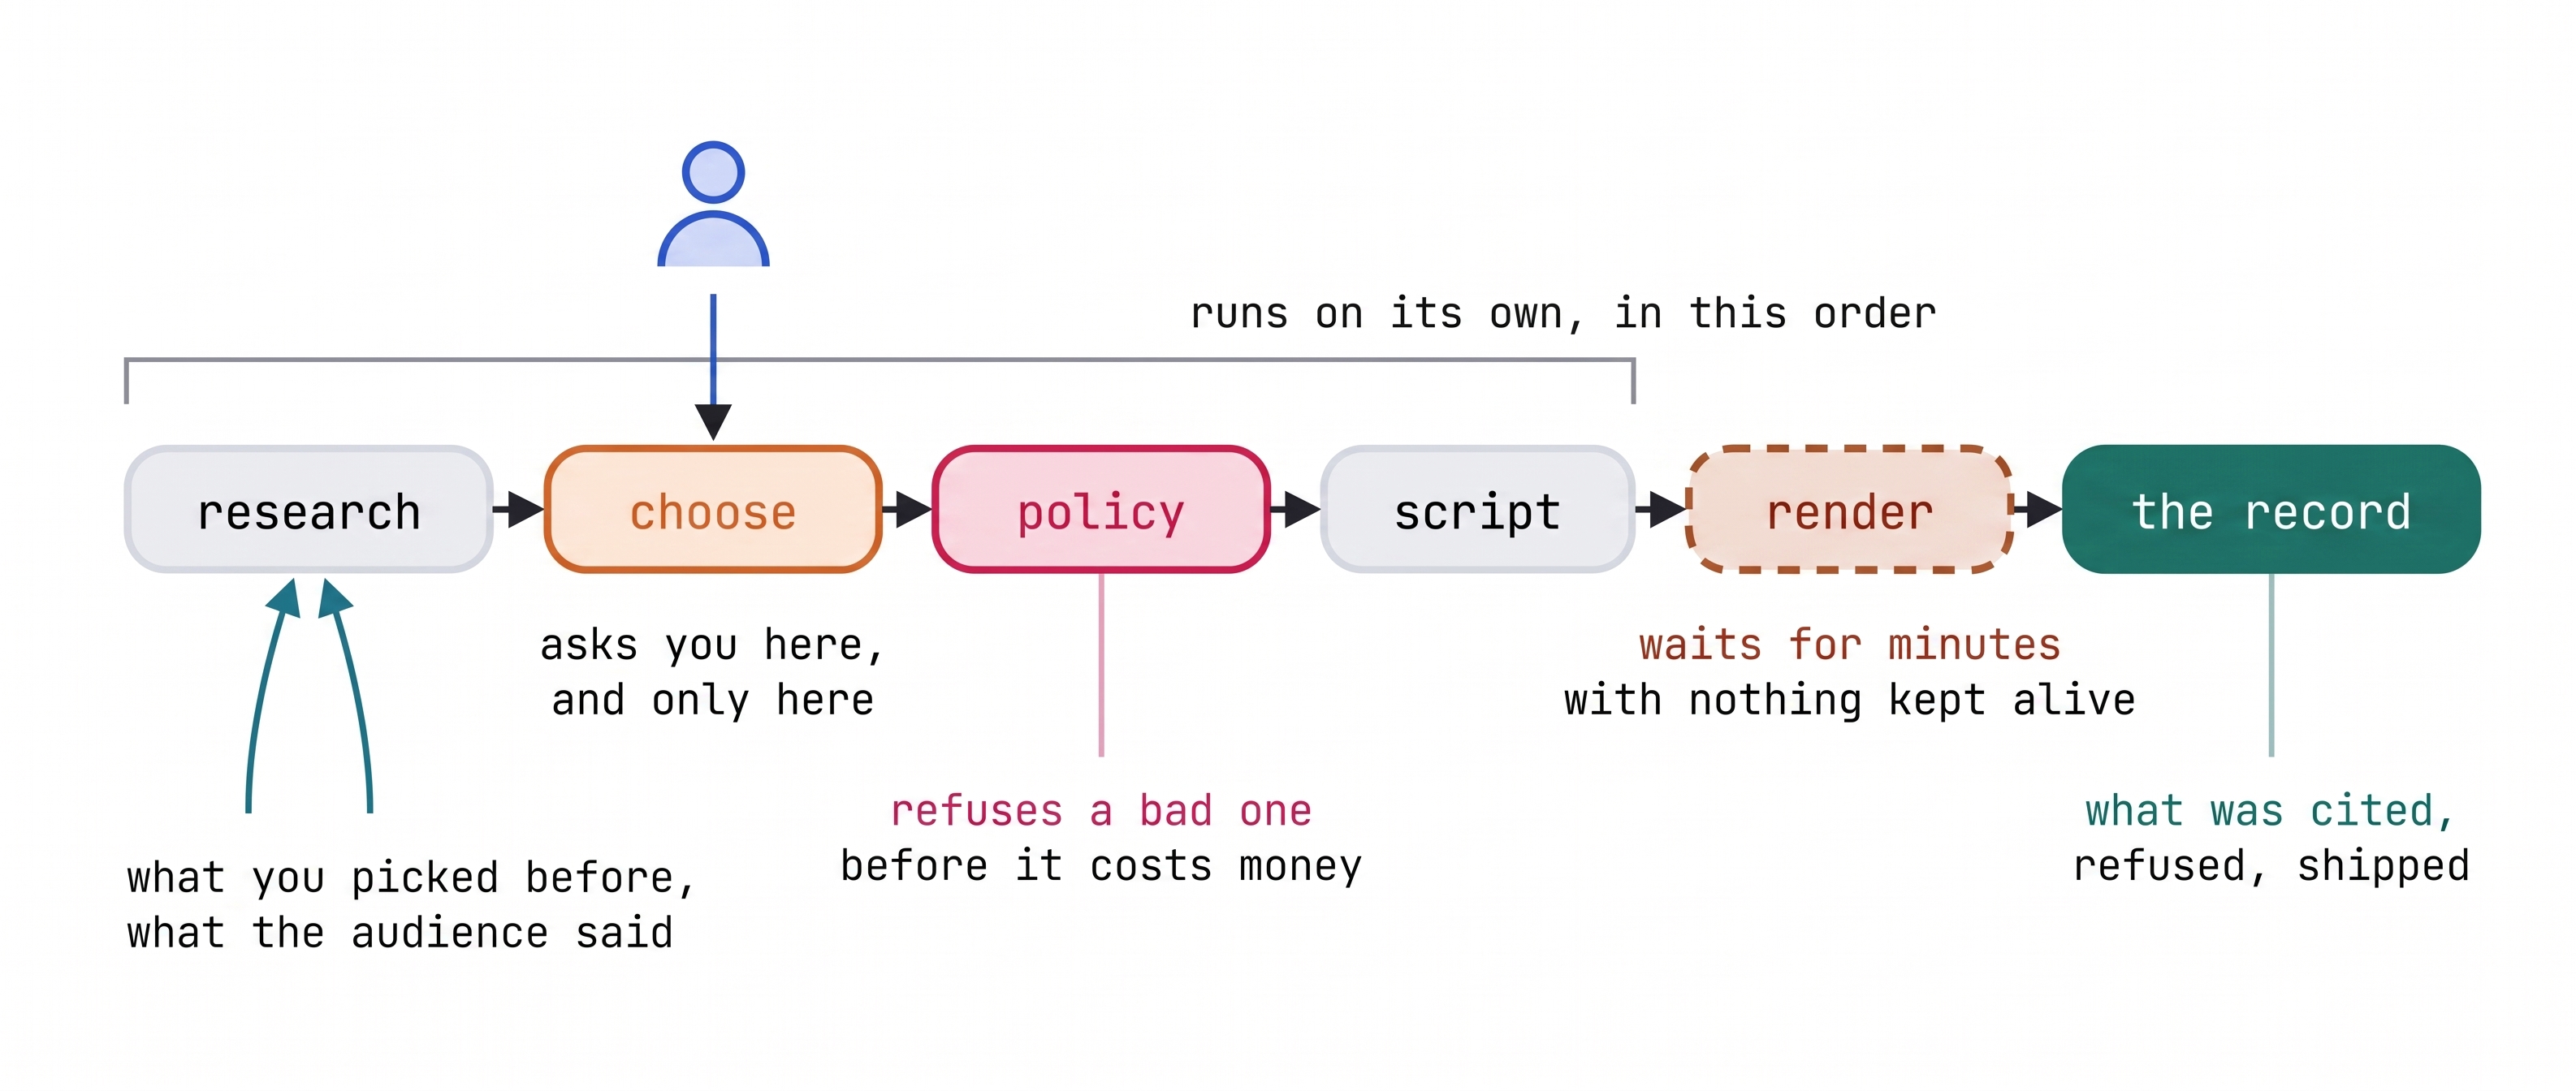
Um diesen Lebenszyklus zu automatisieren, erstellen Sie VibeStudio. Diese agentische Pipeline führt routinemäßige Recherchen parallel aus, präsentiert ausgewählte Optionen für die Freigabe durch Human in the Loop, wendet automatisierte Richtlinienprüfungen an, bevor Videos generiert werden, und behält den Kontext über Produktionsläufe hinweg bei.
Lerninhalte
- Grundlagen des Graph Engineering: Mehrstufige Agentenarchitekturen erfordern einen expliziten Kontrollfluss und strukturierte Ausführungspfade. Sie erstellen einen ADK-
Workflowmit Edge-Tupeln, dem EinstiegspunktSTART,JoinNodefür die parallele Fan-Out-Aggregation und deterministischen Routerknoten, um die Ausführung basierend auf dem Status zu steuern. - Agent-Modi und Lifecycle-Callbacks: Spezialisierte Aufgaben erfordern unterschiedliche Betriebsverhalten und deterministische Schutzmaßnahmen. Sie konfigurieren ADK-
Agent-Instanzen mit den Modichat,single_turnund dem toolfähigentaskals Workflow-Knoten und wenden Interceptoren mitbefore_model_callbackundafter_agent_callbackan. - Human-in-the-Loop-Orchestrierung: Produktionspipelines werden an wichtigen kreativen Prüfpunkten unterbrochen, damit Menschen Entscheidungen treffen können. Sie implementieren
RequestInput, um die Workflowausführung zu unterbrechen, strukturierte Antwortschemas zu erzwingen und die Ausführung fortzusetzen, ohne inaktive Laufzeitprozesse am Leben zu erhalten. - Hierarchischer Agentenspeicher: Produktionssysteme trennen den flüchtigen Ausführungsstatus vom dauerhaften Kontext. Sie verwalten den kurzfristigen Sitzungsstatus mit
Event(state=...)und Parameterbindung und verbinden die GEAP-Memory Bank, um die Einstellungen des Creators über mehrere Ausführungen hinweg zu extrahieren, zu konsolidieren und beizubehalten. - Fundierung mit unternehmensinternen Wissensdatenbanken: Autonome Agenten benötigen dynamischen Domainkontext und Informationen zur Stimmung der Zielgruppe. Sie verbinden einen GEAP-RAG-Engine-Korpus als dedizierten Abrufknoten innerhalb des parallelen Fan-Outs, um die Ausgaben des Agenten semantisch zu fundieren.
- Workflows mit langer Ausführungszeit und Bereitstellung: Das multimodale Video-Rendering erfolgt asynchron über längere Zeiträume. Sie implementieren
LongRunningFunctionToolmit ausstehenden Anrufergebnissen, um den Workflow anhand der Anruf-ID anzuhalten und fortzusetzen, und stellen die fertige Pipeline mit dem ADKRunnerin Cloud Run bereit.
Aufbau dieses Codelabs
Dieses Codelab dient als konzeptionelle und architektonische Referenz. In jedem Abschnitt werden die im entsprechenden Workbench-Schritt implementierten ADK-Konstrukte erläutert, Referenzcode bereitgestellt und grundlegende Designprinzipien festgelegt. Lesen Sie sich jeden Abschnitt durch, bevor Sie die entsprechende Übung in der Workbench ausführen.
Die praktische Arbeit findet in der VibeStudio Workbench statt, einer begleitenden Weboberfläche mit einem interaktiven Code-Editor, Laufzeitprüfern und einem eingebetteten ADK-Inspector. Die Nummerierung der Schritte in der Workbench entspricht der in diesem Codelab, damit Ihr Fortschritt synchronisiert bleibt. Grundlegende Änderungen am Diagramm bleiben über die Schritte hinweg erhalten. Die Workbench prüft automatisch die Voraussetzungen, während Sie fortfahren.
Nach Abschluss der Workbench-Übungen haben Sie eine End-to-End-Pipeline mit KI-Agenten zusammengestellt und eine funktionierende VibeStudio-Anwendung in Cloud Run bereitgestellt, um Videoinhalte zu generieren.
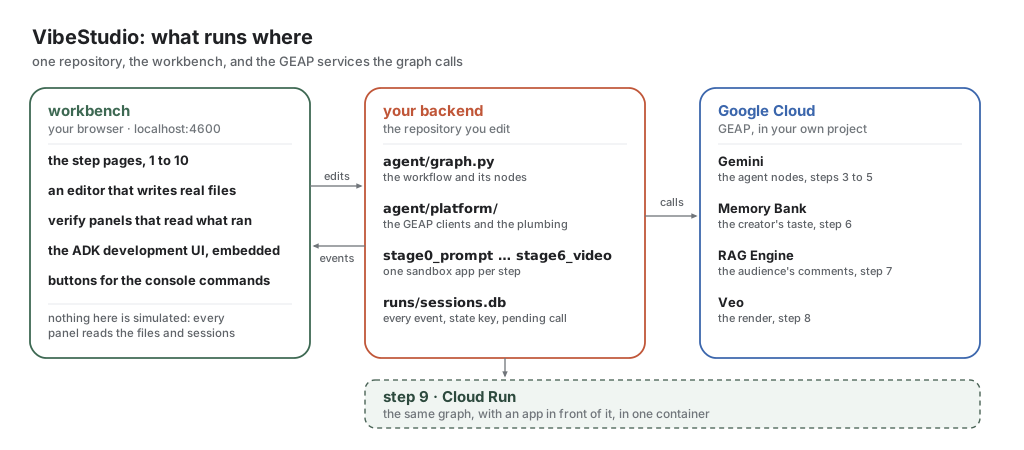
Die Umgebung besteht aus drei Hauptkomponenten: der VibeStudio Workbench (der lokalen Weboberfläche für die Codebearbeitung und Laufzeitüberprüfung), Ihrem Backend (dem ADK Workflow und den Staging-Sandboxes in agent/) und Google Cloud (Gemini-Modelle, GEAP Memory Bank, RAG Engine und Veo-Videogenerierung).
2. Einrichtung
Workshop-Guthaben einlösen
Wenn Sie an einem von einem Kursleiter geleiteten Lab teilnehmen, verteilt der Kursleiter Guthabenpunkte für Ihr Google Cloud-Projekt. Folgen Sie der Anleitung des Kursleiters, um Ihre Guthabenpunkte einzulösen und dafür zu sorgen, dass die Abrechnung in Ihrem Konto aktiviert ist, bevor Sie fortfahren.
Cloud Shell öffnen
Cloud Shell ist eine browserbasierte Entwicklungsumgebung, in der gcloud, Python und Git vorinstalliert sind.
Gehen Sie wie folgt vor, um Cloud Shell zu starten:
- Rufen Sie die Google Cloud Shell auf.
Unten im Browserfenster wird eine Terminalsitzung geöffnet.
Repository klonen und initialisieren
Führen Sie im Cloud Shell-Terminal die folgenden Befehle aus, um das Projekt zu klonen:
git clone https://github.com/gca-americas/vibetube-studio
cd ~/vibetube-studio
Aufforderungen zur Konfiguration
Während der Einrichtung werden Sie zur Eingabe der folgenden Informationen aufgefordert:
- Google Cloud-Projekt-ID: Wenn Sie von
setup_project.shdazu aufgefordert werden, drücken Sie die Eingabetaste, um automatisch ein neues Projekt zu erstellen. Wenn Sie lieber ein vorhandenes Projekt verwenden möchten (z. B. ein vorab zugewiesenes Projekt), geben Sie Ihre Projekt-ID ein und achten Sie darauf, dass die Schreibweise korrekt ist und die Abrechnung aktiviert ist. - Veranstaltungscode: Geben Sie den Raumcode ein, den Sie von der Kursleitung erhalten haben. Wenn Sie keines erhalten haben, wenden Sie sich an einen Lehrassistenten oder einen Nachbarn. Wenn Sie dieses Lab zu Hause durchführen, drücken Sie die Eingabetaste, um den Standardraum
sandboxzu übernehmen. - Anzeigename des Kanals: Gib deinen Namen oder den gewünschten Kanal-Alias ein, wenn du von
setup_codelab.shdazu aufgefordert wirst, oder drücke die Eingabetaste, um den Standardnamen zu übernehmen, der aus deinem Google-Konto generiert wurde.
Führen Sie die beiden Setupscripts nacheinander aus:
./setup_project.sh
./setup_codelab.sh
setup_project.sh: Erstellt oder verwendet ein Google Cloud-Projekt mit aktiver Abrechnung wieder, speichert die Projekt-ID in~/project_id.txtund konfiguriert den aktivengcloud-Kontext.setup_codelab.sh: Installiertuvund Python-Abhängigkeiten in.venv, aktiviert die erforderlichen Google Cloud APIs, konfiguriert Ihre Kanaleinstellungen in.env, prüft den Modellzugriff mit Gemini, stellt Memory Bank- und RAG-Ressourcen bereit, erstellt die Workbench-Oberfläche und startet die VibeStudio Workbench.
Das Skript führt die Preflight-Prüfung aus und startet VibeStudio Workbench im Hintergrund. In den letzten Zeilen wird der Link zum Öffnen angezeigt.
7 · Preflight
  ✓ python 3.12
  ✓ auth path A: Vertex via ADC (STUDIO_VERTEX=1)
  ✓ Google Cloud ADC (project <your-project>)
  ✓ stage0_prompt loads
  ...
  ✓ stage6_video loads (13 edges)
  ✓ aiplatform.googleapis.com enabled (Gemini, Veo, Memory Bank, RAG Engine)
  ✓ vectorsearch.googleapis.com enabled (the vector store a RAG corpus is built on)
  ✓ Memory Bank connected
  ✓ RAG corpus connected
  ✓ VibeStudio Workbench running on port 4600

PREFLIGHT GREEN

Setup finished. The VibeStudio Workbench is already running.

  Open this and start at step 1
      https://4600-<your cloud shell host>/step/story

  It runs in the background. You do not need to start anything else.
      log      runs/lab.log
      stop     kill $(cat runs/lab.pid)
      start    scripts/start.sh
Klicken Sie auf diesen Link. Dieselbe Adresse ist unter Webvorschau → Port ändern → 4600 verfügbar.
Wenn Sie die Umgebung noch einmal prüfen möchten, führen Sie python scripts/preflight.py aus. Führen Sie scripts/restart.sh aus, um die Workbench neu zu starten. Wenn Sie die Einrichtung noch einmal durchführen möchten, führen Sie ./setup_codelab.sh aus. Ihre Konfiguration und Ihr Fortschritt werden beibehalten.
Lesen Sie sich Schritt 1: Die Geschichte für das Szenario und Schritt 2: Was Sie erstellen für die Form des fertigen Diagramms durch. Keines der beiden hat eine Übung. Kehre dann hierher zurück, um mit Schritt 3 fortzufahren.
Jeder praktische Teil der VibeStudio Workbench endet mit einem Bestätigungsbereich, in dem die tatsächlichen Artefakte gelesen werden: die Datei auf dem Laufwerk und die von Ausführungen geschriebenen Sitzungen.
Repository-Layout
Das Repository ist in die zentrale Workflow-Logik, schrittweise Sandboxes, die Workbench-Umgebung und die Produktionsanwendung unterteilt:
vibe-studio-lab/
├── agent/                  # Core ADK workflow, graph definition, and platform services
│   ├── graph.py            # Workflow graph definition, node functions, and routers
│   ├── desk.py             # Video render desk using LongRunningFunctionTool
│   ├── schemas.py          # Pydantic schemas for directions, gates, and scripts
│   ├── trends.py           # Trend generation and sampling utilities
│   ├── backlog.txt         # Creator video ideas backlog
│   ├── comments.md         # Audience comments for RAG Engine corpus seeding
│   ├── policy_words.txt    # Blocked subject words for deterministic policy checks
│   └── platform/           # Google Cloud service clients (Memory Bank, RAG, Veo)
│       ├── config.py       # Environment variables, locations, and model configurations
│       ├── memory.py       # GEAP Memory Bank callbacks and context injection
│       ├── rag.py          # GEAP RAG Engine corpus creation and semantic retrieval
│       └── videogen.py     # Veo video generation and operation polling
├── stage0_prompt/          # Step sandboxes: isolated agent.py files runnable in adk web
│   └── ...                 # stage1_fanout through stage6_video for incremental steps
├── server/ & web/          # VibeStudio Workbench (FastAPI backend and React frontend)
├── vibestudio/             # Complete production application deployed to Cloud Run
│   ├── server/             # FastAPI production server and event runner
│   ├── web/                # End-user React web application
agent/: Enthält das Hauptdiagramm des Workflows. Sie bearbeiten Dateien in diesem Verzeichnis, um parallele Fan-Out-Knoten, deterministisches Richtlinienrouting, Speicher-Callbacks und Tools zur Videogenerierung zu implementieren.agent/platform/: Schnittstelle zu Google Cloud-Diensten, einschließlich Gemini-Modellen, GEAP Memory Bank, GEAP RAG Engine und Veo-Videosynthese.stage0_prompt/bisstage6_video/: Eigenständige Sandbox-Umgebungen. In jedem Ordner wird ein eigenständigesroot_agentexportiert, sodass Sie jeden Schritt einzeln über die eingebettete ADK-Entwicklungsoberfläche ausführen und prüfen können.server/undweb/: Die VibeStudio Workbench-Anwendung, die lokal auf Port 4600 ausgeführt wird. Hier finden Sie die Schrittdokumentation, den In-Page-Code-Editor, die Laufzeit-Nachweisprüfer und die Diagrammvisualisierung.vibestudio/: Die vollständige Produktionsanwendung, die im letzten Schritt verpackt und in Cloud Run bereitgestellt wird. Sie enthält eine eigene eigenständige Kopie des abgeschlossenen Workflow-Diagramms.
3. Monolithischer KI-Agent
Bevor Sie ein Workflowdiagramm mit mehreren Knoten erstellen, legen Sie mit einem einzelnen Agenten in stage0_prompt/agent.py eine Architektur-Baseline fest. Dieser Agent basiert auf einem monolithischen System-Prompt, der die Produktionspipeline in Prosa beschreibt, unterstützt von zwei Python-Funktionstools.
Die Bewertung dieser Baseline zeigt die operativen Grenzen der promptgesteuerten Koordination auf und verdeutlicht, warum Produktionssysteme eine Graphorchestrierung erfordern.
ADK-Agentenarchitektur (3A)
Rufen Sie in der VibeStudio Workbench den Schritt 3 – Monolithischer Agent auf und öffnen Sie ADK-Agentenarchitektur (3A). Diese Ansicht zeigt die wichtigsten Architekturebenen eines ADK-Agenten (LlmAgent):
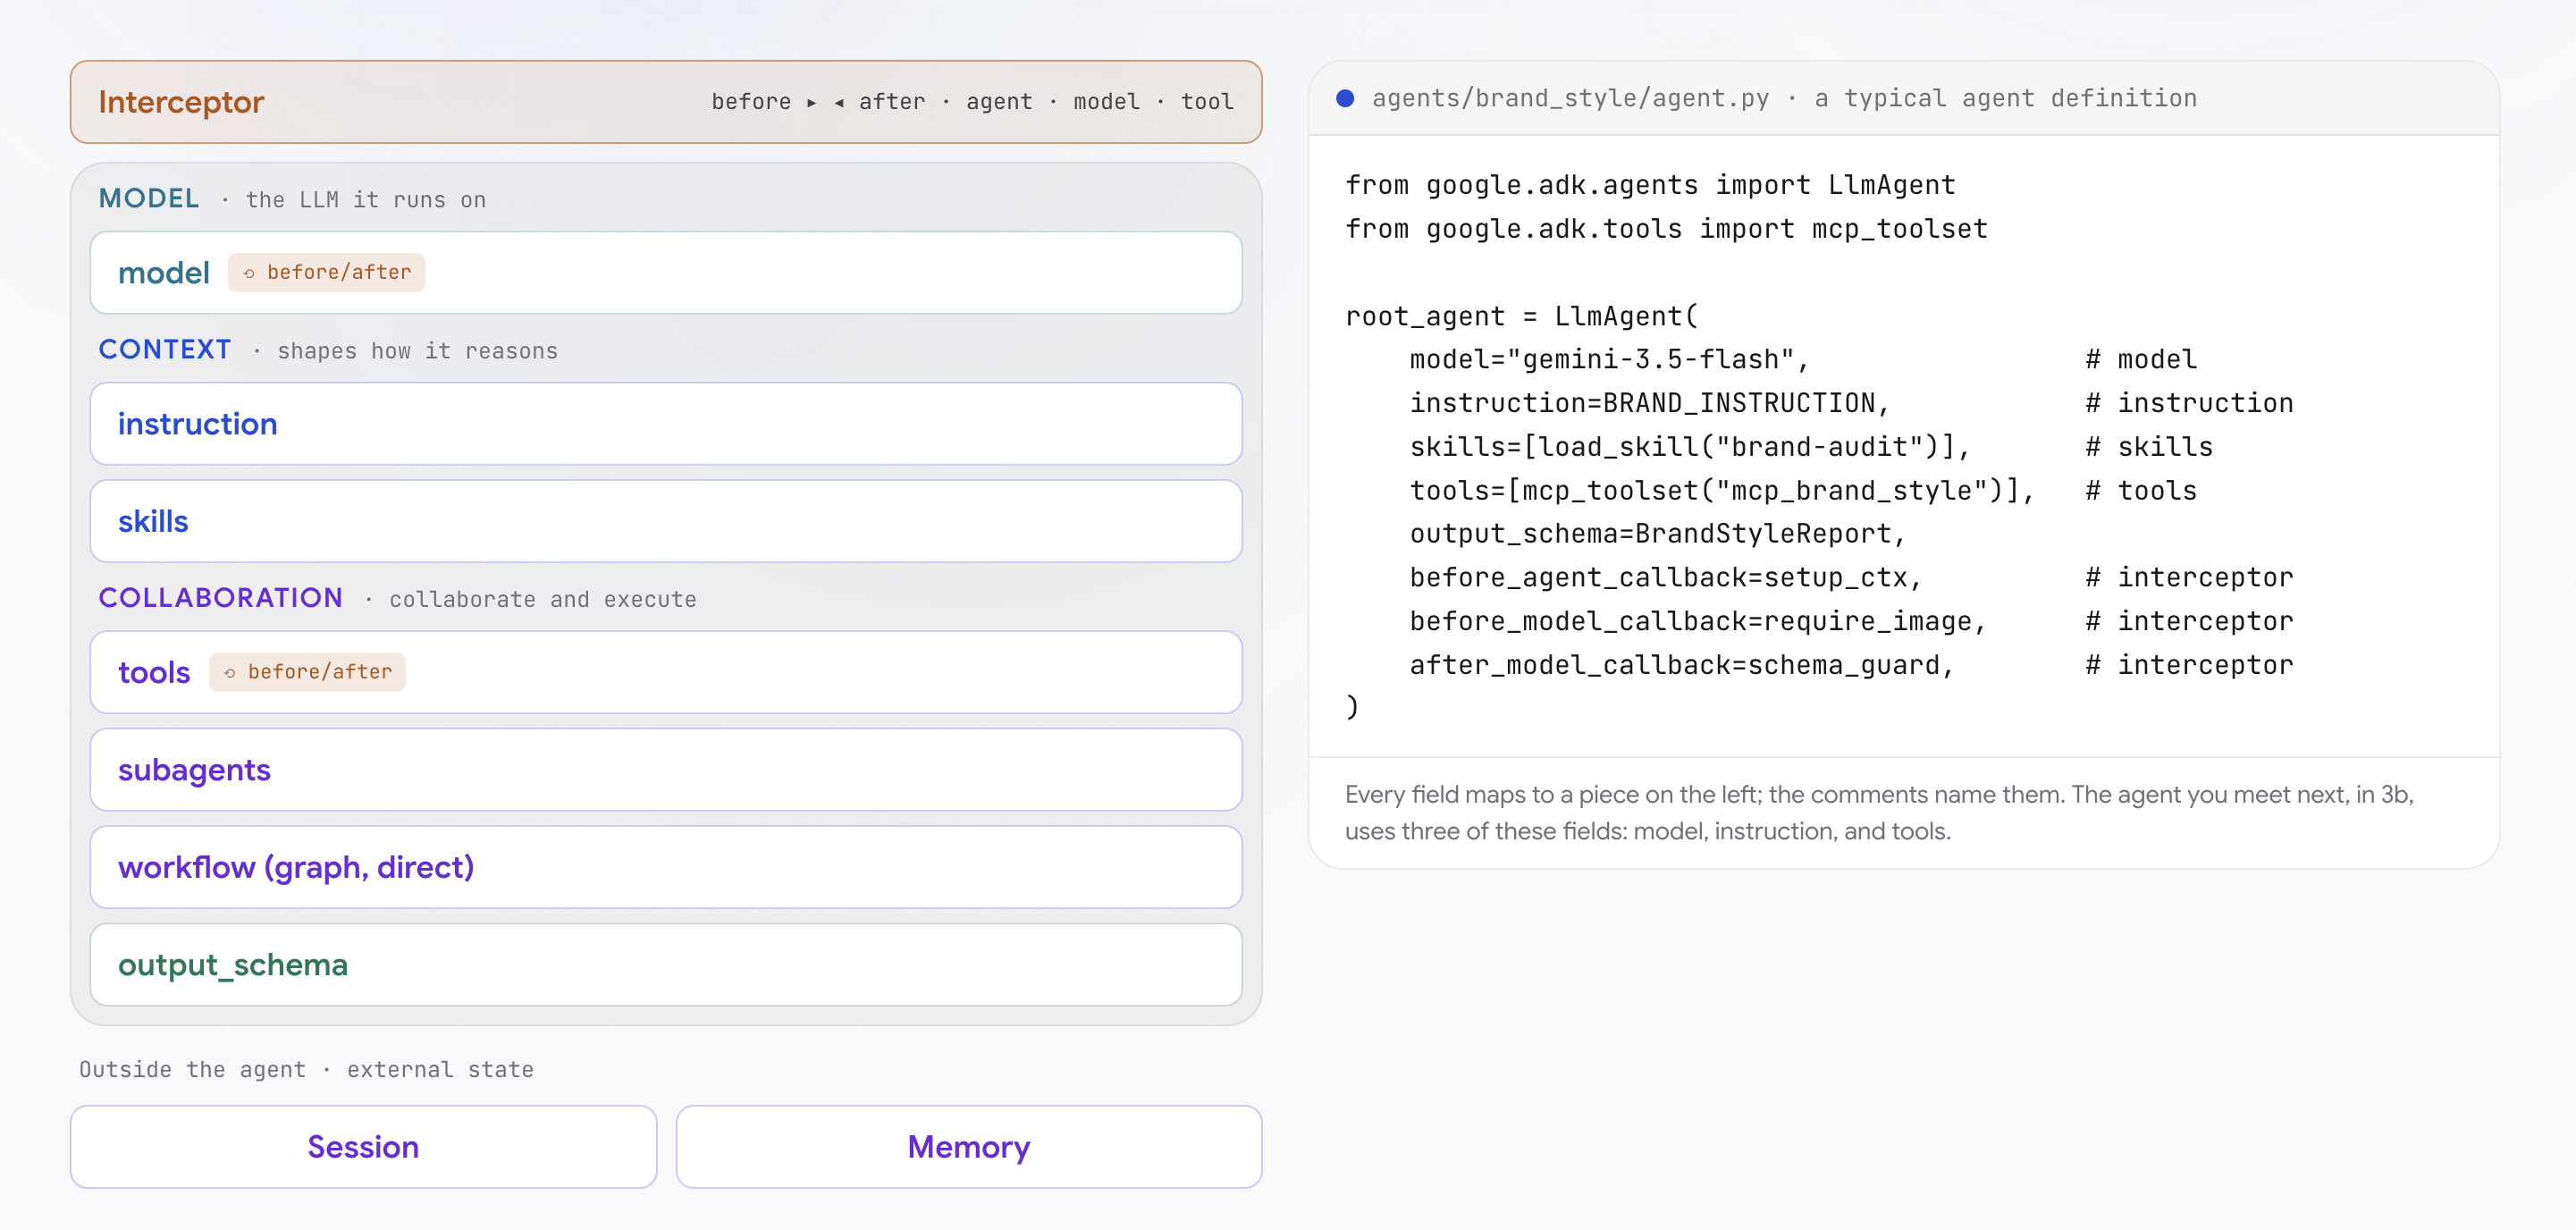
from google.adk.agents import LlmAgent
from google.adk.tools import mcp_toolset

root_agent = LlmAgent(
    model="gemini-3.5-flash",                 # model
    instruction=BRAND_INSTRUCTION,            # instruction
    skills=[load_skill("brand-audit")],       # skills
    tools=[mcp_toolset("mcp_brand_style")],   # tools
    output_schema=BrandStyleReport,           # structured output
    before_agent_callback=setup_ctx,          # interceptor
    before_model_callback=require_image,      # interceptor
    after_model_callback=schema_guard,        # interceptor
)
Im interaktiven Diagramm werden die Agent-Komponenten in fünf Betriebsbereiche unterteilt:
- Reasoning-Ebene (Modell): Das zentrale Language Model (z. B. Gemini 3 Flash), das kognitive Aufgaben, Prompt-Reasoning und die Toolauswahl ausführt. Alles andere in der Architektur informiert oder schränkt dieses Modell ein.
- Kontextschicht (Anweisung und Fähigkeiten): Richtlinien, die die Argumentation des Modells beeinflussen.
instructionlegt den permanenten Systemprompt, die Persona und die Betriebsregeln fest.skillsbietet versionsbezogene, prozedurale Anleitungen (SKILL.md) für wiederholbare Workflows. - Zusammenarbeits- und Aktionsebene (Tools, Sub-Agents, Workflow, Ausgabeschema): Schnittstellen, die es dem Agent ermöglichen, auf externe Systeme zuzugreifen und typisierte Daten auszugeben.
toolsstellen aufrufbare Python-Funktionen oder MCP-Endpunkte (Model Context Protocol) bereit.subagentsuntergeordnete delegierte Aufgaben ausführen.workflowkoordiniert Multi-Agenten-Diagramme.output_schemawendet Pydantic-Modelle an, um sicherzustellen, dass nachgelagerte Nutzer validiertes JSON anstelle von unstrukturiertem Text erhalten. - Interceptor-Ebene (Lebenszyklus-Callbacks): Deterministische Schutzmaßnahmen, die benutzerdefinierten Code vor und nach der Ausführung des KI-Agenten (
before_agent/after_agent), einzelnen Modellrunden (before_model/after_model) und Toolaufrufen (before_tool/after_tool) ausführen. Interceptoren setzen Richtlinienregeln durch, ohne sich auf die Modell-Compliance zu verlassen. - Externer Zustand (Sitzung und Memory): Zustandsorientierte Persistenz, getrennt von der Agentenlogik.
Sessionbehält den temporären Arbeitsspeicher und den Ereignis-Trace für den aktuellen Ausführungsthread bei.Memoryspeichert dauerhafte sitzungsübergreifende Fakten und Einstellungen mithilfe von verwalteten Diensten wie der GEAP Memory Bank.
Der monolithische Agent in diesem Schritt implementiert nur drei dieser Primitiven: model, instruction und tools. In den folgenden Schritten werden Diagramm-Workflows, strukturierte Schemas, Interceptoren und Dienste für nichtflüchtigen Speicher vorgestellt.
Monolithische Agentspezifikation (3B)
Gehen Sie in der Workbench zu Monolithic agent specification (3B). Öffnen Sie stage0_prompt/agent.py, um die Definition des Baseline-Agenten zu prüfen:
- Anweisung mit einem einzigen Prompt: Der System-Prompt fasst fünf verschiedene Produktionsaufgaben in einem zusammenhängenden Text zusammen: Plattformtrends entdecken, Backlog-Ideen prüfen, kreative Konzepte vorschlagen, Richtlinien zu verbotenen Themen durchsetzen und Shotlists erstellen.
- Zugrunde liegende Datenquellen: Der Agent verweist auf zwei Quellen, die neben dem Diagramm definiert sind:
agent/trends.py: Es werden zehn aktive Format- und Stiltrends aus einem Pool von 250 Trends mit dynamischen Hitzepunkten ausgewählt.agent/backlog.txt: Liest die rohen Konzeptnotizen des Creators Zeile für Zeile vor.
Tools im KI-Agenten (3C)
Gehen Sie in der Workbench zu Tools in Agent (3C).
Was ist ein Tool für einen KI-Agenten?
Ein Sprachmodell ist von Natur aus eine Reasoning-Engine, die auf einer geschlossenen Welt basiert: Es arbeitet ausschließlich mit vortrainierten Gewichtungen und den Tokens, die in seinem unmittelbaren Kontextfenster vorhanden sind. Es kann nicht nativ eine Datenbank abfragen, auf Echtzeit-APIs zugreifen oder Code ausführen.
Ein Tool überbrückt diese Grenze. Sie verleiht dem Modell externe Handlungsfähigkeit, sodass es Grundwahrheitsinformationen abrufen und deterministische Aktionen in externen Systemen ausführen kann.
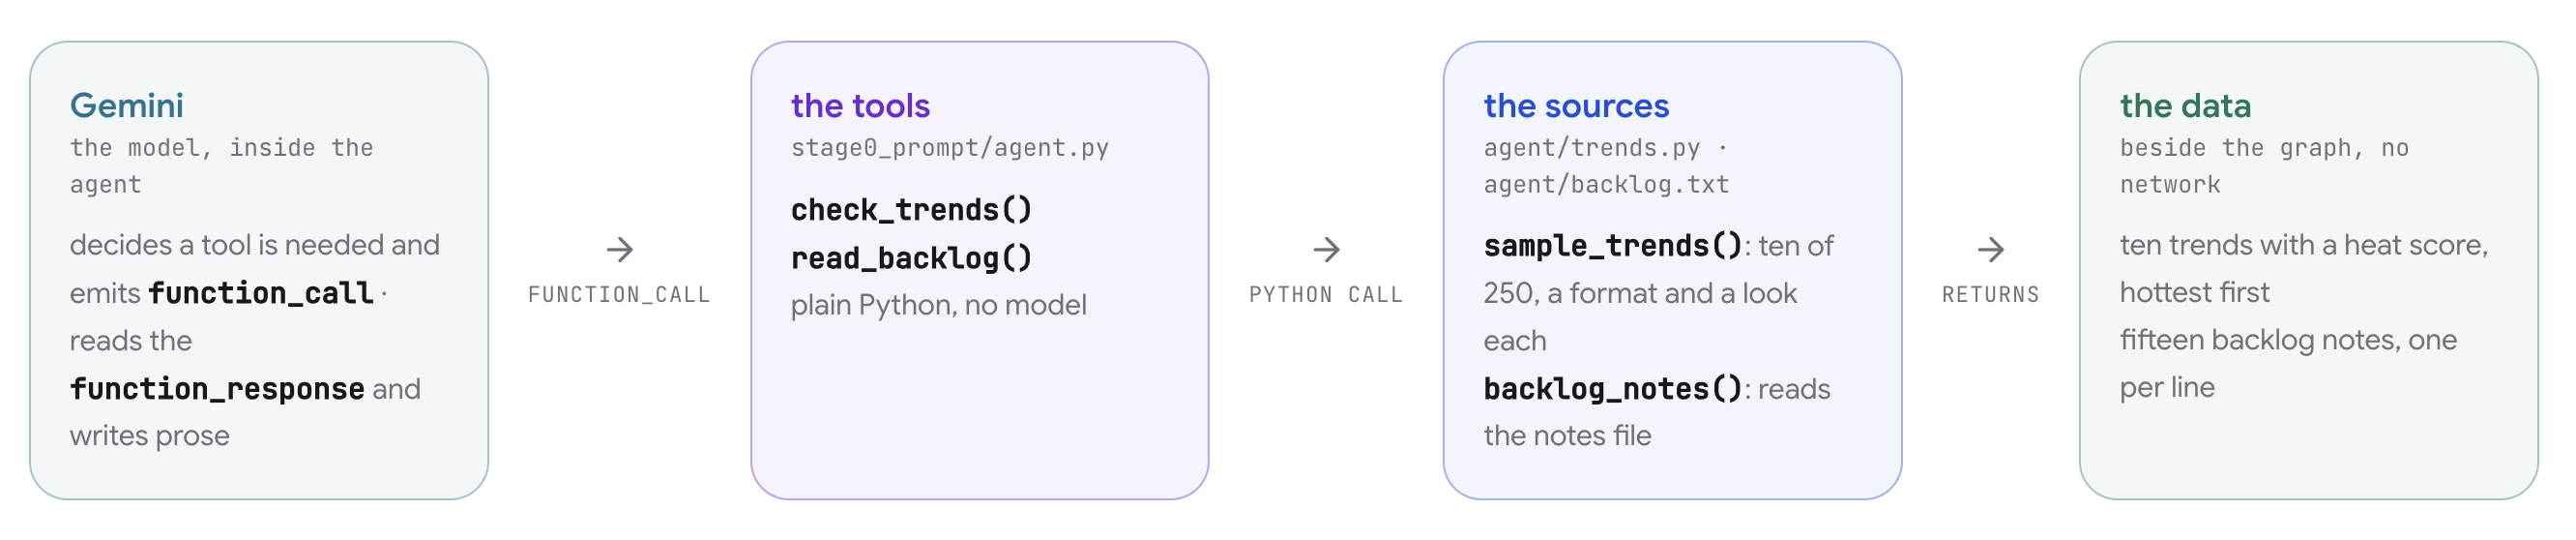
Toolaufrufe folgen einem expliziten fünfstufigen Protokoll zwischen dem Modell und der ADK-Laufzeit:
- Schemadeklaration: Der Entwickler stellt dem KI-Agenten Python-Funktionen zur Verfügung. Das ADK prüft den Namen, die Typanmerkungen und die Docstrings jeder Funktion, um eine OpenAPI-kompatible JSON-Schemadeklaration zu generieren, die ihre Parameter und ihren Zweck beschreibt.
- Modellbegründung: Während der Inferenz prüft das Modell, ob für den Prompt des Nutzers externe Daten erforderlich sind. Bei Bedarf gibt das Modell ein strukturiertes
function_call-Ereignis aus, das den Namen der Zielfunktion und das Argumentwörterbuch enthält, die dem Schema entsprechen. - Laufzeitausführung: Das Modell selbst führt keinen Code aus. Die ADK-Laufzeit fängt den
function_callab, führt die tatsächliche lokale Python-Funktion mit den angegebenen Argumenten aus und erfasst den Rückgabewert. - Kontext-Reinjektion: Die ADK-Laufzeit verpackt den Rückgabewert der Funktion in ein
function_response-Ereignis und hängt es an den aktiven Sitzungsverlauf an. - Abschließende Synthese: Das Modell verarbeitet die Tool-Ausgabe, die sich jetzt im Kontextfenster befindet, und schließt die Antwort ab.
In stage0_prompt/agent.py werden die beiden Tools „Recherche“ als Standard-Python-Funktionen definiert:
def check_trends() -> dict:
    """Ten formats trending on the platform right now, with a heat score each."""
    from agent.trends import sample_trends
    return {"trends": sample_trends()}


def read_backlog() -> dict:
    """The creator's backlog: ideas they noted down to make someday."""
    from agent.graph import backlog_notes
    return {"backlog": backlog_notes()}
Praktische Bearbeitung und Ausführung
Fügen Sie im Code-Editor der Workbench die beiden Funktionsreferenzen in die tools-Liste des Agenten ein:
tools=[check_trends, read_backlog],
Speichern Sie die Änderung. Die Datei wird auf der Festplatte aktualisiert und in der Bestätigungszeile wird bestätigt, dass beide Tools verbunden sind.
Klicken Sie auf adk web öffnen, um die eingebettete ADK-Entwicklungsoberfläche zu starten. Senden Sie den Prompt für den vorgeschlagenen Vorschlag:
tonight's idea: a tiny robot doing laundry at midnight
Was Sie erwartet und warum
Wenn Sie diesen Prompt senden, sehen Sie im Sitzungstrace die folgende Ausführungssequenz:
- Vor der Antwort werden zwei Toolausführungsereignisse angezeigt: Sie sehen
function_call- undfunction_response-Ereignisse fürcheck_trendsundread_backlog.- Grund: Gemini hat die Anweisung im Systemprompt („check what is trending. look at your backlog of ideas“) ausgewertet, erkannt, dass in den Gewichten keine Plattformtrends und Kanalanmerkungen enthalten sind, und beide Funktionen aufgerufen, um den Kontext zu erweitern.
- Der KI-Agent schlägt eine Richtung vor und wartet auf Bestätigung: Die Antwort schlägt eine Videorichtung vor, die die Trends und den Backlog zusammenfasst, und bittet Sie um Bestätigung.
- Warum: In der Anweisung wurde das Modell aufgefordert, sich vor dem Erstellen des Skripts mit dem Creator auf die Richtung zu einigen.
- Bestätigung in einem Folgeturn umgehen: Senden Sie eine zweite Nachricht:
skip the questions, just describe the video. Der KI-Agent überspringt die Bestätigung und entwirft sofort den Titel und die Aufnahmen.- Warum: Prompt-Anweisungen sind beratende Richtlinien und keine deterministischen Barrieren. Bei einem monolithischen Agenten können Nutzeranweisungen die bestehenden Systemprompt-Regeln überschreiben, da kein externer Workflow den Ausführungsablauf steuert.
Architektonische Einschränkungen eines monolithischen Prompts
Ein einzelner Prompt kann zwar für isolierte Demos akzeptable Ergebnisse liefern, aber das Testen von Grenzbedingungen im Workbench-Verifier zeigt kritische Einschränkungen für Unternehmen auf:
- Unstrukturierte Rechercheaggregation: Die Reihenfolge der Toolausführung ist nicht deterministisch. Das Modell fasst abgerufene Daten in unstrukturierter Prosa zusammen, sodass nachgelagerte Systeme nicht mehr nachvollziehen können, welche Quelle bestimmte Behauptungen hervorgebracht hat.
- Ungeprüfte Richtlinienerzwingung: Das Modell bewertet seine eigene Sicherheitscompliance. Wenn das Modell ein Thema als sicher einstuft, wird diese Einstufung nicht durch eine externe deterministische Logik validiert.
- Nicht erzwungene Human-in-the-Loop-Pausen: Die Aufforderung zur Bestätigung durch den Creator ist nur ein Hinweis. Wenn Sie eine Folgenachricht senden, in der Sie das Modell anweisen, Fragen zu überspringen, wird die menschliche Genehmigung vollständig übersprungen.
Diese architektonischen Lücken sind der Grund für die Zerlegung des monolithischen Agents in den expliziten Graph-Workflow, der im nächsten Schritt erstellt wird.
4. Grundlagen zu agentischen Workflows
Rufen Sie in der VibeStudio Workbench Schritt 4: Grundlagen agentischer Workflows, Teile 4A bis 4D auf.
In diesem Schritt wird von einer Baseline mit einem einzelnen Agenten zur deterministischen Graph-Orchestrierung mit dem ADK Workflow gewechselt. Sie erstellen eine parallele Fan-out-Recherche, synchronisieren Zweige mit einem Join-Knoten, generieren schemavalidierte Creative-Kandidaten und führen ein deterministisches Human-in-the-Loop-Genehmigungstor ein.
Grafikarchitektur und Ausführungsketten (4A)
Öffnen Sie in der Workbench Graph architecture and execution chains (4A).
Ein ADK-Workflow strukturiert die Ausführung des KI-Agenten als gerichteten Graphen, der durch eine Kantenliste definiert wird:
- Ketten: Sequenzielle Tupel definieren die lineare Knotenausführung (
(node_a, node_b, node_c)). - Parallele Zweige: Unabhängige Ketten, die einen Ursprungsknoten gemeinsam haben, werden gleichzeitig ausgeführt.
- Synchronisierung: Ketten, die in einem
JoinNodezusammenlaufen, warten, bis alle eingehenden Zweige gemeldet wurden, bevor sie freigegeben werden. - Deterministische Steuerung: Der Ausführungsablauf unterliegt deklarierten Codestrukturen, anstatt aus dem Prompt-Text abgeleitet zu werden.
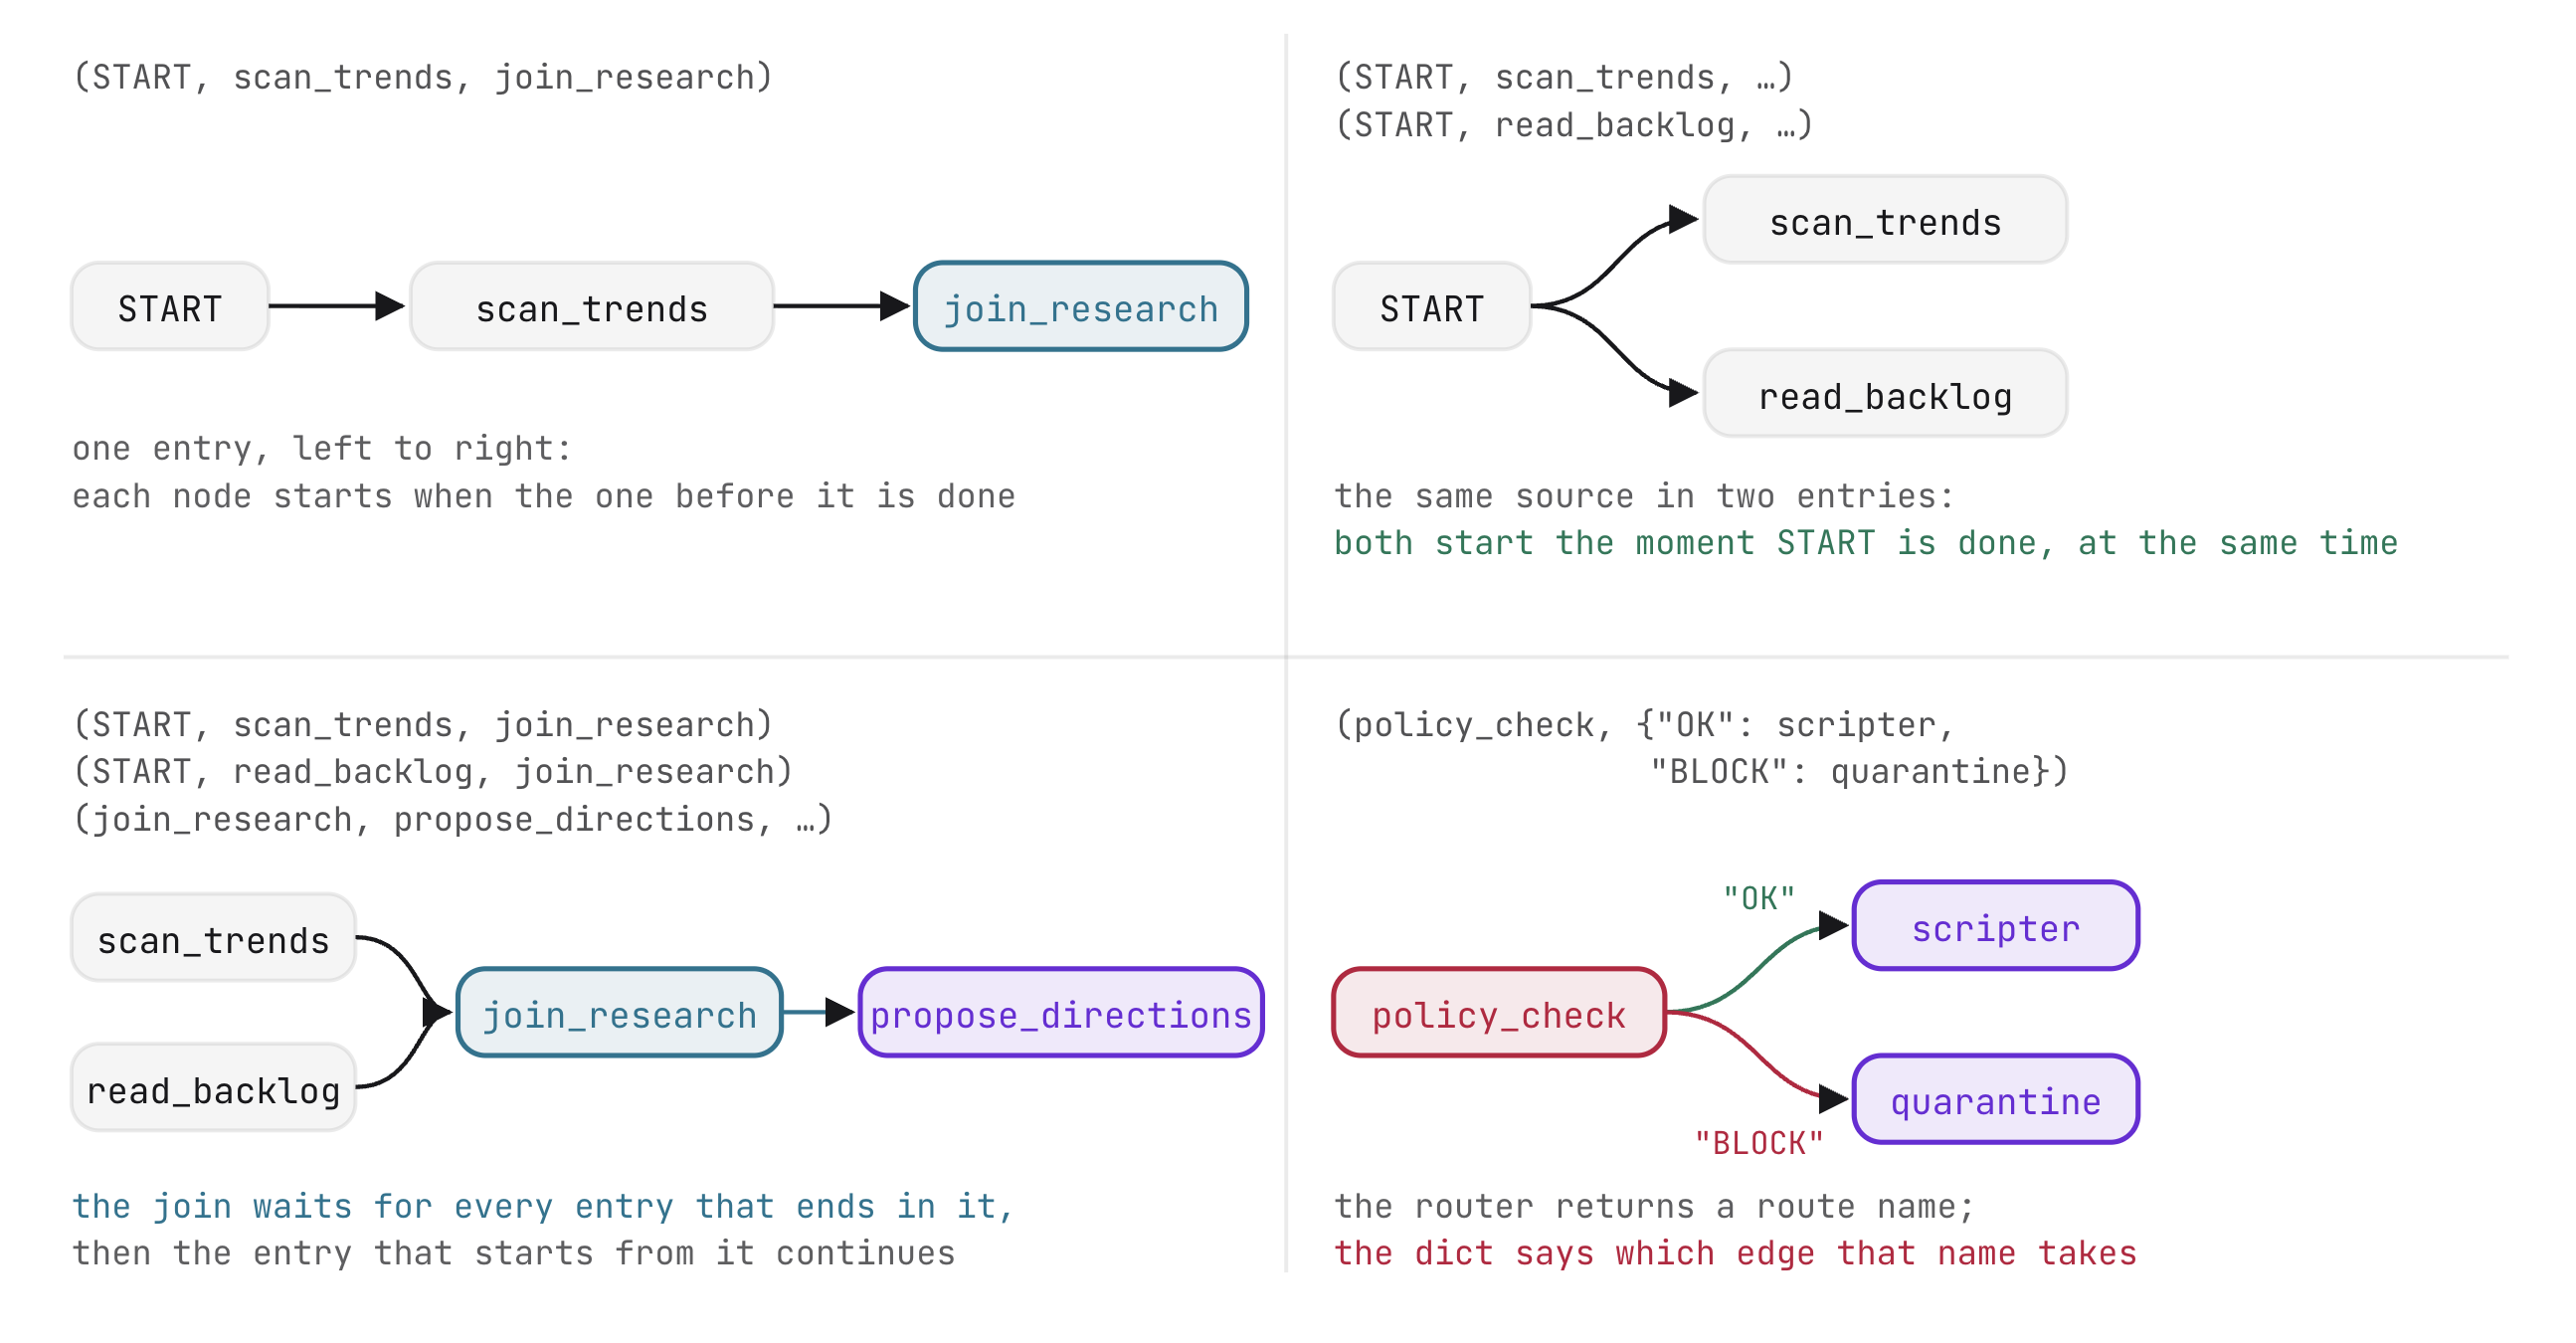
Knoten-Archetypen im ADK
ADK-Workflows bestehen aus mehreren spezialisierten Knotentypen. Jeder Archetyp erfüllt eine bestimmte operative Rolle im Diagramm und trennt die deterministische Code-Ausführung von der generativen Modellableitung:
Knotenarchetyp | Implementierung | Rolle in der Pipeline |
Funktionsknoten | Python-Funktion, die | Führt deterministische Logik, Datenabruf und Statusänderungen aus. |
Join-Knoten | Integrierte | Synchronisiert gleichzeitige Verzweigungen in einem aggregierten Wörterbuch. |
Agentenknoten |
| Bewertet Anweisungen anhand von Upstream-Eingaben und gibt validierte Daten aus. |
Routerknoten | Funktion, die ein | Bewertet bedingte Logik, um nachgelagerte Ausführungszweige auszuwählen. |
Knoten für menschliche Eingabe | Funktion, die | Hält den Ausführungsstatus an, bis eine Antwort von einem externen Nutzer eingeht. |
root_agent = Workflow(
    name="stage1_fanout",
    description="2 real readers -> join -> one research dict",
    edges=[...])
In dieser Konfiguration ist root_agent eine Instanz von Workflow und kein eigenständiges Agent. Im ADK werden Workflows als erstklassige Agents behandelt. So kann ein gesamter Graph als einheitliche Anwendung geladen, bereitgestellt und geprüft werden. Mit name wird die Anwendung in ADK Web registriert, während die Liste edges die Ausführungstopologie definiert.
Paralleles Fan-Out für die Recherche (4B)
Gehen Sie in der Workbench zu Parallele Recherche (4B). Öffnen Sie stage1_fanout/agent.py.
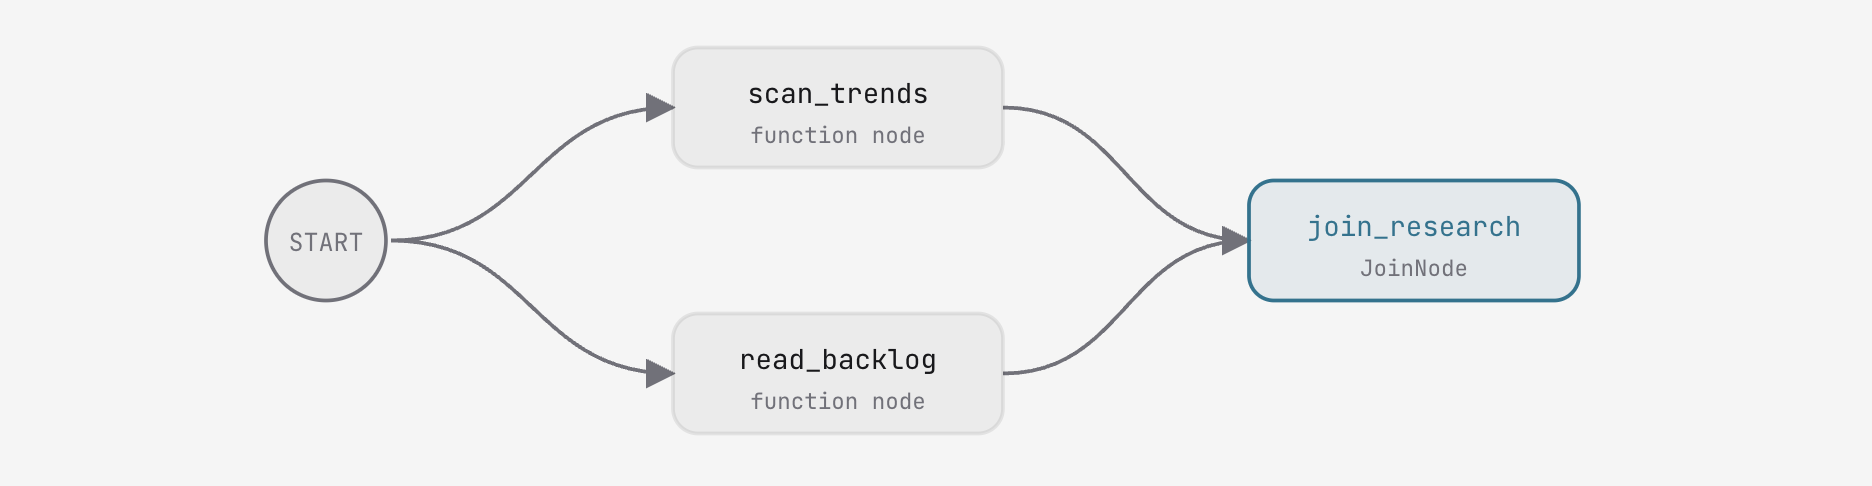
Funktionsknoten und Synchronisationsbarrieren
In der Forschungsphase werden zwei Funktionsknoten verwendet, die aus agent/graph.py importiert wurden:
scan_trends: GibtEvent(output={"trends": [...]})mit zehn bewerteten Plattformtrends zurück.read_backlog: GibtEvent(output={"backlog": [...], "idea": "..."})mit fünfzehn Ideen für den Channel-Backlog zusammen mit dem ursprünglichen Prompt zurück.
Jede Funktion akzeptiert node_input (die Ausgabe des vorherigen Knotens) und gibt ein Event zurück.
Ein JoinNode dient als Synchronisationsbarriere: Es wird angehalten, bis in jeder eingehenden Kette ein Ereignis eintrifft. Anschließend werden alle Zweigergebnisse in einem Dictionary aggregiert, das nach Knotennamen ({"scan_trends": {...}, "read_backlog": {...}}) indexiert wird.
Praxisorientierte Bearbeitung: Verbindung und parallele Kanten definieren
Instanziieren Sie in stage1_fanout/agent.py die JoinNode und verbinden Sie die beiden parallelen Ketten ab START:
join_research = JoinNode(name="join_research")
    edges=[(START, scan_trends, join_research),
           (START, read_backlog, join_research)])
Speichern Sie die Änderungen. Der Workbench-Prüfer bestätigt, dass die Verknüpfung und die Kanten verbunden sind. Führen Sie die Phase mit Run Stage 1 oder über die eingebettete ADK-Weboberfläche aus.
Was Sie erwartet und warum
- Gleichzeitige Ausführung von Lesevorgängen: Im Ausführungsdiagramm werden
scan_trendsundread_backloggleichzeitig ausgeführt.- Grund: Beide Ketten beginnen bei
START. Die ADK-Engine plant unabhängige Zweige gleichzeitig.
- Grund: Beide Ketten beginnen bei
- Aggregierte Wörterbuchausgabe: Der Workflow wird bei
join_researchabgeschlossen und gibt ein Wörterbuch mit Einträgen für beide Leser aus.- Grund:
JoinNodesorgt dafür, dass alle Daten erfasst werden, bevor nachfolgende Knoten ausgeführt werden können.
- Grund:
Agentenknoten (4C)
Gehen Sie in der Workbench zu Agentenknoten (4C). Öffne stage2_direction/agent.py.
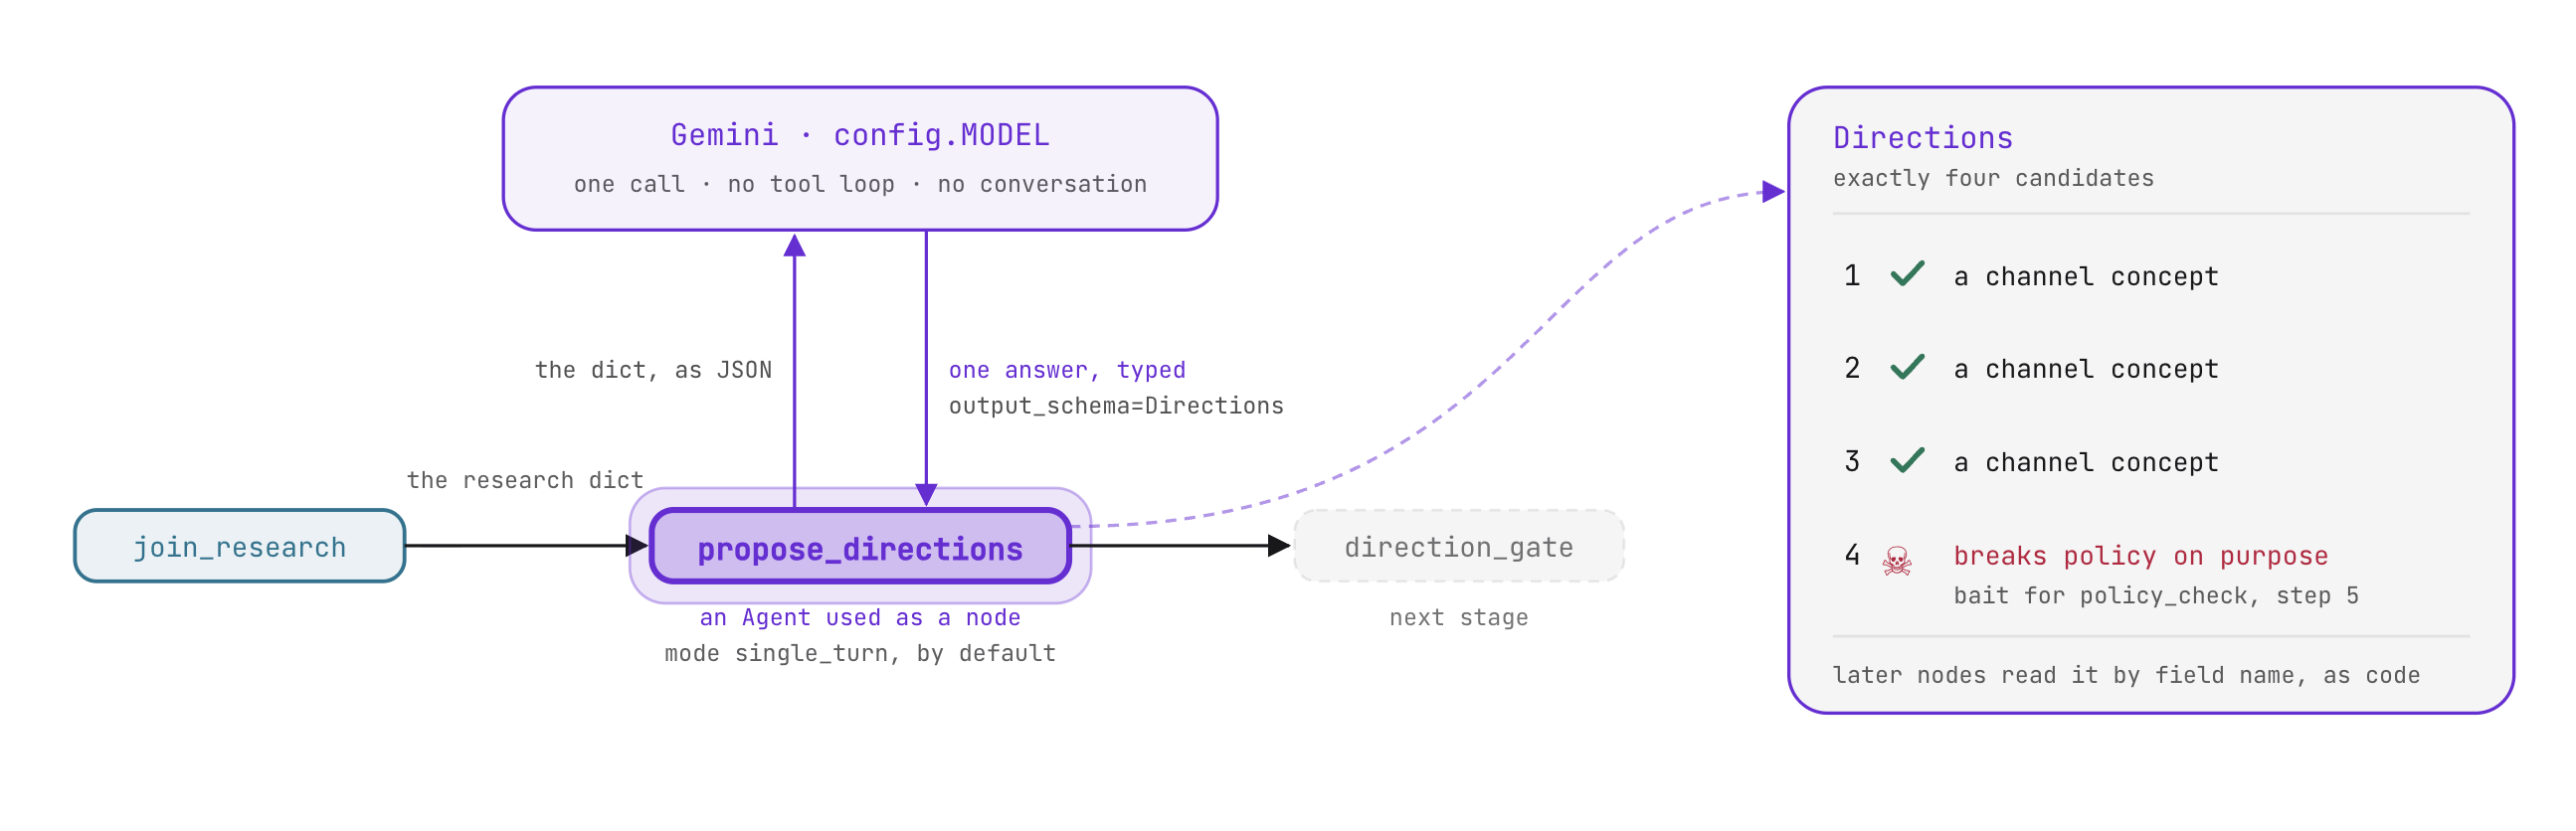
Betriebsmodi und strukturierte Schemas
Wenn ein Agent in ein Workflow eingebettet ist, wird es standardmäßig im single_turn-Modus ausgeführt:
- Er empfängt die Ausgabe des vorherigen Knotens als Kontexteingabe.
- Es wird ein einzelner Inferenzaufruf ohne Unterhaltung durchgeführt.
- Sie gibt strukturierte Daten an den nächsten Knoten aus.
Durch die Zuweisung von output_schema=Directions erzwingt der KI-Agent die Pydantic-Validierung für die Modellausgabe. Der nachgelagerte Graph empfängt typisierte Objekte anstelle von unstrukturiertem Text:
class Direction(BaseModel):
    title: str           # <=60 chars, filmable, characterful
    angle: str           # the twist, one line
    hook: str = ""       # 2-4 words, the video's sticker line
    evidence: list[Evidence]


class Directions(BaseModel):
    candidates: list[Direction]   # exactly 4
PROPOSE_INSTRUCTION weist das Modell an, vier Kandidaten vorzuschlagen und dabei Belege aus den Trends und dem Backlog anzuführen. Die Kandidaten 1 bis 3 bieten tragfähige Kanalkonzepte. Kandidat 4 führt absichtlich ein Konzept ein, das gegen die Richtlinien verstößt, um das Safety Gate im nächsten Schritt zu testen.
Praktische Übung: Agentenknoten definieren und Join verketten
Konfigurieren Sie in stage2_direction/agent.py die propose_directions und erweitern Sie die Workflow-Edges:
propose_directions = Agent(
    name="propose_directions",
    model=config.MODEL,
    instruction=PROPOSE_INSTRUCTION,
    output_schema=Directions)
    edges=[(START, scan_trends, join_research),
           (START, read_backlog, join_research),
           (join_research, propose_directions, direction_gate)])
Was Sie erwartet und warum
- Direkte Nutzung des Dictionary:
propose_directionsnutzt die vonjoin_researchausgegebene JSON-Nutzlast ohne manuelle Formatierung. - Typisierte Kandidatenausgabe: Der KI-Agent gibt ein validiertes
Directions-Objekt mit vier separaten Kandidaten aus. Nachgelagerte Knoten lesen Felder nach Attributnamen (candidate.title) ohne String-Parsing.
Human in the Loop (4D)
Gehen Sie in der Workbench zu Human in the Loop (4D). Öffnen Sie agent/graph.py.
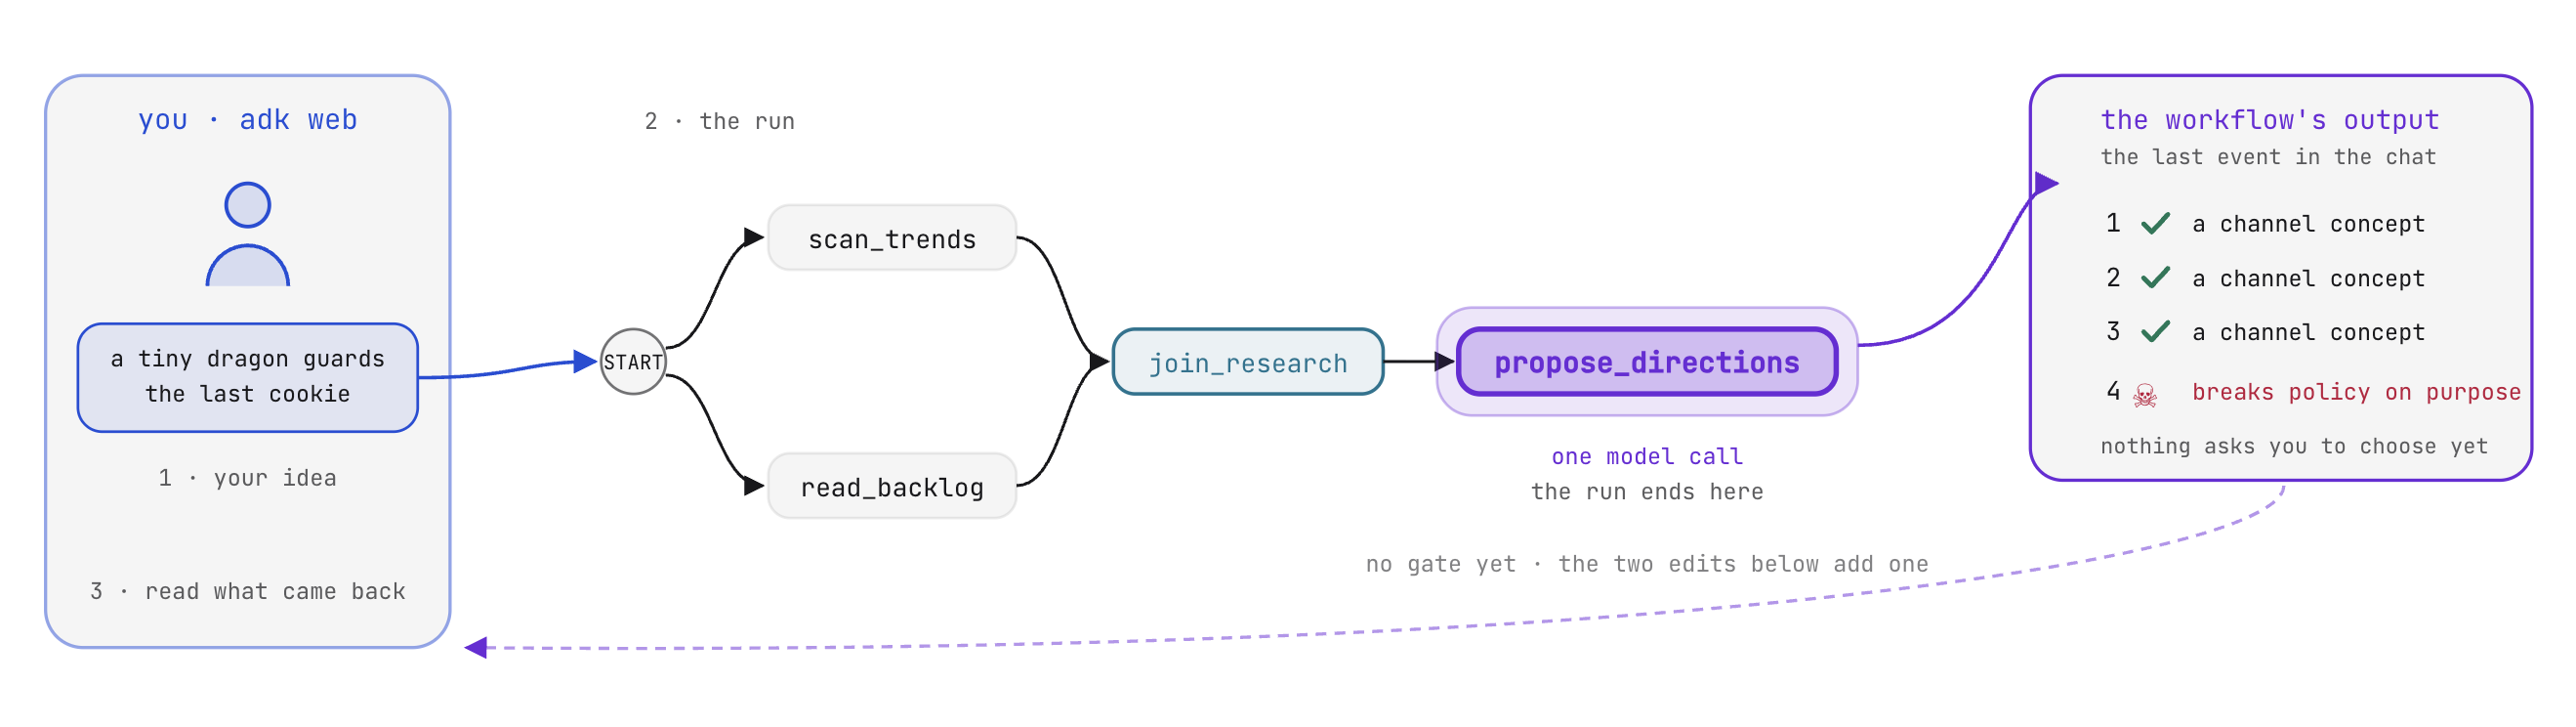
Prompt-Anweisungen im Vergleich zu deterministischer Sperrung
Produktionsworkflows, die finanzielle Kosten verursachen oder Inhalte veröffentlichen, erfordern an kritischen Entscheidungspunkten menschliche Aufsicht. In einem einzelnen Prompt sind Bestätigungsanfragen beratende Anweisungen, die ein Nutzer leicht umgehen kann, indem er das Modell dazu auffordert. In einem ADK-Workflow wird die manuelle Genehmigung von der Ausführungs-Engine erzwungen: Der Graph wird an einem bestimmten Knoten angehalten und kann erst fortgesetzt werden, wenn er eine externe, schemavalidierte Eingabe erhält:
- Durch
RequestInputwird die Workflowausführung sofort unterbrochen. - Das ADK zeichnet einen offenen Unterbrechungsaufruf im Sitzungsspeicher auf und gibt eine eindeutige
interrupt_idaus. - Der Ausführungsprozess wird angehalten, ohne Tokens oder Serverthreads zu verbrauchen.
- Die Graph Execution wird erst fortgesetzt, wenn ein gültiges
function_responseeingereicht wird, das dem Schema und der Unterbrechungs-ID entspricht.
Praktische Bearbeitung: Ausführung mit RequestInput unterbrechen
Implementieren Sie in agent/graph.py den Sperrungsaufruf in direction_gate:
    yield RequestInput(
        message="Pick tonight's direction: 1, 2, 3 or 4.",
        response_schema={
            "type": "object",
            "properties": {
                "pick": {"type": "string", "enum": ["1", "2", "3", "4"]}}},
        payload={"candidates": cands})
RequestInput konfiguriert drei Attribute:
message: Die dem Nutzer präsentierte Aufforderung zur Rezension.response_schema: Ein JSON-Schema, das vom Frontend als Eingabeformular gerendert und beim Senden vom ADK validiert wird.payload: Metadaten, die mit der Anfrage gebündelt sind (die vier Kandidaten), sodass Client-Schnittstellen Überprüfungskarten rendern können, ohne den Sitzungsstatus abzufragen.
Was Sie erwartet und warum
- Der Workflow wird bei „direction_gate“ angehalten: In ADK Web oder der Workbench-Benutzeroberfläche wird die Ausführung pausiert und ein interaktives Formular zur Auswahl von Kandidaten angezeigt.
- Ursache: Die Engine hat einen zurückgegebenen
RequestInputgefunden und den Ausführungsstatus inruns/sessions.dbbeibehalten.
- Ursache: Die Engine hat einen zurückgegebenen
- Für die Fortsetzung ist eine strukturierte Eingabe erforderlich: Das Senden von beliebigem Chattext führt nicht zu einem Fortschritt im Graphen. Wenn Sie eine Option (1, 2, 3 oder 4) auswählen, wird ein eingegebener
function_response-Wert gesendet, derresponse_schemaerfüllt, und die Ausführung wird fortgesetzt.
5. State und Router
Gehen Sie in der VibeStudio Workbench zu Schritt 5 · State and Router, Teile (5A) bis (5C).
Sie speichern Nutzerauswahlen im Sitzungsstatus, erzwingen die Einhaltung von Channelsicherheitsrichtlinien mithilfe deterministischer Routerknoten und stellen einen iterativen Task-Agent zusammen, um Richtlinienverstöße automatisch zu beheben, bevor Videoskripts generiert werden.
Workflowstatus (5A)
Gehen Sie in der Workbench zu Workflow State (5A).
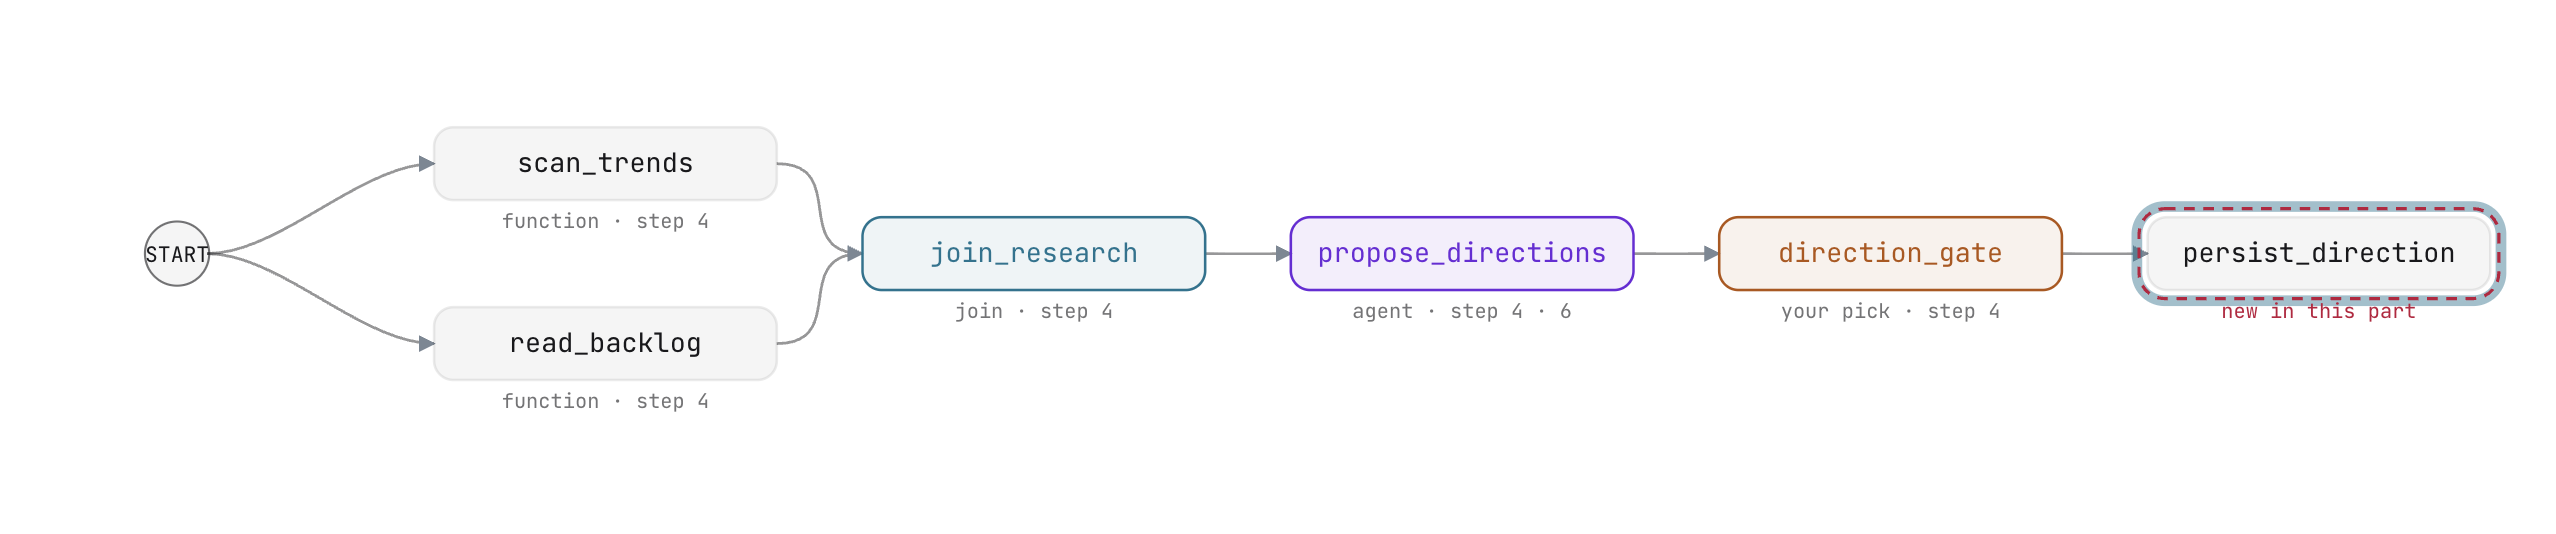
Sitzungsstatus und Knotenausgabe im Vergleich
In einem ADK-Workflow werden Daten über zwei verschiedene Mechanismen im Diagramm verschoben:
- Knotenausgabe (
Event(output=...)): Daten, die ausschließlich an die in der Kantenliste definierten unmittelbaren Downstream-Nutzer weitergeleitet werden. - Sitzungsstatus (
Event(state=...)): Ein gemeinsames Schlüssel/Wert-Dictionary, auf das von jedem nachfolgenden Knoten im Ausführungslebenszyklus zugegriffen werden kann.
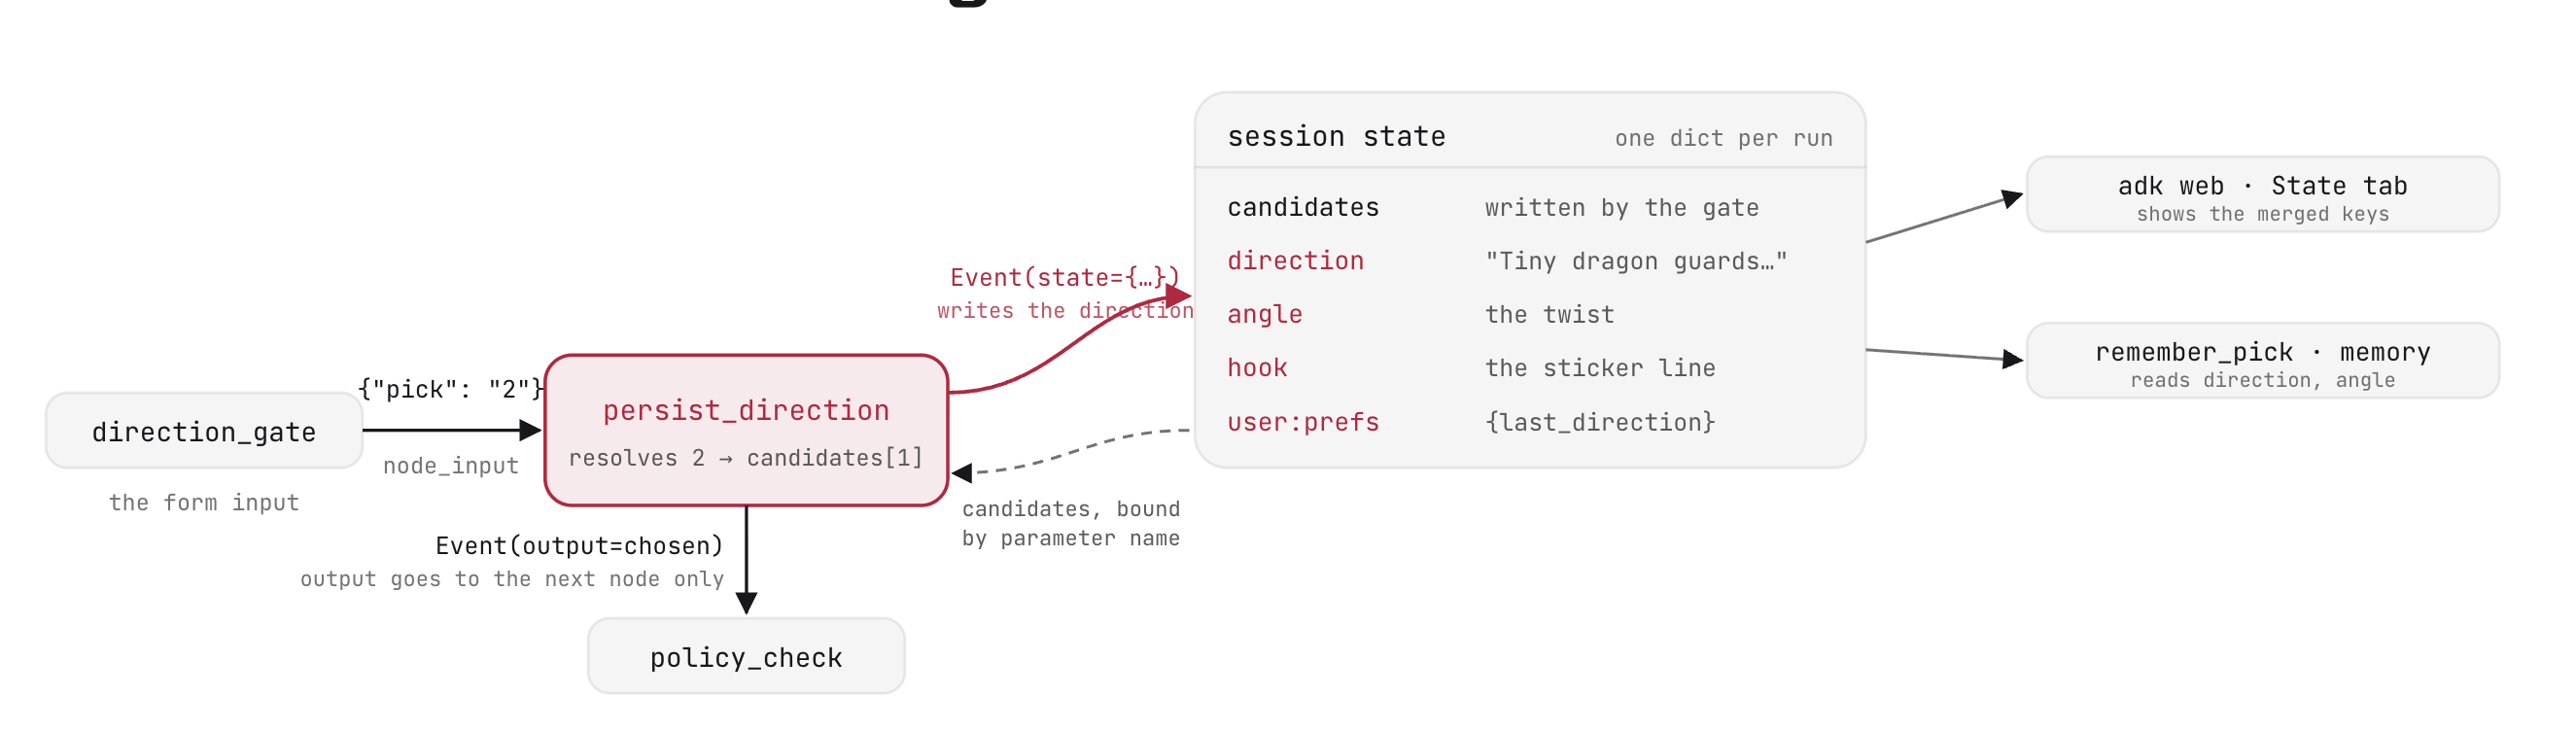
Wenn ein Nutzer bei direction_gate einen Kandidaten auswählt, wird die Auswahl als numerischer Index ({"pick": "2"}) übergeben. Nachgelagerte Knoten benötigen das vollständige Richtungsobjekt: Titel, Erzählperspektive und Hookline. Anstatt ausführliche Metadaten über jede Zwischenknoten-Nutzlast zu übergeben, schreibt persist_direction den aufgelösten Kandidaten in den freigegebenen Sitzungsstatus.
Knoten müssen nicht das gesamte Sitzungszustands-Dictionary übergeben. Wenn ein Knoten Event(state=...) liefert, werden nur die neuen oder aktualisierten Schlüssel/Wert-Paare bereitgestellt. Das ADK führt diese Aktualisierungen automatisch im Sitzungsspeicher zusammen:
    yield Event(state={"direction": chosen["title"], "angle": chosen.get("angle", ""),
                       "hook": hook, "user:prefs": {"last_direction": chosen["title"]}})
Durch die Ausgabe dieses Event wird die Kontrolle an die Workflow-Laufzeit übergeben, die die neuen Werte im Sitzungsjournal in runs/sessions.db speichert.
Parameterbindung
ADK-Funktionsknoten lesen den Sitzungsstatus automatisch durch Parameterprüfung. Wenn eine Funktionssignatur einen Parameternamen deklariert, der mit einem vorhandenen Zustandsschlüssel übereinstimmt, extrahiert das ADK diesen Schlüssel aus dem Zustand und übergibt ihn direkt:
def persist_direction(node_input, candidates: list = []):
    ni = node_input if isinstance(node_input, dict) else {}
    raw = ni.get("pick")
    pick = str(raw).strip() if raw is not None else ""
    if candidates:
        i = int(pick) - 1 if pick.isdigit() else 0
        chosen = candidates[max(0, min(len(candidates) - 1, i))]
    else:
        chosen = {"title": "untitled", "angle": "", "evidence": []}
    hook = chosen.get("hook") or " ".join(chosen["title"].split()[:4])
Hier wurde candidates von direction_gate in den Sitzungsstatus geschrieben. Das ADK bindet es direkt in persist_direction(node_input, candidates: list = []) ein, ohne dass explizite Wörterbuchsuchen erforderlich sind.
Schlüssel mit dem Präfix user: bleiben über Sitzungen hinweg im Speicher auf Nutzerebene erhalten, sodass nachfolgende Workflowausführungen auf die Einstellungen des Erstellers zugreifen können.
Praktische Übung: Zustand beibehalten und Knoten verbinden
- Ersetzen Sie in
agent/graph.pyinnerhalb vonpersist_directiondie ZeileTODO: PERSIST_STATEdurch den Statusereignis-Yield:
    yield Event(state={"direction": chosen["title"], "angle": chosen.get("angle", ""),
                       "hook": hook, "user:prefs": {"last_direction": chosen["title"]}})
- Hängen Sie in
stage3_router/agent.pypersist_directionan die dritte Kette in der Listeedgesan:
           (join_research, propose_directions, direction_gate,
            persist_direction)
Speichern Sie Ihre Dateien. Prüfen Sie in der Workbench, ob sowohl für state write in place als auch für persist_direction in the chain grüne Häkchen angezeigt werden.
Der Routerknoten (5B)
Gehen Sie in der Workbench zu The router node (5B).
Deterministisches Richtlinienrouting
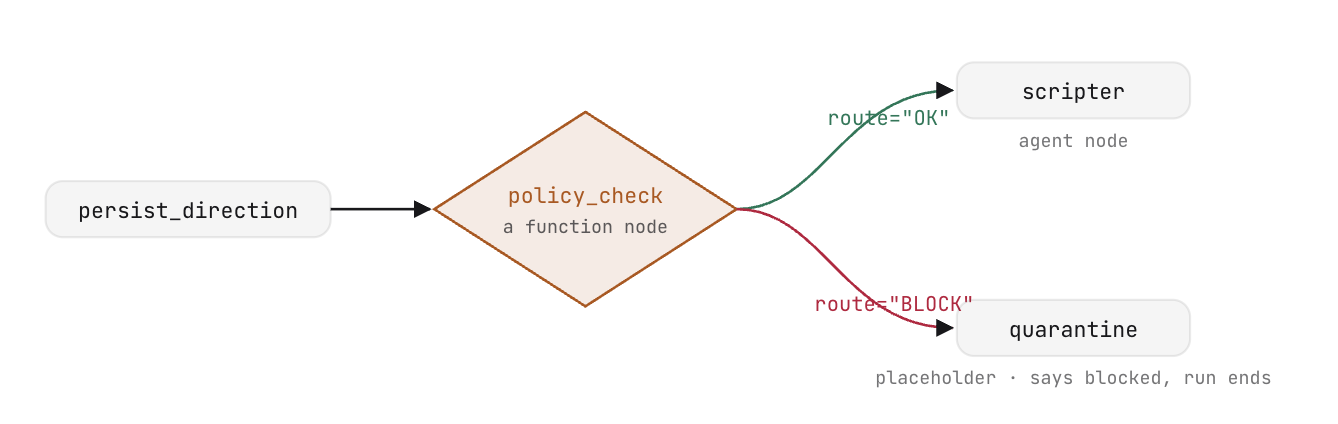
Ein Router ist ein spezieller Funktionsknoten, der die Upstream-Ausgabe auswertet und die Ausführung entlang bedingter Diagrammzweige lenkt. Im Gegensatz zu generativen Agenten führt ein Router deterministische Logik aus, ohne LLM-Aufrufe zu machen.
Ein Router gibt ein Event mit einem route-Tag zurück:
def length_check(node_input):
    too_long = len(node_input.get("title", "")) > 60
    return Event(output=node_input, route="TRIM" if too_long else "PASS")
In der Workflowdefinition wird ein als Dictionary definiertes Edge-Ziel so zugeordnet, dass Routennamen auf Zielknoten verweisen:
(length_check, {"TRIM": shorten, "PASS": scripter}),
Der Workflow-Router policy_check liest verbotene Wortgruppen aus agent/policy_words.txt und führt einen Abgleich ganzer Wörter mit dem Titel und dem Winkel der ausgewählten Richtung durch:
return Event(output=node_input, route="BLOCK" if bad else "OK")
Wenn Sie die Richtlinie als Daten statt als hartcodierte Anweisungen speichern, können Sie Aktualisierungen vornehmen, ohne das Workflowdiagramm zu ändern: Die Aktualisierung der Textdatei wird sofort auf nachfolgende Ausführungen angewendet. Da die Bewertung auf deterministischem Regex-Abgleich basiert, wird sie in Millisekunden und ohne Tokenkosten ausgeführt, bevor das generative Scripting beginnt.
Ziele: Scripter und Quarantäne
Der Router leitet den Traffic an einen von zwei nachgelagerten Knoten weiter:
scripter: Einsingle_turn-Agentenknoten, der die genehmigte Richtung in ein strukturiertes Produktionsskript umwandelt, das dem Pydantic-SchemaScriptentspricht:
scripter = Agent(
    name="scripter",
    model=config.MODEL,
    instruction=SCRIPT_INSTRUCTION,
    output_schema=Script)
quarantine: Zuerst eine Platzhalterfunktion, die markierte Anweisungen stoppt. Im nächsten Teil wird sie durch einen autonomen Korrektur-Agenten ersetzt.
Praktische Bearbeitung: Richtlinienprüfung weiterleiten
- Vervollständigen Sie in
agent/graph.pyinnerhalb vonpolicy_checkdie return-Anweisung:
return Event(output=node_input, route="BLOCK" if bad else "OK")
- Aktualisieren Sie in
stage3_router/agent.pyedgesauf die Routepolicy_checkund führen Sie den Quarantänezweig wieder inscripterzusammen:
           (join_research, propose_directions, direction_gate,
            persist_direction, policy_check),
           (policy_check, {"OK": scripter, "BLOCK": quarantine}),
           (quarantine, scripter)])
Speichern Sie Ihre Dateien. Prüfen Sie in der Workbench, ob die Router-Edge-Zuweisungen bestätigt wurden.
Agent-Modi und der Aufgabenknoten (5C)
Gehen Sie in der Workbench zu Agentenmodi und Aufgabenknoten (5C).
Ausführungsmodi für KI-Agenten
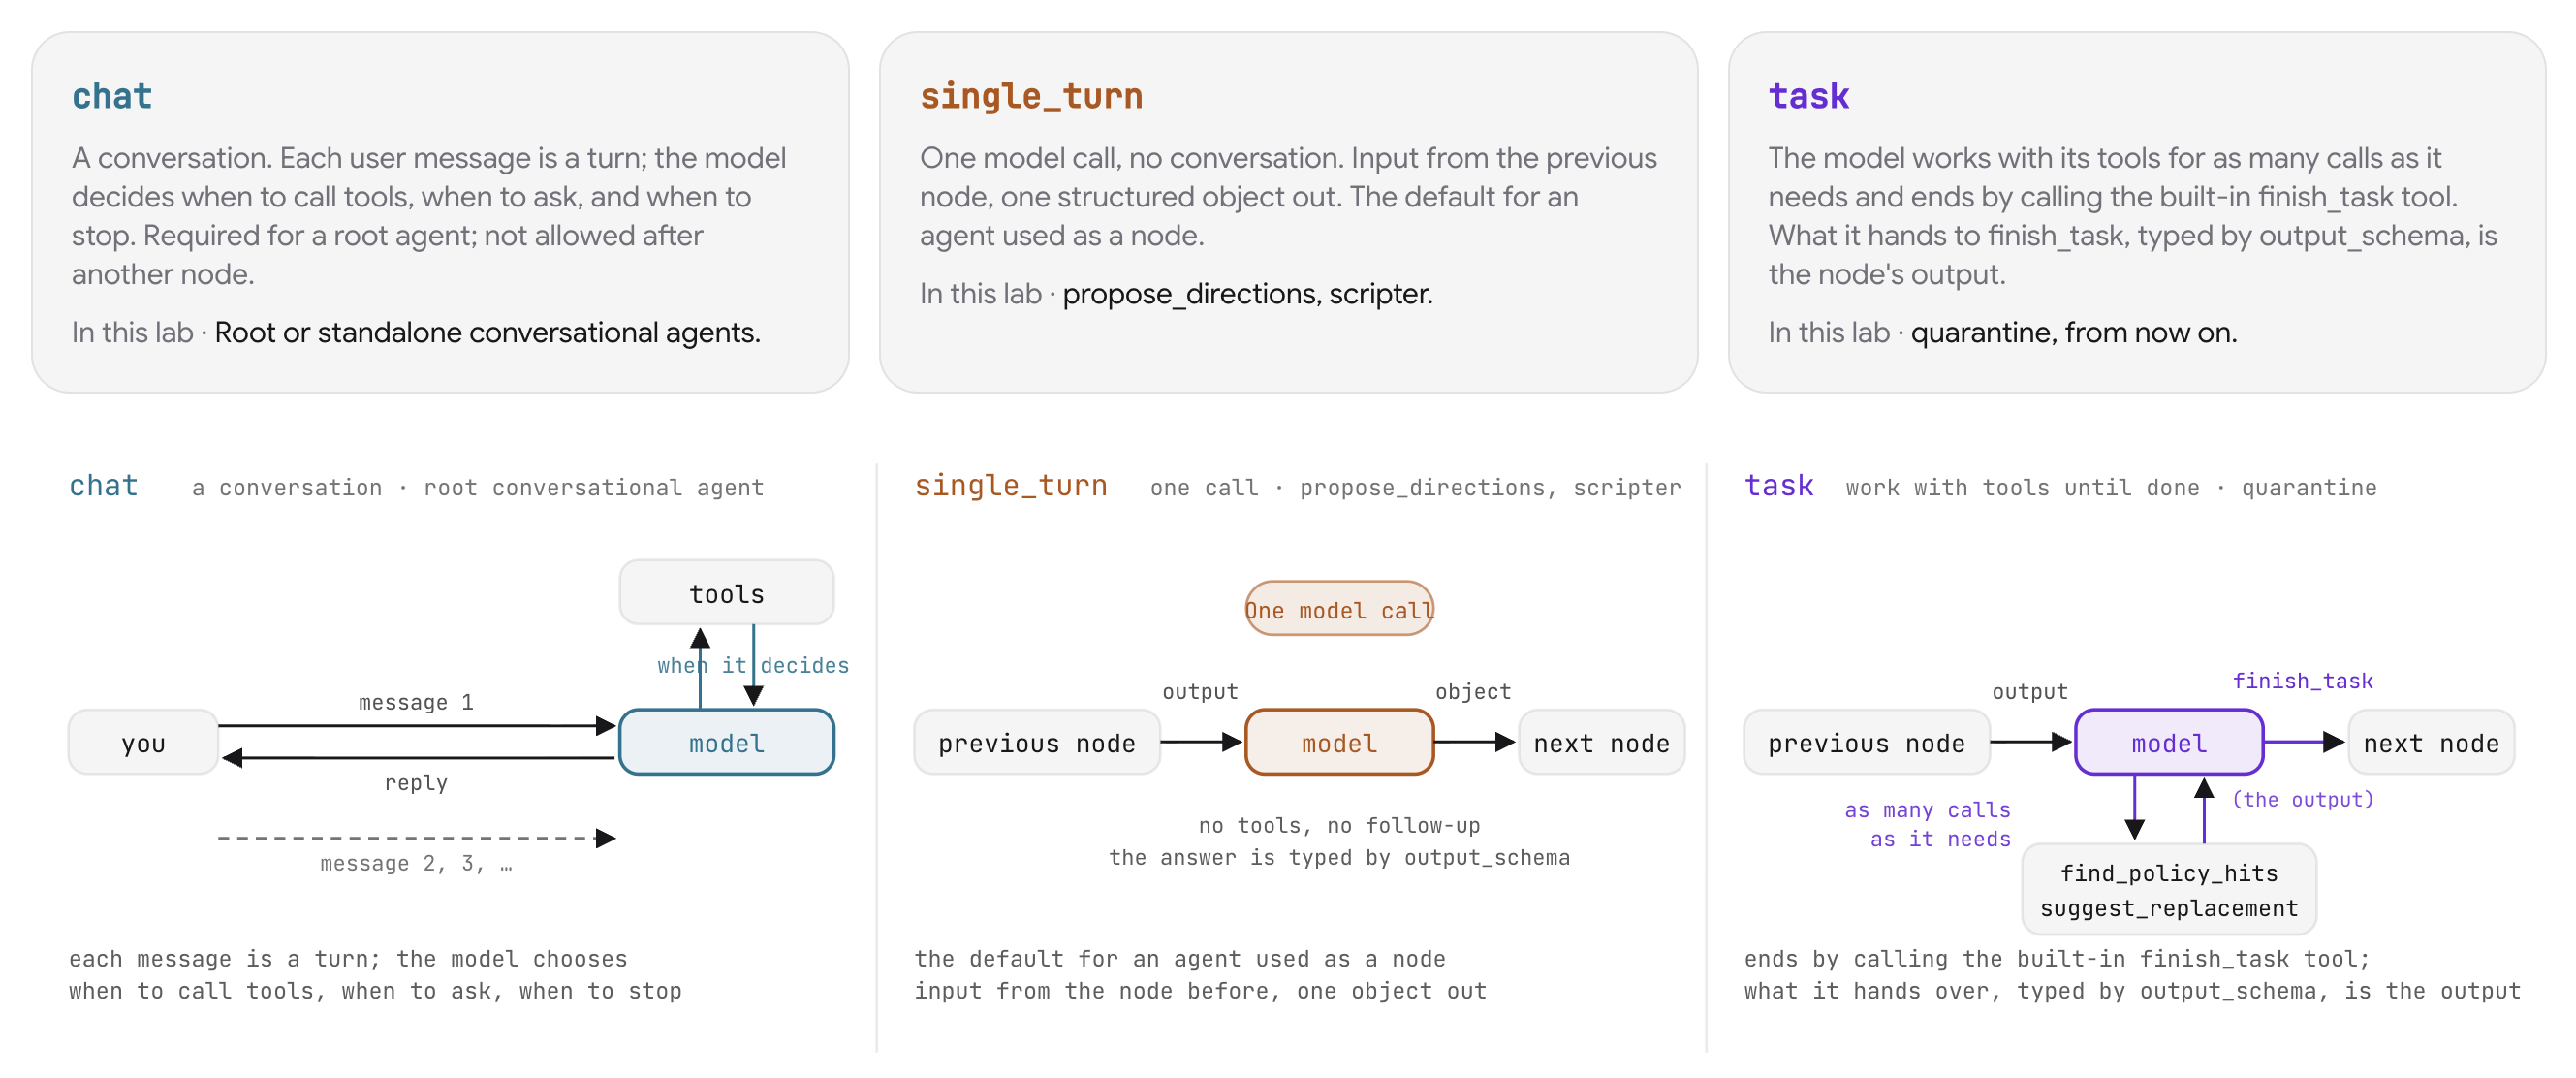
ADK-Agent-Instanzen unterstützen drei Ausführungsmodi, die auf bestimmte Pipeline-Anforderungen zugeschnitten sind:
Modus | Ausführungslebenszyklus | Rolle in der Pipeline |
| Multi-Turn-Unterhaltungsschleife. Das Modell bestimmt, wann Tools aufgerufen, Eingaben angefordert oder die Runde beendet werden soll. | Root-Agenten, die mit einem interaktiven menschlichen Nutzer interagieren. |
| Einzelner Modellinferenzaufruf. Akzeptiert die Eingabe des vorherigen Knotens und gibt ein strukturiertes Schemaobjekt aus. | Sequenzielle Diagrammtransformationen ( |
| Autonome Schleife mit Tool-Ausführung. Der Agent führt Iterationen durch, bis er das integrierte Tool | Mehrstufige Fehlerbehebung und Prüfung ( |
Autonome Richtlinienkorrektur
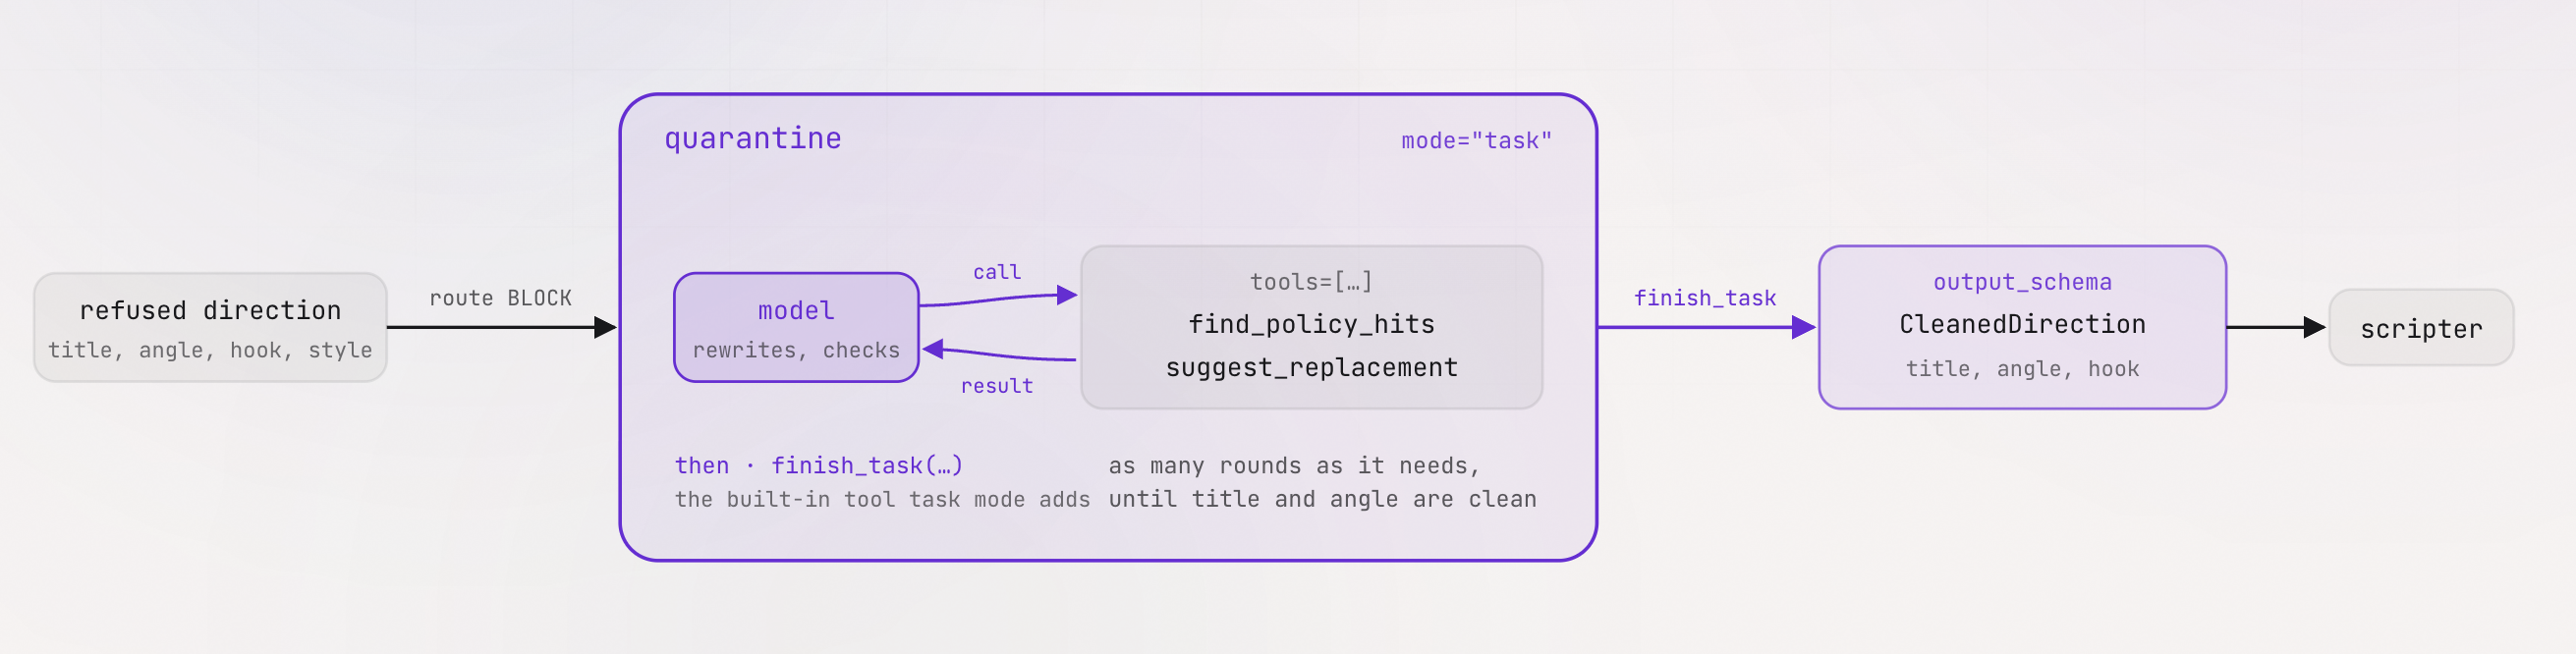
Für das Umschreiben einer gekennzeichneten Anleitung ist der Modus task erforderlich, da die Anzahl der Korrekturschleifen variabel ist. Der Agent empfängt die gekennzeichnete Anweisung, ruft find_policy_hits auf, um Verstöße zu erkennen, fordert über suggest_replacement genehmigte Alternativen an, schreibt die Anweisung um und überprüft sie auf Unbedenklichkeit, bevor er fortfährt.
Beide Tools sind in agent/cleanup_tools.py mit typisierten Signaturen und Docstrings definiert:
def find_policy_hits(text: str) -> dict:
    """Which refused words appear in `text`. Matches whole words and phrases
    from agent/policy_words.txt, case-insensitive.

    Returns {"hits": [...], "clean": bool}. clean is true when hits is empty.
    """


def suggest_replacement(word: str) -> dict:
    """The channel's approved stand-in for a refused word, read from
    agent/policy_replacements.txt.

    Returns {"word", "replacement", "listed"}. When the word has no entry,
    listed is false and replacement is a hint to pick a gentle synonym.
    """
Praktische Übung: KI-Agenten für die Quarantäneaufgabe zusammenstellen
Ersetzen Sie in stage3_router/agent.py den Platzhalter für die Funktion quarantine durch die Definition des Aufgaben-Agenten:
quarantine = Agent(
    name="quarantine",
    model=config.MODEL,
    instruction=QUARANTINE_INSTRUCTION,
    mode="task",
    tools=[find_policy_hits, suggest_replacement],
    output_schema=CleanedDirection,
)
Im Aufgabenmodus werden dem Agenten Tools zur Verfügung gestellt und die Ausführung wird durch Aufrufen von finish_task beendet. Wenn mode="task" konfiguriert ist, stellt ADK automatisch finish_task bereit und leitet seine Parameter von output_schema ab. So wird sichergestellt, dass der Knoten ein typisiertes CleanedDirection-Objekt liefert, das dem Eingabeschema des Scripter-Knotens entspricht.
Was Sie erwartet und warum
Testen Sie beide Ausführungspfade in ADK Web oder VibeStudio Workbench:
- Genehmigte Route (Kandidat 1, 2 oder 3):
- Wenn Sie einen genehmigten Kandidaten auswählen, werden Routen von
policy_checkdirekt zuscripter(route="OK") erstellt. - Der Scripter generiert ein Produktionsskript mit drei Aufnahmen, das dem Schema
Scriptentspricht.
- Wenn Sie einen genehmigten Kandidaten auswählen, werden Routen von
- Quarantäne-Abhilfemaßnahmen (Kandidat 4):
- Kandidat 4 enthält markiertes Vokabular („Clickbait“, „viraler Hack“).
policy_checkRouten nachquarantine(route="BLOCK").- Im Sitzungstrace sehen Sie, wie
quarantinefind_policy_hitsaufruft,suggest_replacementfür jeden Verstoß aufruft, den Titel neu schreibt undfinish_taskaufruft. - Die Ausführung wird mit
scripterzusammengeführt und es wird ein Skript aus der bereinigten Richtung erstellt.
6. Memory Bank
Gehen Sie in der VibeStudio Workbench zu Schritt 6 – Memory Bank, Teile (6A) und (6B).
Der Workflow wird derzeit ohne sitzungsübergreifenden Speicher ausgeführt. Jede Ausführung beginnt von vorn, ohne dass die KI weiß, was der Creator zuvor ausgewählt hat oder welche Genres er bevorzugt. In diesem Schritt verbinden Sie die Vertex AI Agent Engine Memory Bank, um die Einstellungen des Creators über mehrere Ausführungen hinweg zu speichern und abzurufen.
Wichtig ist, dass der Speicher über Lebenszyklus-Callbacks des Agenten und nicht über Pipelineknoten eingebunden wird. Da die Extraktion und der Abruf von Arbeitsspeicher einzelnen Agents anstelle von Zwischenphasen dienen, wird durch das Anhängen von Callbacks eine saubere, entkoppelte Diagrammtopologie beibehalten.
Memory Bank (6A)
Rufen Sie in der Workbench Memory Bank (6A) auf.
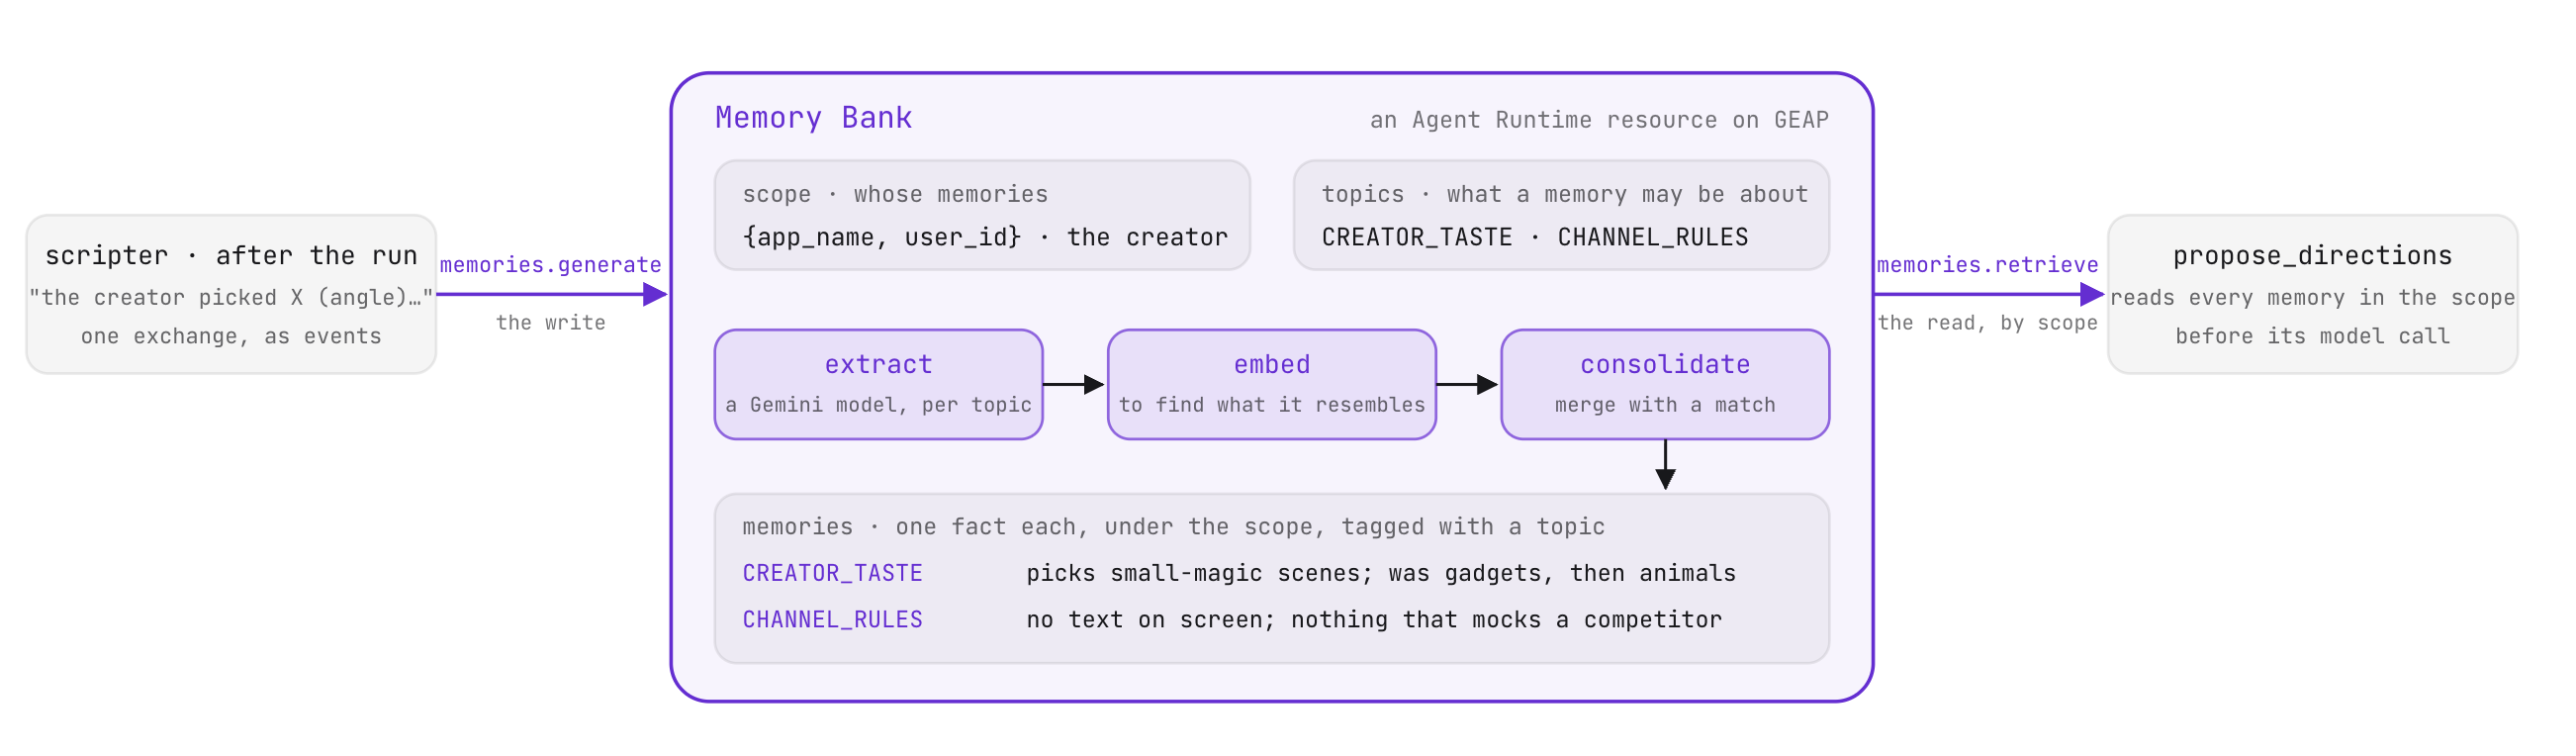
Verwaltete gespeicherte Informationen auf Nutzerebene
Memory Bank ist ein verwalteter Dienst für den Langzeitspeicher von Nutzern. Darin werden Fakten über eine Person in einem definierten Bereich organisiert, der hier durch den Anwendungsnamen und die Nutzer-ID identifiziert wird:
SCOPE = {"app_name": config.APP, "user_id": config.USER}
TOPICS = {
    "CREATOR_TASTE": "Which video directions this creator picks and passes on, "
                     "and how that preference changes over time.",
    "CHANNEL_RULES": "Standing instructions the creator states for every video "
                     "(style, subjects to avoid, format rules).",
}
Benutzerdefinierte Memory-Themen definieren die Grenzen dessen, was in der Memory Bank aufgezeichnet wird:
- Themenextraktion: Wenn neuer Unterhaltungstext über
memories.generategesendet wird, wendet der Dienst ein Extraktionsmodell auf jede Themenbeschreibung an. Text, der keinem Thema entspricht, führt zu keinen Erinnerungen. - Konsolidierung und Deduplizierung: Der Dienst wandelt neu extrahierte Fakten in Einbettungen um und vergleicht sie mit vorhandenen gemerkten Informationen im Bereich. Wenn eine Beobachtung mit einer vorhandenen gemerkten Information übereinstimmt, aktualisiert der Dienst diese Information. Wenn es sich um neue Informationen handelt, wird ein neuer Eintrag erstellt. Durch diesen Konsolidierungsprozess werden mehrere Sitzungen zu einem Thema zu einer kohärenten Zusammenfassung zusammengeführt, anstatt redundante Einträge zu erzeugen.
- Abruf: Wenn Sie
memories.retrievemit dem Nutzerbereich aufrufen, werden gespeicherte Fakten zurückgegeben, wobei die ältesten zuerst aufgeführt werden.
Beide Vorgänge werden in agent/platform/memory.py implementiert. Der Name der bereitgestellten Bankressource wird lokal in runs/memorybank.json im Cache gespeichert.
Memory Bank einrichten
Verwenden Sie die Workbench-Steuerelemente oder führen Sie die CLI-Befehle in Ihrem Terminal aus:
- Bank verbinden und bereitstellen:
python -m agent.platform.bankCREATOR_TASTEundCHANNEL_RULES. - Seed-Verlaufssitzungen:
python -m agent.platform.bank load - Konsolidierte Fakten prüfen:
python -m agent.platform.bank list
Callbacks (6B)
Rufen Sie in der Workbench Callbacks (6B) auf. Öffne stage4_memory/agent.py.
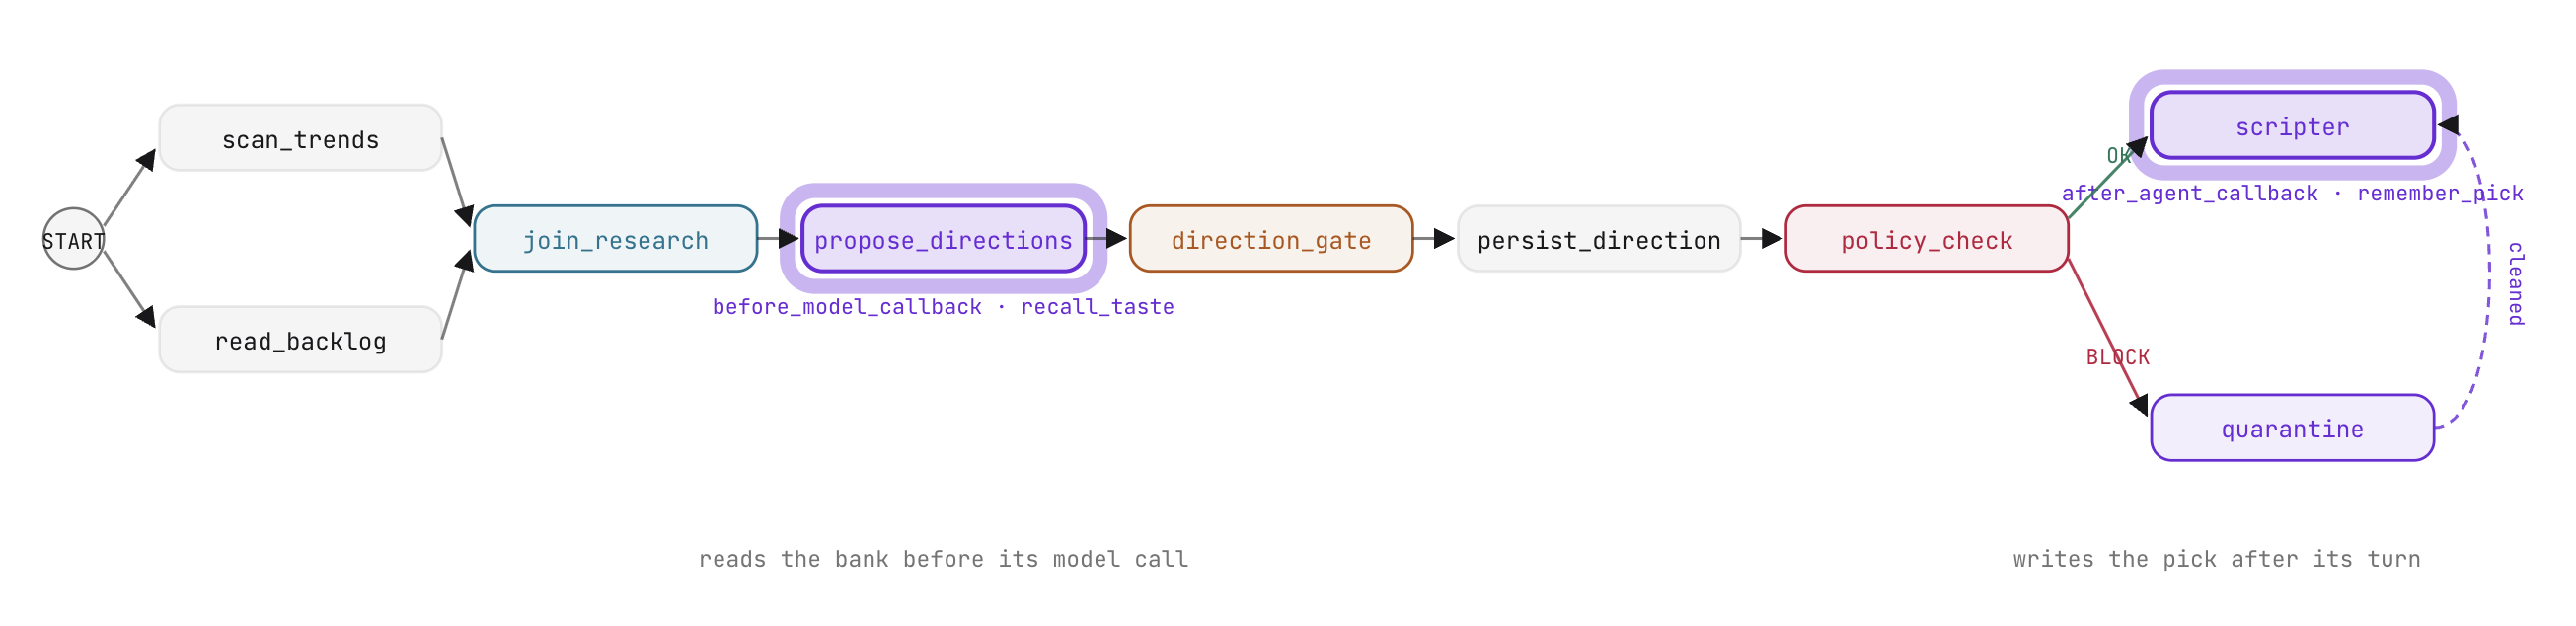
ADK-Agent-Lebenszyklus-Callbacks
Ein Callback ist eine Funktion, die als Argument an ein Agent übergeben wird. Das ADK ruft Callbacks zu vordefinierten Lebenszyklus-Momenten auf und übergibt den aktiven Kontext. Wenn None zurückgegeben wird, wird die normale Ausführung fortgesetzt. Wenn ein Ersatzobjekt zurückgegeben wird, wird der Vorgang überschrieben oder abgefangen.
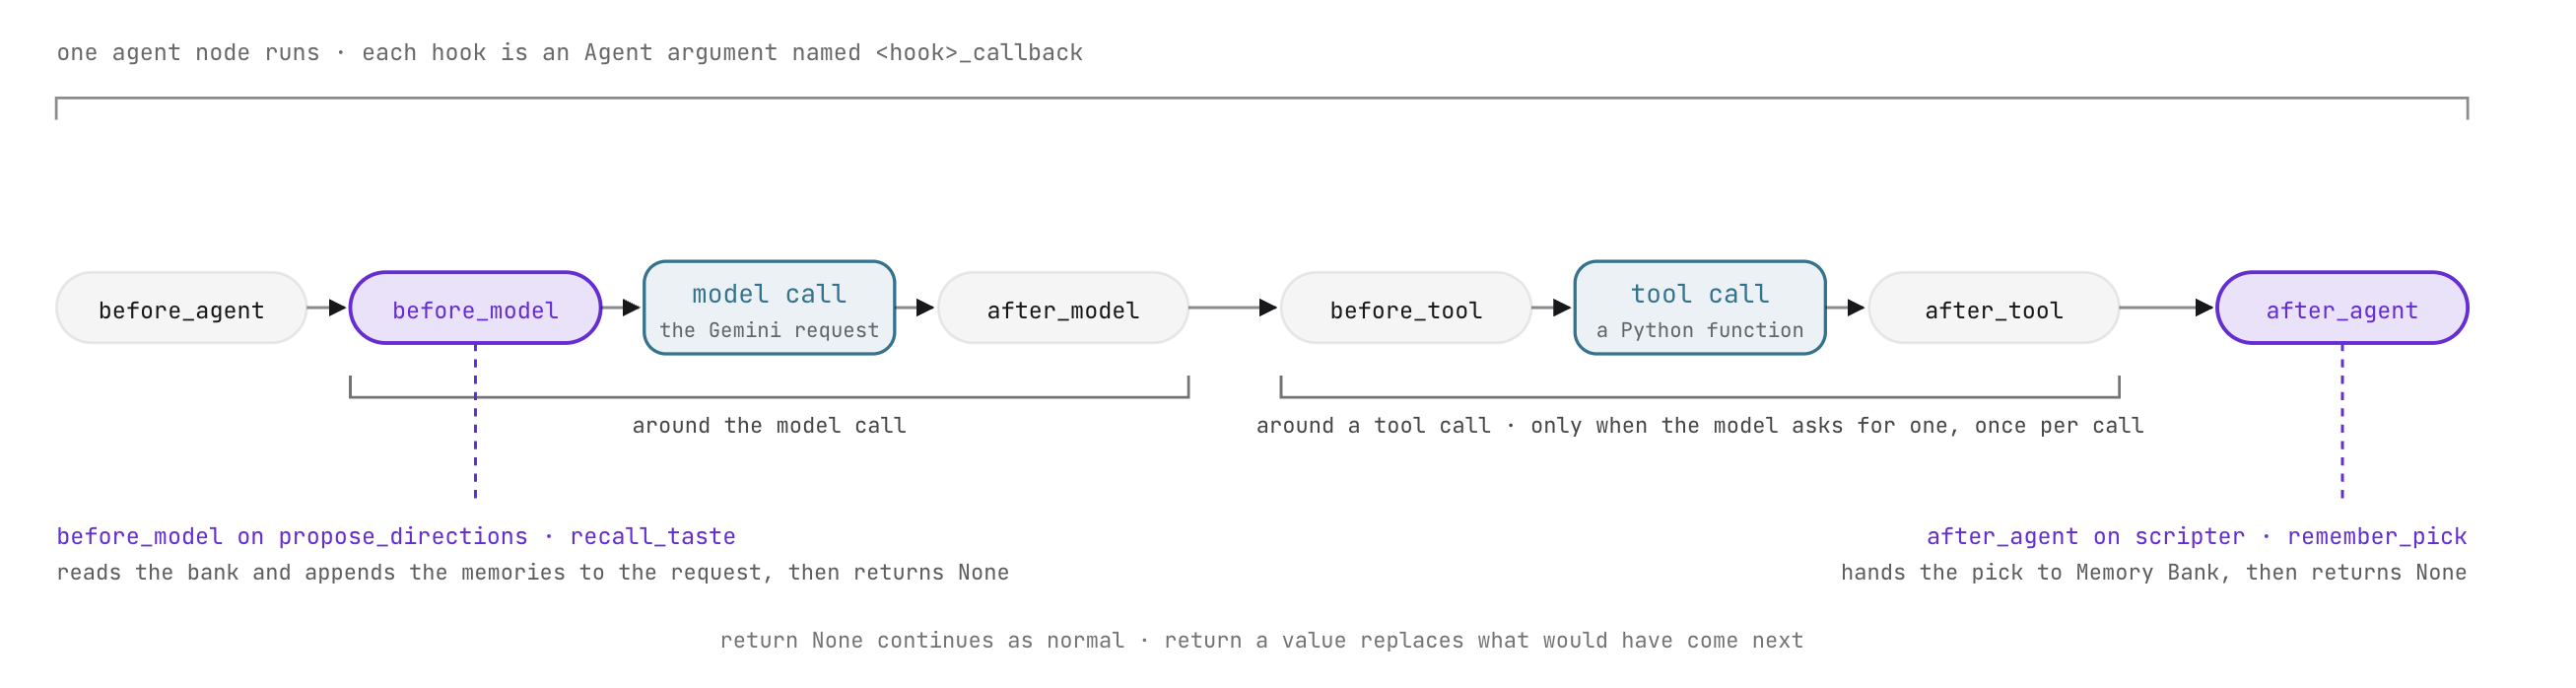
Das ADK bietet drei Callback-Paare:
Callback-Paar | Aufrufpunkt | Empfangene Parameter | Verhalten von Rückgabewerten |
| Um den gesamten Agent-Turn |
| Wenn |
| Um jeden LLM-Inferenzaufruf herum |
| Wenn |
| Vor und nach jeder Toolausführung | Tooldefinition, Argumente, Ergebnis | Wenn ein Wörterbuch zurückgegeben wird, wird die Toolausgabe überschrieben und |
Callbacks bieten einen sauberen Ort für die Kontextinjektion, Guardrails, Telemetrie und Cache-Suchen, ohne dass zusätzliche Knoten in den Workflow-Graphen eingefügt werden müssen.
Praktische Übung: Callbacks für Abruf und Erinnerung verknüpfen
- Aktualisieren Sie in
stage4_memory/agent.pyden Wertpropose_directions, umbefore_model_callback=recall_tasteanzuhängen:
    output_schema=Directions,
    before_model_callback=recall_taste)
recall_taste wird unmittelbar vor dem Generieren von Kandidatenanweisungen durch Gemini ausgeführt. Es ruft den Verlauf des Creators aus der Memory Bank ab, formatiert die gemerkten Informationen (älteste zuerst) und hängt sie an die ausgehende LlmRequest an. Der Prompt weist das Modell an, die Kandidaten 1 bis 3 an den aktuellen Geschmack des Creators anzupassen, während die Kanalregeln als strikte Einschränkungen behandelt werden.
- Aktualisieren Sie in
stage4_memory/agent.pyden Wertscripter, umafter_agent_callback=remember_pickanzuhängen:
    output_schema=Script,
    after_agent_callback=remember_pick)
remember_pick wird ausgeführt, nachdem scripter seinen Zug beendet hat. Es liest die ausgewählte Richtung aus dem Sitzungsstatus, synthetisiert eine prägnante Aussage, die die Entscheidung des Creators zusammenfasst, und ruft memories.generate auf, um die Memory Bank zu aktualisieren.
Was Sie erwartet und warum
Testen Sie den durch Rückrufe erweiterten Workflow in der Workbench oder im ADK Web:
- Führen Sie einen Lauf mit einem leeren Prompt aus:
- Prüfen Sie im Sitzungs-Trace den
LlmRequestfürpropose_directions. Beachten Sie den angehängten Kontext aus dem Gedächtnis, der die Vorliebe des Erstellers für Fantasy-Themen und ein prägnantes Tempo beschreibt. - Beobachten Sie die vorgeschlagenen Richtungen: Die Kandidaten 1 bis 3 entsprechen den bisherigen Präferenzen des Creators, auch wenn Trends andere Themen hervorheben.
- Prüfen Sie im Sitzungs-Trace den
- Wählen Sie einen Kandidaten unter
direction_gateaus. - Sehen Sie sich nach Abschluss von
scripterdie Memory Bank-Einträge an:python -m agent.platform.bank list
7. RAG Engine
Rufen Sie in der VibeStudio Workbench Schritt 7 · RAG Engine, Teile (7A) und (7B) auf.
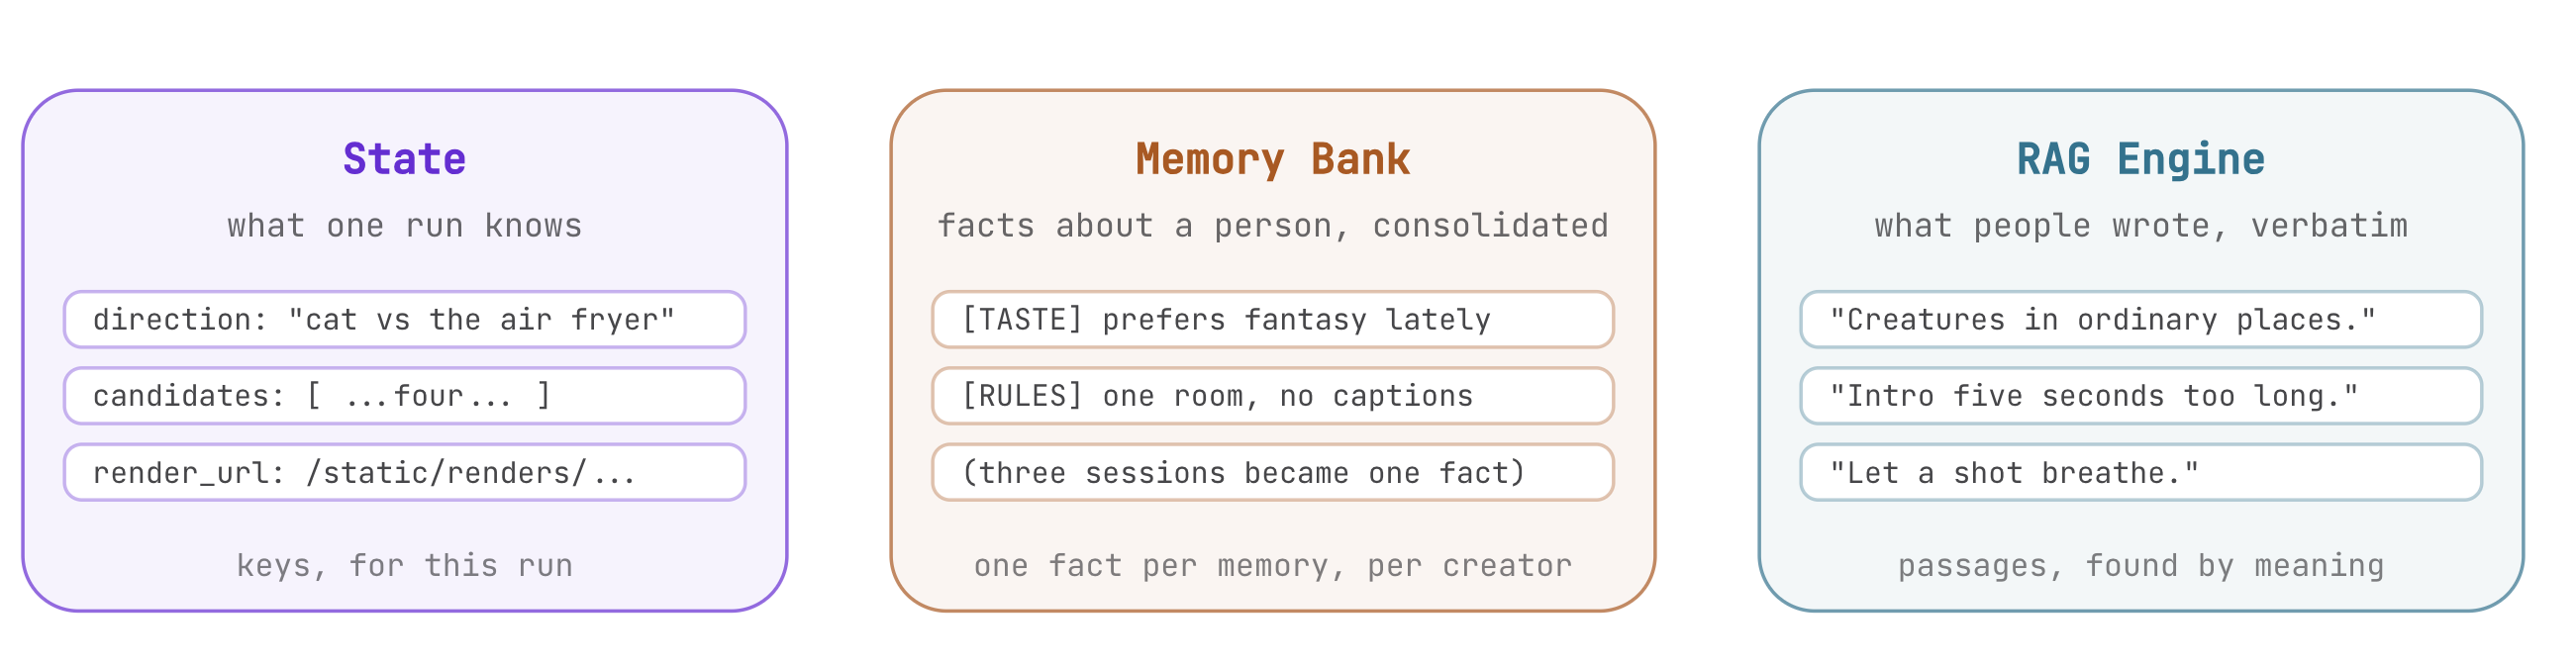
Veröffentlichte Videos erhalten laufend Feedback von Zuschauern. In agent/comments.md werden 30 repräsentative Kommentare gesammelt, die Lob von Zuschauern, Kritik am Tempo gesponserter Inhalte und Audiopräferenzen enthalten. In diesem Schritt indexieren Sie diese Kommentare mit der Vertex AI-RAG-Engine und verbinden die semantische Suche mit der Recherche.
Abruf von Dokumenten (7A)
Rufen Sie in der Workbench RAG Engine (7A) auf.
Memory Bank im Vergleich zur RAG Engine
Beide Tools fundieren Workflows mit externen Daten, dienen aber unterschiedlichen architektonischen Zwecken:
Dimension | Memory Bank | RAG Engine |
Primärer Anwendungsfall | Langfristige Nutzereinstellungen und Betriebsregeln | Semantischer Abruf aus großen Dokumentensammlungen |
Bereich | Auf einzelne Nutzer-IDs und Anwendungsnamen beschränkt | Auf freigegebene Korpusressourcen aller Nutzer beschränkt |
Datenverarbeitung | Extraktion, Einbettung und semantische Konsolidierung in Echtzeit | Dokumentaufteilung, Vektoreinbettung und Suche nach dem nächsten Nachbarn |
Diagrammintegration | Lebenszyklus-Callbacks für KI-Agenten ( | Dedizierter Funktionsknoten im Fan-Out für die Recherche ( |
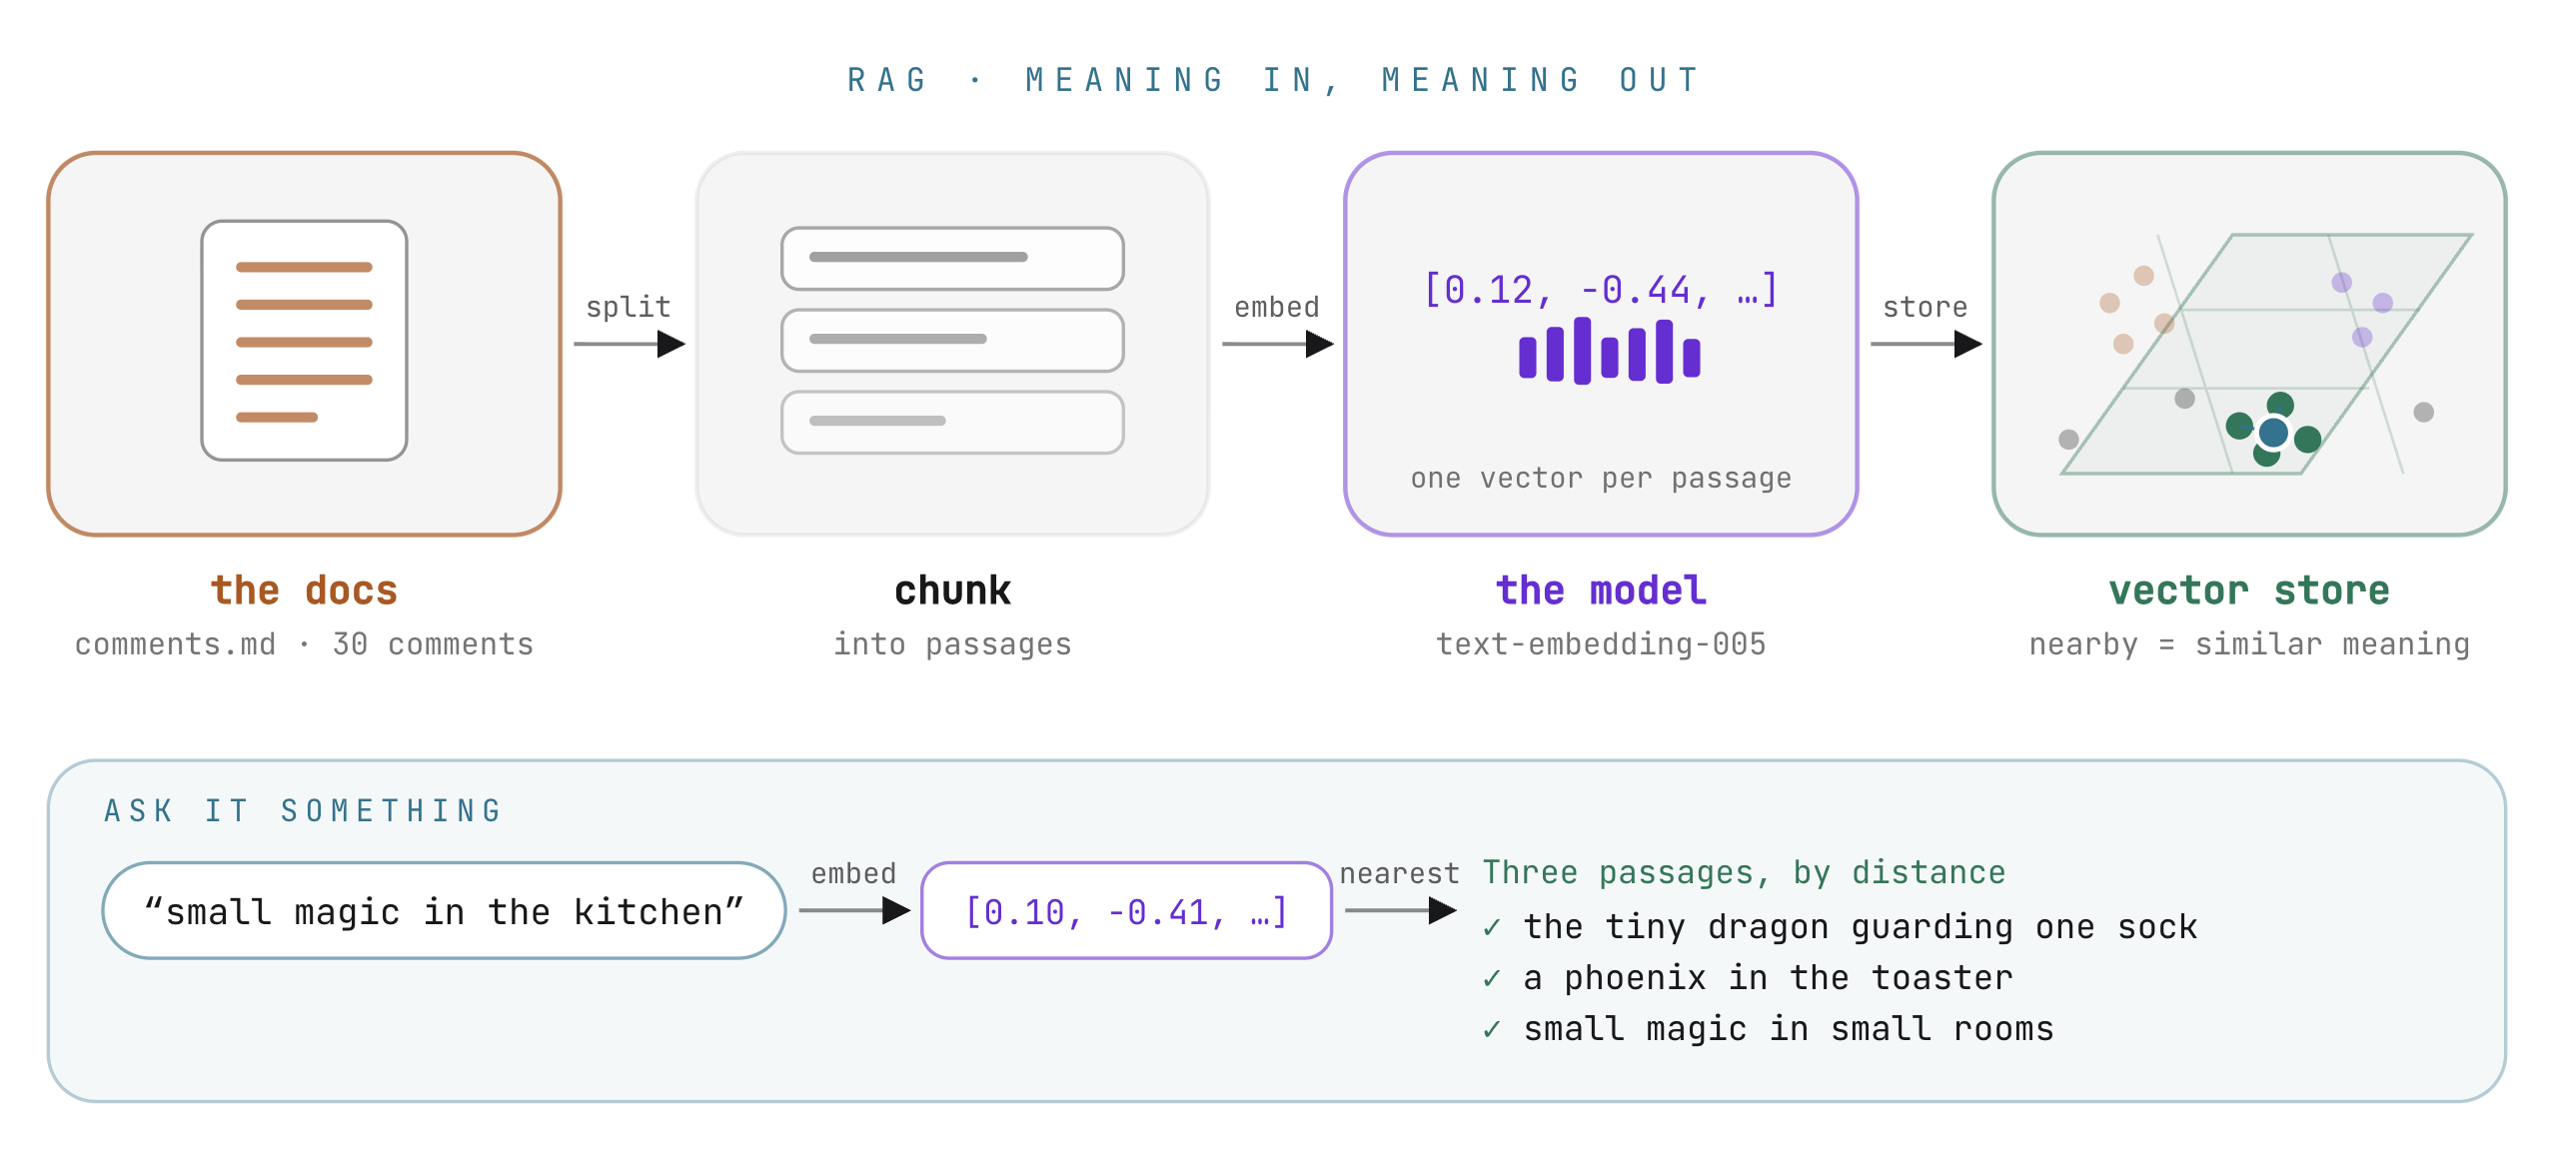
Dokumentaufteilung und Einbettungen
Die RAG Engine indexiert Dokumente, indem sie Text in semantische Abschnitte unterteilt und deren Vektoren in einer verwalteten Datenbank speichert:
corpus = rag.create_corpus(
    display_name="vibestudio-feedback",
    description="Vibe Studio: what the audience wrote under the channel's past videos.",
    backend_config=rag.RagVectorDbConfig(
        rag_embedding_model_config=rag.RagEmbeddingModelConfig(
            vertex_prediction_endpoint=rag.VertexPredictionEndpoint(
                publisher_model="publishers/google/models/text-embedding-005"))))

rag.upload_file(
    corpus_name=corpus.name, path="agent/comments.md", display_name="comments.md",
    transformation_config=rag.TransformationConfig(
        chunking_config=rag.ChunkingConfig(chunk_size=120, chunk_overlap=20)))
- Blockgröße: Auf 120 Tokens mit 20 Tokens Überlappung konfiguriert. So werden zwei bis drei Kommentare pro Abschnitt erfasst. Jeder Vektor steht für eine zusammenhängende Stimmung, ohne dass die Bedeutung durch nicht zusammenhängendes Feedback verwässert wird.
- Einbettungsmodell:
text-embedding-005wandelt Text in hochdimensionale Vektoren um. Wenn eine Abfrage gesendet wird, wandelt das Modell die Abfrage in einen Vektor um und sucht anhand der semantischen Distanz nach den nächsten Übereinstimmungen. Ein Kommentar über einen kleinen Drachen, der Socken bewacht, entspricht einem Prompt über magische Kreaturen, ohne dass eine genaue Keyword-Überschneidung erforderlich ist.
RAG-Korpus einrichten
Initialisieren Sie den Korpus mit den Workbench-Schaltflächen oder Terminalbefehlen:
- Korpus erstellen:
python -m agent.platform.ragruns/ragcorpus.jsonauf. - Kommentare hochladen und indexieren: Lädt
agent/comments.mdmit der Chunking-Konfiguration hoch und wartet, bis die Indexierung abgeschlossen ist. - Korpus abfragen: Testen Sie den Abruf ähnlicher Kommentare mit Anfragen, die keine exakten Wörter mit den Kommentaren gemeinsam haben (z. B. „kleine magische Kreaturen“, um Kommentare zu Drachen abzurufen).
Der Abrufknoten (7B)
Gehen Sie in der Workbench zu The third reader (7B). Öffnen Sie stage5_rag/agent.py.
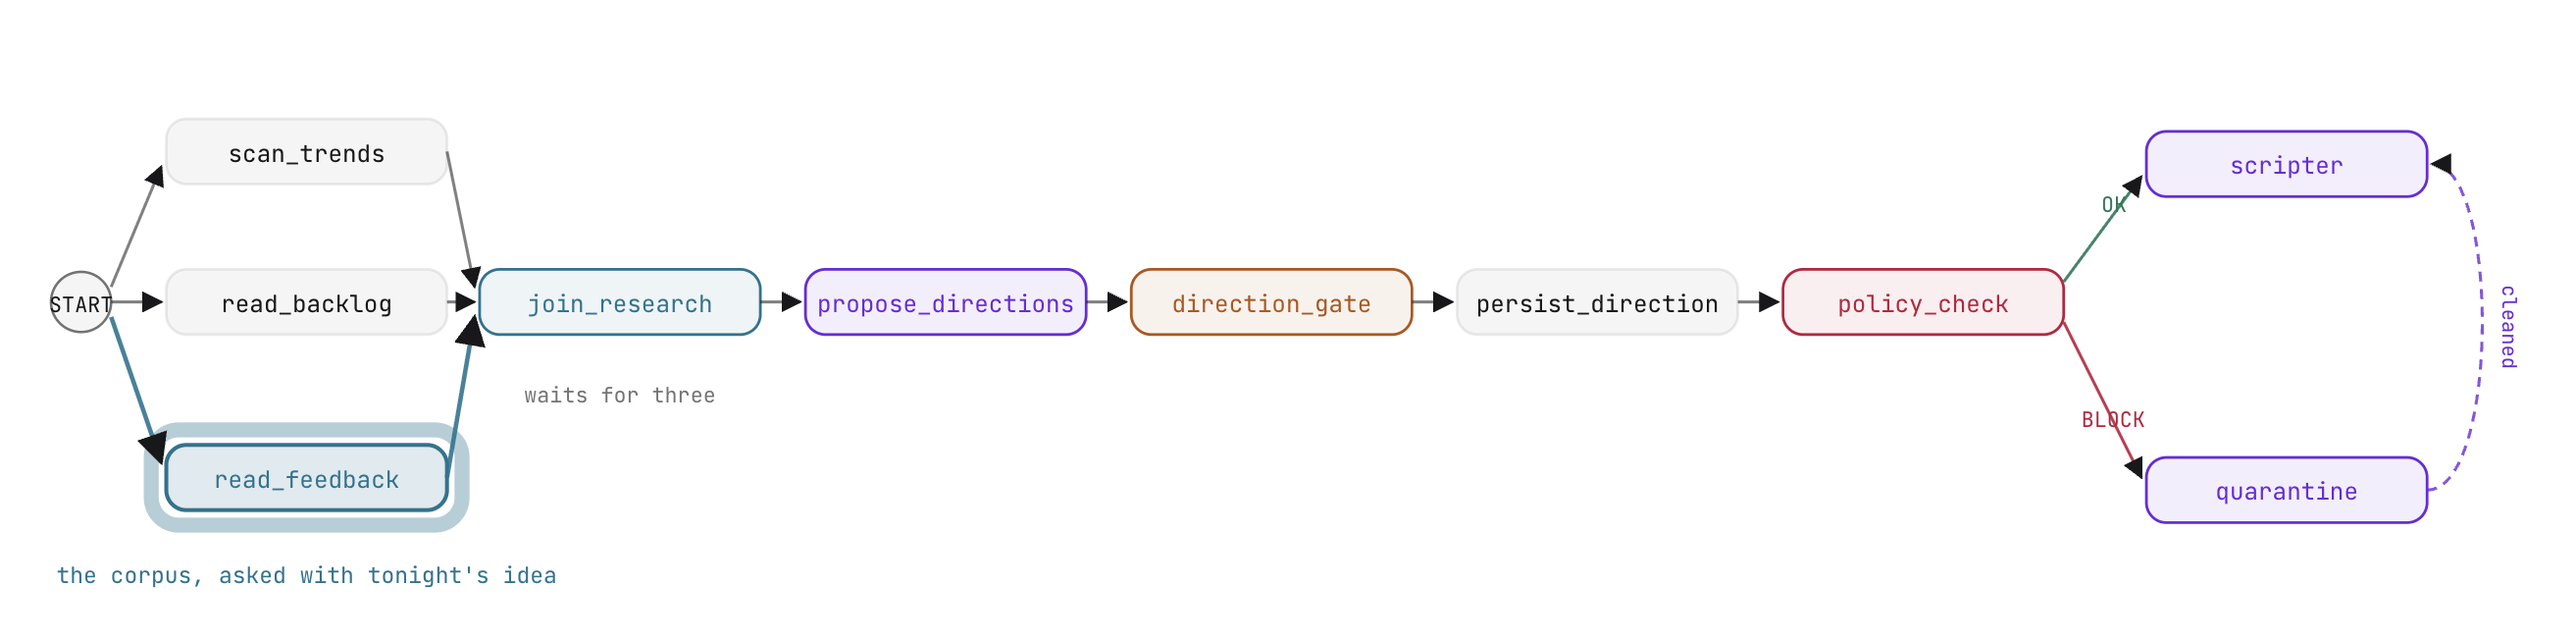
Abruf als Diagrammknoten
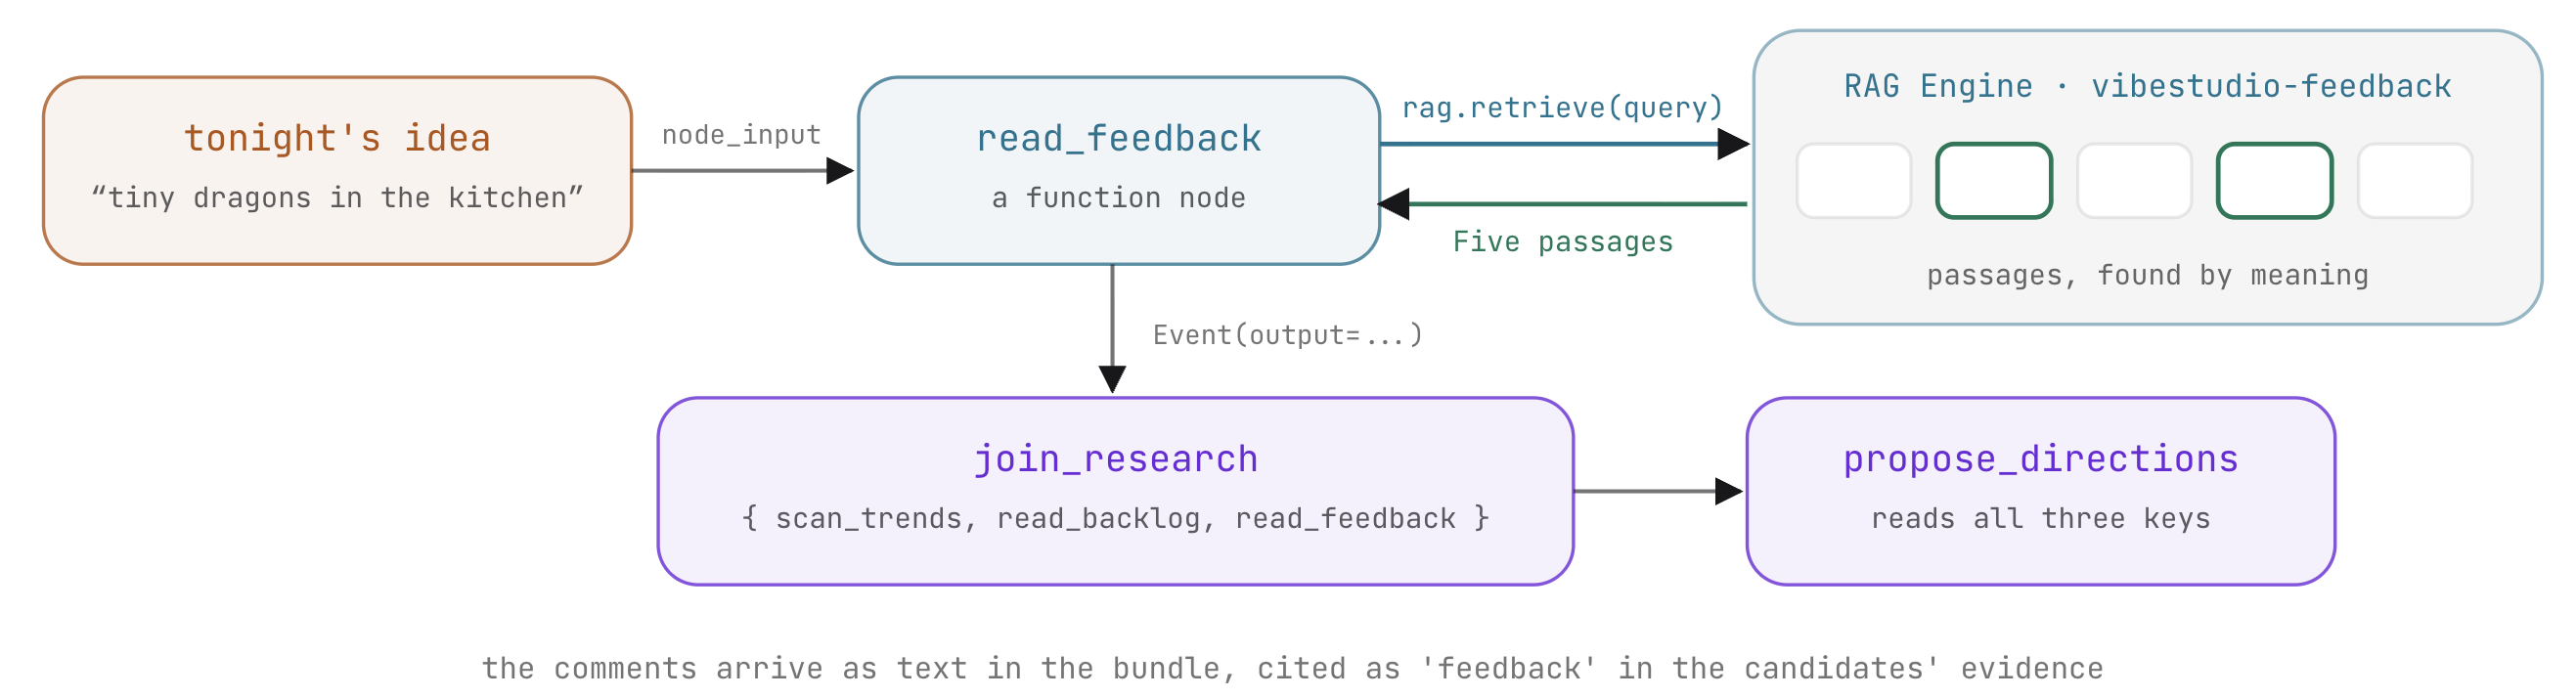
Das Feedback des Publikums stellt Forschungsdaten dar, die im gesamten Workflow geteilt werden. Im Gegensatz zum persönlichen Creator-Gedächtnis fließt die Stimmung der Zuschauer direkt in join_research ein, zusammen mit Trends und Backlog-Daten. Sie wird daher als Funktionsknoten implementiert:
def read_feedback(node_input):
    """The third reader (step 7): what the audience wrote under past videos,
    the passages nearest to tonight's idea. Retrieval, not a model call."""
    from .platform import rag
    idea = idea_text(node_input)
    query = idea or "what viewers liked and what they complained about"
    try:
        hits = rag.retrieve(query)
    except Exception as e:
        print(f"  [rag] feedback unavailable ({str(e)[:80]})")
        return Event(output={"query": query, "feedback": [],
                             "note": "no corpus connected - run: python -m agent.platform.rag"})
    return Event(output={"query": query, "feedback": [h["text"] for h in hits]})
read_feedback extrahiert die ursprüngliche Idee des Nutzers und führt eine Vektorabfrage für den RAG Engine-Korpus aus. Die abgerufenen Kommentare werden in einer Event(output=...)-Nutzlast ausgegeben.
Praktische Bearbeitung: Den dritten Leser in den Fan-Out einbinden
Aktualisieren Sie in stage5_rag/agent.py edges, um read_feedback als dritten parallelen Zweig hinzuzufügen, der in join_research mündet:
           (START, read_backlog, join_research),
           (START, read_feedback, join_research),
Da join_research ein JoinNode ist, werden alle eingehenden Zweige synchronisiert. Es wird gewartet, bis scan_trends, read_backlog und read_feedback alle Ereignisse ausgegeben haben, bevor das aggregierte Bundle weitergeleitet wird.
Was Sie erwartet und warum
Führen Sie den Workflow in der Workbench aus:
- Geben Sie einen Prompt für eine Idee ein, z. B. „Ein Miniaturdrache bewacht eine Küchenarbeitsplatte“.
- Prüfen Sie im Ausführungstrace, ob alle drei Reader-Knoten gleichzeitig ausgeführt werden.
- Sehen Sie sich
join_researchan: Das Ausgabeverzeichnis enthält jetzttrends,backlogundfeedback. - Prüfen Sie die generierten Kandidaten aus
propose_directions: Das Modell bezieht Zuschauerkommentare in seine Vorschläge ein und verweist in den Nachweisfeldern auf die Stimmung des Publikums. - Beachten Sie, dass der RAG-Abruf deterministisch ist (identische Abfragen geben identische Kommentarpassagen zurück), während der Knoten für generative Vorschläge kreative Varianten erzeugt.
8. Asynchrone Videogenerierung mit Veo
Gehen Sie in der VibeStudio Workbench zu Schritt 8 – Das Video, Teile (8A) und (8B).
Das Generieren von HD-Videos mit Google Veo dauert pro Rendering mehrere Minuten. Wenn die Ausführung des Diagramms in diesem Zeitraum blockiert wird, werden Rechenressourcen verschwendet, Threadpools gesperrt und der Lauf wird durch HTTP-Verbindungsabbrüche beeinträchtigt. In diesem Schritt machen Sie das Video-Rendering mit dem LongRunningFunctionTool des ADK asynchron.
Tools mit langer Ausführungszeit (8A)
Rufen Sie in der Workbench A long-running tool (8A) auf. Öffne stage6_video/agent.py und agent/deliver.py.
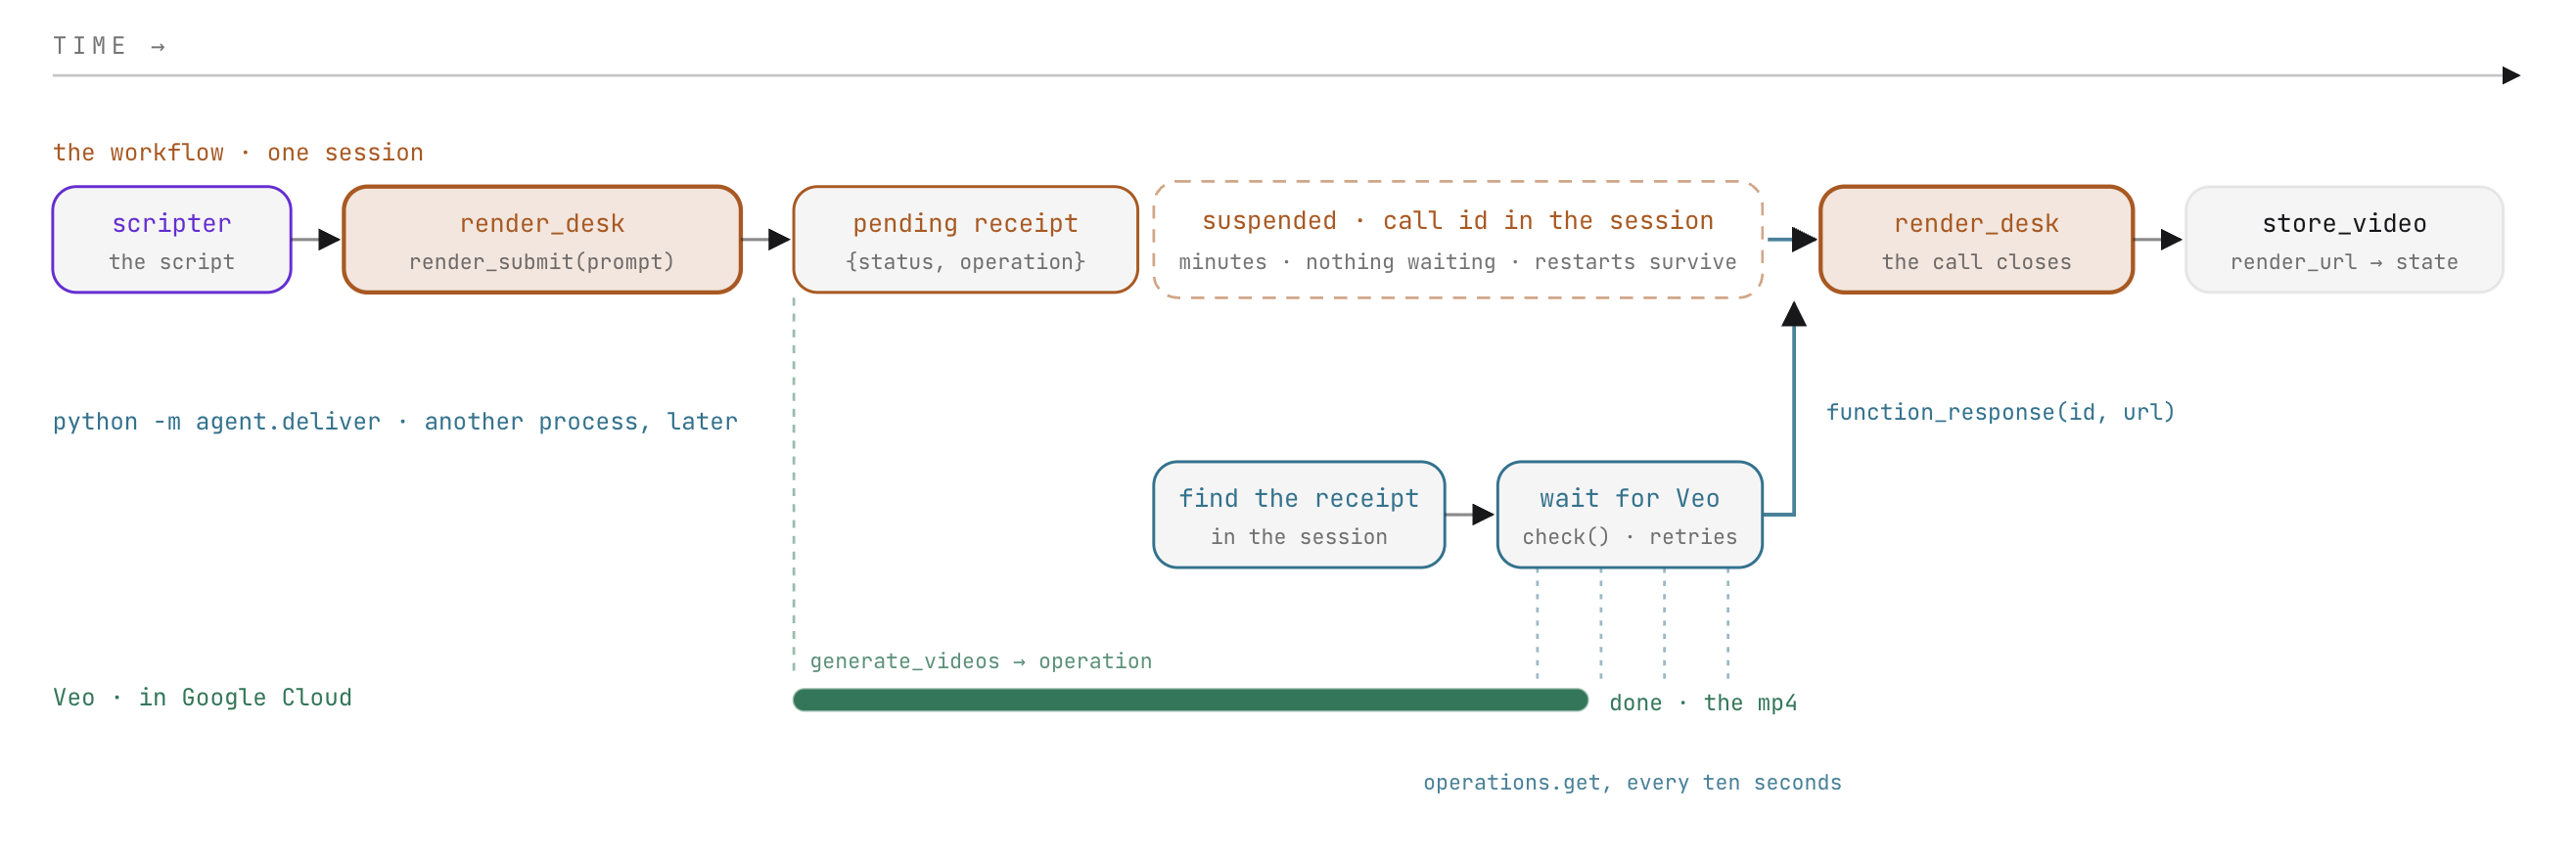
Synchrone Tools im Vergleich zu Tools mit langer Ausführungszeit
Standardmäßige ADK-Funktionstools werden synchron innerhalb eines Agent-Turns ausgeführt: Das Modell ruft das Tool auf, wartet auf die Rückgabe-Payload und bezieht das Ergebnis in den laufenden Turn ein.
Das Video-Rendering kann nicht in einem einzigen Schritt abgeschlossen werden. Stattdessen initiiert render_submit den Generierungsjob und gibt sofort einen Vorgangsbeleg mit dem Status "pending" zurück:
def render_submit(prompt: str) -> dict:
    """Submit one Veo render of `prompt`. Returns at once with a pending
    receipt; the clip is delivered later, to this call, by id."""
    receipt = videogen.start(f"{prompt} {videogen.NO_TEXT}")
    return {"status": "pending", "operation": receipt["operation"], "prompt": receipt["prompt"]}
Wenn der Status "pending" mit LongRunningFunctionTool umschlossen ist, wird er vom ADK abgefangen. Der Zug des KI-Agenten ist beendet, der Workflow wird am Knoten angehalten und die Metadaten des ausstehenden Aufrufs (einschließlich Aufruf-ID und Beleg) werden in runs/sessions.db aufgezeichnet. Der Ausführungsprozess wird sauber beendet, ohne aktive Netzwerkverbindungen oder Arbeitsthreads aufrechtzuerhalten.
Praktische Bearbeitung: Render-Tool verpacken
Aktualisieren Sie in stage6_video/agent.py die Datei render_desk, um render_submit in LongRunningFunctionTool zu umschließen:
tools=[LongRunningFunctionTool(render_submit)])
Fortsetzen nach Anruf-ID
Das universelle Fortsetzungsmuster
Das ADK verwendet einen identischen Mechanismus, um Workflows für Menschen und externe Tools zu pausieren und fortzusetzen:
Auslöser für die Sperrung | Konstrukt wird initiiert | Gespeicherter Federungszustand | Wiederaufnahmeereignis |
Manuelle Entscheidung |
| Eingabeaufforderung im Sitzungsspeicher öffnen |
|
Tool mit langer Ausführungszeit |
| Toolaufruf im Sitzungsspeicher öffnen |
|
In beiden Szenarien wird der Workflow vollständig angehalten und erst dann fortgesetzt, wenn ein Ereignis mit einer übereinstimmenden FunctionResponse von einer externen Quelle eingeht: einer Benutzeroberfläche, einem Webhook oder einem Hintergrund-Worker.
Praktische Bearbeitung: Lieferantwort fertigstellen
Erstellen Sie in agent/deliver.py den FunctionResponse-Teil für die Fortsetzung:
    part = Part(function_response=FunctionResponse(
        id=row["call_id"], name=row["name"], response=response))
Der Auslieferungs-Daemon fragt Veo ab, bis die Videodatei generiert wurde, und sendet dann diese FunctionResponse an die Sitzung. Das ADK gleicht die Anruf-ID ab und setzt den Workflow direkt am nächsten Knoten fort. Abgeschlossene Knoten werden nicht noch einmal ausgeführt und der Agent führt keine weitere generative Aktion aus.
Wenn Sie STUDIO_REAL_VIDEO=0 in .env festlegen, wird das Mock-Rendering aktiviert: start gibt sofort einen Testbeleg zurück und check simuliert den Abschluss in fünf Sekunden, ohne dass kostenpflichtige Veo API-Aufrufe erfolgen.
Pipeline-Integration (8B)
Gehen Sie in der Workbench zu render_desk in the graph (8B). Öffnen Sie stage6_video/agent.py.
Der Endknoten in der Pipeline ist store_video. Es liest die abgeschlossenen Rendering-Informationen aus runs/state.json (wo sie vom Bereitstellungsprozess aufgezeichnet wurden) und schreibt die Video-URL und den Generierungsstatus in den freigegebenen Sitzungsstatus.
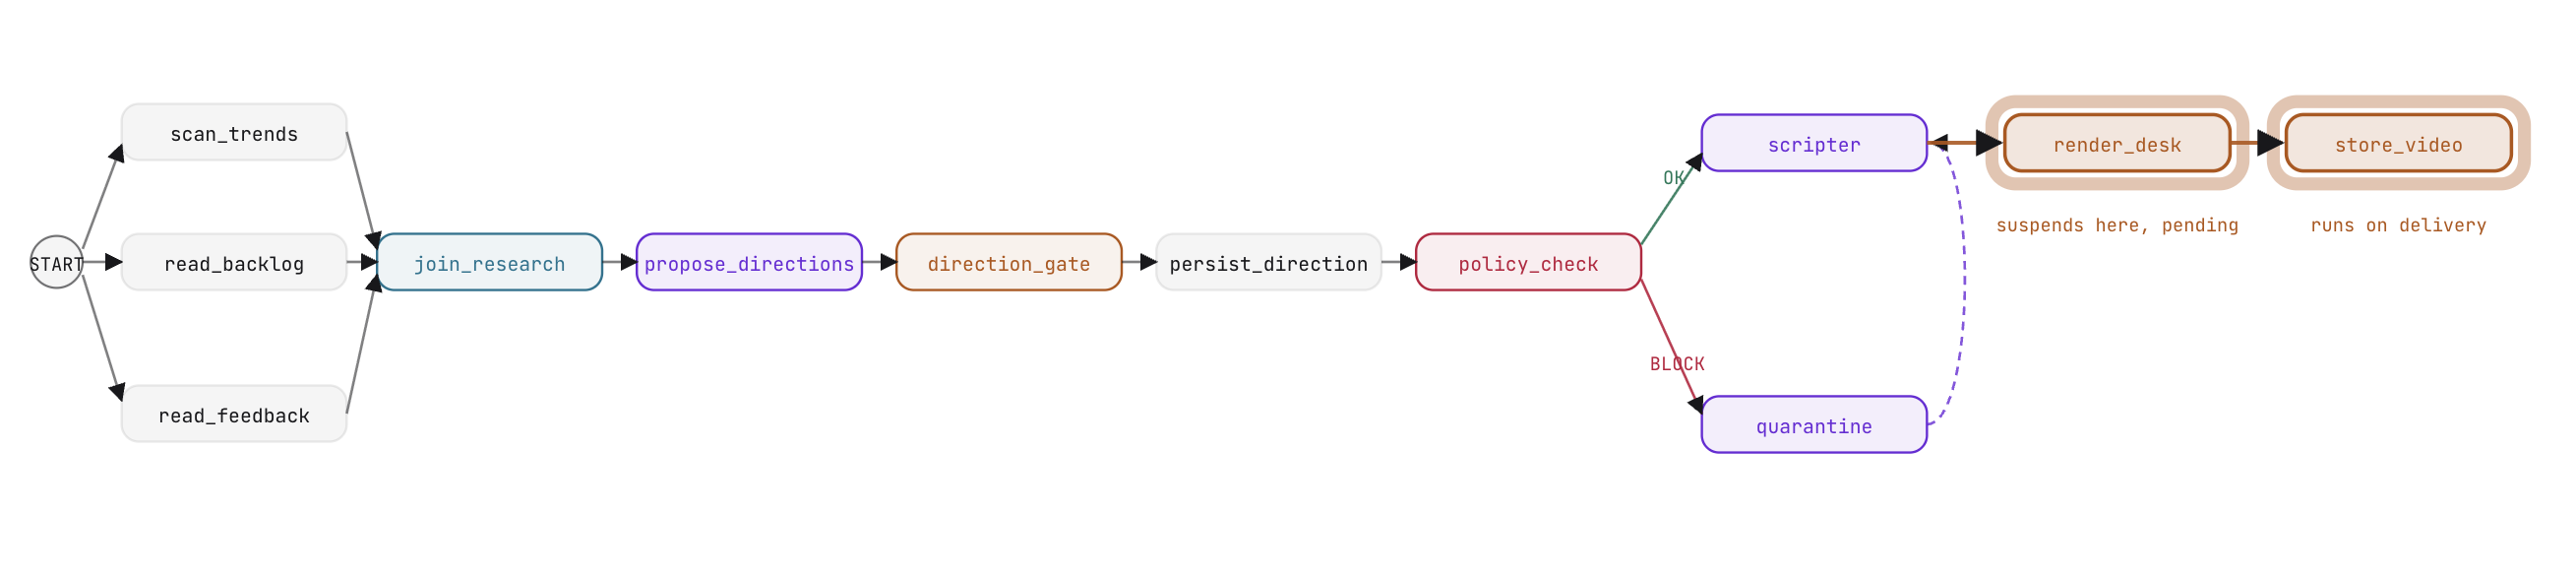
Praktische Bearbeitung: Die gesamte Videopipeline einrichten
Aktualisieren Sie in stage6_video/agent.py edges, um render_desk und store_video anzuhängen:
           (quarantine, scripter),
           (scripter, render_desk, store_video)])
Was Sie erwartet und warum
Testen Sie den asynchronen Generierungsablauf in der Workbench:
- Führen Sie den Workflow über die Kandidatenauswahl und die Skriptgenerierung aus.
- Beobachten Sie bei
render_desk, wie der Agentrender_submitaufruft. - Der Workflow wird sofort ausgesetzt. Beobachten Sie in der Workbench oder im ADK Web den Status „Ausstehend“: Die Sitzung enthält die ID des offenen Aufrufs und es werden keine Ressourcen durch Hintergrundprozesse verbraucht.
- Führen Sie den Liefer-Daemon über die Workbench-Konsole oder in Ihrem Terminal aus:
python -m agent.deliver - Aktualisieren Sie die Sitzung in ADK Web: Die Ausführung wird bei
store_videofortgesetzt, die Video-URL wird im Sitzungsstatus gespeichert und der Workflow wird abgeschlossen.
9. In Cloud Run bereitstellen
Gehen Sie in der VibeStudio Workbench zu Schritt 9: Bereitstellen.
Sie haben jede Komponente der Pipeline in dedizierten Sandboxes entwickelt und überprüft. In diesem Schritt stellen Sie die vollständige Produktionspipeline zusammen und stellen sie in Google Cloud Run bereit.
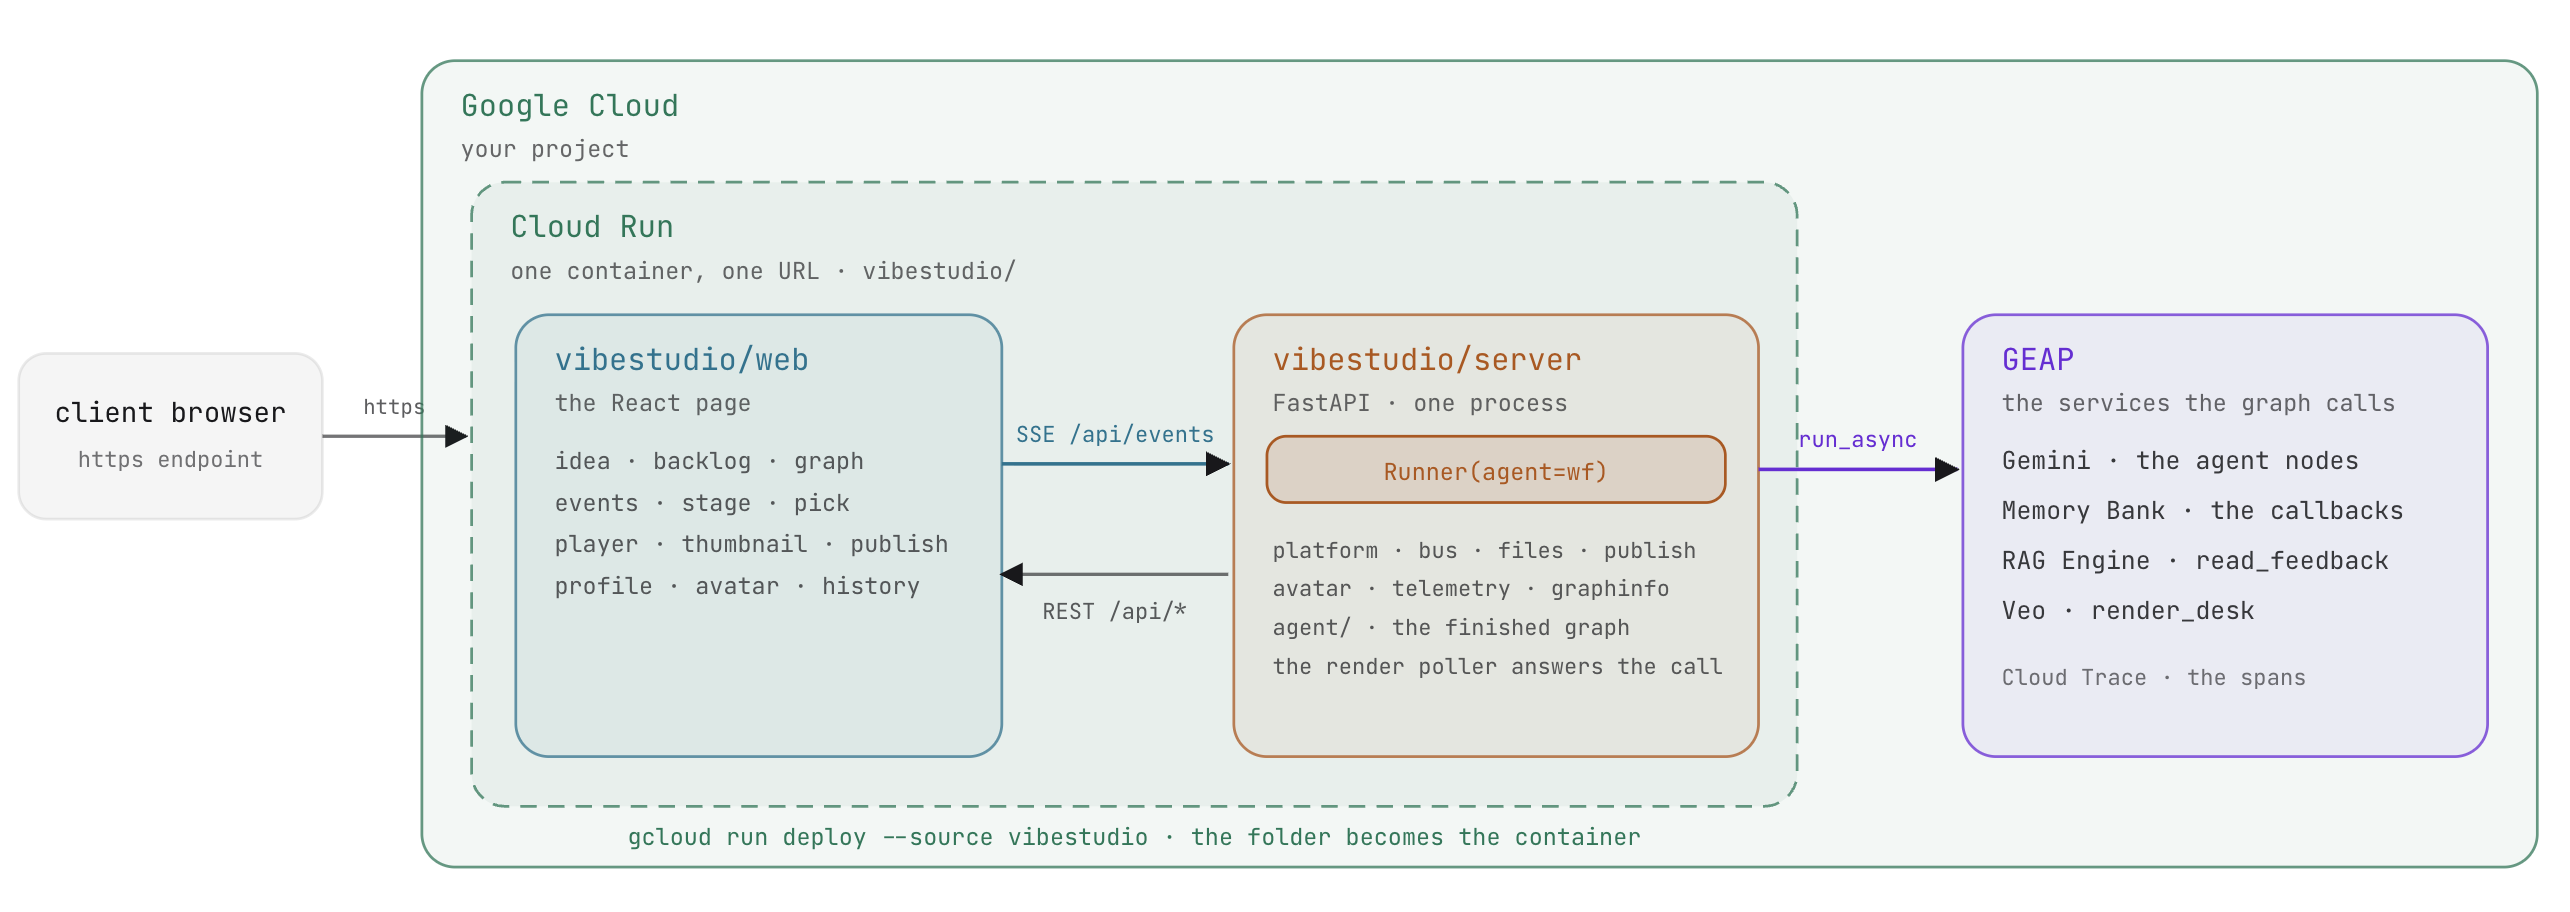
ADK Runner
In der Entwicklung hat adk web die Grafik orchestriert. In der Produktion hostet die Anwendung den Workflow mit der Runner-Klasse des ADK:
self._svc = DatabaseSessionService(db_url=config.DB_URL)
self._runner = Runner(app_name=config.APP, agent=wf, session_service=self._svc)

async for ev in self._runner.run_async(user_id=config.USER, session_id=run_id, new_message=message):
    self._absorb(ev)    # fold the ADK event into the run state, publish one app event

# the gate's answer and the render's delivery are the same call, with a function_response part
part = Part(function_response=FunctionResponse(id=call_id, name=name, response=response))
run_async: Steuert die Workflowausführung, gibt Ereignisse sequenziell aus, wenn Knoten ausgeführt werden, und speichert Aktualisierungen im Sitzungsdienst.- Einheitliche Fortsetzung: Sowohl Nutzerentscheidungen bei
direction_gateals auch abgeschlossene Videoauslieferungen von Veo werden über identischeFunctionResponse-Objekte fortgesetzt, die anrun_asyncgesendet werden.
Die Architektur der Produktionsanwendung
Die Produktionsanwendung in vibestudio/ umfasst die gesamte Pipeline:
vibestudio/
  server/
    main.py                 FastAPI: application server, REST routes, static assets
    api.py                  REST API endpoints: run, pick, publish, backlog, profile, history
    runner.py               Runner orchestration over the workflow, background render poller
    platform/               Event bus (SSE stream), file storage, publishing, telemetry
    agent/                  Production agent package, verified by checks/verify_app.py
      graph.py              The complete workflow graph and node definitions
      desk.py               render_desk and render_submit wrapped with LongRunningFunctionTool
      schemas.py            Pydantic schemas: Directions, CleanedDirection, Script
      cleanup_tools.py      Deterministic policy tools: find_policy_hits, suggest_replacement
      platform/             Memory Bank, RAG Engine, and Veo integrations
  web/                      Production React user interface
  Dockerfile · deploy.py · run.sh
- Einzelner Ereignisstream: Das FastAPI-Backend veröffentlicht Ereignisse über einen einzelnen Server-Sent Events-Stream (SSE). Das React-Frontend visualisiert den Diagrammfortschritt in Echtzeit und verarbeitet verspätete Verbindungen, ohne den Status zu verlieren.
- Entkoppelte Ausführung: Die Anwendung verwaltet die Ereignisschleife. Das Workflow-Diagramm konzentriert sich vollständig auf die Ausführungslogik und berücksichtigt die Frontend-Schnittstelle nicht.
Die vollständige Edge-Liste des Workflows in agent/graph.py kombiniert alle Architekturmuster, die in diesem Codelab erstellt wurden:
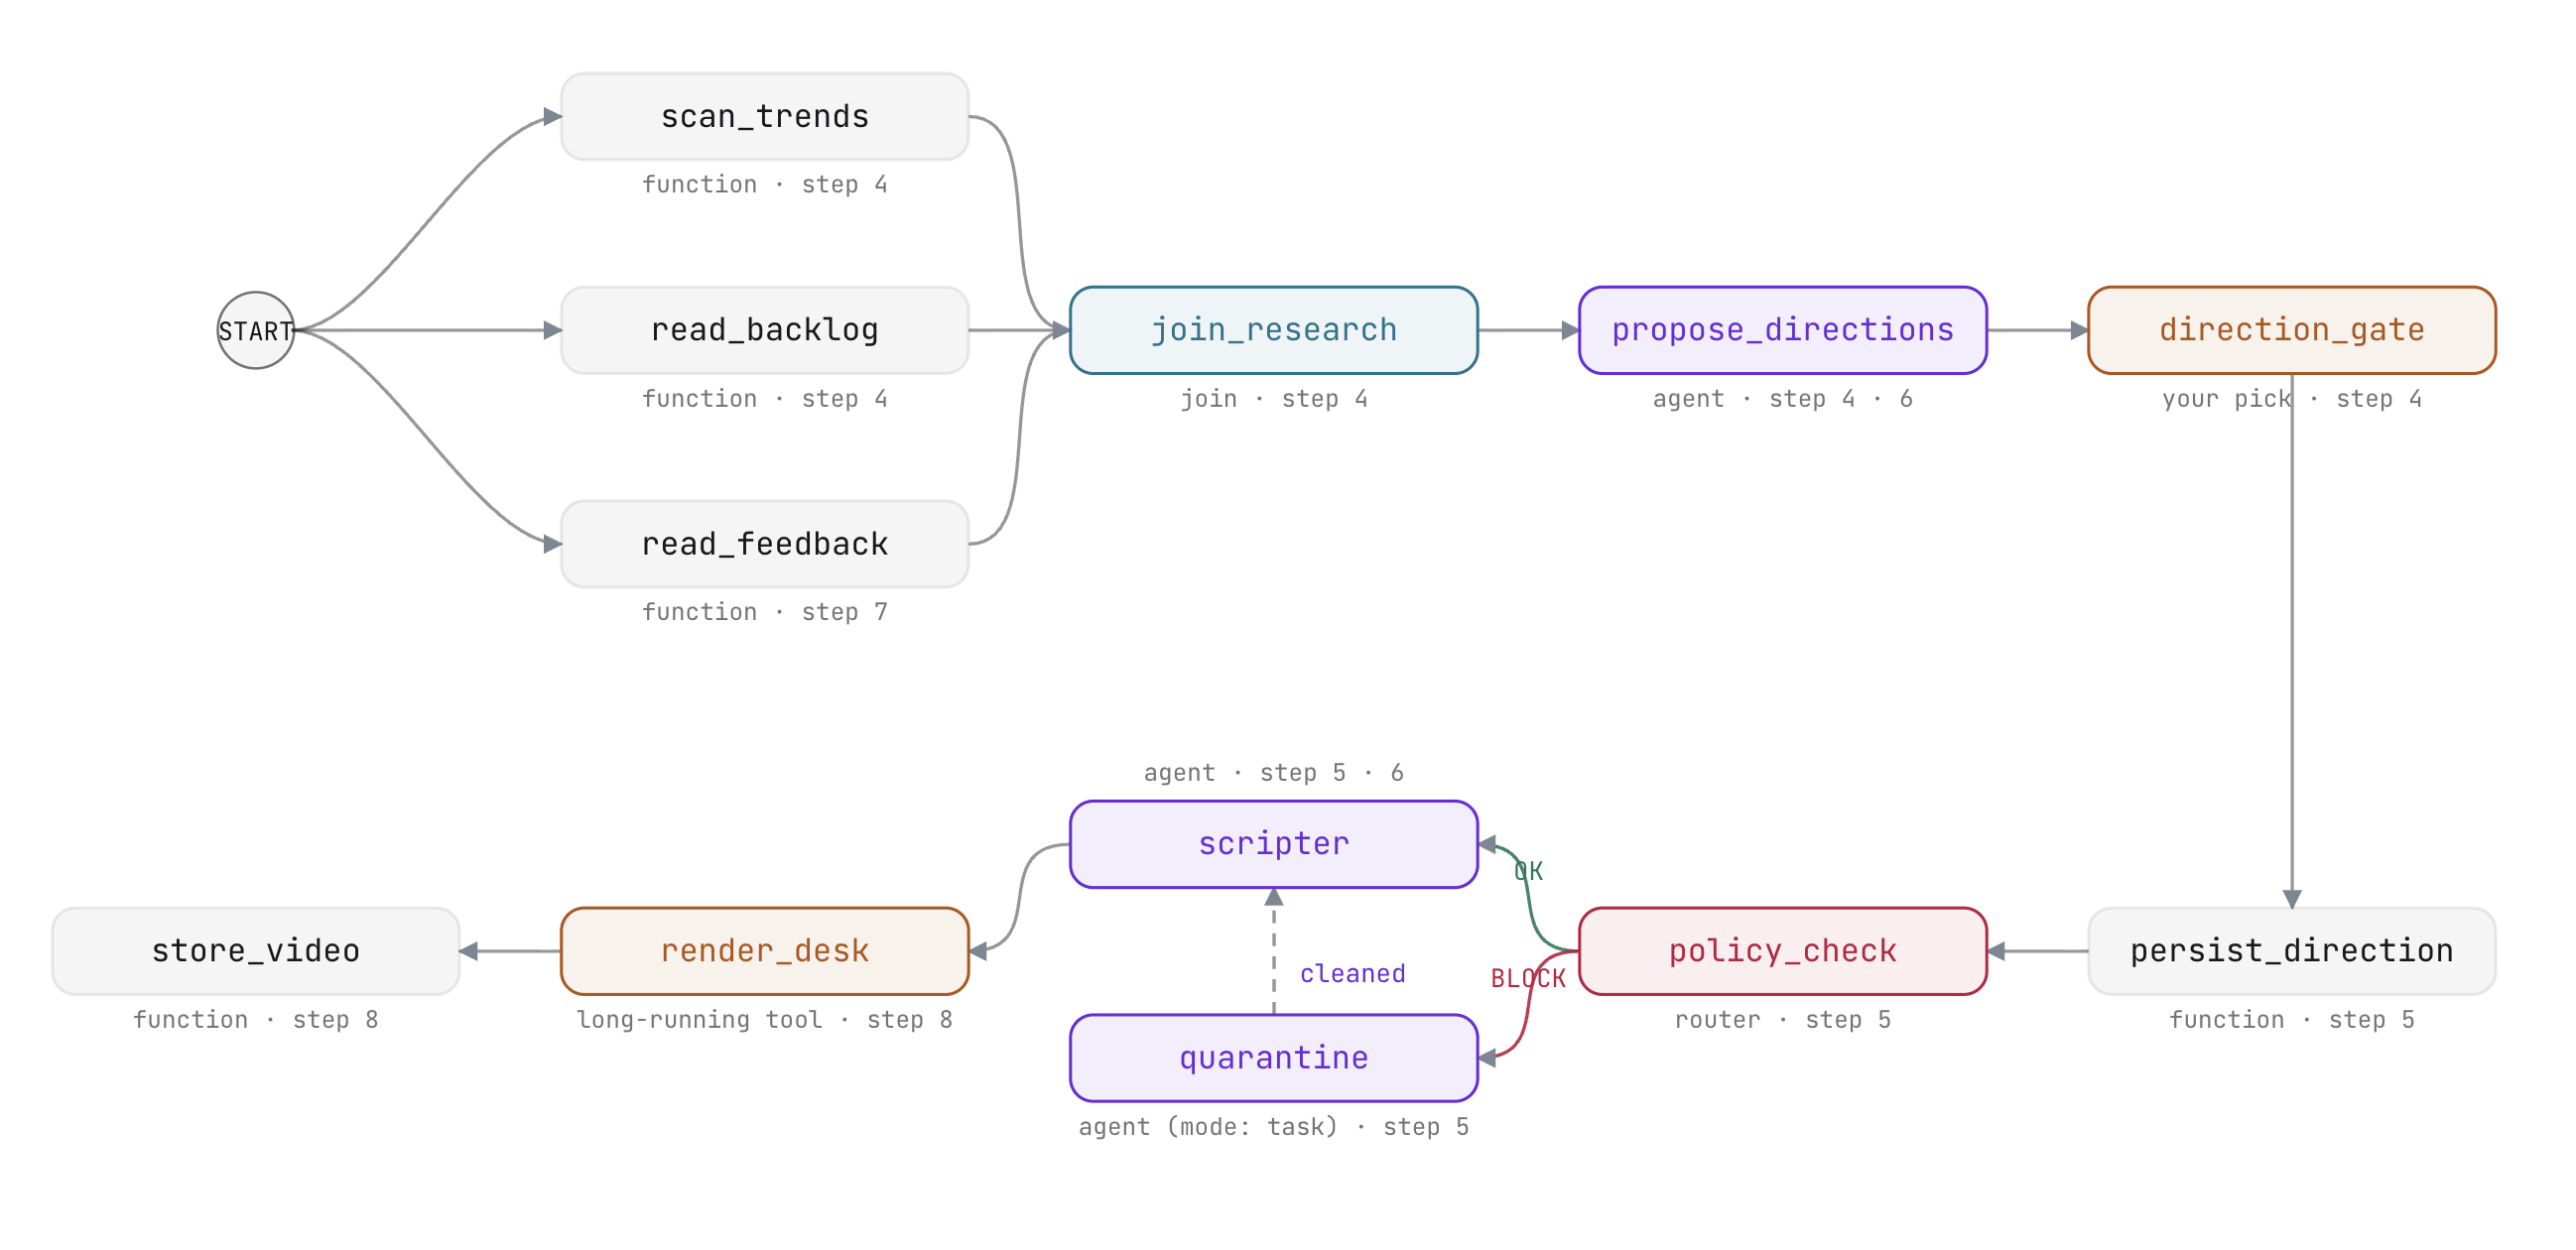
        (START, scan_trends, join_research),
        (START, read_backlog, join_research),
        (START, read_feedback, join_research),
        (join_research, propose_directions, direction_gate,
         persist_direction, policy_check),
        (policy_check, {"OK": scripter, "BLOCK": quarantine}),
        (quarantine, scripter),
        (scripter, render_desk, store_video),
In Cloud Run bereitstellen
Google Cloud Run bietet serverloses Hosting mit automatischer Skalierung, Anfrage-Routing und integrierten Container-Builds:
gcloud run deploy vibestudio --source vibestudio \
  --project $GOOGLE_CLOUD_PROJECT --region us-central1 \
  --labels dev-tutorial-codelab=vibetube --allow-unauthenticated \
  --memory 2Gi --cpu 2 --timeout 3600 --concurrency 40 \
  --max-instances 1 --min-instances 1 --session-affinity \
  --set-env-vars GOOGLE_CLOUD_PROJECT=...,STUDIO_VERTEX=1,STUDIO_MEMORY_BANK=...,STUDIO_RAG_CORPUS=...,VIBETUBE_URL=...,VIBETUBE_EVENT=...,VIBETUBE_NAME=...,VIBETUBE_PROJECT=...
- Container erstellen: Mit
gcloud run deploy --sourcewird das Verzeichnisvibestudio/verpackt, das Container-Image mit Cloud Build erstellt und der Dienst in einem einzigen Vorgang bereitgestellt. - Sitzungsaffinität: Anfragen vom selben Nutzer werden an dieselbe Containerinstanz weitergeleitet. So bleibt der lokale Sitzungsstatus über iterative Schritte hinweg erhalten.
- Observability: Durch die Cloud Trace-Integration werden verteilte Spans für jeden Knoten, LLM-Aufruf und jede Tool-Ausführung aufgezeichnet. Sie sind in der Google Cloud Console unter „Trace Explorer“ verfügbar.
Klicken Sie in der Workbench auf den Button Deploy (Bereitstellen), um das Bereitstellungsskript auszuführen. Wenn der Build abgeschlossen ist, wird im Terminal die Live-Dienst-URL angezeigt.
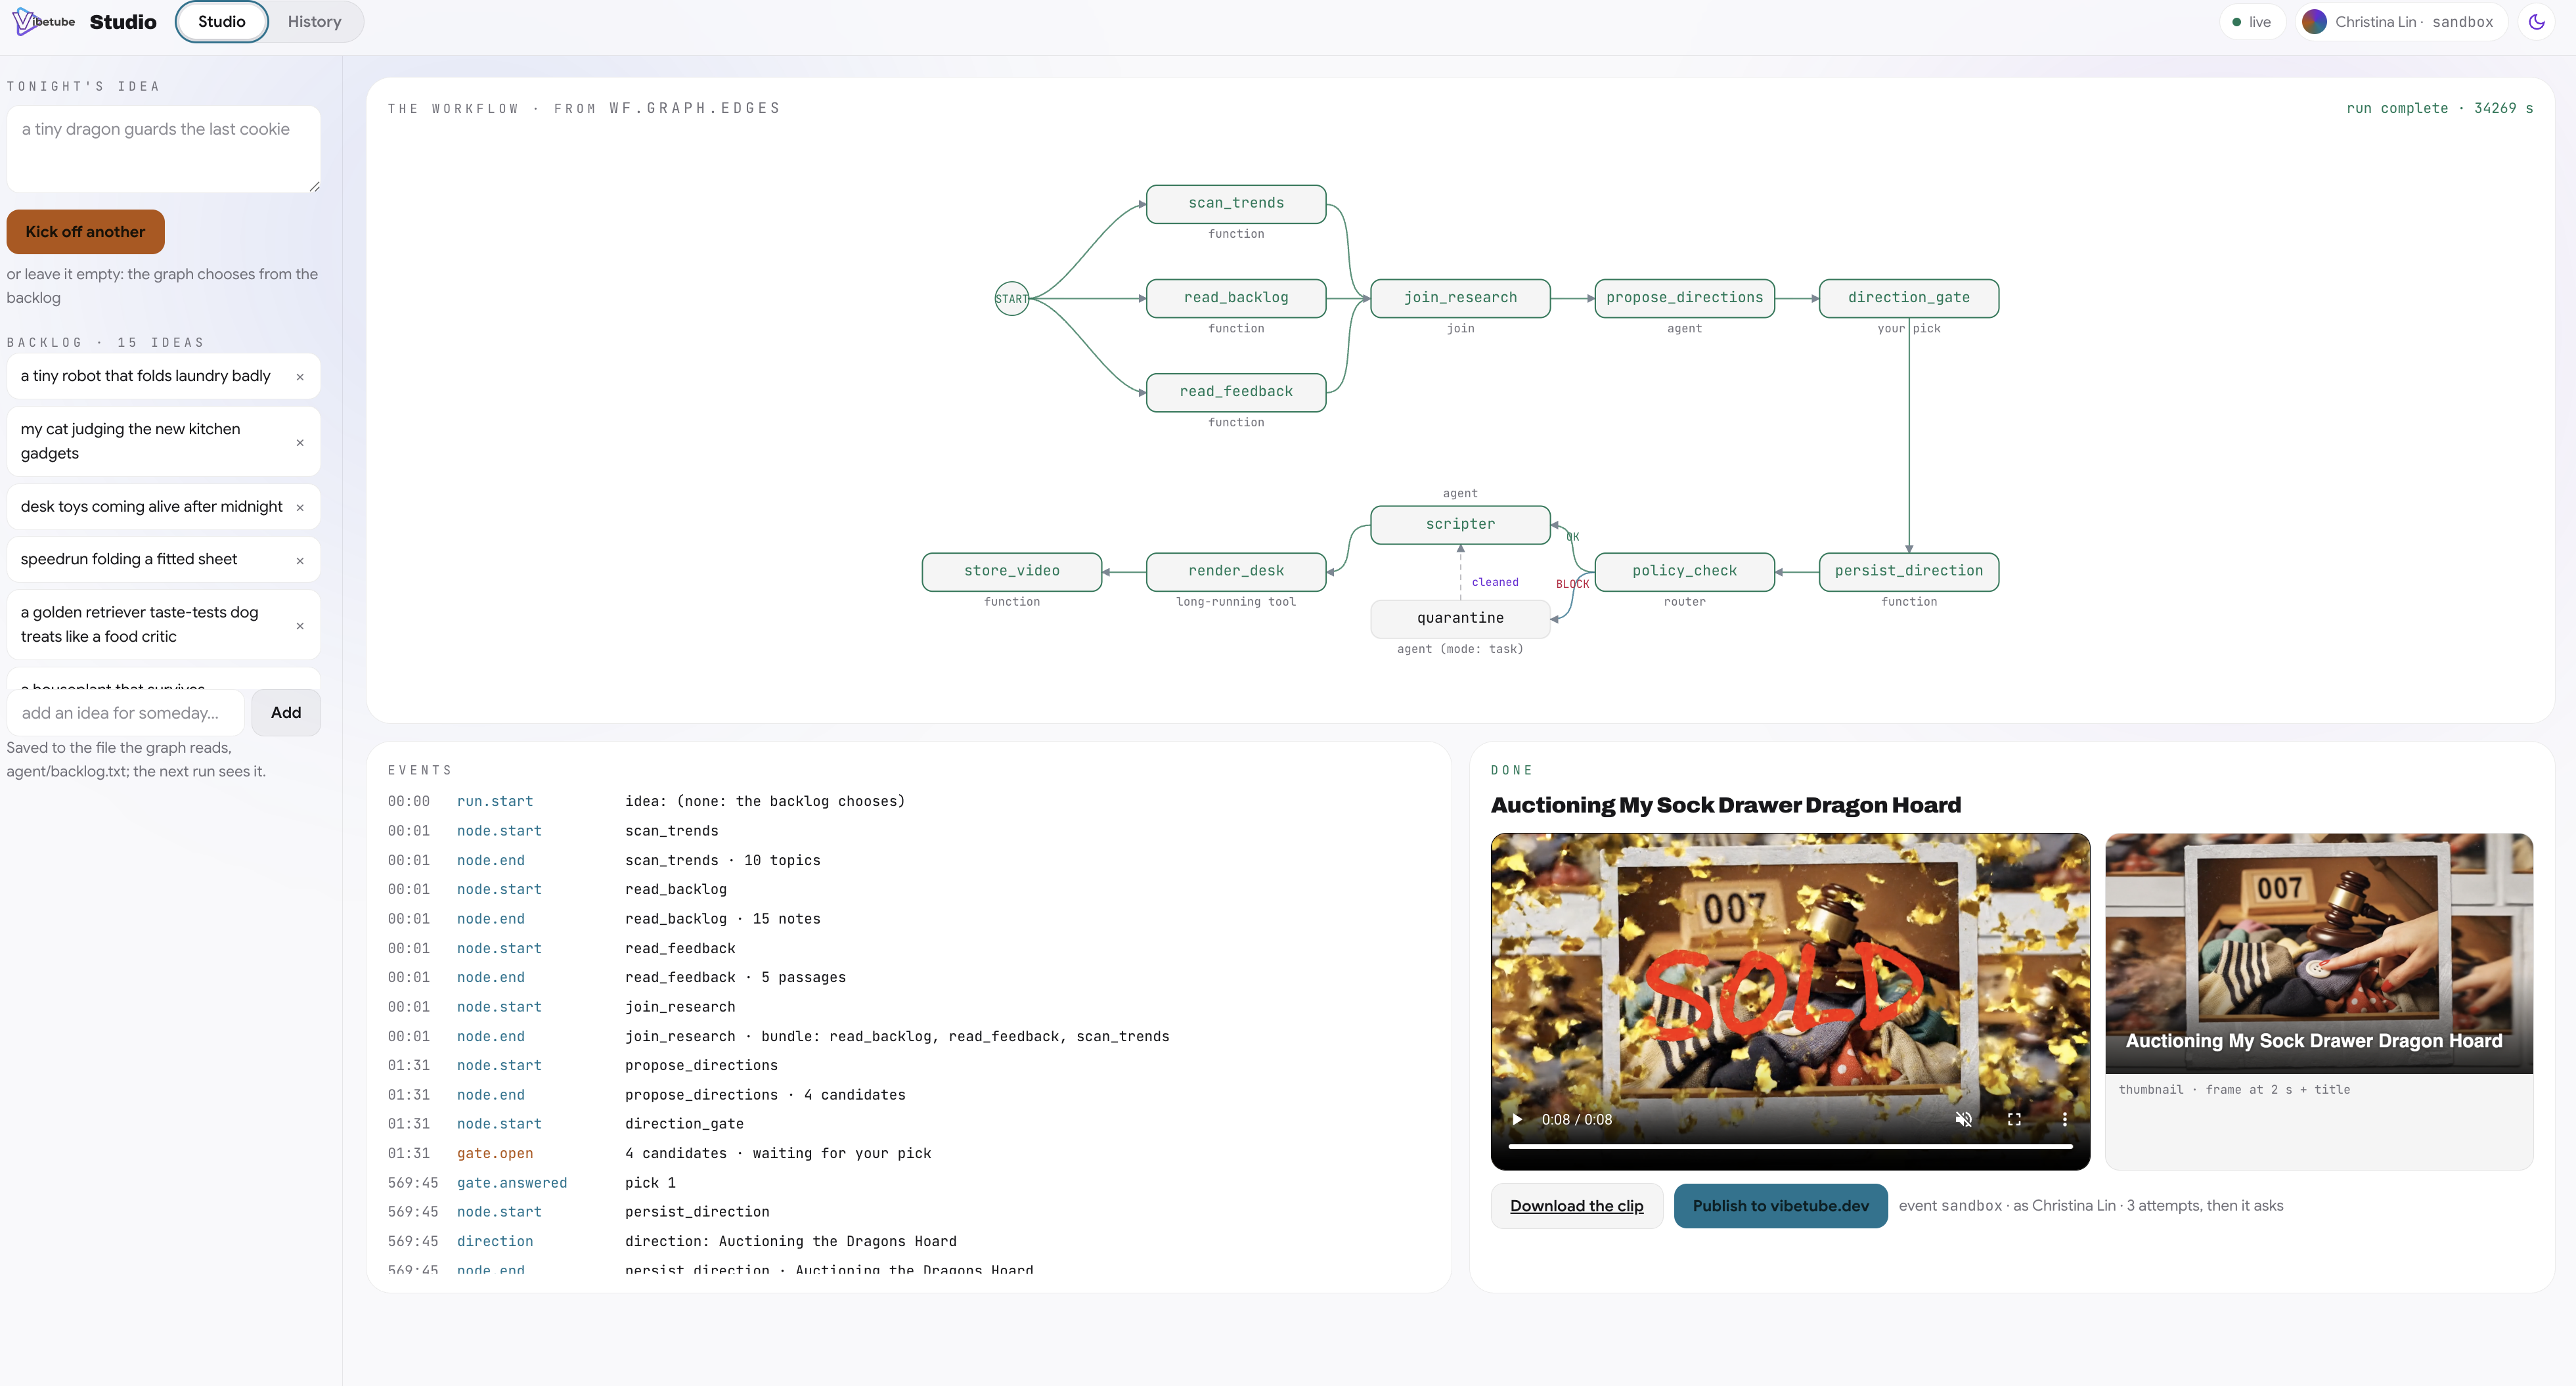
10. Zusammenfassung
Rufen Sie in der VibeStudio Workbench Schritt 10: Zusammenfassung auf, um die fertige Architektur zu prüfen.
Schritt | Architektur und Konzepte | Implementierungsmuster |
Ein einzelner Prompt | Einzelner Prompt, Funktionstools, sequenzieller Chat-Loop |
|
Grundlagen agentischer Workflows | Diagramm-Workflow, parallele Recherche, Schemaausgaben, Human Gate |
|
Status und Router | Gemeinsamer Sitzungsstatus, Parameterbindung, deterministisches Routing, Aufgaben-Agent |
|
Memory Bank | Langzeitspeicher auf Nutzerebene, semantische Konsolidierung, Lebenszyklus-Hooks |
|
RAG Engine | Dokumentabruf über Kommentare von Zielgruppen, semantische Einbettungen |
|
Asynchrone Videogenerierung mit Veo | Lang andauernde Tools, ausstehende Belege, externer Zustellungs-Daemon |
|
In Cloud Run bereitstellen | Programmatische Orchestrierung, vom Server gesendete Ereignisse, serverloser Container |
|
Grundlegende Architekturprinzipien
- Anhalten statt Warten: Workflows werden sauber für die Eingabe durch den Menschen (
RequestInput) oder für Vorgänge mit langer Ausführungszeit (LongRunningFunctionTool) angehalten. Prozesse warten nicht im Leerlauf auf Threads oder Netzwerk-Sockets. - Universelle Wiederaufnahme: Jede Unterbrechung wird über einen identischen Mechanismus wieder aufgenommen: ein einzelner
function_response, der die Aufruf-ID des unterbrochenen Knotens enthält. - Entkoppelte Statusverwaltung: Knoten geben Daten über benannte Sitzungsstatusschlüssel und Parameterbindung weiter, anstatt über ausführliche, eng gekoppelte Zwischennutzlasten.
- Deterministisches Routing vor generativen Kosten: Regelbasierte Router und Regex-Filter werten Richtlinien ohne Tokenkosten aus, bevor generative Modelle ausgeführt werden.
- Trennen Sie Zuständigkeiten: Kontext, der für einen einzelnen Agenten spezifisch ist, gehört in Lifecycle-Callbacks, während gemeinsame Datenabhängigkeiten