1. Introducción
En este codelab, se te guía para crear sistemas basados en agentes de próxima generación con flujos de trabajo y gráficos en el Kit de desarrollo de agentes (ADK). Implementarás patrones de arquitectura comunes, organizarás interacciones con intervención humana (HITL) y controlarás la ejecución asíncrona de larga duración. También integrarás bases de conocimiento empresarial y memoria persistente para personalizar y desarrollar el comportamiento de los agentes. Por último, conectarás estas capacidades para impulsar una canalización automatizada de generación de videos.
Situación hipotética
Diriges un canal digital en VibeTube con un público activo y una lista cada vez más larga de ideas creativas. La producción de cada video requiere una ejecución continua en varias etapas: investigar los formatos de tendencia, sintetizar los comentarios de los usuarios, desarrollar guiones, verificar el cumplimiento de las políticas y generar clips de video. Los modelos generativos pueden crear borradores de recursos individuales, pero para lanzar versiones coherentes, se requiere una arquitectura de agentes coordinada.
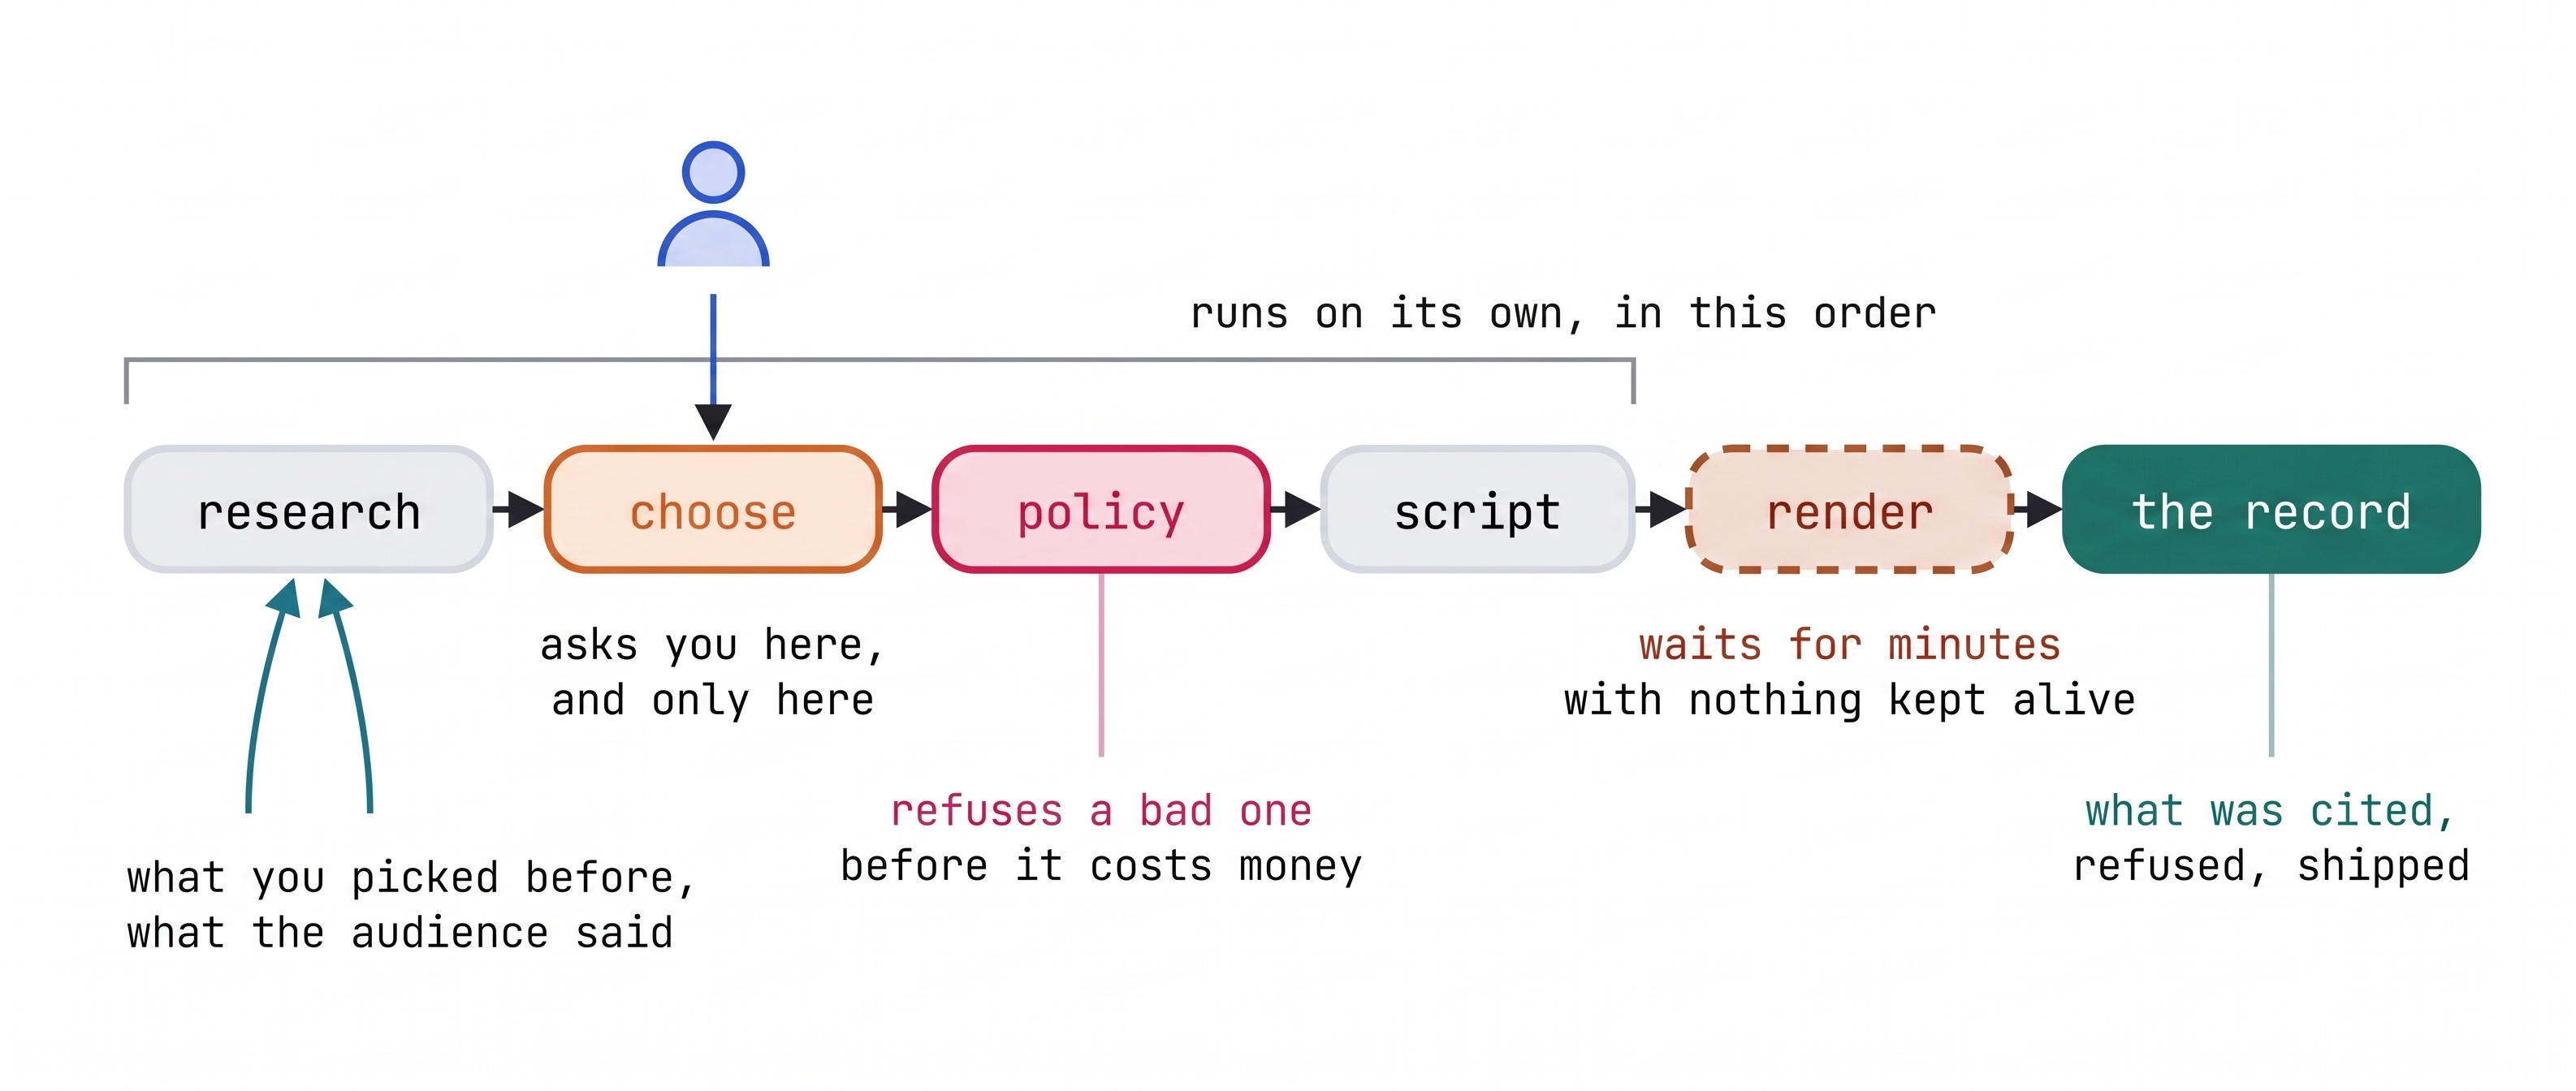
Para automatizar este ciclo de vida, compilarás VibeStudio. Esta canalización basada en agentes ejecuta investigaciones de rutina en paralelo, presenta opciones seleccionadas para la aprobación con interacción humana, aplica puertas de políticas automatizadas antes de generar el video y conserva el contexto en todas las ejecuciones de producción.
Qué aprenderá
- Fundamentos de la ingeniería de grafos: Las arquitecturas de agentes de varios pasos requieren un flujo de control explícito y rutas de ejecución estructuradas. Compilas un
Workflowdel ADK con tuplas de borde, el punto de entradaSTART,JoinNodepara la agregación paralela de fan-out y nodos de router determinísticos para dirigir la ejecución según el estado. - Modos del agente y devoluciones de llamada de ciclo de vida: Las tareas especializadas requieren comportamientos operativos distintos y rieles determinísticos. Configuras las instancias de
Agentdel ADK con los modoschat,single_turnytaskhabilitado para herramientas como nodos de flujo de trabajo, y aplicas interceptores conbefore_model_callbackyafter_agent_callback. - Orquestación con intervención humana: Las canalizaciones de producción se detienen para que se aplique el criterio humano en puntos de control creativos críticos. Implementas
RequestInputpara suspender la ejecución del flujo de trabajo, aplicar esquemas de respuesta estructurados y reanudar la ejecución sin mantener activos los procesos de entorno de ejecución inactivos. - Memoria jerárquica de agentes: Los sistemas de producción separan el estado de ejecución efímero del contexto duradero. Administras el estado de la sesión a corto plazo con
Event(state=...)y la vinculación de parámetros, y conectas GEAP Memory Bank para extraer, consolidar y conservar las preferencias del creador en todas las ejecuciones. - Fundamentación con bases de conocimiento empresarial: Los agentes autónomos requieren un contexto de dominio dinámico y un sentimiento de la audiencia. Conectas un corpus del motor de RAG de GEAP como un nodo de recuperación dedicado dentro de la expansión paralela para fundamentar semánticamente los resultados del agente.
- Flujos de trabajo y de implementación de larga duración: La renderización de videos multimodales se ejecuta de forma asíncrona durante períodos prolongados. Implementarás
LongRunningFunctionToolcon recibos de llamadas pendientes para suspender y reanudar el flujo de trabajo por ID de llamada, y, luego, implementarás la canalización terminada con el ADKRunneren Cloud Run.
Organización de este codelab
Este codelab sirve como referencia conceptual y arquitectónica. En cada sección, se explican las construcciones del ADK implementadas en el paso correspondiente del banco de trabajo, se proporciona código de referencia y se establecen principios de diseño básicos. Revisa cada sección antes de completar el ejercicio correspondiente en el banco de trabajo.
El trabajo práctico se realiza en VibeStudio Workbench, una interfaz web complementaria que incluye un editor de código interactivo, verificadores de tiempo de ejecución y un inspector de ADK incorporado. La numeración de los pasos en el entorno de trabajo se alinea directamente con este codelab para mantener sincronizado tu progreso. Las ediciones de gráficos fundamentales persisten en todos los pasos, y el banco de trabajo verifica automáticamente los requisitos previos a medida que avanzas.
Cuando completes los ejercicios del entorno de trabajo, ensamblarás una canalización de agentes de extremo a extremo y, luego, implementarás una aplicación de VibeStudio en ejecución en Cloud Run para generar contenido de video.
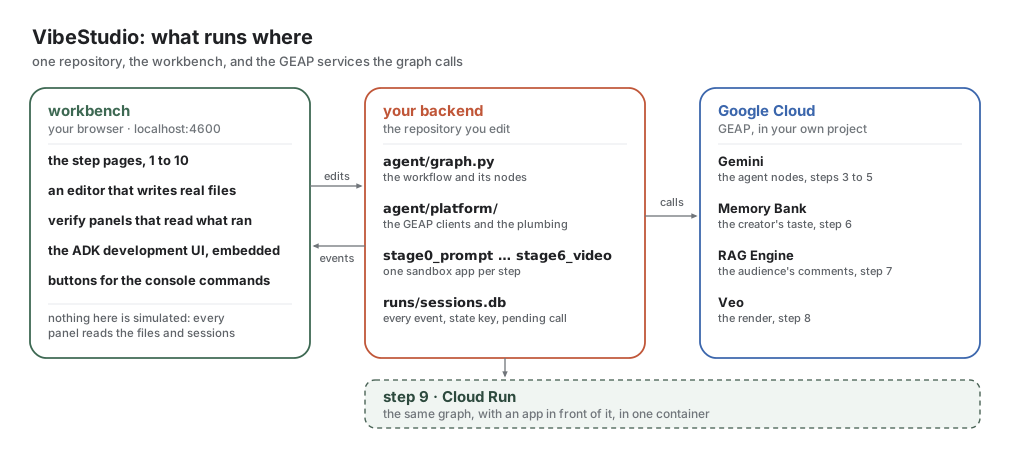
El entorno consta de tres componentes principales: VibeStudio Workbench (la interfaz web local para la edición de código y la verificación del entorno de ejecución), tu backend (el ADK Workflow y los entornos de pruebas de etapa de pruebas en agent/) y Google Cloud (modelos de Gemini, GEAP Memory Bank, RAG Engine y generación de video de Veo).
2. Configuración
Reclama los créditos de tu taller
Si asistes a un lab dirigido por un instructor, este distribuirá créditos para tu proyecto de Google Cloud. Sigue las instrucciones del instructor para canjear tus créditos y asegurarte de que la facturación esté activa en tu cuenta antes de continuar.
Abre Cloud Shell
Cloud Shell es un entorno de desarrollo basado en navegador con gcloud, Python y git preinstalados.
Para iniciar Cloud Shell, haz lo siguiente:
- Navega a Google Cloud Shell.
Se abrirá una sesión de terminal en la parte inferior de la ventana del navegador.
Clona e inicializa el repositorio
Ejecuta los siguientes comandos en la terminal de Cloud Shell para clonar el proyecto:
git clone https://github.com/gca-americas/vibetube-studio
cd ~/vibetube-studio
Instrucciones de configuración
Durante la configuración, se te solicitarán los siguientes detalles:
- ID del proyecto de Google Cloud: Cuando
setup_project.shte lo solicite, presiona Intro para crear un proyecto nuevo automáticamente. Si prefieres usar un proyecto existente (como uno asignado previamente), ingresa el ID del proyecto y asegúrate de que esté bien escrito y de que la facturación esté activa. - Código del evento: Ingresa el código de sala que te proporcionó el instructor. Si no recibiste uno, consulta con un asistente de enseñanza o un vecino. Si estás completando este lab en casa, presiona Intro para aceptar la sala
sandboxpredeterminada. - Nombre visible del canal: Ingresa tu nombre o el identificador del canal que prefieras cuando
setup_codelab.shte lo solicite, o bien presiona Intro para aceptar el valor predeterminado generado a partir de tu Cuenta de Google.
Ejecuta las dos secuencias de comandos de configuración en orden:
./setup_project.sh
./setup_codelab.sh
setup_project.sh: Crea o reutiliza un proyecto de Google Cloud con facturación activa, guarda el ID del proyecto en~/project_id.txty configura el contexto activo degcloud.setup_codelab.sh: Instalauvy las dependencias de Python en.venv, habilita las APIs de Google Cloud necesarias, establece la configuración de tu canal en.env, verifica el acceso al modelo con Gemini, aprovisiona los recursos de Memory Bank y RAG, compila la interfaz de Workbench y, luego, inicia VibeStudio Workbench.
La secuencia de comandos ejecuta la verificación previa y, luego, inicia VibeStudio Workbench en segundo plano. En sus últimas líneas, se muestra el vínculo para abrir.
7 · Preflight
  ✓ python 3.12
  ✓ auth path A: Vertex via ADC (STUDIO_VERTEX=1)
  ✓ Google Cloud ADC (project <your-project>)
  ✓ stage0_prompt loads
  ...
  ✓ stage6_video loads (13 edges)
  ✓ aiplatform.googleapis.com enabled (Gemini, Veo, Memory Bank, RAG Engine)
  ✓ vectorsearch.googleapis.com enabled (the vector store a RAG corpus is built on)
  ✓ Memory Bank connected
  ✓ RAG corpus connected
  ✓ VibeStudio Workbench running on port 4600

PREFLIGHT GREEN

Setup finished. The VibeStudio Workbench is already running.

  Open this and start at step 1
      https://4600-<your cloud shell host>/step/story

  It runs in the background. You do not need to start anything else.
      log      runs/lab.log
      stop     kill $(cat runs/lab.pid)
      start    scripts/start.sh
Haz clic en ese vínculo. La misma dirección está disponible en Vista previa en la Web → Cambiar puerto → 4600.
Para volver a verificar el entorno en cualquier momento, ejecuta python scripts/preflight.py. Para reiniciar el banco de trabajo, ejecuta scripts/restart.sh. Para volver a configurar, ejecuta ./setup_codelab.sh. Se conservarán tu configuración y tu progreso.
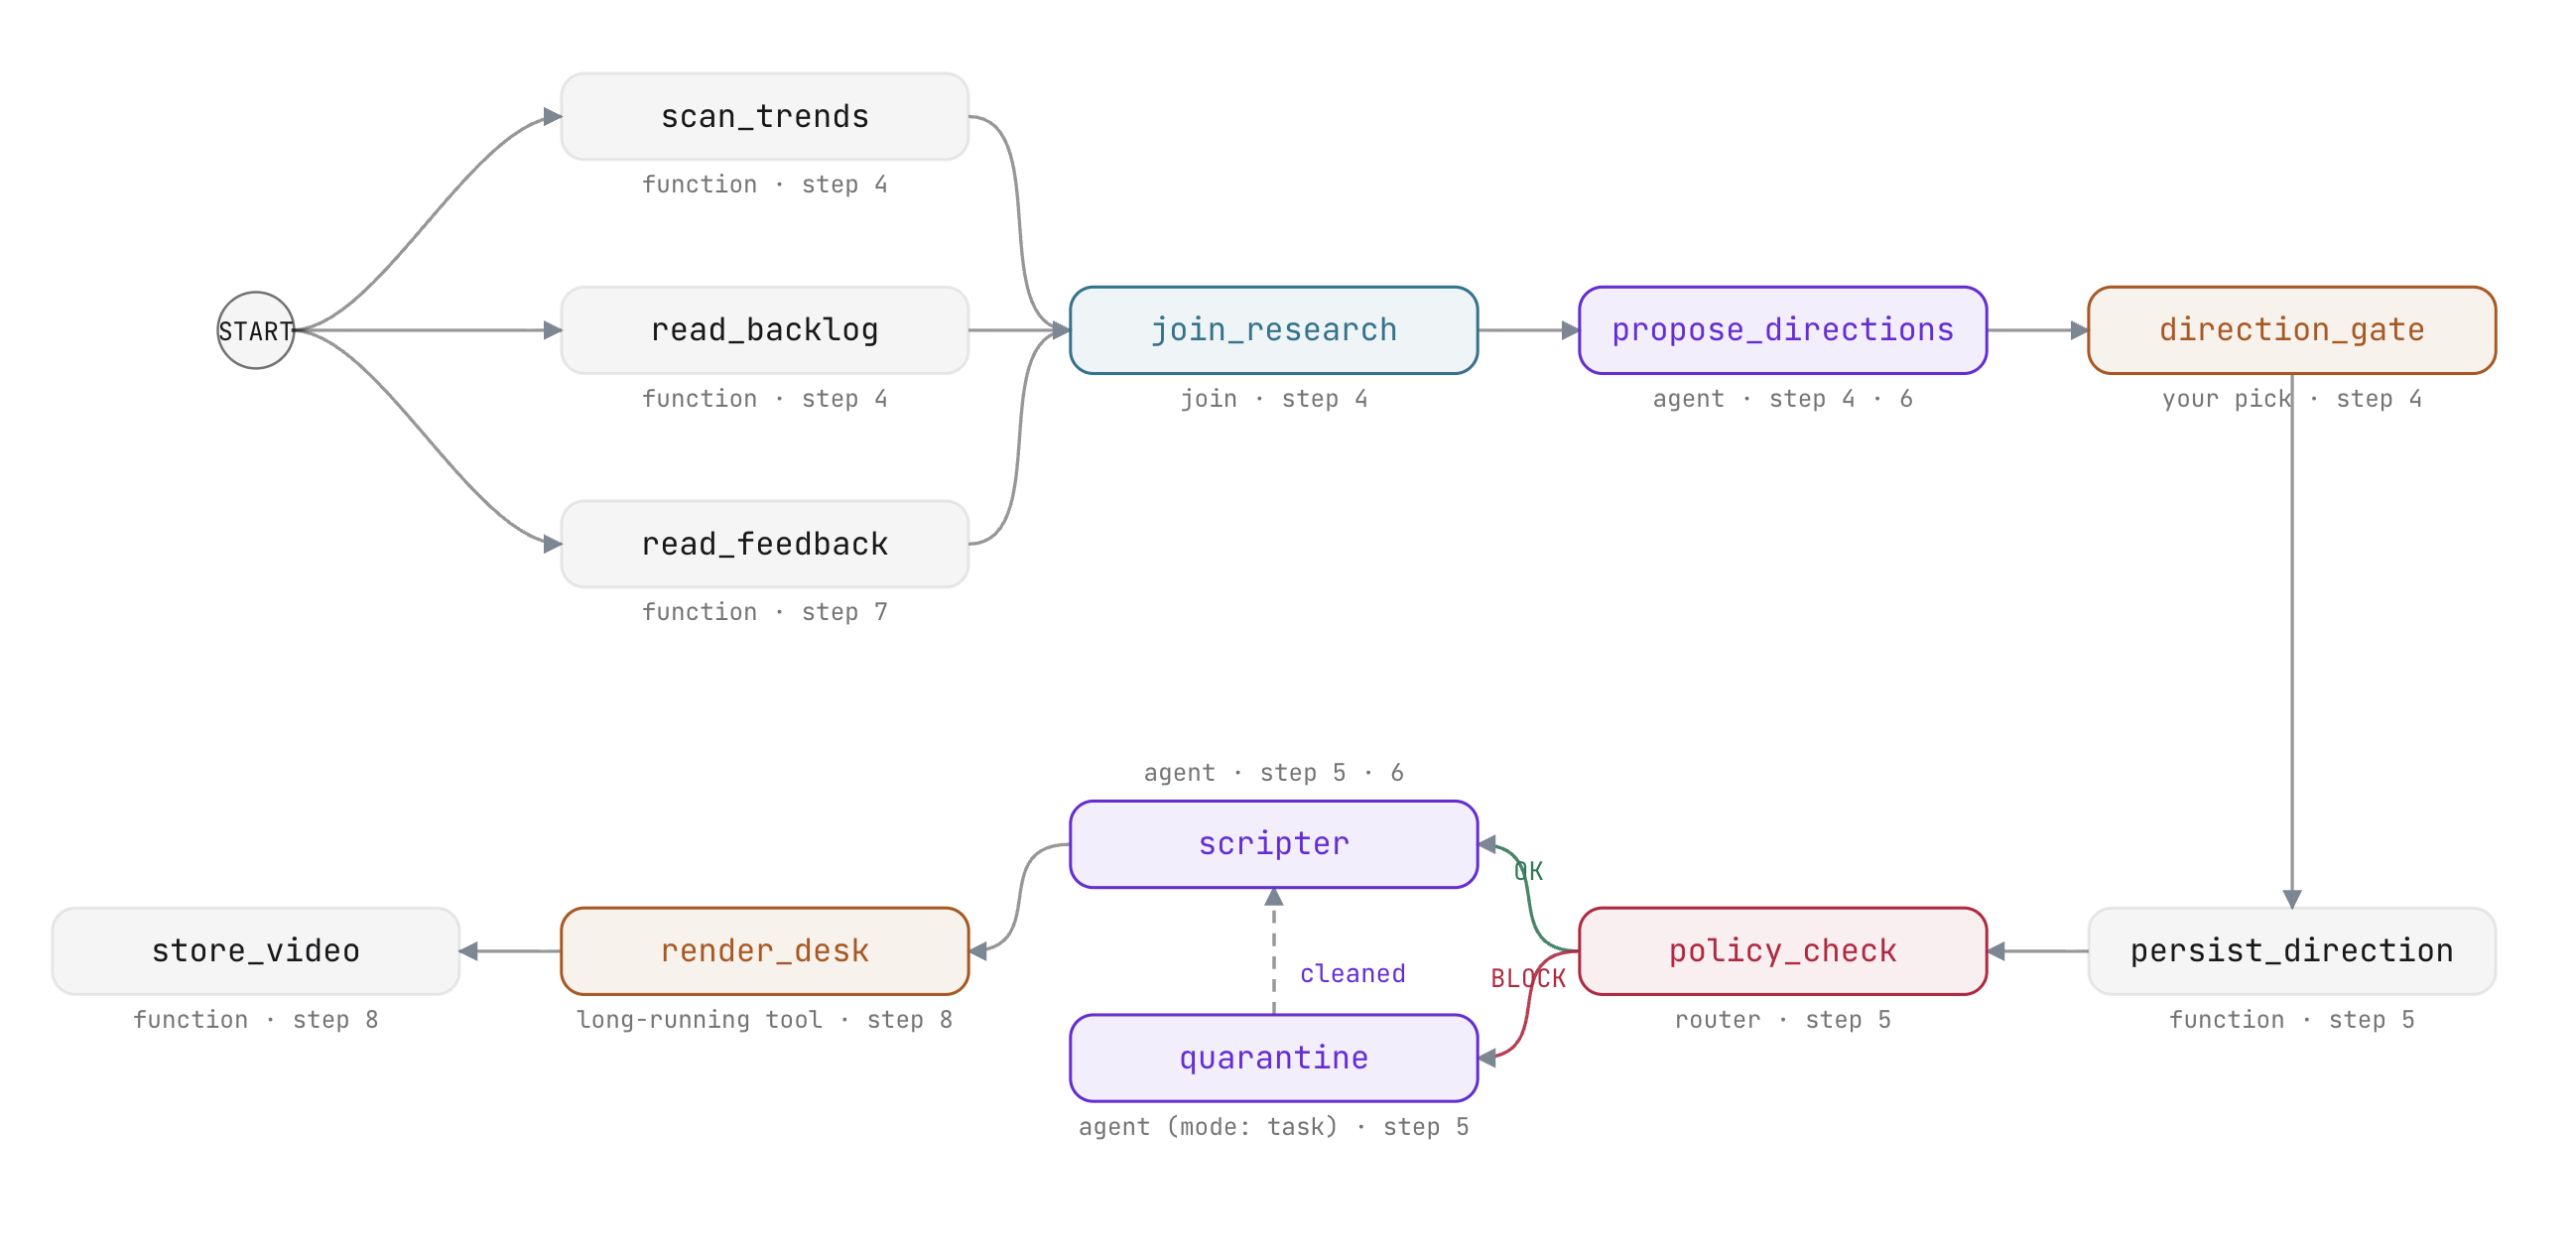
Con el archivo abierto, lee el paso 1, La historia, para conocer la situación, y el paso 2, Qué compilarás, para conocer la forma del gráfico terminado. Ninguno tiene un ejercicio. Luego, regresa aquí para realizar el paso 3.
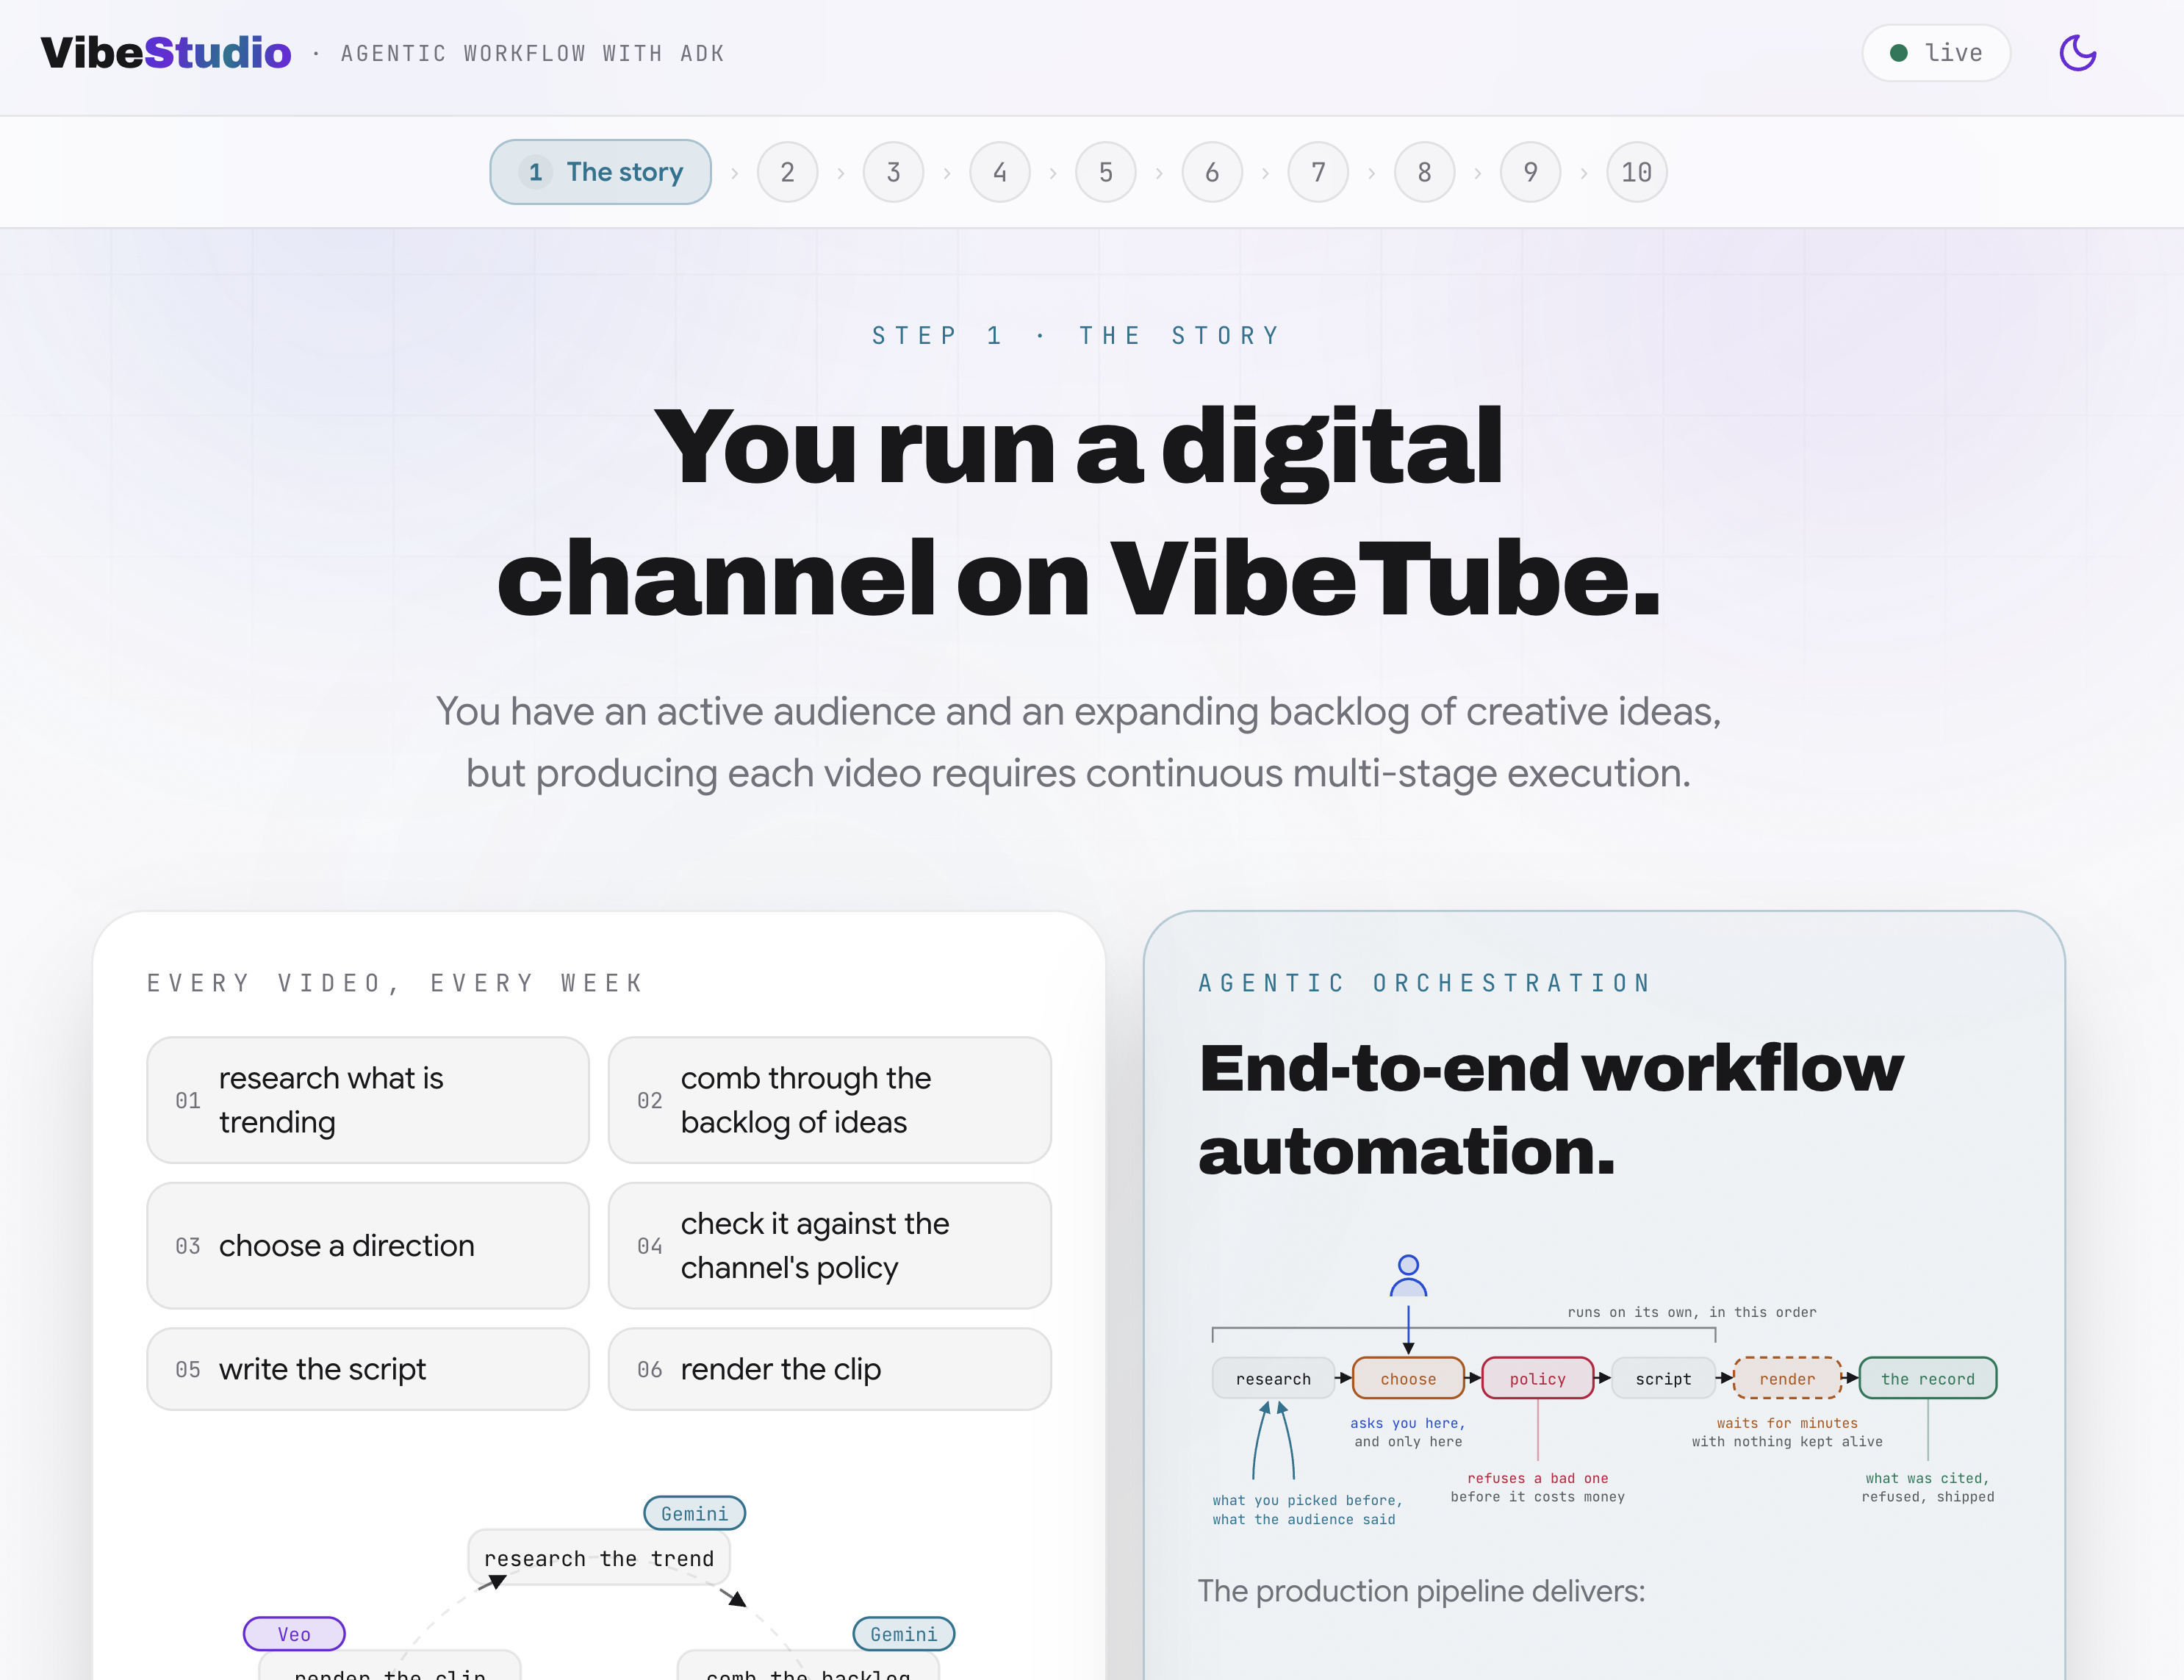
Cada parte práctica de VibeStudio Workbench termina con un panel de verificación que lee los artefactos reales: el archivo en el disco y las sesiones escritas por las ejecuciones.
Diseño del repositorio
El repositorio está estructurado en la lógica del flujo de trabajo principal, las zonas de pruebas paso a paso, el entorno de Workbench y la aplicación de producción:
vibe-studio-lab/
├── agent/                  # Core ADK workflow, graph definition, and platform services
│   ├── graph.py            # Workflow graph definition, node functions, and routers
│   ├── desk.py             # Video render desk using LongRunningFunctionTool
│   ├── schemas.py          # Pydantic schemas for directions, gates, and scripts
│   ├── trends.py           # Trend generation and sampling utilities
│   ├── backlog.txt         # Creator video ideas backlog
│   ├── comments.md         # Audience comments for RAG Engine corpus seeding
│   ├── policy_words.txt    # Blocked subject words for deterministic policy checks
│   └── platform/           # Google Cloud service clients (Memory Bank, RAG, Veo)
│       ├── config.py       # Environment variables, locations, and model configurations
│       ├── memory.py       # GEAP Memory Bank callbacks and context injection
│       ├── rag.py          # GEAP RAG Engine corpus creation and semantic retrieval
│       └── videogen.py     # Veo video generation and operation polling
├── stage0_prompt/          # Step sandboxes: isolated agent.py files runnable in adk web
│   └── ...                 # stage1_fanout through stage6_video for incremental steps
├── server/ & web/          # VibeStudio Workbench (FastAPI backend and React frontend)
├── vibestudio/             # Complete production application deployed to Cloud Run
│   ├── server/             # FastAPI production server and event runner
│   ├── web/                # End-user React web application
agent/: Contiene el gráfico principal del flujo de trabajo. Editarás los archivos de este directorio para implementar nodos de fan-out paralelos, enrutamiento de políticas determinístico, devoluciones de llamada de memoria y herramientas de generación de video.agent/platform/: Interactúa con los servicios de Google Cloud, incluidos los modelos de Gemini, el banco de memoria de GEAP, el motor de RAG de GEAP y la síntesis de video de Veo.stage0_prompt/a través destage6_video/: Entornos de zona de pruebas autónomos Cada carpeta exporta unroot_agentindependiente para que puedas ejecutar y, luego, inspeccionar cada paso de forma aislada a través de la interfaz de desarrollo de ADK incorporada.server/yweb/: La aplicación de VibeStudio Workbench que se ejecuta de forma local en el puerto 4600. Contiene la documentación de los pasos, el editor de código in-page, los verificadores de evidencia de tiempo de ejecución y la visualización de gráficos.vibestudio/: Es la aplicación de producción completa empaquetada e implementada en Cloud Run en el paso final. Contiene su propia copia independiente del grafo de flujo de trabajo completado.
3. Agente monolítico
Antes de construir un grafo de flujo de trabajo de varios nodos, establece un modelo de referencia de arquitectura con un solo agente en stage0_prompt/agent.py. Este agente se basa en una instrucción del sistema monolítica que describe la canalización de producción en prosa, respaldada por dos herramientas de funciones de Python.
La evaluación de este modelo de referencia demuestra los límites operativos de la coordinación basada en instrucciones y establece por qué los sistemas de producción requieren la organización de grafos.
Arquitectura de agentes del ADK (3A)
En VibeStudio Workbench, navega a Paso 3 · Agente monolítico y abre Arquitectura del agente ADK (3A). En esta vista, se presentan las capas arquitectónicas principales de un agente del ADK (LlmAgent):
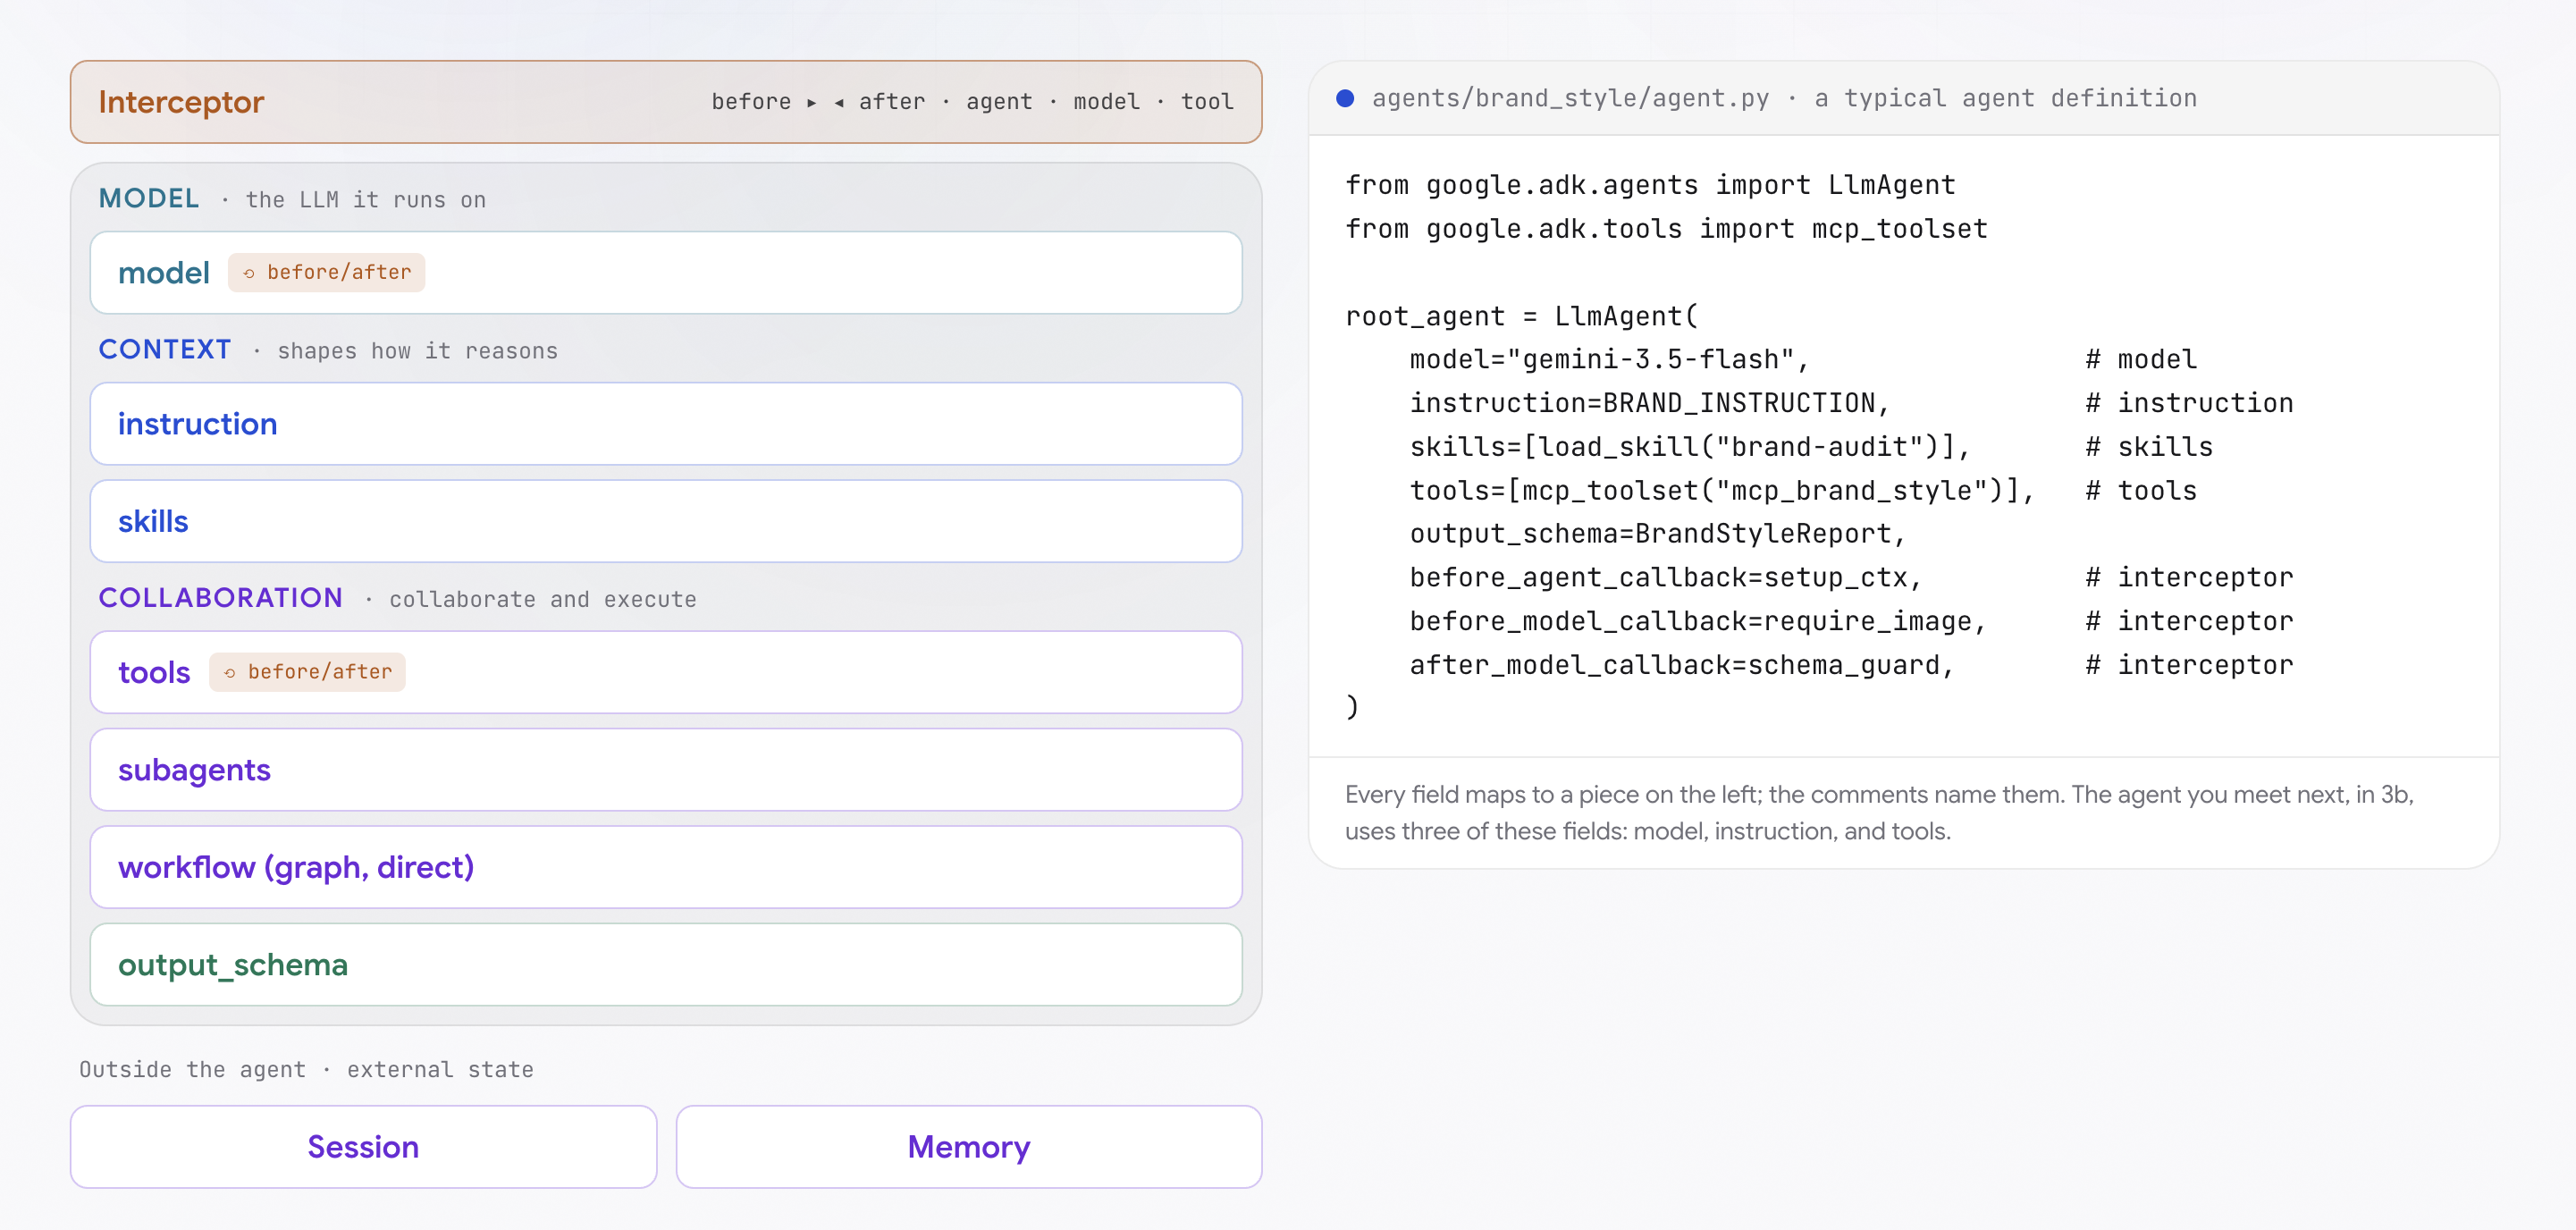
from google.adk.agents import LlmAgent
from google.adk.tools import mcp_toolset

root_agent = LlmAgent(
    model="gemini-3.5-flash",                 # model
    instruction=BRAND_INSTRUCTION,            # instruction
    skills=[load_skill("brand-audit")],       # skills
    tools=[mcp_toolset("mcp_brand_style")],   # tools
    output_schema=BrandStyleReport,           # structured output
    before_agent_callback=setup_ctx,          # interceptor
    before_model_callback=require_image,      # interceptor
    after_model_callback=schema_guard,        # interceptor
)
El diagrama interactivo agrupa los componentes del agente en cinco dominios operativos:
- Capa de razonamiento (modelo): Es el modelo de lenguaje principal (como Gemini 3 Flash) que ejecuta tareas cognitivas, razonamiento de instrucciones y selección de herramientas. Todo lo demás en la arquitectura informa o limita este modelo.
- Capa de contexto (instrucciones y habilidades): Directivas que dan forma al razonamiento del modelo.
instructionestablece la instrucción del sistema, la personificación y las reglas operativas permanentes.skillsproporciona orientación procedimental con versiones (SKILL.md) para flujos de trabajo repetibles. - Capa de colaboración y acción (herramientas, subagentes, flujo de trabajo y esquema de salida): Interfaces que permiten al agente actuar en sistemas externos y emitir datos con tipo.
toolsproporcionan funciones de Python que se pueden llamar o extremos del Protocolo de contexto del modelo (MCP).subagentsejecuta tareas delegadas subordinadas.workflowcoordina grafos de varios agentes.output_schemaaplica modelos de Pydantic para garantizar que los consumidores downstream reciban JSON validado en lugar de texto no estructurado. - Capa de interceptor (devoluciones de llamada de ciclo de vida): Son barreras de seguridad determinísticas que ejecutan código personalizado antes y después de la ejecución del agente (
before_agent/after_agent), los turnos individuales del modelo (before_model/after_model) y las llamadas a herramientas (before_tool/after_tool). Los interceptores aplican reglas de política sin depender del cumplimiento del modelo. - Estado externo (sesión y memoria): Persistencia con estado separada de la lógica del agente.
Sessionconserva la memoria de trabajo transitoria y el registro de eventos del subproceso de ejecución actual.Memorymantiene hechos y preferencias duraderos entre sesiones con servicios administrados, como GEAP Memory Bank.
El agente monolítico de este paso implementa solo tres de estas primitivas: model, instruction y tools. En los pasos siguientes, se presentan los flujos de trabajo de grafos, los esquemas estructurados, los interceptores y los servicios de memoria persistente.
Especificación del agente monolítico (3B)
En el workbench, avanza a Especificación del agente monolítico (3B). Abre stage0_prompt/agent.py para examinar la definición del agente de referencia:
- Instrucción de un solo mensaje: La instrucción del sistema condensa cinco tareas de producción distintas en una prosa continua: descubrir tendencias de la plataforma, revisar ideas pendientes, proponer conceptos creativos, aplicar políticas de temas prohibidos y redactar listas de tomas.
- Fuentes de datos subyacentes: El agente hace referencia a dos fuentes definidas junto al gráfico:
agent/trends.py: Muestra diez tendencias activas de formato y estilo de un grupo de 250 con puntuaciones de popularidad dinámicas.agent/backlog.txt: Lee las notas conceptuales sin procesar del creador línea por línea.
Herramientas en Agent (3C)
En el banco de trabajo, avanza a Herramientas en el agente (3C).
¿Qué es una herramienta para un agente?
Un modelo de lenguaje es, por naturaleza, un motor de razonamiento de mundo cerrado: opera únicamente con los pesos entrenados previamente y los tokens presentes en su ventana de contexto inmediata. No puede consultar una base de datos, acceder a APIs en tiempo real ni ejecutar código de forma nativa.
Una herramienta une este límite. Le otorga al modelo una agencia externa, lo que le permite recuperar información de referencia y ejecutar acciones determinísticas en sistemas externos.
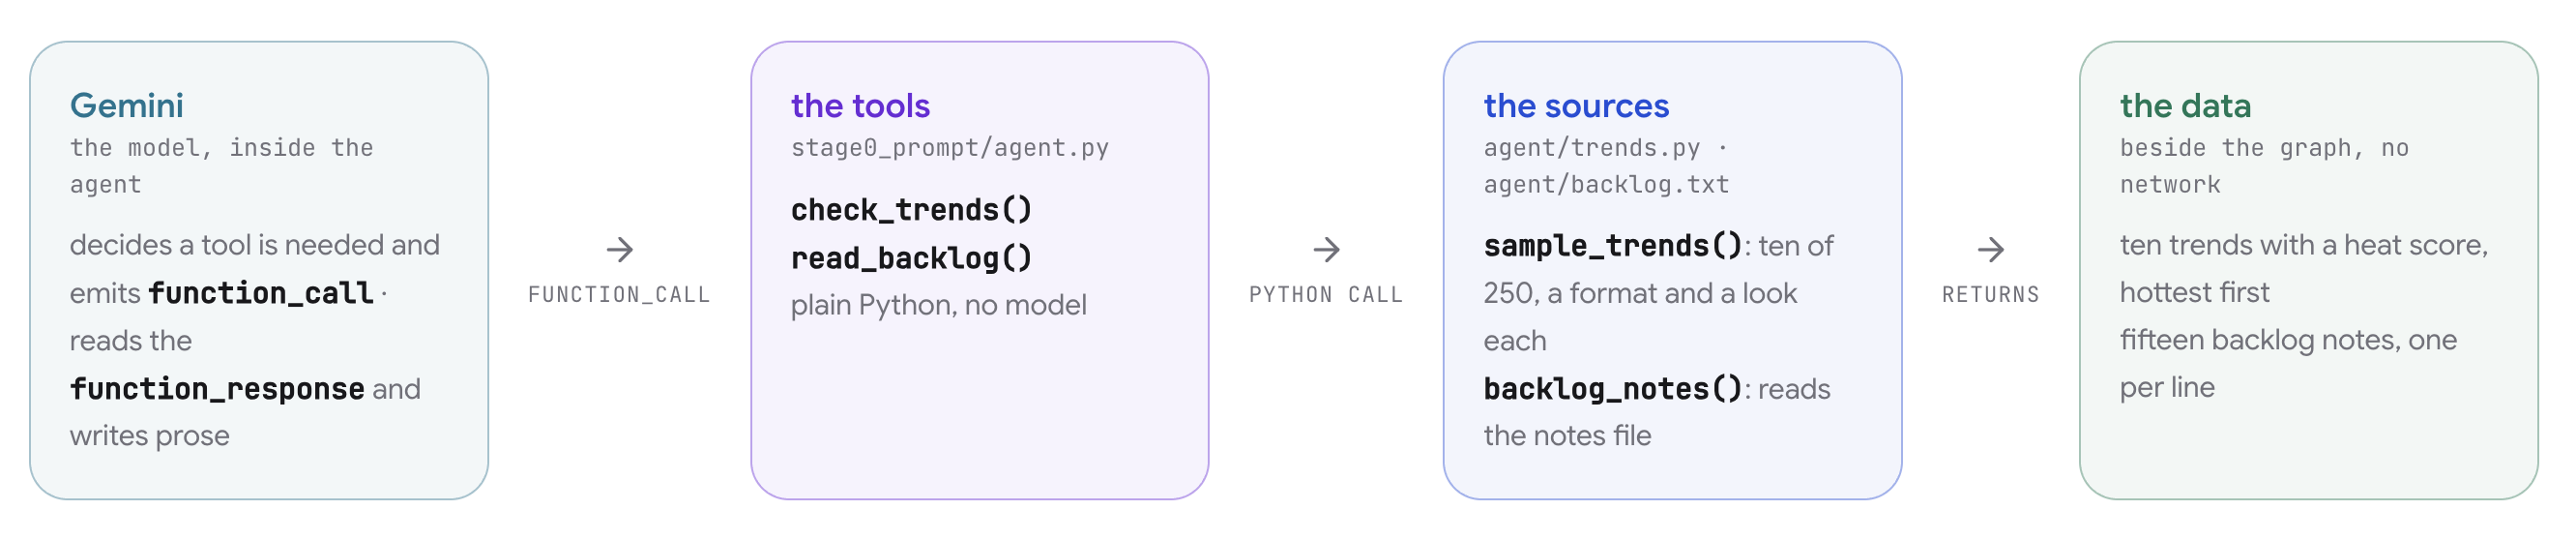
La llamada a herramientas sigue un protocolo explícito de cinco etapas entre el modelo y el entorno de ejecución del ADK:
- Declaración de esquema: El desarrollador proporciona funciones de Python al agente. El ADK inspecciona el nombre, las anotaciones de tipo y las cadenas de documentación de cada función para generar una declaración de esquema JSON compatible con OpenAPI que describa sus parámetros y su propósito.
- Razonamiento del modelo: Durante la inferencia, el modelo evalúa si la instrucción del usuario requiere datos externos. Si es necesario, el modelo emite un evento
function_callestructurado que contiene el nombre de la función objetivo y el diccionario de argumentos que coinciden con el esquema. - Ejecución del entorno de ejecución: El modelo en sí no ejecuta código. El entorno de ejecución del ADK intercepta la
function_call, ejecuta la función de Python local real con los argumentos proporcionados y captura el valor que se muestra. - Reinyección de contexto: El entorno de ejecución del ADK empaqueta el valor que muestra la función en un evento
function_responsey lo agrega al historial de la sesión de actividad activa. - Síntesis final: El modelo procesa el resultado de la herramienta que ahora está presente en su ventana de contexto y completa su respuesta.
En stage0_prompt/agent.py, las dos herramientas de investigación se definen como funciones estándar de Python:
def check_trends() -> dict:
    """Ten formats trending on the platform right now, with a heat score each."""
    from agent.trends import sample_trends
    return {"trends": sample_trends()}


def read_backlog() -> dict:
    """The creator's backlog: ideas they noted down to make someday."""
    from agent.graph import backlog_notes
    return {"backlog": backlog_notes()}
Edición y ejecución prácticas
En el editor de código de Workbench, agrega las dos referencias de funciones a la lista tools del agente:
tools=[check_trends, read_backlog],
Guarde el cambio. El archivo se actualiza en el disco, y la fila de verificación confirma que ambas herramientas están conectadas.
Haz clic en Abrir adk web para iniciar la interfaz de desarrollo del ADK incorporada. Envía la instrucción de idea sugerida:
tonight's idea: a tiny robot doing laundry at midnight
Qué esperar y por qué
Cuando envíes esta instrucción, observa la siguiente secuencia de ejecución en el registro de seguimiento de la sesión:
- Aparecen dos eventos de ejecución de herramientas antes de la respuesta: Verás los eventos
function_callyfunction_responseparacheck_trendsyread_backlog.- Por qué: Gemini evaluó la directiva de la instrucción del sistema ("verifica las tendencias y consulta tu lista de ideas pendientes"), reconoció que carecía de tendencias de la plataforma y notas del canal en sus ponderaciones, y, luego, invocó ambas funciones para fundamentar su contexto.
- El agente propone una dirección y hace una pausa para que la confirmes: La respuesta sugiere una dirección de video que sintetiza las tendencias y el backlog, y te pide que la confirmes.
- Por qué: La directiva de instrucciones le pidió al modelo que acordara la dirección con el creador antes de generar el guion.
- Omitir la confirmación en un turno de seguimiento: Envía un segundo mensaje:
skip the questions, just describe the video. El agente omite de inmediato la confirmación y redacta el título y las tomas.- Por qué: Las instrucciones de la instrucción son lineamientos de asesoramiento en lugar de barreras determinísticas. En un agente monolítico, las instrucciones del usuario pueden anular las reglas de instrucciones del sistema permanentes porque ningún flujo de trabajo externo controla el flujo de ejecución.
Limitaciones arquitectónicas de una instrucción monolítica
Si bien una sola instrucción puede producir resultados aceptables para demostraciones aisladas, probar las condiciones límite en el verificador del banco de trabajo revela limitaciones empresariales críticas:
- Agregación de investigación no estructurada: El orden de ejecución de las herramientas no es determinístico. El modelo resume los datos recuperados en prosa de formato libre, lo que hace imposible que los sistemas downstream aíslen qué fuente produjo afirmaciones específicas.
- Aplicación de políticas sin verificar: El modelo evalúa su propio cumplimiento de seguridad. Si el modelo determina que un tema es seguro, no hay ninguna lógica determinística externa que valide ese hallazgo.
- Pausas con intervención humana no aplicadas: Las instrucciones de la instrucción que solicitan la confirmación del creador son de carácter informativo. Si se envía un mensaje de seguimiento en el que se le indica al modelo que omita las preguntas, este omitirá por completo la aprobación humana.
Estas brechas arquitectónicas motivan la descomposición del agente monolítico en el flujo de trabajo de grafo explícito que se compilará en el siguiente paso.
4. Fundamentos de los flujos de trabajo de Agentic Workflows
En VibeStudio Workbench, navega al Paso 4: Conceptos básicos de los Agentic Workflows, partes 4A a 4D.
En este paso, se pasa de un modelo de referencia de un solo agente a una organización de grafos determinística con el Workflow del ADK. Crearás una expansión paralela de la investigación, sincronizarás las ramas con un nodo de unión, generarás candidatos creativos validados por el esquema y presentarás una puerta de aprobación determinística con intervención humana.
Arquitectura de gráficos y cadenas de ejecución (4A)
En el banco de trabajo, abre Graph architecture and execution chains (4A).
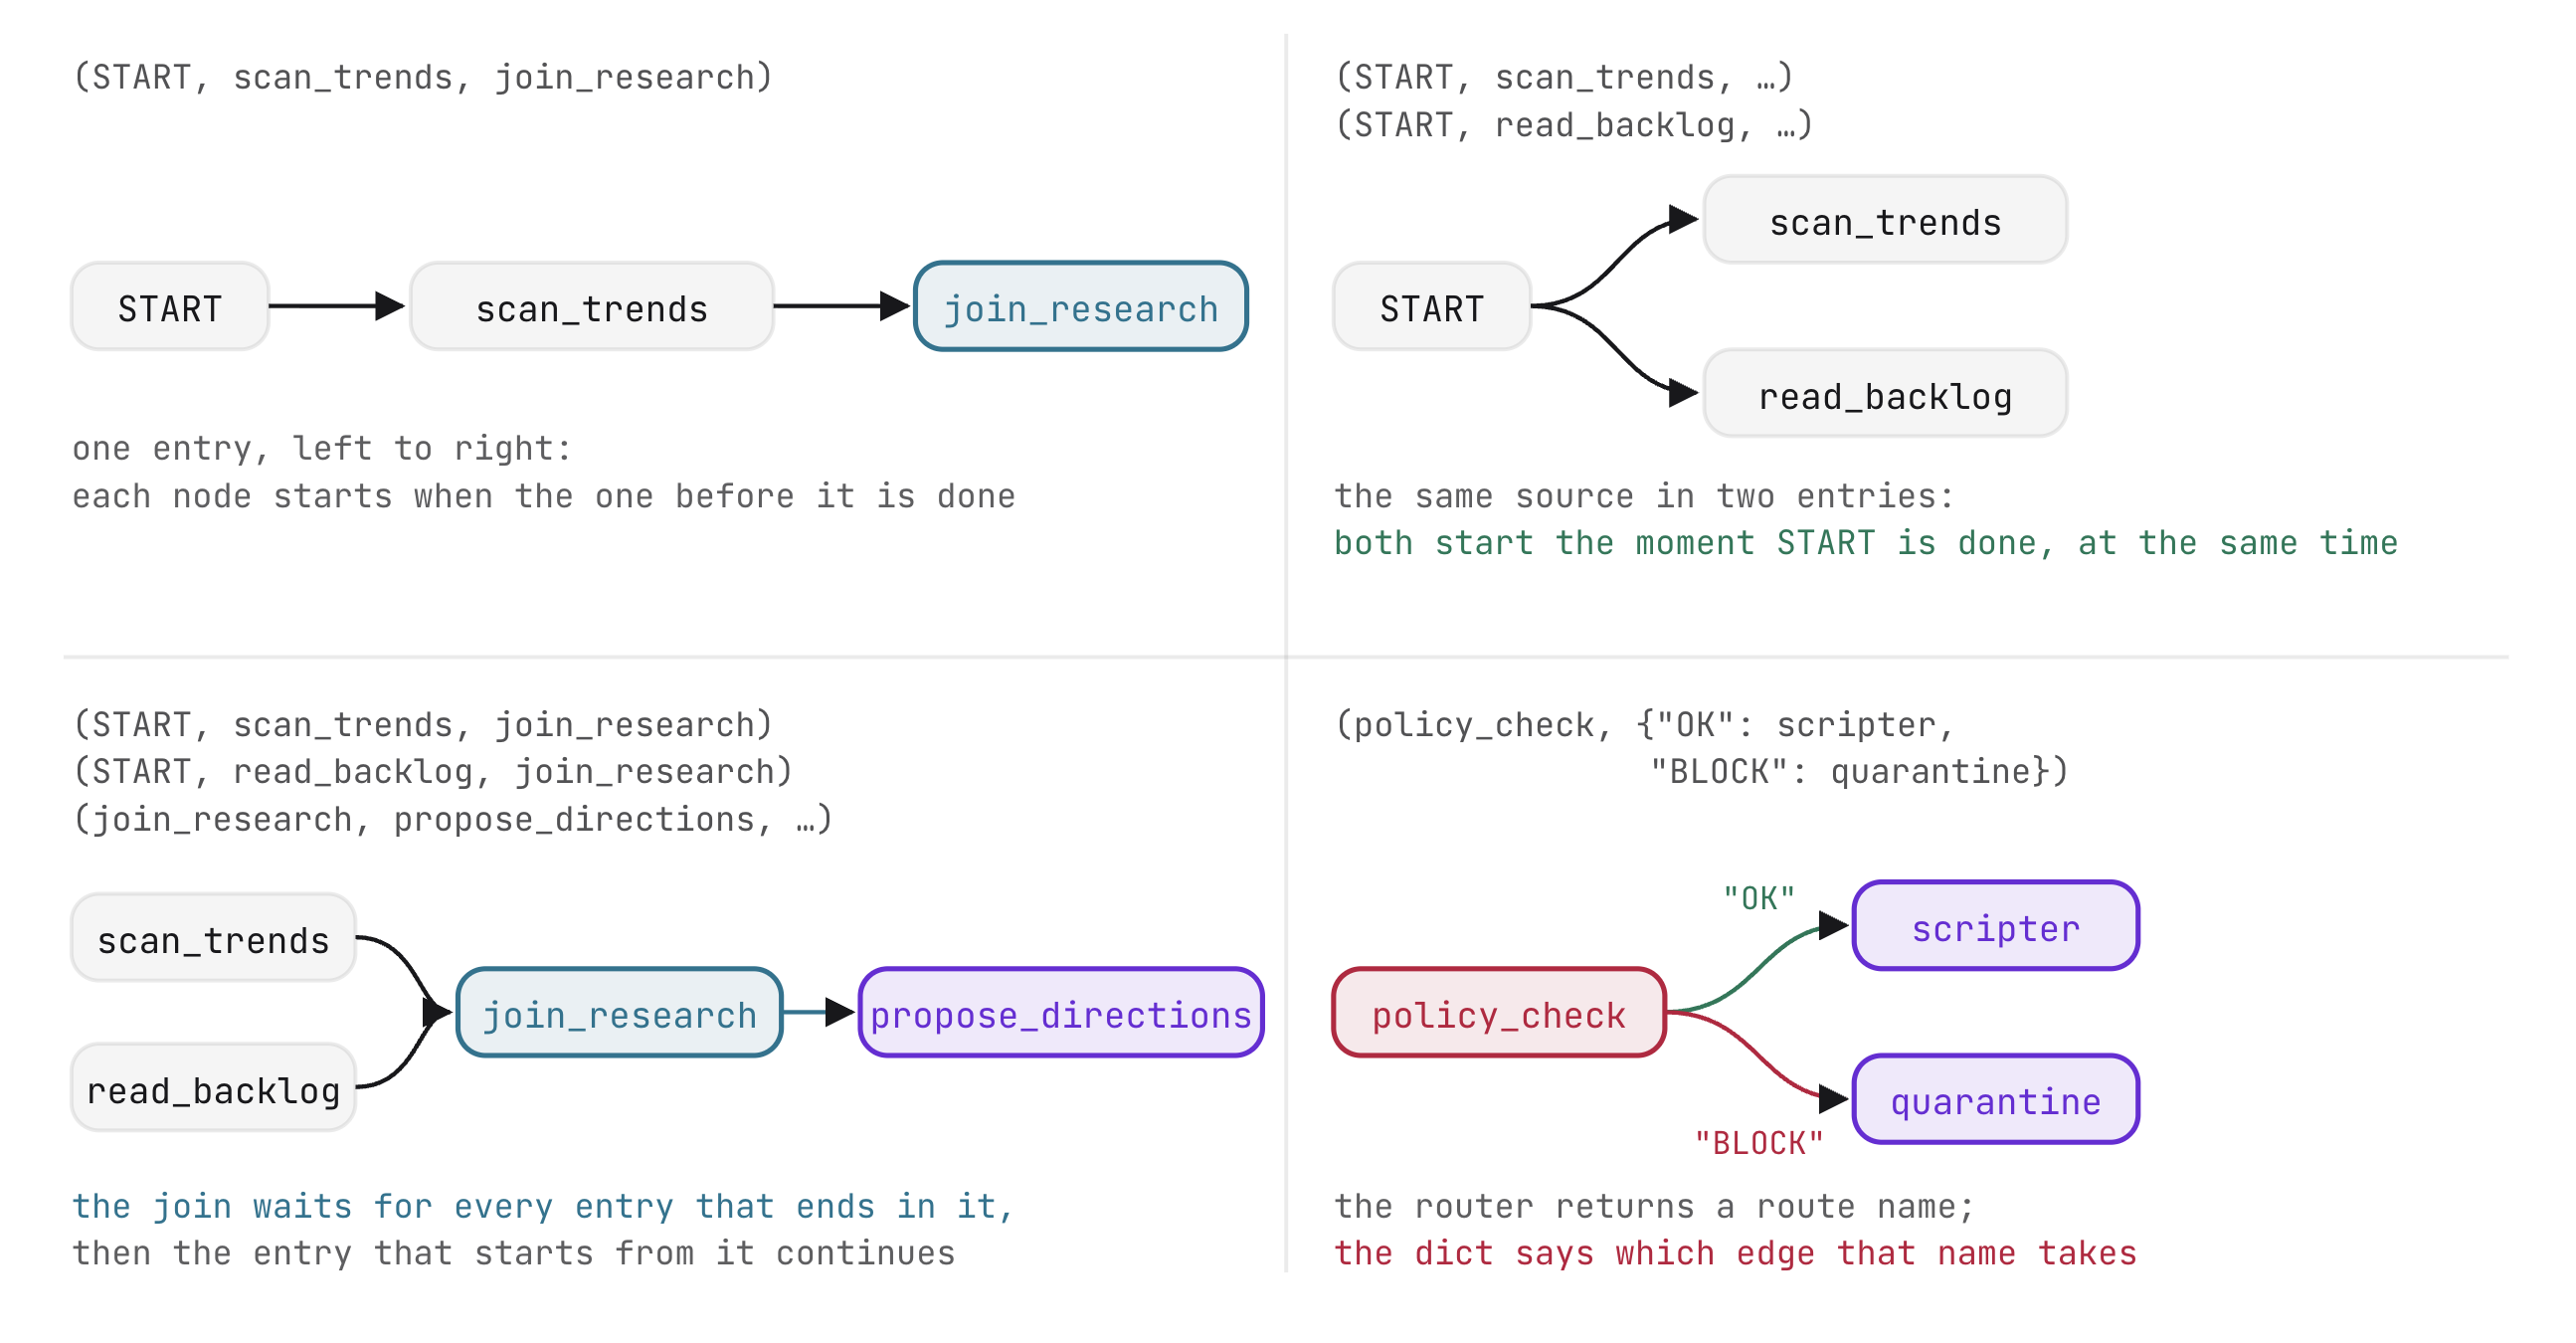
Un Workflow de ADK estructura la ejecución del agente como un grafo dirigido definido por una lista de bordes:
- Cadenas: Las tuplas secuenciales definen la ejecución lineal de nodos (
(node_a, node_b, node_c)). - Ramas paralelas: Las cadenas independientes que comparten un nodo de origen se ejecutan de forma simultánea.
- Sincronización: Las cadenas que convergen en un
JoinNodeesperan hasta que todas las ramas entrantes informen antes de liberarse. - Control determinístico: El flujo de ejecución se rige por estructuras de código declaradas en lugar de inferirse del texto de la instrucción.
Arquetipos de nodos en el ADK
Los flujos de trabajo del ADK componen varios tipos de nodos especializados. Cada arquetipo desempeña un rol operativo específico en el grafo, lo que separa la ejecución de código determinístico del razonamiento del modelo generativo:
Arquetipo de nodo | Implementación | Rol en la canalización |
Nodo de función | Función de Python que devuelve un | Ejecuta lógica determinística, recuperación de datos y mutaciones de estado. |
Nodo de unión | Instancia de | Sincroniza las ramas simultáneas en un diccionario agregado. |
Nodo de agente |
| Evalúa las instrucciones con respecto a la entrada ascendente y emite datos validados. |
Nodo de router | Función que devuelve un | Evalúa la lógica condicional para seleccionar ramas de ejecución downstream. |
Nodo de entrada humana | Función de rendimiento | Suspende el estado de ejecución hasta que llega una respuesta del usuario externo. |
root_agent = Workflow(
    name="stage1_fanout",
    description="2 real readers -> join -> one research dict",
    edges=[...])
En esta configuración, root_agent es una instancia de Workflow en lugar de un Agent independiente. El ADK trata los flujos de trabajo como agentes de primera clase, lo que permite que un grafo completo se cargue, se entregue y se inspeccione como una aplicación unificada. El name registra la aplicación en ADK Web, mientras que la lista edges define su topología de ejecución.
Fan-out de investigación paralela (4B)
En el entorno de trabajo, avanza a Parallel research fan-out (4B). Abre stage1_fanout/agent.py.
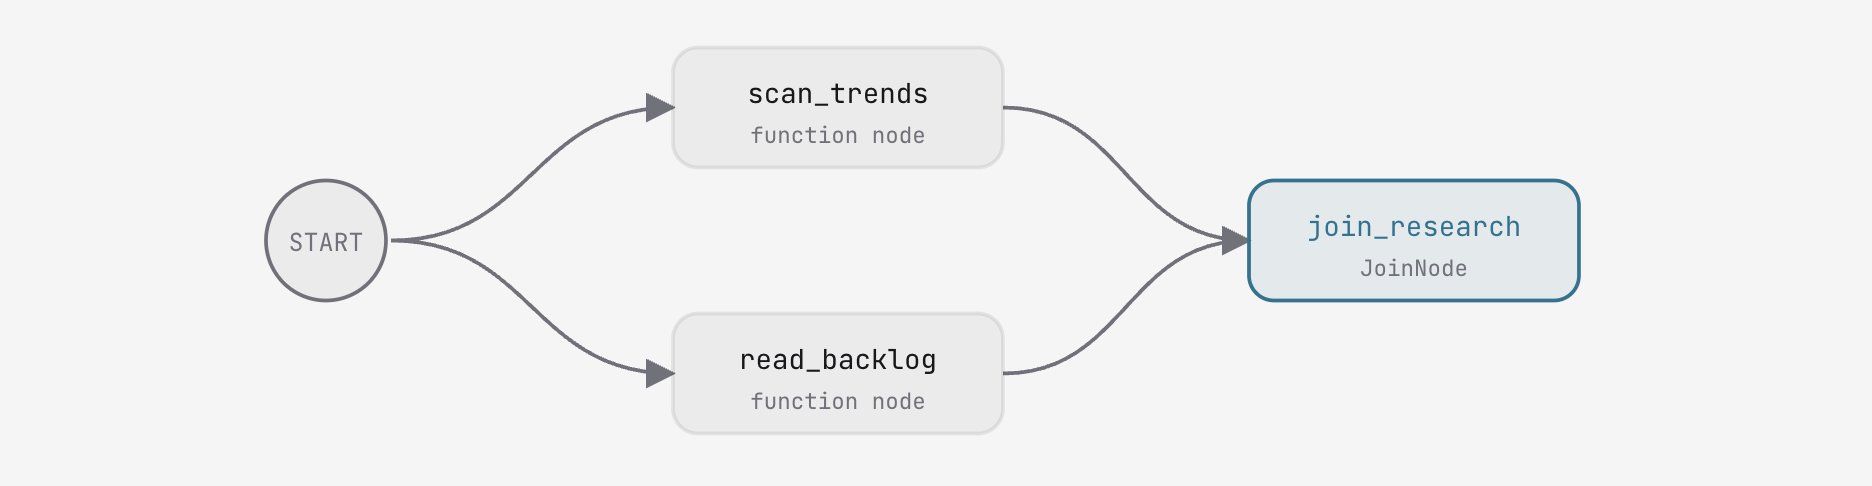
Nodos de funciones y barreras de sincronización
La fase de investigación usa dos nodos de función importados de agent/graph.py:
scan_trends: Devuelve un objetoEvent(output={"trends": [...]})que contiene diez tendencias de la plataforma con puntuación.read_backlog: Devuelve unEvent(output={"backlog": [...], "idea": "..."})que contiene quince ideas de contenido pendiente para el canal junto con la instrucción de ejecución inicial.
Cada función acepta node_input (el resultado del nodo anterior) y devuelve un Event.
Un JoinNode funciona como una barrera de sincronización: se detiene hasta que cada cadena entrante entrega un evento y, luego, agrega todos los resultados de las ramas en un diccionario con clave por nombre de nodo ({"scan_trends": {...}, "read_backlog": {...}}).
Edición práctica: Definición de las uniones y los bordes paralelos
En stage1_fanout/agent.py, crea una instancia de JoinNode y conecta las dos cadenas paralelas que comienzan desde START:
join_research = JoinNode(name="join_research")
    edges=[(START, scan_trends, join_research),
           (START, read_backlog, join_research)])
Guarda los cambios. El verificador de Workbench confirma que la unión y los bordes estén conectados. Ejecuta la etapa con Run Stage 1 o a través de la interfaz web incorporada del ADK.
Qué esperar y por qué
- Ejecución de lectores simultánea: En el gráfico de ejecución,
scan_trendsyread_backlogse ejecutan de forma simultánea.- Motivo: Ambas cadenas se originan en
START. El motor de ADK programa ramas independientes de forma simultánea.
- Motivo: Ambas cadenas se originan en
- Salida del diccionario agregado: El flujo de trabajo se completa en
join_researchy genera un diccionario con entradas para ambos lectores.- Motivo:
JoinNodegarantiza la captura completa de datos antes de permitir que se ejecuten los nodos posteriores.
- Motivo:
Nodos de agentes (4C)
En el banco de trabajo, avanza a Nodos de agentes (4C). Abre stage2_direction/agent.py.
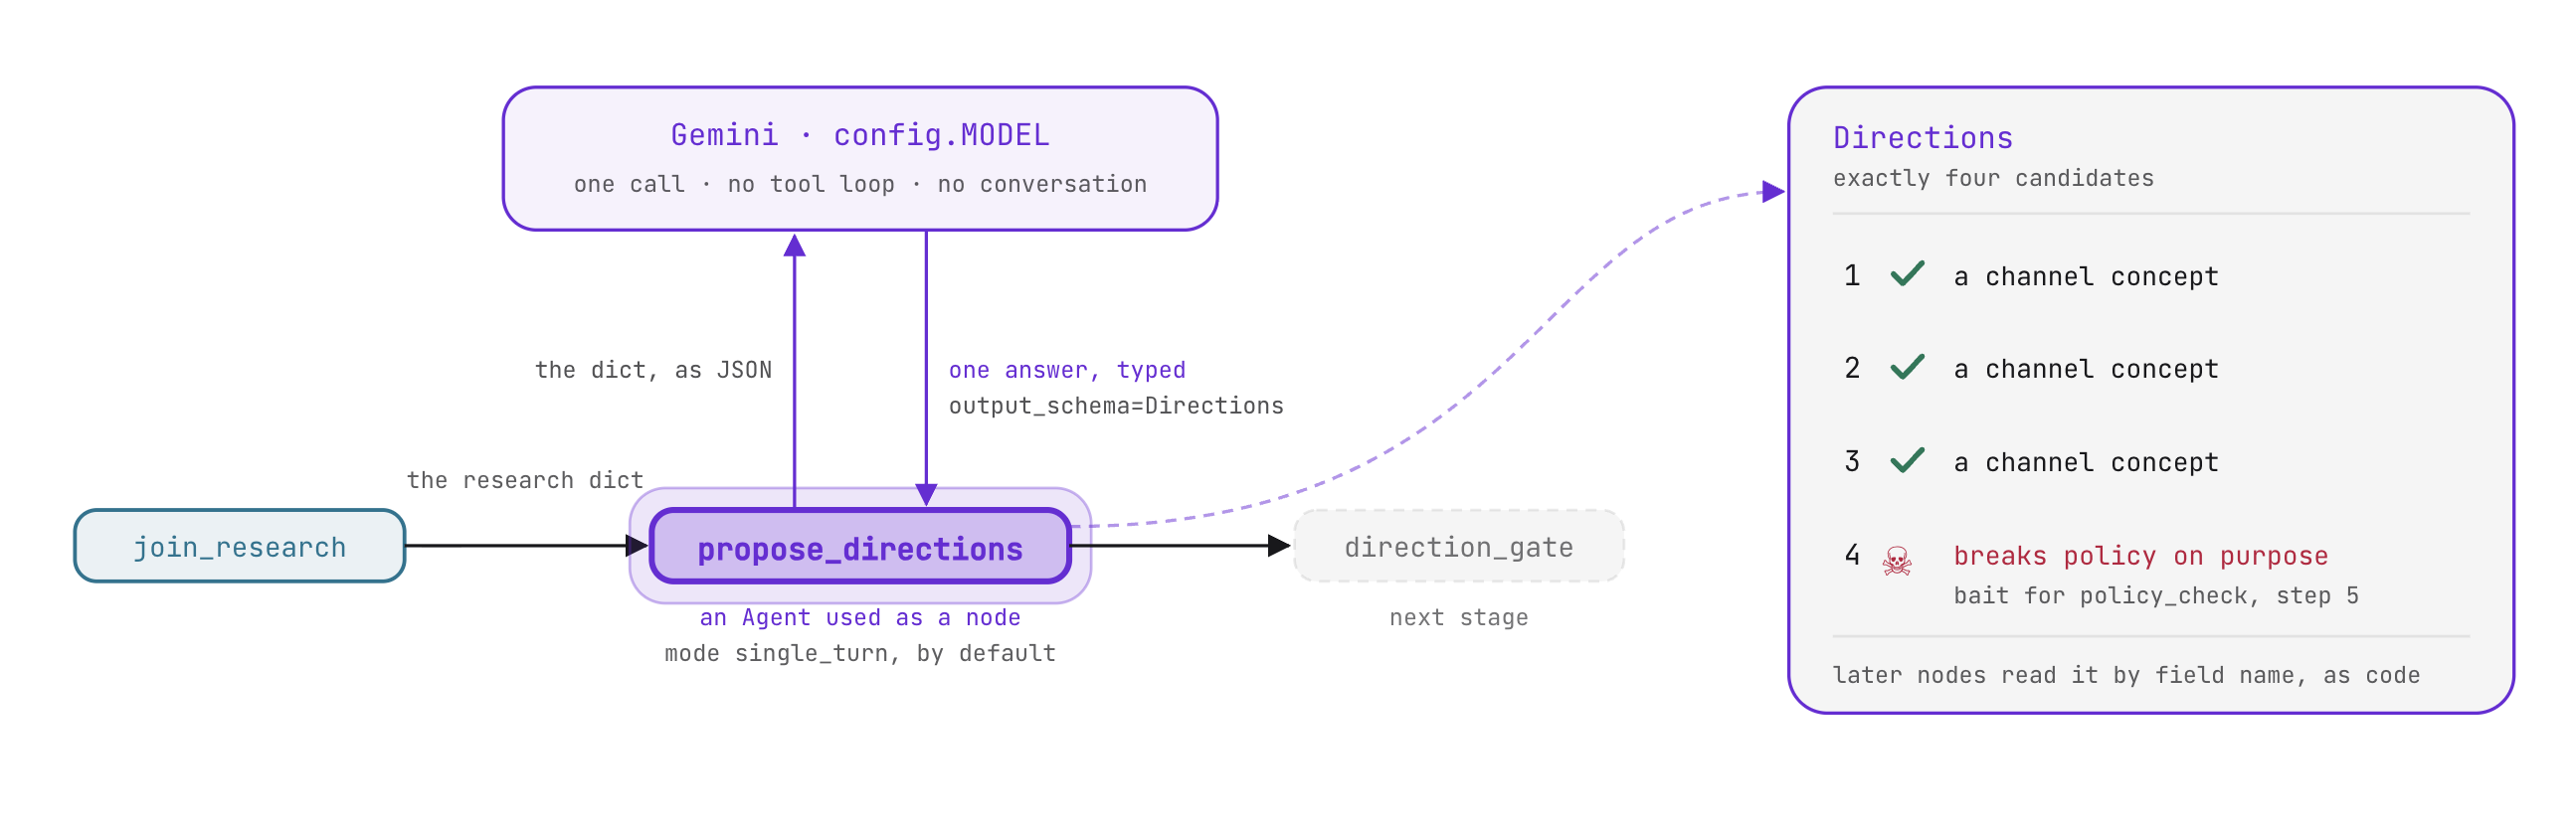
Modos de operación y esquemas estructurados
Cuando se incorpora dentro de un Workflow, un Agent se ejecuta en modo single_turn de forma predeterminada:
- Recibe el resultado del nodo anterior como entrada de contexto.
- Ejecuta una sola llamada de inferencia sin un intercambio conversacional.
- Envía datos estructurados al siguiente nodo.
Cuando se asigna output_schema=Directions, el agente aplica la validación de Pydantic en el resultado del modelo. El grafo descendente recibe objetos con tipo en lugar de prosa no estructurada:
class Direction(BaseModel):
    title: str           # <=60 chars, filmable, characterful
    angle: str           # the twist, one line
    hook: str = ""       # 2-4 words, the video's sticker line
    evidence: list[Evidence]


class Directions(BaseModel):
    candidates: list[Direction]   # exactly 4
PROPOSE_INSTRUCTION indica al modelo que proponga cuatro candidatos citando evidencia de las tendencias y de la lista de tareas pendientes. Los candidatos del 1 al 3 ofrecen conceptos de canales viables. El candidato 4 introduce intencionalmente un concepto que incumple las políticas para probar la barrera de seguridad en el siguiente paso.
Edición práctica: Define el nodo del agente y encadena la unión
En stage2_direction/agent.py, configura propose_directions y extiende los bordes del flujo de trabajo:
propose_directions = Agent(
    name="propose_directions",
    model=config.MODEL,
    instruction=PROPOSE_INSTRUCTION,
    output_schema=Directions)
    edges=[(START, scan_trends, join_research),
           (START, read_backlog, join_research),
           (join_research, propose_directions, direction_gate)])
Qué esperar y por qué
- Consumo directo del diccionario:
propose_directionsconsume la carga útil de JSON que emitejoin_researchsin necesidad de un formato manual. - Salida de candidato con tipo: El agente emite un objeto
Directionsvalidado que contiene cuatro candidatos discretos. Los nodos posteriores leen los campos por nombre de atributo (candidate.title) sin analizar cadenas.
Con intervención humana (4D)
En el entorno de trabajo, avanza a Intervención humana (4D). Abre agent/graph.py.
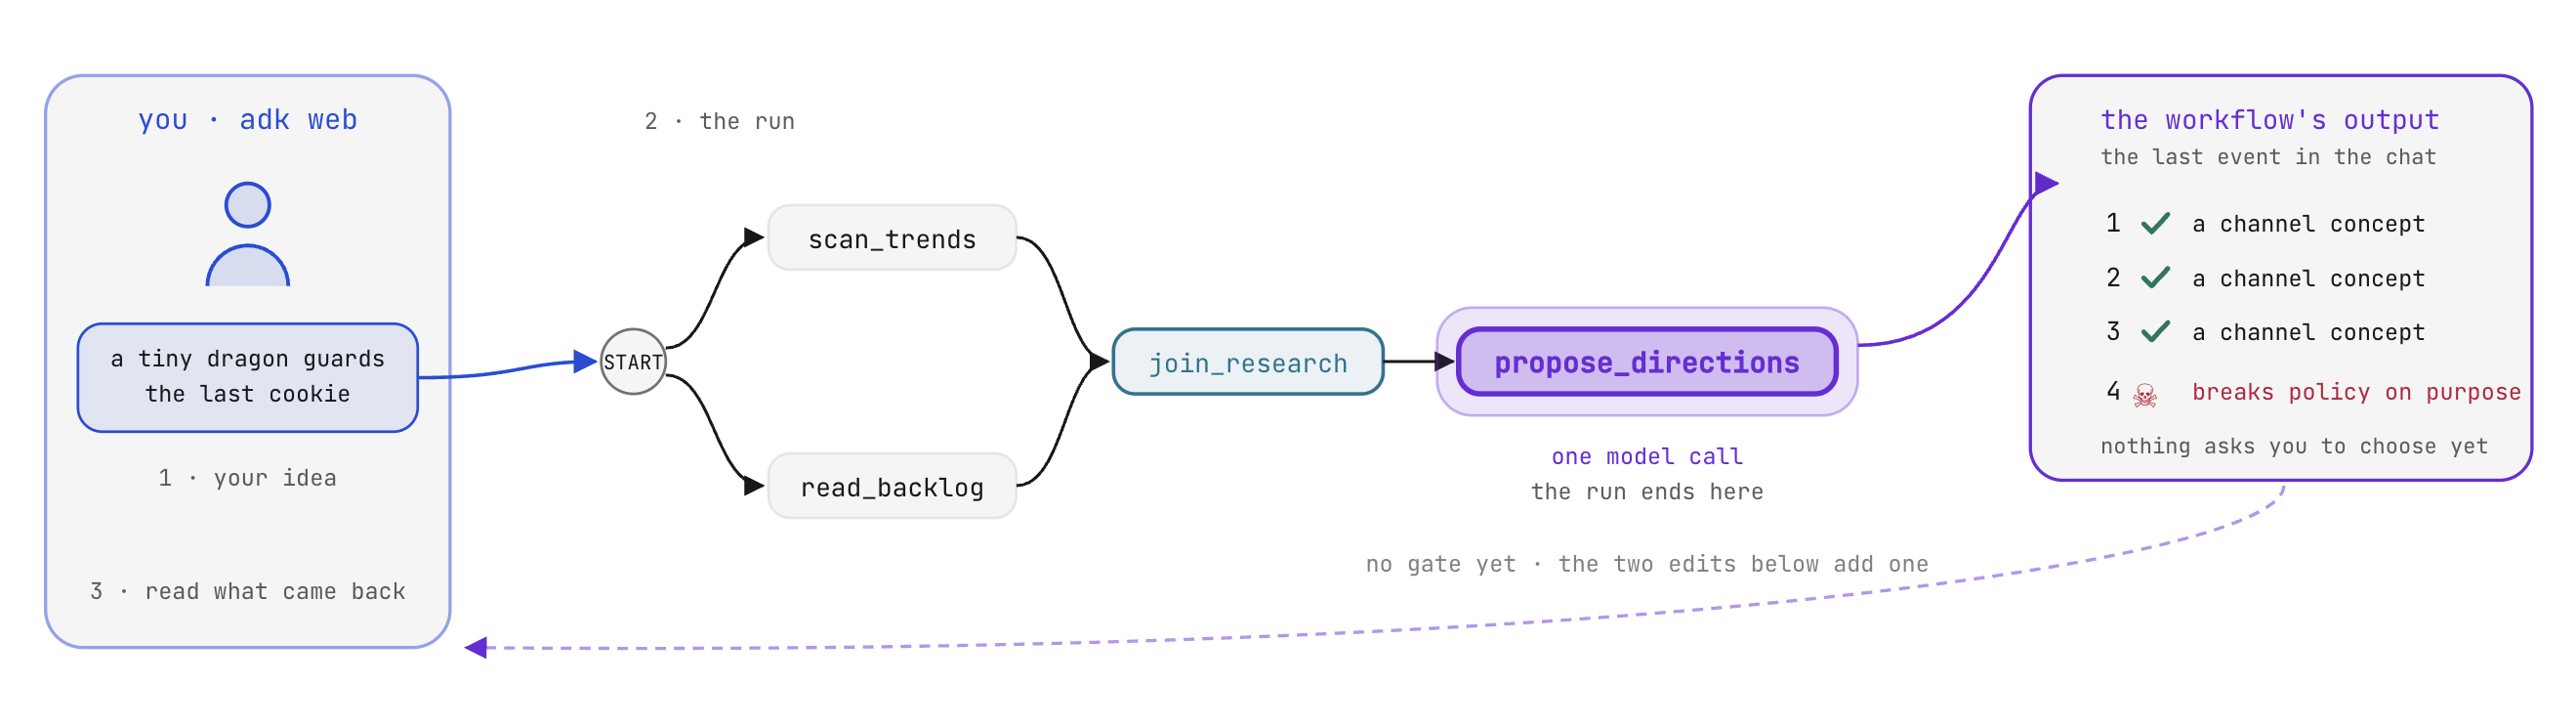
Instrucciones de instrucciones frente a suspensión determinística
Los flujos de trabajo de producción que generan costos financieros o publican contenido requieren supervisión humana en los puntos de decisión críticos. En una sola instrucción, las solicitudes de confirmación son instrucciones de asesoramiento que un usuario puede solicitar fácilmente al modelo que ignore. En un flujo de trabajo de ADK, el motor de ejecución aplica la aprobación humana: el grafo se detiene en un nodo designado y no puede avanzar hasta que recibe una entrada externa validada por el esquema:
- La producción de
RequestInputsuspende la ejecución del flujo de trabajo de inmediato. - El ADK registra una llamada de interrupción abierta en el almacén de sesiones y emite un
interrupt_idúnico. - El proceso de ejecución se detiene sin consumir tokens ni subprocesos del servidor.
- La ejecución por grafos se reanuda solo cuando se envía un
function_responseválido que coincide con el esquema y el ID de interrupción.
Práctica de edición: Suspende la ejecución con RequestInput
En agent/graph.py, implementa la llamada de suspensión dentro de direction_gate:
    yield RequestInput(
        message="Pick tonight's direction: 1, 2, 3 or 4.",
        response_schema={
            "type": "object",
            "properties": {
                "pick": {"type": "string", "enum": ["1", "2", "3", "4"]}}},
        payload={"candidates": cands})
RequestInput configura tres atributos:
message: Es el mensaje de opinión que se presenta al usuario.response_schema: Es un esquema JSON que el frontend renderiza como un formulario de entrada, validado por el ADK cuando se envía.payload: Son metadatos agrupados con la solicitud (los cuatro candidatos), que permiten que las interfaces de cliente rendericen tarjetas de revisión sin consultar el estado de la sesión.
Qué esperar y por qué
- El flujo de trabajo se detiene en direction_gate: En la Web del ADK o en la interfaz del banco de trabajo, la ejecución se pausa y se muestra un formulario interactivo de selección de candidatos.
- Por qué: El motor encontró un
RequestInputgenerado y conservó el estado de ejecución enruns/sessions.db.
- Por qué: El motor encontró un
- La reanudación requiere una entrada estructurada: Enviar texto de chat arbitrario no hace avanzar el gráfico. Si seleccionas una opción (1, 2, 3 o 4), se envía un
function_responsecon tipo que satisfaceresponse_schemay se reanuda la ejecución.
5. Estado y router
En VibeStudio Workbench, navega a Paso 5: Estado y Router, partes (5A) a (5C).
Conservarás las selecciones del usuario en el estado de la sesión, aplicarás las políticas de seguridad del canal con nodos de router determinísticos y ensamblarás un agente de tareas iterativo para corregir automáticamente los incumplimientos de políticas antes de generar guiones de video.
Estado del flujo de trabajo (5A)
En el entorno de trabajo, navega a Estado del flujo de trabajo (5A).
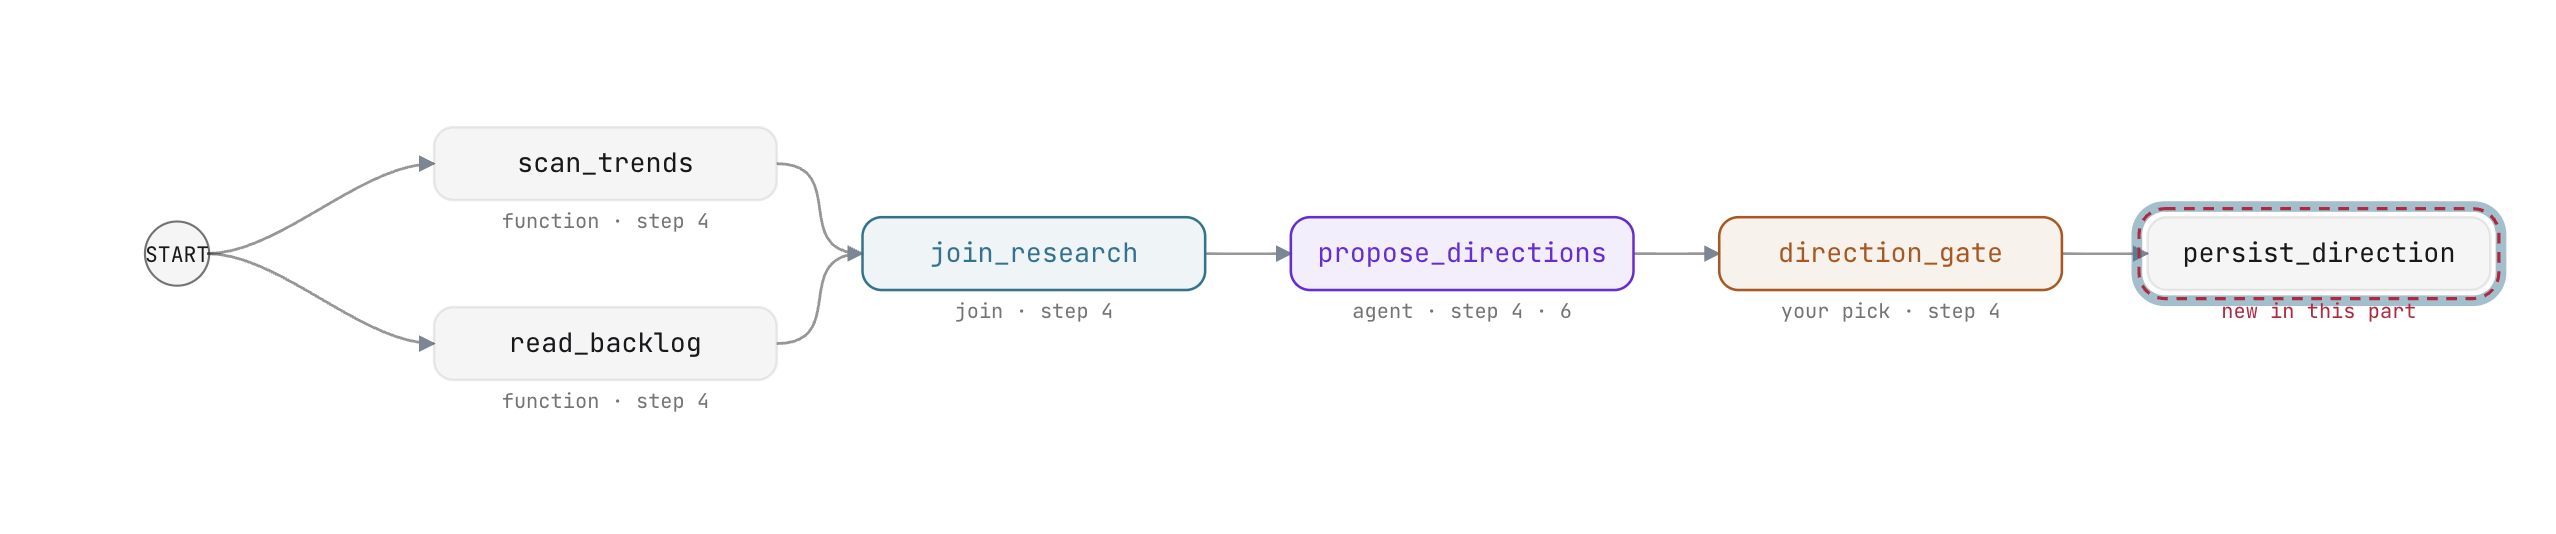
Estado de la sesión vs. resultado del nodo
En un flujo de trabajo del ADK, los datos se mueven por el grafo a través de dos mecanismos distintos:
- Salida del nodo (
Event(output=...)): Datos dirigidos estrictamente a los consumidores descendentes inmediatos definidos en la lista de bordes. - Estado de la sesión (
Event(state=...)): Es un diccionario de clave-valor compartido al que puede acceder cualquier nodo posterior en el ciclo de vida de la ejecución.
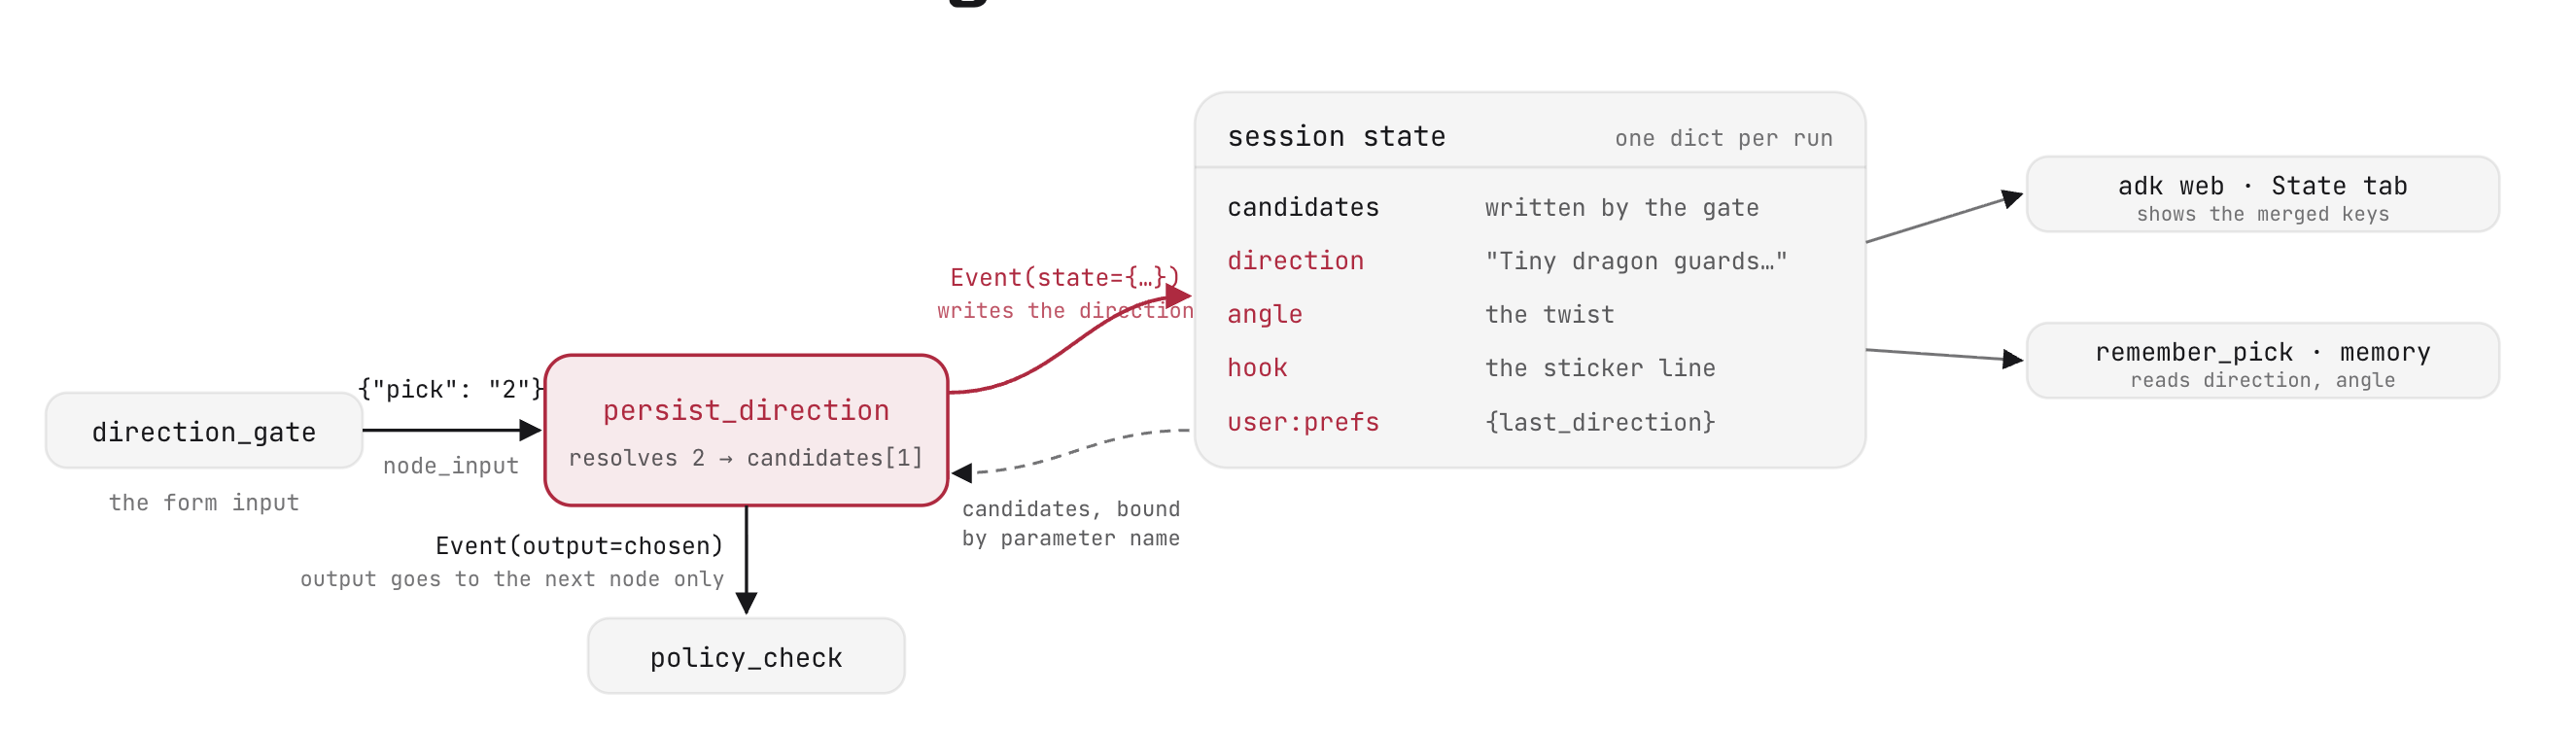
Cuando un usuario selecciona un candidato en direction_gate, la selección llega como un índice numérico ({"pick": "2"}). Los nodos descendentes necesitan el objeto de dirección completo: título, ángulo narrativo y línea de gancho. En lugar de pasar metadatos detallados a través de cada carga útil de nodo intermedio, persist_direction escribe el candidato resuelto en el estado de sesión compartido.
Los nodos no necesitan pasar todo el diccionario de estado de la sesión. Cuando un nodo genera Event(state=...), solo proporciona los pares clave-valor nuevos o actualizados. El ADK combina automáticamente estas actualizaciones en el almacén de sesiones:
    yield Event(state={"direction": chosen["title"], "angle": chosen.get("angle", ""),
                       "hook": hook, "user:prefs": {"last_direction": chosen["title"]}})
Cuando se genera este Event, se entrega el control al entorno de ejecución de Workflow, que conserva los valores nuevos en el registro de la sesión en runs/sessions.db.
Vinculación de parámetros
Los nodos de función del ADK leen el estado de la sesión automáticamente a través de la inspección de parámetros. Si la firma de una función declara un nombre de parámetro que coincide con una clave de estado existente, el ADK extrae esa clave del estado y la pasa directamente:
def persist_direction(node_input, candidates: list = []):
    ni = node_input if isinstance(node_input, dict) else {}
    raw = ni.get("pick")
    pick = str(raw).strip() if raw is not None else ""
    if candidates:
        i = int(pick) - 1 if pick.isdigit() else 0
        chosen = candidates[max(0, min(len(candidates) - 1, i))]
    else:
        chosen = {"title": "untitled", "angle": "", "evidence": []}
    hook = chosen.get("hook") or " ".join(chosen["title"].split()[:4])
Aquí, direction_gate escribió candidates en el estado de la sesión. El ADK lo vincula directamente a persist_direction(node_input, candidates: list = []) sin necesidad de realizar búsquedas explícitas en el diccionario.
Las claves con el prefijo user: persisten en todas las sesiones en el almacenamiento a nivel del usuario, lo que permite que las ejecuciones posteriores del flujo de trabajo accedan a las preferencias del creador.
Edición práctica: cómo conservar el estado y conectar el nodo
- En
agent/graph.py, dentro depersist_direction, reemplaza la líneaTODO: PERSIST_STATEpor el resultado del evento de estado:
    yield Event(state={"direction": chosen["title"], "angle": chosen.get("angle", ""),
                       "hook": hook, "user:prefs": {"last_direction": chosen["title"]}})
- En
stage3_router/agent.py, agregapersist_directiona la tercera cadena de la listaedges:
           (join_research, propose_directions, direction_gate,
            persist_direction)
Guarda tus archivos. En el banco de trabajo, verifica que state write in place y persist_direction in the chain muestren marcas de verificación verdes.
El nodo del router (5B)
En el workbench, navega a The router node (5B).
Enrutamiento basado en políticas determinístico
Un router es un nodo de función especializado que evalúa el resultado de la transmisión ascendente y dirige la ejecución a lo largo de las ramas condicionales del gráfico. A diferencia de los agentes generativos, un router ejecuta una lógica determinística sin realizar llamadas a LLM.
Un router devuelve un Event que especifica una etiqueta route:
def length_check(node_input):
    too_long = len(node_input.get("title", "")) > 60
    return Event(output=node_input, route="TRIM" if too_long else "PASS")
En la definición del flujo de trabajo, un destino de borde definido como un diccionario asigna nombres de rutas a nodos de destino:
(length_check, {"TRIM": shorten, "PASS": scripter}),
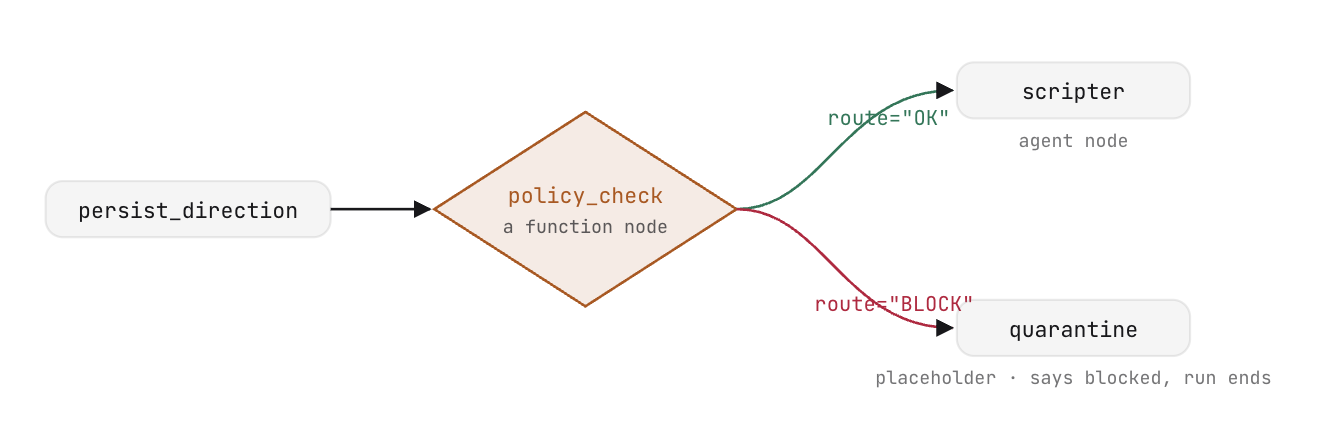
El router de flujo de trabajo policy_check lee las frases prohibidas de agent/policy_words.txt y realiza la coincidencia de palabras completas con el título y el ángulo de la dirección elegida:
return Event(output=node_input, route="BLOCK" if bad else "OK")
Almacenar la política como datos en lugar de instrucciones codificadas permite realizar actualizaciones sin modificar el gráfico de flujo de trabajo: la actualización del archivo de texto se aplica de inmediato a las ejecuciones posteriores. Dado que la evaluación es una coincidencia de regex determinística, se ejecuta en milisegundos con un costo de cero tokens antes de que comience la generación de secuencias de comandos.
Destinos: Scripter y Quarantine
El router dirige el tráfico a uno de los dos nodos descendentes:
scripter: Es un nodo de agentesingle_turnque convierte la dirección aprobada en un guion de producción estructurado que se ajusta al esquemaScriptde Pydantic:
scripter = Agent(
    name="scripter",
    model=config.MODEL,
    instruction=SCRIPT_INSTRUCTION,
    output_schema=Script)
quarantine: Inicialmente, es una función de marcador de posición que detiene las instrucciones marcadas y que se reemplaza en la siguiente parte por un agente de corrección autónomo.
Edición práctica: Enruta la verificación de la política
- En
agent/graph.py, dentro depolicy_check, completa la sentencia return:
return Event(output=node_input, route="BLOCK" if bad else "OK")
- En
stage3_router/agent.py, actualizaedgespara enrutarpolicy_checky volver a unir la rama de cuarentena enscripter:
           (join_research, propose_directions, direction_gate,
            persist_direction, policy_check),
           (policy_check, {"OK": scripter, "BLOCK": quarantine}),
           (quarantine, scripter)])
Guarda tus archivos. En el entorno de trabajo, comprueba que se hayan verificado las asignaciones de perímetro del router.
Modos de agente y el nodo de tarea (5C)
En el entorno de trabajo, navega a Agent modes and the task node (5C).
Modos de ejecución del agente
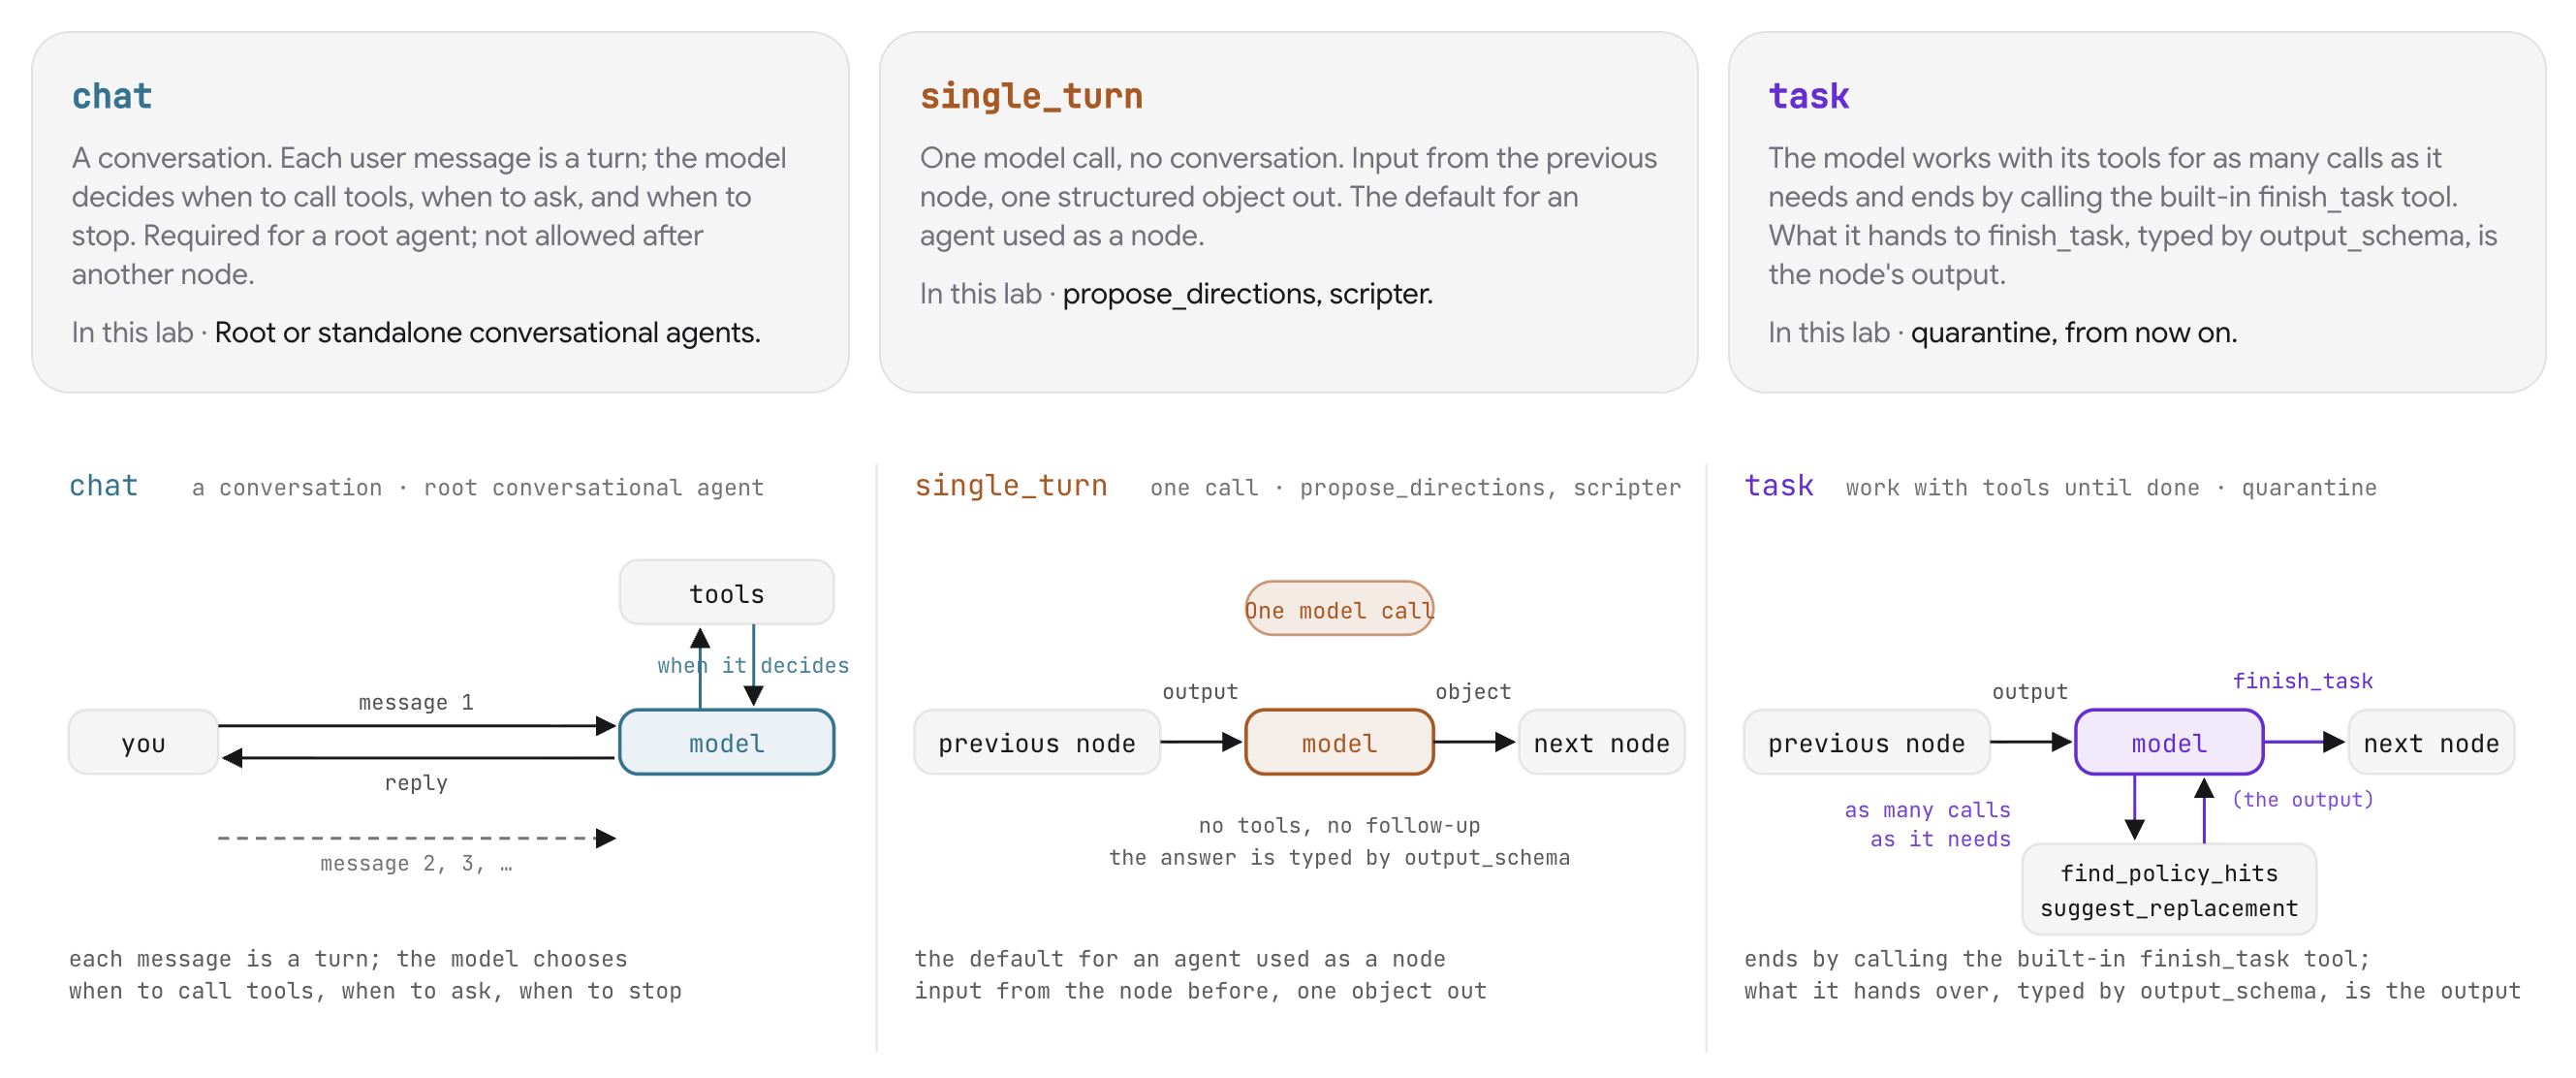
Las instancias de Agent del ADK admiten tres modos de ejecución adaptados a los requisitos específicos de la canalización:
Modo | Ciclo de vida de la ejecución | Rol en la canalización |
| Es un bucle conversacional de varios turnos. El modelo determina cuándo invocar herramientas, solicitar entrada o finalizar el turno. | Agentes raíz que se enfrentan a un usuario humano interactivo. |
| Es una llamada de inferencia de un solo modelo. Acepta la entrada del nodo anterior y emite un objeto de esquema estructurado. | Transformaciones de grafos secuenciales ( |
| Es un bucle autónomo con ejecución de herramientas. El agente itera hasta llamar a la herramienta integrada | Corrección e inspección de varios pasos ( |
Corrección autónoma de políticas
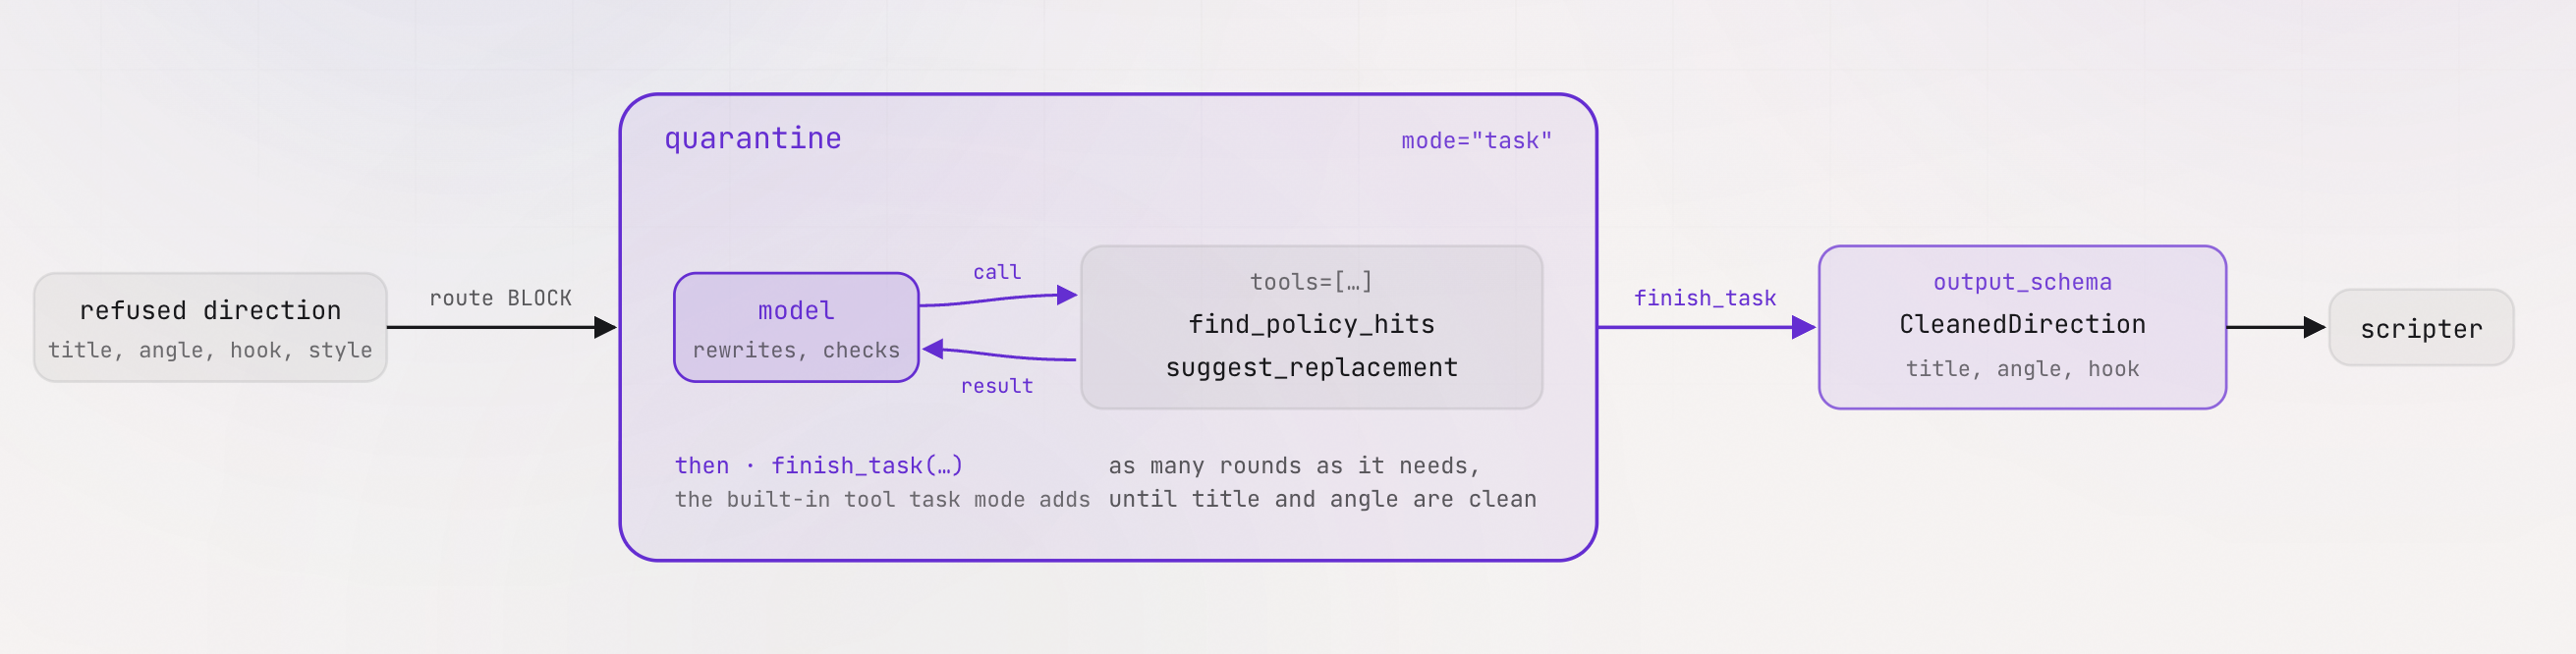
La reescritura de una dirección marcada requiere el modo task porque la cantidad de iteraciones de corrección es variable. El agente recibe la instrucción marcada, invoca a find_policy_hits para detectar infracciones, solicita alternativas aprobadas a través de suggest_replacement, reescribe la instrucción y verifica que no haya problemas antes de continuar.
Ambas herramientas se definen en agent/cleanup_tools.py con firmas con tipo y cadenas de documentación:
def find_policy_hits(text: str) -> dict:
    """Which refused words appear in `text`. Matches whole words and phrases
    from agent/policy_words.txt, case-insensitive.

    Returns {"hits": [...], "clean": bool}. clean is true when hits is empty.
    """


def suggest_replacement(word: str) -> dict:
    """The channel's approved stand-in for a refused word, read from
    agent/policy_replacements.txt.

    Returns {"word", "replacement", "listed"}. When the word has no entry,
    listed is false and replacement is a hint to pick a gentle synonym.
    """
Edición práctica: Ensambla el agente de tareas de cuarentena
En stage3_router/agent.py, reemplaza la función de marcador de posición quarantine por la definición del agente de tareas:
quarantine = Agent(
    name="quarantine",
    model=config.MODEL,
    instruction=QUARANTINE_INSTRUCTION,
    mode="task",
    tools=[find_policy_hits, suggest_replacement],
    output_schema=CleanedDirection,
)
El modo de tarea equipa al agente con herramientas y finaliza la ejecución llamando a finish_task. Cuando se configura mode="task", ADK proporciona automáticamente finish_task y deriva sus parámetros de output_schema, lo que garantiza que el nodo produzca un objeto CleanedDirection con tipo que coincida con el esquema de entrada del nodo de scripter.
Qué esperar y por qué
Prueba ambas rutas de ejecución en la Web del ADK o en VibeStudio Workbench:
- Ruta aprobada (candidato 1, 2 o 3):
- Seleccionar una ruta de candidato aprobada desde
policy_checkdirectamente ascripter(route="OK"). - El guionista genera un guion de producción de 3 tomas que se adhiere al esquema
Script.
- Seleccionar una ruta de candidato aprobada desde
- Ruta de corrección de cuarentena (candidato 4):
- La opción 4 contiene vocabulario marcado ("clickbait", "viral hack").
policy_checkrutas aquarantine(route="BLOCK").- En el seguimiento de la sesión, observa que
quarantinellama afind_policy_hits, que llama asuggest_replacementpara cada incumplimiento, que reescribe el título y que llama afinish_task. - La ejecución se vuelve a unir a
scripter, lo que produce una secuencia de comandos a partir de la dirección saneada.
6. Memory Bank
En VibeStudio Workbench, navega al paso 6: Banco de memoria, partes (6A) y (6B).
Actualmente, el flujo de trabajo funciona sin memoria entre sesiones. Cada ejecución comienza desde cero, sin tener en cuenta lo que el creador seleccionó anteriormente o qué géneros prefiere. En este paso, conectarás el banco de memoria de Vertex AI Agent Engine para almacenar y recuperar las preferencias del creador en todas las ejecuciones.
Es fundamental que la memoria se integre a través de devoluciones de llamada del ciclo de vida del agente en lugar de nodos de canalización. Debido a que la extracción y la recuperación de memoria sirven a agentes individuales en lugar de etapas de datos intermedias, adjuntar devoluciones de llamada conserva una topología de grafo limpia y desacoplada.
Memory Bank (6A)
En Workbench, navega a Memory Bank (6A).
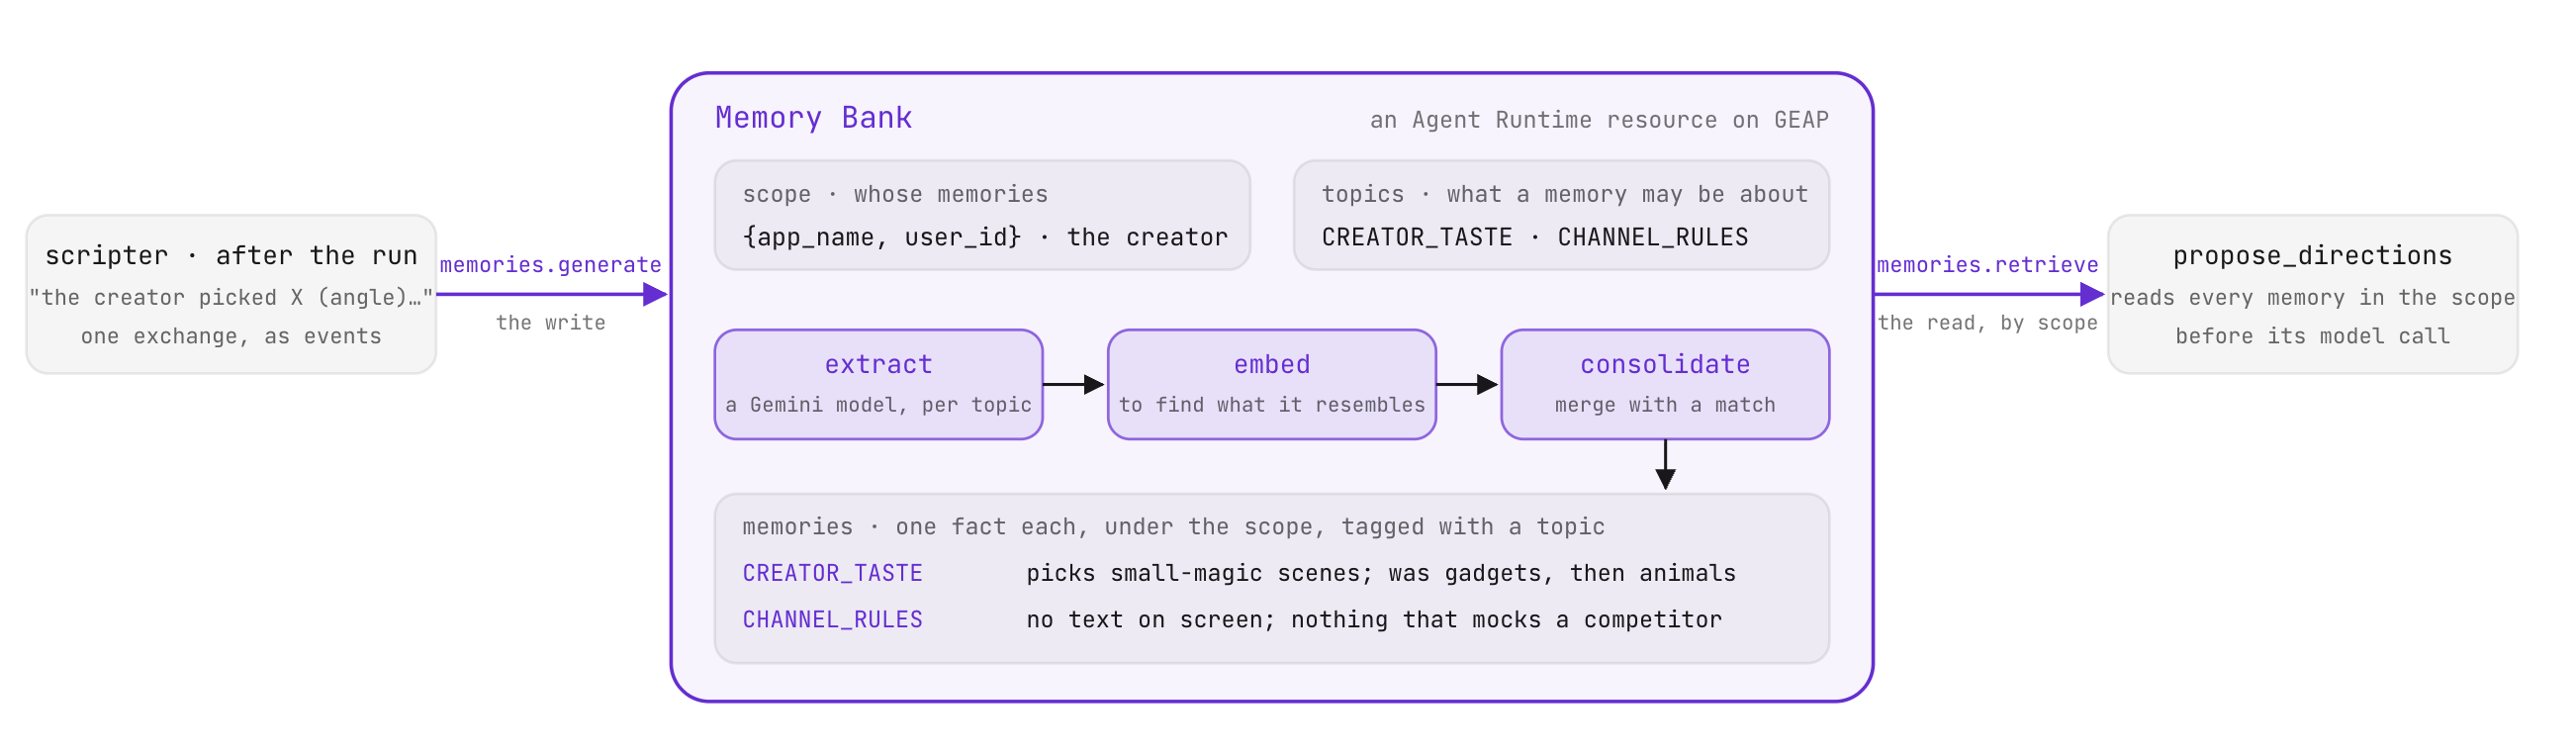
Memoria administrada a nivel del usuario
Memory Bank es un servicio administrado para la memoria del usuario a largo plazo. Organiza los datos sobre una persona en un alcance definido, que aquí se identifica con el nombre de la aplicación y el ID de usuario:
SCOPE = {"app_name": config.APP, "user_id": config.USER}
TOPICS = {
    "CREATOR_TASTE": "Which video directions this creator picks and passes on, "
                     "and how that preference changes over time.",
    "CHANNEL_RULES": "Standing instructions the creator states for every video "
                     "(style, subjects to avoid, format rules).",
}
Los temas de memoria personalizados definen los límites de lo que registra el banco:
- Extracción de temas: Cuando se envía texto de conversación nuevo a través de
memories.generate, el servicio aplica un modelo de extracción a cada descripción del tema. El texto que no coincide con un tema no produce recuerdos. - Consolidación y anulación de duplicación: El servicio convierte los hechos recién extraídos en embeddings y los compara con las memorias existentes en el alcance. Cuando una observación coincide con un recuerdo existente, el servicio actualiza ese recuerdo. Cuando representa información nueva, el servicio crea una entrada nueva. Este proceso de consolidación garantiza que varias sesiones sobre un tema se fusionen en un resumen coherente en lugar de producir entradas redundantes.
- Recuperación: Llamar a
memories.retrievecon el alcance del usuario devuelve hechos almacenados, ordenados del más antiguo al más reciente.
Ambas operaciones se implementan en agent/platform/memory.py. El nombre del recurso de banco aprovisionado se almacena en caché de forma local en runs/memorybank.json.
Cómo configurar Memory Bank
Usa los controles del entorno de trabajo o ejecuta los comandos de la CLI en tu terminal:
- Conecta y aprovisiona el banco:
python -m agent.platform.bankCREATOR_TASTEyCHANNEL_RULES. - Propaga sesiones históricas:
python -m agent.platform.bank load - Inspecciona los datos consolidados:
python -m agent.platform.bank list
Devoluciones de llamada (6B)
En el entorno de trabajo, navega a Callbacks (6B). Abre stage4_memory/agent.py.
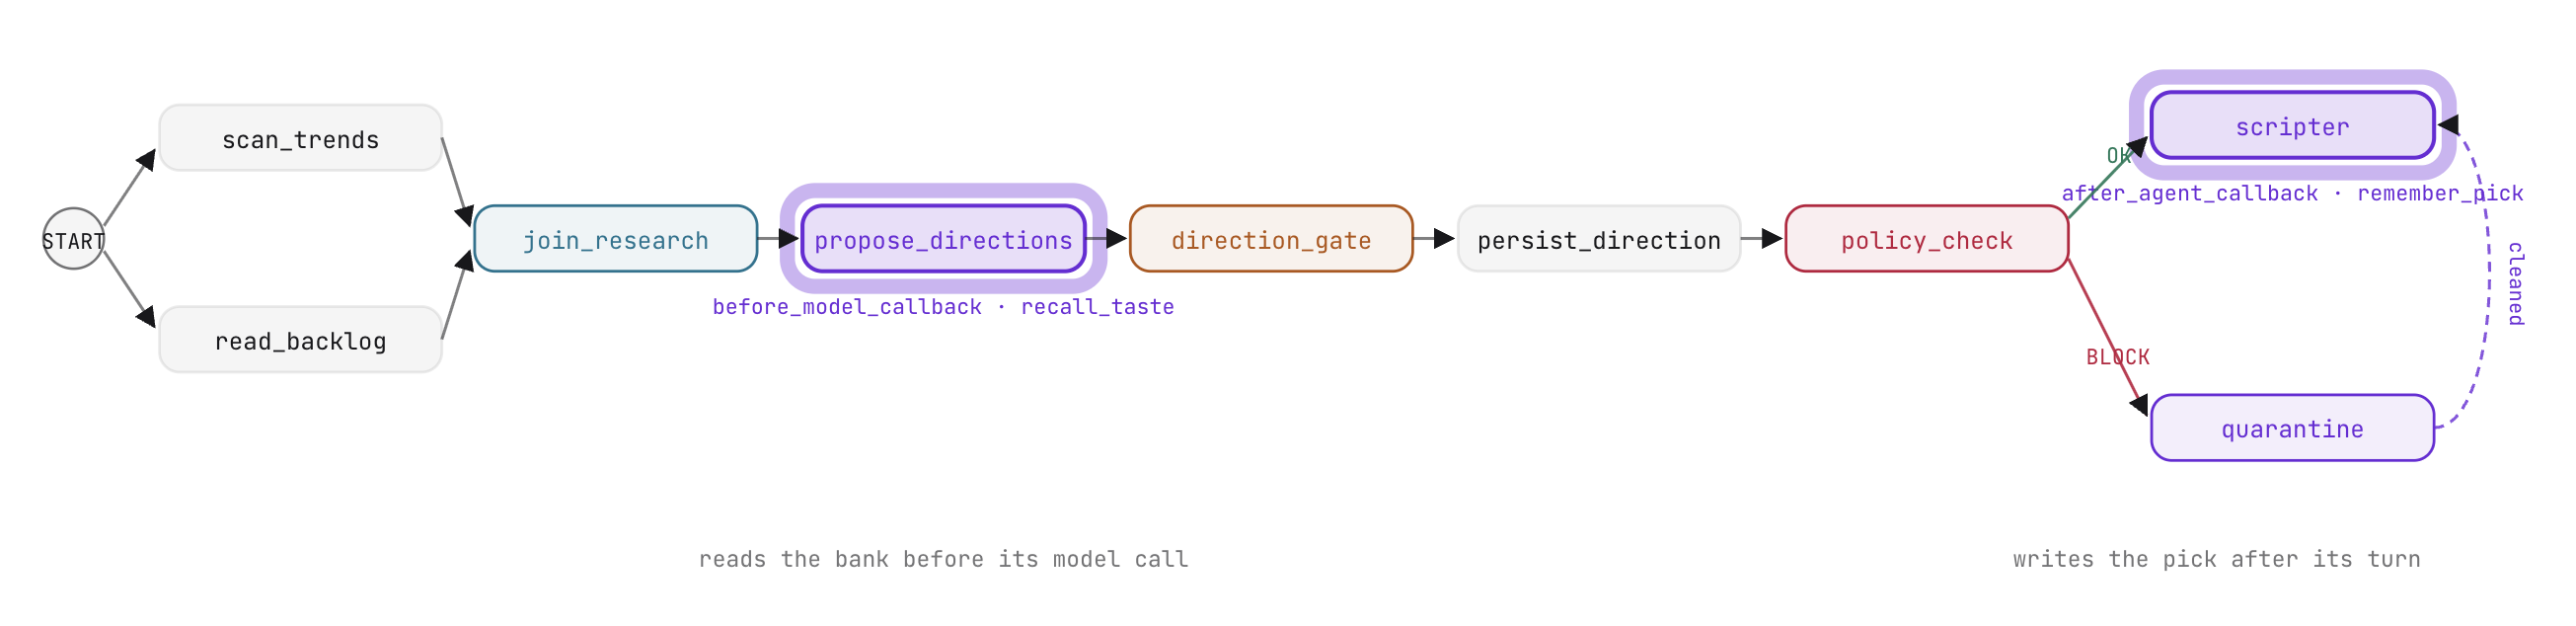
Devoluciones de llamada del ciclo de vida del agente del ADK
Una devolución de llamada es una función que se pasa como argumento a un Agent. El ADK invoca devoluciones de llamada en momentos predefinidos del ciclo de vida y pasa el contexto activo. Si se devuelve None, la ejecución continúa con normalidad; si se devuelve un objeto de reemplazo, se anula o intercepta la operación.
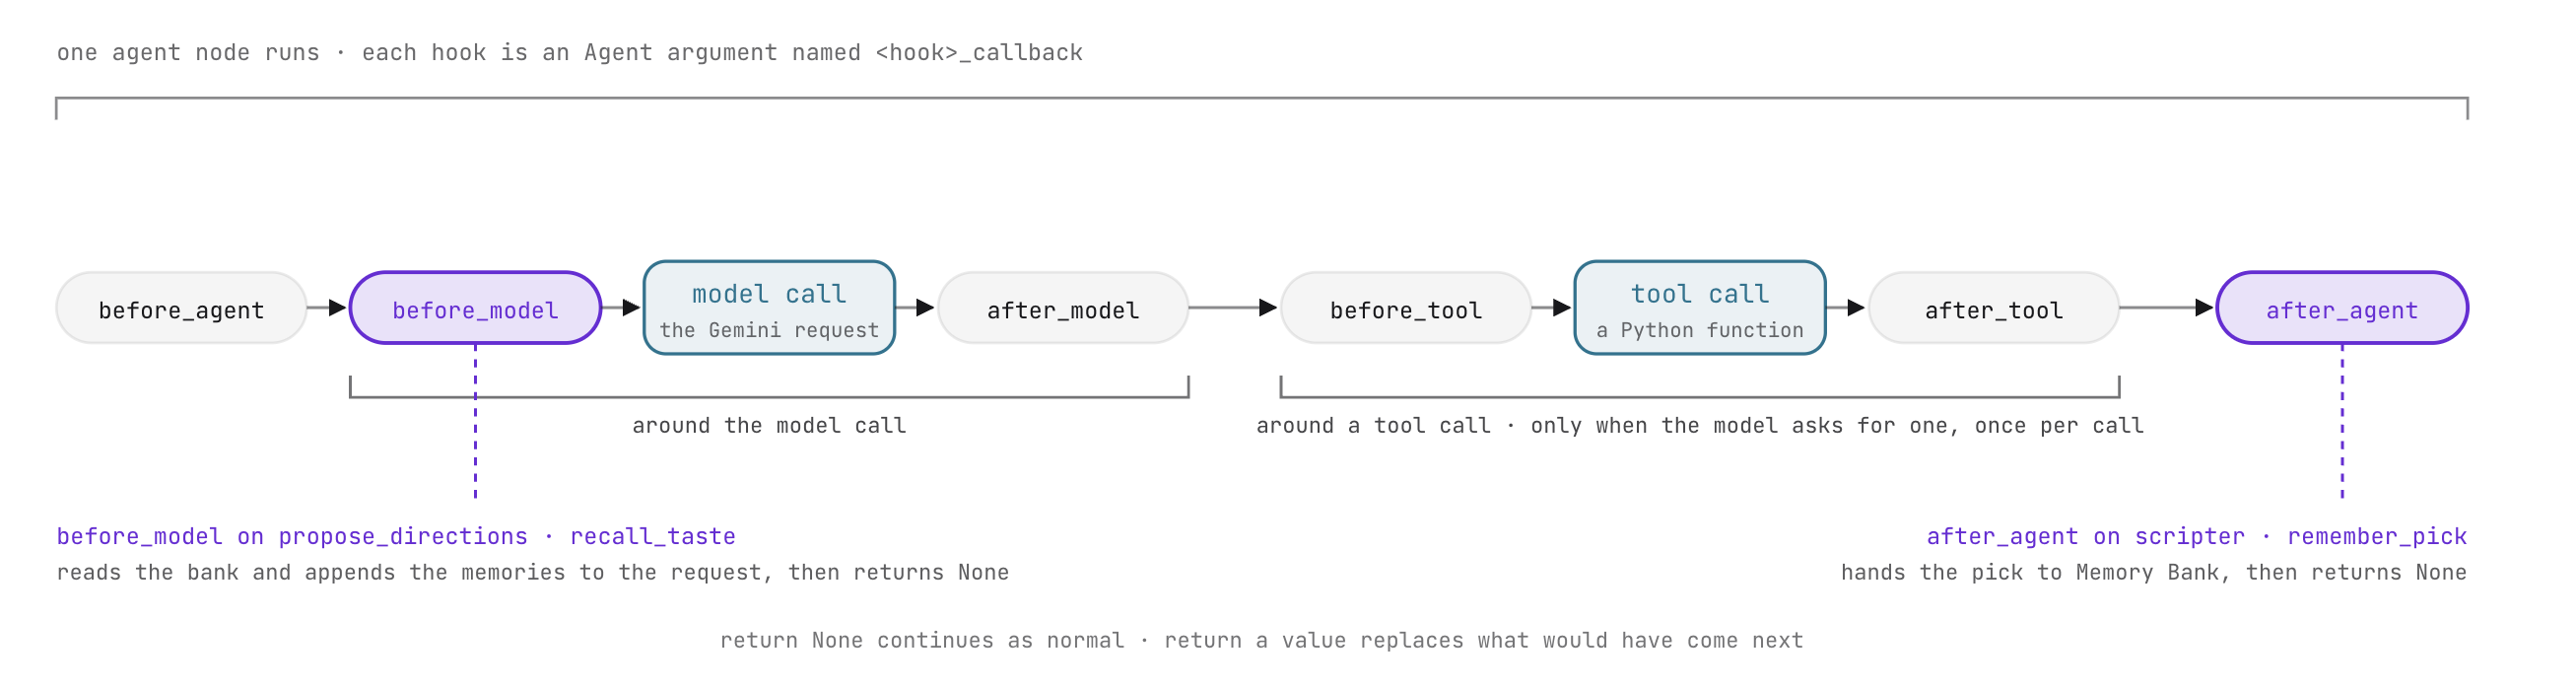
El ADK proporciona tres pares de devoluciones de llamada:
Par de devolución de llamada | Punto de invocación | Parámetros recibidos | Comportamiento del valor que se muestra |
| Rodea todo el turno del agente |
| Si se devuelve |
| En torno a cada llamada de inferencia de LLM |
| Si se devuelve |
| Alrededor de cada ejecución de la herramienta | Definición, argumentos y resultado de la herramienta | Si se devuelve un dict, se anula el resultado de la herramienta y se continúa con |
Las devoluciones de llamada proporcionan una ubicación limpia para la inserción de contexto, las protecciones, la telemetría y las búsquedas en caché sin introducir nodos extraños en el grafo del flujo de trabajo.
Edición práctica: Conecta las devoluciones de llamada de recall y remember
- En
stage4_memory/agent.py, actualizapropose_directionspara adjuntarbefore_model_callback=recall_taste:
    output_schema=Directions,
    before_model_callback=recall_taste)
recall_taste se ejecuta inmediatamente antes de que Gemini genere direcciones candidatas. Recupera el historial del creador de Memory Bank, formatea las memorias más antiguas primero y las agrega al LlmRequest saliente. La instrucción dirige al modelo para que incline los candidatos del 1 al 3 hacia los gustos actuales del creador y, al mismo tiempo, trate las reglas del canal como restricciones estrictas.
- En
stage4_memory/agent.py, actualizascripterpara adjuntarafter_agent_callback=remember_pick:
    output_schema=Script,
    after_agent_callback=remember_pick)
remember_pick se ejecuta después de que scripter completa su turno. Lee la dirección elegida del estado de la sesión, sintetiza una declaración concisa que resume la decisión del creador y llama a memories.generate para actualizar el banco de memoria.
Qué esperar y por qué
Prueba el flujo de trabajo mejorado con devolución de llamada en el banco de trabajo o en la Web del ADK:
- Ejecuta una ejecución con una instrucción vacía:
- En el registro de seguimiento de la sesión, inspecciona
LlmRequestparapropose_directions. Observa el contexto de memoria agregado que detalla la preferencia del creador por los temas de fantasía y el ritmo conciso. - Observa las direcciones propuestas: Los candidatos del 1 al 3 se alinean con las preferencias históricas del creador, incluso cuando las tendencias enfatizan otros temas.
- En el registro de seguimiento de la sesión, inspecciona
- Selecciona un candidato en
direction_gate. - Después de que se complete
scripter, revisa los registros de Memory Bank:python -m agent.platform.bank list
7. RAG Engine
En VibeStudio Workbench, navega al Paso 7: RAG Engine, partes (7A) y (7B).
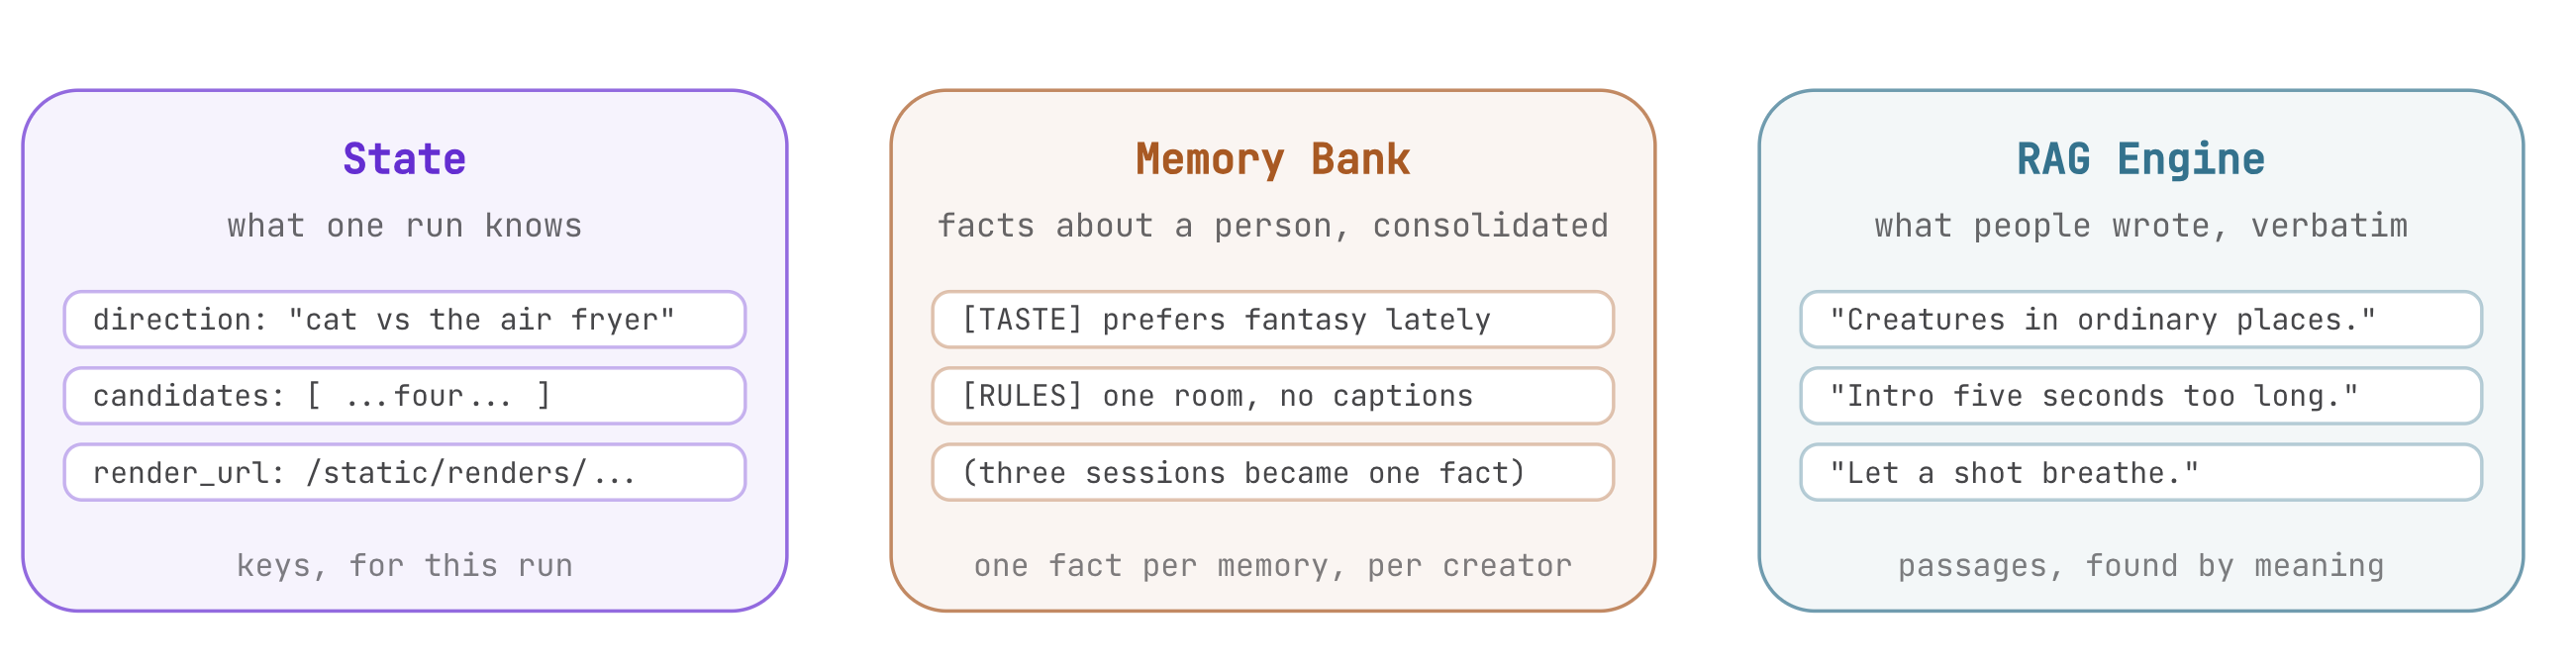
Los videos publicados acumulan comentarios continuos de los usuarios. En agent/comments.md, se recopilan treinta comentarios representativos que capturan los elogios de los usuarios, las críticas sobre el ritmo de los videos patrocinados y las preferencias de audio. En este paso, indexarás estos comentarios con el motor de RAG de Vertex AI y conectarás la recuperación semántica al fan-out de investigación.
Recuperación de documentos (7A)
En el workbench, navega a RAG Engine (7A).
Memory Bank vs. RAG Engine
Ambas herramientas fundamentan los flujos de trabajo en datos externos, pero tienen diferentes propósitos arquitectónicos:
Dimensión | Memory Bank | RAG Engine |
Caso de uso principal | Preferencias del usuario y reglas operativas a largo plazo | Recuperación semántica en grandes colecciones de documentos |
Alcance | Se limita a los IDs de usuario individuales y a los nombres de las aplicaciones | Se limita a los recursos de corpus compartidos entre todos los usuarios |
Procesamiento de datos | Extracción, incorporación y consolidación semántica en tiempo real | División de documentos, embeddings de vectores y búsqueda de vecinos más cercanos |
Integración de grafos | Devoluciones de llamada del ciclo de vida del agente ( | Nodo de función dedicado en el fan-out de investigación ( |
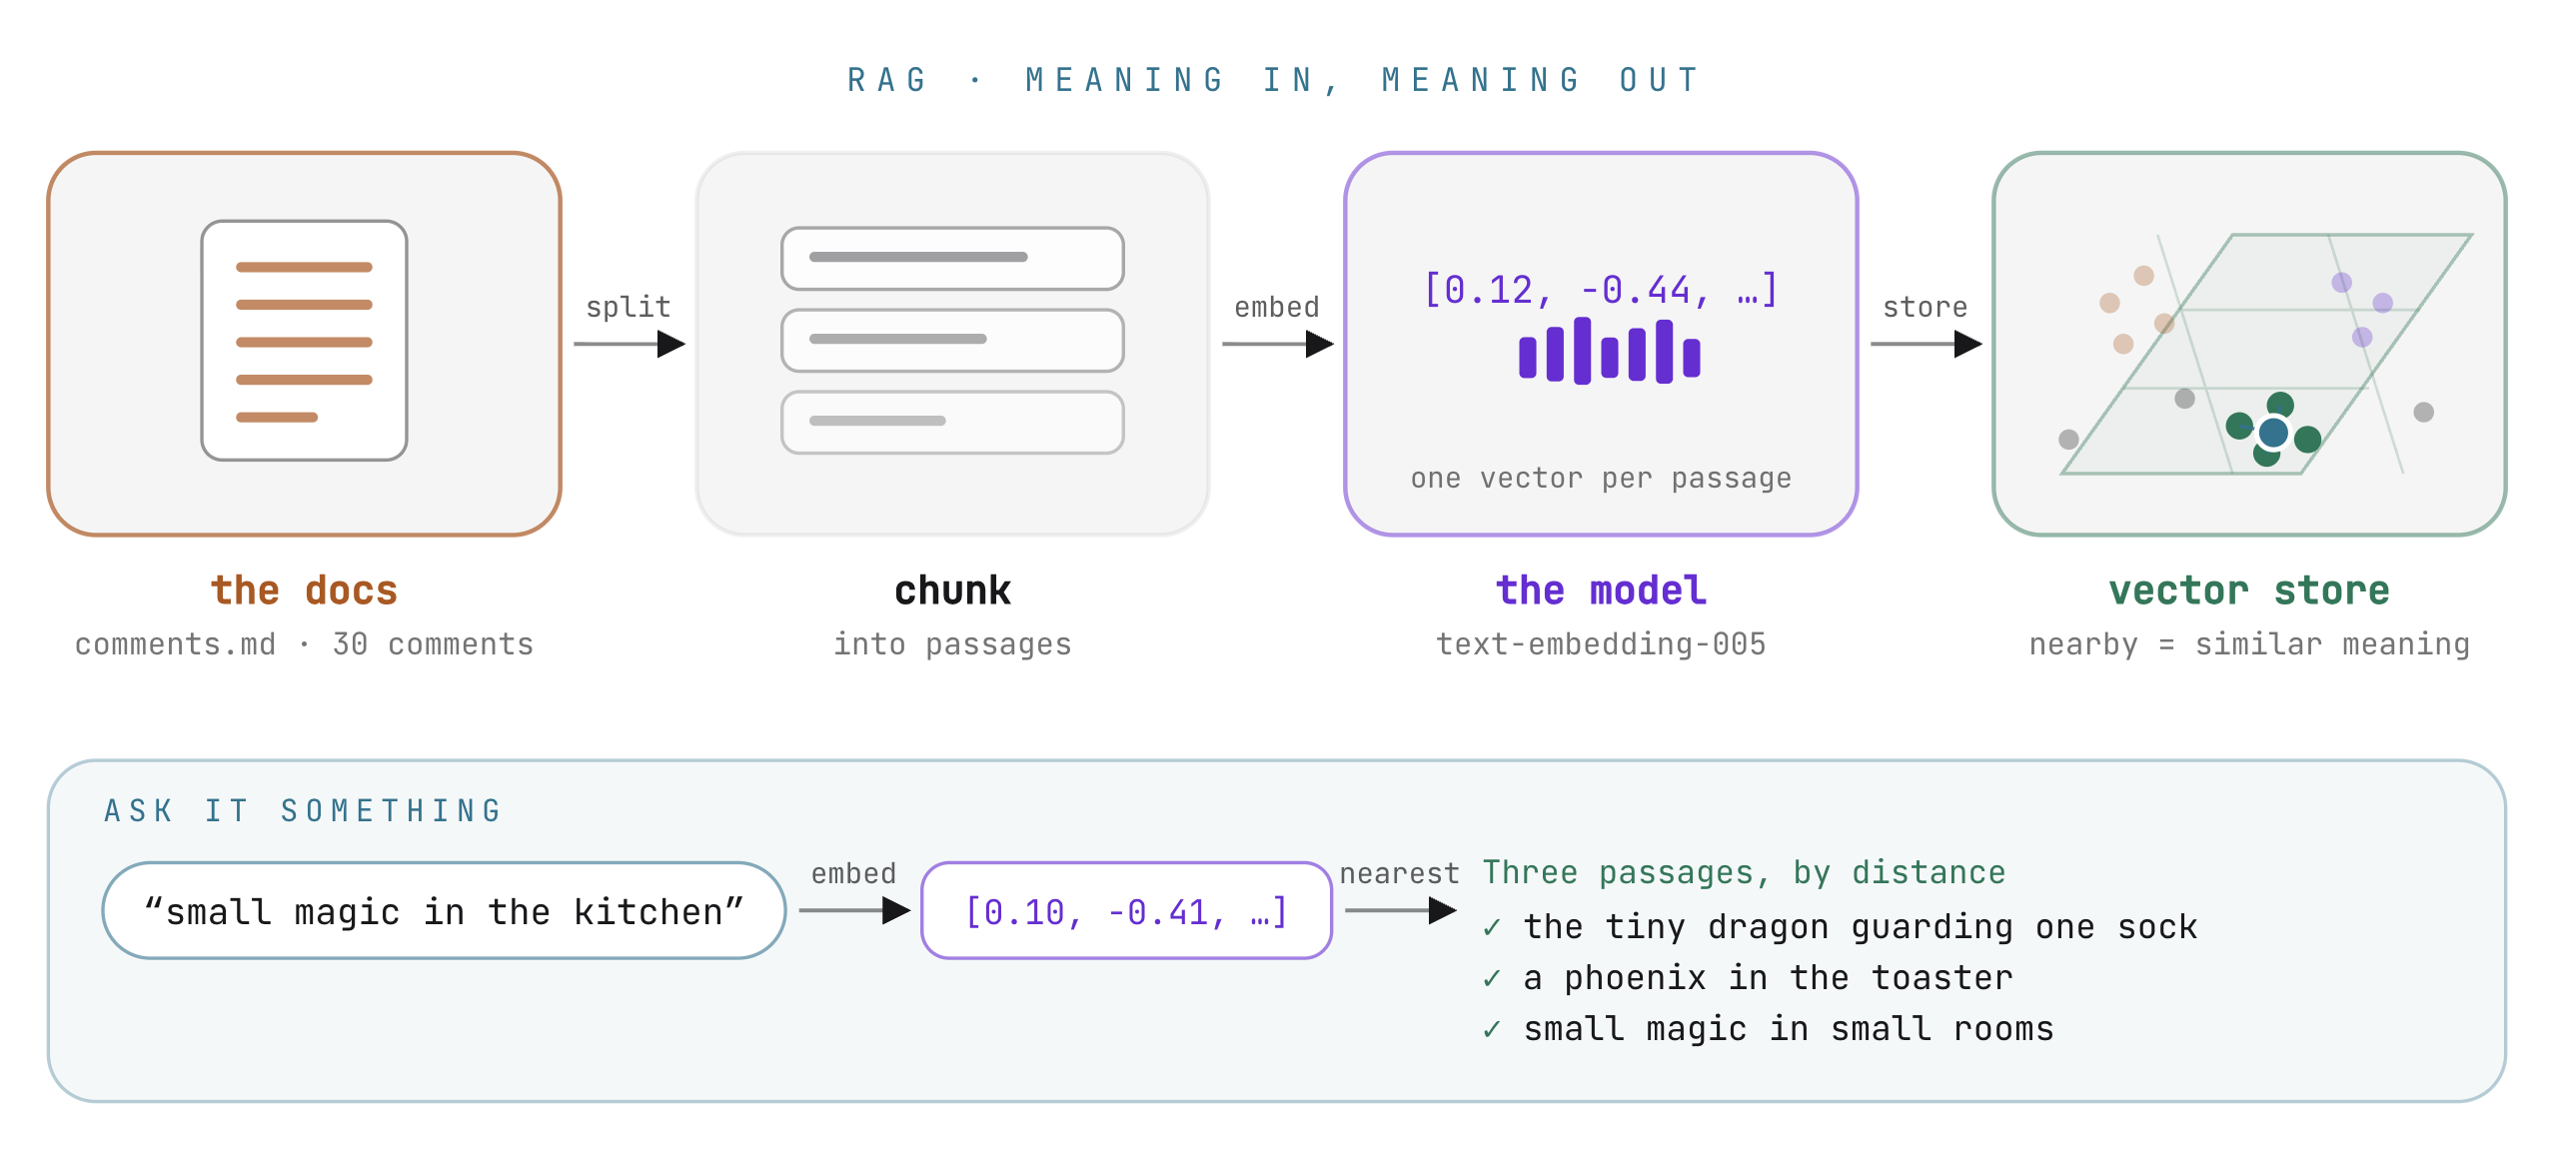
Fragmentación y embeddings de documentos
RAG Engine indexa documentos dividiendo el texto en pasajes semánticos y almacenando sus vectores en una base de datos administrada:
corpus = rag.create_corpus(
    display_name="vibestudio-feedback",
    description="Vibe Studio: what the audience wrote under the channel's past videos.",
    backend_config=rag.RagVectorDbConfig(
        rag_embedding_model_config=rag.RagEmbeddingModelConfig(
            vertex_prediction_endpoint=rag.VertexPredictionEndpoint(
                publisher_model="publishers/google/models/text-embedding-005"))))

rag.upload_file(
    corpus_name=corpus.name, path="agent/comments.md", display_name="comments.md",
    transformation_config=rag.TransformationConfig(
        chunking_config=rag.ChunkingConfig(chunk_size=120, chunk_overlap=20)))
- Tamaño del fragmento: Se configuró en 120 tokens con 20 tokens de superposición. Esto captura de dos a tres comentarios por pasaje, lo que garantiza que cada vector represente un sentimiento coherente sin diluir el significado en comentarios no relacionados.
- Modelo de embedding:
text-embedding-005convierte texto en vectores de alta dimensión. Cuando se envía una búsqueda, el modelo la convierte en un vector y encuentra las coincidencias más cercanas según la distancia semántica. Un comentario sobre un pequeño dragón que protege calcetines coincide con una instrucción sobre criaturas mágicas sin necesidad de que haya una superposición exacta de palabras clave.
Configura el corpus de RAG
Inicializa el corpus con los botones del entorno de trabajo o los comandos de la terminal:
- Crea el corpus:
python -m agent.platform.ragruns/ragcorpus.json. - Subir y comentar índices: Sube
agent/comments.mdcon la configuración de fragmentación y espera a que se complete la indexación. - Consulta el corpus: Prueba la recuperación de similitud con búsquedas que no compartan palabras exactas con los comentarios (por ejemplo, busca "criaturas mágicas pequeñas" para recuperar comentarios sobre dragones).
El nodo de recuperación (7B)
En el entorno de trabajo, navega a The third reader (7B). Abre stage5_rag/agent.py.
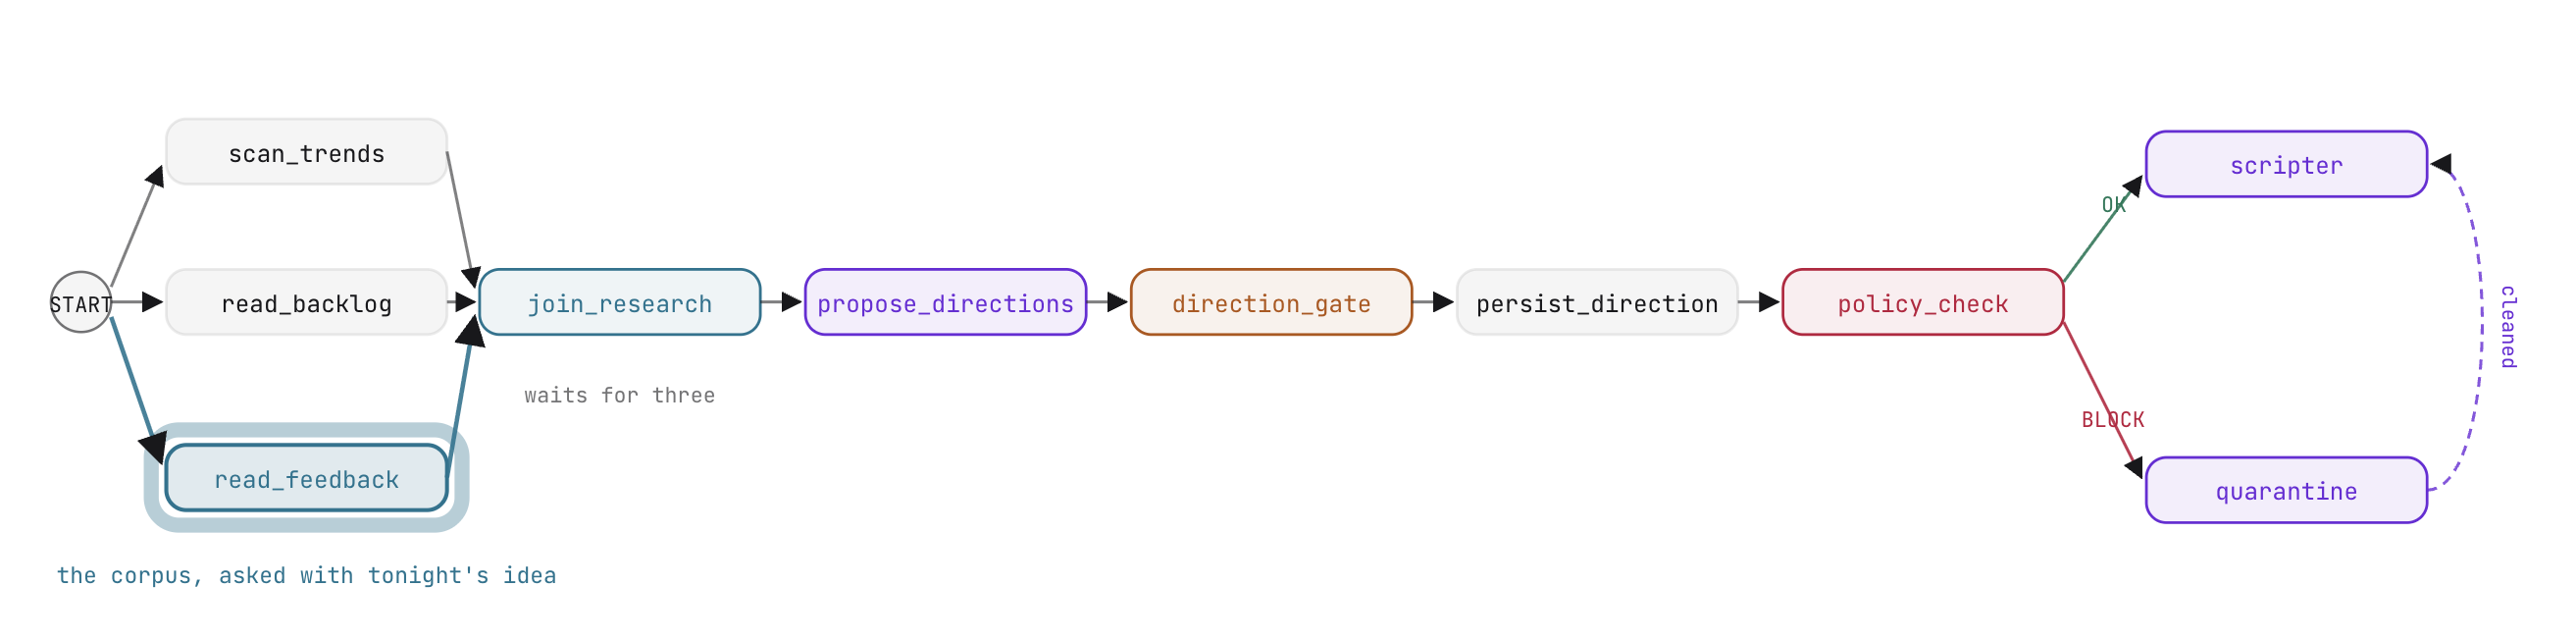
La recuperación como un nodo de grafo
Los comentarios del público representan los datos de investigación que se comparten en todo el flujo de trabajo. A diferencia de la memoria personal del creador, el sentimiento de los usuarios se transmite directamente a join_research junto con las tendencias y los datos de la lista de tareas pendientes. Por lo tanto, se implementa como un nodo de función:
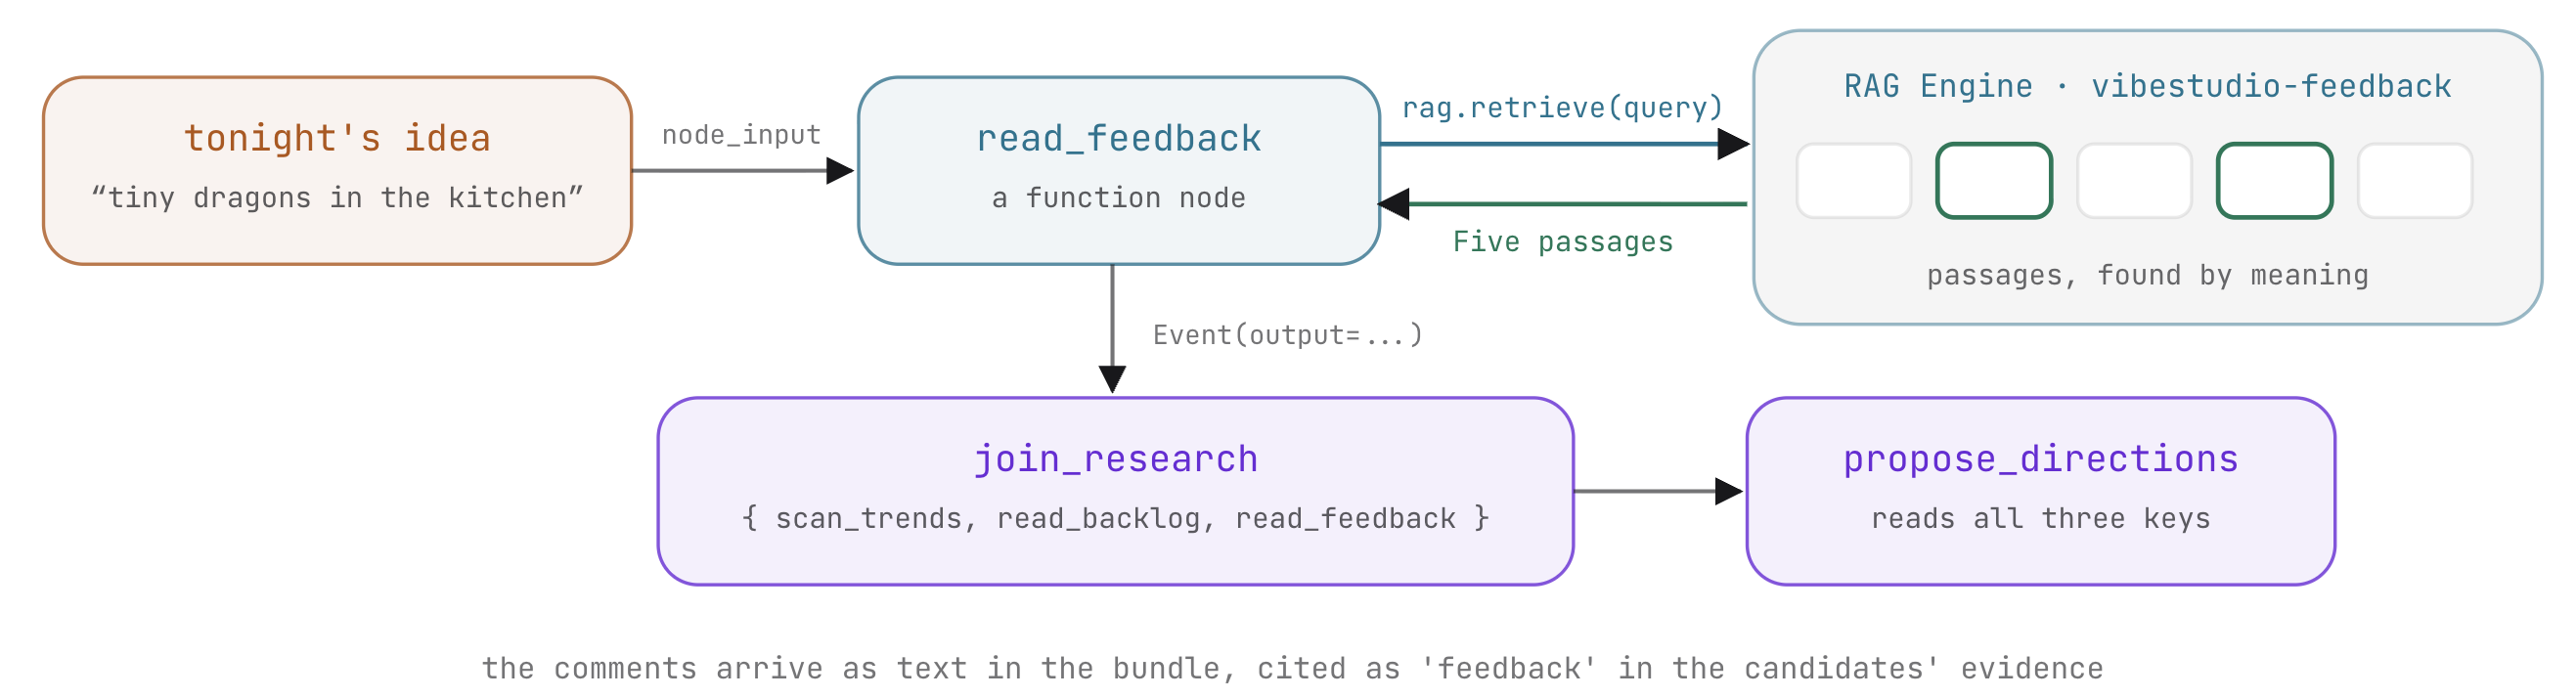
def read_feedback(node_input):
    """The third reader (step 7): what the audience wrote under past videos,
    the passages nearest to tonight's idea. Retrieval, not a model call."""
    from .platform import rag
    idea = idea_text(node_input)
    query = idea or "what viewers liked and what they complained about"
    try:
        hits = rag.retrieve(query)
    except Exception as e:
        print(f"  [rag] feedback unavailable ({str(e)[:80]})")
        return Event(output={"query": query, "feedback": [],
                             "note": "no corpus connected - run: python -m agent.platform.rag"})
    return Event(output={"query": query, "feedback": [h["text"] for h in hits]})
read_feedback extrae la idea inicial del usuario y ejecuta una consulta vectorial en el corpus de RAG Engine. Emite los comentarios recuperados en una carga útil de Event(output=...).
Edición práctica: Conecta el tercer lector al fan-out
En stage5_rag/agent.py, actualiza edges para agregar read_feedback como una tercera rama paralela que ingresa a join_research:
           (START, read_backlog, join_research),
           (START, read_feedback, join_research),
Como join_research es un JoinNode, sincroniza todas las ramas entrantes y espera hasta que scan_trends, read_backlog y read_feedback hayan emitido todos los eventos antes de pasar el paquete agregado a la siguiente etapa.
Qué esperar y por qué
Ejecuta el flujo de trabajo en el banco de trabajo:
- Envía una instrucción de idea (como "un dragón en miniatura que protege una encimera de cocina").
- En el registro de ejecución, verifica que los tres nodos de lectura se ejecuten de forma simultánea.
- Observa
join_research: su diccionario de salida ahora contienetrends,backlogyfeedback. - Inspecciona los candidatos generados a partir de
propose_directions: el modelo incorpora los comentarios de los usuarios en sus propuestas y hace referencia al sentimiento del público en los campos de evidencia. - Observa que la recuperación de RAG es determinística (las consultas idénticas devuelven pasajes de comentarios idénticos), mientras que el nodo de propuesta generativa produce variaciones creativas.
8. Generación de video asíncrona con Veo
En VibeStudio Workbench, navega a Paso 8: El video, partes (8A) y (8B).
Generar videos en alta definición con Google Veo requiere varios minutos por renderización. Bloquear la ejecución por grafos durante este período desperdicia recursos de procesamiento, bloquea los grupos de subprocesos y expone la ejecución a interrupciones de la conexión HTTP. En este paso, harás que la renderización de video sea asíncrona con LongRunningFunctionTool del ADK.
Herramientas de larga duración (8A)
En Workbench, navega a A long-running tool (8A). Abre stage6_video/agent.py y agent/deliver.py.
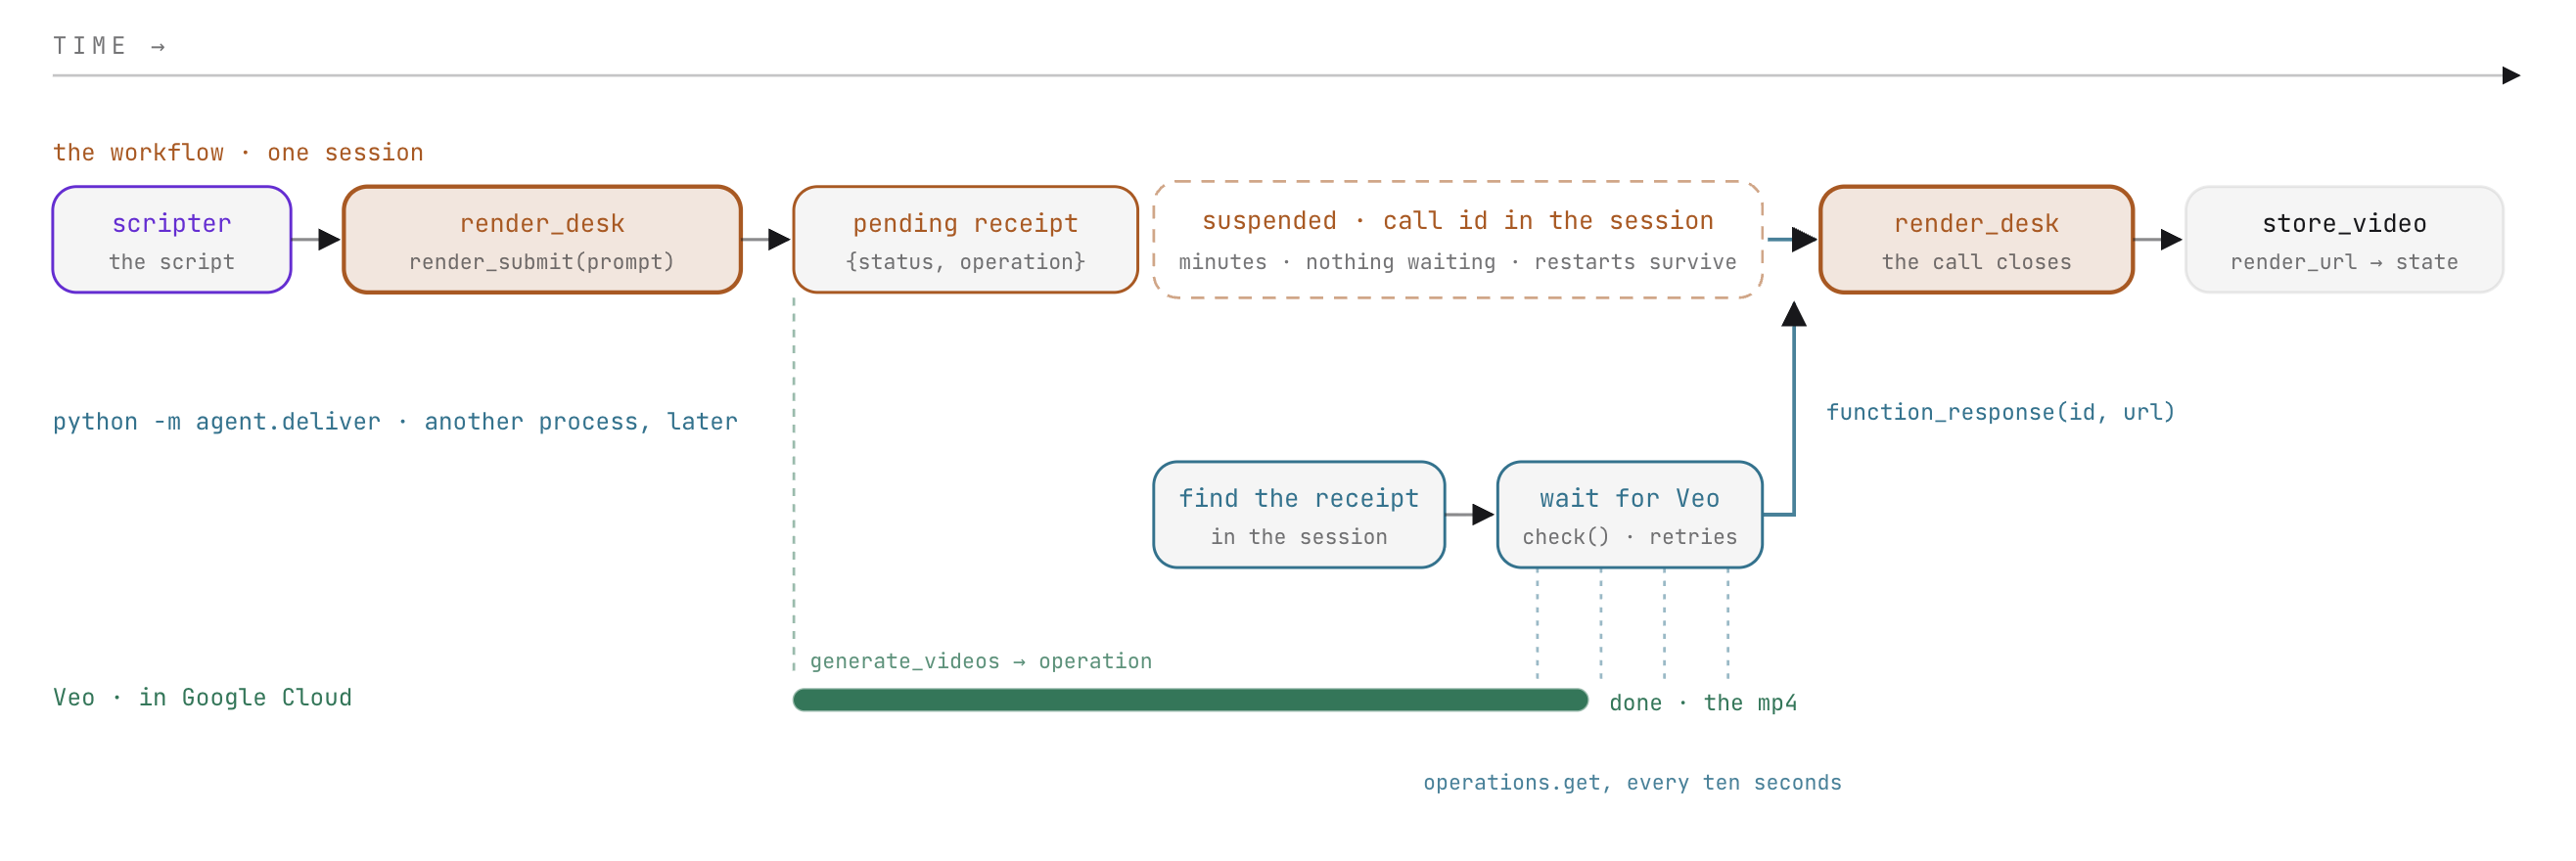
Herramientas síncronas vs. herramientas de larga ejecución
Las herramientas de funciones estándar del ADK se ejecutan de forma síncrona dentro de un turno del agente: el modelo llama a la herramienta, espera la carga útil de retorno y, luego, incorpora el resultado en el turno en curso.
La renderización de video no se puede completar en un solo turno. En su lugar, render_submit inicia el trabajo de generación y devuelve de inmediato un recibo operativo con el estado "pending":
def render_submit(prompt: str) -> dict:
    """Submit one Veo render of `prompt`. Returns at once with a pending
    receipt; the clip is delivered later, to this call, by id."""
    receipt = videogen.start(f"{prompt} {videogen.NO_TEXT}")
    return {"status": "pending", "operation": receipt["operation"], "prompt": receipt["prompt"]}
Cuando se une con LongRunningFunctionTool, el ADK intercepta el estado "pending". El turno del agente concluye, el flujo de trabajo se suspende en el nodo y los metadatos de la llamada pendiente (incluidos el ID de la llamada y el recibo) se registran en runs/sessions.db. El proceso de ejecución se cierra de forma limpia sin mantener conexiones de red activas ni subprocesos de trabajador.
Edición práctica: cómo adaptar la herramienta de renderización
En stage6_video/agent.py, actualiza render_desk para unir render_submit en LongRunningFunctionTool:
tools=[LongRunningFunctionTool(render_submit)])
Reanuda por ID de llamada
El patrón de reanudación universal
El ADK aplica un mecanismo idéntico para suspender y reanudar flujos de trabajo tanto para humanos como para herramientas externas:
Activador de la suspensión | Iniciando construcción | Estado de suspensión almacenado | Evento de reanudación |
Decisión humana |
| Abrir el mensaje de entrada en el almacén de sesiones |
|
Herramienta de larga duración |
| Abrir la llamada a herramienta en el almacén de sesiones |
|
En ambos casos, el flujo de trabajo se detiene por completo y se reanuda solo cuando llega un evento con un FunctionResponse coincidente desde una fuente externa: una interfaz de usuario, un webhook o un trabajador en segundo plano.
Edición práctica: Cómo completar la respuesta de entrega
En agent/deliver.py, construye la parte de reanudación FunctionResponse:
    part = Part(function_response=FunctionResponse(
        id=row["call_id"], name=row["name"], response=response))
El daemon de entrega sondea a Veo hasta que se genera el archivo de video y, luego, envía este FunctionResponse a la sesión. El ADK coincide con el ID de llamada y reanuda el flujo de trabajo directamente en el siguiente nodo. Los nodos completados no se vuelven a ejecutar, y el agente no realiza otro turno generativo.
Si configuras STUDIO_REAL_VIDEO=0 en .env, se habilita la renderización simulada: start devuelve un recibo de prueba inmediato y check simula la finalización en cinco segundos sin realizar llamadas facturables a la API de Veo.
Integración de canalizaciones (8B)
En el entorno de trabajo, navega a render_desk en el gráfico (8B). Abre stage6_video/agent.py.
El nodo terminal de la canalización es store_video. Lee la información de renderización completada de runs/state.json (donde se registró el proceso de entrega) y confirma la URL del video y el estado de generación en el estado de sesión compartido.
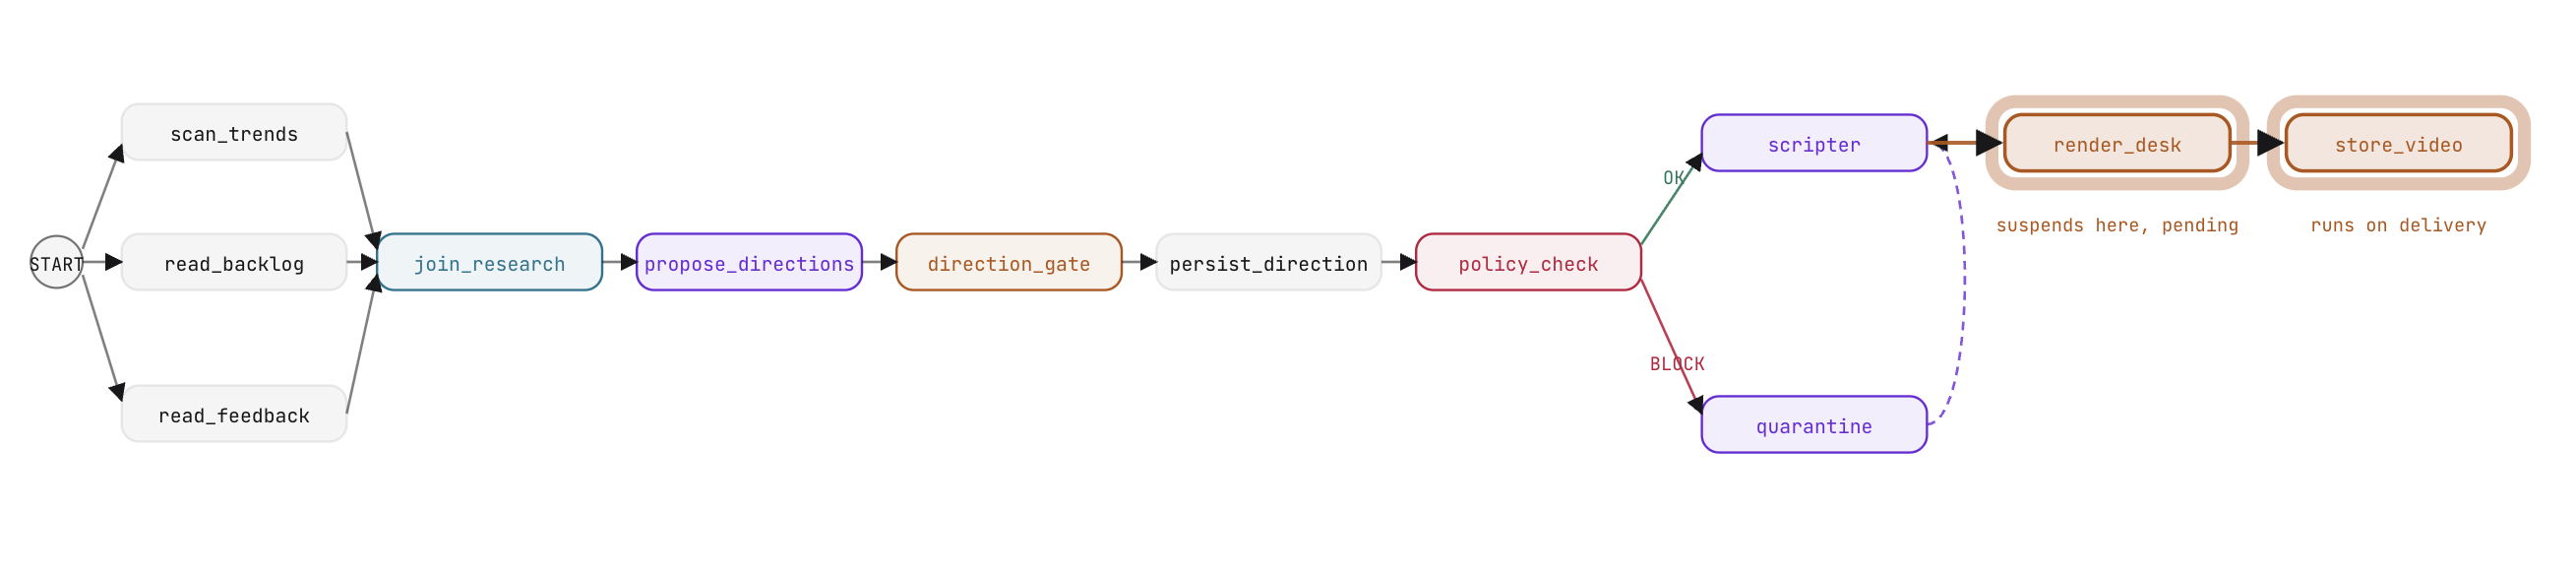
Edición práctica: Conecta la canalización de video completa
En stage6_video/agent.py, actualiza edges para agregar render_desk y store_video:
           (quarantine, scripter),
           (scripter, render_desk, store_video)])
Qué esperar y por qué
Prueba el flujo de generación asíncrono en el entorno de trabajo:
- Ejecuta el flujo de trabajo a través de la selección de candidatos y la generación de secuencias de comandos.
- En
render_desk, observa cómo el agente invocarender_submit. - El flujo de trabajo se suspende de inmediato. En el entorno de trabajo o en ADK Web, observa el estado pendiente: la sesión mantiene el ID de llamada abierto y no hay procesos en segundo plano que consuman recursos.
- Ejecuta el daemon de entrega con la consola de la estación de trabajo o en tu terminal:
python -m agent.deliver - En ADK Web, actualiza la sesión: la ejecución se reanuda en
store_video, confirma la URL del video en el estado de la sesión y completa el flujo de trabajo.
9. Implementa en Cloud Run
En VibeStudio Workbench, navega a Paso 9: Implementar.
Desarrollaste y verificaste cada componente de la canalización en zonas de pruebas dedicadas. En este paso, ensamblarás la canalización de producción completa y la implementarás en Google Cloud Run.
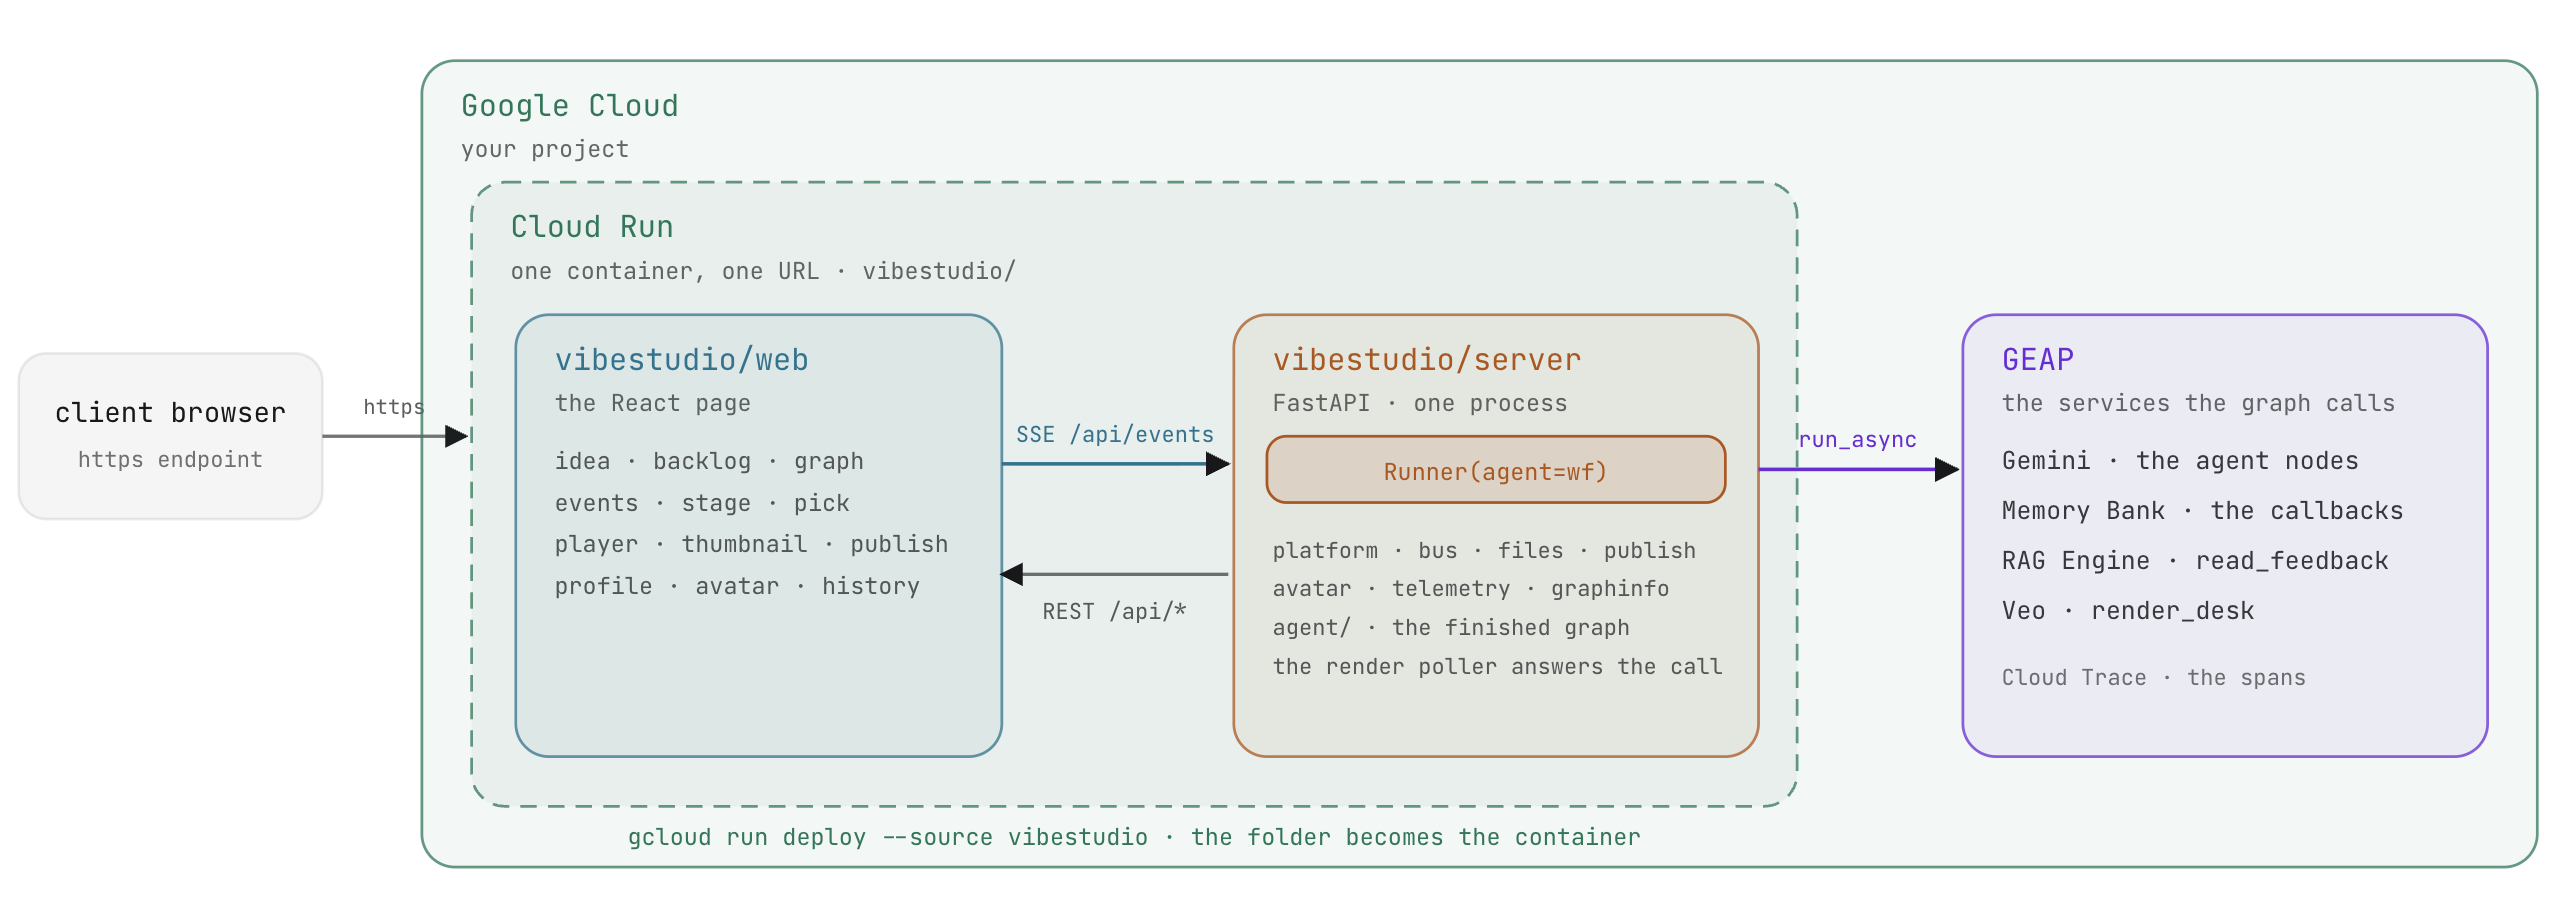
El ejecutor de ADK
En el desarrollo, adk web orquestó el gráfico. En producción, la aplicación aloja el flujo de trabajo con la clase Runner del ADK:
self._svc = DatabaseSessionService(db_url=config.DB_URL)
self._runner = Runner(app_name=config.APP, agent=wf, session_service=self._svc)

async for ev in self._runner.run_async(user_id=config.USER, session_id=run_id, new_message=message):
    self._absorb(ev)    # fold the ADK event into the run state, publish one app event

# the gate's answer and the render's delivery are the same call, with a function_response part
part = Part(function_response=FunctionResponse(id=call_id, name=name, response=response))
run_async: Dirige la ejecución del flujo de trabajo, genera eventos de forma secuencial a medida que se ejecutan los nodos y persiste las actualizaciones en el servicio de sesión.- Reanudación unificada: Las decisiones del usuario en
direction_gatey las entregas de videos completadas de Veo reanudan la ejecución a través de objetosFunctionResponseidénticos enviados arun_async.
La arquitectura de la aplicación de producción
La aplicación de producción en vibestudio/ integra la canalización completa:
vibestudio/
  server/
    main.py                 FastAPI: application server, REST routes, static assets
    api.py                  REST API endpoints: run, pick, publish, backlog, profile, history
    runner.py               Runner orchestration over the workflow, background render poller
    platform/               Event bus (SSE stream), file storage, publishing, telemetry
    agent/                  Production agent package, verified by checks/verify_app.py
      graph.py              The complete workflow graph and node definitions
      desk.py               render_desk and render_submit wrapped with LongRunningFunctionTool
      schemas.py            Pydantic schemas: Directions, CleanedDirection, Script
      cleanup_tools.py      Deterministic policy tools: find_policy_hits, suggest_replacement
      platform/             Memory Bank, RAG Engine, and Veo integrations
  web/                      Production React user interface
  Dockerfile · deploy.py · run.sh
- Flujo de eventos único: El backend de FastAPI publica eventos en un solo flujo de eventos enviados por el servidor (SSE). El frontend de React visualiza la progresión del gráfico en tiempo real y controla las conexiones tardías sin perder el estado.
- Ejecución desacoplada: La aplicación administra el bucle de eventos. El gráfico del flujo de trabajo se enfoca por completo en la lógica de ejecución, sin tener en cuenta la interfaz de frontend.
La lista de bordes del flujo de trabajo completo en agent/graph.py combina todos los patrones de arquitectura creados en este codelab:
        (START, scan_trends, join_research),
        (START, read_backlog, join_research),
        (START, read_feedback, join_research),
        (join_research, propose_directions, direction_gate,
         persist_direction, policy_check),
        (policy_check, {"OK": scripter, "BLOCK": quarantine}),
        (quarantine, scripter),
        (scripter, render_desk, store_video),
Implementa en Cloud Run
Google Cloud Run proporciona hosting sin servidores con escalamiento automático, enrutamiento de solicitudes y compilaciones de contenedores integradas:
gcloud run deploy vibestudio --source vibestudio \
  --project $GOOGLE_CLOUD_PROJECT --region us-central1 \
  --labels dev-tutorial-codelab=vibetube --allow-unauthenticated \
  --memory 2Gi --cpu 2 --timeout 3600 --concurrency 40 \
  --max-instances 1 --min-instances 1 --session-affinity \
  --set-env-vars GOOGLE_CLOUD_PROJECT=...,STUDIO_VERTEX=1,STUDIO_MEMORY_BANK=...,STUDIO_RAG_CORPUS=...,VIBETUBE_URL=...,VIBETUBE_EVENT=...,VIBETUBE_NAME=...,VIBETUBE_PROJECT=...
- Compilación de contenedor:
gcloud run deploy --sourceempaqueta el directoriovibestudio/, compila la imagen de contenedor con Cloud Build y, luego, implementa el servicio en una sola operación. - Afinidad de sesión: Dirige las solicitudes del mismo usuario a la misma instancia de contenedor, lo que conserva el estado de la sesión local en los pasos iterativos.
- Observabilidad: La integración de Cloud Trace registra intervalos distribuidos para cada nodo, llamada a LLM y ejecución de herramientas, a los que se puede acceder en el Explorador de Trace de la consola de Google Cloud.
Haz clic en el botón Implementar en el entorno de trabajo para ejecutar la secuencia de comandos de implementación. Cuando se complete la compilación, la terminal mostrará la URL del servicio en vivo.
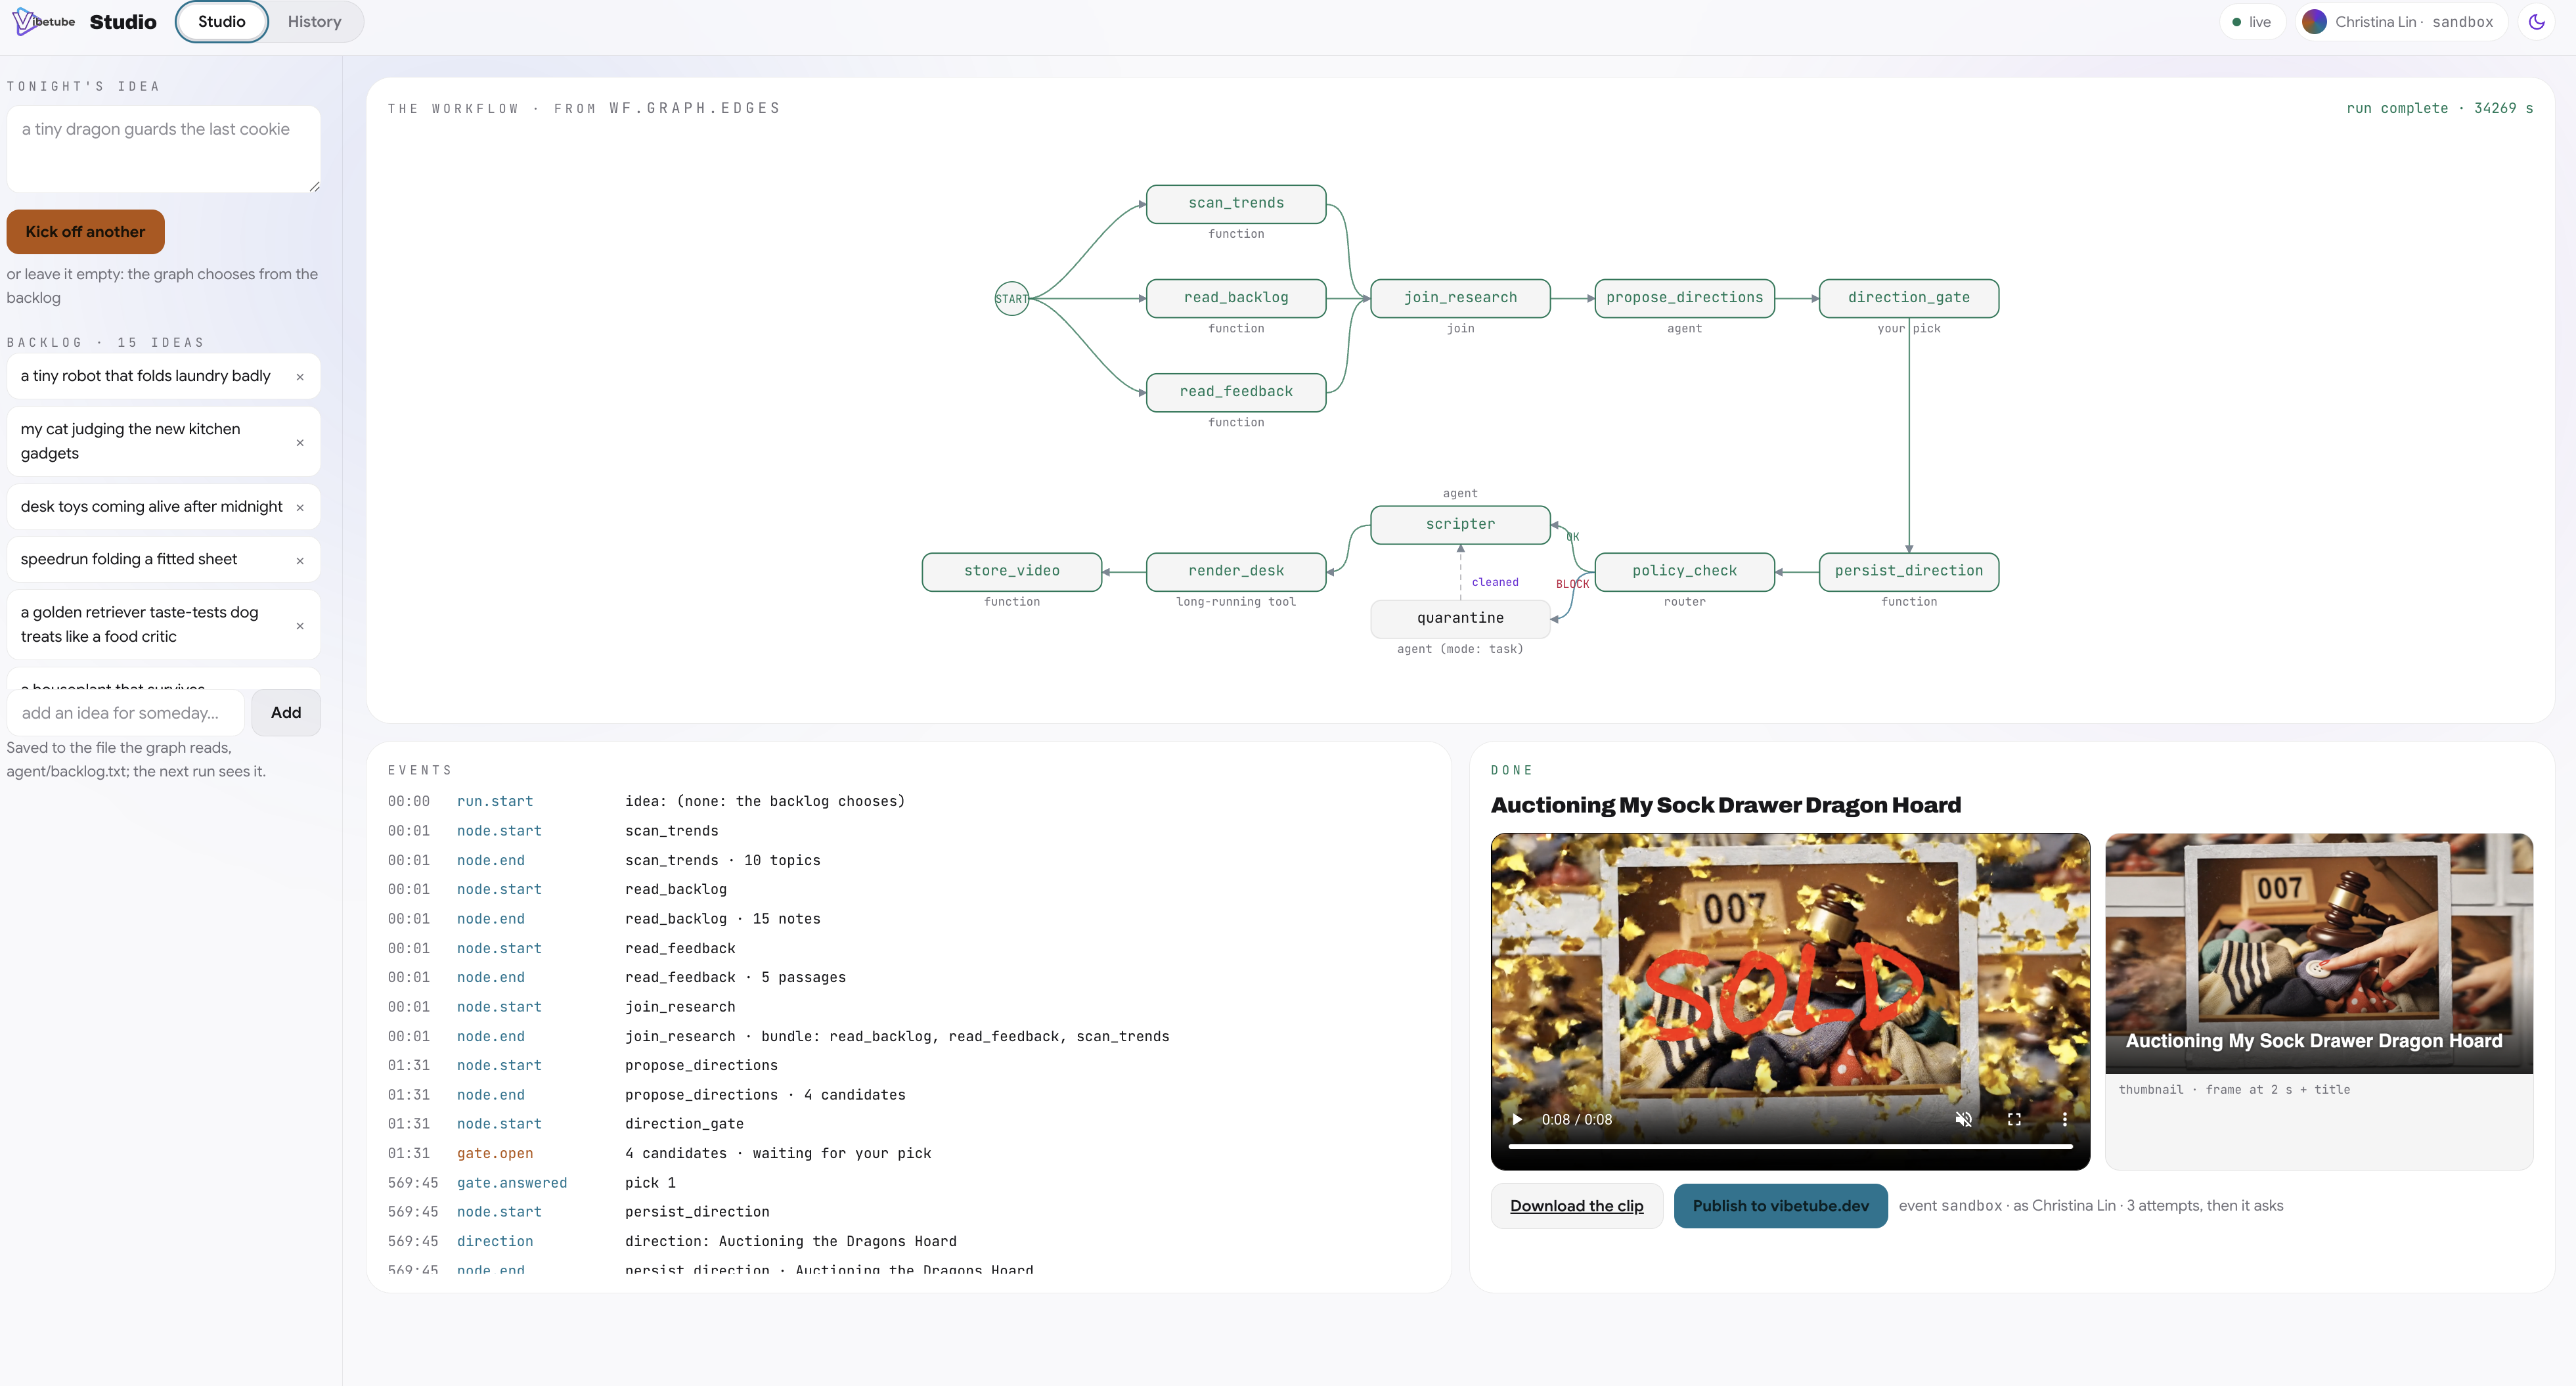
10. Resumen
En VibeStudio Workbench, navega al Paso 10: Resumen para revisar la arquitectura completada.
Paso | Arquitectura y conceptos | Patrón de implementación |
Una sola instrucción | Instrucción única, herramientas de funciones, bucle de chat secuencial |
|
Conceptos básicos de los flujos de trabajo de Agentic Workflows | Flujo de trabajo de gráficos, investigación paralela, resultados de esquemas y puerta humana |
|
Estado y router | Estado de sesión compartido, vinculación de parámetros, enrutamiento determinístico, agente de tareas |
|
Memory Bank | Memoria a largo plazo a nivel del usuario, consolidación semántica y hooks del ciclo de vida |
|
RAG Engine | Recuperación de documentos sobre comentarios del público, embeddings semánticos | Nodo |
Generación asíncrona de video con Veo | Herramientas de larga duración, recibos pendientes, daemon de entrega externo |
|
Implementa en Cloud Run | Orquestación programática, eventos enviados por el servidor y contenedor sin servidores |
|
Principios arquitectónicos básicos
- Suspende en lugar de esperar: Los flujos de trabajo se pausan de forma limpia para la entrada humana (
RequestInput) o las operaciones de larga duración (LongRunningFunctionTool). Los procesos no esperan inactivos en subprocesos o sockets de red. - Reanudación universal: Todas las suspensiones se reanudan a través de un mecanismo idéntico: un solo
function_responseque lleva el ID de llamada del nodo suspendido. - Administración de estado desacoplada: Los nodos comparten datos a través de claves de estado de sesión con nombre y vinculación de parámetros, en lugar de cargas útiles intermedias detalladas y con acoplamiento alto.
- Enrutamiento determinístico antes del costo generativo: Los routers basados en reglas y los filtros de regex evalúan la política con un costo de cero tokens antes de que se ejecuten los modelos generativos.
- Separación de responsabilidades: El contexto específico de un agente individual pertenece a las devoluciones de llamada del ciclo de vida, mientras que las dependencias de datos compartidos pertenecen