۱. مقدمه
این آزمایشگاه کد شما را در ساخت سیستمهای عامل نسل بعدی با استفاده از گردشهای کاری و نمودارها در کیت توسعه عامل (ADK) راهنمایی میکند. شما الگوهای معماری رایج را پیادهسازی خواهید کرد، تعاملات انسان در حلقه (HITL) را هماهنگ میکنید و اجرای ناهمزمان طولانی مدت را مدیریت خواهید کرد. همچنین پایگاههای دانش سازمانی و حافظه پایدار را برای سفارشیسازی و تکامل رفتار عامل ادغام خواهید کرد. در نهایت، این قابلیتها را برای هدایت یک خط تولید ویدیوی خودکار متصل خواهید کرد.
سناریو
شما یک کانال دیجیتال در VibeTube با مخاطبان فعال و انبوهی از ایدههای خلاقانه در حال گسترش را اداره میکنید. تولید هر ویدیو نیاز به اجرای مداوم در چندین مرحله دارد: تحقیق در مورد قالبهای پرطرفدار، ترکیب بازخورد بینندگان، توسعه اسکریپتها، بررسی انطباق با سیاستها و تولید کلیپهای ویدیویی. مدلهای مولد میتوانند داراییهای فردی را تهیه کنند، اما ارائه نسخههای مداوم نیاز به یک معماری عامل هماهنگ دارد.
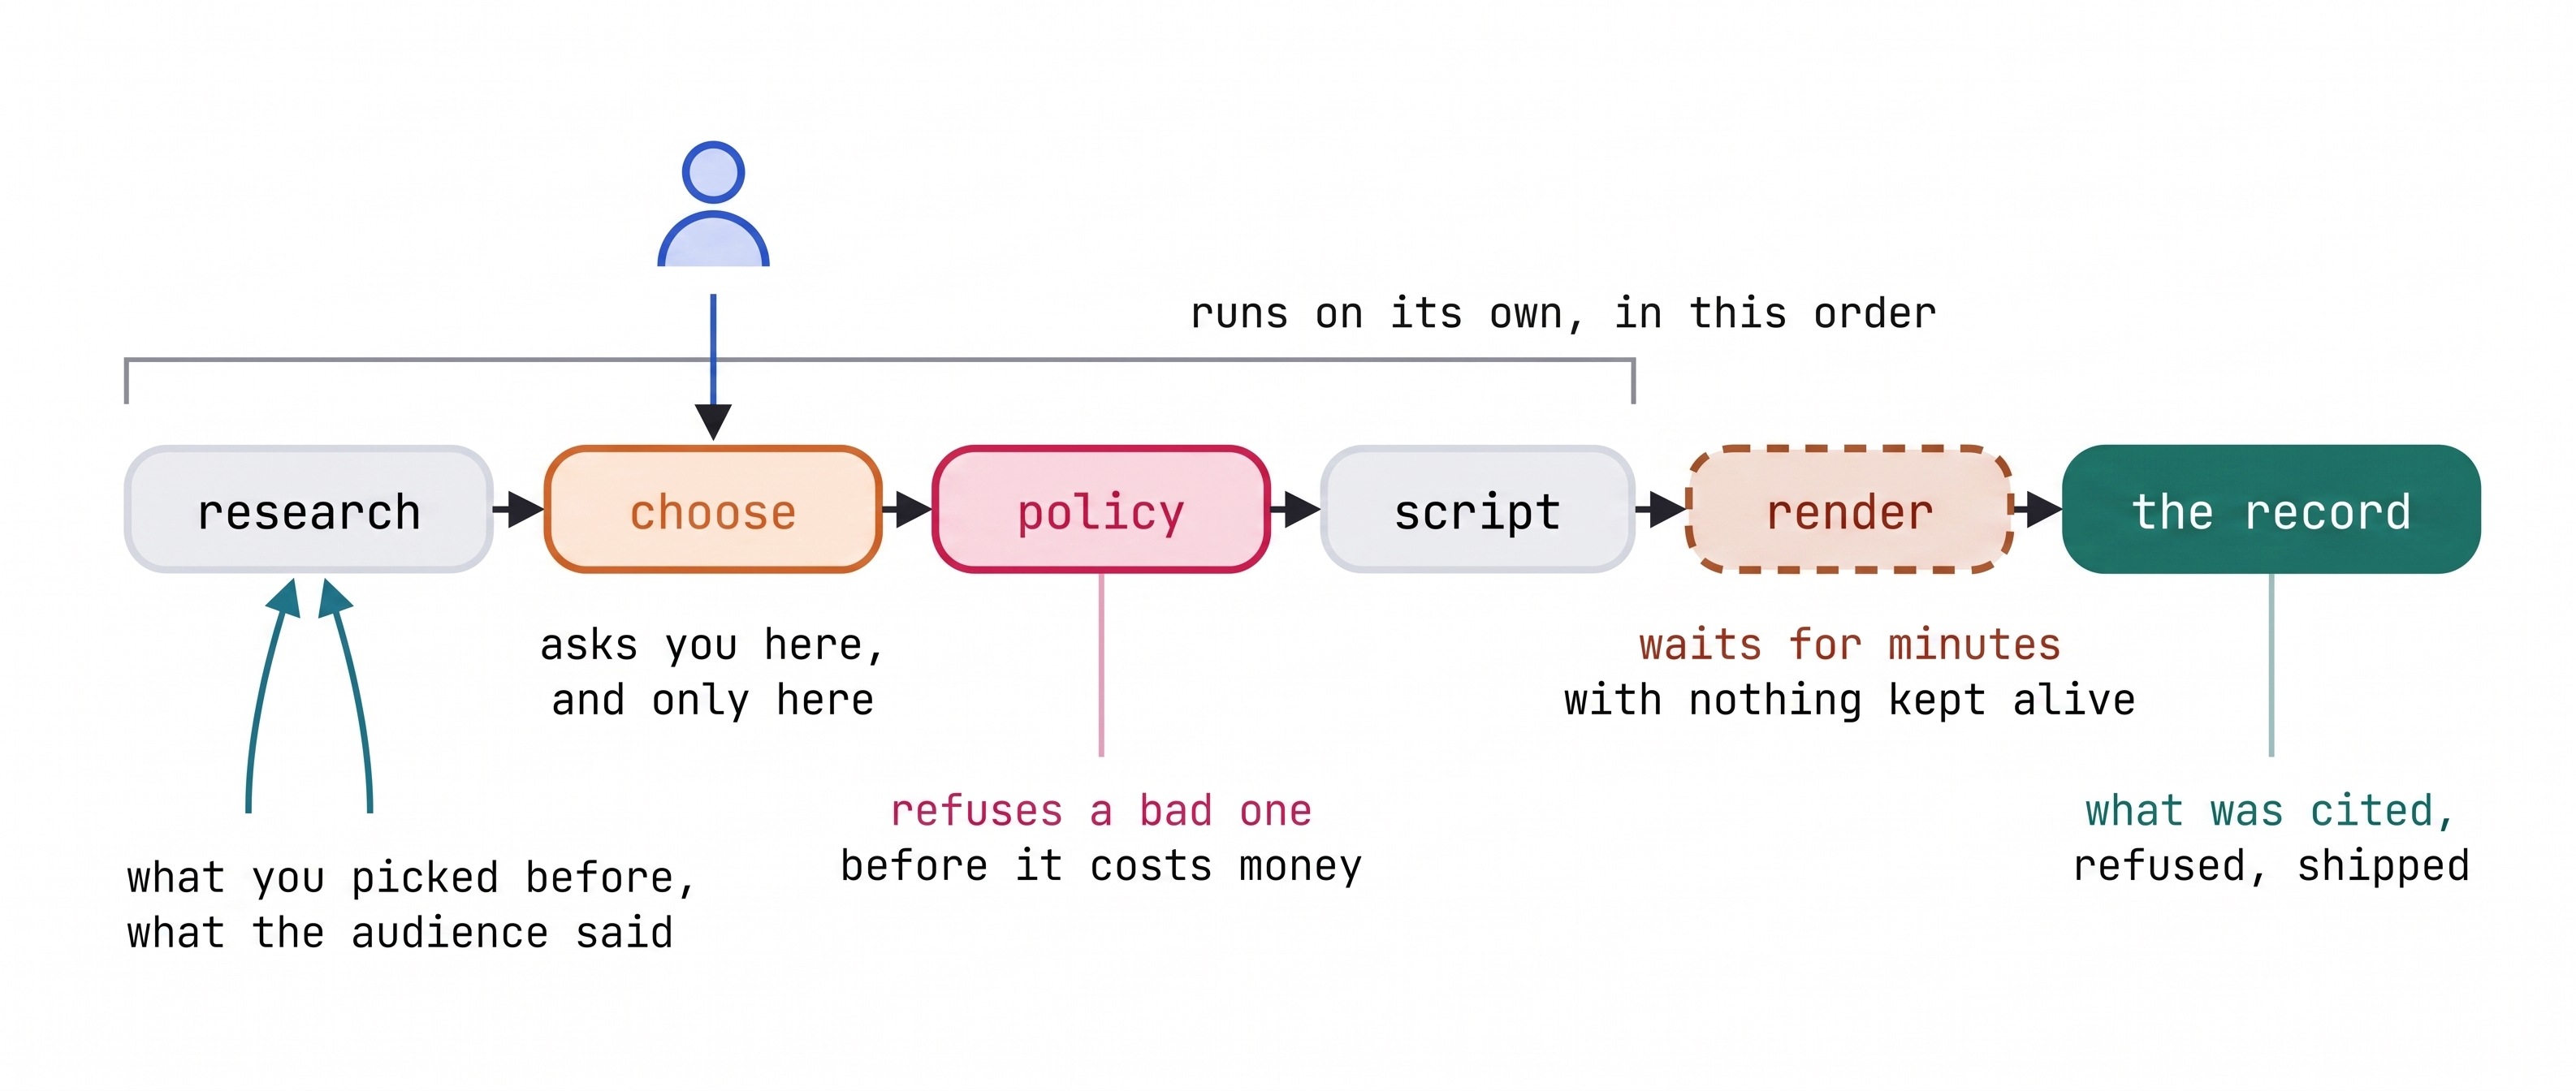
برای خودکارسازی این چرخه حیات، شما VibeStudio را خواهید ساخت. این خط لوله عاملمحور، تحقیقات روتین را به صورت موازی انجام میدهد، گزینههای منتخبی را برای تأیید توسط انسان در حلقه ارائه میدهد، قبل از تولید ویدیو، دروازههای سیاست خودکار را اعمال میکند و زمینه را در طول مراحل تولید حفظ میکند.
آنچه یاد میگیرید
- مبانی مهندسی گراف : معماریهای عامل چند مرحلهای به جریان کنترل صریح و مسیرهای اجرای ساختاریافته نیاز دارند. شما یک
WorkflowADK را با استفاده از تاپلهای لبه، نقطه ورودSTART،JoinNodeبرای تجمیع خروجی موازی و گرههای روتر قطعی برای هدایت اجرا بر اساس حالت، میسازید. - حالتهای عامل و فراخوانیهای چرخه عمر : وظایف تخصصی نیاز به رفتارهای عملیاتی متمایز و محافظهای قطعی دارند. شما نمونههای
AgentADK را با استفاده از حالتهایtaskchat،single_turnو tool-enabled به عنوان گرههای گردش کار پیکربندی میکنید و از interceptorها باbefore_model_callbackوafter_agent_callbackاستفاده میکنید. - هماهنگسازی توسط انسان در حلقه : خطوط تولید در نقاط بازرسی حیاتی و خلاقانه، به دلیل قضاوت انسان متوقف میشوند. شما
RequestInputپیادهسازی میکنید تا اجرای گردش کار را به حالت تعلیق درآورد، طرحهای پاسخ ساختاریافته را اجرا کند و بدون فعال نگه داشتن فرآیندهای زمان اجرای بیکار، اجرا را از سر بگیرد. - حافظه عامل سلسله مراتبی : سیستمهای تولید، حالت اجرای زودگذر را از زمینه پایدار جدا میکنند. شما حالت جلسه کوتاهمدت را با استفاده از
Event(state=...)و اتصال پارامتر مدیریت میکنید و بانک حافظه GEAP را برای استخراج، ادغام و حفظ تنظیمات سازنده در طول اجراها متصل میکنید. - اتصال به پایگاههای دانش سازمانی : عاملهای خودمختار به زمینه پویای دامنه و احساسات مخاطب نیاز دارند. شما یک مجموعه داده GEAP RAG Engine را به عنوان یک گره بازیابی اختصاصی در خروجی موازی به خروجیهای عامل از نظر معنایی متصل میکنید.
- گردشهای کاری طولانی مدت و استقرار : رندرینگ ویدیوی چندوجهی به صورت غیرهمزمان و در مدت زمان طولانی عمل میکند. شما
LongRunningFunctionToolرا با رسیدهای تماس در حال انتظار پیادهسازی میکنید تا گردش کار را بر اساس شناسه تماس متوقف و از سر بگیرید و خط لوله نهایی را با استفاده از ADKRunnerروی Cloud Run مستقر کنید.
نحوه سازماندهی این آزمایشگاه کد
این آزمایشگاه کد به عنوان مرجع مفهومی و معماری شما عمل میکند. هر بخش، ساختارهای ADK پیادهسازی شده در مرحله مربوط به میز کار را توضیح میدهد، کد مرجع ارائه میدهد و اصول طراحی اصلی را تعیین میکند. قبل از تکمیل تمرین مربوطه در میز کار، هر بخش را مرور کنید.
کار عملی در VibeStudio Workbench انجام میشود، یک رابط وب همراه که شامل یک ویرایشگر کد تعاملی، تأییدکنندههای زمان اجرا و یک بازرس ADK تعبیهشده است. شمارهگذاری مراحل در Workbench مستقیماً با این Codelab هماهنگ میشود تا پیشرفت شما هماهنگ بماند. ویرایشهای نمودار پایه در طول مراحل ادامه مییابند و Workbench به طور خودکار پیشنیازها را با پیشرفت شما تأیید میکند.
پس از تکمیل تمرینهای میز کار، شما یک خط لوله عامل سرتاسری را مونتاژ کرده و یک برنامه VibeStudio در حال اجرا را برای تولید محتوای ویدیویی در Cloud Run مستقر خواهید کرد.
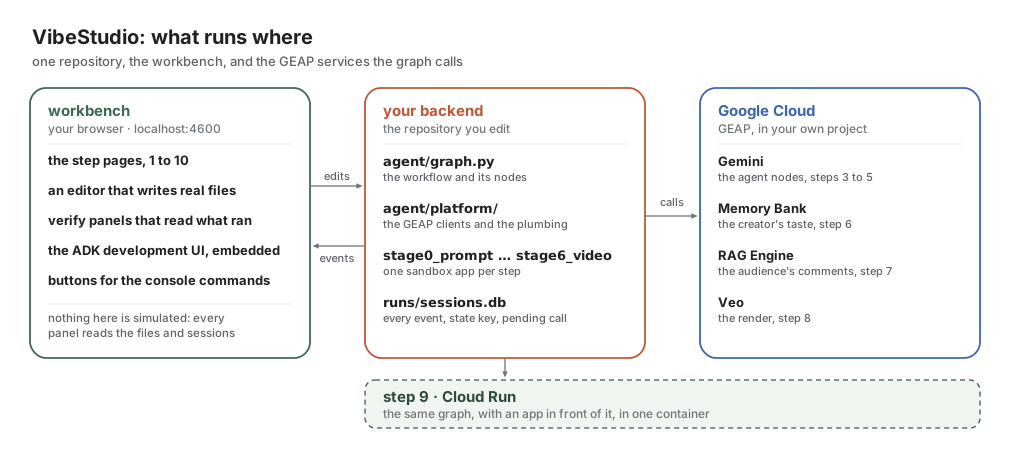
این محیط از سه مؤلفه اصلی تشکیل شده است: میز کار VibeStudio (رابط وب محلی برای ویرایش کد و تأیید زمان اجرا)، بخش مدیریت شما ( Workflow ADK و جعبههای شنی مرحله در agent/ ) و Google Cloud (مدلهای Gemini، بانک حافظه GEAP، موتور RAG و تولید ویدیوی Veo).
۲. راهاندازی
امتیاز کارگاه خود را مطالبه کنید
اگر در یک آزمایشگاه تحت هدایت مربی شرکت میکنید، مربی اعتبارات پروژه Google Cloud شما را توزیع خواهد کرد. دستورالعملهای مربی را برای استفاده از اعتبارات خود دنبال کنید و قبل از ادامه، مطمئن شوید که صورتحساب در حساب شما فعال است.
پوسته ابری را باز کنید
کلود شل یک محیط توسعه مبتنی بر مرورگر است که gcloud ، پایتون و گیت از پیش نصب شده روی آن وجود دارد.
برای راهاندازی Cloud Shell:
- به کنسول گوگل کلود بروید.
- در سربرگ ناوبری بالا، روی فعال کردن Cloud Shell (آیکون پنجره ترمینال) کلیک کنید.
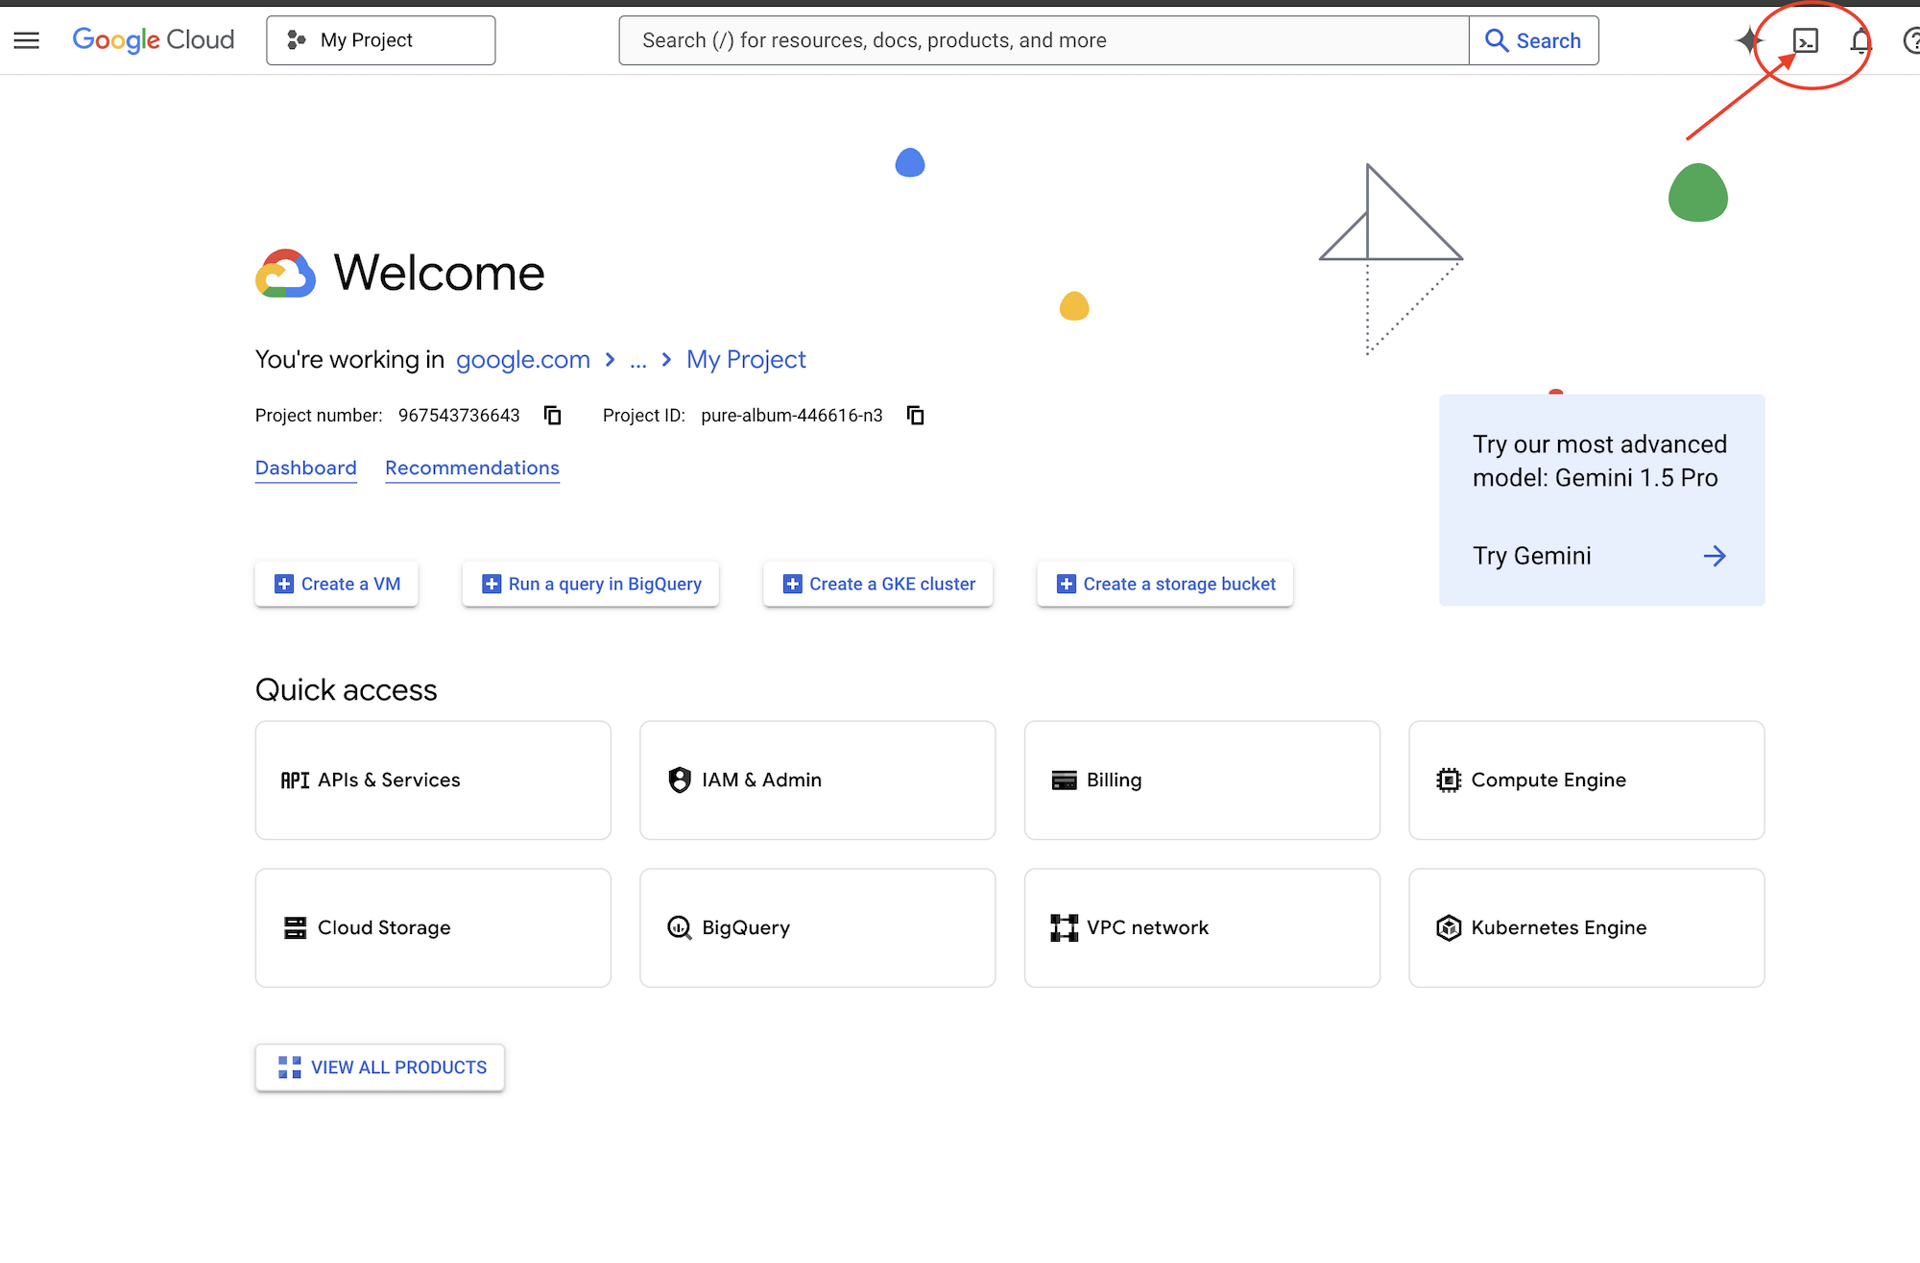
یک جلسه ترمینال در پایین پنجره مرورگر باز میشود.
مخزن را کلون و مقداردهی اولیه کنید
برای کلون کردن پروژه، دستورات زیر را در ترمینال Cloud Shell اجرا کنید:
git clone https://github.com/gca-americas/vibetube-studio
cd ~/vibetube-studio
دستورات پیکربندی
در طول راهاندازی، از شما خواسته میشود جزئیات زیر را وارد کنید:
- شناسه پروژه گوگل کلود : وقتی
setup_project.shاز شما درخواست کرد، Enter را بزنید تا یک پروژه جدید به طور خودکار ایجاد شود. اگر ترجیح میدهید از یک پروژه موجود (مانند یک پروژه از پیش تعیین شده) استفاده کنید، شناسه پروژه خود را وارد کنید و با فعال بودن گزینه billing، مطمئن شوید که املای آن صحیح است. - کد رویداد : کد اتاق ارائه شده توسط مربی خود را وارد کنید. اگر کدی دریافت نکردهاید، با دستیار آموزشی یا همسایه خود مشورت کنید. اگر این آزمایشگاه را در خانه انجام میدهید، برای پذیرش اتاق پیشفرض
sandbox، Enter را فشار دهید. - نام نمایشی کانال : در صورت درخواست
setup_codelab.sh، نام یا شناسه کانال دلخواه خود را وارد کنید، یا برای پذیرش پیشفرض تولید شده از حساب Google خود، Enter را فشار دهید.
دو اسکریپت راهاندازی را به ترتیب اجرا کنید:
./setup_project.sh
./setup_codelab.sh
-
setup_project.sh: یک پروژه Google Cloud با صورتحساب فعال ایجاد یا دوباره استفاده میکند، شناسه پروژه را در~/project_id.txtذخیره میکند و زمینه فعالgcloudرا پیکربندی میکند. -
setup_codelab.sh: وابستگیهایuvو پایتون را در.venvنصب میکند، APIهای مورد نیاز Google Cloud را فعال میکند، تنظیمات کانال شما را در فایل.envپیکربندی میکند، دسترسی مدل را با Gemini تأیید میکند، منابع Memory Bank و RAG را فراهم میکند، رابط کاربری Workbench را میسازد و VibeStudio Workbench را شروع میکند.
این اسکریپت بررسی اولیه را اجرا میکند و VibeStudio Workbench را در پسزمینه اجرا میکند. آخرین خطوط آن لینکی را که باید باز شود نمایش میدهد.
7 · Preflight
  ✓ python 3.12
  ✓ auth path A: Vertex via ADC (STUDIO_VERTEX=1)
  ✓ Google Cloud ADC (project <your-project>)
  ✓ stage0_prompt loads
  ...
  ✓ stage6_video loads (13 edges)
  ✓ aiplatform.googleapis.com enabled (Gemini, Veo, Memory Bank, RAG Engine)
  ✓ vectorsearch.googleapis.com enabled (the vector store a RAG corpus is built on)
  ✓ Memory Bank connected
  ✓ RAG corpus connected
  ✓ VibeStudio Workbench running on port 4600

PREFLIGHT GREEN

Setup finished. The VibeStudio Workbench is already running.

  Open this and start at step 1
      https://4600-<your cloud shell host>/step/story

  It runs in the background. You do not need to start anything else.
      log      runs/lab.log
      stop     kill $(cat runs/lab.pid)
      start    scripts/start.sh
روی آن لینک کلیک کنید. همین آدرس در مسیر پیشنمایش وب → تغییر پورت → ۴۶۰۰ موجود است.
برای بررسی مجدد محیط در هر مرحله، python scripts/preflight.py را اجرا کنید. برای راهاندازی مجدد میز کار، scripts/restart.sh را اجرا کنید. برای راهاندازی مجدد، ./setup_codelab.sh را اجرا کنید؛ این کار پیکربندی و پیشرفت شما را حفظ میکند.
وقتی باز است، برای سناریو ، مرحله ۱، داستان ، و برای شکل نمودار نهایی، مرحله ۲، آنچه میسازید ، را بخوانید. هیچکدام تمرینی ندارند. سپس برای مرحله ۳ به اینجا برگردید.
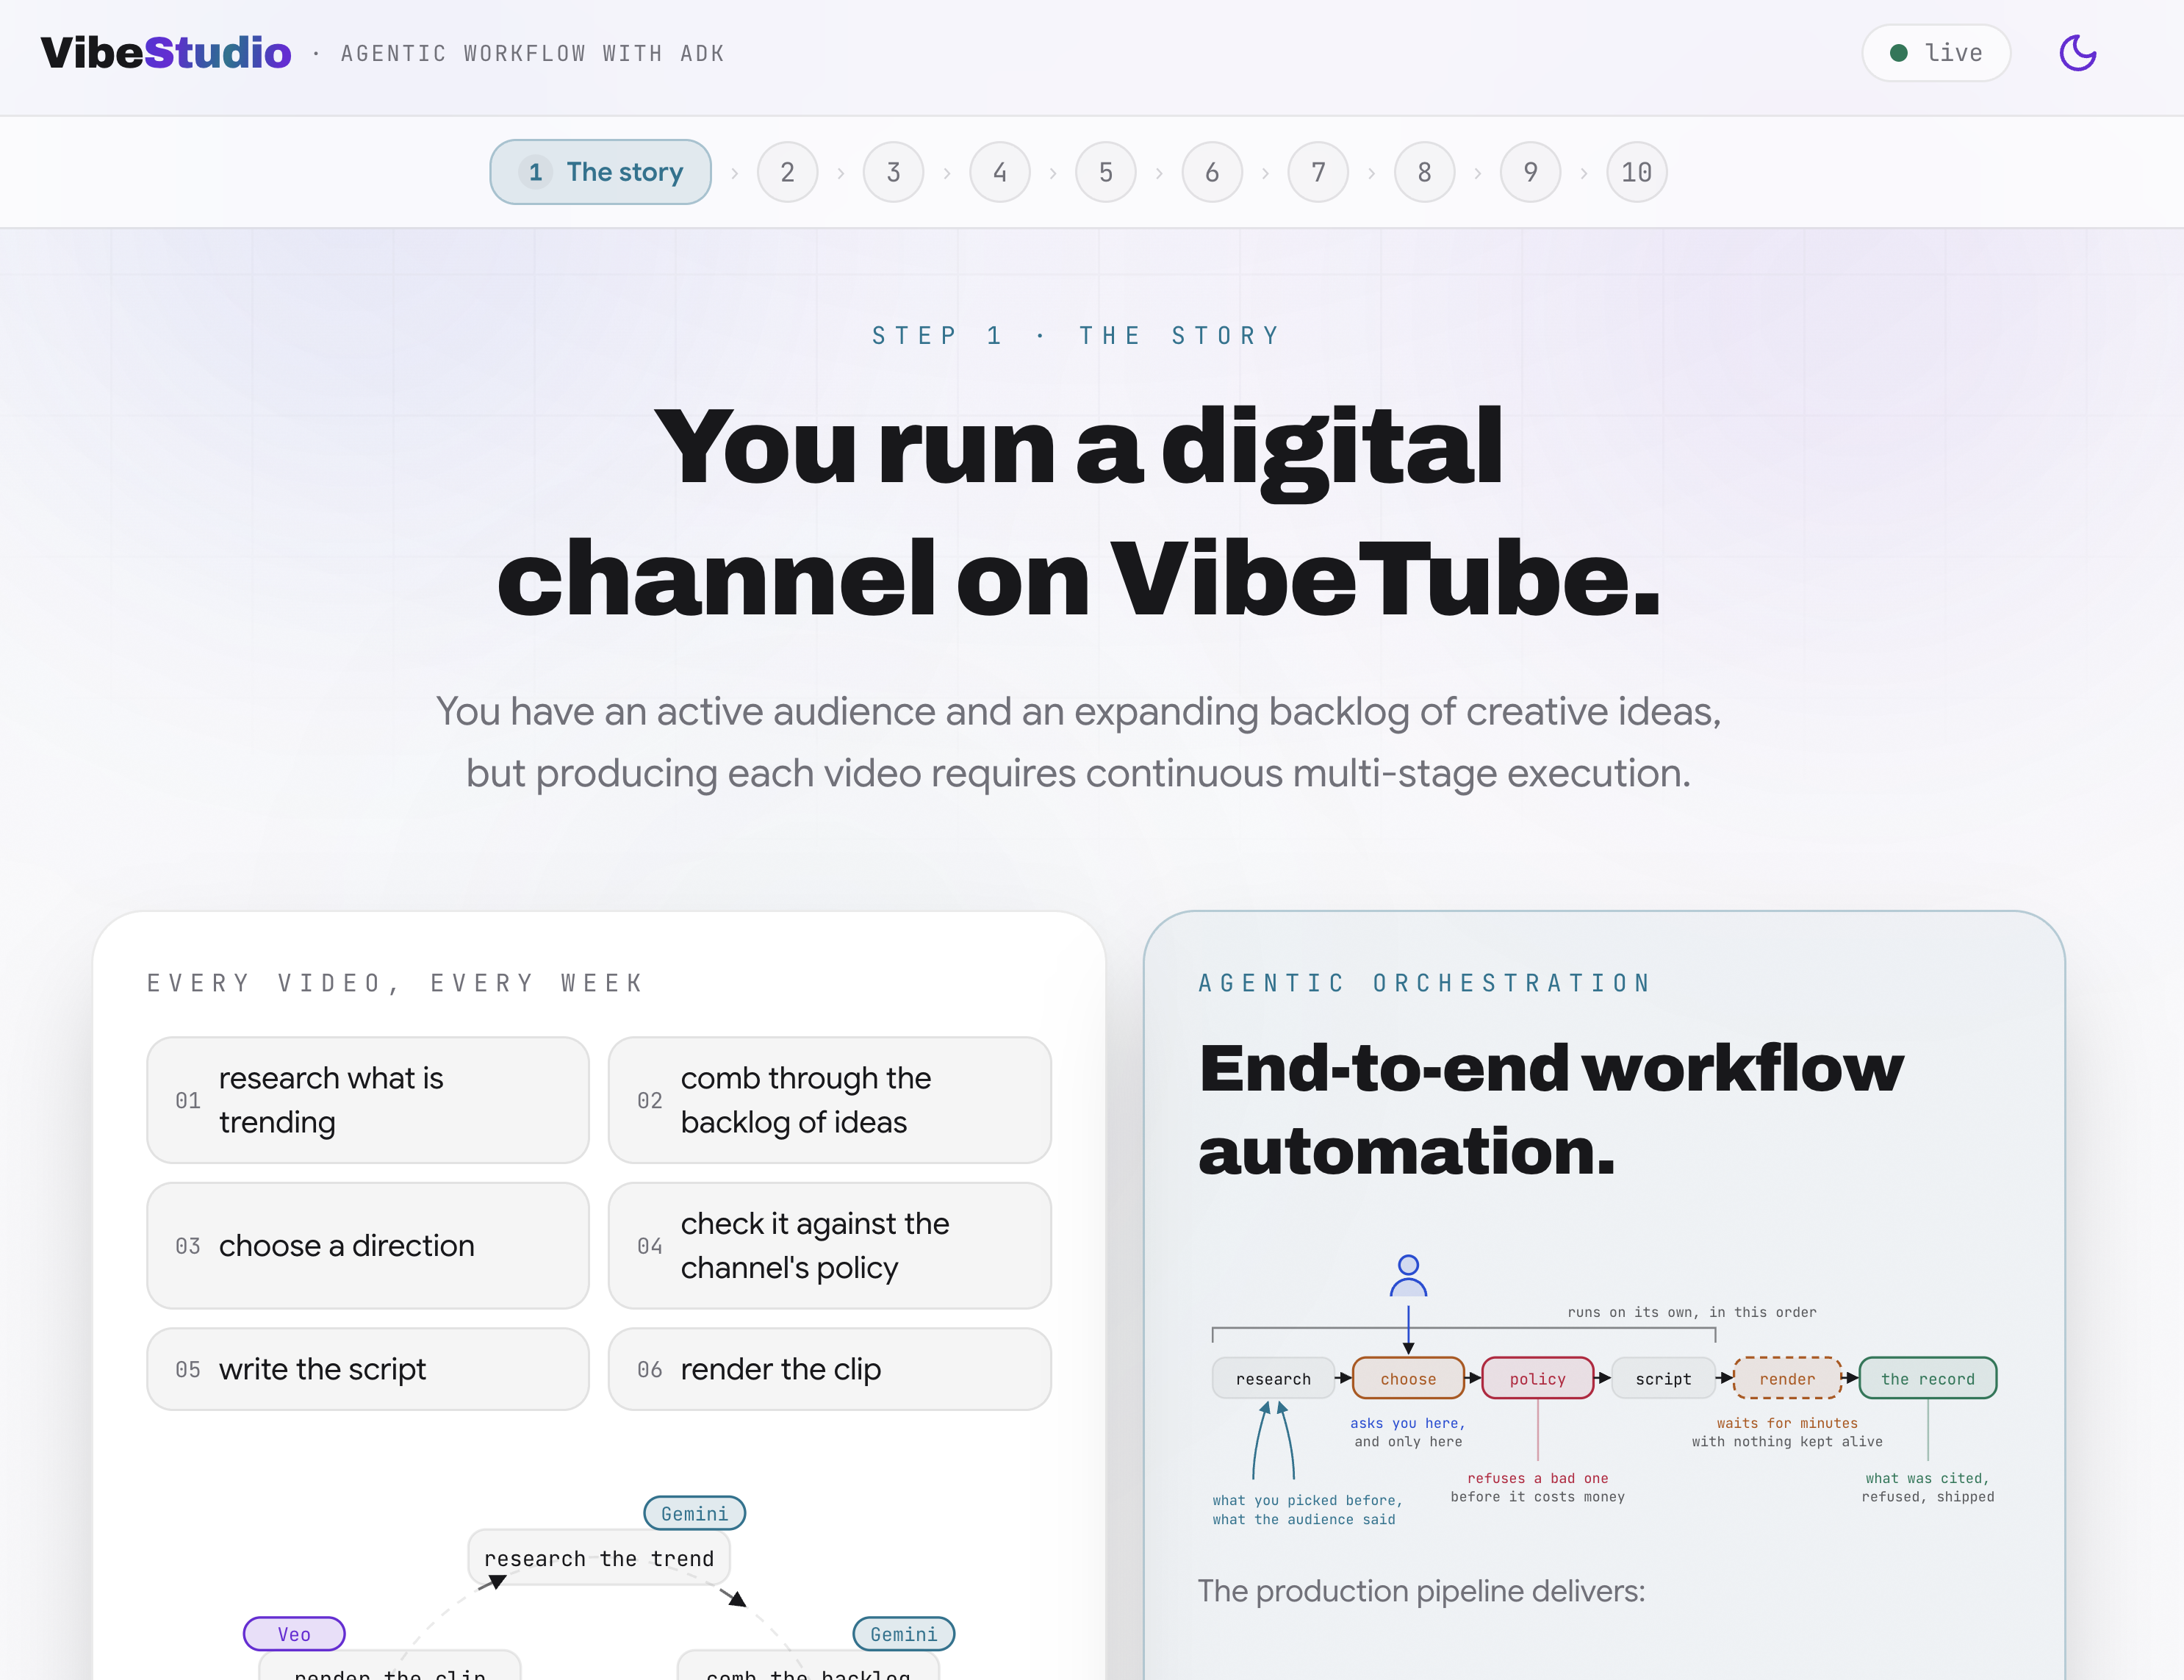
هر بخش عملی از VibeStudio Workbench با یک پنل تأیید به پایان میرسد که مصنوعات واقعی را میخواند: فایل روی دیسک و جلسات نوشته شده توسط اجراها.
طرح مخزن
این مخزن به منطق گردش کار اصلی، جعبههای شنی گام به گام، محیط میز کار و برنامه کاربردی عملیاتی ساختار یافته است:
vibe-studio-lab/
├── agent/                  # Core ADK workflow, graph definition, and platform services
│   ├── graph.py            # Workflow graph definition, node functions, and routers
│   ├── desk.py             # Video render desk using LongRunningFunctionTool
│   ├── schemas.py          # Pydantic schemas for directions, gates, and scripts
│   ├── trends.py           # Trend generation and sampling utilities
│   ├── backlog.txt         # Creator video ideas backlog
│   ├── comments.md         # Audience comments for RAG Engine corpus seeding
│   ├── policy_words.txt    # Blocked subject words for deterministic policy checks
│   └── platform/           # Google Cloud service clients (Memory Bank, RAG, Veo)
│       ├── config.py       # Environment variables, locations, and model configurations
│       ├── memory.py       # GEAP Memory Bank callbacks and context injection
│       ├── rag.py          # GEAP RAG Engine corpus creation and semantic retrieval
│       └── videogen.py     # Veo video generation and operation polling
├── stage0_prompt/          # Step sandboxes: isolated agent.py files runnable in adk web
│   └── ...                 # stage1_fanout through stage6_video for incremental steps
├── server/ & web/          # VibeStudio Workbench (FastAPI backend and React frontend)
├── vibestudio/             # Complete production application deployed to Cloud Run
│   ├── server/             # FastAPI production server and event runner
│   ├── web/                # End-user React web application
-
agent/: شامل نمودار گردش کار اصلی است. شما فایلهای این دایرکتوری را برای پیادهسازی گرههای خروجی موازی، مسیریابی سیاست قطعی، فراخوانیهای حافظه و ابزارهای تولید ویدیو ویرایش خواهید کرد. -
agent/platform/: رابطهایی با سرویسهای ابری گوگل، از جمله مدلهای Gemini، بانک حافظه GEAP، موتور GEAP RAG و سنتز ویدیوی Veo. -
stage0_prompt/تاstage6_video/: محیطهای سندباکس مستقل. هر پوشه یکroot_agentمستقل صادر میکند تا بتوانید هر مرحله را به صورت جداگانه از طریق رابط توسعه ADK تعبیه شده اجرا و بررسی کنید. -
server/وweb/: برنامه VibeStudio Workbench که به صورت محلی روی پورت ۴۶۰۰ اجرا میشود. این برنامه میزبان مستندات مرحله، ویرایشگر کد درون صفحهای، تأییدکنندههای شواهد زمان اجرا و تجسم نمودار است. -
vibestudio/: برنامهی کامل تولید که در مرحلهی نهایی بستهبندی و در Cloud Run مستقر شده است. این برنامه شامل یک کپی مستقل از نمودار گردش کار تکمیلشده است.
۳. عامل یکپارچه
قبل از ساخت نمودار گردش کار چند گرهای، شما یک خط مبنای معماری با یک عامل واحد در stage0_prompt/agent.py ایجاد میکنید. این عامل به یک اعلان سیستم یکپارچه متکی است که خط تولید را به زبان نثر توصیف میکند و توسط دو ابزار تابع پایتون پشتیبانی میشود.
ارزیابی این مبنا، مرزهای عملیاتی هماهنگی مبتنی بر سرعت را نشان میدهد و مشخص میکند که چرا سیستمهای تولید به هماهنگی گراف نیاز دارند.
معماری عامل ADK (3A)
در محیط کاری VibeStudio ، به مرحله 3 بروید · عامل یکپارچه و معماری عامل ADK را باز کنید (3A) . این نما لایههای معماری اصلی یک عامل ADK ( LlmAgent ) را نشان میدهد:
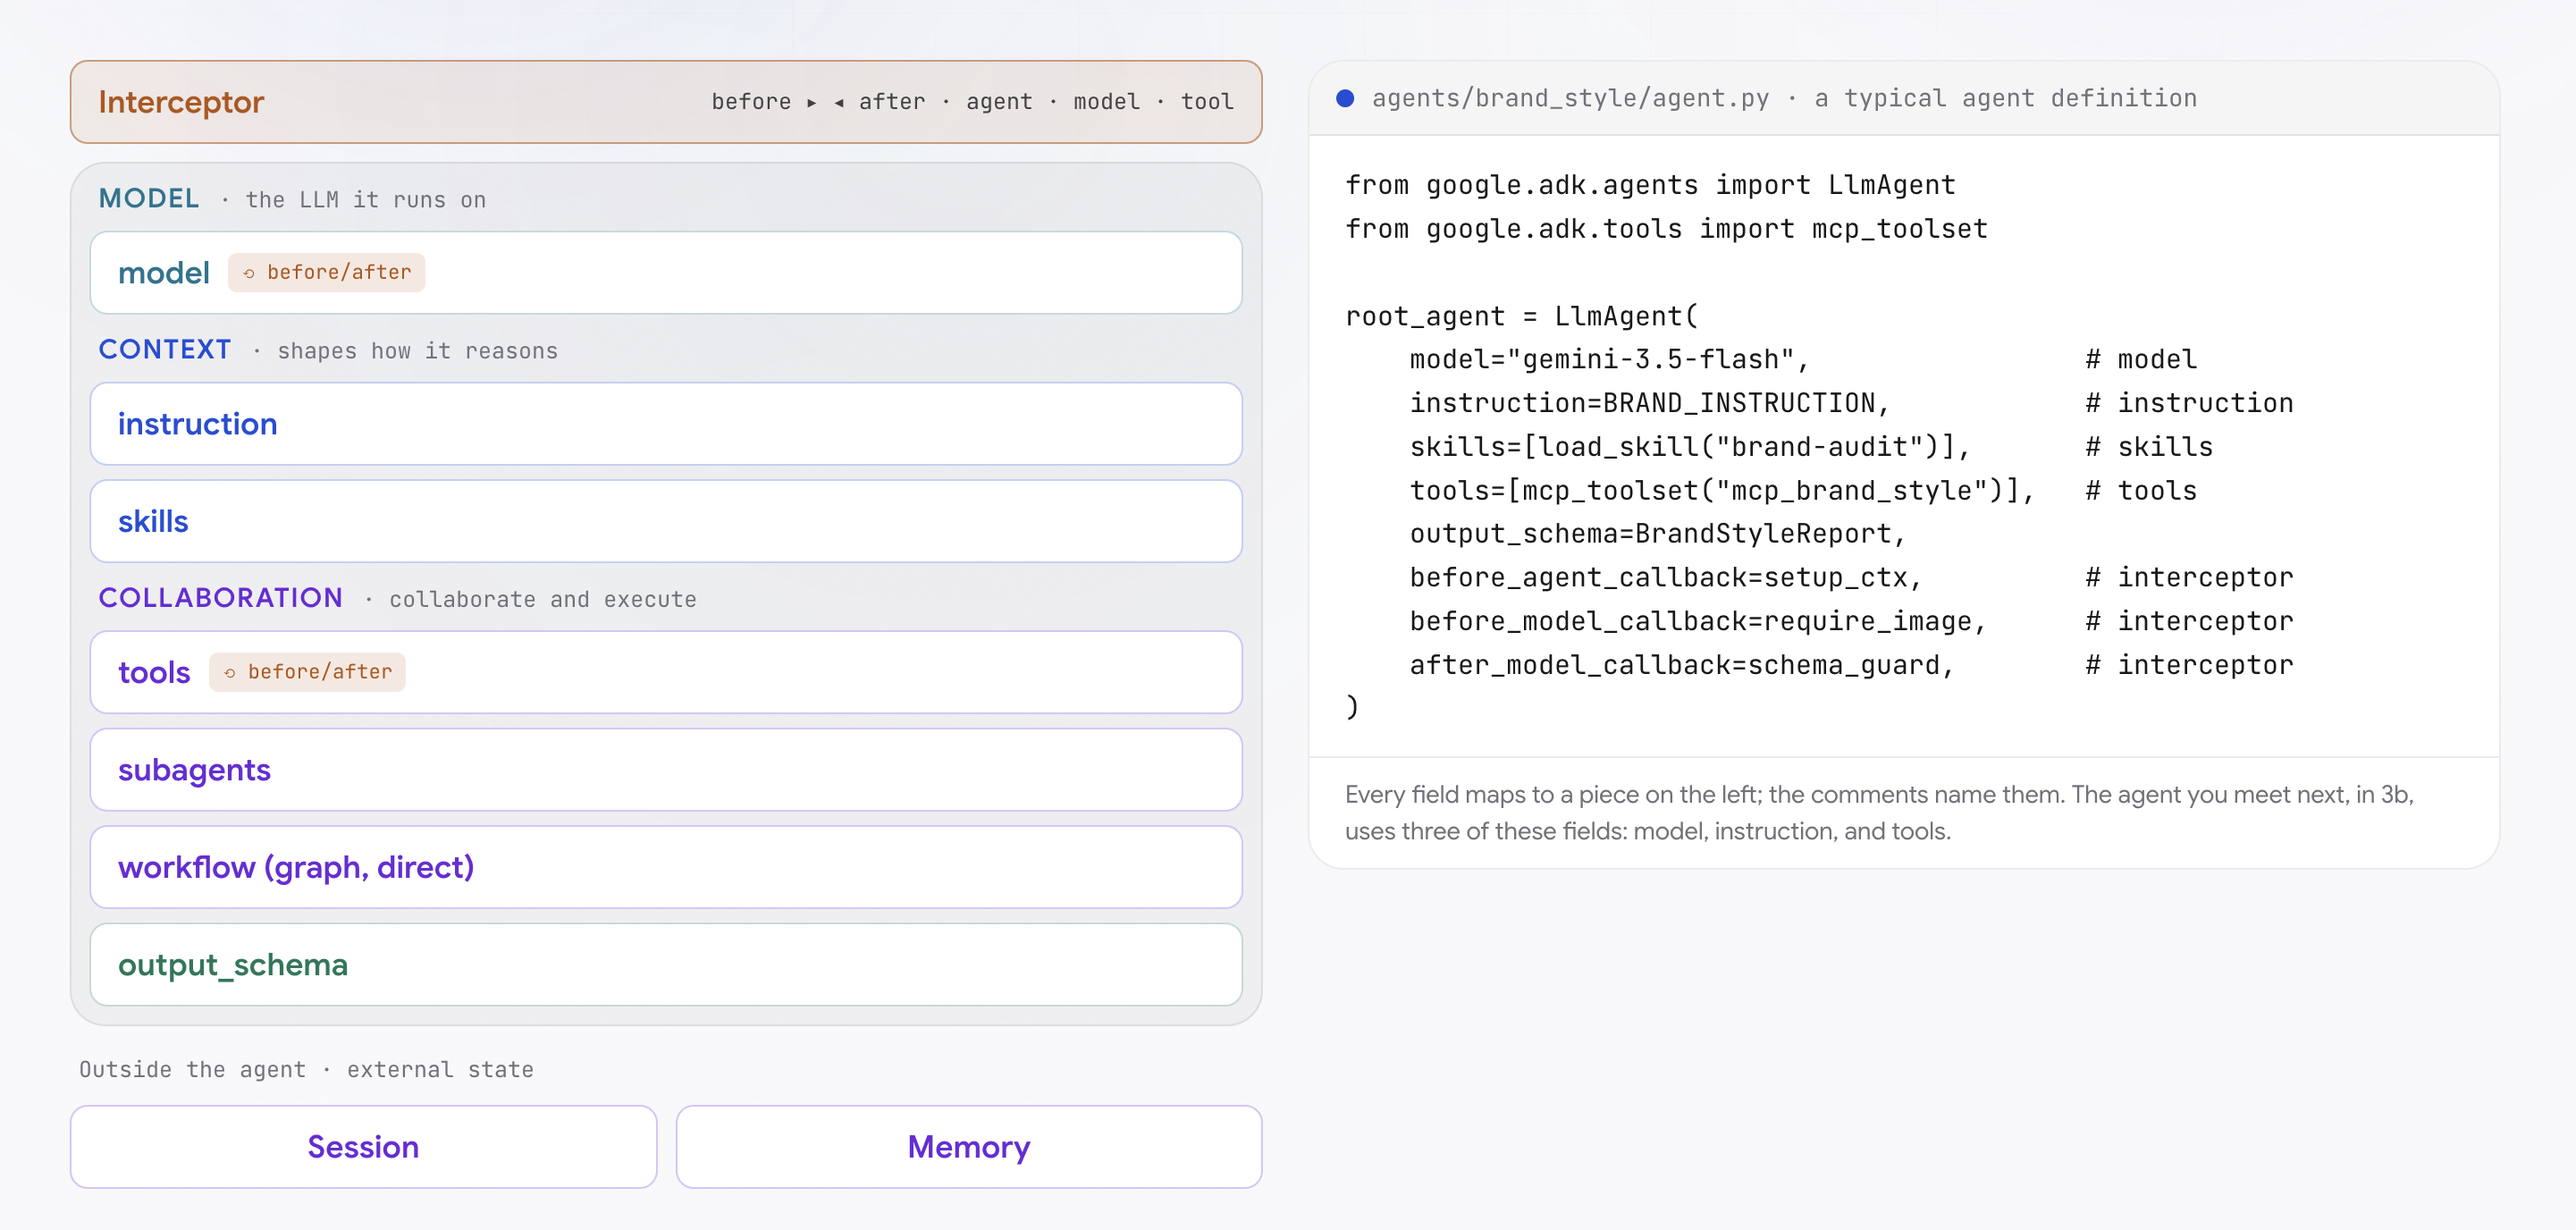
from google.adk.agents import LlmAgent
from google.adk.tools import mcp_toolset

root_agent = LlmAgent(
    model="gemini-3.5-flash",                 # model
    instruction=BRAND_INSTRUCTION,            # instruction
    skills=[load_skill("brand-audit")],       # skills
    tools=[mcp_toolset("mcp_brand_style")],   # tools
    output_schema=BrandStyleReport,           # structured output
    before_agent_callback=setup_ctx,          # interceptor
    before_model_callback=require_image,      # interceptor
    after_model_callback=schema_guard,        # interceptor
)
نمودار تعاملی، اجزای عامل را در پنج حوزه عملیاتی گروهبندی میکند:
- لایه استدلال (مدل) : مدل زبان اصلی (مانند Gemini 3 Flash) که وظایف شناختی، استدلال سریع و انتخاب ابزار را اجرا میکند. هر چیز دیگری در معماری یا به این مدل اطلاعات میدهد یا آن را محدود میکند.
- لایه زمینه (دستورالعمل و مهارتها) : دستورالعملهایی که استدلال مدل را شکل میدهند.
instructionدستورالعملهای دائمی سیستم، شخصیت و قوانین عملیاتی را تعیین میکنند.skills، راهنماییهای رویهای و نسخهبندیشده (SKILL.md) را برای گردشهای کاری تکرارپذیر ارائه میدهند. - لایه همکاری و عمل (ابزارها، زیرعاملها، گردش کار، طرحواره خروجی) : رابطهایی که عامل را قادر میسازند تا روی سیستمهای خارجی عمل کند و دادههای تایپشده را منتشر کند.
toolsتوابع پایتون قابل فراخوانی یا نقاط پایانی پروتکل زمینه مدل (MCP) را فراهم میکنند.subagentsوظایف محولشده تابع را اجرا میکنند.workflowگرافهای چندعاملی را هماهنگ میکند.output_schemaاز مدلهای Pydantic برای تضمین دریافت JSON معتبر توسط مصرفکنندگان پاییندست به جای متن بدون ساختار استفاده میکند. - لایه رهگیر (فراخوانیهای چرخه عمر) : محافظهای قطعی که کد سفارشی را قبل و بعد از اجرای عامل (
before_agent/after_agent)، چرخشهای مدل منفرد (before_model/after_model) و فراخوانیهای ابزار (before_tool/after_tool) اجرا میکنند. رهگیرها قوانین سیاست را بدون تکیه بر انطباق مدل اعمال میکنند. - وضعیت خارجی (جلسه و حافظه) : پایداری وضعیت از منطق عامل جدا شده است.
Sessionحافظه کاری گذرا و رد رویداد را برای نخ اجرای فعلی حفظ میکند.Memoryحقایق و ترجیحات پایدار بین جلسات را با استفاده از سرویسهای مدیریتشده مانند بانک حافظه GEAP حفظ میکند.
عامل یکپارچه در این مرحله تنها سه مورد از این موارد اولیه را پیادهسازی میکند: model ، instruction و tools . مراحل بعدی، گردشهای کاری گراف، طرحهای ساختاریافته، رهگیرها و سرویسهای حافظه پایدار را معرفی میکنند.
مشخصات عامل یکپارچه (3B)
در محیط کار، به بخش مشخصات عامل یکپارچه (3B) بروید. stage0_prompt/agent.py را باز کنید تا تعریف عامل پایه را بررسی کنید:
- دستورالعمل تکجملهای : دستورالعمل سیستم، پنج وظیفه تولیدی متمایز را به نثر پیوسته خلاصه میکند: کشف روندهای پلتفرم، بررسی ایدههای عقبمانده، پیشنهاد مفاهیم خلاقانه، اجرای سیاستهای مربوط به موضوعات ممنوعه و تهیه فهرستهای اولیه.
- منابع داده زیربنایی : عامل به دو منبع تعریف شده در کنار نمودار ارجاع میدهد:
-
agent/trends.py: ده روند فعال در قالبها و سبکها را از مجموعهای ۲۵۰ تایی با امتیازهای حرارتی پویا نمونهبرداری میکند. -
agent/backlog.txt: یادداشتهای مفهومی خام خالق را خط به خط میخواند.
-
ابزارهای موجود در Agent (3C)
در میز کار، به بخش ابزارها در Agent (3C) بروید.
ابزار برای یک نماینده چیست؟
یک مدل زبانی ذاتاً یک موتور استدلال جهان بسته است: این مدل صرفاً بر اساس وزنهای از پیش آموزشدیده و توکنهای موجود در پنجره زمینه فوری خود عمل میکند. این مدل نمیتواند به صورت بومی از یک پایگاه داده پرسوجو کند، به APIهای بلادرنگ دسترسی داشته باشد یا کدی را اجرا کند.
یک ابزار این مرز را میپوشاند. این ابزار به مدل، عاملیت خارجی میدهد و به آن اجازه میدهد تا اطلاعات پایه را بازیابی کرده و اقدامات قطعی را در سیستمهای خارجی اجرا کند.
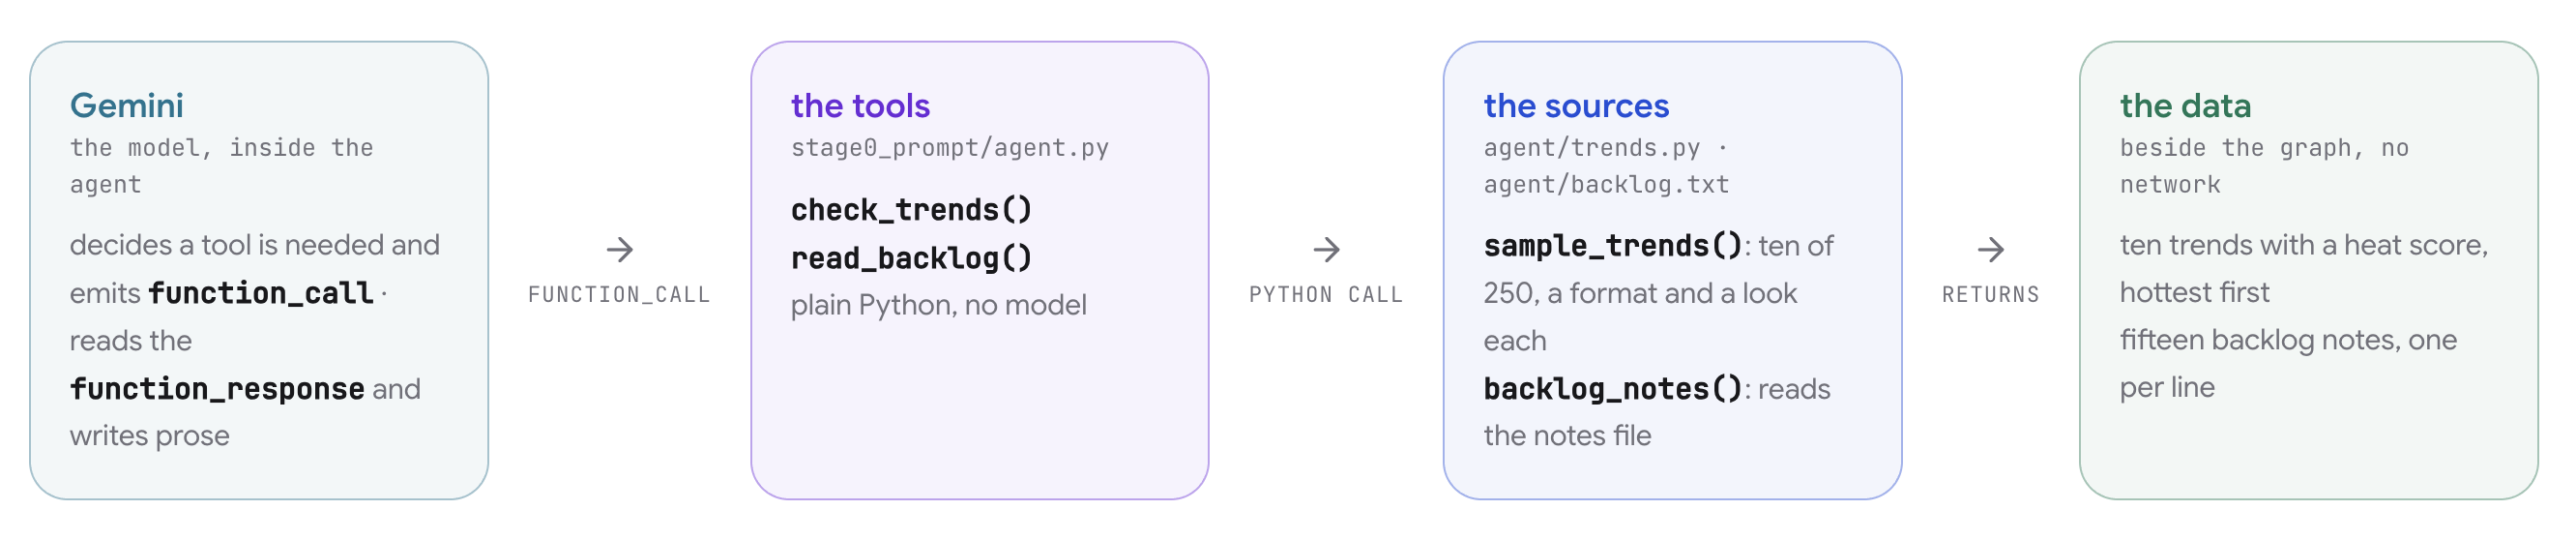
فراخوانی ابزار از یک پروتکل پنج مرحلهای صریح بین مدل و زمان اجرای ADK پیروی میکند:
- اعلان طرحواره : توسعهدهنده توابع پایتون را در اختیار عامل قرار میدهد. ADK نام، حاشیهنویسیهای نوع و رشتههای مستندات هر تابع را بررسی میکند تا یک اعلان طرحواره JSON سازگار با OpenAPI تولید کند که پارامترها و هدف آن را توصیف کند.
- استدلال مدل : در طول استنتاج، مدل ارزیابی میکند که آیا درخواست کاربر به دادههای خارجی نیاز دارد یا خیر. در صورت نیاز، مدل یک رویداد
function_callساختاریافته حاوی نام تابع هدف و دیکشنری آرگومان مطابق با طرحواره منتشر میکند. - اجرای زمان اجرا : خود مدل کد را اجرا نمیکند. زمان اجرای ADK،
function_callرا متوقف میکند، تابع محلی پایتون را با استفاده از آرگومانهای ارائه شده اجرا میکند و مقدار بازگشتی را دریافت میکند. - تزریق مجدد متن : زمان اجرای ADK مقدار بازگشتی تابع را در یک رویداد
function_responseبستهبندی میکند و آن را به تاریخچه جلسه فعال اضافه میکند. - سنتز نهایی : مدل، خروجی ابزار را که اکنون در پنجره زمینه خود ارائه شده است، پردازش کرده و پاسخ خود را تکمیل میکند.
در stage0_prompt/agent.py ، دو ابزار تحقیق به عنوان توابع استاندارد پایتون تعریف شدهاند:
def check_trends() -> dict:
    """Ten formats trending on the platform right now, with a heat score each."""
    from agent.trends import sample_trends
    return {"trends": sample_trends()}


def read_backlog() -> dict:
    """The creator's backlog: ideas they noted down to make someday."""
    from agent.graph import backlog_notes
    return {"backlog": backlog_notes()}
ویرایش و اجرای عملی
در ویرایشگر کد میز کار، دو ارجاع تابع را به لیست tools عامل اضافه کنید:
tools=[check_trends, read_backlog],
تغییر خود را ذخیره کنید. فایل روی دیسک بهروزرسانی میشود و ردیف تأیید، اتصال سیمی هر دو ابزار را تأیید میکند.
برای اجرای رابط توسعه ADK تعبیهشده، روی Open adk web کلیک کنید. ایده پیشنهادی را ارسال کنید:
tonight's idea: a tiny robot doing laundry at midnight
چه انتظاری باید داشت و چرا
هنگام ارسال این اعلان، توالی اجرای زیر را در ردیابی جلسه مشاهده کنید:
- دو رویداد اجرای ابزار قبل از پاسخ ظاهر میشوند : رویدادهای
function_callوfunction_responseرا برایcheck_trendsوread_backlogمیبینید.- چرا : Gemini دستورالعمل اعلان سیستم ("بررسی کنید چه چیزی پرطرفدار است. به انبوه ایدههای خود نگاه کنید") را ارزیابی کرد، تشخیص داد که فاقد روندهای پلتفرم و یادداشتهای کانال در وزنهای خود است و هر دو تابع را برای ایجاد زمینه خود فراخوانی کرد.
- کارشناس، دستورالعملی را پیشنهاد میدهد و برای تأیید مکث میکند : پاسخ، یک دستورالعمل ویدیویی را پیشنهاد میدهد که روندها و موارد باقیمانده را ترکیب میکند و از شما میخواهد که آن را تأیید کنید.
- چرا : دستورالعمل از مدل خواسته است که قبل از تولید اسکریپت، در مورد جهت با سازنده به توافق برسد.
- نادیده گرفتن تایید در نوبت بعدی : پیام دوم را ارسال کنید:
skip the questions, just describe the video. نماینده بلافاصله تایید را نادیده میگیرد و عنوان و نماها را پیشنویس میکند.- چرا : دستورالعملهای سریع، به جای موانع قطعی، دستورالعملهای مشاورهای هستند. در یک عامل یکپارچه، دستورالعملهای کاربر میتوانند قوانین ثابت سیستم را لغو کنند زیرا هیچ گردش کار خارجی جریان اجرا را کنترل نمیکند.
محدودیتهای معماری یک اعلان یکپارچه
در حالی که یک اعلان واحد میتواند خروجی قابل قبولی برای دموهای جداگانه تولید کند، آزمایش شرایط مرزی در تأییدکننده میز کار، محدودیتهای حیاتی سازمانی را آشکار میکند:
- تجمیع تحقیقات بدون ساختار : ترتیب اجرای ابزار غیرقطعی است. این مدل دادههای بازیابی شده را به صورت نثر آزاد خلاصه میکند و جداسازی اینکه کدام منبع ادعاهای خاص را تولید کرده است، برای سیستمهای پاییندستی غیرممکن میسازد.
- اجرای سیاست تأیید نشده : مدل، انطباق ایمنی خود را ارزیابی میکند. اگر مدل تشخیص دهد که یک موضوع ایمن است، هیچ منطق قطعی خارجی این یافته را تأیید نمیکند.
- مکثهای ناخواستهی انسانی در حلقه : دستورالعملهای سریعی که درخواست تأیید سازنده را دارند، هشداردهنده هستند. ارسال یک پیام پیگیری که به مدل دستور میدهد از سؤالات عبور کند، باعث میشود که به طور کامل از تأیید انسانی صرف نظر کند.
این شکافهای معماری، تجزیه عامل یکپارچه به گردش کار گراف صریح ساخته شده در مرحله بعدی را ترغیب میکنند.
۴. اصول گردش کار عاملمحور
در محیط کاری VibeStudio ، به مرحله ۴ · اصول گردش کار Agentic ، بخشهای ۴A تا ۴D بروید.
این مرحله از یک مبنای تک عاملی به یک ارکستراسیون قطعی گراف با استفاده از Workflow ADK منتقل میشود. شما یک خروجی تحقیق موازی ایجاد خواهید کرد، شاخهها را با یک گره اتصال همگامسازی خواهید کرد، کاندیداهای خلاق با اعتبارسنجی طرحواره تولید خواهید کرد و یک دروازه تأیید قطعی انسان در حلقه معرفی خواهید کرد.
معماری گراف و زنجیرههای اجرایی (۴الف)
در محیط کار، معماری گراف و زنجیرههای اجرا (4A) را باز کنید.
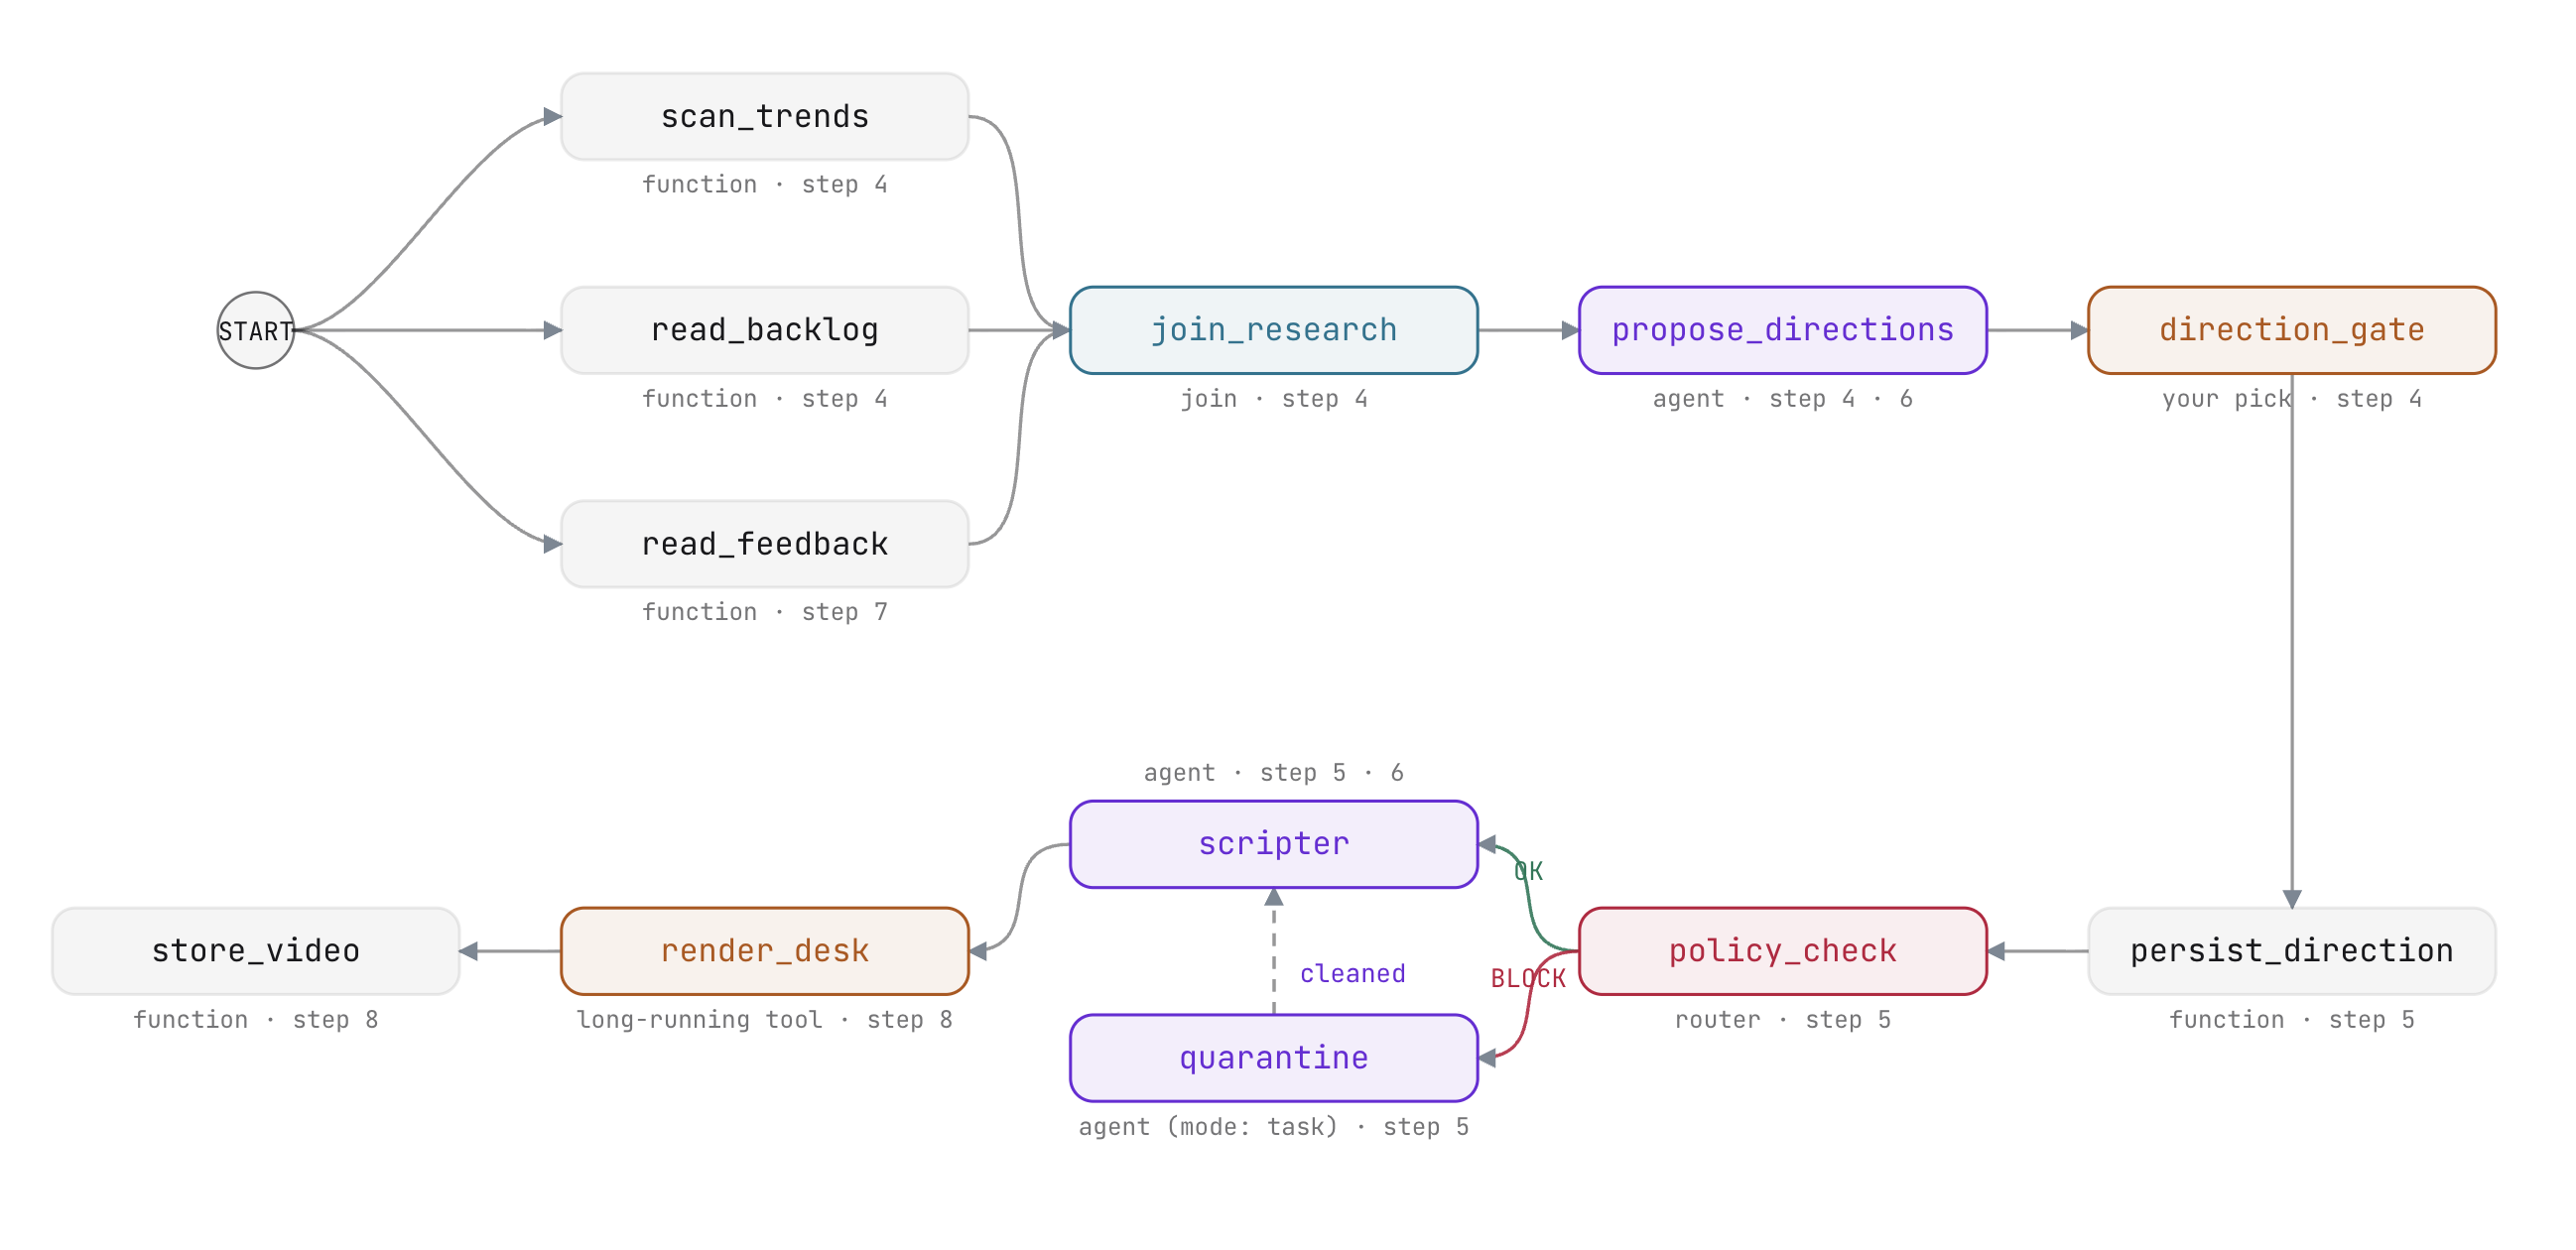
یک Workflow ADK، اجرای عامل را به صورت یک گراف جهتدار که توسط یک لیست لبه تعریف میشود، ساختار میدهد:
- زنجیرهها : تاپلهای متوالی، اجرای خطی گره (
(node_a, node_b, node_c)) را تعریف میکنند. - شاخههای موازی : زنجیرههای مستقلی که یک گره مبدا را به اشتراک میگذارند، به صورت همزمان اجرا میشوند.
- همگامسازی : زنجیرههایی که روی یک
JoinNodeهمگرا میشوند، قبل از انتشار، منتظر میمانند تا تمام شاخههای ورودی گزارش دهند. - کنترل قطعی : جریان اجرا به جای اینکه از متن اعلان استنباط شود، توسط ساختارهای کد اعلام شده اداره میشود.
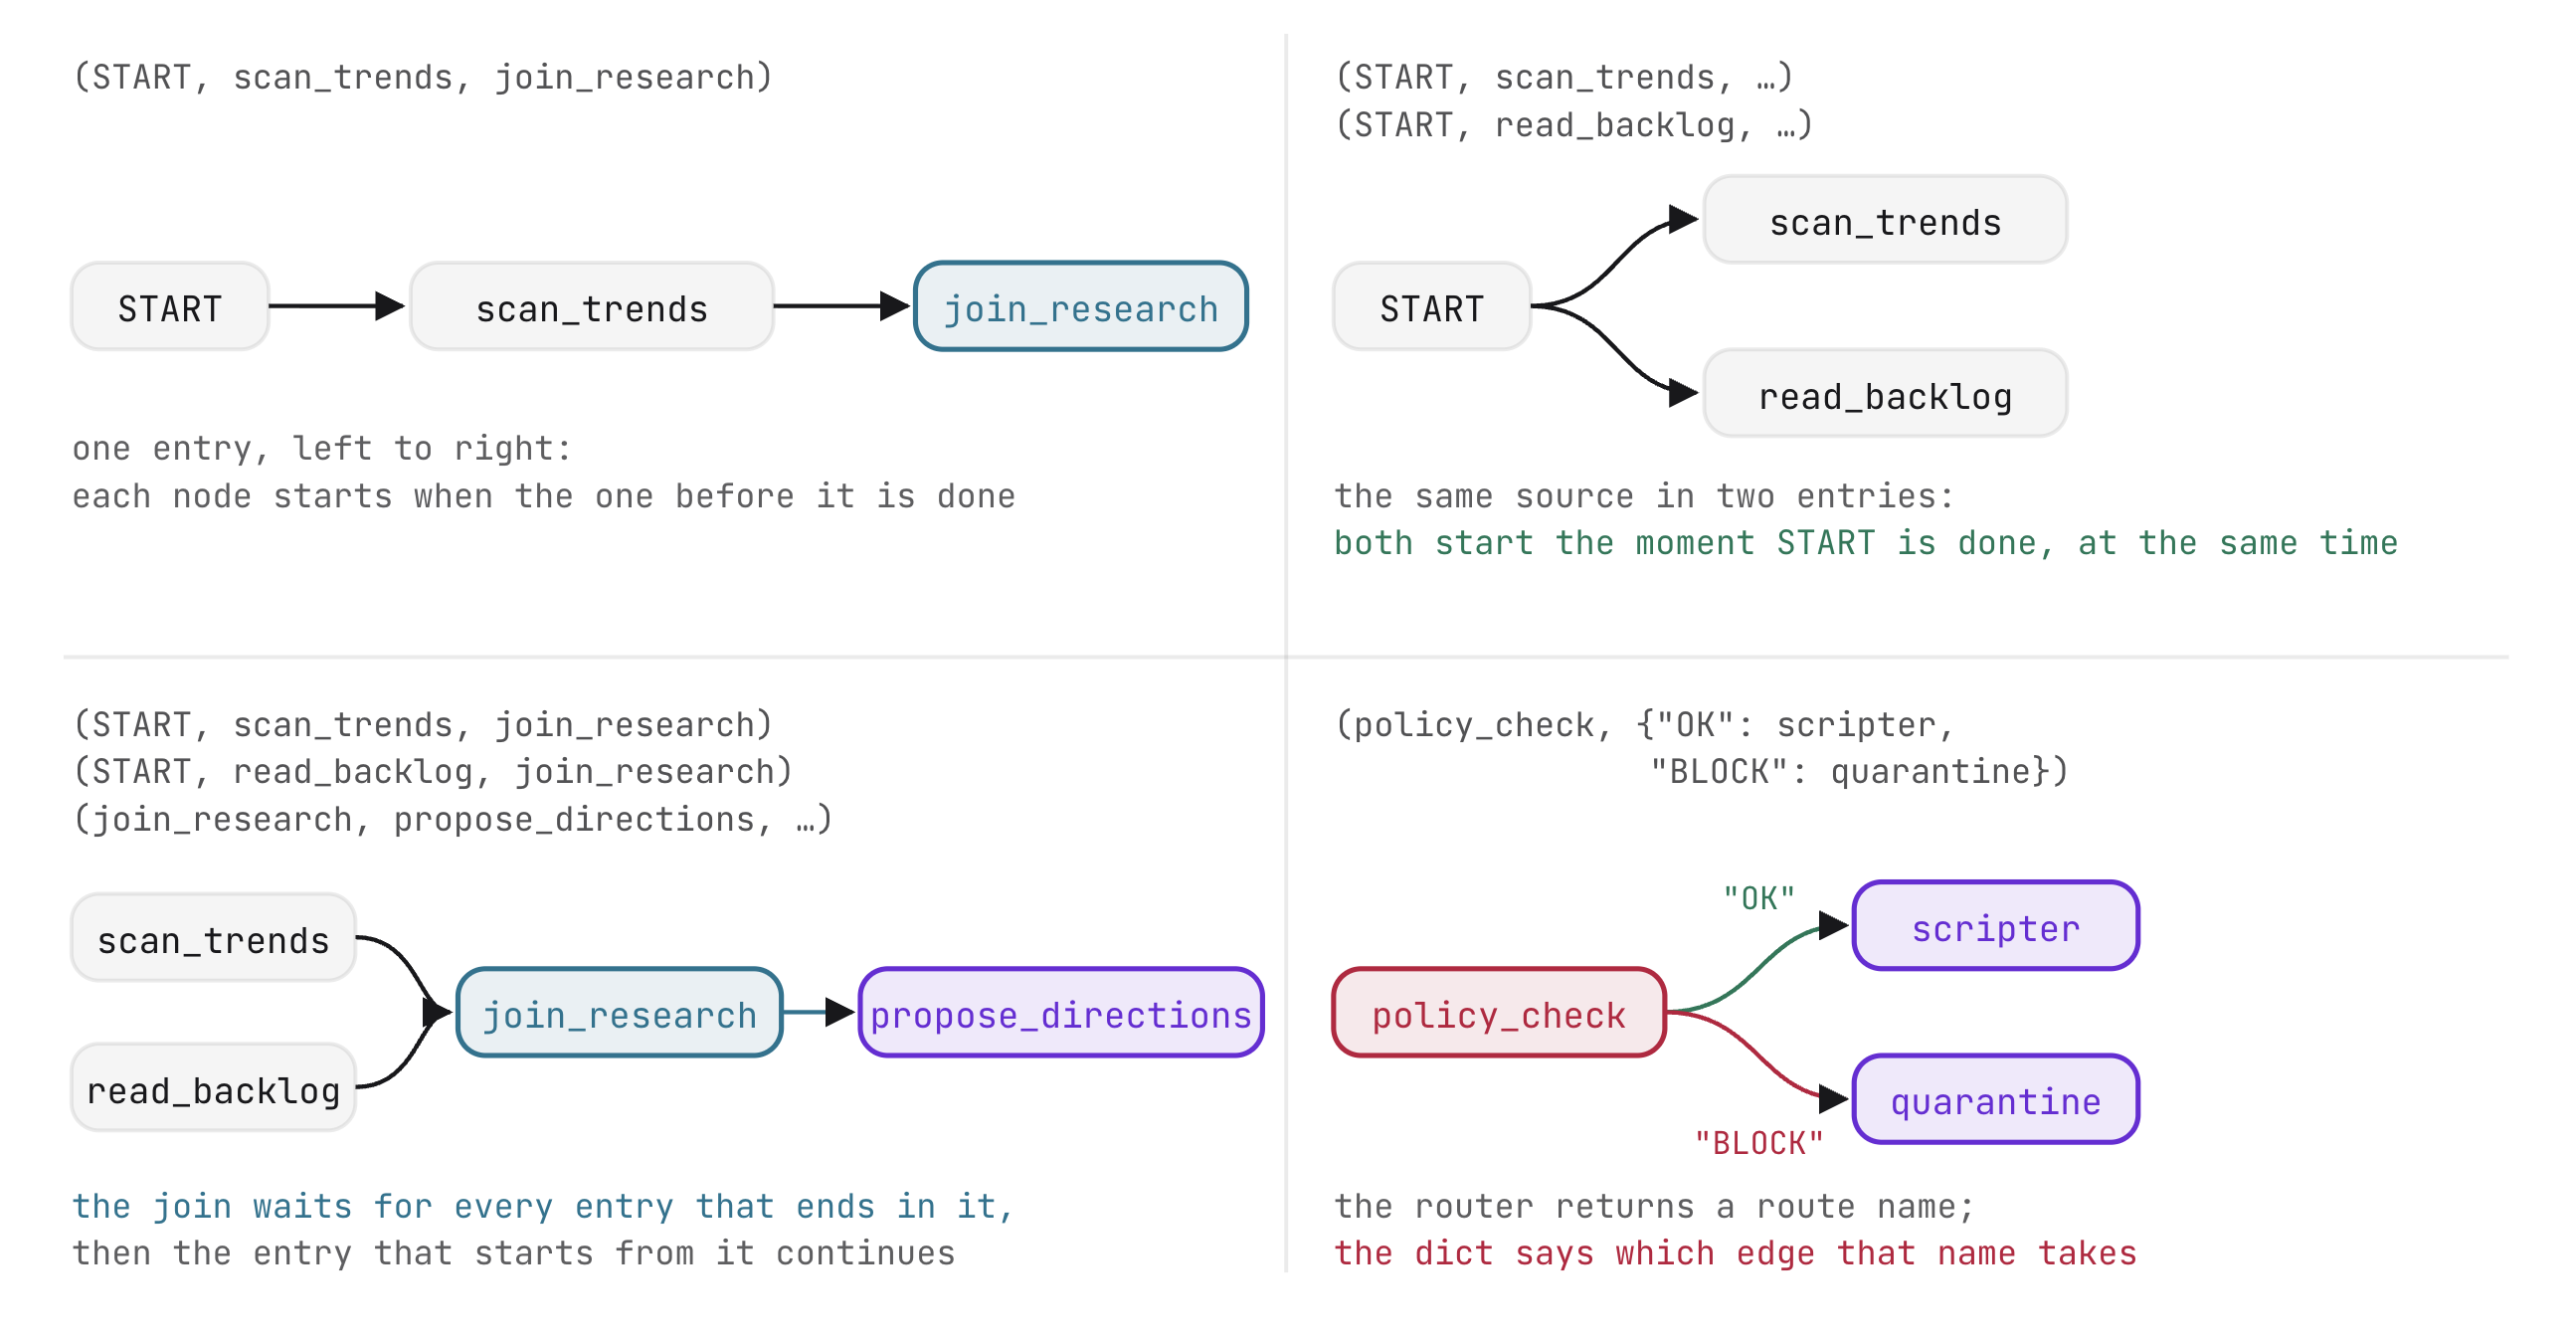
آرکتایپهای گره در ADK
گردشهای کاری ADK چندین نوع گره تخصصی را تشکیل میدهند. هر آرکتایپ نقش عملیاتی خاصی را در گراف ایفا میکند و اجرای قطعی کد را از استدلال مدل مولد جدا میکند:
آرکتایپ گره | پیادهسازی | نقش در خط لوله |
گره تابع | تابع پایتون که یک | منطق قطعی، بازیابی دادهها و جهشهای حالت را اجرا میکند. |
به گره بپیوندید | نمونهی داخلی | شاخههای همزمان را در یک دیکشنری تجمیعشده همگامسازی میکند. |
گره عامل | | دستورالعملها را در مقابل ورودی بالادستی ارزیابی میکند و دادههای معتبر را منتشر میکند. |
گره روتر | تابعی که یک | منطق شرطی را برای انتخاب شاخههای اجرایی پاییندست ارزیابی میکند. |
گره ورودی انسان | تابعی که | وضعیت اجرا را تا رسیدن پاسخ کاربر خارجی به حالت تعلیق در میآورد. |
root_agent = Workflow(
    name="stage1_fanout",
    description="2 real readers -> join -> one research dict",
    edges=[...])
در این پیکربندی، root_agent به جای یک Agent مستقل، نمونهای از Workflow است. ADK با Workflowها به عنوان Agentهای درجه یک رفتار میکند و اجازه میدهد کل یک گراف به عنوان یک برنامه یکپارچه بارگیری، سرویسدهی و بازرسی شود. name برنامه را در ADK Web ثبت میکند، در حالی که لیست edges ، توپولوژی اجرای آن را تعریف میکند.
گنجایش خروجی تحقیقات موازی (4B)
در محیط کار، به بخش خروجی موازی تحقیق (4B) بروید. stage1_fanout/agent.py را باز کنید.
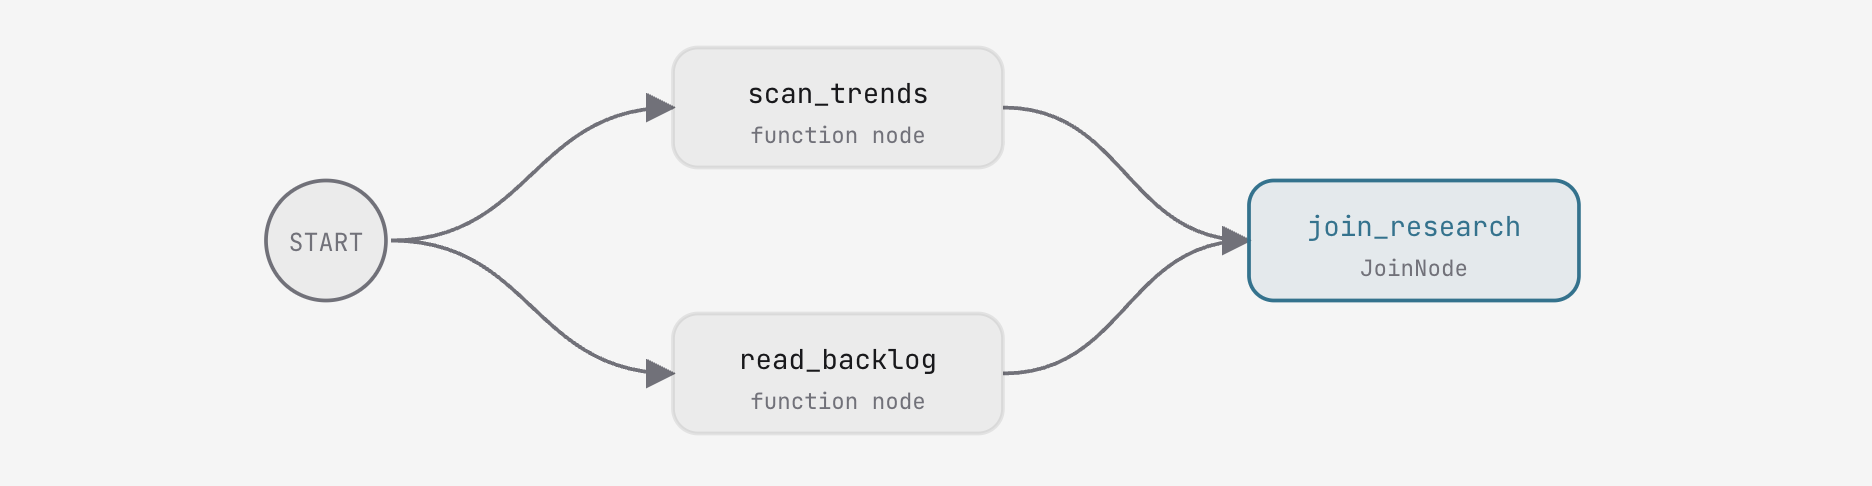
گرههای تابع و موانع همگامسازی
مرحله تحقیق از دو گره تابع که از agent/graph.py وارد شدهاند، استفاده میکند:
-
scan_trends:Event(output={"trends": [...]})شامل ده روند پلتفرم امتیازدهی شده را برمیگرداند. -
read_backlog:Event(output={"backlog": [...], "idea": "..."})را برمیگرداند که شامل پانزده ایده از backlog کانال به همراه اعلان اجرای اولیه است.
هر تابع node_input (خروجی گره قبلی) را میپذیرد و یک Event برمیگرداند.
یک JoinNode به عنوان یک مانع همگامسازی عمل میکند: تا زمانی که هر زنجیره ورودی یک رویداد را ارائه دهد، مکث میکند، سپس تمام نتایج شاخهها را در یک دیکشنری که با نام گره کلیدگذاری شده است، جمع میکند ( {"scan_trends": {...}, "read_backlog": {...}} ).
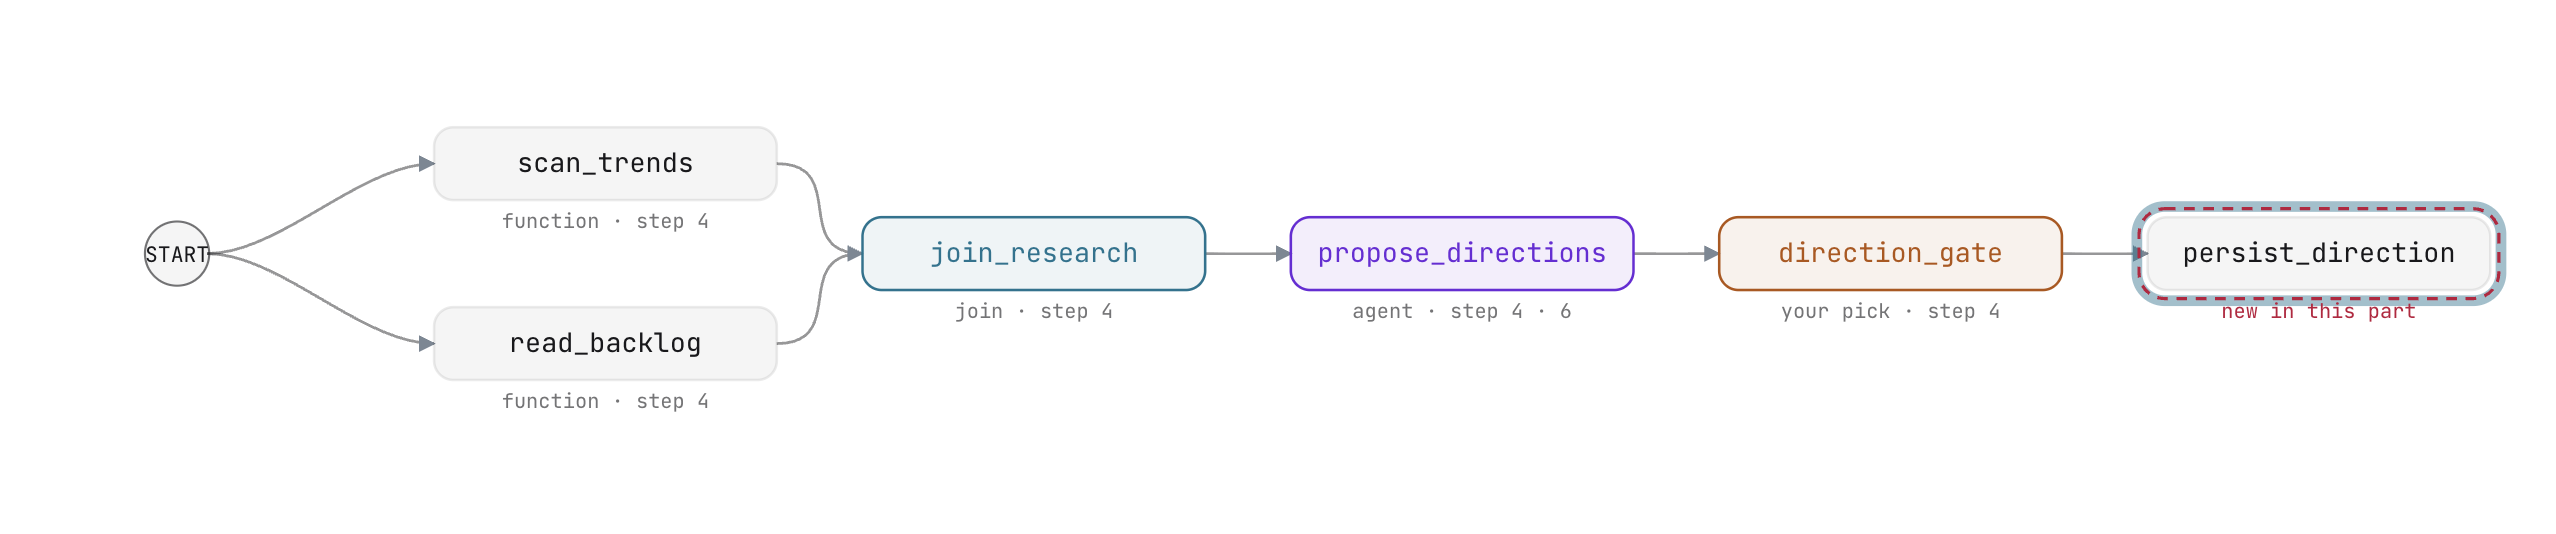
ویرایش عملی: تعریف لبههای اتصال و موازی
در stage1_fanout/agent.py ، JoinNode نمونهسازی کنید و دو زنجیره موازی را با شروع از START به هم سیمکشی کنید:
join_research = JoinNode(name="join_research")
    edges=[(START, scan_trends, join_research),
           (START, read_backlog, join_research)])
تغییرات خود را ذخیره کنید. تأییدکننده میز کار تأیید میکند که اتصال و لبهها سیمکشی شدهاند. مرحله را با استفاده از اجرای مرحله ۱ یا از طریق رابط وب ADK تعبیهشده اجرا کنید.
چه انتظاری باید داشت و چرا
- اجرای همزمان خواننده : در نمودار اجرا،
scan_trendsوread_backlogبه طور همزمان اجرا میشوند.- چرا : هر دو زنجیره از
STARTشروع میشوند. موتور ADK شاخههای مستقل را به طور همزمان زمانبندی میکند.
- چرا : هر دو زنجیره از
- خروجی دیکشنری تجمیعی : گردش کار در
join_researchتکمیل میشود و یک دیکشنری با ورودیهای هر دو خواننده را خروجی میدهد.- چرا :
JoinNodeقبل از اینکه به گرههای بعدی اجازه اجرا بدهد، ضبط کامل دادهها را تضمین میکند.
- چرا :
گرههای عامل (4C)
در محیط کار، به گرههای عامل (4C) بروید. stage2_direction/agent.py را باز کنید.
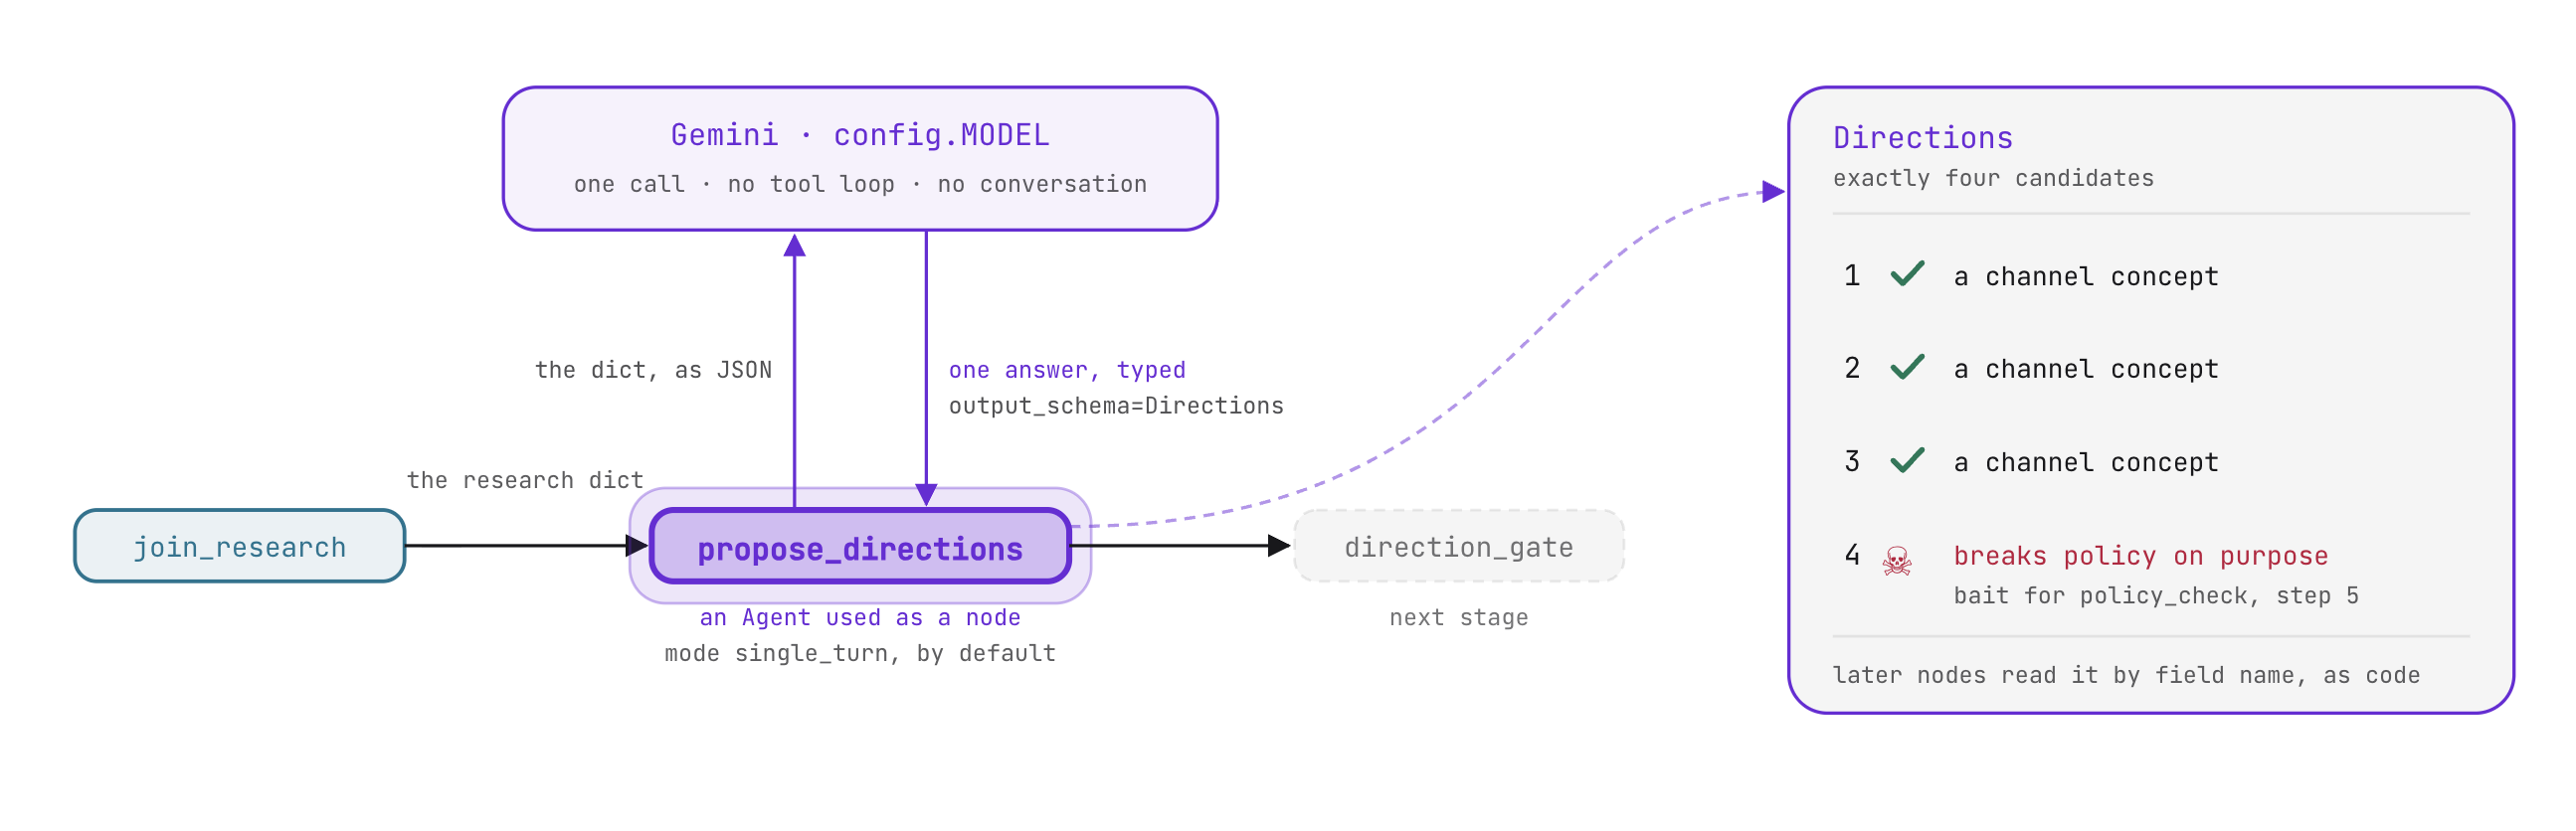
حالتهای عملیاتی و طرحهای ساختاریافته
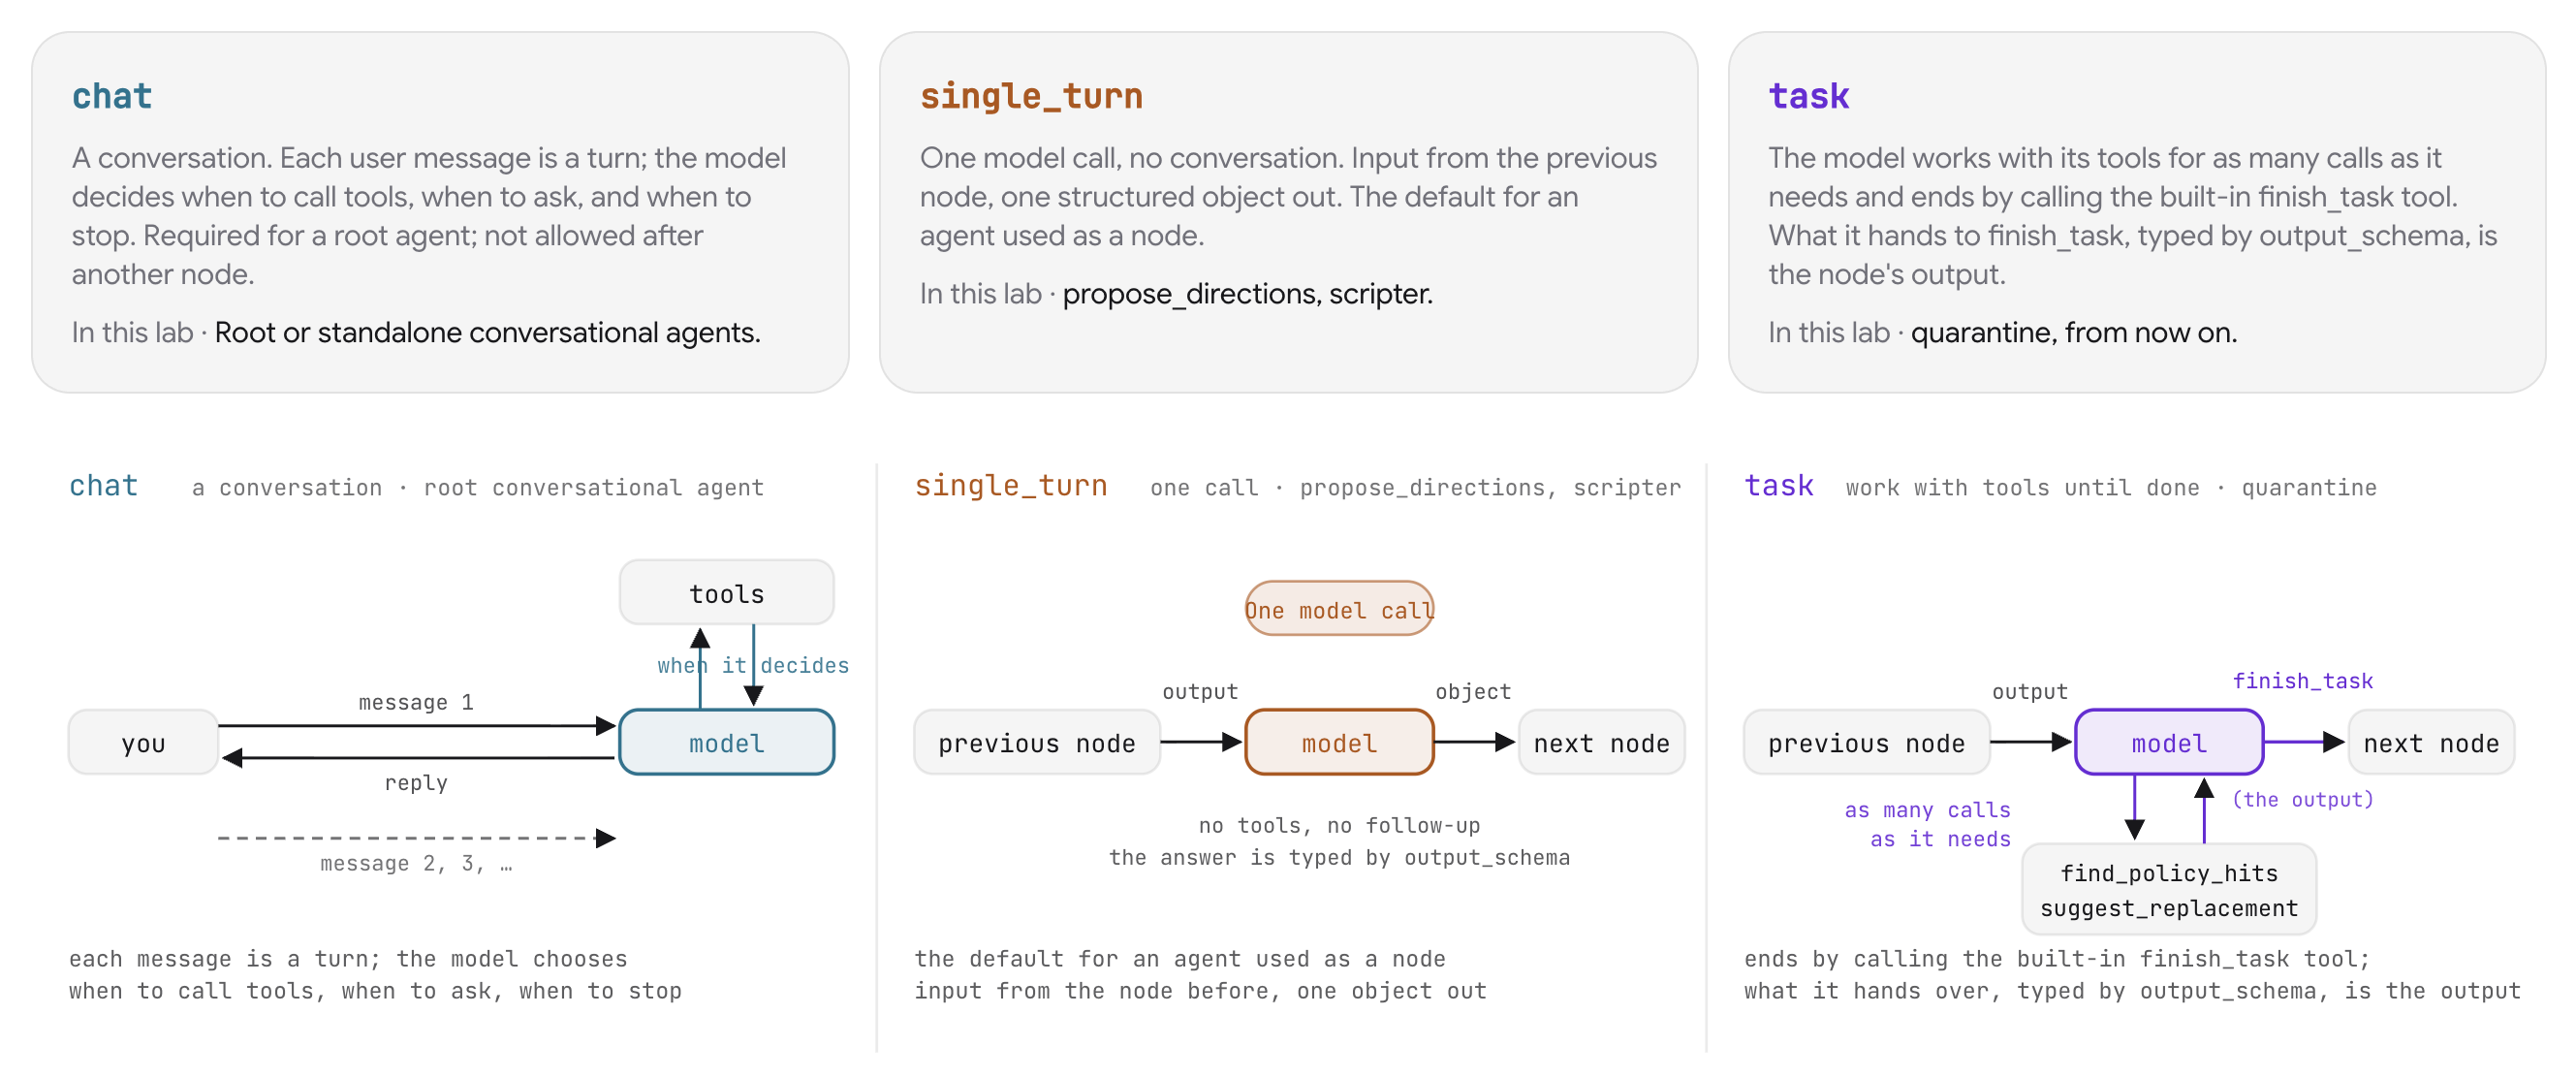
وقتی یک Agent در یک Workflow جاسازی میشود، به طور پیشفرض در حالت single_turn اجرا میشود:
- خروجی گره قبلی را به عنوان ورودی زمینه خود دریافت میکند.
- این یک فراخوانی استنتاج واحد را بدون مکالمهی رفت و برگشتی اجرا میکند.
- دادههای ساختاریافته را به گره بعدی خروجی میدهد.
با اختصاص output_schema=Directions ، عامل اعتبارسنجی Pydantic را بر روی خروجی مدل اعمال میکند. گراف پاییندست به جای نثر بدون ساختار، اشیاء تایپشده را دریافت میکند:
class Direction(BaseModel):
    title: str           # <=60 chars, filmable, characterful
    angle: str           # the twist, one line
    hook: str = ""       # 2-4 words, the video's sticker line
    evidence: list[Evidence]


class Directions(BaseModel):
    candidates: list[Direction]   # exactly 4
PROPOSE_INSTRUCTION مدل را هدایت میکند تا چهار کاندیدا را با استناد به شواهد حاصل از روندها و انباشتگی پیشنهاد دهد. کاندیداهای ۱ تا ۳ مفاهیم کانال مناسبی را ارائه میدهند. کاندیدای ۴ عمداً یک مفهوم ناقض سیاست را برای آزمایش دروازه ایمنی در مرحله بعدی معرفی میکند.
ویرایش عملی: تعریف گره عامل و زنجیر کردن اتصال
در stage2_direction/agent.py ، propose_directions را پیکربندی کنید و لبههای گردش کار را گسترش دهید:
propose_directions = Agent(
    name="propose_directions",
    model=config.MODEL,
    instruction=PROPOSE_INSTRUCTION,
    output_schema=Directions)
    edges=[(START, scan_trends, join_research),
           (START, read_backlog, join_research),
           (join_research, propose_directions, direction_gate)])
چه انتظاری باید داشت و چرا
- مصرف مستقیم دیکشنری :
propose_directionsبدون قالببندی دستی، محتوای JSON منتشر شده توسطjoin_researchرا مصرف میکند. - خروجی کاندید تایپشده : عامل یک شیء
Directionsمعتبر حاوی چهار کاندید گسسته منتشر میکند. گرههای پاییندست فیلدها را بر اساس نام ویژگی (candidate.title) بدون تجزیه رشته میخوانند.
انسان در حلقه (چهاربعدی)
در محیط کار، به بخش Human-in-the-loop (4D) بروید. agent/graph.py را باز کنید.
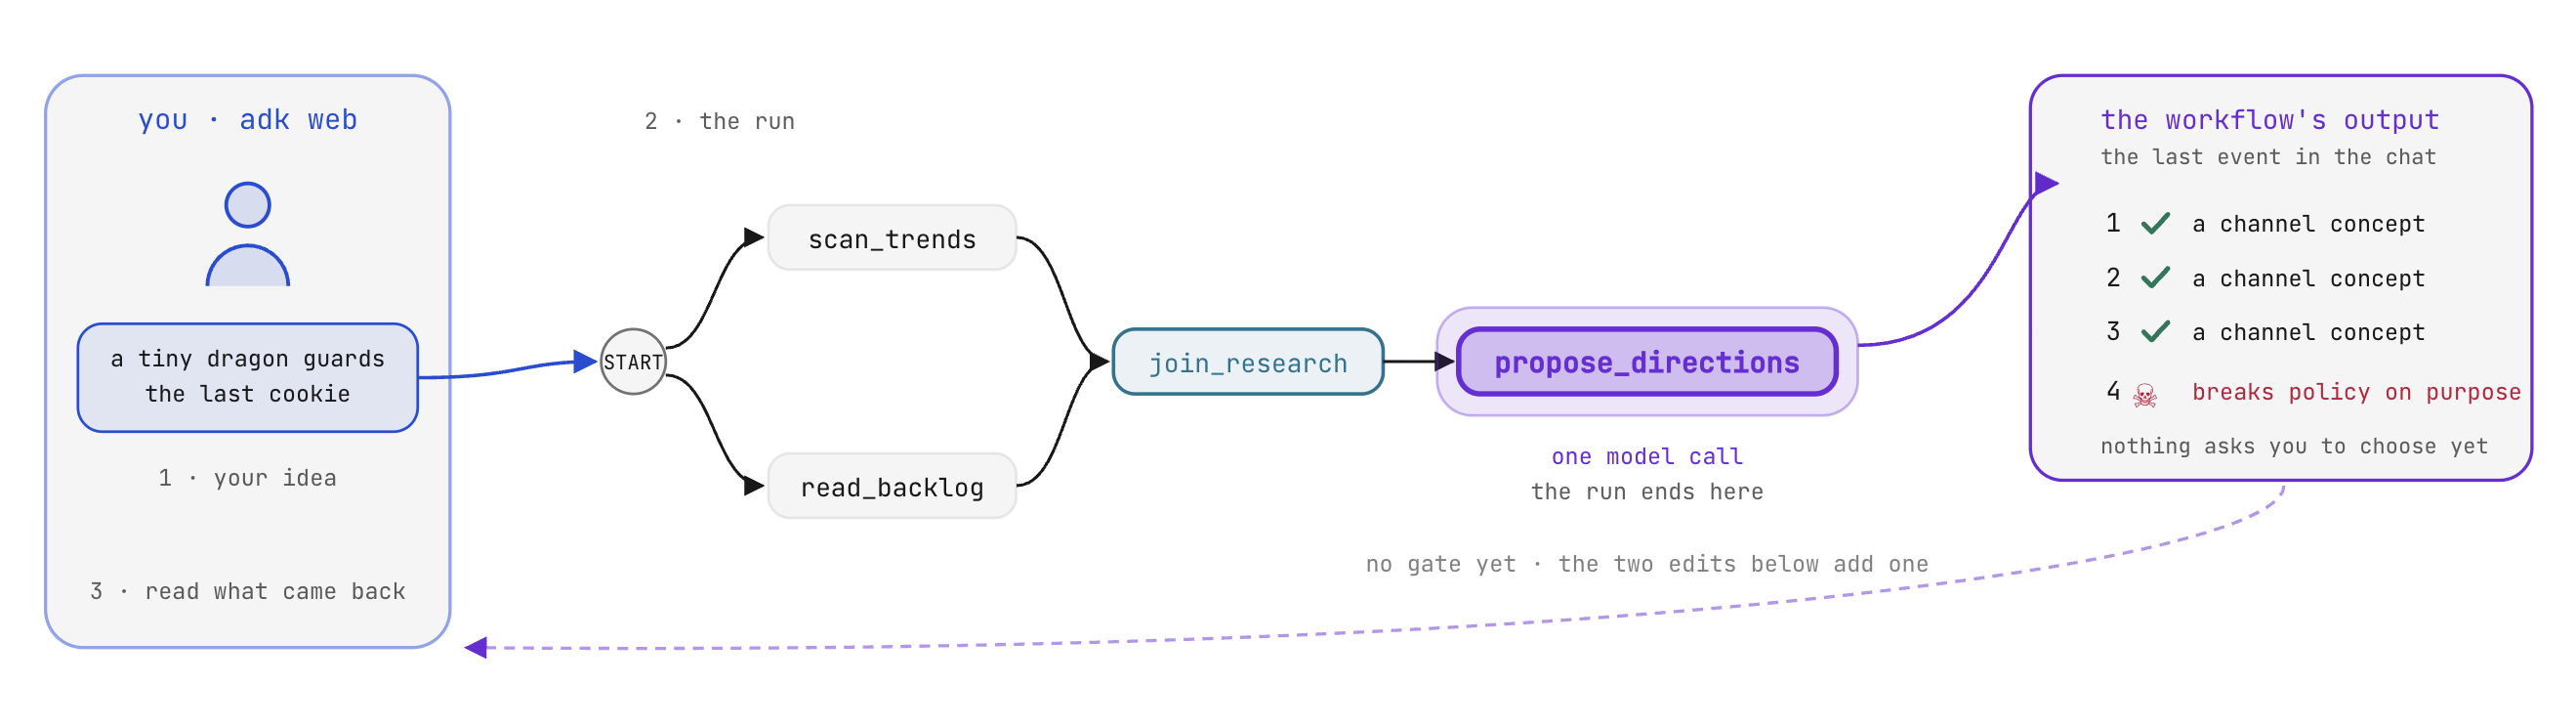
دستورالعملهای سریع در مقابل تعلیق قطعی
گردشهای کاری تولیدی که متحمل هزینههای مالی میشوند یا محتوا را منتشر میکنند، در نقاط تصمیمگیری حیاتی نیاز به نظارت انسانی دارند. در یک اعلان واحد، درخواستهای تأیید، دستورالعملهای مشاورهای هستند که کاربر میتواند به راحتی مدل را وادار به دور زدن آنها کند. در یک گردش کاری ADK، تأیید انسانی توسط موتور اجرا اعمال میشود: گراف در یک گره تعیینشده متوقف میشود و تا زمانی که ورودی خارجی و معتبر از نظر طرحواره دریافت نکند، نمیتواند پیشرفت کند:
- با دادن
RequestInputاجرای گردش کار فوراً متوقف میشود. - ADK یک فراخوانی وقفه باز را در حافظه نشست ثبت میکند و یک
interrupt_idمنحصر به فرد صادر میکند. - فرآیند اجرا بدون مصرف توکنها یا نخهای سرور متوقف میشود.
- اجرای گراف تنها زمانی از سر گرفته میشود که یک
function_responseمعتبر مطابق با طرحواره و شناسه وقفه ارسال شود.
ویرایش عملی: تعلیق اجرا با RequestInput
در agent/graph.py ، فراخوانی تعلیق را درون direction_gate پیادهسازی کنید:
    yield RequestInput(
        message="Pick tonight's direction: 1, 2, 3 or 4.",
        response_schema={
            "type": "object",
            "properties": {
                "pick": {"type": "string", "enum": ["1", "2", "3", "4"]}}},
        payload={"candidates": cands})
RequestInput سه ویژگی را پیکربندی میکند:
-
message: درخواست بررسی که به کاربر ارائه میشود. -
response_schema: یک طرحواره JSON که frontend آن را به عنوان یک فرم ورودی ارائه میدهد و پس از ارسال توسط ADK اعتبارسنجی میشود. -
payload: فرادادهای که همراه با درخواست (چهار کاندید) ارائه میشود و رابطهای کلاینت را قادر میسازد تا کارتهای بررسی را بدون پرسوجو از وضعیت جلسه ارائه دهند.
چه انتظاری باید داشت و چرا
- گردش کار در direction_gate متوقف میشود : در ADK Web یا رابط کاربری میز کار، اجرا متوقف شده و یک فرم انتخاب کاندیدای تعاملی نمایش داده میشود.
- دلیل : موتور با یک
RequestInputناموفق مواجه شد و حالت اجرا را درruns/sessions.dbحفظ کرد.
- دلیل : موتور با یک
- از سرگیری نیاز به ورودی ساختاریافته دارد : ارسال متن چت دلخواه، نمودار را پیش نمیبرد. انتخاب یک گزینه (۱، ۲، ۳ یا ۴) یک
function_responseتایپشده ارسال میکند کهresponse_schemaبرآورده میکند و اجرا را از سر میگیرد.
۵. حالت و روتر
در محیط کاری VibeStudio ، به مرحله ۵ · وضعیت و مسیریاب ، بخشهای (۵A) تا (۵C) بروید.
شما انتخابهای کاربر را در حالت جلسه حفظ خواهید کرد، سیاستهای ایمنی کانال را با استفاده از گرههای روتر قطعی اعمال خواهید کرد و یک عامل وظیفه تکرارشونده را برای اصلاح خودکار نقضهای سیاست قبل از تولید اسکریپتهای ویدیویی، گردآوری خواهید کرد.
وضعیت گردش کار (5A)
در میز کار، به وضعیت گردش کار (5A) بروید.
وضعیت جلسه در مقابل خروجی گره
در یک گردش کار ADK، دادهها از طریق دو مکانیسم مجزا در سراسر نمودار حرکت میکنند:
- خروجی گره (
Event(output=...)) : دادهها مستقیماً به مصرفکنندگان فوری پاییندستی که در لیست لبه تعریف شدهاند، هدایت میشوند. - وضعیت جلسه (
Event(state=...)) : یک دیکشنری کلید-مقدار مشترک که توسط هر گره بعدی در چرخه حیات اجرا قابل دسترسی است.
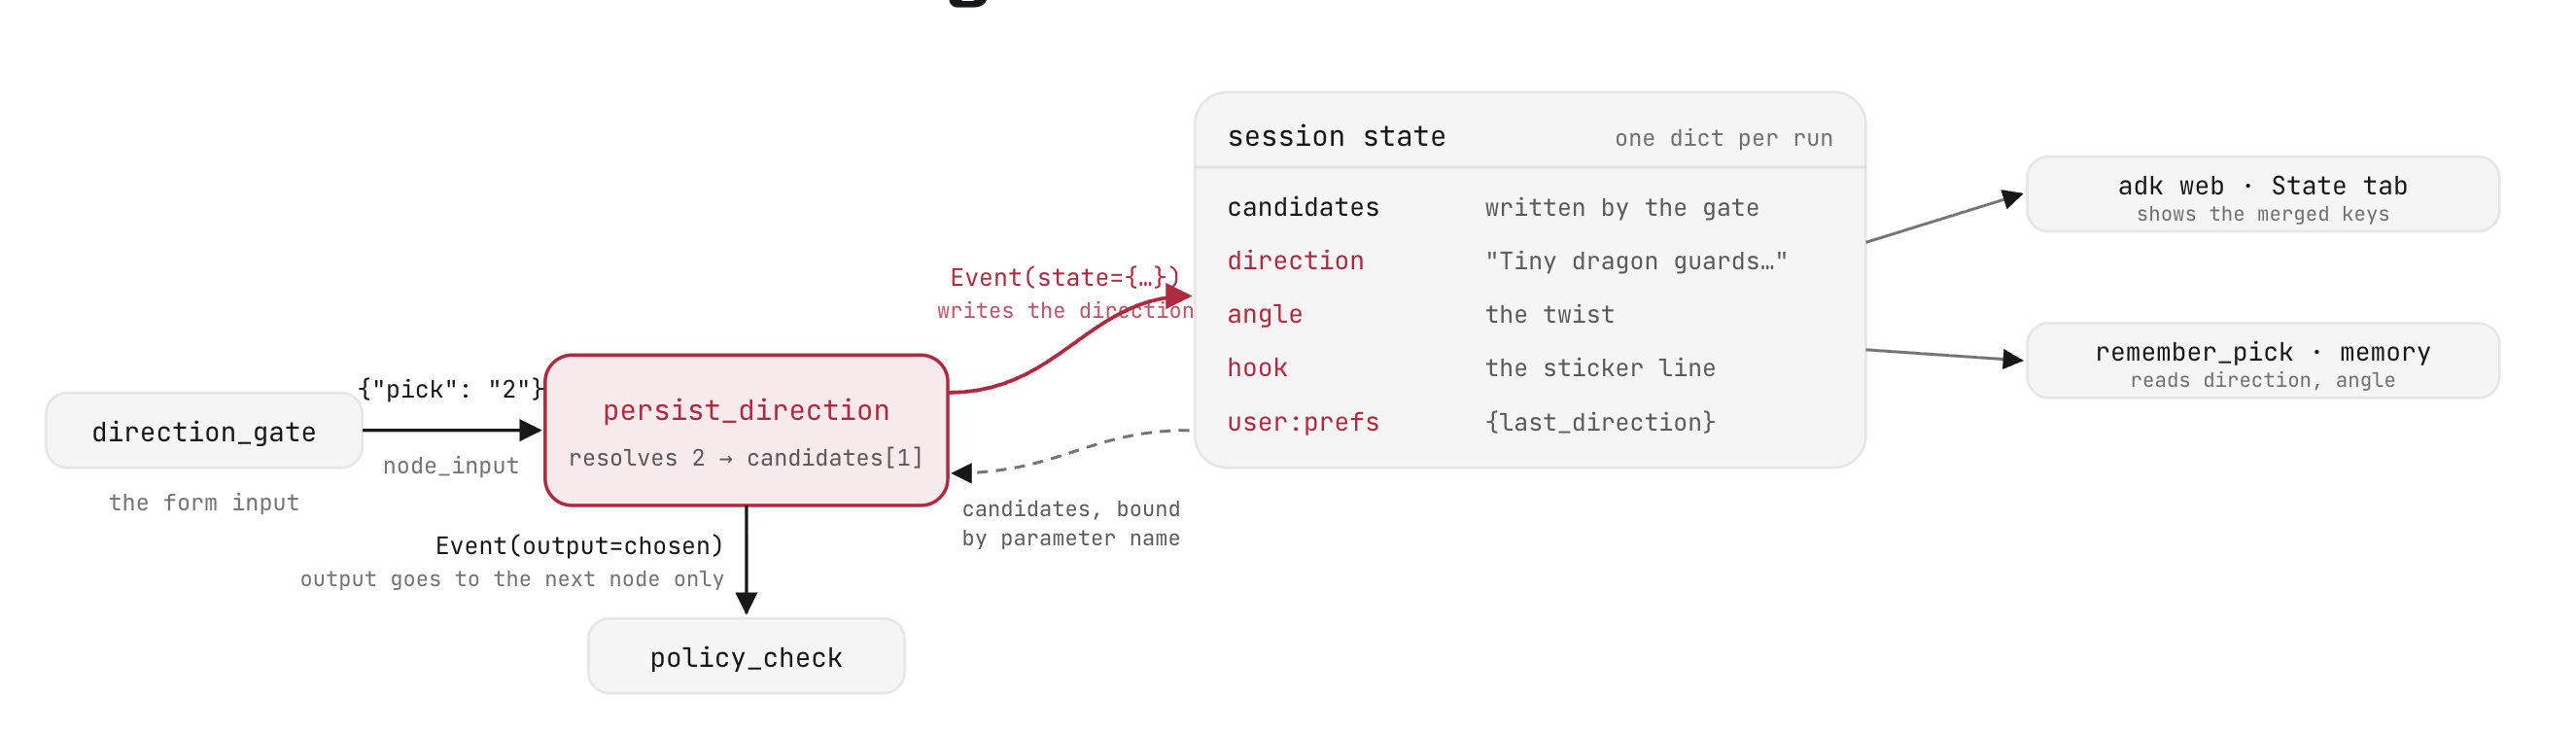
وقتی کاربری یک کاندید را در direction_gate انتخاب میکند، انتخاب به صورت یک اندیس عددی ( {"pick": "2"} ) دریافت میشود. گرههای پاییندست به شیء کامل direction نیاز دارند: عنوان، زاویه روایت و خط قلاب. به جای ارسال فرادادههای طولانی از طریق هر بار داده گره میانی، persist_direction کاندید حلشده را در حالت جلسه مشترک مینویسد.
گرهها نیازی به ارسال کل دیکشنری وضعیت جلسه ندارند. وقتی یک گره Event(state=...) را ارائه میدهد، فقط جفتهای کلید-مقدار جدید یا بهروزرسانیشده را ارائه میدهد. ADK بهطور خودکار این بهروزرسانیها را در حافظه جلسه ادغام میکند:
    yield Event(state={"direction": chosen["title"], "angle": chosen.get("angle", ""),
                       "hook": hook, "user:prefs": {"last_direction": chosen["title"]}})
با اجرای این Event ، کنترل به Workflow runtime منتقل میشود که مقادیر جدید را در session journal در runs/sessions.db ذخیره میکند.
اتصال پارامتر
گرههای تابع ADK به طور خودکار وضعیت جلسه را از طریق بررسی پارامتر میخوانند. اگر امضای یک تابع، نام پارامتری را که با کلید وضعیت موجود مطابقت دارد، اعلام کند، ADK آن کلید را از وضعیت استخراج کرده و مستقیماً آن را ارسال میکند:
def persist_direction(node_input, candidates: list = []):
    ni = node_input if isinstance(node_input, dict) else {}
    raw = ni.get("pick")
    pick = str(raw).strip() if raw is not None else ""
    if candidates:
        i = int(pick) - 1 if pick.isdigit() else 0
        chosen = candidates[max(0, min(len(candidates) - 1, i))]
    else:
        chosen = {"title": "untitled", "angle": "", "evidence": []}
    hook = chosen.get("hook") or " ".join(chosen["title"].split()[:4])
در اینجا، candidates توسط direction_gate در وضعیت جلسه نوشته شدهاند. ADK آن را مستقیماً به persist_direction(node_input, candidates: list = []) بدون نیاز به جستجوی صریح فرهنگ لغت متصل میکند.
کلیدهایی که با user: در طول جلسات در فضای ذخیرهسازی سطح کاربر باقی میمانند و به گردشهای کاری بعدی اجازه میدهند به تنظیمات برگزیدهی سازنده دسترسی داشته باشند.
ویرایش عملی: حفظ حالت و سیمکشی گره
- در
agent/graph.py، درونpersist_direction، خطTODO: PERSIST_STATEرا با yield رویداد state جایگزین کنید:
    yield Event(state={"direction": chosen["title"], "angle": chosen.get("angle", ""),
                       "hook": hook, "user:prefs": {"last_direction": chosen["title"]}})
- در
stage3_router/agent.py،persist_directionبه زنجیره سوم در لیستedgesاضافه کنید:
           (join_research, propose_directions, direction_gate,
            persist_direction)
فایلهای خود را ذخیره کنید. در میز کار، بررسی کنید که آیا state write in place و persist_direction in the chain هر دو علامت سبز رنگ دارند یا خیر.
گره روتر (5B)
در میز کار، به گره روتر (5B) بروید.
مسیریابی قطعی با سیاست
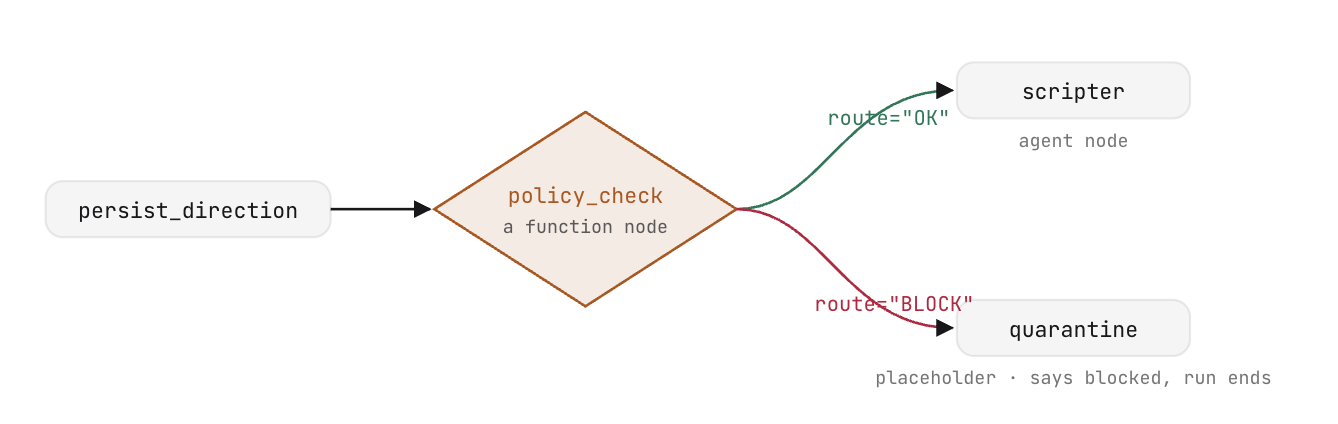
روتر یک گره تابعی تخصصی است که خروجی بالادست را ارزیابی میکند و اجرا را در امتداد شاخههای گراف شرطی هدایت میکند. برخلاف عاملهای مولد، روتر منطق قطعی را بدون انجام فراخوانیهای LLM اجرا میکند.
یک روتر Event را برمیگرداند که یک برچسب route را مشخص میکند:
def length_check(node_input):
    too_long = len(node_input.get("title", "")) > 60
    return Event(output=node_input, route="TRIM" if too_long else "PASS")
در تعریف گردش کار، یک هدف لبهای که به عنوان یک دیکشنری تعریف میشود، نام مسیرها را به گرههای مقصد نگاشت میکند:
(length_check, {"TRIM": shorten, "PASS": scripter}),
مسیریاب گردش کار policy_check عبارات ممنوعه را از agent/policy_words.txt میخواند و تطبیق کل کلمه را با عنوان و زاویه جهت انتخاب شده انجام میدهد:
return Event(output=node_input, route="BLOCK" if bad else "OK")
ذخیره سیاست به عنوان داده به جای دستورالعملهای کدگذاریشده، بهروزرسانیها را بدون تغییر نمودار گردش کار امکانپذیر میکند: بهروزرسانی فایل متنی بلافاصله در اجراهای بعدی اعمال میشود. از آنجا که ارزیابی بر اساس تطبیق قطعی عبارات منظم است، قبل از شروع اسکریپتنویسی مولد، در عرض چند میلیثانیه و با هزینه توکن صفر اجرا میشود.
مقصدها: اسکریپتر و قرنطینه
روتر ترافیک را به یکی از دو گره پاییندستی هدایت میکند:
-
scripter: یک گرهsingle_turnagent که مسیر تایید شده را به یک اسکریپت تولید ساختار یافته مطابق با طرحScriptPydantic تبدیل میکند:
scripter = Agent(
    name="scripter",
    model=config.MODEL,
    instruction=SCRIPT_INSTRUCTION,
    output_schema=Script)
quarantine: در ابتدا یک تابع جانگهدار است که مسیرهای علامتگذاری شده را متوقف میکند و در بخش بعدی با یک عامل اصلاح خودکار جایگزین میشود.
ویرایش عملی: مسیریابی بررسی خطمشی
- در
agent/graph.pyو درونpolicy_check، دستور return را کامل کنید:
return Event(output=node_input, route="BLOCK" if bad else "OK")
- در
stage3_router/agent.py،edgesمسیرpolicy_checkبهروزرسانی کنید و شاخه قرنطینه را دوباره بهscripterمتصل کنید:
           (join_research, propose_directions, direction_gate,
            persist_direction, policy_check),
           (policy_check, {"OK": scripter, "BLOCK": quarantine}),
           (quarantine, scripter)])
فایلهای خود را ذخیره کنید. در میز کار، بررسی کنید که نگاشتهای لبه روتر تأیید شدهاند.
حالتهای عامل و گره وظیفه (5C)
در میز کار، به حالتهای عامل (Agent modes) و گره وظیفه (5C) بروید.
حالتهای اجرای عامل
نمونههای ADK Agent از سه حالت اجرا متناسب با الزامات خاص خط لوله پشتیبانی میکنند:
حالت | چرخه حیات اجرا | نقش در خط لوله |
| حلقه مکالمه چند نوبتی. این مدل تعیین میکند که چه زمانی ابزارها را فراخوانی کند، ورودی درخواست کند یا نوبت را پایان دهد. | عوامل ریشهای که با یک کاربر انسانی تعاملی روبرو هستند. |
| فراخوانی استنتاج مدل واحد. ورودی گره قبلی را میپذیرد و یک شیء طرحواره ساختاریافته منتشر میکند. | تبدیلهای گراف ترتیبی ( |
| حلقه خودکار با اجرای ابزار. عامل تا زمانی که ابزار داخلی | اصلاح و بازرسی چند مرحلهای ( |
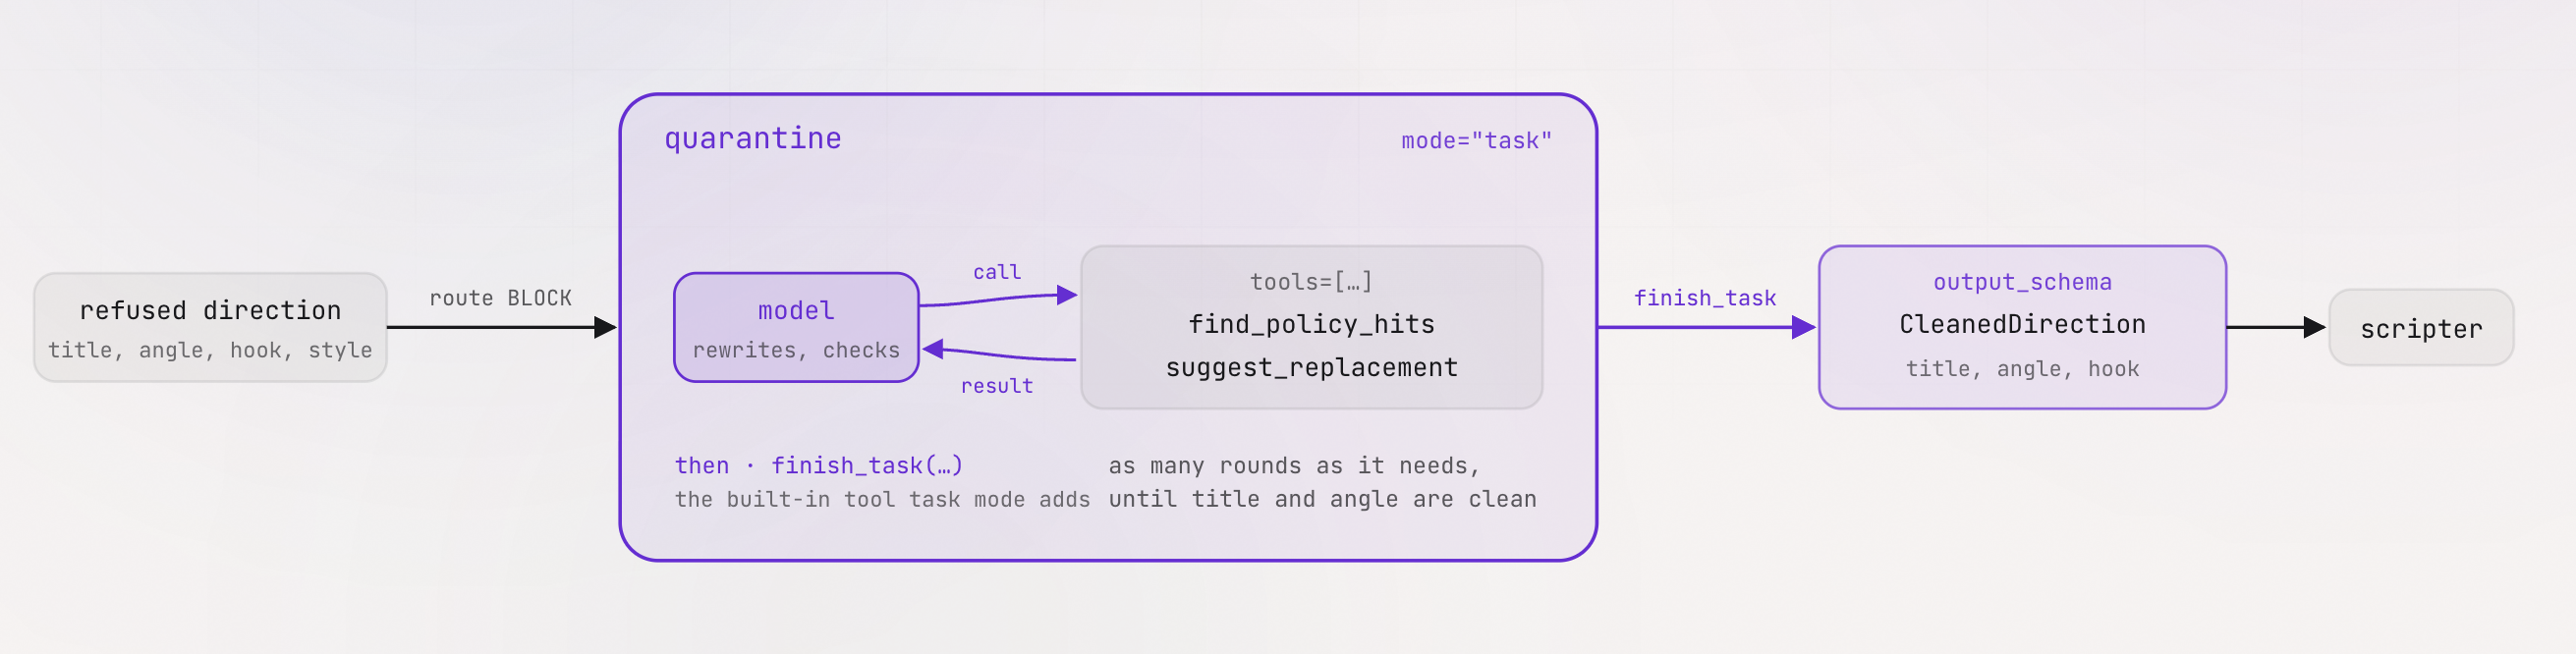
اصلاح خودکار سیاستها
بازنویسی یک مسیر علامتگذاری شده نیاز به حالت task دارد زیرا تعداد تکرارهای اصلاح متغیر است. عامل، مسیر علامتگذاری شده را دریافت میکند، find_policy_hits را برای تشخیص تخلفات فراخوانی میکند، از طریق suggest_replacement درخواست گزینههای تأیید شده را میدهد، مسیر را بازنویسی میکند و قبل از ادامه، پاکیزگی را تأیید میکند.
هر دو ابزار در agent/cleanup_tools.py با امضاها و docstring های تایپ شده تعریف شده اند:
def find_policy_hits(text: str) -> dict:
    """Which refused words appear in `text`. Matches whole words and phrases
    from agent/policy_words.txt, case-insensitive.

    Returns {"hits": [...], "clean": bool}. clean is true when hits is empty.
    """


def suggest_replacement(word: str) -> dict:
    """The channel's approved stand-in for a refused word, read from
    agent/policy_replacements.txt.

    Returns {"word", "replacement", "listed"}. When the word has no entry,
    listed is false and replacement is a hint to pick a gentle synonym.
    """
ویرایش عملی: مونتاژ عامل وظیفه قرنطینه
در stage3_router/agent.py ، تابع quarantine جایگزین را با تعریف عامل وظیفه جایگزین کنید:
quarantine = Agent(
    name="quarantine",
    model=config.MODEL,
    instruction=QUARANTINE_INSTRUCTION,
    mode="task",
    tools=[find_policy_hits, suggest_replacement],
    output_schema=CleanedDirection,
)
حالت Task، عامل را به ابزارهایی مجهز میکند و با فراخوانی finish_task اجرا را خاتمه میدهد. هنگامی که mode="task" پیکربندی میشود، ADK به طور خودکار finish_task ارائه میدهد و پارامترهای آن را از output_schema استخراج میکند و تضمین میکند که گره یک شیء CleanedDirection تایپ شده مطابق با طرح ورودی گره اسکریپتر ارائه میدهد.
چه انتظاری باید داشت و چرا
هر دو مسیر اجرا را در ADK Web یا VibeStudio Workbench آزمایش کنید:
- مسیر تایید شده (کاندیدای ۱، ۲ یا ۳) :
- انتخاب یک مسیر کاندید تایید شده از
policy_checkبه طور مستقیم بهscripter(route="OK"). - اسکریپتنویس یک اسکریپت تولیدی سهمرحلهای مطابق با طرح
Scriptتولید میکند.
- انتخاب یک مسیر کاندید تایید شده از
- مسیر اصلاح قرنطینه (کاندیدای ۴) :
- کاندیدای ۴ شامل واژگان علامتگذاری شده ("کلیکبیت"، "هک ویروسی") است.
-
policy_checkمسیرهای منتهی بهquarantine(route="BLOCK"). - در ردیابی جلسه، مشاهده کنید که
quarantineتابعfind_policy_hitsفراخوانی میکند، برای هر تخلفsuggest_replacementفراخوانی میکند، عنوان را بازنویسی میکند وfinish_taskفراخوانی میکند. - اجرا دوباره به
scripterمتصل میشود و یک اسکریپت از مسیر پاکسازیشده تولید میکند.
۶. بانک حافظه
در محیط کاری VibeStudio ، به مرحله 6 · Memory Bank ، قطعات (6A) و (6B) بروید.
گردش کار در حال حاضر بدون حافظه در طول جلسات اجرا میشود. هر اجرا از ابتدا شروع میشود، بدون اینکه سازنده قبلاً چه چیزی را انتخاب کرده یا کدام ژانرها را ترجیح میدهد. در این مرحله، شما بانک حافظه موتور عامل هوش مصنوعی Vertex را متصل میکنید تا تنظیمات سازنده را در طول اجراها ذخیره و بازیابی کند.
نکته مهم این است که حافظه به جای گرههای خط لوله، از طریق فراخوانیهای چرخه عمر عامل یکپارچه میشود. از آنجا که استخراج و بازیابی حافظه به جای مراحل داده میانی، به عاملهای منفرد سرویس میدهد، اتصال فراخوانیهای مجدد، توپولوژی گراف تمیز و جدا شده را حفظ میکند.
بانک حافظه (6A)
در میز کار، به بانک حافظه (6A) بروید.
حافظه مدیریتشده در سطح کاربر
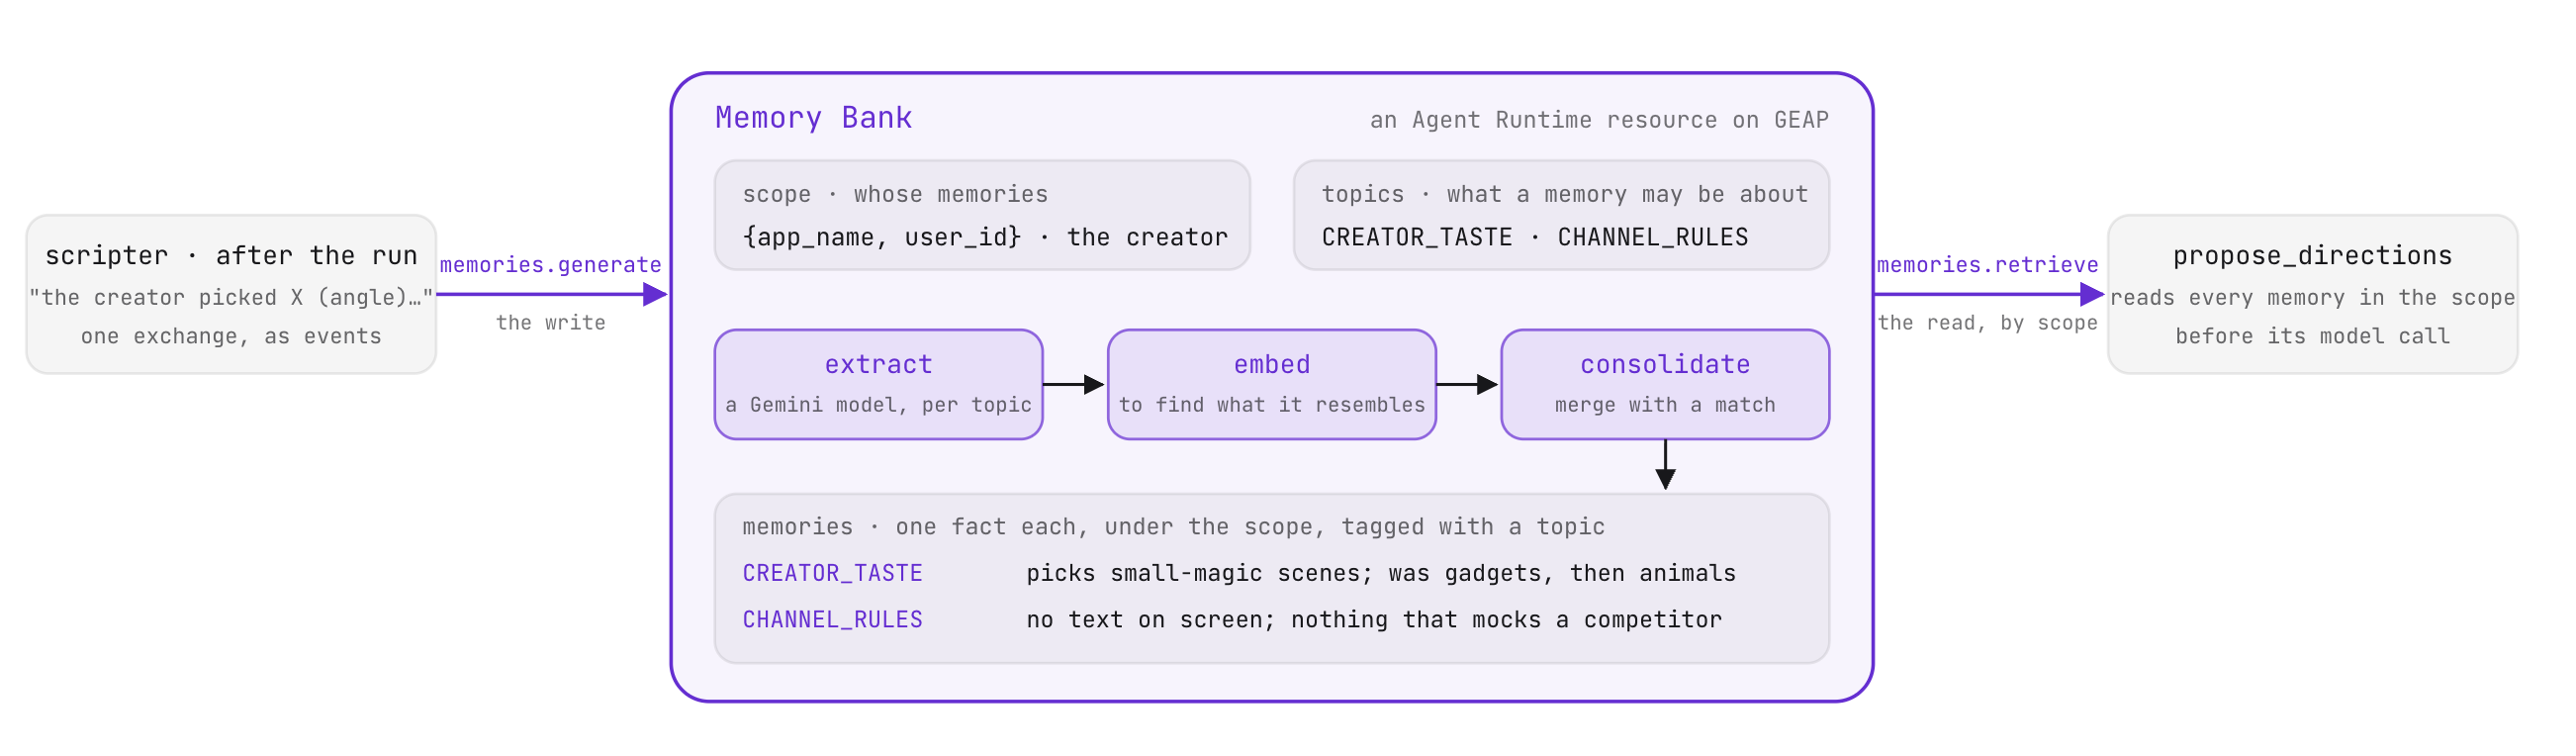
بانک حافظه یک سرویس مدیریتشده برای حافظه بلندمدت کاربر است. این سرویس، اطلاعات مربوط به یک شخص را تحت یک محدوده تعریفشده سازماندهی میکند که در اینجا با نام برنامه و شناسه کاربری مشخص میشود:
SCOPE = {"app_name": config.APP, "user_id": config.USER}
TOPICS = {
    "CREATOR_TASTE": "Which video directions this creator picks and passes on, "
                     "and how that preference changes over time.",
    "CHANNEL_RULES": "Standing instructions the creator states for every video "
                     "(style, subjects to avoid, format rules).",
}
مباحث حافظه سفارشی، مرزهای آنچه بانک ثبت میکند را تعریف میکنند:
- استخراج موضوع : وقتی متن مکالمه جدید از طریق
memories.generateارسال میشود، سرویس یک مدل استخراج را برای هر توضیح موضوع اعمال میکند. متنی که با موضوع مطابقت نداشته باشد، هیچ خاطرهای ایجاد نمیکند. - تجمیع و حذف دادههای تکراری : این سرویس، حقایق تازه استخراجشده را به دادههای جاسازیشده تبدیل کرده و آنها را با حافظههای موجود در محدوده مقایسه میکند. هنگامی که یک مشاهده با حافظه موجود همسو میشود، سرویس آن حافظه را بهروزرسانی میکند. هنگامی که اطلاعات جدیدی را نشان میدهد، سرویس یک ورودی جدید ایجاد میکند. این فرآیند تجمیع تضمین میکند که چندین جلسه در مورد یک موضوع به جای تولید ورودیهای تکراری، در یک خلاصه منسجم ادغام شوند.
- Retrieval : Calling
memories.retrievewith the user scope returns stored facts, ordered oldest first.
Both operations are implemented in agent/platform/memory.py . The provisioned bank resource name is cached locally in runs/memorybank.json .
Setting up the Memory Bank
Use the workbench controls or run the CLI commands in your terminal:
- Connect and provision the bank :
python -m agent.platform.bankCREATOR_TASTEandCHANNEL_RULEStopics. - Seed historical sessions :
python -m agent.platform.bank load - Inspect consolidated facts :
python -m agent.platform.bank list
Callbacks (6B)
In the workbench, navigate to Callbacks (6B) . Open stage4_memory/agent.py .
ADK agent lifecycle callbacks
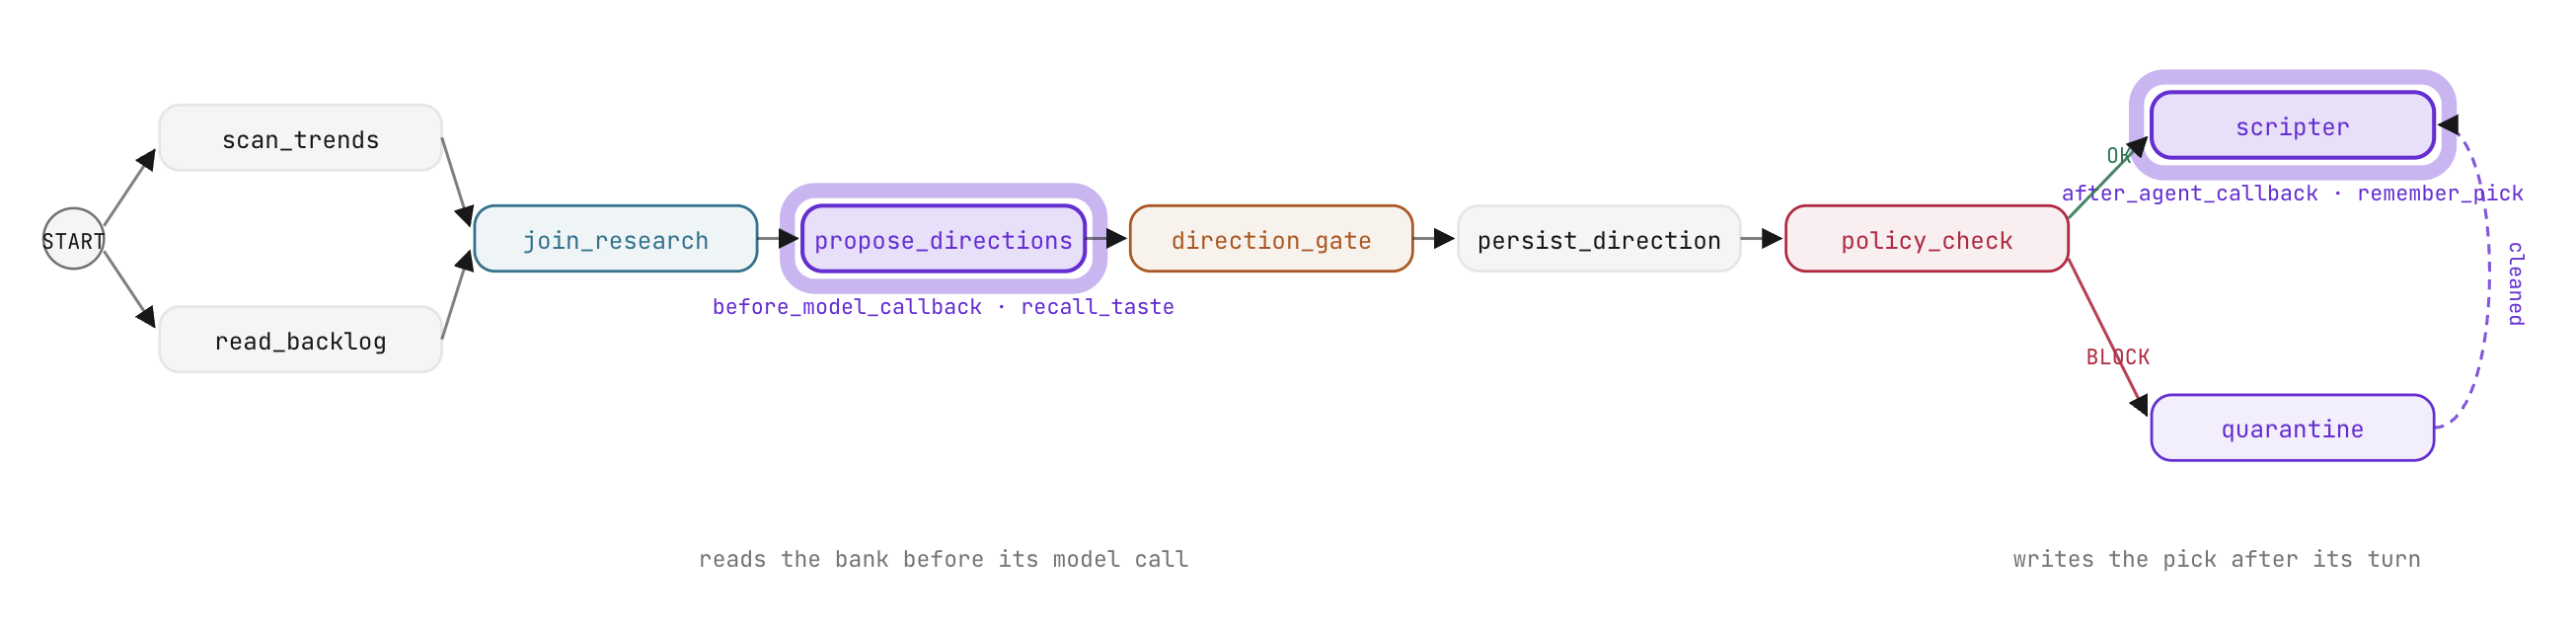
A callback is a function passed as an argument to an Agent . ADK invokes callbacks at predefined lifecycle moments, passing the active context. Returning None continues normal execution; returning a replacement object overrides or intercepts the operation.
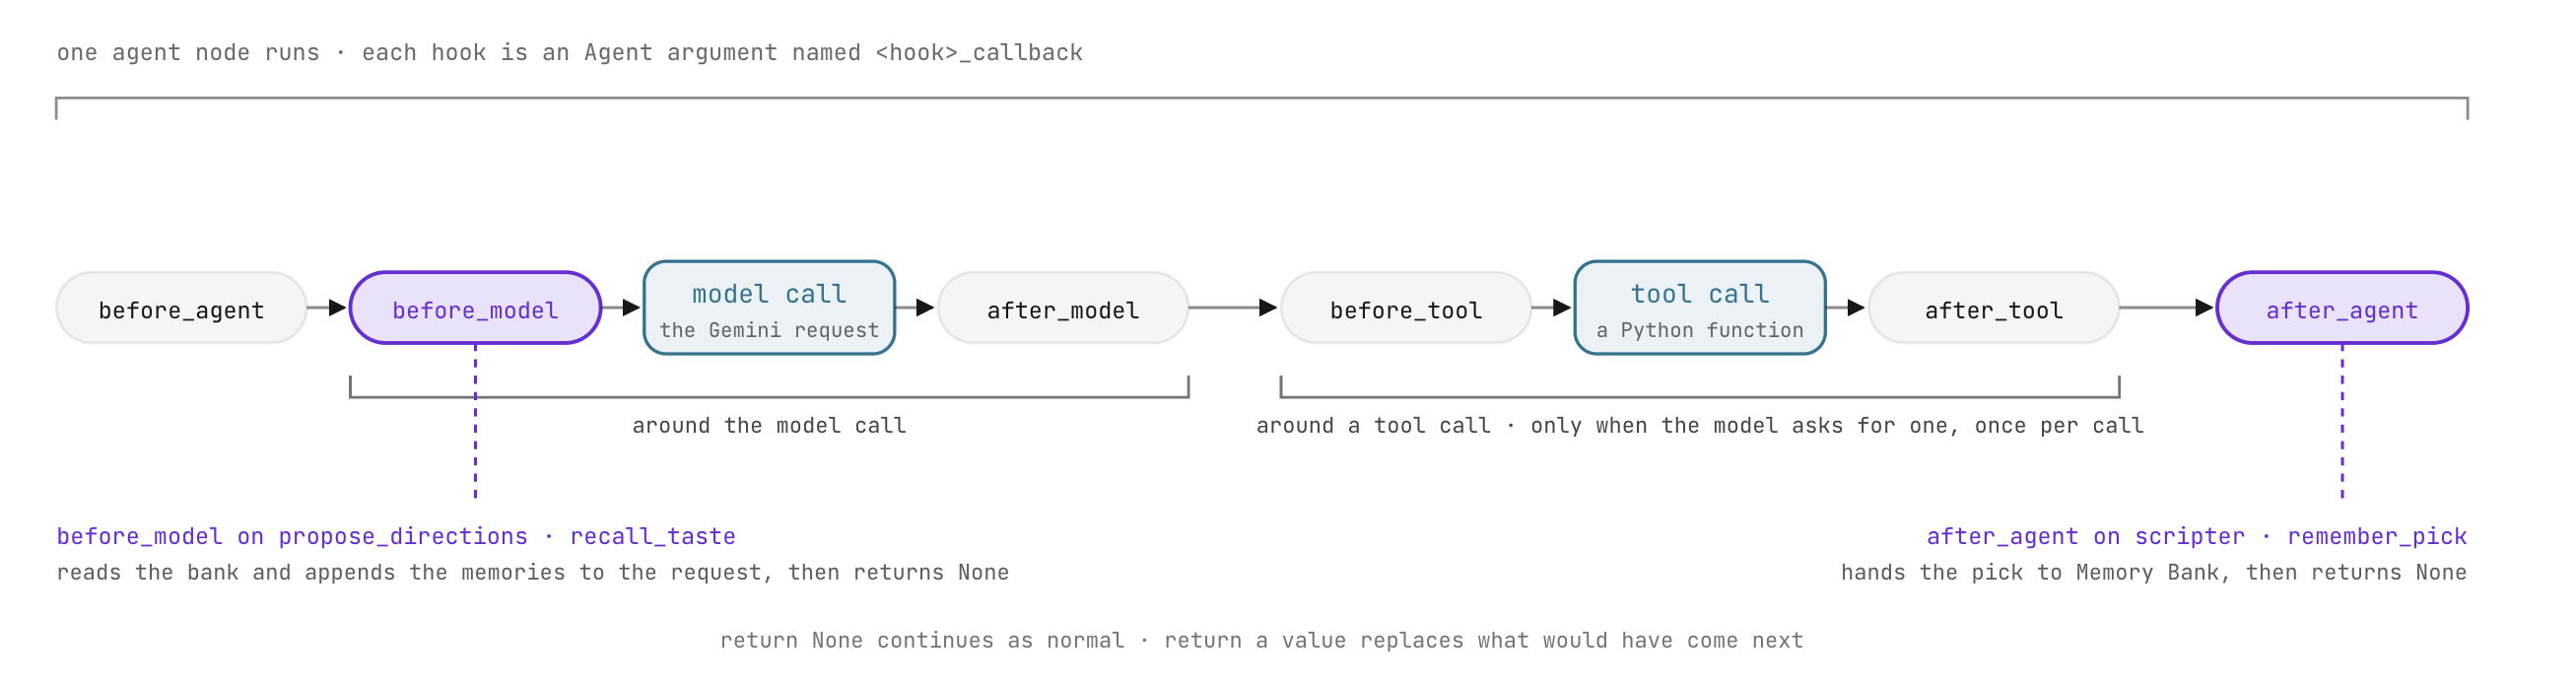
ADK provides three pairs of callbacks:
Callback Pair | Invocation Point | Parameters Received | Return Value Behavior |
| Surrounding the entire agent turn | | Returning |
| Surrounding each LLM inference call | | Returning |
| Surrounding each tool execution | Tool definition, arguments, result | Returning a dict overrides the tool output; |
Callbacks provide a clean location for context injection, guardrails, telemetry, and cache lookups without introducing extraneous nodes into the workflow graph.
Hands-on edit: wiring recall and remember callbacks
- In
stage4_memory/agent.py, updatepropose_directionsto attachbefore_model_callback=recall_taste:
    output_schema=Directions,
    before_model_callback=recall_taste)
recall_taste executes immediately before Gemini generates candidate directions. It fetches the creator's history from Memory Bank, formats the memories oldest first, and appends them to the outgoing LlmRequest . The prompt directs the model to lean candidates 1 to 3 toward the creator's current taste while treating channel rules as strict constraints.
- In
stage4_memory/agent.py, updatescripterto attachafter_agent_callback=remember_pick:
    output_schema=Script,
    after_agent_callback=remember_pick)
remember_pick runs after scripter completes its turn. It reads the chosen direction from session state, synthesizes a concise statement summarizing the creator's decision, and calls memories.generate to update the Memory Bank.
What to expect and why
Test the callback-augmented workflow in the workbench or ADK Web:
- Execute a run with an empty prompt:
- In the session trace, inspect the
LlmRequestforpropose_directions. Notice the appended memory context detailing the creator's preference for fantasy themes and concise pacing. - Observe the proposed directions: candidates 1 to 3 align with the creator's historical preferences even when trends emphasize other topics.
- In the session trace, inspect the
- Select a candidate at
direction_gate. - After
scriptercompletes, review the Memory Bank records:python -m agent.platform.bank list
7. RAG Engine
In the VibeStudio Workbench , navigate to Step 7 · RAG Engine , parts (7A) and (7B) .
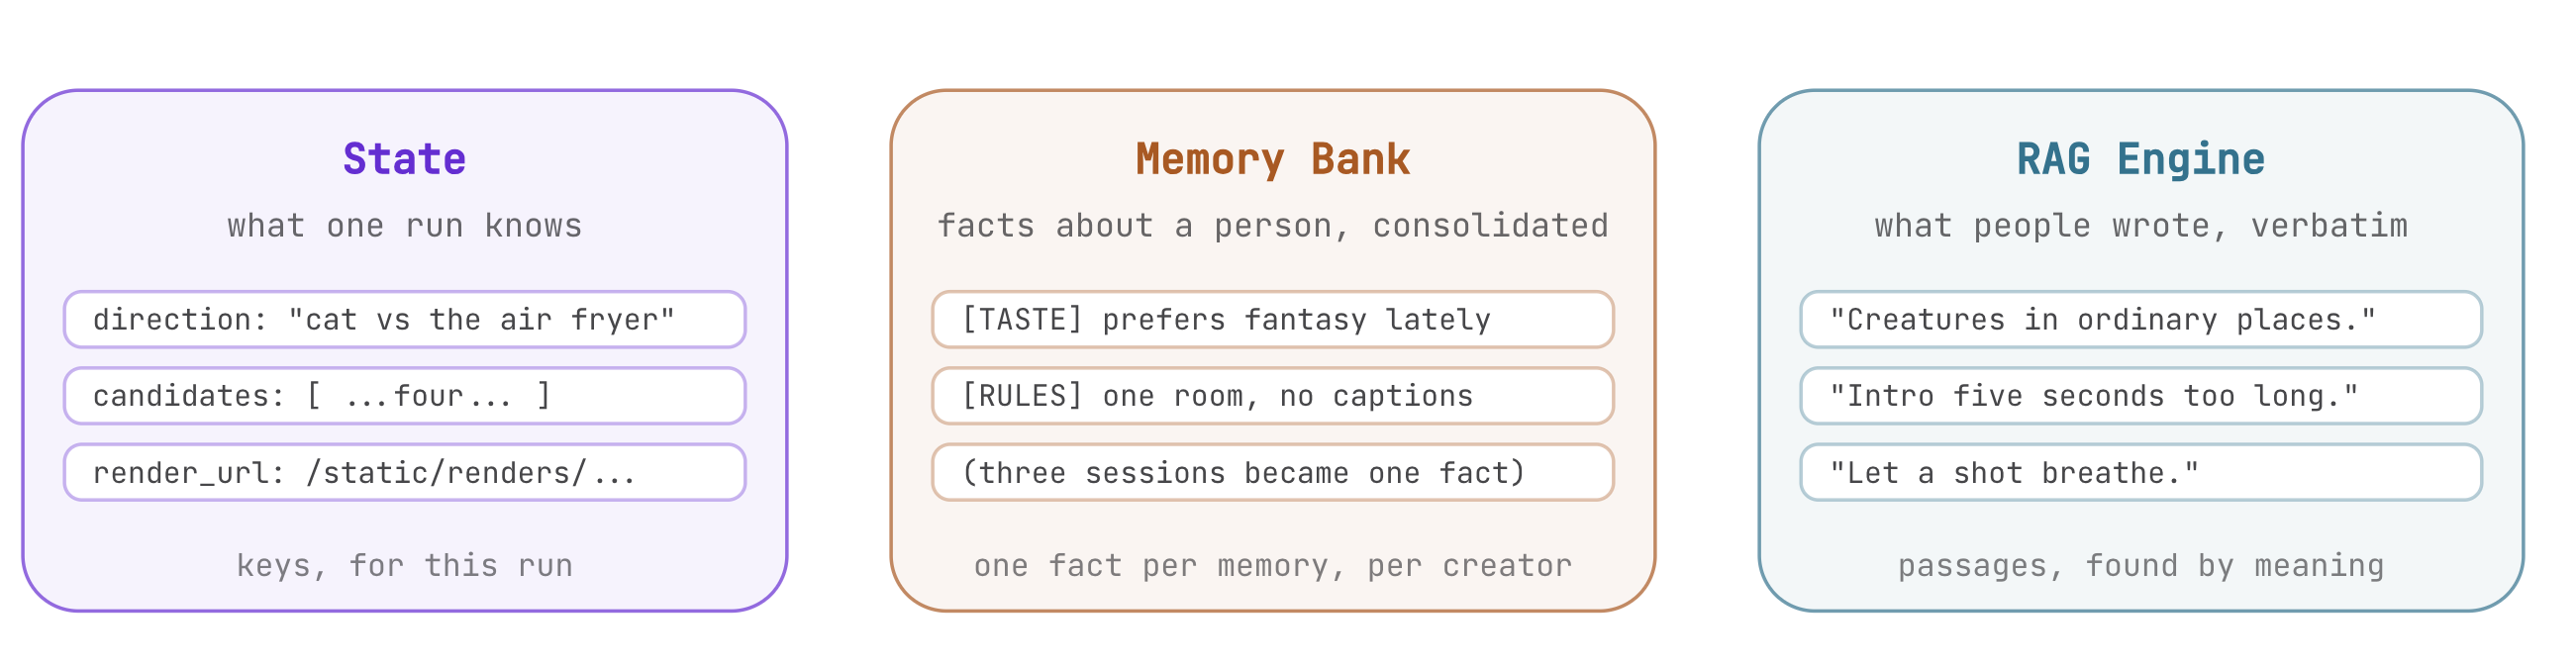
Published videos accumulate ongoing viewer feedback. Thirty representative comments are collected in agent/comments.md , capturing viewer praises, critique of sponsored pacing, and audio preferences. In this step, you index these comments using Vertex AI RAG Engine and connect semantic retrieval into the research fan-out.
Retrieval over documents (7A)
In the workbench, navigate to RAG Engine (7A) .
Memory Bank vs RAG Engine
Both tools ground workflows in external data, but they serve distinct architectural purposes:
ابعاد | بانک حافظه | موتور RAG |
مورد استفاده اصلی | Long-term user preferences and operational rules | Semantic retrieval over large document collections |
دامنه | Scoped to individual user IDs and application names | Scoped to shared corpus resources across all users |
پردازش دادهها | Real-time extraction, embedding, and semantic consolidation | Document chunking, vector embedding, and nearest-neighbor search |
Graph Integration | Agent lifecycle callbacks ( | Dedicated function node in research fan-out ( |
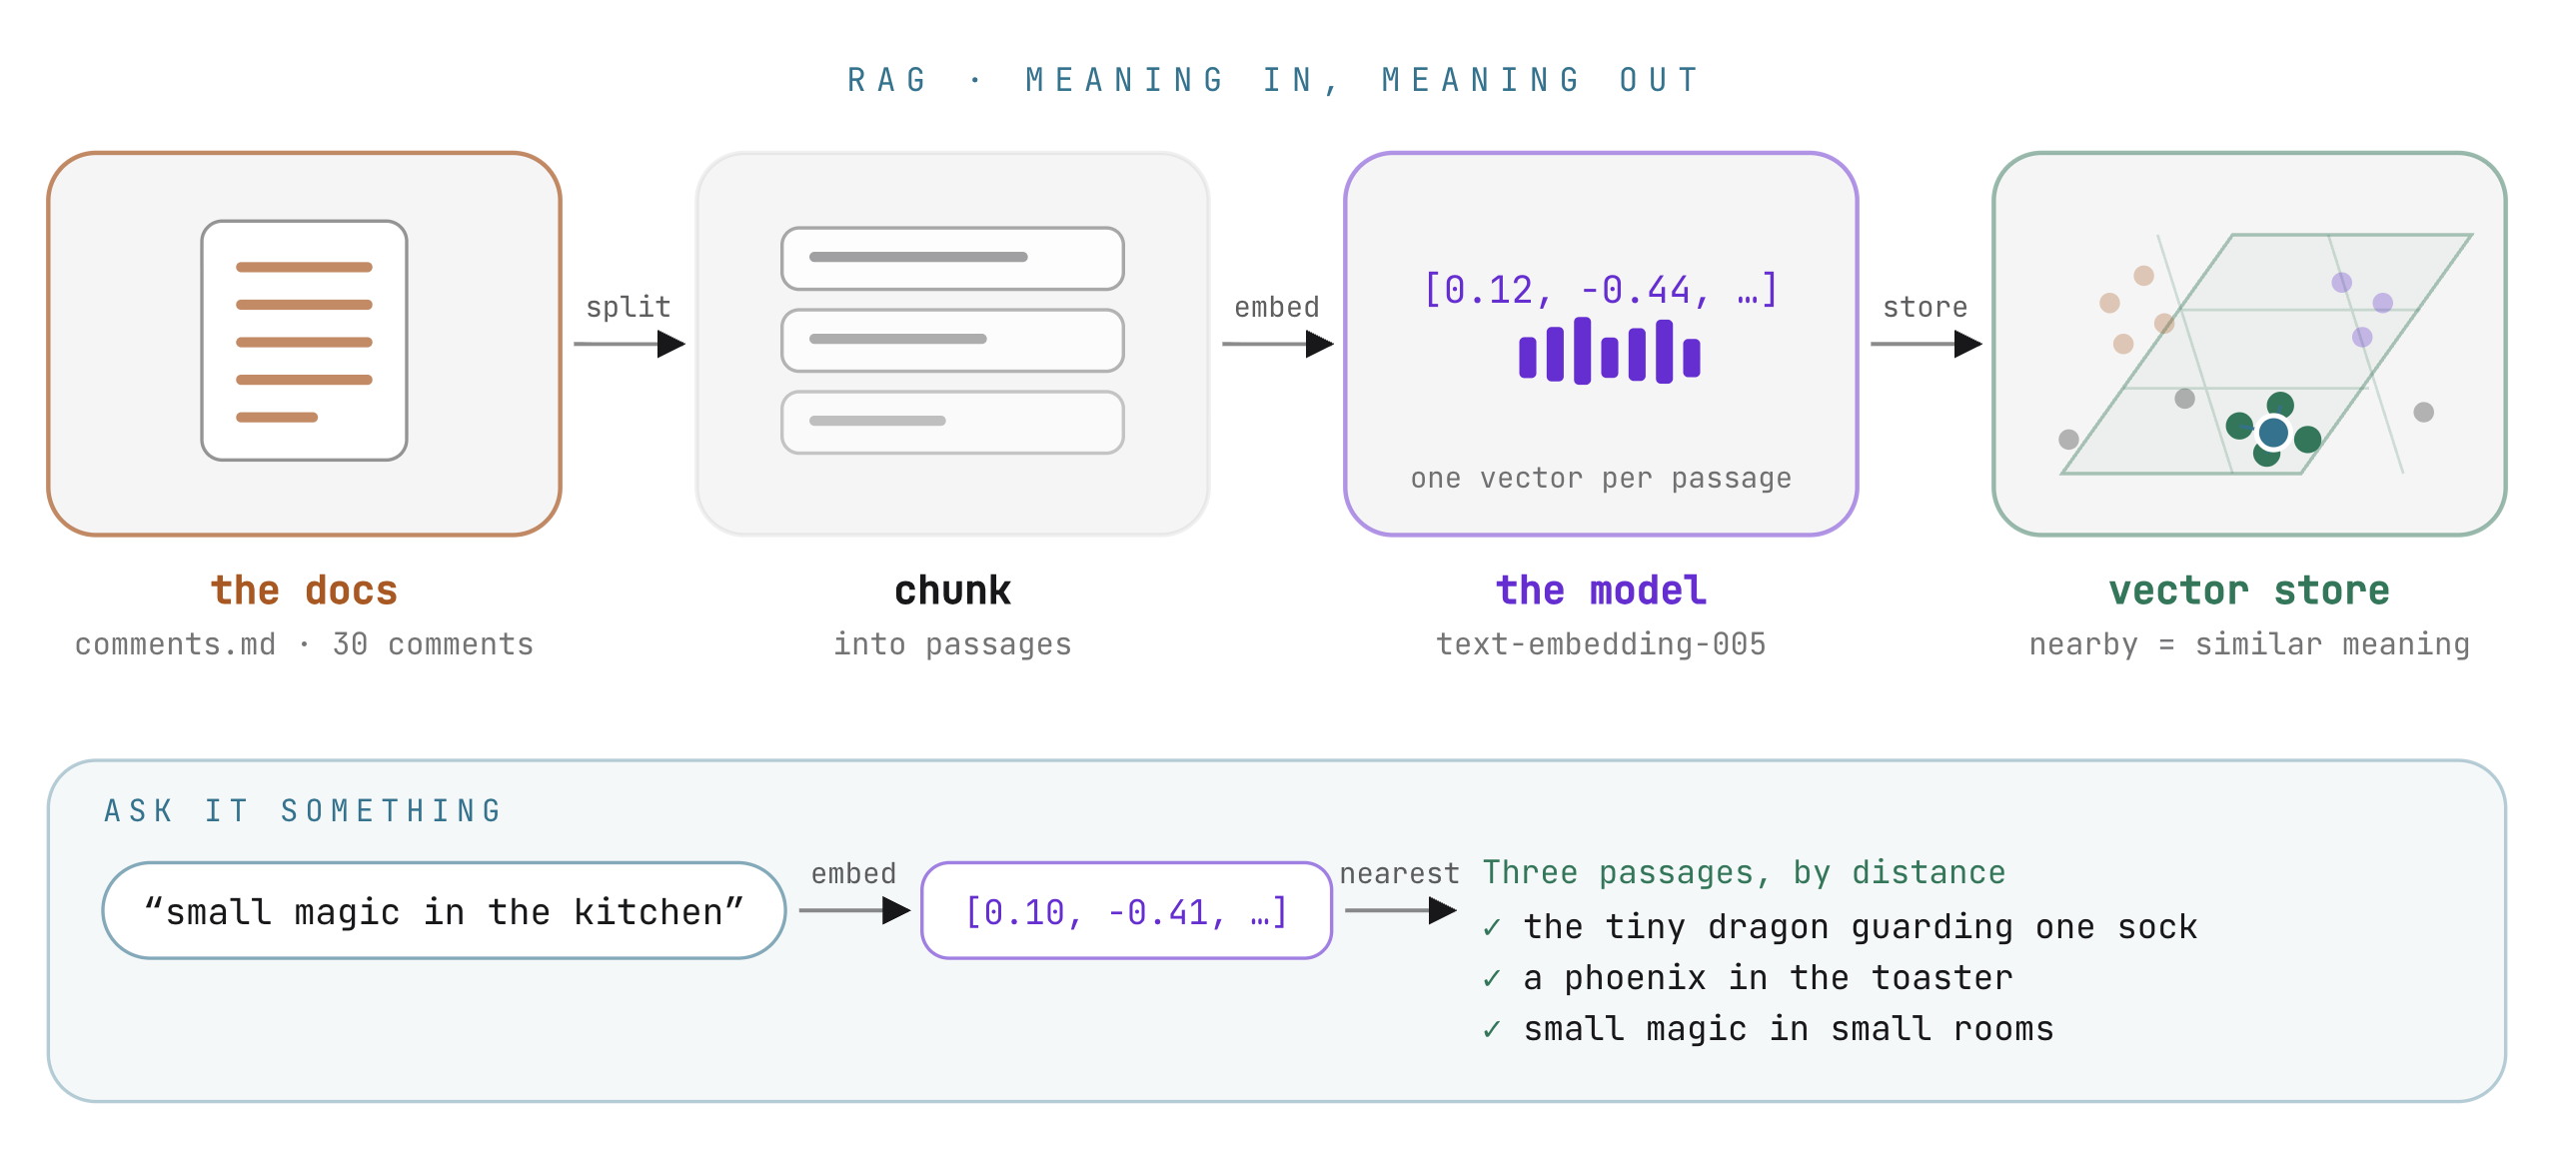
Document chunking and embeddings
RAG Engine indexes documents by dividing text into semantic passages and storing their vectors in a managed database:
corpus = rag.create_corpus(
    display_name="vibestudio-feedback",
    description="Vibe Studio: what the audience wrote under the channel's past videos.",
    backend_config=rag.RagVectorDbConfig(
        rag_embedding_model_config=rag.RagEmbeddingModelConfig(
            vertex_prediction_endpoint=rag.VertexPredictionEndpoint(
                publisher_model="publishers/google/models/text-embedding-005"))))

rag.upload_file(
    corpus_name=corpus.name, path="agent/comments.md", display_name="comments.md",
    transformation_config=rag.TransformationConfig(
        chunking_config=rag.ChunkingConfig(chunk_size=120, chunk_overlap=20)))
- Chunk size : Configured to 120 tokens with 20 tokens of overlap. This captures two to three comments per passage, ensuring each vector represents a cohesive sentiment without diluting meaning across unrelated feedback.
- Embedding model :
text-embedding-005converts text into high-dimensional vectors. When a query is submitted, the model converts the query into a vector and finds nearest matches based on semantic distance. A comment about a tiny dragon guarding socks matches a prompt about magical creatures without requiring exact keyword overlap.
Setting up the RAG corpus
Initialize the corpus using the workbench buttons or terminal commands:
- Create the corpus :
python -m agent.platform.ragruns/ragcorpus.json. - Upload and index comments : Uploads
agent/comments.mdwith chunking configuration and waits for indexing to complete. - Query the corpus : Test similarity retrieval with queries that do not share exact words with the comments (for example, query "small magical creatures" to retrieve comments about dragons).
The retrieval node (7B)
In the workbench, navigate to The third reader (7B) . Open stage5_rag/agent.py .
Retrieval as a graph node
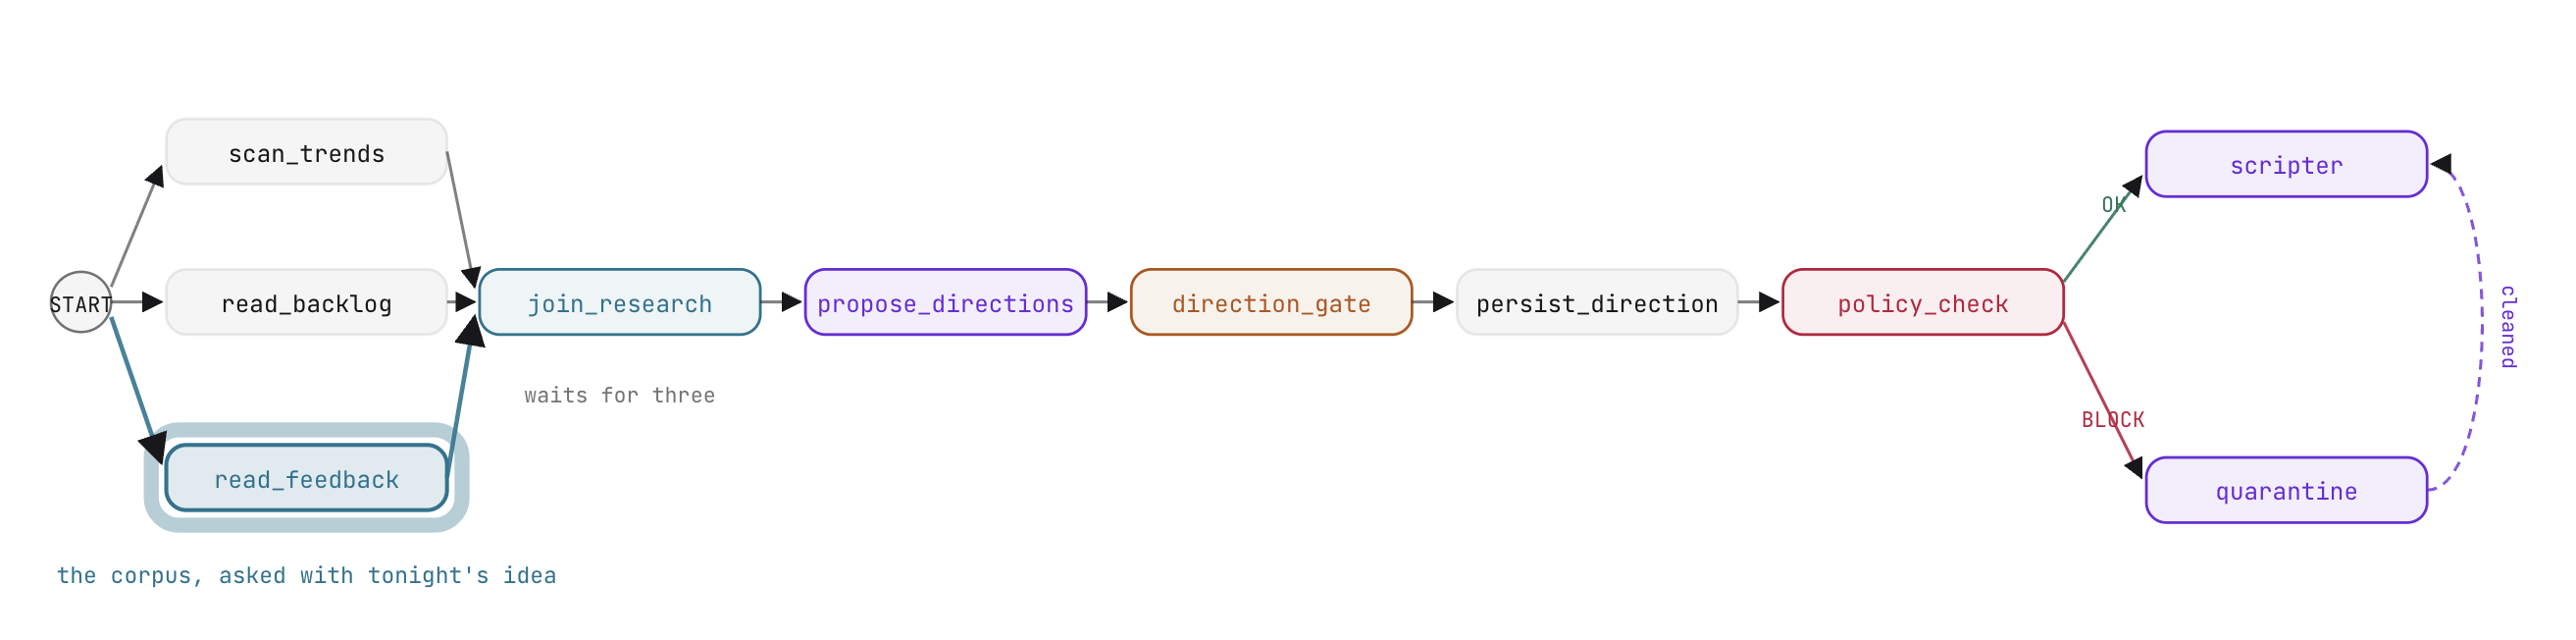
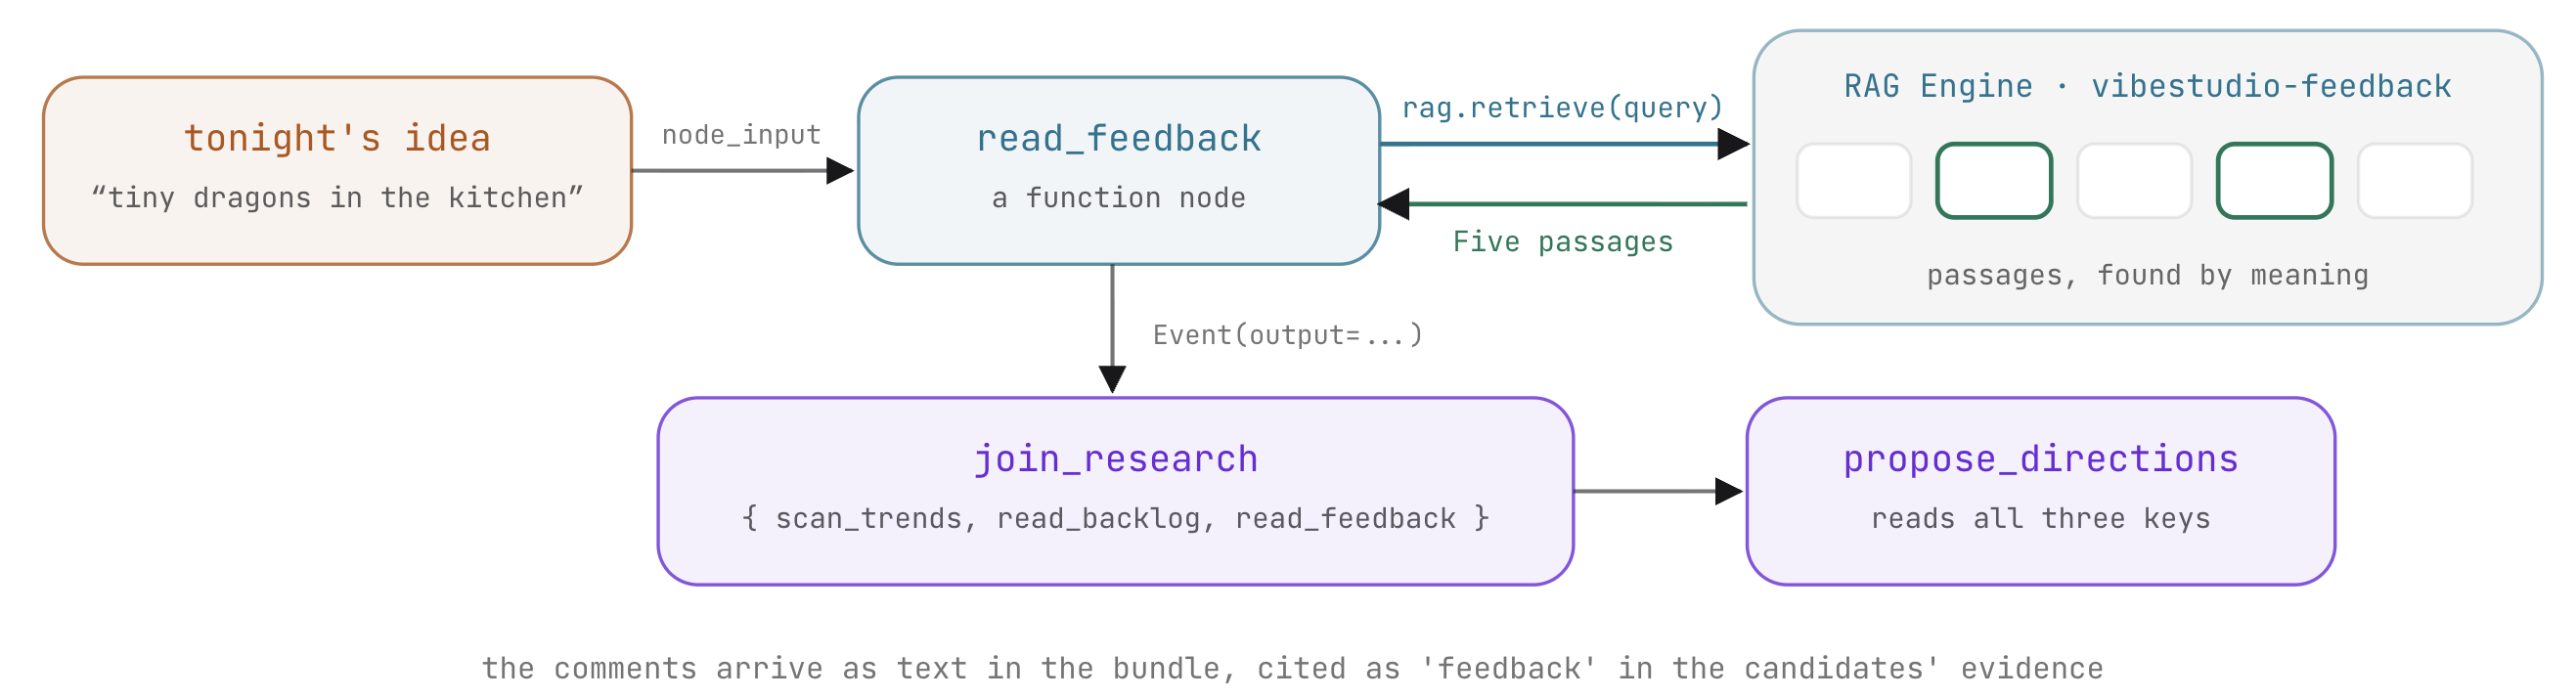
Audience feedback represents research data shared across the workflow. Unlike personal creator memory, viewer sentiment feeds directly into join_research alongside trends and backlog data. It is therefore implemented as a function node:
def read_feedback(node_input):
    """The third reader (step 7): what the audience wrote under past videos,
    the passages nearest to tonight's idea. Retrieval, not a model call."""
    from .platform import rag
    idea = idea_text(node_input)
    query = idea or "what viewers liked and what they complained about"
    try:
        hits = rag.retrieve(query)
    except Exception as e:
        print(f"  [rag] feedback unavailable ({str(e)[:80]})")
        return Event(output={"query": query, "feedback": [],
                             "note": "no corpus connected - run: python -m agent.platform.rag"})
    return Event(output={"query": query, "feedback": [h["text"] for h in hits]})
read_feedback extracts the user's initial idea and executes a vector query against the RAG Engine corpus. It emits the retrieved comments in an Event(output=...) payload.
Hands-on edit: wiring the third reader into the fan-out
In stage5_rag/agent.py , update edges to add read_feedback as a third parallel branch entering join_research :
           (START, read_backlog, join_research),
           (START, read_feedback, join_research),
Because join_research is a JoinNode , it synchronizes all incoming branches, waiting until scan_trends , read_backlog , and read_feedback have all emitted events before passing the aggregated bundle downstream.
What to expect and why
Run the workflow in the workbench:
- Submit an idea prompt (such as "a miniature dragon guarding a kitchen counter").
- In the execution trace, verify that all three reader nodes execute concurrently.
- Observe
join_research: its output dictionary now containstrends,backlog, andfeedback. - Inspect the generated candidates from
propose_directions: the model incorporates viewer comments into its proposals and references audience sentiment in the evidence fields. - Notice that RAG retrieval is deterministic (identical queries return identical comment passages), whereas the generative proposal node produces creative variations.
8. Asynchronous video generation with Veo
In the VibeStudio Workbench , navigate to Step 8 · The video , parts (8A) and (8B) .
Generating high-definition video with Google Veo requires several minutes per render. Blocking graph execution during this period wastes compute resources, locks thread pools, and exposes the run to HTTP connection dropouts. In this step, you make video rendering asynchronous using ADK's LongRunningFunctionTool .
Long-running tools (8A)
In the workbench, navigate to A long-running tool (8A) . Open stage6_video/agent.py and agent/deliver.py .
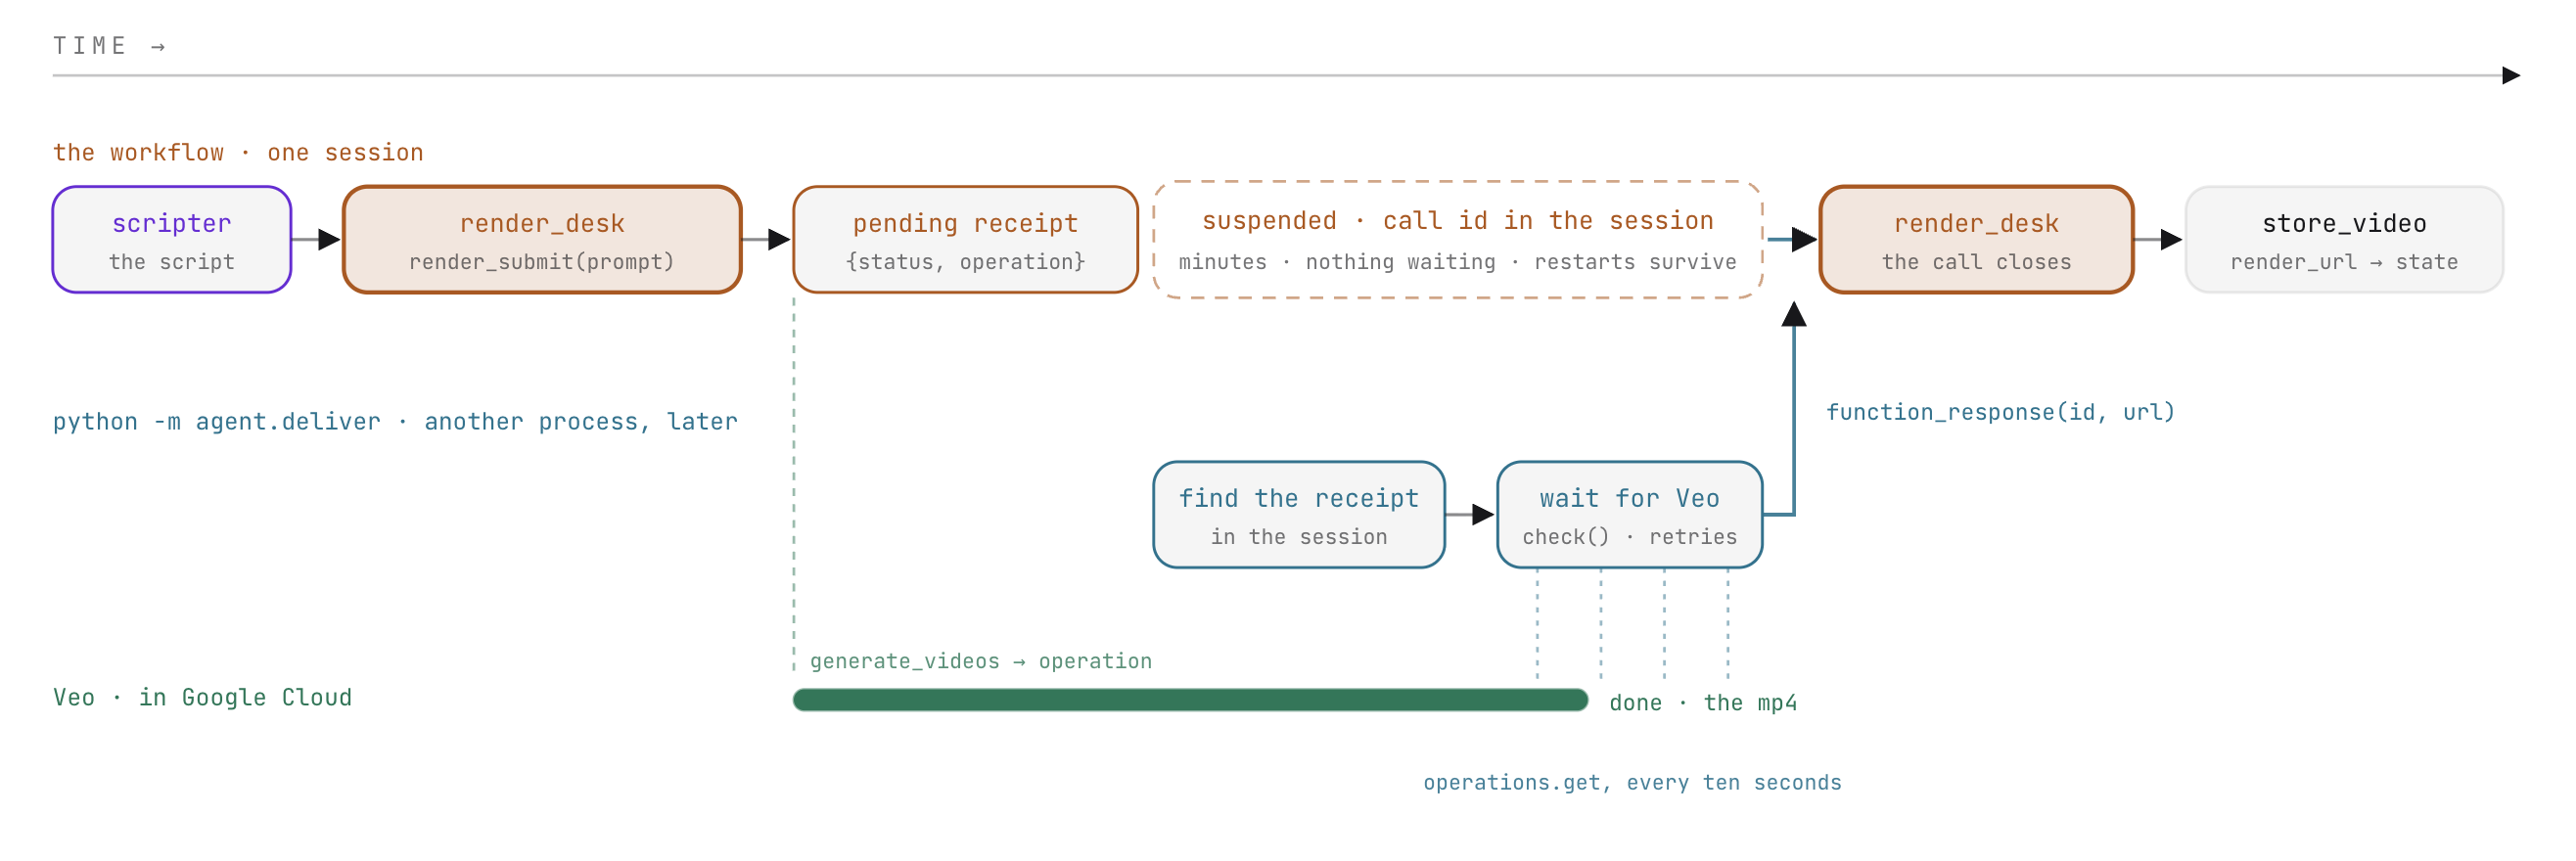
Synchronous tools vs long-running tools
Standard ADK function tools execute synchronously inside an agent turn: the model calls the tool, awaits the return payload, and incorporates the result into the ongoing turn.
Video rendering cannot complete within a single turn. Instead, render_submit initiates the generation job and immediately returns an operational receipt with status "pending" :
def render_submit(prompt: str) -> dict:
    """Submit one Veo render of `prompt`. Returns at once with a pending
    receipt; the clip is delivered later, to this call, by id."""
    receipt = videogen.start(f"{prompt} {videogen.NO_TEXT}")
    return {"status": "pending", "operation": receipt["operation"], "prompt": receipt["prompt"]}
When wrapped with LongRunningFunctionTool , ADK intercepts the "pending" status. The agent's turn concludes, the workflow suspends at the node, and the pending call metadata (including call ID and receipt) is recorded in runs/sessions.db . The execution process exits cleanly without maintaining active network connections or worker threads.
Hands-on edit: wrapping the render tool
In stage6_video/agent.py , update render_desk to wrap render_submit in LongRunningFunctionTool :
tools=[LongRunningFunctionTool(render_submit)])
Resuming by call ID
The universal resumption pattern
ADK applies an identical mechanism to suspend and resume workflows for both humans and external tools:
Suspension Trigger | Initiating Construct | Stored Suspension State | Resumption Event |
Human Decision | | Open input prompt in session store | |
Long-Running Tool | | Open tool call in session store | |
In both scenarios, the workflow halts completely and resumes only when an event bearing a matching FunctionResponse arrives from an external source: a user interface, a webhook, or a background worker.
Hands-on edit: completing the delivery response
In agent/deliver.py , construct the resumption FunctionResponse part:
    part = Part(function_response=FunctionResponse(
        id=row["call_id"], name=row["name"], response=response))
The delivery daemon polls Veo until the video file is generated, then dispatches this FunctionResponse to the session. ADK matches the call ID and resumes the workflow directly at the next node. Completed nodes do not re-execute, and the agent does not take another generative turn.
Setting STUDIO_REAL_VIDEO=0 in .env enables mock rendering: start returns an immediate test receipt, and check simulates completion in five seconds without making billable Veo API calls.
Pipeline integration (8B)
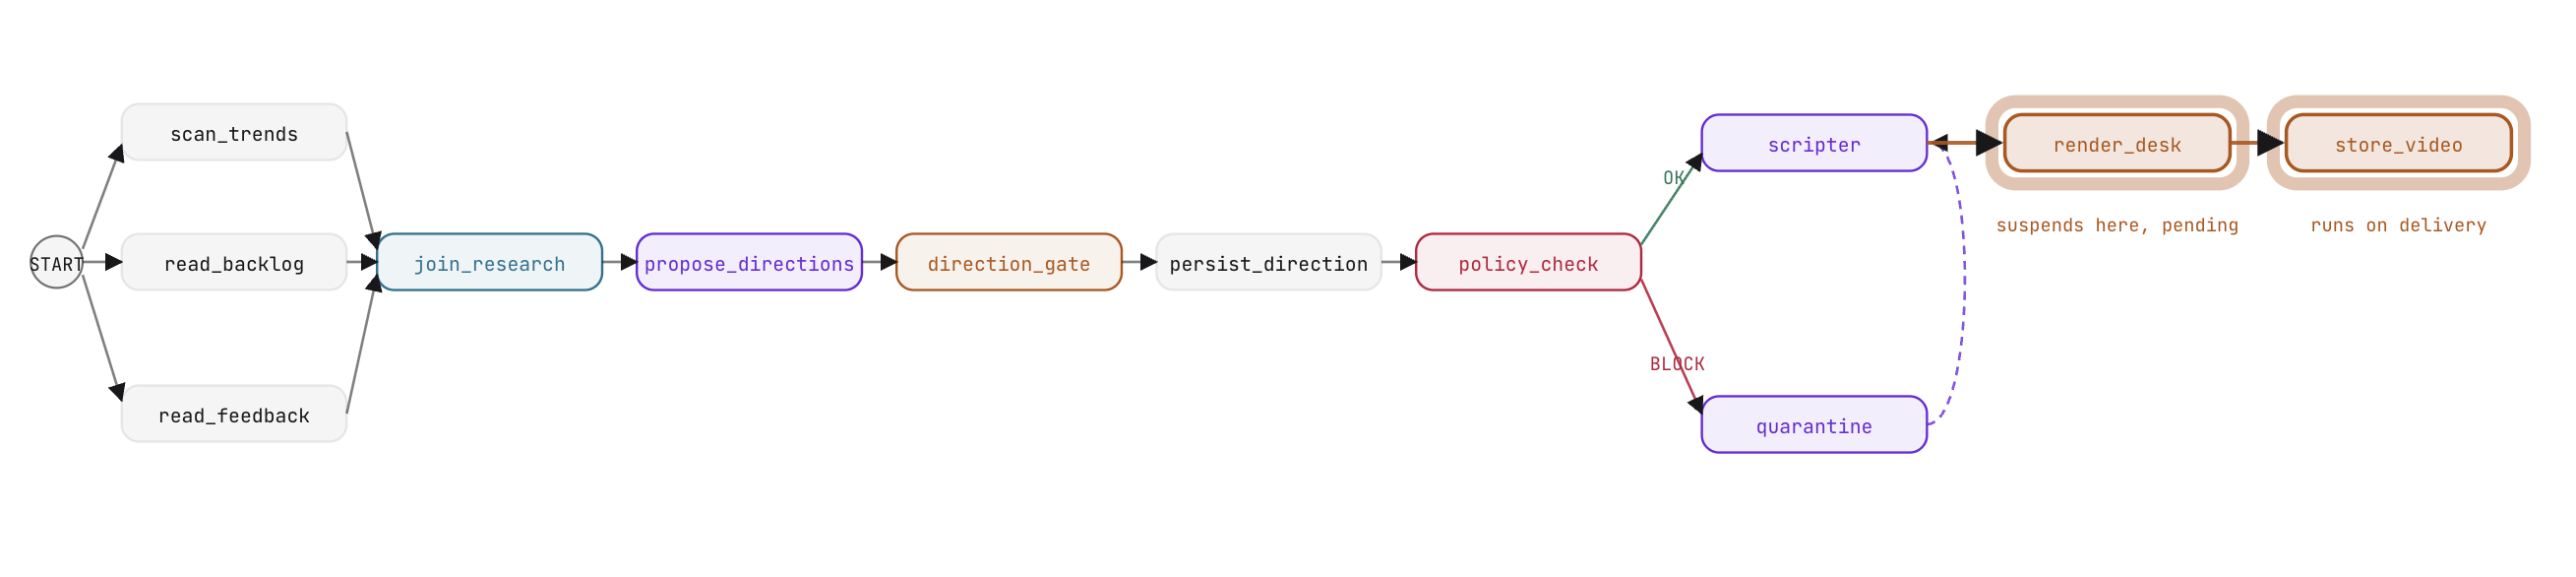
In the workbench, navigate to render_desk in the graph (8B) . Open stage6_video/agent.py .
The terminal node in the pipeline is store_video . It reads the completed render information from runs/state.json (where the delivery process recorded it) and commits the video URL and generation status to shared session state.
Hands-on edit: wiring the complete video pipeline
In stage6_video/agent.py , update edges to append render_desk and store_video :
           (quarantine, scripter),
           (scripter, render_desk, store_video)])
What to expect and why
Test the asynchronous generation flow in the workbench:
- Execute the workflow through candidate selection and script generation.
- At
render_desk, observe the agent invokerender_submit. - The workflow immediately suspends. In the workbench or ADK Web, observe the pending status: the session holds the open call ID, and no background processes are consuming resources.
- Run the delivery daemon using the workbench console or in your terminal:
python -m agent.deliver - In ADK Web, refresh the session: execution resumes at
store_video, commits the video URL to session state, and completes the workflow.
9. Deploy to Cloud Run
In the VibeStudio Workbench , navigate to Step 9 · Deploy .
You have developed and verified each component of the pipeline across dedicated sandboxes. In this step, you assemble the complete production pipeline and deploy it to Google Cloud Run .
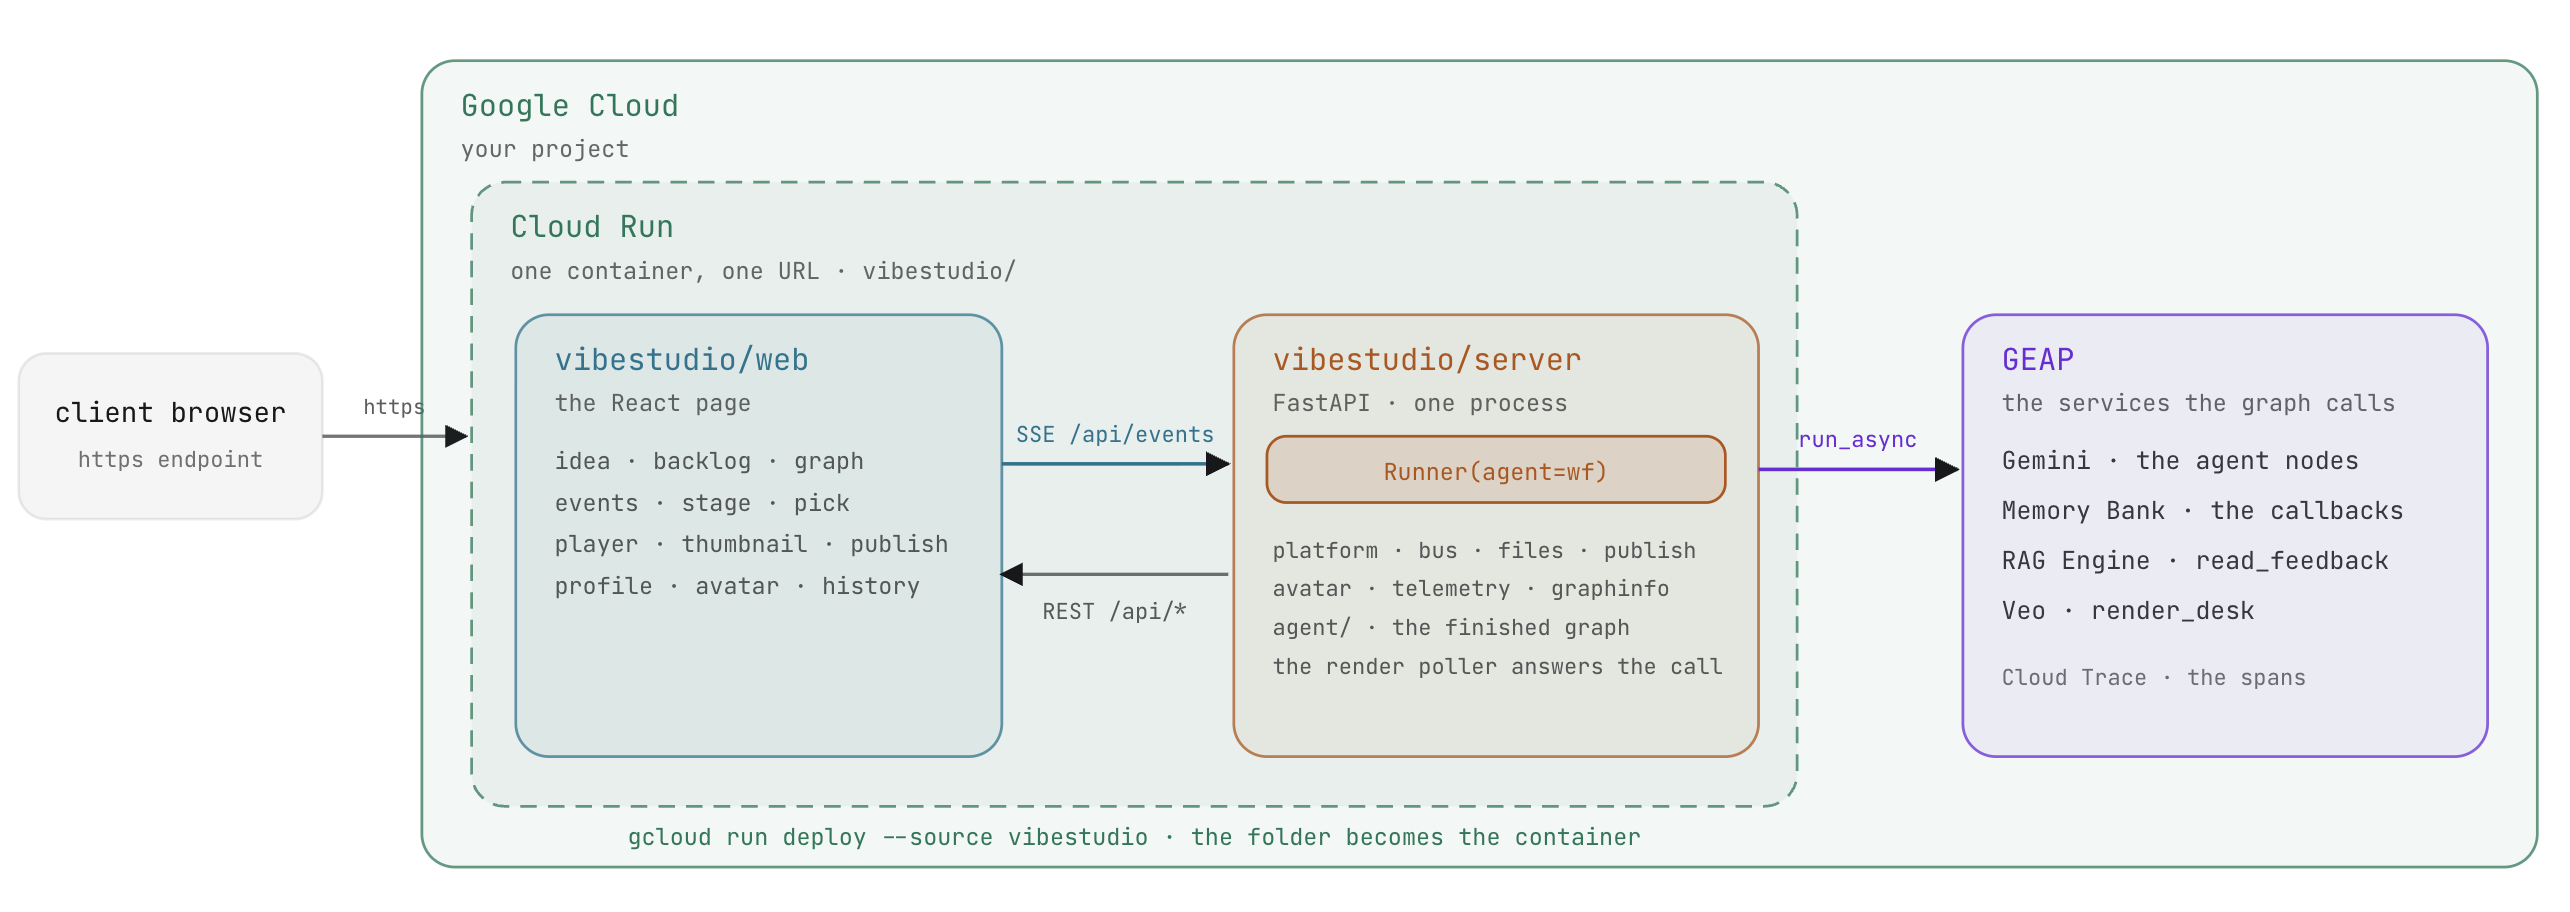
The ADK Runner
In development, adk web orchestrated the graph. In production, the application hosts the workflow using ADK's Runner class:
self._svc = DatabaseSessionService(db_url=config.DB_URL)
self._runner = Runner(app_name=config.APP, agent=wf, session_service=self._svc)

async for ev in self._runner.run_async(user_id=config.USER, session_id=run_id, new_message=message):
    self._absorb(ev)    # fold the ADK event into the run state, publish one app event

# the gate's answer and the render's delivery are the same call, with a function_response part
part = Part(function_response=FunctionResponse(id=call_id, name=name, response=response))
run_async: Drives workflow execution, yielding events sequentially as nodes execute and persisting updates to the session service.- Unified resumption : Both user decisions at
direction_gateand completed video deliveries from Veo resume execution through identicalFunctionResponseobjects submitted torun_async.
The production application architecture
The production application in vibestudio/ integrates the complete pipeline:
vibestudio/
  server/
    main.py                 FastAPI: application server, REST routes, static assets
    api.py                  REST API endpoints: run, pick, publish, backlog, profile, history
    runner.py               Runner orchestration over the workflow, background render poller
    platform/               Event bus (SSE stream), file storage, publishing, telemetry
    agent/                  Production agent package, verified by checks/verify_app.py
      graph.py              The complete workflow graph and node definitions
      desk.py               render_desk and render_submit wrapped with LongRunningFunctionTool
      schemas.py            Pydantic schemas: Directions, CleanedDirection, Script
      cleanup_tools.py      Deterministic policy tools: find_policy_hits, suggest_replacement
      platform/             Memory Bank, RAG Engine, and Veo integrations
  web/                      Production React user interface
  Dockerfile · deploy.py · run.sh
- Single event stream : The FastAPI backend publishes events across a single Server-Sent Events (SSE) stream. The React frontend visualizes graph progression in real time and handles late connections without losing state.
- Decoupled execution : The application manages the event loop. The workflow graph focuses entirely on execution logic, unaware of the frontend interface.
The complete workflow edge list in agent/graph.py combines every architectural pattern built throughout this codelab:
        (START, scan_trends, join_research),
        (START, read_backlog, join_research),
        (START, read_feedback, join_research),
        (join_research, propose_directions, direction_gate,
         persist_direction, policy_check),
        (policy_check, {"OK": scripter, "BLOCK": quarantine}),
        (quarantine, scripter),
        (scripter, render_desk, store_video),
Deploying to Cloud Run
Google Cloud Run provides serverless hosting with automatic scaling, request routing, and integrated container builds:
gcloud run deploy vibestudio --source vibestudio \
  --project $GOOGLE_CLOUD_PROJECT --region us-central1 \
  --labels dev-tutorial-codelab=vibetube --allow-unauthenticated \
  --memory 2Gi --cpu 2 --timeout 3600 --concurrency 40 \
  --max-instances 1 --min-instances 1 --session-affinity \
  --set-env-vars GOOGLE_CLOUD_PROJECT=...,STUDIO_VERTEX=1,STUDIO_MEMORY_BANK=...,STUDIO_RAG_CORPUS=...,VIBETUBE_URL=...,VIBETUBE_EVENT=...,VIBETUBE_NAME=...,VIBETUBE_PROJECT=...
- Container build :
gcloud run deploy --sourcepackages thevibestudio/directory, builds the container image using Cloud Build, and deploys the service in a single operation. - Session affinity : Directs requests from the same user to the same container instance, preserving local session state across iterative steps.
- Observability : Cloud Trace integration records distributed spans for every node, LLM call, and tool execution, accessible in the Google Cloud Console under Trace Explorer.
Click the Deploy button in the workbench to execute the deployment script. When the build completes, the terminal displays the live service URL.
10. Summary
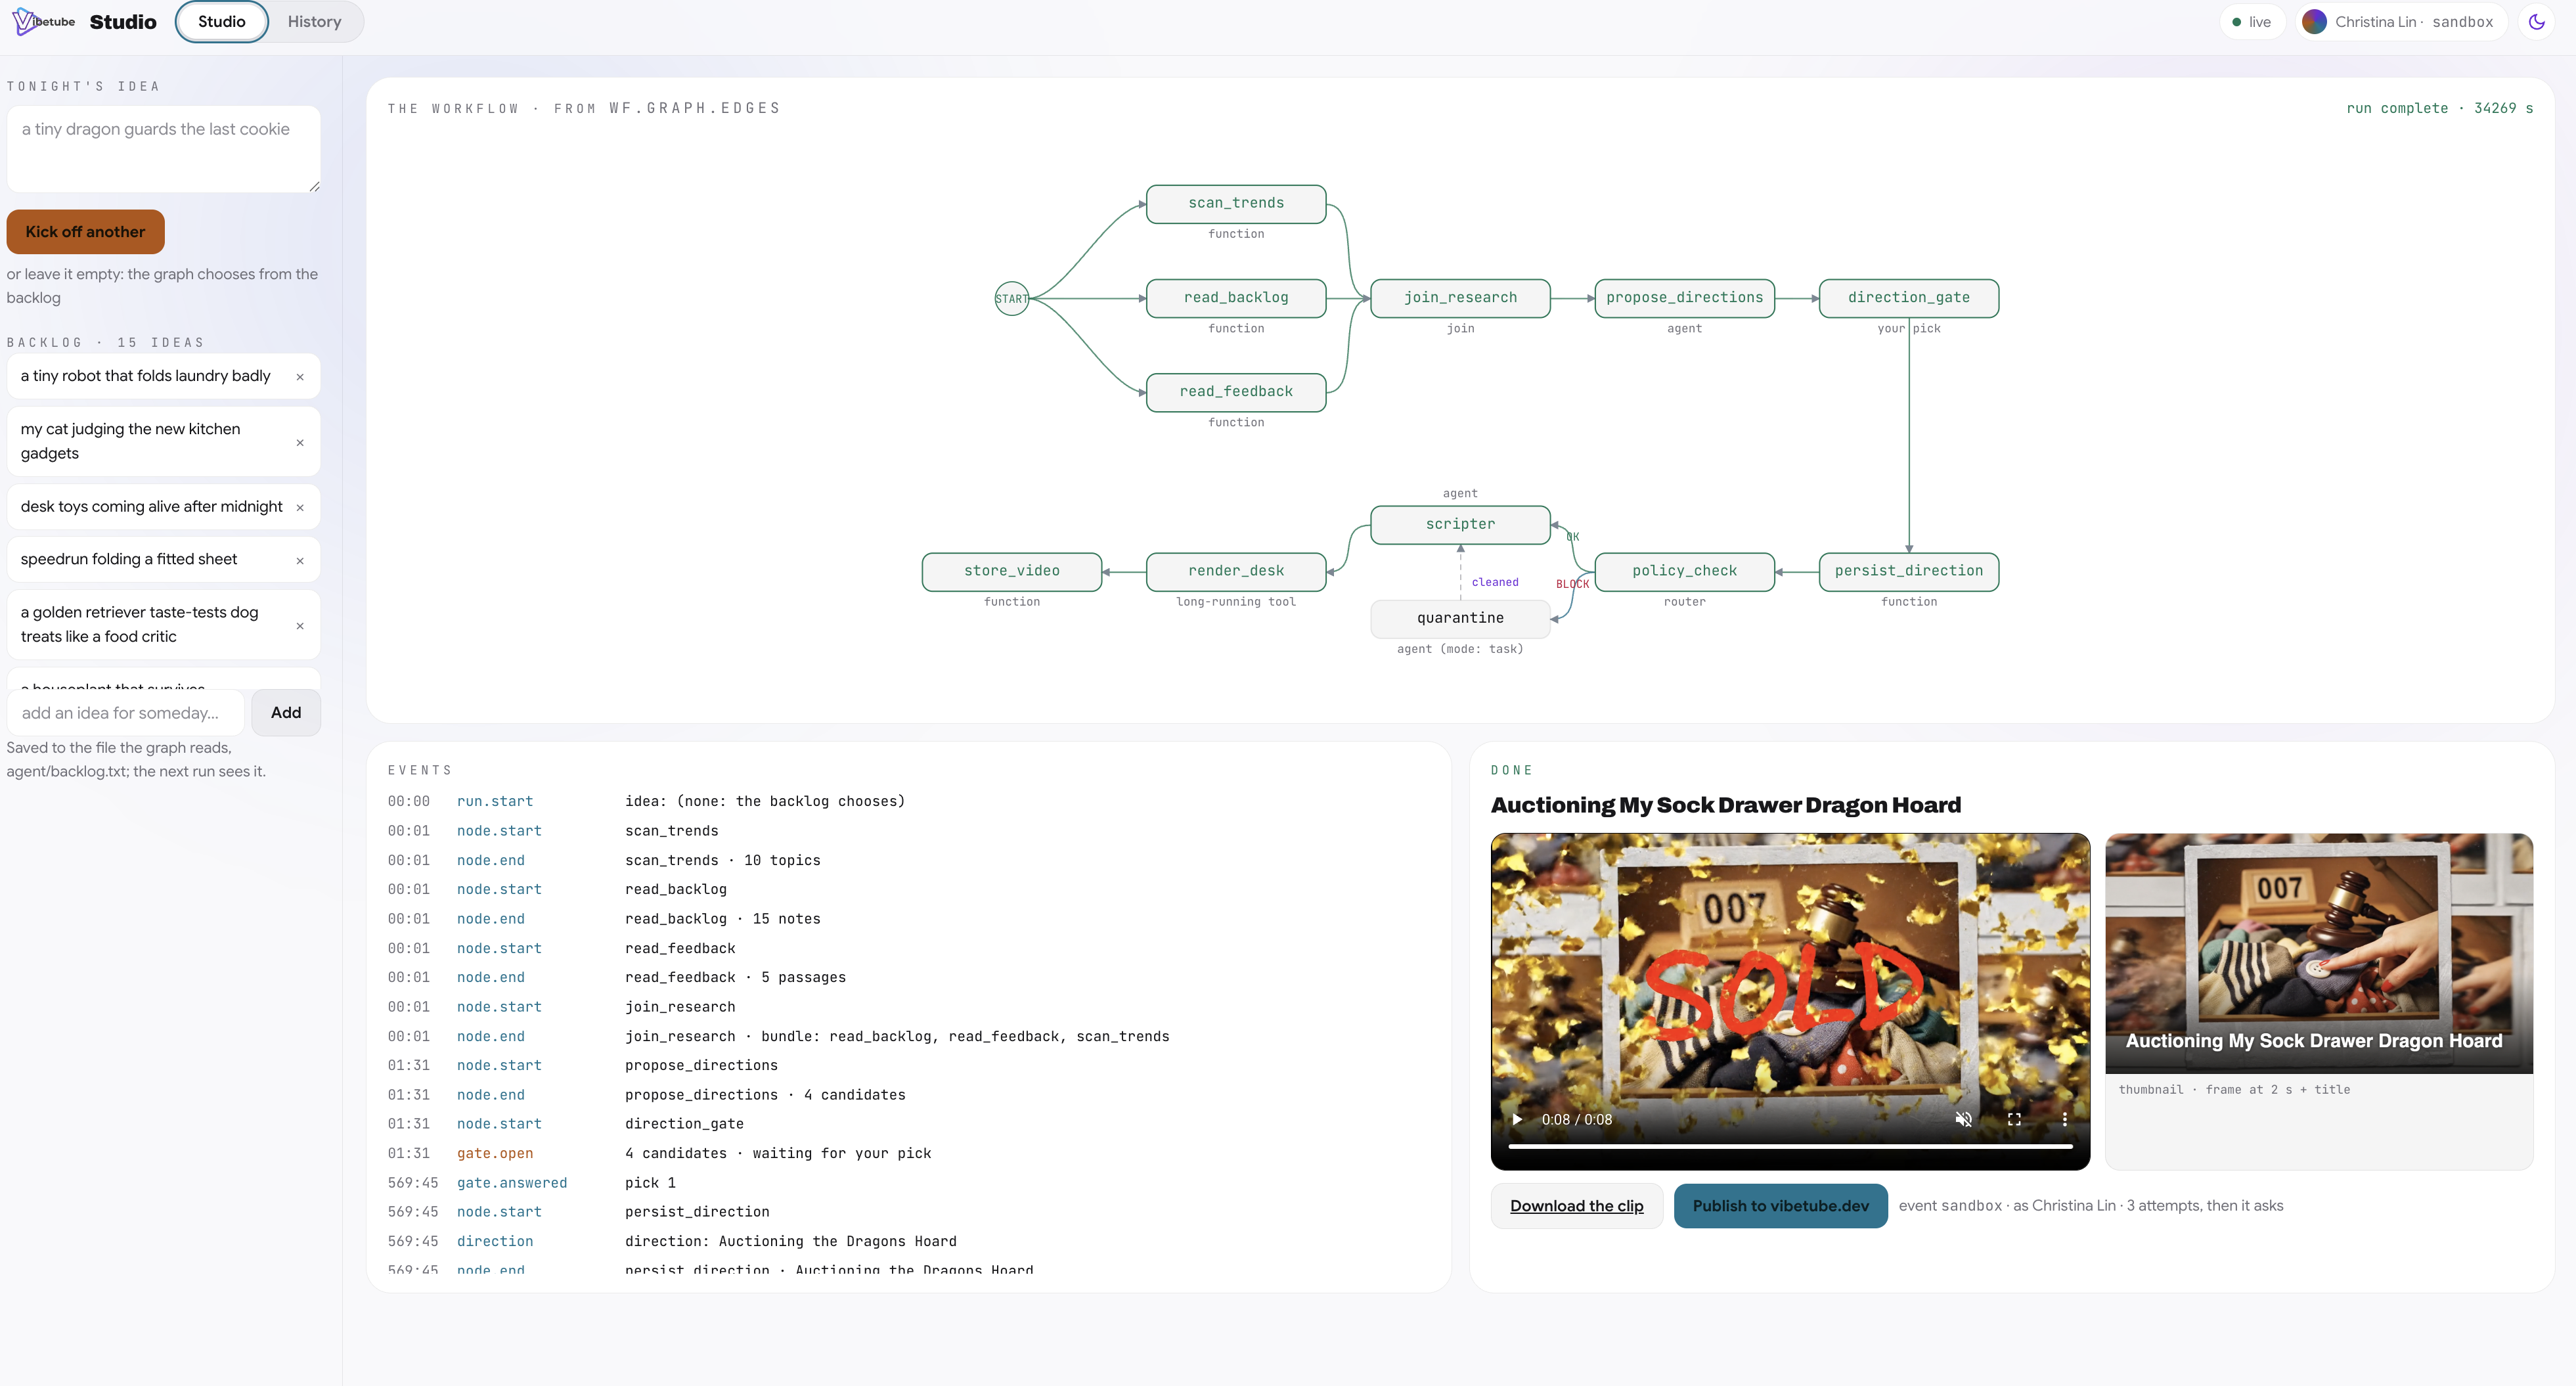
In the VibeStudio Workbench , navigate to Step 10 · Summary to review the completed architecture.
قدم | Architecture & Concepts | Implementation Pattern |
A single prompt | Single prompt, function tools, sequential chat loop | |
Agentic workflow fundamentals | Graph workflow, parallel research, schema outputs, human gate | |
State and Router | Shared session state, parameter binding, deterministic routing, task agent | |
بانک حافظه | User-level long-term memory, semantic consolidation, lifecycle hooks | |
موتور RAG | Document retrieval over audience comments, semantic embeddings | |
Asynchronous video generation with Veo | Long-running tools, pending receipts, external delivery daemon | |
Deploy to Cloud Run | Programmatic orchestration, Server-Sent Events, serverless container | |
Core architectural principles
- Suspend instead of waiting : Workflows pause cleanly for human input (
RequestInput) or long-running operations (LongRunningFunctionTool). Processes do not wait idle on threads or network sockets. - Universal resumption : Every suspension resumes through an identical mechanism: a single
function_responsecarrying the call ID of the suspended node. - Decoupled state management : Nodes share data through named session state keys and parameter binding instead of verbose, tightly coupled intermediate payloads.
- Deterministic routing before generative cost : Rule-based routers and regex filters evaluate policy at zero token cost before generative models run.
- Separation of concerns : Context specific to an individual agent belongs in lifecycle callbacks, while shared data dependencies belong