1. Introduction
Cet atelier de programmation vous explique comment créer des systèmes agentiques de nouvelle génération à l'aide de workflows et de graphiques dans l'Agent Development Kit (ADK). Vous implémenterez des modèles architecturaux courants, orchestrerez des interactions human-in-the-loop (avec intervention humaine, HITL) et gérerez l'exécution asynchrone de longue durée. Vous intégrerez également des bases de connaissances d'entreprise et une mémoire persistante pour personnaliser et faire évoluer le comportement des agents. Enfin, vous connecterez ces fonctionnalités pour piloter un pipeline de génération de vidéos automatisé.
Scénario
Vous gérez une chaîne numérique sur VibeTube avec une audience active et un nombre croissant d'idées créatives. La production de chaque vidéo nécessite l'exécution continue de plusieurs étapes : recherche de formats tendance, synthèse des commentaires des spectateurs, développement de scripts, vérification de la conformité avec les règles et génération d'extraits vidéo. Les modèles génératifs peuvent rédiger des éléments individuels, mais pour proposer des versions cohérentes, il faut une architecture d'agents orchestrée.
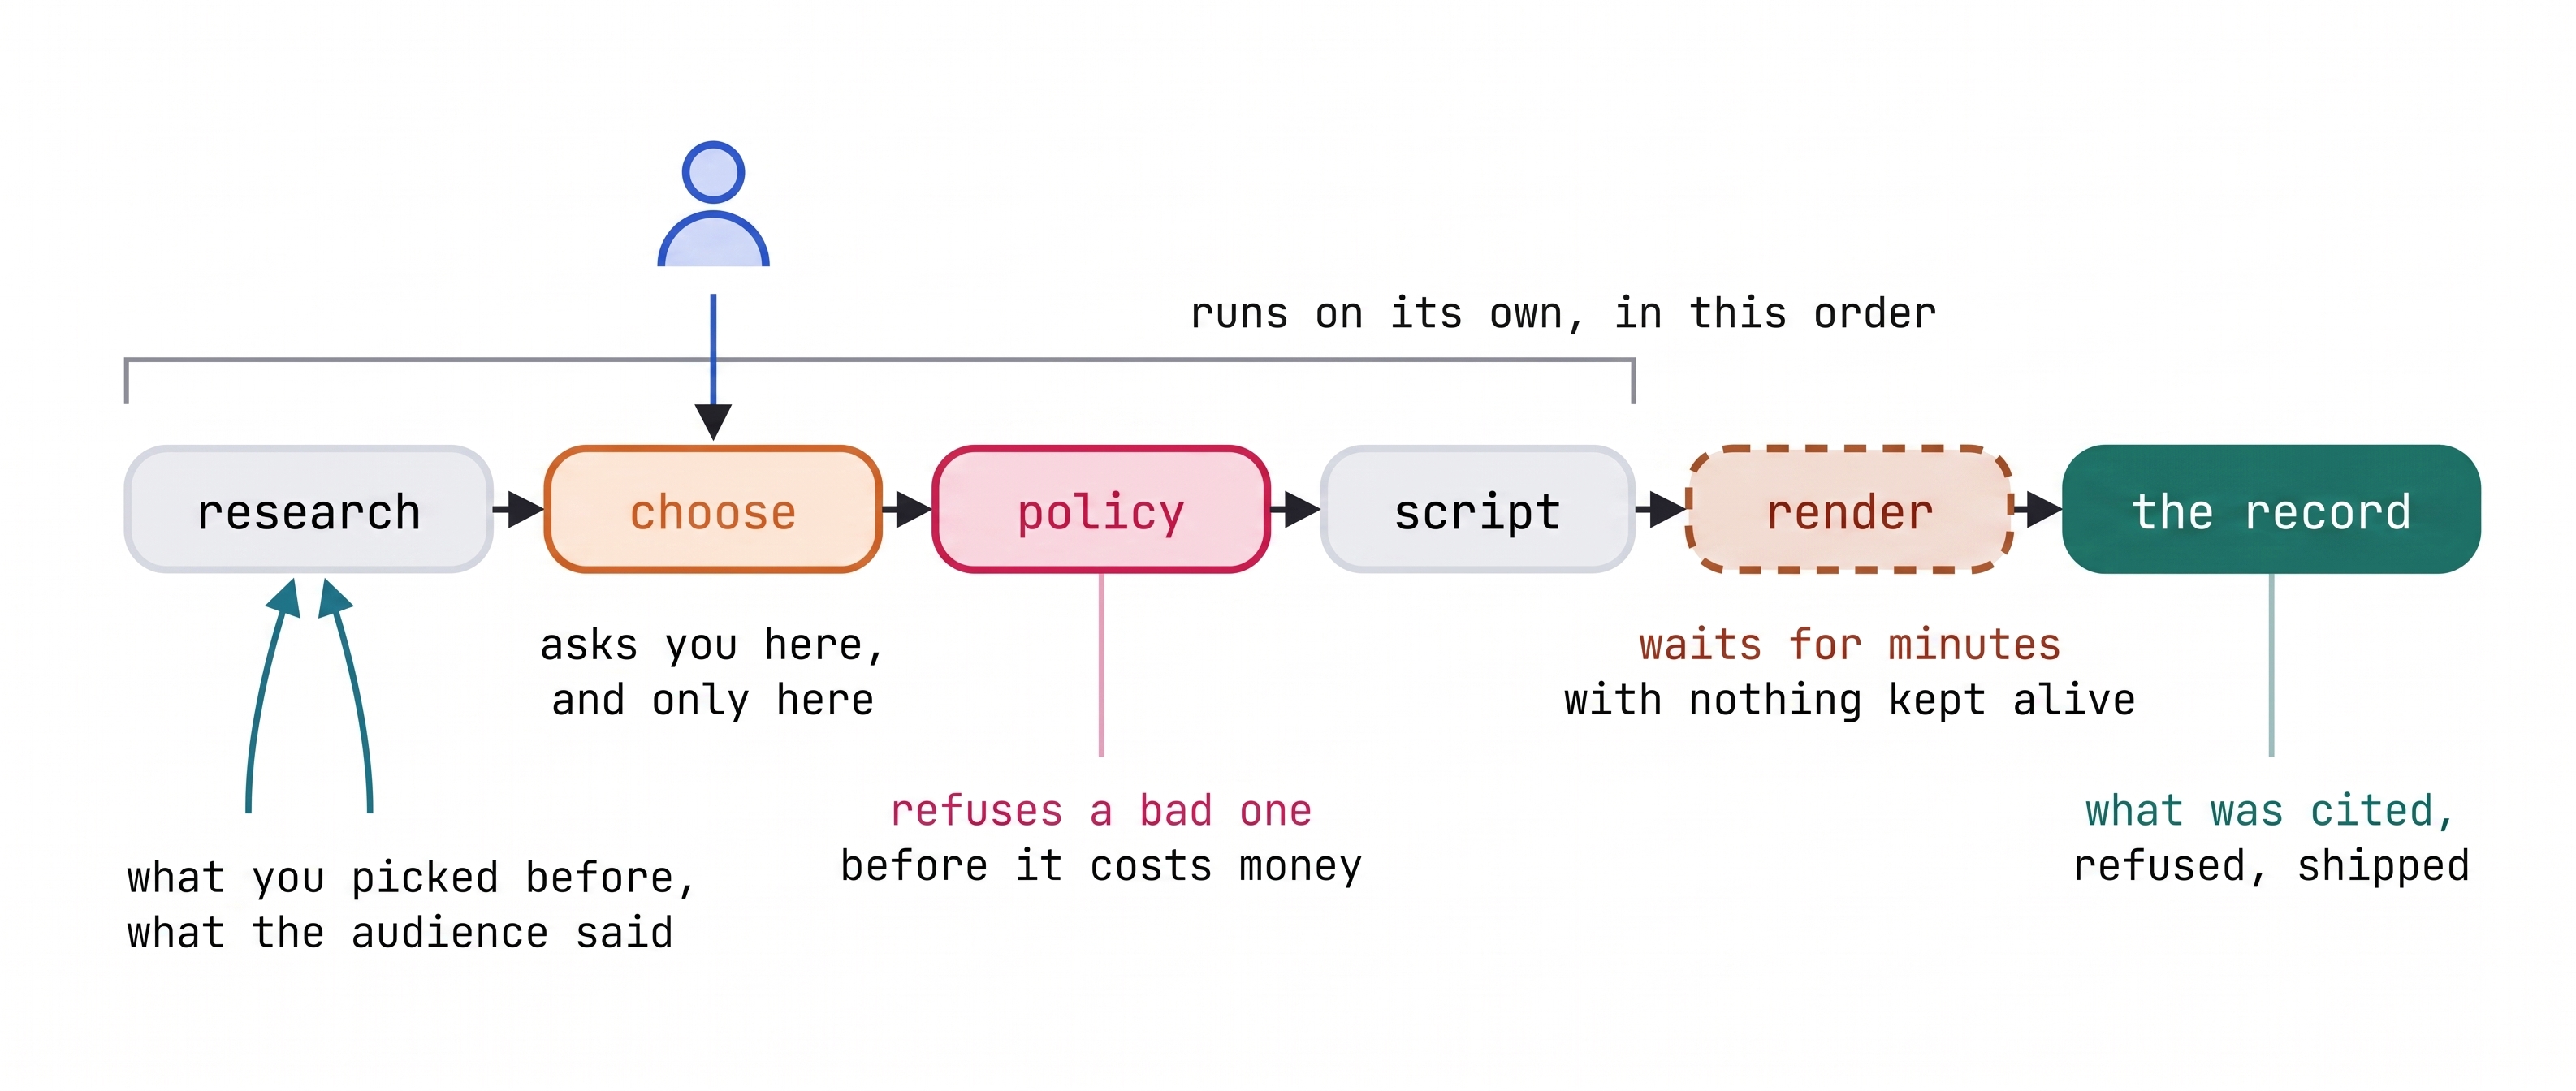
Pour automatiser ce cycle de vie, vous allez créer VibeStudio. Ce pipeline agentique exécute des recherches de routine en parallèle, présente des options sélectionnées pour une validation human-in-the-loop (avec intervention humaine), applique des contrôles de règles automatisés avant de générer la vidéo et préserve le contexte entre les exécutions de production.
Objectifs
- Bases de l'ingénierie des graphes : les architectures d'agents en plusieurs étapes nécessitent un flux de contrôle explicite et des chemins d'exécution structurés. Vous créez un
WorkflowADK à l'aide de tuples de bord, du point d'entréeSTART, deJoinNodepour l'agrégation parallèle de type fan-out et de nœuds de routeur déterministes pour orienter l'exécution en fonction de l'état. - Modes d'agent et rappels de cycle de vie : les tâches spécialisées nécessitent des comportements opérationnels distincts et des garde-fous déterministes. Vous configurez des instances ADK
Agenten utilisant les modeschat,single_turnettask(avec outils activés) comme nœuds de workflow, en appliquant des intercepteurs avecbefore_model_callbacketafter_agent_callback. - Orchestration avec intervention humaine : les pipelines de production s'interrompent pour laisser place au jugement humain lors des étapes de création critiques. Vous implémentez
RequestInputpour suspendre l'exécution du workflow, appliquer des schémas de réponse structurés et reprendre l'exécution sans maintenir actifs les processus d'exécution inactifs. - Mémoire d'agent hiérarchique : les systèmes de production séparent l'état d'exécution éphémère du contexte durable. Vous gérez l'état de la session à court terme à l'aide de
Event(state=...)et de la liaison de paramètres, et vous connectez la banque de mémoire GEAP pour extraire, consolider et conserver les préférences du créateur lors des différentes exécutions. - Ancrage avec des bases de connaissances d'entreprise : les agents autonomes ont besoin d'un contexte de domaine dynamique et de connaître l'opinion de l'audience. Vous connectez un corpus du moteur RAG GEAP en tant que nœud de récupération dédié dans la distribution ramifiée parallèle pour ancrer sémantiquement les résultats de l'agent.
- Workflows et déploiement de longue durée : le rendu vidéo multimodal fonctionne de manière asynchrone sur de longues durées. Vous implémentez
LongRunningFunctionToolavec des reçus d'appel en attente pour suspendre et reprendre le workflow par ID d'appel, et vous déployez le pipeline terminé à l'aide de la commandeRunnerde l'ADK sur Cloud Run.
Organisation de cet atelier de programmation
Cet atelier de programmation sert de référence conceptuelle et architecturale. Chaque section explique les concepts ADK implémentés dans l'étape correspondante du workbench, fournit un code de référence et établit les principes de conception de base. Lisez chaque section avant de réaliser l'exercice correspondant dans l'atelier.
Les exercices pratiques se déroulent dans VibeStudio Workbench, une interface Web complémentaire dotée d'un éditeur de code interactif, de vérificateurs d'exécution et d'un inspecteur ADK intégré. La numérotation des étapes dans l'atelier est directement alignée sur cet atelier de programmation pour que votre progression reste synchronisée. Les modifications apportées au graphique de base persistent d'une étape à l'autre, et l'atelier valide automatiquement les conditions préalables à mesure que vous avancez.
Une fois les exercices de l'atelier terminés, vous assemblerez un pipeline agentique de bout en bout et déploirez une application VibeStudio en cours d'exécution sur Cloud Run pour générer du contenu vidéo.
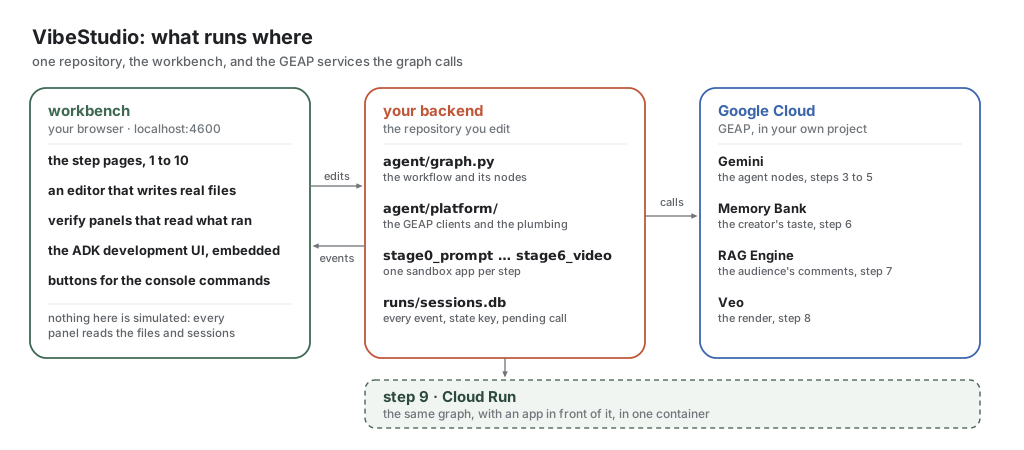
L'environnement se compose de trois composants principaux : VibeStudio Workbench (l'interface Web locale pour la modification du code et la vérification de l'exécution), votre backend (les bacs à sable ADK Workflow et de préproduction dans agent/) et Google Cloud (modèles Gemini, GEAP Memory Bank, RAG Engine et génération de vidéos Veo).
2. Configuration
Demander vos crédits pour l'atelier
Si vous participez à un atelier dirigé par un formateur, celui-ci distribuera des crédits pour votre projet Google Cloud. Suivez les instructions de votre formateur pour utiliser vos crédits et assurez-vous que la facturation est activée sur votre compte avant de continuer.
Ouvrir Cloud Shell
Cloud Shell est un environnement de développement basé sur un navigateur dans lequel gcloud, Python et Git sont préinstallés.
Pour lancer Cloud Shell :
- Accédez à Google Cloud Shell.
Une session de terminal s'ouvre en bas de la fenêtre du navigateur.
Cloner et initialiser le dépôt
Exécutez les commandes suivantes dans le terminal Cloud Shell pour cloner le projet :
git clone https://github.com/gca-americas/vibetube-studio
cd ~/vibetube-studio
Requêtes de configuration
Lors de la configuration, vous serez invité à fournir les informations suivantes :
- ID du projet Google Cloud : lorsque
setup_project.shvous y invite, appuyez sur Entrée pour créer automatiquement un projet. Si vous préférez utiliser un projet existant (comme un projet pré-attribué), saisissez l'ID du projet et assurez-vous qu'il est correctement orthographié et que la facturation est activée. - Code de l'événement : saisissez le code de la salle fourni par votre enseignant. Si vous n'en avez pas reçu, demandez à un assistant pédagogique ou à un voisin. Si vous suivez cet atelier chez vous, appuyez sur Entrée pour accepter la pièce par défaut
sandbox. - Nom à afficher de la chaîne : saisissez votre nom ou le nom de chaîne de votre choix lorsque
setup_codelab.shvous y invite, ou appuyez sur Entrée pour accepter la valeur par défaut générée à partir de votre compte Google.
Exécutez les deux scripts de configuration dans l'ordre :
./setup_project.sh
./setup_codelab.sh
setup_project.sh: crée ou réutilise un projet Google Cloud avec la facturation active, enregistre l'ID du projet dans~/project_id.txtet configure le contextegcloudactif.setup_codelab.sh: installeuvet les dépendances Python dans.venv, active les API Google Cloud requises, configure les paramètres de votre chaîne dans.env, vérifie l'accès au modèle avec Gemini, provisionne les ressources Memory Bank et RAG, crée l'interface Workbench et démarre VibeStudio Workbench.
Le script exécute la vérification préliminaire et démarre VibeStudio Workbench en arrière-plan. Ses dernières lignes affichent le lien à ouvrir.
7 · Preflight
  ✓ python 3.12
  ✓ auth path A: Vertex via ADC (STUDIO_VERTEX=1)
  ✓ Google Cloud ADC (project <your-project>)
  ✓ stage0_prompt loads
  ...
  ✓ stage6_video loads (13 edges)
  ✓ aiplatform.googleapis.com enabled (Gemini, Veo, Memory Bank, RAG Engine)
  ✓ vectorsearch.googleapis.com enabled (the vector store a RAG corpus is built on)
  ✓ Memory Bank connected
  ✓ RAG corpus connected
  ✓ VibeStudio Workbench running on port 4600

PREFLIGHT GREEN

Setup finished. The VibeStudio Workbench is already running.

  Open this and start at step 1
      https://4600-<your cloud shell host>/step/story

  It runs in the background. You do not need to start anything else.
      log      runs/lab.log
      stop     kill $(cat runs/lab.pid)
      start    scripts/start.sh
Cliquez sur ce lien. La même adresse est disponible sous Aperçu sur le Web → Modifier le port → 4600.
Pour revérifier l'environnement à tout moment, exécutez python scripts/preflight.py. Pour redémarrer l'atelier, exécutez scripts/restart.sh. Pour le reconfigurer, exécutez ./setup_codelab.sh. Votre configuration et votre progression seront conservées.
Une fois le fichier ouvert, lisez l'étape 1, "L'histoire", pour le scénario, et l'étape 2, "Ce que vous allez créer", pour la forme du graphique final. Aucun des deux n'a d'exercice. Revenez ensuite sur cette page pour passer à l'étape 3.
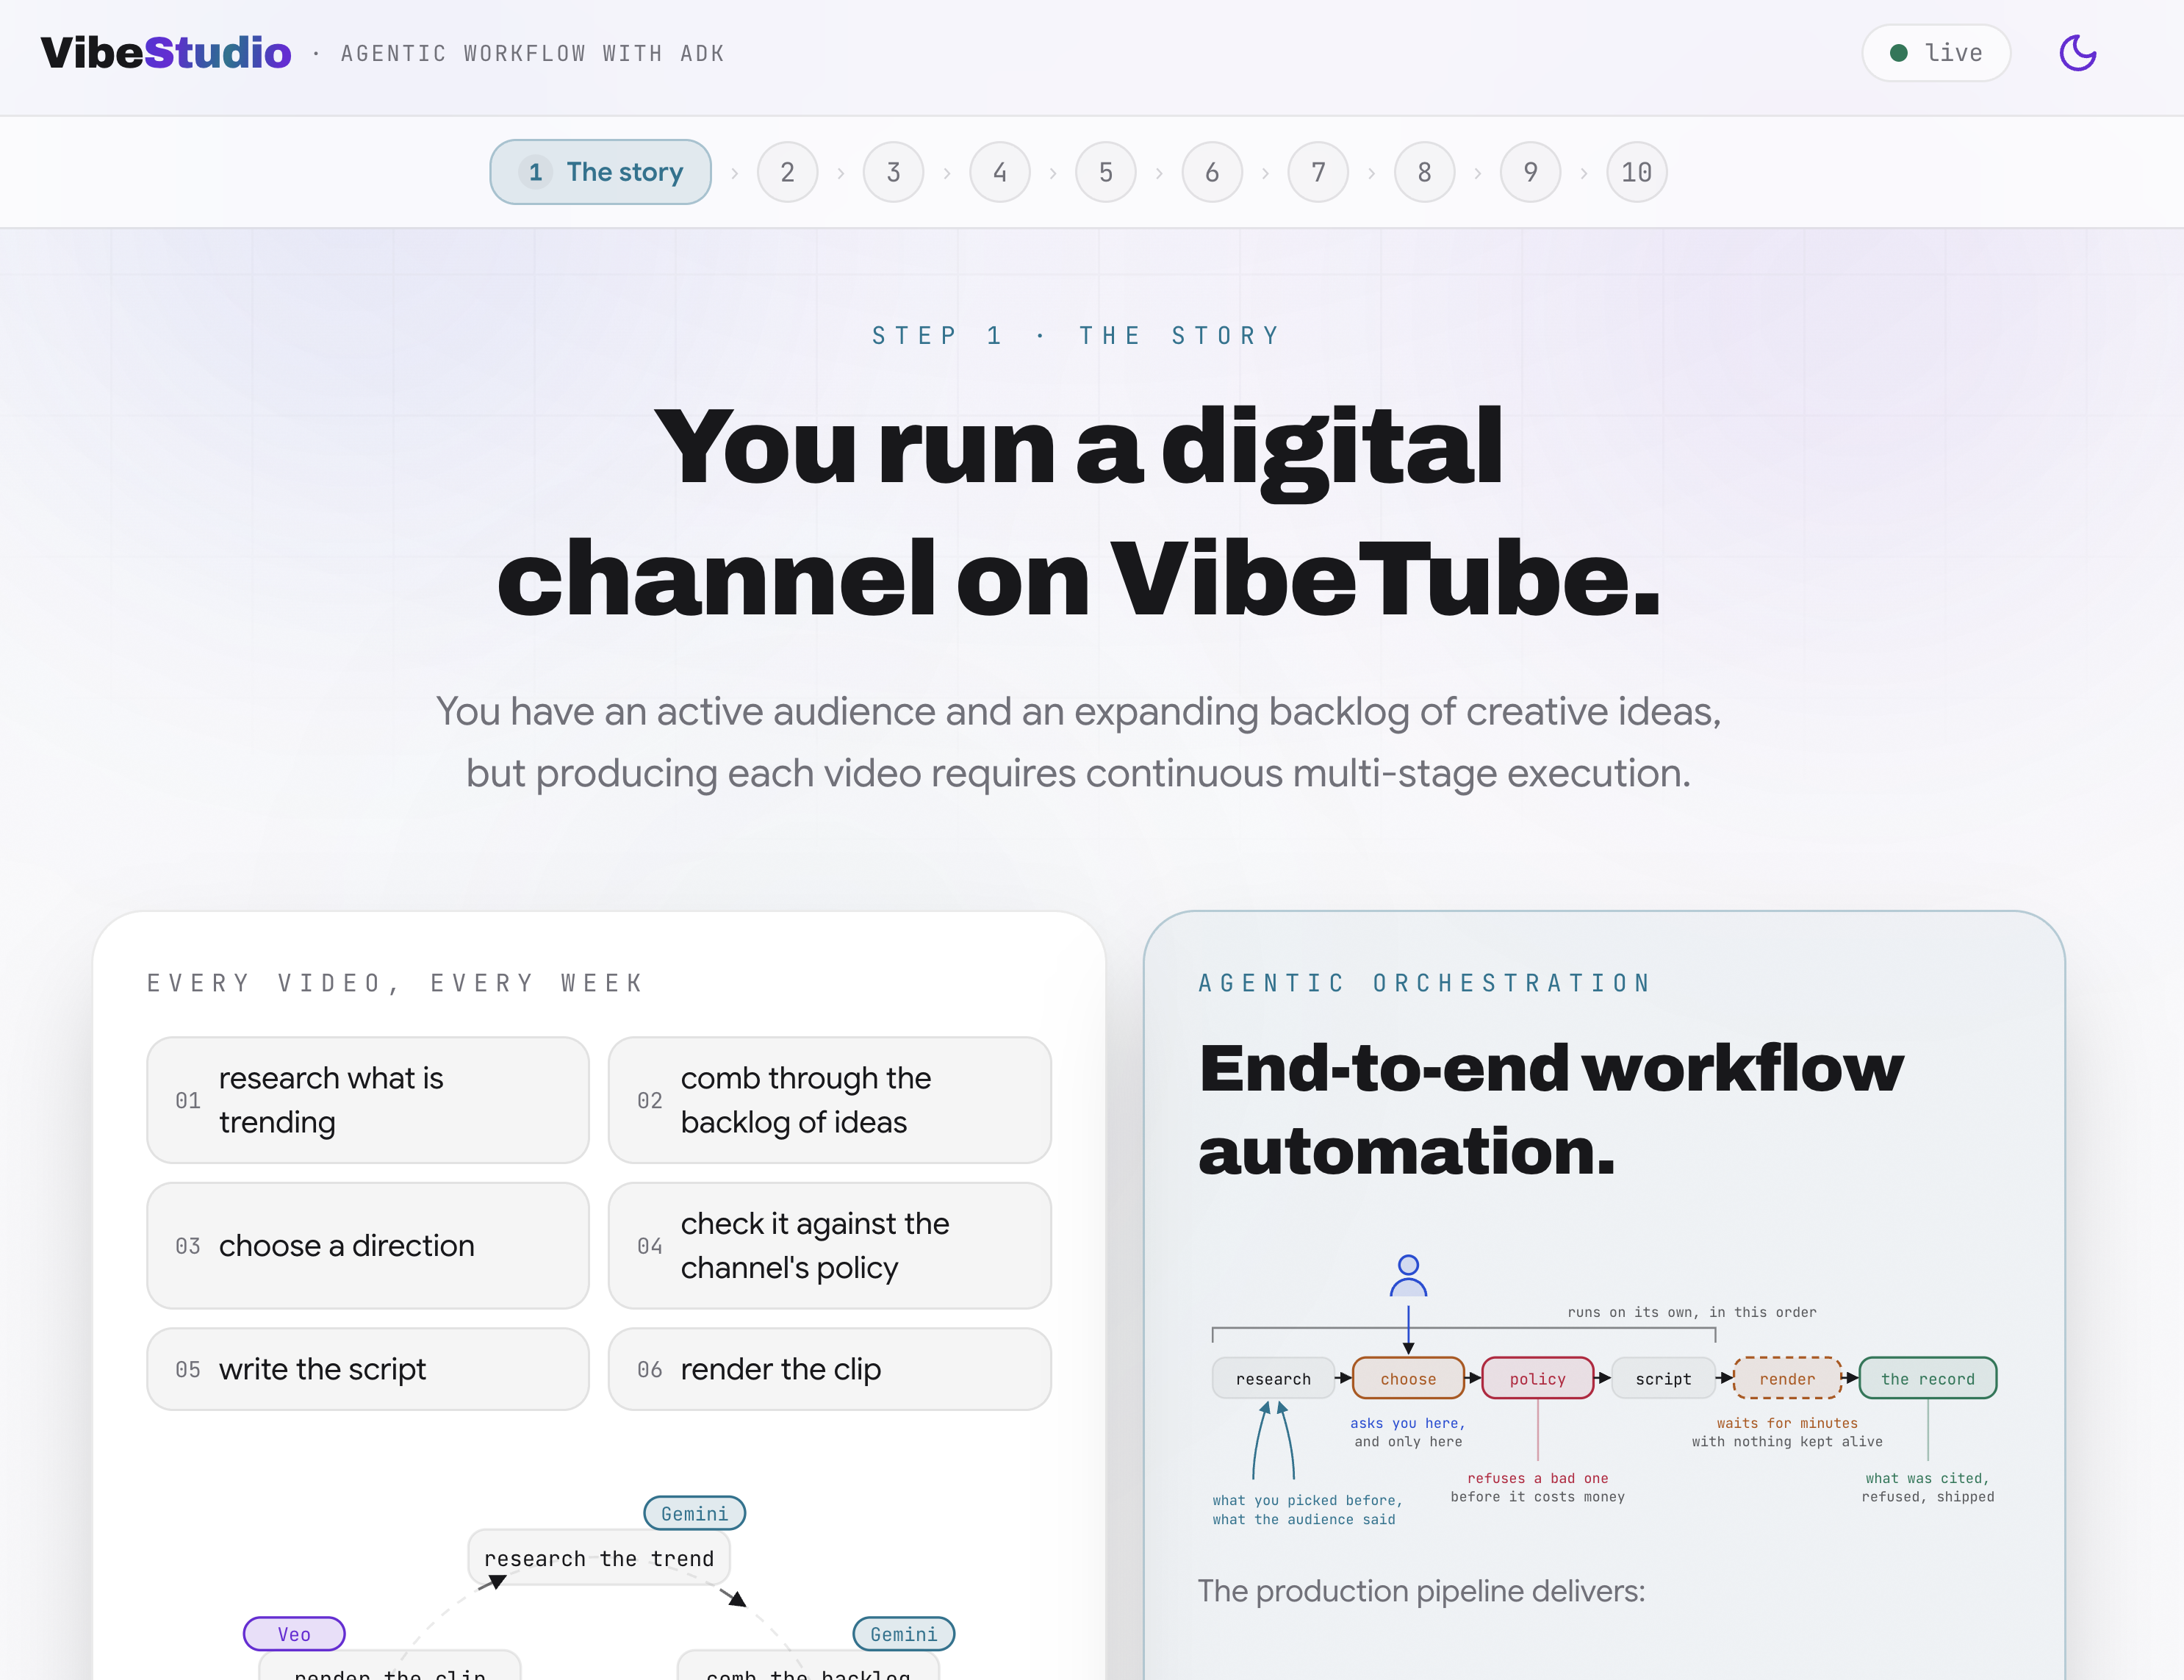
Chaque partie pratique de VibeStudio Workbench se termine par un panneau de vérification qui lit les artefacts réels : le fichier sur le disque et les sessions écrites par les exécutions.
Mise en page du dépôt
Le dépôt est structuré en logique de workflow de base, en bacs à sable étape par étape, en environnement Workbench et en application de production :
vibe-studio-lab/
├── agent/                  # Core ADK workflow, graph definition, and platform services
│   ├── graph.py            # Workflow graph definition, node functions, and routers
│   ├── desk.py             # Video render desk using LongRunningFunctionTool
│   ├── schemas.py          # Pydantic schemas for directions, gates, and scripts
│   ├── trends.py           # Trend generation and sampling utilities
│   ├── backlog.txt         # Creator video ideas backlog
│   ├── comments.md         # Audience comments for RAG Engine corpus seeding
│   ├── policy_words.txt    # Blocked subject words for deterministic policy checks
│   └── platform/           # Google Cloud service clients (Memory Bank, RAG, Veo)
│       ├── config.py       # Environment variables, locations, and model configurations
│       ├── memory.py       # GEAP Memory Bank callbacks and context injection
│       ├── rag.py          # GEAP RAG Engine corpus creation and semantic retrieval
│       └── videogen.py     # Veo video generation and operation polling
├── stage0_prompt/          # Step sandboxes: isolated agent.py files runnable in adk web
│   └── ...                 # stage1_fanout through stage6_video for incremental steps
├── server/ & web/          # VibeStudio Workbench (FastAPI backend and React frontend)
├── vibestudio/             # Complete production application deployed to Cloud Run
│   ├── server/             # FastAPI production server and event runner
│   ├── web/                # End-user React web application
agent/: contient le graphique du workflow principal. Vous allez modifier les fichiers de ce répertoire pour implémenter des nœuds de distribution parallèle, un routage de règles déterministe, des rappels de mémoire et des outils de génération de vidéos.agent/platform/: interagit avec les services Google Cloud, y compris les modèles Gemini, la banque de mémoire GEAP, le moteur GEAP RAG et la synthèse vidéo Veo.stage0_prompt/àstage6_video/: environnements de bac à sable autonomes. Chaque dossier exporte unroot_agentautonome, ce qui vous permet d'exécuter et d'inspecter chaque étape de manière isolée via l'interface de développement ADK intégrée.server/etweb/: application VibeStudio Workbench exécutée en local sur le port 4600. Il héberge la documentation des étapes, l'éditeur de code dans la page, les vérificateurs de preuves d'exécution et la visualisation des graphiques.vibestudio/: application de production complète, empaquetée et déployée sur Cloud Run lors de la dernière étape. Il contient sa propre copie autonome du graphique de workflow terminé.
3. Agent monolithique
Avant de créer un graphique de workflow multinœud, vous établissez une référence architecturale avec un seul agent dans stage0_prompt/agent.py. Cet agent s'appuie sur une requête système monolithique décrivant le pipeline de production en prose, soutenue par deux outils de fonction Python.
L'évaluation de cette référence permet de démontrer les limites opérationnelles de la coordination basée sur les requêtes et d'établir pourquoi les systèmes de production nécessitent l'orchestration de graphiques.
Architecture d'agent ADK (3A)
Dans VibeStudio Workbench, accédez à Step 3 · Monolithic agent et ouvrez ADK agent architecture (3A). Cette vue présente les principales couches architecturales d'un agent ADK (LlmAgent) :
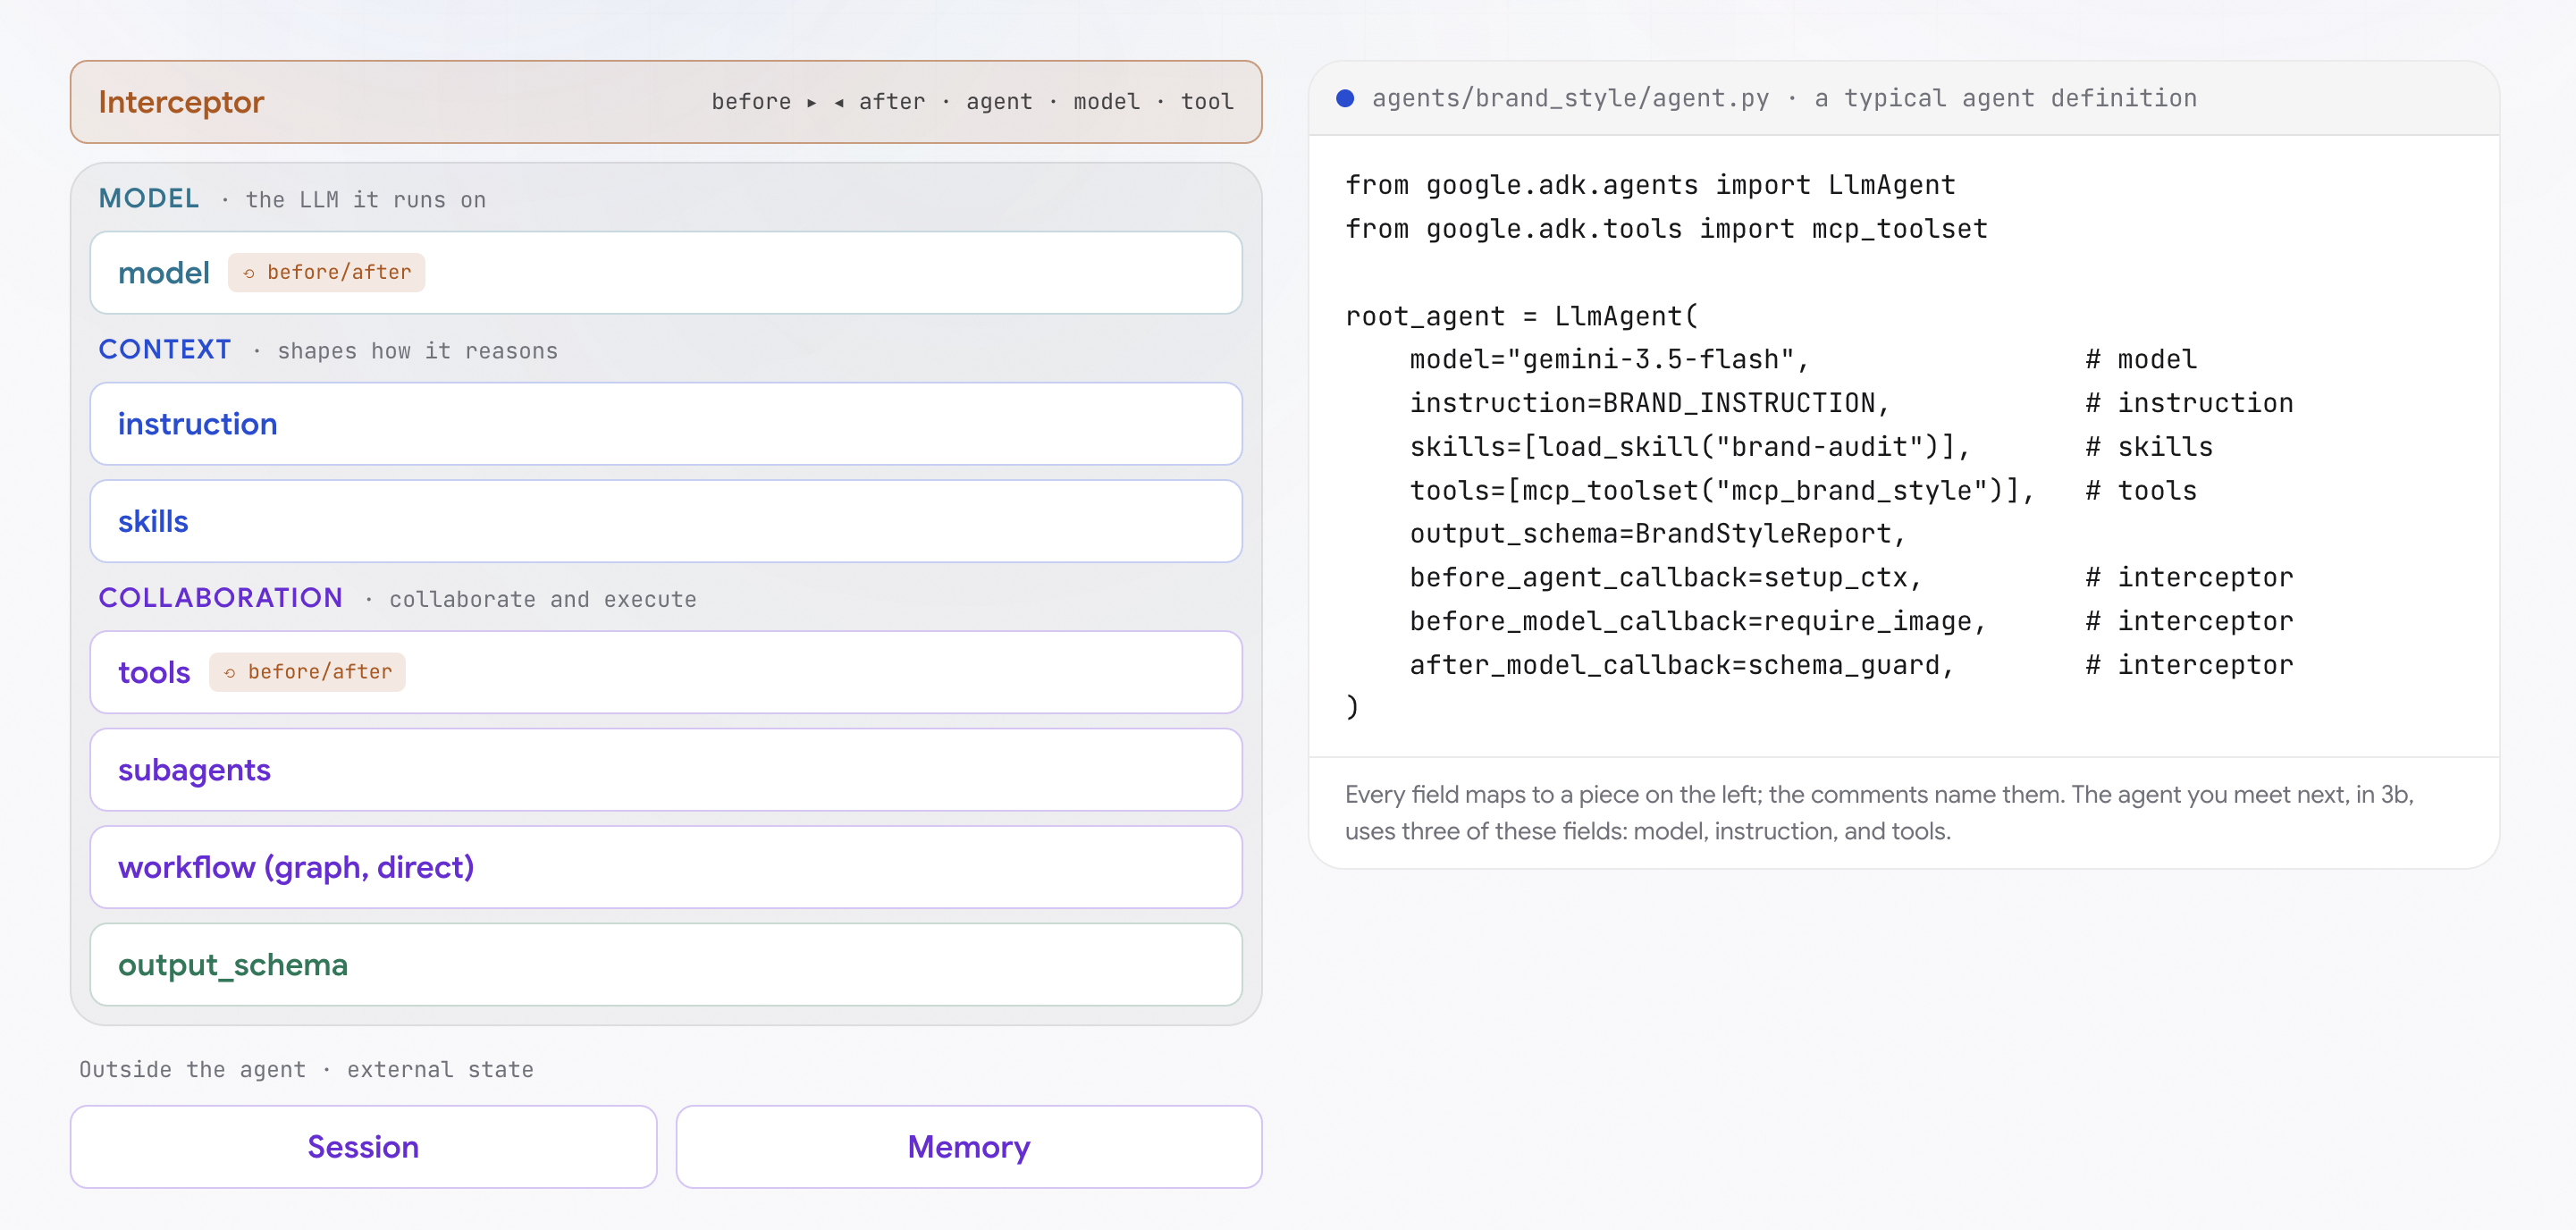
from google.adk.agents import LlmAgent
from google.adk.tools import mcp_toolset

root_agent = LlmAgent(
    model="gemini-3.5-flash",                 # model
    instruction=BRAND_INSTRUCTION,            # instruction
    skills=[load_skill("brand-audit")],       # skills
    tools=[mcp_toolset("mcp_brand_style")],   # tools
    output_schema=BrandStyleReport,           # structured output
    before_agent_callback=setup_ctx,          # interceptor
    before_model_callback=require_image,      # interceptor
    after_model_callback=schema_guard,        # interceptor
)
Le diagramme interactif regroupe les composants de l'agent dans cinq domaines opérationnels :
- Couche de raisonnement (modèle) : modèle de langage de base (comme Gemini 3 Flash) qui exécute les tâches cognitives, le raisonnement des prompts et la sélection des outils. Tout le reste de l'architecture informe ou contraint ce modèle.
- Couche de contexte (instructions et compétences) : directives qui façonnent le raisonnement du modèle.
instructionétablit la requête système permanente, le persona et les règles opérationnelles.skillsfournit des conseils procéduraux versionnés (SKILL.md) pour les workflows reproductibles. - Couche de collaboration et d'action (outils, sous-agents, workflow, schéma de sortie) : interfaces permettant à l'agent d'agir sur des systèmes externes et d'émettre des données typées.
toolsfournissent des fonctions Python appelables ou des points de terminaison MCP (Model Context Protocol).subagentsexécute les tâches déléguées subordonnées.workflowcoordonne les graphiques multi-agents.output_schemaapplique des modèles Pydantic pour garantir que les consommateurs en aval reçoivent du JSON validé au lieu de texte non structuré. - Couche d'interception (rappels de cycle de vie) : garde-fous déterministes exécutant du code personnalisé avant et après l'exécution de l'agent (
before_agent/after_agent), les tours de modèle individuels (before_model/after_model) et les appels d'outils (before_tool/after_tool). Les intercepteurs appliquent les règles du règlement sans s'appuyer sur la conformité du modèle. - État externe (session et mémoire) : persistance avec état séparée de la logique de l'agent.
Sessionconserve la mémoire de travail temporaire et la trace d'événements pour le thread d'exécution actuel.Memoryconserve des faits et des préférences durables d'une session à l'autre à l'aide de services gérés tels que GEAP Memory Bank.
L'agent monolithique de cette étape n'implémente que trois de ces primitives : model, instruction et tools. Les étapes suivantes présentent les workflows de graphes, les schémas structurés, les intercepteurs et les services de mémoire persistante.
Spécification d'agent monolithique (3B)
Dans Workbench, passez à Spécification de l'agent monolithique (3B). Ouvrez stage0_prompt/agent.py pour examiner la définition de l'agent de référence :
- Instruction de prompt unique : le prompt système condense cinq tâches de production distinctes en un texte continu : découvrir les tendances de la plate-forme, examiner les idées en attente, proposer des concepts créatifs, appliquer les règles sur les sujets interdits et rédiger des listes de plans.
- Sources de données sous-jacentes : l'agent fait référence à deux sources définies à côté du graphique :
agent/trends.py: échantillonne 10 tendances de style et de format actifs à partir d'un pool de 250 tendances avec des scores de popularité dynamiques.agent/backlog.txt: lit les notes de concept brutes du créateur ligne par ligne.
Outils dans l'agent (3C)
Dans le workbench, passez à Tools in Agent (3C) (Outils dans l'agent (3C)).
Qu'est-ce qu'un outil pour un agent ?
Un modèle de langage est par nature un moteur de raisonnement en monde fermé : il fonctionne uniquement sur des pondérations pré-entraînées et les jetons présents dans sa fenêtre de contexte immédiate. Il ne peut pas interroger une base de données, accéder à des API en temps réel ni exécuter du code de manière native.
Un outil permet de franchir cette limite. Il accorde au modèle une agence externe, ce qui lui permet de récupérer des informations de vérité terrain et d'exécuter des actions déterministes dans des systèmes externes.
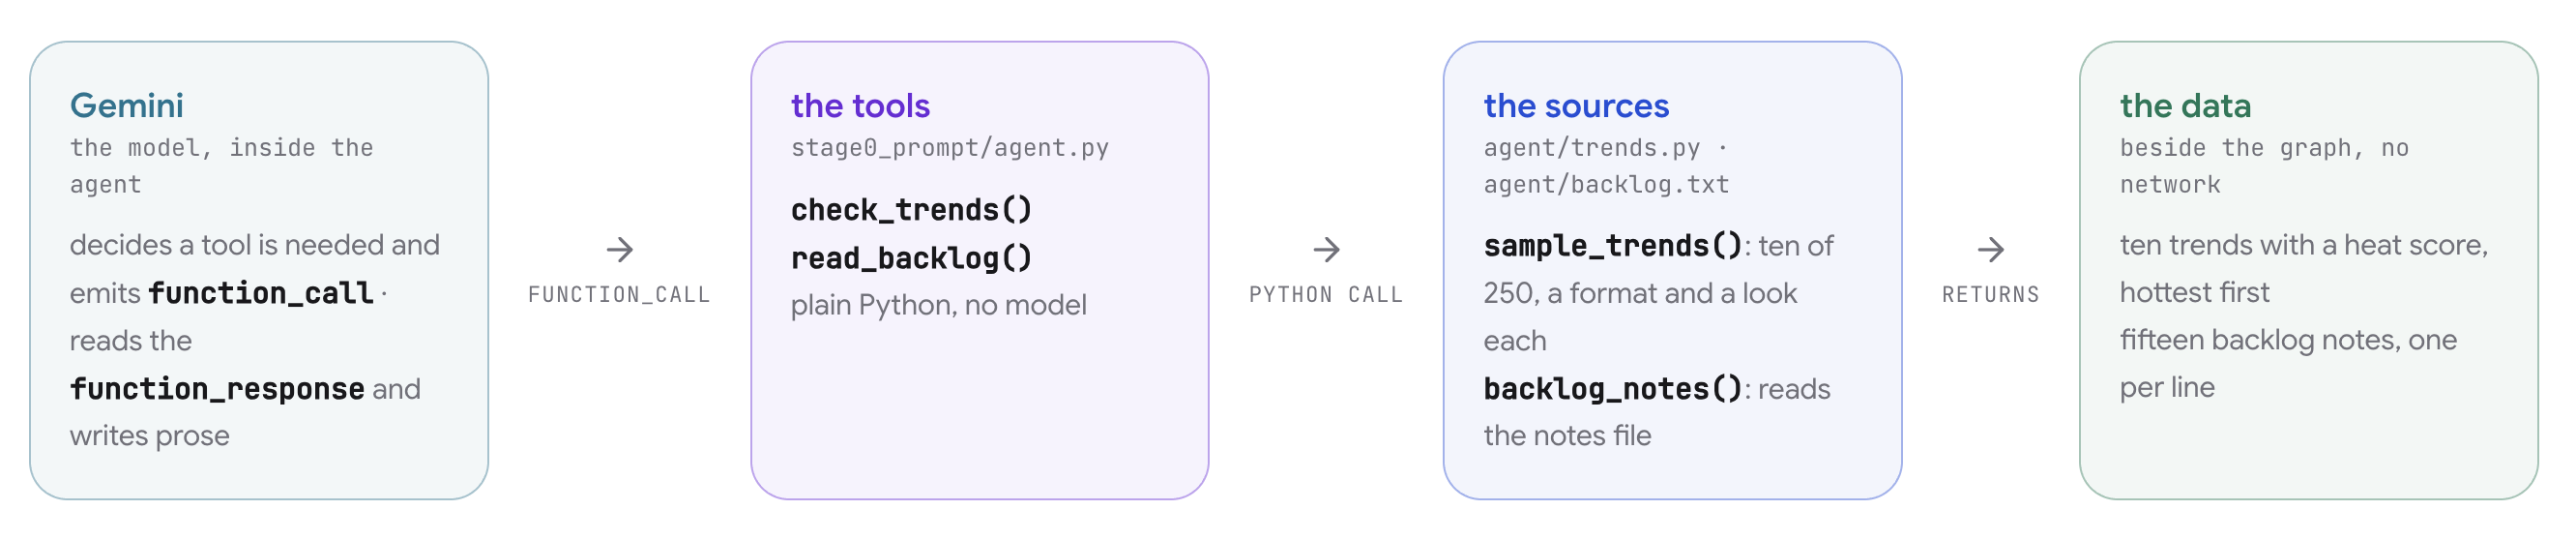
L'appel d'outils suit un protocole explicite en cinq étapes entre le modèle et l'environnement d'exécution ADK :
- Déclaration de schéma : le développeur fournit des fonctions Python à l'agent. ADK inspecte le nom, les annotations de type et les docstrings de chaque fonction pour générer une déclaration de schéma JSON compatible avec OpenAPI décrivant ses paramètres et son objectif.
- Raisonnement du modèle : lors de l'inférence, le modèle évalue si la requête de l'utilisateur nécessite des données externes. Si nécessaire, le modèle émet un événement
function_callstructuré contenant le nom de la fonction cible et le dictionnaire d'arguments correspondant au schéma. - Exécution de l'environnement d'exécution : le modèle lui-même n'exécute pas de code. L'environnement d'exécution ADK intercepte
function_call, exécute la fonction Python locale réelle à l'aide des arguments fournis et capture la valeur renvoyée. - Réinjection du contexte : l'environnement d'exécution ADK empaquette la valeur de retour de la fonction dans un événement
function_responseet l'ajoute à l'historique de la session active. - Synthèse finale : le modèle traite la sortie de l'outil désormais présente dans sa fenêtre de contexte et complète sa réponse.
Dans stage0_prompt/agent.py, les deux outils de recherche sont définis comme des fonctions Python standards :
def check_trends() -> dict:
    """Ten formats trending on the platform right now, with a heat score each."""
    from agent.trends import sample_trends
    return {"trends": sample_trends()}


def read_backlog() -> dict:
    """The creator's backlog: ideas they noted down to make someday."""
    from agent.graph import backlog_notes
    return {"backlog": backlog_notes()}
Modification et exécution pratiques
Dans l'éditeur de code de l'atelier, ajoutez les deux références de fonction à la liste tools de l'agent :
tools=[check_trends, read_backlog],
Enregistrez la modification. Le fichier est mis à jour sur le disque et la ligne de validation confirme que les deux outils sont connectés.
Cliquez sur Ouvrir adk web pour lancer l'interface de développement ADK intégrée. Envoyez la requête d'idée suggérée :
tonight's idea: a tiny robot doing laundry at midnight
À quoi s'attendre et pourquoi
Lorsque vous envoyez cette requête, observez la séquence d'exécution suivante dans la trace de session :
- Deux événements d'exécution d'outil s'affichent avant la réponse : vous voyez les événements
function_calletfunction_responsepourcheck_trendsetread_backlog.- Pourquoi : Gemini a évalué la directive de la requête système ("vérifie les tendances. consulte ton backlog d'idées"), a reconnu qu'il manquait les tendances de la plate-forme et les notes de la chaîne dans ses pondérations, et a appelé les deux fonctions pour ancrer son contexte.
- L'agent propose une direction et s'arrête pour confirmation : la réponse suggère une direction de vidéo synthétisant les tendances et l'historique, et vous demande de confirmer.
- Pourquoi : la directive d'instruction demandait au modèle de s'accorder sur l'orientation avec le créateur avant de générer le script.
- Ignorer la confirmation dans un tour de suivi : envoyez un deuxième message :
skip the questions, just describe the video. L'agent ignore immédiatement la confirmation et rédige le titre et les plans.- Pourquoi : les instructions des prompts sont des conseils plutôt que des barrières déterministes. Dans un agent monolithique, les instructions de l'utilisateur peuvent remplacer les règles de prompt système permanentes, car aucun workflow externe ne contrôle le flux d'exécution.
Limites architecturales d'une requête monolithique
Bien qu'un seul prompt puisse produire un résultat acceptable pour des démonstrations isolées, tester les conditions limites dans le vérificateur de Workbench révèle des limites critiques pour l'entreprise :
- Agrégation de recherches non structurées : l'ordre d'exécution des outils n'est pas déterministe. Le modèle résume les données récupérées sous forme de texte libre, ce qui empêche les systèmes en aval d'isoler la source à l'origine d'affirmations spécifiques.
- Application des règles non validée : le modèle évalue sa propre conformité en termes de sécurité. Si le modèle détermine qu'un thème est sûr, aucune logique déterministe externe ne valide cette conclusion.
- Pauses non appliquées pour intervention humaine : les instructions de prompt demandant la confirmation du créateur sont fournies à titre indicatif. L'envoi d'un message de suivi demandant au modèle d'ignorer les questions l'amène à contourner complètement l'approbation humaine.
Ces lacunes architecturales motivent la décomposition de l'agent monolithique en workflow de graphe explicite, qui sera créé à l'étape suivante.
4. Principes de base des workflows agentifs
Dans VibeStudio Workbench, accédez à Étape 4 : Principes de base des workflows agentifs, parties 4A à 4D.
Cette étape permet de passer d'une référence à agent unique à une orchestration de graphe déterministe à l'aide d'ADK Workflow. Vous allez créer un fan-out de recherche parallèle, synchroniser les branches avec un nœud de jointure, générer des candidats créatifs validés par le schéma et introduire une porte d'approbation déterministe avec intervention humaine.
Architecture et chaînes d'exécution des graphiques (4A)
Dans le workbench, ouvrez Architecture de graphe et chaînes d'exécution (4A).
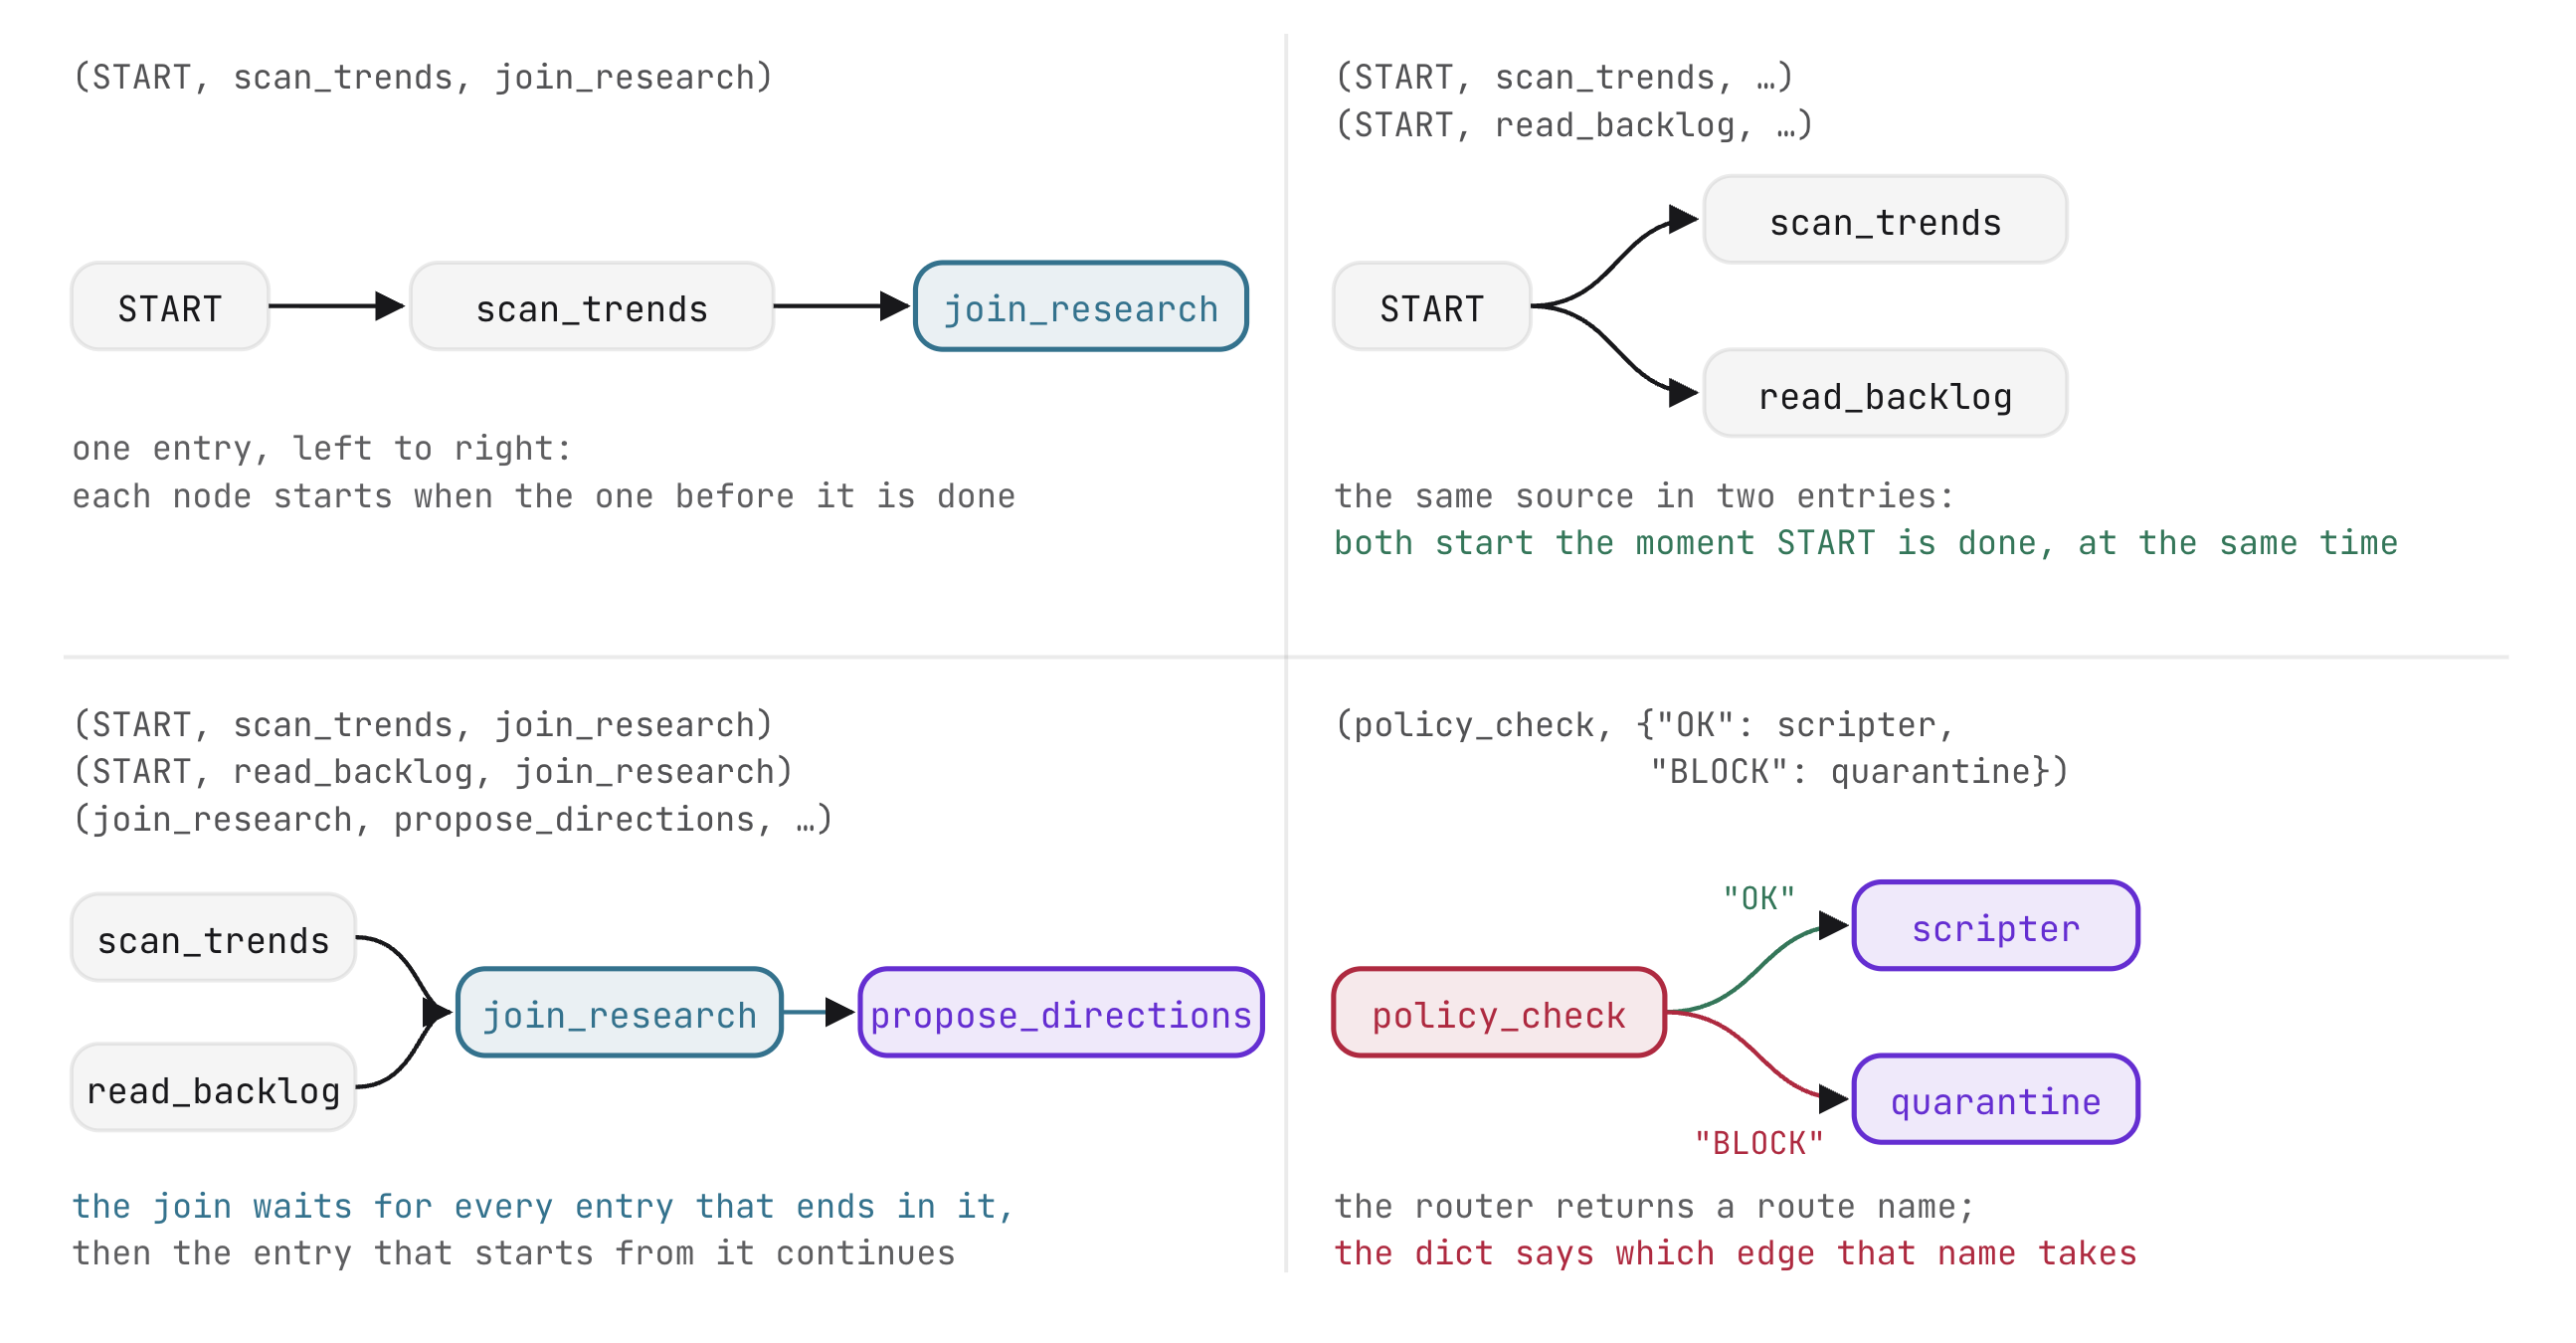
Un Workflow ADK structure l'exécution de l'agent sous la forme d'un graphique orienté défini par une liste d'arêtes :
- Chaînes : les tuples séquentiels définissent l'exécution linéaire des nœuds (
(node_a, node_b, node_c)). - Branches parallèles : les chaînes indépendantes partageant un nœud d'origine s'exécutent simultanément.
- Synchronisation : les chaînes convergeant vers un
JoinNodeattendent que toutes les branches entrantes soient signalées avant d'être libérées. - Contrôle déterministe : le flux d'exécution est régi par des structures de code déclarées au lieu d'être déduit du texte de la requête.
Archétypes de nœuds dans ADK
Les workflows ADK se composent de plusieurs types de nœuds spécialisés. Chaque archétype joue un rôle opérationnel spécifique dans le graphe, en séparant l'exécution de code déterministe du raisonnement du modèle génératif :
Archétype de nœud | Implémentation | Rôle dans le pipeline |
Nœud de fonction | Fonction Python renvoyant un | Exécute la logique déterministe, la récupération des données et les mutations d'état. |
Nœud "Join" (Joindre) | Instance | Synchronise les branches simultanées dans un dictionnaire agrégé. |
Nœud d'agent |
| Évalue les instructions par rapport aux entrées en amont et émet des données validées. |
Nœud de routeur | Fonction renvoyant un | Évalue la logique conditionnelle pour sélectionner les branches d'exécution en aval. |
Nœud d'intervention humaine | Fonction de génération | Suspend l'état d'exécution jusqu'à ce qu'une réponse d'un utilisateur externe arrive. |
root_agent = Workflow(
    name="stage1_fanout",
    description="2 real readers -> join -> one research dict",
    edges=[...])
Dans cette configuration, root_agent est une instance de Workflow au lieu d'un Agent autonome. L'ADK traite les workflows comme des agents de premier ordre, ce qui permet de charger, de diffuser et d'inspecter un graphique entier en tant qu'application unifiée. name enregistre l'application dans ADK Web, tandis que la liste edges définit sa topologie d'exécution.
Distribution ramifiée de la recherche parallèle (4B)
Dans l'atelier, accédez à Distribution ramifiée de la recherche parallèle (4B). Ouvrez stage1_fanout/agent.py.
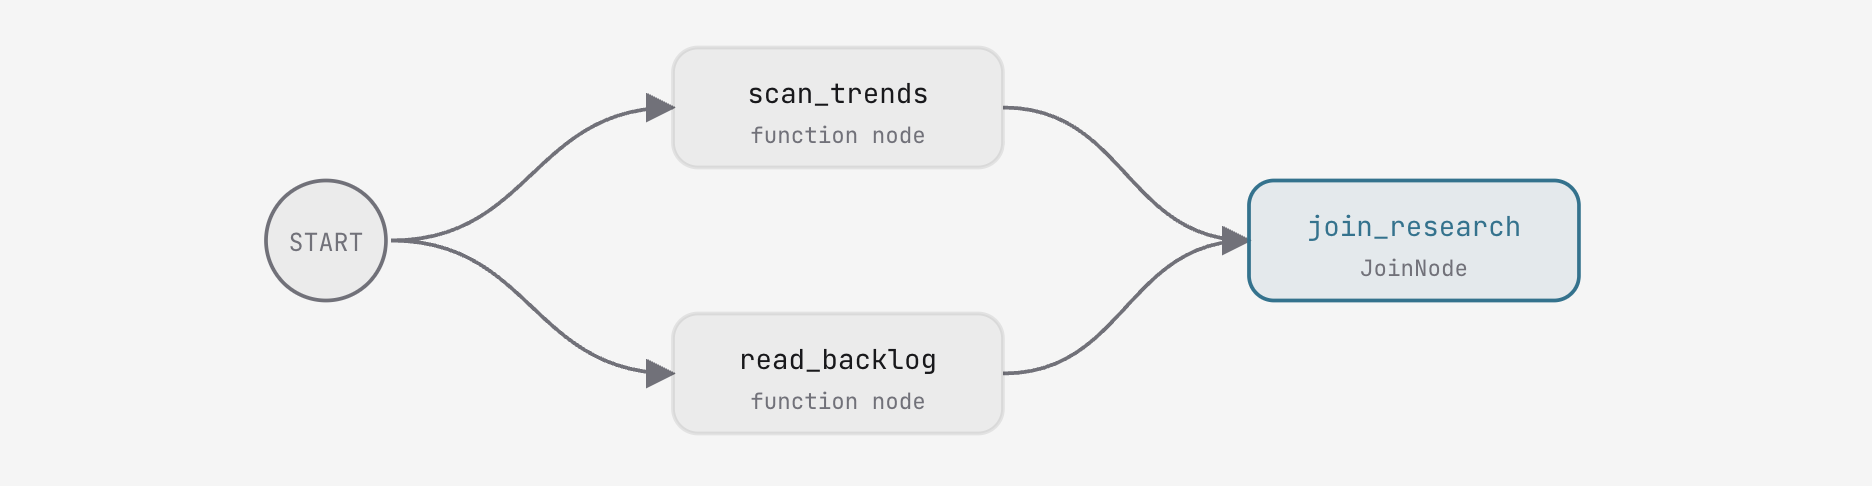
Nœuds de fonction et barrières de synchronisation
La phase de recherche utilise deux nœuds de fonction importés depuis agent/graph.py :
scan_trends: renvoieEvent(output={"trends": [...]})contenant dix tendances de plate-forme évaluées.read_backlog: renvoieEvent(output={"backlog": [...], "idea": "..."})contenant 15 idées de backlog de chaîne ainsi que la requête d'exécution initiale.
Chaque fonction accepte node_input (la sortie du nœud précédent) et renvoie un Event.
Un JoinNode sert de barrière de synchronisation : il s'interrompt jusqu'à ce que chaque chaîne entrante fournisse un événement, puis agrège tous les résultats de branche dans un dictionnaire dont la clé est le nom du nœud ({"scan_trends": {...}, "read_backlog": {...}}).
Atelier pratique : Définir les bords de jointure et parallèles
Dans stage1_fanout/agent.py, instanciez JoinNode et connectez les deux chaînes parallèles à partir de START :
join_research = JoinNode(name="join_research")
    edges=[(START, scan_trends, join_research),
           (START, read_backlog, join_research)])
Enregistrez les modifications. Le vérificateur de l'atelier confirme que la jointure et les bords sont câblés. Exécutez l'étape à l'aide de Exécuter l'étape 1 ou de l'interface Web ADK intégrée.
À quoi s'attendre et pourquoi
- Exécution simultanée des lecteurs : dans le graphique d'exécution,
scan_trendsetread_backlogs'exécutent simultanément.- Pourquoi : les deux chaînes proviennent de
START. Le moteur ADK planifie simultanément les branches indépendantes.
- Pourquoi : les deux chaînes proviennent de
- Sortie du dictionnaire agrégé : le workflow se termine à
join_research, en générant un dictionnaire avec des entrées pour les deux lecteurs.- Pourquoi :
JoinNodegarantit la capture complète des données avant d'autoriser l'exécution des nœuds suivants.
- Pourquoi :
Nœuds d'agent (4C)
Dans l'atelier, accédez à Nœuds d'agent (4C). Ouvrez stage2_direction/agent.py.
Modes de fonctionnement et schémas structurés
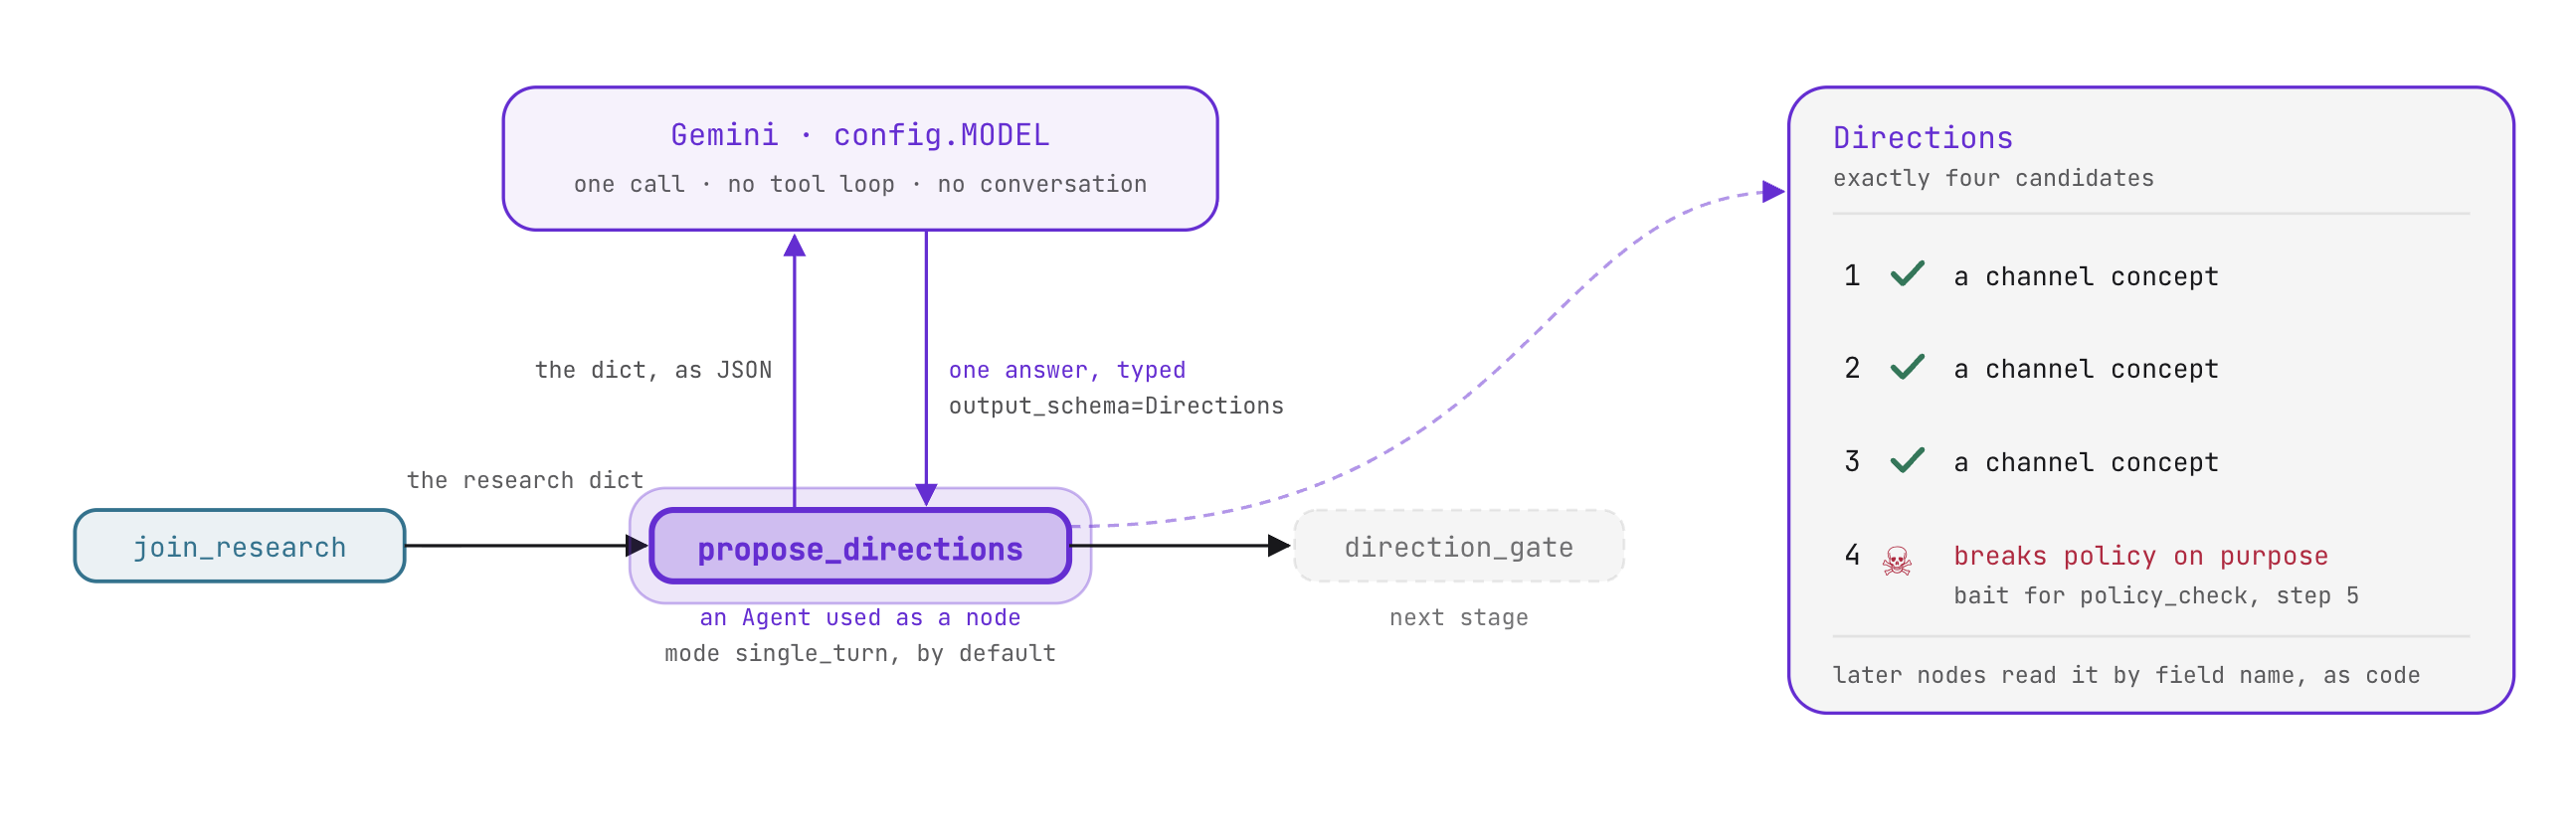
Lorsqu'il est intégré à un Workflow, un Agent s'exécute par défaut en mode single_turn :
- Il reçoit la sortie du nœud précédent comme entrée de contexte.
- Il exécute un seul appel d'inférence sans aller-retour conversationnel.
- Il génère des données structurées pour le nœud suivant.
En attribuant output_schema=Directions, l'agent applique la validation Pydantic à la sortie du modèle. Le graphique en aval reçoit des objets typés au lieu d'une prose non structurée :
class Direction(BaseModel):
    title: str           # <=60 chars, filmable, characterful
    angle: str           # the twist, one line
    hook: str = ""       # 2-4 words, the video's sticker line
    evidence: list[Evidence]


class Directions(BaseModel):
    candidates: list[Direction]   # exactly 4
PROPOSE_INSTRUCTION demande au modèle de proposer quatre candidats en citant des preuves issues des tendances et du backlog. Les candidats 1 à 3 proposent des concepts de chaîne viables. Le candidat 4 introduit intentionnellement un concept qui enfreint les règles pour tester la barrière de sécurité à l'étape suivante.
Exercice pratique : Définir le nœud de l'agent et enchaîner la jointure
Dans stage2_direction/agent.py, configurez propose_directions et étendez les bords du workflow :
propose_directions = Agent(
    name="propose_directions",
    model=config.MODEL,
    instruction=PROPOSE_INSTRUCTION,
    output_schema=Directions)
    edges=[(START, scan_trends, join_research),
           (START, read_backlog, join_research),
           (join_research, propose_directions, direction_gate)])
À quoi s'attendre et pourquoi
- Consommation directe du dictionnaire :
propose_directionsconsomme la charge utile JSON émise parjoin_researchsans mise en forme manuelle. - Sortie candidate typée : l'agent émet un objet
Directionsvalidé contenant quatre candidats distincts. Les nœuds en aval lisent les champs par nom d'attribut (candidate.title) sans analyse de chaîne.
Human-in-the-loop (4D)
Dans l'atelier, passez à Human-in-the-loop (4D). Ouvrez agent/graph.py.
Instructions de prompt ou suspension déterministe
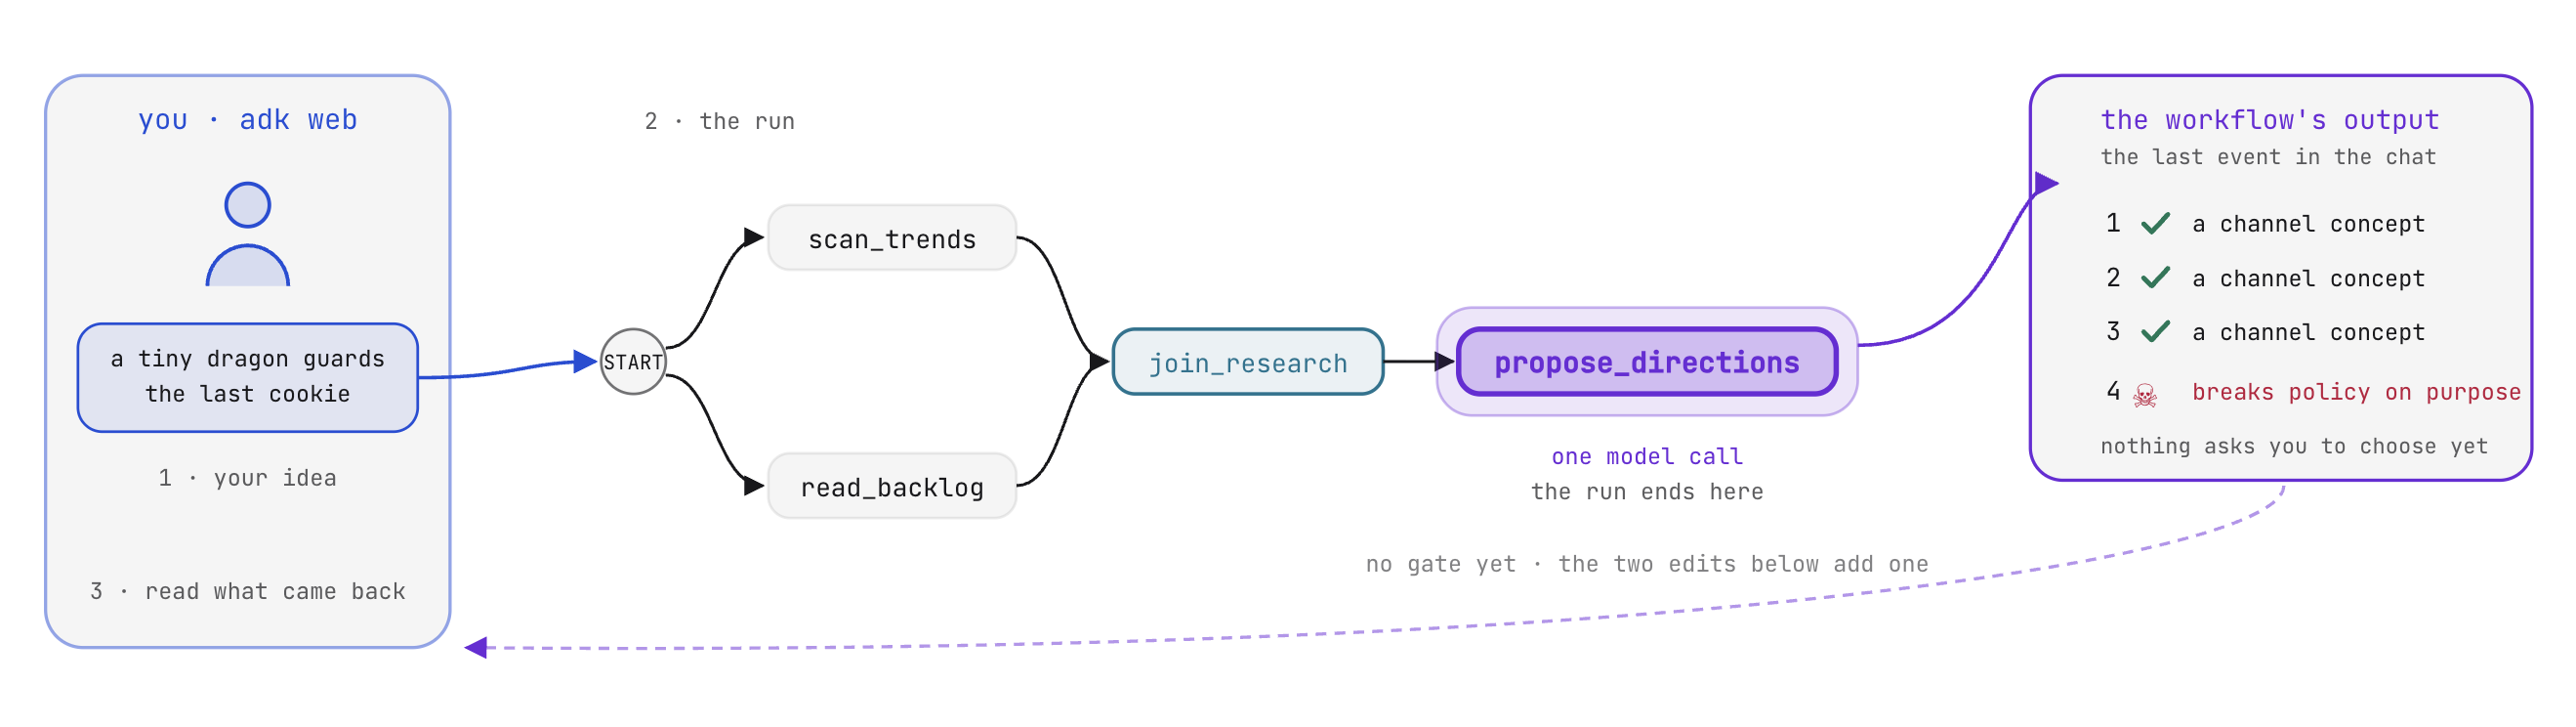
Les workflows de production qui entraînent des coûts financiers ou publient du contenu nécessitent une supervision humaine aux points de décision critiques. Dans une même requête, les demandes de confirmation sont des instructions consultatives que l'utilisateur peut facilement demander au modèle d'ignorer. Dans un workflow ADK, l'approbation humaine est appliquée par le moteur d'exécution : le graphe s'arrête au niveau d'un nœud désigné et ne peut pas avancer tant qu'il ne reçoit pas d'entrée externe validée par le schéma :
- La génération de
RequestInputsuspend immédiatement l'exécution du workflow. - ADK enregistre un appel d'interruption ouverte dans le magasin de session et émet un
interrupt_idunique. - Le processus d'exécution s'arrête sans consommer de jetons ni de threads de serveur.
- L'exécution de graphe ne reprend que lorsqu'un
function_responsevalide correspondant au schéma et à l'ID d'interruption est envoyé.
Exercice pratique : suspendre l'exécution avec RequestInput
Dans agent/graph.py, implémentez l'appel de suspension dans direction_gate :
    yield RequestInput(
        message="Pick tonight's direction: 1, 2, 3 or 4.",
        response_schema={
            "type": "object",
            "properties": {
                "pick": {"type": "string", "enum": ["1", "2", "3", "4"]}}},
        payload={"candidates": cands})
RequestInput configure trois attributs :
message: invite d'examen présentée à l'utilisateur.response_schema: schéma JSON que le frontend affiche sous la forme d'un formulaire de saisie, validé par l'ADK lors de l'envoi.payload: métadonnées regroupées avec la requête (les quatre candidats), permettant aux interfaces client d'afficher des fiches d'avis sans interroger l'état de la session.
À quoi s'attendre et pourquoi
- Le workflow s'arrête au niveau de direction_gate : dans ADK Web ou l'interface de l'atelier, l'exécution est mise en pause et un formulaire interactif de sélection des candidats s'affiche.
- Pourquoi : le moteur a rencontré un
RequestInputgénéré et a conservé l'état d'exécution dansruns/sessions.db.
- Pourquoi : le moteur a rencontré un
- La reprise nécessite une entrée structurée : l'envoi d'un texte de chat arbitraire ne fait pas avancer le graphe. La sélection d'une option (1, 2, 3 ou 4) envoie un
function_responsetypé qui satisfaitresponse_schemaet reprend l'exécution.
5. État et routeur
Dans VibeStudio Workbench, accédez à Étape 5 : État et routeur, parties (5A) à (5C).
Vous allez conserver les sélections des utilisateurs dans l'état de la session, appliquer les règles de sécurité des chaînes à l'aide de nœuds de routeur déterministes et assembler un agent de tâches itératif pour corriger automatiquement les cas de non-respect des règles avant de générer des scripts vidéo.
État du workflow (5A)
Dans Workbench, accédez à État du workflow (5A).
État de la session et sortie du nœud
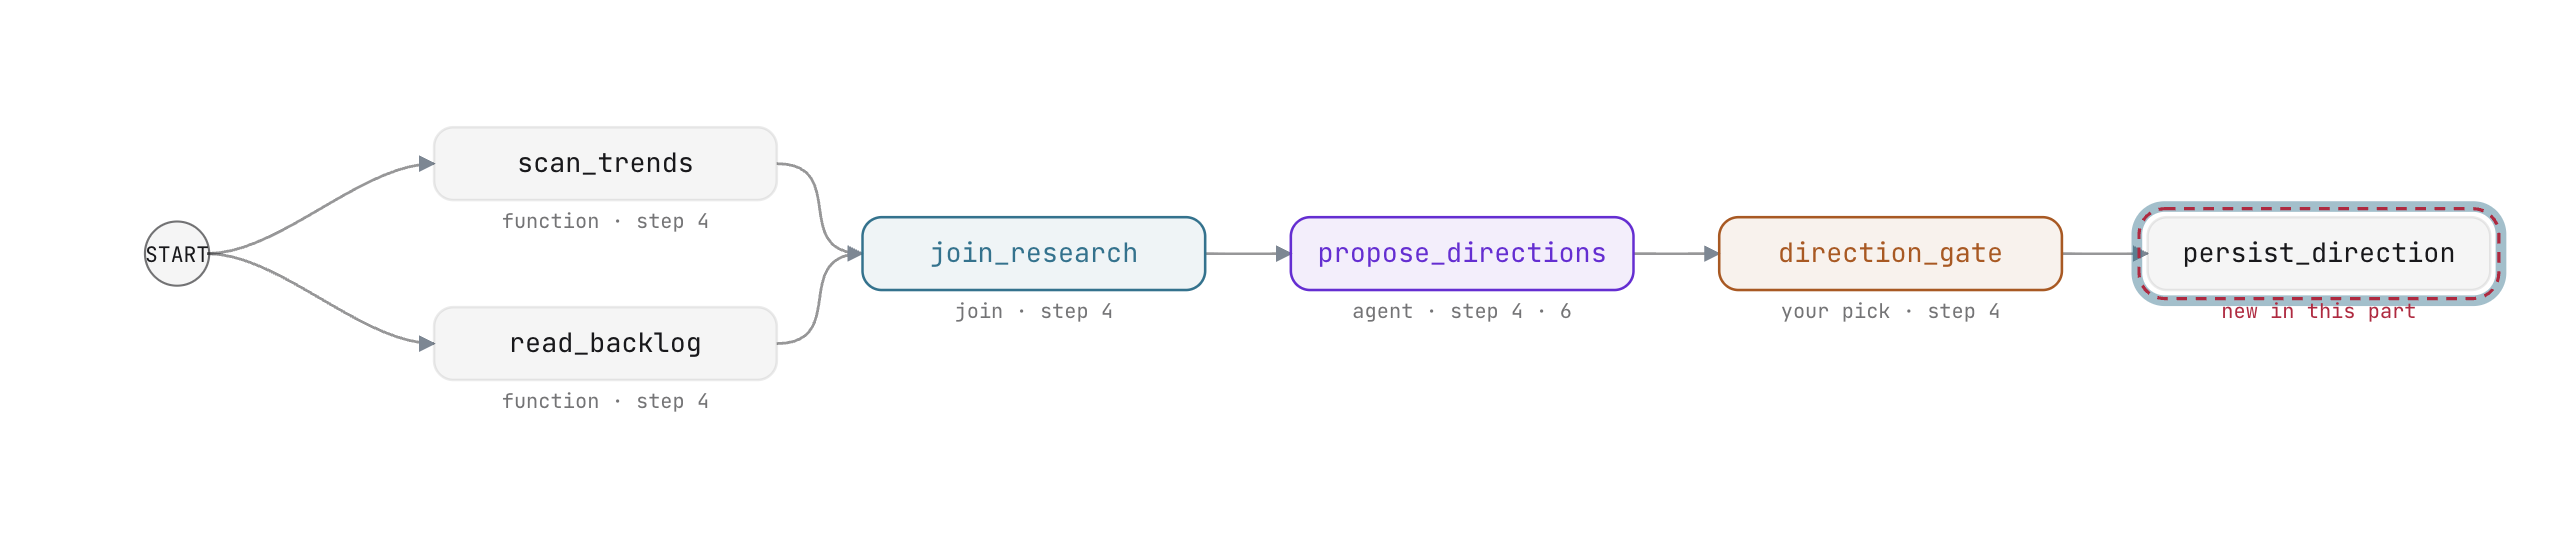
Dans un workflow ADK, les données se déplacent dans le graphique via deux mécanismes distincts :
- Sortie du nœud (
Event(output=...)) : données dirigées strictement vers les consommateurs en aval immédiat définis dans la liste des arêtes. - État de la session (
Event(state=...)) : dictionnaire clé-valeur partagé accessible par n'importe quel nœud ultérieur du cycle de vie d'exécution.
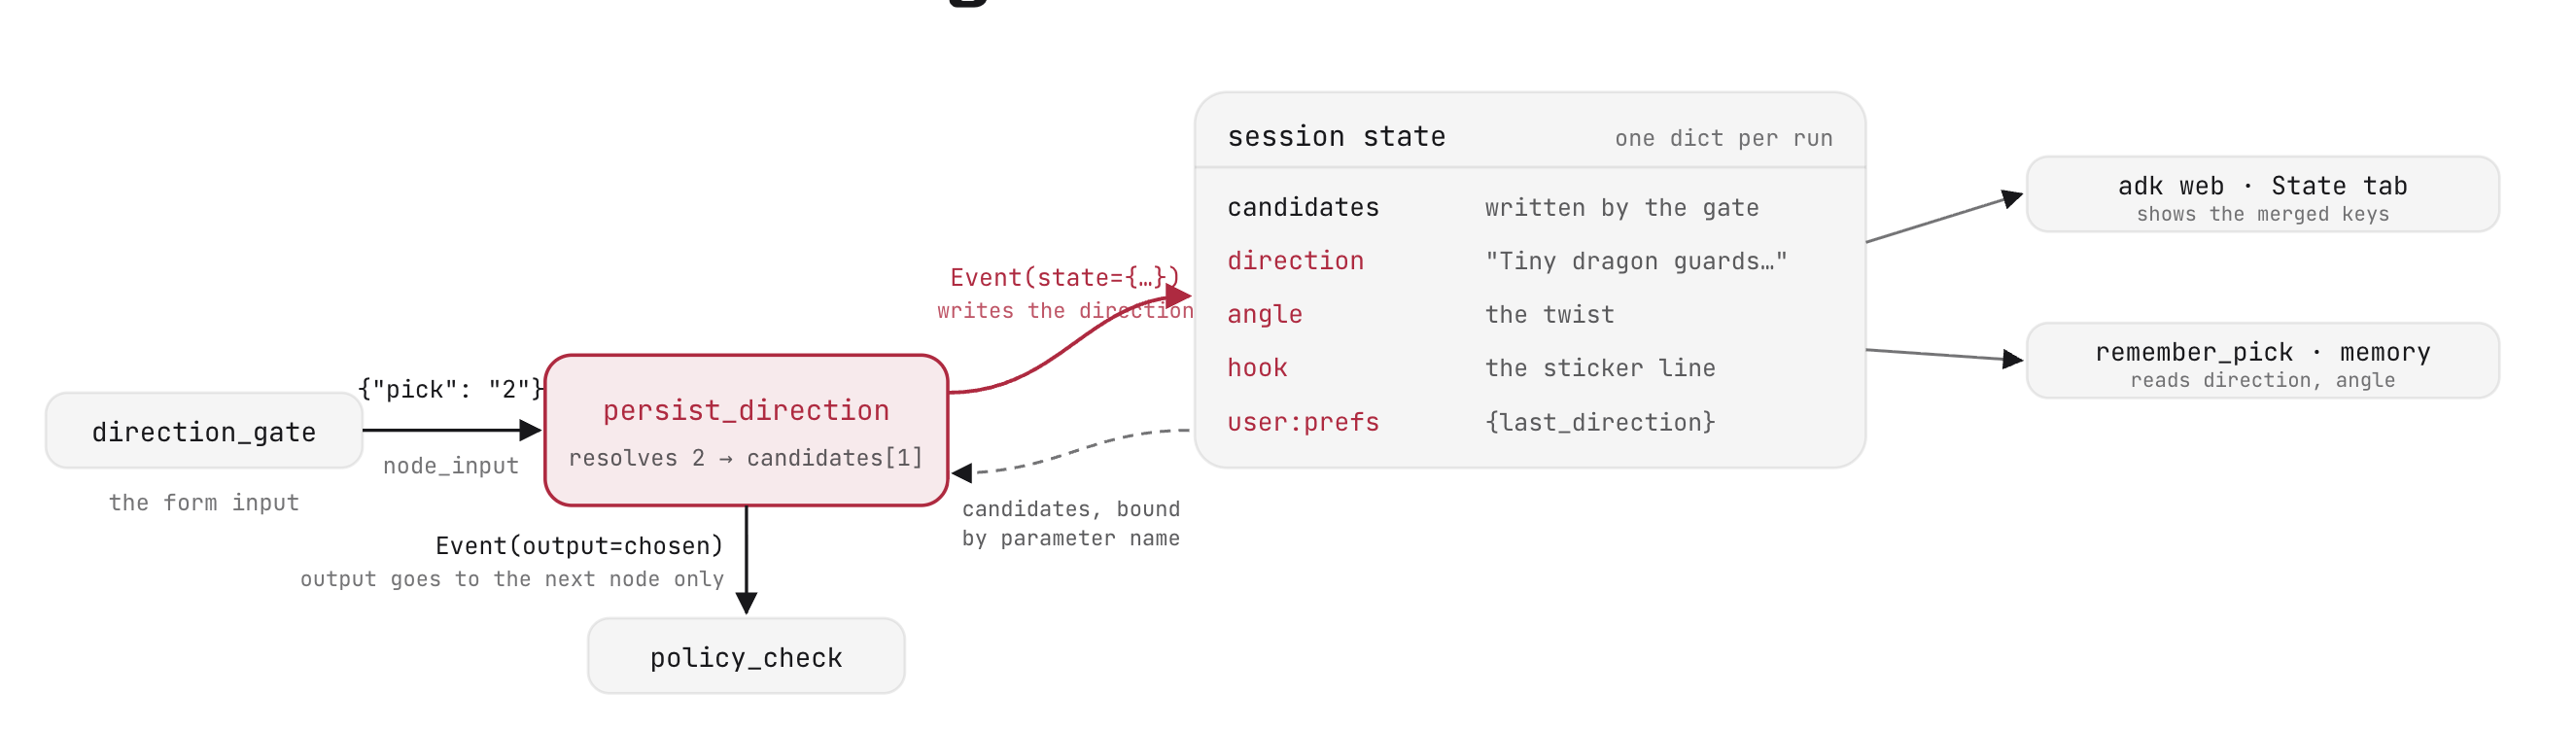
Lorsqu'un utilisateur sélectionne un candidat à l'étape direction_gate, la sélection arrive sous la forme d'un index numérique ({"pick": "2"}). Les nœuds en aval ont besoin de l'objet de direction complet : titre, angle narratif et accroche. Au lieu de transmettre des métadonnées détaillées via chaque charge utile de nœud intermédiaire, persist_direction écrit le candidat résolu dans l'état de session partagé.
Les nœuds n'ont pas besoin de transmettre l'intégralité du dictionnaire d'état de la session. Lorsqu'un nœud génère Event(state=...), il ne fournit que les paires clé/valeur nouvelles ou mises à jour. L'ADK fusionne automatiquement ces mises à jour dans le magasin de session :
    yield Event(state={"direction": chosen["title"], "angle": chosen.get("angle", ""),
                       "hook": hook, "user:prefs": {"last_direction": chosen["title"]}})
Le fait de générer ce Event transfère le contrôle à l'environnement d'exécution Workflow, qui conserve les nouvelles valeurs dans le journal de session dans runs/sessions.db.
Liaison de paramètres
Les nœuds de fonction ADK lisent automatiquement l'état de la session via l'inspection des paramètres. Si une signature de fonction déclare un nom de paramètre correspondant à une clé d'état existante, ADK extrait cette clé de l'état et la transmet directement :
def persist_direction(node_input, candidates: list = []):
    ni = node_input if isinstance(node_input, dict) else {}
    raw = ni.get("pick")
    pick = str(raw).strip() if raw is not None else ""
    if candidates:
        i = int(pick) - 1 if pick.isdigit() else 0
        chosen = candidates[max(0, min(len(candidates) - 1, i))]
    else:
        chosen = {"title": "untitled", "angle": "", "evidence": []}
    hook = chosen.get("hook") or " ".join(chosen["title"].split()[:4])
Ici, candidates a été écrit dans l'état de la session par direction_gate. ADK l'intègre directement dans persist_direction(node_input, candidates: list = []) sans nécessiter de recherches explicites dans le dictionnaire.
Les clés précédées de user: sont conservées d'une session à l'autre dans l'espace de stockage au niveau de l'utilisateur, ce qui permet aux exécutions de workflow ultérieures d'accéder aux préférences du créateur.
Atelier pratique : conserver l'état et connecter le nœud
- Dans
agent/graph.py, à l'intérieur depersist_direction, remplacez la ligneTODO: PERSIST_STATEpar le rendement de l'événement d'état :
    yield Event(state={"direction": chosen["title"], "angle": chosen.get("angle", ""),
                       "hook": hook, "user:prefs": {"last_direction": chosen["title"]}})
- Dans
stage3_router/agent.py, ajoutezpersist_directionà la troisième chaîne de la listeedges:
           (join_research, propose_directions, direction_gate,
            persist_direction)
Enregistrez vos fichiers. Dans Workbench, vérifiez que state write in place et persist_direction in the chain affichent tous deux des coches vertes.
Nœud de routeur (5B)
Dans Workbench, accédez au nœud du routeur (5B).
Routage déterministe basé sur des règles
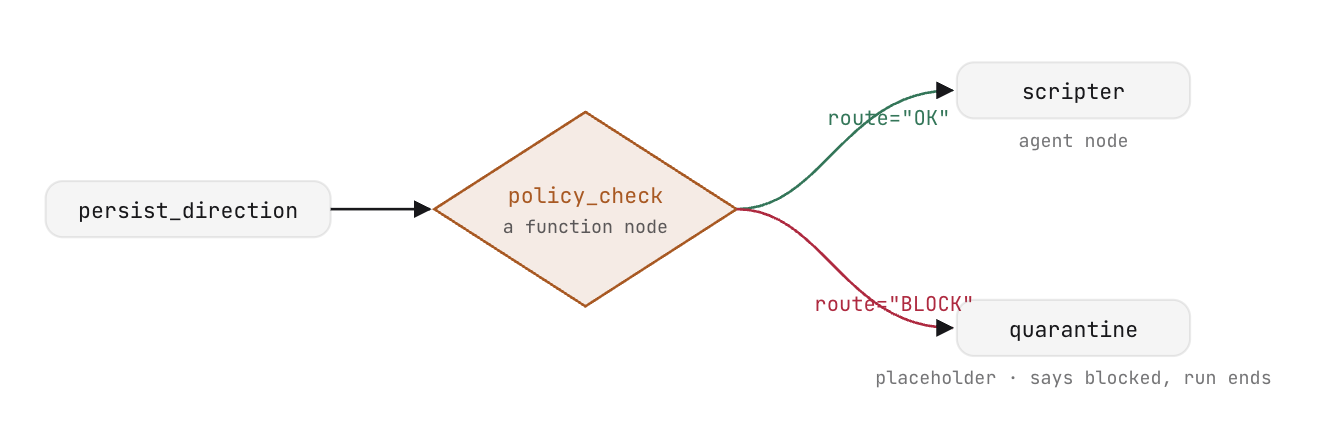
Un routeur est un nœud de fonction spécialisé qui évalue la sortie en amont et dirige l'exécution le long de branches de graphe conditionnelles. Contrairement aux agents génératifs, un routeur exécute une logique déterministe sans effectuer d'appels LLM.
Un routeur renvoie un Event spécifiant une balise route :
def length_check(node_input):
    too_long = len(node_input.get("title", "")) > 60
    return Event(output=node_input, route="TRIM" if too_long else "PASS")
Dans la définition du workflow, une cible d'arête définie comme un dictionnaire mappe les noms de routes aux nœuds de destination :
(length_check, {"TRIM": shorten, "PASS": scripter}),
Le routeur de workflow policy_check lit les expressions interdites à partir de agent/policy_words.txt et effectue une correspondance de mot entier avec le titre et l'angle de la direction choisie :
return Event(output=node_input, route="BLOCK" if bad else "OK")
Le stockage de la règle sous forme de données plutôt que d'instructions codées en dur permet d'effectuer des mises à jour sans modifier le graphique du workflow : la mise à jour du fichier texte s'applique immédiatement aux exécutions suivantes. Comme l'évaluation est une mise en correspondance d'expressions régulières déterministe, elle s'exécute en quelques millisecondes sans coût en jetons avant le début du script génératif.
Destinations : Scripter et Quarantaine
Le routeur dirige le trafic vers l'un des deux nœuds en aval :
scripter: nœud d'agentsingle_turnqui convertit la direction approuvée en un script de production structuré respectant le schéma PydanticScript:
scripter = Agent(
    name="scripter",
    model=config.MODEL,
    instruction=SCRIPT_INSTRUCTION,
    output_schema=Script)
quarantine: fonction d'espace réservé qui arrête les directions signalées. Elle sera remplacée dans la partie suivante par un agent de correction autonome.
Atelier pratique : routage de la vérification de la stratégie
- Dans
agent/graph.py, à l'intérieur depolicy_check, complétez l'instruction return :
return Event(output=node_input, route="BLOCK" if bad else "OK")
- Dans
stage3_router/agent.py, mettez à jouredgespour acheminerpolicy_checket réintégrez la branche de mise en quarantaine dansscripter:
           (join_research, propose_directions, direction_gate,
            persist_direction, policy_check),
           (policy_check, {"OK": scripter, "BLOCK": quarantine}),
           (quarantine, scripter)])
Enregistrez vos fichiers. Dans l'atelier, vérifiez que les mappages de périphérie du routeur sont validés.
Modes d'agent et nœud de tâche (5C)
Dans l'atelier, accédez à Modes d'agent et nœud de tâche (5C).
Modes d'exécution de l'agent
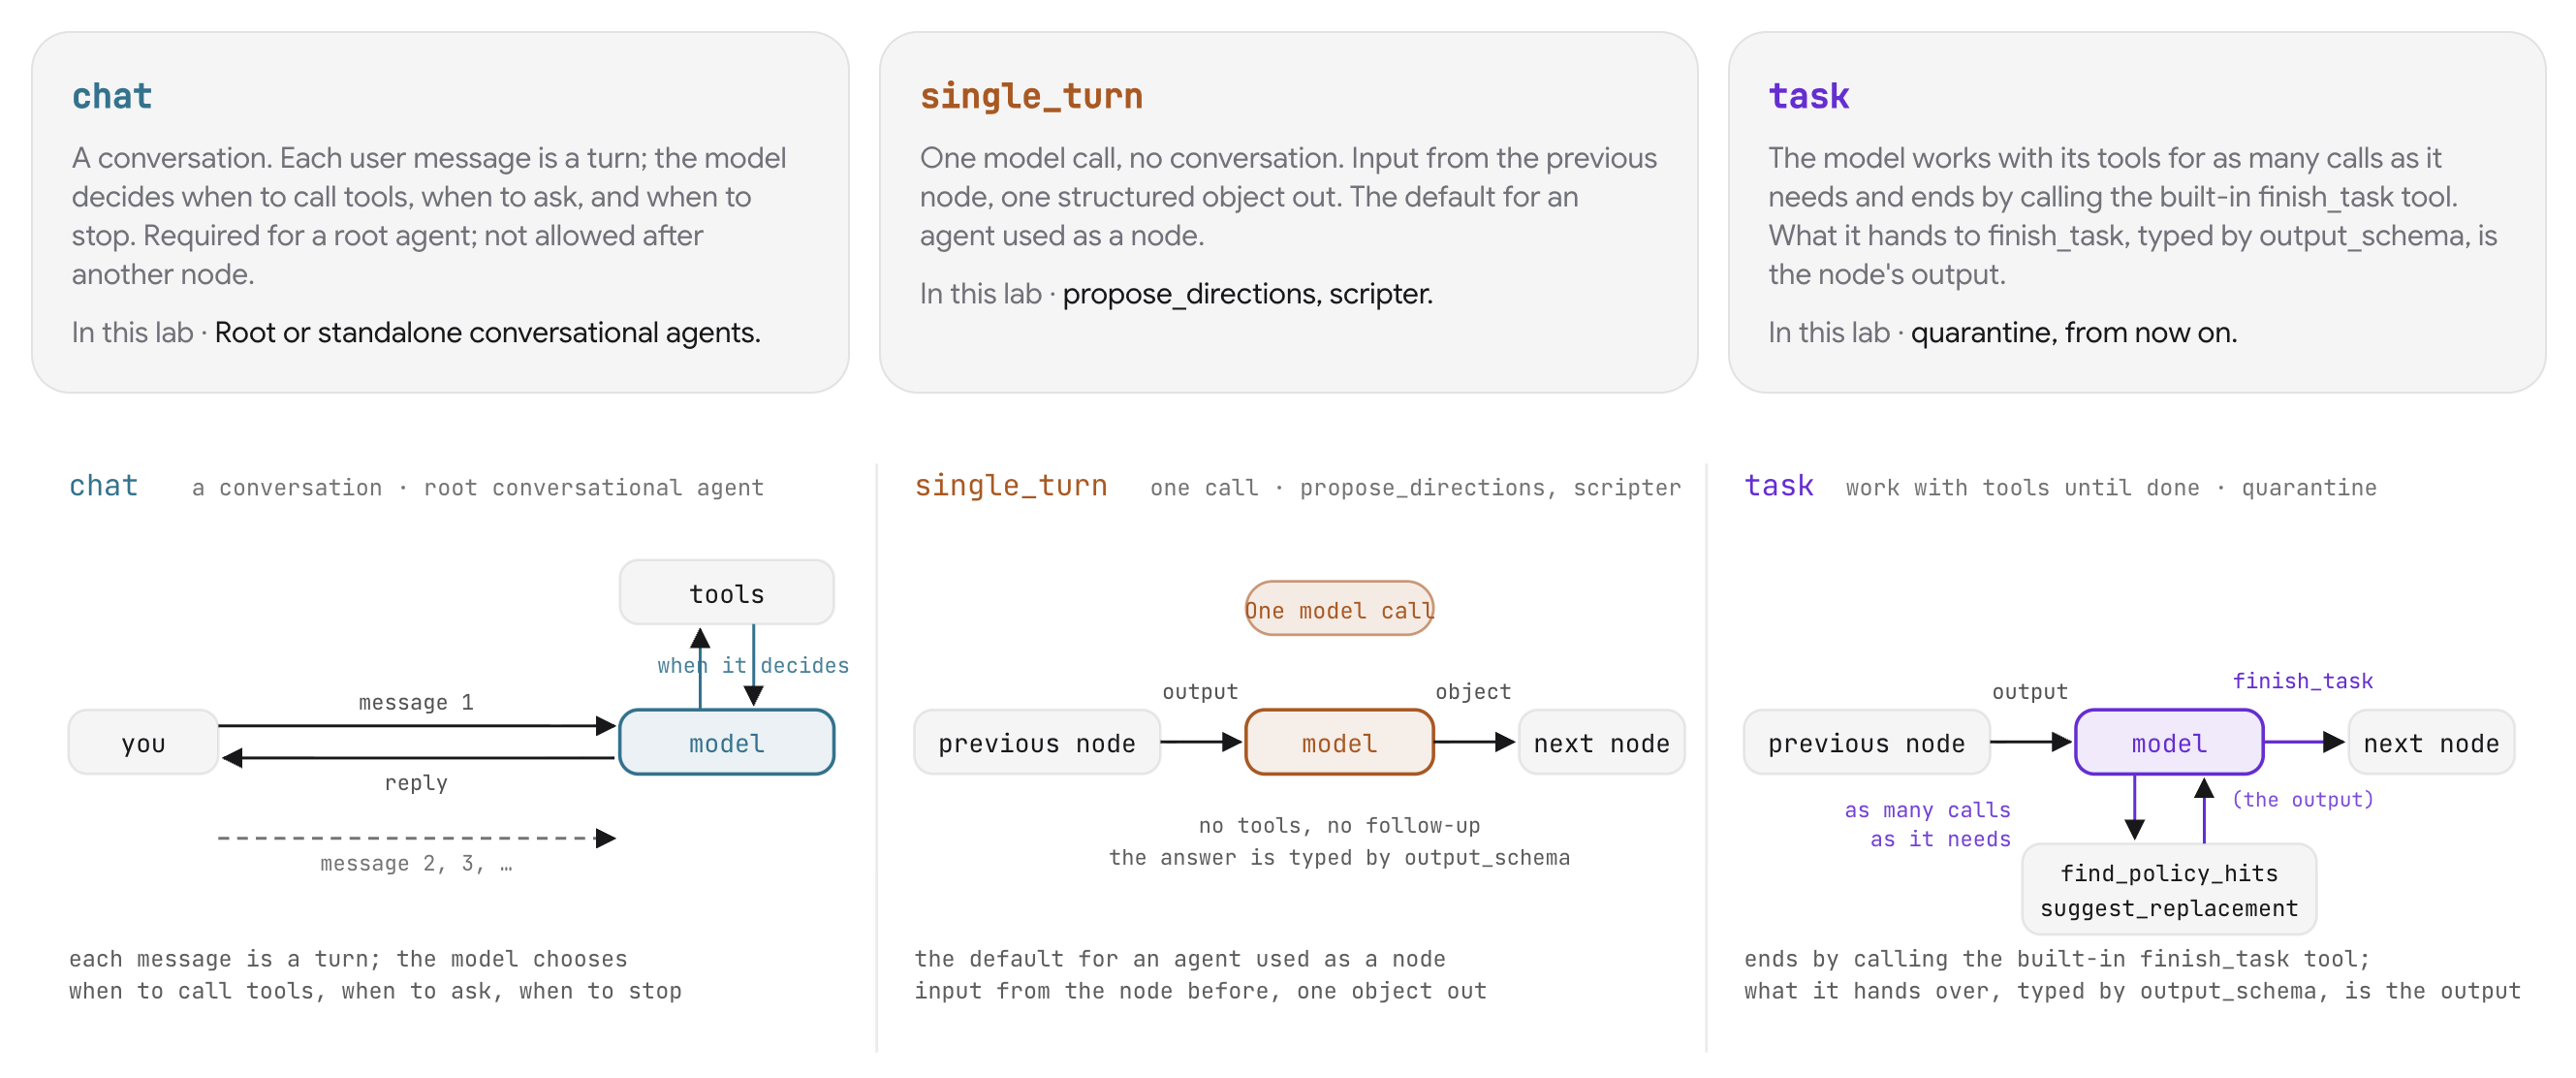
Les instances ADK Agent acceptent trois modes d'exécution adaptés aux exigences spécifiques des pipelines :
Mode | Cycle de vie de l'exécution | Rôle dans le pipeline |
| Boucle de conversation multitour. Le modèle détermine quand appeler des outils, solliciter une entrée ou mettre fin au tour. | Agents racine face à un utilisateur humain interactif. |
| Appel d'inférence de modèle unique. Accepte l'entrée du nœud précédent et émet un objet de schéma structuré. | Transformations de graphes séquentielles ( |
| Boucle autonome avec exécution d'outils. L'agent effectue des itérations jusqu'à ce qu'il appelle l'outil | Correction et inspection en plusieurs étapes ( |
Correction autonome des règles
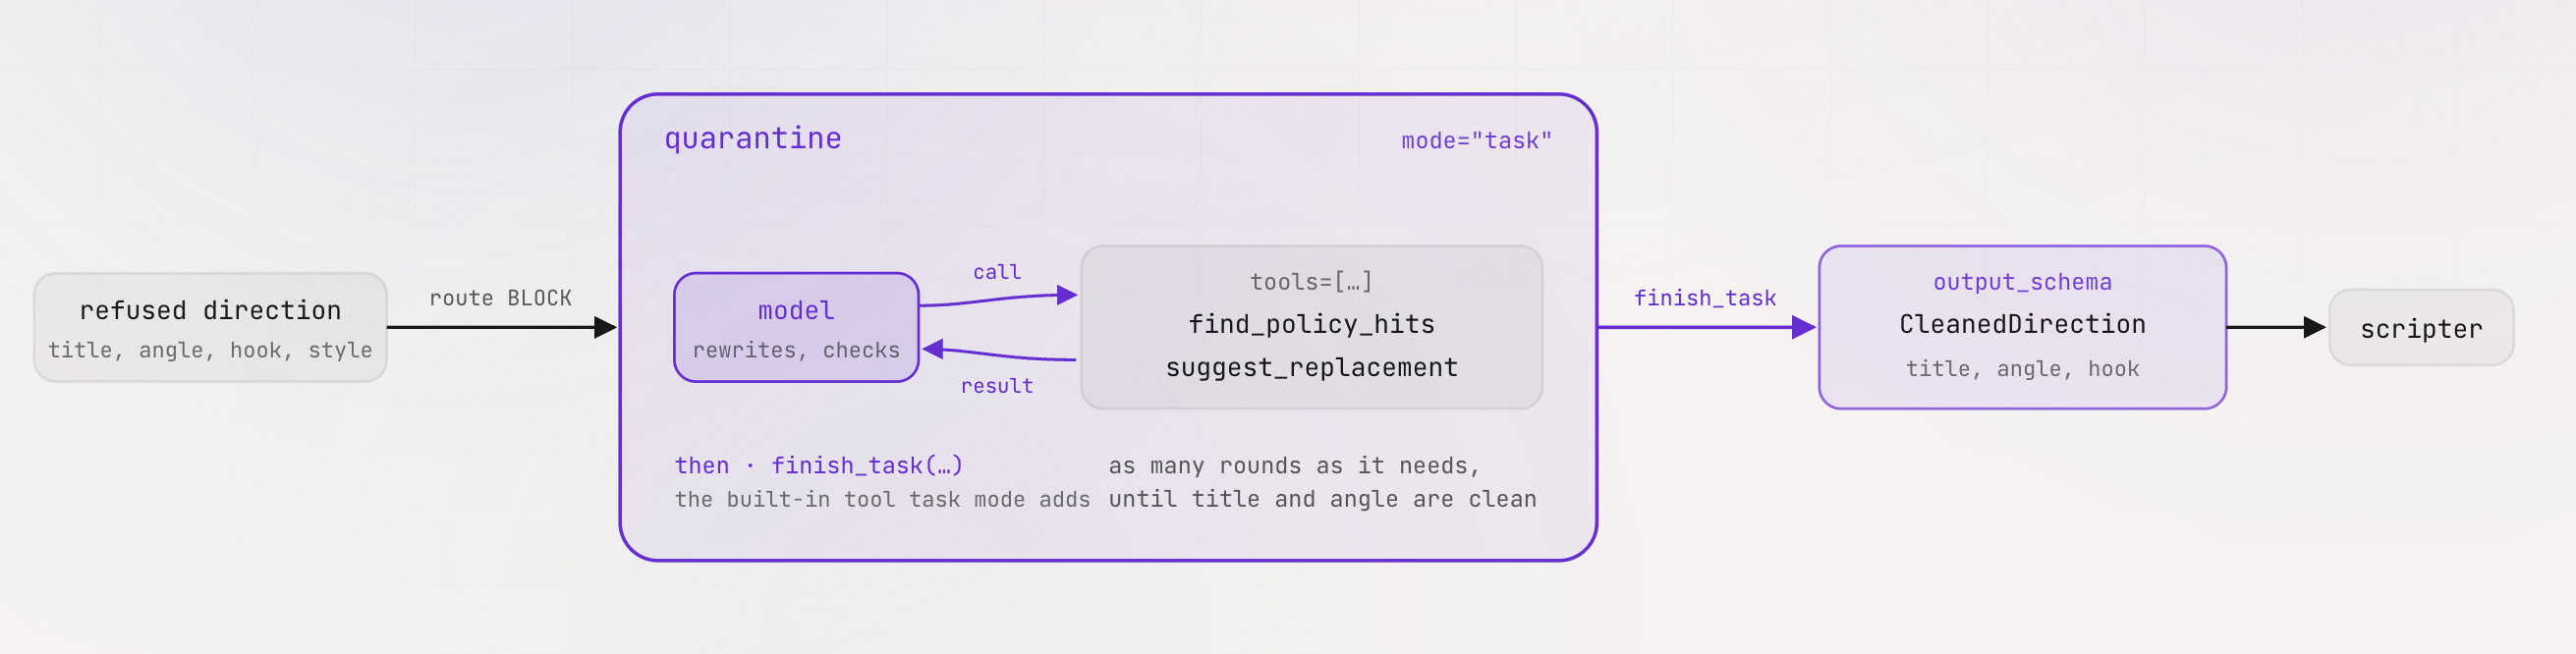
La réécriture d'une instruction signalée nécessite le mode task, car le nombre d'itérations de correction est variable. L'agent reçoit l'instruction signalée, appelle find_policy_hits pour détecter les cas de non-respect, demande des alternatives approuvées via suggest_replacement, réécrit l'instruction et vérifie qu'elle est conforme avant de continuer.
Les deux outils sont définis dans agent/cleanup_tools.py avec des signatures typées et des docstrings :
def find_policy_hits(text: str) -> dict:
    """Which refused words appear in `text`. Matches whole words and phrases
    from agent/policy_words.txt, case-insensitive.

    Returns {"hits": [...], "clean": bool}. clean is true when hits is empty.
    """


def suggest_replacement(word: str) -> dict:
    """The channel's approved stand-in for a refused word, read from
    agent/policy_replacements.txt.

    Returns {"word", "replacement", "listed"}. When the word has no entry,
    listed is false and replacement is a hint to pick a gentle synonym.
    """
Exercice pratique : Assembler l'agent de tâche de quarantaine
Dans stage3_router/agent.py, remplacez la fonction d'espace réservé quarantine par la définition de l'agent de tâches :
quarantine = Agent(
    name="quarantine",
    model=config.MODEL,
    instruction=QUARANTINE_INSTRUCTION,
    mode="task",
    tools=[find_policy_hits, suggest_replacement],
    output_schema=CleanedDirection,
)
Le mode Tâche fournit des outils à l'agent et met fin à l'exécution en appelant finish_task. Lorsque mode="task" est configuré, ADK fournit automatiquement finish_task et dérive ses paramètres de output_schema, ce qui garantit que le nœud génère un objet CleanedDirection typé correspondant au schéma d'entrée du nœud de script.
À quoi s'attendre et pourquoi
Testez les deux chemins d'exécution dans ADK Web ou VibeStudio Workbench :
- Route approuvée (candidat 1, 2 ou 3) :
- Si vous sélectionnez un itinéraire approuvé dans
policy_check, vous êtes directement redirigé versscripter(route="OK"). - Le scripteur génère un script de production en trois plans respectant le schéma
Script.
- Si vous sélectionnez un itinéraire approuvé dans
- Route de correction de la mise en quarantaine (candidat 4) :
- Le candidat 4 contient du vocabulaire signalé ("clickbait", "viral hack").
policy_checkitinéraires versquarantine(route="BLOCK").- Dans la trace de session, observez
quarantineappelerfind_policy_hits, appelersuggest_replacementpour chaque cas de non-respect, réécrire le titre et appelerfinish_task. - L'exécution rejoint
scripter, ce qui produit un script à partir de la direction assainie.
6. Banque de mémoire
Dans VibeStudio Workbench, accédez à Étape 6 : Banque de mémoire, parties (6A) et (6B).
Le workflow fonctionne actuellement sans mémoire d'une session à l'autre. Chaque exécution commence à partir de zéro, sans tenir compte de ce que le créateur a sélectionné précédemment ni des genres qu'il préfère. Dans cette étape, vous allez connecter Vertex AI Agent Engine Memory Bank pour stocker et récupérer les préférences du créateur lors des exécutions.
Il est important de noter que la mémoire est intégrée via des rappels de cycle de vie de l'agent plutôt que via des nœuds de pipeline. Étant donné que l'extraction et la récupération de la mémoire servent des agents individuels plutôt que des étapes de données intermédiaires, l'association de rappels préserve une topologie de graphique propre et découplée.
Memory Bank (6A)
Dans Workbench, accédez à Memory Bank (6A).
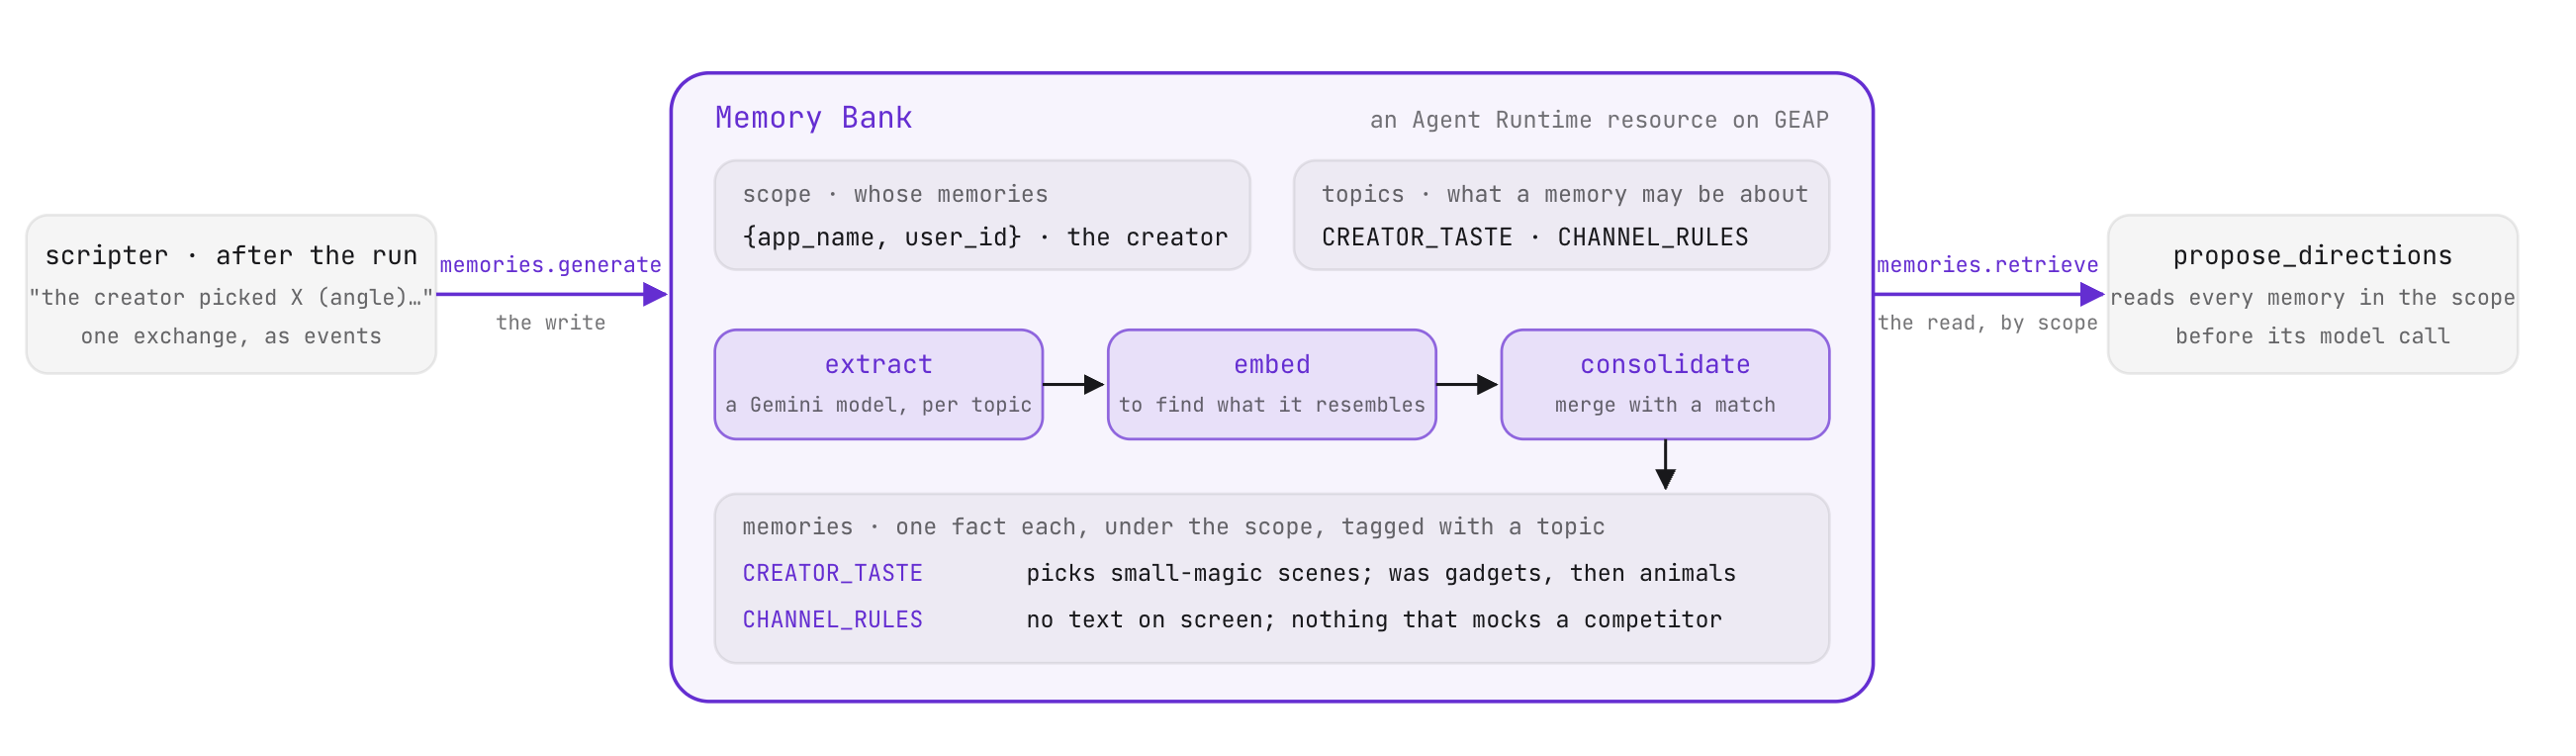
Mémoire gérée au niveau de l'utilisateur
Memory Bank est un service géré pour la mémoire utilisateur à long terme. Il organise les faits concernant une personne dans un champ d'application défini, ici identifié par le nom de l'application et l'ID utilisateur :
SCOPE = {"app_name": config.APP, "user_id": config.USER}
TOPICS = {
    "CREATOR_TASTE": "Which video directions this creator picks and passes on, "
                     "and how that preference changes over time.",
    "CHANNEL_RULES": "Standing instructions the creator states for every video "
                     "(style, subjects to avoid, format rules).",
}
Les thèmes de mémoire personnalisés définissent les limites de ce que la banque enregistre :
- Extraction de thèmes : lorsque le texte d'une nouvelle conversation est envoyé via
memories.generate, le service applique un modèle d'extraction à chaque description de thème. Le texte qui ne correspond pas à un sujet ne produit pas de souvenirs. - Consolidation et déduplication : le service convertit les faits nouvellement extraits en embeddings et les compare aux informations mémorisées existantes dans le champ d'application. Lorsqu'une observation correspond à une mémoire existante, le service met à jour cette mémoire. Lorsqu'il s'agit d'une nouvelle information, le service crée une entrée. Ce processus de consolidation permet de fusionner plusieurs sessions sur un même sujet en un résumé cohérent, au lieu de produire des entrées redondantes.
- Récupération : l'appel de
memories.retrieveavec le champ d'application de l'utilisateur renvoie les faits stockés, classés du plus ancien au plus récent.
Les deux opérations sont implémentées dans agent/platform/memory.py. Le nom de la ressource de banque provisionnée est mis en cache localement dans runs/memorybank.json.
Configurer la banque de mémoire
Utilisez les commandes du workbench ou exécutez les commandes de la CLI dans votre terminal :
- Connectez et provisionnez la banque :
python -m agent.platform.bankCREATOR_TASTEetCHANNEL_RULES. - Amorcer des sessions historiques :
python -m agent.platform.bank load - Inspecter les faits consolidés :
python -m agent.platform.bank list
Rappels (6B)
Dans Workbench, accédez à Callbacks (6B). Ouvrez stage4_memory/agent.py.
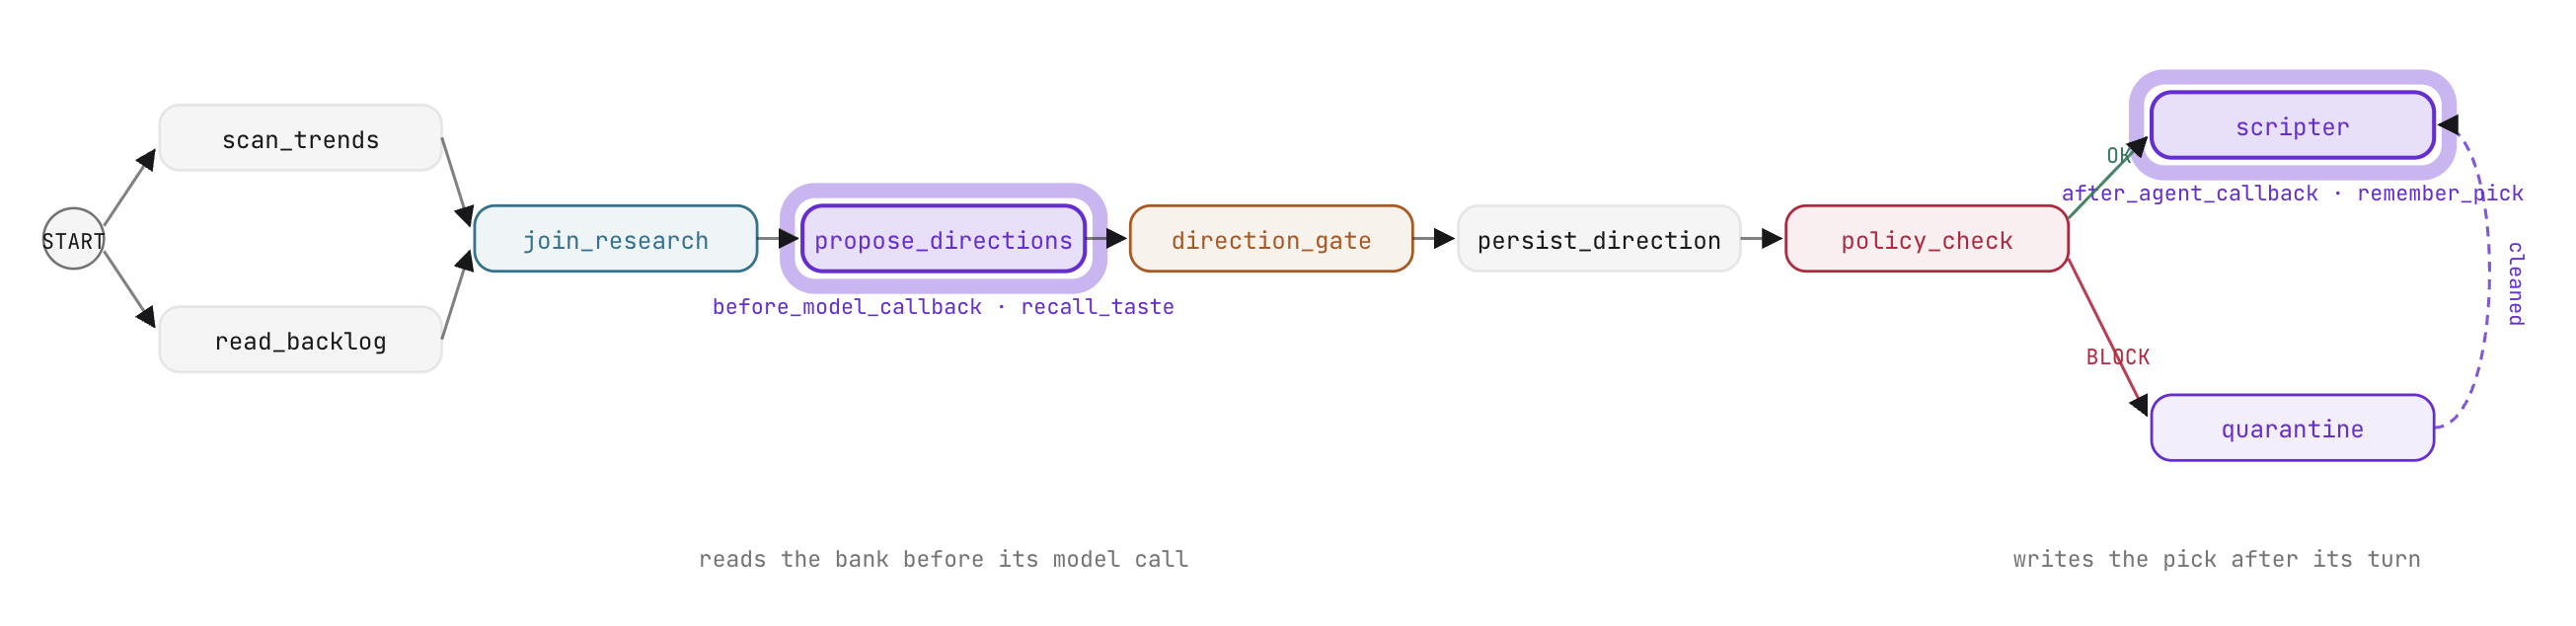
Rappels de cycle de vie de l'agent ADK
Un rappel est une fonction transmise en tant qu'argument à un Agent. ADK appelle des rappels à des moments prédéfinis du cycle de vie, en transmettant le contexte actif. Le renvoi de None poursuit l'exécution normale. Le renvoi d'un objet de remplacement remplace ou intercepte l'opération.
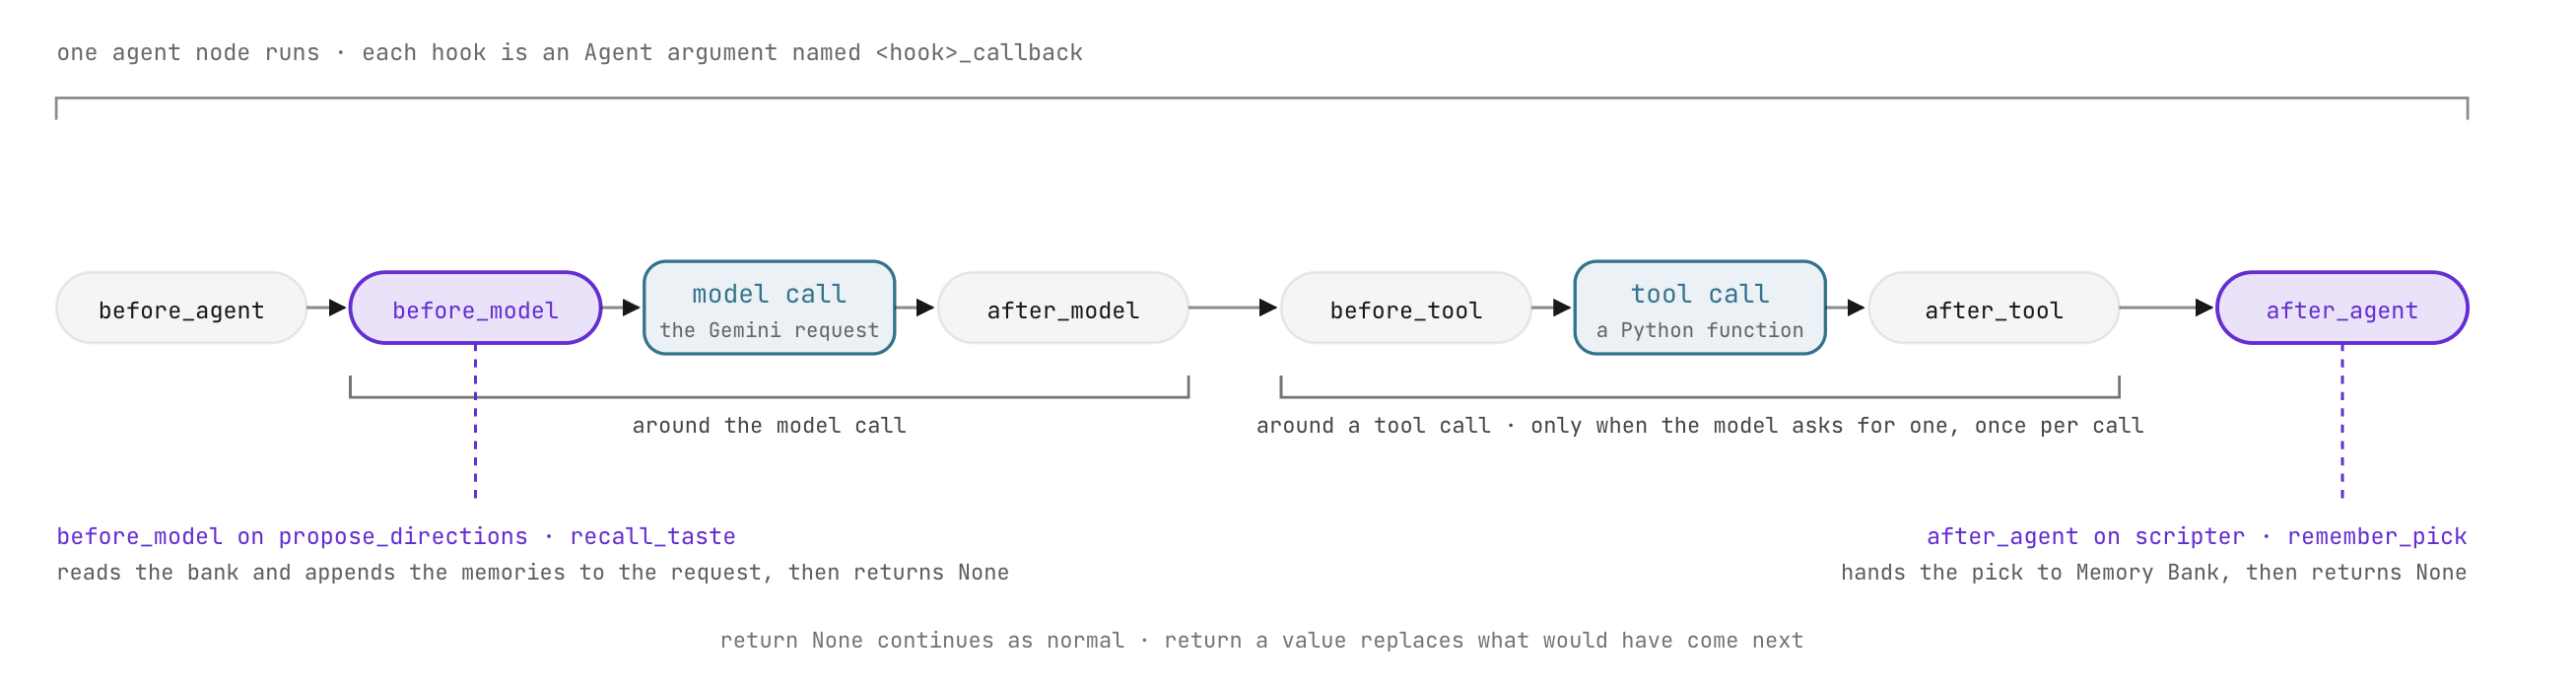
ADK fournit trois paires de rappels :
Paire de rappels | Point d'appel | Paramètres reçus | Comportement de la valeur renvoyée |
| Entourant l'intégralité du tour de l'agent |
| Renvoyer |
| Autour de chaque appel d'inférence LLM |
| Le renvoi de |
| Autour de chaque exécution d'outil | Définition, arguments et résultat de l'outil | Le renvoi d'un dict remplace la sortie de l'outil ; |
Les rappels fournissent un emplacement propre pour l'injection de contexte, les garde-fous, la télémétrie et les recherches dans le cache, sans introduire de nœuds superflus dans le graphique de workflow.
Atelier de modification : connecter les rappels de rappel et de mémorisation
- Dans
stage4_memory/agent.py, mettez à jourpropose_directionspour associerbefore_model_callback=recall_taste:
    output_schema=Directions,
    before_model_callback=recall_taste)
recall_taste s'exécute immédiatement avant que Gemini ne génère des directions candidates. Il récupère l'historique du créateur dans Memory Bank, met en forme les informations mémorisées en commençant par les plus anciennes et les ajoute à la LlmRequest sortante. La requête demande au modèle d'orienter les candidats 1 à 3 vers les goûts actuels du créateur, tout en traitant les règles de la chaîne comme des contraintes strictes.
- Dans
stage4_memory/agent.py, mettez à jourscripterpour associerafter_agent_callback=remember_pick:
    output_schema=Script,
    after_agent_callback=remember_pick)
remember_pick s'exécute une fois que scripter a terminé son tour. Il lit la direction choisie à partir de l'état de session, synthétise une déclaration concise résumant la décision du créateur et appelle memories.generate pour mettre à jour Memory Bank.
À quoi s'attendre et pourquoi
Testez le workflow augmenté par le rappel dans l'atelier ou ADK Web :
- Exécutez une exécution avec un prompt vide :
- Dans la trace de session, inspectez le
LlmRequestpourpropose_directions. Notez le contexte de mémoire ajouté, qui détaille la préférence du créateur pour les thèmes fantastiques et un rythme concis. - Observez les directions proposées : les candidats 1 à 3 correspondent aux préférences historiques du créateur, même lorsque les tendances mettent en avant d'autres thèmes.
- Dans la trace de session, inspectez le
- Sélectionnez un candidat à
direction_gate. - Une fois l'exécution de
scripterterminée, examinez les enregistrements Memory Bank :python -m agent.platform.bank list
7. Moteur RAG
Dans VibeStudio Workbench, accédez à Étape 7 · Moteur RAG, parties (7A) et (7B).
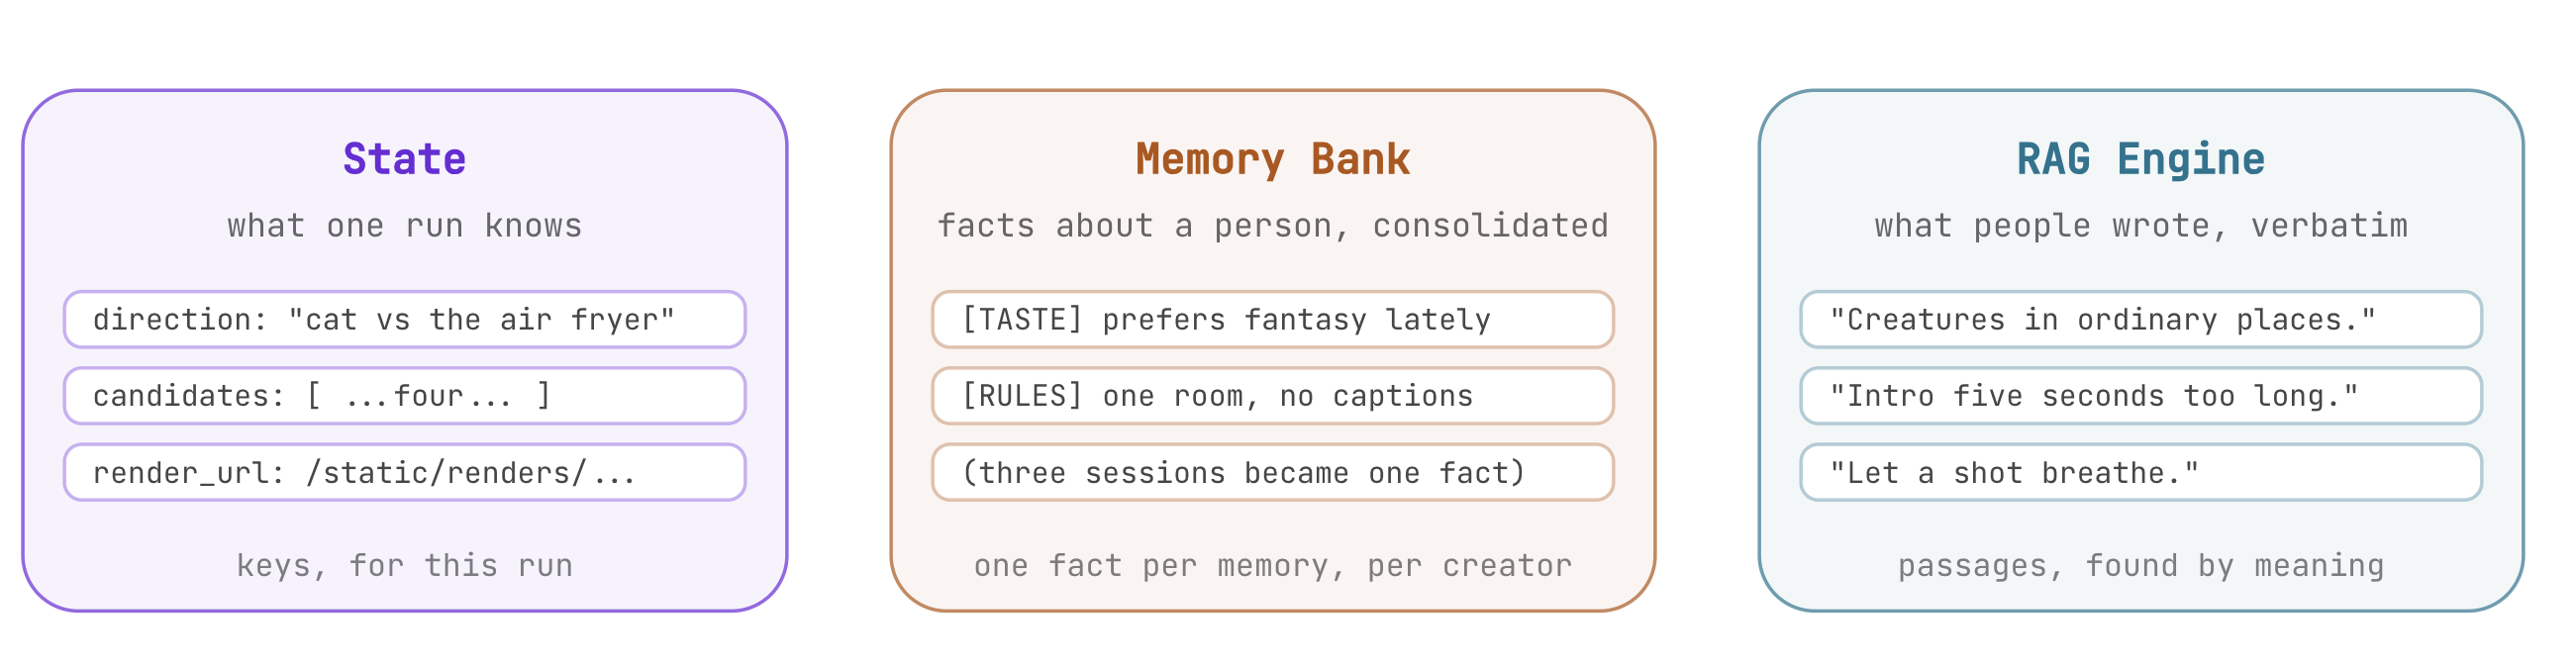
Les vidéos publiées accumulent les commentaires des spectateurs au fil du temps. Trente commentaires représentatifs sont collectés dans agent/comments.md, qui capturent les éloges des spectateurs, les critiques sur le rythme des contenus sponsorisés et les préférences audio. Dans cette étape, vous allez indexer ces commentaires à l'aide du moteur RAG Vertex AI et connecter la récupération sémantique à la distribution ramifiée de la recherche.
Récupération sur des documents (7A)
Dans l'atelier, accédez à Moteur RAG (7A).
Memory Bank et moteur RAG
Les deux outils ancrent les workflows dans des données externes, mais ils ont des objectifs architecturaux distincts :
Dimension | Banque de mémoire | Moteur RAG |
Cas d'utilisation principal | Préférences utilisateur à long terme et règles opérationnelles | Récupération sémantique sur de grandes collections de documents |
Champ d'application | Portée limitée aux ID utilisateur et aux noms d'application individuels | Limité aux ressources de corpus partagées entre tous les utilisateurs |
Traitement de données | Extraction, embedding et consolidation sémantique en temps réel | Segmentation de documents, embedding vectoriel et recherche des plus proches voisins |
Intégration de Graph | Rappels de cycle de vie de l'agent ( | Nœud de fonction dédié dans la distribution de la recherche ( |
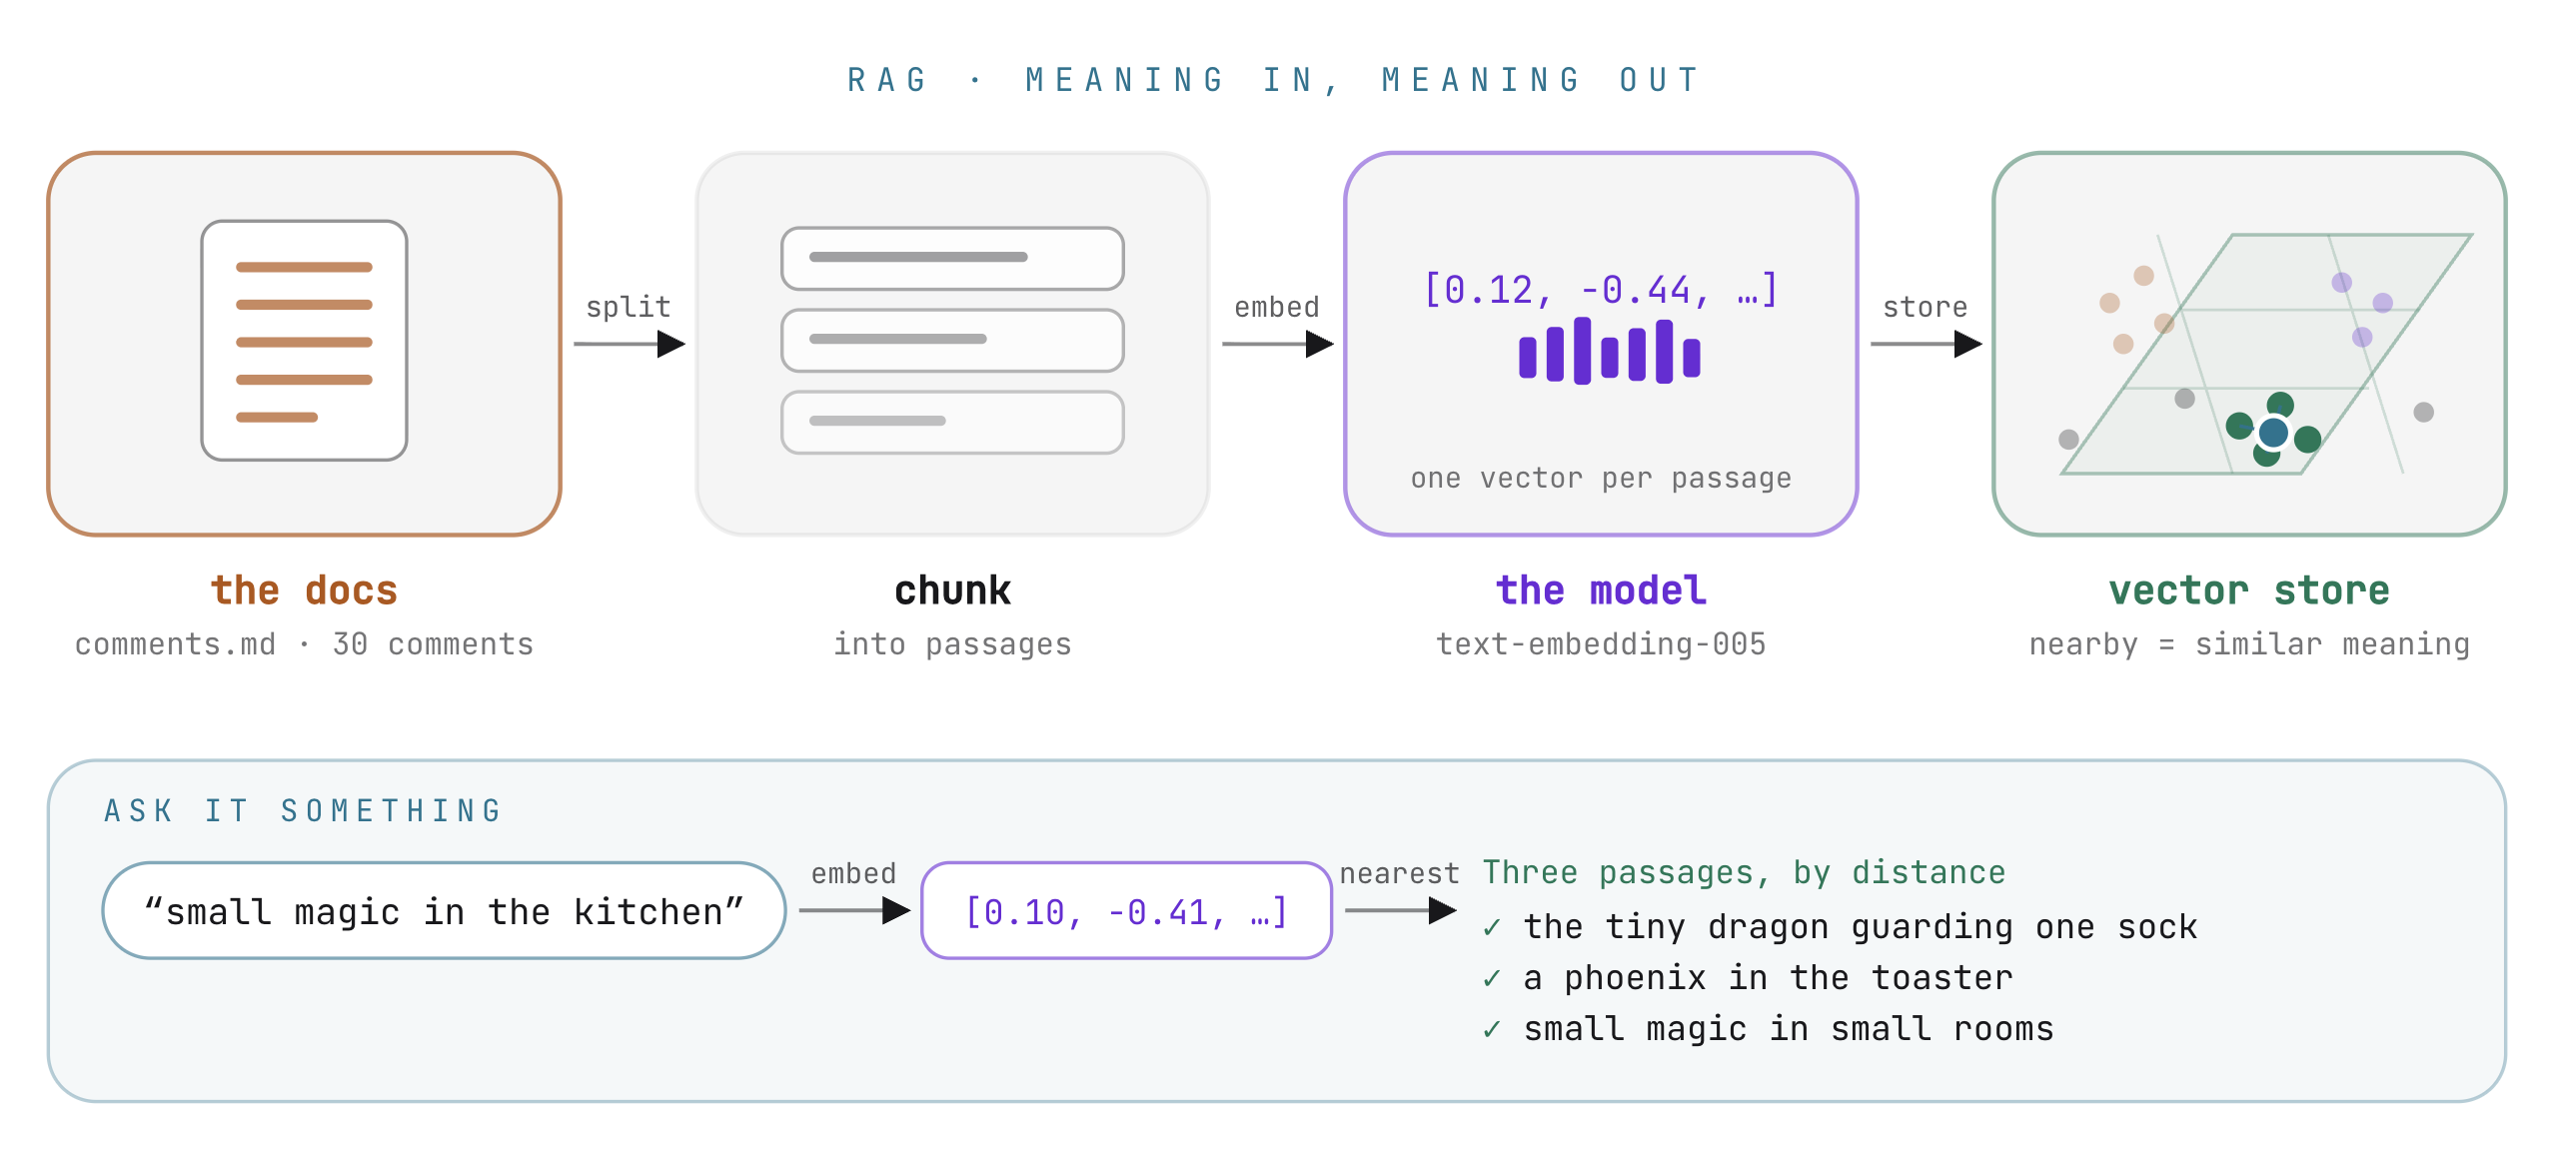
Fragmentation et embeddings de documents
Le moteur RAG indexe les documents en divisant le texte en passages sémantiques et en stockant leurs vecteurs dans une base de données gérée :
corpus = rag.create_corpus(
    display_name="vibestudio-feedback",
    description="Vibe Studio: what the audience wrote under the channel's past videos.",
    backend_config=rag.RagVectorDbConfig(
        rag_embedding_model_config=rag.RagEmbeddingModelConfig(
            vertex_prediction_endpoint=rag.VertexPredictionEndpoint(
                publisher_model="publishers/google/models/text-embedding-005"))))

rag.upload_file(
    corpus_name=corpus.name, path="agent/comments.md", display_name="comments.md",
    transformation_config=rag.TransformationConfig(
        chunking_config=rag.ChunkingConfig(chunk_size=120, chunk_overlap=20)))
- Taille des fragments : configurée sur 120 jetons avec 20 jetons de chevauchement. Cela permet de capturer deux à trois commentaires par passage, ce qui garantit que chaque vecteur représente un sentiment cohérent sans diluer le sens dans des commentaires sans rapport.
- Modèle d'embedding :
text-embedding-005convertit le texte en vecteurs de grande dimension. Lorsqu'une requête est envoyée, le modèle la convertit en vecteur et trouve les correspondances les plus proches en fonction de la distance sémantique. Un commentaire sur un petit dragon gardant des chaussettes correspond à une requête sur des créatures magiques sans qu'il soit nécessaire d'avoir un chevauchement exact des mots clés.
Configurer le corpus RAG
Initialisez le corpus à l'aide des boutons de l'atelier ou des commandes de terminal :
- Créez le corpus :
python -m agent.platform.ragruns/ragcorpus.json. - Importer et indexer des commentaires : importe
agent/comments.mdavec la configuration de segmentation et attend la fin de l'indexation. - Interroger le corpus : testez la récupération de similarité avec des requêtes qui ne partagent pas de mots exacts avec les commentaires (par exemple, interrogez "petites créatures magiques" pour récupérer des commentaires sur les dragons).
Nœud de récupération (7B)
Dans Workbench, accédez à The third reader (7B). Ouvrez stage5_rag/agent.py.
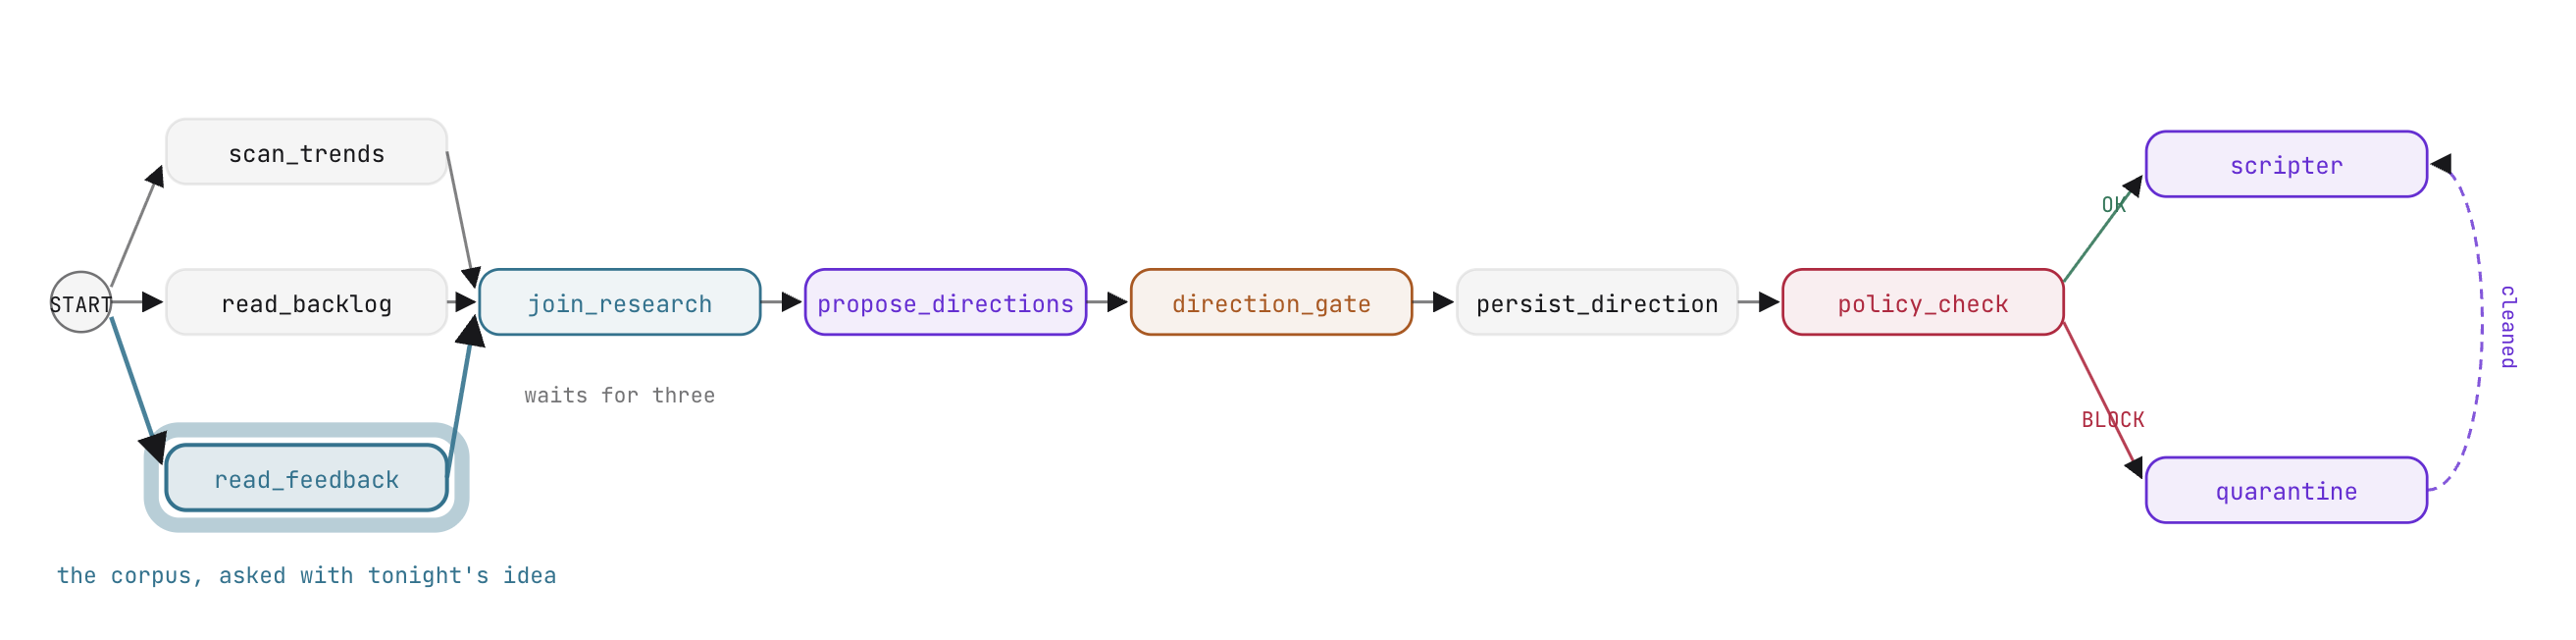
Récupération en tant que nœud de graphique
Les commentaires de l'audience représentent les données de recherche partagées dans le workflow. Contrairement à la mémoire personnelle des créateurs, le sentiment des spectateurs est directement intégré à join_research, en plus des données sur les tendances et le backlog. Il est donc implémenté en tant que nœud de fonction :
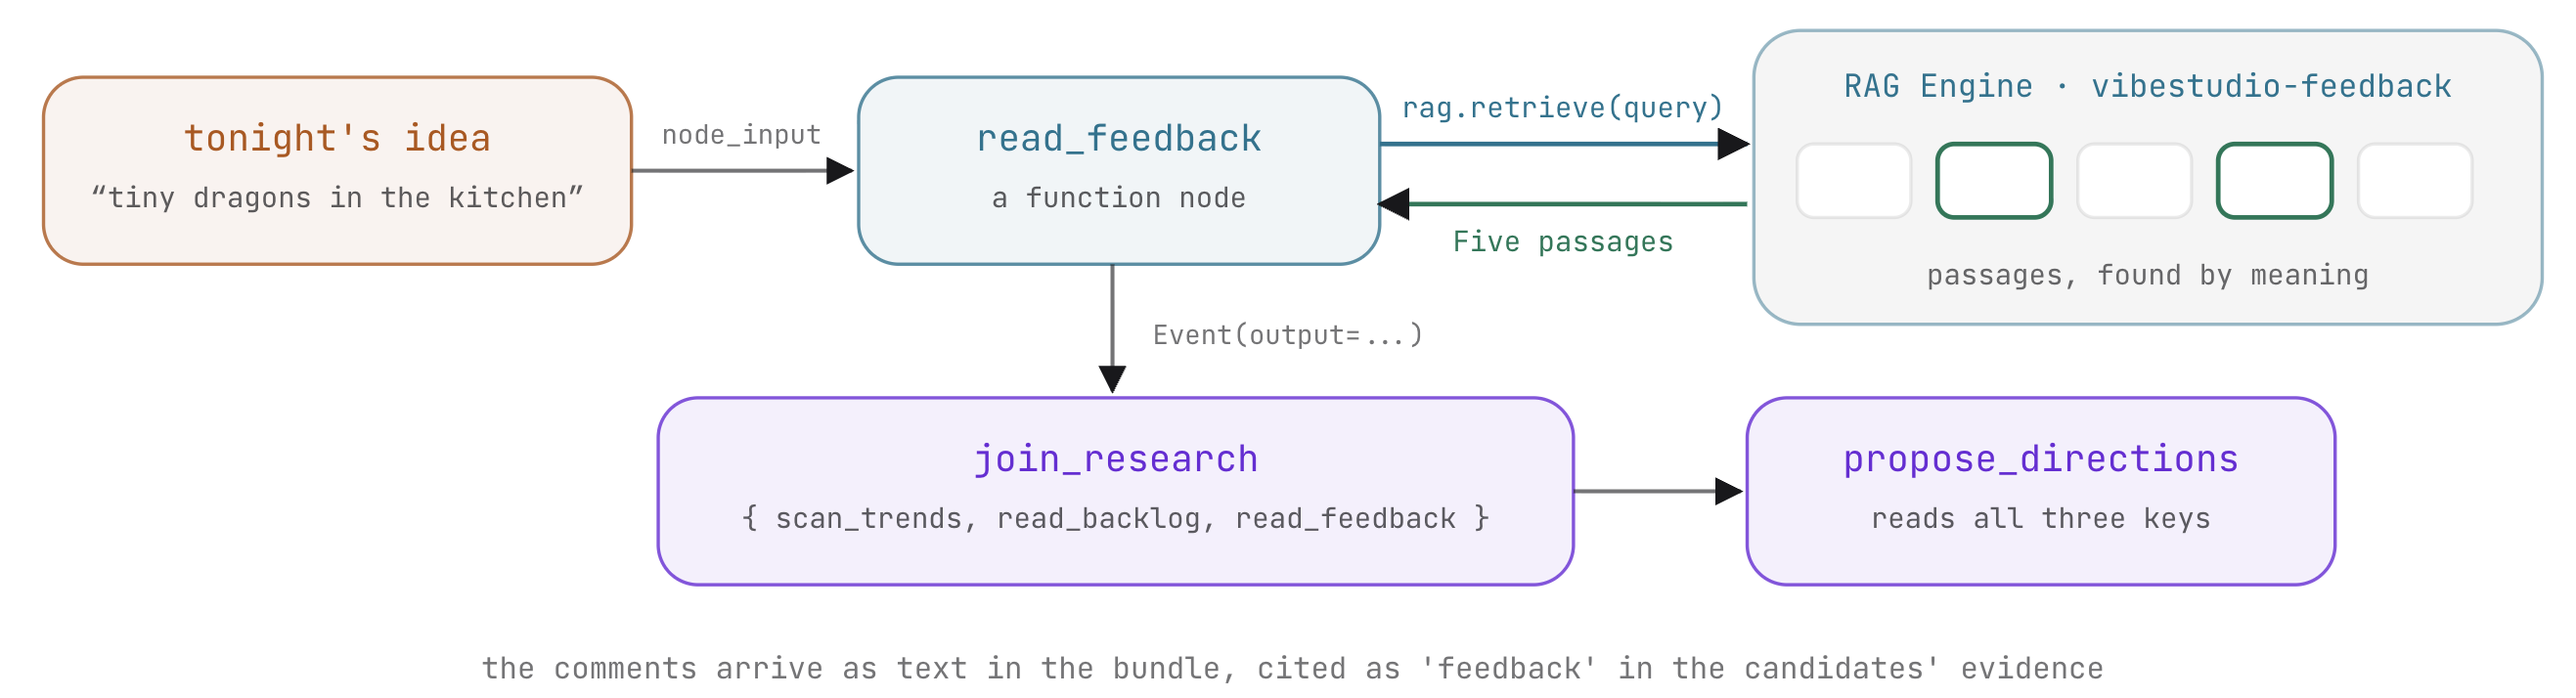
def read_feedback(node_input):
    """The third reader (step 7): what the audience wrote under past videos,
    the passages nearest to tonight's idea. Retrieval, not a model call."""
    from .platform import rag
    idea = idea_text(node_input)
    query = idea or "what viewers liked and what they complained about"
    try:
        hits = rag.retrieve(query)
    except Exception as e:
        print(f"  [rag] feedback unavailable ({str(e)[:80]})")
        return Event(output={"query": query, "feedback": [],
                             "note": "no corpus connected - run: python -m agent.platform.rag"})
    return Event(output={"query": query, "feedback": [h["text"] for h in hits]})
read_feedback extrait l'idée initiale de l'utilisateur et exécute une requête vectorielle sur le corpus du moteur RAG. Il émet les commentaires récupérés dans une charge utile Event(output=...).
Exercice pratique : câbler le troisième lecteur dans la distribution
Dans stage5_rag/agent.py, mettez à jour edges pour ajouter read_feedback en tant que troisième branche parallèle entrant dans join_research :
           (START, read_backlog, join_research),
           (START, read_feedback, join_research),
Comme join_research est un JoinNode, il synchronise toutes les branches entrantes, en attendant que scan_trends, read_backlog et read_feedback aient tous émis des événements avant de transmettre le bundle agrégé en aval.
À quoi s'attendre et pourquoi
Exécutez le workflow dans l'atelier :
- Saisissez un prompt (par exemple, "un dragon miniature gardant un plan de travail de cuisine").
- Dans la trace d'exécution, vérifiez que les trois nœuds de lecture s'exécutent simultanément.
- Observez
join_research: son dictionnaire de sortie contient désormaistrends,backlogetfeedback. - Inspectez les candidats générés à partir de
propose_directions: le modèle intègre les commentaires des spectateurs dans ses propositions et fait référence au sentiment de l'audience dans les champs de preuve. - Notez que la récupération RAG est déterministe (les requêtes identiques renvoient des passages de commentaires identiques), tandis que le nœud de proposition générative produit des variations créatives.
8. Génération de vidéos asynchrone avec Veo
Dans VibeStudio Workbench, accédez à Étape 8 · La vidéo, parties (8A) et (8B).
La génération de vidéos haute définition avec Google Veo nécessite plusieurs minutes par rendu. Le blocage de l'exécution de graphe pendant cette période gaspille des ressources de calcul, verrouille les pools de threads et expose l'exécution à des pertes de connexion HTTP. Dans cette étape, vous allez rendre le rendu vidéo asynchrone à l'aide de LongRunningFunctionTool de l'ADK.
Outils de longue durée (8A)
Dans Workbench, accédez à A long-running tool (8A) (Outil de longue durée (8A)). Ouvrez stage6_video/agent.py et agent/deliver.py.
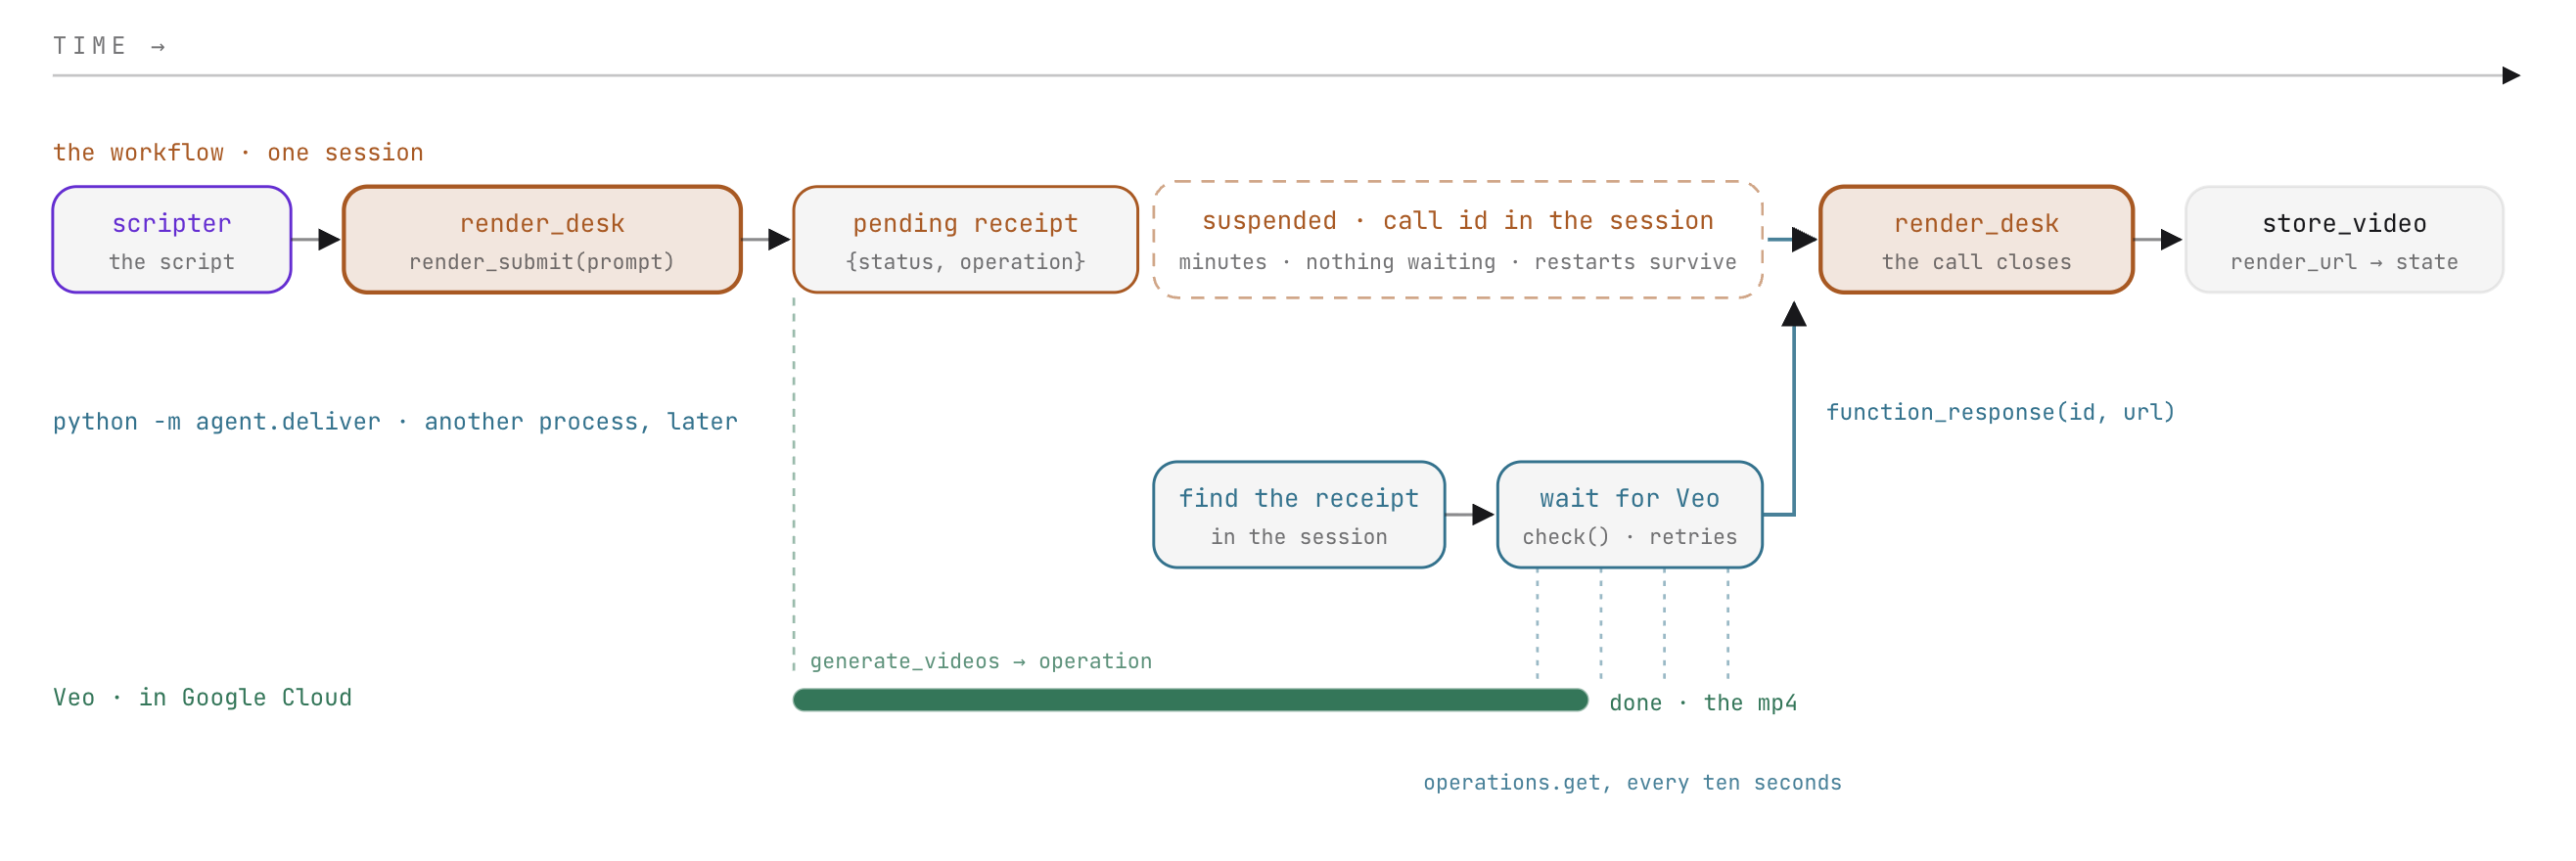
Outils synchrones et outils de longue durée
Les outils de fonction ADK standards s'exécutent de manière synchrone dans un tour d'agent : le modèle appelle l'outil, attend la charge utile de retour et intègre le résultat dans le tour en cours.
Le rendu de la vidéo ne peut pas être effectué en une seule fois. À la place, render_submit lance le job de génération et renvoie immédiatement un reçu opérationnel avec l'état "pending" :
def render_submit(prompt: str) -> dict:
    """Submit one Veo render of `prompt`. Returns at once with a pending
    receipt; the clip is delivered later, to this call, by id."""
    receipt = videogen.start(f"{prompt} {videogen.NO_TEXT}")
    return {"status": "pending", "operation": receipt["operation"], "prompt": receipt["prompt"]}
Lorsqu'il est encapsulé avec LongRunningFunctionTool, ADK intercepte l'état "pending". Le tour de l'agent se termine, le workflow est suspendu au niveau du nœud et les métadonnées de l'appel en attente (y compris l'ID de l'appel et le reçu) sont enregistrées dans runs/sessions.db. Le processus d'exécution se termine correctement sans maintenir de connexions réseau actives ni de threads de travail.
Atelier pratique : encapsuler l'outil de rendu
Dans stage6_video/agent.py, mettez à jour render_desk pour encapsuler render_submit dans LongRunningFunctionTool :
tools=[LongRunningFunctionTool(render_submit)])
Reprise par ID d'appel
Le modèle de reprise universel
ADK applique un mécanisme identique pour suspendre et reprendre les workflows pour les humains et les outils externes :
Déclencheur de suspension | Lancement de la construction… | État de suspension stocké | Événement de reprise |
Décision humaine |
| Ouvrir la requête d'entrée dans le magasin de sessions |
|
Outil à exécution longue |
| Ouvrir l'appel d'outil dans le magasin de sessions |
|
Dans les deux scénarios, le workflow s'arrête complètement et ne reprend que lorsqu'un événement portant un FunctionResponse correspondant arrive d'une source externe : une interface utilisateur, un webhook ou un worker en arrière-plan.
Exercice pratique : finaliser la réponse à la livraison
Dans agent/deliver.py, construisez la partie FunctionResponse de la reprise :
    part = Part(function_response=FunctionResponse(
        id=row["call_id"], name=row["name"], response=response))
Le daemon de diffusion interroge Veo jusqu'à ce que le fichier vidéo soit généré, puis envoie ce FunctionResponse à la session. ADK fait correspondre l'ID d'appel et reprend le workflow directement au nœud suivant. Les nœuds terminés ne sont pas réexécutés et l'agent n'effectue pas d'autre tour génératif.
Définir STUDIO_REAL_VIDEO=0 dans .env permet le rendu fictif : start renvoie un reçu de test immédiat et check simule l'achèvement en cinq secondes sans effectuer d'appels d'API Veo facturables.
Intégration de pipelines (8B)
Dans Workbench, accédez à render_desk in the graph (8B). Ouvrez stage6_video/agent.py.
Le nœud terminal du pipeline est store_video. Il lit les informations de rendu terminées à partir de runs/state.json (où le processus de diffusion les a enregistrées) et valide l'URL de la vidéo et l'état de génération dans l'état de session partagé.
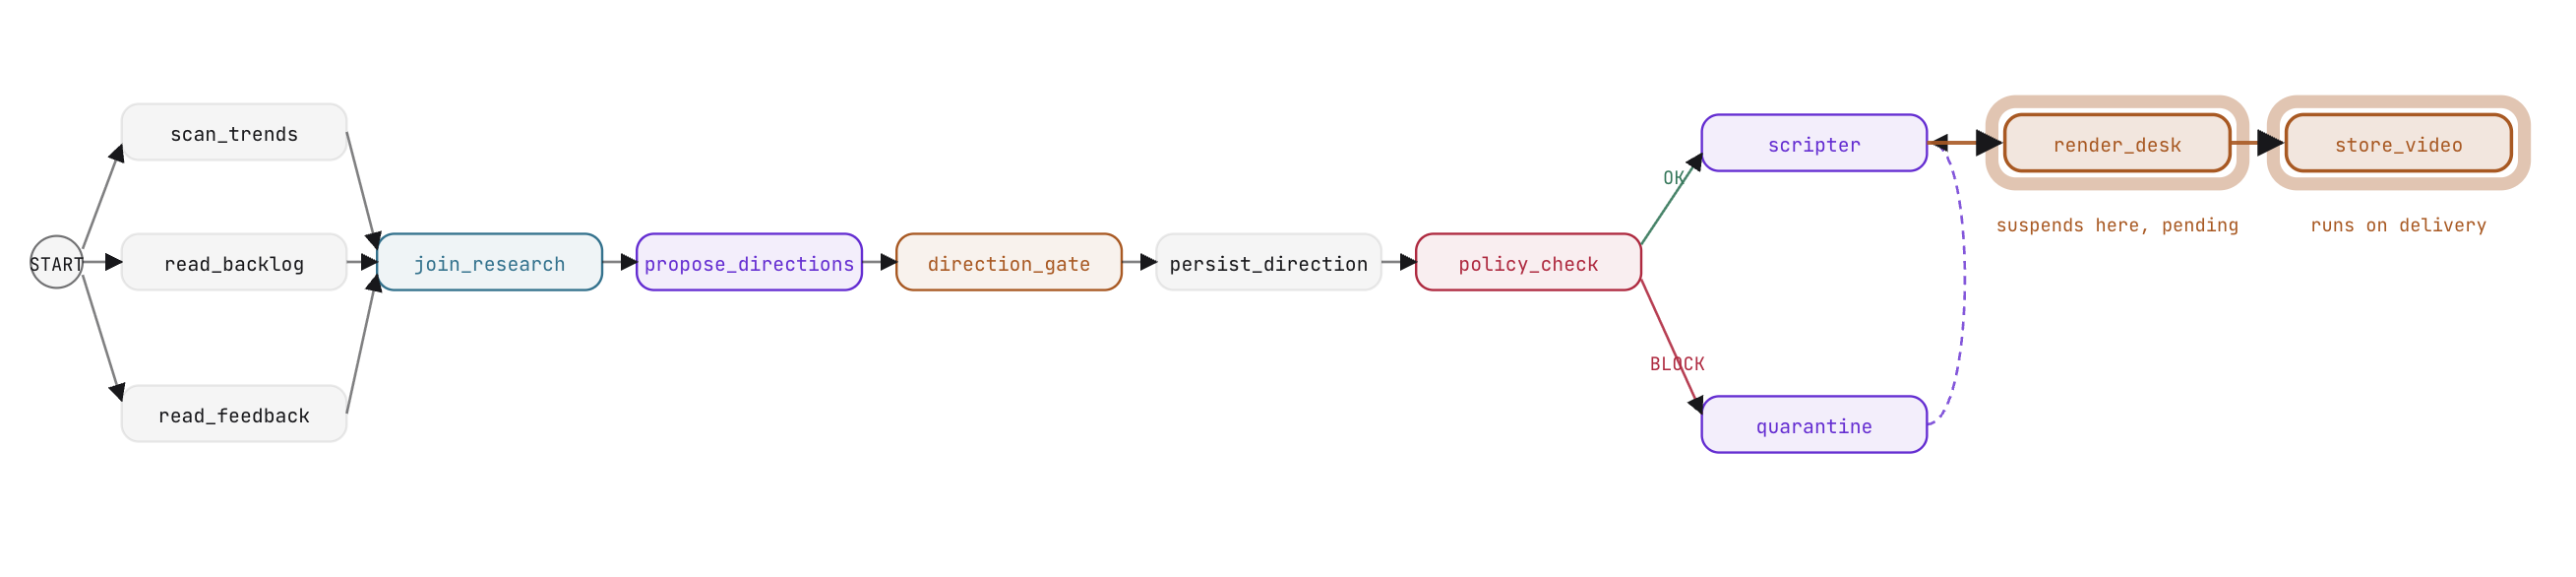
Atelier pratique : connecter l'intégralité du pipeline vidéo
Dans stage6_video/agent.py, mettez à jour edges pour ajouter render_desk et store_video :
           (quarantine, scripter),
           (scripter, render_desk, store_video)])
À quoi s'attendre et pourquoi
Testez le flux de génération asynchrone dans l'atelier :
- Exécutez le workflow en sélectionnant un candidat et en générant un script.
- À
render_desk, observez l'agent appelerrender_submit. - Le workflow est immédiatement suspendu. Dans l'atelier ou ADK Web, observez l'état "En attente" : la session contient l'ID d'appel ouvert et aucun processus en arrière-plan ne consomme de ressources.
- Exécutez le daemon de livraison à l'aide de la console Workbench ou dans votre terminal :
python -m agent.deliver - Dans ADK Web, actualisez la session : l'exécution reprend à
store_video, valide l'URL de la vidéo dans l'état de la session et termine le workflow.
9. Déployer dans Cloud Run
Dans VibeStudio Workbench, accédez à Étape 9 : Déployer.
Vous avez développé et vérifié chaque composant du pipeline dans des bacs à sable dédiés. Dans cette étape, vous allez assembler le pipeline de production complet et le déployer sur Google Cloud Run.
L'exécuteur ADK
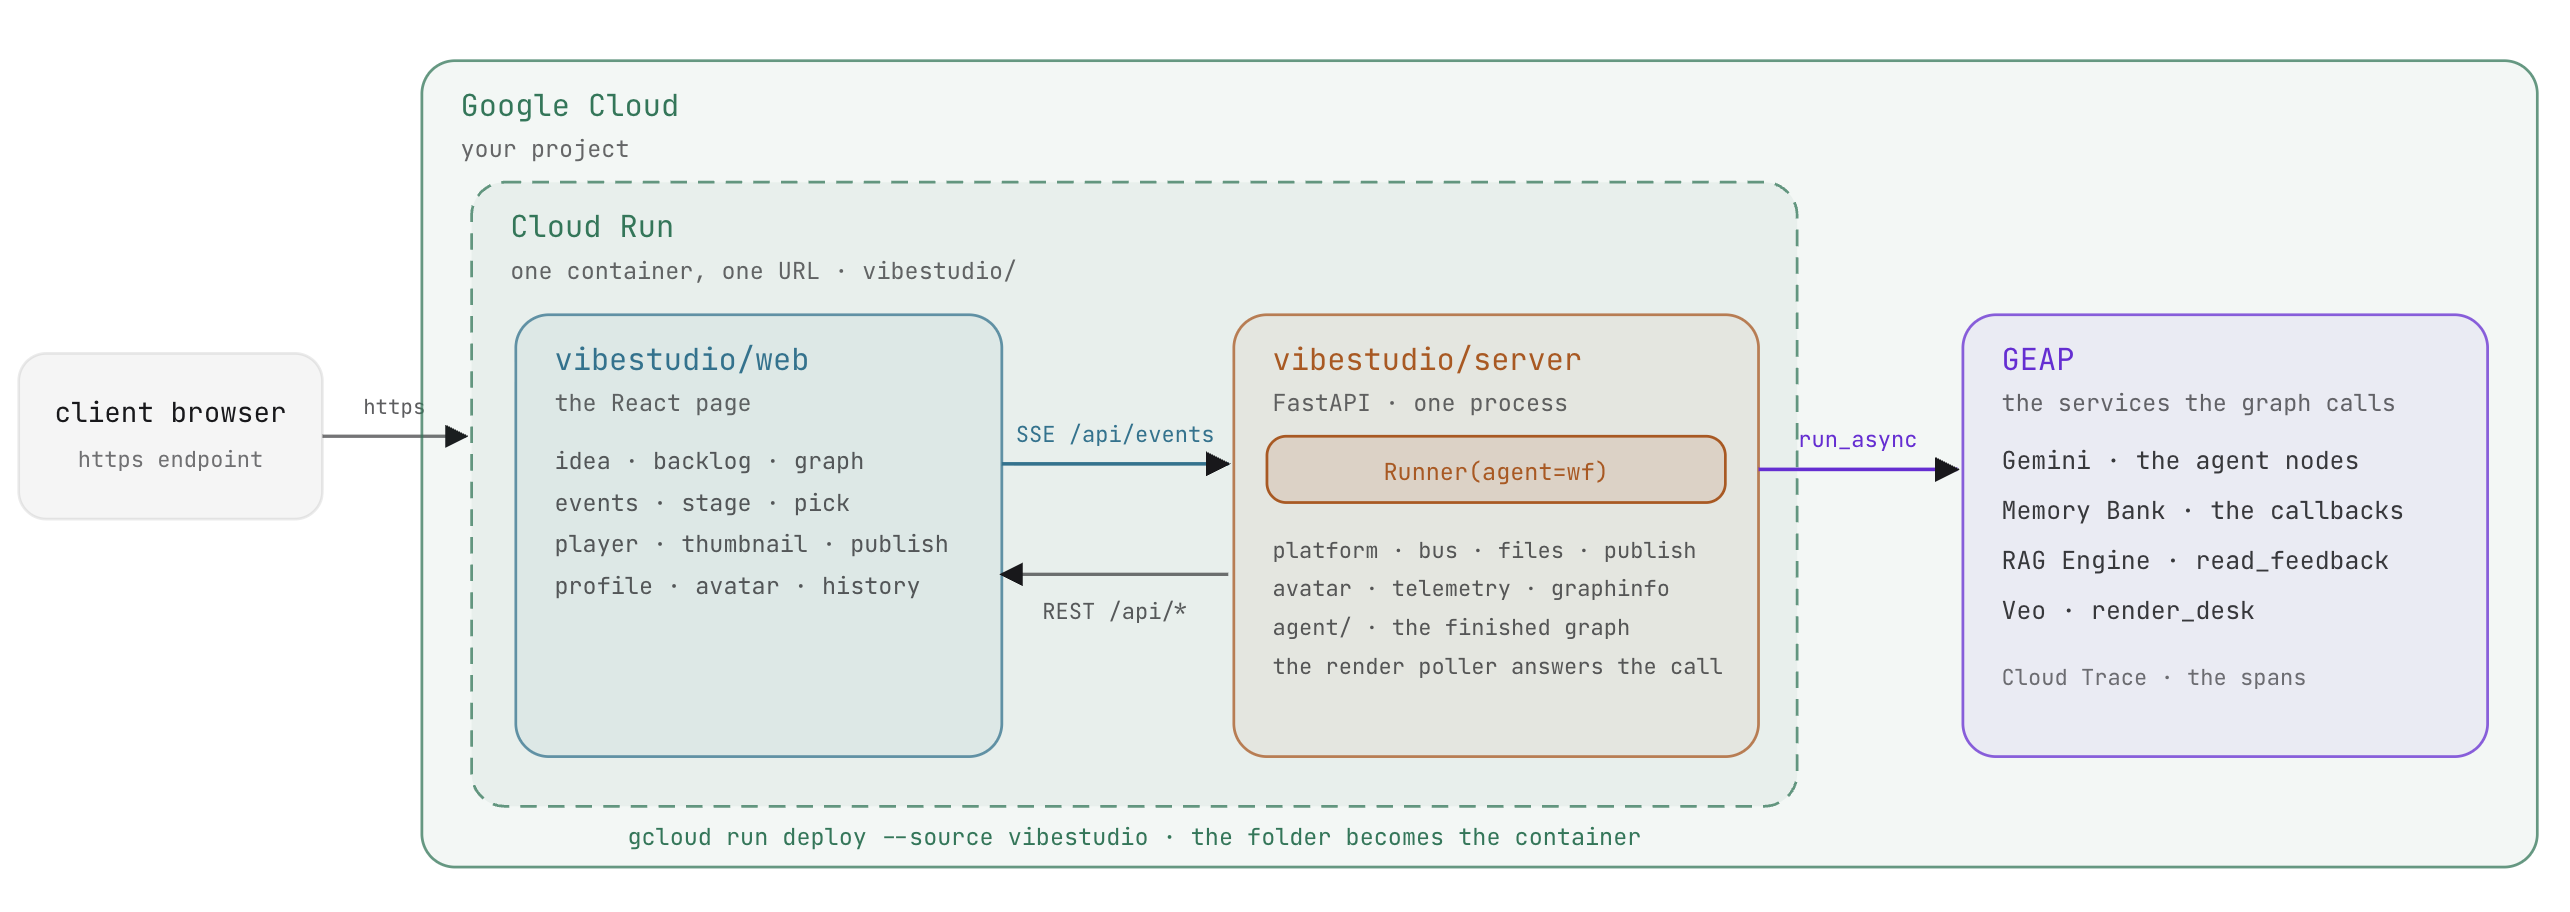
Lors du développement, adk web a orchestré le graphique. En production, l'application héberge le workflow à l'aide de la classe Runner d'ADK :
self._svc = DatabaseSessionService(db_url=config.DB_URL)
self._runner = Runner(app_name=config.APP, agent=wf, session_service=self._svc)

async for ev in self._runner.run_async(user_id=config.USER, session_id=run_id, new_message=message):
    self._absorb(ev)    # fold the ADK event into the run state, publish one app event

# the gate's answer and the render's delivery are the same call, with a function_response part
part = Part(function_response=FunctionResponse(id=call_id, name=name, response=response))
run_async: pilote l'exécution du workflow, génère les événements de manière séquentielle à mesure que les nœuds s'exécutent et conserve les mises à jour dans le service de session.- Reprise unifiée : les décisions de l'utilisateur au niveau de
direction_gateet les livraisons de vidéos terminées de Veo reprennent l'exécution via des objetsFunctionResponseidentiques envoyés àrun_async.
Architecture de l'application de production
L'application de production dans vibestudio/ intègre le pipeline complet :
vibestudio/
  server/
    main.py                 FastAPI: application server, REST routes, static assets
    api.py                  REST API endpoints: run, pick, publish, backlog, profile, history
    runner.py               Runner orchestration over the workflow, background render poller
    platform/               Event bus (SSE stream), file storage, publishing, telemetry
    agent/                  Production agent package, verified by checks/verify_app.py
      graph.py              The complete workflow graph and node definitions
      desk.py               render_desk and render_submit wrapped with LongRunningFunctionTool
      schemas.py            Pydantic schemas: Directions, CleanedDirection, Script
      cleanup_tools.py      Deterministic policy tools: find_policy_hits, suggest_replacement
      platform/             Memory Bank, RAG Engine, and Veo integrations
  web/                      Production React user interface
  Dockerfile · deploy.py · run.sh
- Flux d'événements unique : le backend FastAPI publie les événements sur un seul flux d'événements envoyés par le serveur (SSE). L'interface React visualise la progression du graphique en temps réel et gère les connexions tardives sans perdre l'état.
- Exécution dissociée : l'application gère la boucle d'événements. Le graphique du workflow est entièrement axé sur la logique d'exécution et ne tient pas compte de l'interface utilisateur.
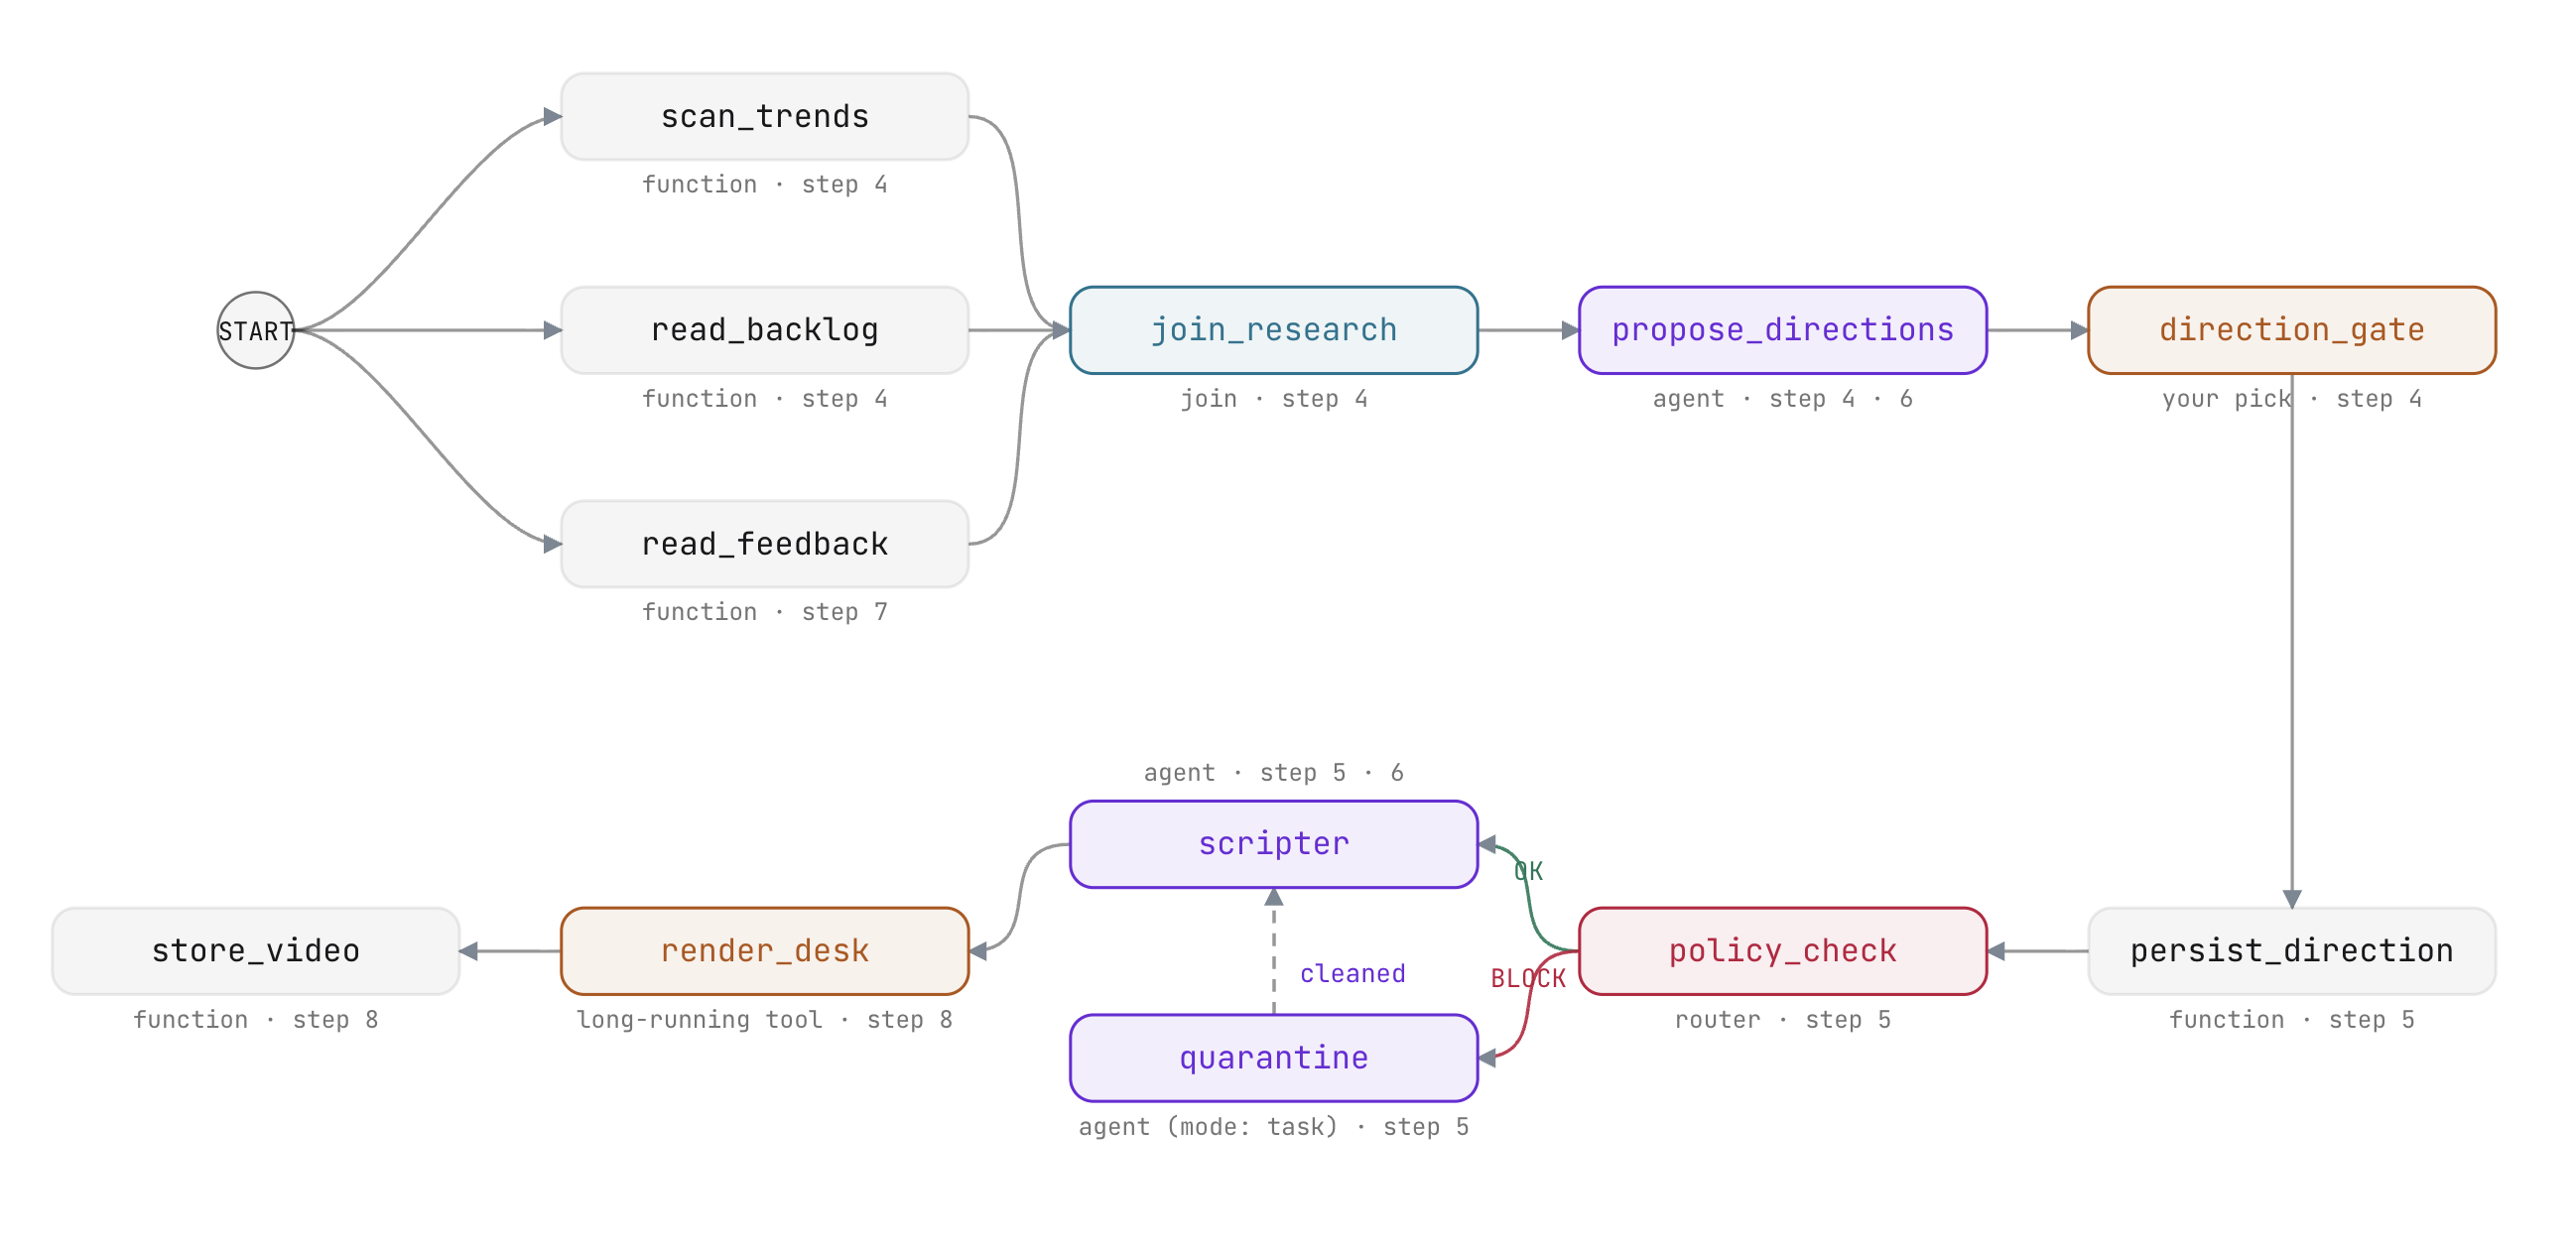
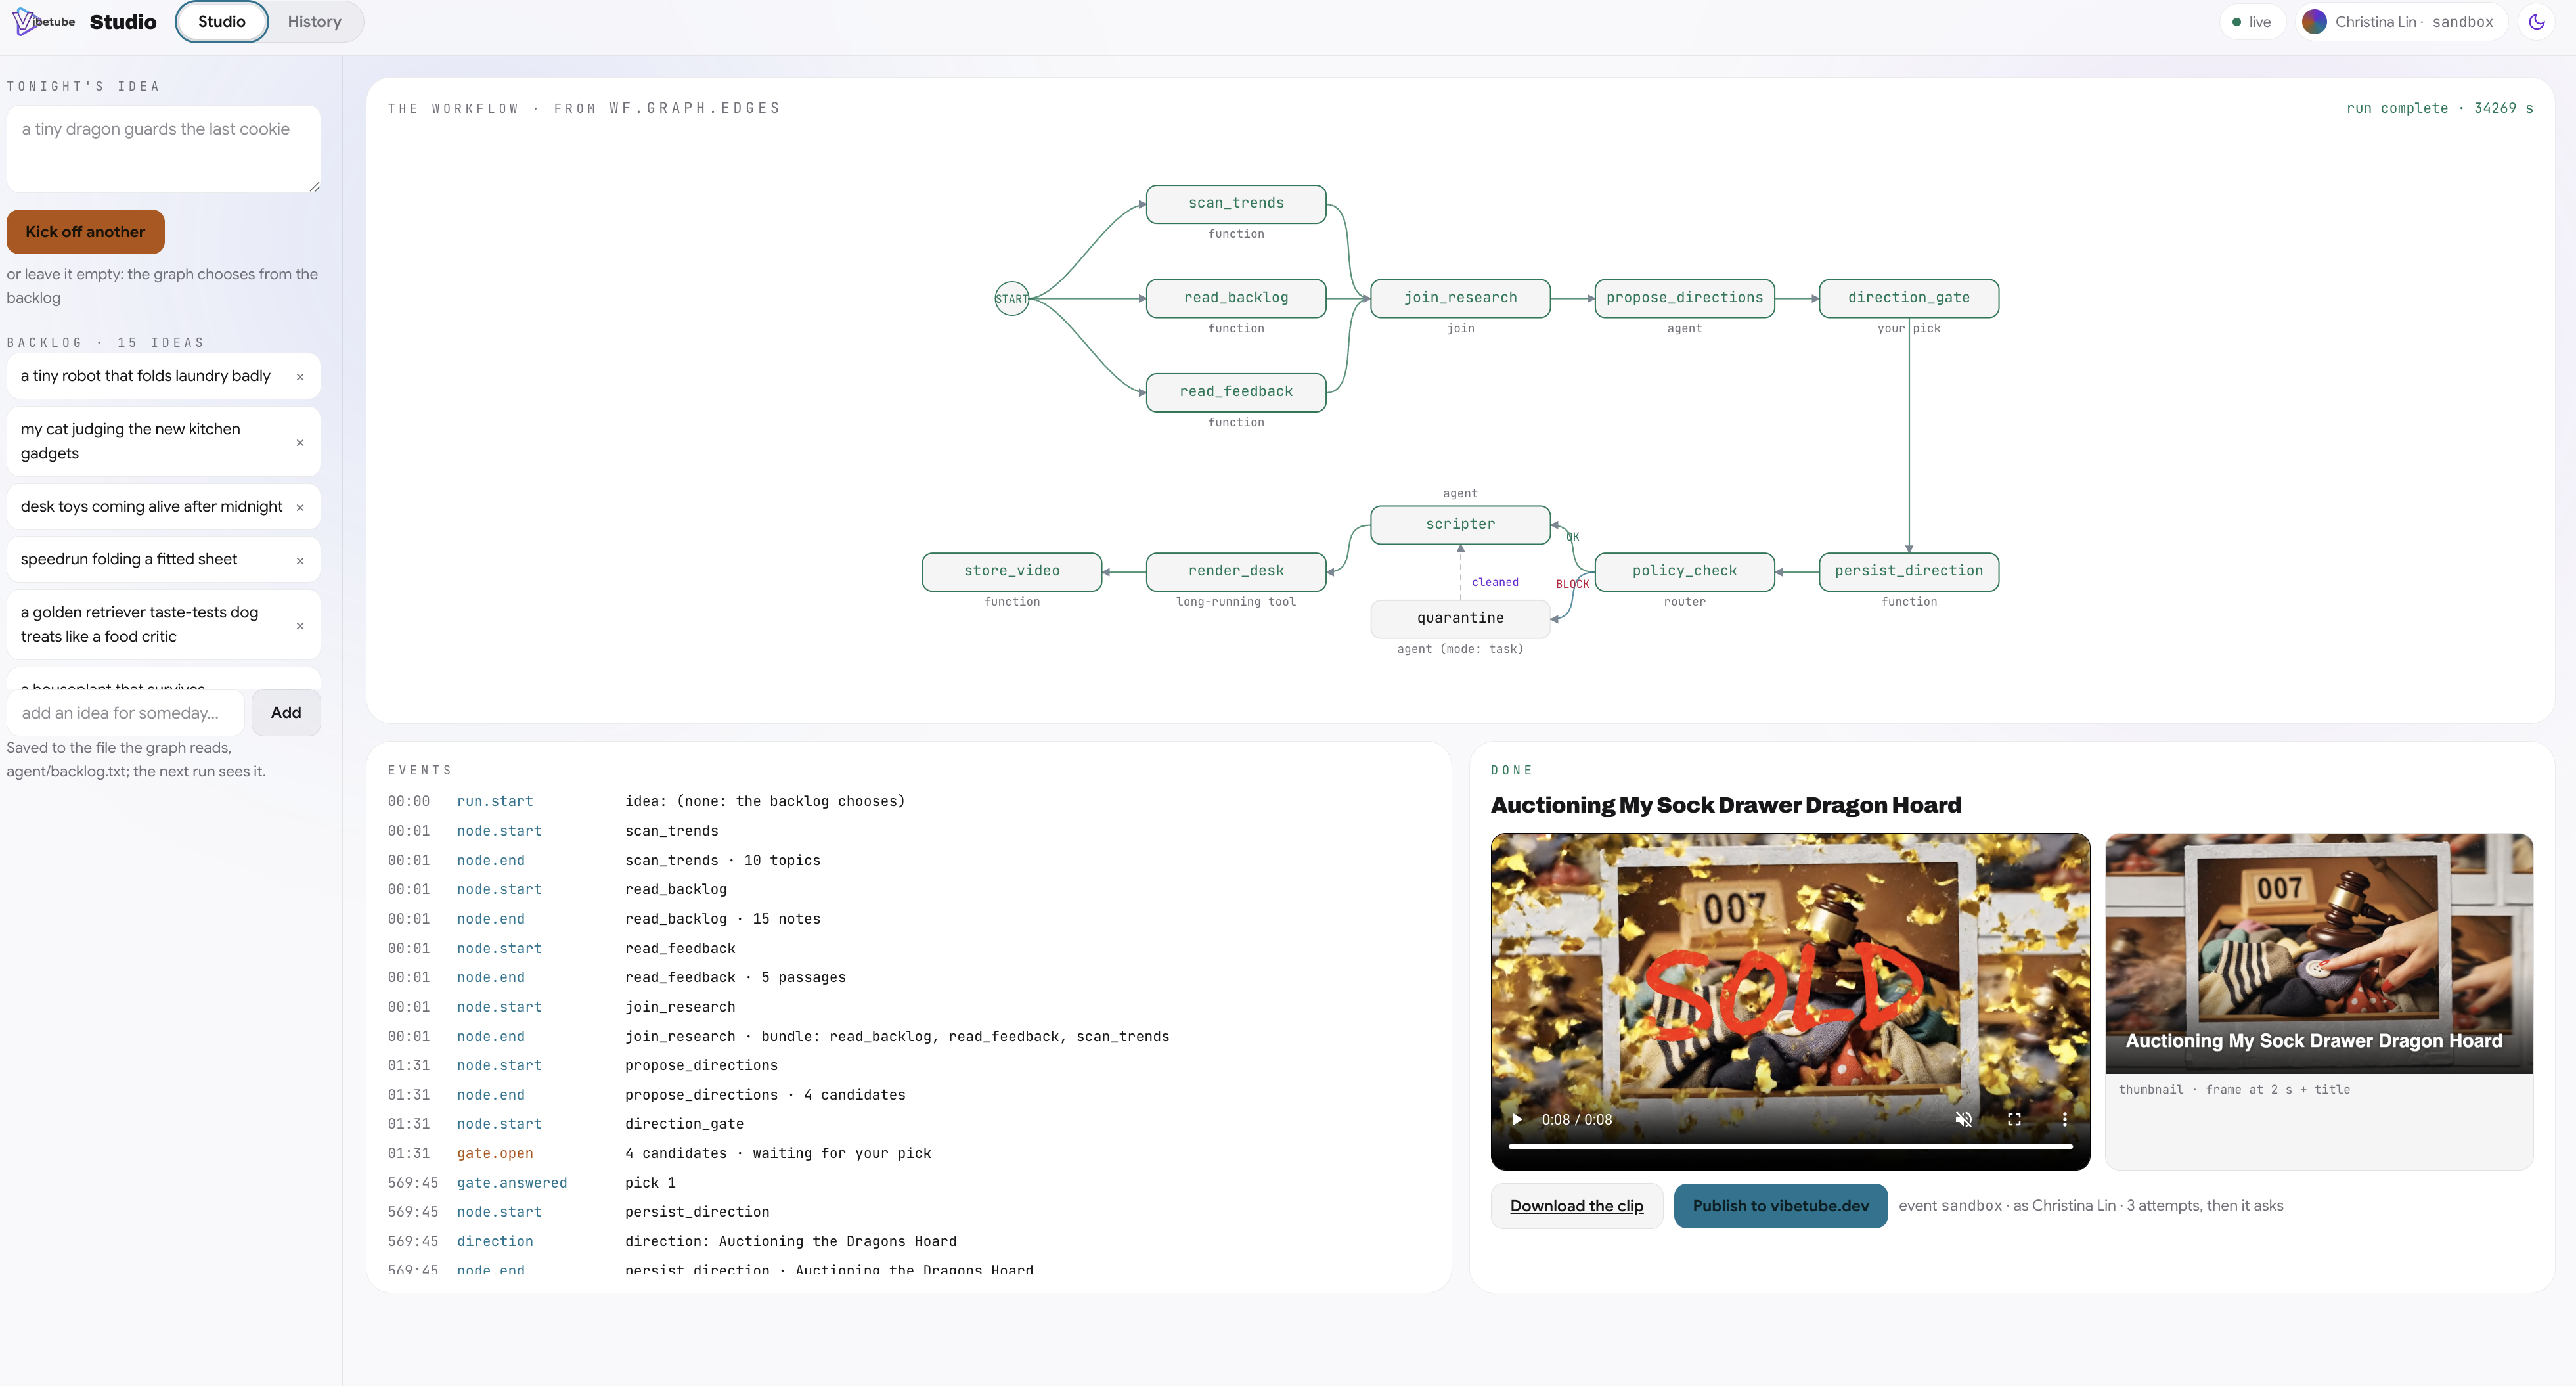
La liste complète des bords du workflow dans agent/graph.py combine tous les modèles d'architecture créés tout au long de cet atelier de programmation :
        (START, scan_trends, join_research),
        (START, read_backlog, join_research),
        (START, read_feedback, join_research),
        (join_research, propose_directions, direction_gate,
         persist_direction, policy_check),
        (policy_check, {"OK": scripter, "BLOCK": quarantine}),
        (quarantine, scripter),
        (scripter, render_desk, store_video),
Déployer sur Cloud Run
Google Cloud Run fournit un hébergement sans serveur avec scaling automatique, routage des requêtes et builds de conteneurs intégrés :
gcloud run deploy vibestudio --source vibestudio \
  --project $GOOGLE_CLOUD_PROJECT --region us-central1 \
  --labels dev-tutorial-codelab=vibetube --allow-unauthenticated \
  --memory 2Gi --cpu 2 --timeout 3600 --concurrency 40 \
  --max-instances 1 --min-instances 1 --session-affinity \
  --set-env-vars GOOGLE_CLOUD_PROJECT=...,STUDIO_VERTEX=1,STUDIO_MEMORY_BANK=...,STUDIO_RAG_CORPUS=...,VIBETUBE_URL=...,VIBETUBE_EVENT=...,VIBETUBE_NAME=...,VIBETUBE_PROJECT=...
- Compilation de conteneur :
gcloud run deploy --sourceempaquette le répertoirevibestudio/, compile l'image de conteneur à l'aide de Cloud Build et déploie le service en une seule opération. - Affinité de session : dirige les requêtes d'un même utilisateur vers la même instance de conteneur, ce qui permet de conserver l'état de la session locale d'une étape à l'autre.
- Observabilité : l'intégration de Cloud Trace enregistre les spans distribués pour chaque nœud, appel de LLM et exécution d'outil. Ils sont accessibles dans la console Google Cloud sous l'explorateur de traces.
Cliquez sur le bouton Deploy (Déployer) dans l'atelier pour exécuter le script de déploiement. Une fois la compilation terminée, le terminal affiche l'URL du service en ligne.
10. Résumé
Dans VibeStudio Workbench, accédez à Étape 10 · Résumé pour examiner l'architecture terminée.
Étape | Architecture et concepts | Modèle d'implémentation |
Un seul prompt | Requête unique, outils de fonction, boucle de chat séquentielle |
|
Principes de base des workflows agentifs | Workflow de graphe, recherche parallèle, sorties de schéma, contrôle humain |
|
État et routeur | État de session partagé, liaison de paramètres, routage déterministe, agent de tâches |
|
Banque de mémoire | Mémoire à long terme au niveau de l'utilisateur, consolidation sémantique, hooks de cycle de vie |
|
Moteur RAG | Récupération de documents à partir de commentaires d'audience, embeddings sémantiques | Nœud |
Génération asynchrone de vidéos avec Veo | Outils de longue durée, reçus en attente, daemon de livraison externe |
|
Déployer dans Cloud Run | Orchestration programmatique, événements envoyés par le serveur, conteneur sans serveur |
|
Principes architecturaux de base
- Suspendre au lieu d'attendre : les workflows sont mis en pause de manière propre pour permettre une saisie humaine (
RequestInput) ou des opérations de longue durée (LongRunningFunctionTool). Les processus n'attendent pas l'inactivité sur les threads ou les sockets réseau. - Reprise universelle : chaque suspension reprend via un mécanisme identique : un seul
function_responsecontenant l'ID d'appel du nœud suspendu. - Gestion d'état découplée : les nœuds partagent des données via des clés d'état de session nommées et la liaison de paramètres au lieu de charges utiles intermédiaires détaillées et étroitement couplées.
- Routage déterministe avant le coût génératif : les routeurs basés sur des règles et les filtres d'expressions régulières évaluent la règle à un coût de zéro jeton avant l'exécution des modèles génératifs.
- Séparation des préoccupations : le contexte spécifique à un agent individuel appartient aux rappels de cycle de vie, tandis que les dépendances aux données partagées appartiennent