1. מבוא
בשיעור Codelab הזה נסביר איך ליצור מערכות מתקדמות של סוכנים באמצעות תהליכי עבודה וגרפים בערכה לפיתוח סוכנים (ADK). תטמיעו דפוסי ארכיטקטורה נפוצים, תתזמנו אינטראקציות של 'האדם שבתהליך' (HITL) ותטפלו בהרצה אסינכרונית ממושכת. בנוסף, תשלבו מאגרי ידע ארגוניים וזיכרון מתמיד כדי להתאים אישית ולפתח את ההתנהגות של הנציג. בסיום, תחברו את היכולות האלה כדי להפעיל צינור עיבוד נתונים אוטומטי ליצירת סרטונים.
התרחיש
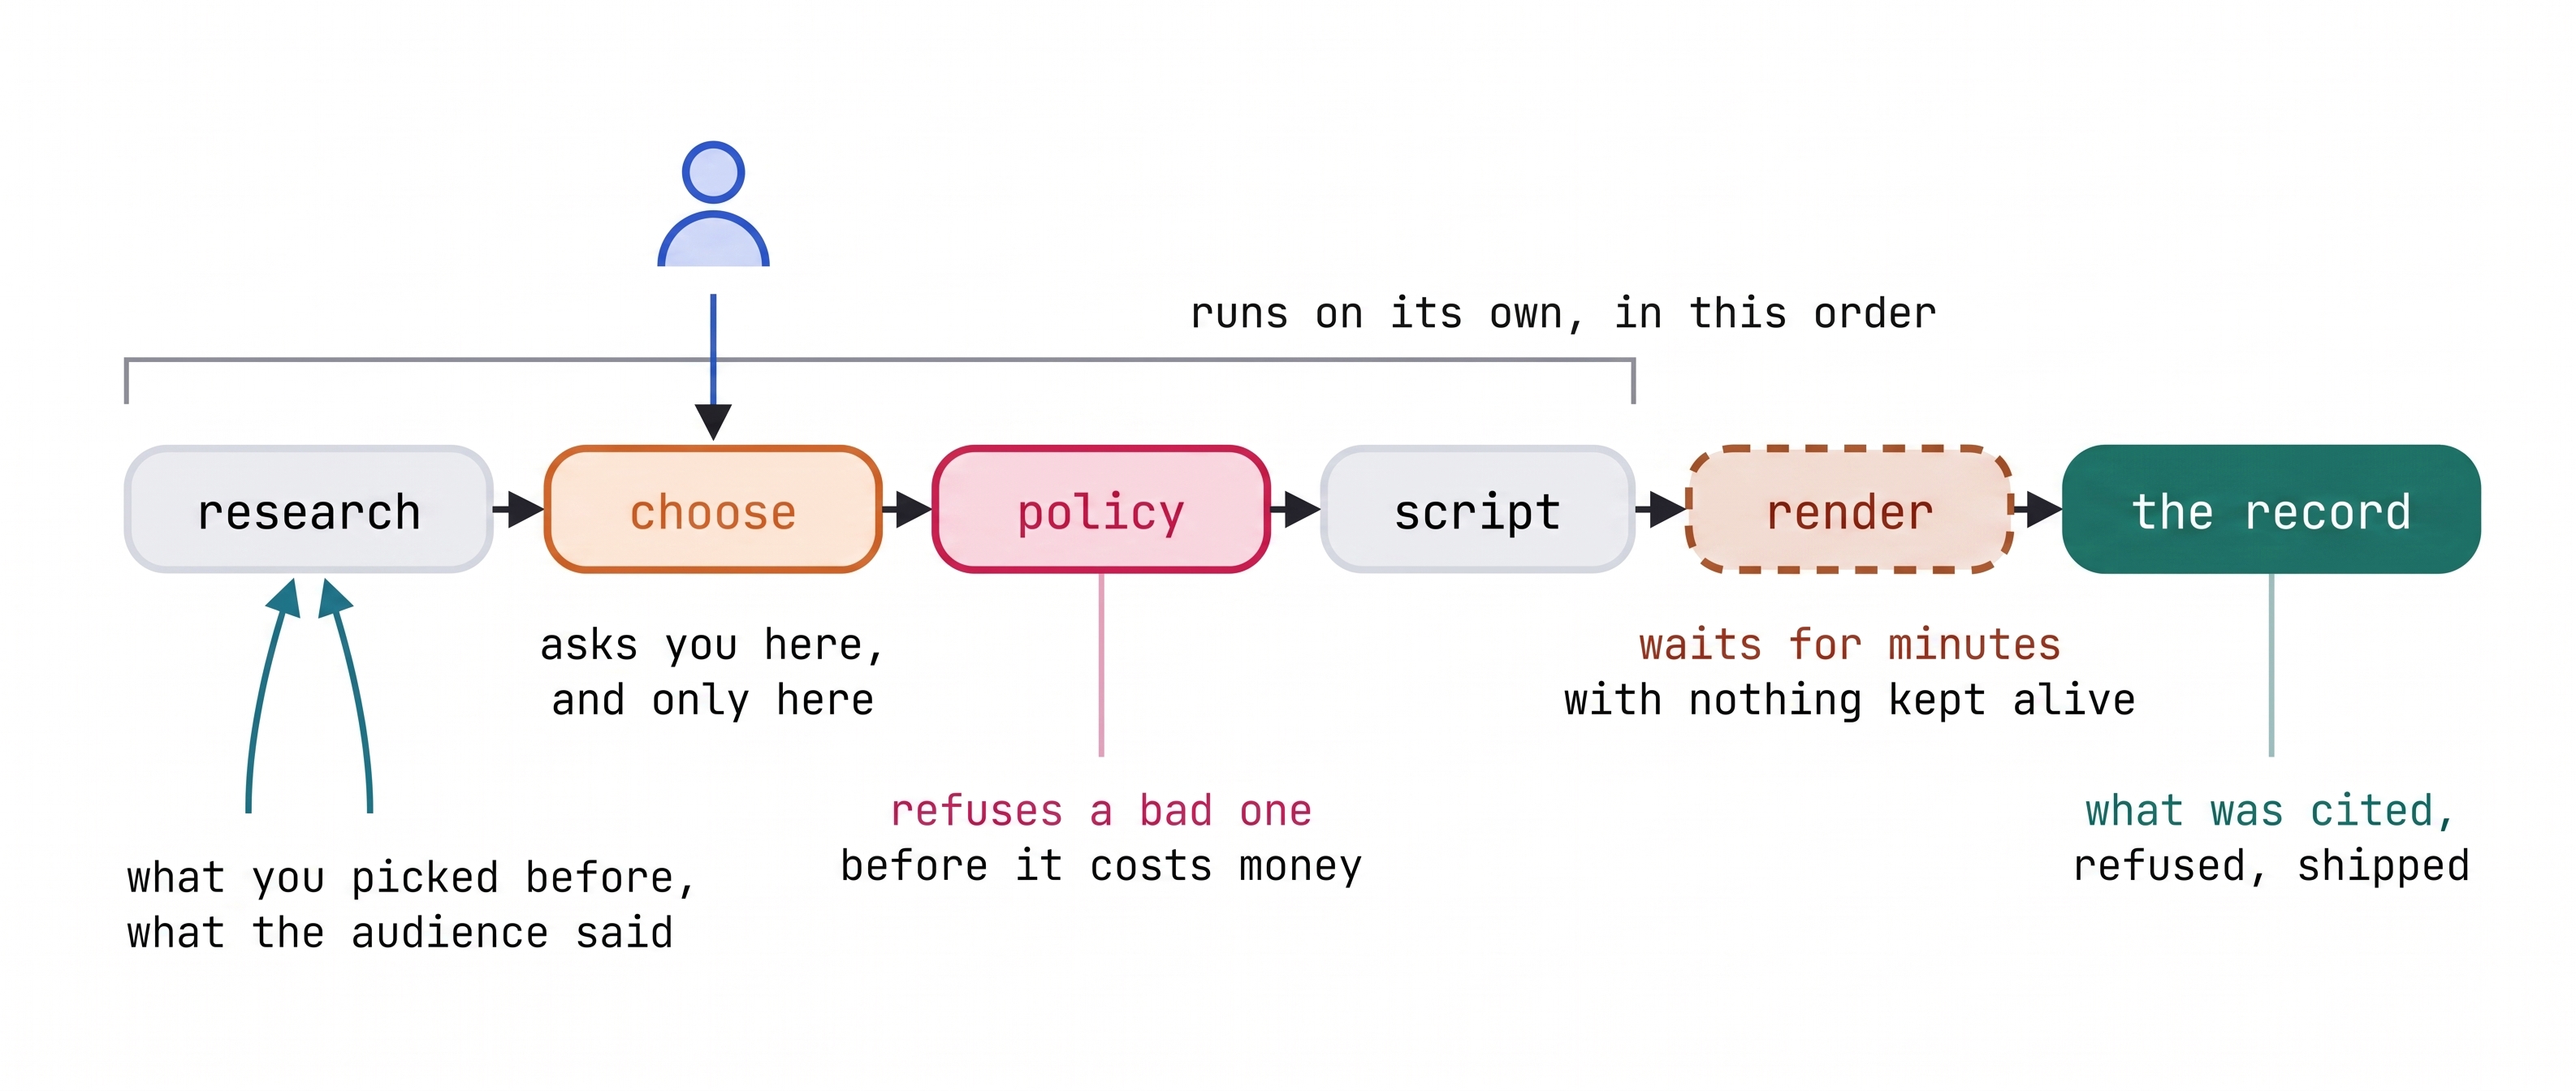
אתם מנהלים ערוץ דיגיטלי ב-VibeTube עם קהל פעיל ורשימה הולכת וגדלה של רעיונות יצירתיים. כדי להפיק כל סרטון, צריך לבצע ברצף כמה שלבים: לחקור פורמטים פופולריים, לסנתז משוב מהצופים, לפתח תסריטים, לבדוק את התאימות למדיניות וליצור קטעי וידאו. מודלים גנרטיביים יכולים ליצור טיוטות של נכסים נפרדים, אבל כדי להפיק גרסאות עקביות צריך ארכיטקטורה מתוזמרת של סוכנים.
כדי להפוך את מחזור החיים הזה לאוטומטי, תבנו את VibeStudio. צינור עיבוד הנתונים הזה מבוסס על סוכנים, והוא מבצע מחקר שגרתי במקביל, מציג אפשרויות שנבחרו בקפידה לאישור של האדם שבתהליך, מחיל שערי מדיניות אוטומטיים לפני יצירת הסרטון ושומר על ההקשר לאורך כל שלבי ההפקה.
מה לומדים
- יסודות של הנדסת גרפים: ארכיטקטורות של סוכנים עם כמה שלבים דורשות זרימת בקרה מפורשת ונתיבי ביצוע מובְנים. אתם יוצרים
Workflowשל ADK באמצעות טאפלים של קצוות, נקודת הכניסהSTART,JoinNodeלצבירת fan-out מקבילה וצומתי נתב דטרמיניסטיים כדי לכוון את הביצוע על סמך המצב. - מצבי סוכן וקריאות חוזרות במחזור חיים: משימות מיוחדות דורשות התנהגויות תפעוליות שונות ומעקות בטיחות דטרמיניסטיים. אתם מגדירים מכונות של ADK
Agentבאמצעות המצביםchat,single_turnו-taskשמופעלים על ידי כלים כצמתים של תהליך עבודה, ומחילים מיירטים באמצעותbefore_model_callbackו-after_agent_callback. - תיזמור של 'האדם שבתהליך': צינורות עיבוד נתונים מושהים לצורך שיקול דעת אנושי בנקודות קריטיות בתהליך הקריאייטיב. אתם מטמיעים את
RequestInputכדי להשעות את ההפעלה של תהליך העבודה, לאכוף סכמות מובנות של תשובות ולהמשיך את ההפעלה בלי להשאיר תהליכי זמן ריצה לא פעילים. - זיכרון היררכי של הנציג: מערכות ייצור מפרידות בין מצב הרצה זמני לבין הקשר קבוע. אתם מנהלים את מצב הסשן לטווח קצר באמצעות
Event(state=...)וקישור פרמטרים, ומחברים את GEAP Memory Bank כדי לחלץ, לאחד ולשמר את ההעדפות של היוצרים בין הרצות. - התבססות על בסיסי ידע ארגוניים: סוכנים אוטונומיים צריכים הקשר דינמי של הדומיין וניתוח סנטימנט של הקהל. אתם מחברים קורפוס של GEAP RAG Engine כצומת אחזור ייעודי בתוך ה-fan-out המקביל כדי לבסס באופן סמנטי את הפלט של הסוכן.
- תהליכי עבודה ופריסה ממושכים: עיבוד וידאו מולטימודלי פועל באופן אסינכרוני לאורך זמן. מטמיעים את
LongRunningFunctionToolעם קבלות על שיחות בהמתנה כדי להשהות ולחדש את תהליך העבודה לפי מזהה השיחה, ופורסים את צינור עיבוד הנתונים שהושלם באמצעות ADKRunnerב-Cloud Run.
איך ה-Codelab הזה מאורגן
ה-Codelab הזה משמש כחומר עזר קונספטואלי וארכיטקטוני. בכל חלק מוסבר על מבני ה-ADK שהוטמעו בשלב המתאים בכלי, מוצג קוד לדוגמה ומוצגים עקרונות עיצוב מרכזיים. חשוב לעבור על כל קטע לפני שמשלימים את התרגיל המתאים בסביבת העבודה.
העבודה המעשית מתבצעת ב-VibeStudio Workbench, ממשק אינטרנט נלווה שכולל עורך קוד אינטראקטיבי, מאמתים של זמן ריצה ומפקח ADK מוטמע. מספרי השלבים בסביבת העבודה תואמים ישירות למספרי השלבים ב-codelab הזה, כדי שההתקדמות שלכם תהיה מסונכרנת. עריכות בסיסיות של תרשימים נשמרות לאורך השלבים, וסביבת העבודה מאמתת באופן אוטומטי את הדרישות המוקדמות ככל שמתקדמים.
אחרי שתסיימו את התרגילים בסביבת העבודה, תרכיבו צינור עיבוד נתונים מקצה לקצה מבוסס-סוכנים ותפרסו אפליקציית VibeStudio פעילה ב-Cloud Run כדי ליצור קטע וידאו.
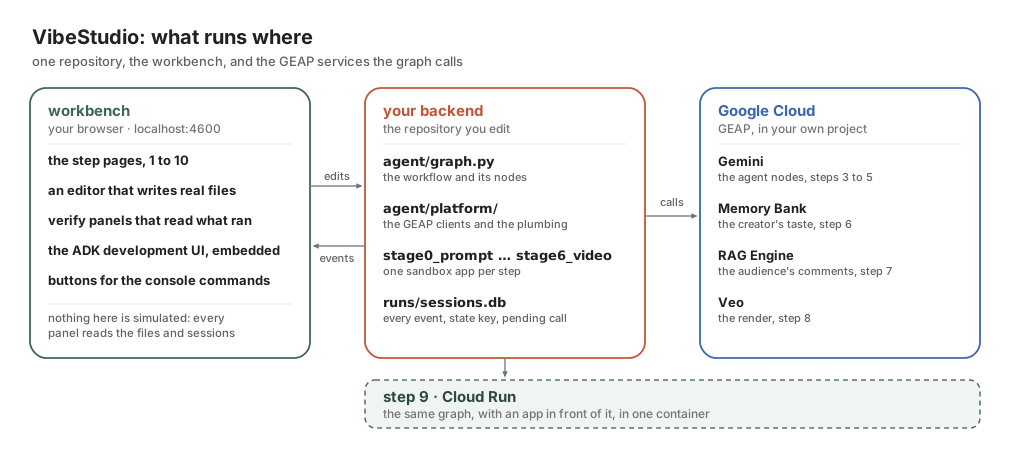
הסביבה מורכבת משלושה רכיבים עיקריים: VibeStudio Workbench (ממשק האינטרנט המקומי לעריכת קוד ולאימות בזמן ריצה), הקצה העורפי (ADK Workflow וארגזי חול של שלבים ב-agent/) ו-Google Cloud (מודלי Gemini, מאגר הזיכרון של GEAP, מנוע RAG ויצירת סרטונים ב-Veo).
2. הגדרה
מימוש הקרדיטים לסדנה
אם אתם משתתפים בשיעור Lab בהנחיית מדריך, המדריך יקצה קרדיטים לפרויקט שלכם ב-Google Cloud. לפני שממשיכים, חשוב לפעול לפי ההוראות של המדריך כדי לממש את הקרדיטים ולוודא שהחיוב פעיל בחשבון.
פתיחת Cloud Shell
Cloud Shell היא סביבת פיתוח מבוססת-דפדפן עם gcloud, Python ו-git שמותקנים מראש.
כדי להפעיל את Cloud Shell:
- עוברים אל Google Cloud Shell.
סשן טרמינל ייפתח בחלק התחתון של חלון הדפדפן.
שכפול והפעלה של המאגר
כדי לשכפל את הפרויקט, מריצים את הפקודות הבאות במסוף Cloud Shell:
git clone https://github.com/gca-americas/vibetube-studio
cd ~/vibetube-studio
הנחיות להגדרות
במהלך ההגדרה תתבקשו לספק את הפרטים הבאים:
- מזהה פרויקט בענן ב-Google Cloud: כשמופיעה בקשה מ-
setup_project.sh, מקישים על Enter כדי ליצור פרויקט חדש באופן אוטומטי. אם אתם מעדיפים להשתמש בפרויקט קיים (כמו פרויקט שהוקצה מראש), הזינו את מזהה הפרויקט וודאו שהאיות נכון ושהחיוב פעיל. - קוד האירוע: מזינים את קוד החדר שקיבלתם מהמורה. אם לא קיבלתם, פנו לעוזר הוראה או לשכן. אם אתם מבצעים את שיעור ה-Lab הזה בבית, לחצו על Enter כדי לאשר את החדר שמוגדר כברירת מחדל,
sandbox. - השם המוצג של הערוץ: מזינים את השם או את הכינוי המועדף של הערוץ כש-
setup_codelab.shמבקש, או לוחצים על Enter כדי לאשר את ברירת המחדל שנוצרה מחשבון Google.
מריצים את שני סקריפטי ההגדרות לפי הסדר:
./setup_project.sh
./setup_codelab.sh
-
setup_project.sh: יוצרת פרויקט בענן ב-Google Cloud עם חיוב פעיל או משתמשת בפרויקט קיים, שומרת את מזהה הפרויקט ב-~/project_id.txtומגדירה את ההקשר הפעיל שלgcloud. -
setup_codelab.sh: מתקין אתuvואת יחסי התלות של Python ב-.venv, מפעיל את Cloud APIs הנדרשים של Google Cloud, קובע את הגדרות הערוץ ב-.env, מאמת את הגישה למודל באמצעות Gemini, מקצה משאבים ל-Memory Bank ול-RAG, יוצר את ממשק סביבת העבודה ומפעיל את VibeStudio Workbench.
הסקריפט מריץ את הבדיקה המקדימה ומפעיל את VibeStudio Workbench ברקע. בשורות האחרונות של הקובץ מופיע הקישור שצריך לפתוח.
7 · Preflight
  ✓ python 3.12
  ✓ auth path A: Vertex via ADC (STUDIO_VERTEX=1)
  ✓ Google Cloud ADC (project <your-project>)
  ✓ stage0_prompt loads
  ...
  ✓ stage6_video loads (13 edges)
  ✓ aiplatform.googleapis.com enabled (Gemini, Veo, Memory Bank, RAG Engine)
  ✓ vectorsearch.googleapis.com enabled (the vector store a RAG corpus is built on)
  ✓ Memory Bank connected
  ✓ RAG corpus connected
  ✓ VibeStudio Workbench running on port 4600

PREFLIGHT GREEN

Setup finished. The VibeStudio Workbench is already running.

  Open this and start at step 1
      https://4600-<your cloud shell host>/step/story

  It runs in the background. You do not need to start anything else.
      log      runs/lab.log
      stop     kill $(cat runs/lab.pid)
      start    scripts/start.sh
לוחצים על הקישור. אותה כתובת זמינה גם בקטע תצוגה מקדימה באינטרנט → שינוי יציאה → 4600.
כדי לבדוק מחדש את הסביבה בכל שלב, מריצים את הפקודה python scripts/preflight.py. כדי להפעיל מחדש את סביבת העבודה, מריצים את scripts/restart.sh. כדי להגדיר שוב, מריצים את ./setup_codelab.sh. הפעולה הזו שומרת את ההגדרות וההתקדמות.
אחרי שפותחים את הקובץ, קוראים את שלב 1, הסיפור כדי להבין את התרחיש, ואת שלב 2, מה יוצרים כדי להבין את הצורה של הגרף הסופי. לאף אחד מהם אין תרגיל. ואז חוזרים לכאן כדי לבצע את שלב 3.
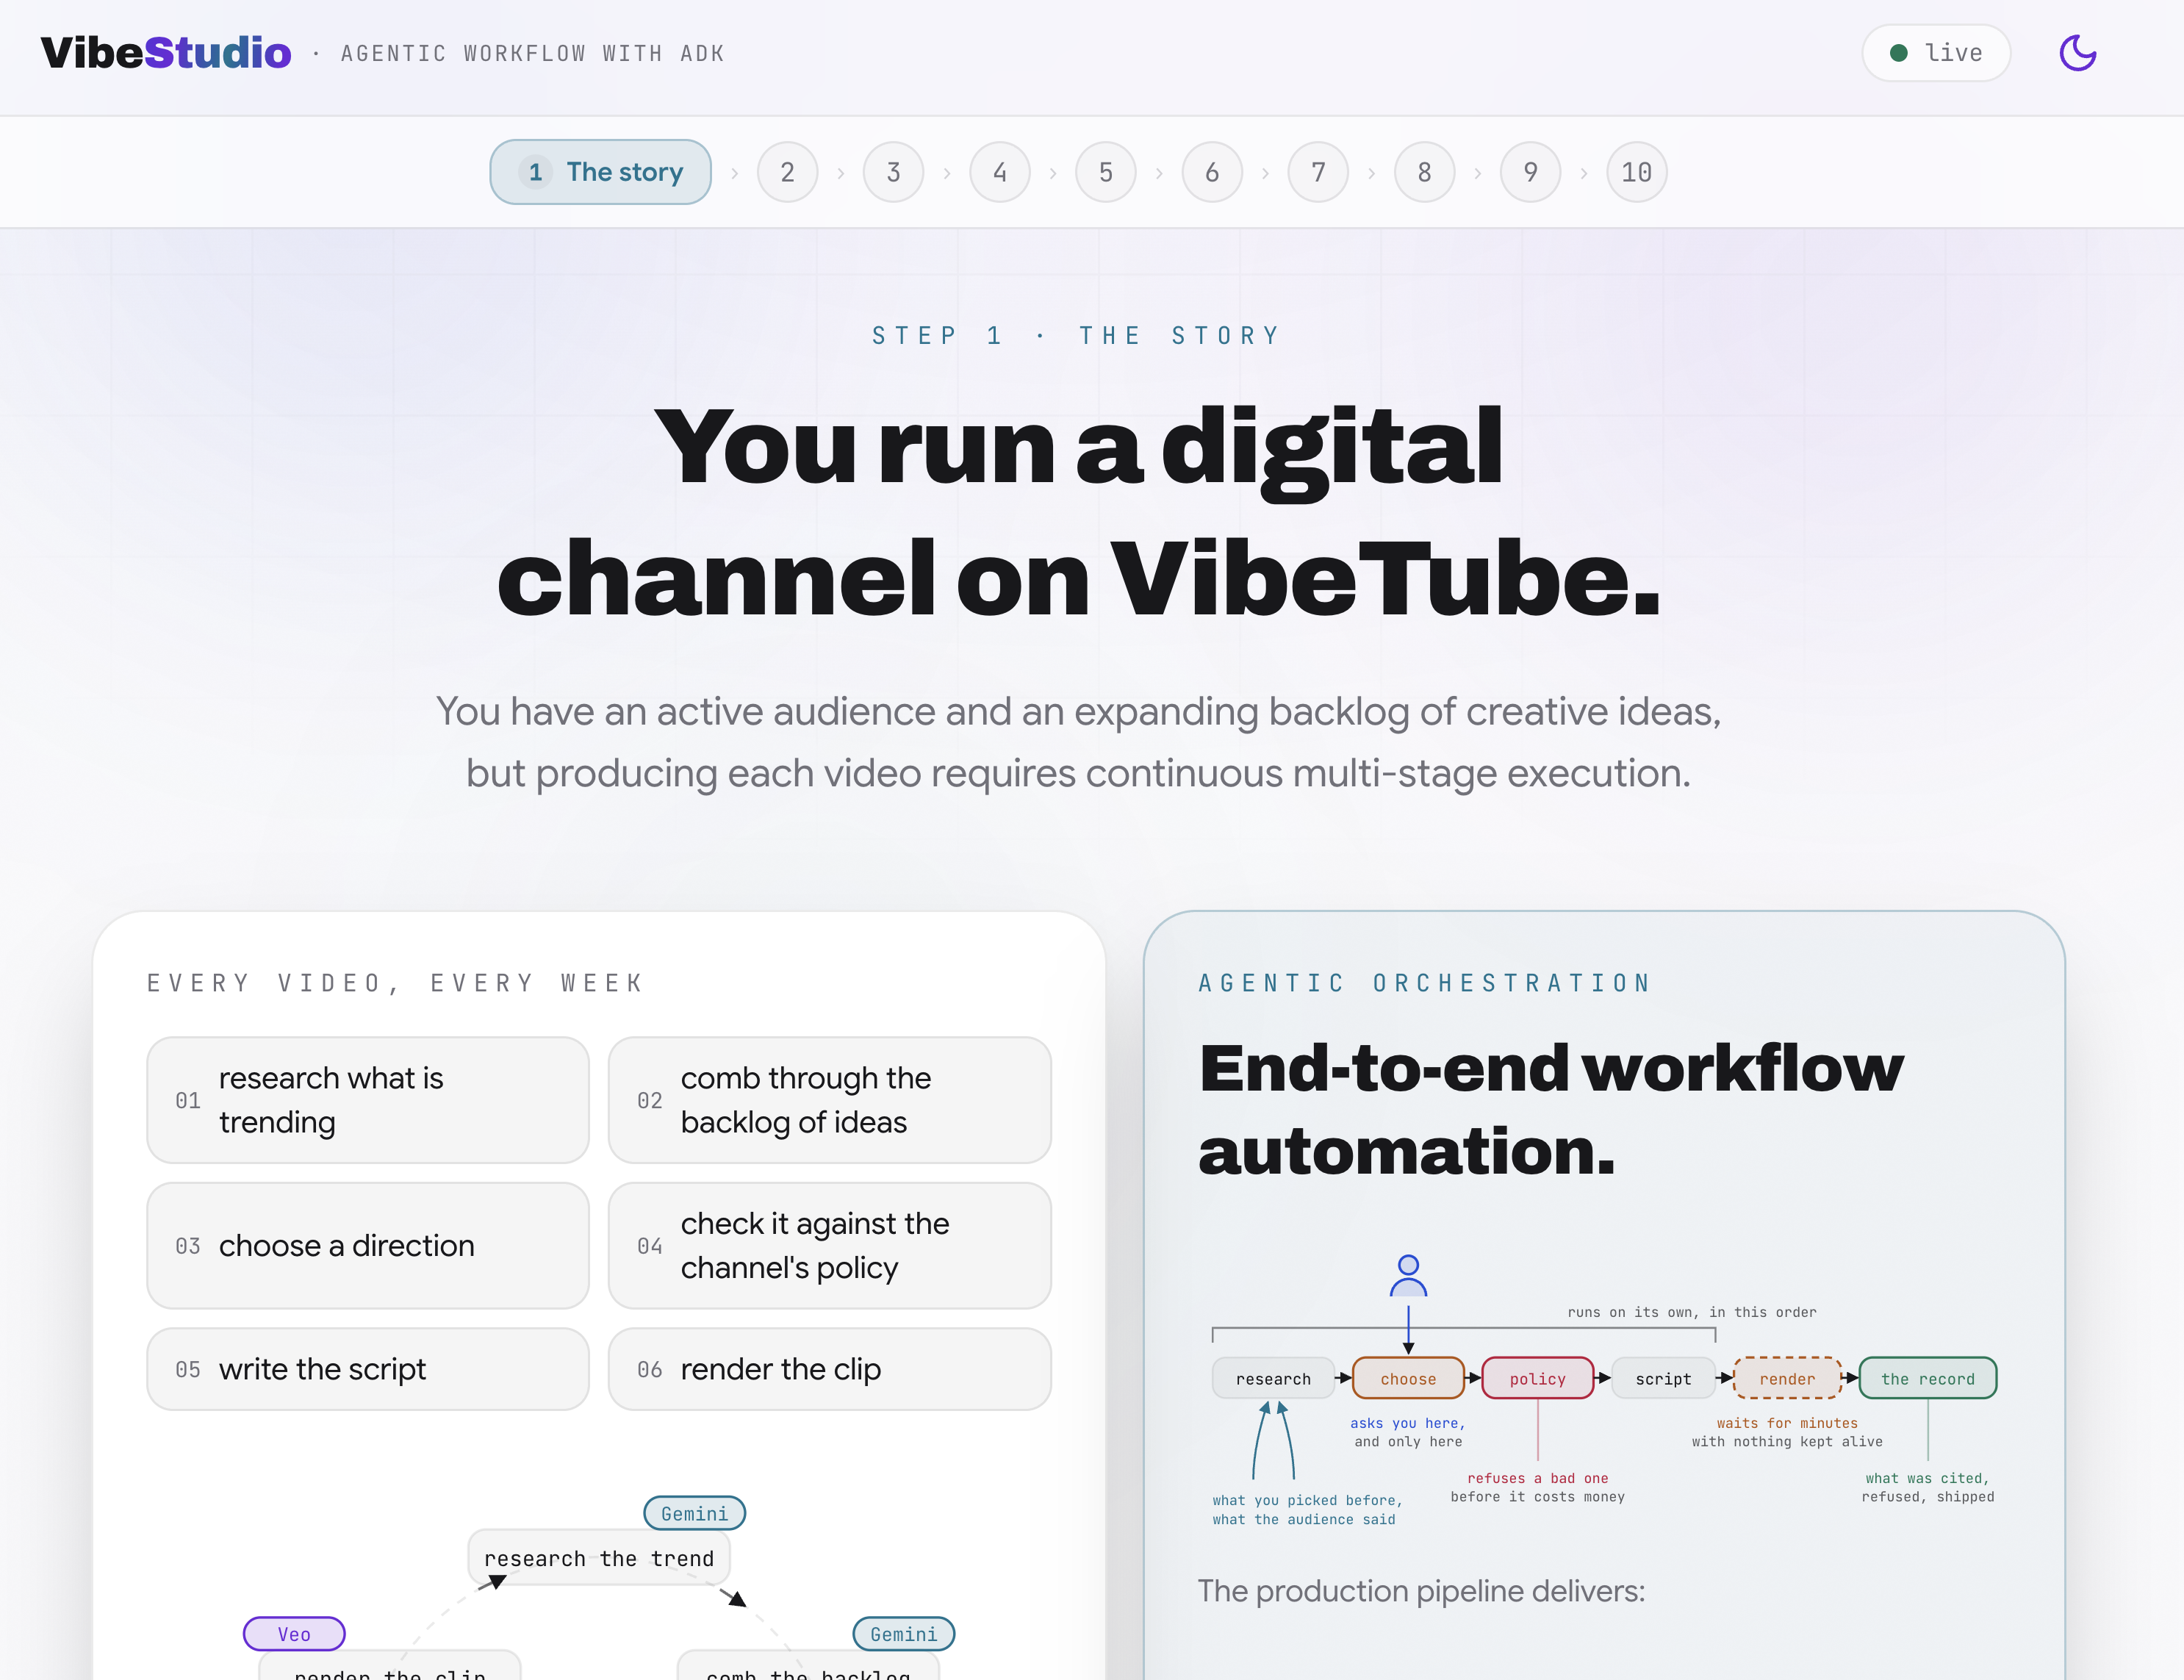
כל חלק מעשי ב-VibeStudio Workbench מסתיים בחלונית אימות שקוראת את הארטיפקטים האמיתיים: הקובץ בדיסק והסשנים שנכתבו על ידי ההרצות.
פריסת מאגר
המאגר מחולק ללוגיקה של תהליך העבודה, ארגזי חול עם הוראות מפורטות, סביבת העבודה והאפליקציה בסביבת הייצור:
vibe-studio-lab/
├── agent/                  # Core ADK workflow, graph definition, and platform services
│   ├── graph.py            # Workflow graph definition, node functions, and routers
│   ├── desk.py             # Video render desk using LongRunningFunctionTool
│   ├── schemas.py          # Pydantic schemas for directions, gates, and scripts
│   ├── trends.py           # Trend generation and sampling utilities
│   ├── backlog.txt         # Creator video ideas backlog
│   ├── comments.md         # Audience comments for RAG Engine corpus seeding
│   ├── policy_words.txt    # Blocked subject words for deterministic policy checks
│   └── platform/           # Google Cloud service clients (Memory Bank, RAG, Veo)
│       ├── config.py       # Environment variables, locations, and model configurations
│       ├── memory.py       # GEAP Memory Bank callbacks and context injection
│       ├── rag.py          # GEAP RAG Engine corpus creation and semantic retrieval
│       └── videogen.py     # Veo video generation and operation polling
├── stage0_prompt/          # Step sandboxes: isolated agent.py files runnable in adk web
│   └── ...                 # stage1_fanout through stage6_video for incremental steps
├── server/ & web/          # VibeStudio Workbench (FastAPI backend and React frontend)
├── vibestudio/             # Complete production application deployed to Cloud Run
│   ├── server/             # FastAPI production server and event runner
│   ├── web/                # End-user React web application
-
agent/: מכיל את תרשים תהליך העבודה העיקרי. תערכו קבצים בספרייה הזו כדי להטמיע צומתי fan-out מקבילים, ניתוב מדיניות דטרמיניסטי, קריאות חוזרות (callbacks) של זיכרון וכלים ליצירת סרטונים. -
agent/platform/: ממשקי משתמש עם שירותי Google Cloud, כולל מודלים של Gemini, GEAP Memory Bank, GEAP RAG Engine וסינתזת וידאו של Veo. -
stage0_prompt/עדstage6_video/: סביבות ארגז חול עצמאיות. כל תיקייה מייצאתroot_agentעצמאי, כך שאפשר להריץ ולבדוק כל שלב בנפרד דרך ממשק הפיתוח המוטמע של ADK. -
server/ו-web/: אפליקציית VibeStudio Workbench שפועלת באופן מקומי ביציאה 4600. הוא כולל את תיעוד השלבים, עורך קוד שמוטמע בדף, מאמתים של ראיות בזמן ריצה ותצוגה חזותית של הגרף. -
vibestudio/: האפליקציה המלאה לייצור, שנארזת ונפרסת ב-Cloud Run בשלב האחרון. הוא מכיל עותק עצמאי משלו של תרשים זרימת העבודה שהושלם.
3. סוכן מונוליתי
לפני שיוצרים תרשים של תהליך עבודה עם כמה צמתים, צריך להגדיר בסיס לארכיטקטורה עם סוכן אחד ב-stage0_prompt/agent.py. הסוכן הזה מסתמך על הנחיית מערכת מונוליתית שמתארת את צינור עיבוד הנתונים של הייצור בפרוזה, ונתמכת על ידי שני כלי פונקציות של Python.
הערכת קו הבסיס הזה מדגימה את הגבולות התפעוליים של תיאום מבוסס-הנחיות, ומסבירה למה מערכות ייצור דורשות תזמור גרפים.
ארכיטקטורה של סוכן ADK (3A)
ב-VibeStudio Workbench, עוברים אל Step 3 · Monolithic agent ופותחים את ADK agent architecture (3A). בתרשים הזה מוצגות שכבות הארכיטקטורה העיקריות של סוכן ADK (LlmAgent):
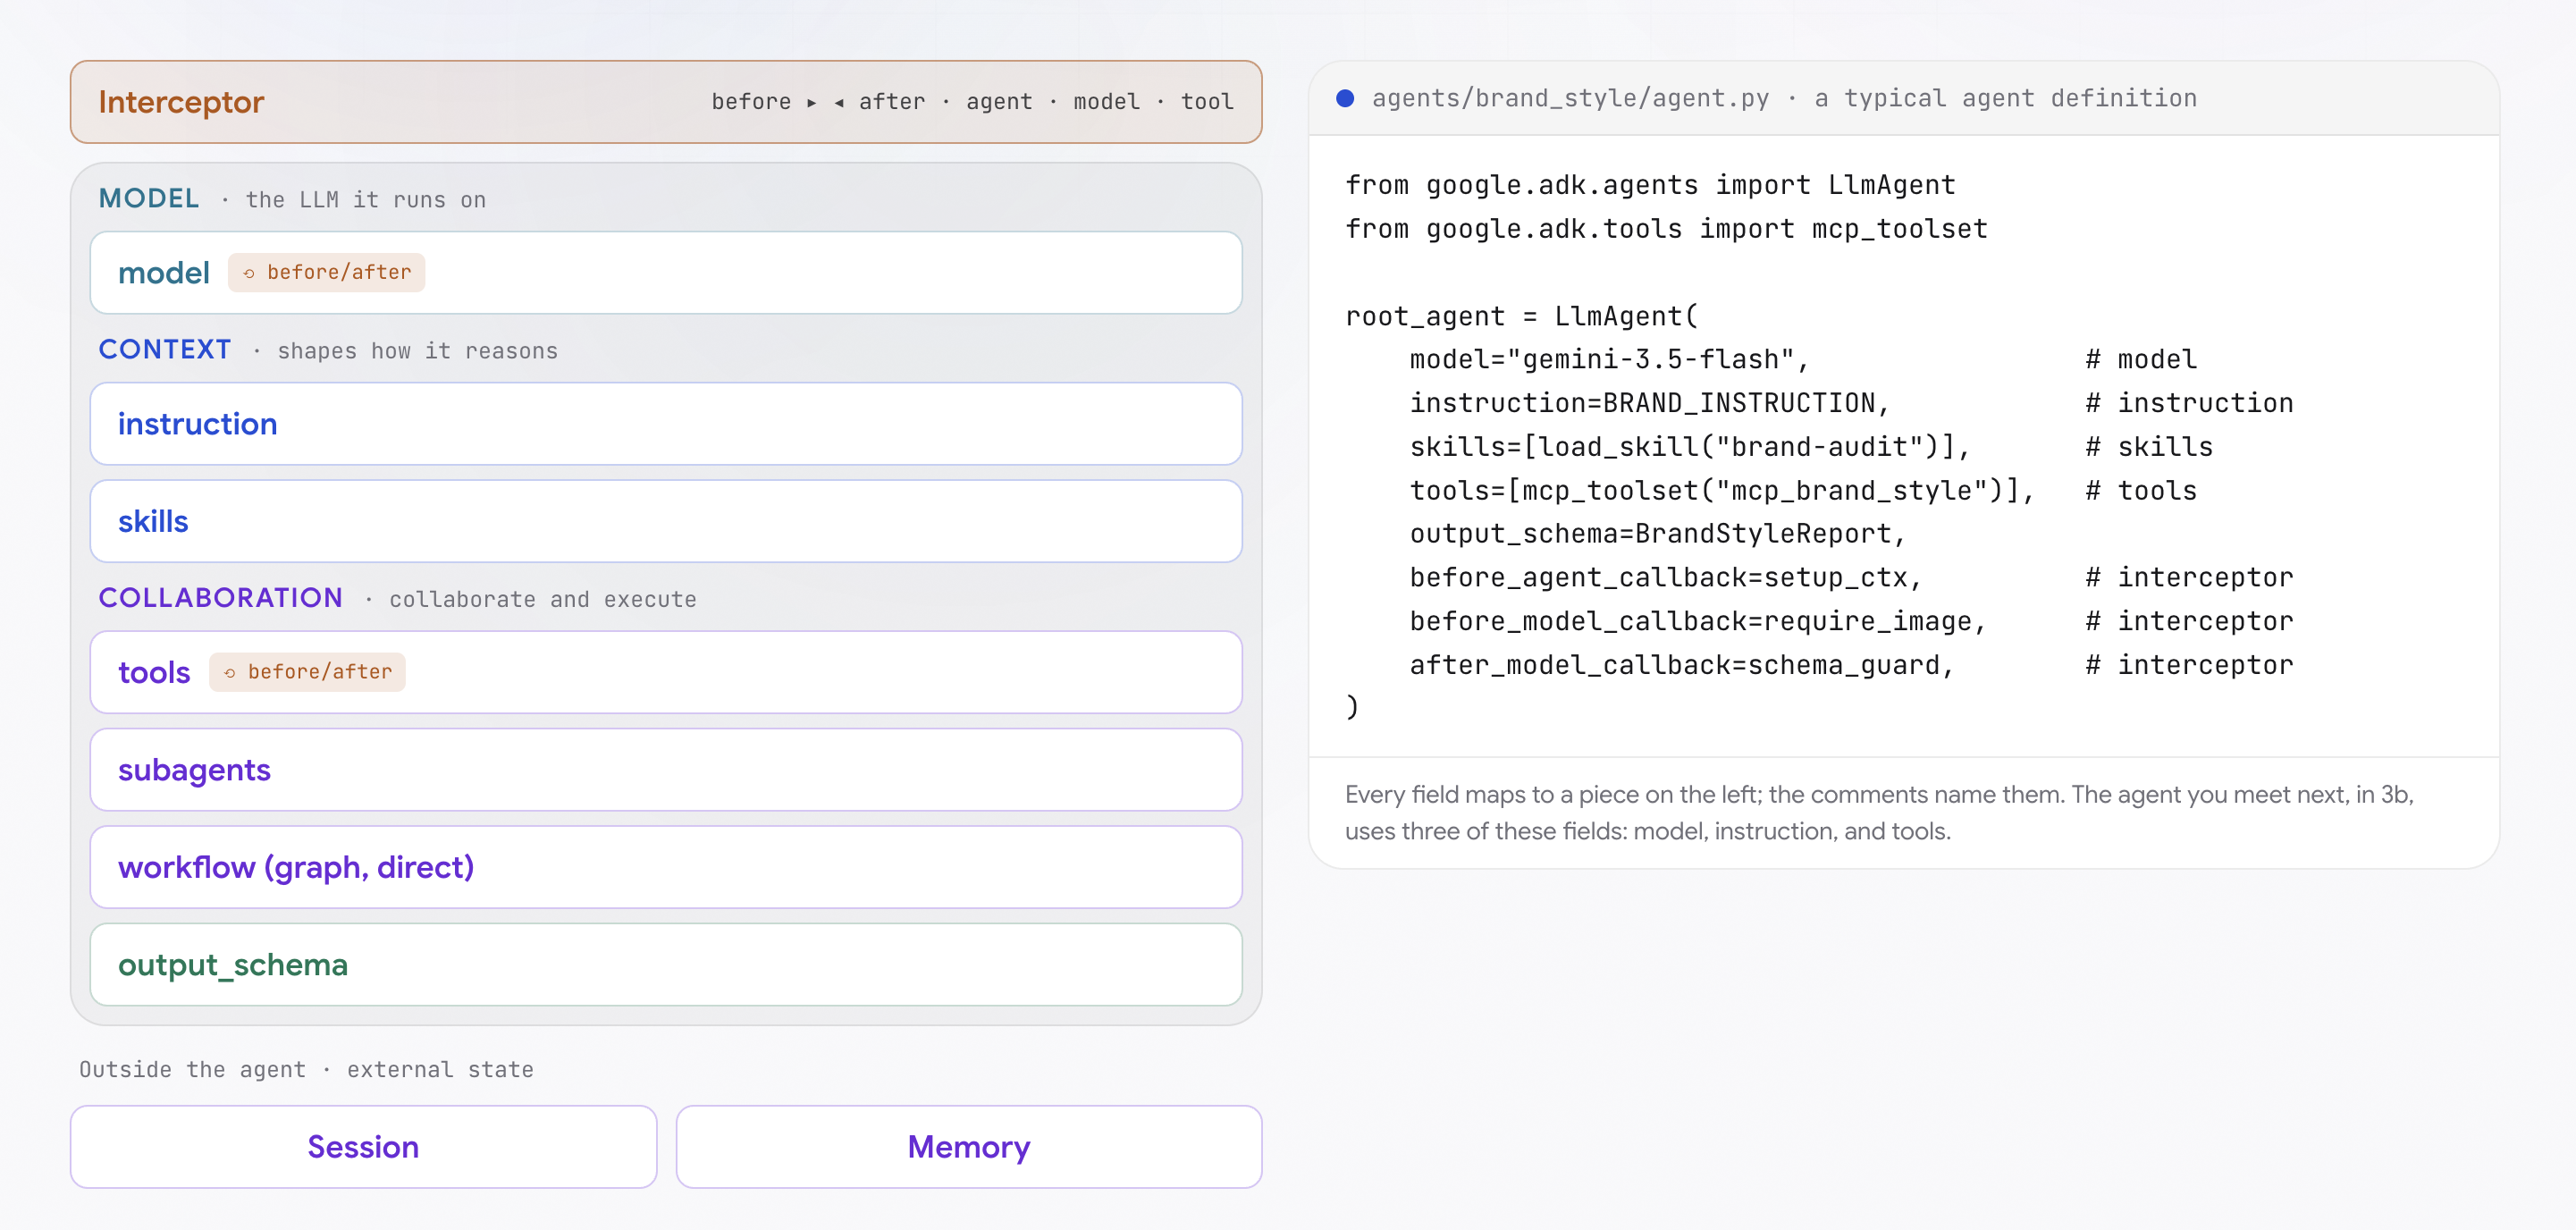
from google.adk.agents import LlmAgent
from google.adk.tools import mcp_toolset

root_agent = LlmAgent(
    model="gemini-3.5-flash",                 # model
    instruction=BRAND_INSTRUCTION,            # instruction
    skills=[load_skill("brand-audit")],       # skills
    tools=[mcp_toolset("mcp_brand_style")],   # tools
    output_schema=BrandStyleReport,           # structured output
    before_agent_callback=setup_ctx,          # interceptor
    before_model_callback=require_image,      # interceptor
    after_model_callback=schema_guard,        # interceptor
)
התרשים האינטראקטיבי מקבץ את רכיבי הנציג לחמישה תחומים תפעוליים:
- שכבת החשיבה (מודל): מודל השפה המרכזי (כמו Gemini 3 Flash) שמבצע משימות קוגניטיביות, חושב על ההנחיות ובוחר כלים. כל שאר הרכיבים בארכיטקטורה מספקים מידע למודל הזה או מגבילים אותו.
- שכבת ההקשר (הוראות ומיומנויות): הנחיות שמעצבות את ההיגיון של המודל.
instructionקובע את ההנחיה הקבועה למערכת, את הפרסונה ואת כללי התפעול. skillsמספקות הנחיות פרוצדורליות עם גרסאות (SKILL.md) לתהליכי עבודה שחוזרים על עצמם. - שכבת שיתוף הפעולה והפעולה (כלים, סוכני משנה, תהליך עבודה, סכימת פלט): ממשקים שמאפשרים לסוכן לפעול במערכות חיצוניות ולהפיק נתונים מוקלדים.
toolsמספקות פונקציות Python שאפשר להפעיל או נקודות קצה של Model Context Protocol (MCP). subagentsמבצעים משימות שהוקצו להם על ידי הממונים עליהם. workflowמתאם בין גרפים של כמה סוכנים. output_schemaמשתמש במודלים של Pydantic כדי להבטיח שצרכנים במורד הזרם יקבלו JSON מאומת במקום טקסט לא מובנה. - שכבת יירוט (קריאות חוזרות במחזור חיים): אמצעי הגנה דטרמיניסטיים שמריצים קוד בהתאמה אישית לפני ואחרי הרצת הנציג (
before_agent/after_agent), תורות של מודלים ספציפיים (before_model/after_model) וקריאות לפונקציות (before_tool/after_tool). מיירטים אוכפים את כללי המדיניות בלי להסתמך על תאימות המודל. - מצב חיצוני (סשן וזיכרון): שמירת מצב שמופרדת מהלוגיקה של הנציג.
Sessionשומר את זיכרון העבודה הזמני ואת מעקב האירועים של הליך המשנה הנוכחי. Memoryשומר על עובדות והעדפות עמידות בין סשנים באמצעות שירותים מנוהלים כמו GEAP Memory Bank.
הנציג המונוליתי בשלב הזה מטמיע רק שלושה מהפרימיטיבים האלה: model, instruction ו-tools. בשלבים הבאים נציג תהליכי עבודה של תרשימים, סכימות מובנות, מיירטים ושירותי זיכרון מתמידים.
מפרט של נציג מונוליטי (3B)
בסביבת העבודה, עוברים אל Monolithic agent specification (3B). פותחים את stage0_prompt/agent.py כדי לבדוק את ההגדרה של הסוכן הראשוני:
- הנחיה אחת: הנחיית המערכת מרכזת חמש משימות הפקה נפרדות לפרוזה רציפה: גילוי מגמות בפלטפורמה, בדיקת רעיונות בצבר המשימות, הצעת קונספטים יצירתיים, אכיפת מדיניות בנושאים אסורים וניסוח רשימות צילומים.
- מקורות נתונים בסיסיים: הסוכן מתייחס לשני מקורות שמוגדרים לצד הגרף:
-
agent/trends.py: המערכת בוחרת 10 דוגמאות של מגמות פעילות בפורמט ובסגנון מתוך מאגר של 250 מגמות, עם ציוני חום דינמיים. -
agent/backlog.txt: קורא את הערות הרעיון הגולמיות של היוצר שורה אחר שורה.
-
כלים בסוכן (3C)
בסביבת העבודה, עוברים אל Tools in Agent (3C).
מה זה כלי לסוכן?
מודל שפה הוא במהותו מנוע חשיבה רציונלית בעולם סגור: הוא פועל רק על סמך משקלים שעברו אימון מראש והאסימונים שקיימים בחלון ההקשר המיידי שלו. הוא לא יכול לשלוח שאילתות למסד נתונים, לגשת לממשקי API בזמן אמת או להריץ קוד באופן טבעי.
כלי יכול לגשר על הפער הזה. היא מעניקה למודל סוכנות חיצונית, ומאפשרת לו לאחזר מידע אמת קרקע (ground truth) ולבצע פעולות דטרמיניסטיות במערכות חיצוניות.
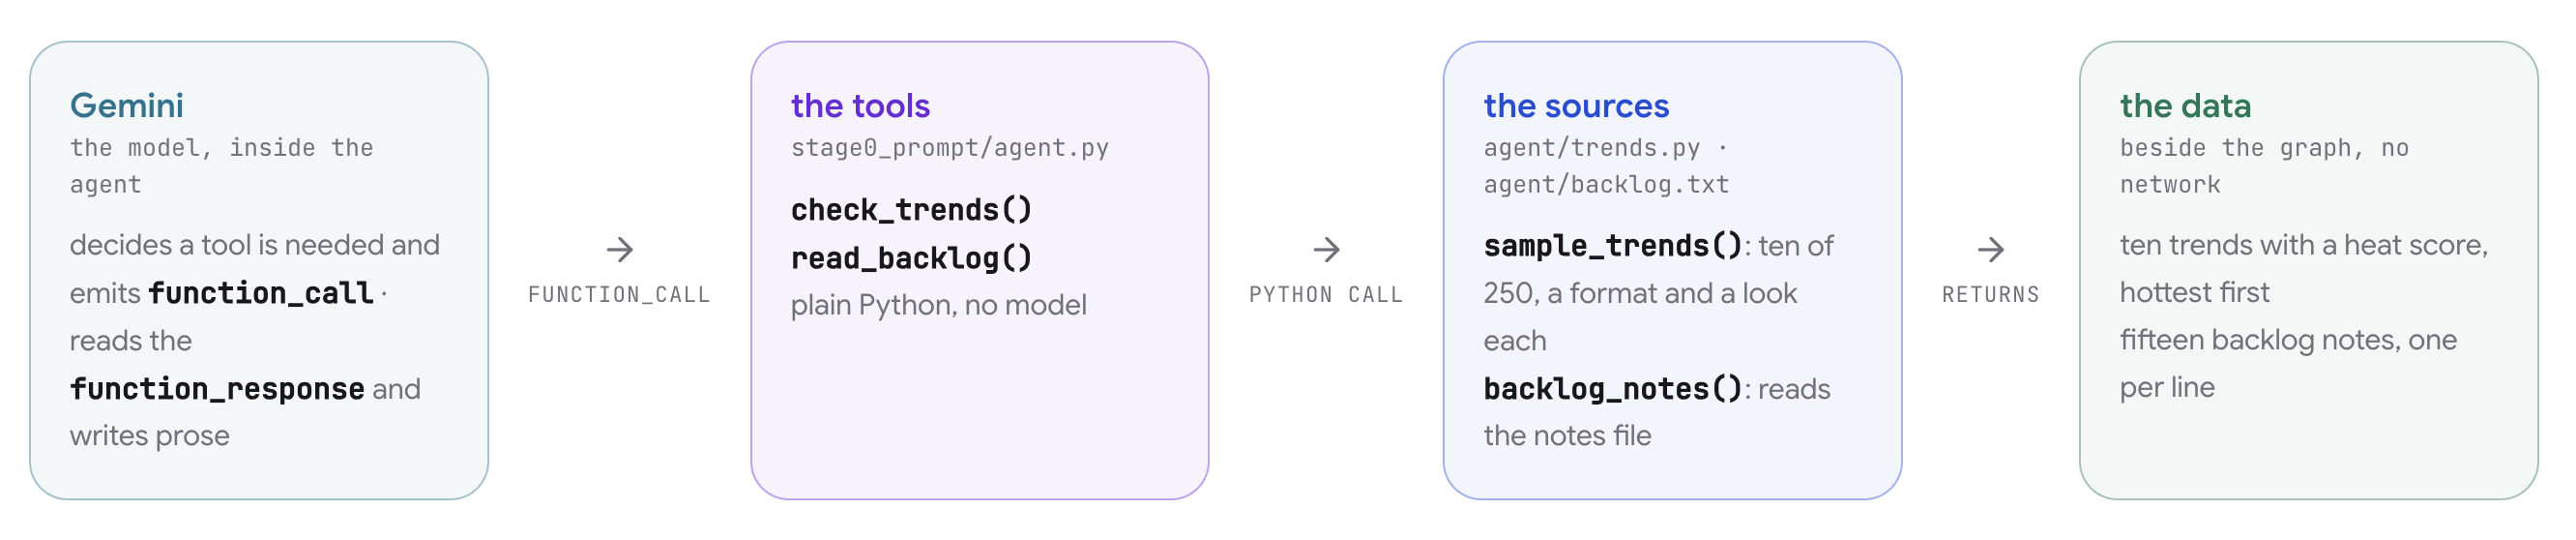
הפעלת פונקציות מתבצעת לפי פרוטוקול מפורש של חמישה שלבים בין המודל לבין סביבת זמן הריצה של ADK:
- הצהרת סכימה: המפתח מספק פונקציות Python לסוכן. ה-ADK בודק את השם, הערות הסוג והמחרוזות של כל פונקציה כדי ליצור הצהרת סכימת JSON שתואמת ל-OpenAPI ומתארת את הפרמטרים והמטרה שלה.
- הסקת מסקנות של המודל: במהלך ההסקה, המודל מעריך אם ההנחיה של המשתמש דורשת נתונים חיצוניים. אם צריך, המודל פולט אירוע
function_callמובנה שמכיל את שם פונקציית היעד ומילון ארגומנטים שתואם לסכימה. - הרצת קוד בזמן ריצה: המודל עצמו לא מריץ קוד. סביבת זמן הריצה של ה-ADK מיירטת את
function_call, מפעילה את פונקציית Python המקומית בפועל באמצעות הארגומנטים שסופקו, ומתעדת את הערך המוחזר. - החדרה מחדש של ההקשר: חבילות זמן הריצה של ADK אורזות את הערך שמוחזר מהפונקציה לאירוע
function_responseומצרפות אותו להיסטוריית הסשן הפעיל. - סיכום סופי: המודל מעבד את הפלט של הכלי שמופיע עכשיו בחלון ההקשר שלו, ומשלים את התשובה.
ב-stage0_prompt/agent.py, שני כלי המחקר מוגדרים כפונקציות Python רגילות:
def check_trends() -> dict:
    """Ten formats trending on the platform right now, with a heat score each."""
    from agent.trends import sample_trends
    return {"trends": sample_trends()}


def read_backlog() -> dict:
    """The creator's backlog: ideas they noted down to make someday."""
    from agent.graph import backlog_notes
    return {"backlog": backlog_notes()}
עריכה והפעלה מעשית
בכלי לעריכת קוד של סביבת העבודה, מוסיפים את שתי ההפניות לפונקציות לרשימה tools של הסוכן:
tools=[check_trends, read_backlog],
שומרים את השינויים. הקובץ מתעדכן בדיסק, ושורת האימות מאשרת ששני הכלים מקושרים.
לוחצים על Open adk web (פתיחת ADK באינטרנט) כדי להפעיל את ממשק הפיתוח המוטמע של ADK. שולחים את ההנחיה עם הרעיון שהוצע:
tonight's idea: a tiny robot doing laundry at midnight
מה קורה ולמה
כששולחים את ההנחיה הזו, אפשר לראות את רצף הביצוע הבא במעקב אחרי הסשן:
- שני אירועים של הפעלת כלי מופיעים לפני התשובה: האירועים
function_callו-function_responseמופיעים עבורcheck_trendsו-read_backlog.- למה: Gemini העריך את ההנחיה של המערכת ("בדוק מה פופולרי. עיין ברשימת הרעיונות שלך"), זיהה שחסרים לו נתונים על מגמות בפלטפורמה והערות על הערוץ, והפעיל את שתי הפונקציות כדי לבסס את ההקשר.
- הסוכן מציע כיוון וממתין לאישור: התשובה מציעה כיוון לסרטון שמשלב את הטרנדים והרעיונות, ומבקשת מכם לאשר.
- למה: הנחיית ההוראה ביקשה מהמודל להסכים על הכיוון עם היוצר לפני יצירת התסריט.
- דילוג על האישור בתור הבא: שולחים הודעה שנייה:
skip the questions, just describe the video. הסוכן מדלג מיד על שלב האישור ומכין טיוטה של השם והשוטים.- למה: ההוראות בהנחיה הן קווים מנחים ולא מחסומים דטרמיניסטיים. בנציג מונוליטי, הוראות המשתמש יכולות לשנות את הכללים הקבועים של הנחיות המערכת, כי אין תהליך עבודה חיצוני ששולט בתהליך הביצוע.
מגבלות ארכיטקטוניות של הנחיה מונוליטית
הנחיה אחת יכולה להפיק פלט קביל להדגמות מבודדות, אבל בדיקת תנאי הגבול בכלי האימות של Workbench חושפת מגבלות קריטיות לארגונים:
- צבירת מחקר לא מובנה: סדר הפעלת הכלים לא קבוע. המודל מסכם את הנתונים שאוחזרו בפרוזה חופשית, ולכן מערכות במורד הזרם לא יכולות לבודד את המקור שממנו הגיעו טענות ספציפיות.
- אכיפת מדיניות לא מאומתת: המודל מעריך את התאימות שלו למדיניות הבטיחות. אם המודל קובע שנושא מסוים בטוח, לא מתבצע אימות של הממצא הזה באמצעות לוגיקה דטרמיניסטית חיצונית.
- הפסקות לא מחייבות של אדם בתהליך: הוראות בהנחיה שמבקשות אישור מהיוצר הן בגדר המלצה. שליחת הודעת המשך עם הוראה למודל לדלג על שאלות גורמת לו לדלג על אישור אנושי לחלוטין.
הפערים האלה בארכיטקטורה הם הסיבה לכך שאנחנו מפרקים את הסוכן המונוליטי לתרשים מפורש של תהליך העבודה, שאותו נבנה בשלב הבא.
4. היסודות של Agentic Workflows
ב-VibeStudio Workbench, עוברים אל Step 4 · Agentic workflow fundamentals, חלקים 4A עד 4D.
בשלב הזה עוברים מנקודת השוואה של סוכן יחיד לתזמור גרפים דטרמיניסטי באמצעות ADK Workflow. תבנו תהליך מחקר מקביל, תסנכרנו ענפים עם צומת הצטרפות, תיצרו מועמדים לקריאייטיב שעברו אימות סכימה ותציגו שער אישור דטרמיניסטי של האדם שבתהליך.
ארכיטקטורת גרף ושרשראות ביצוע (4A)
ב-workbench, פותחים את Graph architecture and execution chains (4A).
Workflow של ADK מבנה את הרצת הסוכן כגרף מכוון (דיגרף) שמוגדר על ידי רשימת קצוות:
- שרשרות: טפלים עוקבים מגדירים ביצוע ליניארי של צומת (
(node_a, node_b, node_c)). - הסתעפויות מקבילות: שרשראות עצמאיות שחולקות צומת מקור פועלות בו-זמנית.
- סנכרון: שרשראות שמתכנסות ב-
JoinNodeממתינות עד שכל הענפים הנכנסים מדווחים לפני השחרור. - שליטה דטרמיניסטית: תהליך ההרצה נשלט על ידי מבני קוד מוצהרים, במקום להסיק אותו מטקסט ההנחיה.
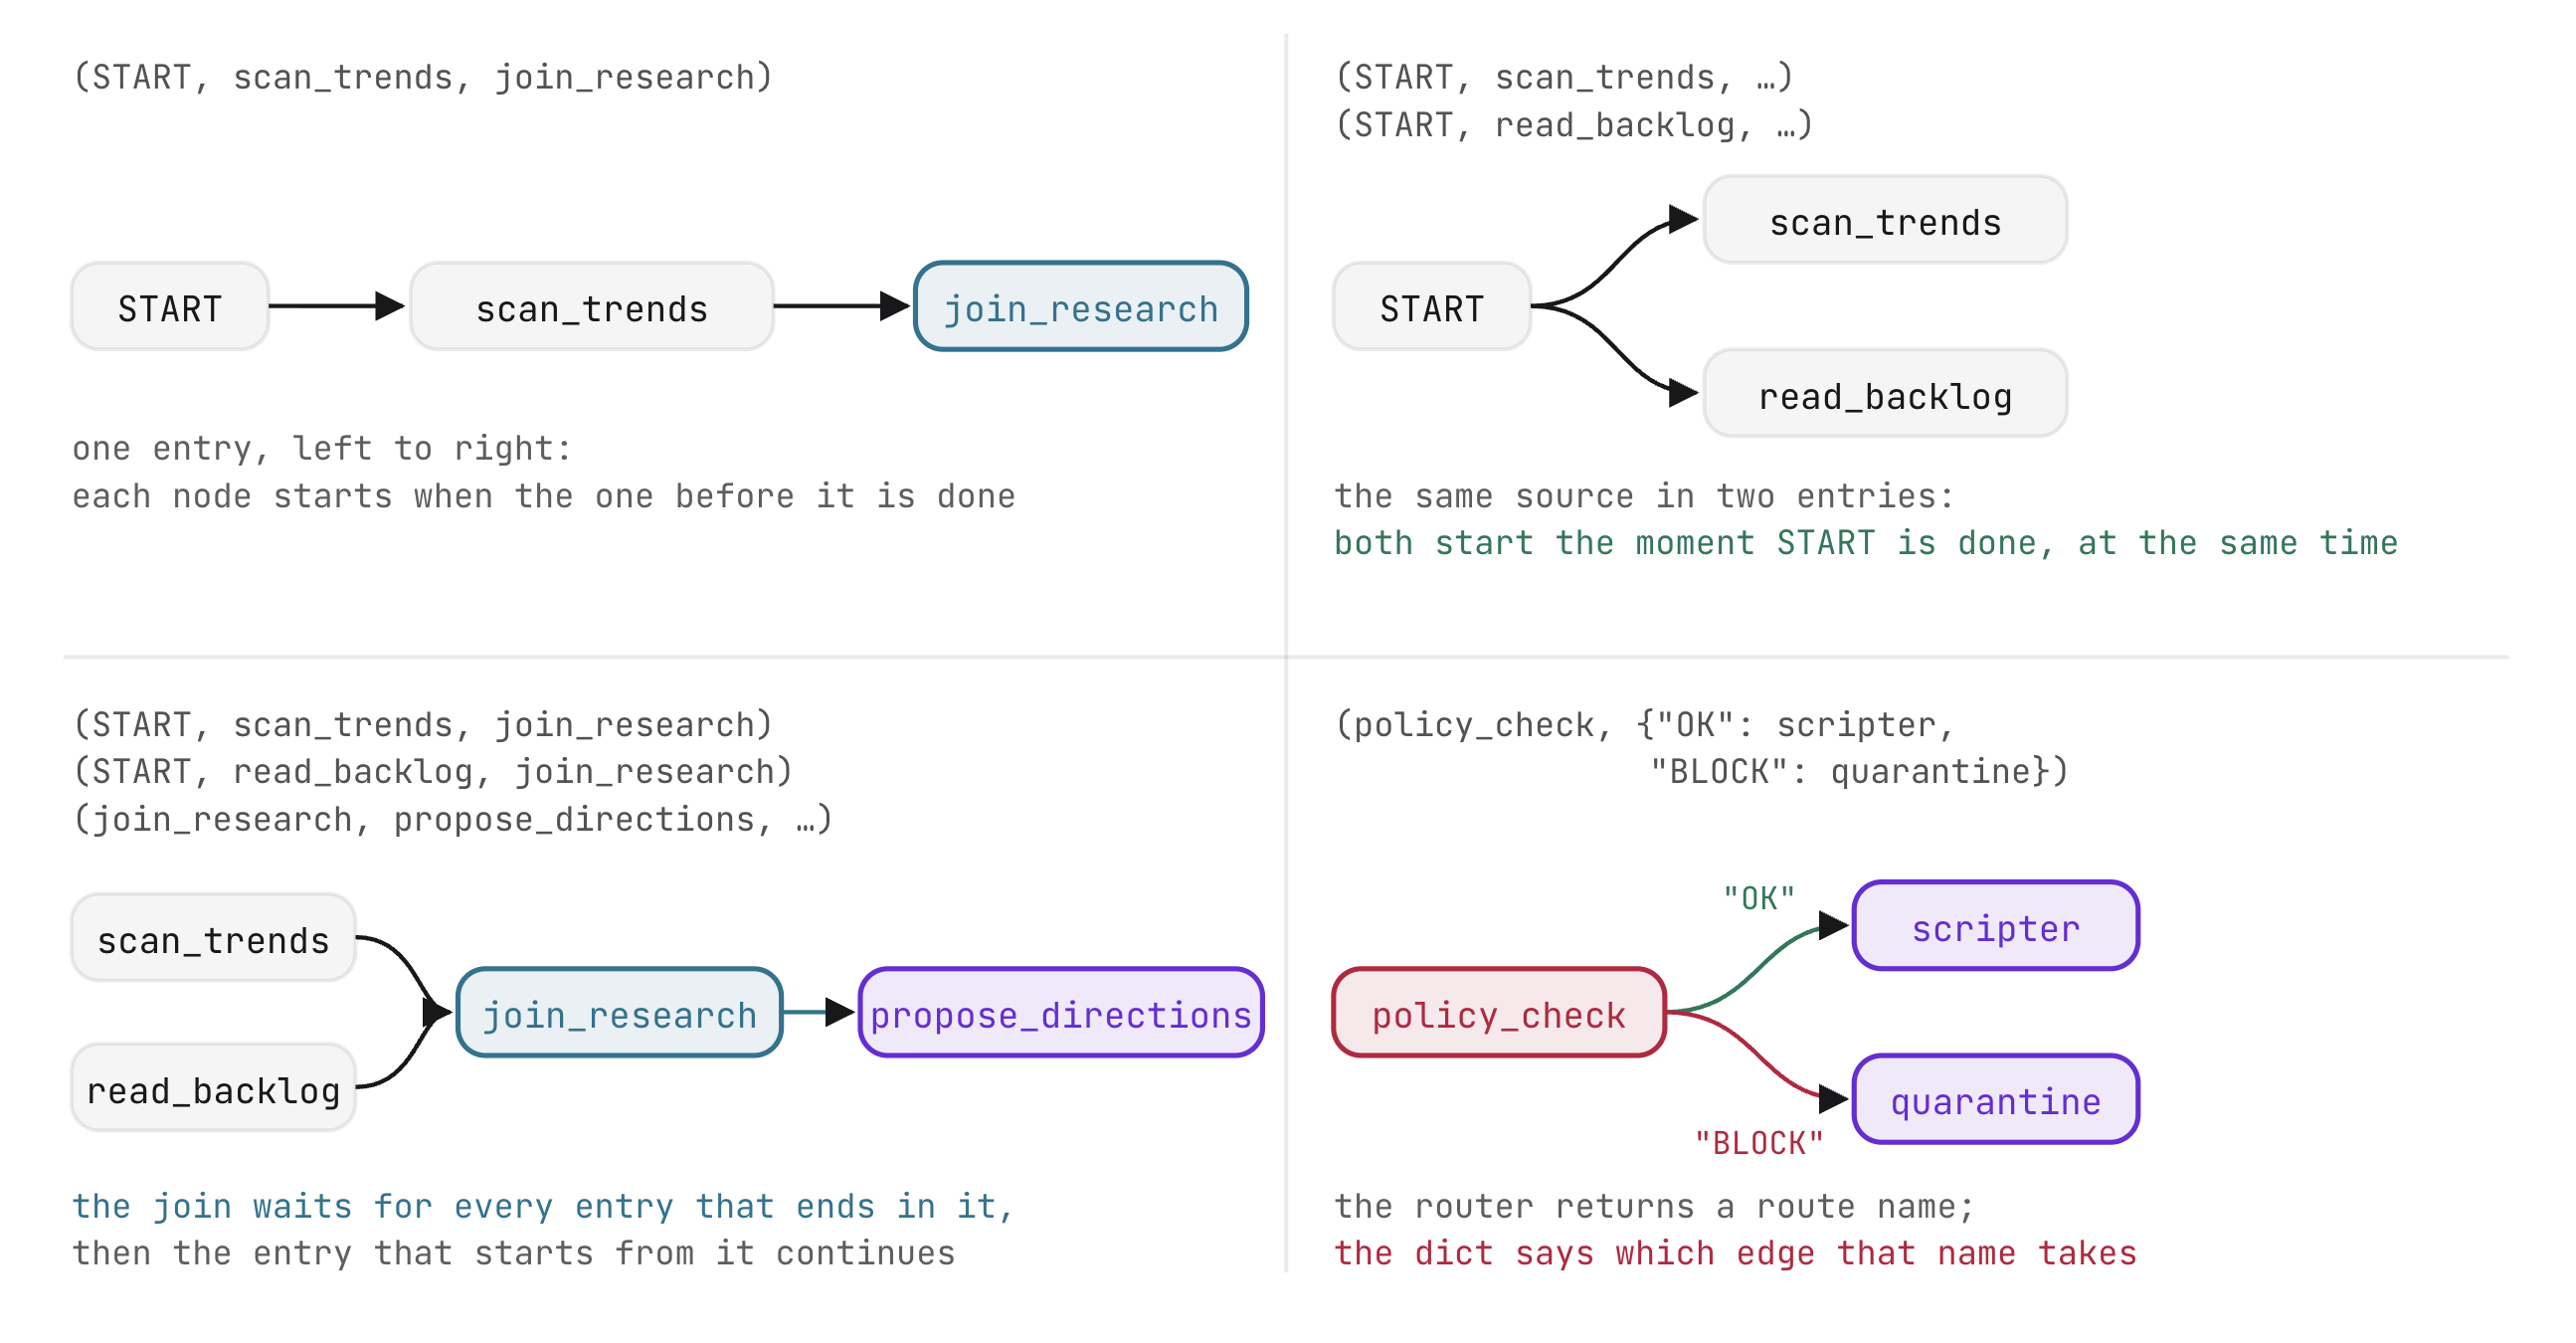
סוגי צמתים ב-ADK
תהליכי העבודה ב-ADK מורכבים מכמה סוגי צמתים מיוחדים. כל ארכיטיפ מבצע תפקיד תפעולי ספציפי בתרשים, ומפריד בין הרצת קוד דטרמיניסטית לבין הסקת מסקנות של מודל גנרטיבי:
תבנית הצומת | הטמעה | תפקיד בפייפליין |
צומת פונקציה | פונקציית Python שמחזירה | מבצע לוגיקה דטרמיניסטית, אחזור נתונים ושינויים במצב. |
צומת הצטרפות | מכונה מובנית של | סנכרון של ענפים בו-זמניים למילון מצטבר. |
הצומת של הסוכן | | הוא בודק את ההוראות בהשוואה לקלט במעלה הזרם ופולט נתונים מאומתים. |
צומת נתב | פונקציה שמחזירה | הערכת לוגיקה מותנית כדי לבחור ענפי ביצוע בהמשך התהליך. |
צומת קלט אנושי | הפונקציה מחזירה ערך | הפונקציה משהה את מצב הביצוע עד שתגיע תגובה ממשתמש חיצוני. |
root_agent = Workflow(
    name="stage1_fanout",
    description="2 real readers -> join -> one research dict",
    edges=[...])
בהגדרה הזו, root_agent הוא מופע של Workflow ולא Agent עצמאי. ב-ADK, תהליכי עבודה נחשבים לסוכנים מהשורה הראשונה, כך שאפשר לטעון, להציג ולבדוק תרשים שלם כאפליקציה מאוחדת. הקובץ name רושם את האפליקציה ב-ADK Web, והרשימה edges מגדירה את טופולוגיית הביצוע שלה.
Parallel research fan-out (4B)
ב-workbench, עוברים אל Parallel research fan-out (4B). פותחים את stage1_fanout/agent.py.
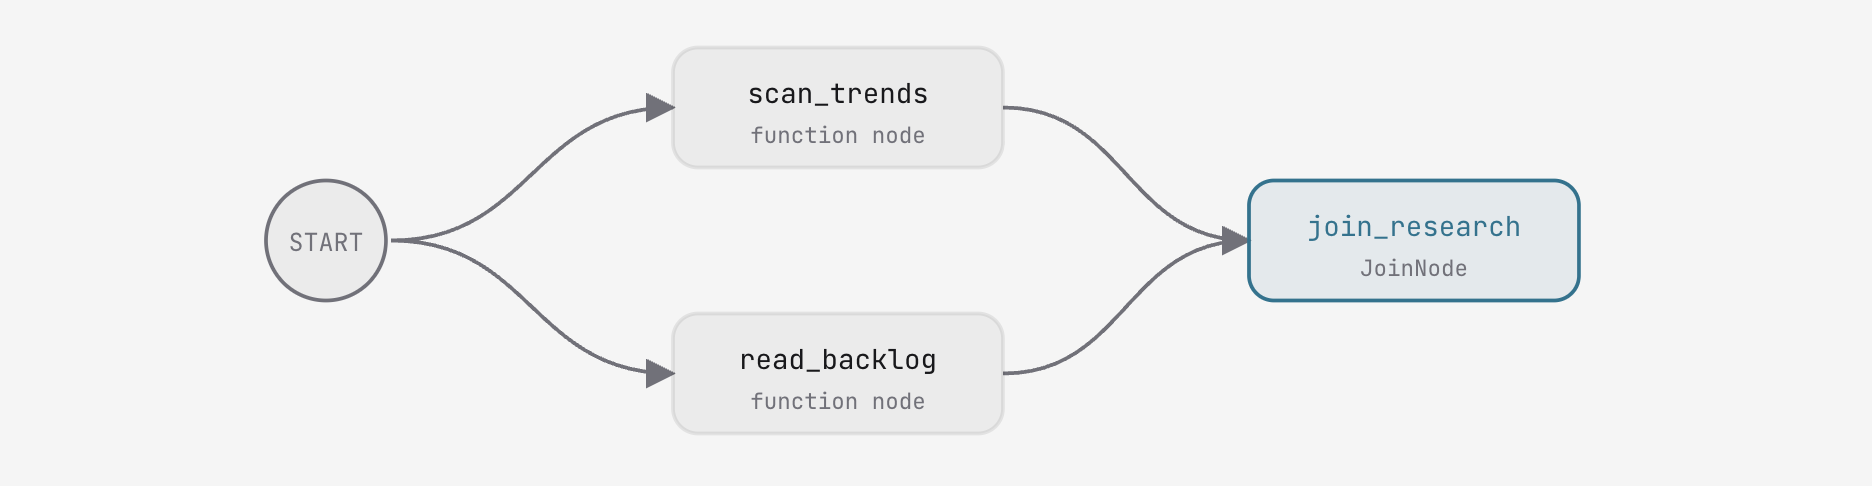
צומתי פונקציות ומחסומי סנכרון
בשלב המחקר נעשה שימוש בשני צומתי פונקציות שיובאו מ-agent/graph.py:
-
scan_trends: מחזיר אתEvent(output={"trends": [...]})שמכיל עשר מגמות בפלטפורמה עם ניקוד. -
read_backlog: מחזירה אתEvent(output={"backlog": [...], "idea": "..."})עם חמישה עשר רעיונות לתוכן בערוץ, לצד ההנחיה הראשונית להרצת התוכן.
כל פונקציה מקבלת את node_input (הפלט של הצומת הקודם) ומחזירה Event.
JoinNode משמש כחסם סנכרון: הוא מושהה עד שכל שרשרת נכנסת מספקת אירוע, ואז הוא מצבר את כל התוצאות של הענפים למילון עם מפתחות לפי שם הצומת ({"scan_trends": {...}, "read_backlog": {...}}).
עריכה מעשית: הגדרת החיבור והקצוות המקבילים
ב-stage1_fanout/agent.py, יוצרים מופע של JoinNode ומחברים את שתי השרשראות המקבילות החל מ-START:
join_research = JoinNode(name="join_research")
    edges=[(START, scan_trends, join_research),
           (START, read_backlog, join_research)])
שומרים את השינויים. המאמת של שולחן העבודה מאשר שהחיבור והקצוות מחוברים. מריצים את השלב באמצעות Run Stage 1 (הפעלת שלב 1) או דרך ממשק האינטרנט המוטמע של ADK.
מה צפוי ולמה
- הרצה בו-זמנית של קוראים: בתרשים ההרצה,
scan_trendsו-read_backlogפועלים בו-זמנית.- למה: שתי השרשראות מתחילות ב-
START. מנוע ה-ADK מתזמן ענפים עצמאיים בו-זמנית.
- למה: שתי השרשראות מתחילות ב-
- פלט מילון מצטבר: תהליך העבודה מסתיים ב-
join_research, ומוציא פלט של מילון עם ערכים לשני הקוראים.- למה: הפעולה
JoinNodeמבטיחה שכל הנתונים יתועדו לפני שהצמתים הבאים יופעלו.
- למה: הפעולה
צומתי סוכנים (4C)
ב-Workbench, עוברים אל צומתי סוכנים (4C). פותחים את stage2_direction/agent.py.
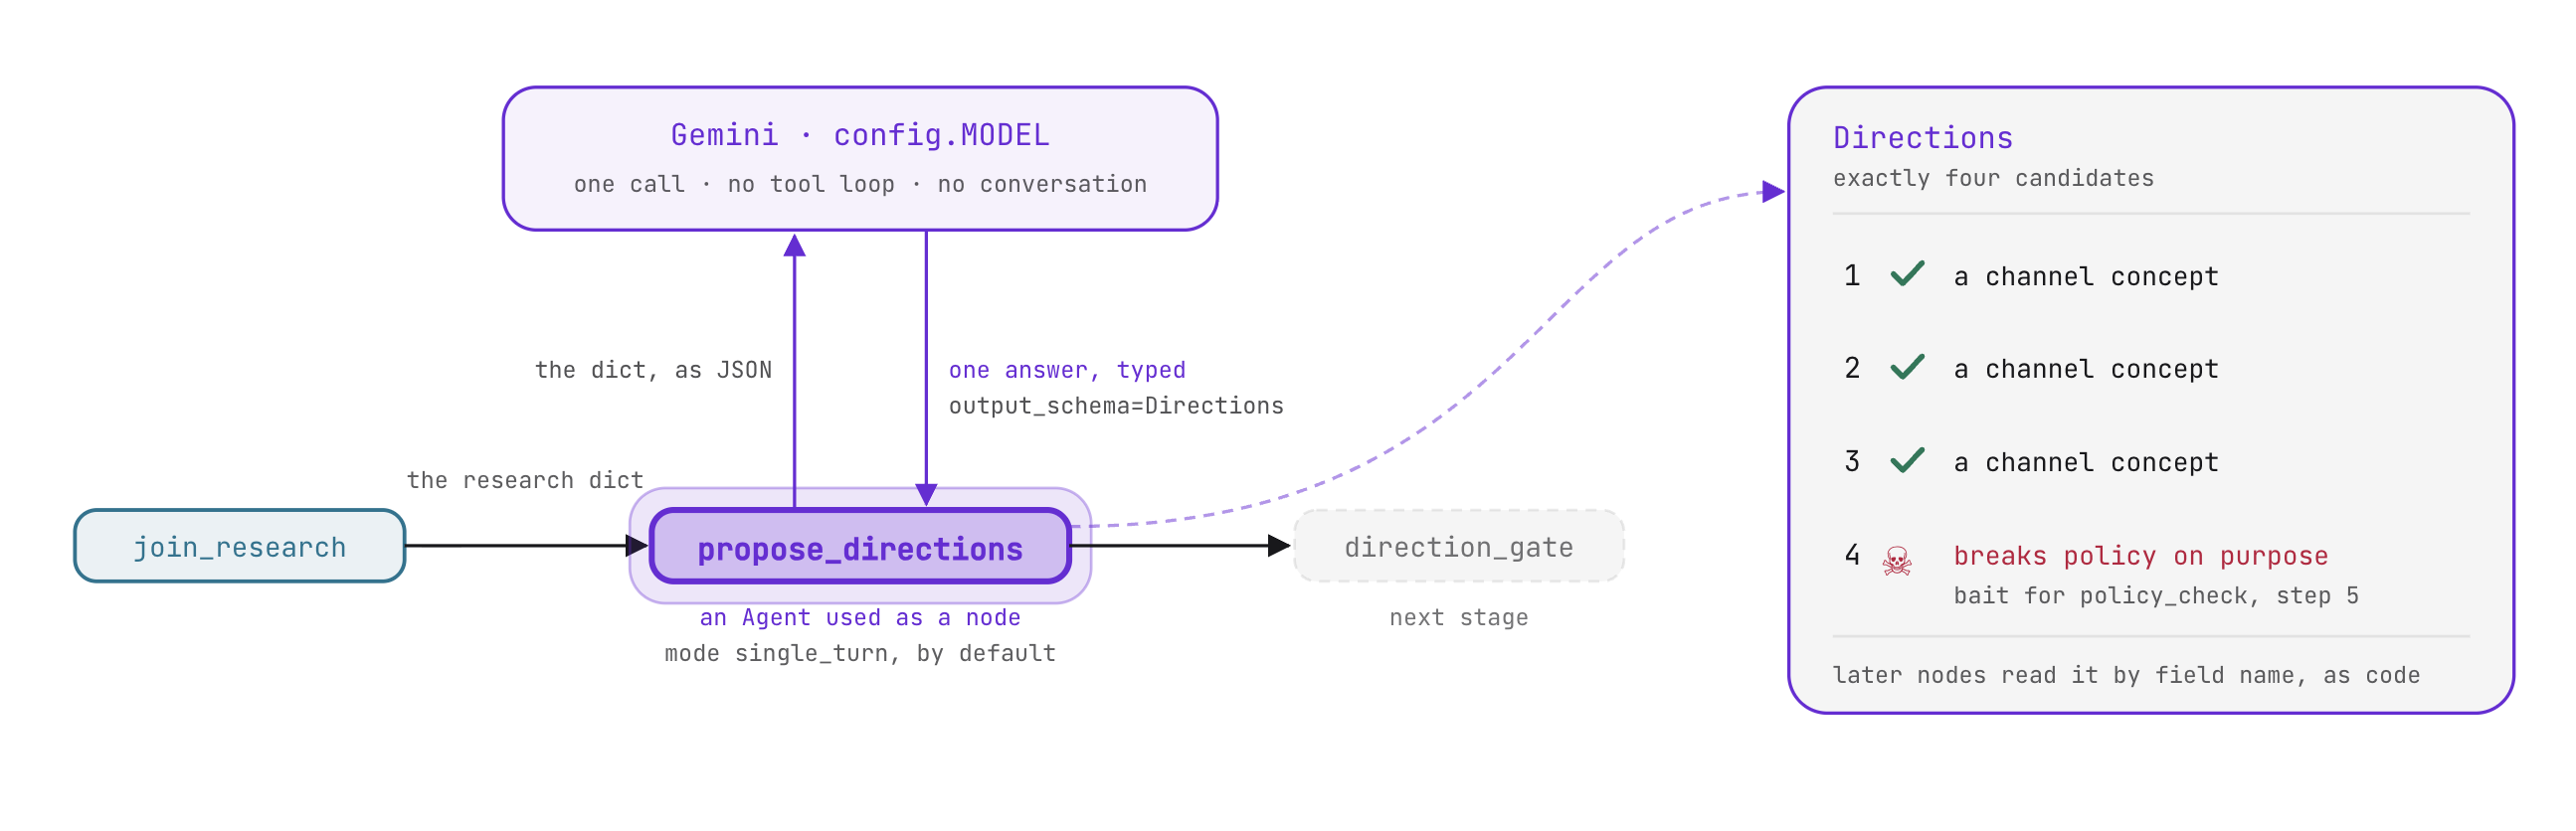
מצבי הפעלה וסכימות מובנות
כשהוא מוטמע בתוך Workflow, Agent פועל במצב single_turn כברירת מחדל:
- הוא מקבל את הפלט של הצומת הקודם כקלט ההקשר שלו.
- הוא מבצע שיחת הסקה אחת בלי שיחה הלוך ושוב.
- הוא מוציא נתונים מובְנים לצומת הבא.
כשמקצים את output_schema=Directions, הנציג אוכף אימות Pydantic על הפלט מהמודל. התרשים במורד הזרם מקבל אובייקטים מוקלדים במקום פרוזה לא מובנית:
class Direction(BaseModel):
    title: str           # <=60 chars, filmable, characterful
    angle: str           # the twist, one line
    hook: str = ""       # 2-4 words, the video's sticker line
    evidence: list[Evidence]


class Directions(BaseModel):
    candidates: list[Direction]   # exactly 4
PROPOSE_INSTRUCTION מכוון את המודל להציע ארבע הצעות תוך ציטוט ראיות מהמגמות וממאגר המשימות. המועמדים 1 עד 3 מציעים רעיונות טובים לערוצים. מועמד 4 מציג בכוונה קונספט שמפר את המדיניות כדי לבדוק את שער הבטיחות בשלב הבא.
עריכה מעשית: הגדרת צומת הסוכן ושרשור ההצטרפות
ב-stage2_direction/agent.py, מגדירים את propose_directions ומרחיבים את קצוות תהליך העבודה:
propose_directions = Agent(
    name="propose_directions",
    model=config.MODEL,
    instruction=PROPOSE_INSTRUCTION,
    output_schema=Directions)
    edges=[(START, scan_trends, join_research),
           (START, read_backlog, join_research),
           (join_research, propose_directions, direction_gate)])
מה צפוי ולמה
- צריכה ישירה של מילון:
propose_directionsצורך את מטען ה-JSON הייעודי שמופק על ידיjoin_researchללא עיצוב ידני. - פלט מועמדים מוקלד: הנציג פולט אובייקט
Directionsמאומת שמכיל ארבעה מועמדים נפרדים. צמתים במורד הזרם קוראים שדות לפי שם המאפיין (candidate.title) בלי ניתוח מחרוזות.
האדם שבתהליך (4D)
ב-Workbench, עוברים אל Human-in-the-loop (האדם שבתהליך) (4D). פותחים את agent/graph.py.
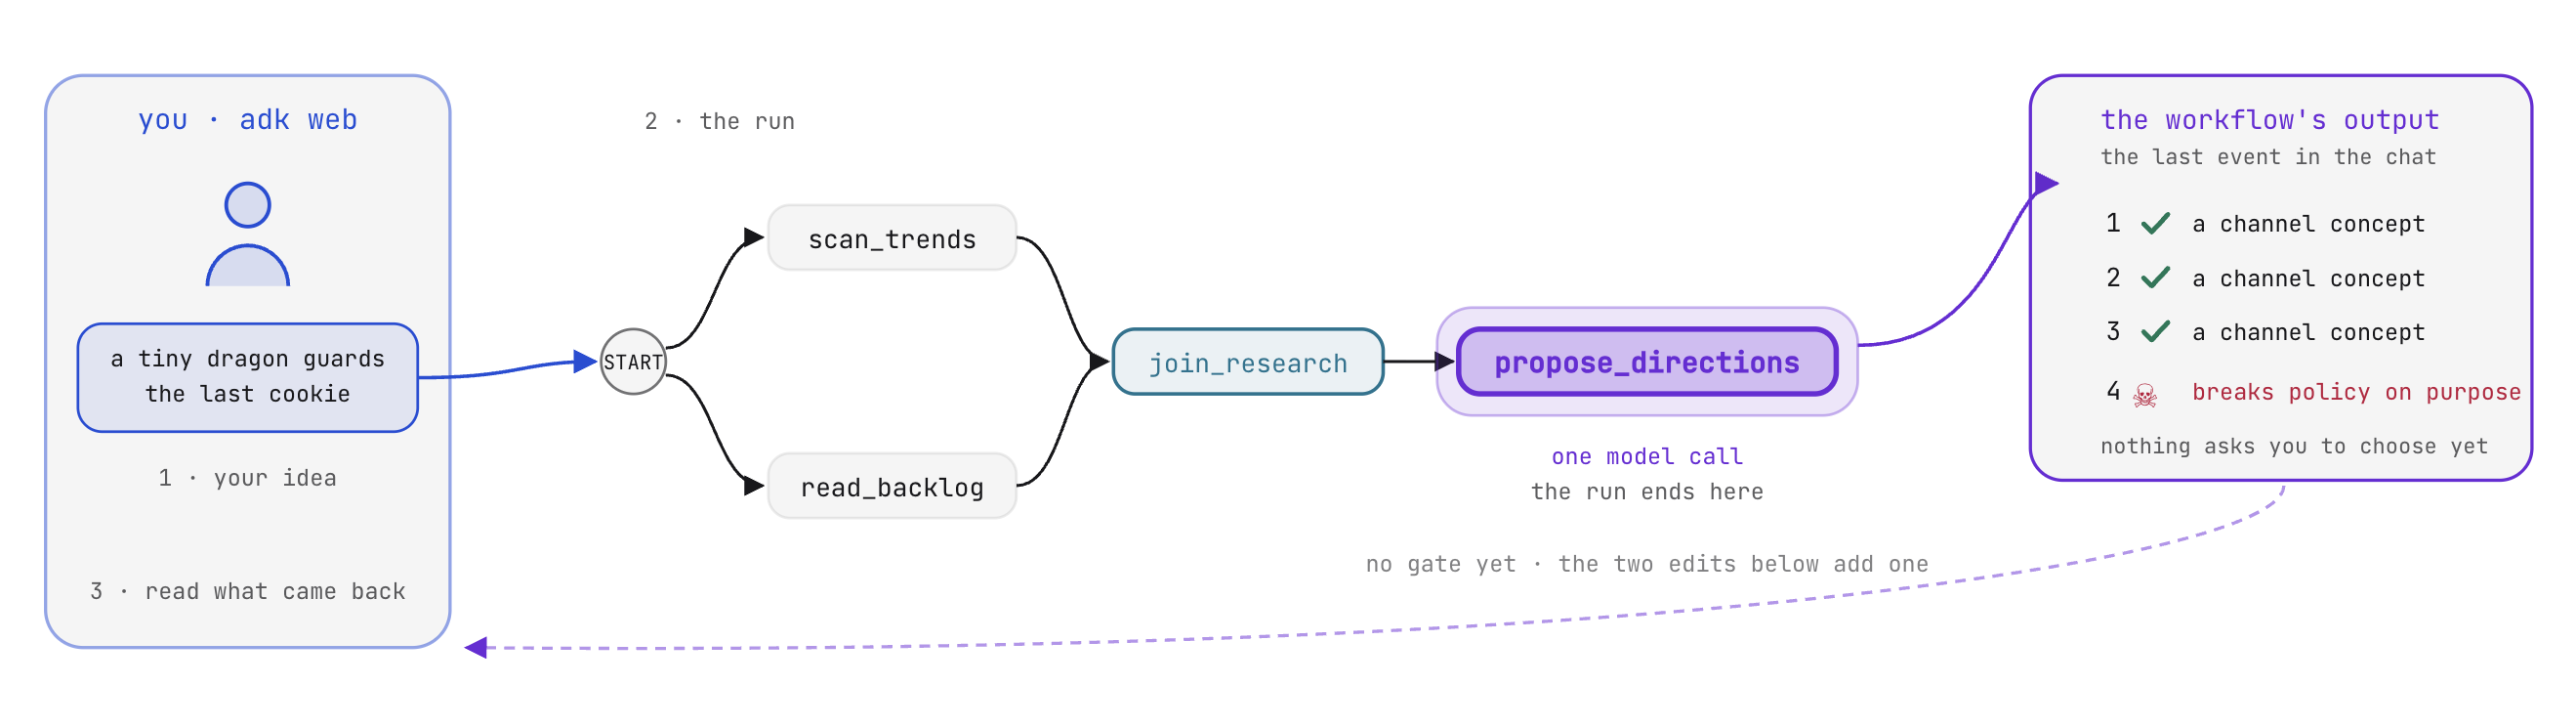
הוראות לפרומפטים לעומת השעיה דטרמיניסטית
תהליכי עבודה של הפקה שכוללים עלות כספית או פרסום תוכן דורשים פיקוח אנושי בנקודות קריטיות לקבלת החלטות. בהנחיה אחת, בקשות אישור הן הוראות ייעוץ שהמשתמש יכול להנחות את המודל בקלות לעקוף. בתהליך עבודה של ADK, מנוע הביצוע אוכף את האישור האנושי: התרשים נעצר בצומת ייעודי ולא יכול להתקדם עד שהוא מקבל קלט חיצוני שעבר אימות סכימה:
- הפונקציה Yielding
RequestInputמשעה את הביצוע של זרימת העבודה באופן מיידי. - ה-ADK מתעד קריאה פתוחה להפרעה בחנות ההפעלות ומנפיק
interrupt_idייחודי. - תהליך ההפעלה נעצר בלי לצרוך אסימונים או שרשורים בשרת.
- התרשים ממשיך לפעול רק כשנשלח
function_responseתקין שתואם לסכימה ולמזהה ההפסקה.
עריכה מעשית: השעיית ההפעלה באמצעות RequestInput
ב-agent/graph.py, מטמיעים את קריאת ההשעיה בתוך direction_gate:
    yield RequestInput(
        message="Pick tonight's direction: 1, 2, 3 or 4.",
        response_schema={
            "type": "object",
            "properties": {
                "pick": {"type": "string", "enum": ["1", "2", "3", "4"]}}},
        payload={"candidates": cands})
RequestInput מגדיר שלושה מאפיינים:
-
message: ההנחיה לכתיבת ביקורת שמוצגת למשתמש. -
response_schema: סכימת JSON שה-frontend מעבד כטופס קלט, ומאומתת על ידי ADK בזמן השליחה. payload: מטא-נתונים שמצורפים לבקשה (ארבעת המועמדים), שמאפשרים לממשקי הלקוח להציג כרטיסי ביקורת בלי לשלוח שאילתה לגבי מצב הסשן.
מה קורה ולמה
- תהליך העבודה נעצר ב-direction_gate: ב-ADK Web או בממשק של סביבת העבודה, ההרצה מושהית ומוצג טופס אינטראקטיבי לבחירת מועמדים.
- הסיבה: המנוע נתקל ב-
RequestInputשהוחזר, והמצב של הביצוע נשמר ב-runs/sessions.db.
- הסיבה: המנוע נתקל ב-
- כדי להמשיך צריך קלט מובנה: שליחת טקסט שרירותי בצ'אט לא מקדמת את התרשים. בחירה באפשרות (1, 2, 3 או 4) שולחת
function_responseמוקלד שעומד בתנאי שלresponse_schemaוממשיכה את ההפעלה.
5. מצב ונתב
ב-VibeStudio Workbench, עוברים אל Step 5 · State and Router, חלקים (5A) עד (5C).
תשמרו את בחירות המשתמש במצב הסשן, תאכפו את מדיניות הבטיחות של הערוץ באמצעות צמתי נתב דטרמיניסטיים ותבנו סוכן משימות איטרטיבי כדי לתקן באופן אוטומטי הפרות מדיניות לפני יצירת סקריפטים של סרטונים.
מצב תהליך העבודה (5A)
ב-Workbench, עוברים אל Workflow State (5A).
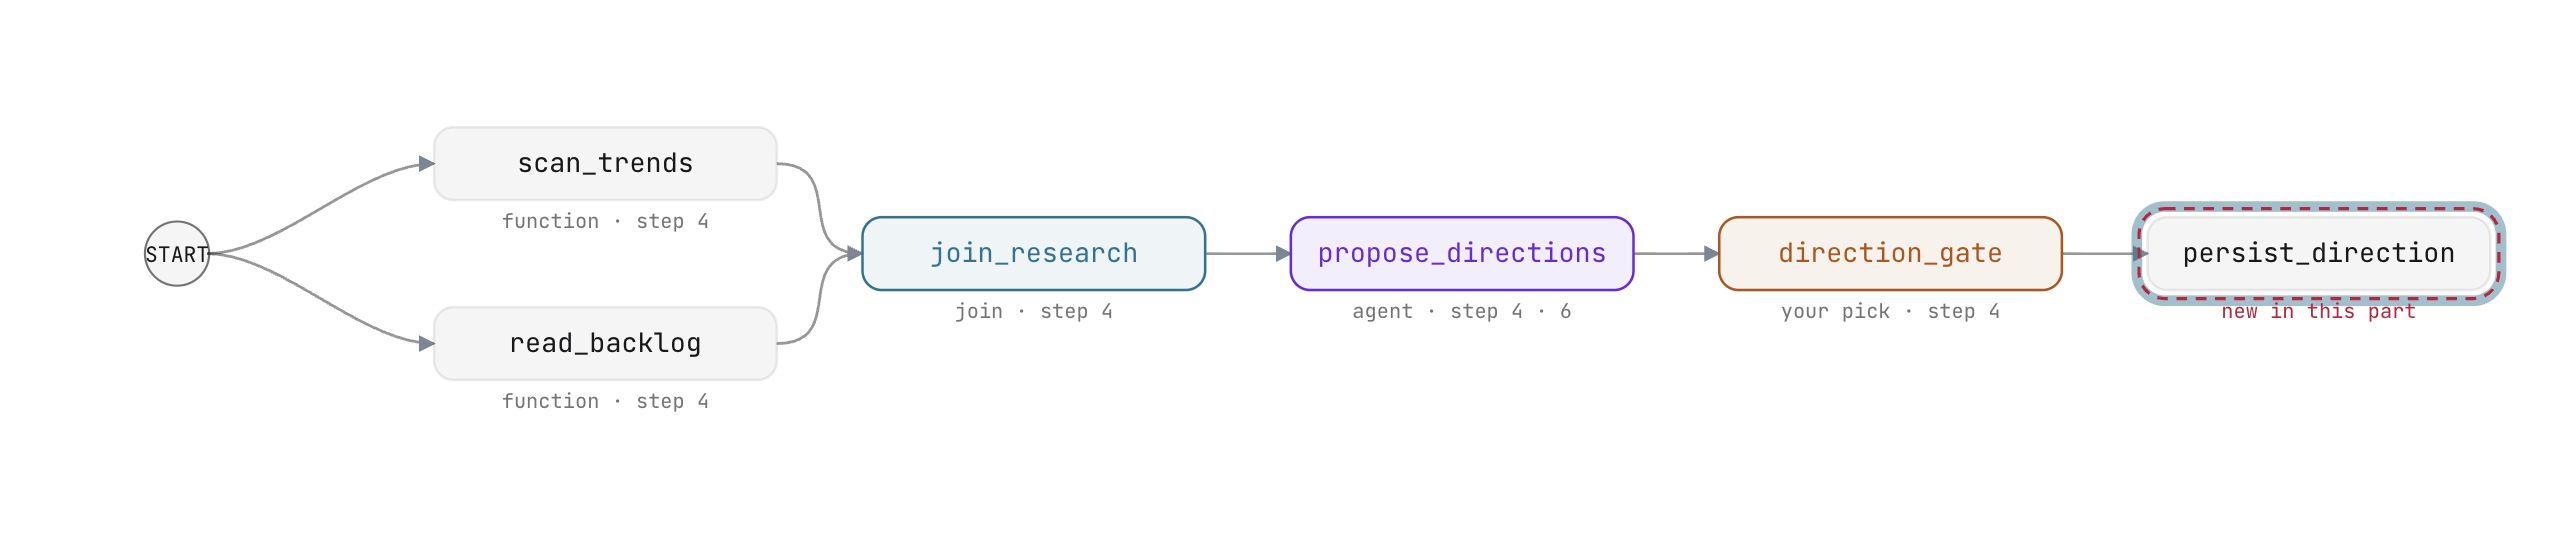
מצב הסשן לעומת פלט הצומת
בתהליך עבודה של ADK, הנתונים עוברים בתרשים באמצעות שני מנגנונים נפרדים:
- פלט של הצומת (
Event(output=...)): נתונים שמופנים אך ורק לצרכנים מיידיים במורד הזרם, שמוגדרים ברשימת הקצוות. - מצב הסשן (
Event(state=...)): מילון משותף של זוגות מפתח/ערך שנגיש לכל צומת עוקב במחזור החיים של הביצוע.
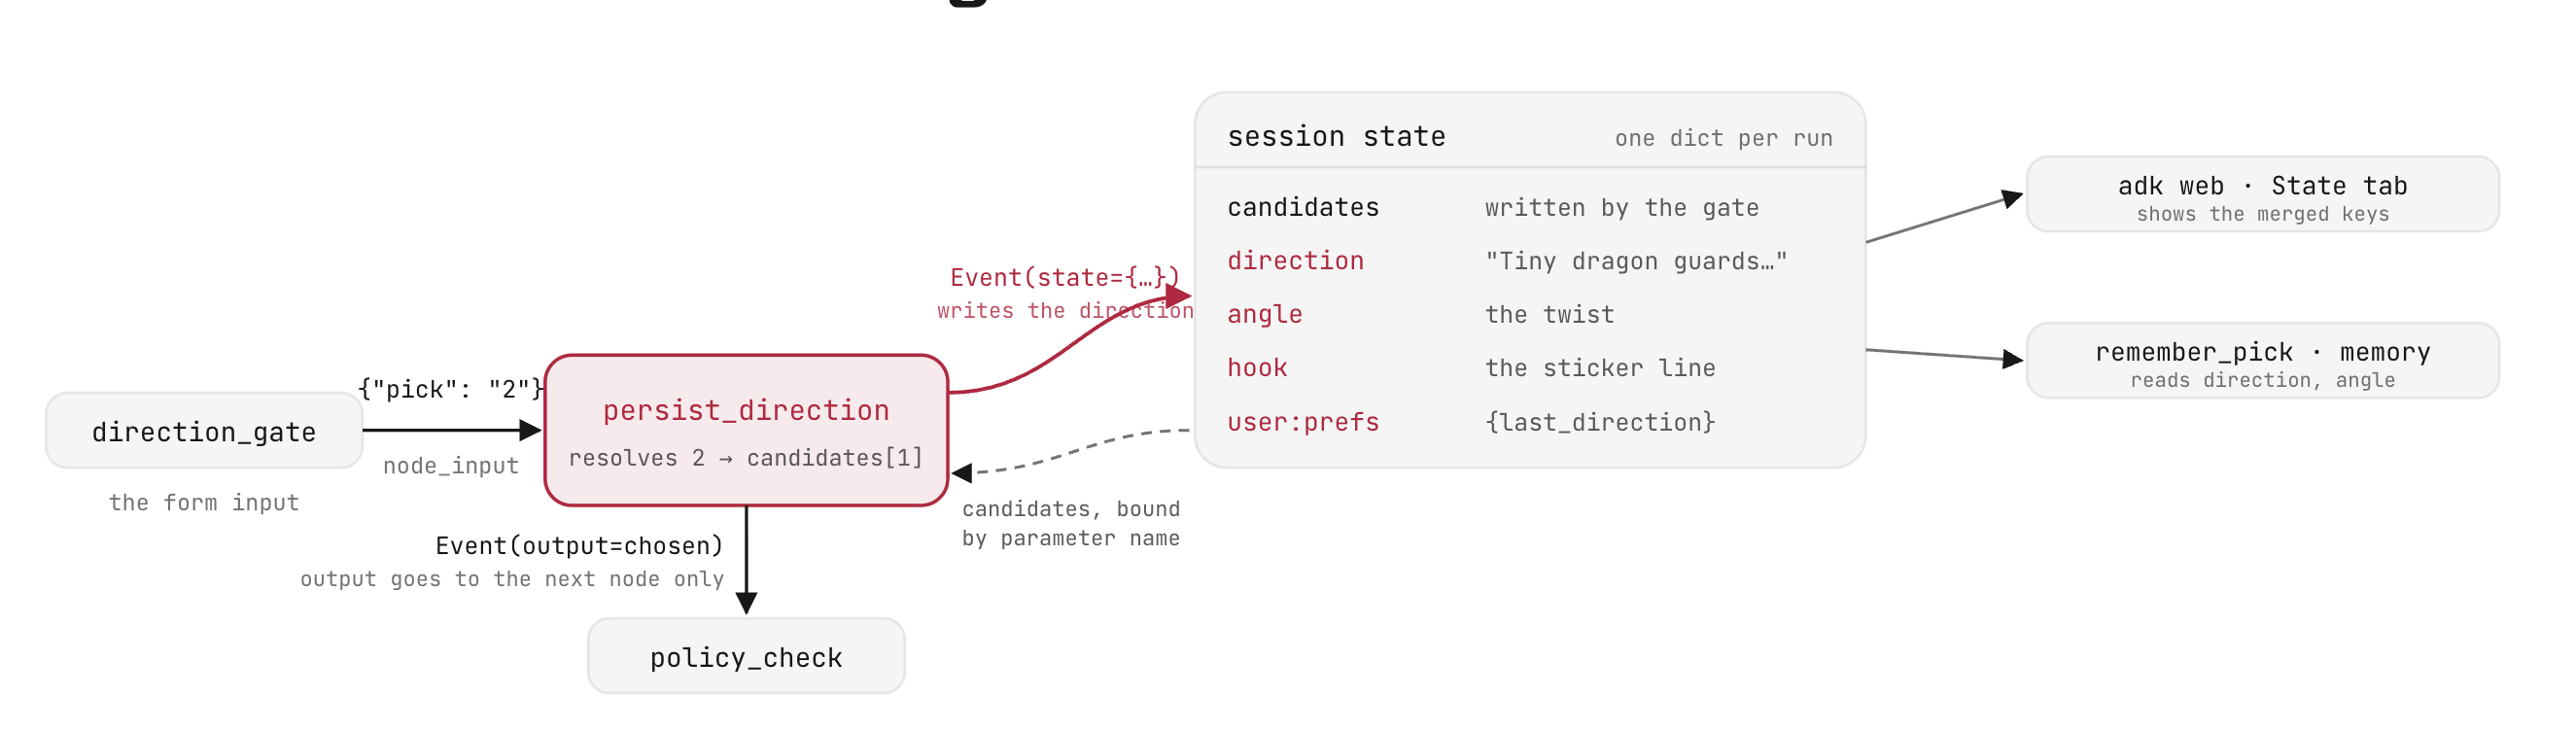
כשמשתמש בוחר מועמד ב-direction_gate, הבחירה מגיעה כאינדקס מספרי ({"pick": "2"}). הצמתים הבאים בשרשרת צריכים את אובייקט ההנחיות המלא: שם, זווית הסיפור ושורת הפתיחה. במקום להעביר מטא-נתונים מפורטים דרך כל מטען ייעודי (payload) של צומת ביניים, persist_direction כותב את המועמד שנפתר למצב סשן משותף.
הצמתים לא צריכים להעביר את כל מילון מצב הסשן. כשצומת מניב Event(state=...), הוא מספק רק את צמדי המפתח/ערך החדשים או המעודכנים. ה-ADK ממזג את העדכונים האלה באופן אוטומטי במאגר הסשנים:
    yield Event(state={"direction": chosen["title"], "angle": chosen.get("angle", ""),
                       "hook": hook, "user:prefs": {"last_direction": chosen["title"]}})
הפונקציה Event מעבירה את השליטה לזמן הריצה Workflow, ששומר את הערכים החדשים ביומן הסשן ב-runs/sessions.db.
קישור פרמטרים
צומתי הפונקציות של ADK קוראים את מצב הסשן באופן אוטומטי באמצעות בדיקת פרמטרים. אם חתימת פונקציה מצהירה על שם פרמטר שתואם למפתח מצב קיים, ADK מחלץ את המפתח הזה מהמצב ומעביר אותו ישירות:
def persist_direction(node_input, candidates: list = []):
    ni = node_input if isinstance(node_input, dict) else {}
    raw = ni.get("pick")
    pick = str(raw).strip() if raw is not None else ""
    if candidates:
        i = int(pick) - 1 if pick.isdigit() else 0
        chosen = candidates[max(0, min(len(candidates) - 1, i))]
    else:
        chosen = {"title": "untitled", "angle": "", "evidence": []}
    hook = chosen.get("hook") or " ".join(chosen["title"].split()[:4])
כאן, candidates נכתב למצב הסשן על ידי direction_gate. ה-ADK מקשר אותו ישירות אל persist_direction(node_input, candidates: list = []) בלי צורך בחיפושים מפורשים במילון.
מפתחות עם הקידומת user: נשמרים בין סשנים באחסון ברמת המשתמש, וכך מאפשרים להפעיל את תהליך העבודה הבא כדי לגשת להעדפות של היוצר.
עריכה מעשית: שמירת המצב וחיבור הצומת
- בקובץ
agent/graph.py, בתוךpersist_direction, מחליפים את השורהTODO: PERSIST_STATEב-state event yield:
    yield Event(state={"direction": chosen["title"], "angle": chosen.get("angle", ""),
                       "hook": hook, "user:prefs": {"last_direction": chosen["title"]}})
- ב-
stage3_router/agent.py, מוסיפים אתpersist_directionלשרשרת השלישית ברשימהedges:
           (join_research, propose_directions, direction_gate,
            persist_direction)
שומרים את הקבצים. בסביבת העבודה, מוודאים שגם state write in place וגם persist_direction in the chain מציגים סימני וי ירוקים.
צומת הנתב (5B)
בסביבת העבודה, עוברים אל צומת הנתב (5B).
ניתוב דטרמיניסטי על סמך מדיניות
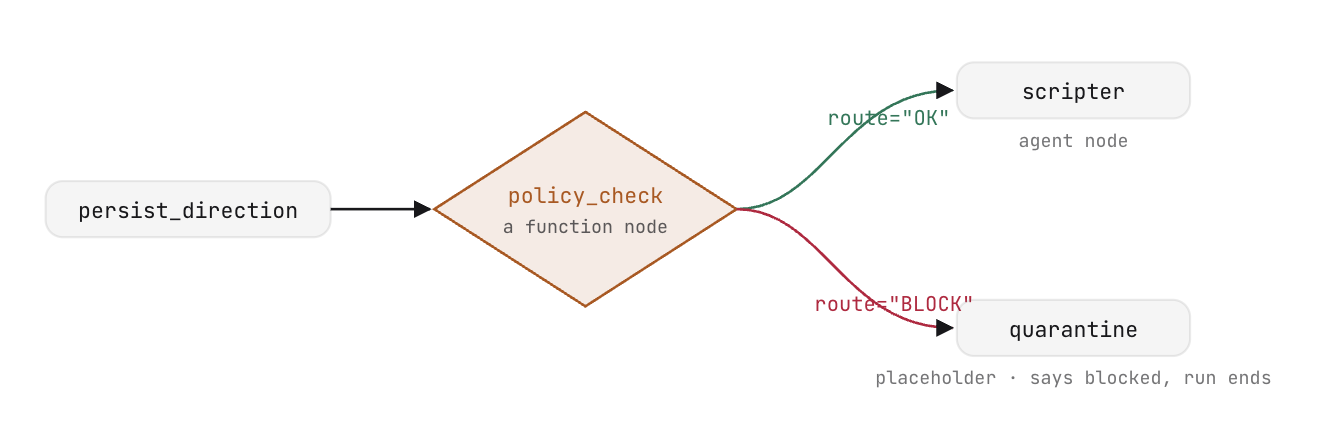
נתב הוא צומת פונקציה מיוחד שמעריך את הפלט של הצומת הקודם ומכוון את הביצוע לאורך ענפי תרשים מותנים. בניגוד לסוכנים גנרטיביים, נתב מפעיל לוגיקה דטרמיניסטית בלי לבצע קריאות ל-LLM.
נתב מחזיר Event שמציין תג route:
def length_check(node_input):
    too_long = len(node_input.get("title", "")) > 60
    return Event(output=node_input, route="TRIM" if too_long else "PASS")
בהגדרת תהליך העבודה, יעד קצה שמוגדר כמילון ממפה שמות של מסלולים לצמתי יעד:
(length_check, {"TRIM": shorten, "PASS": scripter}),
נתב תהליך העבודה policy_check קורא ביטויים אסורים מ-agent/policy_words.txt ומבצע התאמה של מילים שלמות לכותרת ולזווית של הכיוון שנבחר:
return Event(output=node_input, route="BLOCK" if bad else "OK")
שמירת המדיניות כנתונים במקום כהוראות שמוטמעות בקוד מאפשרת לבצע עדכונים בלי לשנות את גרף תהליך העבודה: עדכון קובץ הטקסט חל באופן מיידי על הרצות הבאות. מכיוון שההערכה היא התאמה דטרמיניסטית של ביטויים רגולריים, היא מתבצעת תוך אלפיות השנייה בעלות של אפס אסימונים לפני שמתחיל הסקריפט הגנרטיבי.
יעדים: Scripter ו-Quarantine
הנתב מפנה את התנועה לאחד משני צומתי המשך:
-
scripter: צומת של סוכןsingle_turnשממיר את ההנחיות שאושרו לסקריפט הפקה מובנה בהתאם לסכימתScriptPydantic:
scripter = Agent(
    name="scripter",
    model=config.MODEL,
    instruction=SCRIPT_INSTRUCTION,
    output_schema=Script)
-
quarantine: פונקציית placeholder שבהתחלה עוצרת את ההוראות שסומנו, ומוחלפת בחלק הבא על ידי סוכן תיקון אוטונומי.
עריכה מעשית: ניתוב בדיקת המדיניות
- ב-
agent/graph.py, בתוךpolicy_check, משלימים את פקודת החזרה:
return Event(output=node_input, route="BLOCK" if bad else "OK")
- ב-
stage3_router/agent.py, מעדכנים אתedgesכדי להפנות ל-policy_checkומחברים מחדש את הענף של ההסגר ל-scripter:
           (join_research, propose_directions, direction_gate,
            persist_direction, policy_check),
           (policy_check, {"OK": scripter, "BLOCK": quarantine}),
           (quarantine, scripter)])
שומרים את הקבצים. בסביבת העבודה, מוודאים שהמיפויים של קצוות הנתבים אומתו.
מצבי סוכן וצומת המשימה (5C)
בסביבת העבודה, עוברים אל מצבי הסוכן וצומת המשימה (5C).
מצבי הרצה של סוכנים
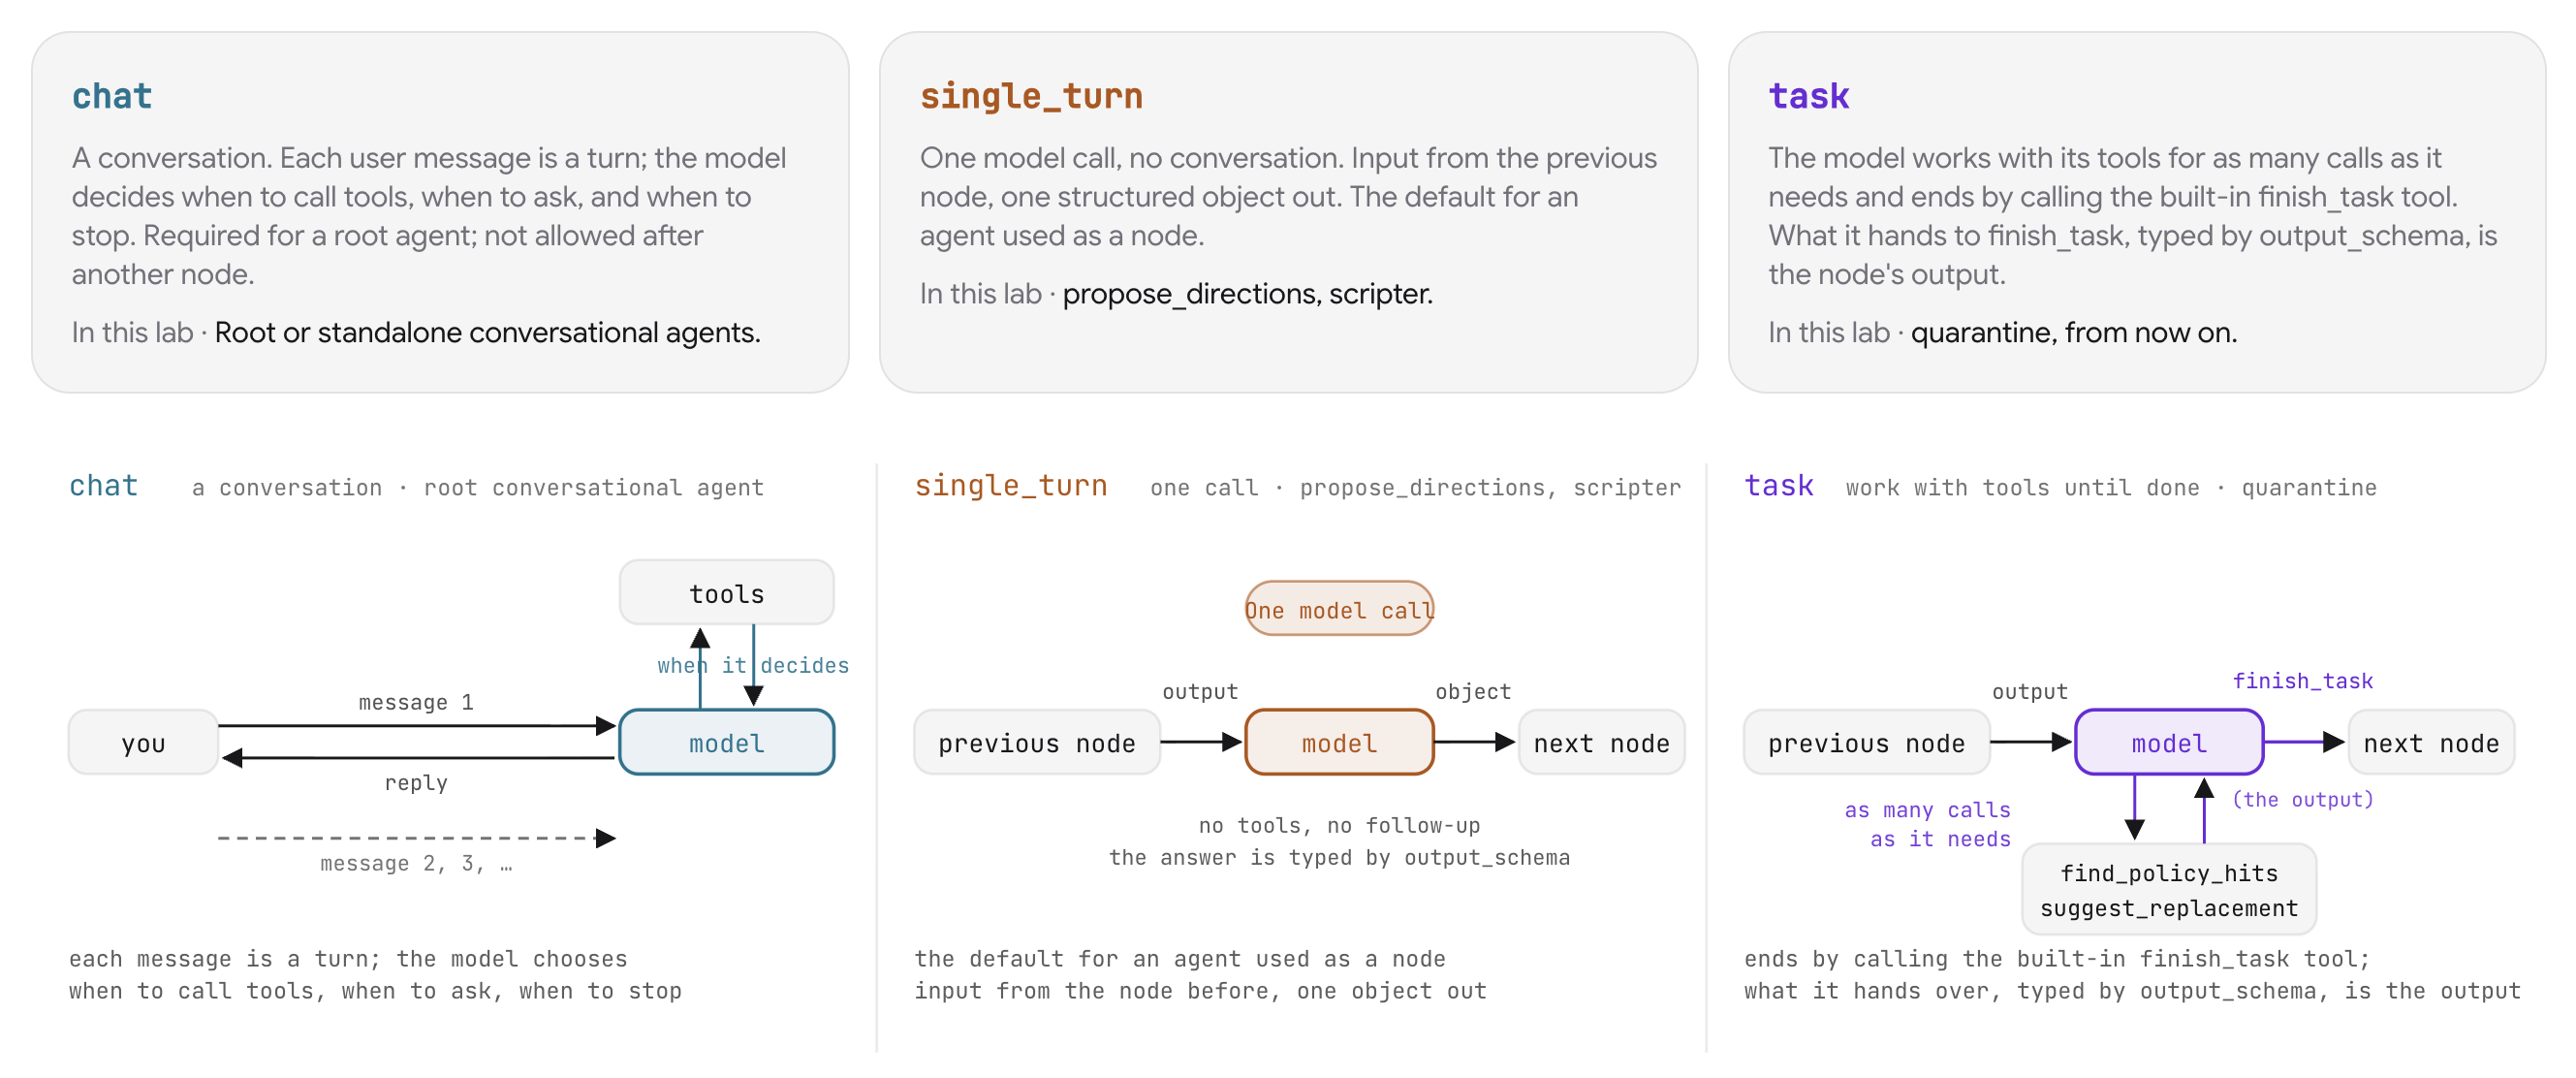
מכונות ADK Agent תומכות בשלושה מצבי הפעלה שמותאמים לדרישות ספציפיות של צינור עיבוד הנתונים:
מצב | מחזור החיים של הביצוע | התפקיד ב-Pipeline |
| לולאה של שיחה עם זיכרון. המודל קובע מתי להפעיל כלים, לבקש קלט או לסיים את התור. | סוכנים ברמת הבסיס שמתמודדים עם משתמש אנושי אינטראקטיבי. |
| קריאה להסקה של מודל יחיד. הצומת מקבל קלט מהצומת הקודם ופולט אובייקט סכימה מובנה. | טרנספורמציות של תרשימים ברצף ( |
| לולאה אוטונומית עם הפעלת כלים. הסוכן חוזר על הפעולה עד שהוא קורא לכלי המובנה | תיקון ובדיקה בכמה שלבים ( |
תיקון אוטונומי של הפרות מדיניות
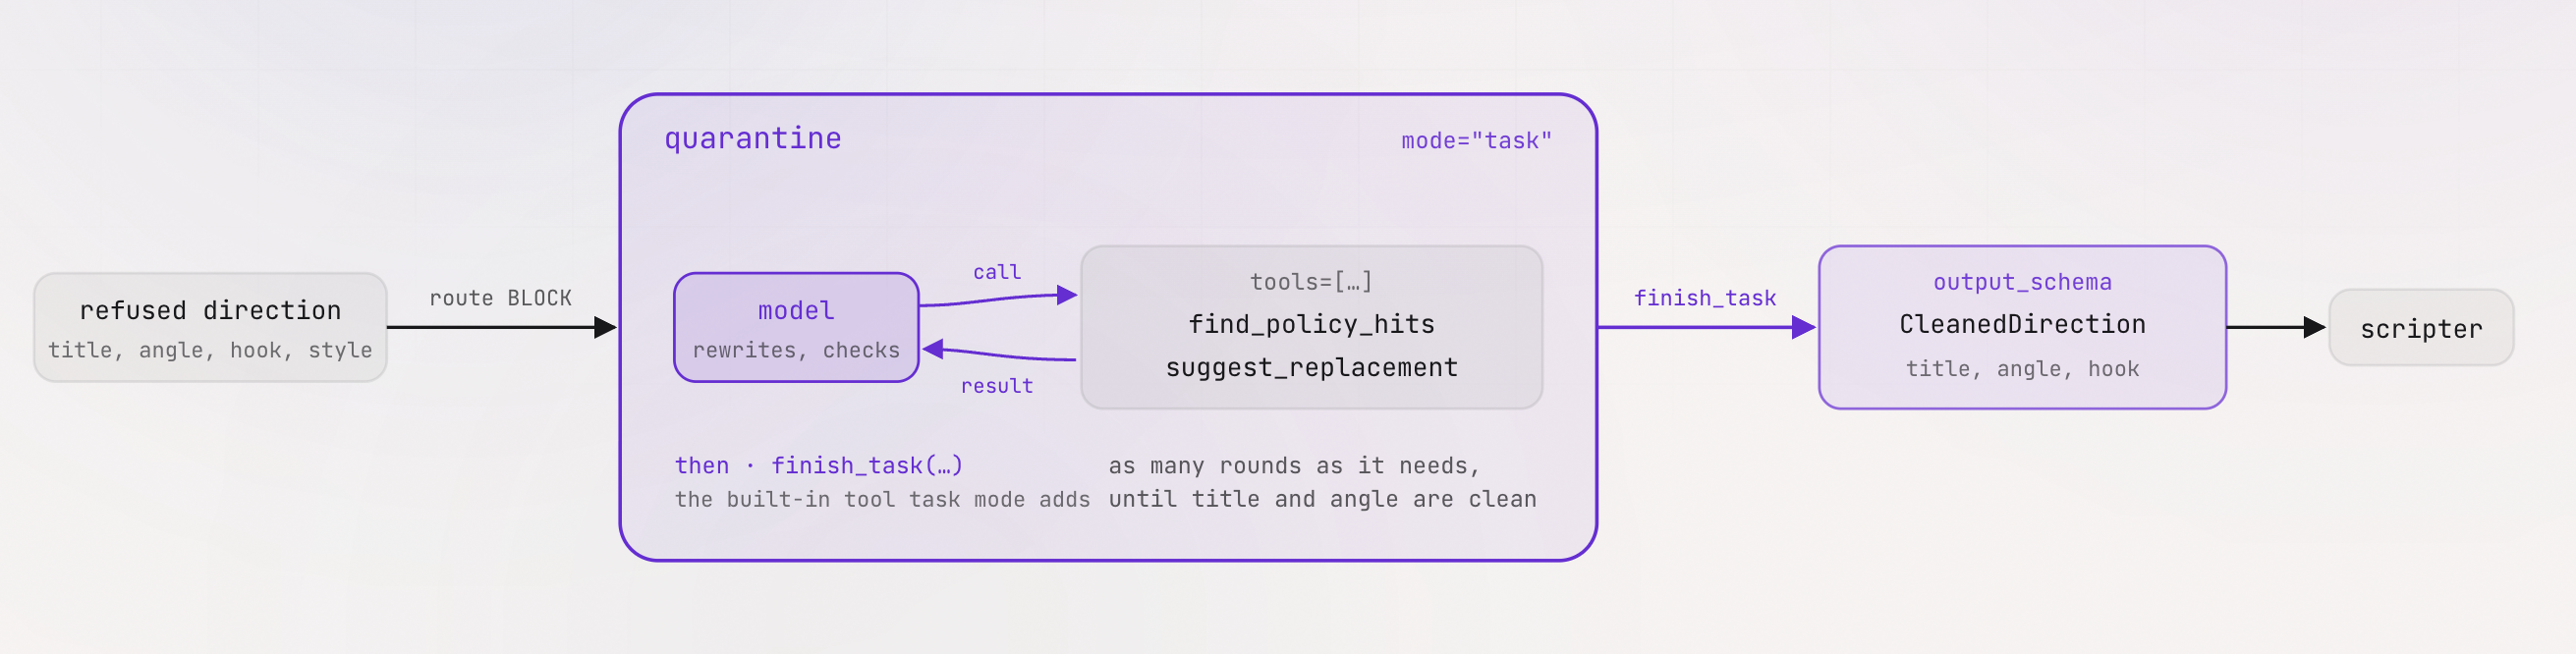
כדי לשכתב הוראה שסומנה, צריך להשתמש במצב task כי מספר האיטרציות של התיקון משתנה. הסוכן מקבל את ההנחיה שסומנה, מפעיל את find_policy_hits כדי לזהות הפרות, מבקש חלופות שאושרו באמצעות suggest_replacement, משכתב את ההנחיה ומוודא שהיא תקינה לפני שהוא ממשיך.
שני הכלים מוגדרים ב-agent/cleanup_tools.py עם חתימות מוקלדות ומחרוזות תיעוד:
def find_policy_hits(text: str) -> dict:
    """Which refused words appear in `text`. Matches whole words and phrases
    from agent/policy_words.txt, case-insensitive.

    Returns {"hits": [...], "clean": bool}. clean is true when hits is empty.
    """


def suggest_replacement(word: str) -> dict:
    """The channel's approved stand-in for a refused word, read from
    agent/policy_replacements.txt.

    Returns {"word", "replacement", "listed"}. When the word has no entry,
    listed is false and replacement is a hint to pick a gentle synonym.
    """
עריכה מעשית: הרכבת סוכן המשימות של ההסגר
ב-stage3_router/agent.py, מחליפים את פונקציית ה-placeholder quarantine בהגדרה של סוכן המשימות:
quarantine = Agent(
    name="quarantine",
    model=config.MODEL,
    instruction=QUARANTINE_INSTRUCTION,
    mode="task",
    tools=[find_policy_hits, suggest_replacement],
    output_schema=CleanedDirection,
)
במצב משימה, הסוכן מצויד בכלים והוא מסיים את ההפעלה באמצעות קריאה ל-finish_task. כשמגדירים את mode="task", ה-ADK מספק באופן אוטומטי את finish_task ומפיק את הפרמטרים שלו מ-output_schema. כך מובטח שהצומת יניב אובייקט CleanedDirection מסוג שתואם לסכימת הקלט של צומת הסקריפט.
מה קורה ולמה
בודקים את שני נתיבי הביצוע ב-ADK Web או ב-VibeStudio Workbench:
- מסלול מאושר (מועמד 1, 2 או 3):
- בחירה במסלול מועמד שאושר מ-
policy_checkישירות אלscripter(route="OK"). - התסריטאי יוצר תסריט הפקה של 3 צילומים בהתאם לסכימה
Script.
- בחירה במסלול מועמד שאושר מ-
- Quarantine remediation route (Candidate 4):
- מועמד 4 מכיל אוצר מילים שסומן ("קליקבייט", "פריצה ויראלית").
-
policy_checkמסלולים אלquarantine(route="BLOCK"). - במעקב אחר הסשן, אפשר לראות את
quarantineקורא ל-find_policy_hits, קורא ל-suggest_replacementלכל הפרה, משכתב את הכותרת וקורא ל-finish_task. - ההרצה חוזרת ל-
scripterויוצרת תסריט מההנחיה שעברה ניקוי.
6. Memory Bank
ב-VibeStudio Workbench, עוברים אל Step 6 · Memory Bank, חלקים (6A) ו-(6B).
תהליך העבודה פועל כרגע בלי זיכרון בין סשנים. כל הפעלה מתחילה מאפס, בלי לדעת מה היוצר בחר קודם או אילו ז'אנרים הוא מעדיף. בשלב הזה, מחברים את Vertex AI Agent Engine Memory Bank כדי לאחסן את ההעדפות של היוצרים ולאחזר אותן בין הפעלות.
חשוב לציין שהזיכרון משולב באמצעות קריאות חוזרות במחזור החיים של הנציג, ולא באמצעות צומתי צינור עיבוד נתונים. מכיוון שחילוץ ואיחזור של זיכרון משרתים סוכנים בודדים במקום שלבי נתונים ביניים, צירוף קריאות חוזרות שומר על טופולוגיית גרף נקייה ומנותקת.
Memory Bank (6A)
ב-Workbench, עוברים אל Memory Bank (6A).
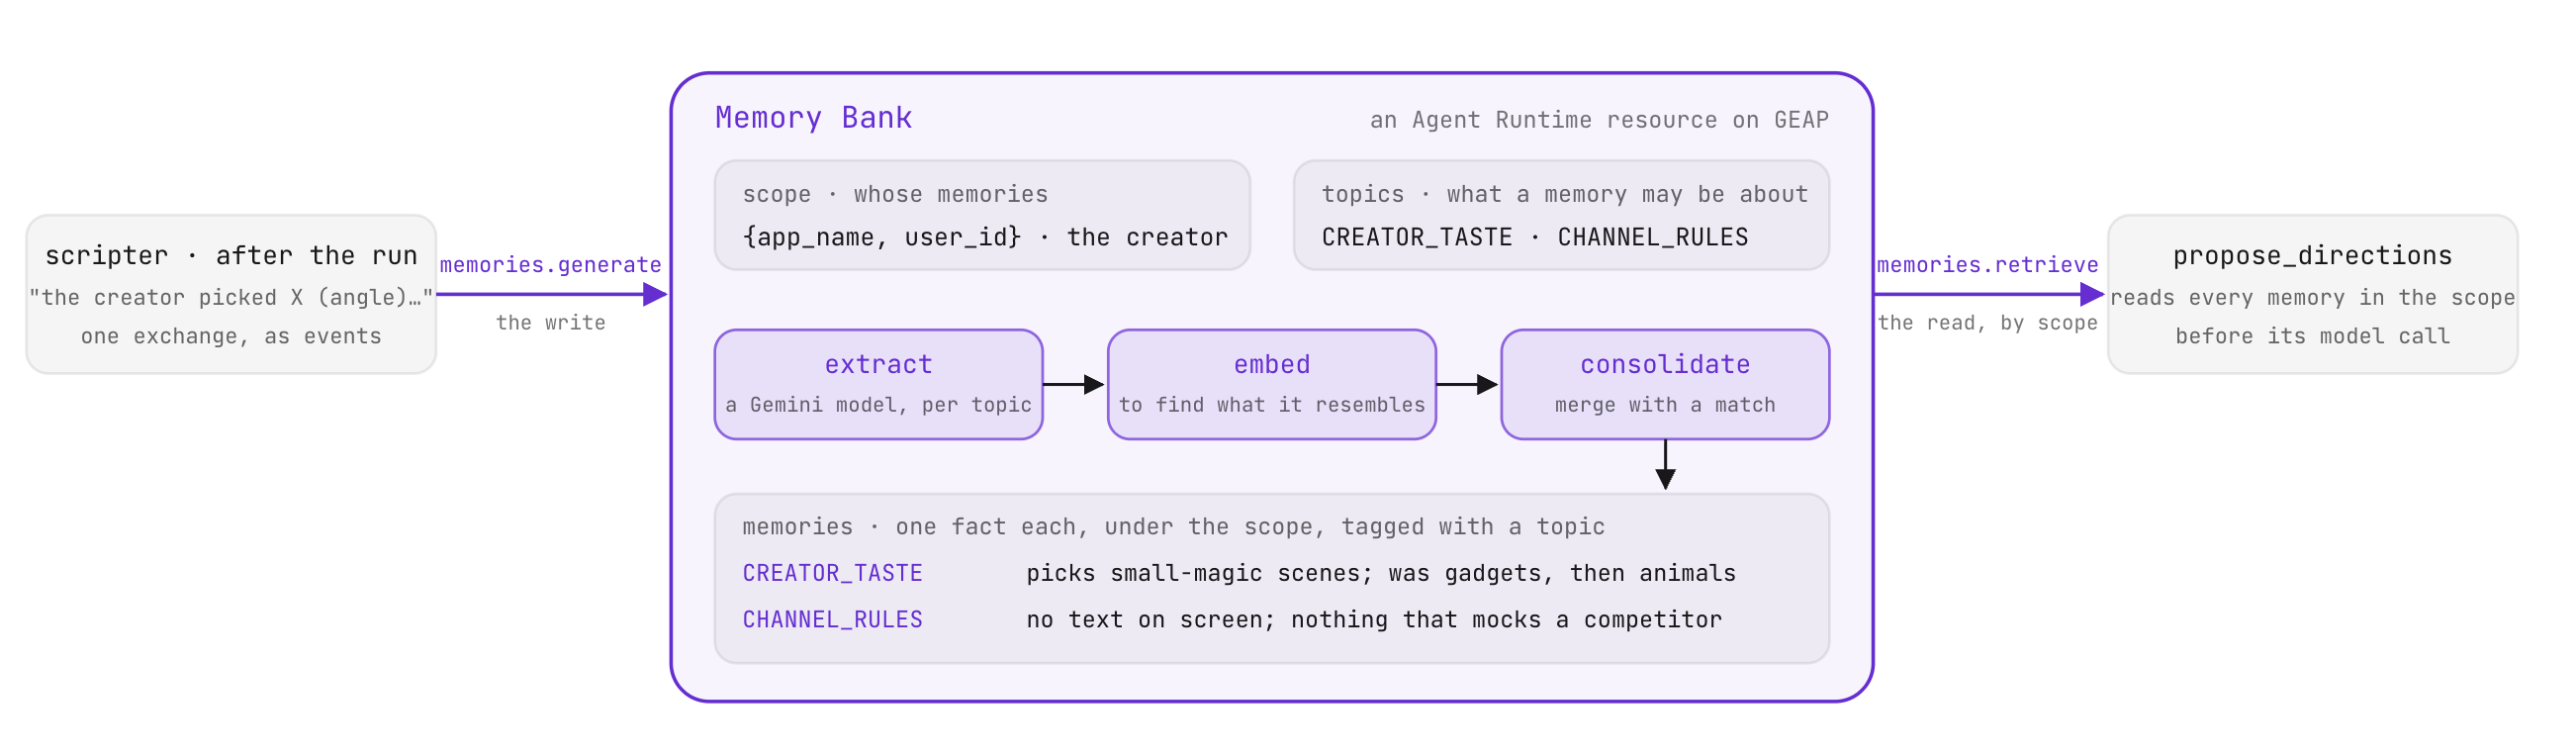
זיכרון נפרד לכל משתמש מנוהל
Memory Bank הוא שירות מנוהל לזיכרון משתמש לטווח ארוך. הוא מארגן עובדות על אדם מסוים בהיקף מוגדר, שמזוהה כאן לפי שם האפליקציה ומזהה המשתמש:
SCOPE = {"app_name": config.APP, "user_id": config.USER}
TOPICS = {
    "CREATOR_TASTE": "Which video directions this creator picks and passes on, "
                     "and how that preference changes over time.",
    "CHANNEL_RULES": "Standing instructions the creator states for every video "
                     "(style, subjects to avoid, format rules).",
}
נושאי הזיכרון המותאמים אישית מגדירים את הגבולות של מה שמאגר הזיכרון מתעד:
- חילוץ נושאים: כשנשלח טקסט חדש של שיחה דרך
memories.generate, השירות מפעיל מודל חילוץ על כל תיאור נושא. טקסט שלא תואם לנושא לא יוצר זיכרונות. - איחוד וביטול כפילויות: השירות ממיר עובדות חדשות שחולצו להטבעות ומשווה אותן לזיכרונות קיימים בהיקף. אם התצפית תואמת לזיכרון קיים, השירות מעדכן את הזיכרון הזה. אם המידע חדש, השירות יוצר רשומה חדשה. תהליך האיחוד הזה מבטיח שסשנים רבים בנושא מסוים יתמזגו לסיכום קוהרנטי במקום ליצור רשומות מיותרות.
- אחזור: קריאה ל-
memories.retrieveעם היקף המשתמש מחזירה עובדות מאוחסנות, בסדר מהישנה ביותר לחדשה ביותר.
שתי הפעולות מוטמעות ב-agent/platform/memory.py. שם המשאב של הבנק שהוקצה נשמר במטמון באופן מקומי ב-runs/memorybank.json.
הגדרת בנק הזיכרונות
משתמשים בפקדים של סביבת העבודה או מריצים את פקודות ה-CLI בטרמינל:
- חיבור הבנק והקצאת הרשאות:
python -m agent.platform.bankCREATOR_TASTEו-CHANNEL_RULES. - הוספת סשנים היסטוריים:
python -m agent.platform.bank load - בדיקת עובדות מאוחדות:
python -m agent.platform.bank list
התקשרות חזרה (6ב)
ב-Workbench, עוברים אל Callbacks (6B). פותחים את stage4_memory/agent.py.
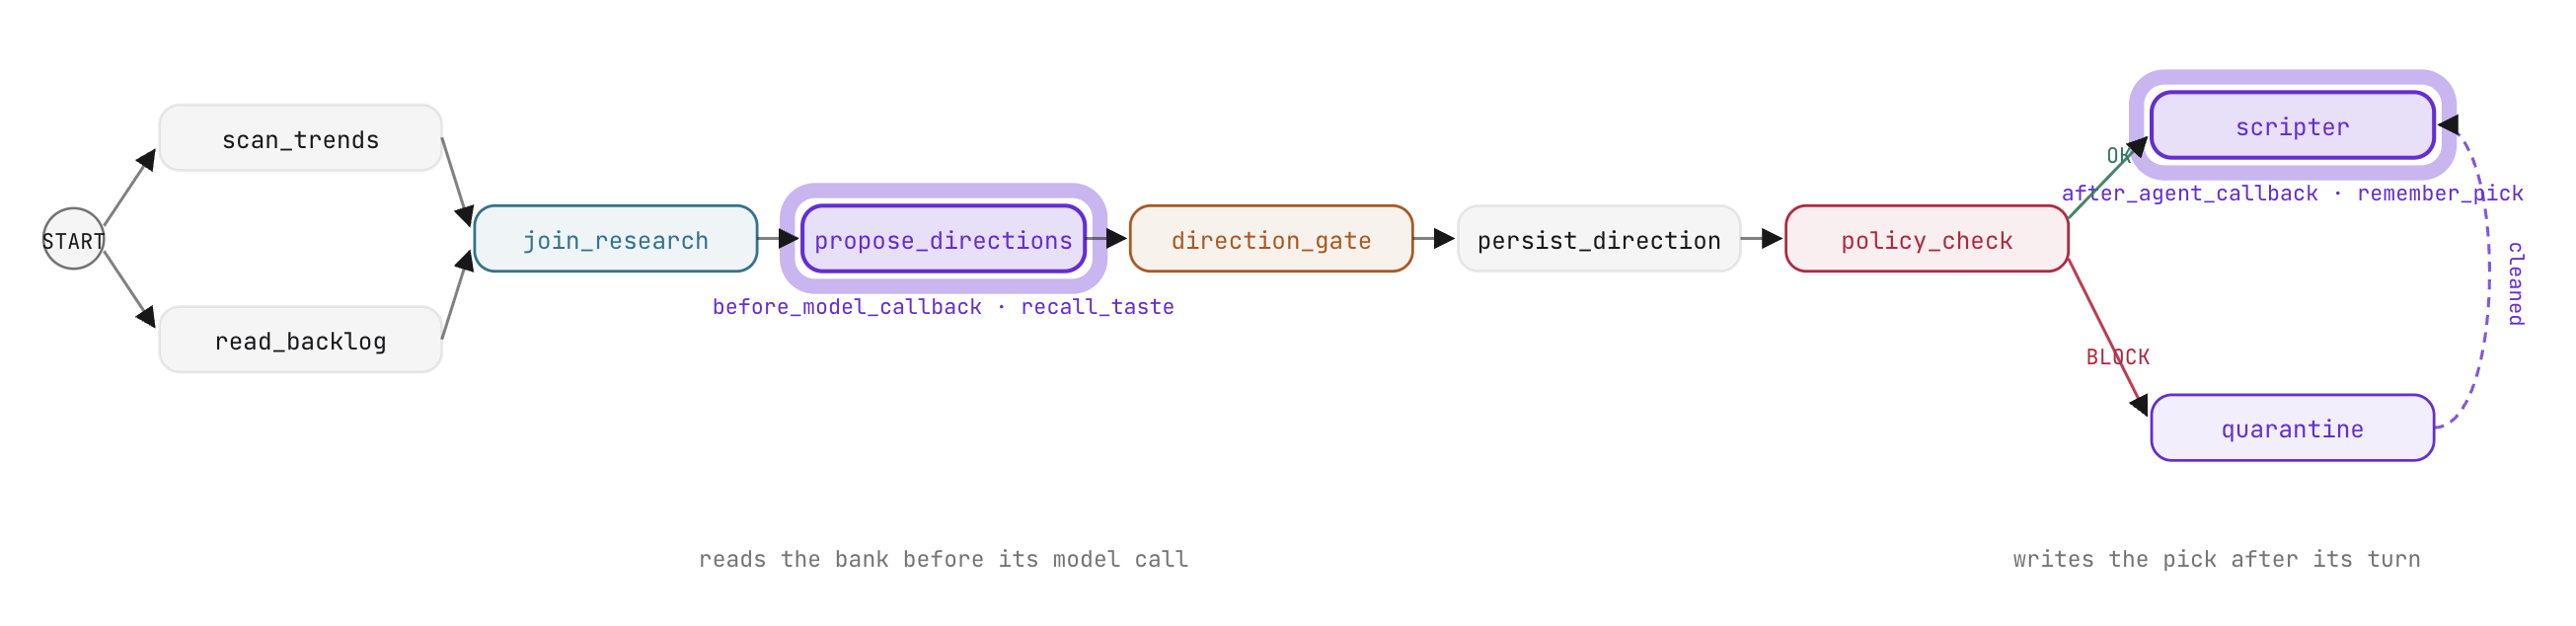
קריאות חוזרות במחזור חיים של סוכן ADK
קריאה חוזרת היא פונקציה שמועברת כארגומנט אל Agent. ערכת ADK מפעילה קריאות חוזרות (callbacks) ברגעים מוגדרים מראש במחזור החיים, ומעבירה את ההקשר הפעיל. החזרה של None ממשיכה את ההפעלה הרגילה. החזרה של אובייקט חלופי מבטלת את הפעולה או מפריעה לה.
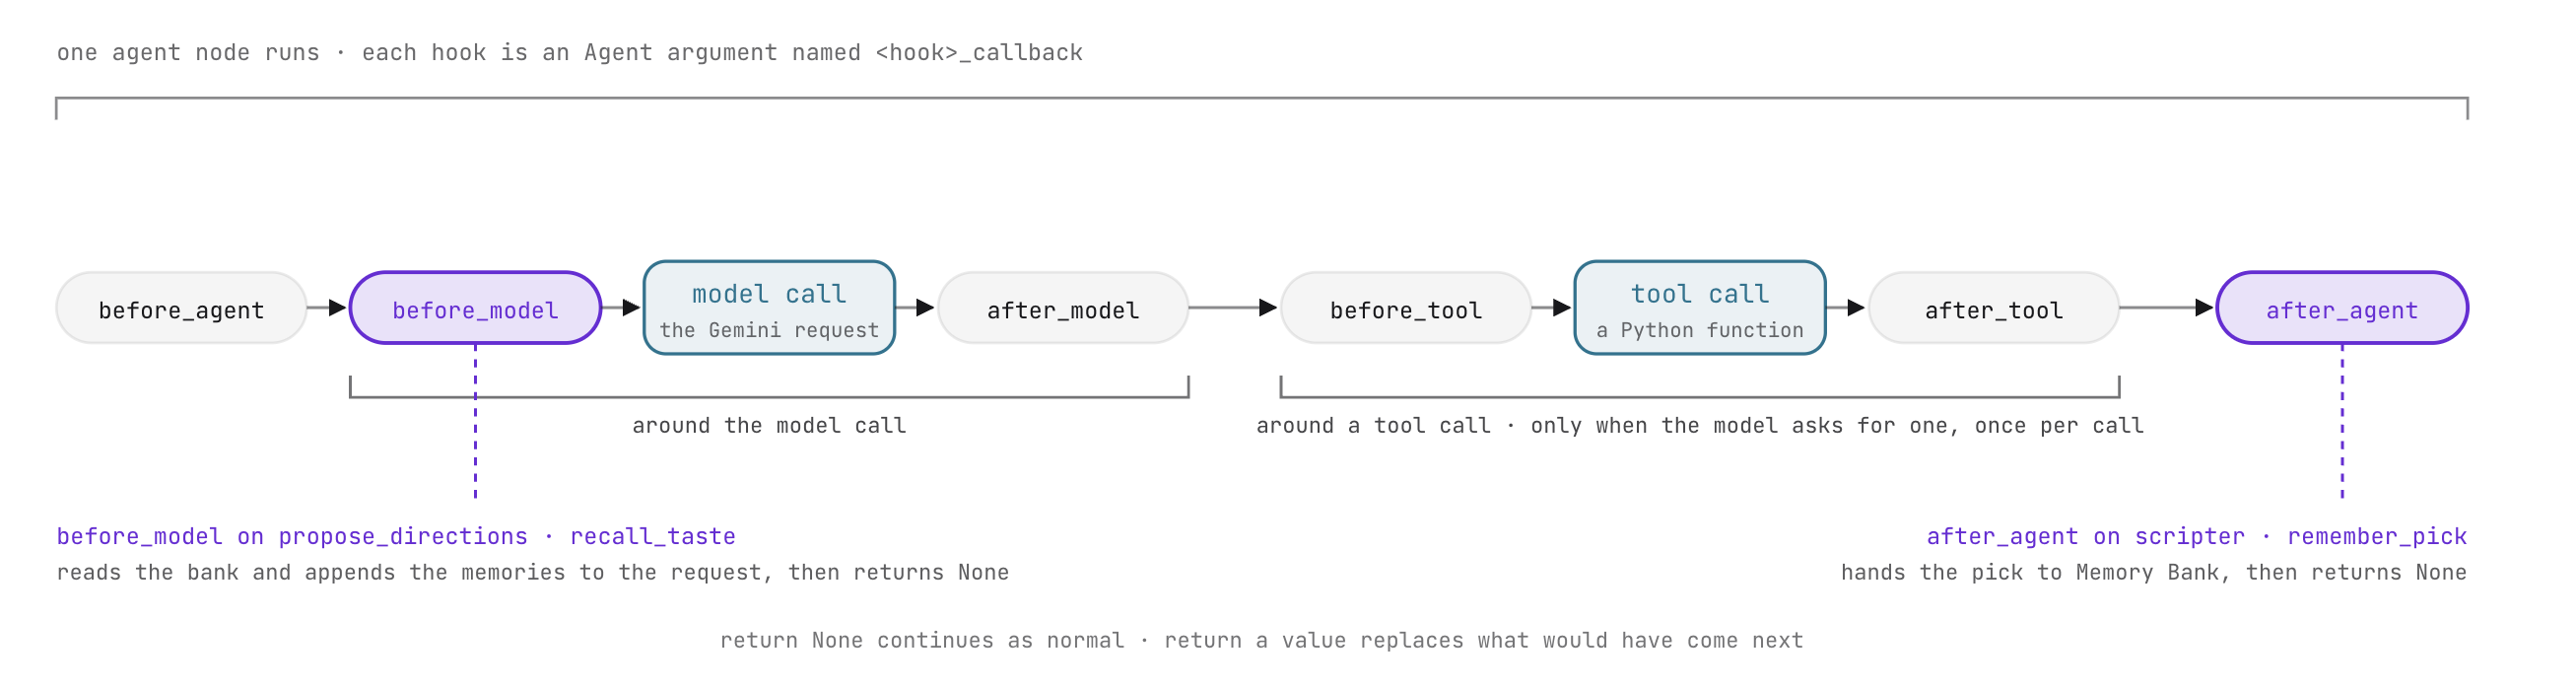
ה-ADK מספק שלושה זוגות של קריאות חוזרות (callback):
התקשרות חזרה (callback) | נקודת הפעלה | פרמטרים שהתקבלו | התנהגות של ערך החזרה |
| מסביב לכל התור של הנציג |
| החזרת |
| בכל קריאה להסקת מסקנות של מודל שפה גדול (LLM) |
| החזרה של |
| לפני ואחרי כל הפעלה של כלי | הגדרת הכלי, ארגומנטים, תוצאה | החזרת dict מבטלת את פלט הכלי; |
הפונקציות החוזרות מספקות מיקום נקי להזרקת הקשר, מעקות בטיחות, טלמטריה וחיפושים במטמון בלי להוסיף צמתים מיותרים לתרשים של תהליך העבודה.
עריכה מעשית: ביטול של חיווט וזכירת קריאות חוזרות
- ב-
stage4_memory/agent.py, מעדכנים אתpropose_directionsכדי לצרף אתbefore_model_callback=recall_taste:
    output_schema=Directions,
    before_model_callback=recall_taste)
recall_taste פועל מיד לפני ש-Gemini יוצר את ההוראות האפשריות. הוא מאחזר את ההיסטוריה של היוצר מ-Memory Bank, מעצב את הזיכרונות לפי הסדר מהישן ביותר לחדש ביותר, ומוסיף אותם ל-LlmRequest היוצא. ההנחיה מורה למודל להטות את מועמדים 1 עד 3 לכיוון הטעם הנוכחי של היוצר, תוך התייחסות לכללי הערוץ כאילוצים מחמירים.
- ב-
stage4_memory/agent.py, מעדכנים אתscripterכדי לצרף אתafter_agent_callback=remember_pick:
    output_schema=Script,
    after_agent_callback=remember_pick)
המשתנה remember_pick מופעל אחרי שהמשתנה scripter מסיים את התור שלו. הוא קורא את הכיוון שנבחר ממצב הסשן, מסנתז הצהרה תמציתית שמסכמת את ההחלטה של היוצר ומפעיל את הפונקציה memories.generate כדי לעדכן את מאגר הזיכרון.
מה קורה ולמה
בודקים את תהליך העבודה שכולל קריאה חוזרת (callback) ב-Workbench או ב-ADK Web:
- מריצים את הפרומפט הריק:
- במעקב אחרי הסשן, בודקים את
LlmRequestעבורpropose_directions. שימו לב להקשר של הזיכרון שנוסף, שכולל את ההעדפה של היוצר לנושאי פנטזיה ולקצב תמציתי. - שימו לב לכיוונים המוצעים: מועמדים 1 עד 3 תואמים להעדפות ההיסטוריות של היוצר, גם כשהמגמות מדגישות נושאים אחרים.
- במעקב אחרי הסשן, בודקים את
- בוחרים מועמד/ת ב-
direction_gate. - אחרי ש-
scripterמסתיים, בודקים את הרשומות ב-Memory Bank:python -m agent.platform.bank list
7. RAG Engine
ב-VibeStudio Workbench, עוברים אל Step 7 · RAG Engine, חלקים (7A) ו-(7B).
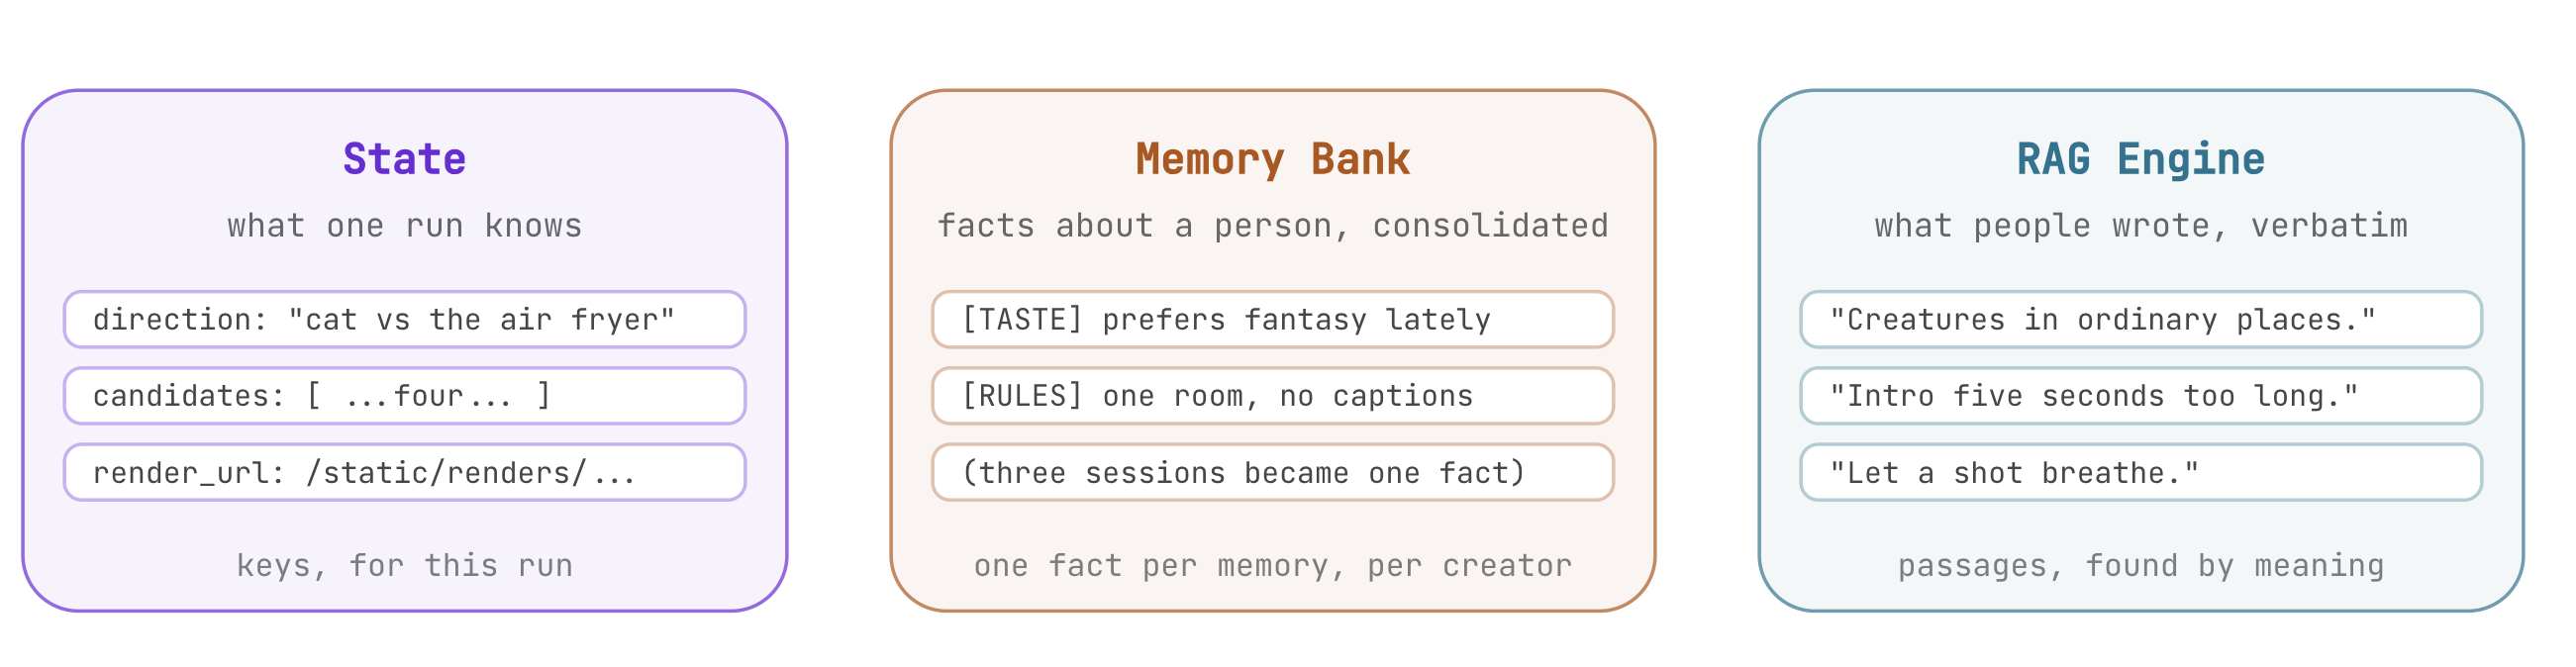
סרטונים שפורסמו צוברים משוב מתמשך מהצופים. נאספו 30 תגובות מייצגות בagent/comments.md, שכוללות שבחים מהצופים, ביקורת על הקצב של התוכן הממומן והעדפות לגבי האודיו. בשלב הזה, אתם מוסיפים את התגובות האלה לאינדקס באמצעות Vertex AI RAG Engine ומחברים את השליפה הסמנטית למחקר המורחב.
שליפת מידע ממסמכים (7A)
ב-workbench, עוברים אל RAG Engine (7A).
Memory Bank לעומת מנוע RAG
שני הכלים מבססים את תהליכי העבודה על נתונים חיצוניים, אבל הם משמשים למטרות ארכיטקטוניות שונות:
מאפיין | Memory Bank | RAG Engine |
תרחיש שימוש ראשי | העדפות משתמשים לטווח ארוך וכללים תפעוליים | אחזור סמנטי של מידע מאוספים גדולים של מסמכים |
היקף | מוגבל למזהי משתמשים ספציפיים ולשמות של אפליקציות | היקף: משאבי קורפוס משותפים לכל המשתמשים |
עיבוד נתונים | חילוץ, הטמעה ואיחוד סמנטי בזמן אמת | חלוקת מסמכים לחלקים, הטמעת וקטורים וחיפוש השכן הקרוב ביותר |
שילוב עם Graph | קריאות חוזרות במחזור החיים של הסוכן ( | צומת פונקציה ייעודית ב-fan-out של המחקר ( |
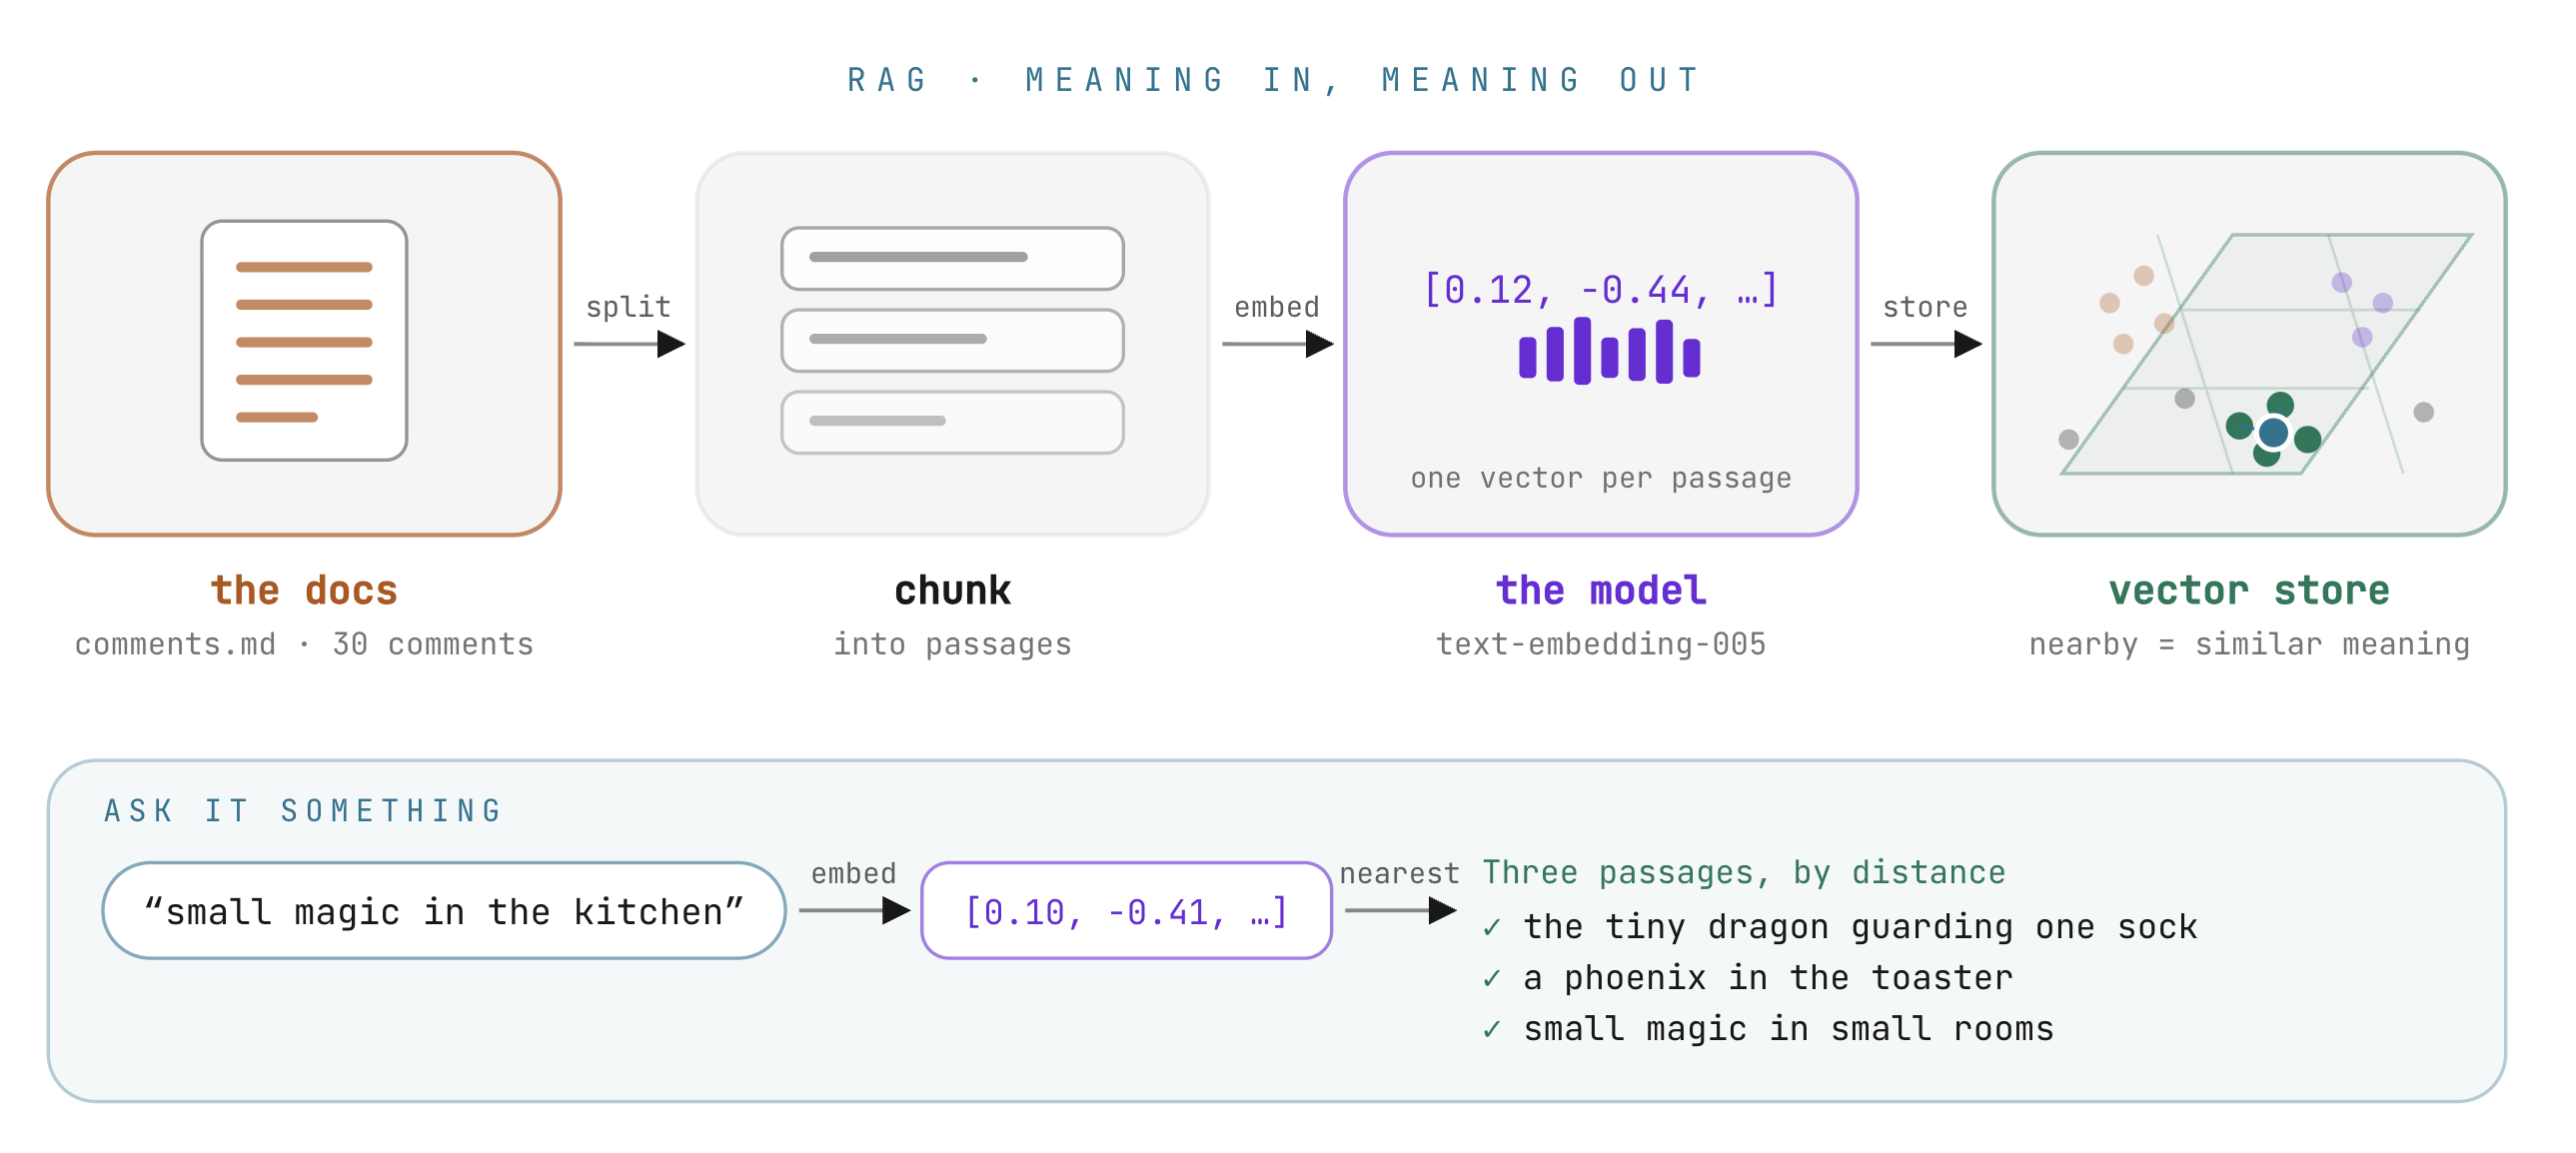
חלוקה לקטעים והטמעה של מסמכים
מנוע RAG מוסיף מסמכים לאינדקס על ידי חלוקת הטקסט לפסקאות סמנטיות ואחסון הווקטורים שלהן במסד נתונים מנוהל:
corpus = rag.create_corpus(
    display_name="vibestudio-feedback",
    description="Vibe Studio: what the audience wrote under the channel's past videos.",
    backend_config=rag.RagVectorDbConfig(
        rag_embedding_model_config=rag.RagEmbeddingModelConfig(
            vertex_prediction_endpoint=rag.VertexPredictionEndpoint(
                publisher_model="publishers/google/models/text-embedding-005"))))

rag.upload_file(
    corpus_name=corpus.name, path="agent/comments.md", display_name="comments.md",
    transformation_config=rag.TransformationConfig(
        chunking_config=rag.ChunkingConfig(chunk_size=120, chunk_overlap=20)))
- גודל מקטע: מוגדר ל-120 טוקנים עם חפיפה של 20 טוקנים. כך נלכדות שתיים עד שלוש תגובות לכל פסקה, וכל וקטור מייצג סנטימנט עקבי בלי לדלל את המשמעות של משוב לא קשור.
- מודל הטמעה:
text-embedding-005ממיר טקסט לווקטורים עם הרבה ממדים. כששולחים שאילתה, המודל ממיר את השאילתה לווקטור ומוצא את ההתאמות הקרובות ביותר על סמך מרחק סמנטי. תגובה על דרקון קטן ששומר על גרביים תואמת להנחיה על יצורים קסומים, בלי צורך בחפיפה מדויקת של מילות מפתח.
הגדרת מאגר המידע של RAG
מאחלים את הקורפוס באמצעות הלחצנים של סביבת העבודה או פקודות במסוף:
- יוצרים את הקורפוס:
python -m agent.platform.ragruns/ragcorpus.json. - העלאה של תגובות והוספה שלהן לאינדקס: העלאה של
agent/comments.mdעם הגדרת חלוקה לחלקים והמתנה לסיום ההוספה לאינדקס. - שליחת שאילתה לקורפוס: בודקים את השליפה לפי דמיון באמצעות שאילתות שלא כוללות מילים זהות לאלה שבתגובות (לדוגמה, שולחים את השאילתה "יצורים קסומים קטנים" כדי לשלוף תגובות על דרקונים).
צומת השליפה (7B)
ב-Workbench, מנווטים אל The third reader (7B). פותחים את stage5_rag/agent.py.
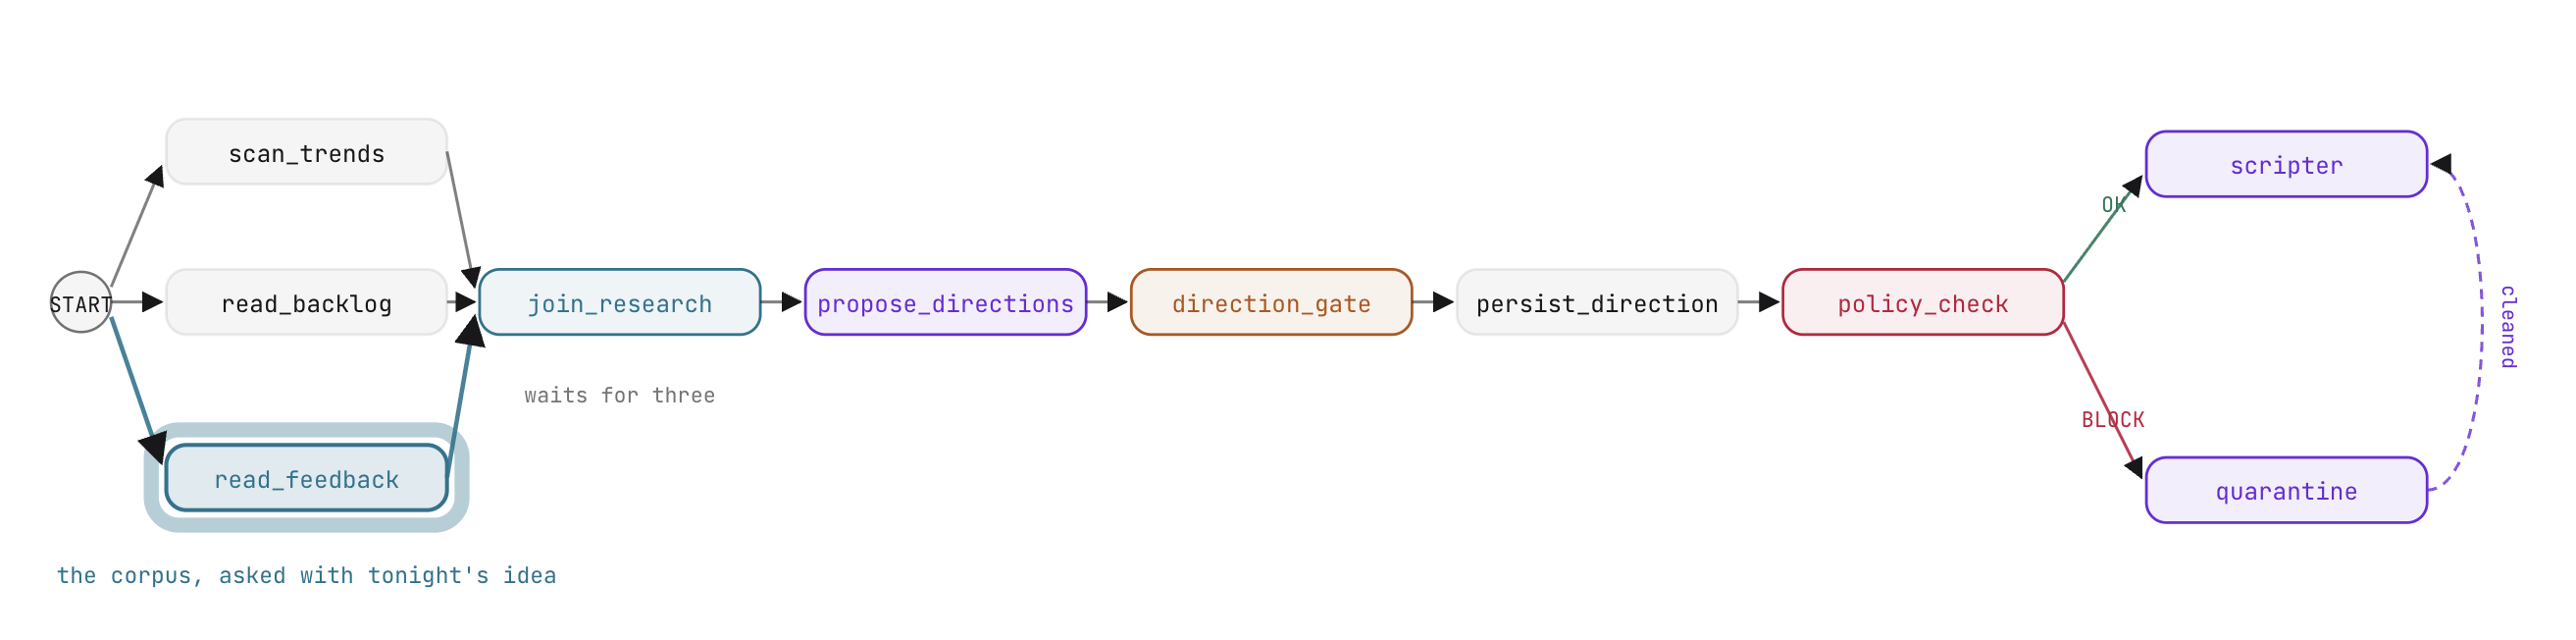
אחזור כצומת בתרשים
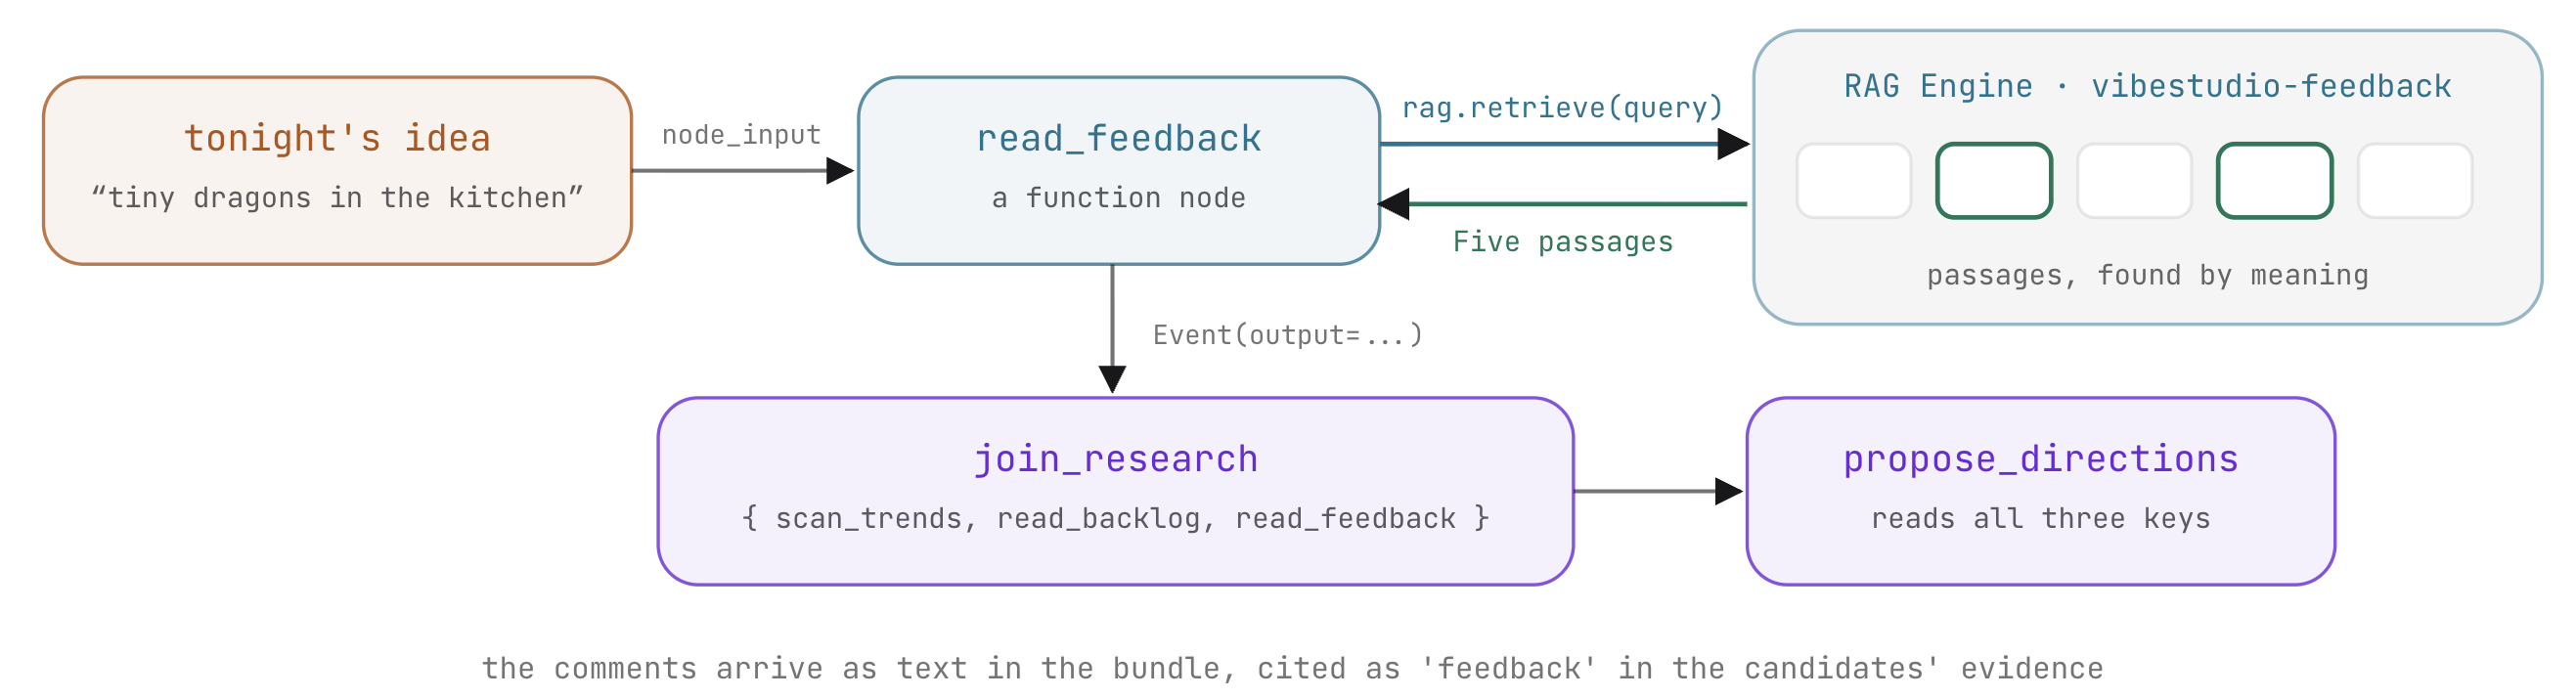
משוב מהקהל מייצג שיתוף נתוני מחקר בתהליך העבודה. בניגוד לזיכרון האישי של היוצר, פידים של סנטימנט הצופים מוזנים ישירות ל-join_research לצד נתוני מגמות ונתוני עומס. לכן, הוא מוטמע כצומת פונקציה:
def read_feedback(node_input):
    """The third reader (step 7): what the audience wrote under past videos,
    the passages nearest to tonight's idea. Retrieval, not a model call."""
    from .platform import rag
    idea = idea_text(node_input)
    query = idea or "what viewers liked and what they complained about"
    try:
        hits = rag.retrieve(query)
    except Exception as e:
        print(f"  [rag] feedback unavailable ({str(e)[:80]})")
        return Event(output={"query": query, "feedback": [],
                             "note": "no corpus connected - run: python -m agent.platform.rag"})
    return Event(output={"query": query, "feedback": [h["text"] for h in hits]})
read_feedback מחלץ את הרעיון הראשוני של המשתמש ומריץ שאילתה וקטורית על הקורפוס של RAG Engine. הוא פולט את התגובות שאוחזרו במטען ייעודי (payload) של Event(output=...).
עריכה מעשית: חיבור הקורא השלישי ל-fan-out
ב-stage5_rag/agent.py, מעדכנים את edges כדי להוסיף את read_feedback כענף מקביל שלישי שנכנס ל-join_research:
           (START, read_backlog, join_research),
           (START, read_feedback, join_research),
מכיוון ש-join_research הוא JoinNode, הוא מסנכרן את כל הענפים הנכנסים, וממתין עד ש-scan_trends, read_backlog ו-read_feedback יפיקו אירועים לפני העברת החבילה המצטברת במורד הזרם.
מה קורה ולמה
מריצים את תהליך העבודה ב-Workbench:
- שולחים הנחיה לרעיון (למשל, "דרקון מיניאטורי ששומר על השיש במטבח").
- במעקב אחר הביצוע, מוודאים שכל שלושת צומתי הקורא פועלים בו-זמנית.
- בודקים את
join_research: מילון הפלט שלו מכיל עכשיו אתtrends,backlogו-feedback. - בודקים את ההצעות שנוצרו על ידי
propose_directions: המודל משלב את תגובות הצופים בהצעות שלו ומפנה לסנטימנט של הקהל בשדות ההוכחה. - שימו לב שהאחזור של RAG הוא דטרמיניסטי (שאילתות זהות מחזירות קטעי תגובות זהים), ואילו צומת ההצעות הגנרטיביות יוצר וריאציות יצירתיות.
8. יצירת סרטונים אסינכרונית באמצעות Veo
ב-VibeStudio Workbench, עוברים אל Step 8 · The video, חלקים (8A) ו-(8B).
יצירת סרטון בהפרדה גבוהה באמצעות Google Veo דורשת כמה דקות לכל רינדור. חסימת הרצת הגרף במהלך התקופה הזו מבזבזת משאבי מחשוב, נועלת מאגרי שרשורים וחושפת את ההרצה לניתוקים בחיבור ה-HTTP. בשלב הזה, אתם הופכים את עיבוד הסרטון לאסינכרוני באמצעות LongRunningFunctionTool של ADK.
כלים למשימות ממושכות (8A)
בסביבת העבודה, עוברים אל כלי שפועל לאורך זמן (8A). פותחים את stage6_video/agent.py ו-agent/deliver.py.
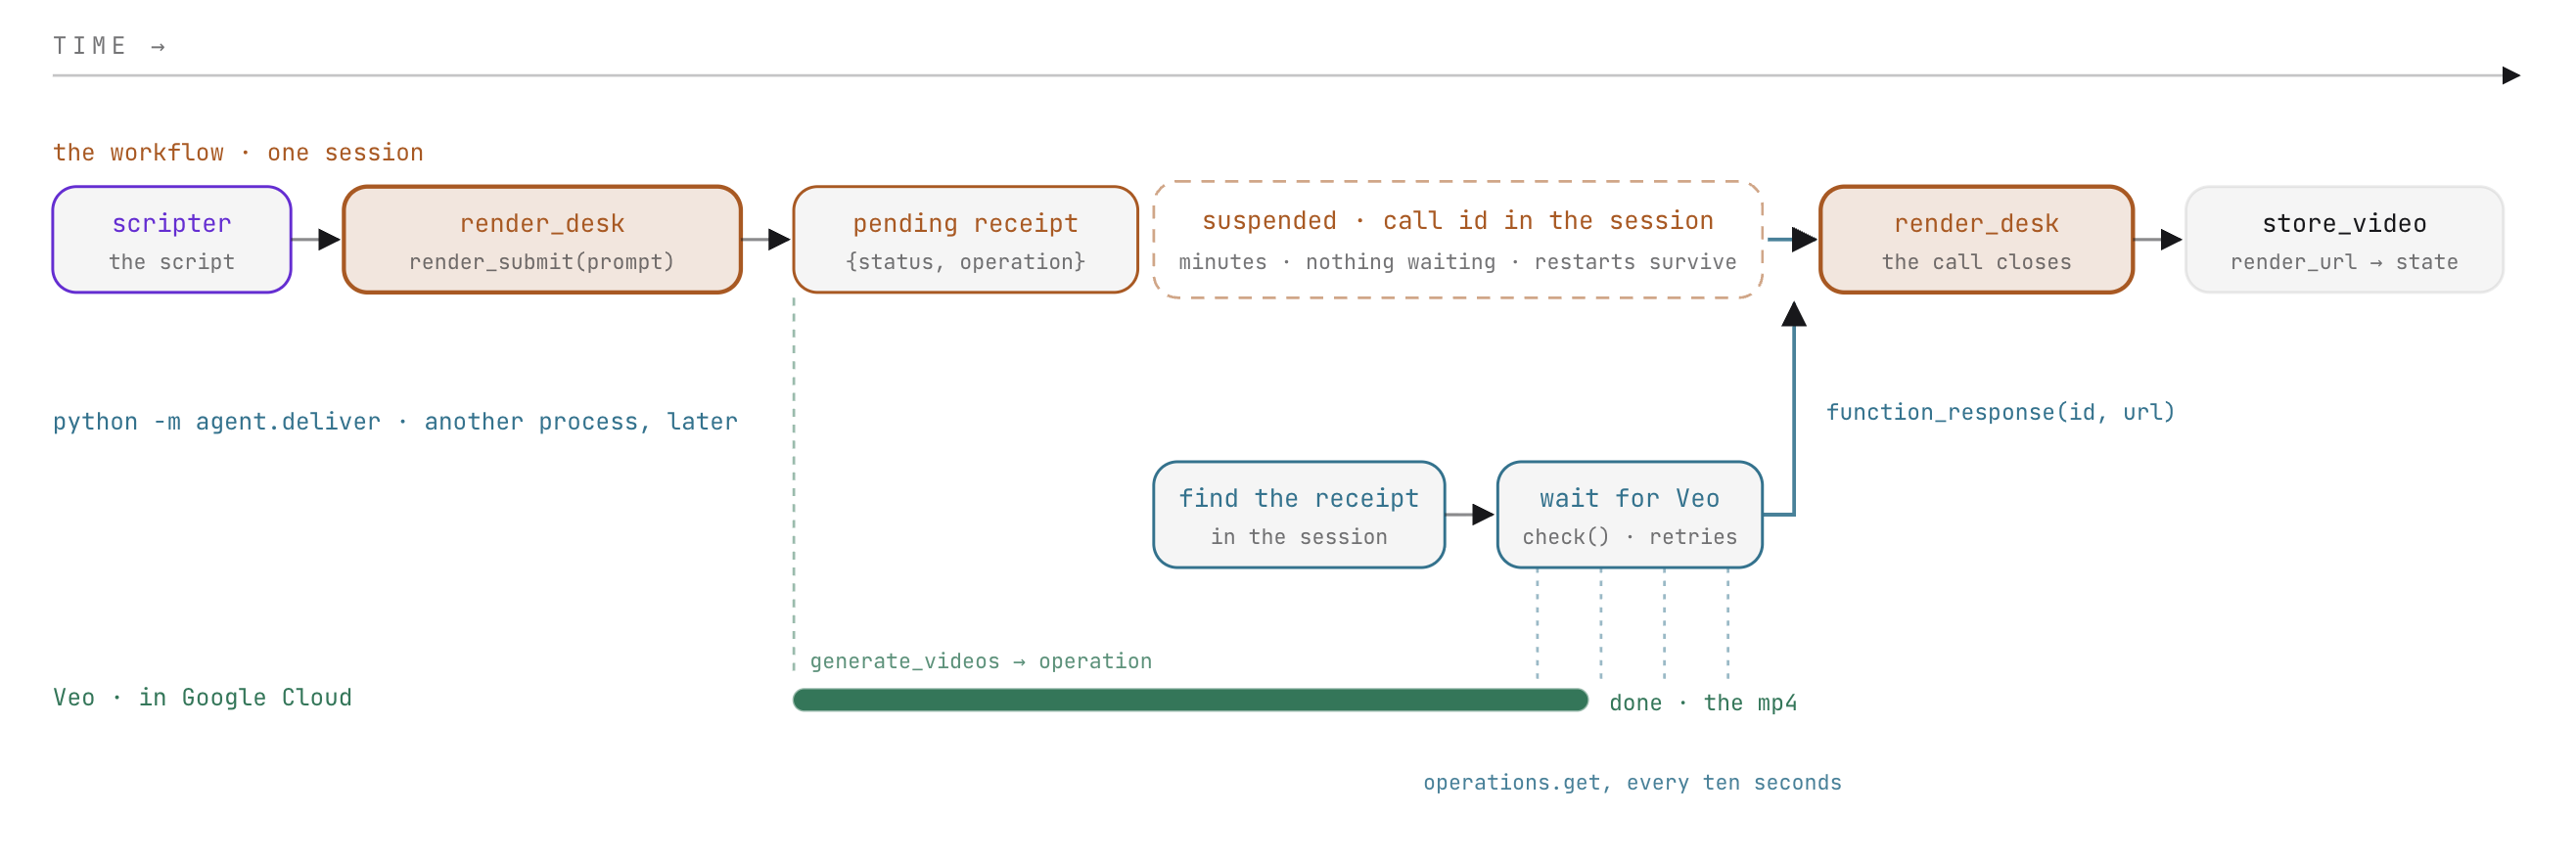
כלים סינכרוניים לעומת כלים שפועלים לאורך זמן
כלי פונקציות רגילים של ADK פועלים באופן סינכרוני בתוך תור של נציג: המודל קורא לכלי, ממתין למטען הייעודי (payload) שמוחזר ומשלב את התוצאה בתור הנוכחי.
אי אפשר להשלים את עיבוד הסרטון בשלב אחד. במקום זאת, הפונקציה render_submit מתחילה את משימת היצירה ומחזירה מיד קבלה תפעולית עם הסטטוס "pending":
def render_submit(prompt: str) -> dict:
    """Submit one Veo render of `prompt`. Returns at once with a pending
    receipt; the clip is delivered later, to this call, by id."""
    receipt = videogen.start(f"{prompt} {videogen.NO_TEXT}")
    return {"status": "pending", "operation": receipt["operation"], "prompt": receipt["prompt"]}
כשהוא עטוף ב-LongRunningFunctionTool, ה-ADK מיירט את הסטטוס "pending". תור הסוכן מסתיים, תהליך העבודה מושהה בצומת, והמטא-נתונים של השיחה בהמתנה (כולל מזהה השיחה והקבלה) נרשמים ב-runs/sessions.db. תהליך ההפעלה מסתיים בצורה חלקה בלי לשמור על חיבורים פעילים לרשת או על שרשורי עבודה.
עריכה מעשית: עטיפת כלי העיבוד
ב-stage6_video/agent.py, מעדכנים את render_desk כדי לעטוף את render_submit ב-LongRunningFunctionTool:
tools=[LongRunningFunctionTool(render_submit)])
המשך לפי מזהה שיחה
דפוס ההפעלה מחדש האוניברסלי
ADK משתמש במנגנון זהה להשהיה ולחידוש של תהליכי עבודה, גם עבור בני אדם וגם עבור כלים חיצוניים:
טריגר השעיה | התחלת הבנייה | מצב ההשעיה השמור | אירוע של חידוש |
החלטה אנושית |
| פתיחת הנחיית קלט במאגר הסשנים | |
כלי למשימות ממושכות |
| פתיחת קריאת הכלי במאגר הסשנים |
|
בשני התרחישים, תהליך העבודה נעצר לחלוטין ומתחדש רק כשאירוע עם FunctionResponse תואם מגיע ממקור חיצוני: ממשק משתמש, תגובה לפעולה מאתר אחר (webhook) או תהליך עבודה ברקע.
עריכה מעשית: השלמת התשובה למסירה
ב-agent/deliver.py, יוצרים את החלק של FunctionResponse:
    part = Part(function_response=FunctionResponse(
        id=row["call_id"], name=row["name"], response=response))
הדמון של השליחה דוגם את Veo עד שקובץ הווידאו נוצר, ואז שולח את ה-FunctionResponse הזה לסשן. ה-ADK מתאים למזהה השיחה וממשיך את תהליך העבודה ישירות בצומת הבא. צמתים שהושלמו לא מופעלים מחדש, והנציג לא מבצע עוד פעולה גנרטיבית.
הגדרת STUDIO_REAL_VIDEO=0 ב-.env מפעילה עיבוד מדומה: start מחזירה קבלה מיידית לבדיקה, ו-check מדמה השלמה תוך חמש שניות בלי לבצע קריאות ל-Veo API שניתנות לחיוב.
שילוב של צינורות (8B)
ב-workbench, עוברים אל render_desk in the graph (8B). פותחים את stage6_video/agent.py.
הצומת הסופי בצינור עיבוד הנתונים הוא store_video. הוא קורא את פרטי העיבוד המקדים שהושלם מ-runs/state.json (שם תהליך ההעברה תועד) ומבצע קומיט של כתובת ה-URL של הסרטון וסטטוס היצירה למצב הסשן המשותף.
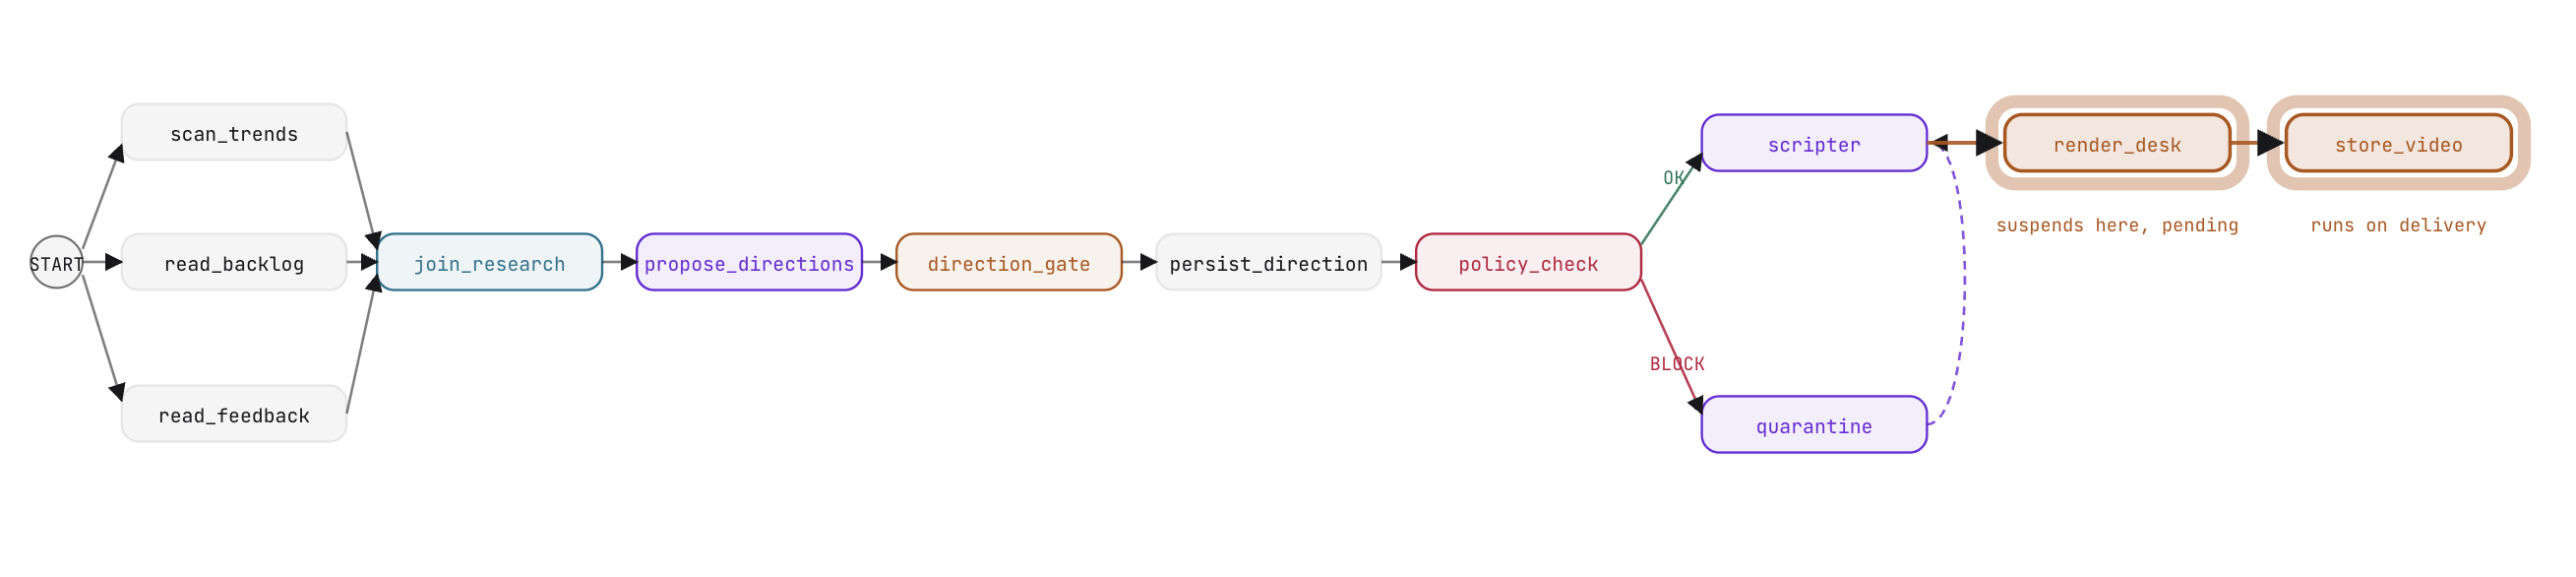
עריכה מעשית: חיבור של צינור העברת נתונים מלא של סרטונים
ב-stage6_video/agent.py, מעדכנים את edges כדי לצרף את render_desk ואת store_video:
           (quarantine, scripter),
           (scripter, render_desk, store_video)])
מה צפוי ולמה
בודקים את תהליך היצירה האסינכרוני ב-workbench:
- מריצים את תהליך העבודה באמצעות בחירת מועמדים ויצירת תסריט.
- בשלב
render_desk, אפשר לראות שהסוכן מפעיל אתrender_submit. - תהליך העבודה מושעה באופן מיידי. ב-workbench או ב-ADK Web, בודקים את הסטטוס "בהמתנה": הסשן מכיל את מזהה השיחה הפתוחה, ואין תהליכים ברקע שצורכים משאבים.
- מריצים את דמון המסירה באמצעות מסוף סביבת העבודה או בטרמינל:
python -m agent.deliver - ב-ADK Web, מרעננים את הסשן: ההרצה ממשיכה בנקודה
store_video, כתובת ה-URL של הסרטון נשמרת במצב הסשן ותהליך העבודה מסתיים.
9. פריסה ב-Cloud Run
ב-VibeStudio Workbench, עוברים אל Step 9 · Deploy (שלב 9: פריסה).
פיתחתם ואימתתם כל רכיב של צינור עיבוד הנתונים בארגזי חול ייעודיים. בשלב הזה מרכיבים את צינור הייצור המלא ומפרסים אותו ב-Google Cloud Run.
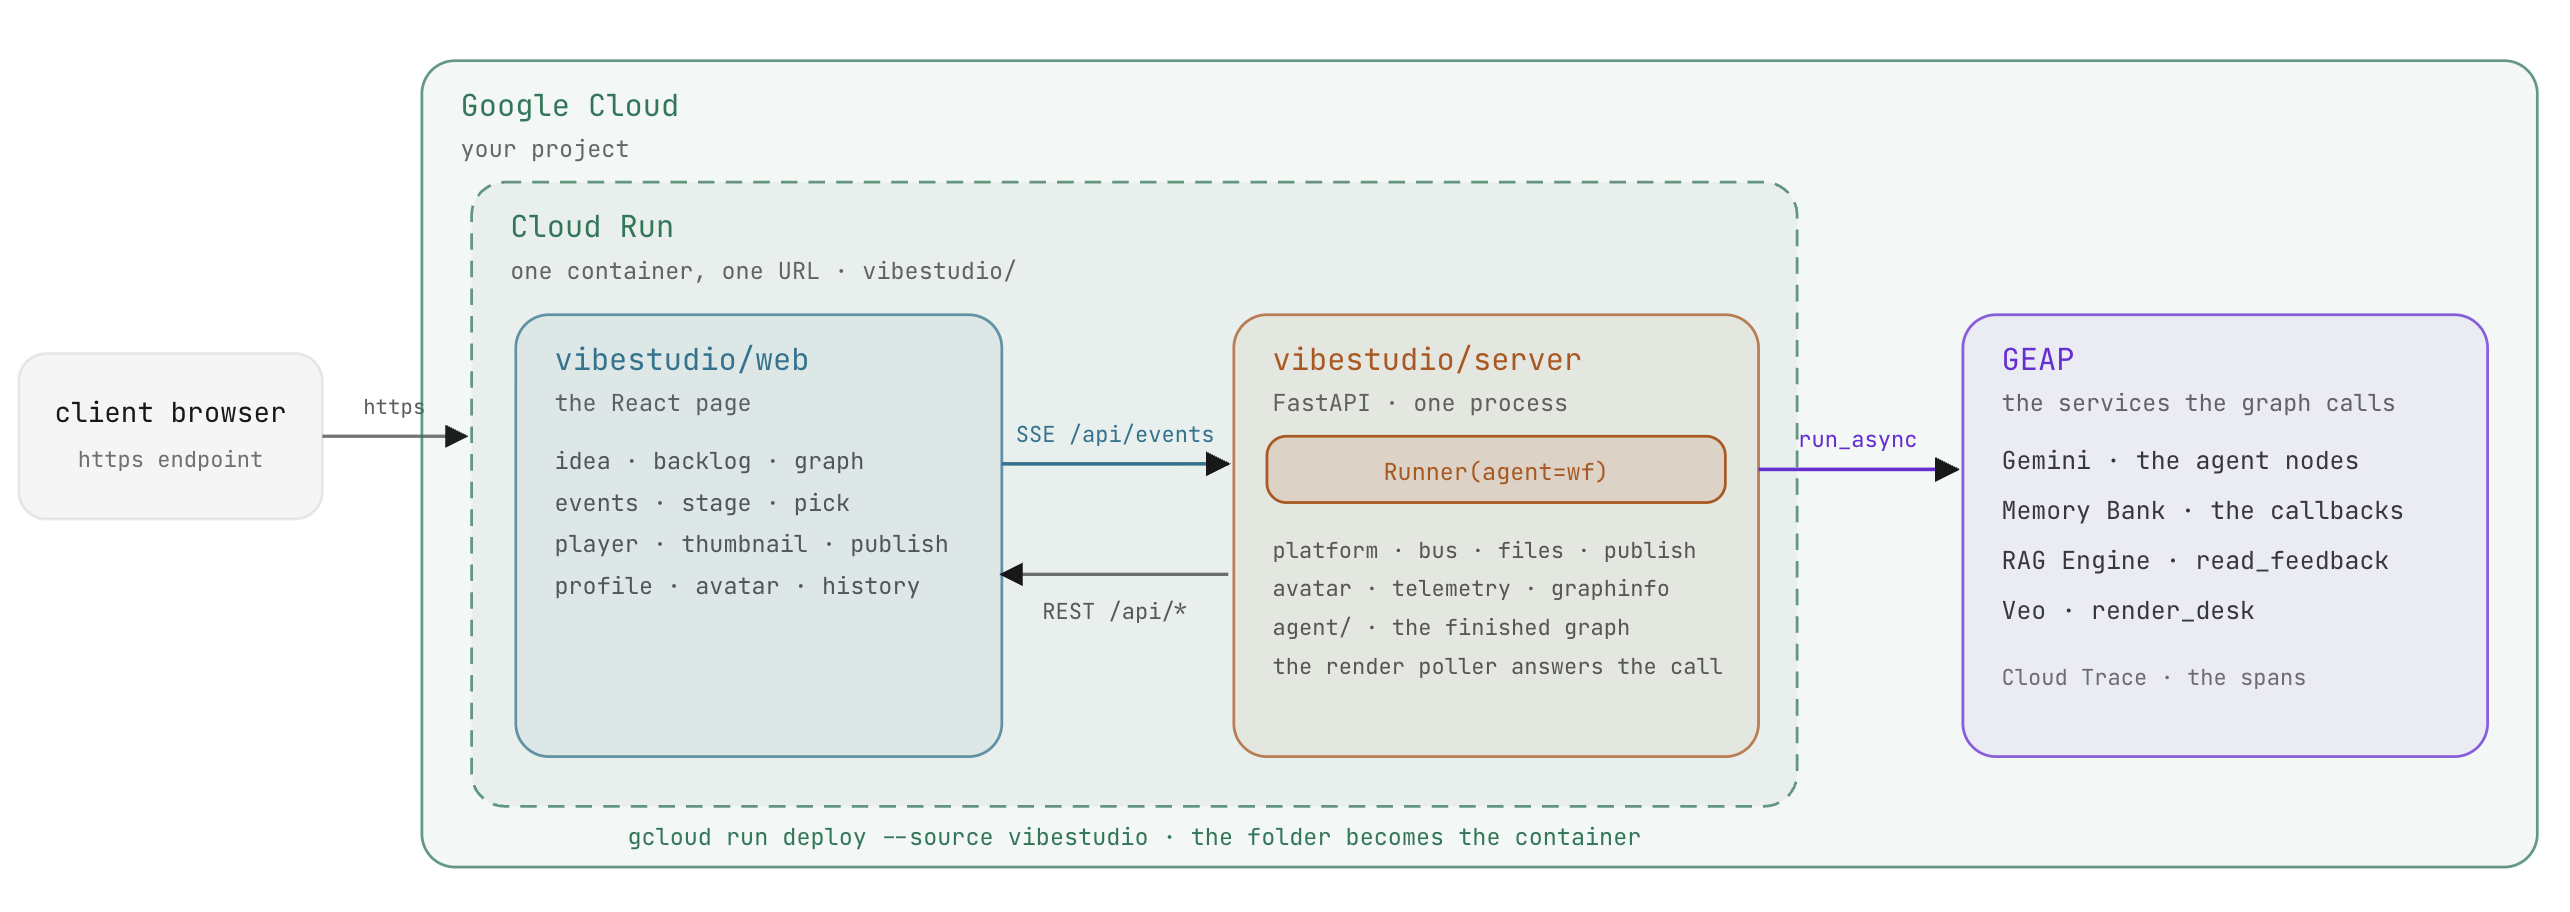
ADK Runner
במהלך הפיתוח, adk web ניהל את התרשים. בסביבת ייצור, האפליקציה מארחת את תהליך העבודה באמצעות המחלקה Runner של ADK:
self._svc = DatabaseSessionService(db_url=config.DB_URL)
self._runner = Runner(app_name=config.APP, agent=wf, session_service=self._svc)

async for ev in self._runner.run_async(user_id=config.USER, session_id=run_id, new_message=message):
    self._absorb(ev)    # fold the ADK event into the run state, publish one app event

# the gate's answer and the render's delivery are the same call, with a function_response part
part = Part(function_response=FunctionResponse(id=call_id, name=name, response=response))
-
run_async: מפעיל את תהליך העבודה, מפיק אירועים ברצף כשהצמתים מופעלים ושומר את העדכונים בשירות הסשן. - המשך מאוחד: גם החלטות המשתמשים ב-
direction_gateוגם סרטונים שהושלמו ב-Veo ממשיכים לפעול באמצעות אובייקטים זהים שלFunctionResponseשנשלחים אלrun_async.
ארכיטקטורת האפליקציה בסביבת הייצור
אפליקציית הייצור ב-vibestudio/ משלבת את הצינור המלא:
vibestudio/
  server/
    main.py                 FastAPI: application server, REST routes, static assets
    api.py                  REST API endpoints: run, pick, publish, backlog, profile, history
    runner.py               Runner orchestration over the workflow, background render poller
    platform/               Event bus (SSE stream), file storage, publishing, telemetry
    agent/                  Production agent package, verified by checks/verify_app.py
      graph.py              The complete workflow graph and node definitions
      desk.py               render_desk and render_submit wrapped with LongRunningFunctionTool
      schemas.py            Pydantic schemas: Directions, CleanedDirection, Script
      cleanup_tools.py      Deterministic policy tools: find_policy_hits, suggest_replacement
      platform/             Memory Bank, RAG Engine, and Veo integrations
  web/                      Production React user interface
  Dockerfile · deploy.py · run.sh
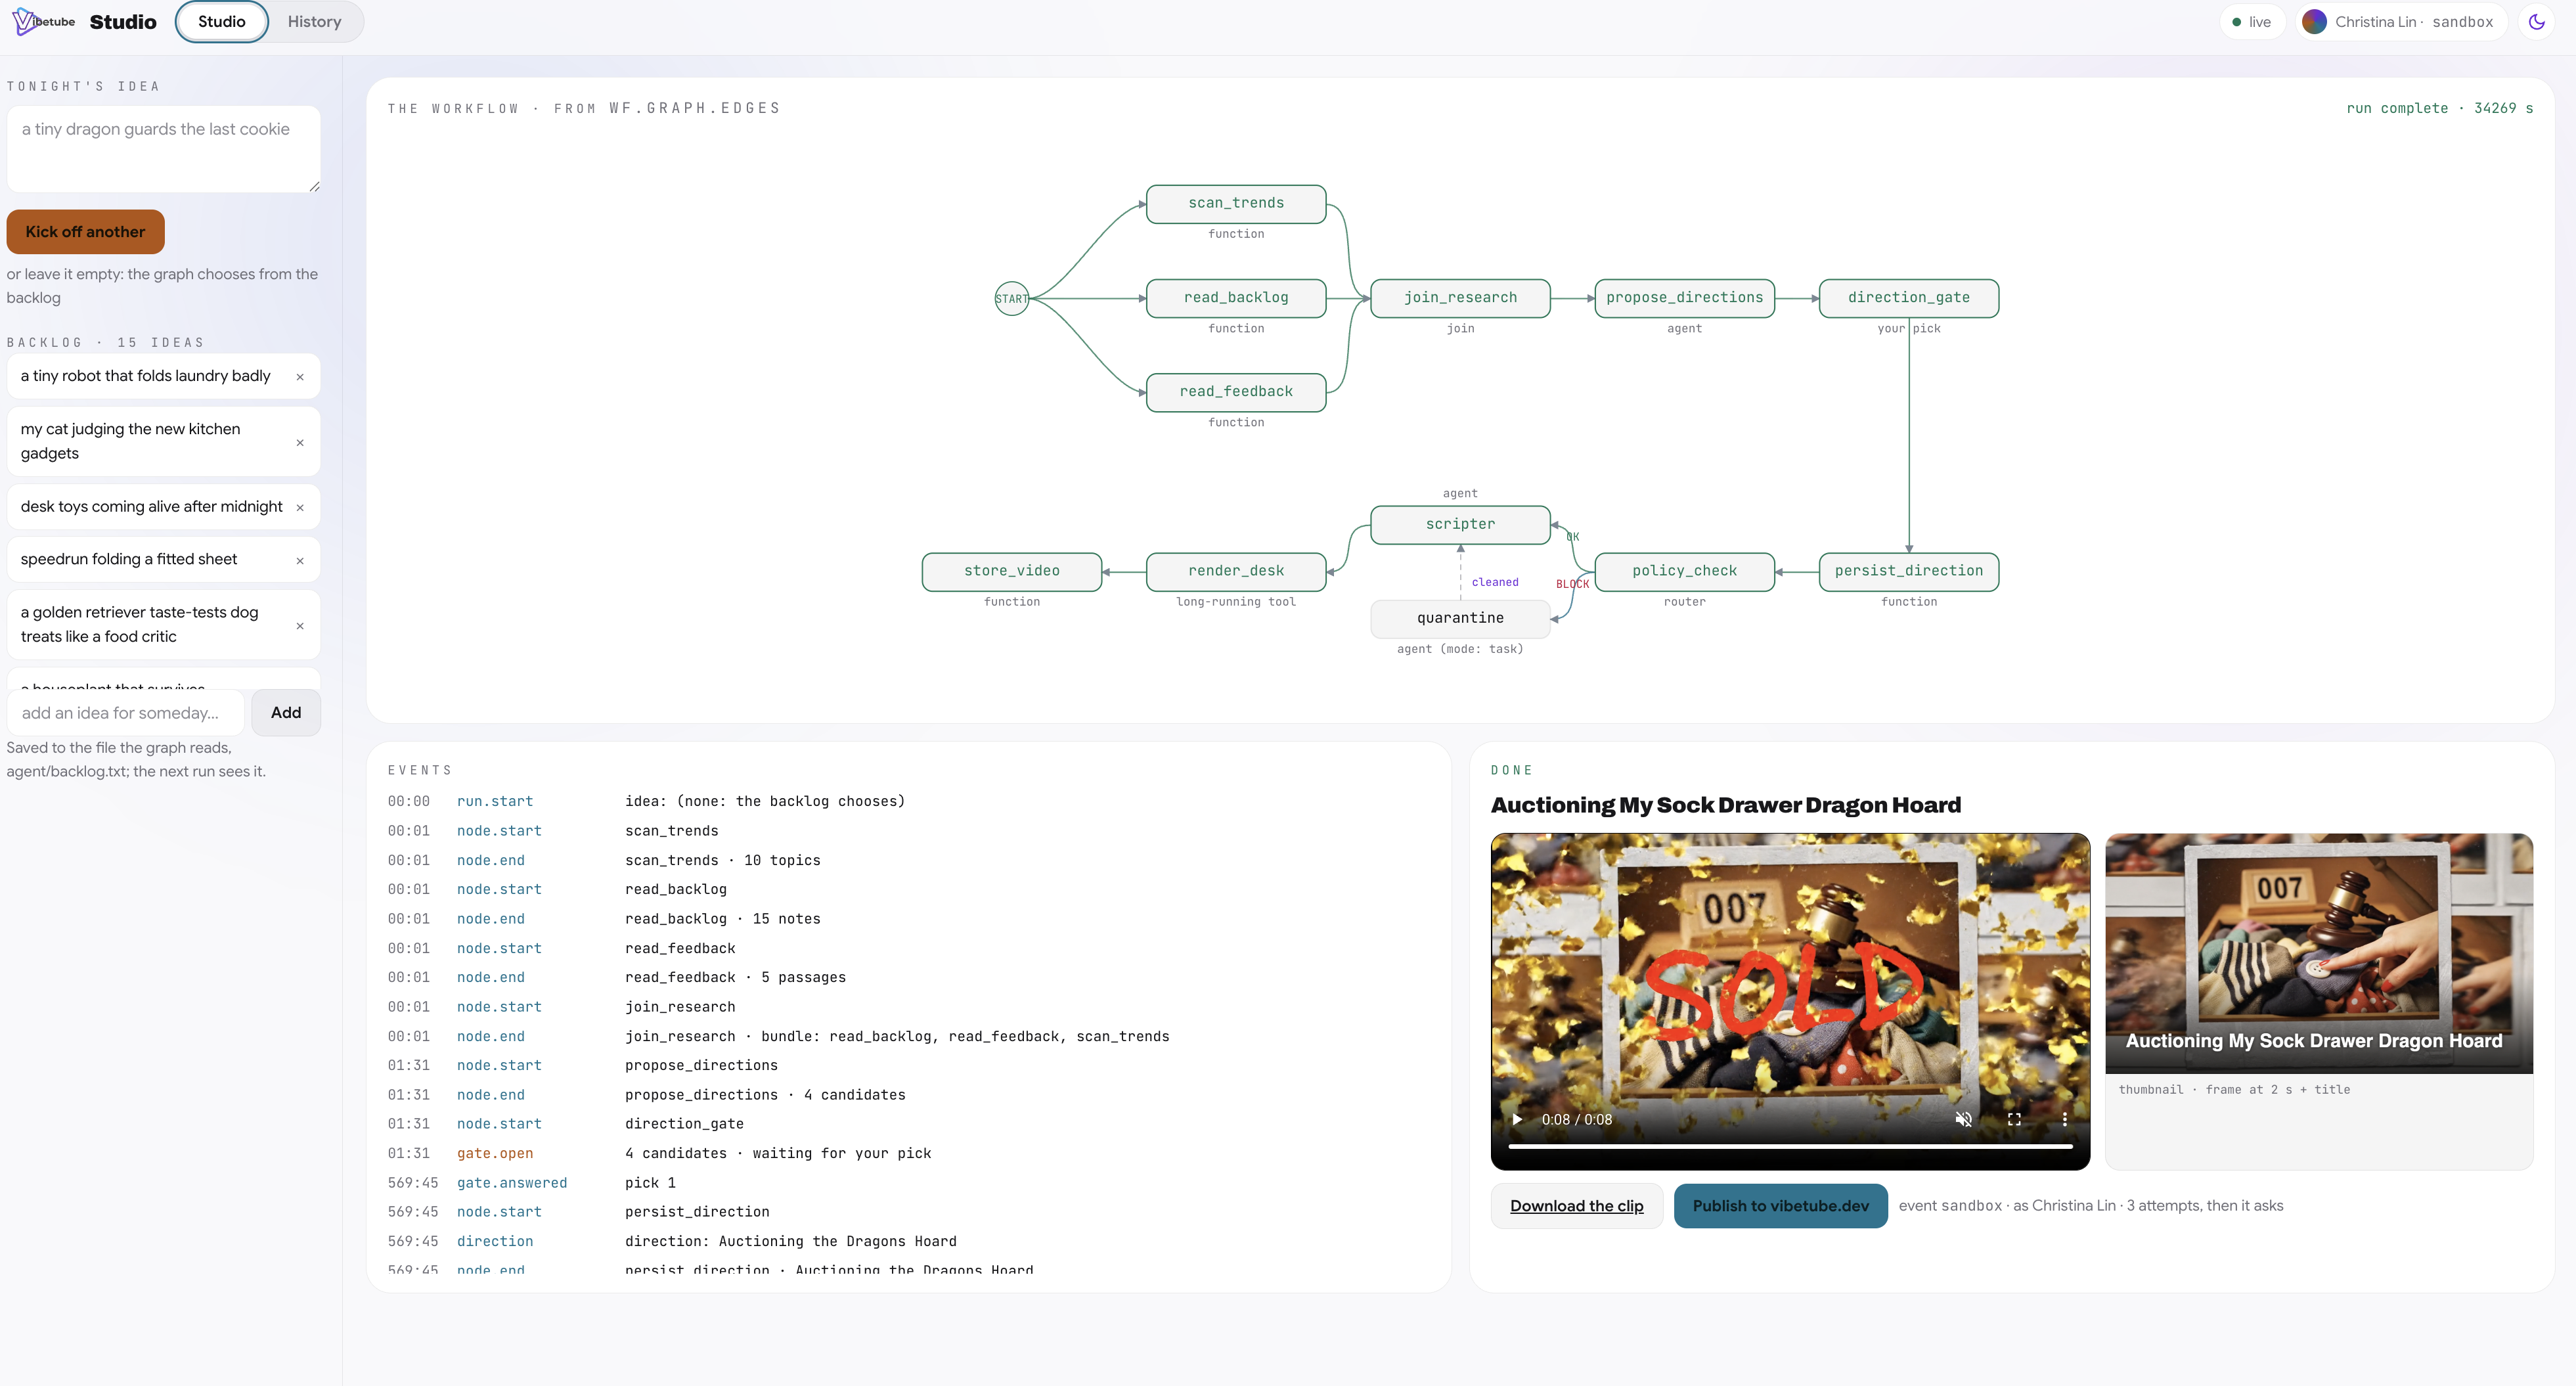
- מקור נתונים יחיד של אירועים: קצה העורפי (backend) של FastAPI מפרסם אירועים במקור נתונים יחיד של אירועים שנשלחים מהשרת (SSE). ממשק הקצה של React מציג את התקדמות הגרף בזמן אמת ומטפל בחיבורים מאוחרים בלי לאבד את המצב.
- ביצוע מנותק: האפליקציה מנהלת את לולאת האירוע. גרף תהליך העבודה מתמקד אך ורק בלוגיקת הביצוע, בלי להתייחס לממשק הקצה.
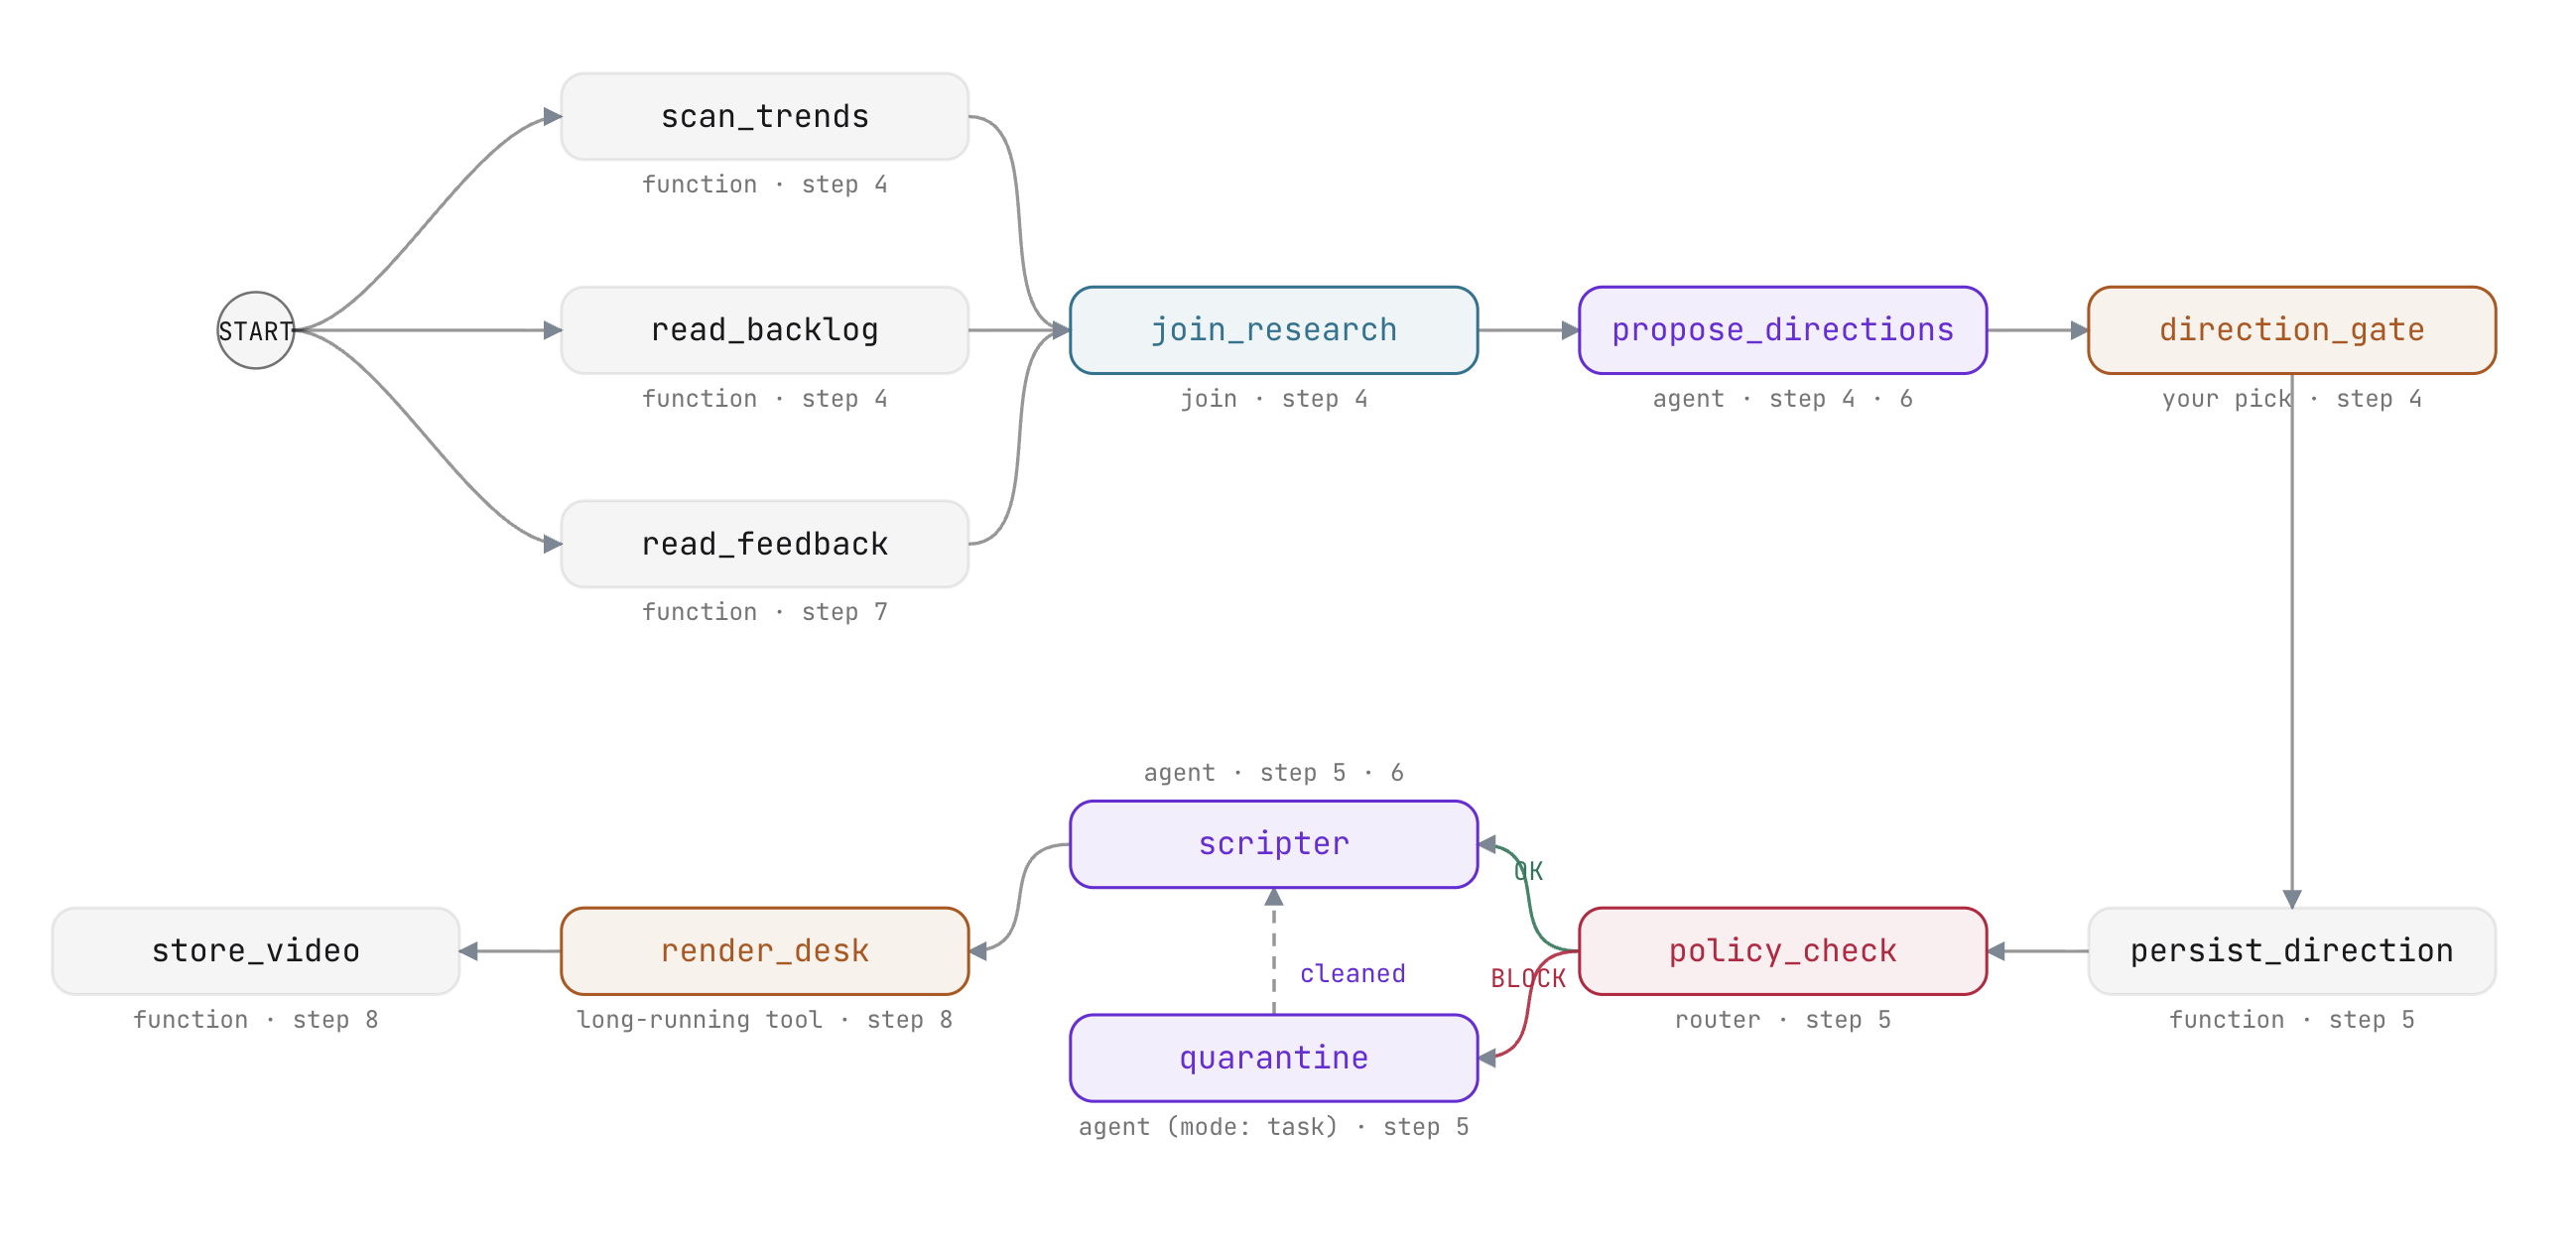
רשימת הקצוות המלאה של תהליך העבודה ב-agent/graph.py משלבת את כל התבניות הארכיטקטוניות שנוצרו ב-Codelab הזה:
        (START, scan_trends, join_research),
        (START, read_backlog, join_research),
        (START, read_feedback, join_research),
        (join_research, propose_directions, direction_gate,
         persist_direction, policy_check),
        (policy_check, {"OK": scripter, "BLOCK": quarantine}),
        (quarantine, scripter),
        (scripter, render_desk, store_video),
פריסה ב-Cloud Run
Google Cloud Run מספק אירוח בלי שרת (serverless) עם התאמה אוטומטית לעומס (automatic scaling), ניתוב בקשות ו-builds משולבים של קונטיינרים:
gcloud run deploy vibestudio --source vibestudio \
  --project $GOOGLE_CLOUD_PROJECT --region us-central1 \
  --labels dev-tutorial-codelab=vibetube --allow-unauthenticated \
  --memory 2Gi --cpu 2 --timeout 3600 --concurrency 40 \
  --max-instances 1 --min-instances 1 --session-affinity \
  --set-env-vars GOOGLE_CLOUD_PROJECT=...,STUDIO_VERTEX=1,STUDIO_MEMORY_BANK=...,STUDIO_RAG_CORPUS=...,VIBETUBE_URL=...,VIBETUBE_EVENT=...,VIBETUBE_NAME=...,VIBETUBE_PROJECT=...
- יצירת קונטיינר: הפקודה
gcloud run deploy --sourceאורזת את הספרייהvibestudio/, יוצרת את קובץ האימג' של הקונטיינר באמצעות Cloud Build ומבצעת פריסה של השירות בפעולה אחת. - זיקה לסשן (session affinity): הפניית בקשות מאותו משתמש לאותו מארז של קונטיינר, תוך שמירה על מצב הסשן המקומי בשלבים איטרטיביים.
- ניטור: שילוב עם Cloud Trace מאפשר לתעד טווחי זמן מבוזרים לכל צומת, קריאה ל-LLM והפעלת כלי. אפשר לגשת לנתונים האלה דרך Trace Explorer במסוף Google Cloud.
לוחצים על הכפתור Deploy ב-workbench כדי להריץ את סקריפט הפריסה. בסיום ה-build, כתובת ה-URL של השירות הפעיל תוצג בטרמינל.
10. סיכום
ב-VibeStudio Workbench, עוברים אל Step 10 · Summary כדי לבדוק את הארכיטקטורה שהושלמה.
שלב | ארכיטקטורה ומושגים | תבנית הטמעה |
פרומפט אחד | הנחיה אחת, כלי פונקציות, לולאת צ'אט רציפה |
|
יסודות של Agentic Workflows | תהליך עבודה של תרשים, מחקר מקביל, פלט של סכימה, שער אנושי |
|
State ו-Router | מצב סשן משותף, קישור פרמטרים, ניתוב דטרמיניסטי, סוכן משימות |
|
Memory Bank | זיכרון לטווח ארוך ברמת המשתמש, איחוד סמנטי, הוקים של מחזור חיים |
|
RAG Engine | אחזור מסמכים על סמך תגובות של קהלים, הטמעות סמנטיות | |
יצירת סרטונים אסינכרונית באמצעות Veo | כלים שפועלים לאורך זמן, קבלות בהמתנה, דימון (daemon) למשלוח חיצוני | |
פריסה ב-Cloud Run | תזמור תוכנות, אירועים שנשלחים מהשרת, מאגר תגים בצד השרת |
|
עקרונות הארכיטקטורה הבסיסיים
- השעיה במקום המתנה: תהליכי העבודה מושהים בצורה מסודרת כדי לאפשר קלט אנושי (
RequestInput) או פעולות ארוכות טווח (LongRunningFunctionTool). התהליכים לא ממתינים ללא פעולה בשרשורים או בשקעי רשת. - הפעלה מחדש אוניברסלית: כל ההשעיות מופעלות מחדש באמצעות מנגנון זהה:
function_responseיחיד שנושא את מזהה השיחה של הצומת שהושעה. - ניהול מצב מנותק: הצמתים משתפים נתונים באמצעות מפתחות מצב של סשנים עם שם וקישור פרמטרים, במקום מטען ייעודי (payload) מפורט ובעל צימוד חזק.
- ניתוב דטרמיניסטי לפני עלות גנרטיבית: נתבים מבוססי-כללים ומסנני ביטויים רגולריים (regex) מעריכים את המדיניות בעלות של אפס טוקנים לפני הפעלת המודלים הגנרטיביים.
- הפרדה בין נושאים: הקשר שספציפי לסוכן מסוים שייך לקריאות חוזרות במחזור חיים, בעוד שתלות בנתונים משותפים שייכת