1. परिचय
इस कोडलैब में, Agent Development Kit (ADK) में वर्कफ़्लो और ग्राफ़ का इस्तेमाल करके, अगली पीढ़ी के एजेंटिक सिस्टम बनाने का तरीका बताया गया है. आपको सामान्य आर्किटेक्चरल पैटर्न लागू करने होंगे, ह्यूमन-इन-द-लूप (एचआईटीएल) इंटरैक्शन को व्यवस्थित करना होगा, और लंबे समय तक चलने वाले एसिंक्रोनस एक्ज़ीक्यूशन को मैनेज करना होगा. एजेंट के व्यवहार को अपनी पसंद के मुताबिक बनाने और उसे बेहतर बनाने के लिए, एंटरप्राइज़ नॉलेज बेस और परसिस्टेंट मेमोरी को भी इंटिग्रेट किया जाएगा. आखिर में, इन सुविधाओं को कनेक्ट करके, वीडियो अपने-आप जनरेट होने की पाइपलाइन को चलाया जाएगा.
स्थिति
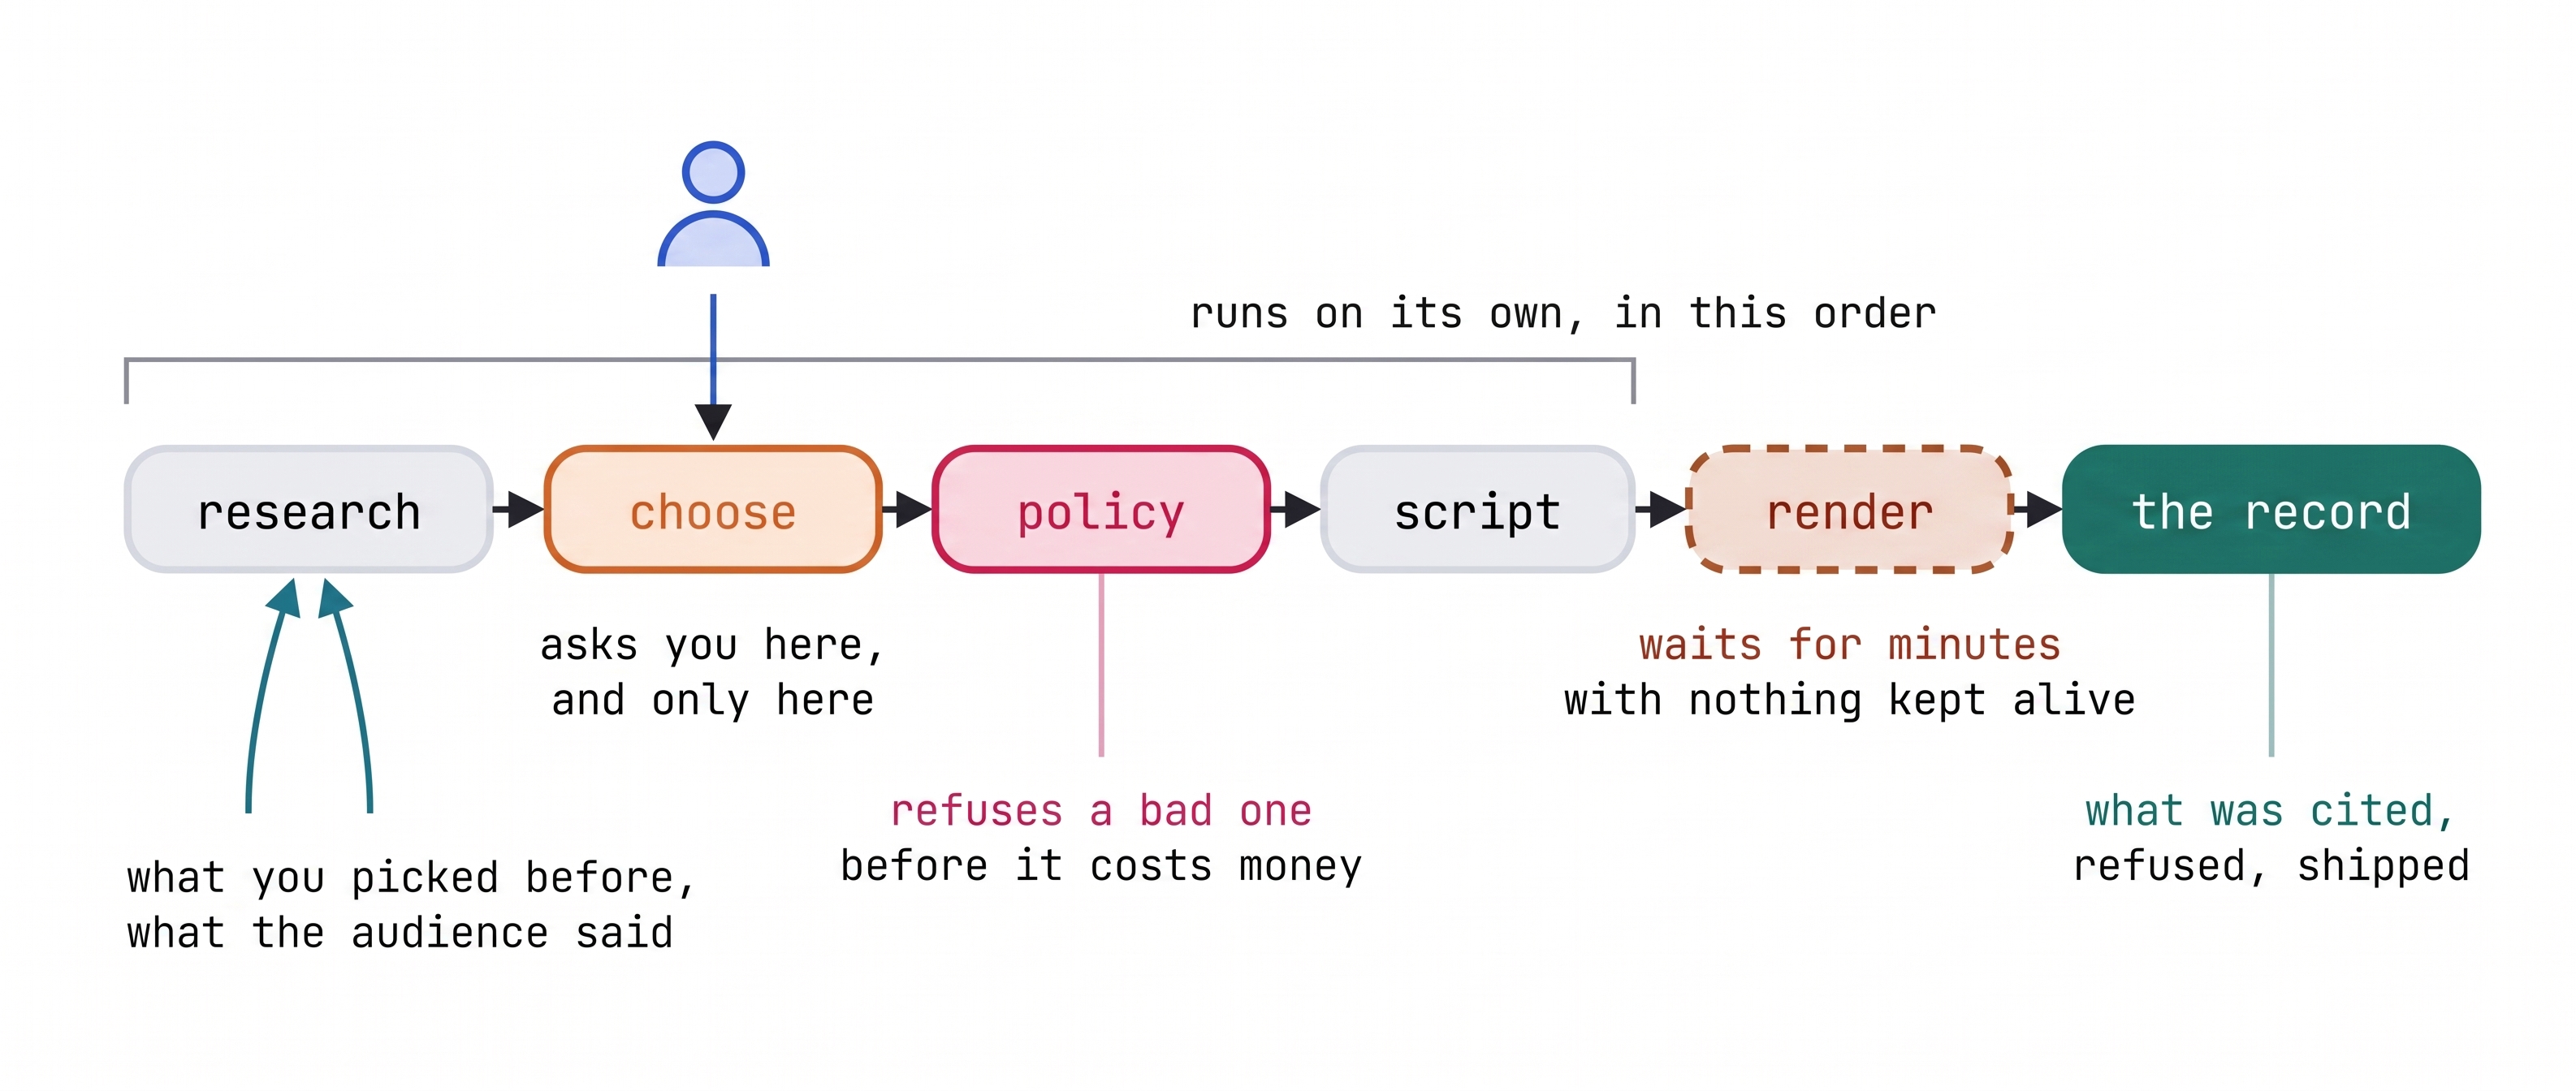
आपने VibeTube पर एक डिजिटल चैनल बनाया है. इस पर दर्शकों की दिलचस्पी बनी रहती है और क्रिएटिव आइडिया की संख्या लगातार बढ़ती जा रही है. हर वीडियो बनाने के लिए, कई चरणों में लगातार काम करना पड़ता है: ट्रेंडिंग फ़ॉर्मैट पर रिसर्च करना, दर्शकों से मिले सुझाव/राय/शिकायत को शामिल करना, स्क्रिप्ट तैयार करना, नीति के मुताबिक वीडियो बनाना, और वीडियो क्लिप जनरेट करना. जनरेटिव मॉडल, अलग-अलग ऐसेट का ड्राफ़्ट बना सकते हैं. हालांकि, लगातार रिलीज़ करने के लिए, ऑर्केस्ट्रेटेड एजेंट आर्किटेक्चर की ज़रूरत होती है.
इस लाइफ़साइकल को ऑटोमेट करने के लिए, VibeStudio बनाया जाएगा. यह एजेंटिक पाइपलाइन, एक साथ कई विषयों पर रिसर्च करती है. साथ ही, मैन्युअल तरीके से फ़ैसले लेने की सुविधा के लिए, चुने गए विकल्प दिखाती है. वीडियो जनरेट करने से पहले, नीति से जुड़े गेट अपने-आप लागू करती है. इसके अलावा, प्रोडक्शन रन के दौरान कॉन्टेक्स्ट को बनाए रखती है.
आपको ये सब सीखने को मिलेगा
- ग्राफ़ इंजीनियरिंग के बुनियादी सिद्धांत: कई चरणों वाले एजेंट आर्किटेक्चर के लिए, कंट्रोल फ़्लो और स्ट्रक्चर्ड एक्ज़ीक्यूशन पाथ को साफ़ तौर पर तय करना ज़रूरी होता है. आपने ADK
Workflowबनाया है. इसमें एज टपल,STARTएंट्री पॉइंट, पैरलल फ़ैन-आउट एग्रीगेशन के लिएJoinNode, और स्थिति के आधार पर एक्ज़ीक्यूशन को कंट्रोल करने के लिए डिटरमिनिस्टिक राउटर नोड का इस्तेमाल किया गया है. - एजेंट मोड और लाइफ़साइकल कॉलबैक: खास कामों के लिए, अलग-अलग तरह के ऑपरेशन और तय किए गए सुरक्षा दिशा-निर्देशों की ज़रूरत होती है. ADK
Agentइंस्टेंस को कॉन्फ़िगर करने के लिए,chat,single_turn, और टूल की सुविधा वालेtaskमोड का इस्तेमाल वर्कफ़्लो नोड के तौर पर किया जाता है. साथ ही,before_model_callbackऔरafter_agent_callbackकी मदद से इंटरसेप्टर लागू किए जाते हैं. - निगरानी में काम करने वाले एआई मॉडल का इस्तेमाल: प्रोडक्शन पाइपलाइन, क्रिएटिविटी से जुड़े अहम चेकपॉइंट पर रुक जाती हैं, ताकि इंसान फ़ैसला ले सकें.
RequestInputको लागू करके, वर्कफ़्लो के एक्ज़ीक्यूशन को निलंबित किया जा सकता है. साथ ही, स्ट्रक्चर्ड रिस्पॉन्स स्कीमा लागू की जा सकती हैं. इसके अलावा, आइडल रनटाइम प्रोसेस को चालू रखे बिना, एक्ज़ीक्यूशन को फिर से शुरू किया जा सकता है. - क्रमिक एजेंट मेमोरी: प्रोडक्शन सिस्टम, कम समय के लिए उपलब्ध एक्ज़ीक्यूशन की स्थिति को लंबे समय तक उपलब्ध रहने वाले कॉन्टेक्स्ट से अलग करते हैं.
Event(state=...)और पैरामीटर बाइंडिंग का इस्तेमाल करके, कम समय के लिए सेशन की स्थिति को मैनेज किया जाता है. साथ ही, GEAP Memory Bank को कनेक्ट किया जाता है, ताकि क्रिएटर की प्राथमिकताओं को एक्सट्रैक्ट, इकट्ठा, और सेव किया जा सके. - एंटरप्राइज़ के नॉलेज बेस के साथ इंटिग्रेशन: ऑटोनॉमस एजेंट को डाइनैमिक डोमेन कॉन्टेक्स्ट और ऑडियंस की भावनाओं की जानकारी की ज़रूरत होती है. आपने GEAP RAG इंजन कॉर्पस को, पैरलल फ़ैन-आउट के अंदर एक खास रिट्रीवल नोड के तौर पर कनेक्ट किया है, ताकि एजेंट के आउटपुट को सिमैंटिक तौर पर सही बनाया जा सके.
- ज़्यादा समय तक चलने वाले वर्कफ़्लो और डिप्लॉयमेंट: मल्टीमॉडल वीडियो रेंडरिंग, लंबे समय तक एसिंक्रोनस तरीके से काम करती है. कॉल आईडी के हिसाब से वर्कफ़्लो को निलंबित और फिर से शुरू करने के लिए, कॉल की रसीदें मिलने तक
LongRunningFunctionToolको लागू करें. साथ ही, Cloud Run पर ADKRunnerका इस्तेमाल करके, पूरी हो चुकी पाइपलाइन को डिप्लॉय करें.
इस कोडलैब को कैसे व्यवस्थित किया गया है
यह कोडलैब, आपके लिए कॉन्सेप्ट और आर्किटेक्चर के रेफ़रंस के तौर पर काम करता है. हर सेक्शन में, वर्कबेंच के संबंधित चरण में लागू किए गए ADK कंस्ट्रक्ट के बारे में बताया गया है. साथ ही, रेफ़रंस कोड दिया गया है और डिज़ाइन के मुख्य सिद्धांतों के बारे में बताया गया है. वर्कबेंच में दी गई कसरत को पूरा करने से पहले, हर सेक्शन को ध्यान से पढ़ें.
VibeStudio Workbench में, कोड लिखने का काम किया जाता है. यह एक वेब इंटरफ़ेस है. इसमें इंटरैक्टिव कोड एडिटर, रनटाइम वेरिफ़ायर, और एम्बेड किया गया एडीके इंस्पेक्टर होता है. वर्कबेंच में दिए गए चरणों की संख्या, इस कोडलैब में दिए गए चरणों की संख्या से मेल खाती है, ताकि आपकी प्रोग्रेस सिंक रहे. फ़ाउंडेशनल ग्राफ़ में किए गए बदलाव, सभी चरणों में बने रहते हैं. साथ ही, वर्कबेंच में आगे बढ़ने पर, ज़रूरी शर्तें अपने-आप पूरी हो जाती हैं.
वर्कबेंच की एक्सरसाइज़ पूरी करने के बाद, आपको एक एंड-टू-एंड एजेंटिक पाइपलाइन बनानी होगी. साथ ही, वीडियो कॉन्टेंट जनरेट करने के लिए, Cloud Run पर VibeStudio ऐप्लिकेशन को डिप्लॉय करना होगा.
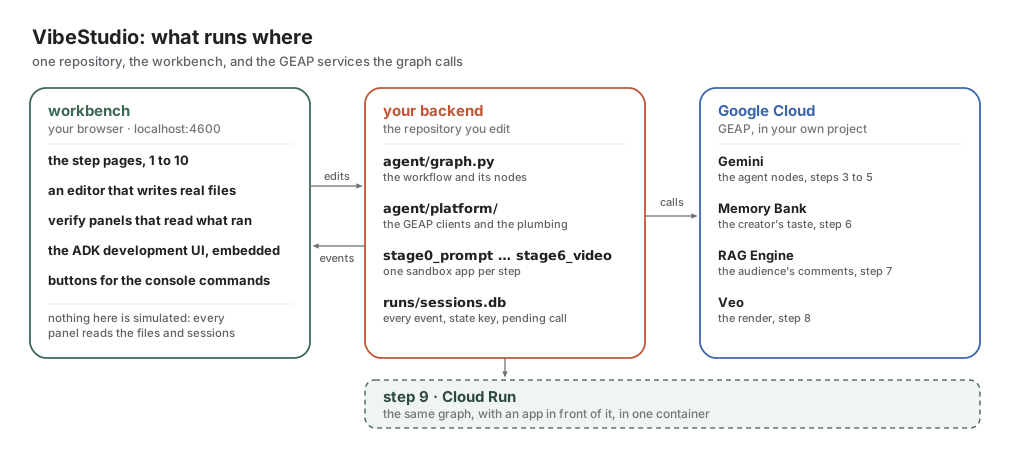
इस एनवायरमेंट में तीन मुख्य कॉम्पोनेंट होते हैं: VibeStudio Workbench (कोड में बदलाव करने और रनटाइम की पुष्टि करने के लिए लोकल वेब इंटरफ़ेस), आपका बैकएंड (ADK Workflow और agent/ में स्टेज सैंडबॉक्स), और Google Cloud (Gemini मॉडल, GEAP Memory Bank, RAG Engine, और Veo वीडियो जनरेशन).
2. सेटअप
वर्कशॉप के क्रेडिट पर दावा करना
अगर आपको किसी प्रशिक्षक की निगरानी में लैब में हिस्सा लेना है, तो प्रशिक्षक आपके Google Cloud प्रोजेक्ट के लिए क्रेडिट देगा. अपने क्रेडिट रिडीम करने के लिए, प्रशिक्षक के निर्देशों का पालन करें. साथ ही, यह पक्का करें कि आपका खाता चालू हो और उस पर बिलिंग की सुविधा चालू हो.
Cloud Shell खोलें
Cloud Shell, ब्राउज़र पर आधारित एक डेवलपमेंट एनवायरमेंट है. इसमें gcloud, Python, और git पहले से इंस्टॉल होते हैं.
Cloud Shell लॉन्च करने के लिए:
- Google Cloud Console पर जाएं.
- सबसे ऊपर मौजूद नेविगेशन हेडर में, Cloud Shell चालू करें (टर्मिनल विंडो आइकॉन) पर क्लिक करें.
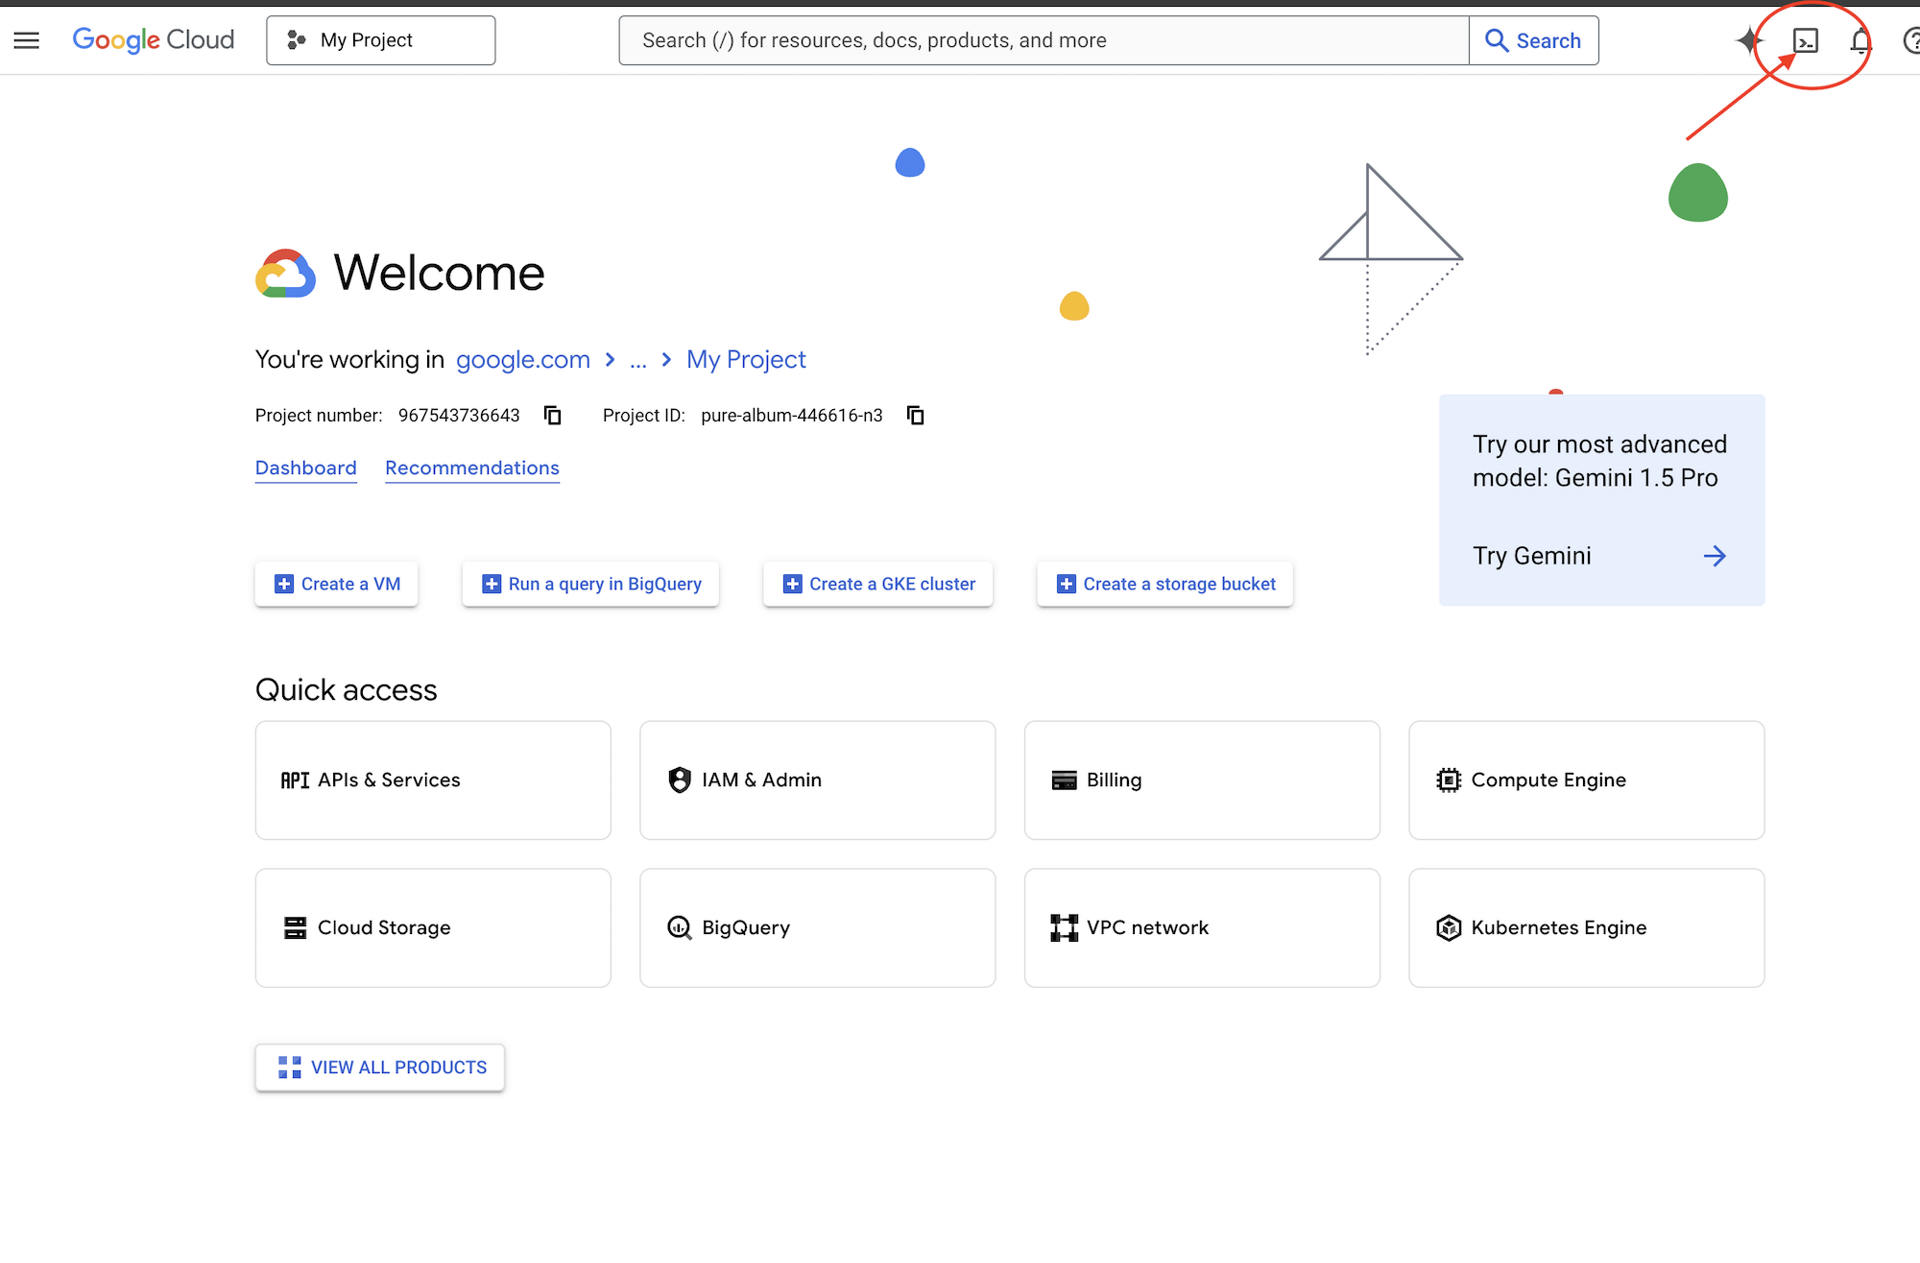
ब्राउज़र विंडो में सबसे नीचे एक टर्मिनल सेशन खुलता है.
रिपॉज़िटरी को क्लोन और शुरू करना
प्रोजेक्ट को क्लोन करने के लिए, Cloud Shell टर्मिनल में ये कमांड चलाएं:
git clone https://github.com/gca-americas/vibetube-studio
cd ~/vibetube-studio
कॉन्फ़िगरेशन के प्रॉम्प्ट
सेटअप के दौरान, आपसे यह जानकारी देने के लिए कहा जाएगा:
- Google Cloud प्रोजेक्ट आईडी:
setup_project.shसे प्रॉम्प्ट मिलने पर, Enter दबाएं. इससे नया प्रोजेक्ट अपने-आप बन जाएगा. अगर आपको किसी मौजूदा प्रोजेक्ट (जैसे कि पहले से असाइन किया गया प्रोजेक्ट) का इस्तेमाल करना है, तो अपना प्रोजेक्ट आईडी डालें. साथ ही, पक्का करें कि स्पेलिंग सही हो और बिलिंग चालू हो. - इवेंट कोड: अपने शिक्षक से मिला रूम कोड डालें. अगर आपको कोई कार्ड नहीं मिला है, तो किसी शिक्षक या पड़ोसी से संपर्क करें. अगर आपको यह लैब घर पर पूरी करनी है, तो डिफ़ॉल्ट
sandboxरूम को स्वीकार करने के लिए, Enter दबाएं. - चैनल का डिसप्ले नेम:
setup_codelab.shके प्रॉम्प्ट करने पर, अपना नाम या पसंदीदा चैनल हैंडल डालें. इसके अलावा, अपने Google खाते से जनरेट किए गए डिफ़ॉल्ट नाम को स्वीकार करने के लिए, Enter दबाएं.
सेटअप की दोनों स्क्रिप्ट को इस क्रम में चलाएं:
./setup_project.sh
./setup_codelab.sh
setup_project.sh: यह कुकी, चालू बिलिंग वाले Google Cloud प्रोजेक्ट को बनाती है या उसका फिर से इस्तेमाल करती है. साथ ही, प्रोजेक्ट आईडी को~/project_id.txtमें सेव करती है और चालूgcloudकॉन्टेक्स्ट को कॉन्फ़िगर करती है.setup_codelab.sh: यह.venvमेंuvऔर Python की डिपेंडेंसी इंस्टॉल करता है. साथ ही, ज़रूरी Google Cloud API चालू करता है. यह.envमें चैनल की सेटिंग कॉन्फ़िगर करता है, Gemini के साथ मॉडल ऐक्सेस की पुष्टि करता है, Memory Bank और RAG के संसाधन उपलब्ध कराता है, वर्कबेंच इंटरफ़ेस बनाता है, और VibeStudio Workbench शुरू करता है.
यह स्क्रिप्ट, प्रीफ़्लाइट जांच करती है और बैकग्राउंड में VibeStudio Workbench शुरू करती है. इसकी आखिरी लाइनों में, इसे खोलने का लिंक दिखता है.
7 · Preflight
  ✓ python 3.12
  ✓ auth path A: Vertex via ADC (STUDIO_VERTEX=1)
  ✓ Google Cloud ADC (project <your-project>)
  ✓ stage0_prompt loads
  ...
  ✓ stage6_video loads (13 edges)
  ✓ aiplatform.googleapis.com enabled (Gemini, Veo, Memory Bank, RAG Engine)
  ✓ vectorsearch.googleapis.com enabled (the vector store a RAG corpus is built on)
  ✓ Memory Bank connected
  ✓ RAG corpus connected
  ✓ VibeStudio Workbench running on port 4600

PREFLIGHT GREEN

Setup finished. The VibeStudio Workbench is already running.

  Open this and start at step 1
      https://4600-<your cloud shell host>/step/story

  It runs in the background. You do not need to start anything else.
      log      runs/lab.log
      stop     kill $(cat runs/lab.pid)
      start    scripts/start.sh
उस लिंक पर क्लिक करें. यह पता, वेब प्रीव्यू → पोर्ट बदलें → 4600 में भी उपलब्ध है.
किसी भी समय एनवायरमेंट की फिर से जांच करने के लिए, python scripts/preflight.py चलाएं. वर्कबेंच को रीस्टार्ट करने के लिए, scripts/restart.sh चलाएं. इसे फिर से सेट अप करने के लिए, ./setup_codelab.sh चलाएं. इससे आपका कॉन्फ़िगरेशन और प्रोग्रेस सेव रहती है.
इसे खोलने के बाद, पहला चरण, कहानी में दिए गए उदाहरण और दूसरा चरण, आपको क्या बनाना है में दिए गए फ़ाइनल ग्राफ़ के बारे में पढ़ें. इनमें से किसी में भी कोई कसरत नहीं है. इसके बाद, तीसरे चरण के लिए यहां वापस आएं.
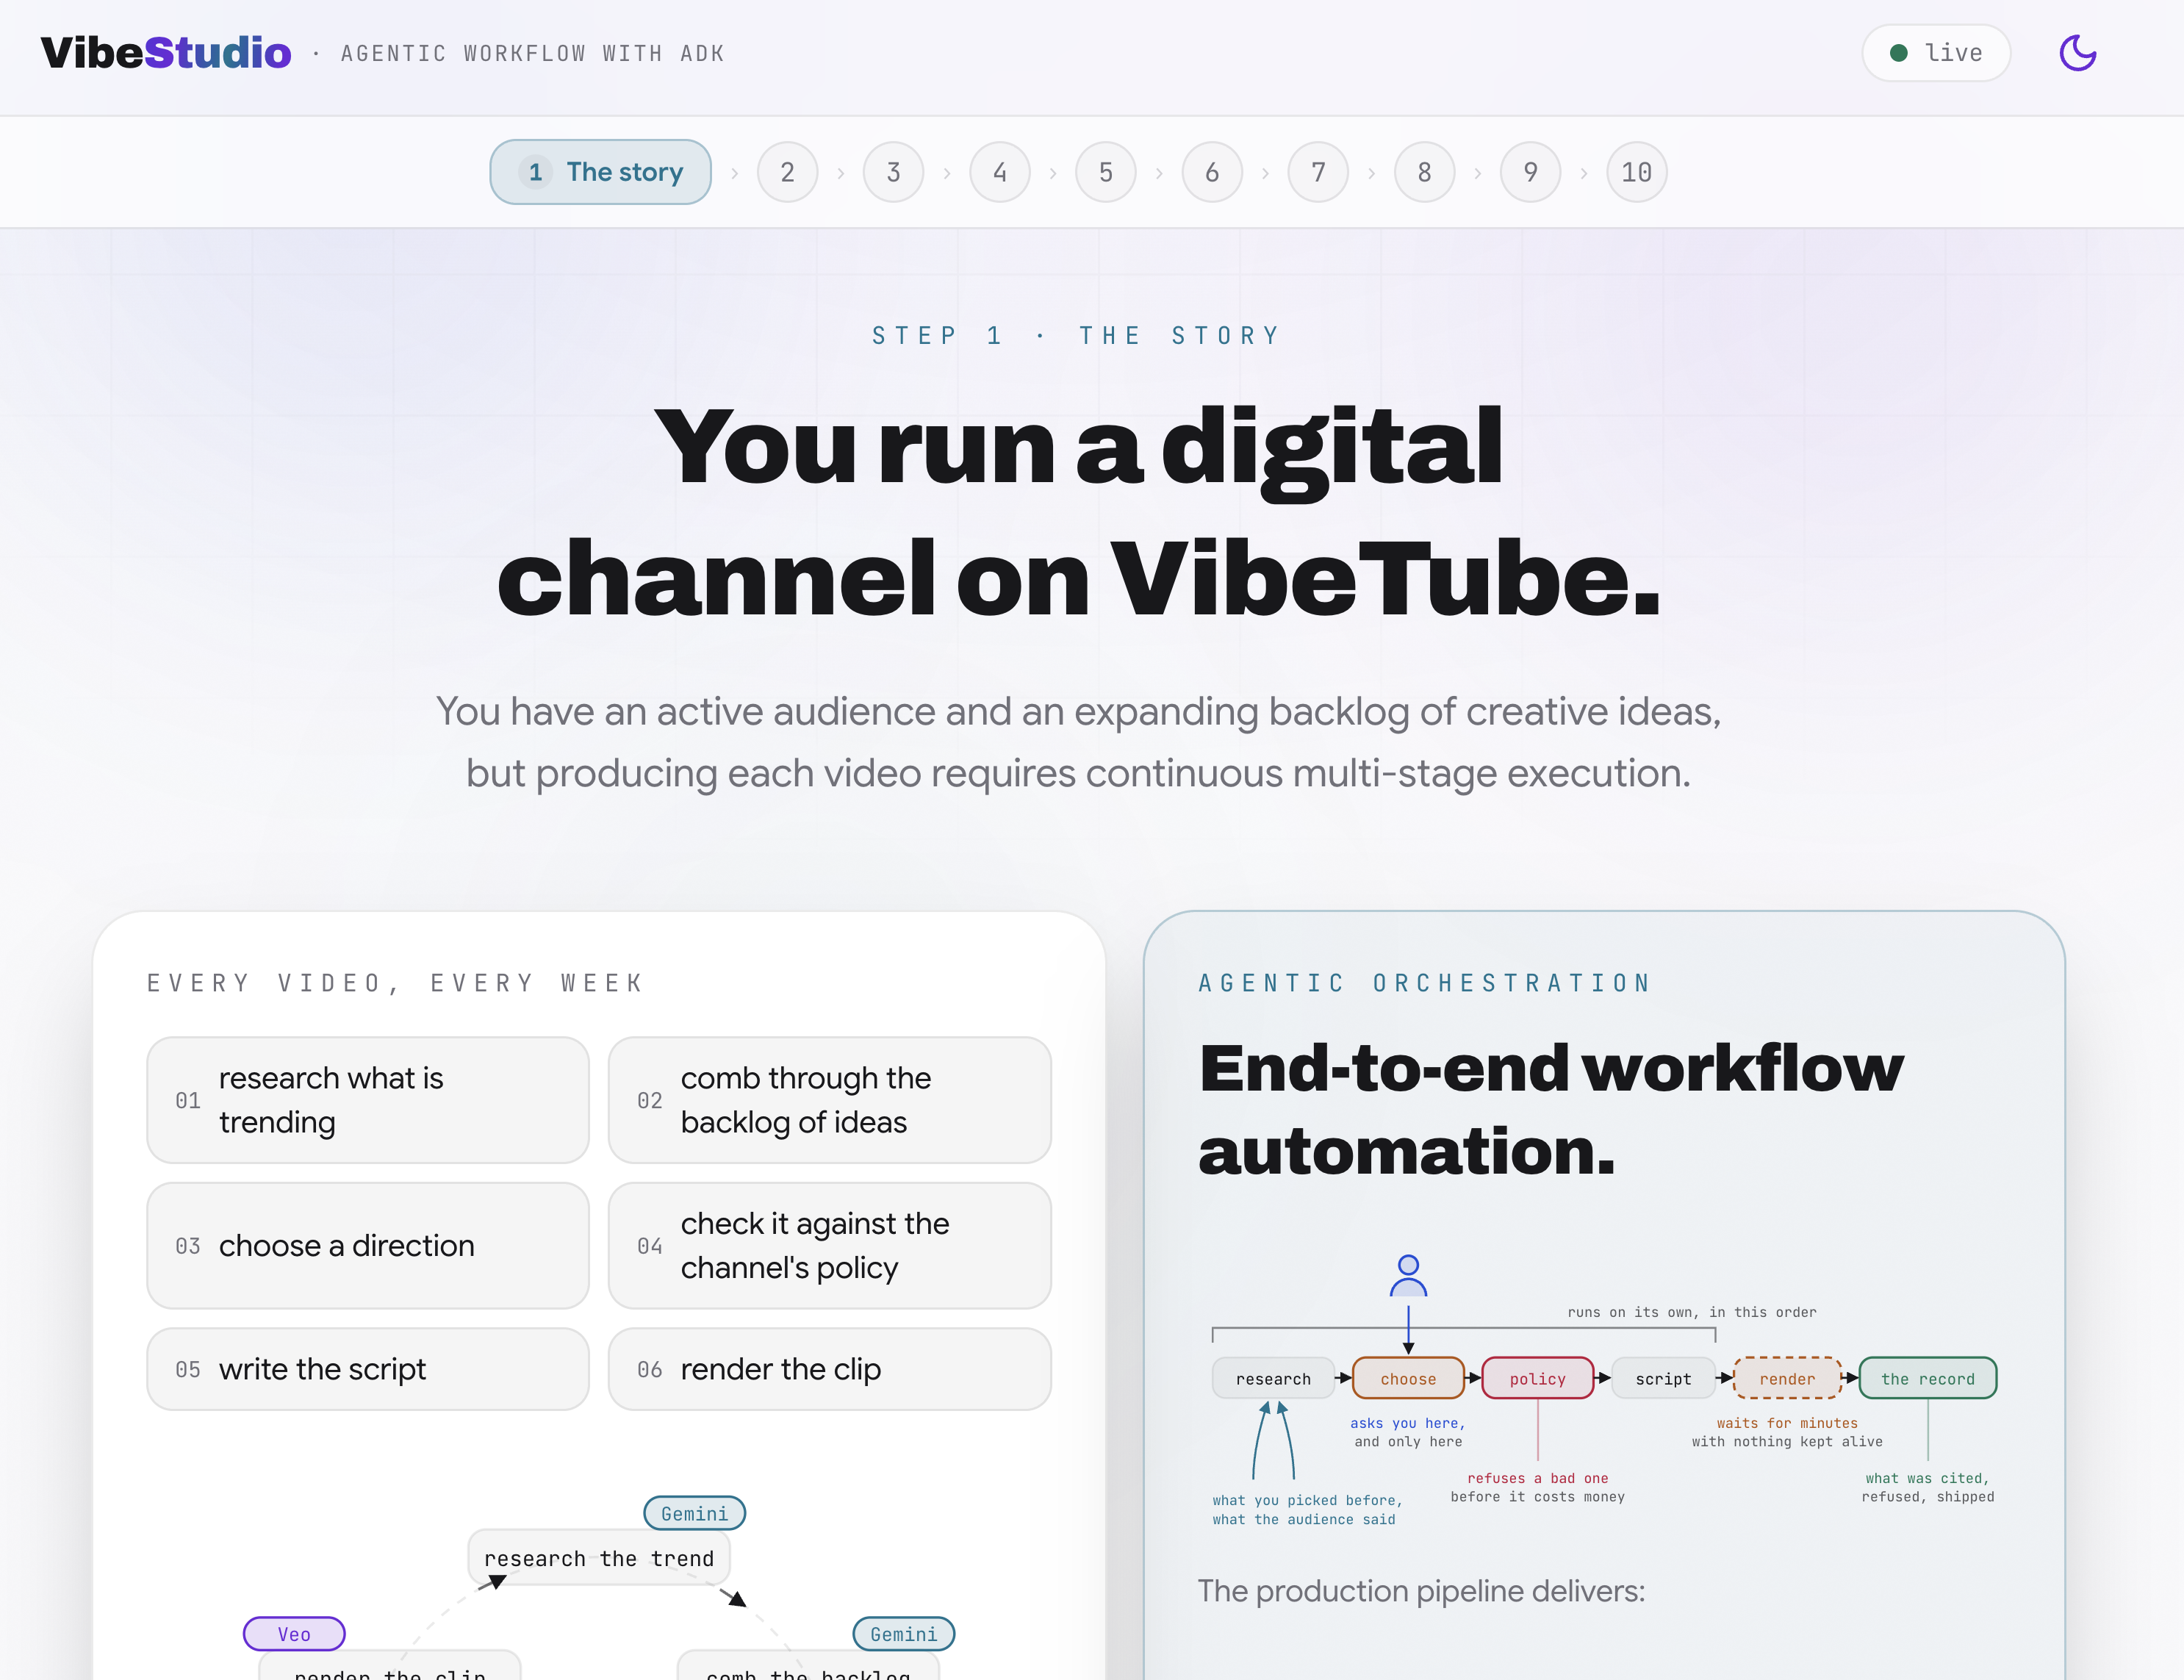
VibeStudio Workbench के हर प्रैक्टिकल हिस्से के आखिर में, पुष्टि करने वाला पैनल होता है. यह पैनल, असली आर्टफ़ैक्ट को पढ़ता है: डिस्क पर मौजूद फ़ाइल और रन से लिखे गए सेशन.
डेटाबेस का लेआउट
रिपॉज़िटरी को मुख्य वर्कफ़्लो लॉजिक, एक-एक करके सैंडबॉक्स, वर्कबेंच एनवायरमेंट, और प्रोडक्शन ऐप्लिकेशन में बांटा गया है:
vibe-studio-lab/
├── agent/                  # Core ADK workflow, graph definition, and platform services
│   ├── graph.py            # Workflow graph definition, node functions, and routers
│   ├── desk.py             # Video render desk using LongRunningFunctionTool
│   ├── schemas.py          # Pydantic schemas for directions, gates, and scripts
│   ├── trends.py           # Trend generation and sampling utilities
│   ├── backlog.txt         # Creator video ideas backlog
│   ├── comments.md         # Audience comments for RAG Engine corpus seeding
│   ├── policy_words.txt    # Blocked subject words for deterministic policy checks
│   └── platform/           # Google Cloud service clients (Memory Bank, RAG, Veo)
│       ├── config.py       # Environment variables, locations, and model configurations
│       ├── memory.py       # GEAP Memory Bank callbacks and context injection
│       ├── rag.py          # GEAP RAG Engine corpus creation and semantic retrieval
│       └── videogen.py     # Veo video generation and operation polling
├── stage0_prompt/          # Step sandboxes: isolated agent.py files runnable in adk web
│   └── ...                 # stage1_fanout through stage6_video for incremental steps
├── server/ & web/          # VibeStudio Workbench (FastAPI backend and React frontend)
├── vibestudio/             # Complete production application deployed to Cloud Run
│   ├── server/             # FastAPI production server and event runner
│   ├── web/                # End-user React web application
agent/: इसमें मुख्य वर्कफ़्लो ग्राफ़ होता है. आपको इस डायरेक्ट्री में मौजूद फ़ाइलों में बदलाव करना होगा. ऐसा पैरलल फ़ैन-आउट नोड, डिटरमिनिस्टिक नीति राउटिंग, मेमोरी कॉलबैक, और वीडियो जनरेशन टूल लागू करने के लिए करना होगा.agent/platform/: यह Google Cloud की सेवाओं के साथ इंटरफ़ेस करता है. इनमें Gemini मॉडल, GEAP मेमोरी बैंक, GEAP RAG इंजन, और Veo वीडियो सिंथेसिस शामिल हैं.stage0_prompt/के ज़रिएstage6_video/: सैंडबॉक्स एनवायरमेंट में मौजूद सभी सुविधाएं. हर फ़ोल्डर, एक स्टैंडअलोनroot_agentएक्सपोर्ट करता है. इससे, एम्बेड किए गए ADK डेवलपमेंट इंटरफ़ेस के ज़रिए, हर चरण को अलग से चलाया और उसकी जांच की जा सकती है.server/औरweb/: VibeStudio Workbench ऐप्लिकेशन, पोर्ट 4600 पर स्थानीय तौर पर चल रहा है. इसमें चरण के दस्तावेज़, इन-पेज कोड एडिटर, रनटाइम एविडेंस वेरिफ़ायर, और ग्राफ़ विज़ुअलाइज़ेशन की सुविधा मिलती है.vibestudio/: यह फ़ाइनल चरण में, पैकेज किया गया और Cloud Run पर डिप्लॉय किया गया पूरा प्रोडक्शन ऐप्लिकेशन है. इसमें पूरे वर्कफ़्लो ग्राफ़ की अपनी स्टैंडअलोन कॉपी होती है.
3. मोनोलिथिक एजेंट
एक से ज़्यादा नोड वाले वर्कफ़्लो ग्राफ़ को बनाने से पहले, stage0_prompt/agent.py में एक एजेंट के साथ आर्किटेक्चरल बेसलाइन सेट अप करें. यह एजेंट, एक बड़े सिस्टम प्रॉम्प्ट पर काम करता है. इसमें प्रॉडक्शन पाइपलाइन के बारे में गद्य में बताया गया है. साथ ही, इसमें दो Python फ़ंक्शन टूल इस्तेमाल किए जाते हैं.
इस बेसलाइन का आकलन करने से, प्रॉम्प्ट के ज़रिए कोऑर्डिनेशन की ऑपरेशनल सीमाओं के बारे में पता चलता है. साथ ही, यह भी पता चलता है कि प्रोडक्शन सिस्टम के लिए ग्राफ़ ऑर्केस्ट्रेशन की ज़रूरत क्यों होती है.
ADK एजेंट का आर्किटेक्चर (3A)
VibeStudio Workbench में, तीसरा चरण · मोनोलिथिक एजेंट पर जाएं और ADK एजेंट आर्किटेक्चर (3A) खोलें. इस व्यू में, ADK एजेंट (LlmAgent) की मुख्य आर्किटेक्चरल लेयर दिखाई गई हैं:
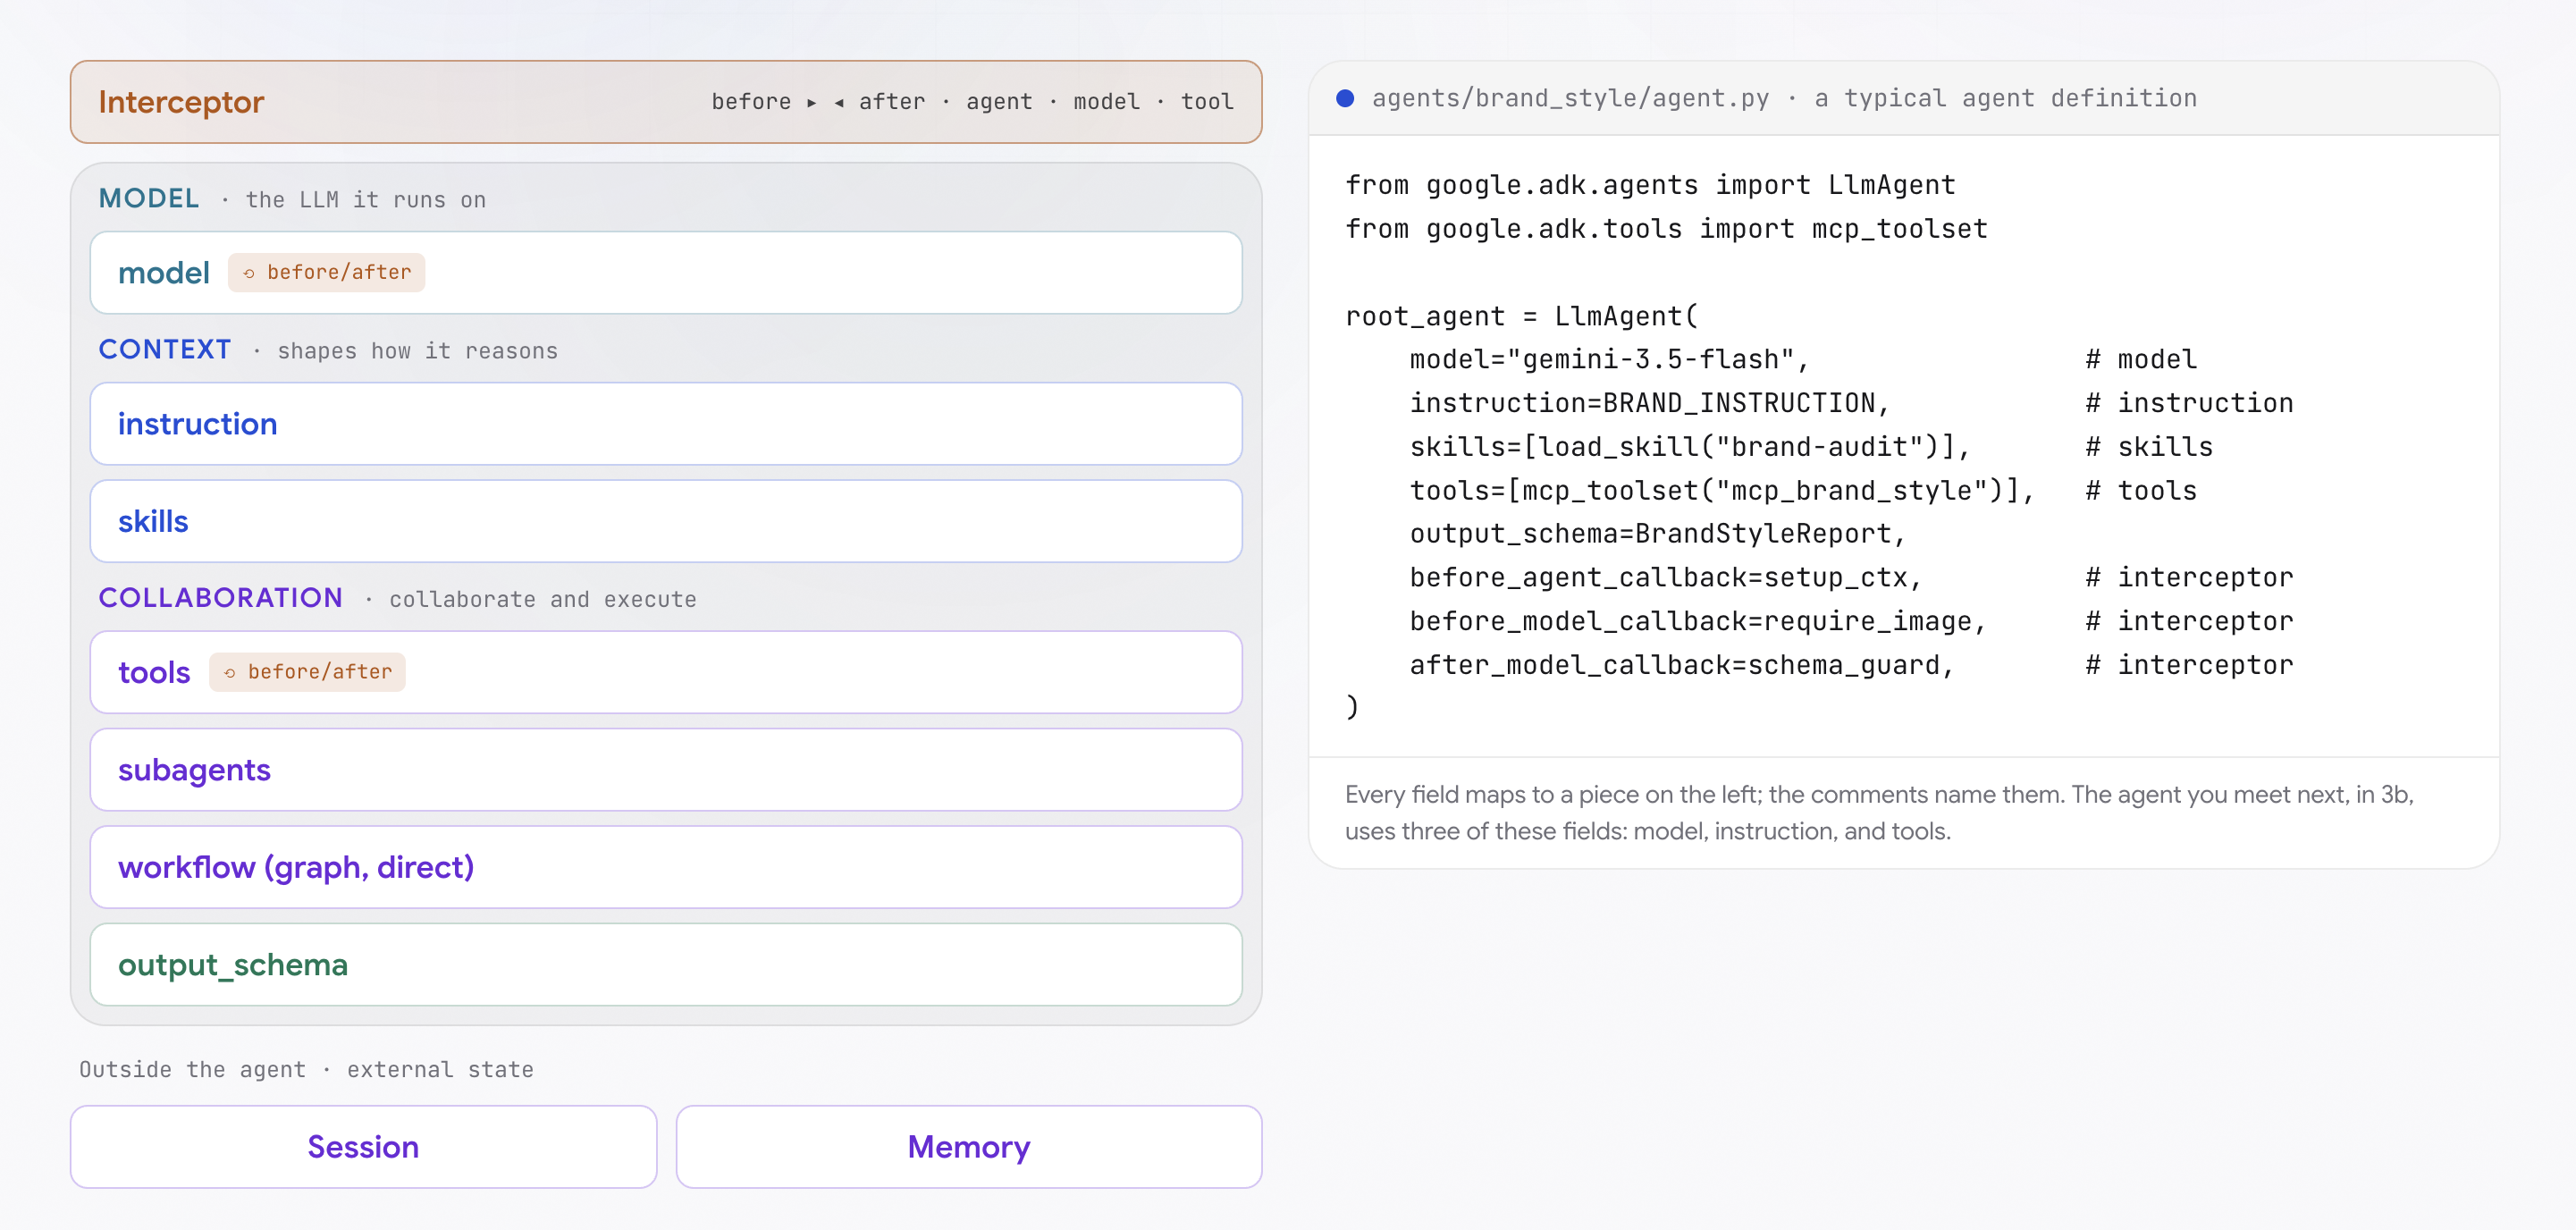
from google.adk.agents import LlmAgent
from google.adk.tools import mcp_toolset

root_agent = LlmAgent(
    model="gemini-3.5-flash",                 # model
    instruction=BRAND_INSTRUCTION,            # instruction
    skills=[load_skill("brand-audit")],       # skills
    tools=[mcp_toolset("mcp_brand_style")],   # tools
    output_schema=BrandStyleReport,           # structured output
    before_agent_callback=setup_ctx,          # interceptor
    before_model_callback=require_image,      # interceptor
    after_model_callback=schema_guard,        # interceptor
)
इंटरैक्टिव डाइग्राम में, एजेंट कॉम्पोनेंट को पांच ऑपरेशनल डोमेन में ग्रुप किया गया है:
- रीज़निंग लेयर (मॉडल): यह मुख्य भाषा मॉडल (जैसे कि Gemini 3 Flash) है. यह संज्ञानात्मक टास्क, प्रॉम्प्ट के आधार पर तर्क, और टूल चुनने का काम करता है. आर्किटेक्चर में मौजूद बाकी सभी चीज़ें, इस मॉडल के बारे में जानकारी देती हैं या इसे सीमित करती हैं.
- कॉन्टेक्स्ट लेयर (निर्देश और स्किल): ऐसे निर्देश जो मॉडल की तर्क क्षमता को बेहतर बनाते हैं.
instructionमें सिस्टम प्रॉम्प्ट, पर्सोना, और ऑपरेशन से जुड़े नियमों के बारे में स्थायी तौर पर जानकारी दी जाती है.skillsबार-बार किए जाने वाले वर्कफ़्लो के लिए, वर्शन के हिसाब से प्रक्रिया से जुड़े दिशा-निर्देश (SKILL.md) उपलब्ध कराएं. - मिलकर काम करने और कार्रवाई करने की लेयर (टूल, सब-एजेंट, वर्कफ़्लो, आउटपुट स्कीमा): ऐसे इंटरफ़ेस जो एजेंट को बाहरी सिस्टम पर कार्रवाई करने और टाइप किया गया डेटा भेजने की सुविधा देते हैं.
toolsकॉल किए जा सकने वाले Python फ़ंक्शन या मॉडल कॉन्टेक्स्ट प्रोटोकॉल (एमसीपी) एंडपॉइंट उपलब्ध कराएं.subagentsसौंपे गए टास्क पूरे करें.workflowमल्टी-एजेंट ग्राफ़ को कोऑर्डिनेट करता है.output_schema, Pydantic मॉडल लागू करता है, ताकि यह पक्का किया जा सके कि डाउनस्ट्रीम उपभोक्ताओं को बिना स्ट्रक्चर वाला टेक्स्ट के बजाय, पुष्टि किया गया JSON मिले. - इंटरसेप्टर लेयर (लाइफ़साइकल कॉलबैक): यह लेयर, एजेंट के एक्ज़ीक्यूशन (
before_agent/after_agent), अलग-अलग मॉडल टर्न (before_model/after_model), और टूल कॉल (before_tool/after_tool) से पहले और बाद में कस्टम कोड को एक्ज़ीक्यूट करने वाले, तय किए गए गार्डरेल होते हैं. इंटरसेप्टर, मॉडल के नियमों का पालन किए बिना नीति के नियमों को लागू करते हैं. - बाहरी स्थिति (सेशन और मेमोरी): एजेंट के लॉजिक से अलग की गई स्टेटफ़ुल परसिस्टेंस.
Session, मौजूदा एक्ज़ीक्यूशन थ्रेड के लिए, कुछ समय के लिए काम करने वाली मेमोरी और इवेंट ट्रेस को सुरक्षित रखता है.Memoryमैनेज की गई सेवाओं का इस्तेमाल करके, अलग-अलग सेशन के तथ्यों और प्राथमिकताओं को बनाए रखता है. जैसे, GEAP Memory Bank.
इस चरण में, मोनोलिथिक एजेंट सिर्फ़ तीन प्रिमिटिव लागू करता है: model, instruction, और tools. इसके बाद के चरणों में, ग्राफ़ वर्कफ़्लो, स्ट्रक्चर्ड स्कीमा, इंटरसेप्टर, और परसिस्टेंट मेमोरी सेवाओं के बारे में बताया गया है.
मोनोलिथिक एजेंट की खास बातें (3B)
वर्कबेंच में, मोनोलिथिक एजेंट स्पेसिफ़िकेशन (3B) पर जाएं. बेसलाइन एजेंट की परिभाषा देखने के लिए, stage0_prompt/agent.py खोलें:
- एक ही प्रॉम्प्ट में निर्देश: सिस्टम प्रॉम्प्ट, प्रोडक्शन से जुड़े पांच अलग-अलग टास्क को एक ही प्रॉम्प्ट में शामिल करता है. जैसे: प्लैटफ़ॉर्म के ट्रेंड का पता लगाना, बैकलॉग आइडिया की समीक्षा करना, क्रिएटिव कॉन्सेप्ट का सुझाव देना, पाबंदी वाले विषयों से जुड़ी नीतियों को लागू करना, और शॉट लिस्ट तैयार करना.
- डेटा सोर्स: एजेंट, ग्राफ़ के बगल में दिए गए दो सोर्स से जानकारी लेता है:
agent/trends.py: यह 250 फ़ॉर्मैट और स्टाइल के पूल से, डाइनैमिक हीट स्कोर के साथ 10 चालू फ़ॉर्मैट और स्टाइल के सैंपल दिखाता है.agent/backlog.txt: क्रिएटर के कॉन्सेप्ट नोट को लाइन-दर-लाइन पढ़ता है.
एजेंट में मौजूद टूल (3C)
वर्कबेंच में, एजेंट में मौजूद टूल (3C) पर जाएं.
एजेंट के लिए टूल क्या होता है?
भाषा मॉडल, मूल रूप से क्लोज़्ड-वर्ल्ड रीज़निंग इंजन होता है. यह सिर्फ़ पहले से ट्रेन किए गए वेट और इसकी कॉन्टेक्स्ट विंडो में मौजूद टोकन के आधार पर काम करता है. यह डेटाबेस से क्वेरी नहीं कर सकता, रीयल-टाइम एपीआई ऐक्सेस नहीं कर सकता या कोड को एक्ज़ीक्यूट नहीं कर सकता.
टूल इस सीमा को पार करने में मदद करता है. यह मॉडल को बाहरी एजेंसी के तौर पर काम करने की अनुमति देता है. इससे मॉडल को सही जानकारी पाने और बाहरी सिस्टम में तय की गई कार्रवाइयां करने में मदद मिलती है.
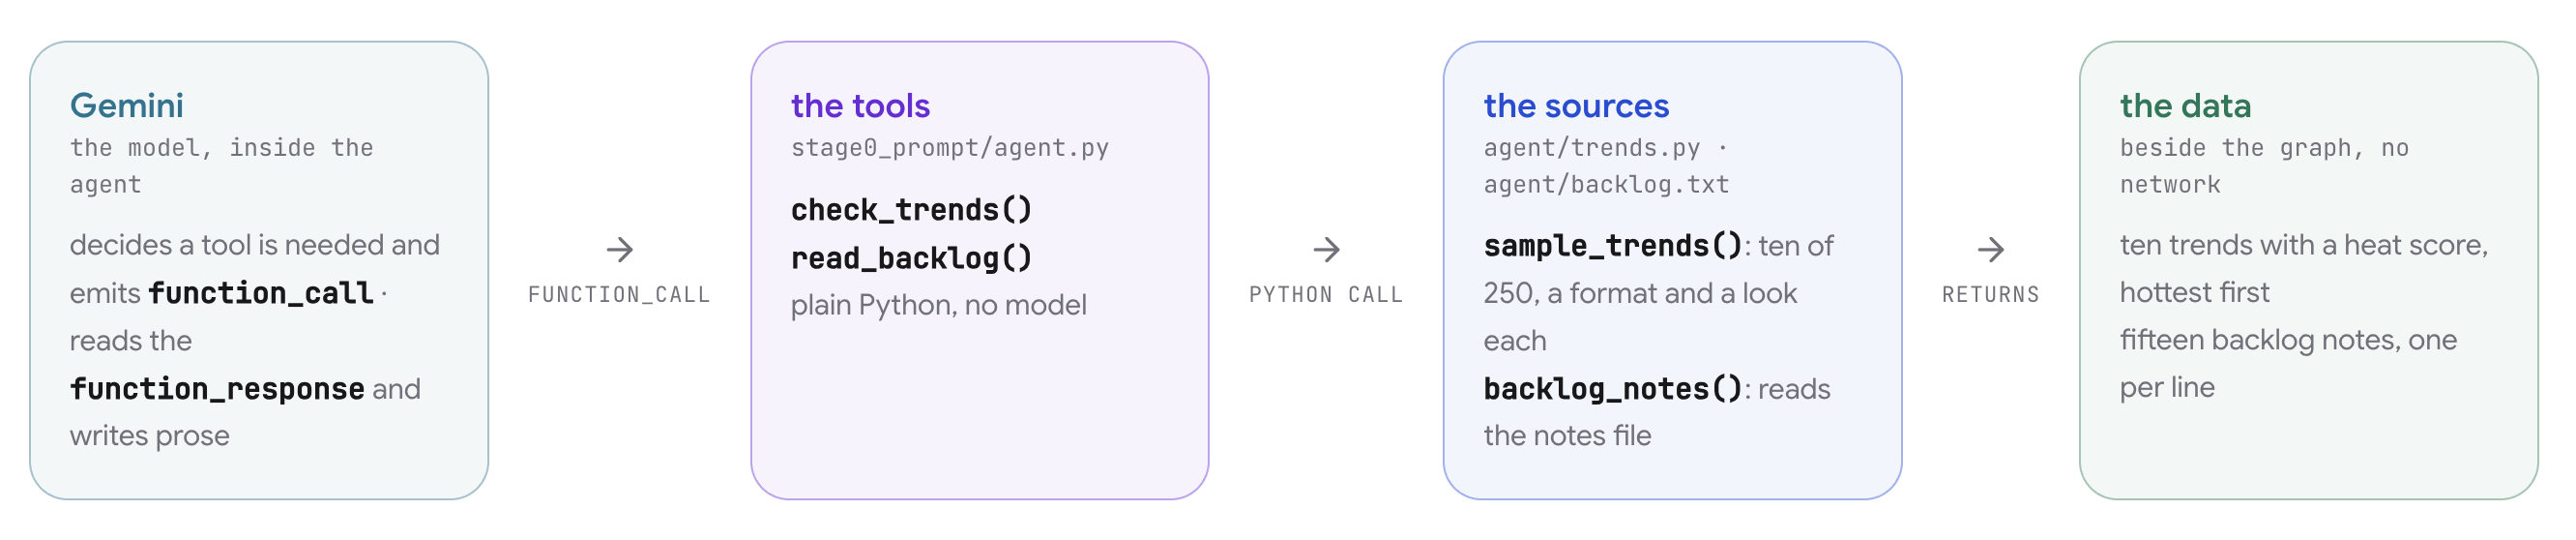
टूल कॉलिंग, मॉडल और एडीके रनटाइम के बीच पांच चरणों वाले प्रोटोकॉल का पालन करती है:
- स्कीमा का एलान: डेवलपर, एजेंट को Python फ़ंक्शन उपलब्ध कराता है. ADK, हर फ़ंक्शन के नाम, टाइप एनोटेशन, और डॉकस्ट्रिंग की जांच करता है. इससे, OpenAPI के साथ काम करने वाला JSON स्कीमा जनरेट किया जा सकता है. इसमें फ़ंक्शन के पैरामीटर और मकसद के बारे में बताया जाता है.
- मॉडल की तर्क क्षमता: अनुमान लगाने के दौरान, मॉडल यह आकलन करता है कि उपयोगकर्ता के प्रॉम्प्ट के लिए बाहरी डेटा की ज़रूरत है या नहीं. ज़रूरत पड़ने पर, मॉडल एक स्ट्रक्चर्ड
function_callइवेंट जनरेट करता है. इसमें टारगेट फ़ंक्शन का नाम और स्कीमा से मेल खाने वाली आर्ग्युमेंट डिक्शनरी शामिल होती है. - रनटाइम के दौरान कोड चलाना: मॉडल खुद कोड नहीं चलाता है. ADK रनटाइम,
function_callको इंटरसेप्ट करता है. इसके बाद, दिए गए तर्कों का इस्तेमाल करके, असल लोकल Python फ़ंक्शन को लागू करता है और उससे मिलने वाली वैल्यू को कैप्चर करता है. - कॉन्टेक्स्ट को फिर से इंजेक्ट करना: ADK रनटाइम, फ़ंक्शन की रिटर्न वैल्यू को
function_responseइवेंट में पैकेज करता है और इसे चालू सेशन के इतिहास में जोड़ता है. - फ़ाइनल सिंथेसिस: मॉडल, टूल के आउटपुट को प्रोसेस करता है. यह आउटपुट अब इसकी कॉन्टेक्स्ट विंडो में मौजूद होता है. इसके बाद, मॉडल अपना जवाब पूरा करता है.
stage0_prompt/agent.py में, रिसर्च के लिए उपलब्ध दोनों टूल को स्टैंडर्ड Python फ़ंक्शन के तौर पर तय किया गया है:
def check_trends() -> dict:
    """Ten formats trending on the platform right now, with a heat score each."""
    from agent.trends import sample_trends
    return {"trends": sample_trends()}


def read_backlog() -> dict:
    """The creator's backlog: ideas they noted down to make someday."""
    from agent.graph import backlog_notes
    return {"backlog": backlog_notes()}
खुद से बदलाव करना और लागू करना
वर्कबेंच के कोड एडिटर में, एजेंट की tools सूची में फ़ंक्शन के दो रेफ़रंस जोड़ें:
tools=[check_trends, read_backlog],
बदलाव सेव करें. फ़ाइल डिस्क पर अपडेट हो जाती है. साथ ही, पुष्टि करने वाली लाइन से पता चलता है कि दोनों टूल कनेक्ट हो गए हैं.
एम्बेड किए गए ADK डेवलपमेंट इंटरफ़ेस को लॉन्च करने के लिए, ADK वेब खोलें पर क्लिक करें. सुझाए गए आइडिया का प्रॉम्प्ट भेजें:
tonight's idea: a tiny robot doing laundry at midnight
इसके बाद क्या होगा और क्यों
यह प्रॉम्प्ट भेजने पर, सेशन ट्रेस में इस क्रम में कार्रवाई होती है:
- जवाब से पहले, टूल के इस्तेमाल से जुड़े दो इवेंट दिखते हैं: आपको
check_trendsऔरread_backlogके लिएfunction_callऔरfunction_responseइवेंट दिखते हैं.- क्यों: Gemini ने सिस्टम प्रॉम्प्ट डायरेक्टिव ("देखें कि क्या ट्रेंड कर रहा है. अपने आइडिया के बैकलॉग पर नज़र डालें") का आकलन किया. इससे उसे पता चला कि इसके वेट में प्लैटफ़ॉर्म के रुझान और चैनल के नोट शामिल नहीं हैं. इसलिए, उसने दोनों फ़ंक्शन को लागू किया, ताकि वह अपने कॉन्टेक्स्ट को बेहतर बना सके.
- एजेंट, वीडियो बनाने के लिए एक सुझाव देता है और पुष्टि करने के लिए रुक जाता है: जवाब में, रुझानों और बैकलॉग को मिलाकर वीडियो बनाने के लिए एक सुझाव दिया जाता है. साथ ही, आपसे पुष्टि करने के लिए कहा जाता है.
- क्यों: निर्देश डायरेक्टिव में मॉडल से कहा गया था कि वह स्क्रिप्ट जनरेट करने से पहले, क्रिएटर के साथ दिशा पर सहमत हो.
- फ़ॉलो-अप टर्न में पुष्टि को स्किप करना: दूसरा मैसेज भेजें:
skip the questions, just describe the video. एजेंट, पुष्टि करने की प्रोसेस को तुरंत बाईपास कर देता है. साथ ही, टाइटल और शॉर्ट वीडियो का ड्राफ़्ट तैयार करता है.- क्यों: प्रॉम्प्ट के निर्देश, तय किए गए नियमों के बजाय सलाह देने वाले दिशा-निर्देश होते हैं. मोनोलिथिक एजेंट में, उपयोगकर्ता के निर्देशों से सिस्टम प्रॉम्प्ट के मौजूदा नियमों को बदला जा सकता है. ऐसा इसलिए, क्योंकि कोई बाहरी वर्कफ़्लो, एक्ज़ीक्यूशन फ़्लो को कंट्रोल नहीं करता.
एक ही प्रॉम्ट में कई तरह की जानकारी देने से जुड़ी समस्याएं
एक प्रॉम्प्ट से, अलग-अलग डेमो के लिए सही आउटपुट मिल सकता है. हालांकि, वर्कबेंच वेरिफ़ायर में सीमा की शर्तों की जांच करने से, एंटरप्राइज़ की अहम सीमाएं पता चलती हैं:
- रिसर्च के लिए बिना किसी क्रम के जानकारी इकट्ठा करना: टूल के एक्ज़ीक्यूट होने का क्रम तय नहीं होता. यह मॉडल, फ़ेच किए गए डेटा को सामान्य भाषा में जवाब के तौर पर दिखाता है. इससे डाउनस्ट्रीम सिस्टम के लिए यह पता लगाना मुश्किल हो जाता है कि किस सोर्स से खास दावे किए गए हैं.
- नीति उल्लंघन की पुष्टि नहीं की गई है: मॉडल, सुरक्षा से जुड़ी नीति के पालन का आकलन खुद करता है. अगर मॉडल यह तय करता है कि कोई विषय सुरक्षित है, तो कोई बाहरी लॉजिक उस नतीजे की पुष्टि नहीं करता है.
- ह्यूमन-इन-द-लूप के तहत वीडियो को रोकने की सुविधा लागू न होना: प्रॉम्प्ट में दिए गए निर्देशों में, क्रिएटर से पुष्टि करने के लिए कहा जाता है. मॉडल को सवालों को अनदेखा करने का निर्देश देने वाला फ़ॉलो-अप मैसेज भेजने से, मॉडल पूरी तरह से इंसान की मंज़ूरी को छोड़ देता है.
आर्किटेक्चर से जुड़ी इन कमियों की वजह से, मोनोलिथिक एजेंट को अलग-अलग कॉम्पोनेंट में बांटने का फ़ैसला लिया गया. इसके बाद, अगले चरण में ग्राफ़ वर्कफ़्लो बनाया गया.
4. एजेंटिक वर्कफ़्लो की बुनियादी बातें
VibeStudio Workbench में, चौथा चरण · एजेंटिक वर्कफ़्लो की बुनियादी बातें पर जाएं. इसके बाद, 4A से लेकर 4D तक के हिस्से पर जाएं.
इस चरण में, सिंगल-एजेंट बेसलाइन से ADK Workflow का इस्तेमाल करके, डिटरमिनिस्टिक ग्राफ़ ऑर्केस्ट्रेशन पर ट्रांज़िशन किया जाता है. आपको पैरलल रिसर्च फ़ैन-आउट बनाना होगा. साथ ही, जॉइन नोड के साथ ब्रांच को सिंक करना होगा. इसके अलावा, स्कीमा की पुष्टि किए गए क्रिएटिव कैंडिडेट जनरेट करने होंगे. साथ ही, ह्यूमन-इन-द-लूप की मंज़ूरी देने वाले गेट को लागू करना होगा.
ग्राफ़ आर्किटेक्चर और एक्ज़ीक्यूशन चेन (4A)
वर्कबेंच में, Graph architecture and execution chains (4A) खोलें.
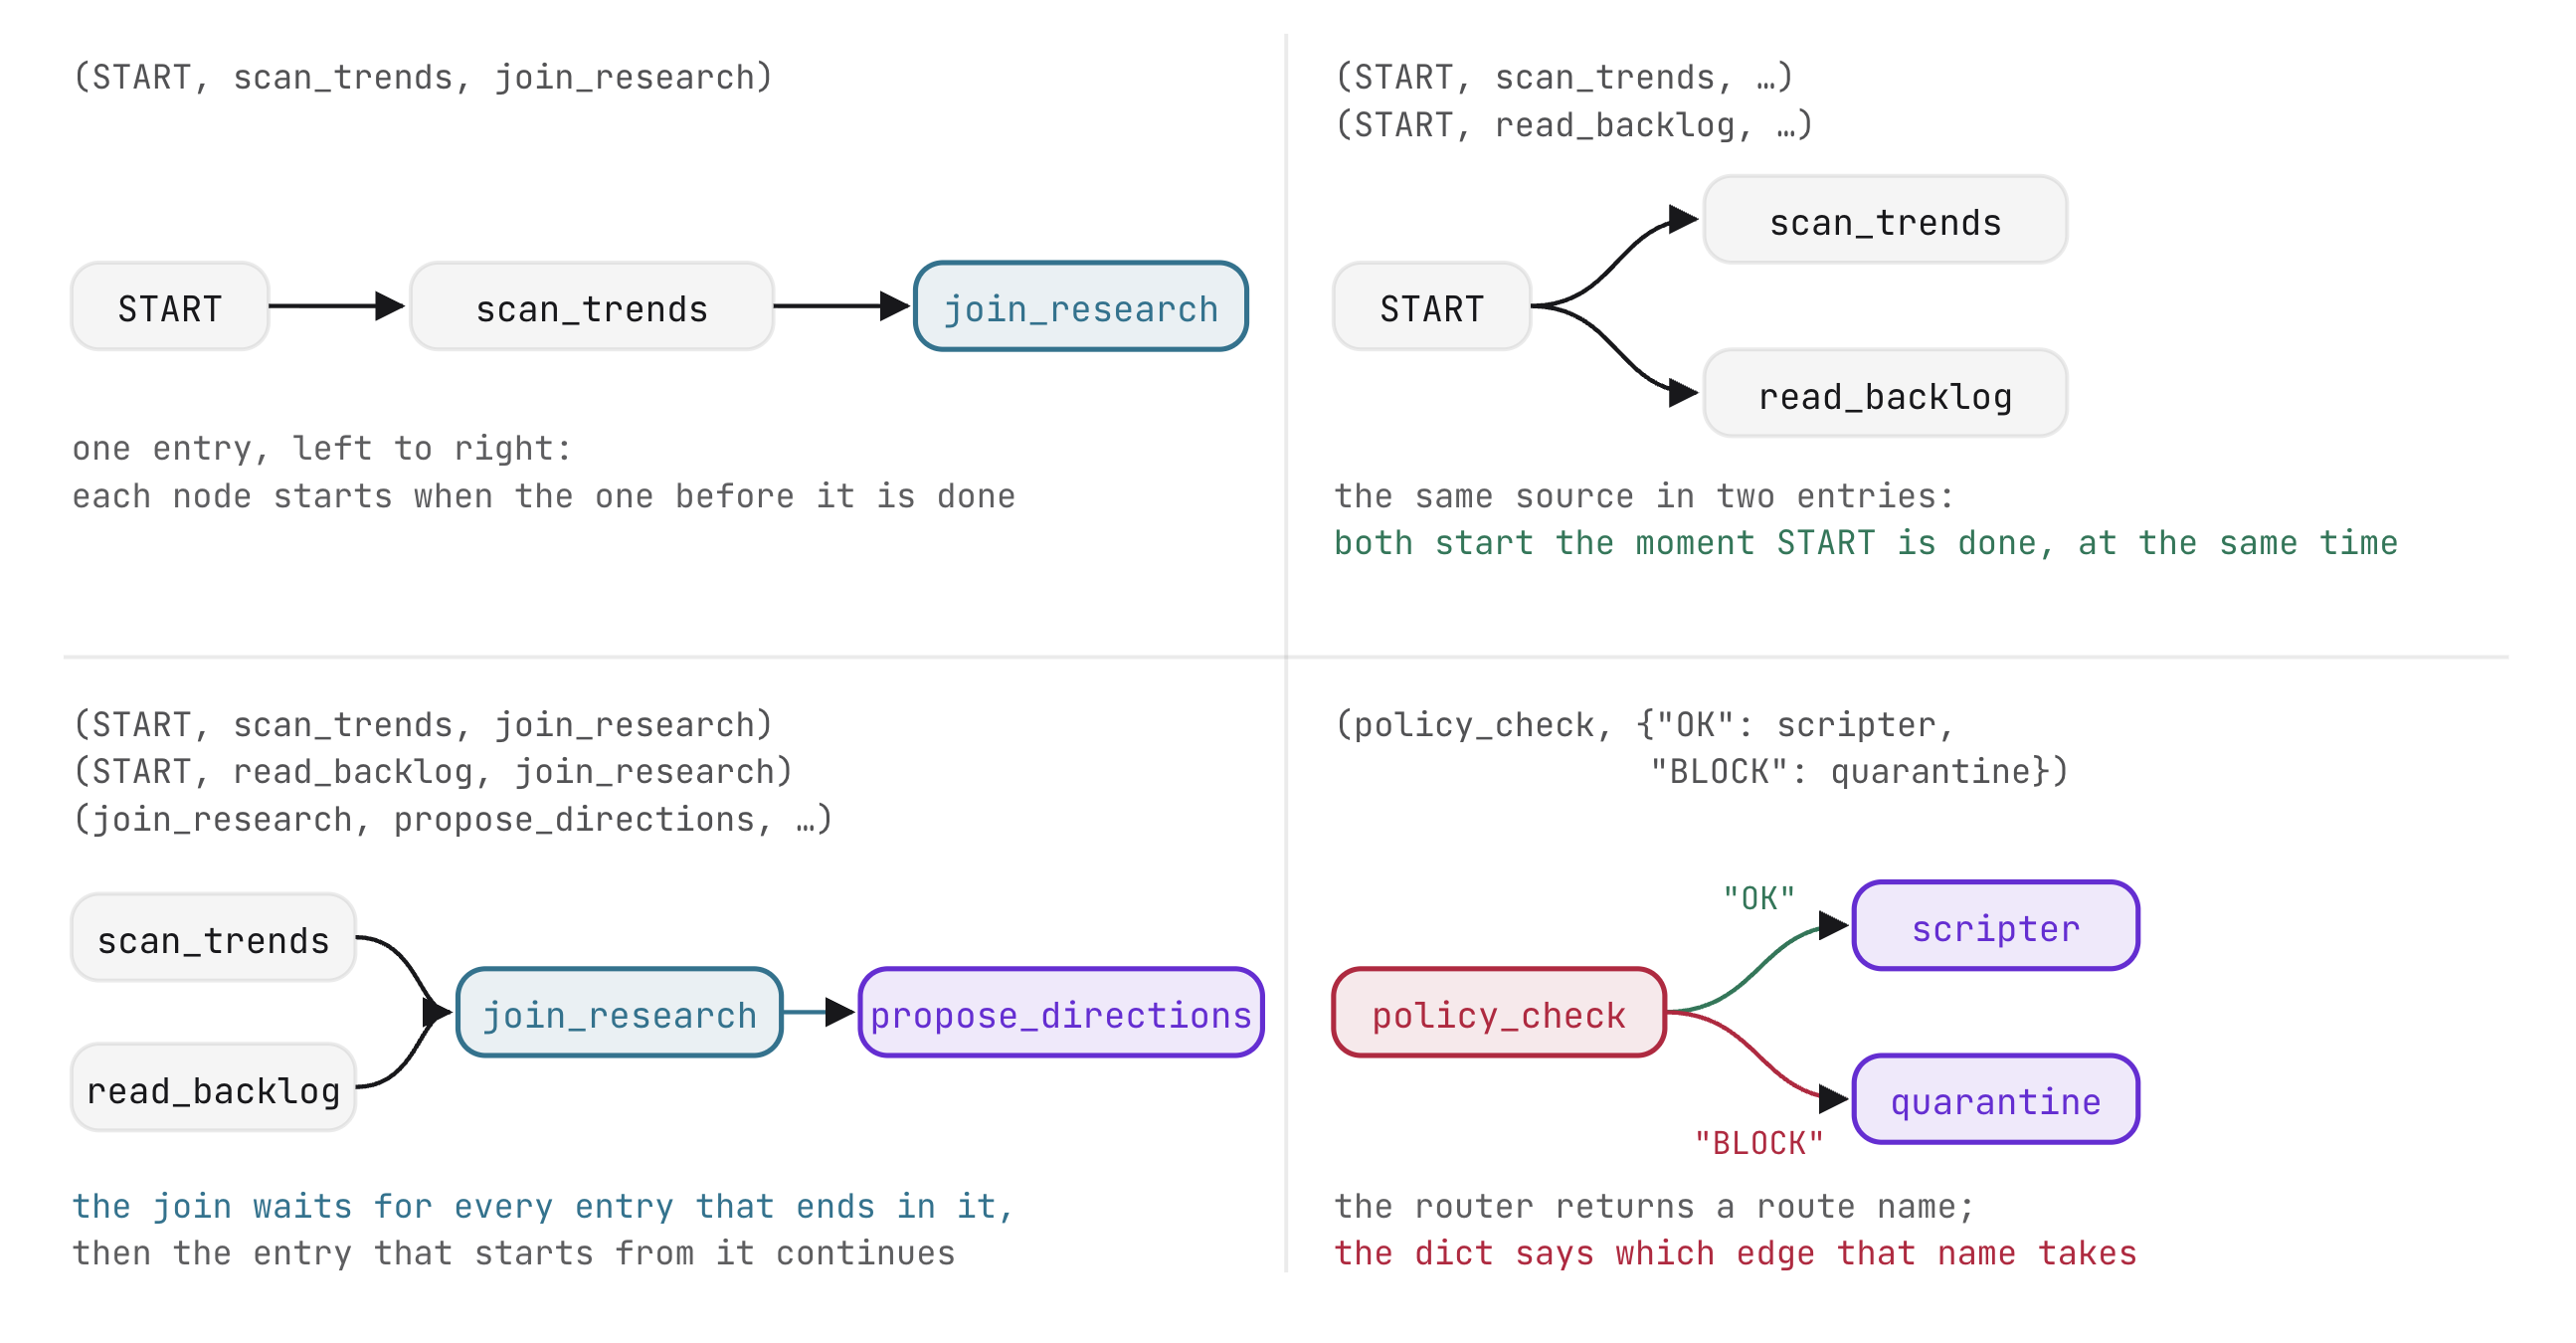
ADK Workflow, एजेंट के एक्ज़ीक्यूशन को एक डायरेक्टेड ग्राफ़ के तौर पर स्ट्रक्चर करता है. इसे एज लिस्ट से तय किया जाता है:
- चेन: क्रम से दिए गए टपल, लीनियर नोड के एक्ज़ीक्यूशन (
(node_a, node_b, node_c)) को तय करते हैं. - पैरलल ब्रांच: एक ही ओरिजन नोड को शेयर करने वाली इंडिपेंडेंट चेन एक साथ एक्ज़ीक्यूट होती हैं.
- सिंक्रनाइज़ेशन:
JoinNodeपर कन्वर्ज होने वाली चेन, तब तक रिलीज़ नहीं होती हैं, जब तक सभी इनकमिंग ब्रांच रिपोर्ट नहीं कर देतीं. - डिटरमिनिस्टिक कंट्रोल: एक्ज़ीक्यूशन फ़्लो, प्रॉम्प्ट टेक्स्ट से अनुमान लगाने के बजाय, कोड स्ट्रक्चर के हिसाब से तय होता है.
ADK में नोड के आर्कटाइप
ADK वर्कफ़्लो में कई तरह के नोड होते हैं. हर आर्किटाइप, ग्राफ़ में एक खास भूमिका निभाता है. यह जनरेटिव मॉडल की तर्क क्षमता को, डिटरमिनिस्टिक कोड के एक्ज़ीक्यूशन से अलग करता है:
नोड आर्किटाइप | लागू करना | पाइपलाइन में भूमिका |
फ़ंक्शन नोड |
| यह लॉजिक, डेटा वापस पाने, और स्टेट म्यूटेशन को लागू करता है. |
जॉइन नोड | पहले से मौजूद | यह फ़ंक्शन, एक साथ कई ब्रांच को एक एग्रीगेटेड डिक्शनरी में सिंक करता है. |
एजेंट नोड |
| यह अपस्ट्रीम इनपुट के आधार पर निर्देशों का आकलन करता है और पुष्टि किया गया डेटा दिखाता है. |
राउटर नोड |
| यह फ़ंक्शन, शर्तों के आधार पर लॉजिक का आकलन करता है, ताकि आगे की प्रोसेस के लिए सही ब्रांच चुनी जा सके. |
लोगों से मिले इनपुट का नोड | फ़ंक्शन से मिलने वाला नतीजा | यह फ़ंक्शन, बाहरी उपयोगकर्ता से जवाब मिलने तक, एक्ज़ीक्यूशन की स्थिति को निलंबित कर देता है. |
root_agent = Workflow(
    name="stage1_fanout",
    description="2 real readers -> join -> one research dict",
    edges=[...])
इस कॉन्फ़िगरेशन में, root_agent, Agent के बजाय Workflow का इंस्टेंस है. ADK, वर्कफ़्लो को सबसे अहम एजेंट के तौर पर मानता है. इससे पूरे ग्राफ़ को एक ही ऐप्लिकेशन के तौर पर लोड, दिखाया, और उसकी जांच की जा सकती है. name, ऐप्लिकेशन को ADK Web में रजिस्टर करता है. वहीं, edges सूची, इसके लागू होने की टोपोलॉजी तय करती है.
पैरलल रिसर्च फ़ैन-आउट (4B)
वर्कबेंच में, पैरलल रिसर्च फ़ैन-आउट (4B) पर जाएं. stage1_fanout/agent.py खोलें.
फ़ंक्शन नोड और सिंक्रनाइज़ेशन बैरियर
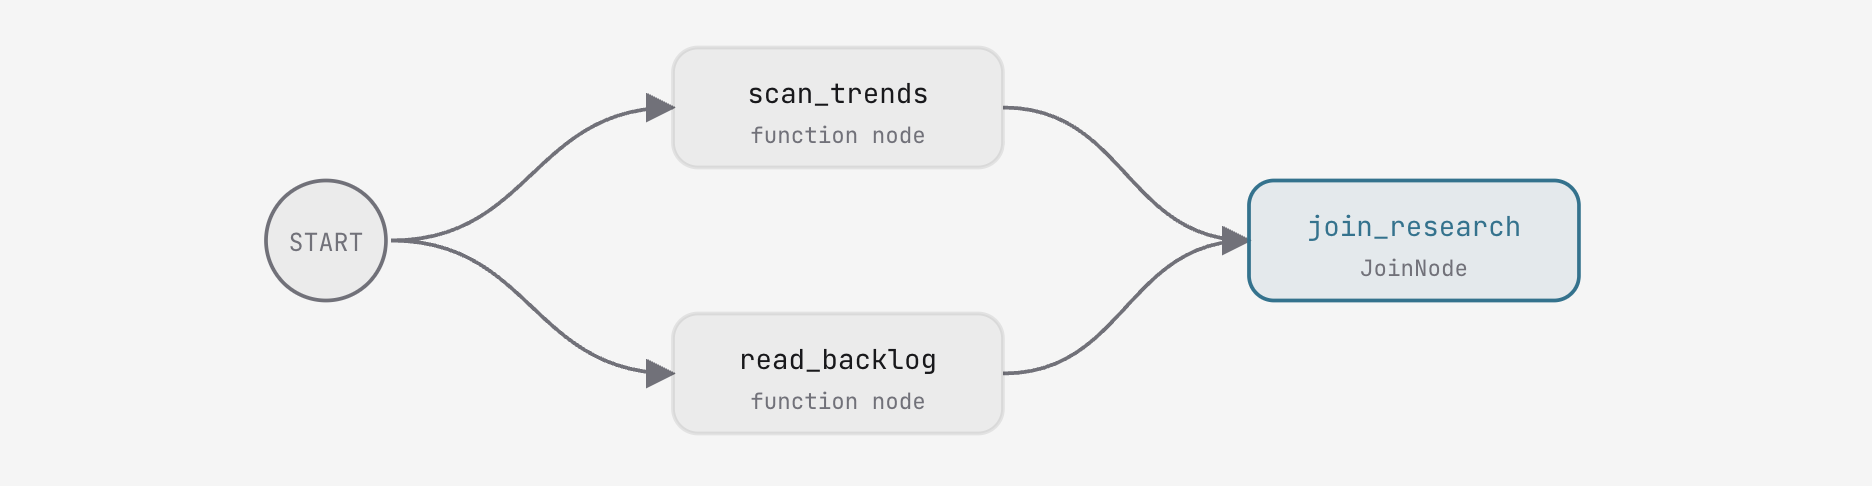
रिसर्च फ़ेज़ में, agent/graph.py से इंपोर्ट किए गए दो फ़ंक्शन नोड का इस्तेमाल किया जाता है:
scan_trends: यहEvent(output={"trends": [...]})दिखाता है. इसमें स्कोर किए गए प्लैटफ़ॉर्म के 10 रुझान शामिल होते हैं.read_backlog: जवाब में,Event(output={"backlog": [...], "idea": "..."})में दिए गए 15 चैनल बैकलॉग के आइडिया के साथ-साथ, शुरुआती रन प्रॉम्प्ट भी शामिल है.
हर फ़ंक्शन, node_input (पिछले नोड का आउटपुट) को स्वीकार करता है और Event दिखाता है.
JoinNode एक सिंक्रनाइज़ेशन बैरियर के तौर पर काम करता है: यह तब तक रुकता है, जब तक हर इनबाउंड चेन एक इवेंट डिलीवर नहीं कर देती. इसके बाद, यह सभी ब्रांच के नतीजों को एक डिक्शनरी में इकट्ठा करता है. इस डिक्शनरी में नोड के नाम ({"scan_trends": {...}, "read_backlog": {...}}) को कुंजी के तौर पर इस्तेमाल किया जाता है.
खुद करके देखें: जॉइन और पैरलल एज तय करना
stage1_fanout/agent.py में, JoinNode को इंस्टैंशिएट करें और START से शुरू होने वाली दो पैरलल चेन को वायर करें:
join_research = JoinNode(name="join_research")
    edges=[(START, scan_trends, join_research),
           (START, read_backlog, join_research)])
बदलावों को सेव करें. वर्कबेंच वेरिफ़ायर पुष्टि करता है कि जॉइन और किनारों को वायर किया गया है. स्टेज 1 चलाएं का इस्तेमाल करके या एम्बेड किए गए ADK वेब इंटरफ़ेस के ज़रिए स्टेज चलाएं.
इसके बाद क्या होगा और क्यों
- एक ही समय में रीडर को लागू करना: एक्ज़ीक्यूशन ग्राफ़ में,
scan_trendsऔरread_backlogएक साथ लागू होते हैं.- क्यों: दोनों चेन
STARTसे शुरू होती हैं. ADK इंजन, अलग-अलग ब्रांच को एक साथ शेड्यूल करता है.
- क्यों: दोनों चेन
- एग्रीगेट किया गया डिक्शनरी आउटपुट: वर्कफ़्लो
join_researchपर पूरा होता है. इससे एक डिक्शनरी मिलती है, जिसमें दोनों लोगों के लिए एंट्री होती हैं.- क्यों:
JoinNodeयह पक्का करता है कि बाद के नोड को एक्ज़ीक्यूट करने की अनुमति देने से पहले, पूरा डेटा कैप्चर कर लिया गया हो.
- क्यों:
एजेंट नोड (4C)
वर्कबेंच में, एजेंट नोड (4C) पर जाएं. stage2_direction/agent.py खोलें.
ऑपरेटिंग मोड और स्ट्रक्चर्ड स्कीमा
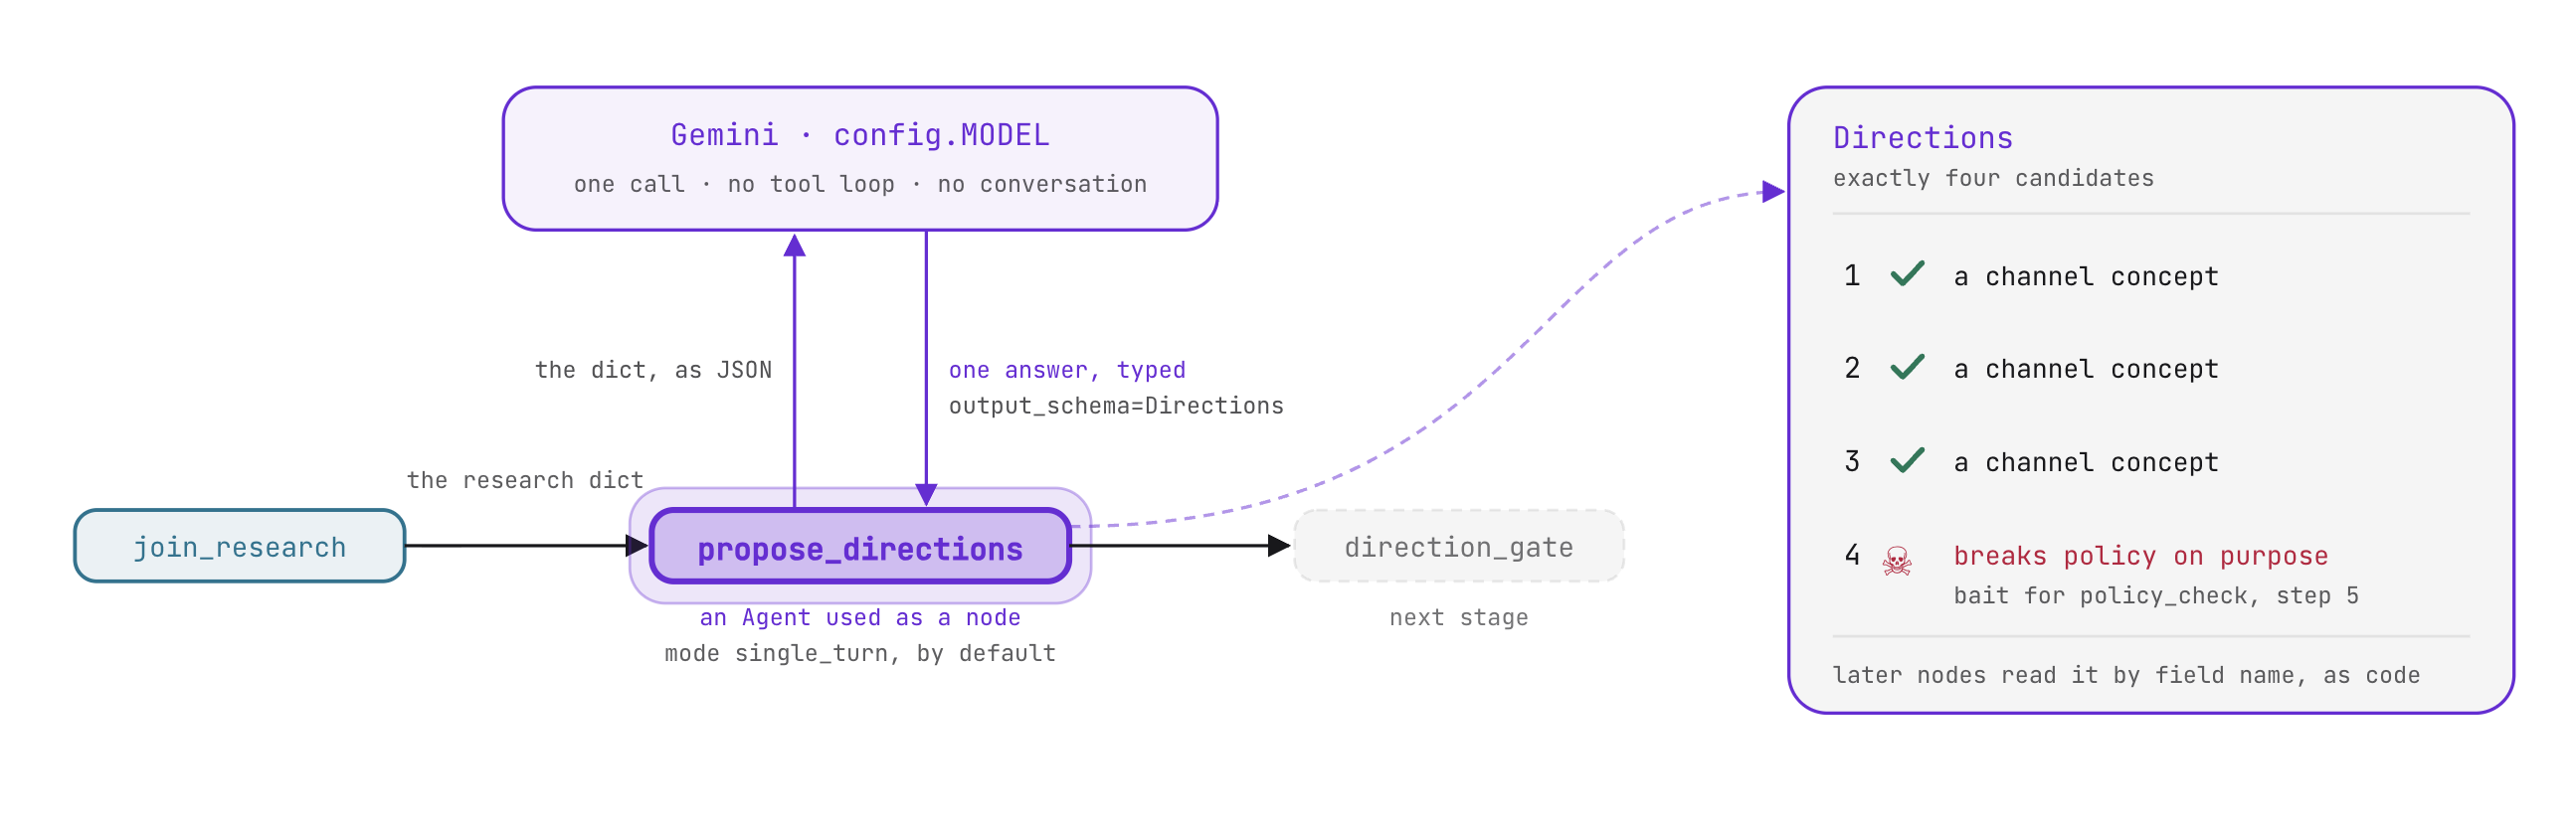
Workflow में एम्बेड किए जाने पर, Agent डिफ़ॉल्ट रूप से single_turn मोड में चलता है:
- इसे पिछले नोड का आउटपुट, कॉन्टेक्स्ट इनपुट के तौर पर मिलता है.
- यह बातचीत के बिना, सिर्फ़ एक बार अनुमान लगाने के लिए कॉल करता है.
- यह स्ट्रक्चर्ड डेटा को अगले नोड पर भेजता है.
output_schema=Directions असाइन करके, एजेंट मॉडल आउटपुट पर Pydantic की पुष्टि लागू करता है. डाउनस्ट्रीम ग्राफ़ को बिना स्ट्रक्चर वाले गद्य के बजाय टाइप किए गए ऑब्जेक्ट मिलते हैं:
class Direction(BaseModel):
    title: str           # <=60 chars, filmable, characterful
    angle: str           # the twist, one line
    hook: str = ""       # 2-4 words, the video's sticker line
    evidence: list[Evidence]


class Directions(BaseModel):
    candidates: list[Direction]   # exactly 4
PROPOSE_INSTRUCTION मॉडल को चार सुझाव देने का निर्देश देता है. इसमें रुझानों और बैकलॉग, दोनों के सबूत शामिल होते हैं. पहले से तीसरे विकल्प में, चैनल के लिए काम के कॉन्सेप्ट दिए गए हैं. चौथे जवाब में, जान-बूझकर नीति का उल्लंघन करने वाला कॉन्सेप्ट शामिल किया गया है, ताकि अगले चरण में सुरक्षा गेट की जांच की जा सके.
खुद करके देखें: एजेंट नोड तय करना और जॉइन को चेन करना
stage2_direction/agent.py में, propose_directions को कॉन्फ़िगर करें और वर्कफ़्लो के किनारों को बढ़ाएं:
propose_directions = Agent(
    name="propose_directions",
    model=config.MODEL,
    instruction=PROPOSE_INSTRUCTION,
    output_schema=Directions)
    edges=[(START, scan_trends, join_research),
           (START, read_backlog, join_research),
           (join_research, propose_directions, direction_gate)])
इसके बाद क्या होगा और क्यों
- डिक्शनरी का सीधे तौर पर इस्तेमाल करना:
propose_directions,join_researchसे मिले JSON पेलोड का इस्तेमाल करता है. इसके लिए, मैन्युअल तरीके से फ़ॉर्मैट करने की ज़रूरत नहीं होती. - टाइप किया गया उम्मीदवार का आउटपुट: एजेंट, पुष्टि किया गया
Directionsऑब्जेक्ट दिखाता है. इसमें चार अलग-अलग उम्मीदवार शामिल होते हैं. डाउनस्ट्रीम नोड, स्ट्रिंग पार्सिंग के बिना एट्रिब्यूट के नाम (candidate.title) से फ़ील्ड पढ़ते हैं.
मैन्युअल प्रक्रिया वाला चरण (4D)
वर्कबेंच में, ह्यूमन-इन-द-लूप (4D) पर जाएं. agent/graph.py खोलें.
प्रॉम्प्ट के निर्देशों और तय किए गए निलंबन के बीच अंतर
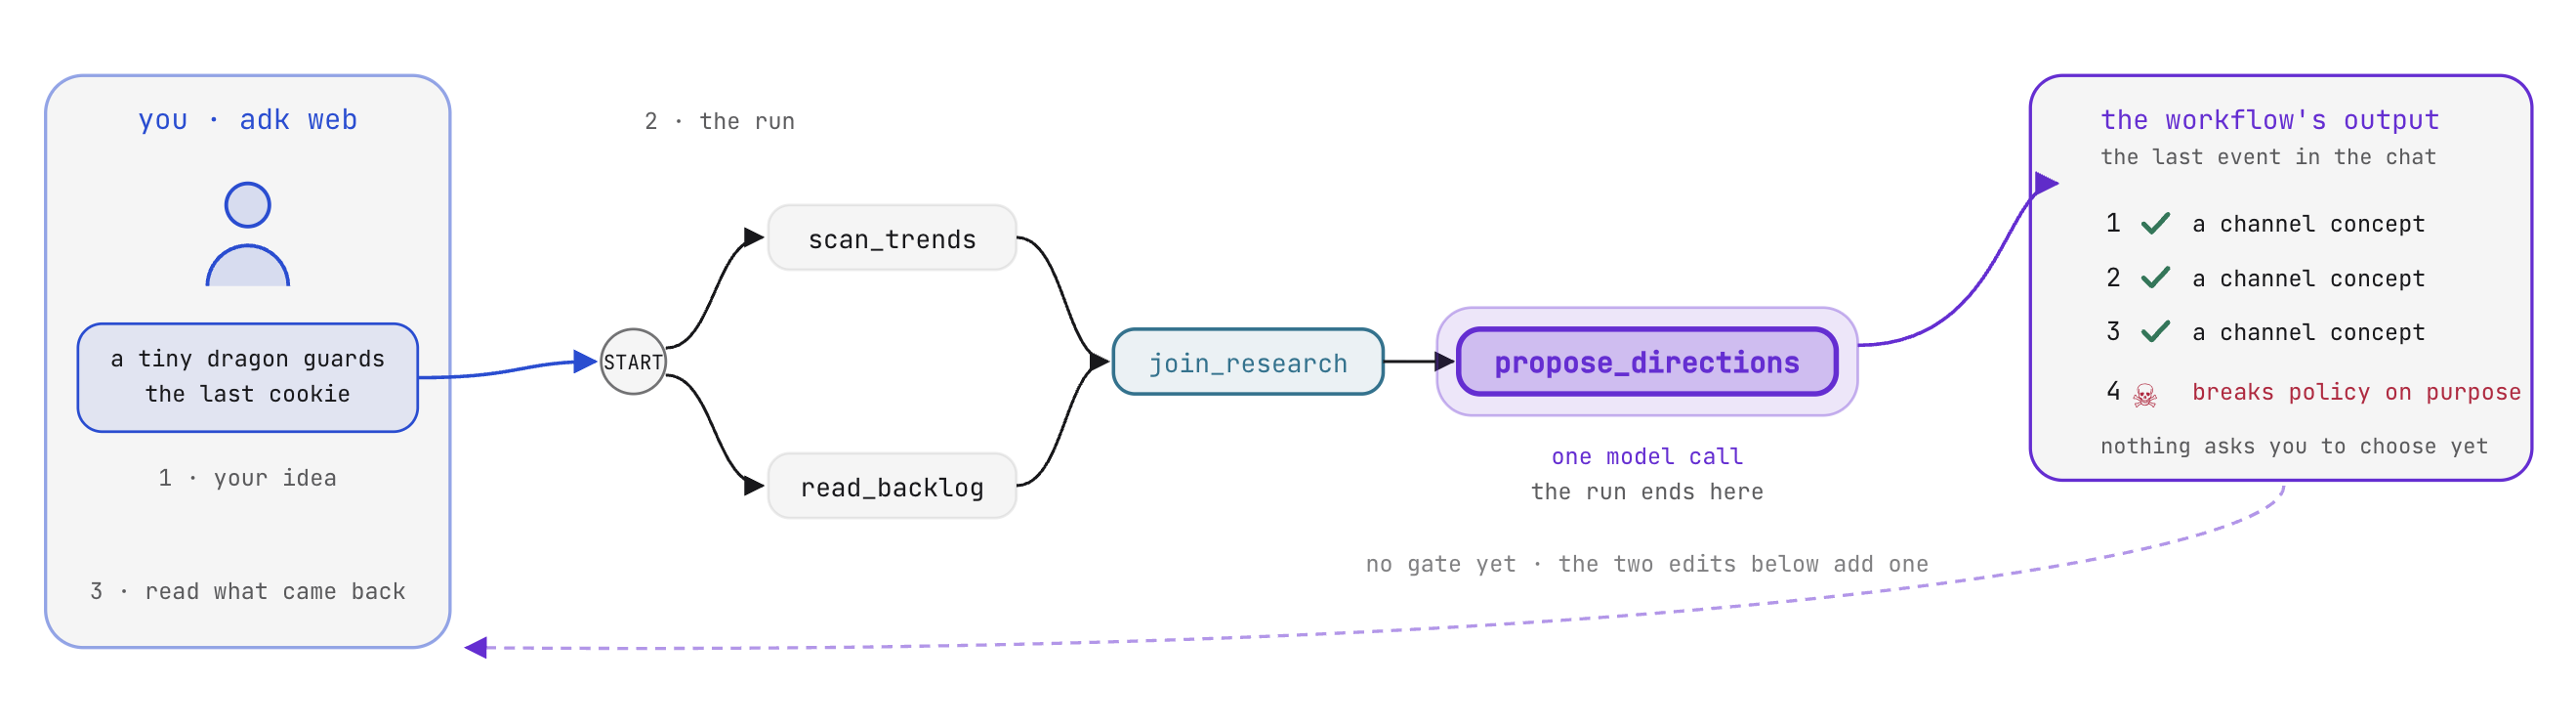
जिन प्रोडक्शन वर्कफ़्लो में वित्तीय लागत लगती है या कॉन्टेंट पब्लिश किया जाता है उनमें अहम फ़ैसलों के लिए, मैन्युअल तरीके से निगरानी करना ज़रूरी होता है. एक ही प्रॉम्प्ट में, पुष्टि करने के अनुरोध, सलाह के तौर पर दिए गए निर्देश होते हैं. उपयोगकर्ता, मॉडल को इन निर्देशों को अनदेखा करने के लिए आसानी से प्रॉम्प्ट कर सकता है. एडीके वर्कफ़्लो में, एक्ज़ीक्यूशन इंजन के ज़रिए मानवीय मंज़ूरी लागू की जाती है: ग्राफ़, तय किए गए नोड पर रुक जाता है और तब तक आगे नहीं बढ़ सकता, जब तक इसे बाहरी, स्कीमा-मान्य इनपुट नहीं मिल जाता:
RequestInputफ़ंक्शन का इस्तेमाल करने पर, वर्कफ़्लो का एक्ज़ीक्यूशन तुरंत रुक जाता है.- ADK, सेशन स्टोर में ओपन इंटरप्ट कॉल रिकॉर्ड करता है और एक यूनीक
interrupt_idजारी करता है. - टोकन या सर्वर थ्रेड का इस्तेमाल किए बिना, प्रोसेस को रोक दिया जाता है.
- ग्राफ़ को फिर से तब ही शुरू किया जा सकता है, जब स्कीमा और इंटरप्ट आईडी से मेल खाने वाला मान्य
function_responseसबमिट किया गया हो.
खुद करके देखें: RequestInput की मदद से, एक्ज़ीक्यूशन को रोकना
agent/graph.py में, direction_gate के अंदर निलंबन कॉल लागू करें:
    yield RequestInput(
        message="Pick tonight's direction: 1, 2, 3 or 4.",
        response_schema={
            "type": "object",
            "properties": {
                "pick": {"type": "string", "enum": ["1", "2", "3", "4"]}}},
        payload={"candidates": cands})
RequestInput तीन एट्रिब्यूट कॉन्फ़िगर करता है:
message: उपयोगकर्ता को दिखाया गया समीक्षा का प्रॉम्प्ट.response_schema: यह एक JSON स्कीमा है, जिसे फ़्रंटएंड, इनपुट फ़ॉर्म के तौर पर रेंडर करता है. सबमिट करने पर, ADK इसकी पुष्टि करता है.payload: अनुरोध के साथ बंडल किया गया मेटाडेटा (चार उम्मीदवार). इससे क्लाइंट इंटरफ़ेस, सेशन की स्थिति के बारे में क्वेरी किए बिना समीक्षा कार्ड रेंडर कर पाते हैं.
इसके बाद क्या होगा और क्यों
- direction_gate पर वर्कफ़्लो रुक जाता है: ADK Web या वर्कबेंच इंटरफ़ेस में, रन रुक जाता है और इंटरैक्टिव कैंडिडेट चुनने का फ़ॉर्म दिखता है.
- वजह: इंजन को
RequestInputमिला और उसनेruns/sessions.dbमें एक्ज़ीक्यूशन की स्थिति को बनाए रखा.
- वजह: इंजन को
- चैट को फिर से शुरू करने के लिए, स्ट्रक्चर्ड इनपुट की ज़रूरत होती है: चैट में कोई भी टेक्स्ट भेजने से, ग्राफ़ आगे नहीं बढ़ता. किसी विकल्प (1, 2, 3 या 4) को चुनने पर, टाइप किया गया
function_responseसबमिट हो जाता है. इससेresponse_schemaकी शर्त पूरी हो जाती है और प्रोग्राम फिर से शुरू हो जाता है.
5. स्टेट और राऊटर
VibeStudio Workbench में, Step 5 · State and Router पर जाएं. इसके बाद, (5A) से लेकर (5C) तक के हिस्से पर जाएं.
उपयोगकर्ता के चुने गए विकल्पों को सेशन की स्थिति में सेव किया जाएगा. साथ ही, डिटरमिनिस्टिक राऊटर नोड का इस्तेमाल करके, चैनल की सुरक्षा से जुड़ी नीतियों को लागू किया जाएगा. इसके अलावा, बार-बार दोहराए जाने वाले टास्क एजेंट को इकट्ठा किया जाएगा, ताकि वीडियो स्क्रिप्ट जनरेट करने से पहले, नीति के उल्लंघनों को अपने-आप ठीक किया जा सके.
वर्कफ़्लो की स्थिति (5A)
वर्कबेंच में, वर्कफ़्लो की स्थिति (5A) पर जाएं.
सेशन की स्थिति बनाम नोड का आउटपुट
ADK वर्कफ़्लो में, डेटा दो अलग-अलग तरीकों से ग्राफ़ में ट्रांसफ़र होता है:
- नोड आउटपुट (
Event(output=...)): डेटा को सिर्फ़ उन उपभोक्ताओं को भेजा जाता है जो एज लिस्ट में शामिल हैं. - सेशन की स्थिति (
Event(state=...)): यह शेयर की गई कुंजी-वैल्यू वाली डिक्शनरी होती है. इसे एक्ज़ीक्यूशन लाइफ़साइकल में मौजूद कोई भी नोड ऐक्सेस कर सकता है.
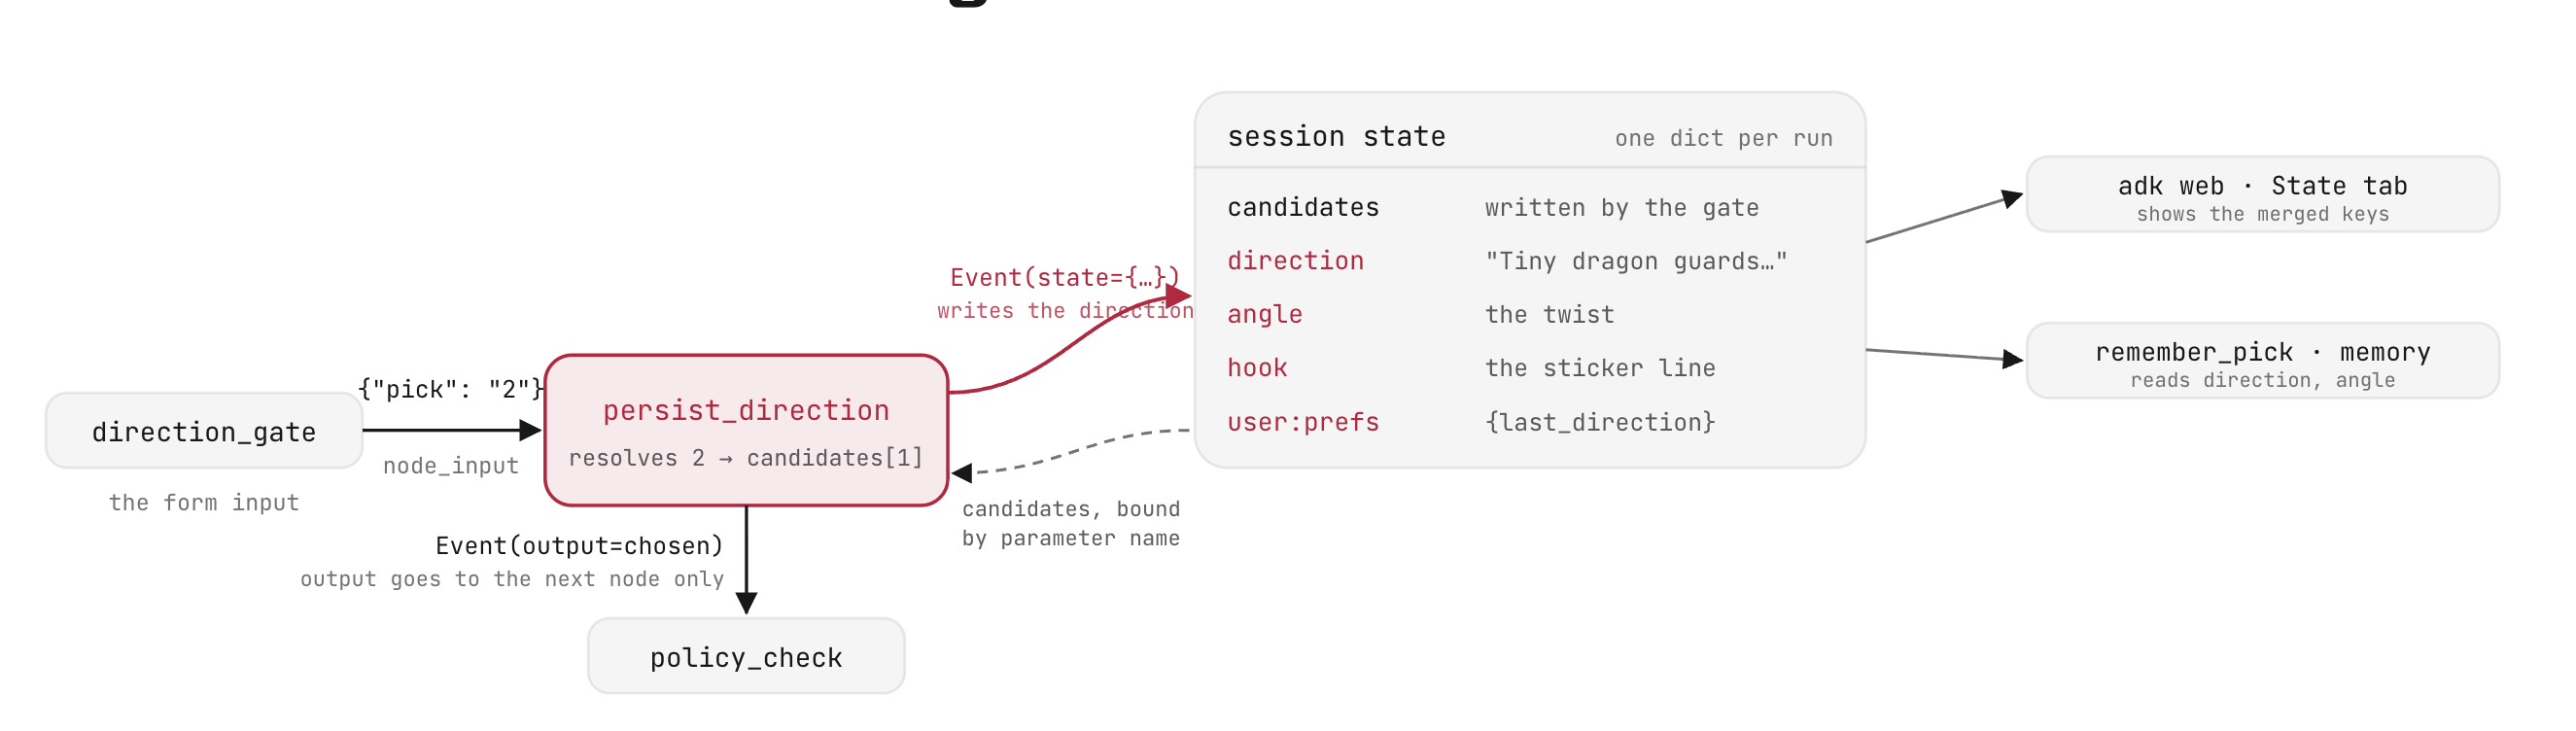
जब कोई उपयोगकर्ता direction_gate पर किसी कैंडिडेट को चुनता है, तो वह संख्या वाले इंडेक्स ({"pick": "2"}) के तौर पर दिखता है. डाउनस्ट्रीम नोड को पूरे दिशा-निर्देश ऑब्जेक्ट की ज़रूरत होती है: टाइटल, कहानी का ऐंगल, और हुक लाइन. हर इंटरमीडिएट नोड पेलोड के ज़रिए ज़्यादा जानकारी वाला मेटाडेटा पास करने के बजाय, persist_direction शेयर की गई सेशन की स्थिति में हल किए गए कैंडिडेट को लिखता है.
नोड को पूरे सेशन की स्थिति वाली डिक्शनरी को पास करने की ज़रूरत नहीं होती. जब कोई नोड Event(state=...) देता है, तो वह सिर्फ़ नए या अपडेट किए गए की-वैल्यू पेयर उपलब्ध कराता है. ADK, इन अपडेट को सेशन स्टोर में अपने-आप मर्ज कर देता है:
    yield Event(state={"direction": chosen["title"], "angle": chosen.get("angle", ""),
                       "hook": hook, "user:prefs": {"last_direction": chosen["title"]}})
इससे Event, Workflow रनटाइम को कंट्रोल करता है. यह नई वैल्यू को runs/sessions.db में सेशन जर्नल में सेव करता है.
पैरामीटर बाइंडिंग
ADK फ़ंक्शन नोड, पैरामीटर की जांच करके सेशन की स्थिति को अपने-आप पढ़ लेते हैं. अगर फ़ंक्शन सिग्नेचर, मौजूदा स्टेट की कुंजी से मेल खाने वाले पैरामीटर के नाम का एलान करता है, तो ADK उस कुंजी को स्टेट से निकालता है और उसे सीधे तौर पर पास करता है:
def persist_direction(node_input, candidates: list = []):
    ni = node_input if isinstance(node_input, dict) else {}
    raw = ni.get("pick")
    pick = str(raw).strip() if raw is not None else ""
    if candidates:
        i = int(pick) - 1 if pick.isdigit() else 0
        chosen = candidates[max(0, min(len(candidates) - 1, i))]
    else:
        chosen = {"title": "untitled", "angle": "", "evidence": []}
    hook = chosen.get("hook") or " ".join(chosen["title"].split()[:4])
यहां, candidates को direction_gate ने सेशन की स्थिति में लिखा था. ADK इसे सीधे persist_direction(node_input, candidates: list = []) में बाइंड करता है. इसके लिए, डिक्शनरी लुकअप की ज़रूरत नहीं होती.
user: से प्रीफ़िक्स की गई कुंजियां, उपयोगकर्ता-लेवल के स्टोरेज में सभी सेशन के लिए बनी रहती हैं. इससे बाद के वर्कफ़्लो रन, क्रिएटर की प्राथमिकताओं को ऐक्सेस कर पाते हैं.
खुद करके देखें: स्थिति को बनाए रखना और नोड को वायर करना
agent/graph.pyमें,persist_directionके अंदर,TODO: PERSIST_STATEलाइन को स्टेट इवेंट यील्ड से बदलें:
    yield Event(state={"direction": chosen["title"], "angle": chosen.get("angle", ""),
                       "hook": hook, "user:prefs": {"last_direction": chosen["title"]}})
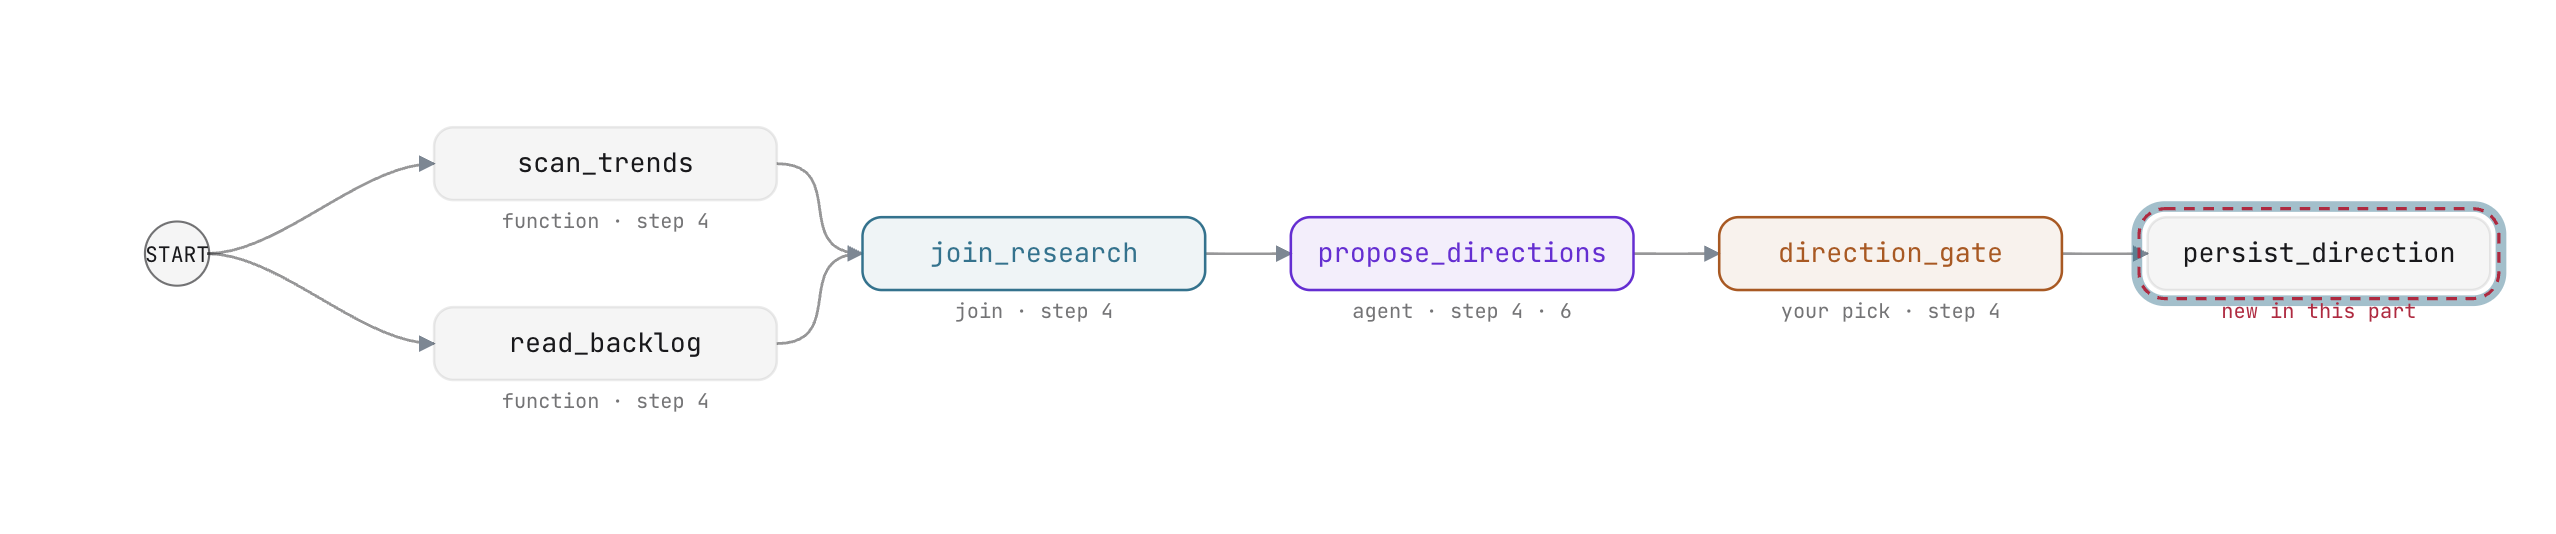
stage3_router/agent.pyमें,edgesसूची में मौजूद तीसरे चेन सेpersist_directionको जोड़ें:
           (join_research, propose_directions, direction_gate,
            persist_direction)
अपनी फ़ाइलें सेव करें. वर्कबेंच में जाकर देखें कि state write in place और persist_direction in the chain, दोनों के बगल में हरे रंग का सही का निशान दिख रहा हो.
राऊटर नोड (5B)
वर्कबेंच में, राउटर नोड (5B) पर जाएं.
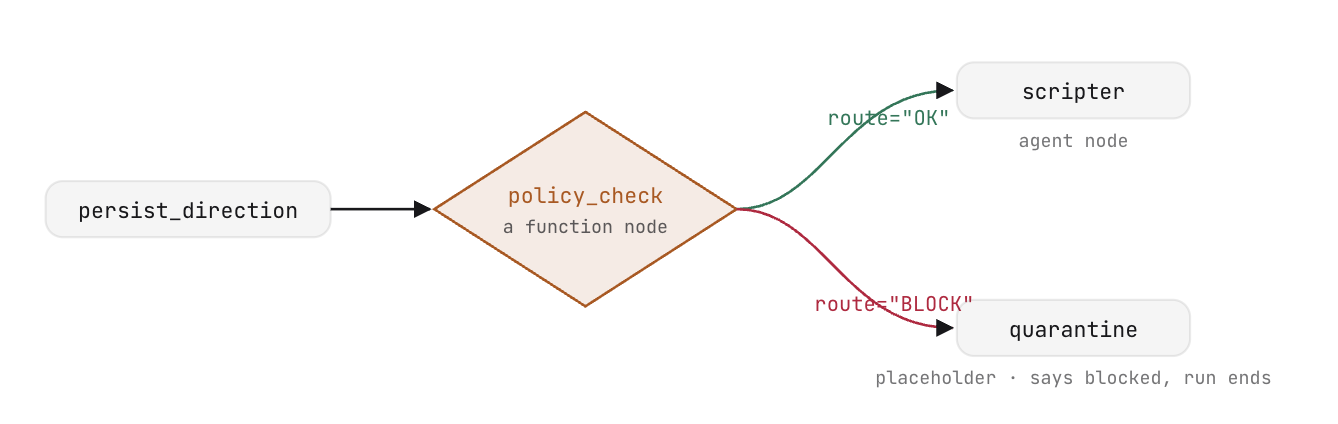
नीति के आधार पर तय की गई रूटिंग
राउटर, एक खास फ़ंक्शन नोड होता है. यह अपस्ट्रीम आउटपुट का आकलन करता है और शर्तों के आधार पर ग्राफ़ की ब्रांच के हिसाब से एक्ज़ीक्यूशन को डायरेक्ट करता है. जनरेटिव एजेंट के उलट, राऊटर एलएलएम कॉल किए बिना, डिटरमिनिस्टिक लॉजिक को लागू करता है.
राउटर, route टैग के बारे में जानकारी देने वाला Event दिखाता है:
def length_check(node_input):
    too_long = len(node_input.get("title", "")) > 60
    return Event(output=node_input, route="TRIM" if too_long else "PASS")
वर्कफ़्लो की परिभाषा में, डिक्शनरी के तौर पर तय किया गया एज टारगेट, रूट के नामों को डेस्टिनेशन नोड पर मैप करता है:
(length_check, {"TRIM": shorten, "PASS": scripter}),
वर्कफ़्लो राउटर policy_check, agent/policy_words.txt से पाबंदी वाले वाक्यांशों को पढ़ता है. इसके बाद, चुने गए दिशा-निर्देश के टाइटल और ऐंगल के हिसाब से, पूरे शब्द का मिलान करता है:
return Event(output=node_input, route="BLOCK" if bad else "OK")
नीति को हार्डकोड किए गए निर्देशों के बजाय डेटा के तौर पर सेव करने से, वर्कफ़्लो ग्राफ़ में बदलाव किए बिना अपडेट किए जा सकते हैं. टेक्स्ट फ़ाइल को अपडेट करने पर, यह बदलाव तुरंत लागू हो जाता है. आकलन, रेगुलर एक्सप्रेशन से मैच करने वाला एक तय तरीका है. इसलिए, जनरेटिव स्क्रिप्टिंग शुरू होने से पहले, यह कुछ मिलीसेकंड में पूरा हो जाता है. इसमें कोई टोकन खर्च नहीं होता.
डेस्टिनेशन: स्क्रिप्ट लिखने वाला और क्वारंटाइन
राउटर, ट्रैफ़िक को दो डाउनस्ट्रीम नोड में से किसी एक पर भेजता है:
scripter: यहsingle_turnएजेंट नोड है. यह मंज़ूरी मिल चुकी स्क्रिप्ट कोScriptPydantic स्कीमा के मुताबिक, स्ट्रक्चर्ड प्रोडक्शन स्क्रिप्ट में बदलता है:
scripter = Agent(
    name="scripter",
    model=config.MODEL,
    instruction=SCRIPT_INSTRUCTION,
    output_schema=Script)
quarantine: यह फ़ंक्शन, शुरुआत में प्लेसहोल्डर के तौर पर काम करता है. यह फ़्लैग किए गए निर्देशों को रोकता है. अगले हिस्से में, इसे अपने-आप समस्या हल करने वाले एजेंट से बदल दिया जाता है.
खुद करके देखें: नीति की जांच को रूट करना
agent/graph.pyमें,policy_checkमें जाकर, रिटर्न स्टेटमेंट पूरा करें:
return Event(output=node_input, route="BLOCK" if bad else "OK")
stage3_router/agent.pyमें,edgesको अपडेट करकेpolicy_checkपर ले जाएं. इसके बाद, क्वारंटाइन ब्रांच कोscripterमें फिर से शामिल करें:
           (join_research, propose_directions, direction_gate,
            persist_direction, policy_check),
           (policy_check, {"OK": scripter, "BLOCK": quarantine}),
           (quarantine, scripter)])
अपनी फ़ाइलें सेव करें. वर्कबेंच में, पुष्टि करें कि राऊटर एज मैपिंग की पुष्टि हो गई है.
एजेंट मोड और टास्क नोड (5C)
Workbench में, Agent modes and the task node (5C) पर जाएं.
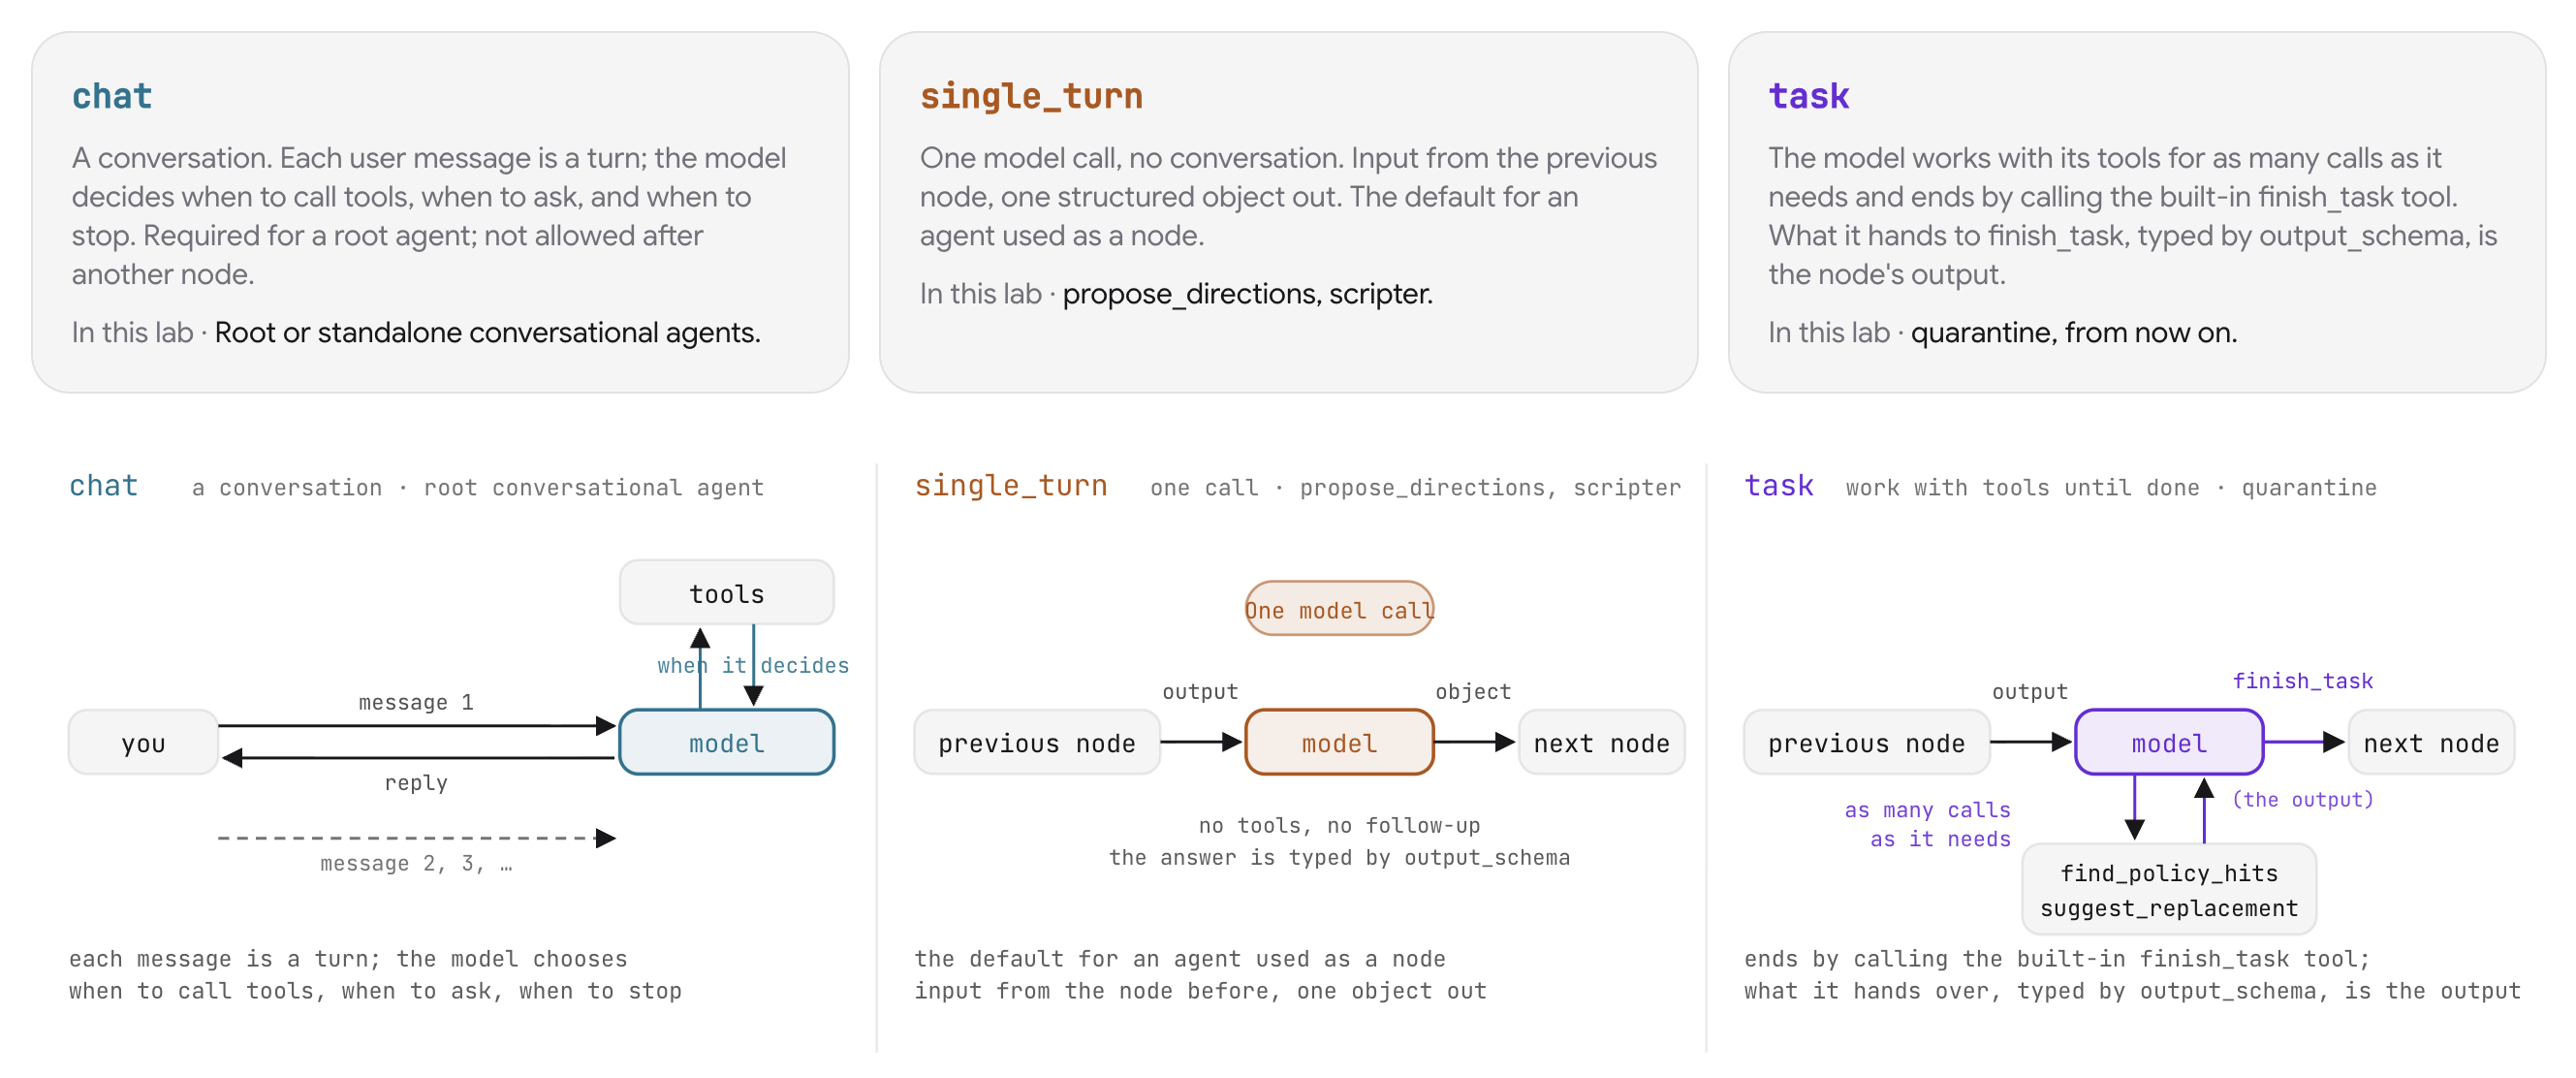
एजेंट को असाइन किए गए टास्क पूरे करने के मोड
ADK Agent इंस्टेंस, तीन एक्ज़ीक्यूशन मोड के साथ काम करते हैं. ये मोड, पाइपलाइन की खास ज़रूरतों के हिसाब से बनाए गए हैं:
मोड | लागू करने का लाइफ़साइकल | पाइपलाइन में भूमिका |
| सिलसिलेवार बातचीत का लूप. मॉडल यह तय करता है कि टूल कब इस्तेमाल करने हैं, इनपुट कब मांगना है या बातचीत कब खत्म करनी है. | रूट एजेंट, जो किसी इंसान से इंटरैक्ट कर रहे हैं. |
| सिंगल मॉडल इन्फ़रेंस कॉल. यह पिछले नोड के इनपुट को स्वीकार करता है और स्ट्रक्चर्ड स्कीमा ऑब्जेक्ट बनाता है. | सीक्वेंशियल ग्राफ़ ट्रांसफ़ॉर्मेशन ( |
| टूल के साथ ऑटोनॉमस लूप. एजेंट, | कई चरणों में समस्या हल करने और जांच करने की सुविधा ( |
नीति के उल्लंघन को अपने-आप ठीक करने की सुविधा
फ़्लैग किए गए निर्देश को फिर से लिखने के लिए, task मोड की ज़रूरत होती है. ऐसा इसलिए, क्योंकि समस्या को ठीक करने के लिए दोहराई जाने वाली प्रोसेस की संख्या अलग-अलग होती है. एजेंट को फ़्लैग किया गया निर्देश मिलता है. इसके बाद, वह उल्लंघन का पता लगाने के लिए find_policy_hits को चालू करता है. साथ ही, suggest_replacement के ज़रिए मंज़ूरी पा चुके विकल्पों का अनुरोध करता है. इसके बाद, वह निर्देश को फिर से लिखता है और आगे बढ़ने से पहले, यह पुष्टि करता है कि निर्देश में कोई गड़बड़ी नहीं है.
दोनों टूल को agent/cleanup_tools.py में टाइप किए गए सिग्नेचर और डॉकस्ट्रिंग के साथ तय किया गया है:
def find_policy_hits(text: str) -> dict:
    """Which refused words appear in `text`. Matches whole words and phrases
    from agent/policy_words.txt, case-insensitive.

    Returns {"hits": [...], "clean": bool}. clean is true when hits is empty.
    """


def suggest_replacement(word: str) -> dict:
    """The channel's approved stand-in for a refused word, read from
    agent/policy_replacements.txt.

    Returns {"word", "replacement", "listed"}. When the word has no entry,
    listed is false and replacement is a hint to pick a gentle synonym.
    """
खुद करके देखें: क्वॉरंटीन टास्क एजेंट को असेंबल करना
stage3_router/agent.py में, प्लेसहोल्डर quarantine फ़ंक्शन को टास्क एजेंट की परिभाषा से बदलें:
quarantine = Agent(
    name="quarantine",
    model=config.MODEL,
    instruction=QUARANTINE_INSTRUCTION,
    mode="task",
    tools=[find_policy_hits, suggest_replacement],
    output_schema=CleanedDirection,
)
टास्क मोड, एजेंट को टूल उपलब्ध कराता है और finish_task को कॉल करके, टास्क को पूरा करता है. mode="task" को कॉन्फ़िगर करने पर, ADK अपने-आप finish_task उपलब्ध कराता है और इसके पैरामीटर output_schema से लेता है. इससे यह पक्का होता है कि नोड, टाइप किया गया CleanedDirection ऑब्जेक्ट जनरेट करता है, जो स्क्रिप्ट नोड के इनपुट स्कीमा से मेल खाता है.
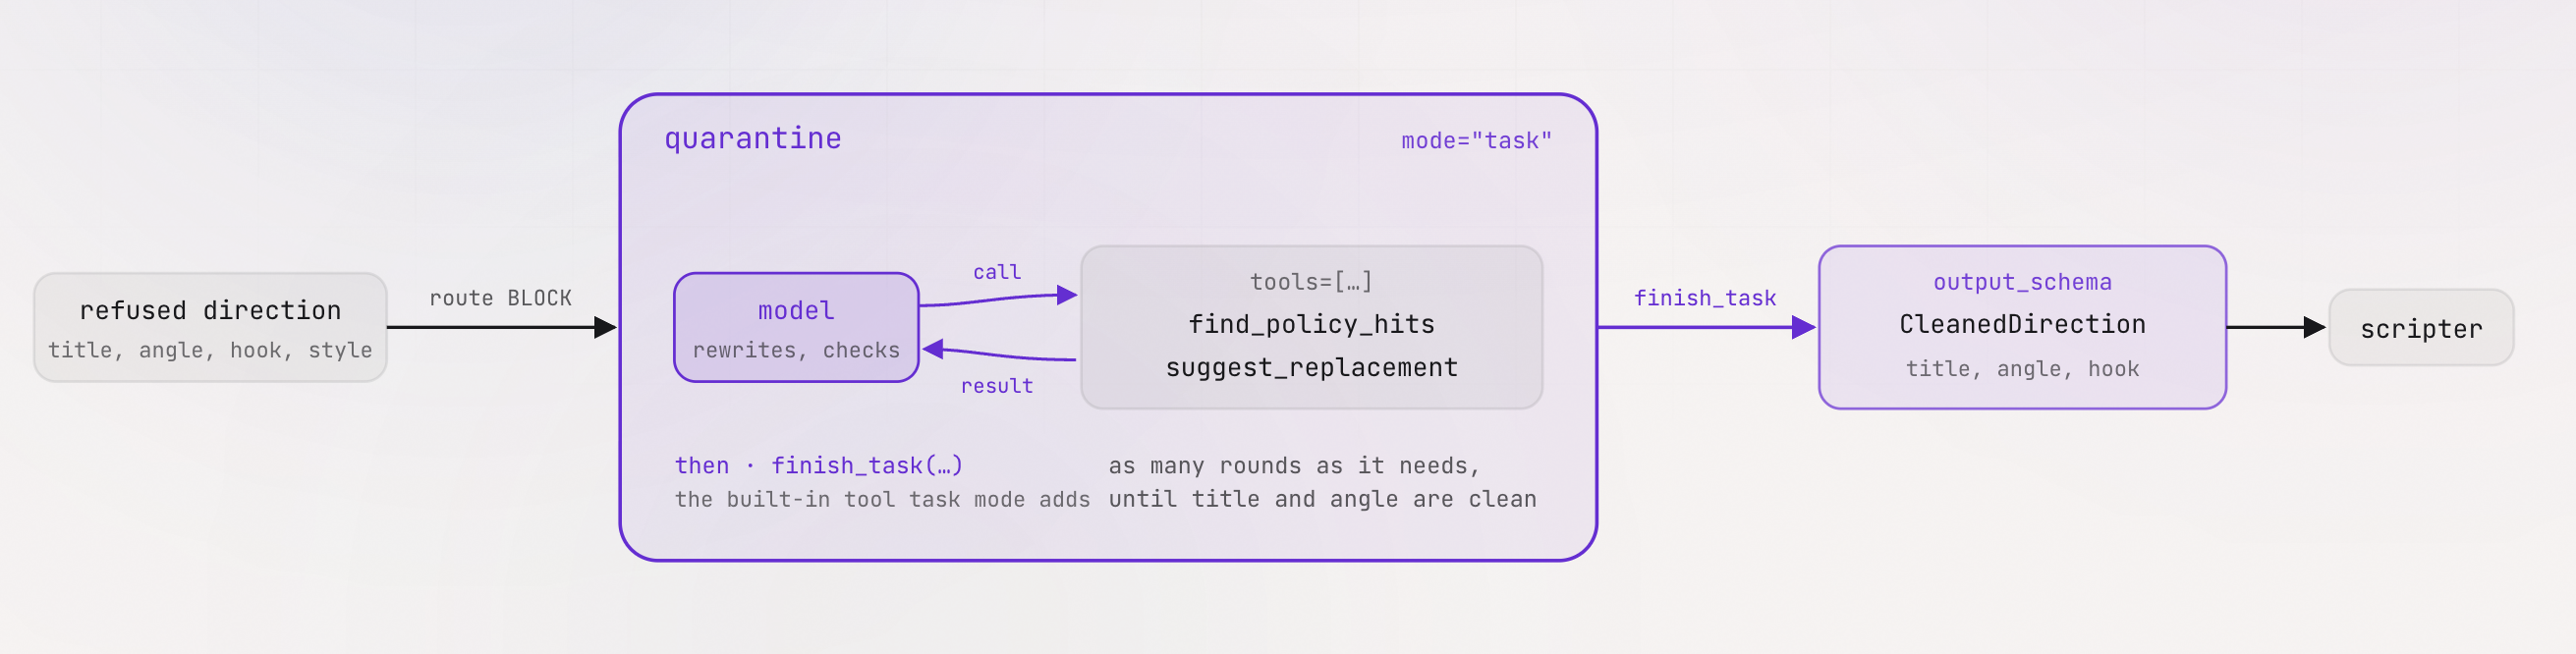
इसके बाद क्या होगा और क्यों
ADK Web या VibeStudio Workbench में, दोनों एक्ज़ीक्यूशन पाथ की जांच करें:
- मंज़ूर किया गया रास्ता (कैंडिडेट 1, 2 या 3):
- मंज़ूरी पा चुके किसी उम्मीदवार को चुनने पर,
policy_checkसे सीधेscripter(route="OK") पर रीडायरेक्ट किया जाता है. - स्क्रिप्ट लिखने वाला व्यक्ति,
Scriptस्कीमा के मुताबिक तीन शॉट वाली प्रोडक्शन स्क्रिप्ट जनरेट करता है.
- मंज़ूरी पा चुके किसी उम्मीदवार को चुनने पर,
- क्वारंटीन से जुड़ी समस्या हल करने का तरीका (कैंडिडेट 4):
- चौथे जवाब में फ़्लैग किए गए शब्द ("क्लिकबेट", "वायरल हैक") शामिल हैं.
quarantine(route="BLOCK") तक जाने केpolicy_checkरास्ते.- सेशन ट्रेस में, हर उल्लंघन के लिए
quarantineकोfind_policy_hitsऔरsuggest_replacementको कॉल करते हुए, टाइटल को फिर से लिखते हुए, औरfinish_taskको कॉल करते हुए देखें. - इसके बाद, स्क्रिप्ट को फिर से
scripterमें शामिल किया जाता है. इससे, साफ़ की गई स्क्रिप्ट जनरेट होती है.
6. मेमोरी बैंक
VibeStudio Workbench में, छठा चरण · मेमोरी बैंक के (6A) और (6B) सेक्शन पर जाएं.
फ़िलहाल, वर्कफ़्लो अलग-अलग सेशन में बिना किसी मेमोरी के काम करता है. हर बार, कॉन्टेंट को शुरू से जनरेट किया जाता है. इसे यह नहीं पता होता कि क्रिएटर ने पहले क्या चुना था या उसे किस तरह के कॉन्टेंट पसंद हैं. इस चरण में, आपको Vertex AI Agent Engine Memory Bank को कनेक्ट करना होगा, ताकि क्रिएटर की प्राथमिकताओं को सेव किया जा सके और उन्हें अलग-अलग रन के दौरान वापस पाया जा सके.
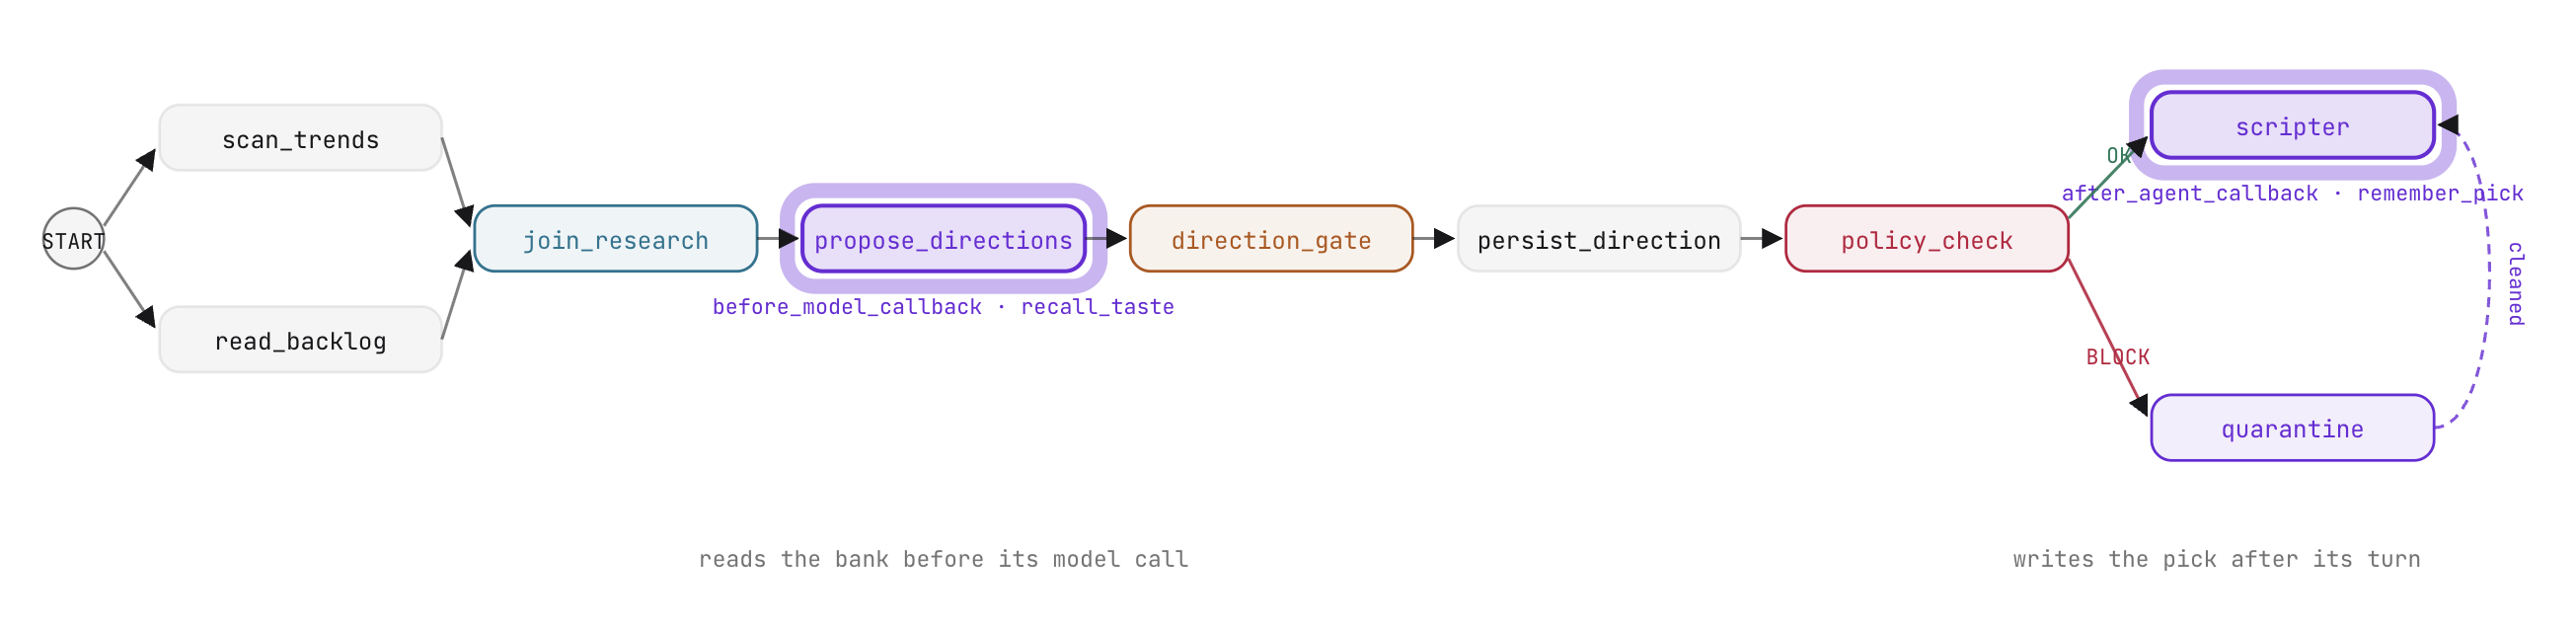
खास तौर पर, मेमोरी को पाइपलाइन नोड के बजाय, एजेंट के लाइफ़साइकल कॉलबैक के ज़रिए इंटिग्रेट किया जाता है. मेमोरी से जानकारी निकालने और उसे वापस पाने की सुविधा, डेटा के बीच के चरणों के बजाय अलग-अलग एजेंट के लिए काम करती है. इसलिए, कॉलबैक अटैच करने से, ग्राफ़ टोपोलॉजी को साफ़ और अलग रखा जा सकता है.
मेमोरी बैंक (6A)
वर्कबेंच में, मेमोरी बैंक (6A) पर जाएं.
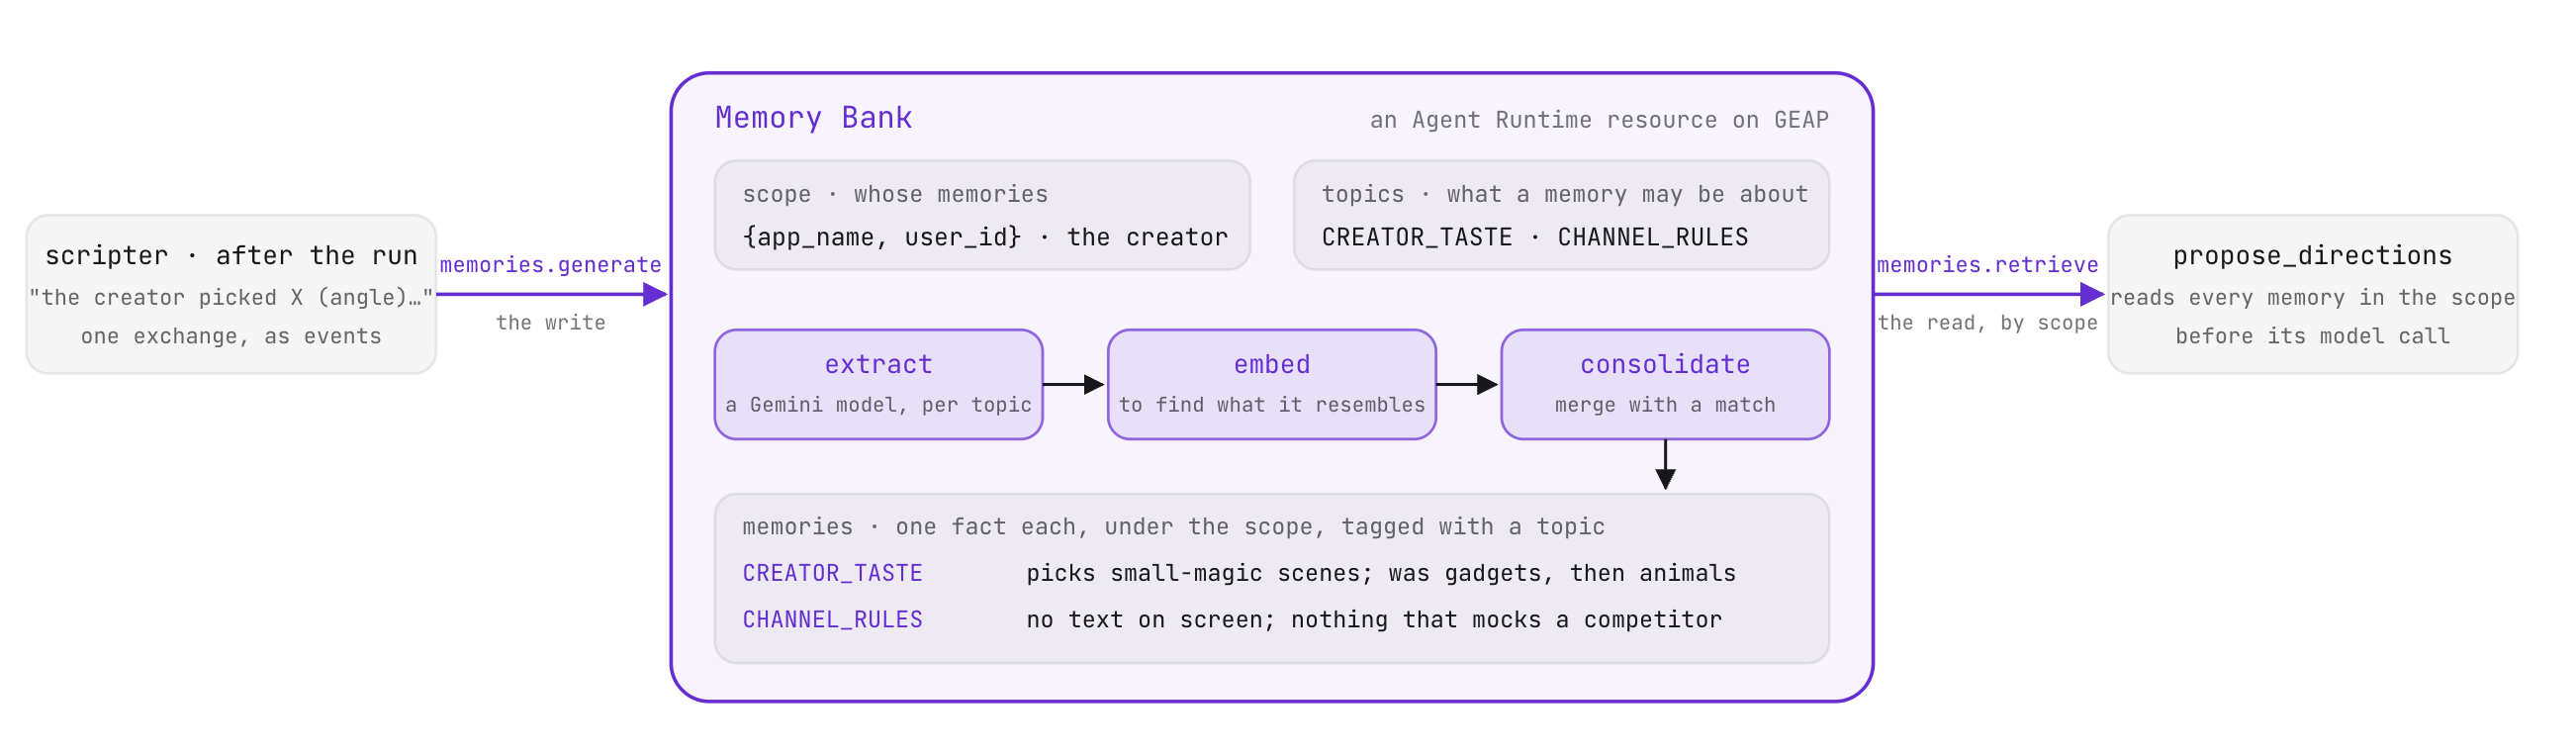
उपयोगकर्ता की प्राथमिकताएं सेव करने की सेटिंग मैनेज की गई
Memory Bank, लंबे समय तक उपयोगकर्ता की मेमोरी को मैनेज करने वाली सेवा है. यह किसी व्यक्ति के बारे में तथ्यों को एक तय दायरे में व्यवस्थित करता है. यहां, इसकी पहचान ऐप्लिकेशन के नाम और उपयोगकर्ता आईडी से की जाती है:
SCOPE = {"app_name": config.APP, "user_id": config.USER}
TOPICS = {
    "CREATOR_TASTE": "Which video directions this creator picks and passes on, "
                     "and how that preference changes over time.",
    "CHANNEL_RULES": "Standing instructions the creator states for every video "
                     "(style, subjects to avoid, format rules).",
}
कस्टम मेमोरी टॉपिक से यह तय होता है कि बैंक किस तरह का डेटा रिकॉर्ड करेगा:
- विषय निकालना: जब
memories.generateके ज़रिए बातचीत का नया टेक्स्ट सबमिट किया जाता है, तो सेवा हर विषय की जानकारी के लिए, विषय निकालने वाला मॉडल लागू करती है. किसी विषय से मेल न खाने वाले टेक्स्ट से, यादें जनरेट नहीं होती हैं. - डेटा को एक जगह इकट्ठा करना और डुप्लीकेट डेटा हटाना: यह सेवा, नए तथ्यों को एम्बेडिंग में बदलती है और उनकी तुलना स्कोप में मौजूद यादों से करती है. जब कोई ऑब्ज़र्वेशन, किसी मौजूदा याद से मेल खाती है, तो सेवा उस याद को अपडेट करती है. जब यह नई जानकारी दिखाता है, तो सेवा एक नई एंट्री बनाती है. इस प्रोसेस से यह पक्का होता है कि किसी विषय के बारे में कई सेशन, एक ही जानकारी में मर्ज हो जाएं. इससे एक ही जानकारी को बार-बार दिखाने से बचा जा सकता है.
- डेटा वापस पाना: उपयोगकर्ता के स्कोप के साथ
memories.retrieveको कॉल करने पर, सेव किए गए तथ्य मिलते हैं. इन्हें सबसे पुराने से लेकर सबसे नए के क्रम में लगाया जाता है.
दोनों कार्रवाइयां, agent/platform/memory.py में लागू की जाती हैं. बैंक के लिए उपलब्ध कराए गए संसाधन का नाम, runs/memorybank.json में स्थानीय तौर पर कैश मेमोरी में सेव किया जाता है.
मेमोरी बैंक सेट अप करना
वर्कबेंच कंट्रोल का इस्तेमाल करें या अपने टर्मिनल में सीएलआई कमांड चलाएं:
- बैंक को कनेक्ट करें और उसे सेट अप करें:
python -m agent.platform.bankCREATOR_TASTEऔरCHANNEL_RULESविषयों को कॉन्फ़िगर करता है. - इतिहास के सेशन के लिए सीड:
python -m agent.platform.bank load - तथ्यों की जांच करना:
python -m agent.platform.bank list
कॉलबैक (6B)
वर्कबेंच में, कॉल बैक (6B) पर जाएं. stage4_memory/agent.py खोलें.
ADK एजेंट के लाइफ़साइकल कॉलबैक
कॉलबैक एक ऐसा फ़ंक्शन होता है जिसे Agent में आर्ग्युमेंट के तौर पर पास किया जाता है. ADK, पहले से तय किए गए लाइफ़साइकल के समय पर कॉलबैक शुरू करता है. साथ ही, चालू कॉन्टेक्स्ट पास करता है. None को वापस लाने पर, सामान्य तरीके से काम करना जारी रहता है. किसी ऑब्जेक्ट को बदलने पर, ऑपरेशन को बदल दिया जाता है या रोक दिया जाता है.
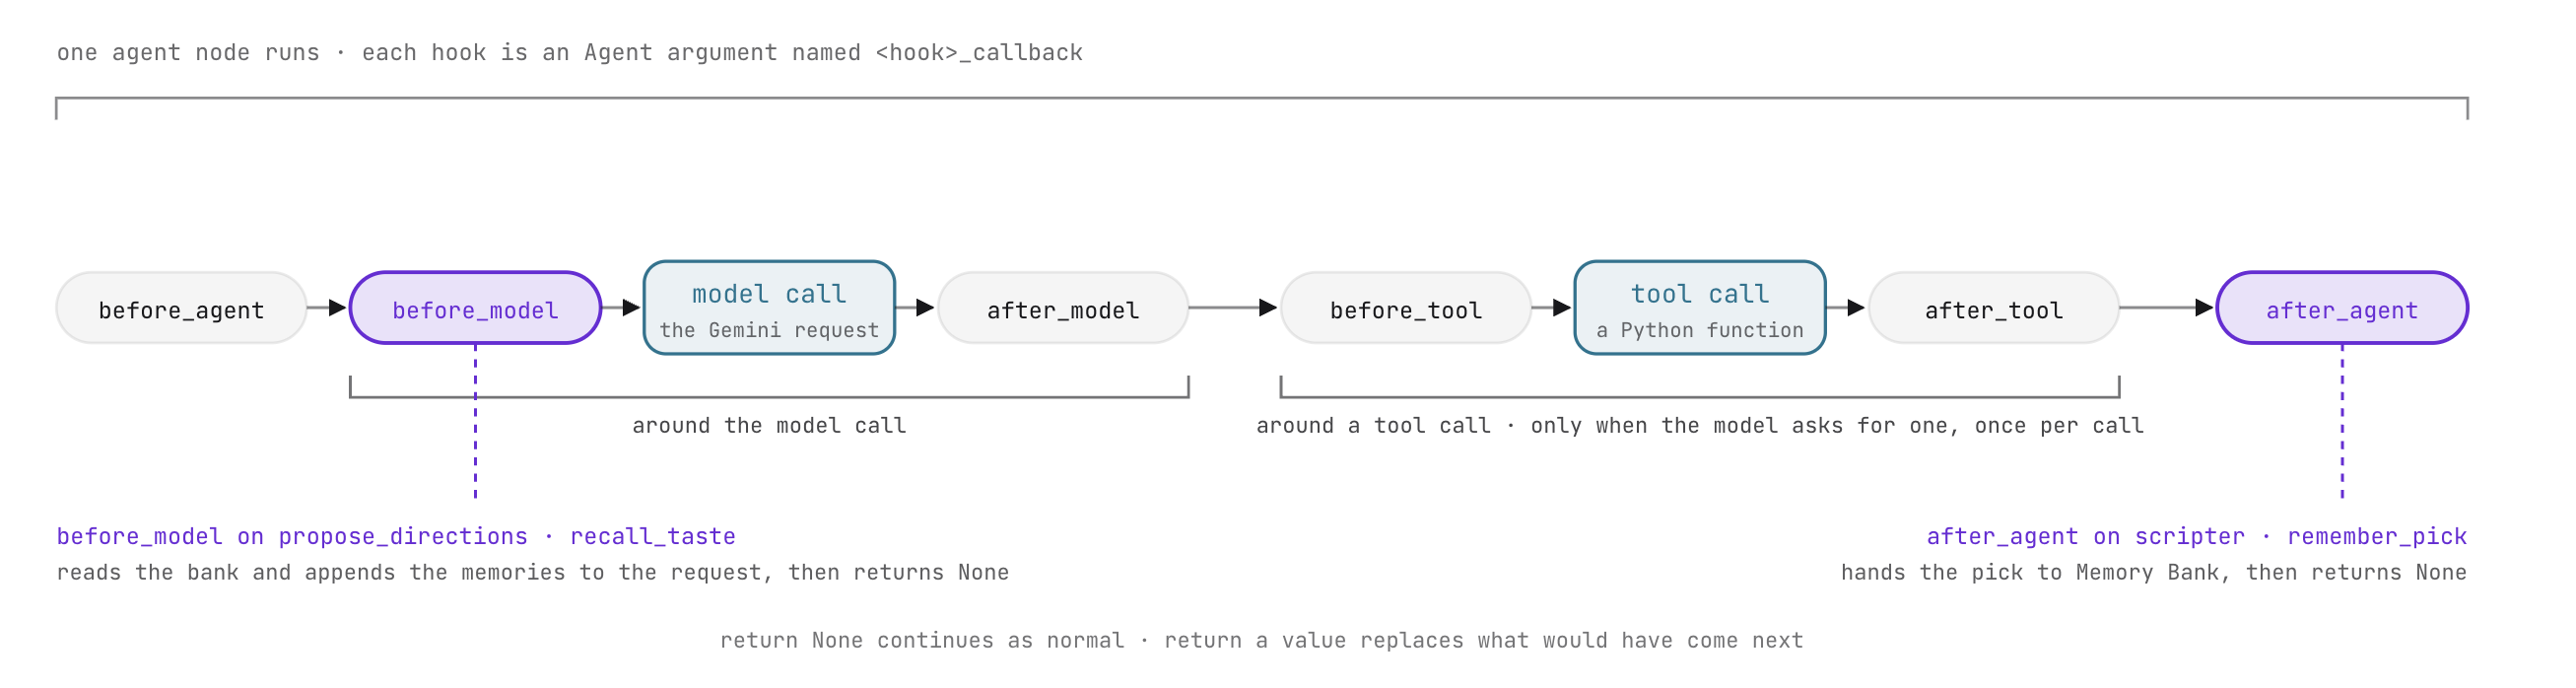
ADK, तीन तरह के कॉलबैक उपलब्ध कराता है:
कॉलबैक पेयर | शुरू करने का पॉइंट | मिले हुए पैरामीटर | रिटर्न वैल्यू का तरीका |
| पूरे एजेंट टर्न के आस-पास |
|
|
| एलएलएम के हर अनुमानित कॉल के आस-पास |
|
|
| हर टूल के एक्ज़ीक्यूशन के बारे में जानकारी | टूल की परिभाषा, आर्ग्युमेंट, नतीजा | डिक्शनरी को वापस करने पर, टूल का आउटपुट बदल जाता है. |
कॉलबैक, कॉन्टेक्स्ट इंजेक्शन, गार्डरेल, टेलीमेट्री, और कैश लुकअप के लिए एक साफ़-सुथरी जगह उपलब्ध कराते हैं. इससे वर्कफ़्लो ग्राफ़ में अतिरिक्त नोड नहीं जुड़ते.
खुद करके देखें: वायरिंग रीकॉल और कॉल बैक याद रखने की सुविधा
stage4_memory/agent.pyमें,propose_directionsको अपडेट करकेbefore_model_callback=recall_tasteअटैच करें:
    output_schema=Directions,
    before_model_callback=recall_taste)
recall_taste, Gemini के संभावित दिशा-निर्देश जनरेट करने से ठीक पहले काम करता है. यह क्रिएटर के इतिहास को मेमोरी बैंक से फ़ेच करता है. साथ ही, यादों को सबसे पुरानी से सबसे नई के क्रम में फ़ॉर्मैट करता है. इसके बाद, उन्हें आउटगोइंग LlmRequest में जोड़ देता है. प्रॉम्प्ट में मॉडल को यह निर्देश दिया गया है कि वह उम्मीदवार 1 से 3 को क्रिएटर की मौजूदा पसंद के हिसाब से तैयार करे. साथ ही, चैनल के नियमों को सख्त शर्तों के तौर पर लागू करे.
stage4_memory/agent.pyमें,scripterको अपडेट करकेafter_agent_callback=remember_pickअटैच करें:
    output_schema=Script,
    after_agent_callback=remember_pick)
remember_pick, scripter के पूरा होने के बाद चलता है. यह सेशन की स्थिति से चुनी गई दिशा को पढ़ता है. साथ ही, क्रिएटर के फ़ैसले के बारे में खास जानकारी देने वाला एक छोटा स्टेटमेंट बनाता है. इसके बाद, मेमोरी बैंक को अपडेट करने के लिए memories.generate को कॉल करता है.
इसके बाद क्या होगा और क्यों
वर्कबेंच या ADK Web में, कॉलबैक की सुविधा वाले वर्कफ़्लो को आज़माएं:
- बिना किसी प्रॉम्प्ट के रन को एक्ज़ीक्यूट करें:
- सेशन ट्रेस में,
LlmRequestके लिएpropose_directionsकी जांच करें. यहां जोड़ी गई मेमोरी के कॉन्टेक्स्ट पर ध्यान दें. इसमें क्रिएटर की फ़ैंटसी थीम और कम समय में ज़्यादा जानकारी देने की प्राथमिकता के बारे में बताया गया है. - सुझाए गए निर्देशों को देखें: उम्मीदवार 1 से 3, क्रिएटर की पिछली प्राथमिकताओं के मुताबिक हैं. भले ही, रुझानों में अन्य विषयों पर ज़ोर दिया गया हो.
- सेशन ट्रेस में,
direction_gateपर कोई उम्मीदवार चुनें.scripterपूरा होने के बाद, मेमोरी बैंक के रिकॉर्ड की समीक्षा करें:python -m agent.platform.bank list
7. RAG Engine
VibeStudio Workbench में, Step 7 · RAG Engine के (7A) और (7B) सेक्शन पर जाएं.
पब्लिश किए गए वीडियो पर, दर्शकों से लगातार सुझाव/राय मिलती रहती है. agent/comments.md में 30 टिप्पणियां इकट्ठा की जाती हैं. इनमें दर्शकों की तारीफ, स्पॉन्सर किए गए कॉन्टेंट की पेसिंग की आलोचना, और ऑडियो की प्राथमिकताएं शामिल होती हैं. इस चरण में, Vertex AI RAG Engine का इस्तेमाल करके इन टिप्पणियों को इंडेक्स किया जाता है. साथ ही, सिमैंटिक रिट्रीवल को रिसर्च फ़ैन-आउट से कनेक्ट किया जाता है.
दस्तावेज़ों से जानकारी पाना (7A)
वर्कबेंच में, RAG Engine (7A) पर जाएं.
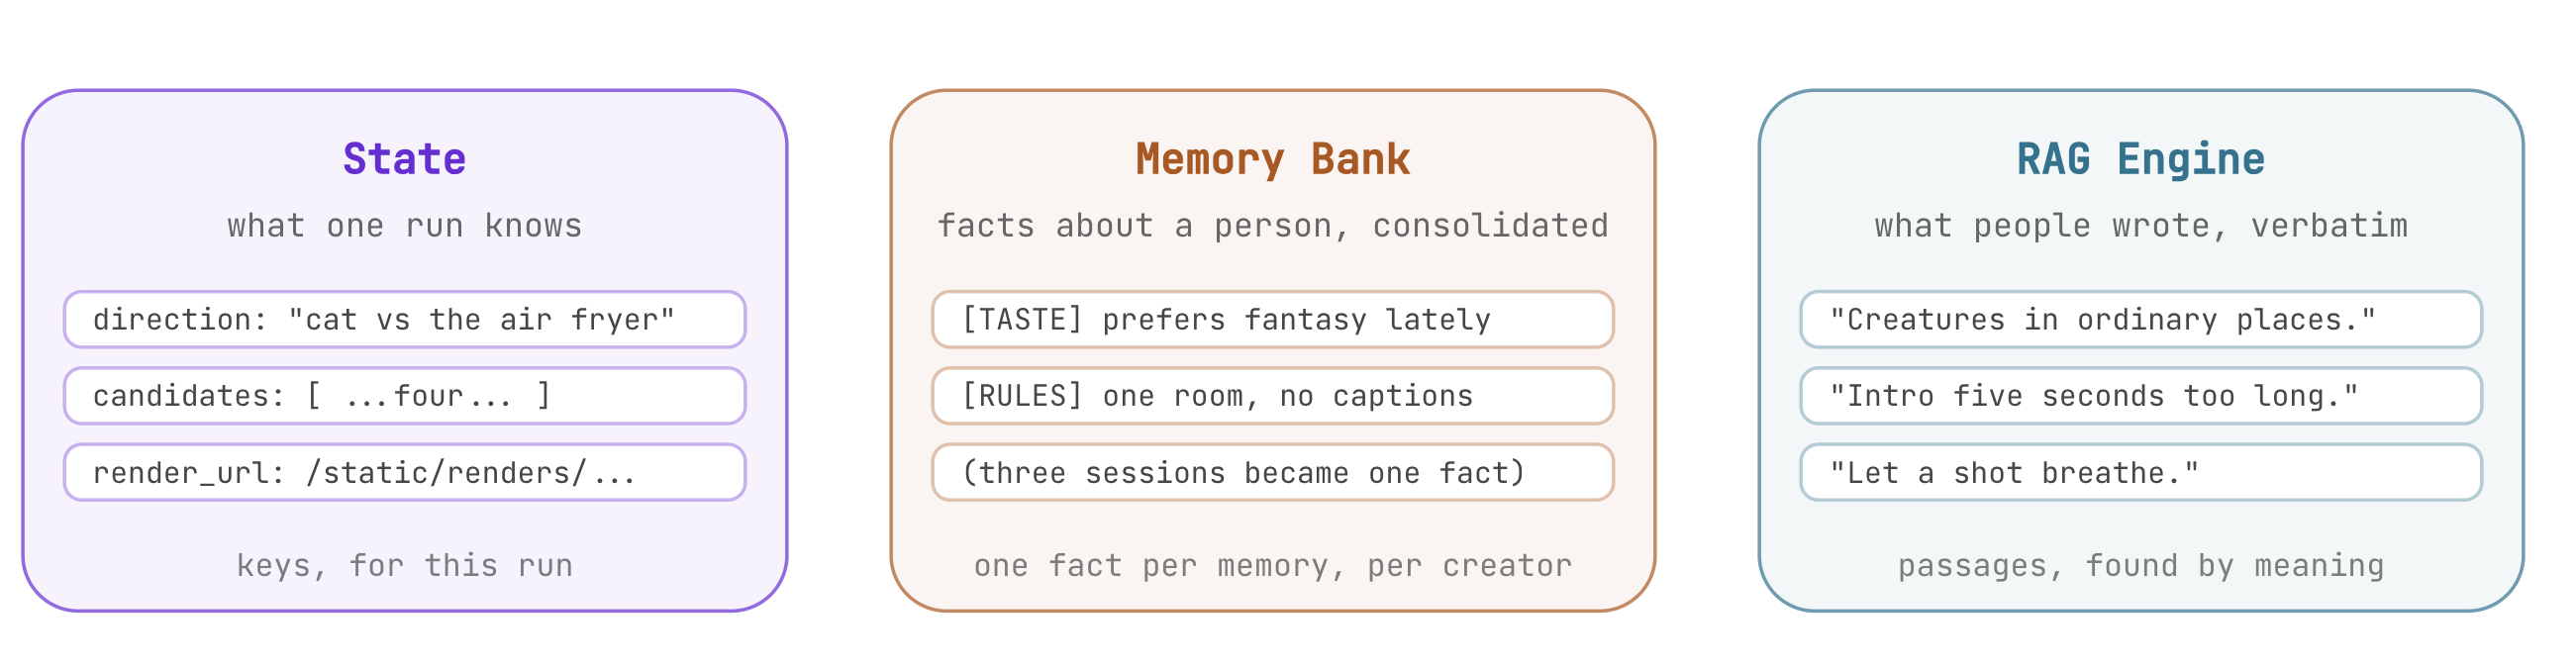
मेमोरी बैंक बनाम RAG इंजन
दोनों टूल, बाहरी डेटा के आधार पर वर्कफ़्लो तैयार करते हैं. हालांकि, ये आर्किटेक्चर के अलग-अलग मकसद पूरे करते हैं:
डाइमेंशन | मेमोरी बैंक | RAG Engine |
इस्तेमाल का मुख्य उदाहरण | उपयोगकर्ता की लंबे समय की प्राथमिकताएं और ऑपरेशन से जुड़े नियम | दस्तावेज़ों के बड़े कलेक्शन में सिमैंटिक रिट्रीवल की सुविधा |
दायरा | यह कुकी, हर उपयोगकर्ता के आईडी और ऐप्लिकेशन के नाम के लिए स्कोप की जाती है | सभी उपयोगकर्ताओं के साथ शेयर की गई कॉर्पस रिसॉर्स के लिए स्कोप किया गया |
डेटा प्रोसेसिंग | रीयल-टाइम में जानकारी निकालना, उसे एम्बेड करना, और सिमैंटिक कंसोलिडेशन करना | दस्तावेज़ को छोटे-छोटे हिस्सों में बांटना, वेक्टर एंबेडिंग, और सबसे मिलते-जुलते दस्तावेज़ों को खोजना |
ग्राफ़ इंटिग्रेशन | एजेंट के लाइफ़साइकल कॉलबैक ( | रिसर्च फ़ैन-आउट में खास फ़ंक्शन नोड ( |
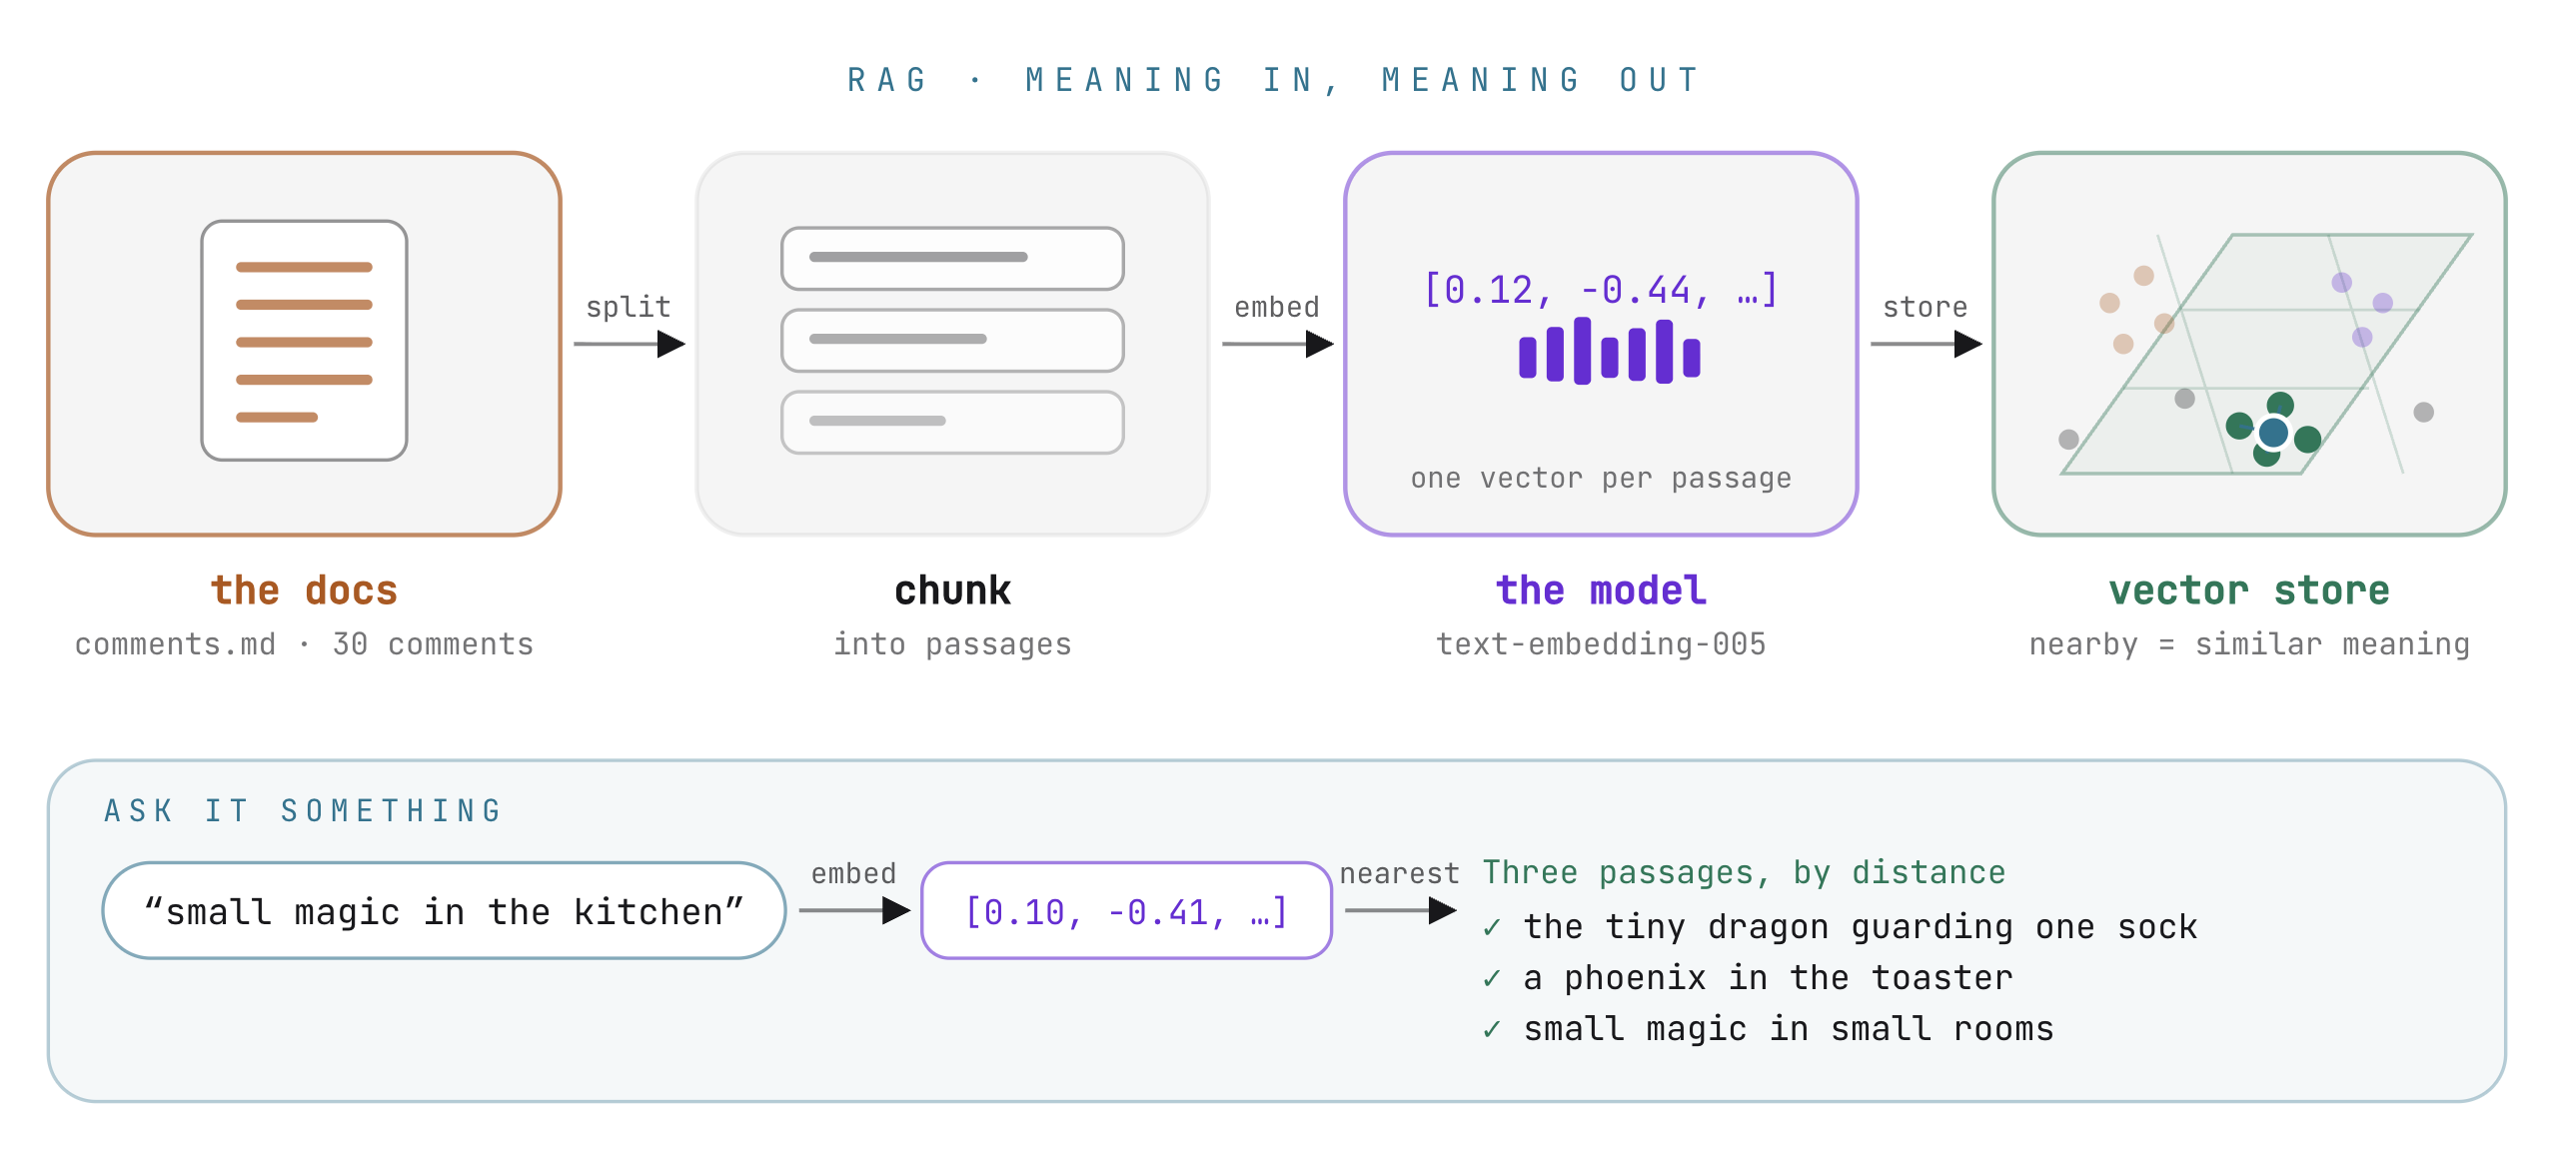
दस्तावेज़ को छोटे-छोटे हिस्सों में बांटना और एम्बेड करना
आरएजी इंजन, दस्तावेज़ों को इंडेक्स करता है. इसके लिए, वह टेक्स्ट को सिमैंटिक पैसेज में बांटता है और उनके वेक्टर को मैनेज किए गए डेटाबेस में सेव करता है:
corpus = rag.create_corpus(
    display_name="vibestudio-feedback",
    description="Vibe Studio: what the audience wrote under the channel's past videos.",
    backend_config=rag.RagVectorDbConfig(
        rag_embedding_model_config=rag.RagEmbeddingModelConfig(
            vertex_prediction_endpoint=rag.VertexPredictionEndpoint(
                publisher_model="publishers/google/models/text-embedding-005"))))

rag.upload_file(
    corpus_name=corpus.name, path="agent/comments.md", display_name="comments.md",
    transformation_config=rag.TransformationConfig(
        chunking_config=rag.ChunkingConfig(chunk_size=120, chunk_overlap=20)))
- चंक का साइज़: इसे 120 टोकन पर कॉन्फ़िगर किया गया है. इसमें 20 टोकन ओवरलैप होते हैं. इससे हर पैसेज के लिए दो से तीन टिप्पणियां कैप्चर की जाती हैं. इससे यह पक्का होता है कि हर वेक्टर, एक साथ जुड़े हुए भाव को दिखाता है. साथ ही, इससे मिलते-जुलते सुझावों के बीच अंतर करने में मदद मिलती है.
- एंबेडिंग मॉडल:
text-embedding-005टेक्स्ट को ज़्यादा डाइमेंशन वाले वेक्टर में बदलता है. क्वेरी सबमिट करने पर, मॉडल उसे वेक्टर में बदल देता है. इसके बाद, सिमैंटिक दूरी के आधार पर सबसे मिलते-जुलते जवाब ढूंढता है. एक छोटी सी ड्रैगन के मोज़ों की रखवाली करने के बारे में की गई टिप्पणी, जादुई जीवों के बारे में दिए गए प्रॉम्प्ट से मेल खाती है. इसके लिए, कीवर्ड का सटीक तौर पर मेल खाना ज़रूरी नहीं है.
RAG कॉर्पस सेट अप करना
वर्कबेंच के बटन या टर्मिनल कमांड का इस्तेमाल करके, कॉर्पस को शुरू करें:
- कॉर्पस बनाना:
python -m agent.platform.ragruns/ragcorpus.jsonमें संसाधन का आईडी रिकॉर्ड करता है. - टिप्पणियां अपलोड और इंडेक्स करना: यह
agent/comments.mdको चंकिंग कॉन्फ़िगरेशन के साथ अपलोड करता है और इंडेक्सिंग पूरी होने का इंतज़ार करता है. - कॉर्पस से क्वेरी करना: ऐसी क्वेरी के साथ मिलती-जुलती जानकारी पाने की सुविधा को टेस्ट करें जिनमें टिप्पणियों के साथ सटीक शब्द शेयर नहीं किए गए हैं. उदाहरण के लिए, ड्रेगन के बारे में टिप्पणियां पाने के लिए, "छोटे जादुई जीव" क्वेरी करें.
डेटा वापस पाने वाला नोड (7B)
वर्कबेंच में, तीसरा रीडर (7B) पर जाएं. stage5_rag/agent.py खोलें.
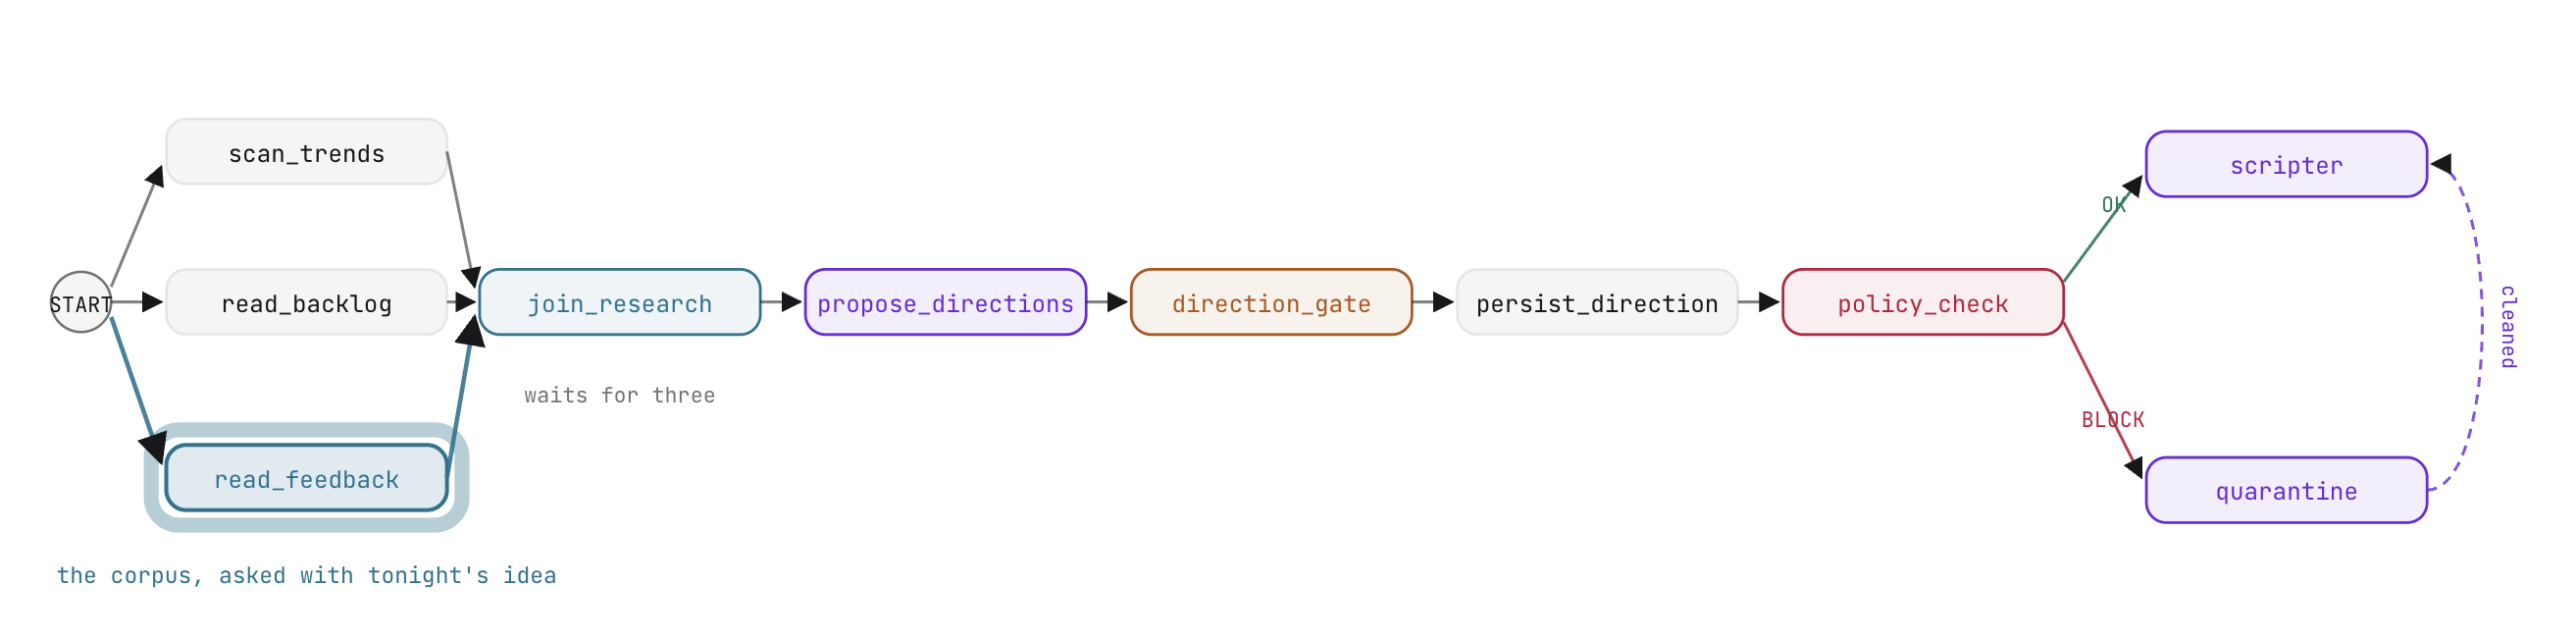
ग्राफ़ नोड के तौर पर जानकारी पाना
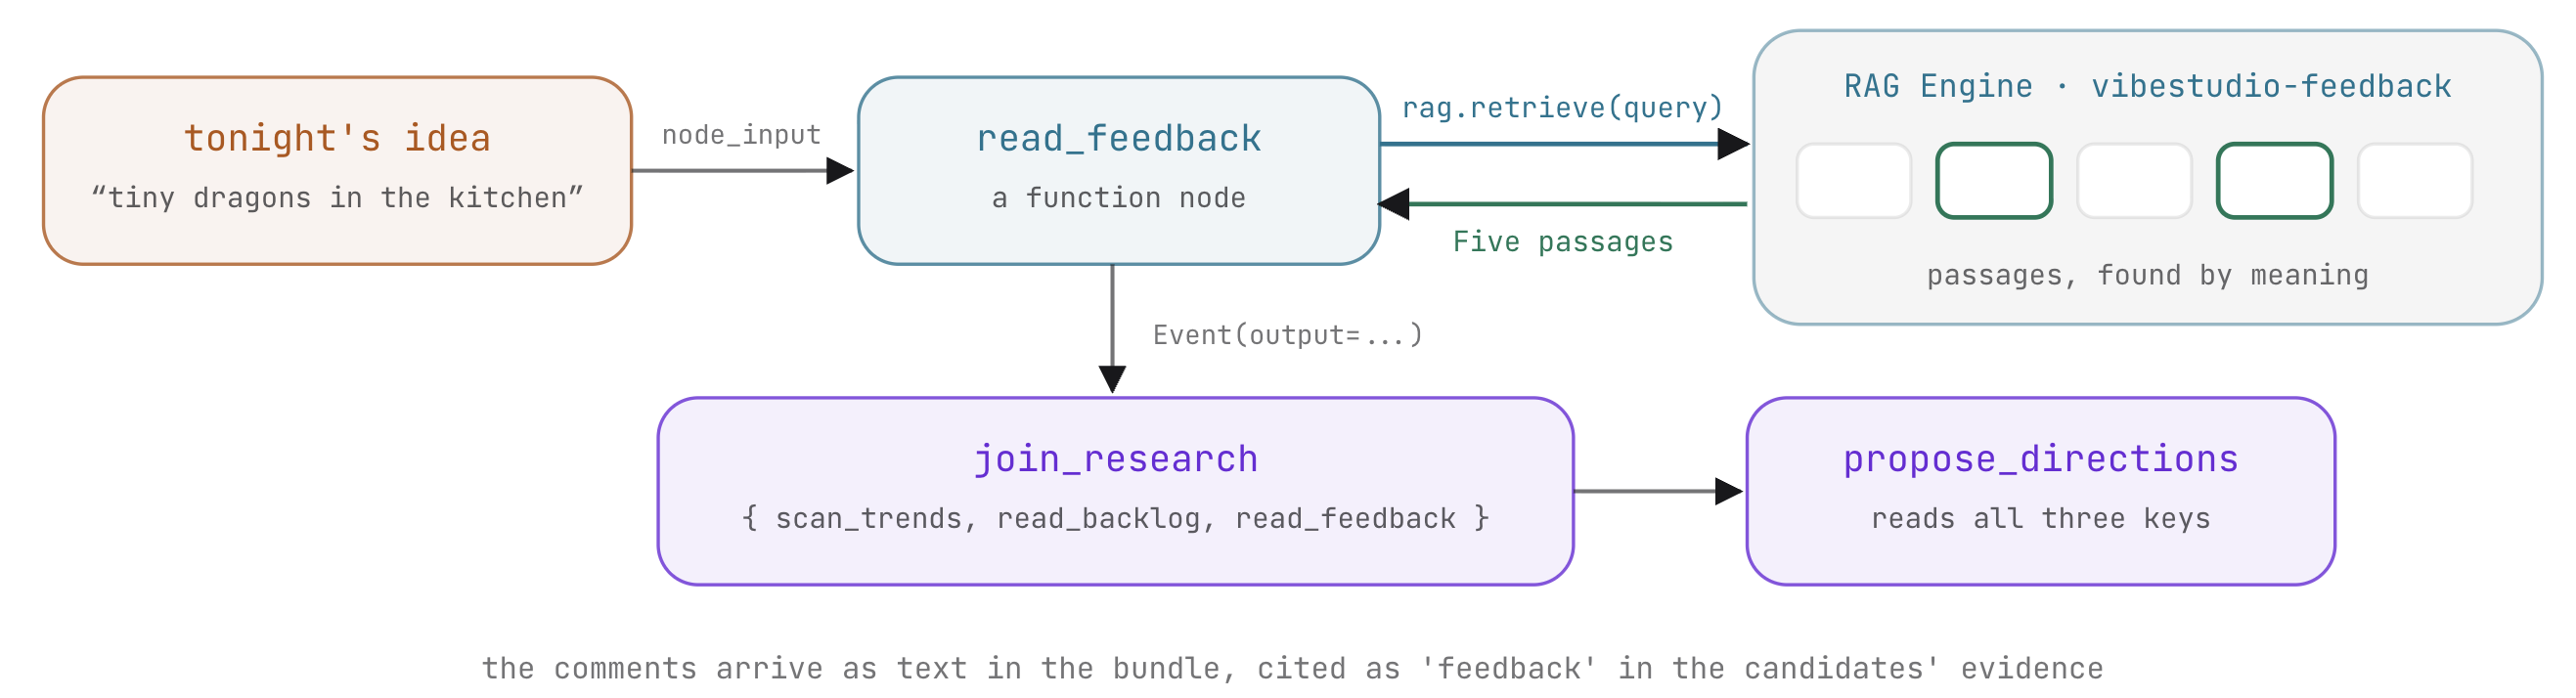
दर्शक से मिले फ़ीडबैक के तौर पर, रिसर्च डेटा को पूरे वर्कफ़्लो में शेयर किया जाता है. निजी क्रिएटर मेमोरी के उलट, दर्शकों की भावनाएं सीधे तौर पर join_research को भेजी जाती हैं. साथ ही, ट्रेंड और बैकलॉग डेटा भी भेजा जाता है. इसलिए, इसे फ़ंक्शन नोड के तौर पर लागू किया जाता है:
def read_feedback(node_input):
    """The third reader (step 7): what the audience wrote under past videos,
    the passages nearest to tonight's idea. Retrieval, not a model call."""
    from .platform import rag
    idea = idea_text(node_input)
    query = idea or "what viewers liked and what they complained about"
    try:
        hits = rag.retrieve(query)
    except Exception as e:
        print(f"  [rag] feedback unavailable ({str(e)[:80]})")
        return Event(output={"query": query, "feedback": [],
                             "note": "no corpus connected - run: python -m agent.platform.rag"})
    return Event(output={"query": query, "feedback": [h["text"] for h in hits]})
read_feedback, उपयोगकर्ता के शुरुआती आइडिया को निकालता है और RAG Engine के कॉर्पस के ख़िलाफ़ वेक्टर क्वेरी को एक्ज़ीक्यूट करता है. यह फ़ंक्शन, फ़ेच की गई टिप्पणियों को Event(output=...) पेलोड में दिखाता है.
खुद करके देखें: तीसरे रीडर को फ़ैन-आउट में जोड़ना
stage5_rag/agent.py में, edges को अपडेट करके read_feedback को join_research में शामिल होने वाली तीसरी पैरलल ब्रांच के तौर पर जोड़ें:
           (START, read_backlog, join_research),
           (START, read_feedback, join_research),
join_research एक JoinNode है. इसलिए, यह सभी इनकमिंग ब्रांच को सिंक करता है. यह तब तक इंतज़ार करता है, जब तक scan_trends, read_backlog, और read_feedback सभी इवेंट को इकट्ठा नहीं कर लेते. इसके बाद, यह एग्रीगेट किए गए बंडल को डाउनस्ट्रीम में पास करता है.
इसके बाद क्या होगा और क्यों
वर्कबेंच में वर्कफ़्लो चलाएं:
- आइडिया प्रॉम्प्ट सबमिट करें. जैसे, "किचन काउंटर की रखवाली करता हुआ एक छोटा ड्रैगन".
- एक्ज़ीक्यूशन ट्रेस में, पुष्टि करें कि तीनों रीडर नोड एक साथ एक्ज़ीक्यूट होते हैं.
join_researchको देखें: इसके आउटपुट डिक्शनरी में अबtrends,backlog, औरfeedbackशामिल हैं.propose_directionsसे जनरेट किए गए जवाबों की जांच करें: मॉडल, दर्शकों की टिप्पणियों को अपने सुझावों में शामिल करता है. साथ ही, सबूत वाले फ़ील्ड में दर्शकों की भावनाओं का हवाला देता है.- ध्यान दें कि आरएजी से जानकारी पाने की प्रोसेस, तय नियमों के हिसाब से काम करती है. इसका मतलब है कि एक जैसी क्वेरी के लिए, टिप्पणी के एक जैसे पैसेज मिलते हैं. वहीं, जनरेटिव प्रपोज़ल नोड से क्रिएटिव वेरिएशन मिलते हैं.
8. Veo की मदद से वीडियो को एसिंक्रोनस तरीके से जनरेट करना
VibeStudio Workbench में, चरण 8 · वीडियो, (8A) और (8B) पर जाएं.
Google Veo की मदद से हाई-डेफ़िनिशन वीडियो जनरेट करने के लिए, हर रेंडर में कई मिनट लगते हैं. इस अवधि के दौरान ग्राफ़ के एक्ज़ीक्यूशन को ब्लॉक करने से, कंप्यूट संसाधनों का इस्तेमाल नहीं हो पाता. साथ ही, थ्रेड पूल लॉक हो जाते हैं और रन को एचटीटीपी कनेक्शन ड्रॉपआउट का सामना करना पड़ता है. इस चरण में, ADK के LongRunningFunctionTool का इस्तेमाल करके, वीडियो रेंडरिंग को एसिंक्रोनस बनाया जाता है.
लंबे समय तक चलने वाले टूल (8A)
वर्कबेंच में, ज़्यादा समय तक चलने वाले टूल (8A) पर जाएं. stage6_video/agent.py और agent/deliver.py खोलें.
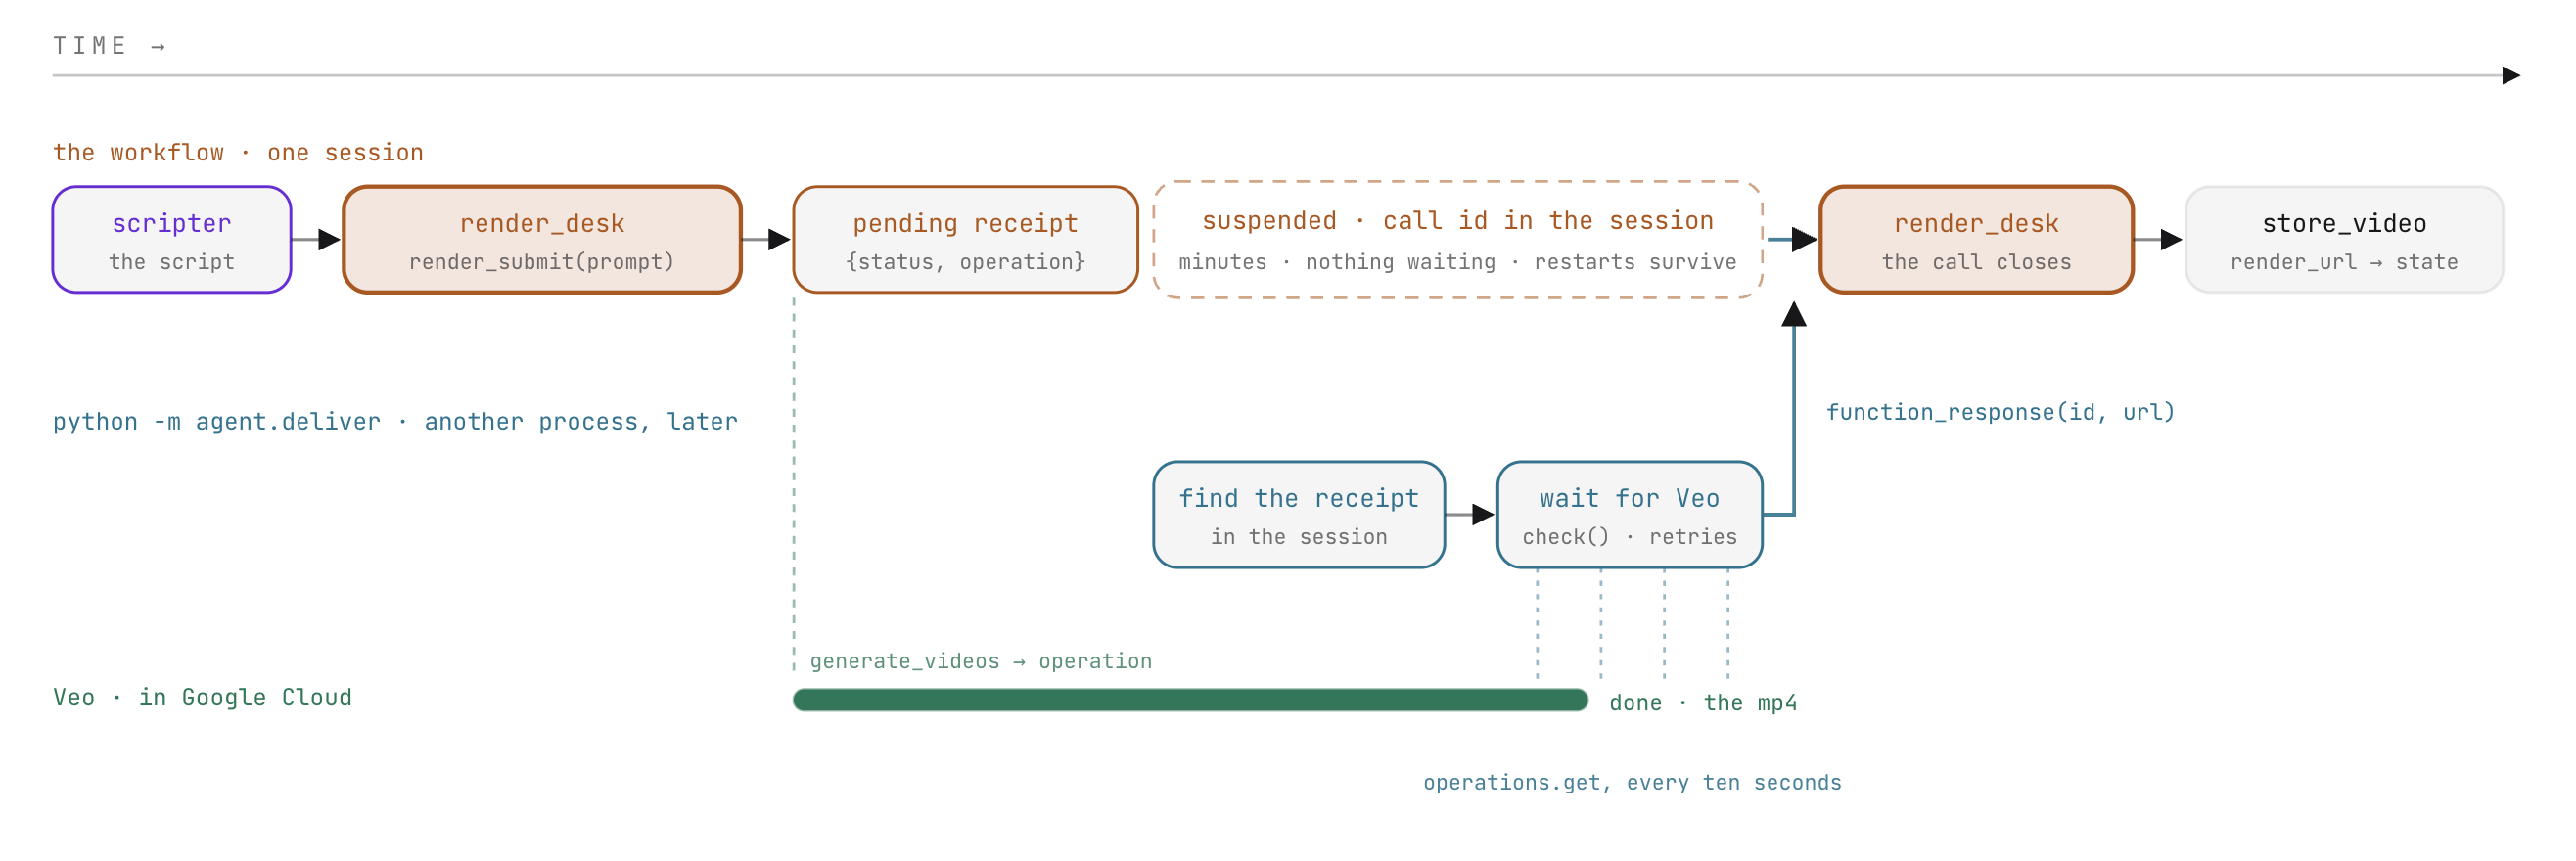
सिंक्रोनस टूल बनाम लंबे समय तक चलने वाले टूल
स्टैंडर्ड एडीके फ़ंक्शन टूल, एजेंट टर्न के दौरान सिंक्रोनस तरीके से काम करते हैं: मॉडल टूल को कॉल करता है, रिटर्न पेलोड का इंतज़ार करता है, और नतीजे को मौजूदा टर्न में शामिल करता है.
वीडियो रेंडरिंग को एक बार में पूरा नहीं किया जा सकता. इसके बजाय, render_submit जनरेट करने का काम शुरू करता है और तुरंत एक रसीद दिखाता है. इसमें स्टेटस "pending" होता है:
def render_submit(prompt: str) -> dict:
    """Submit one Veo render of `prompt`. Returns at once with a pending
    receipt; the clip is delivered later, to this call, by id."""
    receipt = videogen.start(f"{prompt} {videogen.NO_TEXT}")
    return {"status": "pending", "operation": receipt["operation"], "prompt": receipt["prompt"]}
LongRunningFunctionTool के साथ रैप किए जाने पर, ADK "pending" स्टेटस को इंटरसेप्ट करता है. एजेंट का टर्न खत्म हो जाता है, वर्कफ़्लो नोड पर रुक जाता है, और कॉल का मेटाडेटा (इसमें कॉल आईडी और रसीद शामिल है) runs/sessions.db में रिकॉर्ड हो जाता है. एक्ज़ीक्यूशन प्रोसेस, चालू नेटवर्क कनेक्शन या वर्कर थ्रेड को बनाए रखे बिना बंद हो जाती है.
खुद करके देखें: रेंडर टूल को रैप करना
stage6_video/agent.py में, render_desk को अपडेट करके render_submit को LongRunningFunctionTool में रैप करें:
tools=[LongRunningFunctionTool(render_submit)])
कॉल आईडी की मदद से कॉल फिर से शुरू करना
रोके गए मीडिया को फिर से शुरू करने का यूनिवर्सल पैटर्न
ADK, इंसानों और बाहरी टूल, दोनों के लिए वर्कफ़्लो को निलंबित करने और फिर से शुरू करने के लिए एक ही तरीके का इस्तेमाल करता है:
निलंबन ट्रिगर | Initiating Construct | निलंबन की सेव की गई स्थिति | फिर से शुरू होने वाला इवेंट |
मैन्युअल तरीके से लिया गया फ़ैसला |
| सेशन स्टोर में इनपुट प्रॉम्प्ट खोलें |
|
लंबे समय तक चलने वाला टूल |
| सेशन स्टोर में टूल कॉल खोलें |
|
दोनों ही स्थितियों में, वर्कफ़्लो पूरी तरह से रुक जाता है. यह सिर्फ़ तब शुरू होता है, जब किसी बाहरी सोर्स से मैचिंग FunctionResponse वाला कोई इवेंट मिलता है. जैसे, उपयोगकर्ता इंटरफ़ेस, वेबुक या बैकग्राउंड वर्कर.
खुद करके देखें: डिलीवरी के बारे में जवाब देना
agent/deliver.py में, फिर से शुरू करने की FunctionResponse जानकारी दें:
    part = Part(function_response=FunctionResponse(
        id=row["call_id"], name=row["name"], response=response))
डिलीवरी डेमॉन, वीडियो फ़ाइल जनरेट होने तक Veo से पोल करता है. इसके बाद, यह FunctionResponse को सेशन में भेजता है. ADK, कॉल आईडी से मैच करता है और वर्कफ़्लो को सीधे अगले नोड पर फिर से शुरू करता है. पूरे हो चुके नोड फिर से लागू नहीं होते हैं. साथ ही, एजेंट कोई दूसरा जनरेटिव टर्न नहीं लेता है.
.env में STUDIO_REAL_VIDEO=0 सेट करने पर, मॉक रेंडरिंग की सुविधा चालू हो जाती है: start से तुरंत टेस्ट रसीद मिलती है. साथ ही, check से पांच सेकंड में लेन-देन पूरा होने का सिम्युलेशन मिलता है. इसके लिए, Veo API के बिल किए जा सकने वाले कॉल नहीं किए जाते.
पाइपलाइन इंटिग्रेशन (800 करोड़)
वर्कबेंच में, render_desk in the graph (8B) पर जाएं. stage6_video/agent.py खोलें.
पाइपलाइन में टर्मिनल नोड store_video है. यह कुकी, runs/state.json से रेंडर की गई पूरी जानकारी को पढ़ती है. runs/state.json में डिलीवरी प्रोसेस के दौरान यह जानकारी रिकॉर्ड की जाती है. साथ ही, यह वीडियो के यूआरएल और जनरेशन की स्थिति को शेयर की गई सेशन की स्थिति में सेव करती है.
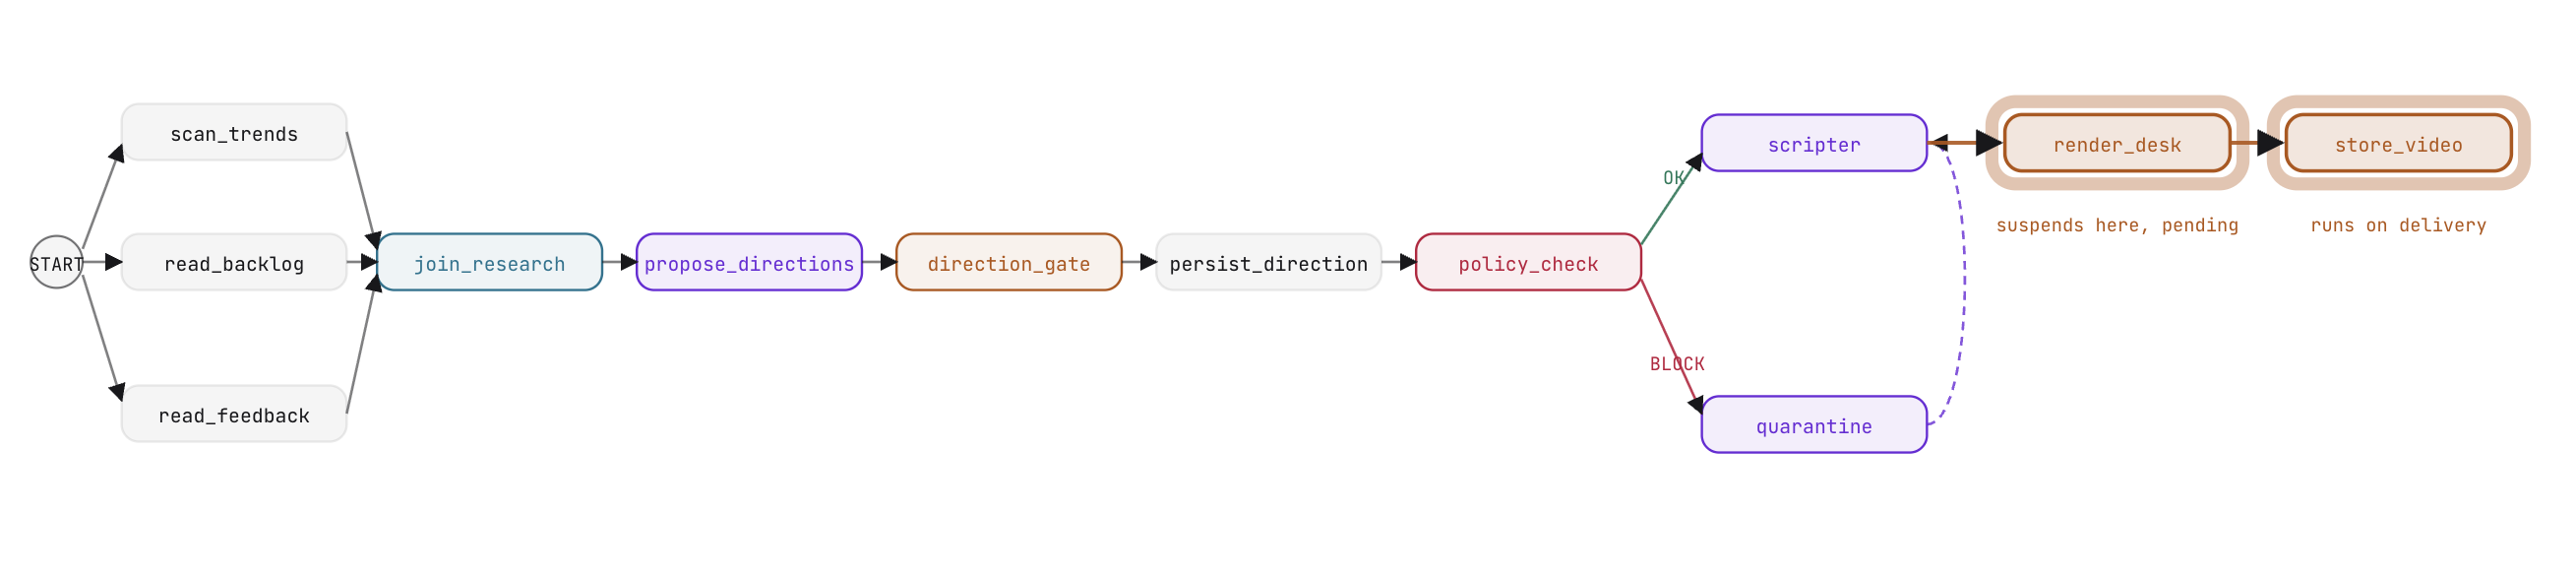
खुद करके देखें: पूरी वीडियो पाइपलाइन को वायर करना
stage6_video/agent.py में, render_desk और store_video जोड़ने के लिए edges को अपडेट करें:
           (quarantine, scripter),
           (scripter, render_desk, store_video)])
इसके बाद क्या होगा और क्यों
वर्कबेंच में, एसिंक्रोनस जनरेशन फ़्लो की जांच करें:
- उम्मीदवार चुनने और स्क्रिप्ट जनरेट करने की प्रोसेस के ज़रिए वर्कफ़्लो को पूरा करें.
render_deskपर, एजेंट कोrender_submitशुरू करते हुए देखें.- वर्कफ़्लो तुरंत निलंबित हो जाता है. वर्कबेंच या ADK Web में, 'लंबित है' स्थिति देखें: सेशन में ओपन कॉल आईडी है और बैकग्राउंड में चल रही कोई भी प्रोसेस संसाधनों का इस्तेमाल नहीं कर रही है.
- वर्कबेंच कंसोल या अपने टर्मिनल में, डिलीवरी डेमॉन चलाएं:
python -m agent.deliver - ADK Web में, सेशन को रीफ़्रेश करें: इससे
store_videoपर एक्ज़ीक्यूशन फिर से शुरू हो जाता है. साथ ही, वीडियो के यूआरएल को सेशन की स्थिति में सेव कर दिया जाता है और वर्कफ़्लो पूरा हो जाता है.
9. Cloud Run पर डिप्लॉय करना
VibeStudio Workbench में, नौवां चरण · डिप्लॉय करें पर जाएं.
आपने अलग-अलग सैंडबॉक्स में पाइपलाइन के हर कॉम्पोनेंट को डेवलप और उसकी पुष्टि की हो. इस चरण में, पूरी प्रोडक्शन पाइपलाइन को असेंबल किया जाता है और उसे Google Cloud Run पर डिप्लॉय किया जाता है.
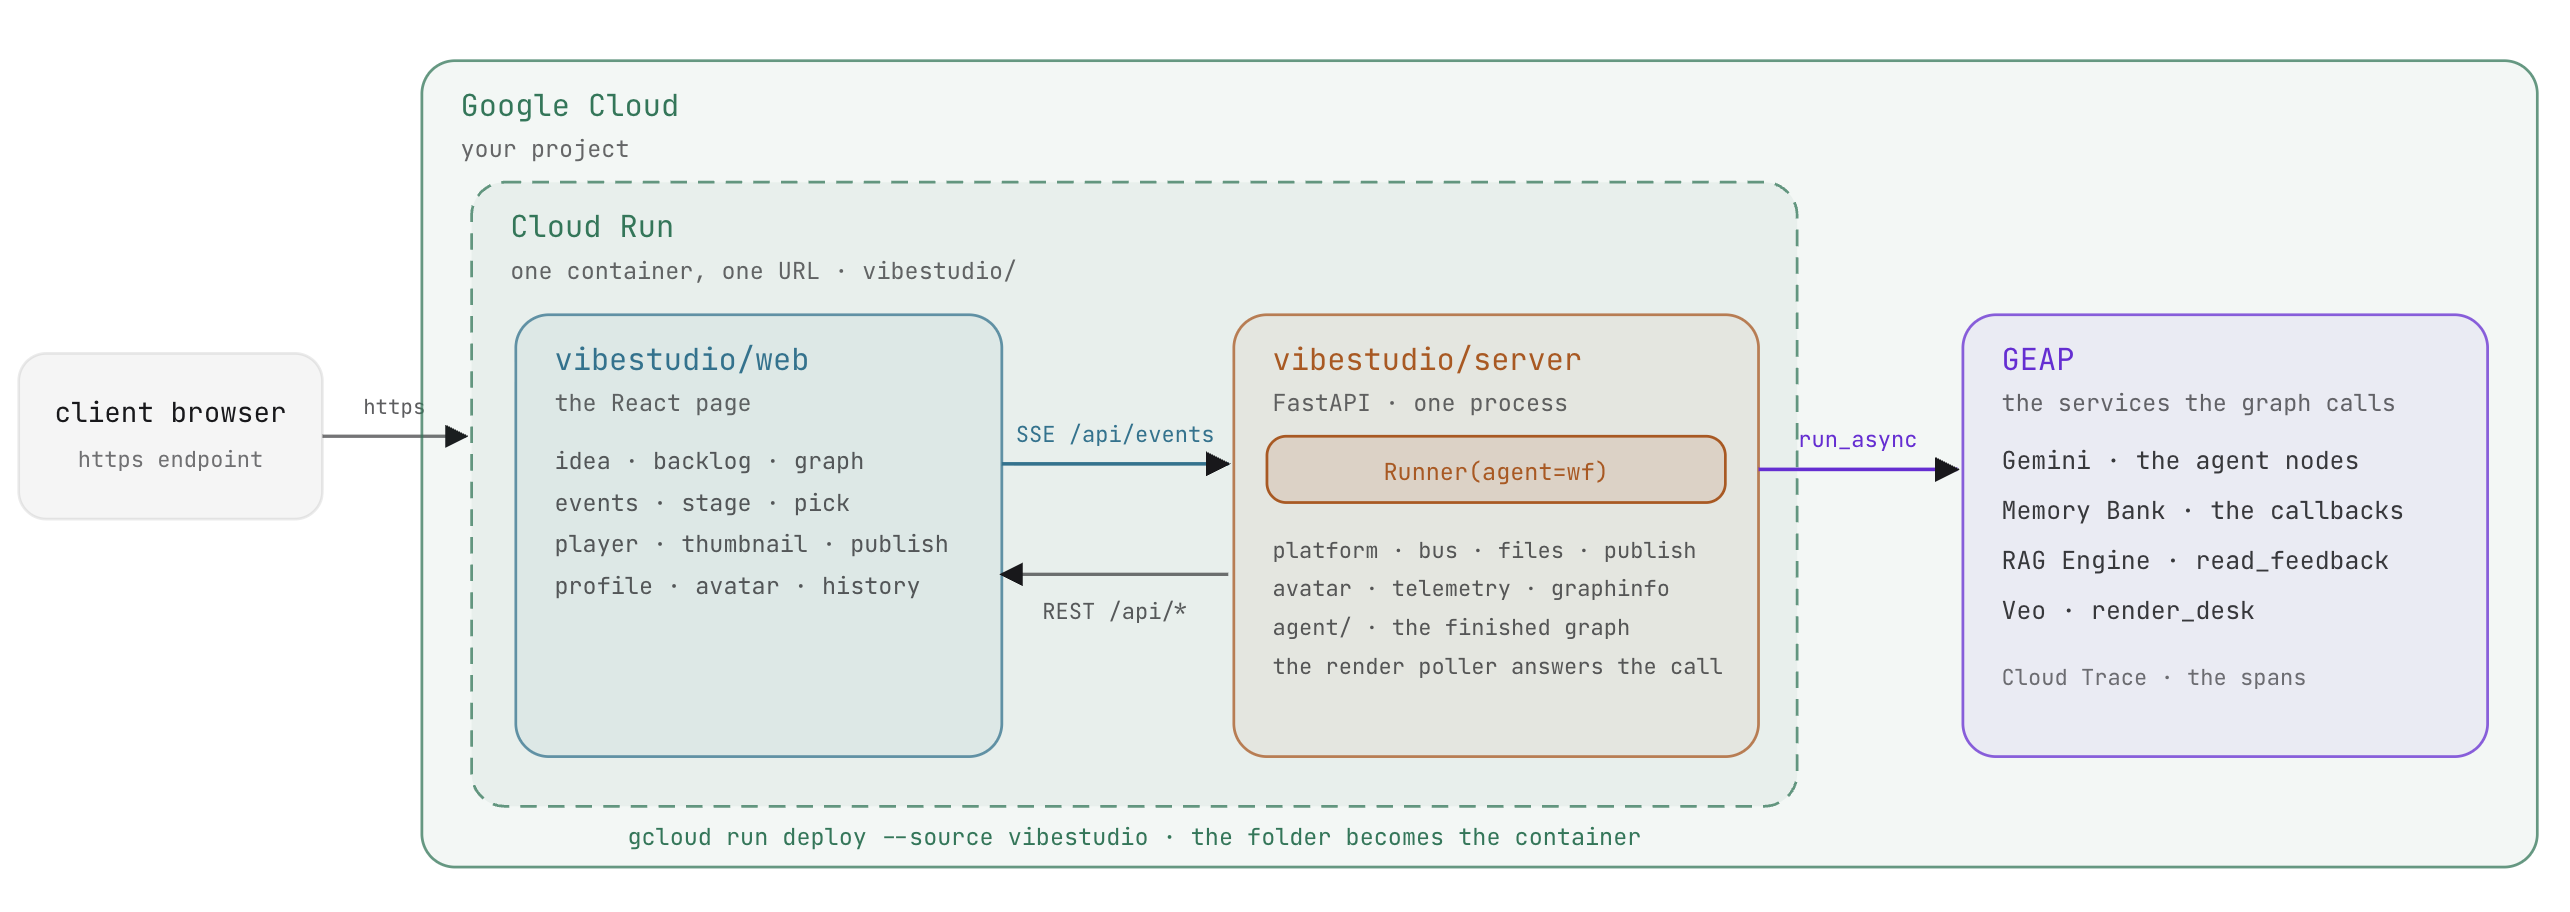
ADK रनर
डेवलपमेंट में, adk web ने ग्राफ़ को व्यवस्थित किया. प्रोडक्शन में, ऐप्लिकेशन ADK की Runner क्लास का इस्तेमाल करके वर्कफ़्लो को होस्ट करता है:
self._svc = DatabaseSessionService(db_url=config.DB_URL)
self._runner = Runner(app_name=config.APP, agent=wf, session_service=self._svc)

async for ev in self._runner.run_async(user_id=config.USER, session_id=run_id, new_message=message):
    self._absorb(ev)    # fold the ADK event into the run state, publish one app event

# the gate's answer and the render's delivery are the same call, with a function_response part
part = Part(function_response=FunctionResponse(id=call_id, name=name, response=response))
run_async: यह वर्कफ़्लो को पूरा करने में मदद करता है. साथ ही, नोड के एक्ज़ीक्यूट होने पर इवेंट को क्रम से जनरेट करता है और सेशन सेवा में अपडेट को सेव करता है.- यूनिफ़ाइड रिज़ंप्शन:
direction_gateपर उपयोगकर्ता के फ़ैसले और Veo से पूरी की गई वीडियो डिलीवरी,run_asyncको सबमिट किए गए एक जैसेFunctionResponseऑब्जेक्ट के ज़रिए फिर से शुरू होती हैं.
प्रोडक्शन ऐप्लिकेशन का आर्किटेक्चर
vibestudio/ में मौजूद प्रोडक्शन ऐप्लिकेशन में पूरी पाइपलाइन इंटिग्रेट की जाती है:
vibestudio/
  server/
    main.py                 FastAPI: application server, REST routes, static assets
    api.py                  REST API endpoints: run, pick, publish, backlog, profile, history
    runner.py               Runner orchestration over the workflow, background render poller
    platform/               Event bus (SSE stream), file storage, publishing, telemetry
    agent/                  Production agent package, verified by checks/verify_app.py
      graph.py              The complete workflow graph and node definitions
      desk.py               render_desk and render_submit wrapped with LongRunningFunctionTool
      schemas.py            Pydantic schemas: Directions, CleanedDirection, Script
      cleanup_tools.py      Deterministic policy tools: find_policy_hits, suggest_replacement
      platform/             Memory Bank, RAG Engine, and Veo integrations
  web/                      Production React user interface
  Dockerfile · deploy.py · run.sh
- सिंगल इवेंट स्ट्रीम: FastAPI बैकएंड, एक ही सर्वर-सेंड इवेंट (एसएसई) स्ट्रीम पर इवेंट पब्लिश करता है. React फ़्रंटएंड, ग्राफ़ की प्रोग्रेस को रीयल टाइम में दिखाता है. साथ ही, यह स्टेट को सेव रखते हुए, देर से होने वाले कनेक्शन को मैनेज करता है.
- डिकपल्ड एक्ज़ीक्यूशन: ऐप्लिकेशन, इवेंट लूप को मैनेज करता है. वर्कफ़्लो ग्राफ़, पूरी तरह से एक्ज़ीक्यूशन लॉजिक पर फ़ोकस करता है. इसे फ़्रंटएंड इंटरफ़ेस के बारे में कोई जानकारी नहीं होती.
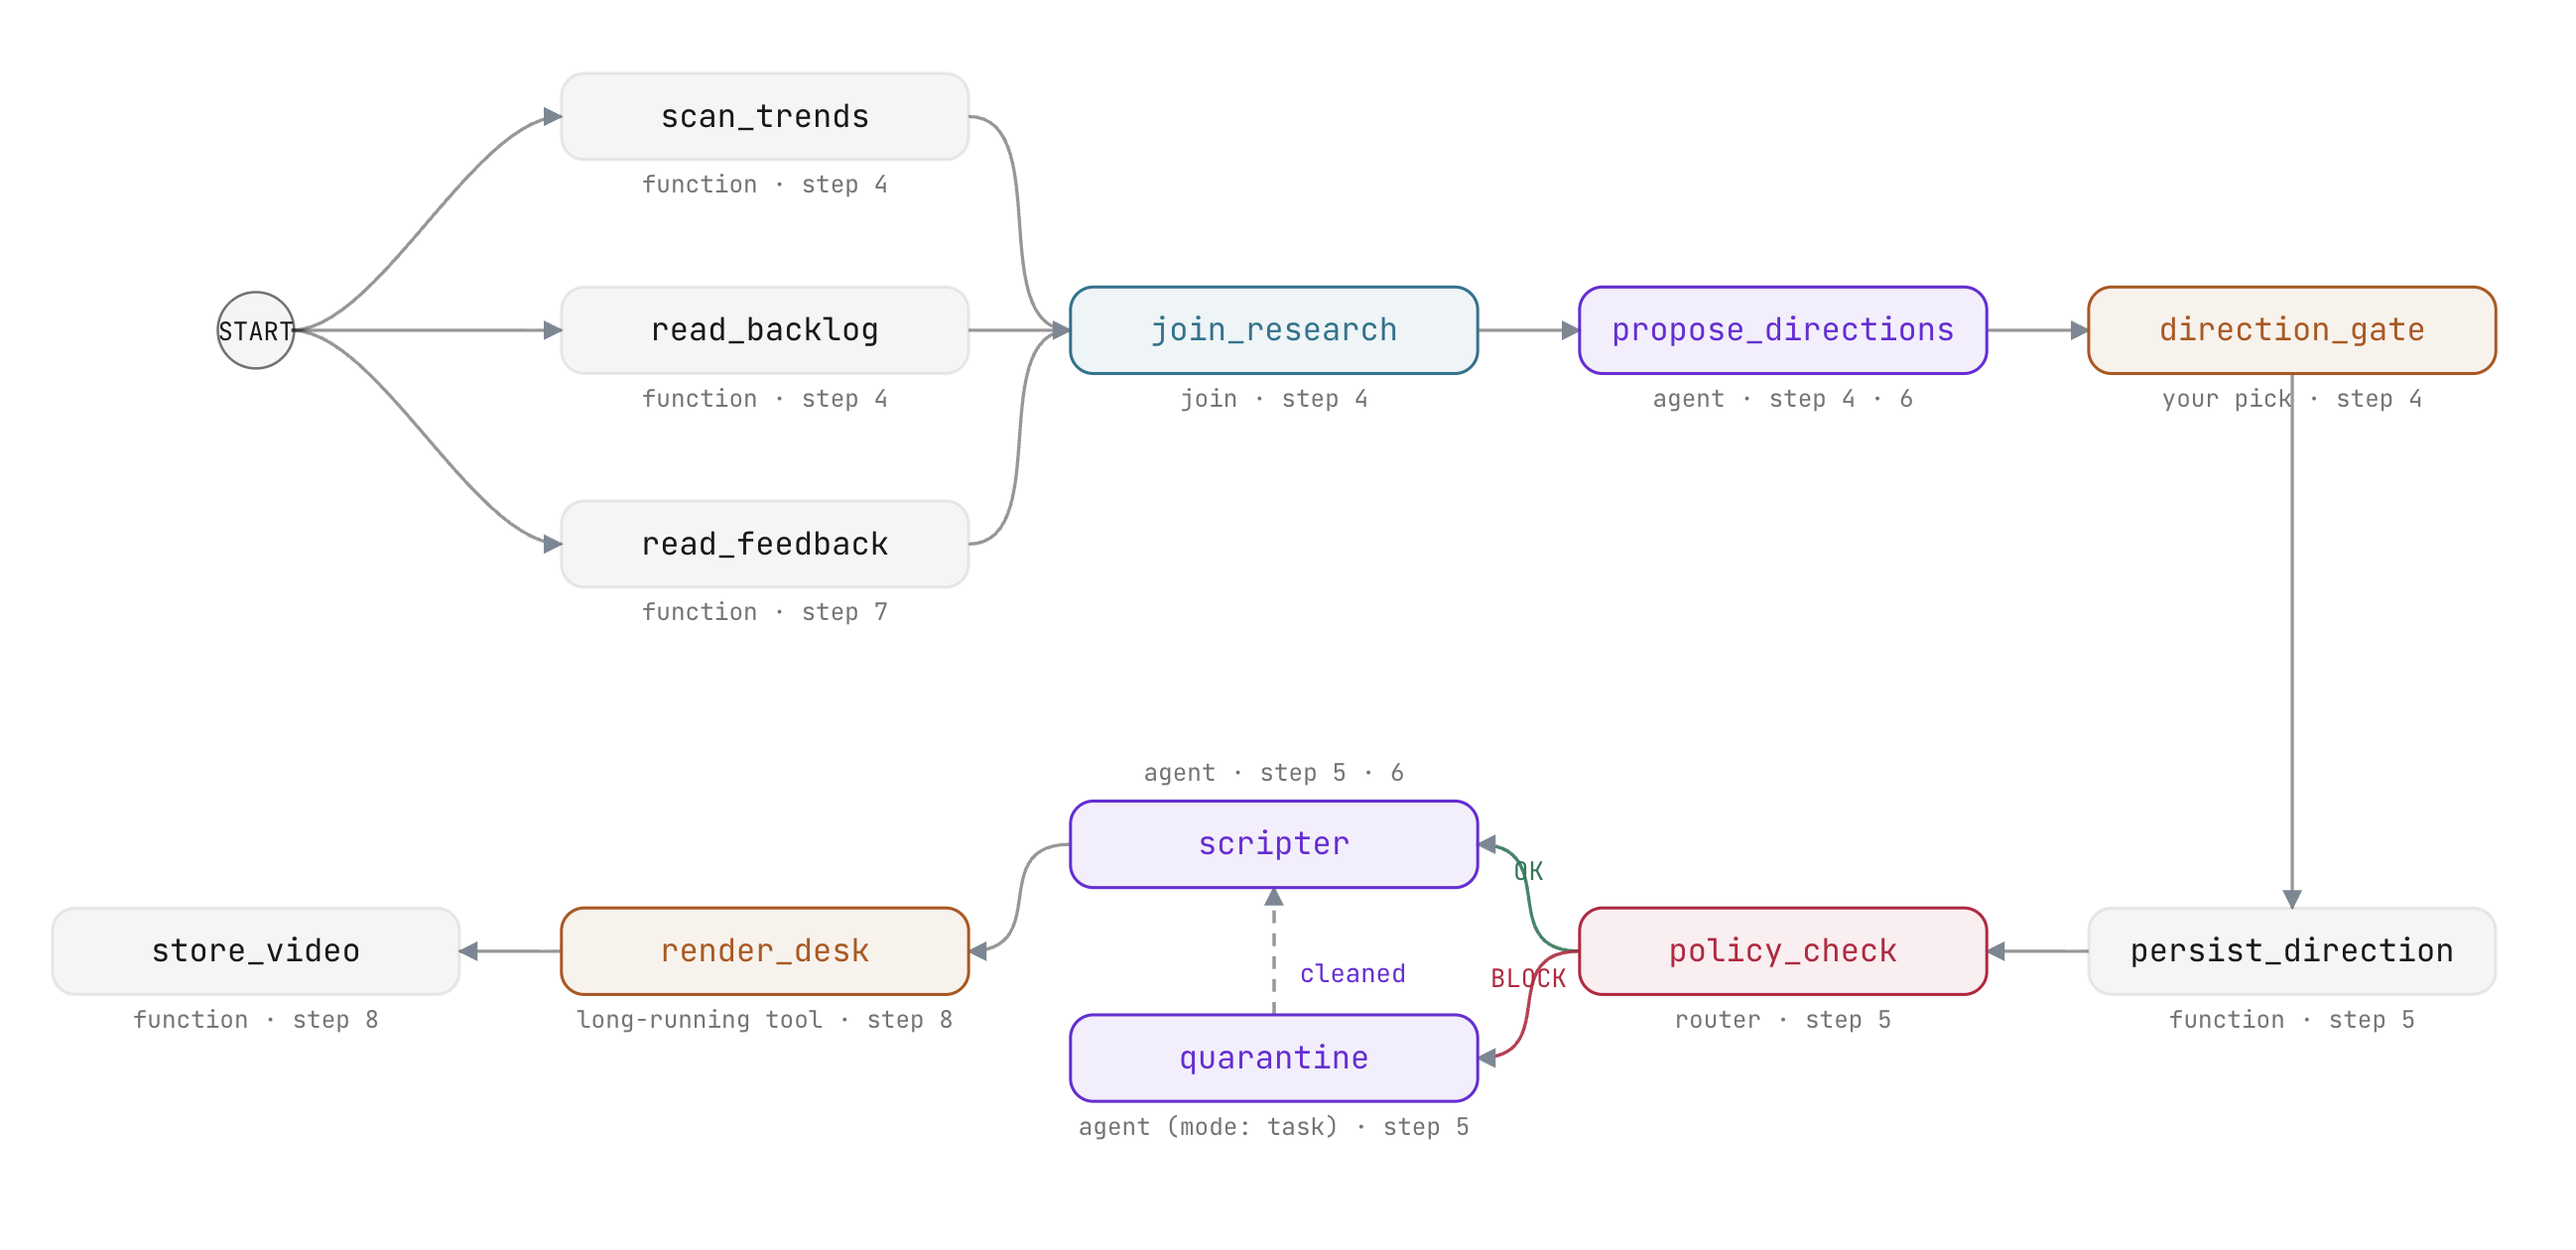
agent/graph.py में मौजूद पूरी वर्कफ़्लो एज लिस्ट में, इस कोडलैब में बनाए गए हर आर्किटेक्चरल पैटर्न को शामिल किया गया है:
        (START, scan_trends, join_research),
        (START, read_backlog, join_research),
        (START, read_feedback, join_research),
        (join_research, propose_directions, direction_gate,
         persist_direction, policy_check),
        (policy_check, {"OK": scripter, "BLOCK": quarantine}),
        (quarantine, scripter),
        (scripter, render_desk, store_video),
Cloud Run पर डिप्लॉय करना
Google Cloud Run, बिना सर्वर वाली होस्टिंग की सुविधा देता है. इसमें ये सुविधाएं शामिल हैं: अपने-आप स्केलिंग, अनुरोध राउटिंग, और इंटिग्रेटेड कंटेनर बिल्ड:
gcloud run deploy vibestudio --source vibestudio \
  --project $GOOGLE_CLOUD_PROJECT --region us-central1 \
  --labels dev-tutorial-codelab=vibetube --allow-unauthenticated \
  --memory 2Gi --cpu 2 --timeout 3600 --concurrency 40 \
  --max-instances 1 --min-instances 1 --session-affinity \
  --set-env-vars GOOGLE_CLOUD_PROJECT=...,STUDIO_VERTEX=1,STUDIO_MEMORY_BANK=...,STUDIO_RAG_CORPUS=...,VIBETUBE_URL=...,VIBETUBE_EVENT=...,VIBETUBE_NAME=...,VIBETUBE_PROJECT=...
- कंटेनर बनाना:
gcloud run deploy --source,vibestudio/डायरेक्ट्री को पैकेज करता है. साथ ही, Cloud Build का इस्तेमाल करके कंटेनर इमेज बनाता है और सेवा को एक ही ऑपरेशन में डिप्लॉय करता है. - सेशन अफ़िनिटी: यह सुविधा, एक ही उपयोगकर्ता के अनुरोधों को एक ही कंटेनर इंस्टेंस पर भेजती है. इससे, बार-बार किए जाने वाले चरणों में स्थानीय सेशन की स्थिति बनी रहती है.
- ऑब्ज़र्वेबिलिटी: Cloud Trace इंटिग्रेशन, हर नोड, एलएलएम कॉल, और टूल के एक्ज़ीक्यूशन के लिए डिस्ट्रिब्यूटेड स्पैन रिकॉर्ड करता है. इन्हें Google Cloud Console में Trace Explorer में ऐक्सेस किया जा सकता है.
डिप्लॉयमेंट स्क्रिप्ट को लागू करने के लिए, वर्कबेंच में मौजूद डिप्लॉय करें बटन पर क्लिक करें. बिल्ड पूरा होने पर, टर्मिनल लाइव सेवा का यूआरएल दिखाता है.
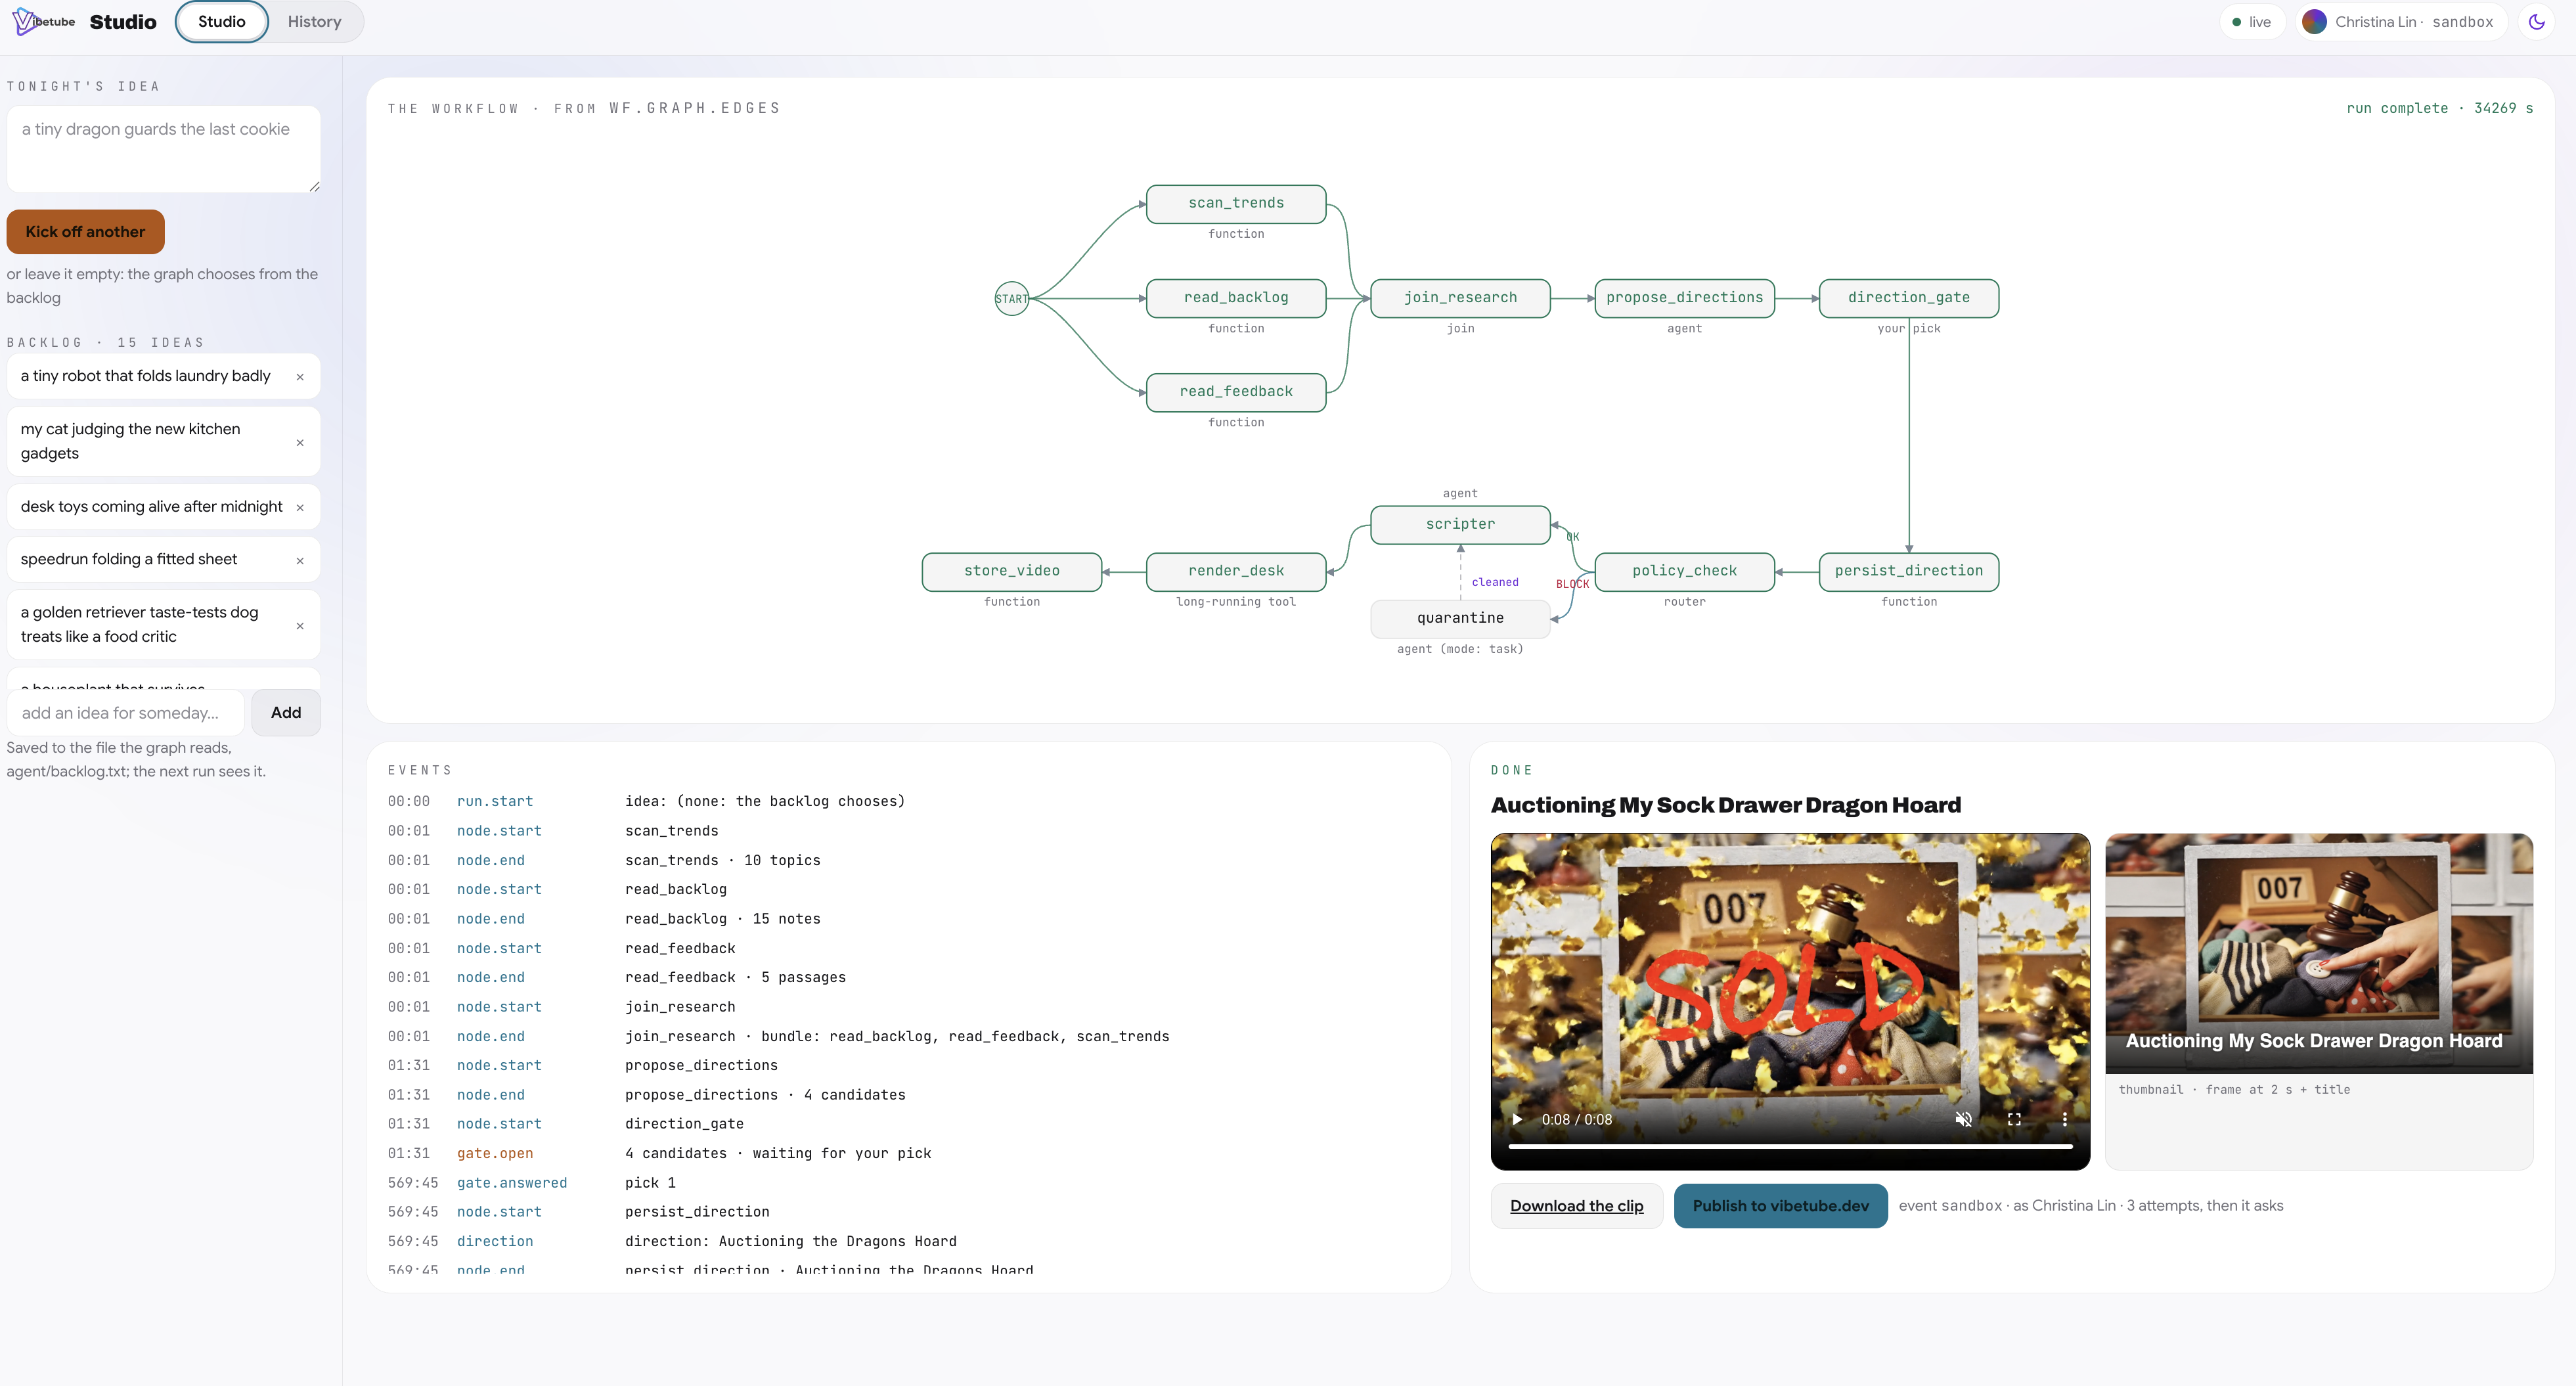
10. खास जानकारी
VibeStudio Workbench में, Step 10 · Summary पर जाकर, पूरे आर्किटेक्चर की समीक्षा करें.
चरण | आर्किटेक्चर और कॉन्सेप्ट | लागू करने का तरीका |
एक प्रॉम्प्ट | सिंगल प्रॉम्प्ट, फ़ंक्शन टूल, क्रम में चलने वाली चैट लूप |
|
एजेंटिक वर्कफ़्लो की बुनियादी बातें | ग्राफ़ वर्कफ़्लो, पैरलल रिसर्च, स्कीमा आउटपुट, ह्यूमन गेट |
|
स्टेट और राऊटर | शेयर की गई सेशन की स्थिति, पैरामीटर बाइंडिंग, डिटरमिनिस्टिक राउटिंग, टास्क एजेंट |
|
मेमोरी बैंक | उपयोगकर्ता-लेवल पर लंबे समय तक याद रखने की सुविधा, सिमैंटिक कंसोलिडेशन, लाइफ़साइकल हुक |
|
RAG Engine | ऑडियंस की टिप्पणियों और सिमैंटिक एम्बेडिंग के आधार पर दस्तावेज़ वापस पाना |
|
Veo की मदद से वीडियो को एसिंक्रोनस तरीके से जनरेट करना | लंबे समय तक चलने वाले टूल, लंबित रसीदें, बाहरी डिलीवरी डेमॉन |
|
Cloud Run पर डिप्लॉय करना | प्रोग्राम के हिसाब से ऑर्केस्ट्रेशन, सर्वर-सेंट इवेंट, बिना सर्वर वाला कंटेनर |
|
आर्किटेक्चर के मुख्य सिद्धांत
- इंतज़ार करने के बजाय निलंबित करें: वर्कफ़्लो को साफ़ तौर पर रोका जाता है, ताकि व्यक्ति से इनपुट लिया जा सके (
RequestInput) या लंबे समय तक चलने वाली कार्रवाइयां की जा सकें (LongRunningFunctionTool). प्रोसेस, थ्रेड या नेटवर्क सॉकेट पर इंतज़ार नहीं करती हैं. - यूनिवर्सल रेज़म्पशन: हर निलंबन एक जैसे तरीके से रेज़्यूम होता है: एक
function_response, जिसमें निलंबित नोड का कॉल आईडी होता है. - डिकपल किए गए स्टेट मैनेजमेंट: नोड, वर्बोस और टाइटली कपल्ड इंटरमीडिएट पेलोड के बजाय, नाम वाली सेशन स्टेट कुंजियों और पैरामीटर बाइंडिंग के ज़रिए डेटा शेयर करते हैं.
- जनरेटिव एआई के इस्तेमाल से पहले, नियमों के आधार पर राउटिंग करना: नियमों के आधार पर काम करने वाले राउटर और रेगुलर एक्सप्रेशन फ़िल्टर, जनरेटिव मॉडल के चलने से पहले, बिना किसी टोकन की लागत के नीति का आकलन करते हैं.
- चिंताओं को अलग करना: किसी एजेंट से जुड़ा कॉन्टेक्स्ट, लाइफ़साइकल कॉलबैक में होना चाहिए. वहीं, शेयर किए गए डेटा की डिपेंडेंसी