1. Introduzione
Questo codelab ti guiderà nella creazione di sistemi di agenti di nuova generazione utilizzando workflow e grafici nell'Agent Development Kit (ADK). Implementerai pattern architetturali comuni, orchestrerai interazioni human-in-the-loop (HITL) e gestirai l'esecuzione asincrona a esecuzione prolungata. Inoltre, integrerai knowledge base aziendali e memoria persistente per personalizzare ed evolvere il comportamento degli agenti. Infine, collegherai queste funzionalità per creare una pipeline automatizzata di generazione di video.
Scenario
Gestisci un canale digitale su VibeTube con un pubblico attivo e un backlog in espansione di idee creative. La produzione di ogni video richiede un'esecuzione continua in più fasi: ricerca di formati di tendenza, sintesi del feedback degli spettatori, sviluppo di script, controllo della conformità alle norme e generazione di video clip. I modelli generativi possono creare bozze di singoli asset, ma per fornire release coerenti è necessaria un'architettura di agenti orchestrata.
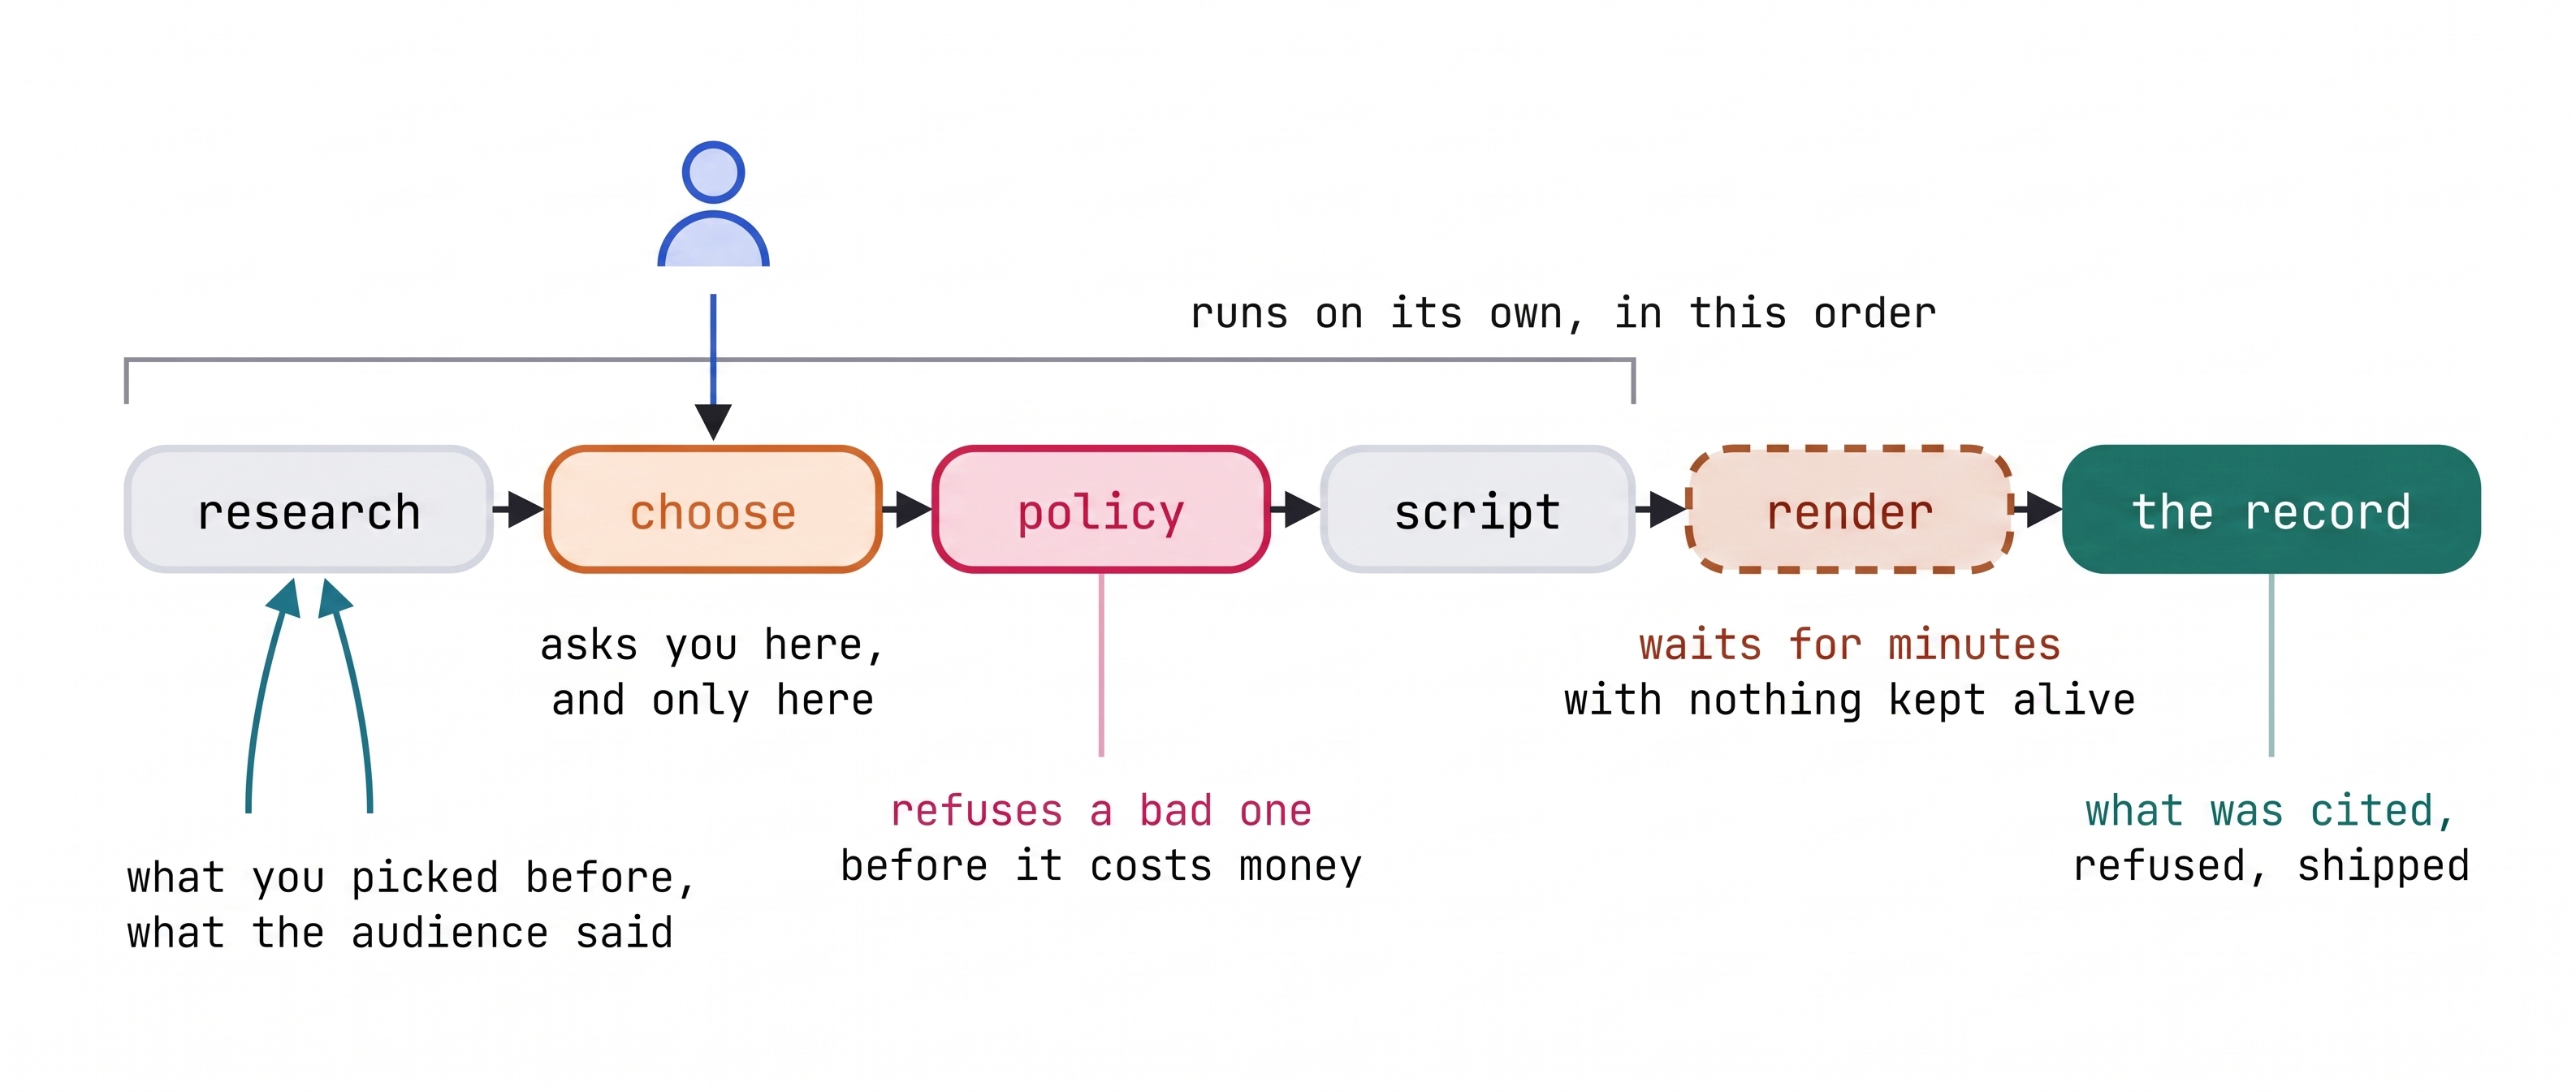
Per automatizzare questo ciclo di vita, creerai VibeStudio. Questa pipeline agentica esegue ricerche di routine in parallelo, presenta opzioni selezionate per l'approvazione human-in-the-loop, applica controlli automatici delle policy prima di generare il video e conserva il contesto tra le esecuzioni di produzione.
Cosa imparerai
- Fondamenti di ingegneria dei grafi: le architetture degli agenti in più fasi richiedono un flusso di controllo esplicito e percorsi di esecuzione strutturati. Puoi creare un ADK
Workflowutilizzando tuple perimetrali, l'entry pointSTART,JoinNodeper l'aggregazione fan-out parallela e nodi router deterministici per indirizzare l'esecuzione in base allo stato. - Modalità agente e callback del ciclo di vita: le attività specializzate richiedono comportamenti operativi distinti e guardrail deterministici. Puoi configurare le istanze ADK
Agentutilizzando le modalitàchat,single_turnetaskabilitate per gli strumenti come nodi del workflow, applicando gli intercettatori conbefore_model_callbackeafter_agent_callback. - Orchestrazione human-in-the-loop: le pipeline di produzione si interrompono per consentire il giudizio umano in punti di controllo creativi critici. Implementi
RequestInputper sospendere l'esecuzione del workflow, applicare schemi di risposta strutturati e riprendere l'esecuzione senza mantenere attivi i processi di runtime inattivi. - Memoria gerarchica degli agenti: i sistemi di produzione separano lo stato di esecuzione temporaneo dal contesto permanente. Gestisci lo stato della sessione a breve termine utilizzando
Event(state=...)e l'associazione dei parametri e connetti GEAP Memory Bank per estrarre, consolidare e rendere persistenti le preferenze dei creator tra le esecuzioni. - Grounding con knowledge base aziendali: gli agenti autonomi richiedono un contesto di dominio dinamico e il sentiment del pubblico. Collega un corpus di GEAP RAG Engine come nodo di recupero dedicato all'interno del fan-out parallelo per eseguire il grounding semantico degli output dell'agente.
- Workflow e deployment a lunga esecuzione: il rendering video multimodale viene eseguito in modo asincrono per periodi di tempo prolungati. Implementi
LongRunningFunctionToolcon le ricevute delle chiamate in attesa per sospendere e riprendere il flusso di lavoro in base all'ID chiamata ed esegui il deployment della pipeline completata utilizzando l'ADKRunnersu Cloud Run.
Come è organizzato questo codelab
Questo codelab funge da riferimento concettuale e architettonico. Ogni sezione spiega i costrutti dell'ADK implementati nel passaggio corrispondente del workbench, fornisce il codice di riferimento e stabilisce i principi di progettazione fondamentali. Esamina ogni sezione prima di completare l'esercizio corrispondente nel workbench.
Il lavoro pratico si svolge in VibeStudio Workbench, un'interfaccia web complementare con un editor di codice interattivo, verificatori di runtime e un inspector ADK incorporato. La numerazione dei passaggi nel workbench è allineata direttamente a questo codelab per mantenere sincronizzati i tuoi progressi. Le modifiche di base al grafo persistono tra i passaggi e il workbench verifica automaticamente i prerequisiti man mano che procedi.
Al termine degli esercizi del workbench, assemblerai una pipeline agentica end-to-end ed eseguirai il deployment di un'applicazione VibeStudio in esecuzione su Cloud Run per generare contenuti video.
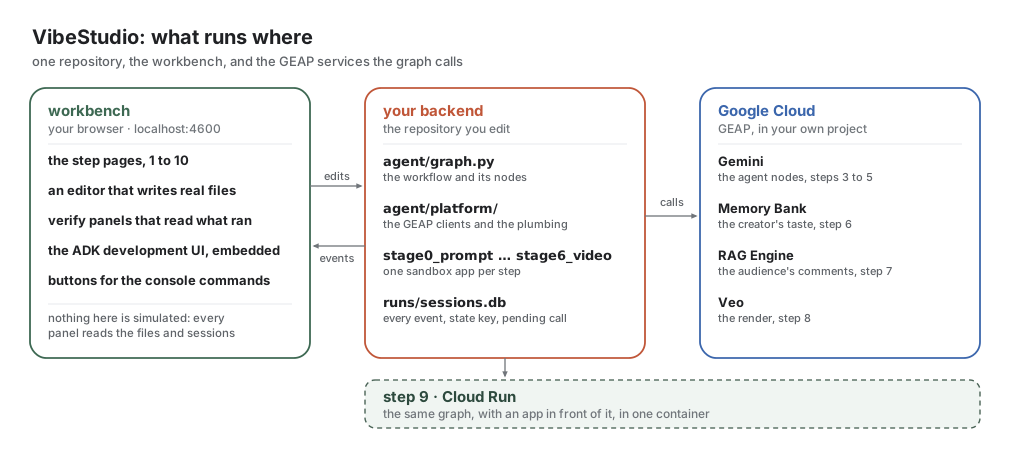
L'ambiente è costituito da tre componenti principali: VibeStudio Workbench (l'interfaccia web locale per la modifica del codice e la verifica in fase di runtime), il backend (l'ADK Workflow e le sandbox di staging in agent/) e Google Cloud (modelli Gemini, GEAP Memory Bank, motore RAG e generazione di video Veo).
2. Configurazione
Richiedere i crediti del workshop
Se partecipi a un lab con insegnante, quest'ultimo distribuirà i crediti per il tuo progetto Google Cloud. Segui le istruzioni dell'insegnante per utilizzare i tuoi crediti e assicurati che la fatturazione sia attiva sul tuo account prima di continuare.
Apri Cloud Shell
Cloud Shell è un ambiente di sviluppo basato su browser con gcloud, Python e git preinstallati.
Per avviare Cloud Shell:
- Vai a Google Cloud Shell.
Si aprirà una sessione del terminale nella parte inferiore della finestra del browser.
Clona e inizializza il repository
Esegui questi comandi nel terminale Cloud Shell per clonare il progetto:
git clone https://github.com/gca-americas/vibetube-studio
cd ~/vibetube-studio
Prompt di configurazione
Durante la configurazione, ti verranno richiesti i seguenti dettagli:
- ID progetto Google Cloud: quando richiesto da
setup_project.sh, premi Invio per creare automaticamente un nuovo progetto. Se preferisci utilizzare un progetto esistente (ad esempio un progetto preassegnato), inserisci l'ID progetto e assicurati che l'ortografia sia corretta con la fatturazione attiva. - Codice evento: inserisci il codice della stanza fornito dall'insegnante. Se non ne hai ricevuto uno, rivolgiti a un assistente all'insegnamento o a un vicino. Se stai completando questo lab a casa, premi Invio per accettare la stanza
sandboxpredefinita. - Nome visualizzato del canale: inserisci il tuo nome o l'handle del canale che preferisci quando richiesto da
setup_codelab.shoppure premi Invio per accettare il nome predefinito generato dal tuo Account Google.
Esegui i due script di configurazione in ordine:
./setup_project.sh
./setup_codelab.sh
setup_project.sh: crea o riutilizza un progetto Google Cloud con fatturazione attiva, salva l'ID progetto in~/project_id.txte configura il contestogcloudattivo.setup_codelab.sh: installauve le dipendenze Python in.venv, attiva le API Google Cloud richieste, configura le impostazioni del canale in.env, verifica l'accesso al modello con Gemini, esegue il provisioning delle risorse Memory Bank e RAG, crea l'interfaccia del workbench e avvia VibeStudio Workbench.
Lo script esegue il controllo preflight e avvia VibeStudio Workbench in background. Le ultime righe mostrano il link da aprire.
7 · Preflight
  ✓ python 3.12
  ✓ auth path A: Vertex via ADC (STUDIO_VERTEX=1)
  ✓ Google Cloud ADC (project <your-project>)
  ✓ stage0_prompt loads
  ...
  ✓ stage6_video loads (13 edges)
  ✓ aiplatform.googleapis.com enabled (Gemini, Veo, Memory Bank, RAG Engine)
  ✓ vectorsearch.googleapis.com enabled (the vector store a RAG corpus is built on)
  ✓ Memory Bank connected
  ✓ RAG corpus connected
  ✓ VibeStudio Workbench running on port 4600

PREFLIGHT GREEN

Setup finished. The VibeStudio Workbench is already running.

  Open this and start at step 1
      https://4600-<your cloud shell host>/step/story

  It runs in the background. You do not need to start anything else.
      log      runs/lab.log
      stop     kill $(cat runs/lab.pid)
      start    scripts/start.sh
Fai clic su questo link. Lo stesso indirizzo è disponibile in Anteprima web → Cambia porta → 4600.
Per ricontrollare l'ambiente in qualsiasi momento, esegui python scripts/preflight.py. Per riavviare il banco di lavoro, esegui scripts/restart.sh. Per eseguire nuovamente la configurazione, esegui ./setup_codelab.sh. In questo modo, la configurazione e i progressi verranno conservati.
Una volta aperto, leggi il passaggio 1, La storia, per lo scenario e il passaggio 2, Cosa crei, per la forma del grafico finito. Nessuno dei due ha un esercizio. Poi torna qui per il passaggio 3.
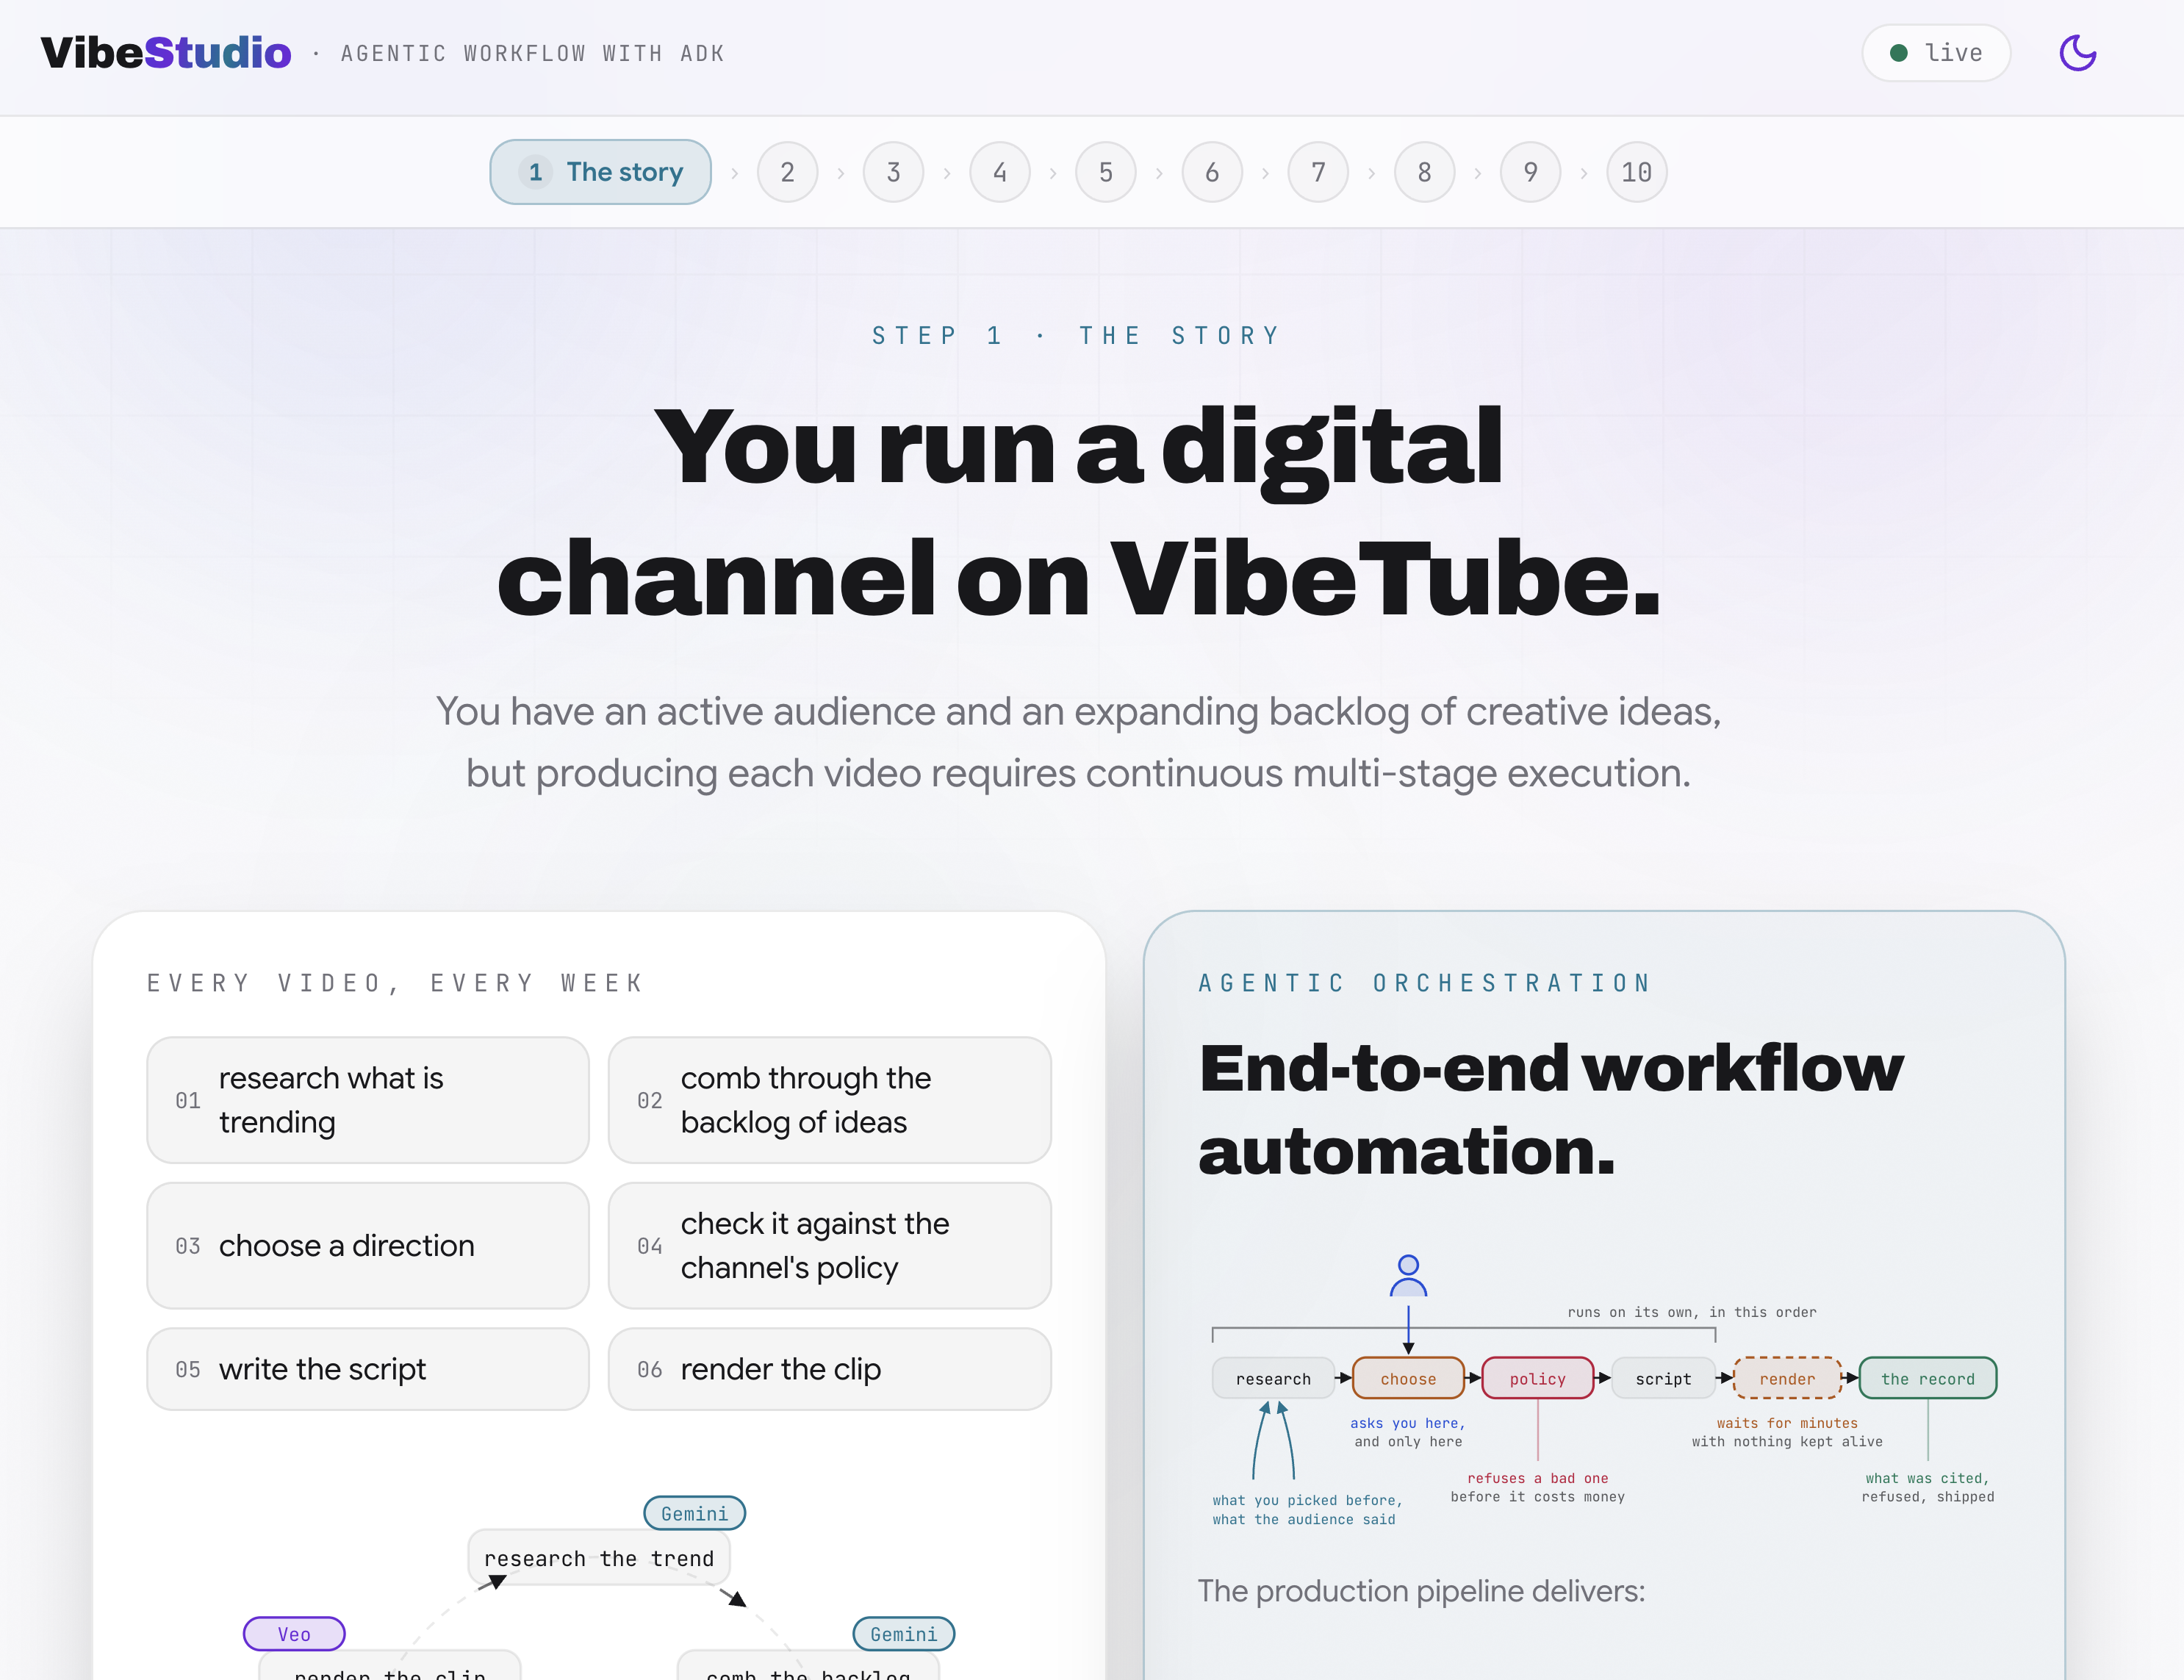
Ogni parte pratica di VibeStudio Workbench termina con un riquadro di verifica che legge gli artefatti reali: il file sul disco e le sessioni scritte dalle esecuzioni.
Layout del repository
Il repository è strutturato in logica del workflow principale, sandbox passo dopo passo, ambiente workbench e applicazione di produzione:
vibe-studio-lab/
├── agent/                  # Core ADK workflow, graph definition, and platform services
│   ├── graph.py            # Workflow graph definition, node functions, and routers
│   ├── desk.py             # Video render desk using LongRunningFunctionTool
│   ├── schemas.py          # Pydantic schemas for directions, gates, and scripts
│   ├── trends.py           # Trend generation and sampling utilities
│   ├── backlog.txt         # Creator video ideas backlog
│   ├── comments.md         # Audience comments for RAG Engine corpus seeding
│   ├── policy_words.txt    # Blocked subject words for deterministic policy checks
│   └── platform/           # Google Cloud service clients (Memory Bank, RAG, Veo)
│       ├── config.py       # Environment variables, locations, and model configurations
│       ├── memory.py       # GEAP Memory Bank callbacks and context injection
│       ├── rag.py          # GEAP RAG Engine corpus creation and semantic retrieval
│       └── videogen.py     # Veo video generation and operation polling
├── stage0_prompt/          # Step sandboxes: isolated agent.py files runnable in adk web
│   └── ...                 # stage1_fanout through stage6_video for incremental steps
├── server/ & web/          # VibeStudio Workbench (FastAPI backend and React frontend)
├── vibestudio/             # Complete production application deployed to Cloud Run
│   ├── server/             # FastAPI production server and event runner
│   ├── web/                # End-user React web application
agent/: contiene il grafico del workflow principale. Modificherai i file in questa directory per implementare nodi di fan-out paralleli, routing deterministico dei criteri, callback di memoria e strumenti di generazione di video.agent/platform/: interagisce con i servizi Google Cloud, tra cui i modelli Gemini, GEAP Memory Bank, GEAP RAG Engine e la sintesi video di Veo.stage0_prompt/fino astage6_video/: ambienti sandbox autonomi. Ogni cartella esporta unroot_agentautonomo, in modo da poter eseguire e ispezionare ogni passaggio in modo isolato tramite l'interfaccia di sviluppo ADK incorporata.server/eweb/: l'applicazione VibeStudio Workbench in esecuzione localmente sulla porta 4600. Ospita la documentazione dei passaggi, l'editor di codice in-page, i verificatori delle prove di runtime e la visualizzazione dei grafici.vibestudio/: l'applicazione di produzione completa pacchettizzata e di cui è stato eseguito il deployment in Cloud Run nel passaggio finale. Contiene una copia autonoma del grafico del workflow completato.
3. Agente monolitico
Prima di creare un grafico del workflow multi-nodo, stabilisci una base di riferimento dell'architettura con un singolo agente in stage0_prompt/agent.py. Questo agente si basa su un prompt di sistema monolitico che descrive la pipeline di produzione in prosa, supportato da due strumenti di funzione Python.
La valutazione di questa baseline dimostra i limiti operativi del coordinamento basato sui prompt e stabilisce perché i sistemi di produzione richiedono l'orchestrazione dei grafici.
Architettura degli agenti ADK (3A)
In VibeStudio Workbench, vai al Passaggio 3 · Agente monolitico e apri Architettura dell'agente ADK (3A). Questa visualizzazione presenta i livelli architetturali principali di un agente ADK (LlmAgent):
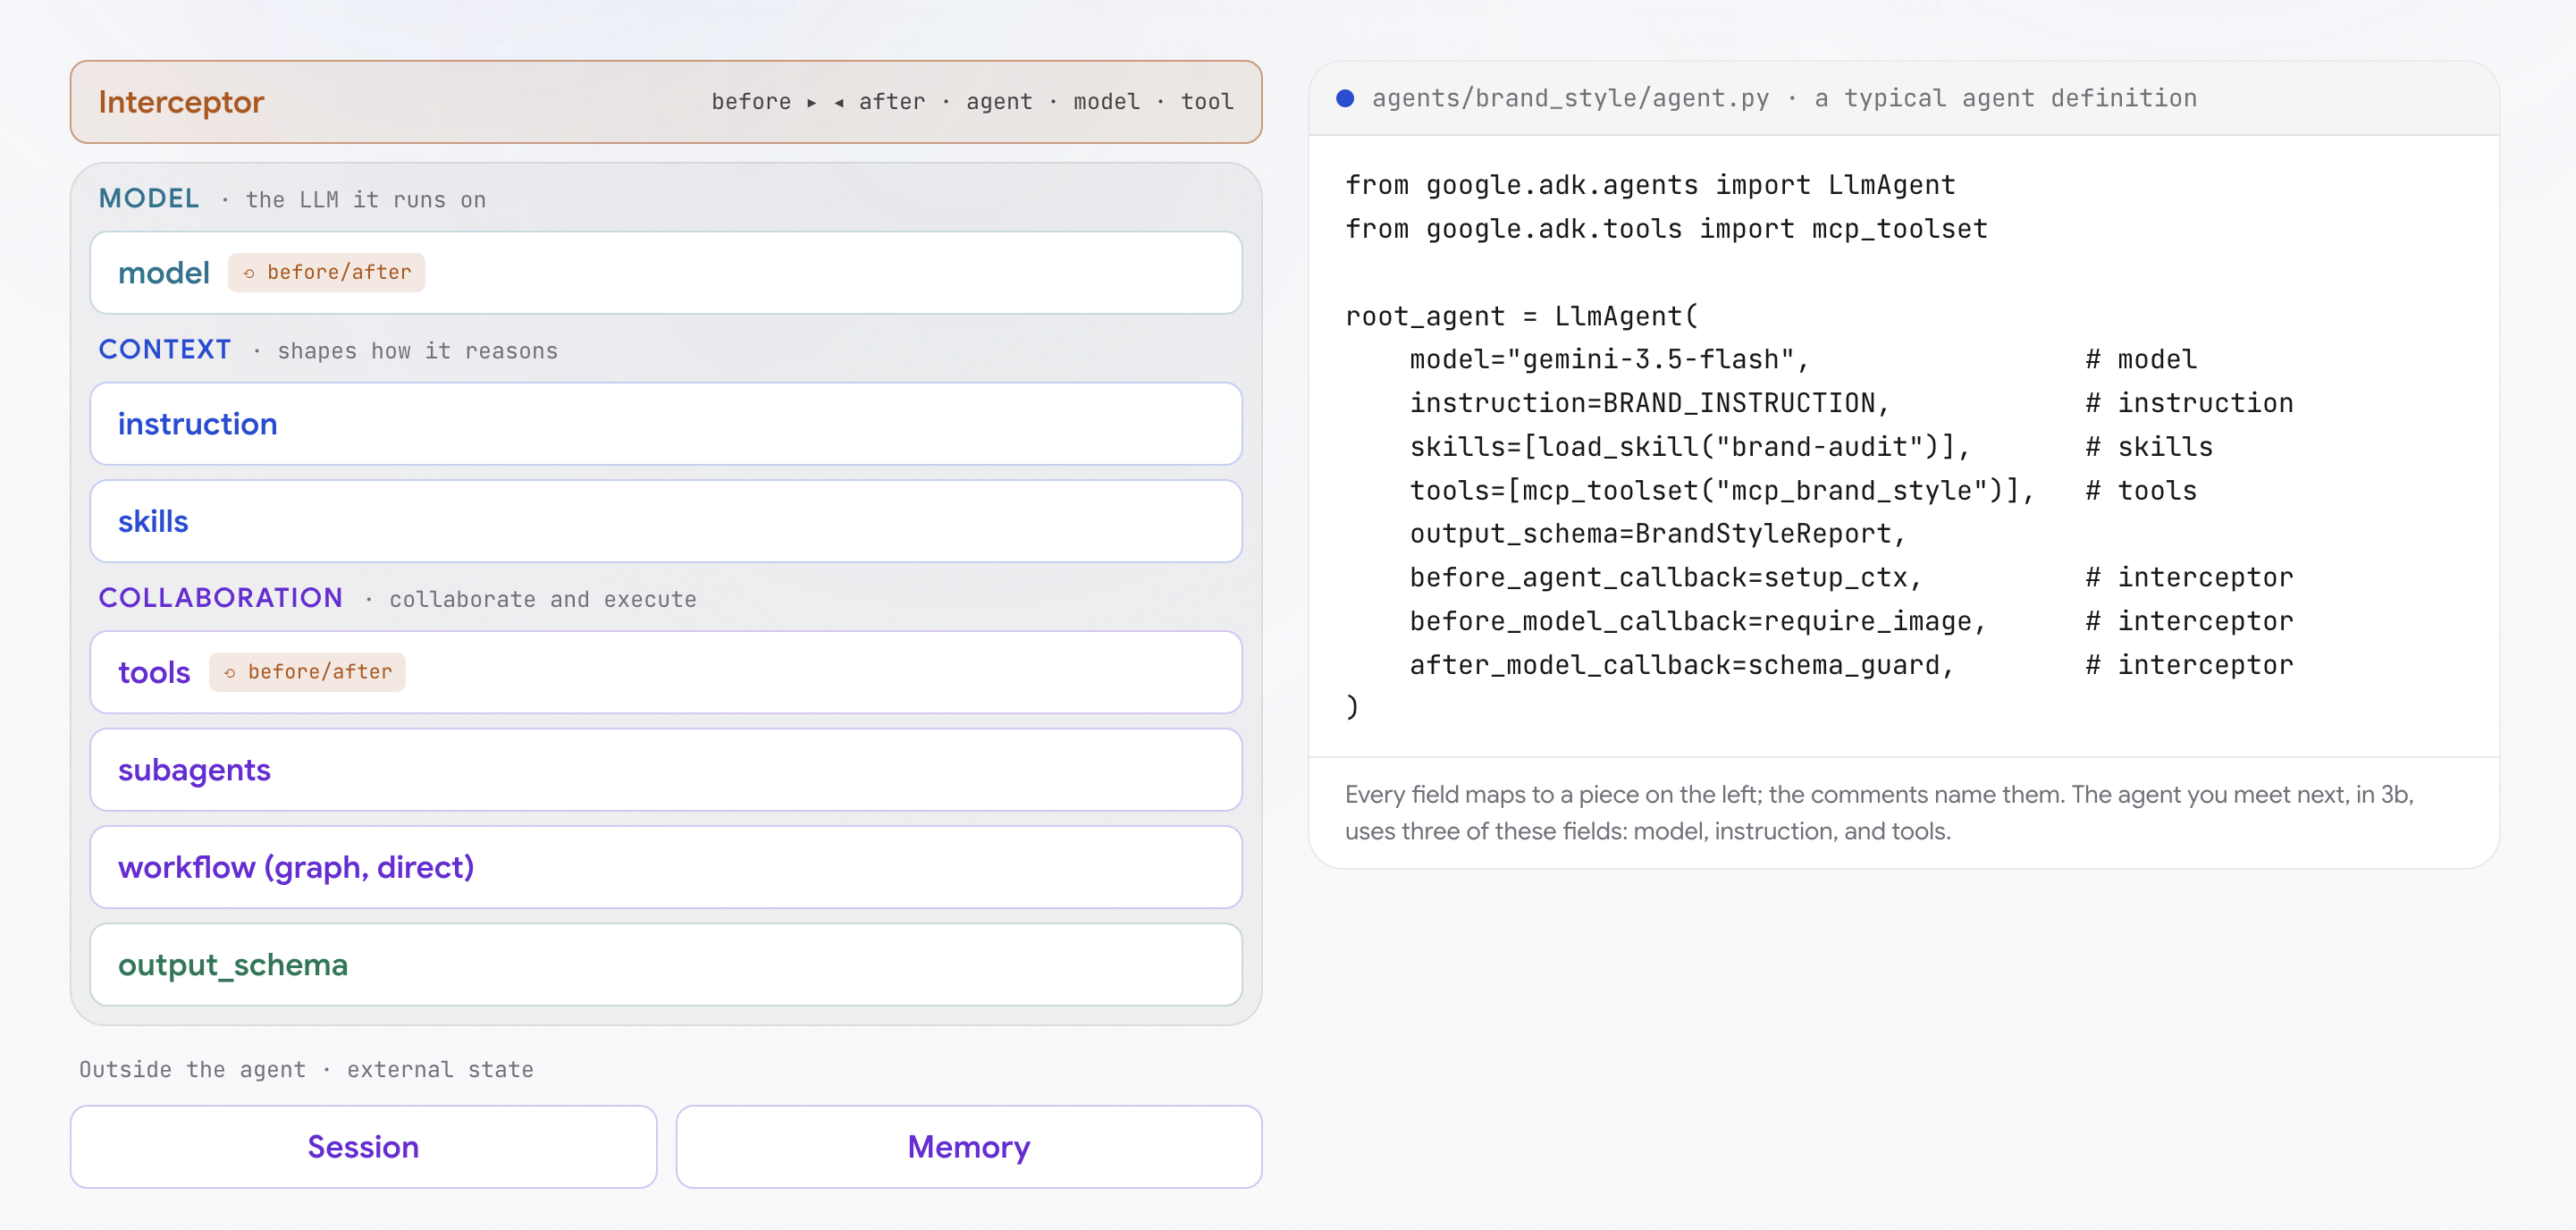
from google.adk.agents import LlmAgent
from google.adk.tools import mcp_toolset

root_agent = LlmAgent(
    model="gemini-3.5-flash",                 # model
    instruction=BRAND_INSTRUCTION,            # instruction
    skills=[load_skill("brand-audit")],       # skills
    tools=[mcp_toolset("mcp_brand_style")],   # tools
    output_schema=BrandStyleReport,           # structured output
    before_agent_callback=setup_ctx,          # interceptor
    before_model_callback=require_image,      # interceptor
    after_model_callback=schema_guard,        # interceptor
)
Il diagramma interattivo raggruppa i componenti dell'agente in cinque domini operativi:
- Livello di ragionamento (modello): il modello linguistico di base (come Gemini 3 Flash) che esegue compiti cognitivi, ragionamento dei prompt e selezione degli strumenti. Tutto il resto dell'architettura informa o vincola questo modello.
- Livello di contesto (istruzioni e skill): direttive che modellano il ragionamento del modello.
instructionstabilisce il prompt di sistema permanente, il ruolo e le regole operative.skillsforniscono indicazioni procedurali con controllo delle versioni (SKILL.md) per workflow ripetibili. - Livello di collaborazione e azione (strumenti, subagenti, flusso di lavoro, schema di output): interfacce che consentono all'agente di agire su sistemi esterni ed emettere dati digitati.
toolsforniscono funzioni Python richiamabili o endpoint Model Context Protocol (MCP).subagentsesegue le attività delegate subordinate.workflowcoordina i grafici multi-agente.output_schemaapplica i modelli Pydantic per garantire che i consumatori downstream ricevano JSON convalidato anziché testo non strutturato. - Livello di intercettazione (callback del ciclo di vita): guardrail deterministici che eseguono codice personalizzato prima e dopo l'esecuzione dell'agente (
before_agent/after_agent), i singoli turni del modello (before_model/after_model) e le chiamate degli strumenti (before_tool/after_tool). Gli intercettatori applicano le regole delle policy senza fare affidamento sulla conformità del modello. - Stato esterno (sessione e memoria): persistenza stateful separata dalla logica dell'agente.
Sessionconserva la memoria di lavoro temporanea e la traccia degli eventi per il thread di esecuzione corrente.Memorymantiene fatti e preferenze duraturi tra le sessioni utilizzando servizi gestiti come GEAP Memory Bank.
L'agente monolitico in questo passaggio implementa solo tre di queste primitive: model, instruction e tools. I passaggi successivi introducono workflow di grafi, schemi strutturati, intercettatori e servizi di memoria persistente.
Specifica dell'agente monolitico (3B)
In Workbench, vai a Monolithic agent specification (3B). Apri stage0_prompt/agent.py per esaminare la definizione dell'agente di base:
- Istruzione con un singolo prompt: il prompt di sistema condensa cinque distinte attività di produzione in un testo continuo: scoprire le tendenze della piattaforma, rivedere le idee in sospeso, proporre concetti creativi, applicare le norme sui soggetti vietati e redigere elenchi di inquadrature.
- Origini dati sottostanti: l'agente fa riferimento a due origini definite accanto al grafico:
agent/trends.py: campiona dieci tendenze attive di formato e stile da un pool di 250 con punteggi di popolarità dinamici.agent/backlog.txt: legge le note grezze del concept del creator riga per riga.
Strumenti nell'agente (3C)
Nel workbench, vai a Strumenti nell'agente (3C).
Che cos'è uno strumento per un agente?
Un modello linguistico è intrinsecamente un motore di ragionamento a mondo chiuso: opera esclusivamente su pesi preaddestrati e sui token presenti nella sua finestra contestuale immediata. Non può eseguire query su un database, accedere ad API in tempo reale o eseguire codice in modo nativo.
Uno strumento colma questo confine. Concede al modello un'agenzia esterna, consentendogli di recuperare informazioni di fatto ed eseguire azioni deterministiche in sistemi esterni.
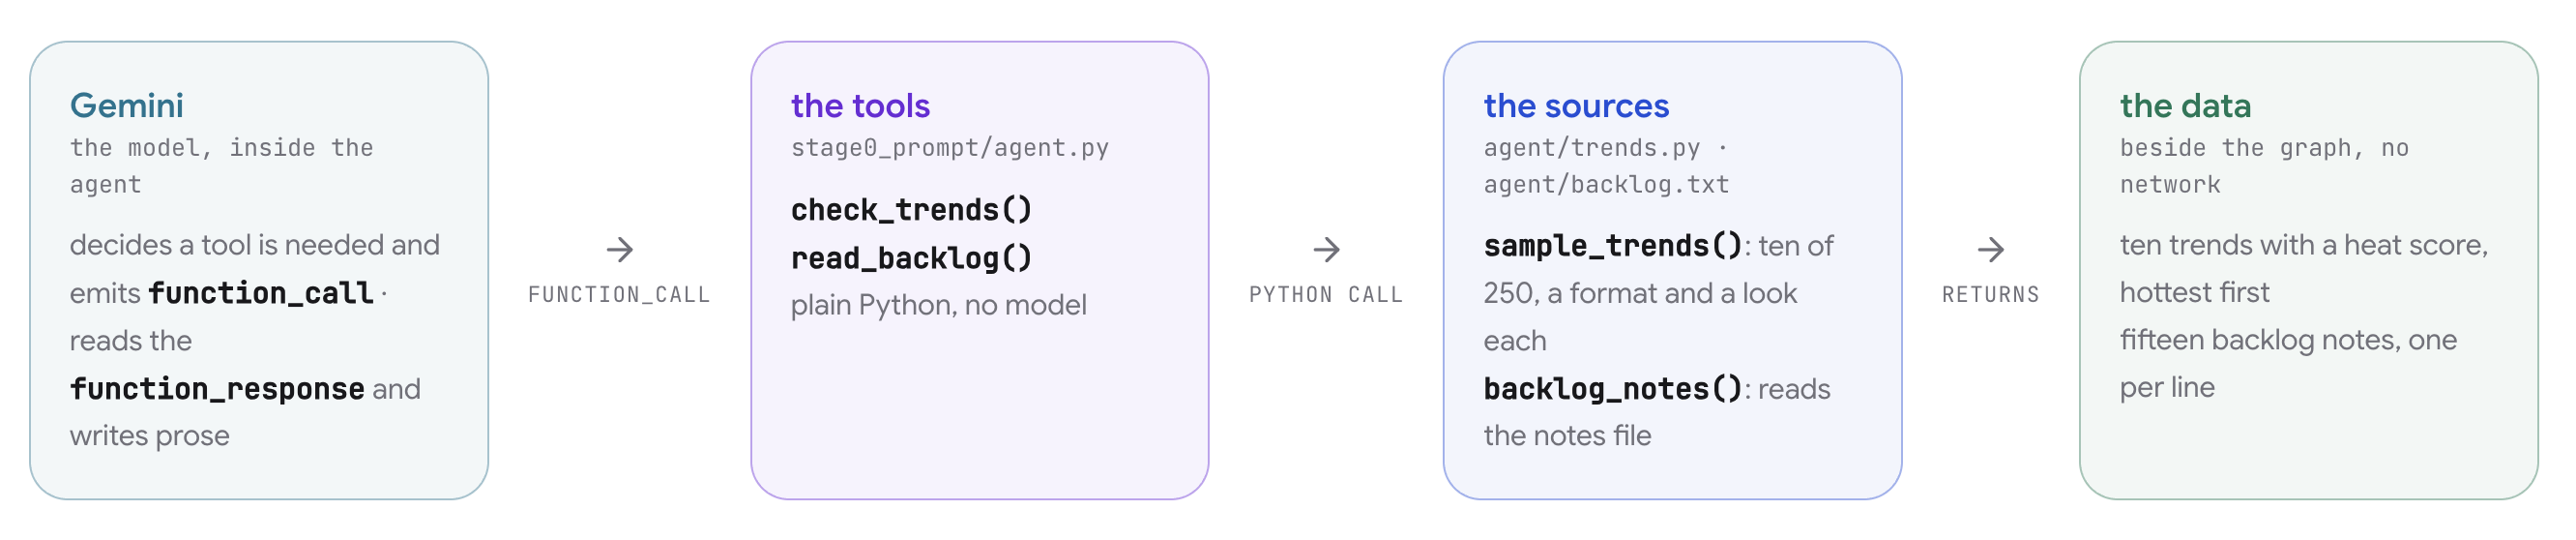
La chiamata degli strumenti segue un protocollo esplicito in cinque fasi tra il modello e il runtime dell'ADK:
- Dichiarazione dello schema: lo sviluppatore fornisce le funzioni Python all'agente. L'ADK esamina il nome, le annotazioni dei tipi e le docstring di ogni funzione per generare una dichiarazione di schema JSON compatibile con OpenAPI che ne descriva i parametri e lo scopo.
- Ragionamento del modello: durante l'inferenza, il modello valuta se il prompt dell'utente richiede dati esterni. Se necessario, il modello genera un evento
function_callstrutturato contenente il nome della funzione di destinazione e il dizionario degli argomenti corrispondente allo schema. - Esecuzione del runtime: il modello stesso non esegue codice. Il runtime dell'ADK intercetta
function_call, esegue la funzione Python locale effettiva utilizzando gli argomenti forniti e acquisisce il valore restituito. - Reinserimento del contesto: il runtime dell'ADK pacchettizza il valore restituito dalla funzione in un evento
function_responsee lo aggiunge alla cronologia della sessione attiva. - Sintesi finale: il modello elabora l'output dello strumento ora presente nella sua finestra contestuale e completa la risposta.
In stage0_prompt/agent.py, i due strumenti di ricerca sono definiti come funzioni Python standard:
def check_trends() -> dict:
    """Ten formats trending on the platform right now, with a heat score each."""
    from agent.trends import sample_trends
    return {"trends": sample_trends()}


def read_backlog() -> dict:
    """The creator's backlog: ideas they noted down to make someday."""
    from agent.graph import backlog_notes
    return {"backlog": backlog_notes()}
Modifica ed esecuzione pratiche
Nell'editor di codice del workbench, aggiungi i due riferimenti alle funzioni all'elenco tools dell'agente:
tools=[check_trends, read_backlog],
Salva la modifica. Il file viene aggiornato sul disco e la riga di verifica conferma che entrambi gli strumenti sono collegati.
Fai clic su Apri ADK web per avviare l'interfaccia di sviluppo ADK incorporata. Invia il prompt con l'idea suggerita:
tonight's idea: a tiny robot doing laundry at midnight
Cosa aspettarsi e perché
Quando invii questo prompt, osserva la seguente sequenza di esecuzione nella traccia della sessione:
- Prima della risposta vengono visualizzati due eventi di esecuzione dello strumento: vengono visualizzati gli eventi
function_callefunction_responsepercheck_trendseread_backlog.- Perché: Gemini ha valutato l'istruzione del prompt di sistema ("controlla cosa è di tendenza. guarda il tuo backlog di idee"), ha riconosciuto che mancavano le tendenze della piattaforma e le note del canale nei suoi pesi e ha richiamato entrambe le funzioni per basare il suo contesto.
- L'agente propone una direzione e si interrompe per la conferma: la risposta suggerisce una direzione per il video sintetizzando le tendenze e il backlog e ti chiede di confermare.
- Perché: l'istruzione chiedeva al modello di concordare la direzione con il creator prima di generare lo script.
- Bypassing confirmation in a follow-up turn: Send a second message:
skip the questions, just describe the video. L'agente ignora immediatamente la conferma e crea una bozza del titolo e delle inquadrature.- Perché: le istruzioni del prompt sono linee guida di consulenza anziché barriere deterministiche. In un agente monolitico, le istruzioni dell'utente possono ignorare le regole del prompt di sistema predefinite perché nessun flusso di lavoro esterno controlla il flusso di esecuzione.
Limitazioni architettoniche di un prompt monolitico
Sebbene un singolo prompt possa produrre un output accettabile per demo isolate, il test delle condizioni limite nel verificatore del workbench rivela limitazioni aziendali critiche:
- Aggregazione di ricerche non strutturate: l'ordine di esecuzione degli strumenti non è deterministico. Il modello riassume i dati recuperati in un testo in formato libero, rendendo impossibile per i sistemi downstream isolare l'origine che ha prodotto affermazioni specifiche.
- Applicazione di policy non verificate: il modello valuta la propria conformità alla sicurezza. Se il modello determina che un argomento è sicuro, nessuna logica deterministica esterna convalida il risultato.
- Pause human-in-the-loop non applicate: le istruzioni del prompt che richiedono la conferma del creator sono indicative. L'invio di un messaggio di follow-up che indica al modello di ignorare le domande fa sì che quest'ultimo salti completamente l'approvazione umana.
Queste lacune architetturali motivano la scomposizione dell'agente monolitico nel flusso di lavoro del grafico esplicito creato nel passaggio successivo.
4. Nozioni di base sugli Agentic Workflows
In VibeStudio Workbench, vai a Passaggio 4 - Nozioni di base degli Agentic Workflows, parti 4A-4D.
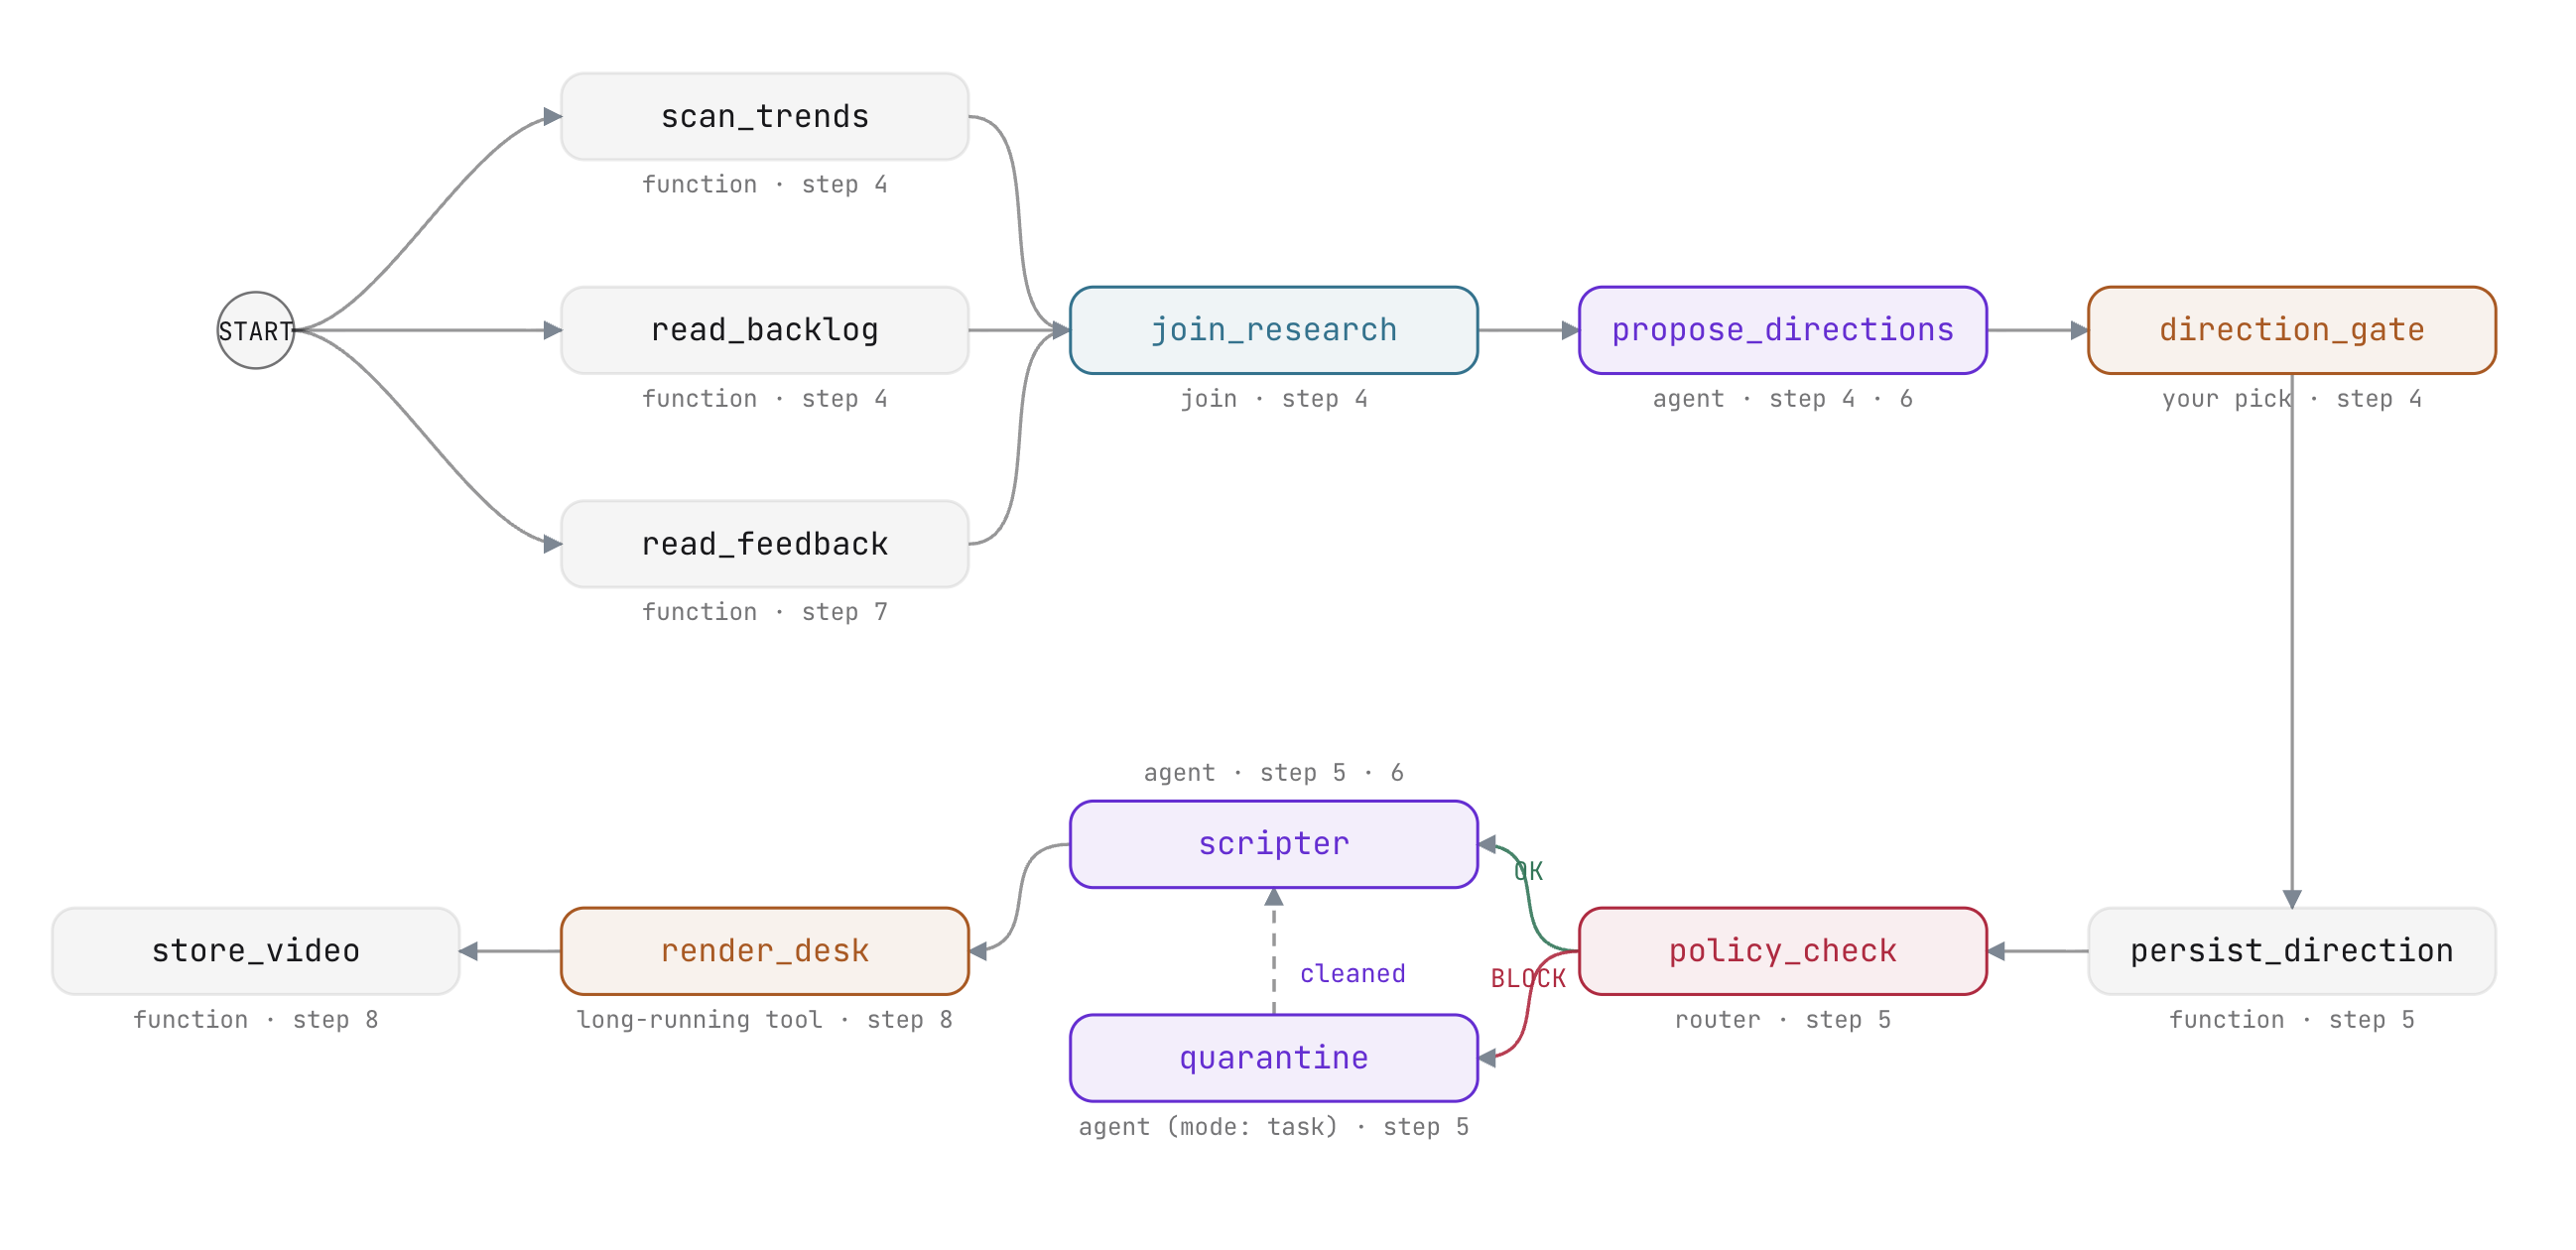
Questo passaggio esegue la transizione da una baseline a singolo agente all'orchestrazione deterministica dei grafici utilizzando ADK Workflow. Creerai un fan-out di ricerca parallela, sincronizzerai i rami con un nodo di join, genererai candidati creativi convalidati dallo schema e introdurrai un gate di approvazione deterministico human-in-the-loop.
Architettura del grafico e catene di esecuzione (4A)
Nel workbench, apri Architettura del grafico e catene di esecuzione (4A).
Un Workflow ADK struttura l'esecuzione dell'agente come un grafo diretto definito da un elenco di archi:
- Catene: le tuple sequenziali definiscono l'esecuzione lineare dei nodi (
(node_a, node_b, node_c)). - Rami paralleli: le catene indipendenti che condividono un nodo di origine vengono eseguite contemporaneamente.
- Sincronizzazione: le catene che convergono su un
JoinNodeattendono che tutti i rami in entrata vengano segnalati prima di essere rilasciati. - Controllo deterministico: il flusso di esecuzione è regolato da strutture di codice dichiarate anziché essere dedotto dal testo del prompt.
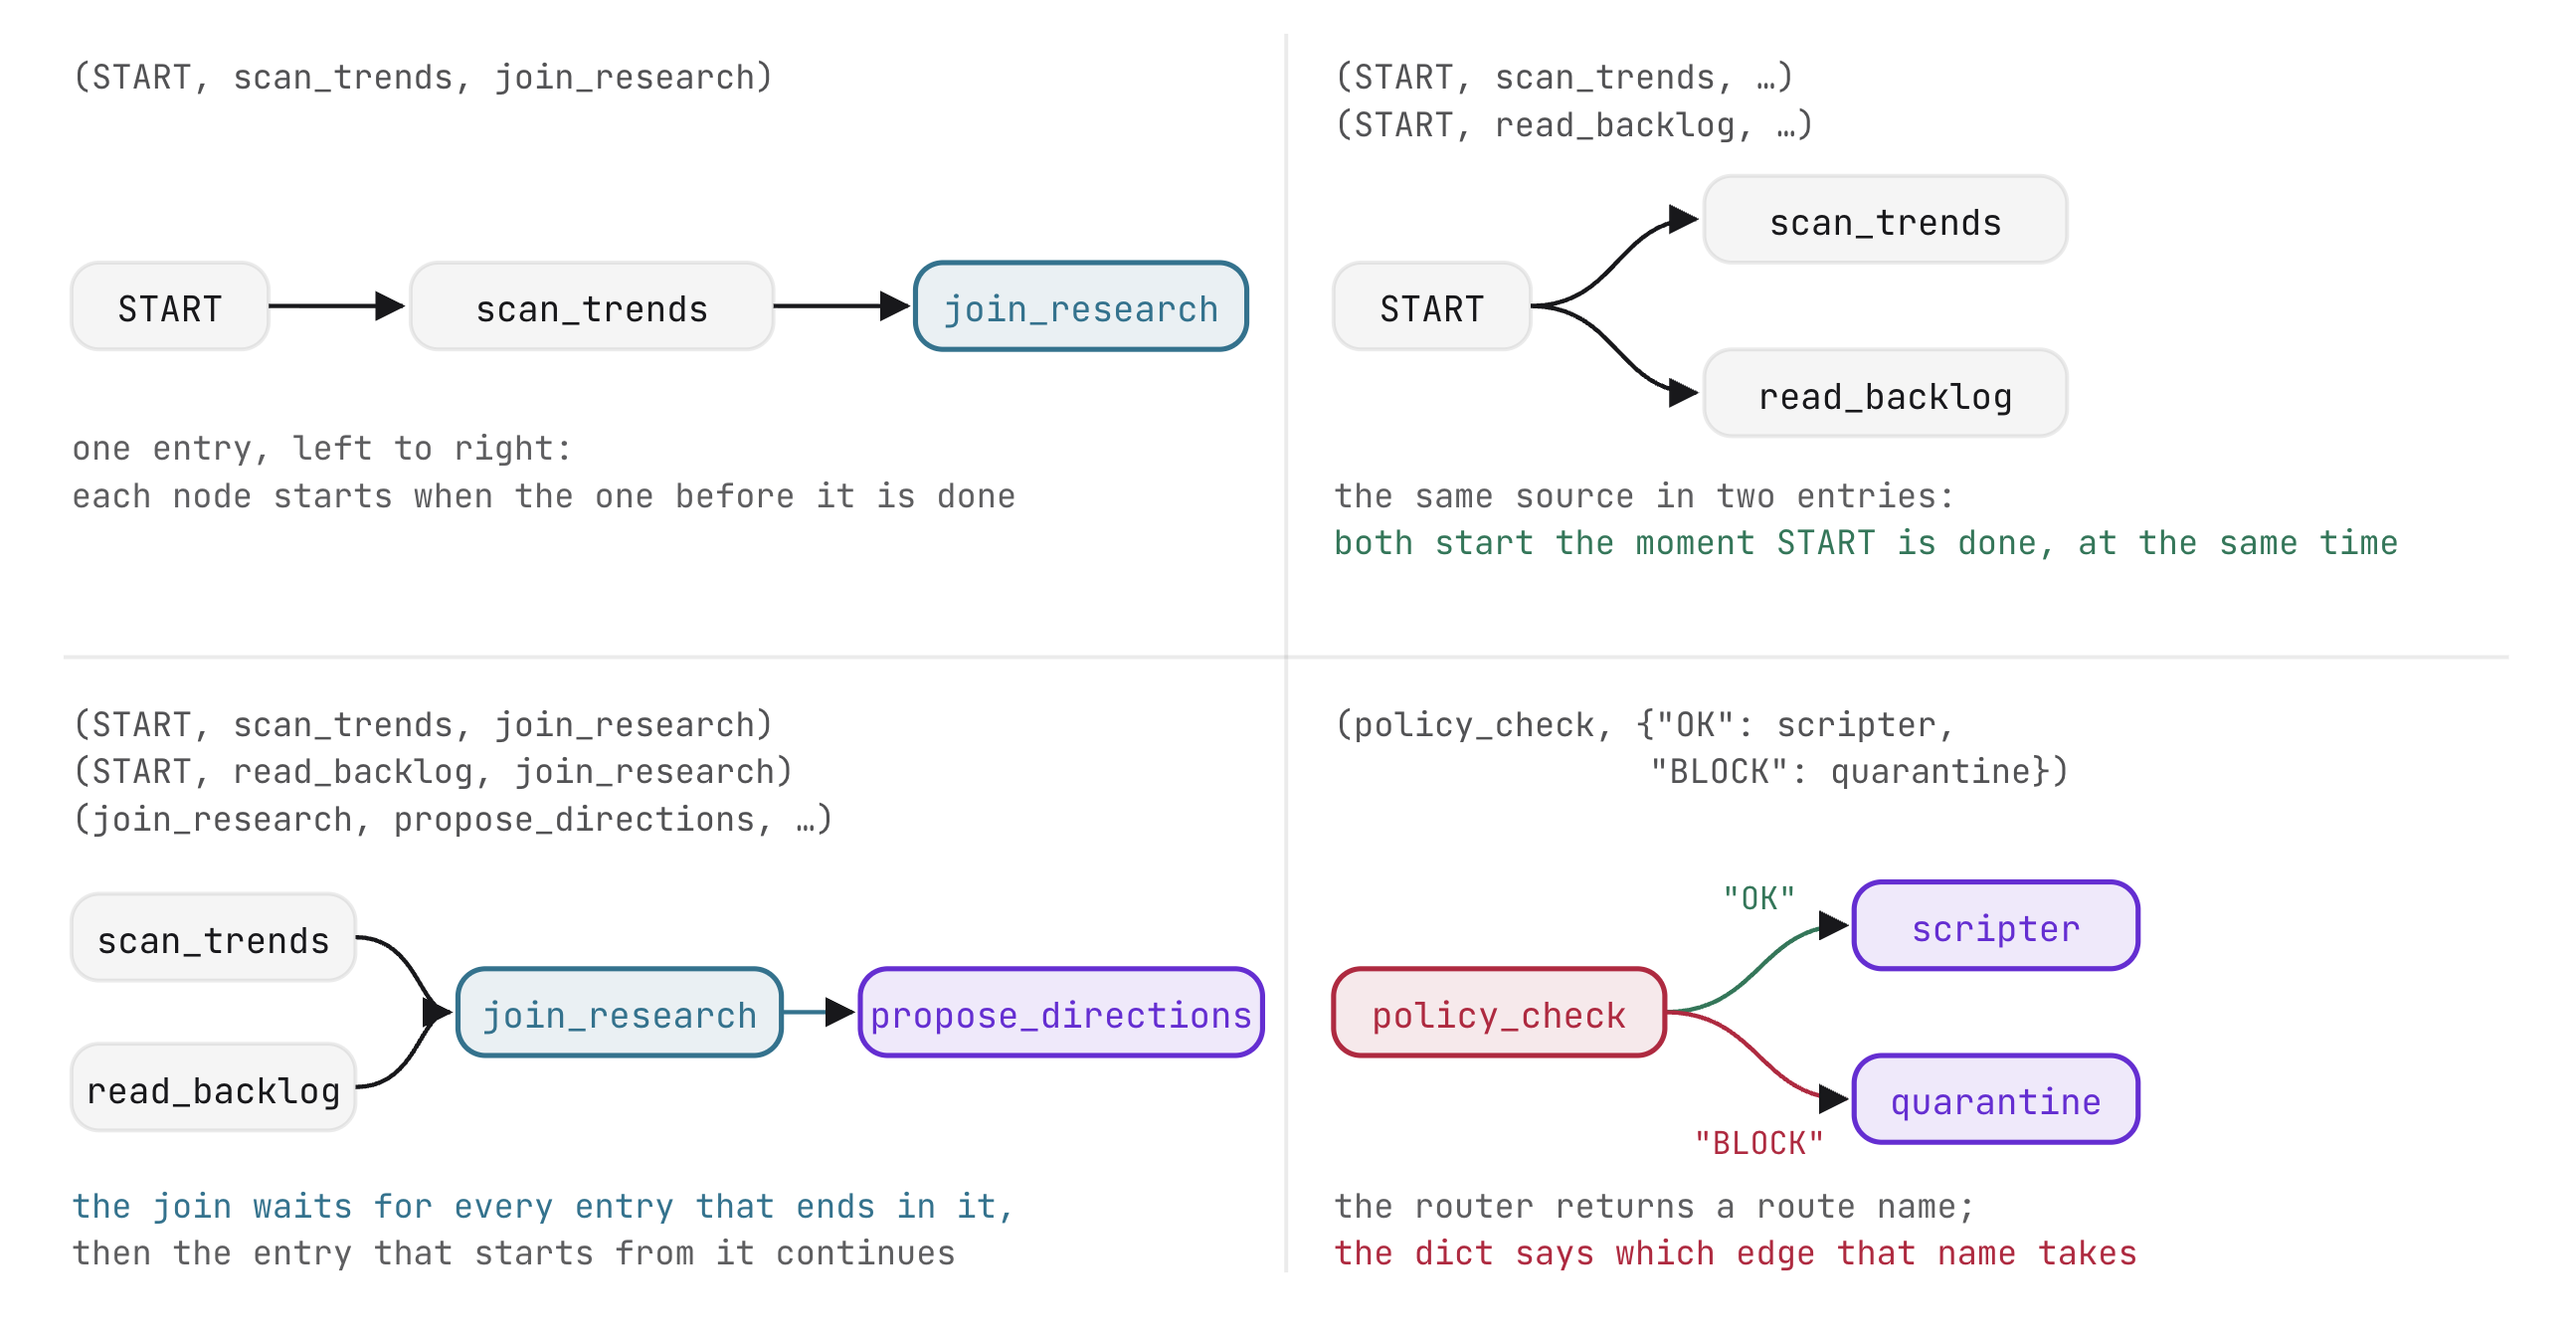
Archetipi di nodi in ADK
I flussi di lavoro ADK sono composti da diversi tipi di nodi specializzati. Ogni archetipo svolge un ruolo operativo specifico nel grafo, separando l'esecuzione di codice deterministico dal ragionamento del modello generativo:
Archetipo del nodo | Implementazione | Ruolo nella pipeline |
Nodo funzione | Funzione Python che restituisce un | Esegue la logica deterministica, il recupero dei dati e le mutazioni di stato. |
Nodo di join | Istanza | Sincronizza i rami simultanei in un dizionario aggregato. |
Nodo agente |
| Valuta le istruzioni rispetto all'input upstream ed emette dati convalidati. |
Nodo router | Funzione che restituisce un | Valuta la logica condizionale per selezionare i rami di esecuzione downstream. |
Nodo di input umano | Funzione di yielding | Sospende lo stato di esecuzione finché non arriva una risposta da un utente esterno. |
root_agent = Workflow(
    name="stage1_fanout",
    description="2 real readers -> join -> one research dict",
    edges=[...])
In questa configurazione, root_agent è un'istanza di Workflow anziché un Agent autonomo. ADK tratta i workflow come agenti di prima classe, consentendo di caricare, pubblicare e ispezionare un intero grafico come un'applicazione unificata. name registra l'applicazione in ADK Web, mentre l'elenco edges ne definisce la topologia di esecuzione.
Fan-out della ricerca parallela (4B)
Nel workbench, vai a Parallel research fan-out (4B). Apri stage1_fanout/agent.py.
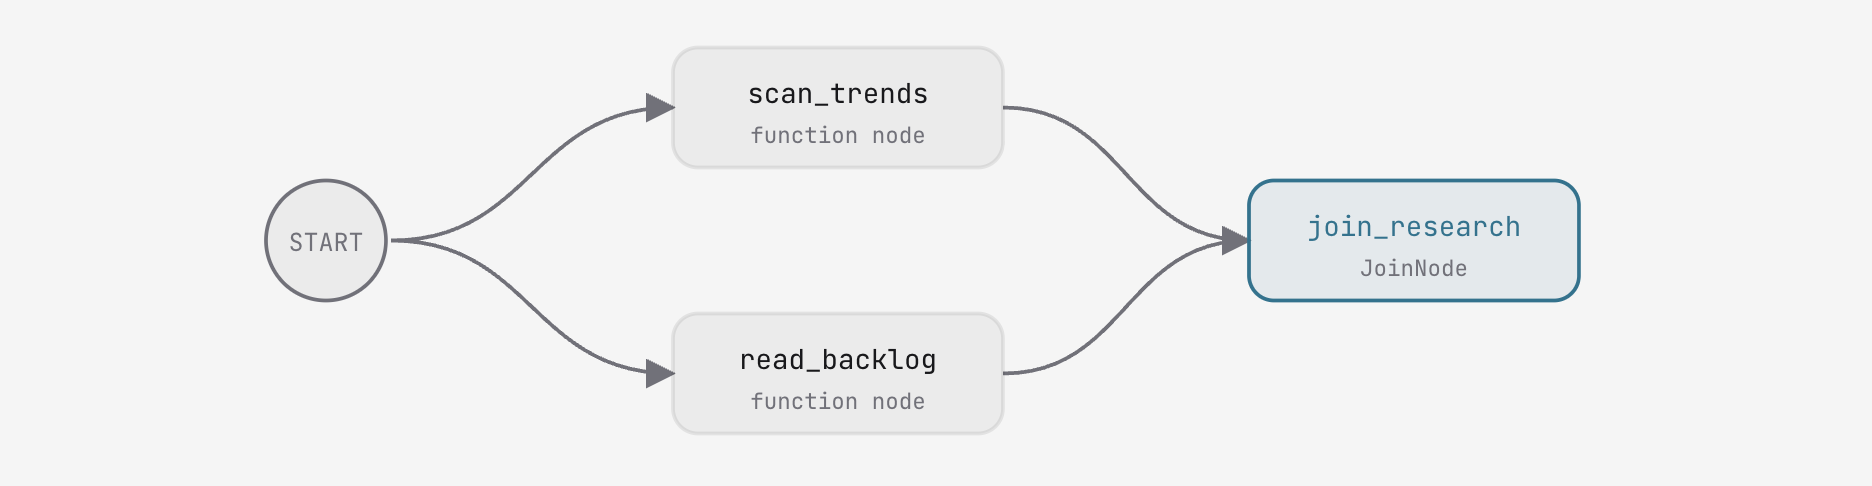
Nodi funzione e barriere di sincronizzazione
La fase di ricerca utilizza due nodi di funzione importati da agent/graph.py:
scan_trends: restituisceEvent(output={"trends": [...]})contenente dieci tendenze della piattaforma con punteggio.read_backlog: restituisceEvent(output={"backlog": [...], "idea": "..."})contenente quindici idee per i contenuti del canale insieme al prompt di esecuzione iniziale.
Ogni funzione accetta node_input (l'output del nodo precedente) e restituisce un Event.
Un JoinNode funge da barriera di sincronizzazione: si mette in pausa finché ogni catena in entrata non genera un evento, quindi aggrega tutti i risultati dei rami in un dizionario con chiave in base al nome del nodo ({"scan_trends": {...}, "read_backlog": {...}}).
Modifica pratica: definizione dei bordi di unione e paralleli
In stage1_fanout/agent.py, crea un'istanza di JoinNode e collega le due catene parallele a partire da START:
join_research = JoinNode(name="join_research")
    edges=[(START, scan_trends, join_research),
           (START, read_backlog, join_research)])
Salva le modifiche. Il verificatore del workbench conferma che il join e gli archi sono collegati. Esegui la fase utilizzando Esegui fase 1 o tramite l'interfaccia web ADK incorporata.
Cosa aspettarsi e perché
- Esecuzione simultanea del lettore: nel grafico di esecuzione,
scan_trendseread_backlogvengono eseguiti contemporaneamente.- Perché: entrambe le catene hanno origine in
START. Il motore ADK pianifica i rami indipendenti contemporaneamente.
- Perché: entrambe le catene hanno origine in
- Output del dizionario aggregato: il workflow viene completato alle ore
join_research, generando un dizionario con voci per entrambi i lettori.- Motivo:
JoinNodegarantisce l'acquisizione completa dei dati prima di consentire l'esecuzione dei nodi successivi.
- Motivo:
Nodi agente (4C)
Nel workbench, vai a Nodi agente (4C). Apri stage2_direction/agent.py.
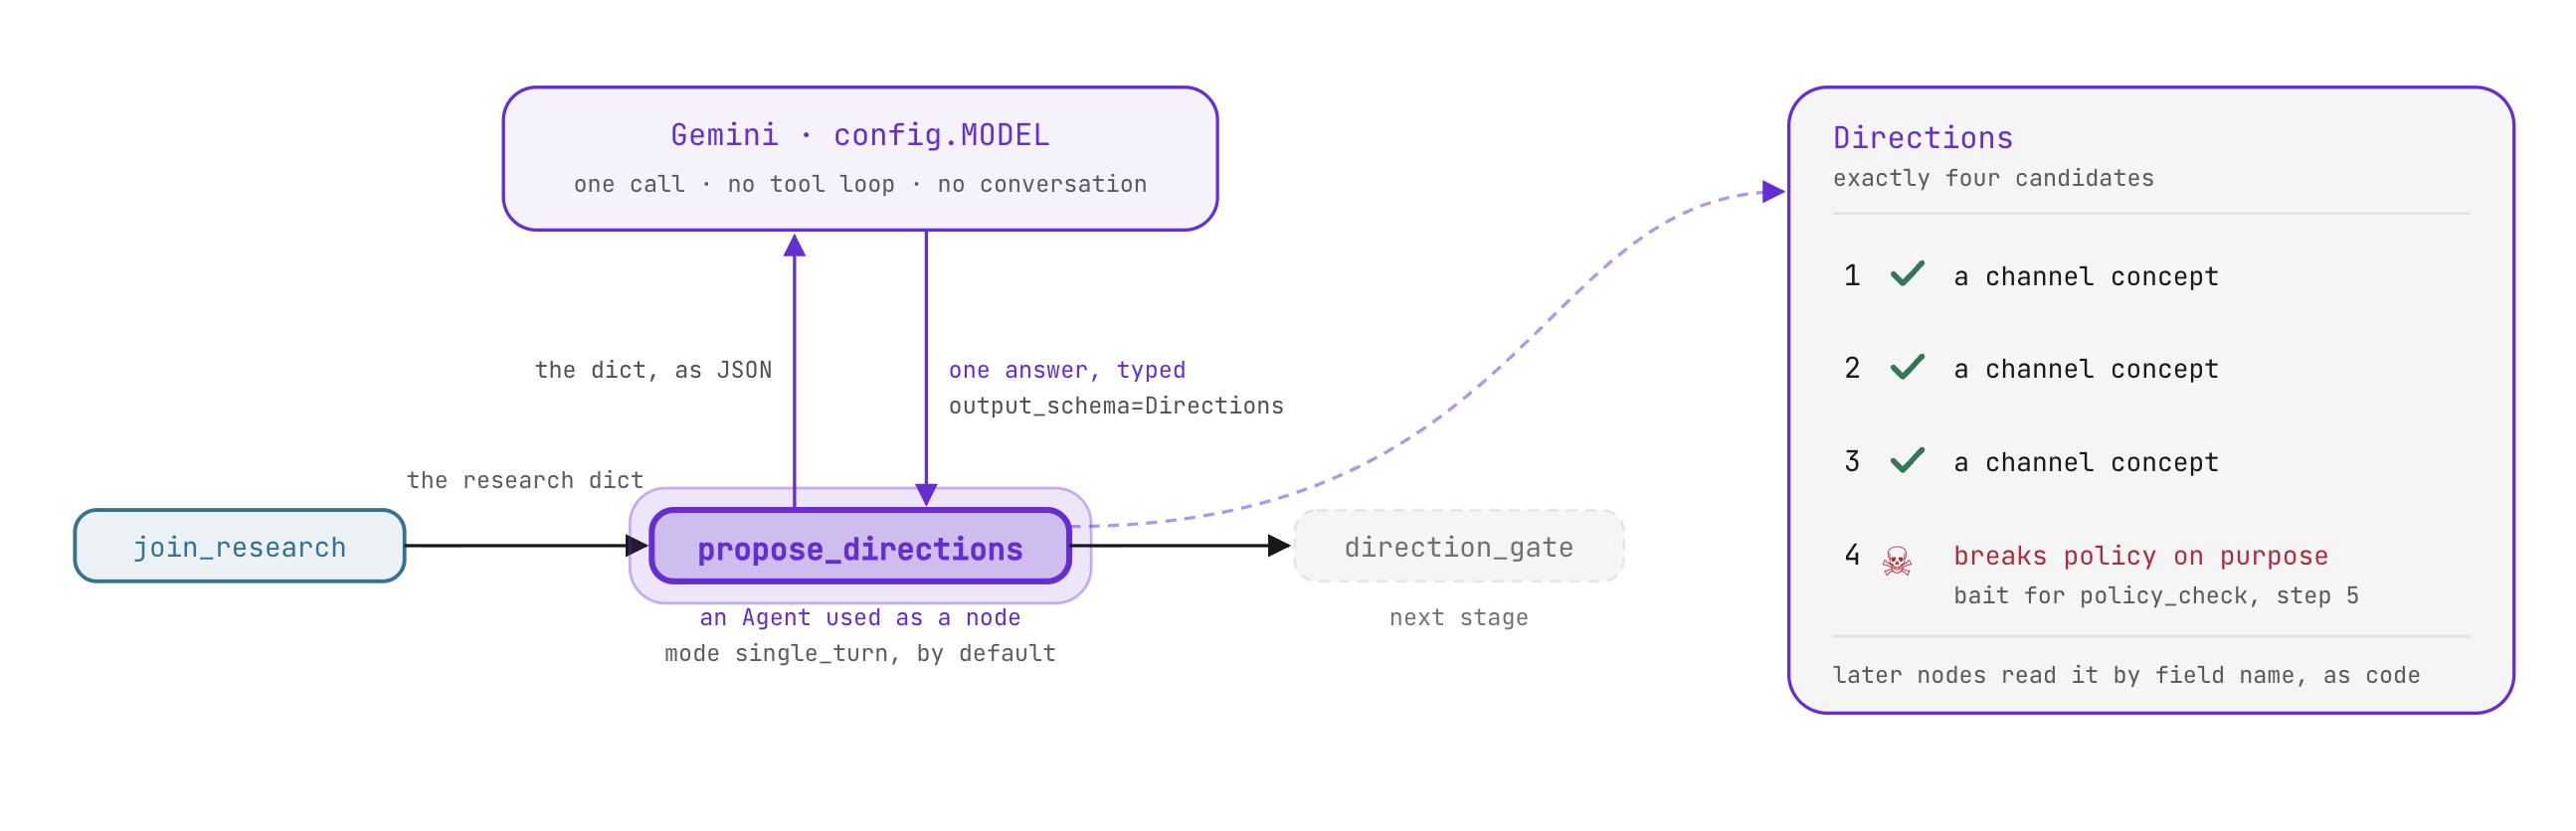
Modalità operative e schemi strutturati
Se incorporato in un Workflow, un Agent viene eseguito in modalità single_turn per impostazione predefinita:
- Riceve l'output del nodo precedente come input di contesto.
- Esegue una singola chiamata di inferenza senza conversazioni avanti e indietro.
- Genera dati strutturati per il nodo successivo.
Assegnando output_schema=Directions, l'agente applica la convalida Pydantic all'output del modello. Il grafico downstream riceve oggetti digitati anziché prosa non strutturata:
class Direction(BaseModel):
    title: str           # <=60 chars, filmable, characterful
    angle: str           # the twist, one line
    hook: str = ""       # 2-4 words, the video's sticker line
    evidence: list[Evidence]


class Directions(BaseModel):
    candidates: list[Direction]   # exactly 4
PROPOSE_INSTRUCTION indica al modello di proporre quattro candidati citando prove sia delle tendenze che del backlog. I candidati da 1 a 3 offrono concetti di canale validi. Il candidato 4 introduce intenzionalmente un concetto che viola le norme per testare il controllo di sicurezza nel passaggio successivo.
Modifica pratica: definizione del nodo dell'agente e concatenazione del join
In stage2_direction/agent.py, configura propose_directions ed estendi gli archi del workflow:
propose_directions = Agent(
    name="propose_directions",
    model=config.MODEL,
    instruction=PROPOSE_INSTRUCTION,
    output_schema=Directions)
    edges=[(START, scan_trends, join_research),
           (START, read_backlog, join_research),
           (join_research, propose_directions, direction_gate)])
Cosa aspettarsi e perché
- Utilizzo diretto del dizionario:
propose_directionsutilizza il payload JSON emesso dajoin_researchsenza formattazione manuale. - Output del candidato digitato: l'agente emette un oggetto
Directionsconvalidato contenente quattro candidati discreti. I nodi downstream leggono i campi in base al nome dell'attributo (candidate.title) senza l'analisi della stringa.
Human-in-the-loop (4D)
Nel workbench, vai a Human-in-the-loop (4D). Apri agent/graph.py.
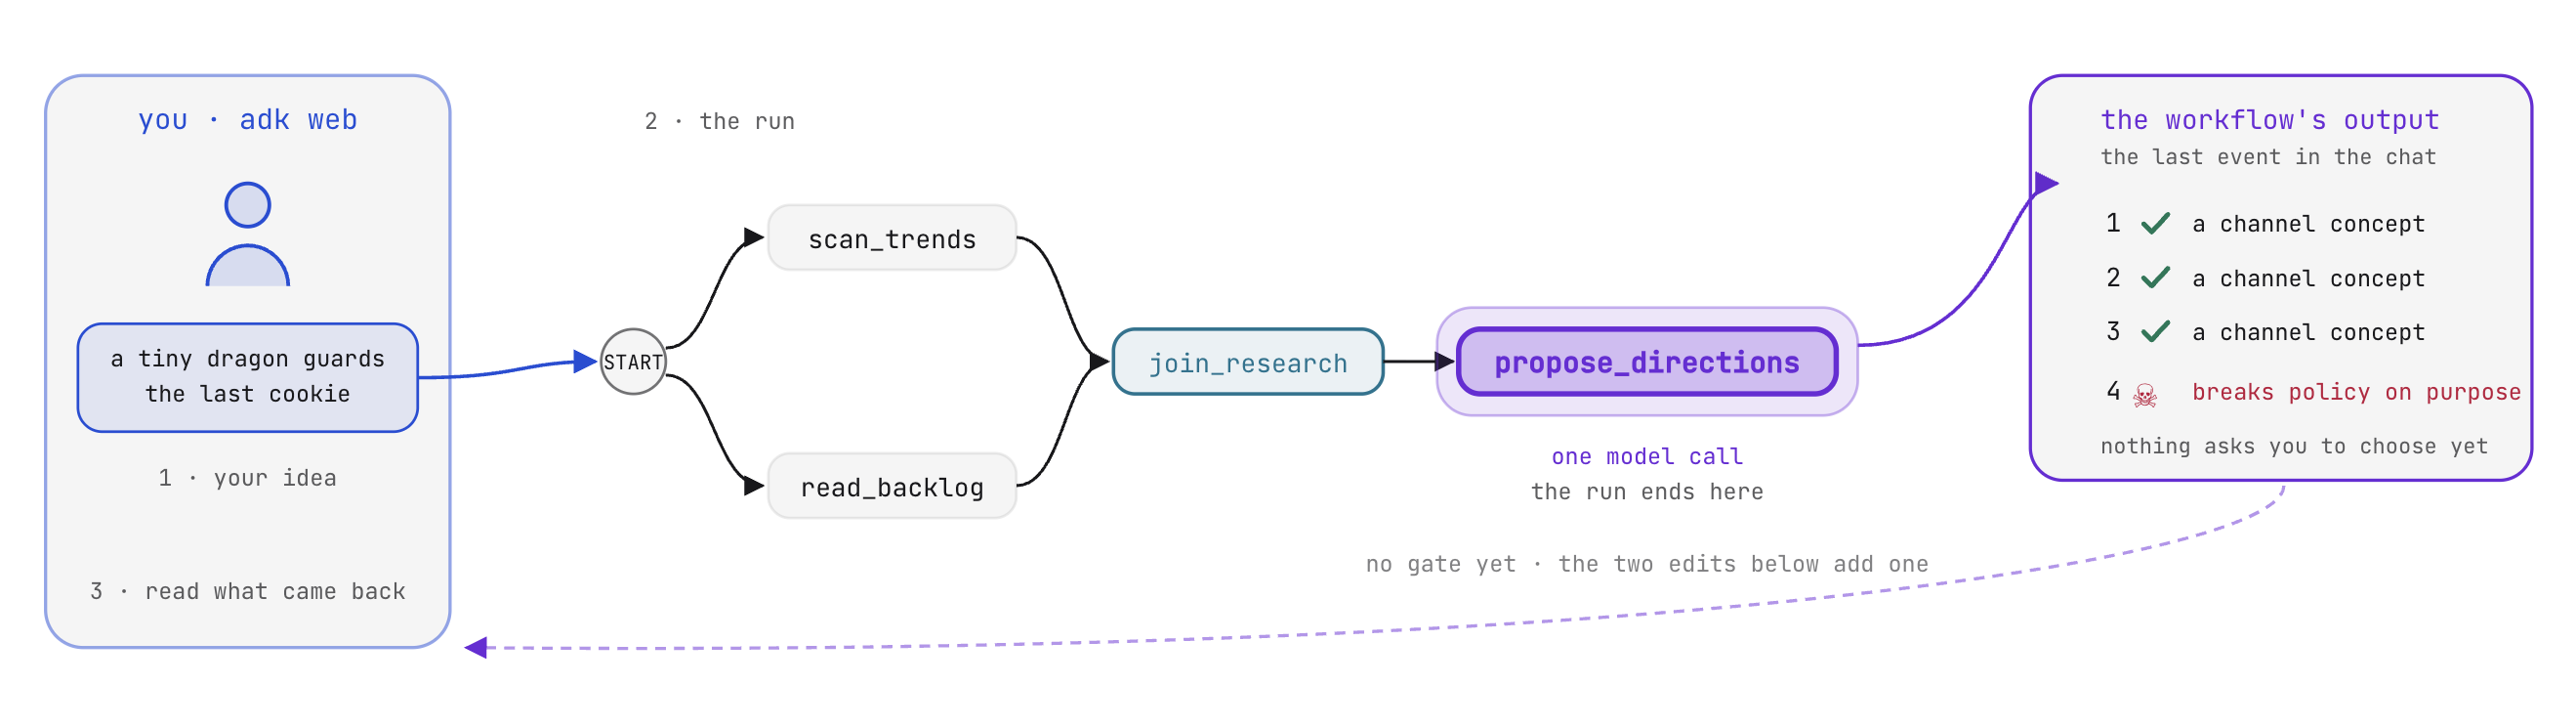
Istruzioni del prompt e sospensione deterministica
I flussi di lavoro di produzione che comportano costi finanziari o pubblicano contenuti richiedono la supervisione umana nei punti decisionali critici. In un singolo prompt, le richieste di conferma sono istruzioni di avviso che un utente può facilmente chiedere al modello di ignorare. In un flusso di lavoro ADK, l'approvazione umana viene applicata dal motore di esecuzione: il grafico si arresta in un nodo designato e non può avanzare finché non riceve un input esterno con schema convalidato:
- La generazione di
RequestInputsospende immediatamente l'esecuzione del workflow. - L'ADK registra una chiamata di interruzione aperta nello spazio di archiviazione della sessione ed emette un
interrupt_idunivoco. - Il processo di esecuzione si interrompe senza consumare token o thread del server.
- L'esecuzione del grafo riprende solo quando viene inviato un
function_responsevalido corrispondente allo schema e all'ID interruzione.
Modifica pratica: sospensione dell'esecuzione con RequestInput
In agent/graph.py, implementa la chiamata di sospensione all'interno di direction_gate:
    yield RequestInput(
        message="Pick tonight's direction: 1, 2, 3 or 4.",
        response_schema={
            "type": "object",
            "properties": {
                "pick": {"type": "string", "enum": ["1", "2", "3", "4"]}}},
        payload={"candidates": cands})
RequestInput configura tre attributi:
message: il prompt di recensione presentato all'utente.response_schema: uno schema JSON che il frontend esegue il rendering come modulo di input, con convalida da parte dell'ADK al momento dell'invio.payload: metadati raggruppati con la richiesta (i quattro candidati), che consentono alle interfacce client di eseguire il rendering delle schede di revisione senza eseguire query sullo stato della sessione.
Cosa aspettarsi e perché
- Il workflow si interrompe in direction_gate: in ADK Web o nell'interfaccia di Workbench, l'esecuzione viene messa in pausa e viene visualizzato un modulo interattivo di selezione dei candidati.
- Perché: il motore ha rilevato un
RequestInpute ha reso persistente lo stato di esecuzione inruns/sessions.db.
- Perché: il motore ha rilevato un
- La ripresa richiede un input strutturato: l'invio di testo della chat arbitrario non fa avanzare il grafico. Selezionando un'opzione (1, 2, 3 o 4), viene inviato un
function_responsedigitato che soddisfaresponse_schemae l'esecuzione viene ripresa.
5. Stato e router
In VibeStudio Workbench, vai a Passaggio 5 - Stato e router, parti (5A)-(5C).
Renderai persistenti le selezioni degli utenti nello stato della sessione, applicherai le policy di sicurezza del canale utilizzando nodi router deterministici e creerai un agente di attività iterativo per correggere automaticamente le violazioni delle policy prima di generare gli script video.
Stato del workflow (5A)
In Workbench, vai a Stato del workflow (5A).
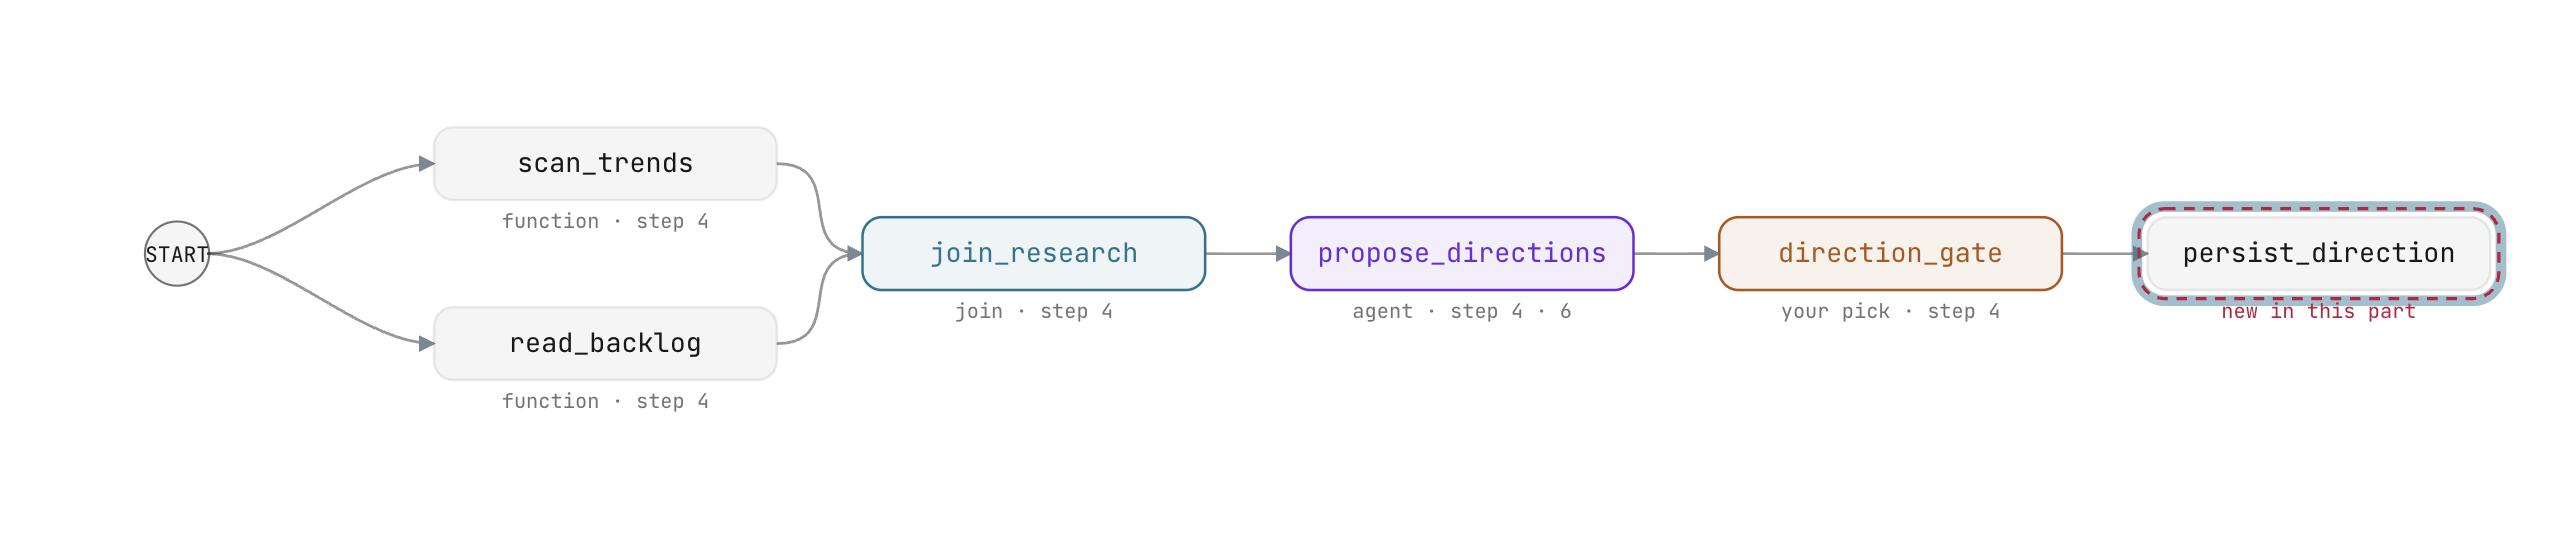
Stato della sessione e output del nodo
In un workflow ADK, i dati si spostano nel grafo attraverso due meccanismi distinti:
- Output del nodo (
Event(output=...)): dati indirizzati rigorosamente ai consumer downstream immediati definiti nell'elenco degli archi. - Stato della sessione (
Event(state=...)): un dizionario di coppie chiave-valore condiviso accessibile da qualsiasi nodo successivo nel ciclo di vita dell'esecuzione.
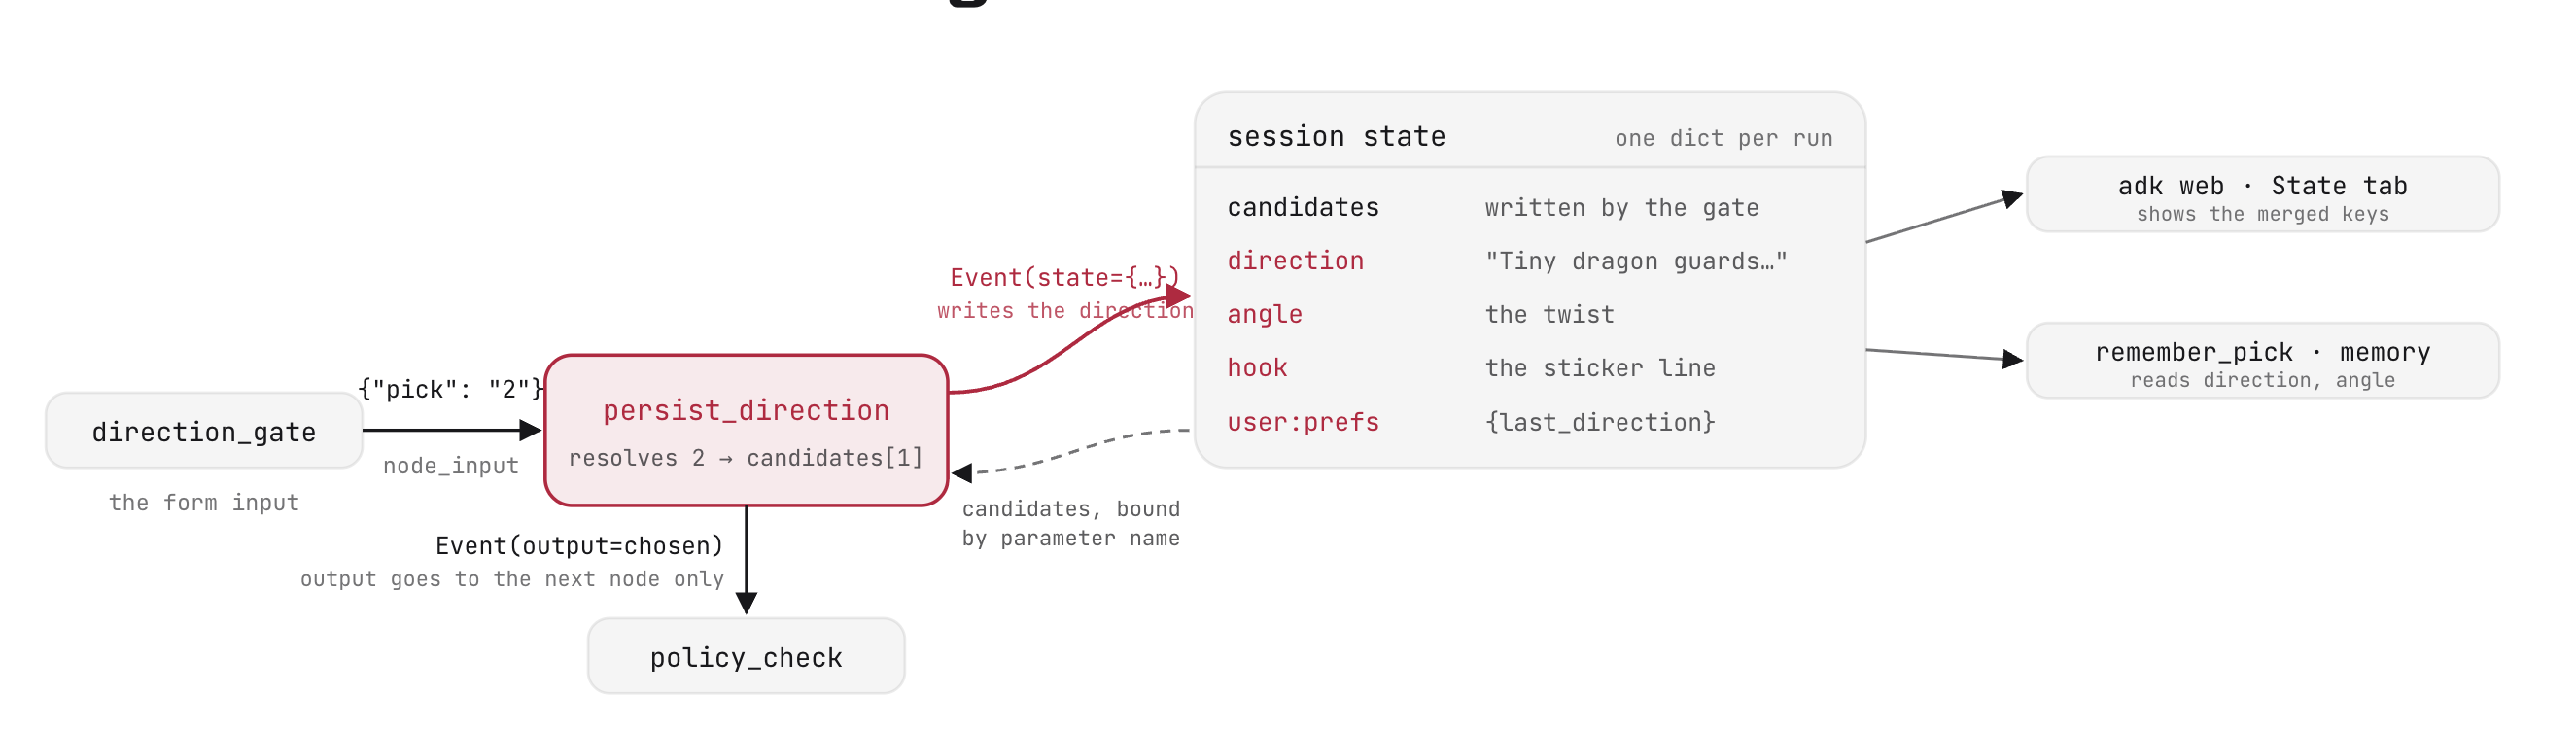
Quando un utente seleziona un candidato in direction_gate, la selezione arriva come indice numerico ({"pick": "2"}). I nodi downstream hanno bisogno dell'oggetto di direzione completo: titolo, angolazione narrativa e hook line. Anziché passare metadati dettagliati attraverso ogni payload del nodo intermedio, persist_direction scrive il candidato risolto nello stato della sessione condivisa.
I nodi non devono superare l'intero dizionario degli stati della sessione. Quando un nodo restituisce Event(state=...), fornisce solo le coppie chiave-valore nuove o aggiornate. ADK unisce automaticamente questi aggiornamenti nell'archivio delle sessioni:
    yield Event(state={"direction": chosen["title"], "angle": chosen.get("angle", ""),
                       "hook": hook, "user:prefs": {"last_direction": chosen["title"]}})
In questo modo, il controllo di Event viene trasferito al runtime Workflow, che salva i nuovi valori nel journal della sessione in runs/sessions.db.
Associazione dei parametri
I nodi funzione dell'ADK leggono automaticamente lo stato della sessione tramite l'ispezione dei parametri. Se la firma di una funzione dichiara un nome di parametro corrispondente a una chiave di stato esistente, ADK estrae la chiave dallo stato e la passa direttamente:
def persist_direction(node_input, candidates: list = []):
    ni = node_input if isinstance(node_input, dict) else {}
    raw = ni.get("pick")
    pick = str(raw).strip() if raw is not None else ""
    if candidates:
        i = int(pick) - 1 if pick.isdigit() else 0
        chosen = candidates[max(0, min(len(candidates) - 1, i))]
    else:
        chosen = {"title": "untitled", "angle": "", "evidence": []}
    hook = chosen.get("hook") or " ".join(chosen["title"].split()[:4])
Qui, candidates è stato scritto nello stato della sessione da direction_gate. ADK lo associa direttamente a persist_direction(node_input, candidates: list = []) senza richiedere ricerche esplicite nel dizionario.
Le chiavi con prefisso user: vengono mantenute tra le sessioni nello spazio di archiviazione a livello di utente, consentendo alle esecuzioni successive del workflow di accedere alle preferenze del creator.
Modifica pratica: rendere persistente lo stato e collegare il nodo
- In
agent/graph.py, all'interno dipersist_direction, sostituisci la rigaTODO: PERSIST_STATEcon il rendimento dell'evento di stato:
    yield Event(state={"direction": chosen["title"], "angle": chosen.get("angle", ""),
                       "hook": hook, "user:prefs": {"last_direction": chosen["title"]}})
- In
stage3_router/agent.py, aggiungipersist_directionalla terza catena nell'elencoedges:
           (join_research, propose_directions, direction_gate,
            persist_direction)
Salva i file. Nel workbench, verifica che state write in place e persist_direction in the chain mostrino entrambi segni di spunta verdi.
Il nodo router (5B)
Nel workbench, vai a The router node (5B).
Routing basato su policy deterministico
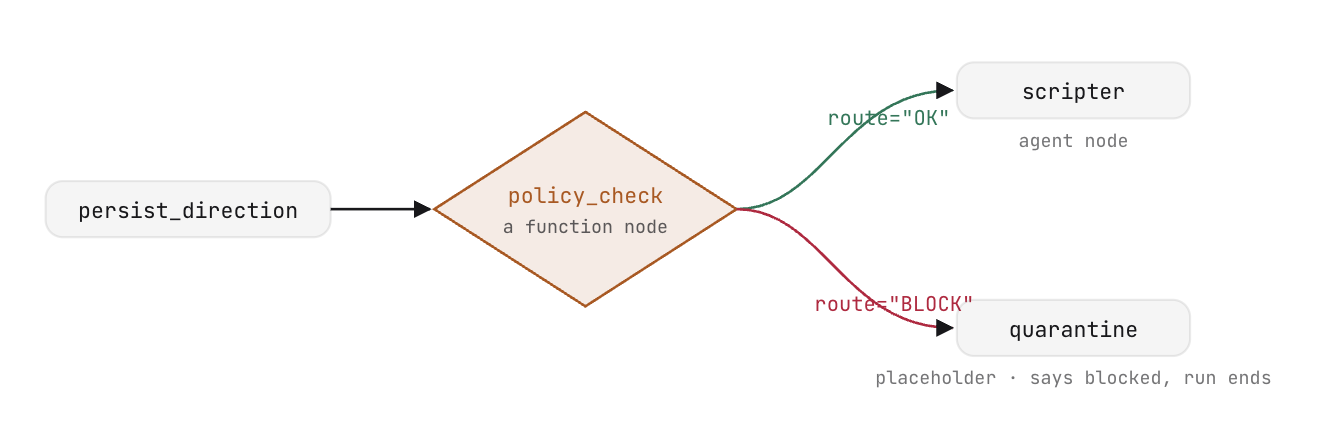
Un router è un nodo di funzione specializzato che valuta l'output upstream e indirizza l'esecuzione lungo i rami del grafo condizionale. A differenza degli agenti generativi, un router esegue una logica deterministica senza effettuare chiamate LLM.
Un router restituisce un Event che specifica un tag route:
def length_check(node_input):
    too_long = len(node_input.get("title", "")) > 60
    return Event(output=node_input, route="TRIM" if too_long else "PASS")
Nella definizione del flusso di lavoro, una destinazione edge definita come dizionario mappa i nomi delle route ai nodi di destinazione:
(length_check, {"TRIM": shorten, "PASS": scripter}),
Il router del flusso di lavoro policy_check legge le frasi vietate da agent/policy_words.txt ed esegue la corrispondenza esatta con il titolo e l'angolazione della direzione scelta:
return Event(output=node_input, route="BLOCK" if bad else "OK")
L'archiviazione della policy come dati anziché come istruzioni impostate come hardcoded consente di eseguire aggiornamenti senza modificare il grafico del workflow: l'aggiornamento del file di testo viene applicato immediatamente alle esecuzioni successive. Poiché la valutazione è una corrispondenza regex deterministica, viene eseguita in millisecondi senza costi di token prima dell'inizio dello scripting generativo.
Destinazioni: Scripter e Quarantena
Il router indirizza il traffico a uno dei due nodi downstream:
scriptersingle_turnScript
scripter = Agent(
    name="scripter",
    model=config.MODEL,
    instruction=SCRIPT_INSTRUCTION,
    output_schema=Script)
quarantine: Inizialmente una funzione segnaposto che interrompe le indicazioni segnalate, sostituita nella parte successiva da un agente di correzione autonomo.
Modifica pratica: routing del controllo delle policy
- In
agent/graph.py, all'interno dipolicy_check, completa la dichiarazione return:
return Event(output=node_input, route="BLOCK" if bad else "OK")
- In
stage3_router/agent.py, aggiornaedgesper indirizzarepolicy_checke unisci nuovamente il ramo di quarantena inscripter:
           (join_research, propose_directions, direction_gate,
            persist_direction, policy_check),
           (policy_check, {"OK": scripter, "BLOCK": quarantine}),
           (quarantine, scripter)])
Salva i file. Nel workbench, verifica che le mappature degli edge del router siano verificate.
Modalità agente e nodo dell'attività (5C)
Nel workbench, vai a Modalità agente e nodo attività (5C).
Modalità di esecuzione degli agenti
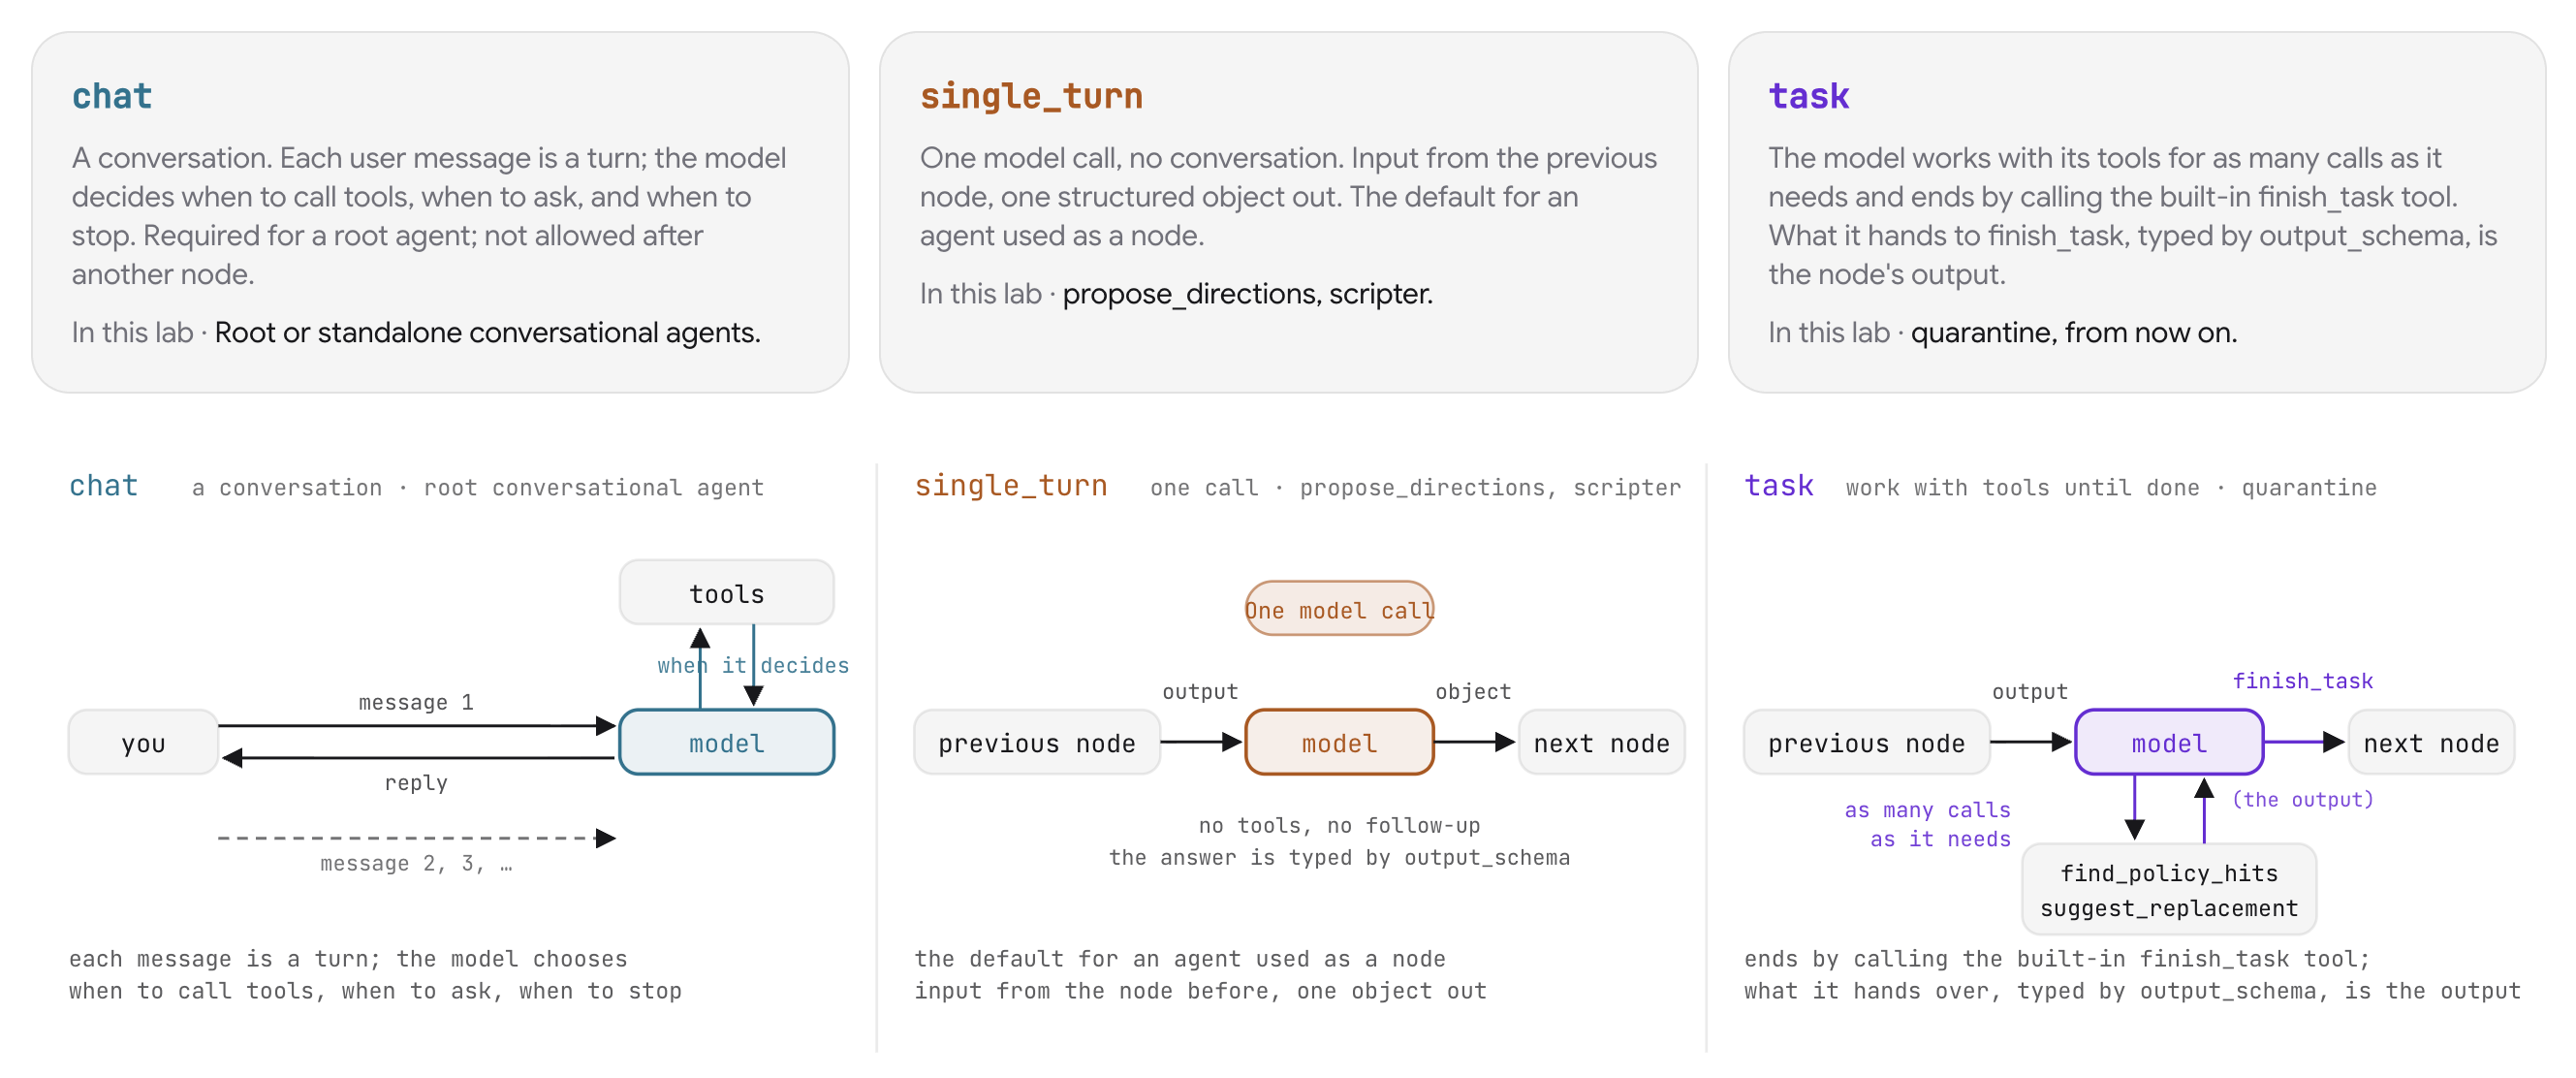
Le istanze ADK Agent supportano tre modalità di esecuzione personalizzate in base ai requisiti specifici della pipeline:
Modalità | Ciclo di vita dell'esecuzione | Ruolo nella pipeline |
| Ciclo conversazionale multi-turno. Il modello determina quando richiamare gli strumenti, richiedere input o terminare il turno. | Agenti root rivolti a un utente umano interattivo. |
| Chiamata di inferenza del modello singolo. Accetta l'input del nodo precedente ed emette un oggetto schema strutturato. | Trasformazioni sequenziali dei grafi ( |
| Loop autonomo con esecuzione dello strumento. L'agente esegue l'iterazione fino a chiamare lo strumento integrato | Correzione e ispezione in più passaggi ( |
Correzione autonoma delle policy
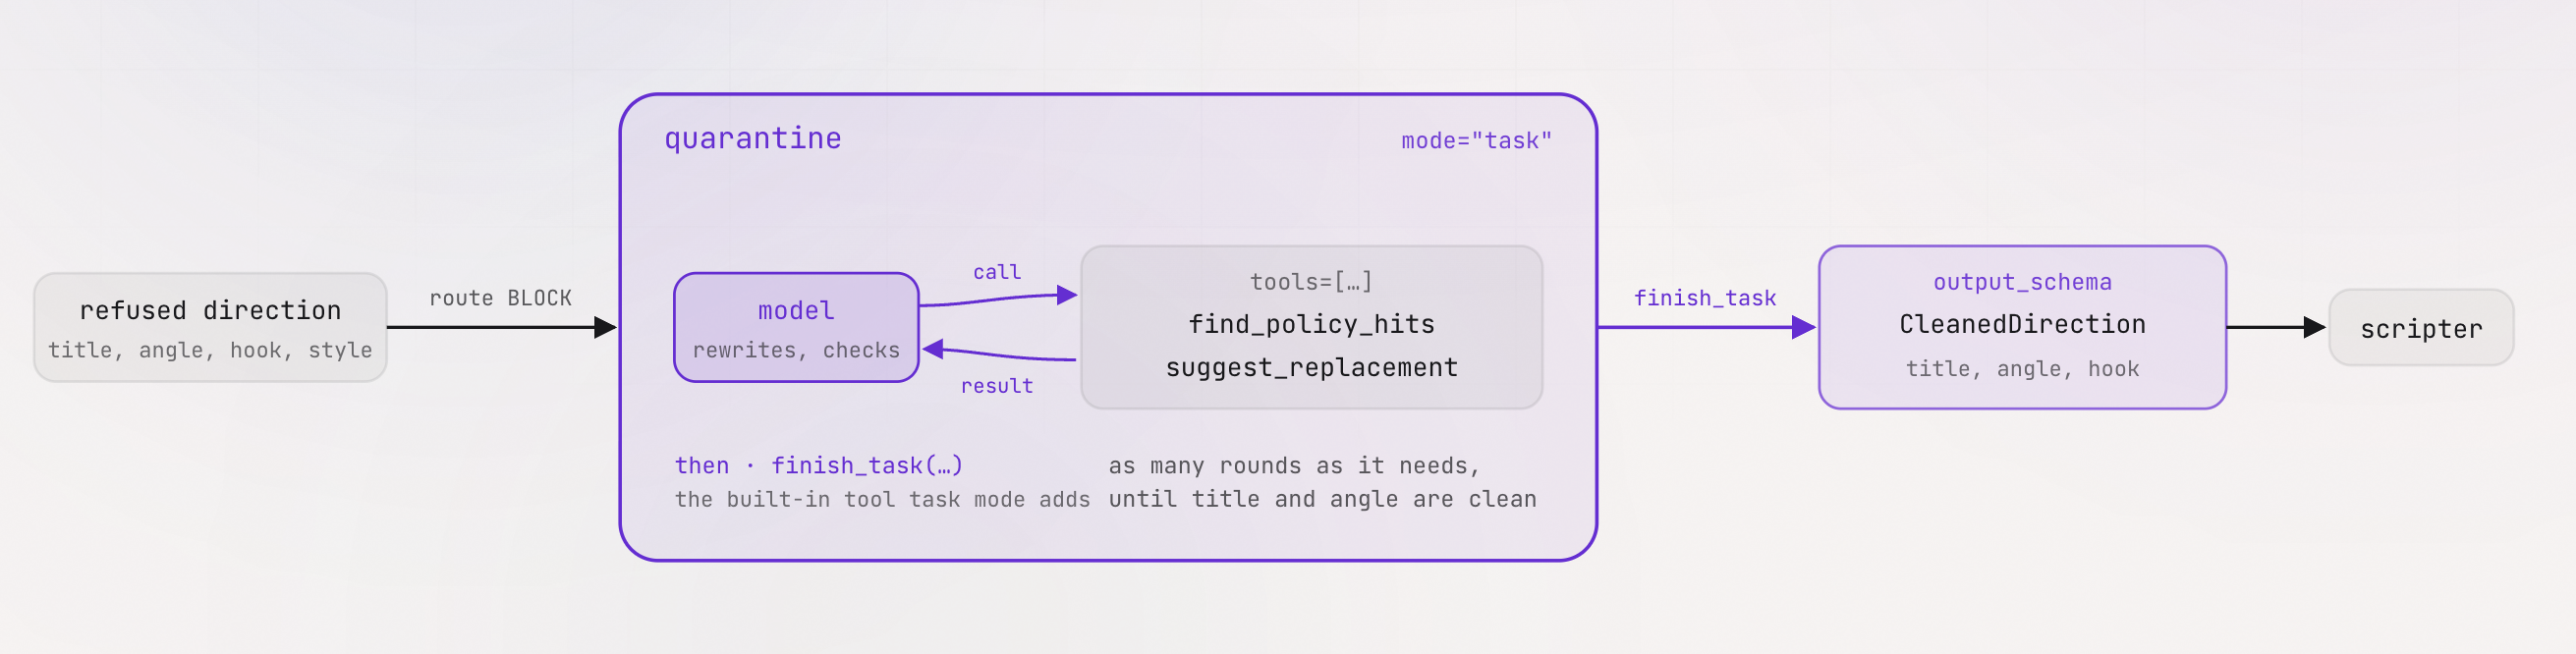
La riscrittura di una direzione segnalata richiede la modalità task perché il numero di iterazioni di correzione è variabile. L'agente riceve l'indicazione segnalata, richiama find_policy_hits per rilevare le violazioni, richiede alternative approvate tramite suggest_replacement, riscrive l'indicazione e verifica la conformità prima di procedere.
Entrambi gli strumenti sono definiti in agent/cleanup_tools.py con firme e docstring tipizzate:
def find_policy_hits(text: str) -> dict:
    """Which refused words appear in `text`. Matches whole words and phrases
    from agent/policy_words.txt, case-insensitive.

    Returns {"hits": [...], "clean": bool}. clean is true when hits is empty.
    """


def suggest_replacement(word: str) -> dict:
    """The channel's approved stand-in for a refused word, read from
    agent/policy_replacements.txt.

    Returns {"word", "replacement", "listed"}. When the word has no entry,
    listed is false and replacement is a hint to pick a gentle synonym.
    """
Modifica pratica: assemblaggio dell'agente per le attività di quarantena
In stage3_router/agent.py, sostituisci la funzione segnaposto quarantine con la definizione dell'agente di attività:
quarantine = Agent(
    name="quarantine",
    model=config.MODEL,
    instruction=QUARANTINE_INSTRUCTION,
    mode="task",
    tools=[find_policy_hits, suggest_replacement],
    output_schema=CleanedDirection,
)
La modalità Attività fornisce all'agente gli strumenti e termina l'esecuzione chiamando finish_task. Quando mode="task" è configurato, ADK fornisce automaticamente finish_task e ne ricava i parametri da output_schema, assicurando che il nodo produca un oggetto CleanedDirection tipizzato corrispondente allo schema di input del nodo scripter.
Cosa aspettarsi e perché
Testa entrambi i percorsi di esecuzione in ADK Web o VibeStudio Workbench:
- Percorso approvato (candidato 1, 2 o 3):
- Selezione di un candidato approvato per il routing da
policy_checkdirettamente ascripter(route="OK"). - L'autore dello script genera uno script di produzione a tre scatti in conformità allo schema
Script.
- Selezione di un candidato approvato per il routing da
- Percorso di correzione della quarantena (Candidato 4):
- Il candidato 4 contiene un vocabolario segnalato ("clickbait", "trucco virale").
policy_checkpercorsi perquarantine(route="BLOCK").- Nella traccia della sessione, osserva
quarantineche chiamafind_policy_hits, che chiamasuggest_replacementper ogni violazione, riscrivendo il titolo e chiamandofinish_task. - L'esecuzione si ricongiunge a
scripter, producendo uno script dalla direzione sanificata.
6. Memory Bank
In VibeStudio Workbench, vai a Step 6 · Memory Bank, parti (6A) e (6B).
Al momento, il workflow funziona senza memoria tra le sessioni. Ogni esecuzione inizia da zero, senza tenere conto di ciò che il creator ha selezionato in precedenza o dei generi che preferisce. In questo passaggio, colleghi Vertex AI Agent Engine Memory Bank per archiviare e recuperare le preferenze dei creator tra un'esecuzione e l'altra.
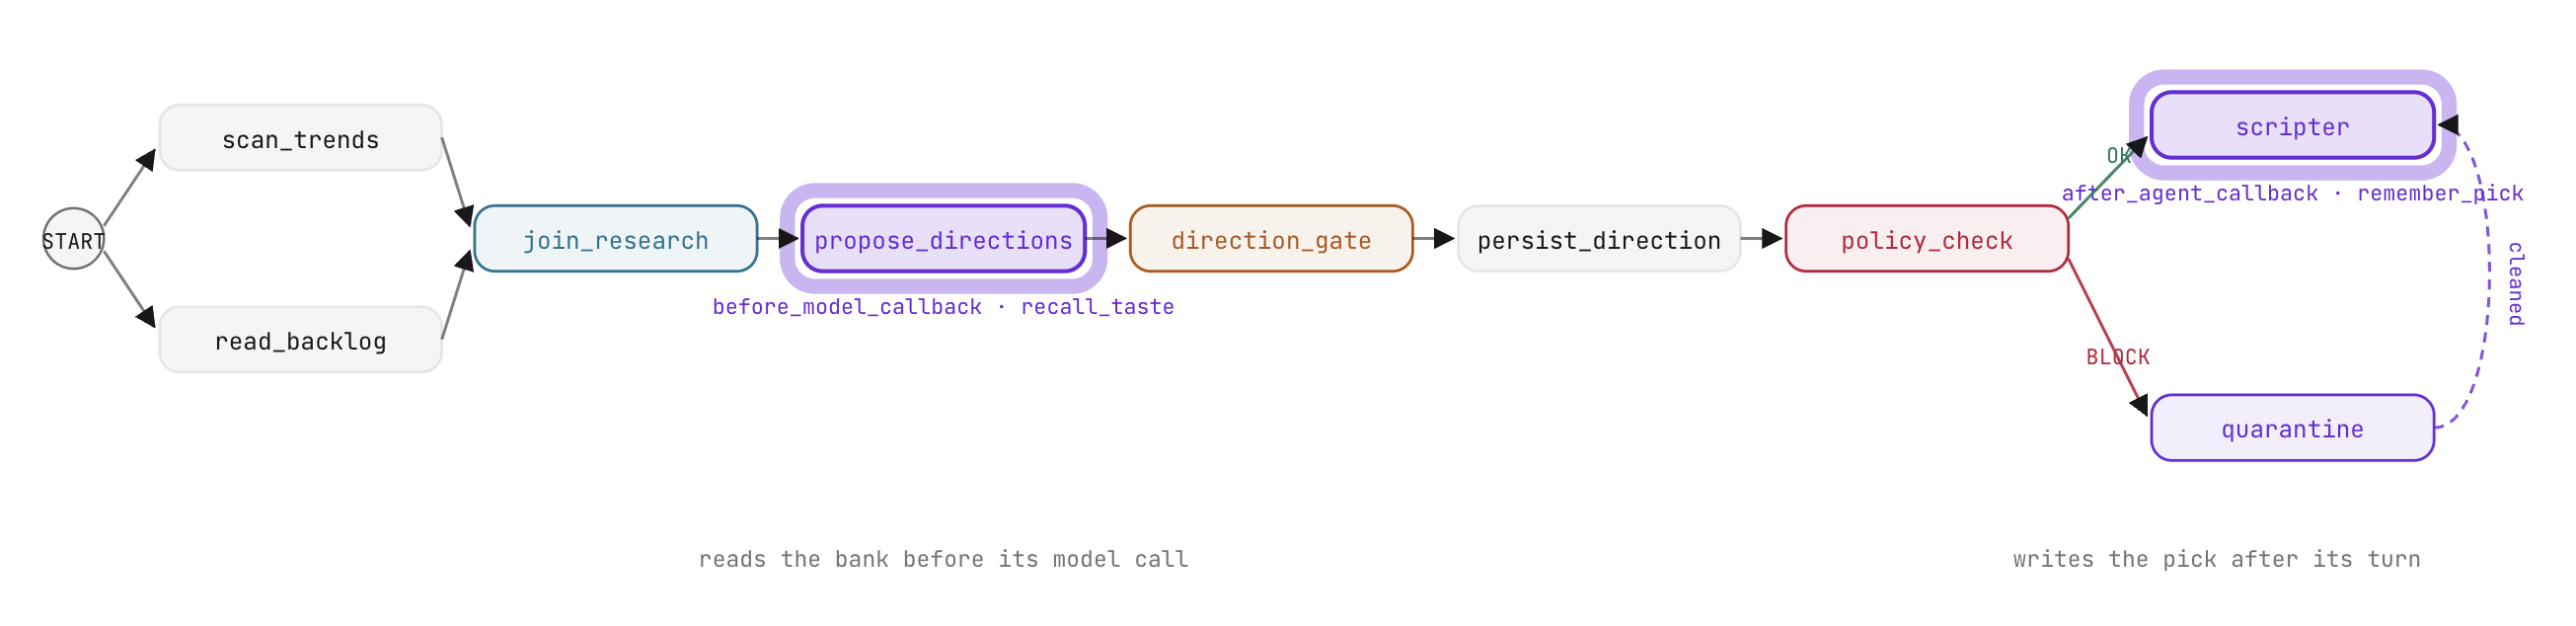
Fondamentalmente, la memoria è integrata tramite i callback del ciclo di vita dell'agente anziché i nodi della pipeline. Poiché l'estrazione e il recupero della memoria servono singoli agenti anziché fasi intermedie dei dati, l'aggiunta di callback preserva una topologia del grafico pulita e disaccoppiata.
Memory Bank (6A)
In Workbench, vai a Memory Bank (6A).
Memoria a livello utente gestita
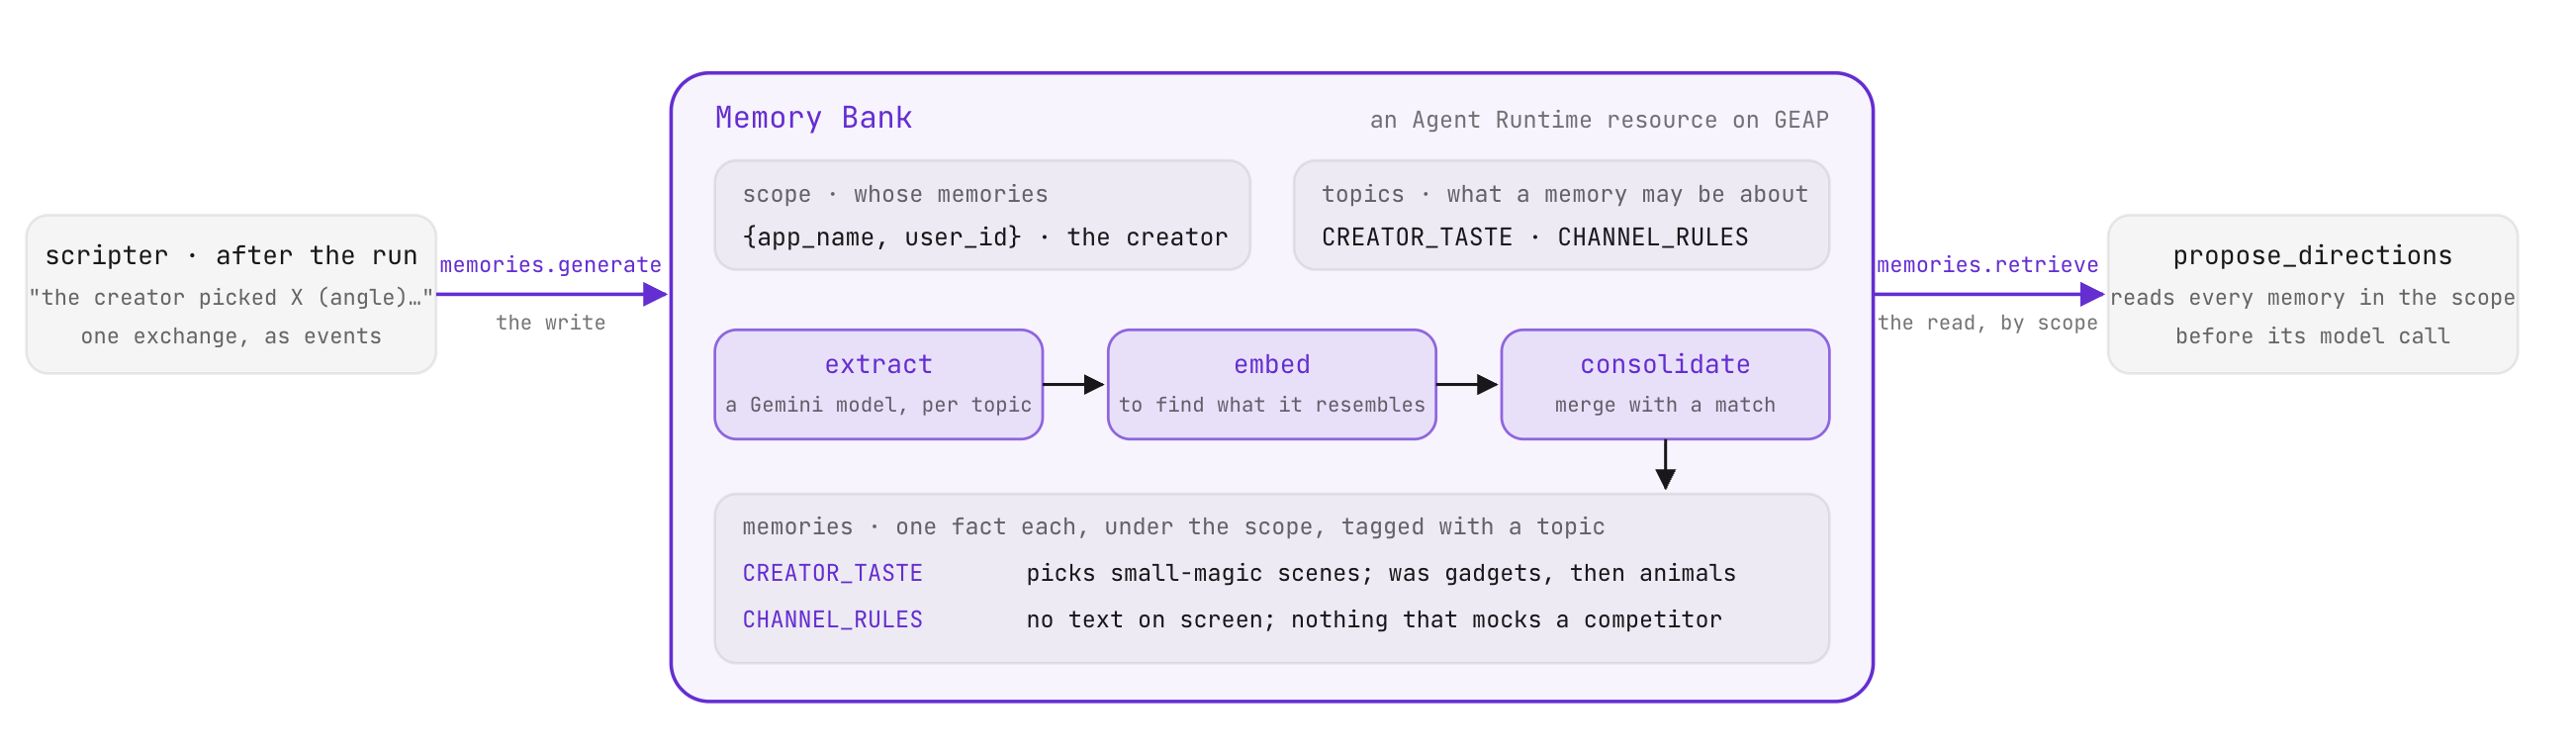
Memory Bank è un servizio gestito per la memoria utente a lungo termine. Organizza i fatti relativi a una persona in un ambito definito, identificato qui dal nome dell'applicazione e dall'ID utente:
SCOPE = {"app_name": config.APP, "user_id": config.USER}
TOPICS = {
    "CREATOR_TASTE": "Which video directions this creator picks and passes on, "
                     "and how that preference changes over time.",
    "CHANNEL_RULES": "Standing instructions the creator states for every video "
                     "(style, subjects to avoid, format rules).",
}
Gli argomenti di memoria personalizzati definiscono i limiti di ciò che la banca registra:
- Estrazione degli argomenti: quando viene inviato un nuovo testo della conversazione tramite
memories.generate, il servizio applica un modello di estrazione a ogni descrizione dell'argomento. Il testo che non corrisponde a un argomento non produce ricordi. - Consolidamento e deduplicazione: il servizio converte i fatti appena estratti in incorporamenti e li confronta con i ricordi esistenti nell'ambito. Quando un'osservazione corrisponde a un ricordo esistente, il servizio aggiorna il ricordo. Quando rappresenta informazioni nuove, il servizio crea una nuova voce. Questo processo di consolidamento garantisce che più sessioni su un argomento vengano unite in un riepilogo coerente anziché produrre voci ridondanti.
- Recupero: la chiamata a
memories.retrievecon l'ambito utente restituisce i fatti memorizzati, ordinati dal meno recente al più recente.
Entrambe le operazioni sono implementate in agent/platform/memory.py. Il nome della risorsa della banca di cui è stato eseguito il provisioning viene memorizzato nella cache locale in runs/memorybank.json.
Configurazione di Memory Bank
Utilizza i controlli del workbench o esegui i comandi dell'interfaccia a riga di comando nel terminale:
- Connetti ed esegui il provisioning della banca:
python -m agent.platform.bankCREATOR_TASTEeCHANNEL_RULES. - Inizializza le sessioni storiche:
python -m agent.platform.bank load - Esamina i fatti consolidati:
python -m agent.platform.bank list
Callback (6B)
Nel workbench, vai a Callback (6B). Apri stage4_memory/agent.py.
Callback del ciclo di vita dell'agente ADK
Un callback è una funzione passata come argomento a un Agent. L'ADK richiama i callback in momenti predefiniti del ciclo di vita, passando il contesto attivo. La restituzione di None continua la normale esecuzione; la restituzione di un oggetto sostitutivo esegue l'override o intercetta l'operazione.
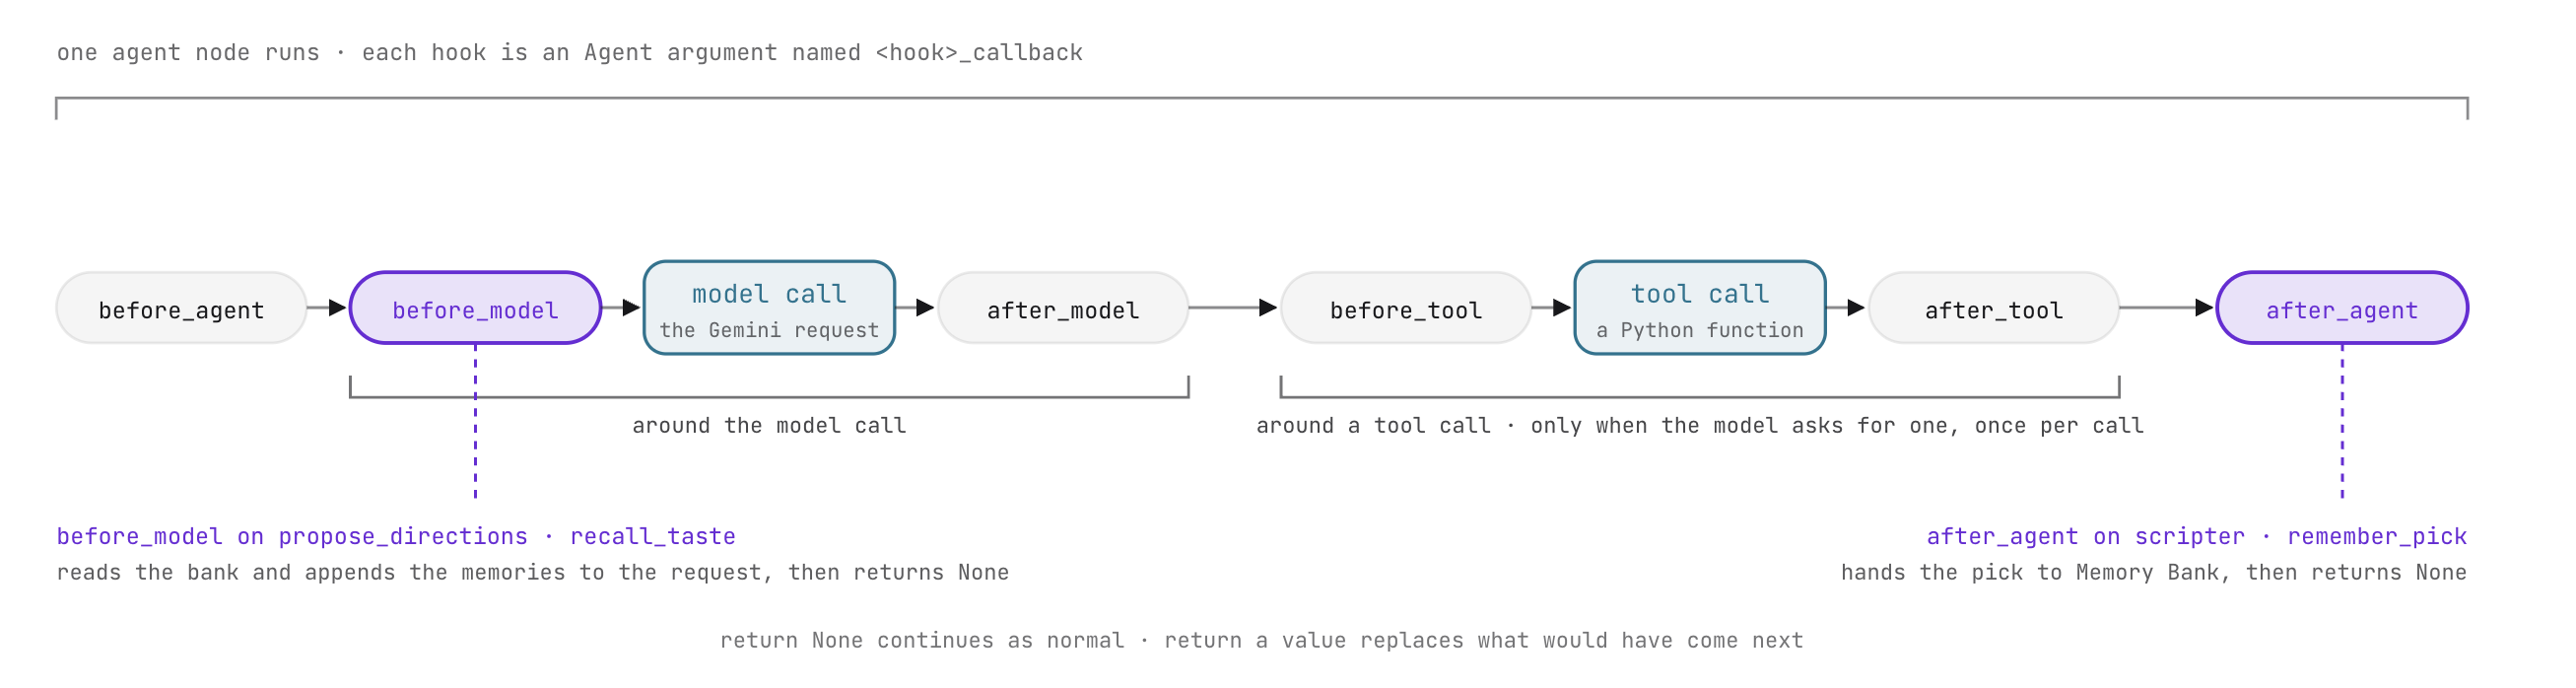
ADK fornisce tre coppie di callback:
Coppia di callback | Punto di chiamata | Parametri ricevuti | Comportamento del valore restituito |
| Intorno all'intera svolta dell'agente |
|
|
| Ogni chiamata di inferenza LLM |
| Il ritorno di |
| Intorno a ogni esecuzione dello strumento | Definizione, argomenti e risultato dello strumento | La restituzione di un dizionario sostituisce l'output dello strumento; |
I callback forniscono una posizione pulita per l'inserimento del contesto, i guardrail, la telemetria e le ricerche nella cache senza introdurre nodi estranei nel grafico del workflow.
Hands-on edit: wiring recall and remember callbacks
- In
stage4_memory/agent.py, aggiornapropose_directionsper allegarebefore_model_callback=recall_taste:
    output_schema=Directions,
    before_model_callback=recall_taste)
recall_taste viene eseguito immediatamente prima che Gemini generi le indicazioni candidate. Recupera la cronologia del creator da Memory Bank, formatta i ricordi in ordine cronologico e li aggiunge all'LlmRequest in uscita. Il prompt indica al modello di orientare i candidati da 1 a 3 verso i gusti attuali del creator, trattando le regole del canale come vincoli rigidi.
- In
stage4_memory/agent.py, aggiornascripterper allegareafter_agent_callback=remember_pick:
    output_schema=Script,
    after_agent_callback=remember_pick)
remember_pick viene eseguito dopo che scripter ha completato il suo turno. Legge la direzione scelta dallo stato della sessione, sintetizza una dichiarazione concisa che riassume la decisione del creator e chiama memories.generate per aggiornare la banca della memoria.
Cosa aspettarsi e perché
Testa il flusso di lavoro aumentato con il callback in workbench o ADK Web:
- Esegui un'esecuzione con un prompt vuoto:
- Nella traccia della sessione, esamina
LlmRequestperpropose_directions. Nota il contesto della memoria aggiunto che descrive in dettaglio la preferenza del creator per i temi fantasy e il ritmo conciso. - Osserva gli indirizzi proposti: i candidati da 1 a 3 sono in linea con le preferenze storiche del creator anche quando le tendenze mettono in evidenza altri argomenti.
- Nella traccia della sessione, esamina
- Seleziona un candidato alle
direction_gate. - Al termine di
scripter, esamina i record della memory bank:python -m agent.platform.bank list
7. RAG Engine
In VibeStudio Workbench, vai al Passaggio 7 · RAG Engine, parti (7A) e (7B).
I video pubblicati accumulano feedback continui degli spettatori. In agent/comments.md vengono raccolti 30 commenti rappresentativi, che catturano i complimenti degli spettatori, le critiche al ritmo della sponsorizzazione e le preferenze audio. In questo passaggio, indicizzi questi commenti utilizzando il motore RAG di Vertex AI e colleghi il recupero semantico al fan-out della ricerca.
Recupero di documenti (7A)
In Workbench, vai a RAG Engine (7A).
Memory Bank e RAG Engine
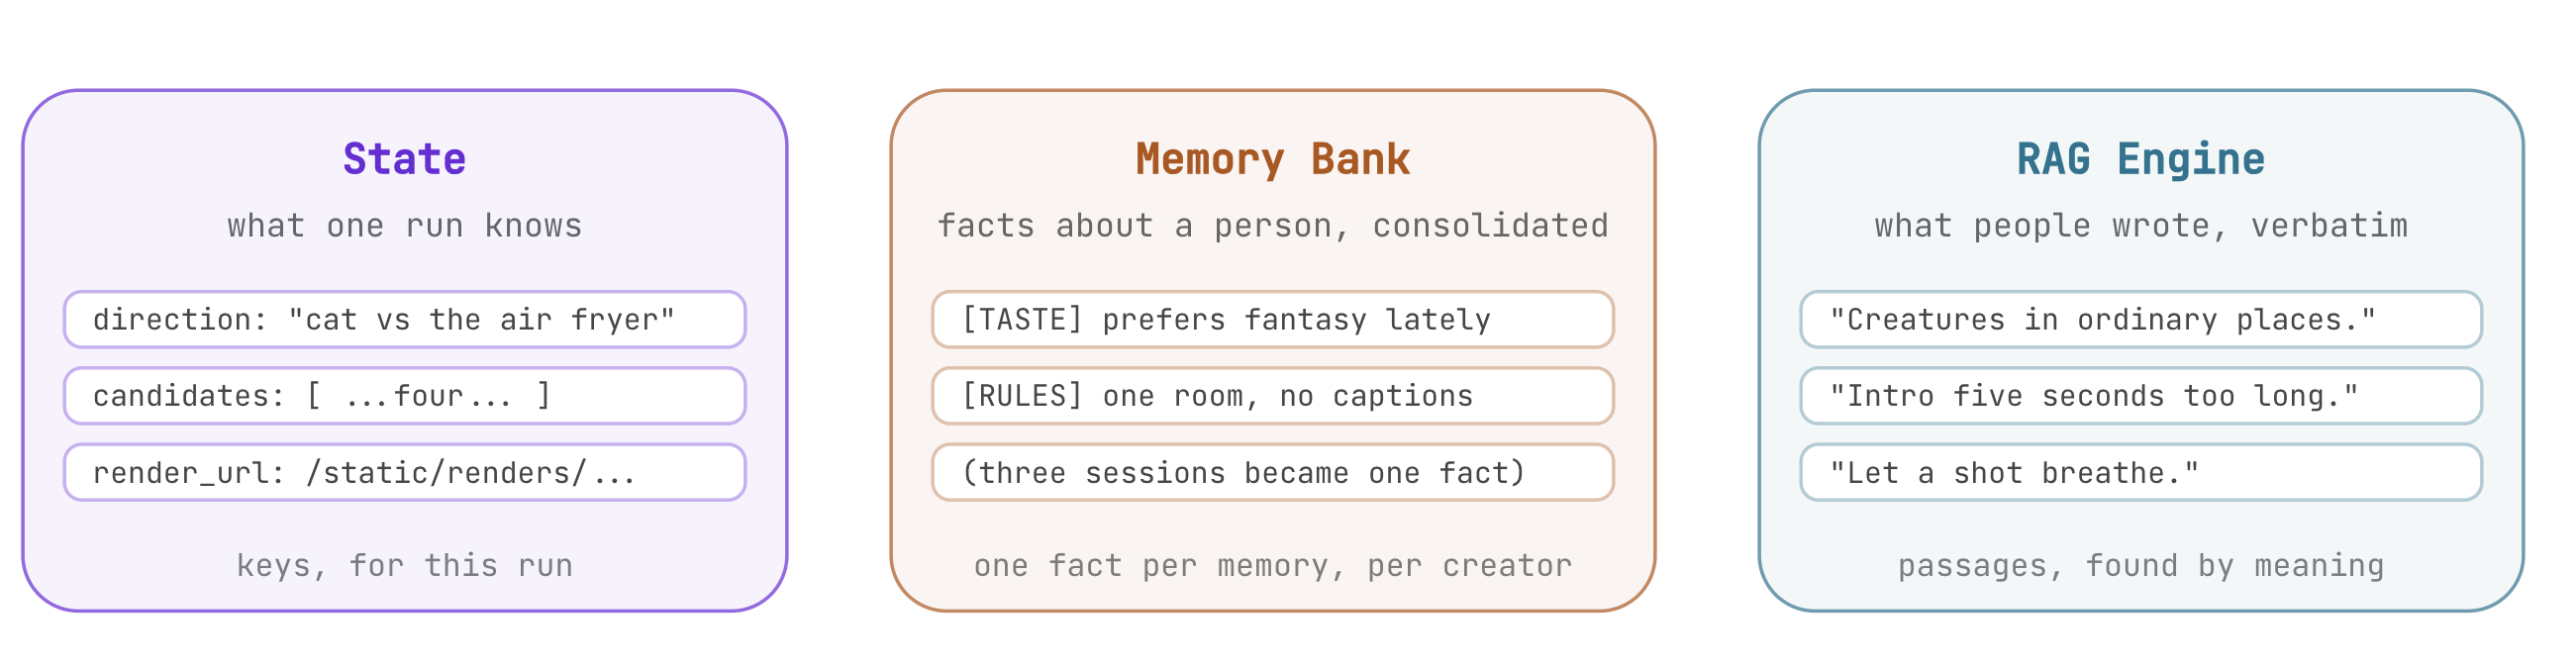
Entrambi gli strumenti basano i workflow su dati esterni, ma hanno scopi architettonici distinti:
Dimensione | Memory Bank | RAG Engine |
Caso d'uso principale | Preferenze utente a lungo termine e regole operative | Recupero semantico su grandi raccolte di documenti |
Ambito | Ambito limitato a singoli ID utente e nomi di applicazioni | Ambito limitato alle risorse del corpus condivise tra tutti gli utenti |
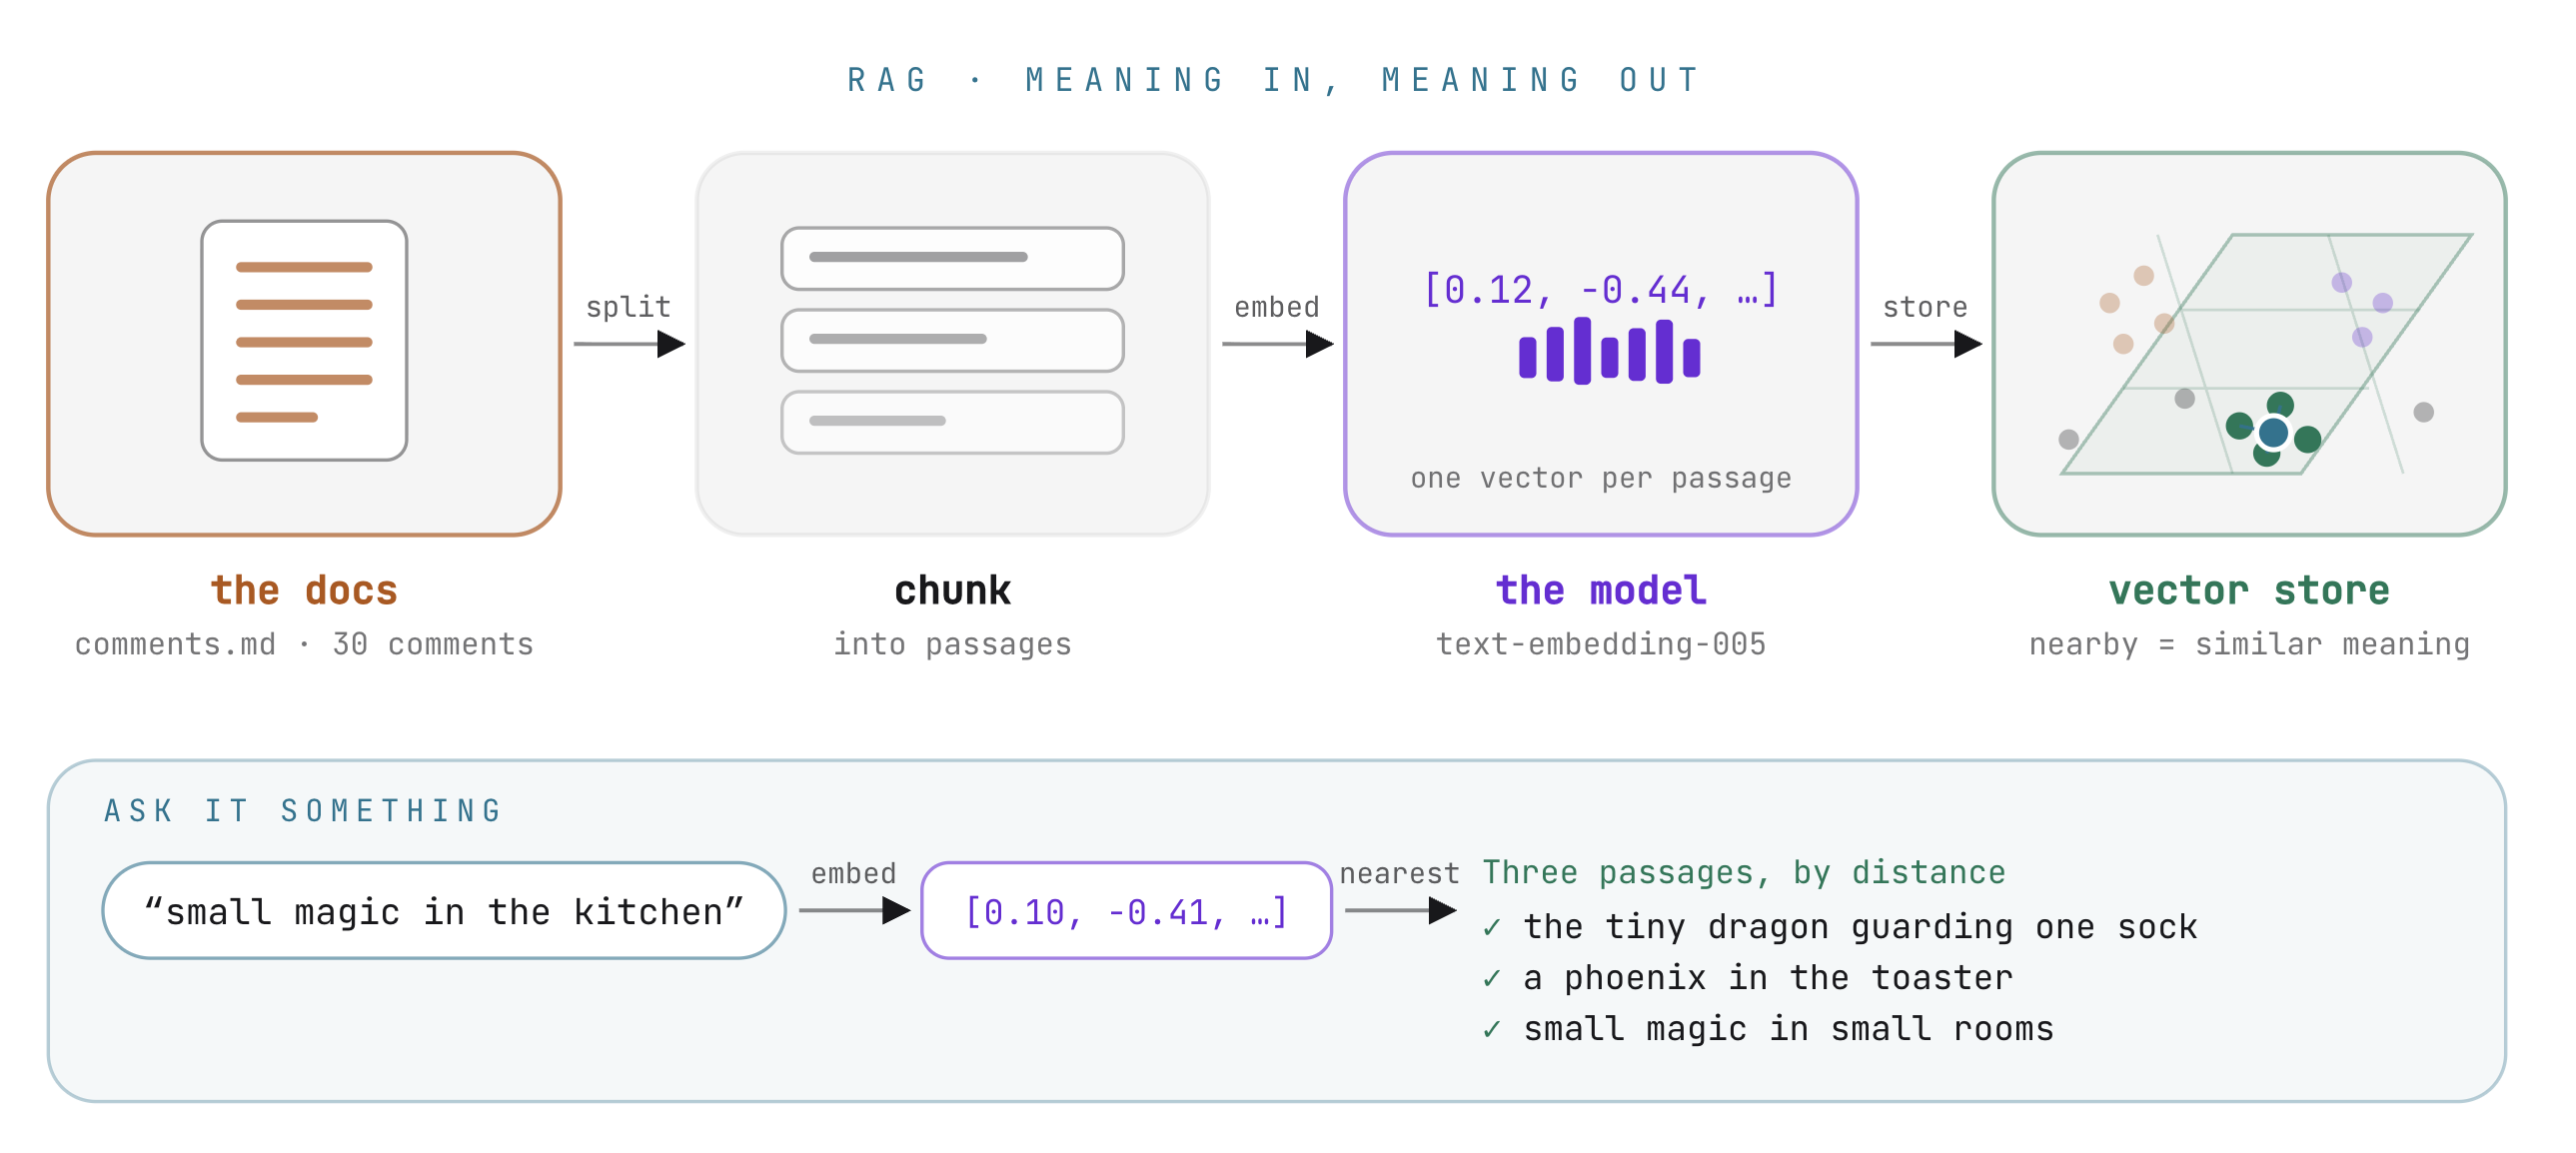
Trattamento dei dati | Estrazione, embedding e consolidamento semantico in tempo reale | Suddivisione dei documenti in blocchi, vector embedding e ricerca del vicino più prossimo |
Integrazione con Graph | Callback del ciclo di vita dell'agente ( | Nodo di funzione dedicato nel fan-out della ricerca ( |
Chunking ed embedding dei documenti
RAG Engine indicizza i documenti dividendo il testo in passaggi semantici e memorizzando i relativi vettori in un database gestito:
corpus = rag.create_corpus(
    display_name="vibestudio-feedback",
    description="Vibe Studio: what the audience wrote under the channel's past videos.",
    backend_config=rag.RagVectorDbConfig(
        rag_embedding_model_config=rag.RagEmbeddingModelConfig(
            vertex_prediction_endpoint=rag.VertexPredictionEndpoint(
                publisher_model="publishers/google/models/text-embedding-005"))))

rag.upload_file(
    corpus_name=corpus.name, path="agent/comments.md", display_name="comments.md",
    transformation_config=rag.TransformationConfig(
        chunking_config=rag.ChunkingConfig(chunk_size=120, chunk_overlap=20)))
- Dimensioni del chunk: configurate su 120 token con 20 token di sovrapposizione. In questo modo vengono acquisiti da due a tre commenti per passaggio, garantendo che ogni vettore rappresenti un sentiment coerente senza diluire il significato tra feedback non correlati.
- Modello di embedding:
text-embedding-005converte il testo in vettori ad alta dimensione. Quando viene inviata una query, il modello la converte in un vettore e trova le corrispondenze più vicine in base alla distanza semantica. Un commento su un minuscolo drago che fa la guardia ai calzini corrisponde a un prompt su creature magiche senza richiedere una sovrapposizione esatta delle parole chiave.
Configurazione del corpus RAG
Inizializza il corpus utilizzando i pulsanti del workbench o i comandi del terminale:
- Crea il corpus:
python -m agent.platform.ragruns/ragcorpus.json. - Carica e indicizza i commenti: carica
agent/comments.mdcon la configurazione di suddivisione in blocchi e attende il completamento dell'indicizzazione. - Esegui query sul corpus: testa il recupero della somiglianza con query che non condividono parole esatte con i commenti (ad esempio, la query "piccole creature magiche" per recuperare i commenti sui draghi).
Il nodo di recupero (7B)
In Workbench, vai a The third reader (7B). Apri stage5_rag/agent.py.
Recupero come nodo del grafico
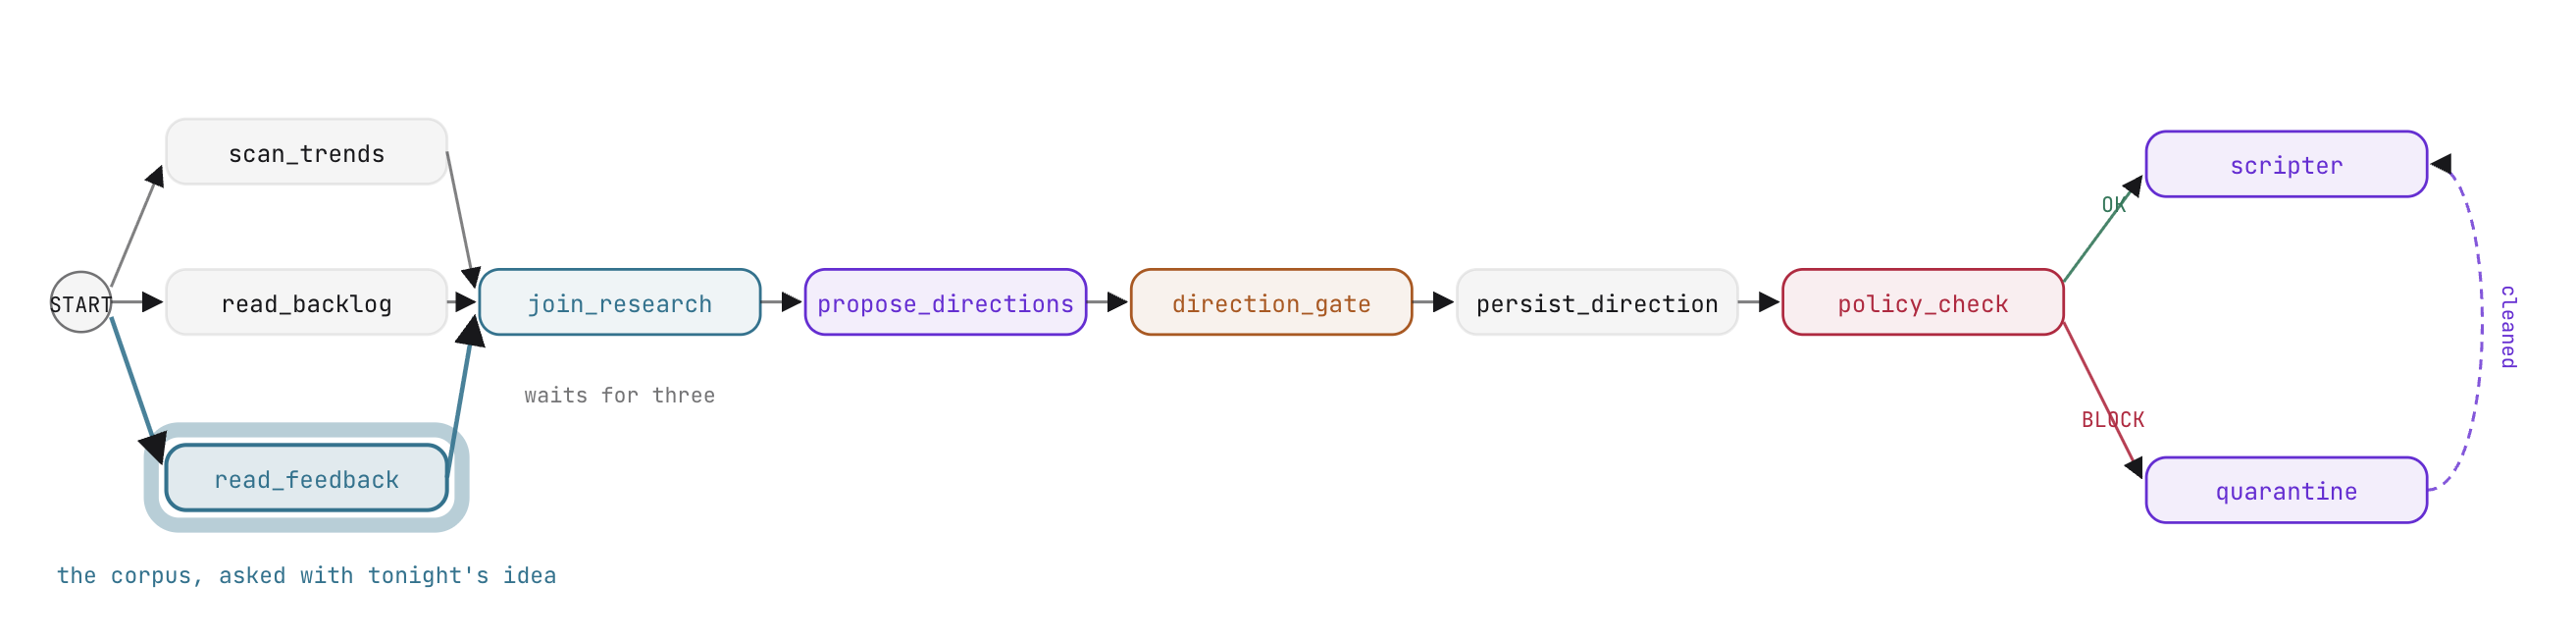
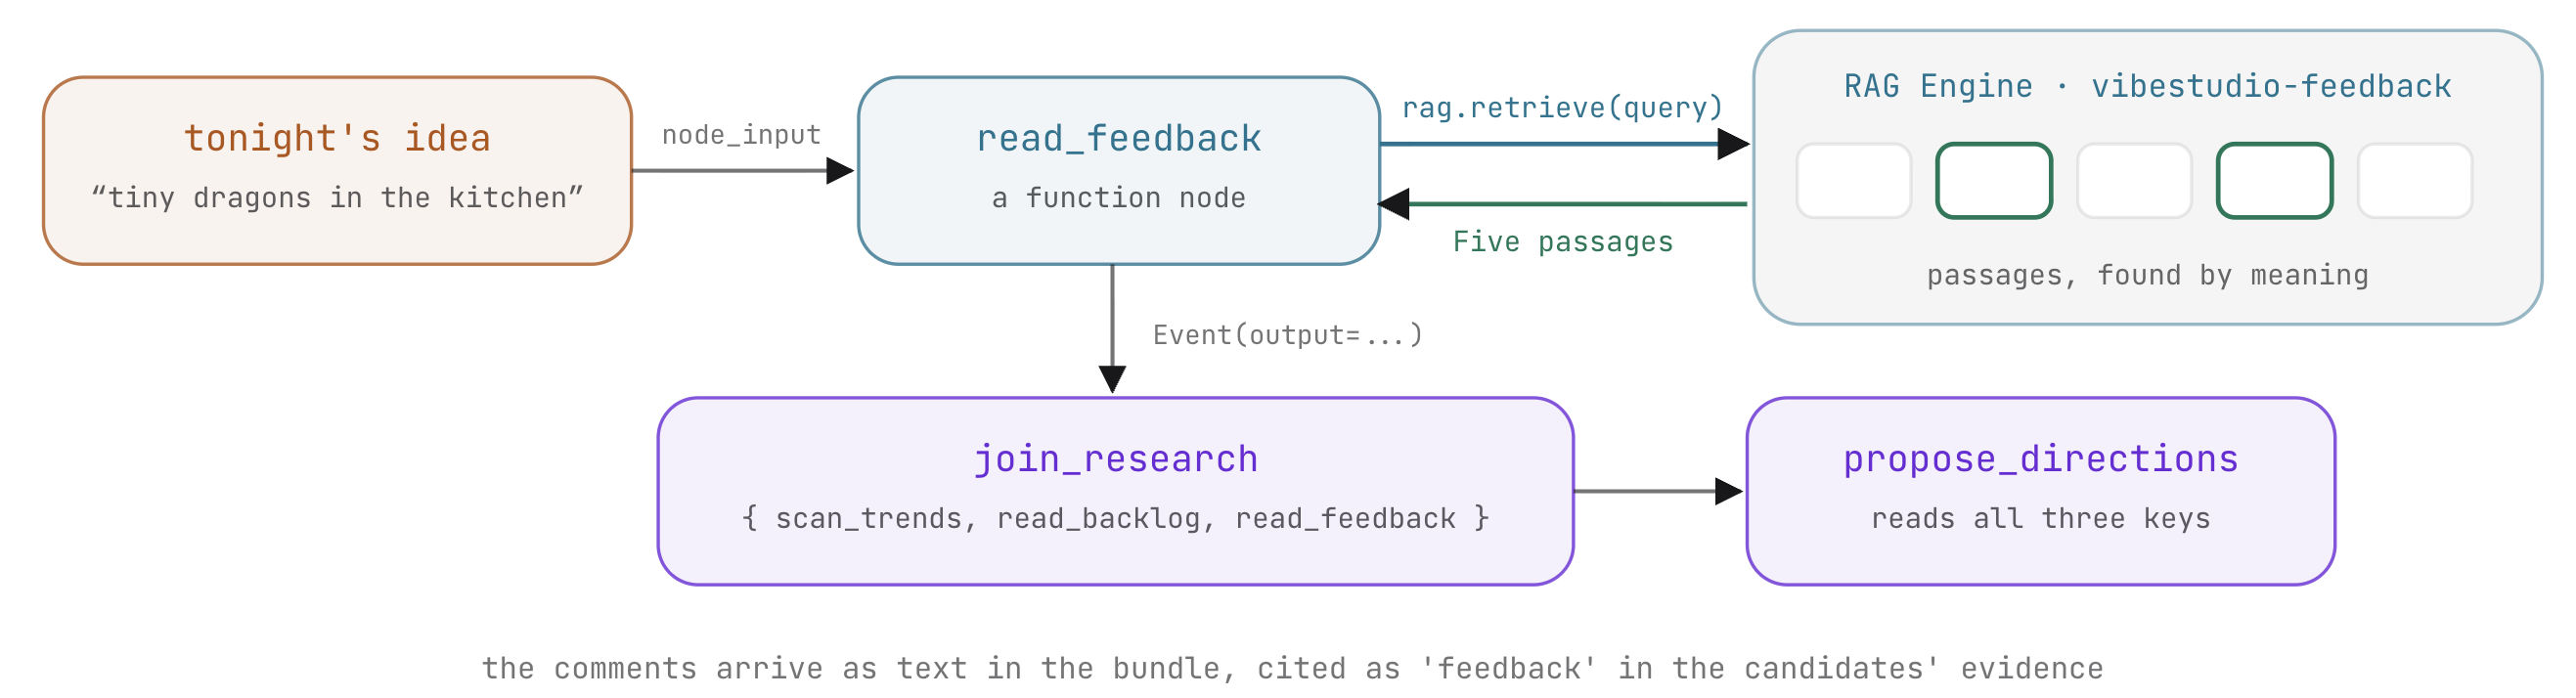
Il feedback del pubblico rappresenta la condivisione dei dati di ricerca nel workflow. A differenza della memoria personale del creator, il sentiment degli spettatori viene inserito direttamente in join_research insieme alle tendenze e ai dati del backlog. Viene quindi implementato come nodo di funzione:
def read_feedback(node_input):
    """The third reader (step 7): what the audience wrote under past videos,
    the passages nearest to tonight's idea. Retrieval, not a model call."""
    from .platform import rag
    idea = idea_text(node_input)
    query = idea or "what viewers liked and what they complained about"
    try:
        hits = rag.retrieve(query)
    except Exception as e:
        print(f"  [rag] feedback unavailable ({str(e)[:80]})")
        return Event(output={"query": query, "feedback": [],
                             "note": "no corpus connected - run: python -m agent.platform.rag"})
    return Event(output={"query": query, "feedback": [h["text"] for h in hits]})
read_feedback estrae l'idea iniziale dell'utente ed esegue una query vettoriale sul corpus di RAG Engine. Genera i commenti recuperati in un payload Event(output=...).
Modifica pratica: collegamento del terzo lettore al fan-out
In stage5_rag/agent.py, aggiorna edges per aggiungere read_feedback come terzo ramo parallelo che entra in join_research:
           (START, read_backlog, join_research),
           (START, read_feedback, join_research),
Poiché join_research è un JoinNode, sincronizza tutti i rami in entrata, attendendo che scan_trends, read_backlog e read_feedback abbiano emesso tutti gli eventi prima di passare il bundle aggregato a valle.
Cosa aspettarsi e perché
Esegui il workflow in Workbench:
- Invia un prompt di idea (ad esempio "un drago in miniatura che fa la guardia a un piano di lavoro della cucina").
- Nella traccia di esecuzione, verifica che tutti e tre i nodi di lettura vengano eseguiti contemporaneamente.
- Osserva
join_research: il suo dizionario di output ora contienetrends,backlogefeedback. - Esamina i candidati generati da
propose_directions: il modello incorpora i commenti degli spettatori nelle sue proposte e fa riferimento al sentiment del pubblico nei campi delle prove. - Nota che il recupero RAG è deterministico (query identiche restituiscono passaggi di commento identici), mentre il nodo di proposta generativa produce variazioni creative.
8. Generazione asincrona di video con Veo
In VibeStudio Workbench, vai a Passaggio 8 · Il video, parti (8A) e (8B).
La generazione di video in alta definizione con Google Veo richiede diversi minuti per il rendering. Il blocco dell'esecuzione del grafo durante questo periodo comporta uno spreco di risorse di calcolo, blocca i pool di thread ed espone l'esecuzione a interruzioni della connessione HTTP. In questo passaggio, renderai asincrono il rendering dei video utilizzando LongRunningFunctionTool di ADK.
Strumenti a esecuzione prolungata (8A)
Nel workbench, vai a A long-running tool (8A). Apri stage6_video/agent.py e agent/deliver.py.
Strumenti sincroni e strumenti a esecuzione prolungata
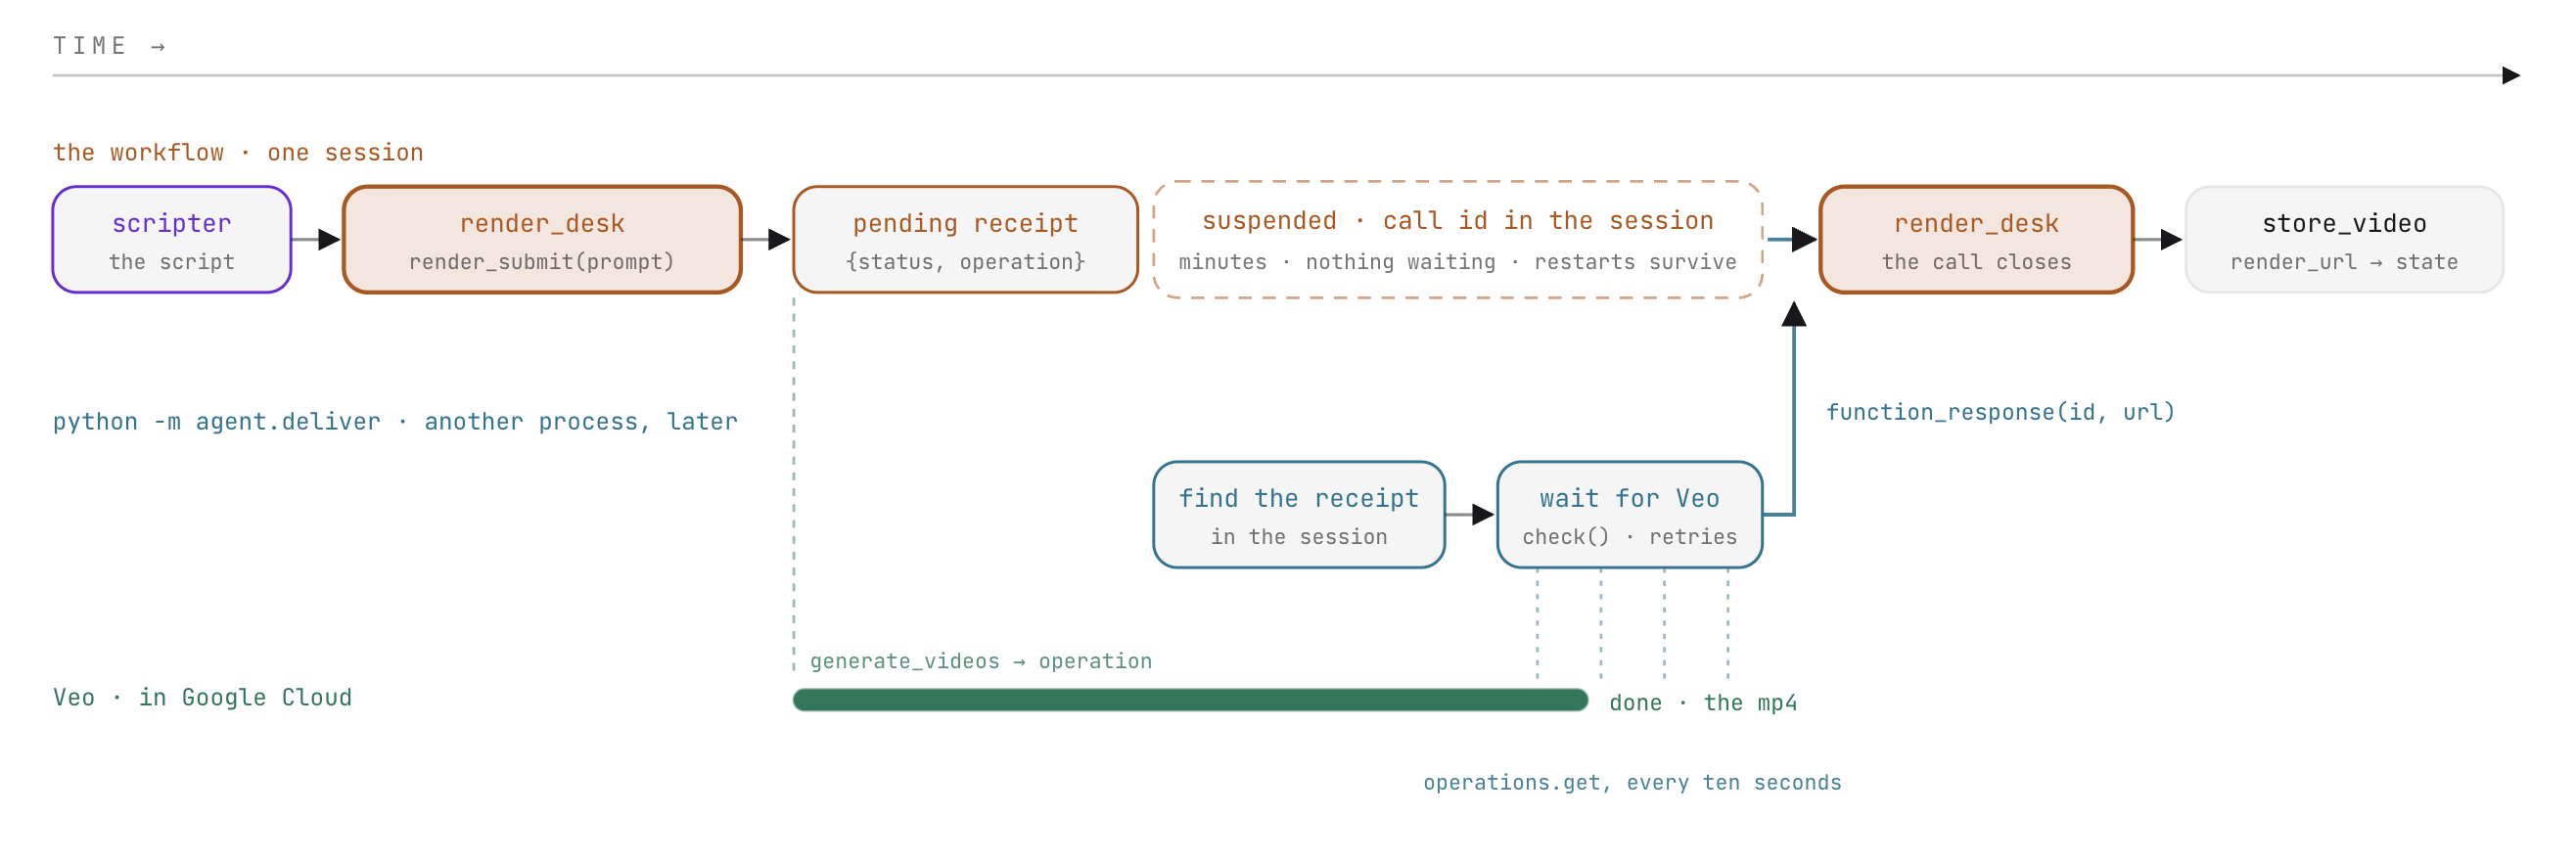
Gli strumenti di funzione ADK standard vengono eseguiti in modo sincrono all'interno di un turno dell'agente: il modello chiama lo strumento, attende il payload restituito e incorpora il risultato nel turno in corso.
Il rendering del video non può essere completato in un unico passaggio. Invece, render_submit avvia il job di generazione e restituisce immediatamente una ricevuta operativa con lo stato "pending":
def render_submit(prompt: str) -> dict:
    """Submit one Veo render of `prompt`. Returns at once with a pending
    receipt; the clip is delivered later, to this call, by id."""
    receipt = videogen.start(f"{prompt} {videogen.NO_TEXT}")
    return {"status": "pending", "operation": receipt["operation"], "prompt": receipt["prompt"]}
Se racchiuso tra LongRunningFunctionTool, ADK intercetta lo stato "pending". Il turno dell'agente termina, il workflow viene sospeso nel nodo e i metadati della chiamata in attesa (inclusi ID chiamata e ricevuta) vengono registrati in runs/sessions.db. Il processo di esecuzione termina in modo pulito senza mantenere connessioni di rete attive o thread di lavoro.
Modifica pratica: wrapping dello strumento di rendering
In stage6_video/agent.py, aggiorna render_desk per aggregare render_submit in LongRunningFunctionTool:
tools=[LongRunningFunctionTool(render_submit)])
Ripresa per ID chiamata
Il pattern di ripresa universale
ADK applica un meccanismo identico per sospendere e riprendere i workflow sia per gli utenti umani sia per gli strumenti esterni:
Trigger di sospensione | Avvio di Construct | Stato di sospensione memorizzato | Evento di ripresa |
Decisione umana |
| Apri il prompt di input nell'archivio delle sessioni |
|
Strumento a lunga esecuzione |
| Apri la chiamata allo strumento nell'archivio delle sessioni |
|
In entrambi gli scenari, il workflow si interrompe completamente e riprende solo quando un evento con un FunctionResponse corrispondente arriva da una fonte esterna: un'interfaccia utente, un webhook o un worker in background.
Modifica pratica: completamento della risposta di consegna
In agent/deliver.py, crea la parte FunctionResponse di ripresa:
    part = Part(function_response=FunctionResponse(
        id=row["call_id"], name=row["name"], response=response))
Il daemon di distribuzione esegue il polling di Veo fino alla generazione del file video, quindi invia questo FunctionResponse alla sessione. L'ADK trova l'ID chiamata corrispondente e riprende il workflow direttamente dal nodo successivo. I nodi completati non vengono eseguiti di nuovo e l'agente non esegue un altro turno generativo.
L'impostazione di STUDIO_REAL_VIDEO=0 in .env consente il rendering simulato: start restituisce una ricevuta di test immediata e check simula il completamento in cinque secondi senza effettuare chiamate API Veo fatturabili.
Integrazione della pipeline (8B)
Nel workbench, vai a render_desk nel grafico (8B). Apri stage6_video/agent.py.
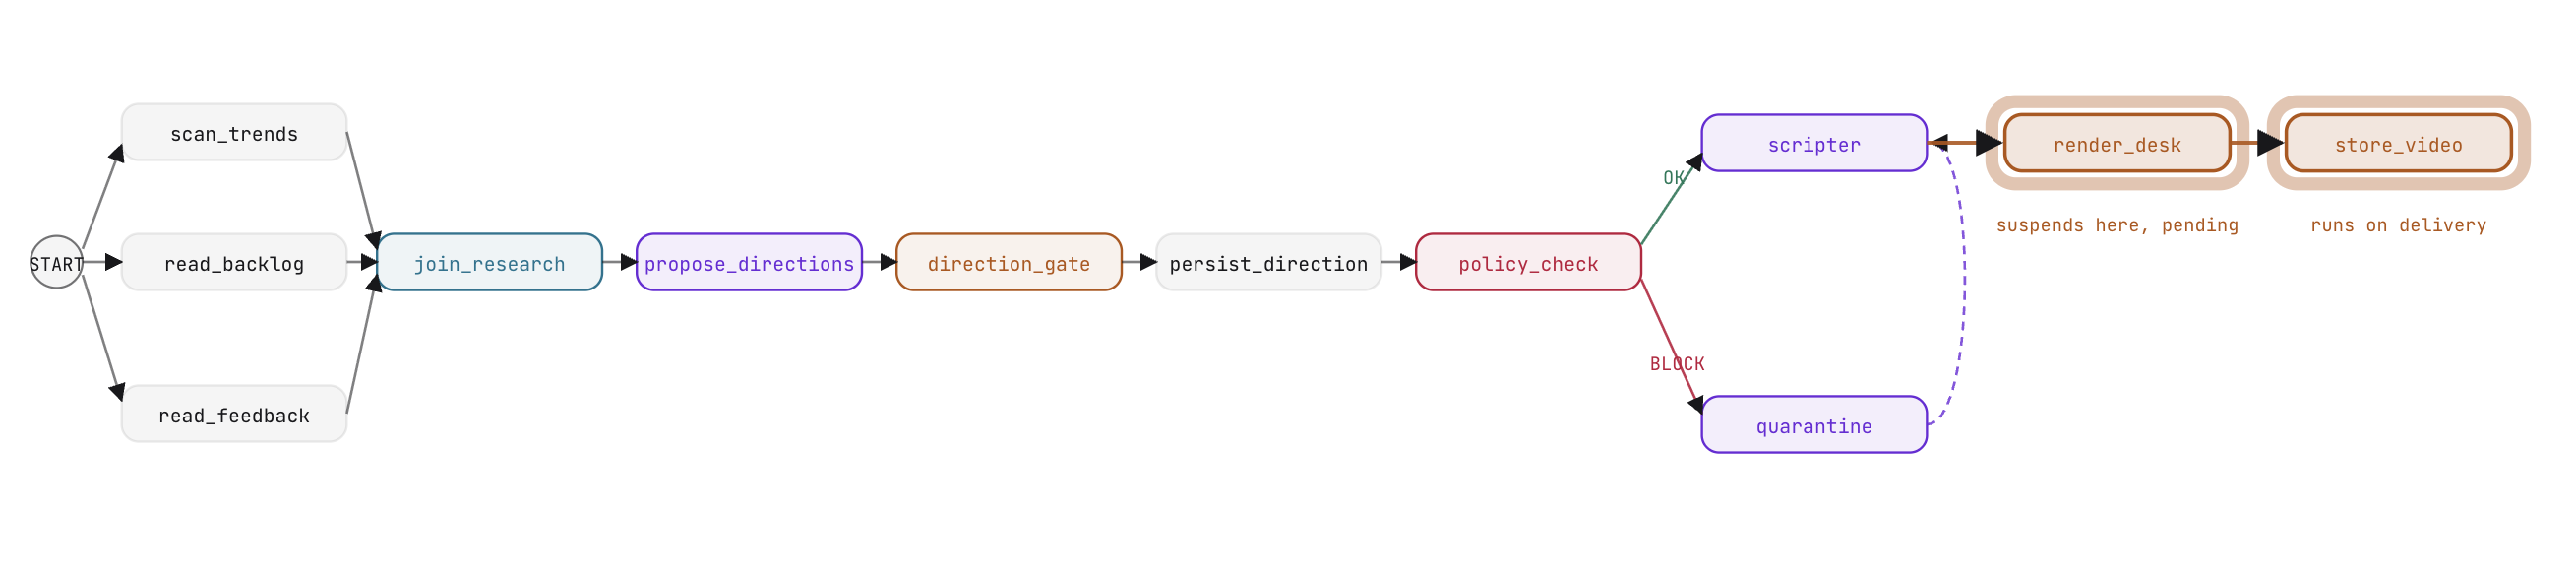
Il nodo terminale nella pipeline è store_video. Legge le informazioni di rendering completate da runs/state.json (dove il processo di pubblicazione le ha registrate) e conferma l'URL del video e lo stato di generazione nello stato della sessione condivisa.
Hands-on edit: wiring the complete video pipeline
In stage6_video/agent.py, aggiorna edges per aggiungere render_desk e store_video:
           (quarantine, scripter),
           (scripter, render_desk, store_video)])
Cosa aspettarsi e perché
Testa il flusso di generazione asincrona nel workbench:
- Esegui il flusso di lavoro tramite la selezione dei candidati e la generazione degli script.
- Alle ore
render_desk, osserva l'agente richiamarerender_submit. - Il workflow viene sospeso immediatamente. Nel workbench o in ADK Web, osserva lo stato in attesa: la sessione contiene l'ID della chiamata aperta e nessun processo in background sta consumando risorse.
- Esegui il daemon di distribuzione utilizzando la console di Workbench o nel terminale:
python -m agent.deliver - In ADK Web, aggiorna la sessione: l'esecuzione riprende in
store_video, esegue il commit dell'URL del video nello stato della sessione e completa il workflow.
9. Esegui il deployment in Cloud Run
In VibeStudio Workbench, vai al Passaggio 9: esegui il deployment.
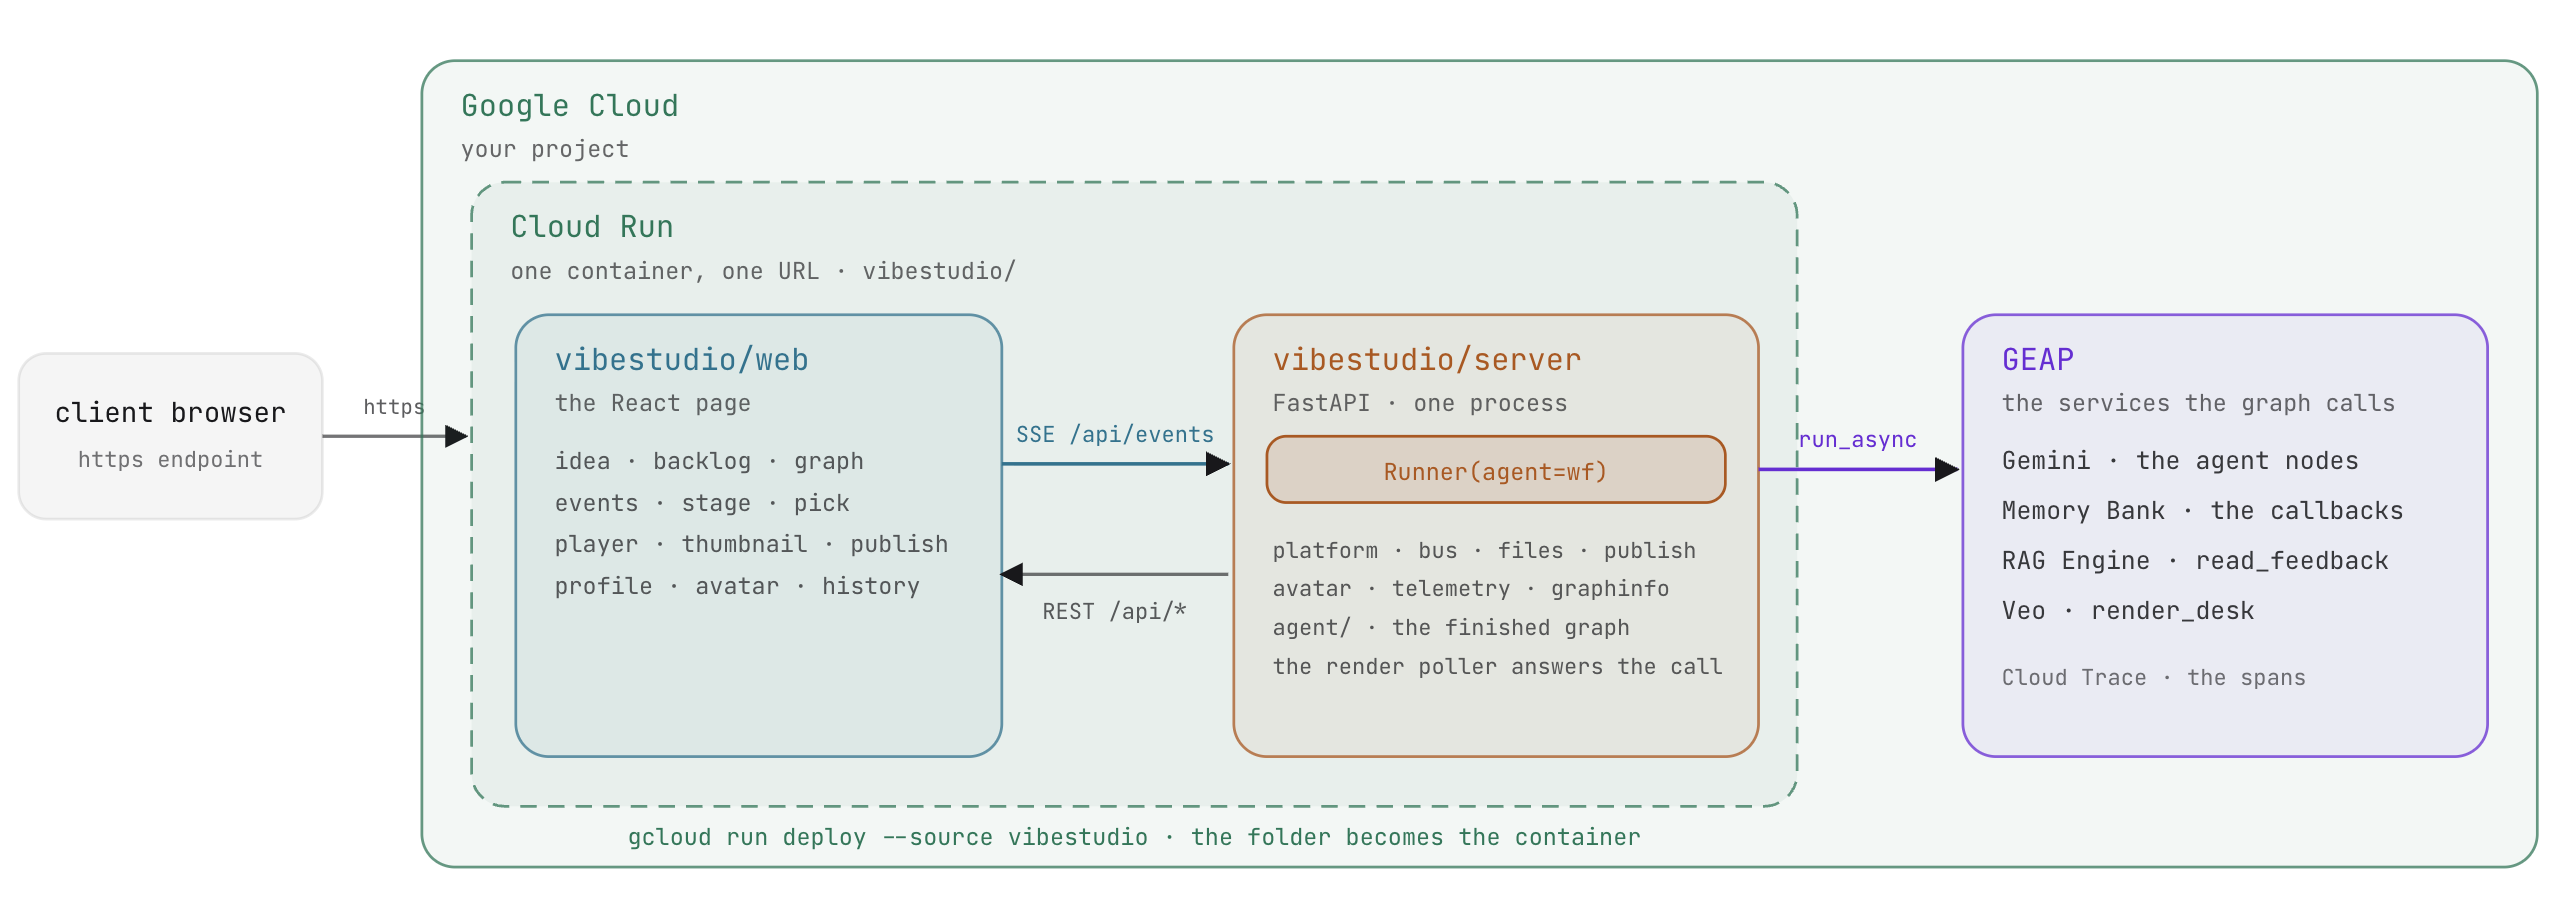
Hai sviluppato e verificato ogni componente della pipeline in sandbox dedicate. In questo passaggio, assemblerai la pipeline di produzione completa ed eseguirai il deployment in Google Cloud Run.
ADK Runner
In fase di sviluppo, adk web orchestrava il grafico. In produzione, l'applicazione ospita il workflow utilizzando la classe Runner dell'ADK:
self._svc = DatabaseSessionService(db_url=config.DB_URL)
self._runner = Runner(app_name=config.APP, agent=wf, session_service=self._svc)

async for ev in self._runner.run_async(user_id=config.USER, session_id=run_id, new_message=message):
    self._absorb(ev)    # fold the ADK event into the run state, publish one app event

# the gate's answer and the render's delivery are the same call, with a function_response part
part = Part(function_response=FunctionResponse(id=call_id, name=name, response=response))
run_async: gestisce l'esecuzione del flusso di lavoro, generando eventi in sequenza man mano che i nodi vengono eseguiti e mantenendo gli aggiornamenti al servizio di sessione.- Ripresa unificata: sia le decisioni degli utenti in
direction_gatesia le consegne dei video completate da Veo riprendono l'esecuzione tramite oggettiFunctionResponseidentici inviati arun_async.
Architettura dell'applicazione di produzione
L'applicazione di produzione in vibestudio/ integra la pipeline completa:
vibestudio/
  server/
    main.py                 FastAPI: application server, REST routes, static assets
    api.py                  REST API endpoints: run, pick, publish, backlog, profile, history
    runner.py               Runner orchestration over the workflow, background render poller
    platform/               Event bus (SSE stream), file storage, publishing, telemetry
    agent/                  Production agent package, verified by checks/verify_app.py
      graph.py              The complete workflow graph and node definitions
      desk.py               render_desk and render_submit wrapped with LongRunningFunctionTool
      schemas.py            Pydantic schemas: Directions, CleanedDirection, Script
      cleanup_tools.py      Deterministic policy tools: find_policy_hits, suggest_replacement
      platform/             Memory Bank, RAG Engine, and Veo integrations
  web/                      Production React user interface
  Dockerfile · deploy.py · run.sh
- Stream di eventi singolo: il backend FastAPI pubblica gli eventi in un unico stream Server-Sent Events (SSE). Il frontend React visualizza l'avanzamento del grafico in tempo reale e gestisce le connessioni tardive senza perdere lo stato.
- Esecuzione disaccoppiata: l'applicazione gestisce il loop di eventi. Il grafico del workflow si concentra interamente sulla logica di esecuzione, senza conoscere l'interfaccia frontend.
L'elenco completo dei bordi del flusso di lavoro in agent/graph.py combina ogni pattern architetturale creato in questo codelab:
        (START, scan_trends, join_research),
        (START, read_backlog, join_research),
        (START, read_feedback, join_research),
        (join_research, propose_directions, direction_gate,
         persist_direction, policy_check),
        (policy_check, {"OK": scripter, "BLOCK": quarantine}),
        (quarantine, scripter),
        (scripter, render_desk, store_video),
Deployment in Cloud Run
Google Cloud Run offre hosting serverless con scalabilità automatica, routing delle richieste e build di container integrate:
gcloud run deploy vibestudio --source vibestudio \
  --project $GOOGLE_CLOUD_PROJECT --region us-central1 \
  --labels dev-tutorial-codelab=vibetube --allow-unauthenticated \
  --memory 2Gi --cpu 2 --timeout 3600 --concurrency 40 \
  --max-instances 1 --min-instances 1 --session-affinity \
  --set-env-vars GOOGLE_CLOUD_PROJECT=...,STUDIO_VERTEX=1,STUDIO_MEMORY_BANK=...,STUDIO_RAG_CORPUS=...,VIBETUBE_URL=...,VIBETUBE_EVENT=...,VIBETUBE_NAME=...,VIBETUBE_PROJECT=...
- Build container:
gcloud run deploy --sourcepacchettizza la directoryvibestudio/, crea l'immagine container utilizzando Cloud Build ed esegue il deployment del servizio in un'unica operazione. - Affinità di sessione: indirizza le richieste dello stesso utente alla stessa istanza container, preservando lo stato della sessione locale nei passaggi iterativi.
- Osservabilità: l'integrazione di Cloud Trace registra gli intervalli distribuiti per ogni nodo, chiamata LLM ed esecuzione di strumenti, accessibili nella console Google Cloud in Esplora tracce.
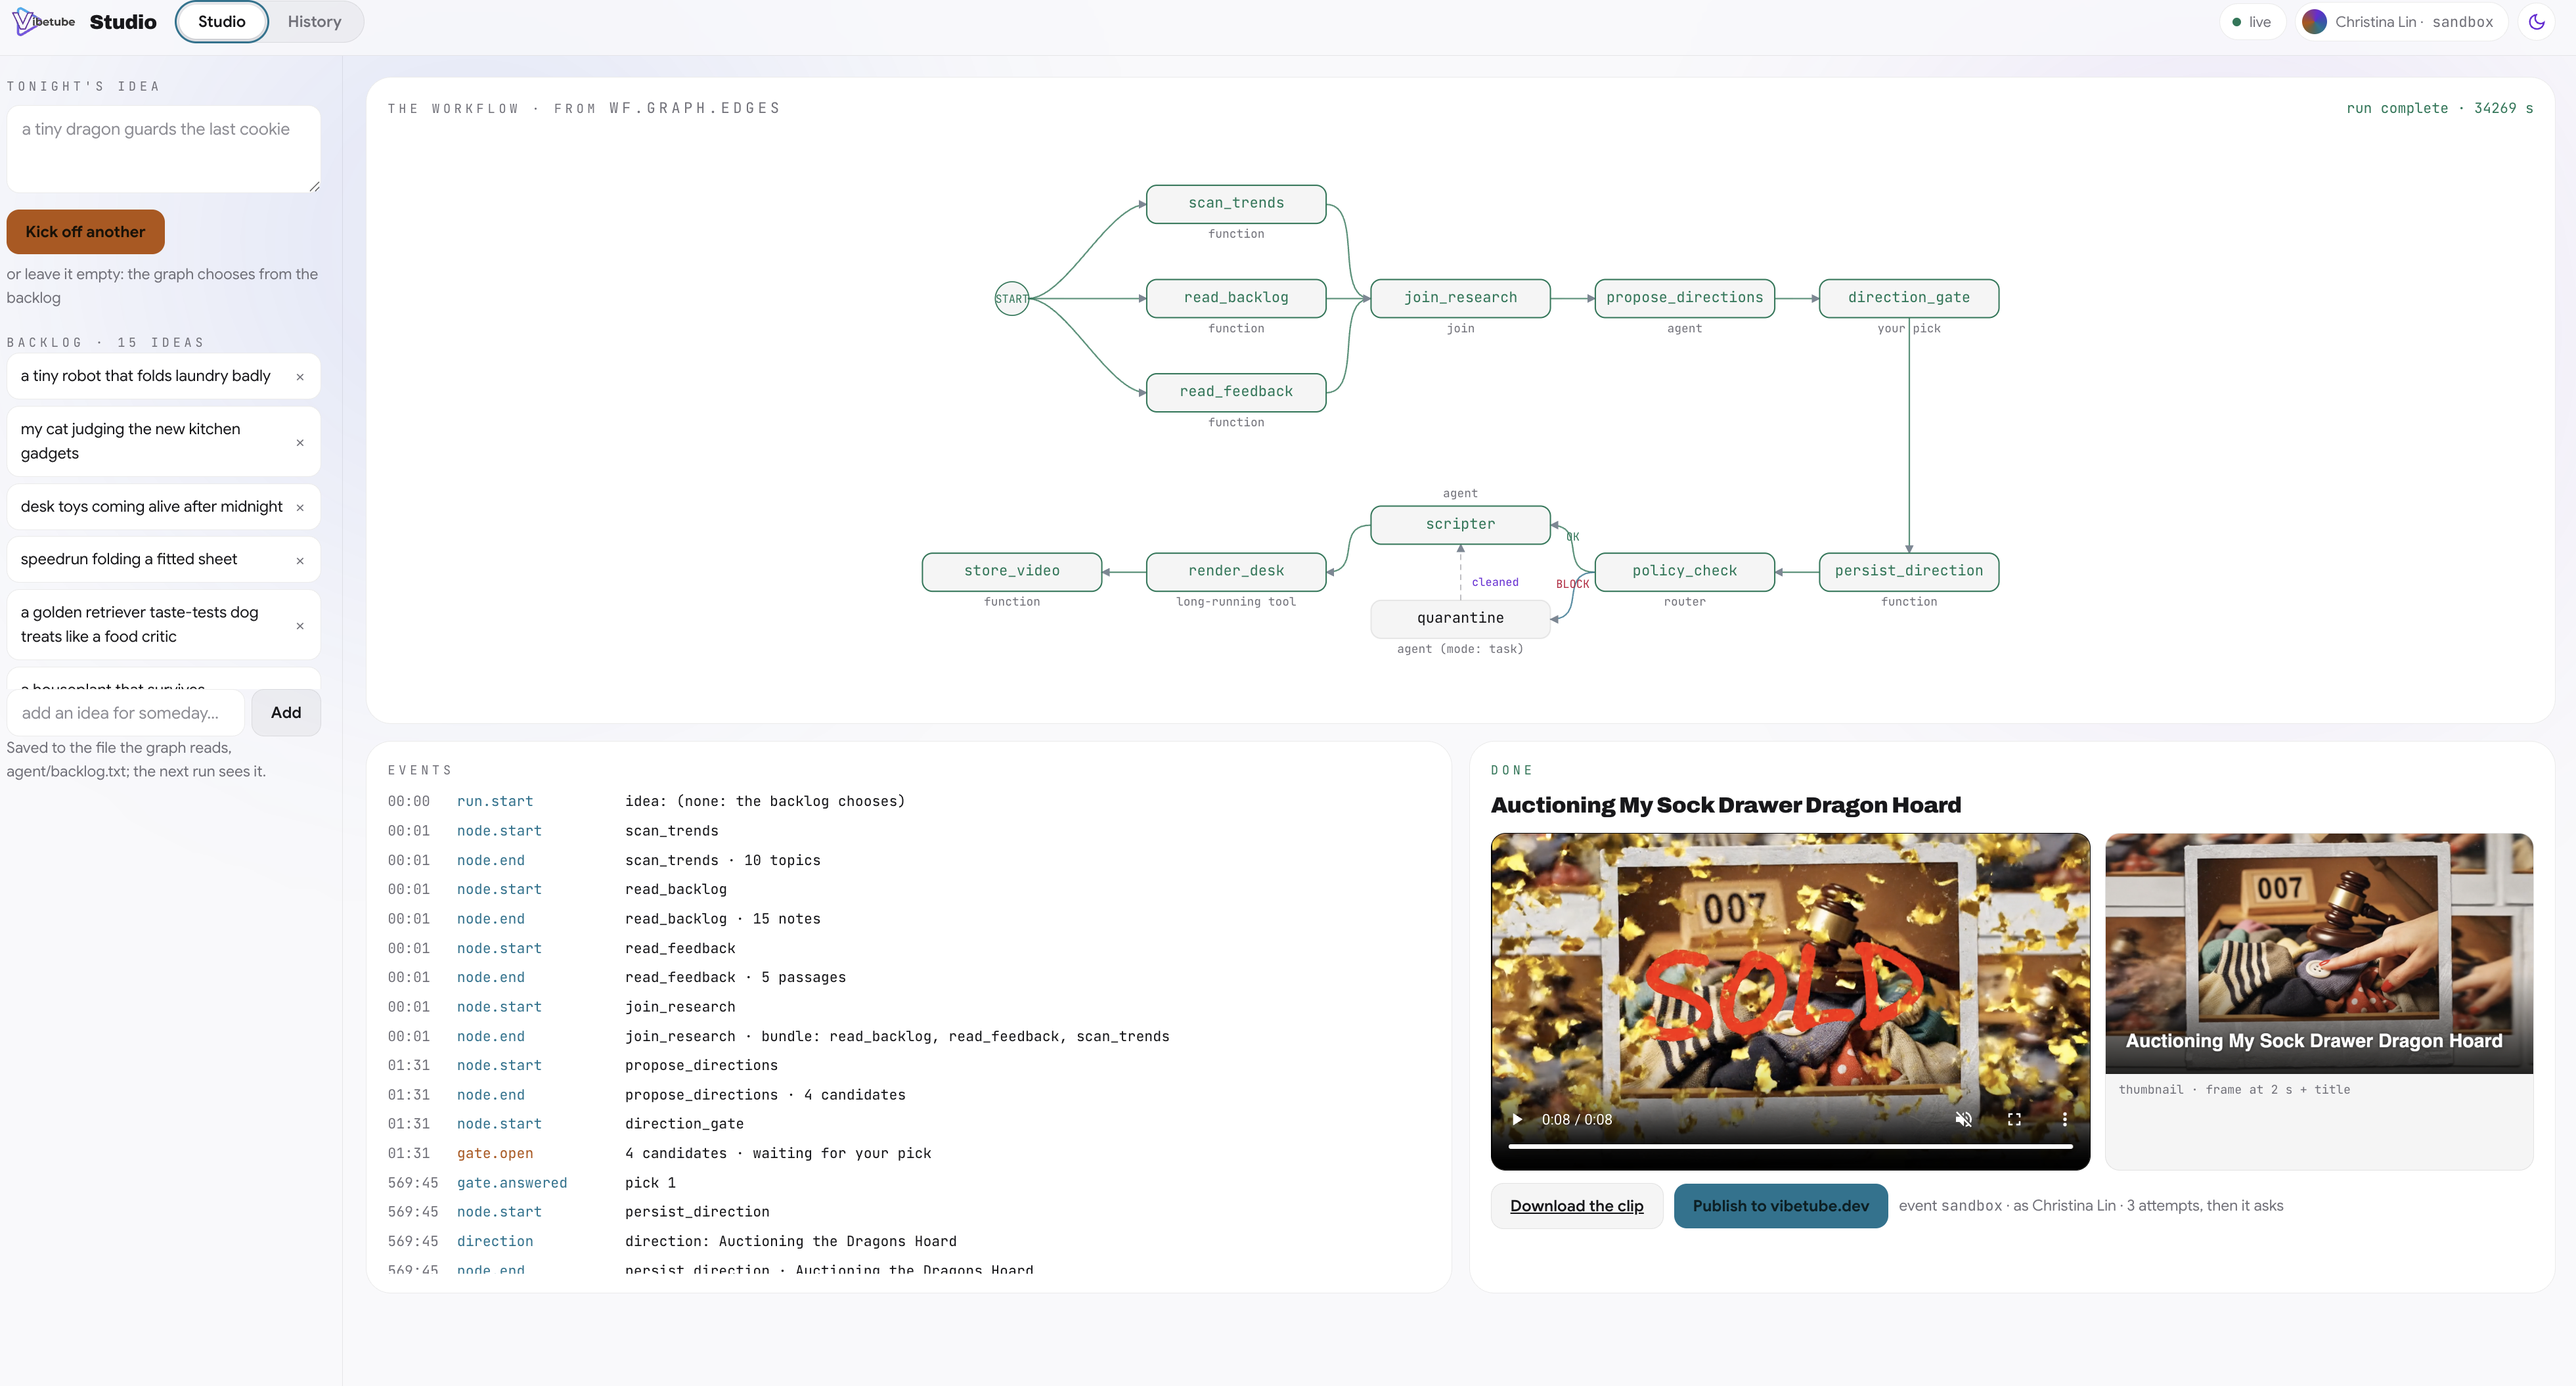
Fai clic sul pulsante Esegui il deployment nel workbench per eseguire lo script di deployment. Al termine della build, il terminale visualizza l'URL del servizio live.
10. Riepilogo
In VibeStudio Workbench, vai al Passaggio 10 · Riepilogo per esaminare l'architettura completata.
Passaggio | Architettura e concetti | Pattern di implementazione |
Un singolo prompt | Prompt singolo, strumenti di funzione, loop di chat sequenziale |
|
Nozioni di base sugli Agentic Workflows | Flusso di lavoro del grafico, ricerca parallela, output dello schema, gate umano |
|
Stato e router | Stato della sessione condiviso, associazione dei parametri, routing deterministico, agente delle attività |
|
Memory Bank | Memoria a lungo termine a livello utente, consolidamento semantico, hook del ciclo di vita |
|
RAG Engine | Recupero di documenti basato su commenti del pubblico, incorporamenti semantici | Nodo |
Generazione asincrona di video con Veo | Strumenti a lunga esecuzione, ricevute in attesa, daemon di distribuzione esterno |
|
Esegui il deployment in Cloud Run | Orchestrazione programmatica, Server-Sent Events, container serverless |
|
Principi architettonici fondamentali
- Sospensione anziché attesa: i workflow vengono sospesi in modo pulito per l'input umano (
RequestInput) o per operazioni a lunga esecuzione (LongRunningFunctionTool). I processi non rimangono inattivi su thread o socket di rete. - Ripresa universale: ogni sospensione riprende tramite un meccanismo identico, ovvero un singolo
function_responseche contiene l'ID chiamata del nodo sospeso. - Gestione dello stato disaccoppiata: i nodi condividono i dati tramite chiavi di stato della sessione denominate e associazione dei parametri, anziché payload intermedi dettagliati e ad alto accoppiamento.
- Routing deterministico prima del costo generativo: i router basati su regole e i filtri regex valutano le policy a costo zero dei token prima dell'esecuzione dei modelli generativi.
- Separazione delle responsabilità: il contesto specifico di un singolo agente appartiene ai callback del ciclo di vita, mentre le dipendenze dai dati condivisi appartengono