1. はじめに
この Codelab では、Agent Development Kit(ADK)のワークフローとグラフを使用して、次世代のエージェント システムを構築する方法を説明します。一般的なアーキテクチャ パターンを実装し、人間参加型(HITL)のインタラクションをオーケストレートし、長時間実行される非同期実行を処理します。また、企業のナレッジベースと永続メモリを統合して、エージェントの動作をカスタマイズして進化させます。最後に、これらの機能を接続して、自動動画生成パイプラインを駆動します。
シナリオ
あなたは VibeTube でデジタル チャンネルを運営しており、アクティブな視聴者がいて、クリエイティブなアイデアのバックログが拡大しています。各動画の制作には、トレンドの形式の調査、視聴者のフィードバックの統合、スクリプトの作成、ポリシーの遵守状況の確認、動画クリップの生成など、複数の段階にわたる継続的な実行が必要です。生成モデルは個々のアセットをドラフトできますが、一貫したリリースを提供するには、オーケストレートされたエージェント アーキテクチャが必要です。
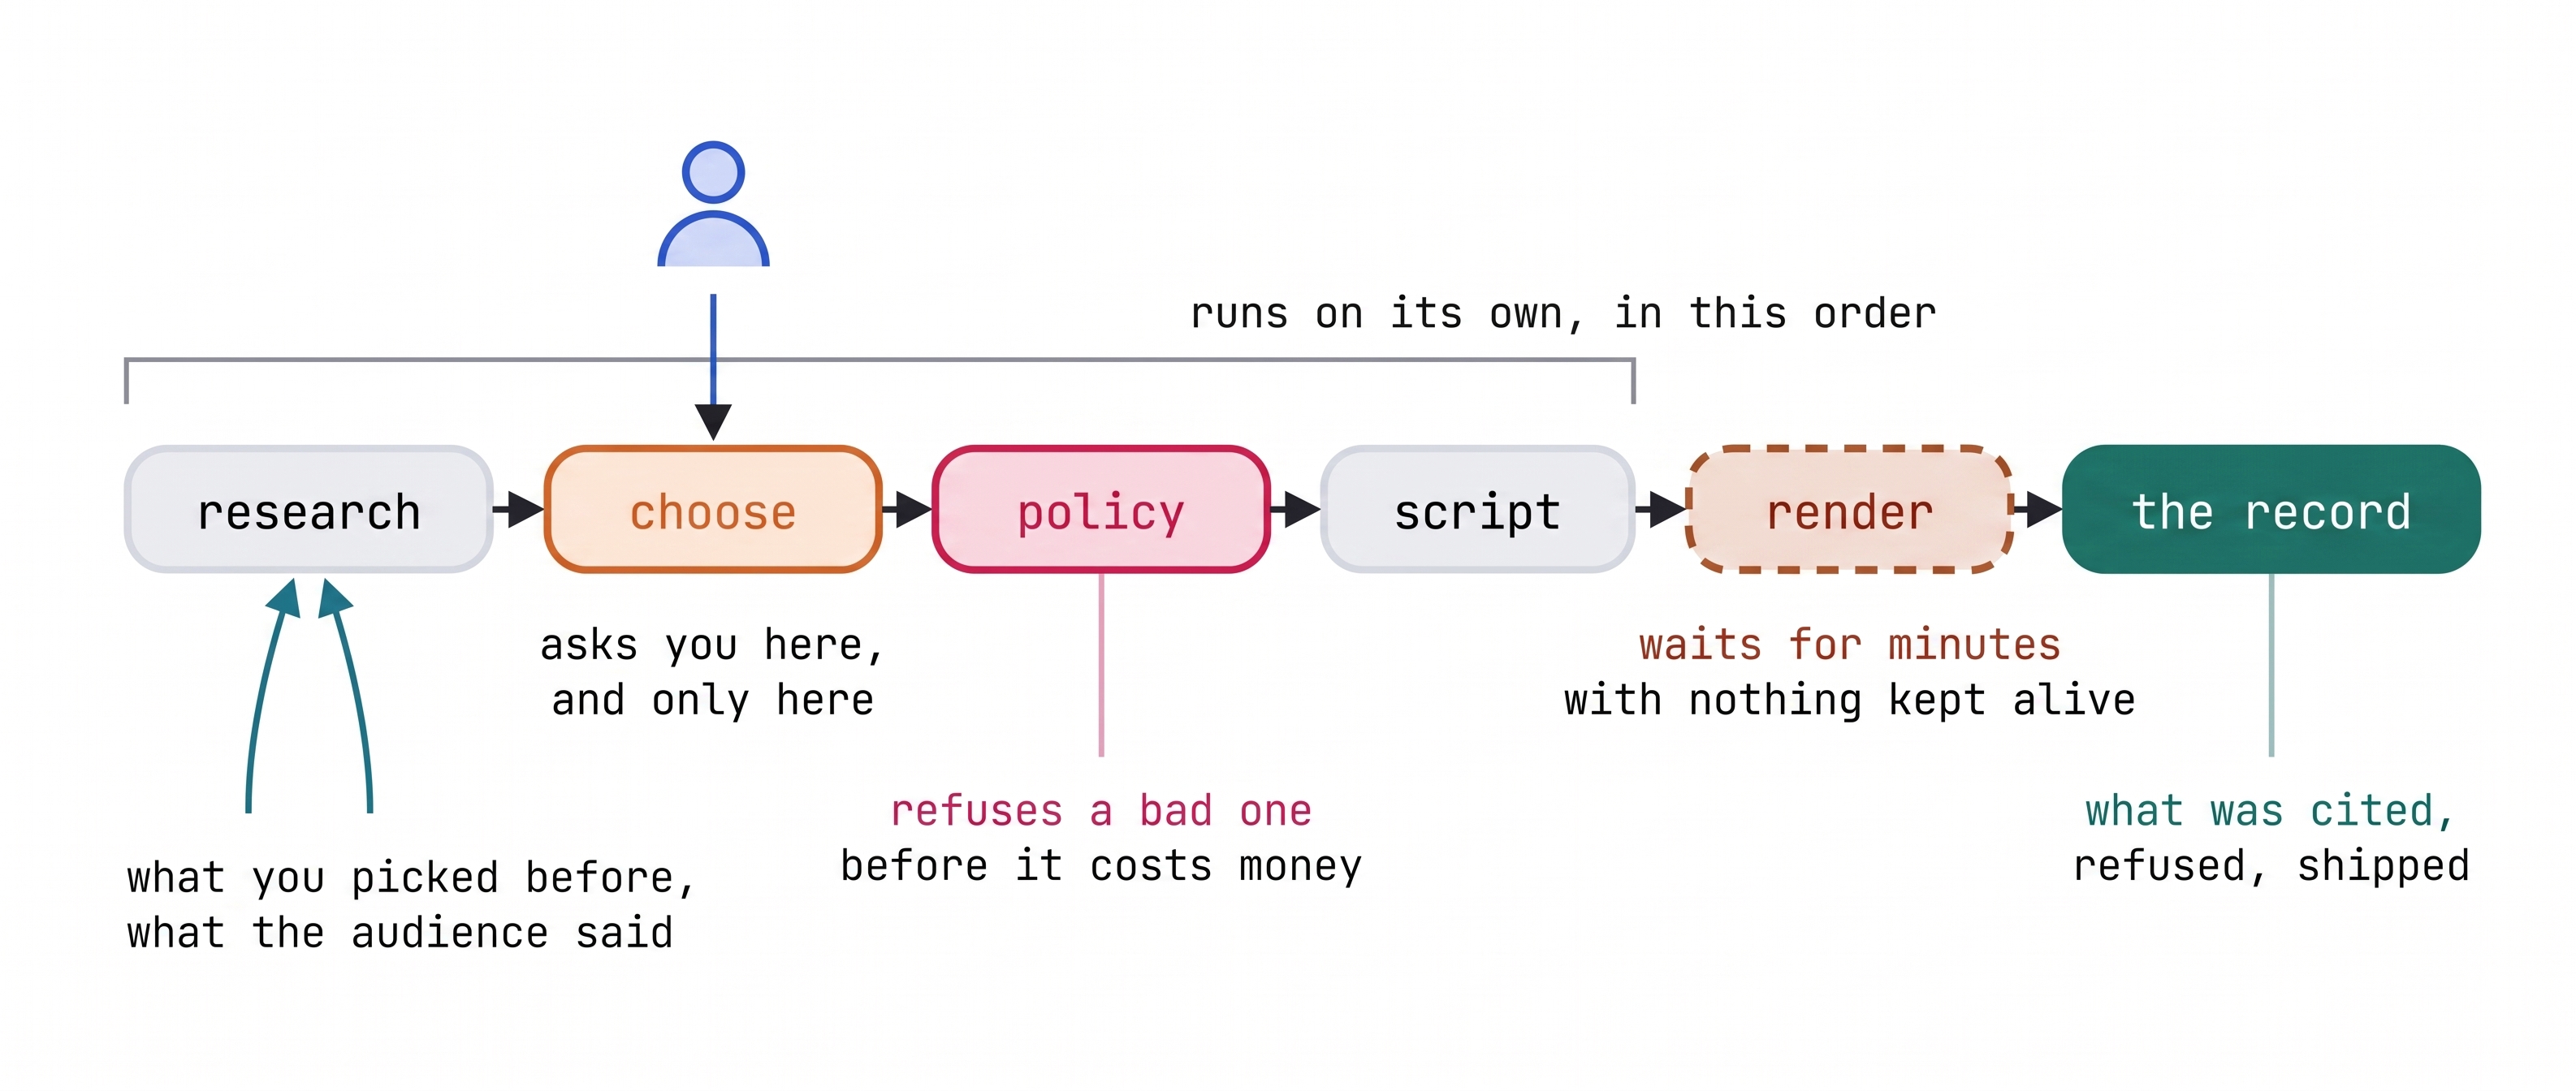
このライフサイクルを自動化するために、VibeStudio を構築します。このエージェント型パイプラインは、日常的な調査を並行して実行し、人間参加型の承認のためにキュレートされたオプションを提示します。また、動画を生成する前に自動化されたポリシーゲートを適用し、本番環境の実行全体でコンテキストを保持します。
学習内容
- グラフ エンジニアリングの基礎: マルチステップ エージェント アーキテクチャには、明示的な制御フローと構造化された実行パスが必要です。エッジタプル、
STARTエントリ ポイント、並列ファンアウト集約用のJoinNode、状態に基づいて実行を制御する決定的ルーターノードを使用して、ADKWorkflowを構築します。 - エージェント モードとライフサイクル コールバック: 特殊なタスクには、明確なオペレーション動作と決定論的なガードレールが必要です。ADK
Agentインスタンスを構成するには、chat、single_turn、ツール対応のtaskモードをワークフロー ノードとして使用し、before_model_callbackとafter_agent_callbackでインターセプターを適用します。 - 人間参加型オーケストレーション: 重要なクリエイティブ チェックポイントで、人間が判断できるようにプロダクション パイプラインが一時停止します。
RequestInputを実装して、ワークフローの実行を一時停止し、構造化されたレスポンス スキーマを適用して、アイドル状態のランタイム プロセスを維持せずに実行を再開します。 - 階層型エージェント メモリ: プロダクション システムでは、一時的な実行状態と永続的なコンテキストが分離されます。
Event(state=...)とパラメータ バインディングを使用して短期セッションの状態を管理し、GEAP Memory Bank を接続して、実行間でクリエイターの設定を抽出、統合、保持します。 - 企業のナレッジベースによるグラウンディング: 自律型エージェントには、動的なドメイン コンテキストとオーディエンスの感情が必要です。GEAP RAG Engine コーパスを並列ファンアウト内の専用の検索ノードとして接続し、エージェントの出力をセマンティックにグラウンディングします。
- 長時間実行されるワークフローとデプロイ: マルチモーダル動画レンダリングは、長時間にわたって非同期で動作します。保留中の通話レシートを使用して
LongRunningFunctionToolを実装し、通話 ID でワークフローを一時停止して再開します。また、ADKRunnerを使用して、完了したパイプラインを Cloud Run にデプロイします。
この Codelab の構成
この Codelab は、コンセプトとアーキテクチャのリファレンスとして機能します。各セクションでは、対応するワークベンチ ステップで実装される ADK 構成要素について説明し、参照コードを提供して、コア設計原則を確立します。各セクションを確認してから、ワークベンチで対応する演習を完了してください。
ハンズオン作業は、インタラクティブなコードエディタ、ランタイム検証ツール、組み込みの ADK インスペクタを備えたコンパニオン ウェブ インターフェースである VibeStudio Workbench で行われます。ワークベンチのステップ番号は、この Codelab と直接対応しており、進捗状況を同期できます。基本的なグラフの編集はステップ間で保持され、作業を進めるにつれてワークベンチが前提条件を自動的に検証します。
ワークベンチの演習を完了すると、エンドツーエンドのエージェント パイプラインを組み立て、実行中の VibeStudio アプリケーションを Cloud Run にデプロイして動画コンテンツを生成します。
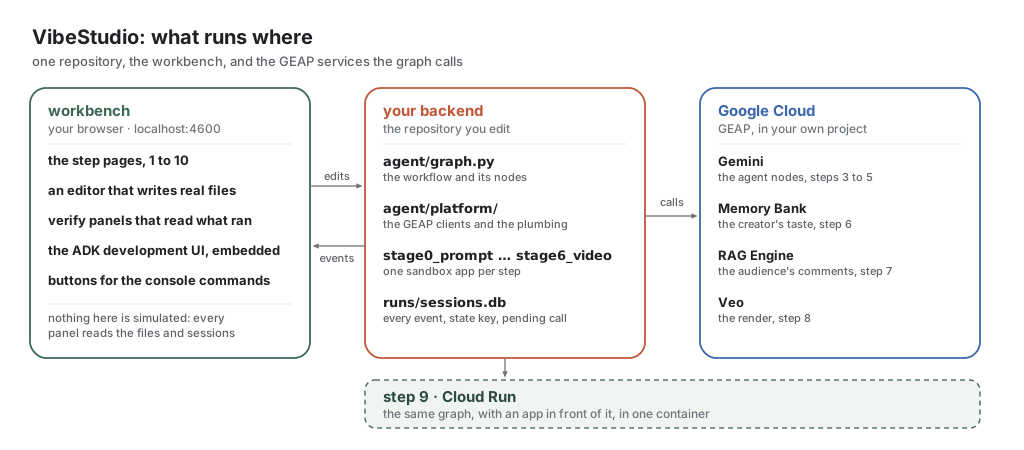
この環境は、VibeStudio Workbench(コード編集とランタイム検証用のローカル ウェブ インターフェース)、バックエンド(ADK Workflow と agent/ のステージ サンドボックス)、Google Cloud(Gemini モデル、GEAP メモリバンク、RAG エンジン、Veo 動画生成)の 3 つの主要コンポーネントで構成されています。
2. セットアップ
ワークショップのクレジットを申請する
講師主導のラボに参加している場合は、講師が Google Cloud プロジェクトのクレジットを配布します。講師の指示に従ってクレジットを利用し、アカウントで請求が有効になっていることを確認してから続行してください。
Cloud Shell を開く
Cloud Shell は、gcloud、Python、git がプリインストールされたブラウザベースの開発環境です。
Cloud Shell を起動するには:
- Google Cloud Shell に移動します。
ブラウザ ウィンドウの下部にターミナル セッションが開きます。
リポジトリのクローンを作成して初期化する
Cloud Shell ターミナルで次のコマンドを実行して、プロジェクトのクローンを作成します。
git clone https://github.com/gca-americas/vibetube-studio
cd ~/vibetube-studio
構成プロンプト
セットアップ中に、次の詳細情報の入力を求められます。
- Google Cloud プロジェクト ID:
setup_project.shから入力を求められたら、Enter キーを押して新しいプロジェクトを自動的に作成します。既存のプロジェクト(事前に割り当てられたプロジェクトなど)を使用する場合は、プロジェクト ID を入力し、スペルが正しいこと、課金が有効になっていることを確認します。 - イベントコード: インストラクターから提供された会議室コードを入力します。届いていない場合は、ティーチング アシスタントまたは近所の方に確認してください。このラボを自宅で完了する場合は、Enter キーを押してデフォルトの
sandboxルームを受け入れます。 - チャンネルの表示名:
setup_codelab.shからメッセージが表示されたら、名前または希望するチャンネル ハンドルを入力するか、Enter キーを押して Google アカウントから生成されたデフォルトをそのまま使用します。
2 つの設定スクリプトを順番に実行します。
./setup_project.sh
./setup_codelab.sh
setup_project.sh: 課金が有効な Google Cloud プロジェクトを作成または再利用し、プロジェクト ID を~/project_id.txtに保存して、アクティブなgcloudコンテキストを構成します。setup_codelab.sh:uvと Python の依存関係を.venvにインストールし、必要な Google Cloud API を有効にします。また、.envでチャンネル設定を構成し、Gemini でモデルアクセスを確認します。さらに、メモリバンクと RAG リソースをプロビジョニングし、ワークベンチ インターフェースを構築して、VibeStudio Workbench を起動します。
スクリプトはプリフライト チェックを実行し、バックグラウンドで VibeStudio Workbench を起動します。最後の行に、開くためのリンクが表示されます。
7 · Preflight
  ✓ python 3.12
  ✓ auth path A: Vertex via ADC (STUDIO_VERTEX=1)
  ✓ Google Cloud ADC (project <your-project>)
  ✓ stage0_prompt loads
  ...
  ✓ stage6_video loads (13 edges)
  ✓ aiplatform.googleapis.com enabled (Gemini, Veo, Memory Bank, RAG Engine)
  ✓ vectorsearch.googleapis.com enabled (the vector store a RAG corpus is built on)
  ✓ Memory Bank connected
  ✓ RAG corpus connected
  ✓ VibeStudio Workbench running on port 4600

PREFLIGHT GREEN

Setup finished. The VibeStudio Workbench is already running.

  Open this and start at step 1
      https://4600-<your cloud shell host>/step/story

  It runs in the background. You do not need to start anything else.
      log      runs/lab.log
      stop     kill $(cat runs/lab.pid)
      start    scripts/start.sh
そのリンクをクリックします。同じアドレスは、[ウェブでプレビュー] → [ポートを変更] → [4600] で確認できます。
いつでも環境を再確認するには、python scripts/preflight.py を実行します。ワークベンチを再起動するには、scripts/restart.sh を実行します。再度設定するには、./setup_codelab.sh を実行します。構成と進行状況は保持されます。
開いたら、シナリオのステップ 1「ストーリー」と、完成したグラフの形状のステップ 2「作成するもの」を読みます。どちらにも演習はありません。その後、このページに戻って手順 3 に進みます。
VibeStudio Workbench のハンズオン部分の最後には、実際のアーティファクト(ディスク上のファイルと実行によって書き込まれたセッション)を読み取る検証パネルが表示されます。
リポジトリのレイアウト
リポジトリは、コア ワークフロー ロジック、ステップバイステップのサンドボックス、ワークベンチ環境、本番環境アプリケーションに構造化されています。
vibe-studio-lab/
├── agent/                  # Core ADK workflow, graph definition, and platform services
│   ├── graph.py            # Workflow graph definition, node functions, and routers
│   ├── desk.py             # Video render desk using LongRunningFunctionTool
│   ├── schemas.py          # Pydantic schemas for directions, gates, and scripts
│   ├── trends.py           # Trend generation and sampling utilities
│   ├── backlog.txt         # Creator video ideas backlog
│   ├── comments.md         # Audience comments for RAG Engine corpus seeding
│   ├── policy_words.txt    # Blocked subject words for deterministic policy checks
│   └── platform/           # Google Cloud service clients (Memory Bank, RAG, Veo)
│       ├── config.py       # Environment variables, locations, and model configurations
│       ├── memory.py       # GEAP Memory Bank callbacks and context injection
│       ├── rag.py          # GEAP RAG Engine corpus creation and semantic retrieval
│       └── videogen.py     # Veo video generation and operation polling
├── stage0_prompt/          # Step sandboxes: isolated agent.py files runnable in adk web
│   └── ...                 # stage1_fanout through stage6_video for incremental steps
├── server/ & web/          # VibeStudio Workbench (FastAPI backend and React frontend)
├── vibestudio/             # Complete production application deployed to Cloud Run
│   ├── server/             # FastAPI production server and event runner
│   ├── web/                # End-user React web application
agent/: コア ワークフロー グラフが含まれます。このディレクトリ内のファイルを編集して、並列ファンアウト ノード、決定論的ポリシー ルーティング、メモリ コールバック、動画生成ツールを実装します。agent/platform/: Gemini モデル、GEAP メモリバンク、GEAP RAG Engine、Veo 動画合成などの Google Cloud サービスと連携します。stage0_prompt/~stage6_video/: 自己完結型のサンドボックス環境。各フォルダはスタンドアロンのroot_agentをエクスポートするため、埋め込み ADK 開発インターフェースを介して各ステップを個別に実行して検査できます。server/とweb/: ポート 4600 でローカルに実行されている VibeStudio Workbench アプリケーション。ステップのドキュメント、ページ埋め込みコードエディタ、ランタイム証拠検証ツール、グラフの可視化をホストします。vibestudio/: 最後のステップでパッケージ化され、Cloud Run にデプロイされる完全な本番環境アプリケーション。これには、完了したワークフロー グラフの独自のスタンドアロン コピーが含まれています。
3. モノリシック エージェント
マルチノード ワークフロー グラフを構築する前に、stage0_prompt/agent.py の単一エージェントを使用してアーキテクチャのベースラインを確立します。このエージェントは、本番環境パイプラインを文章で記述したモノリシックなシステム プロンプトに依存しており、2 つの Python 関数ツールによってサポートされています。
このベースラインを評価することで、プロンプト駆動型調整の運用境界が明らかになり、本番環境システムでグラフ オーケストレーションが必要な理由が明確になります。
ADK エージェント アーキテクチャ(3A)
VibeStudio Workbench で、ステップ 3 · モノリシック エージェントに移動し、ADK エージェント アーキテクチャ(3A)を開きます。このビューには、ADK エージェント(LlmAgent)のコア アーキテクチャ レイヤが表示されます。
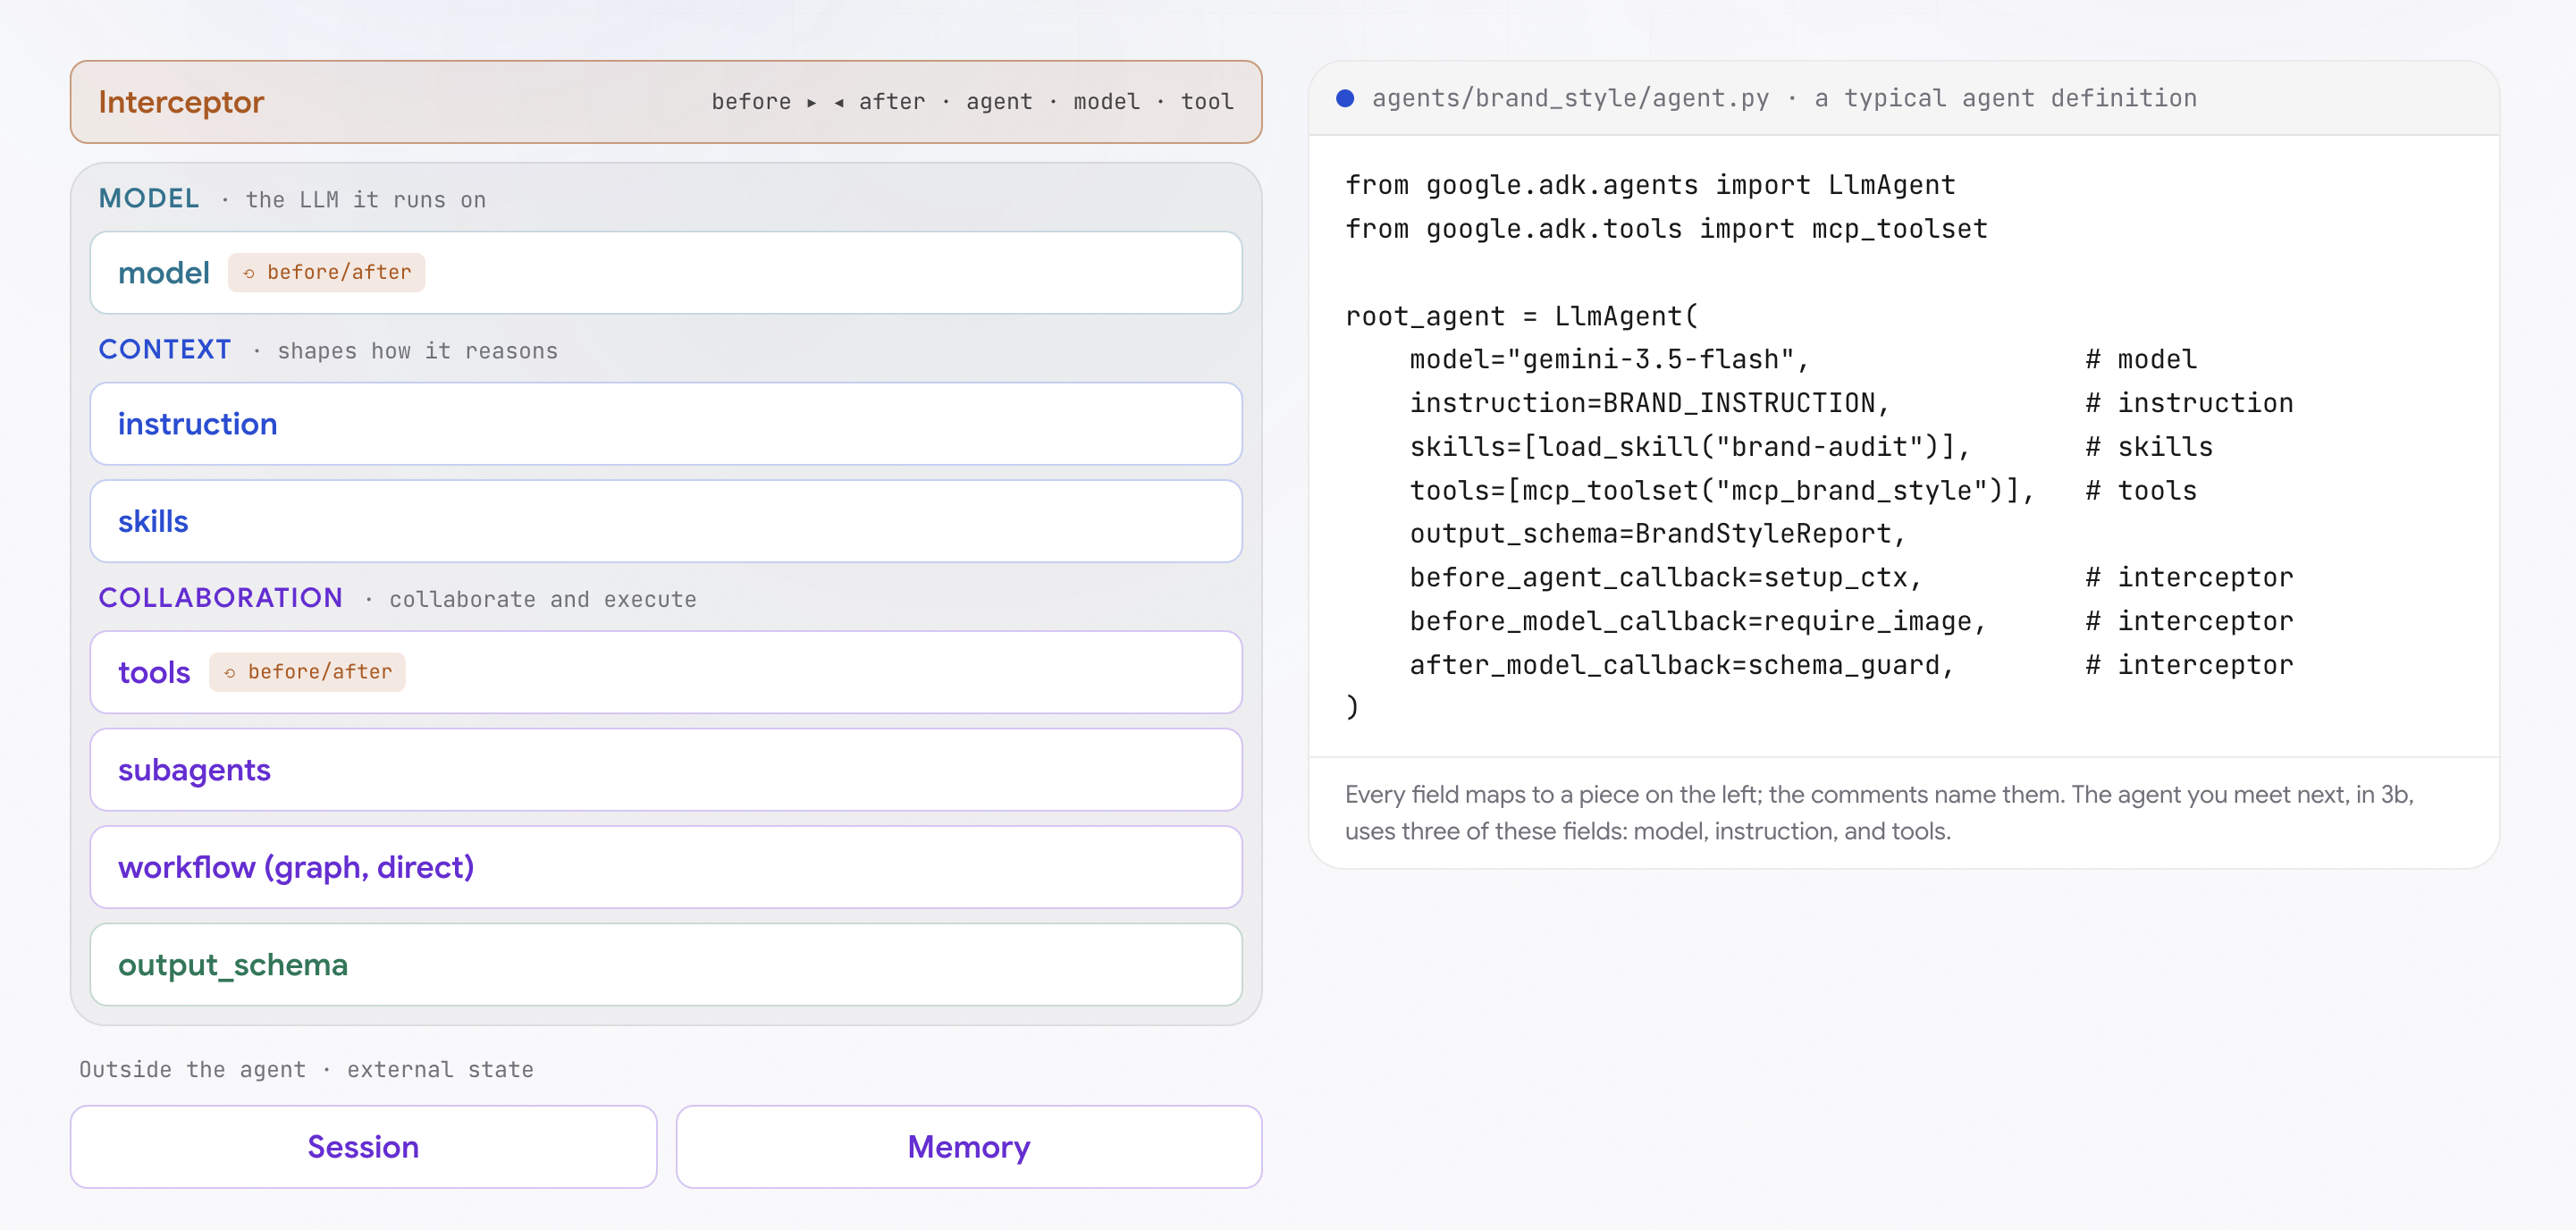
from google.adk.agents import LlmAgent
from google.adk.tools import mcp_toolset

root_agent = LlmAgent(
    model="gemini-3.5-flash",                 # model
    instruction=BRAND_INSTRUCTION,            # instruction
    skills=[load_skill("brand-audit")],       # skills
    tools=[mcp_toolset("mcp_brand_style")],   # tools
    output_schema=BrandStyleReport,           # structured output
    before_agent_callback=setup_ctx,          # interceptor
    before_model_callback=require_image,      # interceptor
    after_model_callback=schema_guard,        # interceptor
)
インタラクティブな図では、エージェント コンポーネントが 5 つの運用ドメインにグループ化されています。
- 推論レイヤ(モデル): 認知タスク、プロンプト推論、ツール選択を実行するコア言語モデル(Gemini 3 Flash など)。アーキテクチャ内の他のすべての要素は、このモデルに情報を提供するか、このモデルを制約します。
- コンテキスト レイヤ(指示とスキル): モデルの推論を形成する指示。
instructionは、永続的なシステム プロンプト、ペルソナ、運用ルールを確立します。skillsは、繰り返し可能なワークフローに対して、バージョン管理された手順ガイダンス(SKILL.md)を提供します。 - コラボレーションとアクション レイヤ(ツール、サブエージェント、ワークフロー、出力スキーマ): エージェントが外部システムでアクションを実行し、型付きデータを出力できるようにするインターフェース。
toolsは、呼び出し可能な Python 関数または Model Context Protocol(MCP)エンドポイントを提供します。subagentsは、委任された下位タスクを実行します。workflowは、マルチエージェント グラフを調整します。output_schemaは Pydantic モデルを適用して、ダウンストリームのコンシューマが非構造化テキストではなく検証済みの JSON を受信できるようにします。 - インターセプタ レイヤ(ライフサイクル コールバック): エージェントの実行(
before_agent/after_agent)、個々のモデルのターン(before_model/after_model)、ツール呼び出し(before_tool/after_tool)の前後にカスタムコードを実行する決定論的ガードレール。インターセプタは、モデルのコンプライアンスに依存せずにポリシー ルールを適用します。 - 外部状態(セッションとメモリ): エージェント ロジックから分離されたステートフルな永続性。
Sessionは、現在の実行スレッドの一時的なワーキング メモリとイベント トレースを保持します。Memoryは、GEAP メモリバンクなどのマネージド サービスを使用して、セッション間で永続的な事実と設定を維持します。
このステップのモノリシック エージェントは、これらのプリミティブのうち model、instruction、tools の 3 つのみを実装します。以降のステップでは、グラフ ワークフロー、構造化スキーマ、インターセプタ、永続メモリ サービスについて説明します。
モノリシック エージェントの仕様(3B)
ワークベンチで、[モノリシック エージェント仕様(3B)] に進みます。stage0_prompt/agent.py を開いて、ベースライン エージェントの定義を確認します。
- 単一プロンプトの指示: システム プロンプトは、プラットフォームのトレンドの発見、バックログ アイデアの確認、クリエイティブ コンセプトの提案、禁止されているテーマに関するポリシーの適用、ショットリストの作成という 5 つの異なる制作タスクを連続した文章にまとめます。
- 基盤となるデータソース: エージェントは、グラフの横に定義された 2 つのソースを参照します。
agent/trends.py: 動的なヒートスコアを持つ 250 のプールから、10 のアクティブなフォーマットとスタイルのトレンドをサンプリングします。agent/backlog.txt: クリエイターの未加工のコンセプト メモを 1 行ずつ読み取ります。
Agent のツール(3C)
ワークベンチで、[Tools in Agent (3C)] に進みます。
エージェントにとってのツールとは
言語モデルは本質的に閉じた世界の推論エンジンです。事前にトレーニングされた重みと、そのコンテキスト ウィンドウに存在するトークンのみに基づいて動作します。データベースのクエリ、リアルタイム API へのアクセス、コードの実行をネイティブに行うことはできません。
ツールはこの境界を橋渡しします。これにより、モデルに外部エージェンシーが付与され、モデルは外部システムでグラウンド トゥルース情報を取得し、確定的なアクションを実行できるようになります。
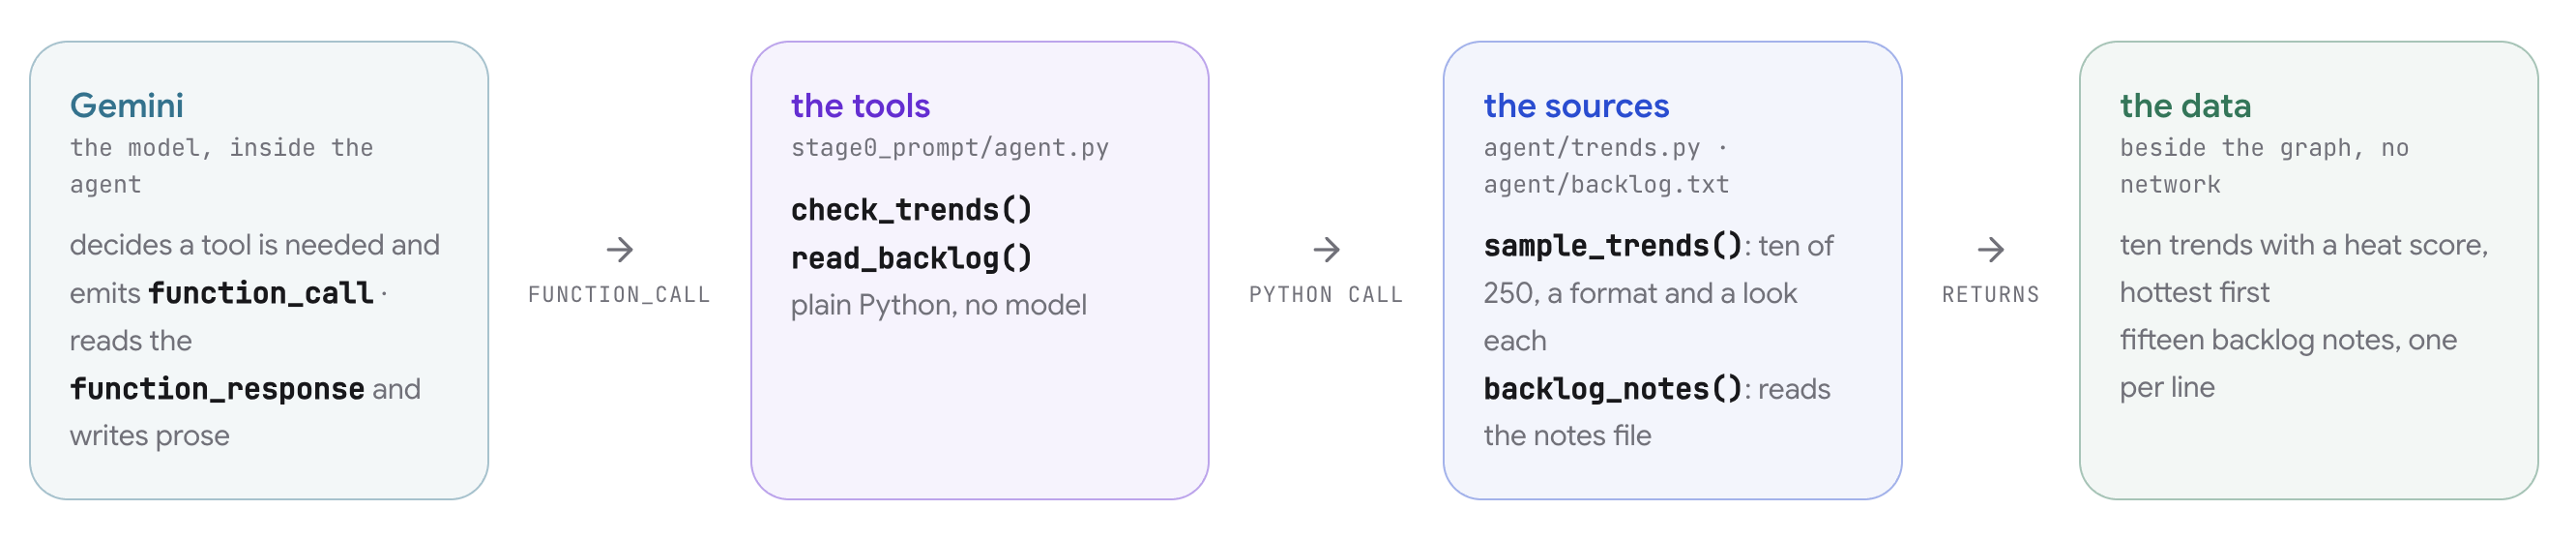
ツール呼び出しは、モデルと ADK ランタイム間の明示的な 5 段階のプロトコルに従います。
- スキーマ宣言: デベロッパーが Python 関数をエージェントに提供します。ADK は、各関数の名前、型アノテーション、docstring を検査して、パラメータと目的を記述する OpenAPI 互換の JSON スキーマ宣言を生成します。
- モデルの推論: 推論中に、モデルはユーザーのプロンプトに外部データが必要かどうかを評価します。必要に応じて、モデルはスキーマに一致するターゲット関数名と引数ディクショナリを含む構造化された
function_callイベントを出力します。 - ランタイム実行: モデル自体はコードを実行しません。ADK ランタイムは
function_callをインターセプトし、指定された引数を使用して実際のローカル Python 関数を実行し、戻り値を取得します。 - コンテキストの再注入: ADK ランタイムは、関数の戻り値を
function_responseイベントにパッケージ化し、アクティブなセッション履歴に追加します。 - 最終的な合成: モデルは、コンテキスト ウィンドウに存在するツールの出力を処理し、レスポンスを完了します。
stage0_prompt/agent.py では、2 つの**リサーチツール**が標準の Python 関数として定義されています。
def check_trends() -> dict:
    """Ten formats trending on the platform right now, with a heat score each."""
    from agent.trends import sample_trends
    return {"trends": sample_trends()}


def read_backlog() -> dict:
    """The creator's backlog: ideas they noted down to make someday."""
    from agent.graph import backlog_notes
    return {"backlog": backlog_notes()}
ハンズオン編集と実行
ワークベンチのコードエディタで、エージェントの tools リストに 2 つの関数参照を追加します。
tools=[check_trends, read_backlog],
変更を保存します。ディスク上のファイルが更新され、検証行で両方のツールが接続されていることが確認されます。
[Open adk web] をクリックして、組み込みの ADK 開発インターフェースを起動します。提案されたアイデアのプロンプトを送信します。
tonight's idea: a tiny robot doing laundry at midnight
想定される事象とその理由
このプロンプトを送信すると、セッション トレースに次の実行シーケンスが表示されます。
- 応答の前に 2 つのツール実行イベントが表示される:
check_trendsとread_backlogのfunction_callイベントとfunction_responseイベントが表示されます。- 理由: Gemini は、システム プロンプトの指示(「トレンドをチェックする。アイデアのバックログを確認する」)を評価し、重み付けにプラットフォームのトレンドとチャンネルのメモが欠けていることを認識して、両方の関数を呼び出してコンテキストをグラウンディングしました。
- エージェントが方向性を提案し、確認のために一時停止する: 回答では、トレンドとバックログを統合した動画の方向性を提案し、確認を求めています。
- 理由: 指示ディレクティブで、スクリプトを生成する前にクリエイターと方向性について合意するようモデルに指示しました。
- フォローアップ ターンで確認をバイパスする: 2 番目のメッセージ「
skip the questions, just describe the video」を送信します。エージェントはすぐに確認をバイパスし、タイトルとショットの下書きを作成します。- 理由: プロンプトの指示は、決定的な障壁ではなく、アドバイス的なガイドラインです。モノリシック エージェントでは、実行フローを制御する外部ワークフローがないため、ユーザーの指示が永続的なシステム プロンプト ルールをオーバーライドする可能性があります。
モノリシック プロンプトのアーキテクチャ上の制限
単一のプロンプトで分離されたデモに許容できる出力を生成できますが、ワークベンチ検証ツールで境界条件をテストすると、企業にとって重要な制限が明らかになります。
- 非構造化リサーチの集約: ツールの実行順序は非決定的です。モデルは取得したデータを自由形式の文章に要約するため、下流システムは特定の主張を生成したソースを特定できません。
- 未検証のポリシーの適用: モデルが独自の安全性コンプライアンスを評価します。モデルがトピックを安全と判断した場合、その検出結果を検証する外部の決定的ロジックはありません。
- 強制されない人間参加型の一時停止: クリエイターの確認を求めるプロンプト指示は、あくまでも推奨事項です。質問をバイパスするようにモデルに指示するフォローアップ メッセージを送信すると、人間の承認が完全にスキップされます。
これらのアーキテクチャ上のギャップを解消するため、モノリシック エージェントを分解して、次のステップで構築する明示的なグラフ ワークフローに変換します。
4. Agentic Workflows の基本
VibeStudio Workbench で、ステップ 4 · Agentic Workflows の基本のパート 4A~4D に移動します。
このステップでは、ADK Workflow を使用して、単一エージェントのベースラインから決定的グラフ オーケストレーションに移行します。並列リサーチ ファンアウトを構築し、結合ノードでブランチを同期し、スキーマ検証済みのクリエイティブ候補を生成し、決定論的な人間参加型の承認ゲートを導入します。
グラフ アーキテクチャと実行チェーン(4A)
ワークベンチで、グラフ アーキテクチャと実行チェーン(4A)を開きます。
ADK Workflow は、エージェントの実行を、エッジリストで定義された有向グラフとして構造化します。
- チェーン: 順次タプルは、線形ノード実行(
(node_a, node_b, node_c))を定義します。 - 並列ブランチ: 起点ノードを共有する独立したチェーンが同時に実行されます。
- 同期:
JoinNodeに収束するチェーンは、すべての受信ブランチがレポートするまで待機してからリリースします。 - 決定的制御: 実行フローは、プロンプト テキストから推測されるのではなく、宣言されたコード構造に則って制御されます。
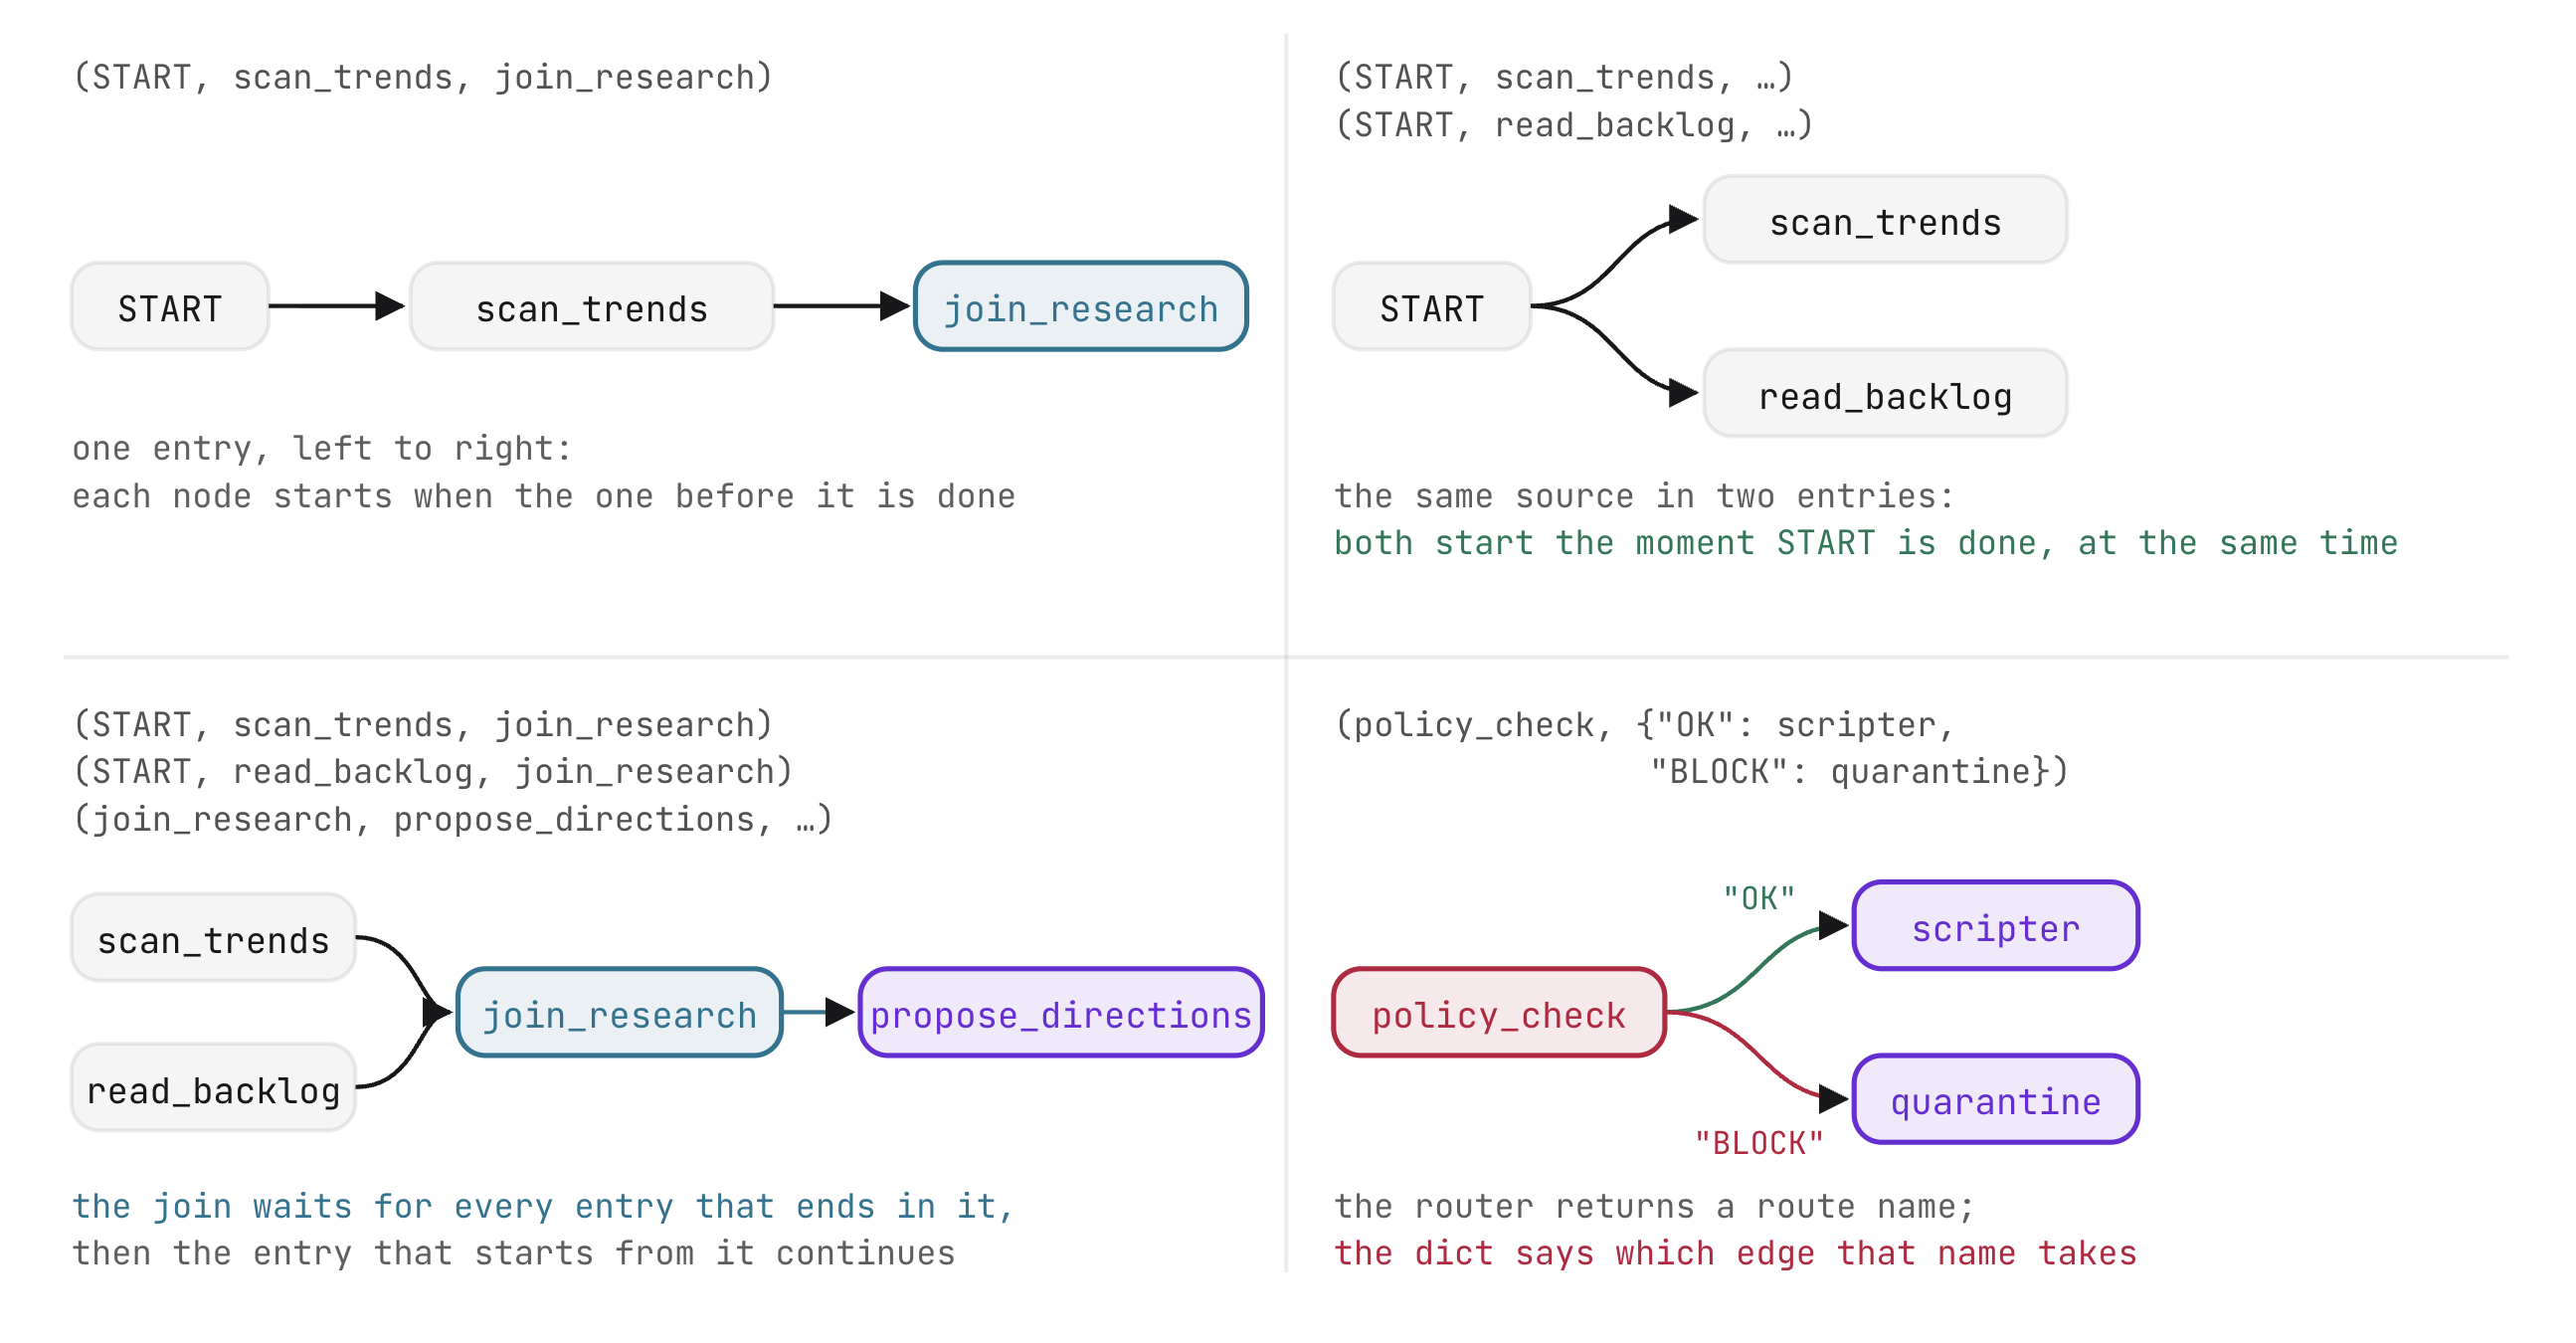
ADK のノード アーキタイプ
ADK ワークフローは、複数の特殊なノードタイプで構成されています。各アーキタイプは、グラフ内で特定の運用上の役割を果たし、決定論的コード実行と生成モデルの推論を分離します。
ノード アーキタイプ | 実装 | パイプラインでの役割 |
関数ノード |
| 決定的ロジック、データ取得、状態変更を実行します。 |
結合ノード | 組み込みの | 同時実行ブランチを集約された辞書に同期します。 |
エージェント ノード |
| アップストリーム入力に対して指示を評価し、検証済みデータを出力します。 |
ルーターノード |
| 条件付きロジックを評価して、ダウンストリームの実行ブランチを選択します。 |
人間入力ノード | 関数が | 外部ユーザーのレスポンスが届くまで実行状態を一時停止します。 |
root_agent = Workflow(
    name="stage1_fanout",
    description="2 real readers -> join -> one research dict",
    edges=[...])
この構成では、root_agent はスタンドアロンの Agent ではなく、Workflow のインスタンスです。ADK はワークフローをファーストクラスのエージェントとして扱うため、グラフ全体を統合アプリケーションとして読み込み、提供、検査できます。name は ADK Web にアプリケーションを登録し、edges リストは実行トポロジを定義します。
並列調査のファンアウト(4B)
ワークベンチで、並列研究ファンアウト(4B)に進みます。stage1_fanout/agent.py を開きます。
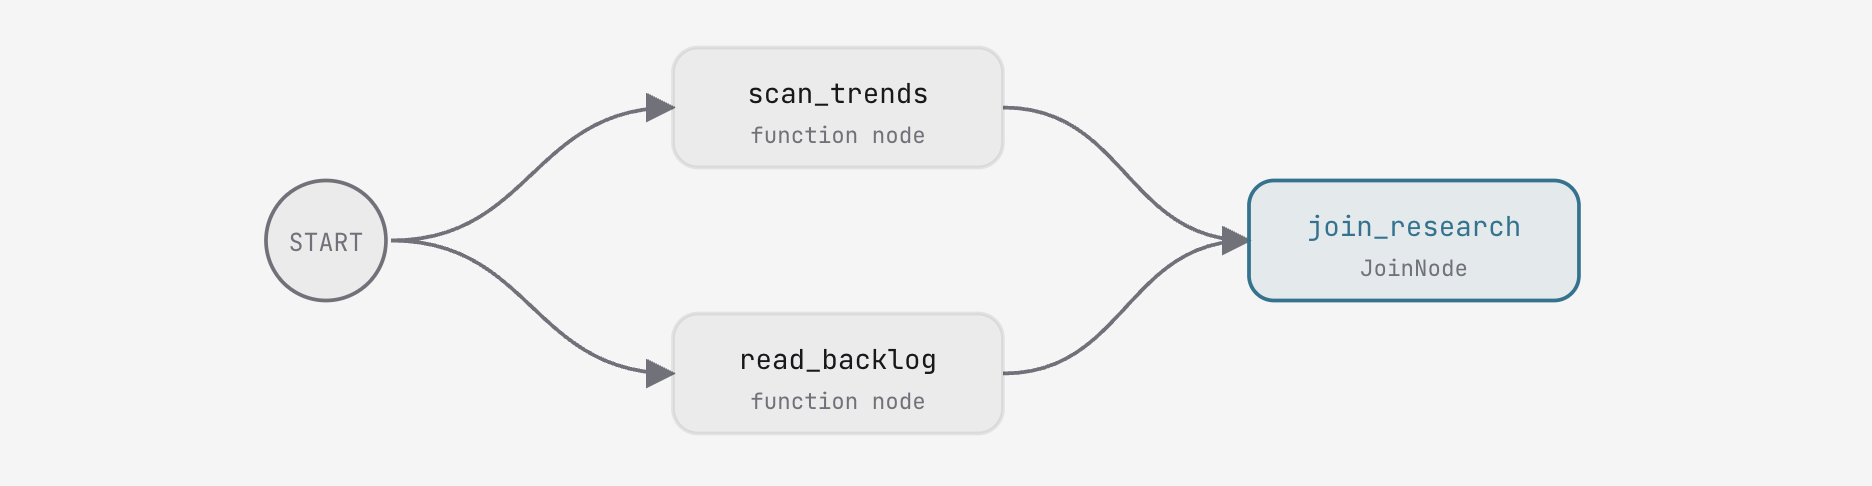
関数ノードと同期バリア
調査フェーズでは、agent/graph.py からインポートされた 2 つの関数ノードを使用します。
scan_trends: スコア付けされた 10 個のプラットフォーム トレンドを含むEvent(output={"trends": [...]})を返します。read_backlog: 15 個のチャンネル バックログ アイデアと最初の実行プロンプトを含むEvent(output={"backlog": [...], "idea": "..."})を返します。
各関数は node_input(前のノードの出力)を受け取り、Event を返します。
JoinNode は同期バリアとして機能します。すべてのインバウンド チェーンがイベントを配信するまで一時停止し、すべてのブランチの結果をノード名({"scan_trends": {...}, "read_backlog": {...}})をキーとする辞書に集約します。
ハンズオン編集: 結合エッジと平行エッジを定義する
stage1_fanout/agent.py で、JoinNode をインスタンス化し、START から始まる 2 つの並列チェーンを接続します。
join_research = JoinNode(name="join_research")
    edges=[(START, scan_trends, join_research),
           (START, read_backlog, join_research)])
変更内容を保存後、ワークベンチの検証ツールは、結合とエッジが配線されていることを確認します。[Run Stage 1] または埋め込み ADK ウェブ インターフェースを使用して、ステージを実行します。
想定される事象とその理由
- 同時リーダー実行: 実行グラフでは、
scan_trendsとread_backlogが同時に実行されます。- 理由: どちらのチェーンも
STARTから始まります。ADK エンジンは、独立したブランチを同時にスケジュールします。
- 理由: どちらのチェーンも
- 集約された辞書出力: ワークフローは
join_researchで完了し、両方のリーダーのエントリを含む辞書を出力します。- 理由:
JoinNodeは、後続のノードの実行を許可する前に、データの完全なキャプチャを保証します。
- 理由:
エージェント ノード(4C)
ワークベンチで、[Agent nodes (4C)] に進みます。stage2_direction/agent.py を開きます。
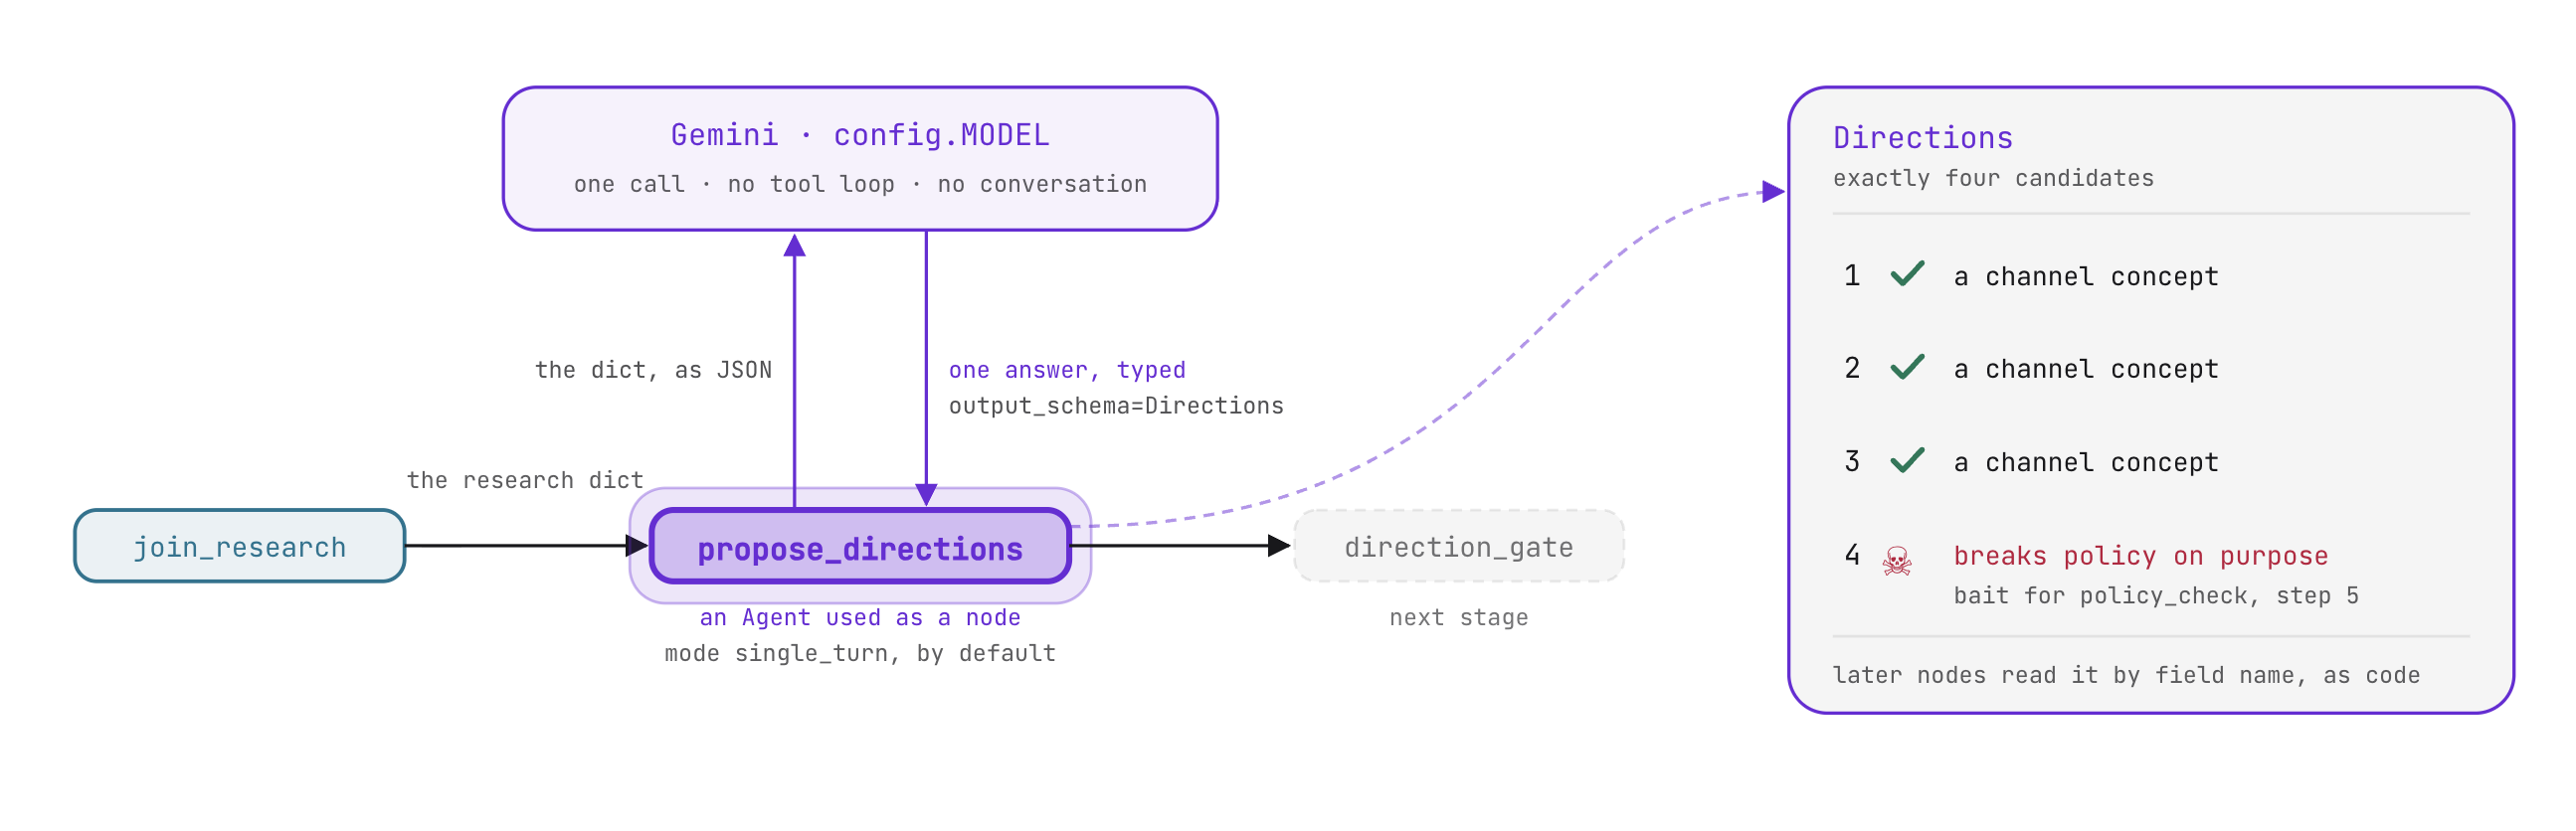
動作モードと構造化スキーマ
Workflow 内に埋め込まれた Agent は、デフォルトで single_turn モードで実行されます。
- 前のノードの出力をコンテキスト入力として受け取ります。
- 会話のやり取りなしで、1 回の推論呼び出しを実行します。
- 構造化データを次のノードに出力します。
output_schema=Directions を割り当てることで、エージェントはモデル出力に Pydantic 検証を適用します。ダウンストリーム グラフは、非構造化テキストではなく、型付きオブジェクトを受け取ります。
class Direction(BaseModel):
    title: str           # <=60 chars, filmable, characterful
    angle: str           # the twist, one line
    hook: str = ""       # 2-4 words, the video's sticker line
    evidence: list[Evidence]


class Directions(BaseModel):
    candidates: list[Direction]   # exactly 4
PROPOSE_INSTRUCTION は、トレンドとバックログの両方の証拠を引用して 4 つの候補を提案するようモデルに指示します。候補 1 ~ 3 は、実現可能なチャンネル コンセプトを提案しています。候補 4 は、次のステップで安全ゲートをテストするために、ポリシーに違反するコンセプトを意図的に導入しています。
ハンズオン編集: エージェント ノードを定義して結合をチェーンする
stage2_direction/agent.py で、propose_directions を構成し、ワークフロー エッジを拡張します。
propose_directions = Agent(
    name="propose_directions",
    model=config.MODEL,
    instruction=PROPOSE_INSTRUCTION,
    output_schema=Directions)
    edges=[(START, scan_trends, join_research),
           (START, read_backlog, join_research),
           (join_research, propose_directions, direction_gate)])
今後の流れと理由
- 辞書の直接使用:
propose_directionsは、手動でフォーマットすることなく、join_researchから出力された JSON ペイロードを使用します。 - 型付き候補出力: エージェントは、4 つの個別の候補を含む検証済みの
Directionsオブジェクトを出力します。ダウンストリーム ノードは、文字列を解析せずに、属性名(candidate.title)でフィールドを読み取ります。
人間参加型(4D)
ワークベンチで、[人間参加型 (4D)] に進みます。agent/graph.py を開きます。
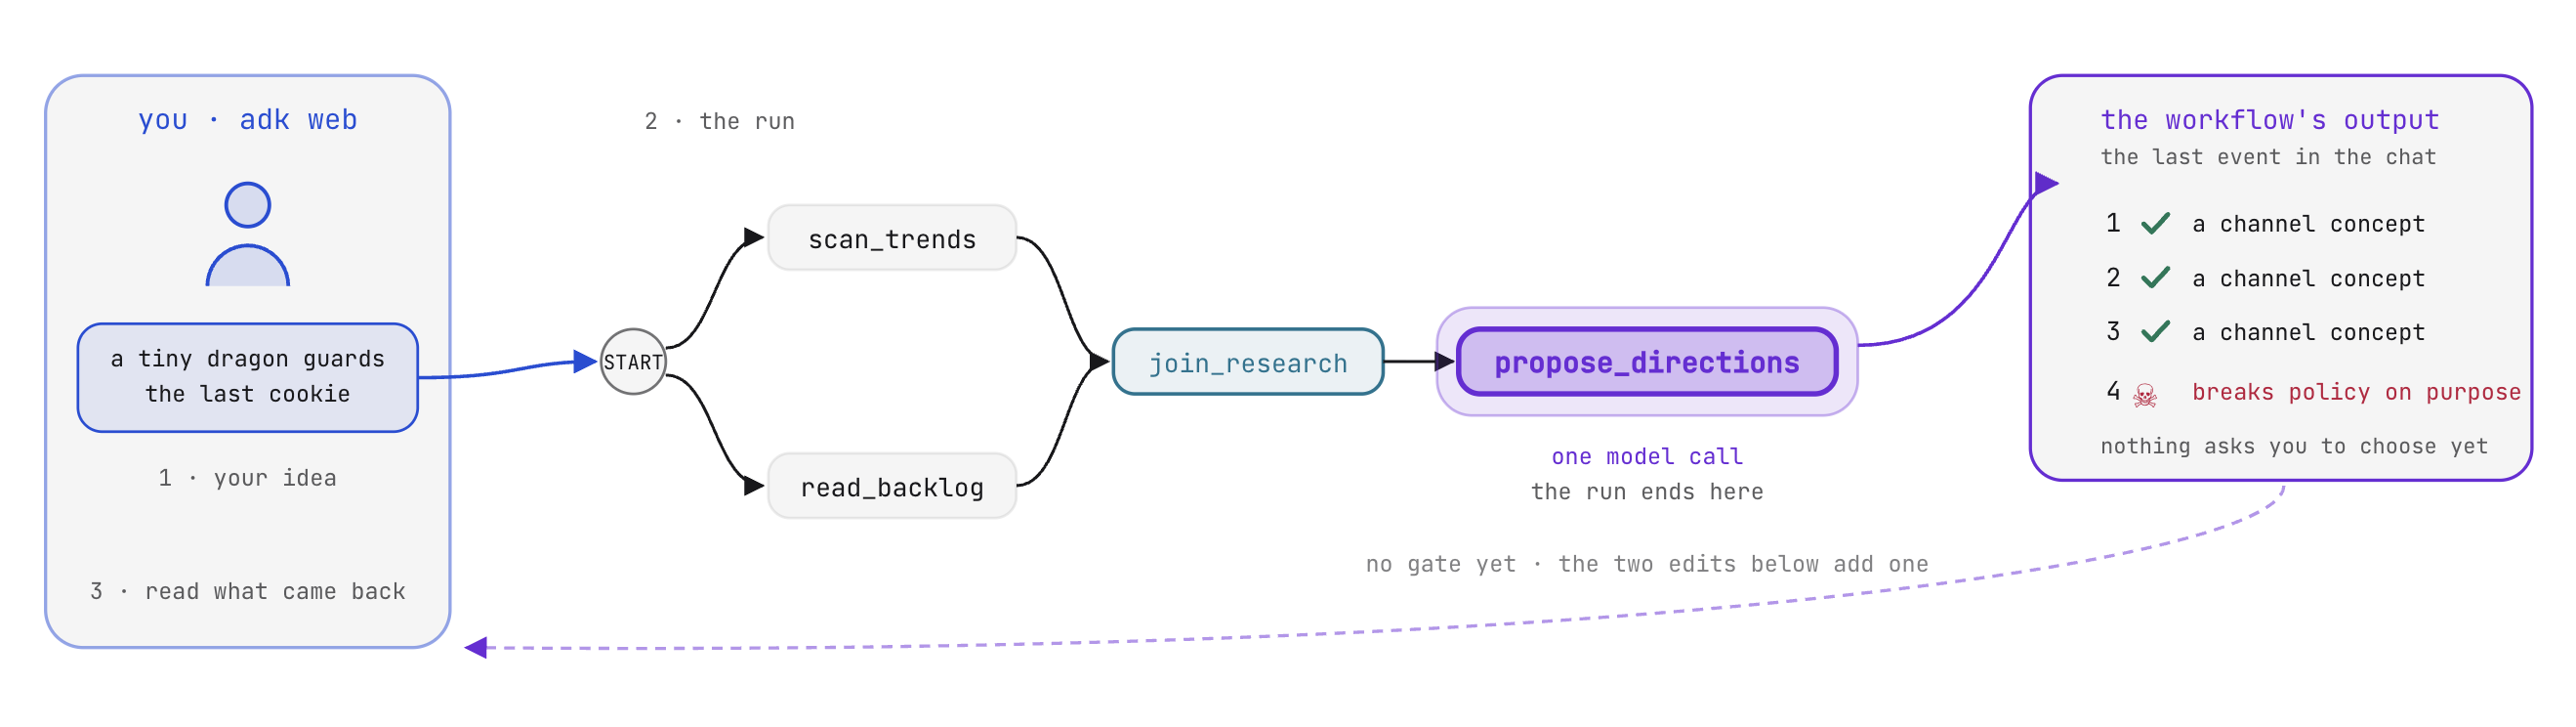
プロンプト指示と決定論的な停止
費用が発生する制作ワークフローやコンテンツの公開には、重要な意思決定ポイントで人間による監督が必要です。単一のプロンプトでは、確認リクエストはアドバイザリ指示であり、ユーザーはモデルに簡単にバイパスを指示できます。ADK ワークフローでは、実行エンジンによって人間の承認が強制されます。グラフは指定されたノードで停止し、スキーマ検証済みの外部入力を受け取るまで先に進むことができません。
RequestInputを生成すると、ワークフローの実行が直ちに一時停止します。- ADK は、セッション ストアにオープン割り込み呼び出しを記録し、一意の
interrupt_idを発行します。 - 実行プロセスは、トークンやサーバー スレッドを消費せずに停止します。
- グラフの実行は、スキーマと割り込み ID に一致する有効な
function_responseが送信された場合にのみ再開されます。
ハンズオン編集: RequestInput で実行を一時停止する
agent/graph.py で、direction_gate 内に一時停止呼び出しを実装します。
    yield RequestInput(
        message="Pick tonight's direction: 1, 2, 3 or 4.",
        response_schema={
            "type": "object",
            "properties": {
                "pick": {"type": "string", "enum": ["1", "2", "3", "4"]}}},
        payload={"candidates": cands})
RequestInput は次の 3 つの属性を構成します。
message: ユーザーに表示されるレビュー プロンプト。response_schema: フロントエンドが入力フォームとしてレンダリングする JSON スキーマ。送信時に ADK によって検証されます。payload: リクエストにバンドルされたメタデータ(4 つの候補)。クライアント インターフェースは、セッションの状態をクエリせずにレビューカードをレンダリングできます。
今後の流れと理由
- ワークフローが direction_gate で停止する: ADK Web またはワークベンチ インターフェースで、実行が一時停止し、インタラクティブな候補選択フォームが表示されます。
- 理由: エンジンが生成された
RequestInputを検出し、実行状態をruns/sessions.dbに保持しました。
- 理由: エンジンが生成された
- 再開には構造化された入力が必要: 任意のチャット テキストを送信しても、グラフは進みません。オプション(1、2、3、4)を選択すると、
response_schemaを満たす型付きのfunction_responseが送信され、実行が再開されます。
5. 状態とルーター
VibeStudio Workbench で、ステップ 5 · 状態とルーターのパート (5A)~(5C)に移動します。
ユーザーの選択をセッション状態に保持し、決定論的ルーターノードを使用してチャンネルの安全に関するポリシーを適用し、反復タスク エージェントを組み立てて、動画スクリプトを生成する前にポリシー違反を自動的に修正します。
ワークフローの状態(5A)
ワークベンチで、[Workflow State (5A)](ワークフローの状態(5A))に移動します。
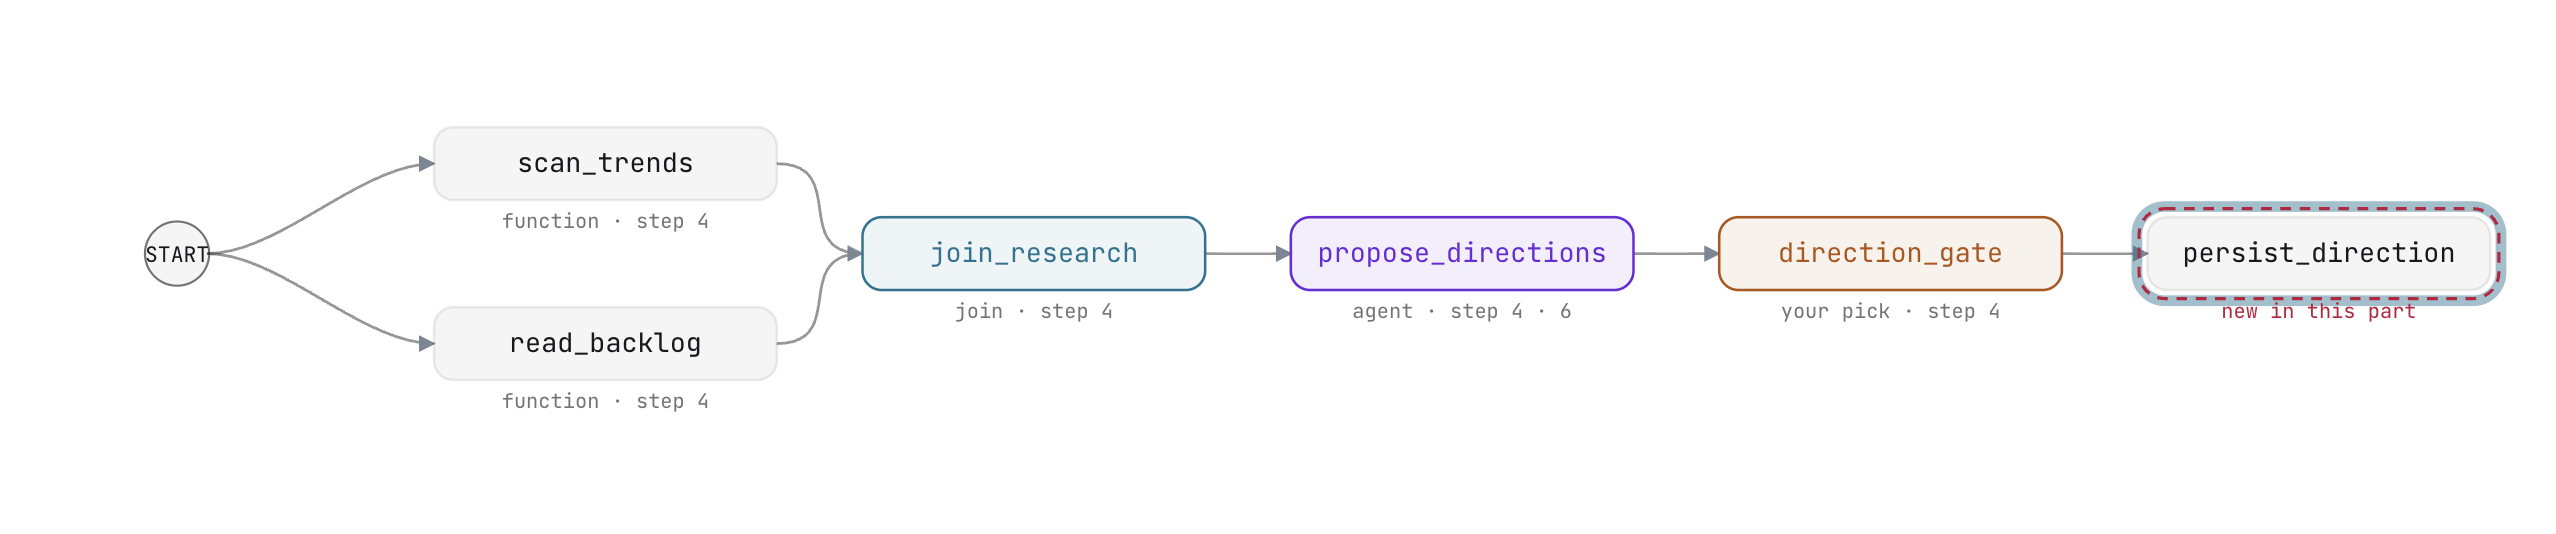
セッション状態とノード出力
ADK ワークフローでは、データは 2 つの異なるメカニズムを介してグラフを移動します。
- ノード出力(
Event(output=...)): エッジリストで定義された直近の下流コンシューマに直接送信されるデータ。 - セッション状態(
Event(state=...)): 実行ライフサイクル内の後続のノードからアクセスできる共有 Key-Value 辞書。
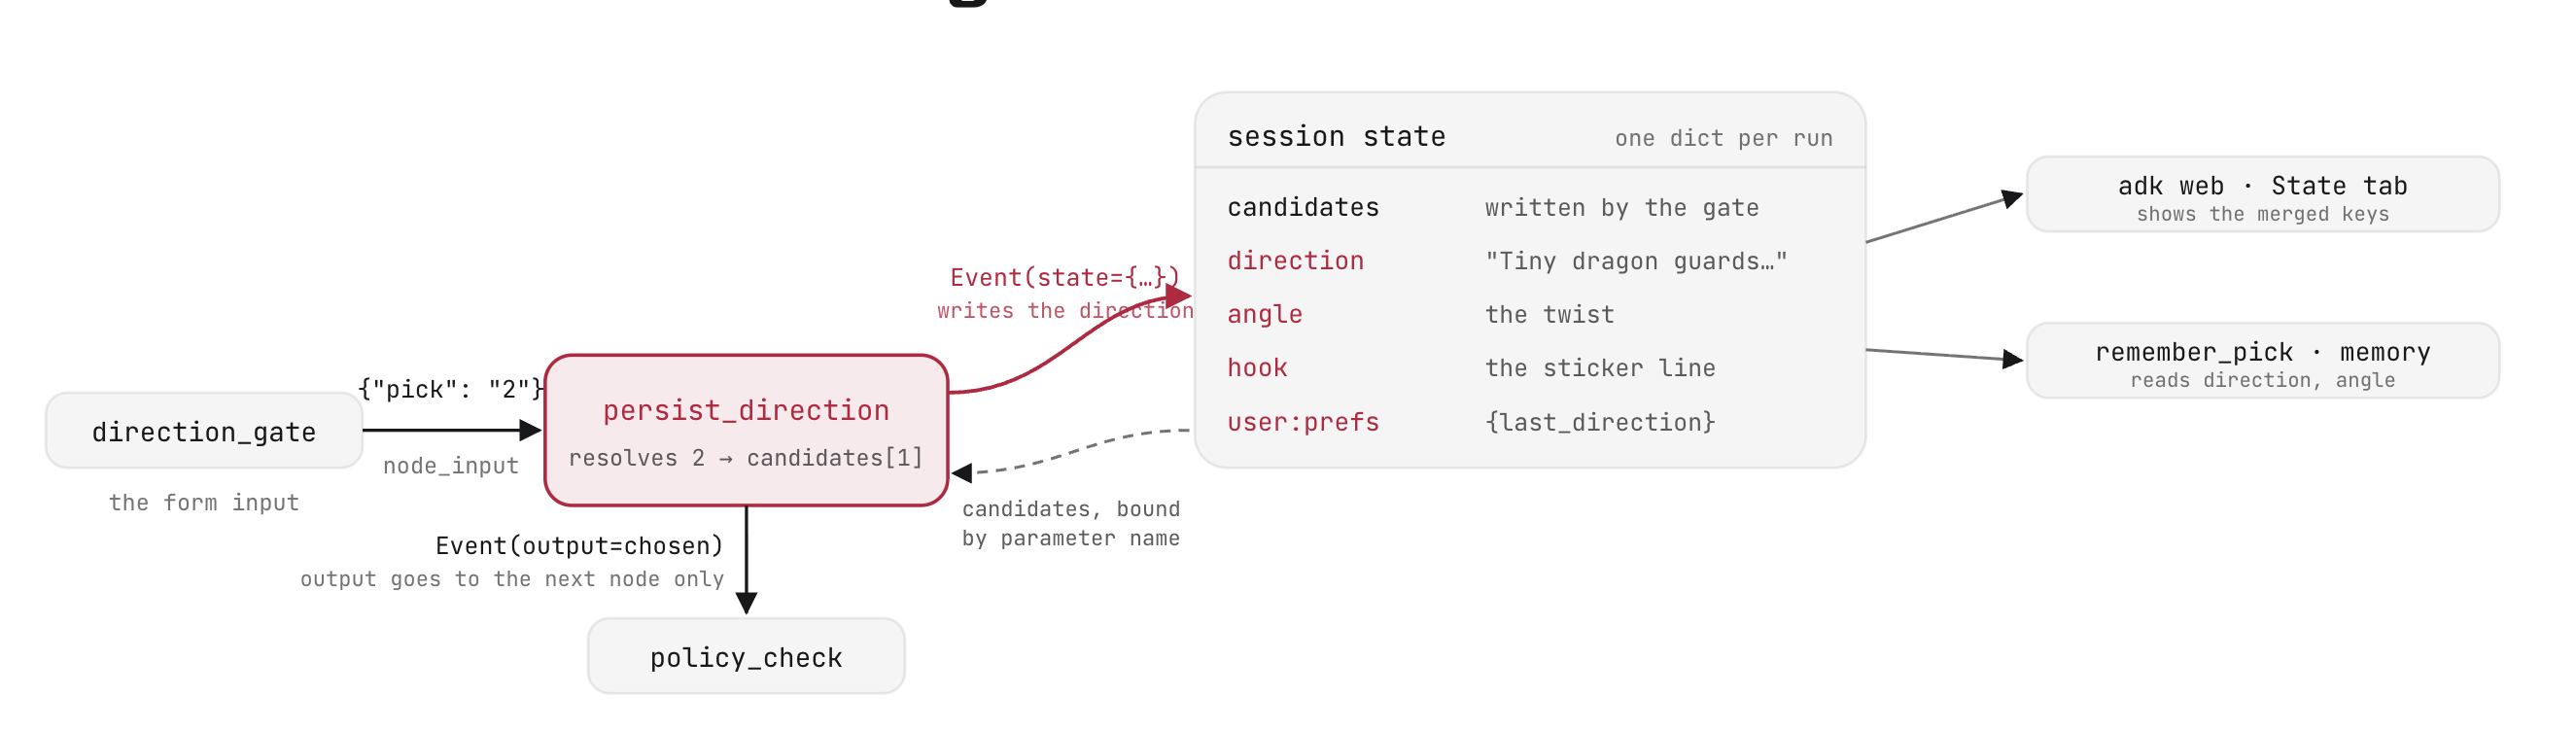
ユーザーが direction_gate で候補を選択すると、選択内容は数値インデックス({"pick": "2"})として届きます。下流のノードには、タイトル、ナラティブの角度、フックラインなど、完全な方向オブジェクトが必要です。persist_direction は、すべての中間ノードのペイロードを介して詳細なメタデータを渡すのではなく、解決された候補を共有セッション状態に書き込みます。
ノードはセッション状態の辞書全体を渡す必要はありません。ノードが Event(state=...) を生成すると、新しい Key-Value ペアまたは更新された Key-Value ペアのみが提供されます。ADK は、これらの更新をセッション ストアに自動的にマージします。
    yield Event(state={"direction": chosen["title"], "angle": chosen.get("angle", ""),
                       "hook": hook, "user:prefs": {"last_direction": chosen["title"]}})
この Event を生成すると、制御が Workflow ランタイムに渡され、新しい値が runs/sessions.db のセッション ジャーナルに保持されます。
パラメータ バインディング
ADK 関数ノードは、パラメータ検査を通じてセッション状態を自動的に読み取ります。関数シグネチャで既存の状態キーと一致するパラメータ名が宣言されている場合、ADK はそのキーを状態から抽出し、直接渡します。
def persist_direction(node_input, candidates: list = []):
    ni = node_input if isinstance(node_input, dict) else {}
    raw = ni.get("pick")
    pick = str(raw).strip() if raw is not None else ""
    if candidates:
        i = int(pick) - 1 if pick.isdigit() else 0
        chosen = candidates[max(0, min(len(candidates) - 1, i))]
    else:
        chosen = {"title": "untitled", "angle": "", "evidence": []}
    hook = chosen.get("hook") or " ".join(chosen["title"].split()[:4])
ここで、candidates は direction_gate によってセッション状態に書き込まれました。ADK は、明示的な辞書ルックアップを必要とせずに、persist_direction(node_input, candidates: list = []) に直接バインドします。
user: で始まるキーは、ユーザーレベルのストレージでセッション間で保持されるため、後続のワークフロー実行でクリエイターの設定にアクセスできます。
ハンズオン編集: 状態の永続化とノードの接続
agent/graph.pyのpersist_direction内で、TODO: PERSIST_STATE行を状態イベントの yield に置き換えます。
    yield Event(state={"direction": chosen["title"], "angle": chosen.get("angle", ""),
                       "hook": hook, "user:prefs": {"last_direction": chosen["title"]}})
stage3_router/agent.pyで、edgesリストの 3 番目のチェーンにpersist_directionを追加します。
           (join_research, propose_directions, direction_gate,
            persist_direction)
ファイルを保存します。ワークベンチで、state write in place と persist_direction in the chain の両方に緑色のチェックマークが表示されていることを確認します。
ルーターノード(5B)
ワークベンチで、ルーターノード(5B)に移動します。
決定論的ポリシー ルーティング
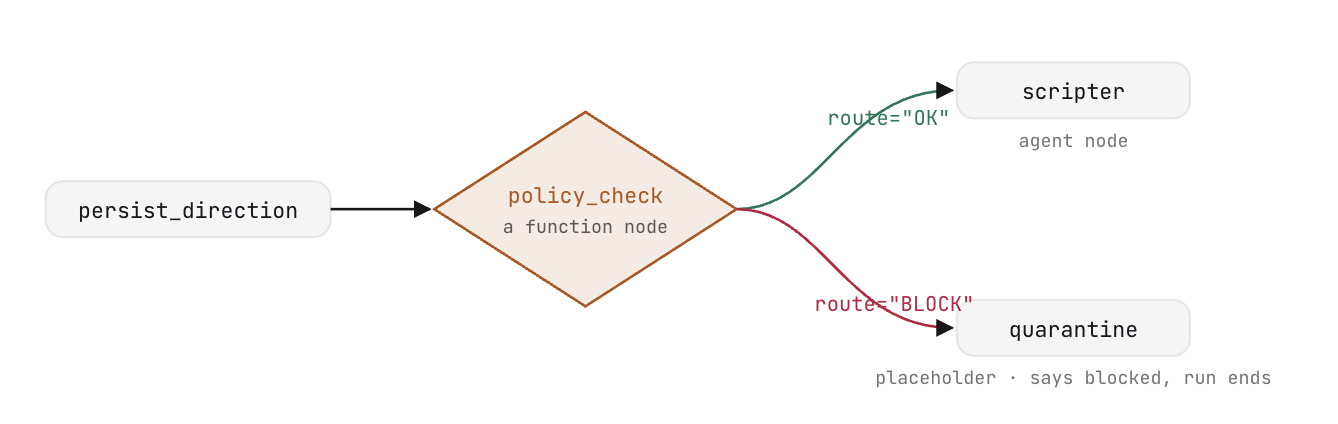
ルーターは、アップストリームの出力を評価し、条件付きグラフの分岐に沿って実行を指示する特別な関数ノードです。生成エージェントとは異なり、ルーターは LLM 呼び出しを行わずに決定論的ロジックを実行します。
ルーターは、route タグを指定する Event を返します。
def length_check(node_input):
    too_long = len(node_input.get("title", "")) > 60
    return Event(output=node_input, route="TRIM" if too_long else "PASS")
ワークフロー定義では、辞書として定義されたエッジ ターゲットが、ルート名を宛先ノードにマッピングします。
(length_check, {"TRIM": shorten, "PASS": scripter}),
ワークフロー ルーター policy_check は、agent/policy_words.txt から禁止フレーズを読み取り、選択した方向のタイトルと角度に対して単語全体の一致を実行します。
return Event(output=node_input, route="BLOCK" if bad else "OK")
ポリシーをハードコードされた指示ではなくデータとして保存することで、ワークフロー グラフを変更せずに更新できます。テキスト ファイルを更新すると、以降の実行にすぐに適用されます。評価は決定論的な正規表現照合であるため、生成スクリプトが開始される前に、トークン費用なしでミリ秒単位で実行されます。
宛先: Scripter と検疫
ルーターは、次の 2 つの下流ノードのいずれかにトラフィックを転送します。
scripter: 承認された指示を、ScriptPydantic スキーマに準拠した構造化された制作スクリプトに変換するsingle_turnエージェント ノード。
scripter = Agent(
    name="scripter",
    model=config.MODEL,
    instruction=SCRIPT_INSTRUCTION,
    output_schema=Script)
quarantine: 最初は、フラグが設定された指示を停止するプレースホルダ関数でしたが、次の部分で自律型修復エージェントに置き換えられます。
実践的な編集: ポリシー チェックのルーティング
agent/graph.pyのpolicy_check内で、return 文を完成させます。
return Event(output=node_input, route="BLOCK" if bad else "OK")
stage3_router/agent.pyで、edgesを更新してpolicy_checkをルーティングし、隔離ブランチをscripterに再結合します。
           (join_research, propose_directions, direction_gate,
            persist_direction, policy_check),
           (policy_check, {"OK": scripter, "BLOCK": quarantine}),
           (quarantine, scripter)])
ファイルを保存します。ワークベンチで、ルーターのエッジ マッピングが検証されていることを確認します。
エージェント モードとタスクノード(5C)
ワークベンチで、エージェント モードとタスクノード(5C)に移動します。
エージェントの実行モード
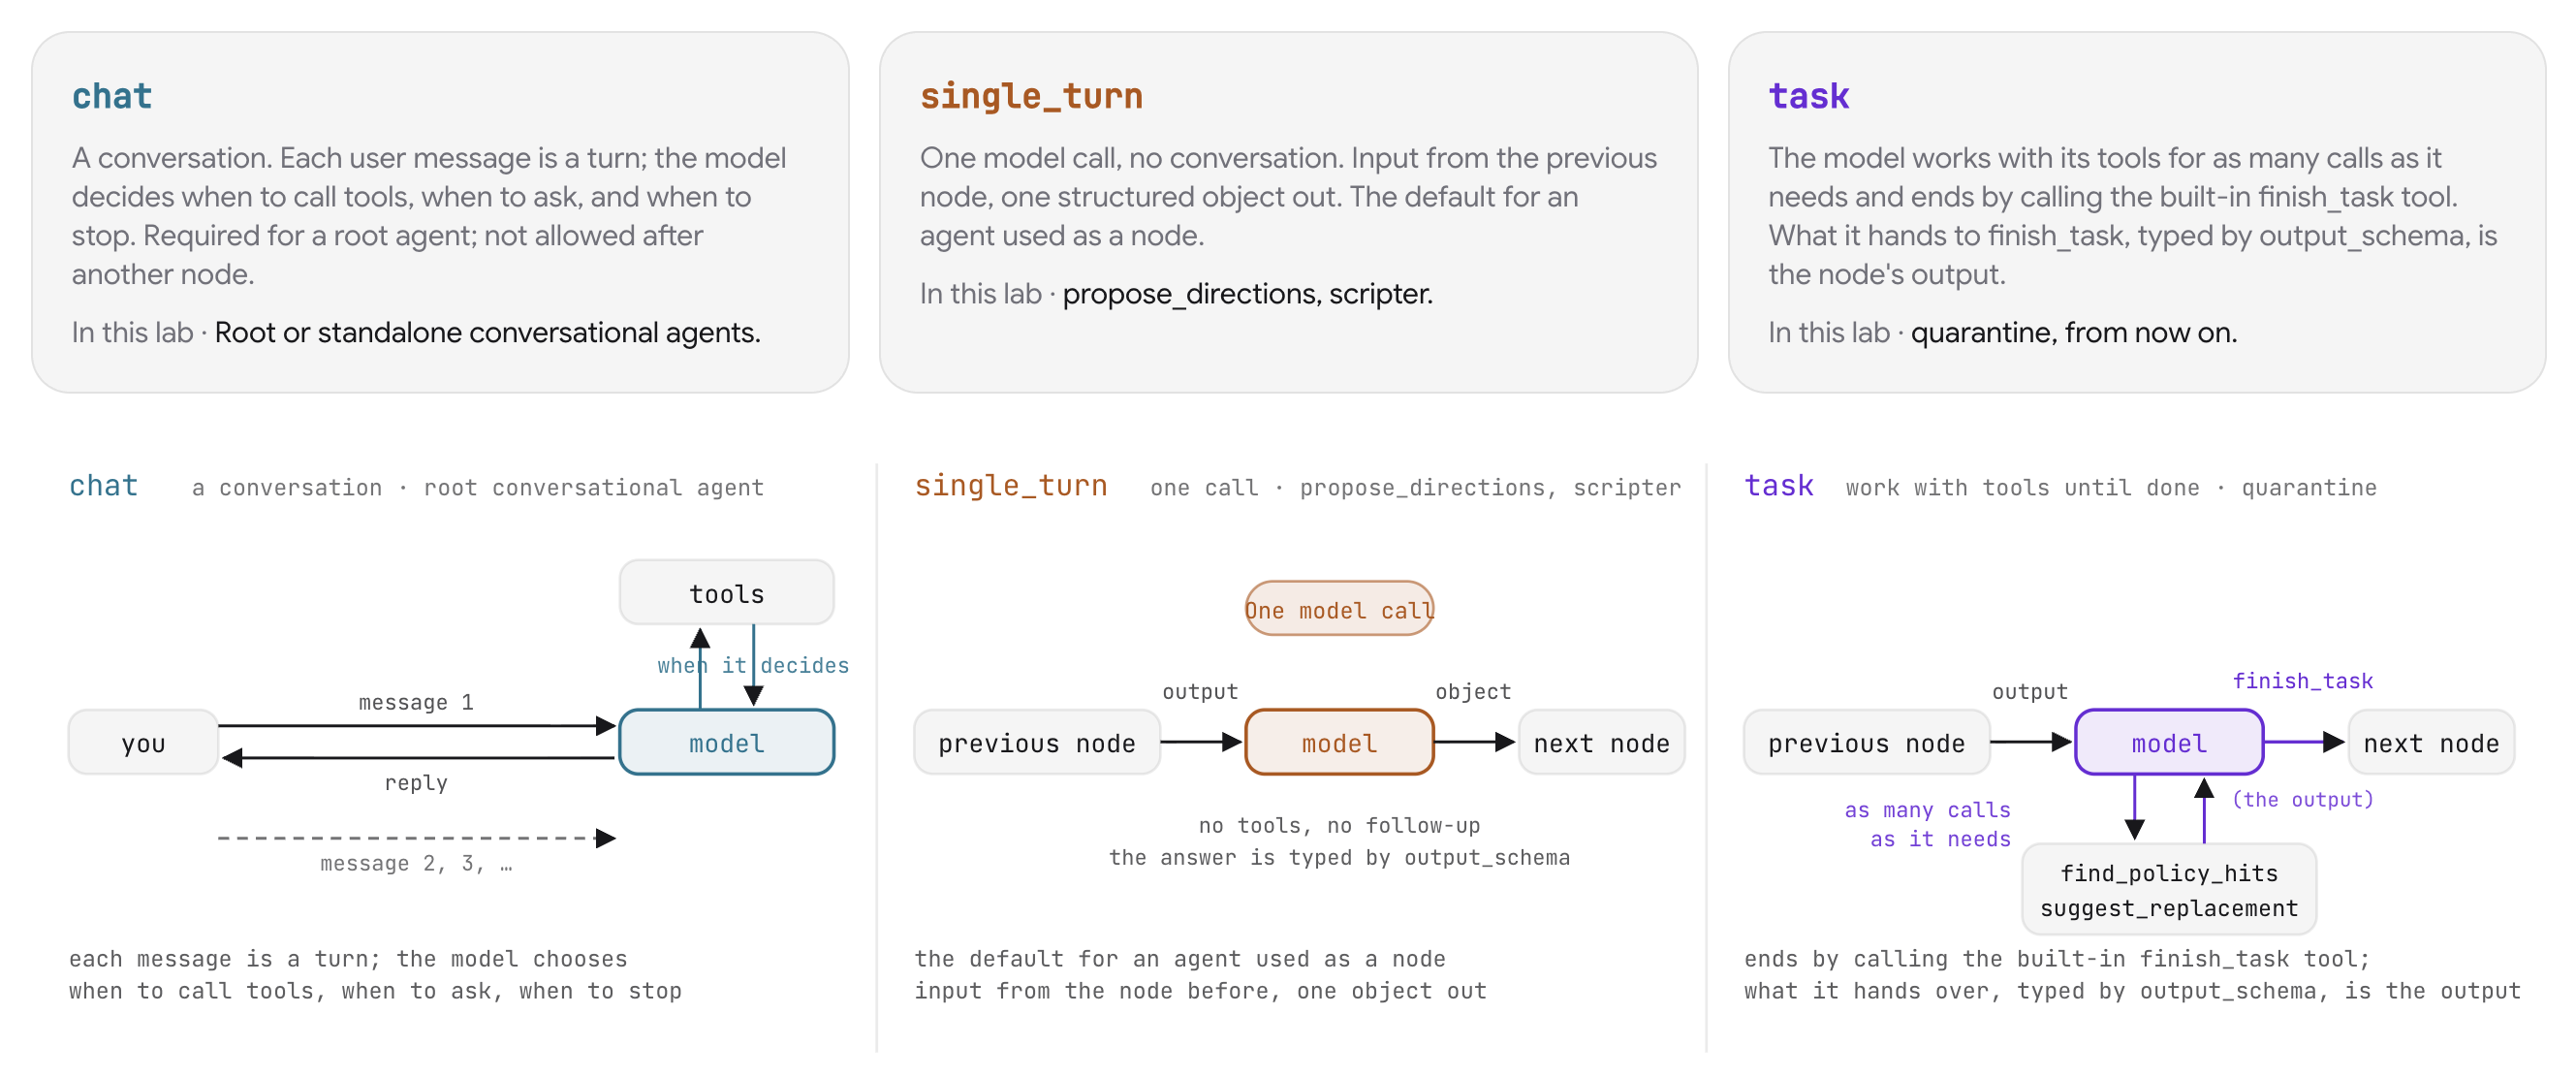
ADK Agent インスタンスは、特定のパイプライン要件に合わせて調整された 3 つの実行モードをサポートしています。
モード | 実行ライフサイクル | パイプラインにおける役割 |
| マルチターンの会話ループ。モデルは、ツールを呼び出すタイミング、入力を求めるタイミング、ターンを終了するタイミングを決定します。 | インタラクティブな人間のユーザーに接するルート エージェント。 |
| 単一モデルの推論呼び出し。前のノードの入力を受け取り、構造化されたスキーマ オブジェクトを出力します。 | シーケンシャル グラフ変換( |
| ツール実行による自律ループ。エージェントは、組み込みの | 複数ステップの修復と検査( |
自律的なポリシーの修復
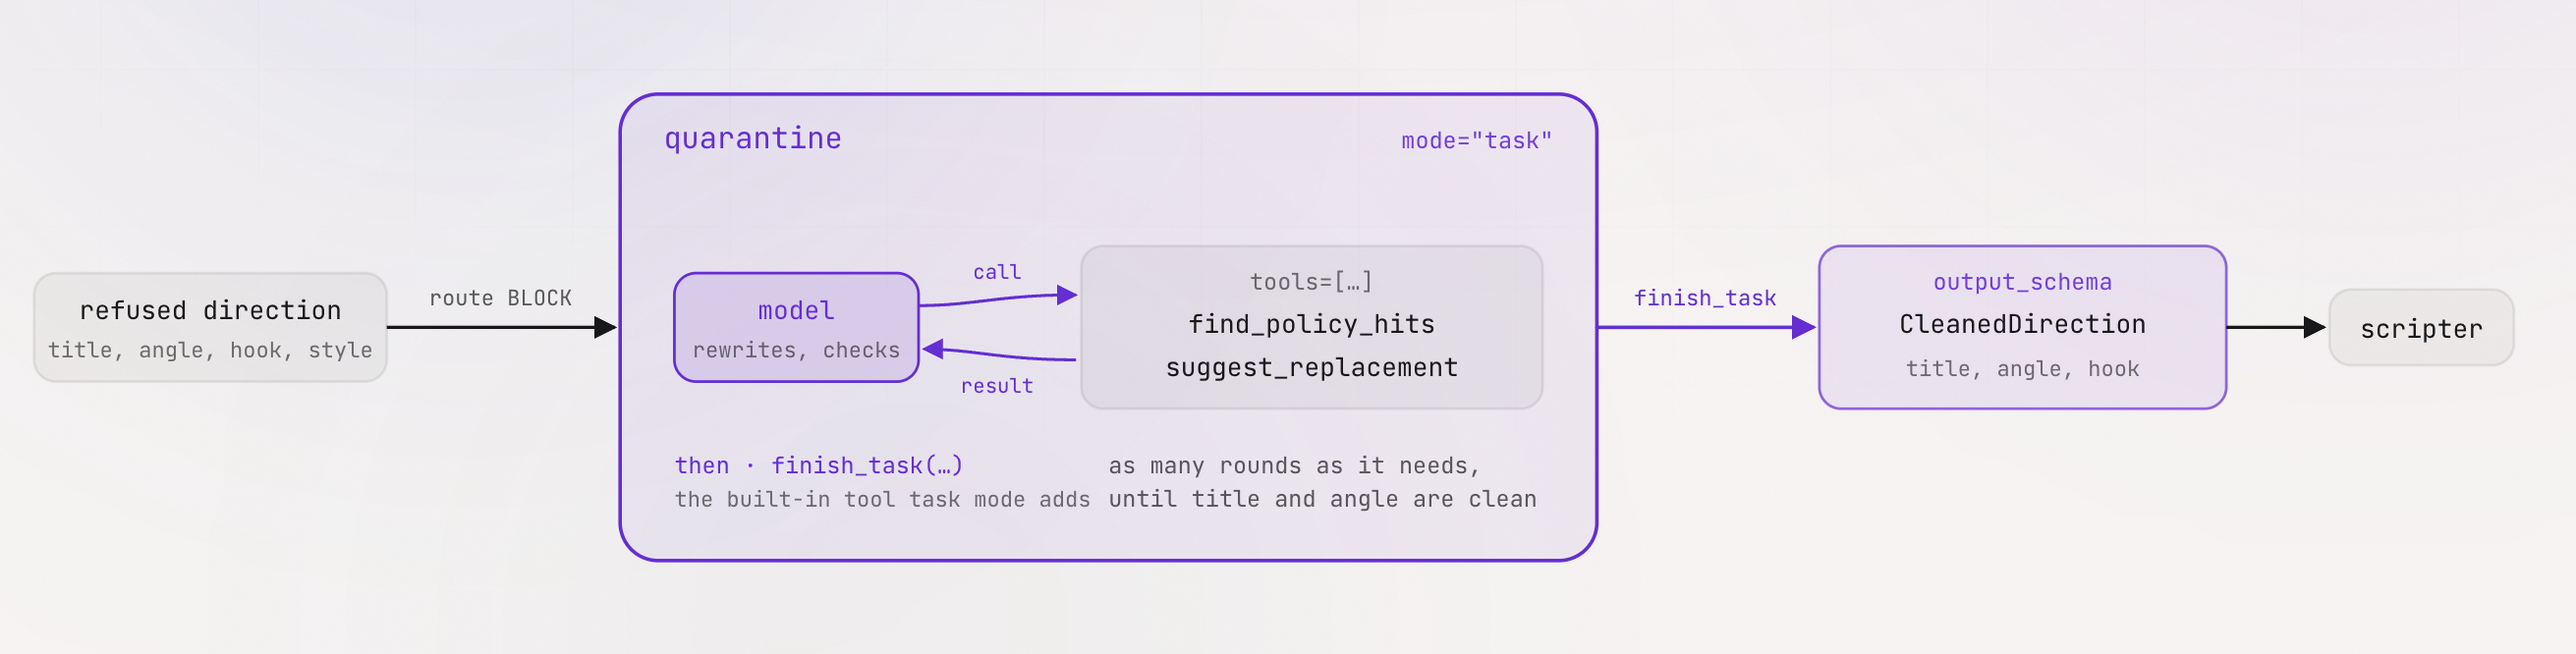
フラグが設定された方向を書き換えるには、修正の反復回数が可変であるため、task モードが必要です。エージェントは、フラグが付けられた指示を受け取り、find_policy_hits を呼び出して違反を検出し、suggest_replacement を介して承認済みの代替案をリクエストし、指示を書き換えて、クリーンであることを確認してから続行します。
どちらのツールも、型付きシグネチャと docstring を使用して agent/cleanup_tools.py で定義されています。
def find_policy_hits(text: str) -> dict:
    """Which refused words appear in `text`. Matches whole words and phrases
    from agent/policy_words.txt, case-insensitive.

    Returns {"hits": [...], "clean": bool}. clean is true when hits is empty.
    """


def suggest_replacement(word: str) -> dict:
    """The channel's approved stand-in for a refused word, read from
    agent/policy_replacements.txt.

    Returns {"word", "replacement", "listed"}. When the word has no entry,
    listed is false and replacement is a hint to pick a gentle synonym.
    """
ハンズオン編集: 検疫タスク エージェントを組み立てる
stage3_router/agent.py で、プレースホルダ quarantine 関数をタスク エージェントの定義に置き換えます。
quarantine = Agent(
    name="quarantine",
    model=config.MODEL,
    instruction=QUARANTINE_INSTRUCTION,
    mode="task",
    tools=[find_policy_hits, suggest_replacement],
    output_schema=CleanedDirection,
)
タスクモードでは、エージェントにツールが提供され、finish_task を呼び出すことで実行が終了します。mode="task" が構成されると、ADK は finish_task を自動的に提供し、そのパラメータを output_schema から導出します。これにより、ノードはスクリプター ノードの入力スキーマに一致する型付き CleanedDirection オブジェクトを生成します。
今後の流れと理由
ADK Web または VibeStudio Workbench で両方の実行パスをテストします。
- 承認済みルート(候補者 1、2、3):
- 承認済みの候補を選択すると、
policy_checkからscripter(route="OK")に直接ルーティングされます。 - スクリプターは、
Scriptスキーマに準拠した 3 ショットの制作スクリプトを生成します。
- 承認済みの候補を選択すると、
- 隔離修復ルート(候補 4):
- 候補 4 には、フラグが立てられた語彙(「クリックベイト」、「バイラル ハック」)が含まれています。
policy_checkからquarantine(route="BLOCK")までのルート。- セッション トレースで、
quarantineがfind_policy_hitsを呼び出し、違反ごとにsuggest_replacementを呼び出し、タイトルを書き換え、finish_taskを呼び出していることを確認します。 - 実行は
scripterに再結合し、サニタイズされた方向からスクリプトを生成します。
6. メモリバンク
VibeStudio Workbench で、ステップ 6 · メモリバンクのパート (6A) と (6B) に移動します。
現在、このワークフローはセッション間でメモリを使用せずに動作します。各実行はゼロから始まり、クリエイターが以前に選択した内容や好みのジャンルは認識されません。このステップでは、Vertex AI Agent Engine Memory Bank を接続して、実行間でクリエイターの好みを保存して取得します。
重要なのは、メモリがパイプライン ノードではなく、エージェント ライフサイクル コールバックを介して統合されることです。メモリの抽出と取得は中間データ ステージではなく個々のエージェントに提供されるため、コールバックをアタッチすると、クリーンで分離されたグラフ トポロジが維持されます。
メモリバンク(6A)
ワークベンチで、[メモリバンク(6A)] に移動します。
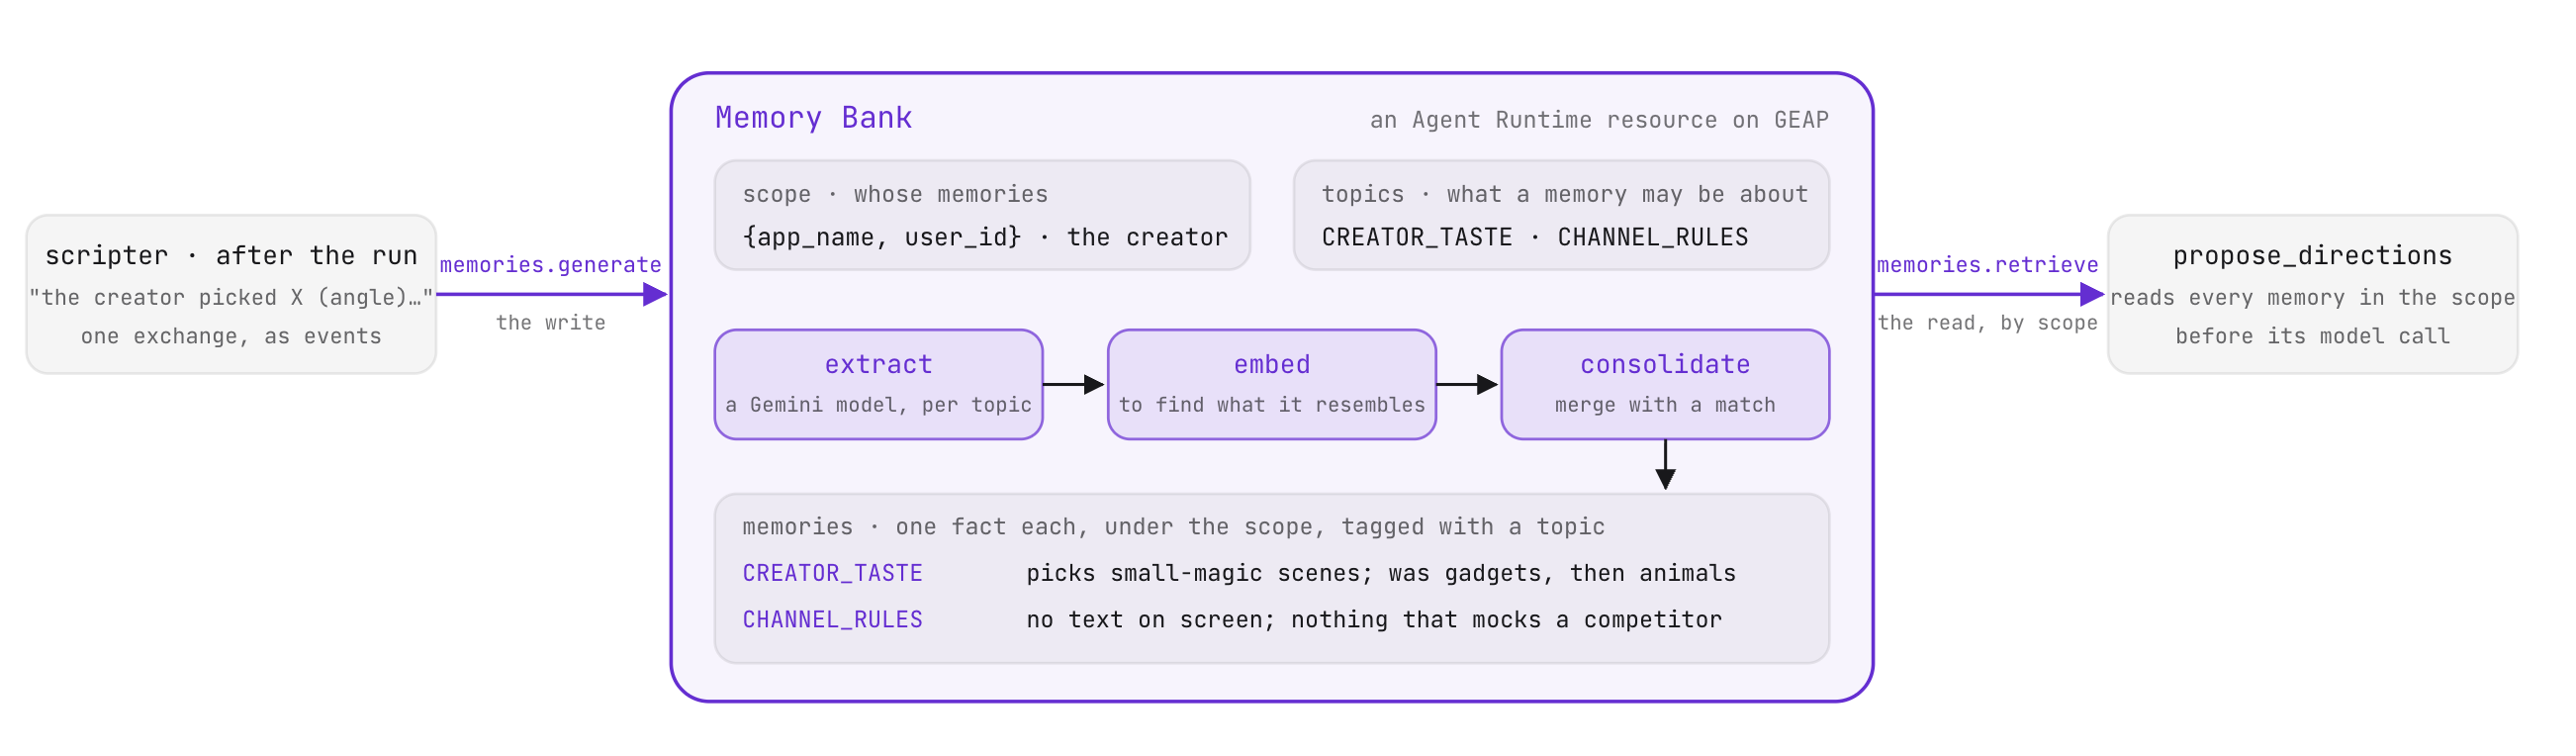
管理対象のユーザーレベルのメモリ
Memory Bank は、長期的なユーザー メモリ用のマネージド サービスです。これは、定義されたスコープ(ここではアプリ名とユーザー ID で識別)の下で、ユーザーに関する事実を整理します。
SCOPE = {"app_name": config.APP, "user_id": config.USER}
TOPICS = {
    "CREATOR_TASTE": "Which video directions this creator picks and passes on, "
                     "and how that preference changes over time.",
    "CHANNEL_RULES": "Standing instructions the creator states for every video "
                     "(style, subjects to avoid, format rules).",
}
カスタム メモリトピックは、バンクが記録する内容の境界を定義します。
- トピックの抽出:
memories.generateを介して新しい会話テキストが送信されると、サービスは各トピックの説明に抽出モデルを適用します。トピックと一致しないテキストは、思い出を生成しません。 - 統合と重複除去: サービスは、新しく抽出された事実をエンベディングに変換し、スコープ内の既存のメモリーと比較します。観察結果が既存のメモリと一致すると、サービスはそのメモリを更新します。新しい情報である場合、サービスは新しいエントリを作成します。この統合プロセスにより、トピックに関する複数のセッションが、冗長なエントリを生成するのではなく、一貫した要約に統合されます。
- 取得: ユーザースコープで
memories.retrieveを呼び出すと、保存されている事実が古い順に返されます。
どちらのオペレーションも agent/platform/memory.py に実装されています。プロビジョニングされた銀行リソース名は、runs/memorybank.json にローカルでキャッシュに保存されます。
メモリバンクの設定
ワークベンチ コントロールを使用するか、ターミナルで CLI コマンドを実行します。
- バンクを接続してプロビジョニングする:
python -m agent.platform.bankCREATOR_TASTEトピックとCHANNEL_RULESトピックを構成します。 - Seed historical sessions(過去のセッションをシード):
python -m agent.platform.bank load - 統合されたファクトを検査する:
python -m agent.platform.bank list
コールバック(6B)
ワークベンチで、[コールバック(6B)] に移動します。stage4_memory/agent.py を開きます。
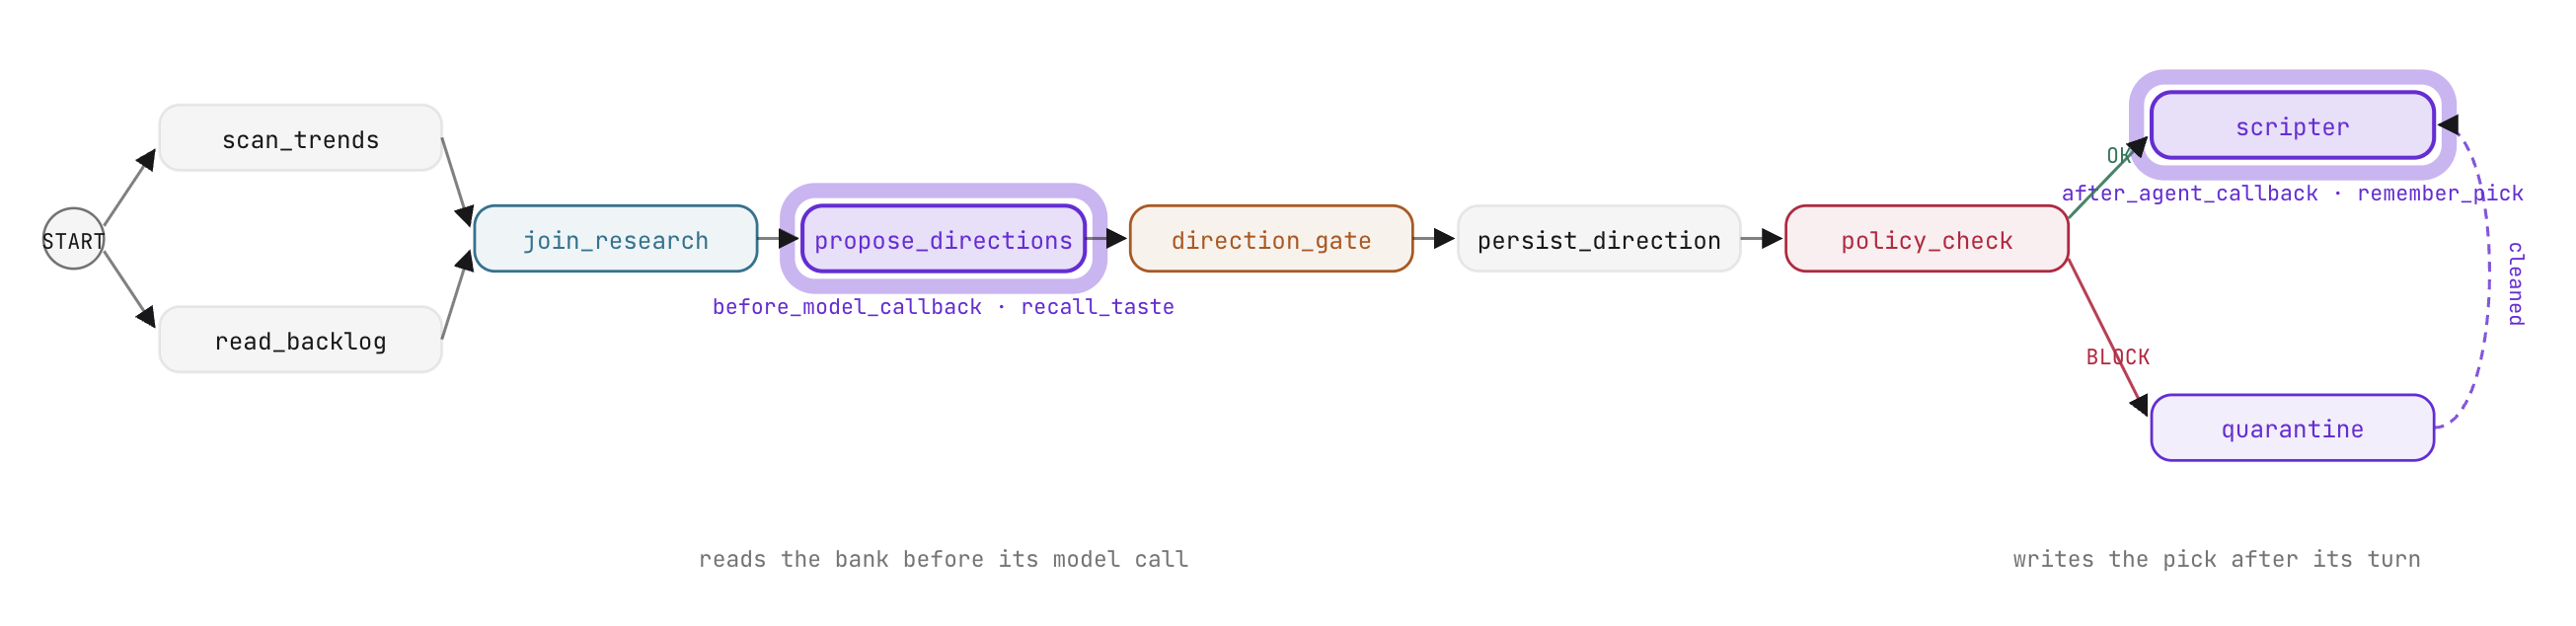
ADK エージェント ライフサイクル コールバック
コールバックは、Agent に引数として渡される関数です。ADK は、事前定義されたライフサイクルのタイミングでコールバックを呼び出し、アクティブなコンテキストを渡します。None を返すと、通常の実行が継続されます。置換オブジェクトを返すと、オペレーションがオーバーライドまたはインターセプトされます。
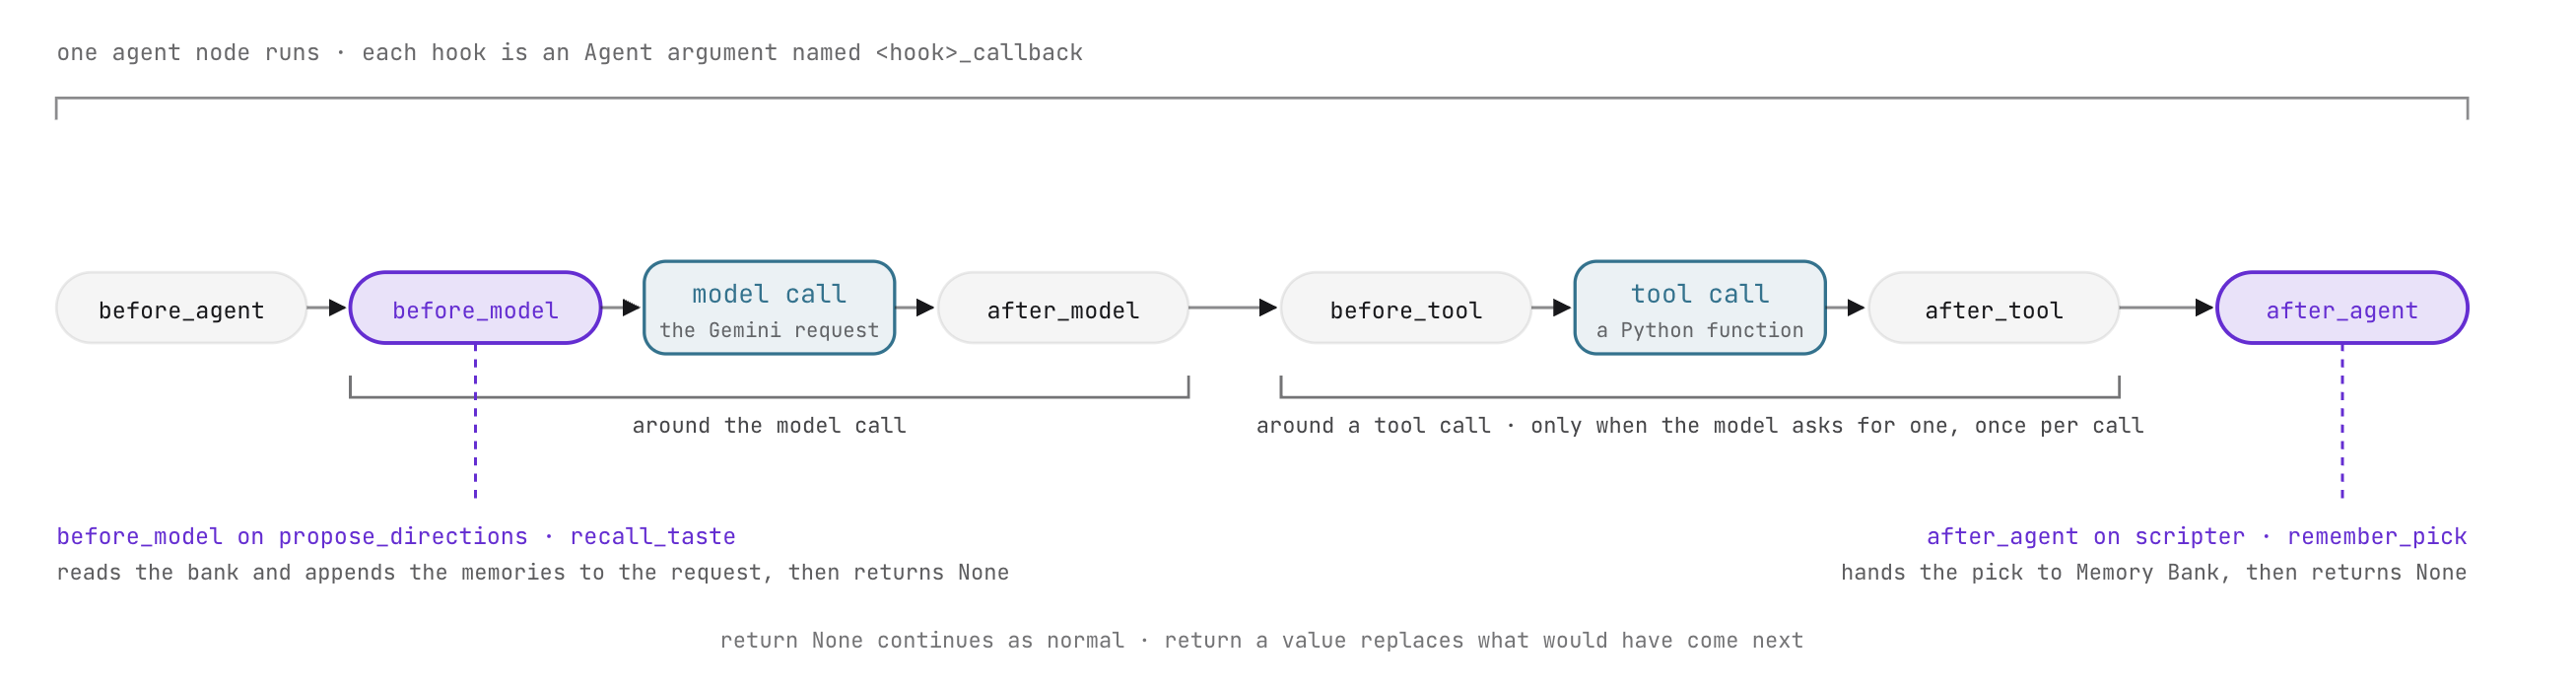
ADK には、次の 3 つのコールバックのペアが用意されています。
コールバック ペア | 呼び出しポイント | 受信したパラメータ | 戻り値の動作 |
| エージェントのターン全体を囲む |
|
|
| 各 LLM 推論呼び出しを囲む |
|
|
| 各ツールの実行を囲む | ツールの定義、引数、結果 | 辞書を返すと、ツールの出力がオーバーライドされ、 |
コールバックは、ワークフロー グラフに余分なノードを導入することなく、コンテキスト インジェクション、ガードレール、テレメトリー、キャッシュ ルックアップをクリーンに実行できる場所を提供します。
ハンズオン編集: コールバックの呼び出しと記憶を接続する
stage4_memory/agent.pyで、propose_directionsを更新してbefore_model_callback=recall_tasteをアタッチします。
    output_schema=Directions,
    before_model_callback=recall_taste)
recall_taste は、Gemini が候補のルートを生成する直前に実行されます。クリエイターの履歴をメモリバンクから取得し、最も古いメモリーから順にフォーマットして、送信する LlmRequest に追加します。このプロンプトは、チャンネル ルールを厳格な制約として扱いながら、候補 1 ~ 3 をクリエイターの現在の好みに近づけるようモデルに指示しています。
stage4_memory/agent.pyで、scripterを更新してafter_agent_callback=remember_pickをアタッチします。
    output_schema=Script,
    after_agent_callback=remember_pick)
remember_pick は、scripter がターンを完了した後に実行されます。セッション状態から選択された方向を読み取り、クリエイターの決定を要約した簡潔なステートメントを合成して、memories.generate を呼び出してメモリバンクを更新します。
今後の流れと理由
ワークベンチまたは ADK Web でコールバック拡張ワークフローをテストします。
- 空のプロンプトで実行を実行します。
- セッション トレースで、
propose_directionsのLlmRequestを確認します。ファンタジー テーマと簡潔なペースを好むクリエイターの好みを詳しく説明するメモリ コンテキストが追加されています。 - 提案された方向性を確認します。候補 1 ~ 3 は、トレンドが他のトピックを強調している場合でも、クリエイターの過去の好みに沿っています。
- セッション トレースで、
direction_gateで候補を選択します。scripterが完了したら、メモリバンクのレコードを確認します。python -m agent.platform.bank list
7. RAG Engine
VibeStudio Workbench で、ステップ 7 · RAG Engine のパート (7A) と (7B) に移動します。
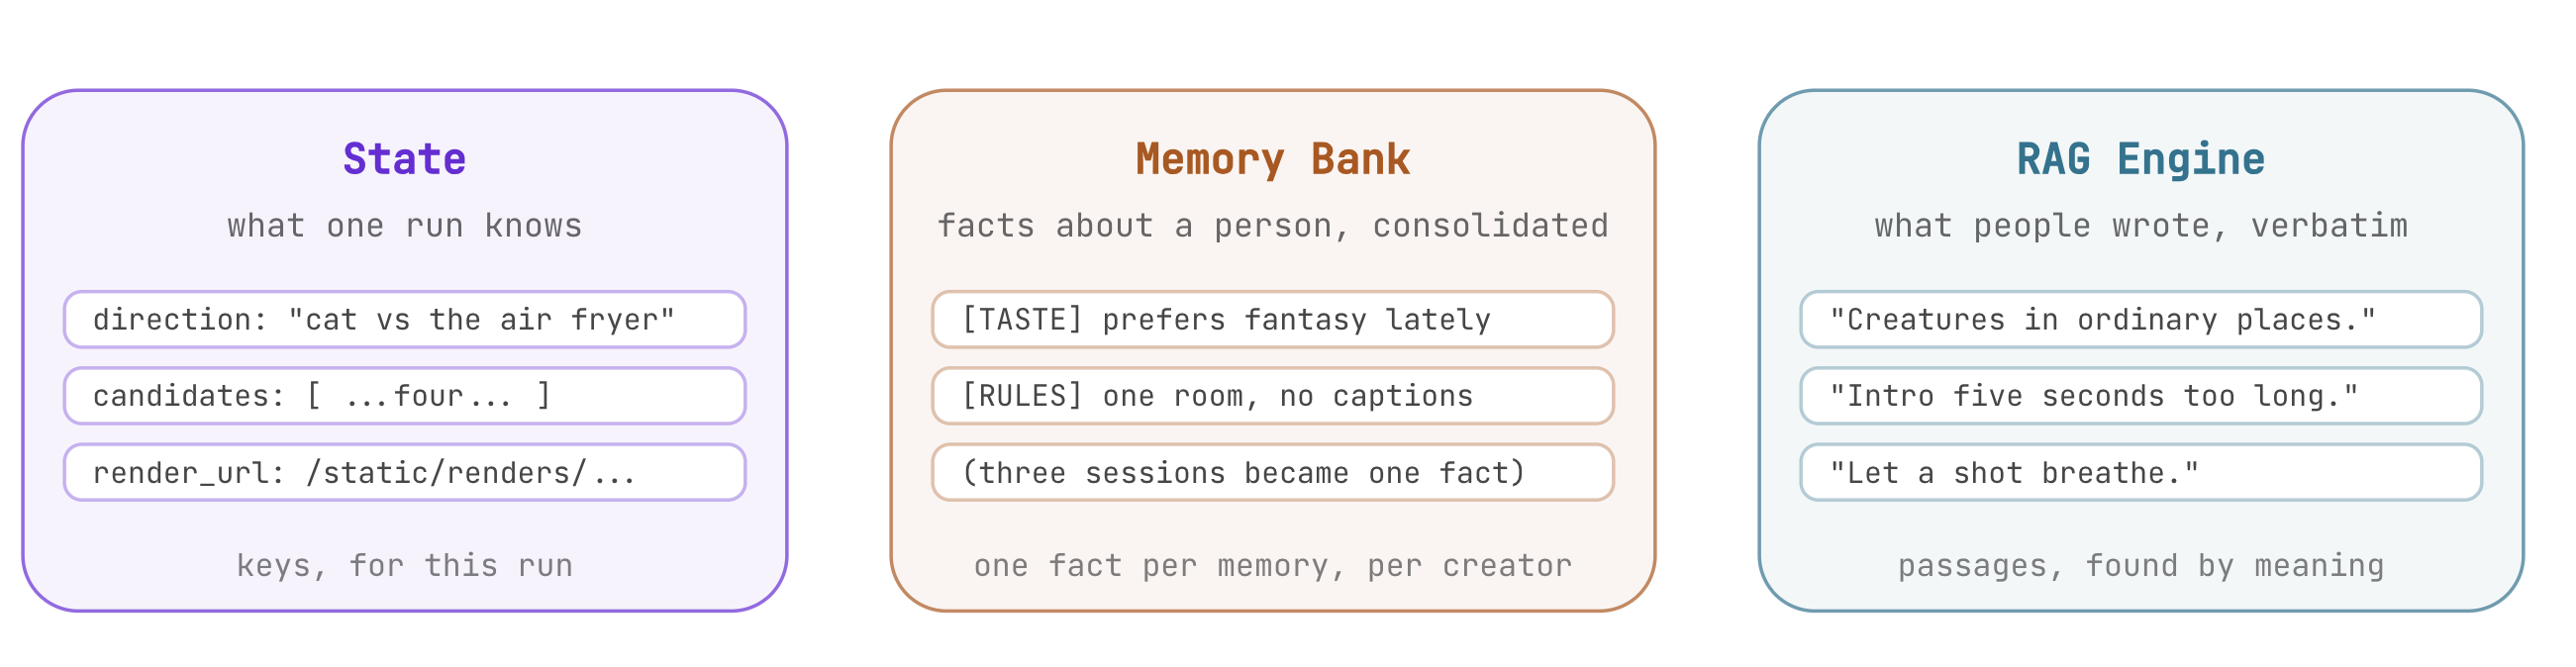
公開された動画には、視聴者からのフィードバックが継続的に蓄積されます。agent/comments.md には 30 件の代表的なコメントが収集され、視聴者の称賛、スポンサー付きコンテンツのペースに関する批判、音声の好みなどが記録されています。このステップでは、Vertex AI RAG Engine を使用してこれらのコメントをインデックスに登録し、セマンティック検索をリサーチ ファンアウトに接続します。
ドキュメントの取得(7A)
ワークベンチで、[RAG Engine (7A)] に移動します。
メモリバンクと RAG Engine の比較
どちらのツールもワークフローを外部データに統合しますが、アーキテクチャ上の目的は異なります。
ディメンション | メモリバンク | RAG Engine |
主なユースケース | 長期的なユーザー設定と運用ルール | 大規模なドキュメント コレクションに対するセマンティック検索 |
スコープ | 個々のユーザー ID とアプリケーション名にスコープ設定 | すべてのユーザーの共有コーパス リソースにスコープ設定 |
データ処理 | リアルタイムの抽出、エンベディング、セマンティック統合 | ドキュメントのチャンク化、ベクトル エンベディング、最近傍探索 |
グラフの統合 | エージェント ライフサイクル コールバック( | リサーチ ファンアウトの専用関数ノード( |
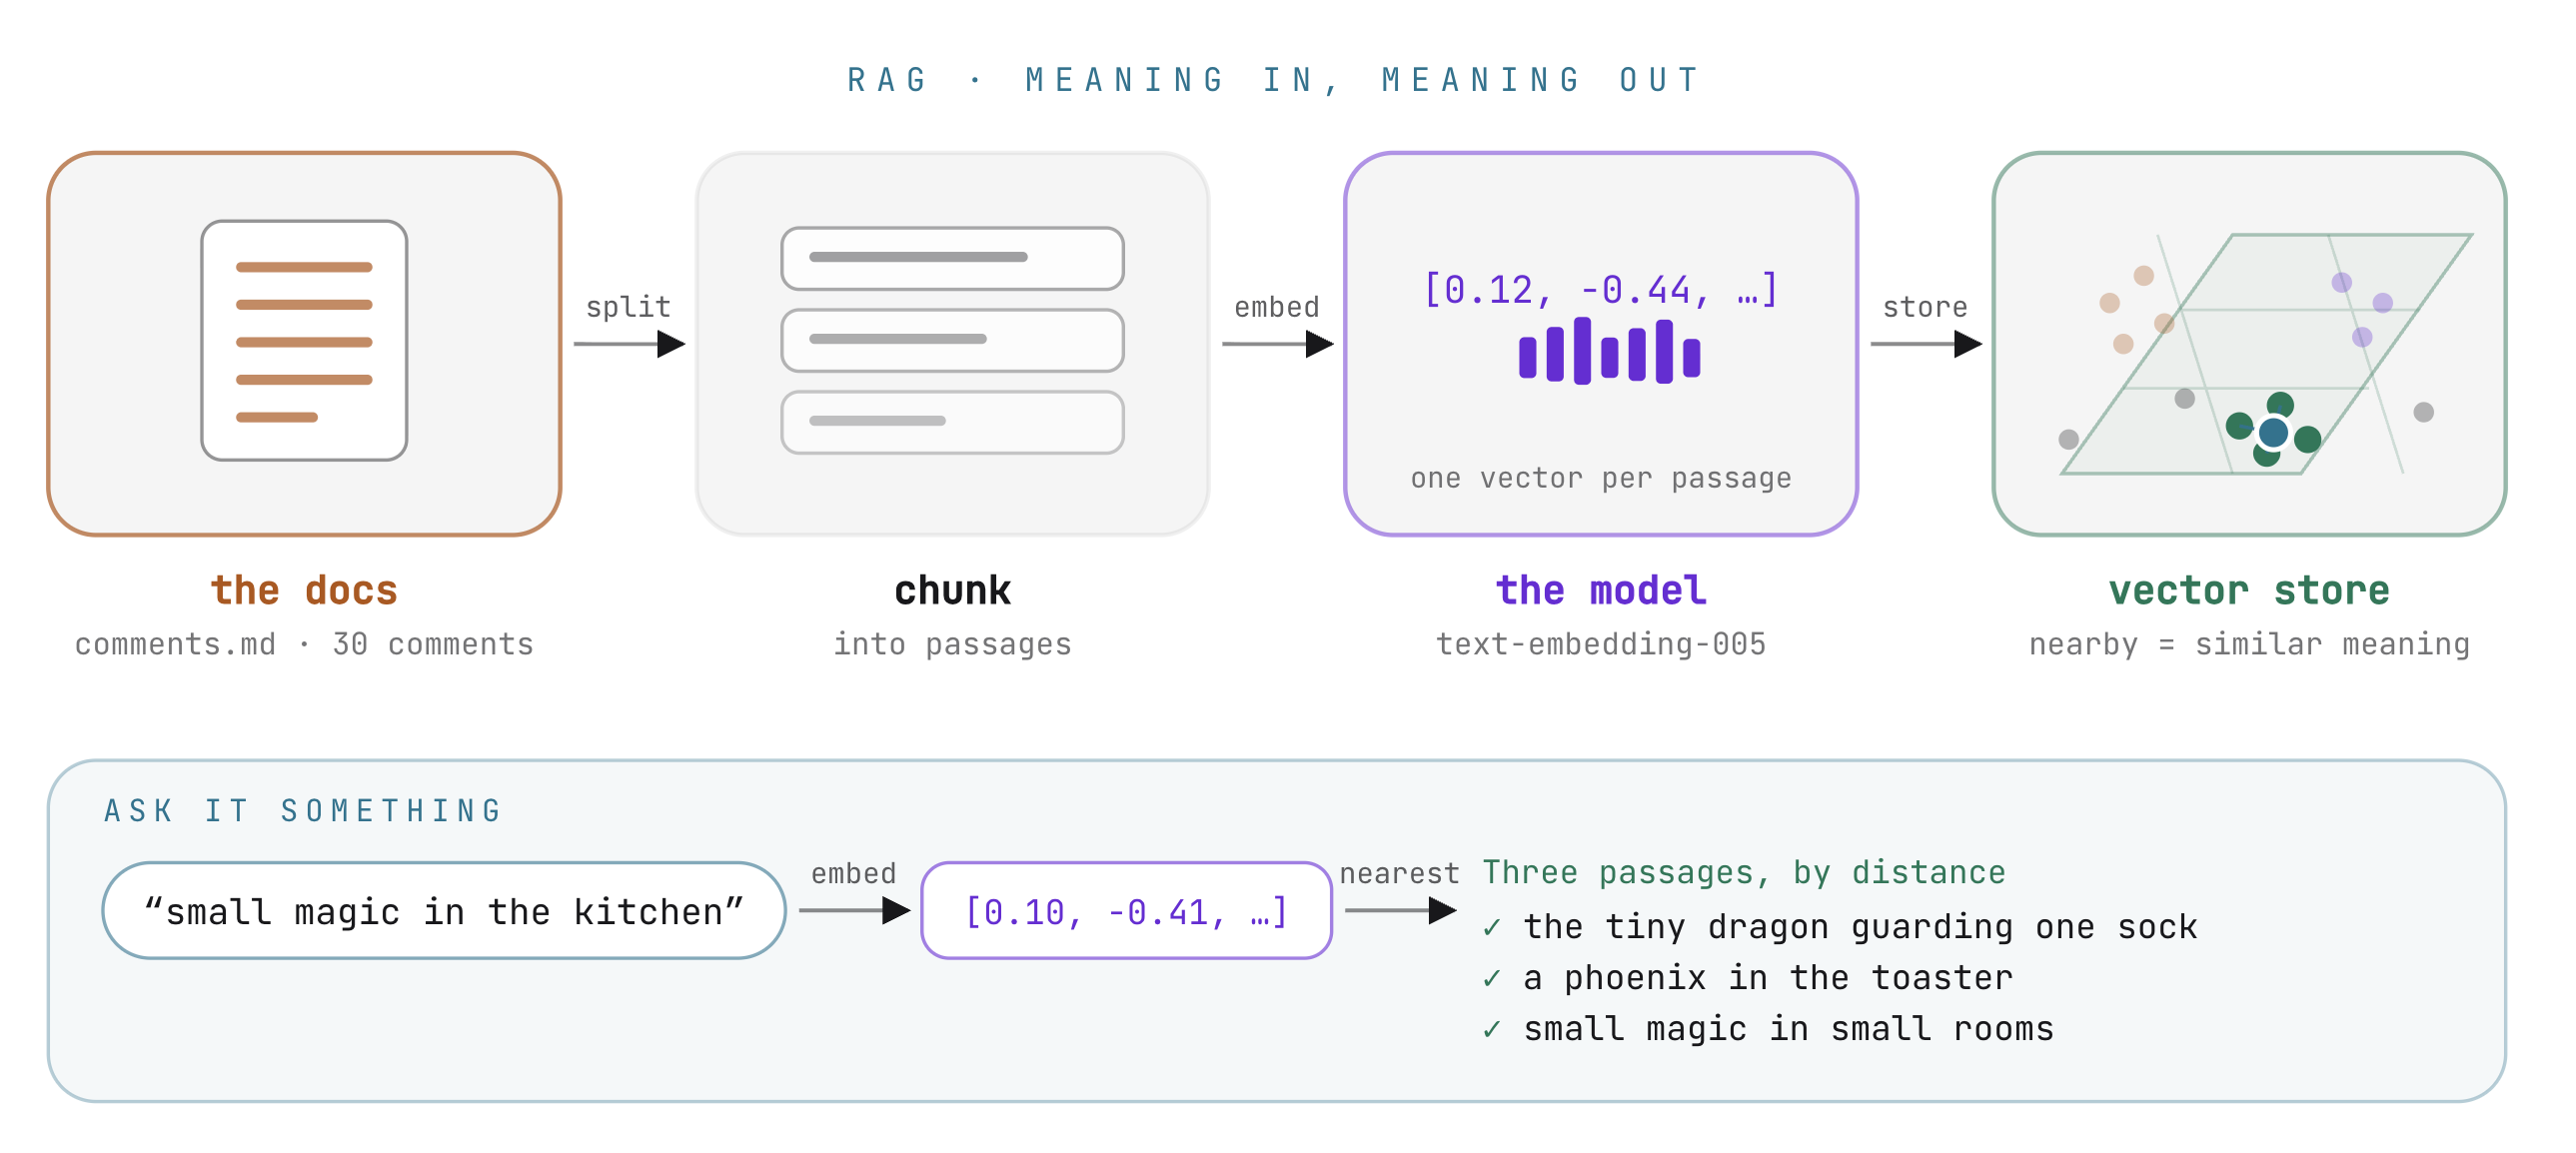
ドキュメント チャンクとエンベディング
RAG Engine は、テキストをセマンティック パッセージに分割し、そのベクトルをマネージド データベースに保存することで、ドキュメントのインデックスを作成します。
corpus = rag.create_corpus(
    display_name="vibestudio-feedback",
    description="Vibe Studio: what the audience wrote under the channel's past videos.",
    backend_config=rag.RagVectorDbConfig(
        rag_embedding_model_config=rag.RagEmbeddingModelConfig(
            vertex_prediction_endpoint=rag.VertexPredictionEndpoint(
                publisher_model="publishers/google/models/text-embedding-005"))))

rag.upload_file(
    corpus_name=corpus.name, path="agent/comments.md", display_name="comments.md",
    transformation_config=rag.TransformationConfig(
        chunking_config=rag.ChunkingConfig(chunk_size=120, chunk_overlap=20)))
- チャンクサイズ: 120 トークンに設定され、20 トークンの重複があります。これにより、1 つの文章につき 2 ~ 3 件のコメントがキャプチャされ、各ベクトルが、無関係なフィードバックによって意味が薄まることなく、まとまりのある感情を表すようになります。
- エンベディング モデル:
text-embedding-005はテキストを高次元ベクトルに変換します。クエリが送信されると、モデルはクエリをベクトルに変換し、セマンティック距離に基づいて最も近い一致を見つけます。靴下を守る小さなドラゴンについてのコメントは、キーワードが完全に一致していなくても、魔法の生き物についてのプロンプトと一致します。
RAG コーパスの設定
ワークベンチのボタンまたはターミナル コマンドを使用して、コーパスを初期化します。
- コーパスを作成する:
python -m agent.platform.ragruns/ragcorpus.jsonに記録します。 - コメントをアップロードしてインデックス登録する: チャンク構成で
agent/comments.mdをアップロードし、インデックス登録が完了するまで待機します。 - コーパスをクエリする: コメントと完全に一致する単語を含まないクエリを使用して、類似性検索をテストします(たとえば、「小さな魔法の生き物」というクエリを使用して、ドラゴンに関するコメントを取得します)。
検索ノード(7B)
ワークベンチで、[3 番目のリーダー(7B)] に移動します。stage5_rag/agent.py を開きます。
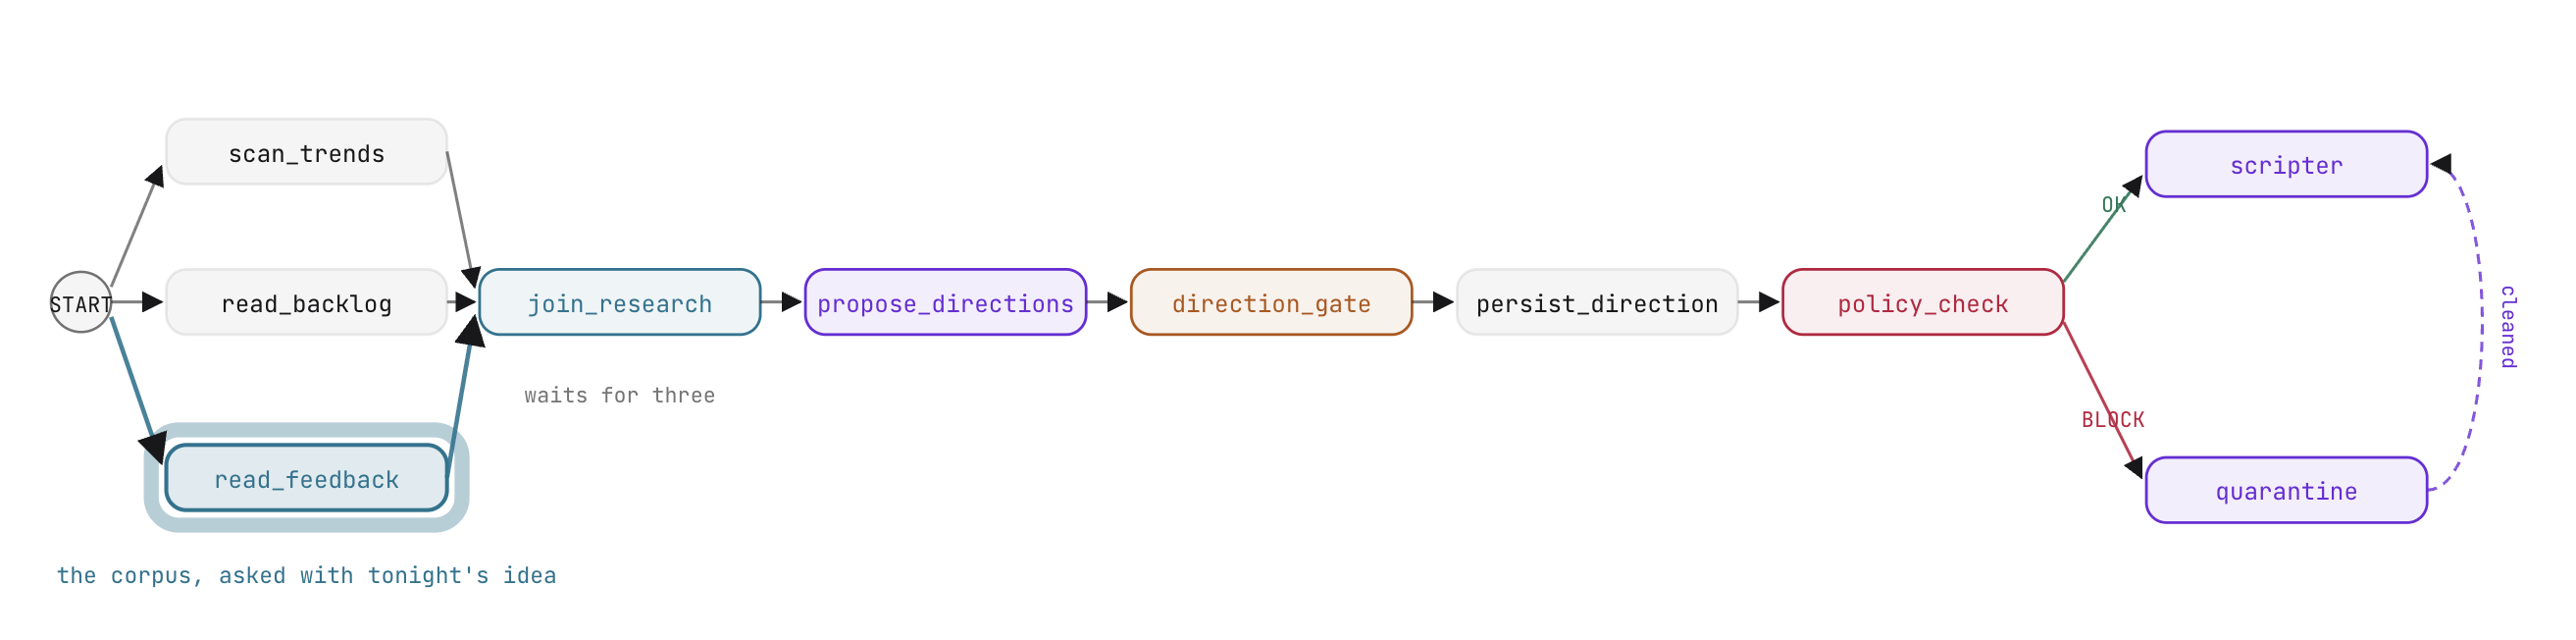
グラフノードとしての取得
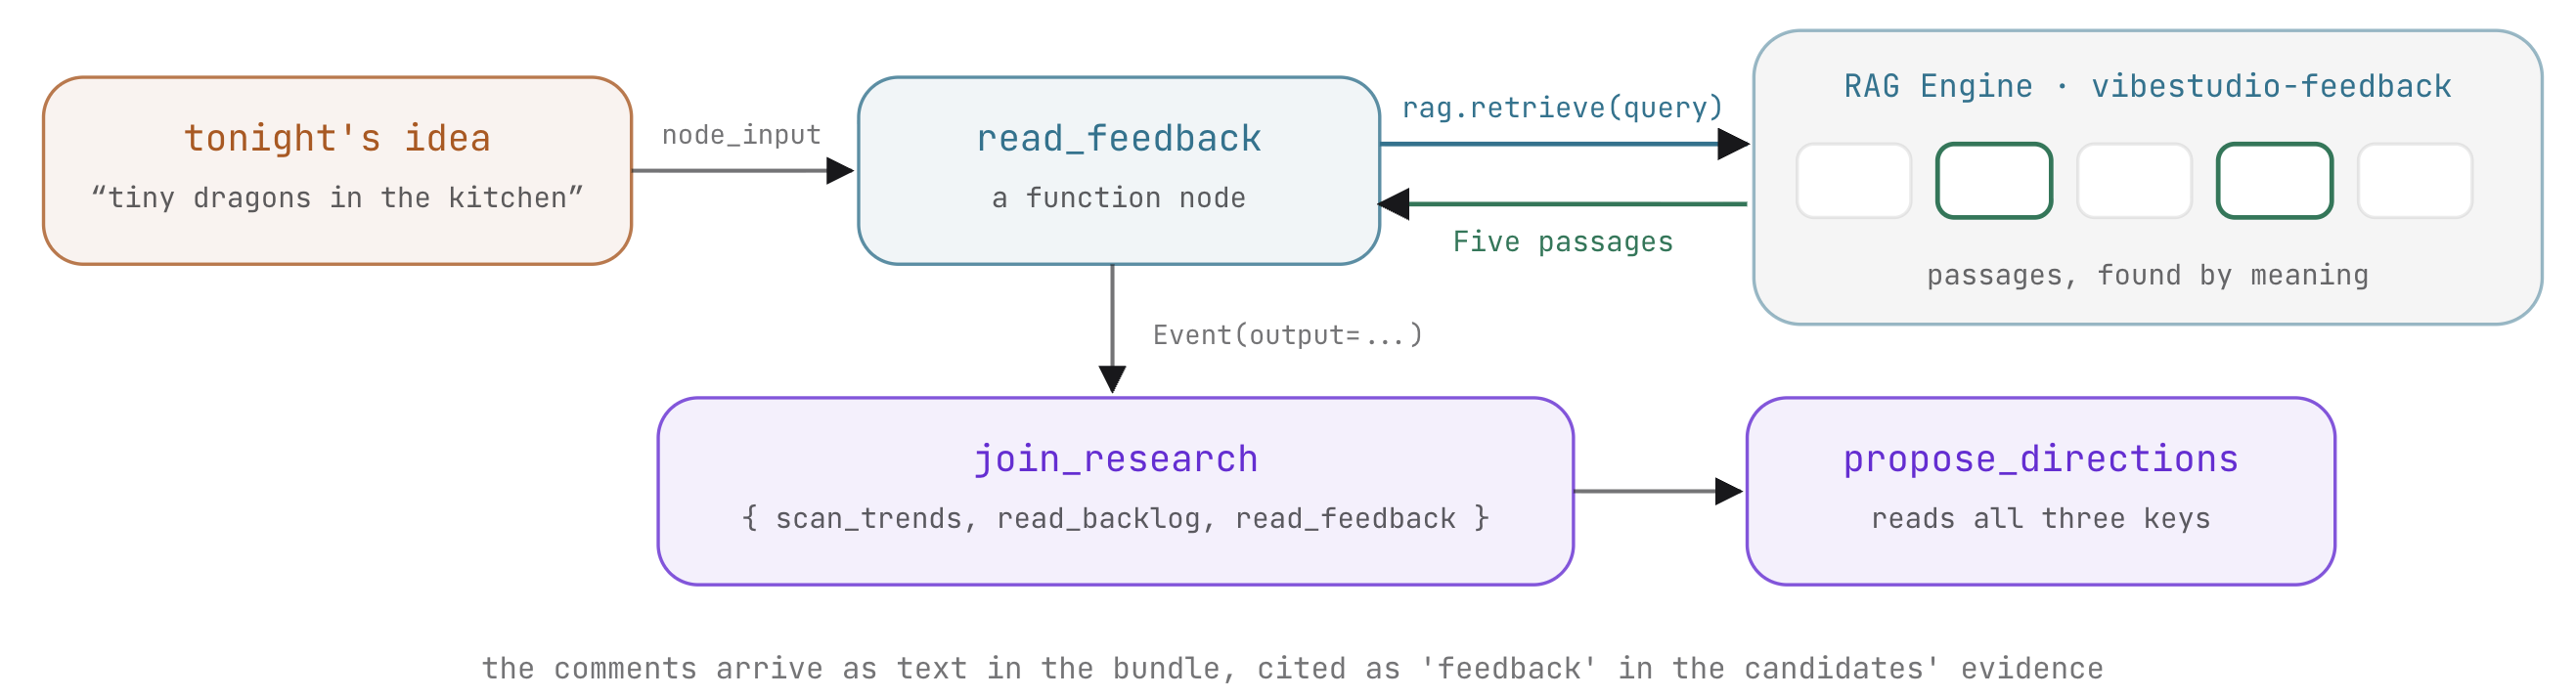
オーディエンス フィードバックは、ワークフロー全体で共有される調査データを表します。クリエイター個人の記憶とは異なり、視聴者の感情は、トレンドやバックログ データとともに join_research に直接フィードされます。そのため、関数ノードとして実装されます。
def read_feedback(node_input):
    """The third reader (step 7): what the audience wrote under past videos,
    the passages nearest to tonight's idea. Retrieval, not a model call."""
    from .platform import rag
    idea = idea_text(node_input)
    query = idea or "what viewers liked and what they complained about"
    try:
        hits = rag.retrieve(query)
    except Exception as e:
        print(f"  [rag] feedback unavailable ({str(e)[:80]})")
        return Event(output={"query": query, "feedback": [],
                             "note": "no corpus connected - run: python -m agent.platform.rag"})
    return Event(output={"query": query, "feedback": [h["text"] for h in hits]})
read_feedback は、ユーザーの最初のアイデアを抽出し、RAG Engine コーパスに対してベクトル クエリを実行します。取得したコメントを Event(output=...) ペイロードで出力します。
ハンズオン編集: 3 つ目のリーダーをファンアウトに接続する
stage5_rag/agent.py で、edges を更新して、join_research に入る 3 番目の並列ブランチとして read_feedback を追加します。
           (START, read_backlog, join_research),
           (START, read_feedback, join_research),
join_research は JoinNode であるため、すべての受信ブランチを同期し、scan_trends、read_backlog、read_feedback がすべてイベントを出力するまで待機してから、集約されたバンドルを下流に渡します。
想定される事象とその理由
ワークベンチでワークフローを実行します。
- アイデアのプロンプト(「キッチンのカウンターを守るミニチュアのドラゴン」など)を送信します。
- 実行トレースで、3 つのリーダーノードがすべて同時に実行されていることを確認します。
join_researchを確認します。出力辞書にtrends、backlog、feedbackが含まれるようになりました。propose_directionsから生成された候補を確認します。モデルは、視聴者のコメントを提案に組み込み、エビデンス フィールドで視聴者の感情を参照しています。- RAG 検索は決定的(同じクエリは同じコメント パッセージを返す)ですが、生成提案ノードはクリエイティブなバリエーションを生成します。
8. Veo による非同期動画生成
VibeStudio Workbench で、ステップ 8 - 動画のパート (8A) と (8B) に移動します。
Google Veo で高画質動画を生成するには、レンダリングごとに数分かかります。この期間中にグラフの実行をブロックすると、コンピューティング リソースが無駄になり、スレッドプールがロックされ、実行が HTTP 接続の切断にさらされます。このステップでは、ADK の LongRunningFunctionTool を使用して動画レンダリングを非同期にします。
長時間実行ツール(8A)
ワークベンチで、[長時間実行ツール(8A)] に移動します。stage6_video/agent.py と agent/deliver.py を開きます。
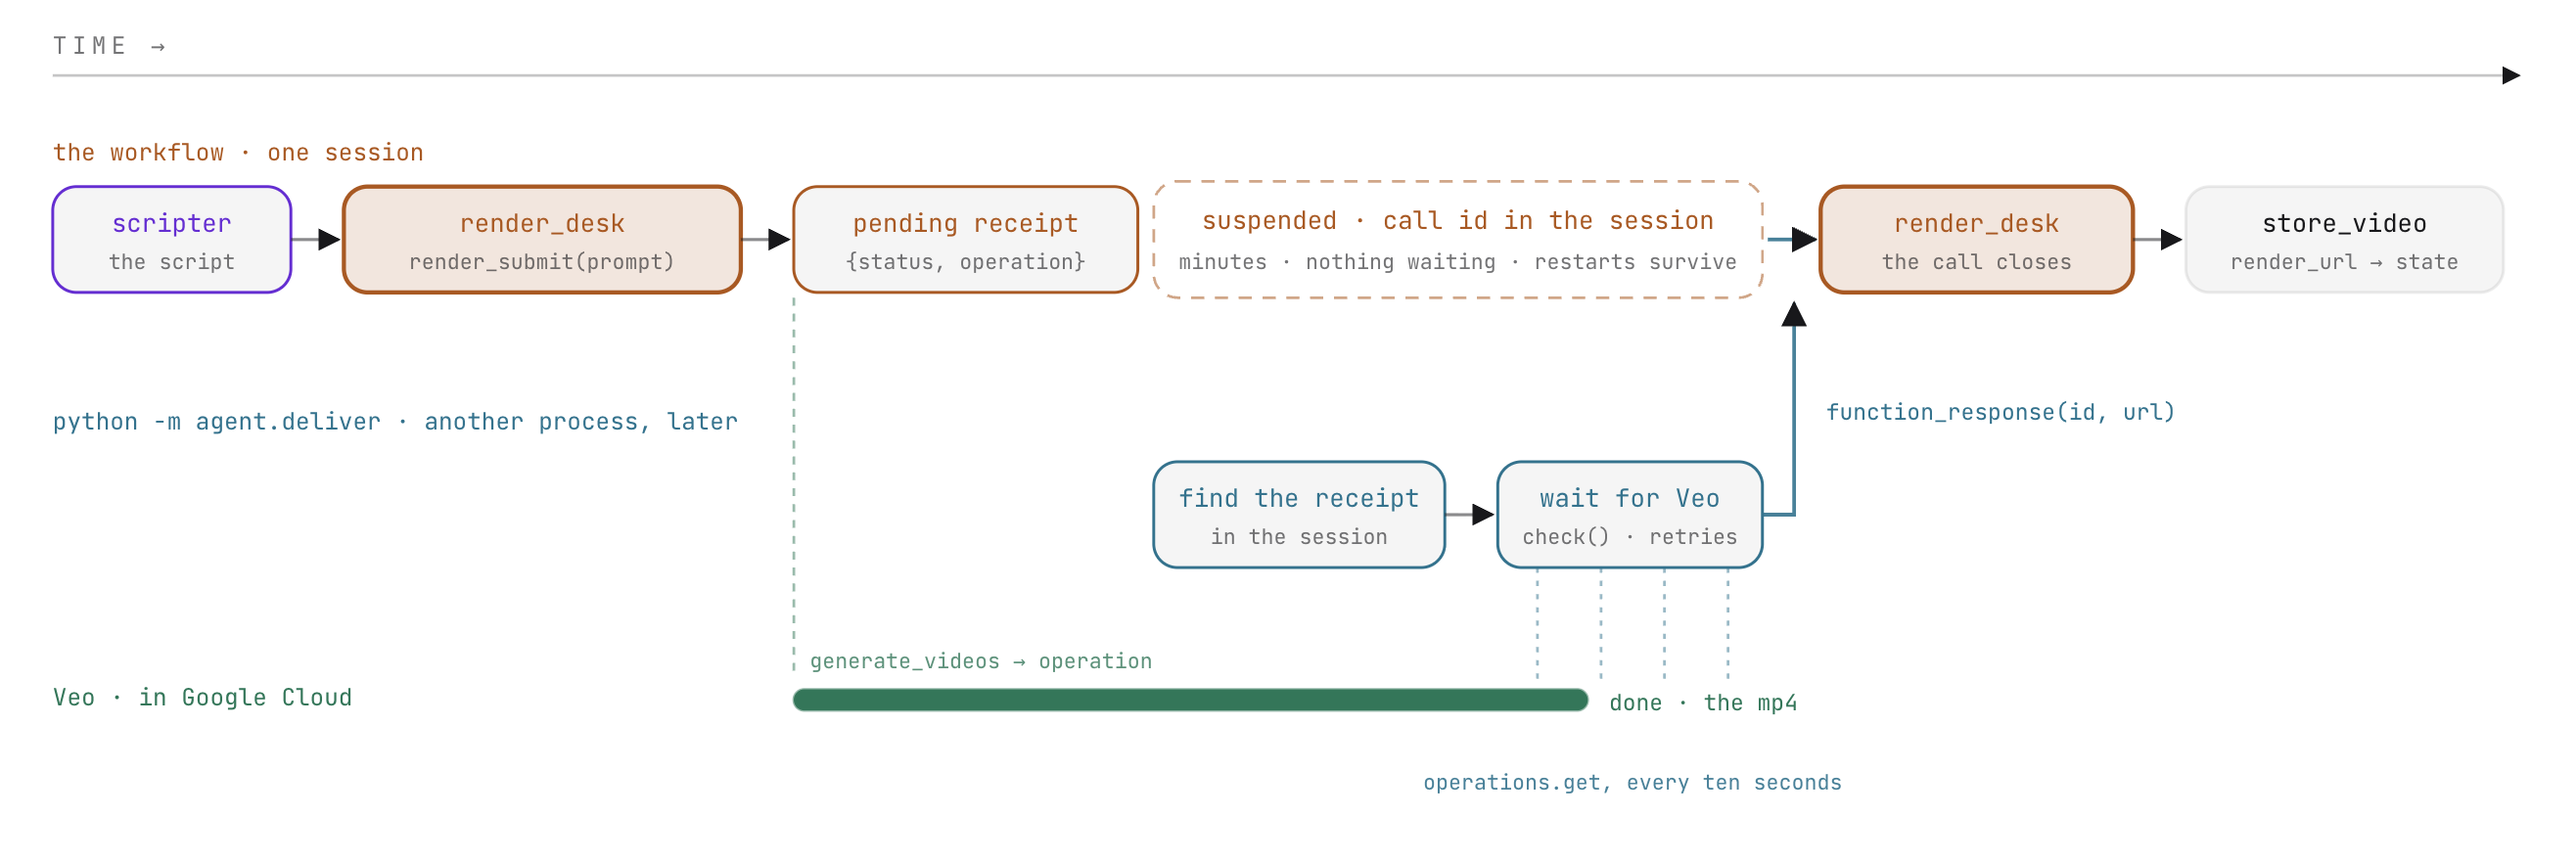
同期ツールと長時間実行ツール
標準の ADK 関数ツールは、エージェント ターン内で同期的に実行されます。モデルがツールを呼び出し、戻りペイロードを待機し、結果を進行中のターンに組み込みます。
動画のレンダリングを 1 ターンで完了できません。代わりに、render_submit は生成ジョブを開始し、ステータス "pending" のオペレーション レシートをすぐに返します。
def render_submit(prompt: str) -> dict:
    """Submit one Veo render of `prompt`. Returns at once with a pending
    receipt; the clip is delivered later, to this call, by id."""
    receipt = videogen.start(f"{prompt} {videogen.NO_TEXT}")
    return {"status": "pending", "operation": receipt["operation"], "prompt": receipt["prompt"]}
LongRunningFunctionTool でラップすると、ADK は "pending" ステータスをインターセプトします。エージェントのターンが終了し、ワークフローがノードで一時停止します。保留中の呼び出しメタデータ(呼び出し ID とレシートを含む)が runs/sessions.db に記録されます。実行プロセスは、アクティブなネットワーク接続やワーカー スレッドを維持することなく、正常に終了します。
実践的な編集: レンダリング ツールをラップする
stage6_video/agent.py で、render_desk を更新して render_submit を LongRunningFunctionTool でラップします。
tools=[LongRunningFunctionTool(render_submit)])
通話 ID による再開
ユニバーサル再開パターン
ADK は、人間と外部ツールの両方に対して、ワークフローの一時停止と再開に同じメカニズムを適用します。
停止のトリガー | 構築を開始しています | 保存された一時停止状態 | 再開イベント |
人間の意思決定 |
| セッション ストアで入力プロンプトを開く |
|
長時間実行ツール |
| セッション ストアでツール呼び出しを開く |
|
どちらのシナリオでも、ワークフローは完全に停止し、一致する FunctionResponse を含むイベントが外部ソース(ユーザー インターフェース、Webhook、バックグラウンド ワーカー)から到着した場合にのみ再開されます。
実践的な編集: 配信レスポンスを完了する
agent/deliver.py で、再開 FunctionResponse 部分を作成します。
    part = Part(function_response=FunctionResponse(
        id=row["call_id"], name=row["name"], response=response))
配信デーモンは、動画ファイルが生成されるまで Veo をポーリングし、この FunctionResponse をセッションにディスパッチします。ADK は通話 ID を照合し、次のノードでワークフローを直接再開します。完了したノードは再実行されず、エージェントは別の生成ターンを実行しません。
.env で STUDIO_REAL_VIDEO=0 を設定すると、モック レンダリングが有効になります。start は即座にテスト レシートを返し、check は課金対象の Veo API 呼び出しを行わずに 5 秒で完了をシミュレートします。
パイプライン統合(8B)
ワークベンチで、グラフの render_desk(8B)に移動します。stage6_video/agent.py を開きます。
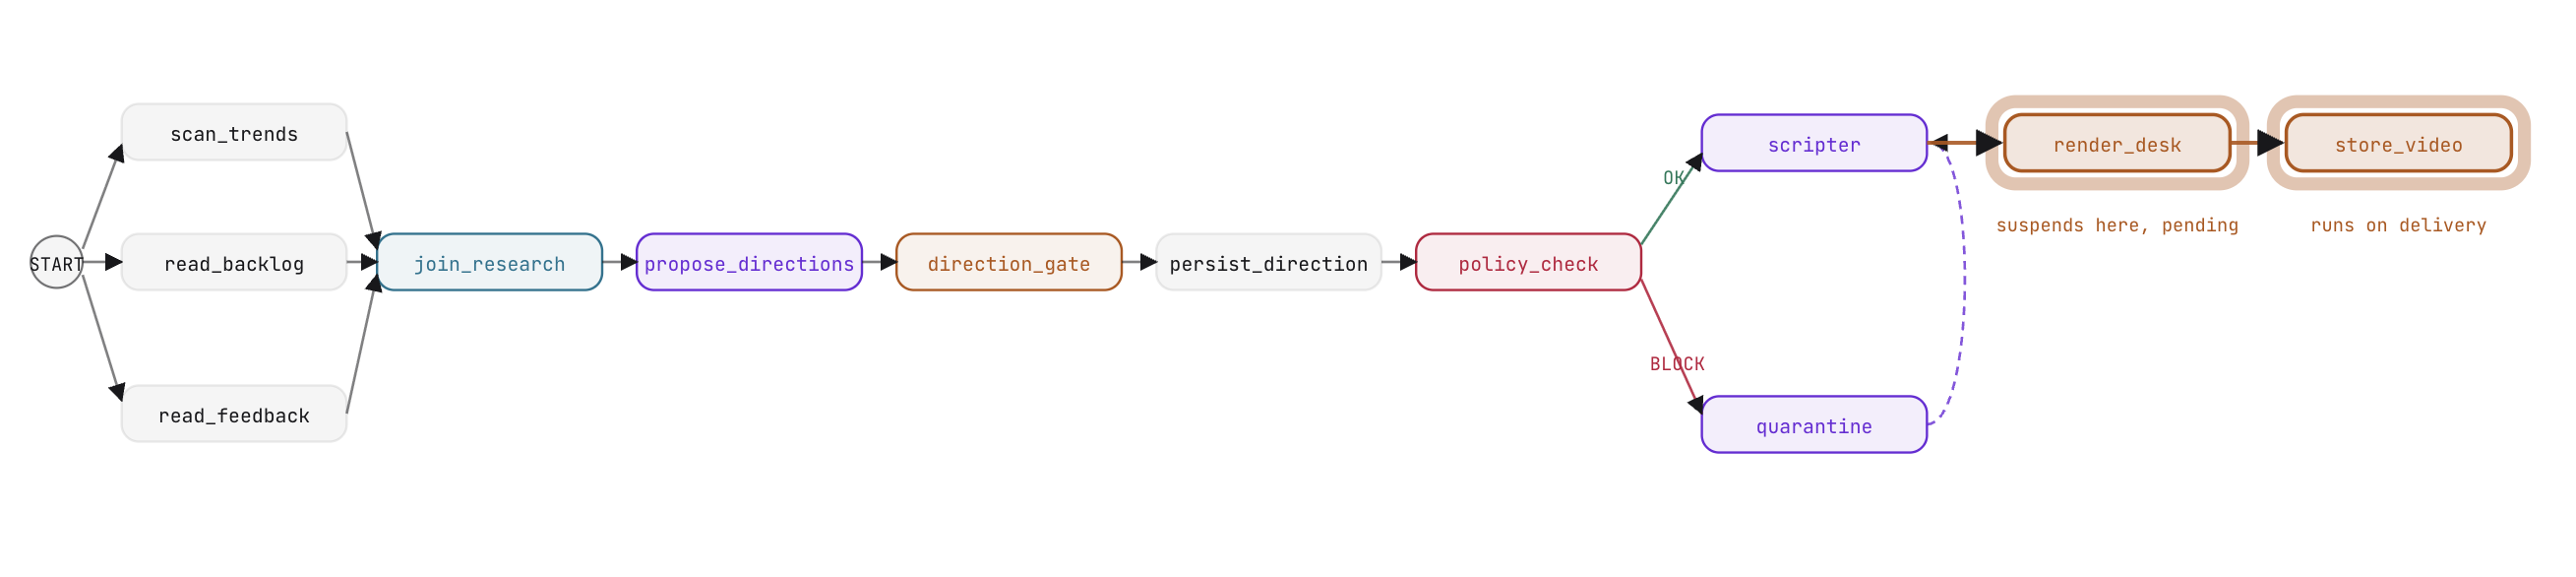
パイプラインのターミナル ノードは store_video です。完了したレンダリング情報を runs/state.json(配信プロセスが記録した場所)から読み取り、動画の URL と生成ステータスを共有セッション状態にコミットします。
ハンズオン編集: 完全な動画パイプラインを接続する
stage6_video/agent.py で、edges を更新して render_desk と store_video を追加します。
           (quarantine, scripter),
           (scripter, render_desk, store_video)])
想定される事象とその理由
ワークベンチで非同期生成フローをテストします。
- 候補の選択とスクリプトの生成を通じてワークフローを実行します。
render_deskで、エージェントがrender_submitを呼び出していることを確認します。- ワークフローはすぐに一時停止します。ワークベンチまたは ADK Web で、保留中のステータスを確認します。セッションはオープン コール ID を保持しており、バックグラウンド プロセスはリソースを消費していません。
- ワークベンチ コンソールまたはターミナルで配信デーモンを実行します。
python -m agent.deliver - ADK Web でセッションを更新します。
store_videoで実行が再開され、動画 URL がセッション状態に commit されて、ワークフローが完了します。
9. Cloud Run にデプロイする
VibeStudio Workbench で、[ステップ 9 · デプロイ] に移動します。
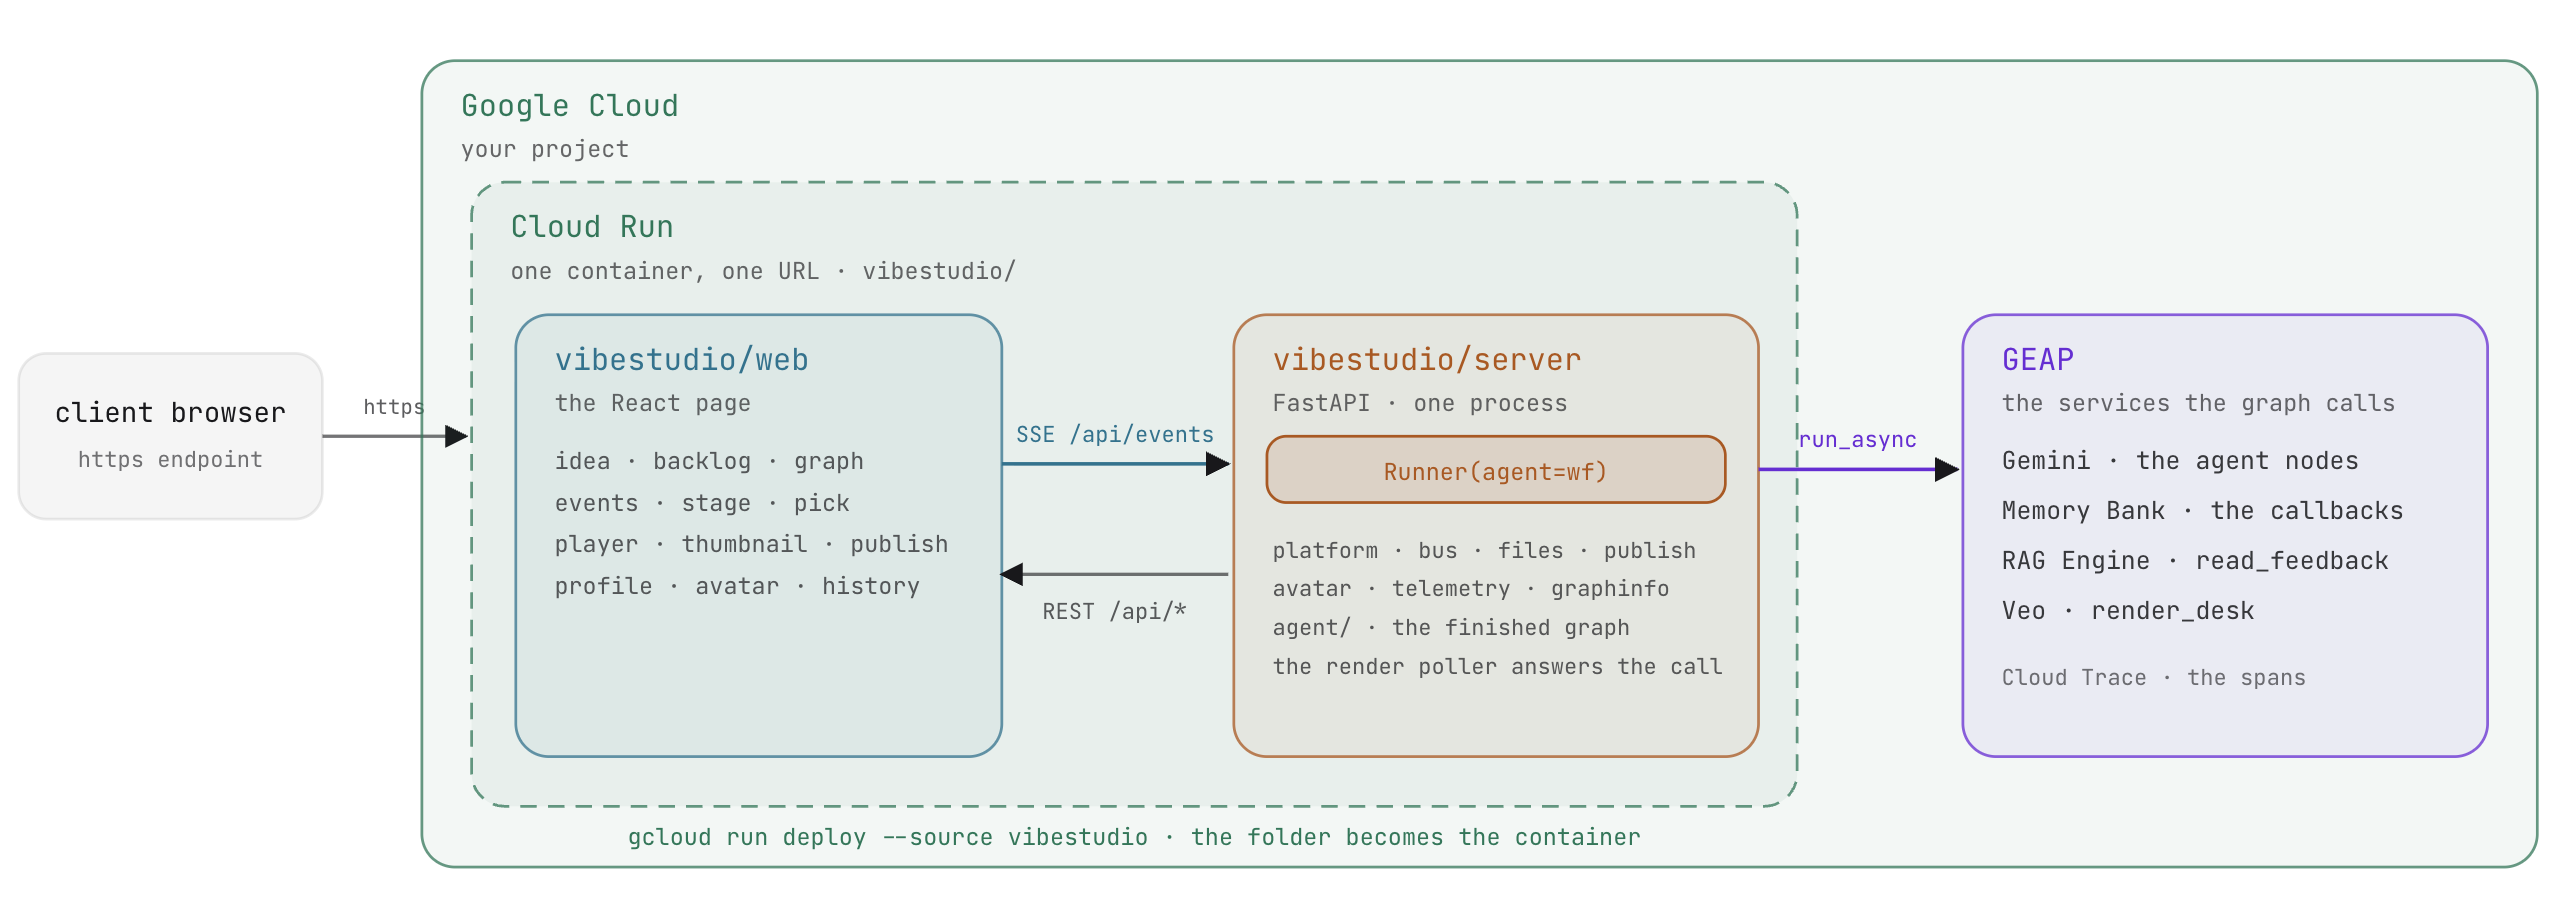
専用のサンドボックスでパイプラインの各コンポーネントを開発して検証した。このステップでは、完全な本番環境パイプラインを組み立てて Google Cloud Run にデプロイします。
ADK ランナー
開発では、adk web がグラフをオーケストレートしました。本番環境では、アプリケーションは ADK の Runner クラスを使用してワークフローをホストします。
self._svc = DatabaseSessionService(db_url=config.DB_URL)
self._runner = Runner(app_name=config.APP, agent=wf, session_service=self._svc)

async for ev in self._runner.run_async(user_id=config.USER, session_id=run_id, new_message=message):
    self._absorb(ev)    # fold the ADK event into the run state, publish one app event

# the gate's answer and the render's delivery are the same call, with a function_response part
part = Part(function_response=FunctionResponse(id=call_id, name=name, response=response))
run_async: ワークフローの実行を推進し、ノードの実行に応じてイベントを順次生成し、セッション サービスへの更新を永続化します。- 統合された再開:
direction_gateでのユーザーの決定と Veo からの動画配信の完了は、どちらもrun_asyncに送信された同じFunctionResponseオブジェクトを介して実行を再開します。
本番環境のアプリケーション アーキテクチャ
vibestudio/ の本番環境アプリケーションは、完全なパイプラインを統合します。
vibestudio/
  server/
    main.py                 FastAPI: application server, REST routes, static assets
    api.py                  REST API endpoints: run, pick, publish, backlog, profile, history
    runner.py               Runner orchestration over the workflow, background render poller
    platform/               Event bus (SSE stream), file storage, publishing, telemetry
    agent/                  Production agent package, verified by checks/verify_app.py
      graph.py              The complete workflow graph and node definitions
      desk.py               render_desk and render_submit wrapped with LongRunningFunctionTool
      schemas.py            Pydantic schemas: Directions, CleanedDirection, Script
      cleanup_tools.py      Deterministic policy tools: find_policy_hits, suggest_replacement
      platform/             Memory Bank, RAG Engine, and Veo integrations
  web/                      Production React user interface
  Dockerfile · deploy.py · run.sh
- 単一のイベント ストリーム: FastAPI バックエンドは、単一のサーバー送信イベント(SSE)ストリームを介してイベントをパブリッシュします。React フロントエンドは、グラフの進行状況をリアルタイムで可視化し、状態を失うことなく遅延接続を処理します。
- 分離された実行: アプリケーションがイベントループを管理します。ワークフロー グラフは実行ロジックにのみ焦点を当てており、フロントエンド インターフェースを認識していません。
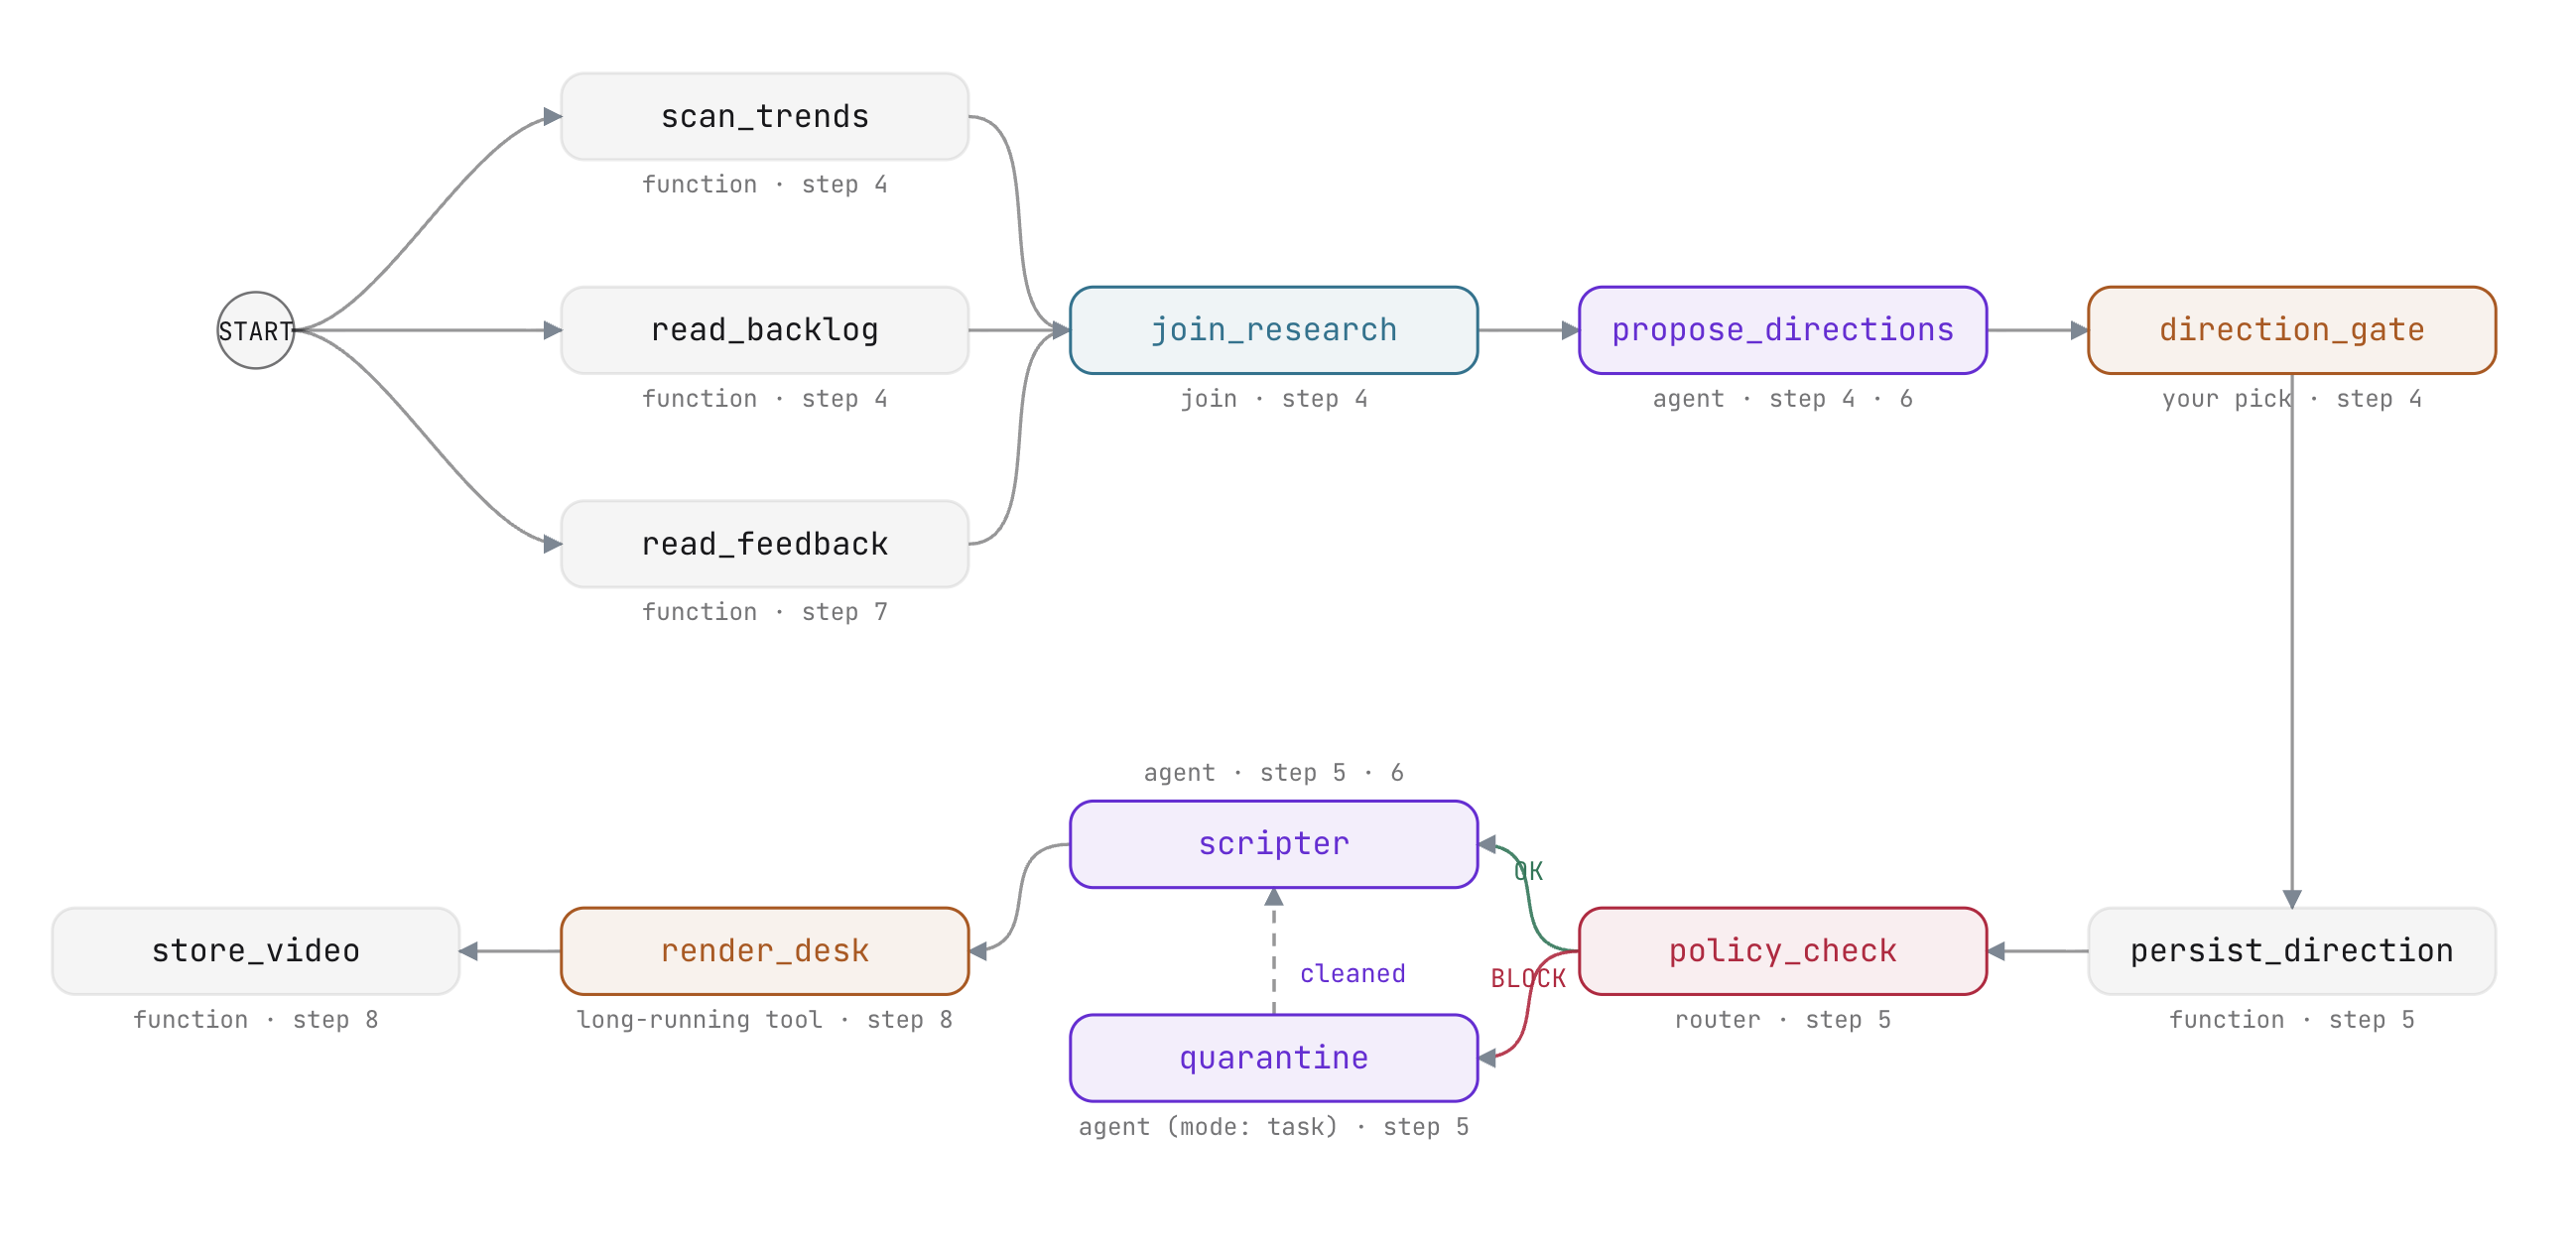
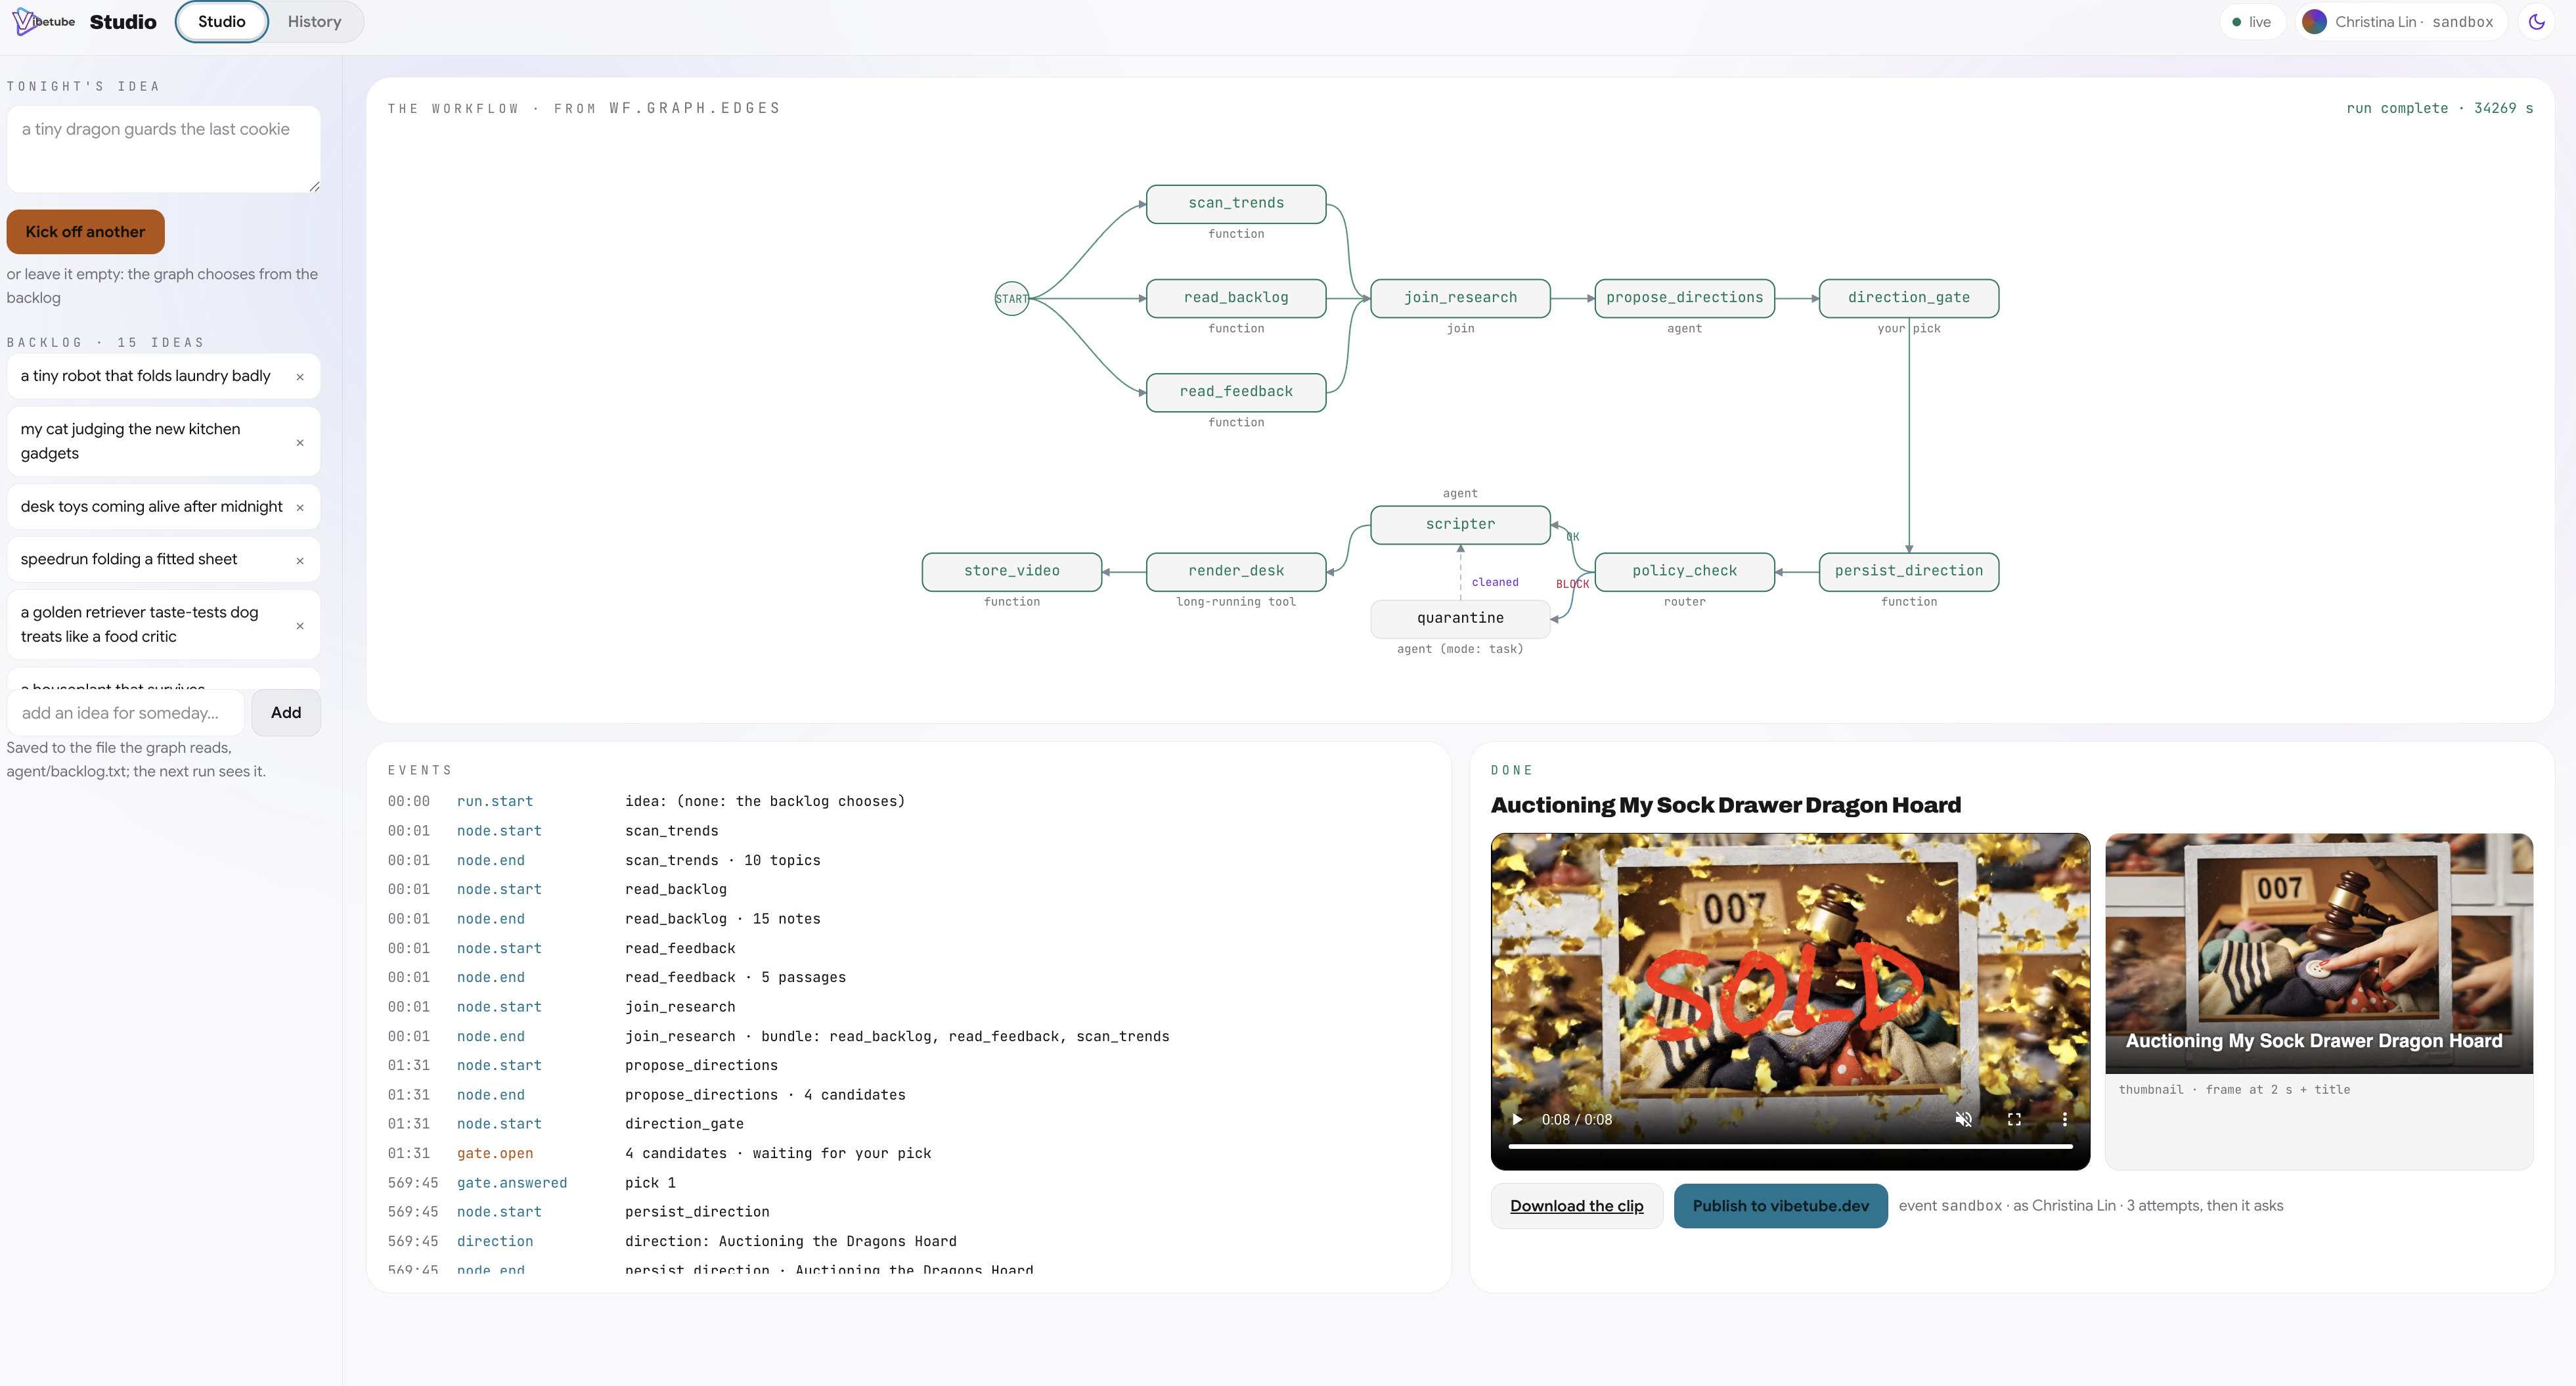
agent/graph.py の完全なワークフロー エッジリストは、この Codelab で構築したすべてのアーキテクチャ パターンを組み合わせたものです。
        (START, scan_trends, join_research),
        (START, read_backlog, join_research),
        (START, read_feedback, join_research),
        (join_research, propose_directions, direction_gate,
         persist_direction, policy_check),
        (policy_check, {"OK": scripter, "BLOCK": quarantine}),
        (quarantine, scripter),
        (scripter, render_desk, store_video),
Cloud Run へのデプロイ
Google Cloud Run は、自動スケーリング、リクエスト ルーティング、統合コンテナ ビルドを備えたサーバーレス ホスティングを提供します。
gcloud run deploy vibestudio --source vibestudio \
  --project $GOOGLE_CLOUD_PROJECT --region us-central1 \
  --labels dev-tutorial-codelab=vibetube --allow-unauthenticated \
  --memory 2Gi --cpu 2 --timeout 3600 --concurrency 40 \
  --max-instances 1 --min-instances 1 --session-affinity \
  --set-env-vars GOOGLE_CLOUD_PROJECT=...,STUDIO_VERTEX=1,STUDIO_MEMORY_BANK=...,STUDIO_RAG_CORPUS=...,VIBETUBE_URL=...,VIBETUBE_EVENT=...,VIBETUBE_NAME=...,VIBETUBE_PROJECT=...
- コンテナ ビルド:
gcloud run deploy --sourceは、vibestudio/ディレクトリをパッケージ化し、Cloud Build を使用してコンテナ イメージをビルドし、1 回のオペレーションでサービスをデプロイします。 - セッション アフィニティ: 同じユーザーからのリクエストを同じコンテナ インスタンスに転送し、反復ステップ全体でローカル セッションの状態を保持します。
- オブザーバビリティ: Cloud Trace 統合により、すべてのノード、LLM 呼び出し、ツール実行の分散スパンが記録され、Google Cloud コンソールの Trace Explorer でアクセスできます。
ワークベンチの [Deploy] ボタンをクリックして、デプロイ スクリプトを実行します。ビルドが完了すると、ターミナルにライブ サービス URL が表示されます。
10. まとめ
VibeStudio Workbench で、[ステップ 10 · 概要] に移動して、完成したアーキテクチャを確認します。
ステップ | アーキテクチャとコンセプト | 実装パターン |
1 つのプロンプト | 単一のプロンプト、関数ツール、順次チャットループ |
|
Agentic Workflows の基本 | グラフ ワークフロー、並列調査、スキーマ出力、ヒューマン ゲート |
|
状態とルーター | 共有セッションの状態、パラメータ バインディング、確定的ルーティング、タスク エージェント |
|
メモリバンク | ユーザーレベルの長期記憶、セマンティック統合、ライフサイクル フック |
|
RAG Engine | 視聴者のコメント、セマンティック エンベディングに対するドキュメントの取得 |
|
Veo を使用した非同期動画生成 | 長時間実行ツール、保留中の領収書、外部配信デーモン |
|
Cloud Run へのデプロイ | プログラムによるオーケストレーション、サーバー送信イベント、サーバーレス コンテナ |
|
アーキテクチャの基本原則
- 待機ではなく一時停止: ワークフローは、人間の入力(
RequestInput)または長時間実行オペレーション(LongRunningFunctionTool)のために、クリーンに一時停止します。プロセスは、スレッドまたはネットワーク ソケットでアイドル状態で待機しません。 - ユニバーサル再開: すべての一時停止は、一時停止されたノードの呼び出し ID を含む単一の
function_responseという同一のメカニズムを介して再開されます。 - 分離された状態管理: ノードは、詳細で密結合された中間ペイロードではなく、名前付きセッション状態キーとパラメータ バインディングを介してデータを共有します。
- 生成コスト前の決定論的ルーティング: ルールベースのルーターと正規表現フィルタは、生成モデルが実行される前に、ゼロトークン コストでポリシーを評価します。
- 関心の分離: 個々のエージェントに固有のコンテキストはライフサイクル コールバックに属し、共有データの依存関係は