1. Wprowadzenie
Z tego ćwiczenia dowiesz się, jak tworzyć systemy oparte na agentach nowej generacji przy użyciu przepływów pracy i grafów w pakiecie Agent Development Kit (ADK). Zaimplementujesz typowe wzorce architektury, skoordynujesz interakcje z udziałem człowieka i obsłużysz długotrwałe wykonywanie asynchroniczne. Zintegrujesz też firmowe bazy wiedzy i pamięć trwałą, aby dostosowywać i rozwijać zachowania agenta. Na koniec połączysz te funkcje, aby utworzyć automatyczny potok generowania filmów.
Scenariusz
Prowadzisz kanał cyfrowy na VibeTube z aktywnymi odbiorcami i coraz większą liczbą kreatywnych pomysłów. Tworzenie każdego filmu wymaga ciągłego działania na wielu etapach: wyszukiwania popularnych formatów, analizowania opinii widzów, opracowywania skryptów, sprawdzania zgodności z zasadami i generowania klipów wideo. Modele generatywne mogą tworzyć wersje robocze poszczególnych zasobów, ale dostarczanie spójnych wersji wymaga skoordynowanej architektury agentów.
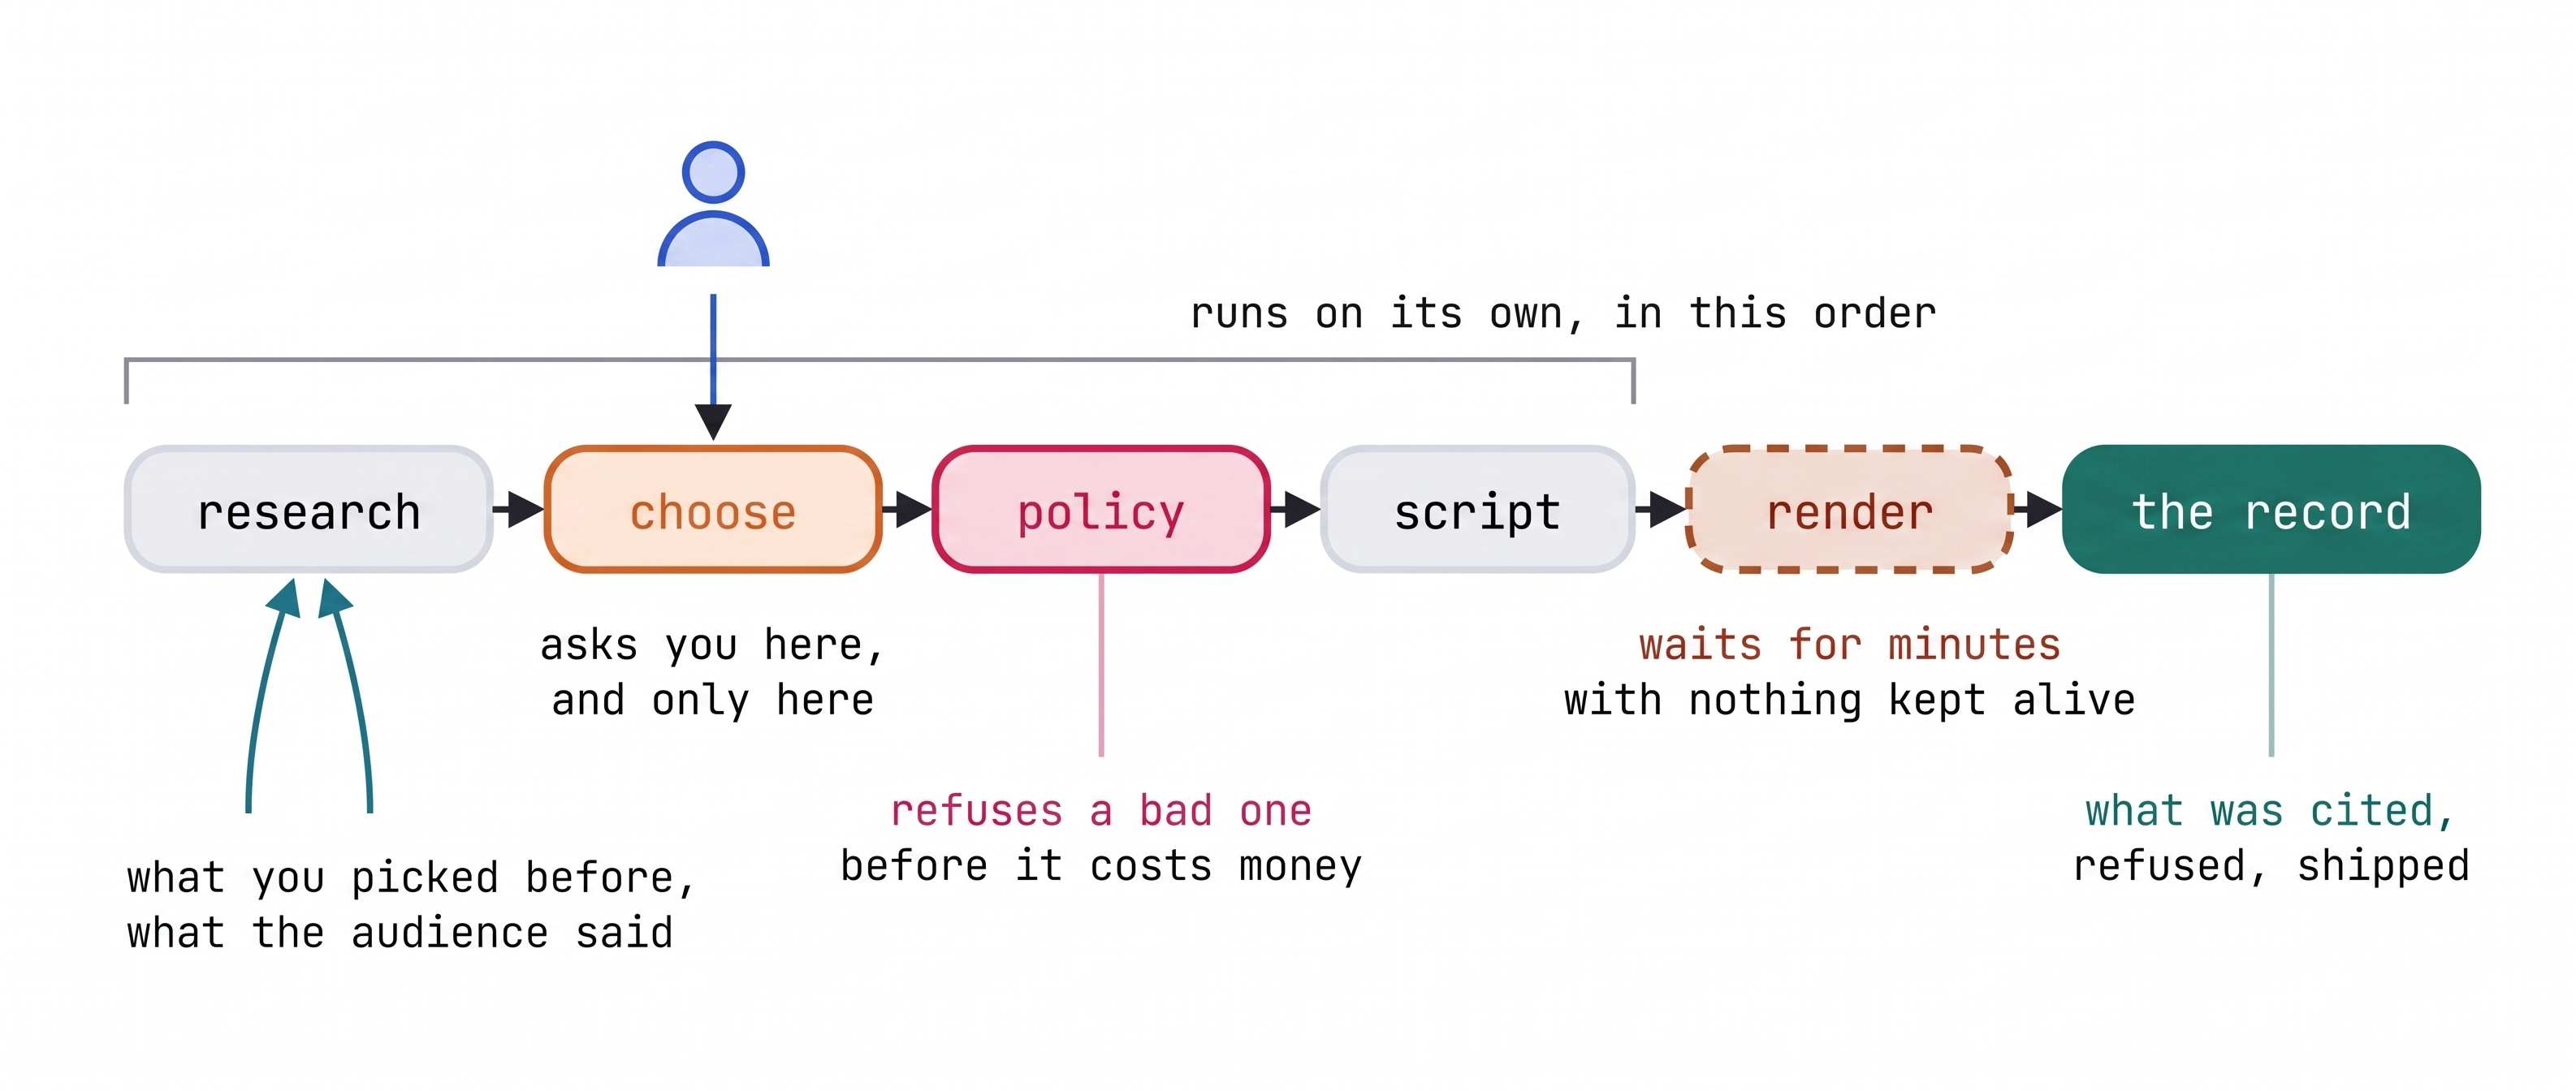
Aby zautomatyzować ten cykl życia, utworzysz VibeStudio. Ten agentowy potok wykonuje rutynowe badania równolegle, przedstawia wyselekcjonowane opcje do zatwierdzenia przez człowieka, stosuje automatyczne bramki zasad przed wygenerowaniem filmu i zachowuje kontekst w przypadku wielu serii produkcyjnych.
Czego się nauczysz
- Podstawy inżynierii grafów: wieloetapowe architektury agentów wymagają wyraźnego przepływu sterowania i ustrukturyzowanych ścieżek wykonywania. ADK
Workflowtworzysz za pomocą krotek krawędziowych, punktu wejściaSTART,JoinNodedo równoległej agregacji rozgałęziającej i deterministycznych węzłów routera, aby sterować wykonywaniem na podstawie stanu. - Tryby agenta i wywołania zwrotne cyklu życia: specjalistyczne zadania wymagają odrębnych zachowań operacyjnych i deterministycznych zabezpieczeń. Instancje ADK
Agentkonfigurujesz za pomocą trybówchat,single_turnitaskz włączonymi narzędziami jako węzłów przepływu pracy, stosując przechwytujące za pomocąbefore_model_callbackiafter_agent_callback. - Orkiestracja z udziałem człowieka: potoki produkcyjne są wstrzymywane w krytycznych punktach kontrolnych, aby umożliwić ocenę przez człowieka. Wdrażasz
RequestInput, aby zawieszać wykonywanie przepływu pracy, wymuszać stosowanie schematów odpowiedzi strukturalnych i wznawiać wykonywanie bez utrzymywania bezczynnych procesów środowiska wykonawczego. - Hierarchiczna pamięć agenta: systemy produkcyjne oddzielają efemeryczny stan wykonywania od trwałego kontekstu. Krótkoterminowym stanem sesji zarządzasz za pomocą
Event(state=...)i wiązania parametrów, a następnie łączysz się z bankiem pamięci GEAP, aby wyodrębniać, konsolidować i trwale przechowywać preferencje twórcy między uruchomieniami. - Ugruntowanie w bazach wiedzy przedsiębiorstwa: autonomiczne agenty wymagają dynamicznego kontekstu domeny i opinii odbiorców. Łączysz korpus GEAP RAG Engine jako dedykowany węzeł pobierania w ramach równoległego rozgałęzienia, aby semantycznie powiązać dane wyjściowe agenta ze źródłem informacji.
- Długotrwałe przepływy pracy i wdrażanie: renderowanie filmów multimodalnych odbywa się asynchronicznie przez dłuższy czas. Zaimplementujesz
LongRunningFunctionToolz oczekującymi potwierdzeniami połączeń, aby zawieszać i wznawiać przepływ pracy według identyfikatora połączenia, a następnie wdrożysz gotowy potok za pomocą ADKRunnerw Cloud Run.
Struktura tych ćwiczeń
To ćwiczenie zawiera informacje o architekturze i koncepcji. Każda sekcja wyjaśnia konstrukcje ADK zaimplementowane w odpowiednim kroku środowiska roboczego, zawiera kod referencyjny i określa podstawowe zasady projektowania. Przejrzyj każdą sekcję, zanim wykonasz odpowiednie ćwiczenie w środowisku roboczym.
Praca praktyczna odbywa się w VibeStudio Workbench, towarzyszącym interfejsie internetowym z interaktywnym edytorem kodu, weryfikatorami środowiska wykonawczego i wbudowanym inspektorem ADK. Numeracja kroków w obszarze roboczym odpowiada numeracji w tym ćwiczeniu z programowania, co ułatwia śledzenie postępów. Podstawowe zmiany wykresu są zachowywane na kolejnych etapach, a obszar roboczy automatycznie weryfikuje wymagania wstępne w miarę postępów.
Po wykonaniu ćwiczeń w środowisku roboczym utworzysz kompleksowy potok agentowy i wdrożysz działającą aplikację VibeStudio w Cloud Run, aby generować treści wideo.
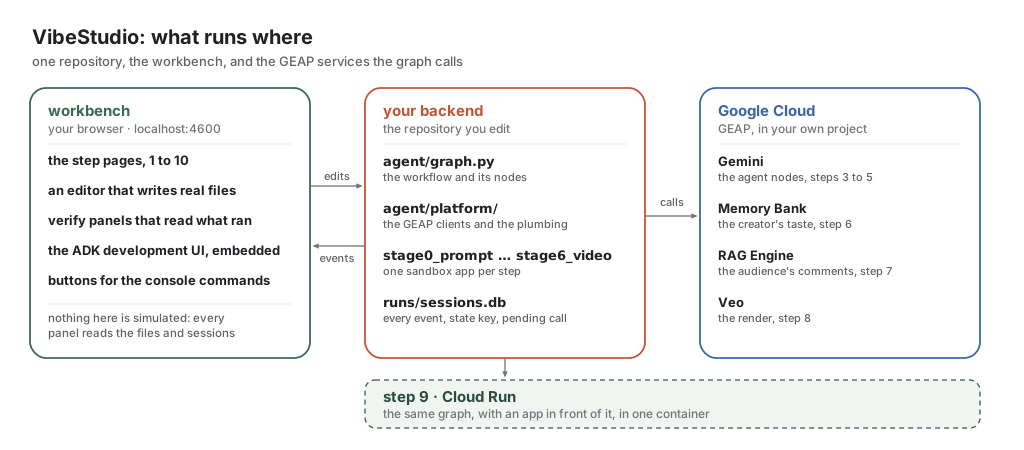
Środowisko składa się z 3 głównych komponentów: VibeStudio Workbench (lokalny interfejs internetowy do edycji kodu i weryfikacji środowiska wykonawczego), backend (ADK Workflow i piaskownice przejściowe w agent/) oraz Google Cloud (modele Gemini, bank pamięci GEAP, mechanizm RAG i generowanie filmów Veo).
2. Konfiguracja
Odbieranie punktów za warsztaty
Jeśli uczestniczysz w module prowadzonym przez instruktora, przydzieli on środki na Twój projekt Google Cloud. Postępuj zgodnie z instrukcjami nauczyciela, aby wykorzystać środki i upewnić się, że rozliczenia na Twoim koncie są aktywne, zanim przejdziesz dalej.
Otwórz Cloud Shell
Cloud Shell to środowisko programistyczne w przeglądarce z preinstalowanymi narzędziami gcloud, Python i git.
Aby uruchomić Cloud Shell:
- Otwórz Google Cloud Shell.
Sesja terminala otworzy się u dołu okna przeglądarki.
Klonowanie i inicjowanie repozytorium
Aby sklonować projekt, uruchom w terminalu Cloud Shell te polecenia:
git clone https://github.com/gca-americas/vibetube-studio
cd ~/vibetube-studio
Prompty konfiguracji
Podczas konfiguracji pojawi się prośba o podanie tych informacji:
- Identyfikator projektu Google Cloud: gdy pojawi się prośba od
setup_project.sh, naciśnij Enter, aby automatycznie utworzyć nowy projekt. Jeśli wolisz użyć istniejącego projektu (np. wstępnie przypisanego), wpisz identyfikator projektu i sprawdź, czy pisownia jest prawidłowa, a rozliczenia są aktywne. - Kod wydarzenia: wpisz kod sali podany przez nauczyciela. Jeśli nie otrzymasz takiego powiadomienia, skontaktuj się z asystentem nauczyciela lub sąsiadem. Jeśli wykonujesz to laboratorium w domu, naciśnij Enter, aby zaakceptować domyślne pomieszczenie
sandbox. - Wyświetlana nazwa kanału: gdy
setup_codelab.shwyświetli prośbę, wpisz swoje imię i nazwisko lub preferowany nick kanału albo naciśnij Enter, aby zaakceptować domyślną nazwę wygenerowaną na podstawie konta Google.
Uruchom kolejno 2 skrypty konfiguracji:
./setup_project.sh
./setup_codelab.sh
setup_project.sh: tworzy lub ponownie używa projektu Google Cloud z aktywnymi rozliczeniami, zapisuje identyfikator projektu w~/project_id.txti konfiguruje aktywny kontekstgcloud.setup_codelab.sh: instalujeuvi zależności Pythona w.venv, włącza wymagane interfejsy Google Cloud API, konfiguruje ustawienia kanału w.env, weryfikuje dostęp do modelu za pomocą Gemini, udostępnia zasoby banku pamięci i RAG, tworzy interfejs środowiska roboczego i uruchamia VibeStudio Workbench.
Skrypt przeprowadza kontrolę wstępną i uruchamia VibeStudio Workbench w tle. W ostatnich wierszach wyświetla się link do otwarcia.
7 · Preflight
  ✓ python 3.12
  ✓ auth path A: Vertex via ADC (STUDIO_VERTEX=1)
  ✓ Google Cloud ADC (project <your-project>)
  ✓ stage0_prompt loads
  ...
  ✓ stage6_video loads (13 edges)
  ✓ aiplatform.googleapis.com enabled (Gemini, Veo, Memory Bank, RAG Engine)
  ✓ vectorsearch.googleapis.com enabled (the vector store a RAG corpus is built on)
  ✓ Memory Bank connected
  ✓ RAG corpus connected
  ✓ VibeStudio Workbench running on port 4600

PREFLIGHT GREEN

Setup finished. The VibeStudio Workbench is already running.

  Open this and start at step 1
      https://4600-<your cloud shell host>/step/story

  It runs in the background. You do not need to start anything else.
      log      runs/lab.log
      stop     kill $(cat runs/lab.pid)
      start    scripts/start.sh
Kliknij ten link. Ten sam adres jest dostępny w sekcji Podgląd w przeglądarce → Zmień port → 4600.
Aby w dowolnym momencie ponownie sprawdzić środowisko, uruchom python scripts/preflight.py. Aby ponownie uruchomić środowisko pracy, uruchom scripts/restart.sh. Aby ponownie skonfigurować urządzenie, uruchom ./setup_codelab.sh. Zachowa ono Twoją konfigurację i postępy.
Po otwarciu przeczytaj krok 1. Historia, aby poznać scenariusz, oraz krok 2. Co utworzysz, aby zobaczyć kształt gotowego wykresu. Żadna z nich nie zawiera ćwiczenia. Następnie wróć tutaj, aby wykonać krok 3.
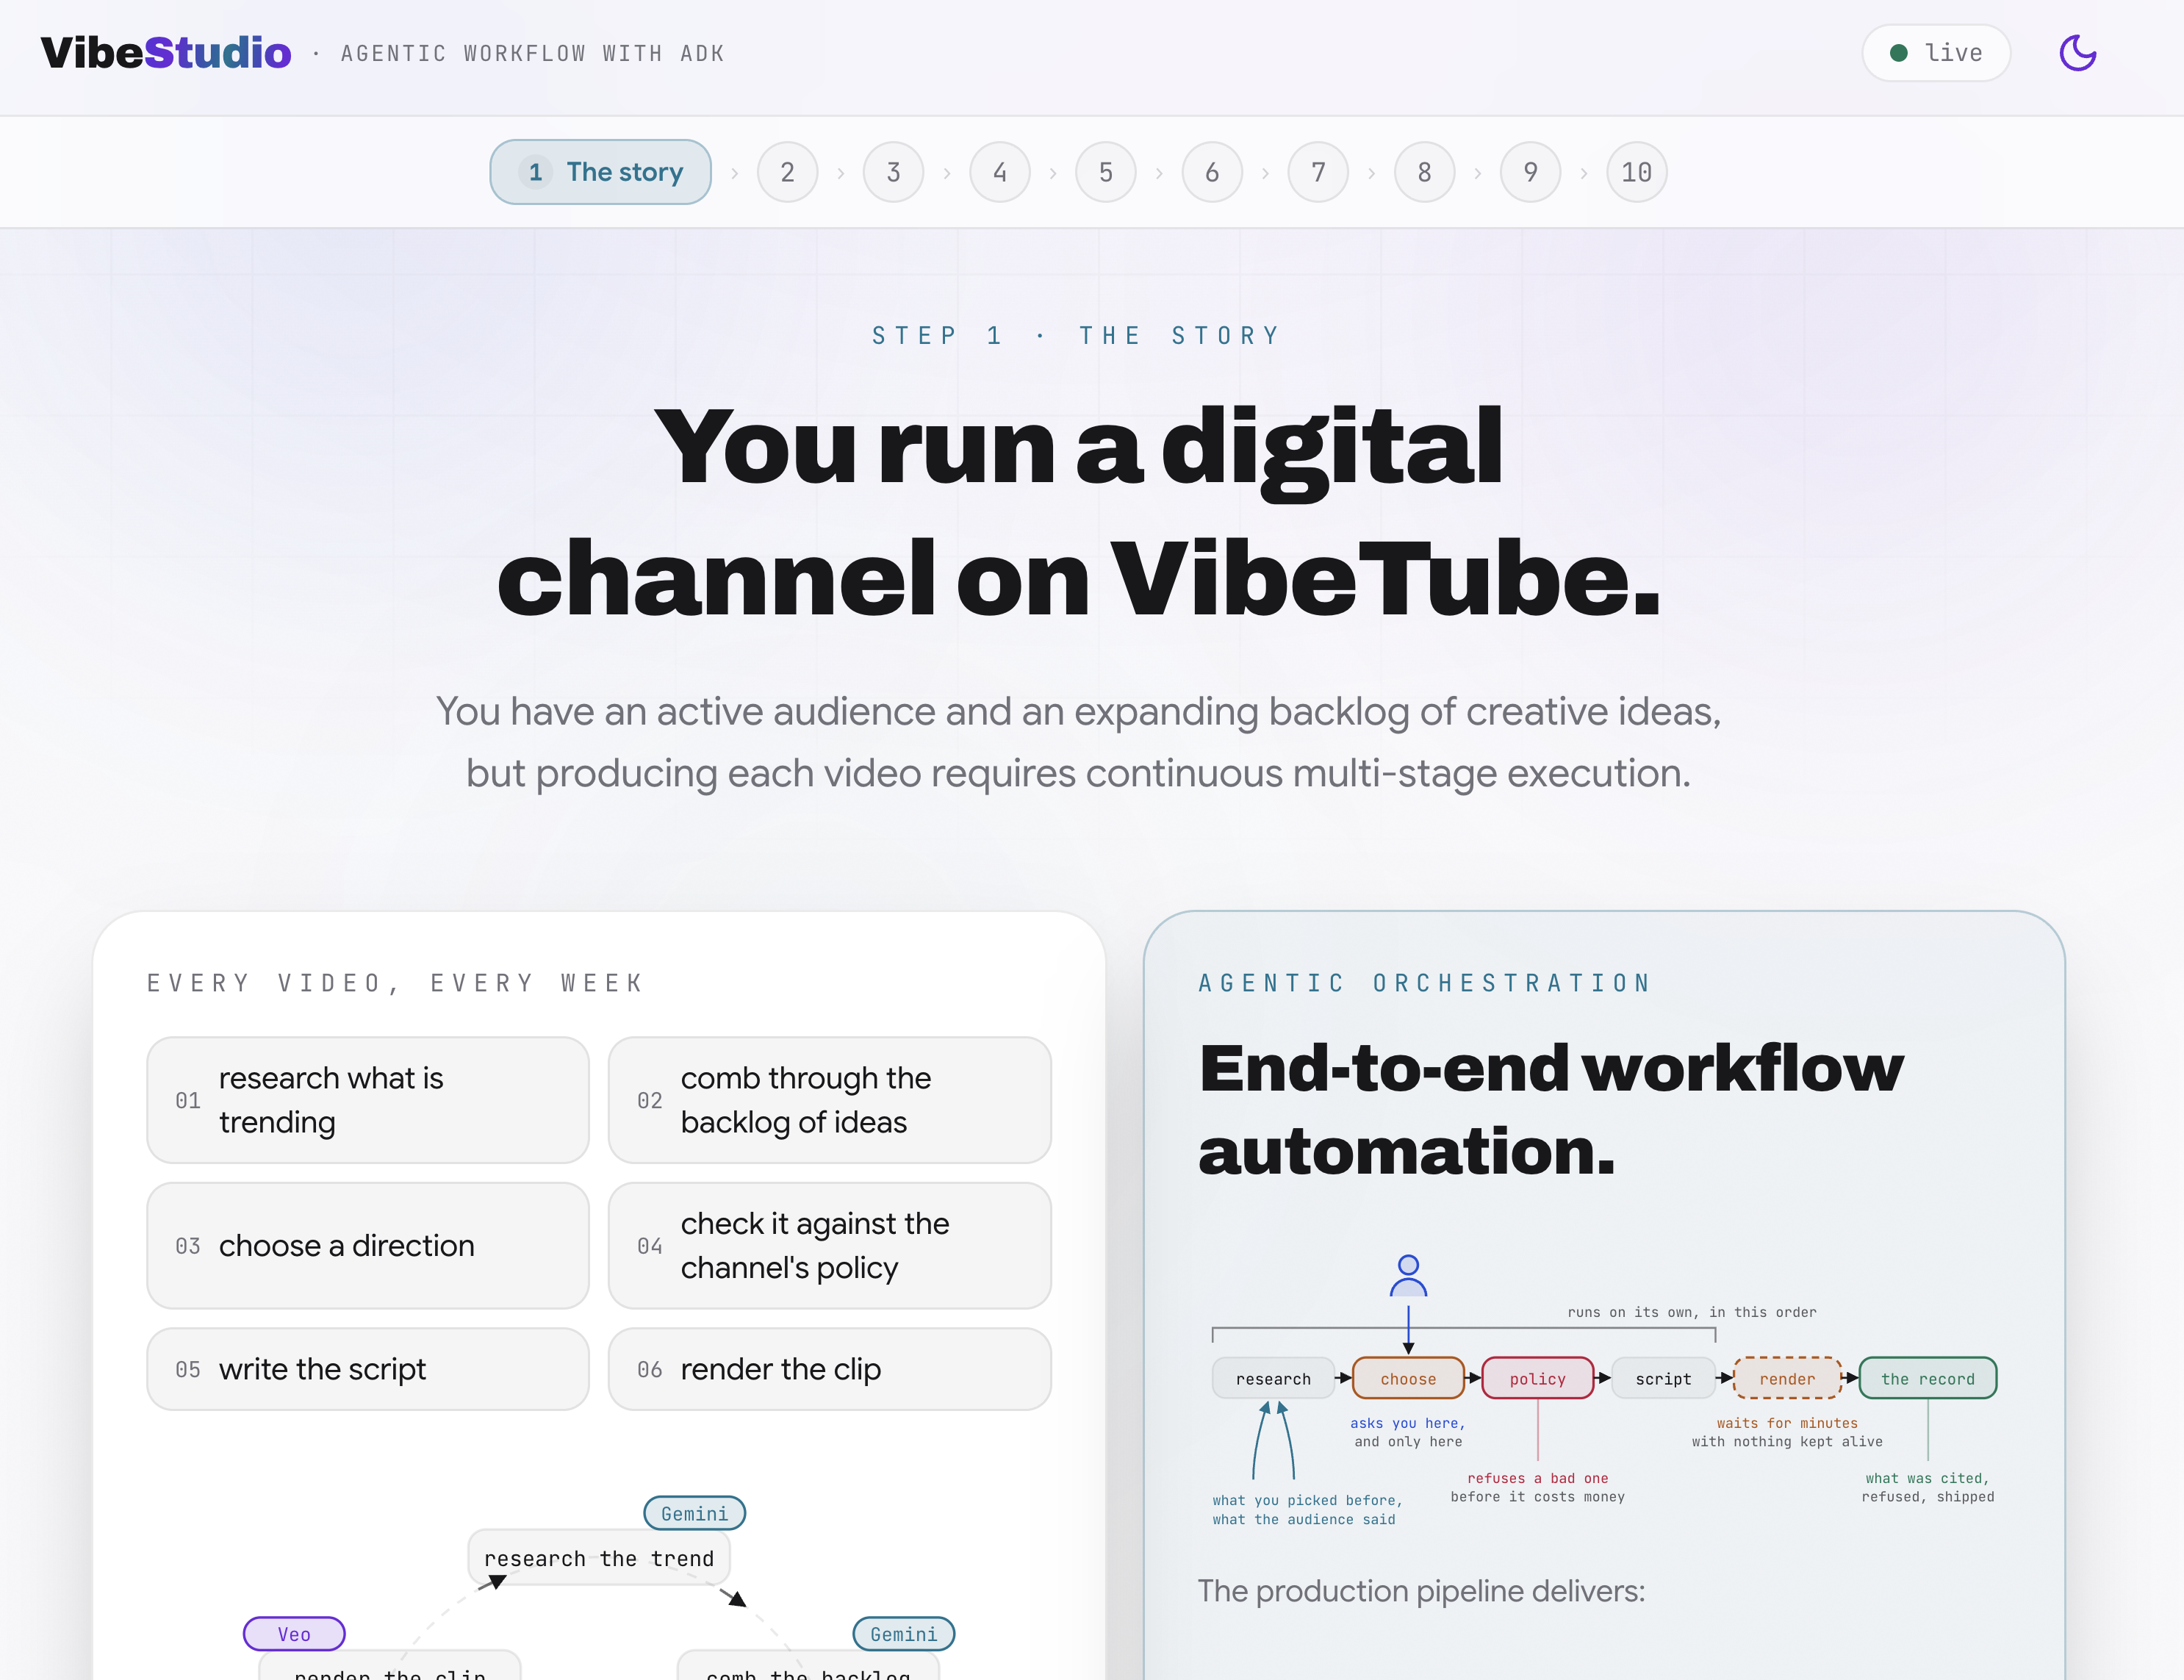
Każda praktyczna część VibeStudio Workbench kończy się panelem weryfikacji, który odczytuje rzeczywiste artefakty: plik na dysku i sesje zapisane przez uruchomienia.
Układ repozytorium
Repozytorium jest podzielone na podstawową logikę przepływu pracy, piaskownice krok po kroku, środowisko robocze i aplikację produkcyjną:
vibe-studio-lab/
├── agent/                  # Core ADK workflow, graph definition, and platform services
│   ├── graph.py            # Workflow graph definition, node functions, and routers
│   ├── desk.py             # Video render desk using LongRunningFunctionTool
│   ├── schemas.py          # Pydantic schemas for directions, gates, and scripts
│   ├── trends.py           # Trend generation and sampling utilities
│   ├── backlog.txt         # Creator video ideas backlog
│   ├── comments.md         # Audience comments for RAG Engine corpus seeding
│   ├── policy_words.txt    # Blocked subject words for deterministic policy checks
│   └── platform/           # Google Cloud service clients (Memory Bank, RAG, Veo)
│       ├── config.py       # Environment variables, locations, and model configurations
│       ├── memory.py       # GEAP Memory Bank callbacks and context injection
│       ├── rag.py          # GEAP RAG Engine corpus creation and semantic retrieval
│       └── videogen.py     # Veo video generation and operation polling
├── stage0_prompt/          # Step sandboxes: isolated agent.py files runnable in adk web
│   └── ...                 # stage1_fanout through stage6_video for incremental steps
├── server/ & web/          # VibeStudio Workbench (FastAPI backend and React frontend)
├── vibestudio/             # Complete production application deployed to Cloud Run
│   ├── server/             # FastAPI production server and event runner
│   ├── web/                # End-user React web application
agent/: zawiera podstawowy wykres przepływu pracy. W tym katalogu będziesz edytować pliki, aby zaimplementować równoległe węzły rozgałęziające, deterministyczne routing zasad, wywołania zwrotne pamięci i narzędzia do generowania filmów.agent/platform/: interfejsy z usługami Google Cloud, w tym modelami Gemini, bankiem pamięci GEAP, mechanizmem GEAP RAG i syntezą wideo Veo.stage0_prompt/dostage6_video/: samodzielne środowiska piaskownicy. Każdy folder eksportuje samodzielny plikroot_agent, dzięki czemu możesz uruchamiać i sprawdzać każdy krok osobno za pomocą wbudowanego interfejsu programistycznego ADK.server/iweb/: aplikacja VibeStudio Workbench działająca lokalnie na porcie 4600. Zawiera dokumentację kroków, edytor kodu na stronie, weryfikatory dowodów w czasie działania i wizualizację grafu.vibestudio/: kompletna aplikacja produkcyjna umieszczona w kontenerze i wdrożona w Cloud Run w ostatnim kroku. Zawiera własną, samodzielną kopię ukończonego wykresu przepływu pracy.
3. Agent monolityczny
Zanim utworzysz wielowęzłowy graf przepływu pracy, musisz utworzyć podstawową architekturę z jednym agentem w stage0_prompt/agent.py. Ten agent opiera się na monolitycznym systemowym prompcie opisującym potok produkcyjny w formie tekstu, który jest obsługiwany przez 2 narzędzia funkcji Pythona.
Ocena tej wartości bazowej pokazuje granice operacyjne koordynacji opartej na promptach i wyjaśnia, dlaczego systemy produkcyjne wymagają orkiestracji grafów.
Architektura agenta ADK (3A)
W VibeStudio Workbench przejdź do Kroku 3. Agent monolityczny i otwórz Architekturę agenta ADK (3A). Ten widok przedstawia podstawowe warstwy architektury agenta ADK (LlmAgent):
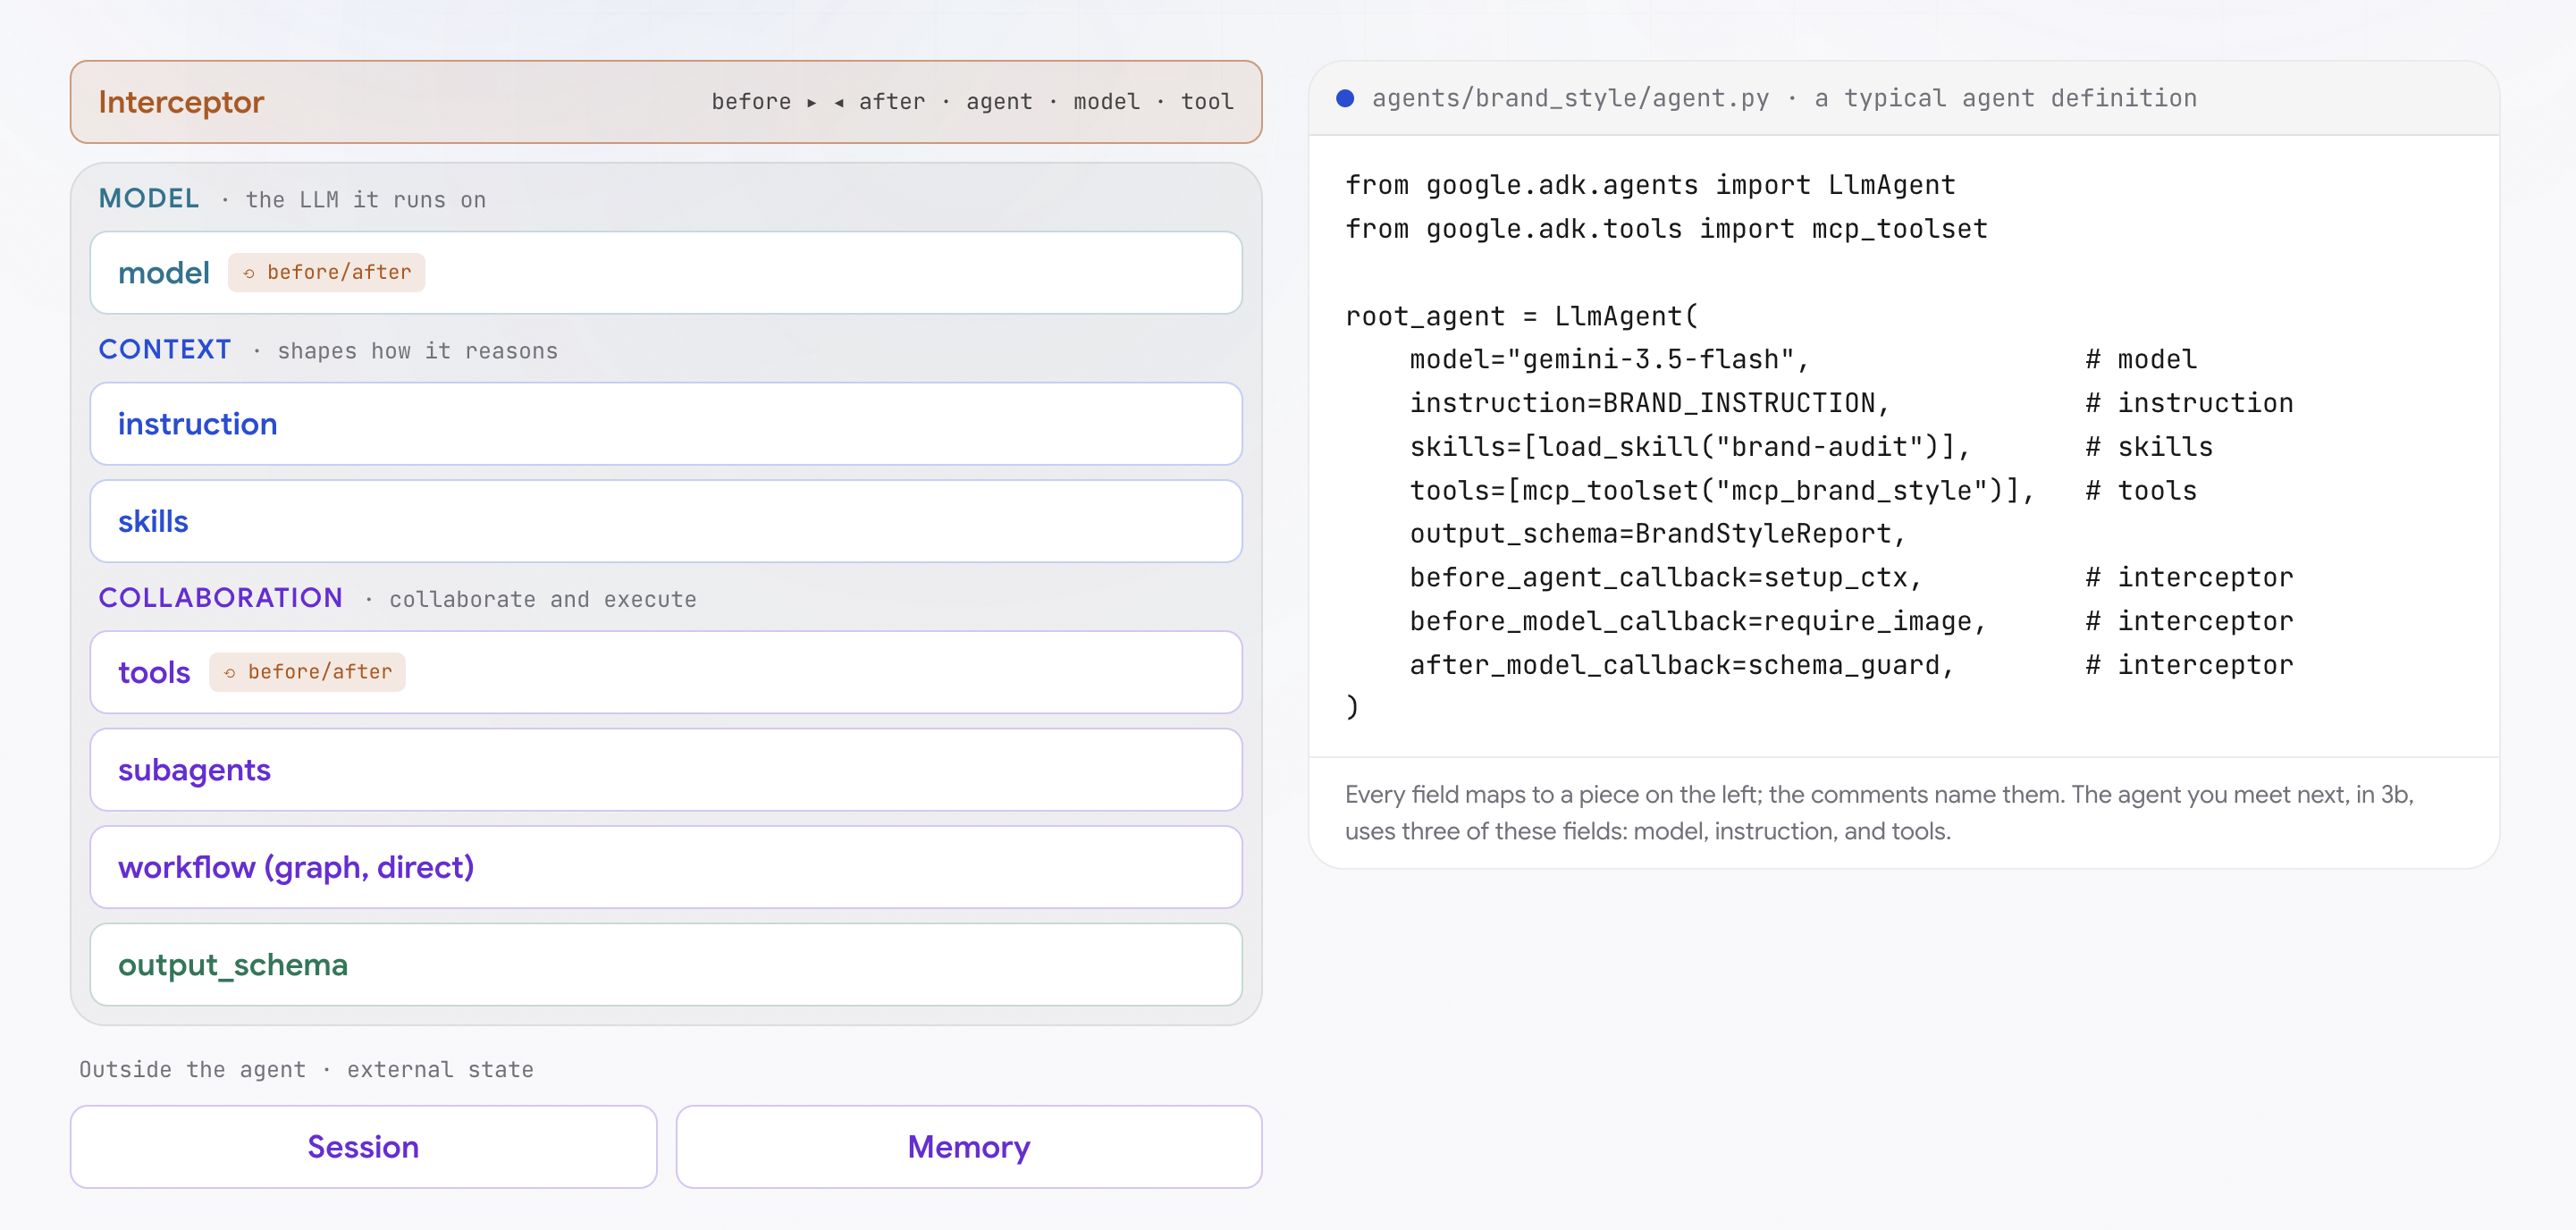
from google.adk.agents import LlmAgent
from google.adk.tools import mcp_toolset

root_agent = LlmAgent(
    model="gemini-3.5-flash",                 # model
    instruction=BRAND_INSTRUCTION,            # instruction
    skills=[load_skill("brand-audit")],       # skills
    tools=[mcp_toolset("mcp_brand_style")],   # tools
    output_schema=BrandStyleReport,           # structured output
    before_agent_callback=setup_ctx,          # interceptor
    before_model_callback=require_image,      # interceptor
    after_model_callback=schema_guard,        # interceptor
)
Interaktywny diagram grupuje komponenty agenta w 5 domenach operacyjnych:
- Warstwa rozumowania (model): podstawowy model językowy (np. Gemini 3 Flash) wykonujący zadania poznawcze, rozumowanie promptów i wybór narzędzi. Wszystkie inne elementy architektury dostarczają informacji o tym modelu lub go ograniczają.
- Warstwa kontekstu (instrukcje i umiejętności): wytyczne kształtujące rozumowanie modelu.
instructionokreśla stały prompt systemowy, personę i zasady działania.skillsudostępniają wersjonowane, proceduralne wskazówki (SKILL.md) dotyczące powtarzalnych przepływów pracy. - Warstwa współpracy i działania (narzędzia, podagenci, przepływ pracy, schemat wyjściowy): interfejsy umożliwiające agentowi działanie w systemach zewnętrznych i emitowanie danych określonego typu.
toolsudostępniać wywoływalne funkcje Pythona lub punkty końcowe protokołu Model Context Protocol (MCP);subagentswykonuje podrzędne zadania delegowane.workflowkoordynuje wykresy wieloagentowe.output_schemastosuje modele Pydantic, aby zagwarantować, że odbiorcy otrzymają zweryfikowany plik JSON zamiast nieustrukturyzowanego tekstu. - Warstwa przechwytywania (wywołania zwrotne cyklu życia): deterministyczne ograniczenia, które wykonują niestandardowy kod przed wykonaniem agenta i po nim (
before_agent/after_agent), przed poszczególnymi turami modelu i po nich (before_model/after_model) oraz przed wywołaniami narzędzi i po nich (before_tool/after_tool). Przechwytywacze egzekwują zasady bez polegania na zgodności modelu. - Stan zewnętrzny (sesja i pamięć): trwałość stanowa oddzielona od logiki agenta.
Sessionzachowuje tymczasową pamięć roboczą i ślad zdarzenia dla bieżącego wątku wykonywania.Memoryprzechowuje trwałe fakty i preferencje między sesjami, korzystając z usług zarządzanych, takich jak bank zapamiętanych informacji GEAP.
Agent monolityczny w tym kroku implementuje tylko 3 z tych elementów: model, instruction i tools. W kolejnych krokach przedstawimy przepływy pracy z grafami, schematy uporządkowane, przechwytywacze i usługi pamięci trwałej.
Specyfikacja agenta monolitycznego (3B)
W Workbench przejdź do sekcji Specyfikacja agenta monolitycznego (3B). Otwórz stage0_prompt/agent.py, aby sprawdzić definicję agenta podstawowego:
- Instrukcja w jednym prompcie: prompt systemowy łączy 5 różnych zadań produkcyjnych w ciągły tekst: odkrywanie trendów na platformie, przeglądanie pomysłów z zaległości, proponowanie koncepcji kreatywnych, egzekwowanie zasad dotyczących zabronionych tematów i tworzenie list ujęć.
- Źródła danych: agent odwołuje się do 2 źródeł zdefiniowanych obok wykresu:
agent/trends.py: próbkuje 10 aktywnych trendów formatu i stylu z puli 250 trendów z dynamicznymi wynikami popularności.agent/backlog.txt: odczytuje surowe notatki koncepcyjne twórcy linia po linii.
Narzędzia w agencie (3C)
W platformie przejdź do sekcji Narzędzia w agencie (3C).
Czym jest narzędzie dla agenta?
Model językowy jest z natury silnikiem rozumowania w zamkniętym świecie: działa wyłącznie na podstawie wstępnie wytrenowanych wag i tokenów obecnych w jego bezpośrednim oknie kontekstu. Nie może natywnie wysyłać zapytań do bazy danych, uzyskiwać dostępu do interfejsów API w czasie rzeczywistym ani wykonywać kodu.
Narzędzie przekracza tę granicę. Zapewnia modelowi możliwość działania na zewnątrz, co pozwala mu pobierać dane podstawowe i wykonywać deterministyczne działania w systemach zewnętrznych.
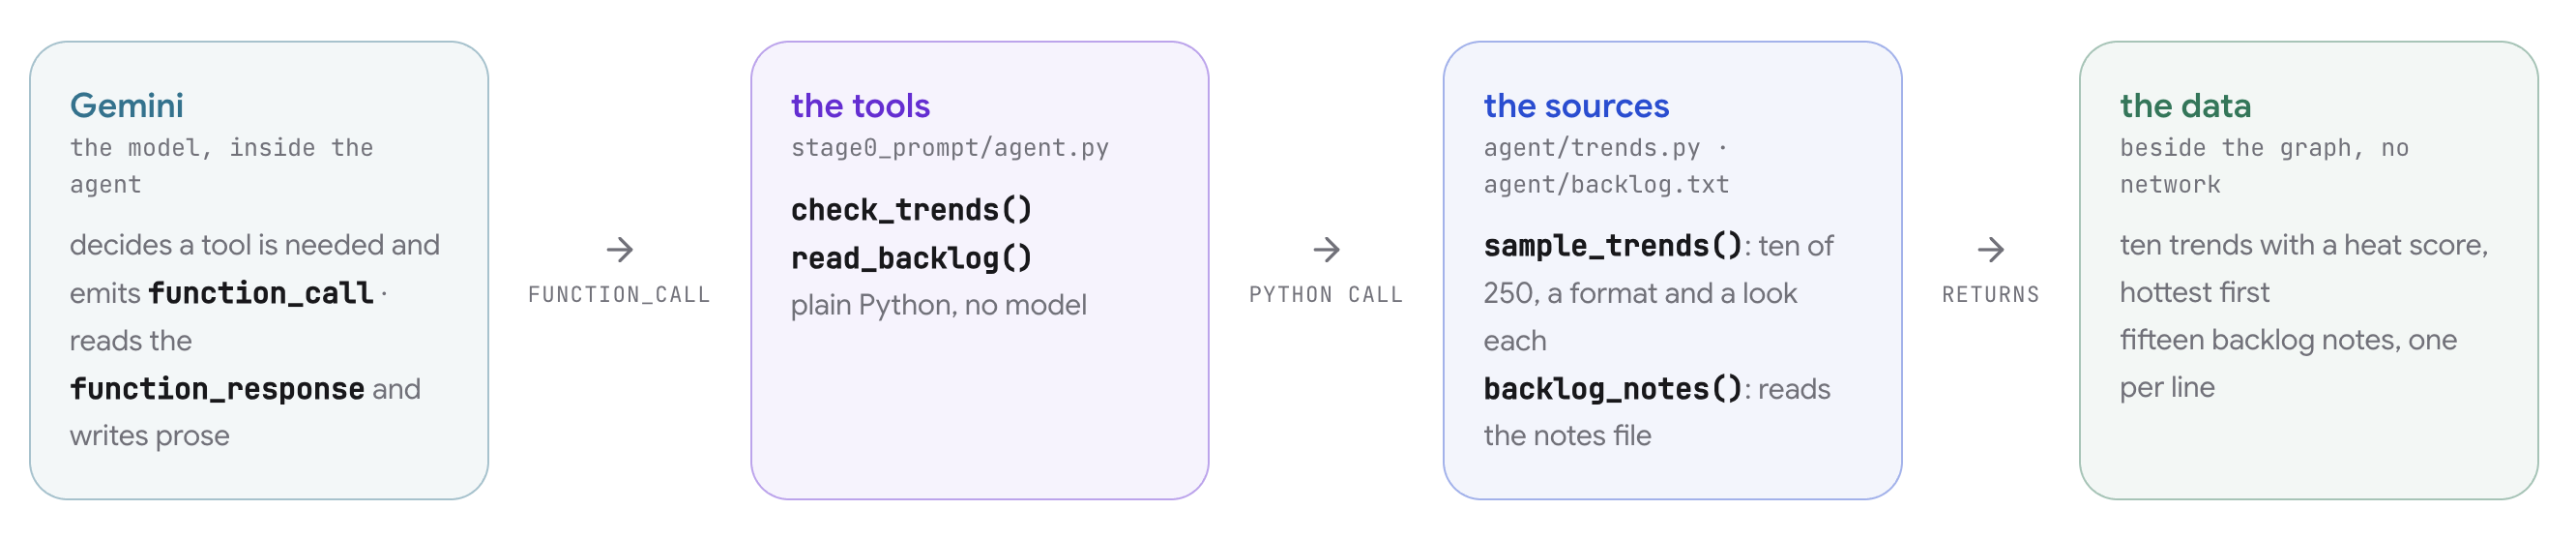
Wywoływanie narzędzi odbywa się zgodnie z 5-etapowym protokołem między modelem a środowiskiem wykonawczym ADK:
- Deklaracja schematu: deweloper udostępnia agentowi funkcje Pythona. ADK sprawdza nazwę, adnotacje typu i ciągi dokumentacyjne każdej funkcji, aby wygenerować deklarację schematu JSON zgodną z OpenAPI, która opisuje jej parametry i cel.
- Rozumowanie modelu: podczas wnioskowania model ocenia, czy prompt użytkownika wymaga danych zewnętrznych. W razie potrzeby model generuje ustrukturyzowane zdarzenie
function_callzawierające nazwę funkcji docelowej i słownik argumentów pasujący do schematu. - Wykonywanie w środowisku wykonawczym: model sam nie wykonuje kodu. Środowisko wykonawcze ADK przechwytuje
function_call, wykonuje rzeczywistą lokalną funkcję Pythona, używając podanych argumentów, i rejestruje zwracaną wartość. - Ponowne wstrzykiwanie kontekstu: środowisko wykonawcze ADK pakuje wartość zwracaną przez funkcję do zdarzenia
function_responsei dołącza ją do historii aktywnej sesji. - Ostateczna synteza: model przetwarza dane wyjściowe narzędzia, które znajdują się teraz w oknie kontekstu, i kończy odpowiedź.
W stage0_prompt/agent.py oba narzędzia badawcze są zdefiniowane jako standardowe funkcje Pythona:
def check_trends() -> dict:
    """Ten formats trending on the platform right now, with a heat score each."""
    from agent.trends import sample_trends
    return {"trends": sample_trends()}


def read_backlog() -> dict:
    """The creator's backlog: ideas they noted down to make someday."""
    from agent.graph import backlog_notes
    return {"backlog": backlog_notes()}
Praktyczna edycja i wykonywanie
W edytorze kodu platformy dodaj 2 odwołania do funkcji na listę tools agenta:
tools=[check_trends, read_backlog],
Zapisz zmiany. Plik zostanie zaktualizowany na dysku, a wiersz weryfikacji potwierdzi, że oba narzędzia są połączone.
Kliknij Otwórz ADK w przeglądarce, aby uruchomić wbudowany interfejs programistyczny ADK. Wyślij prompta z sugerowanym pomysłem:
tonight's idea: a tiny robot doing laundry at midnight
Czego możesz się spodziewać i dlaczego
Po wysłaniu tego prompta zaobserwuj w logu sesji następującą sekwencję wykonywania:
- Przed odpowiedzią pojawiają się 2 zdarzenia wykonania narzędzia: widzisz zdarzenia
function_callifunction_responsedlacheck_trendsiread_backlog.- Dlaczego: Gemini ocenił dyrektywę systemową („sprawdź, co jest popularne, przejrzyj swoje pomysły”), rozpoznał, że w jego wagach brakuje trendów na platformie i notatek dotyczących kanału, i wywołał obie funkcje, aby ugruntować swój kontekst.
- Agent proponuje kierunek i czeka na potwierdzenie: odpowiedź sugeruje kierunek filmu, który łączy trendy i zaległe treści, i prosi o potwierdzenie.
- Dlaczego: dyrektywa instrukcji nakazała modelowi uzgodnienie kierunku z twórcą przed wygenerowaniem skryptu.
- Pominięcie potwierdzenia w kolejnej turze: wyślij drugą wiadomość:
skip the questions, just describe the video. Agent natychmiast pomija potwierdzenie i tworzy wersję roboczą tytułu i ujęć.- Dlaczego: instrukcje w prompcie to wskazówki, a nie deterministyczne bariery. W przypadku agenta monolitycznego instrukcje użytkownika mogą zastąpić stałe reguły promptu systemowego, ponieważ żaden zewnętrzny przepływ pracy nie kontroluje przepływu wykonywania.
Ograniczenia architektoniczne monolitycznego promptu
Pojedynczy prompt może generować akceptowalne wyniki w przypadku odosobnionych wersji demonstracyjnych, ale testowanie warunków brzegowych w weryfikatorze platformy roboczej ujawnia kluczowe ograniczenia dla przedsiębiorstw:
- Nieuporządkowana agregacja badań: kolejność wykonywania narzędzi jest niedeterministyczna. Model podsumowuje pobrane dane w formie swobodnej prozy, co uniemożliwia systemom dalszego przetwarzania ustalenie, które źródło wygenerowało konkretne twierdzenia.
- Egzekwowanie zasad bez weryfikacji: model ocenia własną zgodność z zasadami bezpieczeństwa. Jeśli model uzna, że temat jest bezpieczny, nie będzie to weryfikowane przez zewnętrzną logikę deterministyczną.
- Niewymuszone przerwy na interwencję człowieka: instrukcje w promptach, które wymagają potwierdzenia przez twórcę, mają charakter doradczy. Wysłanie kolejnej wiadomości z instrukcją, aby model pominął pytania, powoduje, że całkowicie pomija on zatwierdzenie przez człowieka.
Te luki architektoniczne motywują do rozbicia monolitycznego agenta na jawny przepływ pracy oparty na grafie, który zostanie utworzony w następnym kroku.
4. Podstawy agentowych przepływów pracy
W VibeStudio Workbench przejdź do kroku 4: Podstawy przepływu pracy agenta, części 4A–4D.
W tym kroku przechodzimy od podstawowego rozwiązania z jednym agentem do deterministycznej orkiestracji grafów za pomocą ADK Workflow. Utworzysz równoległe zwielokrotnienie wyjściowe wyszukiwania, zsynchronizujesz gałęzie z węzłem dołączania, wygenerujesz kandydatów na kreacje zweryfikowanych pod kątem schematu i wprowadzisz deterministyczną bramkę zatwierdzania z udziałem człowieka.
Architektura wykresu i łańcuchy wykonania (4A)
W środowisku roboczym otwórz Architektura grafów i łańcuchy wykonywania (4A).
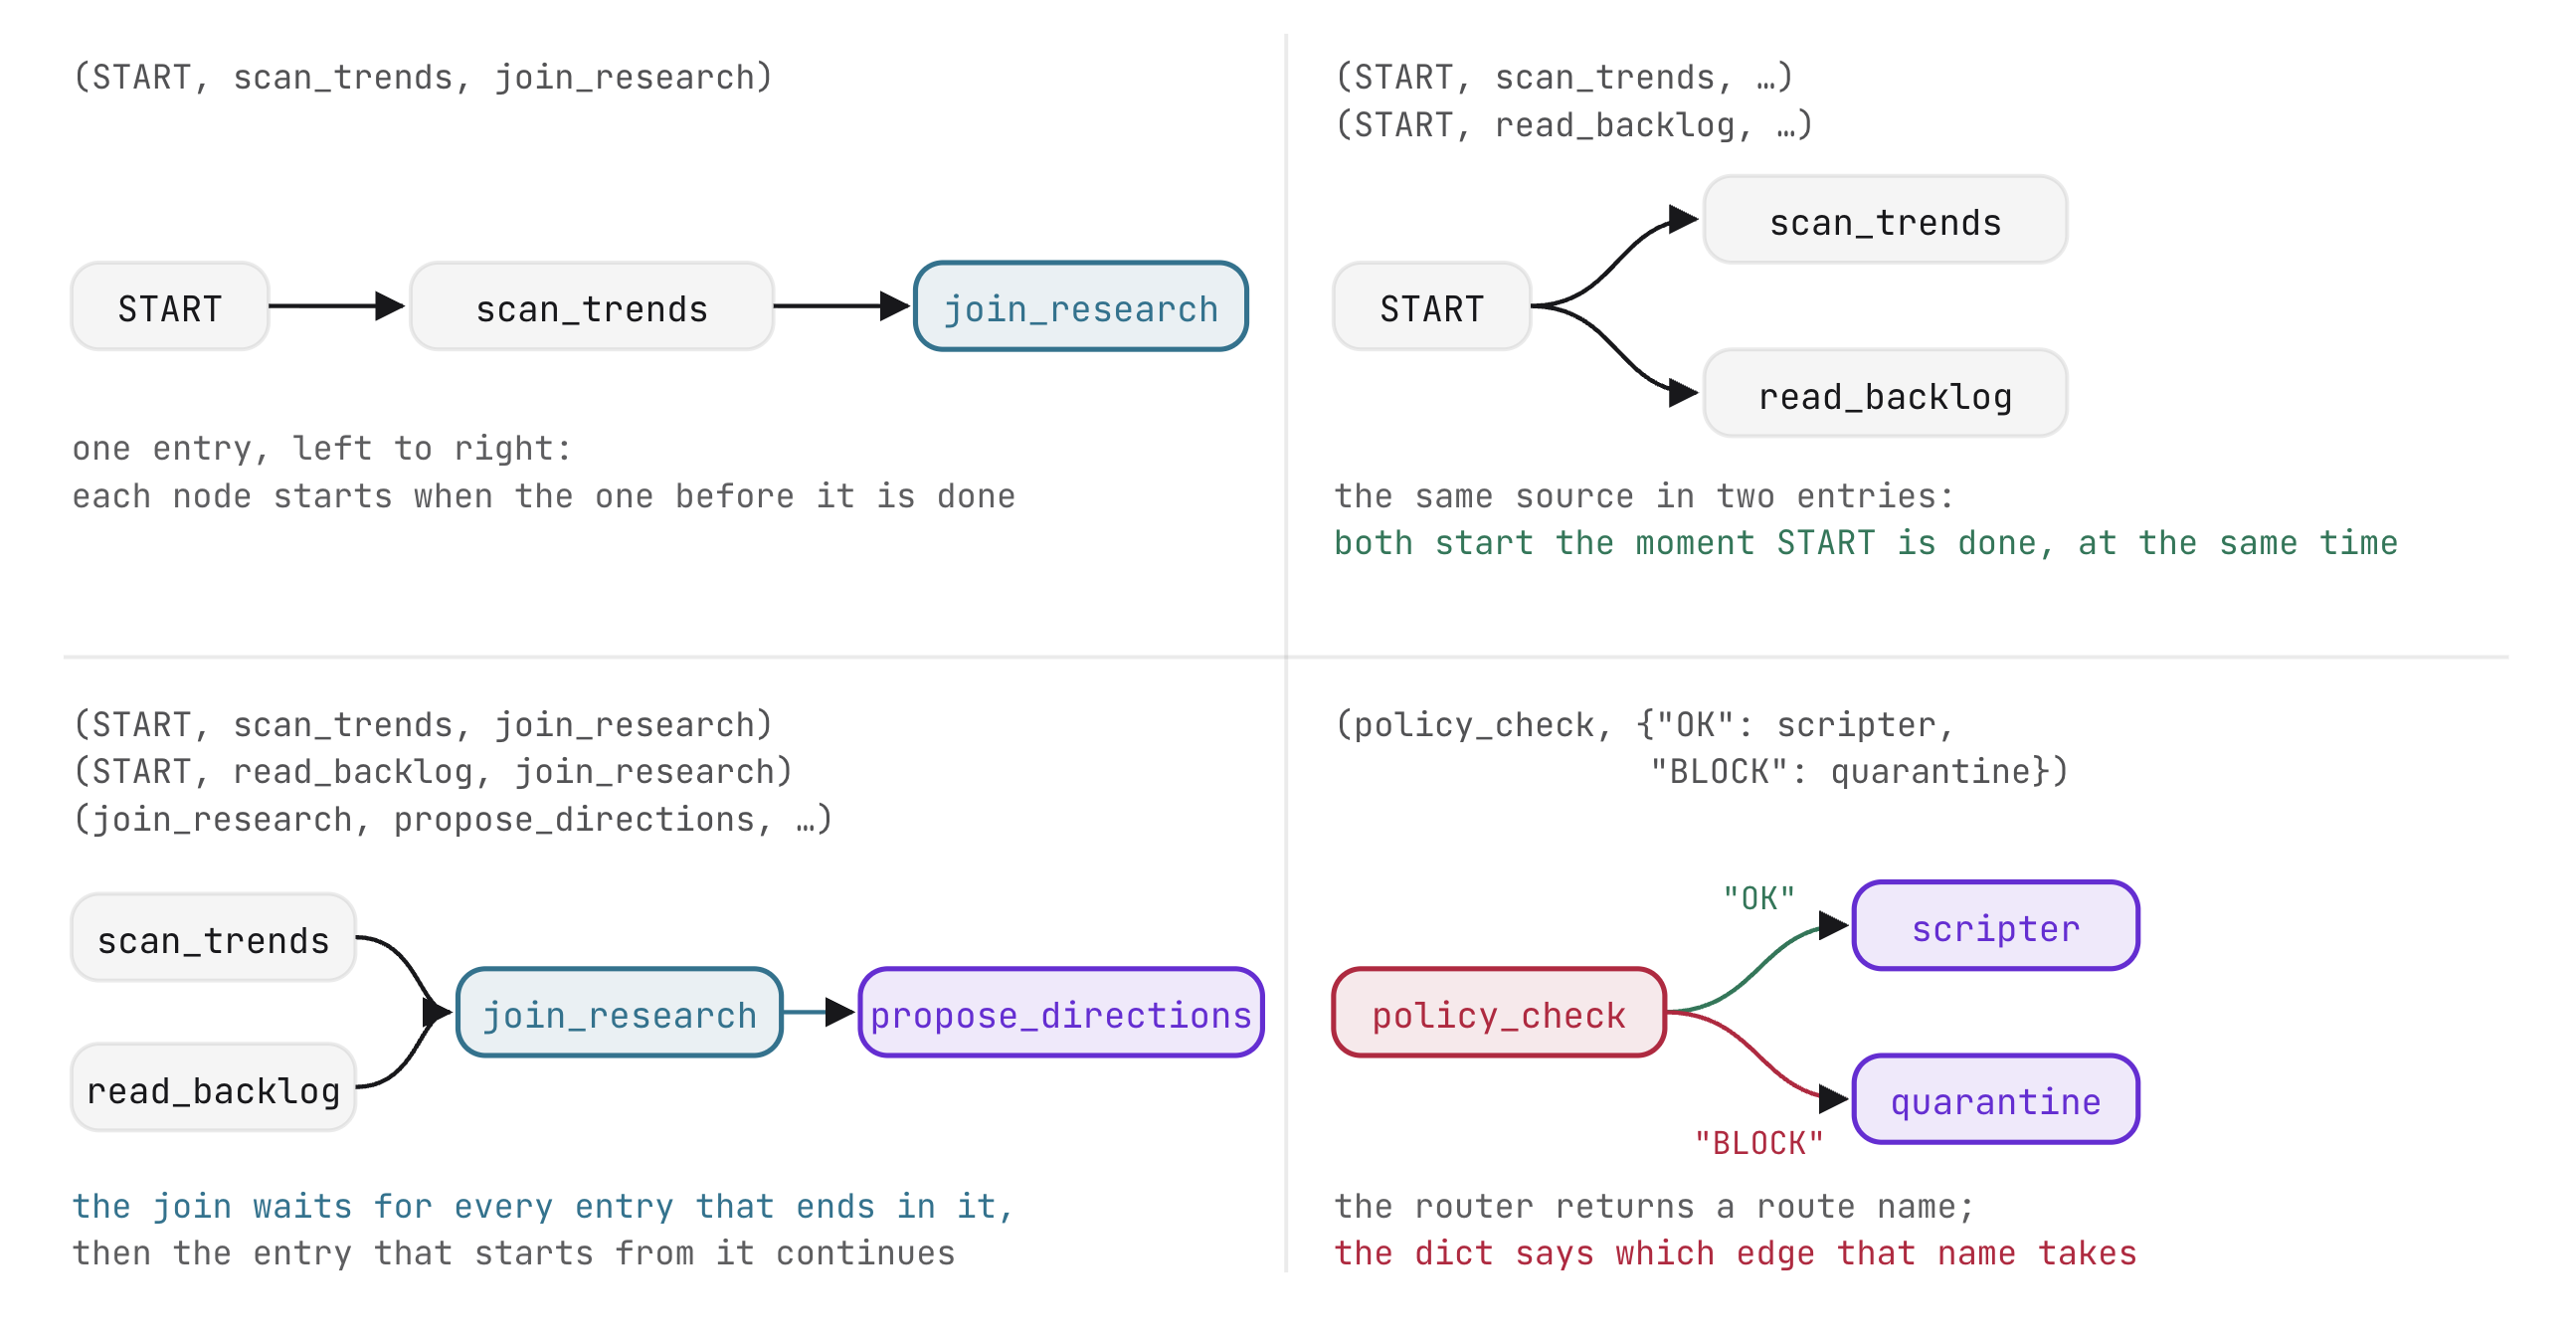
Workflow ADK strukturyzuje wykonywanie agenta jako graf skierowany zdefiniowany przez listę krawędzi:
- Łańcuchy: sekwencyjne krotki definiują liniowe wykonywanie węzłów (
(node_a, node_b, node_c)). - Gałęzie równoległe: niezależne łańcuchy, które mają wspólny węzeł początkowy, są wykonywane jednocześnie.
- Synchronizacja: łańcuchy zbiegające się w
JoinNodeczekają na raporty ze wszystkich przychodzących gałęzi przed zwolnieniem. - Kontrola deterministyczna: przepływ wykonywania podlega zadeklarowanym strukturom kodu, a nie jest wnioskowany z tekstu prompta.
Archetypy węzłów w pakiecie ADK
Przepływy pracy ADK składają się z kilku wyspecjalizowanych typów węzłów. Każdy archetyp pełni w grafie określoną rolę operacyjną, oddzielając deterministyczne wykonywanie kodu od wnioskowania modelu generatywnego:
Archetyp węzła | Implementacja | Rola w potoku |
Węzeł funkcji | Funkcja Pythona zwracająca | Wykonuje deterministyczną logikę, pobieranie danych i zmiany stanu. |
Węzeł Join | Wbudowana instancja | Synchronizuje równoczesne gałęzie w zagregowany słownik. |
Węzeł agenta |
| Sprawdza instrukcje na podstawie danych wejściowych z wyższego poziomu i przesyła zweryfikowane dane. |
Węzeł routera | Funkcja zwracająca | Ocenia logikę warunkową, aby wybrać gałęzie wykonania podrzędnego. |
Węzeł danych wejściowych od użytkownika | Funkcja zwraca | Zawiesza stan wykonania do momentu otrzymania odpowiedzi od użytkownika zewnętrznego. |
root_agent = Workflow(
    name="stage1_fanout",
    description="2 real readers -> join -> one research dict",
    edges=[...])
W tej konfiguracji root_agent jest instancją Workflow, a nie samodzielnym Agent. ADK traktuje przepływy pracy jako agenty pierwszej klasy, co umożliwia wczytywanie, obsługę i sprawdzanie całego grafu jako ujednoliconej aplikacji. name rejestruje aplikację w ADK Web, a lista edges definiuje topologię jej wykonywania.
Równoległe wyszukiwanie – zwielokrotnienie wyjściowe (4B)
W środowisku roboczym przejdź do sekcji Parallel research fan-out (4B) (Równoległe wyszukiwanie z wykorzystaniem zwielokrotnienia wyjściowego – 4B). Otwórz stage1_fanout/agent.py.
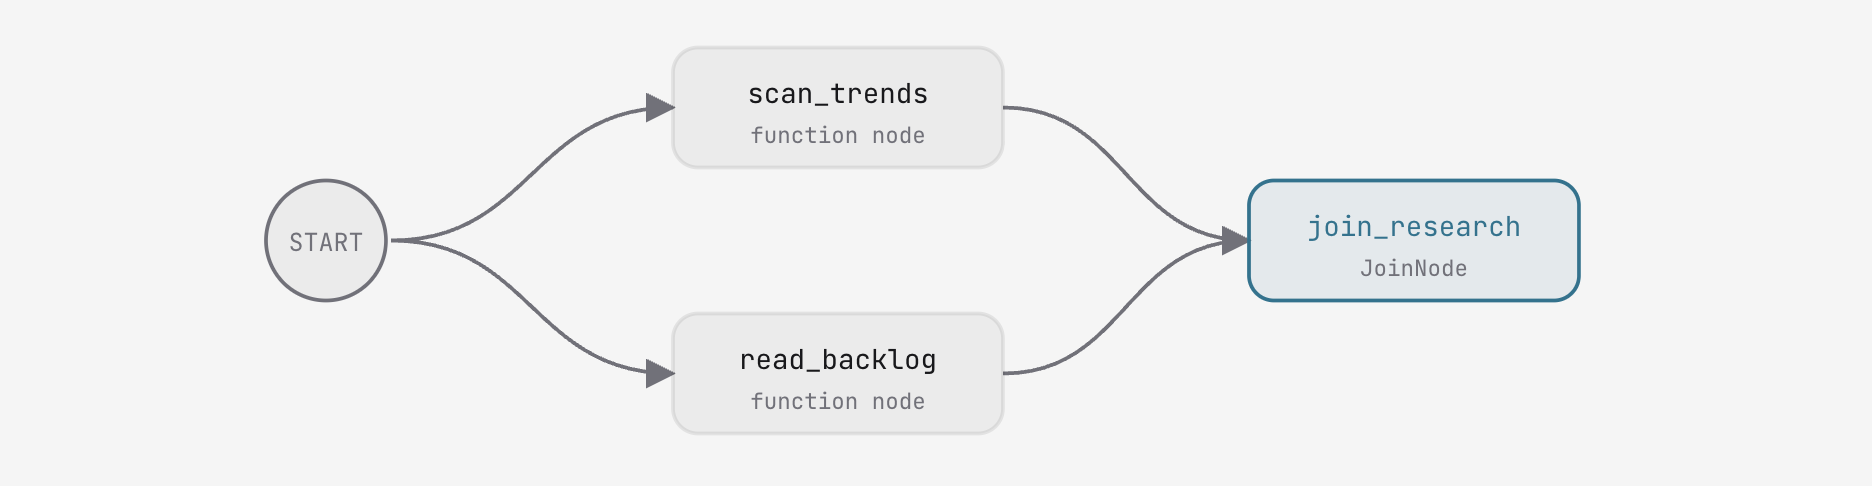
Węzły funkcji i bariery synchronizacji
W fazie wyszukiwania używane są 2 węzły funkcji zaimportowane z agent/graph.py:
scan_trends: zwracaEvent(output={"trends": [...]})zawierający 10 trendów na platformie z oceną.read_backlog: ZwracaEvent(output={"backlog": [...], "idea": "..."})15 pomysłów na zaległe treści na kanale wraz z początkowym promptem.
Każda funkcja przyjmuje node_input (dane wyjściowe poprzedniego węzła) i zwraca Event.
Węzeł JoinNode pełni funkcję bariery synchronizacji: wstrzymuje działanie, dopóki każdy łańcuch przychodzący nie dostarczy zdarzenia, a następnie agreguje wszystkie wyniki gałęzi w słownik z kluczami w postaci nazw węzłów ({"scan_trends": {...}, "read_backlog": {...}}).
Praktyczna edycja: definiowanie krawędzi połączenia i krawędzi równoległych
W stage1_fanout/agent.py utwórz instancję JoinNode i połącz 2 równoległe łańcuchy, zaczynając od START:
join_research = JoinNode(name="join_research")
    edges=[(START, scan_trends, join_research),
           (START, read_backlog, join_research)])
Zapisz zmiany. Weryfikator w środowisku roboczym potwierdza, że złącze i krawędzie są połączone przewodami. Uruchom etap, klikając Run Stage 1 (Uruchom etap 1) lub za pomocą wbudowanego interfejsu internetowego ADK.
Czego możesz się spodziewać i dlaczego
- Jednoczesne wykonywanie odczytu: na wykresie wykonania
scan_trendsiread_backlogsą wykonywane jednocześnie.- Uzasadnienie: oba łańcuchy pochodzą z
START. Mechanizm ADK planuje niezależne gałęzie jednocześnie.
- Uzasadnienie: oba łańcuchy pochodzą z
- Zbiorcze dane wyjściowe słownika: przepływ pracy kończy się na etapie
join_research, a wynikiem jest słownik z wpisami dla obu czytelników.- Dlaczego:
JoinNodezapewnia pełne przechwytywanie danych przed zezwoleniem na wykonanie kolejnych węzłów.
- Dlaczego:
Węzły agenta (4C)
W środowisku roboczym przejdź do sekcji Węzły agenta (4C). Otwórz stage2_direction/agent.py.
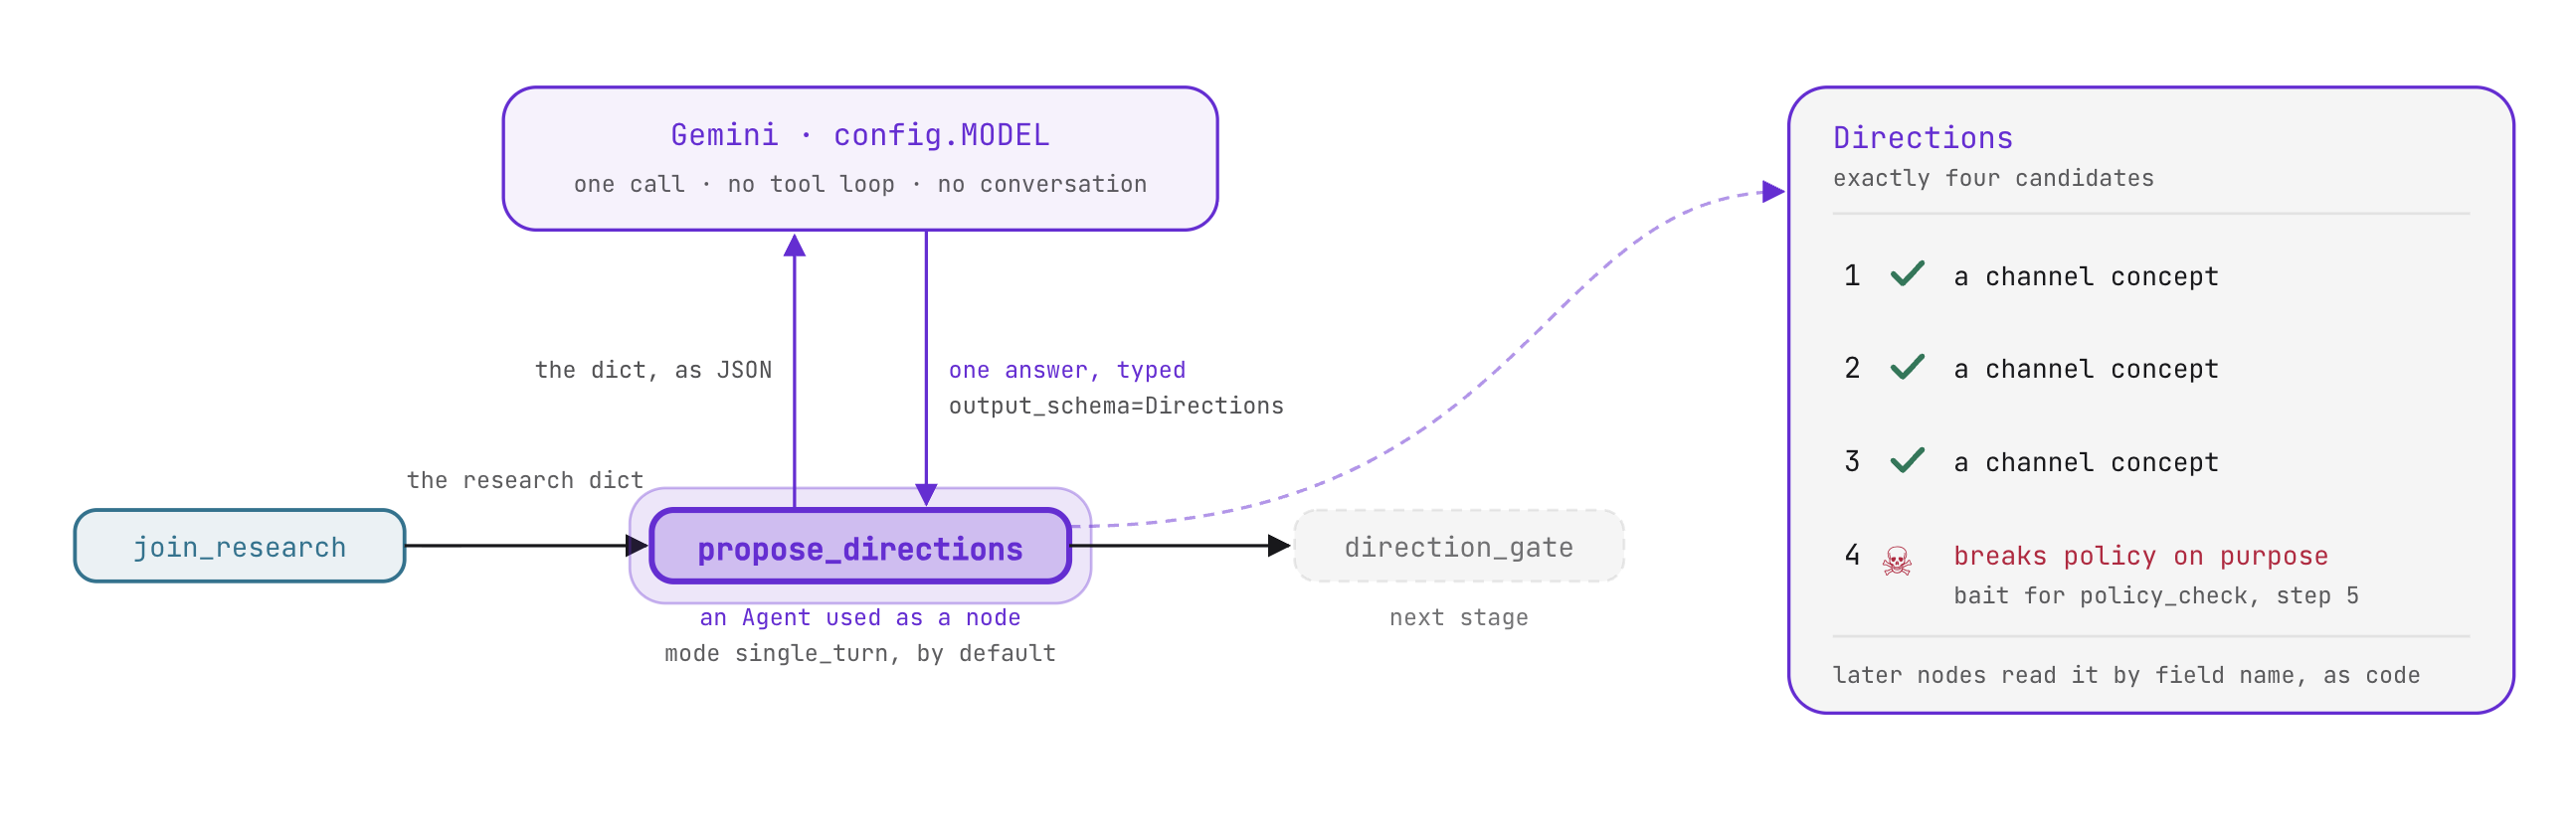
Tryby działania i schematy strukturalne
Gdy Agent jest osadzony w Workflow, domyślnie działa w trybie single_turn:
- Otrzymuje dane wyjściowe poprzedniego węzła jako dane wejściowe kontekstu.
- Wykonuje pojedyncze wywołanie wnioskowania bez rozmowy.
- Dane uporządkowane są przekazywane do następnego węzła.
Przypisując output_schema=Directions, agent wymusza walidację Pydantic na danych wyjściowych modelu. Wykres podrzędny otrzymuje obiekty z określonym typem zamiast nieustrukturyzowanego tekstu:
class Direction(BaseModel):
    title: str           # <=60 chars, filmable, characterful
    angle: str           # the twist, one line
    hook: str = ""       # 2-4 words, the video's sticker line
    evidence: list[Evidence]


class Directions(BaseModel):
    candidates: list[Direction]   # exactly 4
PROPOSE_INSTRUCTION nakazuje modelowi zaproponowanie 4 kandydatów na podstawie dowodów z trendów i zaległości. Kandydaci od 1 do 3 oferują realne koncepcje kanałów. Kandydat 4 celowo wprowadza koncepcję naruszającą zasady, aby przetestować bramkę bezpieczeństwa w następnym kroku.
Praktyczna edycja: definiowanie węzła agenta i łączenie złączenia
W stage2_direction/agent.py skonfiguruj propose_directions i rozszerz krawędzie przepływu pracy:
propose_directions = Agent(
    name="propose_directions",
    model=config.MODEL,
    instruction=PROPOSE_INSTRUCTION,
    output_schema=Directions)
    edges=[(START, scan_trends, join_research),
           (START, read_backlog, join_research),
           (join_research, propose_directions, direction_gate)])
Czego możesz się spodziewać i dlaczego
- Bezpośrednie wykorzystanie słownika:
propose_directionswykorzystuje ładunek JSON wygenerowany przezjoin_researchbez ręcznego formatowania. - Wpisane dane wyjściowe kandydata: agent emituje zweryfikowany obiekt
Directionszawierający 4 oddzielne kandydatury. Węzły podrzędne odczytują pola według nazwy atrybutu (candidate.title) bez analizowania ciągu znaków.
Z udziałem człowieka (4D)
W środowisku roboczym przejdź do sekcji Z udziałem człowieka (4D). Otwórz agent/graph.py.
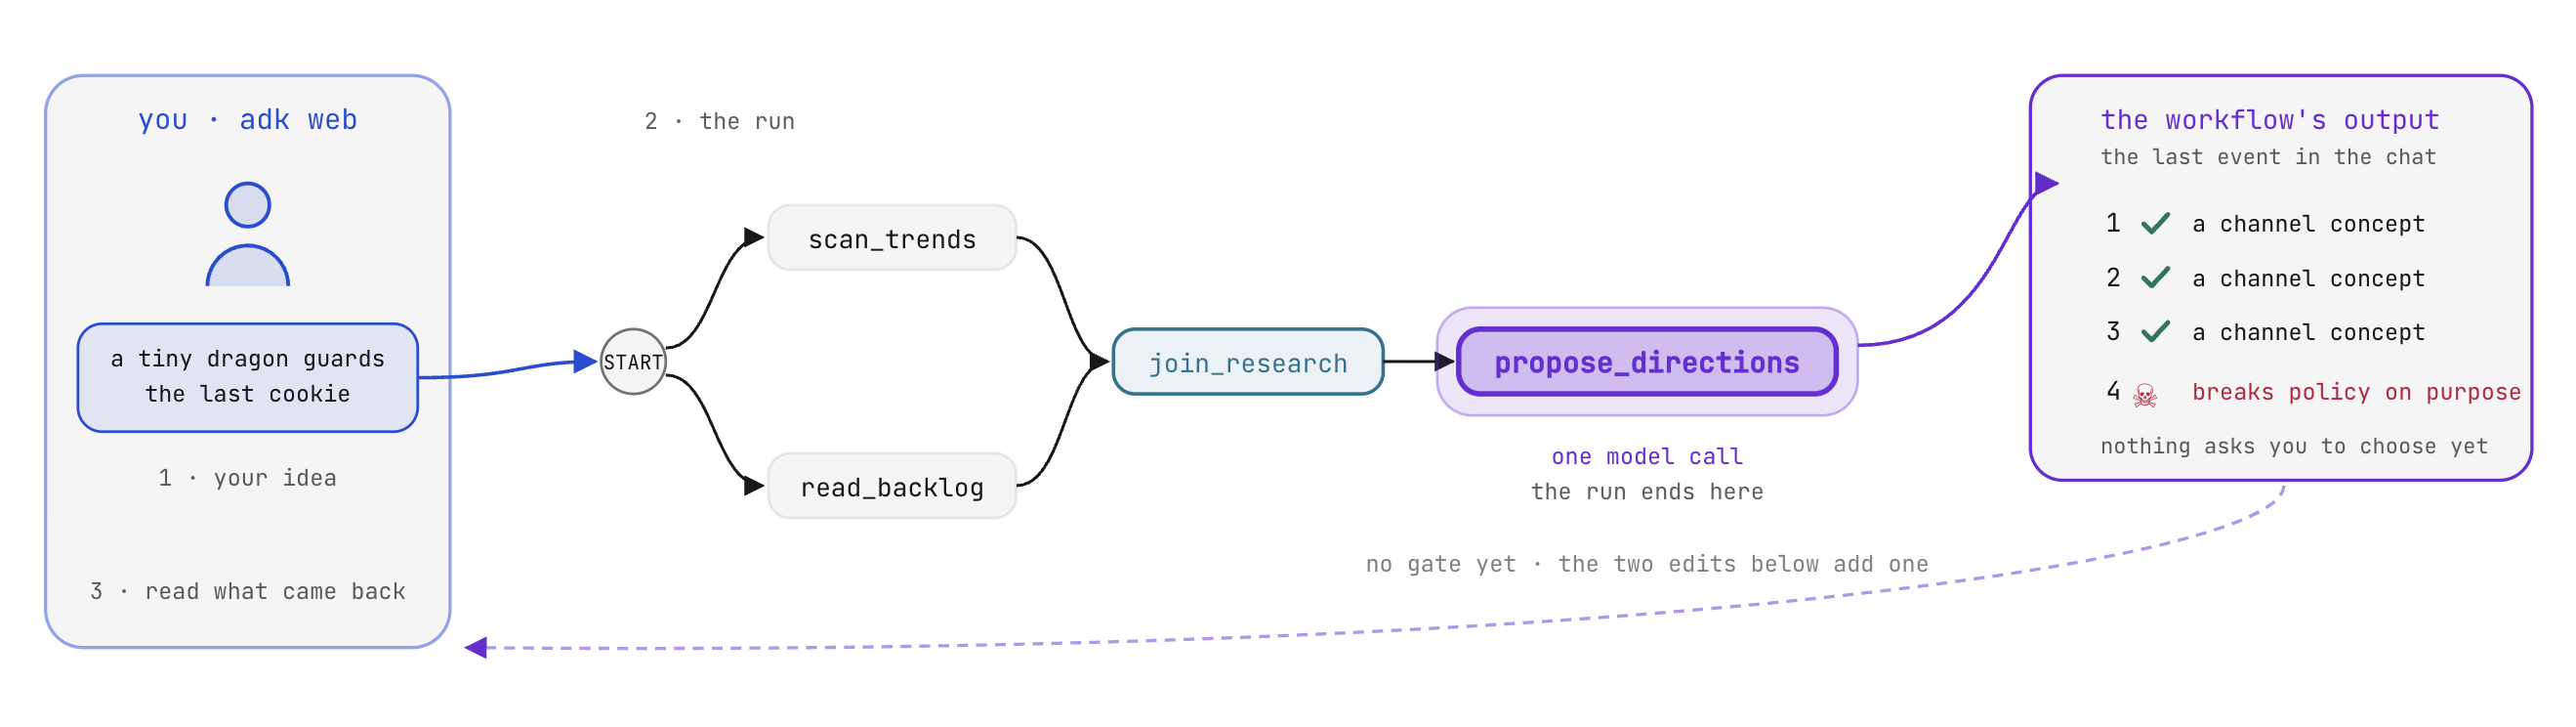
Instrukcje prompta a zawieszenie deterministyczne
Procesy produkcyjne, które wiążą się z kosztami finansowymi lub publikowaniem treści, wymagają nadzoru człowieka w kluczowych momentach podejmowania decyzji. W przypadku pojedynczego prompta prośby o potwierdzenie są instrukcjami doradczymi, które użytkownik może łatwo pominąć, wysyłając prompt do modelu. W przypadku przepływu pracy ADK zatwierdzenie przez człowieka jest wymuszane przez silnik wykonawczy: wykres zatrzymuje się w wyznaczonym węźle i nie może przejść dalej, dopóki nie otrzyma zewnętrznych danych wejściowych zweryfikowanych pod kątem schematu:
- Zastosowanie
RequestInputnatychmiast zawiesza wykonywanie przepływu pracy. - ADK rejestruje wywołanie przerwania otwarcia w magazynie sesji i generuje unikalny identyfikator
interrupt_id. - Proces wykonywania zostaje zatrzymany bez zużywania tokenów ani wątków serwera.
- Wykonywanie grafu zostanie wznowione dopiero po przesłaniu prawidłowego obiektu
function_responsezgodnego ze schematem i identyfikatorem przerwania.
Praktyczna edycja: zawieszanie wykonywania za pomocą RequestInput
W agent/graph.py zaimplementuj wywołanie zawieszenia w direction_gate:
    yield RequestInput(
        message="Pick tonight's direction: 1, 2, 3 or 4.",
        response_schema={
            "type": "object",
            "properties": {
                "pick": {"type": "string", "enum": ["1", "2", "3", "4"]}}},
        payload={"candidates": cands})
RequestInput konfiguruje 3 atrybuty:
message: prośba o opinię wyświetlana użytkownikowi.response_schema: schemat JSON, który interfejs renderuje jako formularz wejściowy, sprawdzany przez ADK po przesłaniu.payload: metadane dołączone do żądania (4 kandydaci), które umożliwiają interfejsom klienta renderowanie kart opinii bez wysyłania zapytań o stan sesji.
Czego możesz się spodziewać i dlaczego
- Przepływ pracy zatrzymuje się na etapie direction_gate: w interfejsie ADK Web lub Workbench uruchomienie zostaje wstrzymane i wyświetla się interaktywny formularz wyboru kandydata.
- Uzasadnienie: silnik napotkał wywołanie
RequestInputi zapisał stan wykonania wruns/sessions.db.
- Uzasadnienie: silnik napotkał wywołanie
- Wznowienie wymaga ustrukturyzowanych danych wejściowych: wysłanie dowolnego tekstu na czacie nie powoduje przejścia do kolejnego węzła. Wybranie opcji (1, 2, 3 lub 4) powoduje przesłanie wpisanego elementu
function_response, który spełnia warunekresponse_schema, i wznowienie wykonywania.
5. Stan i router
W VibeStudio Workbench przejdź do Kroku 5. Stan i router, części (5A)–(5C).
Będziesz trwale przechowywać wybory użytkowników w stanie sesji, egzekwować zasady bezpieczeństwa kanałów za pomocą deterministycznych węzłów routera i tworzyć agenta zadań iteracyjnych, który będzie automatycznie korygować naruszenia zasad przed wygenerowaniem skryptów wideo.
Stan przepływu pracy (5A)
W workbenchu otwórz Stan przepływu pracy (5A).
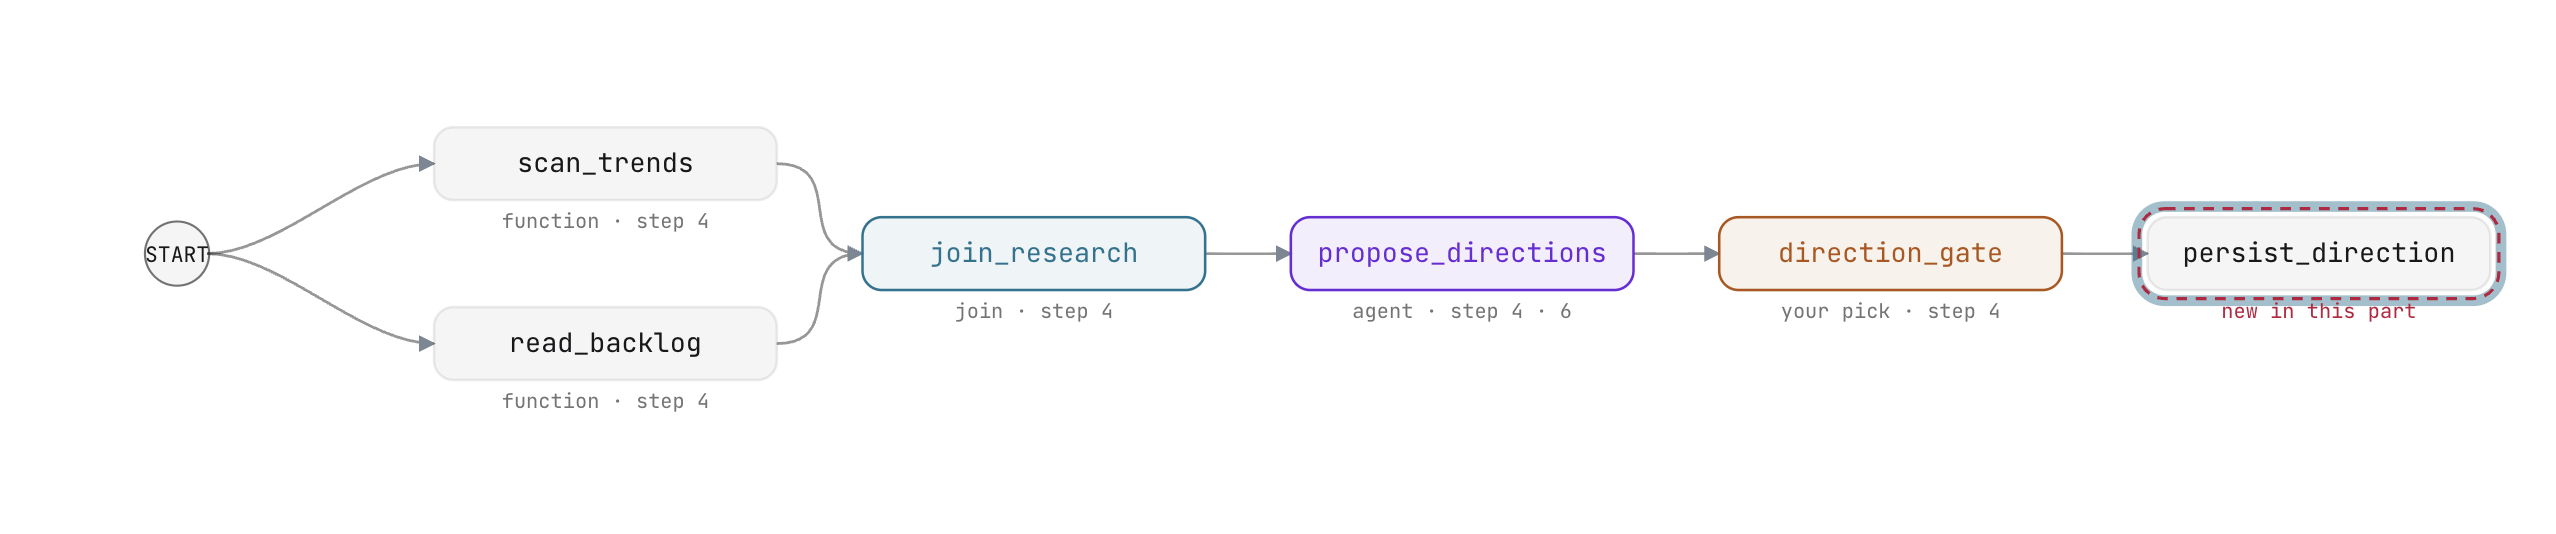
Stan sesji a wyniki węzła
W przepływie pracy ADK dane przemieszczają się po wykresie za pomocą 2 różnych mechanizmów:
- Dane wyjściowe węzła (
Event(output=...)): dane kierowane wyłącznie do bezpośrednich odbiorców na dalszym etapie, zdefiniowanych na liście krawędzi. - Stan sesji (
Event(state=...)): udostępniony słownik klucz-wartość, do którego dostęp ma każdy kolejny węzeł w cyklu życia wykonania.
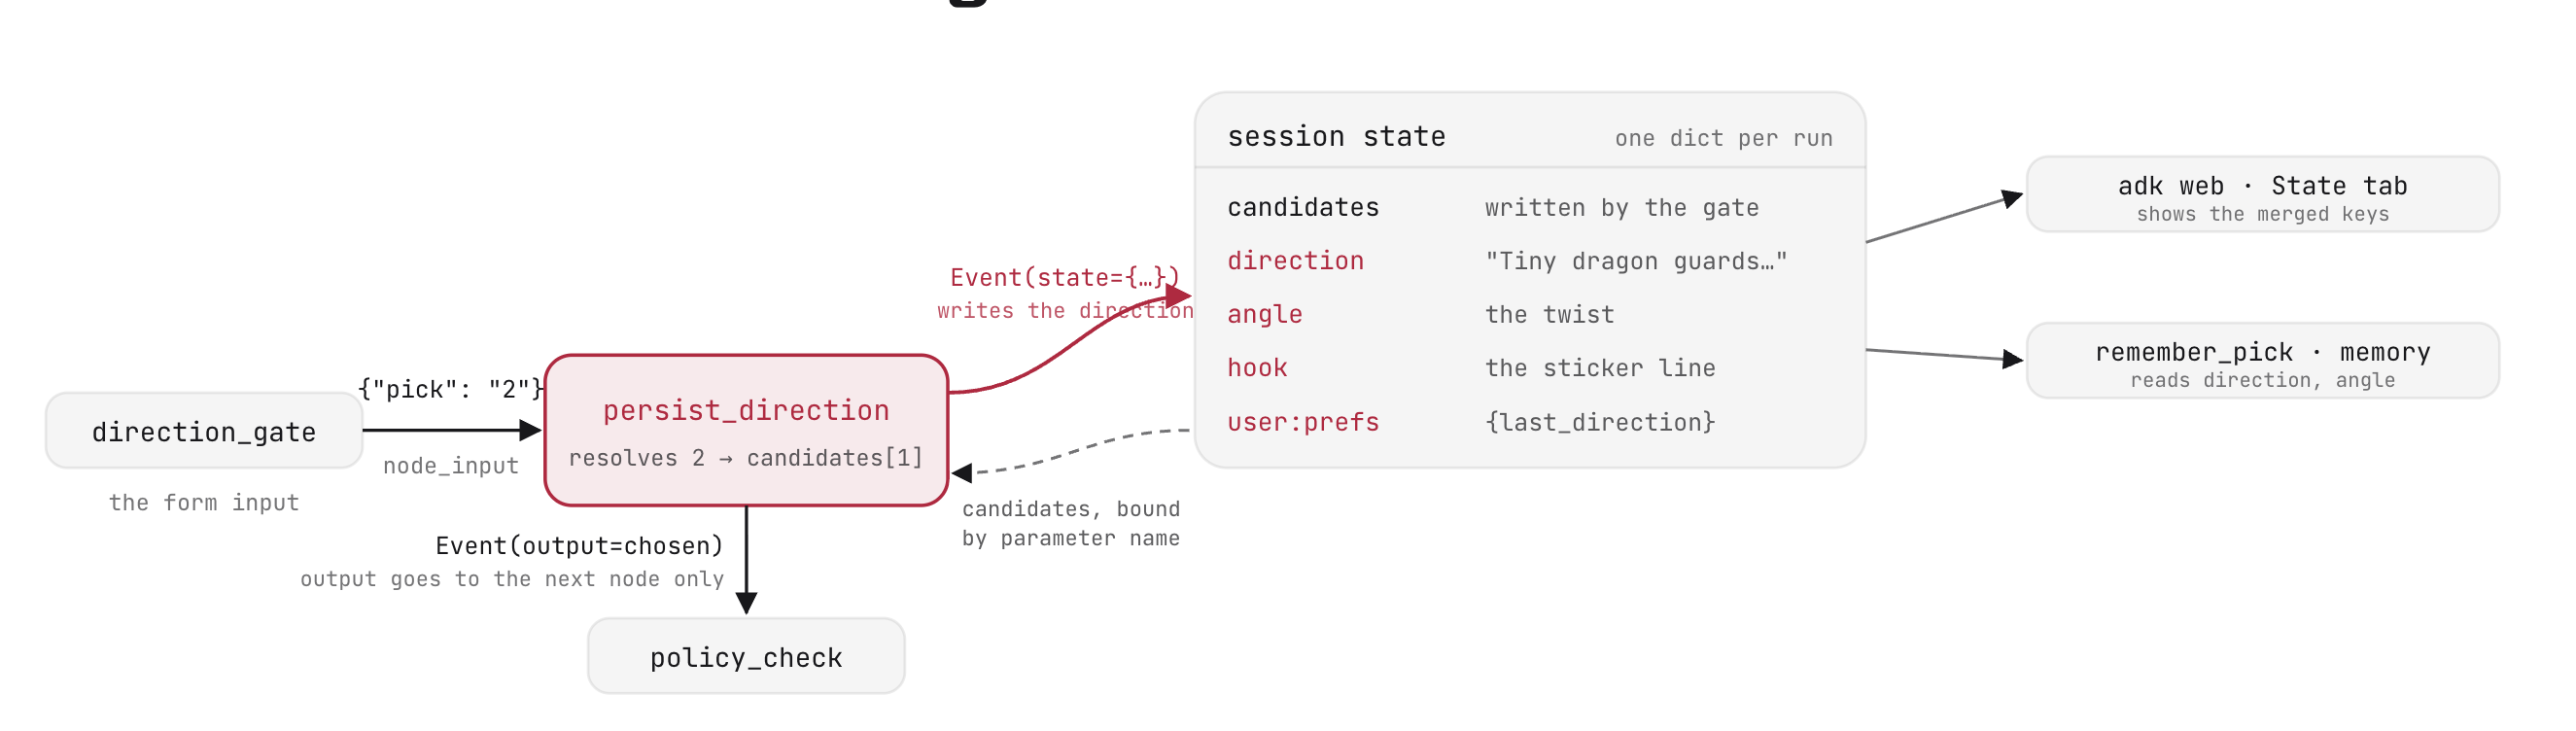
Gdy użytkownik wybierze kandydata w punkcie direction_gate, wybór ten dotrze jako indeks liczbowy ({"pick": "2"}). Węzły podrzędne potrzebują pełnego obiektu kierunku: tytułu, kąta narracji i wiersza przyciągającego uwagę. Zamiast przekazywać szczegółowe metadane przez każdy ładunek węzła pośredniego, persist_direction zapisuje rozwiązany element kandydujący w udostępnionym stanie sesji.
Węzły nie muszą przekazywać całego słownika stanu sesji. Gdy węzeł zwraca Event(state=...), dostarcza tylko nowe lub zaktualizowane pary klucz-wartość. ADK automatycznie scala te aktualizacje w magazynie sesji:
    yield Event(state={"direction": chosen["title"], "angle": chosen.get("angle", ""),
                       "hook": hook, "user:prefs": {"last_direction": chosen["title"]}})
Zwrócenie tego elementu Event przekazuje kontrolę do środowiska wykonawczego Workflow, które zapisuje nowe wartości w dzienniku sesji w runs/sessions.db.
Wiązanie parametrów
Węzły funkcji ADK automatycznie odczytują stan sesji przez sprawdzenie parametrów. Jeśli sygnatura funkcji deklaruje nazwę parametru pasującą do istniejącego klucza stanu, ADK wyodrębnia ten klucz ze stanu i przekazuje go bezpośrednio:
def persist_direction(node_input, candidates: list = []):
    ni = node_input if isinstance(node_input, dict) else {}
    raw = ni.get("pick")
    pick = str(raw).strip() if raw is not None else ""
    if candidates:
        i = int(pick) - 1 if pick.isdigit() else 0
        chosen = candidates[max(0, min(len(candidates) - 1, i))]
    else:
        chosen = {"title": "untitled", "angle": "", "evidence": []}
    hook = chosen.get("hook") or " ".join(chosen["title"].split()[:4])
W tym przypadku wartość candidates została zapisana w stanie sesji przez direction_gate. ADK wiąże go bezpośrednio z persist_direction(node_input, candidates: list = []) bez konieczności jawnego wyszukiwania w słowniku.
Klucze z prefiksem user: są przechowywane w pamięci na poziomie użytkownika między sesjami, co umożliwia dostęp do preferencji twórcy podczas kolejnych uruchomień przepływu pracy.
Praktyczna edycja: trwałe przechowywanie stanu i podłączanie węzła
- W pliku
agent/graph.pyw sekcjipersist_directionzastąp wierszTODO: PERSIST_STATEwartością zwracaną przez zdarzenie stanu:
    yield Event(state={"direction": chosen["title"], "angle": chosen.get("angle", ""),
                       "hook": hook, "user:prefs": {"last_direction": chosen["title"]}})
- W
stage3_router/agent.pydodajpersist_directiondo trzeciego łańcucha na liścieedges:
           (join_research, propose_directions, direction_gate,
            persist_direction)
Zapisz pliki. W obszarze roboczym sprawdź, czy przy state write in place i persist_direction in the chain wyświetlają się zielone znaczniki wyboru.
Węzeł routera (5B)
W środowisku roboczym przejdź do węzła routera (5B).
Deterministyczny routing oparty na zasadach
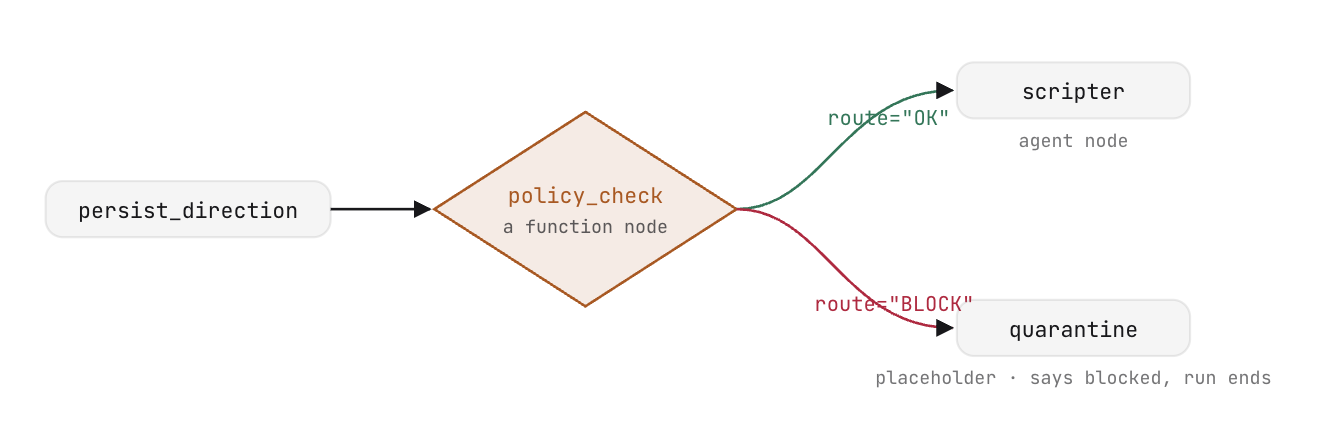
Router to wyspecjalizowany węzeł funkcji, który ocenia dane wyjściowe z poprzednich węzłów i kieruje wykonywanie wzdłuż warunkowych gałęzi grafu. W przeciwieństwie do agentów generatywnych router wykonuje logikę deterministyczną bez wywoływania LLM.
Router zwraca Event z tagiem route:
def length_check(node_input):
    too_long = len(node_input.get("title", "")) > 60
    return Event(output=node_input, route="TRIM" if too_long else "PASS")
W definicji przepływu pracy cel krawędzi zdefiniowany jako słownik mapuje nazwy tras na węzły docelowe:
(length_check, {"TRIM": shorten, "PASS": scripter}),
Router przepływu pracy policy_check odczytuje niedozwolone wyrażenia z agent/policy_words.txt i dopasowuje całe słowa do tytułu i kąta wybranego kierunku:
return Event(output=node_input, route="BLOCK" if bad else "OK")
Przechowywanie zasad jako danych, a nie instrukcji zakodowanych na stałe, umożliwia aktualizacje bez modyfikowania wykresu przepływu pracy: aktualizacja pliku tekstowego jest natychmiast stosowana do kolejnych uruchomień. Ocena jest deterministycznym dopasowywaniem wyrażeń regularnych, więc trwa milisekundy i nie wiąże się z kosztem tokenów. Rozpoczyna się przed skryptami generatywnymi.
Miejsca docelowe: Scripter i kwarantanna
Router kieruje ruch do jednego z 2 węzłów podrzędnych:
scripter: węzeł agentasingle_turn, który przekształca zatwierdzony kierunek w ustrukturyzowany skrypt produkcyjny zgodny ze schematem PydanticScript:
scripter = Agent(
    name="scripter",
    model=config.MODEL,
    instruction=SCRIPT_INSTRUCTION,
    output_schema=Script)
quarantine: początkowo funkcja zastępcza, która zatrzymuje oznaczone wskazówki, zastąpiona w następnej części przez autonomicznego agenta naprawczego.
Praktyczna edycja: przekierowanie sprawdzania zasad
- W pliku
agent/graph.py, wewnątrzpolicy_check, uzupełnij instrukcję powrotu:
return Event(output=node_input, route="BLOCK" if bad else "OK")
- W pliku
stage3_router/agent.pyzaktualizujedges, aby przekierowaćpolicy_checki ponownie dołączyć gałąź kwarantanny doscripter:
           (join_research, propose_directions, direction_gate,
            persist_direction, policy_check),
           (policy_check, {"OK": scripter, "BLOCK": quarantine}),
           (quarantine, scripter)])
Zapisz pliki. W środowisku roboczym sprawdź, czy mapowania serwerów granicznych routera zostały zweryfikowane.
Tryby agenta i węzeł zadania (5C)
W obszarze roboczym otwórz Tryby agenta i węzeł zadania (5C).
Tryby wykonywania agenta
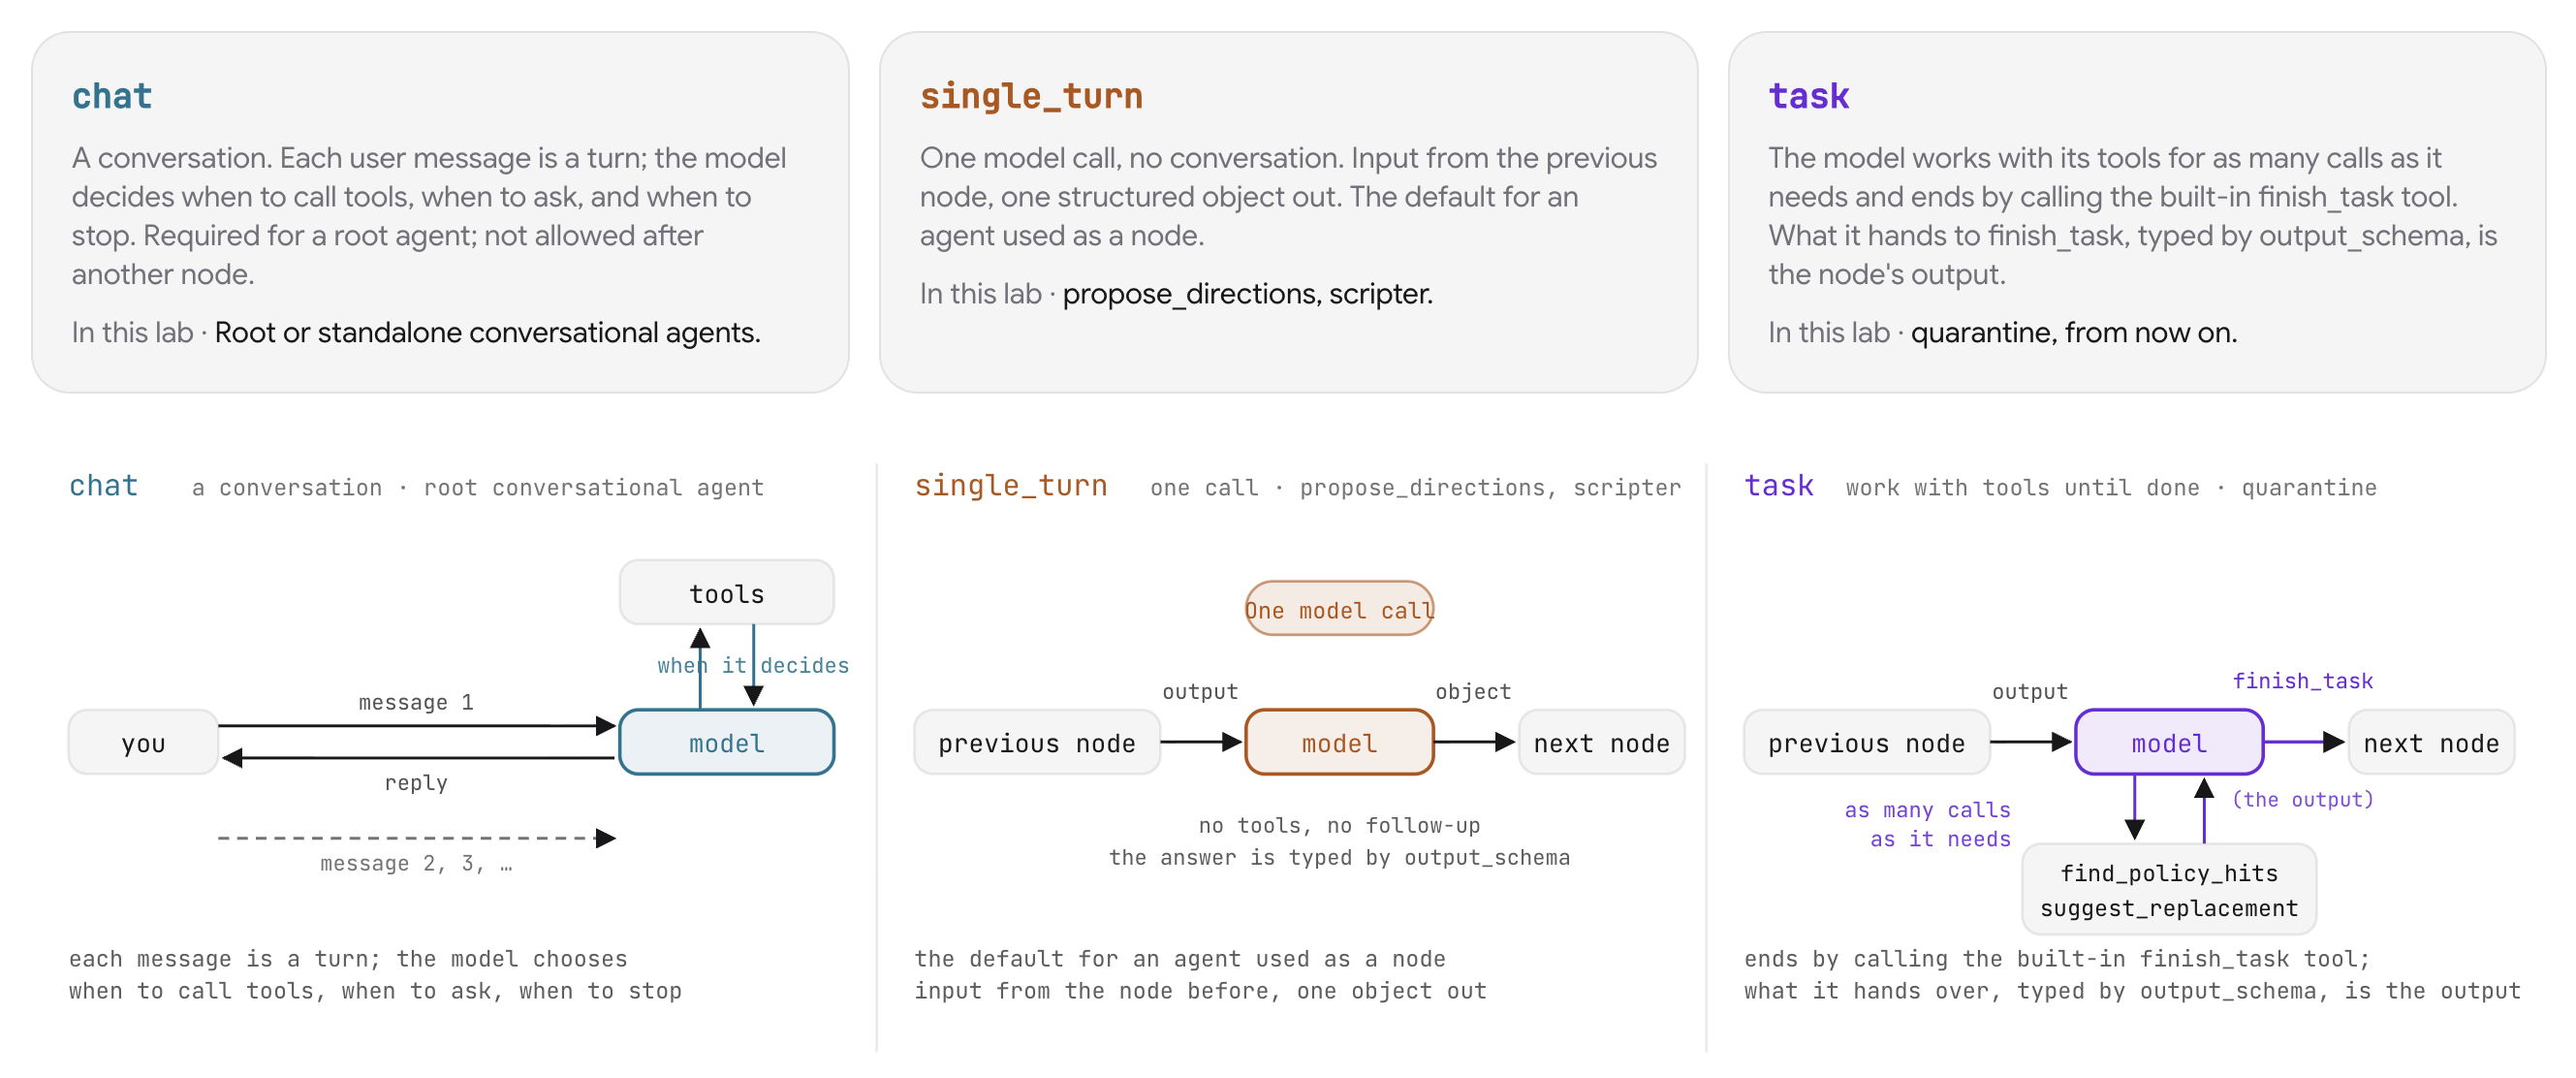
Instancje ADK Agent obsługują 3 tryby wykonywania dostosowane do konkretnych wymagań potoku:
Tryb | Cykl życia wykonania | Rola w potoku |
| Wieloetapowa pętla konwersacyjna. Model określa, kiedy wywołać narzędzia, poprosić o dane wejściowe lub zakończyć turę. | Agenty główne, które wchodzą w interakcję z użytkownikiem. |
| Wywołanie wnioskowania pojedynczego modelu. Przyjmuje dane wejściowe z poprzedniego węzła i emituje obiekt schematu strukturalnego. | Sekwencyjne przekształcenia wykresu ( |
| Autonomiczna pętla z wykonywaniem narzędzi. Agent powtarza ten proces, dopóki nie wywoła wbudowanego narzędzia | Wieloetapowe działania naprawcze i sprawdzanie ( |
Autonomiczne działania naprawcze w przypadku naruszenia zasad
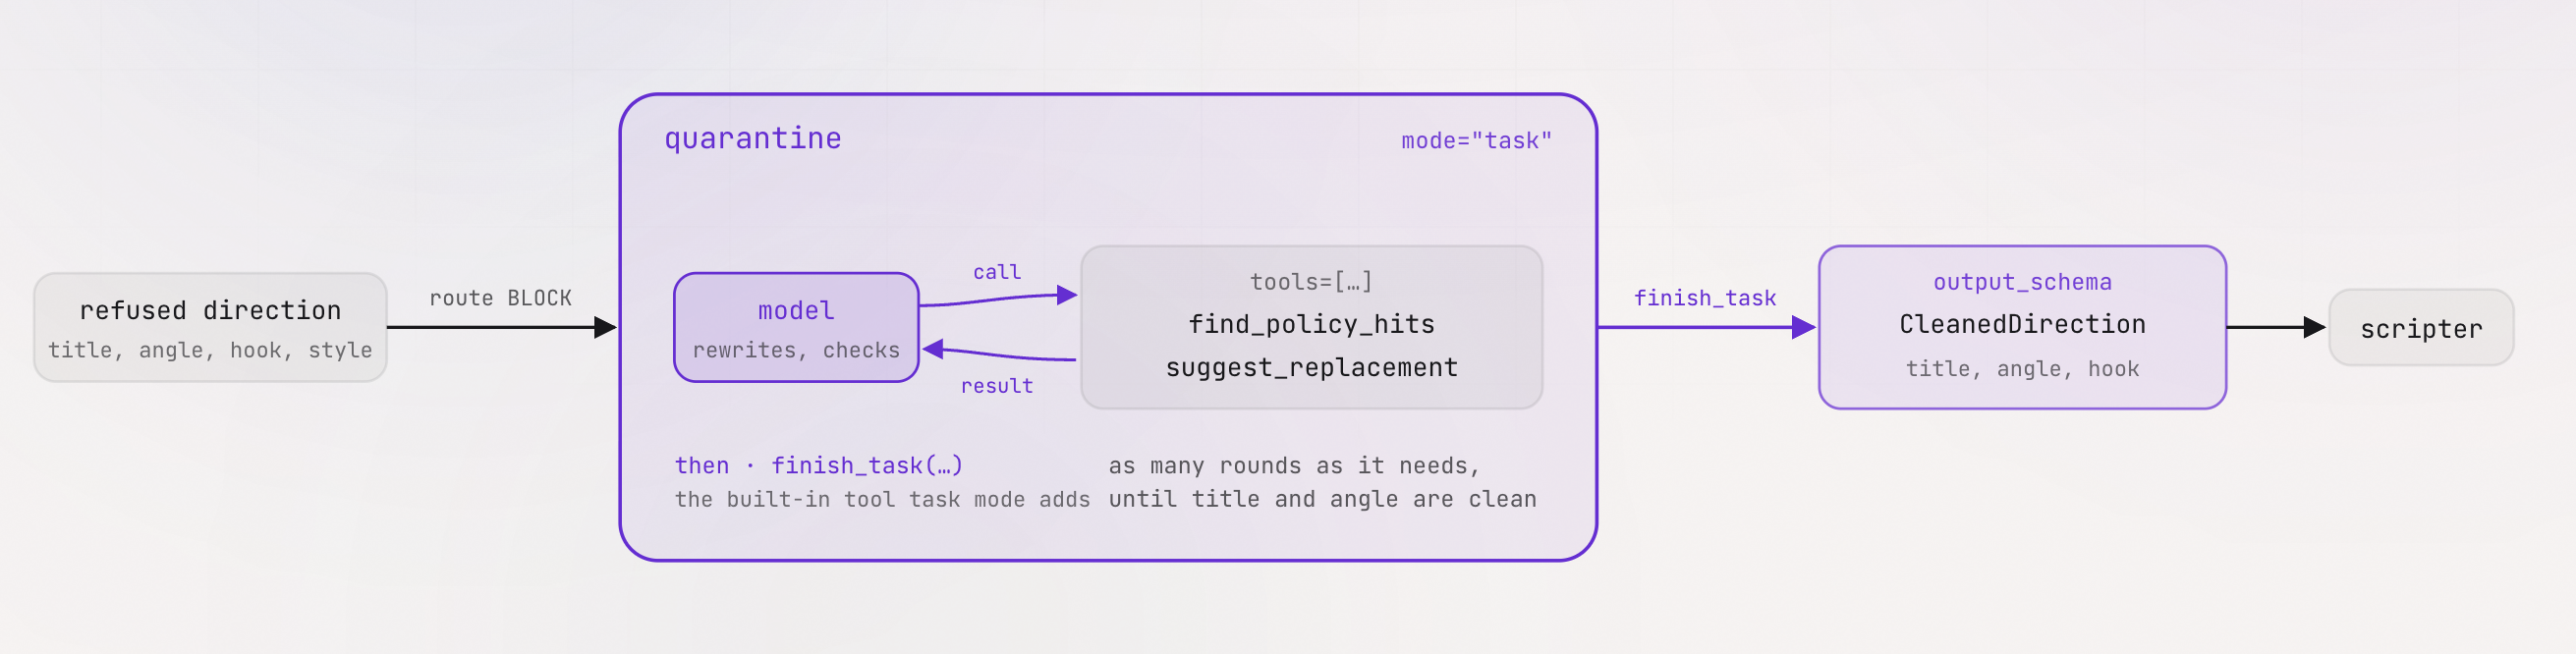
Przepisanie oznaczonej dyrektywy wymaga trybu task, ponieważ liczba iteracji naprawczych jest zmienna. Agent otrzymuje oznaczoną instrukcję, wywołuje find_policy_hits, aby wykryć naruszenia, prosi o zatwierdzone alternatywy za pomocą suggest_replacement, przepisuje instrukcję i weryfikuje jej poprawność przed kontynuowaniem.
Oba narzędzia są zdefiniowane w pliku agent/cleanup_tools.py z wpisanymi podpisami i docstringami:
def find_policy_hits(text: str) -> dict:
    """Which refused words appear in `text`. Matches whole words and phrases
    from agent/policy_words.txt, case-insensitive.

    Returns {"hits": [...], "clean": bool}. clean is true when hits is empty.
    """


def suggest_replacement(word: str) -> dict:
    """The channel's approved stand-in for a refused word, read from
    agent/policy_replacements.txt.

    Returns {"word", "replacement", "listed"}. When the word has no entry,
    listed is false and replacement is a hint to pick a gentle synonym.
    """
Praktyczna edycja: tworzenie agenta zadań kwarantanny
W pliku stage3_router/agent.py zastąp funkcję zastępczą quarantine definicją agenta zadaniowego:
quarantine = Agent(
    name="quarantine",
    model=config.MODEL,
    instruction=QUARANTINE_INSTRUCTION,
    mode="task",
    tools=[find_policy_hits, suggest_replacement],
    output_schema=CleanedDirection,
)
Tryb zadania wyposaża agenta w narzędzia i kończy wykonywanie, wywołując metodę finish_task. Gdy skonfigurujesz mode="task", ADK automatycznie udostępni finish_task i wygeneruje jego parametry z output_schema, dzięki czemu węzeł będzie zwracać obiekt CleanedDirection o określonym typie, który pasuje do schematu wejściowego węzła skryptu.
Czego możesz się spodziewać i dlaczego
Przetestuj obie ścieżki wykonania w ADK Web lub VibeStudio Workbench:
- Zatwierdzona trasa (kandydat 1, 2 lub 3):
- Wybór zatwierdzonego kandydata powoduje przekierowanie z:
policy_checkbezpośrednio do:scripter(route="OK"). - Scenarzysta generuje 3-ujęciowy skrypt produkcyjny zgodny ze schematem
Script.
- Wybór zatwierdzonego kandydata powoduje przekierowanie z:
- Ścieżka naprawcza kwarantanny (kandydat 4):
- Kandydat 4 zawiera oznaczone słownictwo („clickbait”, „viral hack”).
policy_checktras do:quarantine(route="BLOCK").- W śladzie sesji możesz zobaczyć, jak
quarantinewywołujefind_policy_hits, a następniesuggest_replacementw przypadku każdego naruszenia, przepisuje tytuł i wywołujefinish_task. - Wykonanie wraca do
scripter, tworząc skrypt na podstawie oczyszczonych danych.
6. Bank zapamiętanych informacji
W VibeStudio Workbench przejdź do kroku 6 – Bank pamięci, części (6A) i (6B).
Przepływ pracy działa obecnie bez pamięci między sesjami. Każde wykonanie zaczyna się od zera, bez wiedzy o tym, co twórca wybrał wcześniej lub jakie gatunki preferuje. W tym kroku połączysz bank zapamiętanych informacji Vertex AI Agent Engine, aby przechowywać i pobierać preferencje twórcy między uruchomieniami.
Co ważne, pamięć jest zintegrowana za pomocą wywołań zwrotnych cyklu życia agenta, a nie węzłów potoku. Ponieważ wyodrębnianie i pobieranie pamięci służy poszczególnym agentom, a nie pośrednim etapom danych, dołączanie wywołań zwrotnych zachowuje czystą, odseparowaną topologię wykresu.
Bank zapamiętanych informacji (6A)
W obszarze roboczym przejdź do sekcji Bank zapamiętanych informacji (6A).
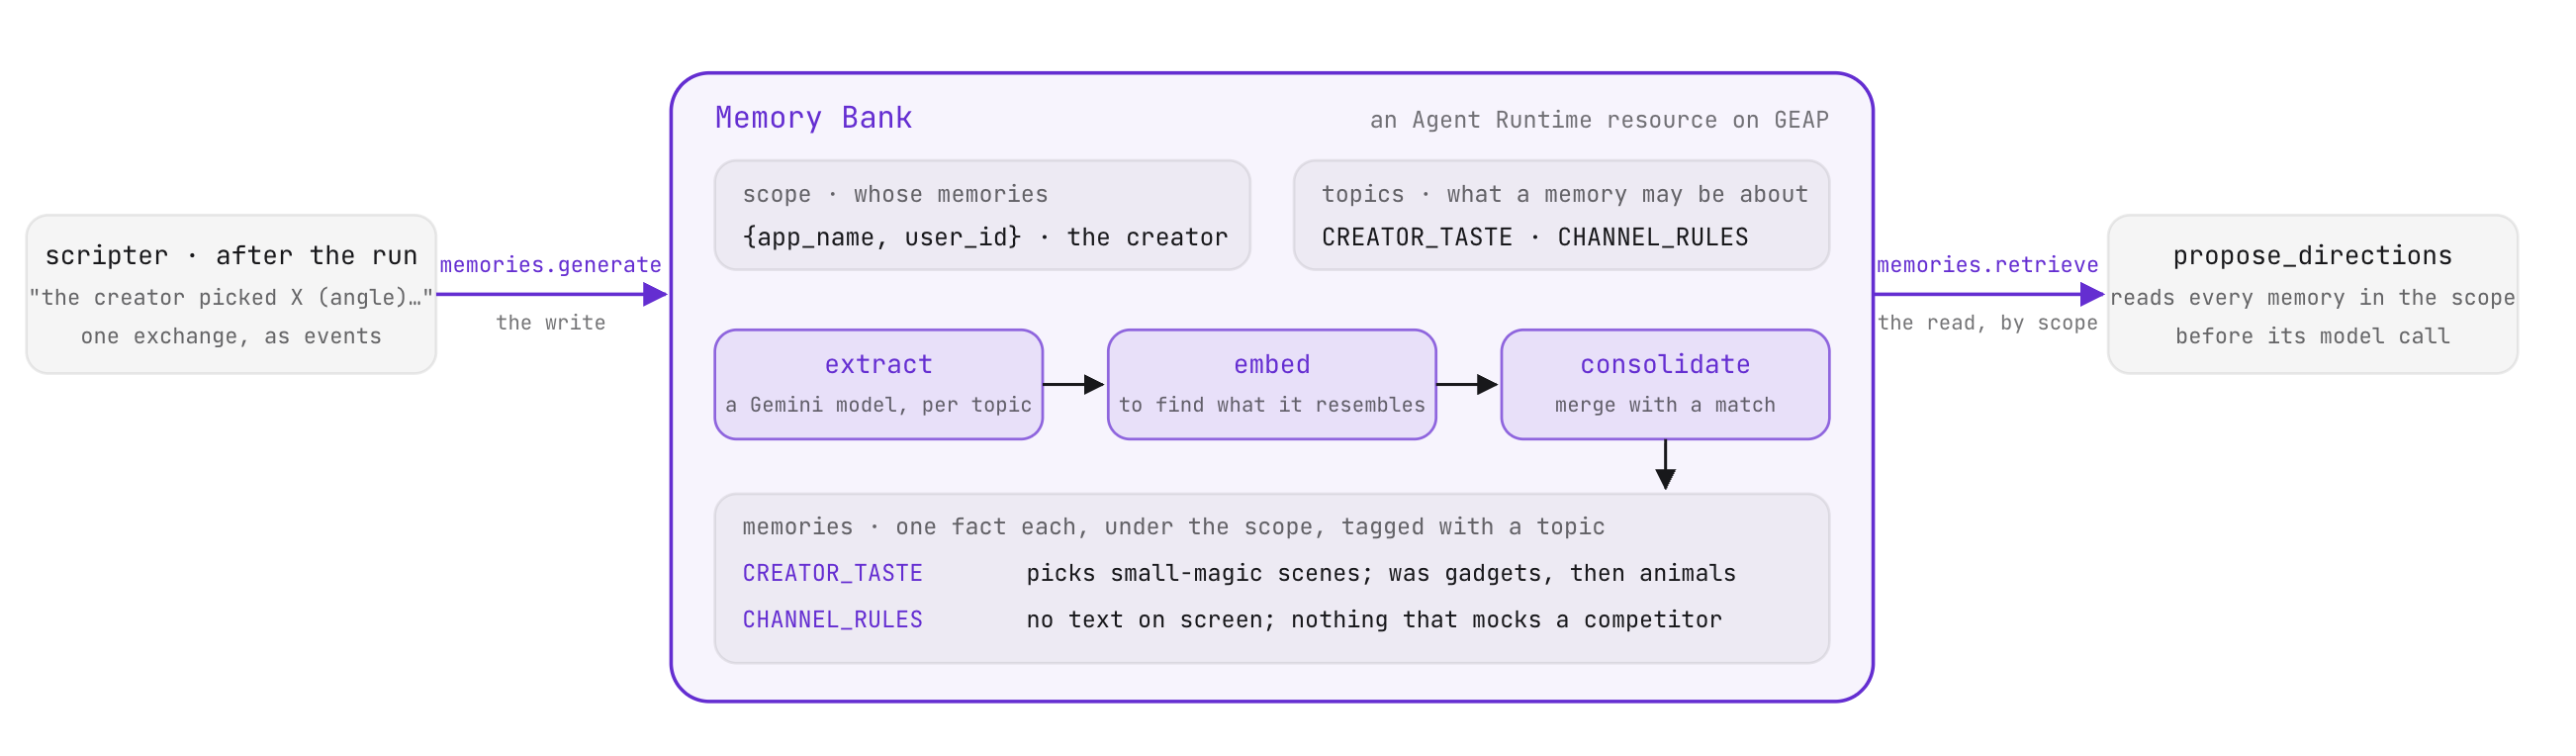
Zarządzana pamięć na poziomie użytkownika
Bank zapamiętanych informacji to zarządzana usługa do długoterminowego przechowywania informacji o użytkownikach. Porządkuje fakty dotyczące osoby w określonym zakresie, który jest tu identyfikowany przez nazwę aplikacji i identyfikator użytkownika:
SCOPE = {"app_name": config.APP, "user_id": config.USER}
TOPICS = {
    "CREATOR_TASTE": "Which video directions this creator picks and passes on, "
                     "and how that preference changes over time.",
    "CHANNEL_RULES": "Standing instructions the creator states for every video "
                     "(style, subjects to avoid, format rules).",
}
Niestandardowe tematy pamięci określają granice tego, co bank zapisuje:
- Wyodrębnianie tematów: gdy nowy tekst rozmowy jest przesyłany przez
memories.generate, usługa stosuje model wyodrębniania do każdego opisu tematu. Tekst, który nie pasuje do tematu, nie generuje wspomnień. - Konsolidacja i deduplikacja: usługa konwertuje nowo wyodrębnione fakty na wektory dystrybucyjne i porównuje je z istniejącymi zapamiętanymi informacjami w danym zakresie. Gdy obserwacja jest zgodna z istniejącą zapamiętaną informacją, usługa ją aktualizuje. Jeśli reprezentuje nowe informacje, usługa tworzy nowy wpis. Ten proces konsolidacji sprawia, że wiele sesji dotyczących danego tematu jest łączonych w spójne podsumowanie, zamiast tworzyć nadmiarowe wpisy.
- Pobieranie: wywołanie funkcji
memories.retrievez zakresem użytkownika zwraca zapisane fakty, zaczynając od najstarszych.
Obie operacje są zaimplementowane w agent/platform/memory.py. Nazwa zasobu udostępnionego banku jest przechowywana lokalnie w pamięci podręcznej w runs/memorybank.json.
Konfigurowanie banku zapamiętanych informacji
Użyj elementów sterujących środowiska pracy lub uruchom polecenia interfejsu wiersza poleceń w terminalu:
- Łączenie i obsługa banku:
python -m agent.platform.bankCREATOR_TASTEiCHANNEL_RULES. - Wypełnianie sesji historycznych:
python -m agent.platform.bank load - Sprawdzanie skonsolidowanych faktów:
python -m agent.platform.bank list
Oddzwanianie (6B)
W środowisku Workbench otwórz Callbacks (6B). Otwórz stage4_memory/agent.py.
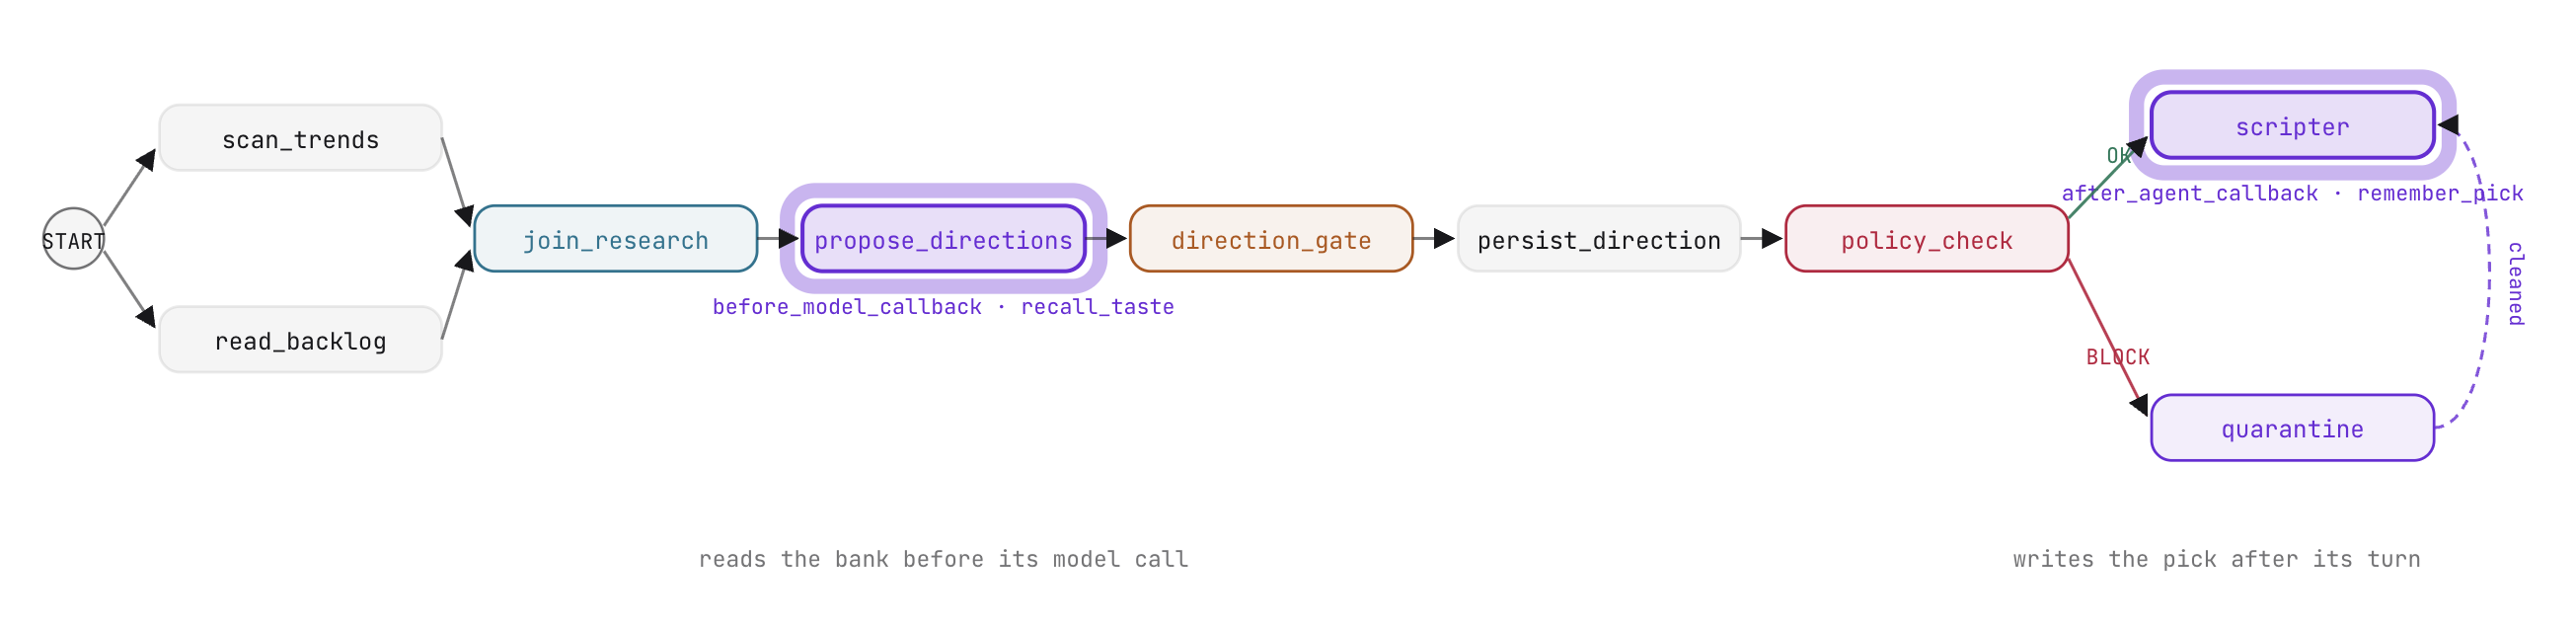
Wywołania zwrotne cyklu życia agenta ADK
Wywołanie zwrotne to funkcja przekazywana jako argument do Agent. ADK wywołuje wywołania zwrotne w określonych momentach cyklu życia, przekazując aktywny kontekst. Zwrócenie None powoduje kontynuowanie normalnego wykonywania, a zwrócenie obiektu zastępczego zastępuje lub przechwytuje operację.
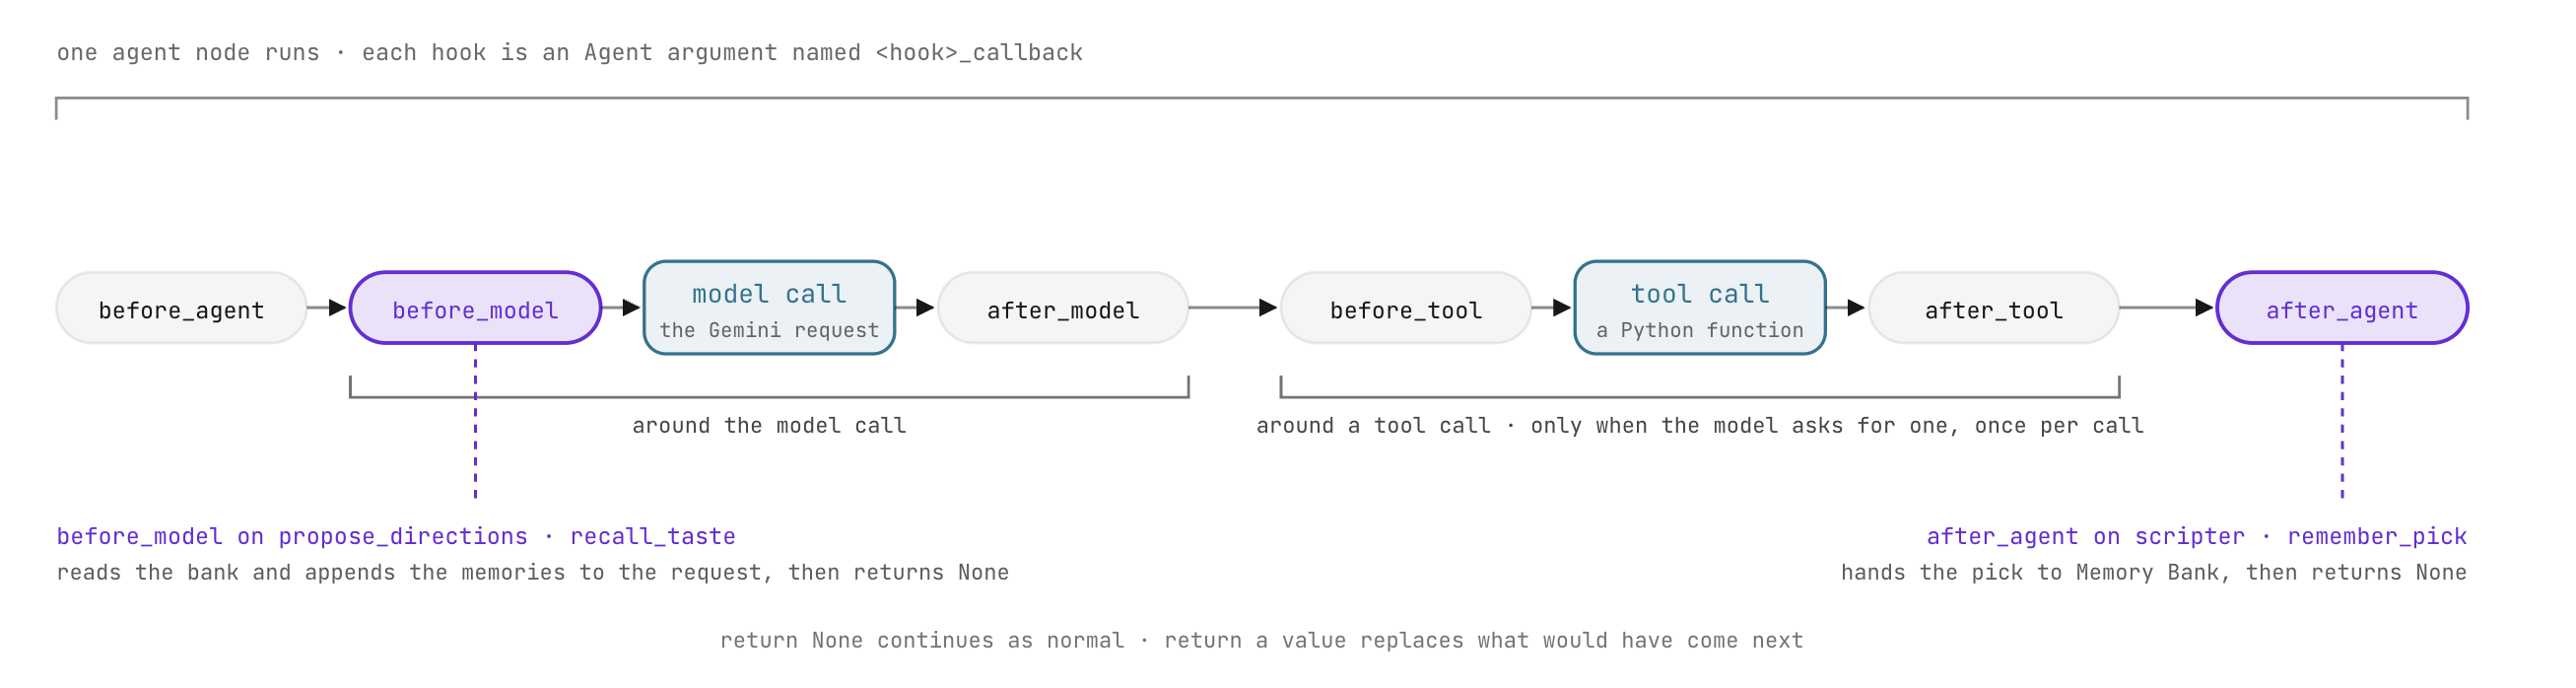
ADK udostępnia 3 pary wywołań zwrotnych:
Para wywołań zwrotnych | Punkt wywołania | Otrzymane parametry | Zachowanie wartości zwracanej |
| Obejmuje całą turę agenta |
| Zwrócenie |
| Wokół każdego wywołania wnioskowania LLM |
| Zwrócenie wartości |
| Wokół każdego wykonania narzędzia | Definicja narzędzia, argumenty, wynik | Zwrócenie słownika zastępuje dane wyjściowe narzędzia; |
Wywołania zwrotne zapewniają czyste miejsce do wstrzykiwania kontekstu, zabezpieczeń, telemetrii i wyszukiwania w pamięci podręcznej bez wprowadzania do wykresu przepływu pracy zbędnych węzłów.
Praktyczna edycja: przypominanie o połączeniach i pamiętanie o oddzwanianiu
- W pliku
stage4_memory/agent.pyzaktualizujpropose_directions, aby dołączyćbefore_model_callback=recall_taste:
    output_schema=Directions,
    before_model_callback=recall_taste)
recall_taste jest wykonywana bezpośrednio przed wygenerowaniem przez Gemini proponowanych wskazówek. Pobiera historię twórcy z Banku zapamiętanych informacji, formatuje wspomnienia, zaczynając od najstarszych, i dołącza je do wychodzącego LlmRequest. Prompt nakazuje modelowi, aby kandydaci 1–3 byli bardziej zgodni z aktualnymi preferencjami twórcy, a reguły kanału traktował jako ścisłe ograniczenia.
- W
stage4_memory/agent.pyzaktualizujscripter, aby dołączyćafter_agent_callback=remember_pick:
    output_schema=Script,
    after_agent_callback=remember_pick)
remember_pick uruchamia się po zakończeniu tury przez scripter. Odczytuje wybrany kierunek ze stanu sesji, tworzy zwięzłe podsumowanie decyzji twórcy i wywołuje funkcję memories.generate, aby zaktualizować bank pamięci.
Czego możesz się spodziewać i dlaczego
Przetestuj przepływ pracy z wywołaniem zwrotnym w środowisku roboczym lub w interfejsie internetowym ADK:
- Uruchom prompt bez treści:
- W logu sesji sprawdź
LlmRequestpod kątempropose_directions. Zwróć uwagę na dodany kontekst pamięci, który zawiera informacje o preferencjach twórcy dotyczące motywów fantasy i zwięzłego tempa. - Zwróć uwagę na proponowane kierunki: kandydaci od 1 do 3 są zgodni z historycznymi preferencjami twórcy, nawet gdy trendy kładą nacisk na inne tematy.
- W logu sesji sprawdź
- Wybierz kandydata w
direction_gate. - Po zakończeniu działania
scriptersprawdź rekordy banku zapamiętanych informacji:python -m agent.platform.bank list
7. RAG Engine
W VibeStudio Workbench przejdź do Kroku 7 – RAG Engine, części (7A) i (7B).
Opublikowane filmy stale zbierają opinie widzów. W agent/comments.md zebrano 30 reprezentatywnych komentarzy, które zawierają pochwały widzów, krytykę tempa treści sponsorowanych i preferencje dotyczące dźwięku. W tym kroku zindeksujesz te komentarze za pomocą silnika RAG w Vertex AI i połączysz wyszukiwanie semantyczne z procesem wyszukiwania.
Pobieranie informacji z dokumentów (7A)
W obszarze roboczym otwórz RAG Engine (7A).
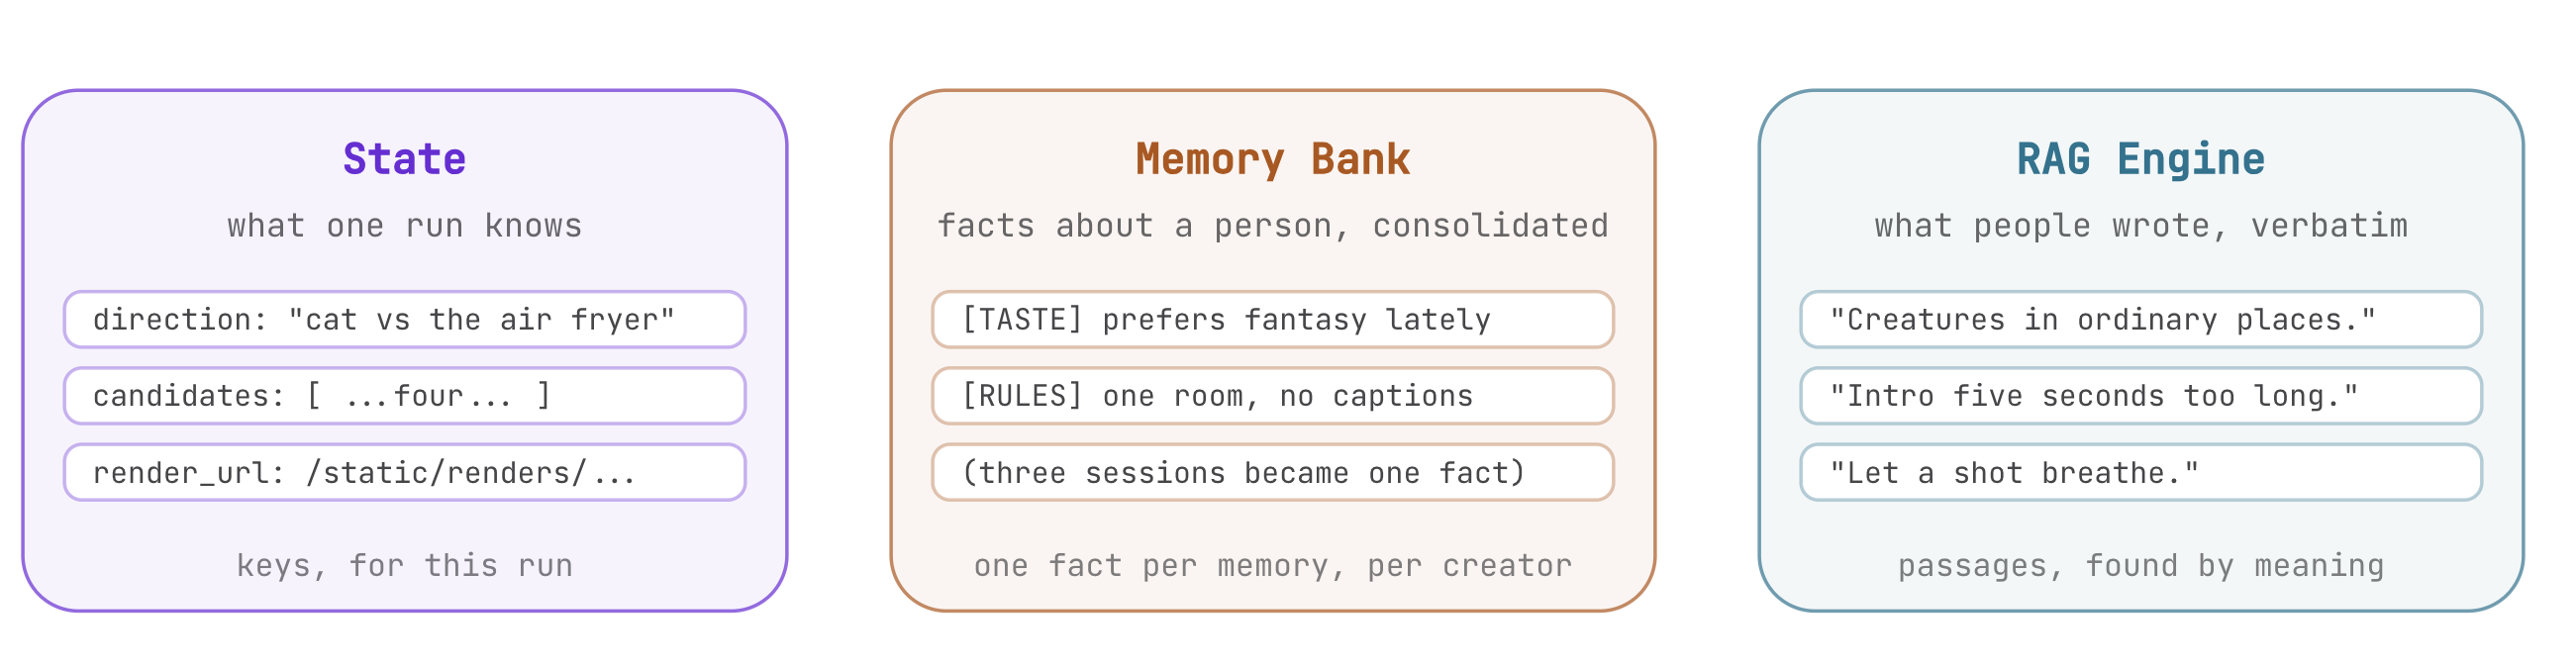
Bank zapamiętanych informacji a RAG Engine
Oba narzędzia opierają przepływy pracy na danych zewnętrznych, ale służą do różnych celów architektonicznych:
Wymiar | Bank zapamiętanych informacji | RAG Engine |
Główny przypadek użycia | Długoterminowe preferencje użytkowników i zasady operacyjne | Wyszukiwanie semantyczne w dużych zbiorach dokumentów |
Zakres | Ograniczone do poszczególnych identyfikatorów użytkowników i nazw aplikacji | Zakres obejmuje zasoby wspólnego korpusu wszystkich użytkowników |
Przetwarzanie danych | Wyodrębnianie, osadzanie i konsolidacja semantyczna w czasie rzeczywistym | Dzielenie dokumentu na fragmenty, wektory dystrybucyjne i wyszukiwanie najbliższych sąsiadów |
Integracja z Graph | Wywołania zwrotne cyklu życia agenta ( | Węzeł funkcji dedykowanej w zwielokrotnieniu wyjściowym wyszukiwania ( |
Dzielenie dokumentu na fragmenty i wektory dystrybucyjne
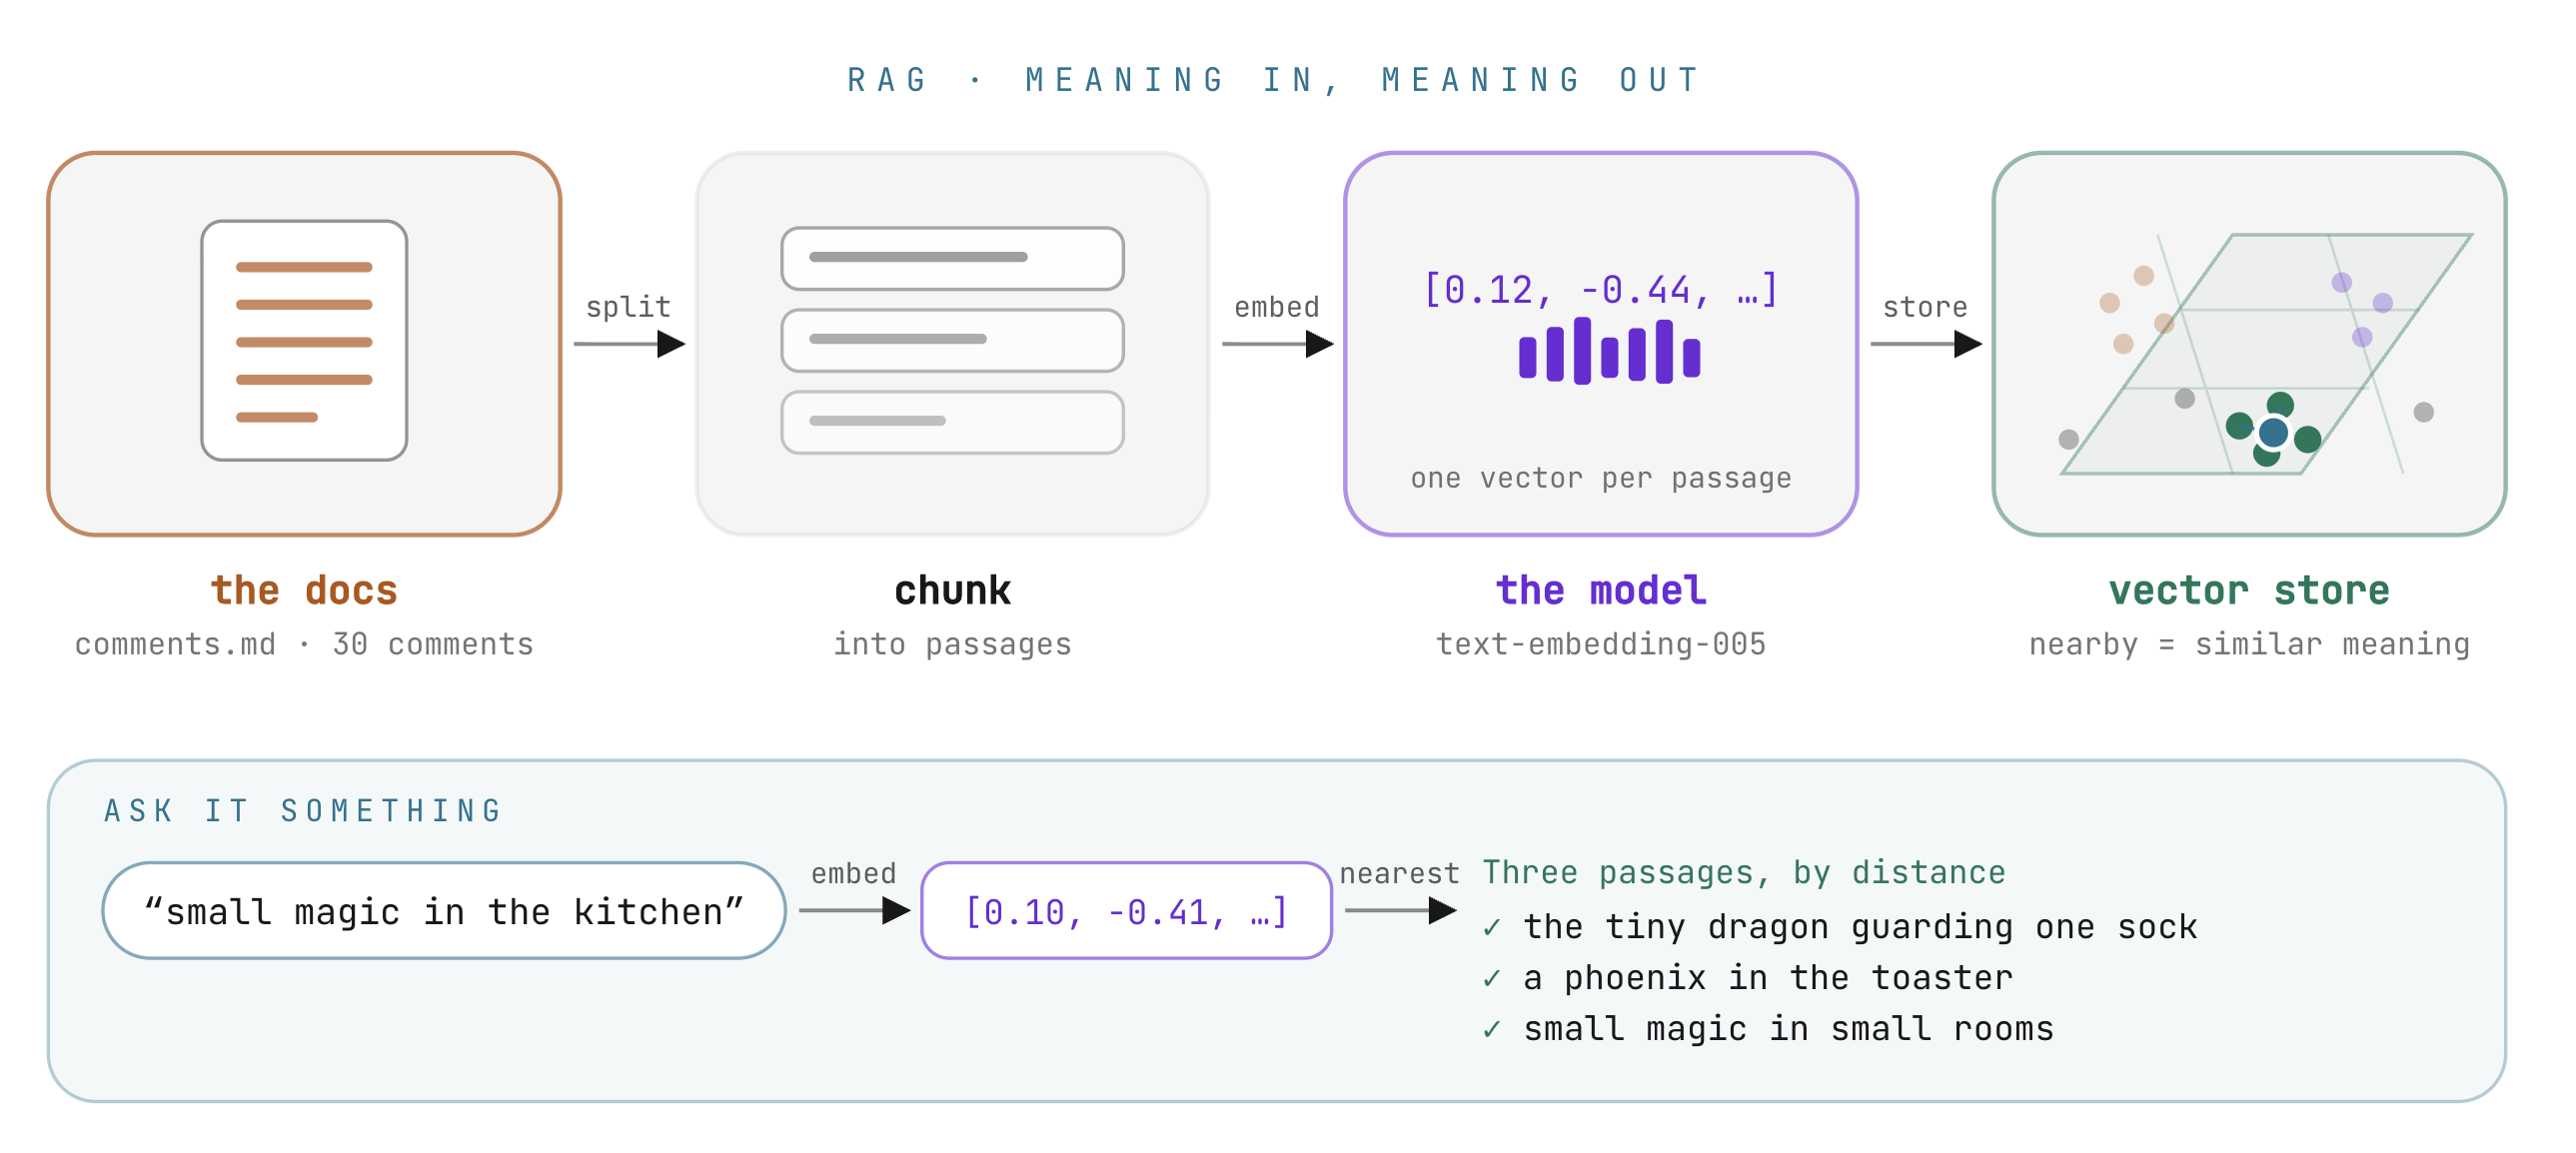
RAG Engine indeksuje dokumenty, dzieląc tekst na fragmenty semantyczne i przechowując ich wektory w zarządzanej bazie danych:
corpus = rag.create_corpus(
    display_name="vibestudio-feedback",
    description="Vibe Studio: what the audience wrote under the channel's past videos.",
    backend_config=rag.RagVectorDbConfig(
        rag_embedding_model_config=rag.RagEmbeddingModelConfig(
            vertex_prediction_endpoint=rag.VertexPredictionEndpoint(
                publisher_model="publishers/google/models/text-embedding-005"))))

rag.upload_file(
    corpus_name=corpus.name, path="agent/comments.md", display_name="comments.md",
    transformation_config=rag.TransformationConfig(
        chunking_config=rag.ChunkingConfig(chunk_size=120, chunk_overlap=20)))
- Rozmiar fragmentu: skonfigurowany na 120 tokenów z 20 tokenami nakładania się. W ten sposób uzyskujemy 2–3 komentarze na fragment, dzięki czemu każdy wektor reprezentuje spójne nastawienie bez rozmywania znaczenia w niepowiązanych opiniach.
- Model wektora dystrybucyjnego:
text-embedding-005przekształca tekst w wektory wielowymiarowe. Gdy przesyłane jest zapytanie, model konwertuje je na wektor i znajduje najbliższe dopasowania na podstawie odległości semantycznej. Komentarz o małym smoku pilnującym skarpetek pasuje do prompta o magicznych stworzeniach, mimo że nie zawiera dokładnie tych samych słów kluczowych.
Konfigurowanie korpusu RAG
Zainicjuj korpus za pomocą przycisków platformy lub poleceń terminala:
- Utwórz korpus:
python -m agent.platform.ragruns/ragcorpus.json. - Przesyłanie i indeksowanie komentarzy: przesyła plik
agent/comments.mdz konfiguracją fragmentacji i czeka na zakończenie indeksowania. - Wysyłanie zapytań do korpusu: przetestuj pobieranie podobnych komentarzy za pomocą zapytań, które nie zawierają dokładnie tych samych słów co komentarze (np. zapytanie „małe magiczne stworzenia” powinno zwrócić komentarze o smokach).
Węzeł pobierania (7B)
W Workbench otwórz The third reader (7B). Otwórz stage5_rag/agent.py.
Pobieranie jako węzeł grafu
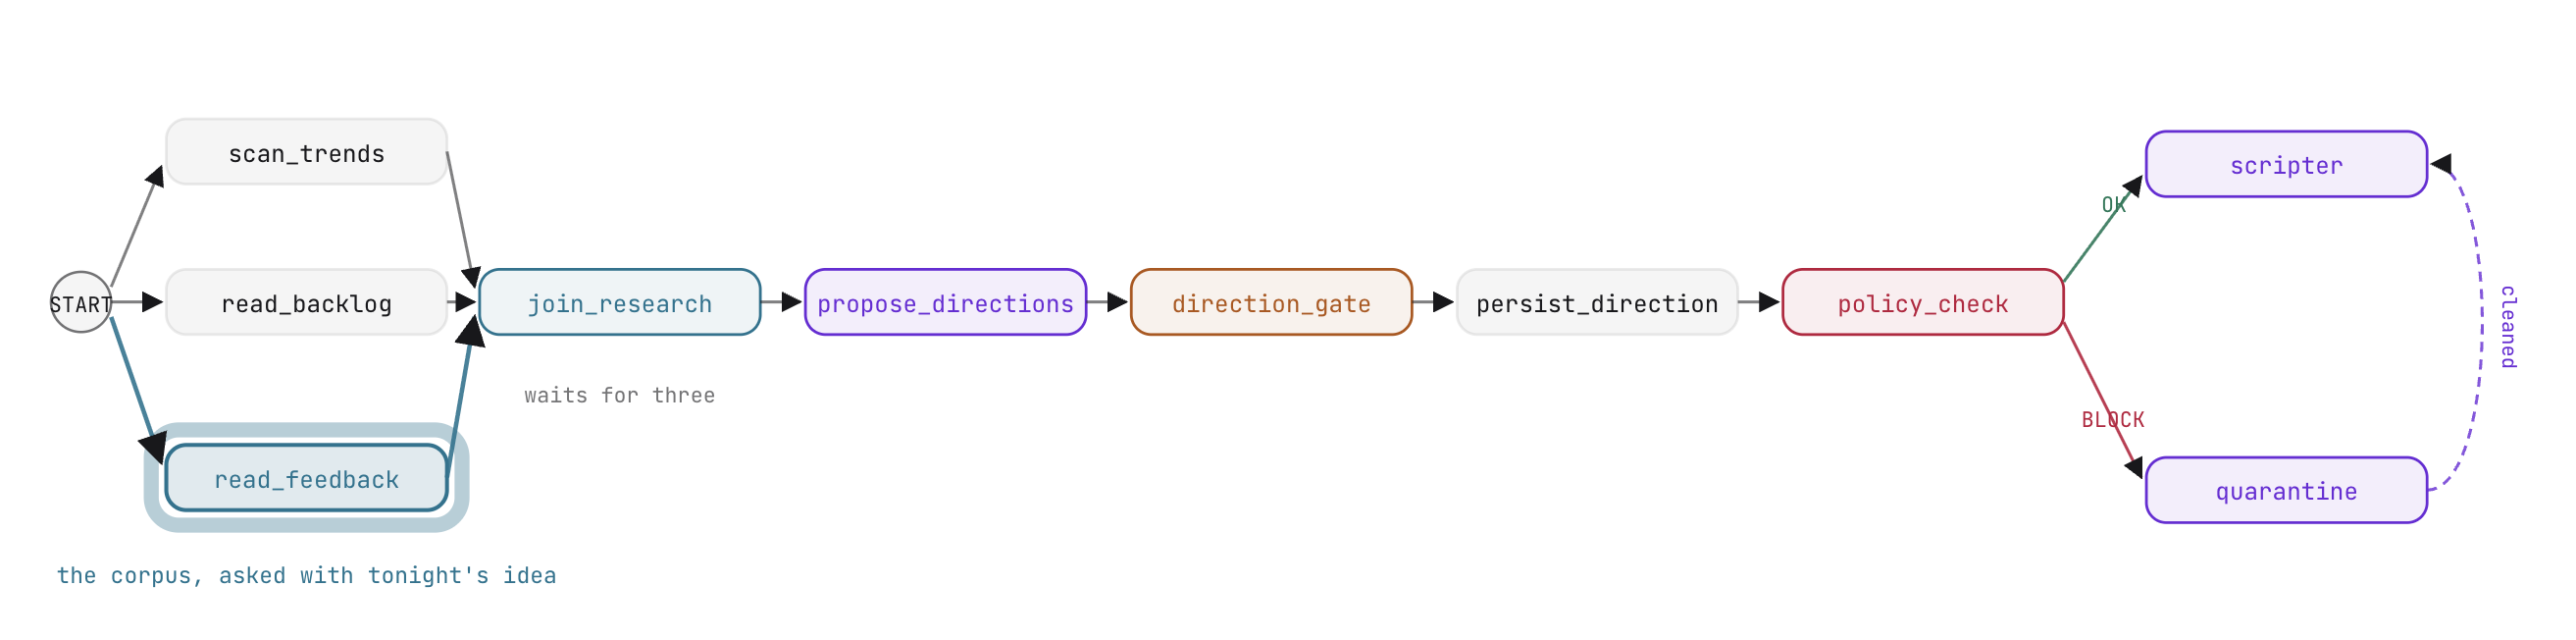
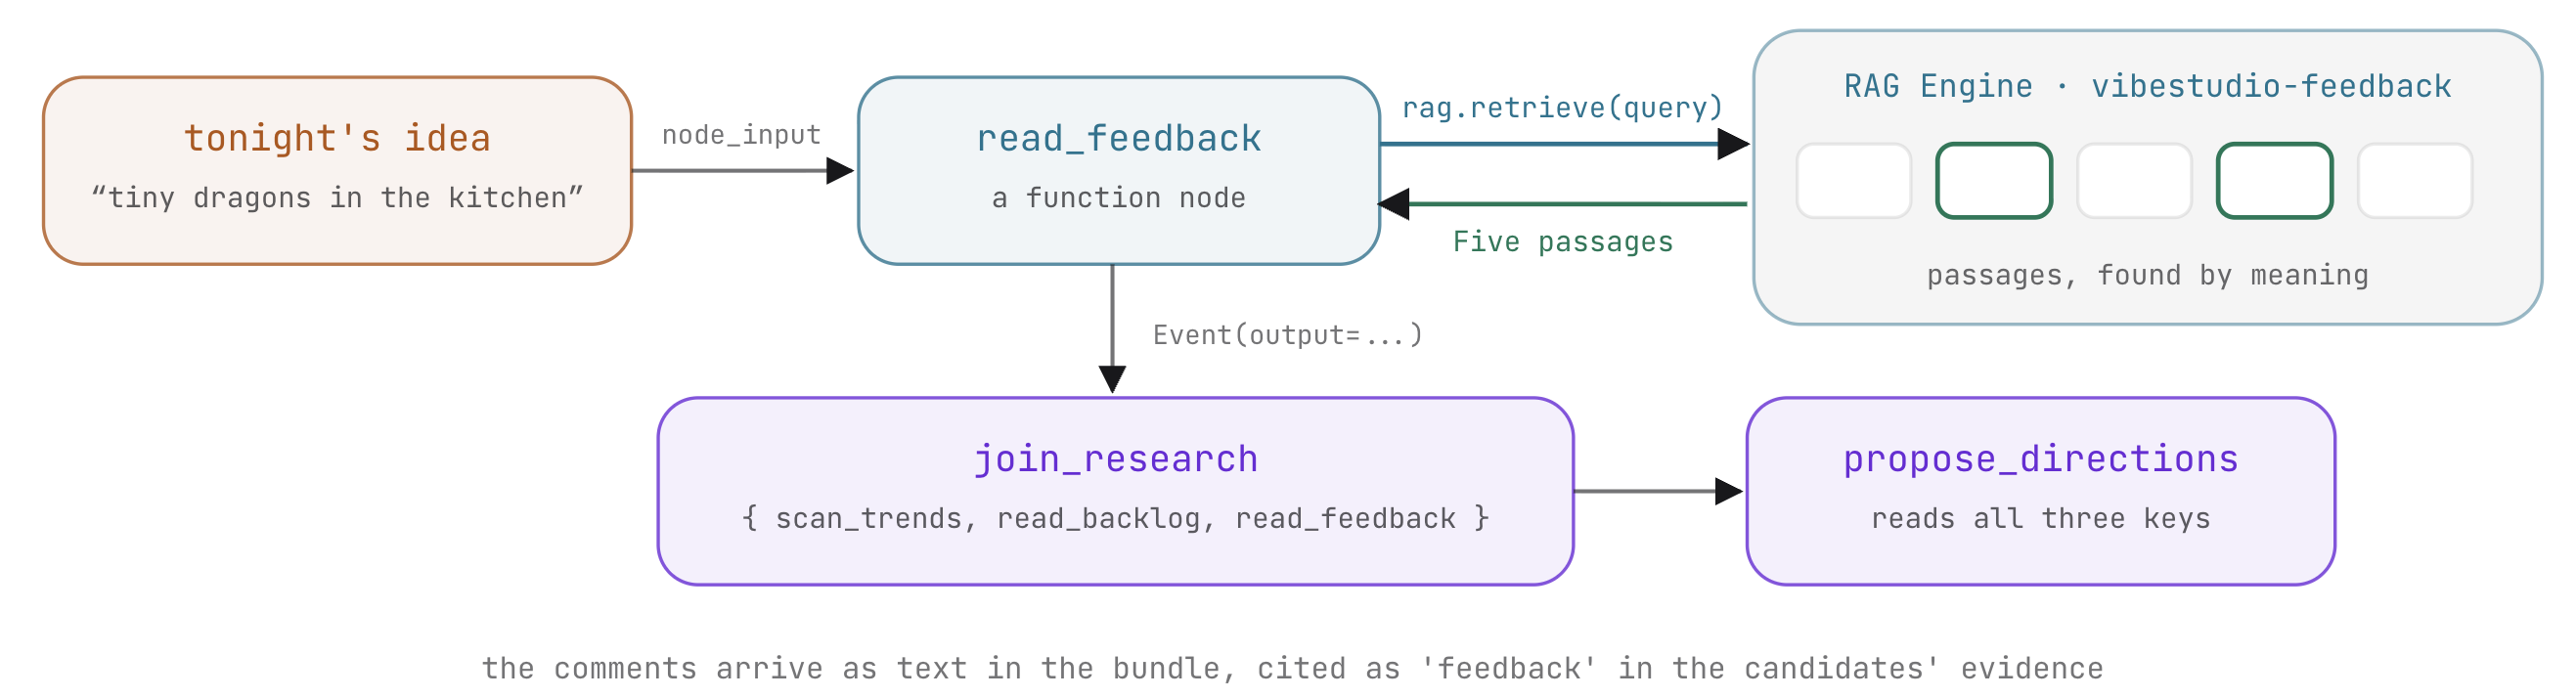
Opinie odbiorców to dane z badań udostępniane w ramach przepływu pracy. W odróżnieniu od osobistej pamięci twórcy nastroje widzów są przekazywane bezpośrednio do join_research wraz z trendami i danymi o zaległościach. Dlatego jest on implementowany jako węzeł funkcji:
def read_feedback(node_input):
    """The third reader (step 7): what the audience wrote under past videos,
    the passages nearest to tonight's idea. Retrieval, not a model call."""
    from .platform import rag
    idea = idea_text(node_input)
    query = idea or "what viewers liked and what they complained about"
    try:
        hits = rag.retrieve(query)
    except Exception as e:
        print(f"  [rag] feedback unavailable ({str(e)[:80]})")
        return Event(output={"query": query, "feedback": [],
                             "note": "no corpus connected - run: python -m agent.platform.rag"})
    return Event(output={"query": query, "feedback": [h["text"] for h in hits]})
read_feedback wyodrębnia początkowy pomysł użytkownika i wykonuje zapytanie wektorowe w korpusie RAG Engine. Zwraca pobrane komentarze w Event(output=...).
Praktyczna edycja: podłączanie trzeciego czytnika do zwielokrotnienia wyjściowego
W pliku stage5_rag/agent.py zaktualizuj edges, aby dodać read_feedback jako trzecią gałąź równoległą wchodzącą do join_research:
           (START, read_backlog, join_research),
           (START, read_feedback, join_research),
join_research to JoinNode, więc synchronizuje wszystkie przychodzące gałęzie i czeka, aż scan_trends, read_backlog i read_feedback wyemitują zdarzenia, zanim przekaże zagregowany pakiet dalej.
Czego możesz się spodziewać i dlaczego
Uruchom przepływ pracy w środowisku roboczym:
- Prześlij prompta z pomysłem (np. „miniaturowy smok pilnujący blatu kuchennego”).
- W śladzie wykonania sprawdź, czy wszystkie 3 węzły czytnika są wykonywane jednocześnie.
- Zwróć uwagę na
join_research: jego słownik wyjściowy zawiera teraztrends,backlogifeedback. - Sprawdź wygenerowane propozycje w
propose_directions: model uwzględnia w swoich propozycjach komentarze widzów i odnosi się do opinii odbiorców w polach dowodów. - Zauważ, że pobieranie RAG jest deterministyczne (identyczne zapytania zwracają identyczne fragmenty komentarzy), podczas gdy węzeł propozycji generatywnej tworzy kreatywne odmiany.
8. Asynchroniczne generowanie filmów za pomocą Veo
W VibeStudio Workbench przejdź do kroku 8: Film, części (8A) i (8B).
Generowanie filmu w wysokiej rozdzielczości za pomocą Google Veo wymaga kilku minut na renderowanie. Blokowanie wykonywania wykresu w tym okresie powoduje marnowanie zasobów obliczeniowych, blokowanie pul wątków i naraża działanie na przerwy w połączeniu HTTP. W tym kroku renderowanie wideo staje się asynchroniczne dzięki użyciu funkcji LongRunningFunctionTool ADK.
Narzędzia długotrwałe (8A)
W środowisku roboczym otwórz Narzędzie długotrwałe (8A). Otwórz stage6_video/agent.py i agent/deliver.py.
Narzędzia synchroniczne a narzędzia długotrwałe
Standardowe narzędzia funkcji ADK są wykonywane synchronicznie w ramach tury agenta: model wywołuje narzędzie, czeka na dane i uwzględnia wynik w bieżącej turze.
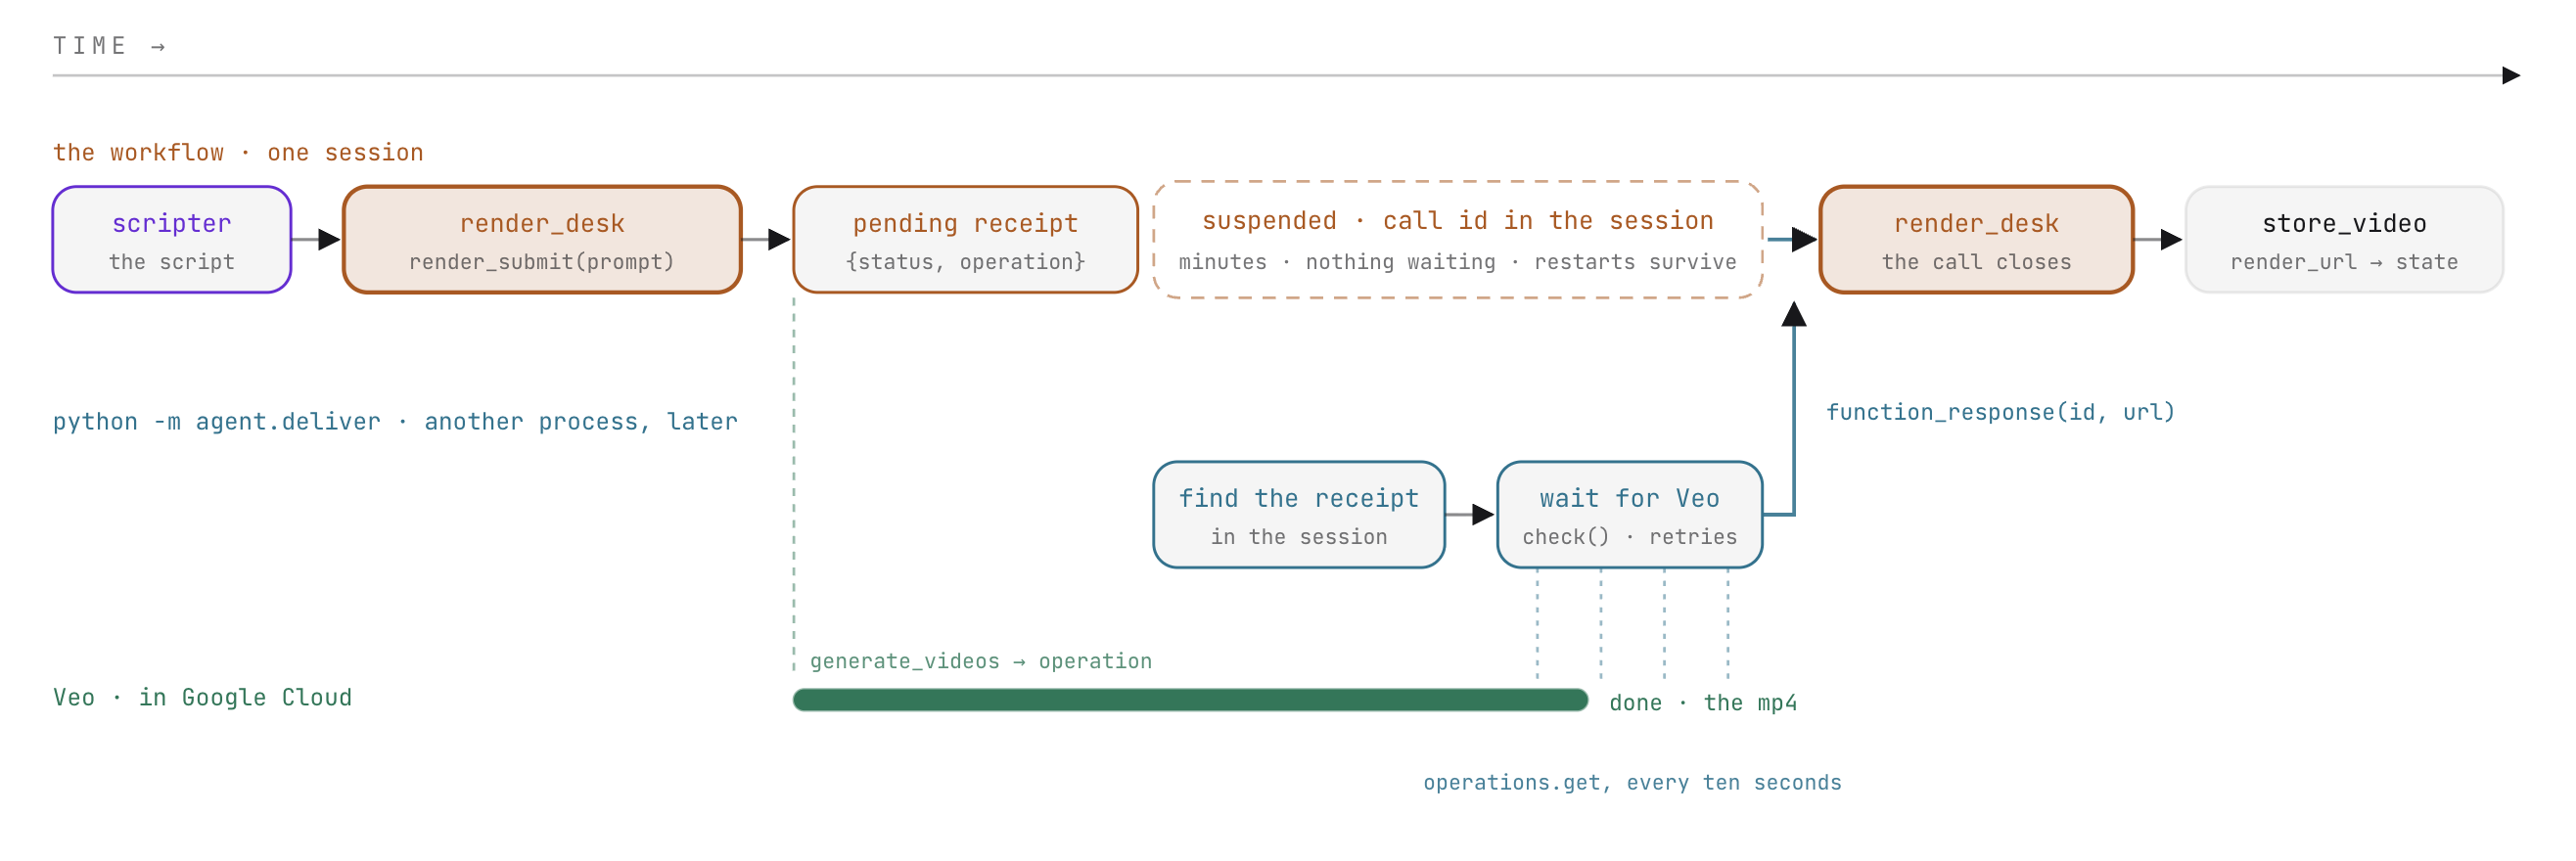
Renderowanie filmu nie może zostać ukończone w ramach jednej tury. Zamiast tego render_submit inicjuje zadanie generowania i natychmiast zwraca potwierdzenie operacji ze stanem "pending":
def render_submit(prompt: str) -> dict:
    """Submit one Veo render of `prompt`. Returns at once with a pending
    receipt; the clip is delivered later, to this call, by id."""
    receipt = videogen.start(f"{prompt} {videogen.NO_TEXT}")
    return {"status": "pending", "operation": receipt["operation"], "prompt": receipt["prompt"]}
Gdy jest opakowany w LongRunningFunctionTool, ADK przechwytuje stan "pending". Tura agenta się kończy, przepływ pracy zostaje zawieszony w węźle, a oczekujące metadane połączenia (w tym identyfikator połączenia i potwierdzenie) są rejestrowane w runs/sessions.db. Proces wykonywania kończy się bez utrzymywania aktywnych połączeń sieciowych ani wątków instancji roboczej.
Praktyczna edycja: zawijanie narzędzia do renderowania
W pliku stage6_video/agent.py zaktualizuj render_desk, aby opakować render_submit w LongRunningFunctionTool:
tools=[LongRunningFunctionTool(render_submit)])
Wznawianie według identyfikatora połączenia
Uniwersalny wzorzec wznowienia
ADK stosuje identyczny mechanizm wstrzymywania i wznawiania przepływów pracy zarówno w przypadku ludzi, jak i narzędzi zewnętrznych:
Reguła zawieszenia | Inicjowanie budowania | Stan zawieszenia przechowywania | Zdarzenie wznowienia |
Decyzja człowieka |
| Otwórz prompt wejściowy w magazynie sesji |
|
Narzędzie długotrwałe |
| Otwórz wywołanie narzędzia w pamięci sesji |
|
W obu przypadkach przepływ pracy zostaje całkowicie wstrzymany i wznawia się dopiero wtedy, gdy ze źródła zewnętrznego (interfejsu użytkownika, webhooka lub procesu działającego w tle) nadejdzie zdarzenie z pasującym FunctionResponse.
Praktyczna edycja: uzupełnianie odpowiedzi na dostawę
W agent/deliver.py utwórz część FunctionResponse dotyczącą wznowienia:
    part = Part(function_response=FunctionResponse(
        id=row["call_id"], name=row["name"], response=response))
Demon dostawy odpytuje Veo, dopóki plik wideo nie zostanie wygenerowany, a następnie wysyła ten FunctionResponse do sesji. ADK dopasowuje identyfikator wywołania i wznawia przepływ pracy bezpośrednio w następnym węźle. Ukończone węzły nie są wykonywane ponownie, a agent nie wykonuje kolejnego ruchu generatywnego.
Ustawienie STUDIO_REAL_VIDEO=0 w .env włącza renderowanie próbne: start natychmiast zwraca testowe potwierdzenie, a check symuluje zakończenie w ciągu 5 sekund bez wykonywania płatnych wywołań interfejsu API Veo.
Integracja potoku (8B)
W platformie roboczej otwórz render_desk w grafie (8B). Otwórz stage6_video/agent.py.
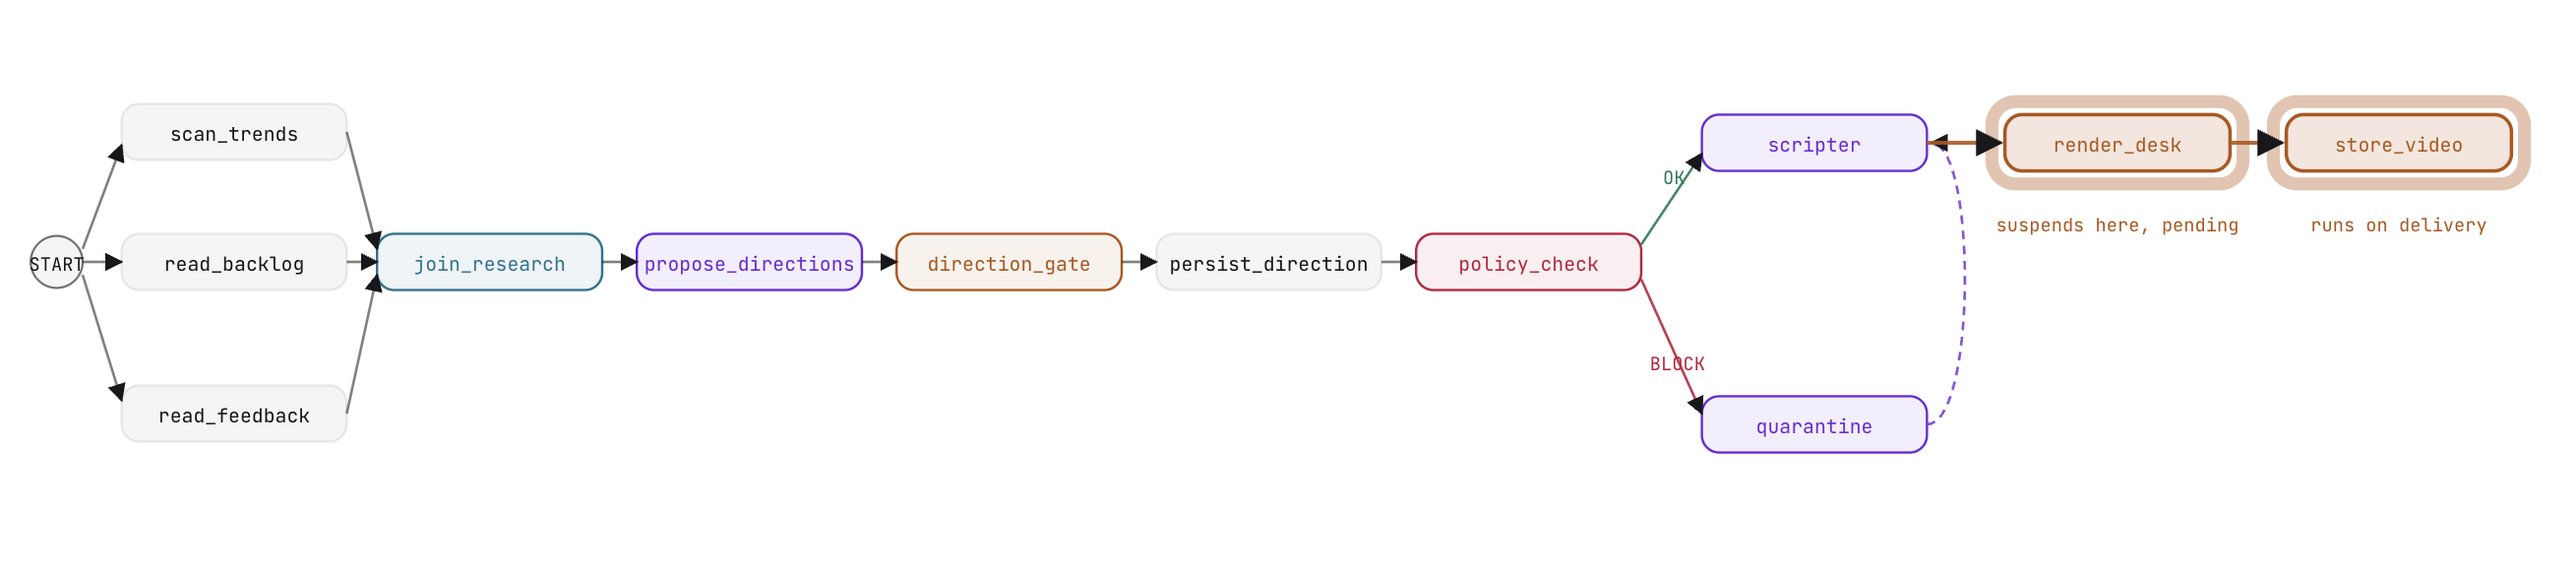
Węzłem końcowym w potoku jest store_video. Odczytuje informacje o ukończonym renderowaniu z runs/state.json (gdzie zostały zapisane przez proces dostarczania) i zapisuje adres URL filmu oraz stan generowania w stanie udostępnionej sesji.
Praktyczna edycja: podłączanie całego potoku wideo
W pliku stage6_video/agent.py zaktualizuj edges, aby dołączyć render_desk i store_video:
           (quarantine, scripter),
           (scripter, render_desk, store_video)])
Czego możesz się spodziewać i dlaczego
Przetestuj asynchroniczny przepływ generowania w środowisku:
- Wykonaj przepływ pracy, wybierając kandydata i generując skrypt.
- W
render_deskzobacz, jak agent wywołujerender_submit. - Przepływ pracy zostanie natychmiast zawieszony. W obszarze roboczym lub ADK Web sprawdź stan oczekiwania: sesja zawiera identyfikator otwartego połączenia i żadne procesy w tle nie zużywają zasobów.
- Uruchom demona dostarczania za pomocą konsoli platformy lub w terminalu:
python -m agent.deliver - W ADK Web odśwież sesję: wykonywanie zostanie wznowione w
store_video, adres URL filmu zostanie zapisany w stanie sesji, a przepływ pracy zostanie zakończony.
9. Wdrożenie w Cloud Run
W VibeStudio Workbench przejdź do Kroku 9. Wdróż.
Każdy komponent potoku został opracowany i sprawdzony w odpowiednich piaskownicach. W tym kroku skompletujesz pełny potok produkcyjny i wdrożysz go w Google Cloud Run.
Moduł uruchamiający ADK
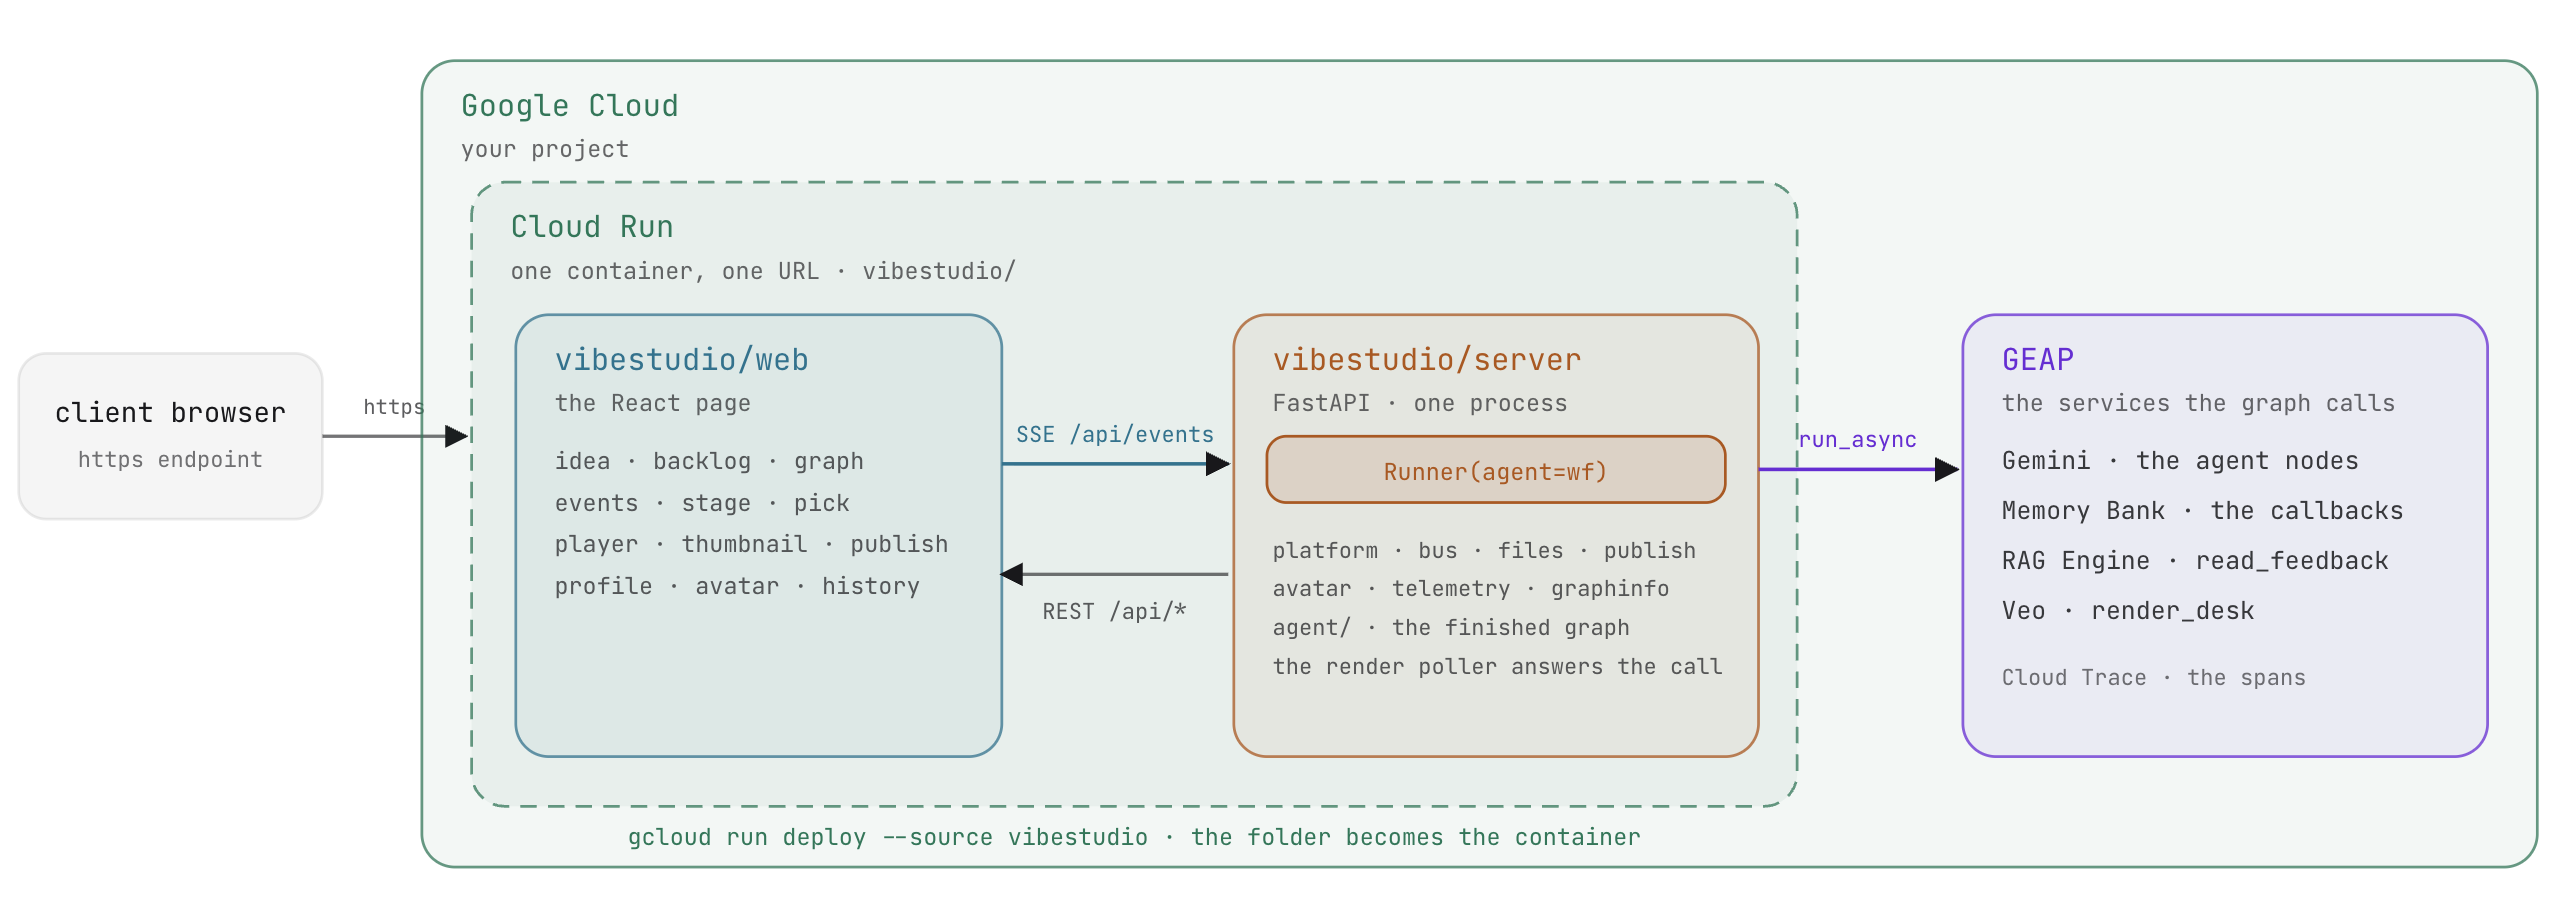
W środowisku programistycznym grafem zarządza adk web. W środowisku produkcyjnym aplikacja hostuje przepływ pracy za pomocą klasy Runner ADK:
self._svc = DatabaseSessionService(db_url=config.DB_URL)
self._runner = Runner(app_name=config.APP, agent=wf, session_service=self._svc)

async for ev in self._runner.run_async(user_id=config.USER, session_id=run_id, new_message=message):
    self._absorb(ev)    # fold the ADK event into the run state, publish one app event

# the gate's answer and the render's delivery are the same call, with a function_response part
part = Part(function_response=FunctionResponse(id=call_id, name=name, response=response))
run_async: uruchamia przepływ pracy, generując zdarzenia sekwencyjnie podczas wykonywania węzłów i utrwalając aktualizacje w usłudze sesji.- Ujednolicone wznawianie: zarówno decyzje użytkownika w
direction_gate, jak i ukończone dostawy filmów z Veo są wznawiane za pomocą identycznych obiektówFunctionResponseprzesłanych dorun_async.
Architektura aplikacji produkcyjnej
Aplikacja produkcyjna w vibestudio/ integruje cały potok:
vibestudio/
  server/
    main.py                 FastAPI: application server, REST routes, static assets
    api.py                  REST API endpoints: run, pick, publish, backlog, profile, history
    runner.py               Runner orchestration over the workflow, background render poller
    platform/               Event bus (SSE stream), file storage, publishing, telemetry
    agent/                  Production agent package, verified by checks/verify_app.py
      graph.py              The complete workflow graph and node definitions
      desk.py               render_desk and render_submit wrapped with LongRunningFunctionTool
      schemas.py            Pydantic schemas: Directions, CleanedDirection, Script
      cleanup_tools.py      Deterministic policy tools: find_policy_hits, suggest_replacement
      platform/             Memory Bank, RAG Engine, and Veo integrations
  web/                      Production React user interface
  Dockerfile · deploy.py · run.sh
- Strumień pojedynczych zdarzeń: backend FastAPI publikuje zdarzenia w ramach jednego strumienia zdarzeń wysyłanych przez serwer (SSE). Interfejs React wizualizuje postęp wykresu w czasie rzeczywistym i obsługuje późne połączenia bez utraty stanu.
- Wykonanie rozdzielone: aplikacja zarządza pętlą zdarzeń. Wykres przepływu pracy koncentruje się wyłącznie na logice wykonywania, nie uwzględniając interfejsu.
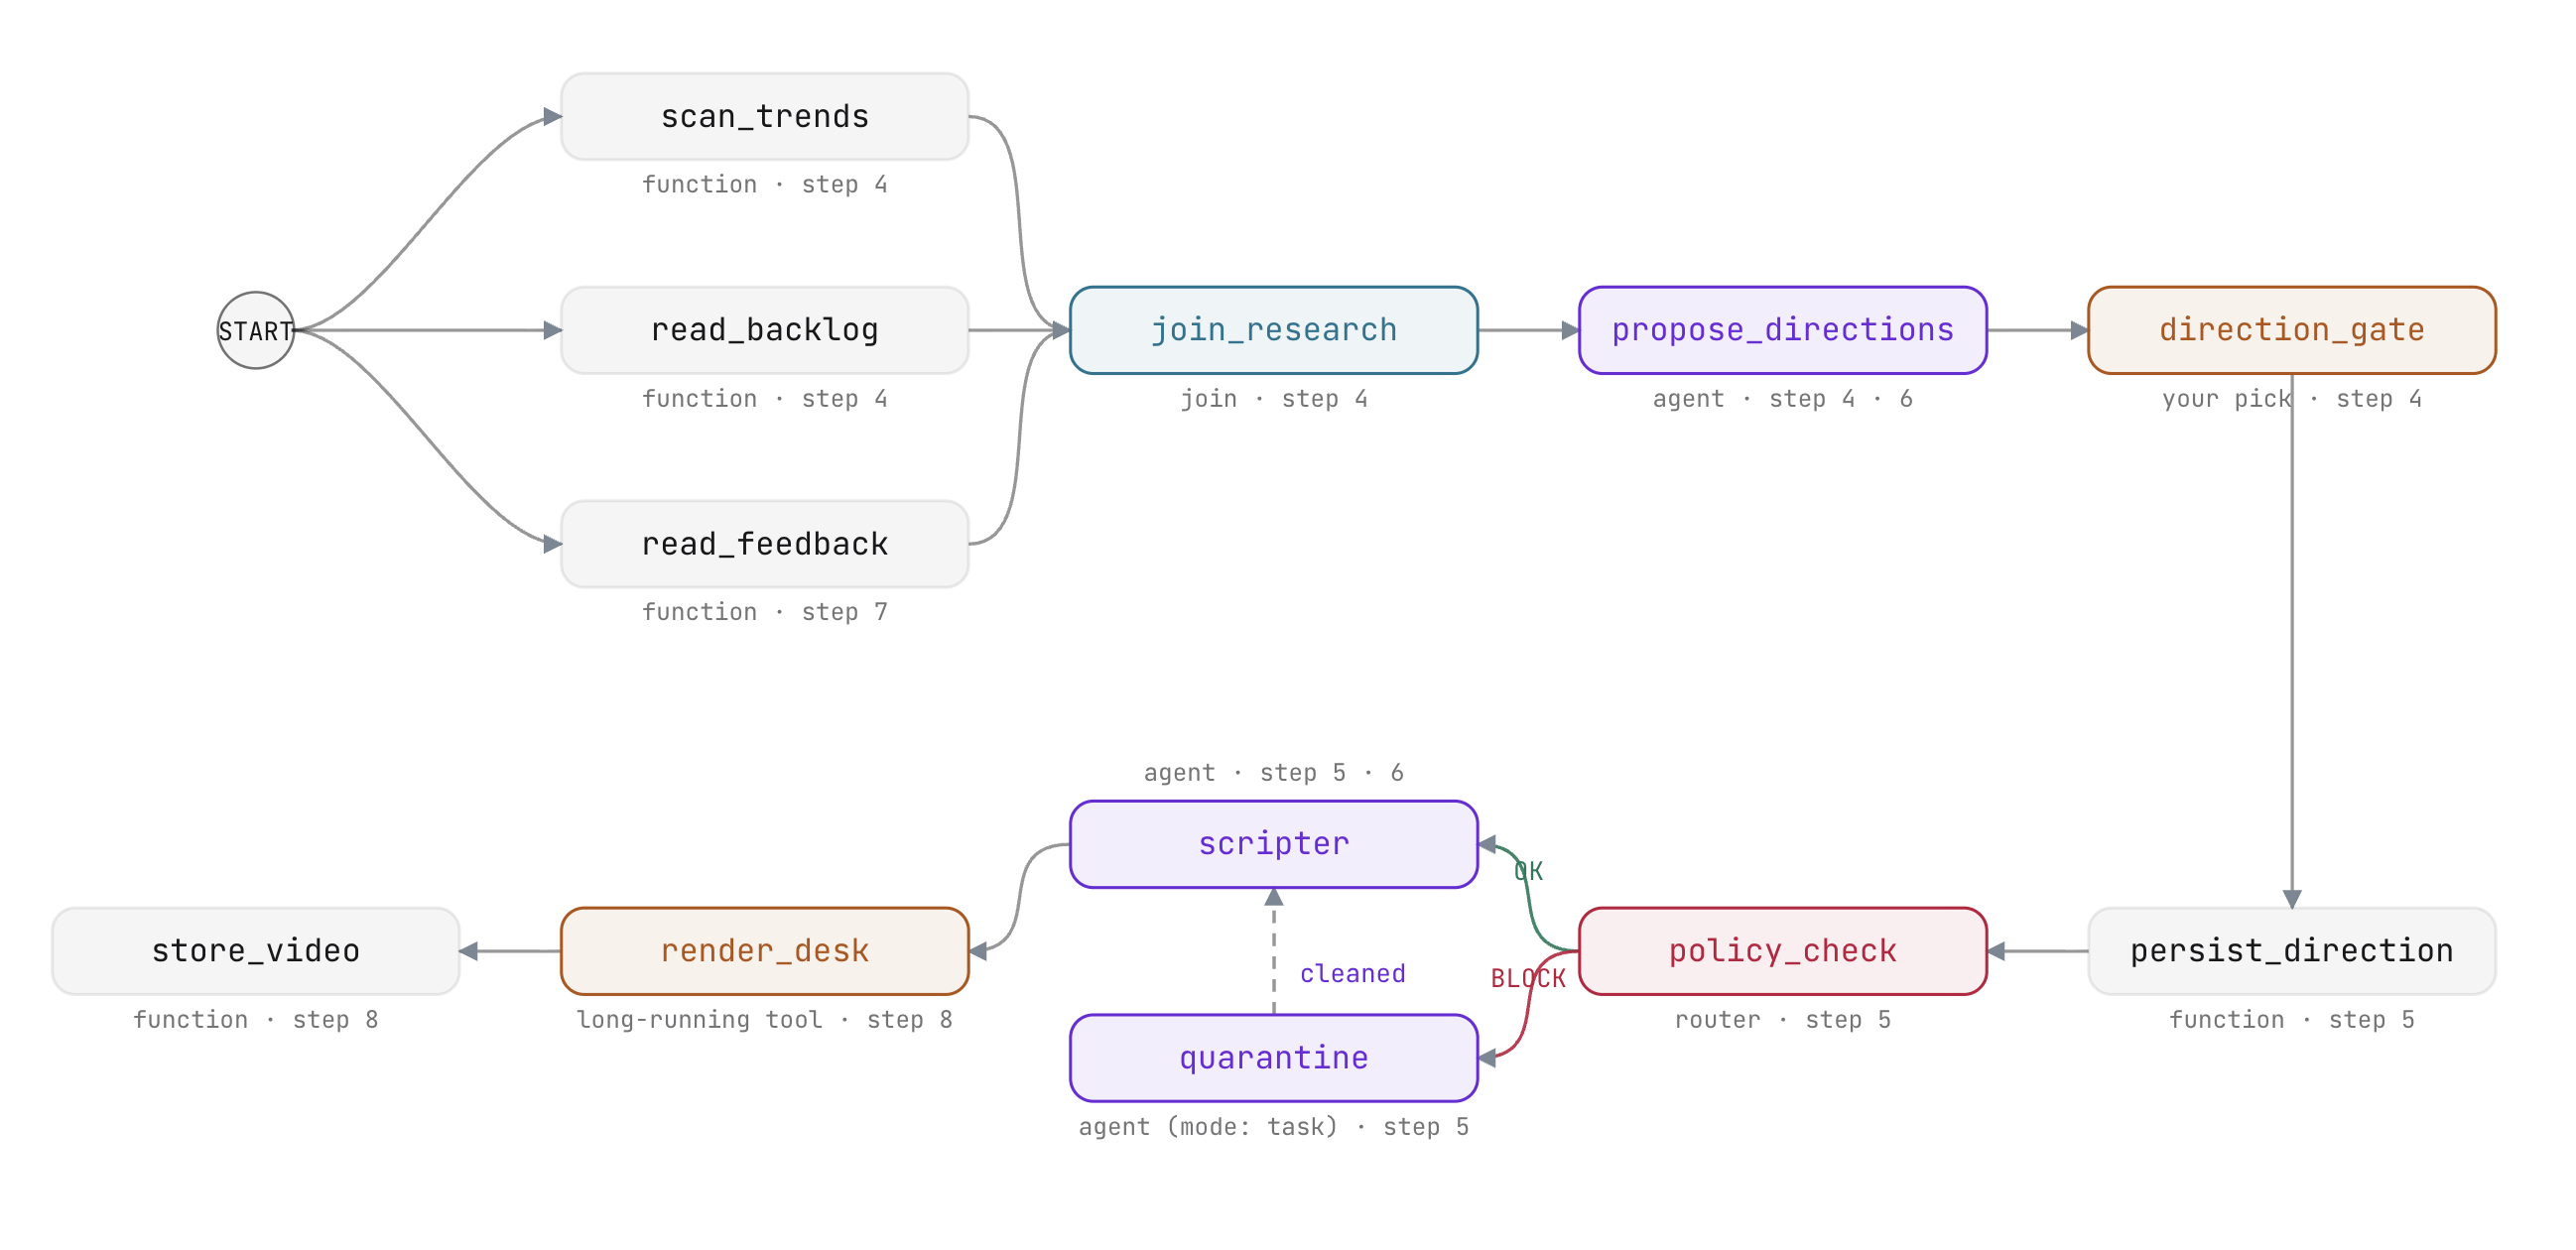
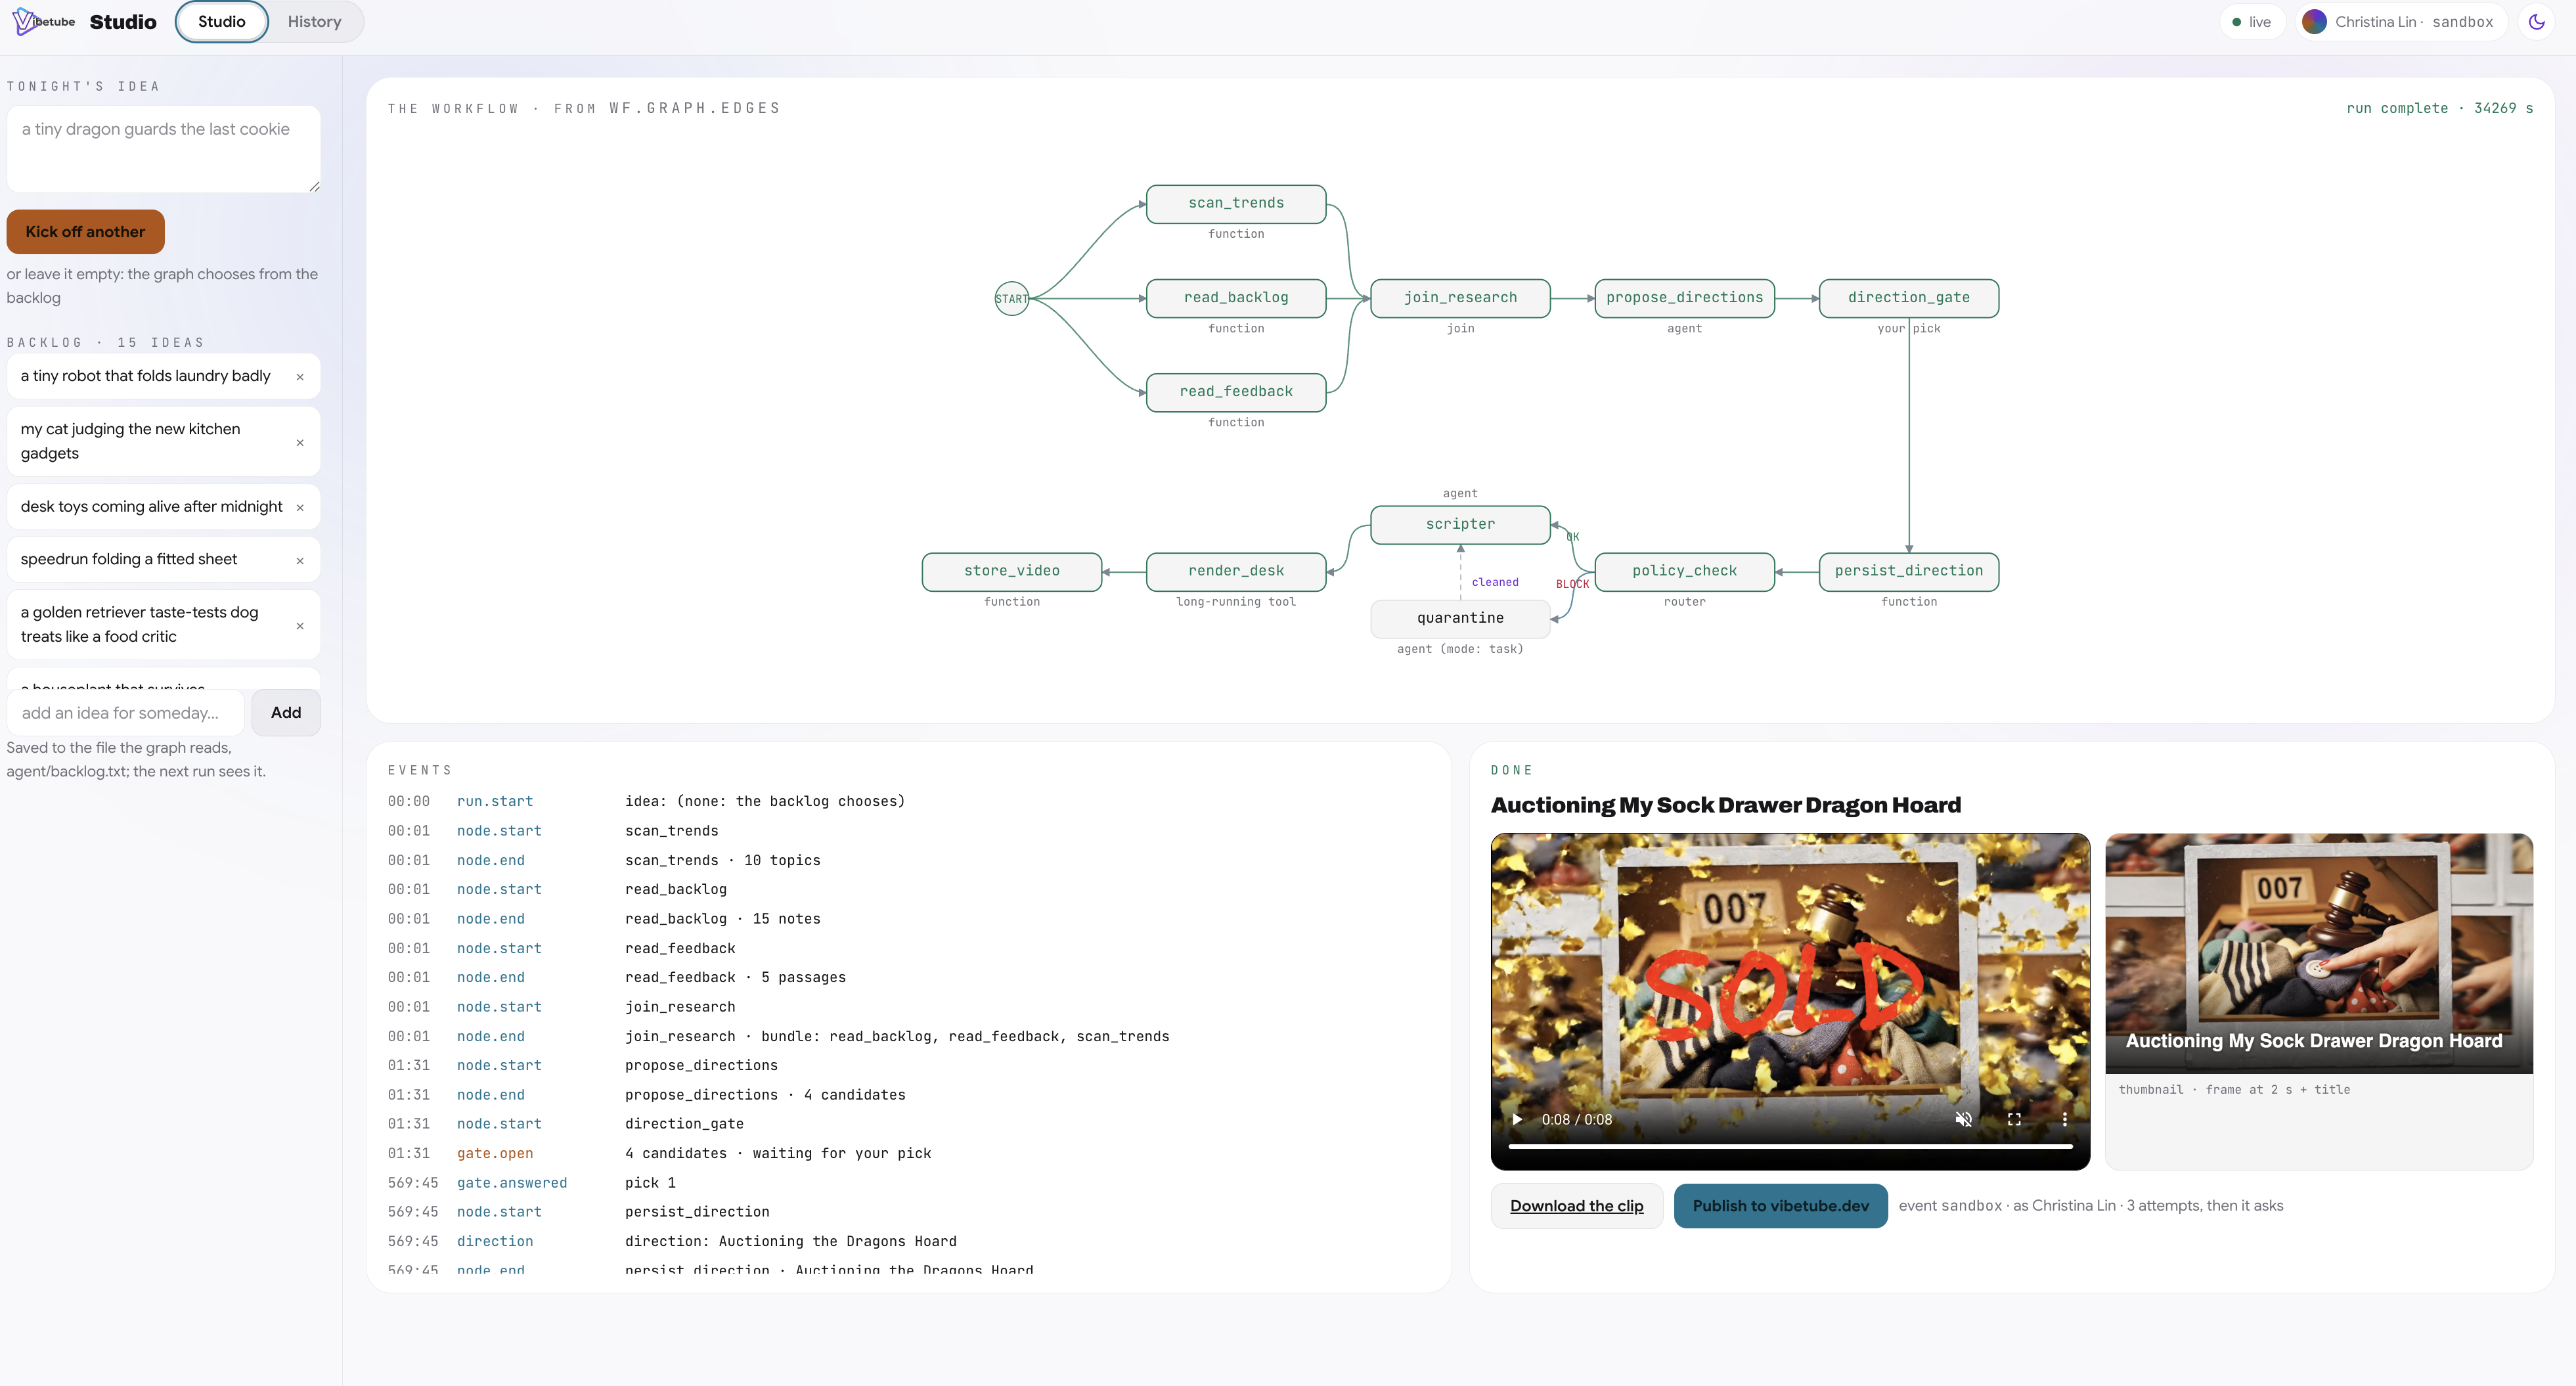
Pełna lista krawędzi przepływu pracy w agent/graph.py łączy wszystkie wzorce architektoniczne utworzone w tym ćwiczeniu:
        (START, scan_trends, join_research),
        (START, read_backlog, join_research),
        (START, read_feedback, join_research),
        (join_research, propose_directions, direction_gate,
         persist_direction, policy_check),
        (policy_check, {"OK": scripter, "BLOCK": quarantine}),
        (quarantine, scripter),
        (scripter, render_desk, store_video),
Wdrażanie w Cloud Run
Google Cloud Run zapewnia hosting bezserwerowy z automatycznym skalowaniem, routingiem żądań i zintegrowanymi kompilacjami kontenerów:
gcloud run deploy vibestudio --source vibestudio \
  --project $GOOGLE_CLOUD_PROJECT --region us-central1 \
  --labels dev-tutorial-codelab=vibetube --allow-unauthenticated \
  --memory 2Gi --cpu 2 --timeout 3600 --concurrency 40 \
  --max-instances 1 --min-instances 1 --session-affinity \
  --set-env-vars GOOGLE_CLOUD_PROJECT=...,STUDIO_VERTEX=1,STUDIO_MEMORY_BANK=...,STUDIO_RAG_CORPUS=...,VIBETUBE_URL=...,VIBETUBE_EVENT=...,VIBETUBE_NAME=...,VIBETUBE_PROJECT=...
- Kompilacja kontenera:
gcloud run deploy --sourcepakuje katalogvibestudio/, tworzy obraz kontenera za pomocą Cloud Build i wdraża usługę w ramach jednej operacji. - Koligacja sesji: kieruje żądania od tego samego użytkownika do tej samej instancji kontenera, zachowując stan sesji lokalnej w kolejnych krokach.
- Możliwość obserwacji: integracja z Cloud Trace rejestruje rozproszone zakresy dla każdego węzła, wywołania LLM i wykonania narzędzia, które są dostępne w konsoli Google Cloud w Eksploratorze logów czasu.
Kliknij przycisk Deploy (Wdróż) w środowisku roboczym, aby wykonać skrypt wdrażania. Po zakończeniu kompilacji w terminalu wyświetli się adres URL usługi na żywo.
10. Podsumowanie
W VibeStudio Workbench przejdź do Krok 10. Podsumowanie, aby sprawdzić ukończoną architekturę.
Krok | Architektura i koncepcje | Wzorzec implementacji |
Pojedynczy prompt | Jeden prompt, narzędzia funkcji, sekwencyjna pętla czatu |
|
Podstawy agentowych przepływów pracy | Przepływ pracy z wykorzystaniem grafu, badania równoległe, dane wyjściowe schematu, weryfikacja przez człowieka |
|
Stan i router | Stan sesji współdzielonej, powiązanie parametrów, deterministyczne przekierowywanie, agent zadań |
|
Bank zapamiętanych informacji | Pamięć długoterminowa na poziomie użytkownika, konsolidacja semantyczna, punkty zaczepienia cyklu życia |
|
RAG Engine | Wyszukiwanie dokumentów na podstawie komentarzy odbiorców, wektorów semantycznych | Węzeł |
Asynchroniczne generowanie filmów za pomocą Veo | Narzędzia działające przez długi czas, oczekujące potwierdzenia, zewnętrzny demon dostarczania |
|
Wdrożenie w Cloud Run | Programmatic orchestration, Server-Sent Events, serverless container |
|
Podstawowe zasady architektury
- Zawieszanie zamiast czekania: Workflows są zawieszane w sposób uporządkowany, aby umożliwić wprowadzenie danych przez użytkownika (
RequestInput) lub wykonanie długo trwających operacji (LongRunningFunctionTool). Procesy nie czekają bezczynnie na wątkach ani gniazdach sieciowych. - Uniwersalne wznawianie: każde zawieszenie jest wznawiane za pomocą identycznego mechanizmu: pojedynczego elementu
function_responsezawierającego identyfikator wywołania zawieszonego węzła. - Rozdzielone zarządzanie stanem: węzły udostępniają dane za pomocą nazwanych kluczy stanu sesji i powiązań parametrów, a nie szczegółowych, ściśle powiązanych ładunków pośrednich.
- Routing deterministyczny przed kosztem generatywnym: routery oparte na regułach i filtry wyrażeń regularnych oceniają zasady przy zerowym koszcie tokena, zanim zostaną uruchomione modele generatywne.
- Rozdzielenie zagadnień: kontekst dotyczący konkretnego agenta należy do wywołań zwrotnych cyklu życia, a współdzielone zależności od danych należą do