1. Introdução
Este codelab ensina a criar sistemas de agentes de última geração usando fluxos de trabalho e gráficos no Kit de Desenvolvimento de Agente (ADK, na sigla em inglês). Você vai implementar padrões arquitetônicos comuns, orquestrar interações human-in-the-loop (HITL) e lidar com a execução assíncrona de longa duração. Você também vai integrar bases de conhecimento corporativas e memória persistente para personalizar e desenvolver o comportamento do agente. Por fim, você vai conectar essas funcionalidades para impulsionar um pipeline automatizado de geração de vídeo.
O cenário
Você tem um canal digital no VibeTube com um público ativo e um número cada vez maior de ideias criativas. A produção de cada vídeo exige execução contínua em várias etapas: pesquisa de formatos em alta, síntese do feedback dos espectadores, desenvolvimento de scripts, verificação da conformidade com a política e geração de videoclipes. Os modelos generativos podem criar recursos individuais, mas o lançamento consistente de versões exige uma arquitetura de agentes orquestrada.
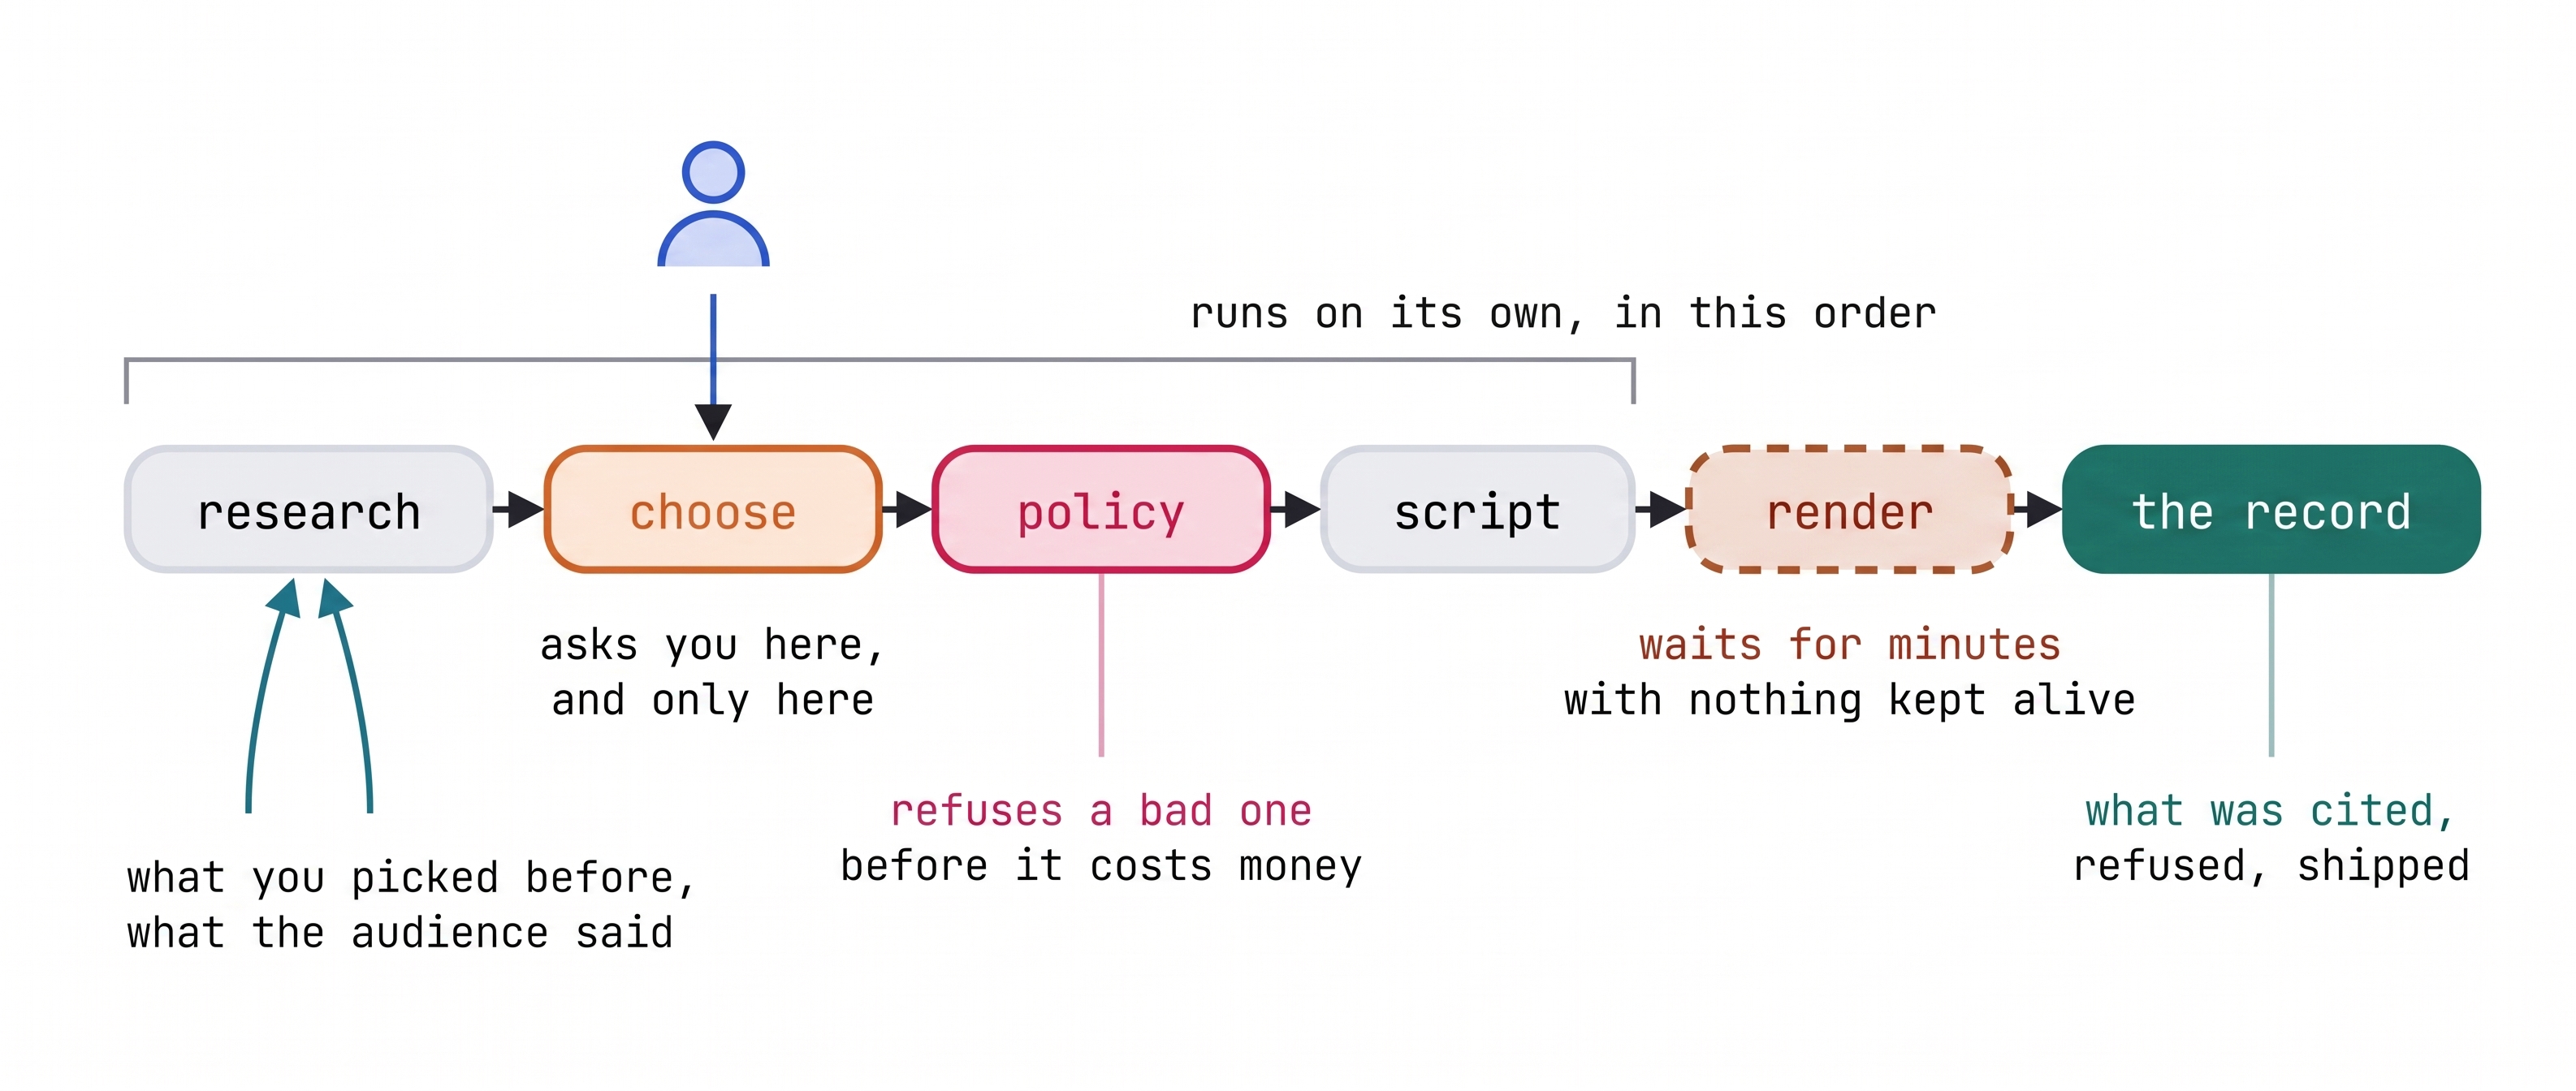
Para automatizar esse ciclo de vida, você vai criar o VibeStudio. Esse pipeline agêntico executa pesquisas de rotina em paralelo, apresenta opções selecionadas para aprovação com human-in-the-loop, aplica gates de política automatizados antes de gerar o vídeo e preserva o contexto em todas as execuções de produção.
Conteúdo do laboratório
- Fundamentos da engenharia de gráficos: as arquiteturas de agentes de várias etapas exigem um fluxo de controle explícito e caminhos de execução estruturados. Você cria um
Workflowdo ADK usando tuplas de borda, o ponto de entradaSTART,JoinNodepara agregação de distribuição de dados paralela e nós de roteador determinísticos para direcionar a execução com base no estado. - Modos de agente e callbacks do ciclo de vida: tarefas especializadas exigem comportamentos operacionais distintos e proteções determinísticas. Configure as instâncias
Agentdo ADK usando os modoschat,single_turnetaskcom ferramentas como nós de fluxo de trabalho, aplicando interceptadores combefore_model_callbackeafter_agent_callback. - Orquestração human-in-the-loop: os pipelines de produção são pausados para julgamento humano em pontos de verificação criativos críticos. Você implementa
RequestInputpara suspender a execução do fluxo de trabalho, aplicar esquemas de resposta estruturados e retomar a execução sem manter ativos os processos de ambiente de execução ociosos. - Memória hierárquica do agente: os sistemas de produção separam o estado de execução temporário do contexto durável. Você gerencia o estado da sessão de curto prazo usando
Event(state=...)e vinculação de parâmetros, além de conectar o banco de memória do GEAP para extrair, consolidar e persistir as preferências do criador entre as execuções. - Embasamento com bases de conhecimento corporativas: os agentes autônomos exigem contexto de domínio dinâmico e sentimento do público. Você conecta um corpus do mecanismo RAG do GEAP como um nó de recuperação dedicado na distribuição de dados paralela para embasar semanticamente as saídas do agente.
- Fluxos de trabalho e implantação de longa duração: a renderização de vídeo multimodal opera de forma assíncrona por períodos prolongados. Você implementa
LongRunningFunctionToolcom recibos de chamada pendentes para suspender e retomar o fluxo de trabalho por ID de chamada e implanta o pipeline concluído usando o ADKRunnerno Cloud Run.
Como este codelab está organizado
Este codelab serve como referência conceitual e arquitetônica. Cada seção explica as construções do ADK implementadas na etapa correspondente do workbench, fornece código de referência e estabelece princípios de design fundamentais. Revise cada seção antes de concluir o exercício correspondente na bancada de trabalho.
O trabalho prático é feito no VibeStudio Workbench, uma interface da Web complementar com um editor de código interativo, verificadores de ambiente de execução e um inspetor de ADK integrado. A numeração das etapas no ambiente de trabalho está alinhada diretamente com este codelab para manter seu progresso sincronizado. As edições fundamentais do gráfico persistem em todas as etapas, e a bancada de trabalho verifica automaticamente os pré-requisitos à medida que você avança.
Ao concluir os exercícios do workbench, você vai montar um pipeline agêntico de ponta a ponta e implantar um aplicativo VibeStudio em execução no Cloud Run para gerar conteúdo de vídeo.
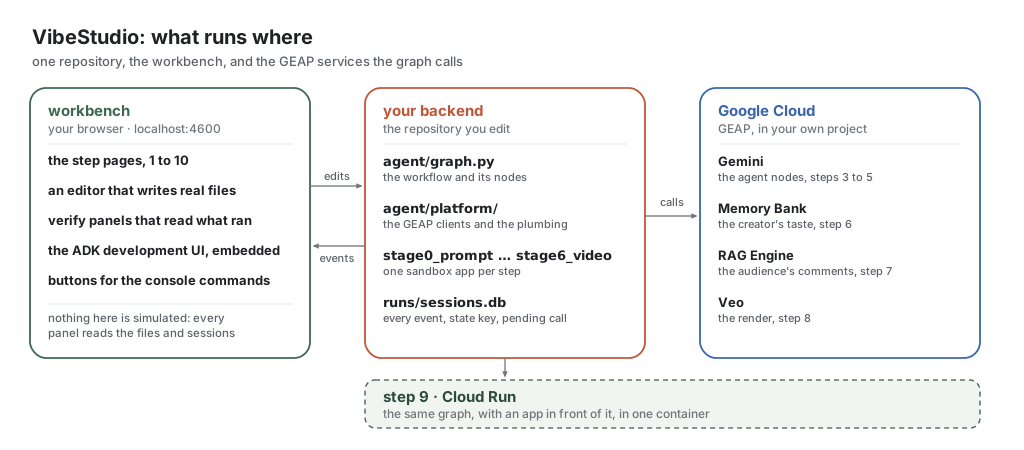
O ambiente consiste em três componentes principais: o VibeStudio Workbench (a interface da Web local para edição de código e verificação de ambiente de execução), seu back-end (o ADK Workflow e os sandboxes de estágio em agent/) e o Google Cloud (modelos do Gemini, banco de memória do GEAP, mecanismo de RAG e geração de vídeo do Veo).
2. Configuração
Resgatar seus créditos do workshop
Se você estiver participando de um laboratório com instrutor, ele vai distribuir créditos para seu projeto do Google Cloud. Siga as instruções do professor para resgatar seus créditos e verifique se o faturamento está ativo na sua conta antes de continuar.
Abrir o Cloud Shell
O Cloud Shell é um ambiente de desenvolvimento baseado no navegador com gcloud, Python e git pré-instalados.
Para inicializar o Cloud Shell:
- Acesse o Google Cloud Shell.
Uma sessão de terminal é aberta na parte de baixo da janela do navegador.
Clonar e inicializar o repositório
Execute os seguintes comandos no terminal do Cloud Shell para clonar o projeto:
git clone https://github.com/gca-americas/vibetube-studio
cd ~/vibetube-studio
Comandos de configuração
Durante a configuração, você precisará informar os seguintes detalhes:
- ID do projeto na nuvem do Google Cloud: quando solicitado por
setup_project.sh, pressione Enter para criar um novo projeto automaticamente. Se preferir usar um projeto atual (como um projeto pré-atribuído), insira o ID do projeto e verifique se a ortografia está correta com o faturamento ativo. - Código do evento: insira o código da sala fornecido pelo professor. Se você não recebeu um, fale com um assistente de ensino ou um colega. Se você estiver fazendo este laboratório em casa, pressione Enter para aceitar a sala
sandboxpadrão. - Nome de exibição do canal: insira seu nome ou identificador de canal preferido quando solicitado pelo
setup_codelab.shou pressione Enter para aceitar o padrão gerado na sua Conta do Google.
Execute os dois scripts de configuração em ordem:
./setup_project.sh
./setup_codelab.sh
setup_project.sh: cria ou reutiliza um projeto na nuvem do Google Cloud com faturamento ativo, salva o ID do projeto em~/project_id.txte configura o contexto ativo dogcloud.setup_codelab.sh: instalauve dependências do Python em.venv, ativa as APIs do Cloud necessárias do Google, configura as definições do canal em.env, verifica o acesso ao modelo com o Gemini, provisiona recursos do Memory Bank e de RAG, cria a interface do ambiente de trabalho e inicia o VibeStudio Workbench.
O script executa a verificação de simulação e inicia o VibeStudio Workbench em segundo plano. As últimas linhas mostram o link para abrir.
7 · Preflight
  ✓ python 3.12
  ✓ auth path A: Vertex via ADC (STUDIO_VERTEX=1)
  ✓ Google Cloud ADC (project <your-project>)
  ✓ stage0_prompt loads
  ...
  ✓ stage6_video loads (13 edges)
  ✓ aiplatform.googleapis.com enabled (Gemini, Veo, Memory Bank, RAG Engine)
  ✓ vectorsearch.googleapis.com enabled (the vector store a RAG corpus is built on)
  ✓ Memory Bank connected
  ✓ RAG corpus connected
  ✓ VibeStudio Workbench running on port 4600

PREFLIGHT GREEN

Setup finished. The VibeStudio Workbench is already running.

  Open this and start at step 1
      https://4600-<your cloud shell host>/step/story

  It runs in the background. You do not need to start anything else.
      log      runs/lab.log
      stop     kill $(cat runs/lab.pid)
      start    scripts/start.sh
Clique nesse link. O mesmo endereço está disponível em Visualização na Web → Alterar porta → 4600.
Para verificar o ambiente novamente a qualquer momento, execute python scripts/preflight.py. Para reiniciar o workbench, execute scripts/restart.sh. Para configurar de novo, execute ./setup_codelab.sh. Isso preserva sua configuração e seu progresso.
Com ele aberto, leia Etapa 1: a história para o cenário e Etapa 2: o que você vai criar para o formato do gráfico finalizado. Nenhum deles tem um exercício. Depois, volte aqui para a etapa 3.
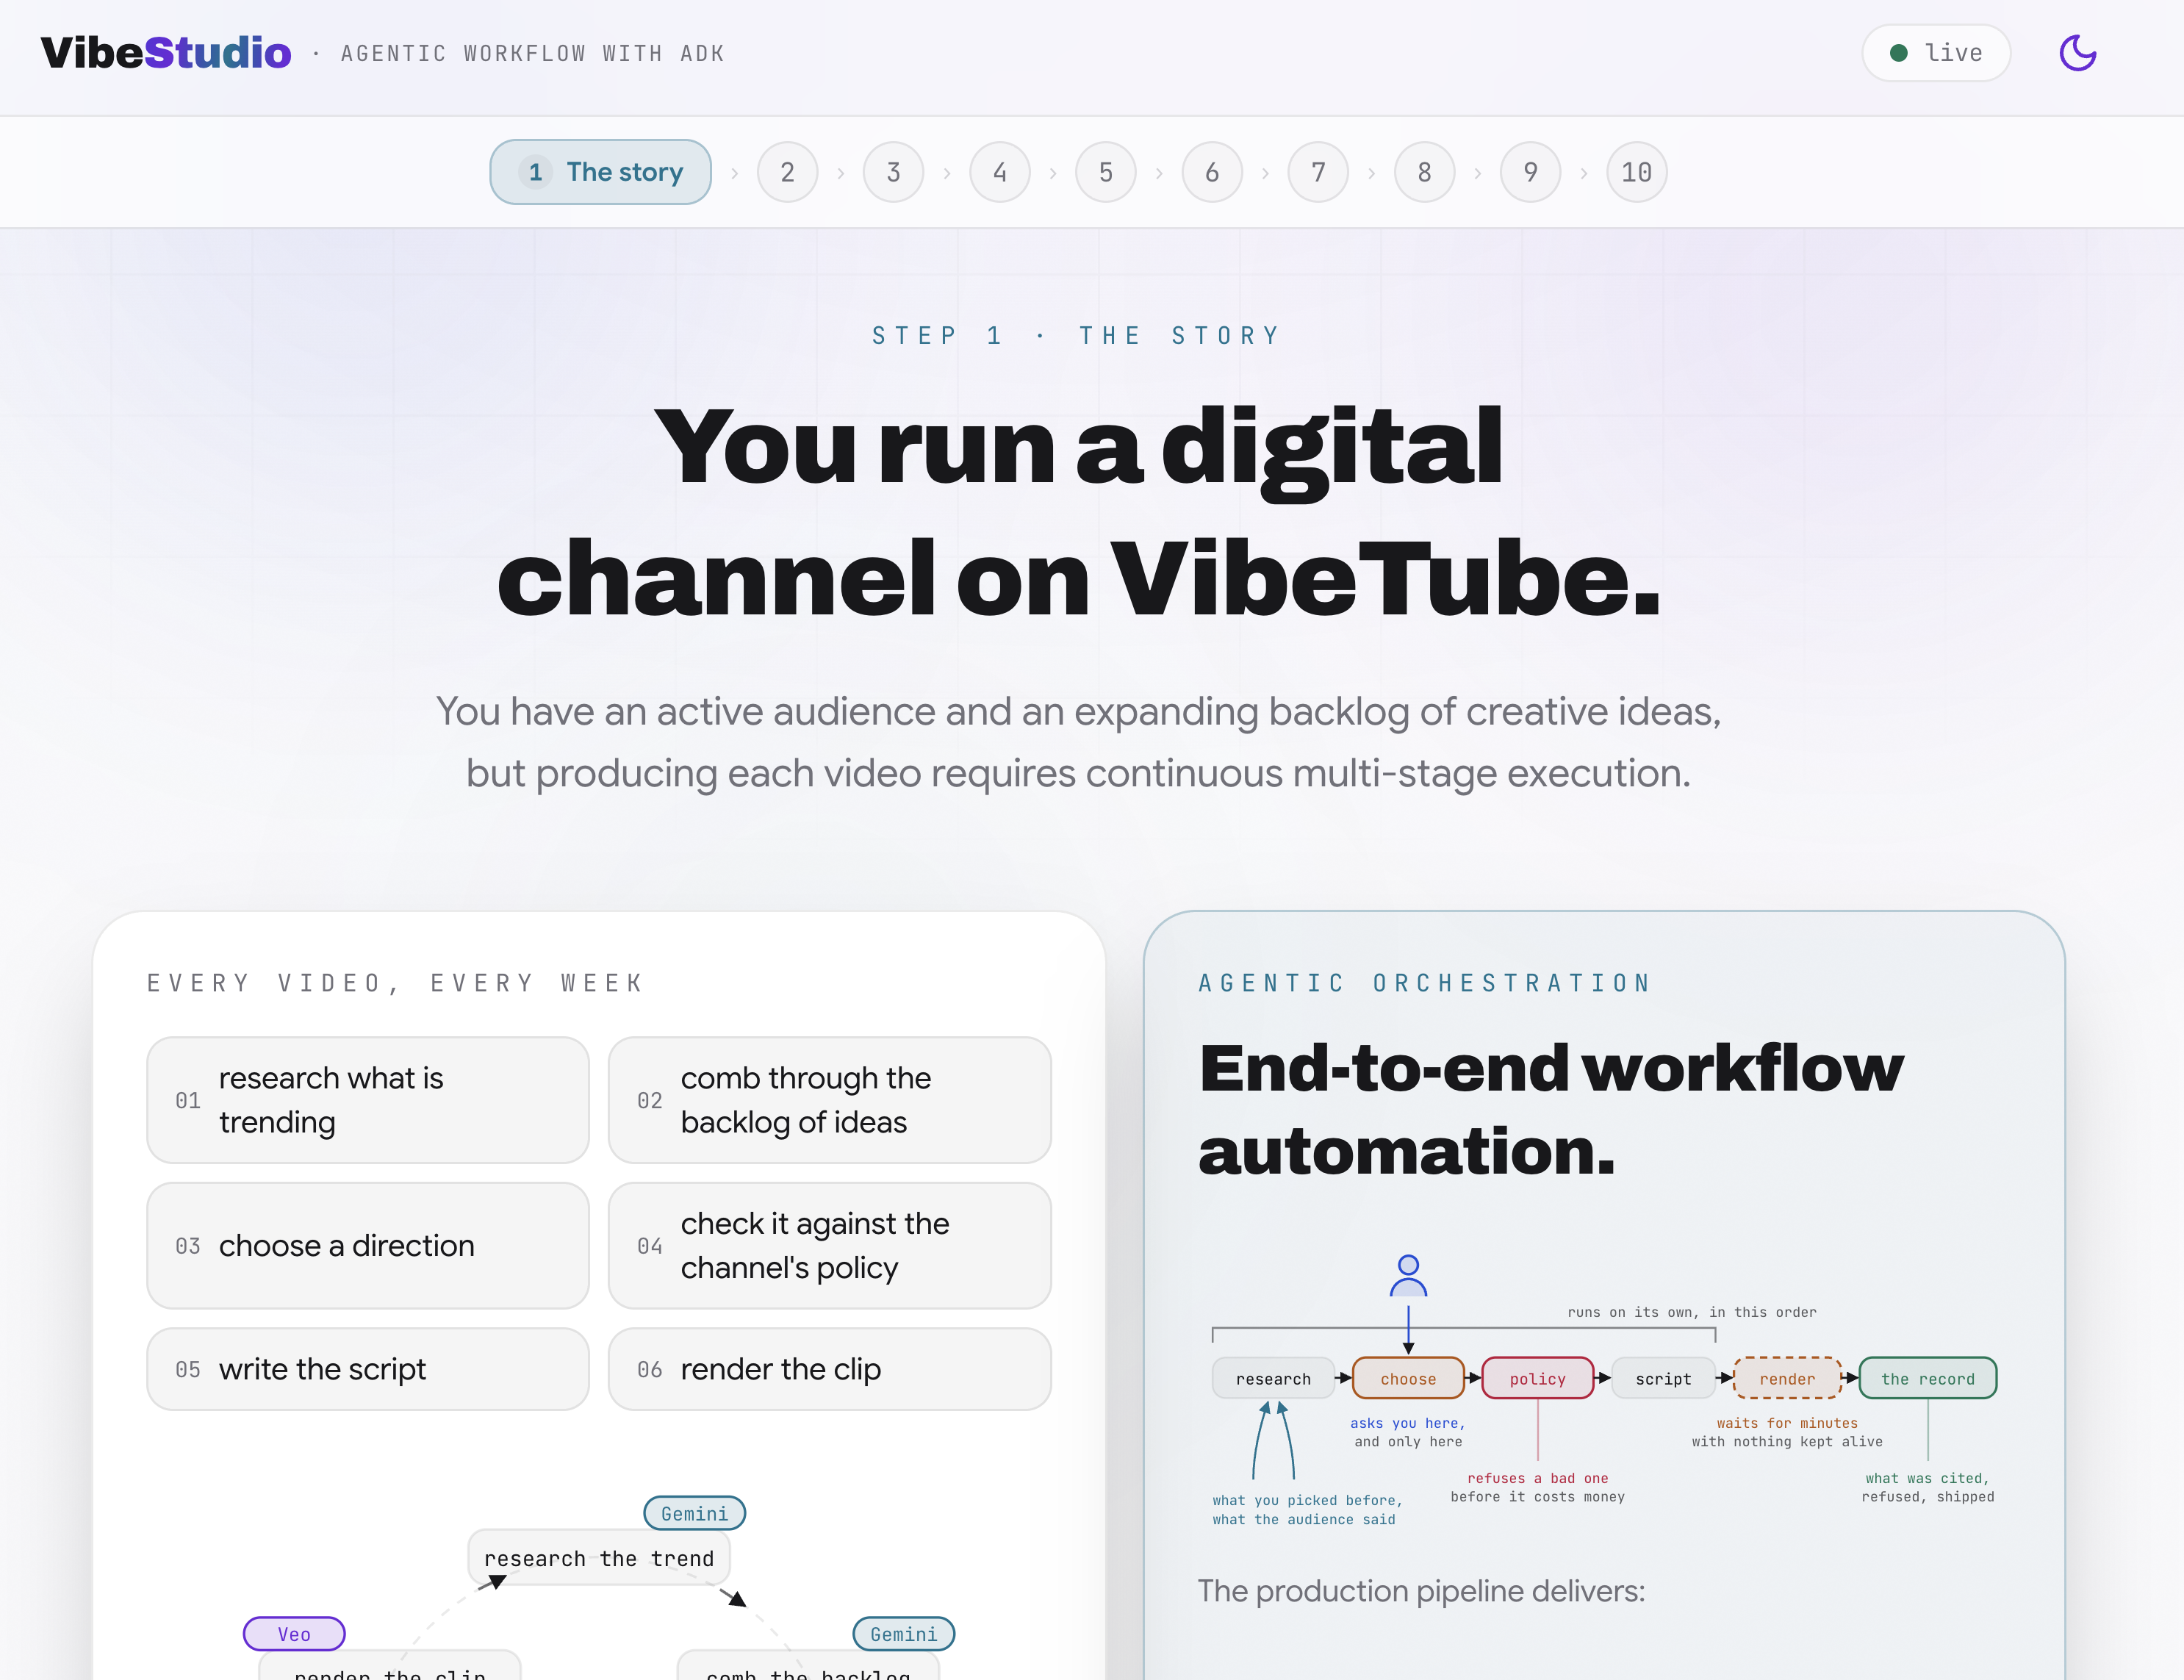
Cada parte prática do VibeStudio Workbench termina com um painel de verificação que lê os artefatos reais: o arquivo no disco e as sessões gravadas pelas execuções.
Layout do repositório
O repositório é estruturado na lógica principal do fluxo de trabalho, em sandboxes detalhados, no ambiente do workbench e no aplicativo de produção:
vibe-studio-lab/
├── agent/                  # Core ADK workflow, graph definition, and platform services
│   ├── graph.py            # Workflow graph definition, node functions, and routers
│   ├── desk.py             # Video render desk using LongRunningFunctionTool
│   ├── schemas.py          # Pydantic schemas for directions, gates, and scripts
│   ├── trends.py           # Trend generation and sampling utilities
│   ├── backlog.txt         # Creator video ideas backlog
│   ├── comments.md         # Audience comments for RAG Engine corpus seeding
│   ├── policy_words.txt    # Blocked subject words for deterministic policy checks
│   └── platform/           # Google Cloud service clients (Memory Bank, RAG, Veo)
│       ├── config.py       # Environment variables, locations, and model configurations
│       ├── memory.py       # GEAP Memory Bank callbacks and context injection
│       ├── rag.py          # GEAP RAG Engine corpus creation and semantic retrieval
│       └── videogen.py     # Veo video generation and operation polling
├── stage0_prompt/          # Step sandboxes: isolated agent.py files runnable in adk web
│   └── ...                 # stage1_fanout through stage6_video for incremental steps
├── server/ & web/          # VibeStudio Workbench (FastAPI backend and React frontend)
├── vibestudio/             # Complete production application deployed to Cloud Run
│   ├── server/             # FastAPI production server and event runner
│   ├── web/                # End-user React web application
agent/: contém o gráfico principal do fluxo de trabalho. Você vai editar arquivos nesse diretório para implementar nós de distribuição de dados paralelos, roteamento de políticas determinísticas, callbacks de memória e ferramentas de geração de vídeo.agent/platform/: interage com os serviços do Google Cloud, incluindo modelos do Gemini, banco de memória do GEAP, mecanismo de RAG do GEAP e síntese de vídeo do Veo.stage0_prompt/astage6_video/: ambientes de sandbox independentes. Cada pasta exporta umroot_agentindependente para que você possa executar e inspecionar cada etapa de forma isolada usando a interface de desenvolvimento do ADK incorporada.server/eweb/: o aplicativo VibeStudio Workbench em execução local na porta 4600. Ele hospeda a documentação da etapa, o editor de código na página, os verificadores de evidências de tempo de execução e a visualização de gráficos.vibestudio/: o aplicativo de produção completo empacotado e implantado no Cloud Run na etapa final. Ele contém uma cópia independente do gráfico de fluxo de trabalho concluído.
3. Agente monolítico
Antes de criar um gráfico de fluxo de trabalho com vários nós, você estabelece uma base arquitetônica com um único agente em stage0_prompt/agent.py. Esse agente depende de um comando de sistema monolítico que descreve o pipeline de produção em prosa, com o suporte de duas ferramentas de função do Python.
A avaliação dessa linha de base demonstra os limites operacionais da coordenação orientada por comandos e estabelece por que os sistemas de produção exigem orquestração de gráficos.
Arquitetura do agente do ADK (3A)
No VibeStudio Workbench, navegue até Etapa 3: agente monolítico e abra Arquitetura do agente ADK (3A). Essa visualização apresenta as principais camadas arquitetônicas de um agente do ADK (LlmAgent):
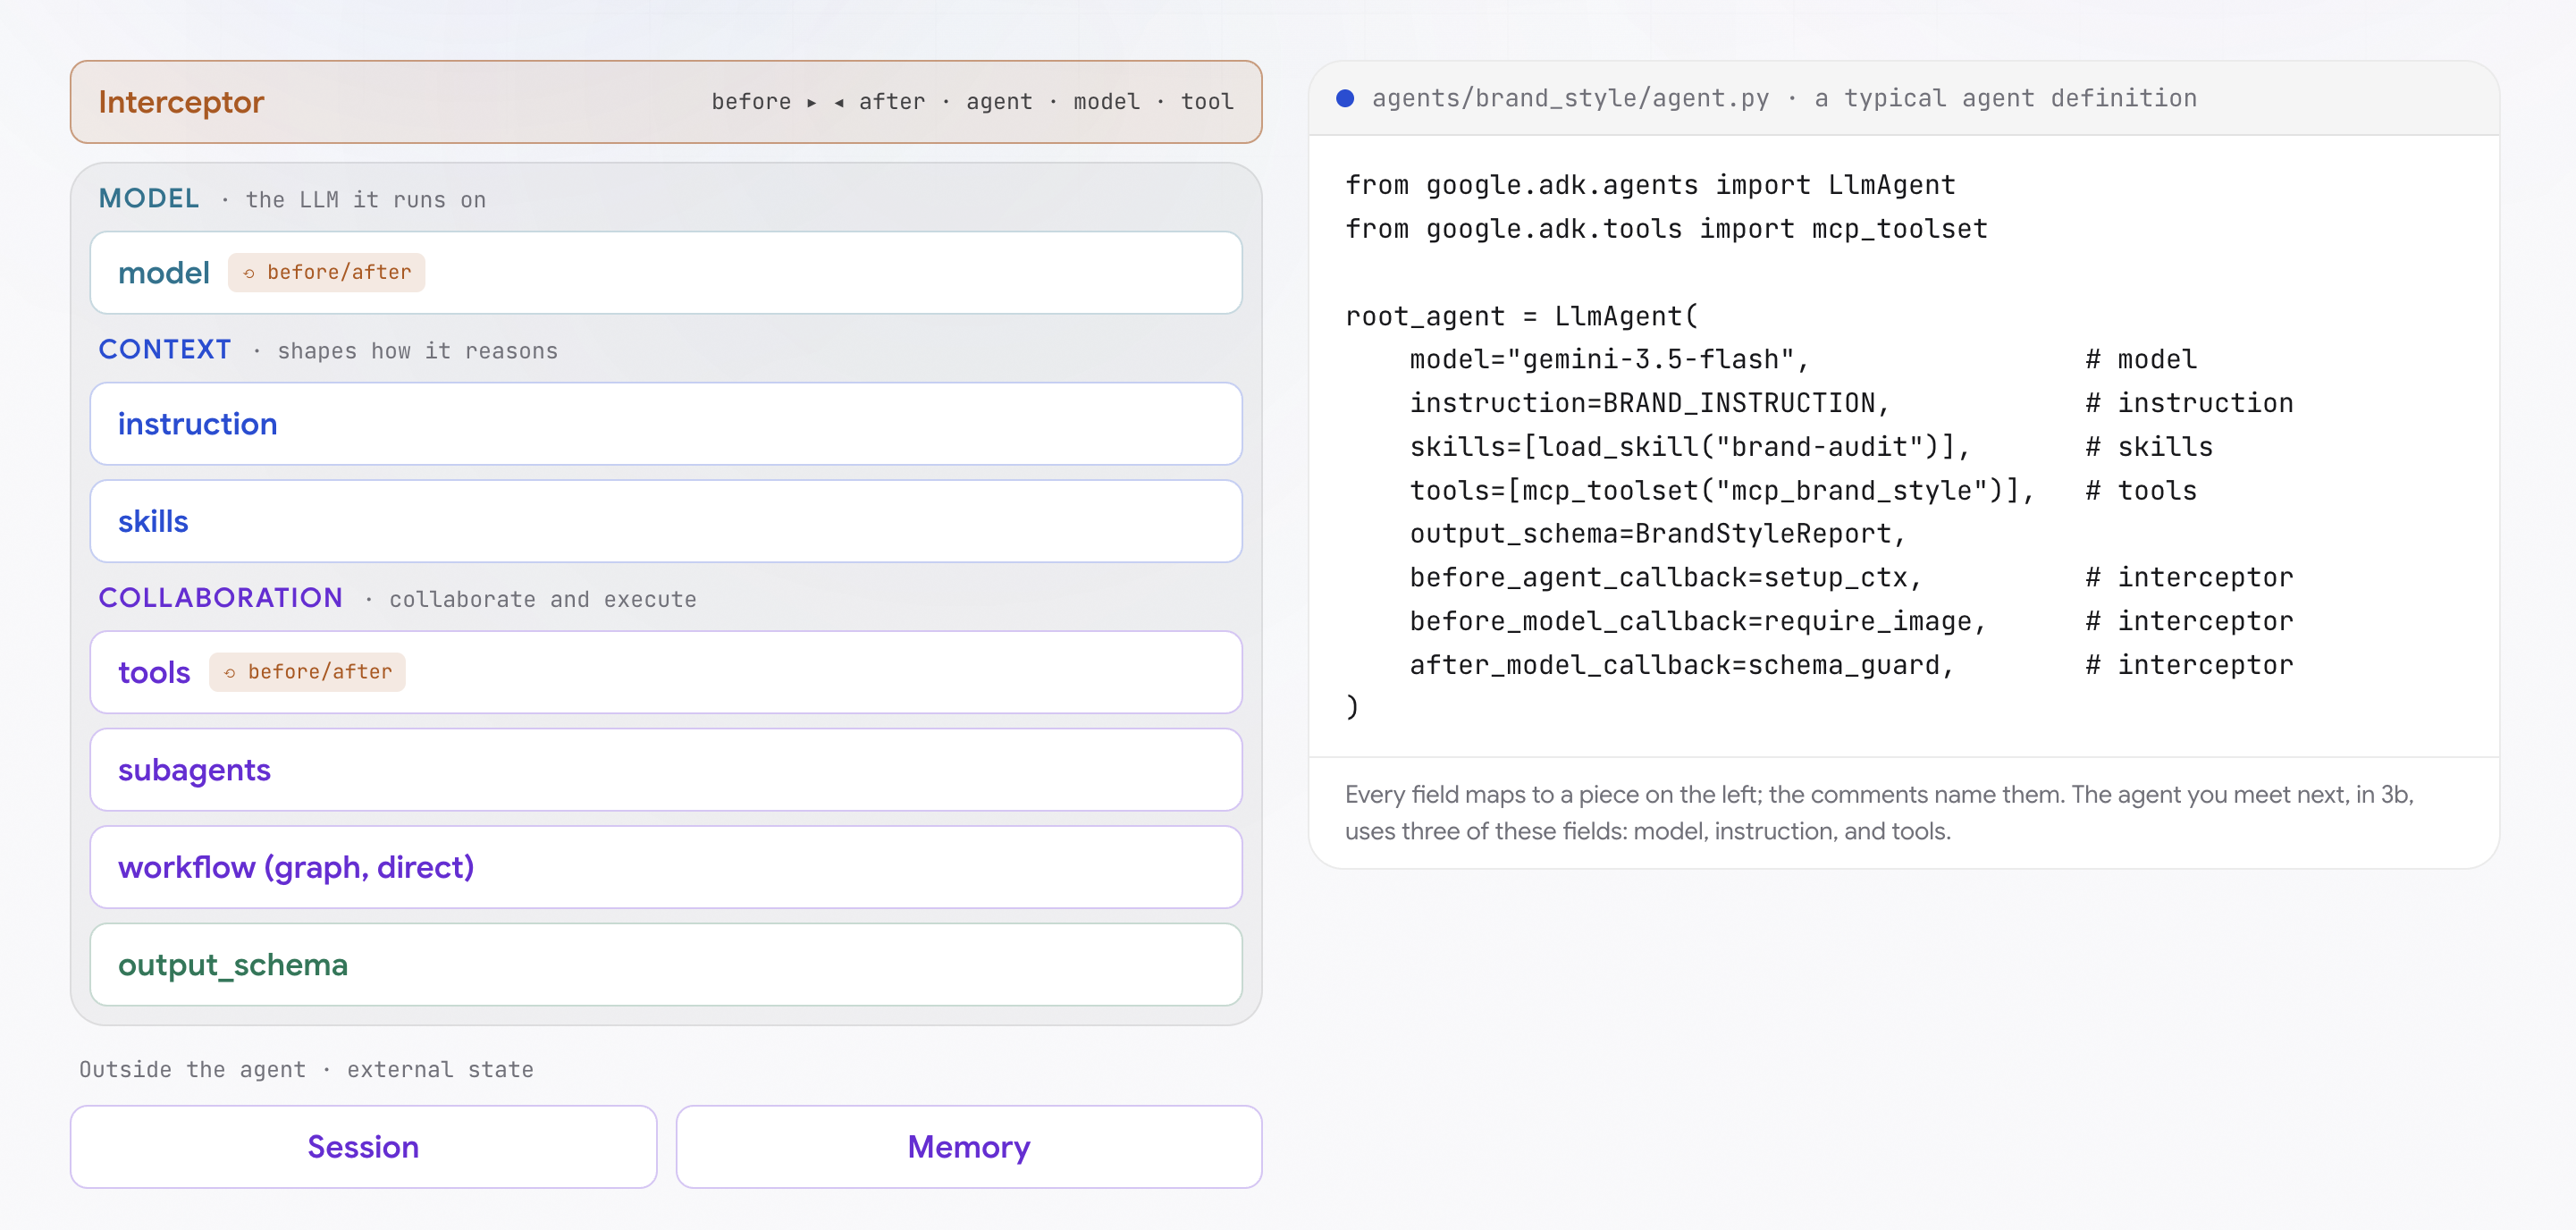
from google.adk.agents import LlmAgent
from google.adk.tools import mcp_toolset

root_agent = LlmAgent(
    model="gemini-3.5-flash",                 # model
    instruction=BRAND_INSTRUCTION,            # instruction
    skills=[load_skill("brand-audit")],       # skills
    tools=[mcp_toolset("mcp_brand_style")],   # tools
    output_schema=BrandStyleReport,           # structured output
    before_agent_callback=setup_ctx,          # interceptor
    before_model_callback=require_image,      # interceptor
    after_model_callback=schema_guard,        # interceptor
)
O diagrama interativo agrupa os componentes do agente em cinco domínios operacionais:
- Camada de raciocínio (modelo): o modelo de linguagem principal (como o Gemini 3 Flash) que executa processos cognitivos, raciocínio de comandos e seleção de ferramentas. Todo o restante da arquitetura informa ou restringe esse modelo.
- Camada de contexto (instrução e habilidades): diretrizes que moldam o raciocínio do modelo.
instructionestabelece o comando do sistema permanente, a persona e as regras operacionais.skillsfornecem orientações processuais com controle de versões (SKILL.md) para fluxos de trabalho repetíveis. - Camada de colaboração e ação (ferramentas, subagentes, fluxo de trabalho, esquema de saída): interfaces que permitem que o agente atue em sistemas externos e emita dados tipados.
toolsfornecem funções Python que podem ser chamadas ou endpoints do Protocolo de Contexto de Modelo (MCP).subagentsexecutar tarefas delegadas subordinadas.workflowcoordena gráficos multiagente.output_schemaaplica modelos Pydantic para garantir que os consumidores downstream recebam JSON validado em vez de texto não estruturado. - Camada de interceptação (callbacks de ciclo de vida): proteções determinísticas que executam código personalizado antes e depois da execução do agente (
before_agent/after_agent), turnos de modelo individuais (before_model/after_model) e chamadas de ferramentas (before_tool/after_tool). Os interceptadores aplicam regras de política sem depender da conformidade do modelo. - Estado externo (sessão e memória): persistência com estado separada da lógica do agente.
Sessionpreserva a memória de trabalho temporária e o rastreamento de eventos da linha de execução atual. OMemorymantém fatos e preferências duráveis entre sessões usando serviços gerenciados, como o Memory Bank do GEAP.
O agente monolítico nesta etapa implementa apenas três dessas primitivas: model, instruction e tools. As etapas subsequentes apresentam fluxos de trabalho de gráficos, esquemas estruturados, interceptadores e serviços de memória persistente.
Especificação de agente monolítico (3B)
No workbench, avance para Especificação de agente monolítico (3B). Abra stage0_prompt/agent.py para analisar a definição do agente de referência:
- Instrução de comando único: o comando do sistema condensa cinco tarefas de produção distintas em prosa contínua: descobrir tendências da plataforma, revisar ideias de backlog, propor conceitos criativos, aplicar políticas de assuntos proibidos e criar listas de planos de filmagem.
- Fontes de dados subjacentes: o agente faz referência a duas fontes definidas ao lado do gráfico:
agent/trends.py: seleciona 10 tendências de formato e estilo ativas de um grupo de 250 com pontuações de calor dinâmicas.agent/backlog.txt: lê as notas conceituais brutas do criador linha por linha.
Ferramentas no agente (3C)
No workbench, avance para Ferramentas no agente (3C).
O que é uma ferramenta para um agente?
Um modelo de linguagem é, por natureza, um mecanismo de raciocínio de mundo fechado: ele opera apenas com pesos pré-treinados e os tokens presentes na janela de contexto imediata. Ele não consegue consultar um banco de dados, acessar APIs em tempo real ou executar código de forma nativa.
Uma ferramenta preenche essa lacuna. Ele concede ao modelo uma agência externa, permitindo que ele recupere informações empíricas e execute ações determinísticas em sistemas externos.
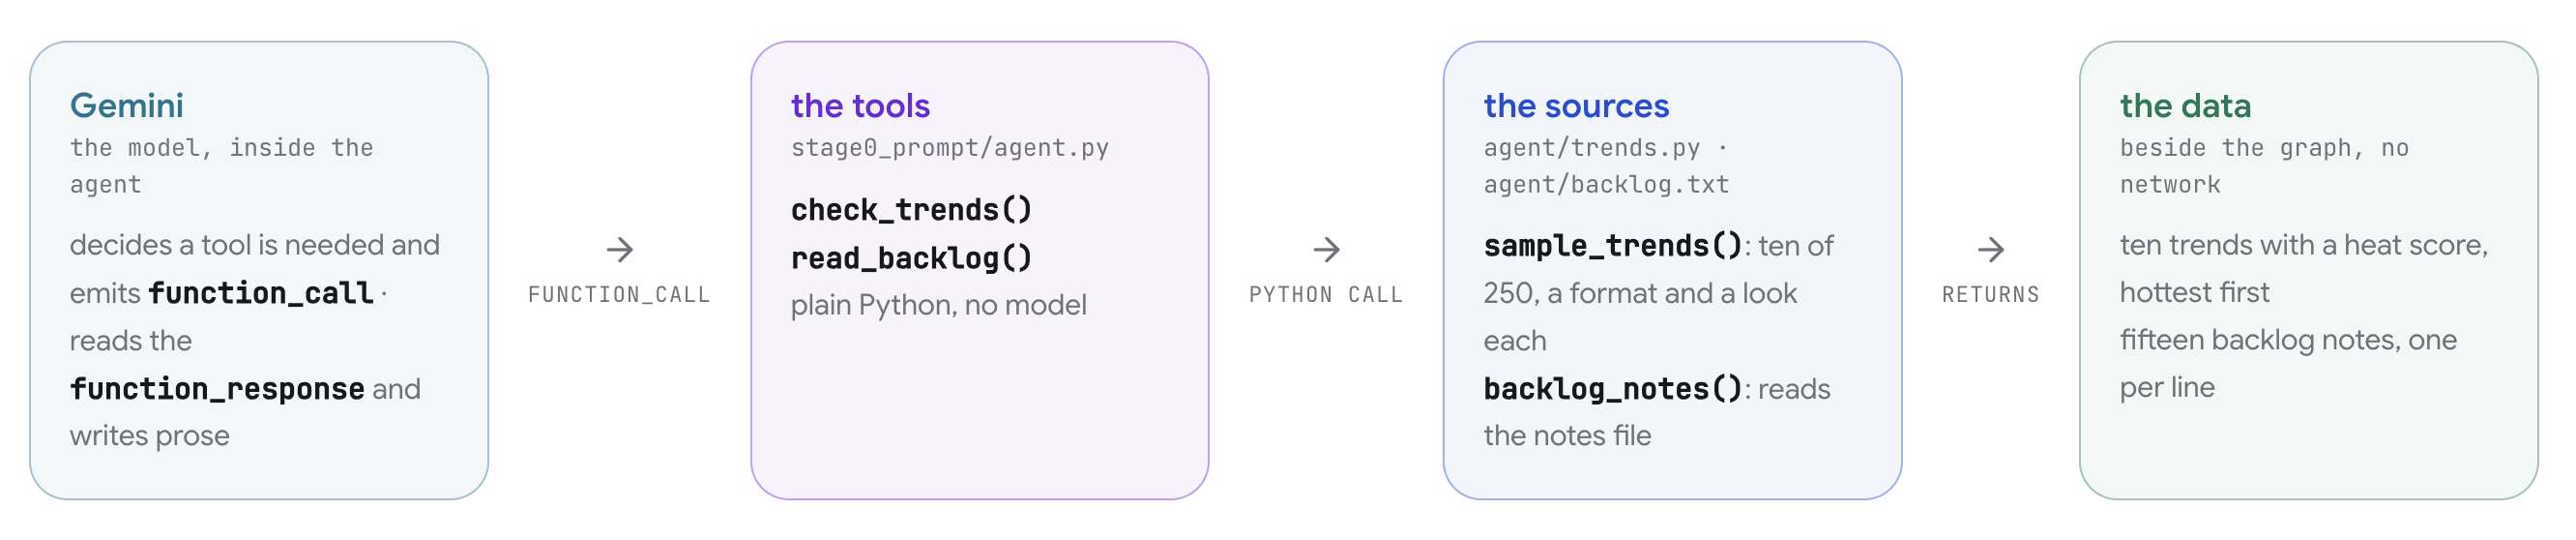
A chamada de ferramenta segue um protocolo explícito de cinco etapas entre o modelo e o ambiente de execução do ADK:
- Declaração de esquema: o desenvolvedor fornece funções Python ao agente. O ADK inspeciona o nome, as anotações de tipo e as docstrings de cada função para gerar uma declaração de esquema JSON compatível com a OpenAPI que descreve os parâmetros e a finalidade dela.
- Raciocínio do modelo: durante a inferência, o modelo avalia se o comando do usuário requer dados externos. Se necessário, o modelo emite um evento
function_callestruturado que contém o nome da função de destino e o dicionário de argumentos que corresponde ao esquema. - Execução no tempo de execução: o modelo não executa código. O ambiente de execução do ADK intercepta o
function_call, executa a função Python local real usando os argumentos fornecidos e captura o valor de retorno. - Reinserção de contexto: o ambiente de execução do ADK empacota o valor de retorno da função em um evento
function_responsee o anexa ao histórico da sessão ativa. - Síntese final: o modelo processa a saída da ferramenta que agora está presente na janela de contexto e conclui a resposta.
Em stage0_prompt/agent.py, as duas ferramentas de pesquisa são definidas como funções Python padrão:
def check_trends() -> dict:
    """Ten formats trending on the platform right now, with a heat score each."""
    from agent.trends import sample_trends
    return {"trends": sample_trends()}


def read_backlog() -> dict:
    """The creator's backlog: ideas they noted down to make someday."""
    from agent.graph import backlog_notes
    return {"backlog": backlog_notes()}
Edição e execução práticas
No editor de código do ambiente de trabalho, adicione as duas referências de função à lista tools do agente:
tools=[check_trends, read_backlog],
Salve a alteração. O arquivo é atualizado no disco, e a linha de verificação confirma que as duas ferramentas estão conectadas.
Clique em Abrir adk web para iniciar a interface de desenvolvimento do ADK incorporada. Envie o comando de sugestão de ideia:
tonight's idea: a tiny robot doing laundry at midnight
O que esperar e por quê
Ao enviar esse comando, observe a seguinte sequência de execução no rastreamento da sessão:
- Dois eventos de execução de ferramentas aparecem antes da resposta: você vê os eventos
function_callefunction_responseparacheck_trendseread_backlog.- Motivo: o Gemini avaliou a diretriz do comando do sistema ("verifique o que está em alta. analise seu backlog de ideias"), reconheceu que não tinha as tendências da plataforma e as notas do canal nos pesos e invocou as duas funções para embasar o contexto.
- O agente propõe uma direção e faz uma pausa para confirmação: a resposta sugere uma direção de vídeo sintetizando as tendências e o backlog e pede que você confirme.
- Por quê: a diretiva de instrução pediu ao modelo para concordar com a direção do criador de conteúdo antes de gerar o roteiro.
- Ignorar a confirmação em uma conversa seguinte: envie uma segunda mensagem:
skip the questions, just describe the video. O agente ignora imediatamente a confirmação e cria o título e as imagens.- Motivo: as instruções do comando são diretrizes de orientação, não barreiras determinísticas. Em um agente monolítico, as instruções do usuário podem substituir as regras de comandos do sistema porque nenhum fluxo de trabalho externo controla o fluxo de execução.
Limitações arquitetônicas de um comando monolítico
Embora um único comando possa produzir uma saída aceitável para demonstrações isoladas, testar condições de limite no verificador do ambiente de trabalho revela limitações empresariais críticas:
- Agregação de pesquisa não estruturada: a ordem de execução da ferramenta não é determinística. O modelo resume os dados recuperados em prosa de formato livre, o que impossibilita que os sistemas downstream identifiquem qual fonte produziu declarações específicas.
- Aplicação de políticas não verificadas: o modelo avalia a própria conformidade de segurança. Se o modelo determinar que um tópico é seguro, nenhuma lógica determinística externa vai validar essa descoberta.
- Pausas human-in-the-loop não aplicadas: as instruções de comando que solicitam a confirmação do criador de conteúdo são consultivas. Enviar uma mensagem de acompanhamento instruindo o modelo a ignorar perguntas faz com que ele pule a aprovação humana completamente.
Essas lacunas arquitetônicas motivam a decomposição do agente monolítico no fluxo de trabalho de gráfico explícito criado na próxima etapa.
4. Princípios básicos dos Agentic Workflows
No VibeStudio Workbench, acesse Etapa 4: fundamentos dos Agentic Workflows, partes 4A a 4D.
Esta etapa faz a transição de um modelo de referência de agente único para a orquestração determinística de gráficos usando o ADK Workflow. Você vai criar uma distribuição de dados de pesquisa paralela, sincronizar ramificações com um nó de mesclagem, gerar candidatos de criativos validados por esquema e introduzir um portão de aprovação determinístico human-in-the-loop.
Arquitetura de gráficos e cadeias de execução (4A)
No workbench, abra Arquitetura de gráfico e cadeias de execução (4A).
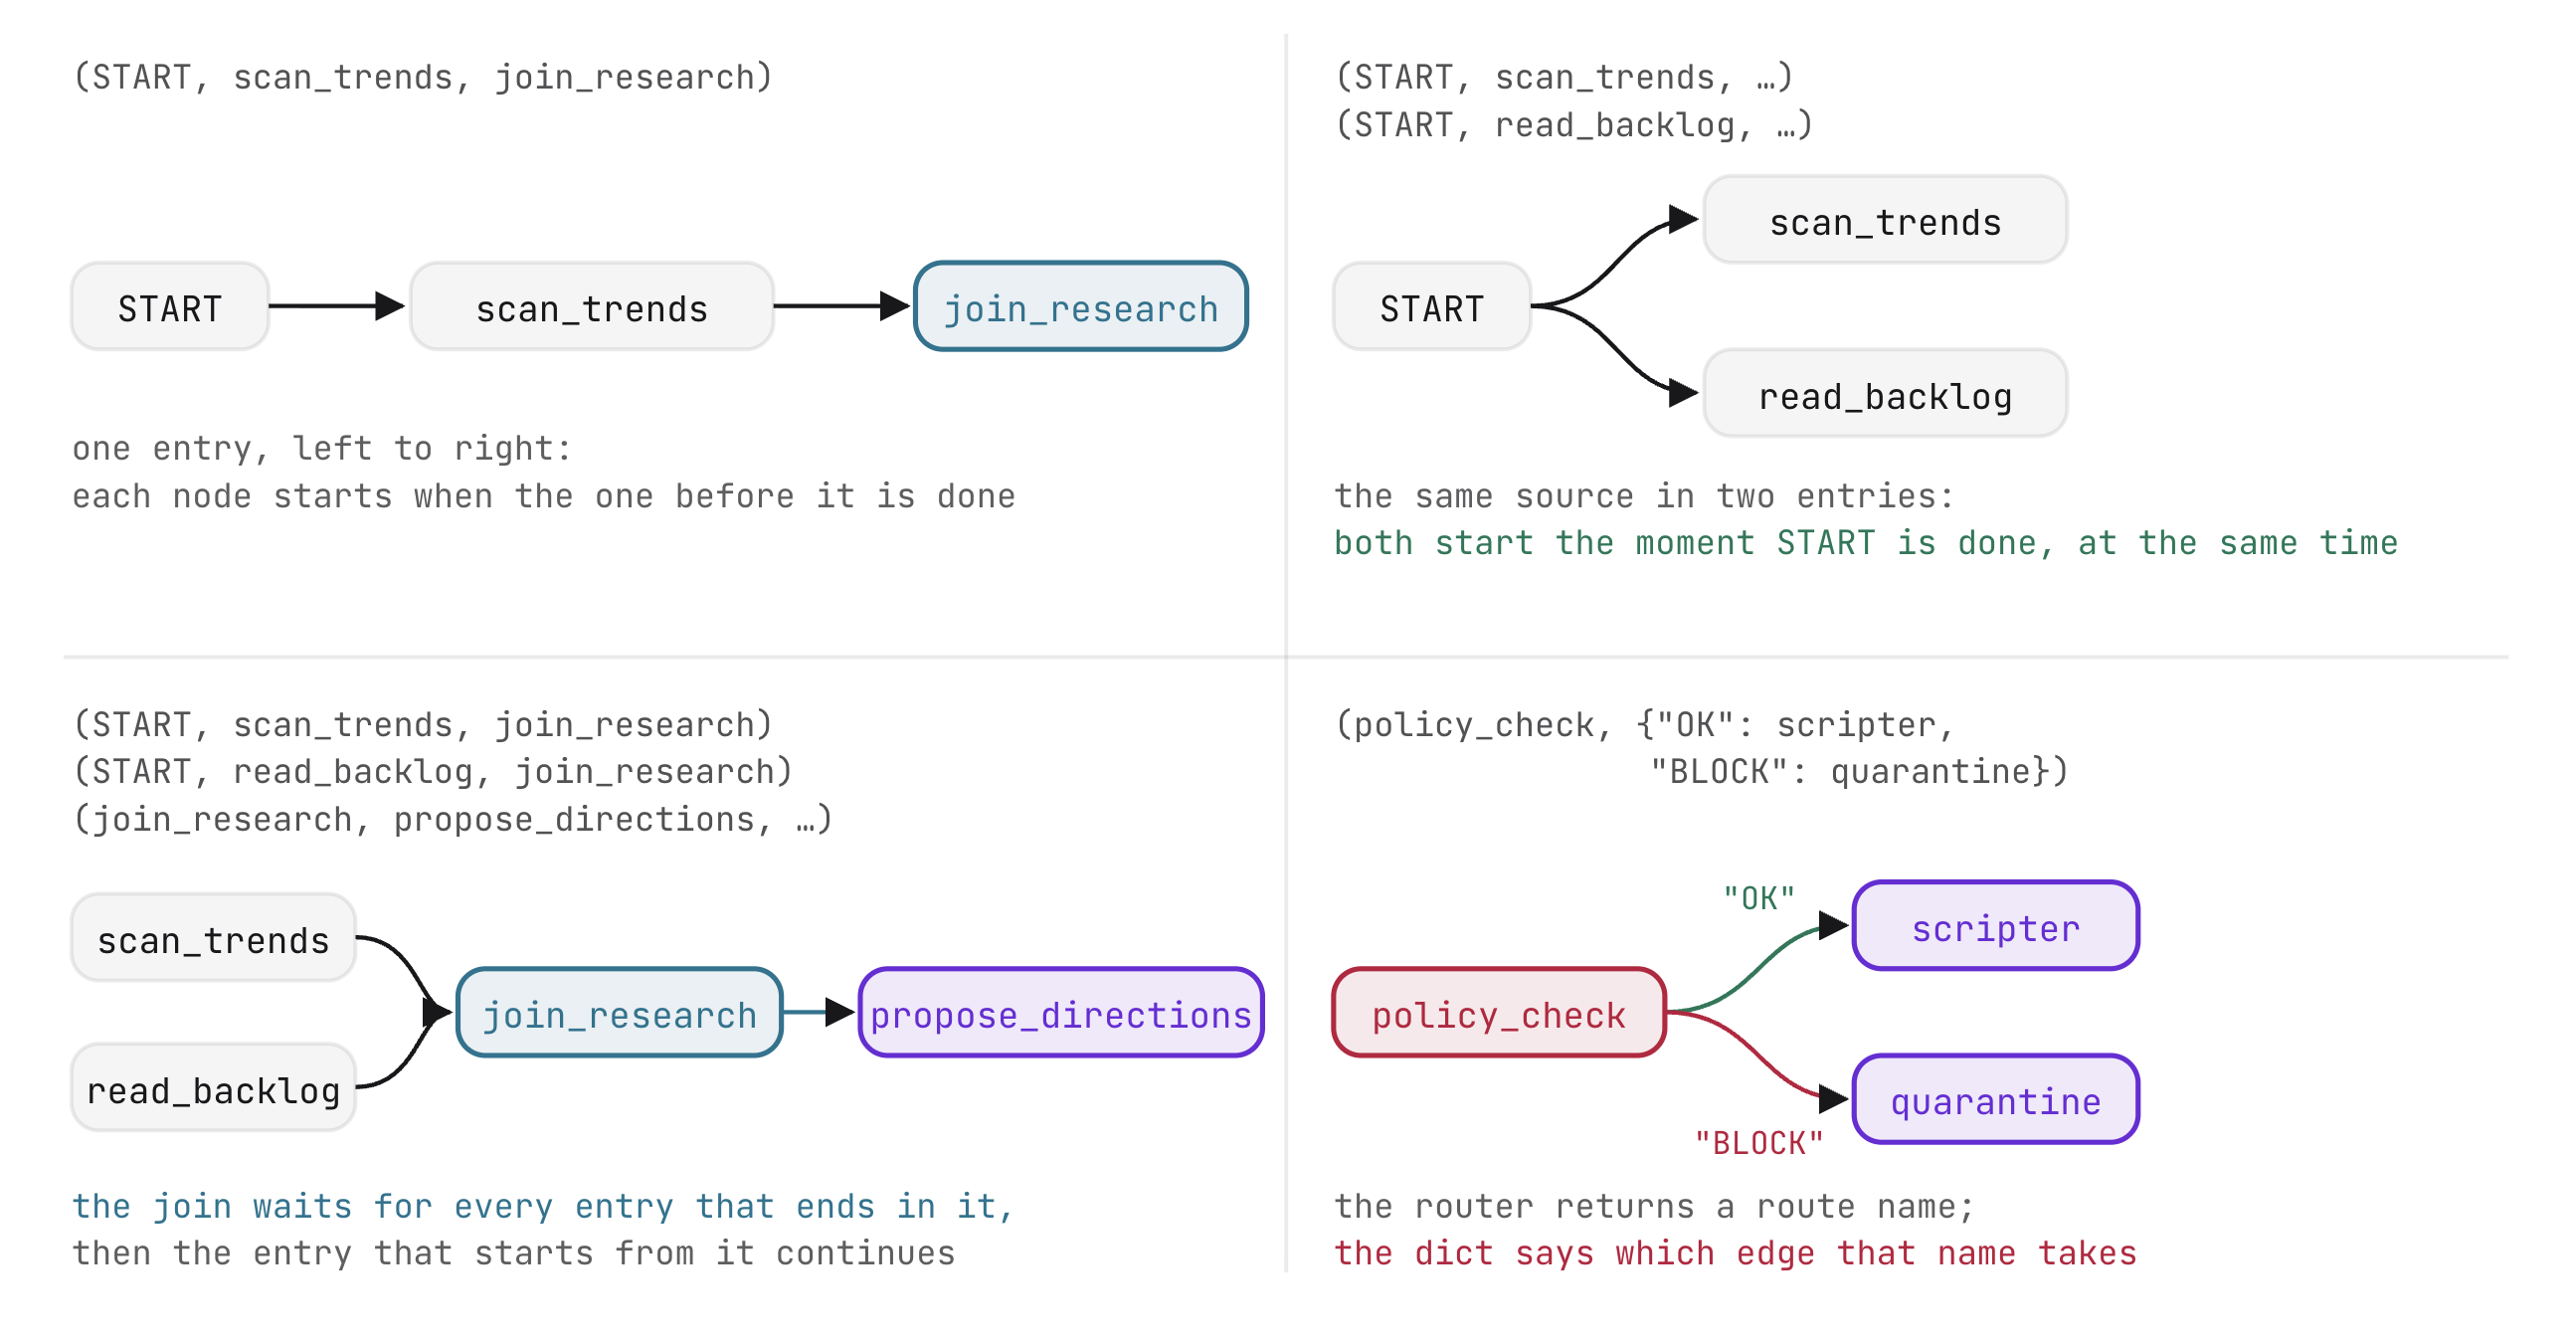
Um Workflow do ADK estrutura a execução do agente como um gráfico direcionado definido por uma lista de arestas:
- Cadeias: tuplas sequenciais definem a execução linear de nós (
(node_a, node_b, node_c)). - Ramificações paralelas: cadeias independentes que compartilham um nó de origem são executadas simultaneamente.
- Sincronização: as cadeias que convergem em um
JoinNodeaguardam até que todas as ramificações recebidas sejam informadas antes de serem liberadas. - Controle determinístico: o fluxo de execução é regido por estruturas de código declaradas, em vez de ser inferido do texto do comando.
Arquétipos de nós no ADK
Os fluxos de trabalho do ADK compõem vários tipos de nós especializados. Cada arquétipo desempenha um papel operacional específico no gráfico, separando a execução de código determinista do raciocínio do modelo generativo:
Arquétipo de nó | Implementação | Papel no pipeline |
Nó de função | Função Python que retorna um | Executa lógica determinística, recuperação de dados e mutações de estado. |
Nó de junção | Instância | Sincroniza ramificações simultâneas em um dicionário agregado. |
Nó do agente |
| Avalia instruções em relação à entrada upstream e emite dados validados. |
Nó do roteador | Função que retorna um | Avalia a lógica condicional para selecionar ramificações de execução downstream. |
Nó de entrada humana | Função que gera | Suspende o estado de execução até que uma resposta de usuário externo chegue. |
root_agent = Workflow(
    name="stage1_fanout",
    description="2 real readers -> join -> one research dict",
    edges=[...])
Nessa configuração, root_agent é uma instância de Workflow, em vez de um Agent independente. O ADK trata os fluxos de trabalho como agentes de primeira classe, permitindo que um gráfico inteiro seja carregado, veiculado e inspecionado como um aplicativo unificado. O name registra o aplicativo no ADK Web, enquanto a lista edges define a topologia de execução.
Distribuição de dados de pesquisa paralela (4B)
No workbench, avance para Parallel research fan-out (4B). Abra stage1_fanout/agent.py.
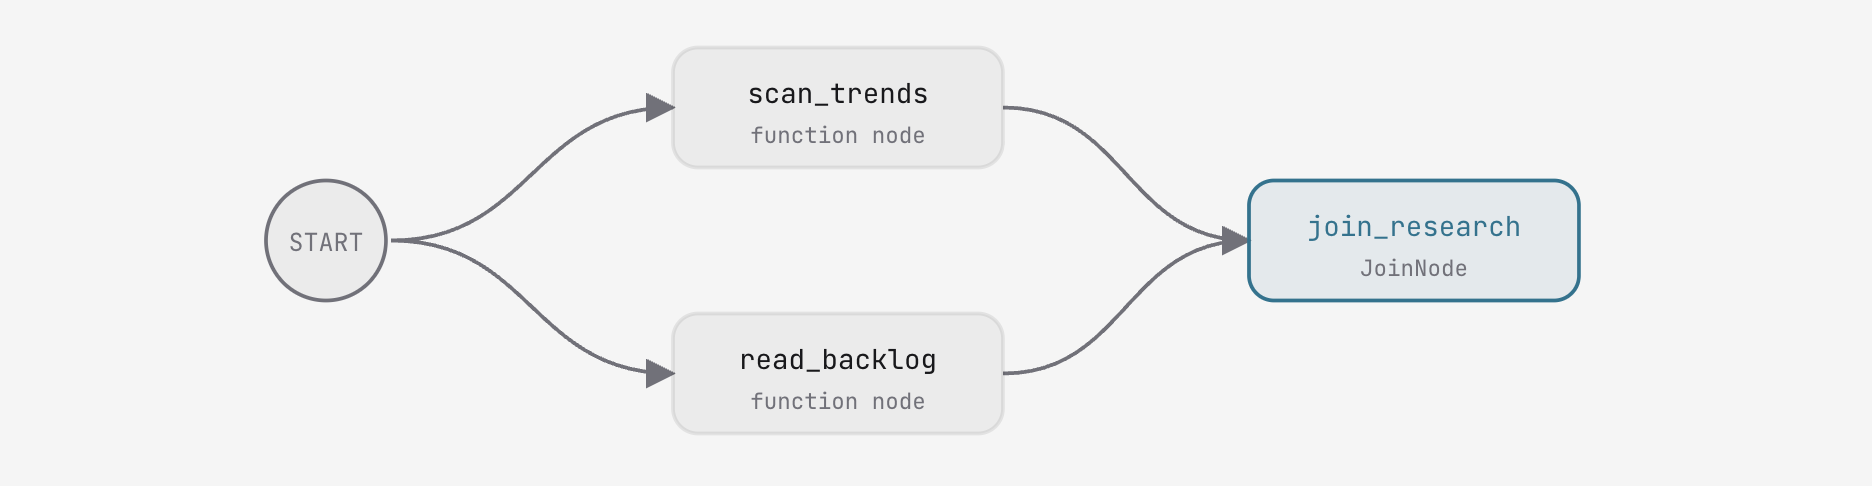
Nós de função e barreiras de sincronização
A fase de pesquisa usa dois nós de função importados de agent/graph.py:
scan_trends: retornaEvent(output={"trends": [...]})contendo dez tendências da plataforma com pontuação.read_backlog: retornaEvent(output={"backlog": [...], "idea": "..."})com 15 ideias de backlog de canais e o comando de execução inicial.
Cada função aceita node_input (a saída do nó anterior) e retorna um Event.
Um JoinNode serve como uma barreira de sincronização: ele pausa até que cada cadeia de entrada entregue um evento e, em seguida, agrega todos os resultados da ramificação em um dicionário com chave pelo nome do nó ({"scan_trends": {...}, "read_backlog": {...}}).
Edição prática: como definir as bordas de mesclagem e paralelas
Em stage1_fanout/agent.py, instancie o JoinNode e conecte as duas cadeias paralelas começando em START:
join_research = JoinNode(name="join_research")
    edges=[(START, scan_trends, join_research),
           (START, read_backlog, join_research)])
Salve as alterações. O verificador do workbench confirma que a junção e as bordas estão conectadas. Execute a etapa usando Executar etapa 1 ou pela interface da Web do ADK incorporada.
O que esperar e por quê
- Execução simultânea de leitores: no gráfico de execução,
scan_trendseread_backlogsão executados simultaneamente.- Motivo: as duas cadeias se originam em
START. O mecanismo do ADK programa ramificações independentes simultaneamente.
- Motivo: as duas cadeias se originam em
- Saída de dicionário agregada: o fluxo de trabalho é concluído em
join_research, gerando um dicionário com entradas para os dois leitores.- Motivo: o
JoinNodegarante a captura completa de dados antes de permitir que os nós subsequentes sejam executados.
- Motivo: o
Nós de agente (4C)
No ambiente de trabalho, avance para Nós de agente (4C). Abra stage2_direction/agent.py.
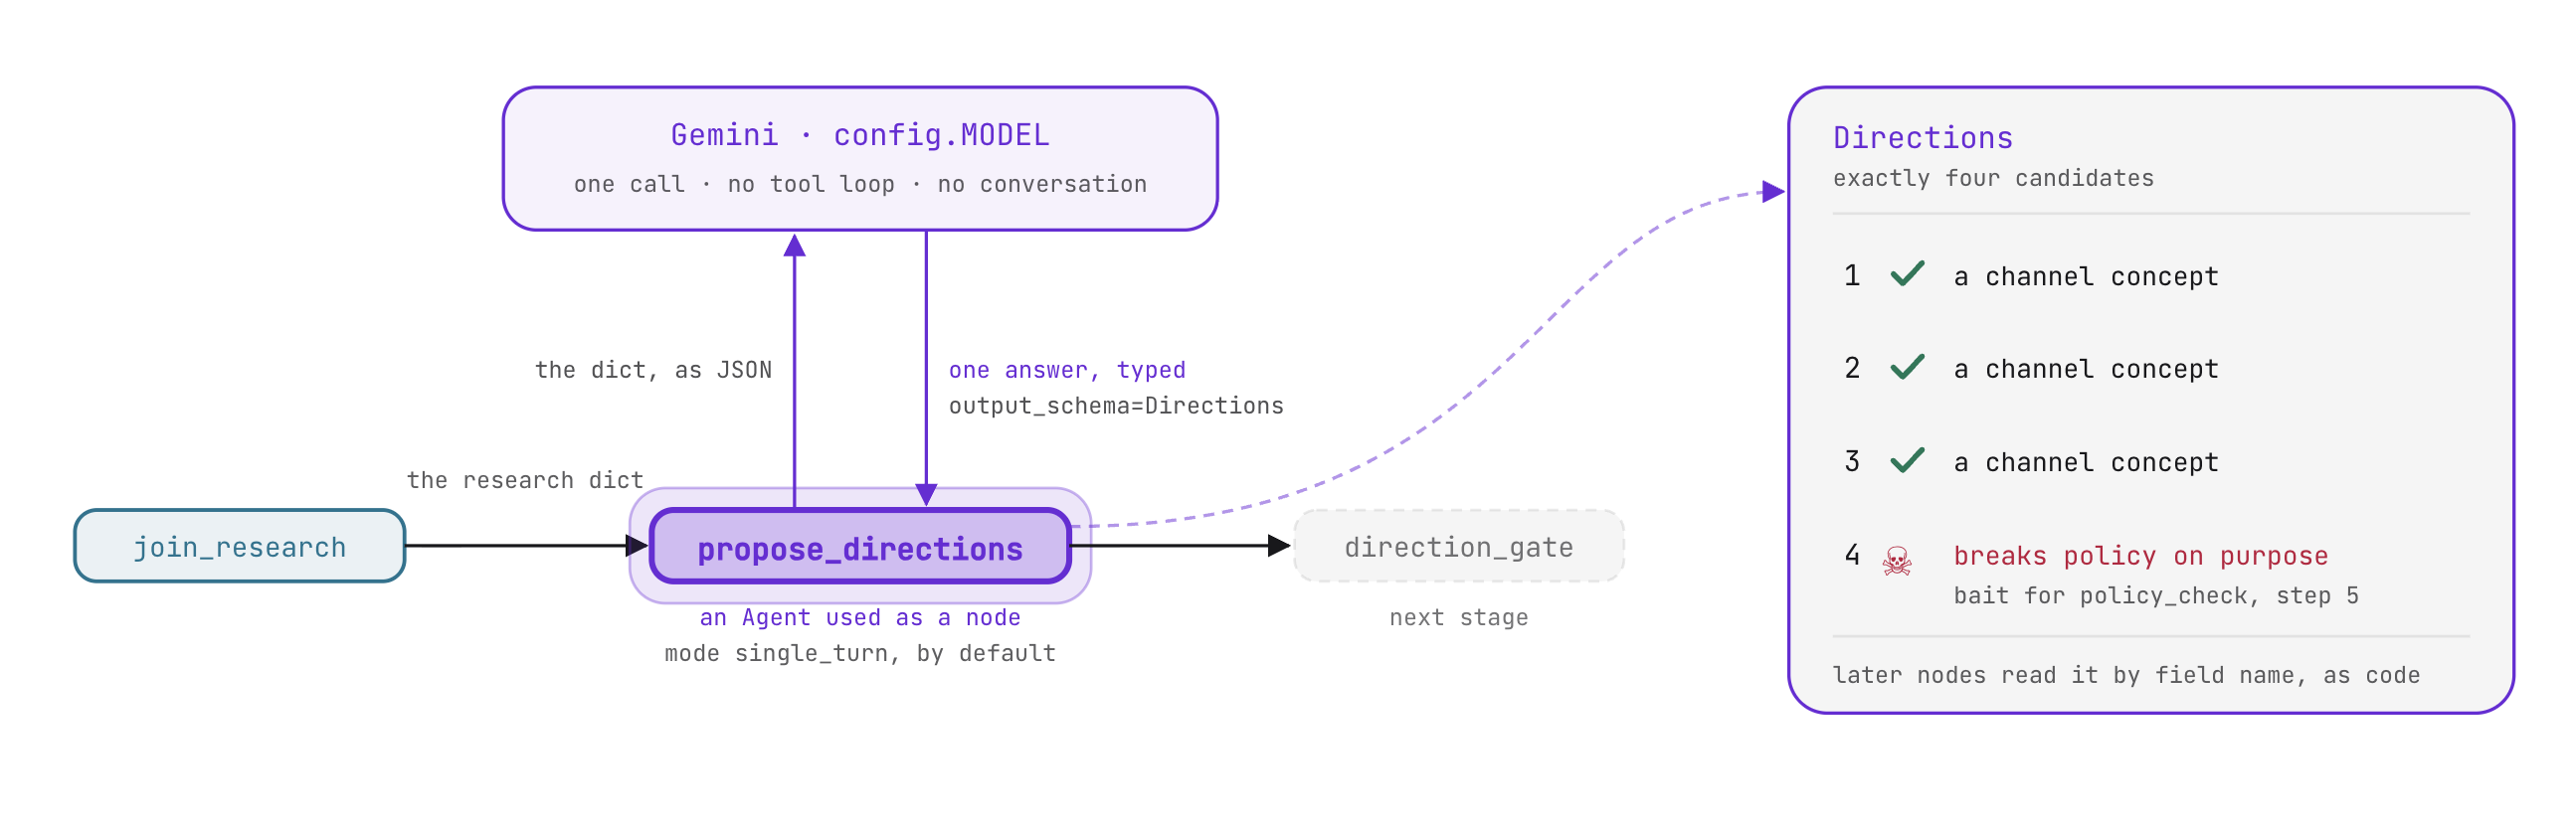
Modos de operação e esquemas estruturados
Quando incorporado a um Workflow, um Agent é executado no modo single_turn por padrão:
- Ele recebe a saída do nó anterior como entrada de contexto.
- Ele executa uma única chamada de inferência sem conversa.
- Ele gera dados estruturados para o próximo nó.
Ao atribuir output_schema=Directions, o agente aplica a validação do Pydantic à saída do modelo. O gráfico downstream recebe objetos tipados em vez de prosa não estruturada:
class Direction(BaseModel):
    title: str           # <=60 chars, filmable, characterful
    angle: str           # the twist, one line
    hook: str = ""       # 2-4 words, the video's sticker line
    evidence: list[Evidence]


class Directions(BaseModel):
    candidates: list[Direction]   # exactly 4
PROPOSE_INSTRUCTION orienta o modelo a propor quatro candidatos citando evidências das tendências e do backlog. Os candidatos de 1 a 3 oferecem conceitos de canal viáveis. O candidato 4 introduz intencionalmente um conceito que viola a política para testar o portão de segurança na próxima etapa.
Edição prática: definir o nó do agente e encadear a mesclagem
Em stage2_direction/agent.py, configure propose_directions e estenda as bordas do fluxo de trabalho:
propose_directions = Agent(
    name="propose_directions",
    model=config.MODEL,
    instruction=PROPOSE_INSTRUCTION,
    output_schema=Directions)
    edges=[(START, scan_trends, join_research),
           (START, read_backlog, join_research),
           (join_research, propose_directions, direction_gate)])
O que esperar e por quê
- Consumo direto de dicionário: o
propose_directionsconsome o payload JSON emitido pelojoin_researchsem formatação manual. - Saída de candidato tipada: o agente emite um objeto
Directionsvalidado que contém quatro candidatos discretos. Os nós downstream leem campos por nome de atributo (candidate.title) sem análise de string.
Human-in-the-loop (4D)
No workbench, avance para Human-in-the-loop (4D). Abra agent/graph.py.
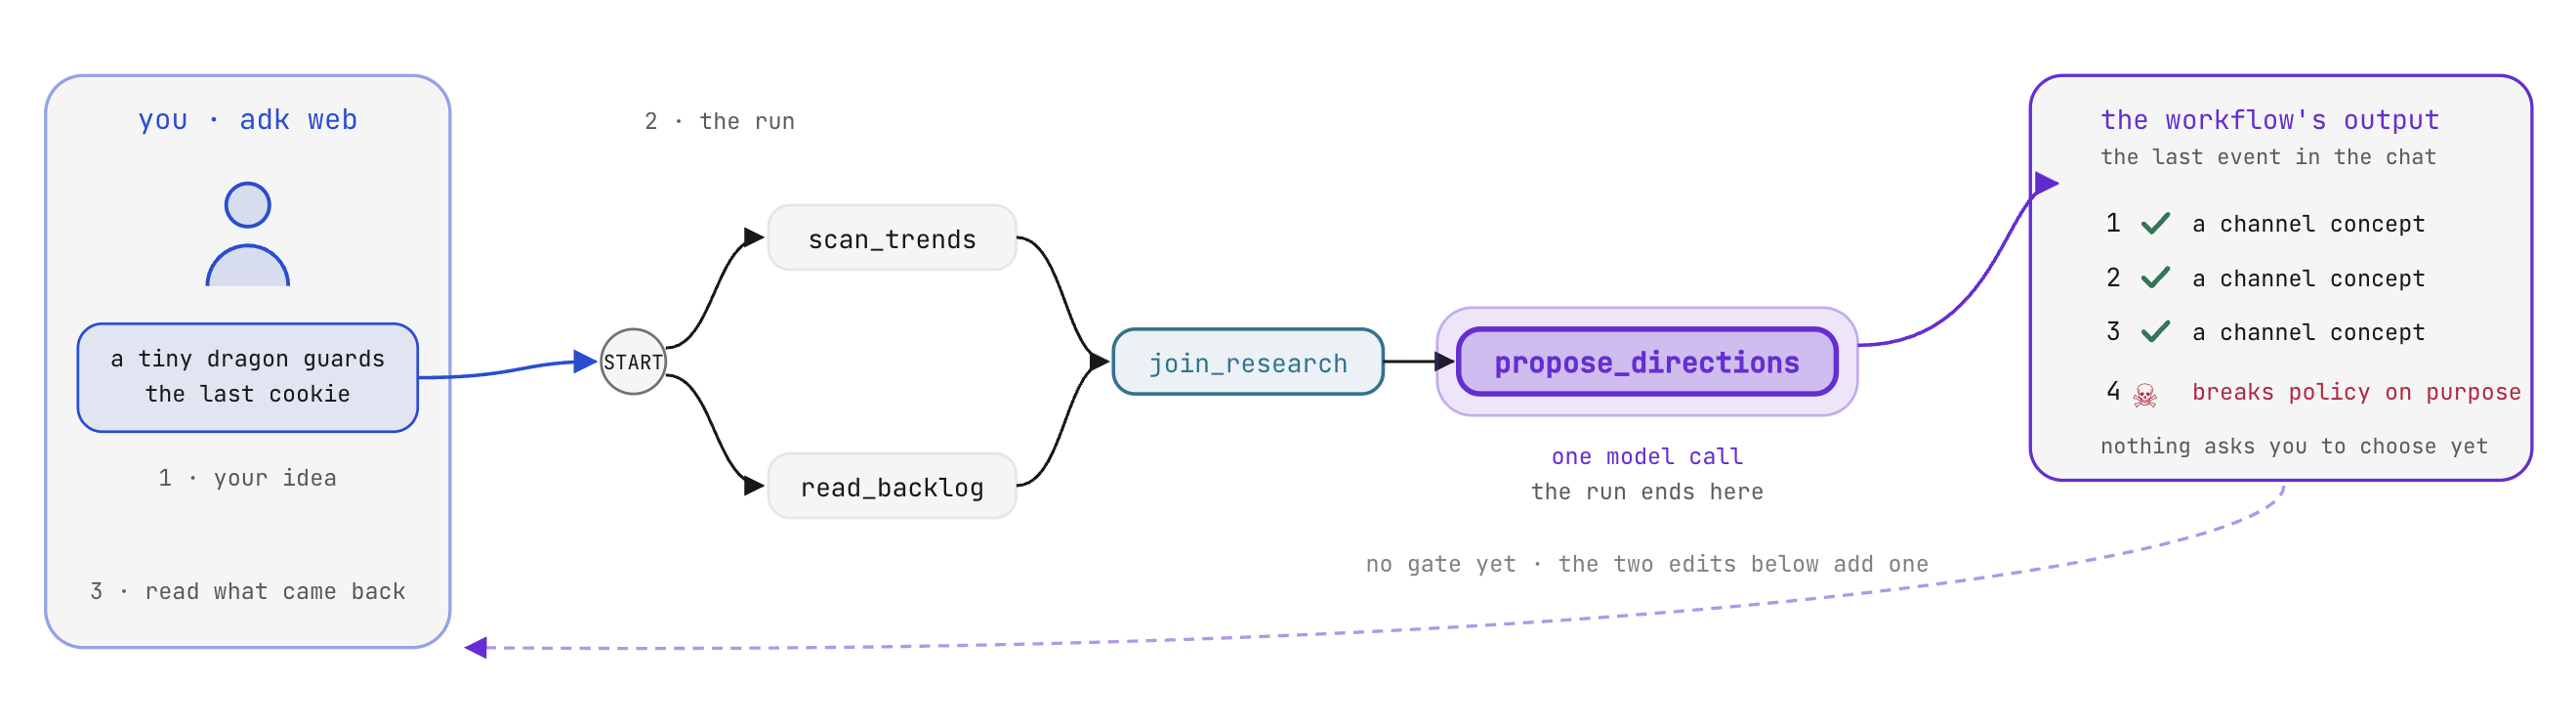
Instruções de comando x suspensão determinística
Os fluxos de trabalho de produção que geram custos financeiros ou publicam conteúdo exigem supervisão humana em pontos de decisão críticos. Em um único comando, as solicitações de confirmação são instruções de aviso que um usuário pode facilmente pedir ao modelo para ignorar. Em um fluxo de trabalho do ADK, a aprovação humana é imposta pelo mecanismo de execução: o gráfico para em um nó designado e não pode avançar até receber entrada externa validada pelo esquema:
- A geração de
RequestInputsuspende a execução do fluxo de trabalho imediatamente. - O ADK registra uma chamada de interrupção aberta no armazenamento da sessão e emite um
interrupt_idexclusivo. - O processo de execução é interrompido sem consumir tokens ou linhas de execução do servidor.
- A execução de grafo só é retomada quando um
function_responseválido que corresponde ao esquema e ao ID de interrupção é enviado.
Edição prática: suspender a execução com RequestInput
Em agent/graph.py, implemente a chamada de suspensão dentro de direction_gate:
    yield RequestInput(
        message="Pick tonight's direction: 1, 2, 3 or 4.",
        response_schema={
            "type": "object",
            "properties": {
                "pick": {"type": "string", "enum": ["1", "2", "3", "4"]}}},
        payload={"candidates": cands})
RequestInput configura três atributos:
message: o pedido de avaliação apresentado ao usuário.response_schema: um esquema JSON que o front-end renderiza como um formulário de entrada, validado pelo ADK no envio.payload: metadados agrupados com a solicitação (os quatro candidatos), permitindo que as interfaces do cliente renderizem cards de revisão sem consultar o estado da sessão.
O que esperar e por quê
- O fluxo de trabalho é interrompido em direction_gate: na Web do ADK ou na interface do workbench, a execução é pausada e um formulário interativo de seleção de candidatos é exibido.
- Motivo: o mecanismo encontrou um
RequestInputgerado e persistiu o estado de execução emruns/sessions.db.
- Motivo: o mecanismo encontrou um
- A retomada requer entrada estruturada: o envio de texto de chat arbitrário não avança o gráfico. Selecionar uma opção (1, 2, 3 ou 4) envia um
function_responsedigitado que satisfazresponse_schemae retoma a execução.
5. Estado e roteador
No VibeStudio Workbench, navegue até Etapa 5 · Estado e roteador, partes (5A) a (5C).
Você vai persistir as seleções do usuário no estado da sessão, aplicar políticas de segurança do canal usando nós de roteador determinísticos e montar um agente de tarefas iterativo para corrigir automaticamente as violações da política antes de gerar scripts de vídeo.
Estado do fluxo de trabalho (5A)
No workbench, acesse Estado do fluxo de trabalho (5A).
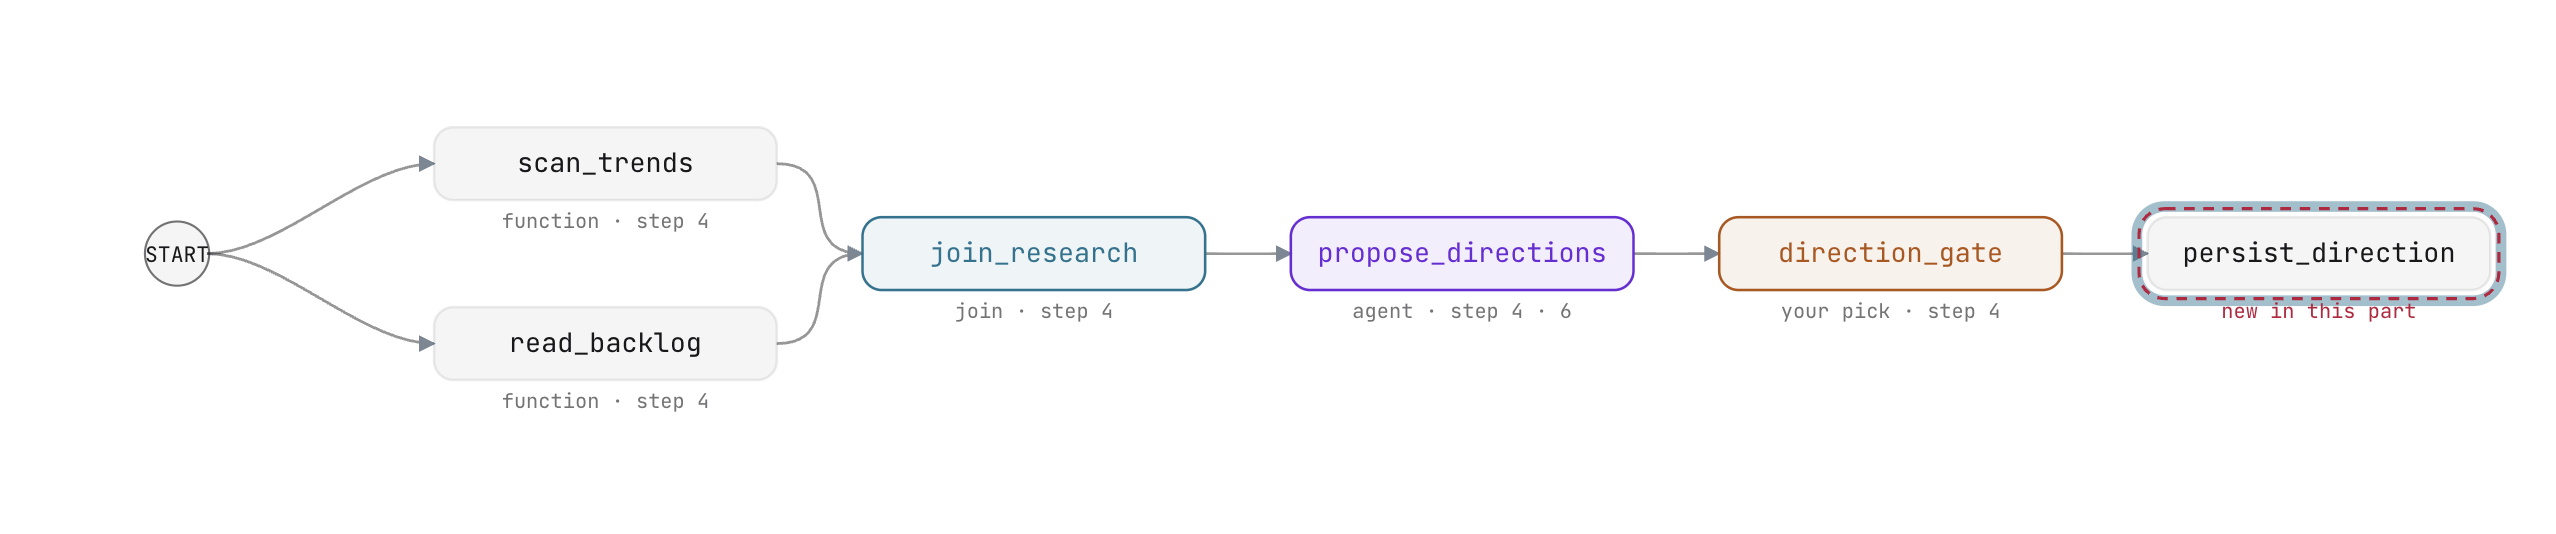
Estado da sessão x saída do nó
Em um fluxo de trabalho do ADK, os dados se movem pelo gráfico por dois mecanismos distintos:
- Saída do nó (
Event(output=...)): dados direcionados estritamente aos consumidores downstream imediatos definidos na lista de bordas. - Estado da sessão (
Event(state=...)): um dicionário de chave-valor compartilhado acessível por qualquer nó subsequente no ciclo de vida de execução.
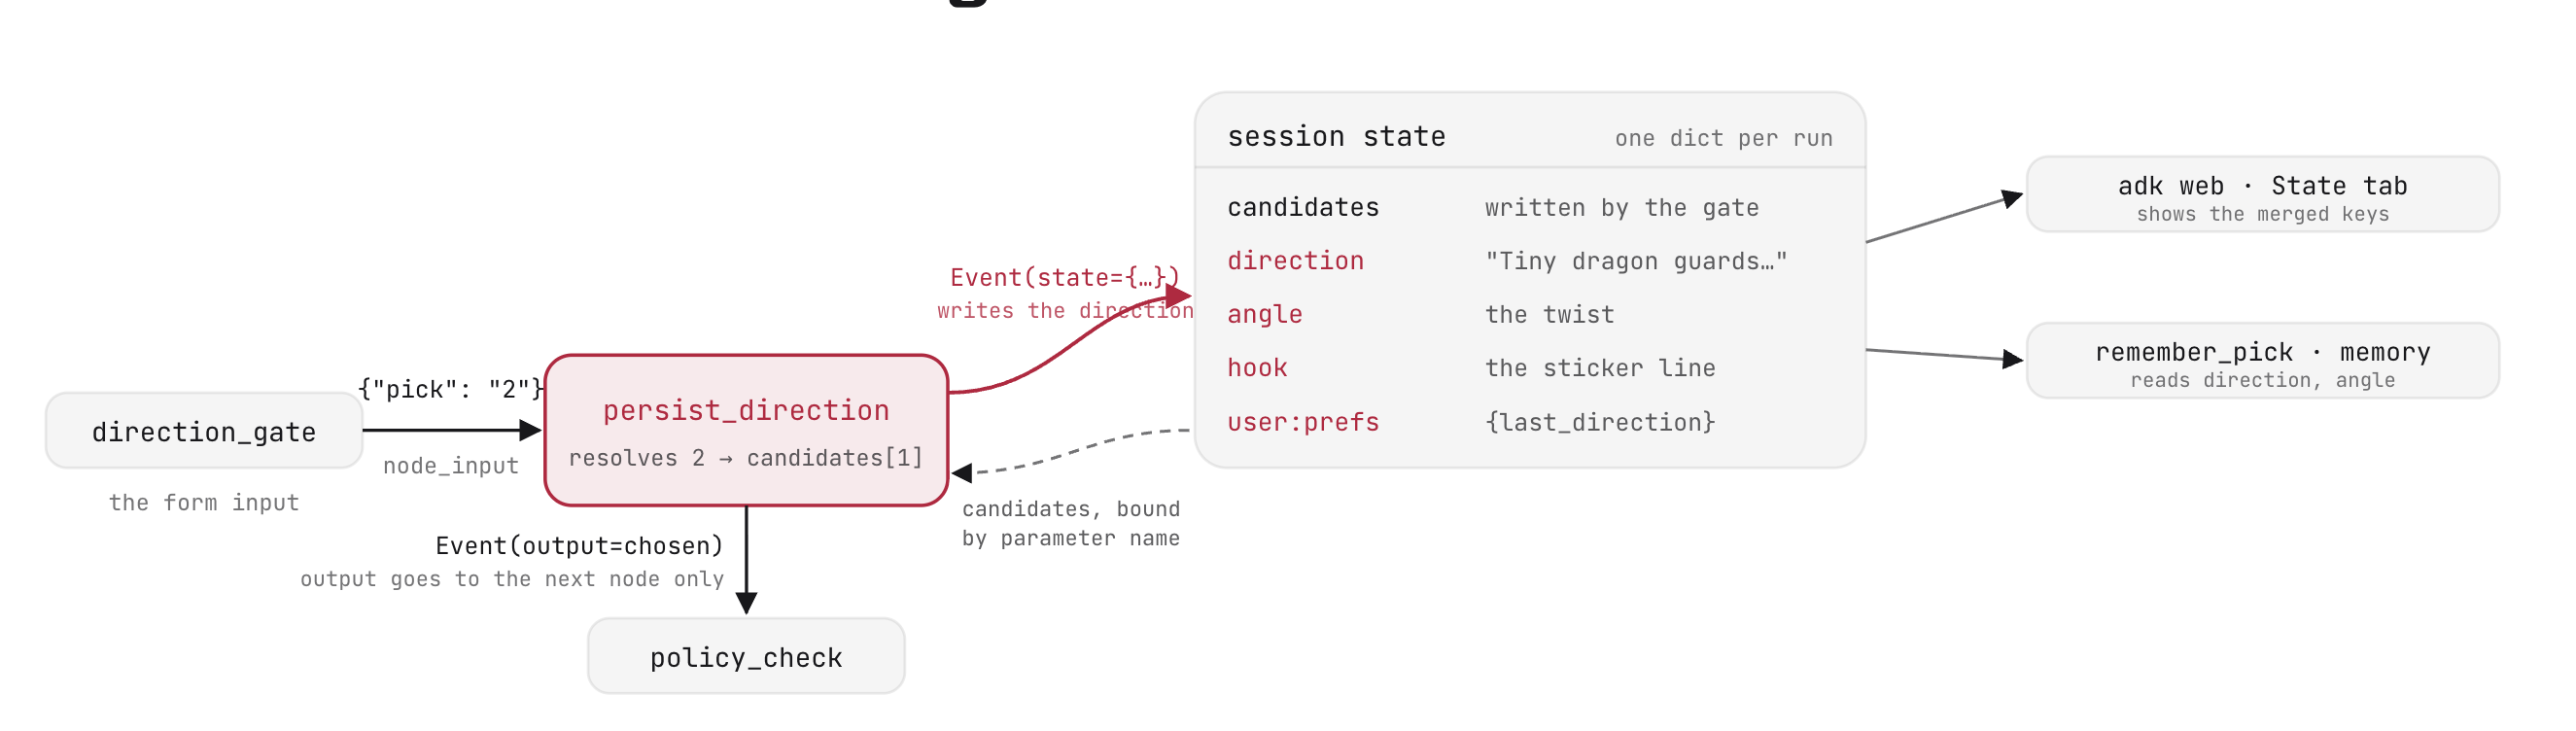
Quando um usuário seleciona um candidato em direction_gate, a seleção chega como um índice numérico ({"pick": "2"}). Os nós downstream precisam do objeto de direção completo: título, ângulo narrativo e frase de efeito. Em vez de transmitir metadados detalhados em cada payload de nó intermediário, o persist_direction grava o candidato resolvido no estado de sessão compartilhado.
Os nós não precisam transmitir todo o dicionário de estado da sessão. Quando um nó gera Event(state=...), ele fornece apenas os pares de chave-valor novos ou atualizados. O ADK mescla automaticamente essas atualizações no armazenamento da sessão:
    yield Event(state={"direction": chosen["title"], "angle": chosen.get("angle", ""),
                       "hook": hook, "user:prefs": {"last_direction": chosen["title"]}})
Ao gerar esse Event, o controle é transferido para o ambiente de execução do Workflow, que persiste os novos valores no diário da sessão em runs/sessions.db.
Vinculação de parâmetros
Os nós de função do ADK leem o estado da sessão automaticamente pela inspeção de parâmetros. Se uma assinatura de função declarar um nome de parâmetro que corresponda a uma chave de estado existente, o ADK vai extrair essa chave do estado e transmiti-la diretamente:
def persist_direction(node_input, candidates: list = []):
    ni = node_input if isinstance(node_input, dict) else {}
    raw = ni.get("pick")
    pick = str(raw).strip() if raw is not None else ""
    if candidates:
        i = int(pick) - 1 if pick.isdigit() else 0
        chosen = candidates[max(0, min(len(candidates) - 1, i))]
    else:
        chosen = {"title": "untitled", "angle": "", "evidence": []}
    hook = chosen.get("hook") or " ".join(chosen["title"].split()[:4])
Aqui, candidates foi gravado no estado da sessão por direction_gate. O ADK o vincula diretamente ao persist_direction(node_input, candidates: list = []) sem exigir pesquisas explícitas de dicionário.
As chaves com o prefixo user: persistem entre as sessões no armazenamento no nível do usuário, permitindo que as execuções subsequentes do fluxo de trabalho acessem as preferências do criador.
Edição prática: persistir o estado e conectar o nó
- Em
agent/graph.py, dentro depersist_direction, substitua a linhaTODO: PERSIST_STATEpelo yield do evento de estado:
    yield Event(state={"direction": chosen["title"], "angle": chosen.get("angle", ""),
                       "hook": hook, "user:prefs": {"last_direction": chosen["title"]}})
- Em
stage3_router/agent.py, anexepersist_directionà terceira cadeia na listaedges:
           (join_research, propose_directions, direction_gate,
            persist_direction)
Salve seus arquivos. No workbench, verifique se state write in place e persist_direction in the chain mostram marcas de seleção verdes.
O nó do roteador (5B)
No workbench, navegue até O nó do roteador (5B).
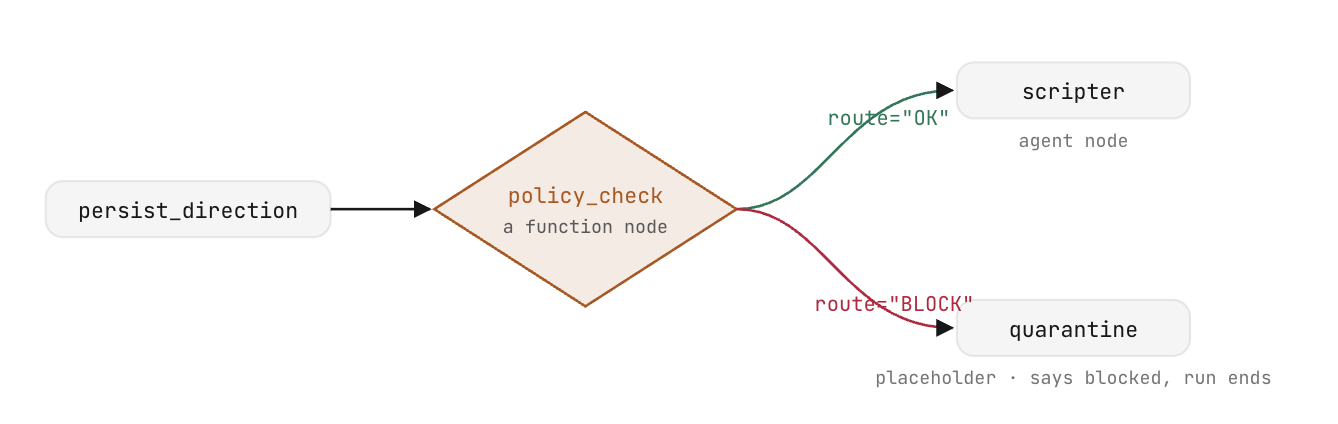
Roteamento de política determinista
Um roteador é um nó de função especializado que avalia a saída upstream e direciona a execução ao longo de ramificações condicionais do gráfico. Ao contrário dos agentes generativos, um roteador executa uma lógica determinista sem fazer chamadas de LLM.
Um roteador retorna um Event especificando uma tag route:
def length_check(node_input):
    too_long = len(node_input.get("title", "")) > 60
    return Event(output=node_input, route="TRIM" if too_long else "PASS")
Na definição do fluxo de trabalho, um destino de borda definido como um dicionário mapeia nomes de rotas para nós de destino:
(length_check, {"TRIM": shorten, "PASS": scripter}),
O roteador de fluxo de trabalho policy_check lê frases proibidas de agent/policy_words.txt e realiza a correspondência de palavras inteiras com o título e o ângulo da direção escolhida:
return Event(output=node_input, route="BLOCK" if bad else "OK")
Armazenar a política como dados em vez de instruções codificadas permite atualizações sem modificar o gráfico de fluxo de trabalho: a atualização do arquivo de texto é aplicada imediatamente às execuções subsequentes. Como a avaliação é uma correspondência de regex determinística, ela é executada em milissegundos com custo zero de token antes do início do script generativo.
Destinos: Scripter e Quarentena
O roteador direciona o tráfego para um dos dois nós downstream:
scripter: um nó de agentesingle_turnque converte a direção aprovada em um script de produção estruturado que segue o esquema PydanticScript:
scripter = Agent(
    name="scripter",
    model=config.MODEL,
    instruction=SCRIPT_INSTRUCTION,
    output_schema=Script)
quarantine: inicialmente, uma função de marcador de posição que interrompe as instruções sinalizadas, substituída na próxima parte por um agente de correção autônomo.
Edição prática: roteamento da verificação de política
- Em
agent/graph.py, dentro depolicy_check, conclua a instrução de retorno:
return Event(output=node_input, route="BLOCK" if bad else "OK")
- Em
stage3_router/agent.py, atualizeedgespara rotearpolicy_checke junte novamente a ramificação de quarentena emscripter:
           (join_research, propose_directions, direction_gate,
            persist_direction, policy_check),
           (policy_check, {"OK": scripter, "BLOCK": quarantine}),
           (quarantine, scripter)])
Salve seus arquivos. No workbench, verifique se os mapeamentos de borda do roteador estão verificados.
Modos de agente e o nó de tarefa (5C)
No workbench, acesse Modos de agente e o nó de tarefa (5C).
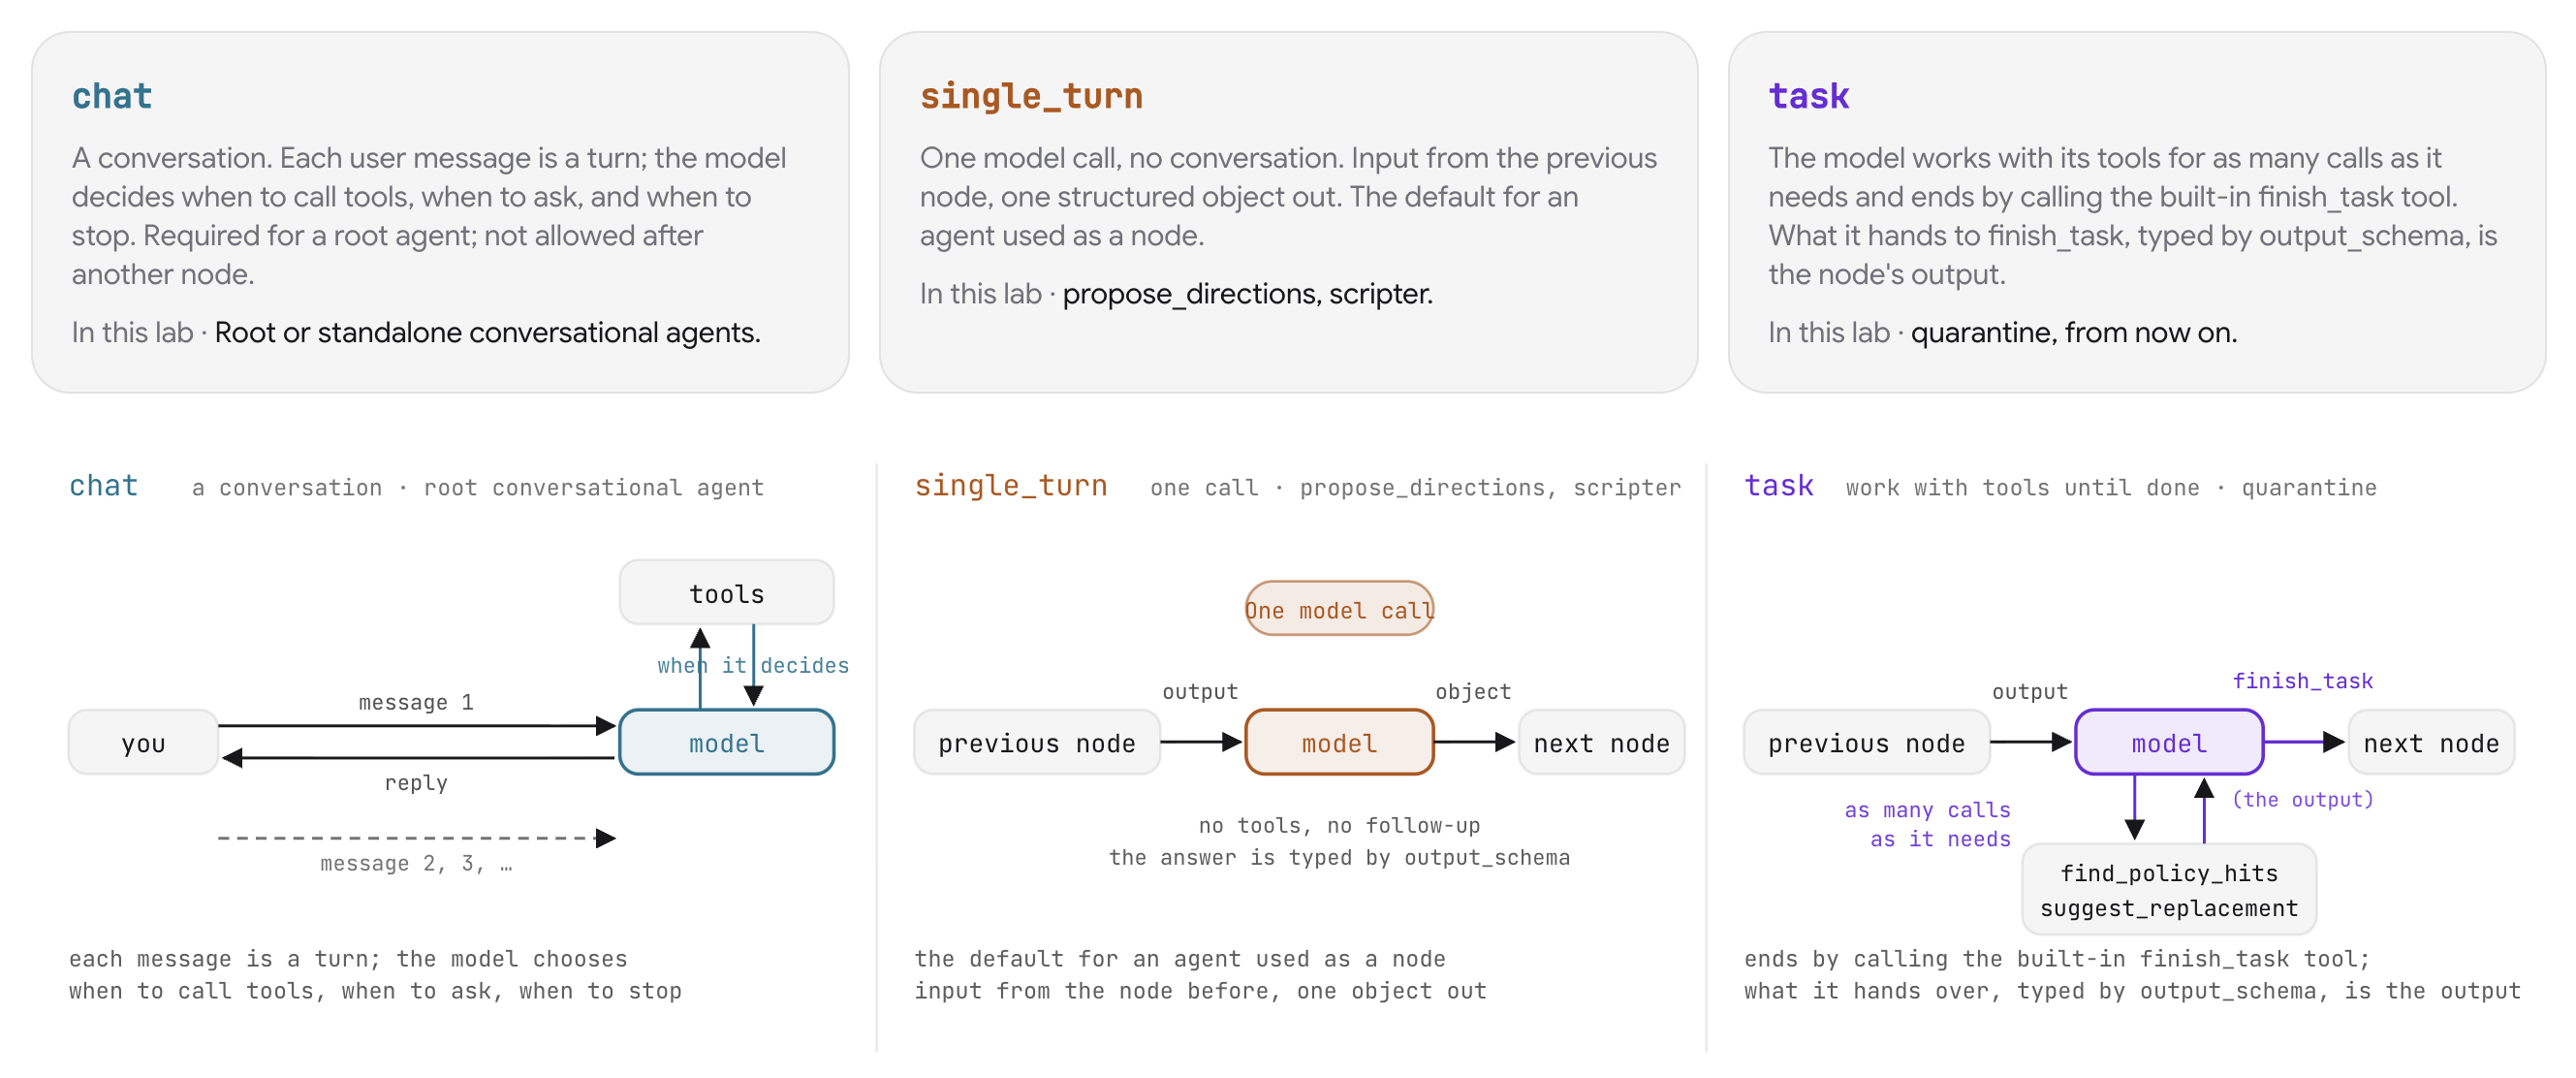
Modos de execução do agente
As instâncias do ADK Agent oferecem suporte a três modos de execução adaptados a requisitos específicos de pipeline:
Modo | Ciclo de vida da execução | Papel no pipeline |
| Loop de conversa multiturno. O modelo determina quando invocar ferramentas, solicitar entrada ou encerrar a vez. | Agentes raiz interagindo com um usuário humano. |
| Chamada de inferência de modelo único. Aceita a entrada do nó anterior e emite um objeto de esquema estruturado. | Transformações de gráfico sequenciais ( |
| Loop autônomo com execução de ferramentas. O agente faz iterações até chamar a ferramenta integrada | Correção e inspeção em várias etapas ( |
Correção autônoma de políticas
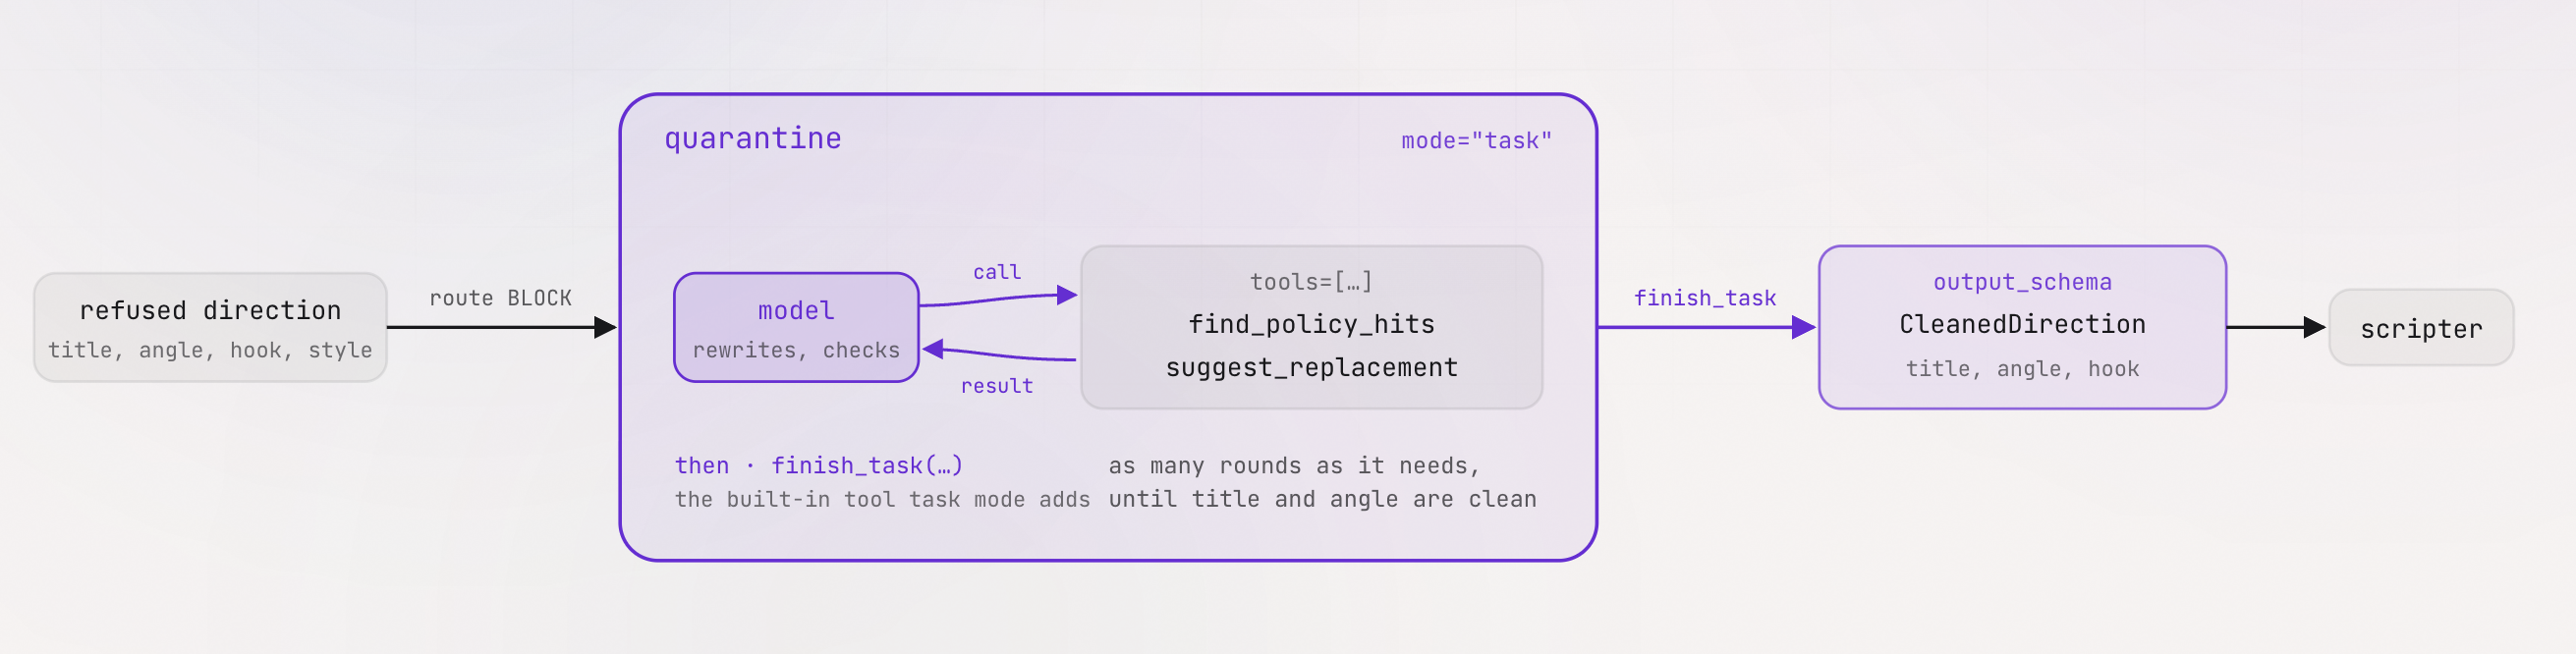
A reescrita de uma direção sinalizada exige o modo task porque o número de iterações de correção é variável. O agente recebe a instrução sinalizada, invoca find_policy_hits para detectar violações, solicita alternativas aprovadas via suggest_replacement, reescreve a instrução e verifica se ela está limpa antes de continuar.
As duas ferramentas são definidas em agent/cleanup_tools.py com assinaturas tipadas e docstrings:
def find_policy_hits(text: str) -> dict:
    """Which refused words appear in `text`. Matches whole words and phrases
    from agent/policy_words.txt, case-insensitive.

    Returns {"hits": [...], "clean": bool}. clean is true when hits is empty.
    """


def suggest_replacement(word: str) -> dict:
    """The channel's approved stand-in for a refused word, read from
    agent/policy_replacements.txt.

    Returns {"word", "replacement", "listed"}. When the word has no entry,
    listed is false and replacement is a hint to pick a gentle synonym.
    """
Edição prática: montagem do agente de tarefas de quarentena
Em stage3_router/agent.py, substitua a função de marcador de posição quarantine pela definição do agente de tarefas:
quarantine = Agent(
    name="quarantine",
    model=config.MODEL,
    instruction=QUARANTINE_INSTRUCTION,
    mode="task",
    tools=[find_policy_hits, suggest_replacement],
    output_schema=CleanedDirection,
)
O modo de tarefa equipa o agente com ferramentas e encerra a execução chamando finish_task. Quando mode="task" é configurado, o ADK fornece automaticamente finish_task e deriva os parâmetros de output_schema, garantindo que o nó produza um objeto CleanedDirection tipado que corresponda ao esquema de entrada do nó do scripter.
O que esperar e por quê
Teste os dois caminhos de execução no ADK Web ou no VibeStudio Workbench:
- Percurso aprovado (candidato 1, 2 ou 3):
- Selecionar um candidato aprovado direciona de
policy_checkdiretamente parascripter(route="OK"). - O roteirista gera um roteiro de produção de 3 cenas que segue o esquema
Script.
- Selecionar um candidato aprovado direciona de
- Rota de correção de quarentena (Candidato 4):
- O candidato 4 contém vocabulário sinalizado ("clickbait", "viral hack").
policy_checkrotas paraquarantine(route="BLOCK").- No trace da sessão, observe
quarantinechamandofind_policy_hits, chamandosuggest_replacementpara cada violação, reescrevendo o título e chamandofinish_task. - A execução volta para
scripter, produzindo um script com base na direção limpa.
6. Memory Bank
No VibeStudio Workbench, acesse Etapa 6 · Banco de memória, partes (6A) e (6B).
No momento, o fluxo de trabalho opera sem memória entre as sessões. Cada execução começa do zero, sem saber o que o criador selecionou anteriormente ou quais gêneros ele prefere. Nesta etapa, você vai conectar o Memory Bank do Vertex AI Agent Engine para armazenar e recuperar as preferências do criador em várias execuções.
A memória é integrada por callbacks do ciclo de vida do agente, em vez de nós de pipeline. Como a extração e a recuperação de memória atendem a agentes individuais em vez de etapas intermediárias de dados, a inclusão de callbacks preserva uma topologia de grafo limpa e desacoplada.
Memory Bank (6A)
No workbench, navegue até Memory Bank (6A).
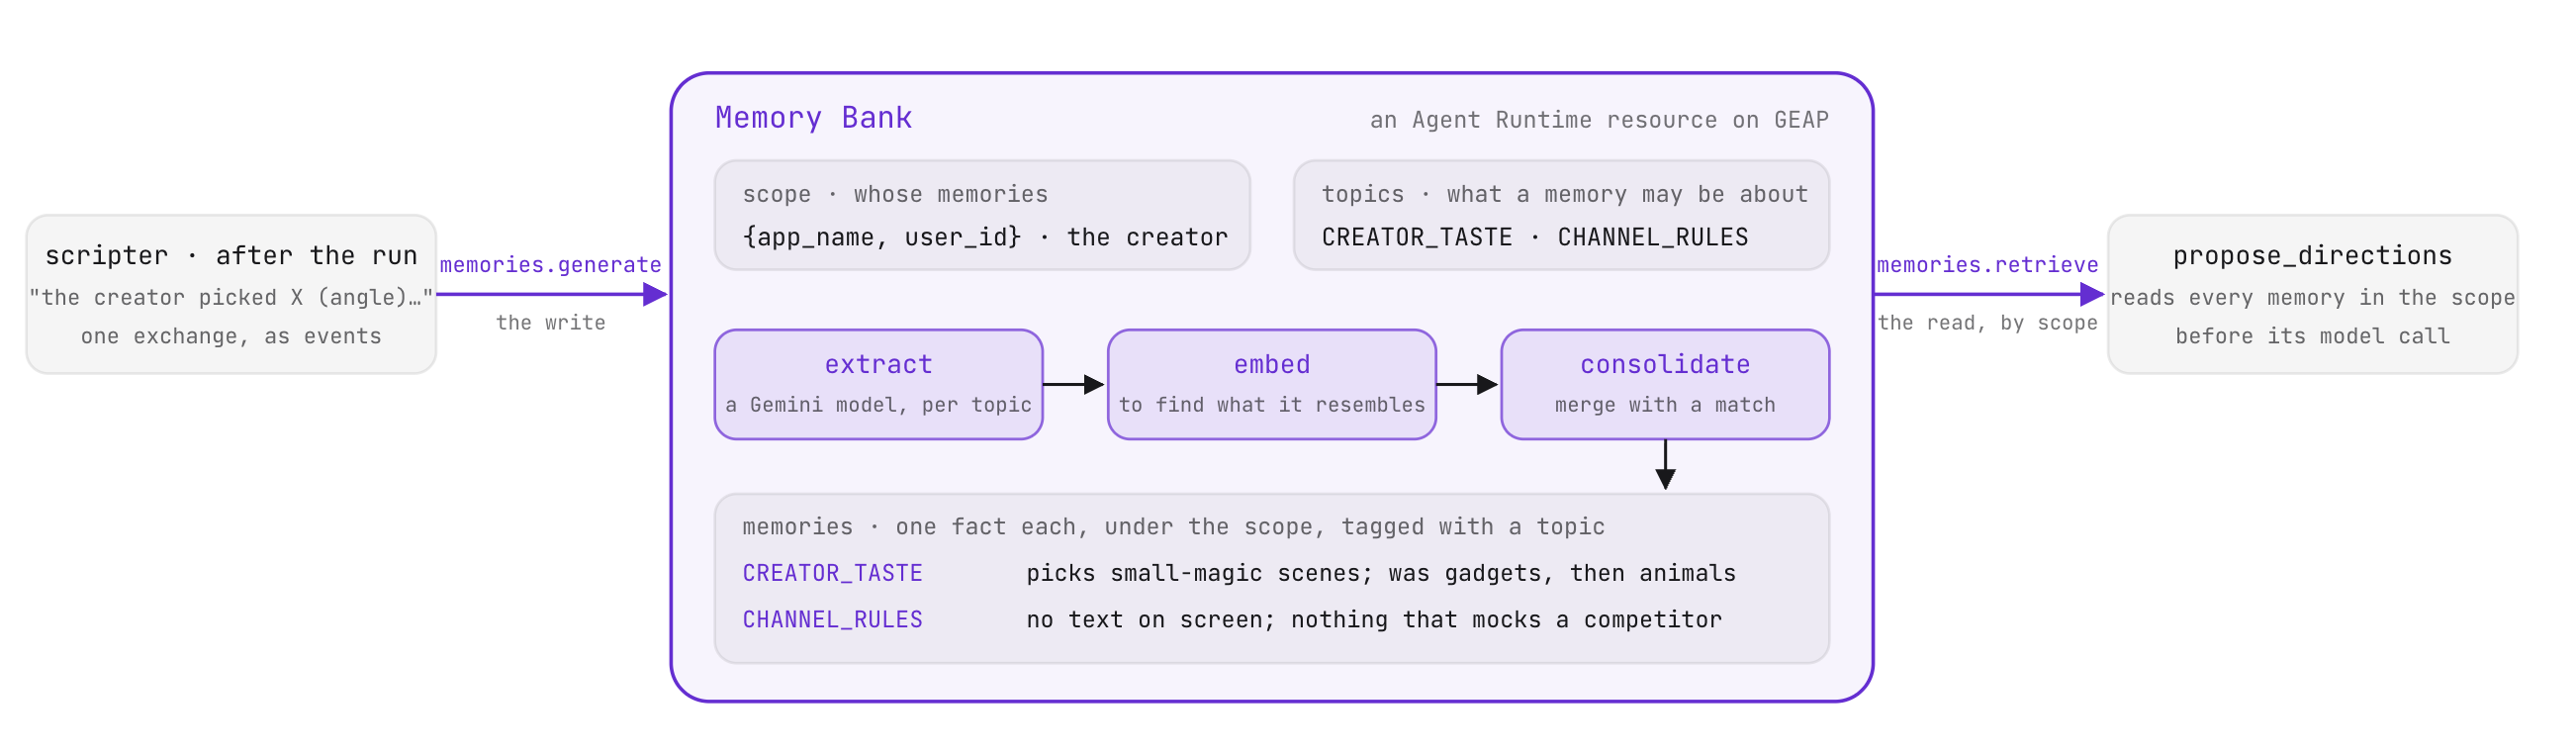
Memória gerenciada no nível do usuário
O Memory Bank é um serviço gerenciado para a memória de longo prazo do usuário. Ele organiza fatos sobre uma pessoa em um escopo definido, identificado aqui pelo nome do aplicativo e pelo ID do usuário:
SCOPE = {"app_name": config.APP, "user_id": config.USER}
TOPICS = {
    "CREATOR_TASTE": "Which video directions this creator picks and passes on, "
                     "and how that preference changes over time.",
    "CHANNEL_RULES": "Standing instructions the creator states for every video "
                     "(style, subjects to avoid, format rules).",
}
Os tópicos de memória personalizados definem os limites do que o banco registra:
- Extração de temas: quando um novo texto de conversa é enviado via
memories.generate, o serviço aplica um modelo de extração a cada descrição de tema. O texto que não corresponde a um tópico não gera recordações. - Consolidação e eliminação de duplicação: o serviço converte os fatos recém-extraídos em embeddings e os compara com as memórias atuais no escopo. Quando uma observação se alinha a uma memória existente, o serviço a atualiza. Quando representa informações novas, o serviço cria uma nova entrada. Esse processo de consolidação garante que várias sessões sobre um tópico sejam mescladas em um resumo coerente, em vez de produzir entradas redundantes.
- Recuperação: chamar
memories.retrievecom o escopo do usuário retorna fatos armazenados, ordenados do mais antigo para o mais recente.
As duas operações são implementadas em agent/platform/memory.py. O nome do recurso de banco provisionado é armazenado em cache localmente em runs/memorybank.json.
Como configurar o Memory Bank
Use os controles do workbench ou execute os comandos da CLI no terminal:
- Conecte e provisione o banco:
python -m agent.platform.bankCREATOR_TASTEeCHANNEL_RULES. - Sessões históricas de seed:
python -m agent.platform.bank load - Inspecionar fatos consolidados:
python -m agent.platform.bank list
Callbacks (6B)
No workbench, acesse Callbacks (6B). Abra stage4_memory/agent.py.
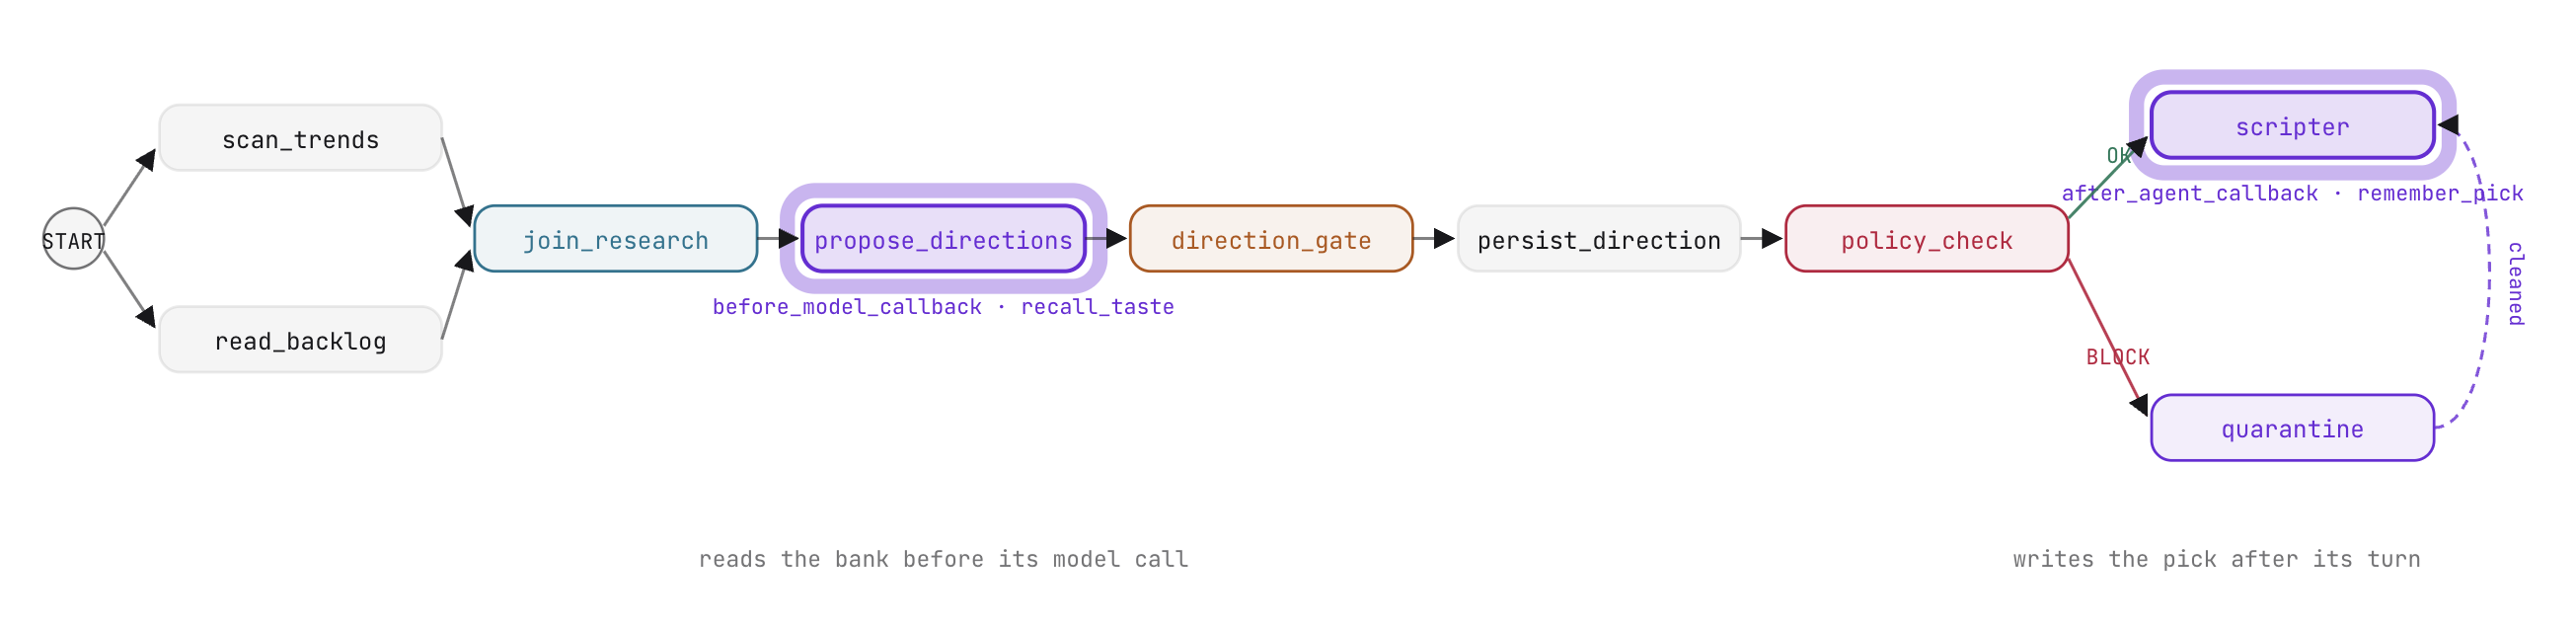
Callbacks do ciclo de vida do agente do ADK
Um callback é uma função transmitida como um argumento para um Agent. O ADK invoca callbacks em momentos predefinidos do ciclo de vida, transmitindo o contexto ativo. Retornar None continua a execução normal. Retornar um objeto de substituição substitui ou intercepta a operação.
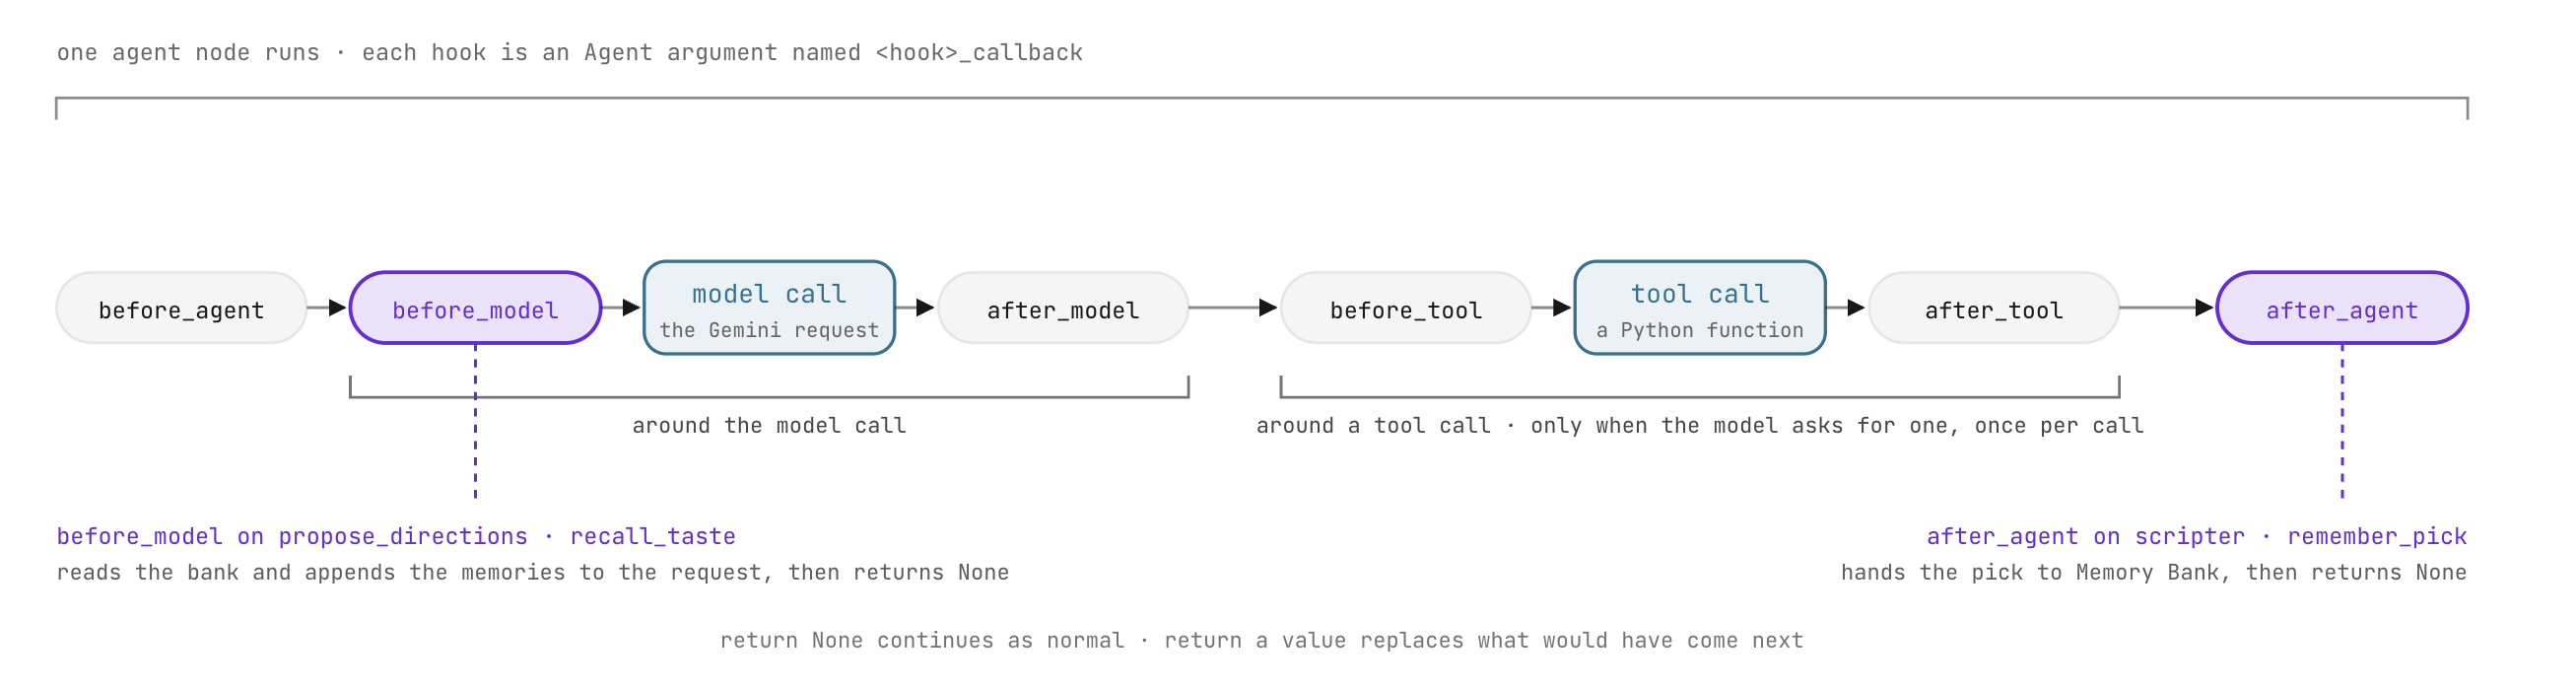
O ADK oferece três pares de callbacks:
Par de callbacks | Ponto de invocação | Parâmetros recebidos | Comportamento do valor de retorno |
| Envolvendo toda a vez do agente |
| Retornar |
| Em cada chamada de inferência de LLM, |
| Retornar |
| Em torno de cada execução de ferramenta | Definição, argumentos e resultado da ferramenta | Retornar um dict substitui a saída da ferramenta. |
Os callbacks oferecem um local limpo para injeção de contexto, barreiras de proteção, telemetria e pesquisas de cache sem introduzir nós estranhos no gráfico de fluxo de trabalho.
Edição prática: conectar callbacks de recall e remember
- Em
stage4_memory/agent.py, atualizepropose_directionspara anexarbefore_model_callback=recall_taste:
    output_schema=Directions,
    before_model_callback=recall_taste)
recall_taste é executado imediatamente antes de o Gemini gerar as rotas candidatas. Ele busca o histórico do criador de conteúdo no Memory Bank, formata as recordações da mais antiga para a mais recente e as anexa ao LlmRequest de saída. O comando direciona o modelo para que os candidatos de 1 a 3 se aproximem do gosto atual do criador, tratando as regras do canal como restrições rígidas.
- Em
stage4_memory/agent.py, atualizescripterpara anexarafter_agent_callback=remember_pick:
    output_schema=Script,
    after_agent_callback=remember_pick)
remember_pick é executado depois que scripter conclui a vez dele. Ele lê a direção escolhida no estado da sessão, sintetiza uma declaração concisa resumindo a decisão do criador de conteúdo e chama memories.generate para atualizar o Memory Bank.
O que esperar e por quê
Teste o fluxo de trabalho aumentado por callback no ambiente de trabalho ou no ADK Web:
- Execute uma execução com um comando vazio:
- No rastreamento da sessão, inspecione o
LlmRequestparapropose_directions. Observe o contexto de memória anexado, que detalha a preferência do criador por temas de fantasia e ritmo conciso. - Observe as direções propostas: os candidatos de 1 a 3 se alinham com as preferências históricas do criador, mesmo quando as tendências enfatizam outros temas.
- No rastreamento da sessão, inspecione o
- Selecione um candidato em
direction_gate. - Depois que
scripterfor concluído, revise os registros do Memory Bank:python -m agent.platform.bank list
7. Mecanismo RAG
No VibeStudio Workbench, acesse Etapa 7 · Mecanismo de RAG, partes (7A) e (7B).
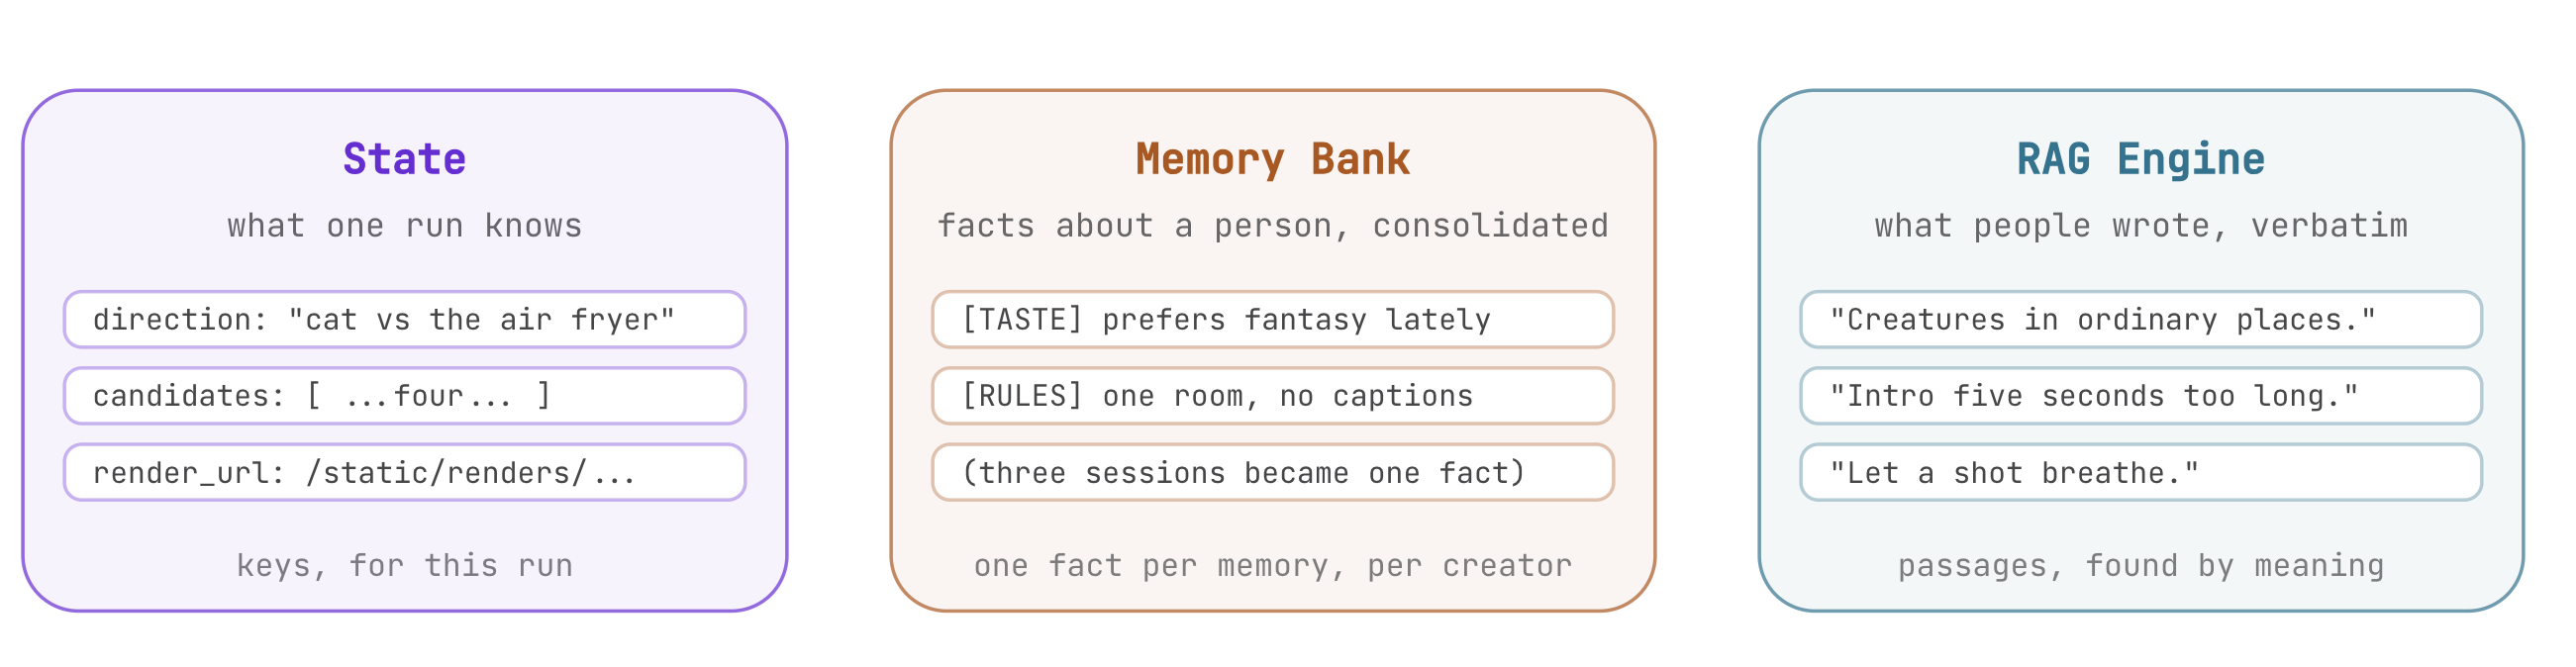
Os vídeos publicados acumulam feedback contínuo dos espectadores. Trinta comentários representativos são coletados em agent/comments.md, capturando elogios dos espectadores, críticas ao ritmo patrocinado e preferências de áudio. Nesta etapa, você vai indexar esses comentários usando o mecanismo de RAG da Vertex AI e conectar a recuperação semântica à distribuição de dados da pesquisa.
Recuperação em documentos (7A)
No workbench, acesse Mecanismo RAG (7A).
Memory Bank x mecanismo RAG
As duas ferramentas baseiam fluxos de trabalho em dados externos, mas têm finalidades arquitetônicas distintas:
Dimensão | Memory Bank | Mecanismo RAG |
Caso de uso principal | Preferências de longo prazo do usuário e regras operacionais | Recuperação semântica em grandes coleções de documentos |
Escopo | Com escopo para IDs de usuário e nomes de aplicativos individuais | Com escopo para recursos de corpus compartilhados entre todos os usuários |
Processamento de dados | Extração, incorporação e consolidação semântica em tempo real | Divisão de documentos em blocos, embedding de vetor e pesquisa de vizinho mais próximo |
Integração de gráficos | Callbacks do ciclo de vida do agente ( | Nó de função dedicado na ramificação de pesquisa ( |
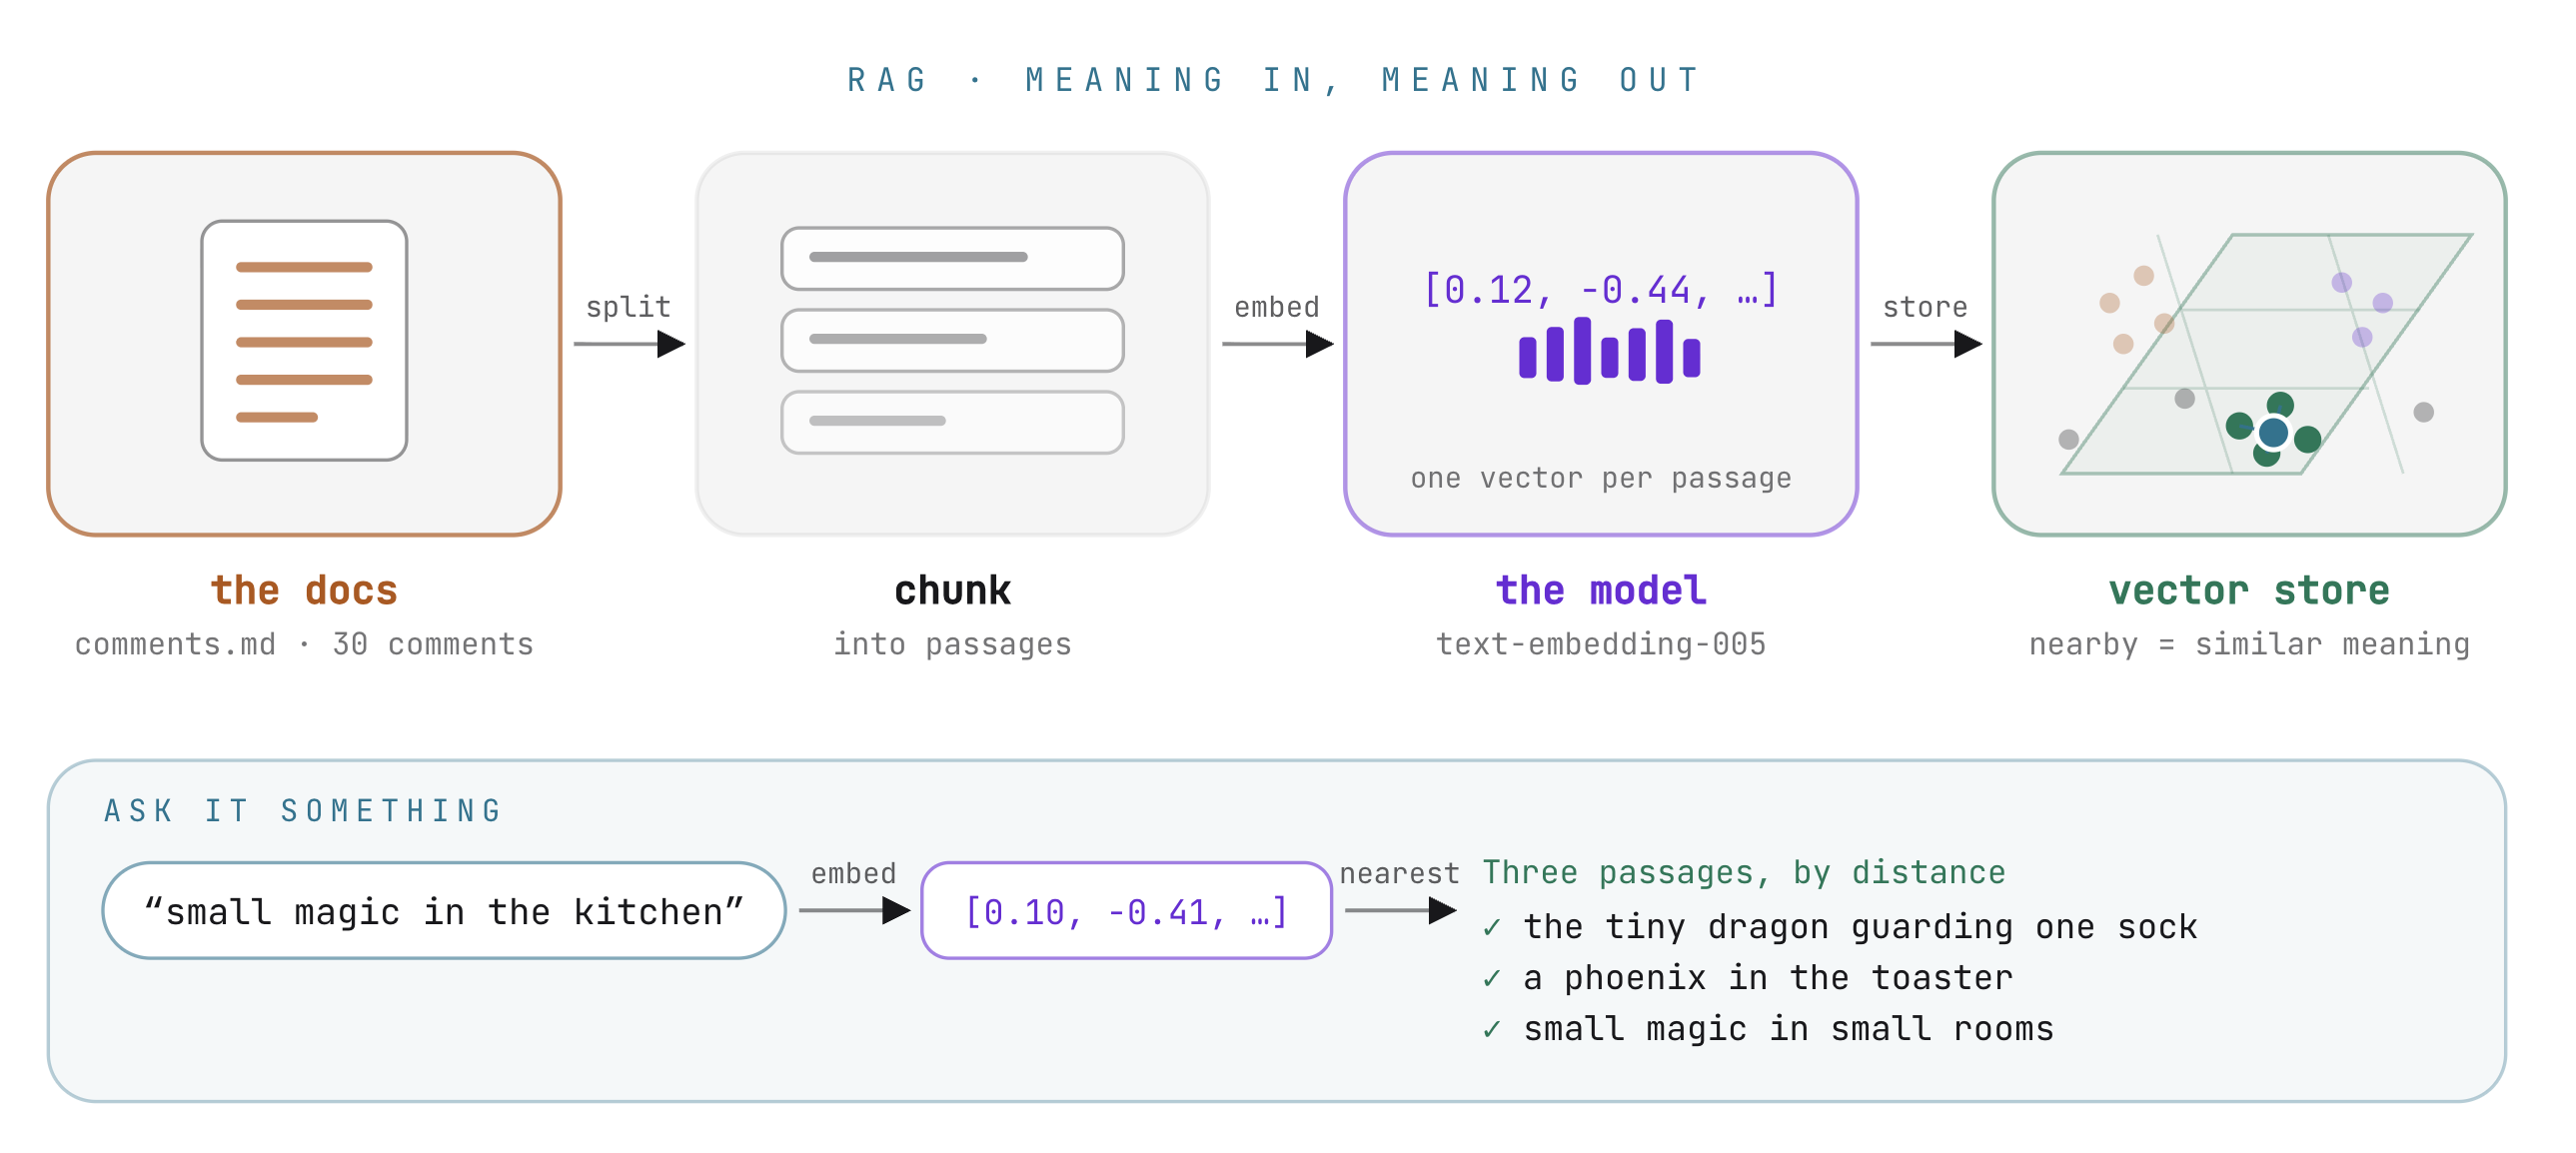
Divisão de documentos e embeddings
O mecanismo RAG indexa documentos dividindo o texto em passagens semânticas e armazenando os vetores em um banco de dados gerenciado:
corpus = rag.create_corpus(
    display_name="vibestudio-feedback",
    description="Vibe Studio: what the audience wrote under the channel's past videos.",
    backend_config=rag.RagVectorDbConfig(
        rag_embedding_model_config=rag.RagEmbeddingModelConfig(
            vertex_prediction_endpoint=rag.VertexPredictionEndpoint(
                publisher_model="publishers/google/models/text-embedding-005"))))

rag.upload_file(
    corpus_name=corpus.name, path="agent/comments.md", display_name="comments.md",
    transformation_config=rag.TransformationConfig(
        chunking_config=rag.ChunkingConfig(chunk_size=120, chunk_overlap=20)))
- Tamanho do bloco: configurado para 120 tokens com 20 tokens de sobreposição. Isso captura de dois a três comentários por trecho, garantindo que cada vetor represente um sentimento coeso sem diluir o significado em feedback não relacionado.
- Modelo de embedding:
text-embedding-005converte texto em vetores de alta dimensão. Quando uma consulta é enviada, o modelo a converte em um vetor e encontra as correspondências mais próximas com base na distância semântica. Um comentário sobre um dragão minúsculo guardando meias corresponde a um comando sobre criaturas mágicas sem exigir sobreposição exata de palavras-chave.
Configurar o corpus de RAG
Inicialize o corpus usando os botões da bancada ou os comandos do terminal:
- Crie o corpus:
python -m agent.platform.ragruns/ragcorpus.json. - Fazer upload e indexar comentários: faz upload de
agent/comments.mdcom configuração de divisão em partes e aguarda a conclusão da indexação. - Consultar o corpus: teste a recuperação de similaridade com consultas que não compartilham palavras exatas com os comentários (por exemplo, consulte "pequenas criaturas mágicas" para recuperar comentários sobre dragões).
O nó de recuperação (7B)
No workbench, navegue até O terceiro leitor (7B). Abra stage5_rag/agent.py.
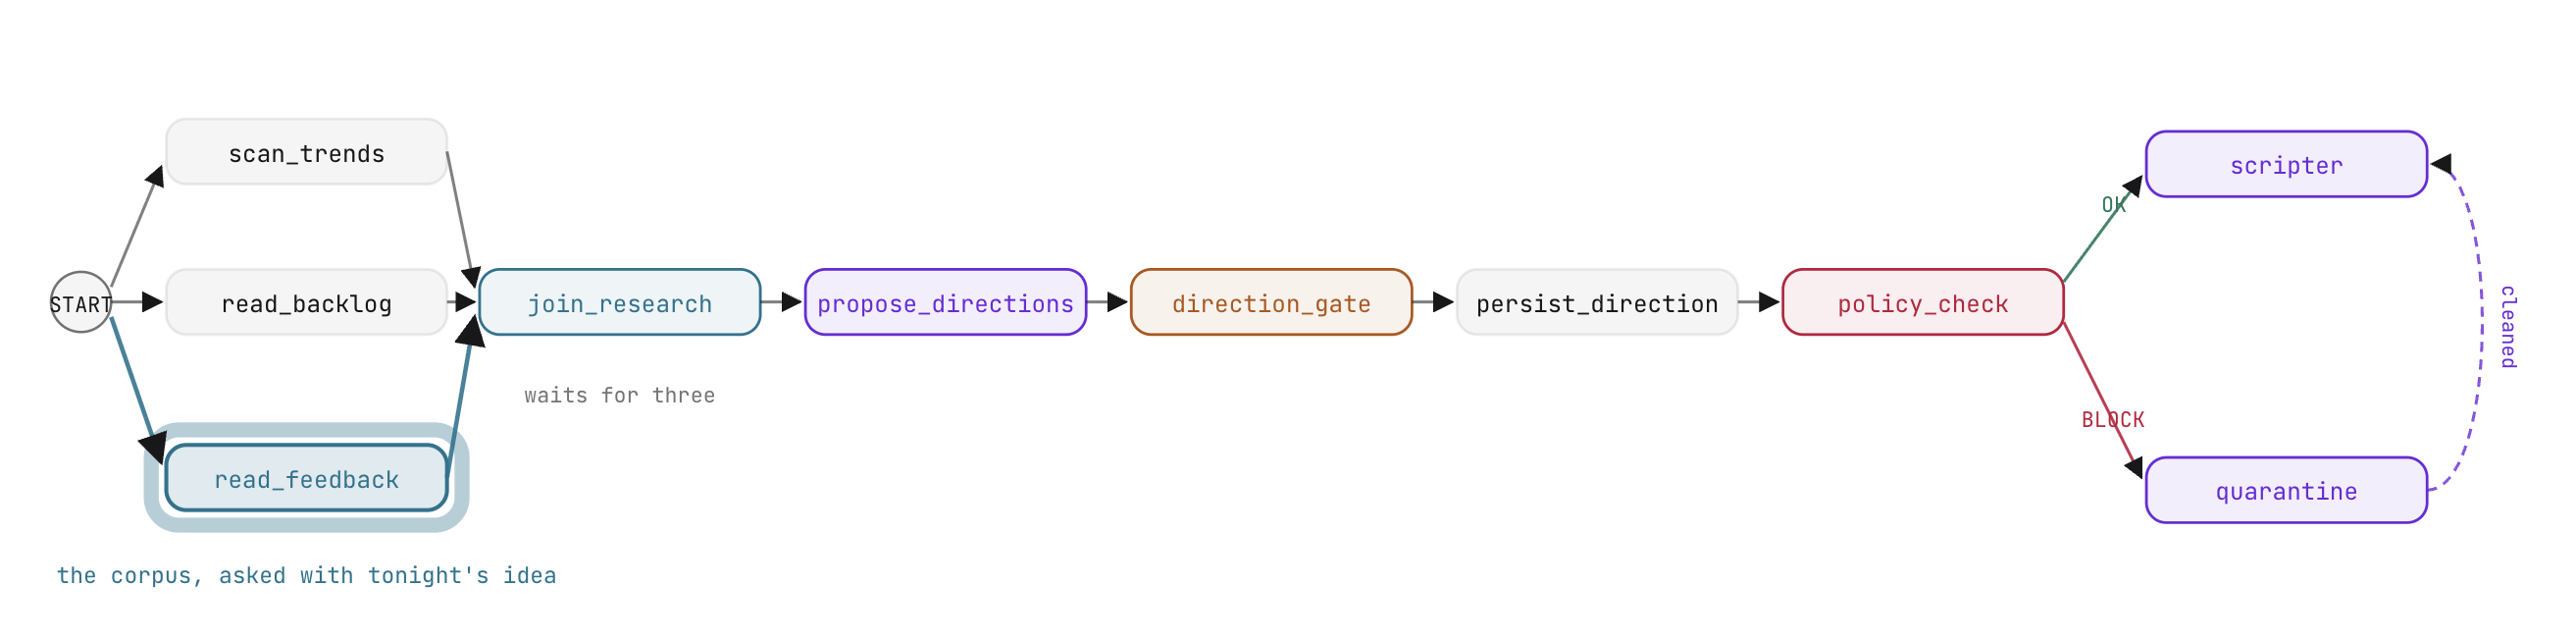
Recuperação como um nó de gráfico
O feedback do público-alvo representa dados de pesquisa compartilhados em todo o fluxo de trabalho. Ao contrário da memória pessoal do criador de conteúdo, o sentimento do espectador alimenta diretamente o join_research junto com tendências e dados de pendências. Portanto, ele é implementado como um nó de função:
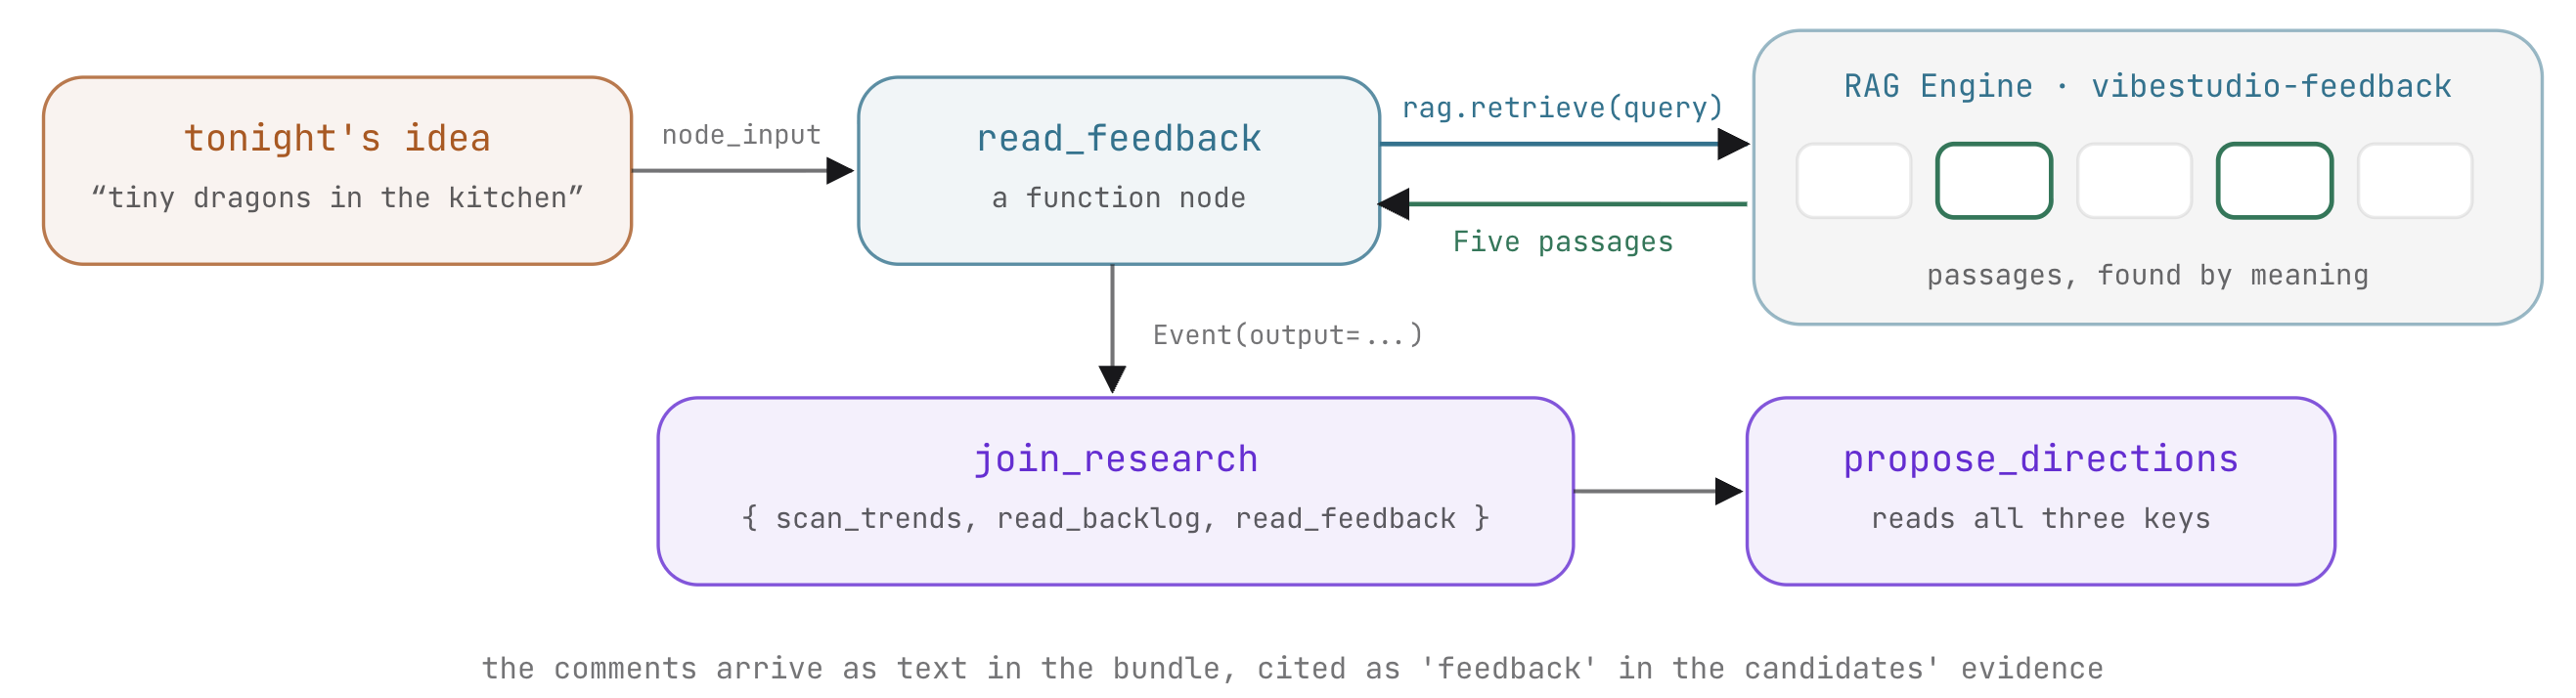
def read_feedback(node_input):
    """The third reader (step 7): what the audience wrote under past videos,
    the passages nearest to tonight's idea. Retrieval, not a model call."""
    from .platform import rag
    idea = idea_text(node_input)
    query = idea or "what viewers liked and what they complained about"
    try:
        hits = rag.retrieve(query)
    except Exception as e:
        print(f"  [rag] feedback unavailable ({str(e)[:80]})")
        return Event(output={"query": query, "feedback": [],
                             "note": "no corpus connected - run: python -m agent.platform.rag"})
    return Event(output={"query": query, "feedback": [h["text"] for h in hits]})
O read_feedback extrai a ideia inicial do usuário e executa uma consulta vetorial no corpus do mecanismo RAG. Ele emite os comentários recuperados em um payload Event(output=...).
Edição prática: conectando o terceiro leitor ao fan-out
Em stage5_rag/agent.py, atualize edges para adicionar read_feedback como uma terceira ramificação paralela que entra em join_research:
           (START, read_backlog, join_research),
           (START, read_feedback, join_research),
Como join_research é um JoinNode, ele sincroniza todas as ramificações de entrada, aguardando até que scan_trends, read_backlog e read_feedback tenham emitido todos os eventos antes de transmitir o pacote agregado para downstream.
O que esperar e por quê
Execute o fluxo de trabalho no workbench:
- Envie um comando de ideia (como "um dragão em miniatura guardando um balcão de cozinha").
- No trace de execução, verifique se os três nós de leitura são executados simultaneamente.
- Observe
join_research: o dicionário de saída agora contémtrends,backlogefeedback. - Inspecione os candidatos gerados em
propose_directions: o modelo incorpora comentários dos espectadores às propostas e faz referência ao sentimento do público nos campos de evidências. - A recuperação de RAG é determinista (consultas idênticas retornam passagens de comentários idênticas), enquanto o nó de proposta generativa produz variações criativas.
8. Geração de vídeo assíncrona com o Veo
No VibeStudio Workbench, acesse Etapa 8 · O vídeo, partes (8A) e (8B).
A geração de vídeos em alta definição com o Google Veo leva vários minutos por renderização. Bloquear a execução de grafo durante esse período desperdiça recursos computacionais, bloqueia pools de linhas de execução e expõe a execução a interrupções de conexão HTTP. Nesta etapa, você vai tornar a renderização de vídeo assíncrona usando o LongRunningFunctionTool do ADK.
Ferramentas de longa duração (8A)
No ambiente de trabalho, navegue até Uma ferramenta de longa duração (8A). Abra stage6_video/agent.py e agent/deliver.py.
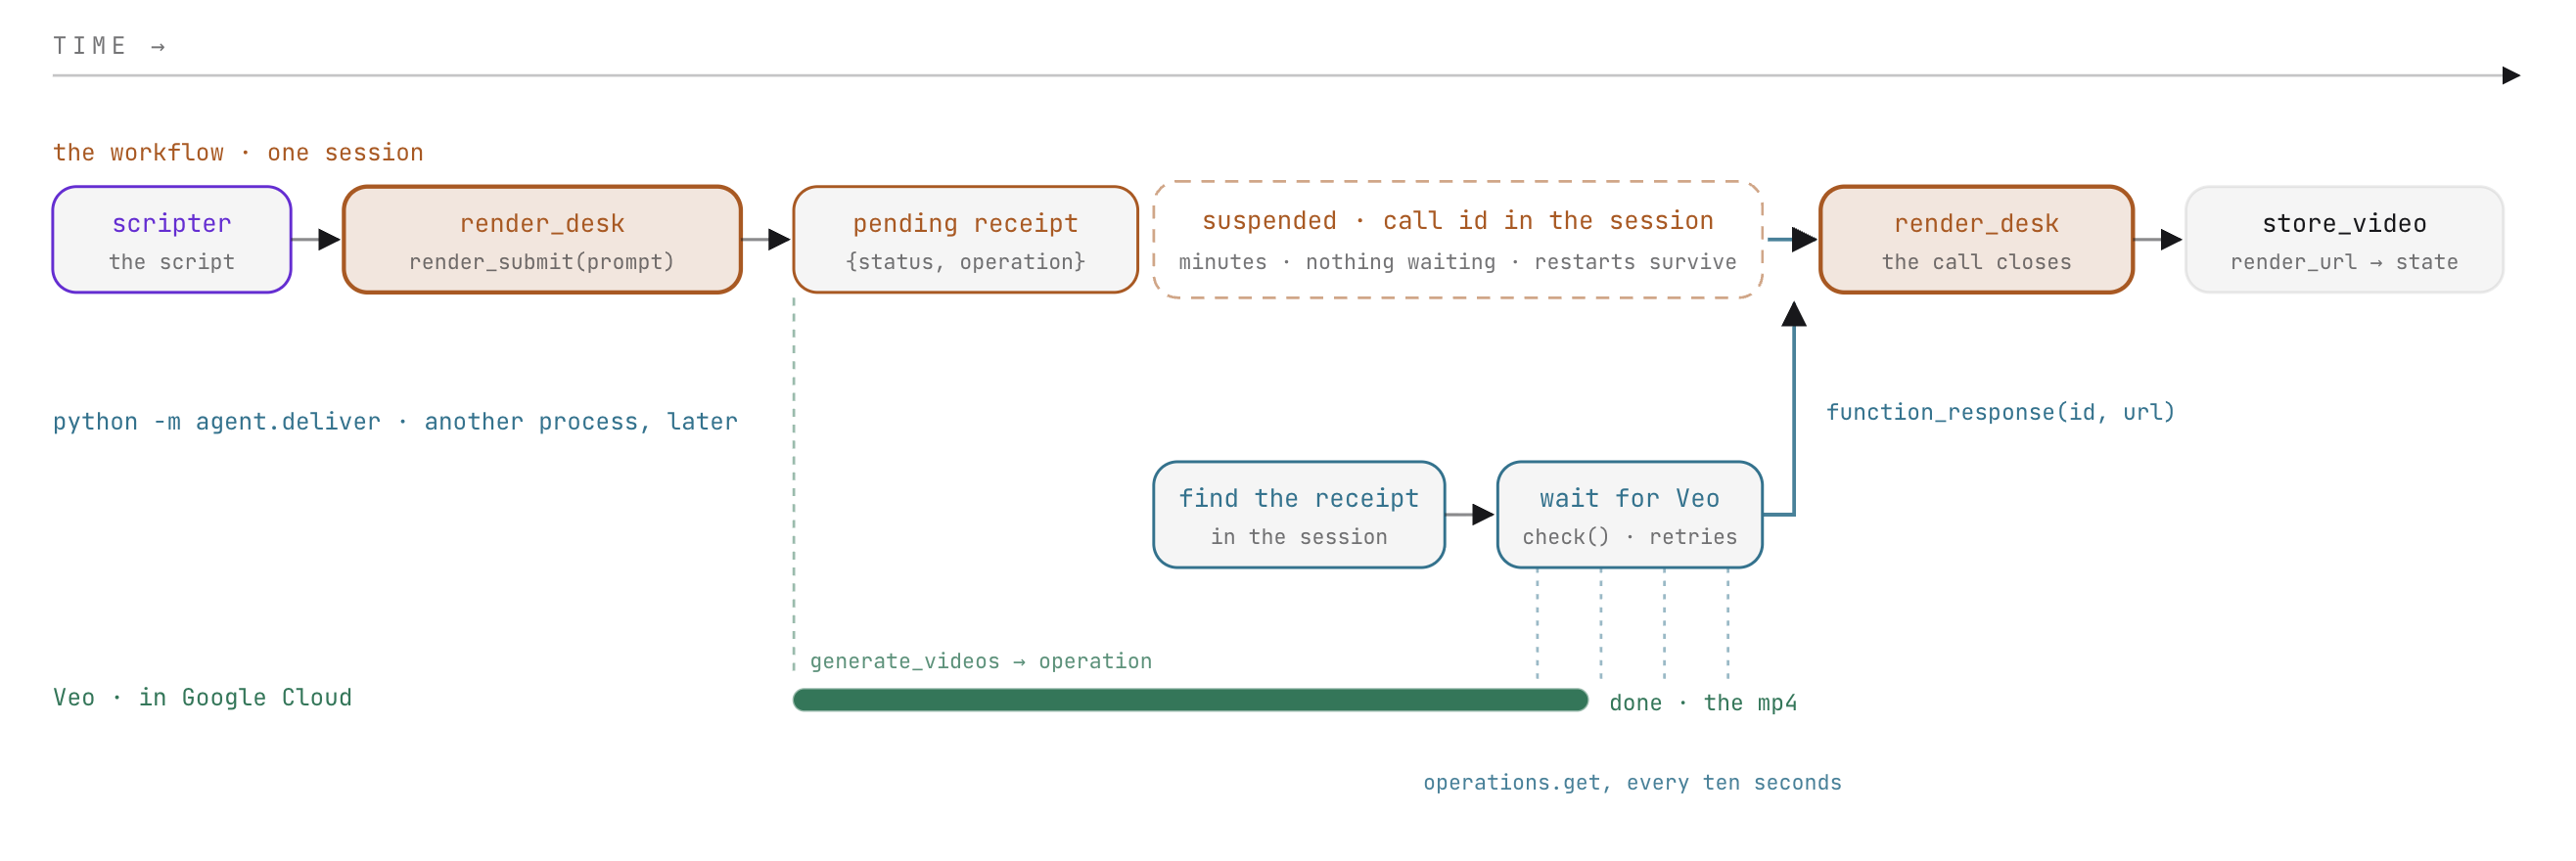
Ferramentas síncronas x ferramentas de longa duração
As ferramentas de função padrão do ADK são executadas de forma síncrona em uma rodada do agente: o modelo chama a ferramenta, aguarda o payload de retorno e incorpora o resultado à rodada em andamento.
A renderização do vídeo não pode ser concluída em uma única rodada. Em vez disso, render_submit inicia o job de geração e retorna imediatamente um recibo operacional com o status "pending":
def render_submit(prompt: str) -> dict:
    """Submit one Veo render of `prompt`. Returns at once with a pending
    receipt; the clip is delivered later, to this call, by id."""
    receipt = videogen.start(f"{prompt} {videogen.NO_TEXT}")
    return {"status": "pending", "operation": receipt["operation"], "prompt": receipt["prompt"]}
Quando envolvido com LongRunningFunctionTool, o ADK intercepta o status "pending". O turno do agente termina, o fluxo de trabalho é suspenso no nó, e os metadados da chamada pendente (incluindo ID e recebimento da chamada) são registrados em runs/sessions.db. O processo de execução é encerrado sem manter conexões de rede ou linhas de execução de worker ativas.
Edição prática: encapsulando a ferramenta de renderização
Em stage6_video/agent.py, atualize render_desk para incluir render_submit em LongRunningFunctionTool:
tools=[LongRunningFunctionTool(render_submit)])
Retomar por ID de chamada
O padrão de retomada universal
O ADK aplica um mecanismo idêntico para suspender e retomar fluxos de trabalho para humanos e ferramentas externas:
Acionador de suspensão | Iniciando construção | Estado de suspensão armazenado | Evento de retomada |
Decisão humana |
| Abrir o comando de entrada no armazenamento de sessão |
|
Ferramenta de longa duração |
| Abrir chamada de ferramenta no armazenamento de sessões |
|
Em ambos os cenários, o fluxo de trabalho é interrompido completamente e só é retomado quando um evento com um FunctionResponse correspondente chega de uma fonte externa: uma interface do usuário, um webhook ou um worker em segundo plano.
Edição prática: como concluir a resposta de entrega
Em agent/deliver.py, crie a parte de retomada FunctionResponse:
    part = Part(function_response=FunctionResponse(
        id=row["call_id"], name=row["name"], response=response))
O daemon de entrega consulta o Veo até que o arquivo de vídeo seja gerado e, em seguida, envia esse FunctionResponse para a sessão. O ADK corresponde ao ID da chamada e retoma o fluxo de trabalho diretamente no próximo nó. Os nós concluídos não são executados novamente, e o agente não faz outra rodada generativa.
Definir STUDIO_REAL_VIDEO=0 em .env permite a renderização simulada: start retorna um recibo de teste imediato, e check simula a conclusão em cinco segundos sem fazer chamadas faturáveis da API Veo.
Integração de pipeline (8B)
No workbench, navegue até render_desk no gráfico (8B). Abra stage6_video/agent.py.
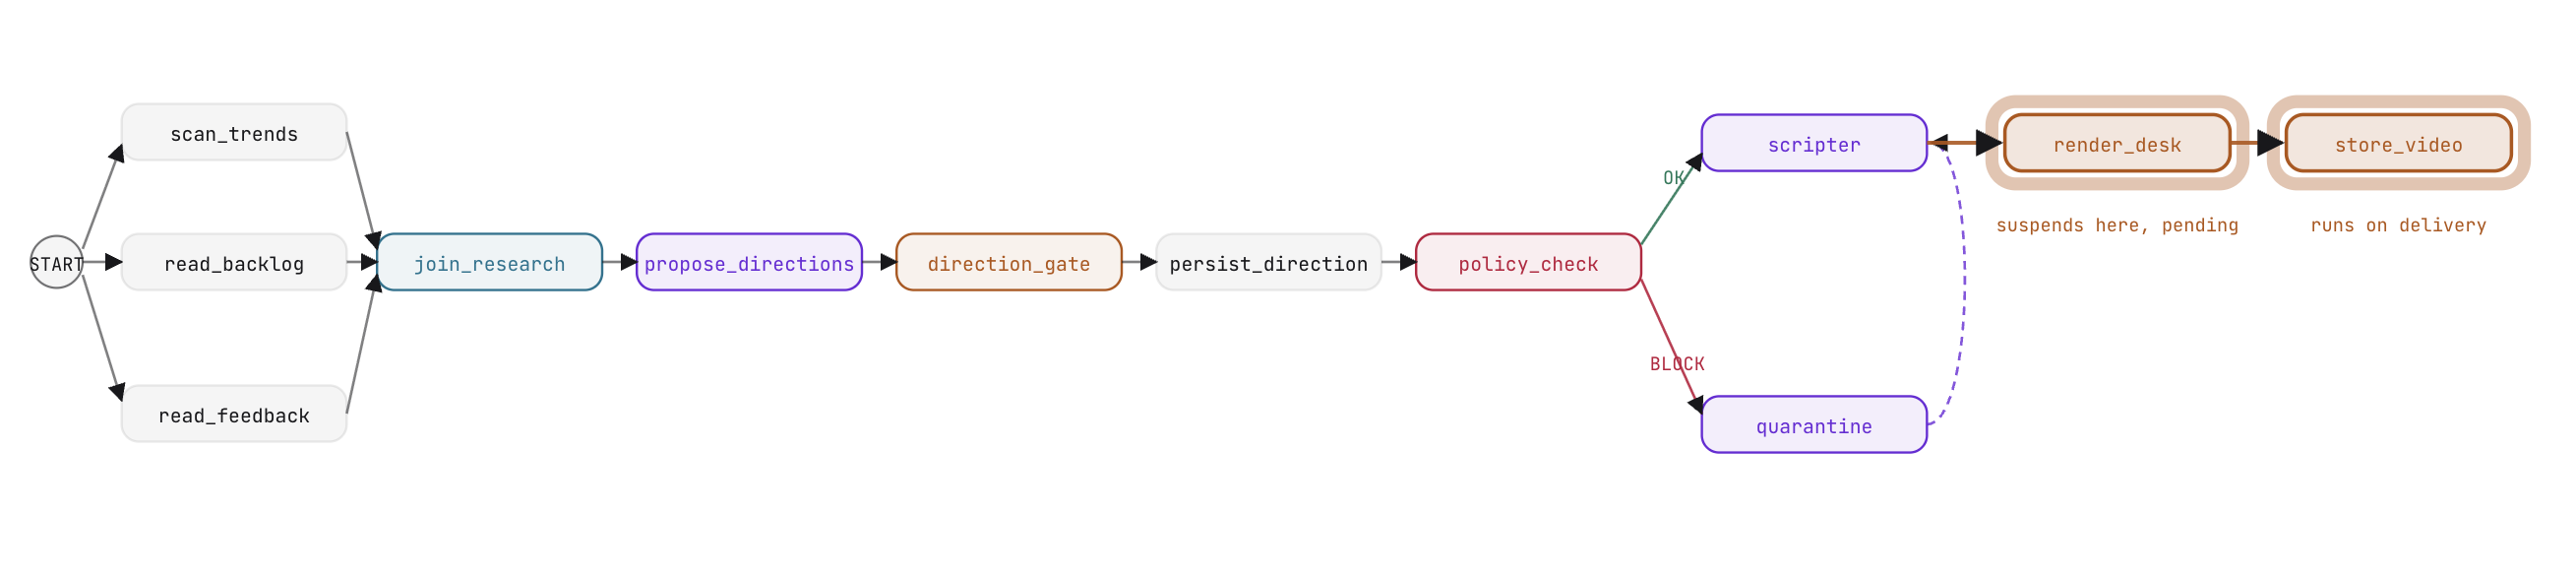
O nó terminal no pipeline é store_video. Ele lê as informações de renderização concluídas de runs/state.json (onde o processo de exibição as registrou) e confirma o URL do vídeo e o status de geração no estado da sessão compartilhada.
Edição prática: conectar o pipeline de vídeo completo
Em stage6_video/agent.py, atualize edges para anexar render_desk e store_video:
           (quarantine, scripter),
           (scripter, render_desk, store_video)])
O que esperar e por quê
Teste o fluxo de geração assíncrona no workbench:
- Execute o fluxo de trabalho com a seleção de candidatos e a geração de scripts.
- Em
render_desk, observe o agente invocarrender_submit. - O fluxo de trabalho é suspenso imediatamente. Na bancada de trabalho ou na Web do ADK, observe o status pendente: a sessão mantém o ID da chamada aberta, e nenhum processo em segundo plano está consumindo recursos.
- Execute o daemon de entrega usando o console do workbench ou no terminal:
python -m agent.deliver - No ADK Web, atualize a sessão: a execução é retomada em
store_video, confirma o URL do vídeo no estado da sessão e conclui o fluxo de trabalho.
9. Implantar no Cloud Run
No VibeStudio Workbench, navegue até Etapa 9 · Implantar.
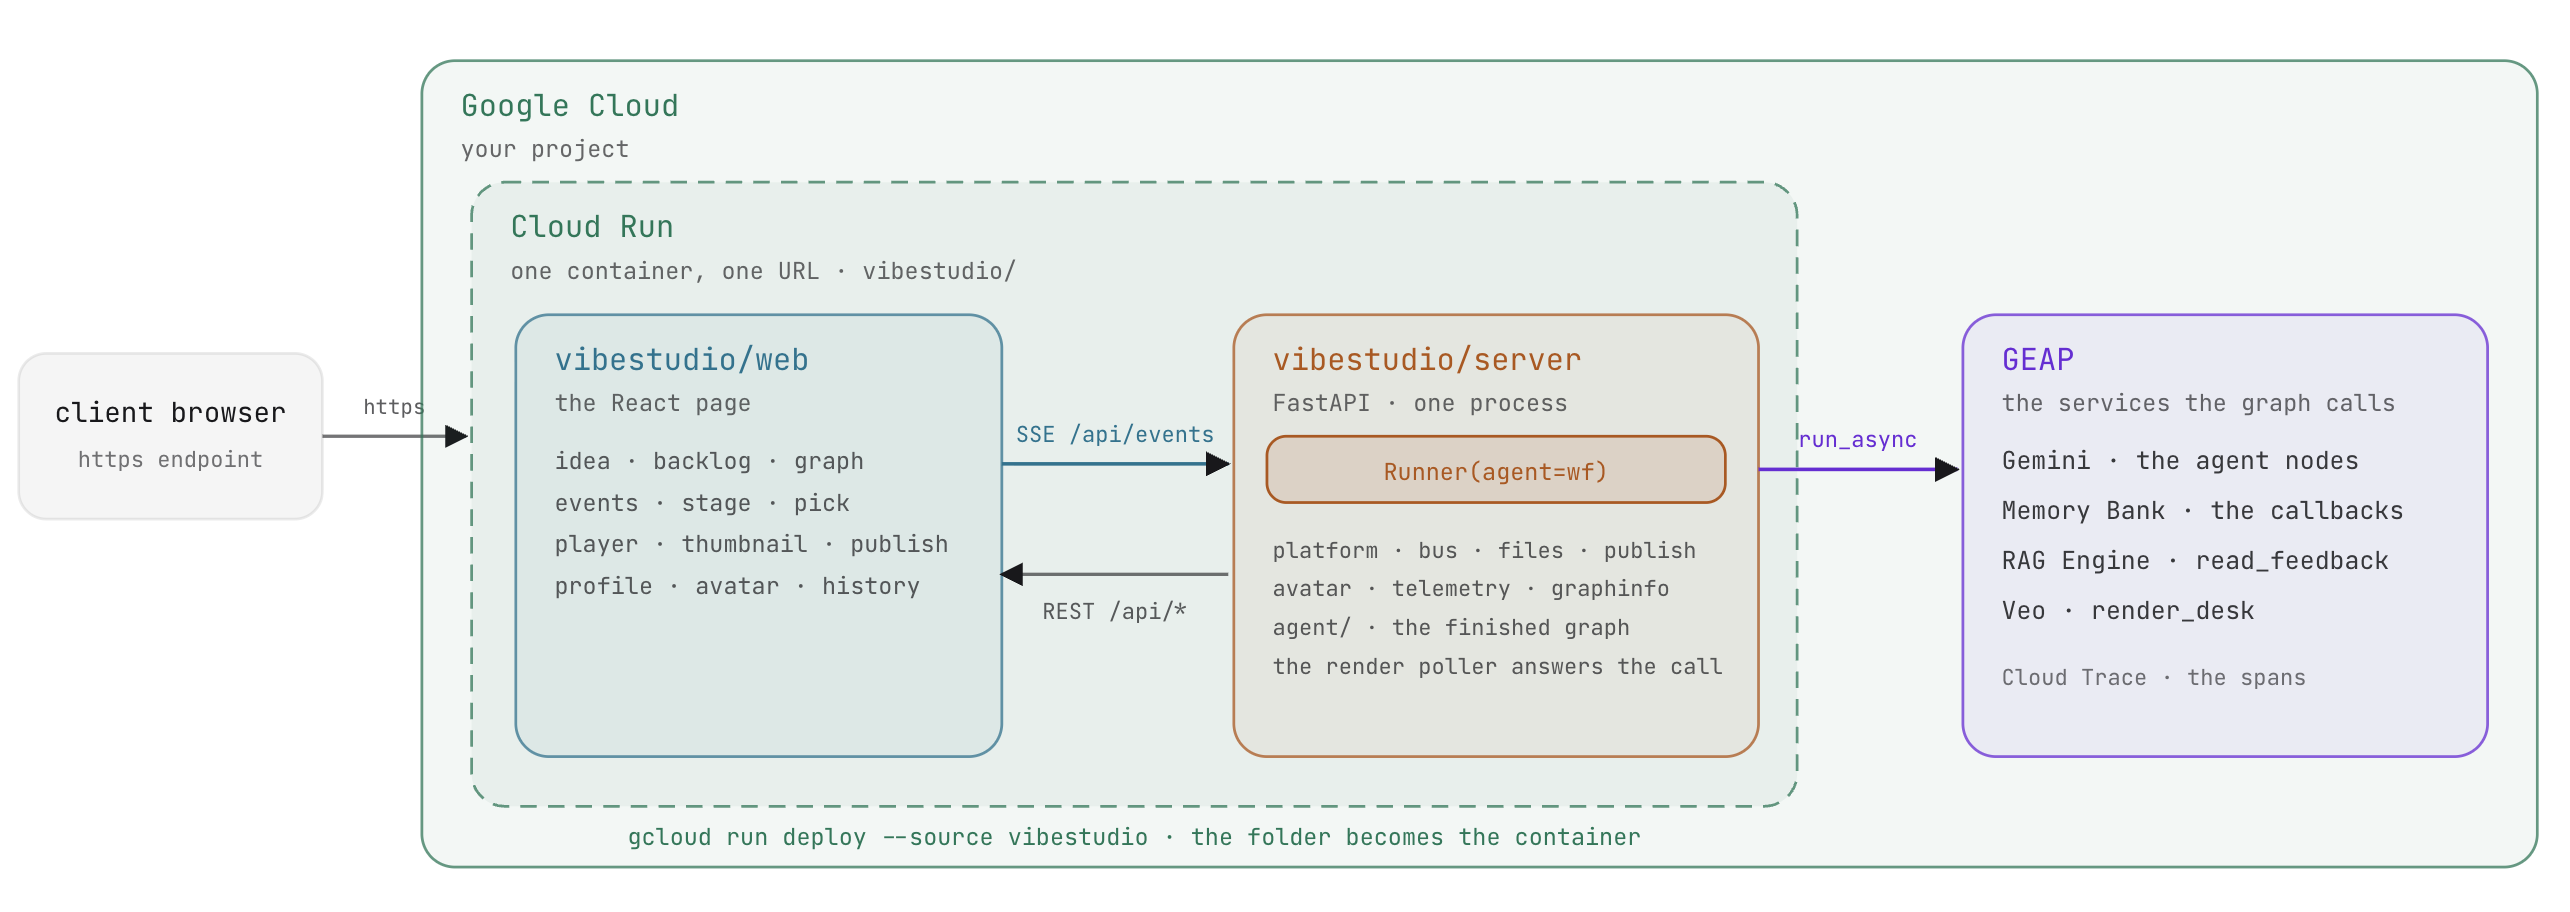
Você desenvolveu e verificou cada componente do pipeline em sandboxes dedicados. Nesta etapa, você vai montar o pipeline de produção completo e implantá-lo no Google Cloud Run.
O executor do ADK
No desenvolvimento, o adk web orquestrou o gráfico. Na produção, o aplicativo hospeda o fluxo de trabalho usando a classe Runner do ADK:
self._svc = DatabaseSessionService(db_url=config.DB_URL)
self._runner = Runner(app_name=config.APP, agent=wf, session_service=self._svc)

async for ev in self._runner.run_async(user_id=config.USER, session_id=run_id, new_message=message):
    self._absorb(ev)    # fold the ADK event into the run state, publish one app event

# the gate's answer and the render's delivery are the same call, with a function_response part
part = Part(function_response=FunctionResponse(id=call_id, name=name, response=response))
run_async: impulsiona a execução do fluxo de trabalho, gerando eventos sequencialmente à medida que os nós são executados e persistindo as atualizações no serviço de sessão.- Retomada unificada: as decisões do usuário em
direction_gatee as entregas de vídeo concluídas do Veo retomam a execução por objetosFunctionResponseidênticos enviados pararun_async.
A arquitetura do aplicativo de produção
O aplicativo de produção em vibestudio/ integra o pipeline completo:
vibestudio/
  server/
    main.py                 FastAPI: application server, REST routes, static assets
    api.py                  REST API endpoints: run, pick, publish, backlog, profile, history
    runner.py               Runner orchestration over the workflow, background render poller
    platform/               Event bus (SSE stream), file storage, publishing, telemetry
    agent/                  Production agent package, verified by checks/verify_app.py
      graph.py              The complete workflow graph and node definitions
      desk.py               render_desk and render_submit wrapped with LongRunningFunctionTool
      schemas.py            Pydantic schemas: Directions, CleanedDirection, Script
      cleanup_tools.py      Deterministic policy tools: find_policy_hits, suggest_replacement
      platform/             Memory Bank, RAG Engine, and Veo integrations
  web/                      Production React user interface
  Dockerfile · deploy.py · run.sh
- Stream de evento único: o back-end do FastAPI publica eventos em um único stream de eventos enviados pelo servidor (SSE). O front-end do React visualiza a progressão do gráfico em tempo real e lida com conexões atrasadas sem perder o estado.
- Execução desacoplada: o aplicativo gerencia o loop de eventos. O gráfico de fluxo de trabalho se concentra totalmente na lógica de execução, sem conhecer a interface de front-end.
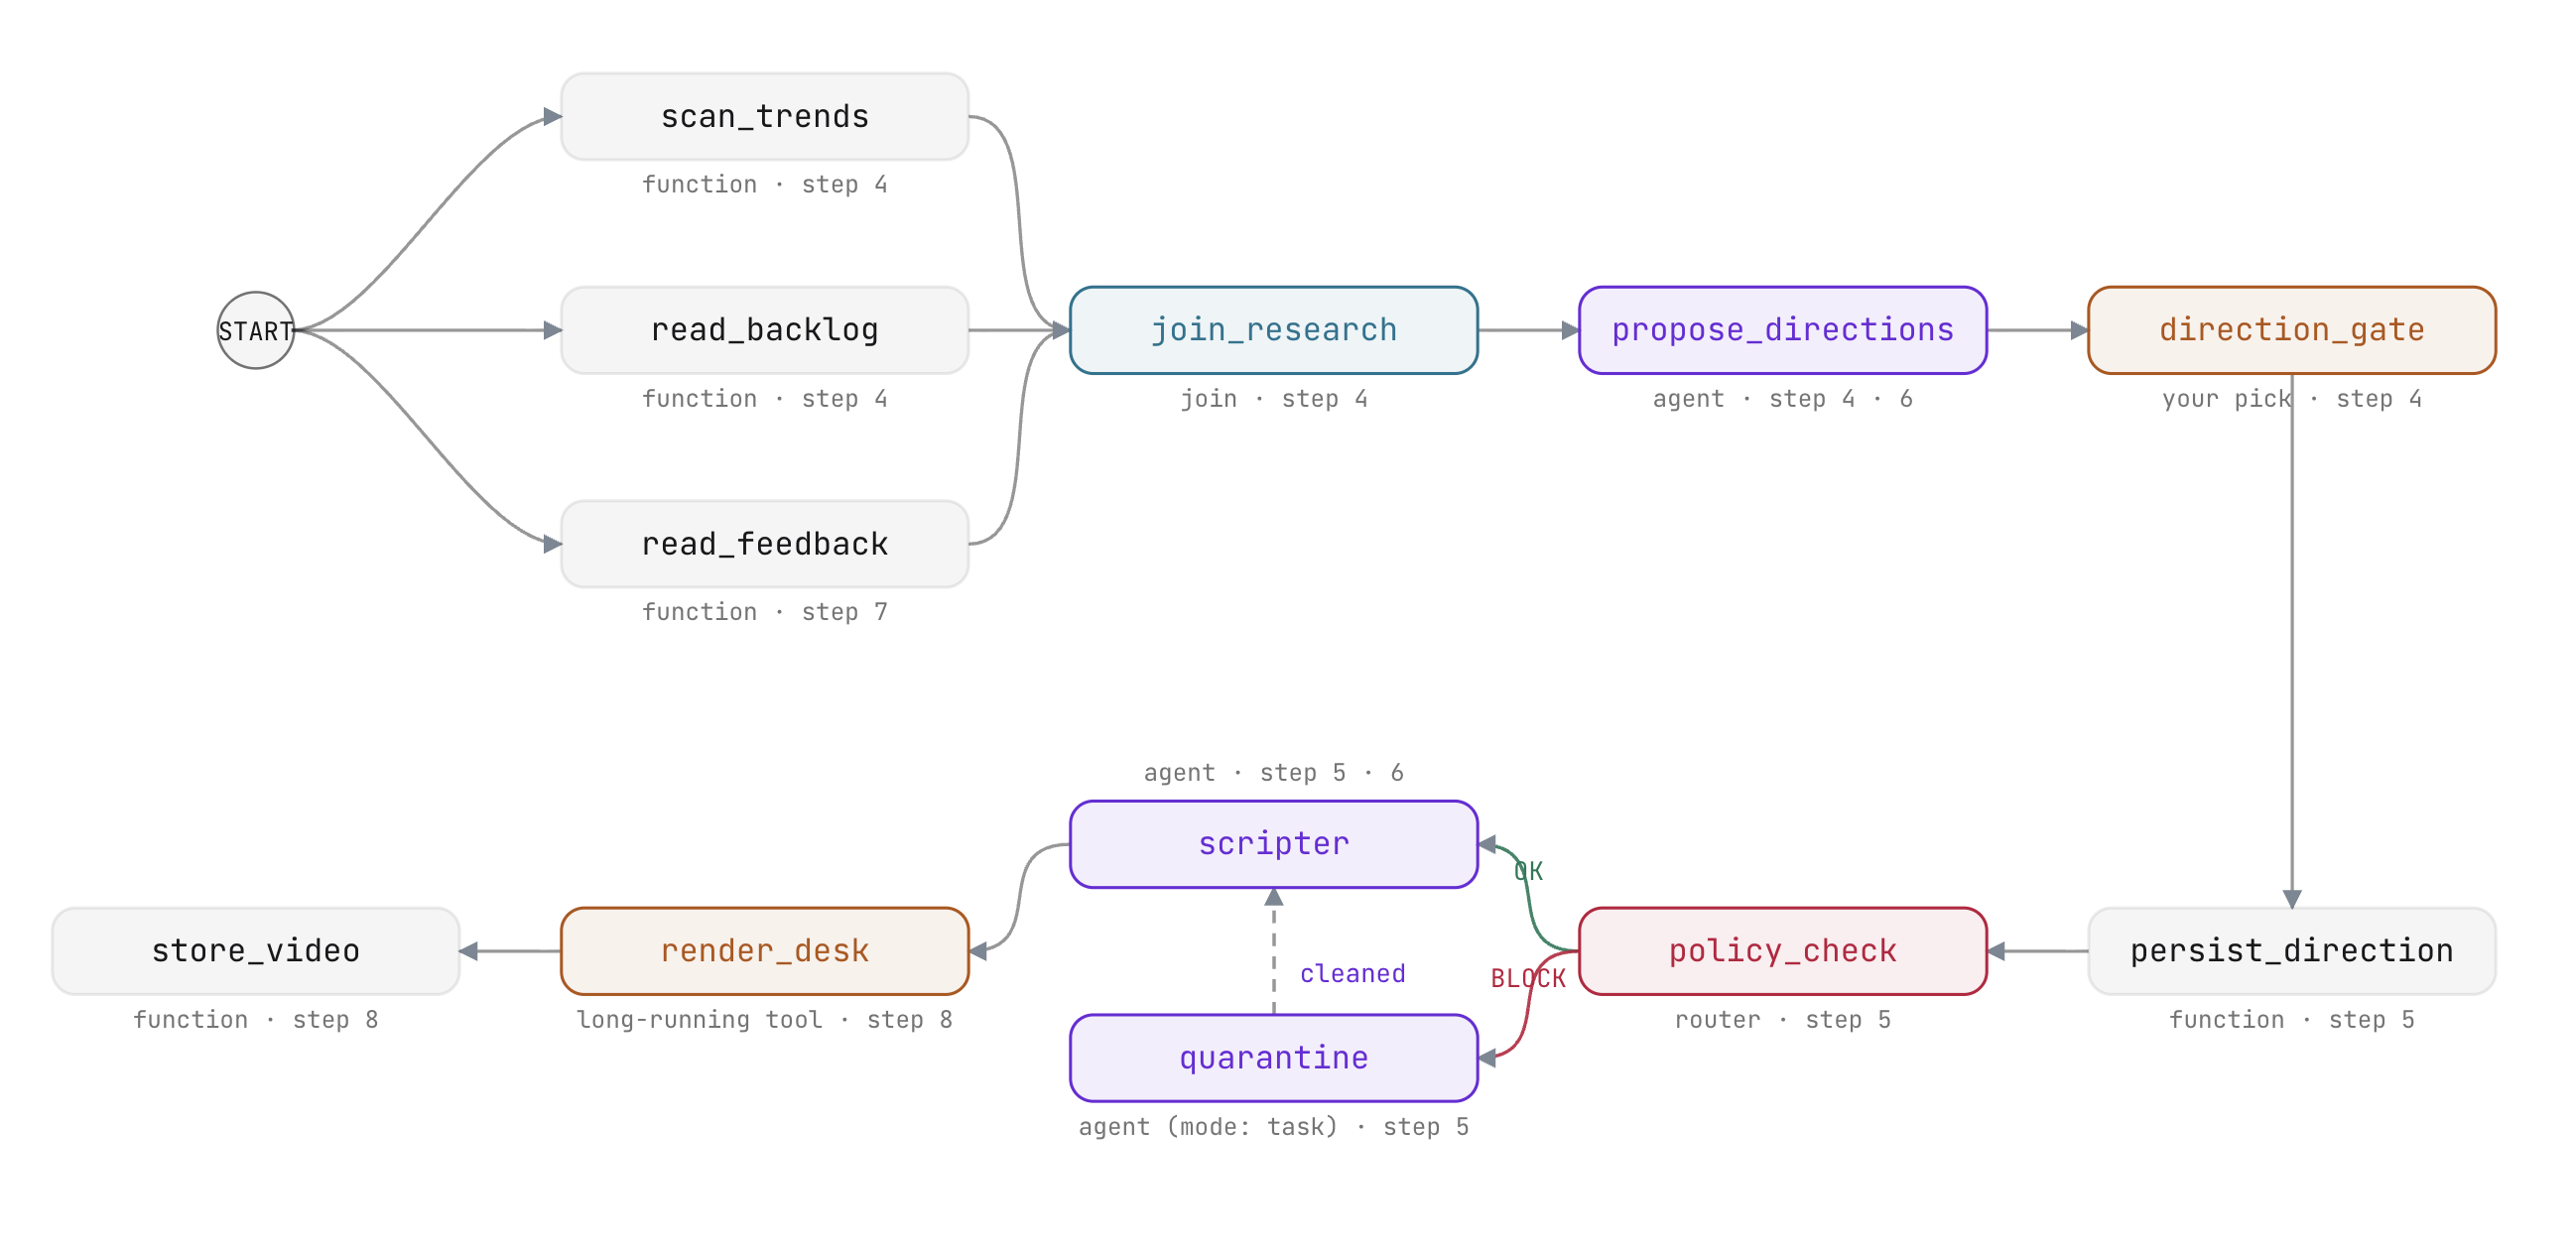
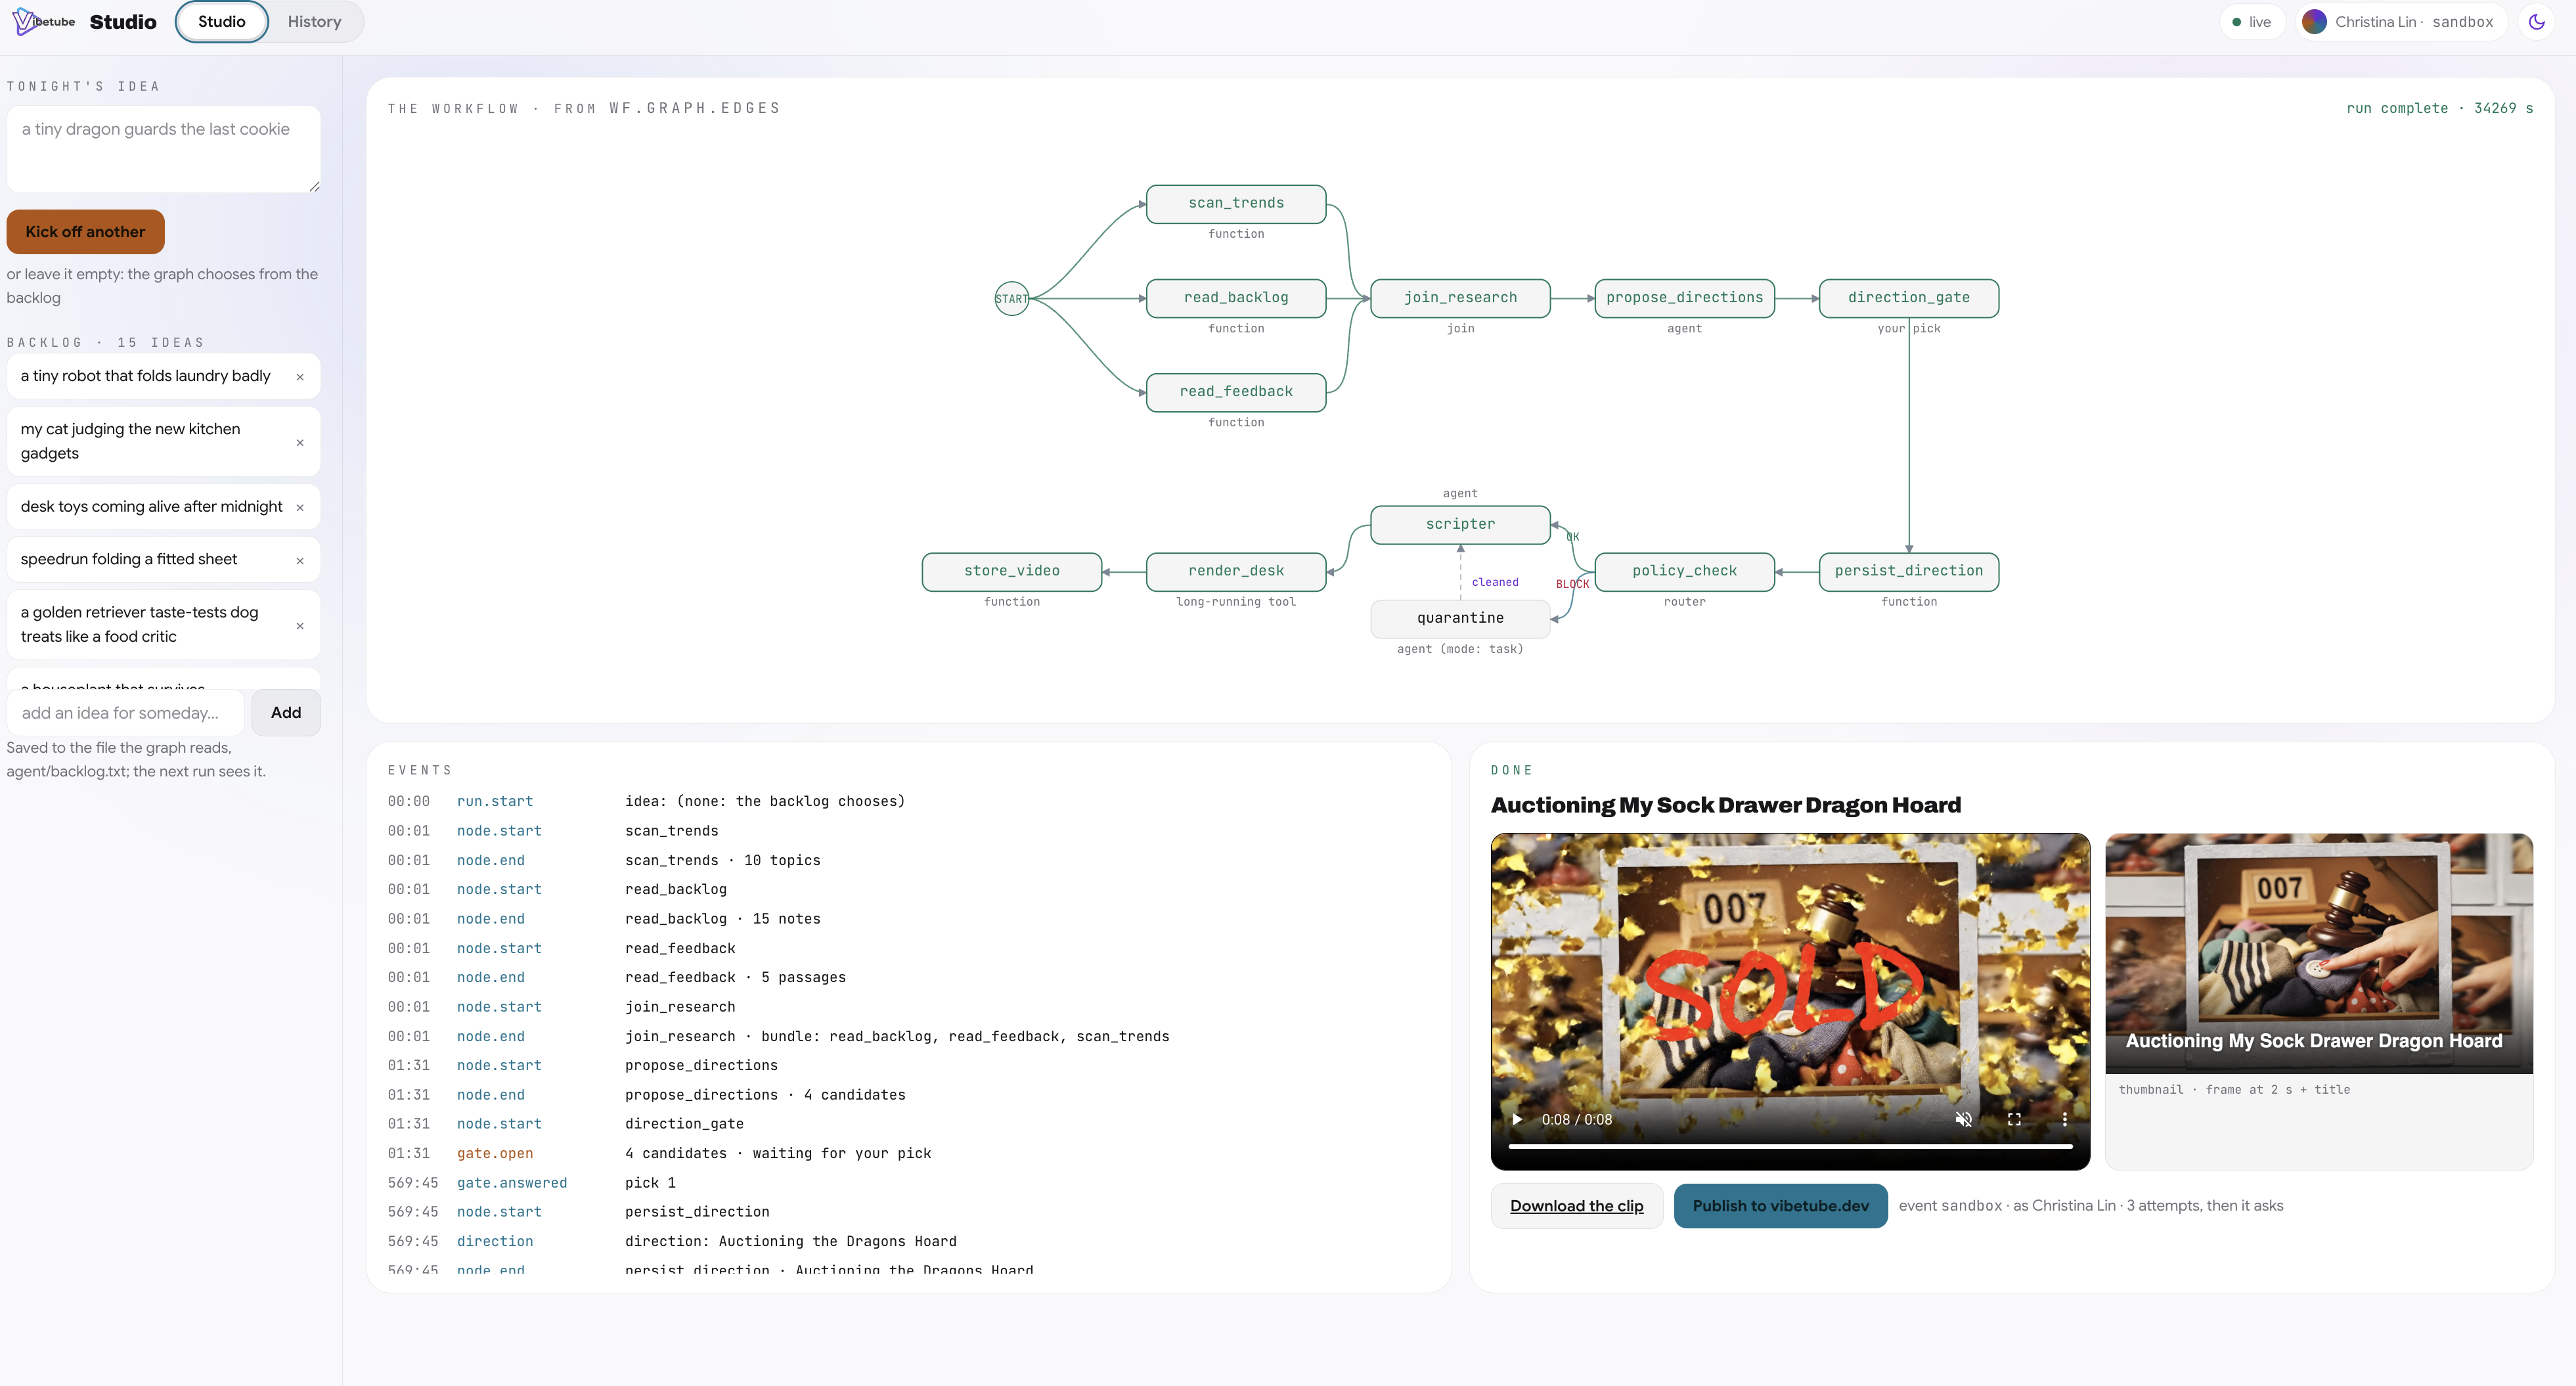
A lista completa de arestas do fluxo de trabalho em agent/graph.py combina todos os padrões de arquitetura criados ao longo deste codelab:
        (START, scan_trends, join_research),
        (START, read_backlog, join_research),
        (START, read_feedback, join_research),
        (join_research, propose_directions, direction_gate,
         persist_direction, policy_check),
        (policy_check, {"OK": scripter, "BLOCK": quarantine}),
        (quarantine, scripter),
        (scripter, render_desk, store_video),
Como implantar no Cloud Run
O Google Cloud Run oferece hospedagem sem servidor com escalonamento automático, roteamento de solicitações e builds de contêineres integrados:
gcloud run deploy vibestudio --source vibestudio \
  --project $GOOGLE_CLOUD_PROJECT --region us-central1 \
  --labels dev-tutorial-codelab=vibetube --allow-unauthenticated \
  --memory 2Gi --cpu 2 --timeout 3600 --concurrency 40 \
  --max-instances 1 --min-instances 1 --session-affinity \
  --set-env-vars GOOGLE_CLOUD_PROJECT=...,STUDIO_VERTEX=1,STUDIO_MEMORY_BANK=...,STUDIO_RAG_CORPUS=...,VIBETUBE_URL=...,VIBETUBE_EVENT=...,VIBETUBE_NAME=...,VIBETUBE_PROJECT=...
- Criação de contêiner:
gcloud run deploy --sourceempacota o diretóriovibestudio/, cria a imagem do contêiner usando o Cloud Build e implanta o serviço em uma única operação. - Afinidade da sessão: direciona as solicitações do mesmo usuário para a mesma instância de contêiner, preservando o estado da sessão local em todas as etapas iterativas.
- Observabilidade: a integração do Cloud Trace registra períodos distribuídos para cada nó, chamada de LLM e execução de ferramenta, acessíveis no console do Google Cloud em "Trace Explorer".
Clique no botão Implantar no workbench para executar o script de implantação. Quando o build for concluído, o terminal vai mostrar o URL do serviço ativo.
10. Resumo
No VibeStudio Workbench, acesse Etapa 10 · Resumo para analisar a arquitetura concluída.
Etapa | Arquitetura e conceitos | Padrão de implementação |
Um único comando | Comando único, ferramentas de função, loop de chat sequencial |
|
Princípios básicos dos Agentic Workflows | Fluxo de trabalho de gráfico, pesquisa paralela, saídas de esquema, controle humano |
|
Estado e roteador | Estado de sessão compartilhado, vinculação de parâmetros, roteamento determinístico, agente de tarefas |
|
Memory Bank | Memória de longo prazo no nível do usuário, consolidação semântica, hooks de ciclo de vida |
|
Mecanismo RAG | Recuperação de documentos em comentários do público, embeddings semânticos | Nó |
Geração assíncrona de vídeos com o Veo | Ferramentas de longa duração, recibos pendentes, daemon de entrega externa |
|
Implantar no Cloud Run | Orquestração programática, eventos enviados pelo servidor, contêiner sem servidor |
|
Princípios básicos de arquitetura
- Suspenda em vez de esperar: os fluxos de trabalho são pausados de maneira limpa para entrada humana (
RequestInput) ou operações de longa duração (LongRunningFunctionTool). Os processos não ficam ociosos em linhas de execução ou sockets de rede. - Retomada universal: todas as suspensões são retomadas por um mecanismo idêntico: um único
function_responseque carrega o ID de chamada do nó suspenso. - Gerenciamento de estado desacoplado: os nós compartilham dados por chaves de estado de sessão nomeadas e vinculação de parâmetros em vez de payloads intermediários verbosos e fortemente acoplados.
- Roteamento determinista antes do custo generativo: roteadores baseados em regras e filtros de regex avaliam a política sem custo de token antes da execução dos modelos generativos.
- Separação de responsabilidades: o contexto específico de um agente individual pertence a callbacks de ciclo de vida, enquanto dependências de dados compartilhados pertencem