1. Введение
Этот практический семинар проведет вас через процесс создания агентных систем нового поколения с использованием рабочих процессов и графов из комплекта разработки агентов (ADK). Вы реализуете распространенные архитектурные шаблоны, организуете взаимодействие с участием человека (HITL) и обрабатываете длительные асинхронные операции. Вы также интегрируете корпоративные базы знаний и постоянную память для настройки и развития поведения агентов. Наконец, вы объедините эти возможности для создания автоматизированного конвейера генерации видео.
Сценарий
Вы ведете цифровой канал на VibeTube с активной аудиторией и постоянно пополняющимся портфелем креативных идей. Создание каждого видеоролика требует непрерывной работы на нескольких этапах: исследование популярных форматов, анализ отзывов зрителей, разработка сценариев, проверка соответствия правилам и генерация видеоклипов. Генеративные модели могут создавать отдельные элементы, но для обеспечения стабильного выпуска контента необходима скоординированная архитектура агентов.
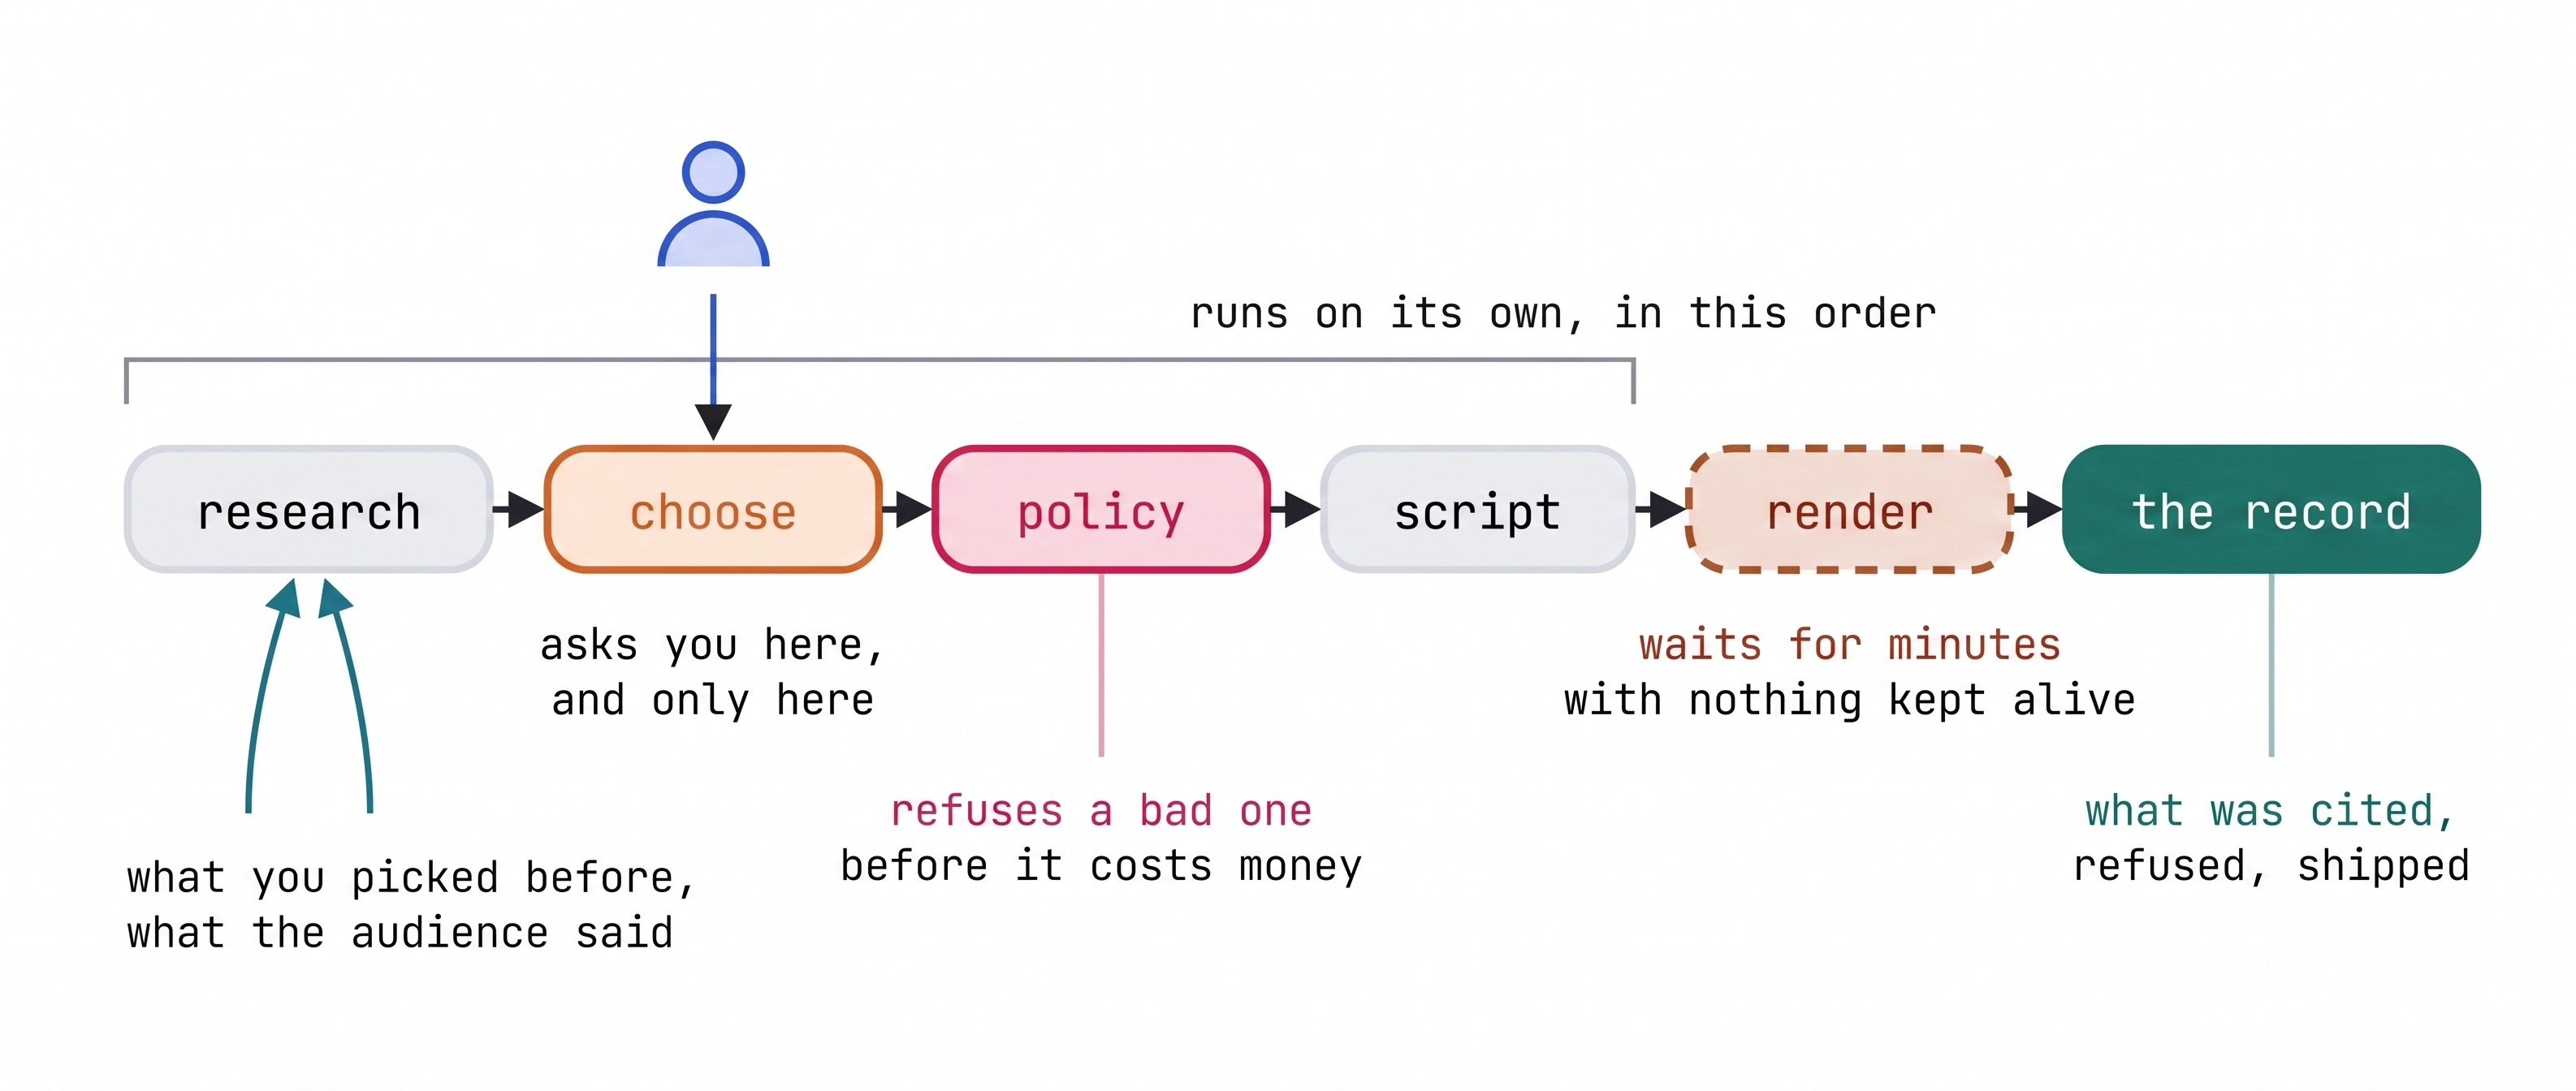
Для автоматизации этого жизненного цикла вы создадите VibeStudio. Этот автоматизированный конвейер выполняет рутинные исследования параллельно, предоставляет тщательно отобранные варианты для утверждения человеком, применяет автоматические проверки политик перед генерацией видео и сохраняет контекст между производственными запусками.
Чему вы научитесь
- Основы проектирования графов : Многошаговые архитектуры агентов требуют явного управления потоком выполнения и структурированных путей выполнения. Вы создаете
WorkflowADK, используя кортежи ребер, точку входаSTART,JoinNodeдля параллельной агрегации с разветвлением и детерминированные узлы маршрутизатора для управления выполнением в зависимости от состояния. - Режимы работы агента и обратные вызовы жизненного цикла : Специализированные задачи требуют особого операционного поведения и детерминированных ограничений. Вы настраиваете экземпляры ADK
Agent, используя режимыtaskchat,single_turnи tool-enabled в качестве узлов рабочего процесса, применяя перехватчики сbefore_model_callbackиafter_agent_callback. - Оркестрация с участием человека : производственные конвейеры приостанавливаются для принятия решения человеком на критически важных этапах разработки. Вы используете
RequestInputдля приостановки выполнения рабочих процессов, обеспечения структурированных схем ответов и возобновления выполнения без поддержания активных процессов среды выполнения. - Иерархическая память агента : в производственных системах временное состояние выполнения отделено от постоянного контекста. Вы управляете краткосрочным состоянием сессии с помощью
Event(state=...)и привязки параметров, а также подключаете GEAP Memory Bank для извлечения, консолидации и сохранения настроек создателя между запусками. - Интеграция с корпоративными базами знаний : Автономным агентам необходим динамический контекст предметной области и анализ настроений аудитории. Вы подключаете корпус GEAP RAG Engine в качестве выделенного узла поиска в параллельной сети для семантической интеграции выходных данных агентов.
- Длительные рабочие процессы и развертывание : Многомодальный рендеринг видео выполняется асинхронно в течение длительного времени. Вы реализуете
LongRunningFunctionToolс ожидающими подтверждениями вызовов для приостановки и возобновления рабочего процесса по идентификатору вызова, а затем развертываете готовый конвейер с помощью ADKRunnerв Cloud Run.
Как организована эта практическая работа.
Данный практический пример послужит вам концептуальным и архитектурным справочником. В каждом разделе объясняются конструкции ADK, реализованные на соответствующем этапе рабочей среды, приводится эталонный код и устанавливаются основные принципы проектирования. Перед выполнением соответствующего упражнения в рабочей среде ознакомьтесь с каждым разделом.
Практическая работа выполняется в VibeStudio Workbench — сопутствующем веб-интерфейсе, включающем интерактивный редактор кода, средства проверки во время выполнения и встроенный инспектор ADK. Нумерация шагов в рабочей среде напрямую соответствует этому практическому заданию, что позволяет синхронизировать ваш прогресс. Основные изменения графа сохраняются между шагами, а рабочая среда автоматически проверяет необходимые условия по мере вашего продвижения.
После выполнения практических заданий вы соберете комплексный конвейер обработки данных и развернете работающее приложение VibeStudio в Cloud Run для генерации видеоконтента.
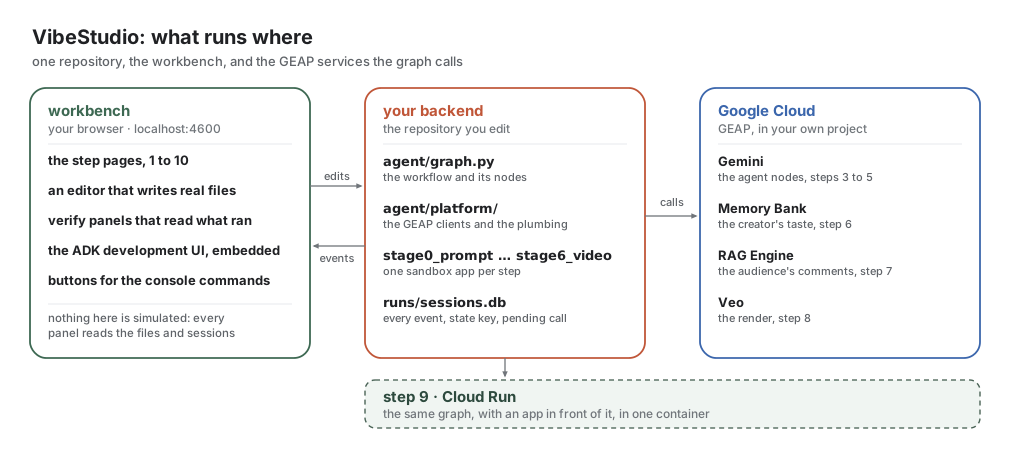
Среда состоит из трех основных компонентов: VibeStudio Workbench (локальный веб-интерфейс для редактирования кода и проверки во время выполнения), вашего бэкэнда (ADK Workflow и тестовые среды в agent/ ) и Google Cloud (модели Gemini, GEAP Memory Bank, RAG Engine и генерация видео Veo).
2. Настройка
Получите зачетные баллы за участие в семинаре.
Если вы посещаете лабораторную работу под руководством преподавателя, он начислит вам баллы за ваш проект в Google Cloud. Следуйте инструкциям преподавателя, чтобы использовать баллы, и убедитесь, что оплата за ваш аккаунт активирована, прежде чем продолжить.
Открытая облачная оболочка
Cloud Shell — это браузерная среда разработки с предустановленными gcloud , Python и git.
Чтобы запустить Cloud Shell:
- Перейдите в консоль Google Cloud .
- В верхней панели навигации нажмите «Активировать Cloud Shell» (значок окна терминала).
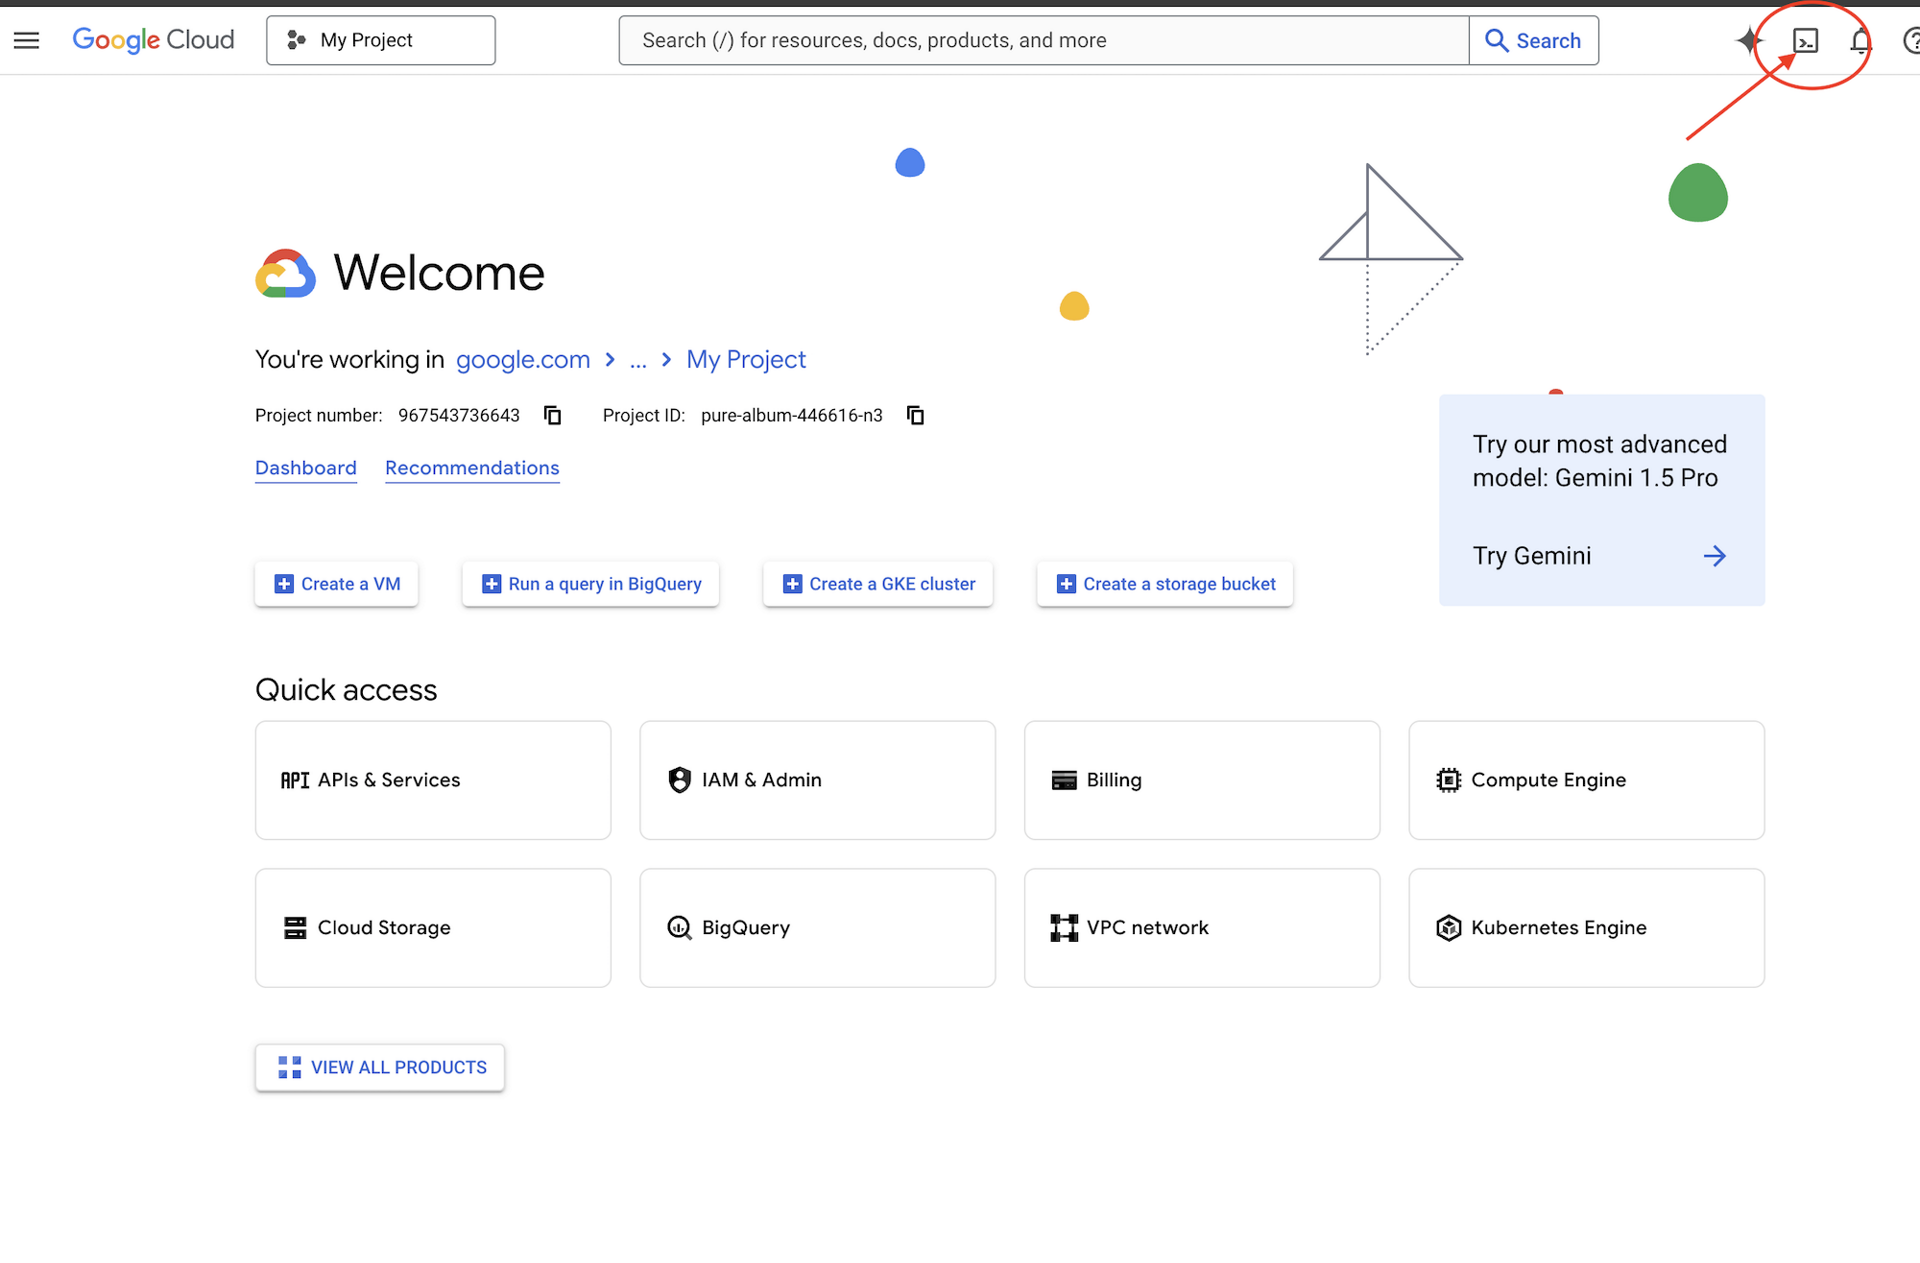
В нижней части окна браузера открывается окно терминала.
Клонируйте и инициализируйте репозиторий.
Для клонирования проекта выполните следующие команды в терминале Cloud Shell:
git clone https://github.com/gca-americas/vibetube-studio
cd ~/vibetube-studio
Запросы на настройку
В процессе настройки вам будет предложено ввести следующие данные:
- Идентификатор проекта Google Cloud : Когда скрипт
setup_project.shзапросит это, нажмите Enter , чтобы автоматически создать новый проект. Если вы предпочитаете использовать существующий проект (например, предварительно назначенный), введите идентификатор своего проекта и убедитесь в правильности написания, при этом оплата должна быть активирована. - Код мероприятия : Введите код комнаты, предоставленный вашим преподавателем. Если вы его не получили, обратитесь к ассистенту преподавателя или к соседу. Если вы выполняете эту лабораторную работу дома, нажмите Enter , чтобы принять комнату-
sandboxпо умолчанию. - Отображаемое имя канала : Введите ваше имя или желаемый никнейм канала, когда скрипт
setup_codelab.shпредложит это, или нажмите Enter, чтобы принять имя по умолчанию, сгенерированное вашей учетной записью Google.
Выполните два скрипта настройки в указанном порядке:
./setup_project.sh
./setup_codelab.sh
-
setup_project.sh: Создает или повторно использует проект Google Cloud с активной оплатой, сохраняет идентификатор проекта в файл~/project_id.txtи настраивает активный контекстgcloud. -
setup_codelab.sh: Устанавливает зависимостиuvи Python в файл.venv, включает необходимые API Google Cloud, настраивает параметры каналов в файле.env, проверяет доступ к модели с помощью Gemini, выделяет ресурсы Memory Bank и RAG, создает интерфейс рабочей среды и запускает VibeStudio Workbench.
Скрипт выполняет предварительную проверку и запускает VibeStudio Workbench в фоновом режиме. В последних строках отображается ссылка для открытия.
7 · Preflight
  ✓ python 3.12
  ✓ auth path A: Vertex via ADC (STUDIO_VERTEX=1)
  ✓ Google Cloud ADC (project <your-project>)
  ✓ stage0_prompt loads
  ...
  ✓ stage6_video loads (13 edges)
  ✓ aiplatform.googleapis.com enabled (Gemini, Veo, Memory Bank, RAG Engine)
  ✓ vectorsearch.googleapis.com enabled (the vector store a RAG corpus is built on)
  ✓ Memory Bank connected
  ✓ RAG corpus connected
  ✓ VibeStudio Workbench running on port 4600

PREFLIGHT GREEN

Setup finished. The VibeStudio Workbench is already running.

  Open this and start at step 1
      https://4600-<your cloud shell host>/step/story

  It runs in the background. You do not need to start anything else.
      log      runs/lab.log
      stop     kill $(cat runs/lab.pid)
      start    scripts/start.sh
Перейдите по этой ссылке. Тот же адрес доступен в разделе «Предварительный просмотр веб-страниц» → «Изменить порт» → «4600» .
Чтобы повторно проверить окружение в любой момент, запустите python scripts/preflight.py . Чтобы перезапустить рабочую среду, запустите scripts/restart.sh . Чтобы настроить заново, запустите ./setup_codelab.sh ; это сохранит вашу конфигурацию и прогресс.
Откройте файл и прочтите шаг 1, «История» , где описан сценарий, и шаг 2, «Что вы создадите» , где описана форма готового графика. Ни в одном из разделов нет упражнений. Затем вернитесь сюда для шага 3.
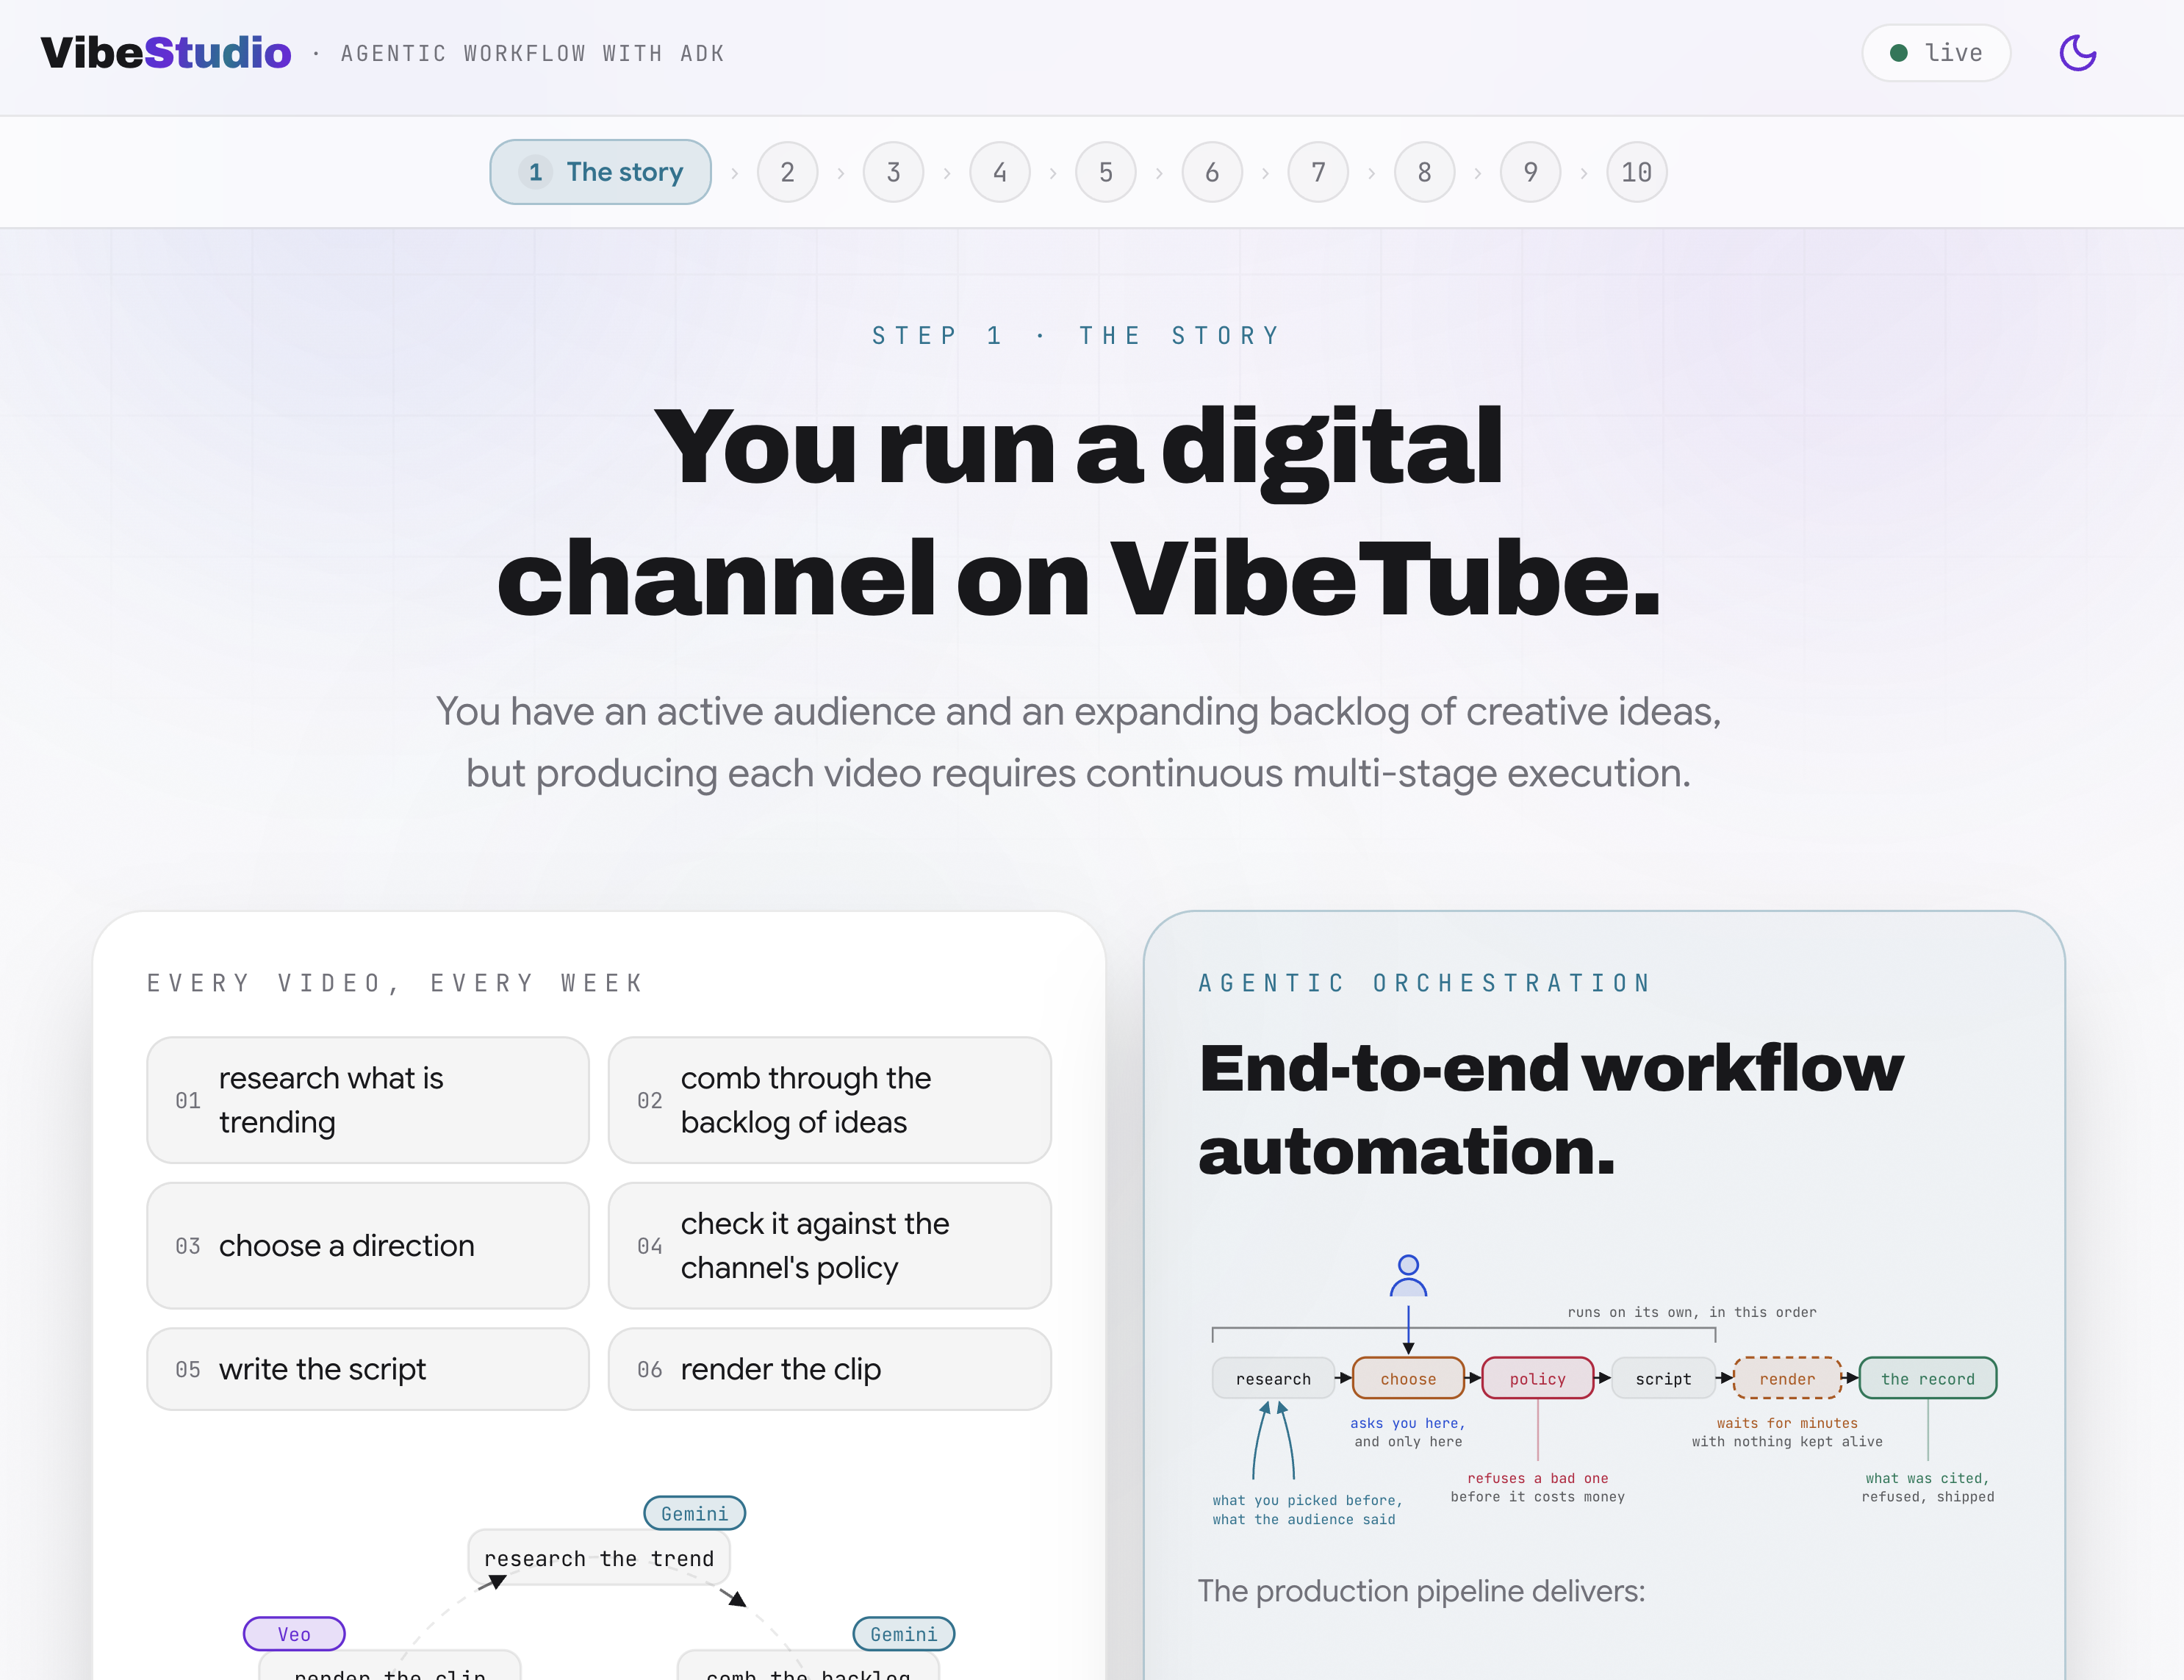
Каждый этап работы с VibeStudio Workbench завершается проверочной панелью, которая считывает реальные данные: файл на диске и сессии, записанные в ходе выполнения программ.
Структура репозитория
Структура репозитория включает основную логику рабочего процесса, пошаговые тестовые среды, рабочую среду и производственное приложение:
vibe-studio-lab/
├── agent/                  # Core ADK workflow, graph definition, and platform services
│   ├── graph.py            # Workflow graph definition, node functions, and routers
│   ├── desk.py             # Video render desk using LongRunningFunctionTool
│   ├── schemas.py          # Pydantic schemas for directions, gates, and scripts
│   ├── trends.py           # Trend generation and sampling utilities
│   ├── backlog.txt         # Creator video ideas backlog
│   ├── comments.md         # Audience comments for RAG Engine corpus seeding
│   ├── policy_words.txt    # Blocked subject words for deterministic policy checks
│   └── platform/           # Google Cloud service clients (Memory Bank, RAG, Veo)
│       ├── config.py       # Environment variables, locations, and model configurations
│       ├── memory.py       # GEAP Memory Bank callbacks and context injection
│       ├── rag.py          # GEAP RAG Engine corpus creation and semantic retrieval
│       └── videogen.py     # Veo video generation and operation polling
├── stage0_prompt/          # Step sandboxes: isolated agent.py files runnable in adk web
│   └── ...                 # stage1_fanout through stage6_video for incremental steps
├── server/ & web/          # VibeStudio Workbench (FastAPI backend and React frontend)
├── vibestudio/             # Complete production application deployed to Cloud Run
│   ├── server/             # FastAPI production server and event runner
│   ├── web/                # End-user React web application
-
agent/: Содержит основной граф рабочего процесса. Вам предстоит редактировать файлы в этом каталоге для реализации параллельных узлов с разветвлением, детерминированной маршрутизации на основе политик, обратных вызовов к памяти и инструментов генерации видео. -
agent/platform/: Интерфейсы для взаимодействия с сервисами Google Cloud, включая модели Gemini, GEAP Memory Bank, GEAP RAG Engine и синтез видео Veo. -
stage0_prompt/throughstage6_video/: Автономные среды песочницы. Каждая папка экспортирует автономныйroot_agent, позволяющий запускать и проверять каждый шаг изолированно через встроенный интерфейс разработки ADK. -
server/andweb/: Приложение VibeStudio Workbench, работающее локально на порту 4600. Оно содержит документацию по шагам, встроенный редактор кода, средства проверки данных во время выполнения и визуализацию графов. -
vibestudio/: Полное рабочее приложение, упакованное и развернутое в Cloud Run на заключительном этапе. Оно содержит собственную автономную копию завершенного графа рабочего процесса.
3. Монолитный агент
Перед построением многоузлового графа рабочего процесса необходимо установить базовую архитектуру с помощью одного агента в stage0_prompt/agent.py . Этот агент использует монолитную системную подсказку, описывающую производственный конвейер в текстовом виде, и поддерживается двумя инструментами на основе функций Python.
Оценка этого базового уровня демонстрирует операционные ограничения координации, основанной на подсказках, и объясняет, почему производственные системы требуют оркестровки графов.
Архитектура агента ADK (3A)
В VibeStudio Workbench перейдите к шагу 3 · Монолитный агент и откройте архитектуру агента ADK (3A) . В этом представлении отображаются основные архитектурные слои агента ADK ( LlmAgent ):
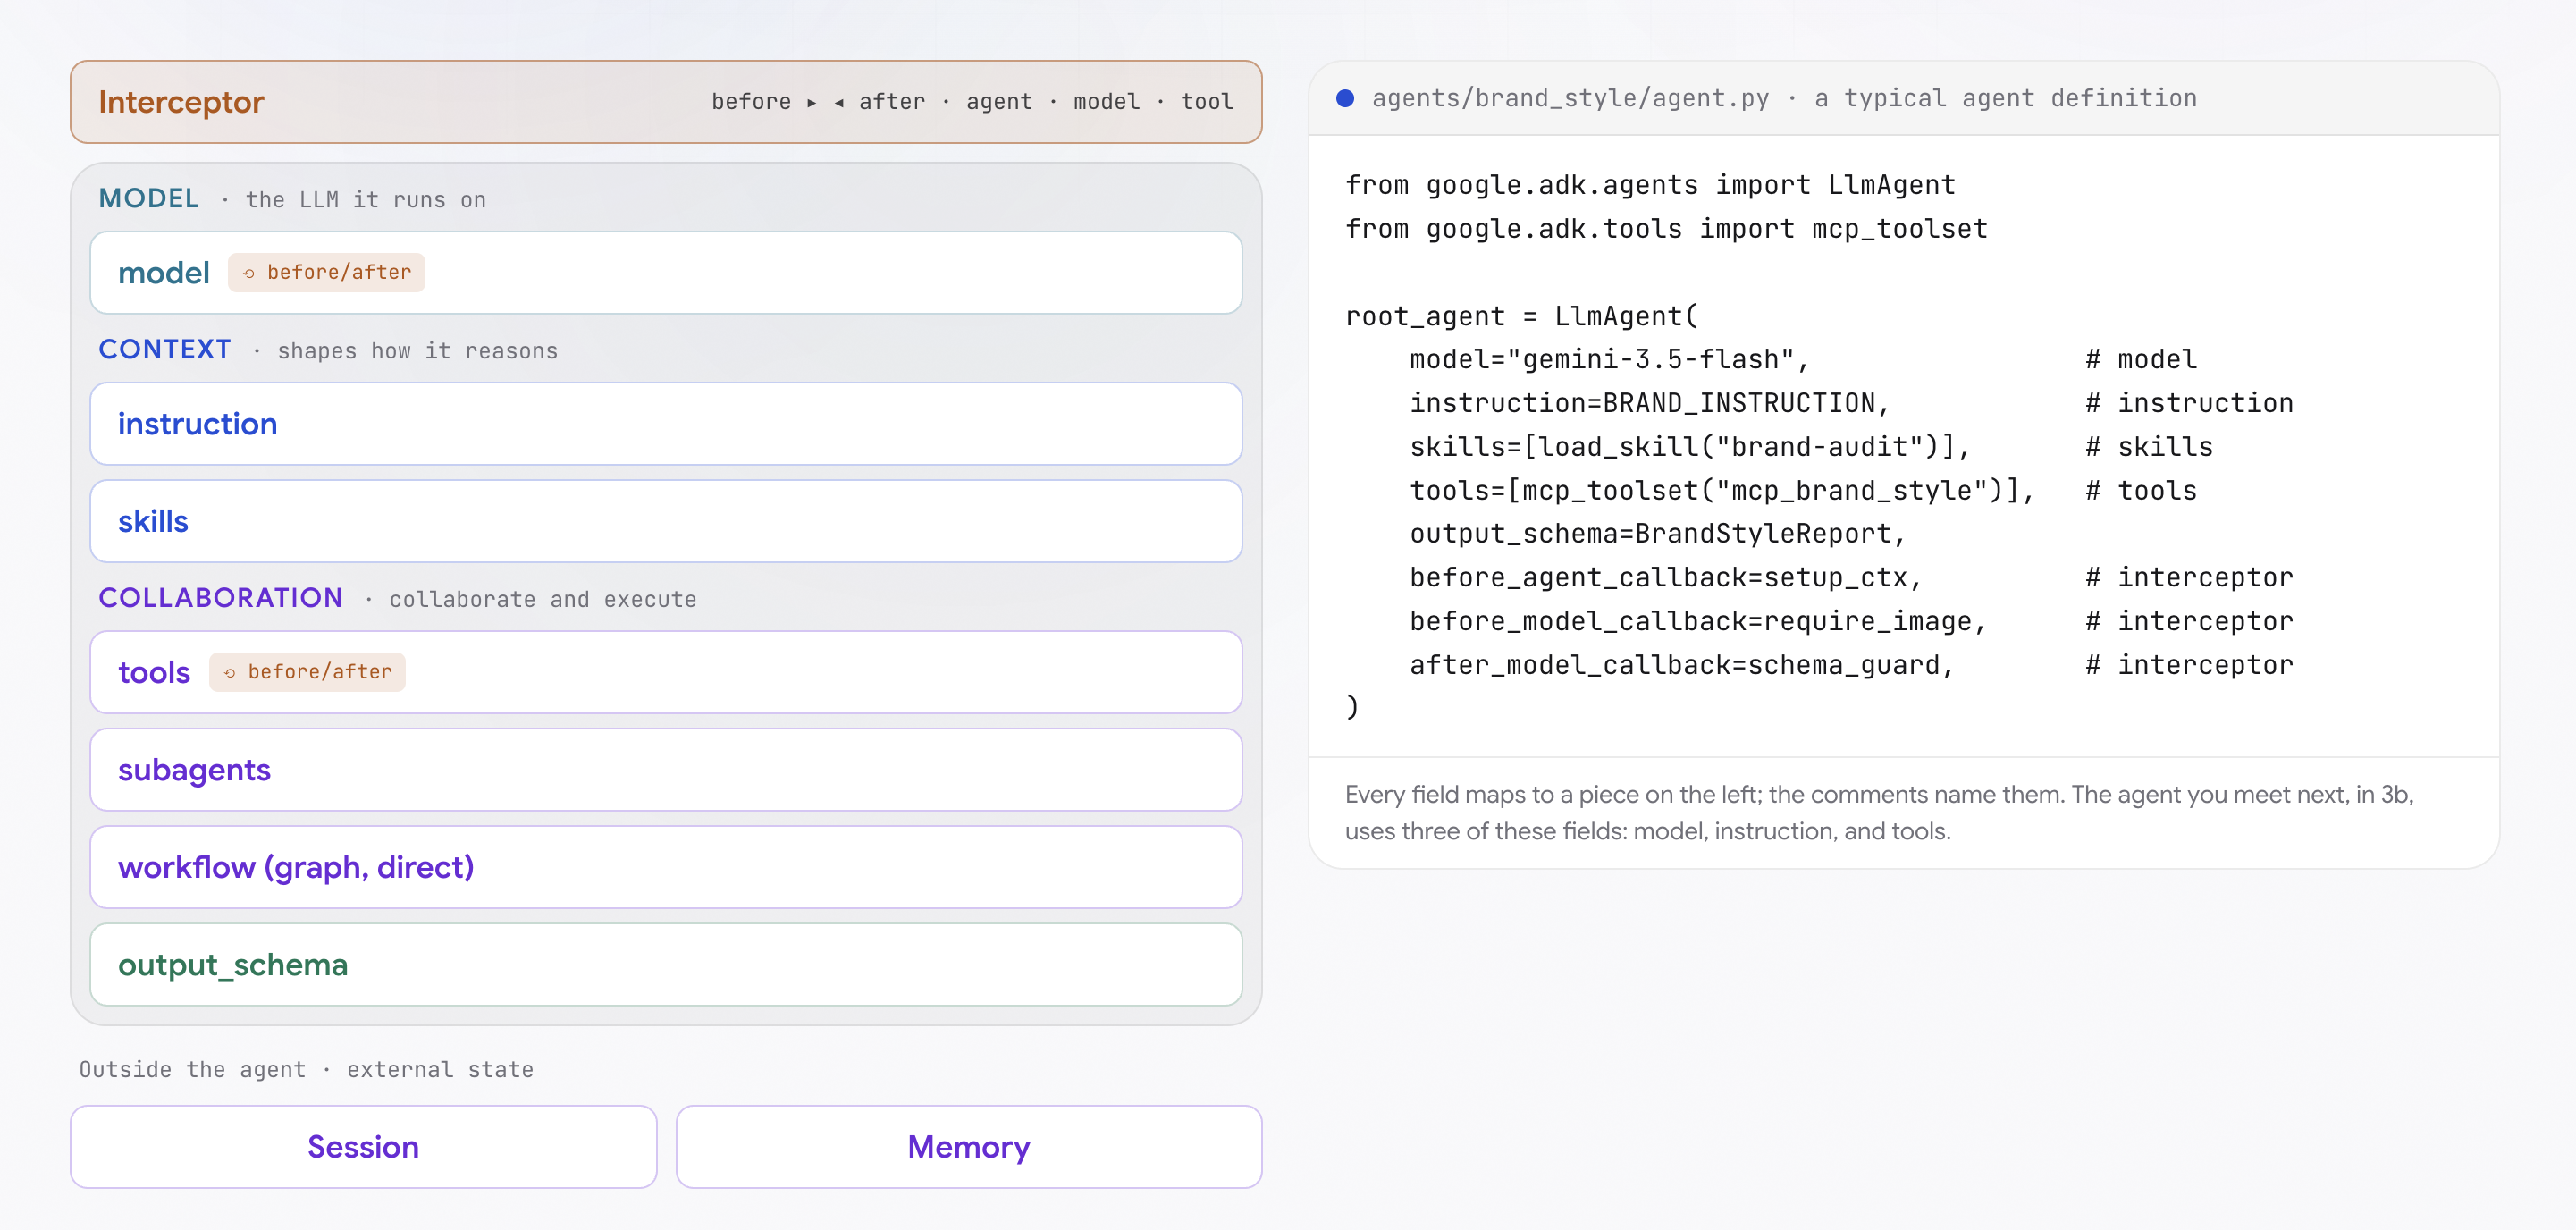
from google.adk.agents import LlmAgent
from google.adk.tools import mcp_toolset

root_agent = LlmAgent(
    model="gemini-3.5-flash",                 # model
    instruction=BRAND_INSTRUCTION,            # instruction
    skills=[load_skill("brand-audit")],       # skills
    tools=[mcp_toolset("mcp_brand_style")],   # tools
    output_schema=BrandStyleReport,           # structured output
    before_agent_callback=setup_ctx,          # interceptor
    before_model_callback=require_image,      # interceptor
    after_model_callback=schema_guard,        # interceptor
)
Интерактивная диаграмма группирует компоненты агента в пять операционных областей:
- Слой рассуждений (модель) : основная языковая модель (например, Gemini 3 Flash), выполняющая когнитивные задачи, подсказки для рассуждений и выбор инструментов. Все остальное в архитектуре либо дополняет, либо ограничивает эту модель.
- Контекстный слой (инструкции и навыки) : директивы, формирующие модель рассуждений.
instructionустанавливают постоянные системные подсказки, персону и правила работы.skillsпредоставляют версионированные, процедурные указания (SKILL.md) для повторяющихся рабочих процессов. - Уровень взаимодействия и действий (Инструменты, Подагенты, Рабочий процесс, Схема вывода) : Интерфейсы, позволяющие агенту взаимодействовать с внешними системами и передавать типизированные данные.
toolsпредоставляют вызываемые функции Python или конечные точки протокола контекста модели (MCP).subagentsвыполняют подчиненные делегированные задачи.workflowкоординирует графы нескольких агентов.output_schemaприменяет модели Pydantic, чтобы гарантировать, что конечные потребители получают проверенный JSON вместо неструктурированного текста. - Слой перехватчиков (коллбэки жизненного цикла) : Детерминированные механизмы контроля, выполняющие пользовательский код до и после выполнения агента (
before_agent/after_agent), отдельных циклов модели (before_model/after_model) и вызовов инструментов (before_tool/after_tool). Перехватчики обеспечивают соблюдение правил политики без опоры на соответствие модели. - Внешнее состояние (сессия и память) : сохранение состояния, отделенное от логики агента.
Sessionсохраняет временную рабочую память и трассировку событий для текущего потока выполнения.Memoryподдерживает надежные данные и предпочтения между сессиями, используя управляемые службы, такие как GEAP Memory Bank.
На этом этапе монолитный агент реализует только три из этих примитивов: model , instruction и tools . На последующих этапах вводятся графовые рабочие процессы, структурированные схемы, перехватчики и службы постоянной памяти.
Спецификация монолитного агента (3B)
В рабочей среде перейдите к спецификации монолитного агента (3B) . Откройте stage0_prompt/agent.py , чтобы изучить базовое определение агента:
- Инструкция по использованию одной подсказки : Системная подсказка сводит пять отдельных производственных задач в единый текст: выявление тенденций платформы, анализ идей из бэклога, предложение креативных концепций, обеспечение соблюдения правил, касающихся запрещенных тем, и составление списков кадров.
- Базовые источники данных : Агент ссылается на два источника, указанных рядом с графом:
-
agent/trends.py: Выбирает десять активных трендов формата и стиля из пула в 250 трендов с динамическим присвоением оценок «теплоты». -
agent/backlog.txt: Построчно читает необработанные концептуальные заметки автора.
-
Инструменты в Агенте (3C)
В рабочей области перейдите в раздел «Инструменты» в Agent (3C) .
Что является инструментом для агента?
Языковая модель по своей сути представляет собой замкнутый мир логических рассуждений: она работает исключительно на основе предварительно обученных весов и токенов, присутствующих в ее непосредственном контекстном окне. Она не может напрямую запрашивать данные из базы данных, получать доступ к API в реальном времени или выполнять код.
Инструмент преодолевает эту границу. Он предоставляет модели внешний механизм управления, позволяя ей получать достоверную информацию и выполнять детерминированные действия во внешних системах.
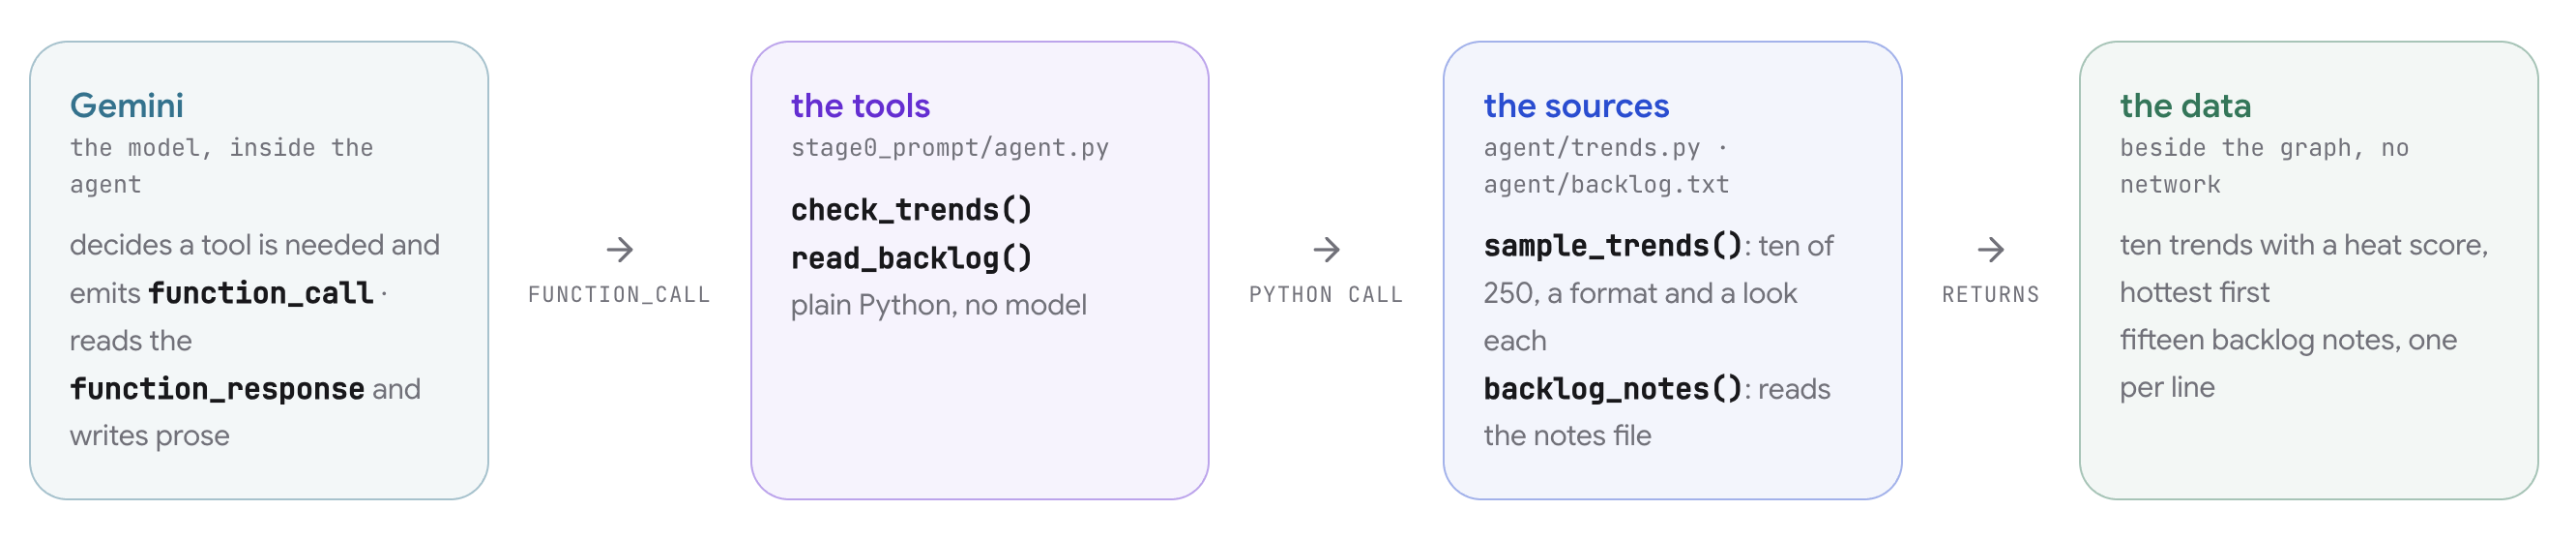
Вызов инструментов осуществляется в соответствии с четко определенным пятиэтапным протоколом между моделью и средой выполнения ADK:
- Объявление схемы : Разработчик предоставляет агенту функции Python. ADK проверяет имя каждой функции, аннотации типов и строки документации для генерации совместимого с OpenAPI объявления схемы в формате JSON, описывающего ее параметры и назначение.
- Рассуждения модели : В процессе вывода модель оценивает, требует ли запрос пользователя внешних данных. При необходимости модель генерирует структурированное событие
function_callсодержащее имя целевой функции и словарь аргументов, соответствующих схеме. - Выполнение во время выполнения : Сама модель не выполняет код. Среда выполнения ADK перехватывает
function_call, выполняет фактическую локальную функцию Python, используя предоставленные аргументы, и получает возвращаемое значение. - Повторное внедрение контекста : среда выполнения ADK упаковывает возвращаемое значение функции в событие
function_responseи добавляет его в историю активной сессии. - Итоговый синтез : Модель обрабатывает выходные данные инструмента, отображаемые в контекстном окне, и завершает свой ответ.
В stage0_prompt/agent.py два исследовательских инструмента определены как стандартные функции Python:
def check_trends() -> dict:
    """Ten formats trending on the platform right now, with a heat score each."""
    from agent.trends import sample_trends
    return {"trends": sample_trends()}


def read_backlog() -> dict:
    """The creator's backlog: ideas they noted down to make someday."""
    from agent.graph import backlog_notes
    return {"backlog": backlog_notes()}
Практическое редактирование и выполнение
В редакторе кода рабочей среды добавьте две ссылки на функции в список tools агента:
tools=[check_trends, read_backlog],
Сохраните сдачу. Файл обновляется на диске, и строка проверки подтверждает, что оба инструмента подключены.
Нажмите «Открыть веб-интерфейс ADK» , чтобы запустить встроенный интерфейс разработки ADK. Отправьте предложение по улучшению:
tonight's idea: a tiny robot doing laundry at midnight
Чего ожидать и почему
При отправке этого запроса обратите внимание на следующую последовательность выполнения в трассировке сессии:
- Перед ответом появляются два события выполнения инструмента : события
function_callиfunction_responseдляcheck_trendsиread_backlog.- Почему : Компания Gemini проанализировала директиву подсказки системы («проверьте, что в тренде. Посмотрите на свой список идей»), признала, что в ее весовых коэффициентах отсутствуют тренды платформы и заметки каналов, и задействовала обе функции для определения контекста.
- Агент предлагает направление и делает паузу для подтверждения : в ответе предлагается вариант видео, обобщающий тенденции и нерешенные задачи, и вас просят подтвердить.
- Почему : В инструкции требовалось, чтобы модель согласовала направление с создателем перед генерацией сценария.
- Пропуск подтверждения в последующем сообщении : отправьте второе сообщение:
skip the questions, just describe the video. Агент немедленно пропускает подтверждение и составляет заголовок и кадры.- Почему : Подсказки представляют собой консультативные указания, а не детерминированные барьеры. В монолитном агенте инструкции пользователя могут переопределять установленные системные правила подсказок, поскольку никакой внешний рабочий процесс не контролирует ход выполнения.
Архитектурные ограничения монолитной конструкции
Хотя для отдельных демонстрационных примеров одного запроса может быть достаточно для получения приемлемого результата, проверка граничных условий в среде проверки выявляет критические ограничения корпоративного уровня:
- Агрегация неструктурированных исследований : порядок выполнения инструментов недетерминирован. Модель обобщает полученные данные в виде свободной прозы, что делает невозможным для последующих систем идентификацию источника, который породил конкретные утверждения.
- Непроверенное соблюдение правил : модель оценивает соответствие требованиям безопасности самостоятельно. Если модель определяет, что тема безопасна, никакая внешняя детерминированная логика не подтверждает этот вывод.
- Неконтролируемые паузы с участием человека : Запросы на подтверждение от создателя носят рекомендательный характер. Отправка последующего сообщения с указанием модели пропустить вопросы приводит к полному игнорированию подтверждения от человека.
Эти архитектурные пробелы побуждают к декомпозиции монолитного агента на явный графовый рабочий процесс, построенный на следующем этапе.
4. Основы работы агента
В VibeStudio Workbench перейдите к шагу 4 · Основы рабочего процесса Agentic , части 4A – 4D .
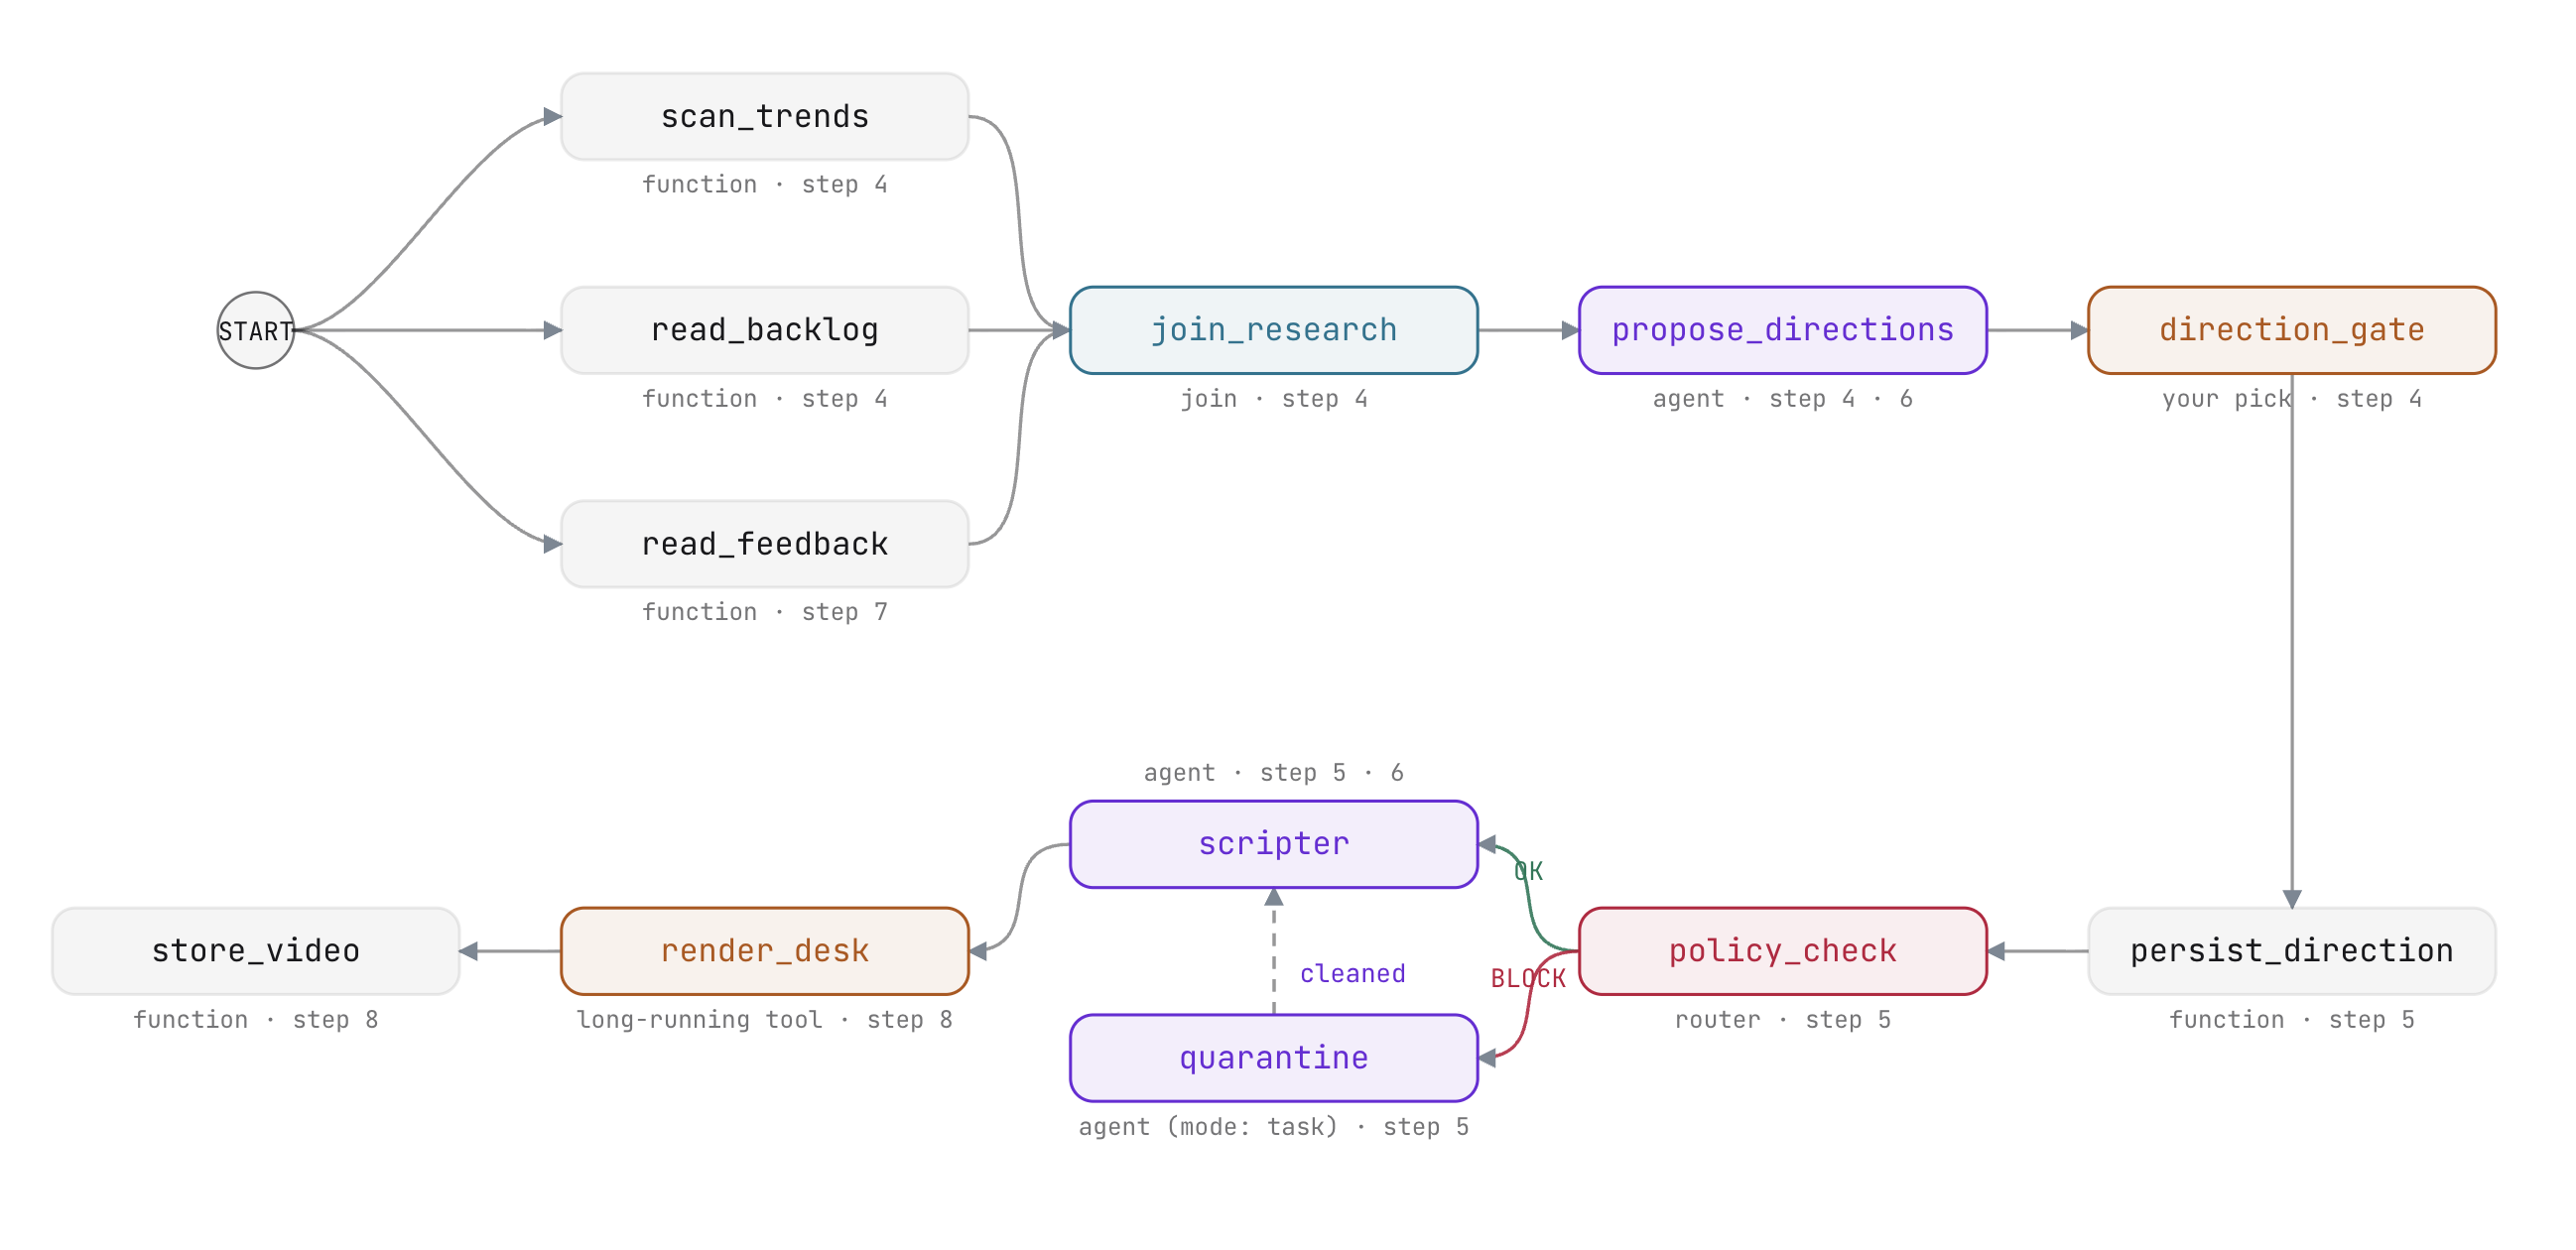
На этом этапе происходит переход от базового варианта с одним агентом к детерминированной оркестрации графа с использованием ADK Workflow . Вы создадите параллельное направление исследований, синхронизируете ветви с узлом соединения, сгенерируете проверенные по схеме варианты креативов и введете детерминированный контрольный пункт с участием человека.
Архитектура графа и цепочки выполнения (4A)
В рабочей среде откройте архитектуру Graph и цепочки выполнения (4A) .
В структуре Workflow ADK выполнение агента представлено в виде ориентированного графа, определяемого списком ребер:
- Цепочки : Последовательные кортежи определяют линейное выполнение узлов (
(node_a, node_b, node_c)). - Параллельные ветви : Независимые цепочки, имеющие общий исходный узел, выполняются одновременно.
- Синхронизация : Цепочки, сходящиеся к
JoinNode, ждут, пока все входящие ветви не сообщат о своем участии, прежде чем освободиться. - Детерминированное управление : ход выполнения определяется объявленными структурами кода, а не выводится из текста подсказки.
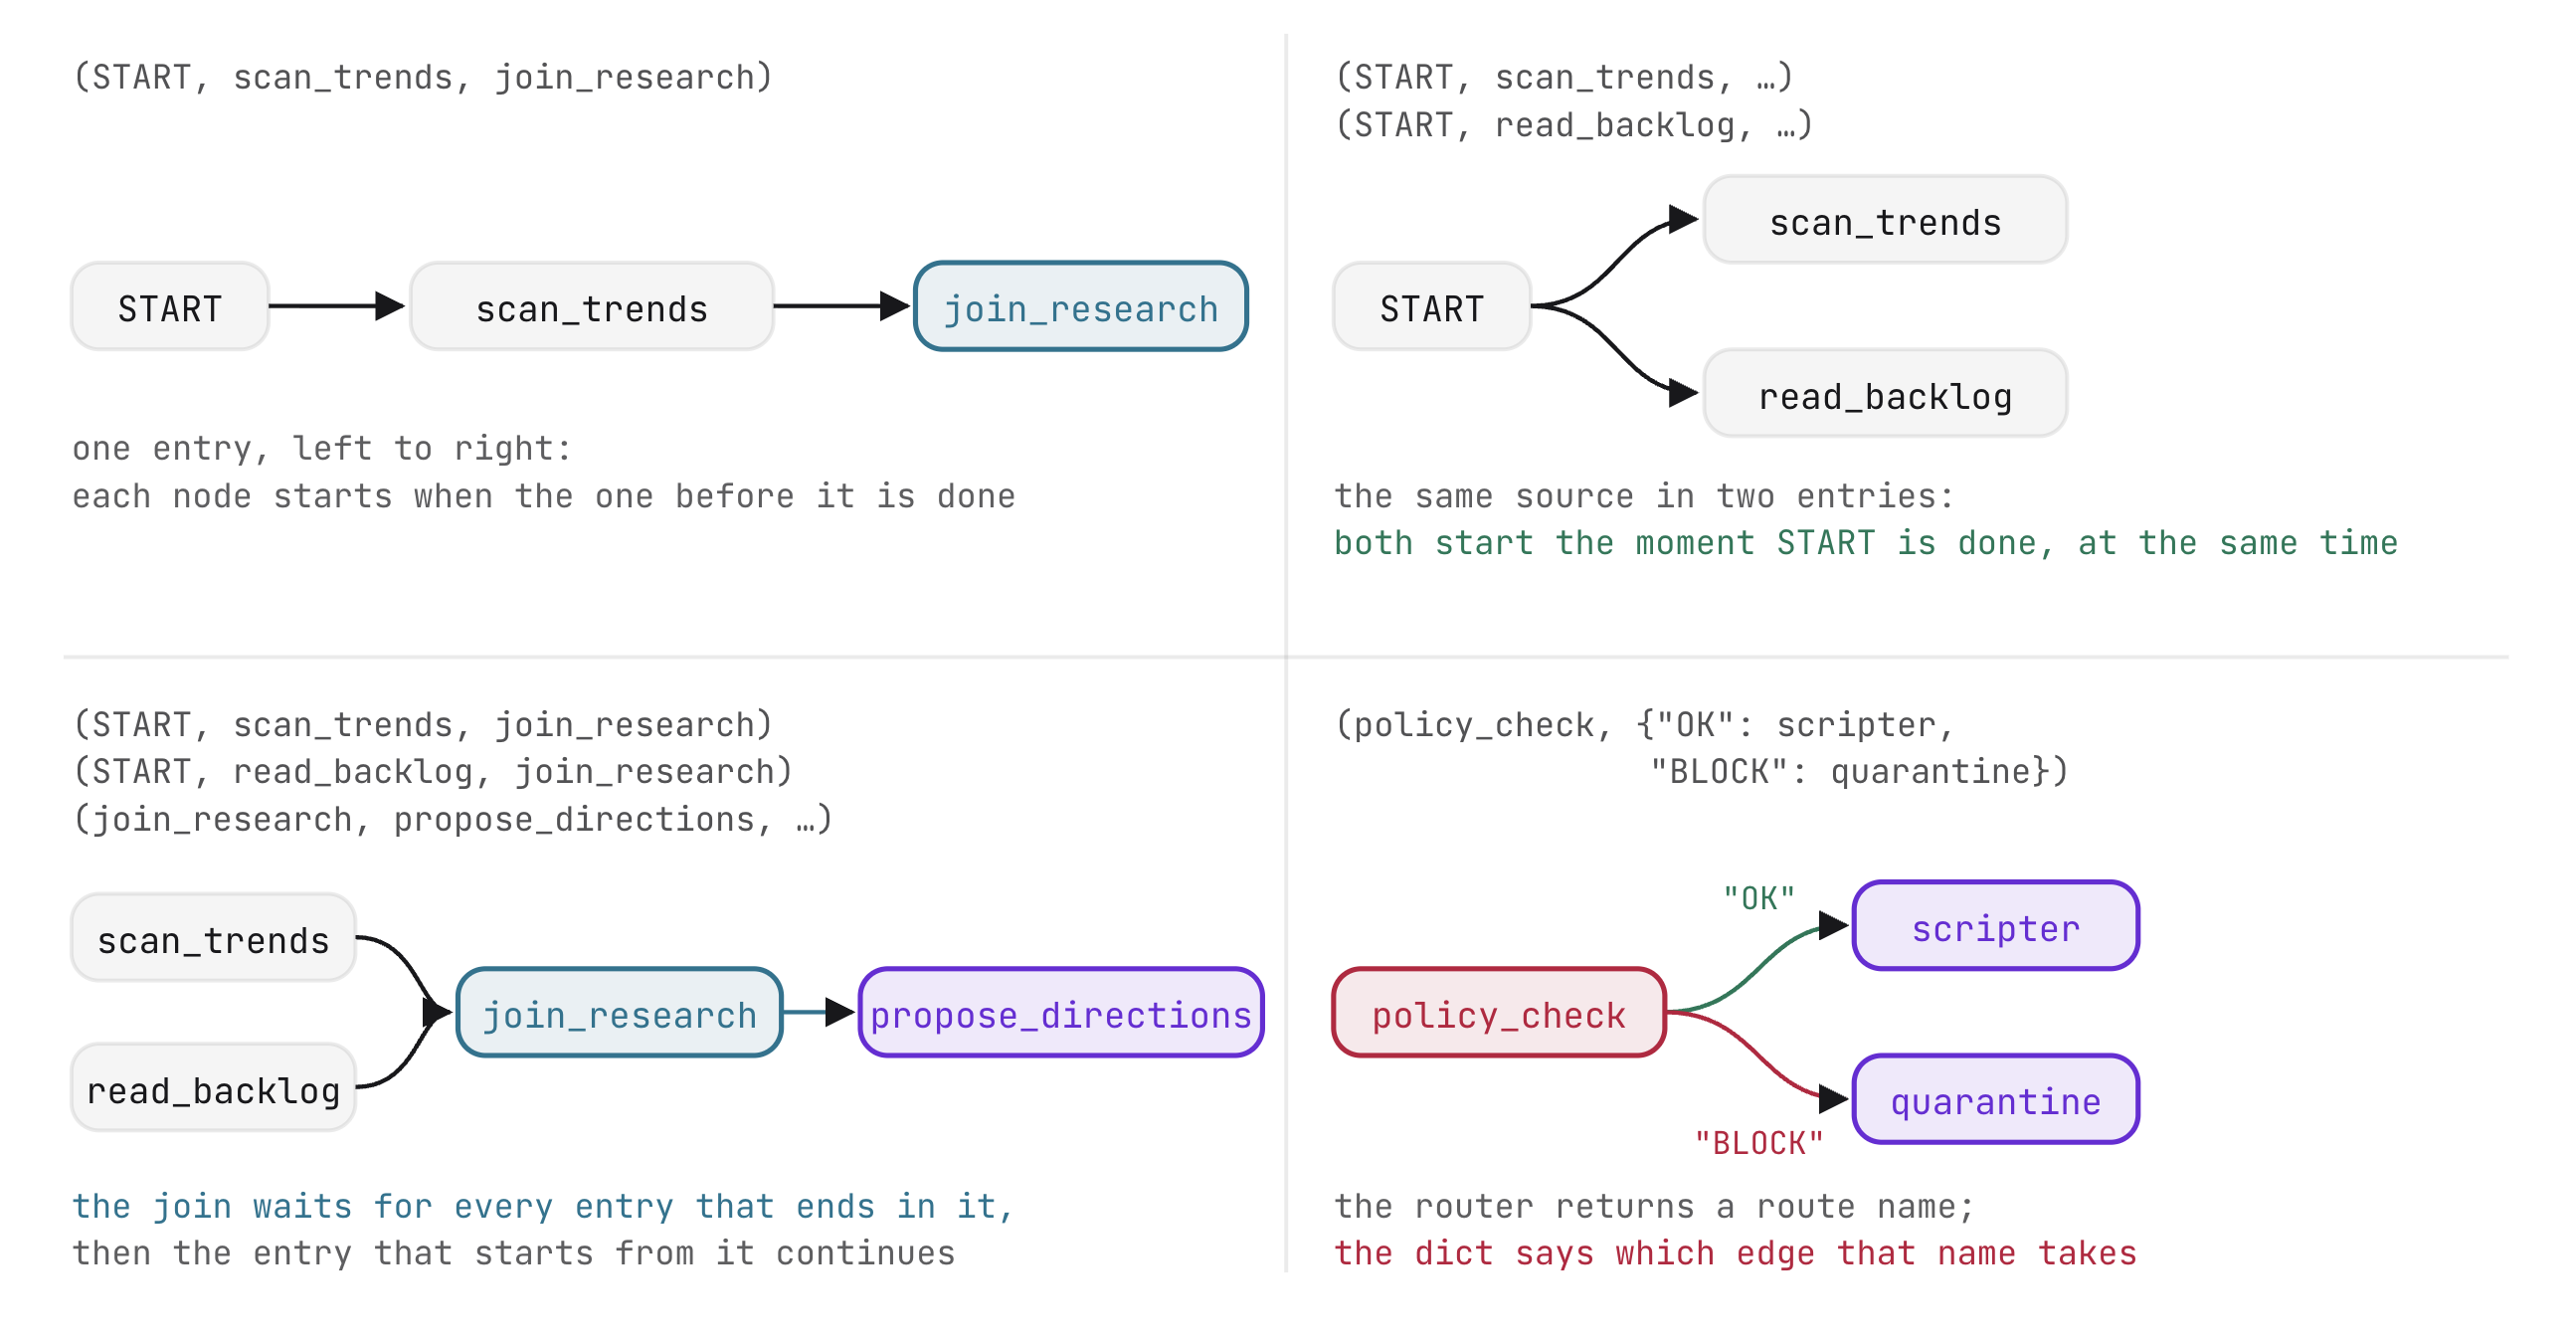
Типы узлов в ADK
Рабочие процессы ADK включают в себя несколько специализированных типов узлов. Каждый архетип выполняет определенную операционную роль в графе, разделяя детерминированное выполнение кода и рассуждения на основе генеративной модели:
Архетип узла | Выполнение | Роль в формировании кадрового резерва |
Функциональный узел | Функция Python, возвращающая | Выполняет детерминированную логику, извлечение данных и изменение состояния. |
Присоединиться к узлу | Встроенный экземпляр | Синхронизирует параллельно работающие ветви в агрегированный словарь. |
Узел агента | | Оценивает инструкции на основе входных данных от вышестоящего источника и выдает проверенные данные. |
Узел маршрутизатора | Функция, возвращающая | Выполняет условную логику для выбора последующих ветвей выполнения. |
Узел ввода данных человеком | Функция, возвращающая | Приостанавливает выполнение программы до получения ответа от внешнего пользователя. |
root_agent = Workflow(
    name="stage1_fanout",
    description="2 real readers -> join -> one research dict",
    edges=[...])
В этой конфигурации root_agent представляет собой экземпляр Workflow , а не отдельный Agent . ADK рассматривает рабочие процессы как полноценных агентов, позволяя загружать, обслуживать и анализировать весь граф как единое приложение. name регистрирует приложение в ADK Web, а список edges определяет топологию его выполнения.
Параллельное распространение исследований (4B)
В рабочей среде перейдите к разделу «Параллельное исследование с разветвлением (4B)» . Откройте stage1_fanout/agent.py .
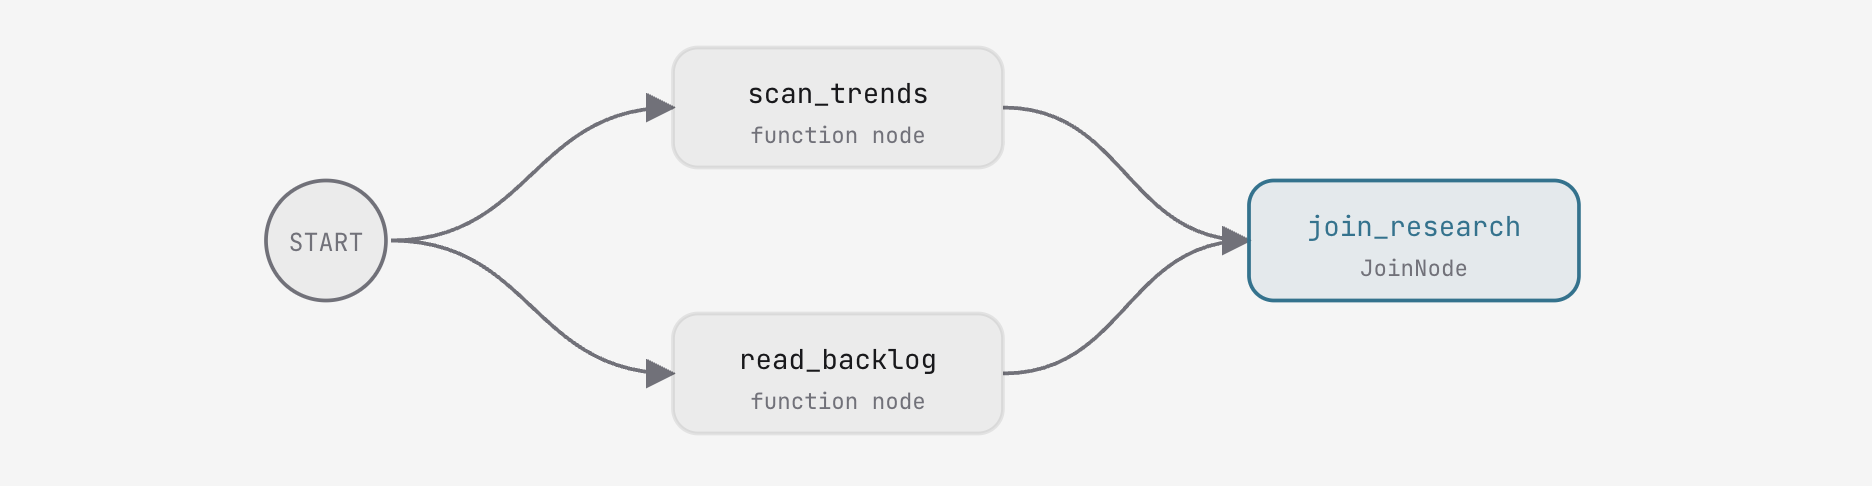
Функциональные узлы и барьеры синхронизации
На этапе исследования используются два функциональных узла, импортированных из agent/graph.py :
-
scan_trends: ВозвращаетEvent(output={"trends": [...]})содержащее десять оцененных трендов платформы. -
read_backlog: ВозвращаетEvent(output={"backlog": [...], "idea": "..."})содержащее пятнадцать идей для бэклога канала, а также первоначальный запрос на запуск.
Каждая функция принимает node_input (выход предыдущего узла) и возвращает Event .
JoinNode служит барьером синхронизации: он приостанавливается до тех пор, пока каждая входящая цепочка не доставит событие, а затем агрегирует все результаты ветвления в словарь, ключом которого является имя узла ( {"scan_trends": {...}, "read_backlog": {...}} ).
Практическое редактирование: определение места соединения и параллельных ребер.
В stage1_fanout/agent.py создайте экземпляр JoinNode и соедините две параллельные цепочки, начиная с START :
join_research = JoinNode(name="join_research")
    edges=[(START, scan_trends, join_research),
           (START, read_backlog, join_research)])
Сохраните изменения. Верификатор рабочей среды подтверждает правильность соединения и связей между ребрами. Запустите этап, используя команду «Запустить этап 1» или через встроенный веб-интерфейс ADK.
Чего ожидать и почему
- Одновременное выполнение операций чтения : В графе выполнения операции
scan_trendsиread_backlogвыполняются одновременно.- Почему : Обе цепочки начинаются с
START. Движок ADK планирует выполнение независимых ветвей одновременно.
- Почему : Обе цепочки начинаются с
- Сводные данные словаря : Рабочий процесс завершается на этапе
join_research, выдавая словарь со статьями для обоих читателей.- Почему :
JoinNodeобеспечивает полный сбор данных, прежде чем разрешить выполнение последующих операций на узлах.
- Почему :
Агентские узлы (4C)
В рабочей области перейдите к узлам агента (4C) . Откройте stage2_direction/agent.py .
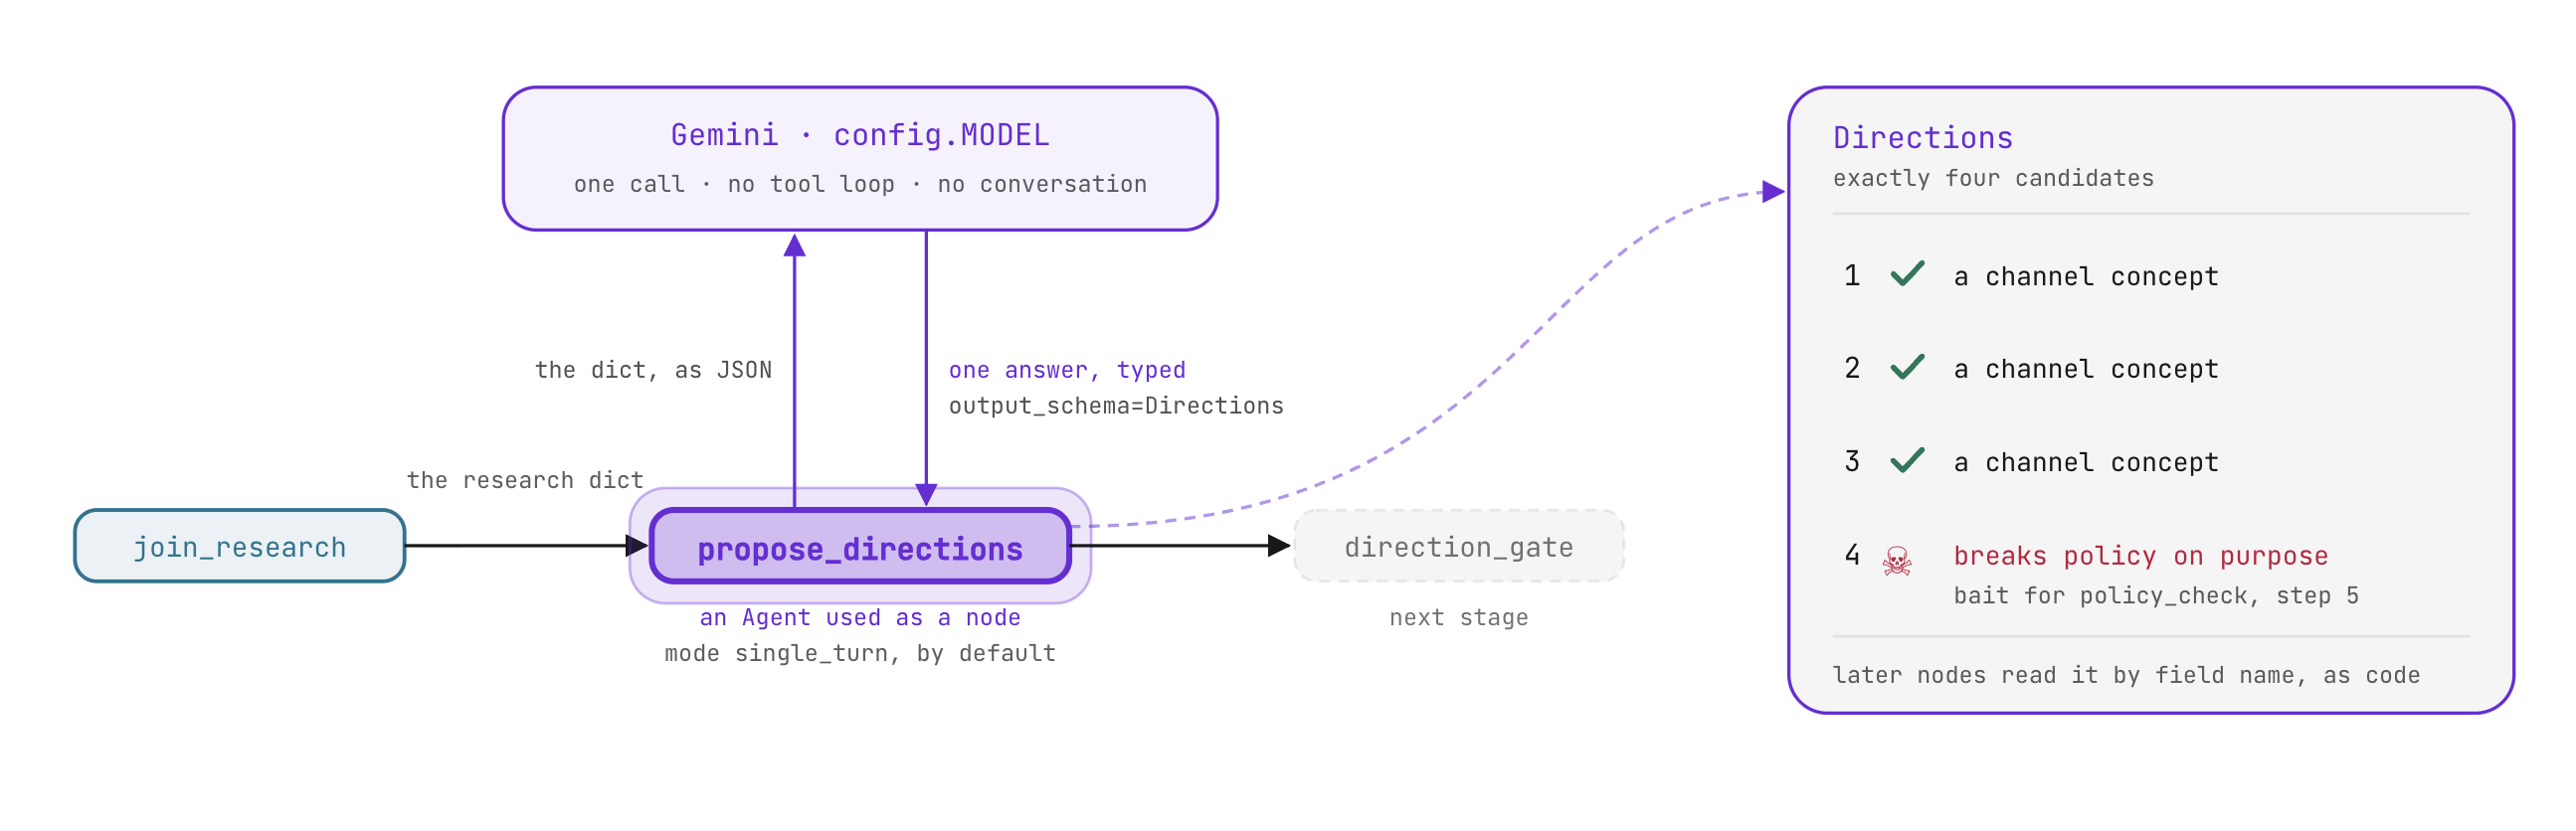
Режимы работы и структурированные схемы
При встраивании в Workflow Agent по умолчанию работает в режиме single_turn :
- В качестве контекстного входного сигнала он получает выходные данные предыдущего узла.
- Он выполняет один вызов функции вывода без диалогового обмена данными.
- Он передает структурированные данные на следующий узел.
Присвоив output_schema=Directions , агент обеспечивает проверку данных модели с помощью Pydantic. В результате в нижестоящий граф поступают типизированные объекты вместо неструктурированного текста:
class Direction(BaseModel):
    title: str           # <=60 chars, filmable, characterful
    angle: str           # the twist, one line
    hook: str = ""       # 2-4 words, the video's sticker line
    evidence: list[Evidence]


class Directions(BaseModel):
    candidates: list[Direction]   # exactly 4
PROPOSE_INSTRUCTION направляет модель на выдвижение четырех кандидатов, основываясь на данных как о тенденциях, так и о текущем списке задач. Кандидаты 1–3 предлагают жизнеспособные концепции каналов. Кандидат 4 намеренно вводит концепцию, нарушающую правила, чтобы проверить защитный механизм на следующем этапе.
Практическое редактирование: определение узла агента и создание цепочки соединений.
В stage2_direction/agent.py настройте параметр propose_directions и расширьте связи рабочего процесса:
propose_directions = Agent(
    name="propose_directions",
    model=config.MODEL,
    instruction=PROPOSE_INSTRUCTION,
    output_schema=Directions)
    edges=[(START, scan_trends, join_research),
           (START, read_backlog, join_research),
           (join_research, propose_directions, direction_gate)])
Чего ожидать и почему
- Прямое использование словаря :
propose_directionsобрабатывает JSON-данные, генерируемые функциейjoin_research, без ручного форматирования. - Типизированный вывод кандидатов : Агент выдает проверенный объект
Directions, содержащий четыре отдельных кандидата. Узлы, расположенные ниже по потоку, считывают поля по имени атрибута (candidate.title) без анализа строк.
Человек в процессе взаимодействия (4D)
В рабочей среде перейдите к режиму "Человек в контуре управления (4D)" . Откройте agent/graph.py .
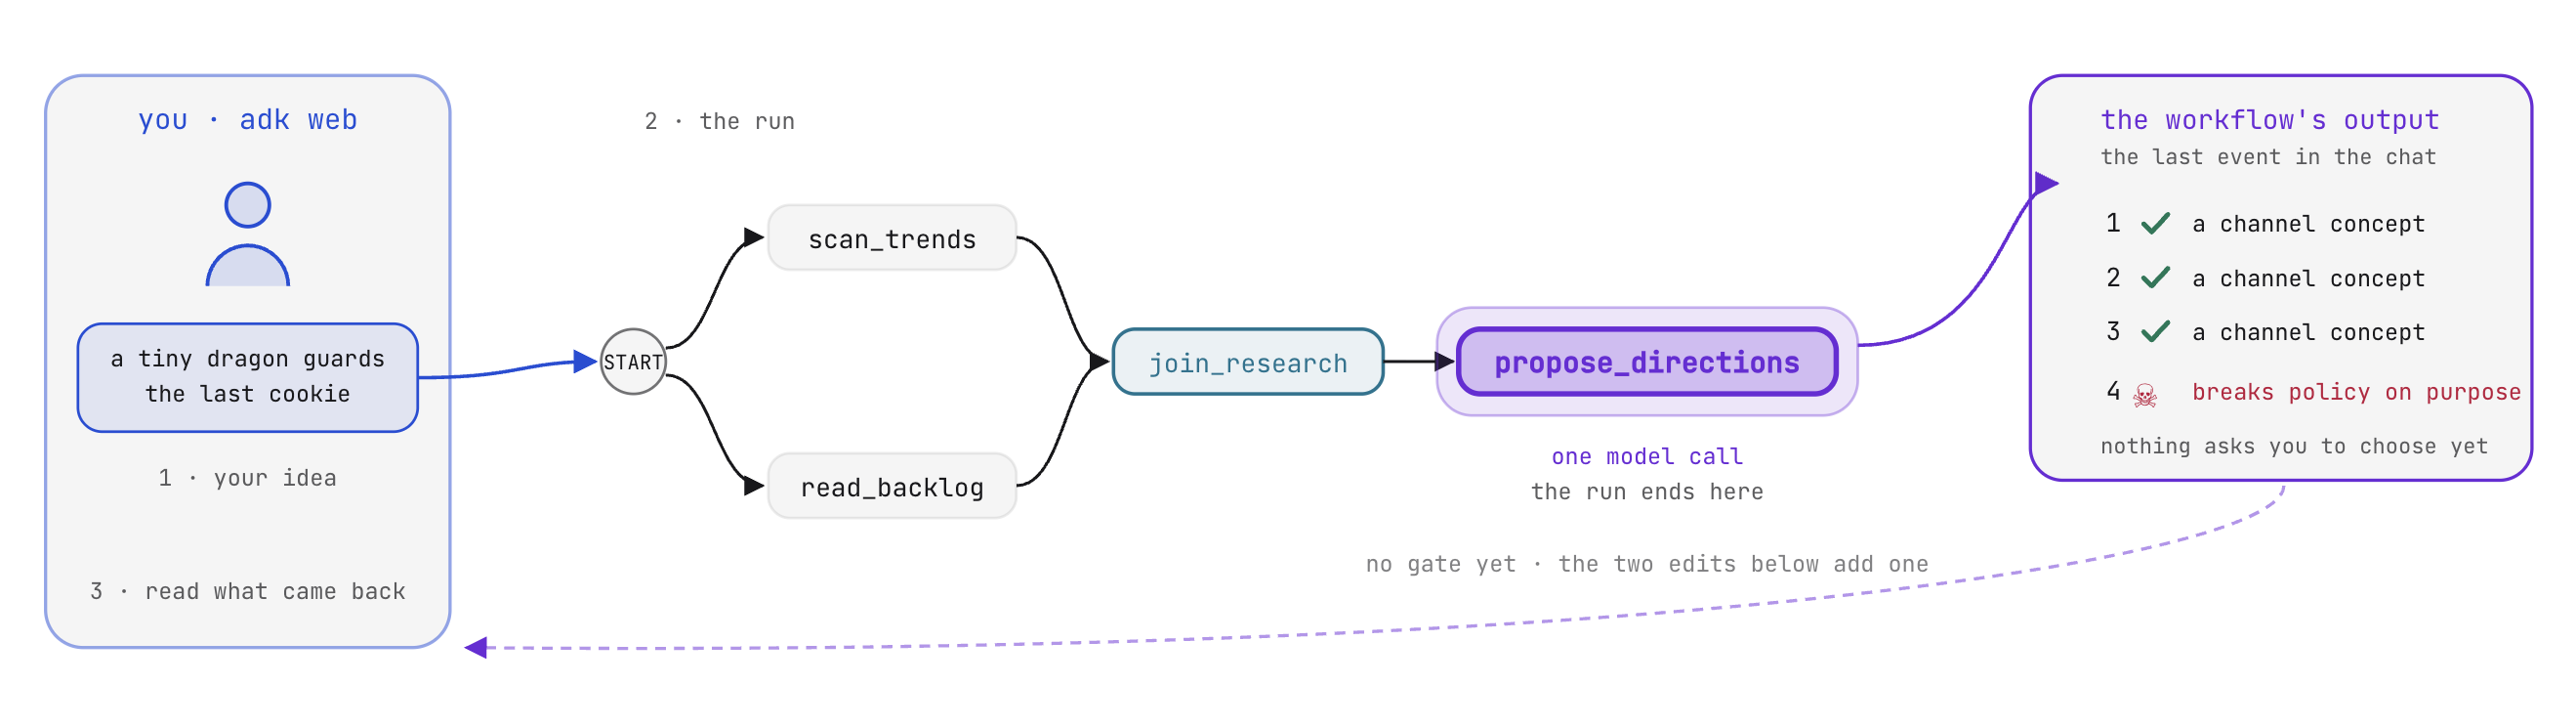
Оперативные инструкции против детерминированного приостановления
Производственные процессы, которые влекут за собой финансовые затраты или публикуют контент, требуют человеческого контроля в критически важных точках принятия решений. В одном запросе на подтверждение представляют собой рекомендательные указания, которые пользователь может легко пропустить, предложив модели пропустить их. В рабочем процессе ADK одобрение человека обеспечивается механизмом выполнения: граф останавливается на указанном узле и не может двигаться дальше, пока не получит внешние входные данные, проверенные по схеме.
- Передача
RequestInputнемедленно приостанавливает выполнение рабочего процесса. - ADK записывает открытый вызов прерывания в хранилище сессий и выдает уникальный
interrupt_id. - Процесс выполнения останавливается, не расходуя токены и не задействуя потоки сервера.
- Выполнение графа возобновляется только после отправки действительного
function_responseсоответствующего схеме и идентификатору прерывания.
Практическое редактирование: приостановка выполнения с помощью RequestInput
В agent/graph.py реализуйте вызов функции приостановки внутри direction_gate :
    yield RequestInput(
        message="Pick tonight's direction: 1, 2, 3 or 4.",
        response_schema={
            "type": "object",
            "properties": {
                "pick": {"type": "string", "enum": ["1", "2", "3", "4"]}}},
        payload={"candidates": cands})
RequestInput настраивает три атрибута:
-
message: Запрос на проверку, отображаемый пользователю. -
response_schema: JSON-схема, которую фронтенд отображает в виде формы ввода, проверяемой ADK при отправке. -
payload: Метаданные, прилагаемые к запросу (четыре варианта), позволяющие клиентским интерфейсам отображать карточки отзывов без запроса состояния сессии.
Чего ожидать и почему
- Рабочий процесс останавливается на этапе direction_gate : в веб-интерфейсе ADK или в интерфейсе рабочей среды выполнение приостанавливается и отображается интерактивная форма выбора кандидата.
- Причина : Движок обнаружил возвращенный
RequestInputи сохранил состояние выполнения вruns/sessions.db.
- Причина : Движок обнаружил возвращенный
- Для возобновления работы требуется структурированный ввод : отправка произвольного текста в чате не продвигает граф. Выбор варианта (1, 2, 3 или 4) отправляет типизированную
function_response, удовлетворяющуюresponse_schema, и возобновляет выполнение.
5. Состояние и маршрутизатор
В VibeStudio Workbench перейдите к шагу 5 · Состояние и маршрутизатор , части (5A) – (5C) .
Вам предстоит сохранять выбор пользователя в состоянии сессии, обеспечивать соблюдение политик безопасности канала с помощью детерминированных узлов маршрутизатора и создать итеративный агент задач для автоматического устранения нарушений политик перед генерацией сценариев видео.
Состояние рабочего процесса (5A)
В рабочей области перейдите к состоянию рабочего процесса (5A) .
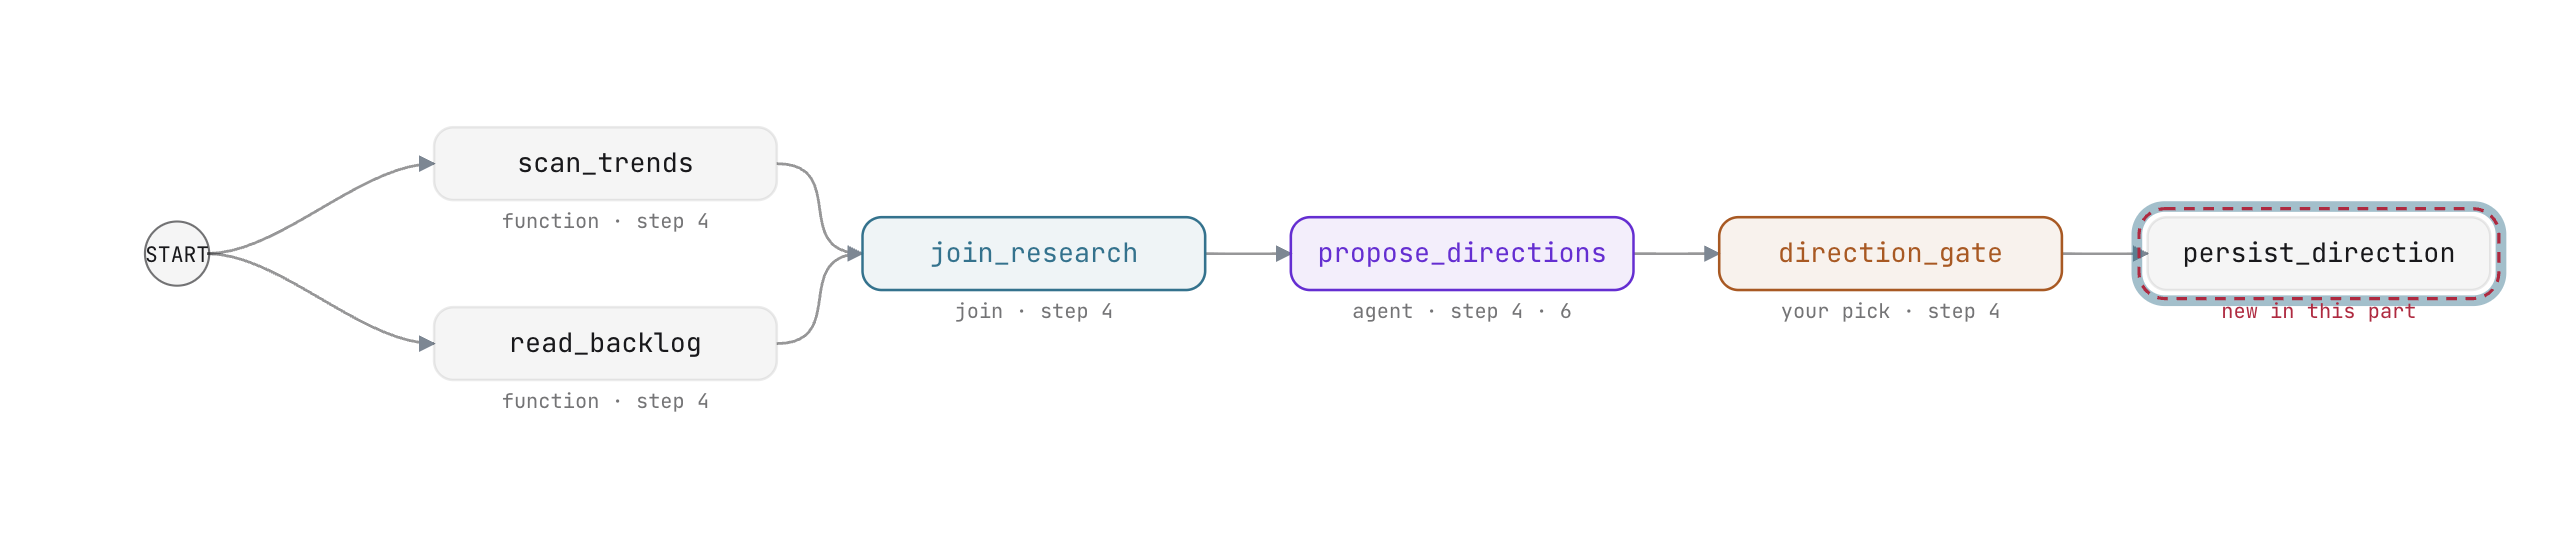
Состояние сессии против выходных данных узла
В рабочем процессе ADK данные перемещаются по графу с помощью двух различных механизмов:
- Выходной сигнал узла (
Event(output=...)) : Данные, предназначенные исключительно для непосредственных потребителей, определенных в списке ребер. - Состояние сессии (
Event(state=...)) : Общий словарь ключ-значение, доступный любому последующему узлу в жизненном цикле выполнения.
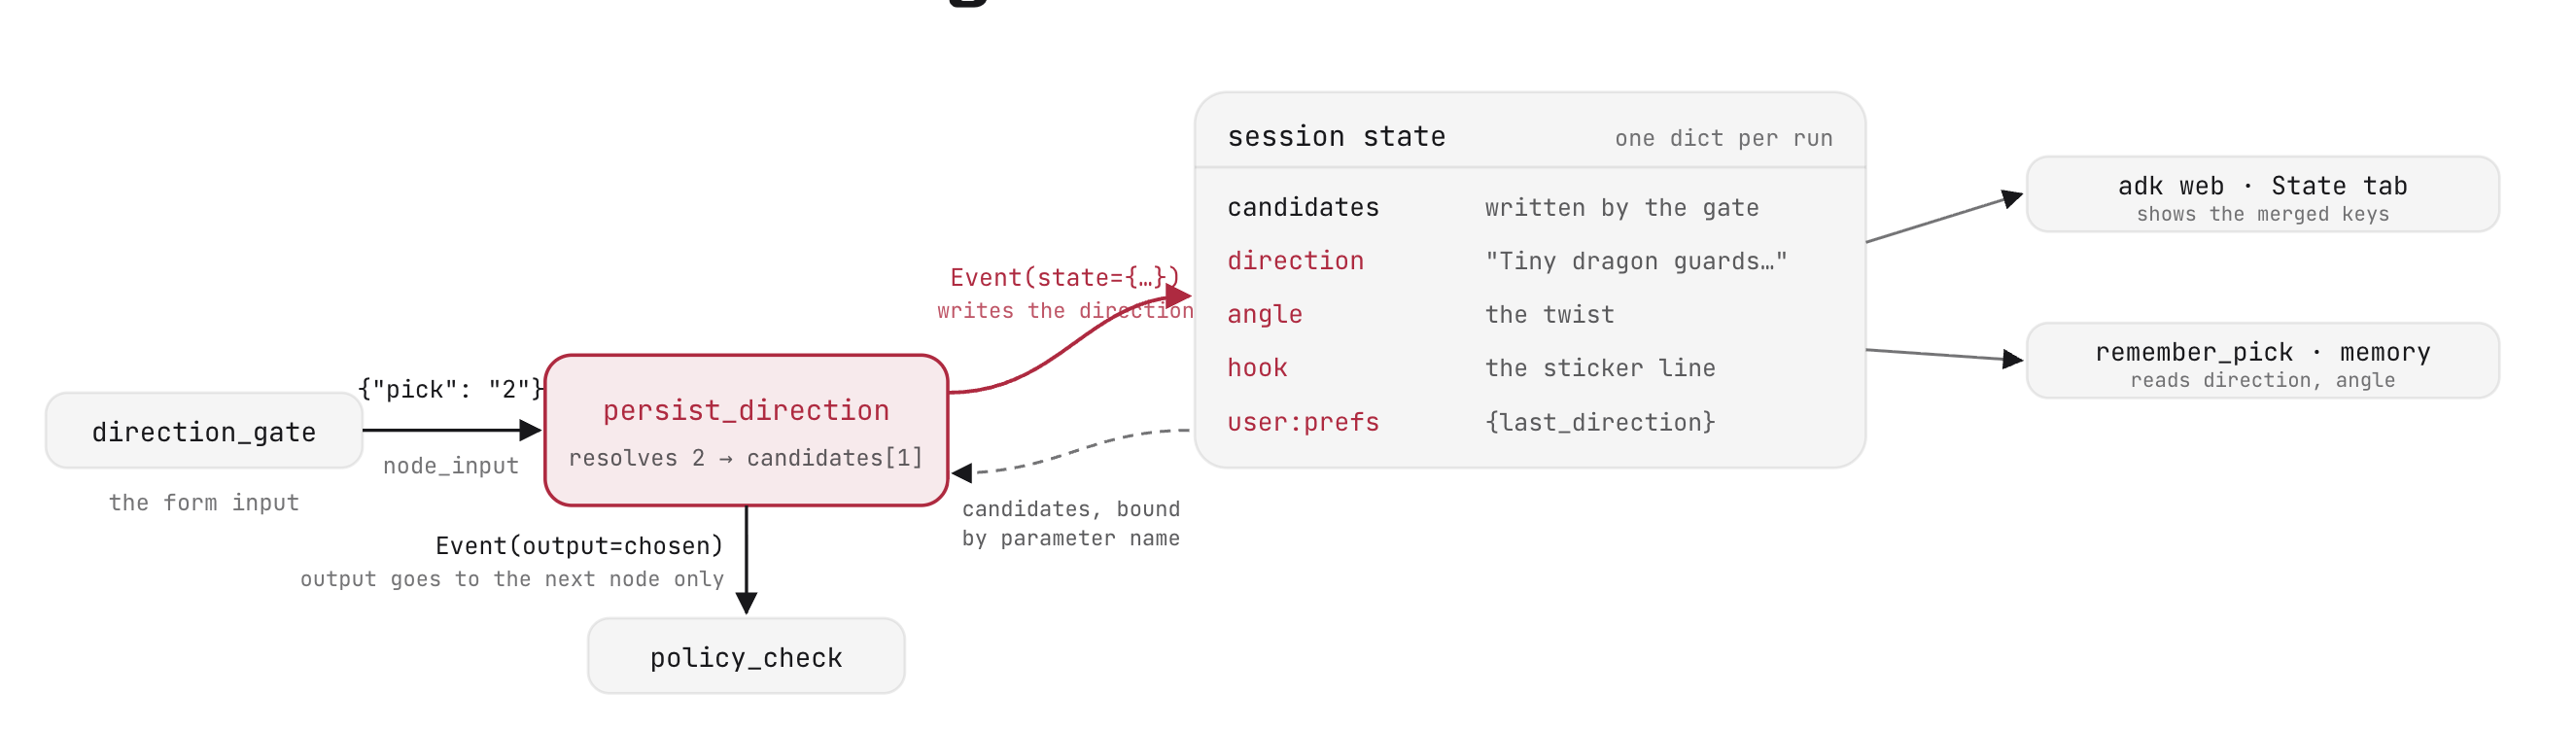
Когда пользователь выбирает кандидата в direction_gate , выбор поступает в виде числового индекса ( {"pick": "2"} ). Последующим узлам необходим полный объект направления: заголовок, ракурс повествования и ключевой момент. Вместо передачи подробных метаданных через каждый промежуточный узел, persist_direction записывает полученный кандидат в общее состояние сессии.
Узлам не нужно передавать весь словарь состояния сессии. Когда узел возвращает Event(state=...) , он предоставляет только новые или обновленные пары ключ-значение. ADK автоматически объединяет эти обновления в хранилище сессий:
    yield Event(state={"direction": chosen["title"], "angle": chosen.get("angle", ""),
                       "hook": hook, "user:prefs": {"last_direction": chosen["title"]}})
Передача управления этому Event ведёт к среде Workflow , которая сохраняет новые значения в журнале сессии в runs/sessions.db .
Привязка параметров
Функциональные узлы ADK автоматически считывают состояние сессии посредством проверки параметров. Если сигнатура функции объявляет имя параметра, соответствующее существующему ключу состояния, ADK извлекает этот ключ из состояния и передает его напрямую:
def persist_direction(node_input, candidates: list = []):
    ni = node_input if isinstance(node_input, dict) else {}
    raw = ni.get("pick")
    pick = str(raw).strip() if raw is not None else ""
    if candidates:
        i = int(pick) - 1 if pick.isdigit() else 0
        chosen = candidates[max(0, min(len(candidates) - 1, i))]
    else:
        chosen = {"title": "untitled", "angle": "", "evidence": []}
    hook = chosen.get("hook") or " ".join(chosen["title"].split()[:4])
Здесь candidates были записаны в состояние сессии с помощью direction_gate . ADK напрямую связывает их с persist_direction(node_input, candidates: list = []) без необходимости явного поиска в словаре.
Ключи с префиксом user: сохраняются между сессиями в хранилище на уровне пользователя, что позволяет последующим запускам рабочих процессов получать доступ к настройкам создателя.
Практическое редактирование: сохранение состояния и подключение узла.
- В
agent/graph.py, внутриpersist_direction, замените строкуTODO: PERSIST_STATEна строку state_event_yield:
    yield Event(state={"direction": chosen["title"], "angle": chosen.get("angle", ""),
                       "hook": hook, "user:prefs": {"last_direction": chosen["title"]}})
- В
stage3_router/agent.pyдобавьтеpersist_directionк третьей цепочке в спискеedges:
           (join_research, propose_directions, direction_gate,
            persist_direction)
Сохраните файлы. В рабочей среде убедитесь, что state write in place и persist_direction in the chain отмечены зелеными галочками.
Узел маршрутизатора (5B)
В рабочей области перейдите к узлу маршрутизатора (5B) .
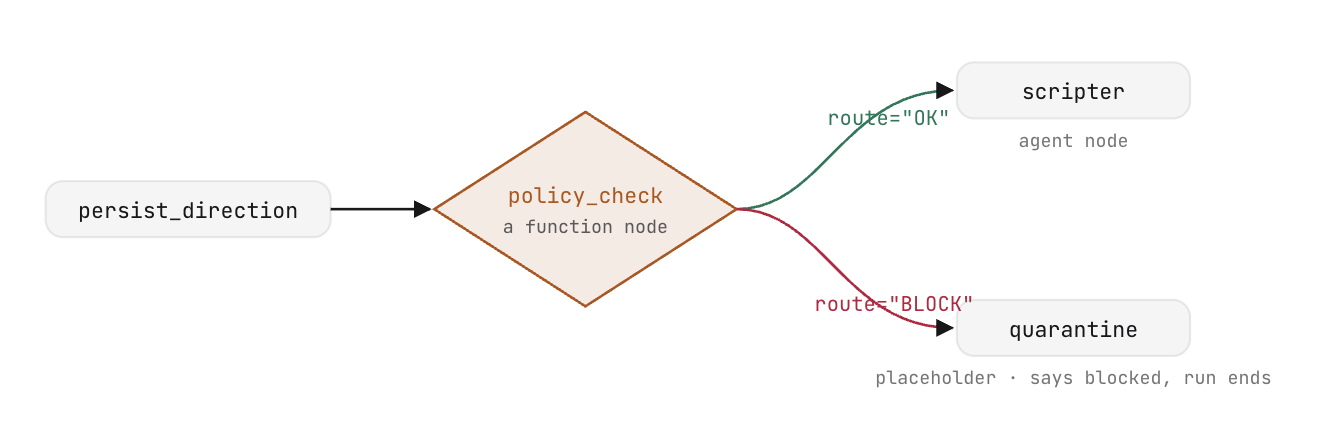
Маршрутизация с детерминированной политикой
Маршрутизатор — это специализированный функциональный узел, который оценивает выходные данные вышестоящего узла и направляет выполнение вдоль условных ветвей графа. В отличие от генеративных агентов, маршрутизатор выполняет детерминированную логику без вызовов LLM.
Маршрутизатор возвращает Event , указывающее на тег route :
def length_check(node_input):
    too_long = len(node_input.get("title", "")) > 60
    return Event(output=node_input, route="TRIM" if too_long else "PASS")
В определении рабочего процесса целевой узел, заданный в виде словаря, сопоставляет имена маршрутов с целевыми узлами:
(length_check, {"TRIM": shorten, "PASS": scripter}),
Маршрутизатор рабочего процесса policy_check считывает запрещенные фразы из файла agent/policy_words.txt и выполняет сопоставление целых слов с заголовком и углом выбранного направления:
return Event(output=node_input, route="BLOCK" if bad else "OK")
Хранение политики в виде данных, а не жестко закодированных инструкций, позволяет обновлять ее без изменения графа рабочего процесса: обновление текстового файла немедленно применяется к последующим запускам. Поскольку оценка представляет собой детерминированное сопоставление регулярных выражений, она выполняется за миллисекунды с нулевыми затратами токена до начала генеративного скриптинга.
Пункты назначения: Сценарист и Карантин
Маршрутизатор направляет трафик к одному из двух нижестоящих узлов:
-
scripter:single_turnагентский узел, преобразующий утвержденное направление в структурированный производственный сценарий, соответствующий схемеScriptPydantic:
scripter = Agent(
    name="scripter",
    model=config.MODEL,
    instruction=SCRIPT_INSTRUCTION,
    output_schema=Script)
quarantine: Изначально это была функция-заглушка, которая останавливала отмеченные направления, а в следующей части её заменит автономный агент по исправлению ситуации.
Практическое редактирование: маршрутизация проверки политики.
- В
agent/graph.py, внутриpolicy_check, дополните оператор return:
return Event(output=node_input, route="BLOCK" if bad else "OK")
- В
stage3_router/agent.pyобновитеedgesмаршрутизации дляpolicy_checkмаршрутизации и снова включите ветку карантина вscripter:
           (join_research, propose_directions, direction_gate,
            persist_direction, policy_check),
           (policy_check, {"OK": scripter, "BLOCK": quarantine}),
           (quarantine, scripter)])
Сохраните файлы. В рабочей среде убедитесь, что сопоставления краев маршрутизатора проверены.
Режимы работы агентов и узел задачи (5C)
В рабочей области перейдите к режимам агента и узлу задачи (5C) .
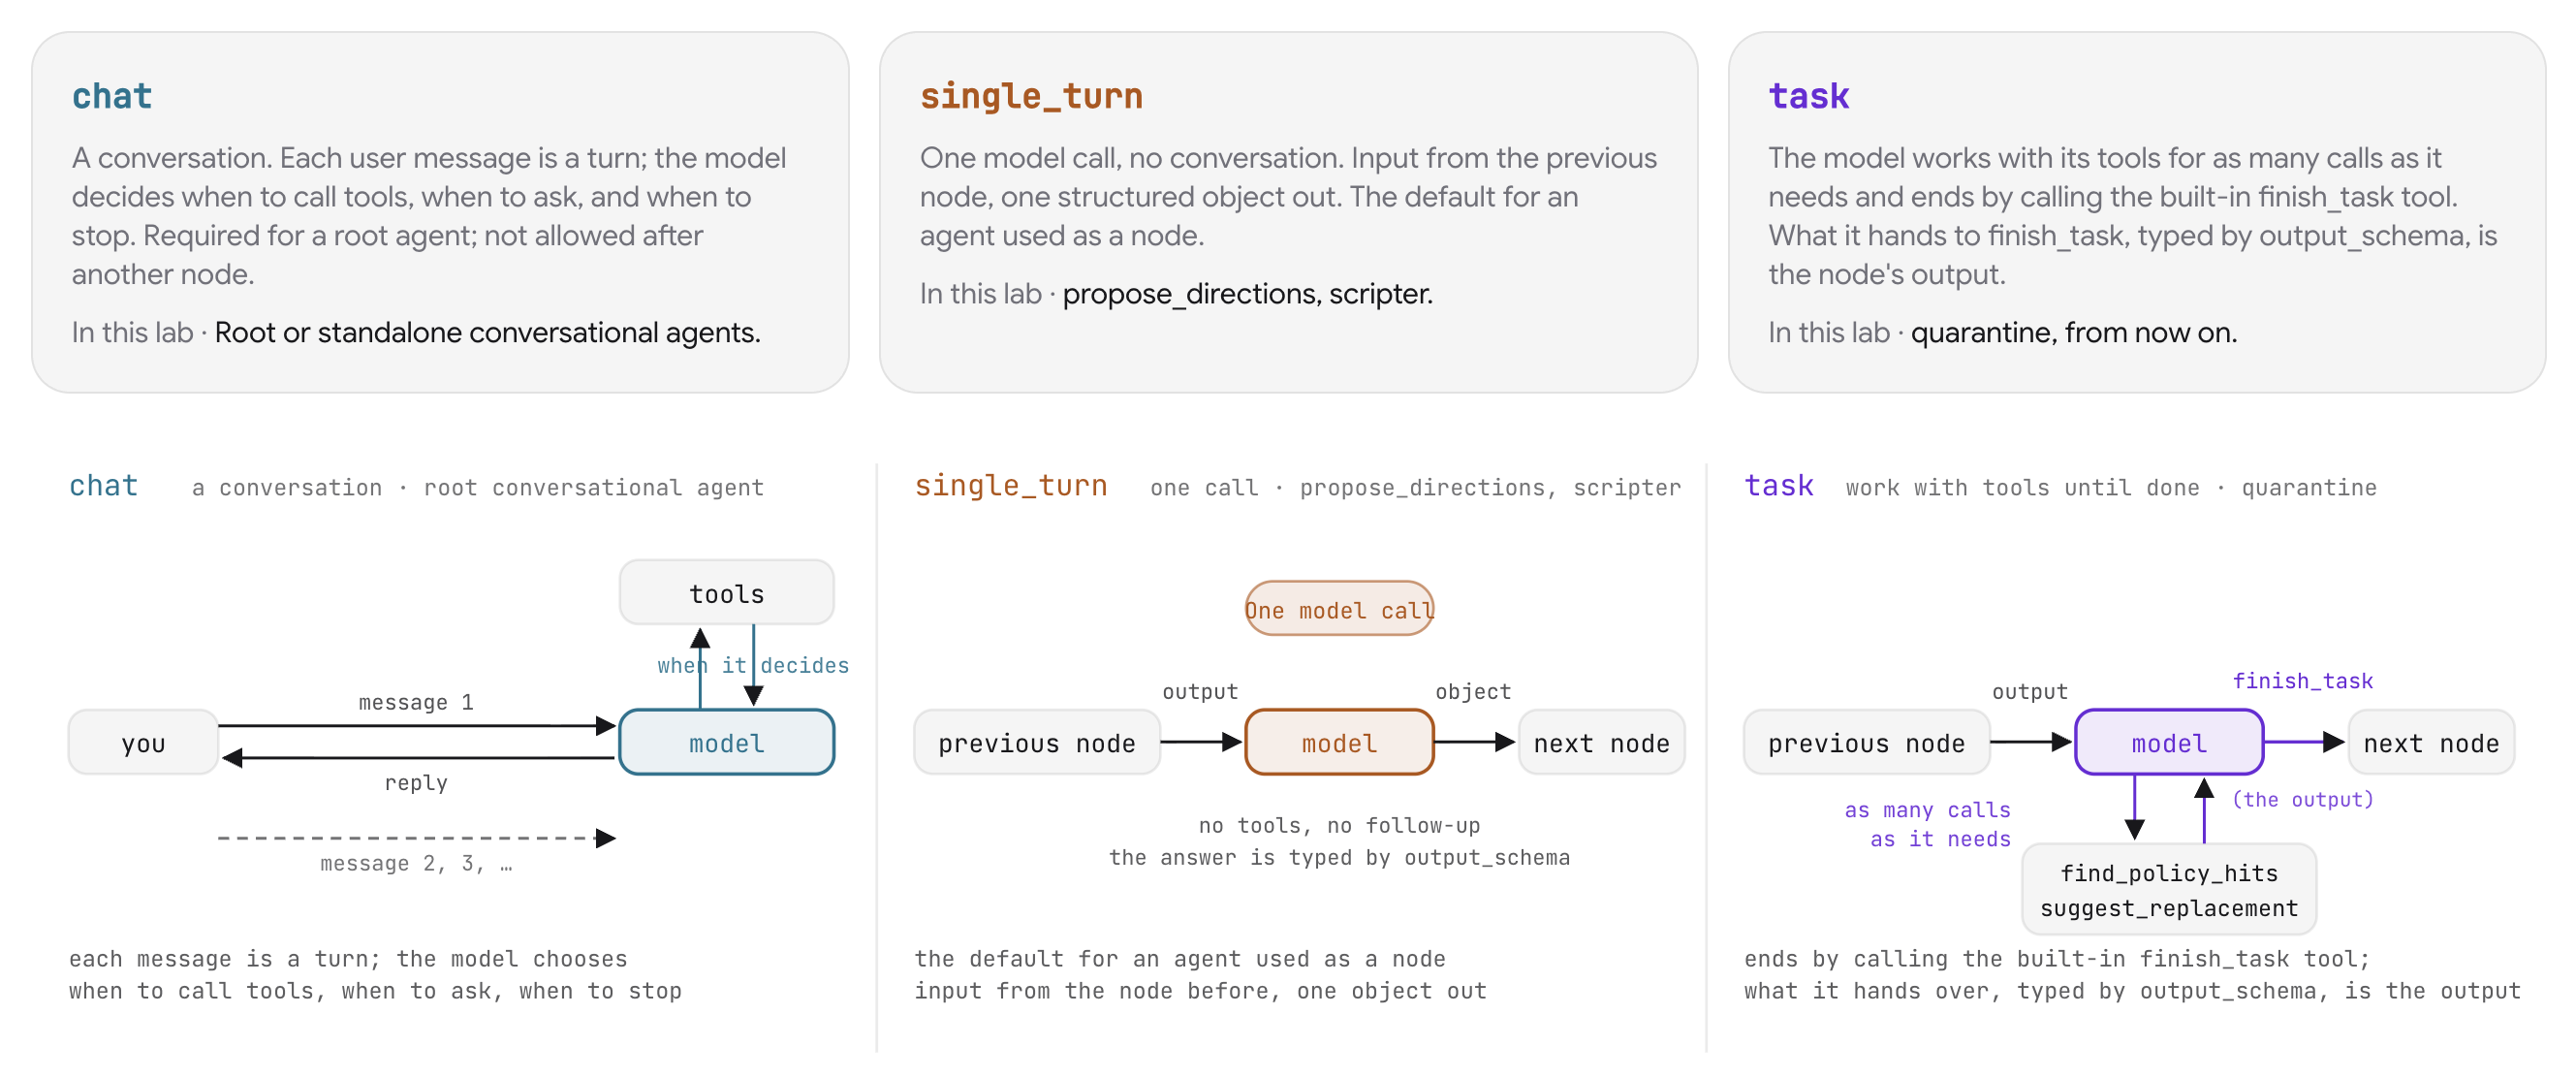
режимы выполнения агентов
Экземпляры ADK Agent поддерживают три режима выполнения, адаптированные к конкретным требованиям конвейера:
Режим | Жизненный цикл выполнения | Роль в формировании кадрового резерва |
| Многоходовой диалоговый цикл. Модель определяет, когда следует задействовать инструменты, запросить обратную связь или завершить ход диалога. | Корневые агенты взаимодействуют с пользователем. |
| Вызов функции вывода модели за один раз. Принимает входные данные от предыдущего узла и выдает структурированный объект схемы. | Последовательные преобразования графов ( |
| Автономный цикл с выполнением инструментов. Агент выполняет итерации до тех пор, пока не будет вызван встроенный инструмент | Многоэтапная очистка и инспекция ( |
Автономное исправление политики
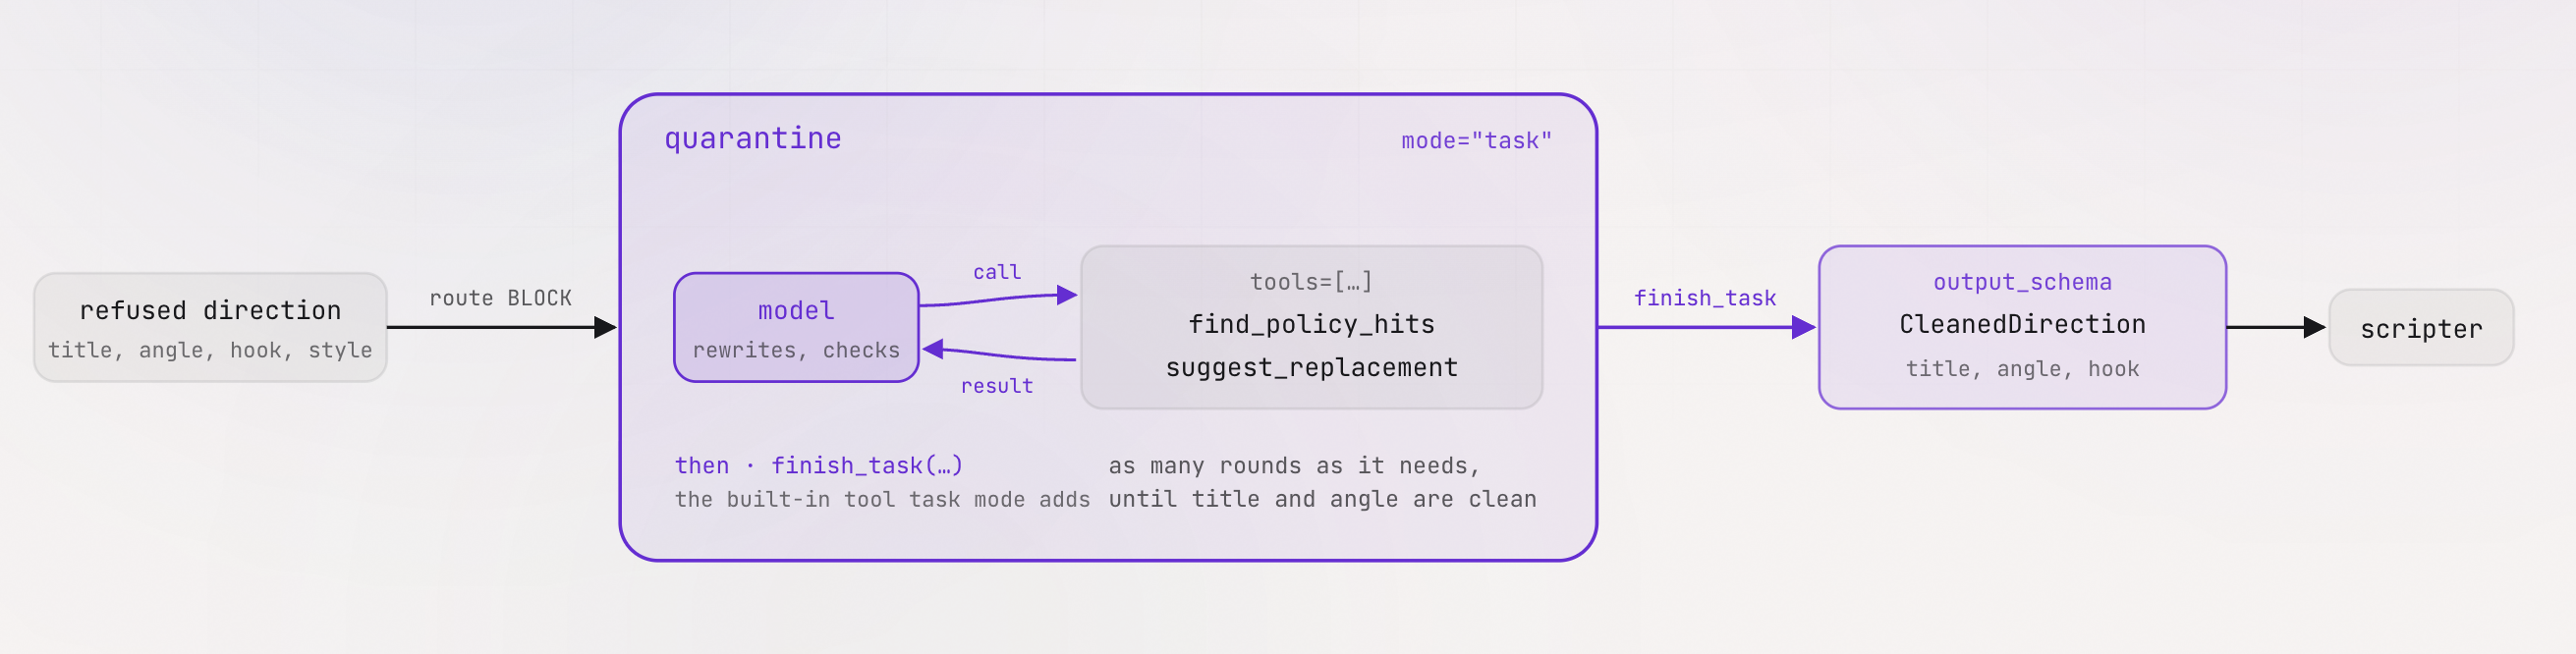
Для изменения отмеченного направления требуется режим task , поскольку количество итераций исправления является переменным. Агент получает отмеченное направление, вызывает find_policy_hits для обнаружения нарушений, запрашивает утвержденные альтернативы через suggest_replacement , переписывает направление и проверяет его корректность перед продолжением.
Оба инструмента определены в agent/cleanup_tools.py с типизированными сигнатурами и строками документации:
def find_policy_hits(text: str) -> dict:
    """Which refused words appear in `text`. Matches whole words and phrases
    from agent/policy_words.txt, case-insensitive.

    Returns {"hits": [...], "clean": bool}. clean is true when hits is empty.
    """


def suggest_replacement(word: str) -> dict:
    """The channel's approved stand-in for a refused word, read from
    agent/policy_replacements.txt.

    Returns {"word", "replacement", "listed"}. When the word has no entry,
    listed is false and replacement is a hint to pick a gentle synonym.
    """
Практическое редактирование: сборка агента задач карантина
В stage3_router/agent.py замените функцию-заполнитель quarantine определением агента задачи:
quarantine = Agent(
    name="quarantine",
    model=config.MODEL,
    instruction=QUARANTINE_INSTRUCTION,
    mode="task",
    tools=[find_policy_hits, suggest_replacement],
    output_schema=CleanedDirection,
)
Режим задачи предоставляет агенту инструменты и завершает выполнение, вызывая функцию finish_task . При настройке mode="task" ADK автоматически предоставляет finish_task и получает её параметры из output_schema , гарантируя, что узел выдаёт типизированный объект CleanedDirection , соответствующий входной схеме узла скриптера.
Чего ожидать и почему
Протестируйте оба варианта выполнения в ADK Web или VibeStudio Workbench:
- Утвержденный маршрут (Кандидат 1, 2 или 3) :
- Выбор одобренного кандидата направляет запрос из
policy_checkнепосредственно кscripter(route="OK"). - Программа для создания сценариев генерирует сценарий из трех кадров, соответствующий схеме
Script.
- Выбор одобренного кандидата направляет запрос из
- Вариант карантинного восстановления (кандидат 4) :
- В варианте 4 содержится отмеченная лексика ("кликбейт", "вирусный взлом").
-
policy_checkмаршруты вquarantine(route="BLOCK"). - В трассировке сессии обратите внимание на вызов функции
find_policy_hitsquarantine, вызов функцииsuggest_replacementдля каждого нарушения, перезапись заголовка и вызов функцииfinish_task. -
scripterвыполнения возобновляется, и скрипт создается из очищенного источника.
6. Банк памяти
В VibeStudio Workbench перейдите к шагу 6 · Банк памяти , части (6A) и (6B) .
В настоящее время рабочий процесс выполняется без сохранения настроек между сессиями. Каждое выполнение начинается с нуля, без учета того, что автор выбрал ранее или какие жанры он предпочитает. На этом этапе вы подключаете Vertex AI Agent Engine Memory Bank для хранения и извлечения настроек автора между запусками.
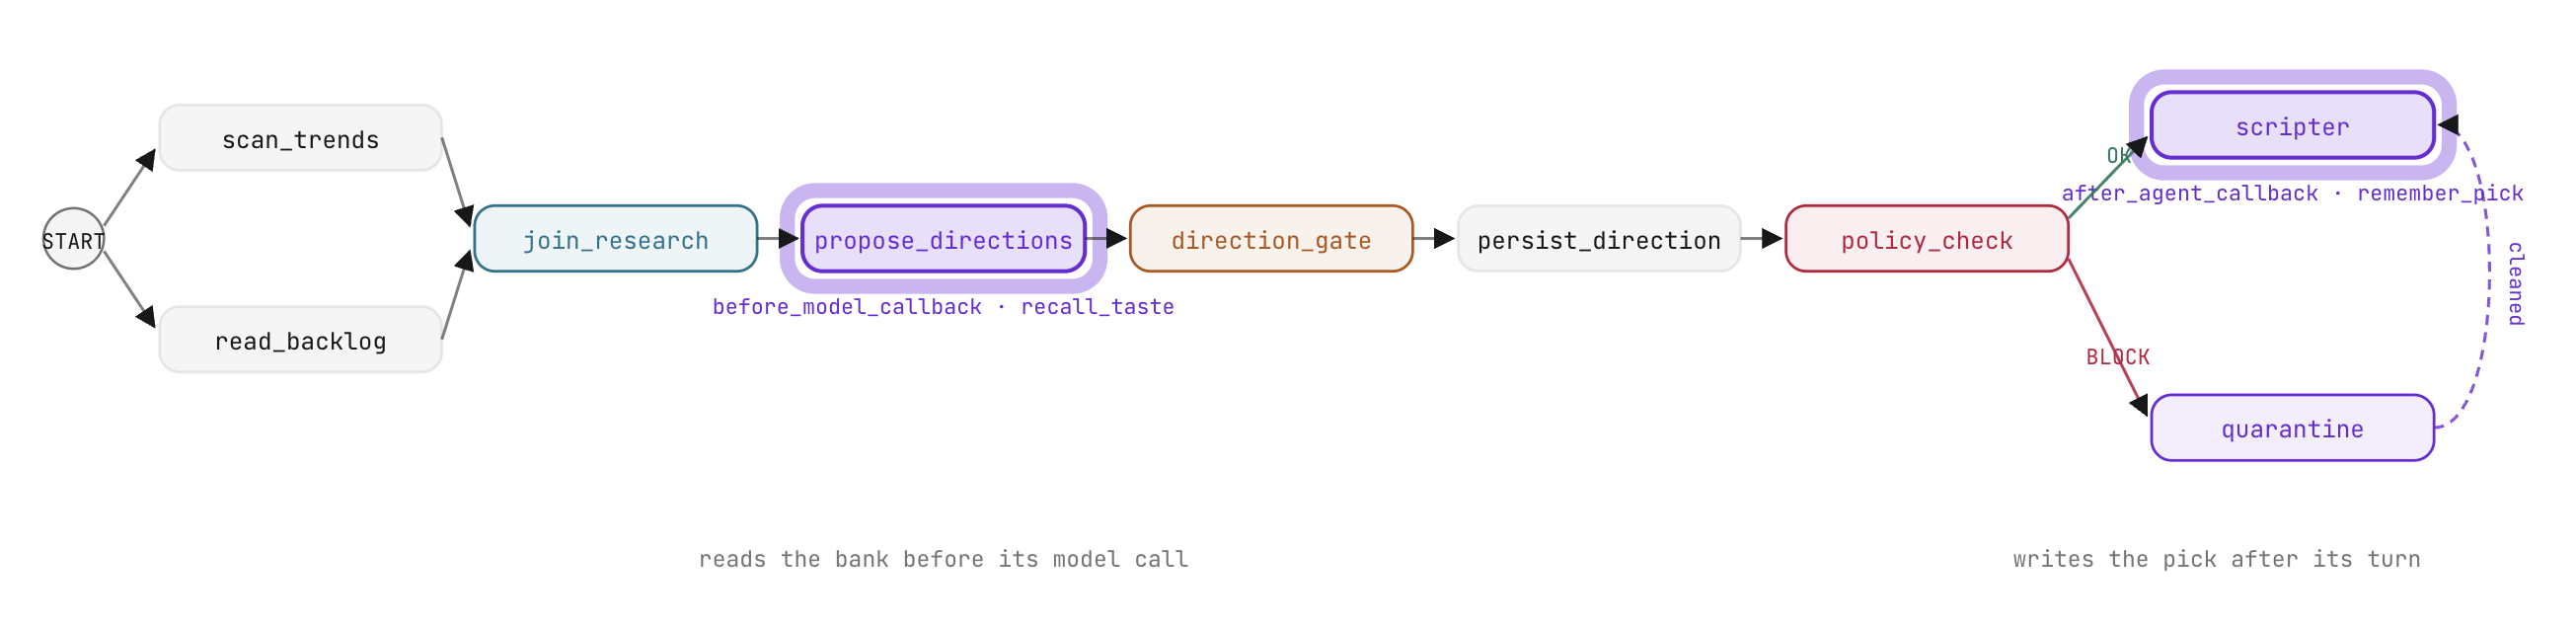
Важно отметить, что интеграция памяти осуществляется посредством обратных вызовов жизненного цикла агента, а не узлов конвейера. Поскольку извлечение и получение данных из памяти обслуживают отдельных агентов, а не промежуточные этапы обработки данных, прикрепление обратных вызовов сохраняет чистую, децентрализованную топологию графа.
Банк памяти (6А)
На рабочем столе перейдите к Банку памяти (6A) .
Управляемая память пользовательского уровня
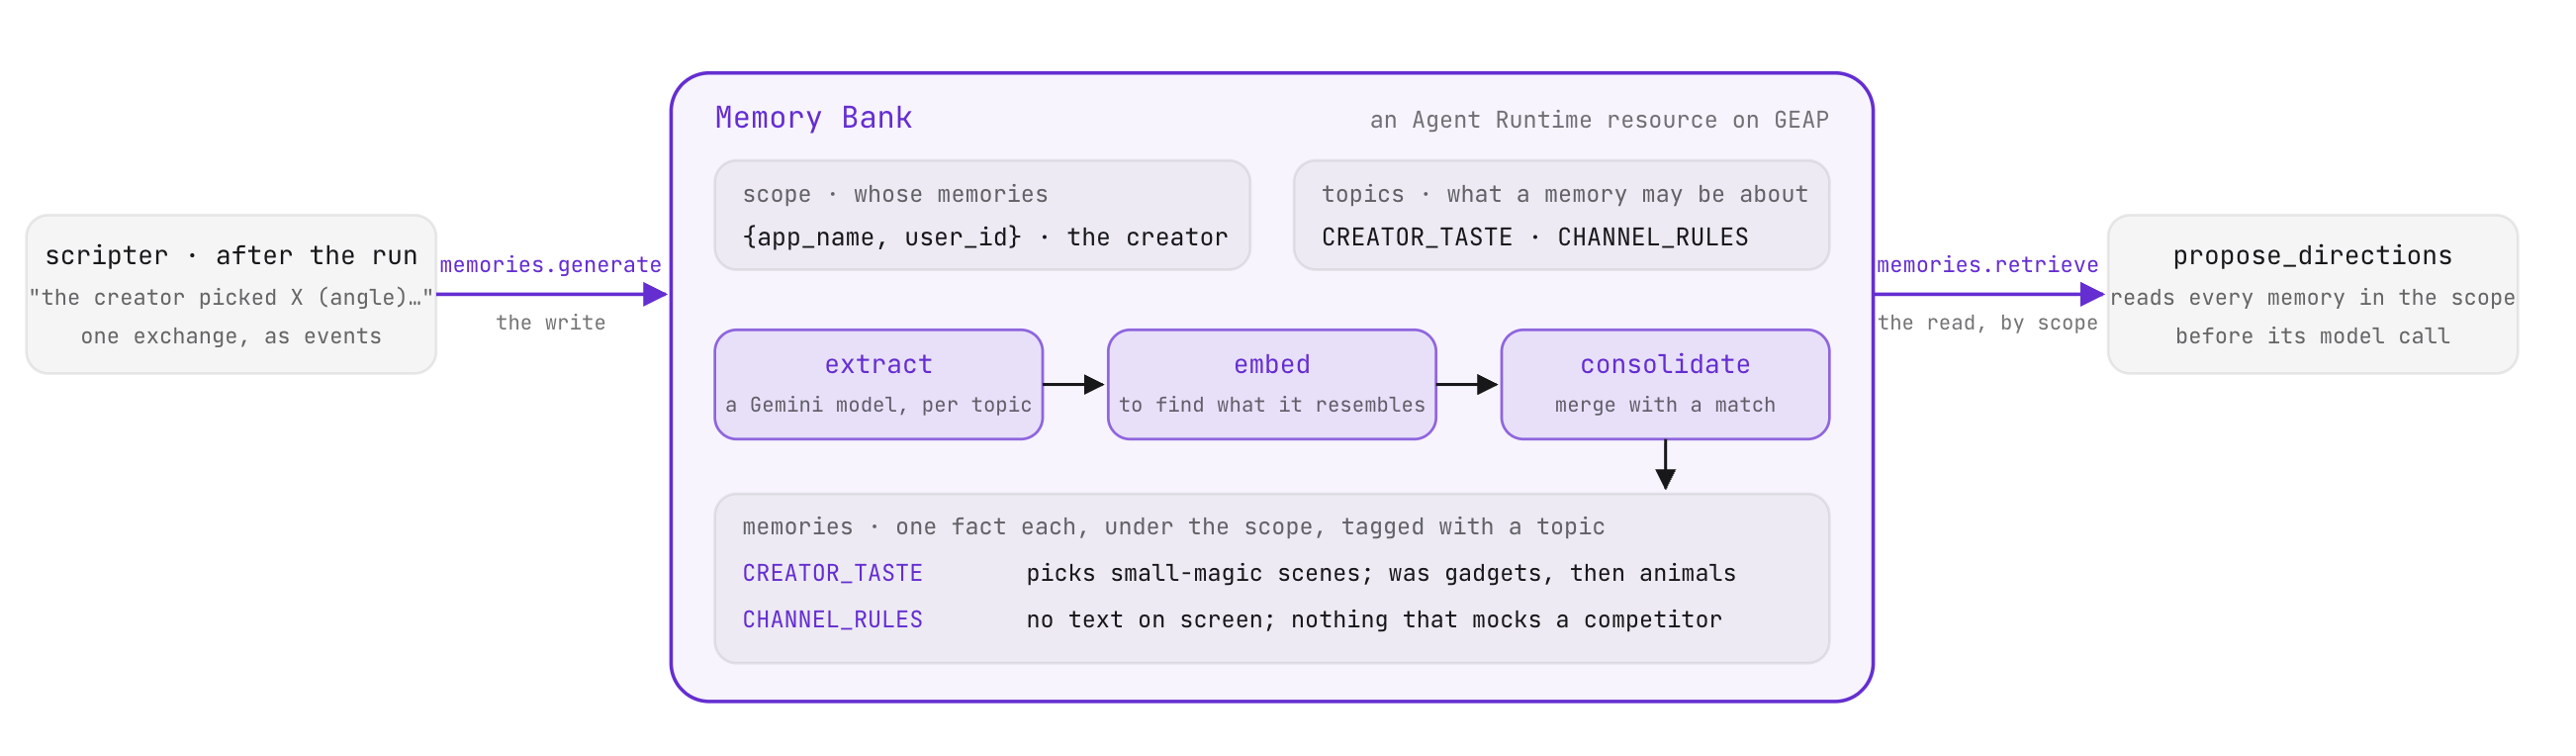
Memory Bank — это управляемый сервис для долговременной памяти пользователя. Он систематизирует информацию о человеке в рамках определенной области, в данном случае определяемой названием приложения и идентификатором пользователя:
SCOPE = {"app_name": config.APP, "user_id": config.USER}
TOPICS = {
    "CREATOR_TASTE": "Which video directions this creator picks and passes on, "
                     "and how that preference changes over time.",
    "CHANNEL_RULES": "Standing instructions the creator states for every video "
                     "(style, subjects to avoid, format rules).",
}
Пользовательские темы памяти определяют границы того, что записывает банк данных:
- Извлечение тем : Когда новый текст разговора отправляется через
memories.generate, сервис применяет модель извлечения к описанию каждой темы. Текст, не соответствующий теме, не создает воспоминаний. - Консолидация и дедупликация : Сервис преобразует вновь извлеченные факты в векторные представления и сравнивает их с существующими данными в области видимости. Когда наблюдение совпадает с существующей записью, сервис обновляет эту запись. Когда же оно представляет собой новую информацию, сервис создает новую запись. Этот процесс консолидации обеспечивает объединение нескольких сессий по одной теме в единое связное резюме вместо создания избыточных записей.
- Retrieval : Calling
memories.retrievewith the user scope returns stored facts, ordered oldest first.
Both operations are implemented in agent/platform/memory.py . The provisioned bank resource name is cached locally in runs/memorybank.json .
Setting up the Memory Bank
Use the workbench controls or run the CLI commands in your terminal:
- Connect and provision the bank :
python -m agent.platform.bankCREATOR_TASTEandCHANNEL_RULEStopics. - Seed historical sessions :
python -m agent.platform.bank load - Inspect consolidated facts :
python -m agent.platform.bank list
Callbacks (6B)
In the workbench, navigate to Callbacks (6B) . Open stage4_memory/agent.py .
ADK agent lifecycle callbacks
A callback is a function passed as an argument to an Agent . ADK invokes callbacks at predefined lifecycle moments, passing the active context. Returning None continues normal execution; returning a replacement object overrides or intercepts the operation.
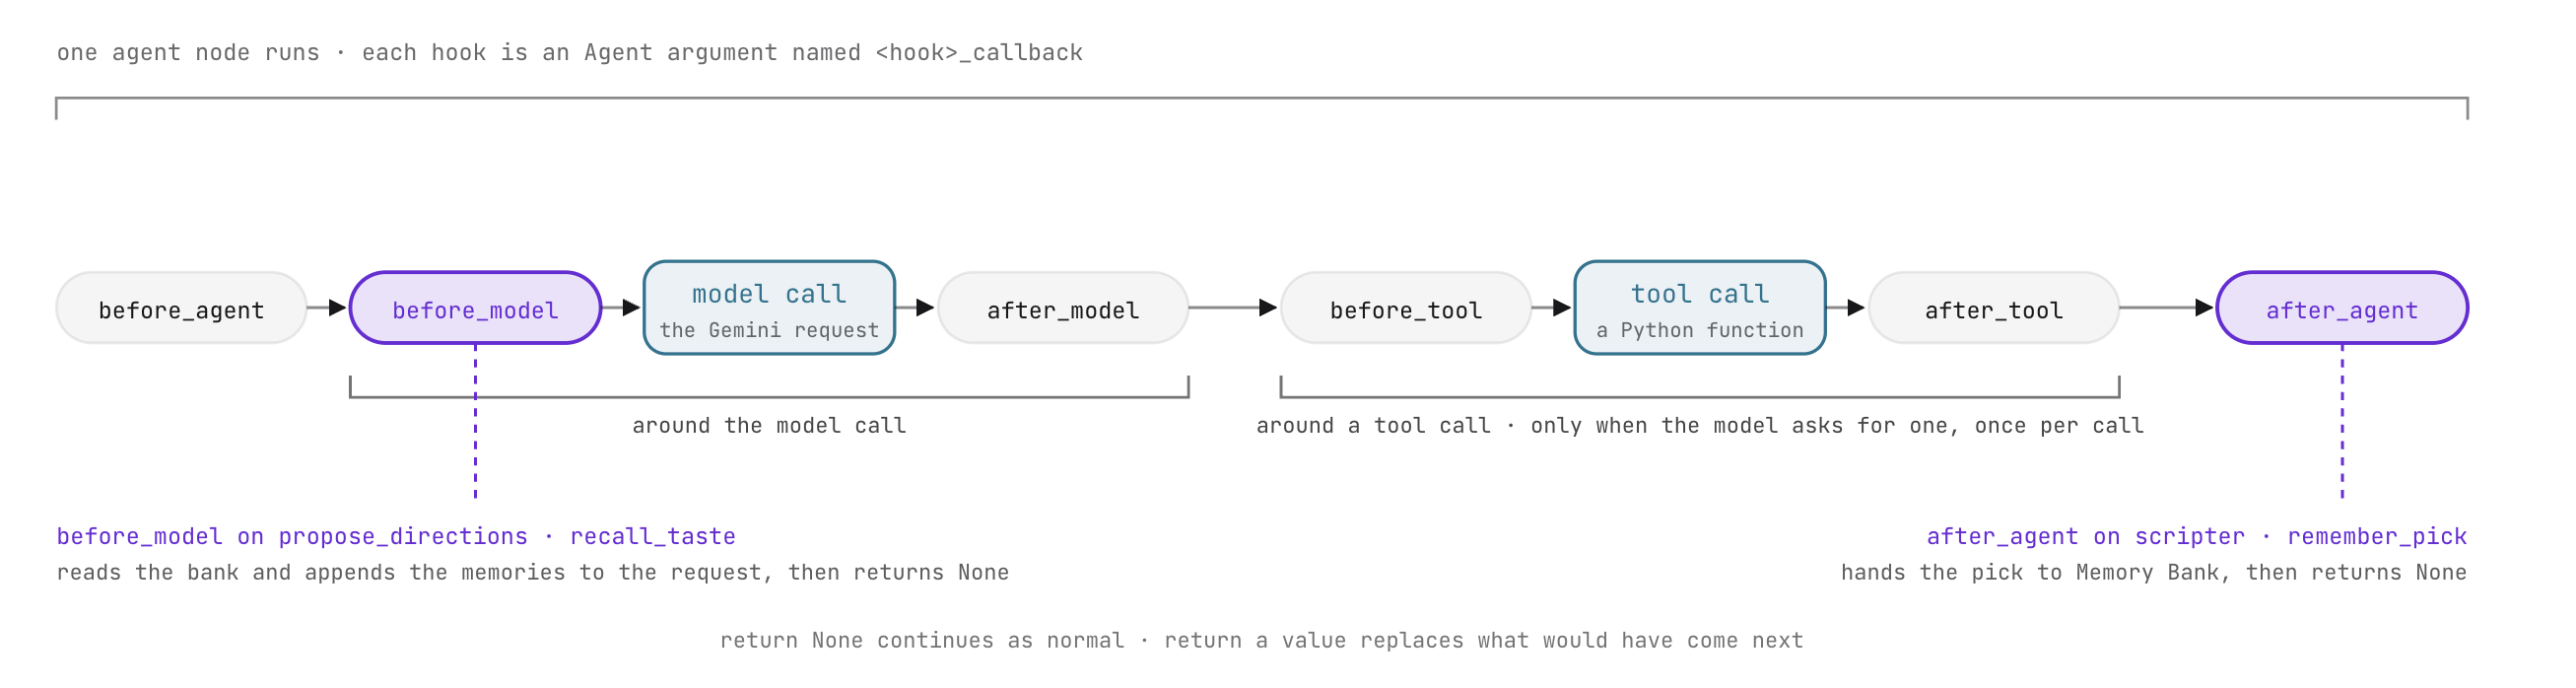
ADK provides three pairs of callbacks:
Callback Pair | Invocation Point | Parameters Received | Return Value Behavior |
| Surrounding the entire agent turn | | Returning |
| Surrounding each LLM inference call | | Returning |
| Surrounding each tool execution | Tool definition, arguments, result | Returning a dict overrides the tool output; |
Callbacks provide a clean location for context injection, guardrails, telemetry, and cache lookups without introducing extraneous nodes into the workflow graph.
Hands-on edit: wiring recall and remember callbacks
- In
stage4_memory/agent.py, updatepropose_directionsto attachbefore_model_callback=recall_taste:
    output_schema=Directions,
    before_model_callback=recall_taste)
recall_taste executes immediately before Gemini generates candidate directions. It fetches the creator's history from Memory Bank, formats the memories oldest first, and appends them to the outgoing LlmRequest . The prompt directs the model to lean candidates 1 to 3 toward the creator's current taste while treating channel rules as strict constraints.
- In
stage4_memory/agent.py, updatescripterto attachafter_agent_callback=remember_pick:
    output_schema=Script,
    after_agent_callback=remember_pick)
remember_pick runs after scripter completes its turn. It reads the chosen direction from session state, synthesizes a concise statement summarizing the creator's decision, and calls memories.generate to update the Memory Bank.
What to expect and why
Test the callback-augmented workflow in the workbench or ADK Web:
- Execute a run with an empty prompt:
- In the session trace, inspect the
LlmRequestforpropose_directions. Notice the appended memory context detailing the creator's preference for fantasy themes and concise pacing. - Observe the proposed directions: candidates 1 to 3 align with the creator's historical preferences even when trends emphasize other topics.
- In the session trace, inspect the
- Select a candidate at
direction_gate. - After
scriptercompletes, review the Memory Bank records:python -m agent.platform.bank list
7. RAG Engine
In the VibeStudio Workbench , navigate to Step 7 · RAG Engine , parts (7A) and (7B) .
Published videos accumulate ongoing viewer feedback. Thirty representative comments are collected in agent/comments.md , capturing viewer praises, critique of sponsored pacing, and audio preferences. In this step, you index these comments using Vertex AI RAG Engine and connect semantic retrieval into the research fan-out.
Retrieval over documents (7A)
In the workbench, navigate to RAG Engine (7A) .
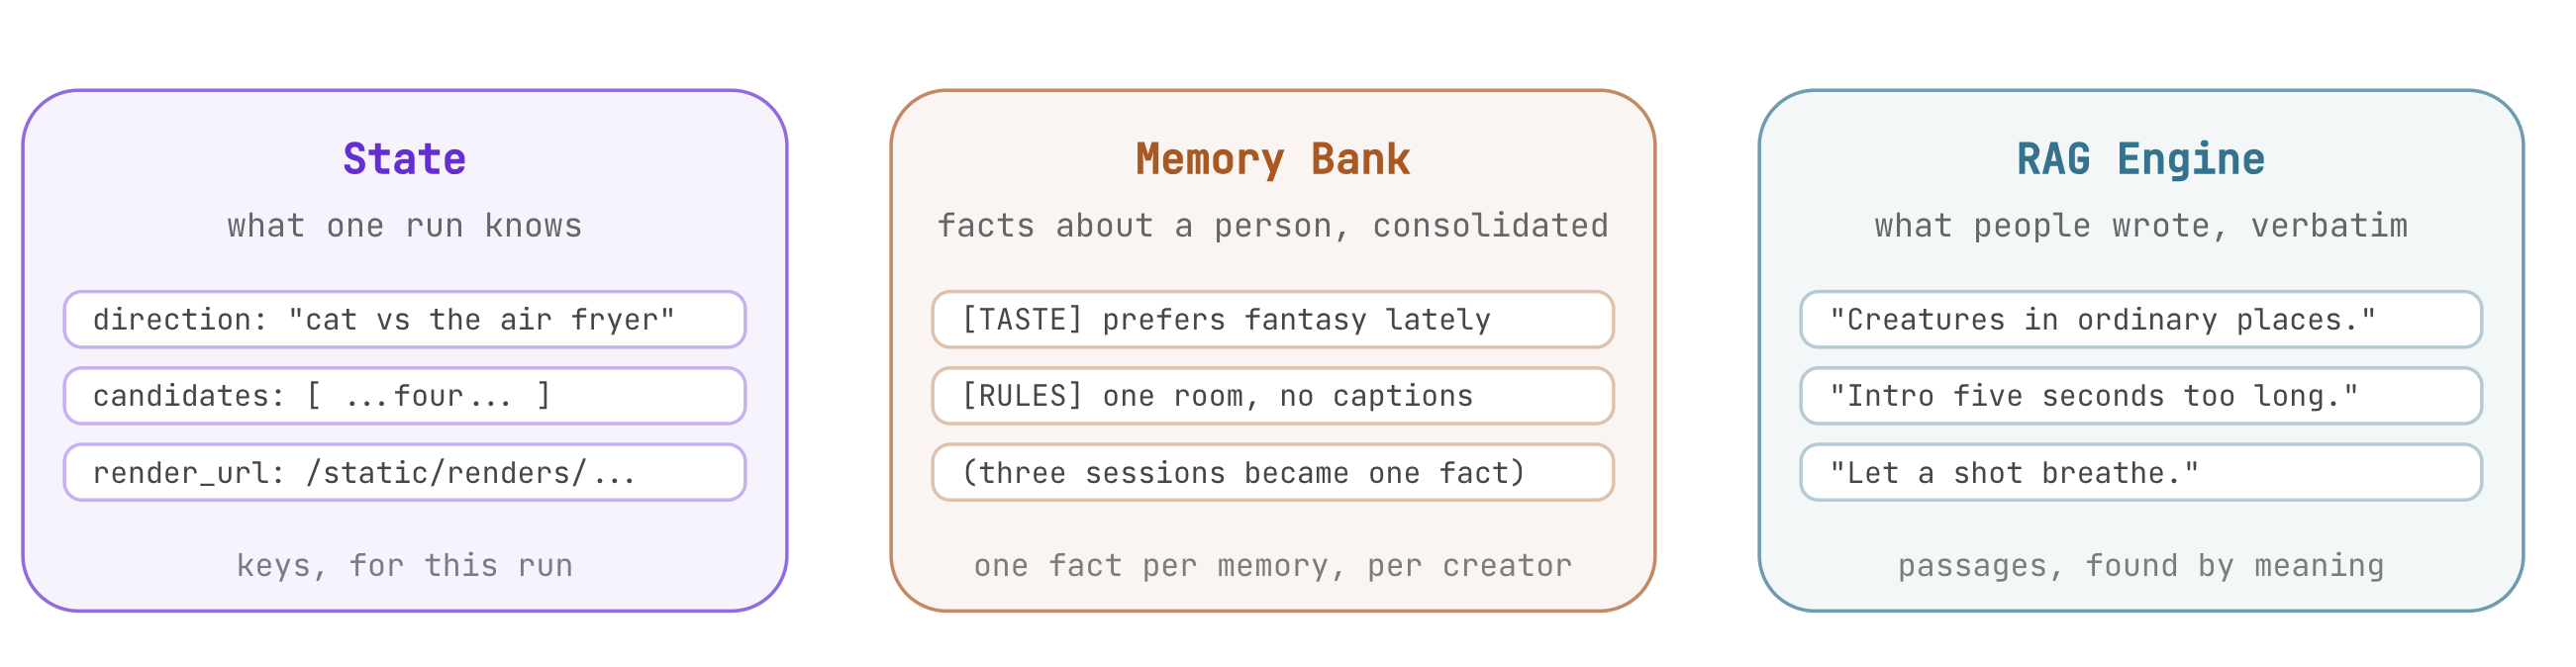
Memory Bank vs RAG Engine
Both tools ground workflows in external data, but they serve distinct architectural purposes:
Измерение | Банк памяти | Двигатель РАГ |
Основной вариант использования | Long-term user preferences and operational rules | Semantic retrieval over large document collections |
Объем | Scoped to individual user IDs and application names | Scoped to shared corpus resources across all users |
Обработка данных | Real-time extraction, embedding, and semantic consolidation | Document chunking, vector embedding, and nearest-neighbor search |
Graph Integration | Agent lifecycle callbacks ( | Dedicated function node in research fan-out ( |
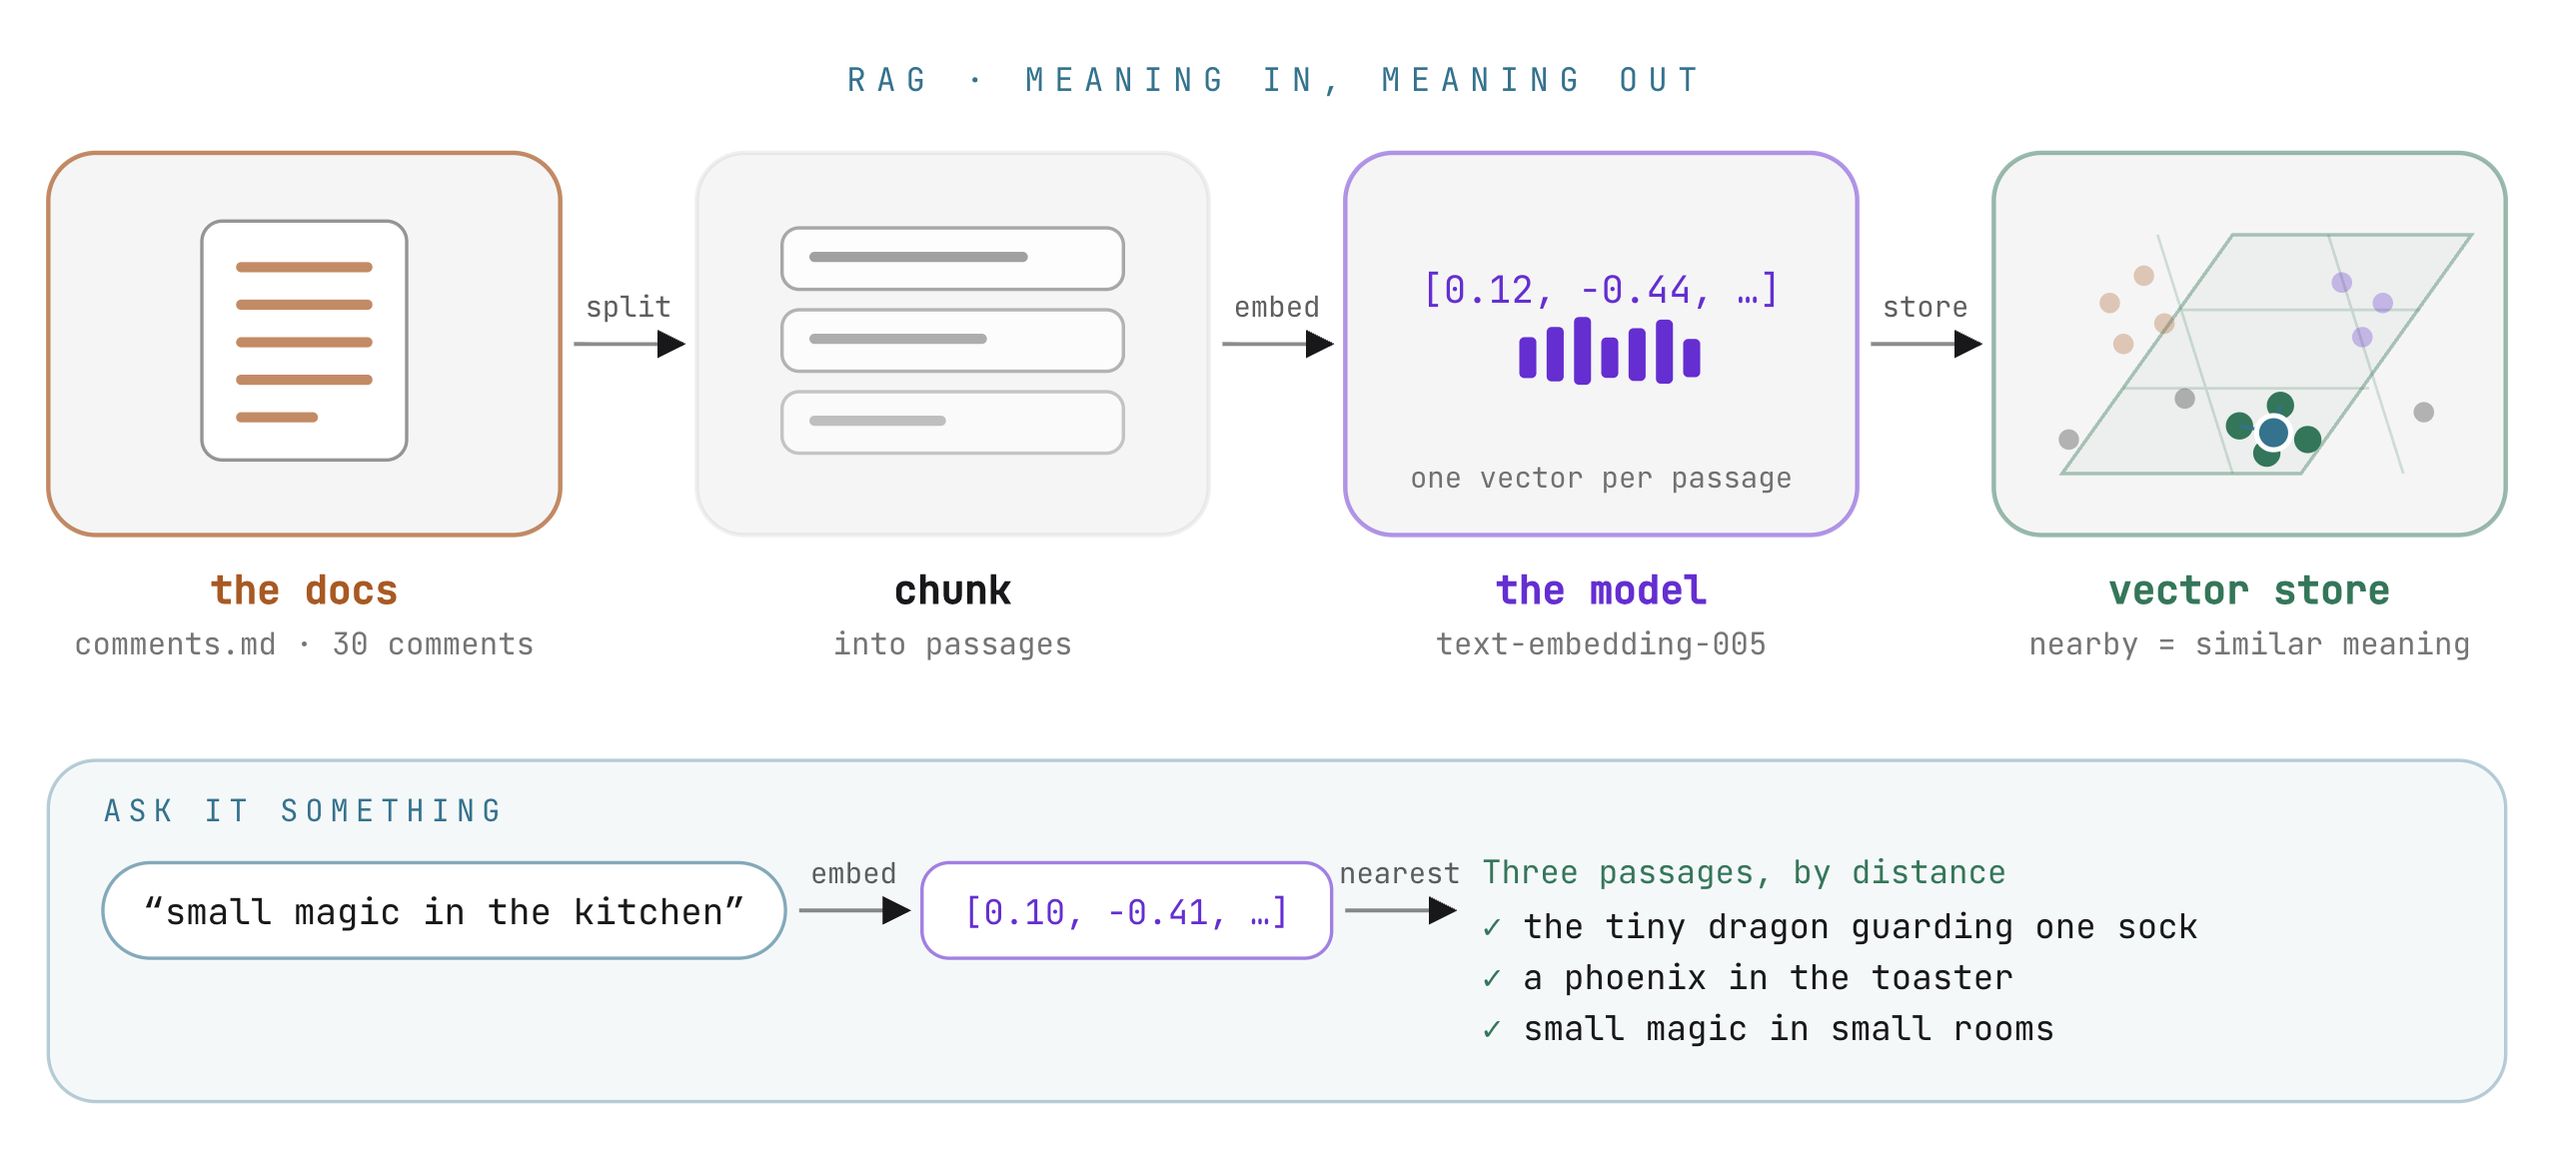
Document chunking and embeddings
RAG Engine indexes documents by dividing text into semantic passages and storing their vectors in a managed database:
corpus = rag.create_corpus(
    display_name="vibestudio-feedback",
    description="Vibe Studio: what the audience wrote under the channel's past videos.",
    backend_config=rag.RagVectorDbConfig(
        rag_embedding_model_config=rag.RagEmbeddingModelConfig(
            vertex_prediction_endpoint=rag.VertexPredictionEndpoint(
                publisher_model="publishers/google/models/text-embedding-005"))))

rag.upload_file(
    corpus_name=corpus.name, path="agent/comments.md", display_name="comments.md",
    transformation_config=rag.TransformationConfig(
        chunking_config=rag.ChunkingConfig(chunk_size=120, chunk_overlap=20)))
- Chunk size : Configured to 120 tokens with 20 tokens of overlap. This captures two to three comments per passage, ensuring each vector represents a cohesive sentiment without diluting meaning across unrelated feedback.
- Embedding model :
text-embedding-005converts text into high-dimensional vectors. When a query is submitted, the model converts the query into a vector and finds nearest matches based on semantic distance. A comment about a tiny dragon guarding socks matches a prompt about magical creatures without requiring exact keyword overlap.
Setting up the RAG corpus
Initialize the corpus using the workbench buttons or terminal commands:
- Create the corpus :
python -m agent.platform.ragruns/ragcorpus.json. - Upload and index comments : Uploads
agent/comments.mdwith chunking configuration and waits for indexing to complete. - Query the corpus : Test similarity retrieval with queries that do not share exact words with the comments (for example, query "small magical creatures" to retrieve comments about dragons).
The retrieval node (7B)
In the workbench, navigate to The third reader (7B) . Open stage5_rag/agent.py .
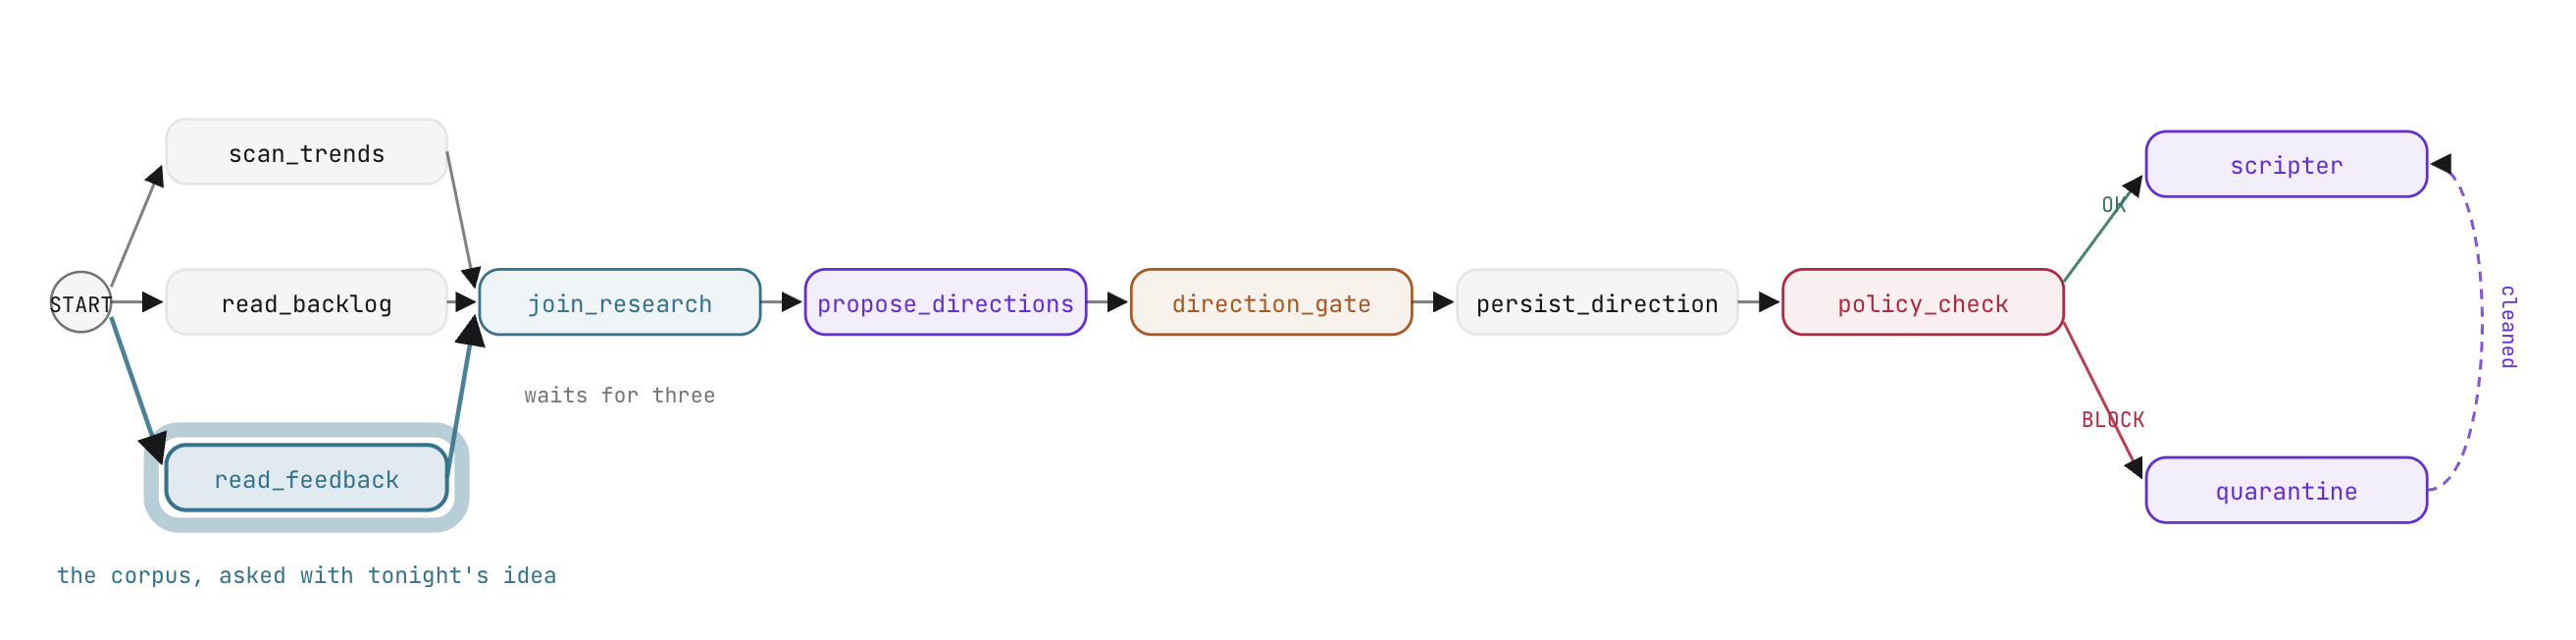
Retrieval as a graph node
Audience feedback represents research data shared across the workflow. Unlike personal creator memory, viewer sentiment feeds directly into join_research alongside trends and backlog data. It is therefore implemented as a function node:
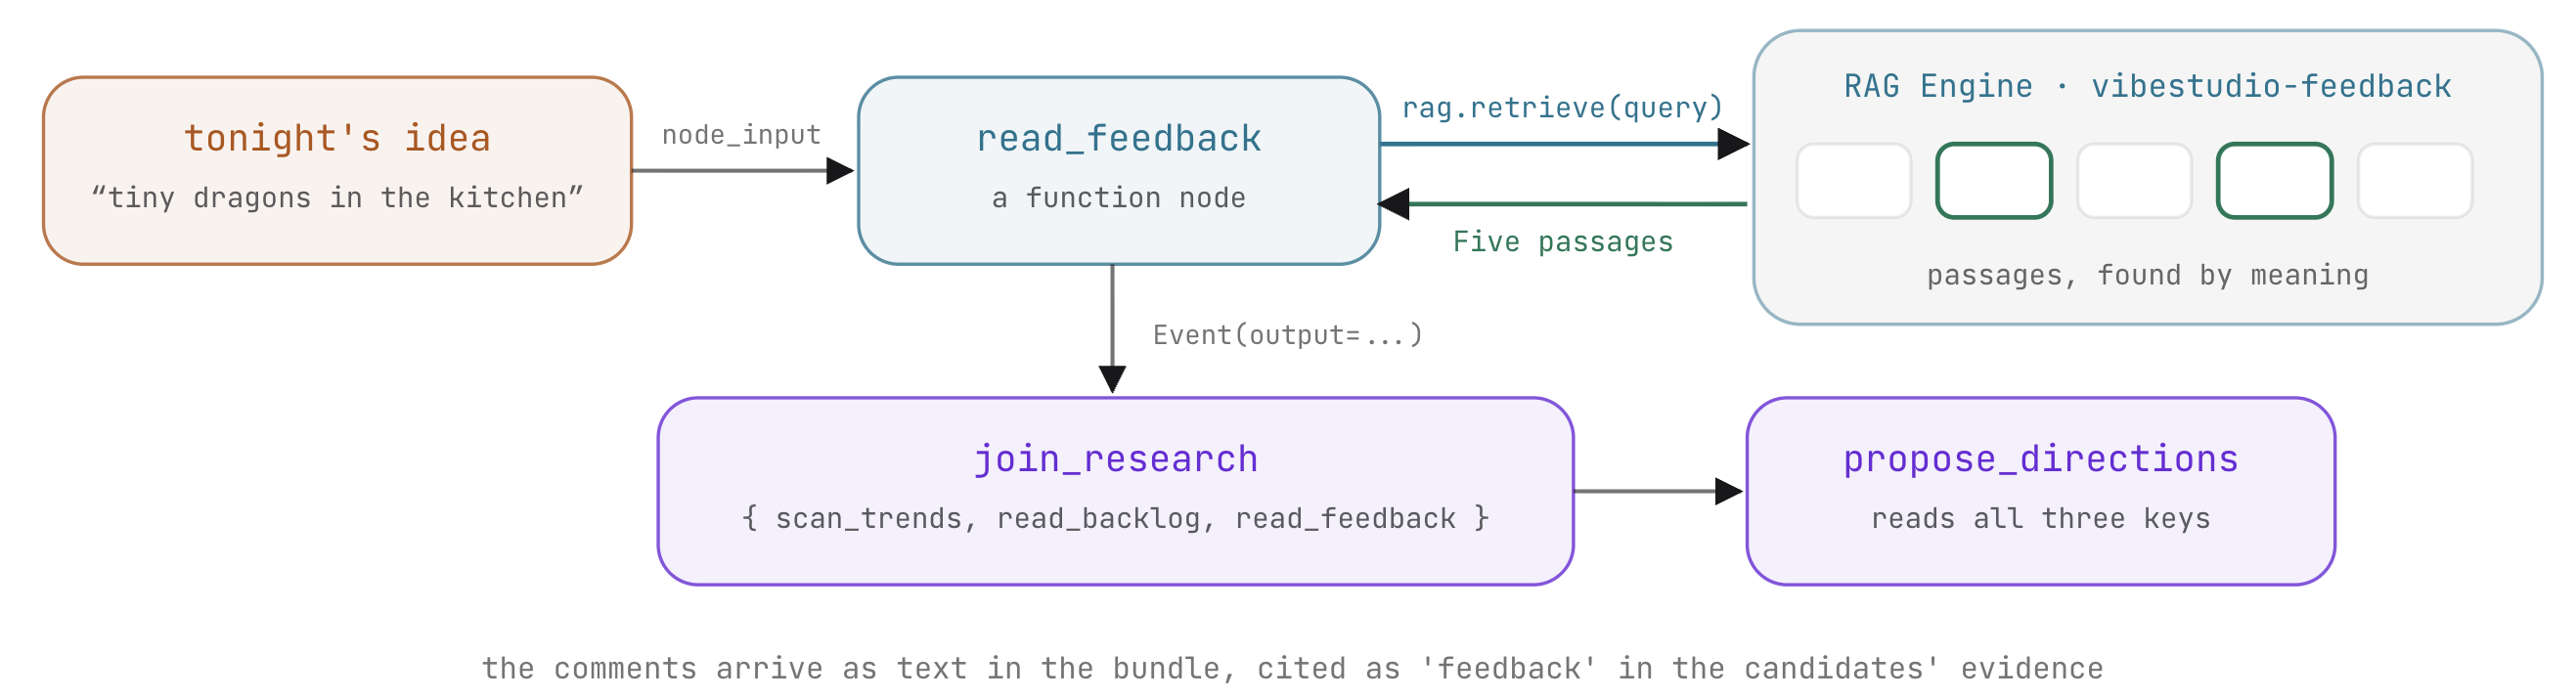
def read_feedback(node_input):
    """The third reader (step 7): what the audience wrote under past videos,
    the passages nearest to tonight's idea. Retrieval, not a model call."""
    from .platform import rag
    idea = idea_text(node_input)
    query = idea or "what viewers liked and what they complained about"
    try:
        hits = rag.retrieve(query)
    except Exception as e:
        print(f"  [rag] feedback unavailable ({str(e)[:80]})")
        return Event(output={"query": query, "feedback": [],
                             "note": "no corpus connected - run: python -m agent.platform.rag"})
    return Event(output={"query": query, "feedback": [h["text"] for h in hits]})
read_feedback extracts the user's initial idea and executes a vector query against the RAG Engine corpus. It emits the retrieved comments in an Event(output=...) payload.
Hands-on edit: wiring the third reader into the fan-out
In stage5_rag/agent.py , update edges to add read_feedback as a third parallel branch entering join_research :
           (START, read_backlog, join_research),
           (START, read_feedback, join_research),
Because join_research is a JoinNode , it synchronizes all incoming branches, waiting until scan_trends , read_backlog , and read_feedback have all emitted events before passing the aggregated bundle downstream.
What to expect and why
Run the workflow in the workbench:
- Submit an idea prompt (such as "a miniature dragon guarding a kitchen counter").
- In the execution trace, verify that all three reader nodes execute concurrently.
- Observe
join_research: its output dictionary now containstrends,backlog, andfeedback. - Inspect the generated candidates from
propose_directions: the model incorporates viewer comments into its proposals and references audience sentiment in the evidence fields. - Notice that RAG retrieval is deterministic (identical queries return identical comment passages), whereas the generative proposal node produces creative variations.
8. Asynchronous video generation with Veo
In the VibeStudio Workbench , navigate to Step 8 · The video , parts (8A) and (8B) .
Generating high-definition video with Google Veo requires several minutes per render. Blocking graph execution during this period wastes compute resources, locks thread pools, and exposes the run to HTTP connection dropouts. In this step, you make video rendering asynchronous using ADK's LongRunningFunctionTool .
Long-running tools (8A)
In the workbench, navigate to A long-running tool (8A) . Open stage6_video/agent.py and agent/deliver.py .
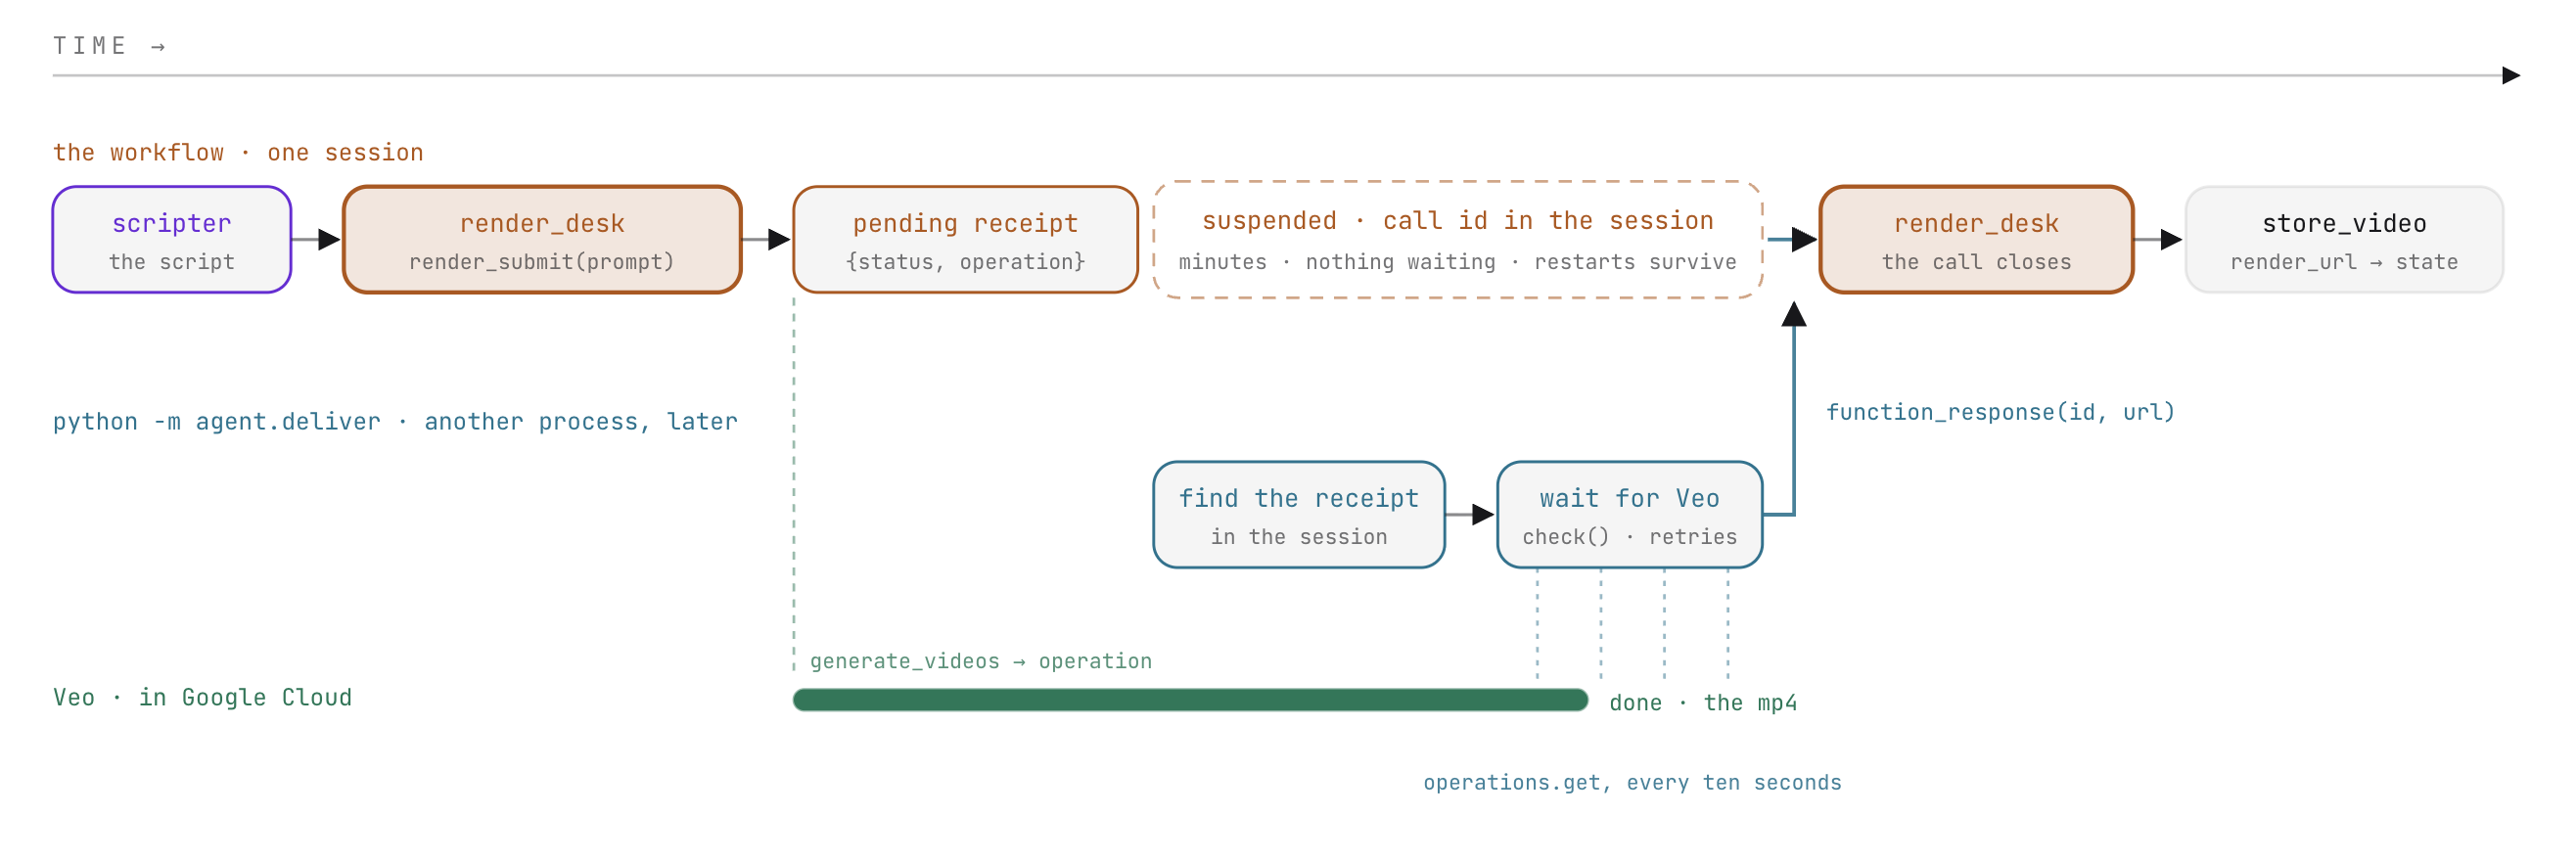
Synchronous tools vs long-running tools
Standard ADK function tools execute synchronously inside an agent turn: the model calls the tool, awaits the return payload, and incorporates the result into the ongoing turn.
Video rendering cannot complete within a single turn. Instead, render_submit initiates the generation job and immediately returns an operational receipt with status "pending" :
def render_submit(prompt: str) -> dict:
    """Submit one Veo render of `prompt`. Returns at once with a pending
    receipt; the clip is delivered later, to this call, by id."""
    receipt = videogen.start(f"{prompt} {videogen.NO_TEXT}")
    return {"status": "pending", "operation": receipt["operation"], "prompt": receipt["prompt"]}
When wrapped with LongRunningFunctionTool , ADK intercepts the "pending" status. The agent's turn concludes, the workflow suspends at the node, and the pending call metadata (including call ID and receipt) is recorded in runs/sessions.db . The execution process exits cleanly without maintaining active network connections or worker threads.
Hands-on edit: wrapping the render tool
In stage6_video/agent.py , update render_desk to wrap render_submit in LongRunningFunctionTool :
tools=[LongRunningFunctionTool(render_submit)])
Resuming by call ID
The universal resumption pattern
ADK applies an identical mechanism to suspend and resume workflows for both humans and external tools:
Suspension Trigger | Initiating Construct | Stored Suspension State | Resumption Event |
Human Decision | | Open input prompt in session store | |
Long-Running Tool | | Open tool call in session store | |
In both scenarios, the workflow halts completely and resumes only when an event bearing a matching FunctionResponse arrives from an external source: a user interface, a webhook, or a background worker.
Hands-on edit: completing the delivery response
In agent/deliver.py , construct the resumption FunctionResponse part:
    part = Part(function_response=FunctionResponse(
        id=row["call_id"], name=row["name"], response=response))
The delivery daemon polls Veo until the video file is generated, then dispatches this FunctionResponse to the session. ADK matches the call ID and resumes the workflow directly at the next node. Completed nodes do not re-execute, and the agent does not take another generative turn.
Setting STUDIO_REAL_VIDEO=0 in .env enables mock rendering: start returns an immediate test receipt, and check simulates completion in five seconds without making billable Veo API calls.
Pipeline integration (8B)
In the workbench, navigate to render_desk in the graph (8B) . Open stage6_video/agent.py .
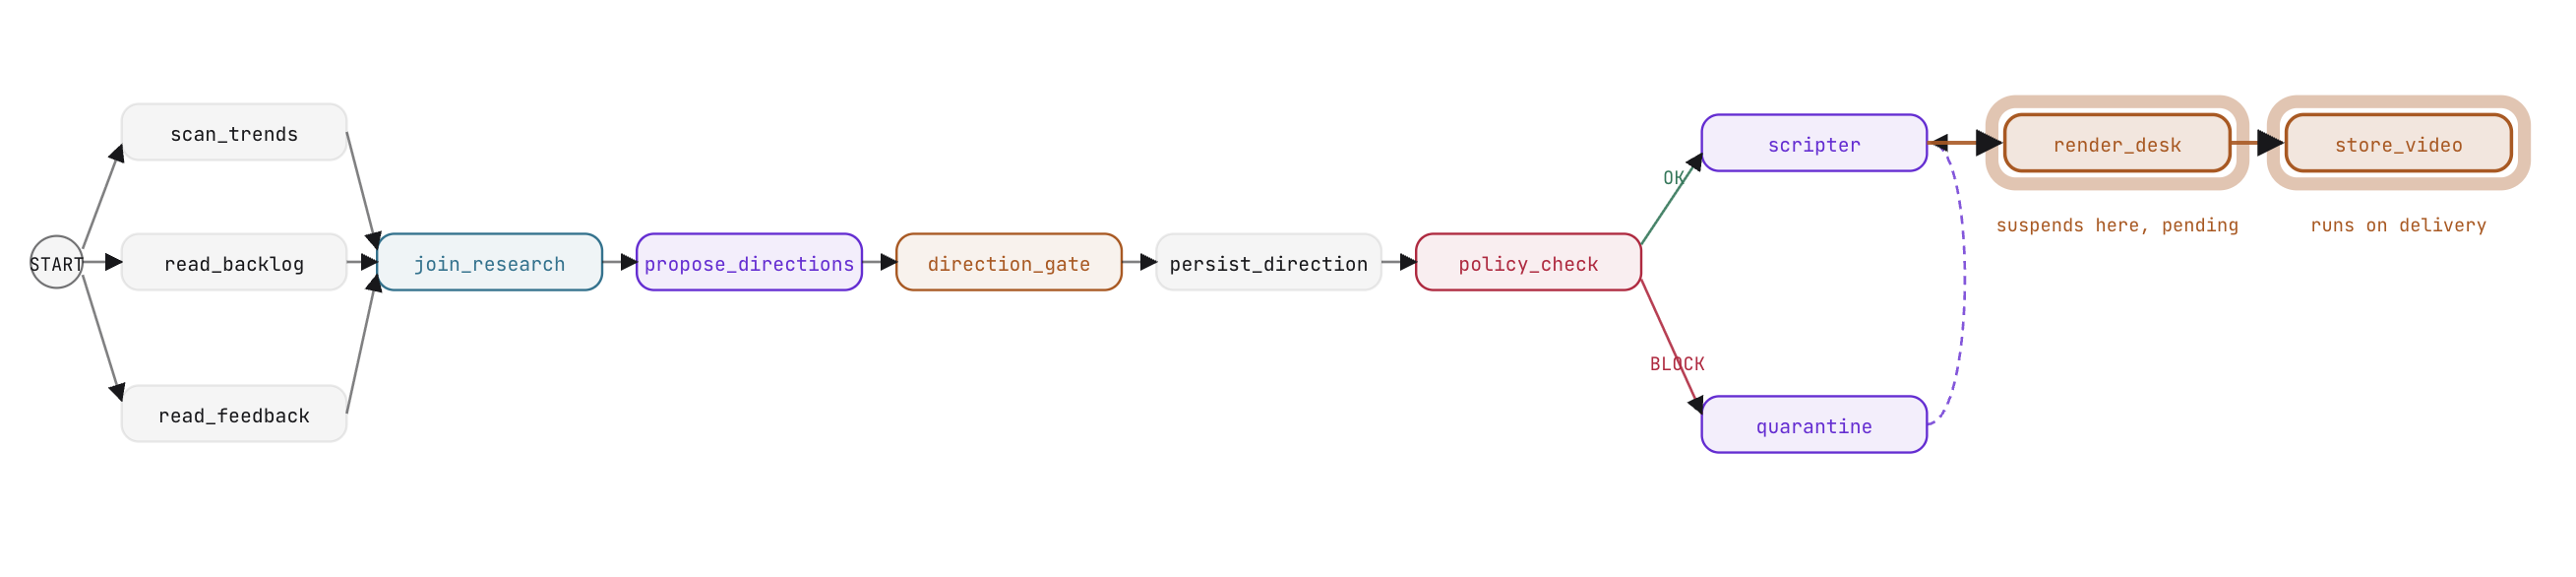
The terminal node in the pipeline is store_video . It reads the completed render information from runs/state.json (where the delivery process recorded it) and commits the video URL and generation status to shared session state.
Hands-on edit: wiring the complete video pipeline
In stage6_video/agent.py , update edges to append render_desk and store_video :
           (quarantine, scripter),
           (scripter, render_desk, store_video)])
What to expect and why
Test the asynchronous generation flow in the workbench:
- Execute the workflow through candidate selection and script generation.
- At
render_desk, observe the agent invokerender_submit. - The workflow immediately suspends. In the workbench or ADK Web, observe the pending status: the session holds the open call ID, and no background processes are consuming resources.
- Run the delivery daemon using the workbench console or in your terminal:
python -m agent.deliver - In ADK Web, refresh the session: execution resumes at
store_video, commits the video URL to session state, and completes the workflow.
9. Deploy to Cloud Run
In the VibeStudio Workbench , navigate to Step 9 · Deploy .
You have developed and verified each component of the pipeline across dedicated sandboxes. In this step, you assemble the complete production pipeline and deploy it to Google Cloud Run .
The ADK Runner
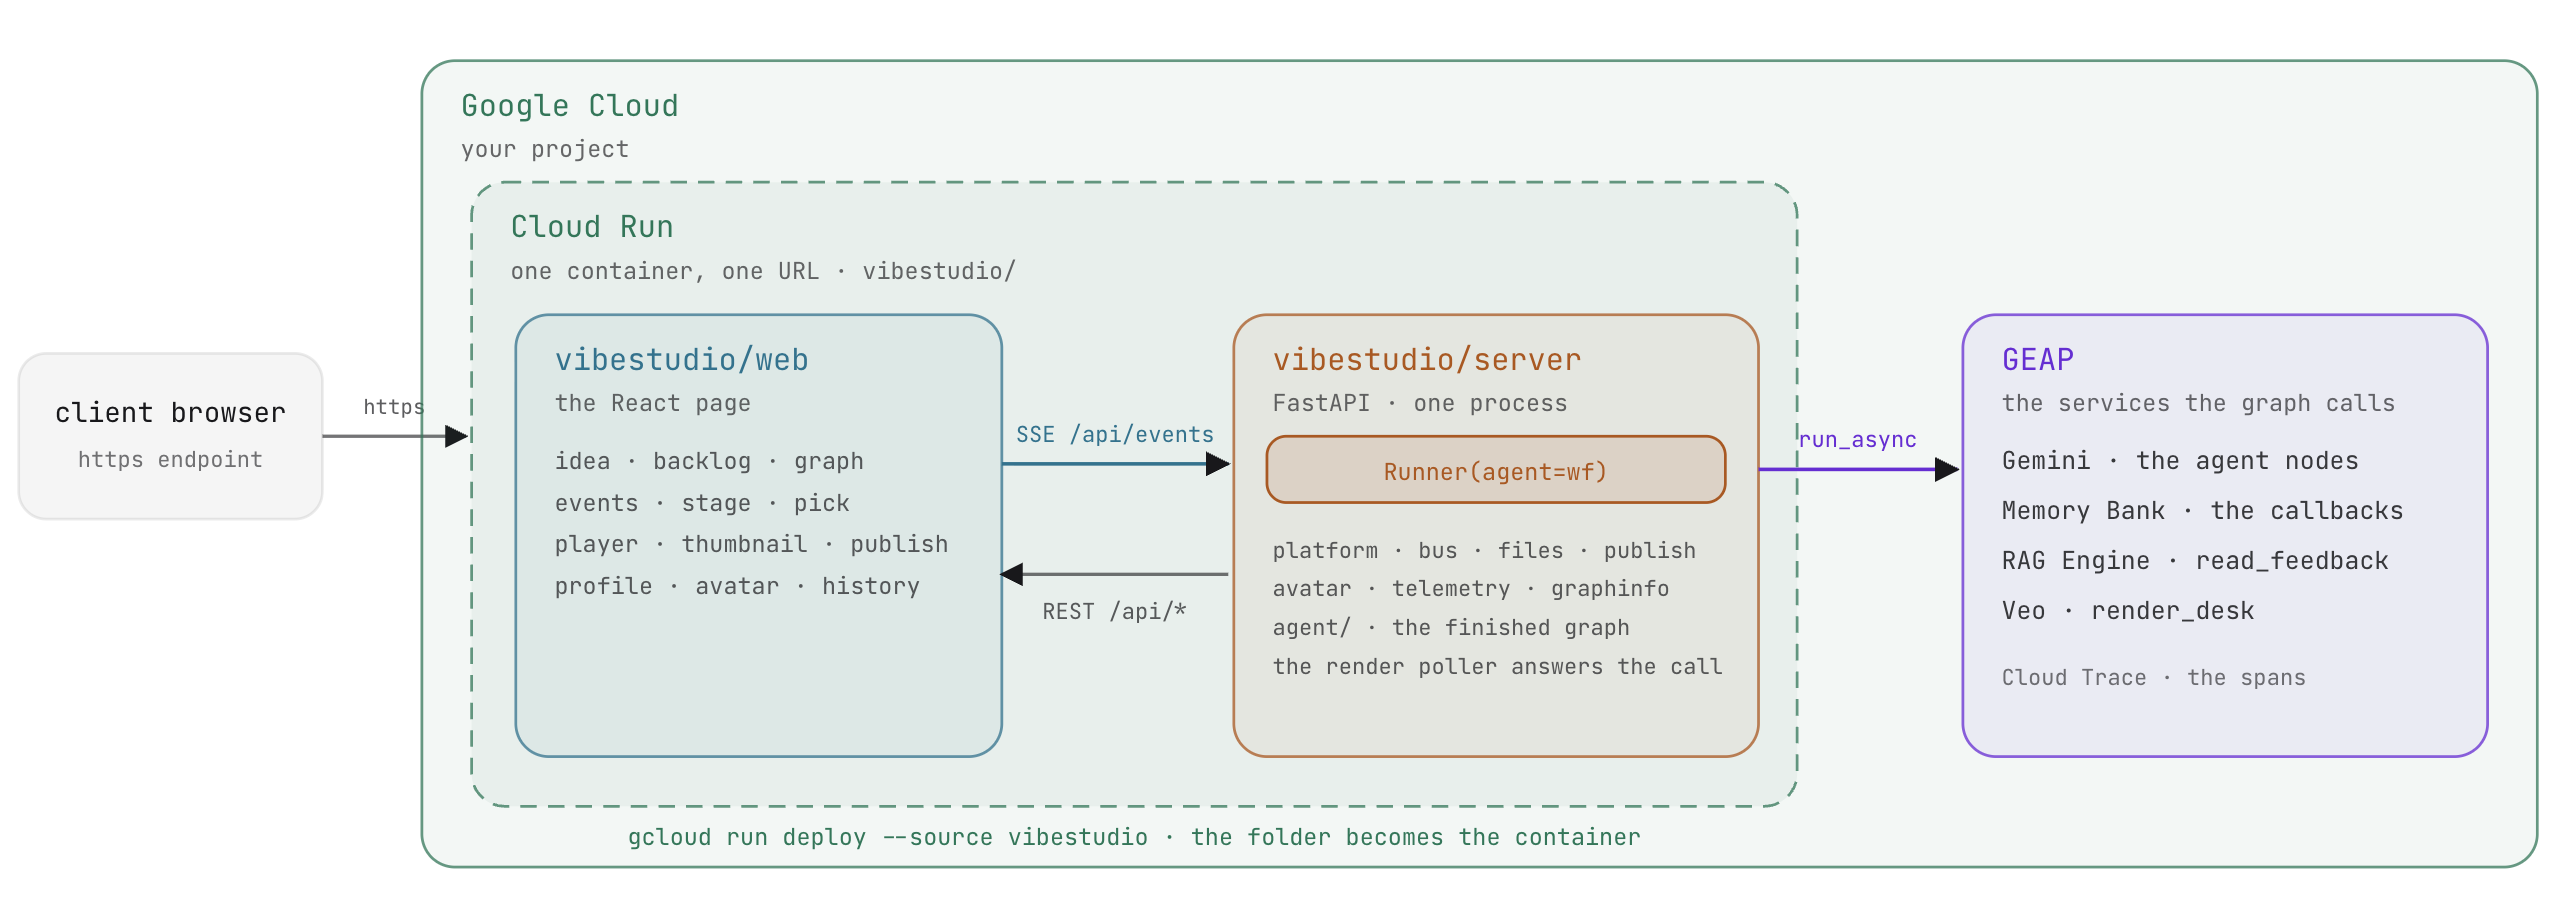
In development, adk web orchestrated the graph. In production, the application hosts the workflow using ADK's Runner class:
self._svc = DatabaseSessionService(db_url=config.DB_URL)
self._runner = Runner(app_name=config.APP, agent=wf, session_service=self._svc)

async for ev in self._runner.run_async(user_id=config.USER, session_id=run_id, new_message=message):
    self._absorb(ev)    # fold the ADK event into the run state, publish one app event

# the gate's answer and the render's delivery are the same call, with a function_response part
part = Part(function_response=FunctionResponse(id=call_id, name=name, response=response))
run_async: Drives workflow execution, yielding events sequentially as nodes execute and persisting updates to the session service.- Unified resumption : Both user decisions at
direction_gateand completed video deliveries from Veo resume execution through identicalFunctionResponseobjects submitted torun_async.
The production application architecture
The production application in vibestudio/ integrates the complete pipeline:
vibestudio/
  server/
    main.py                 FastAPI: application server, REST routes, static assets
    api.py                  REST API endpoints: run, pick, publish, backlog, profile, history
    runner.py               Runner orchestration over the workflow, background render poller
    platform/               Event bus (SSE stream), file storage, publishing, telemetry
    agent/                  Production agent package, verified by checks/verify_app.py
      graph.py              The complete workflow graph and node definitions
      desk.py               render_desk and render_submit wrapped with LongRunningFunctionTool
      schemas.py            Pydantic schemas: Directions, CleanedDirection, Script
      cleanup_tools.py      Deterministic policy tools: find_policy_hits, suggest_replacement
      platform/             Memory Bank, RAG Engine, and Veo integrations
  web/                      Production React user interface
  Dockerfile · deploy.py · run.sh
- Single event stream : The FastAPI backend publishes events across a single Server-Sent Events (SSE) stream. The React frontend visualizes graph progression in real time and handles late connections without losing state.
- Decoupled execution : The application manages the event loop. The workflow graph focuses entirely on execution logic, unaware of the frontend interface.
The complete workflow edge list in agent/graph.py combines every architectural pattern built throughout this codelab:
        (START, scan_trends, join_research),
        (START, read_backlog, join_research),
        (START, read_feedback, join_research),
        (join_research, propose_directions, direction_gate,
         persist_direction, policy_check),
        (policy_check, {"OK": scripter, "BLOCK": quarantine}),
        (quarantine, scripter),
        (scripter, render_desk, store_video),
Deploying to Cloud Run
Google Cloud Run provides serverless hosting with automatic scaling, request routing, and integrated container builds:
gcloud run deploy vibestudio --source vibestudio \
  --project $GOOGLE_CLOUD_PROJECT --region us-central1 \
  --labels dev-tutorial-codelab=vibetube --allow-unauthenticated \
  --memory 2Gi --cpu 2 --timeout 3600 --concurrency 40 \
  --max-instances 1 --min-instances 1 --session-affinity \
  --set-env-vars GOOGLE_CLOUD_PROJECT=...,STUDIO_VERTEX=1,STUDIO_MEMORY_BANK=...,STUDIO_RAG_CORPUS=...,VIBETUBE_URL=...,VIBETUBE_EVENT=...,VIBETUBE_NAME=...,VIBETUBE_PROJECT=...
- Container build :
gcloud run deploy --sourcepackages thevibestudio/directory, builds the container image using Cloud Build, and deploys the service in a single operation. - Session affinity : Directs requests from the same user to the same container instance, preserving local session state across iterative steps.
- Observability : Cloud Trace integration records distributed spans for every node, LLM call, and tool execution, accessible in the Google Cloud Console under Trace Explorer.
Click the Deploy button in the workbench to execute the deployment script. When the build completes, the terminal displays the live service URL.
10. Summary
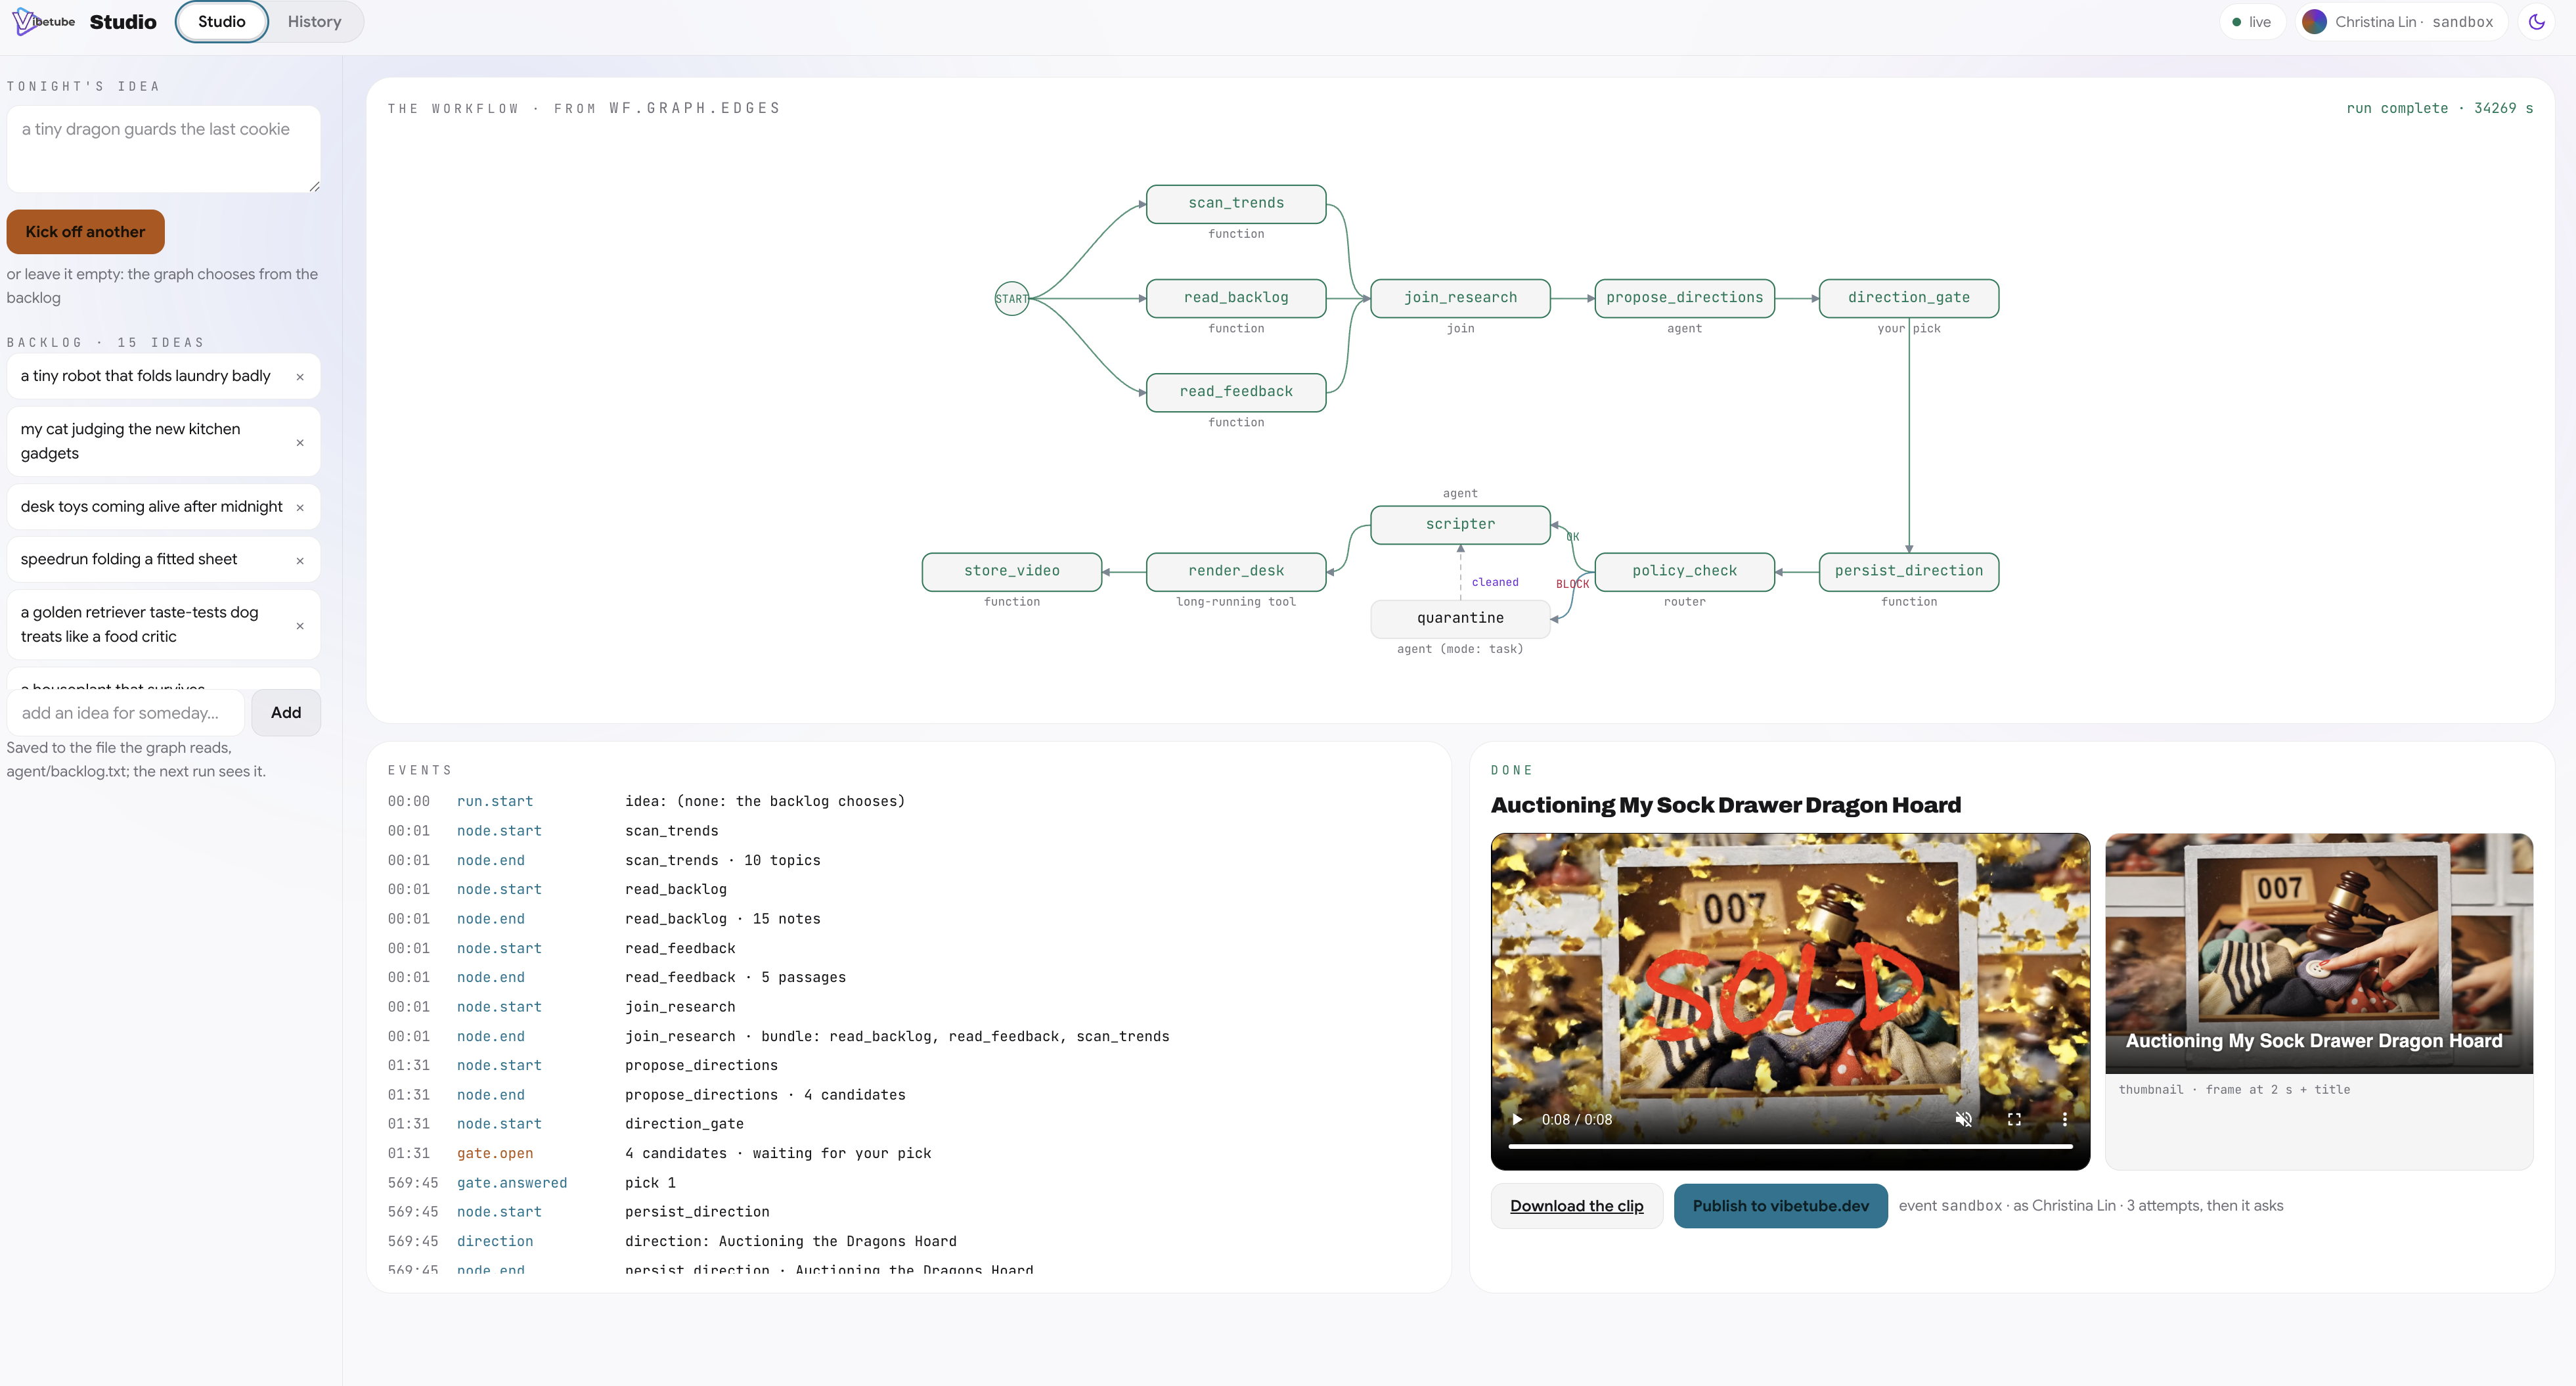
In the VibeStudio Workbench , navigate to Step 10 · Summary to review the completed architecture.
Шаг | Architecture & Concepts | Implementation Pattern |
A single prompt | Single prompt, function tools, sequential chat loop | |
Agentic workflow fundamentals | Graph workflow, parallel research, schema outputs, human gate | |
State and Router | Shared session state, parameter binding, deterministic routing, task agent | |
Банк памяти | User-level long-term memory, semantic consolidation, lifecycle hooks | |
Двигатель РАГ | Document retrieval over audience comments, semantic embeddings | |
Asynchronous video generation with Veo | Long-running tools, pending receipts, external delivery daemon | |
Развертывание в облаке. Запуск. | Programmatic orchestration, Server-Sent Events, serverless container | |
Core architectural principles
- Suspend instead of waiting : Workflows pause cleanly for human input (
RequestInput) or long-running operations (LongRunningFunctionTool). Processes do not wait idle on threads or network sockets. - Universal resumption : Every suspension resumes through an identical mechanism: a single
function_responsecarrying the call ID of the suspended node. - Decoupled state management : Nodes share data through named session state keys and parameter binding instead of verbose, tightly coupled intermediate payloads.
- Deterministic routing before generative cost : Rule-based routers and regex filters evaluate policy at zero token cost before generative models run.
- Separation of concerns : Context specific to an individual agent belongs in lifecycle callbacks, while shared data dependencies belong