1. 简介
本 Codelab 将指导您使用智能体开发套件 (ADK) 中的工作流和图表构建新一代智能体系统。您将实现常见的架构模式,编排人机协同 (HITL) 交互,并处理长时间运行的异步执行。您还将集成企业知识库和持久性记忆,以自定义和改进智能体行为。最后,您将连接这些功能,以打造自动化的视频生成流水线。
场景
您在 VibeTube 上运营着一个数字频道,拥有活跃的观众群,并且积累了越来越多的创意想法。制作每个视频都需要跨多个阶段持续执行:研究热门格式、综合观看者反馈、编写脚本、检查政策合规性以及生成视频片段。生成模型可以起草单个素材资源,但要实现一致的发布,需要精心编排的智能体架构。
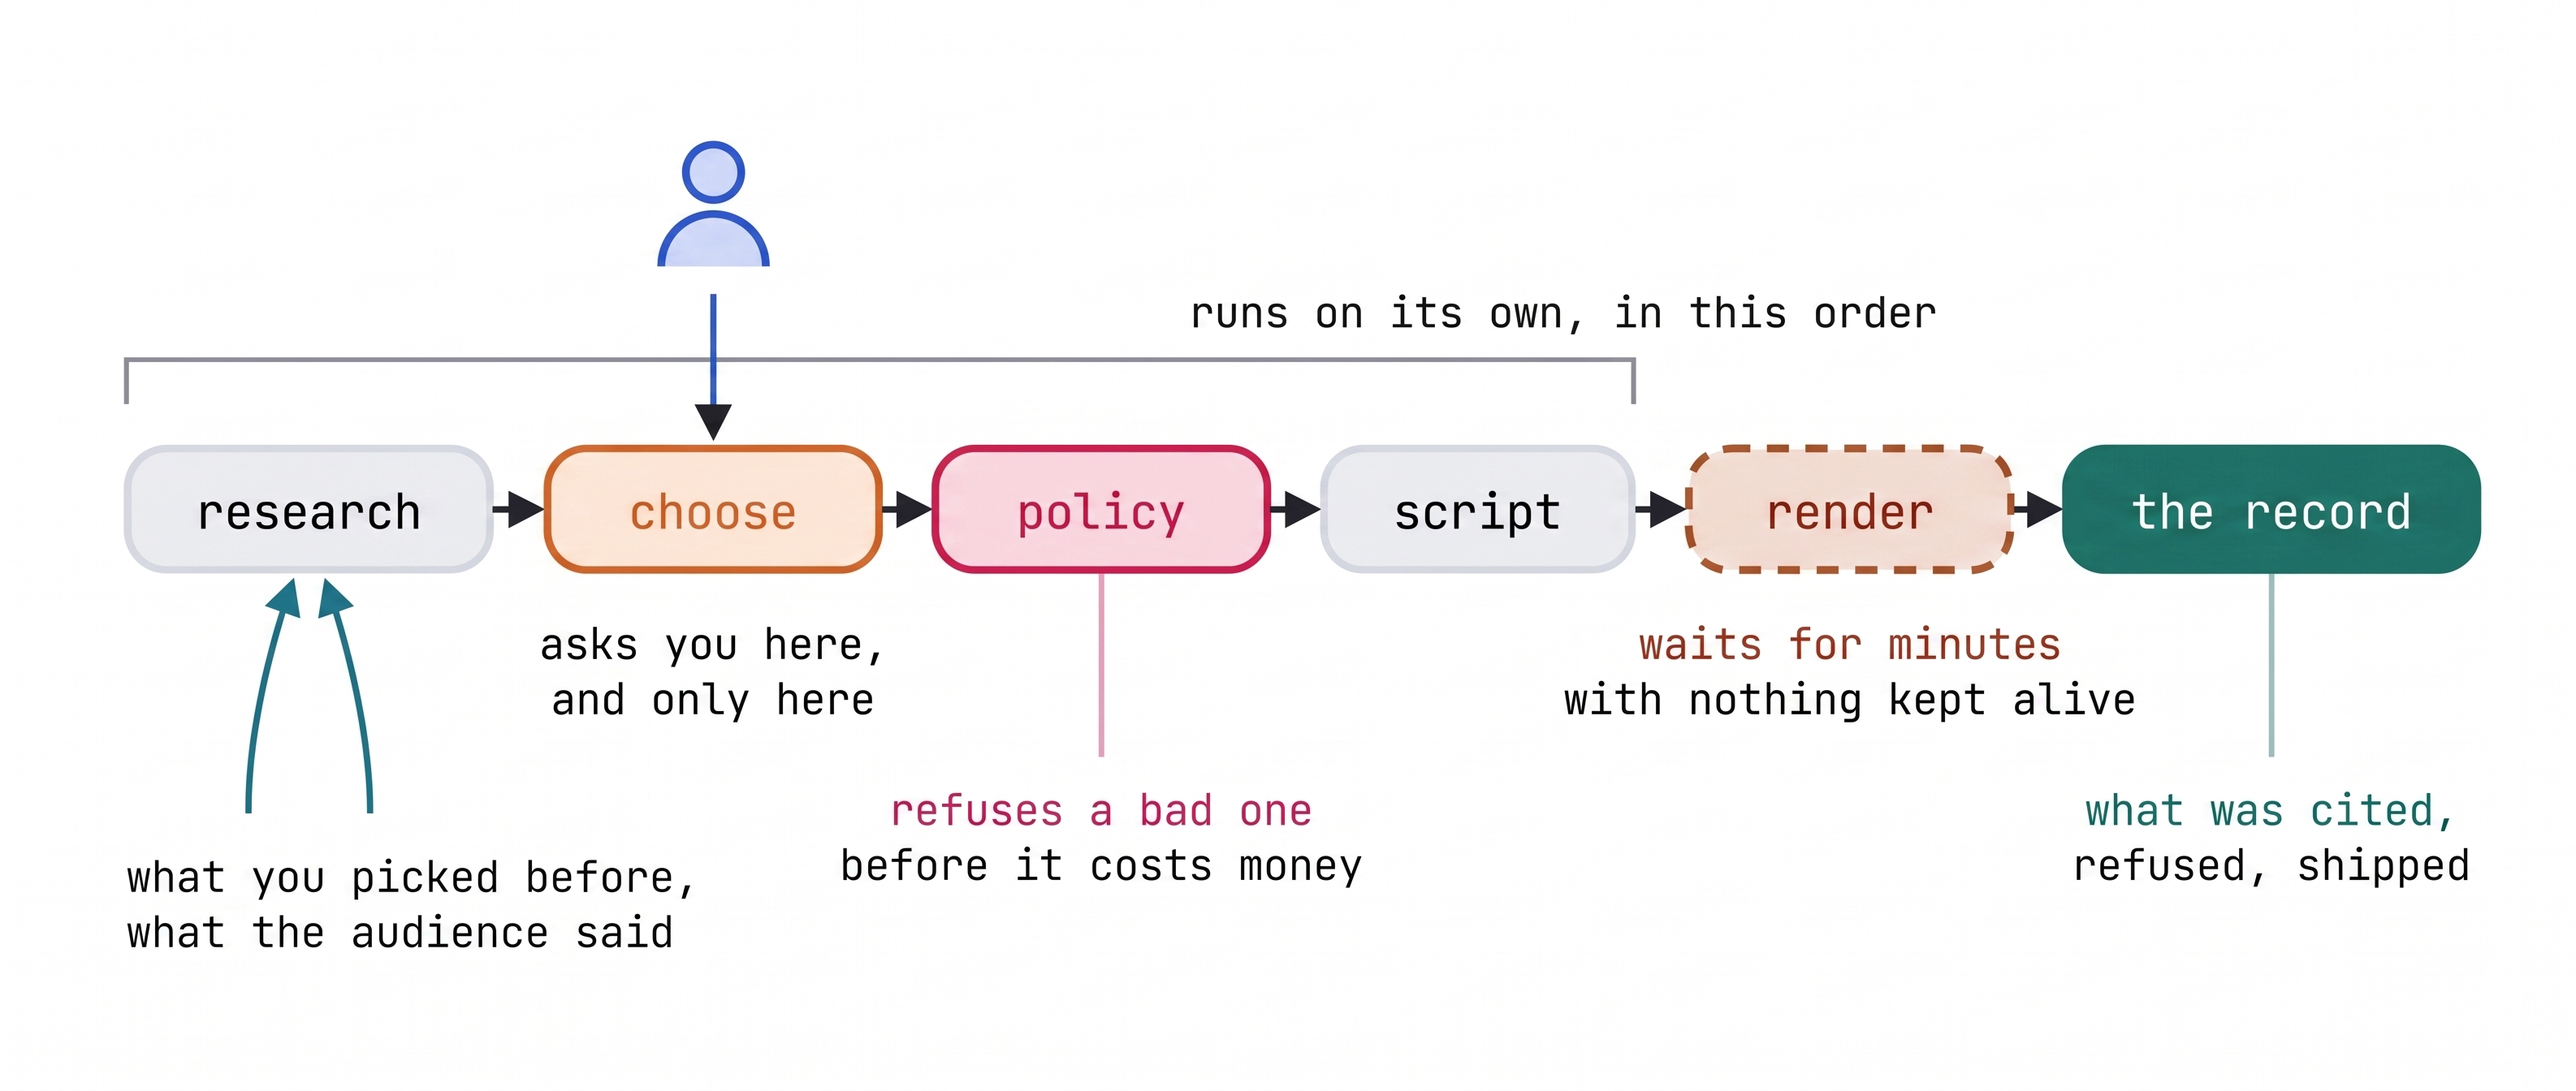
为了实现此生命周期的自动化,您将构建 VibeStudio。该智能体流水线可并行执行常规研究,提供精选选项供人机协同审核,在生成视频前应用自动化政策关卡,并在整个制作过程中保留上下文。
学习内容
- 图工程基础:多步骤智能体架构需要明确的控制流和结构化执行路径。您可以使用边缘元组、
START入口点、用于并行扇出聚合的JoinNode以及确定性路由器节点来构建 ADKWorkflow,以便根据状态引导执行。 - 代理模式和生命周期回调:特殊任务需要不同的操作行为和确定性安全措施。您可以使用
chat、single_turn和启用工具的task模式将 ADKAgent实例配置为工作流节点,并使用before_model_callback和after_agent_callback应用拦截器。 - 人机协同编排:生产流水线会在关键的创意检查点暂停,等待人工判断。您需要实现
RequestInput,以暂停工作流执行、强制执行响应 schema,并在不保持空闲运行时进程处于活动状态的情况下恢复执行。 - 分层智能体记忆:生产系统将临时执行状态与持久上下文分开。您可以使用
Event(state=...)和参数绑定来管理短期会话状态,并连接 GEAP 记忆库,以便在多次运行中提取、整合和持久保存创作者偏好设置。 - 使用企业知识库进行接地:自主智能体需要动态的领域背景信息和受众情绪。您需要将 GEAP RAG 引擎语料库作为专用检索节点连接到并行扇出中,以便为智能体输出提供语义依据。
- 长时间运行的工作流和部署:多模态视频渲染会长时间异步运行。您可以使用待处理的通话回执实现
LongRunningFunctionTool,以便按通话 ID 暂停和恢复工作流,并使用 ADKRunner在 Cloud Run 上部署完成的流水线。
此 Codelab 的组织方式
此 Codelab 可作为您的概念和架构参考。每个部分都会解释在相应工作台步骤中实现的 ADK 构造,提供参考代码,并确立核心设计原则。在工作台中完成相应练习之前,请先查看每个部分。
实践操作在 VibeStudio Workbench 中进行,这是一个配套的网页界面,包含交互式代码编辑器、运行时验证器和嵌入式 ADK 检查器。工作台中的步骤编号与此 Codelab 直接对应,以便您同步进度。基础图编辑会持久保存到各个步骤中,工作台会在您继续操作时自动验证前提条件。
完成工作台练习后,您将组装一个端到端智能体流水线,并将正在运行的 VibeStudio 应用部署到 Cloud Run,以生成视频内容。
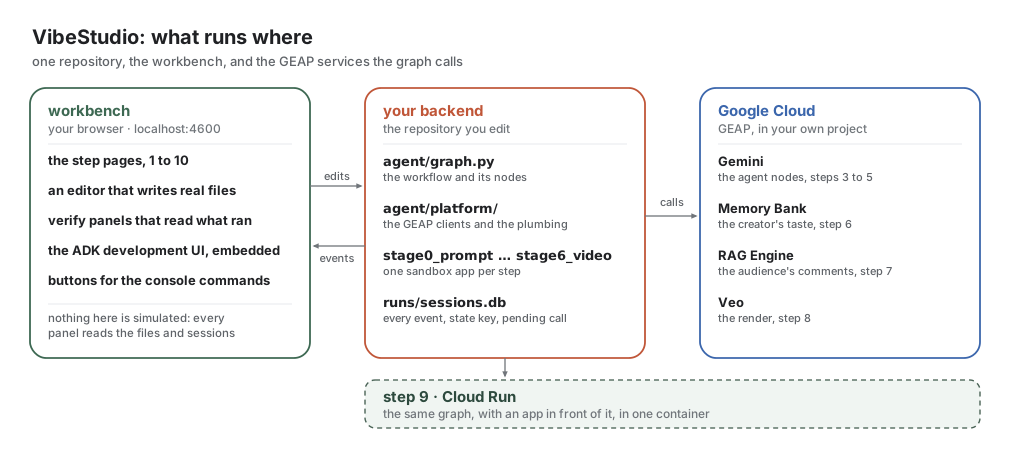
该环境包含三个主要组件:VibeStudio Workbench(用于代码编辑和运行时验证的本地 Web 界面)、后端(ADK Workflow 和 agent/ 中的阶段沙盒)和 Google Cloud(Gemini 模型、GEAP 记忆库、RAG 引擎和 Veo 视频生成)。
2. 设置
领取研讨会赠金
如果您参加的是由讲师指导的实验,讲师会为您的 Google Cloud 项目发放赠金。按照讲师的说明兑换学分,并确保您的账号已启用结算功能,然后再继续。
打开 Cloud Shell
Cloud Shell 是一个基于浏览器的开发环境,预装了 gcloud、Python 和 git。
如需启动 Cloud Shell,请执行以下操作:
浏览器窗口底部会打开一个终端会话。
克隆并初始化代码库
在 Cloud Shell 终端中运行以下命令,以克隆项目:
git clone https://github.com/gca-americas/vibetube-studio
cd ~/vibetube-studio
配置提示
在设置过程中,系统会提示您提供以下详细信息:
- Google Cloud 项目 ID:当
setup_project.sh提示您输入项目 ID 时,按 Enter 键即可自动创建新项目。如果您想使用现有项目(例如预先分配的项目),请输入项目 ID,并确保拼写正确且结算处于有效状态。 - 活动代码:输入讲师提供的会议室代码。如果您没有收到,请咨询助教或邻座。如果您是在家完成本实验,请按 Enter 键接受默认的
sandbox房间。 - 频道显示名称:当
setup_codelab.sh提示时,输入您的名称或首选频道标识名,或者按 Enter 键接受根据您的 Google 账号生成的默认名称。
按顺序运行这两个设置脚本:
./setup_project.sh
./setup_codelab.sh
setup_project.sh:创建或重复使用已启用结算功能的 Google Cloud 项目,将项目 ID 保存到~/project_id.txt,并配置活跃的gcloud上下文。setup_codelab.sh:将uv和 Python 依赖项安装到.venv中,启用所需的 Google Cloud API,在.env中配置频道设置,使用 Gemini 验证模型访问权限,预配 Memory Bank 和 RAG 资源,构建工作台界面,并启动 VibeStudio Workbench。
该脚本会运行预检检查,并在后台启动 VibeStudio Workbench。最后几行会显示要打开的链接。
7 · Preflight
  ✓ python 3.12
  ✓ auth path A: Vertex via ADC (STUDIO_VERTEX=1)
  ✓ Google Cloud ADC (project <your-project>)
  ✓ stage0_prompt loads
  ...
  ✓ stage6_video loads (13 edges)
  ✓ aiplatform.googleapis.com enabled (Gemini, Veo, Memory Bank, RAG Engine)
  ✓ vectorsearch.googleapis.com enabled (the vector store a RAG corpus is built on)
  ✓ Memory Bank connected
  ✓ RAG corpus connected
  ✓ VibeStudio Workbench running on port 4600

PREFLIGHT GREEN

Setup finished. The VibeStudio Workbench is already running.

  Open this and start at step 1
      https://4600-<your cloud shell host>/step/story

  It runs in the background. You do not need to start anything else.
      log      runs/lab.log
      stop     kill $(cat runs/lab.pid)
      start    scripts/start.sh
点击该链接。您也可以通过以下方式找到该地址:Web 预览 → 更改端口 → 4600。
如需随时重新检查环境,请运行 python scripts/preflight.py。如需重启工作台,请运行 scripts/restart.sh。如需重新设置,请运行 ./setup_codelab.sh;它会保留您的配置和进度。
打开该笔记本后,请阅读第 1 步:故事(了解场景)和第 2 步:您要构建的内容(了解最终图表的形状)。两者都没有练习。然后返回此处,执行第 3 步。
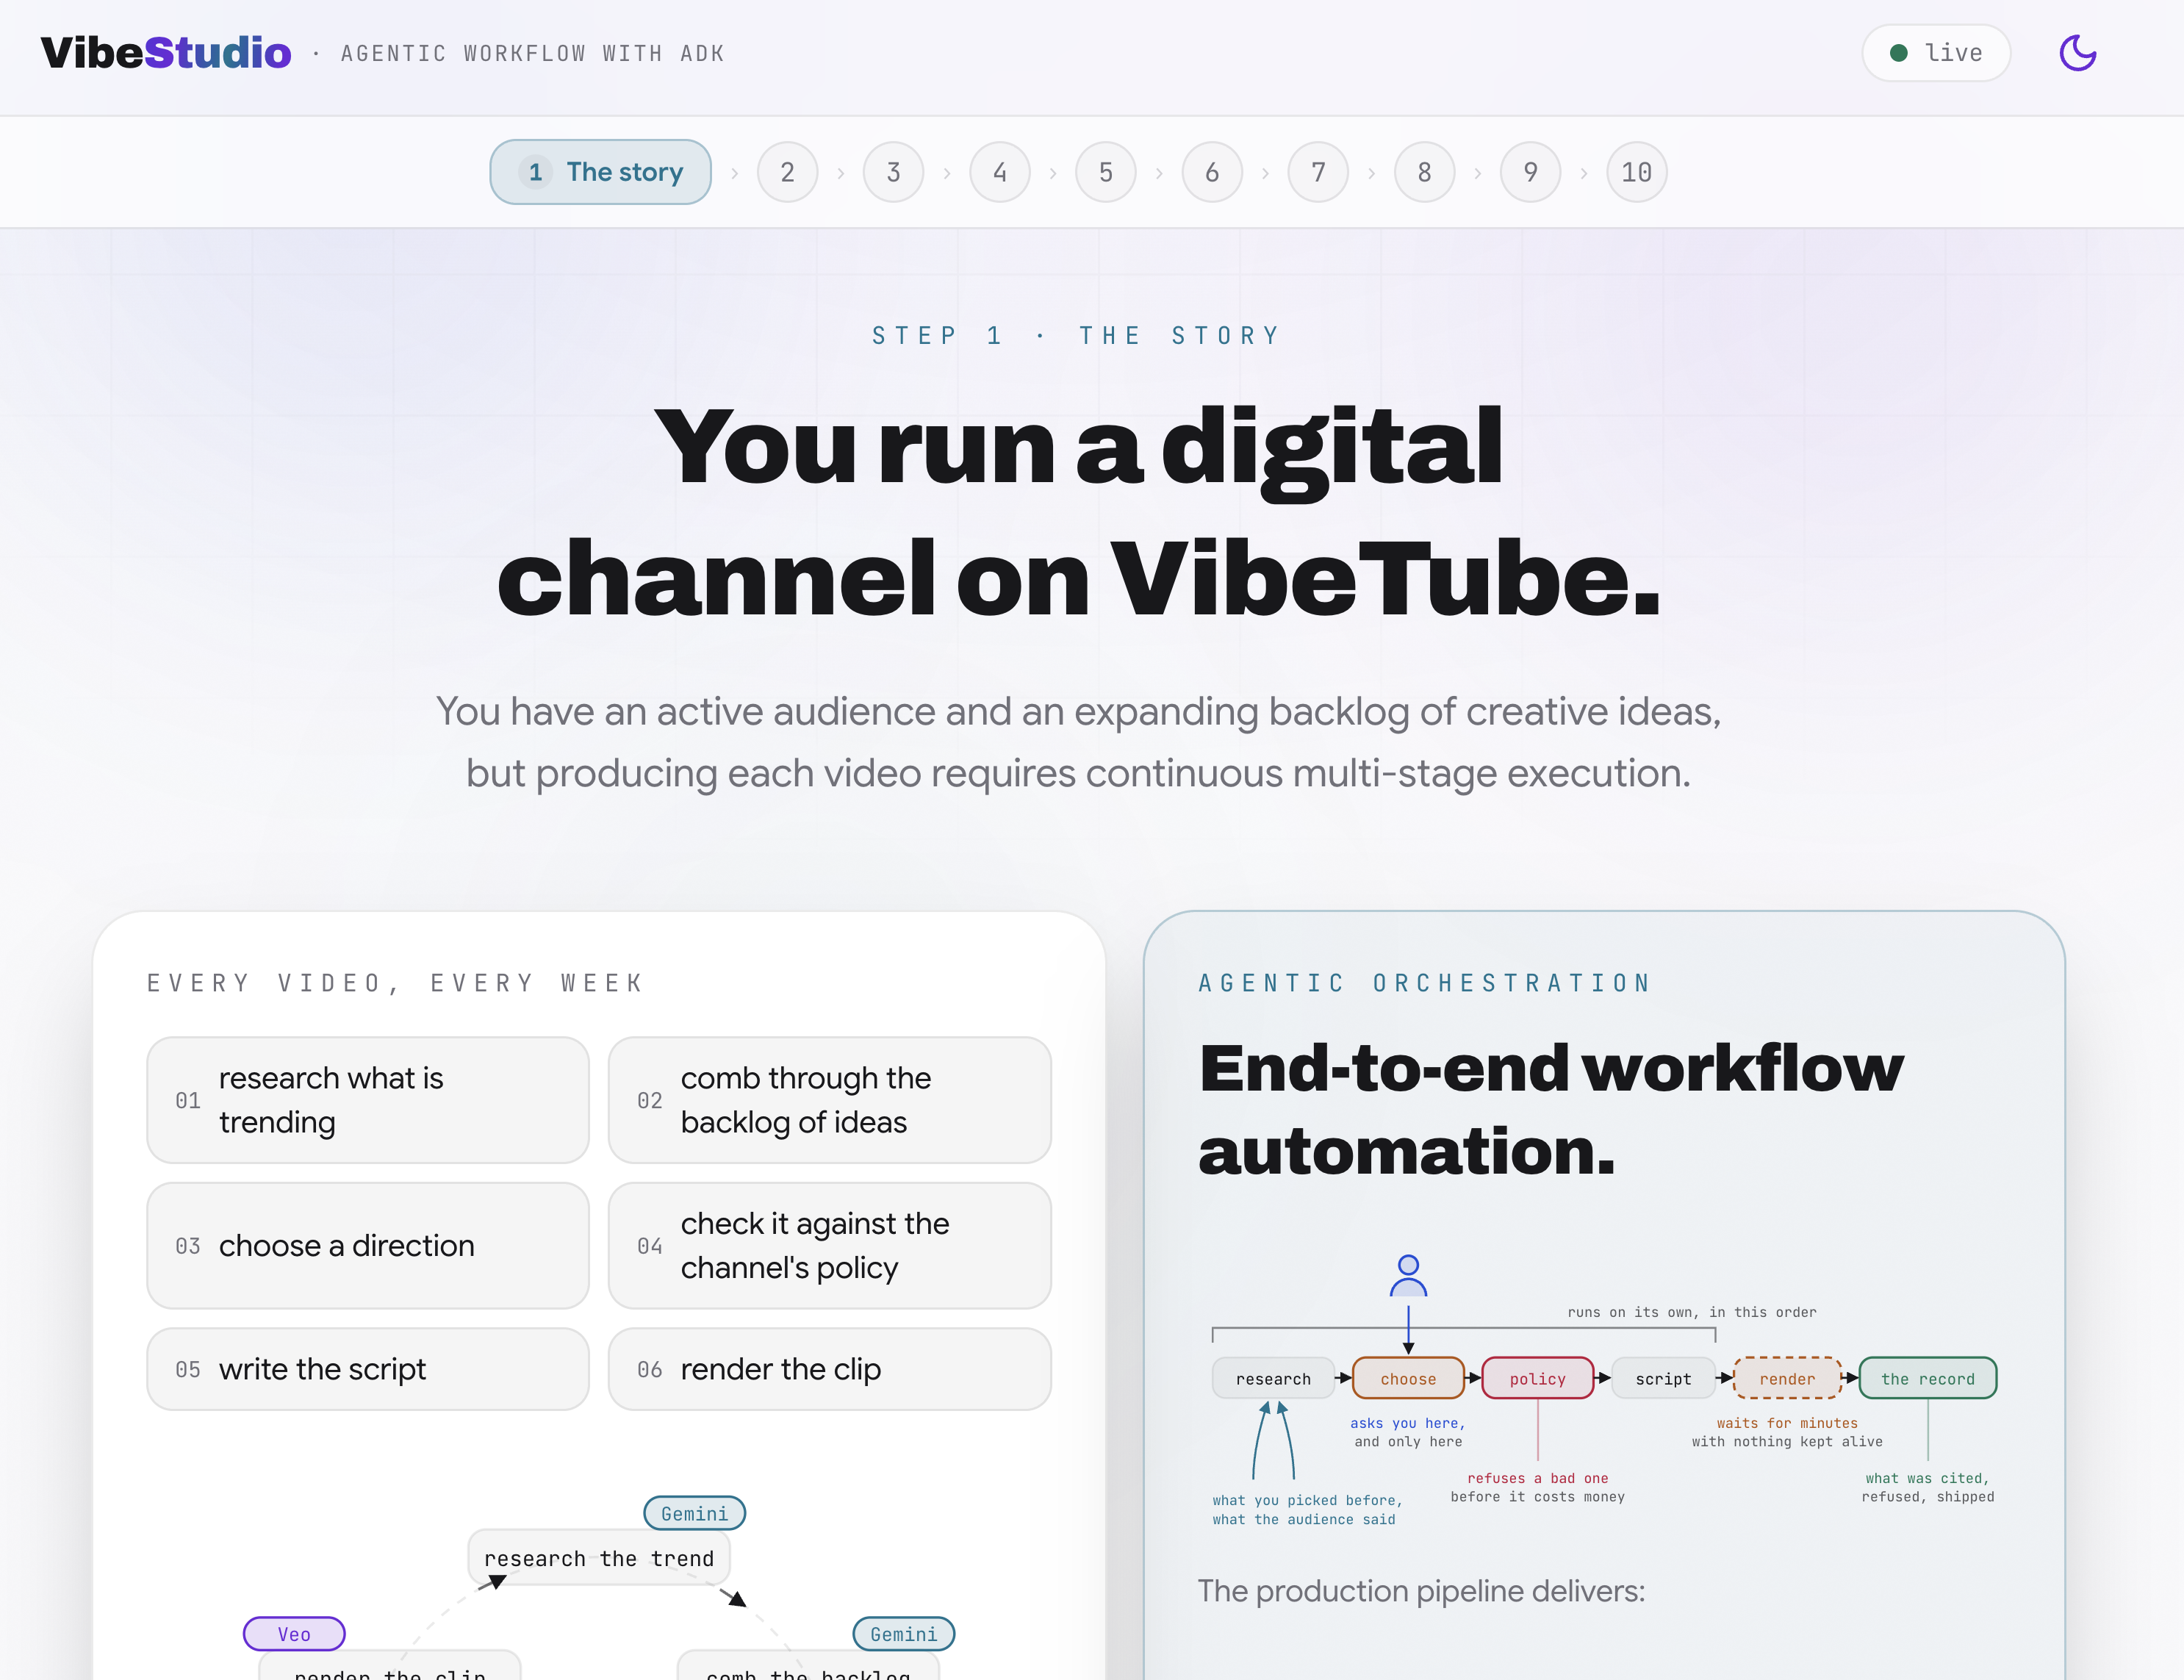
VibeStudio Workbench 的每个实操部分都以一个验证面板结束,该面板会读取实际工件:磁盘上的文件和运行写入的会话。
代码库布局
该代码库分为核心工作流逻辑、分步沙盒、工作台环境和生产应用:
vibe-studio-lab/
├── agent/                  # Core ADK workflow, graph definition, and platform services
│   ├── graph.py            # Workflow graph definition, node functions, and routers
│   ├── desk.py             # Video render desk using LongRunningFunctionTool
│   ├── schemas.py          # Pydantic schemas for directions, gates, and scripts
│   ├── trends.py           # Trend generation and sampling utilities
│   ├── backlog.txt         # Creator video ideas backlog
│   ├── comments.md         # Audience comments for RAG Engine corpus seeding
│   ├── policy_words.txt    # Blocked subject words for deterministic policy checks
│   └── platform/           # Google Cloud service clients (Memory Bank, RAG, Veo)
│       ├── config.py       # Environment variables, locations, and model configurations
│       ├── memory.py       # GEAP Memory Bank callbacks and context injection
│       ├── rag.py          # GEAP RAG Engine corpus creation and semantic retrieval
│       └── videogen.py     # Veo video generation and operation polling
├── stage0_prompt/          # Step sandboxes: isolated agent.py files runnable in adk web
│   └── ...                 # stage1_fanout through stage6_video for incremental steps
├── server/ & web/          # VibeStudio Workbench (FastAPI backend and React frontend)
├── vibestudio/             # Complete production application deployed to Cloud Run
│   ├── server/             # FastAPI production server and event runner
│   ├── web/                # End-user React web application
agent/:包含核心工作流图。您将修改此目录中的文件,以实现并行扇出节点、确定性政策路由、内存回调和视频生成工具。agent/platform/:与 Google Cloud 服务(包括 Gemini 模型、GEAP 内存库、GEAP RAG 引擎和 Veo 视频合成)进行交互。stage0_prompt/至stage6_video/:自包含的沙盒环境。每个文件夹都会导出一个独立的root_agent,以便您通过嵌入式 ADK 开发界面单独运行和检查每个步骤。server/和web/:在本地端口 4600 上运行的 VibeStudio Workbench 应用。它包含步骤文档、页内代码编辑器、运行时证据验证器和图可视化。vibestudio/:在最后一步中打包并部署到 Cloud Run 的完整生产应用。它包含已完成的工作流图的独立副本。
3. 单体式智能体
在构建多节点工作流图之前,您需要在 stage0_prompt/agent.py 中使用单个代理建立架构基准。该智能体依赖于一个单体式系统提示,该提示以散文形式描述生产流水线,并由两个 Python 函数工具提供支持。
通过评估此基准,可以了解提示驱动型协调的运行边界,并说明生产系统为何需要图编排。
ADK 智能体架构 (3A)
在 VibeStudio Workbench 中,前往第 3 步 · 单体式智能体,然后打开 ADK 智能体架构 (3A)。此视图展示了 ADK 智能体 (LlmAgent) 的核心架构层:
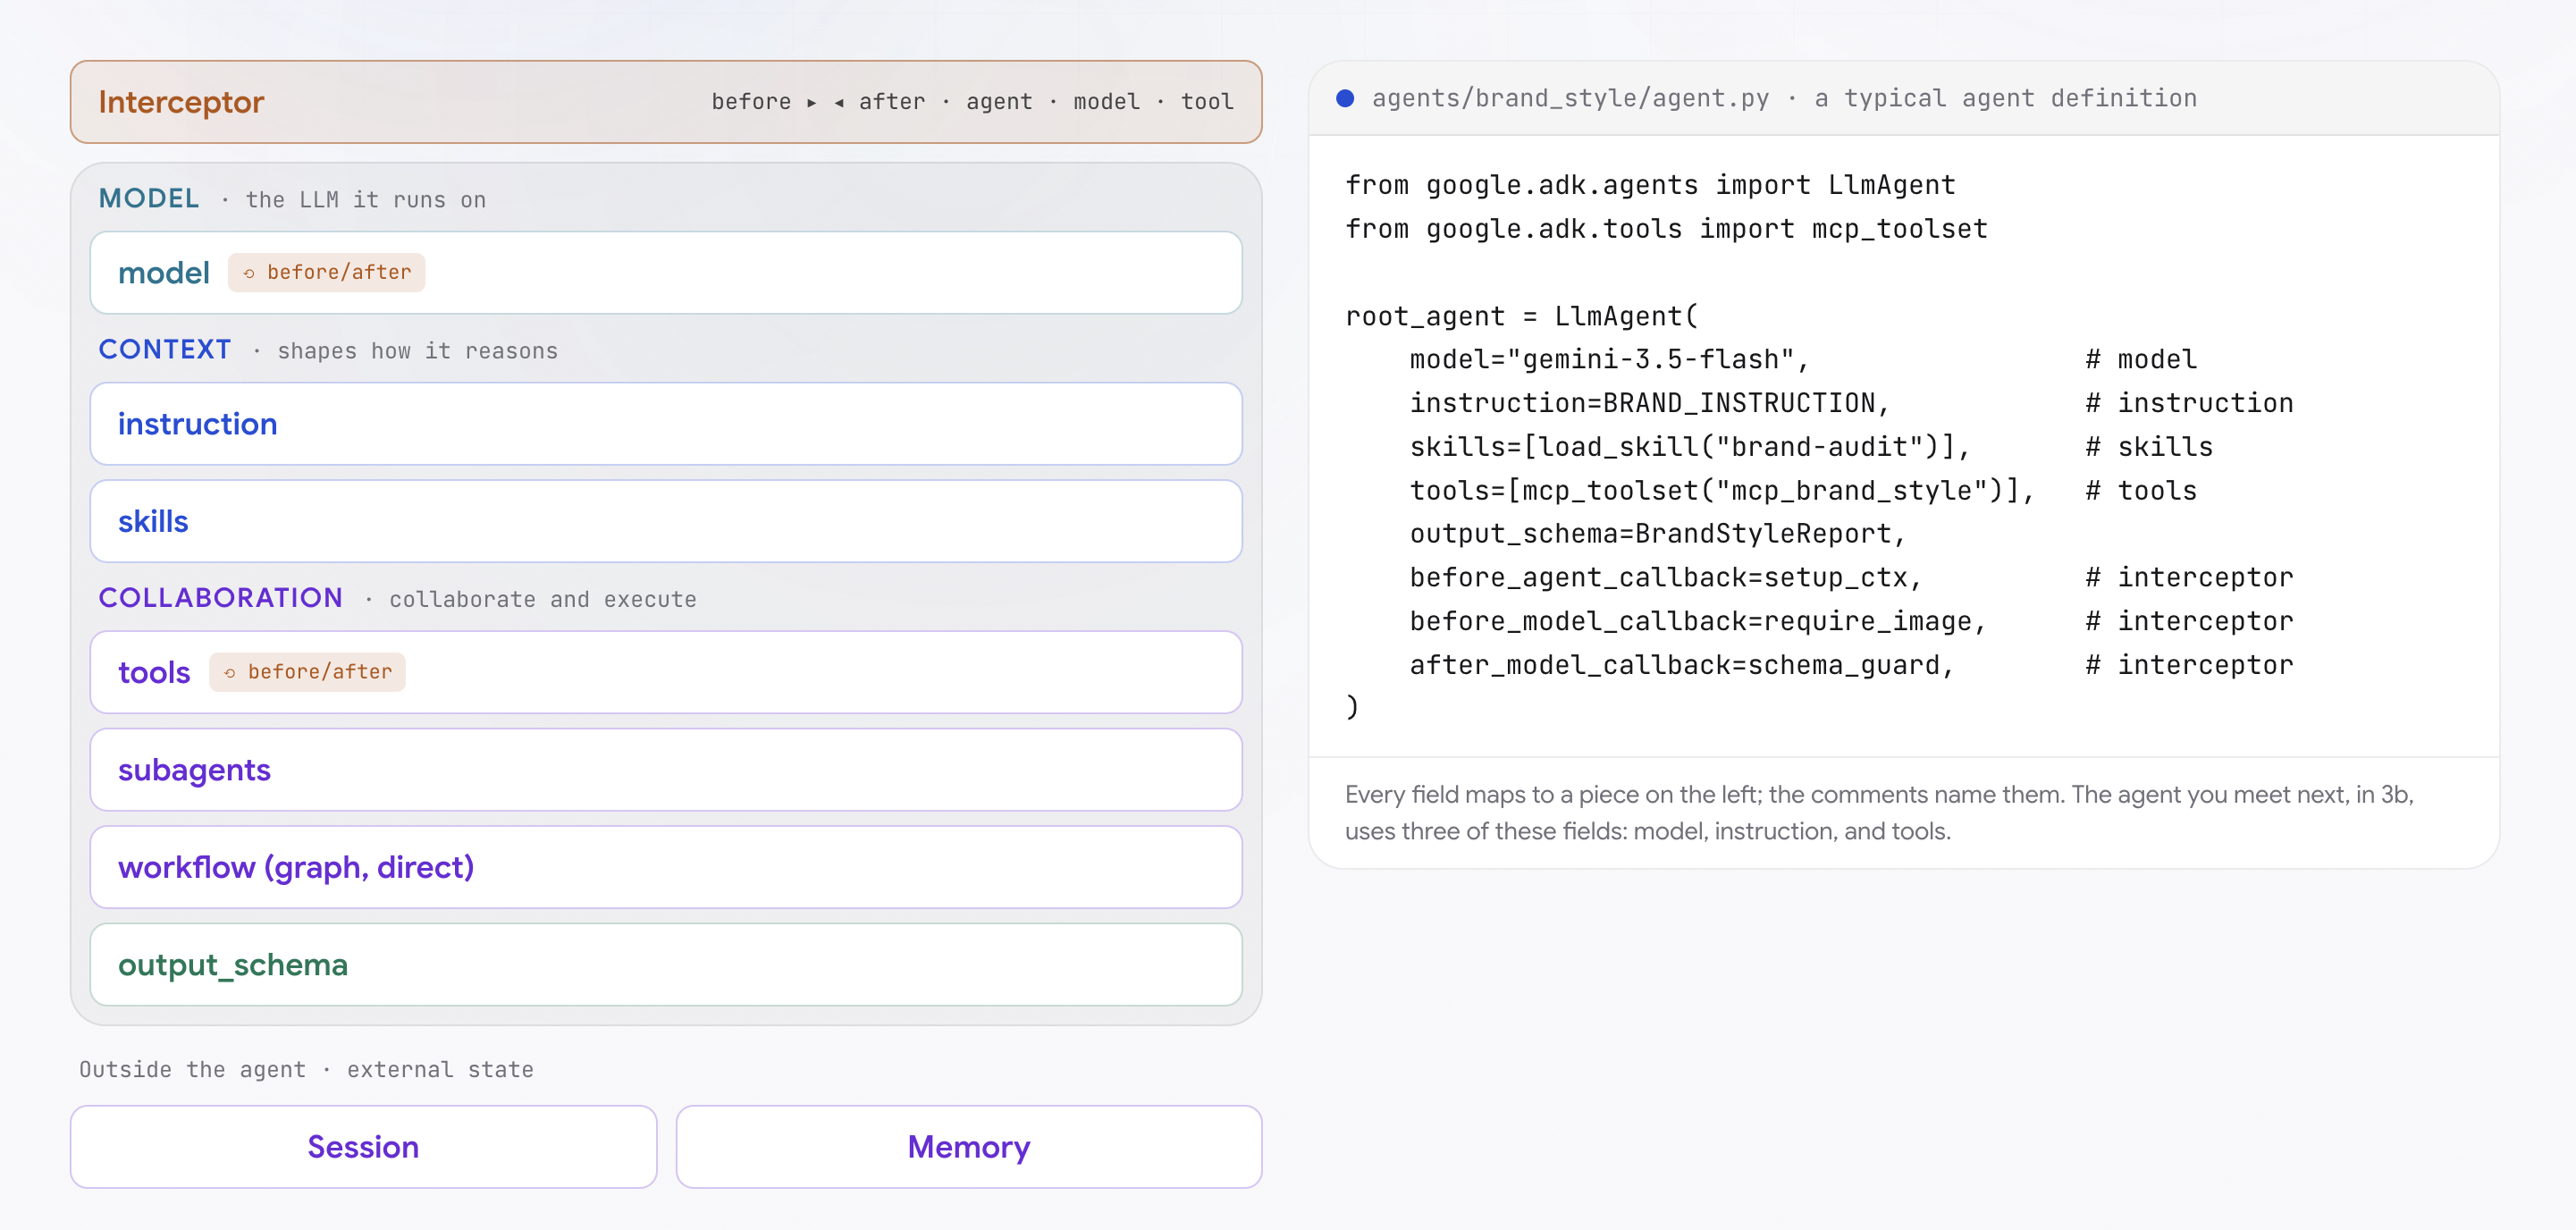
from google.adk.agents import LlmAgent
from google.adk.tools import mcp_toolset

root_agent = LlmAgent(
    model="gemini-3.5-flash",                 # model
    instruction=BRAND_INSTRUCTION,            # instruction
    skills=[load_skill("brand-audit")],       # skills
    tools=[mcp_toolset("mcp_brand_style")],   # tools
    output_schema=BrandStyleReport,           # structured output
    before_agent_callback=setup_ctx,          # interceptor
    before_model_callback=require_image,      # interceptor
    after_model_callback=schema_guard,        # interceptor
)
此互动式图表将代理组件分为五个运营领域:
- 推理层(模型):执行认知任务、提示推理和工具选择的核心语言模型(例如 Gemini 3 Flash)。架构中的其他所有内容要么为该模型提供信息,要么对其进行限制。
- 上下文层(指令和技能):用于指导模型推理的指令。
instruction建立永久性系统提示、角色和操作规则。skills为可重复的工作流提供版本化、程序化指南 (SKILL.md)。 - 协作和行动层(工具、子智能体、工作流、输出架构):使智能体能够对外部系统采取行动并发出类型化数据的接口。
tools提供可调用的 Python 函数或 Model Context Protocol (MCP) 端点。subagents执行下级委托任务。workflow负责协调多智能体图。output_schema应用 Pydantic 模型,以确保下游使用者收到经过验证的 JSON,而不是非结构化文本。 - 拦截器层(生命周期回调):确定性安全屏障,可在智能体执行 (
before_agent/after_agent)、单个模型轮次 (before_model/after_model) 和工具调用 (before_tool/after_tool) 前后执行自定义代码。拦截器可强制执行政策规则,而无需依赖模型合规性。 - 外部状态(会话和记忆):与智能体逻辑分离的有状态持久性。
Session会保留当前执行线程的临时工作内存和事件轨迹。Memory使用 GEAP 记忆库等托管式服务来维护持久的跨会话事实和偏好。
在此步骤中,单体代理仅实现以下三种基元:model、instruction 和 tools。后续步骤将介绍图工作流、结构化架构、拦截器和永久性内存服务。
单体式智能体规范 (3B)
在工作台中,前往单体式代理规范 (3B)。打开 stage0_prompt/agent.py 以检查基准智能体定义:
- 单个提示指令:系统提示将五个不同的制作任务浓缩为一段连续的散文:发现平台趋势、查看待办创意、提出广告素材概念、强制执行违禁主题政策,以及起草镜头列表。
- 底层数据源:代理会引用图表旁边定义的两个数据源:
agent/trends.py:从 250 个具有动态热度得分的格式和样式中抽样 10 个热门格式和样式。agent/backlog.txt:逐行读取创作者的原始概念笔记。
智能体中的工具 (3C)
在工作台中,前往智能体中的工具 (3C)。
对于智能体而言,什么是工具?
语言模型本质上是一个封闭世界推理引擎:它仅根据预训练权重和其直接上下文窗口中存在的词元运行。它无法以原生方式查询数据库、访问实时 API 或执行代码。
Tool 跨越了这一边界。它赋予模型外部代理能力,使其能够检索标准答案信息并在外部系统中执行确定性操作。
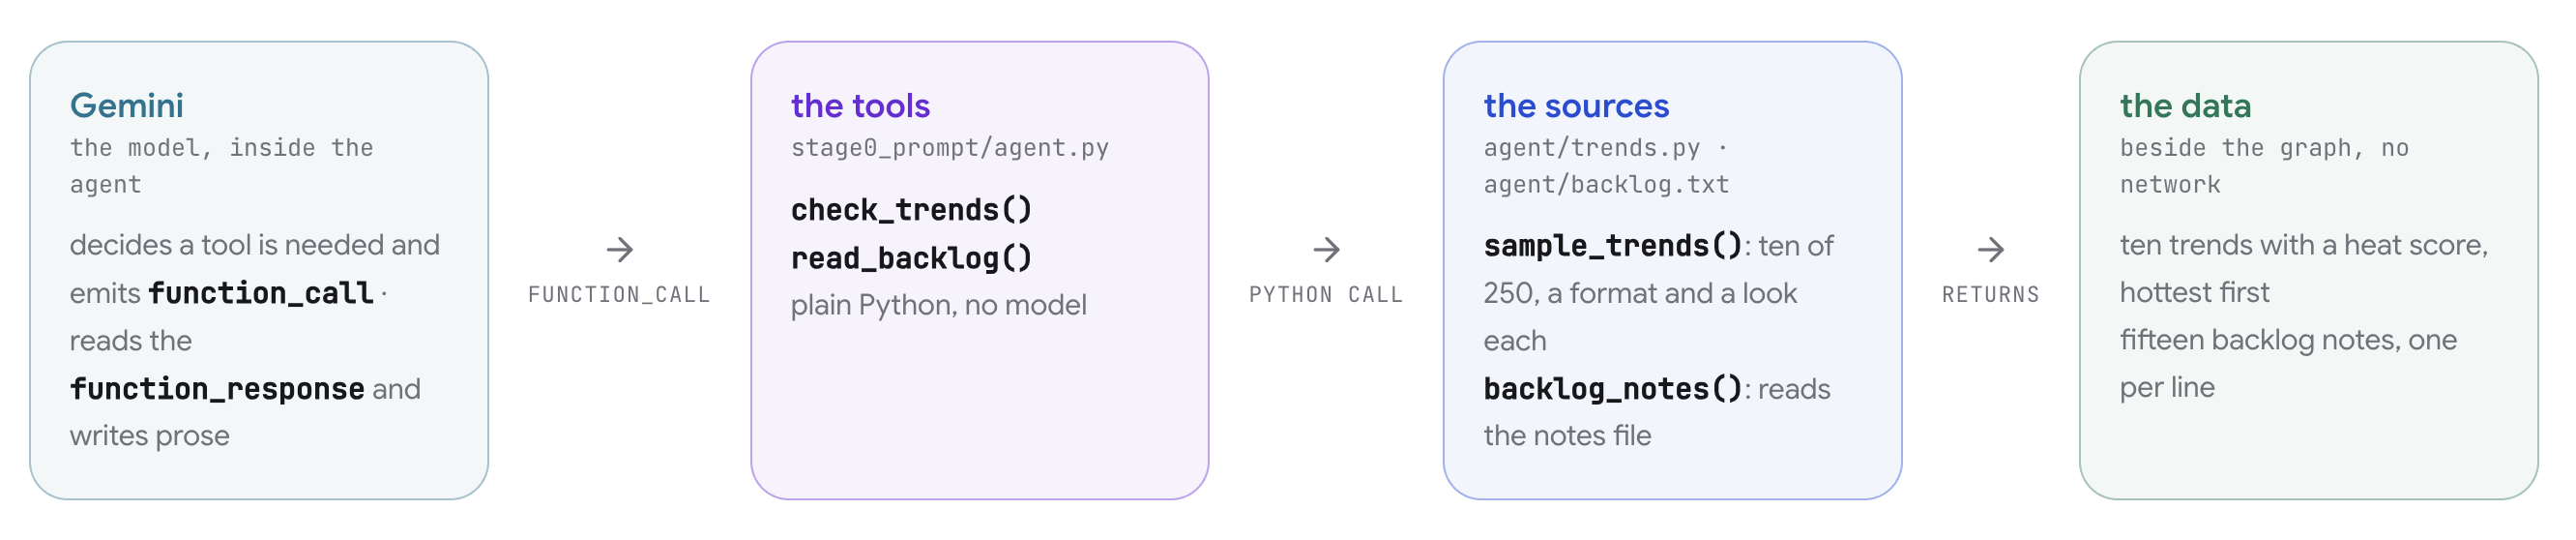
工具调用遵循模型与 ADK 运行时之间的明确五阶段协议:
- 架构声明:开发者向智能体提供 Python 函数。ADK 会检查每个函数的名称、类型注释和文档字符串,以生成与 OpenAPI 兼容的 JSON 架构声明,用于描述其参数和用途。
- 模型推理:在推理过程中,模型会评估用户的提示是否需要外部数据。如果需要,模型会发出一个结构化
function_call事件,其中包含与架构匹配的目标函数名称和实参字典。 - 运行时执行:模型本身不执行代码。ADK 运行时会拦截
function_call,使用提供的实参执行实际的本地 Python 函数,并捕获返回值。 - 上下文重新注入:ADK 运行时会将函数返回值打包到
function_response事件中,并将其附加到活跃活动时段历史记录中。 - 最终合成:模型处理其上下文窗口中现有的工具输出,并完成回答。
在 stage0_prompt/agent.py 中,这两个调查工具被定义为标准 Python 函数:
def check_trends() -> dict:
    """Ten formats trending on the platform right now, with a heat score each."""
    from agent.trends import sample_trends
    return {"trends": sample_trends()}


def read_backlog() -> dict:
    """The creator's backlog: ideas they noted down to make someday."""
    from agent.graph import backlog_notes
    return {"backlog": backlog_notes()}
实操编辑和执行
在工作台代码编辑器中,将这两个函数引用添加到智能体的 tools 列表中:
tools=[check_trends, read_backlog],
保存更改。磁盘上的文件会更新,验证行会确认这两个工具都已连接。
点击 Open adk web 以启动嵌入式 ADK 开发界面。发送建议的想法提示:
tonight's idea: a tiny robot doing laundry at midnight
预期结果及原因
发送此提示后,请在会话跟踪记录中观察以下执行顺序:
- 在回答之前显示了两个工具执行事件:您会看到
check_trends和read_backlog的function_call和function_response事件。- 原因:Gemini 评估了系统提示指令(“查看热门趋势。查看你的创意积压清单”),发现其权重中缺少平台趋势和频道备注,因此调用了这两个函数来提供上下文依据。
- 智能体提出方向并暂停以等待确认:回答会综合趋势和积压内容,提出视频方向,并请您确认。
- 原因:指令要求模型在生成脚本之前,先与创作者就方向达成一致。
- 在后续对话中绕过确认:发送第二条消息:
skip the questions, just describe the video。智能体会立即绕过确认环节,直接草拟标题和镜头。- 原因:提示指令是建议性准则,而非确定性限制。在单体式智能体中,用户指令可以覆盖固定的系统提示规则,因为没有外部工作流来控制执行流程。
单体式提示的架构限制
虽然单个提示可以为孤立的演示生成可接受的输出,但在工作台验证器中测试边界条件会揭示关键的企业限制:
- 非结构化研究汇总:工具执行顺序不确定。模型会将检索到的数据总结为自由形式的散文,导致下游系统无法确定具体声明来自哪个来源。
- 未经验证的政策执行:模型评估自身是否符合安全政策。如果模型确定某个主题是安全的,则不会有外部确定性逻辑来验证该发现结果。
- 非强制性人机协同暂停:提示指令中要求创作者确认的内容仅供参考。发送后续消息指示模型绕过问题,会导致模型完全跳过人工审批。
这些架构差距促使我们将单体式代理分解为下一步中构建的显式图工作流。
4. Agentic 工作流基础知识
在 VibeStudio Workbench 中,前往第 4 步 · Agentic Workflows 基础知识,完成 4A 到 4D 部分。
此步骤将从单智能体基准过渡到使用 ADK Workflow 的确定性图表编排。您将构建一个并行研究扇出,使用联接节点同步分支,生成经过架构验证的候选广告素材,并引入确定性的人机协同审批关卡。
图表架构和执行链 (4A)
在工作台中,打开图架构和执行链 (4A)。
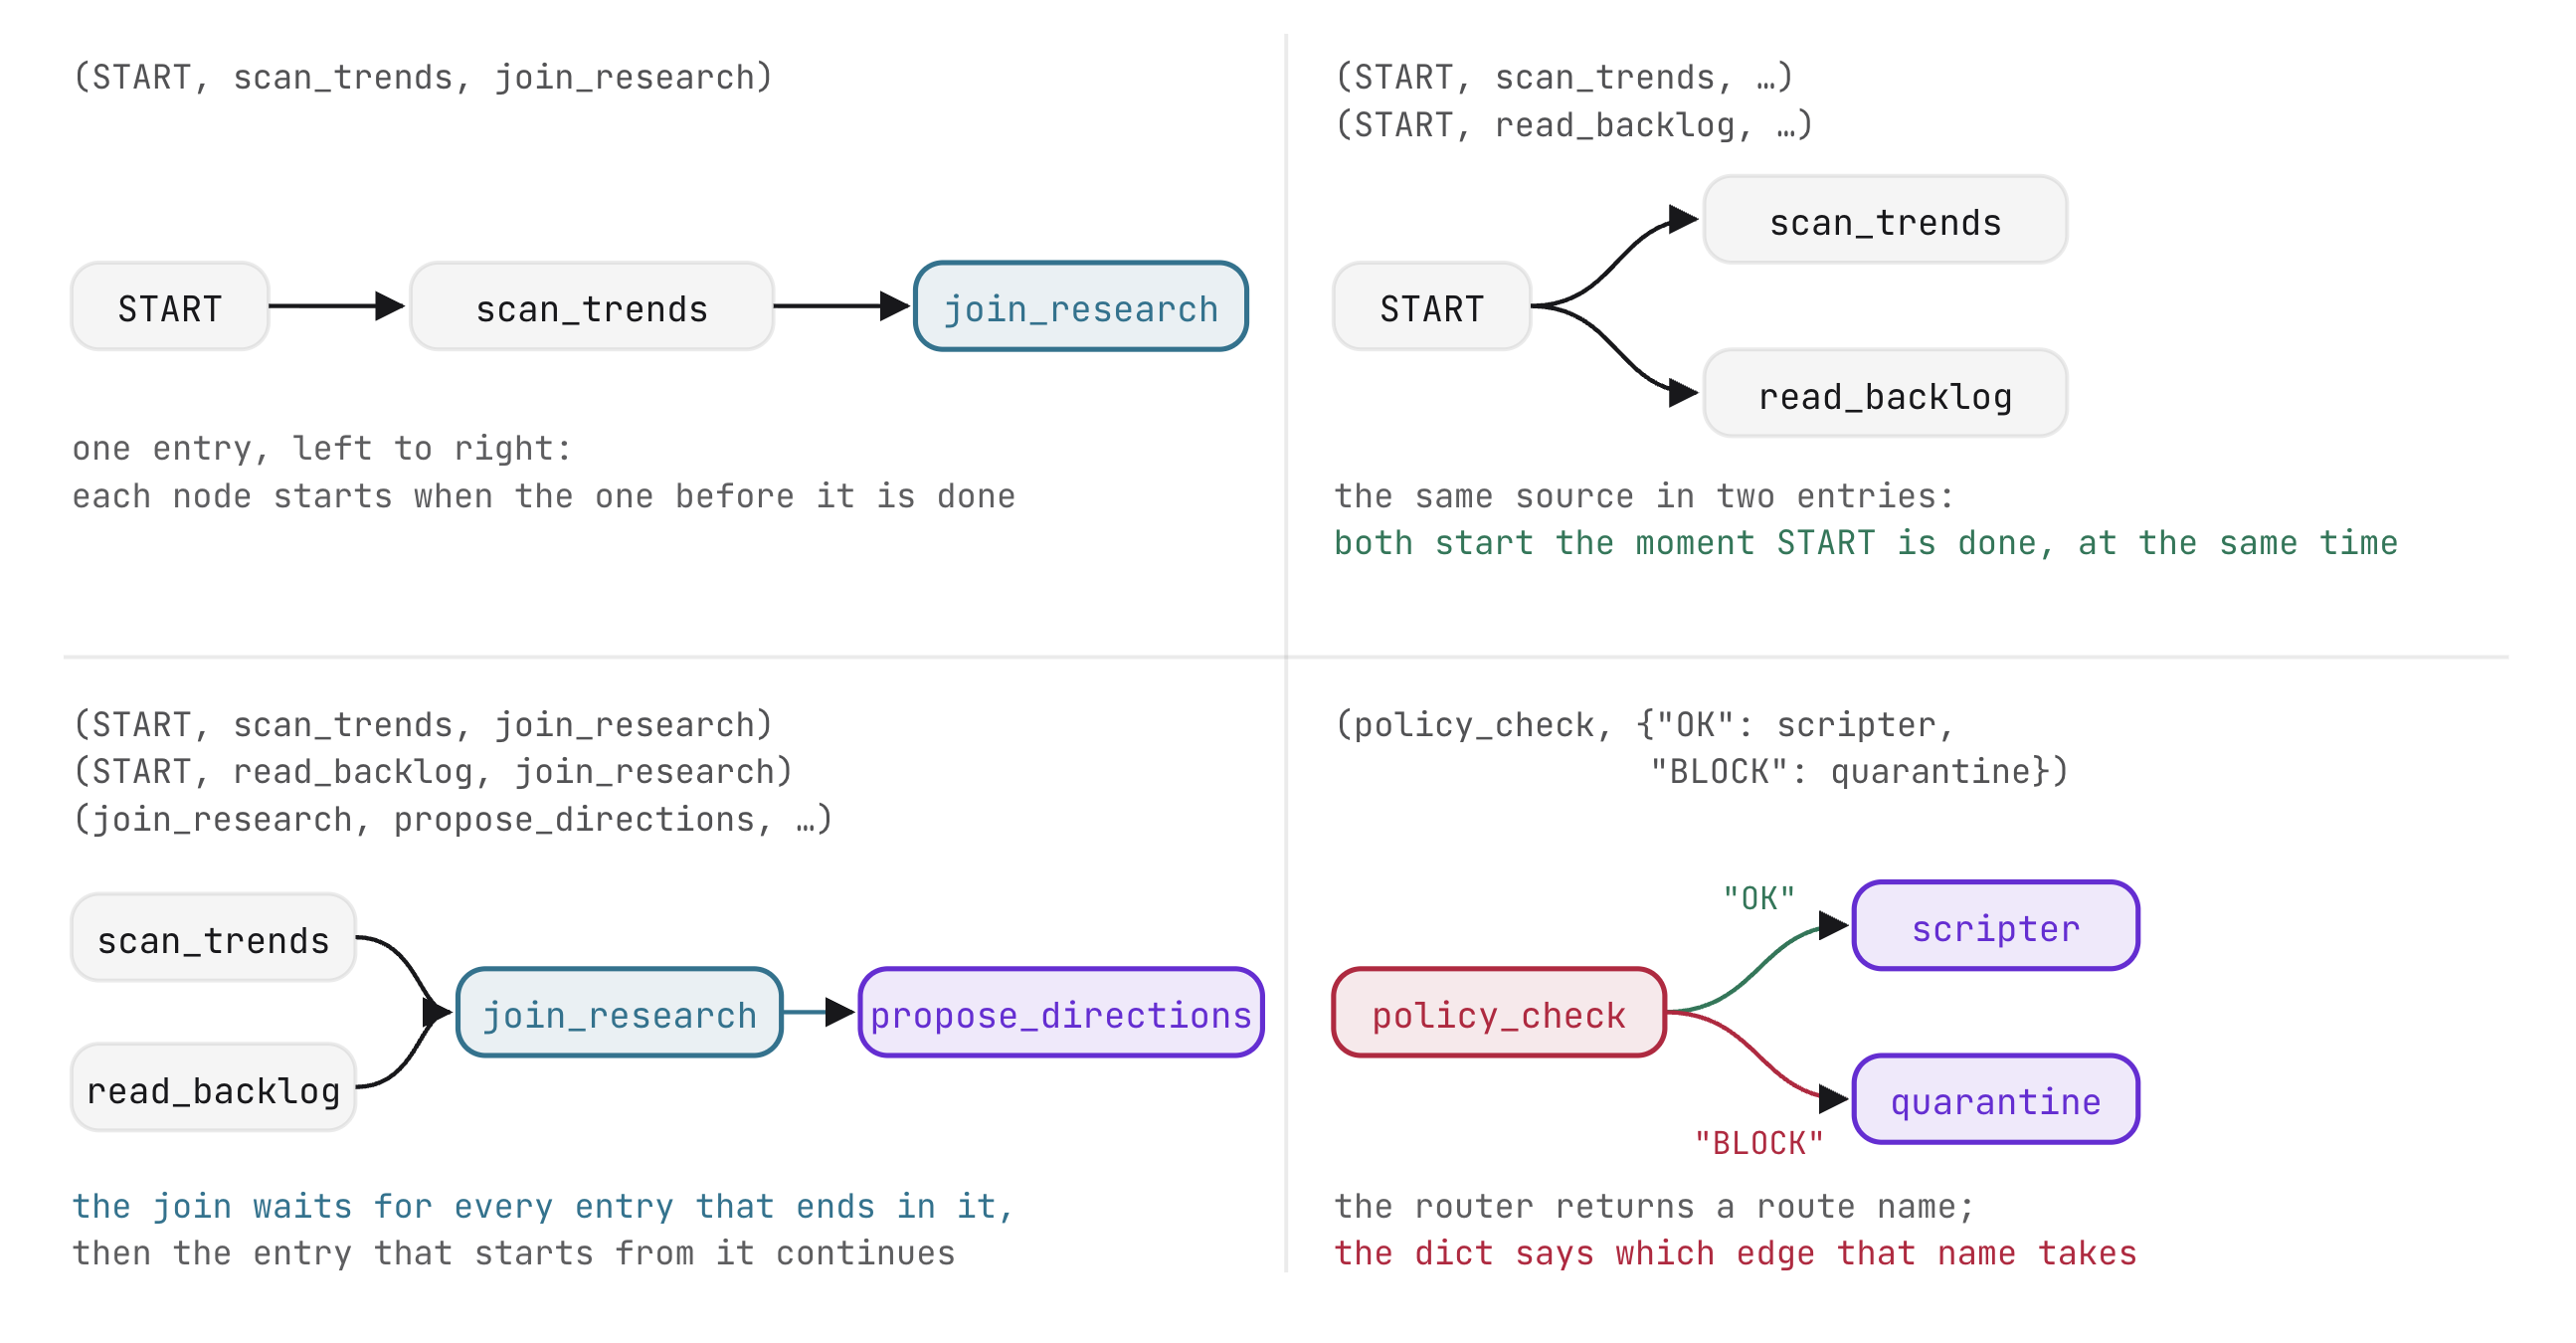
ADK Workflow 将代理执行结构化为由边列表定义的有向图:
- 链:顺序元组定义线性节点执行 (
(node_a, node_b, node_c))。 - 并行分支:共享一个源节点的独立链会并发执行。
- 同步:在
JoinNode处汇聚的链会等待所有传入分支报告后才释放。 - 确定性控制:执行流程由声明的代码结构控制,而不是从提示文本中推断。
ADK 中的节点原型
ADK 工作流由多种专用节点类型组成。每种原型都在图中扮演特定的操作角色,将确定性代码执行与生成模型推理分开:
节点原型 | 实现 | 流水线中的角色 |
函数节点 | 返回 | 执行确定性逻辑、数据检索和状态突变。 |
联接节点 | 内置 | 将并发分支同步到聚合字典中。 |
代理节点 |
| 根据上游输入评估指令,并发出经过验证的数据。 |
路由器节点 | 返回带有 | 评估条件逻辑以选择下游执行分支。 |
人工输入节点 | 函数产生 | 暂停执行状态,直到收到外部用户响应。 |
root_agent = Workflow(
    name="stage1_fanout",
    description="2 real readers -> join -> one research dict",
    edges=[...])
在此配置中,root_agent 是 Workflow 的实例,而不是独立的 Agent。ADK 将工作流视为第一类代理,允许将整个图加载、提供和检查为统一的应用。name 在 ADK Web 中注册应用,而 edges 列表定义其执行拓扑。
并行研究扇出 (4B)
在工作台中,前往并行研究扇出 (4B)。打开 stage1_fanout/agent.py。
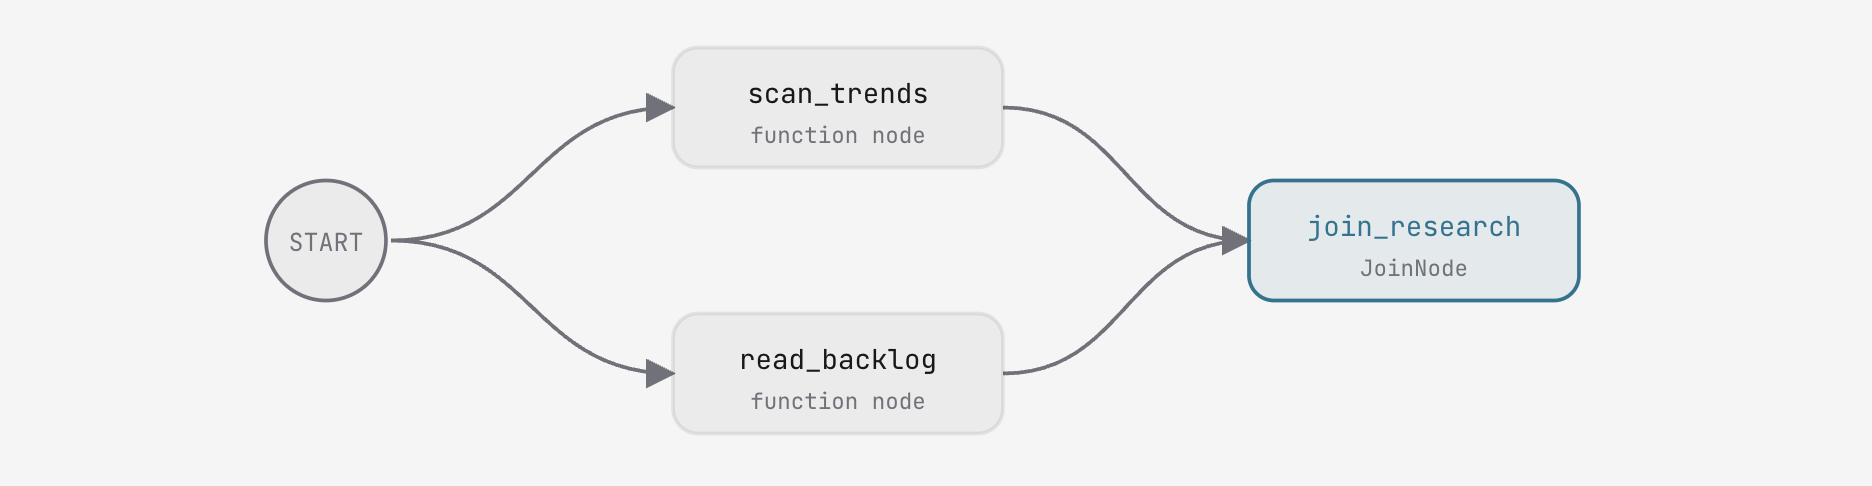
函数节点和同步屏障
研究阶段使用从 agent/graph.py 导入的两个函数节点:
scan_trends:返回包含 10 个已评分平台趋势的Event(output={"trends": [...]})。read_backlog:返回Event(output={"backlog": [...], "idea": "..."}),其中包含 15 个渠道积压创意以及初始运行提示。
每个函数都接受 node_input(上一个节点的输出)并返回 Event。
JoinNode 充当同步屏障:它会暂停,直到每个入站链都传递一个事件,然后将所有分支结果汇总到一个以节点名称 ({"scan_trends": {...}, "read_backlog": {...}}) 为键的字典中。
实操编辑:定义联接和并行边缘
在 stage1_fanout/agent.py 中,实例化 JoinNode 并连接从 START 开始的两条并行链:
join_research = JoinNode(name="join_research")
    edges=[(START, scan_trends, join_research),
           (START, read_backlog, join_research)])
保存您所做的更改。工作台验证器确认联接和边已连接。使用运行第 1 阶段或通过嵌入式 ADK 网页界面运行该阶段。
可能影响及原因
- 并发读取器执行:在执行图中,
scan_trends和read_backlog同时执行。- 原因:两个链都源自
START。ADK 引擎会并发调度独立分支。
- 原因:两个链都源自
- 汇总的字典输出:工作流在
join_research完成,输出一个包含两个阅读器条目的字典。- 原因:
JoinNode可确保在允许后续节点执行之前完整捕获数据。
- 原因:
代理节点 (4C)
在工作台中,前往 Agent nodes (4C)(智能体节点 [4C])。打开 stage2_direction/agent.py。
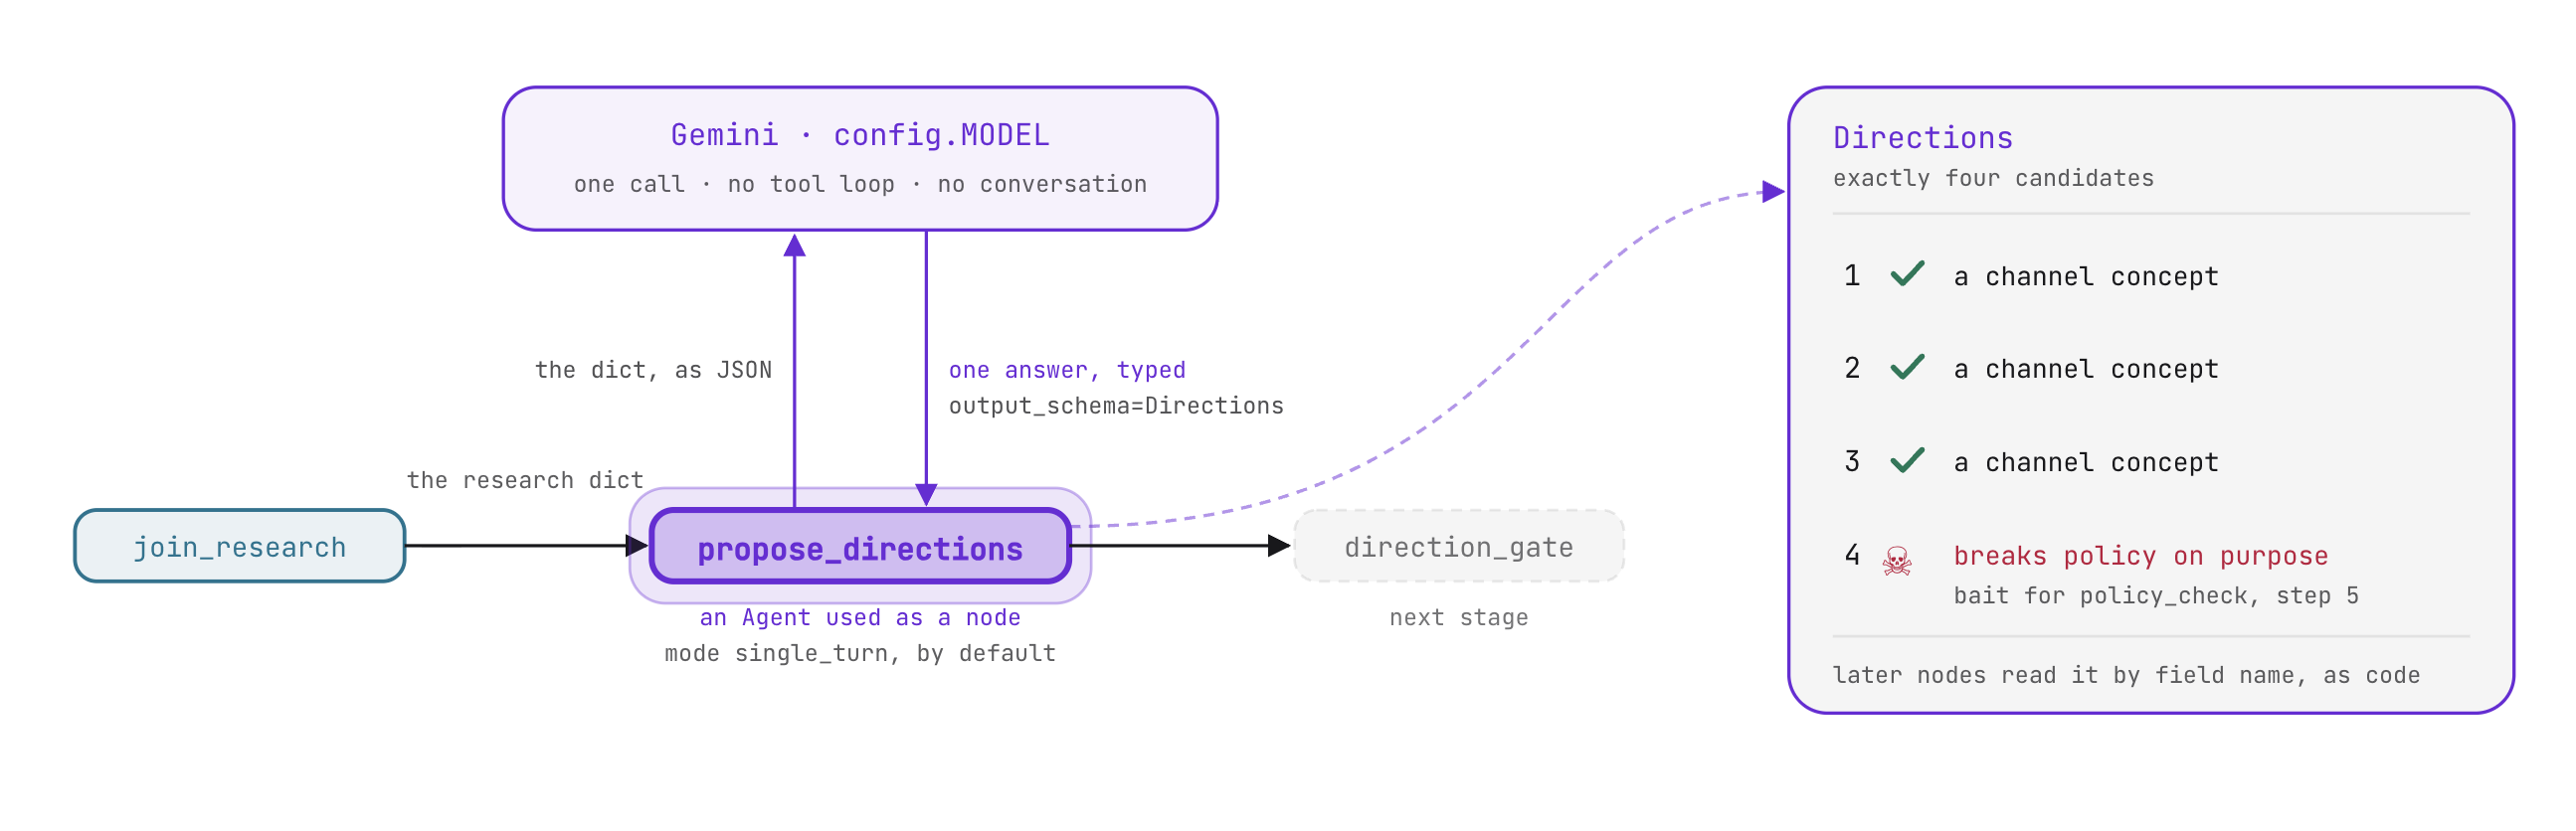
操作模式和结构化架构
嵌入到 Workflow 中时,Agent 默认在 single_turn 模式下运行:
- 它会接收前一个节点的输出作为其上下文输入。
- 它会执行单个推理调用,而无需进行对话式来回互动。
- 它会将结构化数据输出到下一个节点。
通过分配 output_schema=Directions,智能体对模型输出强制执行 Pydantic 验证。下游图接收的是类型化对象,而不是非结构化散文:
class Direction(BaseModel):
    title: str           # <=60 chars, filmable, characterful
    angle: str           # the twist, one line
    hook: str = ""       # 2-4 words, the video's sticker line
    evidence: list[Evidence]


class Directions(BaseModel):
    candidates: list[Direction]   # exactly 4
PROPOSE_INSTRUCTION 指示模型根据趋势和积压工作中的证据提出四个候选方案。候选人 1 至 3 提供了可行的频道概念。候选回答 4 有意引入了违反政策的概念,以便在下一步中测试安全门。
实操编辑:定义代理节点并链接联接
在 stage2_direction/agent.py 中,配置 propose_directions 并扩展工作流边缘:
propose_directions = Agent(
    name="propose_directions",
    model=config.MODEL,
    instruction=PROPOSE_INSTRUCTION,
    output_schema=Directions)
    edges=[(START, scan_trends, join_research),
           (START, read_backlog, join_research),
           (join_research, propose_directions, direction_gate)])
可能影响及原因
- 直接使用字典:
propose_directions会直接使用join_research发出的 JSON 载荷,无需手动设置格式。 - 类型化候选输出:智能体输出一个经过验证的
Directions对象,其中包含四个离散候选。下游节点通过属性名称 (candidate.title) 读取字段,无需进行字符串解析。
人机协同 (4D)
在工作台中,进入人机协同 (4D)。打开 agent/graph.py。
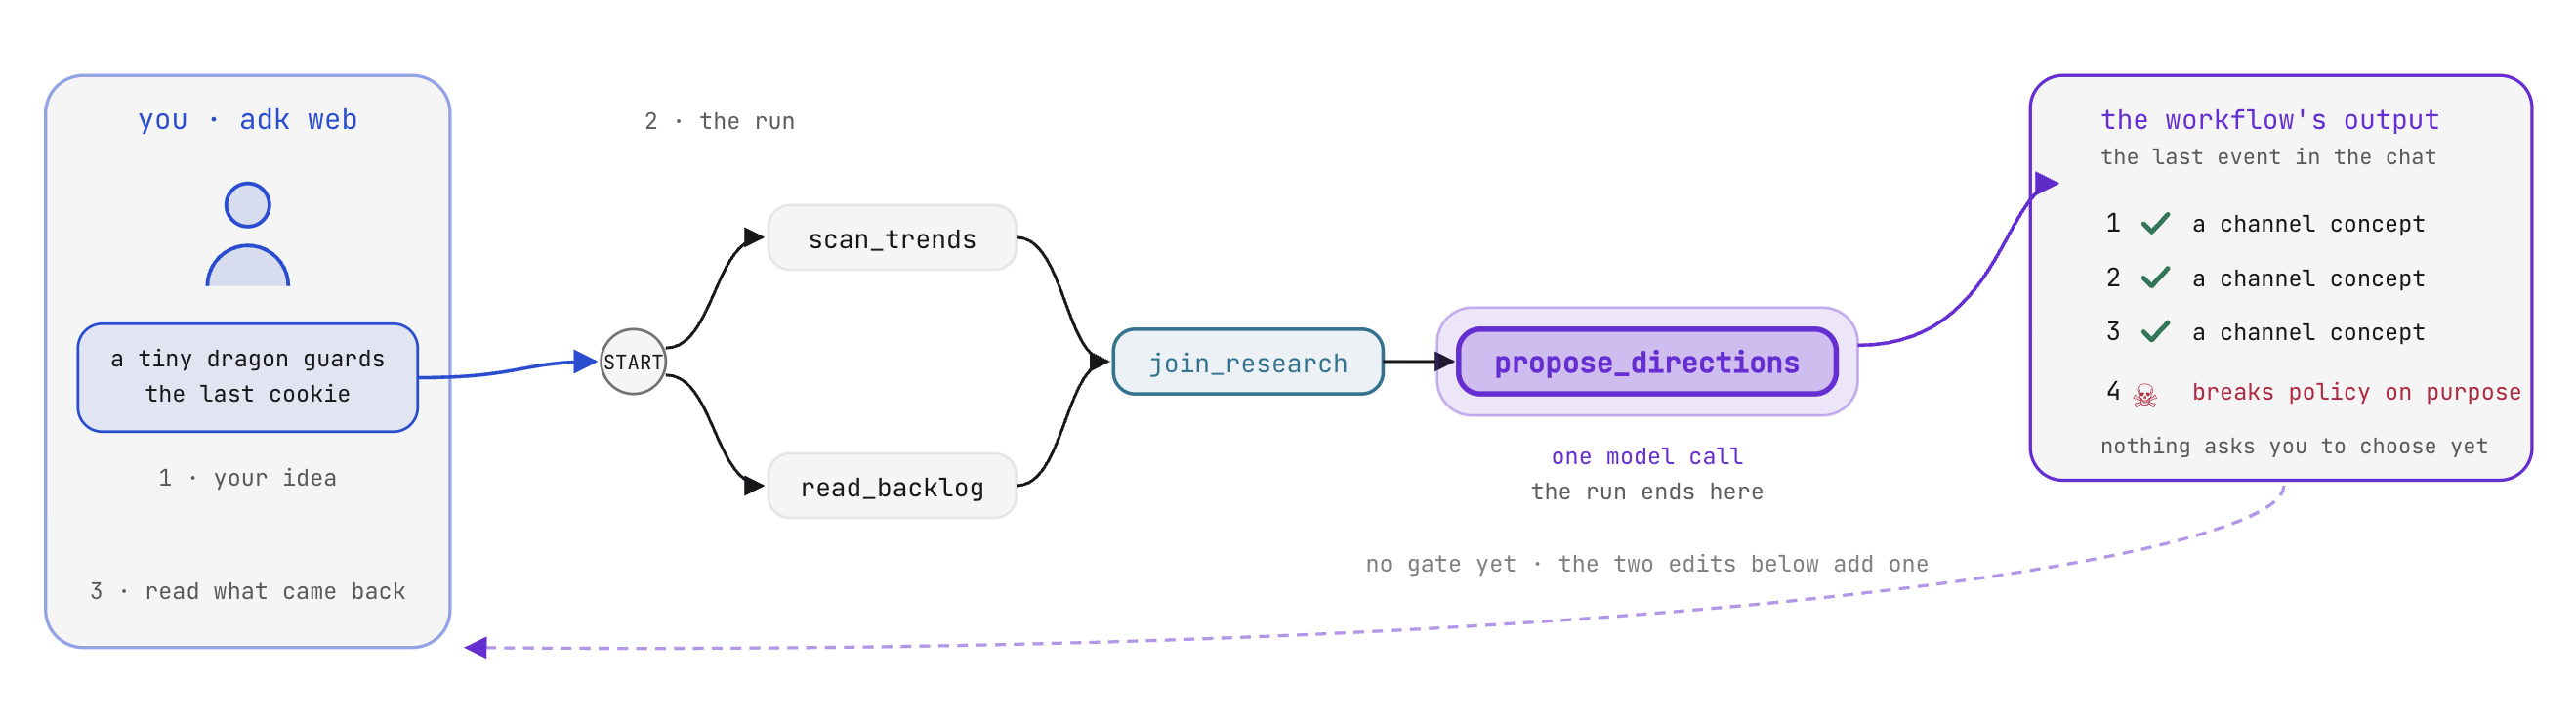
提示指令与确定性暂停
对于会产生财务费用或发布内容的生产工作流,在关键决策点需要人工监督。在单个提示中,确认请求是建议性指令,用户可以轻松提示模型绕过这些指令。在 ADK 工作流中,执行引擎会强制执行人工审批:图表会在指定节点处停止,并且在收到经过架构验证的外部输入之前无法继续:
- 执行
RequestInput会立即暂停工作流执行。 - ADK 会在会话存储区中记录一个打开的中断调用,并发出唯一的
interrupt_id。 - 执行过程会停止,而不会消耗令牌或服务器线程。
- 只有在提交与架构和中断 ID 相匹配的有效
function_response后,图执行才会恢复。
实操编辑:使用 RequestInput 暂停执行
在 agent/graph.py 中,在 direction_gate 内实现挂起调用:
    yield RequestInput(
        message="Pick tonight's direction: 1, 2, 3 or 4.",
        response_schema={
            "type": "object",
            "properties": {
                "pick": {"type": "string", "enum": ["1", "2", "3", "4"]}}},
        payload={"candidates": cands})
RequestInput 配置了三个属性:
message:向用户显示的评价提示。response_schema:前端呈现为输入表单的 JSON 架构,在提交时由 ADK 进行验证。payload:与请求(四个候选回答)捆绑在一起的元数据,使客户端界面无需查询会话状态即可呈现评价卡片。
具体变化及变化原因
- 工作流在 direction_gate 处暂停:在 ADK Web 或 Workbench 界面中,运行会暂停并显示一个交互式候选方案选择表单。
- 原因:引擎遇到了已生成
RequestInput并将执行状态持久化到runs/sessions.db。
- 原因:引擎遇到了已生成
- 恢复需要结构化输入:发送任意聊天文本不会推进图表。选择一个选项(1、2、3 或 4)会提交一个满足
response_schema的类型化function_response,并恢复执行。
5. 状态和路由器
在 VibeStudio 工作台中,前往第 5 步:状态和路由器,即 (5A) 到 (5C) 部分。
您需要将用户选择持久保存到会话状态中,使用确定性路由器节点强制执行渠道安全政策,并组装一个迭代任务智能体,以便在生成视频脚本之前自动修复违规行为。
工作流状态 (5A)
在工作台中,前往工作流状态 (5A)。
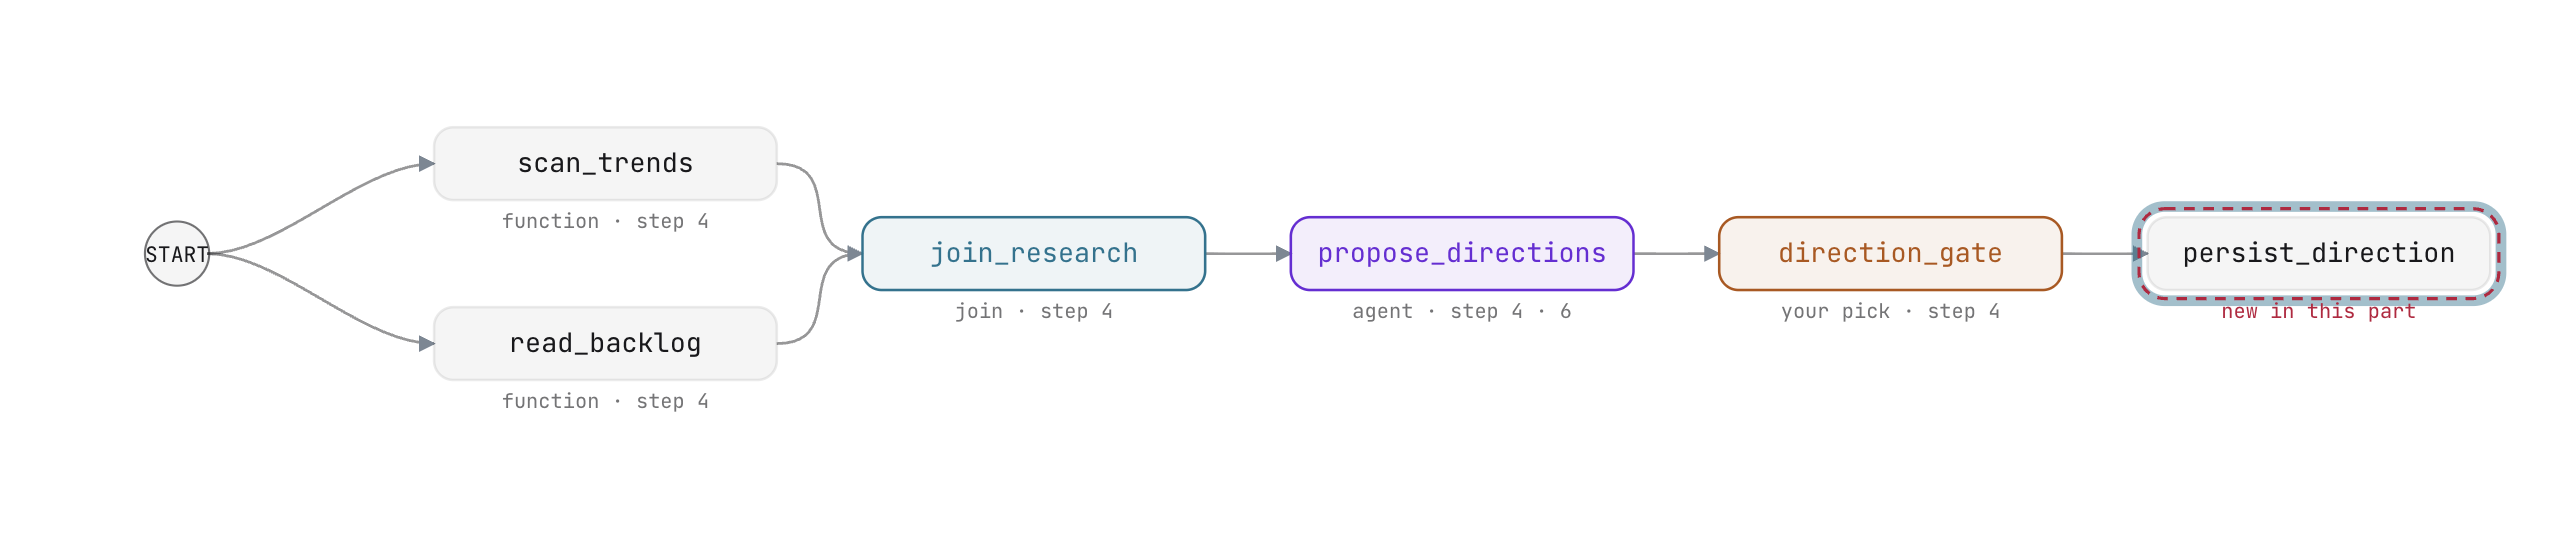
会话状态与节点输出
在 ADK 工作流中,数据通过两种不同的机制在图表中移动:
- 节点输出 (
Event(output=...)):严格定向到边缘列表中定义的直接下游使用者的数据。 - 会话状态 (
Event(state=...)):一个共享的键值对字典,执行生命周期中的任何后续节点都可以访问。
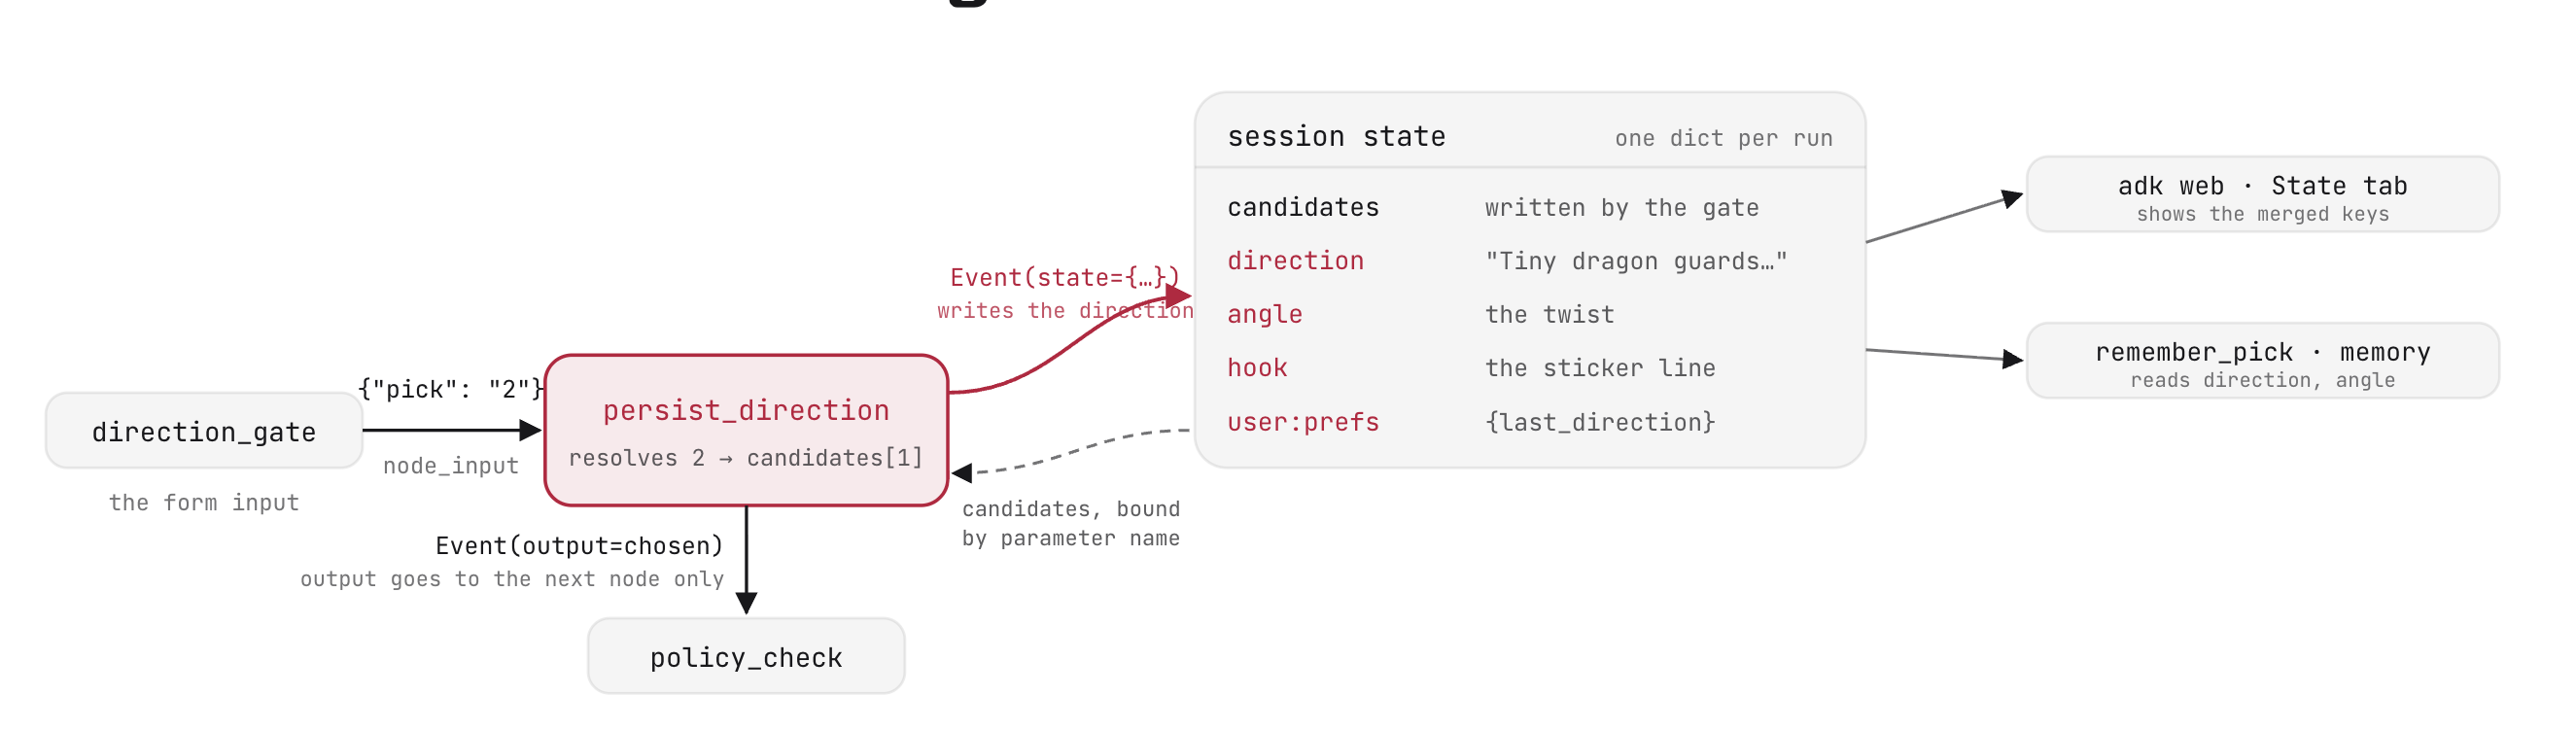
当用户在 direction_gate 处选择一个候选方向时,该选择会以数字索引 ({"pick": "2"}) 的形式到达。下游节点需要完整的方向对象:标题、叙事角度和吸引人的开头。persist_direction 不会通过每个中间节点载荷传递详细元数据,而是将解析后的候选对象写入共享会话状态。
节点无需传递整个会话状态字典。当节点生成 Event(state=...) 时,它仅提供新的或更新后的键值对。ADK 会自动将这些更新合并到会话存储区中:
    yield Event(state={"direction": chosen["title"], "angle": chosen.get("angle", ""),
                       "hook": hook, "user:prefs": {"last_direction": chosen["title"]}})
生成此 Event 会将控制权移交给 Workflow 运行时,该运行时会将新值保留到 runs/sessions.db 中的会话日志。
参数绑定
ADK 函数节点通过参数检查自动读取会话状态。如果函数签名声明的形参名称与现有状态键匹配,ADK 会从状态中提取该键并直接传递:
def persist_direction(node_input, candidates: list = []):
    ni = node_input if isinstance(node_input, dict) else {}
    raw = ni.get("pick")
    pick = str(raw).strip() if raw is not None else ""
    if candidates:
        i = int(pick) - 1 if pick.isdigit() else 0
        chosen = candidates[max(0, min(len(candidates) - 1, i))]
    else:
        chosen = {"title": "untitled", "angle": "", "evidence": []}
    hook = chosen.get("hook") or " ".join(chosen["title"].split()[:4])
在此示例中,candidates 由 direction_gate 写入会话状态。ADK 会将其直接绑定到 persist_direction(node_input, candidates: list = []) 中,而无需显式字典查找。
以 user: 为前缀的键会在用户级存储空间中跨会话持久保存,从而允许后续工作流运行访问创作者偏好设置。
实操编辑:保留状态和连接节点
- 在
agent/graph.py的persist_direction中,将TODO: PERSIST_STATE行替换为状态事件 yield:
    yield Event(state={"direction": chosen["title"], "angle": chosen.get("angle", ""),
                       "hook": hook, "user:prefs": {"last_direction": chosen["title"]}})
- 在
stage3_router/agent.py中,将persist_direction附加到edges列表中的第三个链:
           (join_research, propose_directions, direction_gate,
            persist_direction)
保存文件。在工作台中,验证 state write in place 和 persist_direction in the chain 是否都显示绿色对勾标记。
路由器节点 (5B)
在工作台中,前往路由器节点 (5B)。
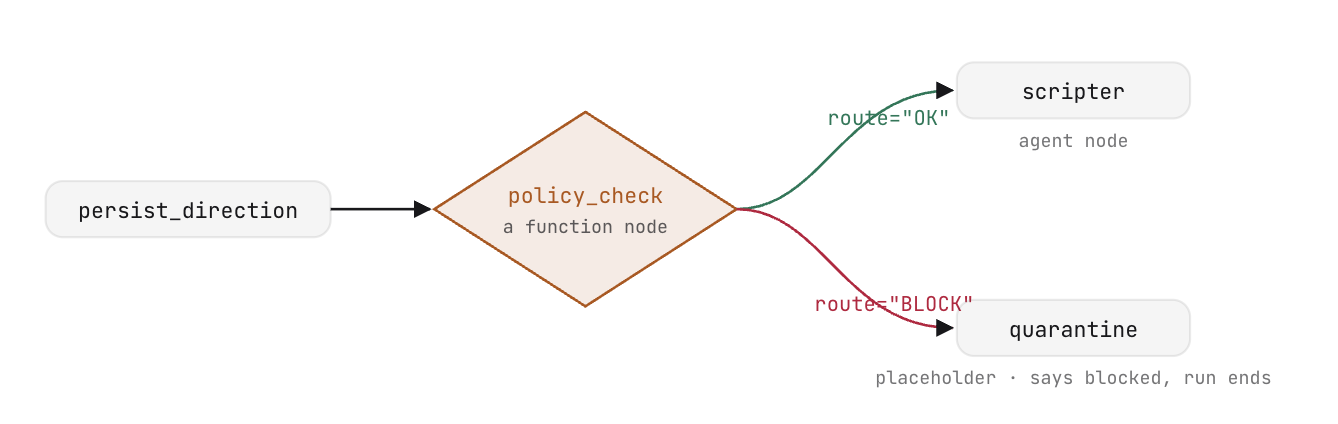
确定性政策路由
路由器是一种专用函数节点,用于评估上游输出并根据条件图分支引导执行。与生成式智能体不同,路由器执行确定性逻辑,而无需调用 LLM。
路由器会返回一个 Event,其中指定了 route 标记:
def length_check(node_input):
    too_long = len(node_input.get("title", "")) > 60
    return Event(output=node_input, route="TRIM" if too_long else "PASS")
在工作流定义中,以字典形式定义的边目标会将路由名称映射到目标节点:
(length_check, {"TRIM": shorten, "PASS": scripter}),
工作流路由器 policy_check 会从 agent/policy_words.txt 中读取禁止使用的词组,并针对所选方向的标题和角度执行全词匹配:
return Event(output=node_input, route="BLOCK" if bad else "OK")
将政策存储为数据而非硬编码指令,这样无需修改工作流图即可进行更新:更新文本文件后,更改会立即应用于后续运行。由于评估是确定性的正则表达式匹配,因此在生成式脚本开始之前,它会在几毫秒内执行完毕,且不会产生任何令牌费用。
目标账号:Scripter 和 Quarantine
路由器将流量定向到两个下游节点之一:
scripter:一个single_turn智能体节点,用于将获批的方向转换为符合ScriptPydantic 架构的结构化制作脚本:
scripter = Agent(
    name="scripter",
    model=config.MODEL,
    instruction=SCRIPT_INSTRUCTION,
    output_schema=Script)
quarantine:最初是一个占位函数,用于阻止被标记的指令,在下一部分中会被自主修复代理替换。
实践操作:路由政策检查
- 在
agent/graph.py中的policy_check内,完成 return 语句:
return Event(output=node_input, route="BLOCK" if bad else "OK")
- 在
stage3_router/agent.py中,更新edges以路由policy_check,并将隔离分支重新加入scripter:
           (join_research, propose_directions, direction_gate,
            persist_direction, policy_check),
           (policy_check, {"OK": scripter, "BLOCK": quarantine}),
           (quarantine, scripter)])
保存文件。在工作台中,验证路由器边缘映射是否已通过验证。
智能体模式和任务节点 (5C)
在工作台中,前往智能体模式和任务节点 (5C)。
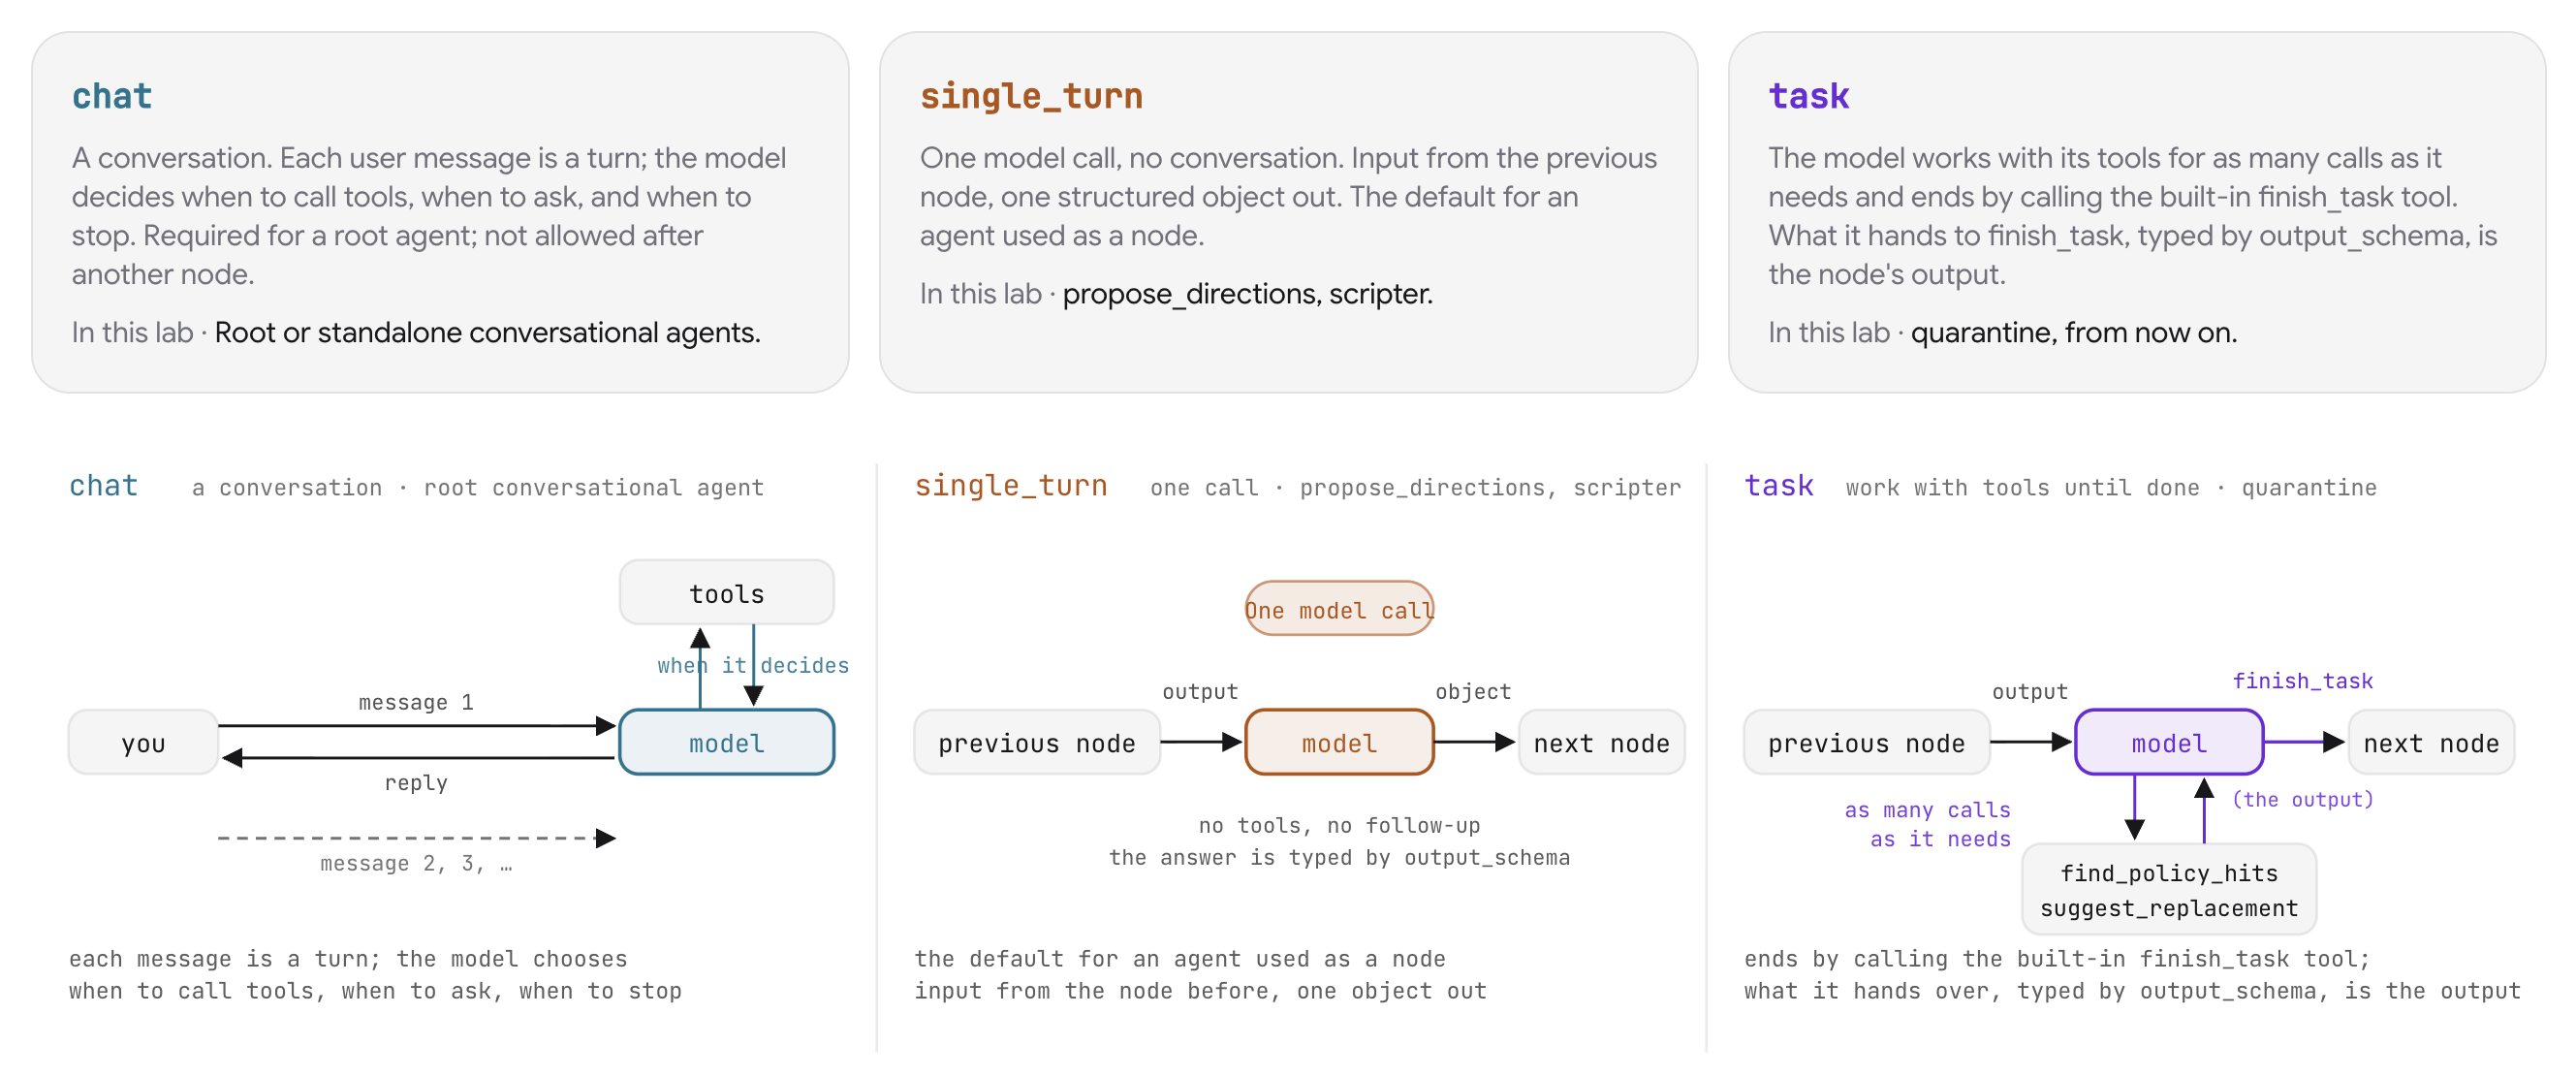
智能体执行模式
ADK Agent 实例支持三种执行模式,可根据特定流水线要求进行定制:
模式 | 执行生命周期 | 在流水线中的角色 |
| 多轮对话循环。模型会确定何时调用工具、征求输入或结束对话轮次。 | 面向交互式人类用户的根代理。 |
| 单次模型推理调用。接受上一个节点的输入,并发出结构化架构对象。 | 顺序图转换( |
| 具有工具执行功能的自主循环。智能体会不断迭代,直到调用内置的 | 多步骤修复和检查 ( |
自主政策修复
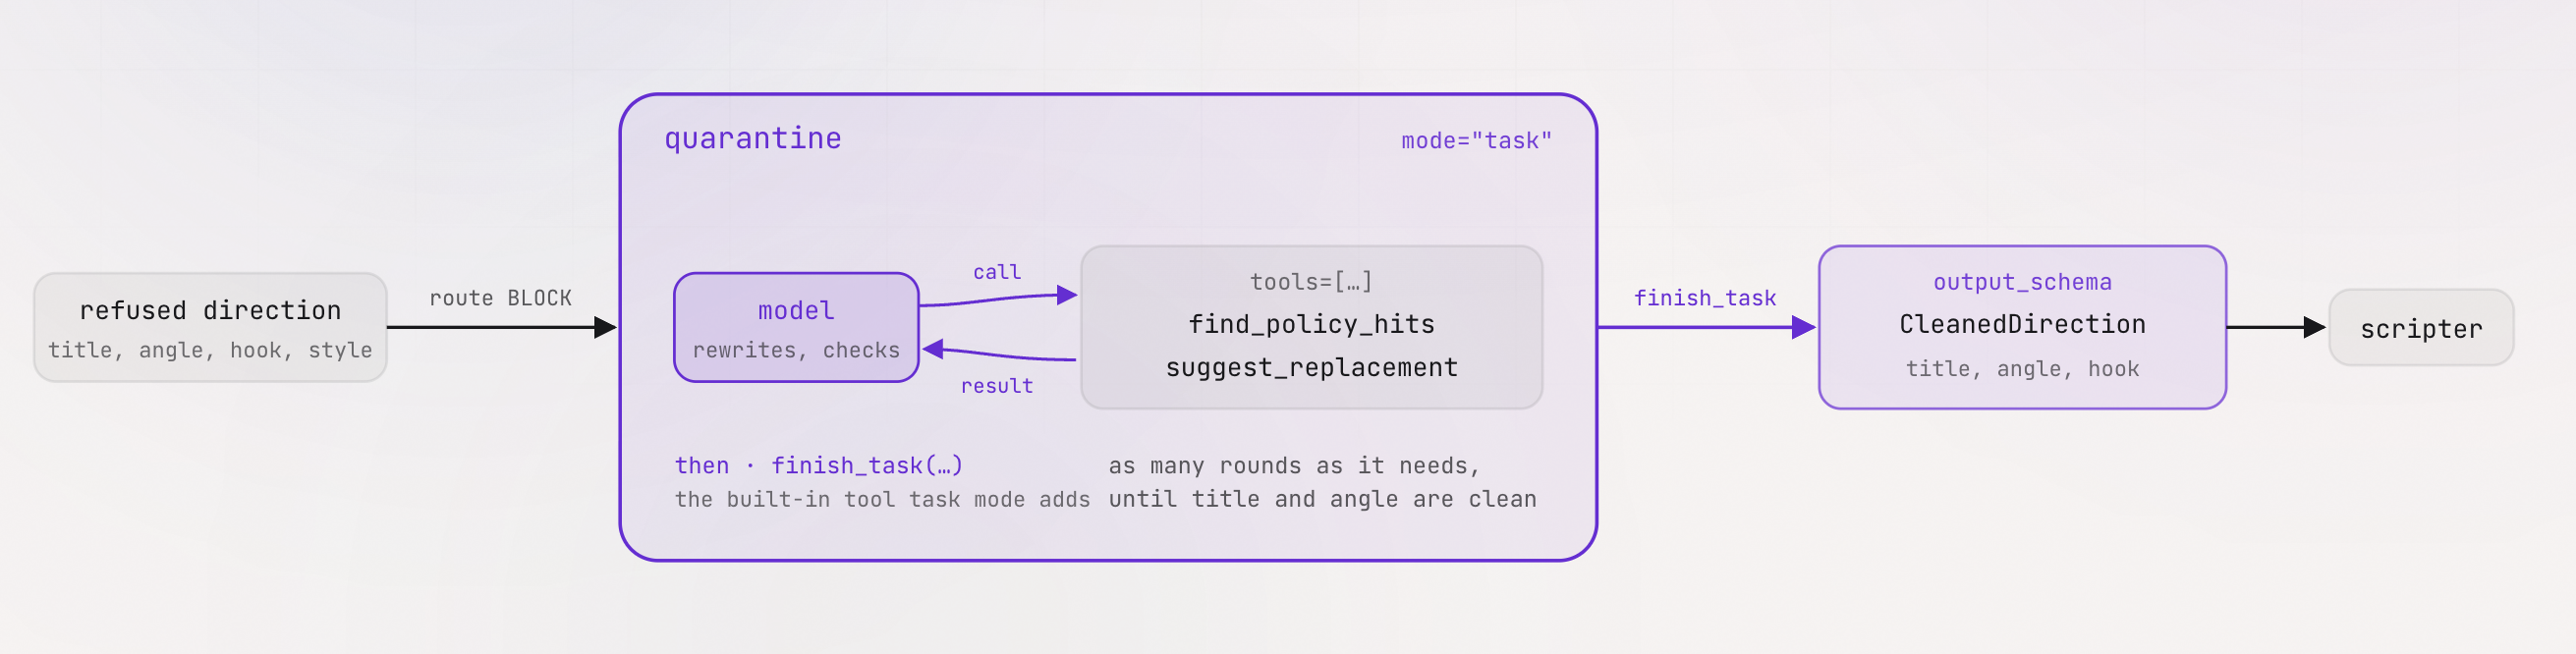
重写被标记的指令需要使用 task 模式,因为修复迭代次数是可变的。代理接收到标记的方向,调用 find_policy_hits 来检测违规情况,通过 suggest_replacement 请求批准的替代方案,重写方向,并在继续之前验证内容是否干净。
这两种工具都在 agent/cleanup_tools.py 中定义,并带有类型化签名和文档字符串:
def find_policy_hits(text: str) -> dict:
    """Which refused words appear in `text`. Matches whole words and phrases
    from agent/policy_words.txt, case-insensitive.

    Returns {"hits": [...], "clean": bool}. clean is true when hits is empty.
    """


def suggest_replacement(word: str) -> dict:
    """The channel's approved stand-in for a refused word, read from
    agent/policy_replacements.txt.

    Returns {"word", "replacement", "listed"}. When the word has no entry,
    listed is false and replacement is a hint to pick a gentle synonym.
    """
实操编辑:组装隔离任务智能体
在 stage3_router/agent.py 中,将占位符 quarantine 函数替换为任务代理定义:
quarantine = Agent(
    name="quarantine",
    model=config.MODEL,
    instruction=QUARANTINE_INSTRUCTION,
    mode="task",
    tools=[find_policy_hits, suggest_replacement],
    output_schema=CleanedDirection,
)
任务模式会为智能体配备工具,并通过调用 finish_task 终止执行。配置 mode="task" 后,ADK 会自动提供 finish_task 并从 output_schema 中派生其参数,从而确保节点生成与脚本编写器节点的输入架构匹配的类型化 CleanedDirection 对象。
预期结果及原因
在 ADK Web 或 VibeStudio Workbench 中测试这两个执行路径:
- 批准的路线(候选路线 1、2 或 3):
- 选择已获批准的候选路由,直接从
policy_check路由到scripter(route="OK")。 - 脚本编写器会生成一个包含 3 个镜头的制作脚本,该脚本遵循
Script架构。
- 选择已获批准的候选路由,直接从
- 隔离修复路线(候选 4):
- Candidate 4 contains flagged vocabulary ("clickbait", "viral hack").
policy_check条前往quarantine(route="BLOCK") 的路线。- 在会话轨迹中,观察
quarantine调用find_policy_hits、针对每次违规调用suggest_replacement、重写标题以及调用finish_task的情况。 - 执行过程重新加入
scripter,从经过清理的方向生成脚本。
6. 记忆库
在 VibeStudio Workbench 中,前往第 6 步:记忆库,找到 (6A) 和 (6B) 部分。
目前,工作流在会话之间不会保留记忆。每次执行都是从头开始,不会记住创作者之前选择的内容或偏好的类型。在此步骤中,您将连接 Vertex AI Agent Engine 记忆库,以便在不同运行之间存储和检索创作者偏好设置。
至关重要的是,内存是通过代理生命周期回调而不是流水线节点集成的。由于内存提取和检索服务于各个代理,而不是中间数据阶段,因此附加回调可保持干净、解耦的图拓扑。
记忆库 (6A)
在工作台中,前往记忆库 (6A)。
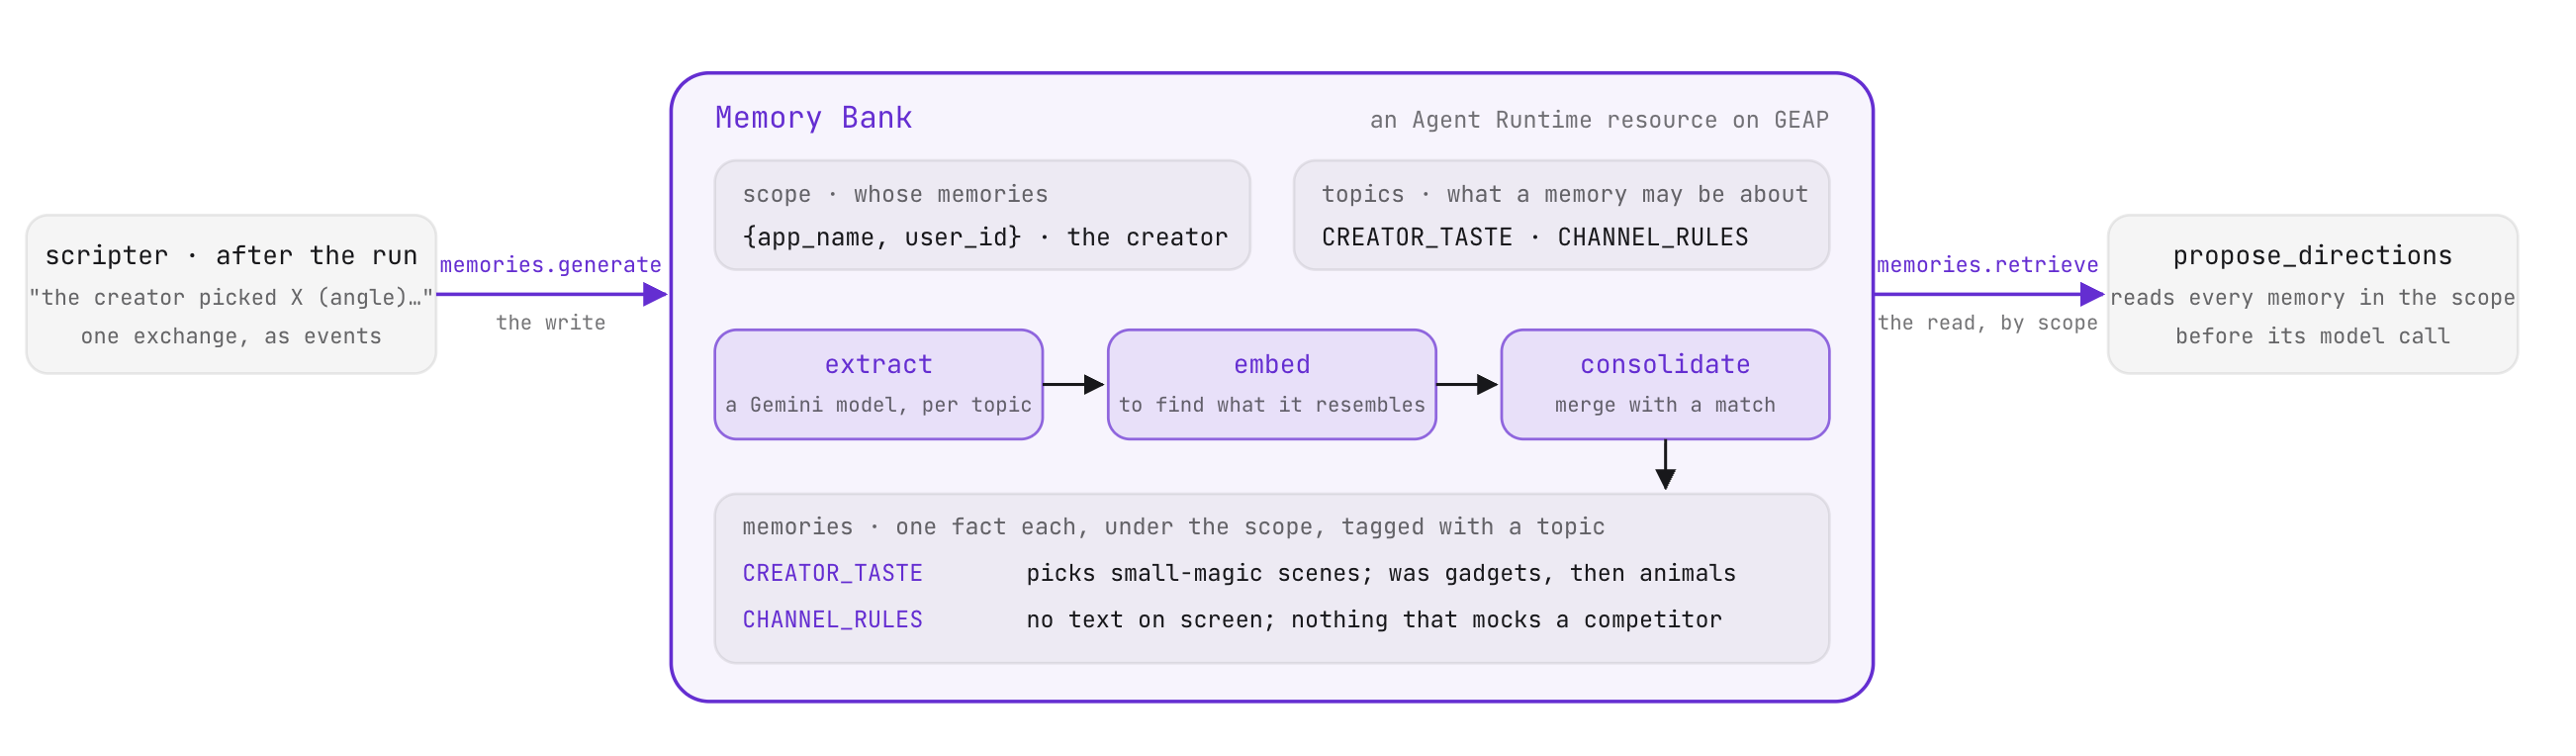
管理用户级记忆
记忆库是一项用于长期存储用户记忆的托管式服务。它会在定义的范围内整理有关某个人的事实,此处由应用名称和用户 ID 标识:
SCOPE = {"app_name": config.APP, "user_id": config.USER}
TOPICS = {
    "CREATOR_TASTE": "Which video directions this creator picks and passes on, "
                     "and how that preference changes over time.",
    "CHANNEL_RULES": "Standing instructions the creator states for every video "
                     "(style, subjects to avoid, format rules).",
}
自定义记忆主题定义了记忆库记录内容的边界:
- 主题提取:通过
memories.generate提交新的对话文本后,该服务会针对每个主题说明应用提取模型。如果文本与任何主题都不匹配,则不会生成回忆。 - 整合和去重:该服务会将新提取的事实转换为嵌入,并将其与范围内的现有记忆进行比较。当观测结果与现有记忆相符时,该服务会更新相应记忆。如果表示的是新信息,该服务会创建一个新条目。此整合流程可确保多个关于某个主题的会话合并为连贯的摘要,而不是生成冗余条目。
- 检索:使用用户范围调用
memories.retrieve会返回存储的事实,并按时间顺序(从旧到新)排列。
这两项操作均在 agent/platform/memory.py 中实现。预配的银行资源名称会缓存在 runs/memorybank.json 中。
设置记忆库
使用工作台控件或在终端中运行 CLI 命令:
- 连接并预配银行:
python -m agent.platform.bankCREATOR_TASTE和CHANNEL_RULES主题。 - 为历史会话设定种子:
python -m agent.platform.bank load - 检查整合后的事实:
python -m agent.platform.bank list
回调 (6B)
在工作台中,前往 Callbacks (6B)。打开 stage4_memory/agent.py。
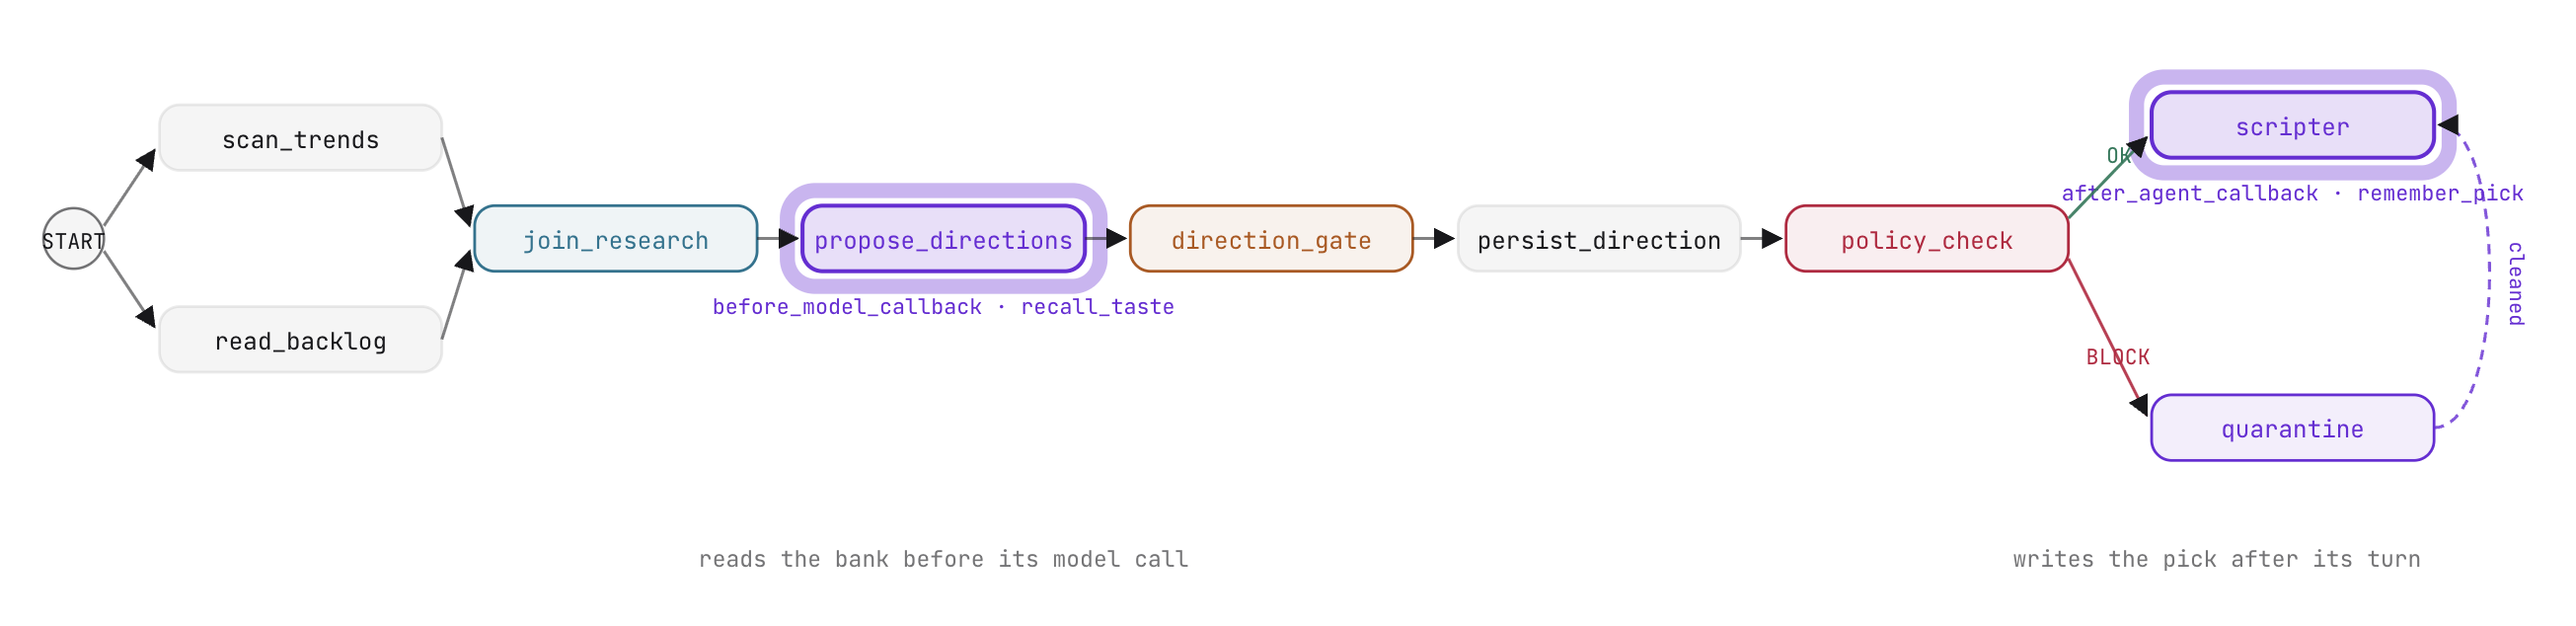
ADK 智能体生命周期回调
回调是作为参数传递给 Agent 的函数。ADK 会在预定义的生命周期时刻调用回调,并传递有效上下文。返回 None 会继续正常执行;返回替换对象会替换或拦截操作。
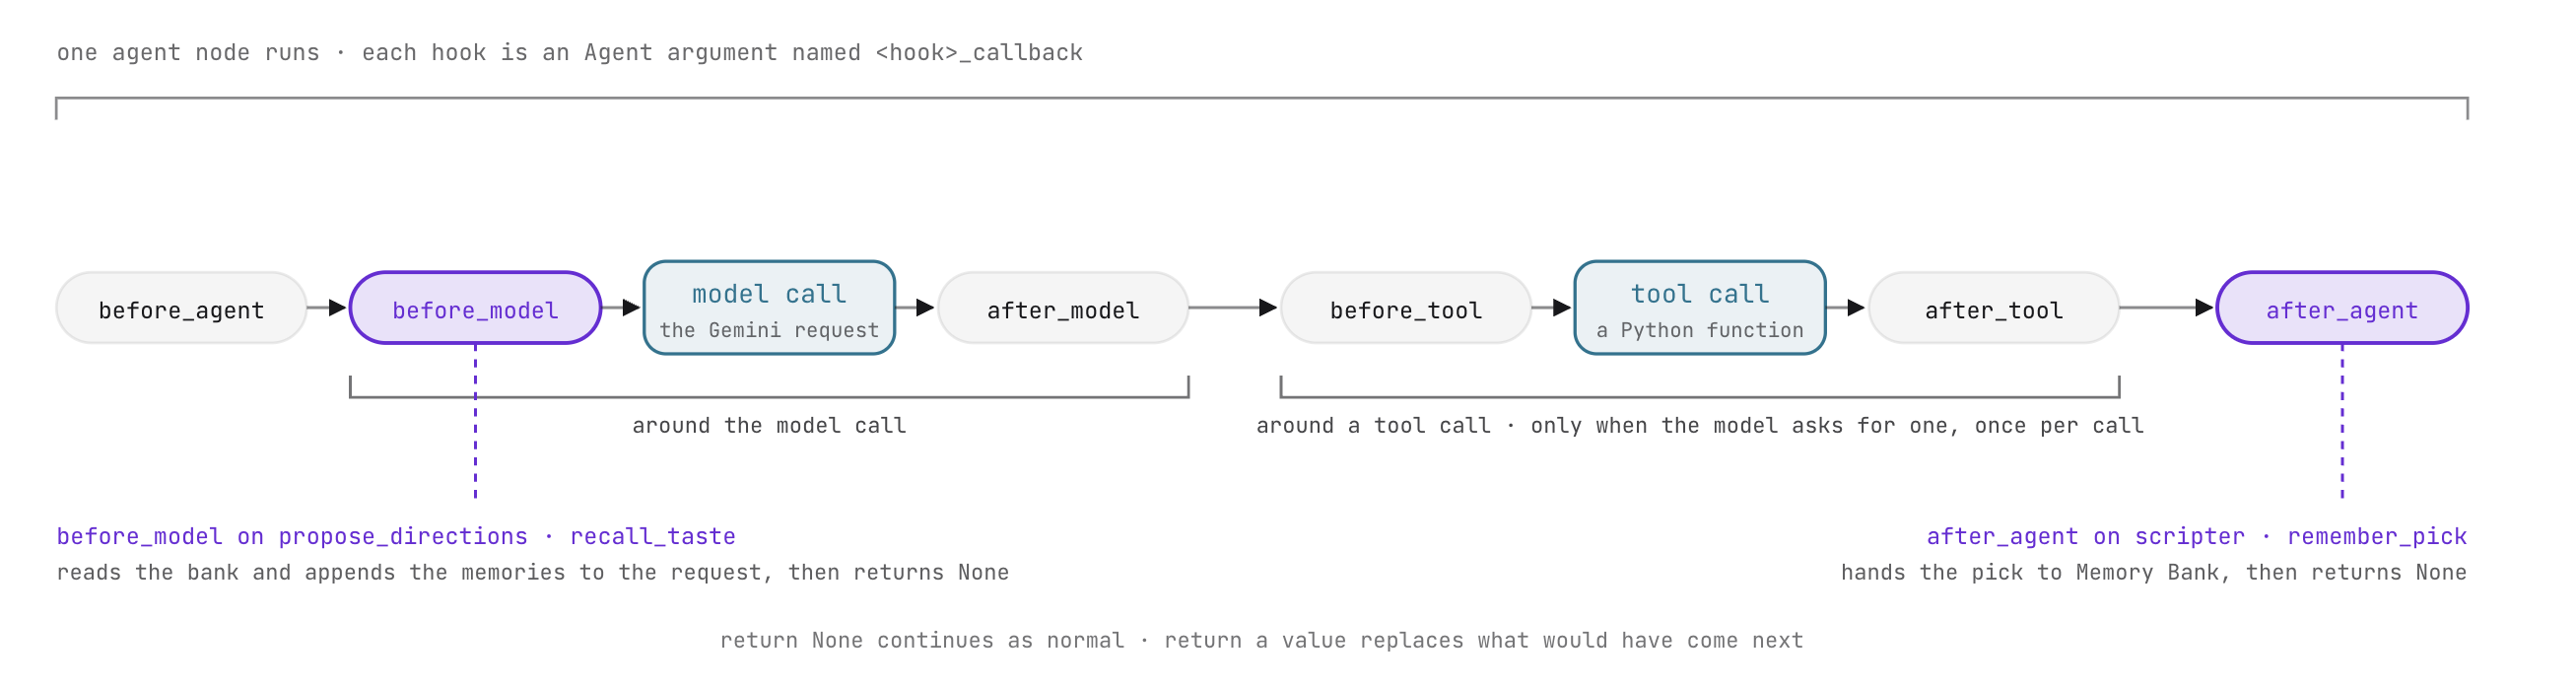
ADK 提供了三对回调:
回调对 | 调用点 | 收到的参数 | 返回值行为 |
| 围绕整个智能体轮次 |
| 返回 |
| 在每次 LLM 推理调用前后 |
| 返回 |
| 在每次工具执行前后 | 工具定义、参数、结果 | 返回字典会替换工具输出; |
回调为上下文注入、安全措施、遥测和缓存查找提供了一个干净的位置,而不会在工作流图中引入无关的节点。
实操编辑:关联 recall 和 remember 回调
- 在
stage4_memory/agent.py中,更新propose_directions以附加before_model_callback=recall_taste:
    output_schema=Directions,
    before_model_callback=recall_taste)
recall_taste 会在 Gemini 生成候选方向之前立即执行。它会从记忆库中提取创作者的历史记录,按时间顺序(从最旧到最新)设置记忆格式,并将其附加到传出的 LlmRequest。该提示指示模型将候选视频 1 至 3 调整为更符合创作者当前喜好的视频,同时将频道规则视为严格的限制条件。
- 在
stage4_memory/agent.py中,更新scripter以附加after_agent_callback=remember_pick:
    output_schema=Script,
    after_agent_callback=remember_pick)
remember_pick 在 scripter 完成其轮次后运行。它会从会话状态中读取所选方向,合成一个简明扼要的陈述来总结创作者的决定,并调用 memories.generate 来更新记忆库。
可能影响及原因
在工作台或 ADK Web 中测试回调增强型工作流:
- 执行提示为空的运行:
- 在会话跟踪记录中,检查
propose_directions的LlmRequest。请注意,附加的记忆上下文详细说明了创作者对奇幻主题和紧凑节奏的偏好。 - 观察建议的方向:即使趋势强调其他主题,候选方向 1 至 3 也与创作者的历史偏好保持一致。
- 在会话跟踪记录中,检查
- 选择
direction_gate处的候选对象。 scripter完成后,查看记忆库记录:python -m agent.platform.bank list
7. RAG 引擎
在 VibeStudio 工作台中,前往第 7 步:RAG 引擎,即 (7A) 和 (7B) 部分。
已发布的视频会不断积累观看者的反馈。agent/comments.md中收集了 30 条具有代表性的评论,涵盖了观看者的赞美、对赞助内容节奏的批评以及音频偏好。在此步骤中,您将使用 Vertex AI RAG Engine 为这些评论建立索引,并将语义检索连接到研究扇出。
文档检索 (7A)
在工作台中,前往 RAG Engine (7A)。
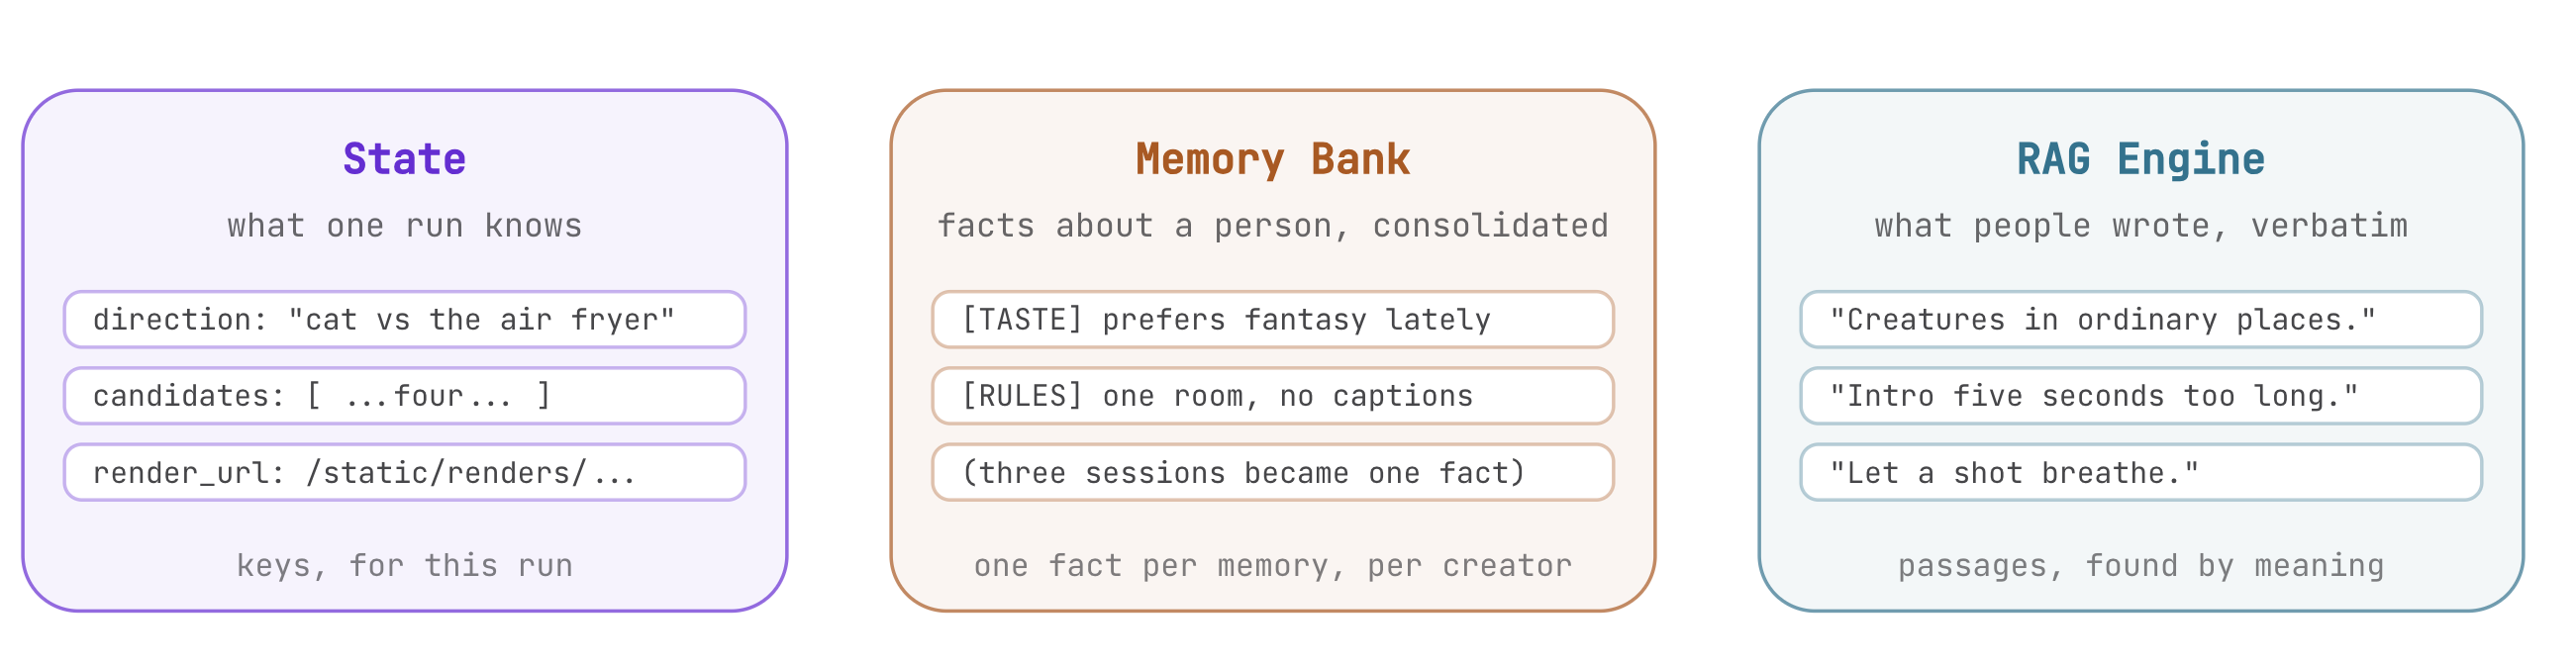
记忆库与 RAG 引擎对比
这两种工具都基于外部数据来构建工作流,但它们在架构方面有不同的用途:
维度 | 记忆库 | RAG 引擎 |
主要应用场景 | 长期用户偏好设置和操作规则 | 对大型文档集合进行语义检索 |
范围 | 范围限定为单个用户 ID 和应用名称 | 范围限定为所有用户共享的语料库资源 |
数据处理 | 实时提取、嵌入和语义整合 | 文档分块、向量嵌入和最近邻搜索 |
图表集成 | 代理生命周期回调( | 研究扇出中的专用函数节点 ( |
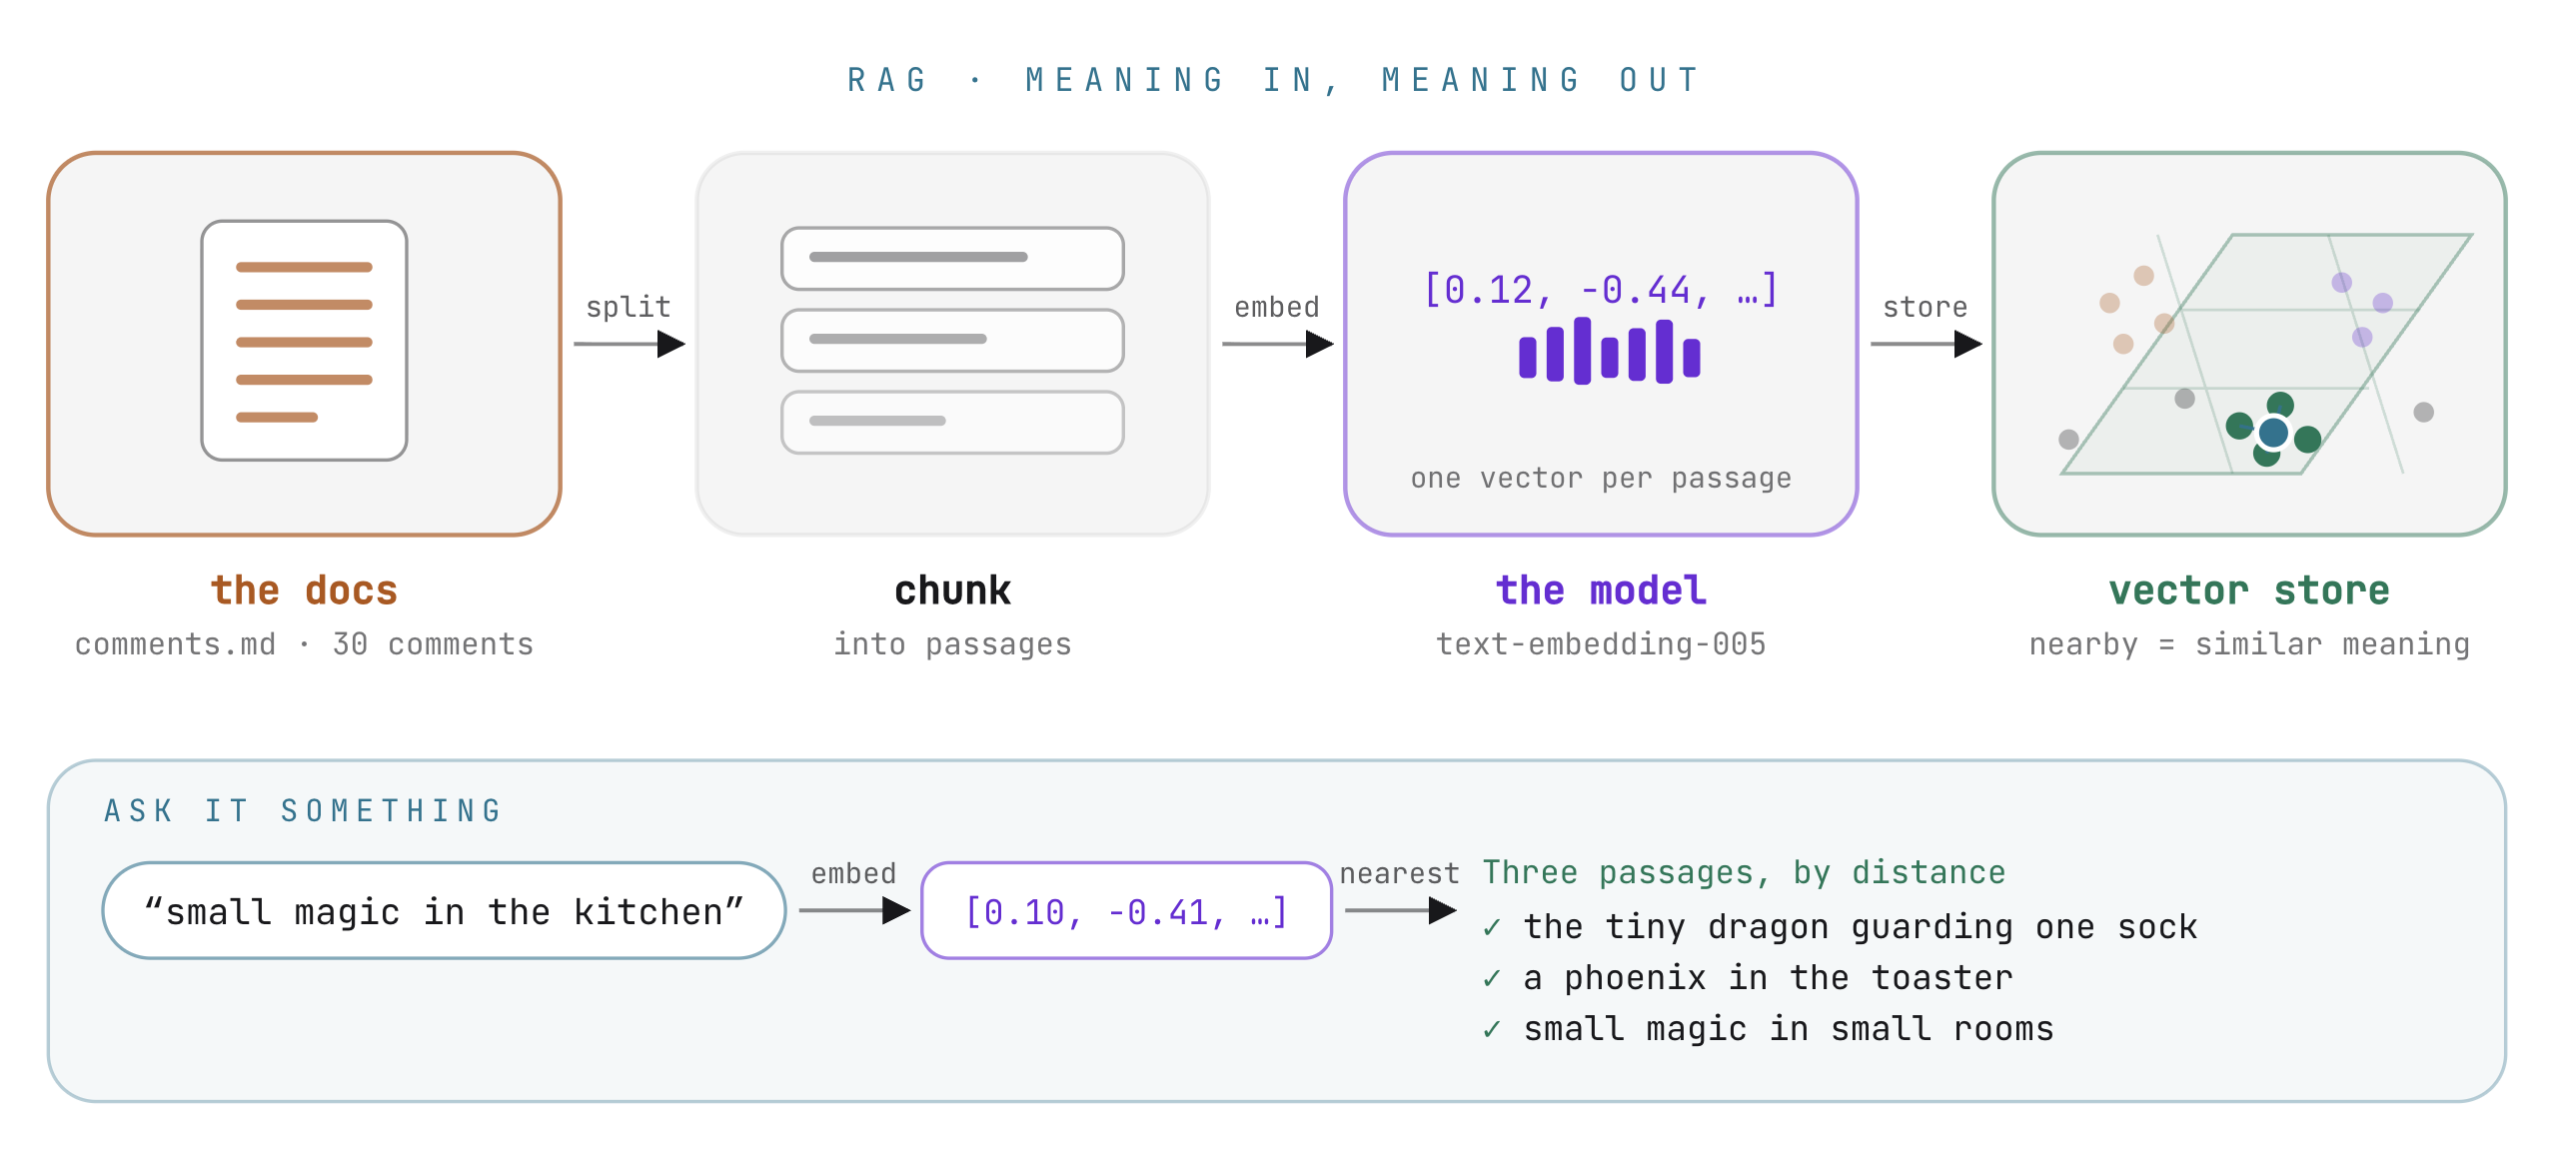
文档分块和嵌入
RAG 引擎通过将文本划分为语义段落并将其向量存储在代管式数据库中,来为文档编制索引:
corpus = rag.create_corpus(
    display_name="vibestudio-feedback",
    description="Vibe Studio: what the audience wrote under the channel's past videos.",
    backend_config=rag.RagVectorDbConfig(
        rag_embedding_model_config=rag.RagEmbeddingModelConfig(
            vertex_prediction_endpoint=rag.VertexPredictionEndpoint(
                publisher_model="publishers/google/models/text-embedding-005"))))

rag.upload_file(
    corpus_name=corpus.name, path="agent/comments.md", display_name="comments.md",
    transformation_config=rag.TransformationConfig(
        chunking_config=rag.ChunkingConfig(chunk_size=120, chunk_overlap=20)))
- 分块大小:配置为 120 个 token,重叠 20 个 token。这样可以捕获每个段落的两到三条评论,确保每个向量都代表一种连贯的情感,而不会因无关的反馈而稀释含义。
- 嵌入模型:
text-embedding-005将文本转换为高维向量。当用户提交查询时,模型会将查询转换为向量,并根据语义距离查找最接近的匹配项。一条关于“守护袜子的迷你龙”的评论与关于“神奇生物”的提示相匹配,而无需完全相同的关键字。
设置 RAG 语料库
使用工作台按钮或终端命令初始化语料库:
- 创建语料库:
python -m agent.platform.ragruns/ragcorpus.json中记录资源 ID。 - 上传并为评论编制索引:上传
agent/comments.md并进行分块配置,然后等待编制索引完成。 - 查询语料库:使用与评论不完全相同的字词进行查询,测试相似度检索(例如,查询“小型魔法生物”以检索有关龙的评论)。
检索节点 (7B)
在工作台中,前往第三个读取器 (7B)。打开 stage5_rag/agent.py。
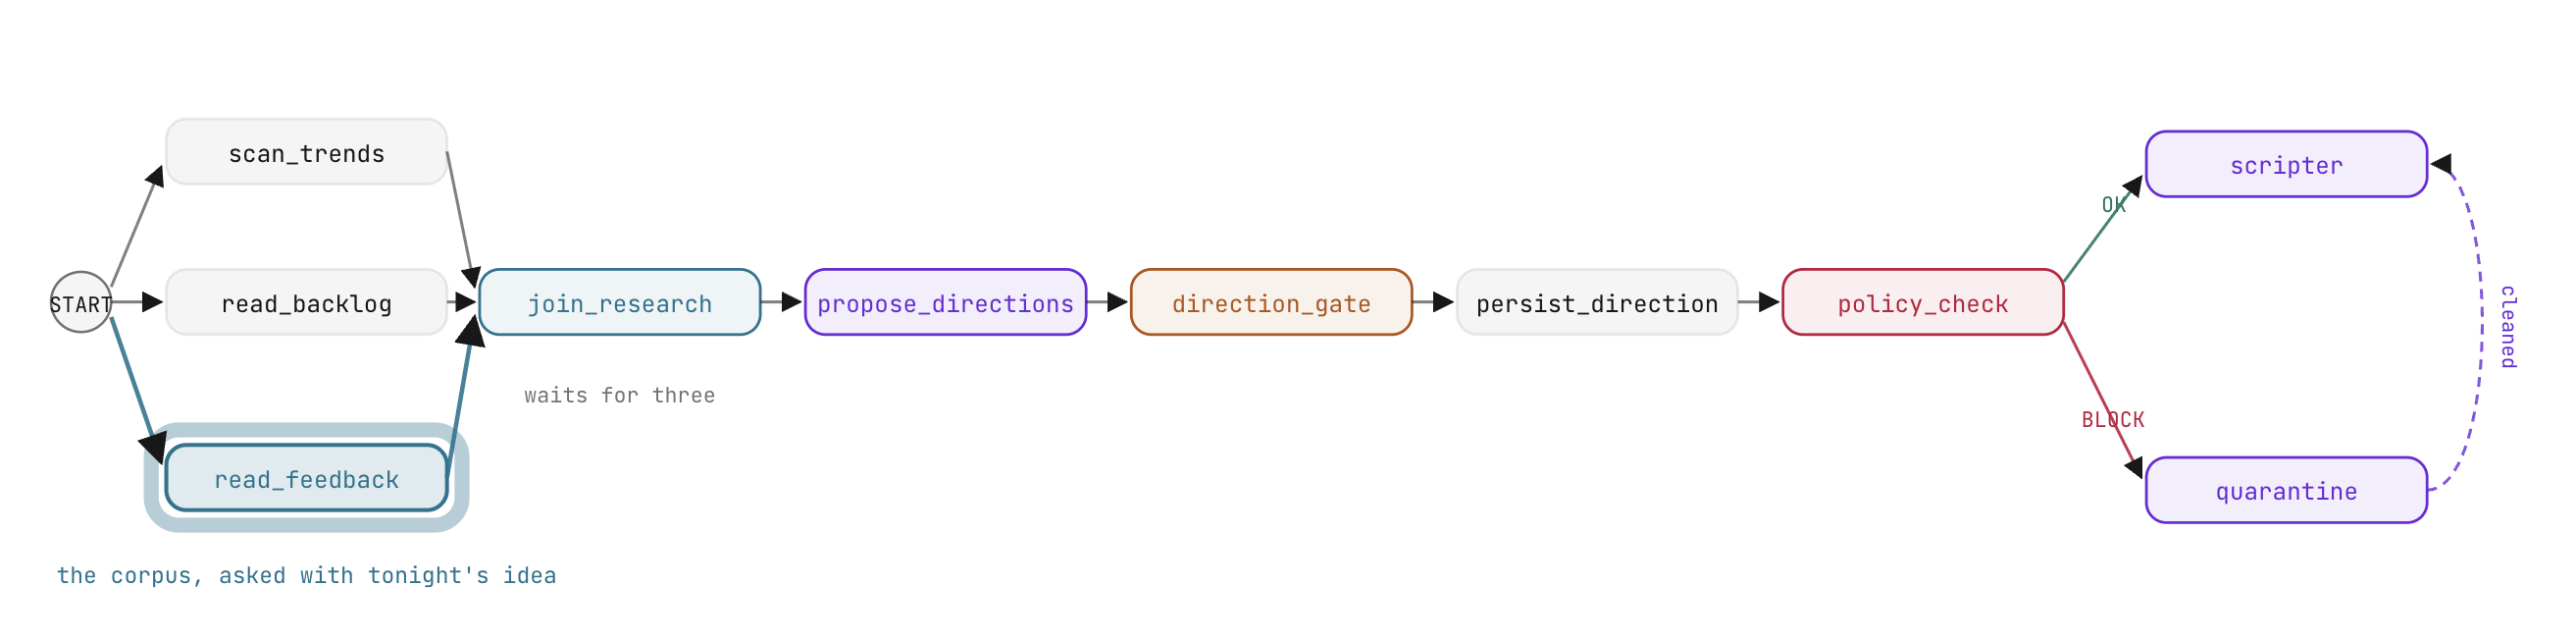
作为图表节点的检索
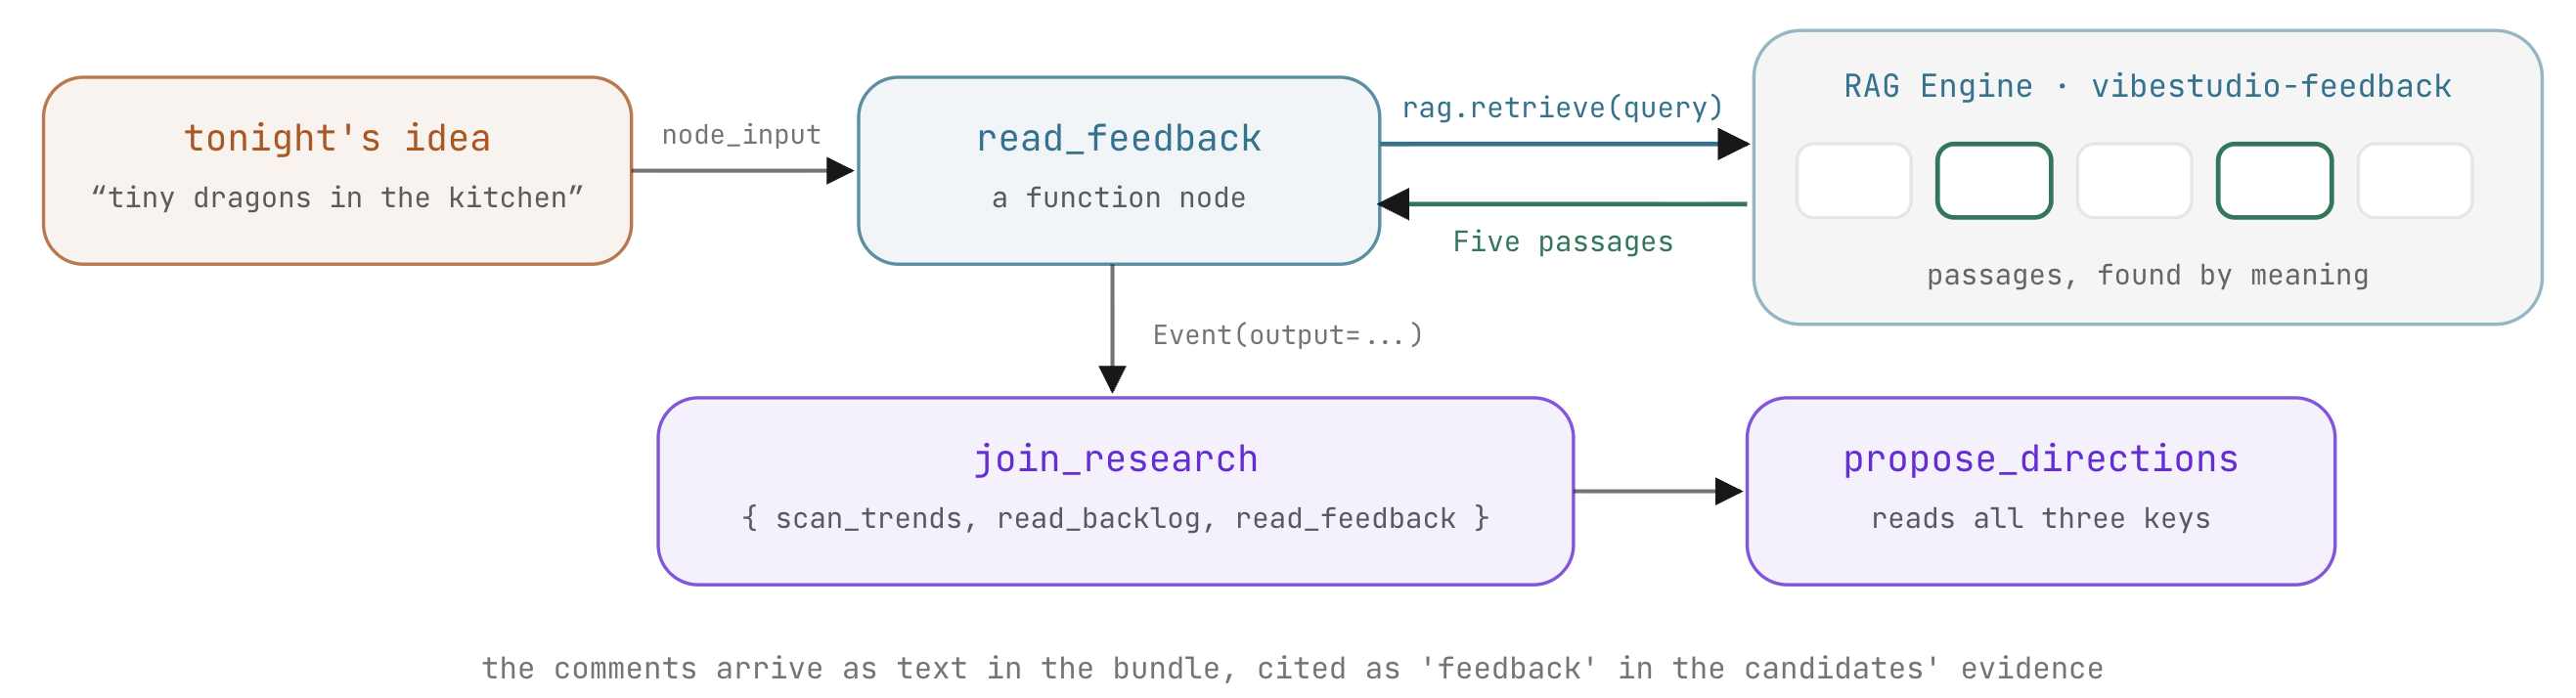
受众群体反馈代表在整个工作流中共享的研究数据。与个人创作者记忆不同,观看者情绪会与趋势和积压数据一起直接输入到 join_research 中。因此,它实现为函数节点:
def read_feedback(node_input):
    """The third reader (step 7): what the audience wrote under past videos,
    the passages nearest to tonight's idea. Retrieval, not a model call."""
    from .platform import rag
    idea = idea_text(node_input)
    query = idea or "what viewers liked and what they complained about"
    try:
        hits = rag.retrieve(query)
    except Exception as e:
        print(f"  [rag] feedback unavailable ({str(e)[:80]})")
        return Event(output={"query": query, "feedback": [],
                             "note": "no corpus connected - run: python -m agent.platform.rag"})
    return Event(output={"query": query, "feedback": [h["text"] for h in hits]})
read_feedback 会提取用户的初始想法,并对 RAG Engine 语料库执行向量查询。它以 Event(output=...) 载荷的形式发出检索到的评论。
实际操作:将第三个读卡器连接到分线器
在 stage5_rag/agent.py 中,更新 edges,将 read_feedback 添加为进入 join_research 的第三个并行分支:
           (START, read_backlog, join_research),
           (START, read_feedback, join_research),
由于 join_research 是 JoinNode,因此它会同步所有传入分支,等待 scan_trends、read_backlog 和 read_feedback 全部发出事件,然后再将汇总的 bundle 传递到下游。
预期结果及原因
在工作台中运行工作流:
- 提交创意提示(例如“一条守护厨房台面的迷你龙”)。
- 在执行轨迹中,验证所有三个读取器节点是否并发执行。
- 观察
join_research:其输出字典现在包含trends、backlog和feedback。 - 检查
propose_directions生成的候选内容:模型将观看者评论纳入其提案中,并在证据字段中引用观众情绪。 - 请注意,RAG 检索是确定性的(相同的查询会返回相同的评论段落),而生成建议节点会生成创意变体。
8. 使用 Veo 异步生成视频
在 VibeStudio Workbench 中,前往第 8 步:视频,即 (8A) 和 (8B) 部分。
使用 Google Veo 生成高清视频时,每次渲染需要几分钟时间。在此期间阻止图执行会浪费计算资源、锁定线程池,并使运行容易受到 HTTP 连接中断的影响。在此步骤中,您将使用 ADK 的 LongRunningFunctionTool 使视频渲染异步进行。
长时间运行的工具 (8A)
在工作台中,前往 A long-running tool (8A)。打开 stage6_video/agent.py 和 agent/deliver.py。
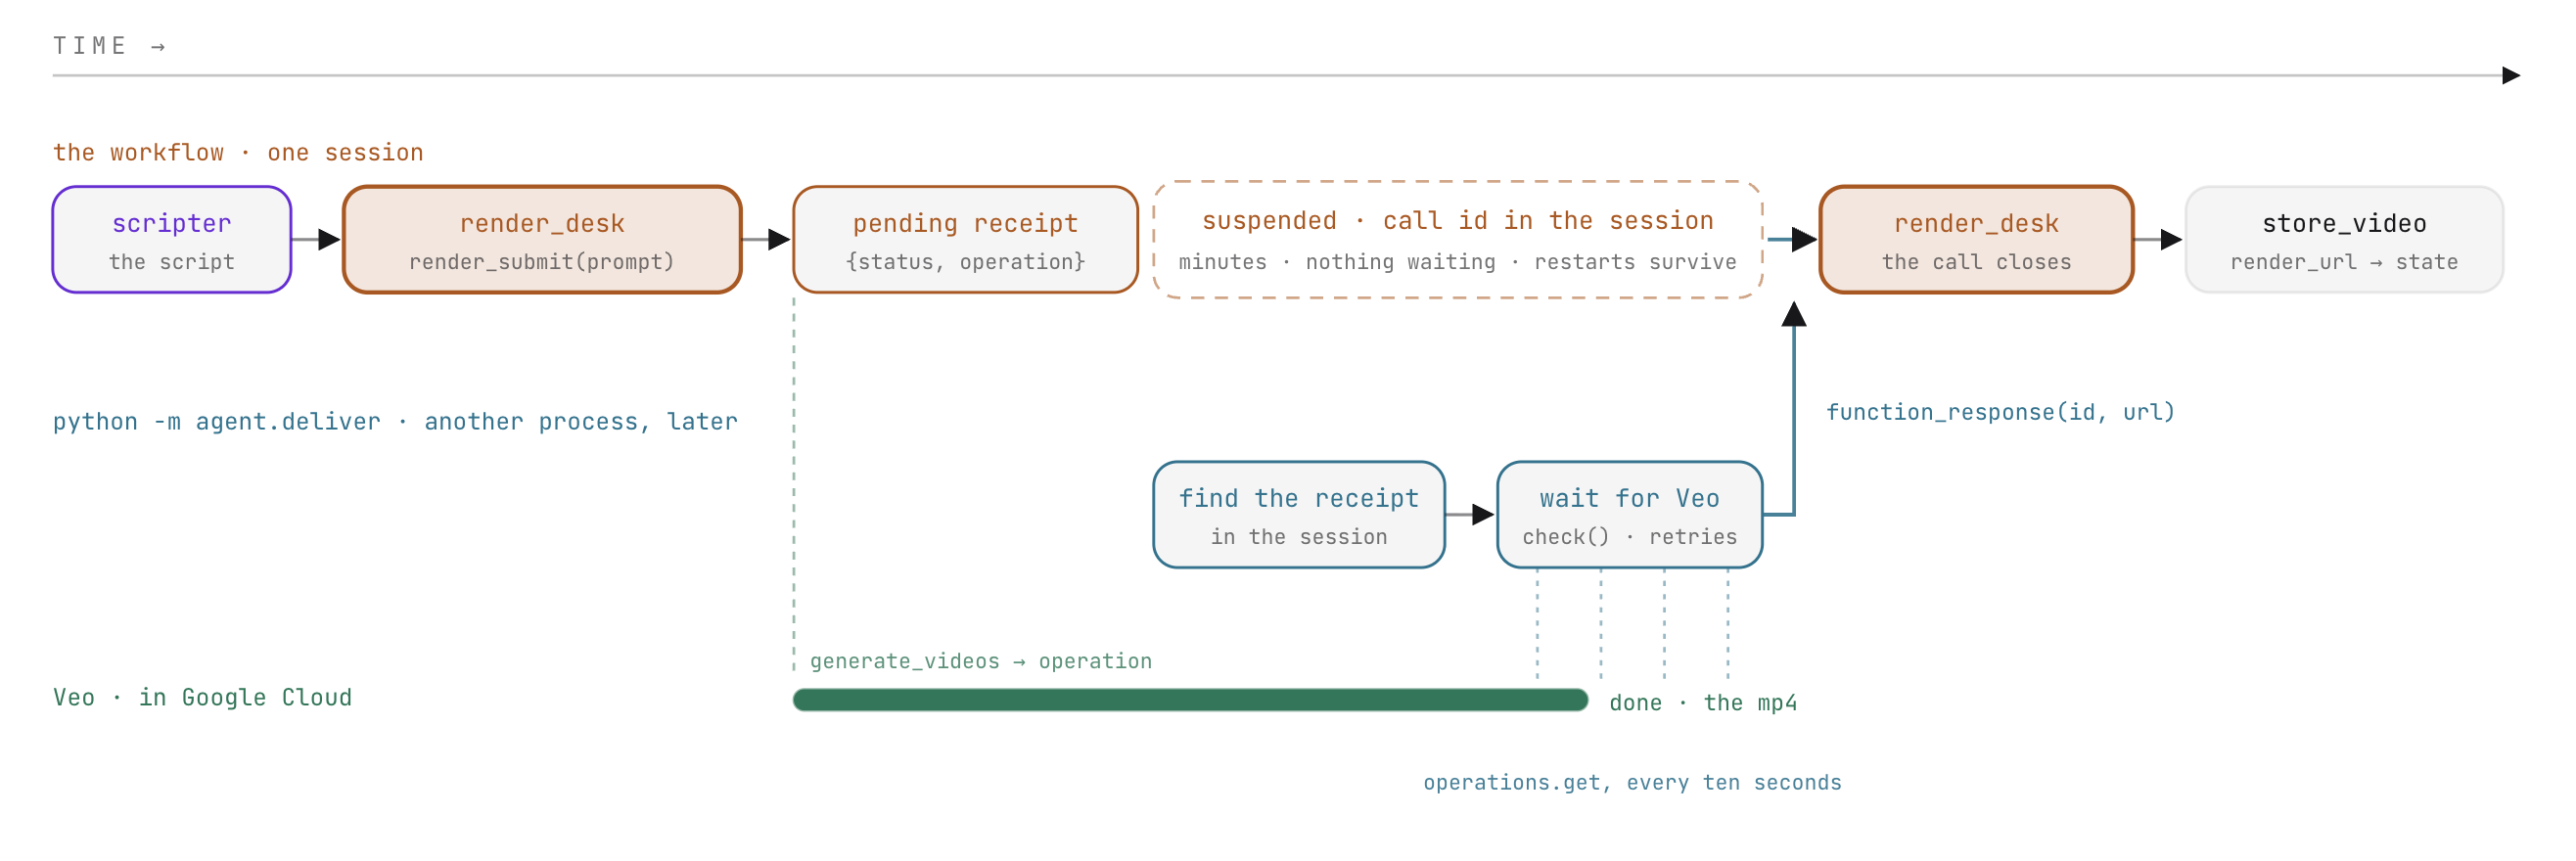
同步工具与长时间运行的工具
标准 ADK 函数工具在代理对话轮次中同步执行:模型调用工具,等待返回载荷,并将结果纳入正在进行的对话轮次中。
视频渲染无法在单轮对话中完成。而是会启动生成作业,并立即返回状态为 "pending" 的操作回执:render_submit
def render_submit(prompt: str) -> dict:
    """Submit one Veo render of `prompt`. Returns at once with a pending
    receipt; the clip is delivered later, to this call, by id."""
    receipt = videogen.start(f"{prompt} {videogen.NO_TEXT}")
    return {"status": "pending", "operation": receipt["operation"], "prompt": receipt["prompt"]}
使用 LongRunningFunctionTool 封装后,ADK 会拦截 "pending" 状态。智能体的轮次结束,工作流在节点处暂停,待处理的调用元数据(包括调用 ID 和收据)记录在 runs/sessions.db 中。执行过程干净利落地退出,不会保持有效的网络连接或工作器线程。
动手编辑:封装渲染工具
在 stage6_video/agent.py 中,更新 render_desk 以在 LongRunningFunctionTool 中封装 render_submit:
tools=[LongRunningFunctionTool(render_submit)])
按通话 ID 恢复
通用恢复模式
ADK 采用相同的机制来暂停和恢复人类和外部工具的工作流:
中止触发器 | 启动 Construct | 存储的暂停状态 | 恢复事件 |
人工判定 |
| 在会话存储区中打开输入提示 |
|
长时间运行的工具 |
| 在会话存储区中打开工具调用 |
|
在这两种情况下,工作流都会完全停止,并且只有在从外部来源(界面、Webhook 或后台工作器)收到带有匹配 FunctionResponse 的事件时才会恢复。
实操编辑:完成交付响应
在 agent/deliver.py 中,构建恢复 FunctionResponse 部分:
    part = Part(function_response=FunctionResponse(
        id=row["call_id"], name=row["name"], response=response))
交付守护程序会轮询 Veo,直到视频文件生成,然后将此 FunctionResponse 分派到会话。ADK 会匹配调用 ID,并直接在下一个节点恢复工作流。已完成的节点不会重新执行,并且代理不会再进行生成式对话。
在 .env 中设置 STUDIO_REAL_VIDEO=0 可启用模拟渲染:start 会立即返回测试收据,check 会在 5 秒内模拟完成,而不会进行可计费的 Veo API 调用。
流水线集成 (8B)
在工作台中,前往图表中的 render_desk (8B)。打开 stage6_video/agent.py。
流水线中的终端节点为 store_video。它会从 runs/state.json(投放流程记录了该信息)中读取已完成的渲染信息,并将视频网址和生成状态提交到共享会话状态。
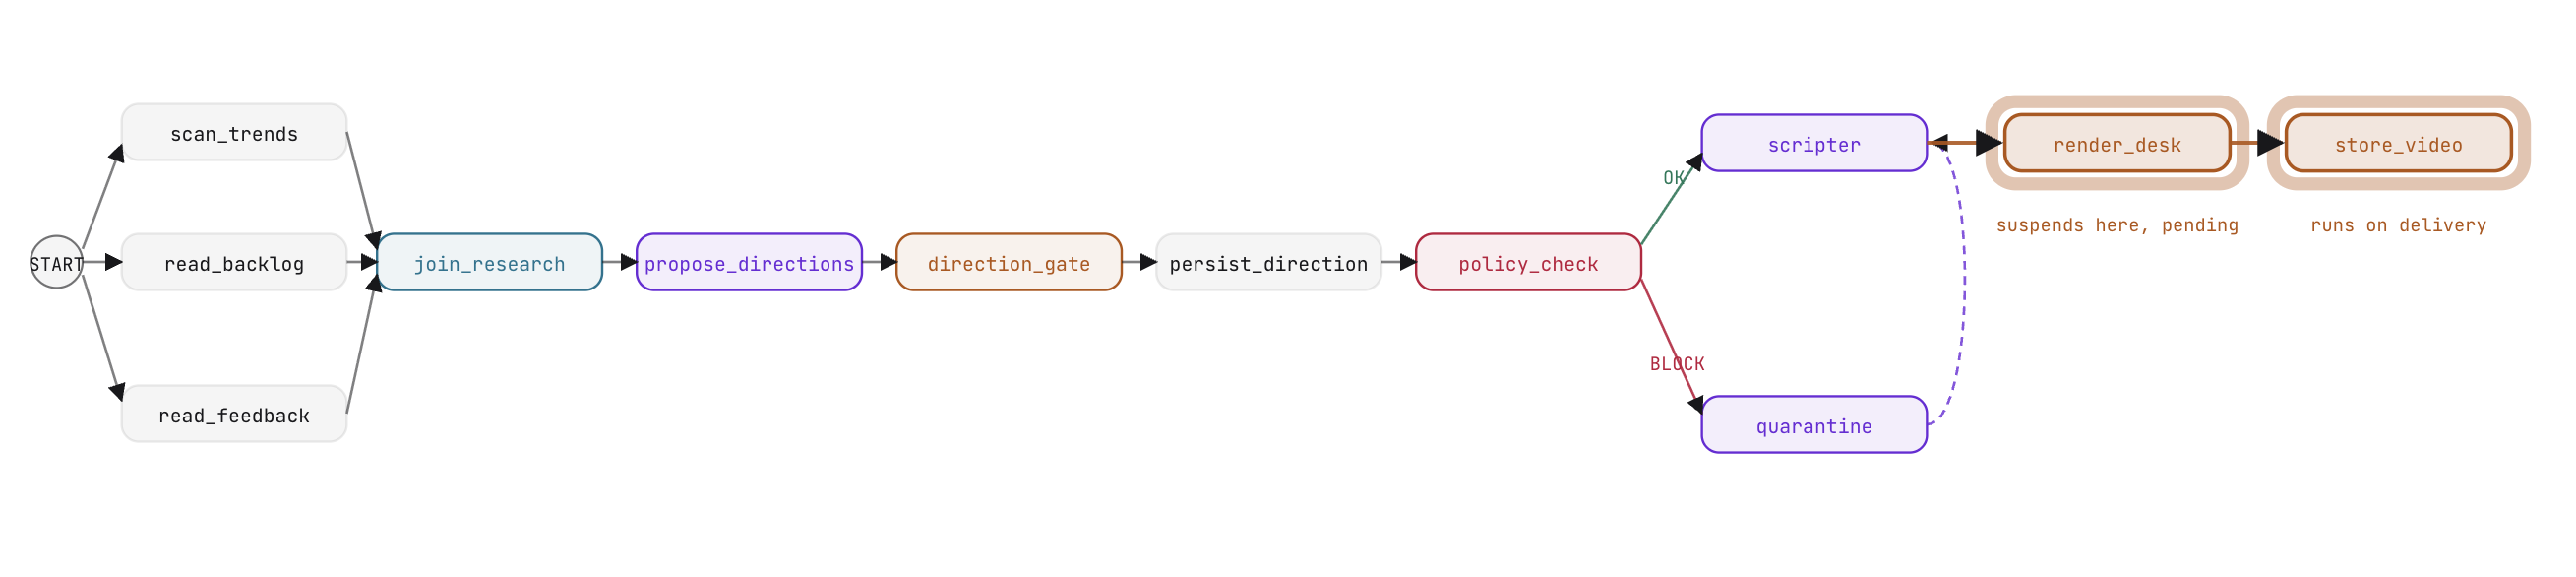
动手编辑:连接完整的视频流水线
在 stage6_video/agent.py 中,更新 edges 以附加 render_desk 和 store_video:
           (quarantine, scripter),
           (scripter, render_desk, store_video)])
可能影响及原因
在工作台中测试异步生成流程:
- 通过候选对象选择和脚本生成来执行工作流程。
- 在
render_desk处,观察智能体调用render_submit。 - 工作流会立即暂停。在工作台或 ADK Web 中,观察待处理状态:会话持有打开的调用 ID,并且没有后台进程消耗资源。
- 使用工作台控制台或在终端中运行传送守护程序:
python -m agent.deliver - 在 ADK Web 中,刷新会话:执行在
store_video处恢复,将视频网址提交到会话状态,并完成工作流。
9. 部署到 Cloud Run
在 VibeStudio Workbench 中,前往第 9 步:部署。
您已在专用沙盒中开发并验证了流水线的每个组件。在此步骤中,您将组装完整的生产流水线并将其部署到 Google Cloud Run。
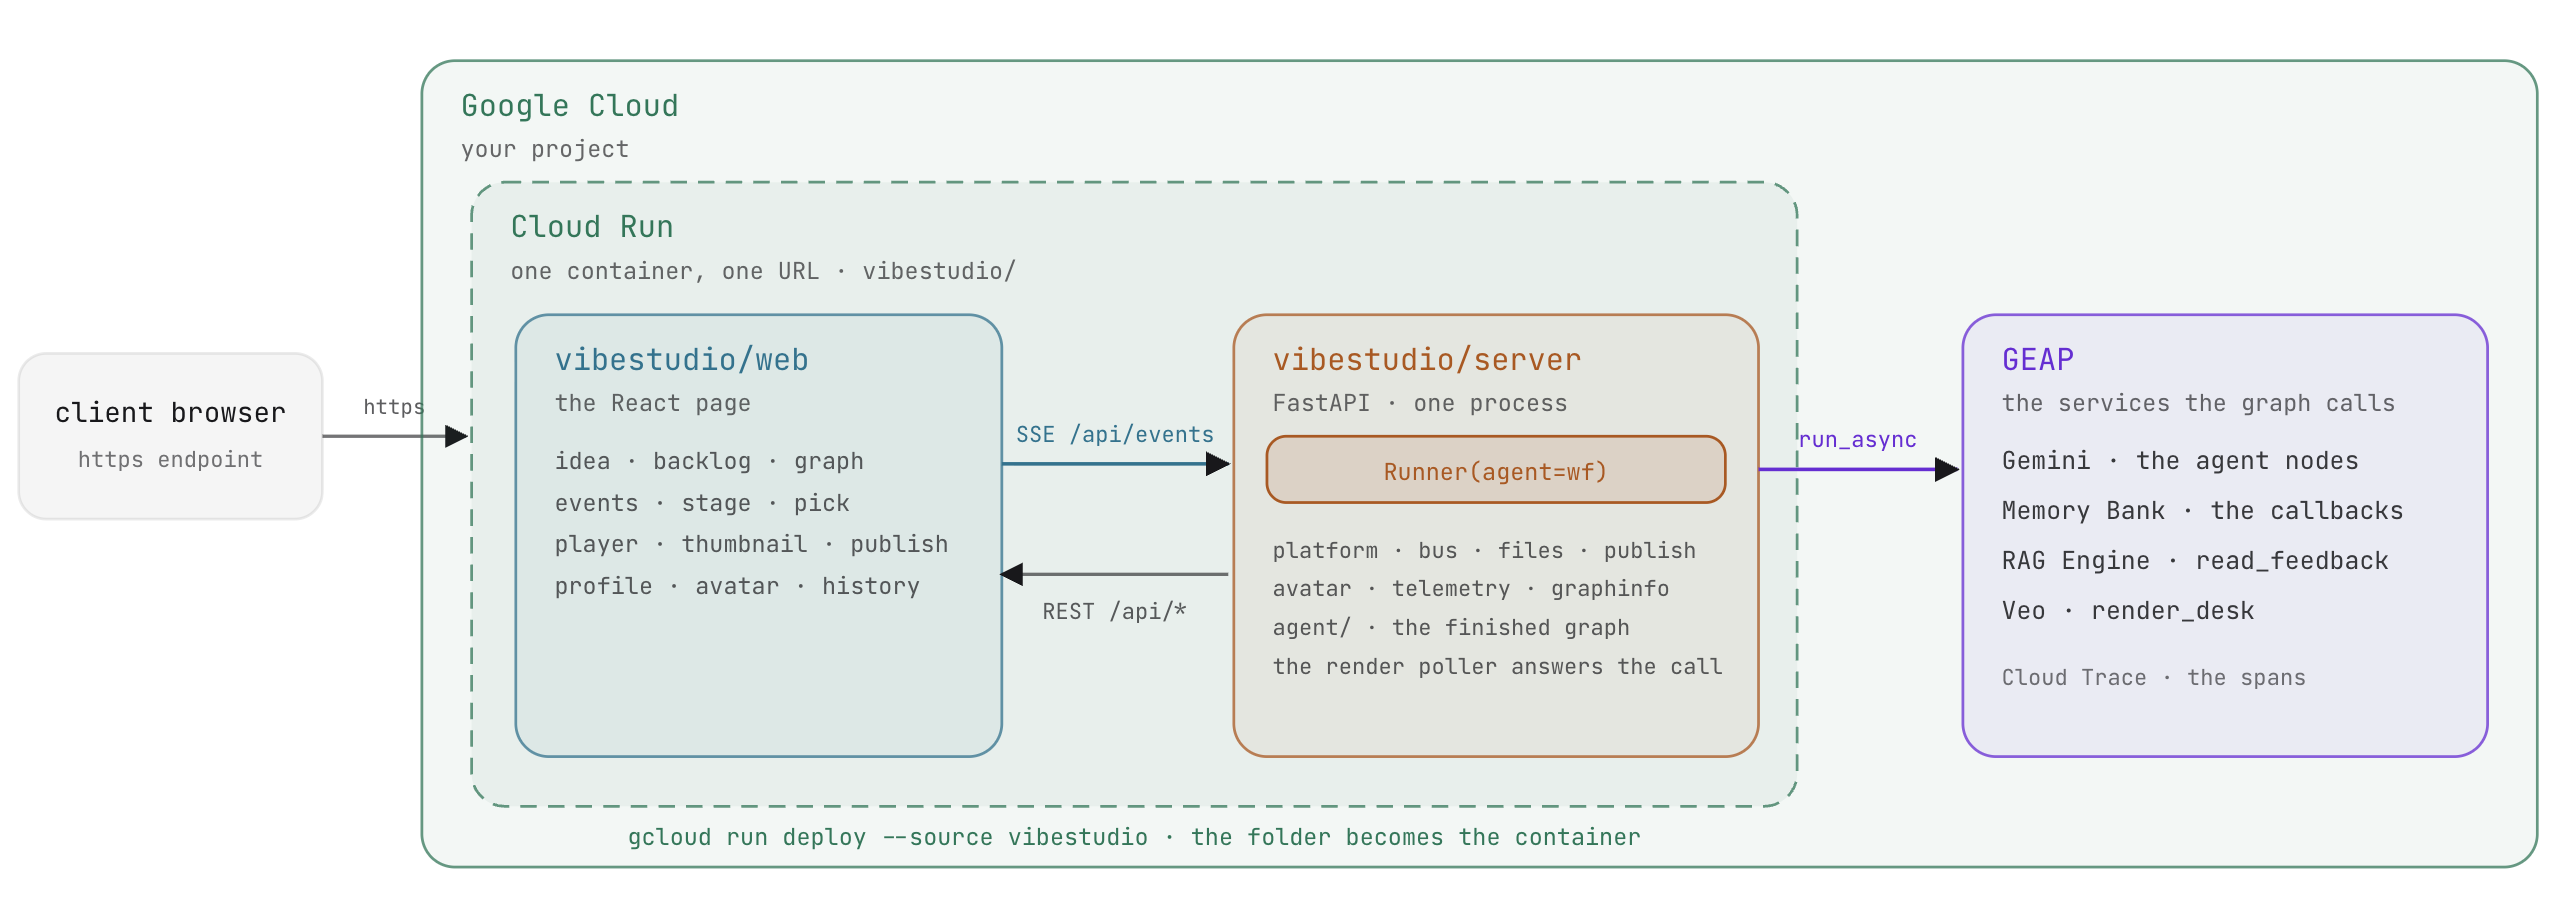
ADK Runner
在开发过程中,adk web 编排了图。在生产环境中,应用使用 ADK 的 Runner 类托管工作流:
self._svc = DatabaseSessionService(db_url=config.DB_URL)
self._runner = Runner(app_name=config.APP, agent=wf, session_service=self._svc)

async for ev in self._runner.run_async(user_id=config.USER, session_id=run_id, new_message=message):
    self._absorb(ev)    # fold the ADK event into the run state, publish one app event

# the gate's answer and the render's delivery are the same call, with a function_response part
part = Part(function_response=FunctionResponse(id=call_id, name=name, response=response))
run_async:驱动工作流执行,在节点执行时按顺序生成事件,并将更新持久保存到会话服务。- 统一恢复:
direction_gate处的用户决策和 Veo 完成的视频交付都会通过提交到run_async的相同FunctionResponse对象恢复执行。
生产应用架构
vibestudio/ 中的生产应用集成了完整的流水线:
vibestudio/
  server/
    main.py                 FastAPI: application server, REST routes, static assets
    api.py                  REST API endpoints: run, pick, publish, backlog, profile, history
    runner.py               Runner orchestration over the workflow, background render poller
    platform/               Event bus (SSE stream), file storage, publishing, telemetry
    agent/                  Production agent package, verified by checks/verify_app.py
      graph.py              The complete workflow graph and node definitions
      desk.py               render_desk and render_submit wrapped with LongRunningFunctionTool
      schemas.py            Pydantic schemas: Directions, CleanedDirection, Script
      cleanup_tools.py      Deterministic policy tools: find_policy_hits, suggest_replacement
      platform/             Memory Bank, RAG Engine, and Veo integrations
  web/                      Production React user interface
  Dockerfile · deploy.py · run.sh
- 单事件流:FastAPI 后端通过单个服务器发送事件 (SSE) 流发布事件。React 前端会实时直观呈现图表进展,并处理延迟连接,而不会丢失状态。
- 解耦执行:应用管理事件循环。工作流图完全专注于执行逻辑,不感知前端界面。
agent/graph.py 中的完整工作流边缘列表结合了在此 Codelab 中构建的每种架构模式:
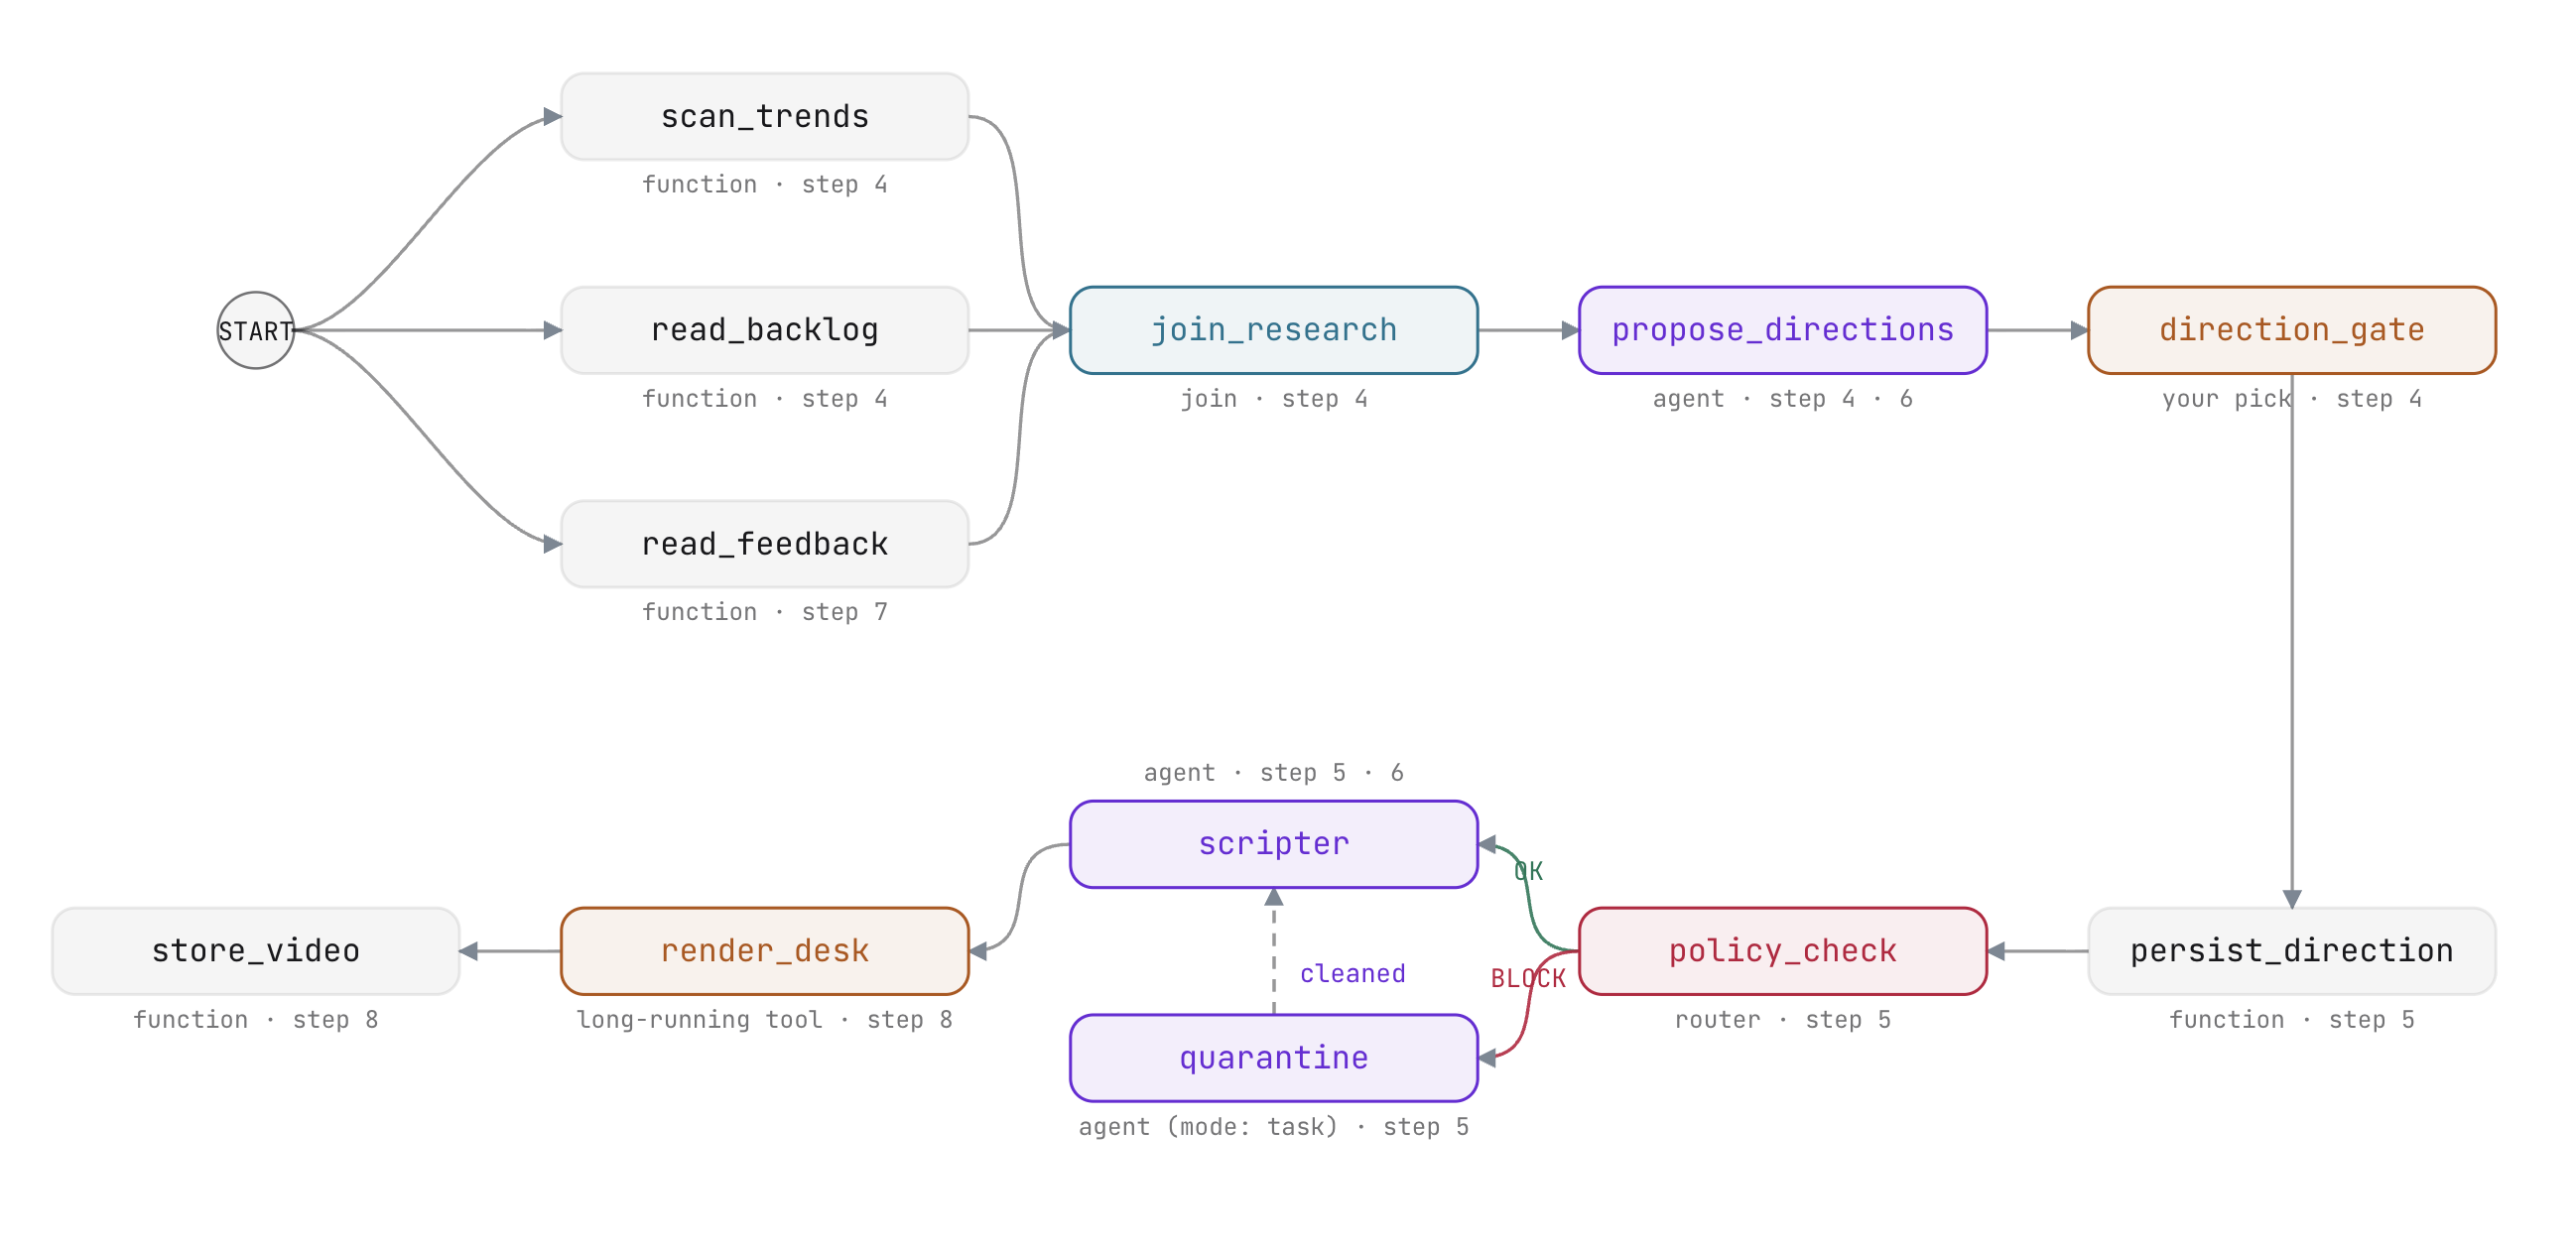
        (START, scan_trends, join_research),
        (START, read_backlog, join_research),
        (START, read_feedback, join_research),
        (join_research, propose_directions, direction_gate,
         persist_direction, policy_check),
        (policy_check, {"OK": scripter, "BLOCK": quarantine}),
        (quarantine, scripter),
        (scripter, render_desk, store_video),
部署到 Cloud Run
Google Cloud Run 提供无服务器托管服务,具有自动扩缩、请求路由和集成式容器构建功能:
gcloud run deploy vibestudio --source vibestudio \
  --project $GOOGLE_CLOUD_PROJECT --region us-central1 \
  --labels dev-tutorial-codelab=vibetube --allow-unauthenticated \
  --memory 2Gi --cpu 2 --timeout 3600 --concurrency 40 \
  --max-instances 1 --min-instances 1 --session-affinity \
  --set-env-vars GOOGLE_CLOUD_PROJECT=...,STUDIO_VERTEX=1,STUDIO_MEMORY_BANK=...,STUDIO_RAG_CORPUS=...,VIBETUBE_URL=...,VIBETUBE_EVENT=...,VIBETUBE_NAME=...,VIBETUBE_PROJECT=...
- 容器构建:
gcloud run deploy --source将vibestudio/目录打包,使用 Cloud Build 构建容器映像,并通过一次操作部署服务。 - 会话亲和性:将来自同一用户的请求定向到同一容器实例,从而在迭代步骤中保留本地会话状态。
- 可观测性:Cloud Trace 集成会记录每个节点、LLM 调用和工具执行的分布式 span,这些 span 可在 Google Cloud 控制台的 Trace Explorer 下访问。
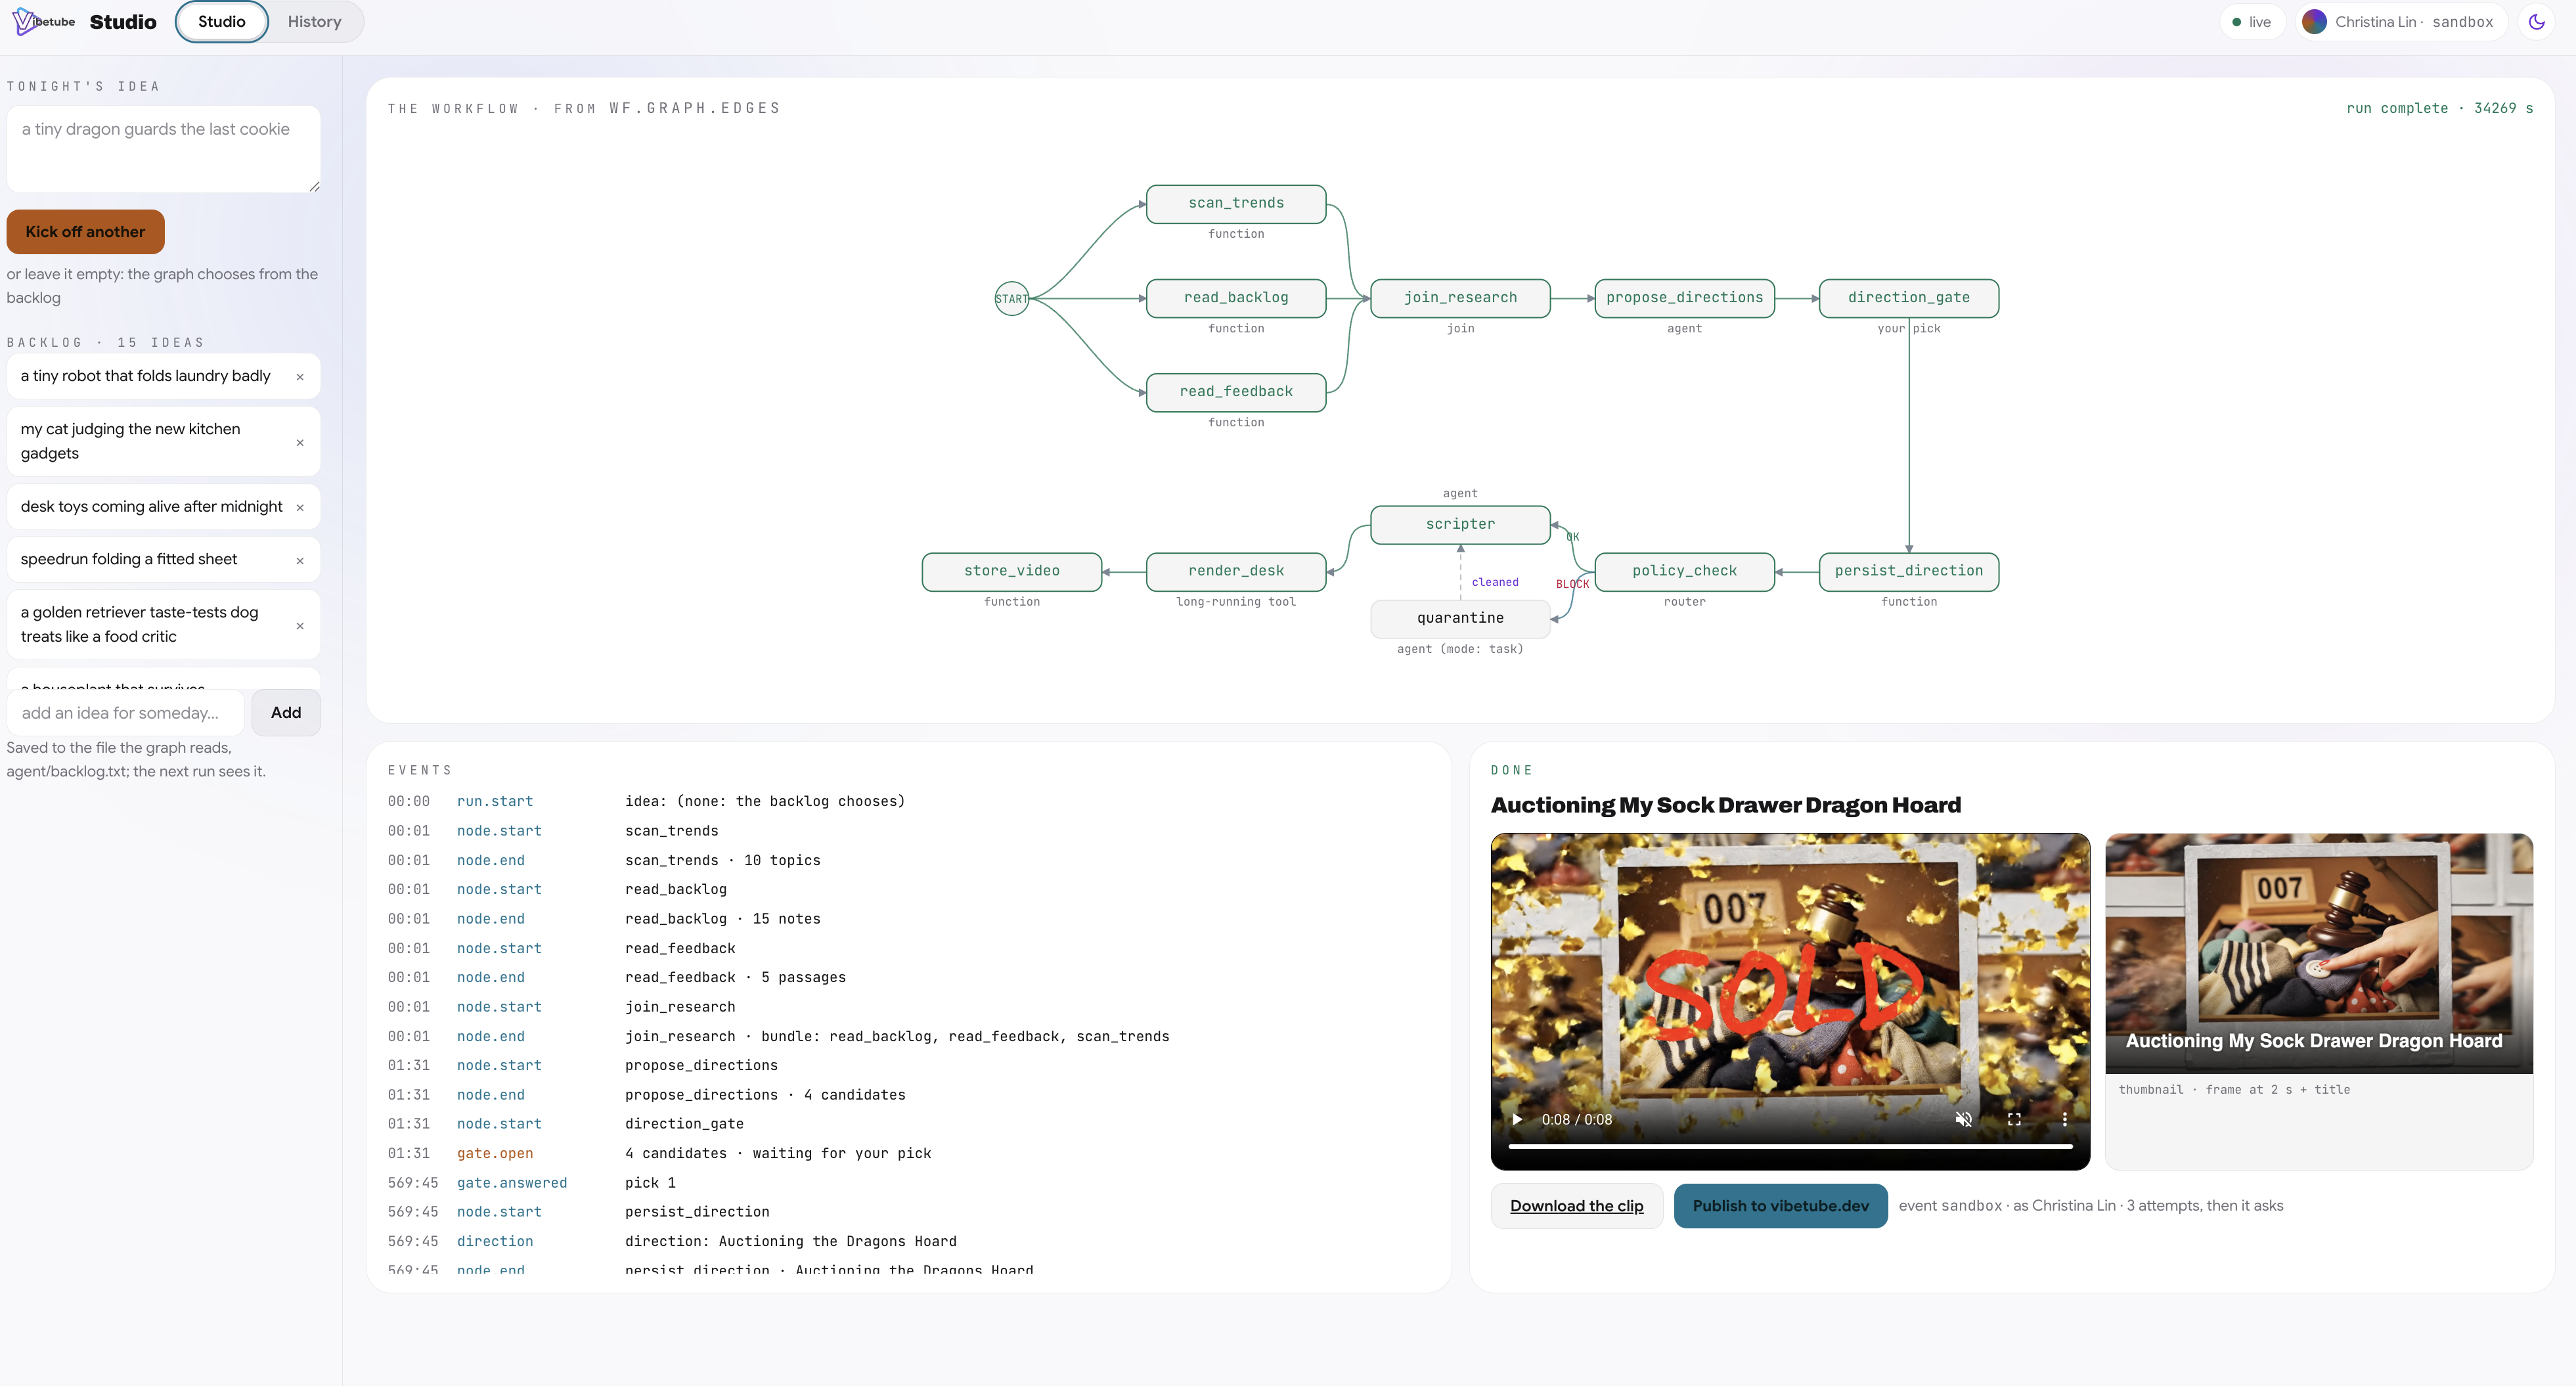
点击工作台中的部署按钮以执行部署脚本。构建完成后,终端会显示实时服务网址。
10. 总结
在 VibeStudio Workbench 中,前往第 10 步:摘要,查看已完成的架构。
步骤 | 架构和概念 | 实现模式 |
单个提示 | 单提示、函数工具、顺序聊天循环 |
|
Agentic Workflows 基础知识 | 图工作流、并行研究、架构输出、人工门控 |
|
State 和 Router | 共享会话状态、参数绑定、确定性路由、任务代理 |
|
记忆库 | 用户级长期记忆、语义整合、生命周期钩子 |
|
RAG 引擎 | 通过受众群体评论和语义嵌入进行文档检索 |
|
使用 Veo 异步生成视频 | 长时间运行的工具、待处理的收据、外部递送守护程序 |
|
部署到 Cloud Run | 程序化编排、服务器发送的事件、无服务器容器 |
|
核心架构原则
- 挂起而非等待:工作流会干净利落地暂停,以等待人工输入 (
RequestInput) 或长时间运行的操作 (LongRunningFunctionTool)。进程不会在线程或网络套接字上空闲等待。 - 通用恢复:每次暂停都通过相同的机制恢复:一个携带暂停节点调用 ID 的
function_response。 - 解耦状态管理:节点通过命名的会话状态键和参数绑定共享数据,而不是通过冗长、紧密耦合的中间载荷。
- 在生成模型成本之前进行确定性路由:基于规则的路由器和正则表达式过滤器会在生成模型运行之前以零 token 成本评估政策。
- 关注点分离:特定于单个智能体的上下文属于生命周期回调,而共享数据依赖性属于