1. 簡介
本程式碼實驗室會引導您使用 Agent Development Kit (ADK) 中的工作流程和圖表,建構新一代代理系統。您將實作常見的架構模式、自動調度管理人工介入迴路 (HITL) 互動,以及處理長時間執行的非同步作業。您也會整合企業知識庫和永久記憶體,自訂及改良代理行為。最後,您會連結這些功能,以推動自動影片生成管道。
應用情境
你在 VibeTube 經營數位頻道,觀眾互動熱烈,創意構想也越來越多。製作每部影片都需要在多個階段持續執行作業,包括研究熱門格式、彙整觀眾意見回饋、編寫腳本、檢查是否符合政策,以及生成短片。生成式模型可以草擬個別資產,但要提供一致的版本,則需要經過協調的代理架構。
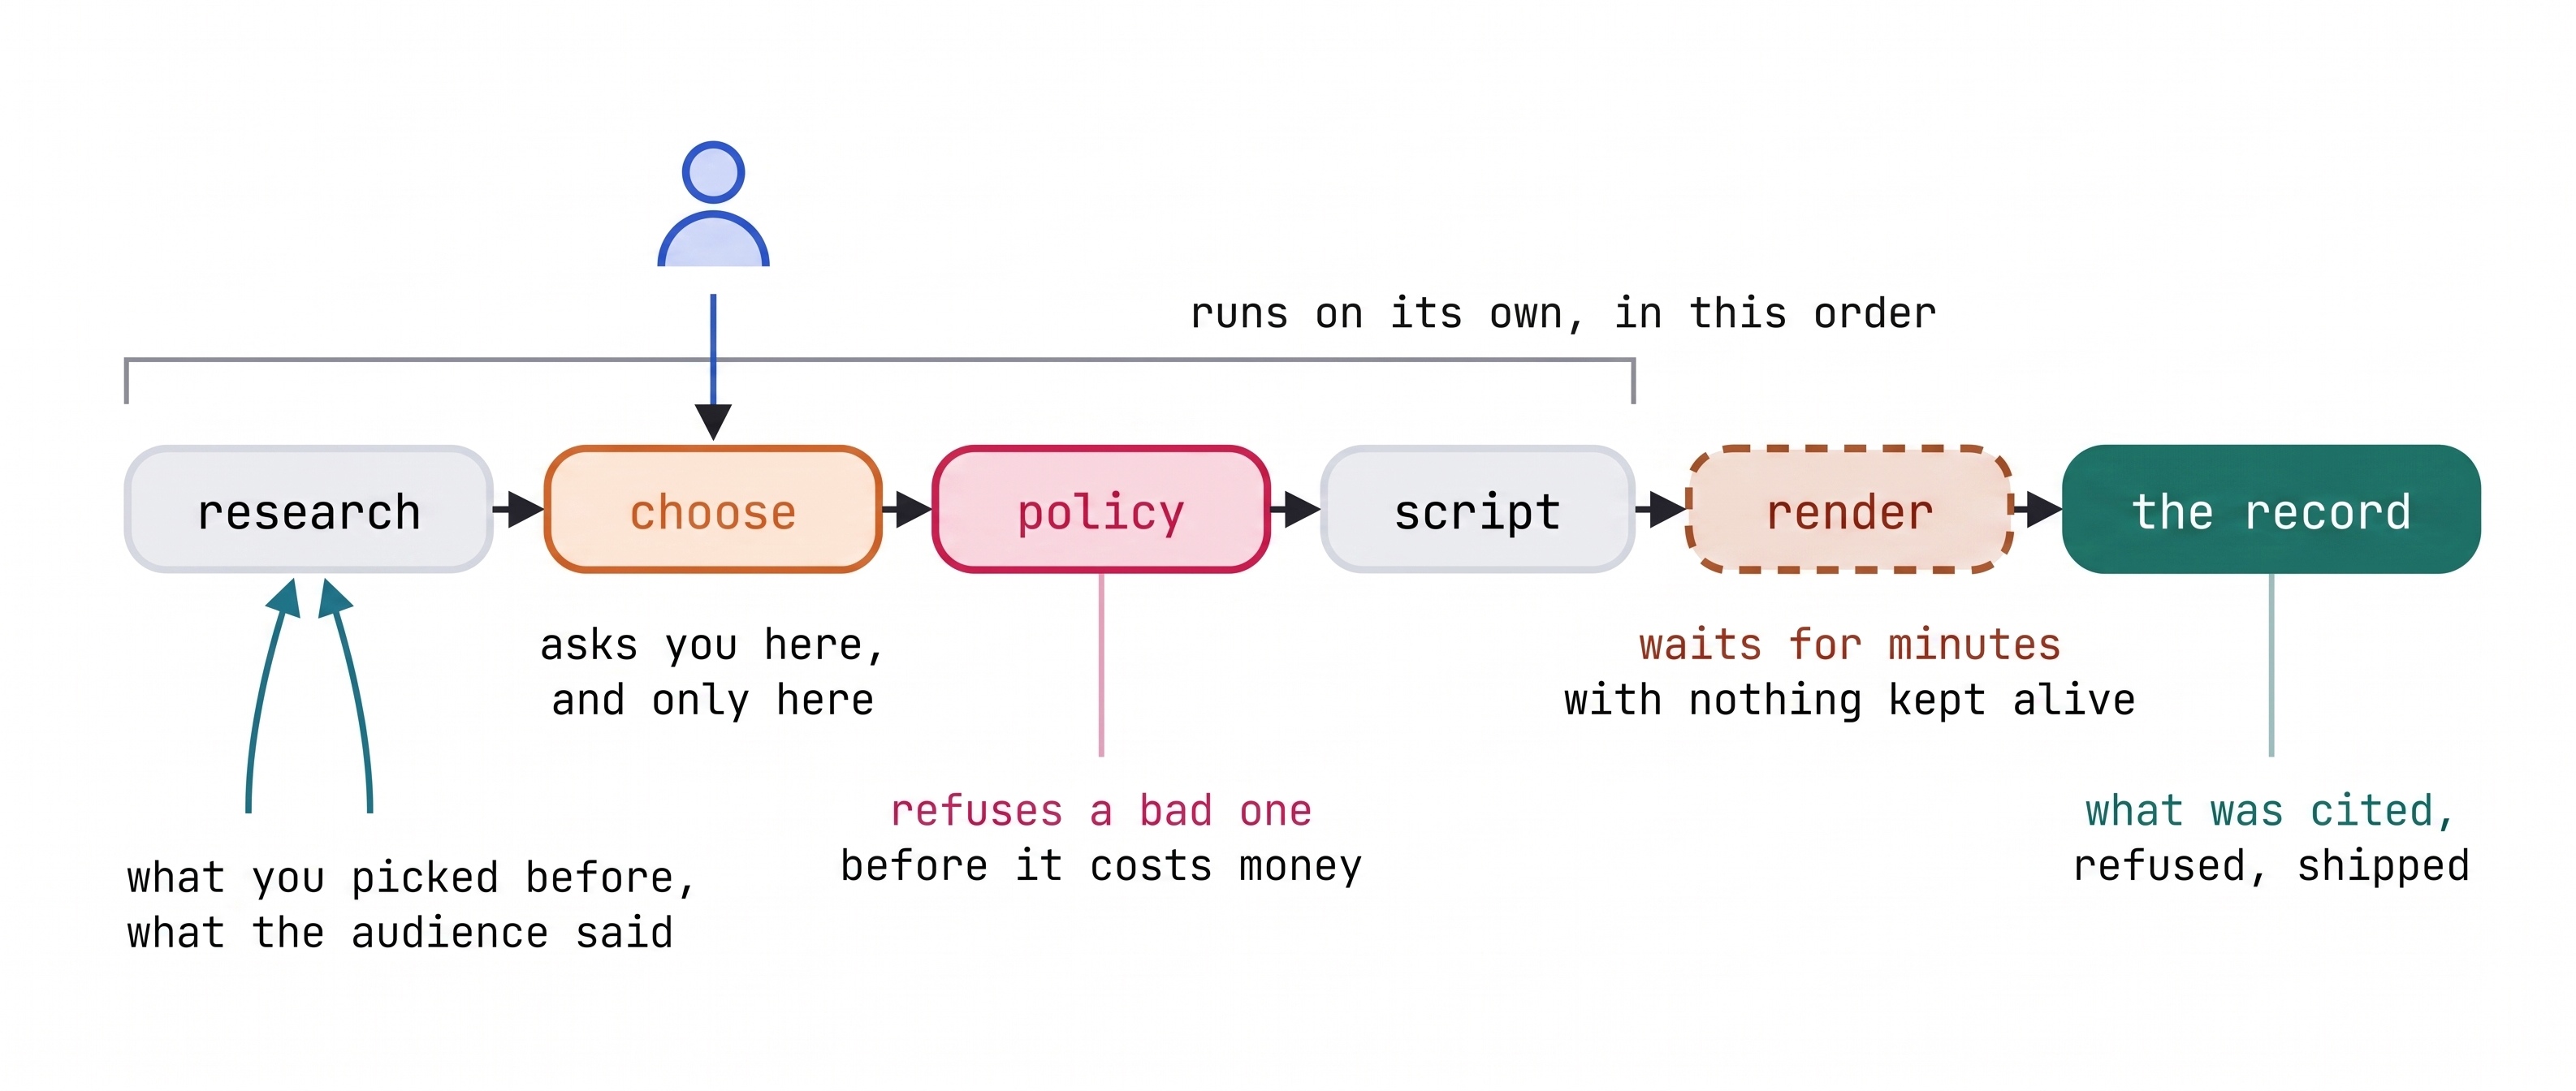
為了自動化這個生命週期,您將建構 VibeStudio。這個代理管道會平行執行例行研究、提供精選選項供人工介入迴路簽核、在生成影片前套用自動化政策閘道,並在各個製作階段保留背景資訊。
課程內容
- 圖譜工程基礎:多步驟代理架構需要明確的控制流程和結構化執行路徑。您可以使用邊緣元組、
START進入點、JoinNode(用於平行擴散傳遞匯總),以及確定性路由器節點 (用於根據狀態引導執行),建構 ADKWorkflow。 - 代理程式模式和生命週期回呼:專門任務需要不同的運作行為和確定性防護措施。您可以使用
chat、single_turn和啟用工具的task模式,將 ADKAgent執行個體設為工作流程節點,並使用before_model_callback和after_agent_callback套用攔截器。 - 人機迴圈自動化調度管理:在關鍵的創意檢查點,製作管道會暫停,等待人工判斷。您實作
RequestInput來暫停工作流程執行、強制執行回覆結構定義,以及繼續執行,而不保留閒置的執行階段程序。 - 階層式代理記憶體:正式環境系統會將暫時執行狀態與永久情境分開。您可以使用
Event(state=...)和參數繫結管理短期工作階段狀態,並連結 GEAP 記憶體庫,以便在執行期間擷取、整合及保留創作者偏好設定。 - 以企業知識庫建立基準:自主代理需要動態領域背景資訊和目標對象情緒。您將 GEAP RAG Engine 語料庫連結為平行擴散傳遞中的專屬檢索節點,為代理輸出內容提供語意基準。
- 長時間執行的工作流程和部署作業:多模態影片算繪作業會以非同步方式長時間執行。您將使用待處理呼叫收據實作
LongRunningFunctionTool,依呼叫 ID 暫停及恢復工作流程,並在 Cloud Run 使用 ADKRunner部署完成的管道。
本程式碼實驗室的架構
本程式碼實驗室提供概念和架構參考。每個部分都會說明在對應工作台步驟中實作的 ADK 建構,提供參考程式碼,並建立核心設計原則。請先詳閱各節內容,再完成工作台中的相應練習。
實際操作會在 VibeStudio Workbench 進行,這個網頁介面提供互動式程式碼編輯器、執行階段驗證工具和內嵌 ADK 檢查工具。工作台中的步驟編號與本程式碼實驗室直接對應,方便您同步進度。基礎圖表編輯內容會保留在各個步驟中,工作台會隨著您的進度自動驗證必要條件。
完成工作台練習後,您將組裝端對端代理管道,並將執行中的 VibeStudio 應用程式部署至 Cloud Run,以生成影片內容。
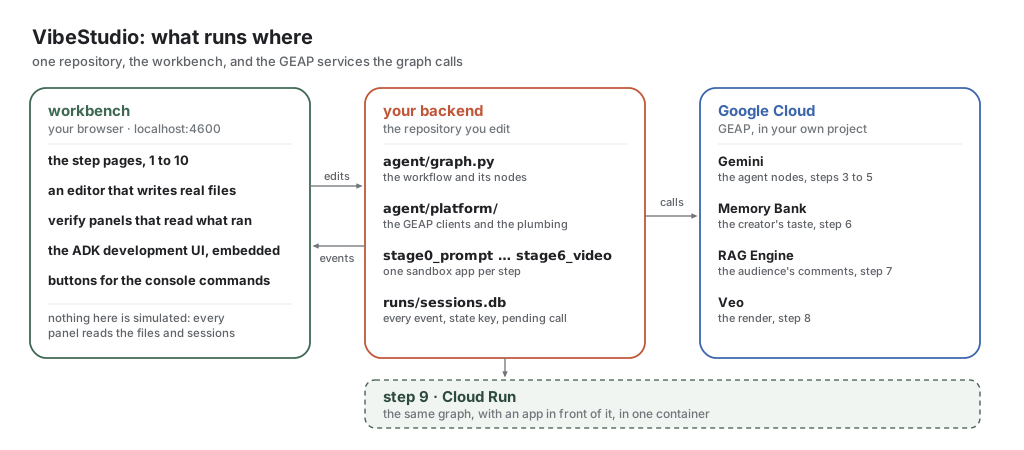
這個環境包含三個主要元件:VibeStudio Workbench (用於程式碼編輯和執行階段驗證的本機網頁介面)、後端 (ADK Workflow 和 agent/ 中的階段沙箱),以及 Google Cloud (Gemini 模型、GEAP Memory Bank、RAG Engine 和 Veo 影片生成)。
2. 設定
領取研討會抵免額
如果您參加的是講師指導實驗室,講師會為您的 Google Cloud 專案發放抵免額。請按照講師的指示兌換抵免額,並確認帳戶已啟用計費功能,再繼續操作。
開啟 Cloud Shell
Cloud Shell 是以瀏覽器為基礎的開發環境,已預先安裝 gcloud、Python 和 git。
啟動 Cloud Shell:
瀏覽器視窗底部會開啟終端機工作階段。
複製並初始化存放區
在 Cloud Shell 終端機執行下列指令,複製專案:
git clone https://github.com/gca-americas/vibetube-studio
cd ~/vibetube-studio
設定提示
設定過程中,系統會提示您提供下列詳細資料:
- Google Cloud 雲端專案 ID:當
setup_project.sh提示時,請按 Enter 鍵,自動建立新專案。如要使用現有專案 (例如預先指派的專案),請輸入專案 ID,並確認拼寫正確且已啟用計費功能。 - 活動代碼:輸入講師提供的會議室代碼。如果沒有收到,請洽詢助教或鄰座同學。如果您是在家完成本實驗室,請按下 Enter 鍵接受預設的
sandbox聊天室。 - 頻道顯示名稱:在
setup_codelab.sh提示時輸入名稱或偏好的頻道代碼,或按 Enter 鍵接受系統根據 Google 帳戶產生的預設名稱。
依序執行兩個設定指令碼:
./setup_project.sh
./setup_codelab.sh
setup_project.sh:建立或重複使用已啟用計費功能的 Google Cloud 雲端專案、將專案 ID 儲存至~/project_id.txt,以及設定有效的gcloud情境。setup_codelab.sh:將uv和 Python 依附元件安裝至.venv、啟用必要的 Google Cloud API、在.env中設定管道、使用 Gemini 驗證模型存取權、佈建 Memory Bank 和 RAG 資源、建構工作台介面,以及啟動 VibeStudio Workbench。
指令碼會執行預檢,並在背景啟動 VibeStudio Workbench。最後幾行會顯示開啟連結。
7 · Preflight
  ✓ python 3.12
  ✓ auth path A: Vertex via ADC (STUDIO_VERTEX=1)
  ✓ Google Cloud ADC (project <your-project>)
  ✓ stage0_prompt loads
  ...
  ✓ stage6_video loads (13 edges)
  ✓ aiplatform.googleapis.com enabled (Gemini, Veo, Memory Bank, RAG Engine)
  ✓ vectorsearch.googleapis.com enabled (the vector store a RAG corpus is built on)
  ✓ Memory Bank connected
  ✓ RAG corpus connected
  ✓ VibeStudio Workbench running on port 4600

PREFLIGHT GREEN

Setup finished. The VibeStudio Workbench is already running.

  Open this and start at step 1
      https://4600-<your cloud shell host>/step/story

  It runs in the background. You do not need to start anything else.
      log      runs/lab.log
      stop     kill $(cat runs/lab.pid)
      start    scripts/start.sh
點選該連結。您也可以依序點選「網頁預覽」→「變更通訊埠」→「4600」,找到相同網址。
如要隨時重新檢查環境,請執行 python scripts/preflight.py。如要重新啟動工作台,請執行 scripts/restart.sh。如要重新設定,請執行 ./setup_codelab.sh,系統會保留設定和進度。
開啟後,請參閱步驟 1:情境,瞭解情境,並參閱步驟 2:建構內容,瞭解完成圖表的形狀。兩者都沒有練習題。然後返回這裡進行步驟 3。
VibeStudio Workbench 的每個實作部分,最後都會出現驗證面板,讀取實際成果:磁碟上的檔案,以及執行作業寫入的工作階段。
存放區版面配置
存放區分為核心工作流程邏輯、逐步沙箱、Workbench 環境和正式版應用程式:
vibe-studio-lab/
├── agent/                  # Core ADK workflow, graph definition, and platform services
│   ├── graph.py            # Workflow graph definition, node functions, and routers
│   ├── desk.py             # Video render desk using LongRunningFunctionTool
│   ├── schemas.py          # Pydantic schemas for directions, gates, and scripts
│   ├── trends.py           # Trend generation and sampling utilities
│   ├── backlog.txt         # Creator video ideas backlog
│   ├── comments.md         # Audience comments for RAG Engine corpus seeding
│   ├── policy_words.txt    # Blocked subject words for deterministic policy checks
│   └── platform/           # Google Cloud service clients (Memory Bank, RAG, Veo)
│       ├── config.py       # Environment variables, locations, and model configurations
│       ├── memory.py       # GEAP Memory Bank callbacks and context injection
│       ├── rag.py          # GEAP RAG Engine corpus creation and semantic retrieval
│       └── videogen.py     # Veo video generation and operation polling
├── stage0_prompt/          # Step sandboxes: isolated agent.py files runnable in adk web
│   └── ...                 # stage1_fanout through stage6_video for incremental steps
├── server/ & web/          # VibeStudio Workbench (FastAPI backend and React frontend)
├── vibestudio/             # Complete production application deployed to Cloud Run
│   ├── server/             # FastAPI production server and event runner
│   ├── web/                # End-user React web application
agent/:包含核心工作流程圖。您將編輯這個目錄中的檔案,實作平行擴散傳遞節點、確定性政策轉送、記憶體回呼和影片生成工具。agent/platform/:與 Google Cloud 服務互動,包括 Gemini 模型、GEAP 記憶庫、GEAP RAG 引擎和 Veo 影片合成。stage0_prompt/透過stage6_video/:獨立的沙箱環境。每個資料夾都會匯出獨立的root_agent,因此您可以透過內嵌的 ADK 開發介面,單獨執行及檢查每個步驟。server/和web/:在通訊埠 4600 本機執行的 VibeStudio Workbench 應用程式。其中包含步驟說明文件、網頁內程式碼編輯器、執行階段證據驗證工具和圖表視覺化。vibestudio/:在最後一個步驟中,將完整的正式版應用程式封裝並部署至 Cloud Run。其中包含已完成工作流程圖的獨立副本。
3. 單體式代理
建構多節點工作流程圖前,請先在 stage0_prompt/agent.py 中建立單一代理,做為架構基準。這個代理仰賴單一系統提示,以文字描述正式版管道,並由兩個 Python 函式工具支援。
評估這個基準,可瞭解提示驅動協調機制的運作界限,並說明為何正式環境系統需要圖表自動化調度管理。
ADK 代理架構 (3A)
在 VibeStudio Workbench 中,前往「步驟 3:單一代理」,然後開啟「ADK 代理架構 (3A)」。這個檢視畫面呈現 ADK 代理 (LlmAgent) 的核心架構層:
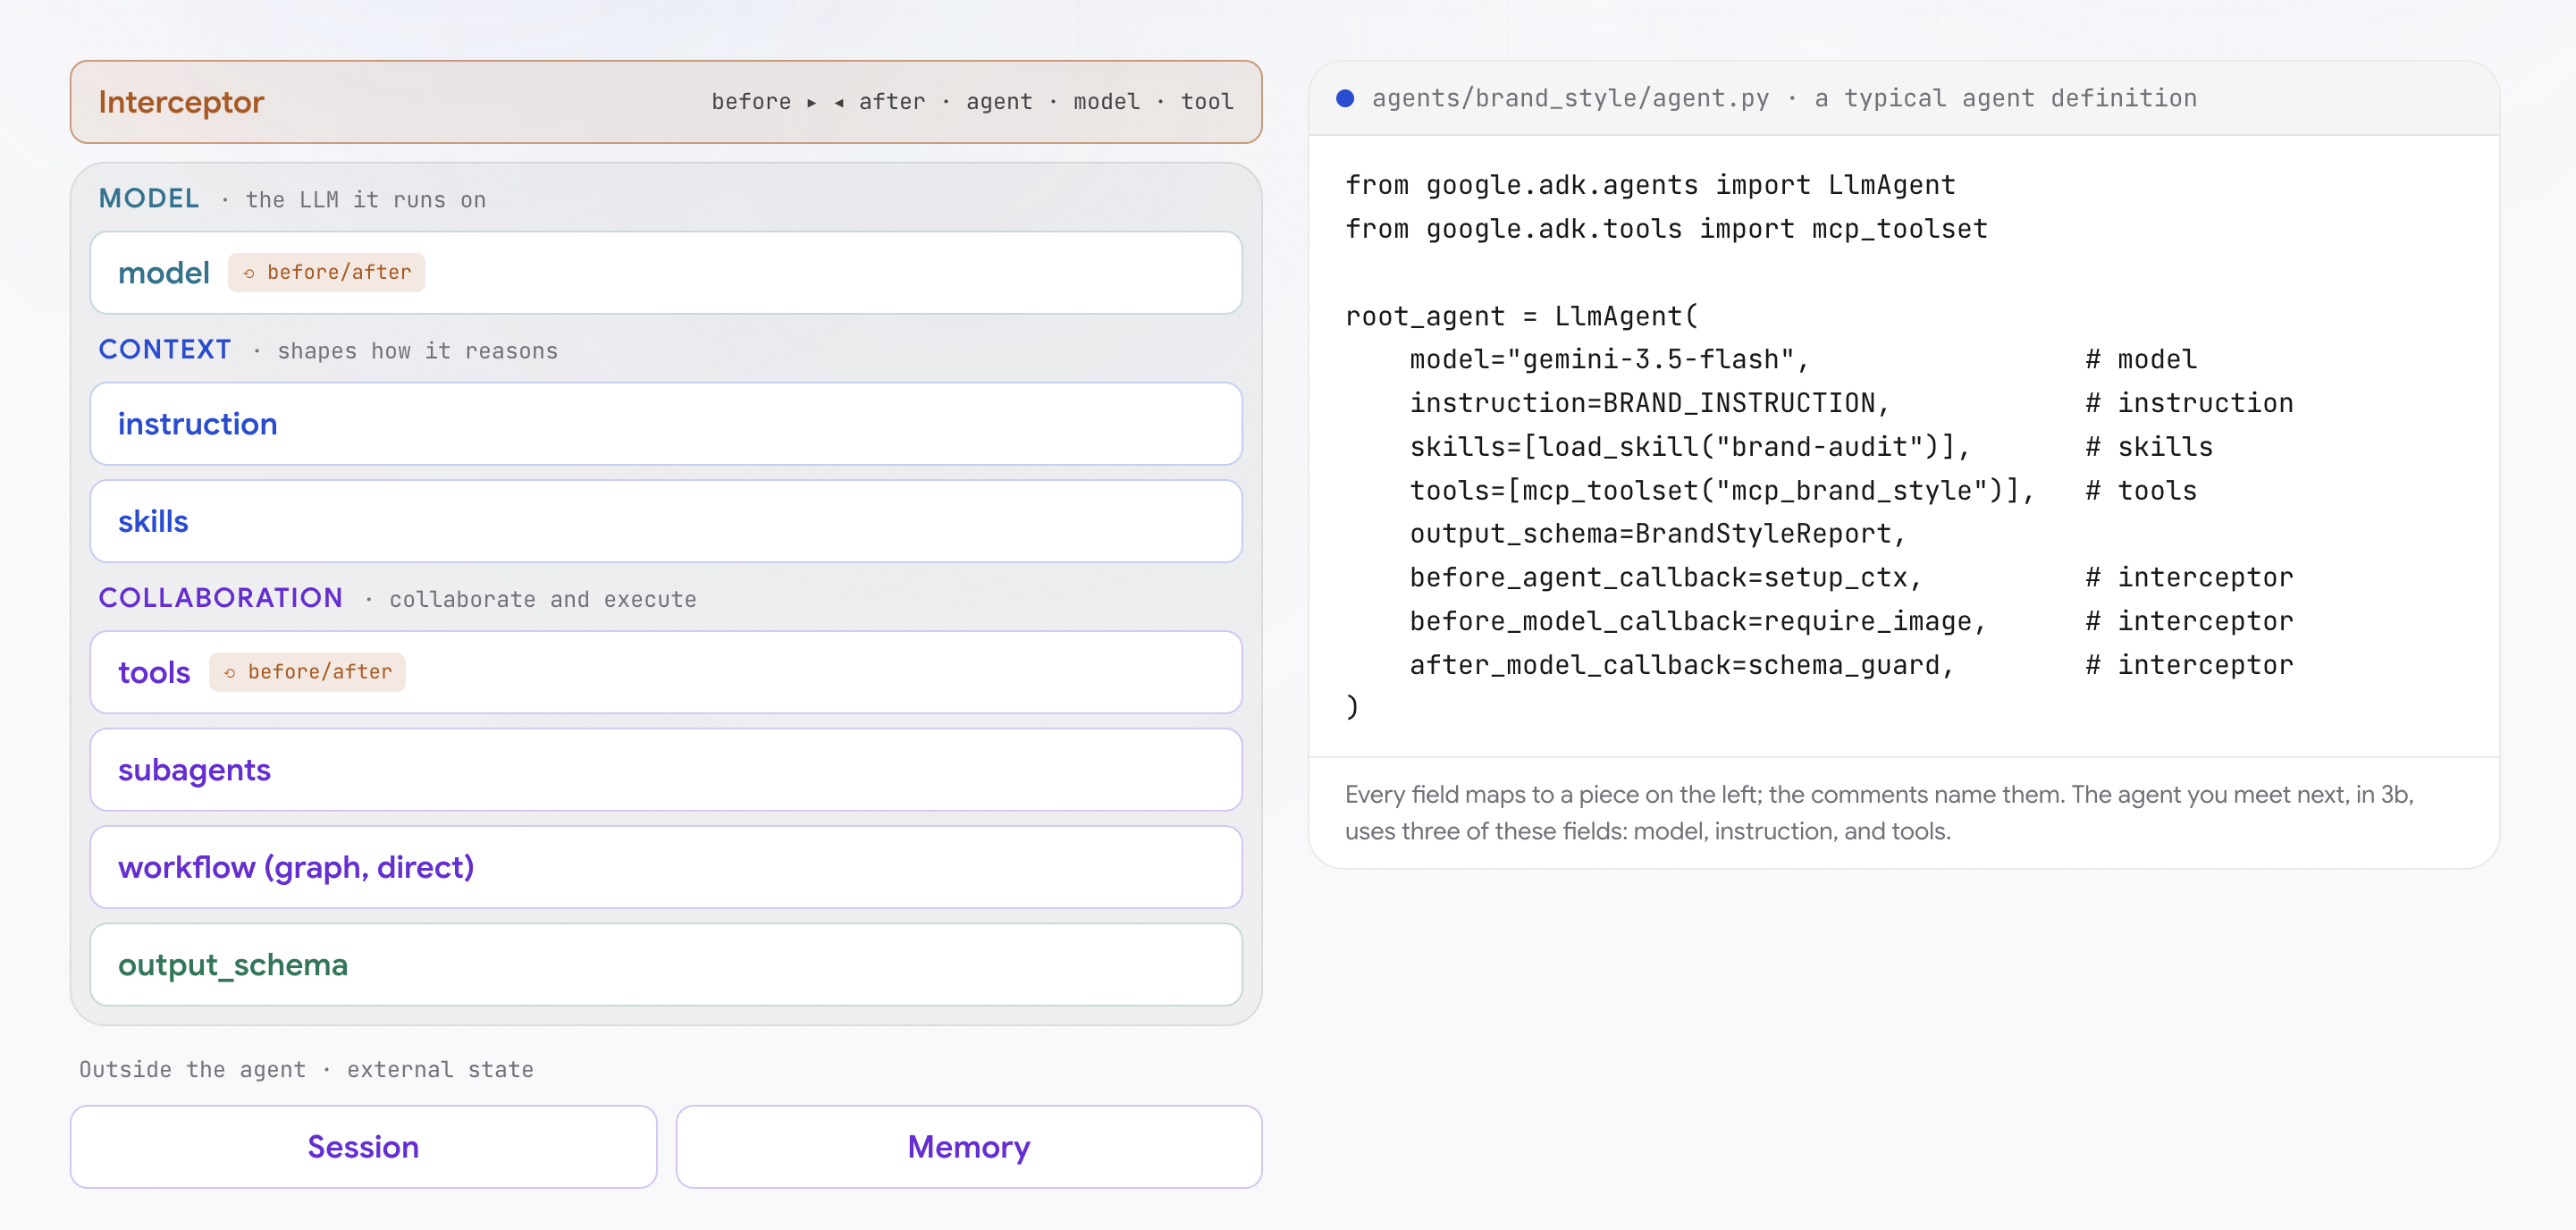
from google.adk.agents import LlmAgent
from google.adk.tools import mcp_toolset

root_agent = LlmAgent(
    model="gemini-3.5-flash",                 # model
    instruction=BRAND_INSTRUCTION,            # instruction
    skills=[load_skill("brand-audit")],       # skills
    tools=[mcp_toolset("mcp_brand_style")],   # tools
    output_schema=BrandStyleReport,           # structured output
    before_agent_callback=setup_ctx,          # interceptor
    before_model_callback=require_image,      # interceptor
    after_model_callback=schema_guard,        # interceptor
)
互動式圖表將代理元件分為五個作業領域:
- 推論層 (模型):核心語言模型 (例如 Gemini 3 Flash),負責執行認知型工作、提示詞推論和工具選取。架構中的其他所有項目都會提供資訊或限制這個模型。
- 脈絡層 (指令和技能):影響模型推理的指令。
instruction建立永久系統提示、角色和作業規則。skills提供可重複工作流程的版本化程序指引 (SKILL.md)。 - 協作與動作層 (工具、子代理、工作流程、輸出結構定義):讓代理能對外部系統執行動作,並輸出類型化資料的介面。
tools提供可呼叫的 Python 函式或 Model Context Protocol (MCP) 端點。subagents執行下屬委派的工作。workflow會協調多代理圖。output_schema套用 Pydantic 模型,確保下游消費者收到的是經過驗證的 JSON,而非非結構化文字。 - 攔截器層 (生命週期回呼):確定性護欄,在代理執行前後 (
before_agent/after_agent)、個別模型回合 (before_model/after_model) 和工具呼叫 (before_tool/after_tool) 前後執行自訂程式碼。攔截器會強制執行政策規則,不依賴模型遵循。 - 外部狀態 (工作階段和記憶體):與代理邏輯分開的有狀態持久性。
Session會保留暫時工作記憶體和目前執行執行緒的事件追蹤記錄。Memory使用 GEAP Memory Bank 等代管服務,維護跨工作階段的持久事實和偏好設定。
本步驟中的單一代理只會實作其中三個基本元素:model、instruction 和 tools。後續步驟會介紹圖表工作流程、結構化結構定義、攔截器和永久記憶體服務。
單體代理規格 (3B)
在工作台中,前往「Monolithic agent specification (3B)」。開啟 stage0_prompt/agent.py,查看基準代理定義:
- 單一提示詞指令:系統提示詞將五項不同的製作工作濃縮成連續的文字:發掘平台趨勢、審查待辦構想、提出創意概念、執行禁止主題政策,以及草擬鏡頭清單。
- 基礎資料來源:代理會參照圖表旁定義的兩個來源:
agent/trends.py:從 250 個動態熱度分數中,抽樣十個活躍的格式和風格趨勢。agent/backlog.txt:逐行讀取創作者的原始概念筆記。
代理程式中的工具 (3C)
在工作台中,前往「Tools in Agent (3C)」。
什麼是代理的工具?
語言模型本質上是封閉式推理引擎,只會根據預先訓練的權重,以及目前脈絡窗口中的詞元運作。無法原生查詢資料庫、存取即時 API 或執行程式碼。
工具可跨越這個界線。這項技術可賦予模型外部代理能力,讓模型擷取基準真相資訊,並在外部系統執行確定性動作。
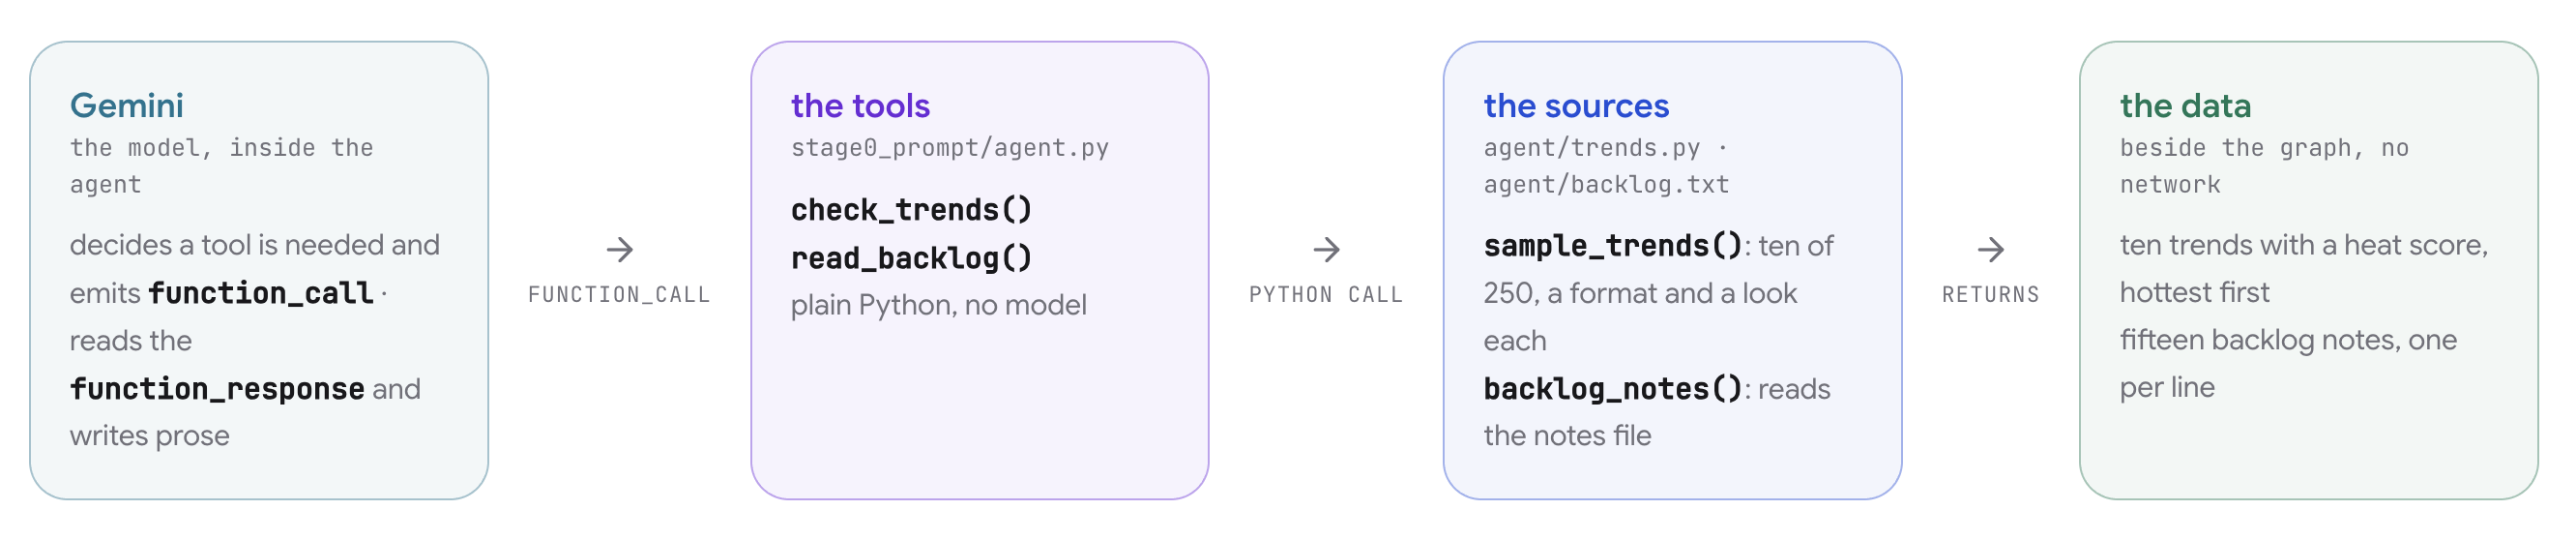
工具呼叫遵循模型與 ADK 執行階段之間的明確五階段通訊協定:
- 結構定義宣告:開發人員會向代理提供 Python 函式。ADK 會檢查每個函式的名稱、類型註解和 docstring,產生與 OpenAPI 相容的 JSON 結構定義宣告,說明其參數和用途。
- 模型推論:推論期間,模型會評估使用者的提示是否需要外部資料。如有需要,模型會發出結構化
function_call事件,其中包含符合結構定義的目標函式名稱和引數字典。 - 執行階段:模型本身不會執行程式碼,ADK 執行階段會攔截
function_call,使用提供的引數執行實際的本機 Python 函式,並擷取傳回值。 - 重新注入內容:ADK 執行階段會將函式傳回值封裝至
function_response事件,並附加至有效的工作階段記錄。 - 最終整合:模型會處理脈絡視窗中顯示的工具輸出內容,並完成回覆。
在 stage0_prompt/agent.py 中,這兩項研究工具定義為標準 Python 函式:
def check_trends() -> dict:
    """Ten formats trending on the platform right now, with a heat score each."""
    from agent.trends import sample_trends
    return {"trends": sample_trends()}


def read_backlog() -> dict:
    """The creator's backlog: ideas they noted down to make someday."""
    from agent.graph import backlog_notes
    return {"backlog": backlog_notes()}
實際編輯和執行
在工作台程式碼編輯器中,將這兩個函式參照新增至代理的 tools 清單:
tools=[check_trends, read_backlog],
儲存變更。磁碟上的檔案會更新,驗證列則會確認兩項工具都已連結。
按一下「Open adk web」(開啟 adk web),啟動內嵌的 ADK 開發介面。傳送建議的提示:
tonight's idea: a tiny robot doing laundry at midnight
後續步驟和原因
傳送這則提示時,請觀察工作階段追蹤記錄中的下列執行順序:
- 回覆前會顯示兩個工具執行事件:您會看到
check_trends和read_backlog的function_call和function_response事件。- 原因:Gemini 評估系統提示指令 (「查看趨勢。查看待處理的構想」),發現權重中缺少平台趨勢和頻道附註,因此叫用這兩項函式來建立背景資訊。
- 代理提出方向並暫停,等待確認:回覆會根據趨勢和待辦事項,提出影片方向,並請你確認。
- 原因:指令指示模型先與創作者確認方向,再生成腳本。
- 在後續對話中略過確認:傳送第二則訊息:
skip the questions, just describe the video。代理會立即略過確認步驟,草擬標題和畫面。- 原因:提示詞指令是建議指南,而非絕對限制。在單一代理程式中,使用者指令可以覆寫現有的系統提示規則,因為沒有外部工作流程控制執行流程。
單體提示的架構限制
雖然單一提示可為獨立的試用版產生可接受的輸出內容,但工作台驗證器中的測試邊界條件會顯示重要的企業限制:
- 非結構化研究匯總:工具執行順序不確定。模型會將擷取的資料彙整成自由形式的散文,因此下游系統無法區分特定聲明的來源。
- 未經驗證的政策執行:模型會評估自身是否符合安全規範。如果模型判定主題安全,就不會有外部確定性邏輯驗證該結果。
- 未強制執行的人工介入迴路暫停:要求創作者確認的提示指示僅供參考。如果傳送後續訊息,指示模型略過問題,模型就會完全略過人工核准。
這些架構落差促使我們將單一代理程式分解為明確的圖表工作流程,並在下一個步驟中建構。
4. Agentic Workflows 基本概念
在 VibeStudio Workbench 中,前往「Step 4 · Agentic workflow fundamentals」,然後依序完成 4A 至 4D 部分。
這個步驟會從單一代理基準轉換為使用 ADK Workflow 的確定性圖形自動化調度管理。您將建構平行研究擴散傳遞功能、使用聯結節點同步處理分支、產生通過結構定義驗證的廣告素材候選項目,並導入確定性的人工介入迴路核准閘道。
圖表架構和執行鏈 (4A)
在工作台中,開啟「Graph architecture and execution chains (4A)」。
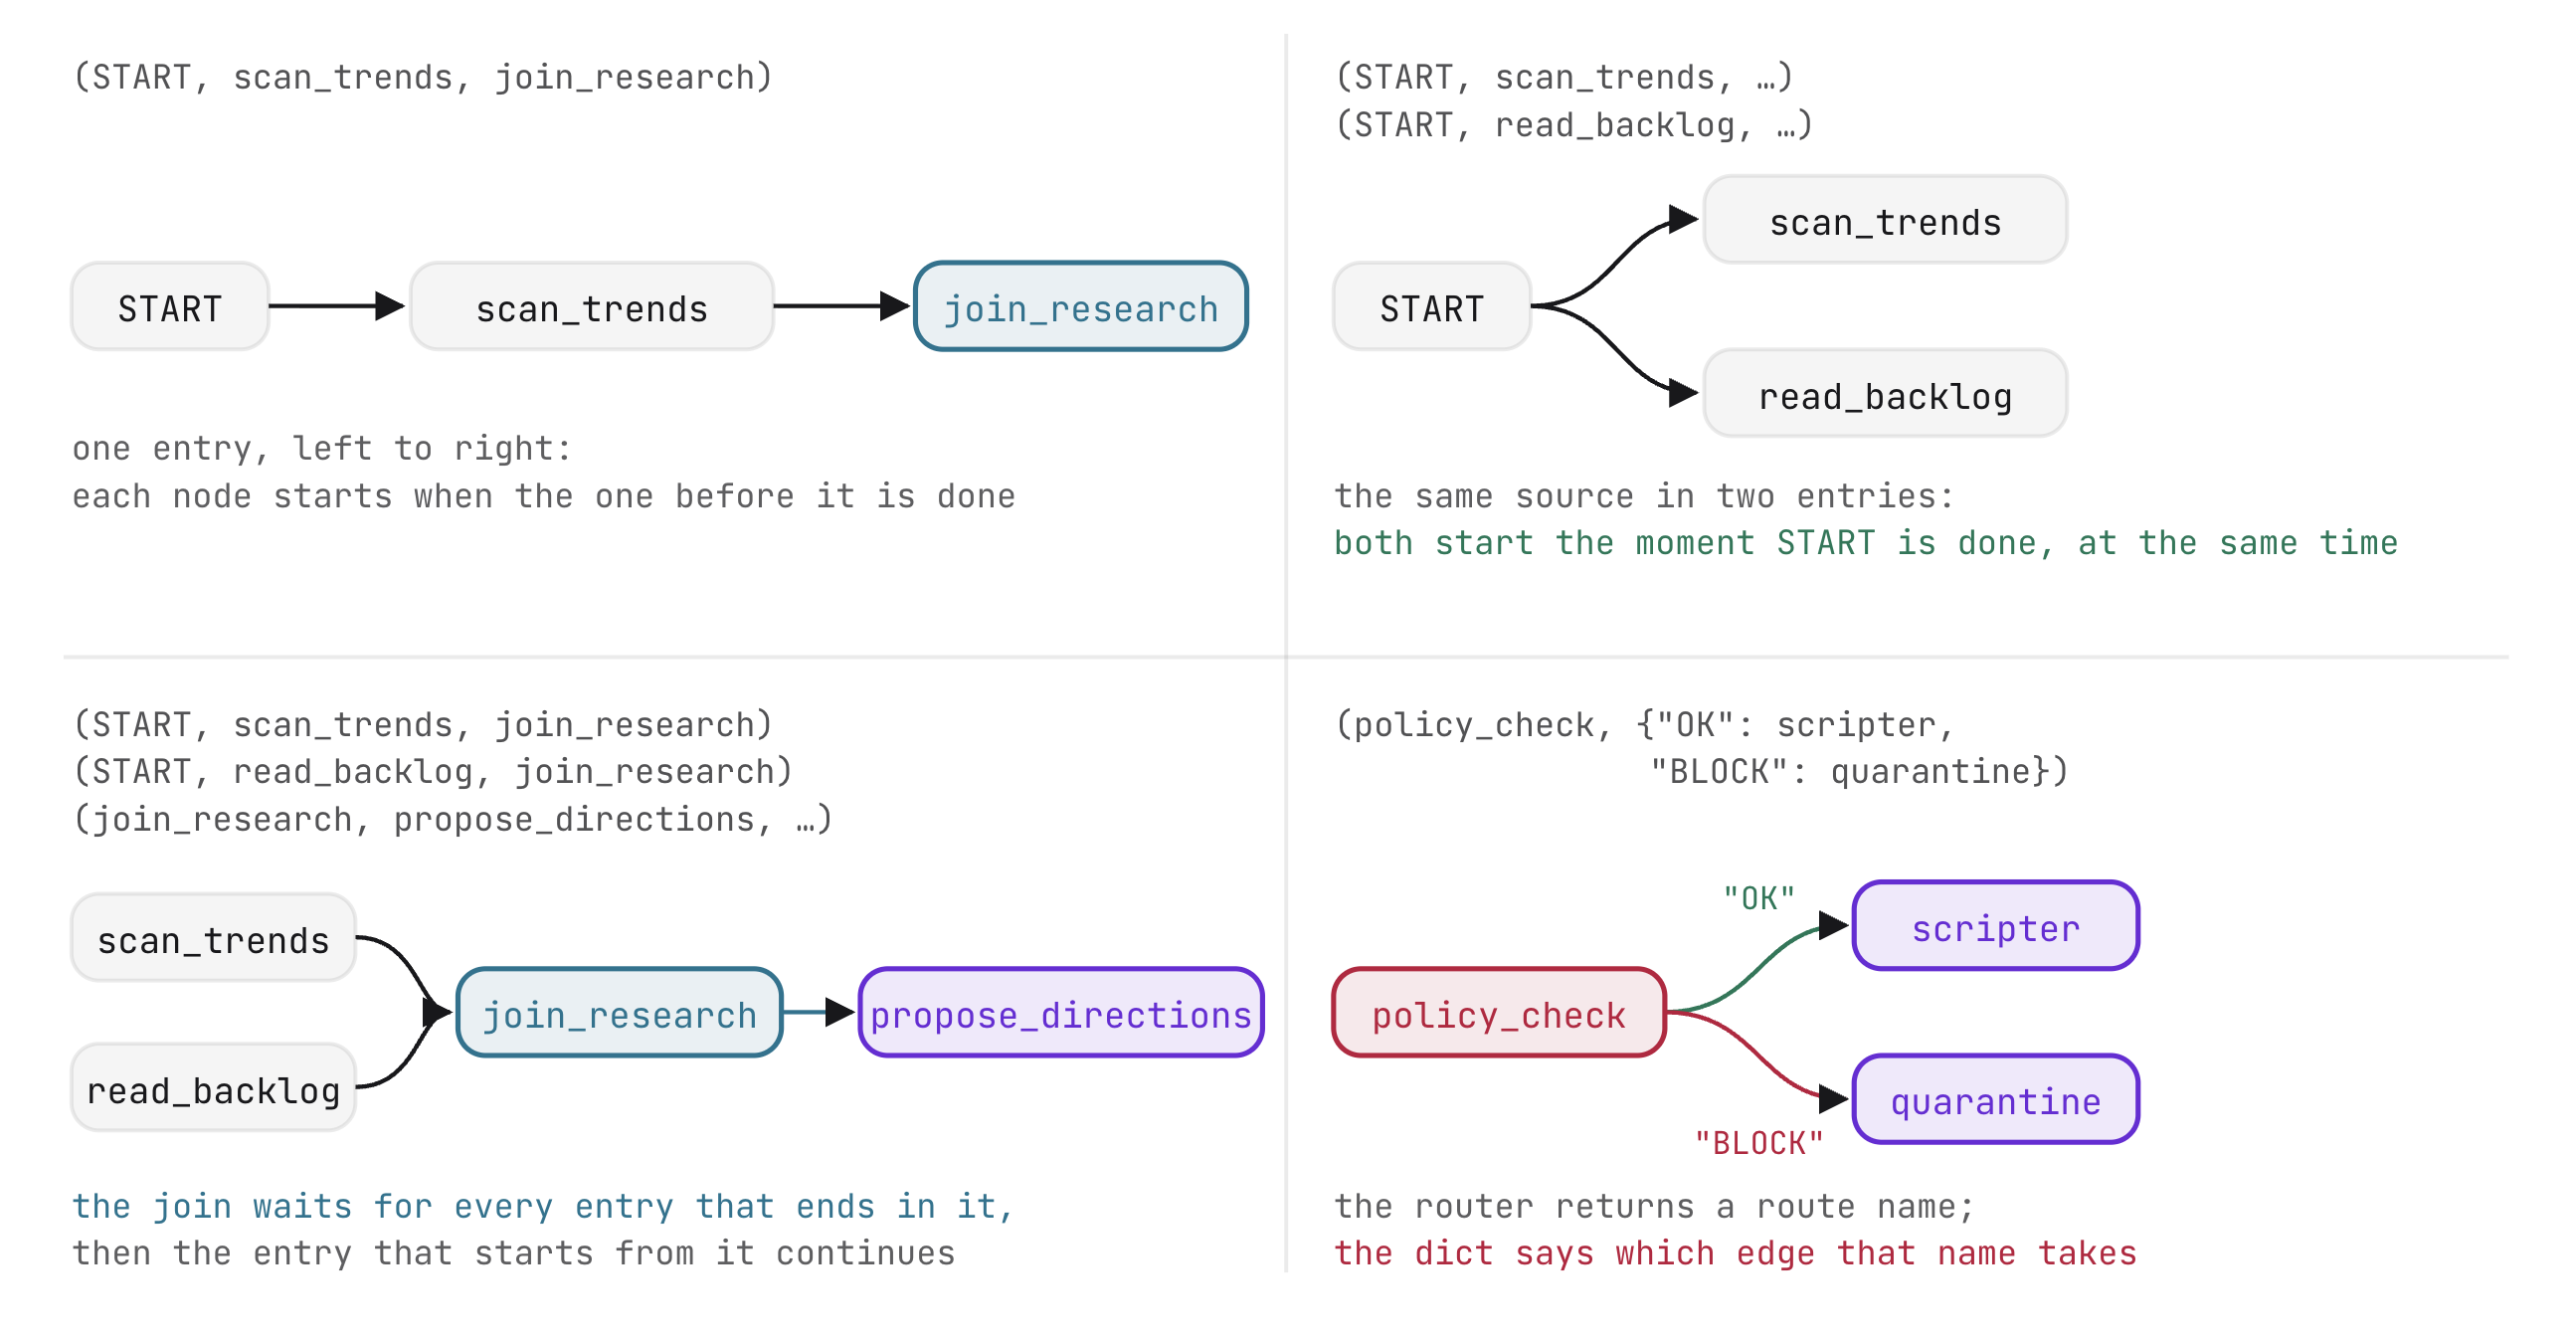
ADK Workflow 會將代理執行作業建構為邊緣清單定義的有向圖:
- 鏈結:循序元組會定義線性節點執行作業 (
(node_a, node_b, node_c))。 - 平行分支:共用來源節點的獨立鏈會同時執行。
- 同步:鏈結匯聚在
JoinNode時,會等待所有傳入分支回報後再釋出。 - 確定性控制:執行流程由宣告的程式碼結構控管,而非從提示文字推斷。
ADK 中的節點原型
ADK 工作流程由多種專用節點類型組成。每個原型在圖表中都扮演特定的運算角色,將決定性程式碼執行作業與生成模型推理作業分開:
節點原型 | 導入作業 | 管道中的角色 |
函式節點 | 傳回 | 執行確定性邏輯、資料擷取和狀態變動。 |
Join 節點 | 內建 | 將並行分支同步處理至匯總字典。 |
代理節點 |
| 根據上游輸入內容評估指令,並輸出經過驗證的資料。 |
路由器節點 | 傳回 | 評估條件邏輯,選取下游執行分支。 |
手動輸入節點 | 產生 | 暫停執行狀態,直到外部使用者回覆為止。 |
root_agent = Workflow(
    name="stage1_fanout",
    description="2 real readers -> join -> one research dict",
    edges=[...])
在此設定中,root_agent 是 Workflow 的執行個體,而非獨立的 Agent。ADK 將工作流程視為優先代理,可將整個圖表載入、提供及檢查,做為統一的應用程式。name 會在 ADK Web 中註冊應用程式,而 edges 清單則會定義其執行拓撲。
平行研究擴散傳遞 (4B)
在工作台中,前往「Parallel research fan-out (4B)」。開啟 stage1_fanout/agent.py。
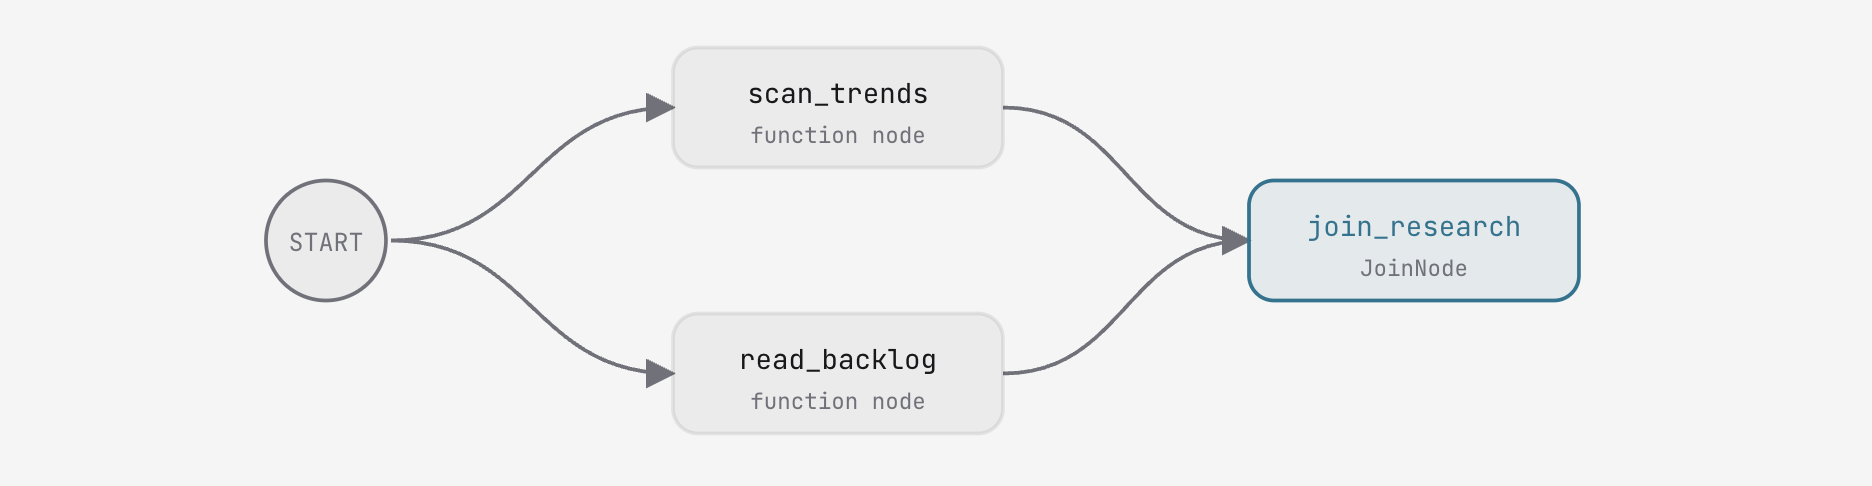
函式節點和同步處理障礙
研究階段會使用從 agent/graph.py 匯入的兩個函式節點:
scan_trends:傳回Event(output={"trends": [...]}),其中包含十個評分的平台趨勢。read_backlog:傳回Event(output={"backlog": [...], "idea": "..."}),其中包含 15 個頻道待辦事項構想,以及初始執行提示。
每個函式都會接受 node_input (前一個節點的輸出內容),並傳回 Event。
JoinNode 是同步處理屏障:會暫停直到每個傳入鏈結傳送事件,然後將所有分支結果匯總至以節點名稱 ({"scan_trends": {...}, "read_backlog": {...}}) 為索引鍵的字典。
實作編輯:定義彙整和並行邊緣
在 stage1_fanout/agent.py 中,例項化 JoinNode 並連結從 START 開始的兩個平行鏈結:
join_research = JoinNode(name="join_research")
    edges=[(START, scan_trends, join_research),
           (START, read_backlog, join_research)])
儲存變更。工作台驗證器會確認接合處和邊緣是否已接線。使用「Run Stage 1」(執行第 1 階段) 或透過內嵌的 ADK 網頁介面執行階段。
後續步驟和原因
- 並行讀取器執行:在執行圖中,
scan_trends和read_backlog會同時執行。- 原因:兩條鏈結都源自
START。ADK 引擎會同時排定獨立分支機構。
- 原因:兩條鏈結都源自
- 匯總字典輸出:工作流程在
join_research完成,輸出包含兩個讀取器項目的字典。- 原因:
JoinNode可確保完整擷取資料,再允許後續節點執行。
- 原因:
代理節點 (4C)
在工作台中,前往「代理節點 (4C)」。開啟 stage2_direction/agent.py。
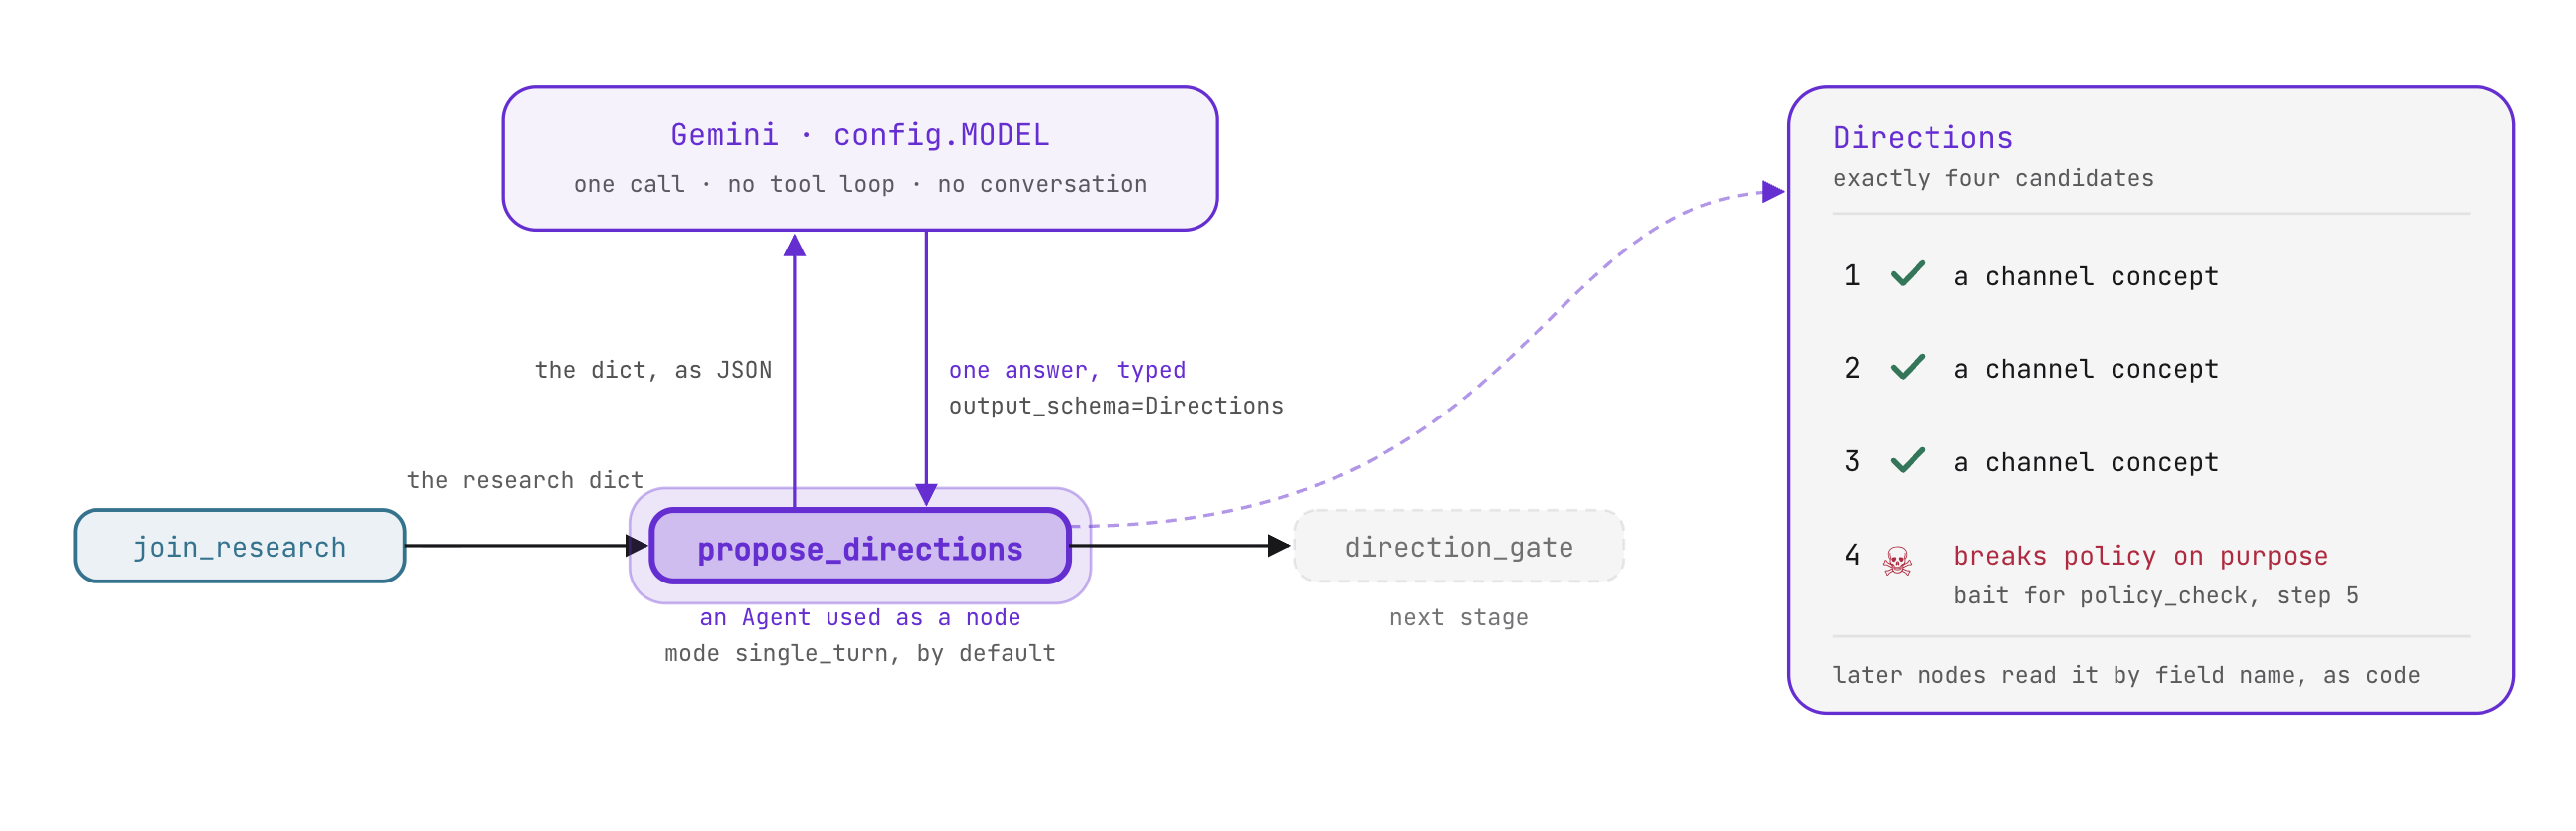
運作模式和結構化結構定義
嵌入 Workflow 時,Agent 預設會以 single_turn 模式執行:
- 並將前一個節點的輸出內容做為脈絡輸入內容。
- 這項功能會執行單一推論呼叫,不會進行對話。
- 並將結構化資料輸出至下一個節點。
指派 output_schema=Directions 後,代理會對模型輸出內容強制執行 Pydantic 驗證。下游圖表會收到型別物件,而非非結構化散文:
class Direction(BaseModel):
    title: str           # <=60 chars, filmable, characterful
    angle: str           # the twist, one line
    hook: str = ""       # 2-4 words, the video's sticker line
    evidence: list[Evidence]


class Directions(BaseModel):
    candidates: list[Direction]   # exactly 4
PROPOSE_INSTRUCTION 指示模型根據趨勢和待辦事項中的證據,提出四個候選項目。候選人 1 到 3 提出的頻道概念都可行。候選 4 刻意引入違反政策的概念,以便在下一個步驟測試安全閘。
動手編輯:定義代理節點並鏈結彙整
在 stage2_direction/agent.py 中,設定 propose_directions 並擴充工作流程邊緣:
propose_directions = Agent(
    name="propose_directions",
    model=config.MODEL,
    instruction=PROPOSE_INSTRUCTION,
    output_schema=Directions)
    edges=[(START, scan_trends, join_research),
           (START, read_backlog, join_research),
           (join_research, propose_directions, direction_gate)])
預期結果和原因
- 直接使用字典:
propose_directions會使用join_research發出的 JSON 酬載,不必手動設定格式。 - 輸入候選輸出內容:代理會發出經過驗證的
Directions物件,其中包含四個獨立候選項目。下游節點會依屬性名稱 (candidate.title) 讀取欄位,不需剖析字串。
人工介入迴路 (4D)
在工作台中,前往「人工介入迴路 (4D)」。開啟 agent/graph.py。
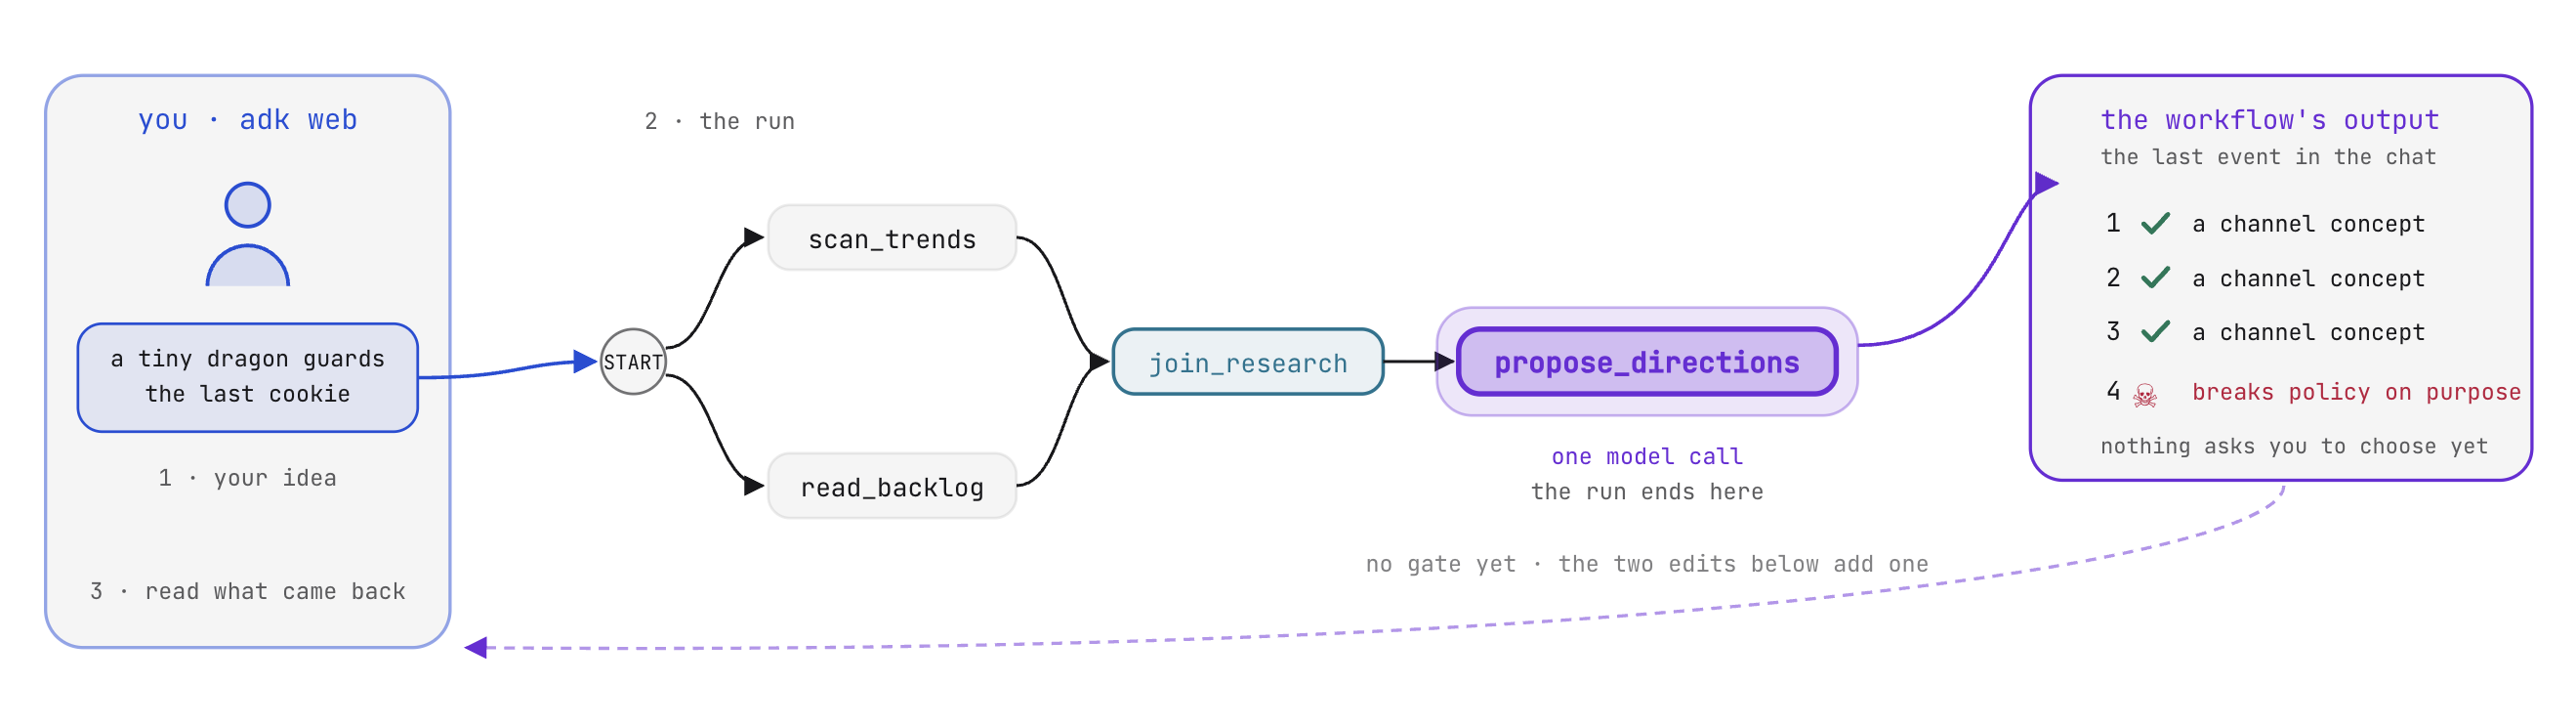
提示詞指令與確定性暫停
如果製作工作流程會產生財務成本或發布內容,請在關鍵決策點安排人員監督。在單一提示中,確認要求是建議指示,使用者可以輕鬆提示模型略過。在 ADK 工作流程中,執行引擎會強制要求人工核准:圖表會在指定節點停止,直到收到經過結構定義驗證的外部輸入內容,才會繼續執行:
- 產生
RequestInput會立即暫停工作流程執行。 - ADK 會在工作階段儲存空間中記錄開啟的中斷呼叫,並發出專屬的
interrupt_id。 - 執行程序會停止,不會耗用權杖或伺服器執行緒。
- 只有在提交符合結構定義和中斷 ID 的有效
function_response時,Graph Execution 作業才會繼續。
實際操作編輯:使用 RequestInput 暫停執行
在 agent/graph.py 中,實作 direction_gate 內的暫停呼叫:
    yield RequestInput(
        message="Pick tonight's direction: 1, 2, 3 or 4.",
        response_schema={
            "type": "object",
            "properties": {
                "pick": {"type": "string", "enum": ["1", "2", "3", "4"]}}},
        payload={"candidates": cands})
RequestInput 會設定三項屬性:
message:向使用者顯示的評論提示。response_schema:前端會將這個 JSON 結構定義算繪為輸入表單,並在提交時由 ADK 驗證。payload:與要求 (四個候選項目) 綁定的中繼資料,可讓用戶端介面顯示評論資訊卡,而不必查詢工作階段狀態。
預期結果和原因
- 工作流程在 direction_gate 停止:在 ADK Web 或工作台介面中,執行作業會暫停,並顯示互動式候選人選取表單。
- 原因:引擎遇到產生的
RequestInput,並將執行狀態保留至runs/sessions.db。
- 原因:引擎遇到產生的
- 恢復需要結構化輸入:傳送任意對話文字不會推進圖表。選取選項 (1、2、3 或 4) 會提交符合
response_schema的型別function_response,並繼續執行。
5. 狀態和路由器
在 VibeStudio Workbench 中,前往「Step 5 · State and Router」,也就是 (5A) 到 (5C) 的部分。
您會將使用者選取項目保留在工作階段狀態中,使用確定性路由器節點強制執行頻道安全政策,並組裝疊代工作代理程式,在產生影片腳本前自動修正違反政策。
工作流程狀態 (5A)
在工作台中,前往「Workflow State (5A)」。
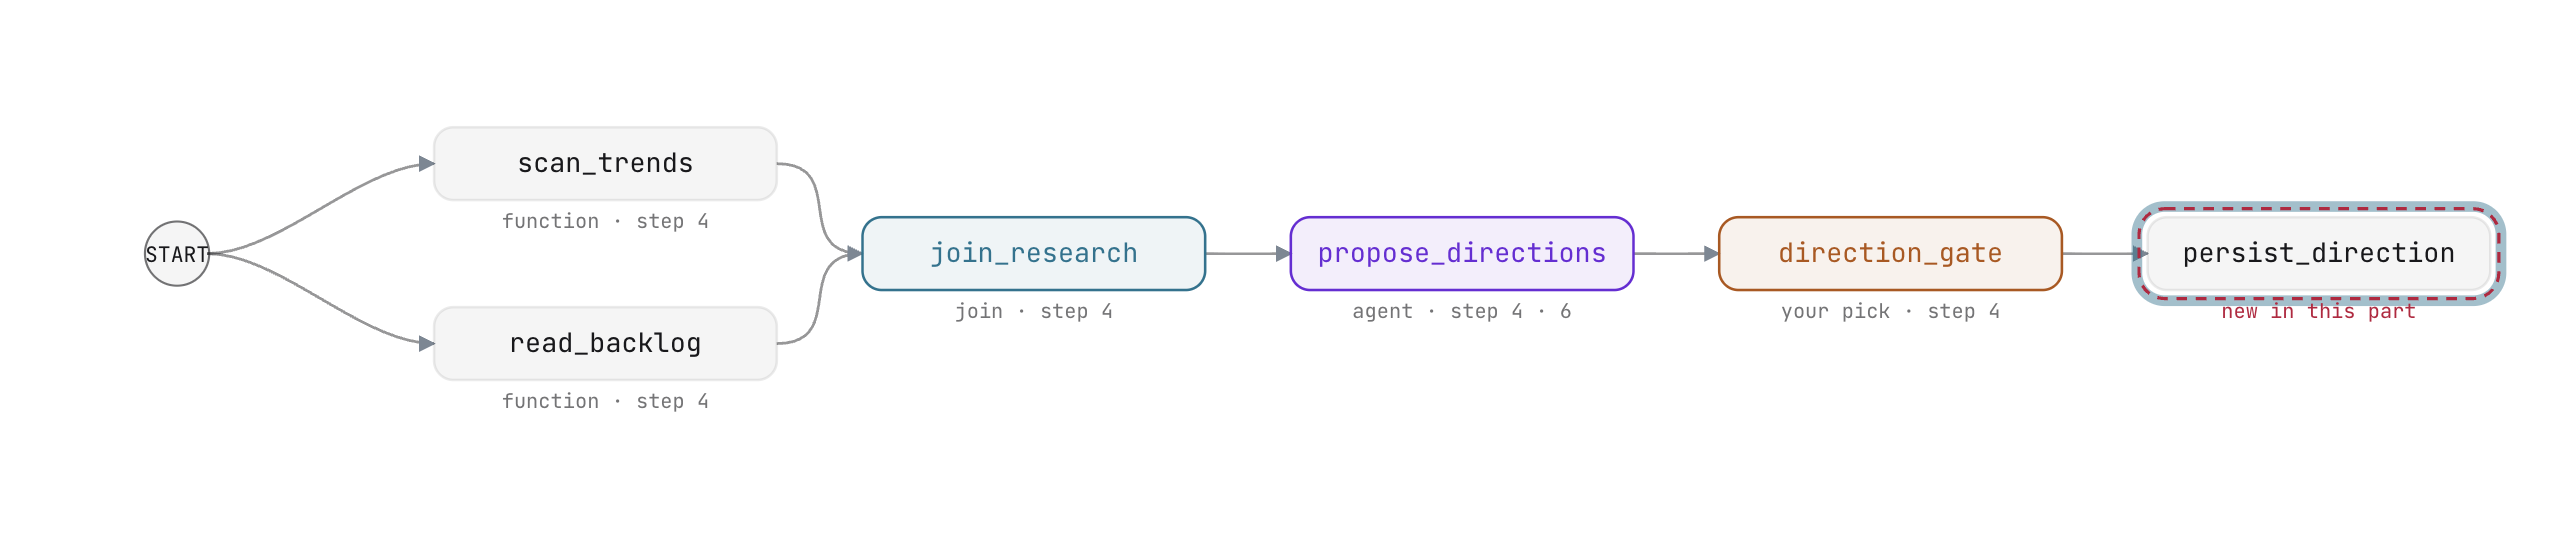
工作階段狀態與節點輸出內容
在 ADK 工作流程中,資料會透過兩種不同的機制在圖表中移動:
- 節點輸出 (
Event(output=...)):嚴格導向邊緣清單中定義的直接下游消費者。 - 工作階段狀態 (
Event(state=...)):共用的鍵/值字典,執行生命週期中的任何後續節點都能存取。
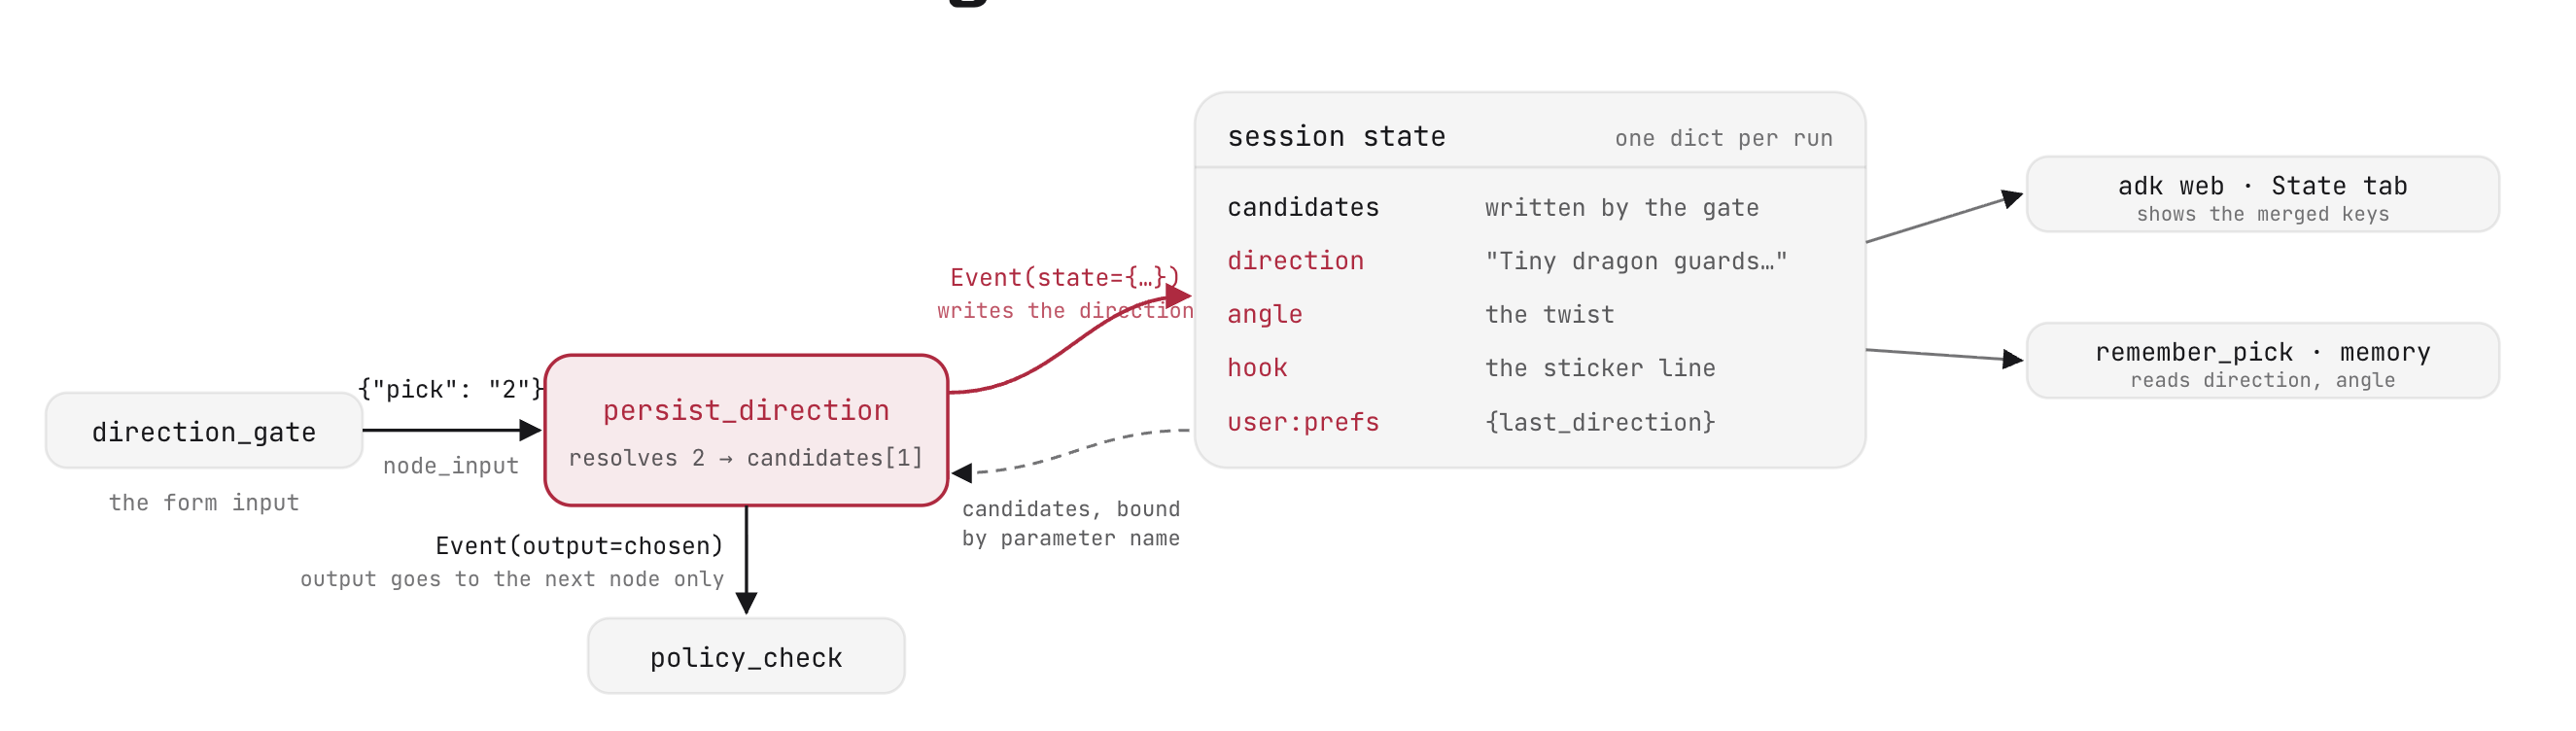
使用者在 direction_gate 選取候選項目時,系統會以數字索引 ({"pick": "2"}) 的形式傳送所選項目。下游節點需要完整的方向物件:標題、敘事角度和吸引人的開場白。persist_direction 不會透過每個中繼節點酬載傳遞冗長的中繼資料,而是將解析後的候選項目寫入共用工作階段狀態。
節點不需要傳遞整個工作階段狀態字典。當節點產生 Event(state=...) 時,只會提供新的或更新的鍵/值組合。ADK 會自動將這些更新合併到工作階段儲存庫:
    yield Event(state={"direction": chosen["title"], "angle": chosen.get("angle", ""),
                       "hook": hook, "user:prefs": {"last_direction": chosen["title"]}})
產生這個 Event 會將控制權交給 Workflow 執行階段,該執行階段會將新值保留在 runs/sessions.db 的工作階段日誌中。
參數繫結
ADK 函式節點會透過參數檢查,自動讀取工作階段狀態。如果函式簽章宣告的參數名稱與現有狀態索引鍵相符,ADK 會從狀態中擷取該索引鍵,並直接傳遞:
def persist_direction(node_input, candidates: list = []):
    ni = node_input if isinstance(node_input, dict) else {}
    raw = ni.get("pick")
    pick = str(raw).strip() if raw is not None else ""
    if candidates:
        i = int(pick) - 1 if pick.isdigit() else 0
        chosen = candidates[max(0, min(len(candidates) - 1, i))]
    else:
        chosen = {"title": "untitled", "angle": "", "evidence": []}
    hook = chosen.get("hook") or " ".join(chosen["title"].split()[:4])
在這裡,candidates 是由 direction_gate 寫入工作階段狀態。ADK 會直接將其繫結至 persist_direction(node_input, candidates: list = []),不需要明確查詢字典。
前置字元為 user: 的鍵會跨工作階段保留在使用者層級儲存空間,讓後續工作流程執行時能存取建立者偏好設定。
實作編輯:保留狀態並連結節點
- 在
agent/graph.py的persist_direction內,將TODO: PERSIST_STATE行替換為狀態事件產生器:
    yield Event(state={"direction": chosen["title"], "angle": chosen.get("angle", ""),
                       "hook": hook, "user:prefs": {"last_direction": chosen["title"]}})
- 在
stage3_router/agent.py中,將persist_direction附加至edges清單中的第三個鏈結:
           (join_research, propose_directions, direction_gate,
            persist_direction)
儲存檔案。在工作台中,確認 state write in place 和 persist_direction in the chain 都顯示綠色勾號。
路由器節點 (5B)
在工作台中,前往「路由器節點 (5B)」。
確定性策略路由
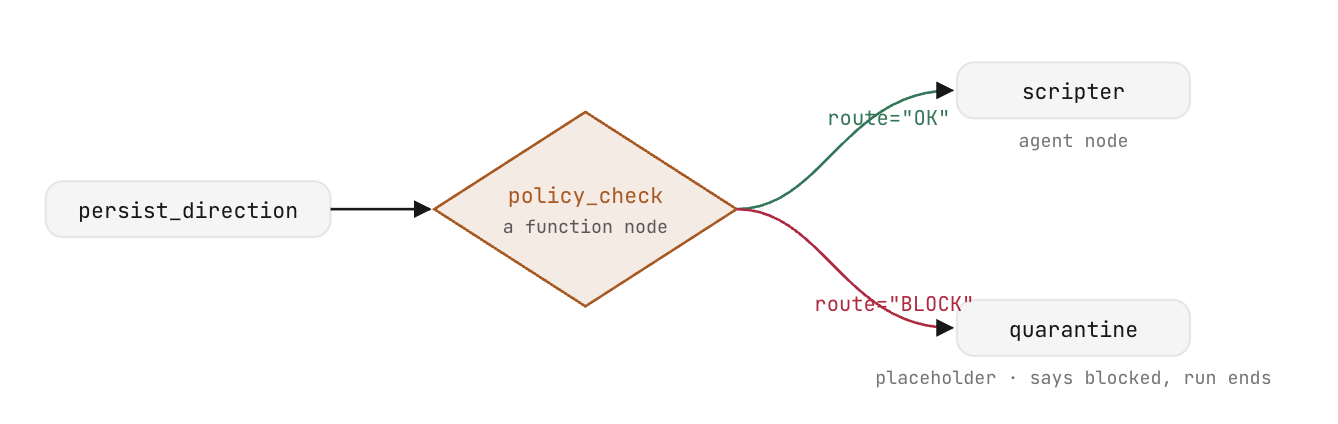
路由器是專門的函式節點,可評估上游輸出內容,並根據條件圖分支導向執行作業。與生成式代理不同,路由器會執行確定性邏輯,不會呼叫 LLM。
路由器會傳回指定 route 標記的 Event:
def length_check(node_input):
    too_long = len(node_input.get("title", "")) > 60
    return Event(output=node_input, route="TRIM" if too_long else "PASS")
在工作流程定義中,以字典形式定義的邊緣目標會將路徑名稱對應至目的地節點:
(length_check, {"TRIM": shorten, "PASS": scripter}),
工作流程路由器會從 policy_check讀取禁止使用的片語,並針對所選方向的標題和角度執行全字比對:agent/policy_words.txt
return Event(output=node_input, route="BLOCK" if bad else "OK")
將政策儲存為資料,而非硬式編碼指令,即可在不修改工作流程圖的情況下更新政策:更新文字檔後,後續執行作業會立即套用新政策。由於評估作業是確定性規則運算式比對,因此會在生成式指令碼開始前執行,只需幾毫秒,且不需耗用權杖。
目的地:Scripter 和隔離區
路由器會將流量導向兩個下游節點之一:
scripter:single_turn代理節點,可將核准的方向轉換為符合ScriptPydantic 結構定義的結構化製作腳本:
scripter = Agent(
    name="scripter",
    model=config.MODEL,
    instruction=SCRIPT_INSTRUCTION,
    output_schema=Script)
quarantine:一開始是預留位置函式,用於停止標記的方向,在下一部分會由自主修復代理取代。
實際操作:轉送政策檢查
- 在
agent/graph.py的policy_check內,完成回傳敘述:
return Event(output=node_input, route="BLOCK" if bad else "OK")
- 在
stage3_router/agent.py中,將edges更新為路由policy_check,然後將隔離分支重新加入scripter:
           (join_research, propose_directions, direction_gate,
            persist_direction, policy_check),
           (policy_check, {"OK": scripter, "BLOCK": quarantine}),
           (quarantine, scripter)])
儲存檔案。在工作台中,確認路由器邊緣對應已通過驗證。
代理模式和工作節點 (5C)
在工作台中,前往「代理程式模式和工作節點 (5C)」。
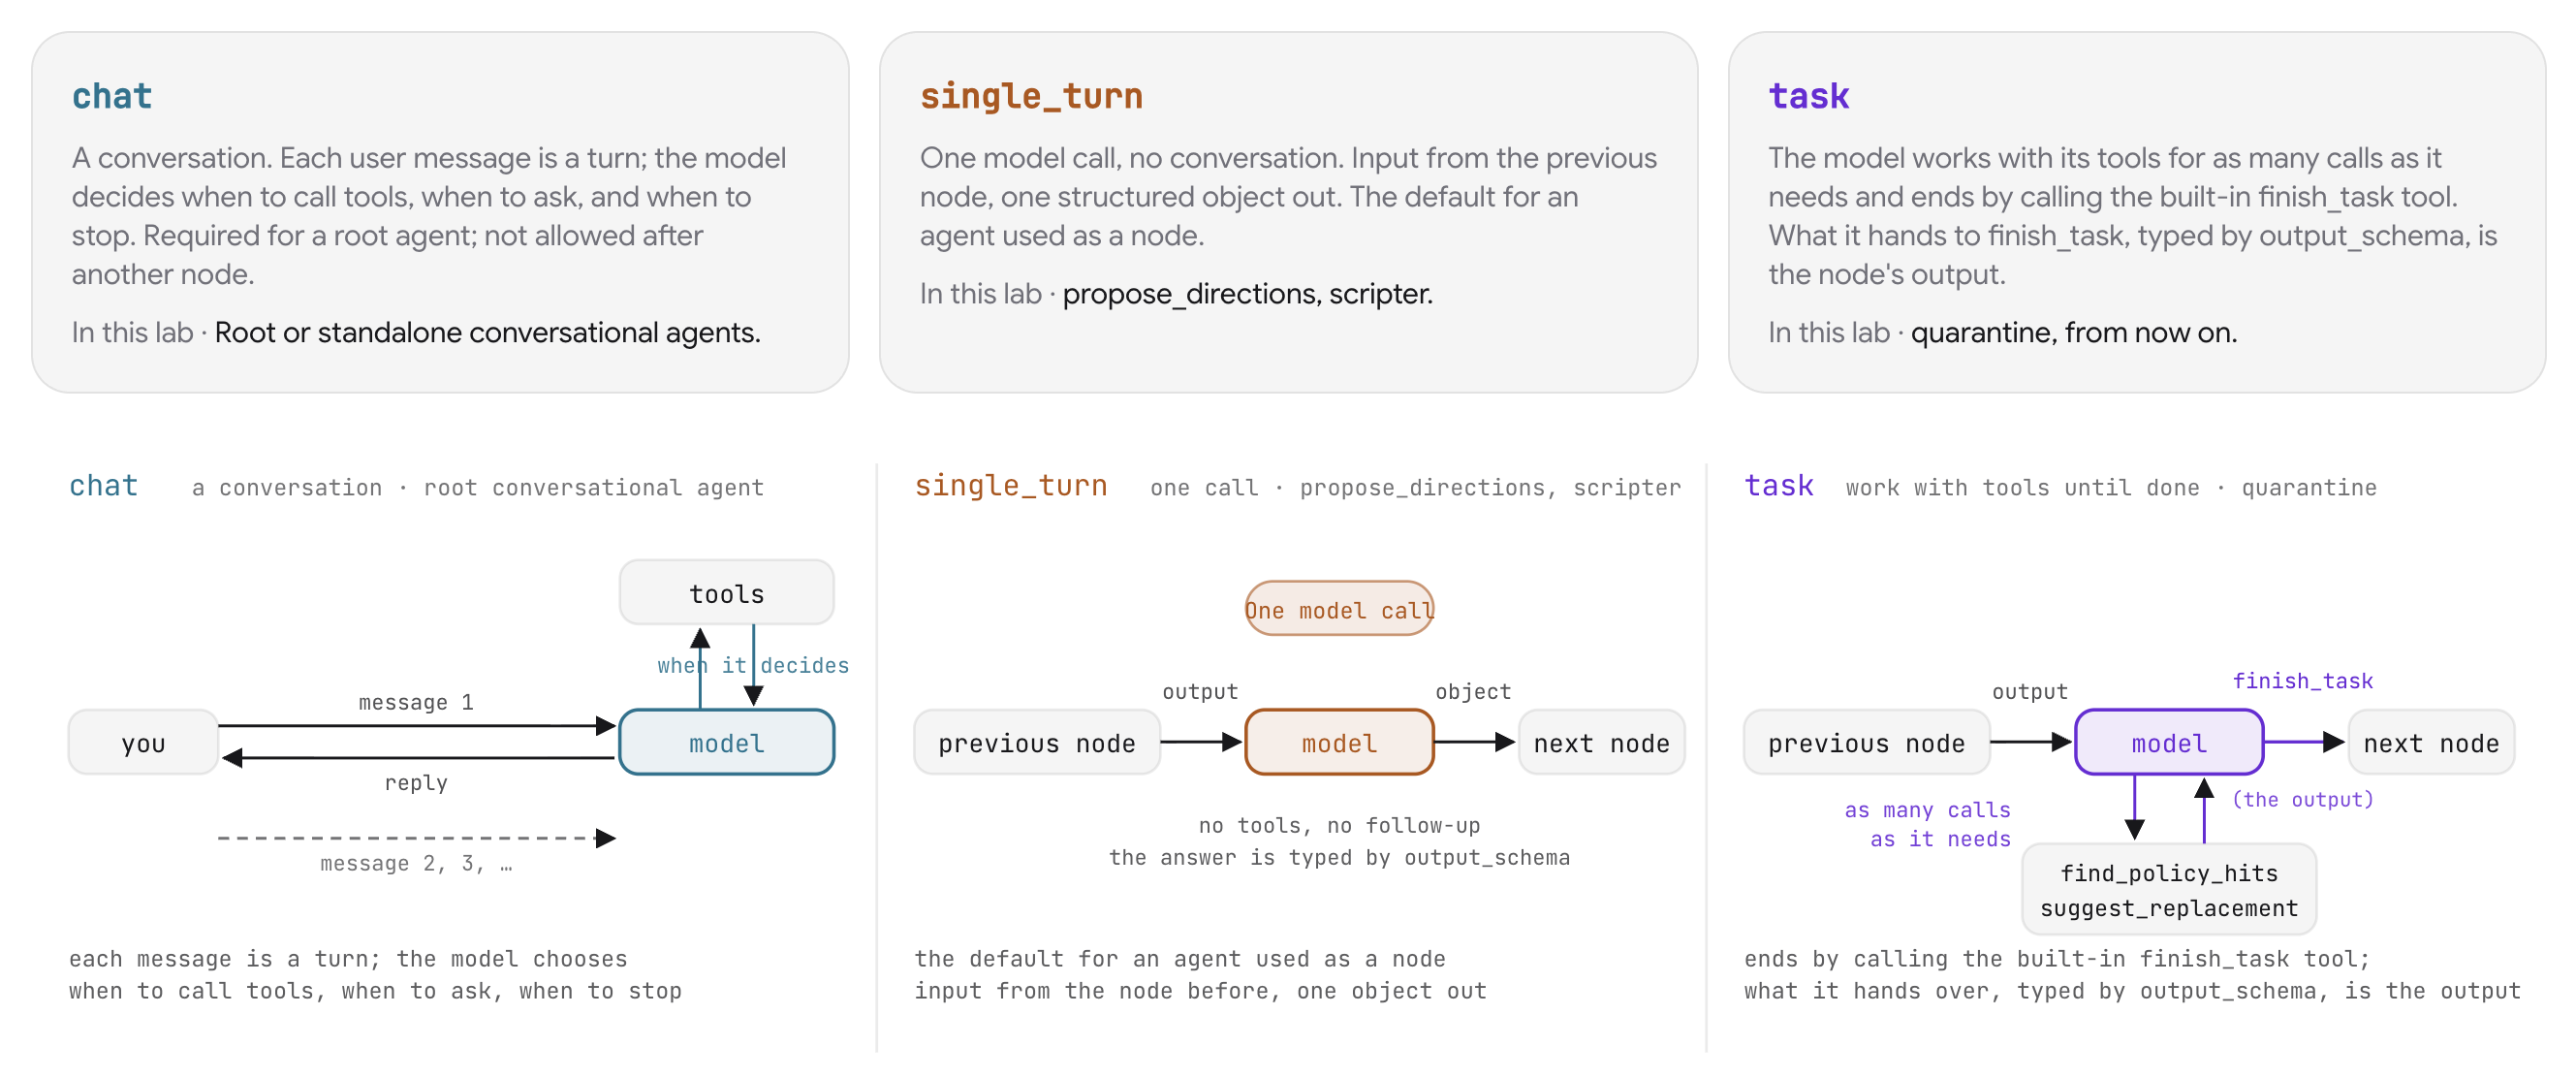
代理執行模式
ADK Agent 執行個體支援三種執行模式,可滿足特定管道需求:
模式 | 執行作業生命週期 | 管道中的角色 |
| 多輪對話循環。模型會判斷何時要叫用工具、要求輸入內容或結束回合。 | 與互動式人類使用者互動的根代理。 |
| 單一模型推論呼叫。接受前一個節點的輸入內容,並輸出結構化結構定義物件。 | 依序轉換圖表 ( |
| 自主迴圈,可執行工具。代理會反覆執行,直到呼叫內建 | 多步驟修復和檢查 ( |
自主政策修復
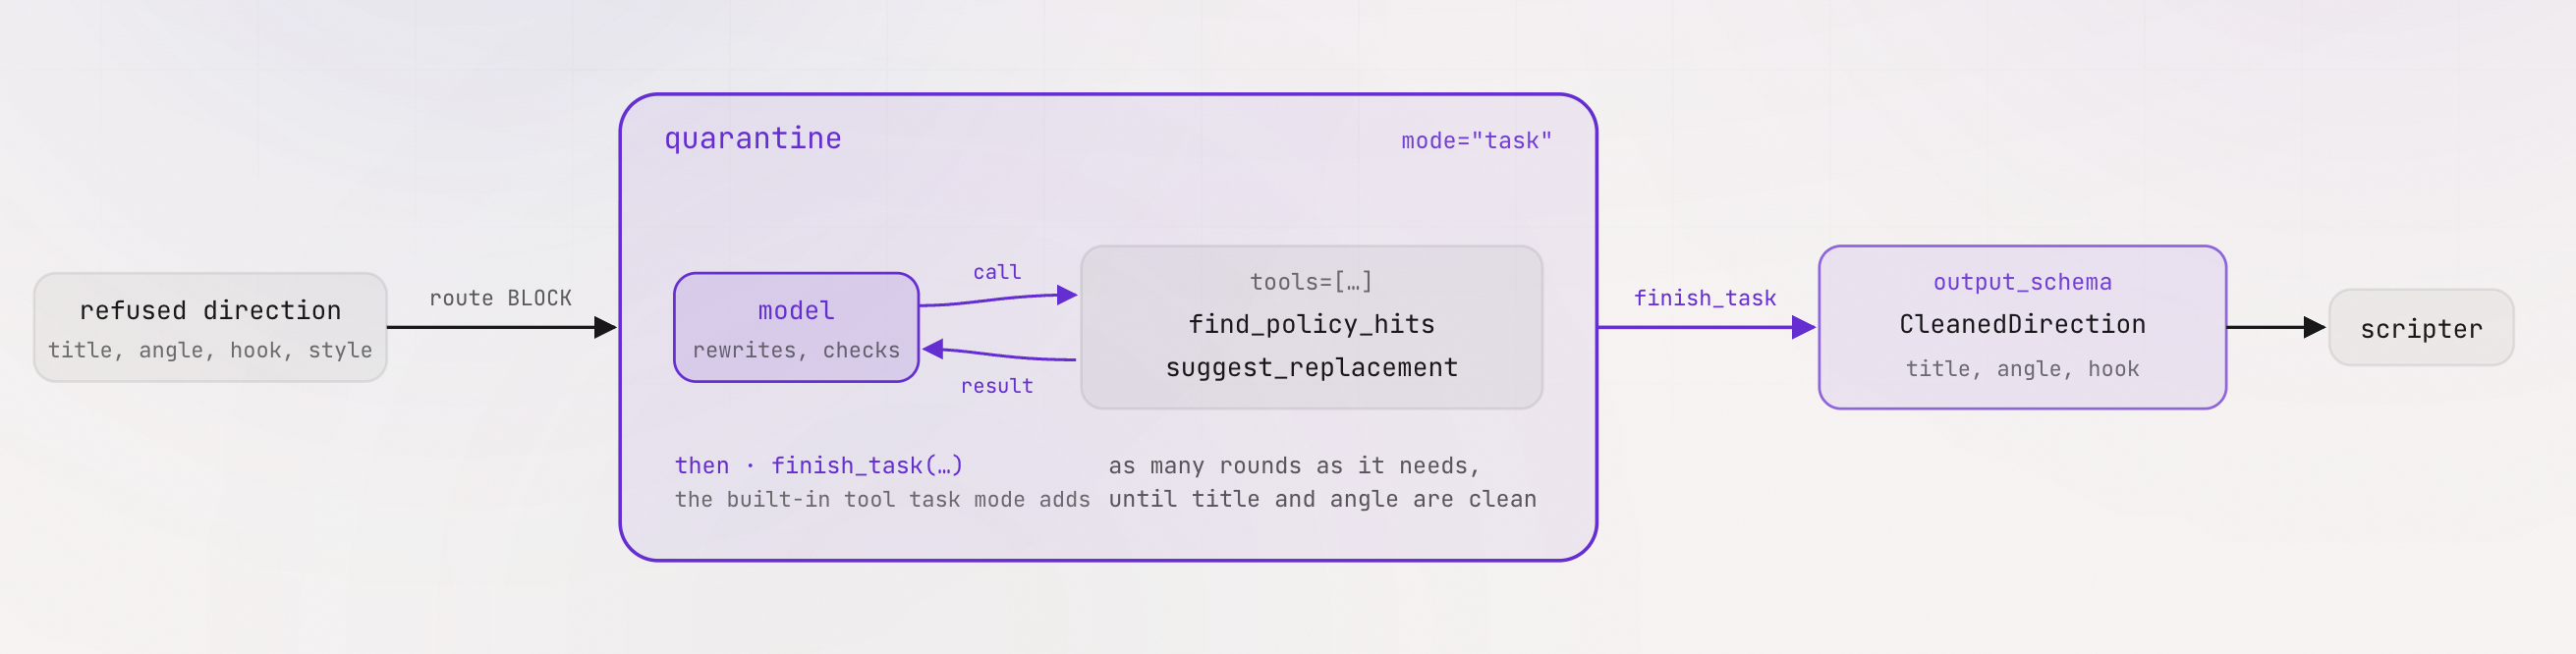
重寫標記的指令需要 task 模式,因為修正疊代次數不固定。代理收到標記的指示後,會叫用 find_policy_hits 偵測違規情形、透過 suggest_replacement 要求核准的替代方案、重寫指示,並在繼續操作前驗證內容是否乾淨。
這兩項工具都在 agent/cleanup_tools.py 中定義,並附有類型簽章和 docstring:
def find_policy_hits(text: str) -> dict:
    """Which refused words appear in `text`. Matches whole words and phrases
    from agent/policy_words.txt, case-insensitive.

    Returns {"hits": [...], "clean": bool}. clean is true when hits is empty.
    """


def suggest_replacement(word: str) -> dict:
    """The channel's approved stand-in for a refused word, read from
    agent/policy_replacements.txt.

    Returns {"word", "replacement", "listed"}. When the word has no entry,
    listed is false and replacement is a hint to pick a gentle synonym.
    """
動手編輯:建構隔離工作代理
在 stage3_router/agent.py 中,將預留位置 quarantine 函式替換為工作代理定義:
quarantine = Agent(
    name="quarantine",
    model=config.MODEL,
    instruction=QUARANTINE_INSTRUCTION,
    mode="task",
    tools=[find_policy_hits, suggest_replacement],
    output_schema=CleanedDirection,
)
工作模式會為代理提供工具,並呼叫 finish_task 終止執行。設定 mode="task" 後,ADK 會自動提供 finish_task,並從 output_schema 衍生參數,確保節點產生與指令碼節點輸入結構定義相符的 CleanedDirection 物件。
預期結果和原因
在 ADK Web 或 VibeStudio Workbench 中測試這兩種執行路徑:
- 核准路線 (候選路線 1、2 或 3):
- 從
policy_check直接選取核准的候選路線到scripter(route="OK")。 - 腳本撰寫工具會根據
Script結構定義,生成 3 個鏡頭的製作腳本。
- 從
- 隔離補救措施路徑 (候選項目 4):
- 候選 4 包含標記詞彙 (「clickbait」、「viral hack」)。
policy_check條航線飛往quarantine(route="BLOCK")。- 在工作階段追蹤記錄中,觀察
quarantine呼叫find_policy_hits、針對每個違規事項呼叫suggest_replacement、重寫標題,以及呼叫finish_task。 - 執行作業會重新加入
scripter,並根據清理後的指示產生腳本。
6. 記憶庫
在 VibeStudio Workbench 中,前往「Step 6 · Memory Bank」的 (6A) 和 (6B) 部分。
目前工作流程不會在不同工作階段之間保留記憶。每次執行都會從頭開始,不會知道創作者先前選取的內容或偏好的類型。在這個步驟中,您將連結 Vertex AI Agent Engine Memory Bank,以便在不同執行作業中儲存及擷取創作者偏好設定。
重要的是,記憶體是透過代理生命週期回呼整合,而非管道節點。由於記憶體擷取和檢索是為個別代理服務,而非中繼資料階段,因此附加回呼可保留乾淨、分離的圖表拓撲。
Memory Bank (6A)
在工作台中,前往「記憶庫 (6A)」。
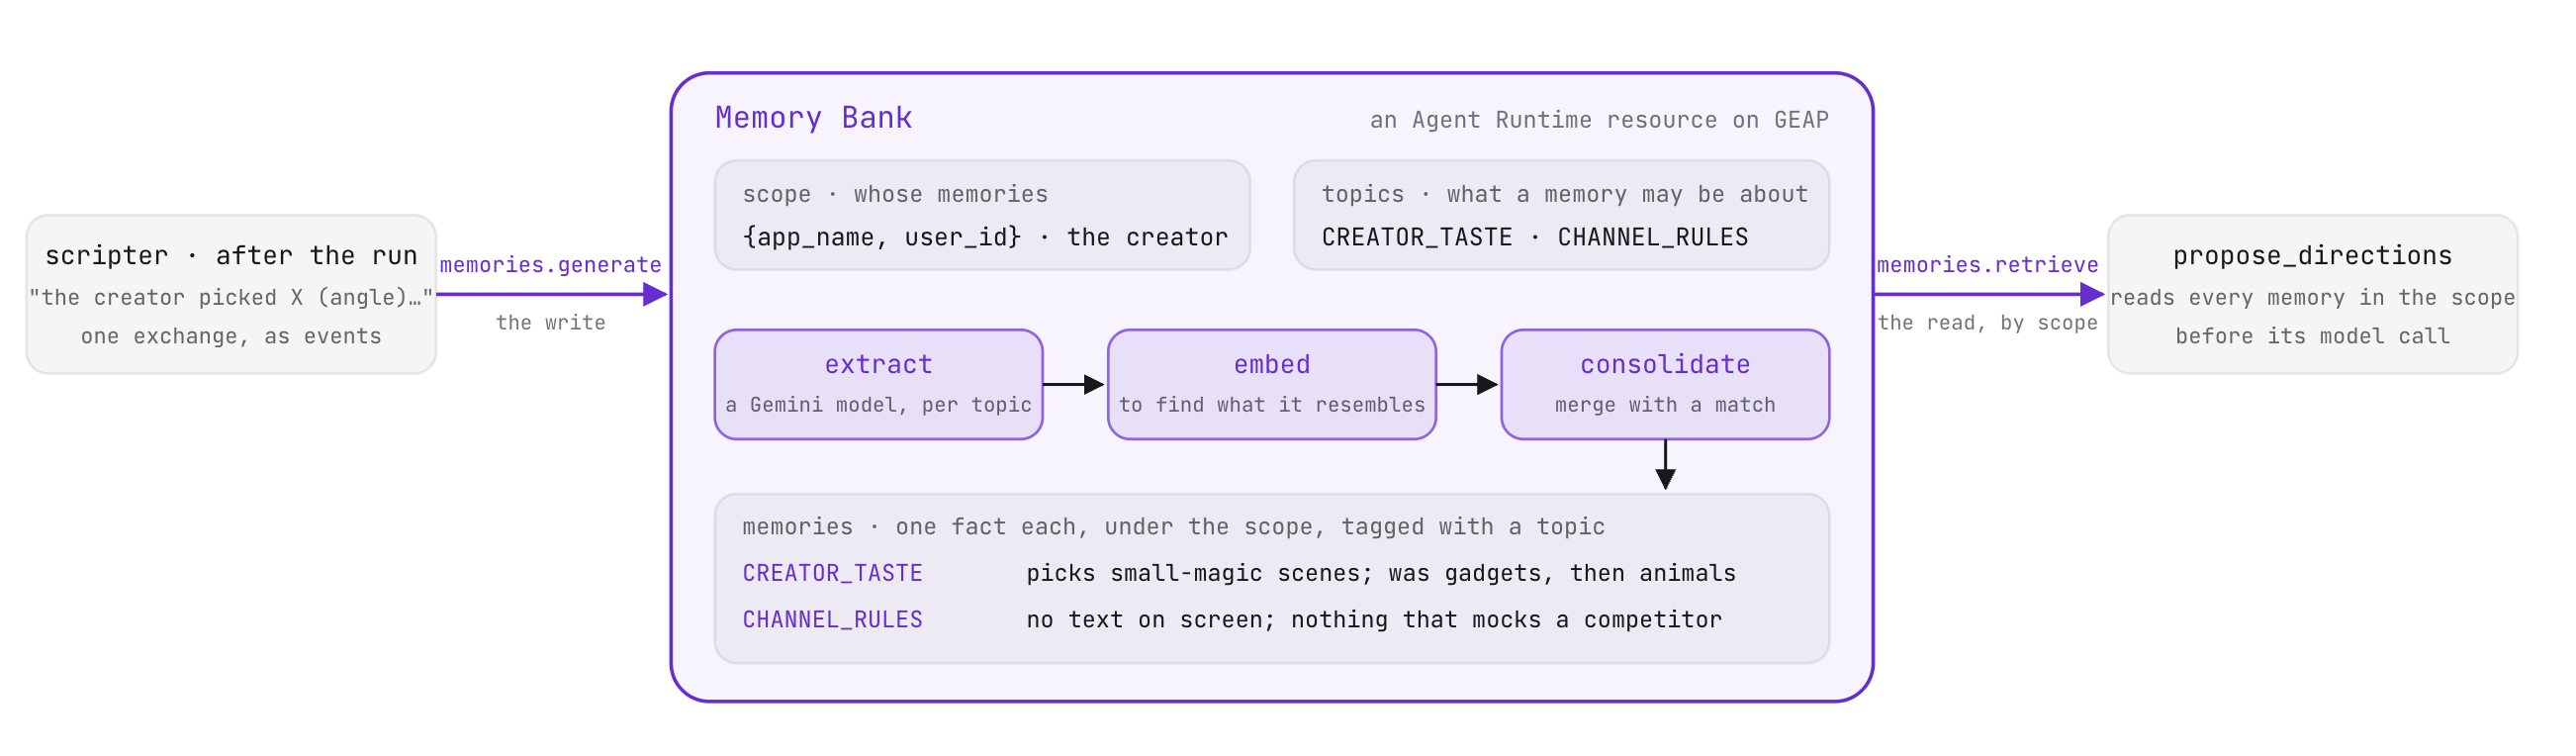
管理使用者層級個人化記憶
Memory Bank 是用於長期儲存使用者記憶的代管服務。這項功能會整理特定範圍內有關某人的事實,這裡的範圍由應用程式名稱和使用者 ID 決定:
SCOPE = {"app_name": config.APP, "user_id": config.USER}
TOPICS = {
    "CREATOR_TASTE": "Which video directions this creator picks and passes on, "
                     "and how that preference changes over time.",
    "CHANNEL_RULES": "Standing instructions the creator states for every video "
                     "(style, subjects to avoid, format rules).",
}
自訂記憶主題會定義記憶庫記錄內容的範圍:
- 主題擷取:透過
memories.generate提交新的對話文字時,服務會對每個主題說明套用擷取模型。如果文字與主題不符,系統就不會生成回憶集錦。 - 整合與簡化:服務會將新擷取的事實轉換為嵌入,並與範圍內的現有記憶進行比較。如果觀察結果與現有記憶相符,服務就會更新該記憶。如果代表新資訊,服務會建立新項目。這項整合程序可確保與某個主題相關的多個工作階段合併為連貫的摘要,而不是產生多餘的項目。
- 擷取:使用使用者範圍呼叫
memories.retrieve會傳回儲存的事實,並依時間排序,最舊的事實會排在最前面。
這兩項作業都是在 agent/platform/memory.py 中實作。系統會在 runs/memorybank.json 中,於本機快取已佈建的銀行資源名稱。
設定記憶庫
使用工作台控制項,或在終端機中執行 CLI 指令:
- 連結並佈建銀行:
python -m agent.platform.bankCREATOR_TASTE和CHANNEL_RULES主題。 - 植入歷來工作階段:
python -m agent.platform.bank load - 檢查整合事實:
python -m agent.platform.bank list
回呼 (6B)
在工作台中,前往「Callbacks (6B)」。開啟 stage4_memory/agent.py。
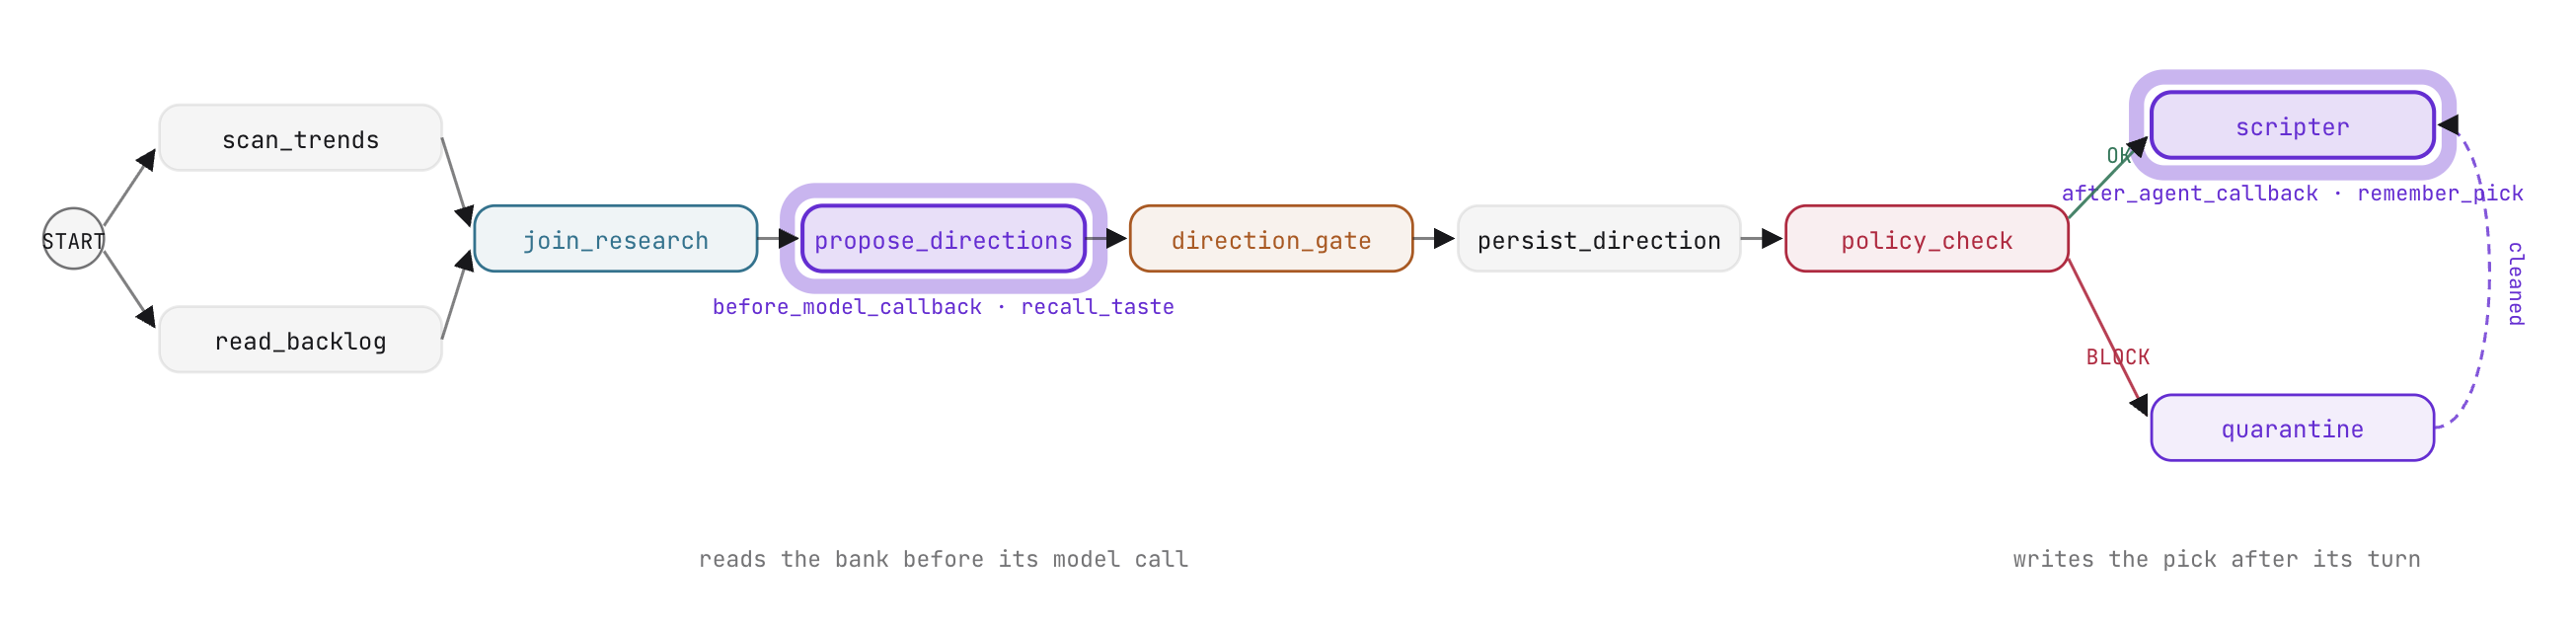
ADK 代理程式生命週期回呼
回呼是做為引數傳遞至 Agent 的函式。ADK 會在預先定義的生命週期時刻叫用回呼,並傳遞有效內容。傳回 None 會繼續正常執行;傳回替代物件會覆寫或攔截作業。
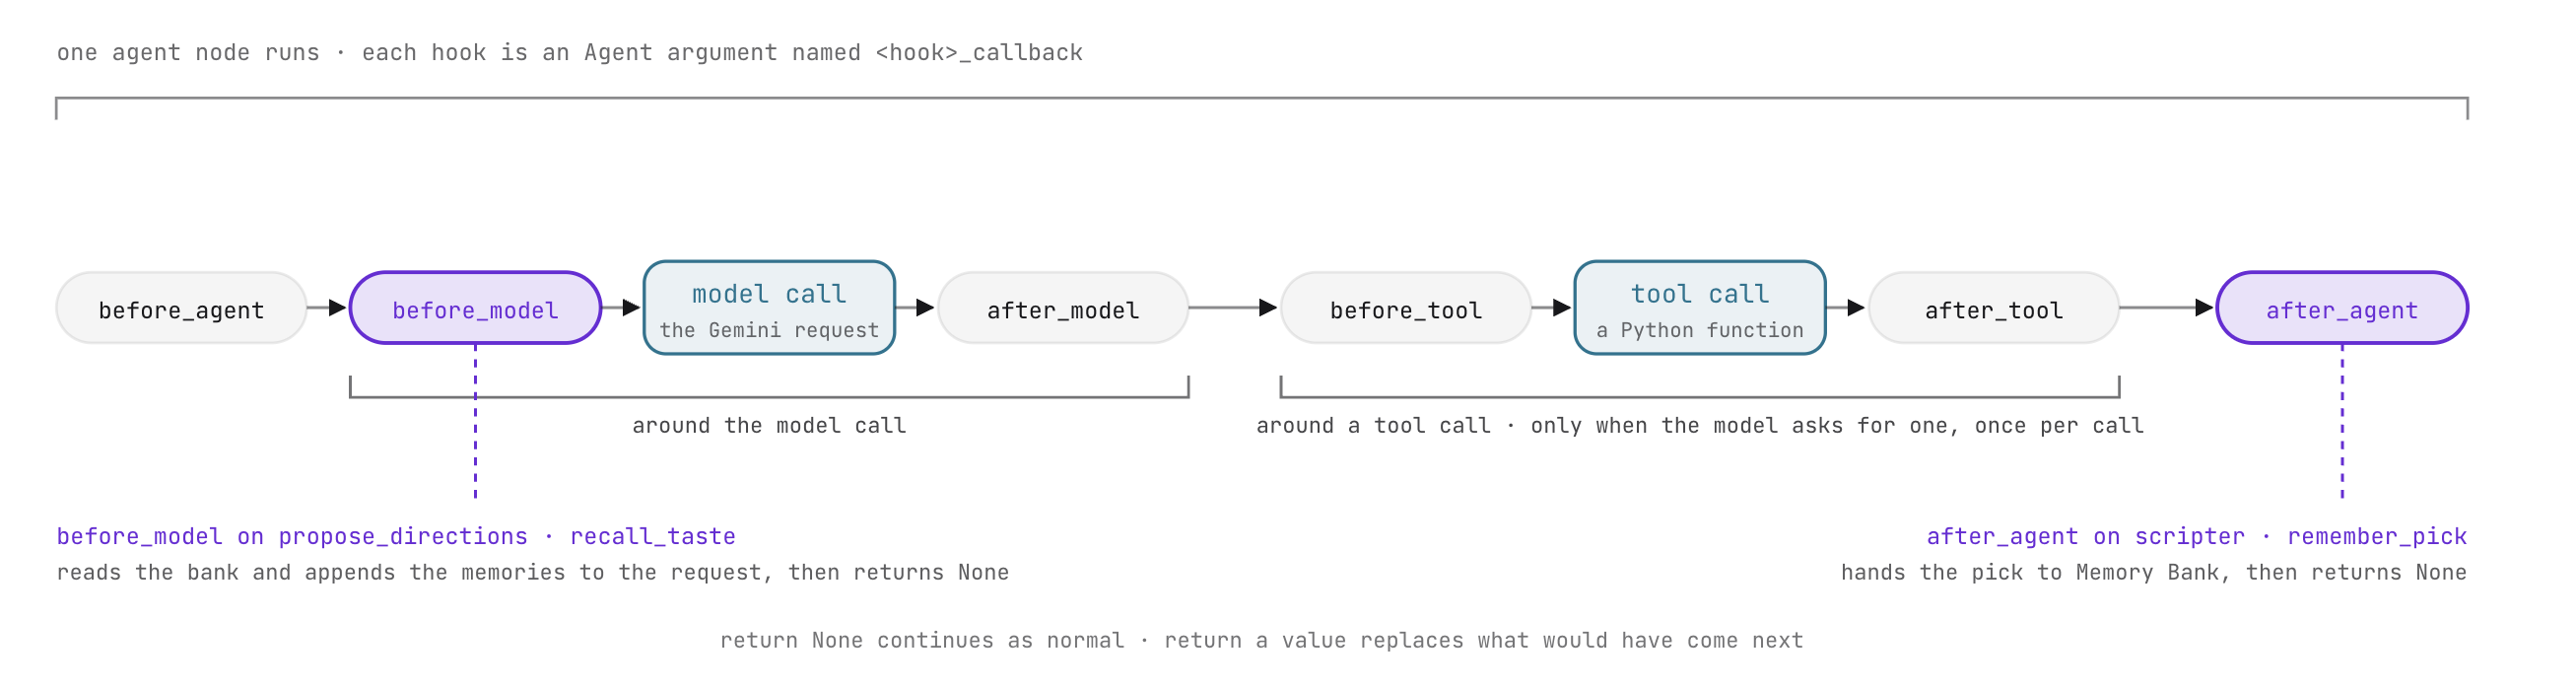
ADK 提供三組回呼:
回呼組合 | 叫用點 | 收到的參數 | 傳回值行為 |
| 包圍整個代理回覆 |
| 傳回 |
| 在每個 LLM 推論呼叫前後 |
| 傳回 |
| 在每次執行工具前後 | 工具定義、引數、結果 | 傳回字典會覆寫工具輸出內容, |
回呼提供一個乾淨的位置,用於插入情境、護欄、遙測和快取查詢,而不會在工作流程圖中引入不必要的節點。
動手編輯:連結回呼和記住回呼
- 在
stage4_memory/agent.py中,更新propose_directions以附加before_model_callback=recall_taste:
    output_schema=Directions,
    before_model_callback=recall_taste)
recall_taste 會在 Gemini 生成候選方向前立即執行。這項工具會從 Memory Bank 擷取建立者的記錄,並依時間順序格式化記憶,然後附加至外寄的 LlmRequest。提示詞會指示模型,讓候選項目 1 到 3 偏向創作者目前的喜好,同時將頻道規則視為嚴格限制。
- 在
stage4_memory/agent.py中,更新scripter以附加after_agent_callback=remember_pick:
    output_schema=Script,
    after_agent_callback=remember_pick)
remember_pick 會在 scripter 完成回合後執行。它會從工作階段狀態讀取所選方向,合成簡潔的陳述式來總結創作者的決定,並呼叫 memories.generate 更新記憶庫。
預期結果和原因
在工作台或 ADK Web 測試回呼增強型工作流程:
- 使用空白提示詞執行:
- 在工作階段追蹤記錄中,檢查
propose_directions的LlmRequest。請注意,記憶體內容會附加創作者偏好奇幻主題和簡潔步調的詳細資訊。 - 觀察建議方向:即使趨勢強調其他主題,候選方向 1 到 3 仍符合創作者的過往偏好。
- 在工作階段追蹤記錄中,檢查
- 選取
direction_gate的候選項目。 scripter完成後,請查看 Memory Bank 記錄:python -m agent.platform.bank list
7. RAG Engine
在 VibeStudio Workbench 中,前往「Step 7 · RAG Engine」的 (7A) 和 (7B) 部分。
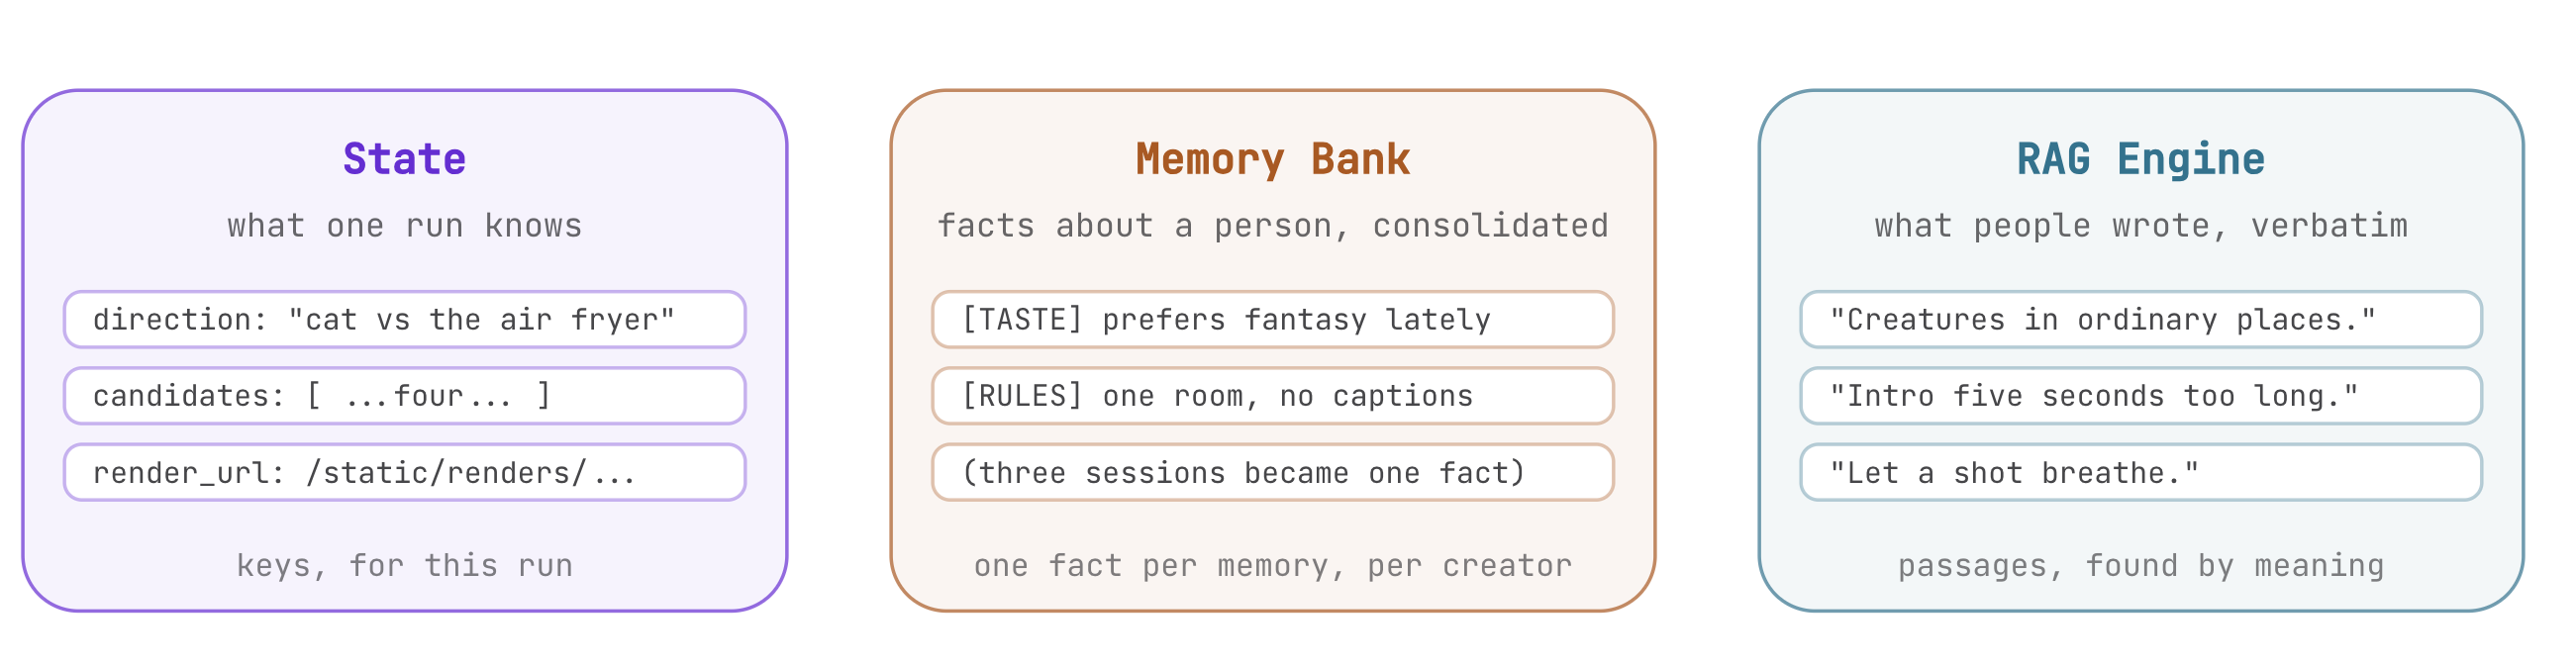
影片發布後,會持續累積觀眾意見回饋。系統會收集 30 則代表性留言,agent/comments.md擷取觀眾的讚美、對贊助內容節奏的批評,以及音訊偏好。在這個步驟中,您將使用 Vertex AI RAG Engine 為這些評論建立索引,並將語意檢索功能連結至研究擴散傳遞。
文件檢索 (7A)
在 Workbench 中,前往「RAG Engine (7A)」。
Memory Bank 與 RAG Engine
這兩項工具都會以外部資料做為工作流程的基準,但架構用途不同:
維度 | Memory Bank | RAG Engine |
主要用途 | 長期使用者偏好設定和作業規則 | 從大量文件集中進行語意檢索 |
範圍 | 範圍限於個別使用者 ID 和應用程式名稱 | 範圍限定為所有使用者共用的語料庫資源 |
資料處理 | 即時擷取、嵌入和語意整合 | 文件分塊、向量嵌入和最鄰近搜尋 |
Graph Integration | Agent 生命週期回呼 ( | 研究扇出中的專用函式節點 ( |
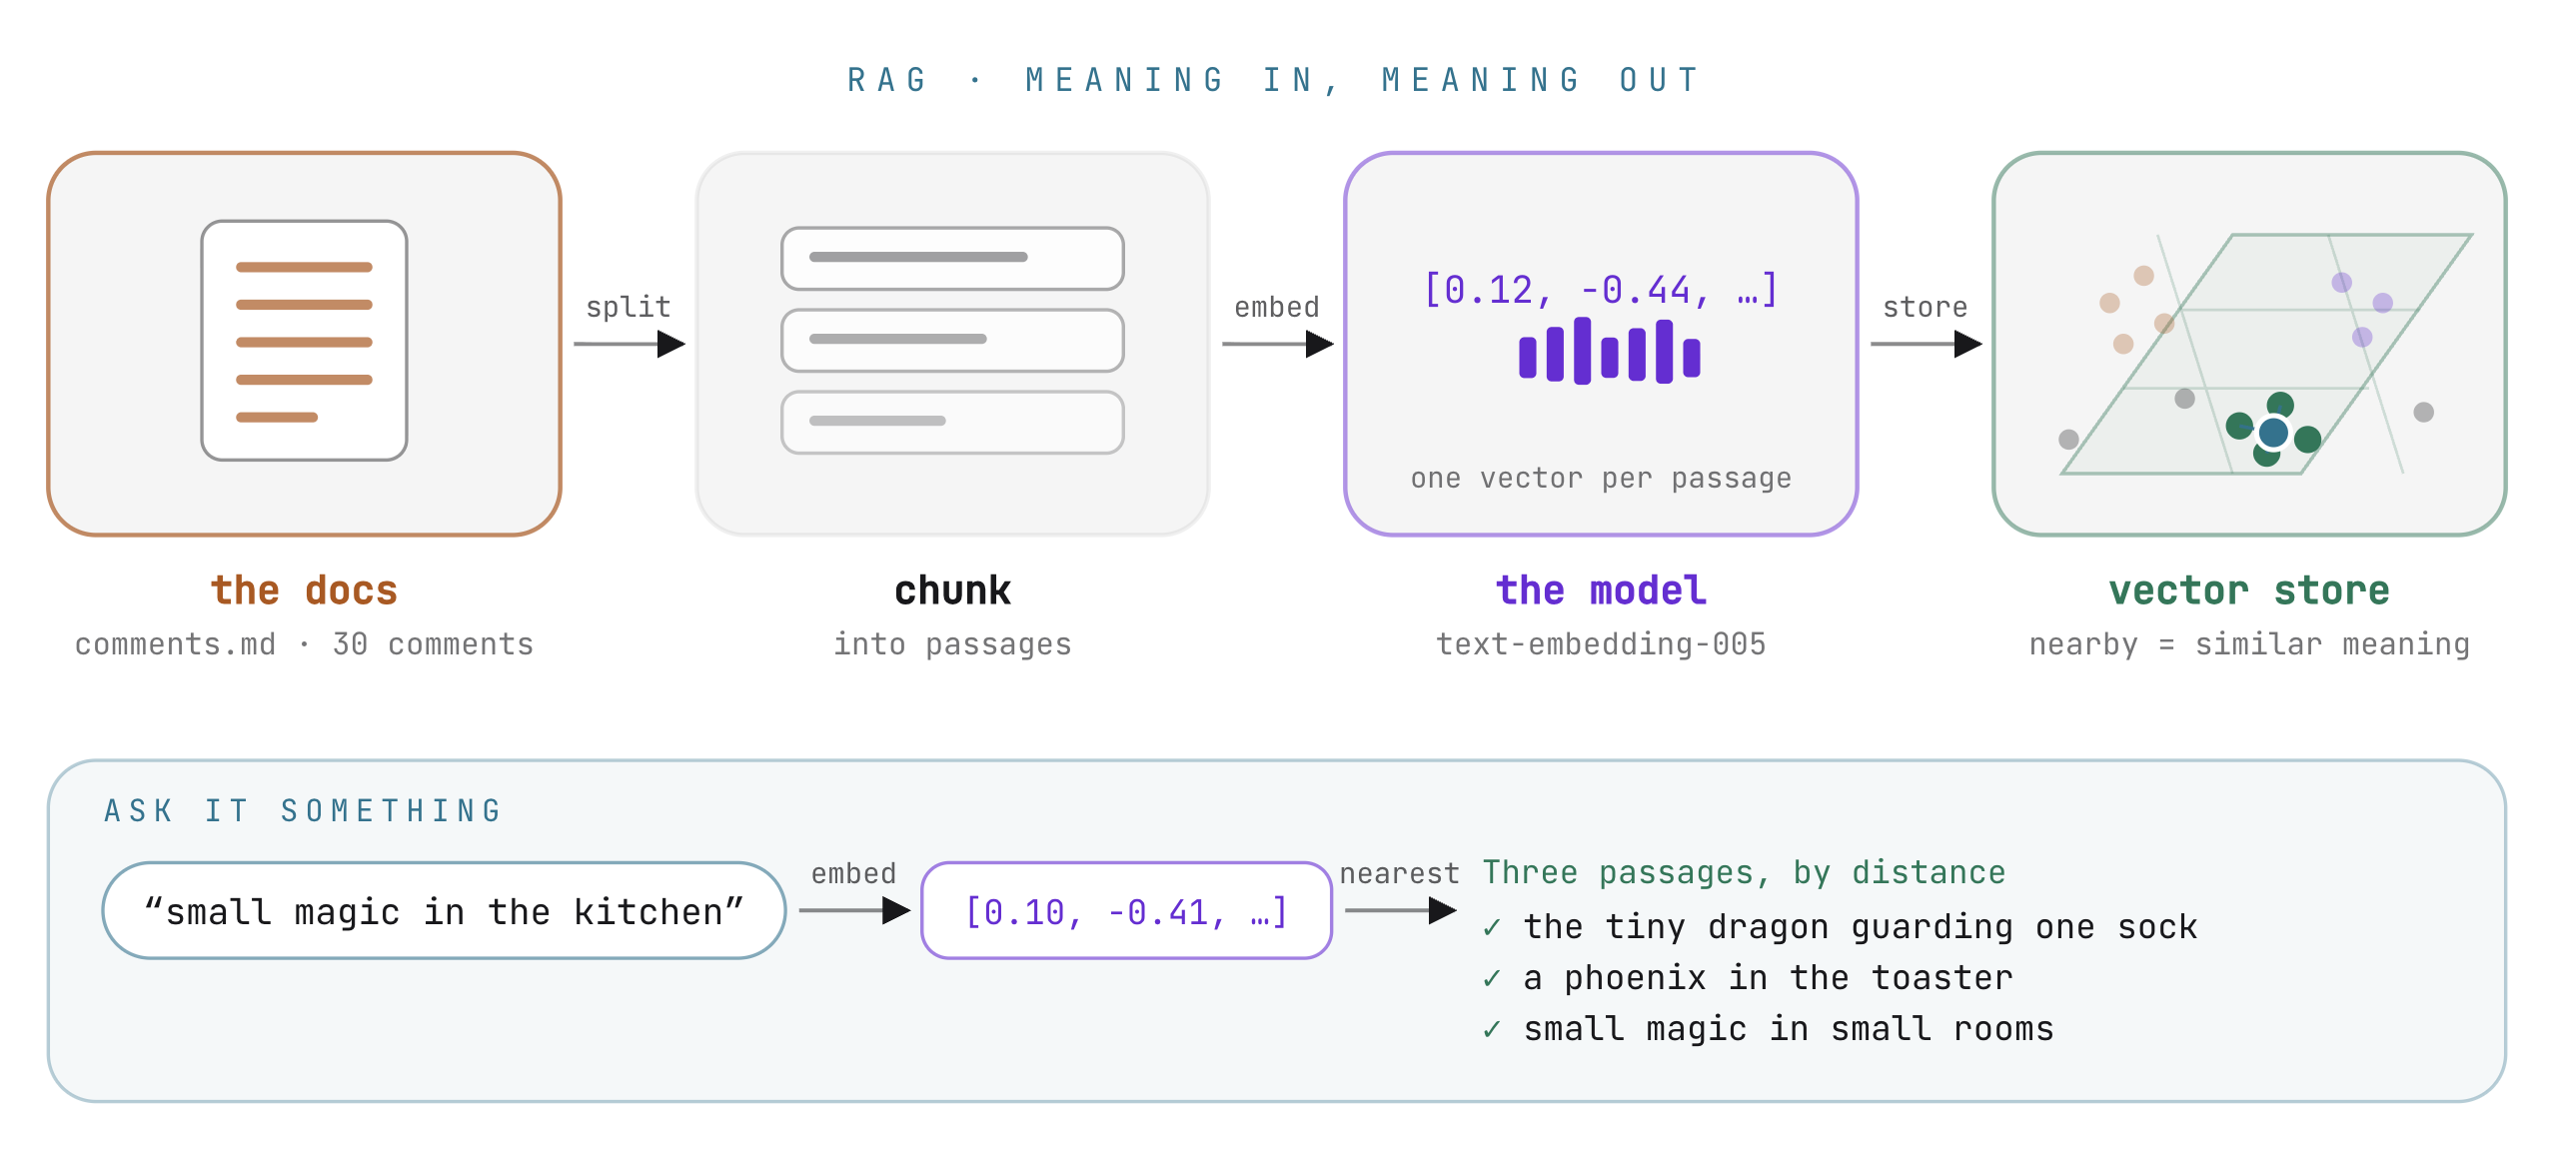
文件分塊和嵌入
RAG Engine 會將文字劃分為語意段落,並將這些段落的向量儲存在受管理資料庫中,藉此為文件建立索引:
corpus = rag.create_corpus(
    display_name="vibestudio-feedback",
    description="Vibe Studio: what the audience wrote under the channel's past videos.",
    backend_config=rag.RagVectorDbConfig(
        rag_embedding_model_config=rag.RagEmbeddingModelConfig(
            vertex_prediction_endpoint=rag.VertexPredictionEndpoint(
                publisher_model="publishers/google/models/text-embedding-005"))))

rag.upload_file(
    corpus_name=corpus.name, path="agent/comments.md", display_name="comments.md",
    transformation_config=rag.TransformationConfig(
        chunking_config=rag.ChunkingConfig(chunk_size=120, chunk_overlap=20)))
- 分塊大小:設定為 120 個權杖,重疊 20 個權杖。這樣一來,每個段落會擷取兩到三則留言,確保每個向量代表一致的情感,不會因不相關的意見回饋而稀釋意義。
- 嵌入模型:
text-embedding-005可將文字轉換為高維度向量。提交查詢後,模型會將查詢轉換為向量,並根據語意距離找出最接近的相符項目。例如,關於「守護襪子的小龍」的留言,與「魔法生物」的提示相符,即使關鍵字不完全相同也沒關係。
設定 RAG 語料庫
使用工作台按鈕或終端機指令初始化語料庫:
- 建立語料庫:
python -m agent.platform.ragruns/ragcorpus.json。 - 上傳及建立註解索引:上傳
agent/comments.md並設定分塊,然後等待索引建立完成。 - 查詢語料庫:使用與留言沒有完全相同字詞的查詢,測試相似度擷取功能 (例如,查詢「小型魔法生物」來擷取有關龍的留言)。
檢索節點 (7B)
在工作台中,前往「第三個讀取器 (7B)」。開啟 stage5_rag/agent.py。
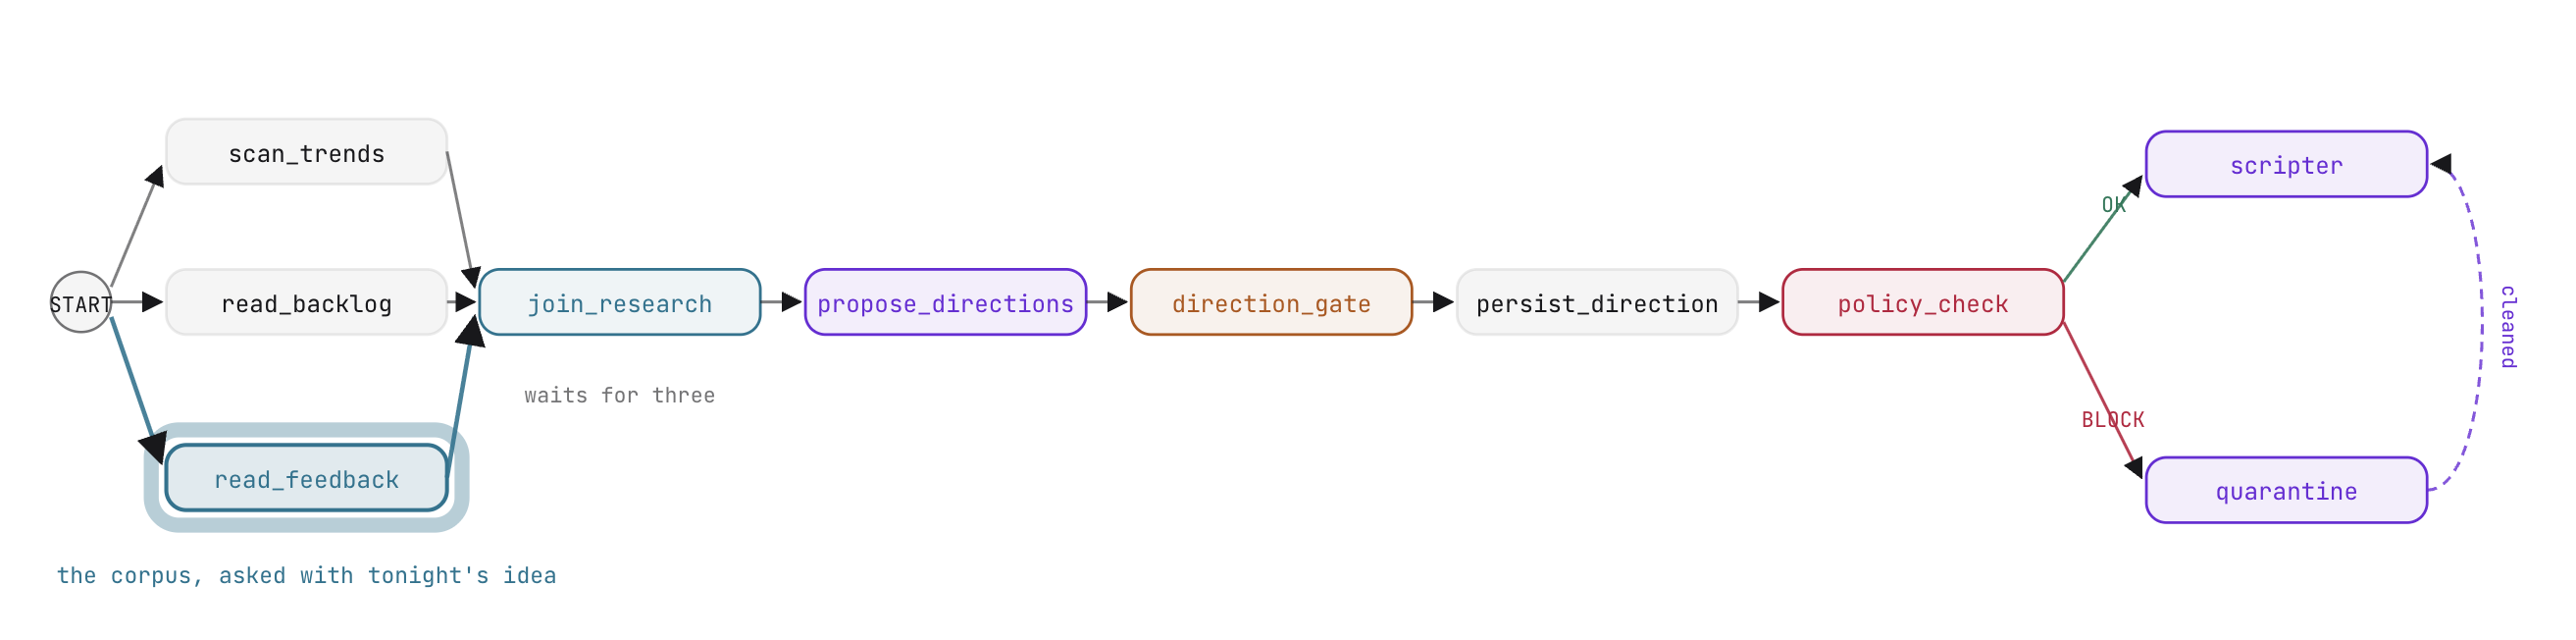
以圖表節點形式擷取
觀眾意見回饋代表在工作流程中分享的研究資料。與個人創作者記憶不同,觀眾情緒會與趨勢和待辦事項資料一起直接饋送至 join_research。因此,這項功能會以函式節點的形式實作:
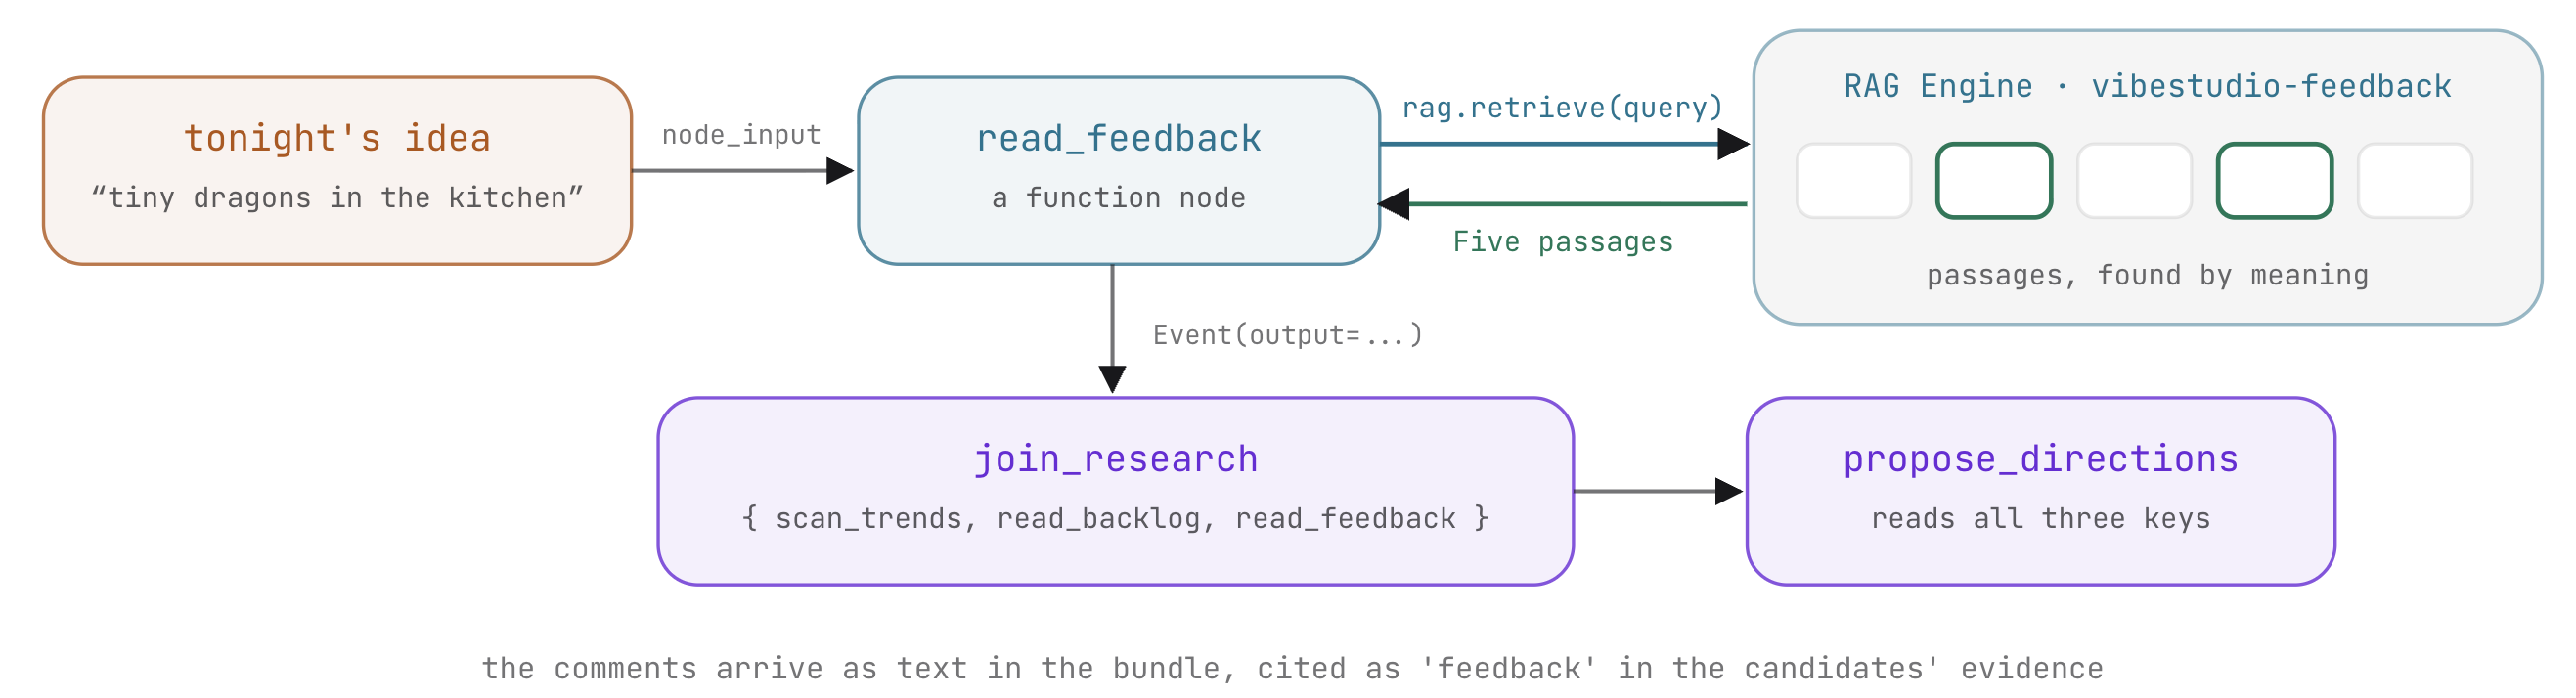
def read_feedback(node_input):
    """The third reader (step 7): what the audience wrote under past videos,
    the passages nearest to tonight's idea. Retrieval, not a model call."""
    from .platform import rag
    idea = idea_text(node_input)
    query = idea or "what viewers liked and what they complained about"
    try:
        hits = rag.retrieve(query)
    except Exception as e:
        print(f"  [rag] feedback unavailable ({str(e)[:80]})")
        return Event(output={"query": query, "feedback": [],
                             "note": "no corpus connected - run: python -m agent.platform.rag"})
    return Event(output={"query": query, "feedback": [h["text"] for h in hits]})
read_feedback 會擷取使用者的初始想法,並對 RAG Engine 語料庫執行向量查詢。並以 Event(output=...) 酬載的形式發出擷取的留言。
實際編輯:將第三個讀取器接線到扇出
在 stage5_rag/agent.py 中更新 edges,將 read_feedback 新增為進入 join_research 的第三個平行分支:
           (START, read_backlog, join_research),
           (START, read_feedback, join_research),
由於 join_research 是 JoinNode,因此會同步處理所有傳入分支,等到 scan_trends、read_backlog 和 read_feedback 都發出事件後,再將匯總的套件傳遞至下游。
後續步驟和原因
在 Workbench 中執行工作流程:
- 提交構想提示 (例如「一隻迷你龍守護廚房流理台」)。
- 在執行追蹤記錄中,確認三個讀取器節點同時執行。
- 觀察
join_research:其輸出字典現在包含trends、backlog和feedback。 - 檢查
propose_directions生成的候選提案:模型會將觀眾留言納入提案,並在證據欄位中參考觀眾情緒。 - 請注意,RAG 擷取作業是確定性的 (相同的查詢會傳回相同的留言段落),而生成建議節點會產生創意變化。
8. 使用 Veo 非同步生成影片
在 VibeStudio Workbench 中,前往「Step 8 · The video」的 (8A) 和 (8B) 部分。
使用 Google Veo 生成高畫質影片時,每次算繪需要幾分鐘。在這段期間封鎖 Graph Execution 會浪費運算資源、鎖定執行緒集區,並導致執行作業發生 HTTP 連線中斷。在這個步驟中,您會使用 ADK 的 LongRunningFunctionTool,讓影片算繪作業非同步執行。
長時間運作的工具 (8A)
在工作台中,前往「A long-running tool (8A)」。開啟 stage6_video/agent.py 和 agent/deliver.py。
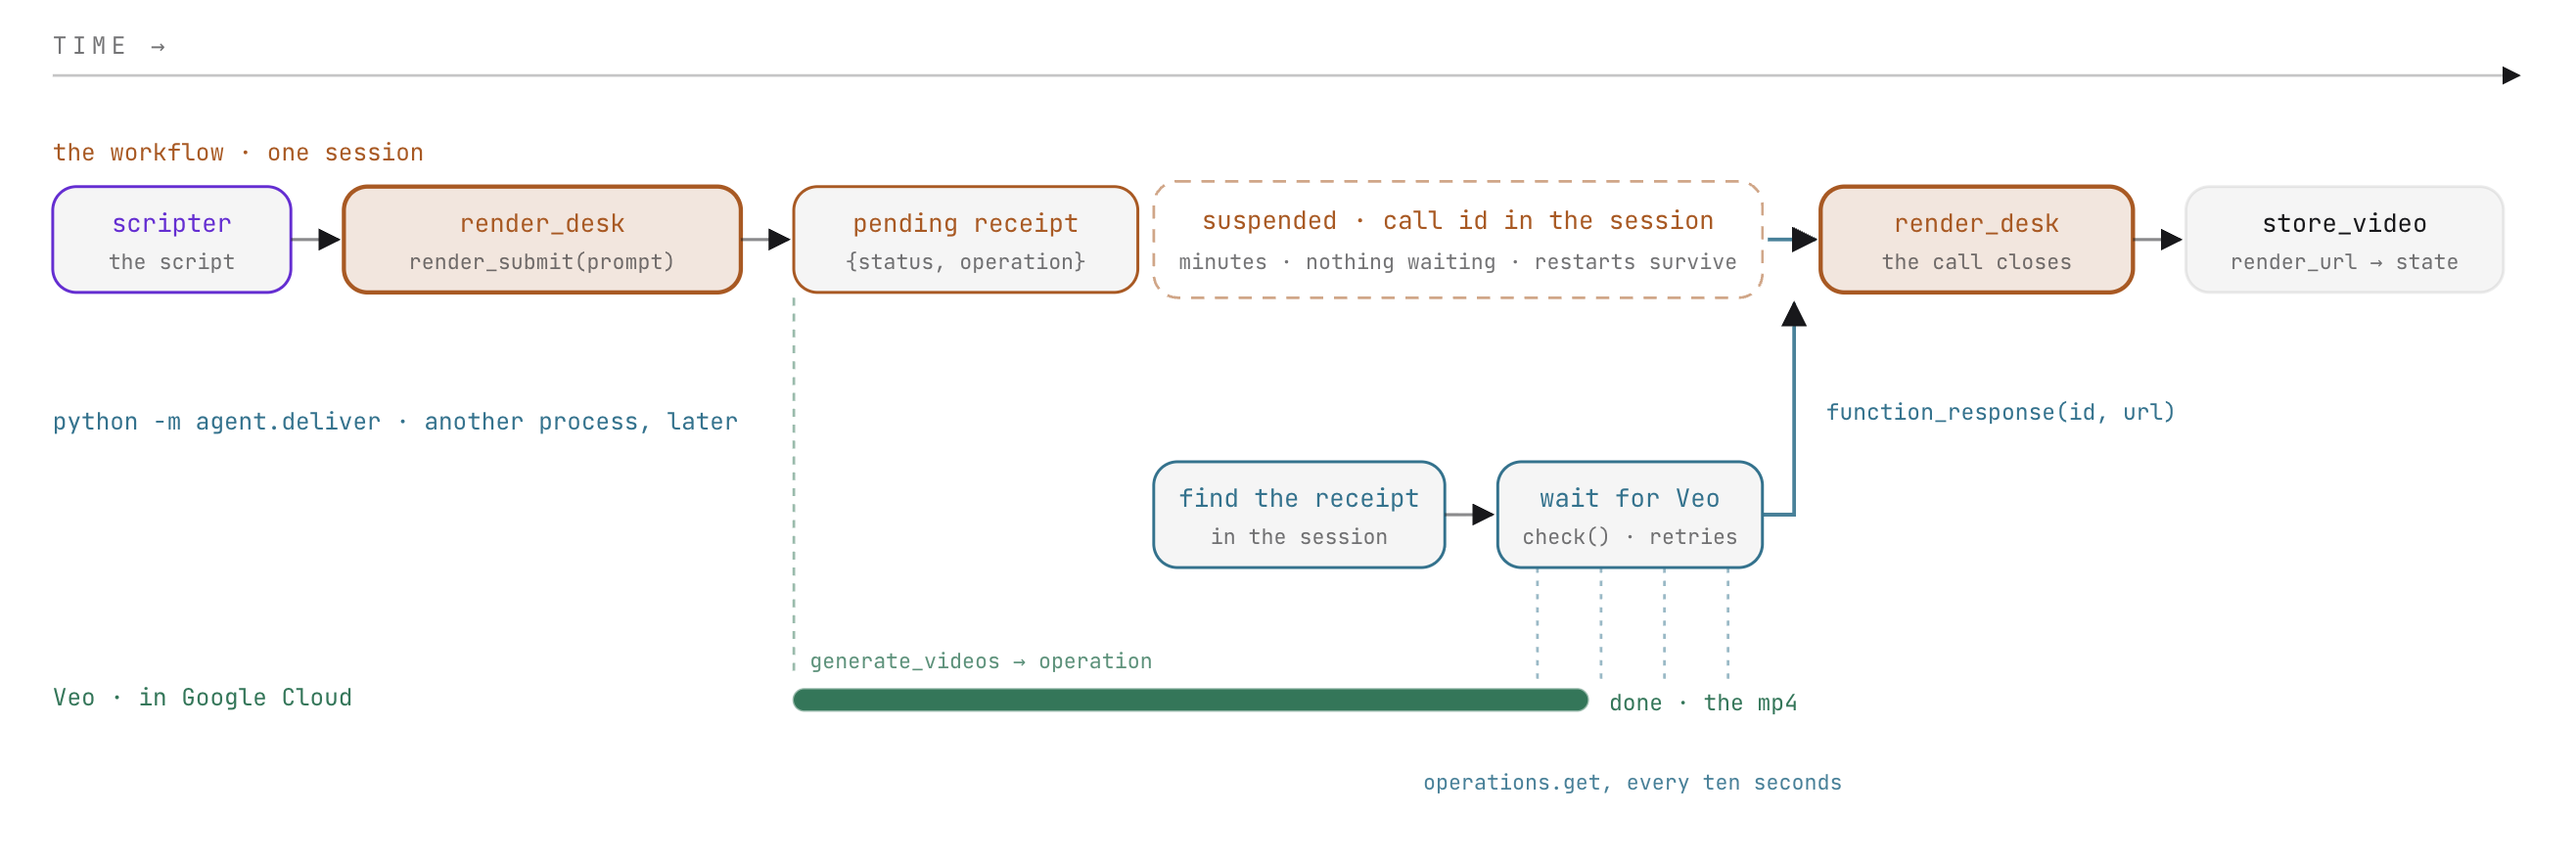
同步工具與長時間執行的工具
標準 ADK 函式工具會在代理回合中同步執行:模型會呼叫工具、等待傳回酬載,並將結果納入進行中的回合。
影片無法在單一回合內完成算繪。render_submit 會啟動生成工作,並立即傳回作業收據,狀態為 "pending":
def render_submit(prompt: str) -> dict:
    """Submit one Veo render of `prompt`. Returns at once with a pending
    receipt; the clip is delivered later, to this call, by id."""
    receipt = videogen.start(f"{prompt} {videogen.NO_TEXT}")
    return {"status": "pending", "operation": receipt["operation"], "prompt": receipt["prompt"]}
以 LongRunningFunctionTool 包裝時,ADK 會攔截 "pending" 狀態。專員的輪流對話結束後,工作流程會在節點暫停,而待處理的通話中繼資料 (包括通話 ID 和收據) 會記錄在 runs/sessions.db 中。執行程序會完全退出,不會維持有效的網路連線或背景工作執行緒。
實作編輯:包裝轉譯工具
在 stage6_video/agent.py 中,更新 render_desk,將 render_submit 包裝在 LongRunningFunctionTool 中:
tools=[LongRunningFunctionTool(render_submit)])
依通話 ID 繼續
通用恢復模式
ADK 會對人類和外部工具套用相同的機制,暫停及繼續工作流程:
停權觸發條件 | 啟動建構 | 儲存的停權狀態 | 繼續事件 |
專人審查 |
| 在工作階段儲存庫中開啟輸入提示 |
|
長時間執行的工具 |
| 在工作階段商店中開啟工具呼叫 |
|
在這兩種情況下,工作流程都會完全停止,直到從外部來源 (使用者介面、Webhook 或背景工作站) 收到具有相符 FunctionResponse 的事件,才會繼續執行。
實際操作編輯:完成外送回覆
在 agent/deliver.py 中,建構繼續 FunctionResponse 部分:
    part = Part(function_response=FunctionResponse(
        id=row["call_id"], name=row["name"], response=response))
傳送 Daemon 會輪詢 Veo,直到影片檔案生成,然後將這個 FunctionResponse 傳送至工作階段。ADK 會比對呼叫 ID,並直接在下一個節點繼續執行工作流程。已完成的節點不會重新執行,且代理程式不會進行其他生成式對話。
在 .env 中設定 STUDIO_REAL_VIDEO=0 即可啟用模擬算繪:start 會立即傳回測試收據,check 則會在五秒內模擬完成,不會產生 Veo API 呼叫費用。
管道整合 (8B)
在工作台中,前往「render_desk in the graph (8B)」。開啟 stage6_video/agent.py。
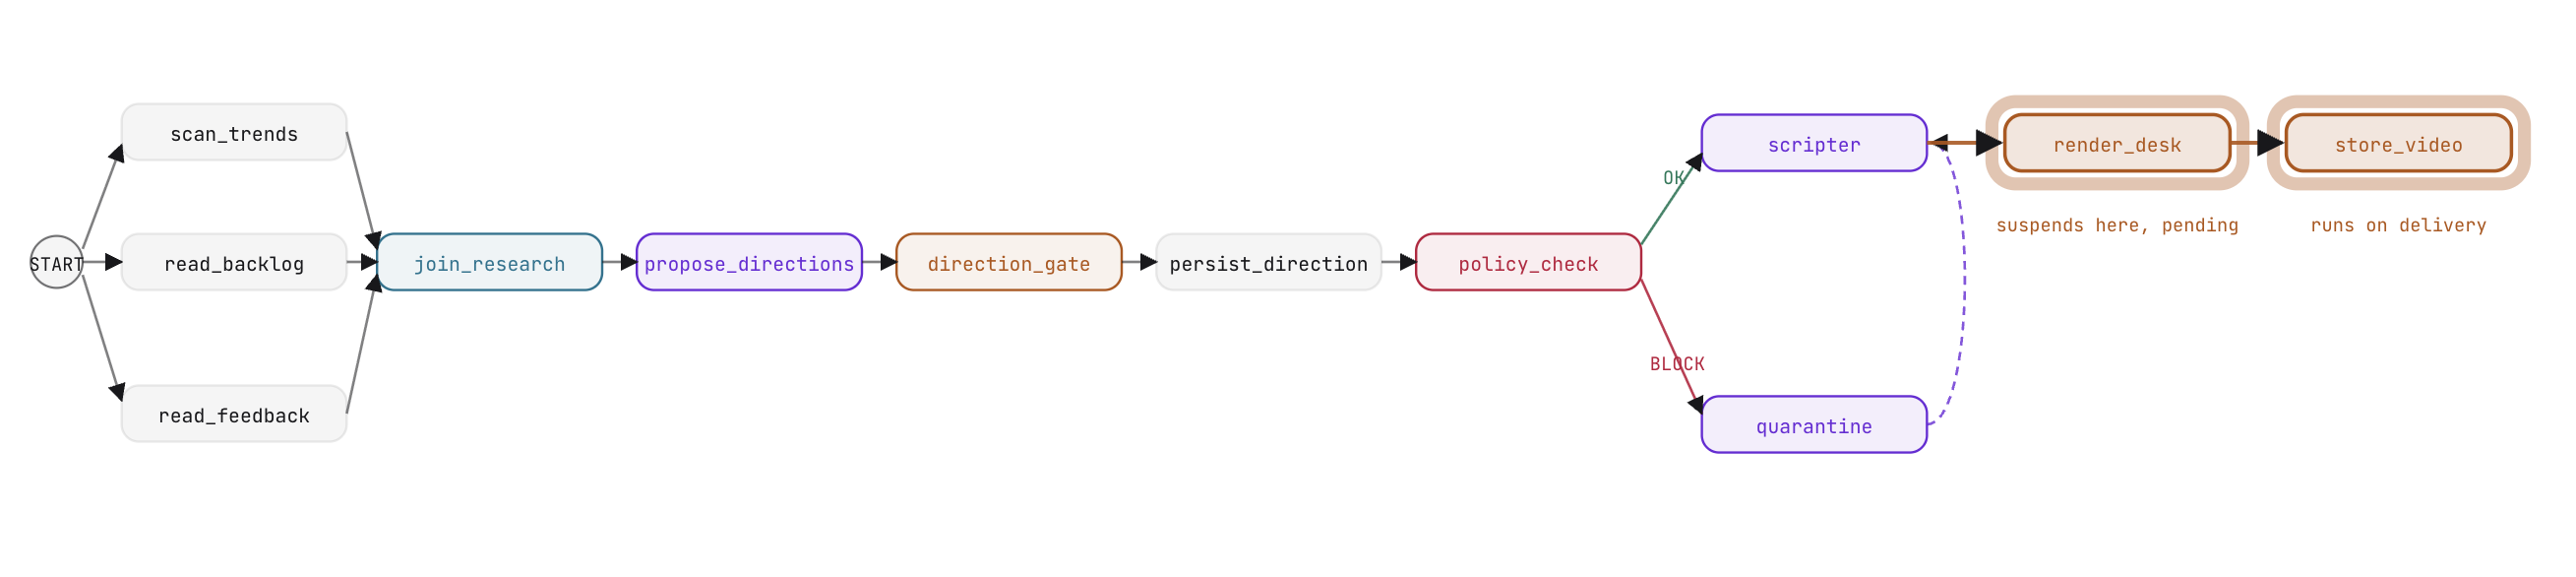
管道中的終端節點為 store_video。它會從 runs/state.json (傳送程序記錄的位置) 讀取完成的算繪資訊,並將影片網址和生成狀態提交至共用工作階段狀態。
實作編輯:連結完整的影片管道
在 stage6_video/agent.py 中,更新 edges 以附加 render_desk 和 store_video:
           (quarantine, scripter),
           (scripter, render_desk, store_video)])
預期結果和原因
在工作台中測試非同步生成流程:
- 透過候選項目選取和指令碼生成功能執行工作流程。
- 在
render_desk,觀察代理叫用render_submit。 - 工作流程會立即暫停。在工作台或 ADK Web 中,觀察待處理狀態:工作階段會保留開啟的通話 ID,且沒有背景程序消耗資源。
- 使用工作台控制台或在終端機中執行傳送精靈:
python -m agent.deliver - 在 ADK Web 重新整理工作階段:執行作業會從
store_video繼續,將影片網址提交至工作階段狀態,並完成工作流程。
9. 部署至 Cloud Run
在 VibeStudio Workbench 中,前往「步驟 9 · 部署」。
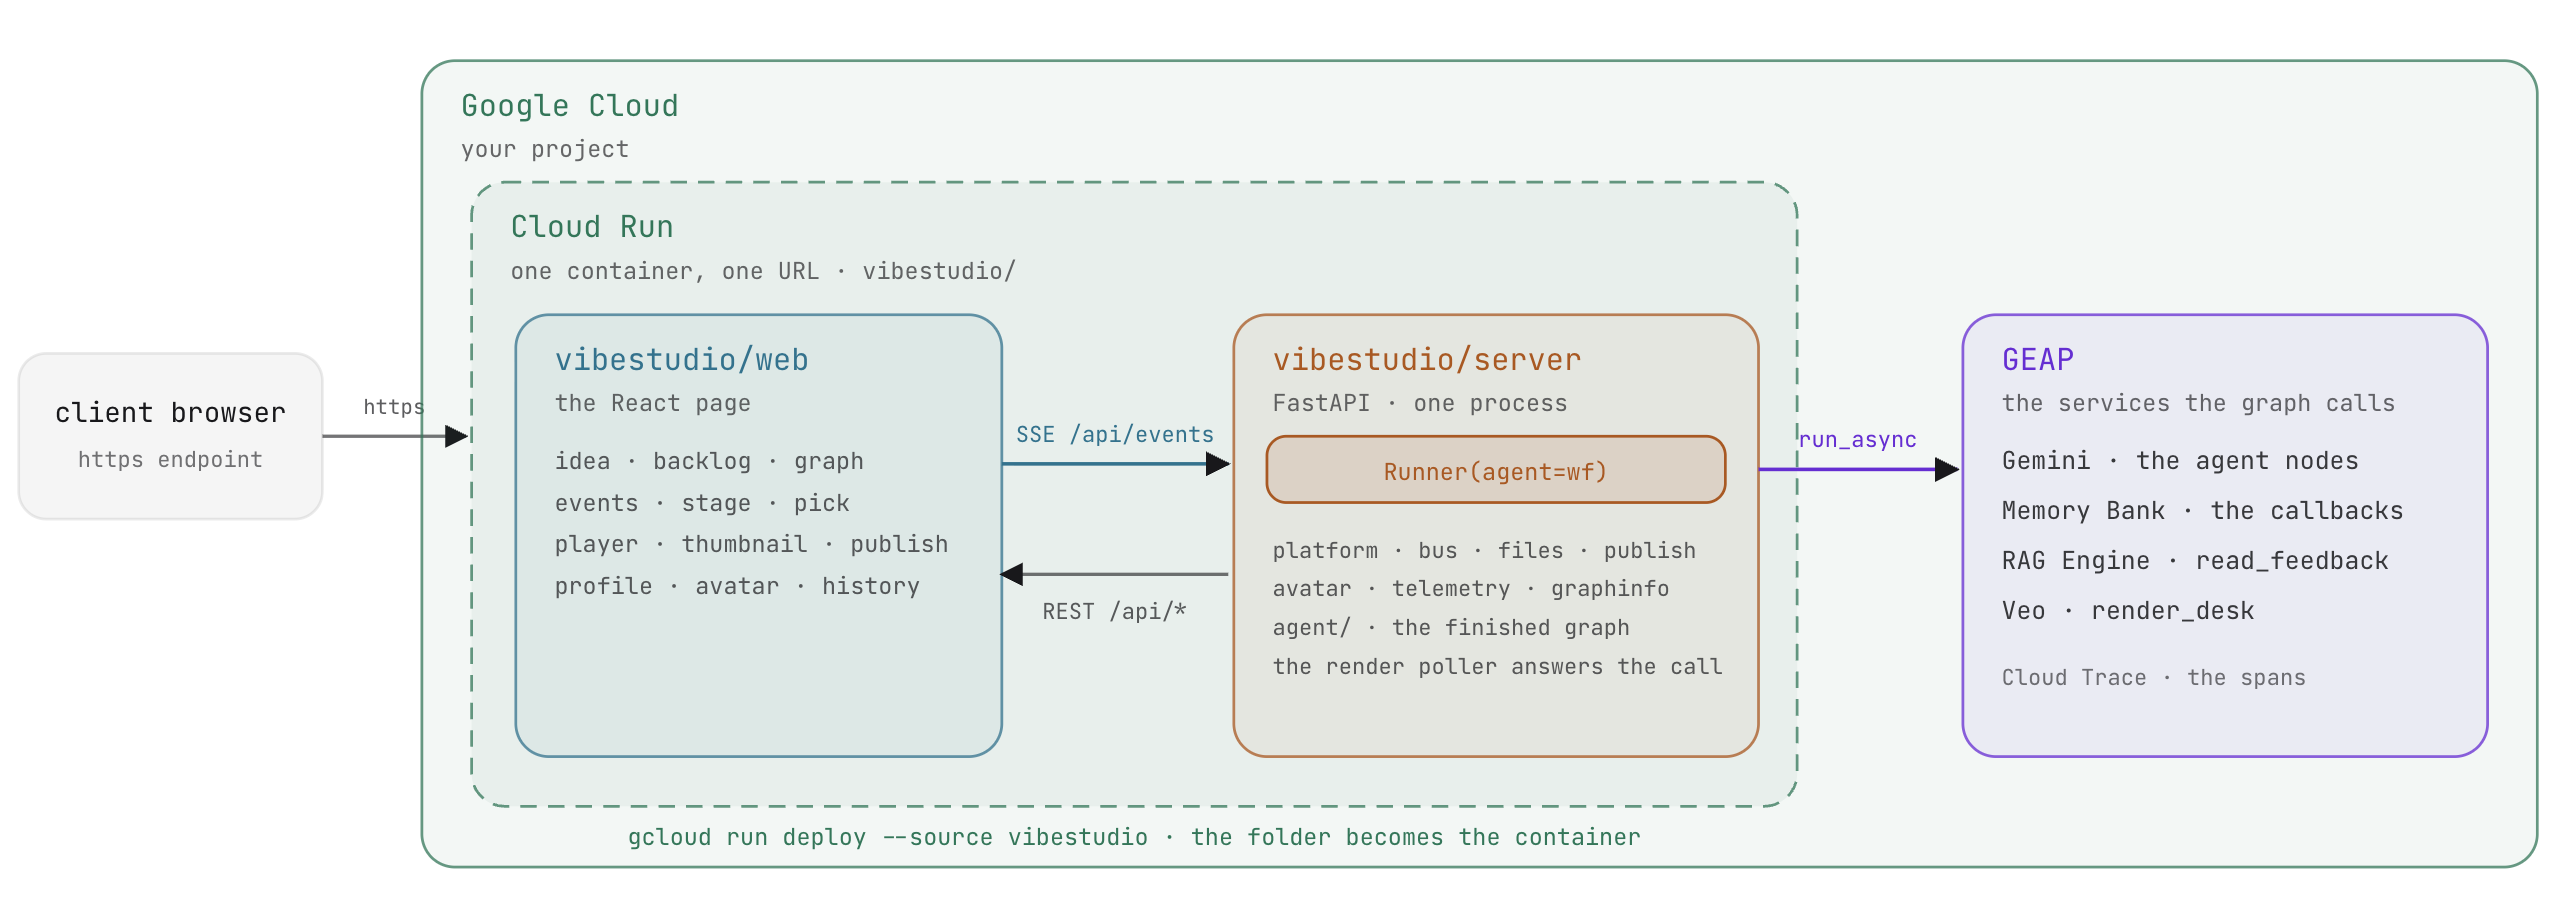
您已在專屬沙箱中開發及驗證管道的每個元件。在這個步驟中,您將組裝完整的正式環境管道,並部署至 Google Cloud Run。
ADK 執行器
在開發階段,adk web 會安排圖表。在正式環境中,應用程式會使用 ADK 的 Runner 類別託管工作流程:
self._svc = DatabaseSessionService(db_url=config.DB_URL)
self._runner = Runner(app_name=config.APP, agent=wf, session_service=self._svc)

async for ev in self._runner.run_async(user_id=config.USER, session_id=run_id, new_message=message):
    self._absorb(ev)    # fold the ADK event into the run state, publish one app event

# the gate's answer and the render's delivery are the same call, with a function_response part
part = Part(function_response=FunctionResponse(id=call_id, name=name, response=response))
run_async:驅動工作流程執行作業,在節點執行時依序產生事件,並將更新內容保存至工作階段服務。- 統一續傳:使用者在
direction_gate做出決定,以及 Veo 傳送完成的影片後,系統會透過提交至run_async的相同FunctionResponse物件繼續執行作業。
正式版應用程式架構
vibestudio/ 中的正式版應用程式整合了完整管道:
vibestudio/
  server/
    main.py                 FastAPI: application server, REST routes, static assets
    api.py                  REST API endpoints: run, pick, publish, backlog, profile, history
    runner.py               Runner orchestration over the workflow, background render poller
    platform/               Event bus (SSE stream), file storage, publishing, telemetry
    agent/                  Production agent package, verified by checks/verify_app.py
      graph.py              The complete workflow graph and node definitions
      desk.py               render_desk and render_submit wrapped with LongRunningFunctionTool
      schemas.py            Pydantic schemas: Directions, CleanedDirection, Script
      cleanup_tools.py      Deterministic policy tools: find_policy_hits, suggest_replacement
      platform/             Memory Bank, RAG Engine, and Veo integrations
  web/                      Production React user interface
  Dockerfile · deploy.py · run.sh
- 單一事件串流:FastAPI 後端會透過單一伺服器傳送事件 (SSE) 串流發布事件。React 前端會即時顯示圖表進度,並處理延遲連線,不會遺失狀態。
- 分離執行:應用程式會管理事件迴圈。工作流程圖完全著重於執行邏輯,不會涉及前端介面。
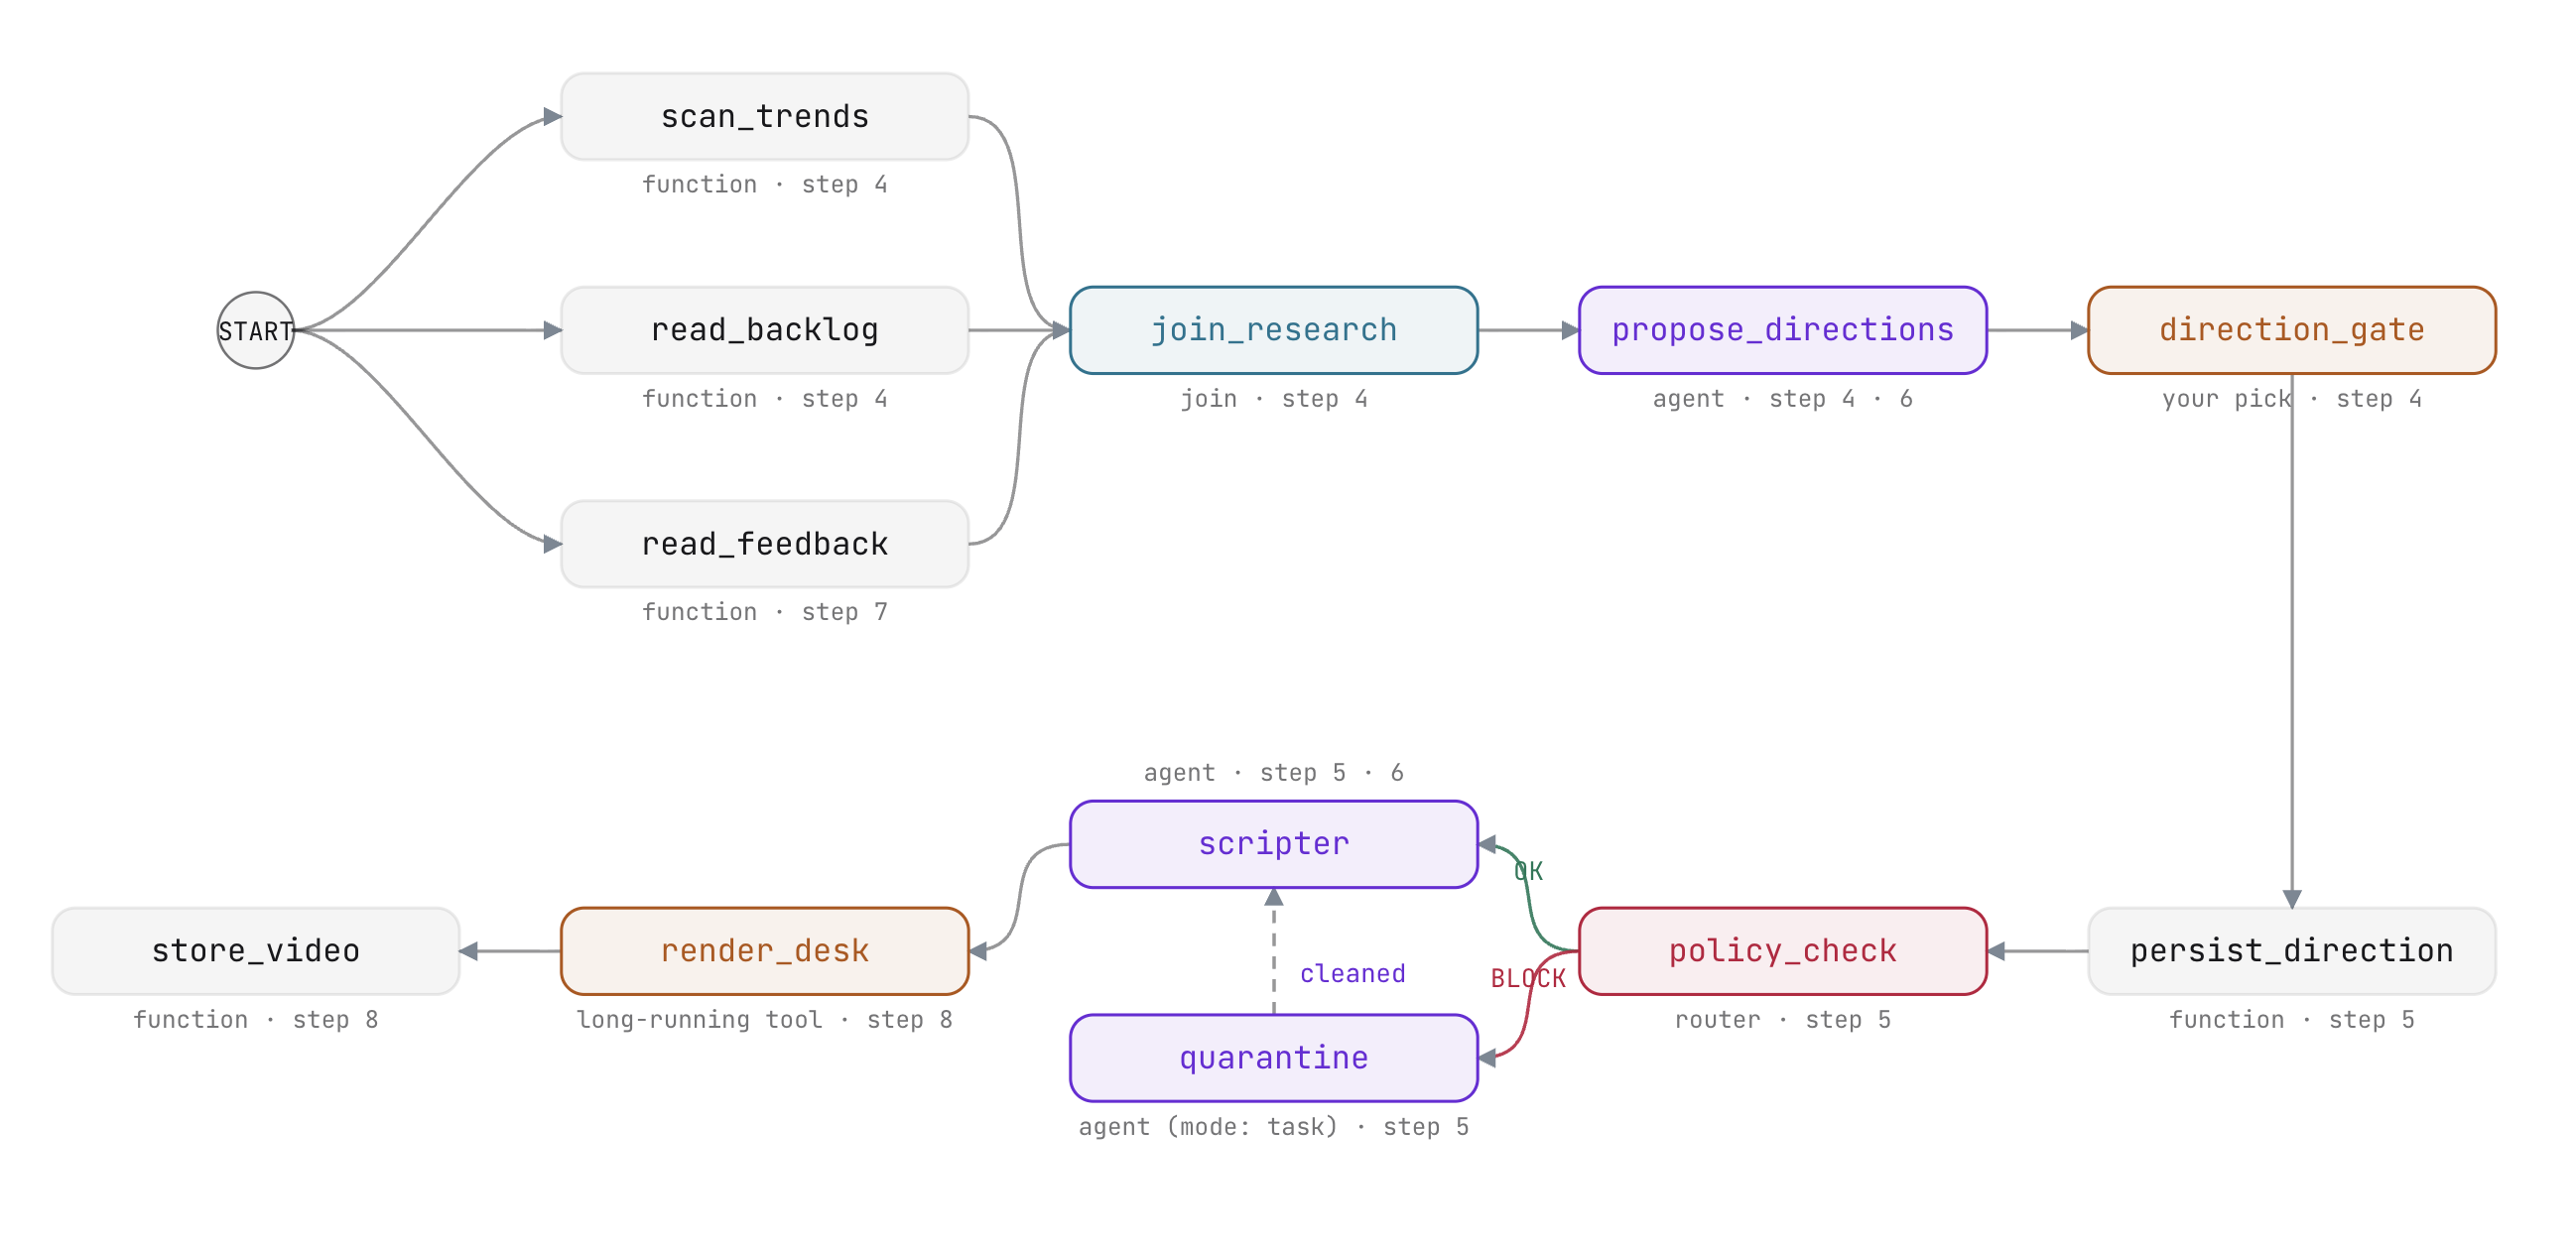
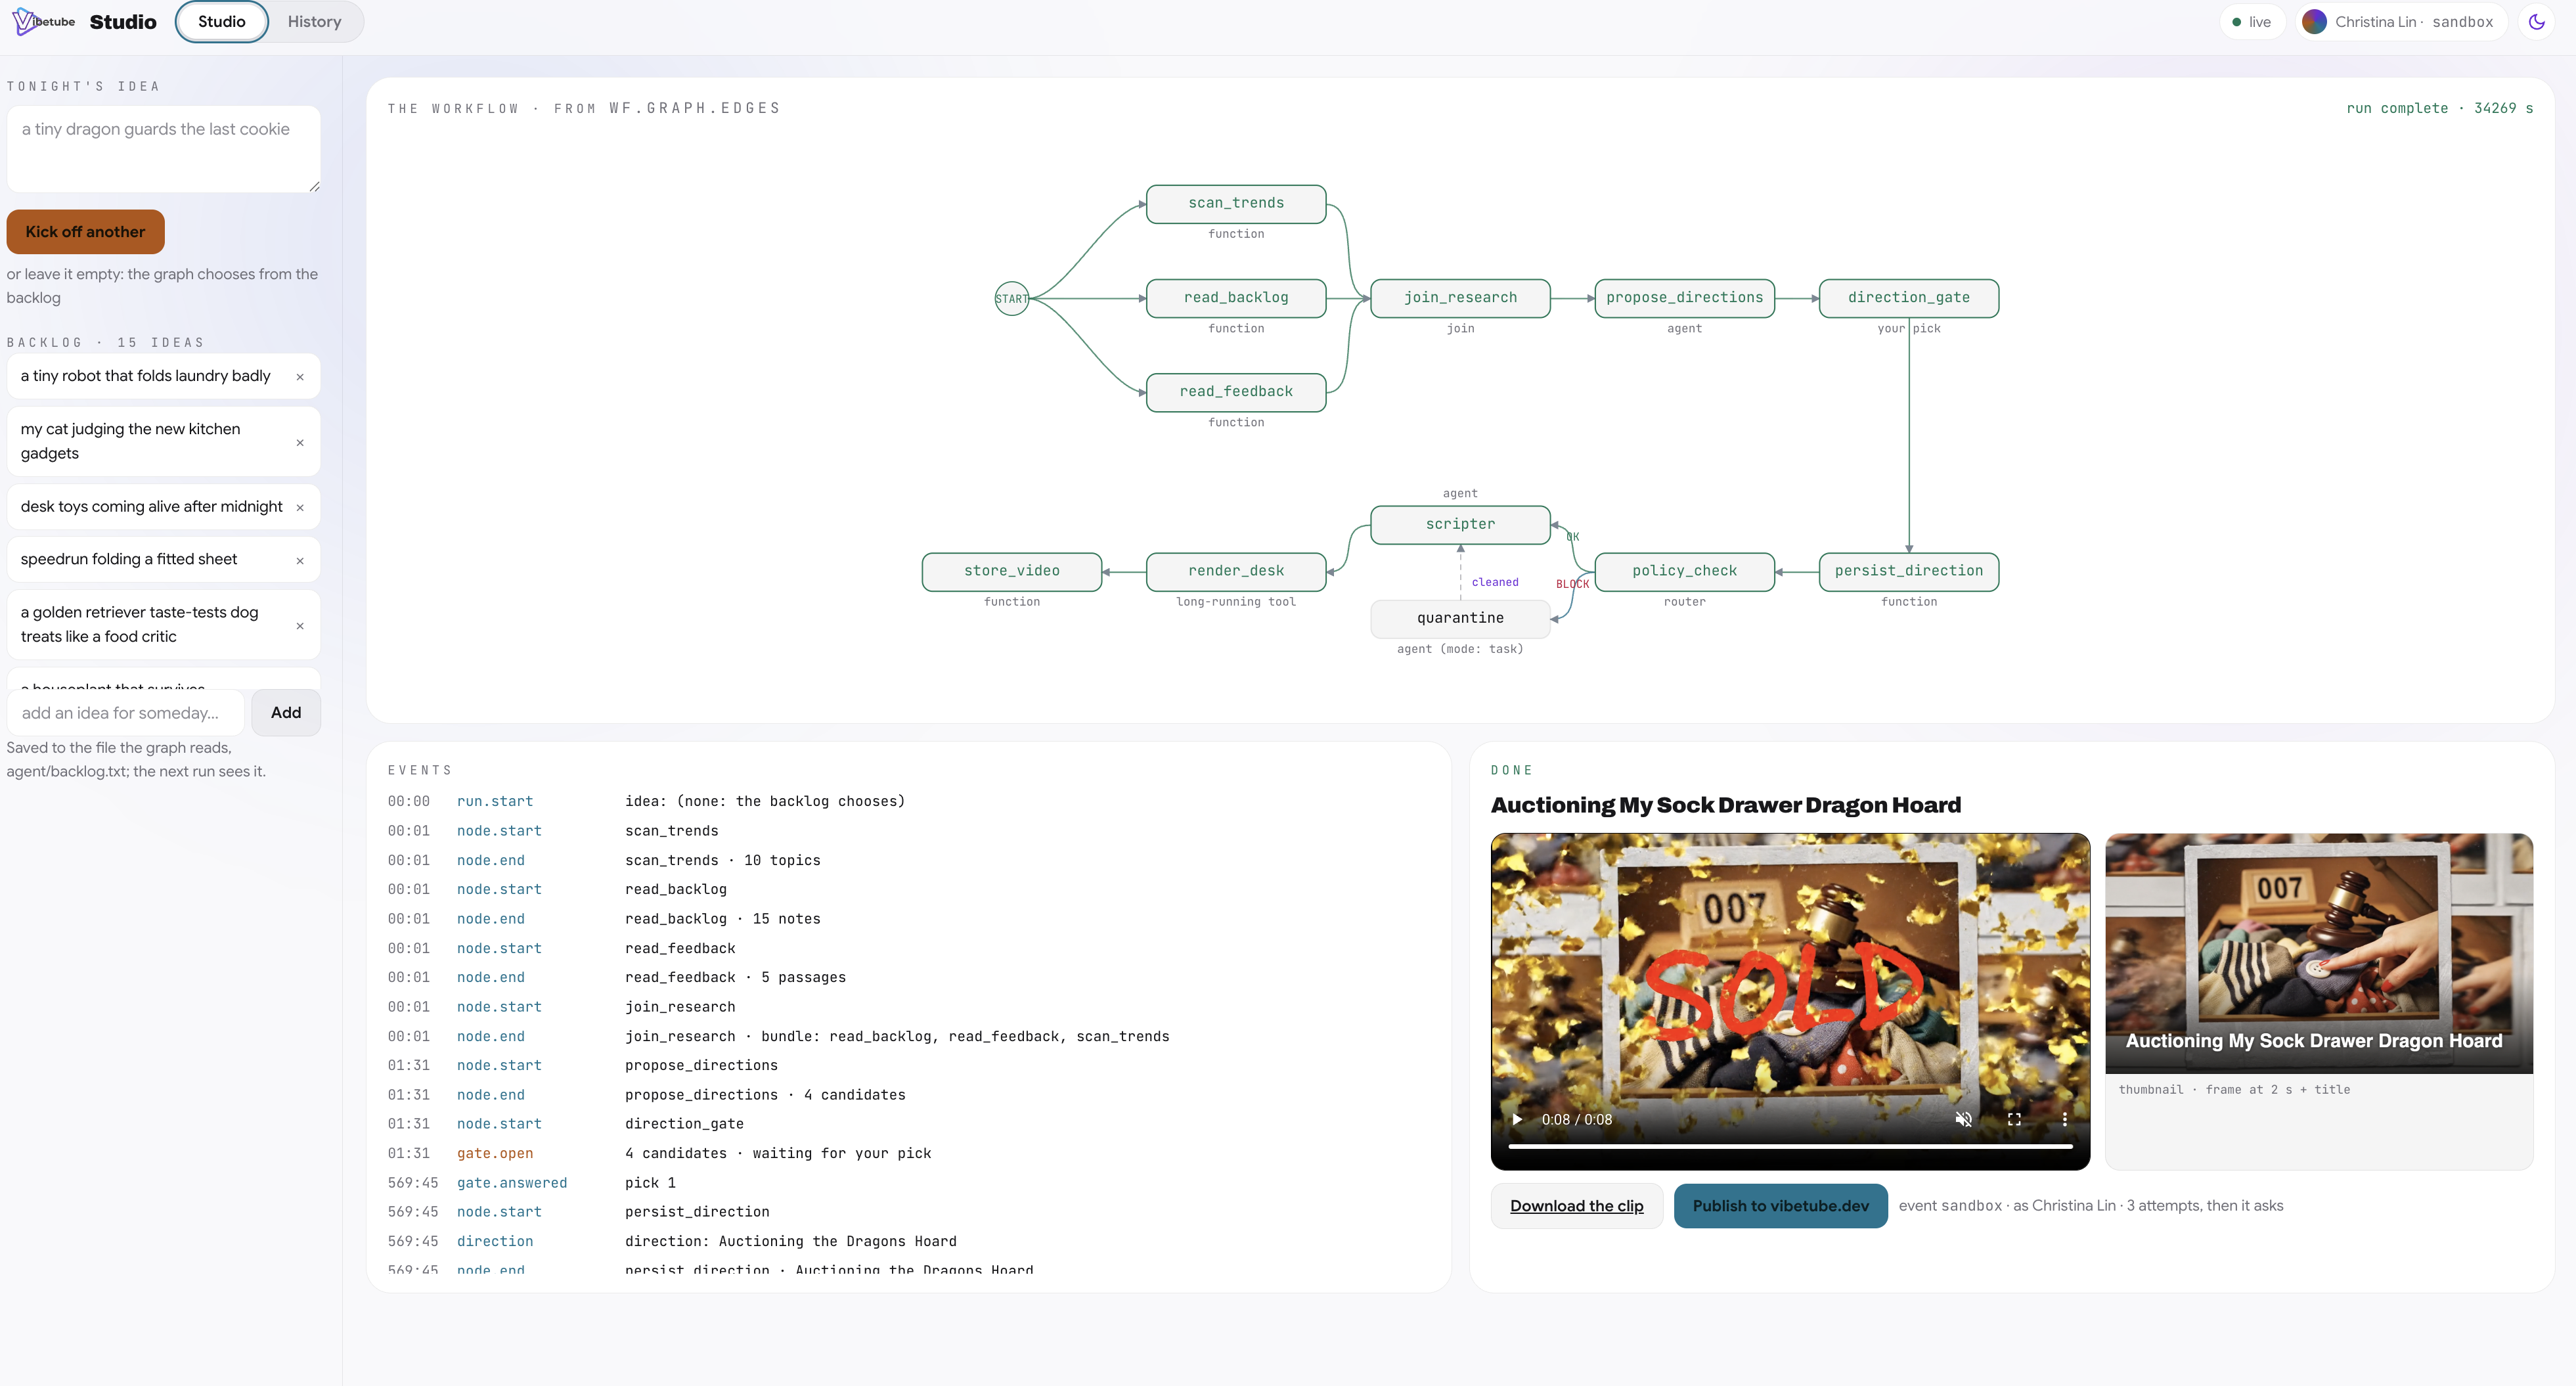
agent/graph.py 中的完整工作流程邊緣清單會合併本程式碼研究室中建構的每個架構模式:
        (START, scan_trends, join_research),
        (START, read_backlog, join_research),
        (START, read_feedback, join_research),
        (join_research, propose_directions, direction_gate,
         persist_direction, policy_check),
        (policy_check, {"OK": scripter, "BLOCK": quarantine}),
        (quarantine, scripter),
        (scripter, render_desk, store_video),
部署至 Cloud Run
Google Cloud Run 提供無伺服器主機,具備自動調整資源配置、要求路由和整合式容器建構功能:
gcloud run deploy vibestudio --source vibestudio \
  --project $GOOGLE_CLOUD_PROJECT --region us-central1 \
  --labels dev-tutorial-codelab=vibetube --allow-unauthenticated \
  --memory 2Gi --cpu 2 --timeout 3600 --concurrency 40 \
  --max-instances 1 --min-instances 1 --session-affinity \
  --set-env-vars GOOGLE_CLOUD_PROJECT=...,STUDIO_VERTEX=1,STUDIO_MEMORY_BANK=...,STUDIO_RAG_CORPUS=...,VIBETUBE_URL=...,VIBETUBE_EVENT=...,VIBETUBE_NAME=...,VIBETUBE_PROJECT=...
- 容器建構:
gcloud run deploy --source會封裝vibestudio/目錄、使用 Cloud Build 建構容器映像檔,並在單一作業中部署服務。 - 工作階段相依性:將來自同一位使用者的要求導向至相同容器執行個體,在反覆步驟中保留本機工作階段狀態。
- 觀測能力:Cloud Trace 整合功能會記錄每個節點、LLM 呼叫和工具執行的分散式 span,您可以在 Google Cloud 控制台的 Trace Explorer 中存取這些資料。
在工作台點選「Deploy」按鈕,執行部署指令碼。建構作業完成後,終端機會顯示即時服務網址。
10. 摘要
在 VibeStudio Workbench 中,前往「Step 10 · Summary」,查看完成的架構。
步驟 | 架構與概念 | 實作模式 |
單一提示 | 單一提示、函式工具、循序對話迴圈 |
|
Agentic Workflows 基本概念 | 圖形工作流程、平行研究、結構定義輸出內容、人工閘道 |
|
狀態和路由器 | 共用工作階段狀態、參數繫結、確定性路由、工作代理 |
|
Memory Bank | 使用者層級長期記憶、語意整合、生命週期掛鉤 |
|
RAG Engine | 從觀眾留言和語意嵌入中擷取文件 |
|
使用 Veo 非同步生成影片 | 長時間執行的工具、待處理的收據、外部傳送 Daemon |
|
部署至 Cloud Run | 程式輔助自動化調度管理、伺服器傳送事件、無伺服器容器 |
|
核心架構原則
- 暫停而非等待:工作流程會暫停,等待使用者輸入內容 (
RequestInput) 或長時間執行的作業 (LongRunningFunctionTool)。程序不會在執行緒或網路通訊端上閒置等待。 - 通用恢復:所有暫停作業都會透過相同機制恢復:單一
function_response攜帶暫停節點的呼叫 ID。 - 分離狀態管理:節點透過具名工作階段狀態金鑰和參數繫結共用資料,而非冗長、緊密耦合的中繼酬載。
- 先確定性轉送,再生成成本:規則型路由器和規則運算式篩選器會在生成模型執行前,以零詞元成本評估政策。
- 分離關注點:個別代理專屬的背景資訊屬於生命週期回呼,共用資料依賴則屬於