

1. はじめに
あなたは VibeTube で、ハロウィーンまで毎晩 1 本のショート動画を投稿する、居心地が良く不気味なチャンネルを運営しています。視聴者は小さな部屋で小さな魔法を求めており、コメント、音声メモ、自分の幽霊が出る引き出しの写真、夕暮れ時の玄関のクリップなど、あらゆる方法でそれを送ってきます。バックログにはアイデアが満載です。毎晩、同じ作業を繰り返します。フィードで何が話題になっているかを調べ、バックログを整理し、視聴者から送られてきたものを読み、方向性を決め、チャンネルのポリシーに照らし合わせて確認し、スクリプトを書き、ポスターを描き、クリップをレンダリングして公開します。
生成モデルは、各タスクを単独で実行できます。Gemini が調査、聞き取り、確認、書き込みを行い、画像モデルが描画し、Veo がレンダリングします。AI が単独でできないことは、夜間に順番に実行すること、人間の判断が必要なときに停止すること、費用がかかる前に不適切な指示を拒否すること、何も開かずにレンダリングを数分待つこと、記録を残すことです。
この Codelab では、その夜を ADK Workflow に変換します。これは、ノードとエッジの描画されたグラフで、自動的に実行され、判断が必要な場所のみを尋ね、VibeTube でクリップとそのポスターを使用して実行を終了します。
プロンプトは、順序、停止、チェックを保証できません。グラフなら可能です。
学習内容
- 1 つのエージェントと、ツールとしての画像モデル。
Agentは、モデル、指示、ツールです。3 番目のツールが画像モデルを呼び出し、最初の実行はポスターで終了します。そして、このラボの残りの部分を推進する文は、プロンプトが順序、停止、チェックを約束できないということです。 - グラフを構成する構造。
Workflowはエッジリストです。ファンアウトと結合(JoinNodeで合流する並列リーダー)と、独自の出口に名前を付けるルーターを構築します。拒否された出口の背後には、ツール呼び出しのループで方向をクリーンアップしてメインラインに再結合するタスクモード エージェントがあります。 - マルチモーダル取り込みパイプライン。オーディエンスから送信された 4 種類のコンテンツを、種類ごとに 1 つのリーダーが処理します。Gemini は、音声メモを文字に変換し、写真にキャプションを付け、クリップを視聴してサウンドトラックを聴きます。そして、すべてのリーダーが同じラインシェイプを 1 つの RAG Engine コーパスに書き込みます。ファンアウトの 3 番目のリーダーは、意味に基づいて取得し、メディアをパッセージとともに返します。
- 2 種類のサスペンション、1 つのメカニズム。ランは、人(
RequestInput: 4 枚のカード、あなたが回答)と、遅いツール(Veo がLongRunningFunctionToolの後ろ: レシート)のために停止します。どちらも同じもので、セッション ストア内のオープンコールであり、フォームまたは別のプロセスから ID によって再開されます。メディアデスクの 2 つの部門は、州ごとに名前でポスターを共有しています。 - 夜間のメモリ。メモリバンクの 2 つのライフサイクル コールバック:
before_model_callbackは、提案者が読み取る前に作成者の好みを呼び出し、after_agent_callbackは、スクリプターの後に今夜の選択を記憶します。 - リリース。ADK
Runnerを使用するアプリ内のグラフ、ページへのサーバー送信イベント、セッション アフィニティを使用する Cloud Run、ポスターをサムネイルとして VibeTube にクリップを配置する 1 つのマルチパート POST。
作業内容
ブラウザで実行中のアプリ: VibeStudio Workbench。これは、ページ埋め込みコードエディタ、ディスク上のファイルと実行によって書き込まれたセッションを読み取る検証ツール、埋め込み adk web を備えたコンパニオン ページです。7 つのセッションは、この Codelab の 7 つのページに対応しており、同じ番号と同じパート文字が付けられているため、2 つのセッションは同じステップにあります。各ページは、セッションを 1 つの文で説明する帯と、そこで行う 3 つのこと(編集、実行、検証)が表示された状態で開きます。ここでセクションを読み、ワークベンチで編集を行います。すべての編集は、実際に何が起こったかを示す検証パネルで終了します。
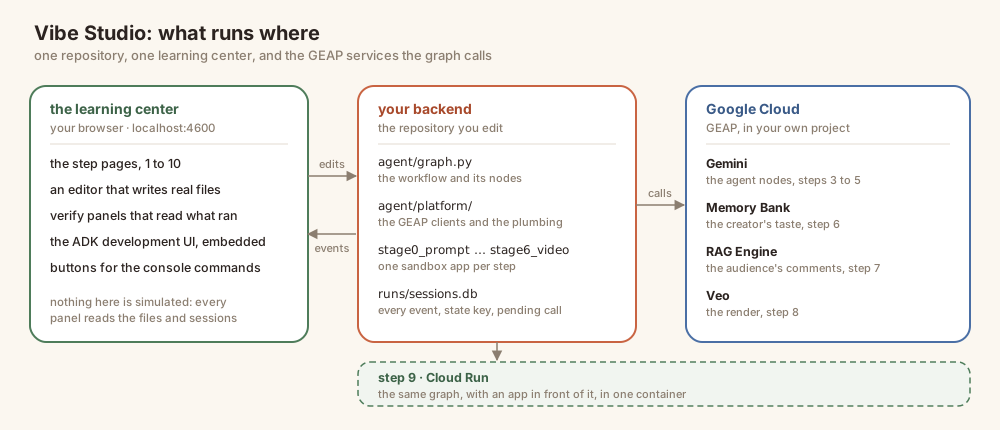
実行されるものは、Workbench(ポート 4600 のページ、エディタ、検証ツール)、バックエンド(agent/ の Workflow と、stage0_prompt/ から stage6_video/ のセッションごとに 1 つのサンドボックス アプリ。adk web が提供)、Google Cloud(Gemini、画像モデル、RAG Engine、Veo、Memory Bank。すべて独自の認証情報を使用して Vertex AI 経由でアクセス)の 3 つです。
7 つのセッション
セッション | 構築内容 | 自分の編集 |
1 · ストーリー | まだ何もありません。夜になるとグラフが表示されます | — |
2 · 画像生成 | 1 つ目のエージェントが最初のポスターを描画 |
|
3 · ワークフロー | グラフとしての夜: ファンアウトと結合、ルーターとそのループ |
|
4 · マルチモーダルな取り込み | 視聴者が送信した内容を 1 つのコーパスに読み込む。3 人目の読者 |
|
5 · 動画生成 | 2 種類の停止。ポスターに州名が記載されている |
|
6 · メモリ | チャンネルが夜間に記憶する情報 |
|
7 · デプロイと公開 | Cloud Run の VibeStudio、VibeTube の夜 | 部屋のイベントコードを入力して |
この Codelab の使用方法。コンセプトを重視した構成になっており、各セッションでは、まずアイデアを説明し、次に変更が反映された後のコードを示して、そのコードを詳しく説明します。ここでファイルを編集するよう求められることはありません。編集はワークベンチで行われます。ワークベンチでは、1 つの編集、その横のヒント、その下の検証パネルが一度に表示されます。セッションを読み、ページに沿って進めます。
この機能の位置付け
VibeTube のグラフ、テーマ、部屋は、Lin の VibeStudio の Haunted Edition から取得されています。これは、Agent Valley ラボの 1 ページのインタラクティブな形式で、視聴者が送信した内容と 2 種類のサスペンションに焦点を当てたマルチモーダルなカットです。スタジオは舞台装置です。その下にあるすべてのメカニズムは、サポート パイプライン、コンテンツ審査担当者フロー、または人間が介入して時間のかかるジョブを待つ必要があるその他の処理に使用する通常のものです。
2. 🧰 設定
- 何 — 支払い可能なアカウント、プロジェクト、インストールされたラボ、回答が実証されたモデル、1 つのポートでバックグラウンドで実行されているワークベンチ。
- 理由 - 1 つのポートで 1 つのプロセス: ページ、エディタ、検証ツール、
/api/*、adk webはオリジンを共有するため、このラボでは 2 つ目のターミナルや 2 つ目のポートは必要ありません。 - 方法 - クローン、2 つのスクリプト。2 つ目のセルは、実際のモデル呼び出しを行い、ワークベンチを起動して、RAG コーパスとメモリバンクの作成を開始します。これにより、セッション 4 と 6 でそれらを使用できるようになります。
このラボのすべての処理は Cloud Shell で実行されます。gcloud、Python、Node、ffmpeg、git はすでにインストールされており、Gemini、画像モデル、Veo、RAG Engine、Memory Bank にはすべて、独自の認証情報を使用して Vertex AI 経由でアクセスできます。このラボでは API キーは使用しません。また、ノートパソコンにインストールするものもありません。Google Cloud SDK、Python 3.12、Node 20 以降を搭載したノートパソコンでも同様に動作します。
このラボでは、課金が有効になっている Google Cloud プロジェクトは提供されません。ステップ 1 で、支払いに使用できるアカウントを取得します。ステップ 4 で、そのアカウントをプロジェクトに変換します。この順序で行います。ステップ 4 の後のすべてのステップでは、ステップ 4 で設定したプロジェクトが読み取られます。
1 · 課金が有効なアカウントを取得する(約 1 分)
課金が有効になっている Google アカウントでログインします。そのようなアカウントであれば、どれでも使用できます。お持ちでない場合は、無料トライアルを開始してください。これにより、ステップ 4 で必要な請求先アカウントが作成されます。講師主導のラボに参加している場合は、まずこのセッションのクレジットを申請してください。これにより、請求先アカウントが作成されます。
2 · Cloud Shell を開く(約 2 分)
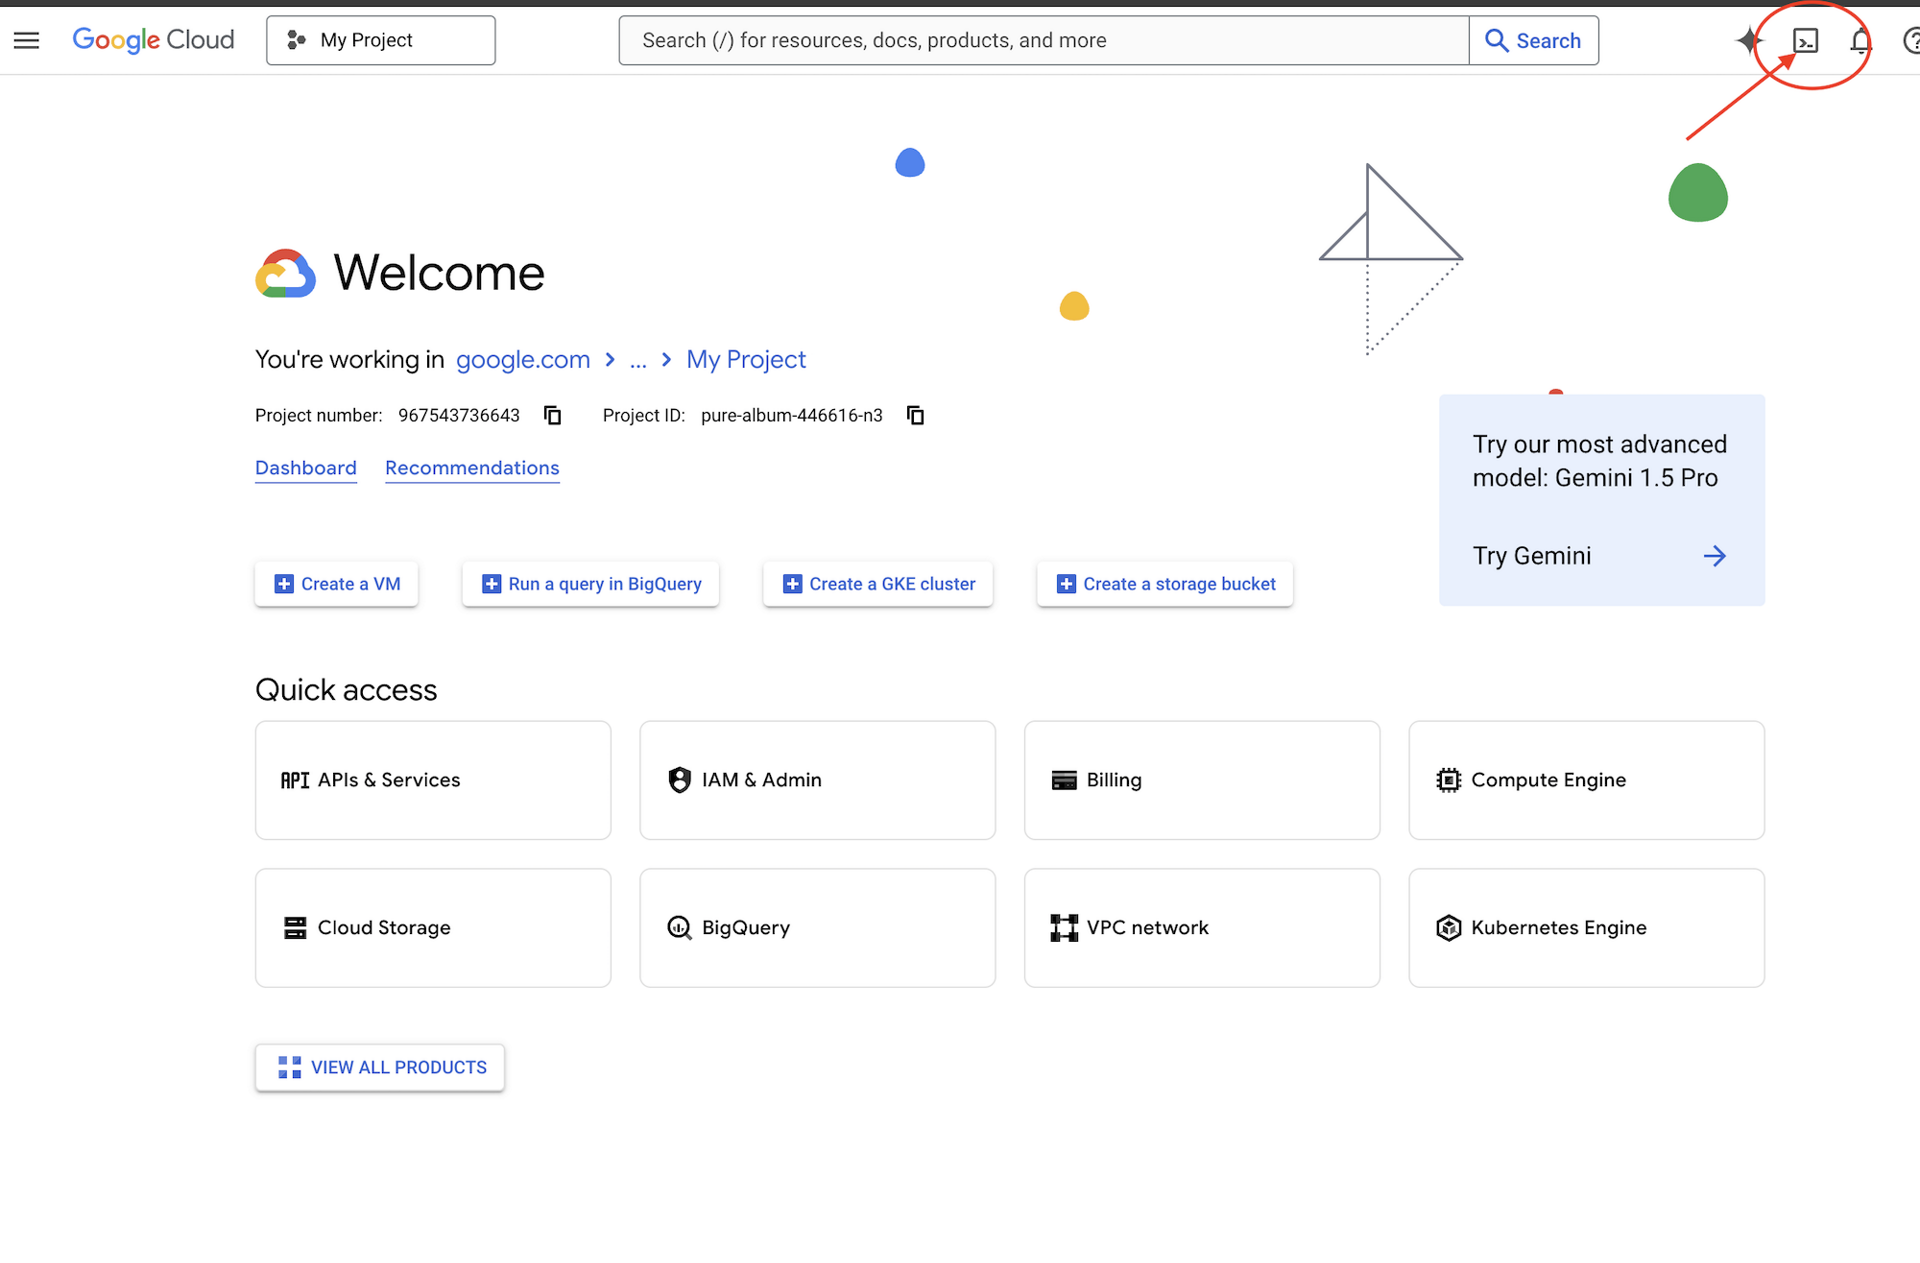
👉🖥 Google Cloud コンソールの上部にある [Cloud Shell をアクティブにする](ヘッダーにあるターミナル型のアイコン)をクリックします。
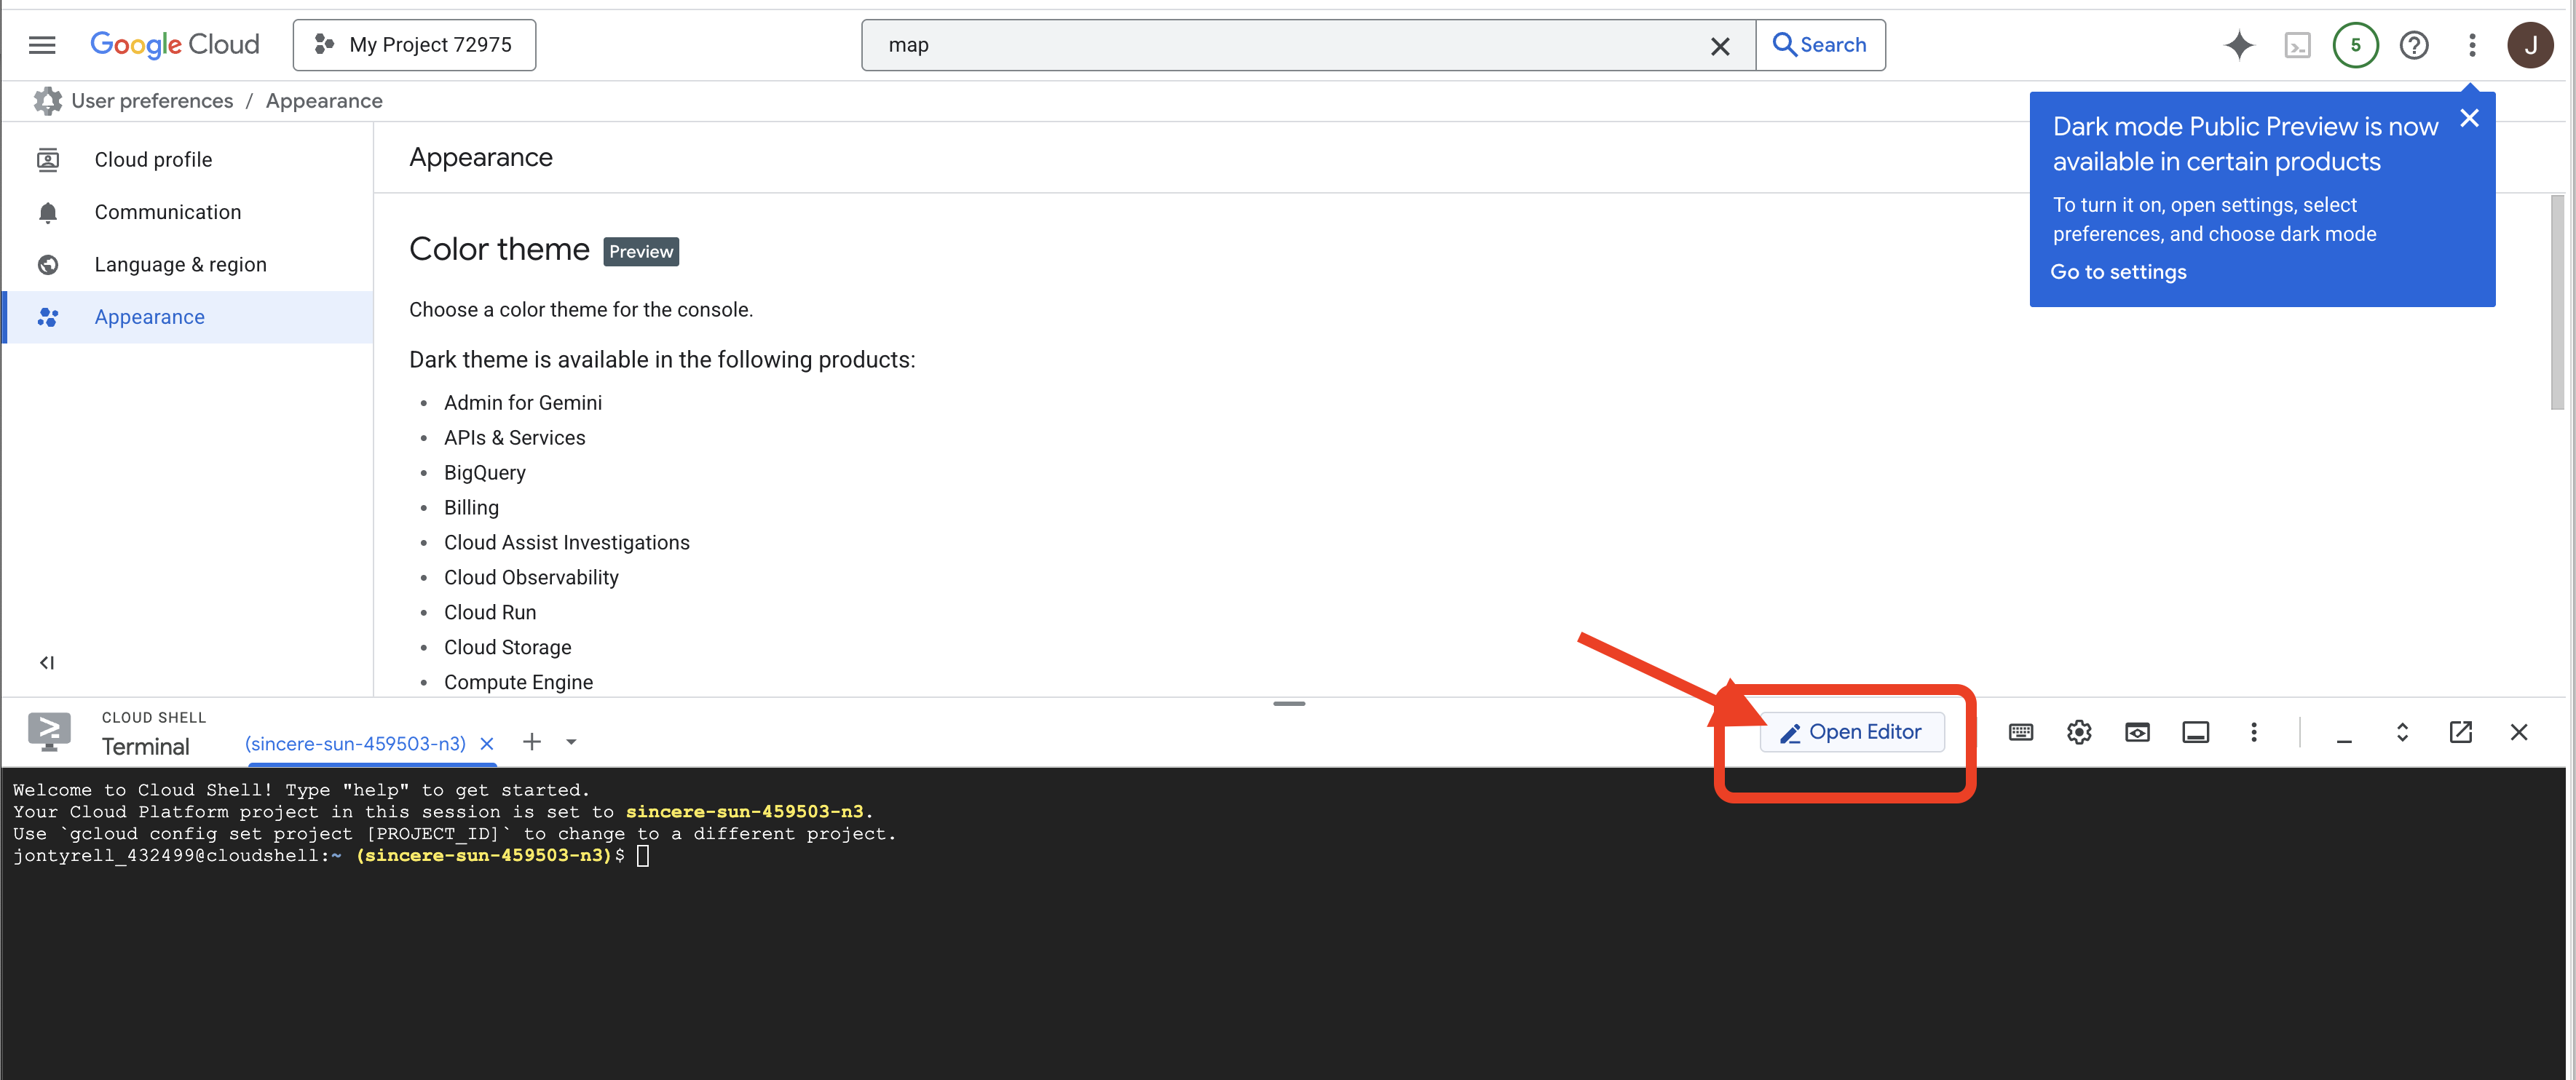
👉🖥 [エディタを開く](鉛筆付きのフォルダを開くアイコン)をクリックします。これにより、左側にファイル エクスプローラが表示された Cloud Shell エディタが開きます。ファイル全体を読み取る場合は、このエクスプローラを使用します。
👉🖥 本日、承認を求められた場合は、[承認] をクリックして続行します。
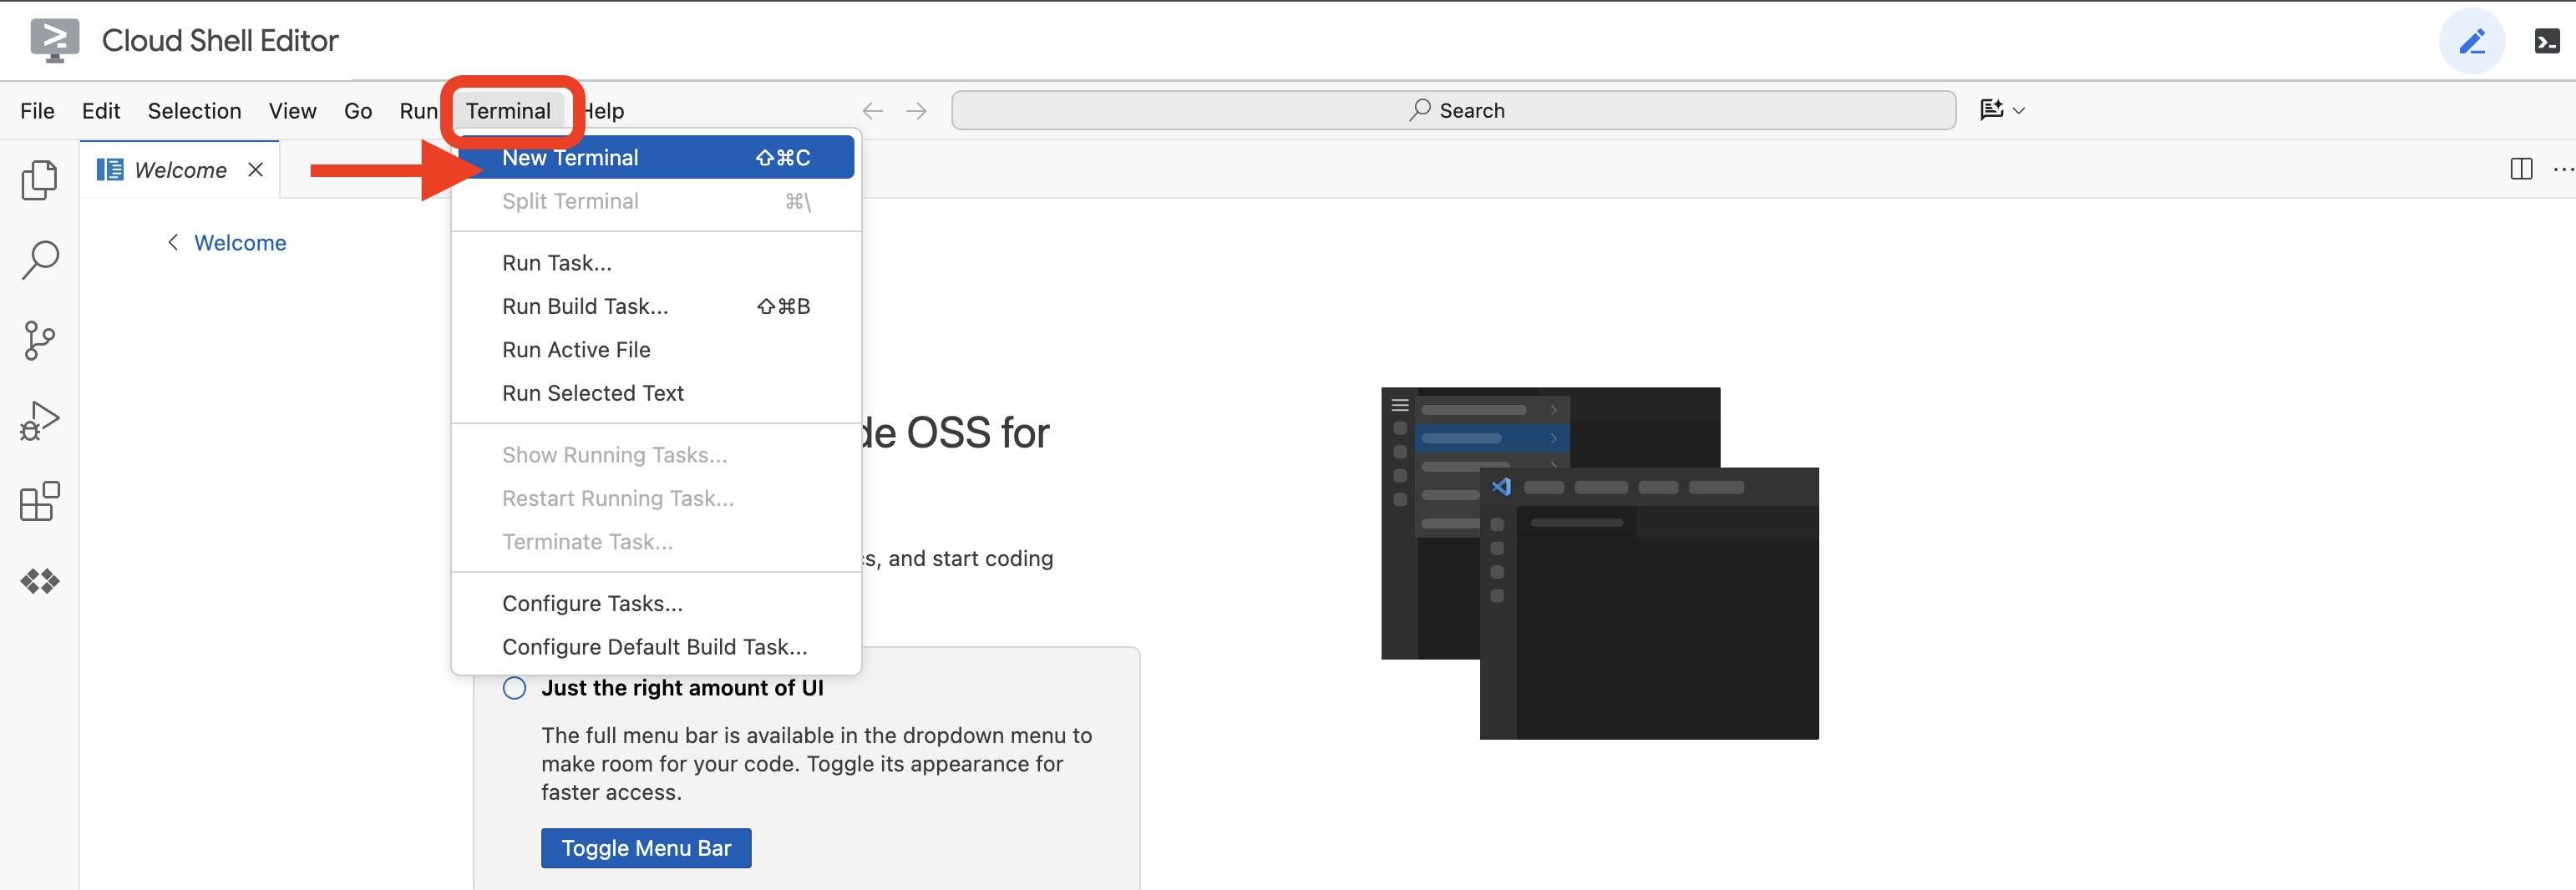
👉🖥 エディタ内でターミナルを開きます。これはタブ 1 で、すべての 👉💻 ステップがそこで実行されます。タブ 2 はワークベンチ自体で、ステップ 7 で開きます。ターミナルが画面の下部に表示されていない場合は、[表示] → [ターミナル] で開きます。
👉💻 ログインしているアカウントを確認します。ステップ 1 のアカウントである必要があります。
gcloud auth list
3 · ラボを入手する(約 1 分)
👉💻 リポジトリのクローンを作成します。
cd ~
git clone https://github.com/cuppibla/vibe-studio-multimodal
cd vibe-studio-multimodal
4 · プロジェクトを作成する(約 2 分)
👉💻 1 つのスクリプトで、請求先アカウントを検索し、そのアカウントにプロジェクトを作成して、課金をリンクし、Cloud Shell でそのプロジェクトを指定します。
cd ~/vibe-studio-multimodal
./setup_project.sh
選択した請求先アカウントの ✓、作成したプロジェクトの ✓、および次のような終了メッセージが表示されます。
Project ready: vibe-studio-4271
  Next:  ./setup_codelab.sh
vibe-studio-4271 はプロジェクト ID です。実際の ID の数字は異なります。ここでは、次の 4 つの処理が行われます。
請求 |
| |
project |
| |
選択 | ID を | |
waits | プロジェクトが実際にサービスを提供できるようになるまで、最大 2 分間ポーリングします。 | |
👉🖥 同じプロジェクトがコンソールに表示されます。その ID は、ダッシュボードの [プロジェクト情報] カードに表示されます。
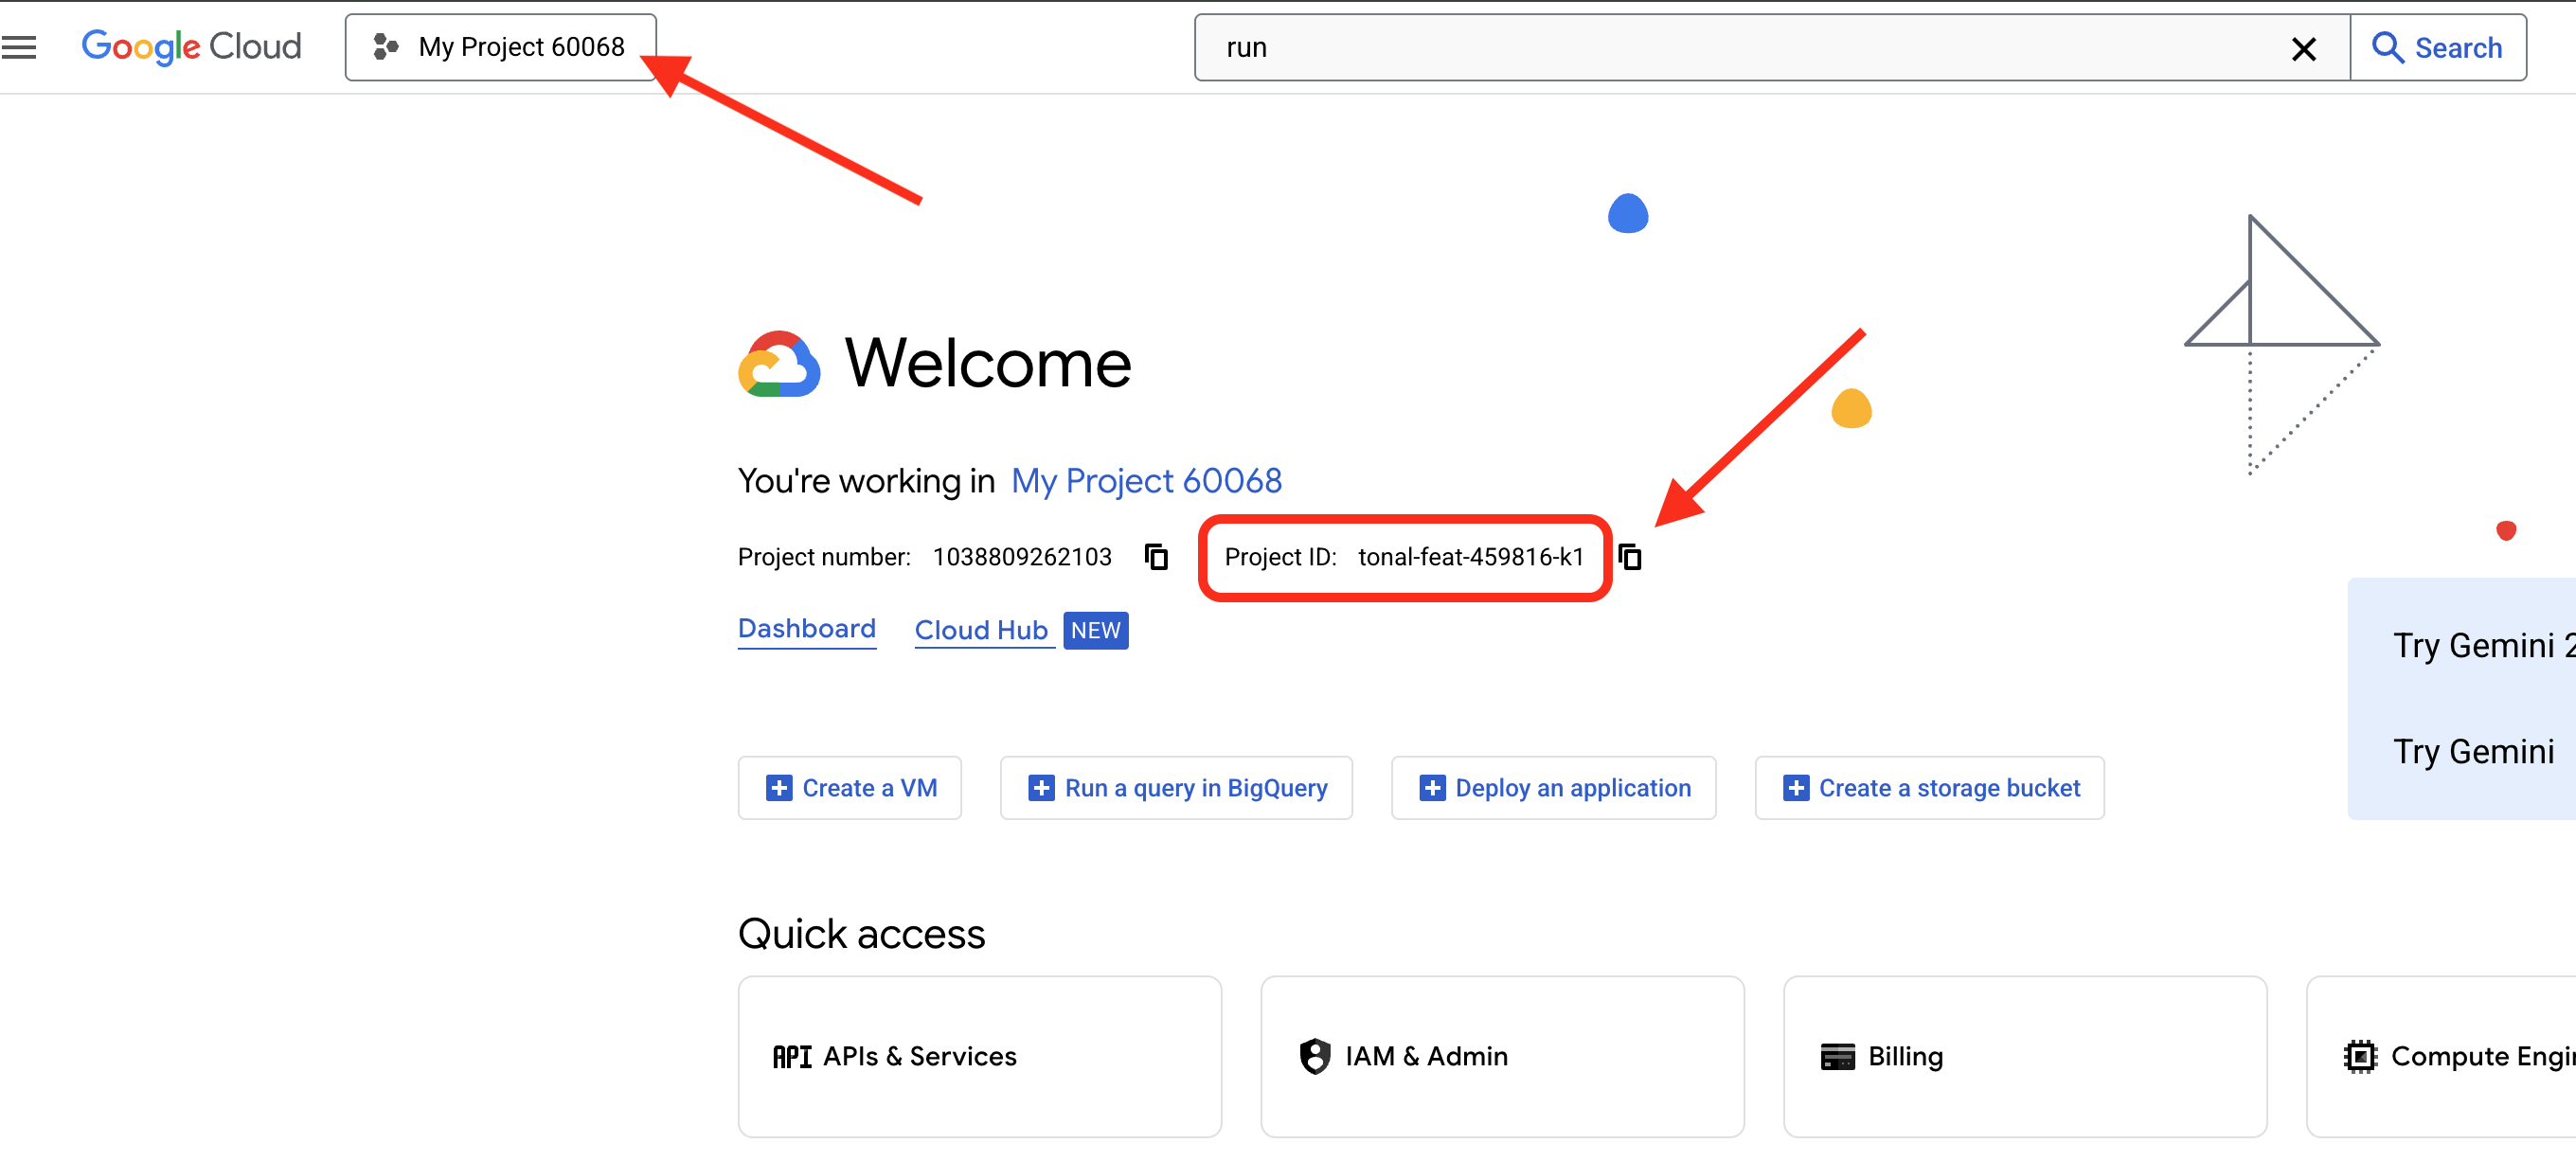
5 · ラボをインストールして設定する(約 4 分)
👉💻
cd ~/vibe-studio-multimodal
./setup_codelab.sh
1 つのスクリプトで、再度実行しても安全です。2 回目の実行では、1 回目に指定したすべての回答が保持されます。開始時に 2 つの質問が表示されます。Enter キーを押すと、両方のデフォルトが選択されます。
イベントコード | セッション 7 で動画が公開される VibeTube ルーム。教師から受け取ったルームコードを入力するか、Enter キーを押して | |
表示名 | ルームのクレジットに表示される名前を入力するか、Enter キーを押してアカウントから作成された名前を使用します。 | |
どちらも .env に保存され、後で .env または公開ページで変更できます。その後、次の処理が自動的に行われます。
uv env | uv がない場合はインストールし、 | |
apis | ステップ 4 で選択したプロジェクトで 6 つの API を有効にし、それぞれが応答することを確認してから続行します。 | |
アカウント | プロジェクトのデフォルトのコンピューティング サービス アカウントが存在し、セッション 7 のビルドとサービスに必要なロールを保持していることを確認します。 | |
.env |
| |
veo · room |
| |
model | Gemini への実際の呼び出しを 1 回行うため、不適切なプロジェクトはセッション内ではなく、設定時に失敗します。 | |
starter | 編集する 9 つのファイルを | |
ページ |
| |
cloud | バックグラウンドで RAG Engine コーパスと Memory Bank の作成を開始するため、セッション 4 と 6 ではそれらが準備完了している | |
preflight |
| |
6 · プリフライトを読む (約 1 分)
ステップ 5 で最後に出力されたのは、プリフライトです。すべての行が推測ではなく、実際のプローブです。
  ✓ python 3.12
  ✓ auth path A: Vertex via ADC (STUDIO_VERTEX=1)
  ✓ Google Cloud ADC (project vibe-studio-4271)
  ✓ Memory Bank SDK
  ✓ stage0_prompt loads
  ✓ stage1_fanout loads (0 edges)
  ✓ stage3_router loads (... edges)
  ✓ stage4_memory loads (... edges)
  ✓ stage5_rag loads (... edges)
  ✓ stage6_video loads (... edges)
  ✓ node and npm (build the learning center's page)
  ✓ learning center page built (web/dist)
  ✓ aiplatform.googleapis.com enabled (Gemini, Veo, Memory Bank, RAG Engine)
  ...
  - Memory Bank: still being created in the background
  - RAG corpus: still being created in the background
  ✓ session 7 runtime account 123456789-compute@developer.gserviceaccount.com has its roles
  ✓ learning center running on port 4600

PREFLIGHT GREEN

Open session 1 here:  https://4600-cs-...cloudshell.dev/step/story
stage1_fanout loads (0 edges) さんの言うとおり、このグラフは空の状態で出荷され、セッション 3 で入力します。2 つの - 行も正しいです。コーパスの起動には 1 ~ 2 分、バンクの起動には約 20 秒かかります。セッション 4 の前にはどちらも必要ありません。
👉💻 任意の時点で再度実行して、現在の状況を確認します。このコマンドは、チェックリストではなく、ファイル、プロジェクト、実行中のサーバーを読み取ります。
cd ~/vibe-studio-multimodal
uv run python scripts/preflight.py
7 · ワークベンチを開く(約 1 分)
ワークベンチはすでに実行されています。ステップ 5 で、バックグラウンドで起動しました。ポート 4600 で 1 つの uvicorn プロセスが、ページ、すべての /api/* ルート、/workbench にマウントされた adk web を提供します。開始する必要はなく、このラボで再起動を求められることもありません。編集内容は次回の実行時に反映されます。
👉🖥 preflight で出力されたリンクをクリックするか、Cloud Shell で [ウェブでプレビュー] → [ポートを変更] → [4600] を選択します。これをタブ 2 とします。[セッション 1 · ストーリー] が開きます。
後で必要になる可能性がある 3 つのコマンド(すべて ~/vibe-studio-multimodal から):
| ワークベンチを停止する | |
| フォアグラウンドで起動します。Ctrl+C キーを押すと、起動したプロセスがすべて停止します。 | |
|
| |
リポジトリのレイアウト
vibe-studio-multimodal/
├── agent/                  # the workflow and the platform clients
│   ├── graph.py            # the graph: three readers, the proposer, the gate, the router, the script, the desk
│   ├── desk.py             # render_desk and render_submit, the LongRunningFunctionTool
│   ├── deliver.py          # the delivery console: find the pending call, wait for Veo, answer by id
│   ├── schemas.py          # Direction, Directions, CleanedDirection, Script, each with a poster idea
│   ├── cleanup_tools.py    # find_policy_hits, suggest_replacement: the task agent's tools
│   ├── policy_words.txt    # the policy, as data; policy_replacements.txt, the approved stand-ins
│   ├── backlog.txt         # the creator's Halloween ideas; comments.md, the audience's comments
│   ├── audience/           # what else the audience sent: voice/*.mp3, photo/*.jpg, clip/*.mp4
│   ├── media/past/         # six past posters and captions.md, what Gemini sees in each
│   └── platform/           # config, audience (the readers), rag (RAG Engine), images, videogen (Veo), memory (Memory Bank)
├── stage0_prompt/ ... stage6_video/   # one sandbox app per session, runnable in adk web
├── server/ & web/          # the VibeStudio Workbench (FastAPI + React, port 4600)
├── vibestudio/             # the app deployed in session 7, with its own copy of agent/
├── checks/ & scripts/      # the hole registry, the verifiers, preflight, start/stop/restart
└── starter/                # the nine files you edit, as students receive them
3. 1 · ストーリー - 夜、そしてグラフ化
👉🖥 タブ 2 が [Session 1 · The story](セッション 1 - ストーリー)で開きます。読んでみてください。1 人の周りに 6 つの雑用が輪になって並んでいます。トレンドを調査する、バックログを整理する、方向性を決める、ポリシーを確認する、スクリプトを書く、クリップをレンダリングする。そして、この輪は毎晩繰り返されます。Gemini はリサーチ、バックログ、スクリプトを単独で行うことができ、Veo は単独でレンダリングできます。選択と確認は人間が行います。
リングの下には、このラボの残りの部分で構築するグラフが表示されます。このグラフは、アイデアからクリップとそのポスターまでの 13 個のノードで構成されています。ノードにカーソルを合わせると、ノードの機能とノードをビルドするセッションが表示されます。ここでは何も編集しません。ページの [Generate the first poster] ボタンはセッション 2 です。
語彙。次の 6 ページは、途中で止まらずに読み上げられます。
word | ここでいう意味 |
エージェント | ADK |
ノード | グラフの 1 つのステップ(Python 関数、エージェント、結合、ルーター) |
エッジ | 順番に実行されるノードのタプル。グラフはそれらのリストです。セッション 3 |
session |
|
state | ノードがキー名で共有する辞書。1 つのノードが |
memory | セッションよりも長く存続するもの(メモリバンク、コールバック経由)。セッション 6 |
4. 2 · 画像生成 - 1 つのエージェントと、ツールとしての画像モデル
👉🖥 ワークベンチで、[Session 2 · 画像生成] を開きます。グラフの前に、最もシンプルな方法として、1 つの Agent(指示は夜全体を文章で記述)、3 つの Python 関数(手として機能)、画像で終わる実行を試しました。
エージェントはモデル、指示、ツール
stage0_prompt/agent.py は、ADK エージェントの 3 つのフィールドで root_agent を定義します。model は agent/platform/config.py の Gemini モデルです。instruction はシステム プロンプトです。6 つのジョブを一度に実行し、最後のジョブは画像です。tools には 3 つの関数があります。
root_agent = Agent(
    name="solo_channel", model=config.MODEL,
    tools=[check_trends, read_backlog, make_poster],
    instruction=(
        "You run the creator's cozy-spooky short-video channel, alone, every "
        "night until Halloween.\n"
        "When the creator gives you an idea (or nothing), do ALL of this:\n"
        "check what is trending. look at your backlog of ideas. propose a "
        "direction and agree on it with the creator. refuse blacklisted "
        "subjects (competitor, hateful, gore). then describe the video you "
        "would make: a title (<=60 chars) and 3 shots, one visual sentence "
        "each. then draw its poster: call make_poster once with one line that "
        "names the single image that sells the video, and tell the creator "
        "where the poster is.\n"
        "Ask the creator to confirm the direction before describing the "
        "video."))
モデルは閉じた世界です。モデルは、その重みとコンテキスト内のトークンに基づいて推論します。ツールは、モデルがリクエストする可能性のある Python 関数です。ADK は各関数のシグネチャと docstring を読み取り、モデルに宣言します。モデルが関数を必要とすると、function_call イベントを出力します。ランタイムは Python を実行し、function_response イベントをコンテキストに書き戻します。モデルは、その結果を目の前にして処理を続行します。
3 つの関数があり、そのうちの 1 つが
3 人のうち 2 人が調査を読みました。3 つ目のプロンプトでは、画像モデルにポスターをリクエストします。
def check_trends() -> dict:
    """Ten formats trending on the platform right now, with a heat score each."""
    from agent.trends import sample_trends
    return {"trends": sample_trends()}


def read_backlog() -> dict:
    """The creator's backlog: ideas they noted down to make someday."""
    from agent.graph import backlog_notes
    return {"backlog": backlog_notes()}


def make_poster(subject: str) -> dict:
    """Draw tonight's poster: one image of `subject` in the channel's cozy
    low-poly style. Returns where the PNG landed (path, url) in a few seconds."""
    ...
make_poster は agent/platform/images.py を呼び出します。これは、videogen.py が Veo をラップするのと同じように、プレーンな関数としてラップされた画像モデルです。ハウススタイルのプレフィックス(チャンネルの居心地の良いローポリ ハロウィーンの外観、ミッドナイト プラムに対するパンプキン オレンジとキャンドルライト クリーム)、被写体、縦向きの 9:16 フレーム、runs/media/posters 未満の 1 つの PNG、/static/posters で提供されます。STUDIO_REAL_IMAGES=0 を指定すると、代わりのポスターがコピーされ、結果に prebaked のフラグが付けられるため、ラボをどこでも実行できます。
MODEL = os.environ.get("STUDIO_IMAGE_MODEL", "gemini-2.5-flash-image")
ASPECT = "9:16"

def generate(subject: str, visual_style: str = "", name: str | None = None) -> dict:
    """One poster for `subject`. Returns where it landed: status, path, url,
    prompt, and prebaked=True when the stand-in was used instead of the model."""
同じ呼び出しが、セッション 5 のグラフのノードになっています。
ハンズオン: 1 つの編集
出荷時の状態では、make_poster はポスターがスキップされたことを示す辞書を返します。👉🖥 Workbench エディタで、TODO 行の代わりに画像モデルを呼び出すようにします。
    from agent.platform import images
    return images.generate(subject, name="solo")
保存] をタップします。検証行はファイルを読み取ります。エージェントに 3 つのツールがあり、画像モデル呼び出しが配置されています。👉🖥 [Check the workflow loads] をクリックし、[Open adk web] をクリックして、以下を送信します。
tonight's idea: a tiny ghost learning to haunt a sock drawer
今後の流れと理由
- 返信の前に 2 つのツールイベントがあり、その後に質問があります。
check_trendsとread_backlogが実行されるのは、指示に「確認する」と「見る」とあり、モデルの重みにはどちらも含まれていないためです。指示で最初に同意を求めたため、返信では方向性を提案し、確認を求めています。 - 2 番目のメッセージはすべてを受け取ります。
skip the questions, describe the video and draw the posterを送信します。モデルは動画を説明し、自身で作成した件名でmake_posterを 1 回呼び出し、PNG の保存場所を通知します。確認パネルには、行の横にポスターが表示されます。チャンネルの外観のハロウィーンのシーンが約 8 秒で描画されます。 - これがチャンネルではない理由。調査結果は、引用できない文章に組み込まれています。このポリシーは、指示を書いたモデルによって認定され、ポスターは、チェックされる前に描かれました。1 つのメッセージで合意が成立しました。プロンプト テキストはゲートではありません。このラボの残りの部分では、これら 6 つのジョブをグラフに分解します。
このページの最後には、ADK エージェントの構成要素が記載されています。これは、モデル、推論に使用するコンテキスト、動作に使用するツールとコラボレーター、各呼び出しをラップするコールバック、外部に存在するセッションとメモリなど、後で参照できるリファレンスです。
5. 3 · ワークフロー - ファンアウトと結合、ルーターとループ
👉🖥 ワークベンチで、セッション 3 · ワークフローのパート 3a と 3b を開きます。各部分はサンドボックス アプリでビルドされるため、adk web で個別に実行できます。stage1_fanout のファンアウト、stage3_router のルーターとそのループです。
ファンアウトと結合(3a)
ADK Workflow はエッジリストです。各エントリはチェーン(順番に実行されるノードのタプル)です。START から出る 2 つのチェーンは並列で実行されます。JoinNode で終わるチェーンは、そのノードにレポートします。結合は、そこで終わるすべてのチェーンを待ってから、ノード名をキーとする 1 つの辞書を渡して続行します。辞書として記述されたターゲットは、ルーターのルート名をノードにマッピングします。ワークベンチの 3a ページでは、図形を描画し、エッジを記述する演習を行います。
ノードの種類 | 次のように記述します。 | 機能 |
関数ノード |
| プレーンな Python。 |
結合ノード |
| すべての受信チェーンが報告するまで待機し、すべての出力を 1 つの辞書として渡します。 |
エージェント ノード |
|
|
ルーター |
| 戻り値が送信エッジの名前となる関数ノード。 |
人間による入力ノード |
| ユーザーがフォームに回答するまでグラフを一時停止します。セッション 5 |
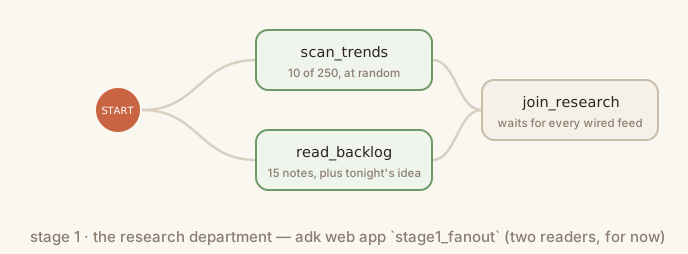
最初のグラフは、セッション 2 の調査をノードとして表したものです。agent/graph.py の scan_trends と read_backlog は 2 つのリーダーです。read_backlog は、今夜のアイデアを共有状態に書き込みます。stage1_fanout/agent.py は結合を定義し、EDGES という名前のリストから Workflow をビルドします。このリストは空の状態で出荷されます(プリフライトの 0 edges)。👉🖥 2 つのチェーンを入力します。
EDGES = [(START, scan_trends, join_research),
         (START, read_backlog, join_research)]
👉🖥 adk web で実行します。2 つのノードが同時に点灯し、その後結合します。join_research のイベントを開き、scan_trends キーと read_backlog キーを持つ 1 つの辞書を読み取ります。モデル呼び出しは行われませんでした。結合の辞書を再フォーマットするものはありません。3b の後のノードはエージェントであり、エージェント ノードは node_input をメッセージとして受け取るため、辞書はモデルが直接読み取る JSON として到着します。
ルーターとループ(3b)
Workflow 内の Agent は single_turn モードで実行されます。前のノードの出力をメッセージとして受け取り、モデルを 1 回呼び出して、1 回回答します。output_schema を使用すると、次のノードが回答を認識する前に、回答が Pydantic モデルに対して検証されるため、グラフは文章ではなく型付きオブジェクトを渡します。propose_directions は、結合されたリサーチ辞書を読み取り、4 つの候補を提案します。すべてハロウィンのシーンです。候補 4 はおとりです。タイトルにチャンネルが拒否する単語が含まれているため、ルーターがキャッチする対象となります。各候補には、動画を売り込む 1 つの画像の名前を 1 行で示す poster_idea が付いています。スクリプターがこれを保持し、メディアデスクがセッション 5 で描画します。
ルーターは、実行するエッジを返す関数ノードです。モデル呼び出しなし: policy_check は、決定時に agent/policy_words.txt を読み取り、単語全体を方向のタイトルと角度に一致させ、スクリプトが作成される前、または費用が発生する前にルーティングします。ポリシーはデータです。ファイルを編集すると、次の実行時に読み取られます。
def policy_check(node_input):
    """The policy gate: a router. Refused words in the direction send it to
    quarantine; a clean one goes to the scripter. Code, not a model."""
    chosen = _as_dict(node_input)
    bad = policy_hits(f"{chosen.get('title', '')} {chosen.get('angle', '')}")
    return Event(output=node_input, route="BLOCK" if bad else "OK")
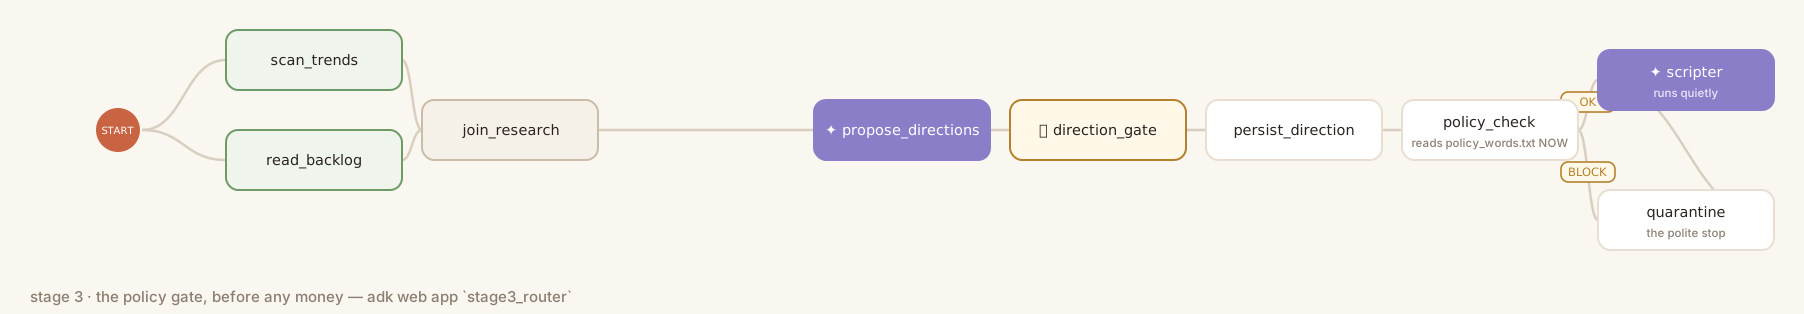
stage3_router/agent.py は、ファンアウトに propose_directions と choose_direction を加えたもので、セッション 5 で作成した人間のドアの代わりになります。番号が今夜のアイデア(..., pick 4)で終わる候補を選択し、それ以外の場合は最初の候補を選択して、選択した候補を状態に書き込みます。scripter は single_turn エージェントで、承認された方向性を Script に変換します。タイトル、説明、タグ、オープニング ライン、3 つのショット、ポスターのアイデア、すべてのショットがチャンネルのルックのハロウィーン画像です。
拒否された出口の背後にあるループ。quarantine は、タスクモード エージェントとして提供されます。Agent には mode があります。chat はルート エージェントがユーザーと実行する会話ループ、single_turn は構造化された回答を含む 1 回の呼び出し、task はエージェントが組み込みの finish_task を呼び出すまで独自に実行するツール呼び出しのループです。の引数は ADK が output_schema から取得します。検疫は、拒否された方向で find_policy_hits を呼び出し、各単語(agent/policy_replacements.txt、データは再度)のチャネルの承認済み代用を suggest_replacement に要求し、書き換え、再度チェックし、入力された CleanedDirection で終了します。ページに表示されているものを読み上げます。入力はしません。
quarantine = Agent(
    name="quarantine",
    model=config.MODEL,
    mode="task",
    instruction=QUARANTINE_INSTRUCTION,
    tools=[find_policy_hits, suggest_replacement],
    output_schema=CleanedDirection)
出荷時のチェーンは、ピックからスクリプターに直接つながっています。👉🖥 ルーターをその間に配置し、2 つの出口と検疫からの戻り道を設けます。1 本の回線が 3 本に置き換わります。
           (join_research, propose_directions, choose_direction, policy_check),
           (policy_check, {"OK": scripter, "BLOCK": quarantine}),
           (quarantine, scripter),
👉🖥 両方のルートを実行します。アイデアをそのまま送信する: choose_direction が候補 1 を受け取り、policy_check が OK を出力し、スクリプターが構造化されたスクリプトを作成します。[新しいセッション] をクリックし、最後に , pick 4 を付けてアイデアを再度送信します。候補 4 がおとりとなり、policy_check が BLOCK を出力し、隔離がツールを呼び出し、拒否された単語を書き換え、finish_task を呼び出し、クリーンアップされた指示がスクリプターに戻ります。verify 行は、セッション ストアから両方の実行を読み取ります。
セッション 2 のプロンプトのすべての文にノードが割り当てられました。調査は 2 つのリーダーと結合、拒否はルーターとタスク エージェント、スクリプトはエージェント ノードです。グラフ全体で、代わりの選択は 2 つの関数ノード direction_gate と persist_direction です。これらは、セッション 5 でドアが停止するまで、そのまま実行されます。クリエイターとの契約はまだ仮のものであり、視聴者の意見をまだ聞いていない調査も同様です。
6. 4 · マルチモーダルな取り込み - 視聴者が送信したものを 1 つのコーパスに読み込む
👉🖥 ワークベンチで、セッション 4 · マルチモーダル取り込みのパート 4a と 4b を開きます。視聴者は、ただ書くだけではありませんでした。種類ごとに 1 つのリーダーが、送信されたすべてのものを同じ形状のテキストに変換し、1 つの RAG Engine コーパスがすべてを保持します。ファンアウトの 3 番目のリーダーが、意味に基づいて検索し、メディアを返します。
視聴者が送信した内容(4a)
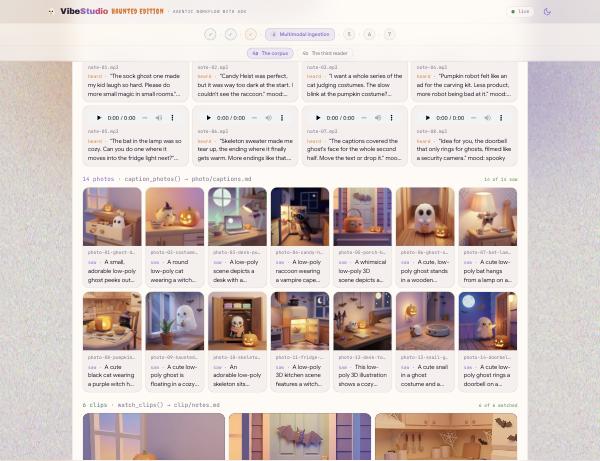
agent/comments.md には、チャンネルの 6 本のハロウィン動画に書き込まれた 12 件のコメントが格納されています。agent/audience/ には、残りの 8 つの音声メモ(voice/*.mp3)、視聴者自身の部屋の写真 14 枚(photo/*.jpg)、6 つのクリップ(clip/*.mp4)が保存されています。クリップは、写真の上に視聴者の音声が重なった、ゆっくりとしたパンです。4a のページが開き、すべての音声メモが再生され、すべての写真が表示され、すべてのクリップが実行されます。
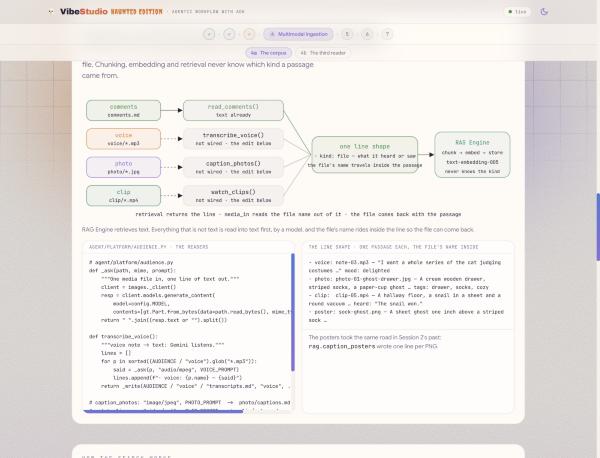
RAG Engine はテキストを取得します。音声メモ、写真、クリップは、rag.caption_posters で過去の投稿者が行った方法でのみコーパスに加えることができます。モデルがそれをファイル名を示すテキスト行に変換し、その行がパッセージになり、パッセージが戻ってくるとファイルも一緒に戻ってきます。agent/platform/audience.py には、種類ごとに 1 つのリーダーがあります。各スクリプトは、1 つのファイルと 1 つのプロンプトを Gemini に送信し、ファイルごとに 1 行を書き込みます。
VOICE_PROMPT = ("Transcribe this voice note word for word inside double quotes. Then add: mood: and one word. "
                "Plain text on one line, nothing else.")
PHOTO_PROMPT = ("Two sentences: what is in the picture, the palette, the mood. Then: tags: and three short tags. "
                "Plain text on one line, no headings, no markdown.")
CLIP_PROMPT = ("Describe the shots in two sentences, then quote what you HEAR on the soundtrack as: heard: \"...\". "
               "Plain text on one line, no headings, no markdown.")


def _ask(path: pathlib.Path, mime: str, prompt: str) -> str:
    """One media file in, one line of text out."""
    from google.genai import types as gt
    client = images._client()
    resp = client.models.generate_content(
        model=config.MODEL,
        contents=[gt.Part.from_bytes(data=path.read_bytes(), mime_type=mime), prompt],
        config=gt.GenerateContentConfig(automatic_function_calling=gt.AutomaticFunctionCallingConfig(disable=True)))
    return " ".join((resp.text or "").split())


def transcribe_voice() -> pathlib.Path:
    """voice note -> text: Gemini listens."""
    files = sorted((AUDIENCE / "voice").glob("*.mp3"))
    lines = []
    for p in files:
        said = _ask(p, "audio/mpeg", VOICE_PROMPT)
        lines.append(f"- voice: {p.name} — {said}")
    return _write(AUDIENCE / "voice" / "transcripts.md", "voice", "What Gemini heard in the audience's voice notes", lines)
caption_photos は image/jpeg と PHOTO_PROMPT で、watch_clips は video/mp4 と CLIP_PROMPT で同じことを行います。Gemini は 1 回の呼び出しで画像を確認し、サウンドトラックを聴きます。すべてのリーダーが同じ行形状を書き込むため、チャンク化、エンベディング、取得では、パッセージがどの種類から取得されたかがわかりません。
- voice: note-03.mp3 — "I want a whole series of the cat judging costumes ..." mood: delighted
- photo: photo-01-ghost-drawer.jpg — A cream wooden drawer, striped socks, a paper-cup ghost ... tags: drawer, socks, cozy
- clip:  clip-05.mp4 — A hallway floor, a snail in a sheet and a round vacuum ... heard: "The snail won."
- poster: sock-ghost.png — A sheet ghost one inch above a striped sock ...
コーパス。Vertex AI RAG Engine はドキュメントを検索します。コーパスは約 120 トークンのパッセージにチャンク化され、各パッセージは text-embedding-005 でエンベディングされます。クエリも同じ方法でエンベディングされ、共有された単語ではなく、意味的に最も近いパッセージで回答されます。「家の中の小さな居心地の良い幽霊」は、小さな部屋で小さな魔法を求めるコメント、電球を抱きしめるコウモリについての音声メモ、サウンドトラックで幽霊が紙コップだと言っているクリップを見つけます。
corpus = rag.create_corpus(
    display_name="vibestudio-feedback",
    backend_config=rag.RagVectorDbConfig(
        rag_embedding_model_config=rag.RagEmbeddingModelConfig(
            vertex_prediction_endpoint=rag.VertexPredictionEndpoint(
                publisher_model="publishers/google/models/text-embedding-005"))))

rag.upload_file(
    corpus_name=corpus.name, path="agent/comments.md", display_name="comments.md",
    transformation_config=rag.TransformationConfig(
        chunking_config=rag.ChunkingConfig(chunk_size=120, chunk_overlap=20)))
設定ですでにコーパスの作成が開始されています。4a ページの接続行に、コーパスが作成されているかどうかが表示されます。設定で作成できなかった場合は、コーパスが作成されます。ページ上のボタンまたはターミナルから: python -m agent.platform.rag はコーパスを作成し、runs/ragcorpus.json に記録します。python -m agent.platform.rag load --audience は audience.READERS 内のすべてのリーダーを実行し、コメントと投稿者のキャプションの横に書き込まれた内容をアップロードします。各ファイルは独自の名前でアップロードされ、インデックスが応答するのを待ちます。python -m agent.platform.rag query "cozy little hauntings at home" は、クエリと単語を共有していないパッセージを検索するリトリーバルを示します。
編集。出荷時の READERS には read_comments のみが搭載されています。3 つのメディア リーダーは 1 つの # の背後にあります。👉🖥 読み込みをそのまま 1 回実行します。出力には not read (no reader wired in audience.READERS): voice, photo, clip と表示され、コメントと字幕のみが読み込まれます。次に、# を削除します。
transcribe_voice, caption_photos, watch_clips,
👉🖥 保存して、取り込みを再度実行します。リーダーが 40 個のアイテムを読み取るのに約 3 分かかります。コンソールには heard、saw、watched が 1 行ずつ表示され、グリッド内の各カードにその行が入力されます。検証行は、ファイル、リーダーの出力、コーパスを読み取ります。4 つのリーダーが接続され、8 つの音声メモが聞かれ、14 枚の写真が表示され、6 つのクリップが視聴され、コーパスに 5 つのファイルがあります。
3 人目の読者(4b)
オーディエンス フィードバックは、すべての実行で共有されるリサーチであるため、リサーチと同じように、3 番目のリーダーとして結合にグラフに入力されます。agent/graph.py の read_feedback は、今夜のアイデアを受け取り、コーパスに最も近いパッセージをリクエストして、join_research に報告します。は 3 つのパッセージを待ちます。エッジ (START, read_feedback, join_research) は、セッション 3 で説明したシェイプ stage5_rag/agent.py で出荷されます。編集はノード内で行われます。モデル呼び出しではなく、決定論的な検索: 提案者が異なっても、同じアイデアで同じパッセージが見つかります。
def read_feedback(node_input):
    """The third reader: what the audience sent - comments, and what Gemini
    heard and saw in their voice notes, photos and clips - the passages
    nearest to tonight's idea, and the media those passages came with.
    Retrieval, not a model call."""
    from .platform import rag
    idea = idea_text(node_input)
    query = idea or "what viewers liked and what they complained about"
    try:
        hits = rag.retrieve(query)
    except Exception as e:
        print(f"  [rag] feedback unavailable ({str(e)[:80]})")
        return Event(output={"query": query, "feedback": [], "media": [],
                             "note": "no corpus connected - run: python -m agent.platform.rag"})
    return Event(output={"query": query, "feedback": [h["text"] for h in hits]})  # TODO: RAG_MEDIA
コーパス内の音声メモ、写真、クリップ、ポスターに由来するすべての行に、ファイル名が付けられています。rag.media_in(hits) は、それらの名前をパッセージから読み取り、ページで表示および再生できる URL に変換します。👉🖥 参加者が送信した内容が、参加者の発言とともに表示されるように、メディアを参加者に返します。
    return Event(output={"query": query, "feedback": [h["text"] for h in hits],
                         "media": rag.media_in(hits)})
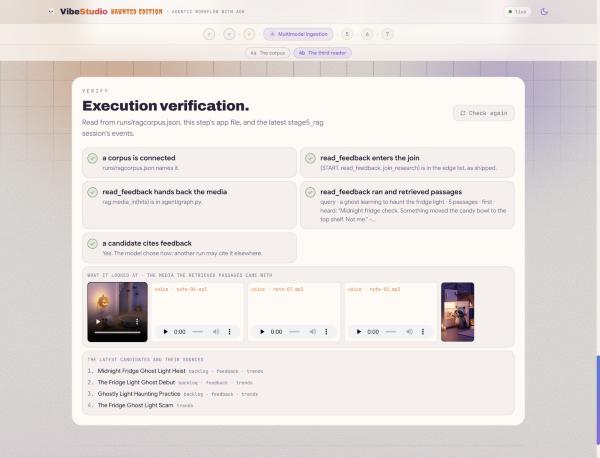
👉🖥 アイデアを指定して stage5_rag を実行します。read_feedback を開きます。クエリはアイデアで、出力には最も近い 5 つのパッセージと、ファイルごとに URL を含む media リストが表示されます。join_research を開く: 3 つのキー。propose_directions を開きます。候補 1 ~ 3 は、証拠として feedback を引用しています。検証パネルには、読者が行の下で見たもの(クリップ、3 つの音声メモ、冷蔵庫のライトに映る幽霊のポスター)が表示されます。
7. 5 · 動画生成 - 2 種類の停止、1 つのメカニズム
👉🖥 ワークベンチで、stage6_video で構築されたセッション 5 · 動画生成のパート 5a と 5b を開き、グラフ全体を表示します。クリップの生成には数分、ポスターの生成には数秒かかります。その間に、ユーザーと Veo のそれぞれで 1 回ずつ、計 2 回実行が停止します。2 つのストップは 1 つのメカニズムであり、デスクの 2 つのブランチは、作成したものを名前で共有します。
2 種類の停止(5a)
待つ必要はありません。停止する必要がある実行は、セッションにオープンコールを書き込んで終了します。そのコールに応答する人またはプロセスが、実行を継続します。ページが 1 つのテーブルで開きます。
1 人あたり · | ツールの動作が遅い · | |
ランニングを停止する人 |
|
|
待機対象 | 人物: 4 枚のカードのうちの 1 枚 | 低速なジョブ: Veo のオペレーション、数分 |
セッションに何が含まれているか | オープン | オープン |
再開方法 |
| その通話の ID を含む |
送信者 |
|
|
その間、どこに保存されるか |
| 同じ行、同じ ID · 何も実行されない |
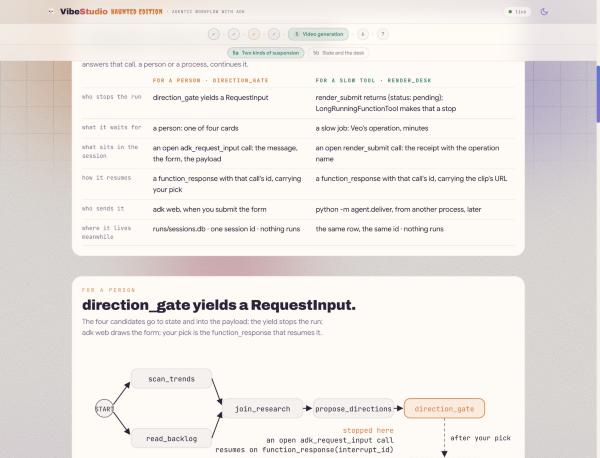
人物の場合。1 つのプロンプトで「クリエイターに確認を求める」はアドバイスであり、セッション 2 では 1 つのメッセージでそれを超えていました。ワークフローでは、一時停止はエンジンのものです。RequestInput を生成するノードは実行を一時停止します。ADK は、message、response_schema、payload を含む adk_request_input という名前のオープン呼び出しをセッションに書き込み、interrupt_id を割り当てて、呼び出し元に戻ります。スレッドの待機はありません。再開するには、その ID を含む function_response をスキーマに照らして検証する必要があります。ワークフローへのチャット メッセージは新しいターンであり、回答ではありません。スキーマはフォームでもあります。adk web はフォームをレンダリングし、VibeStudio アプリは同じスキーマを 4 つのカードとしてレンダリングします。direction_gate はすでに候補を状態に書き込んでいます。👉🖥 停止する:
    yield RequestInput(
        message="Pick tonight's direction: 1, 2, 3 or 4.",
        response_schema={
            "type": "object",
            "properties": {
                "pick": {"type": "string", "enum": ["1", "2", "3", "4"]}}},
        payload={"candidates": cands})
回答は persist_direction に node_input として届きます。これは 1 つのキー pick を持つ dict です。4 つの候補は別の方法で取得されます。ゲートが candidates の下の共有状態に候補を書き込み、ADK が状態キーを同じ名前のパラメータにバインドします。ノードは選択を 1 つの候補に解決し、direction、angle、hook、user:prefs を Event(state=...) で書き戻します。user: という接頭辞が付いたキーは、そのユーザーのセッション間で保持されます。
ツールの動作が遅い場合。Veo のレンダリングには数分かかりますが、グラフはそれほど長く待つべきではありません。agent/desk.py の render_submit はジョブを開始し、ステータスが pending のレシートをすぐに返します。
def render_submit(prompt: str) -> dict:
    """Submit one Veo render of `prompt`. Returns at once with a pending
    receipt; the clip is delivered later, to this call, by id."""
    receipt = videogen.start(f"{prompt} {videogen.NO_TEXT}")
    return {"status": "pending", "operation": receipt["operation"], "prompt": receipt["prompt"]}
LongRunningFunctionTool でラップされたこのレシートは、ADK にとって意味があります。エージェントのターンが終了し、ワークフローが render_desk で一時停止します。ID とレシートを含むオープンコールは、runs/sessions.db の行になります。👉🖥 stage6_video/agent.py で、ツールをラップします。
tools=[LongRunningFunctionTool(render_submit)])
別のプロセスから ID で再開します。agent/deliver.py は、セッション ストアで保留中の呼び出しを見つけ、クリップが存在するまで Veo をポーリングし、結果を runs/state.json に書き込み、その呼び出しの ID を含む function_response を同じセッションに送信します。👉🖥 レスポンス部分を構築する:
    part = Part(function_response=FunctionResponse(
        id=row["call_id"], name=row["name"], response=response))
👉🖥 stage6_video を 2 回停止するまで実行します。アイデアを送信します。実行は、スキーマから構築されたフォームで停止します。ペイロードには 4 つの候補が含まれています。pick に 2 と入力して送信します。グラフは persist_direction で再開されます。ここで強制終了テストを試します。フォームで一時停止し、サーバーを停止して(タブ 1 で scripts/stop.sh)、再度起動し(scripts/restart.sh)、セッションを再度開きます。一時停止はスレッドではなく行であるため、フォームはそのまま残ります。script_ready の後、render_desk は render_submit を呼び出し、領収書を取得して WAITING を返信し、実行が終了します。セッションは通話 ID を保持します。ページのコンソールまたはタブ 1 から配信を実行します。
cd ~/vibe-studio-multimodal
uv run python -m agent.deliver status   # the pending renders, by session, call id and operation
uv run python -m agent.deliver          # wait for Veo, answer the newest pending call by id
👉🖥 [Refresh adk web] をクリックします。function_response が保留中の呼び出しをフォローし、join_media がリリースされ、store_release が実行されます。8 つの検証行は、セッションから 2 つのストップ(ゲートの呼び出しと回答、レンダリングの受信と配信)を読み取ります。
状態とデスク(5b)
メディアデスクは、3a の構造、つまりファンアウトと結合で、1 つの遅いブランチがあります。script_ready は、2 つの方法でスクリプトを送信します。render_desk はクリップを送信し、実行を一時停止します。make_poster は、ノードとしてのセッション 2 ツールです。スクリプトの poster_idea、チャンネルのスタイル、メモリーバンクが把握しているクリエイターのポスターの好み(セッション 6 の memory_facts として状態からバインド)が画像モデルに渡され、9:16 の PNG が数秒で返されます。join_media は遅い方を待ち、store_release は見つかったものを状態に書き込みます。
名前で共有する。store_release がポスターを受け取ることはありません。poster_url という名前のパラメータを宣言し、ADK はそれを共有状態からバインドします。これは、別のブランチのノードがそのキーを書き込んだためです。ブランチ間でペイロードが交差することはありません。
def store_release(node_input, poster_url: str = "", poster_path: str = ""):
    """`poster_url` and `poster_path` are not passed by anyone: ADK binds them
    from shared STATE because the parameter names match the keys make_poster
    wrote (the STATE_SHARE edit). The two branches of the desk never hand each
    other payloads; they share what they made by name."""
    render = state.load().get("render") or {}          # the delivered clip, written by deliver
    url, status = render.get("url") or "", render.get("status", "")
    ...
    if not poster_url:
        said += " · poster: not in state (did make_poster write poster_url to state? the STATE_SHARE edit)"
    yield Event(output={"status": status, "url": url, "poster_url": poster_url},
                state={"render_url": url, "render_status": status, "poster_url": poster_url},
                message=f"video: {said} · poster: {poster_url or 'none'}")
出荷時の make_poster は、出力としてポスターとメッセージを生成し、store_release は poster: not in state と表示します。👉🖥 状態の書き込みを最終的な yield に追加します。
                state={"poster_url": rec.get("url", ""), "poster_path": rec.get("path", "")},
                message=f"poster: {said}")
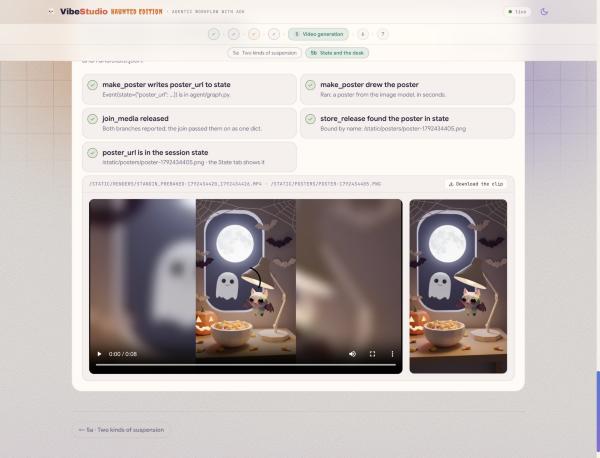
👉🖥 もう一度実行して、配信します。make_poster のイベントを開きます。出力にポスターの URL が表示され、poster_url との状態差分が表示されます。store_release を開きます。メッセージには投稿者の名前が記載されています。ページの [This run's session] ブロックには、adk web の [State] タブと同じ行が表示されます。再開に必要なセッション ID、開いている呼び出し、ノードが書き込んだキー(poster_url など)が表示されます。確認パネルに、クリップとポスターが並んで表示されます。
8. 6 · メモリ - チャンネルが夜間に記憶する内容
👉🖥 ワークベンチで、stage4_memory に組み込まれている Session 6 · Memory のパート 6a と 6b を開きます。セッション 5 は、1 回の実行の状態に関するものでした。このセッションでは、実行間でチャネルが記憶する内容、つまり 2 つのコールバックを介してグラフが外部から受け取る内容について説明します。
メモリバンク(6a)
Vertex AI Memory Bank は、個人に関する長期記憶を管理するサービスです。ファクトは、スコープ(アプリ名とユーザー ID)と、定義したトピックの下に存在します。memories.generate とのやり取りを渡すと、トピックに適合するものを抽出し、埋め込み、すでに保持しているものと統合します。新しい事実が作成され、変更された事実が更新され、重複がマージされます。memories.retrieve は、スコープのファクトを返します。どちらの呼び出しも agent/platform/memory.py にあります。
SCOPE = {"app_name": config.APP, "user_id": config.USER}
TOPICS = {
    "CREATOR_TASTE": "Which video directions this creator picks and passes on, "
                     "and how that preference changes over time.",
    "CHANNEL_RULES": "Standing instructions the creator states for every video "
                     "(style, subjects to avoid, format rules).",
    "VISUAL_STYLE": "What this creator approves and rejects in a poster: palettes, "
                    "framing, props and mood of the posters they shipped.",
}
3 つ目のトピックは、チャンネルの画像の好みです。リリースはセッション 5 で書き込みを行いました。出荷されたポスターが 1 文で記述されて記憶され、次のポスターはその文をプロンプトに含めて描画されます。
セットアップですでにバンクの作成が開始されています。6a ページの接続行に、バンクが稼働しているかどうかが表示されます。ページのボタンまたはターミナルから: python -m agent.platform.bank はバンクとそのトピックを作成し、リソース名を runs/memorybank.json にキャッシュします。python -m agent.platform.bank load は、過去の 4 つのセッション(スタイルルールが適用された 2 つの動物の時代、ガジェットの時代、最近のファンタジーの時代)をシードします。python -m agent.platform.bank list は、文字起こしがどのように変化したかを示します。文字起こしではなく、統合された事実の記述です。
コールバック(6b)
メモリはノードではありません。コールバックは、Agent に渡す関数です。ADK は、ライブ コンテキストを使用して、特定のタイミングでコールバックを呼び出します。None を返すと、通常の処理が行われます。3 つのペア: エージェントのターン(before_agent_callback、after_agent_callback、CallbackContext)、各モデル呼び出し(LlmRequest を含む before_model_callback、LlmResponse を含む after_model_callback)、各ツール呼び出し。ガードレール、テレメトリー、キャッシュ、コンテキスト インジェクションは、グラフ内のノードなしでここに配置されます。
stage4_memory/agent.py では、propose_directions はモデル呼び出しの前にバンクを読み取ります。recall_taste は事実を取得し、古いものから順に MEMORY ブロックとしてリクエストに追加します。そして、候補 1 ~ 3 を現在の好みに近づけ、ルールを制約として扱うようモデルに指示します。また、make_poster が検出する memory_facts として状態にファクトを書き込みます。👉🖥 接続する:
    output_schema=Directions,
    before_model_callback=recall_taste)
スクリプターは、クリエイターが選択した内容を書き留めます。remember_pick は状態から direction を読み取り、選択内容について 1 文を書き、memories.generate に渡します。👉🖥 接続する:
    output_schema=Script,
    after_agent_callback=remember_pick)
👉🖥 空のメッセージで実行し、カードを選択します。propose_directions イベントを開きます。リクエストには 3 つの時代が含まれており、候補 1 ~ 3 は現在の好みに傾いていますが、トレンドは別のものを示しています。スクリプターの後、[バンクを表示] をクリックします。今夜の選択のためにメモリが変更または追加されました。2 日目の夜に実行すると、1 日目の夜のことが記憶されています。
9. 7 · デプロイと公開 - アプリ内のグラフ、VibeTube の夜
👉🖥 ワークベンチで、セッション 7 · デプロイと公開のパート 7a と 7b を開きます。
VibeStudio をデプロイする(7a)
サンドボックスでは、adk web がグラフを駆動しました。VibeStudio は、独自のイベントループを持つワーカー スレッドで ADK の Runner を使用してこれを駆動し、すべてのイベントを 1 つの実行状態にまとめます。この実行状態は、サーバー送信イベントを介してページが読み取ります。読み取り、4 枚のカードとしての選択、ポスターの着地、レンダリングの配信です。ゲートの回答とレンダリングの配信は同じ呼び出し(function_response 部分)であり、アプリはコンソールを待つのではなく、Veo 自体をポーリングします。
self._svc = DatabaseSessionService(db_url=config.DB_URL)
self._runner = Runner(app_name=config.APP, agent=wf, session_service=self._svc)

async for ev in self._runner.run_async(user_id=config.USER, session_id=run_id, new_message=message):
    self._absorb(ev)    # fold the ADK event into the run state, publish one app event

part = Part(function_response=FunctionResponse(id=call_id, name=name, response=response))
vibestudio/server/agent/ は、ラボの agent/ のバイト単位のコピーであり、checks/verify_app.py によってチェックされます。agent/graph.py の完全なエッジリストは、この Codelab のすべての構造を 1 か所にまとめたもので、13 個のノードがあります。このリストは、入力するのではなく、読み取るために、あらかじめ入力されています。
        (START, scan_trends, join_research),
        (START, read_backlog, join_research),
        (START, read_feedback, join_research),
        (join_research, propose_directions, direction_gate,
         persist_direction, policy_check),
        (policy_check, {"OK": scripter, "BLOCK": quarantine}),
        (quarantine, scripter),
        (scripter, script_ready),
        (script_ready, render_desk, join_media),
        (script_ready, make_poster, join_media),
        (join_media, store_release),
👉🖥 ワークベンチの [デプロイ] ボタンを使用してデプロイするか、👉💻 タブ 1 からデプロイします。
cd ~/vibe-studio-multimodal
uv run python vibestudio/deploy.py
.env の値が入力された状態で実行されます。
gcloud run deploy vibestudio --source vibestudio \
  --project $GOOGLE_CLOUD_PROJECT --region us-central1 \
  --labels dev-tutorial-codelab=vibetube --allow-unauthenticated \
  --memory 2Gi --cpu 2 --timeout 3600 --concurrency 40 \
  --max-instances 1 --min-instances 1 --session-affinity \
  --set-env-vars GOOGLE_CLOUD_PROJECT=...,STUDIO_VERTEX=1,STUDIO_MEMORY_BANK=...,STUDIO_RAG_CORPUS=...,VIBETUBE_URL=...,VIBETUBE_EVENT=...,VIBETUBE_NAME=...,VIBETUBE_PROJECT=...
--source は Cloud Build でコンテナをビルドし、1 つのステップでデプロイします。最初のビルドには 4 ~ 5 分かかります。1 つのウォーム インスタンスを持つ --session-affinity は、セッション 5 のセッション ストアを保持するインスタンスで、一時停止された実行を保持します。大規模なデプロイでは、セッション ストアが VertexAiSessionService に移動し、アフィニティがなくなります。ビルドとサービスは、プロジェクトのデフォルトのコンピューティング サービス アカウントとして実行されます。このアカウントには、設定によって必要なロールが付与されています。
👉🖥 サービス URL を開き、アプリでアイデア、選択、クリップとポスターの待機という一連の操作を実行します。[履歴] タブには両方が表示されます。
公開(7b)
公開は、アプリから VibeTube のルームのエンドポイント(vibestudio/server/platform/publish.py)への 1 つのマルチパート POST です。クリップは動画、ポスターはサムネイル、プロフィールは部屋とあなたの名前です。
url = f"{prof['platform_url']}/api/events/{prof['event_code']}/videos"
data = {"title": state.script["title"], "description": state.script["description"],
        "duration": "0:08", "displayName": prof["display_name"],
        "projectId": prof["project_id"]}        # one video per project and room: publishing again replaces it
files = {"videoFile": (clip.name, clip.open("rb"), "video/mp4"),
         "thumbnailFile": (poster.name, poster.open("rb"), "image/png")}   # the poster, not a frame
r = httpx.post(url, data=data, files=files, timeout=120)
video_id = r.json()["id"]                       # watch it at {platform}/e/{event}?v={video_id}
VibeTube は projectId とルームごとに 1 つの動画を保持します。アプリが送信するプロジェクトは Google Cloud プロジェクトであるため、再度公開すると、動画が追加されるのではなく、動画が置き換えられます。代わりのポスターがアップロードされることはありません。実際のポスターがサムネイルであり、バイト単位で一致します。
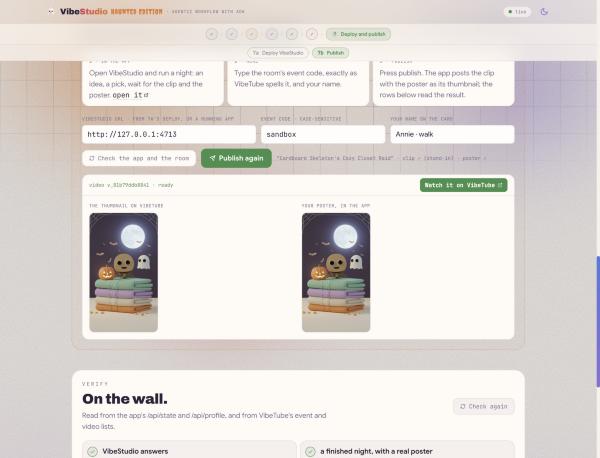
最後の編集は、コード行ではなく構成です。👉🖥 7b ページ: VibeStudio の URL(7a のデプロイから入力)、部屋のイベントコード(VibeTube のスペルどおり。インストラクターが別の部屋を開いていない限り、セットアップで指定したもの)、名前。[公開] をクリックします。ワークベンチはクリックをアプリにリレーし、アプリは夜を投稿します。下の行は、アプリと VibeTube からの結果を読み取ります。アプリが応答し、夜は実際のポスターで終了し、コードはオープンルームに名前を付け、VibeTube は動画 ID を返し、動画は壁にあり、そのサムネイルはポスターです。結果カードには、アプリ内のポスターの横に VibeTube のサムネイルが表示されます。
10. 作成したもの
👉🖥 7b ページの最後では、アイデアからクリップとそのポスターまでの 13 個のノードを含むグラフ全体が描画されます。ノードにカーソルを合わせると、そのノードの機能と、そのノードを構築したセッションが表示されます。
セッション | 学んだこと | 次のように記述します。 |
2 · 画像生成 | エージェント: モデル、指示、ツール、ツールとしての画像モデル、プロンプトで保証できないこと |
|
3 · ワークフロー | エッジリスト、ファンアウトと結合、タスクモードのループが背後にあるルーター |
|
4 · マルチモーダル取り込み | 種類ごとに 1 つのリーダー、1 つの行の形状、1 つのコーパス。意味による 3 つ目のリーダー(メディア付き) |
|
5 · 動画生成 | 2 種類のサスペンド、1 つのメカニズム、セッション ストア、名前で共有されるポスター |
|
6 · メモリ | 夜間のメモリ、2 つのコールバック |
|
7 · デプロイと公開 | Cloud Run 上のアプリ内のグラフ。VibeTube の夜 |
|
グラフが従う 5 つのルール:
- 待機する代わりに一時停止する。一時停止は、スレッドではなく、セッション ストア内の行です。
- すべてを同じ方法で再開する - 人間が応答するかプロセスが応答するかにかかわらず、オープンコールの ID で再開します。
- すべてのペイロードにスレッド化するのではなく、状態の名前でデータを共有します。
- モデルの料金を支払う前に、コードで判断する。ポリシーはテキスト ファイルとルーターであり、レンダリングの前に実行されます。
- テキスト以外のすべてのファイルを、コーパスに到達する前にテキストに読み込みます。その際、ファイル名を行内に含めて、ファイルが戻ってくるようにします。
プロンプトは、順序、停止、チェックを保証できません。グラフなら可能です。
次のステップ
VertexAiSessionService(インスタンスよりも長く存続するセッションの場合)。--session-affinityは削除します。- ポーラーの代わりにレンダリングの呼び出しに応答する Webhook:
FunctionResponse(id=...)は同じで、送信者が異なります。 - 公開前の 2 つ目の
RequestInput- スキーマはフォームであるため、1 つのノードであり、ページコードはありません。 - リリースごとに、視聴者の新しいコメント、音声メモ、クリップが、送信されたポスターとともにコーパスに追加されます。
クリーンアップ
このラボで作成したものはすべて、ステップ 4 で作成したプロジェクトに存在するため、最も費用のかからないクリーンアップ方法はプロジェクトを削除することです。Cloud Shell で次を処理します。
gcloud projects delete $(cat ~/project_id.txt)
プロジェクトを保持し、有料部分のみを削除するには、Cloud Run サービス(gcloud run services delete vibestudio --region us-central1)、RAG コーパスとメモリバンク(リソース名は runs/ragcorpus.json と runs/memorybank.json にあり、コンソールの Agent Engine ページと RAG Engine ページで削除します)、Artifact Registry のコンテナ イメージを削除します。