

1. 소개
VibeTube에서 아늑하면서도 으스스한 채널을 운영하고 있습니다. 핼러윈까지 매일 밤 Shorts 동영상을 하나씩 게시합니다. 시청자는 작은 방에서 일어나는 작은 마법을 원하며 댓글, 음성 메모, 귀신이 나오는 서랍 사진, 해질녘 현관의 클립 등 가능한 모든 방법으로 이를 보냅니다. 백로그에는 아이디어가 가득합니다. 매일 저녁 같은 일과를 반복합니다. 피드에 어떤 콘텐츠가 올라오는지 조사하고, 밀린 작업을 처리하고, 시청자가 보낸 내용을 읽고, 방향을 정하고, 채널 정책에 맞는지 확인하고, 스크립트를 작성하고, 포스터를 그리고, 클립을 렌더링하고, 게시합니다.
생성 모델은 각 집안일을 혼자서 수행할 수 있습니다. Gemini는 조사하고, 듣고, 보고, 작성합니다. 이미지 모델은 그리고, Veo는 렌더링합니다. AI가 혼자서 할 수 없는 일은 밤새 순서대로 실행하고, 사용자의 결정을 기다리며 멈추고, 비용이 들기 전에 잘못된 방향을 거부하고, 아무것도 열어두지 않은 채 렌더링을 몇 분 동안 기다리고, 기록을 남기는 것입니다.
이 Codelab에서는 해당 저녁을 ADK Workflow로 전환합니다. ADK는 노드와 에지의 그려진 그래프로, 자체적으로 실행되고 판단이 필요한 위치만 묻고 VibeTube에서 클립과 포스터로 모든 실행을 종료합니다.
프롬프트는 순서, 중지 또는 확인을 보장할 수 없습니다. 그래프는 가능합니다.
학습할 내용
- 에이전트 하나와 이미지 모델을 도구로 사용합니다.
Agent는 모델, 요청 사항, 도구입니다. 세 번째 도구는 이미지 모델을 호출하고 첫 번째 실행은 포스터로 끝납니다. 그런 다음 실습의 나머지 부분을 이끄는 문장인 프롬프트는 순서, 중지 또는 확인을 약속할 수 없습니다. - 그래프를 구성하는 구조
Workflow는 에지 목록입니다. 팬아웃과 조인 (JoinNode에서 만나는 병렬 리더)을 빌드하고, 자체 종료를 지정하는 라우터를 빌드합니다. 거부된 종료 뒤에는 작업 모드 에이전트가 있어 도구 호출 루프에서 방향을 정리하고 기본 라인에 다시 조인합니다. - 멀티모달 수집 파이프라인 시청자가 보낸 네 가지 종류의 콘텐츠를 각각 한 명의 리더가 처리합니다. Gemini가 음성 메모를 스크립트로 작성하고, 사진에 자막을 달고, 클립을 시청하고, 사운드트랙을 듣습니다. 그리고 모든 리더가 동일한 선 모양을 하나의 RAG Engine 코퍼스에 작성합니다. 팬아웃의 세 번째 리더는 의미별로 검색하고 구절과 함께 미디어를 다시 전달합니다.
- 두 가지 유형의 정지, 하나의 메커니즘 사람 (
RequestInput: 카드 4장, 답변)과 느린 도구 (Veo 뒤에LongRunningFunctionTool: 영수증)에 대해 실행이 중지됩니다. 둘 다 동일한 것으로, 세션 저장소에서 열린 호출이며, 양식 또는 다른 프로세스에서 ID로 재개됩니다. 미디어 데스크의 두 지점은 주 내에서 이름으로 포스터를 공유합니다. - 밤새도록 지속되는 메모리 메모리 뱅크의 수명 주기 콜백 두 개:
before_model_callback는 제안자가 읽기 전에 크리에이터의 취향을 기억하고,after_agent_callback는 스크립트 작성자 이후에 오늘 밤의 선택을 기억합니다. - 발표 ADK
Runner가 있는 앱 내부의 그래프, 페이지로 전송되는 서버 전송 이벤트, 세션 어피니티가 있는 Cloud Run, 포스터를 썸네일로 사용하여 VibeTube에 클립을 게시하는 하나의 멀티파트 POST가 있습니다.
빌드 대상
브라우저에서 실행 중인 앱: VibeStudio Workbench, 인페이지 코드 편집기가 있는 컴패니언 페이지, 디스크의 파일과 실행에서 작성한 세션을 읽는 검증 도구, 삽입된 adk web. 7개의 세션은 이 Codelab의 7개 페이지로, 동일한 번호와 동일한 파트 문자를 사용하므로 두 세션이 일치합니다. 각 페이지는 세션을 한 문장으로 설명하고, 수정, 실행, 확인이라는 세 가지 작업을 수행하는 밴드에서 열립니다. 여기에서 섹션을 읽은 다음 워크벤치에서 수정합니다. 모든 수정은 실제로 발생한 상황을 읽는 확인 패널로 끝납니다.
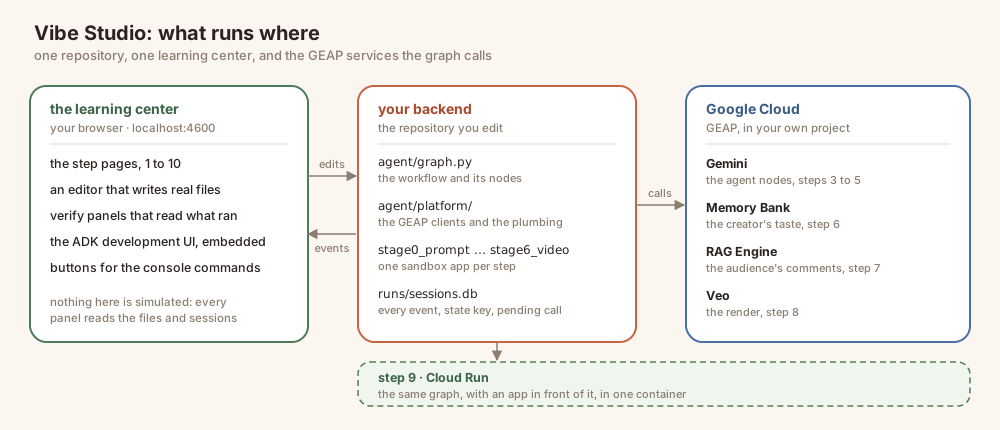
Workbench (포트 4600의 페이지, 편집기, 검증 도구), 백엔드 (agent/의 Workflow 및 stage0_prompt/~stage6_video/의 세션당 샌드박스 앱 1개, adk web에서 제공), Google Cloud (Gemini, 이미지 모델, RAG Engine, Veo, Memory Bank — 모두 자체 사용자 인증 정보를 사용하여 Vertex AI를 통해 액세스)의 세 가지가 실행됩니다.
7개의 세션
세션 | 빌드할 항목 | 내 수정사항 |
1 · 스토리 | 아직은 아무것도 없습니다. 밤이 되면 그래프가 나타납니다. | — |
2 · 이미지 생성 | 에이전트 한 명이 첫 번째 포스터를 그립니다. |
|
3 · 워크플로 | 그래프로서의 밤: 팬아웃과 조인, 라우터와 루프 |
|
4 · 멀티모달 수집 | 청중이 보낸 것, 하나의 코퍼스로 읽기, 세 번째 독자 |
|
5 · 동영상 생성 | 두 가지 정지 유형, 주에서 이름으로 공유된 포스터 |
|
6 · 메모리 | 채널이 밤 사이에 기억하는 내용 |
|
7 · 배포 및 게시 | Cloud Run의 VibeStudio, VibeTube의 밤 | 회의실의 이벤트 코드를 입력하고 |
이 Codelab을 사용하는 방법 개념 우선: 각 세션에서 아이디어를 설명한 다음 변경사항이 적용된 후 읽는 코드를 보여주고 살펴봅니다. 여기서는 파일을 수정하라는 메시지가 표시되지 않습니다. 수정은 워크벤치에서 이루어지며, 한 번에 하나의 수정 사항이 제공되고 그 옆에 힌트가, 그 아래에 확인 패널이 표시됩니다. 세션을 읽은 후 페이지를 따라 진행합니다.
위치
VibeTube의 그래프, 테마, 방은 Lin의 VibeStudio Haunted Edition에서 가져온 것입니다. 이는 Agent Valley 실험실의 한 페이지 대화형 형식으로, 시청자가 보낸 내용과 두 가지 유형의 서스펜션에 다시 초점을 맞춘 멀티모달 버전입니다. 스튜디오는 배경일 뿐이며, 그 아래에 있는 모든 메커니즘은 지원 파이프라인, 콘텐츠 검토 흐름 또는 사람을 위해 일시중지하고 느린 작업을 기다려야 하는 기타 모든 작업에 사용하는 일반적인 메커니즘입니다.
2. 설정
- 무엇 — 결제할 수 있는 계정, 프로젝트, 설치된 실습, 답변이 검증된 모델, 한 포트에서 백그라운드로 실행되는 워크벤치
- 이유 — 하나의 포트에서 하나의 프로세스: 페이지, 편집기, 검증기,
/api/*,adk web가 출처를 공유하므로 이 실습에서는 두 번째 터미널이나 두 번째 포트가 필요하지 않습니다. - 방법 — 클론, 스크립트 2개 두 번째는 실제 모델 호출을 실행하고, 워크벤치를 시작하고, 읽는 동안 RAG 코퍼스와 메모리 뱅크를 만들기 시작하므로 세션 4와 6에서 준비가 완료됩니다.
이 실습의 모든 항목은 Cloud Shell에서 실행됩니다. gcloud, Python, Node, ffmpeg, git가 이미 설치되어 있으며 Gemini, 이미지 모델, Veo, RAG Engine, Memory Bank는 모두 자체 사용자 인증 정보를 사용하여 Vertex AI를 통해 액세스할 수 있습니다. 이 실습에는 API 키가 없으며 노트북에 설치할 항목도 없습니다. Google Cloud SDK, Python 3.12, Node 20 이상이 설치된 노트북도 동일한 방식으로 작동합니다.
이 실습에서 제공할 수 없는 것이 하나 있습니다. 바로 결제가 사용 설정된 Google Cloud 프로젝트입니다. 1단계에서는 비용을 지불할 수 있는 계정을 만들고, 4단계에서는 해당 계정을 프로젝트로 전환합니다. 이 순서대로 진행하세요. 4단계 이후의 모든 단계는 4단계에서 결정된 프로젝트를 읽습니다.
1 · 결제 계정 만들기(~1분)
결제가 사용 설정된 Google 계정으로 로그인합니다. 이러한 계정은 모두 사용할 수 있습니다. 그렇지 않은 경우 무료 체험을 시작하세요. 그러면 4단계에 필요한 결제 계정이 제공됩니다. 강사 주도형 실습에 참여하는 경우 먼저 이 세션의 크레딧을 사용하세요. 그러면 결제 계정이 생성됩니다.
2 · Cloud Shell 열기(~2분)
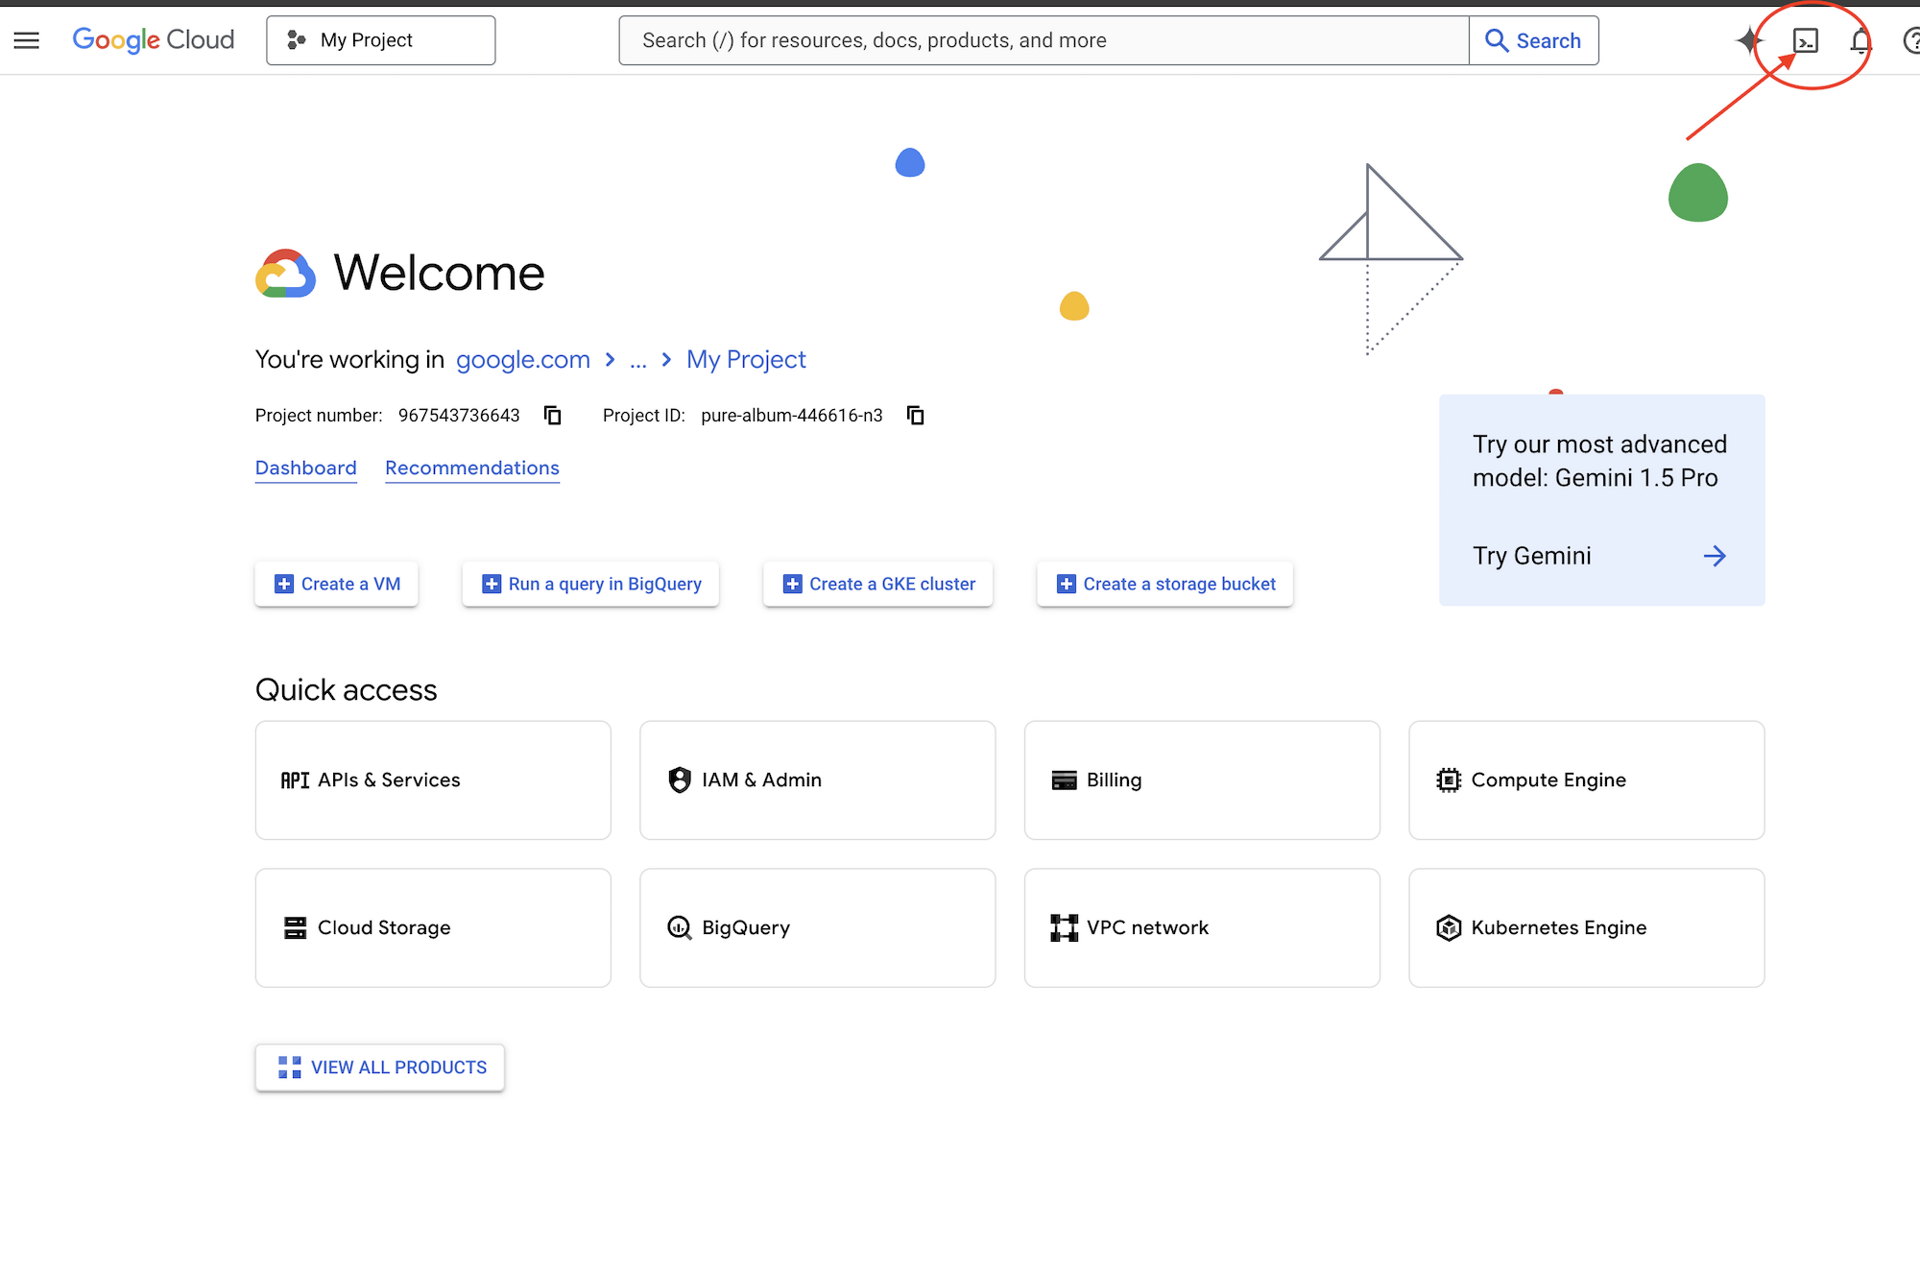
👉🖥 Google Cloud 콘솔 상단에서 Cloud Shell 활성화를 클릭합니다. 헤더에 있는 터미널 모양 아이콘입니다.
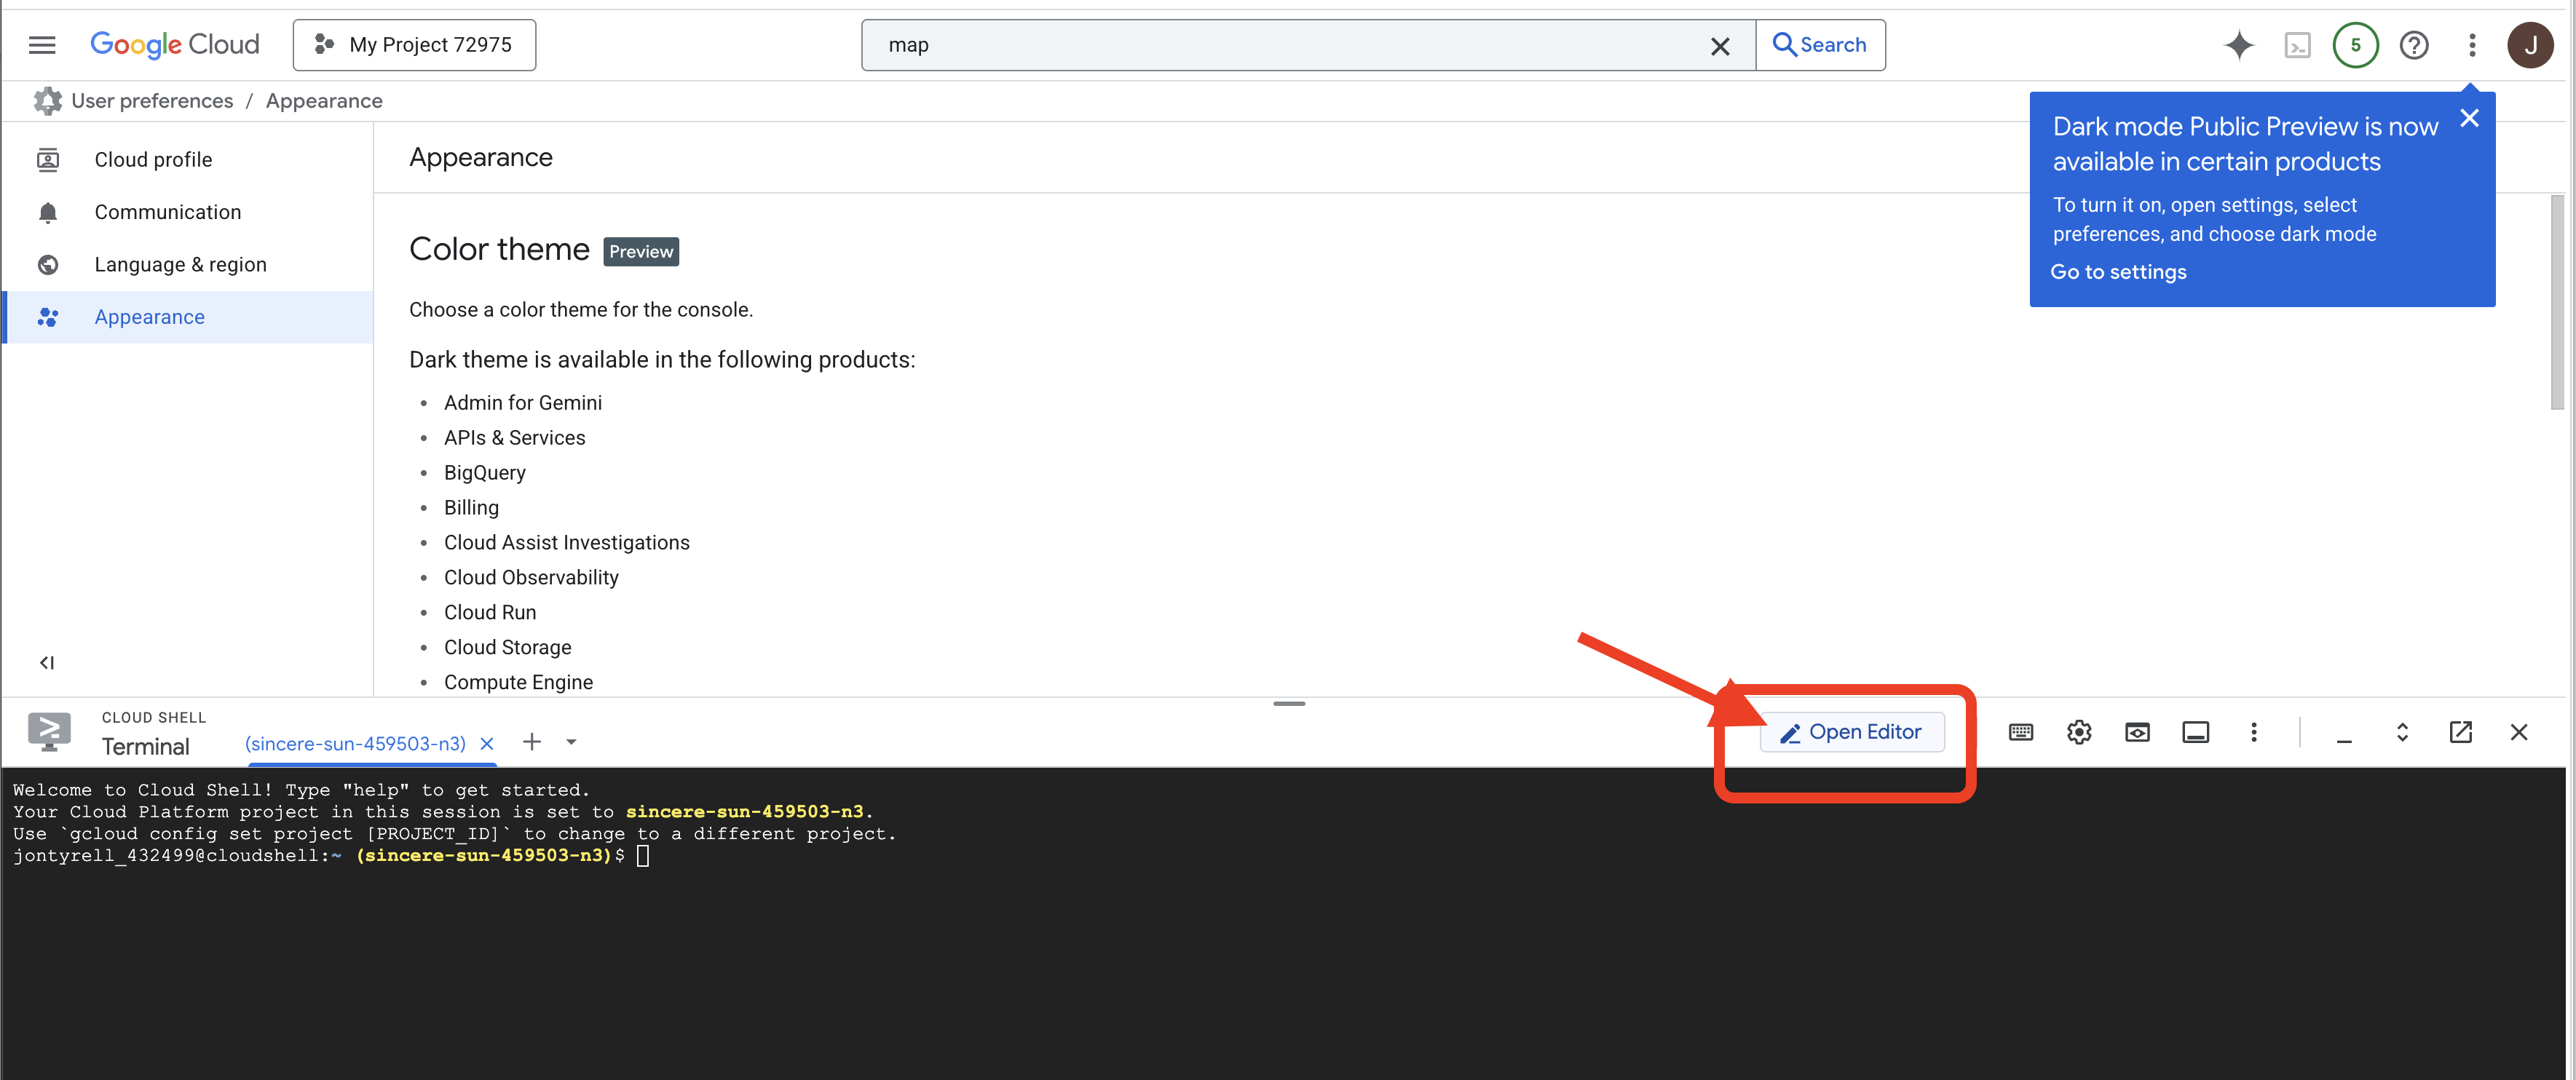
👉🖥 편집기 열기 (연필 아이콘이 있는 폴더 열기 아이콘)를 클릭합니다. 그러면 왼쪽에 파일 탐색기가 있는 Cloud Shell 편집기가 표시됩니다. 전체 파일을 읽으려면 여기로 이동하면 됩니다.
👉🖥 오늘 승인하라는 메시지가 표시되면 승인을 클릭하여 계속 진행합니다.
👉🖥 편집기 내에서 터미널을 엽니다(탭 1). 모든 👉💻 단계가 여기에서 실행됩니다. 탭 2는 워크벤치 자체이며 7단계에서 엽니다. 터미널이 화면 하단에 표시되지 않으면 보기 → 터미널을 사용하여 터미널을 엽니다.
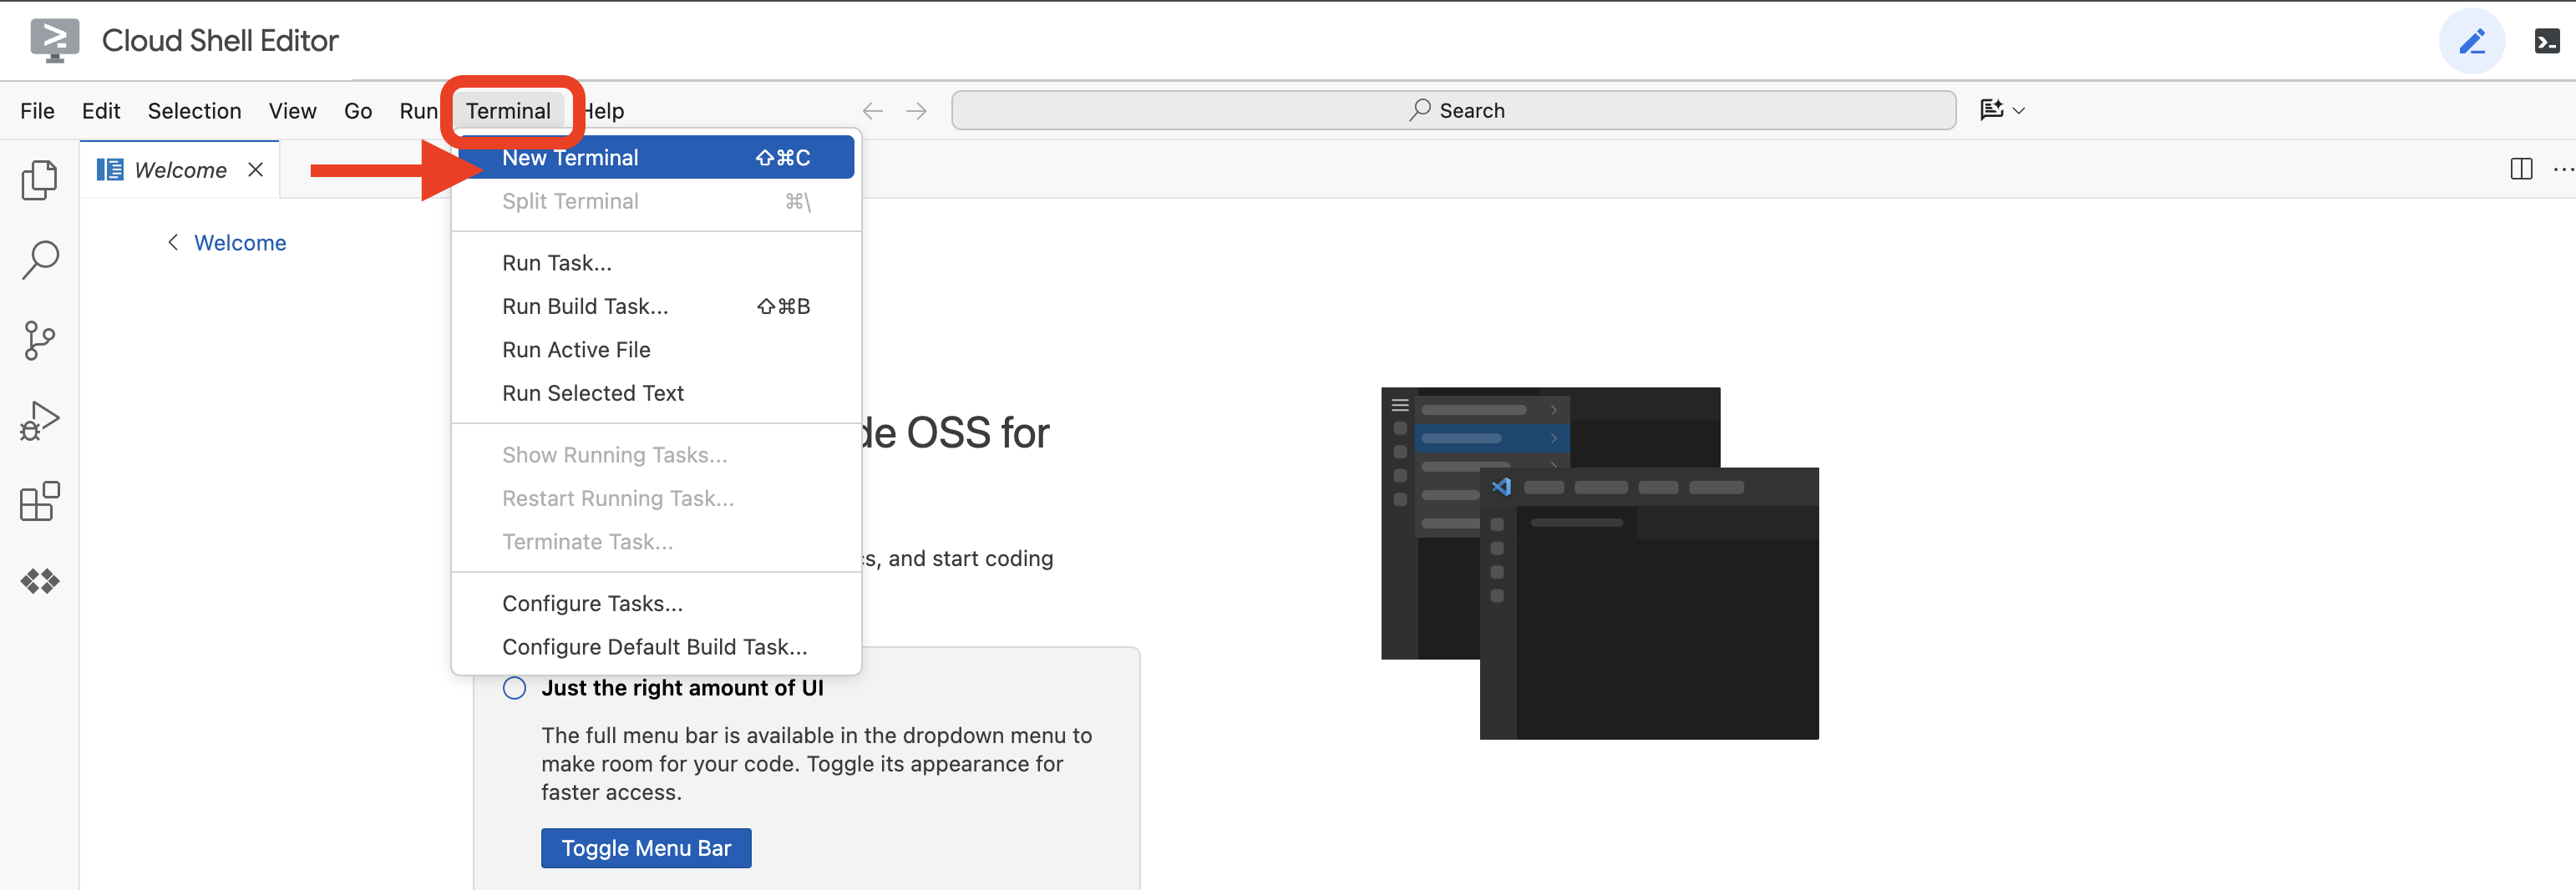
👉💻 로그인한 계정을 확인합니다. 1단계에서 사용한 계정이어야 합니다.
gcloud auth list
3 · 실습 가져오기(~1분)
👉💻 저장소를 클론합니다.
cd ~
git clone https://github.com/cuppibla/vibe-studio-multimodal
cd vibe-studio-multimodal
4 · 프로젝트 만들기(~2분)
👉💻 스크립트 하나로 결제 계정을 찾고, 해당 계정에 프로젝트를 만들고, 결제를 연결하고, Cloud Shell이 해당 프로젝트를 가리키도록 할 수 있습니다.
cd ~/vibe-studio-multimodal
./setup_project.sh
선택한 결제 계정에 대한 ✓, 생성된 프로젝트에 대한 ✓, 다음과 같은 엔딩이 표시됩니다.
Project ready: vibe-studio-4271
  Next:  ./setup_codelab.sh
vibe-studio-4271는 프로젝트 ID입니다. 프로젝트 ID는 다른 숫자로 구성됩니다. 여기에서 네 가지 작업이 수행됩니다.
결제 | 최신 | |
project |
| |
선택 | ID를 | |
대기 | 프로젝트가 실제로 제공될 수 있을 때까지 최대 2분 동안 폴링합니다. | |
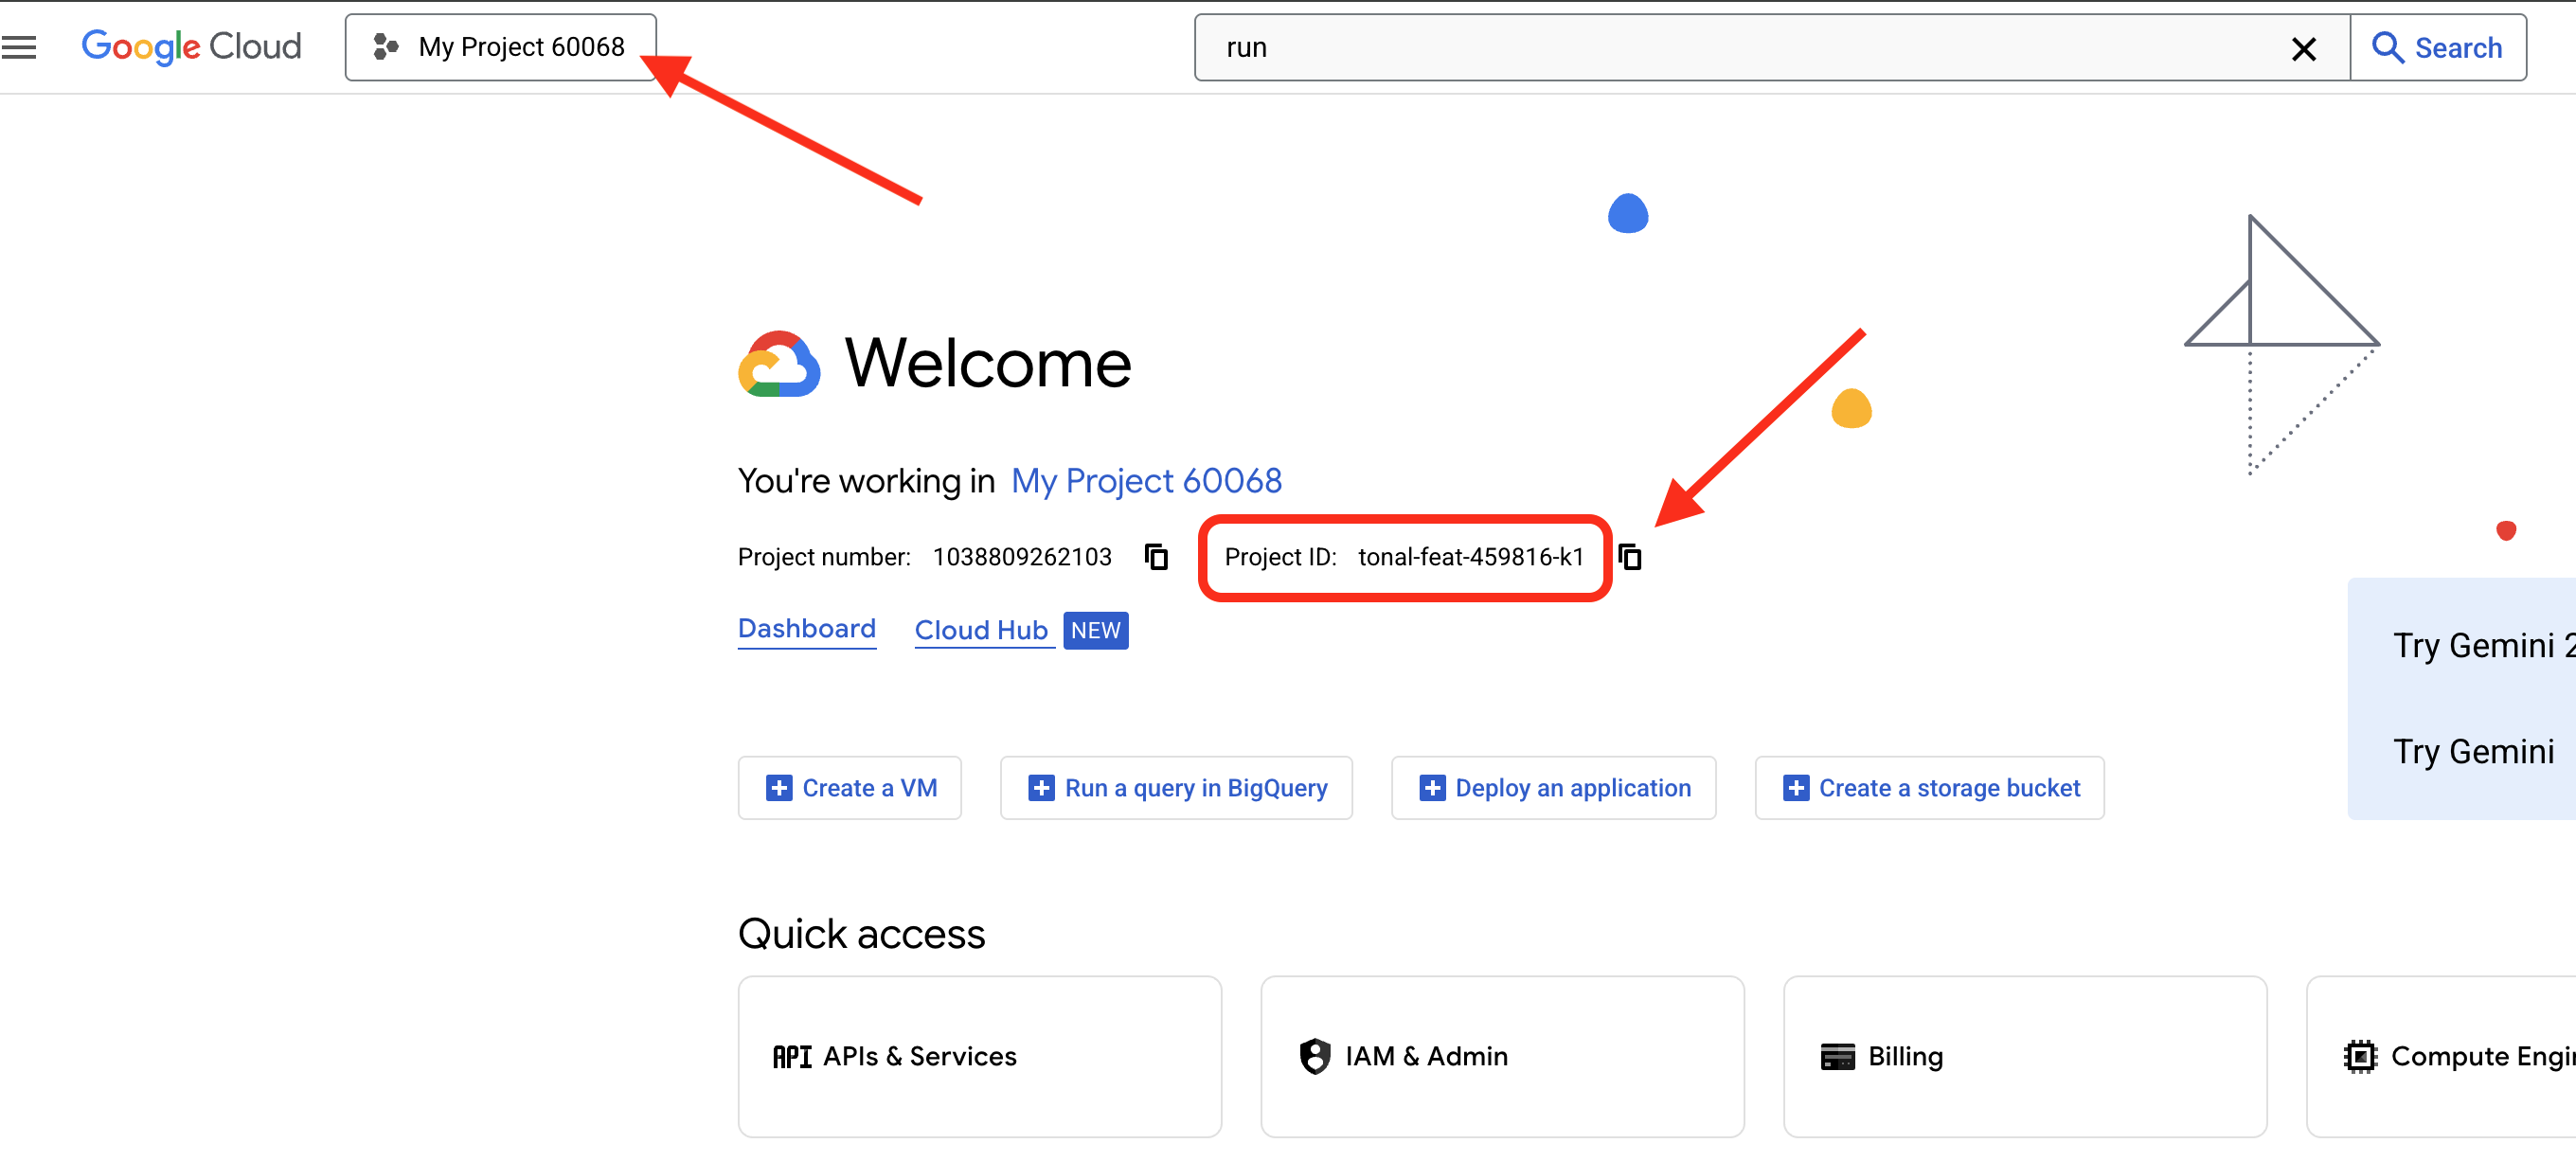
👉🖥 이제 콘솔에 동일한 프로젝트가 표시됩니다. 프로젝트 ID는 대시보드의 프로젝트 정보 카드에 있습니다.
5 · 실습 설치 및 설정(~4분)
👉💻
cd ~/vibe-studio-multimodal
./setup_codelab.sh
다시 실행해도 안전한 하나의 스크립트 — 두 번째 실행은 처음 제공한 모든 답변을 유지합니다. 시작 부분에서 두 가지 질문을 하고 Enter 키를 누르면 두 질문 모두 기본값이 사용됩니다.
이벤트 코드 | 세션 7에서 동영상이 게시되는 VibeTube 방입니다. 강사가 제공한 회의실 코드를 입력하거나 Enter 키를 눌러 언제든지 누구나 참여할 수 있는 | |
표시 이름 | 방에서 나를 표시하는 이름 또는 Enter를 눌러 내 계정에서 만든 이름을 사용합니다. | |
두 항목 모두 .env에 표시되며 나중에 .env 또는 게시 페이지에서 변경할 수 있습니다. 그런 다음 나머지 작업은 다음 순서로 자체적으로 수행됩니다.
uv env | uv가 없으면 설치한 다음 | |
apis | 4단계에서 선택한 프로젝트에서 6개의 API를 사용 설정하고 각 API가 응답하는지 확인한 후 다음으로 진행합니다. | |
account | 프로젝트의 기본 컴퓨팅 서비스 계정이 존재하고 세션 7의 빌드 및 서비스에 필요한 역할을 보유하고 있는지 확인합니다. | |
.env | 프로젝트의 Vertex AI( | |
veo · room |
| |
model | Gemini에 실제 호출을 한 번 수행하므로 잘못된 프로젝트는 세션 내부가 아닌 설정 시점에 실패합니다. | |
starter |
| |
페이지 | 워크벤치 페이지인 | |
cloud | 백그라운드에서 RAG Engine 코퍼스와 메모리 뱅크를 만들기 시작하므로 세션 4와 6에서 준비된 상태로 찾을 수 있습니다. | |
preflight |
| |
6 · 프리플라이트 읽기(~1분)
5단계에서 마지막으로 출력된 것은 프리플라이트입니다. 모든 줄은 추측이 아닌 실제 프로브입니다.
  ✓ python 3.12
  ✓ auth path A: Vertex via ADC (STUDIO_VERTEX=1)
  ✓ Google Cloud ADC (project vibe-studio-4271)
  ✓ Memory Bank SDK
  ✓ stage0_prompt loads
  ✓ stage1_fanout loads (0 edges)
  ✓ stage3_router loads (... edges)
  ✓ stage4_memory loads (... edges)
  ✓ stage5_rag loads (... edges)
  ✓ stage6_video loads (... edges)
  ✓ node and npm (build the learning center's page)
  ✓ learning center page built (web/dist)
  ✓ aiplatform.googleapis.com enabled (Gemini, Veo, Memory Bank, RAG Engine)
  ...
  - Memory Bank: still being created in the background
  - RAG corpus: still being created in the background
  ✓ session 7 runtime account 123456789-compute@developer.gserviceaccount.com has its roles
  ✓ learning center running on port 4600

PREFLIGHT GREEN

Open session 1 here:  https://4600-cs-...cloudshell.dev/step/story
stage1_fanout loads (0 edges)이 맞습니다. 이 그래프는 비어 있으며 세션 3에서 채우게 됩니다. - 줄 두 개도 맞습니다. 코퍼스가 표시되는 데 1~2분, 은행이 표시되는 데 약 20초가 걸리며 세션 4 전에는 둘 다 필요하지 않습니다.
👉💻 언제든지 다시 실행하여 진행 상황을 확인하세요. 체크리스트가 아닌 파일, 프로젝트, 실행 중인 서버를 읽습니다.
cd ~/vibe-studio-multimodal
uv run python scripts/preflight.py
7 · 워크벤치 열기(~1분)
워크벤치가 이미 실행 중입니다. 5단계에서는 백그라운드에서 시작했습니다. 포트 4600에서 페이지, 모든 /api/* 경로, /workbench에 마운트된 adk web를 제공하는 uvicorn 프로세스 하나가 실행됩니다. 시작할 항목이 없으며 이 실습에서는 다시 시작하라는 메시지가 표시되지 않습니다. 수정사항은 다음 실행에 적용됩니다.
👉🖥 사전 확인에서 출력된 링크를 클릭하거나 Cloud Shell에서 웹 미리보기 → 포트 변경 → 4600을 클릭합니다. 이 탭을 탭 2라고 부르겠습니다. 세션 1 · 스토리가 열립니다.
나중에 필요할 수 있는 세 가지 명령어(모두 ~/vibe-studio-multimodal에서 가져옴):
| 워크벤치를 중지합니다. | |
| 포그라운드에서 시작합니다. Ctrl+C는 시작된 모든 프로세스를 중지합니다. | |
|
| |
저장소 레이아웃
vibe-studio-multimodal/
├── agent/                  # the workflow and the platform clients
│   ├── graph.py            # the graph: three readers, the proposer, the gate, the router, the script, the desk
│   ├── desk.py             # render_desk and render_submit, the LongRunningFunctionTool
│   ├── deliver.py          # the delivery console: find the pending call, wait for Veo, answer by id
│   ├── schemas.py          # Direction, Directions, CleanedDirection, Script, each with a poster idea
│   ├── cleanup_tools.py    # find_policy_hits, suggest_replacement: the task agent's tools
│   ├── policy_words.txt    # the policy, as data; policy_replacements.txt, the approved stand-ins
│   ├── backlog.txt         # the creator's Halloween ideas; comments.md, the audience's comments
│   ├── audience/           # what else the audience sent: voice/*.mp3, photo/*.jpg, clip/*.mp4
│   ├── media/past/         # six past posters and captions.md, what Gemini sees in each
│   └── platform/           # config, audience (the readers), rag (RAG Engine), images, videogen (Veo), memory (Memory Bank)
├── stage0_prompt/ ... stage6_video/   # one sandbox app per session, runnable in adk web
├── server/ & web/          # the VibeStudio Workbench (FastAPI + React, port 4600)
├── vibestudio/             # the app deployed in session 7, with its own copy of agent/
├── checks/ & scripts/      # the hole registry, the verifiers, preflight, start/stop/restart
└── starter/                # the nine files you edit, as students receive them
3. 1 · 이야기 — 밤, 그리고 그래프
👉🖥 탭 2가 세션 1 · 스토리에서 열립니다. 트렌드 조사, 백로그 정리, 방향 선택, 정책 확인, 스크립트 작성, 클립 렌더링 등 한 사람이 처리해야 하는 6가지 작업이 원형으로 배열되어 있으며, 이 원형은 매일 밤 반복됩니다. Gemini는 조사, 백로그, 스크립트를 혼자서 처리할 수 있고, Veo는 혼자서 렌더링할 수 있습니다. 선택하고 확인하는 것은 사람의 몫입니다.
링 아래에는 나머지 실습에서 빌드하는 그래프가 있으며, 아이디어에서 클립과 포스터에 이르는 13개의 노드가 있습니다. 노드 위로 마우스를 가져가면 노드의 기능과 노드를 빌드하는 세션이 표시됩니다. 여기서는 수정할 사항이 없습니다. 페이지의 첫 번째 포스터 생성 버튼은 세션 2입니다.
어휘, 다음 6페이지를 멈추지 않고 읽기:
word | 여기서 의미하는 바는 |
에이전트 | ADK |
노드 | 그래프의 한 단계(Python 함수, 에이전트, 조인, 라우터) |
에지 | 순서대로 실행되는 노드의 튜플입니다. 그래프는 이러한 튜플의 목록입니다. 세션 3 |
session |
|
state | 노드가 키 이름으로 공유하는 사전. 한 노드가 |
메모리 | 세션보다 오래 지속되는 것, 즉 콜백을 통한 메모리 뱅크입니다. 세션 6 |
4. 2 · 이미지 생성 — 에이전트 1개, 이미지 모델을 도구로 사용
👉🖥 워크벤치에서 세션 2 · 이미지 생성을 엽니다. 그래프를 사용하기 전에는 가장 간단한 방법으로, 밤새도록 작성한 산문 형식의 요청 사항이 포함된 하나의 Agent, 이를 실행하는 세 개의 Python 함수, 그리고 사진으로 끝나는 실행이 있었습니다.
에이전트는 모델, 요청 사항, 도구로 구성됩니다.
stage0_prompt/agent.py는 ADK 에이전트의 세 가지 필드로 root_agent를 정의합니다. model는 agent/platform/config.py의 Gemini 모델입니다. instruction는 시스템 프롬프트입니다. 한 번에 6개의 작업을 수행하며, 마지막 작업은 사진입니다. tools에는 세 가지 함수가 있습니다.
root_agent = Agent(
    name="solo_channel", model=config.MODEL,
    tools=[check_trends, read_backlog, make_poster],
    instruction=(
        "You run the creator's cozy-spooky short-video channel, alone, every "
        "night until Halloween.\n"
        "When the creator gives you an idea (or nothing), do ALL of this:\n"
        "check what is trending. look at your backlog of ideas. propose a "
        "direction and agree on it with the creator. refuse blacklisted "
        "subjects (competitor, hateful, gore). then describe the video you "
        "would make: a title (<=60 chars) and 3 shots, one visual sentence "
        "each. then draw its poster: call make_poster once with one line that "
        "names the single image that sells the video, and tell the creator "
        "where the poster is.\n"
        "Ask the creator to confirm the direction before describing the "
        "video."))
모델은 폐쇄된 세계입니다. 가중치와 컨텍스트의 토큰을 기반으로 추론합니다. 도구는 모델이 요청할 수 있는 Python 함수입니다. ADK는 각 함수의 시그니처와 docstring을 읽고 이를 모델에 선언합니다. 모델이 함수를 원하면 function_call 이벤트를 내보내고, 런타임은 Python을 실행하고 function_response 이벤트를 컨텍스트에 다시 작성하며, 모델은 결과를 앞에 두고 계속 진행합니다.
세 가지 함수가 있고 그중 하나는
3명 중 2명은 연구를 읽습니다. 세 번째는 이미지 모델에 포스터를 요청합니다.
def check_trends() -> dict:
    """Ten formats trending on the platform right now, with a heat score each."""
    from agent.trends import sample_trends
    return {"trends": sample_trends()}


def read_backlog() -> dict:
    """The creator's backlog: ideas they noted down to make someday."""
    from agent.graph import backlog_notes
    return {"backlog": backlog_notes()}


def make_poster(subject: str) -> dict:
    """Draw tonight's poster: one image of `subject` in the channel's cozy
    low-poly style. Returns where the PNG landed (path, url) in a few seconds."""
    ...
make_poster는 videogen.py가 Veo를 래핑하는 방식으로 일반 함수로 래핑된 이미지 모델인 agent/platform/images.py를 호출합니다. 하우스 스타일 접두사 (채널의 아늑한 로우 폴리 할로윈 분위기, 미드나잇 플럼에 대비되는 호박 오렌지와 촛불 크림), 주제, 세로 9:16 프레임, runs/media/posters 미만의 PNG 하나가 /static/posters에 제공됩니다. STUDIO_REAL_IMAGES=0를 사용하면 대체 포스터를 복사하고 결과에 prebaked 플래그를 지정하므로 어디서나 실습을 실행할 수 있습니다.
MODEL = os.environ.get("STUDIO_IMAGE_MODEL", "gemini-2.5-flash-image")
ASPECT = "9:16"

def generate(subject: str, visual_style: str = "", name: str | None = None) -> dict:
    """One poster for `subject`. Returns where it landed: status, path, url,
    prompt, and prebaked=True when the stand-in was used instead of the model."""
동일한 호출이 세션 5의 그래프에서 노드입니다.
실습: 한 번의 수정
출시된 상태에서 make_poster는 포스터를 건너뛰었다는 딕셔너리를 반환합니다. 👉🖥 워크벤치 편집기에서 TODO 줄 대신 이미지 모델을 호출하도록 합니다.
    from agent.platform import images
    return images.generate(subject, name="solo")
저장합니다. 확인 행은 파일을 읽습니다. 에이전트의 세 가지 도구, 이미지 모델 호출이 준비되었습니다. 👉🖥 워크플로 로드 확인을 클릭한 다음 ADK 웹 열기를 클릭하고 다음을 전송합니다.
tonight's idea: a tiny ghost learning to haunt a sock drawer
예상되는 상황 및 이유
- 답장 전에 도구 이벤트가 두 개 있고 그 뒤에 질문이 있습니다.
check_trends및read_backlog는 지침에서 확인하고 살펴보라고 했지만 모델의 가중치에 둘 다 없었기 때문에 실행됩니다. 요청 사항에서 먼저 동의를 구했기 때문에 대답은 방향을 제안하고 확인을 요청합니다. - 두 번째 메시지에는 모든 내용이 포함됩니다.
skip the questions, describe the video and draw the poster을 보냅니다. 모델은 동영상을 설명하고, 직접 작성한 제목으로make_poster를 한 번 호출하고, PNG가 저장된 위치를 알려줍니다. 확인 패널에는 행 옆에 포스터가 표시됩니다. 채널의 디자인에 맞게 약 8초 만에 그려진 할로윈 장면입니다. - 채널이 아닌 이유 조사 결과는 인용할 수 없는 산문으로 정리됩니다. 이 정책은 방향을 작성한 모델에 의해 인증되었으며, 포스터는 확인되기 전에 그려졌습니다. 한 메시지에서 계약에 대한 논의가 이루어졌습니다. 프롬프트 텍스트는 게이트가 아닙니다. 실습의 나머지 부분에서는 이 6가지 작업을 그려진 그래프로 분리합니다.
이 페이지는 ADK 에이전트의 구성 요소로 끝납니다. 이 구성 요소는 모델, 추론에 사용하는 컨텍스트, 작업을 수행하는 도구 및 공동작업자, 각 호출을 래핑하는 콜백, 외부에 존재하는 세션 및 메모리 등 다시 참고할 수 있는 참조입니다.
5. 3 · 워크플로 — 팬아웃 및 조인, 라우터 및 루프
👉🖥 워크벤치에서 세션 3 · 워크플로, 3a 및 3b 부분을 엽니다. 각 부분은 샌드박스 앱에서 빌드되므로 adk web에서 자체적으로 실행할 수 있습니다. stage1_fanout의 팬아웃, stage3_router의 라우터 및 루프가 있습니다.
팬아웃 및 조인 (3a)
ADK Workflow는 에지 목록입니다. 각 항목은 순서대로 실행되는 노드의 튜플인 체인입니다. START에서 나가는 두 체인이 동시에 실행됩니다. JoinNode에서 끝나는 체인은 여기에 보고하고, 조인은 계속하기 전에 거기에서 끝나는 모든 체인을 기다리며 노드 이름으로 키가 지정된 하나의 dict를 전달합니다. dict로 작성된 타겟은 라우터의 경로 이름을 노드에 매핑합니다. 워크벤치의 3a 페이지는 도형을 그리고 가장자리 쓰기 연습을 합니다.
노드 종류 | 다음과 같이 작성됩니다. | 기능 |
함수 노드 |
| 일반 Python |
조인 노드 |
| 모든 수신 체인이 보고할 때까지 기다린 후 모든 출력을 하나의 사전으로 전달합니다. |
에이전트 노드 |
|
|
라우터 |
| 반환이 나가는 에지의 이름을 지정하는 함수 노드입니다. |
사람의 입력 노드 |
| 사용자가 양식에 답변할 때까지 그래프를 정지합니다. 세션 5. |
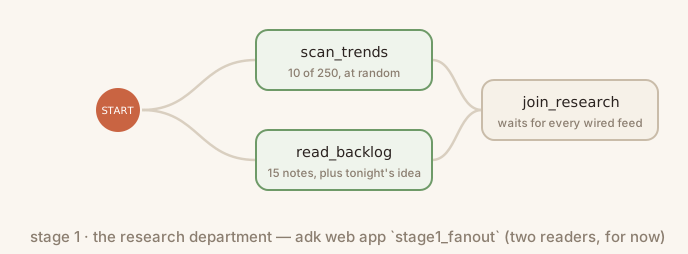
첫 번째 그래프는 세션 2의 연구를 노드로 나타냅니다. agent/graph.py의 scan_trends 및 read_backlog는 두 명의 리더입니다. read_backlog는 오늘 밤의 아이디어를 공유 상태에 기록하기도 합니다. stage1_fanout/agent.py는 조인을 정의하고 비어 있는 상태로 제공되는 EDGES라는 목록에서 Workflow를 빌드합니다 (사전 검사의 0 edges). 👉🖥 두 체인으로 채웁니다.
EDGES = [(START, scan_trends, join_research),
         (START, read_backlog, join_research)]
👉🖥 adk web에서 실행합니다. 두 노드가 함께 켜진 다음 조인됩니다. join_research의 이벤트를 열고 scan_trends 키와 read_backlog 키가 있는 하나의 dict를 읽습니다. 모델 호출이 발생하지 않았습니다. 조인의 dict를 다시 포맷하는 것은 없습니다. 3b에서 조인 뒤에 있는 노드는 에이전트이고 에이전트 노드는 node_input를 메시지로 수신하므로 dict는 모델이 직접 읽는 JSON으로 도착합니다.
라우터 및 루프 (3b)
Workflow 내부의 Agent는 single_turn 모드로 실행됩니다. 이전 노드의 출력을 메시지로 수신하고, 모델을 한 번 호출하고, 한 번 응답합니다. output_schema를 사용하면 다음 노드에서 답변을 보기 전에 Pydantic 모델을 기준으로 답변이 검증되므로 그래프는 산문이 아닌 유형이 지정된 객체를 전달합니다. propose_directions는 조인의 조사 사전을 읽고 4명의 후보를 피칭하며, 모두 할로윈 장면입니다. 후보 4는 미끼입니다. 제목에 채널에서 거부하는 단어가 포함되어 있으므로 라우터가 포착할 수 있습니다. 모든 후보에는 동영상을 홍보하는 단일 이미지의 이름을 지정하는 한 줄인 poster_idea가 있습니다. 스크립트 작성자가 이를 보관하고 미디어 데스크가 세션 5에서 이를 그립니다.
라우터는 실행이 사용하는 에지의 이름을 반환하는 함수 노드입니다. 모델 호출 없음: policy_check는 결정 시점에 agent/policy_words.txt를 읽고, 전체 단어를 방향의 제목 및 각도와 일치시키고, 스크립트가 작성되거나 비용이 지출되기 전에 라우팅합니다. 정책은 데이터입니다. 파일을 수정하면 다음 실행에서 이를 읽습니다.
def policy_check(node_input):
    """The policy gate: a router. Refused words in the direction send it to
    quarantine; a clean one goes to the scripter. Code, not a model."""
    chosen = _as_dict(node_input)
    bad = policy_hits(f"{chosen.get('title', '')} {chosen.get('angle', '')}")
    return Event(output=node_input, route="BLOCK" if bad else "OK")
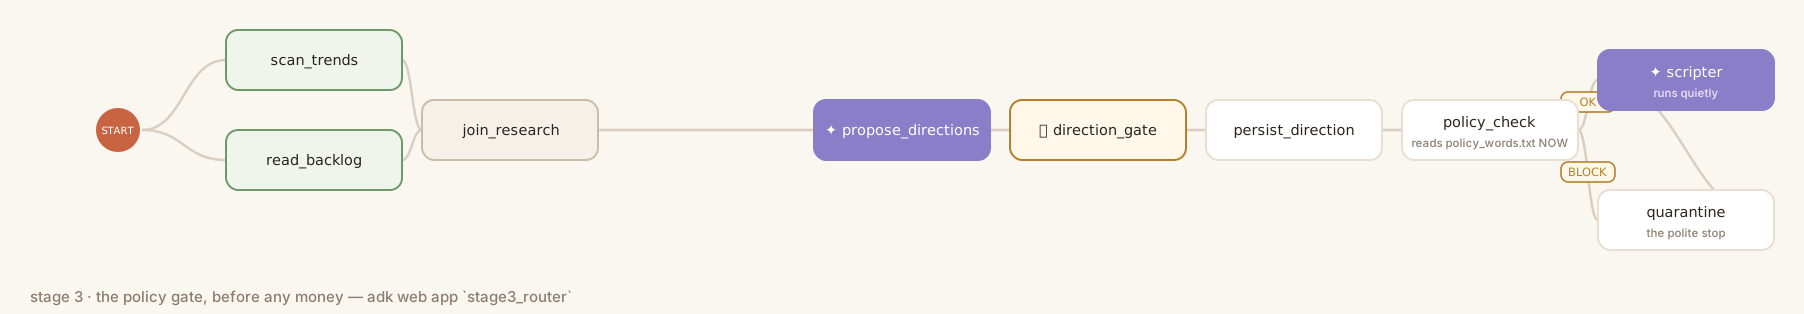
stage3_router/agent.py는 팬아웃에 propose_directions 및 choose_direction를 더한 것으로, 세션 5에서 빌드하는 사람 문을 대체합니다. 이 문은 숫자가 오늘 밤의 아이디어 (..., pick 4)로 끝나는 후보를 선택하고, 그렇지 않으면 첫 번째 후보를 선택하여 선택한 후보를 상태에 기록합니다. scripter는 승인된 방향을 Script로 변환하는 single_turn 에이전트입니다. 제목, 설명, 태그, 오프닝 대사, 3개의 장면, 포스터 아이디어가 포함되며, 모든 장면은 채널의 스타일에 맞는 할로윈 이미지입니다.
거부된 출구 뒤에 있는 루프입니다. quarantine는 작업 모드 에이전트로 제공됩니다. Agent에는 mode가 있습니다. chat는 루트 에이전트가 사용자와 실행하는 대화 루프이고, single_turn는 구조화된 답변이 있는 하나의 호출이며, task는 에이전트가 기본 제공 finish_task를 호출할 때까지 자체적으로 실행하는 도구 호출 루프입니다. 이 도구의 인수는 ADK가 output_schema에서 파생합니다. Quarantine은 거부된 방향으로 find_policy_hits를 호출하고, suggest_replacement에게 각 단어에 대해 채널에서 승인된 대체 단어 (agent/policy_replacements.txt, 데이터 다시)를 요청하고, 다시 작성하고, 다시 확인하고, 입력된 CleanedDirection로 완료합니다. 페이지에서 읽고 입력하지 않습니다.
quarantine = Agent(
    name="quarantine",
    model=config.MODEL,
    mode="task",
    instruction=QUARANTINE_INSTRUCTION,
    tools=[find_policy_hits, suggest_replacement],
    output_schema=CleanedDirection)
출시된 상태에서는 체인이 선택에서 스크립터로 바로 실행됩니다. 👉🖥 라우터를 두 노드 사이에 배치하고, 두 개의 출구와 격리에서 돌아오는 경로를 추가합니다. 한 줄이 세 줄로 바뀝니다.
           (join_research, propose_directions, choose_direction, policy_check),
           (policy_check, {"OK": scripter, "BLOCK": quarantine}),
           (quarantine, scripter),
👉🖥 두 경로를 모두 실행합니다. 아이디어를 그대로 전송합니다. choose_direction는 후보 1을 사용하고 policy_check는 OK를 내보내며 스크립트 작성자는 구조화된 스크립트를 작성합니다. 새 세션을 클릭하고 끝에 , pick 4를 붙여 아이디어를 다시 보냅니다. 후보 4가 미끼이고, policy_check가 BLOCK를 내보내고, 격리가 도구를 호출하고, 거부된 단어를 다시 작성하고, finish_task를 호출하고, 정리된 방향이 스크립터로 돌아갑니다. 확인 행은 세션 저장소에서 두 실행을 모두 읽습니다.
이제 세션 2 프롬프트의 모든 문장에 노드가 있습니다. 조사는 리더 2개와 조인, 거부는 라우터와 작업 에이전트, 스크립트는 에이전트 노드입니다. 전체 그래프에서 대체 선택은 두 개의 함수 노드인 direction_gate 및 persist_direction이며, 세션 5에서 문이 멈출 때까지 계속 실행됩니다. 크리에이터와의 계약은 아직 임시 상태이며, 시청자의 의견을 아직 듣지 못한 조사도 마찬가지입니다.
6. 4 · 멀티모달 수집 — 시청자가 보낸 내용을 하나의 코퍼스로 읽어 들임
👉🖥 워크벤치에서 세션 4 · 멀티모달 수집, 4a 및 4b 부분을 엽니다. 시청자들은 글만 쓴 것이 아닙니다. 종류별로 하나의 리더가 전송된 모든 항목을 동일한 형태의 텍스트로 변환하고, 하나의 RAG Engine 코퍼스가 이를 모두 보유하며, 팬아웃의 세 번째 리더가 의미별로 검색하여 미디어를 다시 전달합니다.
시청자가 보낸 내용 (4a)
agent/comments.md에는 채널의 할로윈 동영상 6개에 작성된 댓글 12개가 포함되어 있습니다. agent/audience/에는 나머지 8개의 음성 메모 (voice/*.mp3), 시청자 자신의 방 사진 14장 (photo/*.jpg), 시청자의 음성 해설이 포함된 사진을 천천히 패닝하는 클립 6개 (clip/*.mp4)가 포함되어 있습니다. 4a 페이지가 열리면 모든 음성 메모가 재생되고, 모든 사진이 표시되며, 모든 클립이 실행됩니다.
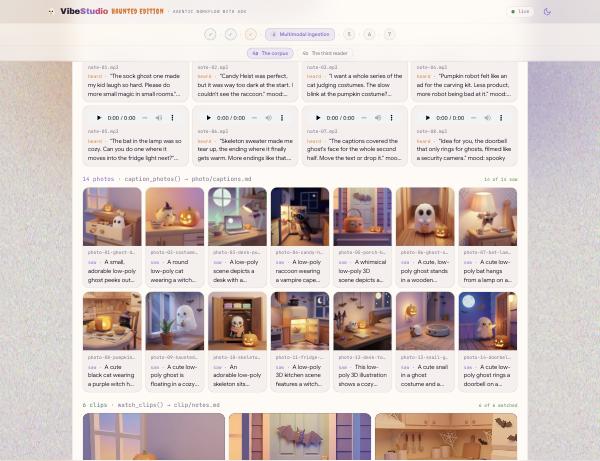
RAG Engine은 텍스트를 검색합니다. 음성 메모, 사진, 클립은 rag.caption_posters에서 과거 게시자가 했던 방식, 즉 모델이 이를 파일 이름을 지정하는 텍스트 줄로 변환하고, 이 줄이 구절이 되고, 구절이 다시 돌아오면 파일도 함께 돌아오는 방식으로만 코퍼스에 참여할 수 있습니다. agent/platform/audience.py에는 종류당 하나의 리더가 있습니다. 각각 하나의 파일과 하나의 프롬프트를 Gemini에 전송하고 파일당 한 줄을 작성합니다.
VOICE_PROMPT = ("Transcribe this voice note word for word inside double quotes. Then add: mood: and one word. "
                "Plain text on one line, nothing else.")
PHOTO_PROMPT = ("Two sentences: what is in the picture, the palette, the mood. Then: tags: and three short tags. "
                "Plain text on one line, no headings, no markdown.")
CLIP_PROMPT = ("Describe the shots in two sentences, then quote what you HEAR on the soundtrack as: heard: \"...\". "
               "Plain text on one line, no headings, no markdown.")


def _ask(path: pathlib.Path, mime: str, prompt: str) -> str:
    """One media file in, one line of text out."""
    from google.genai import types as gt
    client = images._client()
    resp = client.models.generate_content(
        model=config.MODEL,
        contents=[gt.Part.from_bytes(data=path.read_bytes(), mime_type=mime), prompt],
        config=gt.GenerateContentConfig(automatic_function_calling=gt.AutomaticFunctionCallingConfig(disable=True)))
    return " ".join((resp.text or "").split())


def transcribe_voice() -> pathlib.Path:
    """voice note -> text: Gemini listens."""
    files = sorted((AUDIENCE / "voice").glob("*.mp3"))
    lines = []
    for p in files:
        said = _ask(p, "audio/mpeg", VOICE_PROMPT)
        lines.append(f"- voice: {p.name} — {said}")
    return _write(AUDIENCE / "voice" / "transcripts.md", "voice", "What Gemini heard in the audience's voice notes", lines)
caption_photos는 image/jpeg 및 PHOTO_PROMPT와 동일한 작업을 수행하고, watch_clips는 video/mp4 및 CLIP_PROMPT와 동일한 작업을 수행하며, Gemini는 한 번의 호출로 사진을 보고 사운드트랙을 듣습니다. 모든 리더는 동일한 줄 형태를 작성하므로 청킹, 임베딩, 검색은 구절이 어떤 종류에서 왔는지 알 수 없습니다.
- voice: note-03.mp3 — "I want a whole series of the cat judging costumes ..." mood: delighted
- photo: photo-01-ghost-drawer.jpg — A cream wooden drawer, striped socks, a paper-cup ghost ... tags: drawer, socks, cozy
- clip:  clip-05.mp4 — A hallway floor, a snail in a sheet and a round vacuum ... heard: "The snail won."
- poster: sock-ghost.png — A sheet ghost one inch above a striped sock ...
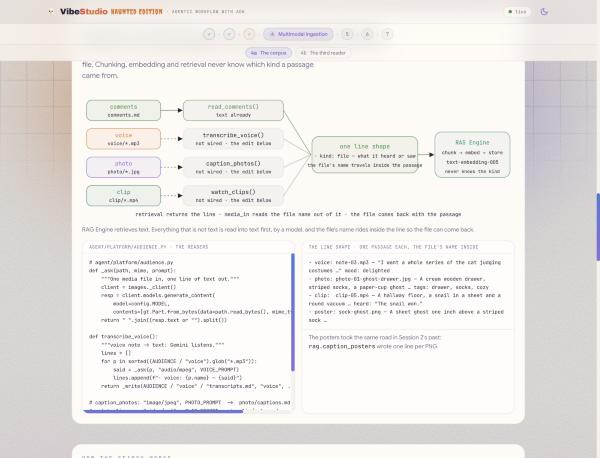
자료입니다. Vertex AI RAG Engine은 문서 검색을 수행합니다. 코퍼스는 약 120개의 토큰으로 구성된 구절로 청킹되고, 각 구절은 text-embedding-005로 임베딩되며, 쿼리도 동일한 방식으로 임베딩되고, 공유된 단어가 아닌 의미상 가장 가까운 구절로 답변됩니다. 'cozy little hauntings at home'은 작은 방에서 작은 마법을 요청하는 댓글, 전구를 안고 있는 박쥐에 관한 음성 메모, 사운드트랙에서 유령이 종이컵이라고 말하는 클립을 찾습니다.
corpus = rag.create_corpus(
    display_name="vibestudio-feedback",
    backend_config=rag.RagVectorDbConfig(
        rag_embedding_model_config=rag.RagEmbeddingModelConfig(
            vertex_prediction_endpoint=rag.VertexPredictionEndpoint(
                publisher_model="publishers/google/models/text-embedding-005"))))

rag.upload_file(
    corpus_name=corpus.name, path="agent/comments.md", display_name="comments.md",
    transformation_config=rag.TransformationConfig(
        chunking_config=rag.ChunkingConfig(chunk_size=120, chunk_overlap=20)))
설정에서 이미 코퍼스 생성을 시작했습니다. 4a 페이지의 연결 행에 코퍼스가 생성되었는지 여부가 표시되며, 설정에서 생성할 수 없는 경우 생성합니다. 페이지의 버튼 또는 터미널에서: python -m agent.platform.rag는 코퍼스를 만들고 runs/ragcorpus.json에 기록합니다. python -m agent.platform.rag load --audience는 audience.READERS의 모든 리더를 실행한 다음 댓글과 포스터의 자막 옆에 작성한 내용을 업로드하고(각 파일은 자체 이름으로) 색인이 응답할 때까지 기다립니다. python -m agent.platform.rag query "cozy little hauntings at home"는 검색어와 단어를 공유하지 않는 구절을 찾는 검색을 보여줍니다.
편집 출고 시 READERS에는 read_comments만 포함되며, 세 개의 미디어 리더는 하나의 # 뒤에 있습니다 . 👉🖥 제공된 상태 그대로 수집을 한 번 실행합니다. 출력에 not read (no reader wired in audience.READERS): voice, photo, clip가 표시되고 댓글과 자막만 입력됩니다. 그런 다음 #을 삭제합니다.
transcribe_voice, caption_photos, watch_clips,
👉🖥 저장하고 수집을 다시 실행합니다. 리더가 40개 항목을 읽는 데 약 3분이 걸립니다. 콘솔에는 heard, saw, watched가 한 번에 한 줄씩 표시되고 그리드의 모든 카드가 해당 줄로 채워집니다. 확인 행은 파일, 리더의 출력, 코퍼스를 읽습니다. 4명의 리더가 연결되고, 8개의 음성 메모가 들리고, 14개의 사진이 표시되고, 6개의 클립이 시청되고, 코퍼스에 5개의 파일이 있습니다.
세 번째 리더 (4b)
시청자 의견은 모든 실행에서 공유되는 조사이므로 조사가 들어가는 그래프에 세 번째 리더로 조인에 들어갑니다. agent/graph.py의 read_feedback는 오늘 밤의 아이디어를 가져와 코퍼스에 가장 가까운 구절을 요청하고 join_research에 보고합니다. 는 3개를 기다립니다. (START, read_feedback, join_research) 에지에는 stage5_rag/agent.py가 포함되어 있습니다. 이는 세션 3에서 배운 형태입니다. 수정사항은 노드 내부에 있습니다. 모델 호출이 아닌 검색이며 결정론적입니다. 제안자가 달라도 동일한 아이디어는 동일한 구절을 찾습니다.
def read_feedback(node_input):
    """The third reader: what the audience sent - comments, and what Gemini
    heard and saw in their voice notes, photos and clips - the passages
    nearest to tonight's idea, and the media those passages came with.
    Retrieval, not a model call."""
    from .platform import rag
    idea = idea_text(node_input)
    query = idea or "what viewers liked and what they complained about"
    try:
        hits = rag.retrieve(query)
    except Exception as e:
        print(f"  [rag] feedback unavailable ({str(e)[:80]})")
        return Event(output={"query": query, "feedback": [], "media": [],
                             "note": "no corpus connected - run: python -m agent.platform.rag"})
    return Event(output={"query": query, "feedback": [h["text"] for h in hits]})  # TODO: RAG_MEDIA
음성 메모, 사진, 클립 또는 포스터에서 가져온 말뭉치의 모든 줄에는 파일 이름이 지정됩니다. rag.media_in(hits)는 구절에서 이러한 이름을 읽고 페이지에서 표시하고 재생할 수 있는 URL로 변환합니다. 👉🖥 미디어와 함께 문구를 다시 전달하여 시청자가 보낸 내용이 시청자의 말과 함께 전달되도록 합니다.
    return Event(output={"query": query, "feedback": [h["text"] for h in hits],
                         "media": rag.media_in(hits)})
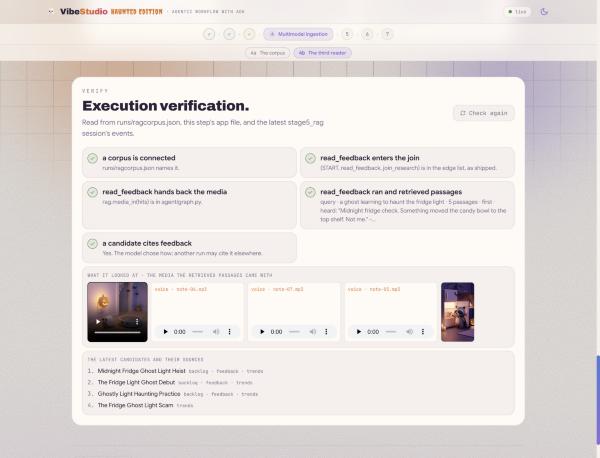
👉🖥 stage5_rag를 실행하여 아이디어를 얻으세요. read_feedback를 엽니다. 쿼리는 아이디어이고 출력에는 가장 가까운 구절 5개와 파일당 URL이 있는 media 목록이 있습니다. join_research 열기: 키 3개 propose_directions 열기: 후보 1~3은 증거에서 feedback을(를) 인용합니다. 확인 패널에는 독자가 행 아래에서 본 내용이 표시됩니다. 클립, 음성 메모 3개, 냉장고 조명 속 유령 포스터가 있습니다.
7. 5 · 동영상 생성 — 두 가지 정지, 하나의 메커니즘
👉🖥 워크벤치에서 stage6_video로 빌드된 세션 5 · 동영상 생성, 5a 및 5b 부분, 전체 그래프를 엽니다. 클립은 몇 분, 포스터는 몇 초가 걸리며, 도중에 두 번 멈춥니다. 한 번은 사용자를 위해, 한 번은 Veo를 위해 멈춥니다. 두 정류장은 하나의 메커니즘이며, 데스크의 두 지점은 Made by Google 이름으로 만든 것을 공유합니다.
두 가지 유형의 정지 (5a)
기다릴 필요가 없습니다. 중지해야 하는 실행은 세션에 공개 호출을 작성하고 종료됩니다. 이 호출에 응답하는 사람이나 프로세스가 이를 계속합니다. 페이지가 하나의 테이블로 열립니다.
1인당 · | 느린 도구 · | |
실행을 중지하는 사용자 |
|
|
대기 대상 | 사람: 카드 4장 중 하나 | 느린 작업: Veo의 작업, 분 |
세션에 있는 항목 | 공개 | 열린 |
재개 방식 |
| 해당 통화의 ID가 포함된 |
발송 담당 |
|
|
그동안 어디에 있는지 |
| 동일한 행, 동일한 ID · 아무것도 실행되지 않음 |
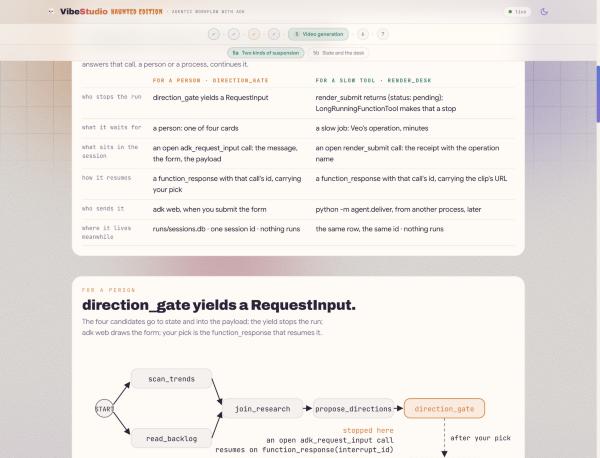
사용자 단일 프롬프트에서 '크리에이터에게 확인 요청'은 권고 사항이며, 세션 2에서는 한 메시지에서 이를 언급했습니다. 워크플로에서 일시중지는 엔진의 일시중지입니다. RequestInput를 생성하는 노드는 실행을 정지합니다. ADK는 message, response_schema, payload를 사용하여 세션에 adk_request_input라는 열린 호출을 작성하고, interrupt_id를 부여하고, 호출자에게 반환합니다. 스레드 대기가 없습니다. 해당 ID를 전달하고 스키마에 대해 검증된 function_response만 워크플로를 재개할 수 있습니다. 워크플로에 대한 채팅 메시지는 답변이 아닌 새로운 대화 차례입니다. 스키마는 양식이기도 합니다. adk web에서 렌더링하고 VibeStudio 앱에서 동일한 스키마를 카드 4개로 렌더링합니다. direction_gate는 이미 후보를 상태에 작성합니다. 👉🖥 중지하기:
    yield RequestInput(
        message="Pick tonight's direction: 1, 2, 3 or 4.",
        response_schema={
            "type": "object",
            "properties": {
                "pick": {"type": "string", "enum": ["1", "2", "3", "4"]}}},
        payload={"candidates": cands})
답변은 persist_direction에 node_input로 도착합니다. 이는 하나의 키 pick가 있는 딕셔너리입니다. 네 명의 후보는 다른 방식으로 도착합니다. 게이트가 candidates 아래의 공유 상태에 후보를 기록하고 ADK가 상태 키를 동일한 이름의 매개변수에 바인딩합니다. 노드는 선택을 하나의 후보로 확인하고 direction, angle, hook, user:prefs를 Event(state=...)와 함께 다시 작성합니다. user: 프리픽스가 있는 키는 해당 사용자의 세션 간에 유지됩니다.
도구가 느린 경우 Veo 렌더링에는 몇 분이 걸리며 그래프는 그렇게 오래 기다려서는 안 됩니다. agent/desk.py의 render_submit는 작업을 시작하고 상태가 pending인 영수증을 즉시 반환합니다.
def render_submit(prompt: str) -> dict:
    """Submit one Veo render of `prompt`. Returns at once with a pending
    receipt; the clip is delivered later, to this call, by id."""
    receipt = videogen.start(f"{prompt} {videogen.NO_TEXT}")
    return {"status": "pending", "operation": receipt["operation"], "prompt": receipt["prompt"]}
LongRunningFunctionTool로 래핑된 이 영수증은 ADK에 의미가 있습니다. 에이전트의 차례가 끝나고 워크플로가 render_desk에서 정지되며 ID와 영수증이 있는 미해결 호출은 runs/sessions.db의 행입니다. 👉🖥 stage6_video/agent.py에서 도구를 래핑합니다.
tools=[LongRunningFunctionTool(render_submit)])
다른 프로세스에서 ID로 재개합니다. agent/deliver.py는 세션 저장소에서 대기 중인 호출을 찾고, 클립이 존재할 때까지 Veo를 폴링하고, 결과를 runs/state.json에 쓰고, 동일한 세션에 해당 호출의 ID가 포함된 function_response를 전송합니다. 👉🖥 응답 부분 빌드:
    part = Part(function_response=FunctionResponse(
        id=row["call_id"], name=row["name"], response=response))
👉🖥 stage6_video를 두 번 중지될 때까지 실행합니다. 아이디어 전송: 스키마에서 빌드된 양식에서 실행이 중지되고 페이로드에 4개의 후보가 있습니다. pick에 2를 입력하고 제출합니다. 그래프가 persist_direction에서 다시 시작됩니다. 여기에서 종료 테스트를 시도해 보세요. 양식에서 일시중지하고 서버를 중지한 다음 (탭 1에서 scripts/stop.sh) 다시 시작하고 (scripts/restart.sh) 세션을 다시 엽니다. 일시중지는 스레드가 아닌 행이므로 양식은 그대로 유지됩니다. script_ready 이후 render_desk는 render_submit를 호출하고 영수증을 가져오고 WAITING에 답장하고 실행이 종료됩니다. 세션은 통화 ID를 유지합니다. 페이지의 콘솔 또는 탭 1에서 전송을 실행합니다.
cd ~/vibe-studio-multimodal
uv run python -m agent.deliver status   # the pending renders, by session, call id and operation
uv run python -m agent.deliver          # wait for Veo, answer the newest pending call by id
👉🖥 Refresh adk web을 클릭합니다. function_response가 대기 중인 호출을 따르고, join_media가 해제되고, store_release가 실행됩니다. 8개의 확인 행은 세션에서 두 개의 중지, 즉 게이트의 호출과 답변, 렌더링의 수신 및 전송을 읽습니다.
상태 및 데스크 (5b)
미디어 데스크는 다시 3a의 구조로, 하나의 느린 브랜치가 있는 팬아웃과 조인입니다. script_ready는 두 가지 방법으로 스크립트를 전송합니다. render_desk가 클립을 제출하고 실행이 정지됩니다. make_poster는 세션 2 도구를 노드로 나타낸 것입니다. 스크립트의 poster_idea, 채널의 스타일, 메모리 뱅크가 크리에이터의 포스터 취향에 대해 알고 있는 정보 (세션 6에서 memory_facts 상태로 바인딩됨)가 이미지 모델로 전달되고, 몇 초 만에 9:16 PNG가 반환됩니다. join_media는 느린 작업을 기다리고 store_release는 찾은 내용을 상태에 기록합니다.
이름으로 공유합니다. store_release님은 포스터를 받지 못합니다. poster_url라는 매개변수를 선언하고 ADK는 다른 브랜치의 노드가 해당 키를 작성했기 때문에 공유 상태에서 이를 바인딩합니다. 브랜치 간에 페이로드가 교차하지 않습니다.
def store_release(node_input, poster_url: str = "", poster_path: str = ""):
    """`poster_url` and `poster_path` are not passed by anyone: ADK binds them
    from shared STATE because the parameter names match the keys make_poster
    wrote (the STATE_SHARE edit). The two branches of the desk never hand each
    other payloads; they share what they made by name."""
    render = state.load().get("render") or {}          # the delivered clip, written by deliver
    url, status = render.get("url") or "", render.get("status", "")
    ...
    if not poster_url:
        said += " · poster: not in state (did make_poster write poster_url to state? the STATE_SHARE edit)"
    yield Event(output={"status": status, "url": url, "poster_url": poster_url},
                state={"render_url": url, "render_status": status, "poster_url": poster_url},
                message=f"video: {said} · poster: {poster_url or 'none'}")
제공된 대로 make_poster는 포스터를 출력으로 생성하고 메시지를 표시하며 store_release는 poster: not in state를 표시합니다. 👉🖥 최종 yield에 상태 쓰기를 추가합니다.
                state={"poster_url": rec.get("url", ""), "poster_path": rec.get("path", "")},
                message=f"poster: {said}")
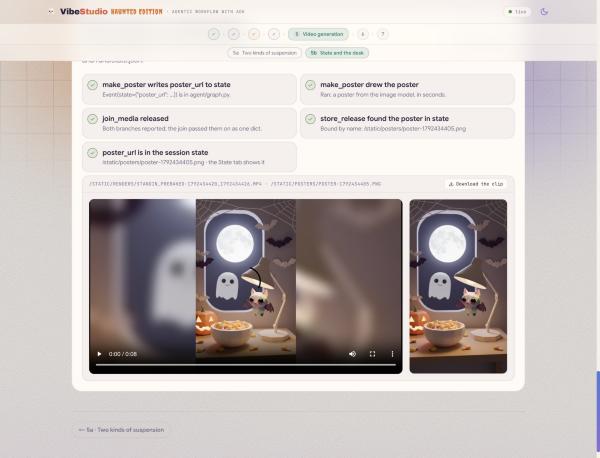
👉🖥 한 번 더 실행하고 전달합니다. make_poster 열기 이벤트: 출력의 포스터 URL 및 poster_url가 있는 상태 델타 store_release를 엽니다. 메시지에 게시자의 이름이 표시됩니다. 페이지의 이 실행의 세션 블록에는 동일한 행 adk web의 상태 탭에 표시되는 내용이 표시됩니다. 여기에는 재개에 필요한 세션 ID, 열려 있는 호출, 노드가 작성한 키(poster_url 포함)가 표시됩니다. 확인 패널에는 클립과 포스터가 나란히 표시됩니다.
8. 6 · 메모리 — 채널이 밤 사이에 기억하는 내용
👉🖥 워크벤치에서 stage4_memory로 빌드된 세션 6 · 메모리의 6a 및 6b 부분을 엽니다. 세션 5에서는 한 번의 실행 상태에 대해 알아봤습니다. 이 세션에서는 채널이 실행 간에 기억하는 내용, 즉 그래프가 두 콜백을 통해 외부에서 듣는 내용에 대해 설명합니다.
메모리 뱅크 (6a)
Vertex AI Memory Bank는 사용자에 대한 장기 메모리를 관리합니다. 사실은 범위, 앱 이름, 사용자 ID, 정의한 주제 아래에 있습니다. memories.generate를 사용하여 대화를 전달하면 주제에 맞는 내용을 추출하고, 이를 임베딩한 후 이미 보유하고 있는 내용과 통합합니다. 즉, 새로운 사실은 생성되고, 변경된 내용은 업데이트되며, 중복된 내용은 병합됩니다. memories.retrieve는 범위의 사실을 반환합니다. 두 호출 모두 agent/platform/memory.py에 있습니다.
SCOPE = {"app_name": config.APP, "user_id": config.USER}
TOPICS = {
    "CREATOR_TASTE": "Which video directions this creator picks and passes on, "
                     "and how that preference changes over time.",
    "CHANNEL_RULES": "Standing instructions the creator states for every video "
                     "(style, subjects to avoid, format rules).",
    "VISUAL_STYLE": "What this creator approves and rejects in a poster: palettes, "
                    "framing, props and mood of the posters they shipped.",
}
세 번째 주제는 채널의 이미지 취향입니다. 이 버전은 세션 5에서 이 메모리에 기록했습니다. 배송된 포스터를 한 문장으로 설명하고 기억한 다음, 이 문장을 프롬프트에 포함하여 다음 포스터를 그립니다.
설정에서 이미 뱅크를 만들기 시작했습니다. 6a 페이지의 연결 행에 뱅크가 가동 중인지 표시됩니다. 페이지의 버튼 또는 터미널에서: python -m agent.platform.bank는 뱅크와 주제를 만들고 runs/memorybank.json에서 리소스 이름을 캐시합니다. python -m agent.platform.bank load는 이전 세션 4개 (스타일 규칙이 있는 동물 시대 2개, 가젯 시대, 최근 판타지 시대)를 시드합니다. python -m agent.platform.bank list는 스크립트가 어떻게 되었는지 보여줍니다. 스크립트가 아닌 통합된 사실 진술입니다.
콜백 (6b)
메모리는 노드가 아닙니다. 콜백은 Agent에 전달하는 함수입니다. ADK는 라이브 컨텍스트를 사용하여 정해진 순간에 이를 호출하고 None를 반환하면 정상적인 작업이 수행됩니다. 세 쌍: 에이전트 차례 (before_agent_callback, after_agent_callback, CallbackContext), 각 모델 호출 (LlmRequest가 있는 before_model_callback, LlmResponse가 있는 after_model_callback), 각 도구 호출 가드레일, 원격 분석, 캐시, 컨텍스트 삽입은 그래프에 노드가 없어도 여기에 배치됩니다.
stage4_memory/agent.py에서 propose_directions는 모델 호출 전에 뱅크를 읽습니다. recall_taste는 사실을 가져와 MEMORY 블록으로 요청에 추가하고(가장 오래된 것부터) 모델에 후보 1~3을 현재 취향에 맞게 조정하고 규칙을 제약 조건으로 처리하도록 지시합니다. 또한 make_poster가 찾을 수 있는 memory_facts로 상태를 작성합니다. 👉🖥 유선 연결:
    output_schema=Directions,
    before_model_callback=recall_taste)
스크립트 작성자는 크리에이터가 선택한 내용을 차례가 끝난 후 작성합니다. remember_pick는 상태에서 direction를 읽고 선택에 관한 한 문장을 작성한 후 memories.generate에게 전달합니다. 👉🖥 유선 연결:
    output_schema=Script,
    after_agent_callback=remember_pick)
👉🖥 빈 메시지로 실행하고 카드를 선택합니다. propose_directions 이벤트를 엽니다. 요청에는 세 가지 시대가 포함되며 후보 1~3은 현재 취향에 가깝지만 트렌드는 다른 것을 제안합니다. 스크립트 작성 후 Show the bank(뱅크 표시)를 클릭합니다. 오늘 밤의 추천 항목에 대한 메모리가 변경되거나 추가되었습니다. 두 번째 밤을 실행하면 첫 번째 밤을 기억합니다.
9. 7 · 배포 및 게시 — 앱 내 그래프, VibeTube의 밤
👉🖥 워크벤치에서 세션 7 · 배포 및 게시, 7a 및 7b 부분을 엽니다.
VibeStudio 배포 (7a)
샌드박스에서는 adk web가 그래프를 구동했습니다. VibeStudio는 자체 이벤트 루프가 있는 작업자 스레드에서 ADK의 Runner를 사용하여 이를 구동하고, 페이지가 서버 전송 이벤트를 통해 읽는 하나의 실행 상태로 모든 이벤트를 접습니다. 즉, 리더, 4장의 카드로 선택한 항목, 포스터가 도착할 때, 렌더링이 전송될 때입니다. 게이트의 답변과 렌더링의 전송은 동일한 호출인 function_response 부분이며, 앱은 콘솔을 기다리는 대신 Veo 자체를 폴링합니다.
self._svc = DatabaseSessionService(db_url=config.DB_URL)
self._runner = Runner(app_name=config.APP, agent=wf, session_service=self._svc)

async for ev in self._runner.run_async(user_id=config.USER, session_id=run_id, new_message=message):
    self._absorb(ev)    # fold the ADK event into the run state, publish one app event

part = Part(function_response=FunctionResponse(id=call_id, name=name, response=response))
vibestudio/server/agent/는 실습의 agent/를 바이트 단위로 복사한 것으로, checks/verify_app.py에서 확인합니다. agent/graph.py의 전체 에지 목록은 이 Codelab의 모든 구조를 한곳에 모은 것으로, 13개의 노드가 있습니다. 이 목록은 입력하지 않고 읽을 수 있도록 채워진 상태로 제공됩니다.
        (START, scan_trends, join_research),
        (START, read_backlog, join_research),
        (START, read_feedback, join_research),
        (join_research, propose_directions, direction_gate,
         persist_direction, policy_check),
        (policy_check, {"OK": scripter, "BLOCK": quarantine}),
        (quarantine, scripter),
        (scripter, script_ready),
        (script_ready, render_desk, join_media),
        (script_ready, make_poster, join_media),
        (join_media, store_release),
👉🖥 워크벤치의 배포 버튼을 사용하여 배포하거나 👉💻 탭 1에서 배포합니다.
cd ~/vibe-studio-multimodal
uv run python vibestudio/deploy.py
.env의 값이 채워진 상태로 실행됩니다.
gcloud run deploy vibestudio --source vibestudio \
  --project $GOOGLE_CLOUD_PROJECT --region us-central1 \
  --labels dev-tutorial-codelab=vibetube --allow-unauthenticated \
  --memory 2Gi --cpu 2 --timeout 3600 --concurrency 40 \
  --max-instances 1 --min-instances 1 --session-affinity \
  --set-env-vars GOOGLE_CLOUD_PROJECT=...,STUDIO_VERTEX=1,STUDIO_MEMORY_BANK=...,STUDIO_RAG_CORPUS=...,VIBETUBE_URL=...,VIBETUBE_EVENT=...,VIBETUBE_NAME=...,VIBETUBE_PROJECT=...
--source는 Cloud Build로 컨테이너를 빌드하고 한 단계로 배포합니다. 첫 번째 빌드는 4~5분 정도 걸립니다. 웜 인스턴스가 하나 있는 --session-affinity는 세션 5의 세션 저장소를 보유하는 인스턴스에서 일시중지된 실행을 유지합니다. 대규모 배포에서는 세션 저장소가 VertexAiSessionService로 이동하고 어피니티가 사라집니다. 빌드와 서비스는 프로젝트의 기본 컴퓨팅 서비스 계정으로 실행되며, 설정에서 필요한 역할을 부여했습니다.
👉🖥 서비스 URL을 열고 앱에서 아이디어, 선택, 클립 및 포스터 대기 등 밤에 실행합니다. 기록 탭에는 두 가지가 모두 보관됩니다.
게시 (7b)
게시는 앱에서 VibeTube의 채팅방 엔드포인트로의 멀티파트 POST이며 vibestudio/server/platform/publish.py에 있습니다. 클립은 동영상, 포스터는 썸네일, 프로필은 회의실과 내 이름을 나타냅니다.
url = f"{prof['platform_url']}/api/events/{prof['event_code']}/videos"
data = {"title": state.script["title"], "description": state.script["description"],
        "duration": "0:08", "displayName": prof["display_name"],
        "projectId": prof["project_id"]}        # one video per project and room: publishing again replaces it
files = {"videoFile": (clip.name, clip.open("rb"), "video/mp4"),
         "thumbnailFile": (poster.name, poster.open("rb"), "image/png")}   # the poster, not a frame
r = httpx.post(url, data=data, files=files, timeout=120)
video_id = r.json()["id"]                       # watch it at {platform}/e/{event}?v={video_id}
VibeTube는 projectId 및 방당 하나의 동영상을 유지하며 앱이 전송하는 프로젝트는 Google Cloud 프로젝트이므로 다시 게시하면 동영상이 추가되는 대신 대체됩니다. 대체 포스터는 업로드되지 않으며 실제 포스터가 썸네일로 사용됩니다.
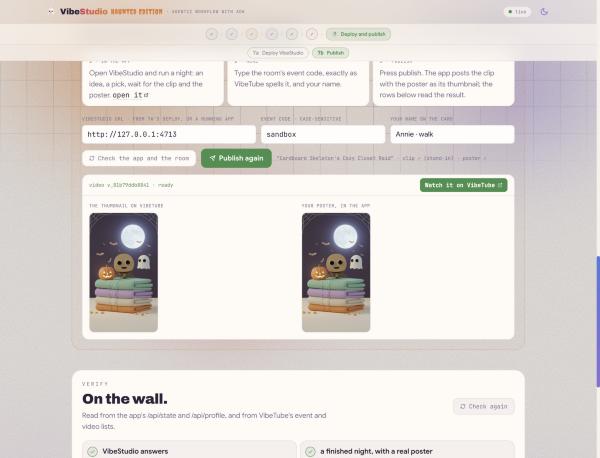
마지막 수정은 코드 줄이 아닌 구성입니다. 👉🖥 7b 페이지: VibeStudio URL (7a의 배포에서 입력됨), VibeTube에서 철자 그대로 입력한 회의실의 이벤트 코드 (강사가 다른 코드를 열지 않은 경우 설정한 코드), 이름 게시를 누릅니다. 워크벤치는 클릭을 앱에 전달하고, 앱은 밤을 게시하고, 아래 행은 앱과 VibeTube에서 결과를 읽습니다. 앱이 응답하고, 밤은 실제 포스터로 완료되고, 코드는 열린 방의 이름을 지정하고, VibeTube는 동영상 ID를 반환하고, 동영상은 벽에 있고, 썸네일은 포스터입니다. 결과 카드에는 앱의 포스터 옆에 VibeTube의 썸네일이 표시됩니다.
10. 빌드한 항목
👉🖥 7b 페이지의 마지막 부분에서는 아이디어에서 클립과 포스터에 이르는 13개의 노드로 구성된 전체 그래프를 그립니다. 노드 위로 마우스를 가져가면 노드의 기능과 노드를 빌드한 세션을 확인할 수 있습니다.
세션 | 학습 내용 | 다음과 같이 작성됩니다. |
2 · 이미지 생성 | 에이전트: 모델, 요청 사항, 도구, 도구로서의 이미지 모델, 프롬프트가 보장할 수 없는 것 |
|
3 · 워크플로 | 에지 목록, 팬아웃 및 조인, 뒤에 태스크 모드 루프가 있는 라우터 |
|
4 · 멀티모달 수집 | 종류별로 하나의 리더, 하나의 선 모양, 하나의 코퍼스, 의미별로 세 번째 리더, 미디어 포함 | 오디오, 이미지, 동영상 부분이 포함된 |
5 · 동영상 생성 | 두 가지 정지, 하나의 메커니즘, 세션 저장소, 이름으로 공유되는 포스터 |
|
6 · 메모리 | 밤새 메모리, 콜백 2개 |
|
7 · 배포 및 게시 | Cloud Run의 앱 내부 그래프, VibeTube의 밤 |
|
그래프가 따르는 5가지 규칙:
- 기다리지 않고 일시중지합니다. 일시중지는 스레드가 아닌 세션 저장소의 행입니다.
- 모든 작업을 동일한 방식으로 재개: 사람 또는 프로세스가 응답하는지 여부에 관계없이 열려 있는 통화의 ID를 사용합니다.
- 모든 페이로드에 스레드를 연결하는 대신 상태에서 이름으로 데이터를 공유합니다.
- 모델 비용을 지불하기 전에 코드로 결정하세요. 정책은 텍스트 파일이자 라우터이며 렌더링 전에 실행됩니다.
- 텍스트가 아닌 모든 항목을 텍스트로 읽어 코퍼스에 도달하기 전에 파일 이름을 줄 안에 넣어 파일이 다시 돌아올 수 있도록 합니다.
프롬프트는 순서, 중지 또는 확인을 보장할 수 없습니다. 그래프는 가능합니다.
다음 단계
- 인스턴스보다 오래 지속되는 세션의 경우
VertexAiSessionService,--session-affinity는 삭제합니다. - 폴러 대신 렌더링 호출에 응답하는 웹훅: 동일한
FunctionResponse(id=...), 다른 발신자 - 게시 전 두 번째
RequestInput— 스키마는 양식이므로 하나의 노드이며 페이지 코드가 없습니다. - 각 버전이 출시된 후 시청자의 새로운 댓글, 음성 메모, 클립이 전송된 포스터와 함께 코퍼스에 추가됩니다.
삭제
이 실습에서 만든 모든 항목은 4단계에서 만든 프로젝트에 있으므로 가장 저렴한 정리 방법은 프로젝트를 삭제하는 것입니다. Cloud Shell에서 다음을 실행합니다.
gcloud projects delete $(cat ~/project_id.txt)
프로젝트를 유지하고 유료 부분만 삭제하려면 Cloud Run 서비스 (gcloud run services delete vibestudio --region us-central1), RAG 코퍼스 및 메모리 뱅크 (리소스 이름은 runs/ragcorpus.json 및 runs/memorybank.json에 있으며 콘솔의 Agent Engine 및 RAG Engine 페이지에서 삭제), Artifact Registry의 컨테이너 이미지를 삭제합니다.