

1. Introdução
Você tem um canal de terror aconchegante no VibeTube: um Short por noite até o Halloween. O público quer pequenas mágicas em pequenos cômodos e envia isso para você de todas as formas possíveis: comentários, notas de voz, fotos das próprias gavetas assombradas e clipes da varanda ao anoitecer. O backlog está cheio de ideias. Todas as noites, ele faz as mesmas tarefas: pesquisa o que está em alta no feed, analisa o backlog, lê o que o público enviou, escolhe uma direção, verifica se está de acordo com a política do canal, escreve o roteiro, desenha o pôster, renderiza o clipe e publica.
Os modelos generativos podem fazer cada tarefa sozinhos. O Gemini pesquisa, ouve, observa e escreve; o modelo de imagem desenha; o Veo renderiza. O que elas não podem fazer sozinhas é executar a noite em ordem, parar para a única decisão que é sua, recusar uma direção ruim antes que ela custe dinheiro, esperar minutos por uma renderização sem manter nada aberto e deixar um registro.
Este codelab transforma essa noite em um ADK Workflow: um gráfico desenhado de nós e arestas que é executado sozinho, pergunta apenas onde seu julgamento é necessário e termina cada execução com um clipe e o pôster dele no VibeTube.
Um comando não pode prometer ordem, interrupção ou verificação. Um gráfico pode.
O que você vai aprender
- Um agente e o modelo de imagem como ferramenta. Um
Agenté um modelo, uma instrução e ferramentas. A terceira ferramenta chama o modelo de imagem, e a primeira execução termina com um pôster. Depois, a frase que orienta o restante do laboratório: um comando não pode prometer ordem, uma parada ou uma verificação. - As estruturas que compõem um gráfico. Um
Workflowé uma lista de arestas. Você cria o fan-out e a junção (leitores paralelos que se encontram em umJoinNode) e um roteador que nomeia a própria saída, com um agente de modo de tarefa por trás da saída recusada que limpa uma direção em um loop de chamadas de ferramenta e se junta novamente à linha principal. - Um pipeline de ingestão multimodal. Quatro tipos de coisas que o público enviou, um leitor por tipo: o Gemini transcreve as notas de voz, legenda as fotos, assiste aos clipes e ouve as trilhas sonoras, e cada leitor escreve a mesma forma de linha em um corpus do mecanismo de RAG. Um terceiro leitor no fan-out recupera por significado e devolve a mídia com as passagens.
- Dois tipos de suspensão, um mecanismo. Uma corrida para uma pessoa (
RequestInput: quatro cartas, você responde) e para uma ferramenta lenta (Veo atrás deLongRunningFunctionTool: um recibo). Ambos são a mesma coisa: uma chamada aberta no armazenamento de sessões, retomada pelo ID, do formulário ou de outro processo. As duas filiais da agência de mídia compartilham o pôster por nome, no estado. - Memória ao longo das noites. Dois callbacks do ciclo de vida no banco de memória:
before_model_callbackrecupera o gosto do criador antes que o proponente leia,after_agent_callbacklembra da escolha de hoje à noite depois do criador de script. - A versão. O gráfico dentro de um app com um ADK
Runner, eventos enviados pelo servidor para a página, Cloud Run com afinidade de sessão e um POST de várias partes que coloca o clipe no VibeTube com o pôster como miniatura.
O que você criará
Um app em execução no navegador: o VibeStudio Workbench, uma página complementar com um editor de código in-page, verificadores que leem os arquivos no disco e as sessões que suas execuções gravaram, além de um adk web incorporado. As sete sessões são as sete páginas deste codelab, com os mesmos números e as mesmas letras de parte, para que os dois fiquem em sincronia. Cada página abre em uma faixa que descreve a sessão em uma frase e as três ações que você pode realizar: editar, executar e verificar. Leia uma seção aqui e faça a edição no ambiente de trabalho. Cada edição termina com um painel de verificação que mostra o que realmente aconteceu.
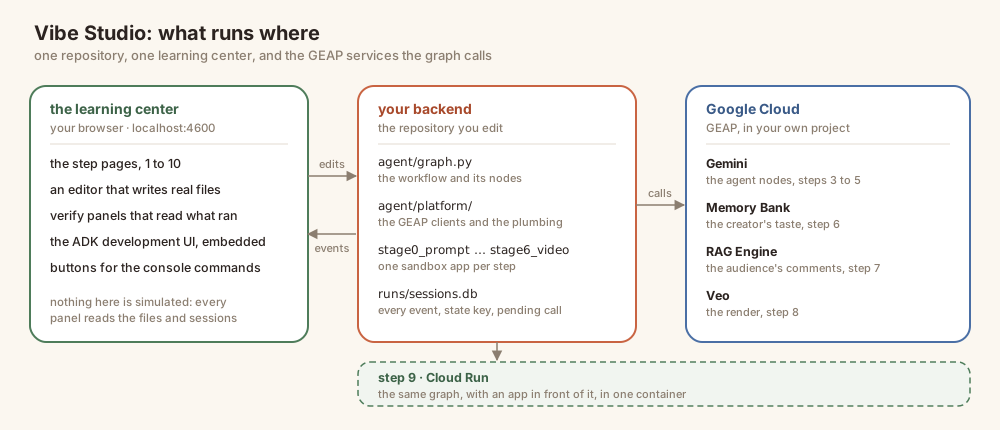
Três coisas são executadas: o Workbench (a página na porta 4600, o editor, os verificadores), seu back-end (o Workflow em agent/ e um app de sandbox por sessão em stage0_prompt/ até stage6_video/, que o adk web disponibiliza) e o Google Cloud (Gemini, o modelo de imagem, o mecanismo RAG, o Veo, o Memory Bank — todos acessados pela Vertex AI com suas próprias credenciais).
As sete sessões
Sessão | O que você vai criar | Suas edições |
1 · A história | Nada ainda: a noite e o gráfico que ela se torna | — |
2 · Geração de imagens | Um agente desenha o primeiro pôster |
|
3 · Workflows | A noite como um gráfico: o fan-out e a mesclagem, o roteador e o loop dele |
|
4 · Ingestão multimodal | O que o público enviou, lido em um corpus; o terceiro leitor |
|
5 · Geração de vídeo | Dois tipos de suspensão: o cartaz compartilhado por nome no estado |
|
6 · Memória | O que o canal lembra entre as noites |
|
7 · Implantar e publicar | VibeStudio no Cloud Run; a noite no VibeTube | o código do evento da sala e publicar |
Como usar este codelab. Ele prioriza os conceitos: cada sessão explica a ideia, mostra o código como ele fica depois da mudança e o analisa. Ele nunca pede para você editar um arquivo aqui. A edição acontece no workbench, que mostra uma edição por vez, uma dica ao lado e um painel de verificação abaixo. Leia a sessão e deixe que a página guie você.
Onde isso se encaixa
O gráfico, o tema e a sala no VibeTube vêm da edição assombrada do VibeStudio de Lin. Este é o corte multimodal, focado no que o público enviou e nos dois tipos de suspensão, no formato interativo de uma página dos laboratórios do Agent Valley. O estúdio é o cenário. Cada mecanismo abaixo dele é o comum que você usaria para um pipeline de suporte, um fluxo de revisão de conteúdo ou qualquer outra coisa que precise pausar para uma pessoa e esperar por um trabalho lento.
2. 🧰 Configuração
- O que: uma conta que pode pagar, um projeto, o laboratório instalado, o modelo que comprovadamente responde e o workbench em execução em segundo plano em uma porta.
- Por quê: um processo em uma porta. A página, o editor, os verificadores,
/api/*eadk webcompartilham uma origem. Portanto, nada neste laboratório precisa de um segundo terminal ou de uma segunda porta. - Como: clonar, dois scripts. O segundo faz uma chamada de modelo real, inicia o workbench e começa a criar o corpus de RAG e o banco de memória enquanto você lê, para que as sessões 4 e 6 os encontrem prontos.
Tudo neste laboratório é executado no Cloud Shell: gcloud, Python, Node, ffmpeg e git já estão instalados, e o Gemini, o modelo de imagem, o Veo, o mecanismo de RAG e o banco de memória são acessados pela Vertex AI usando suas próprias credenciais. Não há nenhuma chave de API neste laboratório, e você não precisa instalar nada no seu laptop. Um laptop com o SDK Google Cloud, Python 3.12 e Node 20+ funciona da mesma forma.
Há uma coisa que este laboratório não pode fornecer: um projeto do Google Cloud com o faturamento ativado. A etapa 1 cria uma conta que pode pagar por ele, e a etapa 4 transforma essa conta em um projeto. Siga essa ordem. Todas as etapas após a 4 vão ler o projeto definido nela.
1 · Criar uma conta com faturamento (~1 min)
Faça login com uma Conta do Google que tenha o faturamento ativado. Qualquer conta desse tipo funciona. Se não tiver, inicie um teste sem custo financeiro. Ele oferece uma conta de faturamento, que é tudo o que a etapa 4 precisa. Se você estiver em um laboratório com instrutor, resgate os créditos desta sessão primeiro. Isso cria a conta de faturamento para você.
2 · Abrir o Cloud Shell (~2 min)
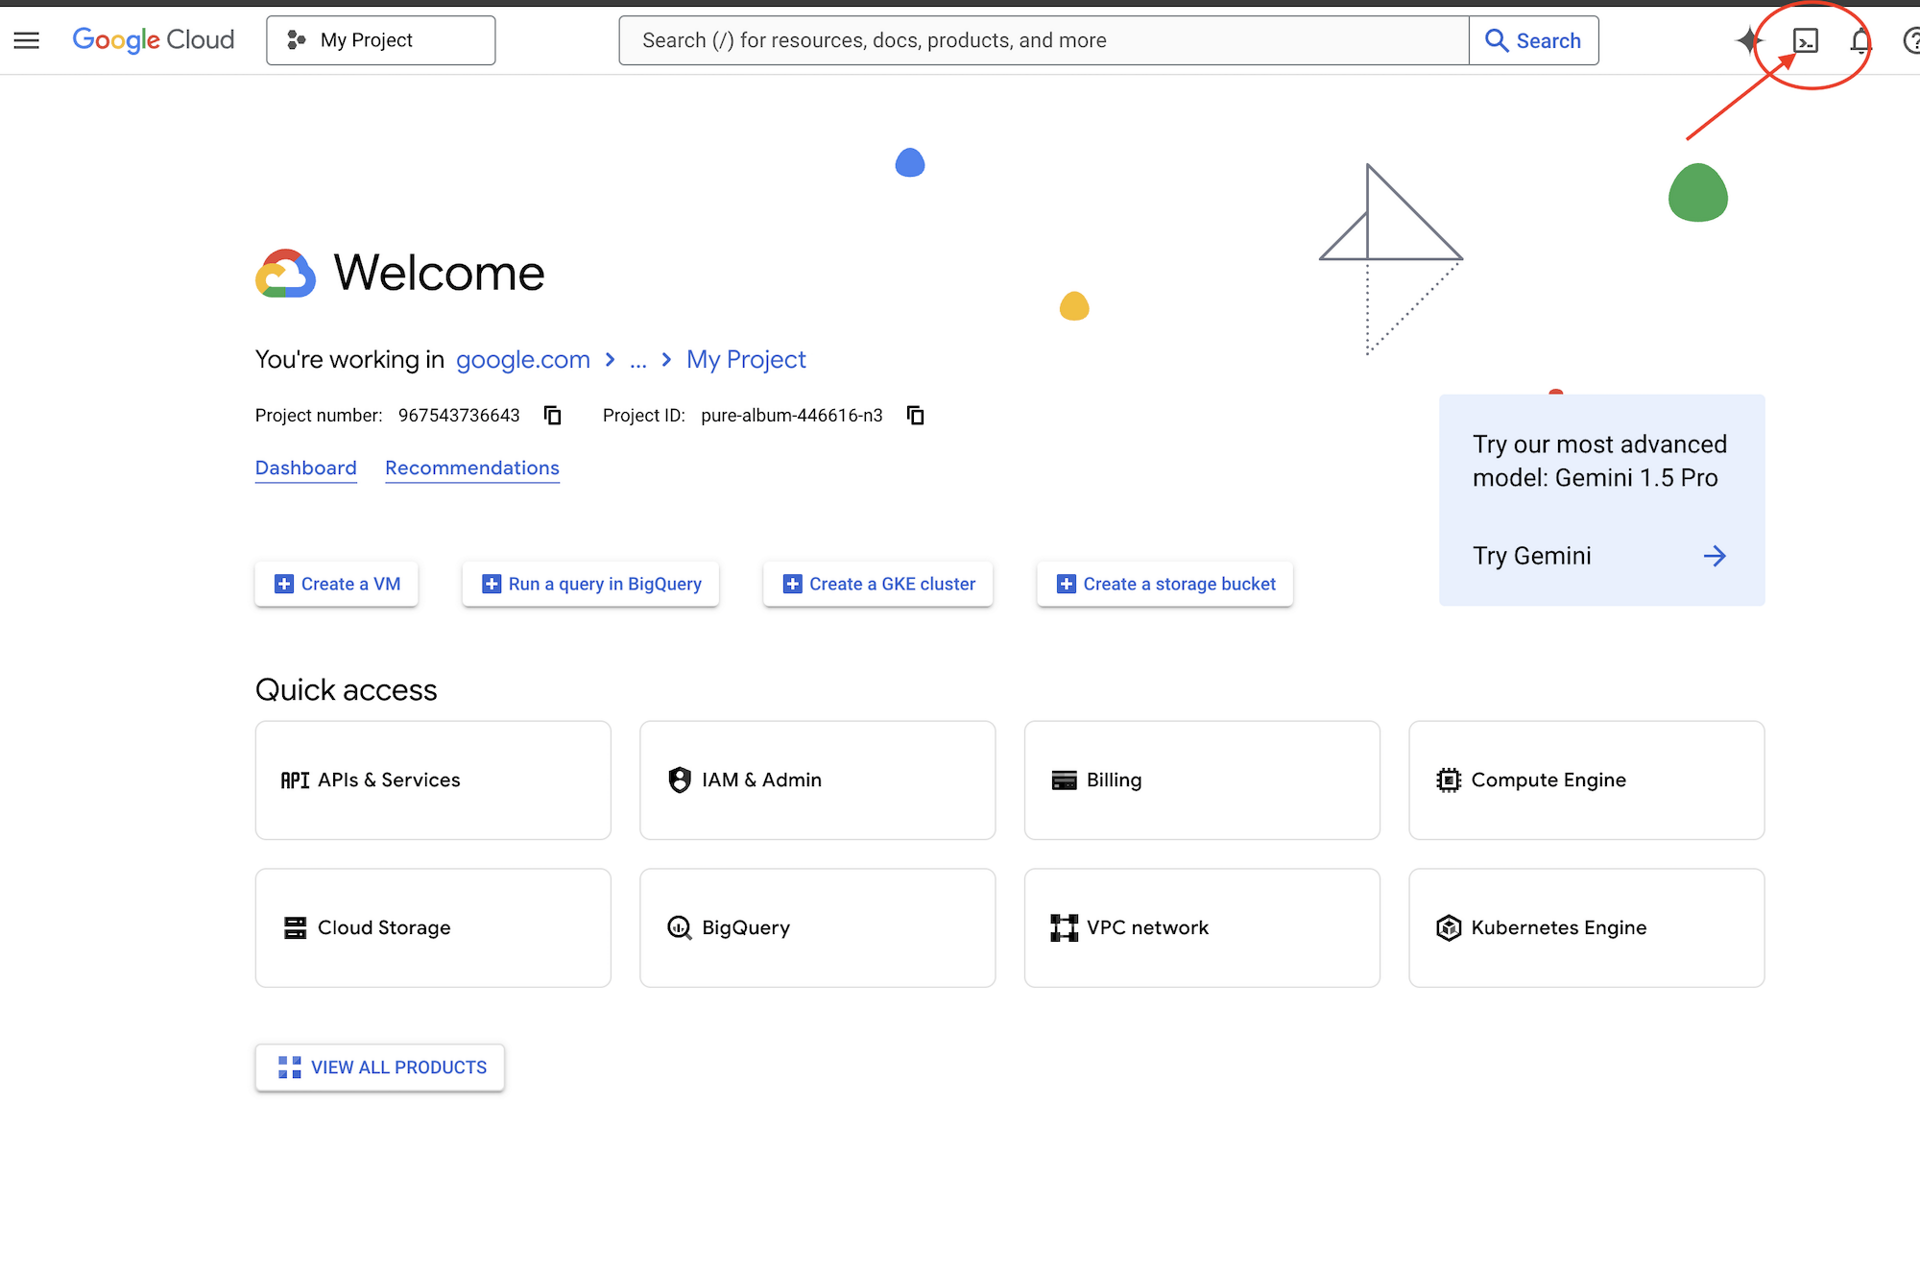
👉🖥 Clique em Ativar o Cloud Shell na parte de cima do console do Google Cloud. É o ícone em forma de terminal no cabeçalho.
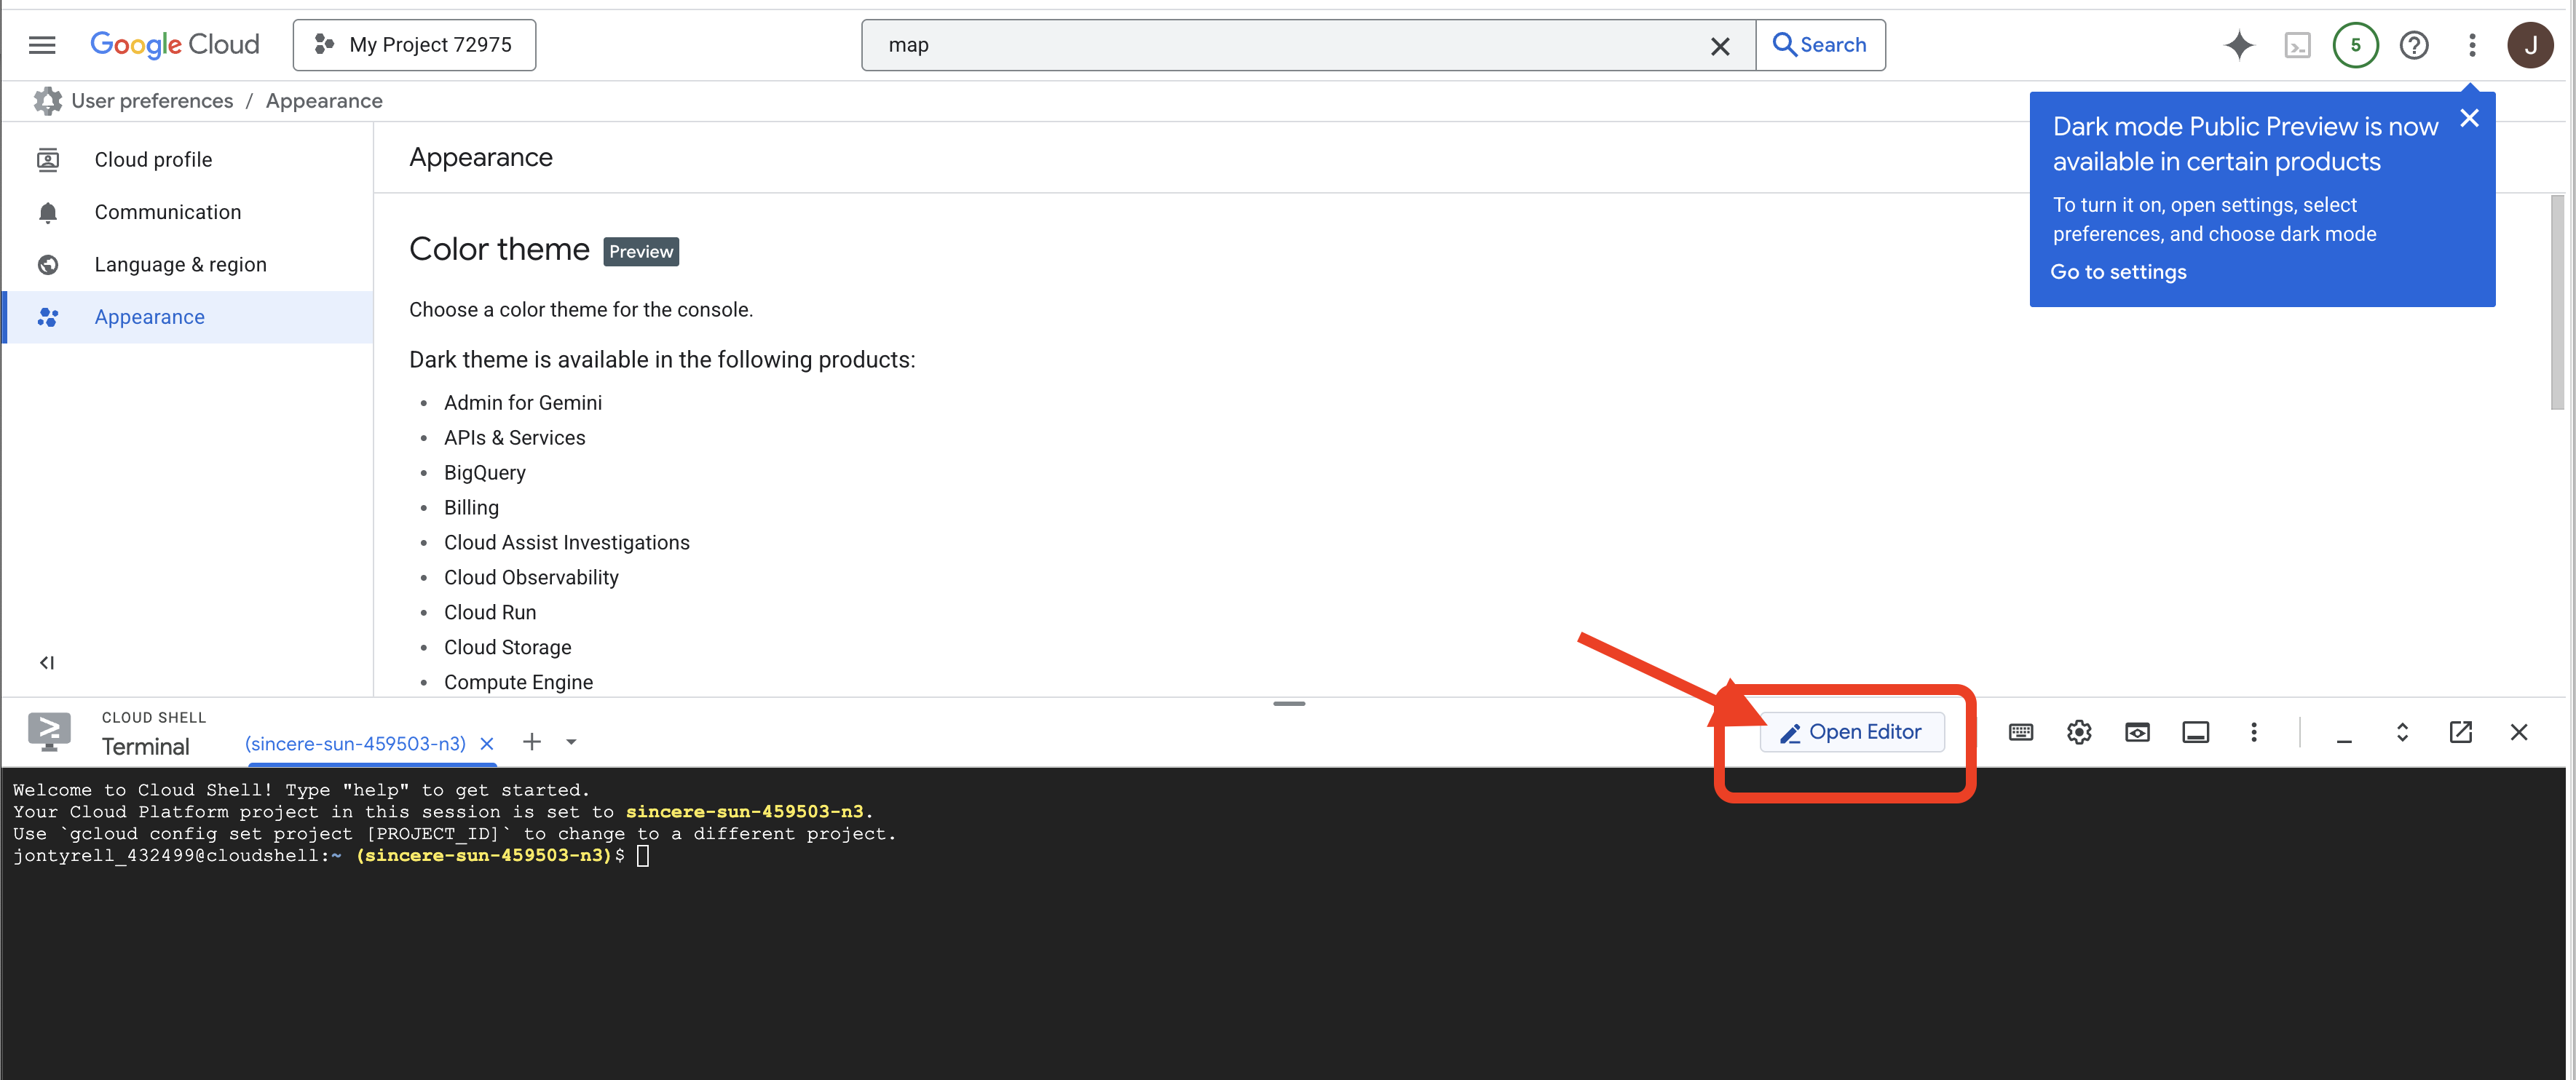
👉🖥 Clique em Abrir editor (o ícone de pasta aberta com um lápis). Isso abre o editor do Cloud Shell com um explorador de arquivos à esquerda, que é onde você vai sempre que quiser ler um arquivo inteiro.
👉🖥 Se for preciso autorizar em algum momento, clique em Autorizar para continuar.
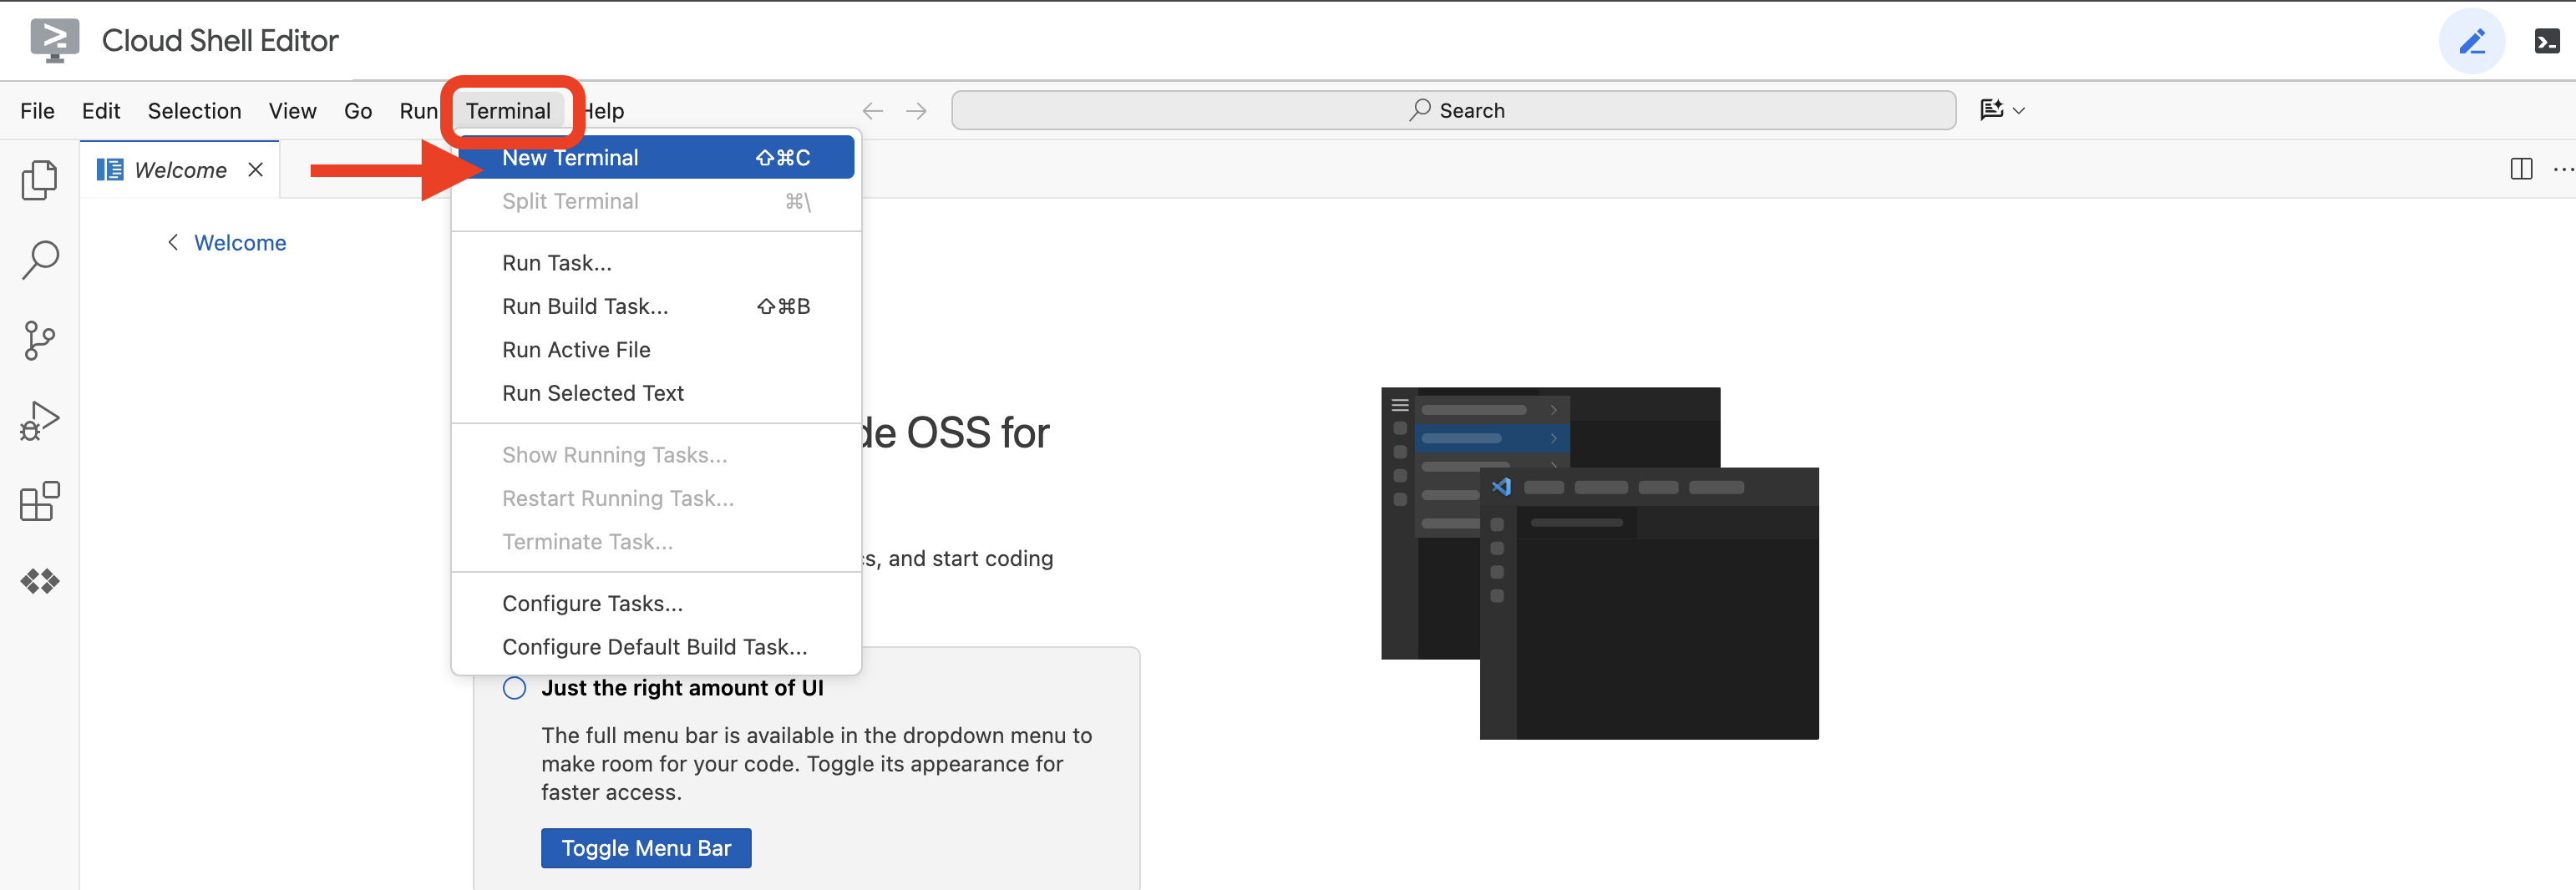
👉🖥 Abra um terminal no editor, que é a guia 1, e todas as etapas 👉💻 são executadas nele. A guia 2 é o próprio workbench, que você vai abrir na etapa 7. Se o terminal não estiver na parte de baixo da tela, abra-o com View → Terminal:
👉💻 Verifique em qual conta você fez login. Ela precisa ser a mesma da etapa 1:
gcloud auth list
3 · Acesse o laboratório (~1 min)
👉💻 Clone o repositório:
cd ~
git clone https://github.com/cuppibla/vibe-studio-multimodal
cd vibe-studio-multimodal
4 · Criar seu projeto (~2 min)
👉💻 Um script encontra sua conta de faturamento, cria um projeto nela, vincula o faturamento e direciona o Cloud Shell para esse projeto:
cd ~/vibe-studio-multimodal
./setup_project.sh
Espere um ✓ para a conta de faturamento escolhida, um ✓ para o projeto criado e um final como:
Project ready: vibe-studio-4271
  Next:  ./setup_codelab.sh
vibe-studio-4271 é o ID do projeto. O seu terá dígitos diferentes. Quatro coisas acontecem lá:
faturamento | usa a conta mais recente do | |
project | cria | |
seleciona | grava o ID em | |
waits | faz sondagens até que o projeto possa ser veiculado, por até dois minutos | |
👉🖥 O mesmo projeto agora está no console. O ID dele fica no card Informações do projeto no painel:
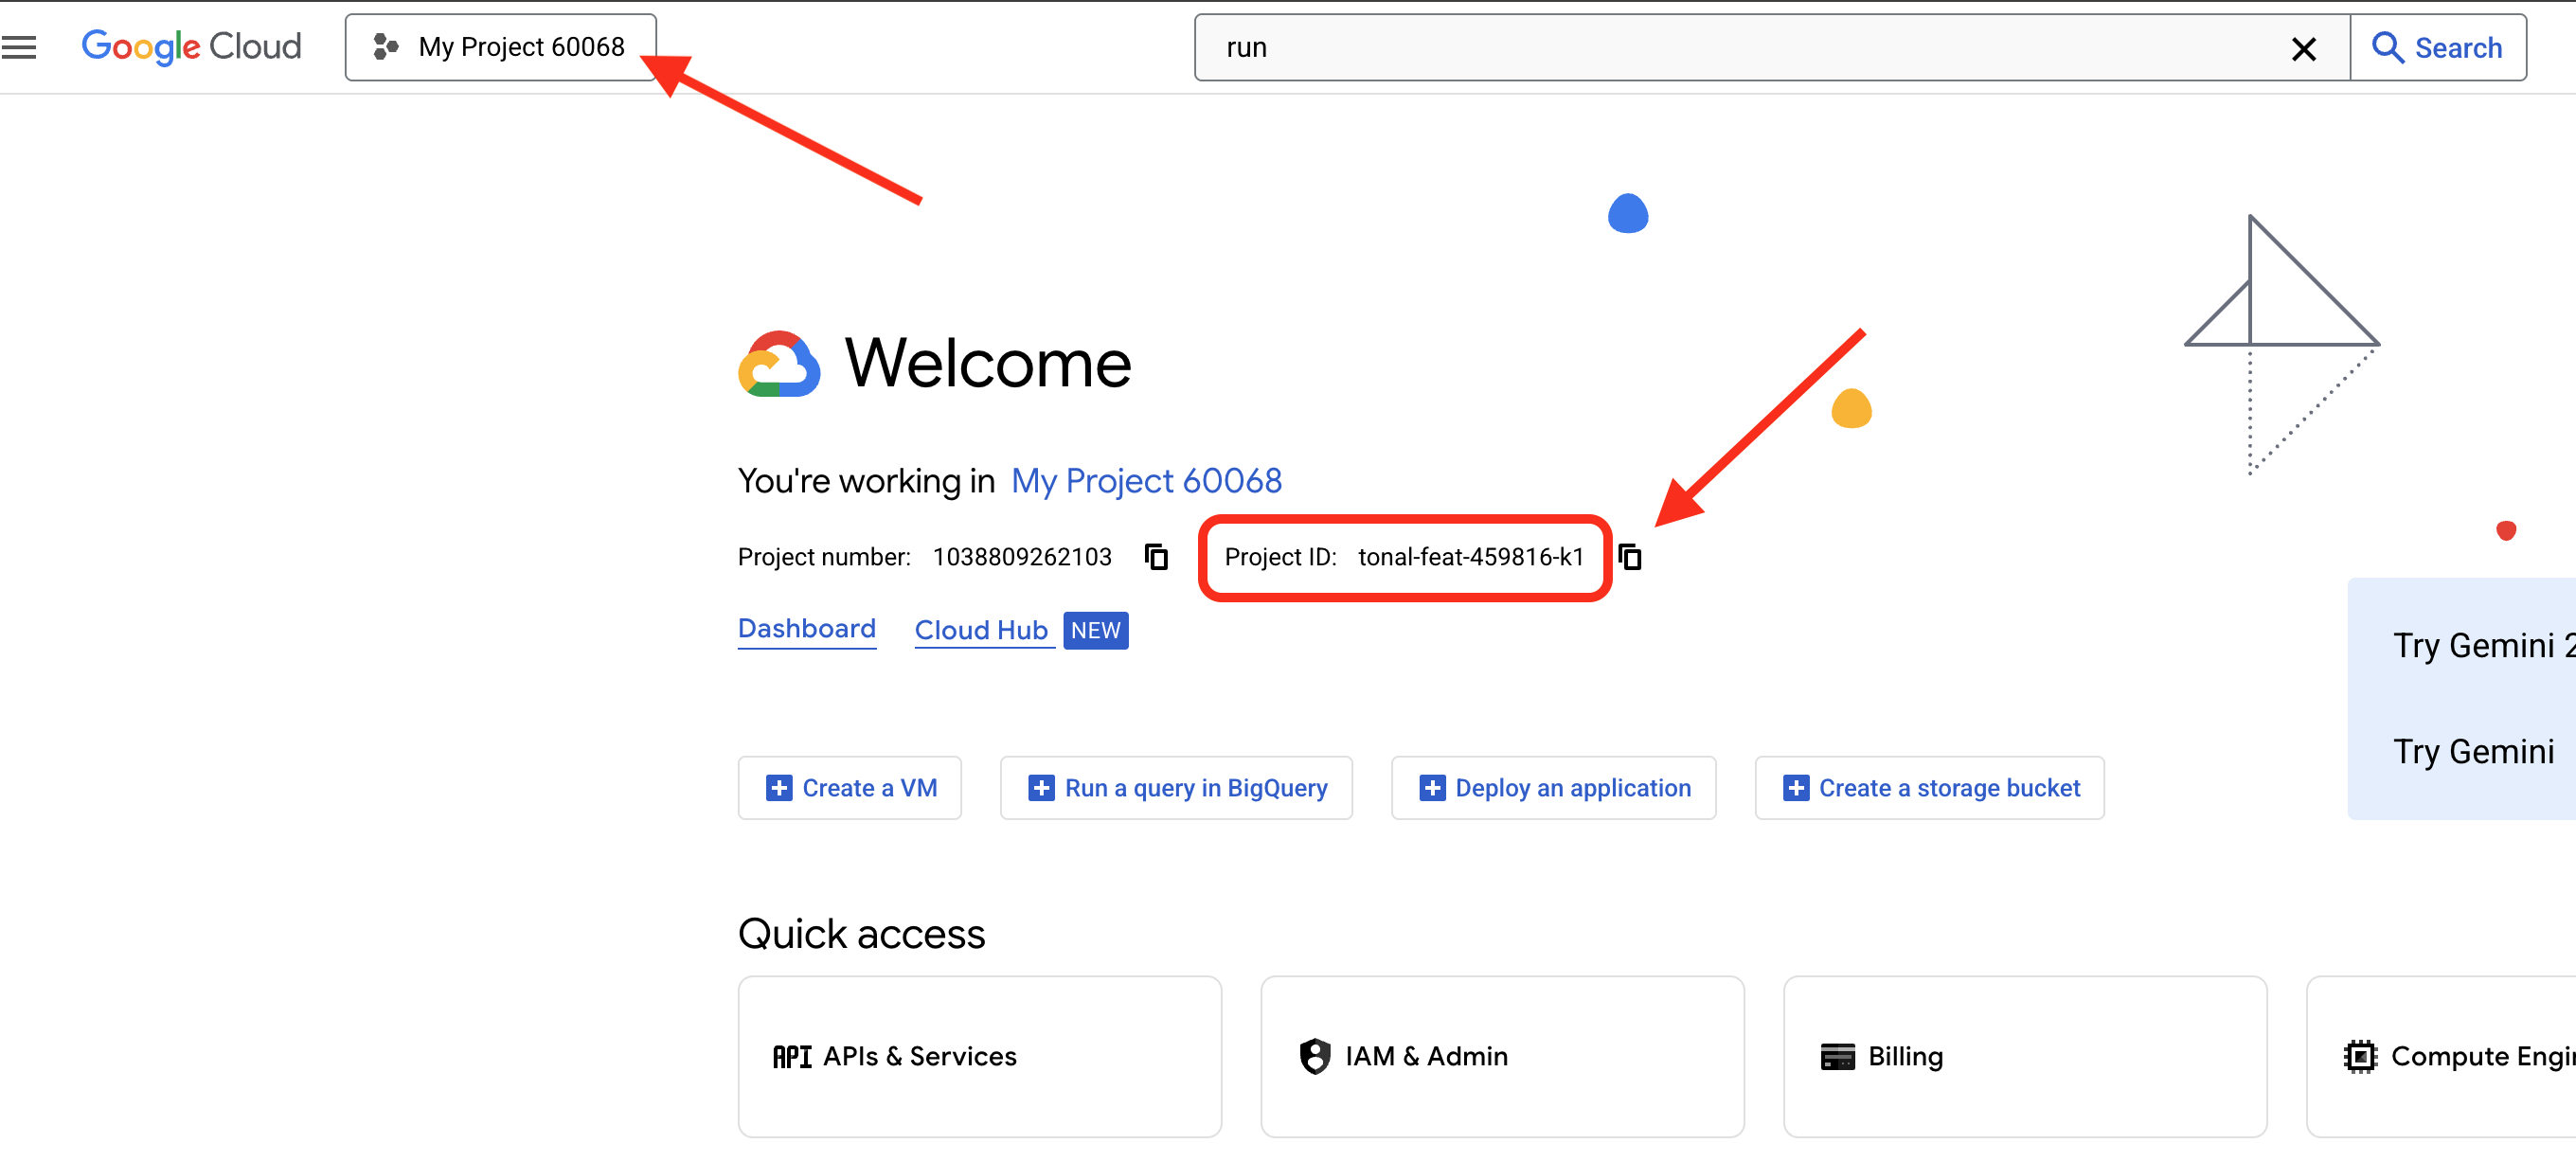
5 · Instalar e configurar o laboratório (~4 min)
👉💻
cd ~/vibe-studio-multimodal
./setup_codelab.sh
Um script, seguro para ser executado novamente. Uma segunda execução mantém todas as respostas que você deu na primeira vez. Ele faz duas perguntas no início, e Enter usa o padrão para ambas:
código do evento | a sala do VibeTube em que seu vídeo será publicado na sessão 7. Digite o código da sala fornecido pelo professor ou pressione Enter para | |
nome de exibição | o nome que a sala atribui a você ou Enter para um nome criado na sua conta. | |
Ambos vão para .env e podem ser alterados mais tarde, em .env ou na página de publicação. Em seguida, ele faz o resto por conta própria, em ordem:
uv env | instala o uv se ele estiver ausente, depois | |
apis | Ativa seis APIs no projeto selecionado na etapa 4 e confirma que cada uma delas responde antes de continuar: | |
conta | garante que a conta de serviço de computação padrão do projeto exista e tenha os papéis necessários para o build e o serviço da sessão 7 | |
.env | grava | |
veo · room | confirma que | |
model | faz uma chamada real para o Gemini, então um projeto ruim falha aqui no momento da configuração, e não dentro de uma sessão | |
starter | coloca os nove arquivos que você vai editar no lugar de | |
página | instala e cria | |
cloud | começa a criar o corpus do mecanismo RAG e o banco de memória em segundo plano, para que as sessões 4 e 6 os encontrem prontos | |
preflight | executa | |
6 · Leia a simulação (~1 min)
A última coisa que a etapa 5 imprimiu é a simulação, em que cada linha é uma sondagem real, não uma estimativa:
  ✓ python 3.12
  ✓ auth path A: Vertex via ADC (STUDIO_VERTEX=1)
  ✓ Google Cloud ADC (project vibe-studio-4271)
  ✓ Memory Bank SDK
  ✓ stage0_prompt loads
  ✓ stage1_fanout loads (0 edges)
  ✓ stage3_router loads (... edges)
  ✓ stage4_memory loads (... edges)
  ✓ stage5_rag loads (... edges)
  ✓ stage6_video loads (... edges)
  ✓ node and npm (build the learning center's page)
  ✓ learning center page built (web/dist)
  ✓ aiplatform.googleapis.com enabled (Gemini, Veo, Memory Bank, RAG Engine)
  ...
  - Memory Bank: still being created in the background
  - RAG corpus: still being created in the background
  ✓ session 7 runtime account 123456789-compute@developer.gserviceaccount.com has its roles
  ✓ learning center running on port 4600

PREFLIGHT GREEN

Open session 1 here:  https://4600-cs-...cloudshell.dev/step/story
stage1_fanout loads (0 edges) está certo: esse gráfico é enviado vazio, e a sessão 3 é onde você o preenche. As duas linhas - também estão corretas: um corpus leva um ou dois minutos para aparecer, e o banco leva cerca de 20 segundos. Você não vai precisar de nenhum deles antes da sessão 4.
👉💻 Execute-o novamente a qualquer momento para ver onde você está. Ele lê seus arquivos, seu projeto e o servidor em execução, não uma lista de verificação:
cd ~/vibe-studio-multimodal
uv run python scripts/preflight.py
7 · Abrir o workbench (~1 min)
O workbench já está em execução. A etapa 5 iniciou o processo em segundo plano, um processo uvicorn na porta 4600 que exibe a página, cada rota /api/* e adk web montada em /workbench. Não é preciso iniciar nada, e nada neste laboratório pede para você reiniciar: uma edição é aplicada na próxima execução.
👉🖥 Clique no link que o preflight exibiu ou, no Cloud Shell: Visualização na Web → Alterar porta → 4600. Vamos chamar essa de guia 2. Ele abre na Sessão 1 · A história.
Os três comandos que você pode precisar mais tarde, todos do ~/vibe-studio-multimodal:
| interrompe o workbench | |
| inicia o processo em primeiro plano; Ctrl+C interrompe o processo e todos os outros iniciados por ele | |
|
| |
Layout do repositório
vibe-studio-multimodal/
├── agent/                  # the workflow and the platform clients
│   ├── graph.py            # the graph: three readers, the proposer, the gate, the router, the script, the desk
│   ├── desk.py             # render_desk and render_submit, the LongRunningFunctionTool
│   ├── deliver.py          # the delivery console: find the pending call, wait for Veo, answer by id
│   ├── schemas.py          # Direction, Directions, CleanedDirection, Script, each with a poster idea
│   ├── cleanup_tools.py    # find_policy_hits, suggest_replacement: the task agent's tools
│   ├── policy_words.txt    # the policy, as data; policy_replacements.txt, the approved stand-ins
│   ├── backlog.txt         # the creator's Halloween ideas; comments.md, the audience's comments
│   ├── audience/           # what else the audience sent: voice/*.mp3, photo/*.jpg, clip/*.mp4
│   ├── media/past/         # six past posters and captions.md, what Gemini sees in each
│   └── platform/           # config, audience (the readers), rag (RAG Engine), images, videogen (Veo), memory (Memory Bank)
├── stage0_prompt/ ... stage6_video/   # one sandbox app per session, runnable in adk web
├── server/ & web/          # the VibeStudio Workbench (FastAPI + React, port 4600)
├── vibestudio/             # the app deployed in session 7, with its own copy of agent/
├── checks/ & scripts/      # the hole registry, the verifiers, preflight, start/stop/restart
└── starter/                # the nine files you edit, as students receive them
3. 1 · A história: a noite e o gráfico que ela se torna
👉🖥 A guia 2 abre na Sessão 1 · A história. São seis tarefas que giram em torno de uma pessoa: pesquisar a tendência, analisar o backlog, escolher uma direção, verificar a política, escrever o roteiro, renderizar o clipe. E o ciclo se repete todas as noites. O Gemini pode fazer a pesquisa, o backlog e o roteiro sozinho. O Veo pode renderizar sozinho. A escolha e a verificação são da pessoa.
Abaixo do anel, está o gráfico que o restante do laboratório cria, com 13 nós que vão de uma ideia até um clipe e o pôster dele. Passe o cursor sobre um nó para saber o que ele faz e a sessão que o cria. Não há nada para editar aqui. O botão Gerar o primeiro pôster da página é a sessão 2.
O vocabulário, para que as próximas seis páginas sejam lidas sem interrupção:
palavra | o que isso significa aqui |
agente | um ADK |
nó | uma etapa do gráfico: uma função Python, um agente, uma mesclagem, um roteador |
edge | uma tupla de nós que são executados em ordem. O gráfico é uma lista deles. Sessão 3 |
seção | o registro de uma execução em |
state | um dict que os nós compartilham por nome de chave; um nó grava |
memória | o que dura mais do que uma sessão: o Memory Bank, por meio de callbacks. Sessão 6 |
4. 2 · Geração de imagens: um agente e o modelo de imagem como ferramenta
👉🖥 No workbench, abra Sessão 2 · Geração de imagens. Antes do gráfico, a coisa mais simples que poderia funcionar: um Agent com uma instrução que descreve a noite inteira em prosa, três funções Python como as mãos e uma execução que termina com uma imagem.
Um agente é um modelo, uma instrução e ferramentas
stage0_prompt/agent.py define root_agent com três campos de um agente do ADK. model é o modelo do Gemini do agent/platform/config.py. instruction é o comando do sistema: seis tarefas de uma só vez, sendo a última uma imagem. tools tem três funções.
root_agent = Agent(
    name="solo_channel", model=config.MODEL,
    tools=[check_trends, read_backlog, make_poster],
    instruction=(
        "You run the creator's cozy-spooky short-video channel, alone, every "
        "night until Halloween.\n"
        "When the creator gives you an idea (or nothing), do ALL of this:\n"
        "check what is trending. look at your backlog of ideas. propose a "
        "direction and agree on it with the creator. refuse blacklisted "
        "subjects (competitor, hateful, gore). then describe the video you "
        "would make: a title (<=60 chars) and 3 shots, one visual sentence "
        "each. then draw its poster: call make_poster once with one line that "
        "names the single image that sells the video, and tell the creator "
        "where the poster is.\n"
        "Ask the creator to confirm the direction before describing the "
        "video."))
Um modelo é um mundo fechado: ele raciocina com base nos pesos e nos tokens do contexto. Uma ferramenta é uma função Python que o modelo pode solicitar. O ADK lê a assinatura e a docstring de cada função e as declara para o modelo. Quando o modelo precisa de uma, ele emite um evento function_call, o ambiente de execução executa o Python e grava um evento function_response de volta no contexto, e o modelo continua com o resultado em mãos.
Três funções, e uma delas desenha
Duas das três pessoas leram a pesquisa. O terceiro pede ao modelo de imagem um pôster:
def check_trends() -> dict:
    """Ten formats trending on the platform right now, with a heat score each."""
    from agent.trends import sample_trends
    return {"trends": sample_trends()}


def read_backlog() -> dict:
    """The creator's backlog: ideas they noted down to make someday."""
    from agent.graph import backlog_notes
    return {"backlog": backlog_notes()}


def make_poster(subject: str) -> dict:
    """Draw tonight's poster: one image of `subject` in the channel's cozy
    low-poly style. Returns where the PNG landed (path, url) in a few seconds."""
    ...
make_poster chama agent/platform/images.py, o modelo de imagem encapsulado como uma função simples, da mesma forma que videogen.py encapsula o Veo: um prefixo de estilo de casa (o visual aconchegante de Halloween do canal, laranja abóbora e creme à luz de velas contra ameixa meia-noite), o assunto, um frame vertical de 9:16, um PNG abaixo de runs/media/posters, veiculado em /static/posters. Com STUDIO_REAL_IMAGES=0, ele copia um pôster substituto e sinaliza o resultado prebaked para que o laboratório seja executado em qualquer lugar.
MODEL = os.environ.get("STUDIO_IMAGE_MODEL", "gemini-2.5-flash-image")
ASPECT = "9:16"

def generate(subject: str, visual_style: str = "", name: str | None = None) -> dict:
    """One poster for `subject`. Returns where it landed: status, path, url,
    prompt, and prebaked=True when the stand-in was used instead of the model."""
A mesma chamada é um nó no gráfico da sessão 5.
Na prática: a edição única
Como enviado, make_poster retorna um dict que diz que o pôster foi ignorado. 👉🖥 No editor do workbench, faça com que ele chame o modelo de imagem, em vez da linha TODO:
    from agent.platform import images
    return images.generate(subject, name="solo")
Salvar. As linhas de verificação leem o arquivo: três ferramentas no agente, a chamada do modelo de imagem em vigor. 👉🖥 Clique em Verificar as cargas do fluxo de trabalho, depois em Abrir o ADK Web e envie:
tonight's idea: a tiny ghost learning to haunt a sock drawer
O que esperar e por quê
- Dois eventos de ferramenta antes da resposta e, em seguida, uma pergunta.
check_trendseread_backlogsão executados porque a instrução dizia para verificar e procurar, e o modelo não tinha nenhum dos dois nos pesos. A resposta propõe uma direção e pede que você confirme, porque a instrução pediu um acordo primeiro. - A segunda mensagem recebe tudo. Envie
skip the questions, describe the video and draw the poster. O modelo descreve o vídeo, chamamake_posteruma vez com um assunto que ele mesmo escreveu e informa onde o PNG foi salvo. O painel de verificação mostra o pôster ao lado das linhas: uma cena de Halloween no estilo do canal, desenhada em cerca de oito segundos. - Por que não é um canal. A pesquisa é incorporada em uma prosa que não pode ser citada. A política foi certificada pelo modelo que escreveu a direção, e o pôster foi desenhado antes de qualquer verificação. O contrato foi mencionado em uma mensagem. O texto do comando não é um bloqueio. O restante do laboratório divide esses seis jobs em um gráfico desenhado.
A página termina com Do que um agente do ADK é feito, uma referência que você pode consultar sempre que precisar: o modelo, o contexto em que ele raciocina, as ferramentas e os colaboradores que ele usa, os callbacks que envolvem cada chamada e a sessão e a memória que existem fora dele.
5. 3 · Fluxos de trabalho: fan-out e junção, roteador e loop
👉🖥 No ambiente de trabalho, abra a Sessão 3 · Fluxos de trabalho, partes 3a e 3b. Cada parte é criada em um app de sandbox para que você possa executá-la no adk web por conta própria: o fan-out em stage1_fanout, o roteador e o loop em stage3_router.
Distribuição de dados e mesclagem (3a)
Um Workflow do ADK é uma lista de bordas. Cada entrada é uma cadeia, uma tupla de nós que são executados em ordem. Duas cadeias que saem de START são executadas em paralelo. Uma cadeia que termina em um JoinNode se reporta a ele, e a mesclagem aguarda todas as cadeias que terminam ali antes de continuar, entregando um dicionário com chave pelo nome do nó. Um destino escrito como um dicionário mapeia os nomes de rota de um roteador para nós. A página 3a do workbench desenha as formas e tem um exercício de escrita das bordas.
Tipo de nó | Escrito como | O que faz? |
Nó de função |
| Python simples. Também pode gravar o estado compartilhado com |
Nó de mesclagem |
| Aguarda até que todas as cadeias de entrada sejam informadas e, em seguida, transmite todas as saídas como um dict. |
Nó do agente |
| Uma chamada de modelo no modo |
Roteador |
| Um nó de função cujo retorno nomeia a borda de saída. |
Nó de entrada humana |
| Suspende o gráfico até que uma pessoa responda a um formulário. Sessão 5. |
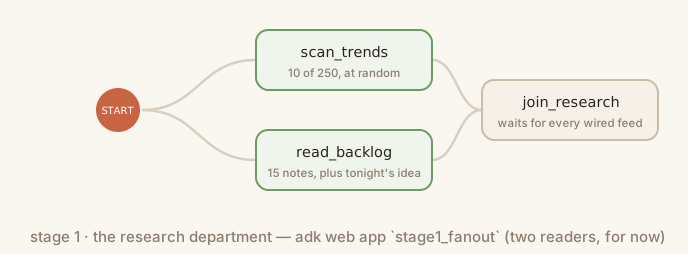
O primeiro gráfico é a pesquisa da sessão 2 como nós. scan_trends e read_backlog em agent/graph.py são os dois leitores. read_backlog também grava a ideia de hoje no estado compartilhado. stage1_fanout/agent.py define a mesclagem e cria o Workflow com base em uma lista chamada EDGES, que é enviada vazia (o 0 edges da simulação). 👉🖥 Preencha-a com as duas cadeias:
EDGES = [(START, scan_trends, join_research),
         (START, read_backlog, join_research)]
👉🖥 Execute no adk web. Dois nós se acendem juntos e, em seguida, a junção; abra o evento de join_research e leia um dict com uma chave scan_trends e uma chave read_backlog. Nenhuma chamada de modelo aconteceu. Nada reformata o dict da mesclagem: o nó depois dele, em 3b, é um agente, e um nó de agente recebe o node_input como mensagem. Portanto, um dict chega como JSON que o modelo lê diretamente.
O roteador e o loop (3b)
Um Agent dentro de um Workflow é executado no modo single_turn: ele recebe a saída do nó anterior como mensagem, faz uma chamada de modelo e responde uma vez. Com output_schema, a resposta é validada em relação a um modelo Pydantic antes que o próximo nó a veja. Assim, o gráfico transmite objetos tipados, não texto. propose_directions lê o dicionário de pesquisa da junção e apresenta quatro candidatos, cada um com uma cena de Halloween. O candidato 4 é a isca: o título dele tem uma palavra que o canal recusa, então o roteador tem algo para capturar. Cada candidato carrega um poster_idea, uma linha que nomeia a única imagem que vende o vídeo. O roteirista fica com ele, e a mesa de mídia o desenha na sessão 5.
Um roteador é um nó de função cujo retorno nomeia a borda que a execução segue. Sem chamada de modelo: o policy_check lê agent/policy_words.txt no momento da decisão, compara palavras inteiras com o título e o ângulo da direção e as encaminha antes que qualquer script seja escrito ou qualquer dinheiro seja gasto. A política é um dado: edite o arquivo, e a próxima execução vai ler as informações.
def policy_check(node_input):
    """The policy gate: a router. Refused words in the direction send it to
    quarantine; a clean one goes to the scripter. Code, not a model."""
    chosen = _as_dict(node_input)
    bad = policy_hits(f"{chosen.get('title', '')} {chosen.get('angle', '')}")
    return Event(output=node_input, route="BLOCK" if bad else "OK")
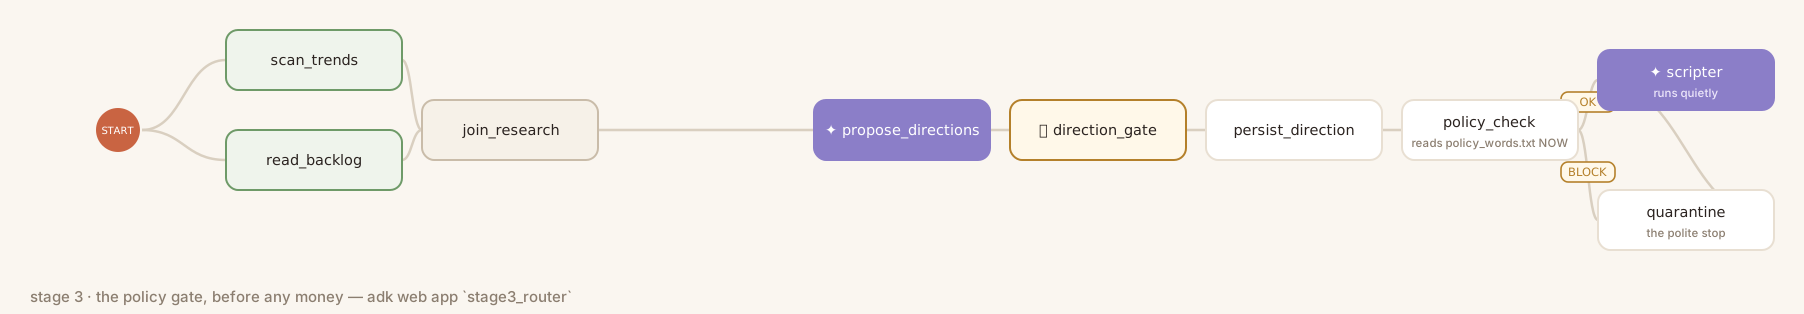
stage3_router/agent.py é o fan-out mais propose_directions e choose_direction, um substituto para a porta humana que você cria na sessão 5: ele escolhe o candidato cujo número termina a ideia de hoje (..., pick 4), caso contrário, o primeiro, e grava a escolha no estado. scripter é um agente do single_turn que transforma uma direção aprovada em um Script: um título, uma descrição, tags, uma frase de abertura, três cenas e uma ideia de pôster, com cada cena sendo uma imagem de Halloween no estilo do canal.
O loop por trás da saída recusada. O quarantine é enviado como um agente de modo de tarefa. Um Agent tem um mode: chat é o loop de conversa que um agente raiz executa com uma pessoa, single_turn é uma chamada com uma resposta estruturada e task é um loop de chamadas de ferramenta que o agente executa por conta própria até chamar o finish_task integrado, cujos argumentos o ADK deriva de output_schema. A quarentena chama find_policy_hits na direção recusada, pede a suggest_replacement o substituto aprovado do canal para cada palavra (agent/policy_replacements.txt, dados novamente), reescreve, verifica novamente e termina com um CleanedDirection digitado. Leia o texto na página, não digite.
quarantine = Agent(
    name="quarantine",
    model=config.MODEL,
    mode="task",
    instruction=QUARANTINE_INSTRUCTION,
    tools=[find_policy_hits, suggest_replacement],
    output_schema=CleanedDirection)
Como enviado, a cadeia vai da seleção direto para o criador de scripts. 👉🖥 Coloque o roteador entre eles, com as duas saídas e o caminho de volta da quarentena. Três linhas substituem uma:
           (join_research, propose_directions, choose_direction, policy_check),
           (policy_check, {"OK": scripter, "BLOCK": quarantine}),
           (quarantine, scripter),
👉🖥 Execute as duas rotas. Enviar a ideia como está: o choose_direction usa o candidato 1, o policy_check emite OK e o criador de scripts escreve um script estruturado. Clique em Nova sessão e envie a ideia novamente com , pick 4 no final: o candidato 4 é a isca, policy_check emite BLOCK, a quarentena chama as ferramentas, reescreve as palavras recusadas, chama finish_task e a direção limpa volta para o roteirista. As linhas de verificação leem as duas execuções do armazenamento de sessões.
Cada frase do comando da sessão 2 agora tem um nó: a pesquisa é composta por dois leitores e uma mesclagem, a recusa é um roteador e um agente de tarefas, e o script é um nó de agente. No gráfico inteiro, a escolha substituta são dois nós de função, direction_gate e persist_direction, que vão ser executados até que a sessão 5 faça a porta parar. O acordo com o criador de conteúdo ainda é provisório, assim como a pesquisa, que ainda não ouviu o público.
6. 4 · Ingestão multimodal: o que o público enviou, lido em um corpus
👉🖥 No workbench, abra a Sessão 4 · Ingestão multimodal, partes 4a e 4b. O público não apenas escreveu. Um leitor por tipo transforma tudo o que foi enviado em texto com o mesmo formato, um corpus do mecanismo de RAG armazena tudo, e um terceiro leitor no fan-out pesquisa por significado e retorna a mídia.
O que o público enviou (4a)
agent/comments.md contém 12 comentários escritos nos seis vídeos de Halloween do canal. agent/audience/ contém o restante: oito notas de voz (voice/*.mp3), 14 fotos dos quartos dos espectadores (photo/*.jpg) e seis clipes (clip/*.mp4), uma panorâmica lenta sobre uma foto com a voz do espectador. A página do 4a abre tudo: todas as notas de voz são reproduzidas, todas as fotos são mostradas, todos os clipes são executados.
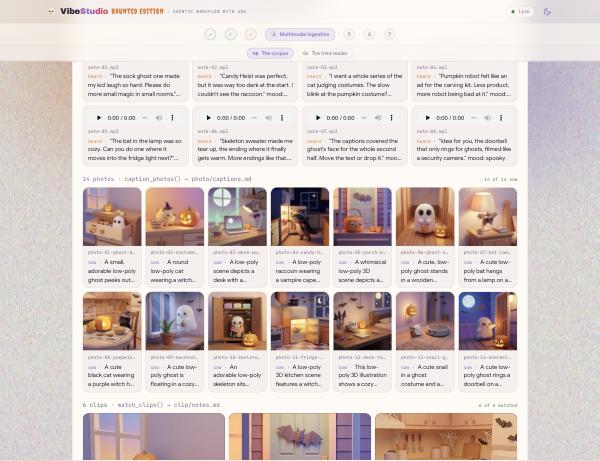
O mecanismo RAG recupera texto. Uma nota de voz, uma foto ou um clipe só podem entrar no corpus da mesma forma que os pôsteres anteriores em rag.caption_posters: um modelo os transforma em uma linha de texto que nomeia o arquivo, a linha se torna um trecho e, quando o trecho volta, o arquivo volta com ele. agent/platform/audience.py tem um leitor por tipo. Cada um envia um arquivo e um comando para o Gemini e grava uma linha por arquivo:
VOICE_PROMPT = ("Transcribe this voice note word for word inside double quotes. Then add: mood: and one word. "
                "Plain text on one line, nothing else.")
PHOTO_PROMPT = ("Two sentences: what is in the picture, the palette, the mood. Then: tags: and three short tags. "
                "Plain text on one line, no headings, no markdown.")
CLIP_PROMPT = ("Describe the shots in two sentences, then quote what you HEAR on the soundtrack as: heard: \"...\". "
               "Plain text on one line, no headings, no markdown.")


def _ask(path: pathlib.Path, mime: str, prompt: str) -> str:
    """One media file in, one line of text out."""
    from google.genai import types as gt
    client = images._client()
    resp = client.models.generate_content(
        model=config.MODEL,
        contents=[gt.Part.from_bytes(data=path.read_bytes(), mime_type=mime), prompt],
        config=gt.GenerateContentConfig(automatic_function_calling=gt.AutomaticFunctionCallingConfig(disable=True)))
    return " ".join((resp.text or "").split())


def transcribe_voice() -> pathlib.Path:
    """voice note -> text: Gemini listens."""
    files = sorted((AUDIENCE / "voice").glob("*.mp3"))
    lines = []
    for p in files:
        said = _ask(p, "audio/mpeg", VOICE_PROMPT)
        lines.append(f"- voice: {p.name} — {said}")
    return _write(AUDIENCE / "voice" / "transcripts.md", "voice", "What Gemini heard in the audience's voice notes", lines)
caption_photos faz o mesmo com image/jpeg e PHOTO_PROMPT; watch_clips com video/mp4 e CLIP_PROMPT, e o Gemini assiste à imagem e ouve a trilha sonora em uma chamada. Cada leitor escreve o mesmo formato de linha, então a divisão, a incorporação e a recuperação nunca sabem de que tipo um trecho veio:
- voice: note-03.mp3 — "I want a whole series of the cat judging costumes ..." mood: delighted
- photo: photo-01-ghost-drawer.jpg — A cream wooden drawer, striped socks, a paper-cup ghost ... tags: drawer, socks, cozy
- clip:  clip-05.mp4 — A hallway floor, a snail in a sheet and a round vacuum ... heard: "The snail won."
- poster: sock-ghost.png — A sheet ghost one inch above a striped sock ...
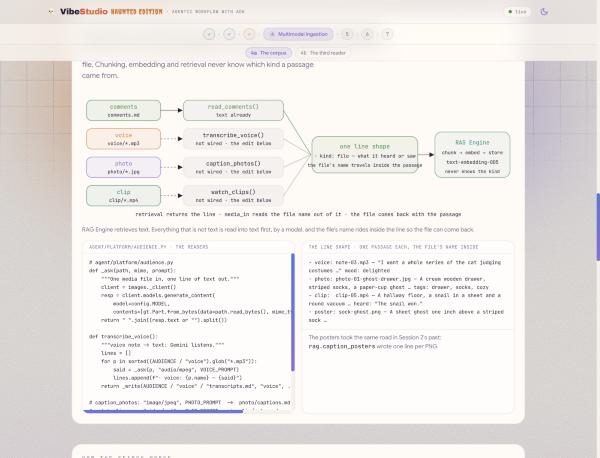
O corpus. O mecanismo de RAG da Vertex AI é uma recuperação de documentos: um corpus é dividido em trechos de cerca de 120 tokens, cada trecho é incorporado com text-embedding-005, e uma consulta é incorporada da mesma forma e respondida com os trechos mais próximos por significado, não por palavras compartilhadas. "assombrações aconchegantes em casa" encontra o comentário que pede uma pequena magia em quartos pequenos, a nota de voz sobre o morcego abraçando a lâmpada e o clipe em que a trilha sonora diz que o fantasma é um copo de papel.
corpus = rag.create_corpus(
    display_name="vibestudio-feedback",
    backend_config=rag.RagVectorDbConfig(
        rag_embedding_model_config=rag.RagEmbeddingModelConfig(
            vertex_prediction_endpoint=rag.VertexPredictionEndpoint(
                publisher_model="publishers/google/models/text-embedding-005"))))

rag.upload_file(
    corpus_name=corpus.name, path="agent/comments.md", display_name="comments.md",
    transformation_config=rag.TransformationConfig(
        chunking_config=rag.ChunkingConfig(chunk_size=120, chunk_overlap=20)))
A configuração já começou a criar o corpus. A linha de conexão da página 4a informa se ele está ativo e o cria se a configuração não conseguir. Nos botões da página ou no terminal: python -m agent.platform.rag cria o corpus e o registra em runs/ragcorpus.json; python -m agent.platform.rag load --audience executa cada leitor em audience.READERS e, em seguida, faz upload do que eles escreveram ao lado dos comentários e das legendas dos autores, cada arquivo com o próprio nome, e aguarda a resposta do índice; python -m agent.platform.rag query "cozy little hauntings at home" mostra a recuperação de trechos que não compartilham nenhuma palavra com a consulta.
A edição. Como enviado, o READERS contém apenas read_comments. Os três leitores de mídia ficam atrás de um #. 👉🖥 Execute a ingestão uma vez, conforme ela é enviada: a saída diz not read (no reader wired in audience.READERS): voice, photo, clip, e apenas os comentários e as legendas são incluídos. Em seguida, exclua o # :
transcribe_voice, caption_photos, watch_clips,
👉🖥 Salve e execute a ingestão novamente. Os leitores levam cerca de três minutos para os 40 itens. O console diz heard, saw e watched uma linha por vez, e cada card na grade é preenchido com a linha correspondente. As linhas de verificação leem o arquivo, a saída dos leitores e o corpus: quatro leitores conectados, oito notas de voz ouvidas, 14 fotos vistas, seis clipes assistidos, cinco arquivos no corpus.
O terceiro leitor (4b)
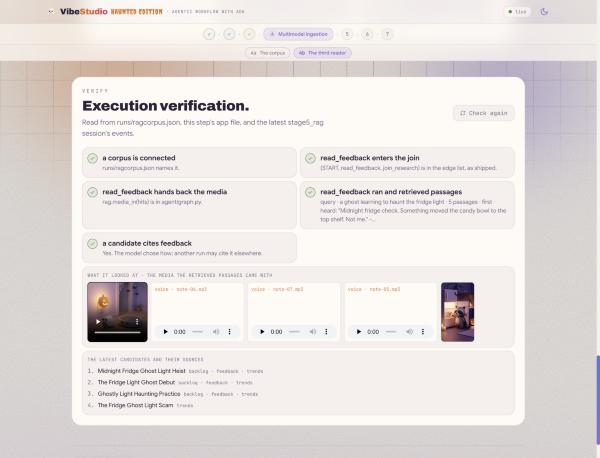
O feedback do público é uma pesquisa, compartilhada por todas as execuções, então ele entra no gráfico onde a pesquisa entra: como um terceiro leitor na junção. read_feedback em agent/graph.py pega a ideia de hoje, pede ao corpus as passagens mais próximas e informa a join_research, que espera por três. A borda (START, read_feedback, join_research) é enviada em stage5_rag/agent.py, a forma que a sessão 3 ensinou. Sua edição está dentro do nó. Recuperação, não uma chamada de modelo, e determinística: a mesma ideia encontra as mesmas passagens, enquanto o proponente varia.
def read_feedback(node_input):
    """The third reader: what the audience sent - comments, and what Gemini
    heard and saw in their voice notes, photos and clips - the passages
    nearest to tonight's idea, and the media those passages came with.
    Retrieval, not a model call."""
    from .platform import rag
    idea = idea_text(node_input)
    query = idea or "what viewers liked and what they complained about"
    try:
        hits = rag.retrieve(query)
    except Exception as e:
        print(f"  [rag] feedback unavailable ({str(e)[:80]})")
        return Event(output={"query": query, "feedback": [], "media": [],
                             "note": "no corpus connected - run: python -m agent.platform.rag"})
    return Event(output={"query": query, "feedback": [h["text"] for h in hits]})  # TODO: RAG_MEDIA
Cada linha no corpus que veio de uma nota de voz, foto, clipe ou pôster nomeia o arquivo. O rag.media_in(hits) lê esses nomes nos trechos e os transforma em URLs que a página pode mostrar e reproduzir. 👉🖥 Devolva a mídia com as passagens para que as coisas que o público enviou acompanhem o que eles disseram:
    return Event(output={"query": query, "feedback": [h["text"] for h in hits],
                         "media": rag.media_in(hits)})
👉🖥 Execute stage5_rag com uma ideia. Abra read_feedback: a consulta é sua ideia, a saída tem os cinco trechos mais próximos e uma lista media com um URL por arquivo. Abrir join_research: três teclas. Abra propose_directions: os candidatos de 1 a 3 citam feedback nas evidências. O painel de verificação mostra o que o leitor analisou nas linhas: um clipe, três notas de voz e um pôster do fantasma na luz da geladeira.
7. 5 · Geração de vídeo: dois tipos de suspensão, um mecanismo
👉🖥 No workbench, abra a Sessão 5 · Geração de vídeo, partes 5a e 5b, criadas no stage6_video, o gráfico inteiro. O clipe leva minutos e o pôster leva segundos, e a execução para duas vezes no caminho: uma para você e outra para o Veo. As duas paradas são um mecanismo, e as duas ramificações da mesa compartilham o que fizeram por nome.
Dois tipos de suspensão (5a)
Nada espera. Uma execução que precisa ser interrompida grava uma chamada aberta na sessão e é encerrada. Quem atender a essa chamada, seja uma pessoa ou um processo, vai continuar a execução. A página é aberta em uma tabela:
para uma pessoa · | para uma ferramenta lenta · | |
que interrompe a execução |
|
|
o que ele espera | uma pessoa: um de quatro cards | um trabalho lento: a operação do Veo, minutos |
o que está na sessão | uma chamada | uma chamada |
como ele é retomado | um | um |
quem deve enviar |
|
|
onde ele vive enquanto isso |
| mesma linha, mesmo ID · nada é executado |
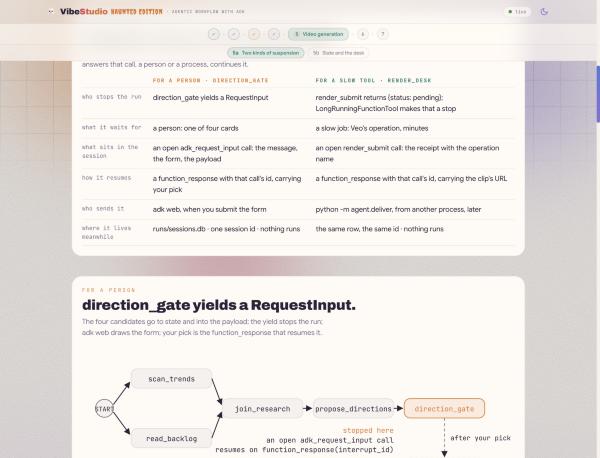
Para uma pessoa Em um único comando, "pedir para o criador confirmar" é uma recomendação, e a sessão 2 ignorou isso em uma mensagem. Em um fluxo de trabalho, a pausa é do mecanismo. Um nó que gera RequestInput suspende a execução: o ADK grava uma chamada aberta chamada adk_request_input na sessão com seu message, response_schema e payload, atribui um interrupt_id a ela e retorna ao autor da chamada. Nenhuma thread aguarda. A única coisa que o retoma é um function_response que carrega esse ID, validado em relação ao seu esquema. Uma mensagem de chat para o fluxo de trabalho é uma nova vez, não uma resposta. O esquema também é o formulário: o adk web o renderiza, e o app VibeStudio renderiza o mesmo esquema como quatro cards. O direction_gate já grava os candidatos no estado. 👉🖥 Como parar:
    yield RequestInput(
        message="Pick tonight's direction: 1, 2, 3 or 4.",
        response_schema={
            "type": "object",
            "properties": {
                "pick": {"type": "string", "enum": ["1", "2", "3", "4"]}}},
        payload={"candidates": cands})
Sua resposta chega a persist_direction como node_input, um dicionário com uma chave, pick. Os quatro candidatos chegam de outra forma: o portão os gravou no estado compartilhado em candidates, e o ADK vincula uma chave de estado a um parâmetro com o mesmo nome. O nó resolve a escolha em um candidato e grava direction, angle, hook e user:prefs de volta com Event(state=...). As chaves com o prefixo user: persistem em todas as sessões desse usuário.
Para uma ferramenta lenta. Uma renderização do Veo leva minutos, e um gráfico não deve esperar tanto tempo. render_submit em agent/desk.py inicia o job e retorna imediatamente com um recibo cujo status é pending:
def render_submit(prompt: str) -> dict:
    """Submit one Veo render of `prompt`. Returns at once with a pending
    receipt; the clip is delivered later, to this call, by id."""
    receipt = videogen.start(f"{prompt} {videogen.NO_TEXT}")
    return {"status": "pending", "operation": receipt["operation"], "prompt": receipt["prompt"]}
Encapsulado em LongRunningFunctionTool, esse recibo significa algo para o ADK: a vez do agente termina, o fluxo de trabalho é suspenso em render_desk e a chamada aberta com o ID e o recibo é uma linha em runs/sessions.db. 👉🖥 Em stage6_video/agent.py, una a ferramenta:
tools=[LongRunningFunctionTool(render_submit)])
Retomar por ID, de outro processo. agent/deliver.py encontra a chamada pendente no armazenamento da sessão, consulta o Veo até que o clipe exista, grava o resultado em runs/state.json e envia à mesma sessão um function_response com o ID dessa chamada. 👉🖥 Crie a parte da resposta:
    part = Part(function_response=FunctionResponse(
        id=row["call_id"], name=row["name"], response=response))
👉🖥 Execute stage6_video até que ele pare duas vezes. Envie uma ideia: a execução é interrompida em um formulário criado com base no seu esquema, com os quatro candidatos no payload. Digite 2 em pick e envie. O gráfico será retomado em persist_direction. Faça o teste de encerramento aqui: suspenda no formulário, interrompa o servidor (scripts/stop.sh na guia 1), inicie-o novamente (scripts/restart.sh) e reabra a sessão. O formulário ainda está de pé, porque uma pausa é uma linha, não uma linha de execução. Depois de script_ready, render_desk chama render_submit, recebe o comprovante, responde WAITING e a execução termina. A sessão mantém o ID da chamada. Execute a entrega no console da página ou na guia 1:
cd ~/vibe-studio-multimodal
uv run python -m agent.deliver status   # the pending renders, by session, call id and operation
uv run python -m agent.deliver          # wait for Veo, answer the newest pending call by id
👉🖥 Clique em Atualizar adk web: o function_response segue a chamada pendente, o join_media é liberado e o store_release é executado. Oito linhas de verificação leem as duas paradas da sessão: a chamada do portão e sua resposta, o recebimento da renderização e a entrega.
Estado e mesa (5b)
A mesa de mídia é a estrutura de 3a novamente, uma distribuição e uma mesclagem, com uma ramificação lenta. O script_ready envia o script de duas maneiras. render_desk envia o clipe, e a execução é suspensa. make_poster é a ferramenta da sessão 2 como um nó: o poster_idea do script, o estilo do canal e o que o Memory Bank sabe sobre o gosto do criador em pôsteres (vinculado ao estado como memory_facts, sessão 6) vão para o modelo de imagem, e um PNG 9:16 é retornado em segundos. join_media aguarda o mais lento, e store_release grava o que encontrou no estado.
Compartilhar por nome. store_release nunca recebe o pôster. Ele declara um parâmetro chamado poster_url, e o ADK o vincula do estado compartilhado, porque um nó na outra ramificação gravou essa chave. Nenhum payload cruza as ramificações:
def store_release(node_input, poster_url: str = "", poster_path: str = ""):
    """`poster_url` and `poster_path` are not passed by anyone: ADK binds them
    from shared STATE because the parameter names match the keys make_poster
    wrote (the STATE_SHARE edit). The two branches of the desk never hand each
    other payloads; they share what they made by name."""
    render = state.load().get("render") or {}          # the delivered clip, written by deliver
    url, status = render.get("url") or "", render.get("status", "")
    ...
    if not poster_url:
        said += " · poster: not in state (did make_poster write poster_url to state? the STATE_SHARE edit)"
    yield Event(output={"status": status, "url": url, "poster_url": poster_url},
                state={"render_url": url, "render_status": status, "poster_url": poster_url},
                message=f"video: {said} · poster: {poster_url or 'none'}")
Como enviado, make_poster gera o pôster como saída e uma mensagem, e store_release diz poster: not in state. 👉🖥 Adicione a gravação de estado ao resultado final:
                state={"poster_url": rec.get("url", ""), "poster_path": rec.get("path", "")},
                message=f"poster: {said}")
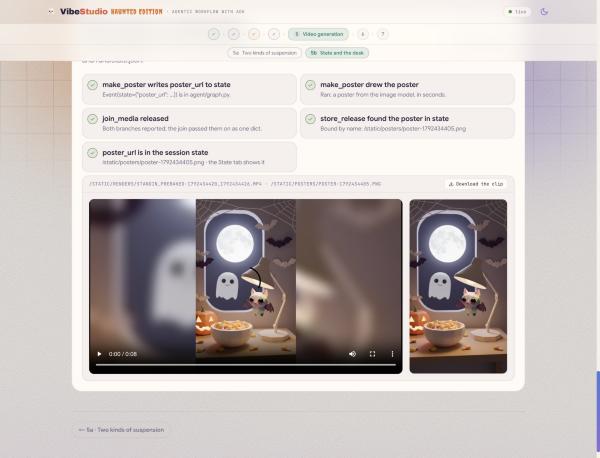
👉🖥 Execute mais uma vez e entregue. Evento de abertura de make_poster: o URL do pôster na saída e um delta de estado com poster_url. Abra store_release: a mensagem indica o nome do autor do post. O bloco Sessão desta execução da página mostra a mesma linha que a guia "Estado" de adk web: o ID da sessão que uma retomada precisa, a chamada que está aberta e as chaves que os nós escreveram, incluindo poster_url. O painel de verificação mostra o clipe e o pôster lado a lado.
8. 6 · Memória: o que o canal lembra entre as noites
👉🖥 No workbench, abra a Sessão 6 · Memória, partes 6a e 6b, criadas em stage4_memory. A sessão 5 foi sobre o estado de uma execução. Esta sessão é sobre o que o canal lembra entre as execuções: o que o gráfico ouve de fora, por meio de dois callbacks.
Memory Bank (6a)
O Vertex AI Memory Bank é uma memória de longo prazo gerenciada sobre uma pessoa. Os fatos ficam em um escopo, no nome do app e no ID do usuário, além dos tópicos que você define. Quando você fornece uma troca com memories.generate, ele extrai o que se encaixa em um tópico, incorpora e consolida com o que já tem: um novo fato é criado, um fato alterado é atualizado, uma repetição é mesclada. memories.retrieve retorna os fatos de um escopo. As duas chamadas estão em agent/platform/memory.py.
SCOPE = {"app_name": config.APP, "user_id": config.USER}
TOPICS = {
    "CREATOR_TASTE": "Which video directions this creator picks and passes on, "
                     "and how that preference changes over time.",
    "CHANNEL_RULES": "Standing instructions the creator states for every video "
                     "(style, subjects to avoid, format rules).",
    "VISUAL_STYLE": "What this creator approves and rejects in a poster: palettes, "
                    "framing, props and mood of the posters they shipped.",
}
O terceiro tópico é o gosto do canal em imagens. A versão escreveu nele na sessão 5: um pôster enviado é descrito em uma frase e lembrado, e o próximo pôster é desenhado com essa frase no comando.
A configuração já começou a criar o banco. A linha de conexão da página 6a informa se ele está ativo. Nos botões da página ou no terminal: python -m agent.platform.bank cria o banco e os tópicos dele e armazena em cache o nome do recurso em runs/memorybank.json; python -m agent.platform.bank load gera quatro sessões anteriores (duas eras de animais com uma regra de estilo, uma era de gadgets, uma era de fantasia recente); python -m agent.platform.bank list mostra o que as transcrições se tornaram: declarações consolidadas de fatos, não transcrições.
Callbacks (6b)
A memória não é um nó. Um callback é uma função que você transmite para um Agent. O ADK o chama em um momento fixo com o contexto ativo, e o retorno de None permite que o processo normal aconteça. Três pares: em torno da vez do agente (before_agent_callback, after_agent_callback, com um CallbackContext), em torno de cada chamada de modelo (before_model_callback com o LlmRequest, after_model_callback com o LlmResponse) e em torno de cada chamada de ferramenta. As proteções, a telemetria, os caches e a injeção de contexto ficam aqui, sem um nó no gráfico.
Em stage4_memory/agent.py, propose_directions lê o banco antes da chamada do modelo: recall_taste busca os fatos, os anexa à solicitação como um bloco MEMORY, do mais antigo para o mais recente, e diz ao modelo para inclinar os candidatos de 1 a 3 em direção ao gosto atual e tratar as regras como restrições. Ele também grava os fatos no estado como memory_facts, onde o make_poster os encontra. 👉🖥 Conecte:
    output_schema=Directions,
    before_model_callback=recall_taste)
O roteirista escreve o que o criador escolheu após a vez dele: remember_pick lê direction do estado, escreve uma frase sobre a escolha e a entrega para memories.generate. 👉🖥 Conecte:
    output_schema=Script,
    after_agent_callback=remember_pick)
👉🖥 Execute com uma mensagem vazia e escolha um card. Abra o evento propose_directions: a solicitação contém as três eras, e os candidatos de 1 a 3 se inclinam para o gosto atual, enquanto as tendências sugerem outra coisa. Depois do roteirista, clique em Mostrar o banco: uma memória foi alterada ou adicionada para a escolha de hoje à noite. Execute uma segunda noite: ele se lembra da primeira.
9. 7 · Implantar e publicar: o gráfico em um app, a noite no VibeTube
👉🖥 No workbench, abra a Sessão 7 · Implantar e publicar, partes 7a e 7b.
Implantar o VibeStudio (7a)
Nos sandboxes, o adk web impulsionou o gráfico. O VibeStudio usa o Runner do ADK em uma linha de execução de worker com o próprio loop de eventos e junta todos os eventos em um estado de execução que a página lê por eventos enviados pelo servidor: os leitores, sua escolha de quatro cartas, o pôster quando ele chega e a renderização quando é entregue. A resposta do portão e a entrega da renderização são a mesma chamada, uma parte function_response, e o app pesquisa o próprio Veo em vez de esperar pelo console.
self._svc = DatabaseSessionService(db_url=config.DB_URL)
self._runner = Runner(app_name=config.APP, agent=wf, session_service=self._svc)

async for ev in self._runner.run_async(user_id=config.USER, session_id=run_id, new_message=message):
    self._absorb(ev)    # fold the ADK event into the run state, publish one app event

part = Part(function_response=FunctionResponse(id=call_id, name=name, response=response))
vibestudio/server/agent/ é uma cópia byte por byte do agent/ do laboratório, verificada por checks/verify_app.py. A lista completa de arestas em agent/graph.py é cada estrutura deste codelab em um só lugar, com 13 nós. Ela é enviada preenchida para você ler, não digitar:
        (START, scan_trends, join_research),
        (START, read_backlog, join_research),
        (START, read_feedback, join_research),
        (join_research, propose_directions, direction_gate,
         persist_direction, policy_check),
        (policy_check, {"OK": scripter, "BLOCK": quarantine}),
        (quarantine, scripter),
        (scripter, script_ready),
        (script_ready, render_desk, join_media),
        (script_ready, make_poster, join_media),
        (join_media, store_release),
👉🖥 Implante com o botão Implantar do workbench ou 👉💻 na guia 1:
cd ~/vibe-studio-multimodal
uv run python vibestudio/deploy.py
que é executado com os valores do seu .env preenchidos:
gcloud run deploy vibestudio --source vibestudio \
  --project $GOOGLE_CLOUD_PROJECT --region us-central1 \
  --labels dev-tutorial-codelab=vibetube --allow-unauthenticated \
  --memory 2Gi --cpu 2 --timeout 3600 --concurrency 40 \
  --max-instances 1 --min-instances 1 --session-affinity \
  --set-env-vars GOOGLE_CLOUD_PROJECT=...,STUDIO_VERTEX=1,STUDIO_MEMORY_BANK=...,STUDIO_RAG_CORPUS=...,VIBETUBE_URL=...,VIBETUBE_EVENT=...,VIBETUBE_NAME=...,VIBETUBE_PROJECT=...
--source cria o contêiner com o Cloud Build e o implanta em uma única etapa. A primeira criação leva de quatro a cinco minutos. --session-affinity com uma instância de inicialização rápida mantém uma execução suspensa na instância que a contém: o armazenamento da sessão 5, mais uma vez. Em uma implantação maior, o armazenamento de sessões é movido para VertexAiSessionService, e a afinidade é removida. A versão e o serviço são executados como a conta de serviço de computação padrão do projeto, que recebeu os papéis necessários durante a configuração.
👉🖥 Abra o URL do serviço e faça uma sessão de cinema no app: uma ideia, uma escolha, espere o clipe e o pôster. A guia "Histórico" mantém os dois.
Publicar (7b)
A publicação é um POST de várias partes do app para o endpoint da sala no VibeTube, em vibestudio/server/platform/publish.py. O clipe é o vídeo, o pôster é a miniatura, e o perfil nomeia a sala e você:
url = f"{prof['platform_url']}/api/events/{prof['event_code']}/videos"
data = {"title": state.script["title"], "description": state.script["description"],
        "duration": "0:08", "displayName": prof["display_name"],
        "projectId": prof["project_id"]}        # one video per project and room: publishing again replaces it
files = {"videoFile": (clip.name, clip.open("rb"), "video/mp4"),
         "thumbnailFile": (poster.name, poster.open("rb"), "image/png")}   # the poster, not a frame
r = httpx.post(url, data=data, files=files, timeout=120)
video_id = r.json()["id"]                       # watch it at {platform}/e/{event}?v={video_id}
O VibeTube mantém um vídeo por projectId e sala, e o projeto que o app envia é o seu projeto na nuvem do Google Cloud. Portanto, publicar novamente substitui o vídeo em vez de adicionar um novo. Um pôster substituto nunca é enviado. O real é a miniatura, byte por byte.
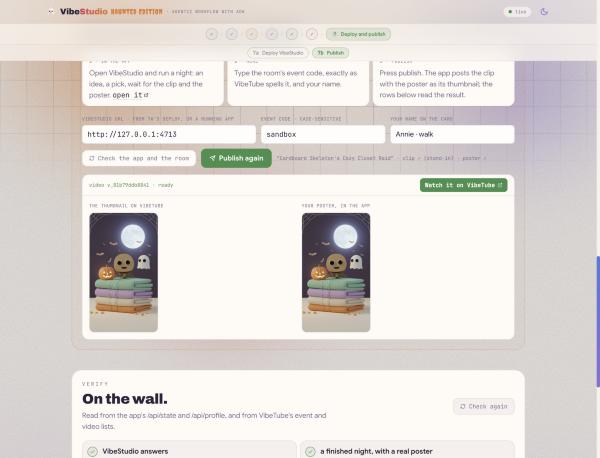
A última edição é uma configuração, não uma linha de código. 👉🖥 Na página 7b: o URL do VibeStudio (preenchido na implantação da 7a), o código do evento da sala, exatamente como o VibeTube o escreve (aquele que você configurou, a menos que o professor tenha aberto outro) e seu nome. Pressione Publicar. A bancada transmite o clique para o app, que publica a noite, e as linhas abaixo leem o resultado do app e do VibeTube: o app responde, a noite é finalizada com um pôster real, o codinome nomeia uma sala aberta, o VibeTube retorna um ID do vídeo, o vídeo está no mural e a miniatura dele é seu pôster. O card de resultado mostra a miniatura no VibeTube ao lado do pôster no app.
10. O que você criou
👉🖥 O final da página 7b mostra o gráfico completo, com 13 nós que vão de uma ideia até um clipe e o pôster dele. Passe o cursor sobre um nó para saber o que ele faz e a sessão que o criou.
Sessão | O que ele ensinou | Escrito como |
2 · Geração de imagens | Um agente: modelo, instrução, ferramentas; o modelo de imagem como ferramenta; o que um comando não pode prometer |
|
3 · Workflows | A lista de bordas, o fan-out e a mesclagem, um roteador com um loop de modo de tarefa por trás dele |
|
4 · Ingestão multimodal | Um leitor por tipo, uma forma de linha, um corpus; um terceiro leitor por significado, com a mídia |
|
5 · Geração de vídeo | Dois tipos de suspensão, um mecanismo; o armazenamento de sessão; o poster compartilhado por nome |
|
6 · Memória | Memória entre noites, dois callbacks |
|
7 · Implantar e publicar | O gráfico dentro de um app no Cloud Run; a noite no VibeTube |
|
Cinco regras que o gráfico segue:
- Suspender em vez de esperar. Uma pausa é uma linha no armazenamento de sessões, não uma linha de execução.
- Retome tudo da mesma forma: pelo ID da chamada aberta, seja uma pessoa ou um processo que atenda.
- Compartilhe dados por nome no estado, não por meio de cada payload.
- Decida com código antes de pagar por um modelo. A política é um arquivo de texto e um roteador, e é executada antes da renderização.
- Leia tudo o que não é texto em texto antes de chegar ao corpus, com o nome do arquivo dentro da linha para que ele possa voltar.
Um comando não pode prometer ordem, interrupção ou verificação. Um gráfico pode.
Próximas etapas
VertexAiSessionServicepara sessões que duram mais que uma instância e descartar--session-affinity.- Um webhook que responde à chamada da renderização em vez de um poller: o mesmo
FunctionResponse(id=...), mas um remetente diferente. - Um segundo
RequestInputantes da publicação: o esquema é o formulário, então é um nó e nenhum código de página. - Os novos comentários, notas de voz e clipes do público são adicionados ao corpus após cada lançamento, com o pôster em que foram enviados.
Limpar
Tudo o que foi criado neste laboratório está no projeto da etapa 4. Portanto, a limpeza mais barata é excluir o projeto. No Cloud Shell, faça o seguinte:
gcloud projects delete $(cat ~/project_id.txt)
Para manter o projeto e remover apenas as partes pagas: o serviço do Cloud Run (gcloud run services delete vibestudio --region us-central1), o corpus de RAG e o banco de memória (os nomes dos recursos estão em runs/ragcorpus.json e runs/memorybank.json, e as páginas do Agent Engine e do RAG Engine do console os excluem) e a imagem do contêiner no Artifact Registry.