

1. 简介
你在 VibeTube 上运营着一个温馨又带点惊悚的频道,计划在万圣节前每晚发布一个短视频。观众希望在小房间里看到小魔法,并会通过各种方式将这些魔法发送给你,比如评论、语音留言、自家闹鬼抽屉的照片,以及黄昏时分自家门廊的视频片段。待办事项中有很多想法。每天晚上,他都要重复同样的流程:研究动态中正在热议的话题、梳理积压的内容、阅读观众的来信、确定方向、对照频道政策进行检查、撰写脚本、绘制海报、渲染视频片段,最后发布。
生成模型可以单独完成每项任务。Gemini 负责研究、聆听、观察和撰写;图片模型负责绘制;Veo 负责渲染。他们无法独自完成的工作包括:按顺序运行夜间作业、在需要您做出决策时停下来、在错误的方向造成损失之前拒绝它、在不打开任何内容的情况下等待渲染完成,以及留下记录。
此 Codelab 将那个夜晚变成了一个 ADK Workflow:一个由节点和边组成的绘制图,它会自行运行,仅在需要您做出判断时询问您,并在每次运行结束时在 VibeTube 上发布一个片段及其海报。
提示无法保证顺序、停止或检查。图表可以。
学习内容
- 一个智能体,并将图片模型作为工具。
Agent由模型、指令和工具组成。第三个工具调用图片模型,首次运行以生成海报结束。接下来是贯穿本实验其余部分的句子:提示无法保证顺序、停止或检查。 - 图表的结构。
Workflow是边缘列表。您需要构建扇出和联接(并行读取器在JoinNode处汇合),以及一个可自行命名出口的路由器,在被拒绝的出口后面有一个任务模式智能体,它会在工具调用循环中清理方向,并重新加入主线。 - 多模态提取流水线。观众发送了四种内容,每种内容对应一个读取器:Gemini 转录语音留言、为照片添加说明、观看视频片段并聆听其配乐,每个读取器都将相同的线条形状写入一个 RAG Engine 语料库。扇出中的第三个读取器会按含义检索,并将媒体与段落一起返回。
- 两种暂停,一种机制。A run stops for a person (
RequestInput: four cards, you answer) and for a slow tool (Veo behindLongRunningFunctionTool: a receipt). 两者是同一回事:会话存储区中的一个开放调用,通过其 ID 从表单或另一个进程恢复。媒体台的两个分支在状态中按名称共享海报。 - 多晚记忆。记忆库上的两个生命周期回调:
before_model_callback在提议者读取之前回忆创作者的喜好,after_agent_callback在脚本编写者之后记住今晚的选择。 - 发布版本。应用内的图表,其中包含 ADK
Runner、发送到页面的服务器发送事件、具有会话亲和性的 Cloud Run,以及一个将视频片段发布到 VibeTube 并将海报作为缩略图的多部分 POST。
构建内容
浏览器中运行的应用:VibeStudio Workbench,这是一个配套页面,其中包含一个页内代码编辑器、用于读取磁盘上的文件和运行所写入的会话的验证器,以及一个嵌入式 adk web。它的七个课程就是本 Codelab 的七个页面,编号和部分字母相同,因此两者保持同步。每个页面都会打开一个条带,其中用一句话说明了该会话,以及您在该会话中要做的三件事:修改、运行、验证。先阅读此处的一个部分,然后在工作台中进行编辑;每次编辑结束时,都会出现一个验证面板,其中会显示实际发生的情况。
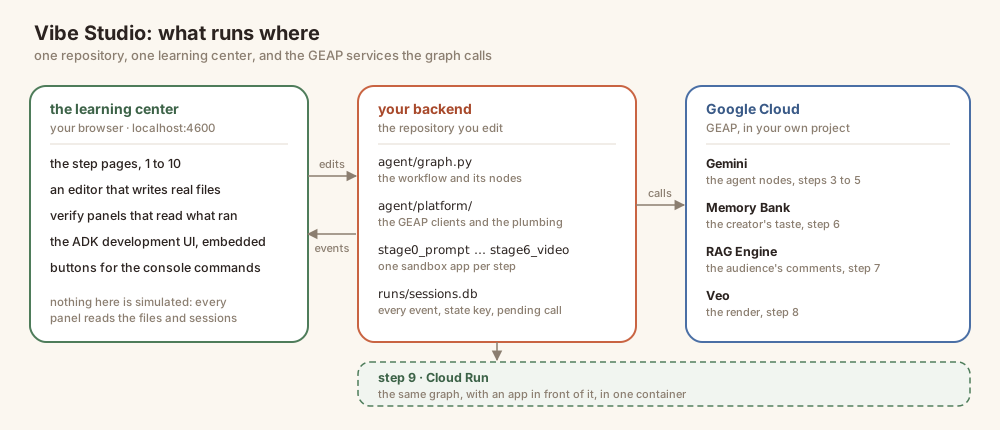
三个部分会运行:Workbench(端口 4600 上的页面、编辑器、验证器)、您的后端(agent/ 中的 Workflow,以及 stage0_prompt/ 到 stage6_video/ 中每个会话一个沙盒应用,由 adk web 提供服务)和 Google Cloud(Gemini、图片模型、RAG Engine、Veo、Memory Bank - 均通过 Vertex AI 使用您自己的凭证访问)。
这七个会话
会话 | 构建内容 | 您的修改 |
1 · 故事 | Nothing yet — the night, and the graph it becomes | — |
2 · 图片生成 | 一个智能体绘制第一张海报 |
|
3 · 工作流 | 夜晚如同一张图:扇出与联接,路由器及其循环 |
|
4 · 多模态数据注入 | 观众发送的内容,汇集成一个语料库;第三位读者 |
|
5 · 视频生成 | 两种暂停;海报按州名称分享 |
|
6 · 记忆 | 频道在不同夜晚记住的内容 |
|
7 · 部署和发布 | Cloud Run 上的 VibeStudio;VibeTube 上的夜晚 | 房间的活动代码,然后发布 |
如何使用此 Codelab。它采用概念优先的方式:每个部分都会先解释概念,然后展示更改后的代码并进行讲解。它绝不会要求您在此处修改文件,修改操作是在工作台中进行的,工作台会一次向您提供一项修改,旁边有提示,下方有验证面板。阅读课程内容,然后让页面引导您完成课程。
此设置的位置
VibeTube 上的图表、主题和房间均来自 Lin 的 VibeStudio 闹鬼版;这是多模态剪辑,以观众发送的内容和两种悬念为中心,采用 Agent Valley 实验室的单页互动格式。工作室只是一个场景;其下的每个机制都是您用于支持流水线、内容审核流程或任何其他必须暂停以等待人工操作和等待慢速作业的普通机制。
2. 🧰 设置
- 一个可以付款的账号、一个项目、已安装的实验、已证明可以回答问题的模型,以及在后台的一个端口上运行的工作台。
- 原因 - 一个端口上运行一个进程:网页、编辑器、验证器、
/api/*和adk web共享一个源,因此本实验中的所有内容都不需要第二个终端或第二个端口。 - 如何操作 - 克隆,两个脚本。第二个笔记本会进行实际的模型调用,启动工作台,并在您阅读时开始创建 RAG 语料库和记忆库,以便在第 4 和第 6 节中直接使用。
本实验中的所有内容都在 Cloud Shell 中运行,其中已安装 gcloud、Python、Node、ffmpeg 和 git,并且您可以使用自己的凭据通过 Vertex AI 访问 Gemini、图片模型、Veo、RAG Engine 和 Memory Bank。本实验中没有任何 API 密钥,也无需在笔记本电脑上安装任何内容。装有 Google Cloud SDK、Python 3.12 和 Node 20+ 的笔记本电脑也同样适用。
有一项内容是本实验无法提供的:启用了结算功能的 Google Cloud 项目。第 1 步为您提供一个可以支付费用的账号;第 4 步将该账号转换为项目。请按顺序执行这些步骤,因为第 4 步之后的每个步骤都会读取第 4 步确定的项目。
1 · 获取已启用结算功能的账号(约 1 分钟)
使用已启用结算功能的 Google 账号登录。任何此类账号都可以。如果没有,请开始免费试用;这样您就会获得一个结算账号,这是第 4 步所需的全部内容。如果您参加的是讲师主导的实验,请先兑换本课程的赠金,系统会为您创建结算账号。
2 · 打开 Cloud Shell(约 2 分钟)
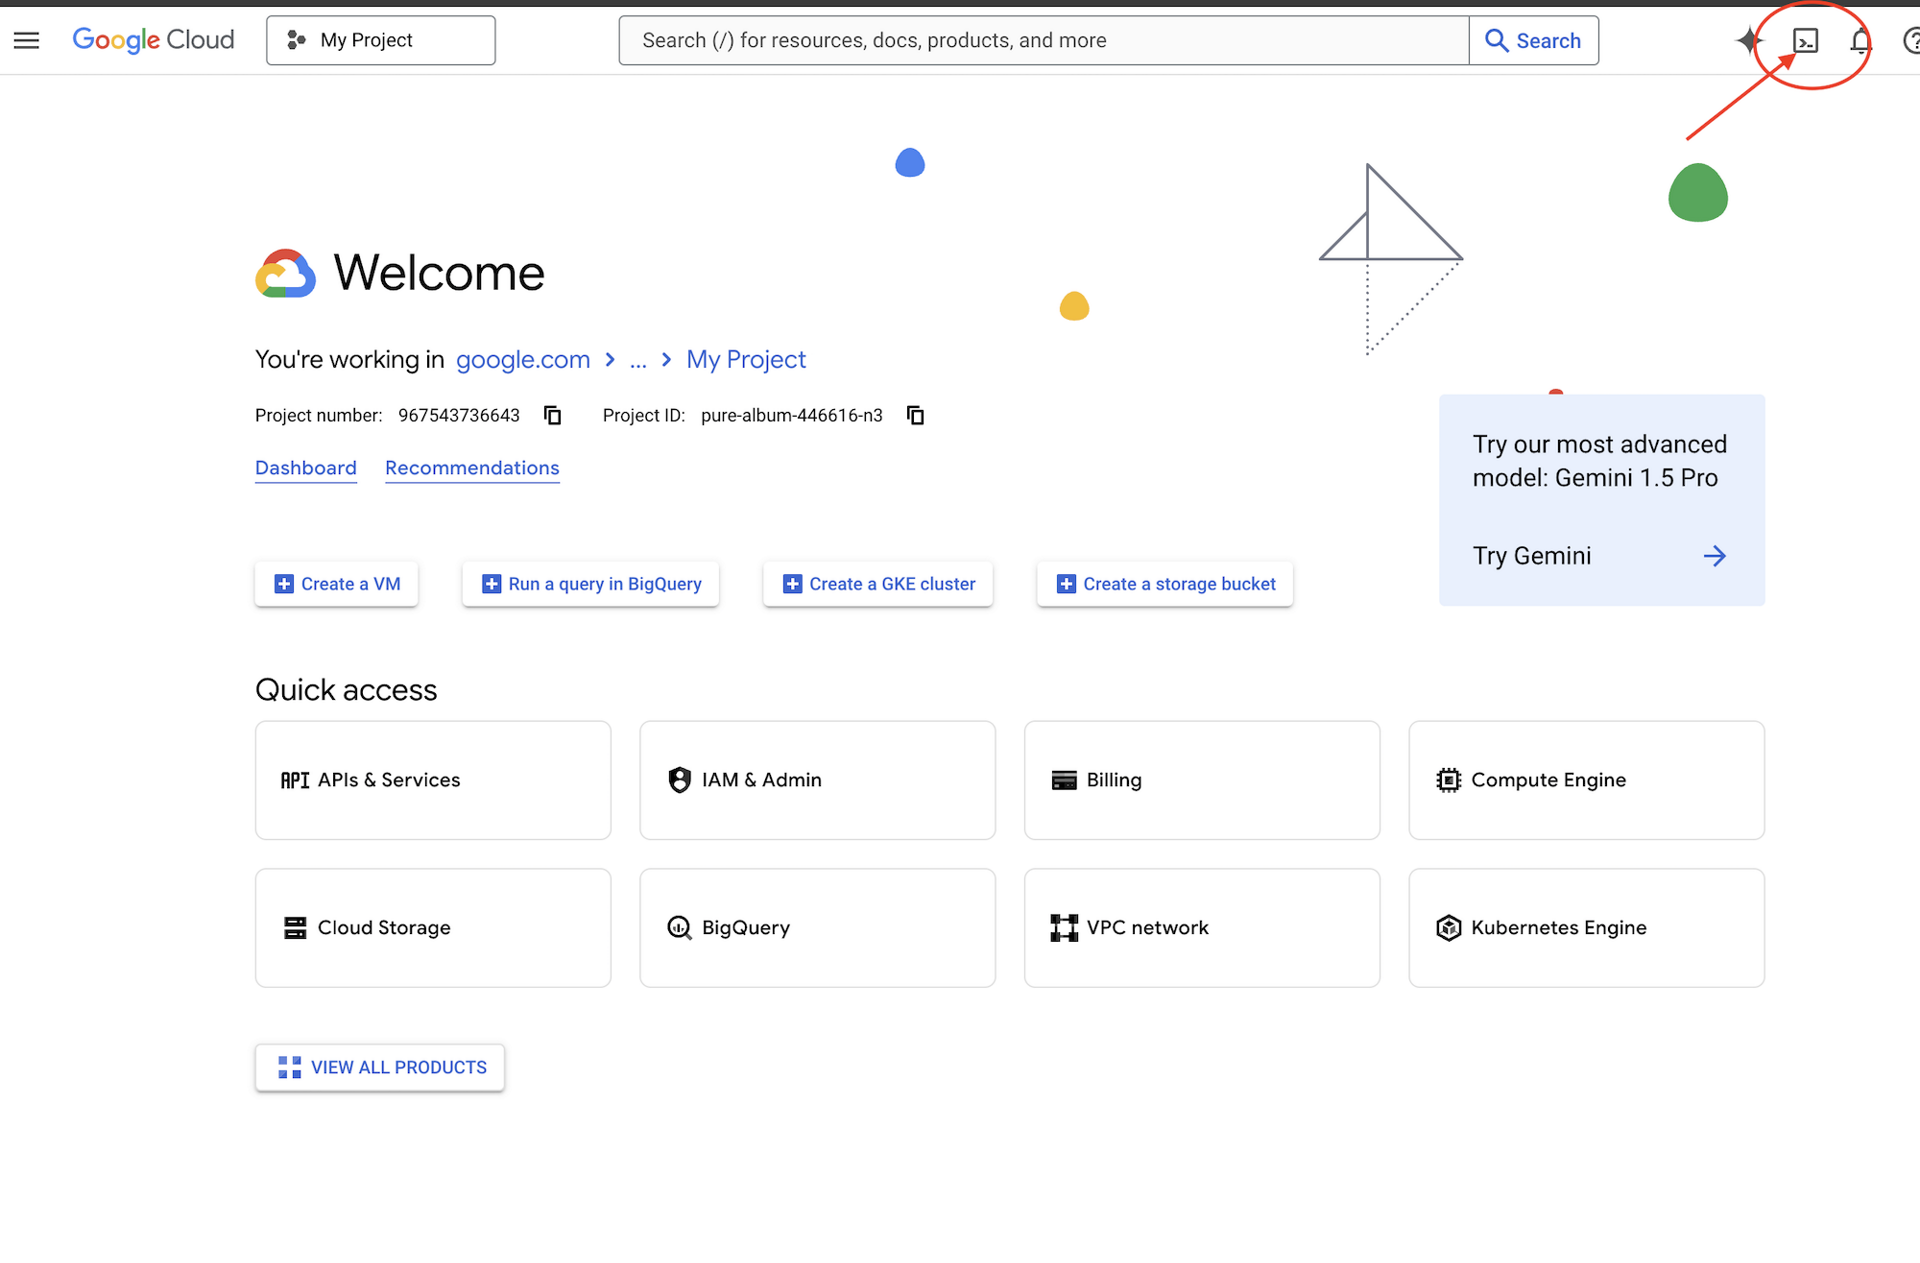
👉🖥 点击 Google Cloud 控制台顶部的激活 Cloud Shell(标题栏中的终端形状图标)。
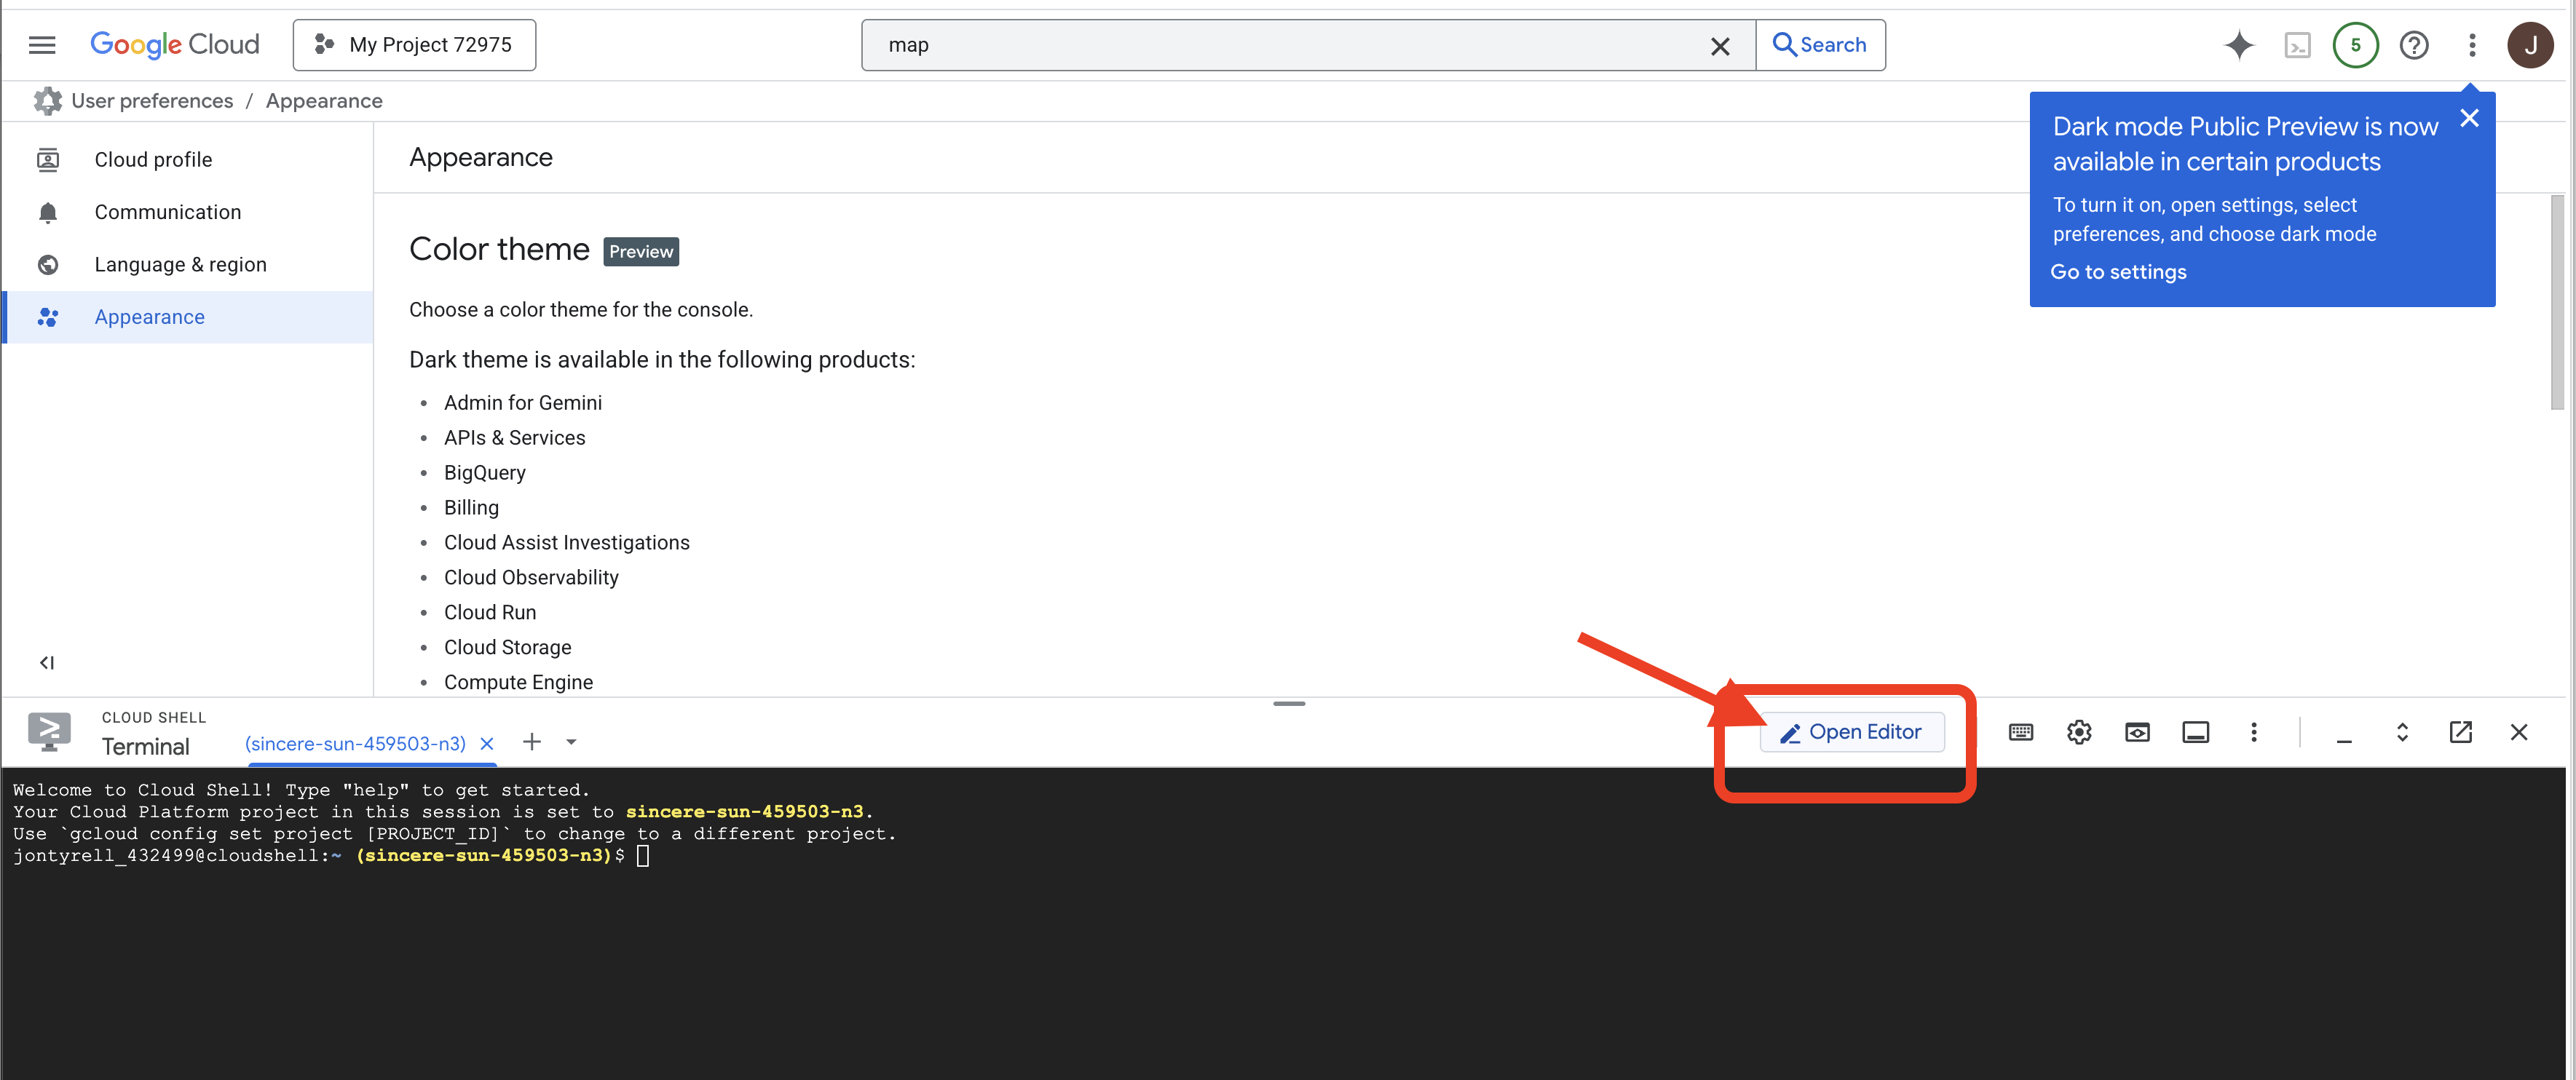
👉🖥 点击打开编辑器(带铅笔的打开文件夹图标)。这将打开 Cloud Shell 编辑器,左侧会显示文件资源管理器,您可以在其中查看整个文件。
👉🖥 如果今天在任何时候系统提示您进行授权,请点击授权继续。
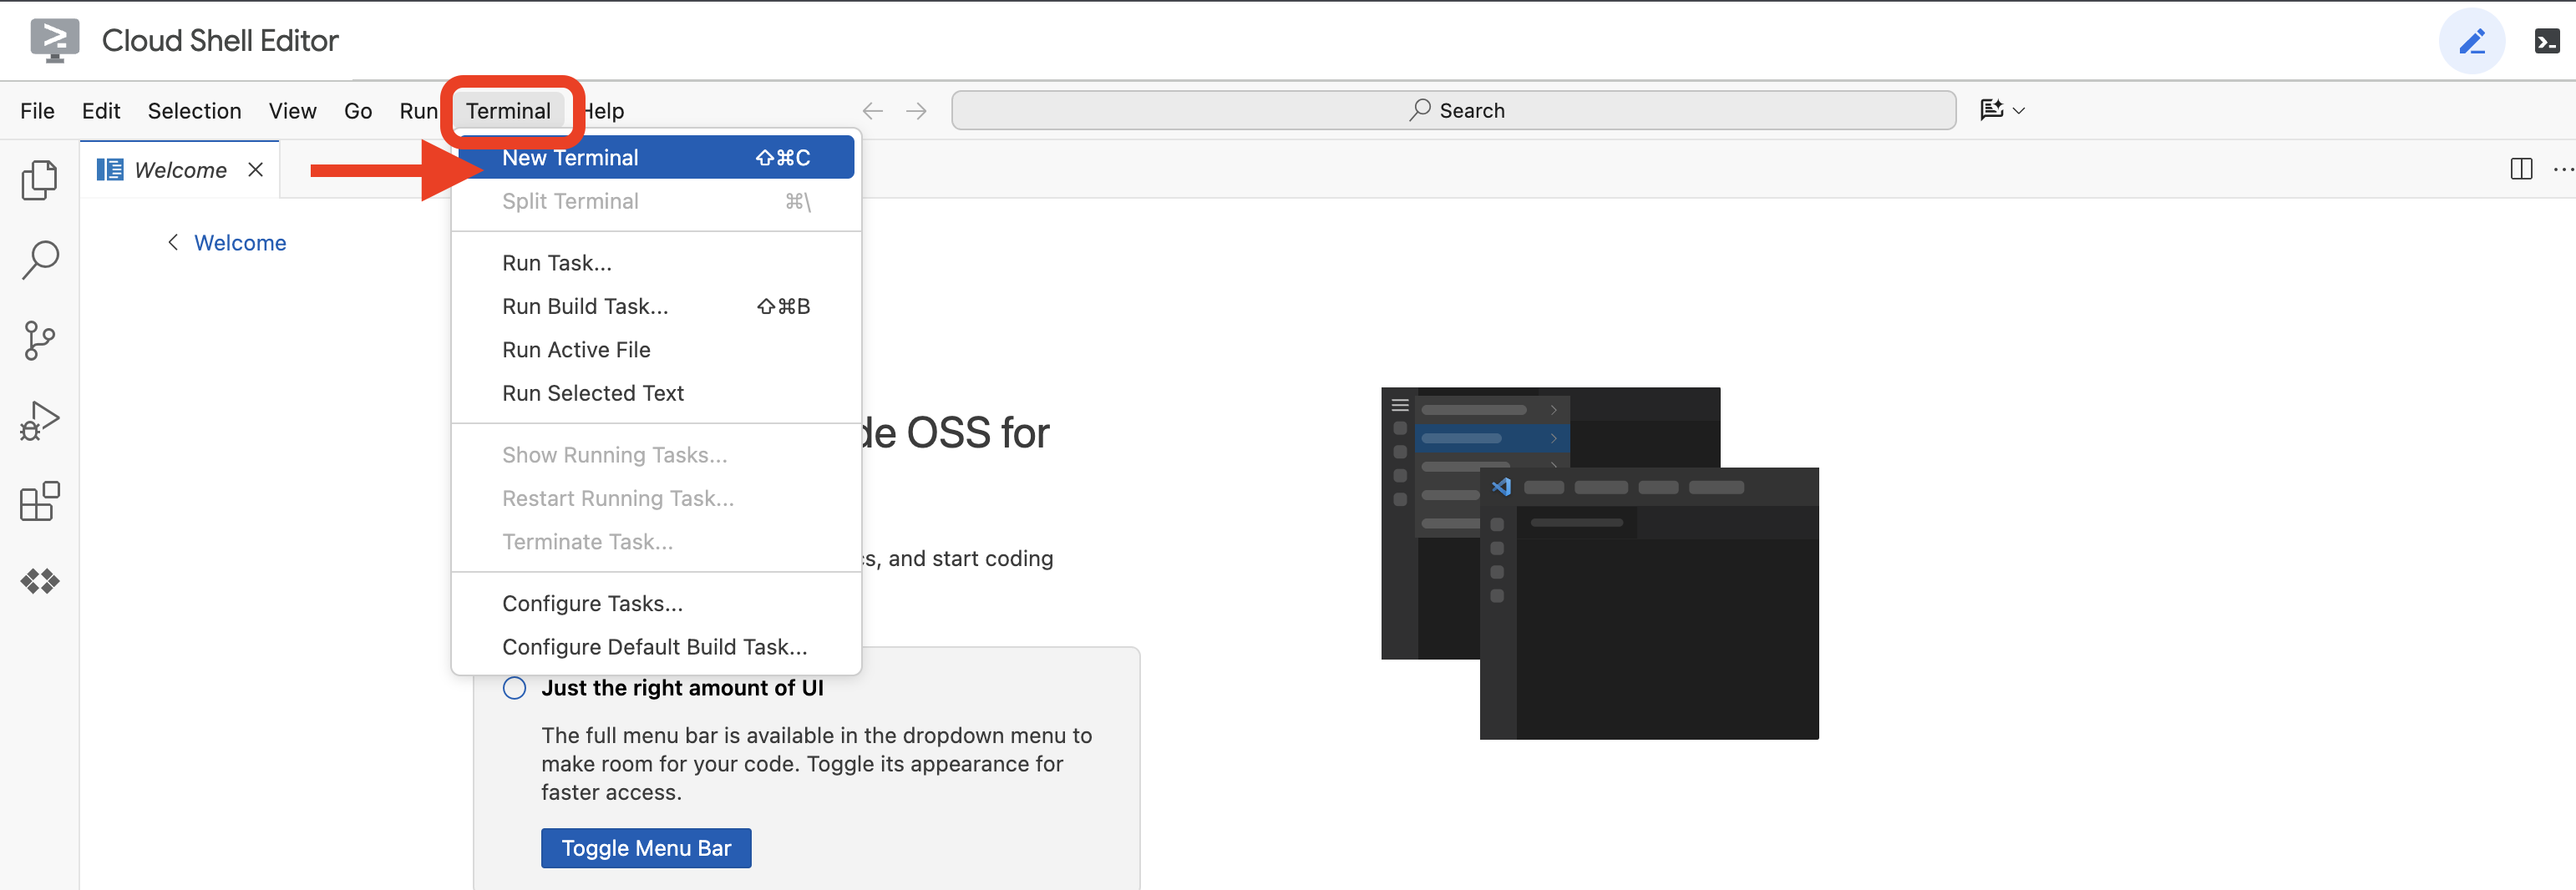
👉🖥 在编辑器中打开一个终端,即标签页 1,每个 👉💻 步骤都在其中运行。标签页 2 是工作台本身,您将在第 7 步中打开它。如果终端尚未显示在屏幕底部,请依次点击视图 → 终端将其打开:
👉💻 检查您登录的是哪个账号,该账号应与第 1 步中的账号一致:
gcloud auth list
3 · 获取实验(约 1 分钟)
👉💻 克隆代码库:
cd ~
git clone https://github.com/cuppibla/vibe-studio-multimodal
cd vibe-studio-multimodal
4 · 创建项目(约 2 分钟)
👉💻 一个脚本即可找到您的结算账号、在其中创建项目、关联结算信息,并将 Cloud Shell 指向该项目:
cd ~/vibe-studio-multimodal
./setup_project.sh
您应该会看到它选择的结算账号 ✓、它创建的项目 ✓,以及如下所示的结尾:
Project ready: vibe-studio-4271
  Next:  ./setup_codelab.sh
vibe-studio-4271 是您的项目 ID,您的项目 ID 将具有不同的数字。其中会发生四件事:
billing | 如果您有 账号,则会选择最新的 | |
project | 创建 | |
精选 | 将 ID 写入 | |
waits | 轮询,直到项目实际获准提供服务,最长 2 分钟 | |
👉🖥 现在,控制台中会显示同一项目,其 ID 位于信息中心的项目信息卡片中:
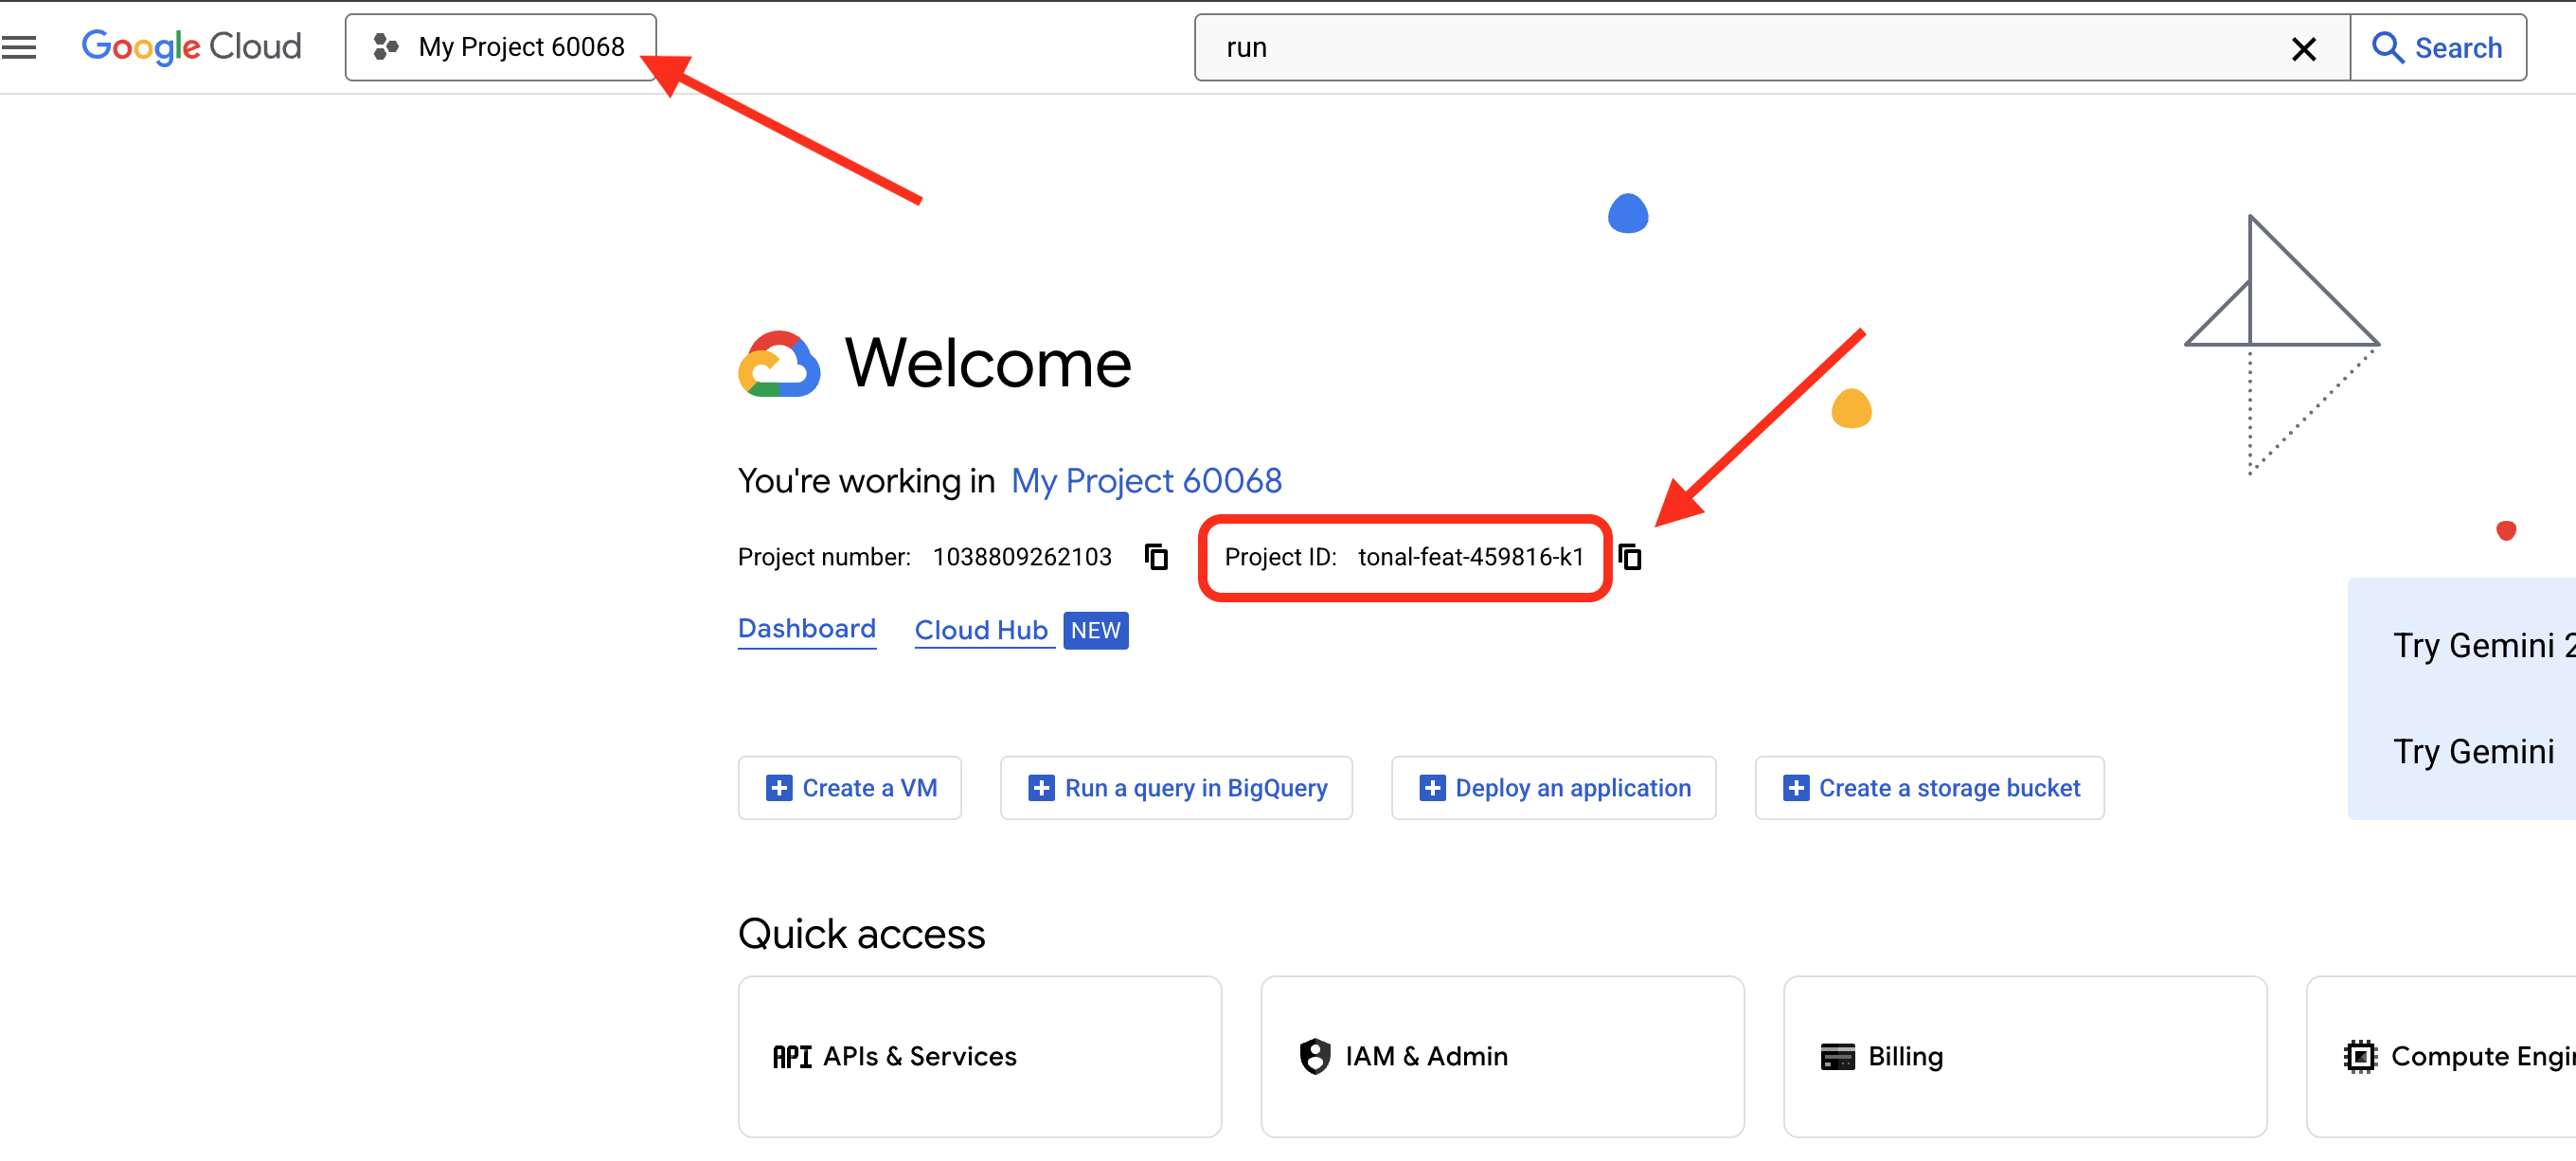
5 · 安装和设置实验(约 4 分钟)
👉💻
cd ~/vibe-studio-multimodal
./setup_codelab.sh
一个脚本,可安全地再次运行 - 第二次运行会保留您第一次给出的每个答案。它会在开始时提出两个问题,按 Enter 键会为这两个问题选择默认值:
事件代码 | 你的视频在第 7 节课中发布的 VibeTube 房间。输入讲师提供的聊天室代码,或按 Enter 键进入 | |
显示名称 | 输入聊天室用来注明您身份的名称,或按 Enter 键以使用根据您的账号生成的名称。 | |
这两项设置都会在 .env 中生效,并且以后可以在 .env 或发布页面中更改。然后,它会按顺序自行完成其余操作:
uv env | 如果缺少 uv,则安装它,然后 | |
apis | 在第 4 步中选择的项目上启用 6 个 API,并确认每个 API 均已响应,然后继续: | |
账号 | 确保项目的默认计算服务账号存在,并拥有第 7 单元的构建和服务所需的角色 | |
.env | 写入 | |
veo · room | 确认 | |
model | 对 Gemini 进行一次实际调用,因此错误的项目会在设置时失败,而不是在会话中失败 | |
starter | 将您要修改的 9 个文件从 | |
页面 | 安装并构建 | |
cloud | 开始在后台创建 RAG 引擎语料库和记忆库,以便会话 4 和 6 能够直接使用 | |
preflight | 运行 | |
6 · 阅读预检 (约 1 分钟)
第 5 步最后输出的是预检结果,每一行都是真实的探测结果,而不是猜测:
  ✓ python 3.12
  ✓ auth path A: Vertex via ADC (STUDIO_VERTEX=1)
  ✓ Google Cloud ADC (project vibe-studio-4271)
  ✓ Memory Bank SDK
  ✓ stage0_prompt loads
  ✓ stage1_fanout loads (0 edges)
  ✓ stage3_router loads (... edges)
  ✓ stage4_memory loads (... edges)
  ✓ stage5_rag loads (... edges)
  ✓ stage6_video loads (... edges)
  ✓ node and npm (build the learning center's page)
  ✓ learning center page built (web/dist)
  ✓ aiplatform.googleapis.com enabled (Gemini, Veo, Memory Bank, RAG Engine)
  ...
  - Memory Bank: still being created in the background
  - RAG corpus: still being created in the background
  ✓ session 7 runtime account 123456789-compute@developer.gserviceaccount.com has its roles
  ✓ learning center running on port 4600

PREFLIGHT GREEN

Open session 1 here:  https://4600-cs-...cloudshell.dev/step/story
stage1_fanout loads (0 edges) 说的没错:该图表最初是空的,您将在第 3 节课中填充它。这两行 - 也是正确的,语料库需要一两分钟才能启动,而银行需要大约 20 秒,在第 4 节课之前,您不需要使用这两者。
👉💻 您可以随时再次运行该命令,查看当前进度。它会读取您的文件、项目和正在运行的服务器,而不是检查清单:
cd ~/vibe-studio-multimodal
uv run python scripts/preflight.py
7 · 打开工作台(约 1 分钟)
工作台已在运行。第 5 步在后台启动了该应用,即在端口 4600 上运行一个 uvicorn 进程,该进程负责提供页面、每个 /api/* 路由以及装载在 /workbench 的 adk web。无需启动任何内容,本实验中也没有任何内容要求您重启:修改会在下次运行时生效。
👉🖥 点击预检输出的链接,或在 Cloud Shell 中依次点击网页预览 → 更改端口 → 4600。将该标签页称为标签页 2。系统会打开第 1 节 · 故事。
您稍后可能需要用到的三个命令,均来自 ~/vibe-studio-multimodal:
| 停止工作台 | |
| 在前台启动它;Ctrl+C 会停止它及其启动的每个进程 | |
|
| |
代码库布局
vibe-studio-multimodal/
├── agent/                  # the workflow and the platform clients
│   ├── graph.py            # the graph: three readers, the proposer, the gate, the router, the script, the desk
│   ├── desk.py             # render_desk and render_submit, the LongRunningFunctionTool
│   ├── deliver.py          # the delivery console: find the pending call, wait for Veo, answer by id
│   ├── schemas.py          # Direction, Directions, CleanedDirection, Script, each with a poster idea
│   ├── cleanup_tools.py    # find_policy_hits, suggest_replacement: the task agent's tools
│   ├── policy_words.txt    # the policy, as data; policy_replacements.txt, the approved stand-ins
│   ├── backlog.txt         # the creator's Halloween ideas; comments.md, the audience's comments
│   ├── audience/           # what else the audience sent: voice/*.mp3, photo/*.jpg, clip/*.mp4
│   ├── media/past/         # six past posters and captions.md, what Gemini sees in each
│   └── platform/           # config, audience (the readers), rag (RAG Engine), images, videogen (Veo), memory (Memory Bank)
├── stage0_prompt/ ... stage6_video/   # one sandbox app per session, runnable in adk web
├── server/ & web/          # the VibeStudio Workbench (FastAPI + React, port 4600)
├── vibestudio/             # the app deployed in session 7, with its own copy of agent/
├── checks/ & scripts/      # the hole registry, the verifiers, preflight, start/stop/restart
└── starter/                # the nine files you edit, as students receive them
3. 1 · 故事:夜晚,以及它所变成的图表
👉🖥 标签页 2 会打开第 1 节 · 故事。请看:六项任务围绕着一个人排成一圈,分别是研究趋势、梳理积压工作、选择方向、查看政策、撰写脚本、渲染片段,这个圈每天晚上都在重复。Gemini 可以独立完成研究、积压工作和脚本;Veo 可以独立完成渲染;选择和检查则由人来完成。
圆环下方是本实验其余部分要构建的图,其中包含 13 个节点,涵盖从创意到片段及其海报的整个过程。将鼠标悬停在某个节点上,即可查看其作用以及构建该节点的会话。此处无需修改;该页面的生成第一张海报按钮是第 2 课的内容。
词汇,这样接下来的六页就可以不间断地朗读:
字词 | 在这里的含义 |
代理 | ADK |
节点 | 图中的一个步骤,可以是 Python 函数、智能体、联接或路由器 |
edge | 按顺序运行的节点元组;图表是这些元组的列表。专题演讲 3 |
session |
|
state | 节点通过键名共享的字典;一个节点写入 |
记忆 | 记忆库通过回调实现跨会话记忆。会议 6 |
4. 2 · 图片生成 - 一个智能体,将图片模型作为工具
👉🖥 在工作台中,打开第 2 节 · 图片生成。在图表之前,最简单的做法是:一个 Agent,其指令是整晚的散文,三个 Python 函数作为其手,以及一个以图片结尾的运行。
智能体由模型、指令和工具组成
stage0_prompt/agent.py 使用 ADK 智能体的三个字段定义 root_agent。model 是 agent/platform/config.py 提供的 Gemini 模型。instruction 是系统提示:一口气完成六项任务,最后一项是生成图片。tools 包含三个函数。
root_agent = Agent(
    name="solo_channel", model=config.MODEL,
    tools=[check_trends, read_backlog, make_poster],
    instruction=(
        "You run the creator's cozy-spooky short-video channel, alone, every "
        "night until Halloween.\n"
        "When the creator gives you an idea (or nothing), do ALL of this:\n"
        "check what is trending. look at your backlog of ideas. propose a "
        "direction and agree on it with the creator. refuse blacklisted "
        "subjects (competitor, hateful, gore). then describe the video you "
        "would make: a title (<=60 chars) and 3 shots, one visual sentence "
        "each. then draw its poster: call make_poster once with one line that "
        "names the single image that sells the video, and tell the creator "
        "where the poster is.\n"
        "Ask the creator to confirm the direction before describing the "
        "video."))
模型是一个封闭的世界:它根据其权重和上下文中的词元进行推理。工具是模型可能请求的 Python 函数。ADK 会读取每个函数的签名和文档字符串,并将其声明给模型;当模型需要某个函数时,它会发出 function_call 事件,运行时会运行 Python 并将 function_response 事件写回上下文,然后模型会根据其前面的结果继续运行。
三个函数,其中一个
其中两人阅读了研究报告。第三个提示要求图片模型生成一张海报:
def check_trends() -> dict:
    """Ten formats trending on the platform right now, with a heat score each."""
    from agent.trends import sample_trends
    return {"trends": sample_trends()}


def read_backlog() -> dict:
    """The creator's backlog: ideas they noted down to make someday."""
    from agent.graph import backlog_notes
    return {"backlog": backlog_notes()}


def make_poster(subject: str) -> dict:
    """Draw tonight's poster: one image of `subject` in the channel's cozy
    low-poly style. Returns where the PNG landed (path, url) in a few seconds."""
    ...
make_poster 调用 agent/platform/images.py,后者是封装为普通函数的图片模型,封装方式与 videogen.py 封装 Veo 的方式相同:一个具有特定风格的前缀(频道温馨的低多边形万圣节风格,南瓜橙和烛光奶油色,背景为午夜梅子色)、主题、垂直 9:16 画幅、一个小于 runs/media/posters 的 PNG 文件,通过 /static/posters 提供。使用 STUDIO_REAL_IMAGES=0 时,它会复制一个替身海报,并将结果标记为 prebaked,以便实验可以在任何地方运行。
MODEL = os.environ.get("STUDIO_IMAGE_MODEL", "gemini-2.5-flash-image")
ASPECT = "9:16"

def generate(subject: str, visual_style: str = "", name: str | None = None) -> dict:
    """One poster for `subject`. Returns where it landed: status, path, url,
    prompt, and prebaked=True when the stand-in was used instead of the model."""
在会话 5 中,同一调用是图中的一个节点。
实操:一次编辑
在发布时,make_poster 会返回一个字典,指明海报已被跳过。👉🖥 在工作台编辑器中,让其调用图片模型,而不是 TODO 行:
    from agent.platform import images
    return images.generate(subject, name="solo")
保存。验证行读取文件:智能体上有三个工具,图片模型调用已就位。👉🖥 点击检查工作流加载情况,然后点击打开 ADK Web 并发送:
tonight's idea: a tiny ghost learning to haunt a sock drawer
可能影响及原因
- 回复前有两个工具事件,然后是一个问题。
check_trends和read_backlog运行,因为指令要求检查和查看,而模型的权重中没有这两项。回复中提出了一个方向,并要求您确认,因为指令要求先征得同意。 - 第二条消息会收到所有内容。发送
skip the questions, describe the video and draw the poster。模型会描述视频,使用自己编写的主题行调用make_poster一次,并告诉您 PNG 文件的保存位置。验证面板中显示了这些行旁边的海报:一个万圣节场景,采用该频道的风格,大约八秒钟就画好了。 - 为什么这不是一个渠道。研究成果被融入到无法引用的散文中。该政策由撰写指示的模型进行认证,而海报是在任何检查之前绘制的。协议在一条消息中被忽略了。提示文字并非一道门槛。本实验的其余部分会将这六个作业拆分为一个绘制的图表。
本页最后介绍了 ADK 智能体的组成部分,供您随时参考:模型、模型推理所依据的上下文、模型执行操作所使用的工具和协作者、封装每个调用的回调,以及模型外部的会话和记忆。
5. 3 · 工作流 - 扇出和联接、路由器和循环
👉🖥 在工作台中,打开第 3 单元 · 工作流的 3a 和 3b 部分。每个部分都在沙盒应用中构建,因此您可以在 adk web 中单独运行:stage1_fanout 中的扇出、stage3_router 中的路由器及其循环。
扇出和联接 (3a)
ADK Workflow 是一个边缘列表。每个条目都是一个链,即按顺序运行的节点元组。离开 START 的两条链并行运行。以 JoinNode 结尾的链会向其报告,而联接会等待以该节点结尾的每个链,然后再继续,并传递一个以节点名称为键的字典。以字典形式编写的目标会将路由器的路由名称映射到节点。工作台的 3a 页面会绘制形状,并提供一个“写出边缘”练习。
节点类型 | 书写形式 | 作用 |
函数节点 |
| 纯 Python。还可能使用 |
联接节点 |
| 等待每个传入链报告结果,然后将它们的所有输出作为一个字典传递。 |
代理节点 |
| 在 |
路由器 |
| 一个函数节点,其返回值命名了传出边缘。 |
人工输入节点 |
| 暂停图表,直到有人回答表单。第 5 场。 |
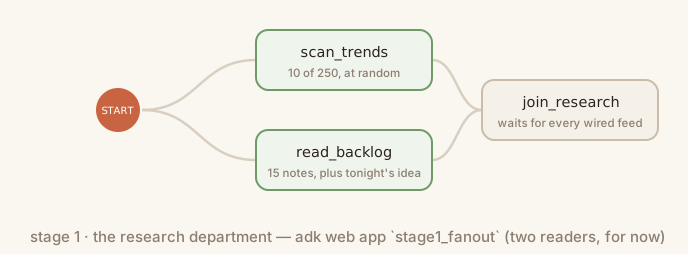
第一个图表将第 2 节课的研究内容作为节点。agent/graph.py 中的 scan_trends 和 read_backlog 是两个读取器;read_backlog 还会将今晚的想法写入共享状态。stage1_fanout/agent.py 定义了联接,并根据名为 EDGES 的列表(该列表最初为空,即预检的 0 edges)构建其 Workflow。👉🖥 用两条链填充该列表:
EDGES = [(START, scan_trends, join_research),
         (START, read_backlog, join_research)]
👉🖥 在 adk web 中运行。两个节点同时亮起,然后连接;打开 join_research 的事件,并读取一个包含 scan_trends 键和 read_backlog 键的字典。未发生模型调用。没有任何节点会重新设置联接字典的格式:3b 中联接节点后面的节点是一个智能体,智能体节点会接收其 node_input 作为消息,因此字典会以 JSON 格式到达,模型可以直接读取。
路由器和循环 (3b)
Workflow 中的 Agent 会在 single_turn 模式下运行:它会接收上一个节点的输出作为其消息,进行一次模型调用,并回答一次。借助 output_schema,系统会在下一个节点看到答案之前,根据 Pydantic 模型验证答案,因此图会传递类型化对象,而不是散文。propose_directions 读取了联接的研究字典,并推荐了四个候选场景,每个都是万圣节场景。候选 4 是诱饵:其标题包含频道拒绝的字词,因此路由器有东西可以捕获。每个候选视频都带有一个 poster_idea,即一行文字,用于命名推销视频的单张图片;脚本编写者会保留该图片,媒体部门会在第 5 节课中绘制该图片。
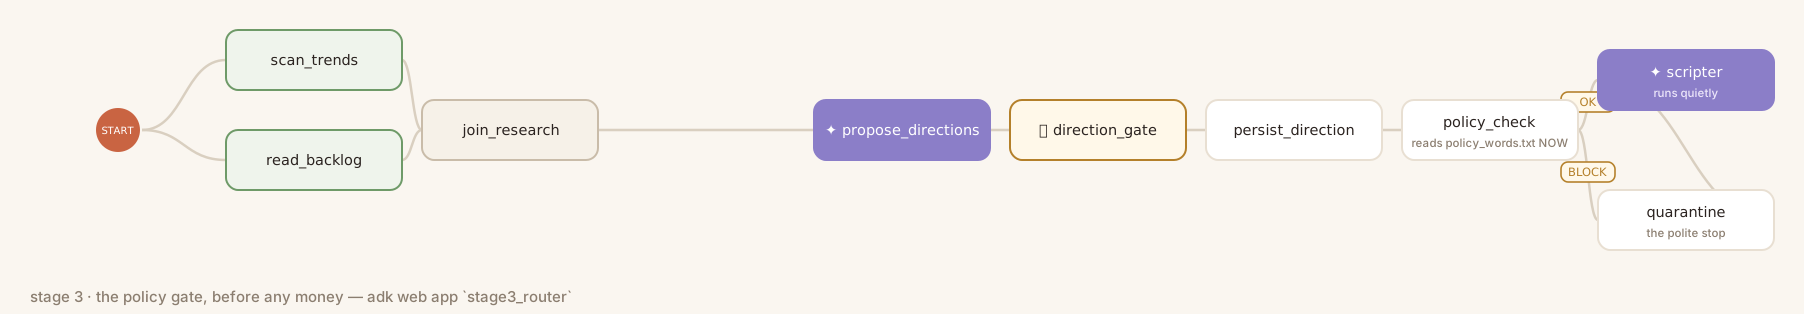
路由器是一个函数节点,其返回值指定了运行所采用的边。无需调用模型:policy_check 会在决策时读取 agent/policy_words.txt,将完整字词与方向的标题和角度进行匹配,并在编写任何脚本或花费任何资金之前进行路由。政策就是数据:修改文件,下次运行就会读取该文件。
def policy_check(node_input):
    """The policy gate: a router. Refused words in the direction send it to
    quarantine; a clean one goes to the scripter. Code, not a model."""
    chosen = _as_dict(node_input)
    bad = policy_hits(f"{chosen.get('title', '')} {chosen.get('angle', '')}")
    return Event(output=node_input, route="BLOCK" if bad else "OK")
stage3_router/agent.py 是扇出加上 propose_directions 和 choose_direction,它是您在第 5 节中构建的人工门的替代品:它会选择编号以今晚的想法 (..., pick 4) 结尾的候选人,否则选择第一个,并将选择写入状态。scripter是一个single_turn智能体,可将获批的方向转化为Script:标题、说明、标签、开场白、三个镜头和一个海报创意,每个镜头都是符合频道风格的万圣节图片。
拒绝退出背后的循环。quarantine 以任务模式智能体形式提供。Agent 具有 mode:chat 是根智能体与用户运行的对话循环,single_turn 是具有结构化答案的一次调用,task 是智能体自行运行的工具调用循环,直到它调用内置 finish_task,其参数由 ADK 从 output_schema 派生。隔离区会针对被拒绝的方向调用 find_policy_hits,向 suggest_replacement 询问每个字词的渠道批准替代词(agent/policy_replacements.txt,再次提供数据),重写,再次检查,最后使用类型化 CleanedDirection 完成。请朗读页面上的内容,而不是输入内容。
quarantine = Agent(
    name="quarantine",
    model=config.MODEL,
    mode="task",
    instruction=QUARANTINE_INSTRUCTION,
    tools=[find_policy_hits, suggest_replacement],
    output_schema=CleanedDirection)
在出厂状态下,该链条从拨片直接连接到脚本器。👉🖥 将路由器放在它们之间,路由器有两个出口,以及从隔离区返回的路径;三条线取代了一条线:
           (join_research, propose_directions, choose_direction, policy_check),
           (policy_check, {"OK": scripter, "BLOCK": quarantine}),
           (quarantine, scripter),
👉🖥 运行这两条路线。直接发送创意:choose_direction 采用候选创意 1,policy_check 发出 OK,脚本编写者编写结构化脚本。点击新会话,在结尾加上 , pick 4 再次发送该创意:候选 4 是诱饵,policy_check 发出 BLOCK,隔离区调用其工具,重写被拒绝的词,调用 finish_task,清理后的方向返回给脚本编写者。验证行会从会话存储区中读取两次运行。
现在,会话 2 提示中的每个句子都有一个节点:研究部分包含两个读取器和一个联接节点,拒绝部分包含一个路由器和一个任务代理,脚本部分则是一个代理节点。在整个图表中,替代选择是两个函数节点:direction_gate 和 persist_direction,您会看到它们一直运行,直到会话 5 使门停止。与创作者的协议仍处于初步阶段,调研也尚未触及观众。
6. 4 · 多模态提取 - 将观众发送的内容读取到一个语料库中
👉🖥 在工作台中,打开第 4 单元:多模态提取的 4a 和 4b 部分。观众不仅会写评论,每种类型都有一个读取器,可将用户发送的所有内容转换为相同格式的文本,一个 RAG Engine 语料库可容纳所有这些内容,而扇出中的第三个读取器则可按含义搜索这些内容,并将媒体内容返回。
观众发送的内容 (4a)
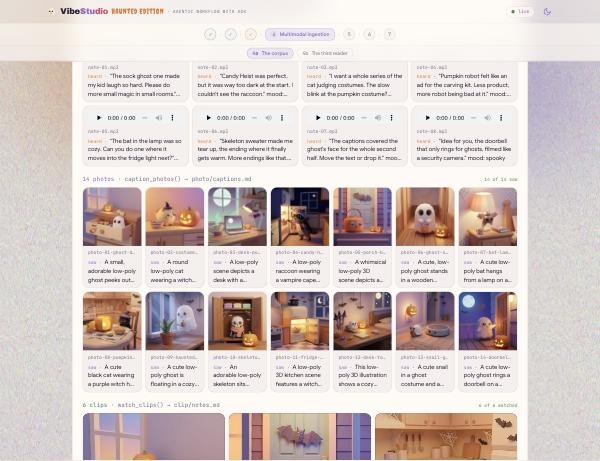
agent/comments.md 包含在该频道的六个万圣节视频下发表的 12 条评论。agent/audience/ 包含其余内容:八条语音笔记 (voice/*.mp3)、十四张观看者自己房间的照片 (photo/*.jpg) 和六个片段 (clip/*.mp4),其中一个片段是观看者在照片上缓慢平移并配有旁白。4a 页面会打开所有内容:播放每条语音备忘录、显示每张照片、运行每个片段。
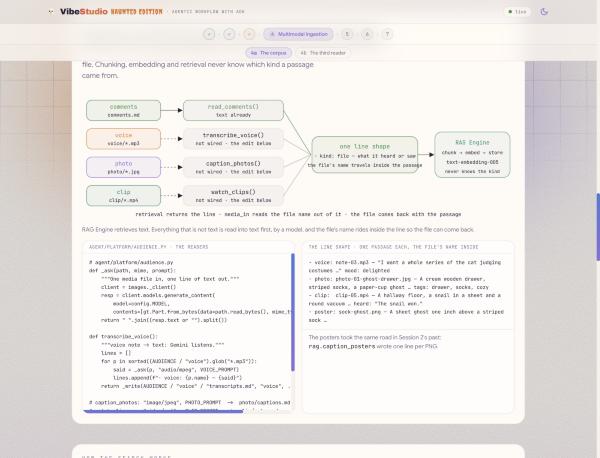
RAG 引擎会检索文本。语音记事、照片或视频片段只能像 rag.caption_posters 中过去的帖子一样加入语料库:模型将其转换为一行文本,其中包含其文件名,该行文本会成为一个段落,当该段落返回时,文件也会随之返回。agent/platform/audience.py 每种类型有一个读取器。每个脚本都会向 Gemini 发送一个文件和一个提示,并为每个文件写入一行:
VOICE_PROMPT = ("Transcribe this voice note word for word inside double quotes. Then add: mood: and one word. "
                "Plain text on one line, nothing else.")
PHOTO_PROMPT = ("Two sentences: what is in the picture, the palette, the mood. Then: tags: and three short tags. "
                "Plain text on one line, no headings, no markdown.")
CLIP_PROMPT = ("Describe the shots in two sentences, then quote what you HEAR on the soundtrack as: heard: \"...\". "
               "Plain text on one line, no headings, no markdown.")


def _ask(path: pathlib.Path, mime: str, prompt: str) -> str:
    """One media file in, one line of text out."""
    from google.genai import types as gt
    client = images._client()
    resp = client.models.generate_content(
        model=config.MODEL,
        contents=[gt.Part.from_bytes(data=path.read_bytes(), mime_type=mime), prompt],
        config=gt.GenerateContentConfig(automatic_function_calling=gt.AutomaticFunctionCallingConfig(disable=True)))
    return " ".join((resp.text or "").split())


def transcribe_voice() -> pathlib.Path:
    """voice note -> text: Gemini listens."""
    files = sorted((AUDIENCE / "voice").glob("*.mp3"))
    lines = []
    for p in files:
        said = _ask(p, "audio/mpeg", VOICE_PROMPT)
        lines.append(f"- voice: {p.name} — {said}")
    return _write(AUDIENCE / "voice" / "transcripts.md", "voice", "What Gemini heard in the audience's voice notes", lines)
caption_photos 同样可以处理 image/jpeg 和 PHOTO_PROMPT;watch_clips 可以处理 video/mp4 和 CLIP_PROMPT,而 Gemini 可以在一次调用中同时处理图片和音频。每个读取器都会写入相同的行形状,因此分块、嵌入和检索永远不会知道段落来自哪种类型:
- voice: note-03.mp3 — "I want a whole series of the cat judging costumes ..." mood: delighted
- photo: photo-01-ghost-drawer.jpg — A cream wooden drawer, striped socks, a paper-cup ghost ... tags: drawer, socks, cozy
- clip:  clip-05.mp4 — A hallway floor, a snail in a sheet and a round vacuum ... heard: "The snail won."
- poster: sock-ghost.png — A sheet ghost one inch above a striped sock ...
语料库。Vertex AI RAG Engine 是一种文档检索技术:它将语料库切分为约 120 个词元的段落,每个段落都使用 text-embedding-005 进行嵌入,查询也以相同的方式进行嵌入,并根据含义(而非共享词汇)最接近的段落来回答。“cozy little hauntings at home”(家中的温馨小鬼屋)找到了要求在小房间里施展小魔法的评论、关于蝙蝠拥抱灯泡的语音记事,以及配乐说鬼魂是纸杯的片段。
corpus = rag.create_corpus(
    display_name="vibestudio-feedback",
    backend_config=rag.RagVectorDbConfig(
        rag_embedding_model_config=rag.RagEmbeddingModelConfig(
            vertex_prediction_endpoint=rag.VertexPredictionEndpoint(
                publisher_model="publishers/google/models/text-embedding-005"))))

rag.upload_file(
    corpus_name=corpus.name, path="agent/comments.md", display_name="comments.md",
    transformation_config=rag.TransformationConfig(
        chunking_config=rag.ChunkingConfig(chunk_size=120, chunk_overlap=20)))
设置已开始创建语料库;第 4a 页的连接行会显示语料库是否已启动,如果设置无法创建语料库,则会创建语料库。通过页面上的按钮或终端:python -m agent.platform.rag 创建语料库并将其记录在 runs/ragcorpus.json 中;python -m agent.platform.rag load --audience 运行 audience.READERS 中的每个读取器,然后上传它们在评论和发布者图片说明旁边写的内容,每个文件都以自己的名称命名,并等待索引回答;python -m agent.platform.rag query "cozy little hauntings at home" 显示检索结果,找到与查询没有共同词汇的段落。
编辑。在出厂时,READERS 仅包含 read_comments;三个媒体读取器位于一个 # 后面。👉🖥 运行一次提取,输出结果为 not read (no reader wired in audience.READERS): voice, photo, clip,并且只有评论和字幕会进入。然后删除 #:
transcribe_voice, caption_photos, watch_clips,
👉🖥 保存并再次运行提取。朗读者大约需要三分钟才能读完这四十个条目;控制台会逐行显示 heard、saw 和 watched,网格中的每张卡片都会填充其对应的行。验证行读取了文件、读取器的输出和语料库:连接了 4 个读取器,听了 8 条语音记事,看了 14 张照片,看了 6 个片段,语料库中有 5 个文件。
第三个读取器 (4b)
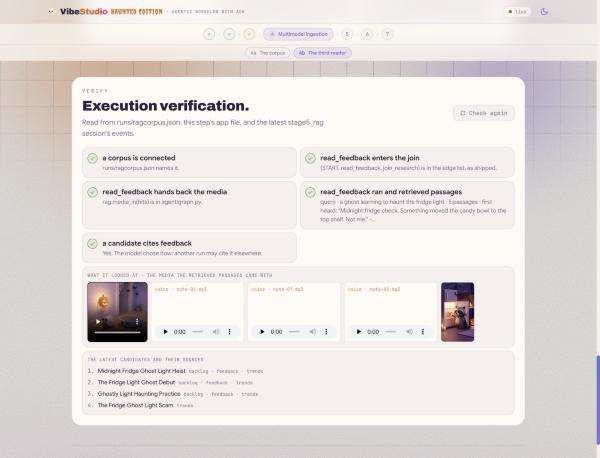
观众反馈属于研究,由每次运行共享,因此它会像研究一样进入图:作为第三个读取器进入联接。agent/graph.py 中的 read_feedback 接收今晚的想法,向语料库请求最接近的段落,并向 join_research 报告,后者会等待三个段落。边缘 (START, read_feedback, join_research) 采用 stage5_rag/agent.py 形状,这是第 3 课中讲授的形状;您的修改位于节点内。检索,而非模型调用,且具有确定性:相同的想法会找到相同的段落,而提议者则各不相同。
def read_feedback(node_input):
    """The third reader: what the audience sent - comments, and what Gemini
    heard and saw in their voice notes, photos and clips - the passages
    nearest to tonight's idea, and the media those passages came with.
    Retrieval, not a model call."""
    from .platform import rag
    idea = idea_text(node_input)
    query = idea or "what viewers liked and what they complained about"
    try:
        hits = rag.retrieve(query)
    except Exception as e:
        print(f"  [rag] feedback unavailable ({str(e)[:80]})")
        return Event(output={"query": query, "feedback": [], "media": [],
                             "note": "no corpus connected - run: python -m agent.platform.rag"})
    return Event(output={"query": query, "feedback": [h["text"] for h in hits]})  # TODO: RAG_MEDIA
语料库中来自语音记事、照片、剪辑或海报的每一行都会指明其文件名称。rag.media_in(hits) 会从段落中读取这些名称,并将其转换为页面可以显示和播放的网址。👉🖥 将媒体内容与文字一起交还,让观众发送的内容与他们说的话一起传递:
    return Event(output={"query": query, "feedback": [h["text"] for h in hits],
                         "media": rag.media_in(hits)})
👉🖥 运行 stage5_rag,并输入一个创意。打开 read_feedback:查询是您的想法,输出是五个最接近的段落,以及一个包含每个文件网址的 media 列表。打开join_research:三把钥匙。打开 propose_directions:候选 1 到 3 在其证据中引用了 feedback。验证面板显示了读者在这些行下查看的内容:一个片段、三个语音笔记和一张冰箱灯光中的鬼魂海报。
7. 5 · 视频生成 - 两种中止,一种机制
👉🖥 在工作台中,打开第 5 单元:视频生成,第 5a 部分和第 5b 部分,在 stage6_video 中构建,整个图。生成片段需要几分钟,生成海报需要几秒钟,运行过程中会暂停两次:一次是为您暂停,一次是为 Veo 暂停。这两个止损点是一个机制,办公桌的两个分支按名称共享它们所做的内容。
两种中止类型 (5a)
一切都在瞬息万变。必须停止的运行会将一个开放式调用写入其会话并结束;无论谁接听该调用(无论是人还是进程),都会继续该调用。该页面会打开一个表格:
个人 · | 工具运行缓慢 · | |
谁停止了运行 |
|
|
它在等待什么 | 一个人:四张卡片之一 | a slow job: Veo's operation, minutes |
会话中包含的内容 | 一个打开的 | 一个开放式 |
如何恢复 | 一个 | 一个 |
谁发送 |
|
|
它平时生活的地方 |
| 同一行,同一 ID · 不运行任何内容 |
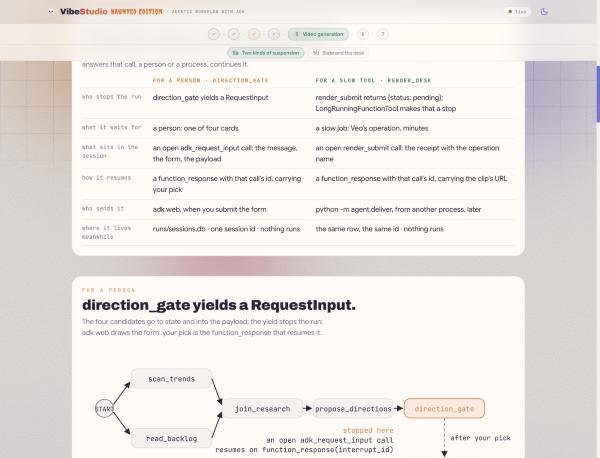
对于个人。在单条提示中,“请创作者确认”是建议性的,而会话 2 在一条消息中就忽略了这一点。在工作流中,暂停是引擎的暂停。生成 RequestInput 的节点会暂停运行:ADK 会将一个名为 adk_request_input 的开放调用写入会话,其中包含您的 message、response_schema 和 payload,并为其分配一个 interrupt_id,然后返回给调用方。没有线程等待。只有携带该 ID 且经过架构验证的 function_response 才能恢复工作流;向工作流发送聊天消息会开启新一轮对话,而不是提供答案。该架构也是表单:adk web 会呈现该架构,而 VibeStudio 应用会将同一架构呈现为四张卡片。direction_gate 已将候选字词写入状态。👉🖥 停止:
    yield RequestInput(
        message="Pick tonight's direction: 1, 2, 3 or 4.",
        response_schema={
            "type": "object",
            "properties": {
                "pick": {"type": "string", "enum": ["1", "2", "3", "4"]}}},
        payload={"candidates": cands})
您的回答会作为 persist_direction 的 node_input(一个包含一个键 pick 的字典)到达。这四个候选答案通过另一种方式到达:门控将它们写入 candidates 下的共享状态,ADK 将状态键绑定到同名形参。节点将选择解析为一个候选对象,并使用 Event(state=...) 写回 direction、angle、hook 和 user:prefs。前缀为 user: 的键会在对应用户的所有会话中保留。
对于运行缓慢的工具。Veo 渲染需要几分钟时间,而图表不应等待那么长时间。agent/desk.py 中的 render_submit 会启动作业,并立即返回状态为 pending 的收据:
def render_submit(prompt: str) -> dict:
    """Submit one Veo render of `prompt`. Returns at once with a pending
    receipt; the clip is delivered later, to this call, by id."""
    receipt = videogen.start(f"{prompt} {videogen.NO_TEXT}")
    return {"status": "pending", "operation": receipt["operation"], "prompt": receipt["prompt"]}
该收据封装在 LongRunningFunctionTool 中,对 ADK 具有特定含义:智能体的轮次结束,工作流在 render_desk 处暂停,而包含其 ID 和收据的开放调用则作为一行记录在 runs/sessions.db 中。👉🖥 在 stage6_video/agent.py 中,封装该工具:
tools=[LongRunningFunctionTool(render_submit)])
从另一个进程按 ID 恢复。agent/deliver.py 会在会话存储区中找到待处理的调用,轮询 Veo 直到片段存在,将结果写入 runs/state.json,并向同一会话发送包含该调用 ID 的 function_response。👉🖥 构建响应部分:
    part = Part(function_response=FunctionResponse(
        id=row["call_id"], name=row["name"], response=response))
👉🖥 运行 stage6_video,直到它停止两次。发送一个想法:运行会在根据您的架构构建的表单上停止,其载荷中有四个候选对象。在 pick 中输入 2 并提交;图表会在 persist_direction 处恢复。在这里尝试终止测试:在表单处暂停,停止服务器(在标签页 1 中运行 scripts/stop.sh),再次启动服务器 (scripts/restart.sh),重新打开会话。表单仍然存在,因为暂停的是行,而不是线程。script_ready 之后,render_desk 会调用 render_submit,获取收据,回复 WAITING,然后运行结束;会话会保留调用 ID。从页面的控制台或标签页 1 运行传送:
cd ~/vibe-studio-multimodal
uv run python -m agent.deliver status   # the pending renders, by session, call id and operation
uv run python -m agent.deliver          # wait for Veo, answer the newest pending call by id
👉🖥 点击刷新 adk web:function_response 紧随待处理调用,join_media 释放,store_release 运行。八个验证行读取会话中的两个停靠点:大门的呼叫和您的回答、渲染器的收据及其交付。
状态和书桌 (5b)
媒体服务台再次采用 3a 的结构,即扇出和联接,其中有一个慢速分支。script_ready 会通过两种方式发送脚本。render_desk 提交片段,运行暂停。make_poster 是第 2 节课中作为节点的工具:脚本的 poster_idea、频道的风格以及记忆库中关于创作者对海报偏好的信息(从状态绑定为 memory_facts,第 6 节课)都会输入到图片模型中,几秒钟后就会返回一张 9:16 的 PNG 图片。join_media 会等待速度较慢的那个,而 store_release 会将其发现的内容写入状态。
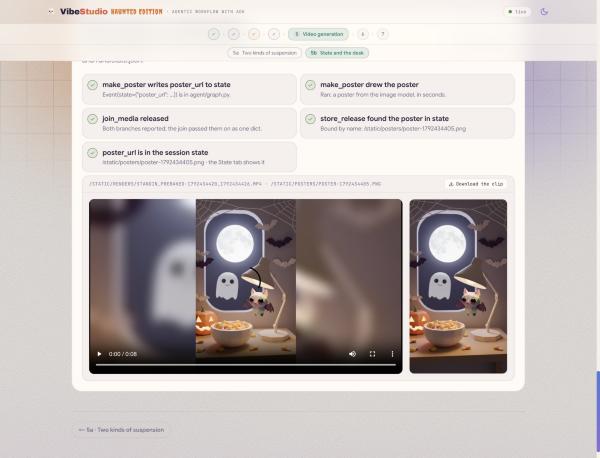
按名称分享。store_release 永远不会收到海报。它声明了一个名为 poster_url 的形参,ADK 会从共享状态中绑定该形参,因为另一个分支中的节点写入了该键。分支之间不会传递任何载荷:
def store_release(node_input, poster_url: str = "", poster_path: str = ""):
    """`poster_url` and `poster_path` are not passed by anyone: ADK binds them
    from shared STATE because the parameter names match the keys make_poster
    wrote (the STATE_SHARE edit). The two branches of the desk never hand each
    other payloads; they share what they made by name."""
    render = state.load().get("render") or {}          # the delivered clip, written by deliver
    url, status = render.get("url") or "", render.get("status", "")
    ...
    if not poster_url:
        said += " · poster: not in state (did make_poster write poster_url to state? the STATE_SHARE edit)"
    yield Event(output={"status": status, "url": url, "poster_url": poster_url},
                state={"render_url": url, "render_status": status, "poster_url": poster_url},
                message=f"video: {said} · poster: {poster_url or 'none'}")
在默认情况下,make_poster 会输出海报和一条消息,而 store_release 会显示 poster: not in state。👉🖥 将状态写入添加到其最终 yield:
                state={"poster_url": rec.get("url", ""), "poster_path": rec.get("path", "")},
                message=f"poster: {said}")
👉🖥 再次运行并交付。打开 make_poster 的事件:其输出中的海报网址和 poster_url 的状态增量。打开 store_release:其消息中指明了发帖人。该页面的此运行的会话块显示了与行 adk web 的“状态”标签页相同的内容:恢复所需的会话 ID、打开的调用以及节点写入的密钥(其中包括 poster_url)。验证面板会并排显示剪辑和海报。
8. 6 · 记忆 - 频道在不同夜晚之间记住的内容
👉🖥 在工作台中,打开在 stage4_memory 中构建的第 6 单元 · 记忆,包括 6a 和 6b 部分。第 5 课介绍了单次运行的状态。本节课将介绍通道在两次运行之间会记住哪些内容:图通过两个回调从外部听到什么。
记忆库 (6a)
Vertex AI 记忆库是关于某个人的受管理长期记忆。事实存在于某个范围(应用名称和用户 ID)以及您定义的主题下。当您向它提供 memories.generate 的对话内容时,它会提取与主题相关的内容,将其嵌入,并与已有的内容进行整合:创建新事实、更新已更改的事实、合并重复的事实。memories.retrieve 会返回范围的事实。这两个调用都位于 agent/platform/memory.py 中。
SCOPE = {"app_name": config.APP, "user_id": config.USER}
TOPICS = {
    "CREATOR_TASTE": "Which video directions this creator picks and passes on, "
                     "and how that preference changes over time.",
    "CHANNEL_RULES": "Standing instructions the creator states for every video "
                     "(style, subjects to avoid, format rules).",
    "VISUAL_STYLE": "What this creator approves and rejects in a poster: palettes, "
                    "framing, props and mood of the posters they shipped.",
}
第三个主题是频道的图片风格。该版本在第 5 次对话中写入了记忆:用一句话描述已发货的海报并记住,然后在提示中使用这句话绘制下一张海报。
设置已开始创建银行;6a 页面的连接行会显示其是否已启动。通过页面上的按钮或终端:python -m agent.platform.bank 创建知识库及其主题,并将资源名称缓存在 runs/memorybank.json 中;python -m agent.platform.bank load 播种四个过去的会话(两个带有风格规则的动物时代、一个工具时代、一个最近的奇幻时代);python -m agent.platform.bank list 显示转录内容变成了什么:整合的事实陈述,而不是转录内容。
回调 (6b)
记忆功能不是节点。回调是您传递给 Agent 的函数;ADK 会在固定时刻使用实时上下文调用该函数,返回 None 会让正常情况发生。三对:围绕智能体的轮次(before_agent_callback、after_agent_callback,带有 CallbackContext)、围绕每个模型调用(before_model_callback 带有 LlmRequest,after_model_callback 带有 LlmResponse)、围绕每个工具调用。护栏、遥测、缓存和上下文注入都位于此处,在图中没有节点。
在 stage4_memory/agent.py 中,propose_directions 会在调用模型之前读取记忆库:recall_taste 会提取事实,并将其作为 MEMORY 块附加到请求中(最早的事实排在最前面),然后指示模型根据当前偏好调整候选结果 1 到 3,并将规则视为约束条件。它还会将事实写入状态 memory_facts,make_poster 会在其中找到这些事实。👉🖥 连线:
    output_schema=Directions,
    before_model_callback=recall_taste)
脚本编写者在创作者选择后撰写内容:remember_pick 从状态中读取 direction,撰写一句关于该选择的话,然后将其交给 memories.generate。👉🖥 连线:
    output_schema=Script,
    after_agent_callback=remember_pick)
👉🖥 运行空消息并选择一张卡片。打开 propose_directions 事件:请求中包含三个时代,候选 1 到 3 倾向于当前品味,而趋势则表明了其他内容。在脚本编写器之后,点击显示记忆库:今晚精选的记忆已更改或添加。运行第二个晚上:它会记住第一个晚上。
9. 7 · 部署和发布 - 应用内的图表,VibeTube 上的夜晚
👉🖥 在工作台中,打开第 7 单元:部署和发布中的 7a 和 7b 部分。
部署 VibeStudio (7a)
在沙盒中,adk web 驱动了图表。VibeStudio 使用 ADK 的 Runner 驱动它,在具有自己的事件循环的工作器线程上运行,并将每个事件折叠成一个运行状态,页面通过服务器发送事件读取该状态:读取器、您选择的四张卡片、海报落地时的状态、渲染完成时的状态。Gate 的回答和 Render 的交付是同一个调用,即 function_response 部分,应用会自行轮询 Veo,而不是等待控制台。
self._svc = DatabaseSessionService(db_url=config.DB_URL)
self._runner = Runner(app_name=config.APP, agent=wf, session_service=self._svc)

async for ev in self._runner.run_async(user_id=config.USER, session_id=run_id, new_message=message):
    self._absorb(ev)    # fold the ADK event into the run state, publish one app event

part = Part(function_response=FunctionResponse(id=call_id, name=name, response=response))
vibestudio/server/agent/ 是实验 agent/ 的逐字节副本,由 checks/verify_app.py 检查。agent/graph.py 中的完整边缘列表将此 Codelab 的每个结构都集中在一个位置,共 13 个节点;它已填充完毕,供您阅读,无需输入:
        (START, scan_trends, join_research),
        (START, read_backlog, join_research),
        (START, read_feedback, join_research),
        (join_research, propose_directions, direction_gate,
         persist_direction, policy_check),
        (policy_check, {"OK": scripter, "BLOCK": quarantine}),
        (quarantine, scripter),
        (scripter, script_ready),
        (script_ready, render_desk, join_media),
        (script_ready, make_poster, join_media),
        (join_media, store_release),
👉🖥 使用工作台的部署按钮进行部署,或 👉💻 在标签页 1 中运行以下命令:
cd ~/vibe-studio-multimodal
uv run python vibestudio/deploy.py
该命令会运行,并填入 .env 中的值:
gcloud run deploy vibestudio --source vibestudio \
  --project $GOOGLE_CLOUD_PROJECT --region us-central1 \
  --labels dev-tutorial-codelab=vibetube --allow-unauthenticated \
  --memory 2Gi --cpu 2 --timeout 3600 --concurrency 40 \
  --max-instances 1 --min-instances 1 --session-affinity \
  --set-env-vars GOOGLE_CLOUD_PROJECT=...,STUDIO_VERTEX=1,STUDIO_MEMORY_BANK=...,STUDIO_RAG_CORPUS=...,VIBETUBE_URL=...,VIBETUBE_EVENT=...,VIBETUBE_NAME=...,VIBETUBE_PROJECT=...
--source 使用 Cloud Build 构建容器,并一步完成部署;首次构建需要四到五分钟。--session-affinity 具有一个温实例,该实例上保留了一个暂停的运行,即会话 5 的会话存储。在较大的部署中,会话存储区会移至 VertexAiSessionService,并且亲和性会消失。构建和服务作为项目的默认计算服务账号运行,设置已向该账号授予所需的角色。
👉🖥 打开服务网址,在应用中运行一个夜晚:一个想法,一个选择,等待片段和海报。“历史记录”标签页会同时保留这两项。
发布 (7b)
发布操作是应用向 VibeTube 上的聊天室端点发送的一个多部分 POST 请求,格式为 vibestudio/server/platform/publish.py。剪辑是视频,海报是缩略图,个人资料则命名了会议室和您:
url = f"{prof['platform_url']}/api/events/{prof['event_code']}/videos"
data = {"title": state.script["title"], "description": state.script["description"],
        "duration": "0:08", "displayName": prof["display_name"],
        "projectId": prof["project_id"]}        # one video per project and room: publishing again replaces it
files = {"videoFile": (clip.name, clip.open("rb"), "video/mp4"),
         "thumbnailFile": (poster.name, poster.open("rb"), "image/png")}   # the poster, not a frame
r = httpx.post(url, data=data, files=files, timeout=120)
video_id = r.json()["id"]                       # watch it at {platform}/e/{event}?v={video_id}
VibeTube 会为每个 projectId 和房间保留一个视频,并且应用发送的项目是您的 Google Cloud 项目,因此再次发布会替换您的视频,而不是添加视频。系统绝不会上传替身海报;真实海报就是缩略图,字节对字节。
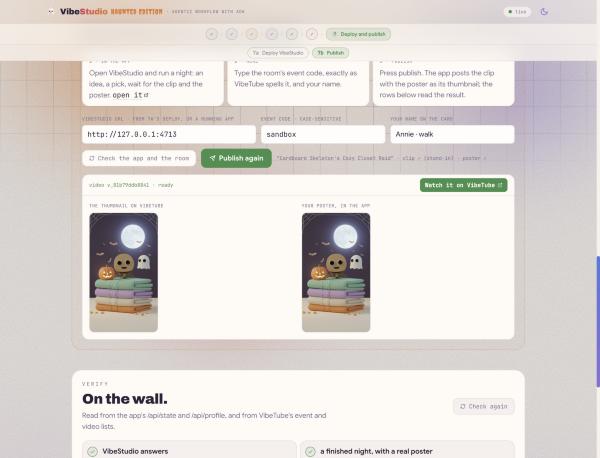
最后一次修改是配置,而不是代码行。👉🖥 在 7b 页面上:VibeStudio 网址(从 7a 的部署中填写)、聊天室的活动代码(与 VibeTube 拼写完全一致,即您在设置中提供的代码,除非您的讲师打开了另一个聊天室)以及您的姓名。按发布。工作台将点击操作传递给应用,应用发布夜晚,下面的行从应用和 VibeTube 读取结果:应用回答,夜晚以真实海报结束,代号命名一个开放房间,VibeTube 返回一个视频 ID,视频在墙上,其缩略图是您的海报。结果卡片显示了 VibeTube 上的缩略图,旁边是应用中的海报。
10. 您构建的内容
👉🖥 7b 页面最后会绘制整个图,其中包含从一个想法到一段视频及其海报的 13 个节点;将鼠标悬停在某个节点上,即可查看其功能以及构建该节点的会话。
会话 | 所学内容 | 书写形式 |
2 · 图片生成 | 智能体:模型、指令、工具;作为工具的图片模型;提示无法保证的事项 |
|
3 · 工作流 | 边缘列表、扇出和联接,以及后面带有任务模式循环的路由器 |
|
4 · 多模态数据注入 | 每种类型一个阅读器,一个线条形状,一个语料库;第三个阅读器按含义,与媒体 |
|
5 · 视频生成 | 两种暂停,一种机制;会话存储区;按名称共享的海报 |
|
6 · 记忆 | 跨夜记忆,两次回调 |
|
7 · 部署和发布 | Cloud Run 上应用内的图表;VibeTube 上的夜晚 |
|
图表遵循的五条规则:
- 挂起而非等待。暂停是会话存储区中的一行,而不是一个线程。
- 以相同的方式恢复所有内容 - 通过开放式调用的 ID,无论是由人还是由流程回答。
- 在状态中按名称共享数据,而不是通过每个载荷传递数据。
- 在为模型付费之前,先通过代码进行决策。该政策是一个文本文件和一个路由器,在渲染之前运行。
- 在非文本内容进入语料库之前,将其全部转换为文本,并在行内包含文件名,以便文件可以返回。
提示无法保证顺序、停止或检查。图表可以。
下一步
VertexAiSessionService,用于在实例生命周期结束后继续存在的会话,并丢弃--session-affinity。- 一个响应渲染调用的 webhook,而不是轮询器:
FunctionResponse(id=...)相同,发送者不同。 - 发布前再进行一次
RequestInput- 架构就是表单,因此它是一个节点,没有页面代码。 - 每次发布后,观众的新评论、语音留言和片段都会附加到语料库中,并附带发送这些内容的宣传海报。
清理
本实验创建的所有内容都位于第 4 步创建的项目中,因此最经济的清理方法是删除该项目。在 Cloud Shell 中:
gcloud projects delete $(cat ~/project_id.txt)
如需保留项目并仅移除付费部分,请移除:Cloud Run 服务 (gcloud run services delete vibestudio --region us-central1)、RAG 语料库和 Memory Bank(其资源名称位于 runs/ragcorpus.json 和 runs/memorybank.json 中,控制台的 Agent Engine 和 RAG Engine 页面会将其删除),以及 Artifact Registry 中的容器映像。