

1. परिचय
मान लें कि आप Cymbal Financial में डेटा साइंटिस्ट हैं. यह कंपनी, पेमेंट प्रोसेस करने वाली एक बड़ी कंपनी है. पेमेंट में देरी की कई शिकायतें मिली हैं. अनुपालन टीम को लगता है कि यह धोखाधड़ी एक साथ की गई है. आपको रॉ क्लियरिंगहाउस ट्रांज़ैक्शन लॉग को प्रोसेस करने के लिए एक पाइपलाइन बनानी होगी. साथ ही, डेटा को साफ़ करना होगा, मशीन लर्निंग मॉडल को ट्रेन करना होगा, बैच इन्फ़रेंस चलाना होगा, और ज़्यादा जोखिम वाले लेन-देन को मैन्युअल ऑडिट के लिए, Cloud Spanner की समीक्षा कतार में डालना होगा.
आम तौर पर, इसके लिए सेटअप कोड (स्पार्क नोटबुक, डीबीटी कॉन्फ़िगरेशन, ट्रेनिंग स्क्रिप्ट, Airflow DAG) को बार-बार लिखना पड़ता है. साथ ही, कंसोल इंटरफ़ेस और एडिटर के बीच लगातार स्विच करना पड़ता है.
इस कोडलैब में, Antigravity IDE में Google Cloud Data Agent Kit (DAK) का इस्तेमाल करके, किसी एजेंट के साथ पेयर-प्रोग्रामिंग की जाएगी. बातचीत वाली नैचुरल लैंग्वेज का इस्तेमाल करके, एजेंट आपकी इन कामों में मदद करेगा: स्पार्क नोटबुक जनरेट करना, dbt प्रोजेक्ट को कंपाइल करना, इन्फ़रेंस लूप बनाना, और Managed Service for Apache Airflow का इस्तेमाल करके वर्कफ़्लो को व्यवस्थित करना.
आपको क्या करना होगा
- Managed Service for Apache Spark (Spark Serverless) का इस्तेमाल करके, Cloud Storage से क्लियरिंगहाउस लॉग इंपोर्ट करें और उन्हें BigQuery टेबल में सेव करें.
- dbt का इस्तेमाल करके, लेन-देन को डुप्लीकेट होने से बचाएं और उन्हें नॉर्मलाइज़ करें. इससे साफ़ डेटा लेयर (रॉ, स्टेजिंग, बेहतर) तैयार की जा सकती हैं.
- Spark Serverless पर, डिस्ट्रीब्यूटेड रैंडम फ़ॉरेस्ट क्लासिफ़िकेशन मॉडल को ट्रेन करें (
RandomForestClassifier). - नए लेन-देन पर बैच इन्फ़रेंस की सुविधा चालू करें और ज़्यादा जोखिम वाली चेतावनियों को सीधे Cloud Spanner में लिखें.
- Managed Service for Apache Airflow का इस्तेमाल करके, पूरी पाइपलाइन को व्यवस्थित करें, उसे विज़ुअली कॉन्फ़िगर करें, और डिप्लॉय करें. साथ ही, IDE में इंटरैक्टिव DAG मॉनिटरिंग की सुविधा का इस्तेमाल करें.
आपको किन चीज़ों की ज़रूरत होगी
- कोई वेब ब्राउज़र, जैसे कि Chrome
- बिलिंग की सुविधा वाला Google Cloud प्रोजेक्ट. हमारा सुझाव है कि हैंड्स-ऑन लैब के लिए, एक नया प्रोजेक्ट इस्तेमाल करें.
- एसक्यूएल, Python, और PySpark की बुनियादी जानकारी.
- Google AI Pro की सदस्यता के साथ Antigravity IDE (सुझाया गया)
इस कोडलैब में बनाए गए संसाधनों की लागत 5 डॉलर से कम होनी चाहिए. प्रोविज़न किए गए संसाधनों को मिटाने के लिए, लैब के आखिर में दिए गए साफ़ करें निर्देशों का पालन ज़रूर करें.
2. एनवायरमेंट सेटअप करना
लैब शुरू करने के लिए, आपको बूटस्ट्रैप स्क्रिप्ट चलानी होगी. यह स्क्रिप्ट, ज़रूरी GCP API अपने-आप चालू करती है. साथ ही, डेटा को इकट्ठा करने के लिए Cloud Storage बकेट बनाती है, नकली लेन-देन और डायरेक्ट्री डेटासेट जनरेट करती है, रेफ़रंस डायरेक्ट्री को BigQuery में लोड करती है, और Cloud Spanner और Managed Service for Apache Airflow (जिसे पहले Cloud Composer कहा जाता था) की बैकग्राउंड प्रोविज़निंग शुरू करती है.
कोई प्रोजेक्ट चुनें या बनाएं
Google Cloud Console में, कोई मौजूदा प्रोजेक्ट चुनें या नया प्रोजेक्ट बनाएं.
बिलिंग की पुष्टि करना
पक्का करें कि आपके Google Cloud प्रोजेक्ट के लिए बिलिंग की सुविधा चालू हो. ऐसा करने के तरीके के बारे में ज़्यादा जानने के लिए, यह गाइड पढ़ें.
सेटअप स्क्रिप्ट चलाना
एनवायरमेंट सेटअप करने के लिए, Google Cloud Shell या Google Cloud CLI के साथ कॉन्फ़िगर किए गए अपने लोकल शेल का इस्तेमाल करें.
- Google Cloud Console खोलें.
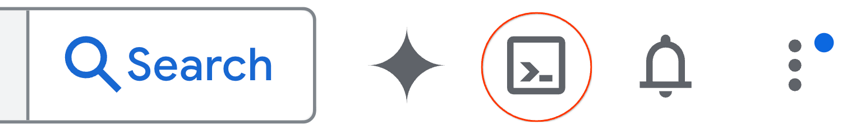
- सबसे ऊपर दाएं कोने में मौजूद टूलबार में, Cloud Shell चालू करें पर क्लिक करें.
- Cloud Shell टर्मिनल में, अपना ऐक्टिव प्रोजेक्ट कॉन्फ़िगर करें:
gcloud config set project <<YOUR_PROJECT_ID>>
export PROJECT_ID=$(gcloud config get-value project)
- codelab रिपॉज़िटरी को क्लोन करें और स्क्रिप्ट फ़ोल्डर पर जाएं:
cd ~/
git clone --filter=blob:none --no-checkout https://github.com/GoogleCloudPlatform/devrel-demos.git
cd ~/devrel-demos
git sparse-checkout init --cone
git sparse-checkout set codelabs/agentic-data-labs/data-science
git checkout main
cd codelabs/agentic-data-labs/data-science/scripts
- सभी संसाधनों को
us-central1में डिप्लॉय करने के लिए, बूटस्ट्रैप सेटअप स्क्रिप्ट चलाएं:
chmod +x setup.sh setup_spanner.sh setup_composer.sh
export REGION=us-central1
./setup.sh
- स्क्रिप्ट पूरी होने के बाद, आपको एक खास आउटपुट दिखेगा. इससे पता चलेगा कि आपका BigQuery डेटासेट और Cloud Storage बकेट तैयार है. बैकग्राउंड में, Cloud Spanner (इसमें ~2 मिनट लगते हैं) और Managed Airflow (इसमें ~20 मिनट लगते हैं) का प्रावधान जारी रहेगा. इनकी प्रोग्रेस को किसी भी समय मॉनिटर किया जा सकता है. इसके लिए, यह कमांड चलाएं:
tail -f /tmp/spanner_setup.log
tail -f /tmp/composer_setup.log
Antigravity IDE खोलें
- Google Antigravity के डाउनलोड पेज से, Antigravity IDE को डाउनलोड और इंस्टॉल करें.
- Antigravity IDE लॉन्च करें.
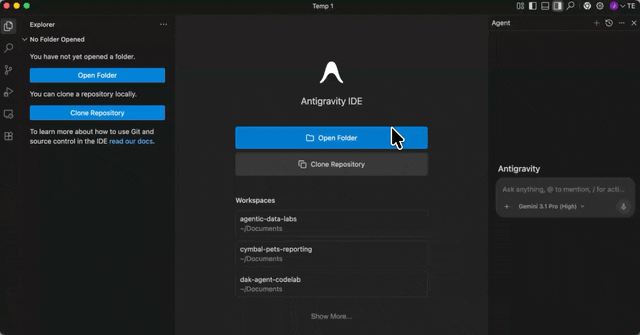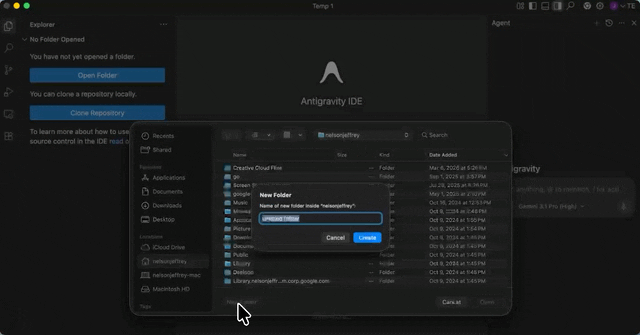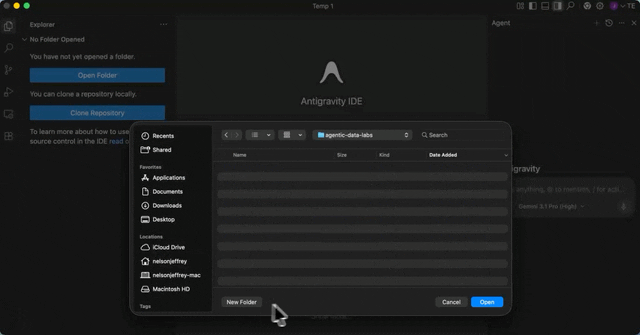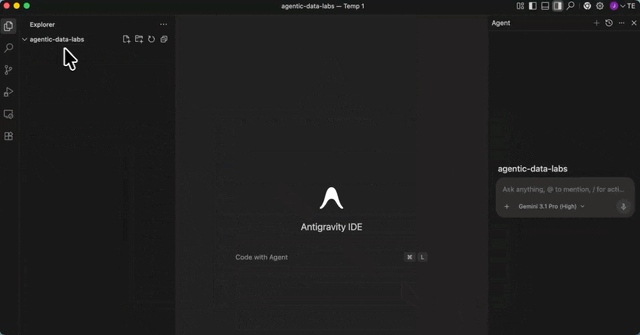
- अपनी लोकल मशीन पर एक नया, खाली फ़ोल्डर बनाएं. उदाहरण के लिए,
agentic-data-labsनाम का फ़ोल्डर बनाएं. इसके बाद, फ़ोल्डर खोलें को चुनकर, उसे IDE में खोलें. यह कोडलैब के लिए, आपके लोकल वर्कस्पेस के तौर पर काम करेगा.
Data Agent Kit एक्सटेंशन इंस्टॉल करना
Google Cloud Data Agent Kit एक्सटेंशन, Google Cloud की डेटा सेवाओं के साथ सीधे तौर पर इंटिग्रेट होता है. इससे आपको अपने एडिटर में ही BigQuery, Cloud SQL, Cloud Storage वगैरह के साथ इंटरैक्ट करने की सुविधा मिलती है. इसके लिए, आपको कॉन्टेक्स्ट स्विच करने की ज़रूरत नहीं होती.
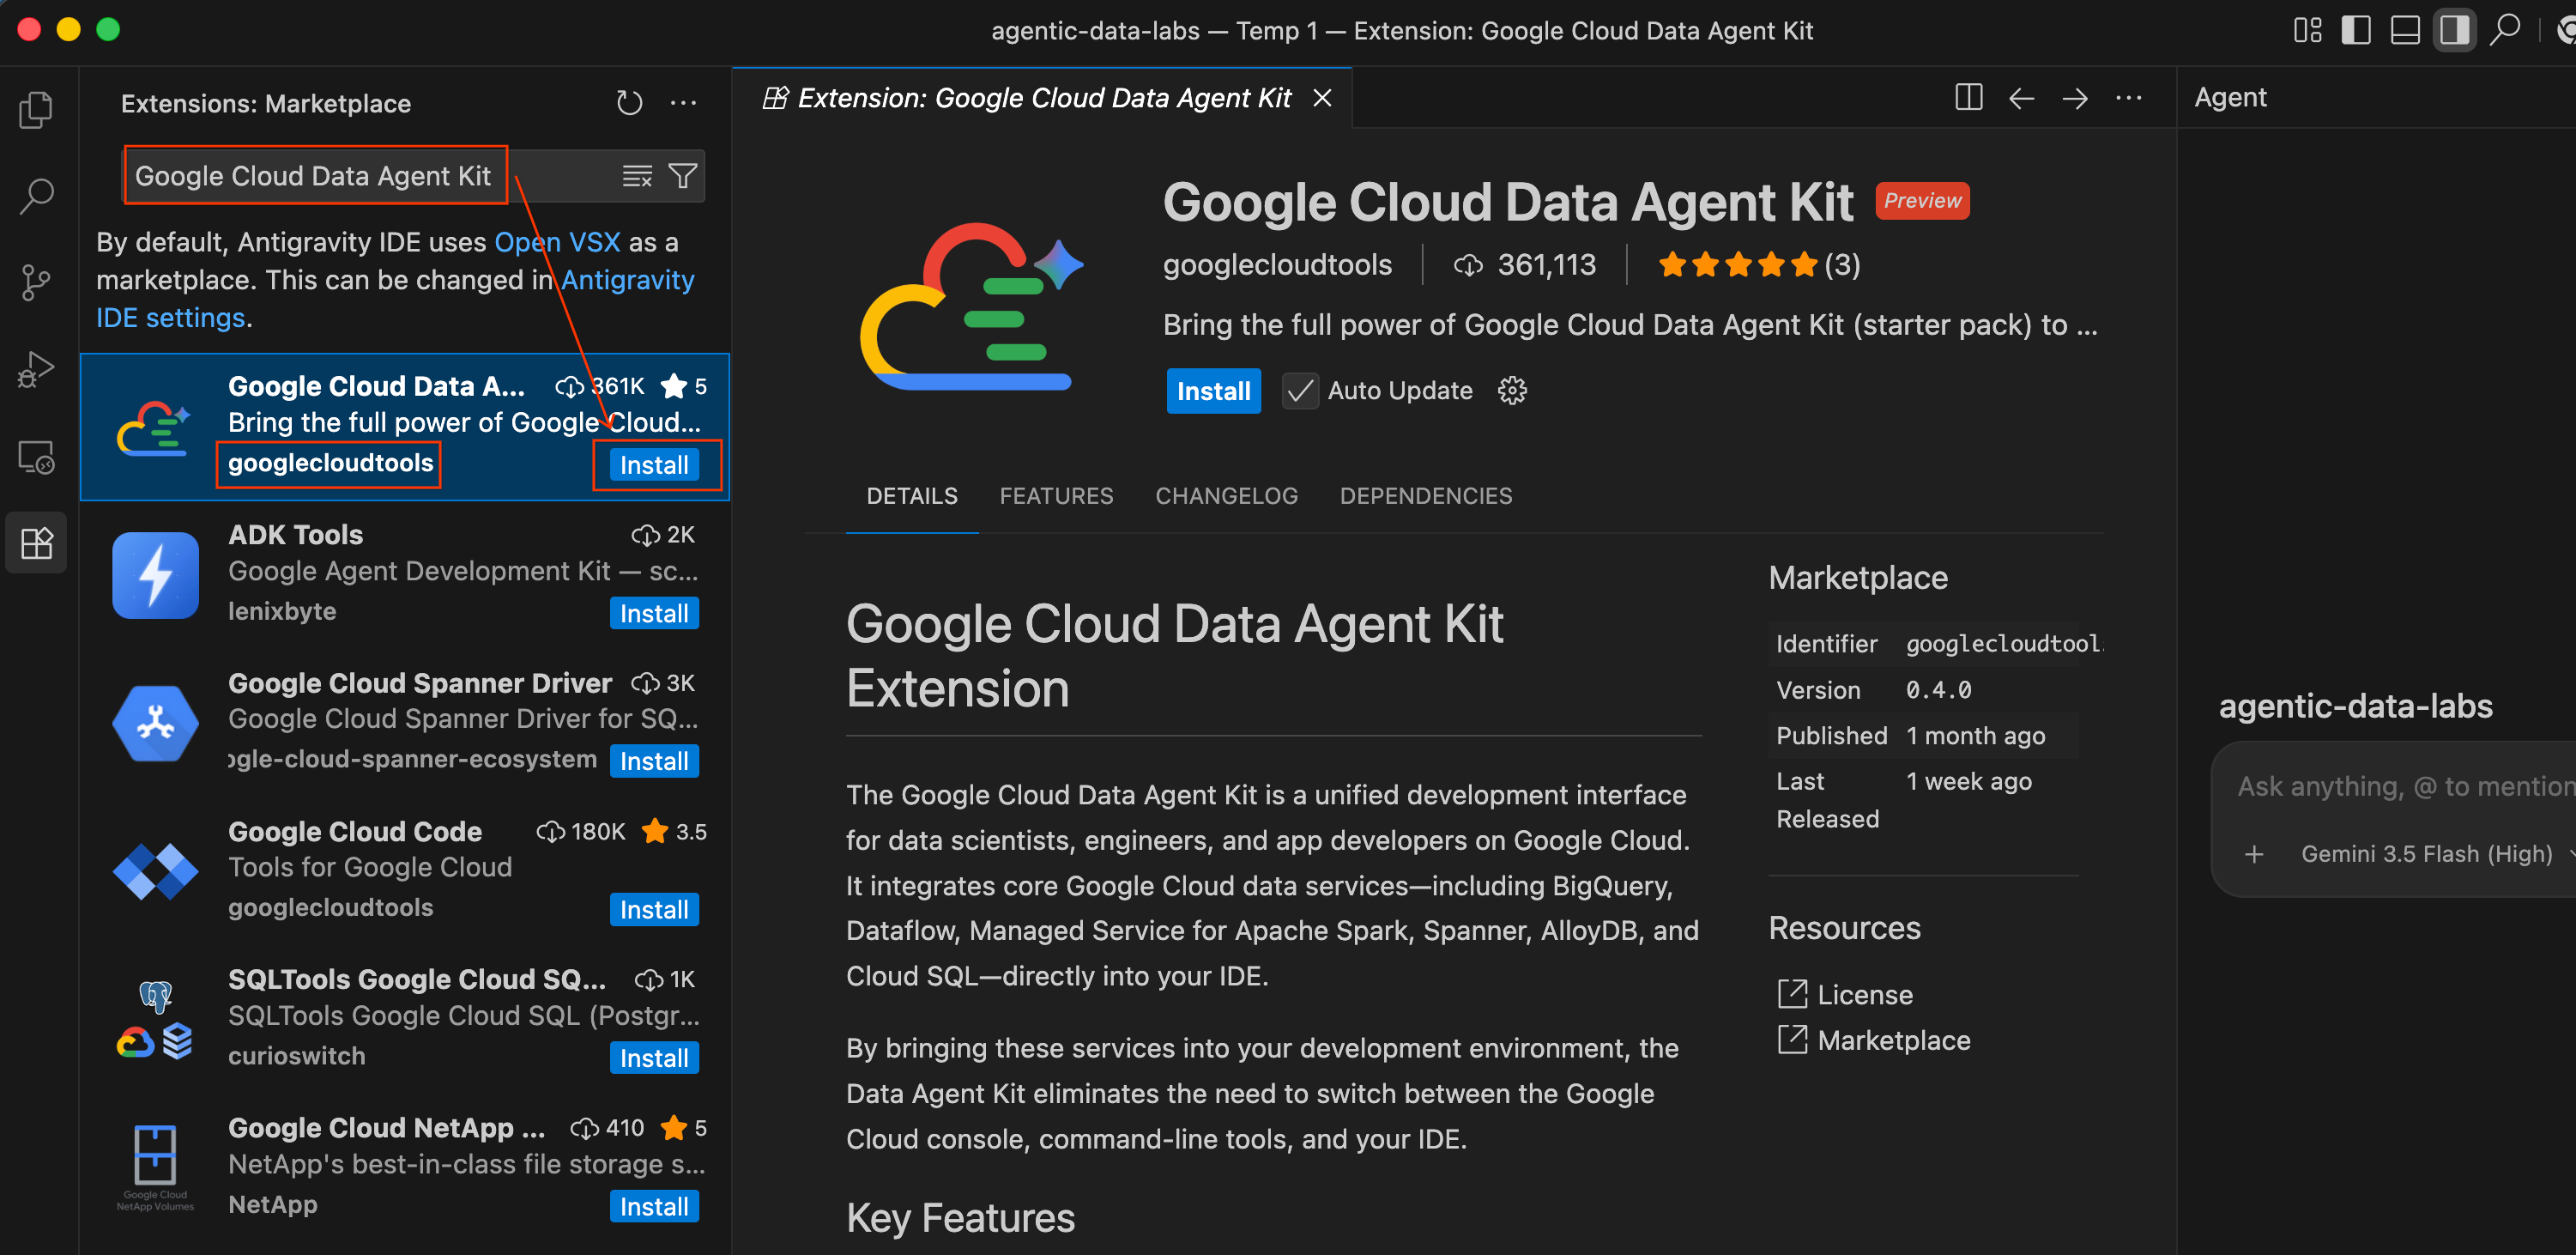
- Antigravity IDE में, स्क्रीन की बाईं ओर मौजूद Activity Bar में, Extensions आइकॉन पर क्लिक करें. यह आइकॉन, चार स्क्वेयर की तरह दिखता है.
- एक्सटेंशन पैनल में सबसे ऊपर मौजूद खोज बार में,
Google Cloud Data Agent Kitटाइप करें. googlecloudtoolsने Google Cloud Data Agent Kit नाम का एक्सटेंशन पब्लिश किया है. इसे ढूंढें- इंस्टॉल करें बटन पर क्लिक करें.
- आपको यह मैसेज दिख सकता है, "क्या आपको पब्लिशर ‘googlecloudtools' और उसके एक्सटेंशन पर भरोसा है?". आगे बढ़ने के लिए, भरोसेमंद पब्लिशर और इंस्टॉल करें पर क्लिक करें.
इंस्टॉल हो जाने के बाद, आपको Antigravity IDE के सबसे बाईं ओर मौजूद ऐक्टिविटी बार में, नया Google Cloud Data Agent Kit आइकॉन दिखेगा.
- "Google Cloud Data Agent Kit में आपका स्वागत है" नाम का एक पेज अपने-आप खुल जाएगा. अगर आपने Cloud खाते में साइन इन नहीं किया है, तो ऐक्सेस की अनुमति देने के लिए दिए गए निर्देशों का पालन करें.
- कॉन्फ़िगरेशन की खास जानकारी सेक्शन में, प्रोजेक्ट फ़ील्ड ढूंढें. ड्रॉपडाउन पर क्लिक करें और अपना Google Cloud प्रोजेक्ट चुनें. अपने देश/इलाके को
us-central1के तौर पर सेट करें. इसके बाद, Configure MCP Servers को चुनें.
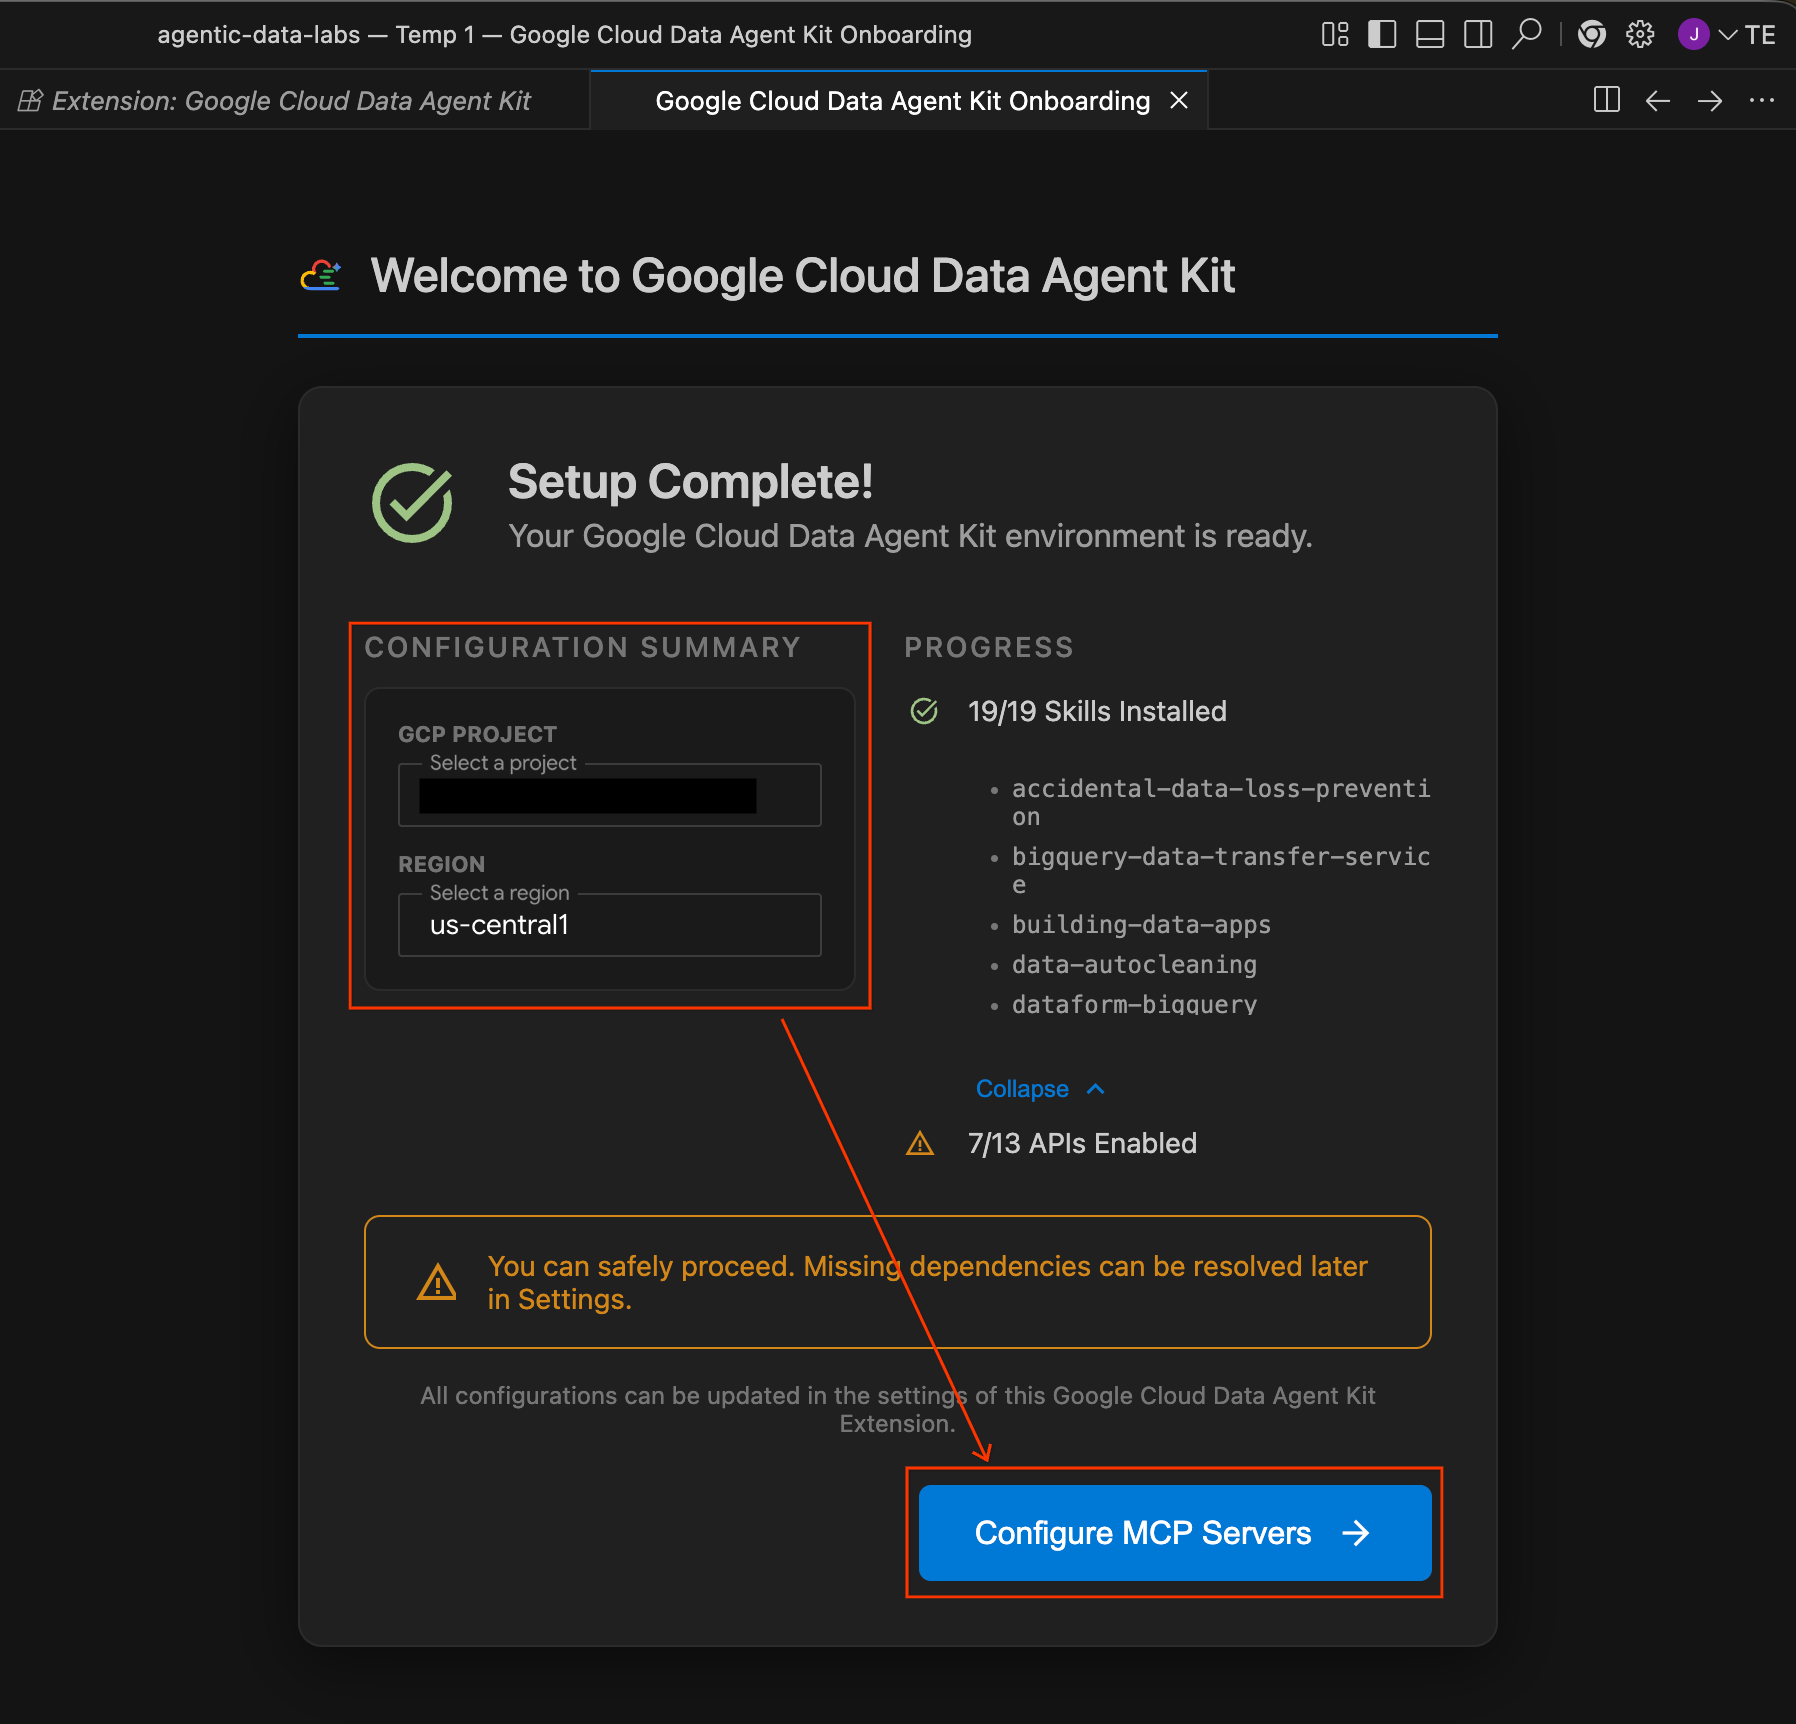
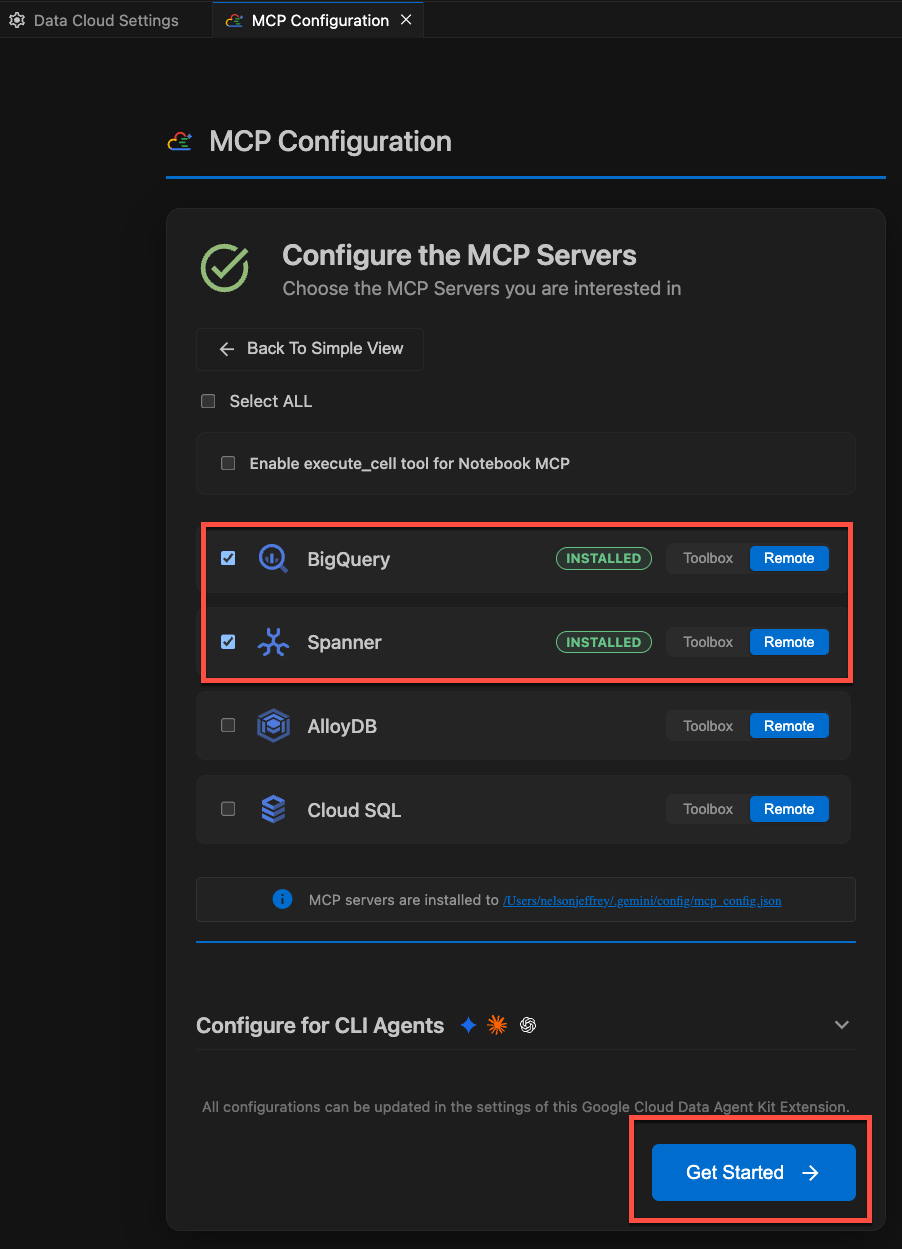
- एमसीपी सर्वर कॉन्फ़िगर करें को चुनें. एमसीपी कॉन्फ़िगरेशन पैनल में जाकर, पक्का करें कि आपने इन रिमोट एमसीपी सर्वर को चालू किया हो:
- BigQuery
- Spanner
- नोटबुक
इसके बाद, शुरू करें पर क्लिक करें.
कॉन्फ़िगरेशन के विकल्प देखना
सेटअप पूरा होने के बाद, आपको "Google Cloud Data Agent Kit का इस्तेमाल शुरू करें" पेज पर रीडायरेक्ट कर दिया जाएगा.
- "सेटअप और कॉन्फ़िगरेशन" में जाकर, शुरू करें पर क्लिक करें.
- इससे डेटा एजेंट किट का कॉन्फ़िगरेशन पैनल खुलता है. टैब एक्सप्लोर करें:
- प्रोजेक्ट और क्षेत्र: चुने गए प्रोजेक्ट आईडी की पुष्टि करें. साथ ही, यह पक्का करें कि सेटअप स्क्रिप्ट ने सभी ज़रूरी एपीआई (Compute Engine, Cloud Storage, BigQuery, Spanner वगैरह) चालू किए हों.
- BigQuery: BigQuery क्वेरी के लिए जगह की डिफ़ॉल्ट जानकारी कॉन्फ़िगर करें. क्षेत्र
us-central1का इस्तेमाल करें. - एमसीपी सर्वर कॉन्फ़िगर करें: चालू किए गए एमसीपी सर्वर (BigQuery, Notebooks, Spanner वगैरह) देखें. इनकी मदद से, एआई एजेंट आपके डेटा के साथ सुरक्षित तरीके से इंटरैक्ट कर सकते हैं.
- स्किल: पहले से बनी हुई स्किल एक्सप्लोर करें. ये स्किल, एजेंट को मुश्किल डेटा टास्क के लिए खास सुविधाएं देती हैं.
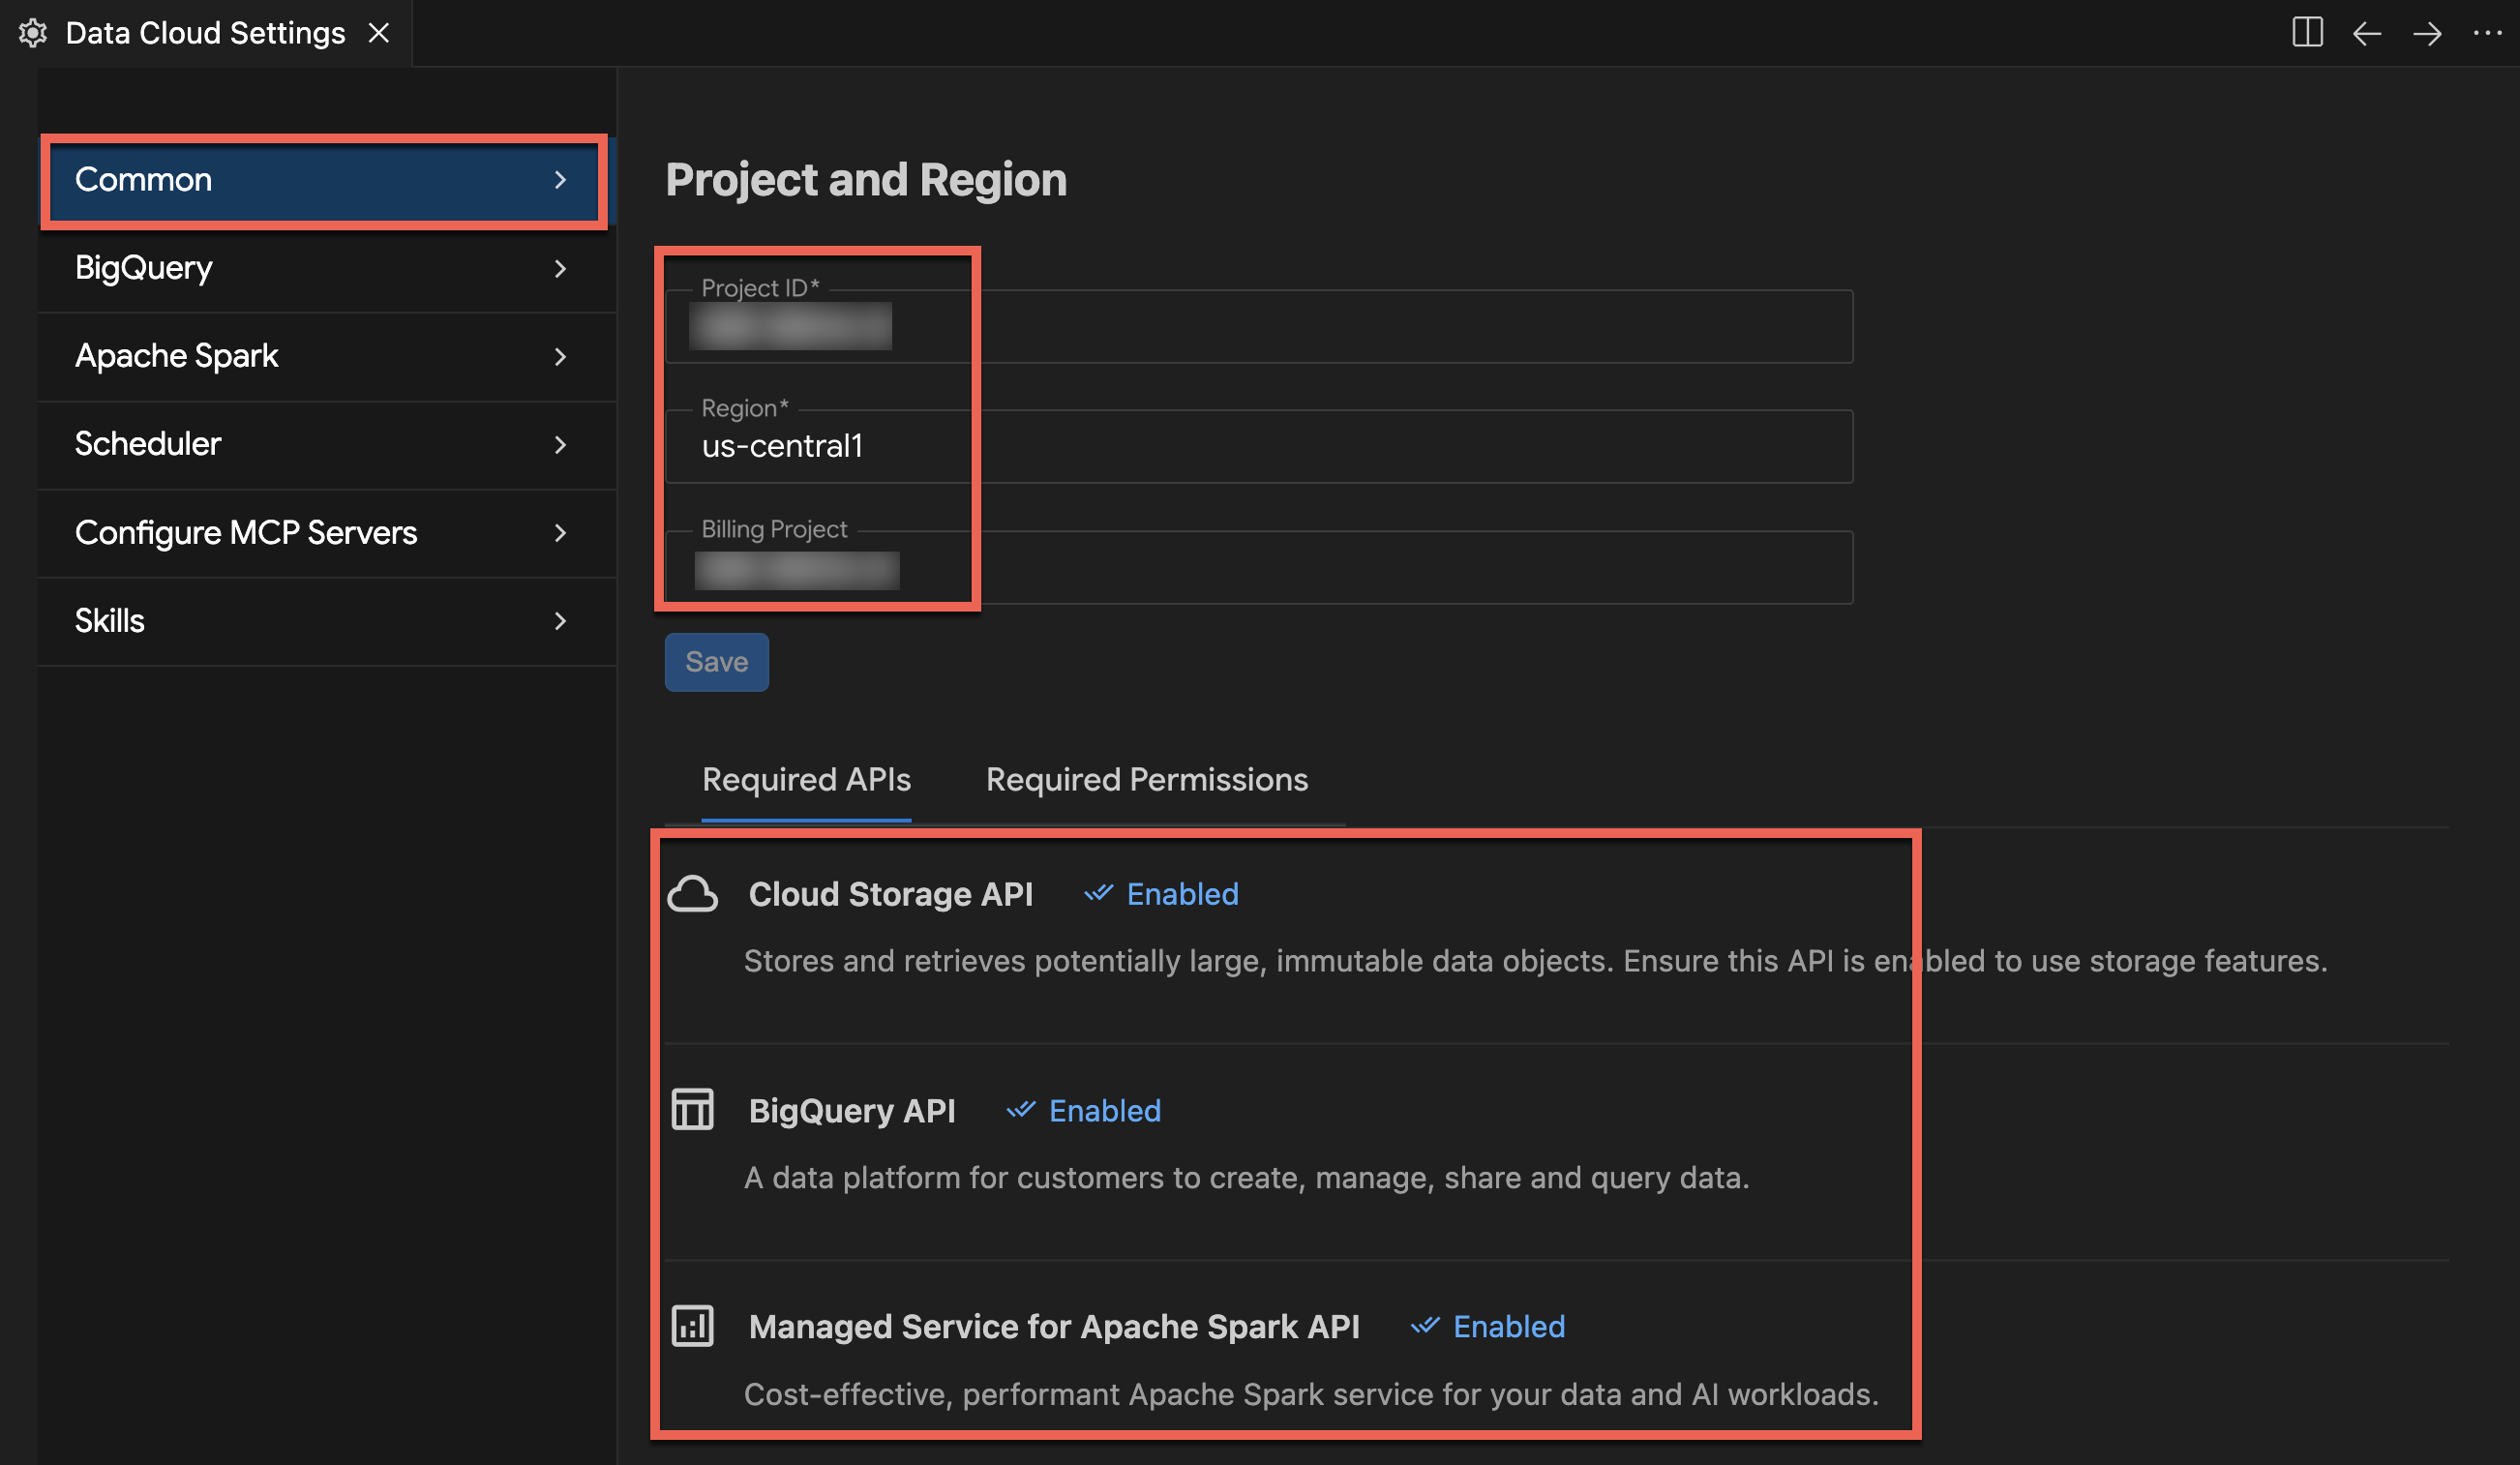
सेक्शन की खास जानकारी: आपने GCS और BigQuery ऐसेट बनाने के लिए, बूटस्ट्रैप स्क्रिप्ट चलाई. वहीं, Spanner और Airflow बैकग्राउंड में काम करते हैं. इसके बाद, आपने Antigravity IDE में प्रोजेक्ट खोला और Google Cloud Data Agent Kit एक्सटेंशन चालू किया. अब आपके पास अपनी पहली नोटबुक लिखने का विकल्प है.
3. Spark Serverless का इस्तेमाल करके, रॉ लॉग को प्रोसेस करना
इस सेक्शन में, डेटा लेक में रॉ JSON ट्रांज़ैक्शन लॉग डाले जाएंगे. Apache Spark के लिए मैनेज की गई सेवा (Spark Serverless), BigQuery के नेटिव स्टोरेज से सीधे कनेक्ट होती है. टेबल के फ़ॉर्मैट में मौजूद डेटा को मैनेज करने के लिए, BigQuery के स्टैंडर्ड कनेक्टर का इस्तेमाल किया जाएगा. इससे सीधे तौर पर क्वेरी करने और डेटा का विश्लेषण करने की सुविधा मिलेगी.
पहले से कॉन्फ़िगर किए गए Spark Serverless रनटाइम के बारे में जानें
स्पार्क कोड को चलाने से पहले, सेटअप स्क्रिप्ट से पहले से कॉन्फ़िगर किए गए Serverless Runtime टेंप्लेट की जांच करें. यह टेंप्लेट, टारगेट एक्ज़ीक्यूशन एनवायरमेंट के बैकएंड को तय करता है. साथ ही, कनेक्टर की ज़रूरी डिपेंडेंसी को बंडल करता है.
- IDE की गतिविधि बार में, Google Cloud Data Agent Kit पैनल खोलें.
- Apache Spark ड्रॉप-डाउन मेन्यू को बड़ा करें. इसके बाद, Serverless को बड़ा करें.
fraud-pipeline-runtimeपर राइट क्लिक करें और प्रोफ़ाइल चुनें. इससे एडिटर में, प्रोफ़ाइल का कॉन्फ़िगरेशन व्यू खुल जाएगा.- प्रोफ़ाइल टैब में, नीचे की ओर स्क्रोल करें और प्रॉपर्टी को बड़ा करें. इससे एनवायरमेंट से जुड़ी कस्टम डिपेंडेंसी की जांच की जा सकती है:
spark.jars: इसमेंgs://spark-lib/spanner/spark-3.5-spanner-1.4.0.jarशामिल है. यह Spark Spanner कनेक्टर का इस्तेमाल करता है, ताकि Spark के जॉब, अनुमान के नतीजों को सीधे Cloud Spanner में लिख सकें. ऐसा लैब में बाद में किया जा सकता है. (ध्यान दें: Dataproc Serverless में, Google Cloud का Spark BigQuery कनेक्टर डिफ़ॉल्ट रूप से शामिल होता है. इसलिए, BigQuery टेबल को पढ़ने और लिखने के लिए, किसी अतिरिक्त जार कॉन्फ़िगरेशन की ज़रूरत नहीं होती).
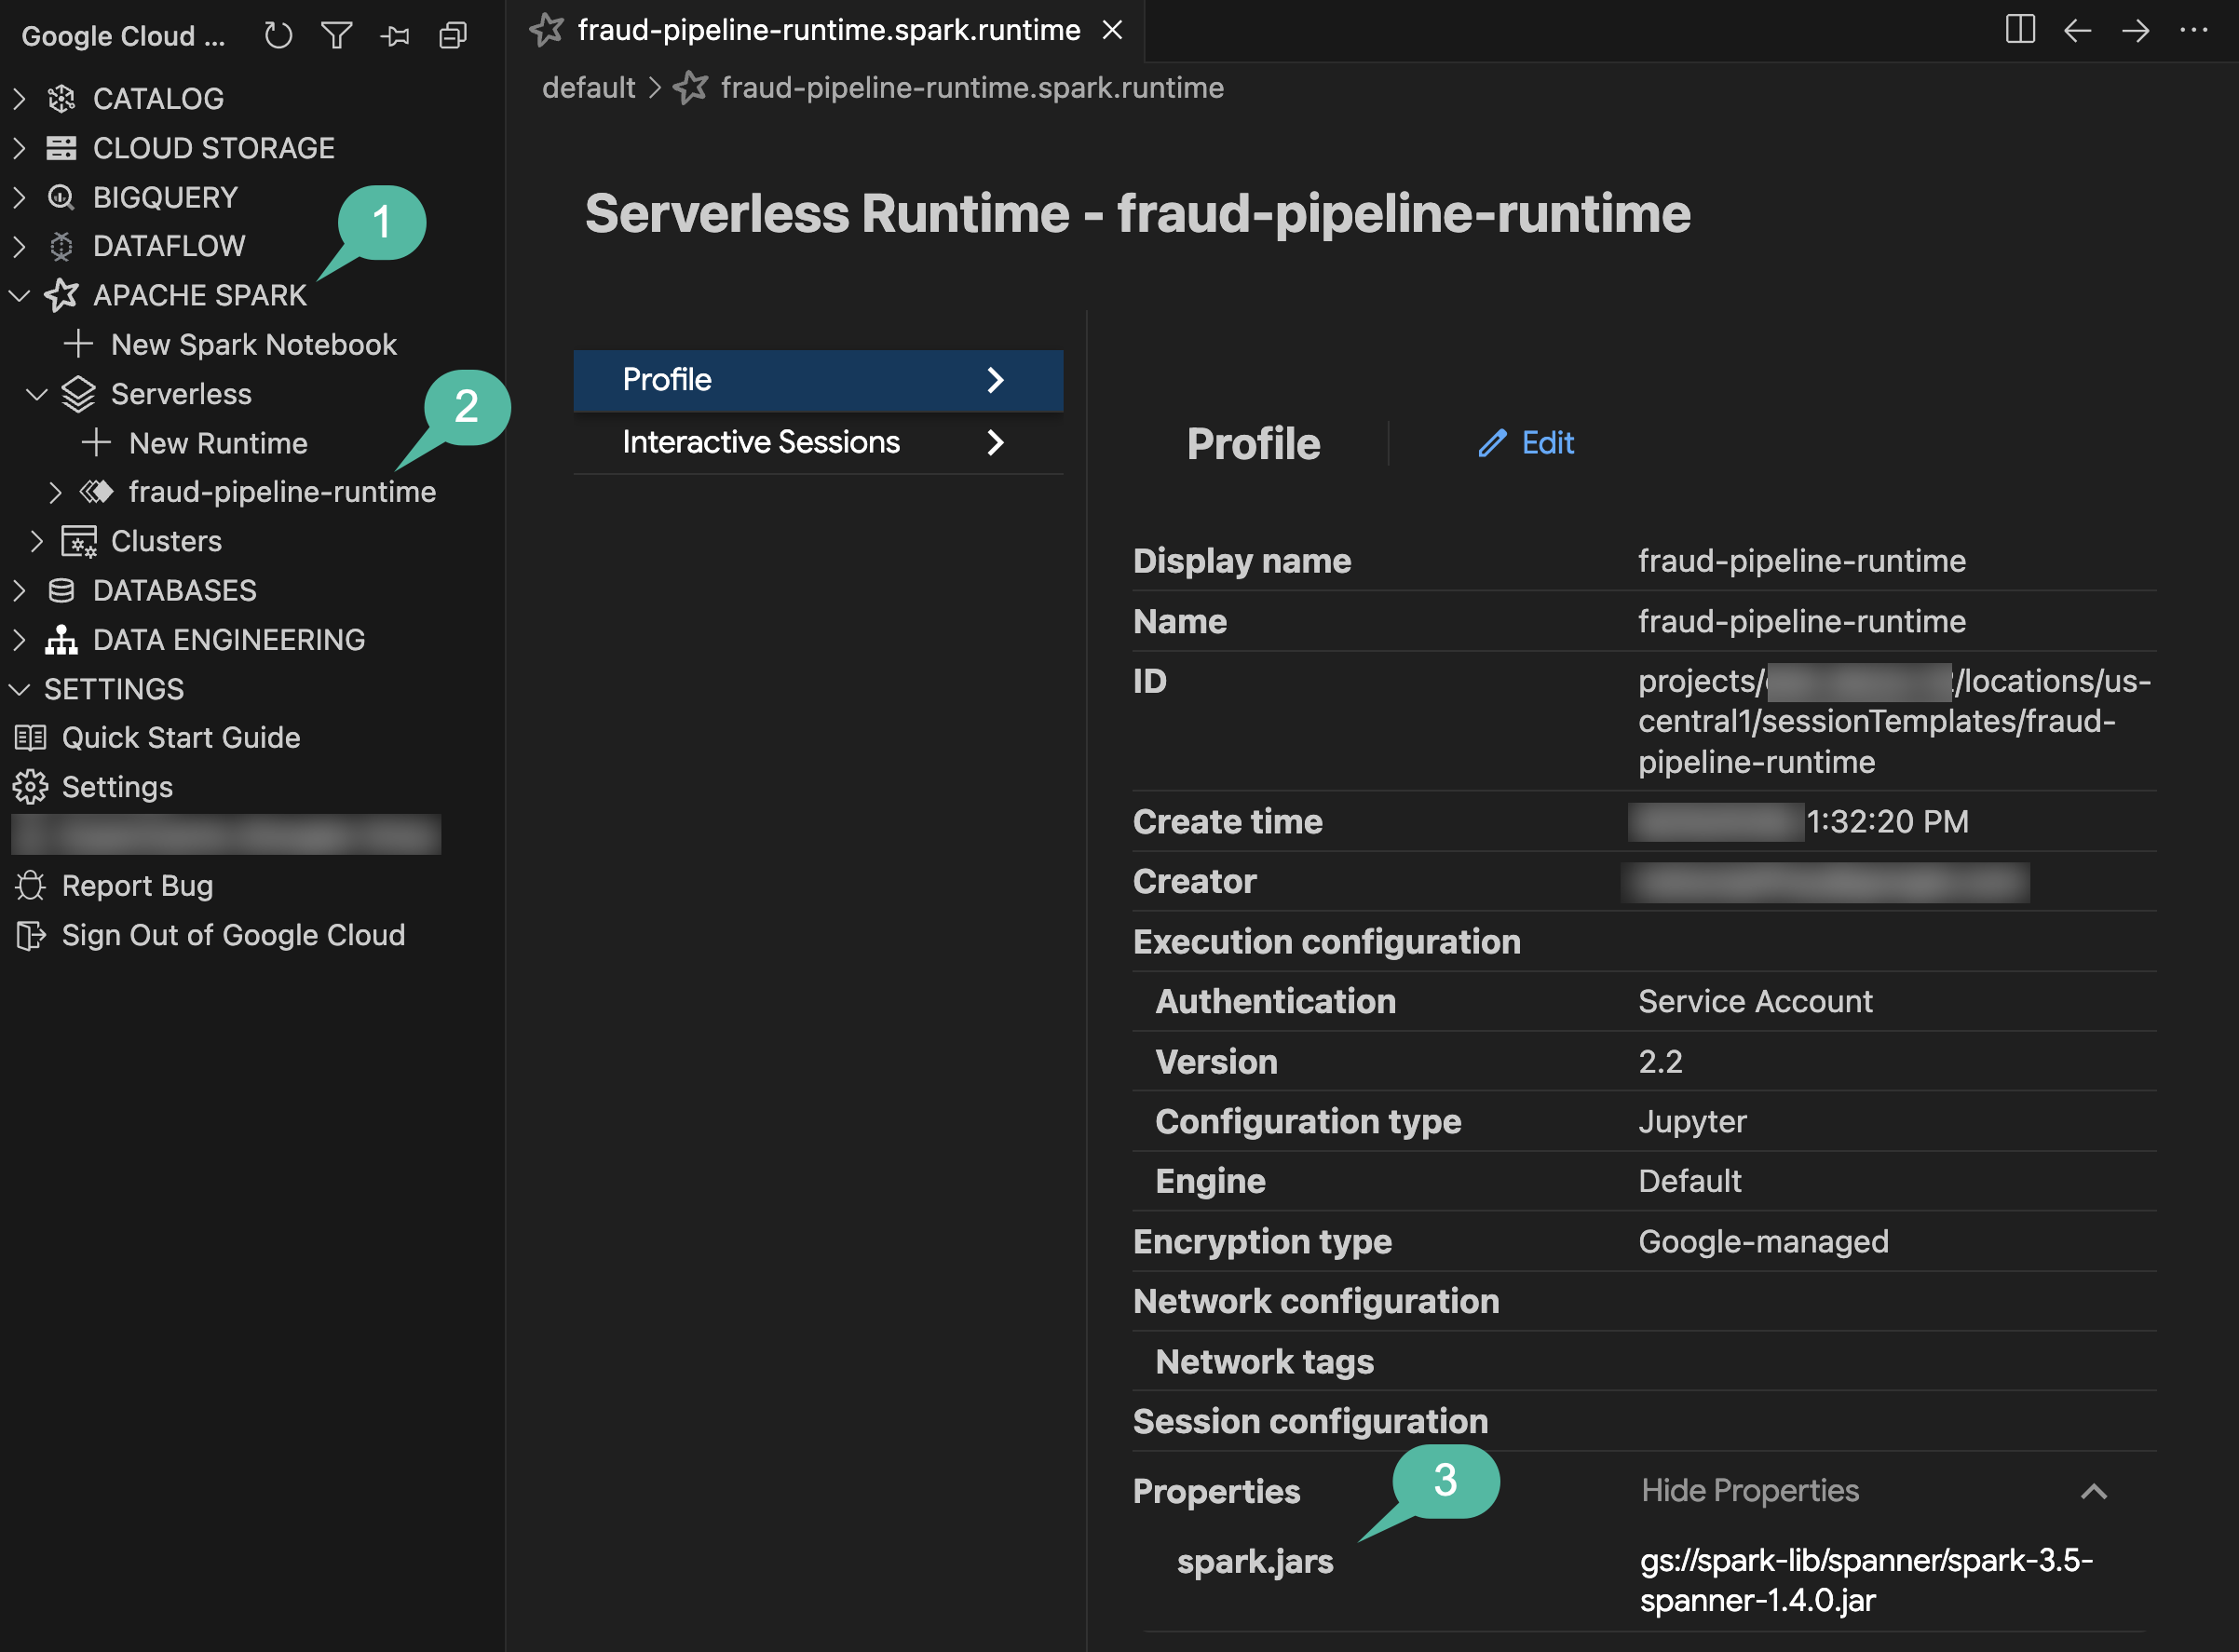
- बाईं ओर मौजूद, इंटरैक्टिव सेशन टैब पर ध्यान दें. फ़िलहाल, यह खाली है, क्योंकि आपने अब तक कोई कोड नहीं चलाया है. अगले चरण में नोटबुक चलाने पर, लाइव सर्वरलेस कंप्यूट सेशन डाइनैमिक तरीके से उपलब्ध कराया जाएगा और यहां दिखेगा!
Data Agent Kit का इस्तेमाल करके डेटा इनजेस्ट करना
आपको Spark सेशन को मैन्युअल तरीके से कॉन्फ़िगर करने या PySpark की लोडिंग स्क्रिप्ट को शुरू से लिखने के बजाय, डेटा एजेंट किट का इस्तेमाल करके किसी एजेंट के साथ पेयर-प्रोग्रामिंग करनी होगी.
- सबसे ऊपर दाएं कोने में मौजूद टूलबार में, टॉगल एजेंट आइकॉन पर क्लिक करके, एजेंट चैट पैनल खोलें.
- नीचे दिए गए प्रॉम्प्ट को चैट में चिपकाएं.
${PROJECT_ID}की जगह Google Cloud का अपना प्रोजेक्ट आईडी डालना न भूलें:
Create a PySpark notebook (01_ingestion.ipynb) to ingest JSON transaction logs
from gs://${PROJECT_ID}-fin-clearing-raw/ into a BigQuery table
`${PROJECT_ID}.transactions_dataset_evals.raw_transactions`
using the Spark BigQuery connector (`format("bigquery")`) with overwrite mode.
- अगर एजेंट, बैकग्राउंड की पुष्टि करने वाली कमांड (जैसे, "क्या इस कमांड को चलाने की अनुमति देनी है?") को लागू करने की अनुमति मांगता है, तो सुझाई गई कमांड की समीक्षा करें. इसके बाद, हां, इस बार अनुमति दें या हां, हमेशा अनुमति दें को चुनें.
- जब एजेंट फ़ाइल जनरेट कर लेता है, तब चैट पैनल में सबसे नीचे मौजूद नीले रंग के सभी स्वीकार करें बटन (या सही का निशान वाला आइकॉन) पर क्लिक करके,
notebooks/01_ingestion.ipynbको अपने वर्कस्पेस में सेव करें.
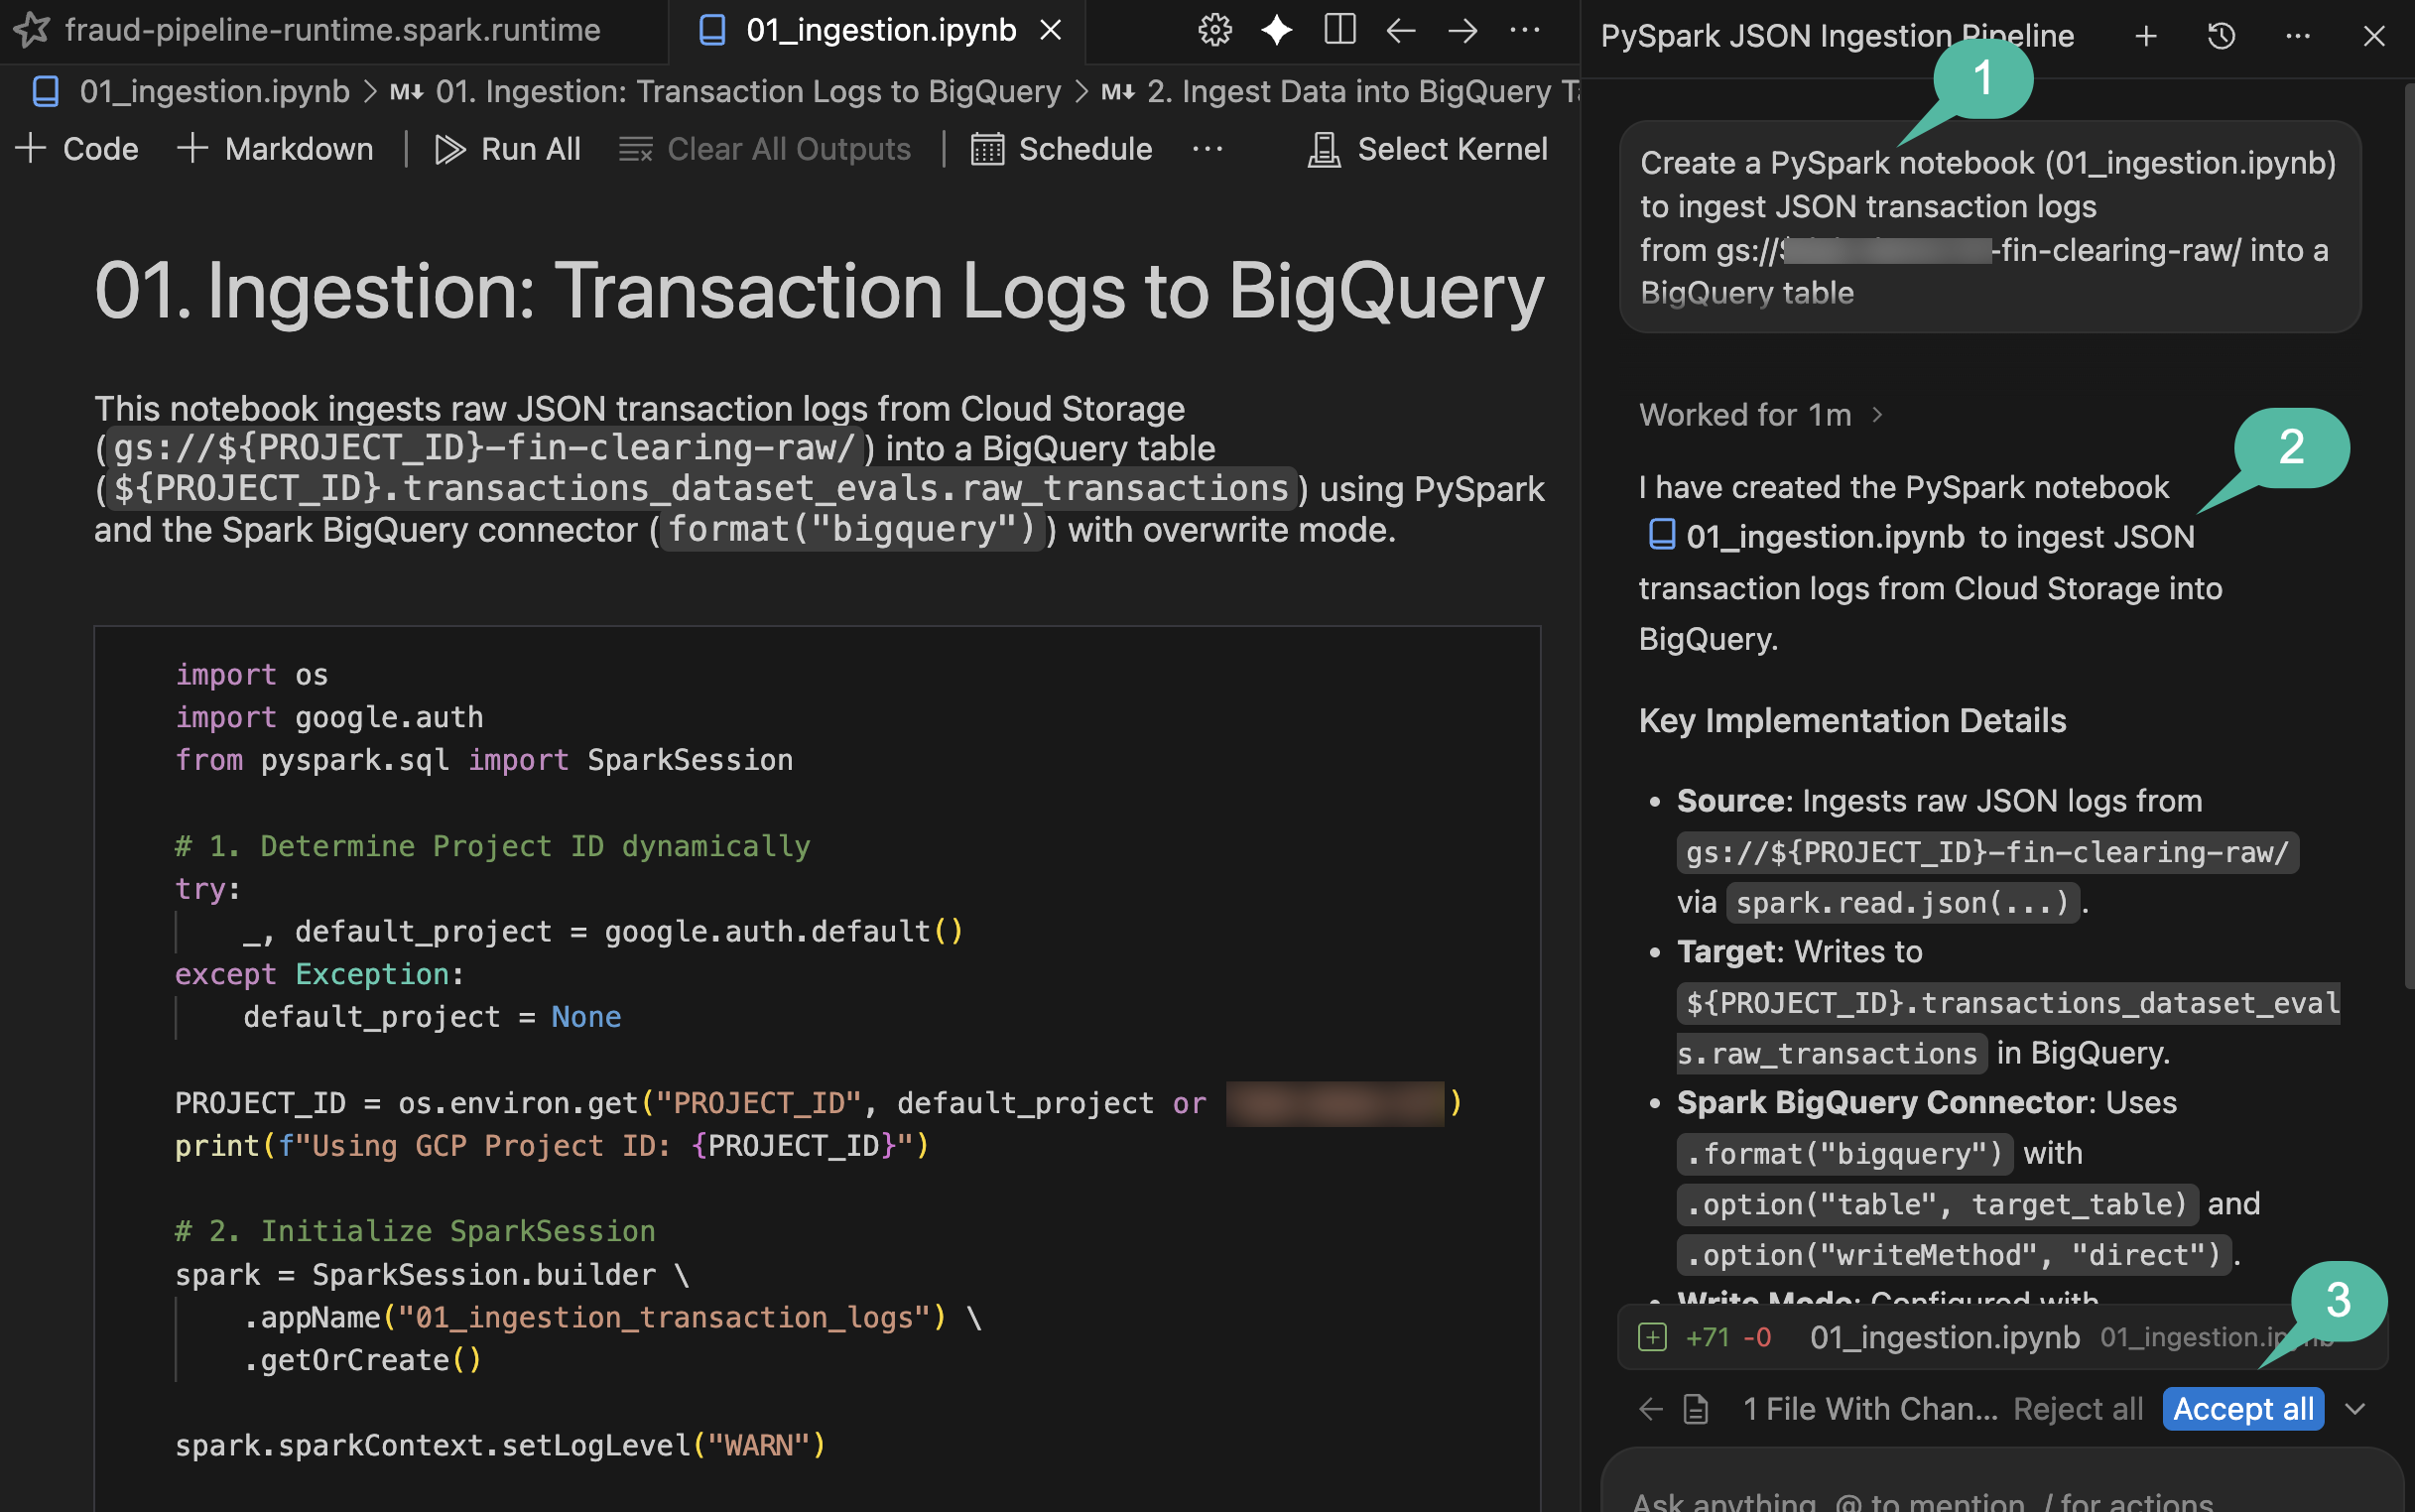
नोटबुक की समीक्षा करना और उसे लागू करना
- आईडीई में, हाल ही में जनरेट किया गया
notebooks/01_ingestion.ipynbखोलें. - BigQuery कनेक्टर के राइट लॉजिक के लिए, PySpark कोड की समीक्षा करें.
- IDE के नोटबुक टूलबार में, सभी सेल चलाएं पर क्लिक करें.
- अगर रिमोट Spark नोटबुक को पहली बार चलाया जा रहा है, तो IDE आपसे लोकल डिपेंडेंसी इंस्टॉल करने के लिए कह सकता है. अगर कहा जाए, तो रिमोट स्पार्क कर्नल के लिए डिपेंडेंसी इंस्टॉल करें पर क्लिक करें. इसके बाद, इंस्टॉलेशन डायलॉग की पुष्टि करें. इसके बाद, सभी चलाएं पर फिर से क्लिक करें.
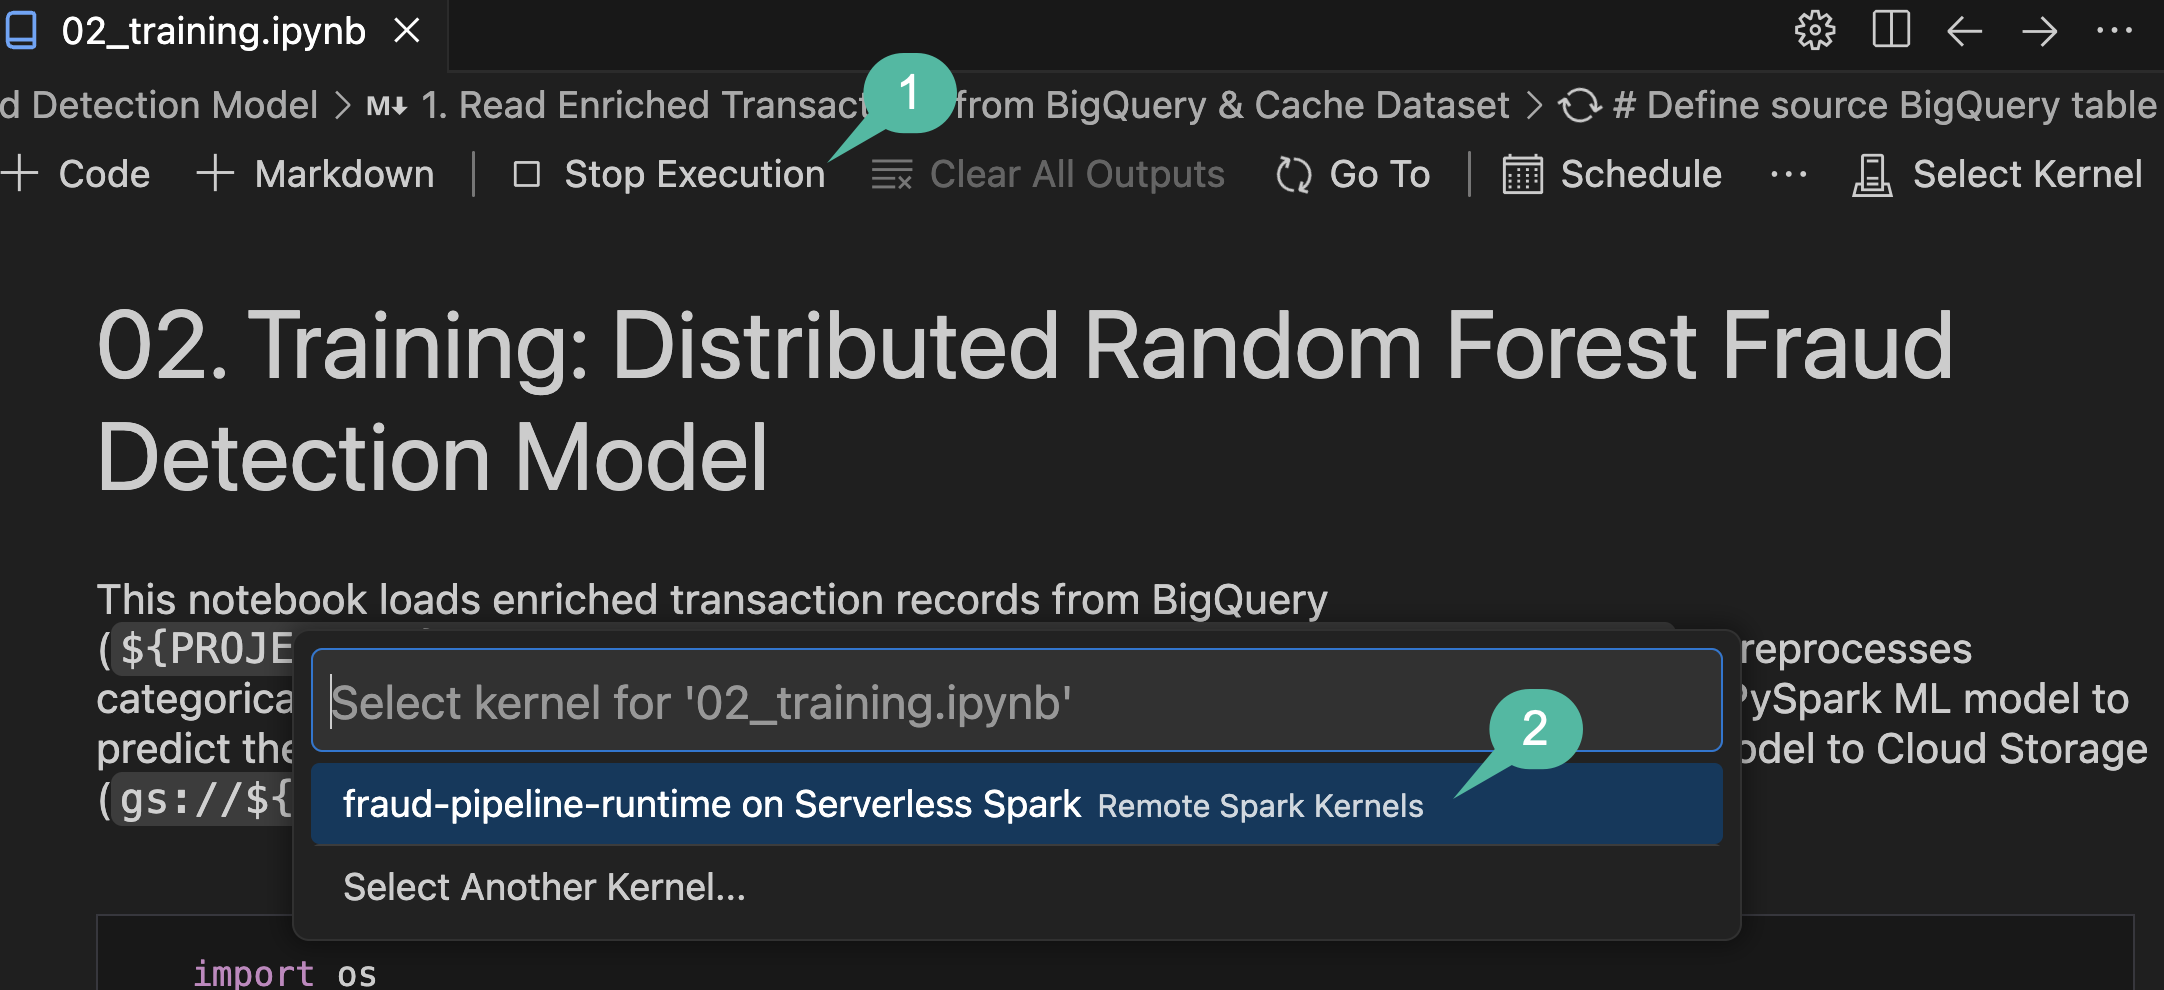
- Select Kernel ड्रॉपडाउन मेन्यू में, Remote Spark Kernels -> fraud-pipeline-runtime on Serverless Spark चुनें. (अहम जानकारी: अगर आपको पहले से कॉन्फ़िगर किया गया रनटाइम टेंप्लेट नहीं दिखता है, तो कर्नल पिकर ड्रॉपडाउन में सबसे ऊपर दाईं ओर मौजूद रीफ़्रेश आइकॉन पर क्लिक करें, ताकि उपलब्ध रिमोट कर्नल फिर से लोड हो जाएं).
- एडिटर में सबसे नीचे बाईं ओर मौजूद स्टेटस बार देखें. आपको
Connecting to kernel: fraud-pipeline-runtime on Serverless Spark...दिखेगा. Spark Serverless runtime kernel backend को पहली बार लॉन्च किया जा रहा है. इसलिए, इसे चालू होने में कुछ मिनट लगेंगे. - कर्नल के कनेक्ट होने के बाद, नोटबुक सभी सेल को क्रम से अपने-आप एक्ज़ीक्यूट करना शुरू कर देगी. इससे, तैयार नहीं किए गए लेन-देन के लॉग को आपके BigQuery डेटासेट में प्रोसेस किया जा सकेगा.
पुष्टि
एक्ज़ीक्यूशन पूरा होने के बाद, टेबल बनने की पुष्टि करने के लिए, Data Agent Kit कैटलॉग देखें:
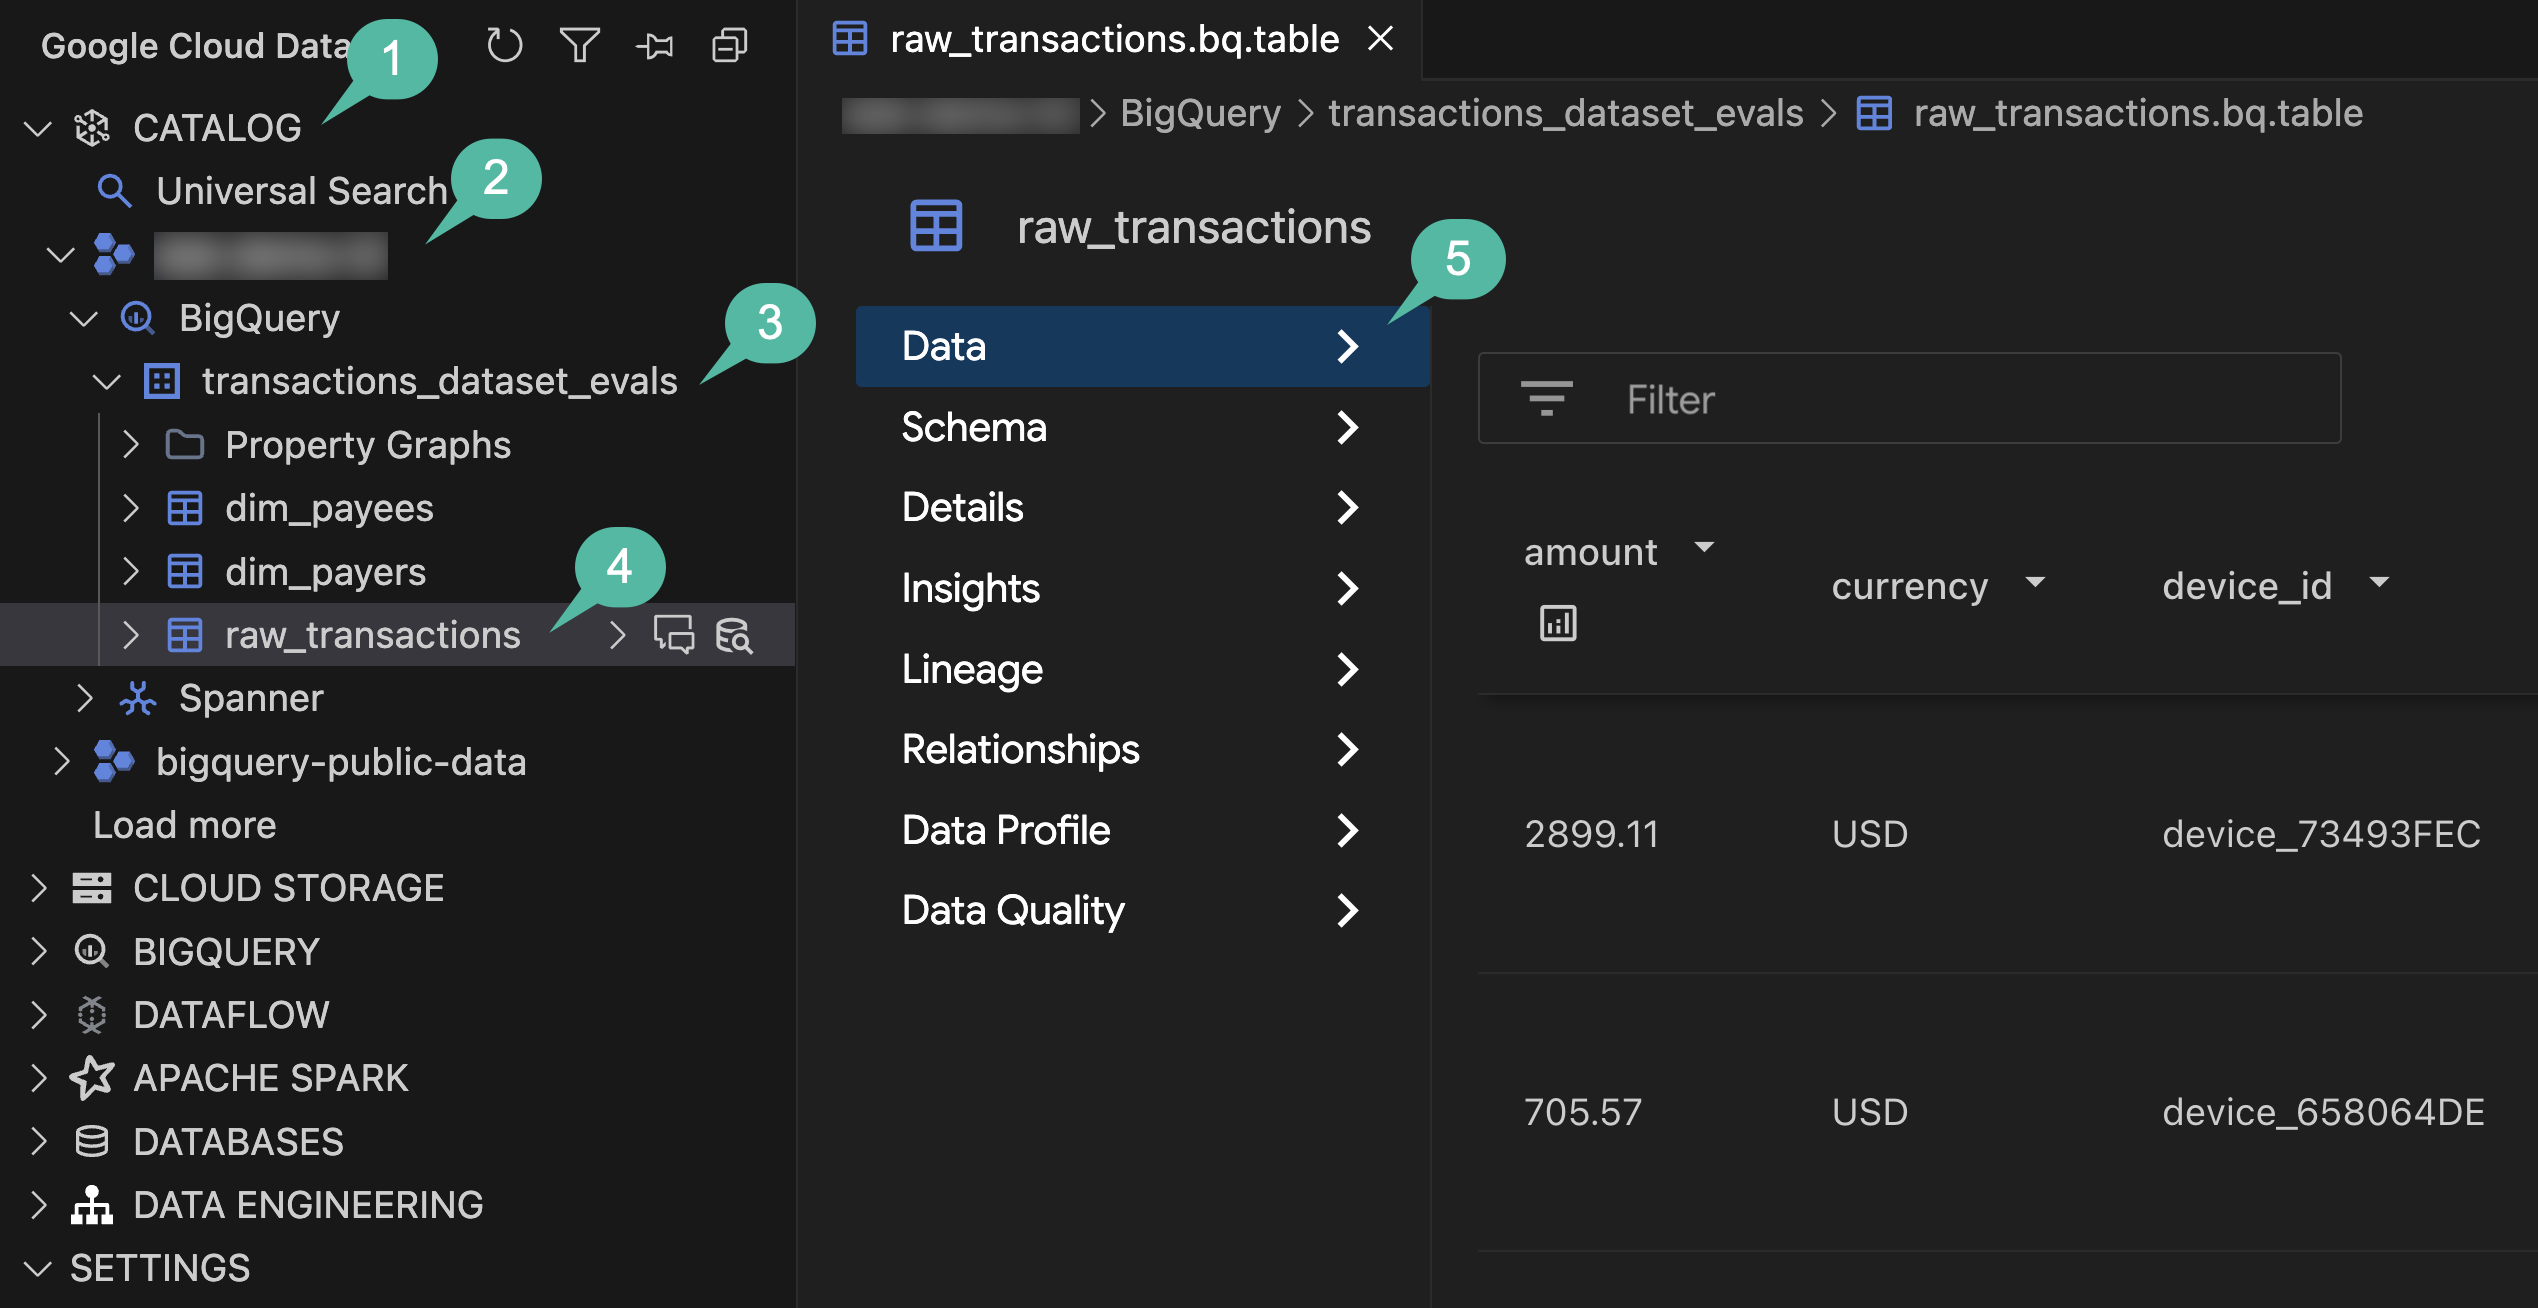
- IDE की गतिविधि बार में, Google Cloud Data Agent Kit पैनल खोलें.
- कैटलॉग सेक्शन को बड़ा करें.
- अपना प्रोजेक्ट आईडी बड़ा करें.
- BigQuery को बड़ा करें.
transactions_dataset_evalsडेटासेट को बड़ा करें.- मुख्य एडिटर में टेबल की ज़्यादा जानकारी वाला व्यू खोलने के लिए,
raw_transactionsटेबल पर क्लिक करें. - बाईं ओर मौजूद नेविगेशन में, डेटा, स्कीमा, और जानकारी टैब एक्सप्लोर करें. इससे, आपको शामिल किए गए रिकॉर्ड और मेटाडेटा की जांच करने में मदद मिलेगी.
सेक्शन की खास जानकारी: आपने एजेंट चैट में नैचुरल लैंग्वेज का इस्तेमाल करके, Spark Serverless के पूरे वर्कलोड को जनरेट किया. इसके बाद, आपने इसका इस्तेमाल करके अनस्ट्रक्चर्ड JSON लॉग को BigQuery (रॉ) टेबल में प्रोसेस किया.
4. dbt की मदद से डुप्लीकेट कॉपी हटाना और डेटा को सामान्य बनाना
एमएल मॉडल को ट्रेनिंग देने से पहले, डेटा क्वालिटी को बेहतर बनाया जाएगा. इसके लिए, डुप्लीकेट स्ट्रीमिंग लॉग हटाए जाएंगे, खराब रिकॉर्ड (जैसे कि खाली लेन-देन आईडी) अलग किए जाएंगे, और डाइमेंशनल डेटा (पेयर और पेमेंट पाने वाला व्यक्ति या कारोबार) को जोड़ा जाएगा. इस प्रोसेस के लिए, आइडमपोटेंट और भरोसेमंद एसक्यूएल ट्रांसफ़ॉर्मेशन की ज़रूरत होती है. इसलिए, dbt (डेटा बिल्ड टूल) एक बेहतरीन विकल्प है.
dbt पाइपलाइन का ढांचा तैयार करना
BigQuery डेटासेट पर dbt प्रोजेक्ट जनरेट करने के लिए, एजेंट का इस्तेमाल करें:
- एजेंट चैट पैनल पर वापस जाएं.
- dbt प्रोजेक्ट जनरेट करने के लिए, यह निर्देश दें:
Scaffold a us-central1 dbt project in dbt_project/ that maps raw_transactions
through to an enriched_transactions model in dataset transactions_dataset_evals.

Deduplicate by transaction_id in staging. Quarantine null IDs to an invalid_transactions model.
Join the valid staging records with dim_payers and dim_payees for the enriched_transactions model,
preserving the historical `is_fraud` label column, and finally add a transaction uniqueness test.

Create an implementation plan first.
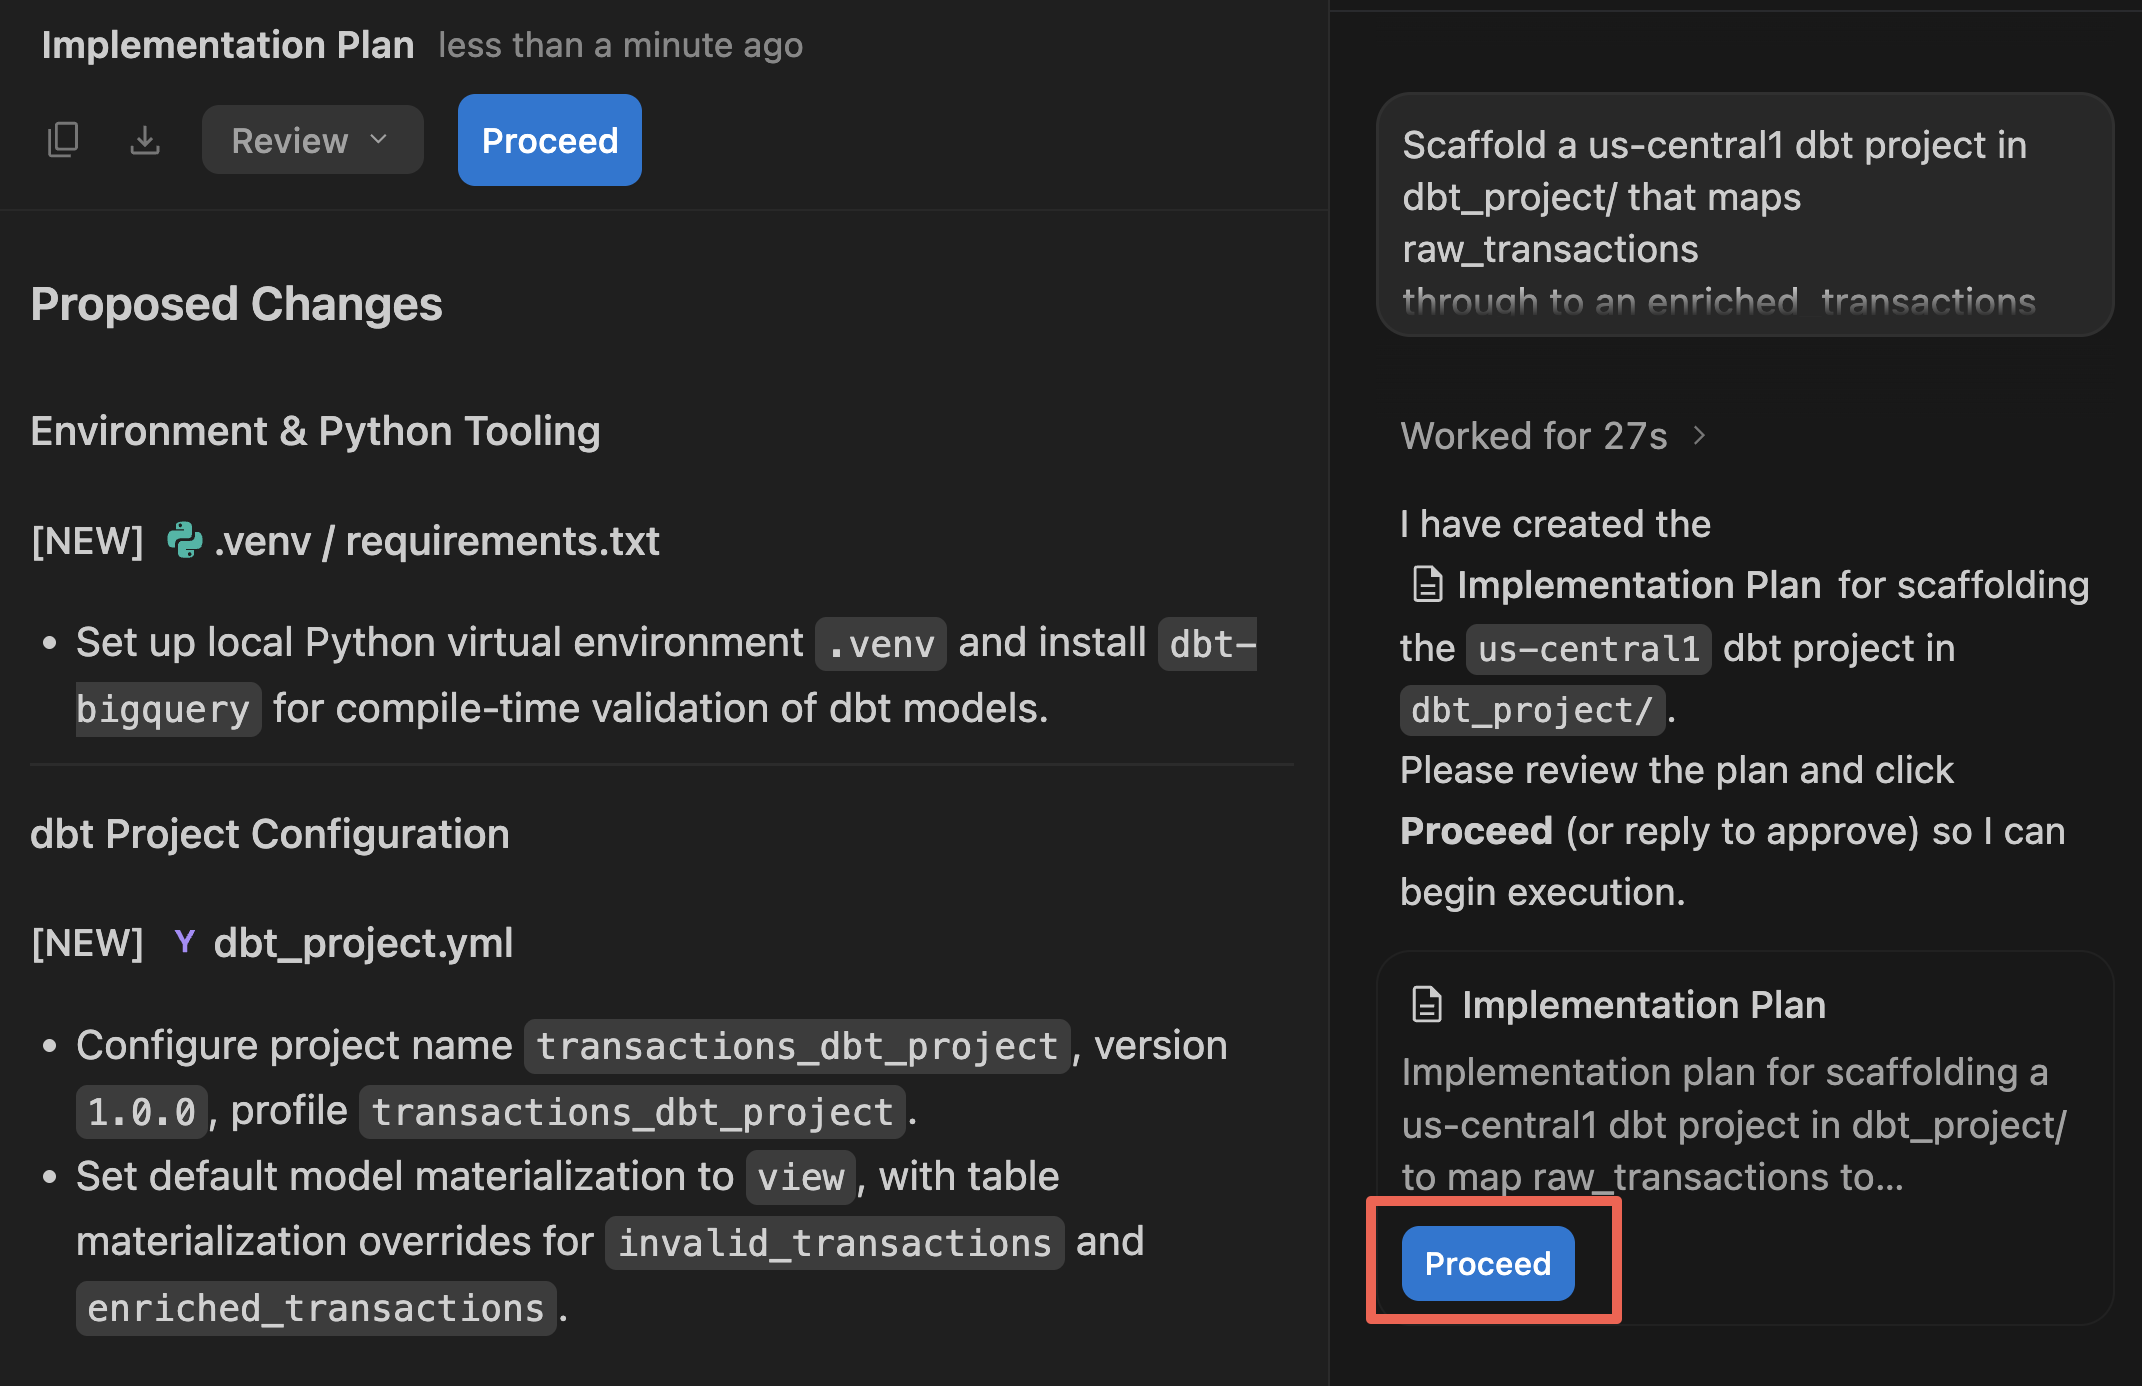
- एजेंट, मुख्य एडिटर पैन में लागू करने का प्लान आर्टफ़ैक्ट दिखाएगा. प्रस्तावित फ़ाइल स्ट्रक्चर और एसक्यूएल लॉजिक की समीक्षा करें.
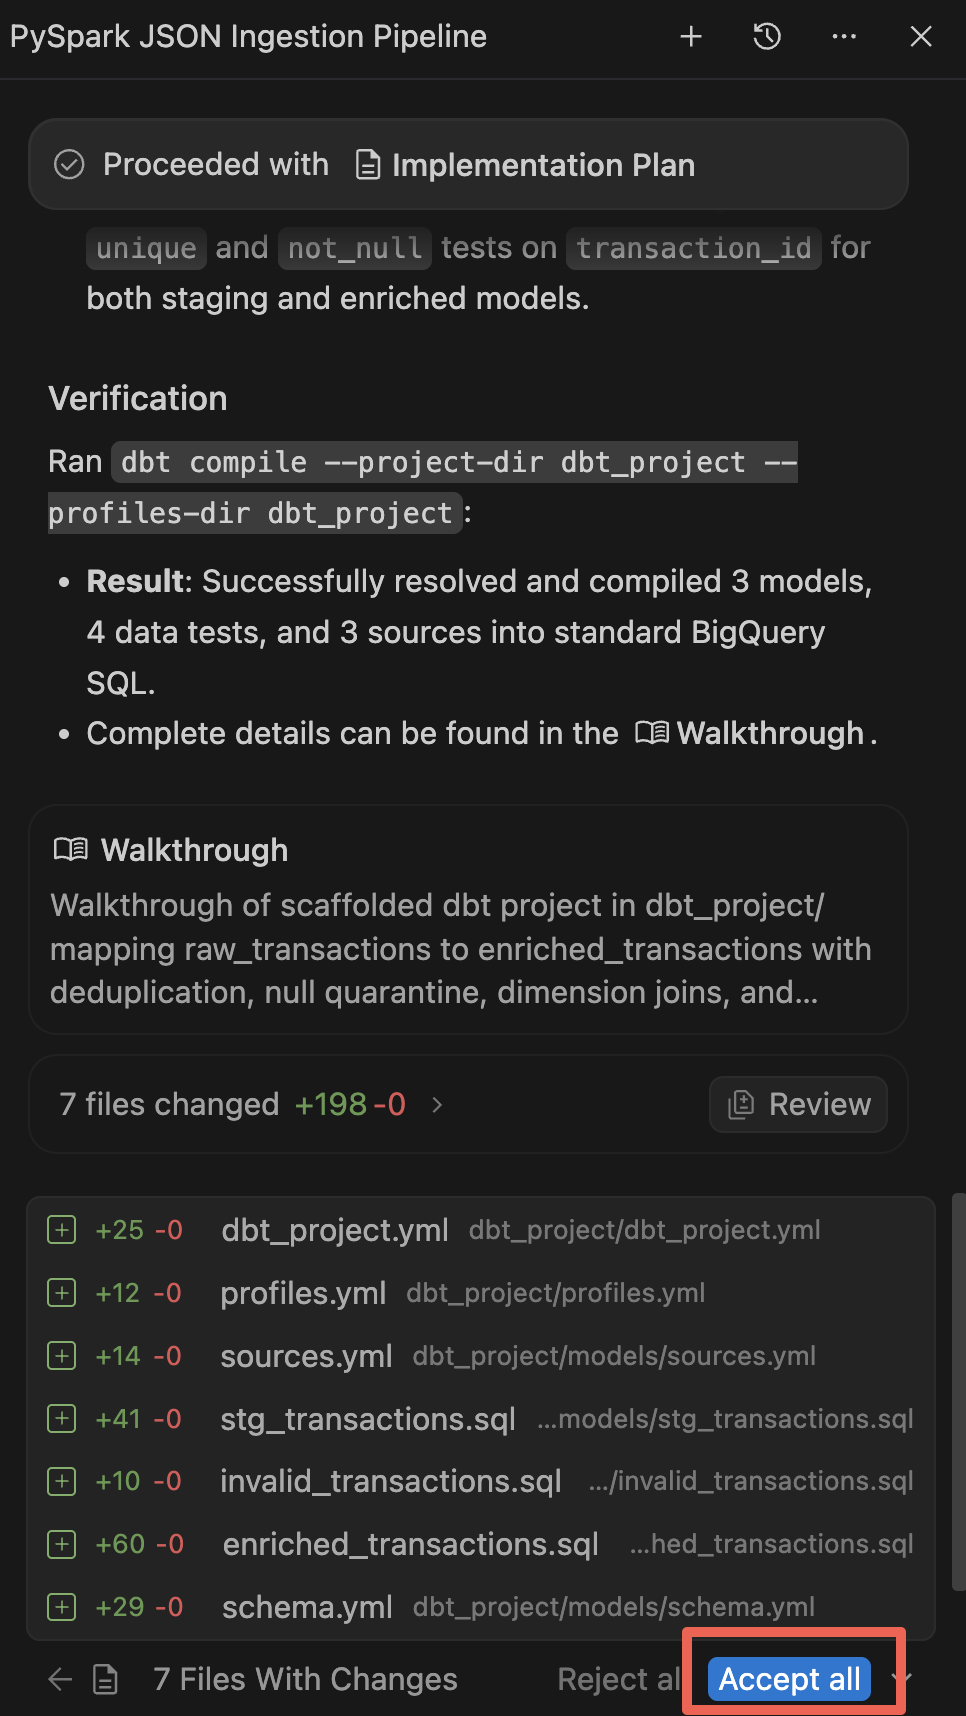
- एजेंट को आपके फ़ाइल फ़ोल्डर में फ़ाइलें जनरेट करने की अनुमति देने के लिए, आगे बढ़ें पर क्लिक करें. इसके बाद, सभी स्वीकार करें पर क्लिक करें.
- जनरेट होने के बाद, एजेंट एक वॉकट्रू दिखाता है. इसमें नए कॉम्पोनेंट के बारे में खास जानकारी होती है. अगर कहा जाए, तो सभी बदलाव स्वीकार करें.
बनाना और टेस्ट करना
हालांकि, एजेंट ने जनरेट किए गए एसक्यूएल की सिंटैक्टिकल पुष्टि करने के लिए, dbt compile को अपने-आप चलाया था. अब आपको इन व्यू और टेबल को BigQuery में बदलना होगा. साथ ही, स्थानीय पुष्टि के लिए डेटा क्वालिटी टेस्ट चलाने होंगे. (ध्यान दें: लैब में बाद में, इस dbt चरण को एंड-टू-एंड Airflow DAG के हिस्से के तौर पर ऑटोमेट किया जाएगा).
- सबसे बाईं ओर मौजूद गतिविधि बार में, एक्सप्लोरर आइकॉन पर क्लिक करें या
Cmd/Ctrl+Shift+Eदबाएं. - जनरेट किए गए एसक्यूएल मॉडल की जांच करने के लिए,
dbt_project->modelsको बड़ा करें. एडिटर में, डेटा में बदलाव करने और धोखाधड़ी रोकने से जुड़ी सुविधा के लॉजिक को खोलने और उसकी समीक्षा करने के लिए,enriched_transactions.sqlपर क्लिक करें. - File Explorer में,
dbt_projectफ़ोल्डर पर राइट क्लिक करें और Integrated Terminal में खोलें को चुनें. इससे, टर्मिनल पैन अपने-आप खुल जाता है. इसे सीधे तौर पर ज़रूरीdbt_projectवर्किंग डायरेक्ट्री पर सेट किया जाता है. - अगर आपने पहले से
dbtइंस्टॉल नहीं किया है, तोdbt_project/के बाहर (अपने घर या वर्कस्पेस के रूट पर) एक वर्चुअल एनवायरमेंट बनाएं और BigQuery अडैप्टर इंस्टॉल करें:
python3 -m venv ~/.venv/dbt
source ~/.venv/dbt/bin/activate
pip install dbt-bigquery
- dbt मॉडल और उनसे जुड़े डेटा क्वालिटी टेस्ट चलाएं:
dbt build
- टर्मिनल आउटपुट देखें. dbt, एसक्यूएल को कंपाइल करेगा. साथ ही, BigQuery में स्टेजिंग और बेहतर टेबल को मटीरियलाइज़ करेगा. इसके बाद, डेटा टेस्ट को एक्ज़ीक्यूट करेगा.
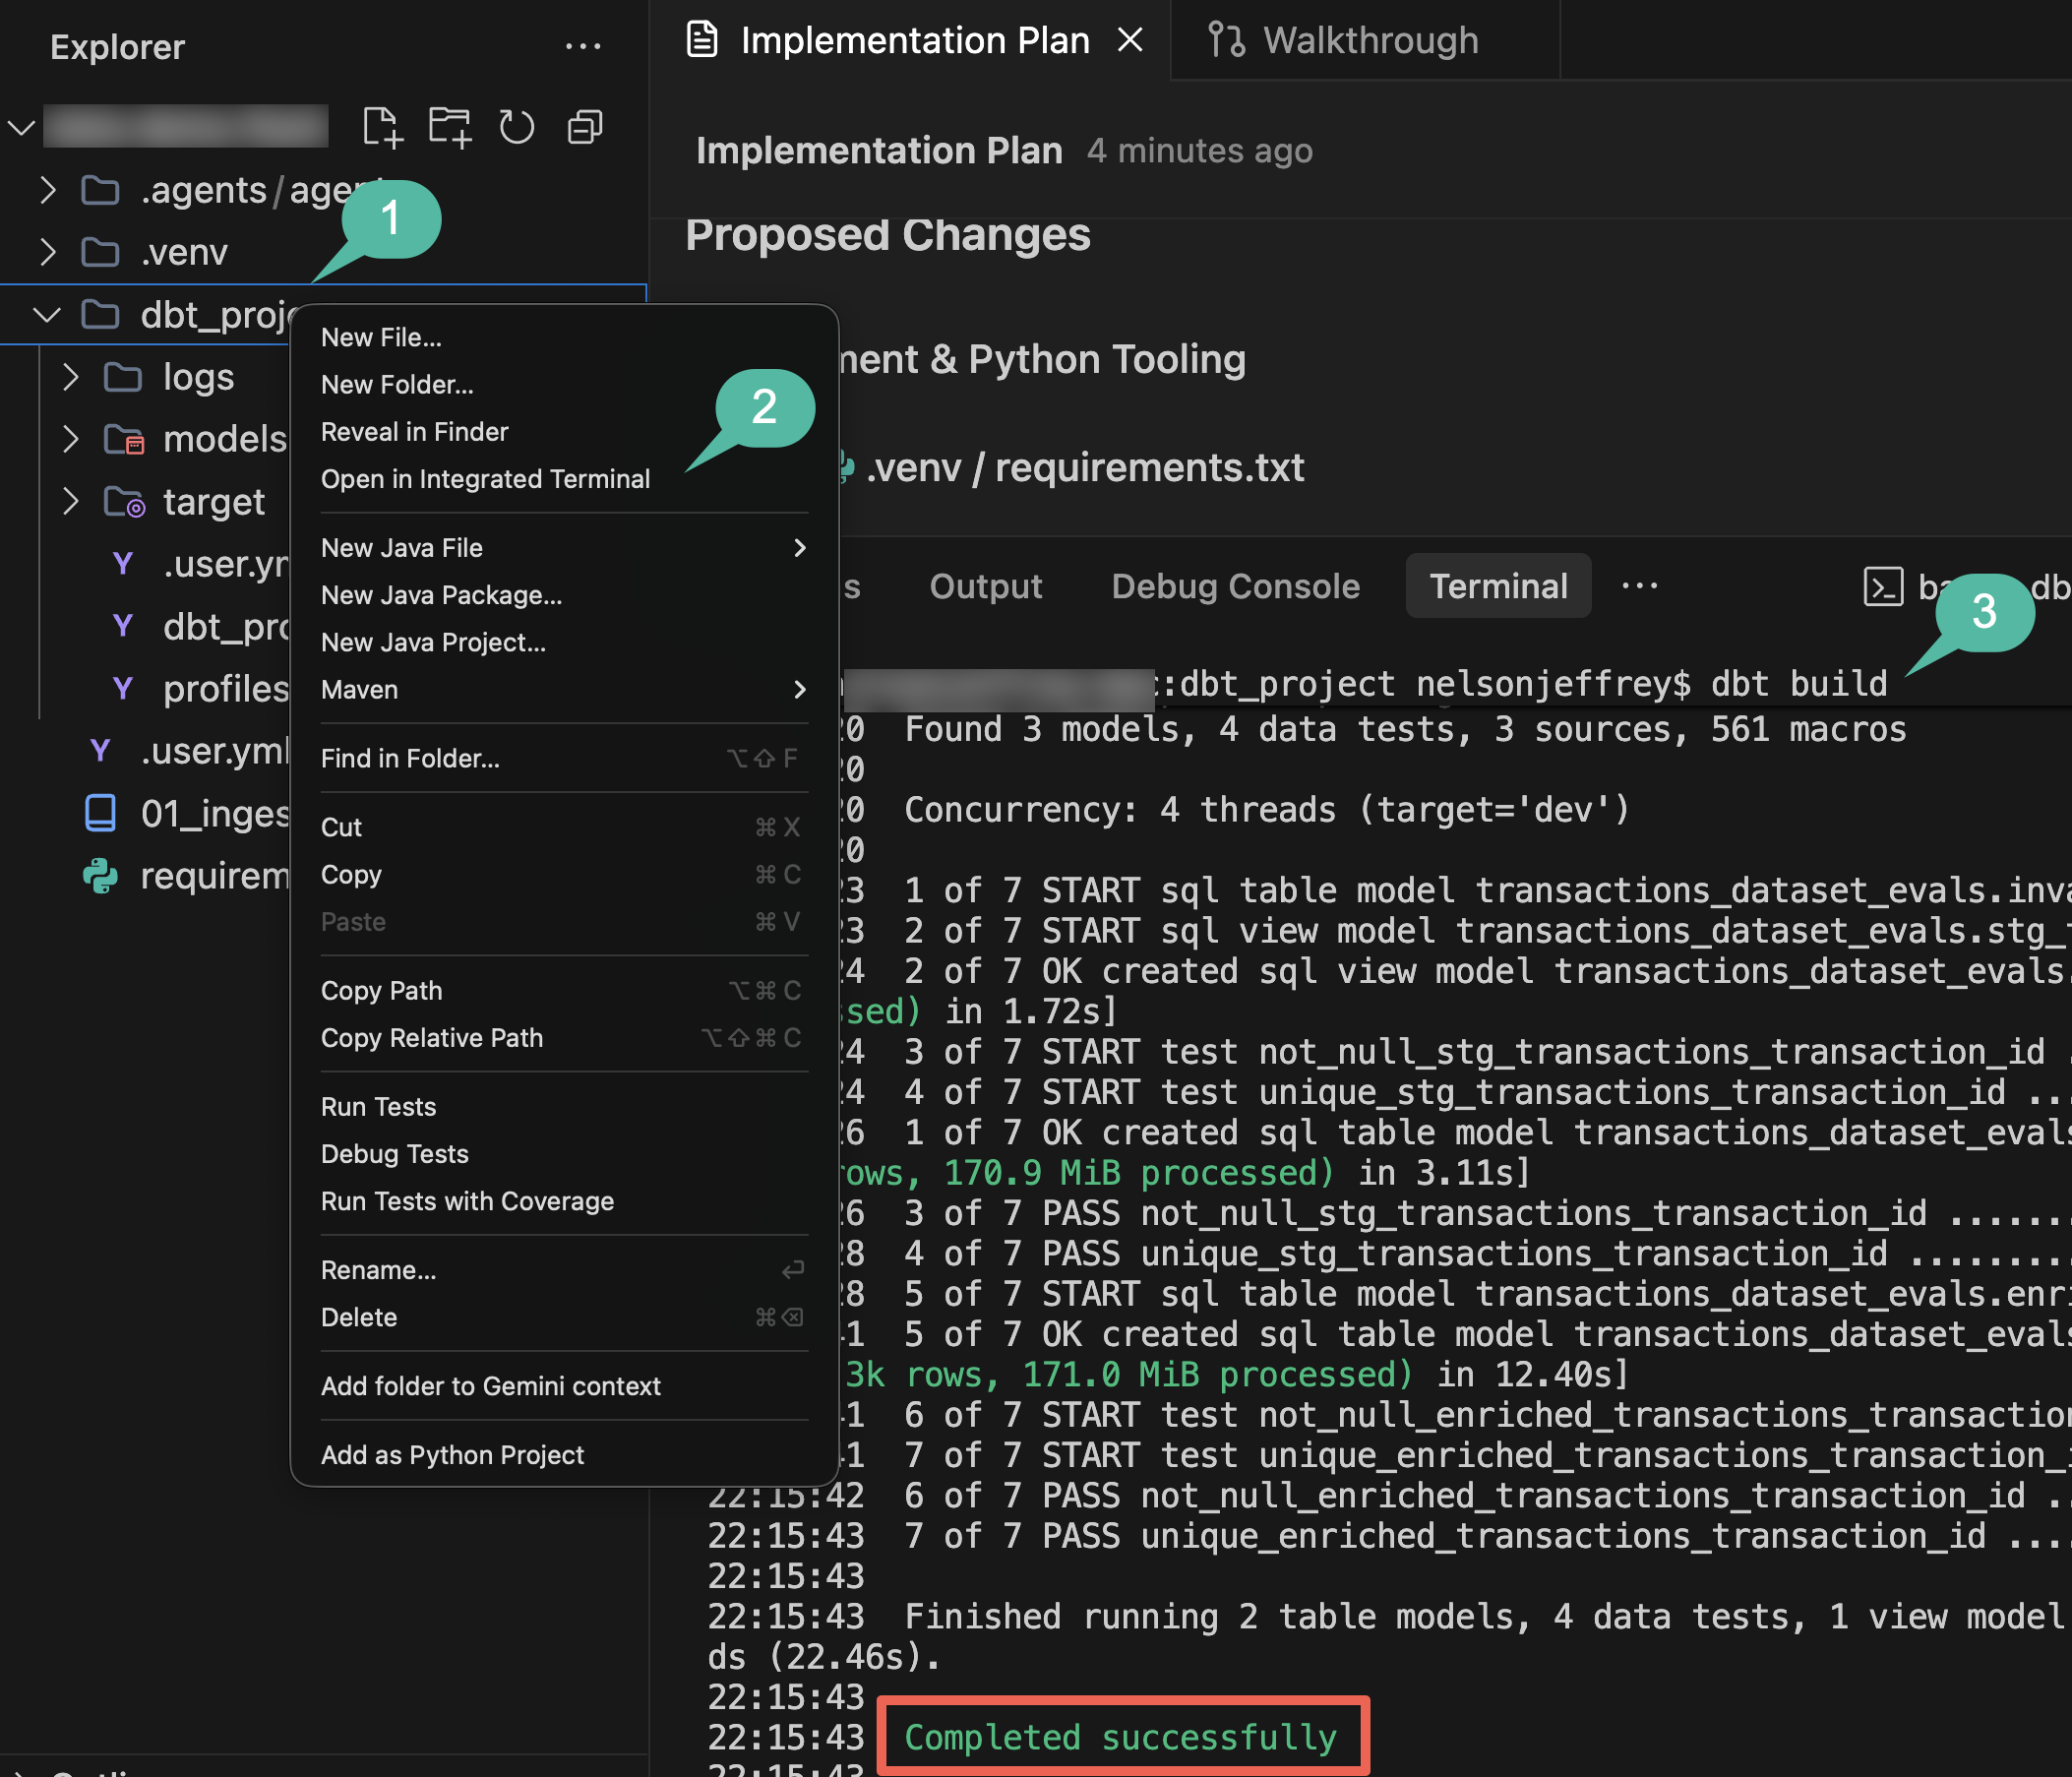
- बिल्ड पूरा होने के बाद, टर्मिनल पैन को बंद करें, ताकि बाकी चरणों के लिए स्क्रीन पर जगह खाली हो जाए.
सेक्शन की खास जानकारी: आपने एजेंट की मदद से dbt प्रोजेक्ट जनरेट किया, डेटा क्वालिटी टेस्ट किए, और रॉ रिकॉर्ड को स्टेजिंग और बेहतर BigQuery टेबल में बदला.
5. रैंडम फ़ॉरेस्ट की मदद से, धोखाधड़ी का पता लगाने वाले डिस्ट्रिब्यूटेड मॉडल को ट्रेन करना
BigQuery में मौजूद बेहतर बनाए गए लेन-देन के डेटा की मदद से, धोखाधड़ी वाले इवेंट का पता लगाने के लिए मशीन लर्निंग मॉडल बनाया जाएगा. रैंडम फ़ॉरेस्ट, ग्रुप लर्निंग का एक तरीका है. यह टेबल के फ़ॉर्मैट में मौजूद क्लासिफ़िकेशन डेटा के लिए सबसे सही है. Spark Serverless पर RandomForestClassifier चलाने से, मॉडल की ट्रेनिंग को वर्कर नोड में डिस्ट्रिब्यूट किया जाता है. इसके लिए, आपको इंफ़्रास्ट्रक्चर को मैनेज करने की ज़रूरत नहीं होती.
इस चरण में, Spark ML ट्रेनिंग पाइपलाइन जनरेट करने के लिए एजेंट का इस्तेमाल किया जाएगा.
एमएल ट्रेनिंग नोटबुक जनरेट करना
- एजेंट से चैट करें पैनल खोलें.
- मॉडल ट्रेनिंग के क्रम को डिज़ाइन करने के लिए, यह प्रॉम्प्ट दें.
${PROJECT_ID}की जगह अपने ऐक्टिव प्रोजेक्ट आईडी का इस्तेमाल करना न भूलें:
Create a PySpark notebook (02_training.ipynb) to train a distributed Random Forest
(RandomForestClassifier) model on the BigQuery table
`transactions_dataset_evals`.`enriched_transactions`, predicting the `is_fraud` label.
Train only on historically labeled records where `is_fraud` is not null.

One-hot encode categorical strings, scale amounts, cache the dataset in memory,
evaluate AUC, and save the evaluated model to gs://${PROJECT_ID}-models/fraud_model.
- एजेंट के प्लान या जनरेट किए गए कोड की समीक्षा करें. इसके बाद, को अपने वर्कस्पेस में सेव करने के लिए, आगे बढ़ें / सभी स्वीकार करें पर क्लिक करें.
notebooks/02_training.ipynb
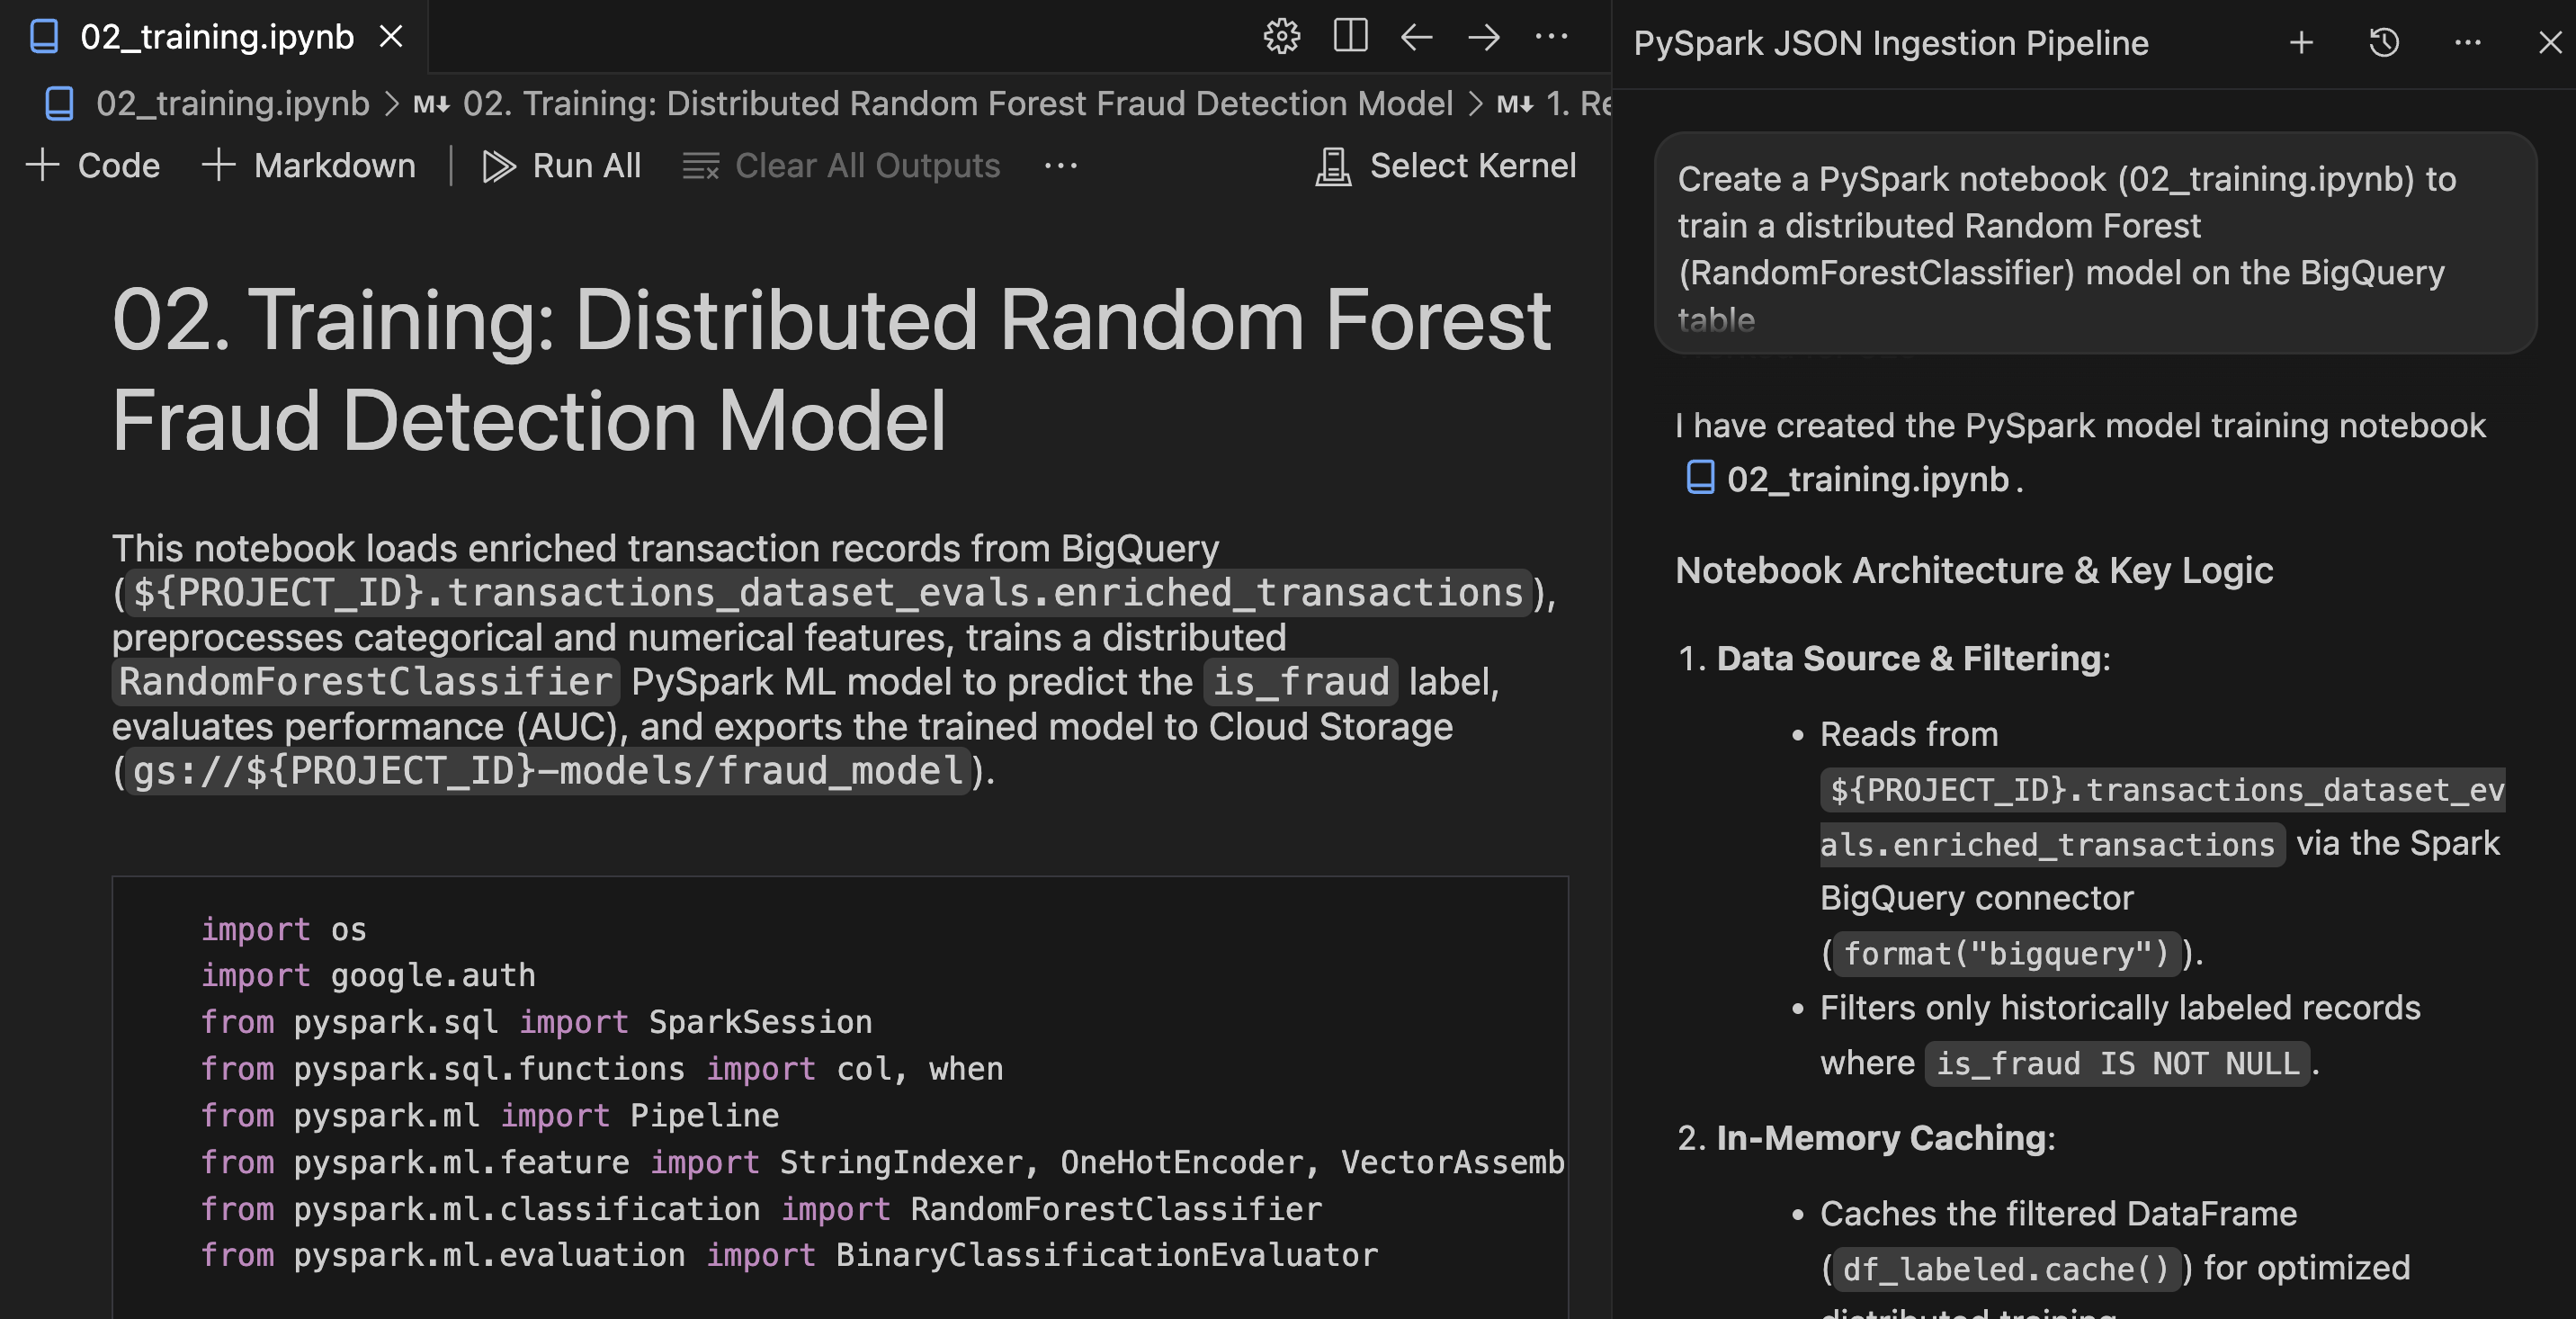
नोटबुक की समीक्षा करना और उसे लागू करना
- एडिटर में
notebooks/02_training.ipynbखोलें. - PySpark ML पाइपलाइन के चरणों की समीक्षा करें. इनमें फ़ीचर एन्कोडिंग, वेक्टर असेंबली, और रैंडम फ़ॉरेस्ट क्लासिफ़िकेशन लॉजिक शामिल हैं.
- IDE के नोटबुक टूलबार में, सभी सेल चलाएं पर क्लिक करें.
- Select Kernel ड्रॉपडाउन पिकर खुलने पर, fraud-pipeline-runtime on Serverless Spark को चुनें.
पुष्टि
मॉडल को लागू करने के बाद, पुष्टि करें कि उसे सही तरीके से ट्रेन किया गया है और एक्सपोर्ट किया गया है:
- रिपोर्ट किए गए ROC (एयूसी) स्कोर की पुष्टि करने के लिए, नोटबुक में सबसे नीचे मौजूद मूल्यांकन सेल के आउटपुट देखें.
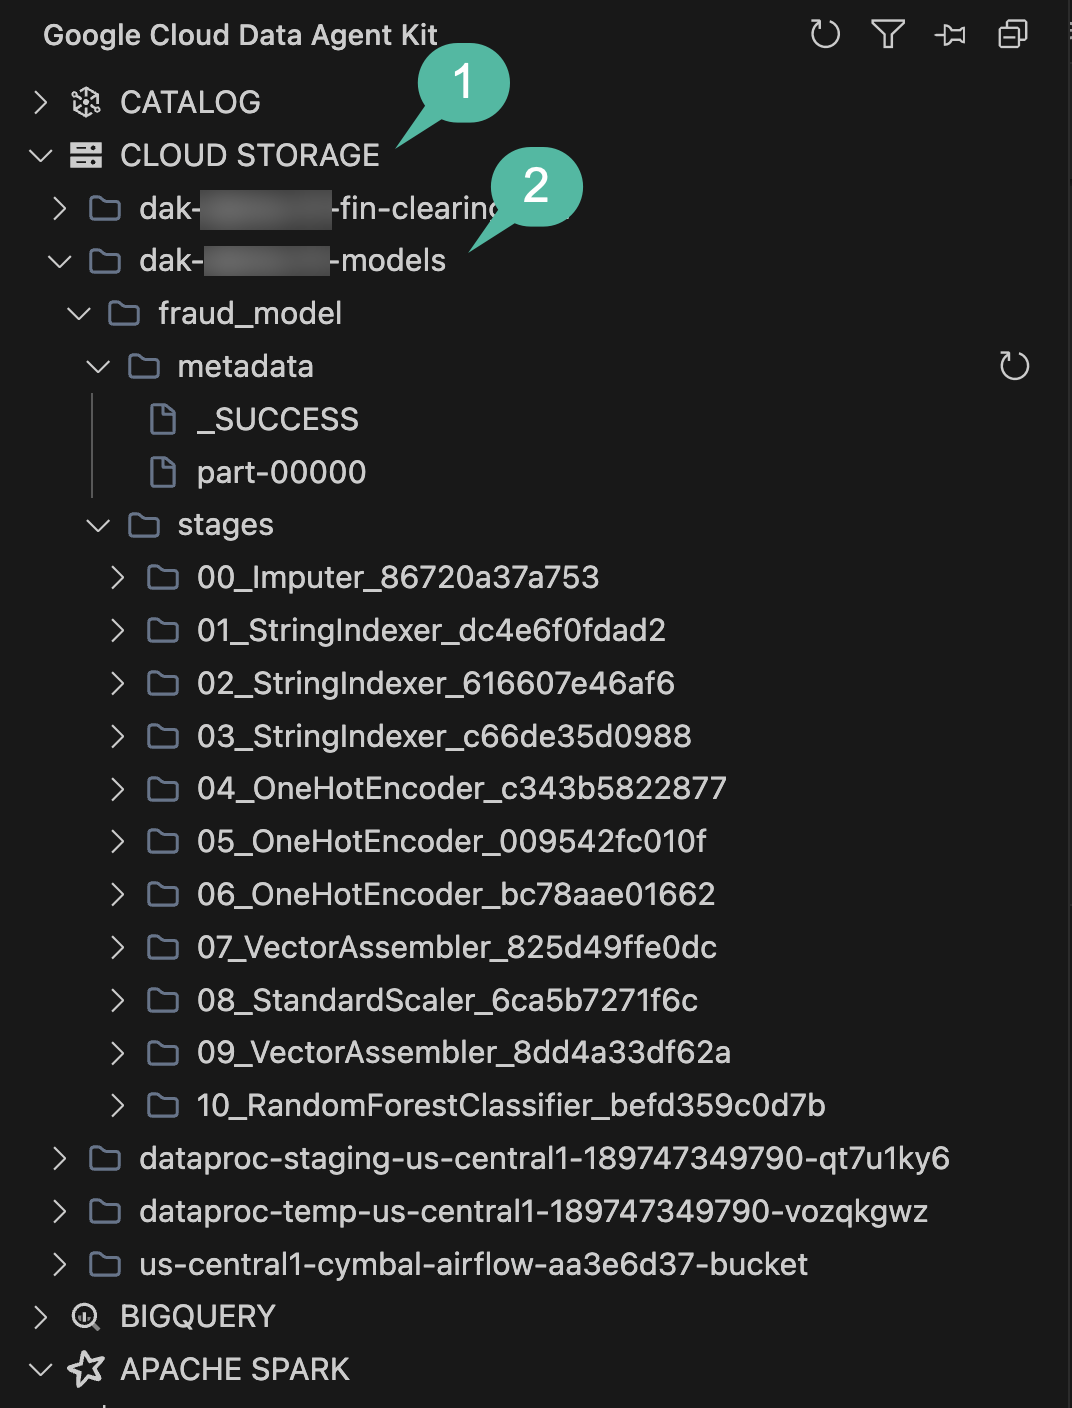
- मॉडल आर्टफ़ैक्ट को GCS में सेव किया गया है या नहीं, यह देखने के लिए Data Agent Kit के साइडबार में मौजूद STORAGE एक्सप्लोरर पैन को बड़ा करें.
-modelsसे खत्म होने वाले बकेट (आपके चालू प्रोजेक्ट आईडी से जुड़ा) को ढूंढें. इसके बाद, उसे बड़ा करें और यह देखने के लिए ड्रिल-डाउन करें किfraud_modelडायरेक्ट्री और उसके पाइपलाइन स्टेज मौजूद हैं या नहीं.
सेक्शन की खास जानकारी: आपने एजेंट का इस्तेमाल करके, PySpark ML ट्रेनिंग पाइपलाइन बनाई. साथ ही, आपने अपनी बेहतर बनाई गई BigQuery टेबल पर रैंडम फ़ॉरेस्ट मॉडल को ट्रेन किया और मॉडल को Cloud Storage में एक्सपोर्ट किया.
6. बैच इन्फ़ेरेंस और Cloud Spanner में डेटा लिखना
Cloud Storage में सेव किए गए, ट्रेन किए गए अनुमानित मॉडल की मदद से, BigQuery से आने वाले नए लेन-देन पर बैच इन्फ़रेंस चलाया जाएगा. ज़्यादा जोखिम वाले लेन-देन को चालू सिस्टम पर रूट किया जाना चाहिए, ताकि अनुपालन टीम उनकी समीक्षा कर सके. Cloud Spanner, समीक्षा के लिए सबमिट किए गए आइटम की इस सूची के लिए, ज़रूरत के हिसाब से बढ़ाया जा सकने वाला ट्रांज़ैक्शनल डेटाबेस उपलब्ध कराता है.
बैच इन्फ़रेंस नोटबुक जनरेट करना
BigQuery, Cloud Storage, और Cloud Spanner को कनेक्ट करने वाला अनुमान नोटबुक बनाने के लिए, एजेंट का इस्तेमाल करें:
- एजेंट से चैट करें पैनल खोलें.
- यह प्रॉम्प्ट दें:
Create an inference notebook (03_inference.ipynb) that loads the RandomForestClassifier
model to score unlabeled records (where `is_fraud` is null) from the BigQuery table
`transactions_dataset_evals`.`enriched_transactions`.

Filter for high-risk transactions with a 50%+ fraud probability score (probability >= 0.50)
and write them to the Cloud Spanner table SparkEvalFraudReviewQueue in the cymbal-fraud instance
under fraud-db.
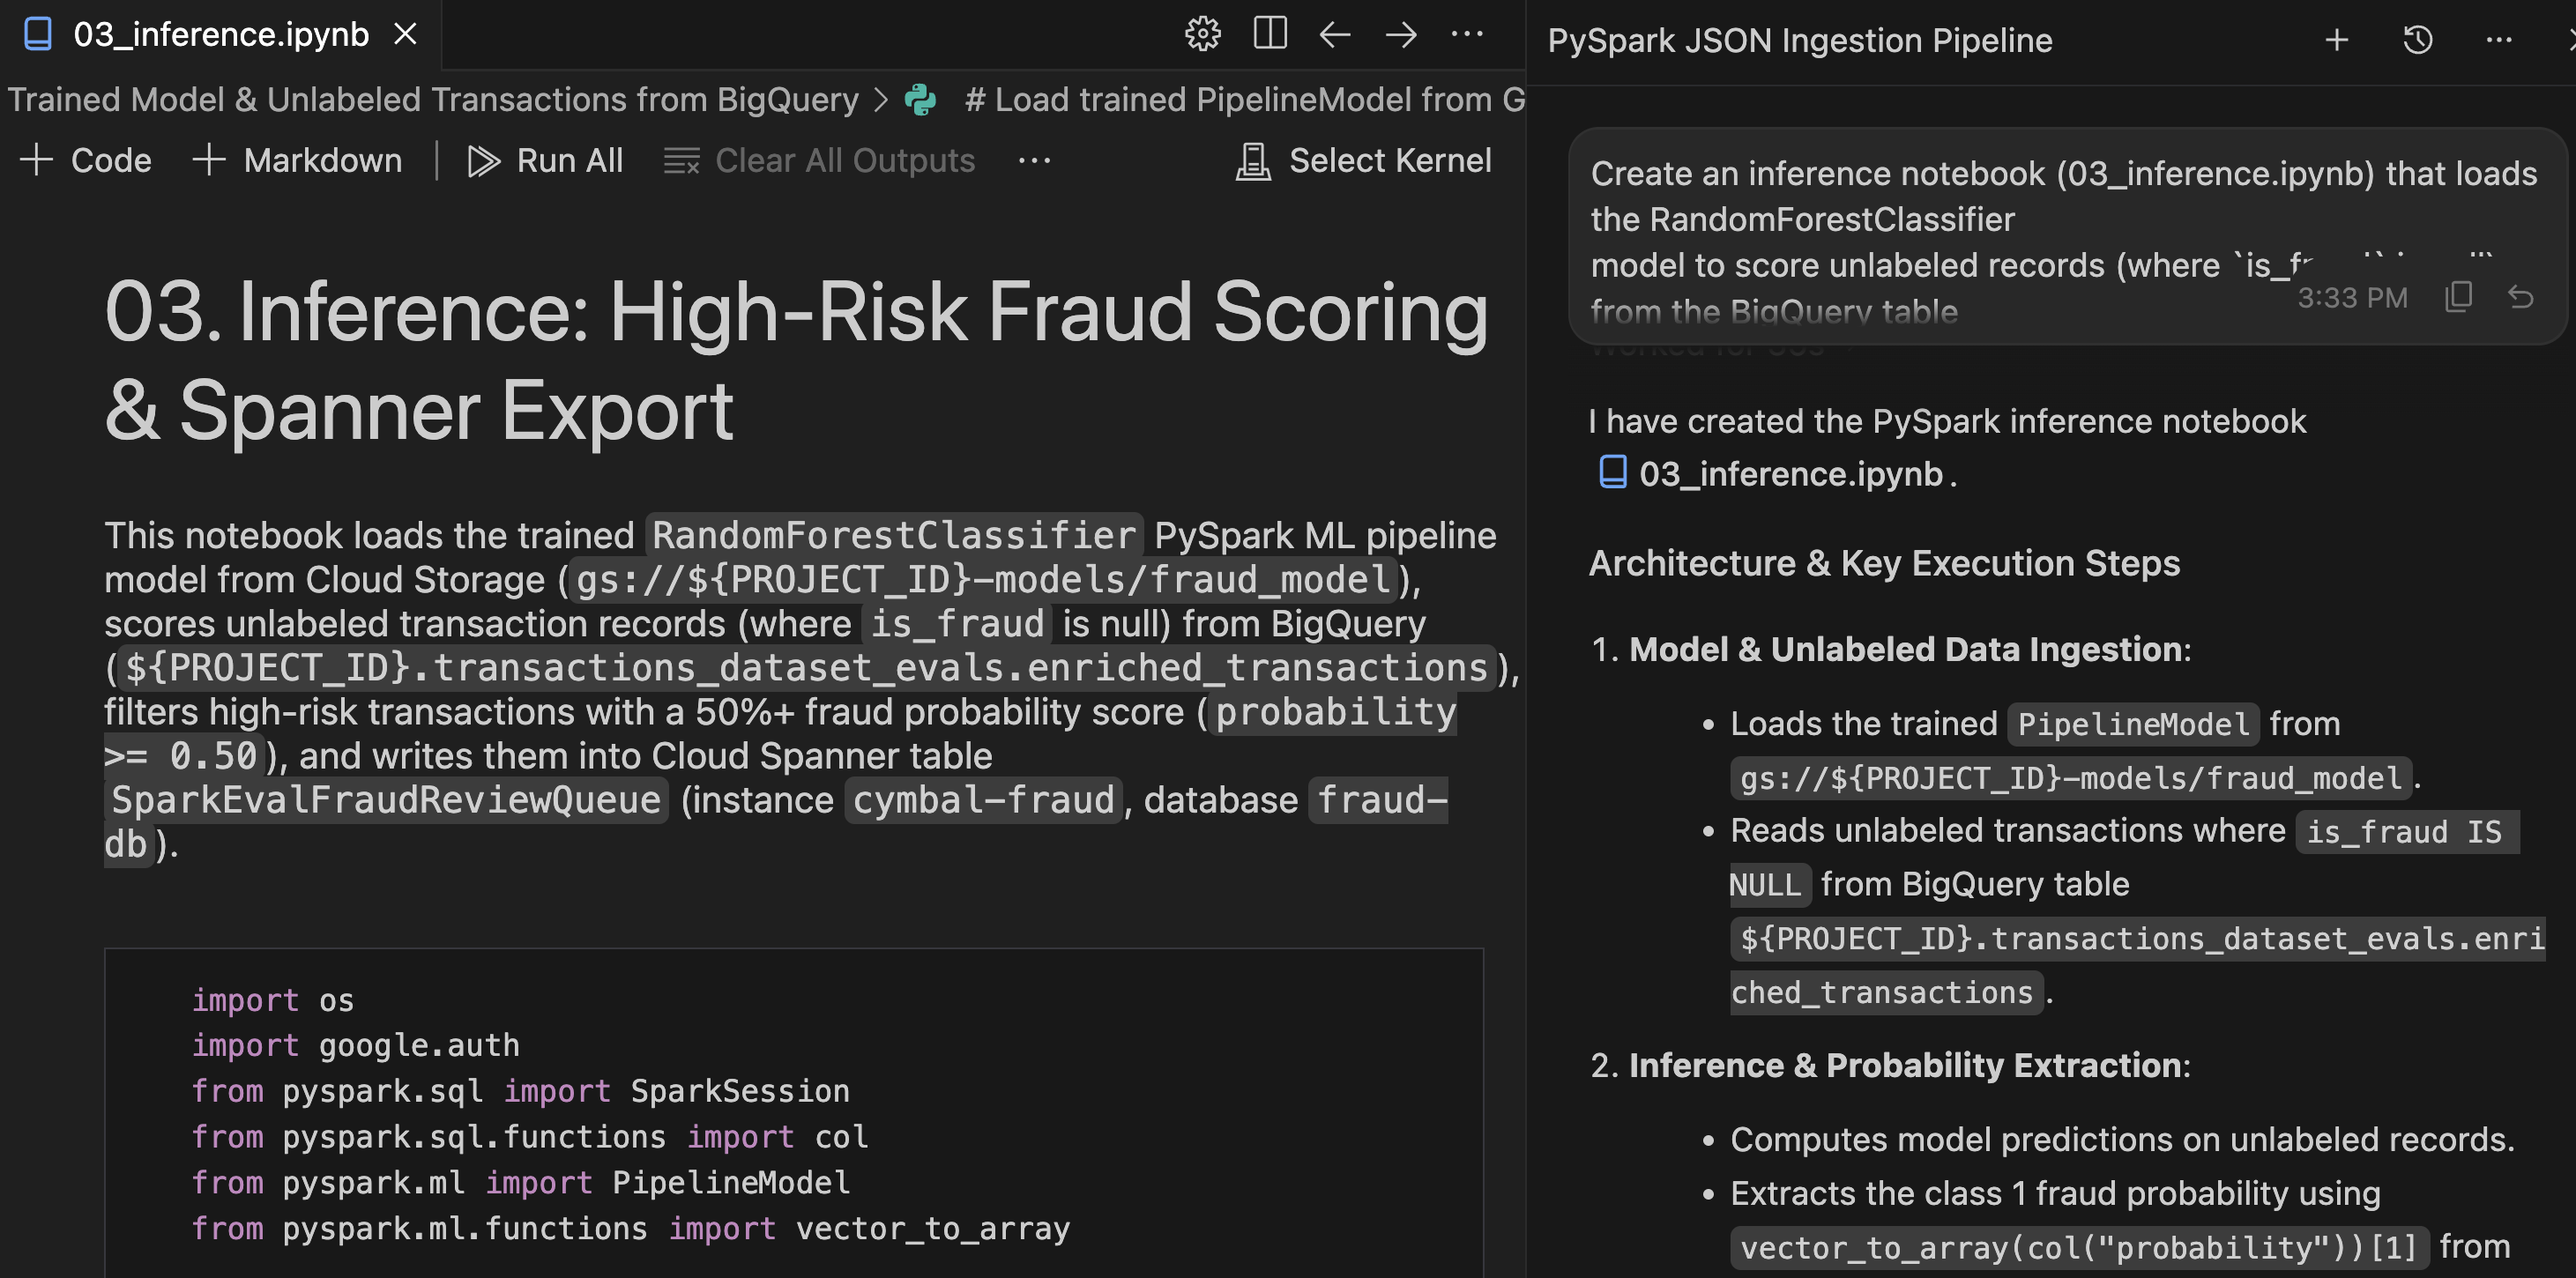
- जनरेट की गई नोटबुक को स्वीकार करके,
notebooks/03_inference.ipynbको अपने Workspace में सेव करें.
नोटबुक की समीक्षा करना और उसे लागू करना
- एडिटर में, नई जनरेट की गई
notebooks/03_inference.ipynbखोलें. - PySpark के अनुमान लगाने के क्रम की समीक्षा करें:
- डिपेंडेंसी: Serverless Runtime टेंप्लेट, Spark को एक्ज़ीक्यूट करने के लिए ज़रूरी
cloud-spannerJAR डिपेंडेंसी उपलब्ध कराता है. - डेटा फ़ॉर्मैट करना: स्पैनर टेबल स्कीमा से मैच करने के लिए, यह स्क्रिप्ट स्पार्क एमएल के जटिल वेक्टर कॉलम (जैसे कि रॉ फ़ीचर और संभावनाएं) को ड्रॉप करती है.
- Spanner कनेक्टर: यह
.format("cloud-spanner")का इस्तेमाल करके, फ़्लैग की गई लाइनों को लिखता है, ताकि उन्हें सीधे समीक्षा के लिए भेजी गई लाइनों की सूची में जोड़ा जा सके.
- डिपेंडेंसी: Serverless Runtime टेंप्लेट, Spark को एक्ज़ीक्यूट करने के लिए ज़रूरी
- IDE के नोटबुक टूलबार में, सभी सेल चलाएं पर क्लिक करें.
- जब आपसे कर्नल चुनने के लिए कहा जाए, तब fraud-pipeline-runtime on Serverless Spark चुनें.
पुष्टि
इन्फ़रेंस नोटबुक के प्रोसेस होने के बाद, सीधे तौर पर आईडीई में जाकर अपने ऑपरेशनल Spanner डेटाबेस से क्वेरी की जा सकती है:
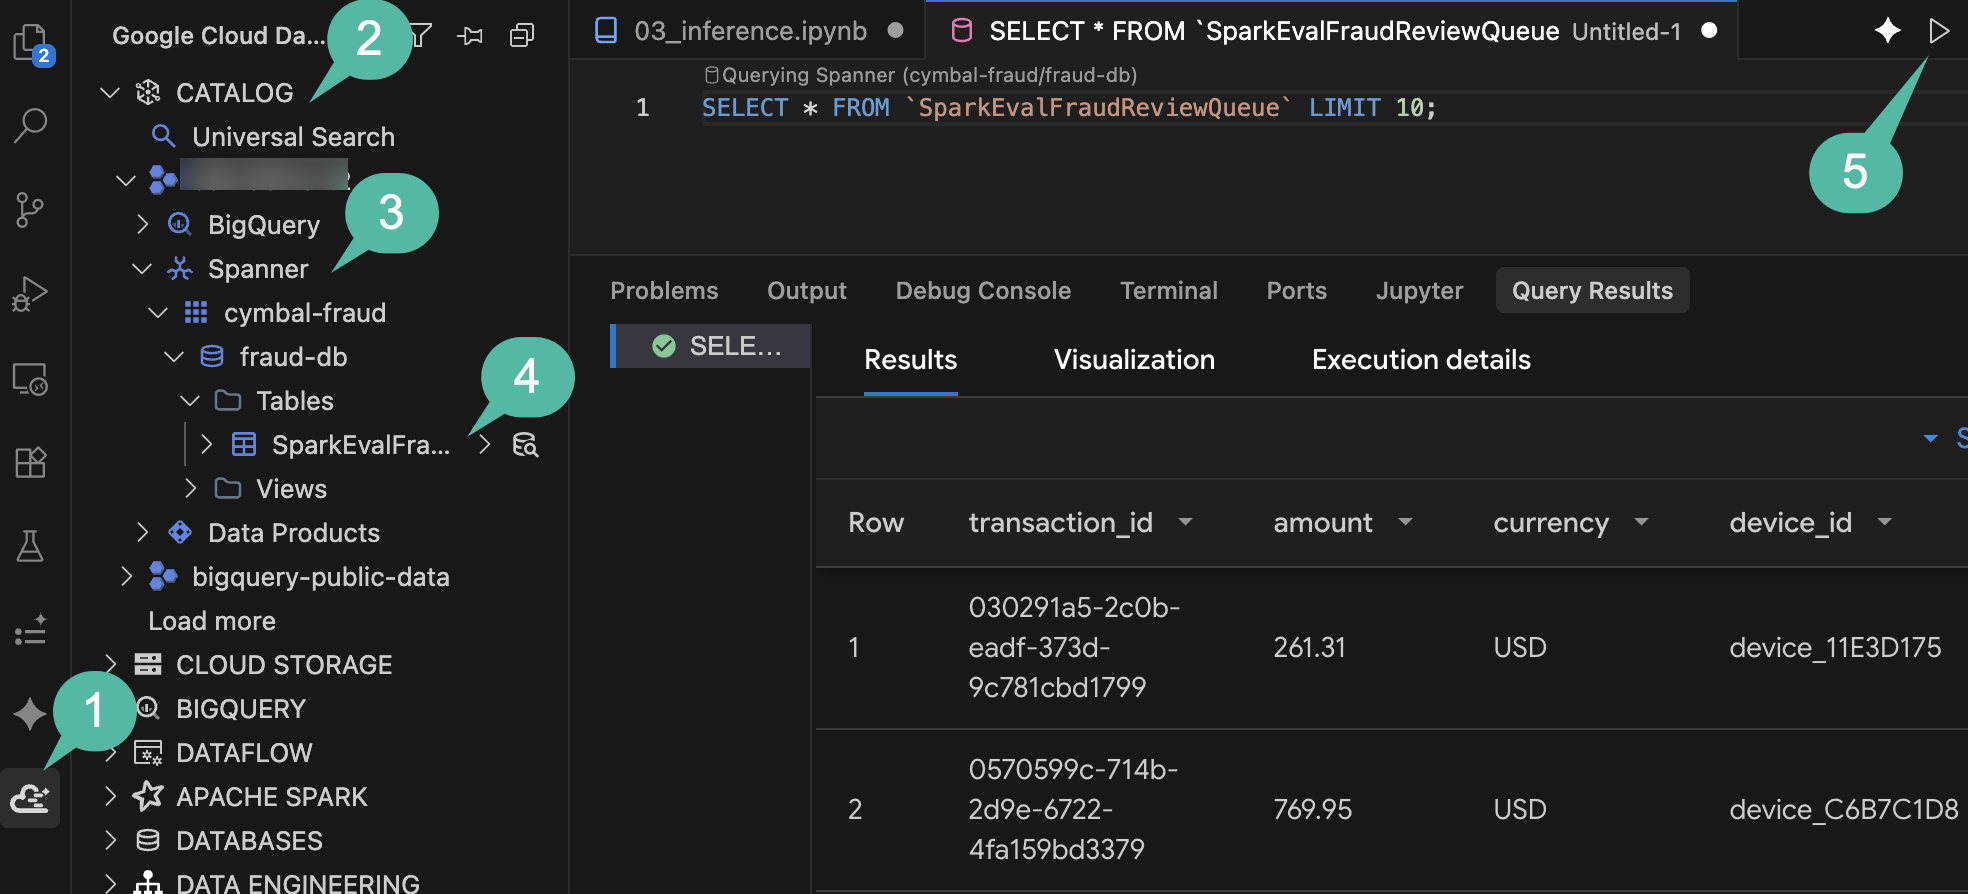
- IDE की गतिविधि बार में, Google Cloud Data Agent Kit पैनल खोलें.
- कैटलॉग सेक्शन को बड़ा करें.
- अपने प्रोजेक्ट आईडी को बड़ा करें. इसके बाद, Spanner को बड़ा करें.
cymbal-fraud->fraud-db->Tables->SparkEvalFraudReviewQueueपर जाएं.- टेबल पर राइट क्लिक करके, क्वेरी टेबल चुनें. इसके बाद, क्वेरी चलाएं:
SELECT *
FROM `SparkEvalFraudReviewQueue`
LIMIT 100;
- नीचे दिए गए क्वेरी के नतीजे वाले पैनल में, आपको नई जोड़ी गई ऐसी लाइनें दिखेंगी जिनमें ज़्यादा जोखिम वाले लेन-देन दिखाए गए हैं. इन लेन-देन को मैन्युअल तरीके से समीक्षा करने के लिए फ़्लैग किया गया है.
सेक्शन की खास जानकारी: आपने एजेंट का इस्तेमाल करके, बैच इन्फ़रेंस नोटबुक बनाई. साथ ही, आपने ट्रेनिंग दिए गए मॉडल की मदद से, बिना लेबल वाले BigQuery रिकॉर्ड को स्कोर किया. इसके अलावा, आपने ज़्यादा जोखिम वाले लेन-देन को सीधे तौर पर Cloud Spanner में लिखा.
7. Managed Airflow की मदद से, वर्कफ़्लो को व्यवस्थित और मैनेज करना
फ़िलहाल, आपकी पाइपलाइन में अलग-अलग चरण शामिल हैं: डेटा इंटेक करने वाली नोटबुक, dbt ट्रांसफ़ॉर्मेशन प्रोजेक्ट, और बैच इन्फ़रेंस नोटबुक. इसे प्रोडक्शन के लिए तैयार करने के लिए, आपको इन्हें शेड्यूल किए गए डिपेंडेंसी ग्राफ़ में एक साथ जोड़ना होगा.
Managed Service for Apache Airflow (जिसे पहले Cloud Composer कहा जाता था) इस वर्कफ़्लो के लिए, मैनेज किया गया ऑर्केस्ट्रेशन इंजन उपलब्ध कराता है. Data Agent Kit में ऑर्केस्ट्रेशन पाइपलाइन की सुविधा शामिल होती है. यह सुविधा, डिक्लेरेटिव YAML पाइपलाइन की परिभाषाओं को सीधे तौर पर Airflow DAG में बदल देती है.
पाइपलाइन तय करना
ऑर्केस्ट्रेशन पाइपलाइन का कॉन्फ़िगरेशन जनरेट करने के लिए, एजेंट का इस्तेमाल करें:
- एजेंट चैट में, यह प्रॉम्प्ट दें.
${PROJECT_ID}को अपनी जानकारी से बदलना न भूलें:
Initialize and define an orchestration pipeline (fraud_analysis_pipeline) triggering
the ingestion notebook, dbt project, and inference notebook in sequential order.
For Dataproc Serverless engine configs in us-central1, use resourceProfile.inline
(defining properties with spark.jars: "gs://spark-lib/spanner/spark-3.5-spanner-1.4.0.jar"
for inference) rather than resourceProfile.path or overrides.

Set the schedule interval to run daily at midnight, and use
gs://${PROJECT_ID}-airflow-artifacts for artifact storage.
DAG कॉन्फ़िगरेशन की समीक्षा करना
Data Agent Kit Orchestrator, डिक्लेरेटिव YAML कॉन्फ़िगरेशन का इस्तेमाल करके, Apache Airflow में पाइपलाइन तय करता है और उन्हें डिप्लॉय करता है. इससे, वर्शन कंट्रोल की मदद से परिभाषाएं तय की जा सकती हैं और CI/CD के ज़रिए उन्हें डिप्लॉय किया जा सकता है.
IDE Explorer पैन में, एजेंट की ओर से आपके वर्कस्पेस के रूट में जनरेट की गई दो पाइपलाइन फ़ाइलों की समीक्षा करें:
deployment.yaml: इस फ़ाइल को खोलें. यह आपके एनवायरमेंट रजिस्ट्री के तौर पर काम करता है. यह आपके लॉजिकलdevपाइपलाइन कोcymbal-airflowएनवायरमेंट से मैप करता है, एक्ज़ीक्यूशन रीजन (us-central1) सेट करता है, औरartifact_storageबकेट तय करता है. इस बकेट में कंपाइल किए गए डीएजी और डिपेंडेंसी को स्टेज किया जाता है.fraud_analysis_pipeline.yaml: इस फ़ाइल को खोलें. इससे एक्ज़ीक्यूशन ग्राफ़ तय होता है. इसमें ट्रिगर शेड्यूल (interval: '0 0 * * *') के बारे में बताया गया है. साथ ही,actionsब्लॉक में तीन चरणों को क्रम से दिखाया गया है:- Dataproc Serverless पर चल रहे
01_ingestion.ipynbके लिए, डेटा ट्रांसफ़र करने कीnotebookकार्रवाई. dbt_projectडायरेक्ट्री को टारगेट करने वाला ट्रांसफ़ॉर्मेशनpipelineऐक्शन. इसमेंdependsOnडिपेंडेंसी होती है, जो डेटा इंटेक के चरण की ओर इशारा करती है.03_inference.ipynbके लिए अनुमान लगाने वालीnotebookकार्रवाई. इसमेंdependsOnडिपेंडेंसी होती है, जो dbt चरण की ओर इशारा करती है. साथ ही, इसमें Spanner JAR प्रॉपर्टी बंडल होती है.
- Dataproc Serverless पर चल रहे
- इसके अलावा, एजेंट जनरेट किए गए इन आर्टफ़ैक्ट को आपके एडिटर पैनल में मौजूद वॉकट्रू टैब में खास जानकारी के तौर पर दिखाएगा. इसमें किए गए कॉन्फ़िगरेशन और पुष्टि की जानकारी भी शामिल होगी.
इंटरैक्टिव डीएजी कॉन्फ़िगरेशन
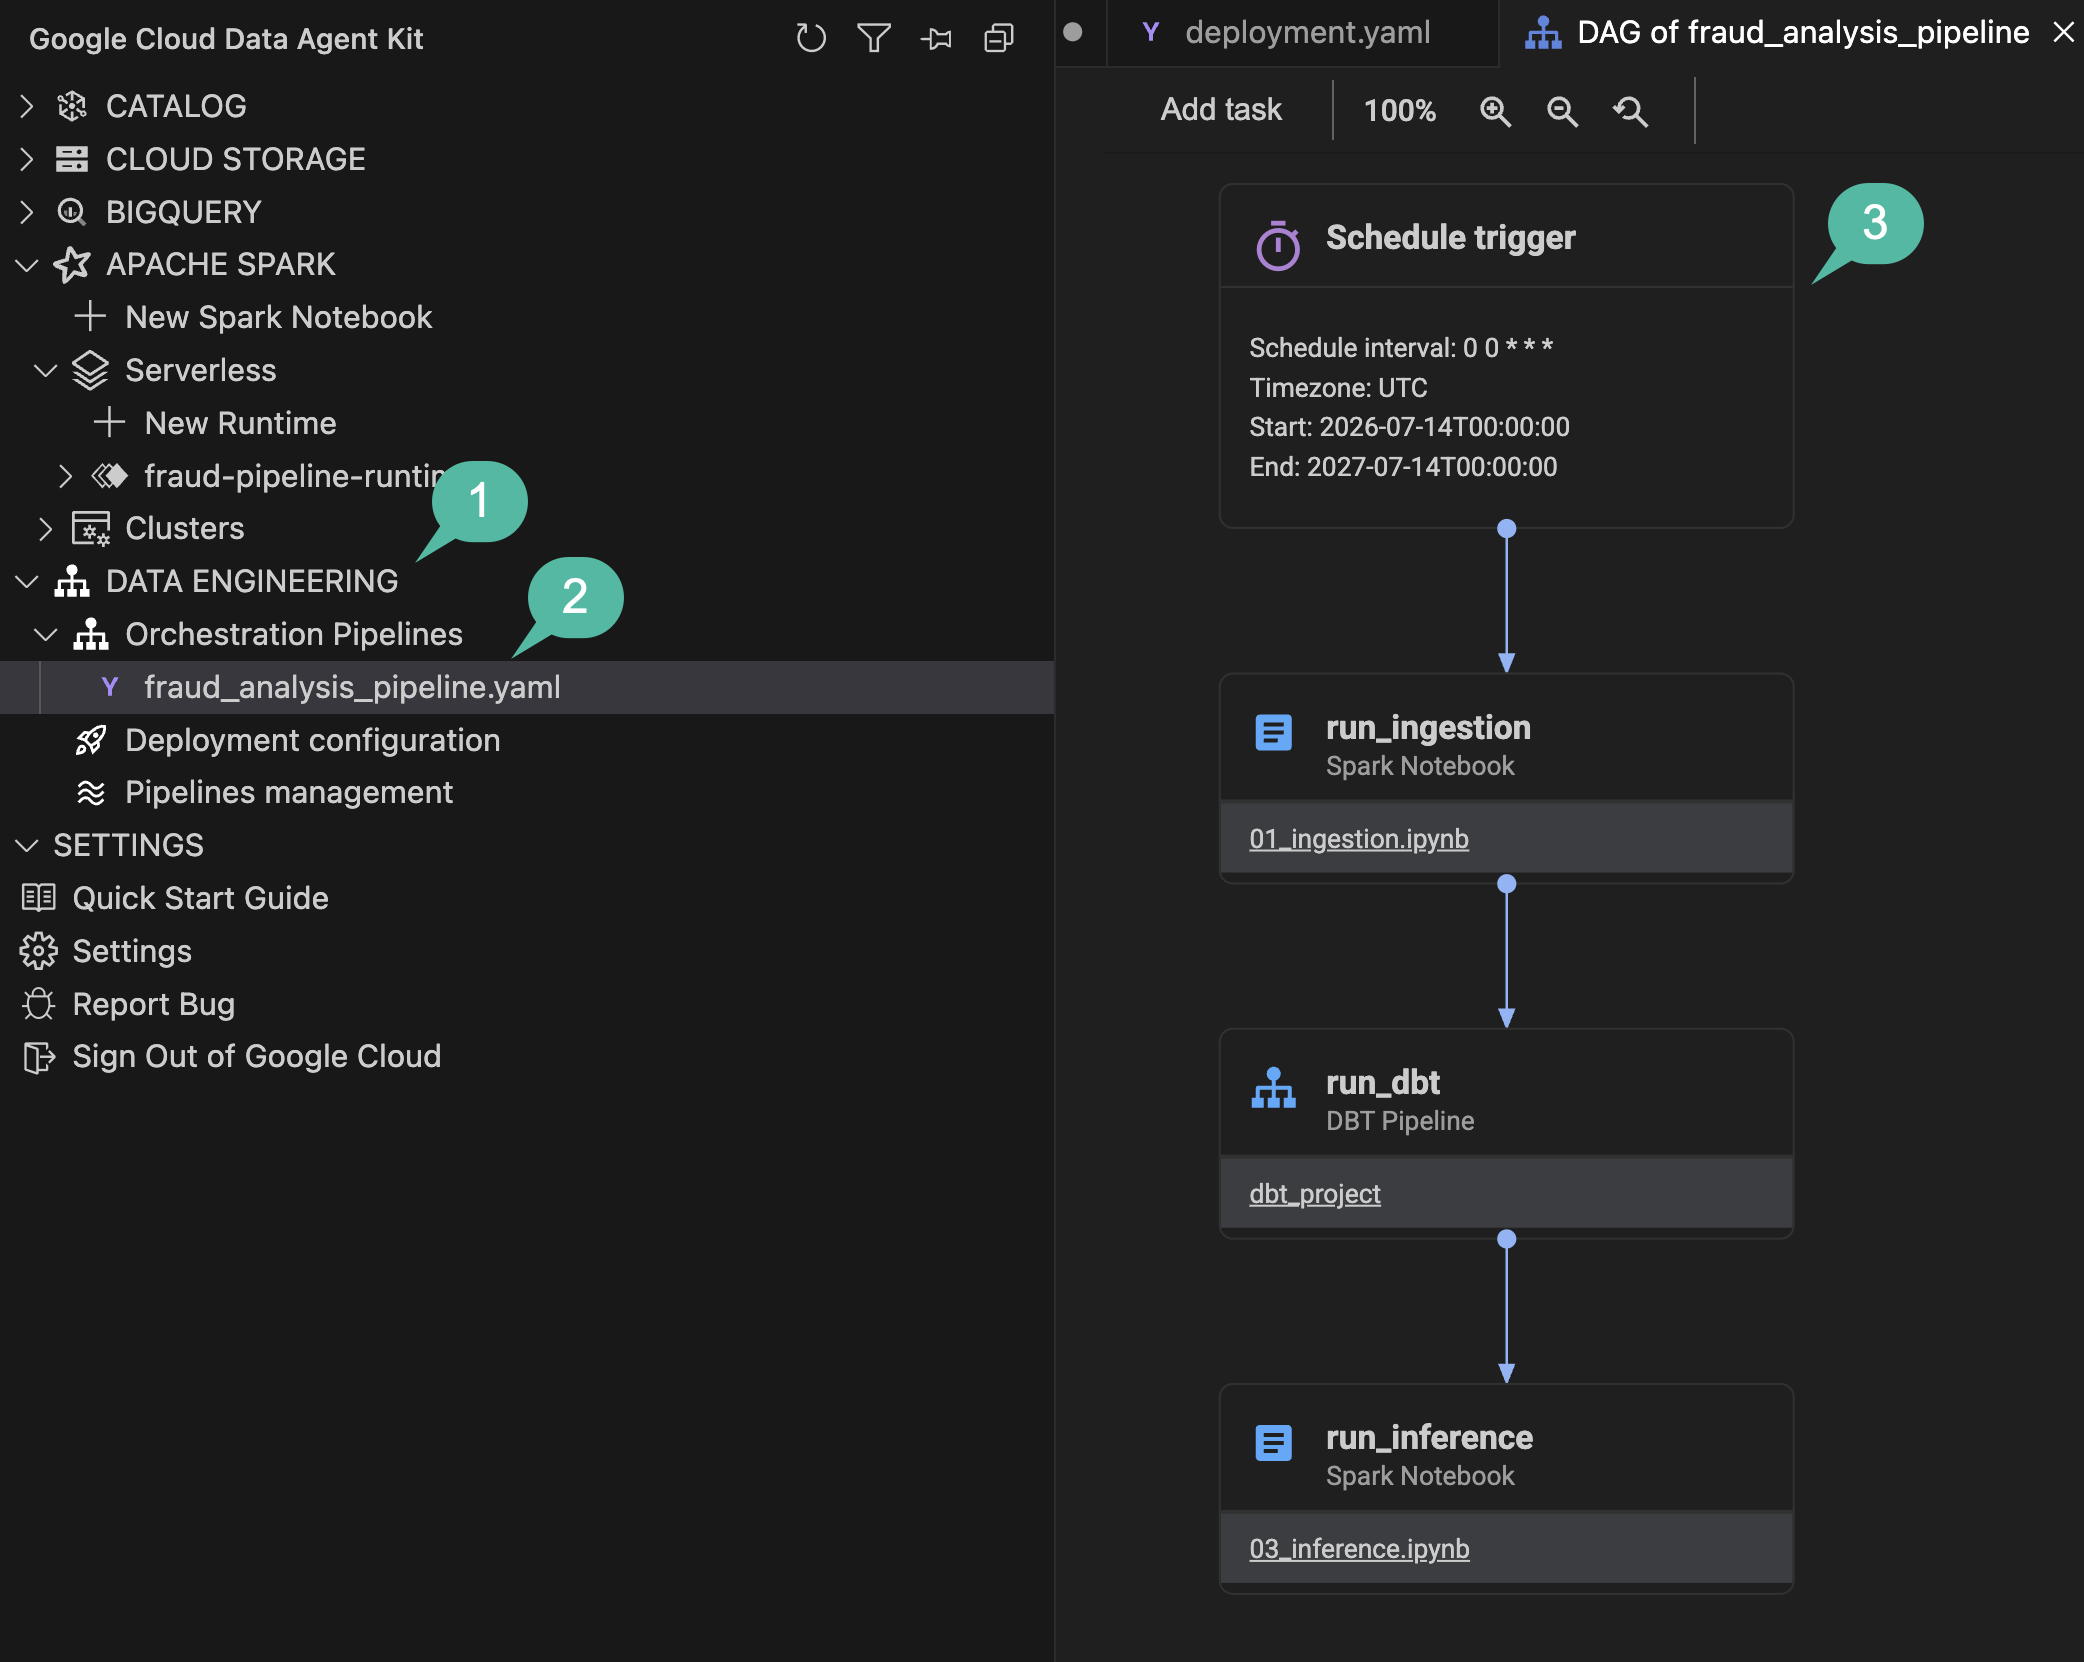
डेटा एजेंट किट, आपकी पाइपलाइन कॉन्फ़िगरेशन को इंटरैक्टिव विज़ुअल ग्राफ़ के तौर पर रेंडर करती है. इससे Airflow DAG प्रॉपर्टी की जांच और उनमें बदलाव किया जा सकता है.
- IDE की गतिविधि बार में, Google Cloud Data Agent Kit पैनल खोलें.
DATA ENGINEERINGमें जाकर,Orchestration Pipelinesको बड़ा करें.- मुख्य एडिटर में विज़ुअल डीएजी कैनवस खोलने के लिए,
fraud_analysis_pipeline.yamlपर क्लिक करें.
- सबसे ऊपर मौजूद
Schedule triggerनोड पर क्लिक करें. दाईं ओर कॉन्फ़िगरेशन फ़्लायआउट खुलता है. इसमें पार्स की गई क्रॉन स्ट्रिंग (0 0 * * *) दिखती है. साथ ही, बैकफ़िल और कैचअप जैसे पैरामीटर में बदलाव करने का विकल्प मिलता है. - नोटबुक टास्क नोड (जैसे, डेटा ट्रांसफ़र या अनुमान लगाने का चरण) पर क्लिक करें. फ़्लायआउट अपडेट हो जाता है. इसमें Dataproc Serverless के एक्ज़ीक्यूशन की मैपिंग और कनेक्टर की प्रॉपर्टी दिखती हैं.
- नोड ब्लॉक में, नोटबुक के फ़ाइल नाम वाले हाइपरलिंक (जैसे कि
01_ingestion.ipynb) पर ध्यान दें. इस पर क्लिक करने से, नोटबुक सीधे आपके एडिटर में खुल जाती है. - बाईं ओर मौजूद साइडबार में, ऑर्केस्ट्रेशन पाइपलाइन के नीचे,
Deployment configurationपर क्लिक करें. इस व्यू में, आपके टारगेटdevएनवायरमेंट क्लस्टर और आउटपुट GCS बकेट के आर्टफ़ैक्ट दिखाए जाते हैं.
सेक्शन की खास जानकारी: आपने एजेंट की मदद से, ऑर्केस्ट्रेशन पाइपलाइन का कॉन्फ़िगरेशन जनरेट किया. इसमें इंटरैक्टिव विज़ुअल कैनवस में, डेटा लेने, dbt, और अनुमान लगाने के टास्क के बीच की डिपेंडेंसी तय की गई.
8. डिप्लॉय करना, लागू करना, और मॉनिटर करना
DAG को स्थानीय तौर पर तय करने के बाद, आपको सेटअप के दौरान उपलब्ध कराए गए मैनेज किए गए Airflow एनवायरमेंट से कनेक्ट करना होगा. इसके बाद, पाइपलाइन को डिप्लॉय करना होगा.
Managed Service for Apache Airflow को कॉन्फ़िगर करना
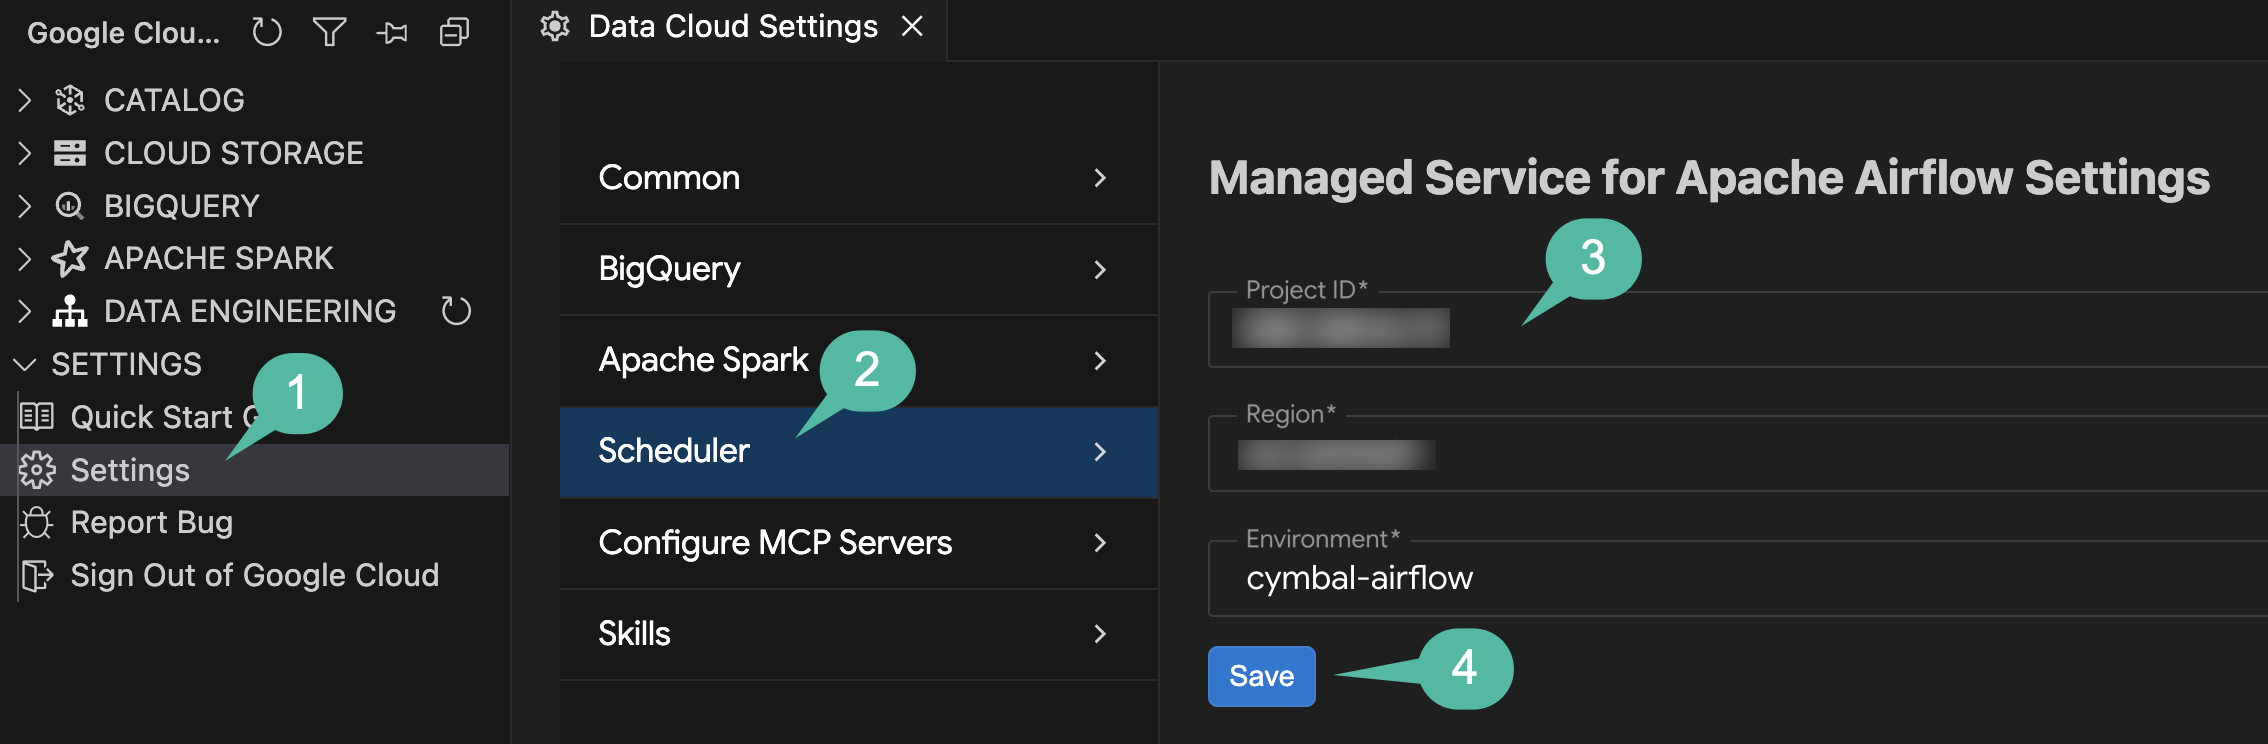
डेटा एजेंट किट की सेटिंग में, शेड्यूलर कनेक्शन को कॉन्फ़िगर करें. इससे एक्सटेंशन, आपके मैनेज किए जा रहे Airflow एनवायरमेंट को टारगेट करेगा.
- IDE की गतिविधि बार में, Google Cloud Data Agent Kit पैनल खोलें.
SETTINGSमें जाकर, सेटिंग पर क्लिक करें.- बाईं ओर मौजूद मेन्यू से, शेड्यूलर को चुनें.
- सेटिंग कॉन्फ़िगर करें:
- प्रोजेक्ट आईडी: अपना चालू प्रोजेक्ट आईडी चुनें.
- इलाका:
us-central1को चुनें. - एनवायरमेंट:
cymbal-airflowको चुनें.
- सेव करें पर क्लिक करें.
DAG डिप्लॉय करना
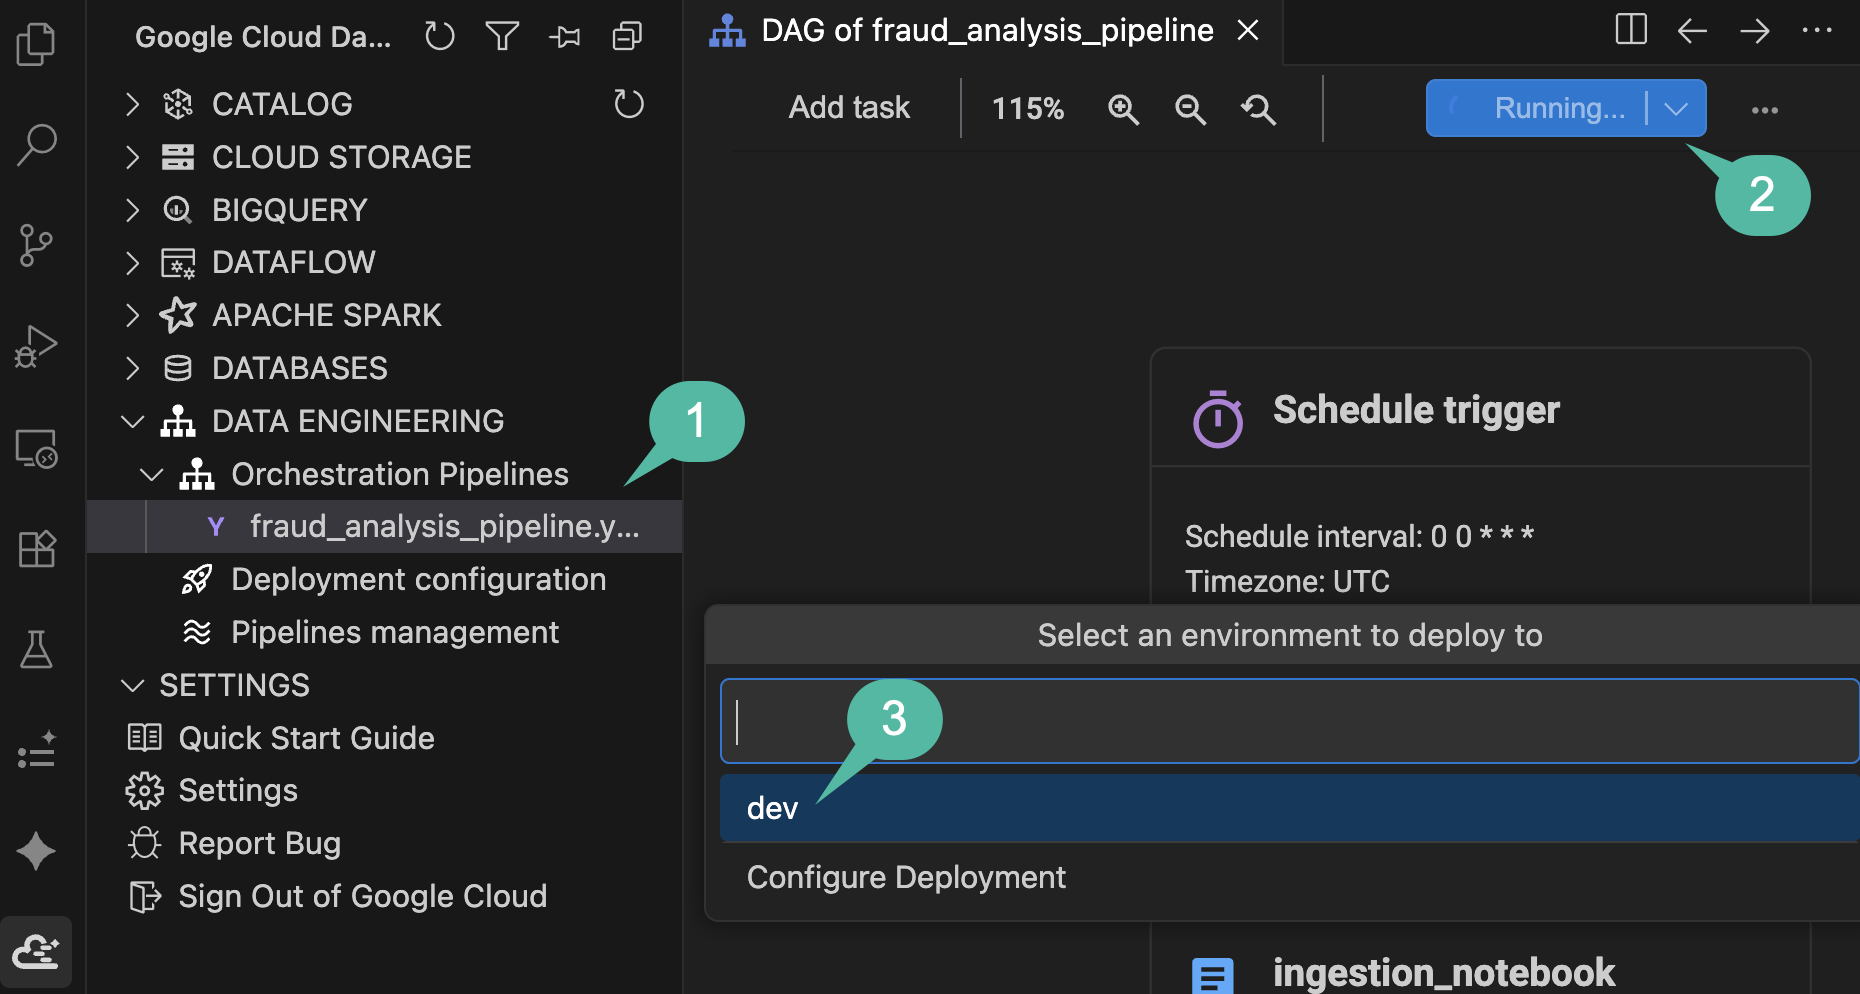
अब कॉन्फ़िगर की गई पाइपलाइन को सीधे विज़ुअल कैनवस से, मैनेज किए जा रहे Airflow एनवायरमेंट में डिप्लॉय करें:
- Google Cloud Data Agent Kit साइडबार में,
DATA ENGINEERING>Orchestration Pipelinesको बड़ा करें और विज़ुअल डीएजी कैनवस खोलने के लिए,fraud_analysis_pipeline.yamlपर क्लिक करें. - कैनवस टूलबार के सबसे ऊपर दाएं कोने में, नीले रंग के पाइपलाइन चलाएं बटन पर क्लिक करें.
- एनवायरमेंट के ड्रॉपडाउन पिकर में,
devको चुनें. - नीचे मौजूद स्टेटस एरिया (
Running pipeline: Building pipeline locally...) में, प्रोसेस की प्रोग्रेस की सूचना देखें. एक्सटेंशन, आपके डीएजी को अपने-आप कंपाइल करेगा. साथ ही, नोटबुक और डीबीटी ऐसेट को पैकेज करेगा और उन्हें आपके मैनेज किए गए Airflow एनवायरमेंट के GCS बकेट में अपलोड करेगा. इसमें करीब तीन से चार मिनट लगते हैं.
रन को मॉनिटर करना
स्थानीय कंपाइलेशन पूरा होने के बाद, पॉप-अप सूचना में Triggered a new run for pipeline... successfully की पुष्टि हो जाती है. इसके बाद, लाइव एक्ज़ीक्यूशन को मॉनिटर करें:
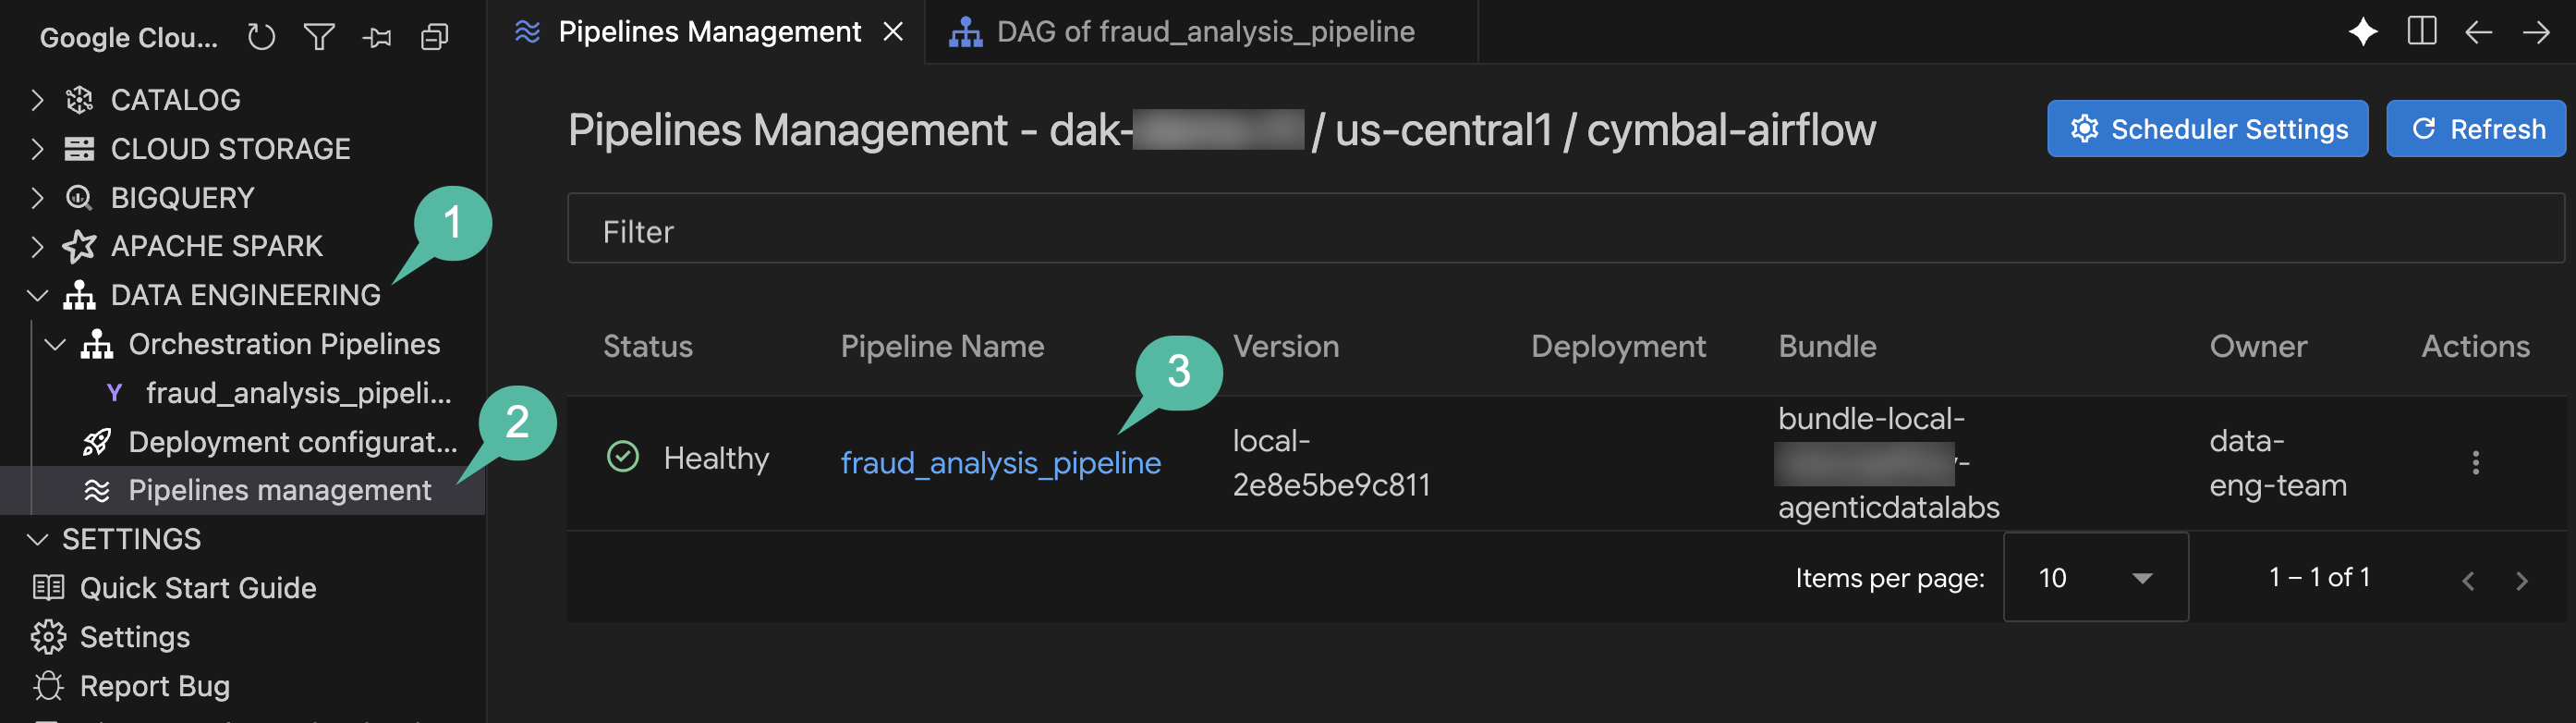
- Google Cloud Data Agent Kit साइडबार में,
DATA ENGINEERING>Orchestration Pipelinesको बड़ा करें. - पाइपलाइन मैनेजमेंट पर क्लिक करें.
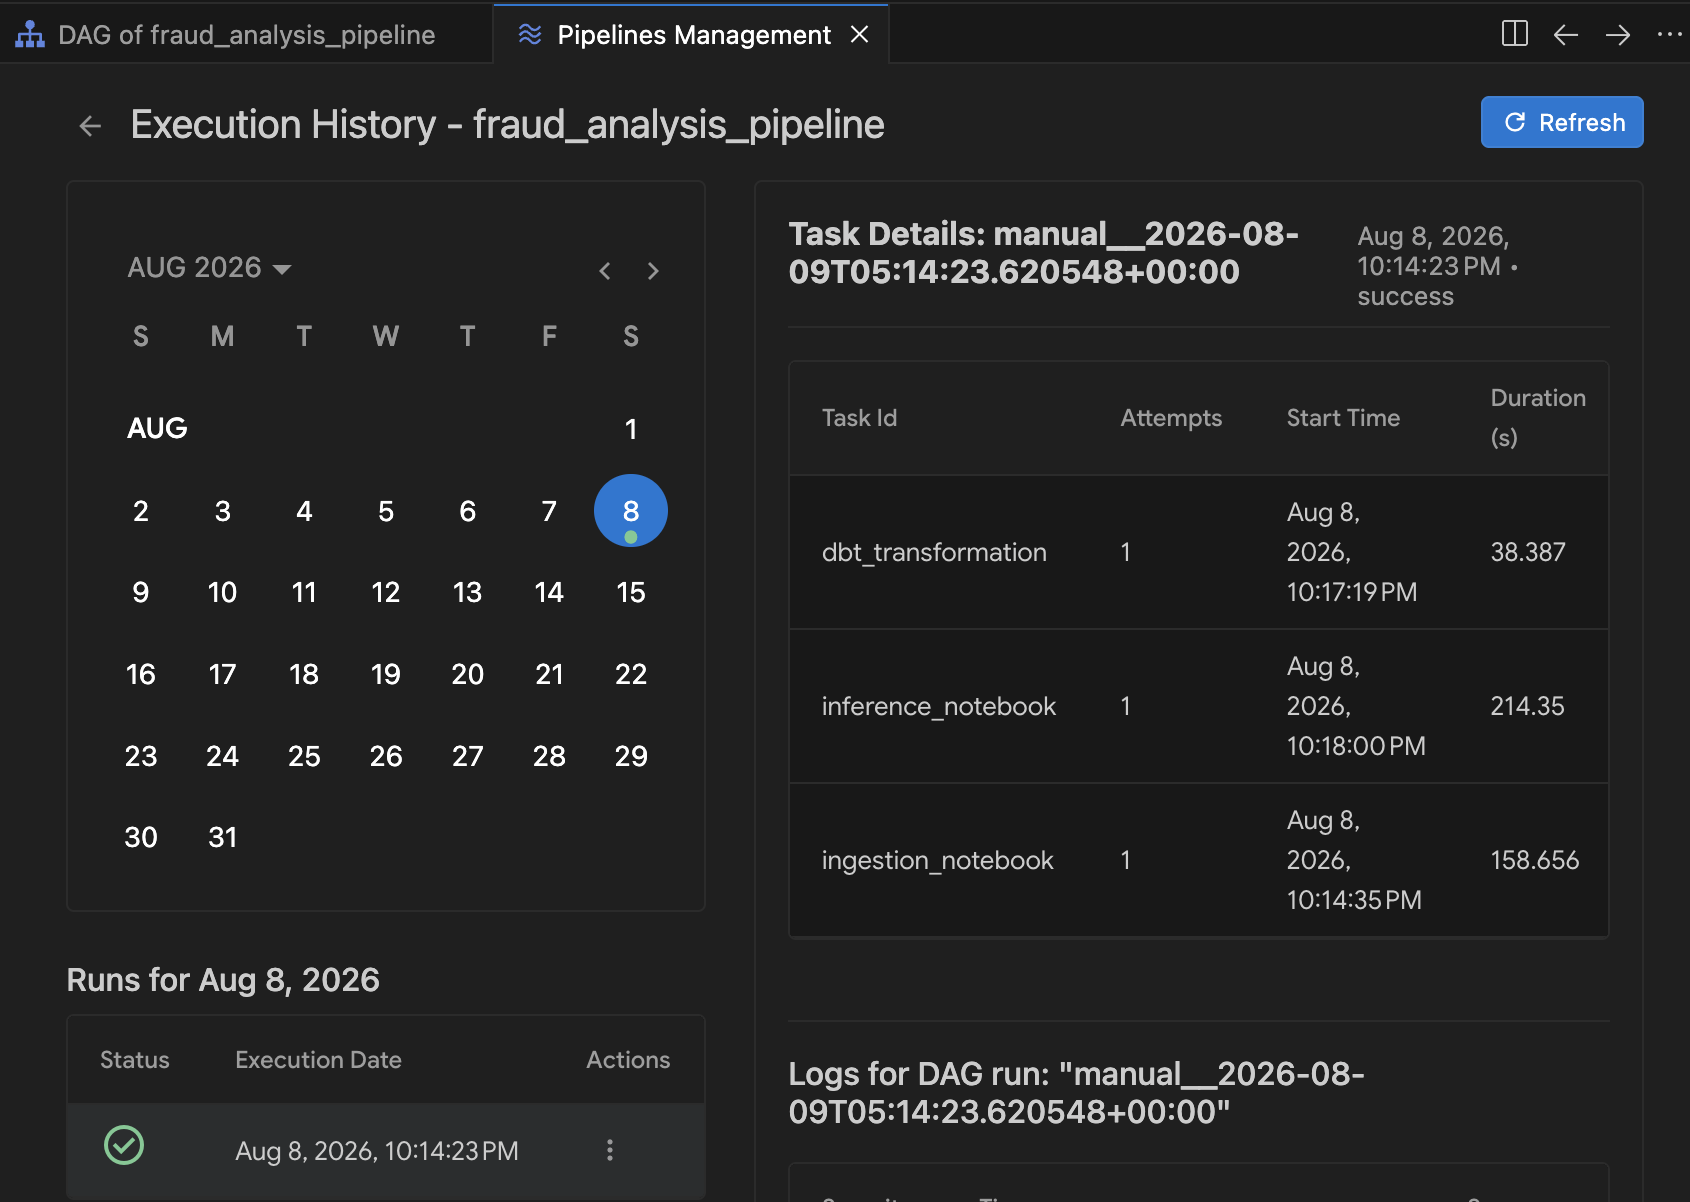
- पाइपलाइन मैनेजमेंट टेबल में,
fraud_analysis_pipelineपर क्लिक करके, पाइपलाइन के एक्ज़ीक्यूशन का इतिहास खोलें.
- Execution History व्यू में, कैलेंडर से चालू रन चुनें.
- हर पाइपलाइन टास्क (डेटा इंटेक, डीबीटी ट्रांसफ़ॉर्मेशन, और अनुमान) के पूरा होने पर, स्टेटस इंडिकेटर अपडेट होते हैं और टास्क की अवधि दिखती है. किसी टास्क के लाइव एक्ज़ीक्यूशन का आउटपुट और Airflow DAG लॉग देखने के लिए, उस पर क्लिक करें.
सेक्शन की खास जानकारी: आपने Airflow Scheduler कनेक्शन को कॉन्फ़िगर किया, मैनेज किए गए Airflow पर एंड-टू-एंड ऐनलिटिकल पाइपलाइन को डिप्लॉय किया, और लाइव एक्ज़ीक्यूशन की निगरानी की. साथ ही, सिस्टम की पुष्टि की. इसमें रॉ लॉग से लेकर Cloud Spanner की फ़ाइनल अनुमानों तक की जानकारी शामिल है.
9. व्यवस्थित करें
इस कोडलैब में इस्तेमाल किए गए संसाधनों के लिए, Google Cloud प्रोजेक्ट पर लगने वाले शुल्क से बचने के लिए, अपने-आप काम करने वाली स्क्रिप्ट का इस्तेमाल करके एनवायरमेंट को बंद करें.
- टर्मिनल पैनल (या Cloud Shell) में, स्क्रिप्ट डायरेक्ट्री पर जाएं और यह कमांड चलाएं:
cd ~/devrel-demos/codelabs/agentic-data-labs/data-science/scripts
chmod +x teardown.sh
./teardown.sh
- स्क्रिप्ट उन सभी संसाधनों की सूची दिखाएगी जिन्हें मिटाया जाना है. साथ ही, पुष्टि करने के लिए कहेगी:
- मैनेज किया गया Airflow एनवायरमेंट (
cymbal-airflow) - Cloud Spanner इंस्टेंस (
cymbal-fraud) - BigQuery डेटासेट (
transactions_dataset_evals) - Cloud Storage बकेट (
gs://${PROJECT_ID}-fin-clearing-rawऔरgs://${PROJECT_ID}-models) - वर्कर सेवा खाता (
composer-worker-sa)
- मैनेज किया गया Airflow एनवायरमेंट (
- पुष्टि करने के लिए,
yटाइप करें. टियरडाउन स्क्रिप्ट, GCP की सभी चालू की गई सेवाओं को हटा देगी और लोकल फ़ाइलों को मिटा देगी.
10. बधाई हो!
आपने Cloud Storage, BigQuery, Managed Service for Apache Spark (Spark Serverless), dbt, Cloud Spanner, और Managed Service for Apache Airflow को शामिल करके, धोखाधड़ी का पता लगाने वाली एंड-टू-एंड पाइपलाइन बनाई है. साथ ही, Antigravity IDE में Google Cloud Data Agent Kit के साथ पेयर-प्रोग्रामिंग की है.
आपने क्या-क्या हासिल किया
- 📥 Managed Service for Apache Spark और Data Agent Kit का इस्तेमाल करके, BigQuery टेबल में इंजस्ट किए गए रॉ लेन-देन के लॉग.
- 🧹 डेटा क्वालिटी टेस्ट के साथ dbt प्रोजेक्ट बनाकर, डुप्लीकेट डेटा हटाया गया और डेटा को सामान्य बनाया गया.
- 🤖 डिस्ट्रिब्यूटेड रैंडम फ़ॉरेस्ट मॉडल को ट्रेनिंग दी. इसके लिए,
RandomForestClassifierका इस्तेमाल किया गया. साथ ही, ट्रेन किए गए मॉडल को Cloud Storage में एक्सपोर्ट किया. - ⚡ आने वाले लेन-देन पर बैच इन्फ़रेंस लागू किया और ज़्यादा जोखिम वाले रिकॉर्ड को ऑडिट की समीक्षा के लिए Cloud Spanner में भेजा.
- 🔄 Managed Service for Apache Airflow और IDE के विज़ुअल DAG मैनेजमेंट टूल का इस्तेमाल करके, शेड्यूल किए गए Airflow DAG के तौर पर वर्कफ़्लो को व्यवस्थित, डिप्लॉय, और मॉनिटर किया गया.
मुख्य सिद्धांत
सिद्धांत | आपने क्या सीखा |
नैचुरल लैंग्वेज का इस्तेमाल करके, IDE में पेयर-प्रोग्रामिंग की सुविधा. इससे PySpark नोटबुक जनरेट की जा सकती हैं, dbt मॉडल कॉन्फ़िगर किए जा सकते हैं, और Airflow DAG तय किए जा सकते हैं | |
विश्लेषणात्मक एसक्यूएल, डीबीटी ट्रांसफ़ॉर्मेशन, और एमएल ट्रेनिंग के लिए, टेबल के तौर पर डेटा को बड़े पैमाने पर स्टोर करने की सुविधा | |
डेटा को डिस्ट्रिब्यूट करने के लिए PySpark का इस्तेमाल करके, सर्वर के बिना डेटा लोड करना और रैंडम फ़ॉरेस्ट एमएल ट्रेनिंग करना | |
स्पार्क इन्फ़रेंस की बैच प्रोसेस से मिले अनुमानों को सीधे तौर पर ऑपरेशनल डेटाबेस की समीक्षा कतारों में लिखना | |
YAML DAG Declarations | आईडीई में, इंटरैक्टिव Airflow विज़ुअल ग्राफ़ के तौर पर रेंडर की गई डिक्लेरेटिव पाइपलाइन की परिभाषाएं |
विज़ुअल डीएजी मैनेजमेंट | पाइपलाइन की डिपेंडेंसी की जांच करना, Managed Airflow पर डिप्लॉय करना, और IDE में लाइव टास्क के एक्ज़ीक्यूशन के इतिहास की निगरानी करना |
अगले चरण
- Google Cloud Data Agent Kit के दस्तावेज़ पढ़ें
- Managed Service for Apache Spark के बारे में ज़्यादा जानें
- Managed Service for Apache Airflow के बारे में ज़्यादा जानें
- Antigravity IDE का इस्तेमाल करके, एक से ज़्यादा सेवाओं वाली पाइपलाइन बनाएं