

1. 소개
대량 결제 처리 업체인 Cymbal Financial의 데이터 과학자라고 가정해 보세요. 결제 지연이 연이어 발생하고 있으며, 규정 준수팀은 조직적인 사기를 의심하고 있습니다. 원시 결제원 거래 로그를 수집하고, 데이터를 정리하고, 머신러닝 모델을 학습시키고, 일괄 추론을 실행하고, 고위험 거래를 수동 감사를 위한 Cloud Spanner 검토 대기열에 싱크하는 파이프라인을 빌드해야 합니다.
일반적으로 이 작업에는 반복적인 설정 코드 (Spark 노트북, dbt 구성, 학습 스크립트, Airflow DAG)를 작성하는 데 며칠이 걸리고 콘솔 인터페이스와 편집기 간에 지속적으로 컨텍스트를 전환해야 합니다.
이 Codelab에서는 Antigravity IDE 내에서 Google Cloud 데이터 에이전트 키트 (DAK)를 사용하여 에이전트와 페어 프로그래밍을 진행합니다. 대화형 자연어를 사용하여 에이전트는 Spark 노트북을 생성하고, dbt 프로젝트를 컴파일하고, 추론 루프를 구성하고, Managed Service for Apache Airflow를 사용하여 워크플로를 조정하는 데 도움을 줍니다.
실습할 내용
- Managed Service for Apache Spark (Spark 서버리스)를 사용하여 Cloud Storage에서 정산소 로그를 수집하여 BigQuery 테이블에 저장합니다.
- dbt를 사용하여 거래를 중복 제거하고 정규화하여 정리된 데이터 레이어 (원시, 스테이징, 보강)를 설정합니다.
- Spark 서버리스에서 분산 랜덤 포레스트 분류 모델을 학습합니다 (
RandomForestClassifier). - 새 트랜잭션에서 일괄 추론을 실행하고 위험도가 높은 알림을 Cloud Spanner에 직접 작성합니다.
- Managed Service for Apache Airflow와 IDE 내의 대화형 DAG 모니터링을 사용하여 전체 파이프라인을 조정하고, 시각적으로 구성하고, 배포합니다.
필요한 항목
- 웹브라우저(예: Chrome)
- 결제가 사용 설정된 Google Cloud 프로젝트 (실습에는 새 전용 프로젝트를 사용하는 것이 좋습니다).
- SQL, Python, PySpark에 대한 기본 지식
- Google AI Pro 구독이 있는 Antigravity IDE (권장)
이 Codelab에서 만든 리소스의 비용은 5달러 미만이어야 합니다. 실습이 끝나면 삭제 안내에 따라 프로비저닝된 리소스를 삭제하세요.
2. 환경 설정
실습을 시작하려면 부트스트랩 스크립트를 실행합니다. 이 스크립트는 필요한 GCP API를 자동으로 사용 설정하고, 수집 Cloud Storage 버킷을 만들고, 모의 거래 및 디렉터리 데이터 세트를 생성하고, 참조 디렉터리를 BigQuery에 로드하고, Cloud Spanner 및 Managed Service for Apache Airflow (이전 명칭: Cloud Composer)의 백그라운드 프로비저닝을 시작합니다.
프로젝트 선택 또는 생성
Google Cloud 콘솔에서 기존 프로젝트를 선택하거나 새 프로젝트를 만듭니다.
결제 확인
Google Cloud 프로젝트에 결제가 사용 설정되어 있는지 확인합니다. 이 가이드를 따라 자세한 내용을 알아보세요.
설정 스크립트 실행
Google Cloud Shell (또는 Google Cloud CLI로 구성된 로컬 셸)을 사용하여 환경 설정을 시작합니다.
- Google Cloud Console을 엽니다.
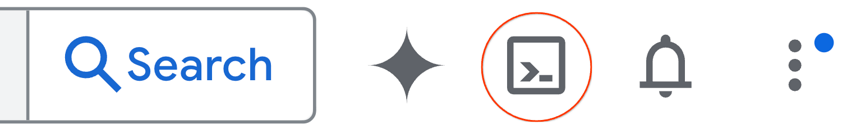
- 오른쪽 상단 툴바에서 Cloud Shell 활성화를 클릭합니다.
- Cloud Shell 터미널에서 활성 프로젝트를 구성합니다.
gcloud config set project <<YOUR_PROJECT_ID>>
export PROJECT_ID=$(gcloud config get-value project)
- Codelab 저장소를 클론하고 스크립트 폴더로 이동합니다.
cd ~/
git clone --filter=blob:none --no-checkout https://github.com/GoogleCloudPlatform/devrel-demos.git
cd ~/devrel-demos
git sparse-checkout init --cone
git sparse-checkout set codelabs/agentic-data-labs/data-science
git checkout main
cd codelabs/agentic-data-labs/data-science/scripts
- 부트스트랩 설정 스크립트를 실행하여 모든 리소스를
us-central1에 배포합니다.
chmod +x setup.sh setup_spanner.sh setup_composer.sh
export REGION=us-central1
./setup.sh
- 스크립트가 완료되면 BigQuery 데이터 세트와 Cloud Storage 버킷이 준비되었음을 나타내는 요약 출력이 표시됩니다. 백그라운드에서 Cloud Spanner (~2분 소요)와 Managed Airflow (~20분 소요)의 프로비저닝이 계속됩니다. 다음을 실행하여 언제든지 진행 상황을 모니터링할 수 있습니다.
tail -f /tmp/spanner_setup.log
tail -f /tmp/composer_setup.log
Antigravity IDE 열기
- Google Antigravity 다운로드 페이지에서 Antigravity IDE를 다운로드하여 설치합니다.
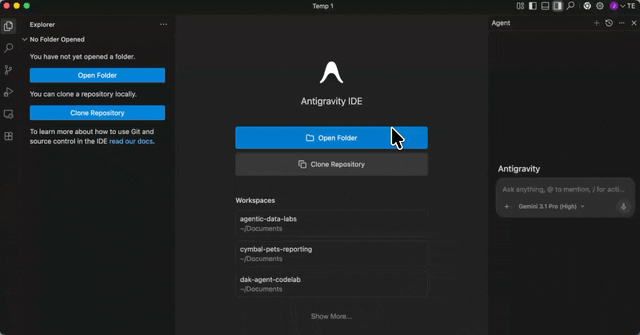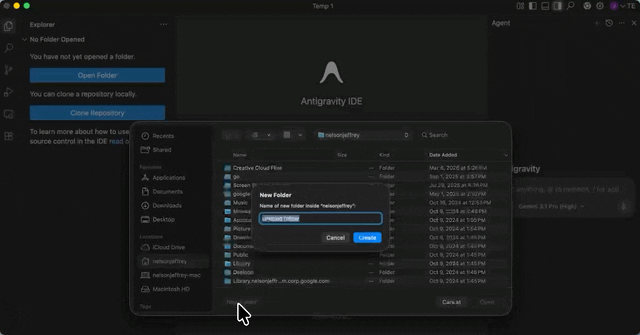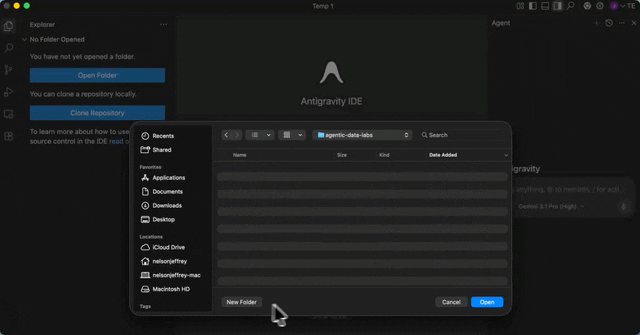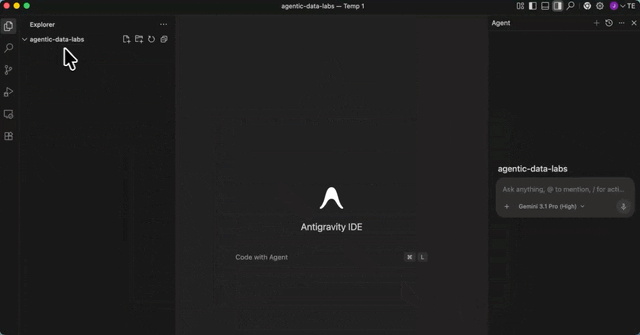
- Antigravity IDE를 실행합니다.
- 로컬 머신에 빈 새 폴더 (예:
agentic-data-labs)를 만들고 폴더 열기를 선택하여 IDE에서 엽니다. 이 폴더는 Codelab의 로컬 작업공간 역할을 합니다.
Data Agent Kit 확장 프로그램 설치
Google Cloud 데이터 에이전트 키트 확장 프로그램은 편집기 내에서 직접 Google Cloud 데이터 서비스와 긴밀하게 통합되므로 컨텍스트를 전환하지 않고도 BigQuery, Cloud SQL, Cloud Storage 등과 상호작용할 수 있습니다.
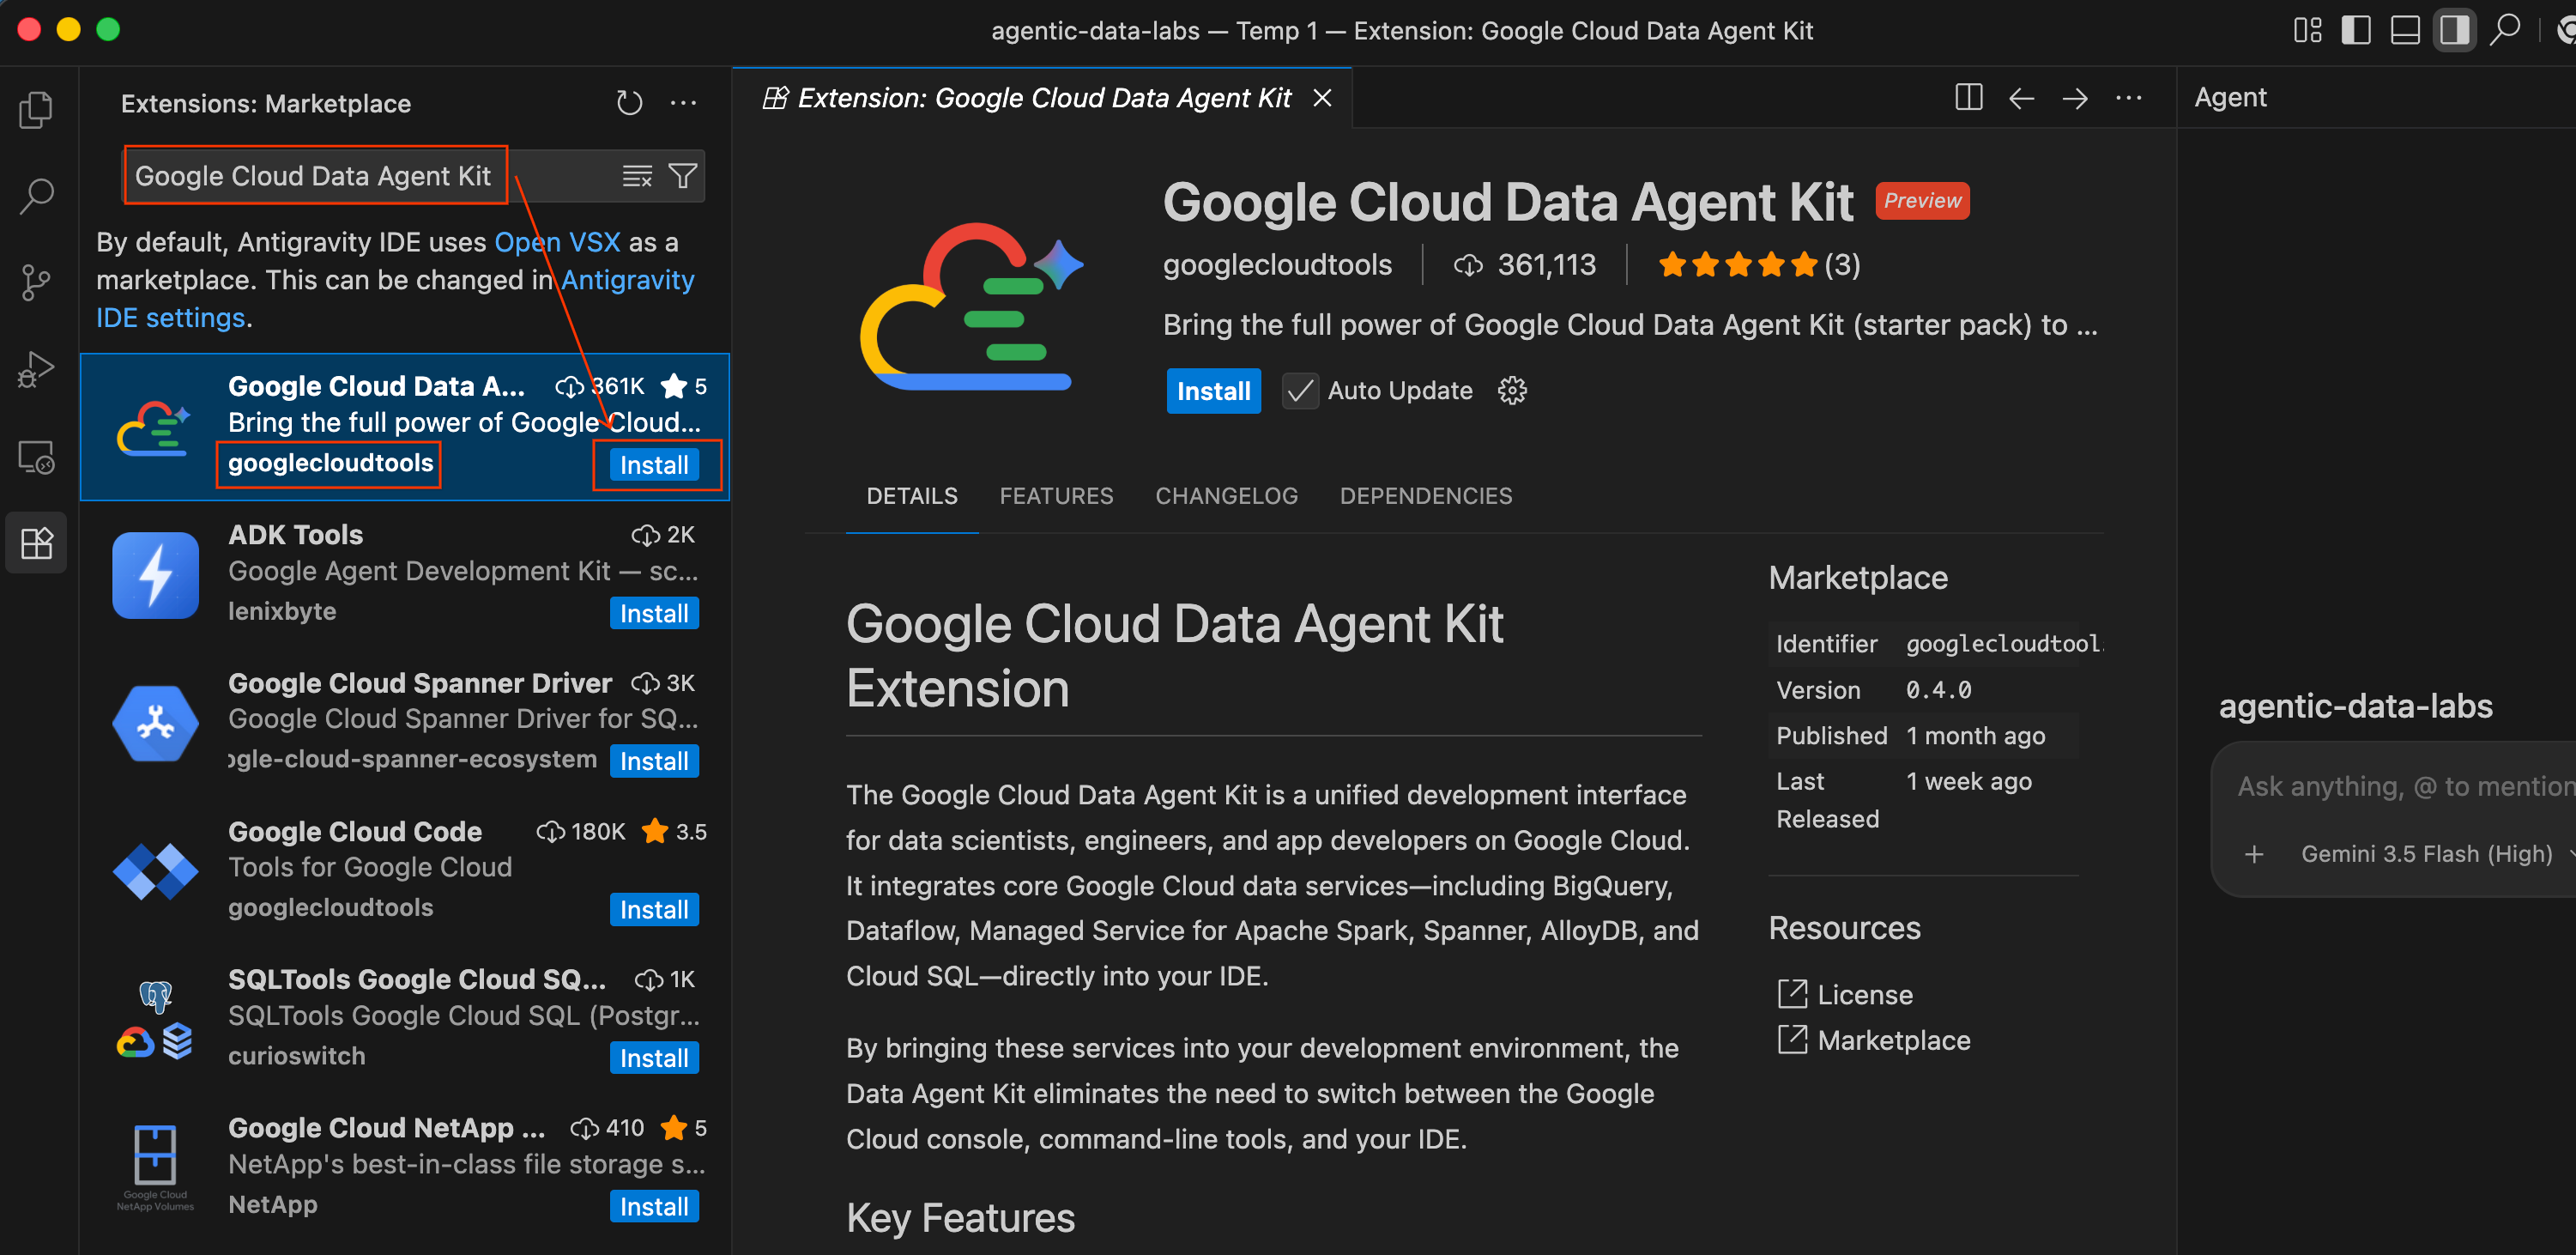
- Antigravity IDE에서 화면 맨 왼쪽에 있는 작업 표시줄의 확장 프로그램 아이콘을 클릭합니다 (사각형 4개 모양).
- 확장 프로그램 창 상단의 검색창에
Google Cloud Data Agent Kit를 입력합니다. googlecloudtools에서 게시한 Google Cloud Data Agent Kit이라는 확장 프로그램을 찾습니다.- Install 버튼을 클릭합니다.
- '게시자 'googlecloudtools' 및 확장 프로그램을 신뢰하시겠습니까?'라는 메시지가 표시될 수 있습니다. 게시자 신뢰 및 설치를 클릭하여 계속합니다.
설치가 완료되면 Antigravity IDE의 맨 왼쪽에 있는 활동 표시줄에 새 Google Cloud Data Agent Kit 아이콘이 표시됩니다.
- 'Google Cloud 데이터 에이전트 키트 시작하기'라는 제목의 온보딩 페이지가 자동으로 열립니다. Cloud 계정에 로그인하지 않은 경우 액세스를 허용하라는 메시지에 따라 액세스를 허용합니다.
- 구성 요약 섹션에서 프로젝트 필드를 찾습니다. 드롭다운을 클릭하고 Google Cloud 프로젝트를 선택합니다. 리전을
us-central1으로 설정합니다. 그런 다음 MCP 서버 구성을 선택합니다.
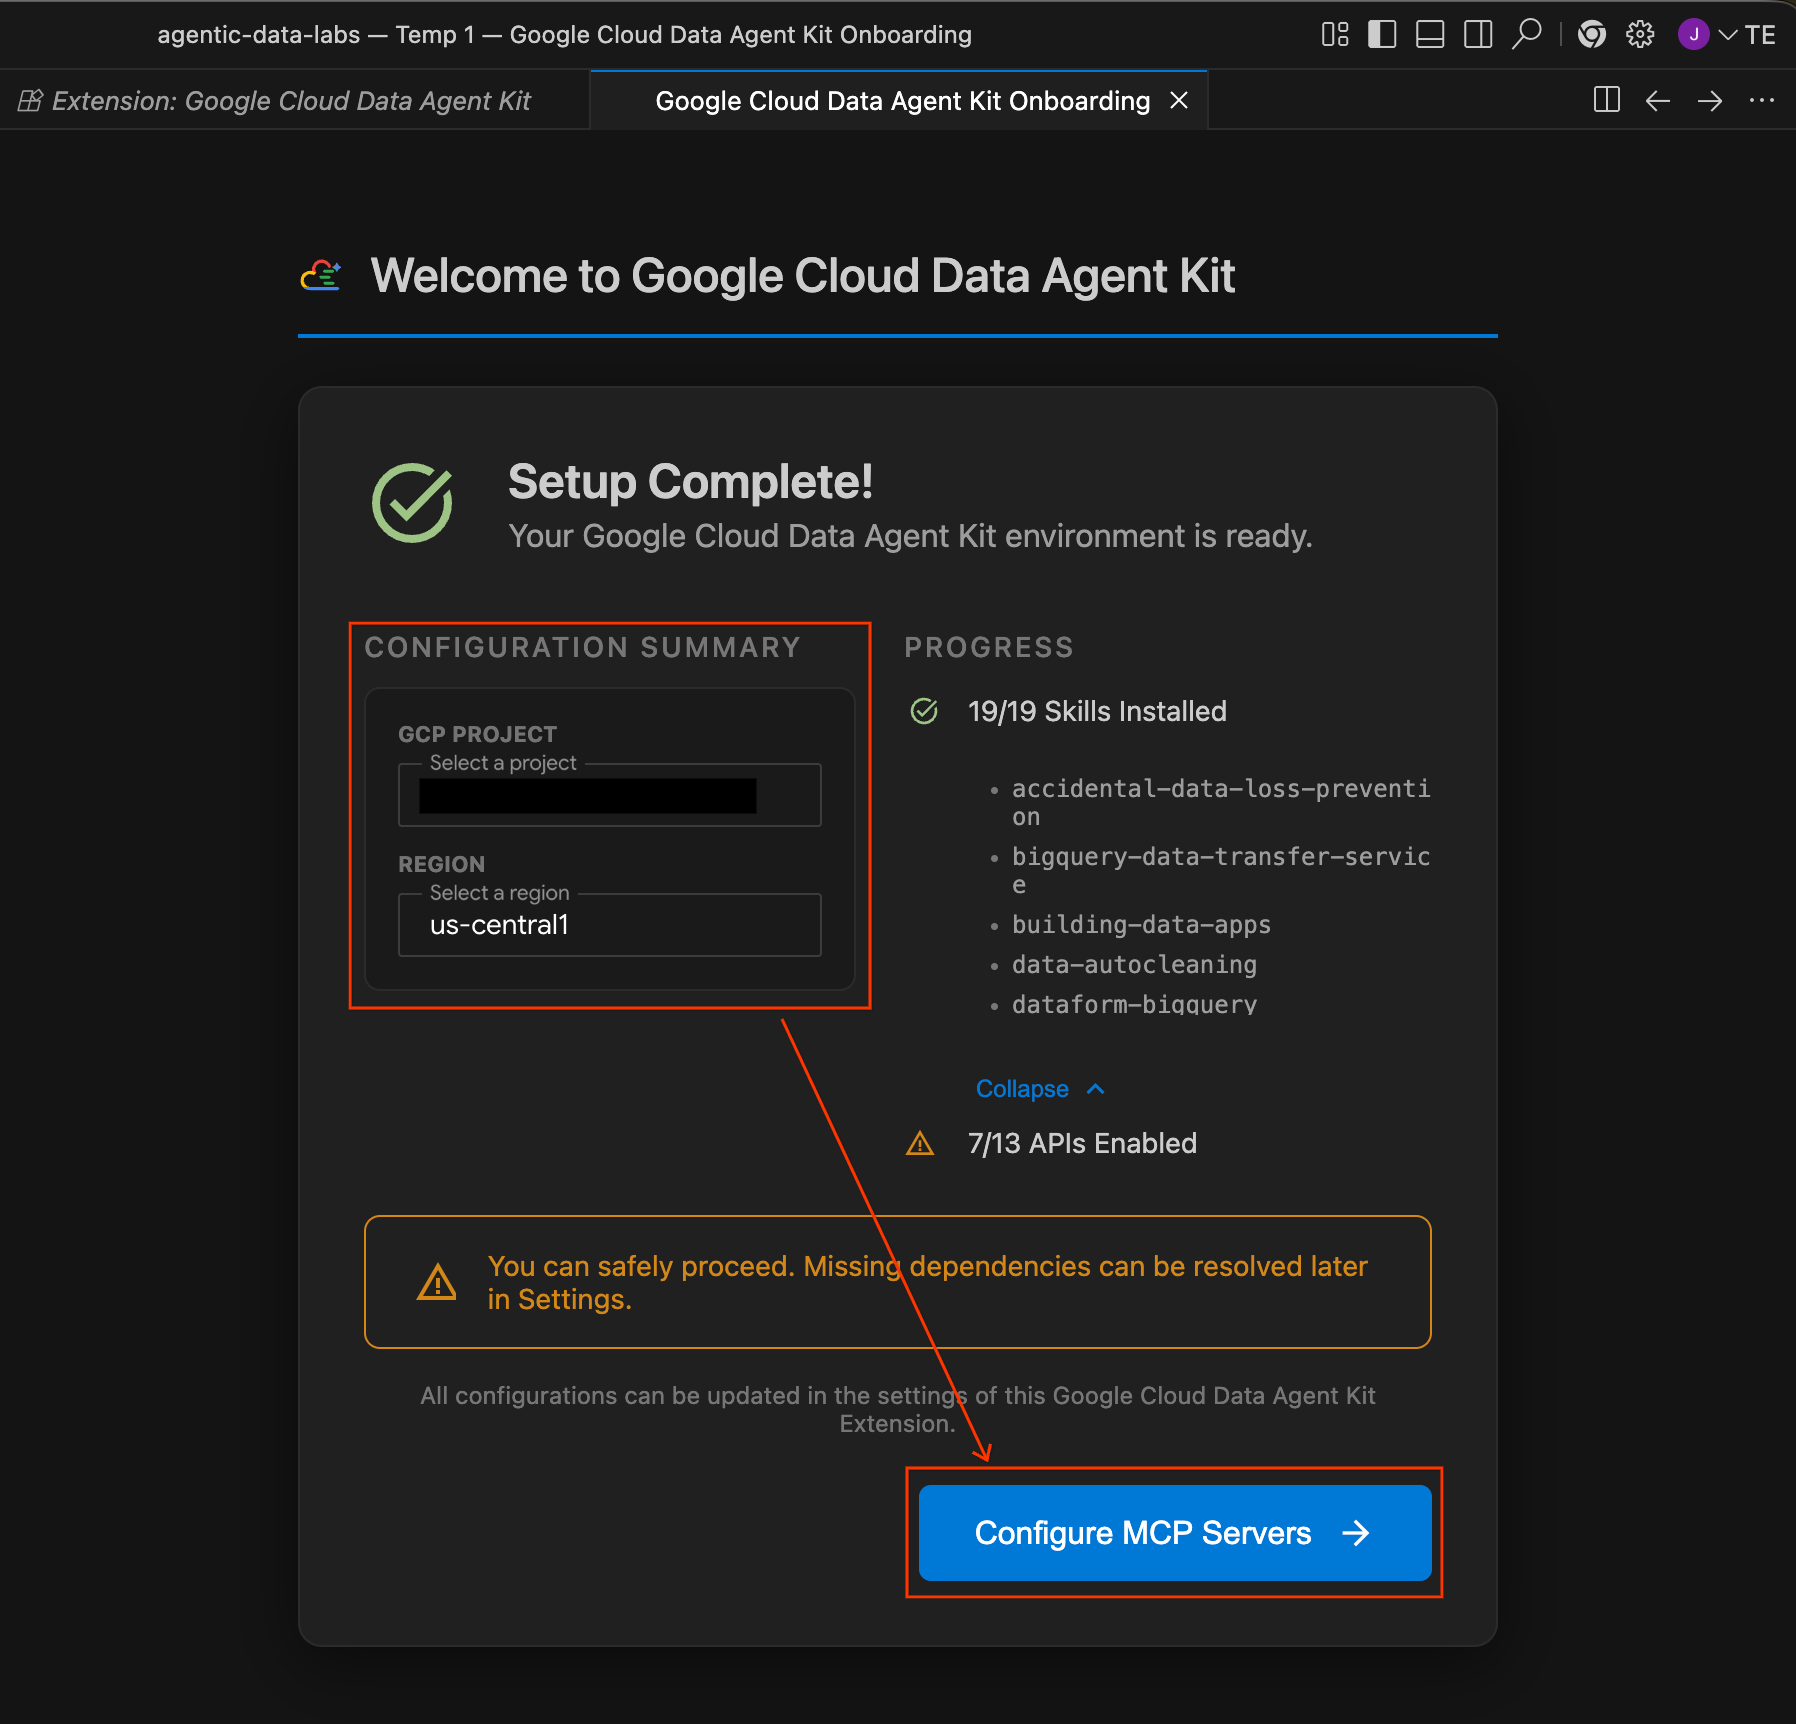
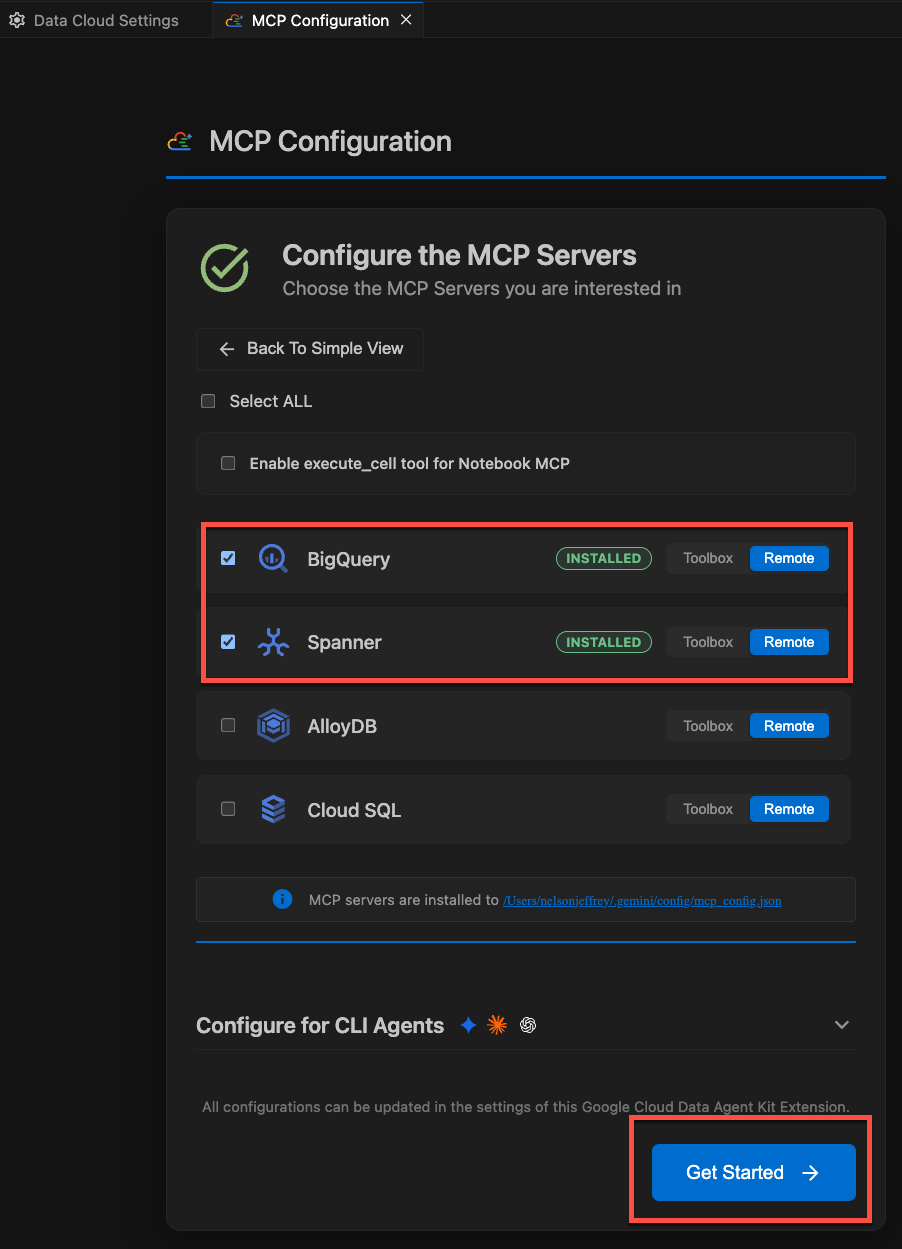
- MCP 서버 구성을 선택합니다. MCP 구성 창에서 다음 원격 MCP 서버를 사용 설정해야 합니다.
- BigQuery
- Spanner
- Notebooks
그런 다음 시작하기를 클릭합니다.
구성 옵션 살펴보기
설정이 완료되면 'Google Cloud Data Agent Kit 시작하기' 페이지로 이동합니다.
- '설정 및 구성'에서 시작하기를 클릭합니다.
- 그러면 데이터 에이전트 키트 구성 패널이 열립니다. 탭을 살펴봅니다.
- 프로젝트 및 리전: 선택한 프로젝트 ID를 확인하고 설정 스크립트에서 필수 API (Compute Engine, Cloud Storage, BigQuery, Spanner 등)를 모두 사용 설정했는지 확인합니다.
- BigQuery: BigQuery 쿼리의 기본 위치를 구성합니다.
us-central1리전을 사용합니다. - MCP 서버 구성: AI 에이전트가 데이터와 안전하게 상호작용할 수 있도록 지원하는 사용 설정된 MCP 서버 (BigQuery, Notebooks, Spanner 등)를 확인합니다.
- 스킬: 에이전트에게 복잡한 데이터 작업을 위한 전문 기능을 제공하는 사전 빌드된 스킬을 살펴봅니다.
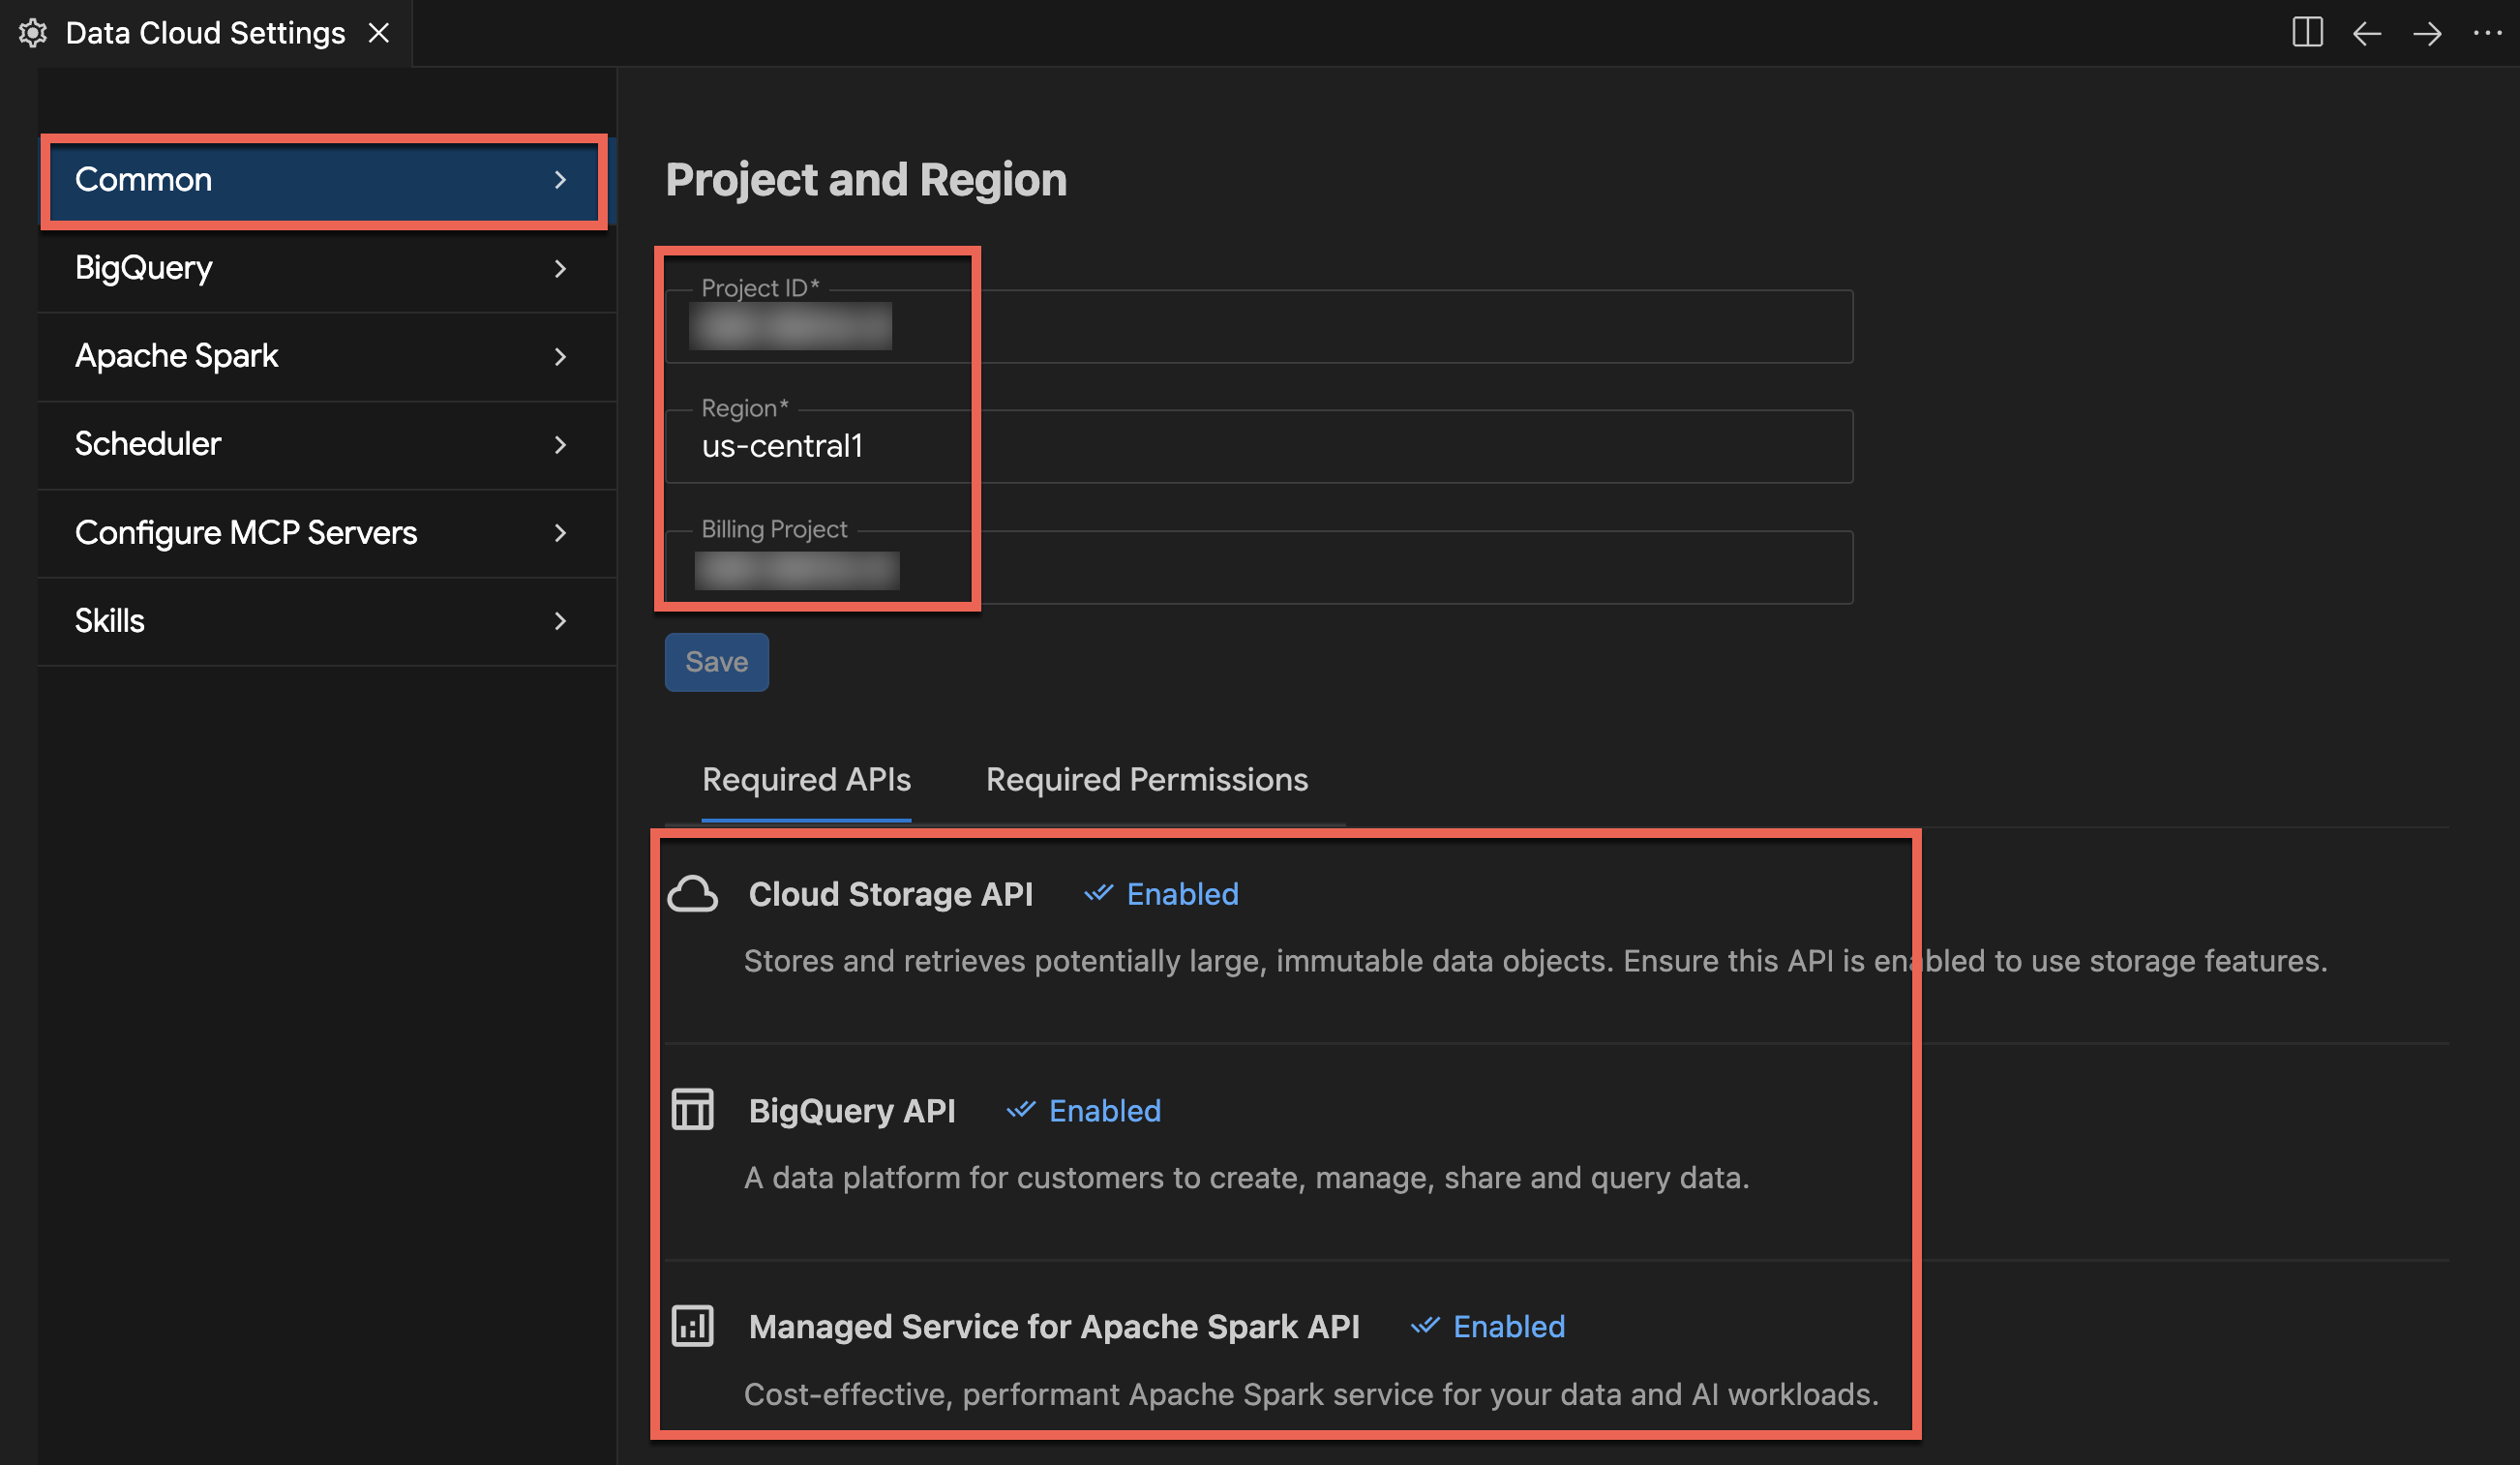
섹션 요약: 부트스트랩 스크립트를 실행하여 GCS 및 BigQuery 애셋을 만들고 Spanner와 Airflow는 백그라운드에서 빌드합니다. 그런 다음 Antigravity IDE에서 프로젝트를 열고 Google Cloud Data Agent Kit 확장 프로그램을 활성화했습니다. 이제 첫 번째 노트북을 작성할 준비가 되었습니다.
3. Spark Serverless를 사용하여 원시 로그 수집
이 섹션에서는 원시 JSON 트랜잭션 로그를 데이터 레이크로 수집합니다. Managed Service for Apache Spark (Spark 서버리스)는 BigQuery의 기본 스토리지에 직접 연결됩니다. 표 형식 데이터를 관리하고 직접 쿼리 및 분석을 사용 설정하려면 표준 BigQuery 커넥터를 사용합니다.
사전 구성된 Spark 서버리스 런타임 살펴보기
Spark 코드를 실행하기 전에 설정 스크립트에 의해 사전 구성된 Serverless Runtime 템플릿을 검사합니다. 이 템플릿은 타겟 실행 환경 백엔드를 정의하고 필요한 커넥터 종속 항목을 번들로 묶습니다.
- IDE 작업 표시줄에서 Google Cloud Data Agent Kit 패널을 엽니다.
- Apache Spark 드롭다운 메뉴를 펼친 다음 서버리스를 펼칩니다.
fraud-pipeline-runtime을 마우스 오른쪽 버튼으로 클릭하고 프로필을 선택하여 편집기에서 구성 뷰를 엽니다.- 프로필 탭에서 아래로 스크롤하고 속성을 펼쳐 환경에 연결된 맞춤 종속 항목을 검사합니다.
spark.jars:gs://spark-lib/spanner/spark-3.5-spanner-1.4.0.jar을 포함하며, 이는 Spark Spanner 커넥터를 사용하여 Spark 작업이 나중에 실습에서 추론 결과를 Cloud Spanner에 직접 쓸 수 있도록 합니다. (참고: Dataproc Serverless에는 기본적으로 Google Cloud의 Spark BigQuery 커넥터가 포함되어 있으므로 BigQuery 테이블을 읽고 쓰는 데 추가 jar 구성이 필요하지 않습니다.)
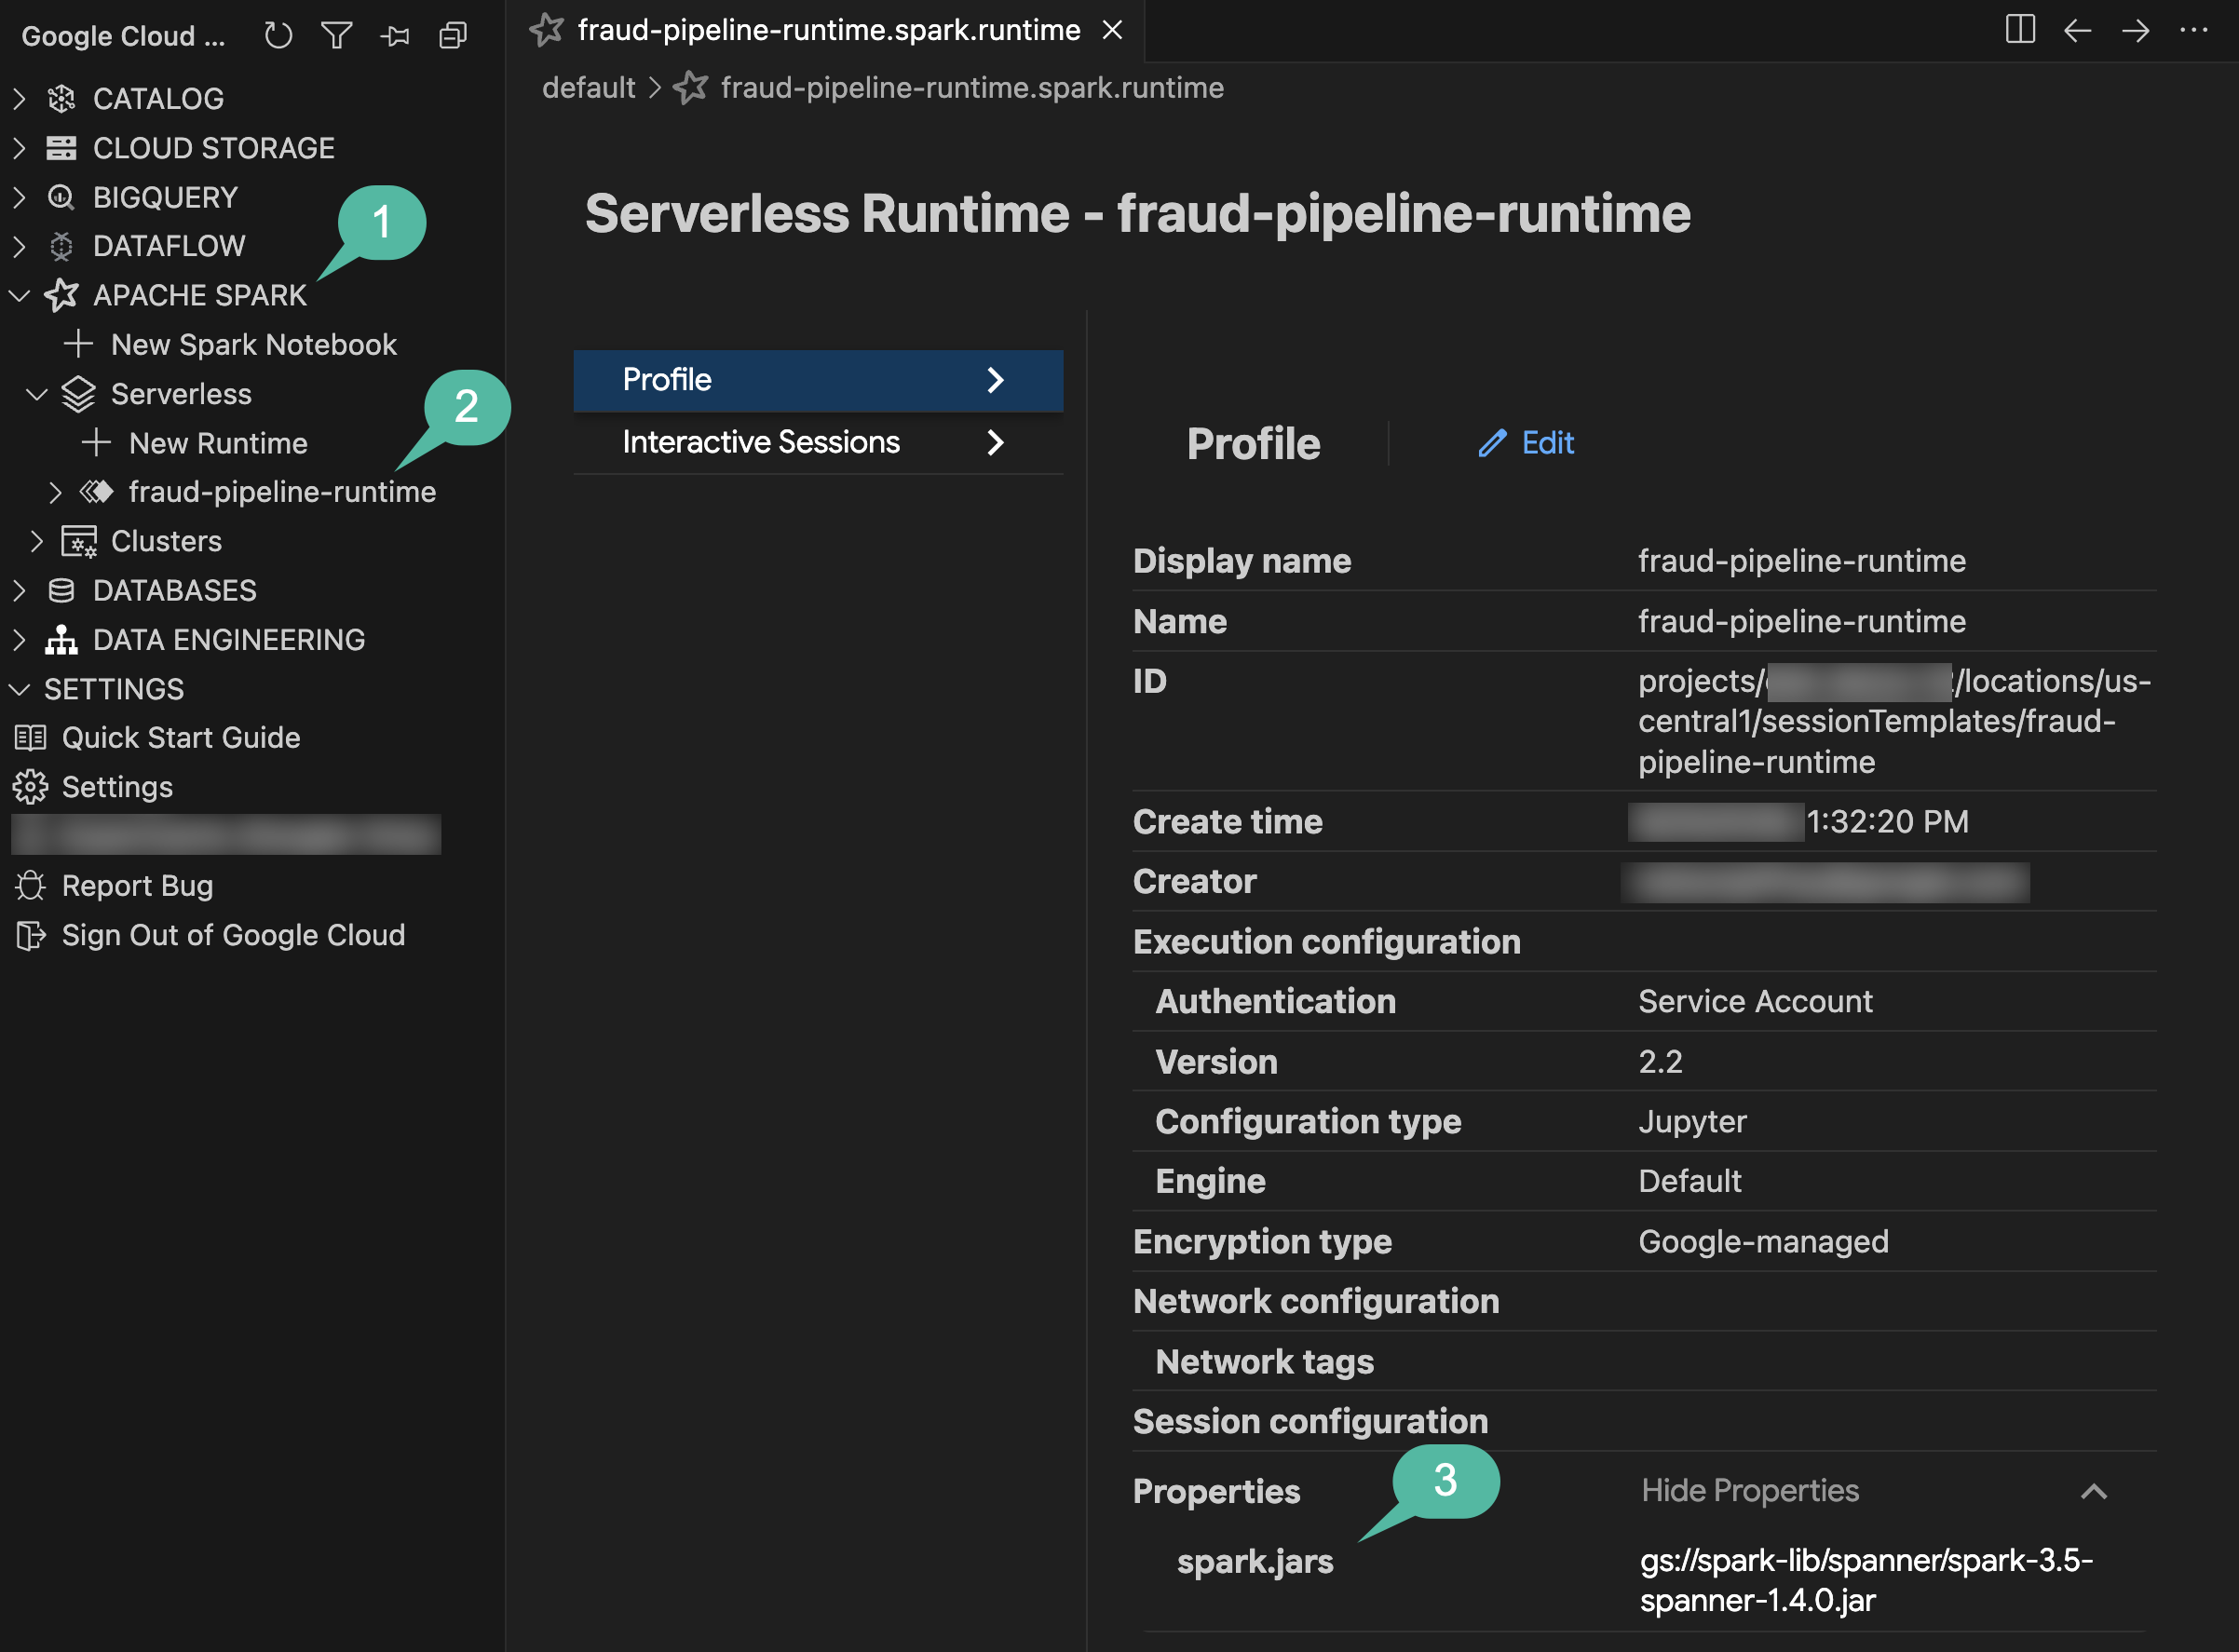
- 왼쪽의 대화형 세션 탭을 확인합니다. 아직 코드를 실행하지 않았으므로 현재는 비어 있습니다. 다음 단계에서 노트북을 실행하면 라이브 서버리스 컴퓨팅 세션이 동적으로 프로비저닝되고 여기에 표시됩니다.
Data Agent Kit를 사용하여 데이터 수집
Spark 세션을 수동으로 구성하거나 PySpark 로드 스크립트를 처음부터 작성하는 대신 Data Agent Kit를 사용하여 에이전트와 페어 프로그래밍을 진행합니다.
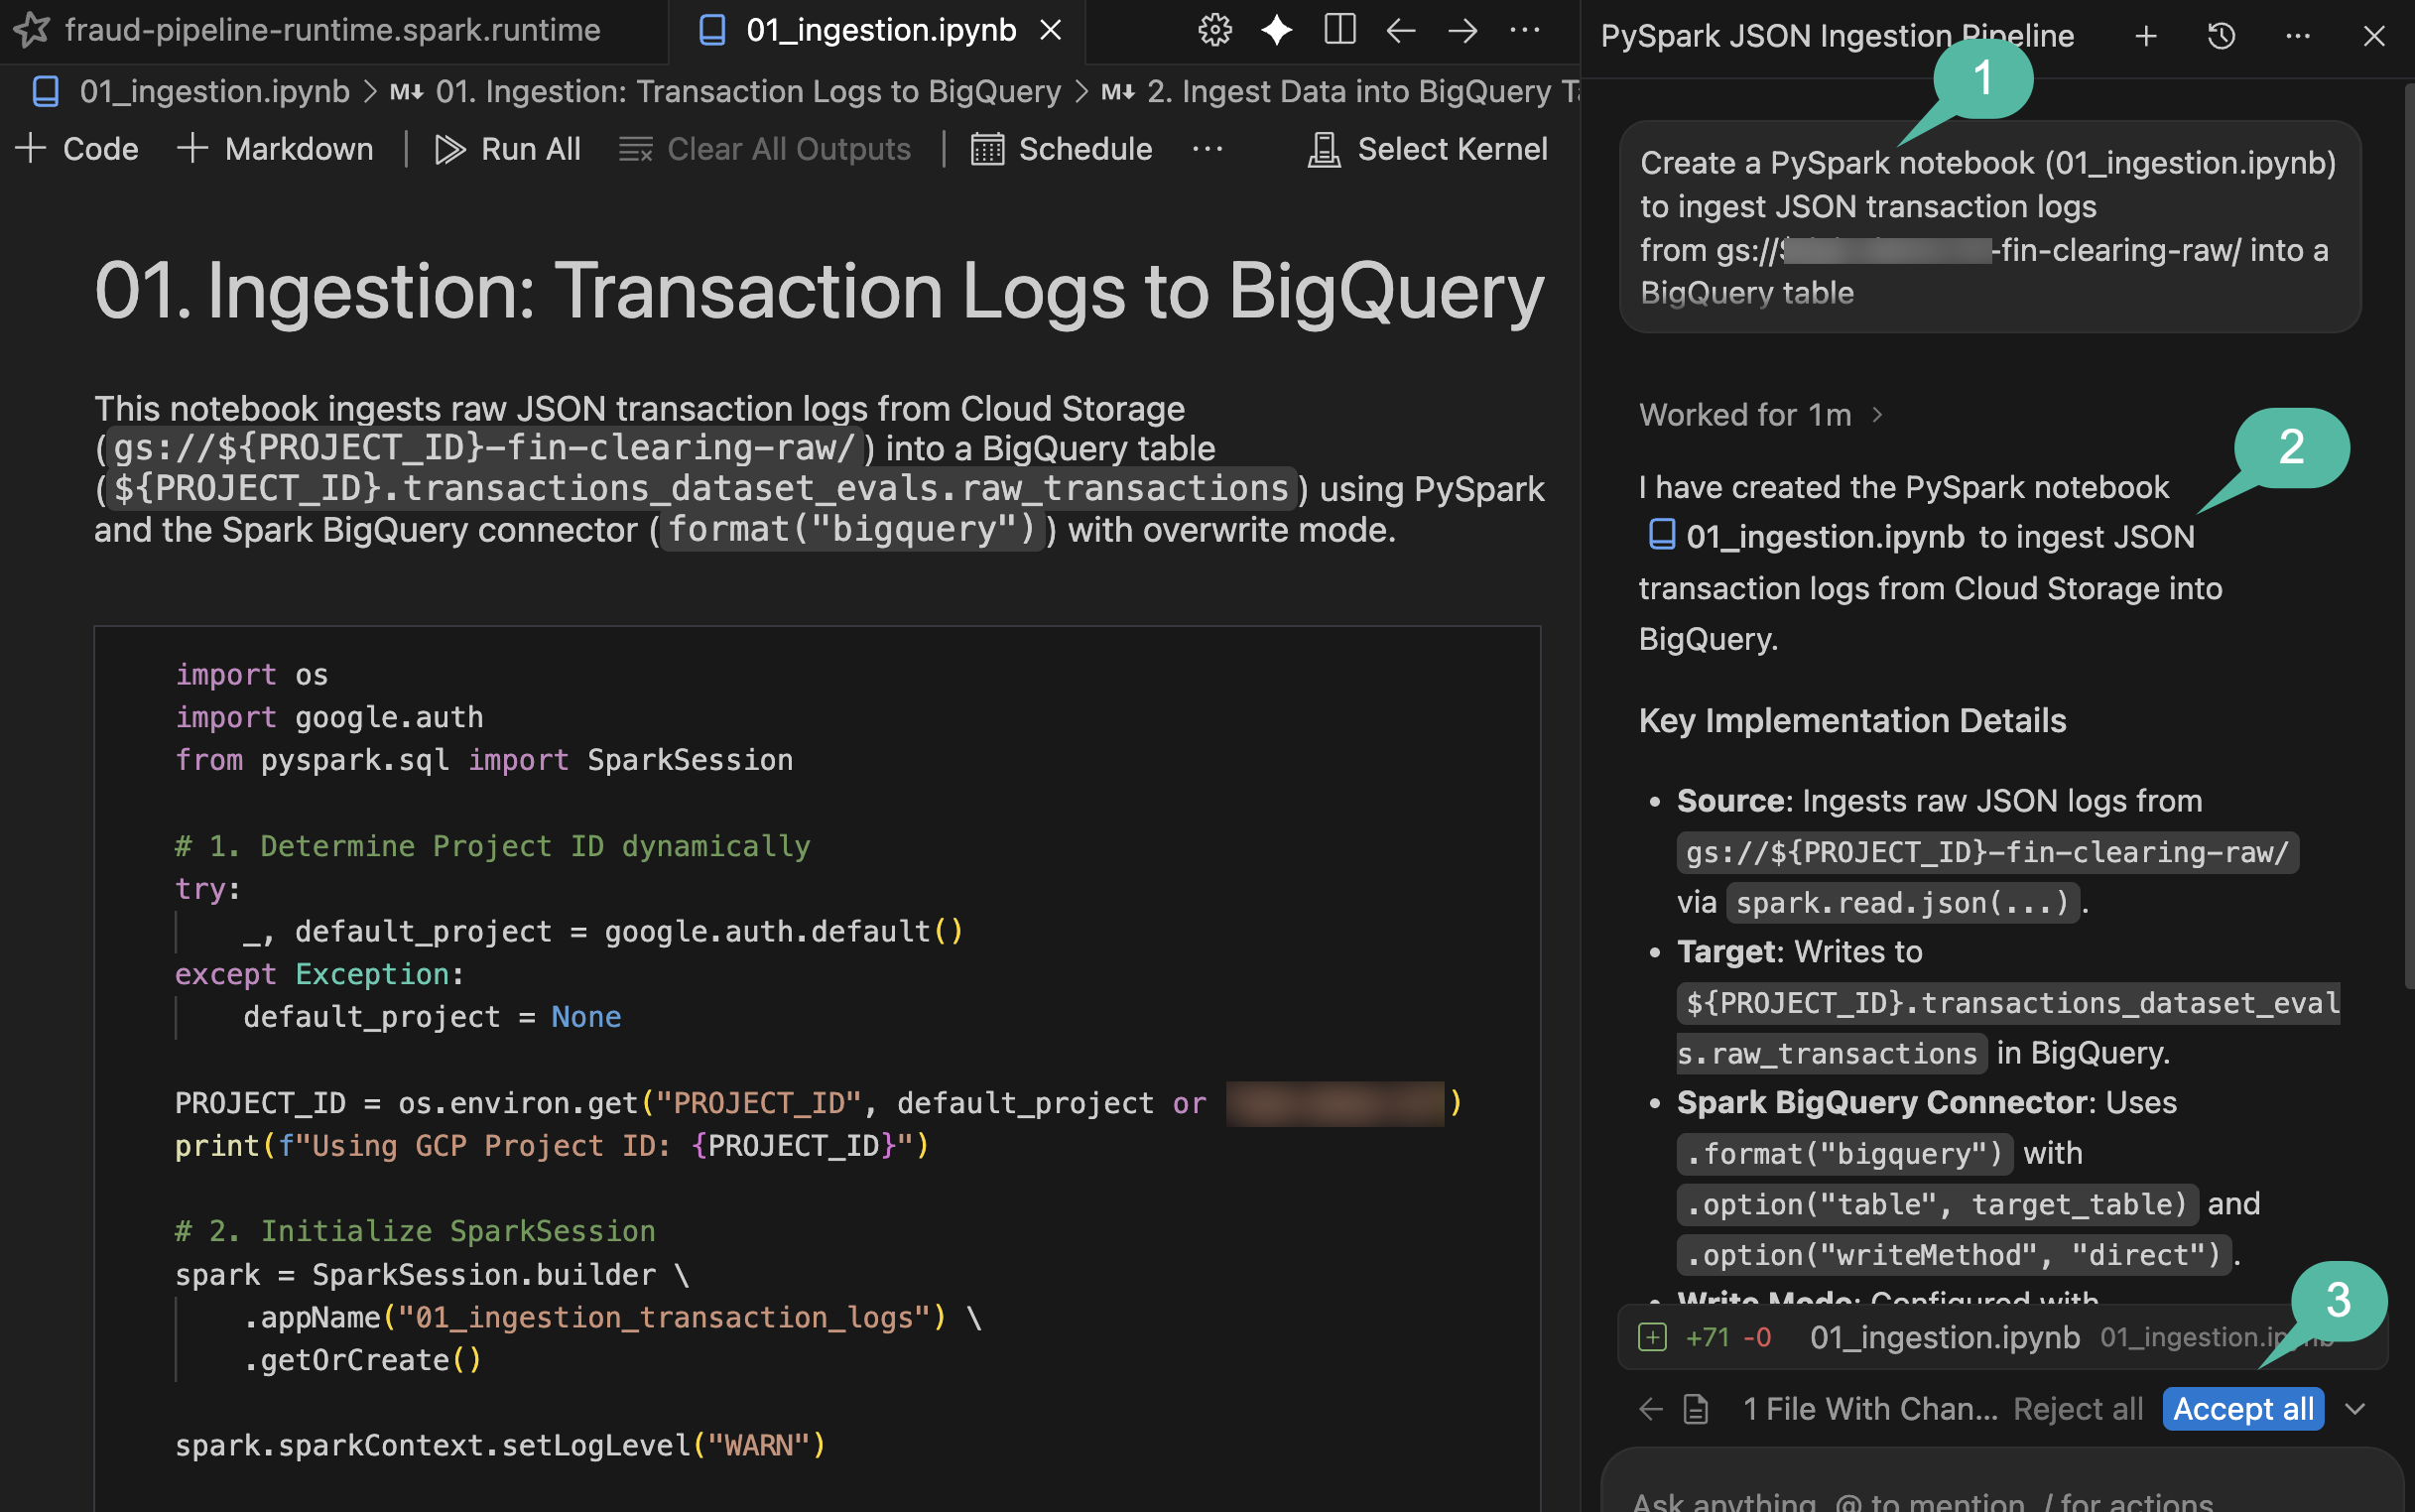
- 오른쪽 상단의 툴바에서 에이전트 전환 아이콘을 클릭하여 에이전트 채팅 창을 엽니다.
- 다음 프롬프트를 채팅에 붙여넣습니다 (
${PROJECT_ID}를 실제 Google Cloud 프로젝트 ID로 바꿔야 함).
Create a PySpark notebook (01_ingestion.ipynb) to ingest JSON transaction logs
from gs://${PROJECT_ID}-fin-clearing-raw/ into a BigQuery table
`${PROJECT_ID}.transactions_dataset_evals.raw_transactions`
using the Spark BigQuery connector (`format("bigquery")`) with overwrite mode.
- 에이전트가 백그라운드 확인 명령어 실행 권한을 요청하는 경우 (예: '이 명령어를 실행하도록 허용하시겠어요?') 제안된 명령어를 검토하고 예, 이번에만 허용 (또는 예, 항상 허용)을 선택합니다.
- 상담사가 파일 생성을 완료하면 채팅 창 하단의 파란색 모두 수락 버튼 (또는 체크표시 아이콘)을 클릭하여
notebooks/01_ingestion.ipynb을 작업공간에 저장합니다.
노트북 검토 및 실행
- IDE에서 새로 생성된
notebooks/01_ingestion.ipynb를 엽니다. - BigQuery 커넥터 쓰기 로직의 PySpark 코드를 검토합니다.
- IDE의 노트북 툴바에서 모두 실행을 클릭합니다.
- 원격 Spark 노트북을 처음 실행하는 경우 IDE에서 로컬 종속 항목을 설치하라는 메시지가 표시될 수 있습니다. 메시지가 표시되면 원격 Spark 커널의 종속 항목 설치를 클릭하고 설치 대화상자를 확인한 다음 모두 실행을 다시 클릭합니다.
- 커널 선택 드롭다운 메뉴에서 원격 Spark 커널 -> 서버리스 Spark의 fraud-pipeline-runtime을 선택합니다. (도움말: 미리 구성된 런타임 템플릿이 표시되지 않으면 커널 선택기 드롭다운의 오른쪽 상단에 있는 새로고침 아이콘을 클릭하여 사용 가능한 원격 커널을 다시 로드하세요.)
- 편집기의 왼쪽 하단에 있는 상태 표시줄을 확인합니다.
Connecting to kernel: fraud-pipeline-runtime on Serverless Spark...이 표시됩니다. Spark 서버리스 런타임 커널 백엔드를 처음 실행하는 것이므로 프로비저닝하고 부팅하는 데 몇 분 정도 걸립니다. - 커널 연결이 완료되면 노트북에서 모든 셀을 순차적으로 실행하여 원시 트랜잭션 로그를 BigQuery 데이터 세트로 처리하기 시작합니다.
인증
실행이 완료되면 Data Agent Kit 카탈로그를 확인하여 테이블 생성을 확인합니다.
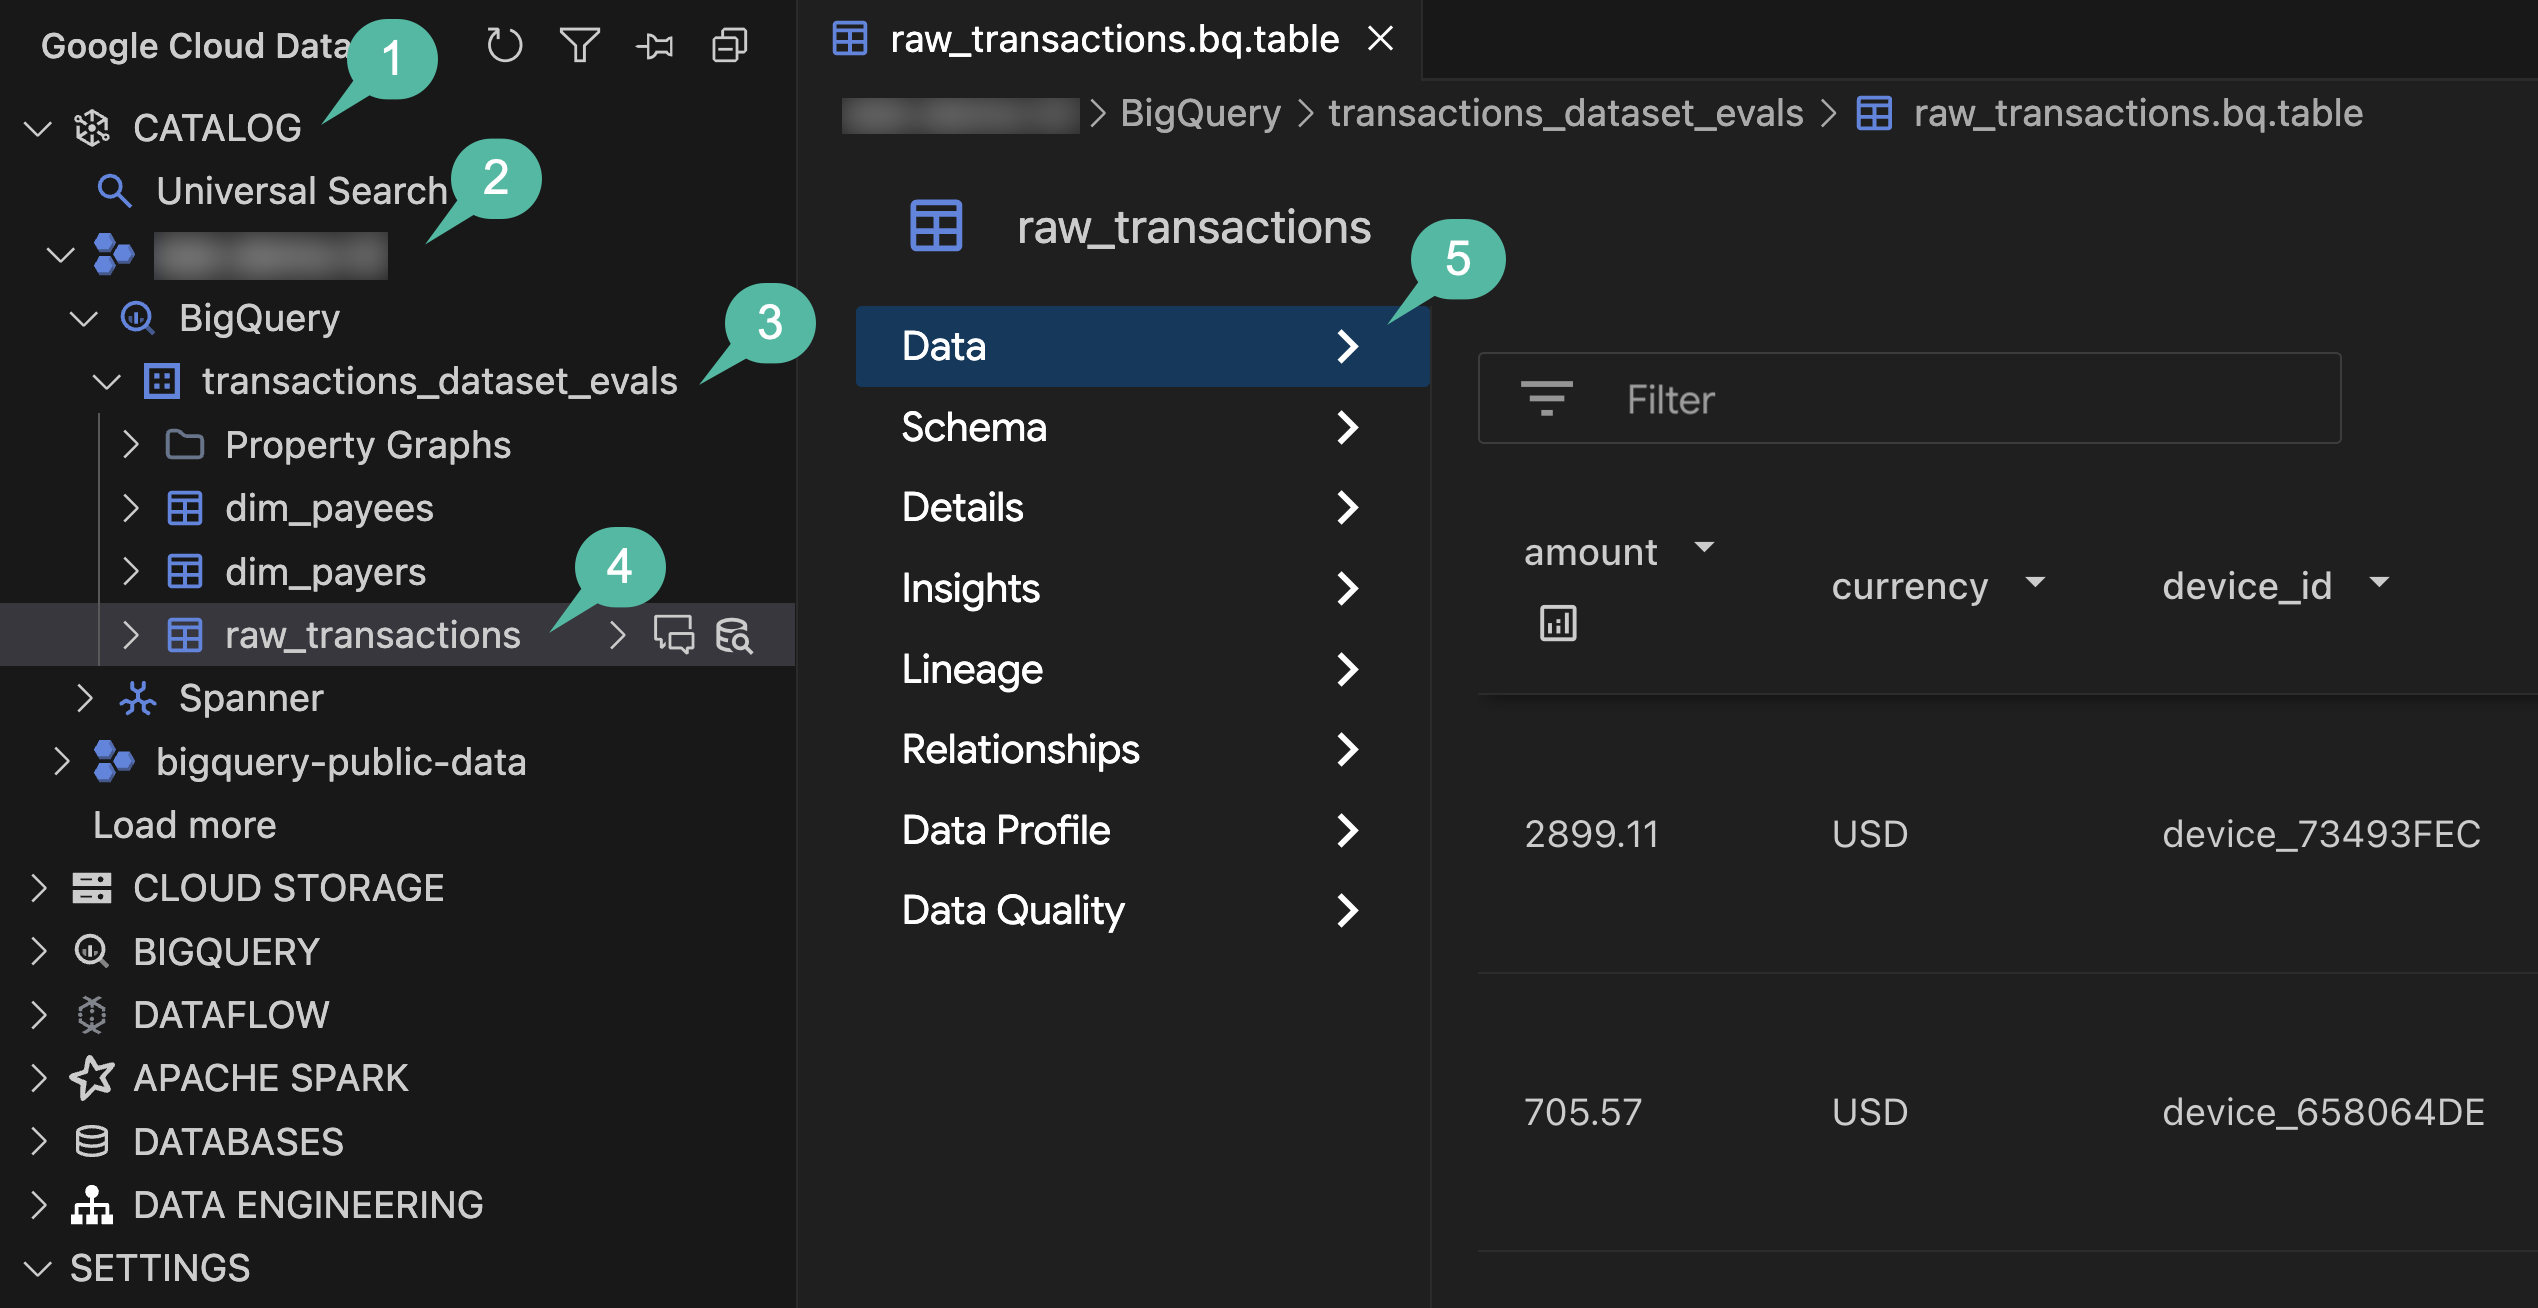
- IDE 작업 표시줄에서 Google Cloud Data Agent Kit 패널을 엽니다.
- 카탈로그 섹션을 펼칩니다.
- 프로젝트 ID를 펼칩니다.
- BigQuery를 펼칩니다.
transactions_dataset_evals데이터 세트를 펼칩니다.raw_transactions테이블을 클릭하여 기본 편집기에서 세부정보 보기를 엽니다.- 왼쪽 탐색에서 데이터, 스키마, 세부정보 탭을 살펴보고 수집된 레코드와 메타데이터를 검사합니다.
섹션 요약: 에이전트 채팅에서 자연어를 사용하여 완전한 Spark 서버리스 워크로드를 생성했습니다. 그런 다음 이를 실행하여 비구조화된 JSON 로그를 BigQuery (원시) 테이블로 처리했습니다.
4. dbt로 중복 제거 및 정규화
ML 모델을 학습시키기 전에 중복 스트리밍 로그를 삭제하고, 잘못된 레코드 (예: 빈 거래 ID)를 격리하고, 차원 데이터 (지불인 및 수령인)를 조인하여 데이터 품질을 적용합니다. 이 프로세스에는 동일한 결과를 보장하는 안정적인 SQL 변환이 필요하므로 dbt (데이터 빌드 도구)가 적합합니다.
dbt 파이프라인 스캐폴드
에이전트를 사용하여 BigQuery 데이터 세트에서 dbt 프로젝트를 생성합니다.
- 상담사 채팅 창으로 돌아갑니다.
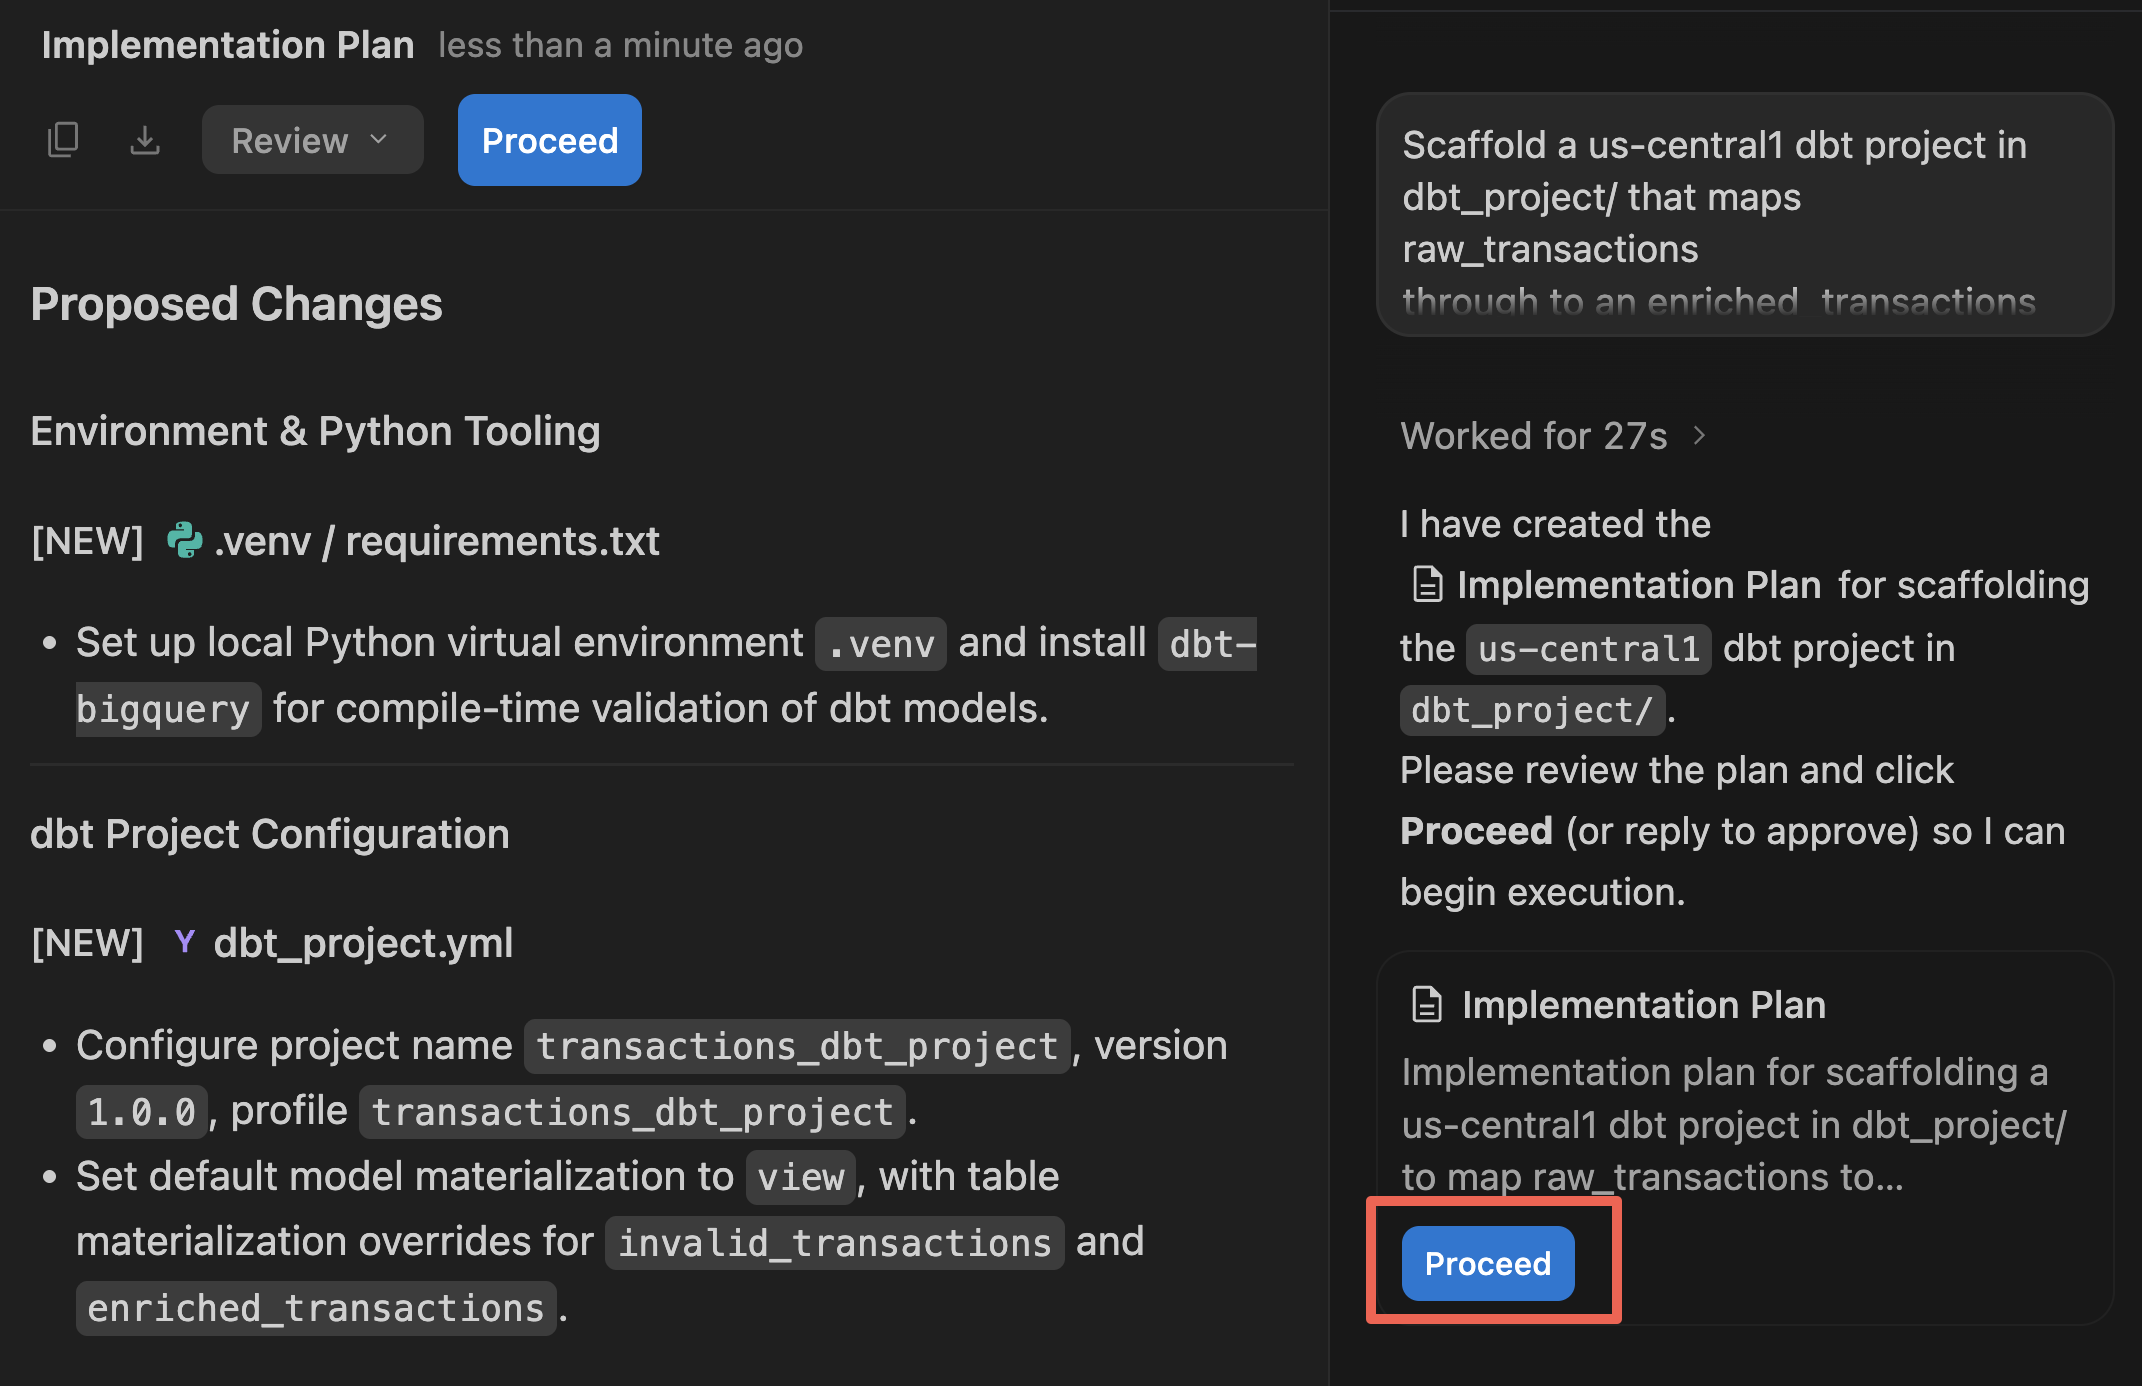
- 다음 안내를 제공하여 dbt 프로젝트를 생성합니다.
Scaffold a us-central1 dbt project in dbt_project/ that maps raw_transactions
through to an enriched_transactions model in dataset transactions_dataset_evals.

Deduplicate by transaction_id in staging. Quarantine null IDs to an invalid_transactions model.
Join the valid staging records with dim_payers and dim_payees for the enriched_transactions model,
preserving the historical `is_fraud` label column, and finally add a transaction uniqueness test.

Create an implementation plan first.
- 에이전트가 기본 편집기 창에 구현 계획 아티팩트를 표시합니다. 제안된 파일 구조와 SQL 논리를 검토합니다.
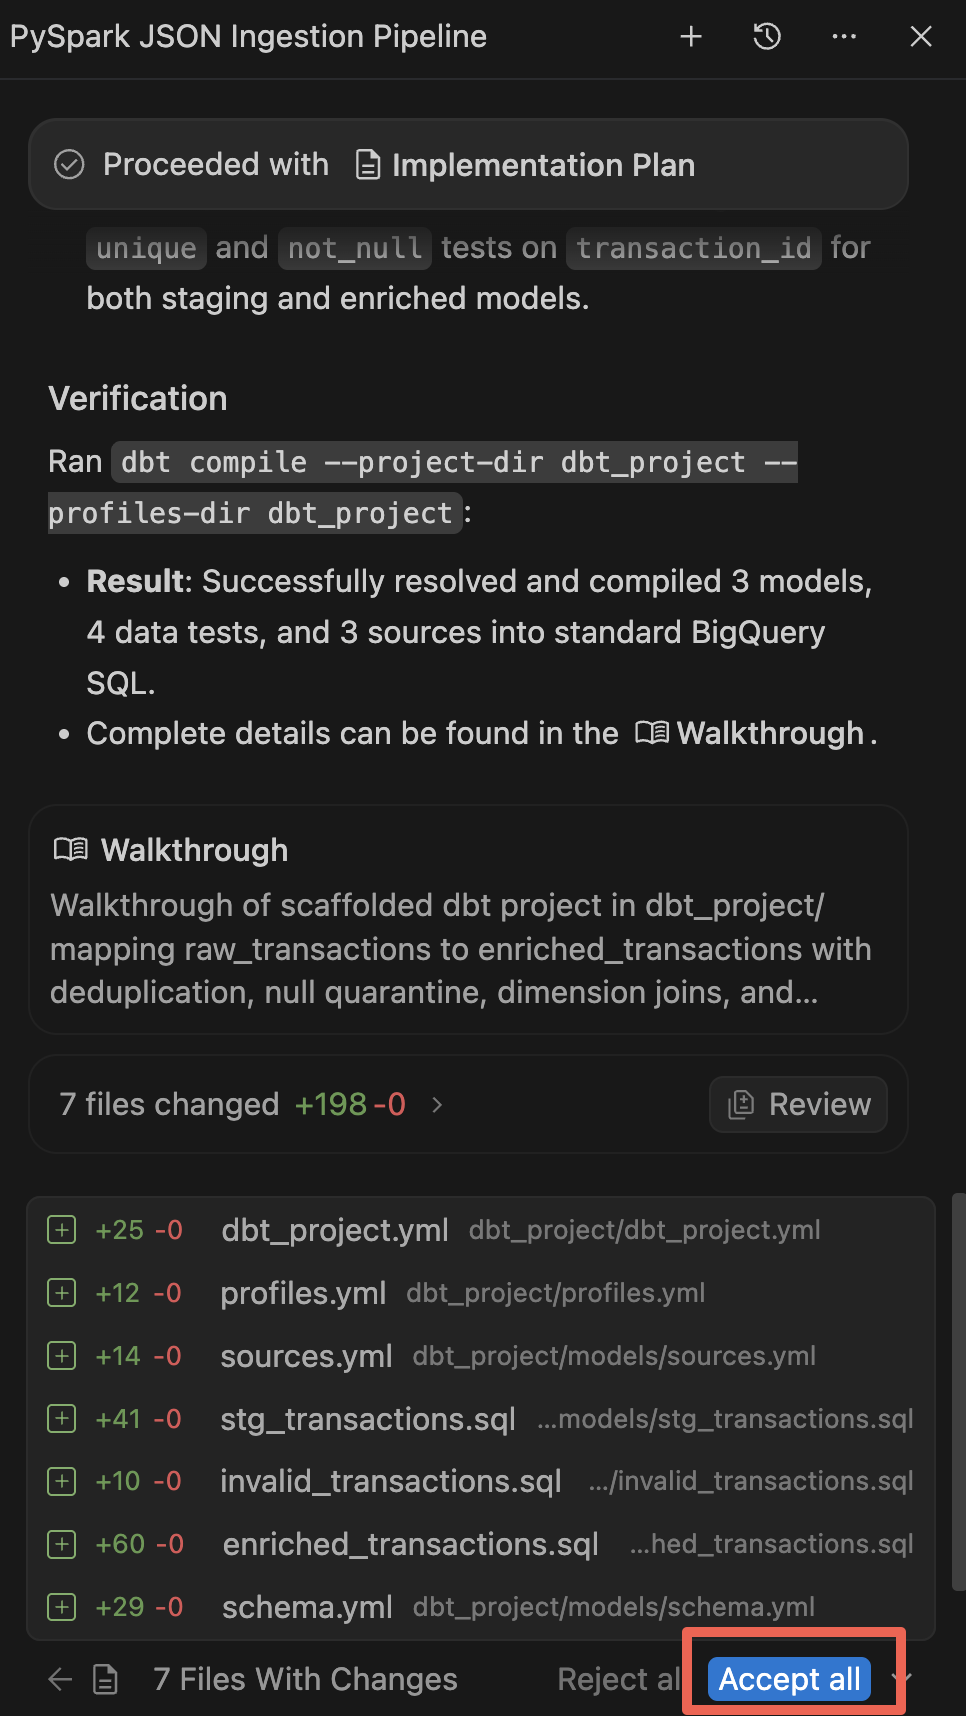
- 계속 (그런 다음 모두 수락)을 클릭하여 에이전트가 작업공간에서 파일을 생성하도록 허용합니다.
- 생성이 완료되면 에이전트가 새 구성요소를 요약하는 둘러보기를 표시합니다. 메시지가 표시되면 모든 변경사항을 수락합니다.
빌드 및 테스트
에이전트가 생성된 SQL의 구문이 유효한지 확인하기 위해 dbt compile를 자동으로 실행했지만 이제 이러한 뷰와 테이블을 BigQuery에 구체화하고 로컬 확인을 위해 데이터 품질 테스트를 실행합니다. (참고: 실습 후반부에서 엔드 투 엔드 Airflow DAG의 일부로 이 dbt 단계를 자동화합니다.)
- 가장 왼쪽에 있는 활동 표시줄에서 탐색기 아이콘을 클릭하거나
Cmd/Ctrl+Shift+E키를 누릅니다. dbt_project->models을 펼쳐 생성된 SQL 모델을 검사합니다.enriched_transactions.sql를 클릭하여 편집기에서 변환 및 사기 기능 로직을 열고 검토합니다.- 파일 탐색기에서
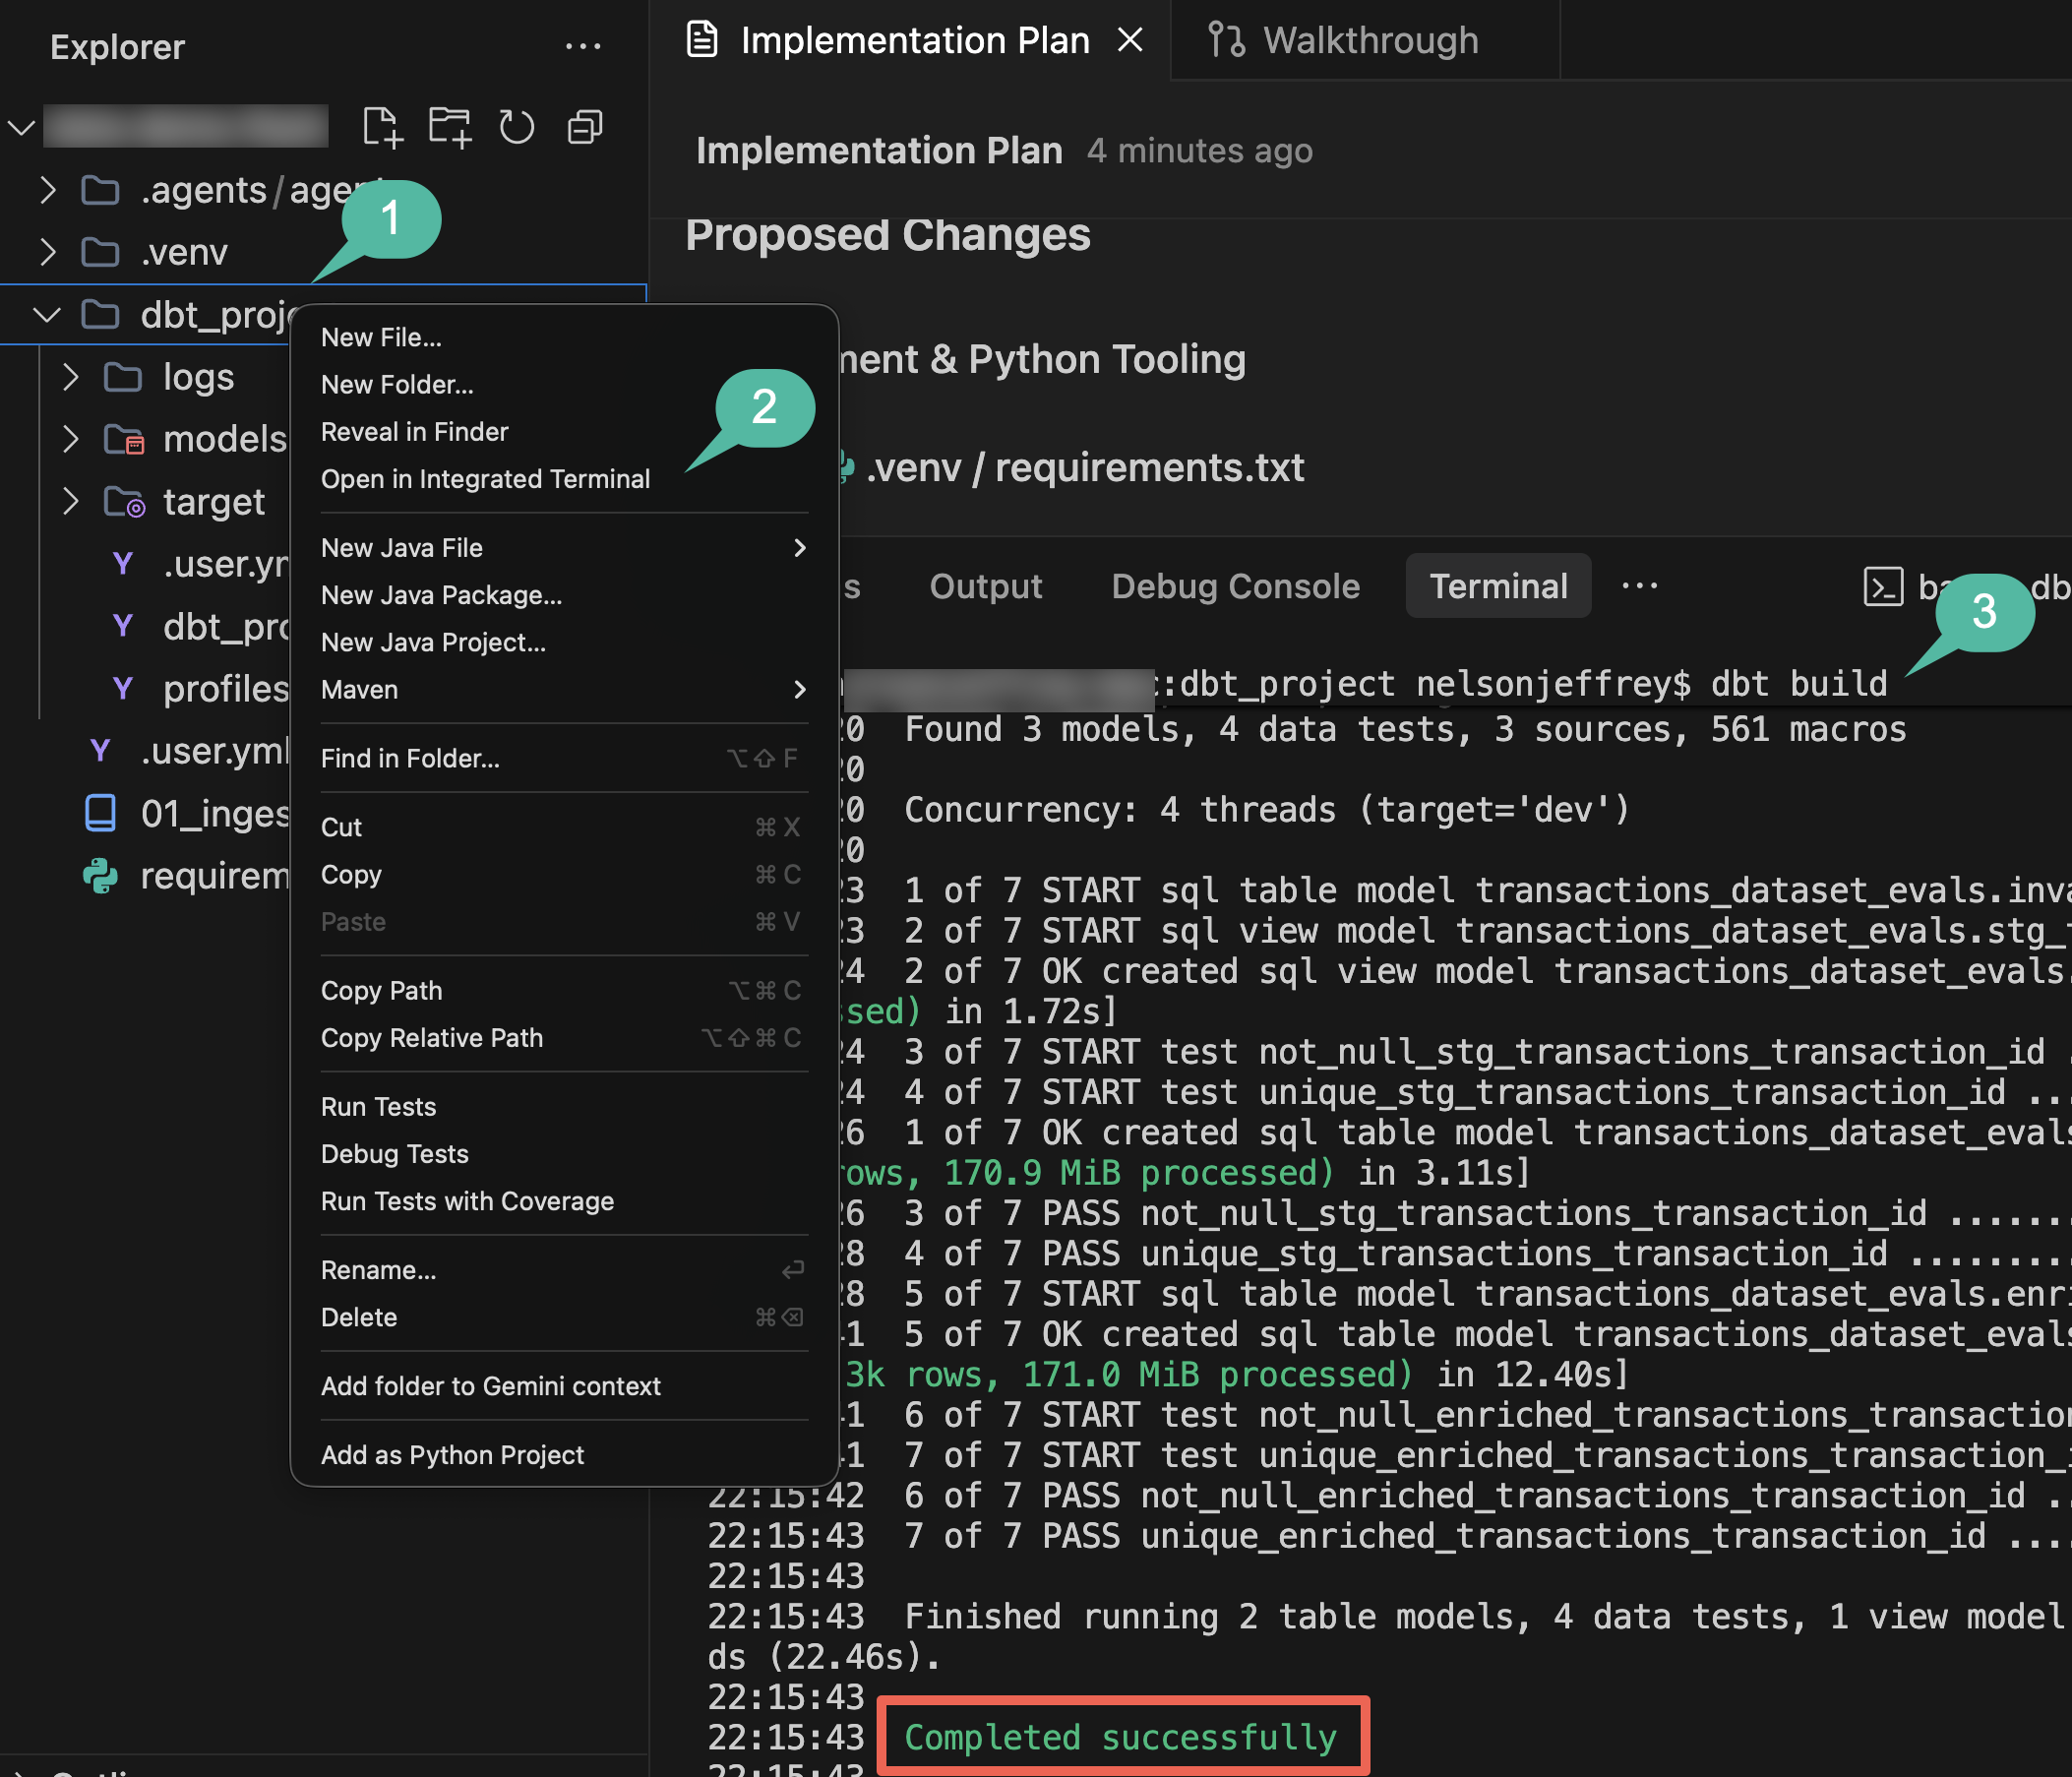
dbt_project폴더를 마우스 오른쪽 버튼으로 클릭하고 통합 터미널에서 열기를 선택합니다. 그러면 필요한dbt_project작업 디렉터리로 바로 설정된 터미널 창이 자동으로 열립니다. dbt가 아직 설치되어 있지 않다면dbt_project/외부 (홈 또는 작업공간 루트)에 가상 환경을 만들고 BigQuery 어댑터를 설치합니다.
python3 -m venv ~/.venv/dbt
source ~/.venv/dbt/bin/activate
pip install dbt-bigquery
- dbt 모델과 연결된 데이터 품질 테스트를 실행합니다.
dbt build
- 터미널 출력을 확인합니다. dbt는 SQL을 컴파일하고, BigQuery에서 스테이징 및 보강된 테이블을 구체화하고, 데이터 테스트를 실행합니다.
- 빌드가 완료되면 터미널 창을 닫아 나머지 단계를 위한 화면 공간을 확보합니다.
섹션 요약: 에이전트로 dbt 프로젝트를 생성하고, 데이터 품질 테스트를 실행하고, 원시 레코드를 스테이징 및 보강된 BigQuery 테이블로 변환했습니다.
5. 랜덤 포레스트를 사용하여 분산 사기 감지 모델 학습
BigQuery에 구체화된 풍부한 거래를 사용하여 사기 이벤트를 분류하는 머신러닝 모델을 빌드합니다. 랜덤 포레스트는 테이블 형식 분류 데이터에 적합한 앙상블 학습 방법입니다. Spark 서버리스에서 RandomForestClassifier를 실행하면 인프라를 관리하지 않고도 작업자 노드에 모델 학습이 분산됩니다.
이 단계에서는 에이전트를 사용하여 Spark ML 학습 파이프라인을 생성합니다.
ML 학습 노트북 생성
- 상담사 채팅 창을 엽니다.
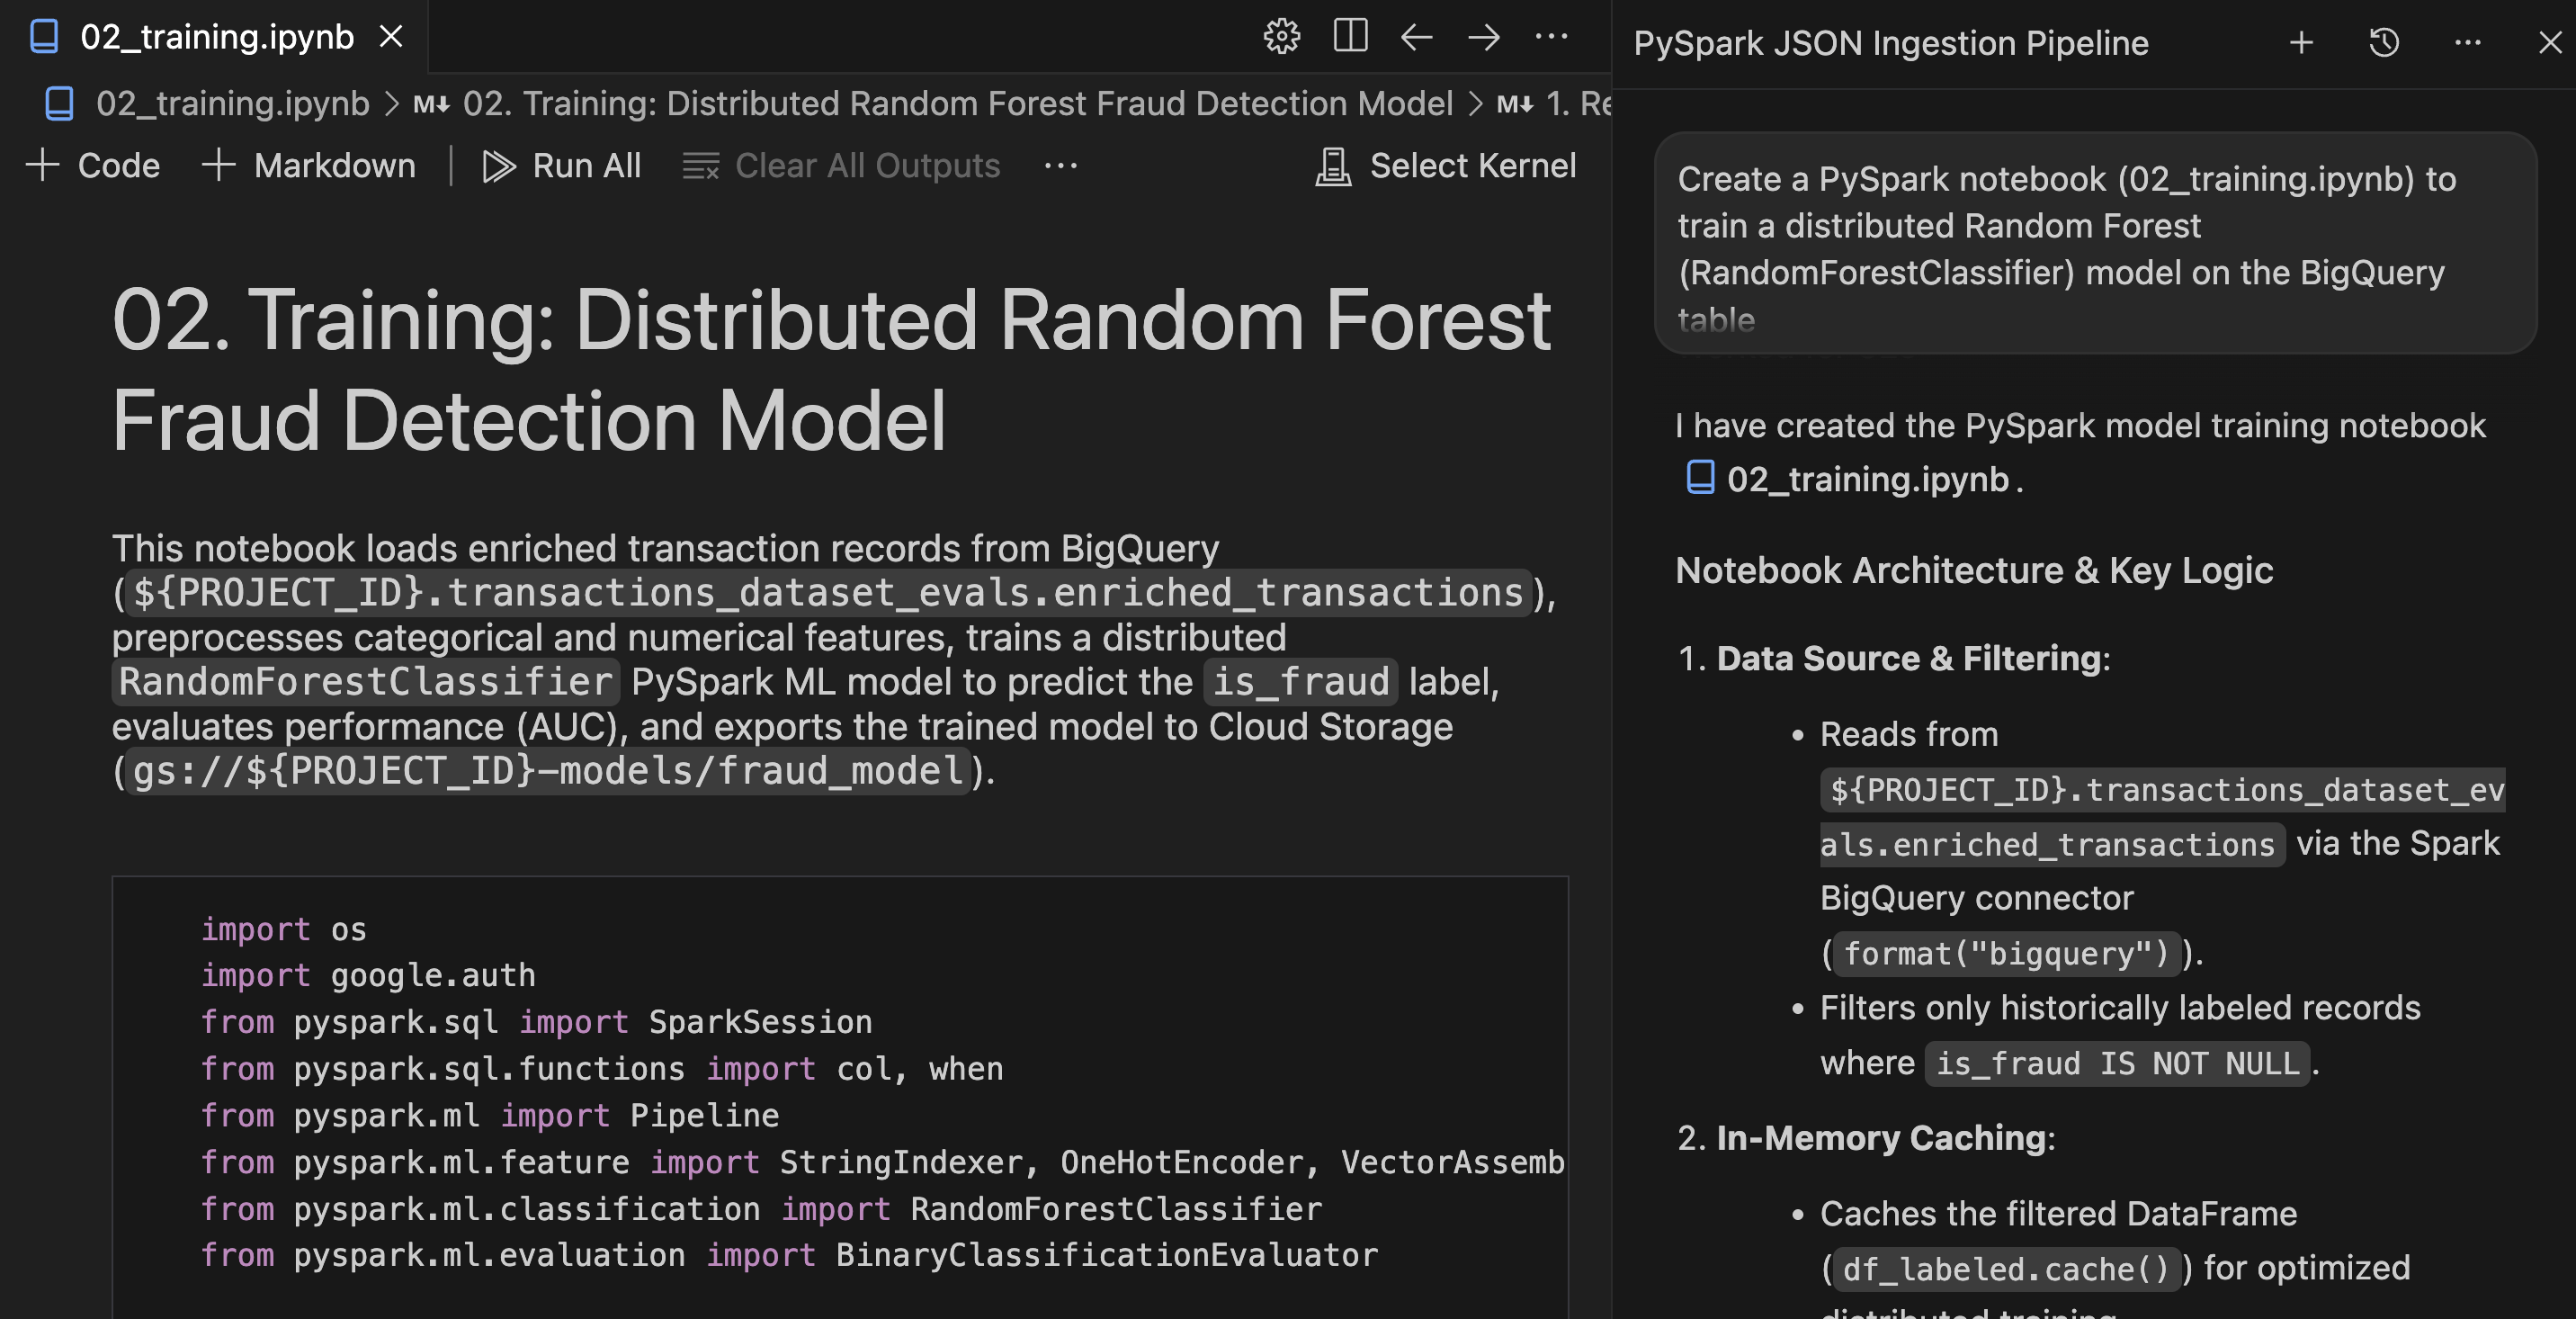
- 다음 프롬프트를 제공하여 모델 학습 시퀀스를 설계합니다 (
${PROJECT_ID}를 활성 프로젝트 ID로 바꿔야 함).
Create a PySpark notebook (02_training.ipynb) to train a distributed Random Forest
(RandomForestClassifier) model on the BigQuery table
`transactions_dataset_evals`.`enriched_transactions`, predicting the `is_fraud` label.
Train only on historically labeled records where `is_fraud` is not null.

One-hot encode categorical strings, scale amounts, cache the dataset in memory,
evaluate AUC, and save the evaluated model to gs://${PROJECT_ID}-models/fraud_model.
- 에이전트의 계획 또는 생성된 코드를 검토하고 계속 / 모두 수락을 클릭하여
notebooks/02_training.ipynb를 작업공간에 저장합니다.
노트북 검토 및 실행
- 편집기에서
notebooks/02_training.ipynb을 엽니다. - 특성 인코딩, 벡터 어셈블리, 랜덤 포레스트 분류 로직을 위한 PySpark ML 파이프라인 단계를 검토합니다.
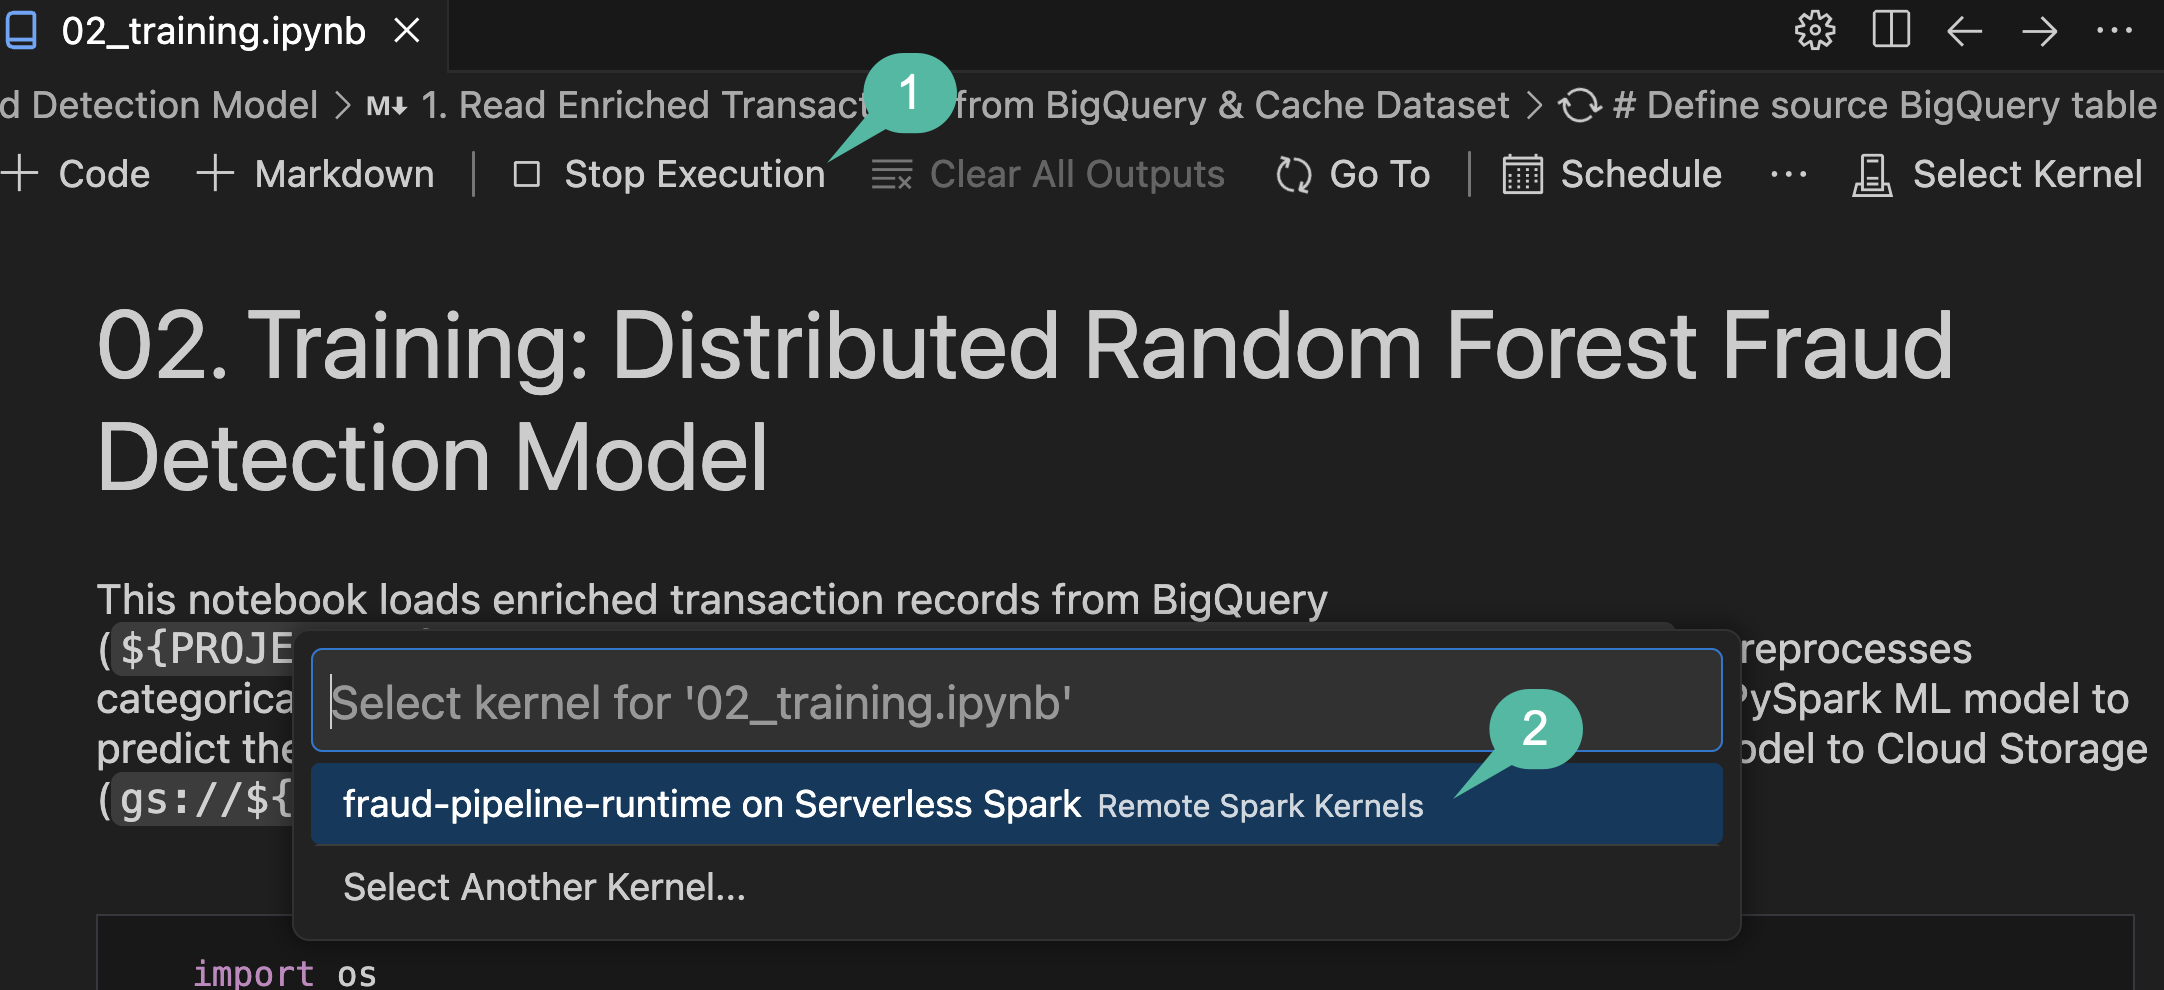
- IDE의 노트북 툴바에서 모두 실행을 클릭합니다.
- 커널 선택 드롭다운 선택기가 열리면 서버리스 Spark의 fraud-pipeline-runtime을 선택합니다.
인증
실행이 완료되면 모델이 올바르게 학습되고 내보내졌는지 확인합니다.
- 노트북 하단에 있는 평가 셀 출력을 검토하여 신고된 ROC 곡선 아래 영역 (AUC) 점수를 확인합니다.
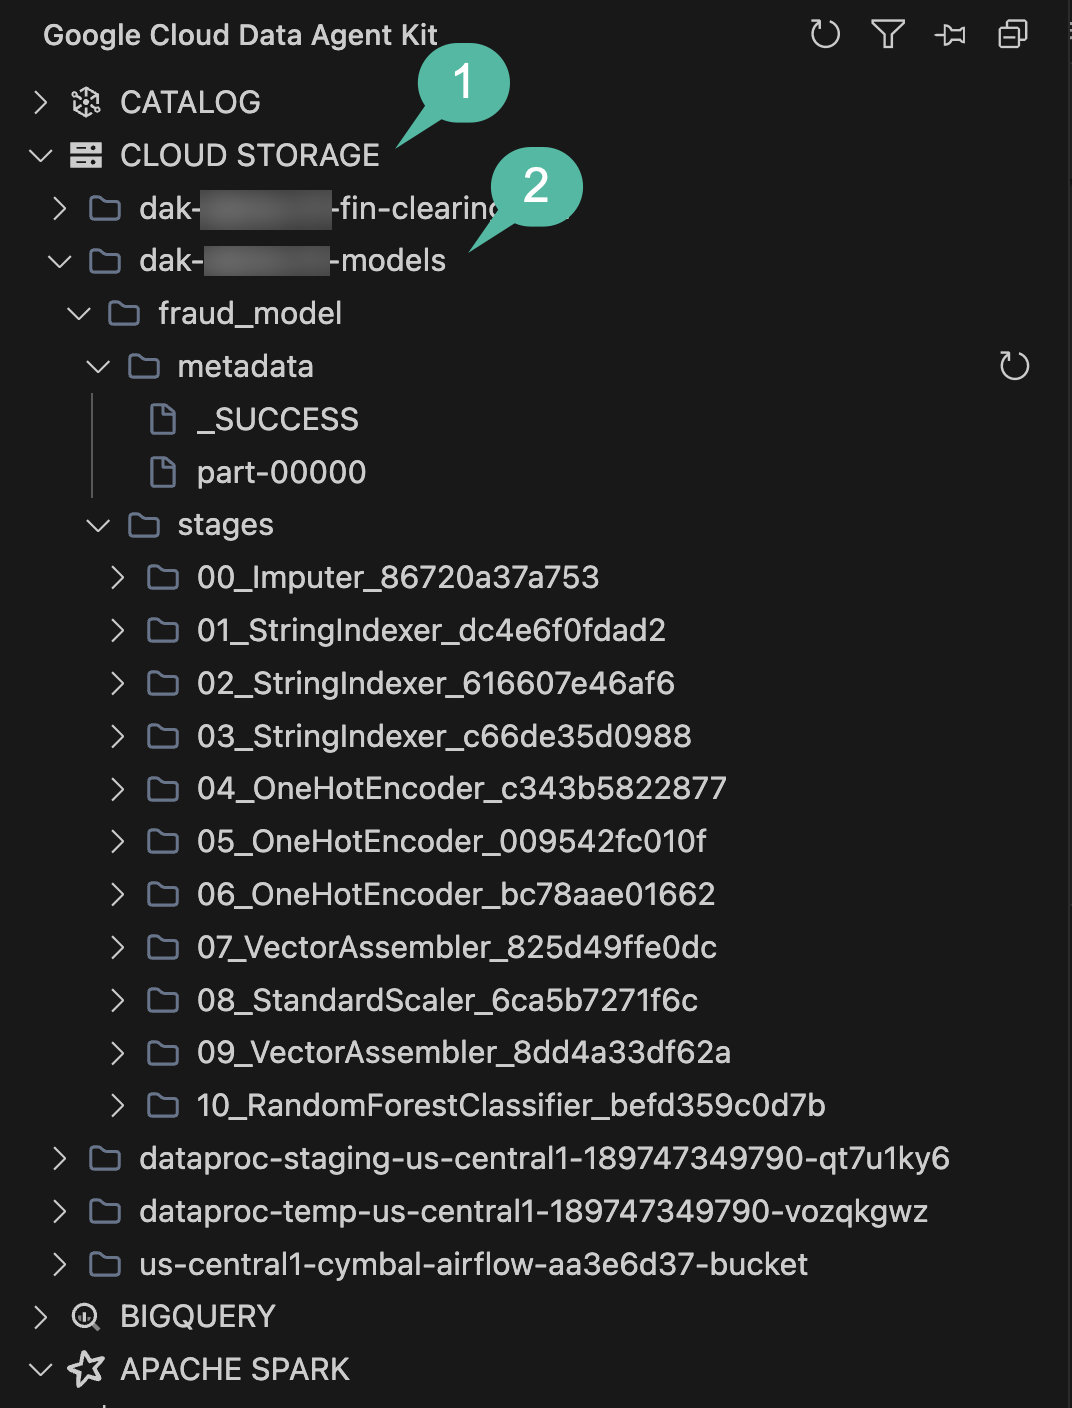
- 모델 아티팩트가 GCS에 성공적으로 저장되었는지 확인하려면 Data Agent Kit 사이드바에서 STORAGE 탐색기 창을 펼칩니다.
-models로 끝나는 버킷 (활성 프로젝트 ID에 연결됨)을 찾아 확장하고 드릴다운하여fraud_model디렉터리와 파이프라인 단계가 있는지 확인합니다.
섹션 요약: 에이전트를 사용하여 PySpark ML 학습 파이프라인을 만들고, 보강된 BigQuery 테이블에서 Random Forest 모델을 학습시키고, 모델을 Cloud Storage로 내보냈습니다.
6. 일괄 추론 및 Cloud Spanner 쓰기
Cloud Storage에 저장된 학습된 예측 모델을 사용하여 BigQuery를 통해 흐르는 새 거래에 대해 일괄 추론을 실행합니다. 규정 준수팀에서 검토할 수 있도록 위험도가 높은 거래는 운영 시스템으로 라우팅해야 합니다. Cloud Spanner는 이 검토 대기열에 확장 가능한 트랜잭션 데이터베이스를 제공합니다.
일괄 추론 노트북 생성
에이전트를 사용하여 BigQuery, Cloud Storage, Cloud Spanner를 연결하는 추론 노트북을 만듭니다.
- 상담사 채팅 창을 엽니다.
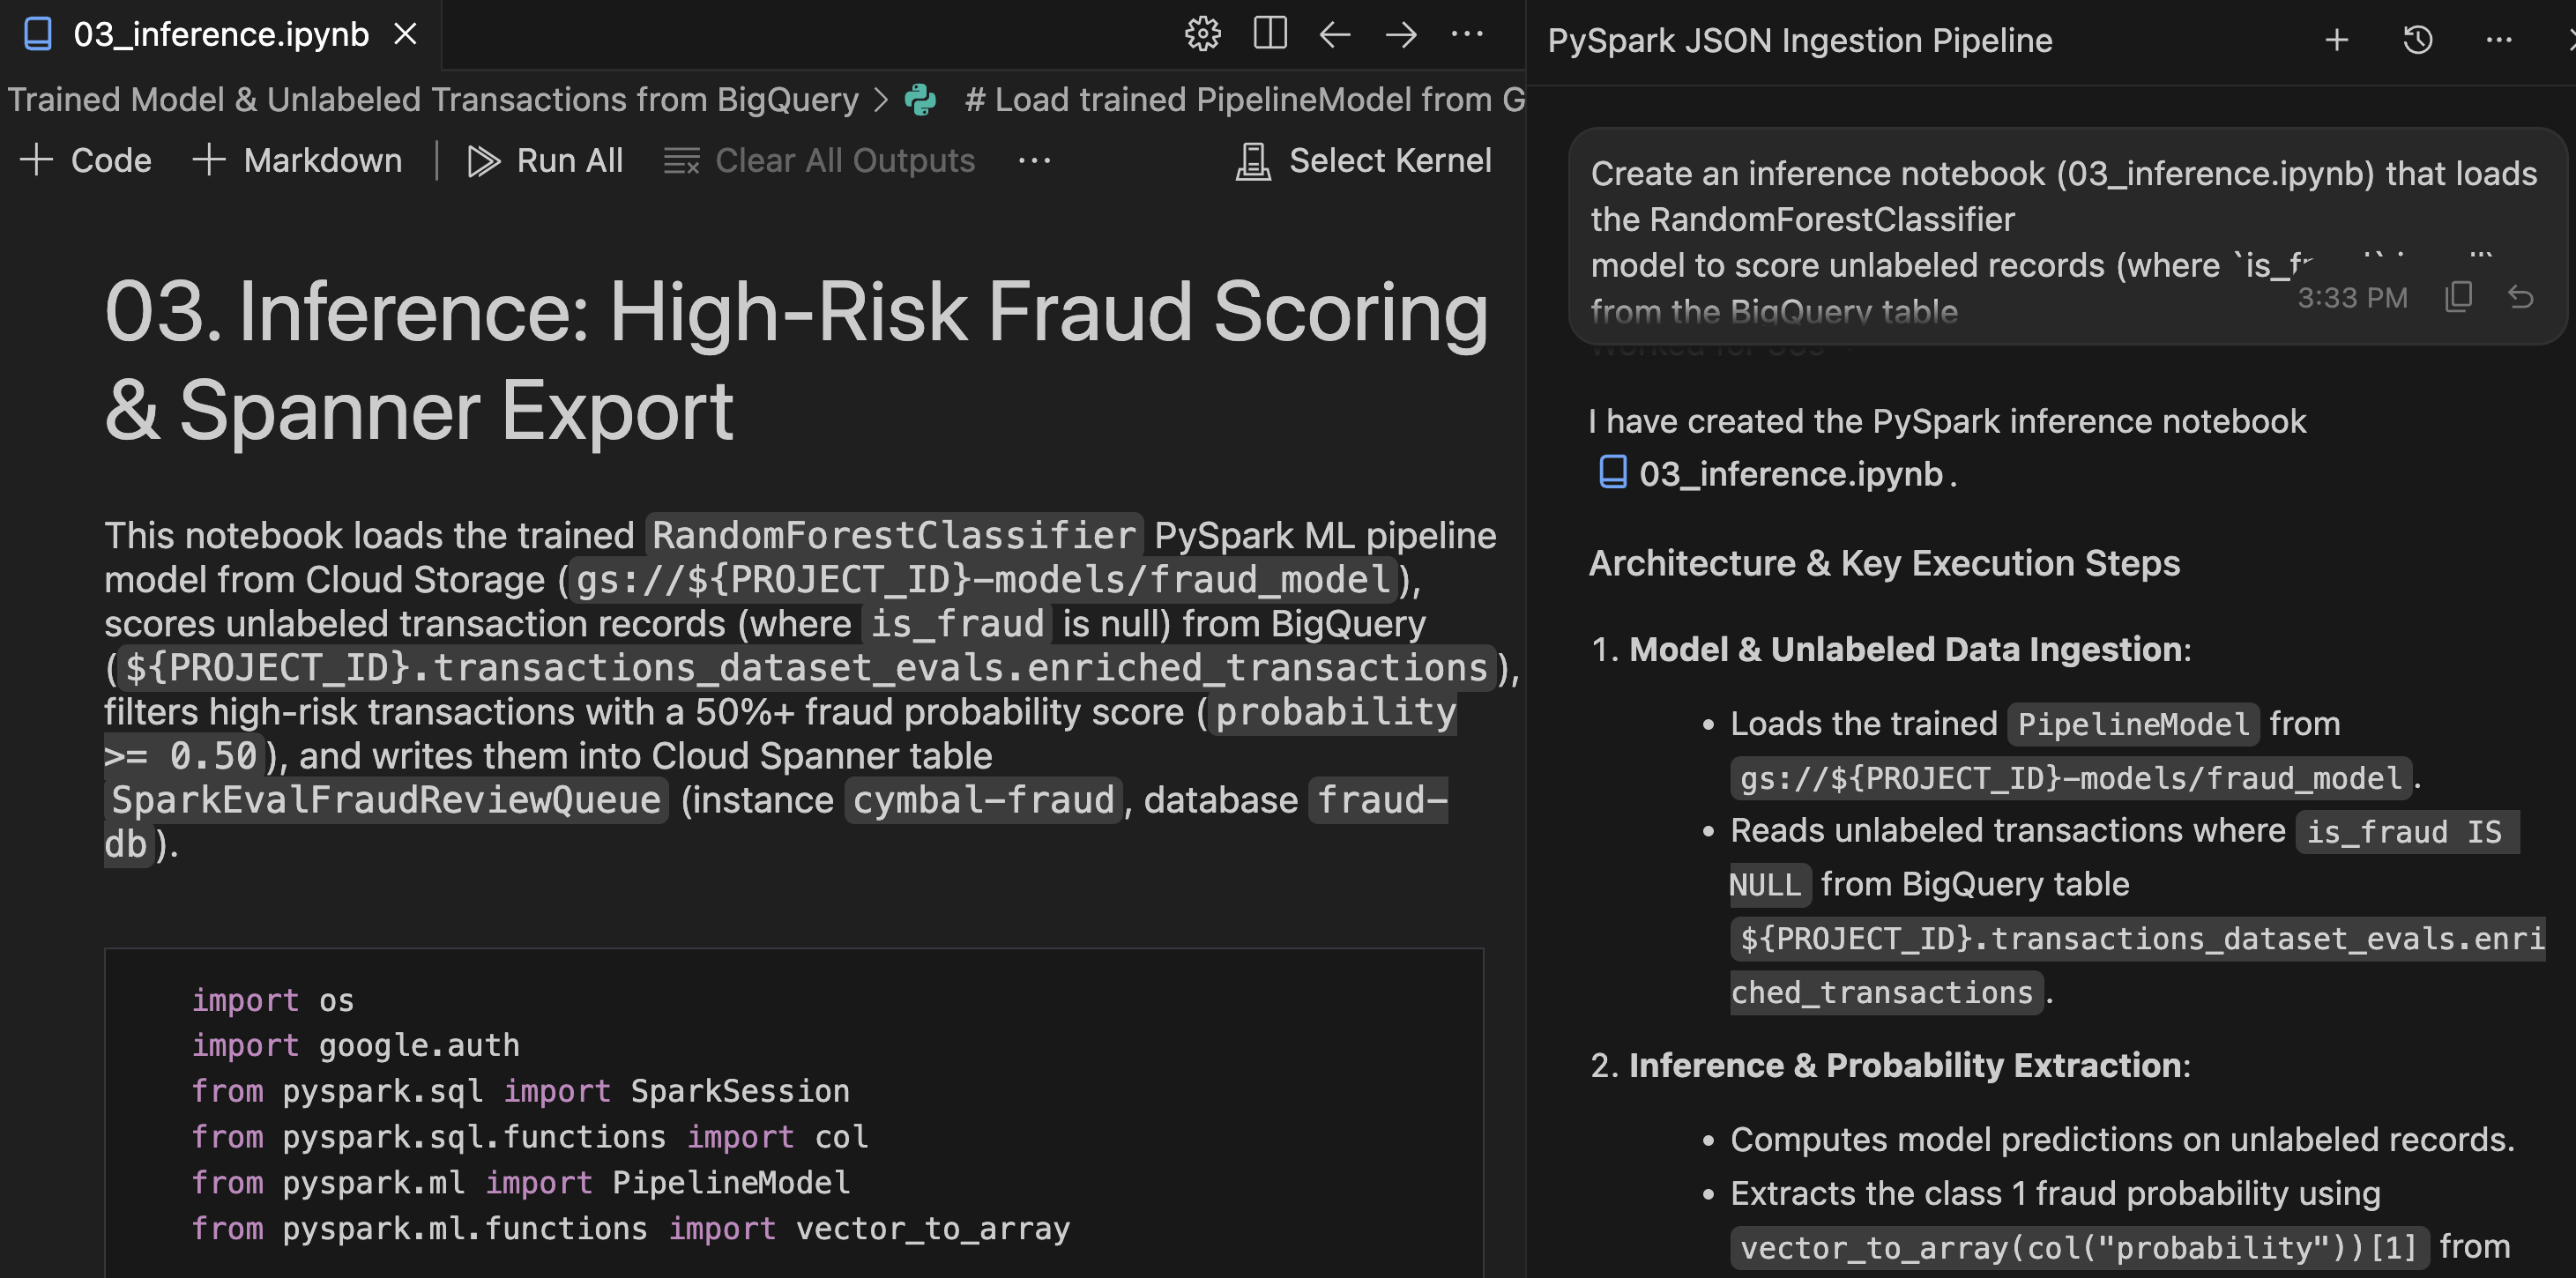
- 다음 프롬프트를 입력합니다.
Create an inference notebook (03_inference.ipynb) that loads the RandomForestClassifier
model to score unlabeled records (where `is_fraud` is null) from the BigQuery table
`transactions_dataset_evals`.`enriched_transactions`.

Filter for high-risk transactions with a 50%+ fraud probability score (probability >= 0.50)
and write them to the Cloud Spanner table SparkEvalFraudReviewQueue in the cymbal-fraud instance
under fraud-db.
- 생성된 노트북을 수락하여
notebooks/03_inference.ipynb을 작업공간에 저장합니다.
노트북 검토 및 실행
- 편집기에서 새로 생성된
notebooks/03_inference.ipynb을 엽니다. - PySpark 추론 시퀀스를 검토합니다.
- 종속 항목: 서버리스 런타임 템플릿은 Spark 실행에 필요한
cloud-spannerJAR 종속 항목을 제공합니다. - 데이터 형식 지정: 스크립트는 Spanner 테이블 스키마와 일치하도록 쓰기 전에 복잡한 Spark ML 벡터 열 (예: 원시 기능 및 확률)을 삭제합니다.
- Spanner 커넥터:
.format("cloud-spanner")를 사용하여 플래그가 지정된 행을 작성하여 검토 대기열에 직접 추가합니다.
- 종속 항목: 서버리스 런타임 템플릿은 Spark 실행에 필요한
- IDE의 노트북 툴바에서 모두 실행을 클릭합니다.
- 커널을 선택하라는 메시지가 표시되면 fraud-pipeline-runtime on Serverless Spark를 선택합니다.
인증
추론 노트북의 처리가 완료되면 IDE 내에서 운영 Spanner 데이터베이스를 직접 쿼리할 수 있습니다.
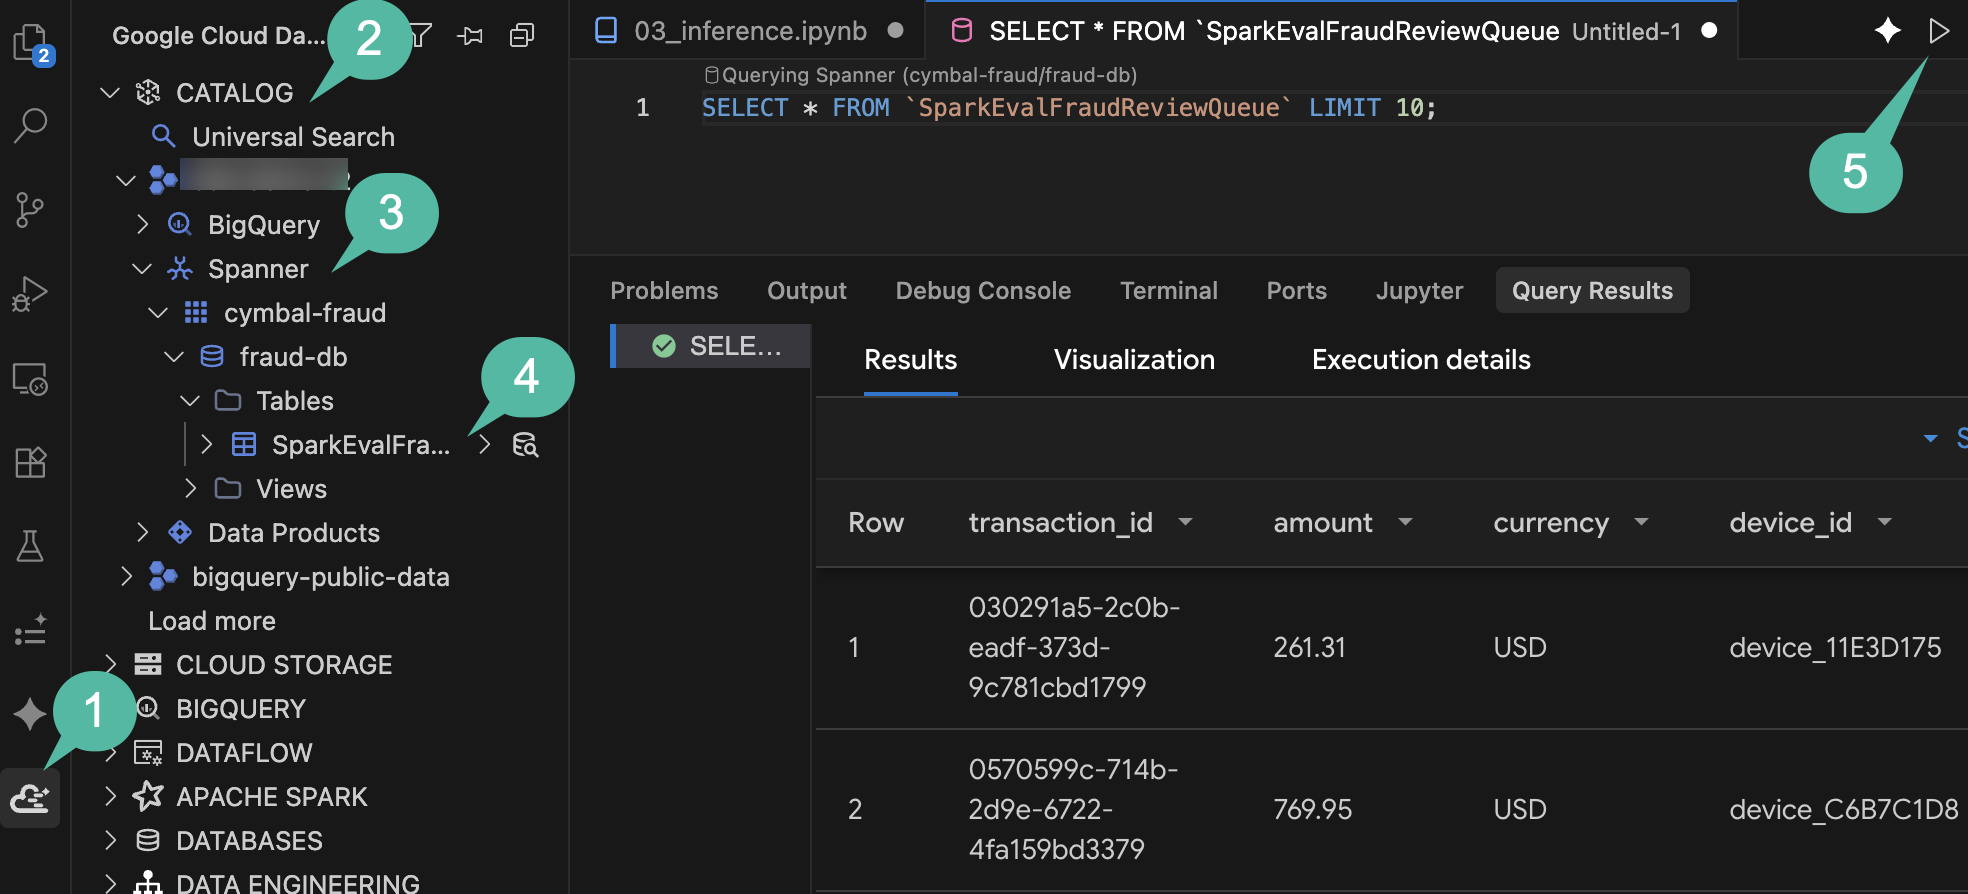
- IDE 작업 표시줄에서 Google Cloud Data Agent Kit 패널을 엽니다.
- 카탈로그 섹션을 펼칩니다.
- 프로젝트 ID를 펼친 다음 Spanner를 펼칩니다.
cymbal-fraud->fraud-db->Tables->SparkEvalFraudReviewQueue로 이동합니다.- 표를 마우스 오른쪽 버튼으로 클릭하고 표 쿼리를 선택한 다음 쿼리를 실행합니다.
SELECT *
FROM `SparkEvalFraudReviewQueue`
LIMIT 100;
- 아래의 쿼리 결과 창에 수동 검토를 위해 플래그가 지정된 고위험 거래를 나타내는 새로 삽입된 행이 표시됩니다.
섹션 요약: 에이전트를 사용하여 일괄 추론 노트북을 만들고, 학습된 모델로 라벨이 지정되지 않은 BigQuery 레코드에 점수를 매기고, 위험도가 높은 거래를 Cloud Spanner에 직접 작성했습니다.
7. Managed Airflow로 스캐폴딩 및 오케스트레이션
현재 파이프라인은 수집 노트북, dbt 변환 프로젝트, 일괄 추론 노트북과 같은 개별 단계로 구성되어 있습니다. 프로덕션에 사용할 수 있도록 이를 스티칭하여 예약된 종속성 그래프로 만듭니다.
Managed Service for Apache Airflow (이전 명칭: Cloud Composer)는 이 워크플로를 위한 관리형 조정 엔진을 제공합니다. Data Agent Kit에는 선언적 YAML 파이프라인 정의를 Airflow DAG로 직접 변환하는 오케스트레이션 파이프라인 기능이 포함되어 있습니다.
파이프라인 정의
에이전트를 사용하여 오케스트레이션 파이프라인 구성을 생성합니다.
- 에이전트 채팅에서 다음 프롬프트를 제공합니다 (
${PROJECT_ID}를 대체해야 함).
Initialize and define an orchestration pipeline (fraud_analysis_pipeline) triggering
the ingestion notebook, dbt project, and inference notebook in sequential order.
For Dataproc Serverless engine configs in us-central1, use resourceProfile.inline
(defining properties with spark.jars: "gs://spark-lib/spanner/spark-3.5-spanner-1.4.0.jar"
for inference) rather than resourceProfile.path or overrides.

Set the schedule interval to run daily at midnight, and use
gs://${PROJECT_ID}-airflow-artifacts for artifact storage.
DAG 구성 검토
Data Agent Kit Orchestrator는 선언적 YAML 구성을 사용하여 Apache Airflow에 파이프라인을 정의하고 배포하므로 정의를 버전 제어하고 CI/CD를 통해 배포할 수 있습니다.
IDE 탐색기 창에서 에이전트가 작업공간의 루트에 생성한 두 파이프라인 파일을 검토합니다.
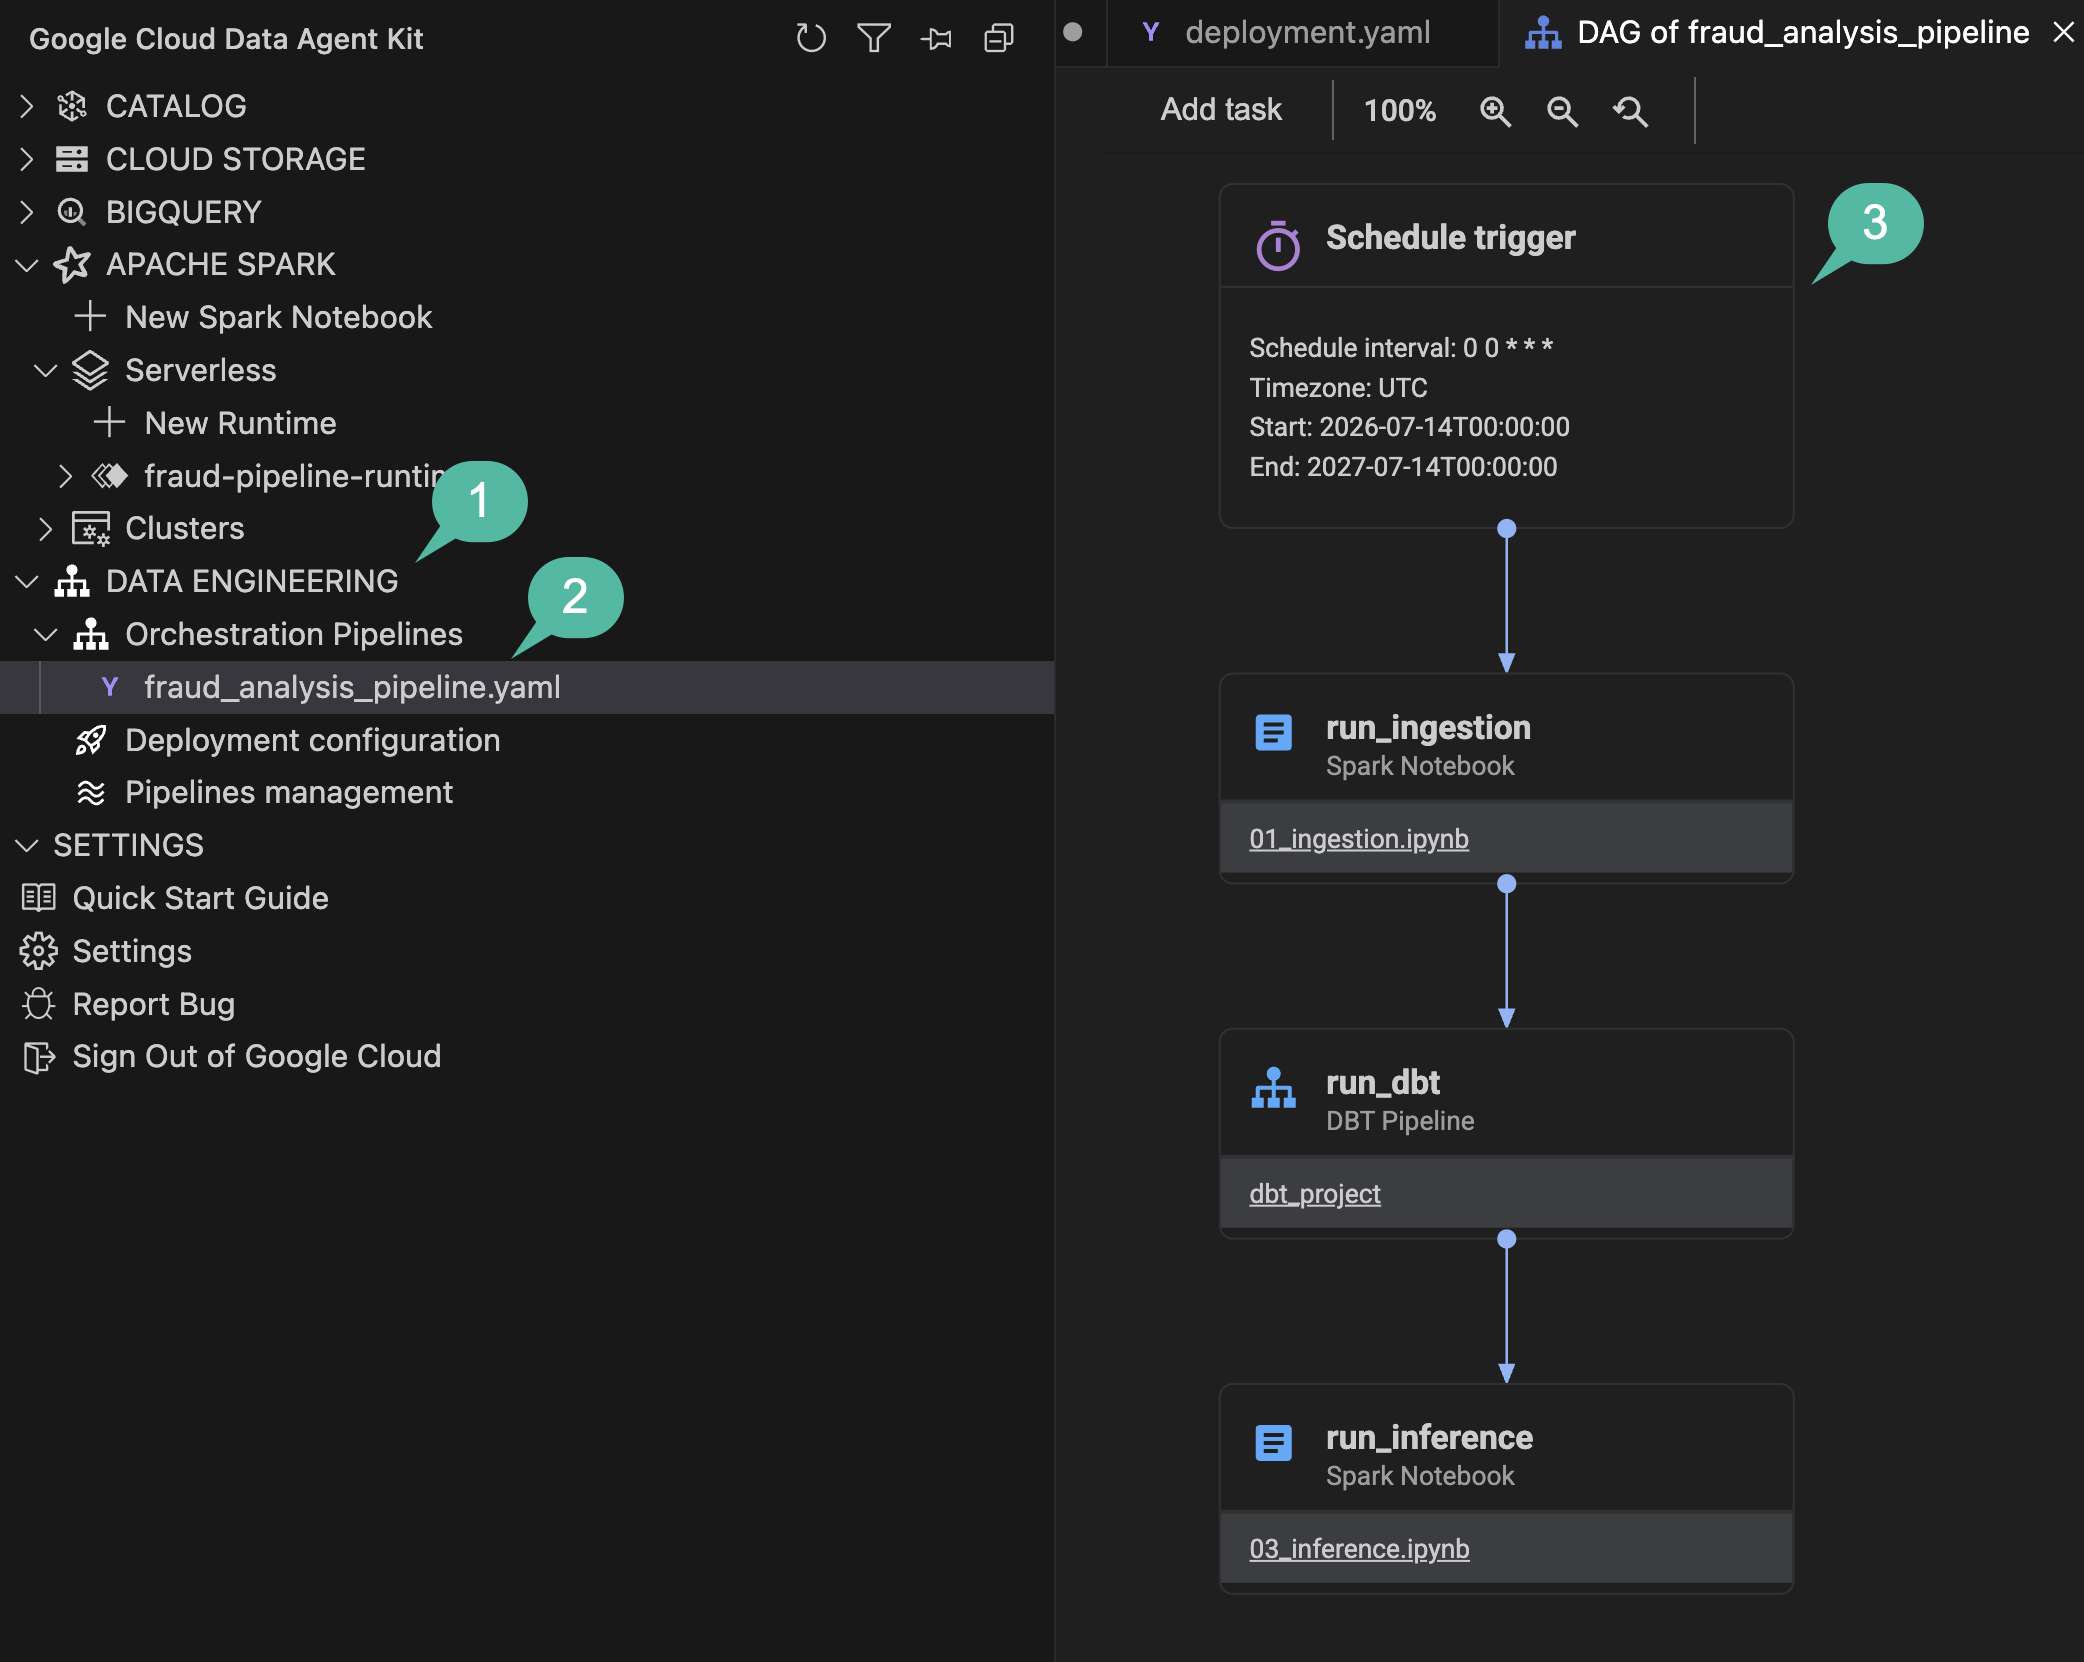
deployment.yaml: 이 파일을 엽니다. 이는 환경 레지스트리 역할을 합니다. 논리적dev파이프라인을cymbal-airflow환경에 매핑하고 실행 리전 (us-central1)을 설정하며 컴파일된 DAG와 종속 항목이 스테이징되는artifact_storage버킷을 정의합니다.fraud_analysis_pipeline.yaml: 이 파일을 엽니다. 이는 실행 그래프를 정의합니다. 트리거 일정 (interval: '0 0 * * *')을 지정하고actions블록 아래의 세 단계를 순서대로 실행합니다.- Dataproc Serverless에서 실행되는
01_ingestion.ipynb의 수집notebook작업 dbt_project디렉터리를 타겟팅하는 변환pipeline작업으로,dependsOn종속 항목이 수집 단계를 가리킵니다.- dbt 단계로 연결되는
dependsOn종속 항목이 있고 Spanner JAR 속성을 번들로 묶는03_inference.ipynb의 추론notebook작업
- Dataproc Serverless에서 실행되는
- 또한 에이전트는 생성된 이러한 아티팩트를 편집기 창의 둘러보기 탭에 요약하여 수행된 구성과 검증을 간략하게 설명합니다.
대화형 DAG 구성
Data Agent Kit는 파이프라인 구성을 대화형 시각적 그래프로 렌더링하여 Airflow DAG 속성을 검사하고 수정할 수 있도록 지원합니다.
- IDE 작업 표시줄에서 Google Cloud Data Agent Kit 패널을 엽니다.
DATA ENGINEERING에서Orchestration Pipelines을 펼칩니다.fraud_analysis_pipeline.yaml를 클릭하여 기본 편집기에서 시각적 DAG 캔버스를 엽니다.
- 상단의
Schedule trigger노드를 클릭합니다. 오른쪽에 구성 플라이아웃이 열리고 파싱된 Cron 문자열 (0 0 * * *)이 표시되며 백필 및 따라잡기와 같은 매개변수를 조정할 수 있습니다. - 노트북 작업 노드 (예: 수집 또는 추론 단계)를 클릭합니다. 플라이아웃이 업데이트되어 특정 Dataproc Serverless 실행 매핑 및 커넥터 속성이 표시됩니다.
- 노드 블록 내의 노트북 파일 이름 하이퍼링크 (예:
01_ingestion.ipynb)를 확인합니다. 이 버튼을 클릭하면 편집기에서 바로 노트북이 열립니다. - 오케스트레이션 파이프라인 아래의 왼쪽 사이드바에서
Deployment configuration을 클릭합니다. 이 뷰에는 타겟dev환경 클러스터와 출력 GCS 버킷 아티팩트가 표시됩니다.
섹션 요약: 에이전트를 사용하여 조정 파이프라인 구성을 생성하고 대화형 시각적 캔버스에서 수집, dbt, 추론 작업 간의 종속 항목을 정의했습니다.
8. 배포, 실행, 모니터링
DAG가 로컬로 정의되면 설정 중에 프로비저닝된 Managed Airflow 환경에 연결하고 파이프라인을 배포합니다.
Managed Service for Apache Airflow 구성
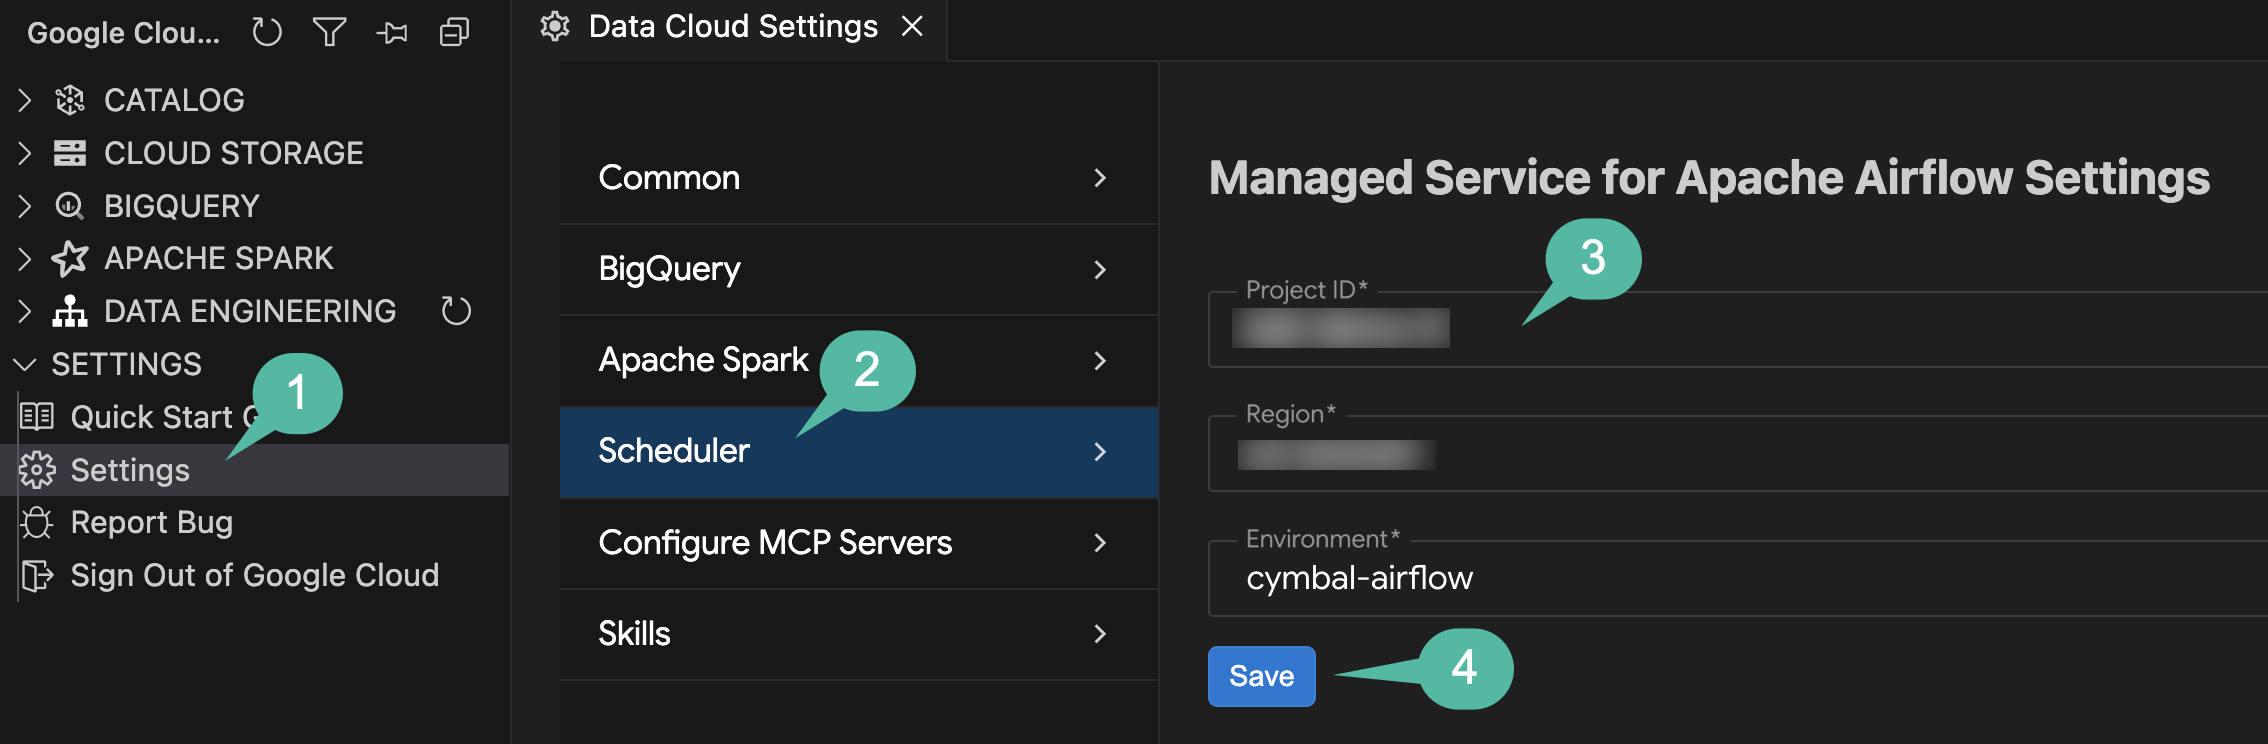
배포하기 전에 확장 프로그램이 Managed Airflow 환경을 타겟팅하도록 Data Agent Kit 설정에서 스케줄러 연결을 구성합니다.
- IDE 작업 표시줄에서 Google Cloud Data Agent Kit 패널을 엽니다.
SETTINGS에서 설정을 클릭합니다.- 왼쪽 메뉴에서 스케줄러를 선택합니다.
- 설정을 구성합니다.
- 프로젝트 ID: 활성 프로젝트 ID를 선택합니다.
- 리전:
us-central1을 선택합니다. - 환경:
cymbal-airflow를 선택합니다.
- 저장을 클릭합니다.
DAG 배포
이제 구성된 파이프라인을 시각적 캔버스에서 Managed Airflow 환경에 직접 배포합니다.
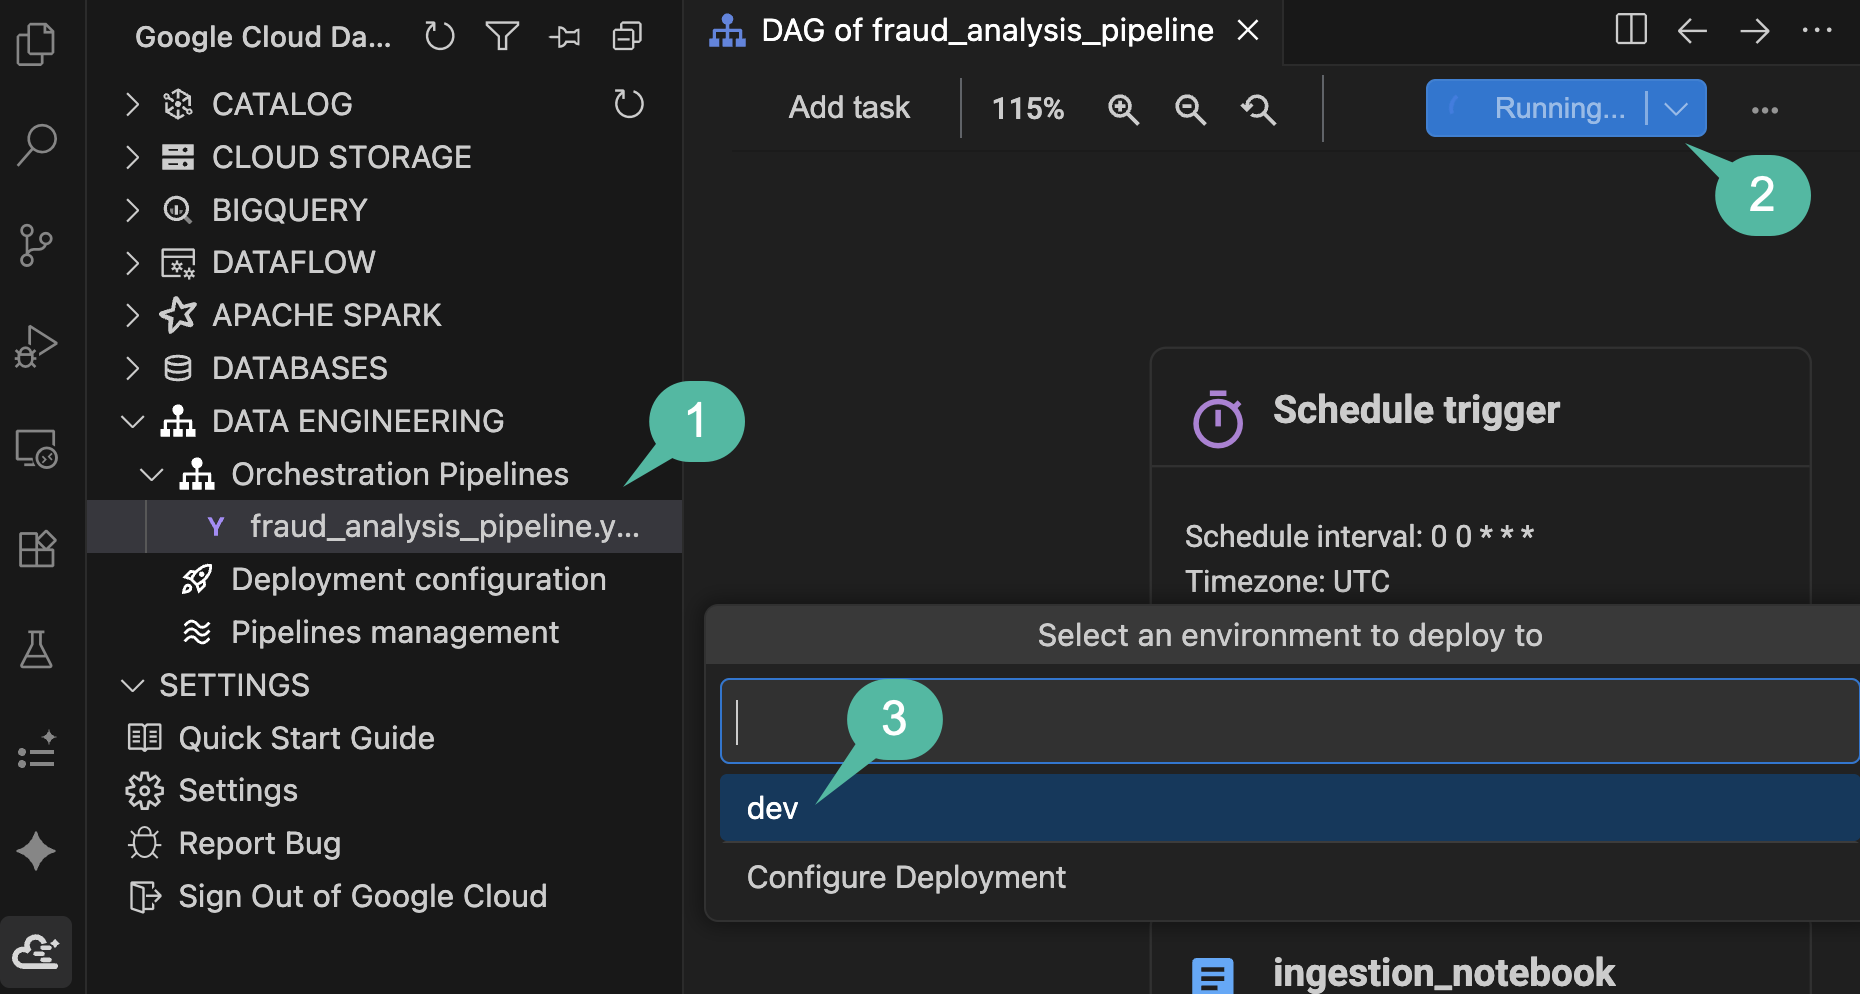
- Google Cloud 데이터 에이전트 키트 사이드바에서
DATA ENGINEERING>Orchestration Pipelines를 펼치고fraud_analysis_pipeline.yaml를 클릭하여 시각적 DAG 캔버스를 엽니다. - 캔버스 툴바의 오른쪽 상단에서 파란색 파이프라인 실행 버튼을 클릭합니다.
- 환경 드롭다운 선택기에서
dev을 선택합니다. - 하단 상태 영역(
Running pipeline: Building pipeline locally...)에서 진행 상황 알림을 확인합니다. 확장 프로그램이 DAG를 자동으로 컴파일하고, 노트북과 dbt 애셋을 패키징하고, Managed Airflow 환경의 GCS 버킷에 업로드합니다. 이 작업은 완료하는 데 3~4분 정도 걸립니다.
실행 모니터링
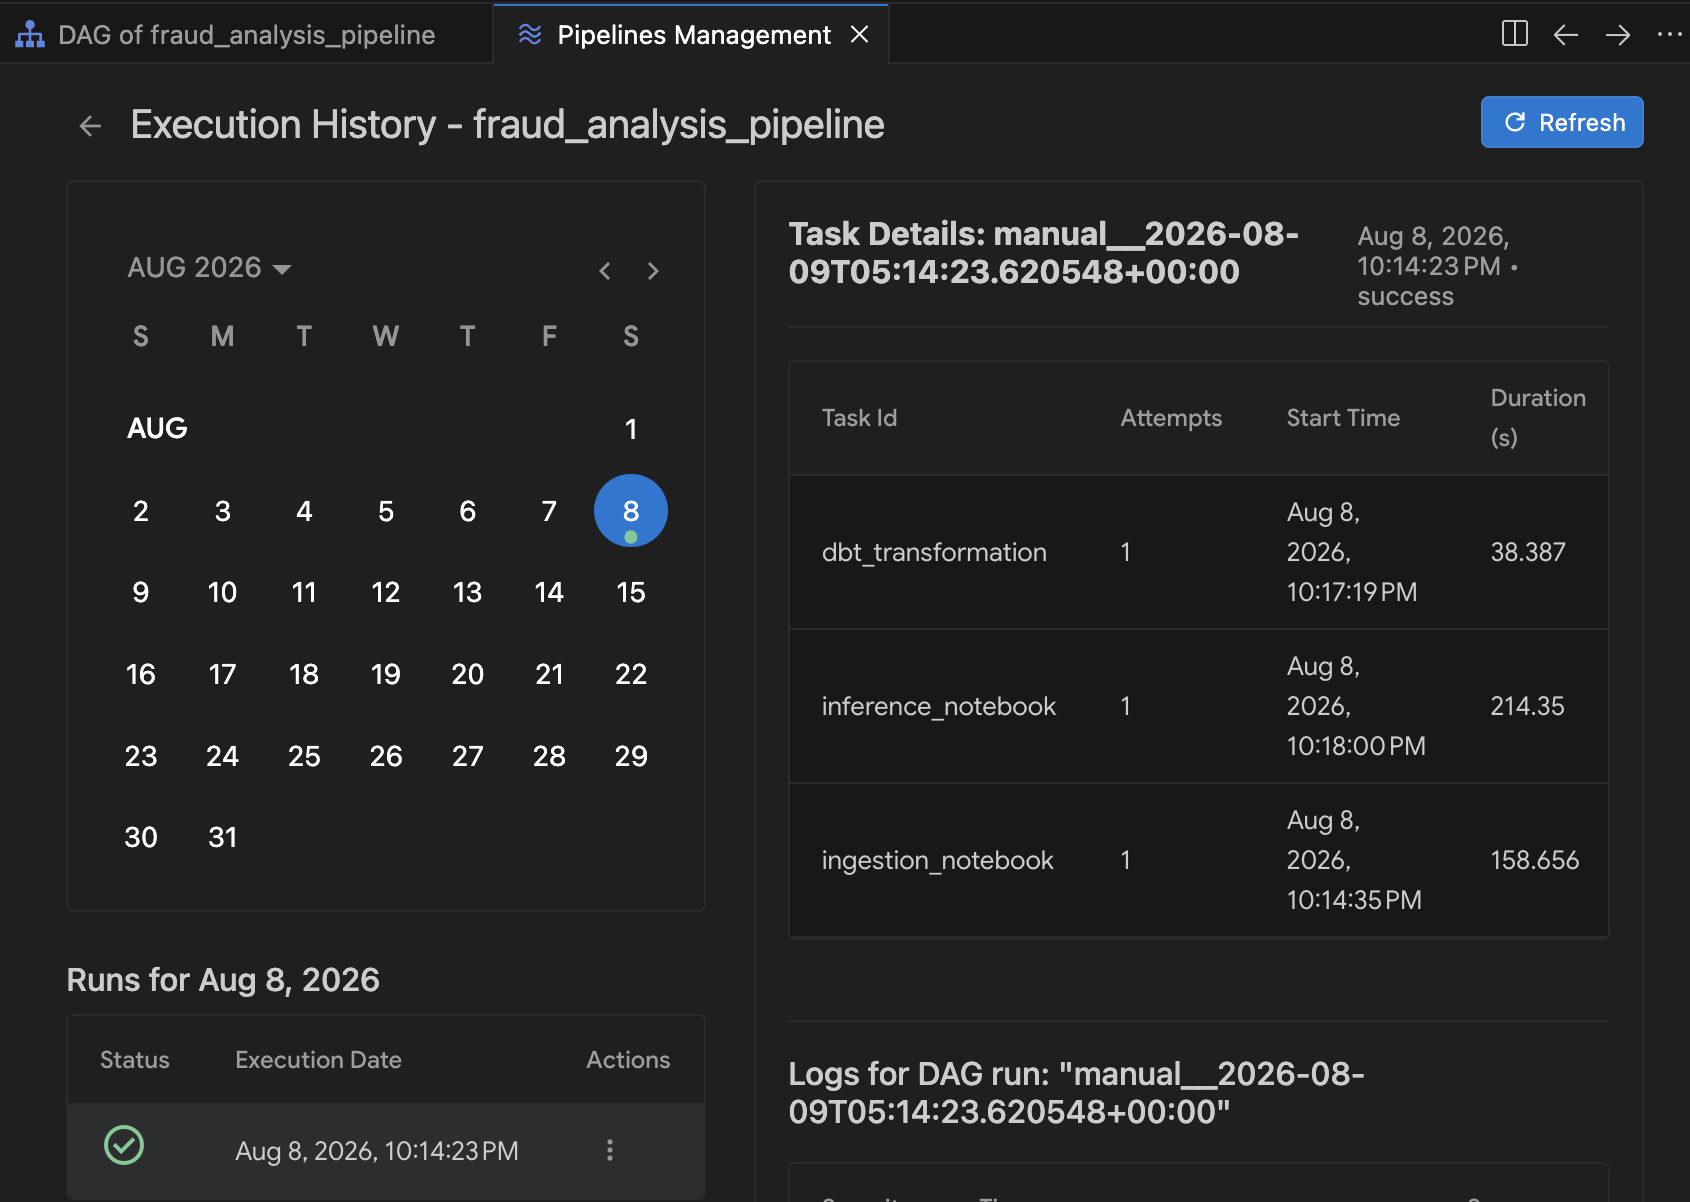
로컬 컴파일이 완료되고 팝업 알림에서 Triggered a new run for pipeline... successfully를 확인하면 라이브 실행을 모니터링합니다.
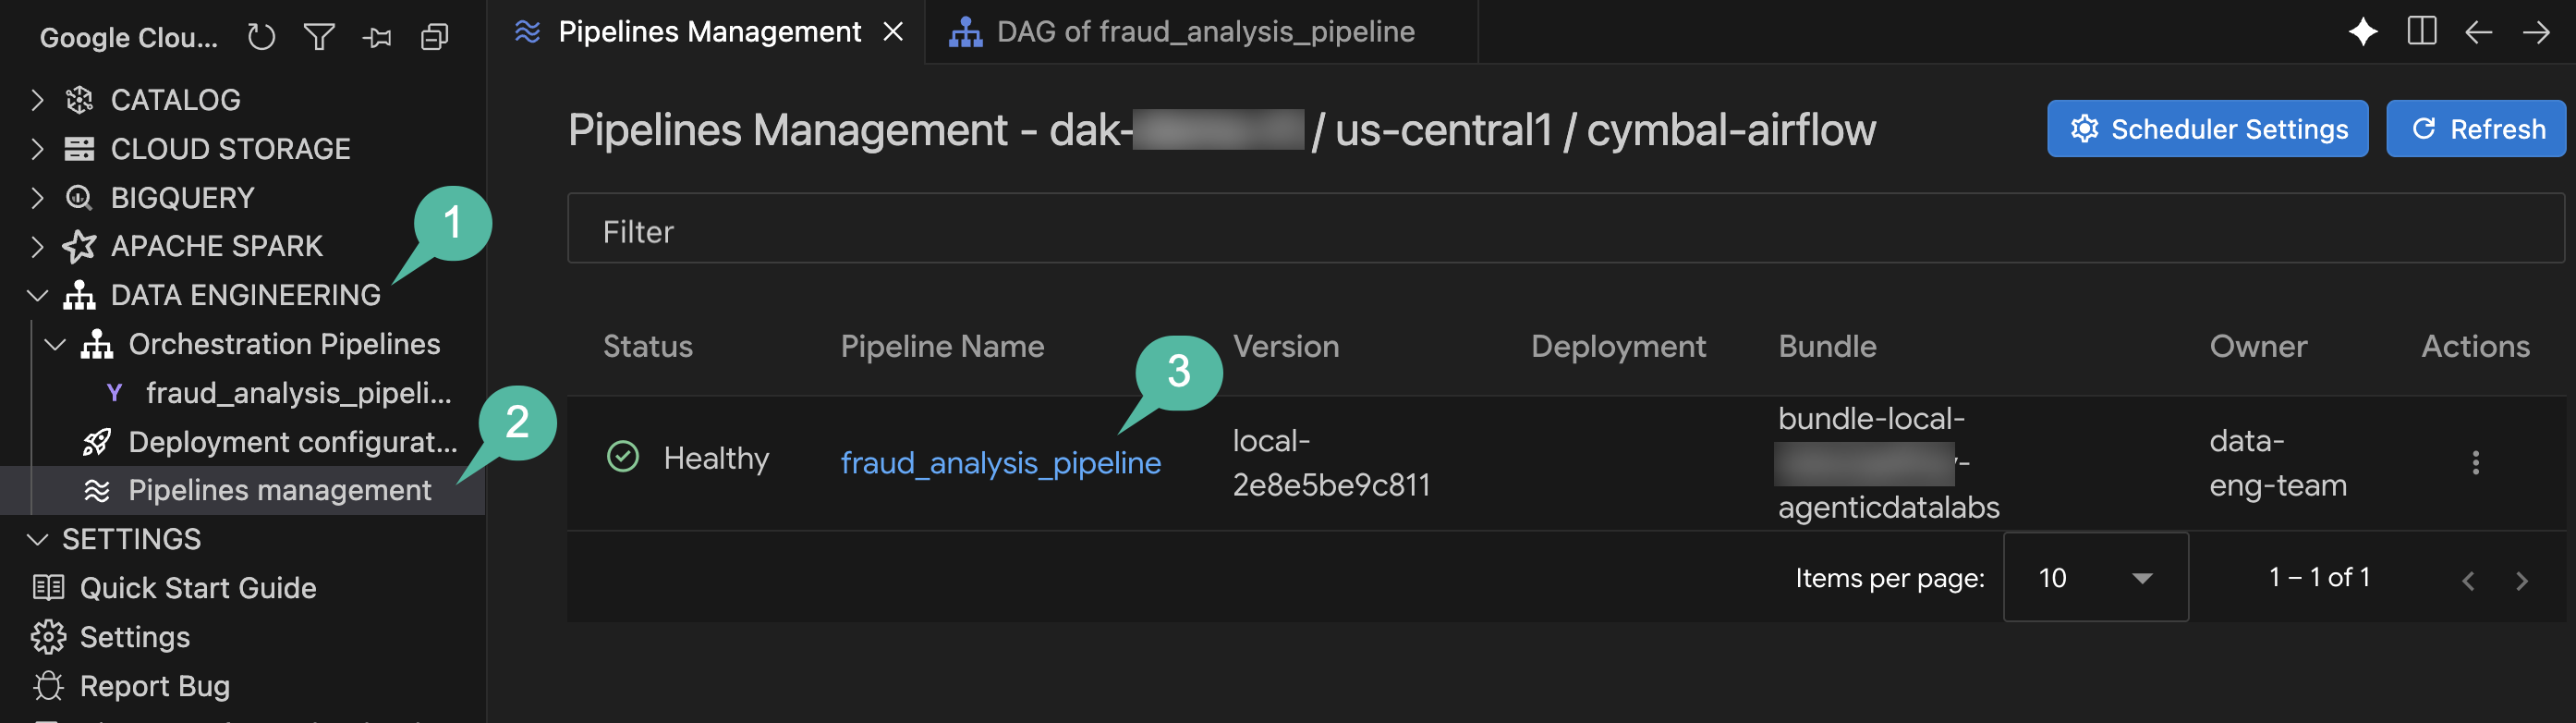
- Google Cloud Data Agent Kit 사이드바에서
DATA ENGINEERING>Orchestration Pipelines을 펼칩니다. - 파이프라인 관리를 클릭합니다.
- 파이프라인 관리 표에서
fraud_analysis_pipeline를 클릭하여 실행 기록을 엽니다.
- 실행 기록 뷰에서 캘린더의 활성 실행을 선택합니다.
- 각 파이프라인 작업 (수집, dbt 변환, 추론)이 진행됨에 따라 상태 표시기가 업데이트되고 작업 기간이 채워집니다. 태스크를 클릭하여 실시간 실행 출력 및 Airflow DAG 로그를 검사합니다.
섹션 요약: Airflow 스케줄러 연결을 구성하고, 엔드 투 엔드 분석 파이프라인을 관리형 Airflow에 배포하고, 실시간 실행을 모니터링하여 원시 로그에서 최종 Cloud Spanner 예측까지 시스템을 검증했습니다.
9. 삭제
이 Codelab에서 사용한 리소스 비용이 Google Cloud 프로젝트에 계속 청구되지 않도록 하려면 자동 스크립트를 사용하여 환경을 해체하세요.
- 터미널 패널 (또는 Cloud Shell)에서 스크립트 디렉터리로 이동하여 다음을 실행합니다.
cd ~/devrel-demos/codelabs/agentic-data-labs/data-science/scripts
chmod +x teardown.sh
./teardown.sh
- 스크립트에서 삭제할 모든 리소스를 나열하고 확인을 요청합니다.
- 관리형 Airflow 환경 (
cymbal-airflow) - Cloud Spanner 인스턴스 (
cymbal-fraud) - BigQuery 데이터 세트 (
transactions_dataset_evals) - Cloud Storage 버킷 (
gs://${PROJECT_ID}-fin-clearing-raw및gs://${PROJECT_ID}-models) - 작업자 서비스 계정 (
composer-worker-sa)
- 관리형 Airflow 환경 (
y를 입력하여 확인합니다. 테어다운 스크립트는 프로비저닝된 모든 GCP 서비스를 삭제하고 로컬 파일을 정리합니다.
10. 수고하셨습니다
Antigravity IDE 내에서 Google Cloud Data Agent Kit을 사용하여 페어 프로그래밍을 통해 Cloud Storage, BigQuery, Managed Service for Apache Spark (Spark 서버리스), dbt, Cloud Spanner, Managed Service for Apache Airflow에 걸쳐 엔드 투 엔드 사기 감지 파이프라인을 빌드했습니다.
학습한 내용
- 📥 Managed Service for Apache Spark 및 Data Agent Kit를 사용하여 원시 거래 로그를 BigQuery 테이블로 수집했습니다.
- 🧹 데이터 품질 테스트를 사용하여 dbt 프로젝트를 만들어 데이터를 중복 삭제하고 정규화합니다.
- 🤖
RandomForestClassifier를 사용하여 분산 랜덤 포레스트 모델을 학습하고 학습된 모델을 Cloud Storage로 내보냈습니다. - ⚡ 수신 트랜잭션에 대해 일괄 추론을 실행하고 감사 검토를 위해 위험도가 높은 레코드를 Cloud Spanner로 라우팅했습니다.
- 🔄 Managed Service for Apache Airflow 및 IDE의 시각적 DAG 관리 도구를 사용하여 예약된 Airflow DAG로 워크플로를 조정, 배포, 모니터링했습니다.
주요 개념
개념 | 학습한 내용 |
자연어를 사용하여 PySpark 노트북을 생성하고, dbt 모델을 구성하고, Airflow DAG를 정의하는 IDE 내 페어 프로그래밍 | |
분석 SQL, dbt 변환, ML 학습을 위한 확장 가능한 테이블 형식 스토리지 | |
분산 PySpark 데이터 로드 및 Random Forest ML 학습을 위한 서버리스 실행 | |
일괄 Spark 추론 예측을 운영 데이터베이스 검토 대기열에 직접 작성 | |
YAML DAG 선언 | 선언적 파이프라인 정의가 IDE에서 대화형 Airflow 시각적 그래프로 렌더링됨 |
시각적 DAG 관리 | 파이프라인 종속 항목 검사, Managed Airflow에 배포, IDE 내에서 실시간 태스크 실행 기록 모니터링 |
다음 단계
- Google Cloud Data Agent Kit 문서 살펴보기
- Managed Service for Apache Spark 자세히 알아보기
- Managed Service for Apache Airflow에 대해 자세히 알아보기
- Antigravity IDE를 사용하여 자체 멀티 서비스 파이프라인 빌드