

1. 简介
假设您是 Cymbal Financial(一家交易量巨大的支付处理机构)的数据科学家。出现了一系列结算延迟问题,合规团队怀疑存在有组织的欺诈行为。您需要构建一个流水线,用于注入原始清算所交易日志、清理数据、训练机器学习模型、运行批量推理,并将高风险交易下沉到 Cloud Spanner 审核队列以进行人工审核。
通常,这需要花费数天时间来编写重复的设置代码(Spark Notebook、dbt 配置、训练脚本、Airflow DAG),并在控制台界面和编辑器之间不断切换。
在此 Codelab 中,您将使用 Antigravity IDE 内的 Google Cloud Data Agent Kit (DAK) 与智能体进行结对编程。该代理将使用对话式自然语言帮助您生成 Spark 笔记本、编译 dbt 项目、构建推理循环,并使用 Managed Service for Apache Airflow 编排工作流。
您将执行的操作
- 使用 Managed Service for Apache Spark (Spark Serverless) 将结算中心日志从 Cloud Storage 注入到 BigQuery 表中。
- 使用 dbt 对交易进行去重和归一化处理,以建立干净的数据层(原始、暂存、丰富)。
- 在 Spark Serverless 上训练分布式随机森林分类模型 (
RandomForestClassifier)。 - 对新交易运行批量推理,并将高风险提醒直接写入 Cloud Spanner。
- 使用 Managed Service for Apache Airflow 和 IDE 内的交互式 DAG 监控功能,编排、直观配置和部署整个流水线。
所需条件
- 网络浏览器,例如 Chrome
- 启用了结算功能的 Google Cloud 云项目(我们建议使用新的专用项目来完成实践实验)。
- 基本熟悉 SQL、Python 和 PySpark。
- 订阅 Google AI Pro 的 Antigravity IDE(推荐)
本 Codelab 中创建的资源费用应低于 5 美元。请务必按照实验结束时的清理说明删除已预配的资源。
2. 环境设置
若要开始实验,您需要运行一个引导脚本。此脚本会自动启用所需的 GCP API,创建提取 Cloud Storage 存储分区,生成模拟交易和目录数据集,将参考目录加载到 BigQuery 中,并启动 Cloud Spanner 和 Managed Service for Apache Airflow(以前称为 Cloud Composer)的后台预配。
选择或创建项目
在 Google Cloud 控制台中,选择现有项目或创建新项目。
验证结算信息
确保您的 Google Cloud 项目已启用结算功能。如需详细了解如何执行此操作,请参阅本指南。
运行设置脚本
您将使用 Google Cloud Shell(或配置了 Google Cloud CLI 的本地 shell)启动环境设置。
- 打开 Google Cloud 控制台。
- 点击右上角工具栏中的激活 Cloud Shell。
- 在 Cloud Shell 终端中,配置您的有效项目:
gcloud config set project <<YOUR_PROJECT_ID>>
export PROJECT_ID=$(gcloud config get-value project)
- 克隆 Codelab 代码库并前往脚本文件夹:
cd ~/
git clone --filter=blob:none --no-checkout https://github.com/GoogleCloudPlatform/devrel-demos.git
cd ~/devrel-demos
git sparse-checkout init --cone
git sparse-checkout set codelabs/agentic-data-labs/data-science
git checkout main
cd codelabs/agentic-data-labs/data-science/scripts
- 运行引导设置脚本以将所有资源部署到
us-central1:
chmod +x setup.sh setup_spanner.sh setup_composer.sh
export REGION=us-central1
./setup.sh
- 脚本完成后,您会看到一个摘要输出,指示您的 BigQuery 数据集和 Cloud Storage 存储分区已准备就绪。在后台,Cloud Spanner(大约需要 2 分钟)和 Managed Airflow(大约需要 20 分钟)将继续预配。您可以随时运行以下命令来监控其进度:
tail -f /tmp/spanner_setup.log
tail -f /tmp/composer_setup.log
打开 Antigravity IDE
- 从 Google Antigravity 下载页面下载并安装 Antigravity IDE。
- 启动 Antigravity IDE。
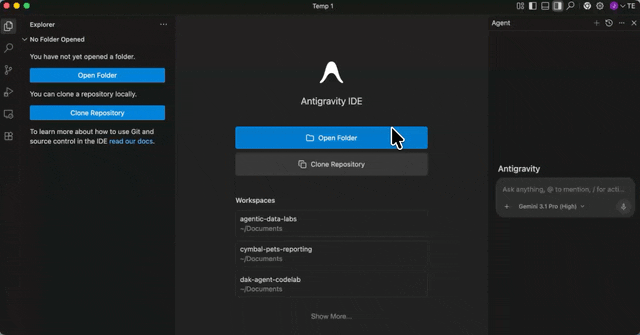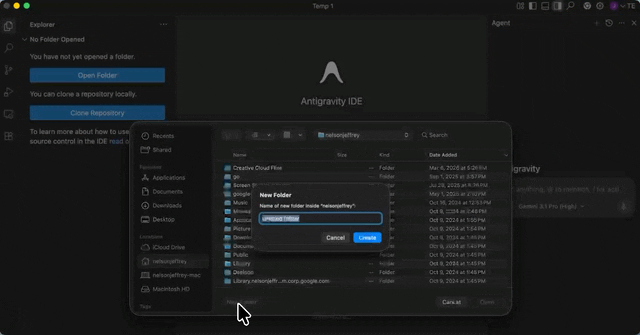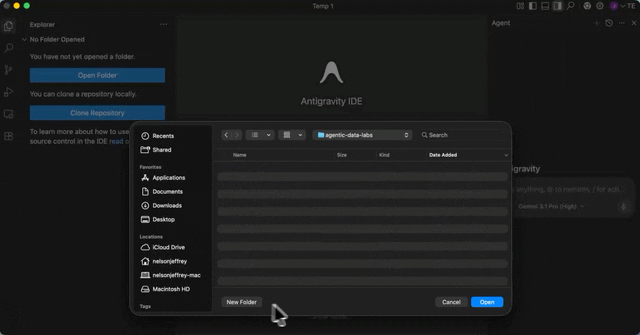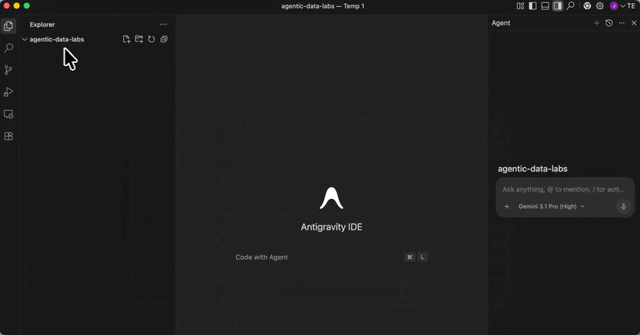
- 在本地机器上创建一个新的空文件夹(例如,命名为
agentic-data-labs),然后选择 Open Folder 在 IDE 中打开该文件夹。此目录将作为您在此 Codelab 中的本地工作区。
安装 Data Agent Kit 扩展程序
Google Cloud Data Agent Kit 扩展程序可直接在编辑器中与 Google Cloud 数据服务深度集成,让您无需切换上下文即可与 BigQuery、Cloud SQL、Cloud Storage 等服务进行交互。
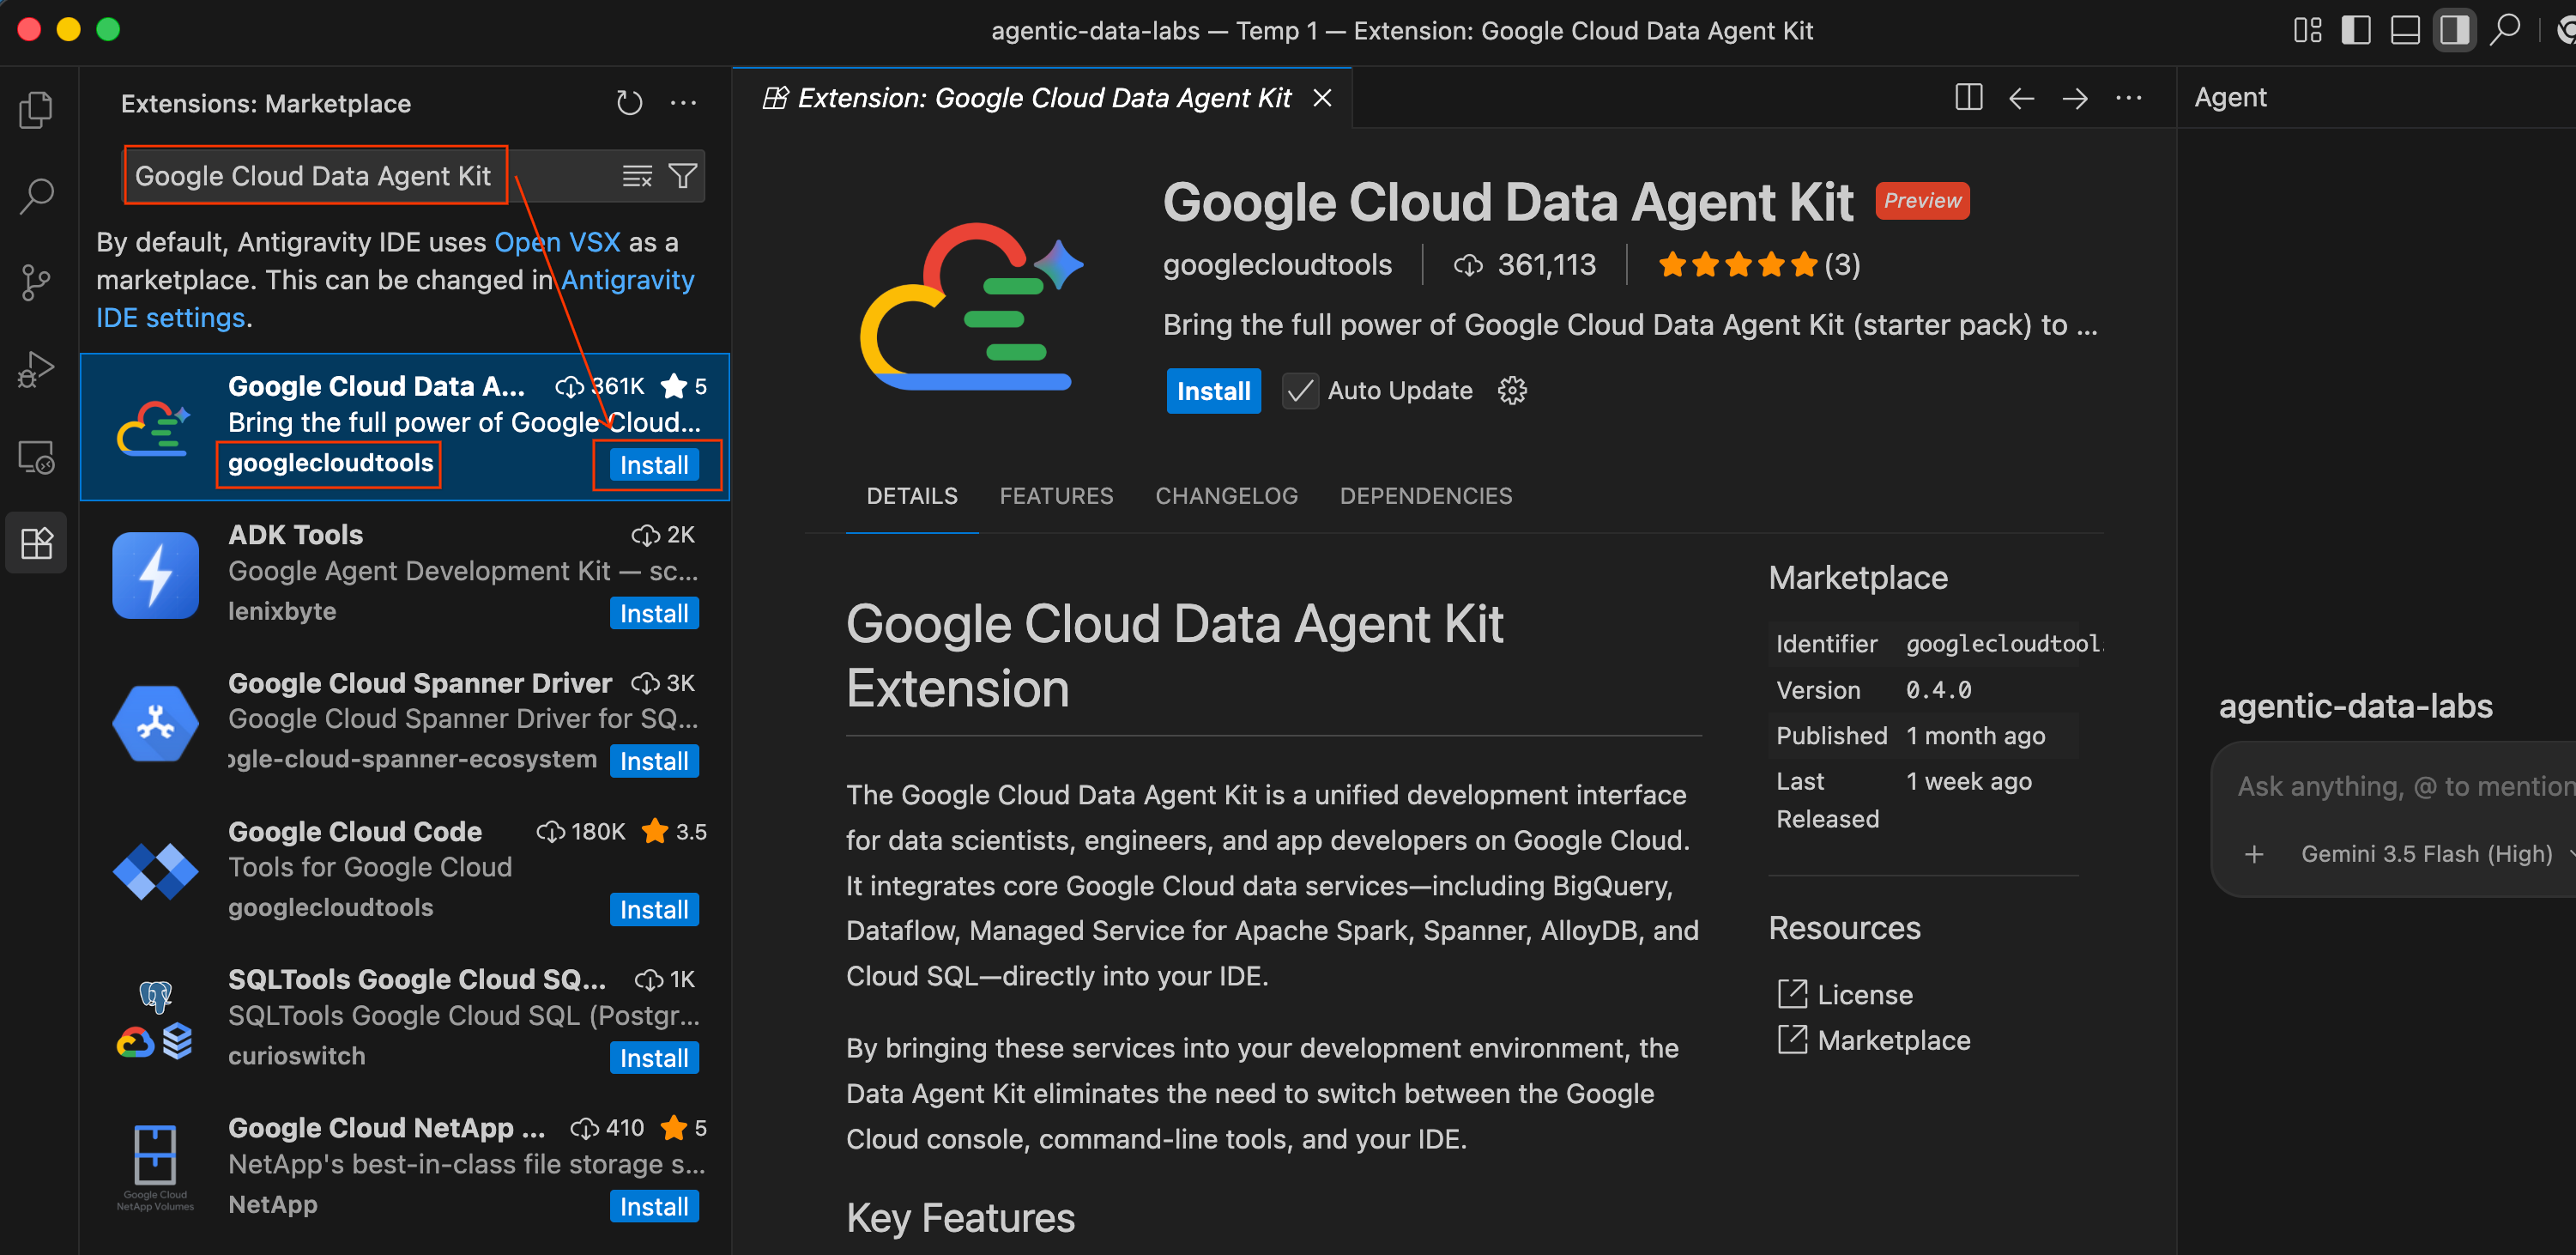
- 在 Antigravity IDE 中,点击屏幕最左侧活动栏中的扩展程序图标(看起来像四个正方形)。
- 在“扩展程序”窗格顶部的搜索栏中,输入
Google Cloud Data Agent Kit。 - 找到由
googlecloudtools发布的名为 Google Cloud Data Agent Kit 的扩展程序 - 点击 Install 按钮。
- 系统可能会显示提示,询问“您是否信任发布者 ‘googlecloudtools’ 及其扩展程序?”。点击信任发布者并安装以继续。
安装完成后,您会在 Antigravity IDE 最左侧的活动栏中看到新的 Google Cloud Data Agent Kit 图标。
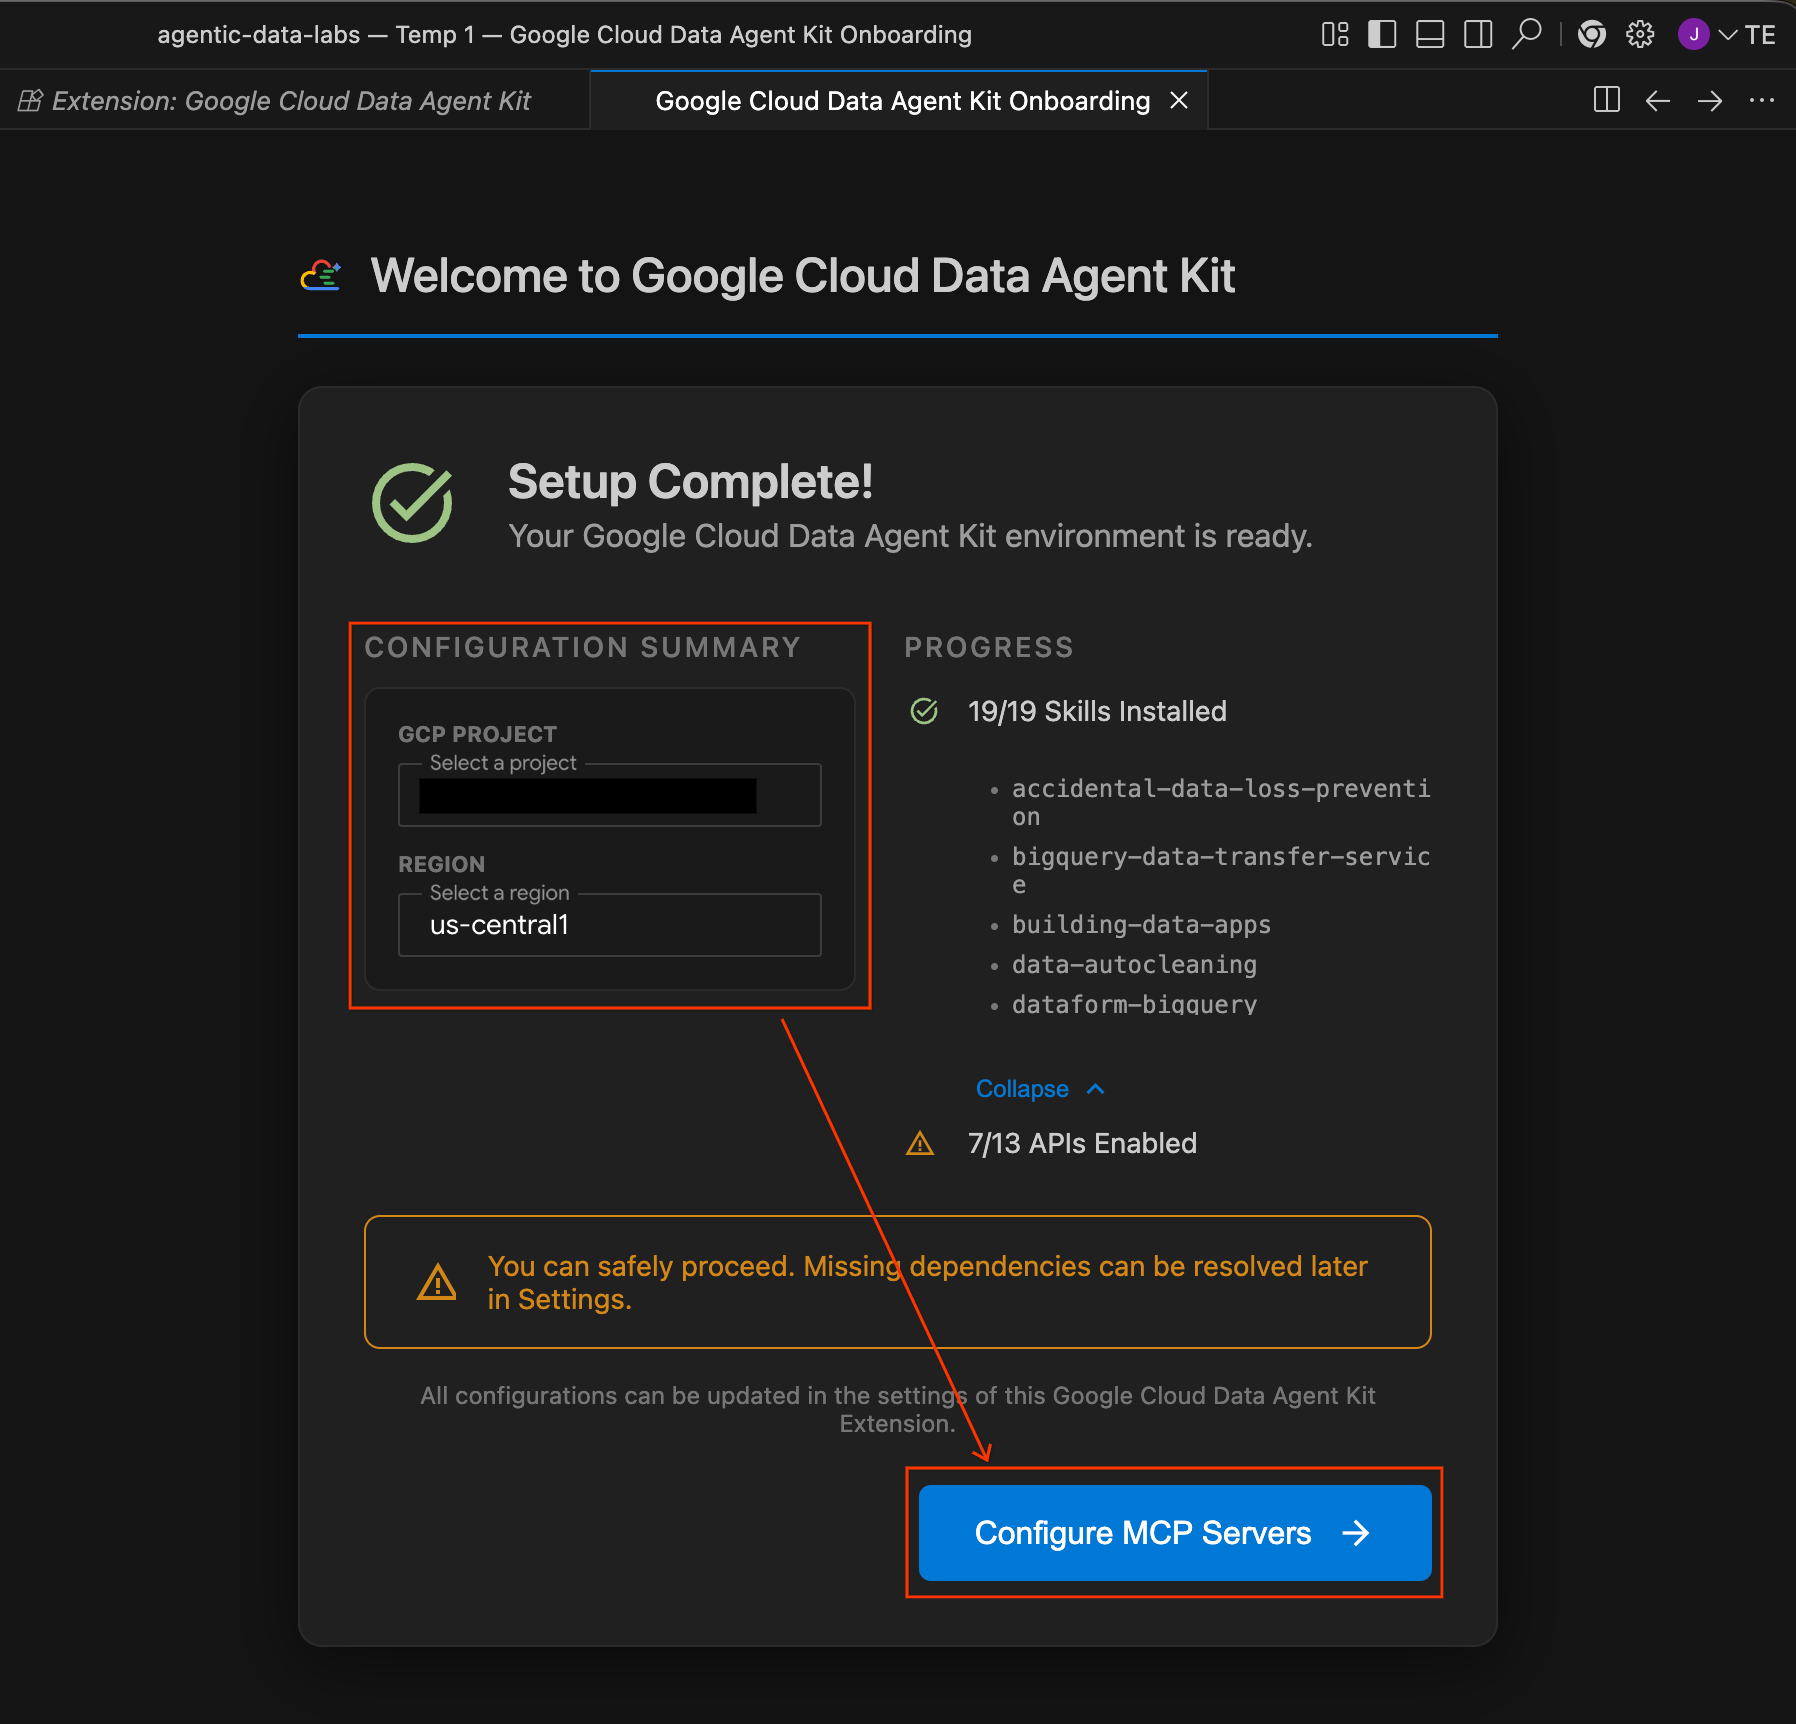
- 系统应会自动打开一个名为“欢迎使用 Google Cloud Data Agent Kit”的初始配置页面。如果您未登录 Cloud 账号,请按照提示授予访问权限。
- 在配置摘要部分中,找到项目字段。点击下拉菜单,然后选择您的 Google Cloud 项目。将您的区域设置为
us-central1。然后选择配置 MCP 服务器。
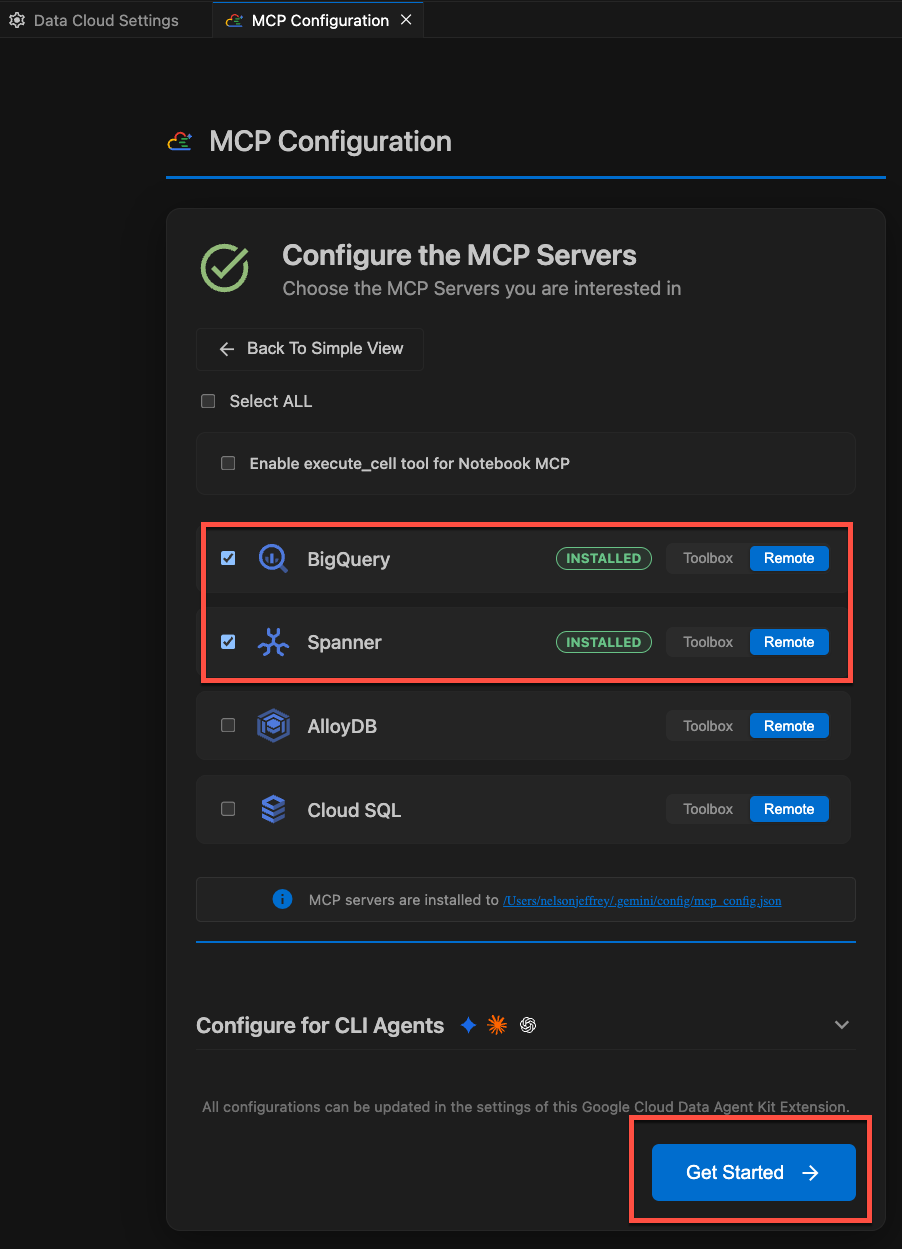
- 选择配置 MCP 服务器。在 MCP 配置窗格中,确保您已启用以下远程 MCP 服务器:
- BigQuery
- Spanner
- 笔记本
然后点击开始使用。
探索配置选项
设置完成后,您会进入“开始使用 Google Cloud Data Agent Kit”页面。
- 在“设置和配置”下,点击开始。
- 系统随即会打开Data Agent Kit 配置面板。探索各个标签页:
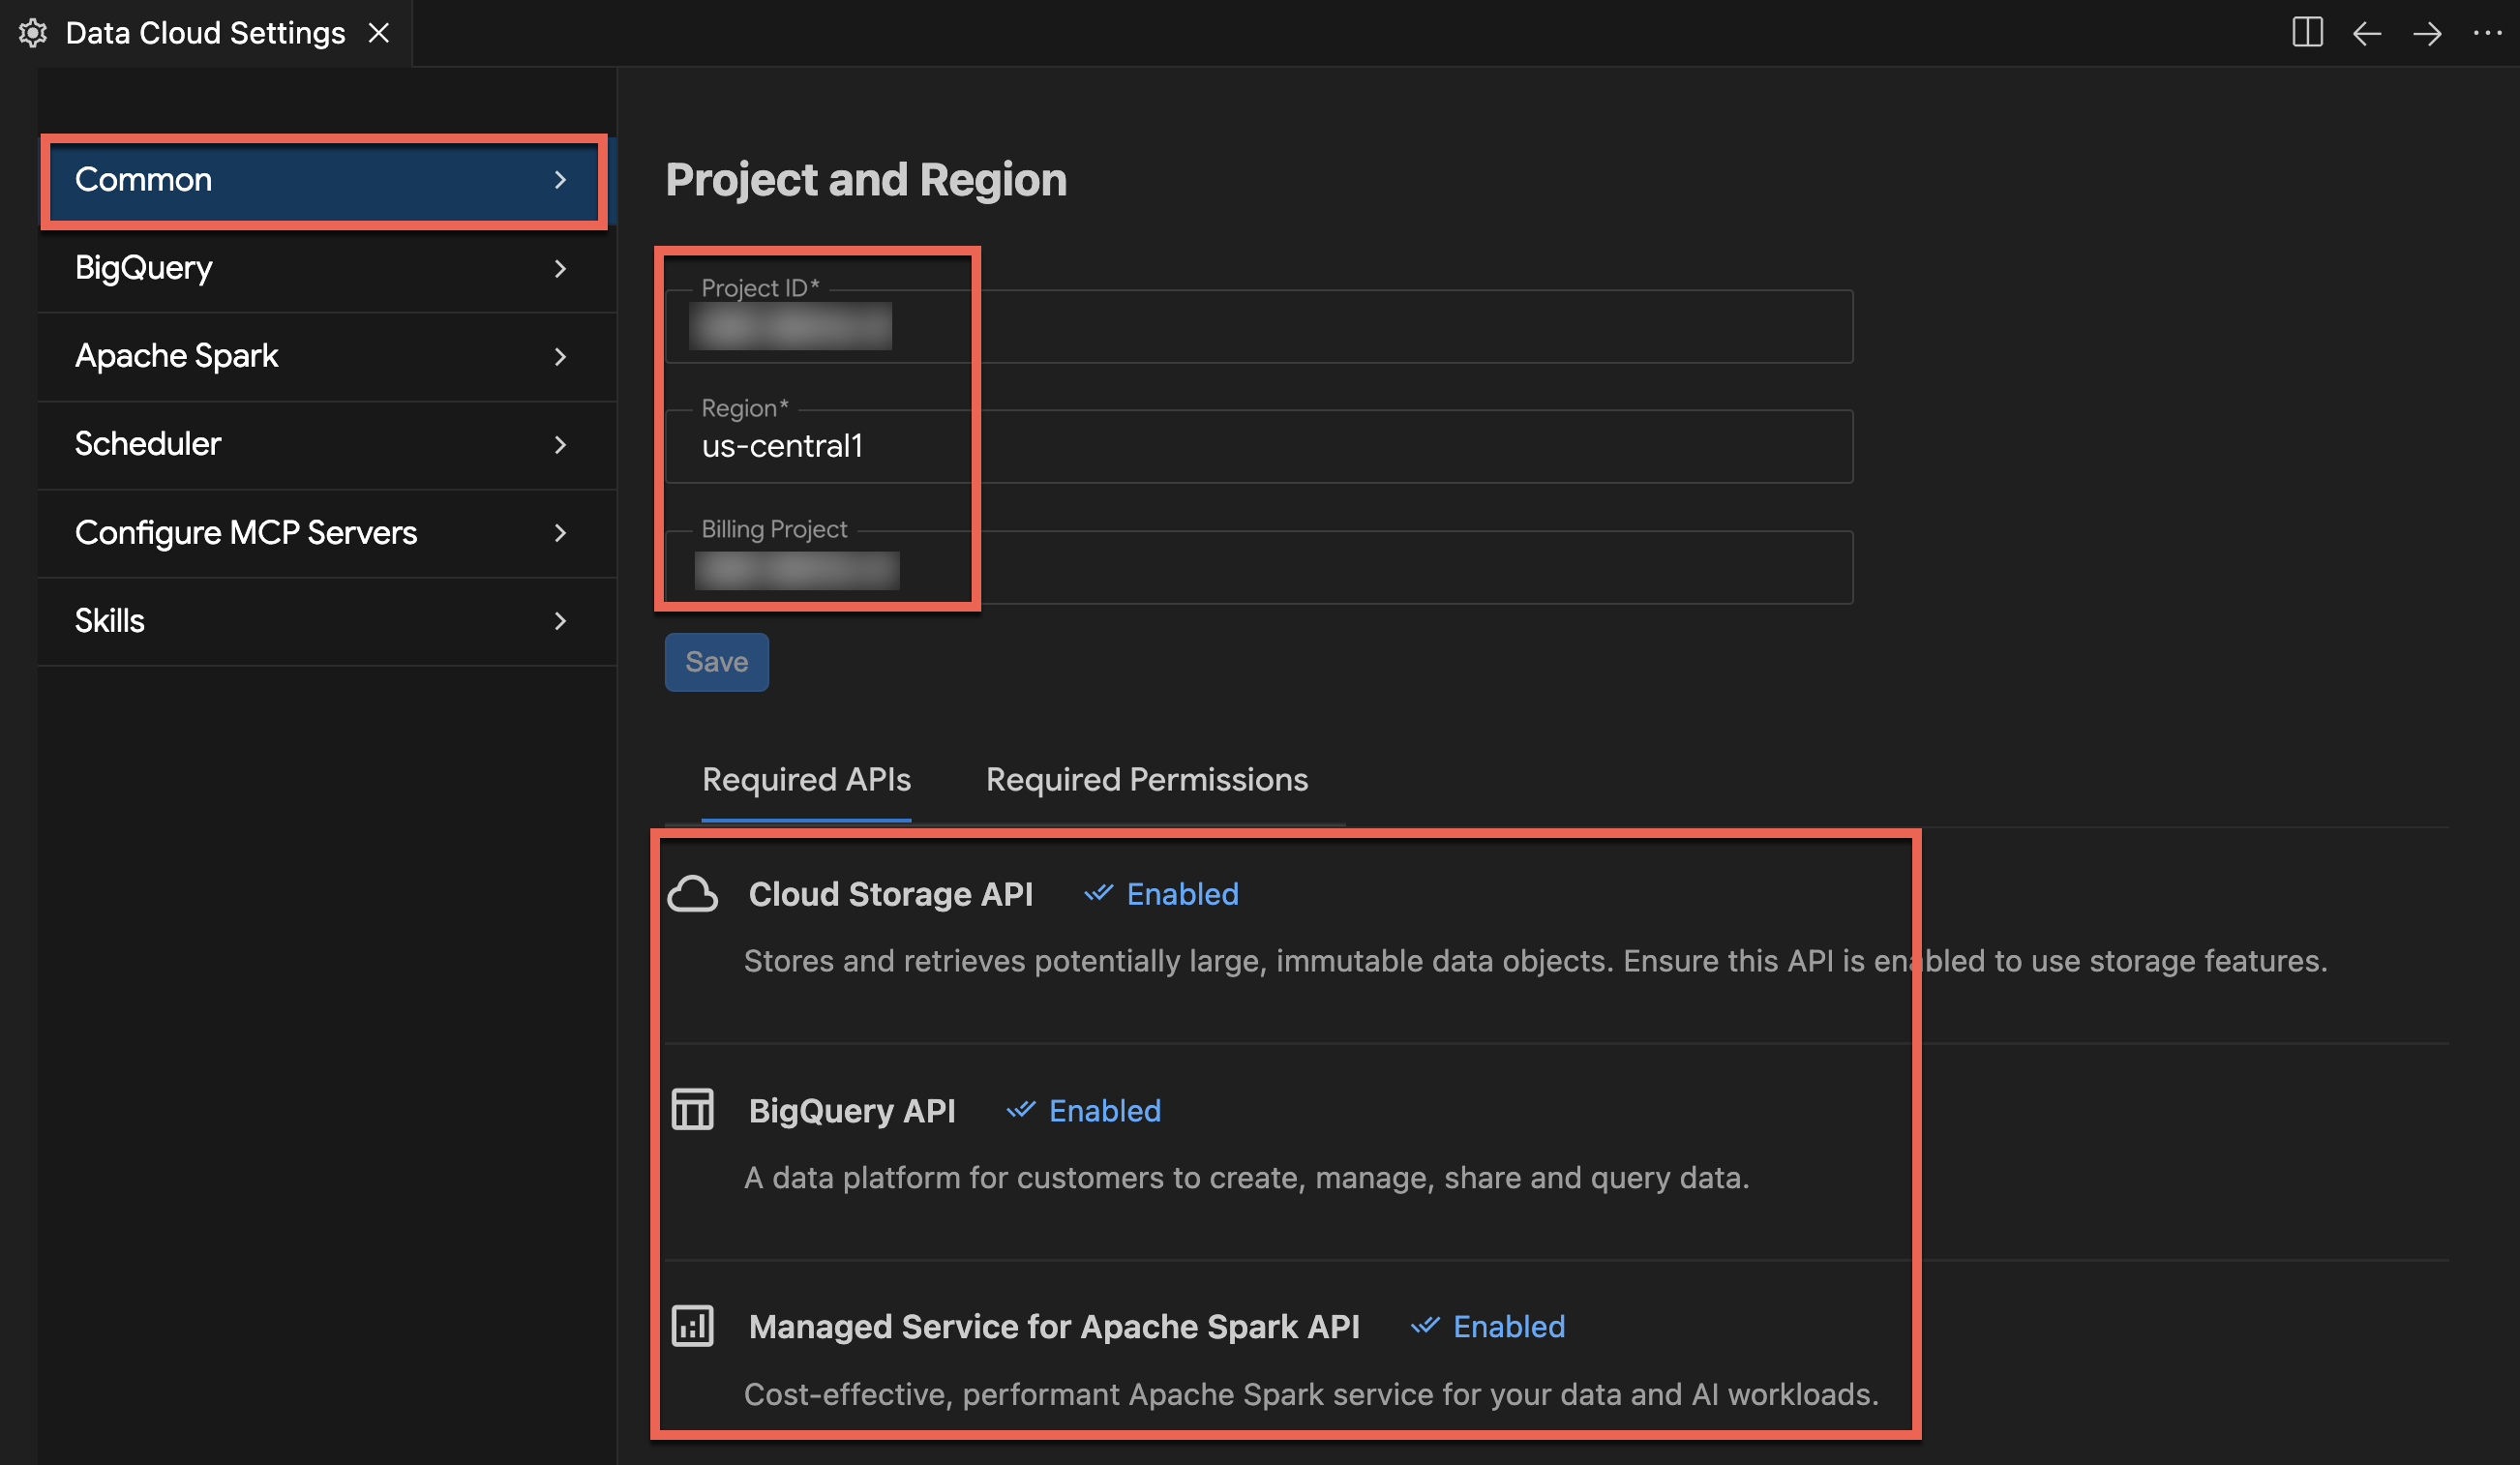
部分总结:您运行了引导脚本来创建 GCS 和 BigQuery 资源,而 Spanner 和 Airflow 在后台构建。然后,您在 Antigravity IDE 中打开了项目,并激活了 Google Cloud Data Agent Kit 扩展程序。您现在可以编写第一个笔记本了。
3. 使用 Spark Serverless 提取原始日志
在本部分中,您会将原始 JSON 交易日志提取到数据湖中。Managed Service for Apache Spark(Spark 无服务器)可直接与 BigQuery 的原生存储空间连接。您将使用标准 BigQuery 连接器来管理表格数据,并实现直接查询和分析。
探索预配置的 Spark Serverless 运行时
在执行 Spark 代码之前,请检查设置脚本预配置的无服务器运行时模板。此模板定义了目标执行环境后端,并捆绑了必要的连接器依赖项。
- 在 IDE 活动栏中,打开 Google Cloud Data Agent Kit 面板。
- 展开 Apache Spark 下拉菜单,然后展开 Serverless。
- 右键点击
fraud-pipeline-runtime,然后选择 Profile 以在编辑器中打开其配置视图。 - 在个人资料标签页中,向下滚动并展开属性,以检查附加到环境的自定义依赖项:
spark.jars:包含gs://spark-lib/spanner/spark-3.5-spanner-1.4.0.jar,该模块使用 Spark Spanner 连接器,以便 Spark 作业在实验后期将推理结果直接写入 Cloud Spanner。(注意:Dataproc Serverless 默认包含 Google Cloud 的 Spark BigQuery 连接器,无需进行额外的 JAR 配置即可读取和写入 BigQuery 表)。
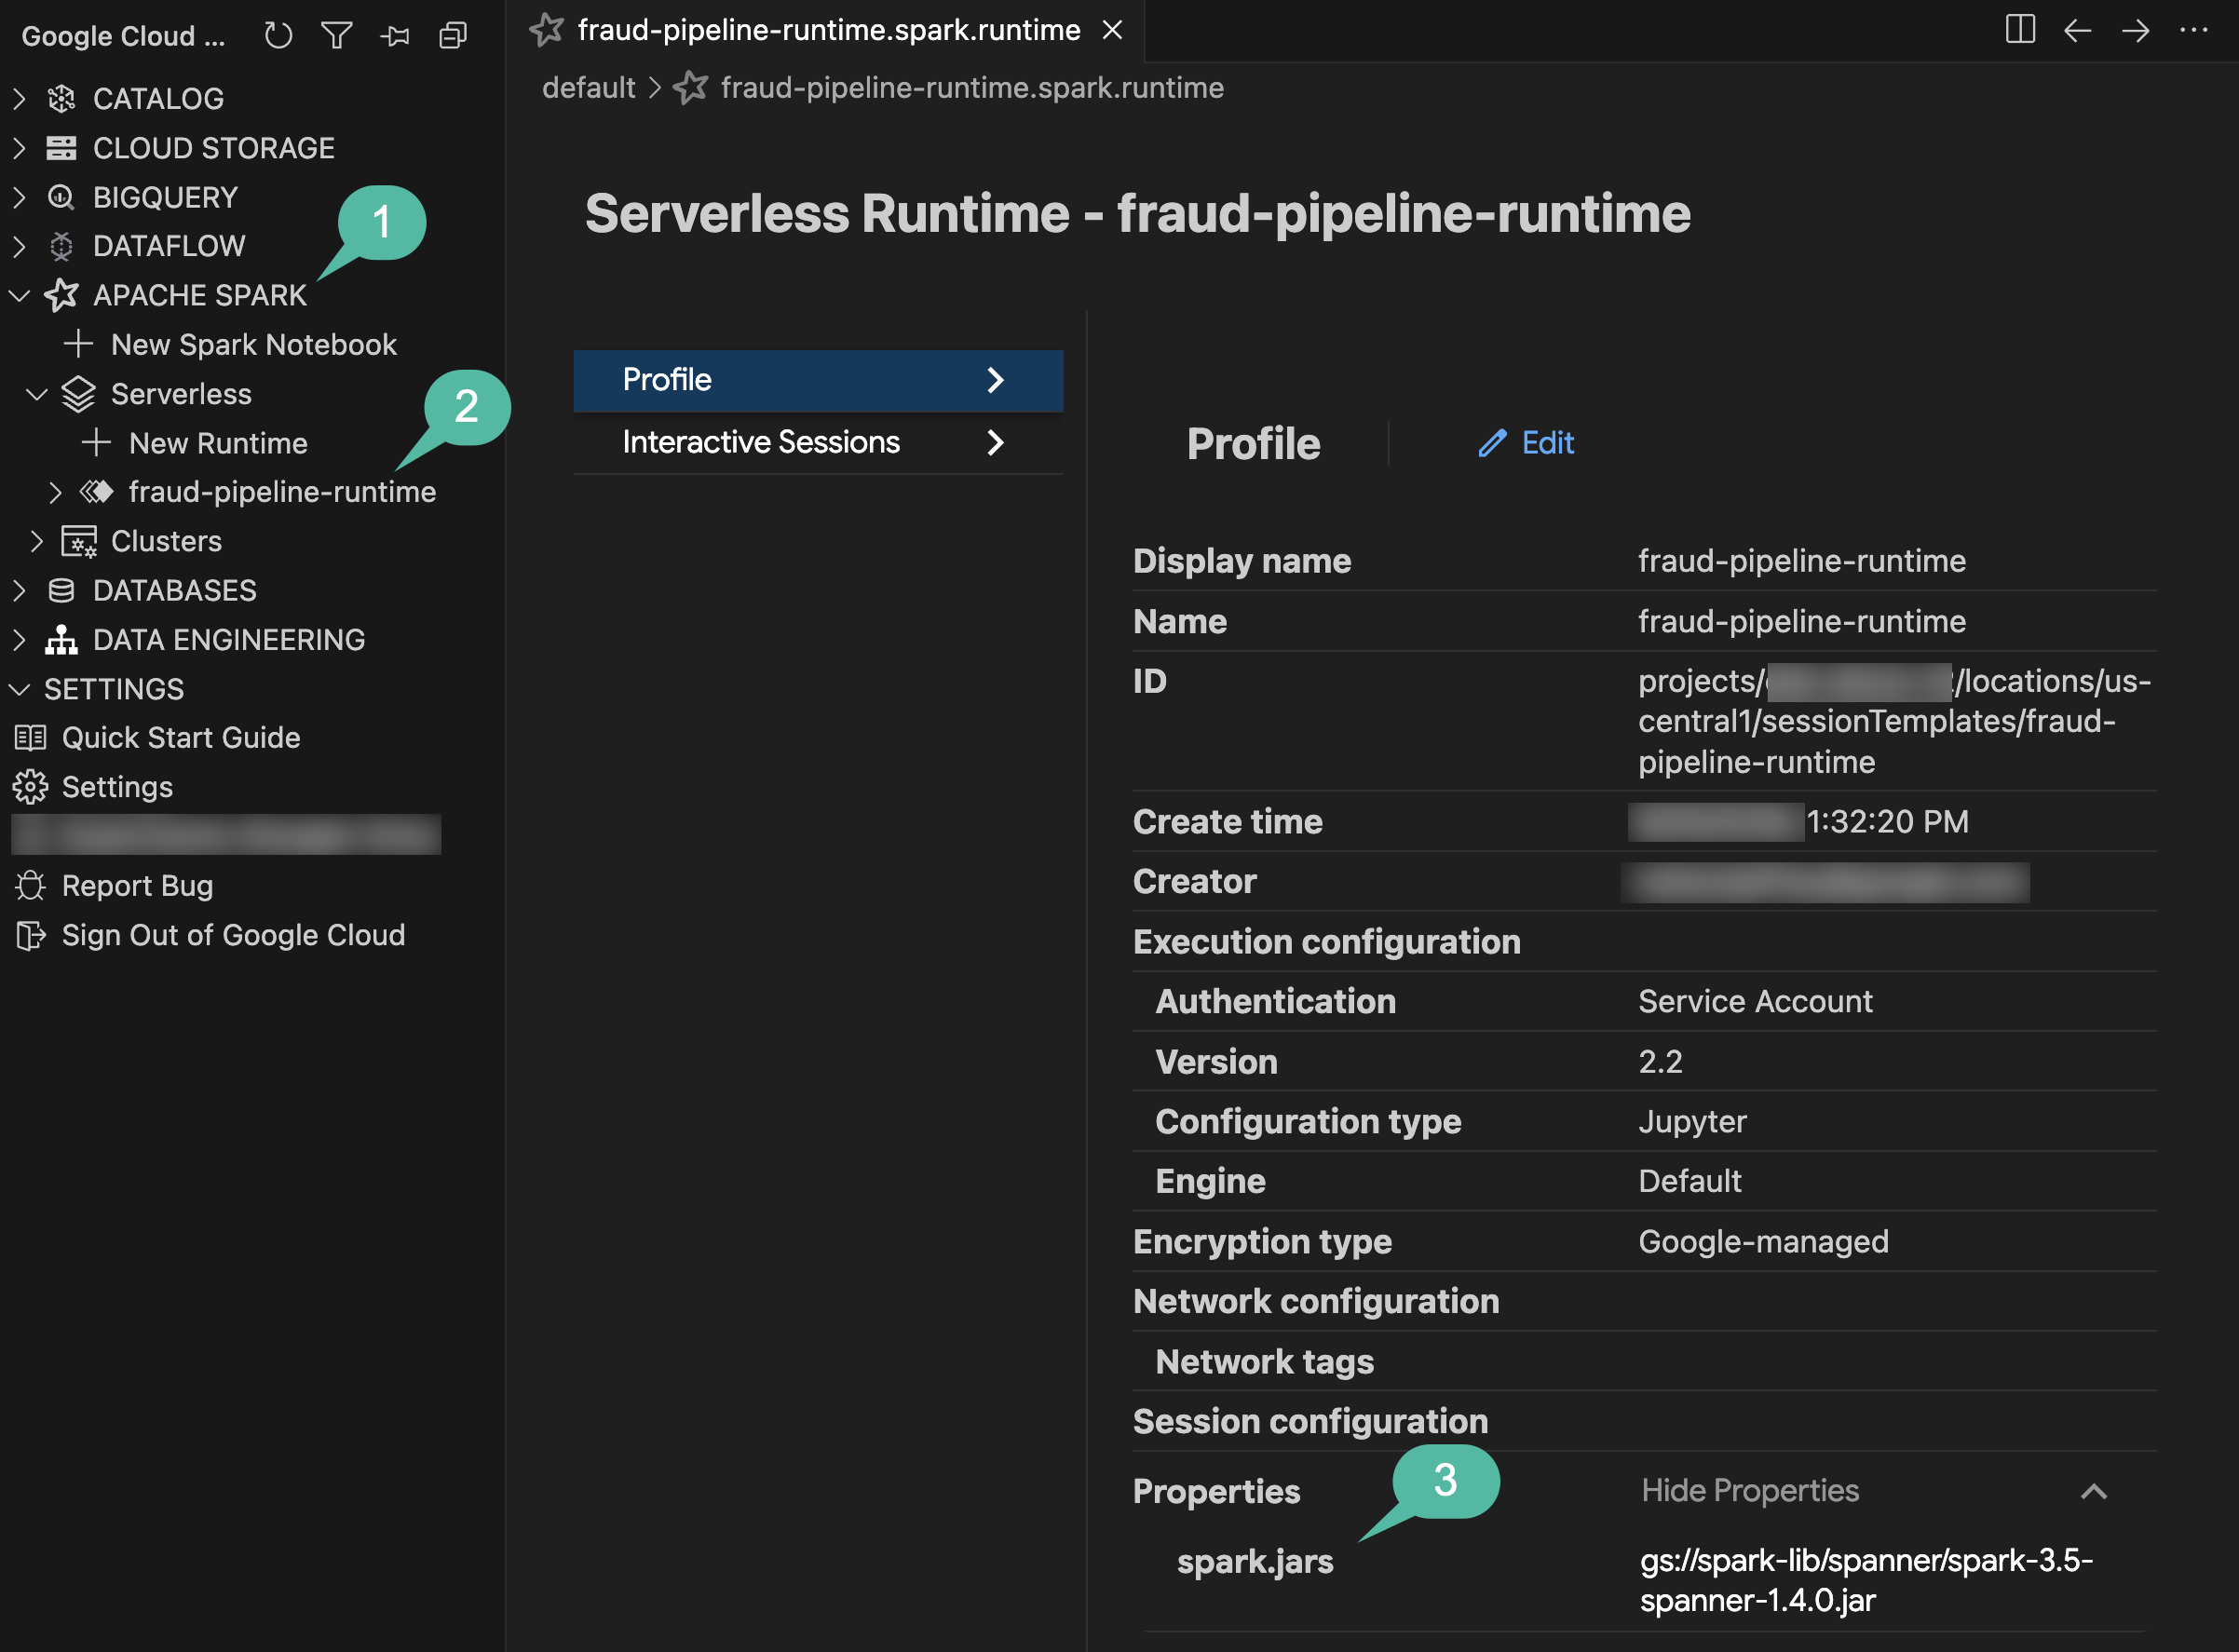
- 请注意左侧的交互式会话标签页。目前为空,因为您尚未执行任何代码。在下一步中运行笔记本后,系统会立即动态预配无服务器计算会话,并在此处显示!
使用 Data Agent Kit 注入数据
您将使用 Data Agent Kit 与智能体进行结对编程,而不是手动配置 Spark 会话或从头开始编写 PySpark 加载脚本。
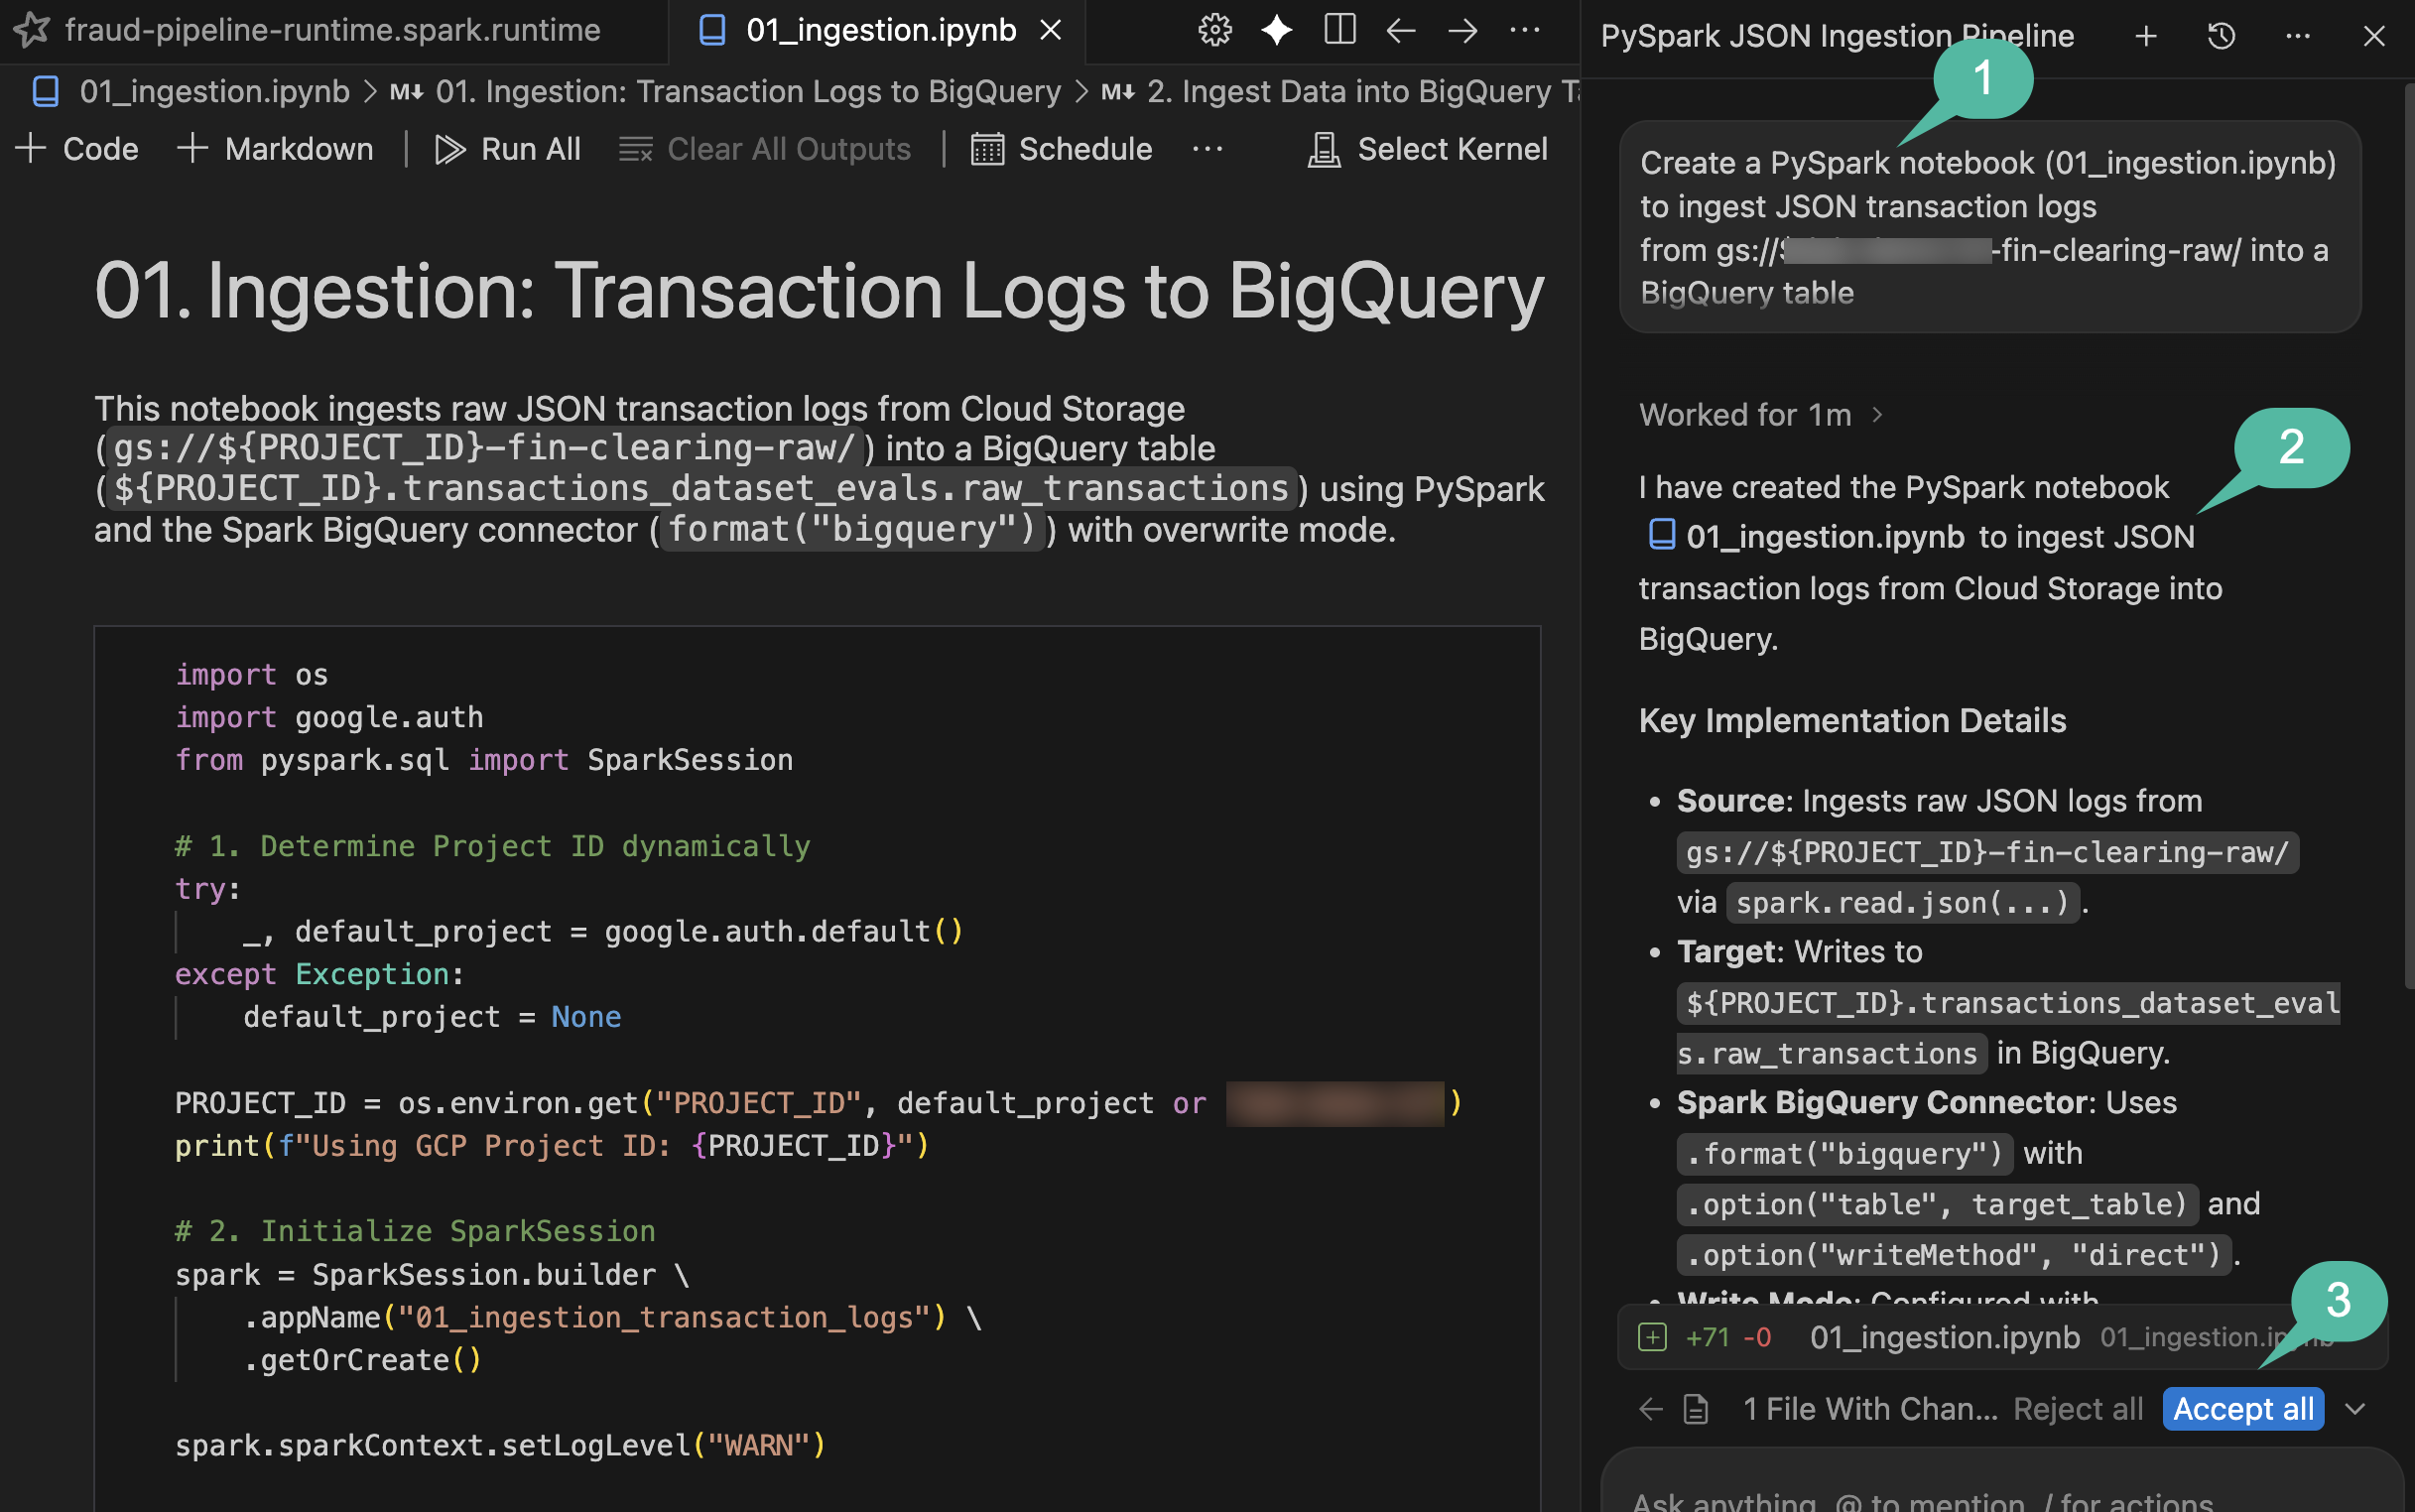
- 点击右上角工具栏中的切换代理图标,打开代理聊天窗格。
- 将以下提示粘贴到对话中(请务必将
${PROJECT_ID}替换为您的实际 Google Cloud 项目 ID):
Create a PySpark notebook (01_ingestion.ipynb) to ingest JSON transaction logs
from gs://${PROJECT_ID}-fin-clearing-raw/ into a BigQuery table
`${PROJECT_ID}.transactions_dataset_evals.raw_transactions`
using the Spark BigQuery connector (`format("bigquery")`) with overwrite mode.
- 如果智能体请求执行后台验证命令的权限(例如“允许运行此命令吗?”),请查看建议的命令,然后选择是,允许本次(或是,并始终允许)。
- 当代理完成文件生成后,点击聊天窗格底部的蓝色全部接受按钮(或对勾标记图标),将
notebooks/01_ingestion.ipynb保存到您的工作区。
查看并执行笔记本
- 在 IDE 中打开新生成的
notebooks/01_ingestion.ipynb。 - 查看 BigQuery 连接器写入逻辑的 PySpark 代码。
- 点击 IDE 的笔记本工具栏中的全部运行。
- 如果您是首次运行远程 Spark 笔记本,IDE 可能会提示您安装本地依赖项。如果系统提示,请点击 Install dependencies for Remote Spark Kernels 并确认安装对话框,然后再次点击 Run All。
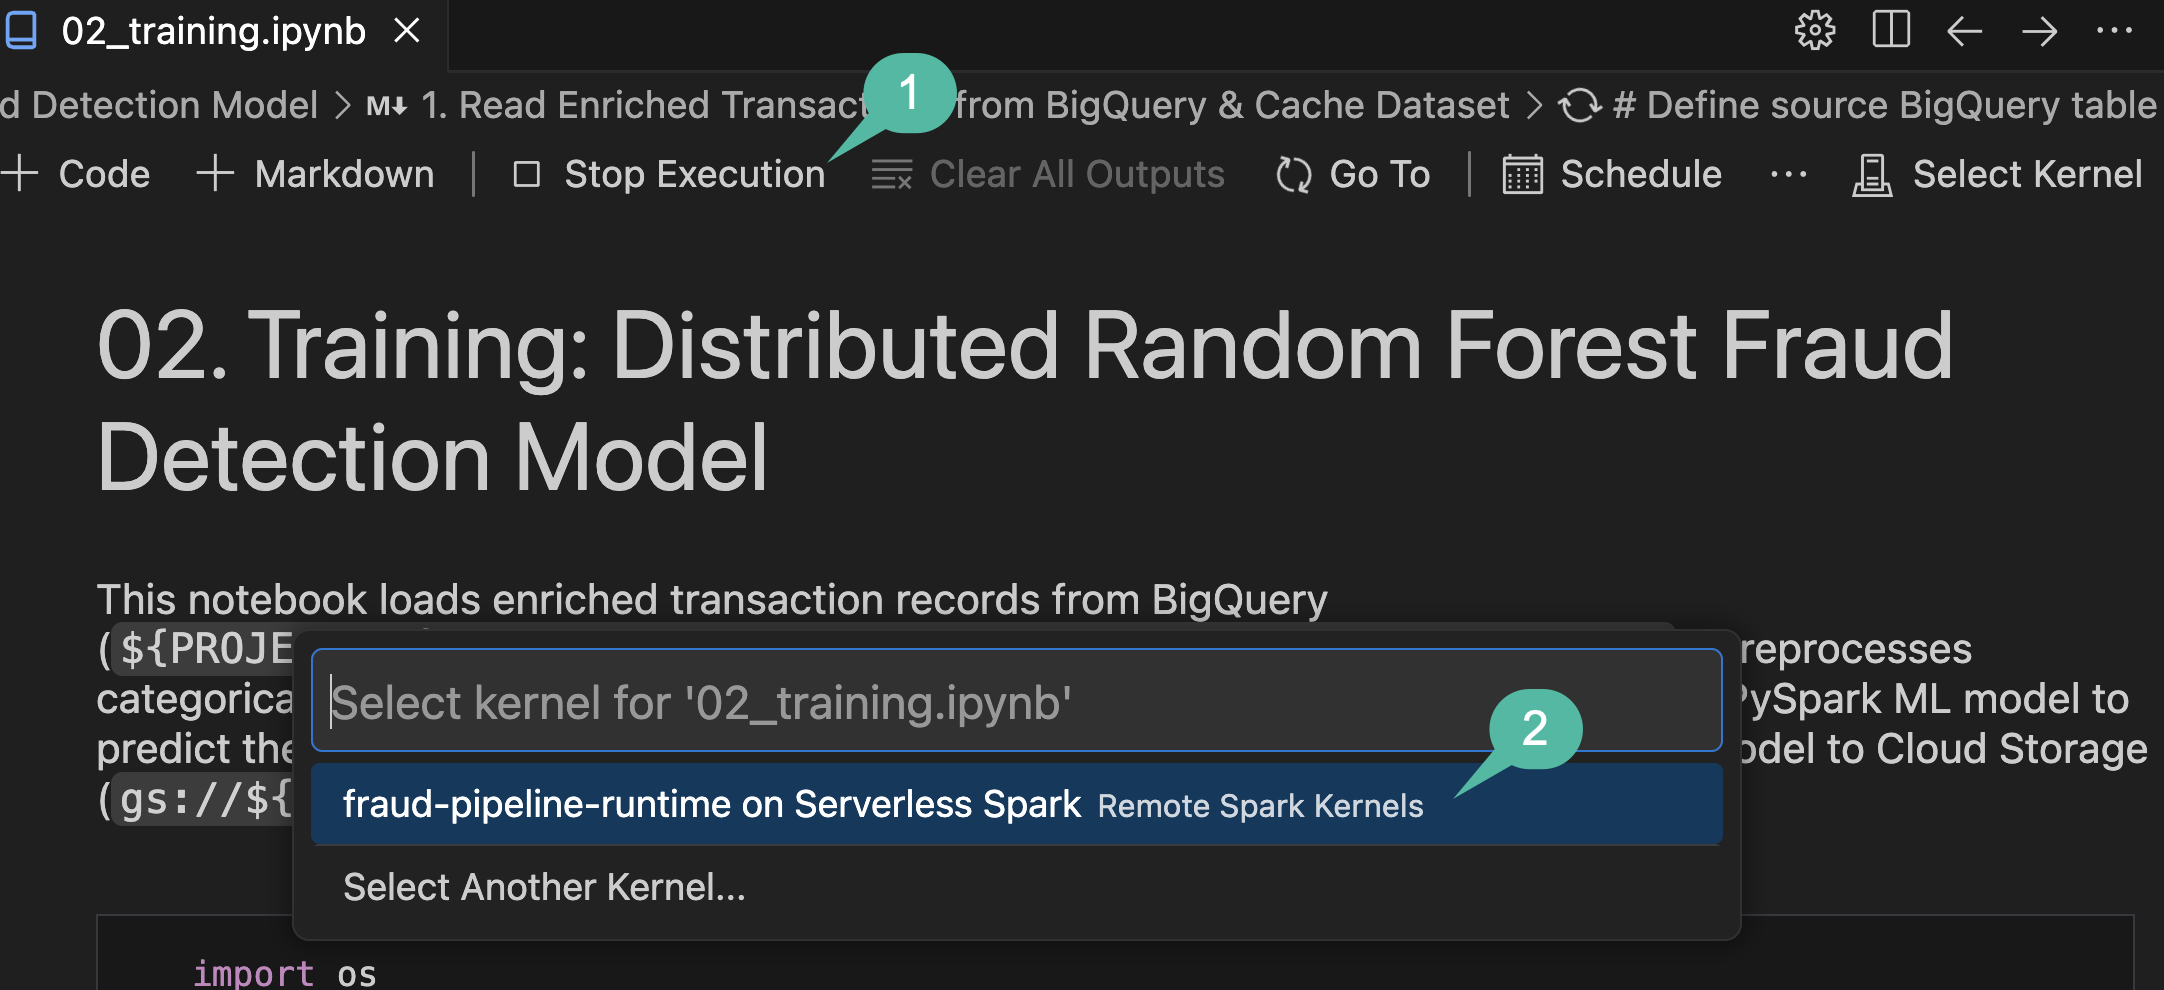
- 在选择内核下拉菜单中,依次选择 Remote Spark Kernels -> fraud-pipeline-runtime on Serverless Spark。(提示:如果您没有看到列出的预配置运行时模板,请点击内核选择器下拉菜单右上角的刷新图标,以重新加载可用的远程内核)。
- 查看编辑器左下角的状态栏。您会看到
Connecting to kernel: fraud-pipeline-runtime on Serverless Spark...。由于这是 Spark Serverless 运行时内核后端的首次启动,因此需要几分钟时间来完成配置和启动。 - 内核完成连接后,笔记本会自动开始按顺序执行所有单元格,以将原始交易日志处理到您的 BigQuery 数据集中。
验证
执行完成后,检查 Data Agent Kit 目录以验证表创建情况:
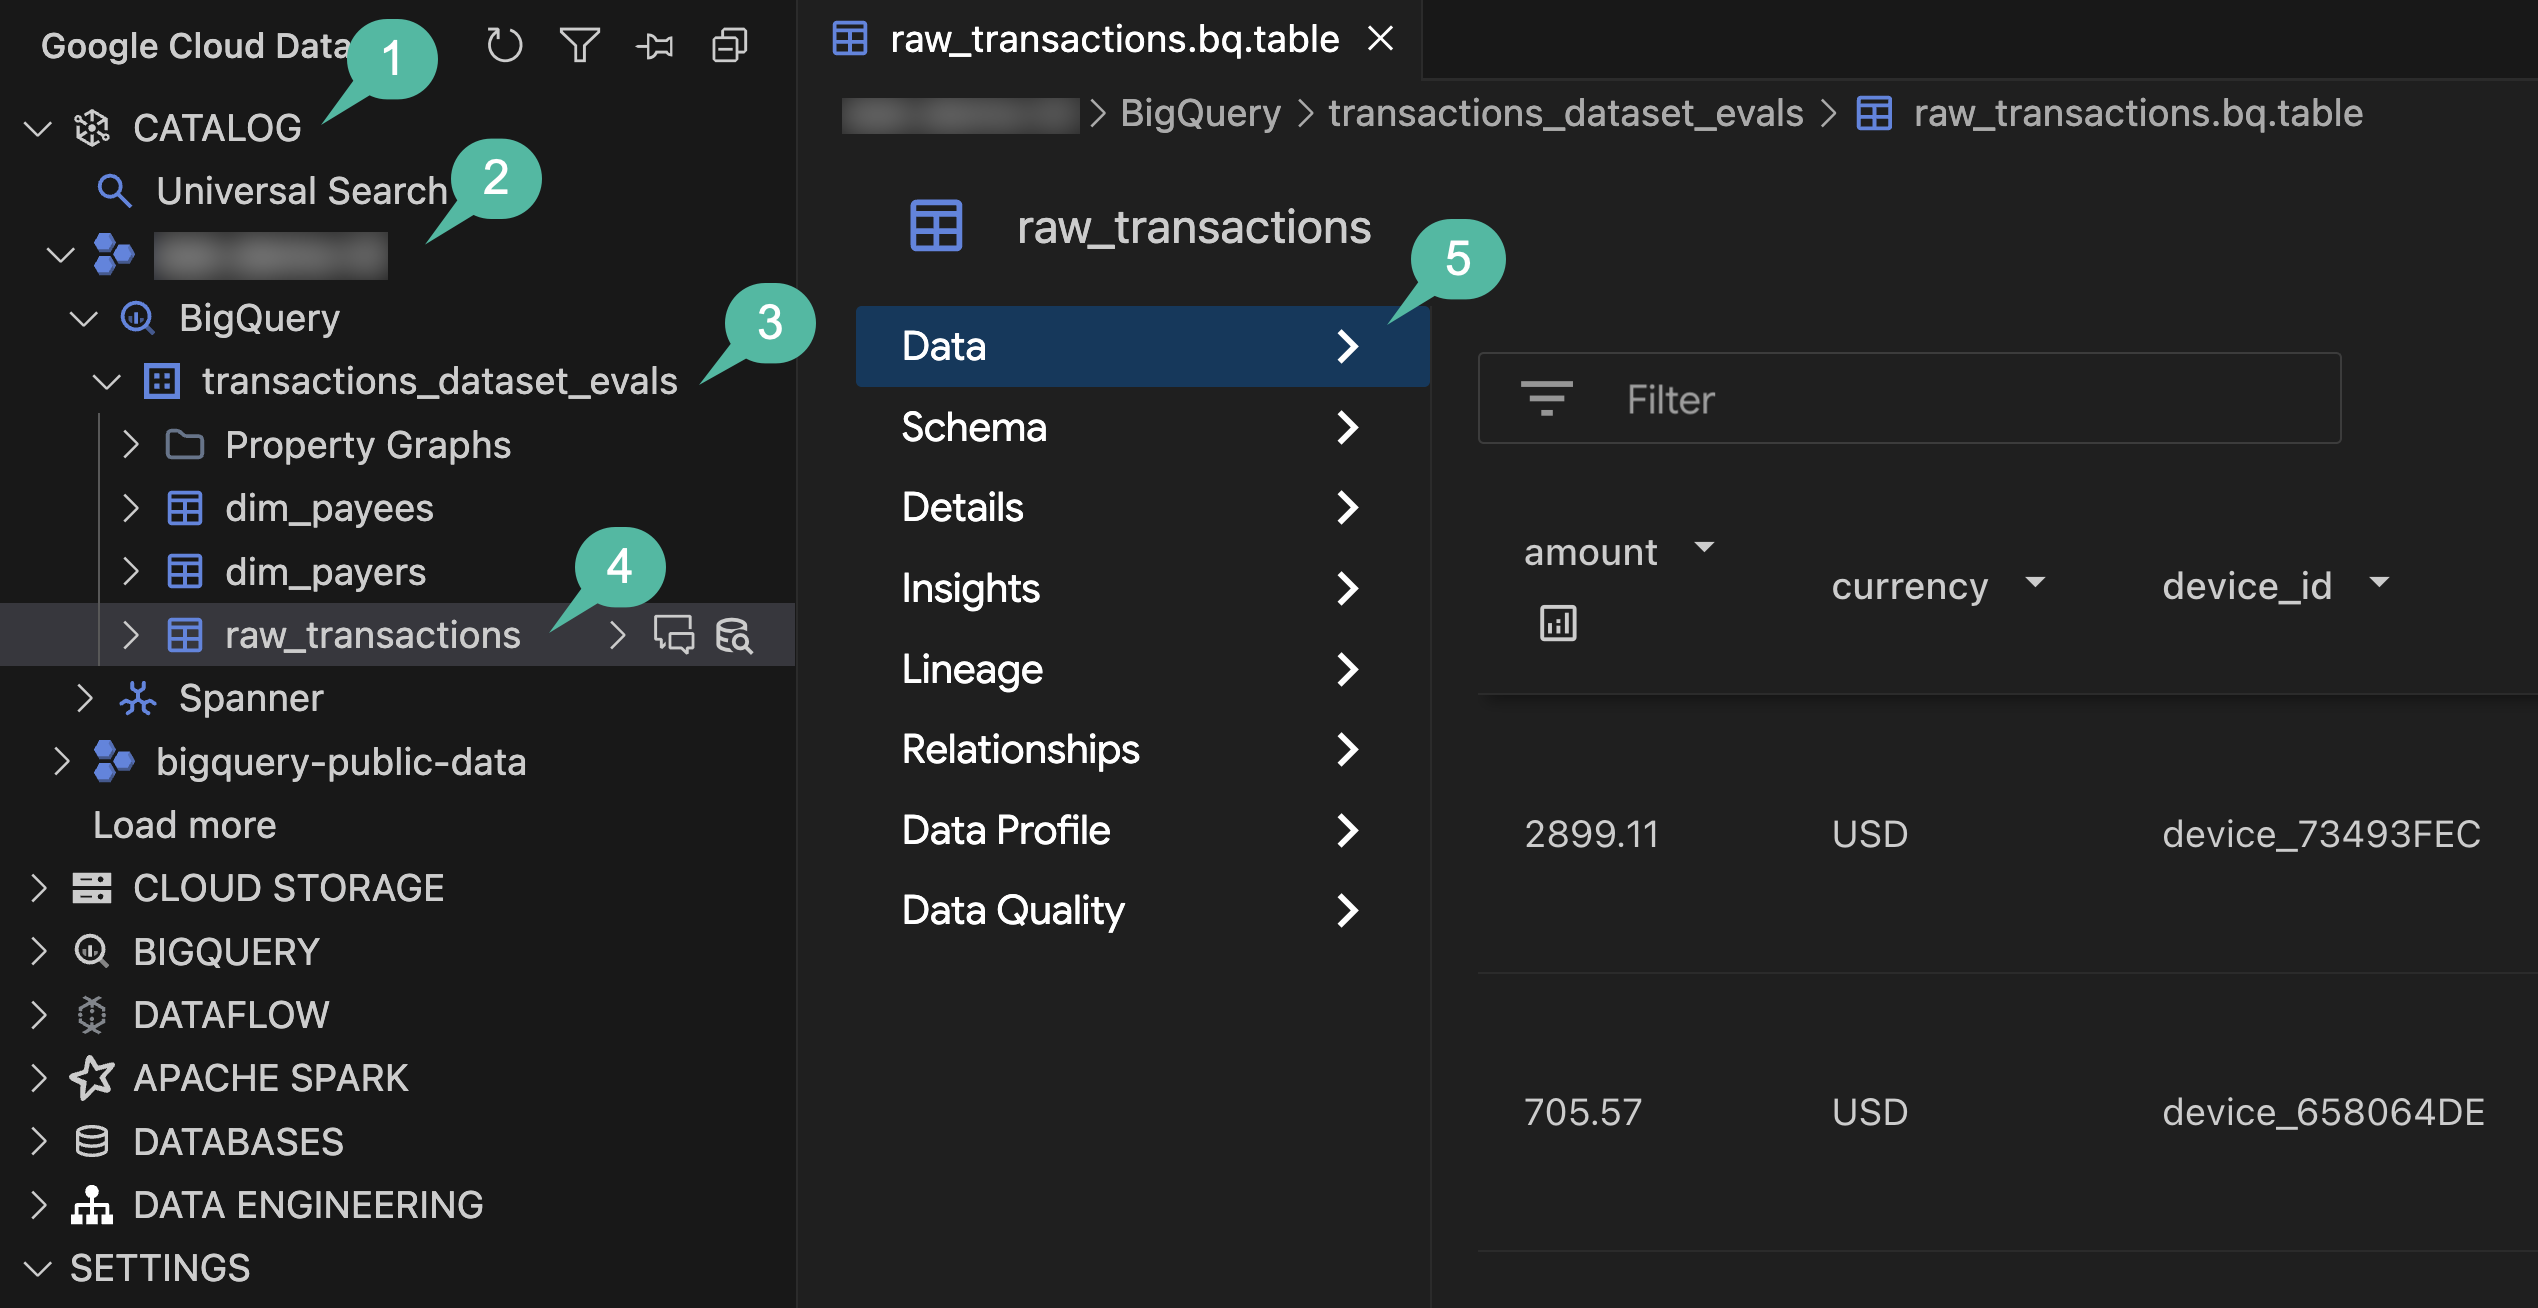
- 在 IDE 活动栏中,打开 Google Cloud Data Agent Kit 面板。
- 展开目录部分。
- 展开您的项目 ID。
- 展开 BigQuery。
- 展开
transactions_dataset_evals数据集。 - 点击
raw_transactions表,以在主编辑器中打开其详细视图。 - 在左侧导航栏中,探索数据、架构和详细信息标签页,以检查提取的记录和元数据。
本部分总结:您在 Agent Chat 中使用自然语言生成了完整的 Spark 无服务器工作负载。然后,您执行了该脚本,将非结构化 JSON 日志处理到 BigQuery(原始)表中。
4. 使用 dbt 进行去重和标准化
在训练机器学习模型之前,您将通过以下方式来确保数据质量:移除重复的流式传输日志、隔离不良记录(例如空的交易 ID),以及联接维度数据(付款人和收款人)。此过程需要幂等且可靠的 SQL 转换,因此 dbt(数据构建工具)非常适合。
搭建 dbt 流水线
使用代理基于 BigQuery 数据集生成 dbt 项目:
- 返回到代理聊天窗格。
- 提供以下指令以生成 dbt 项目:
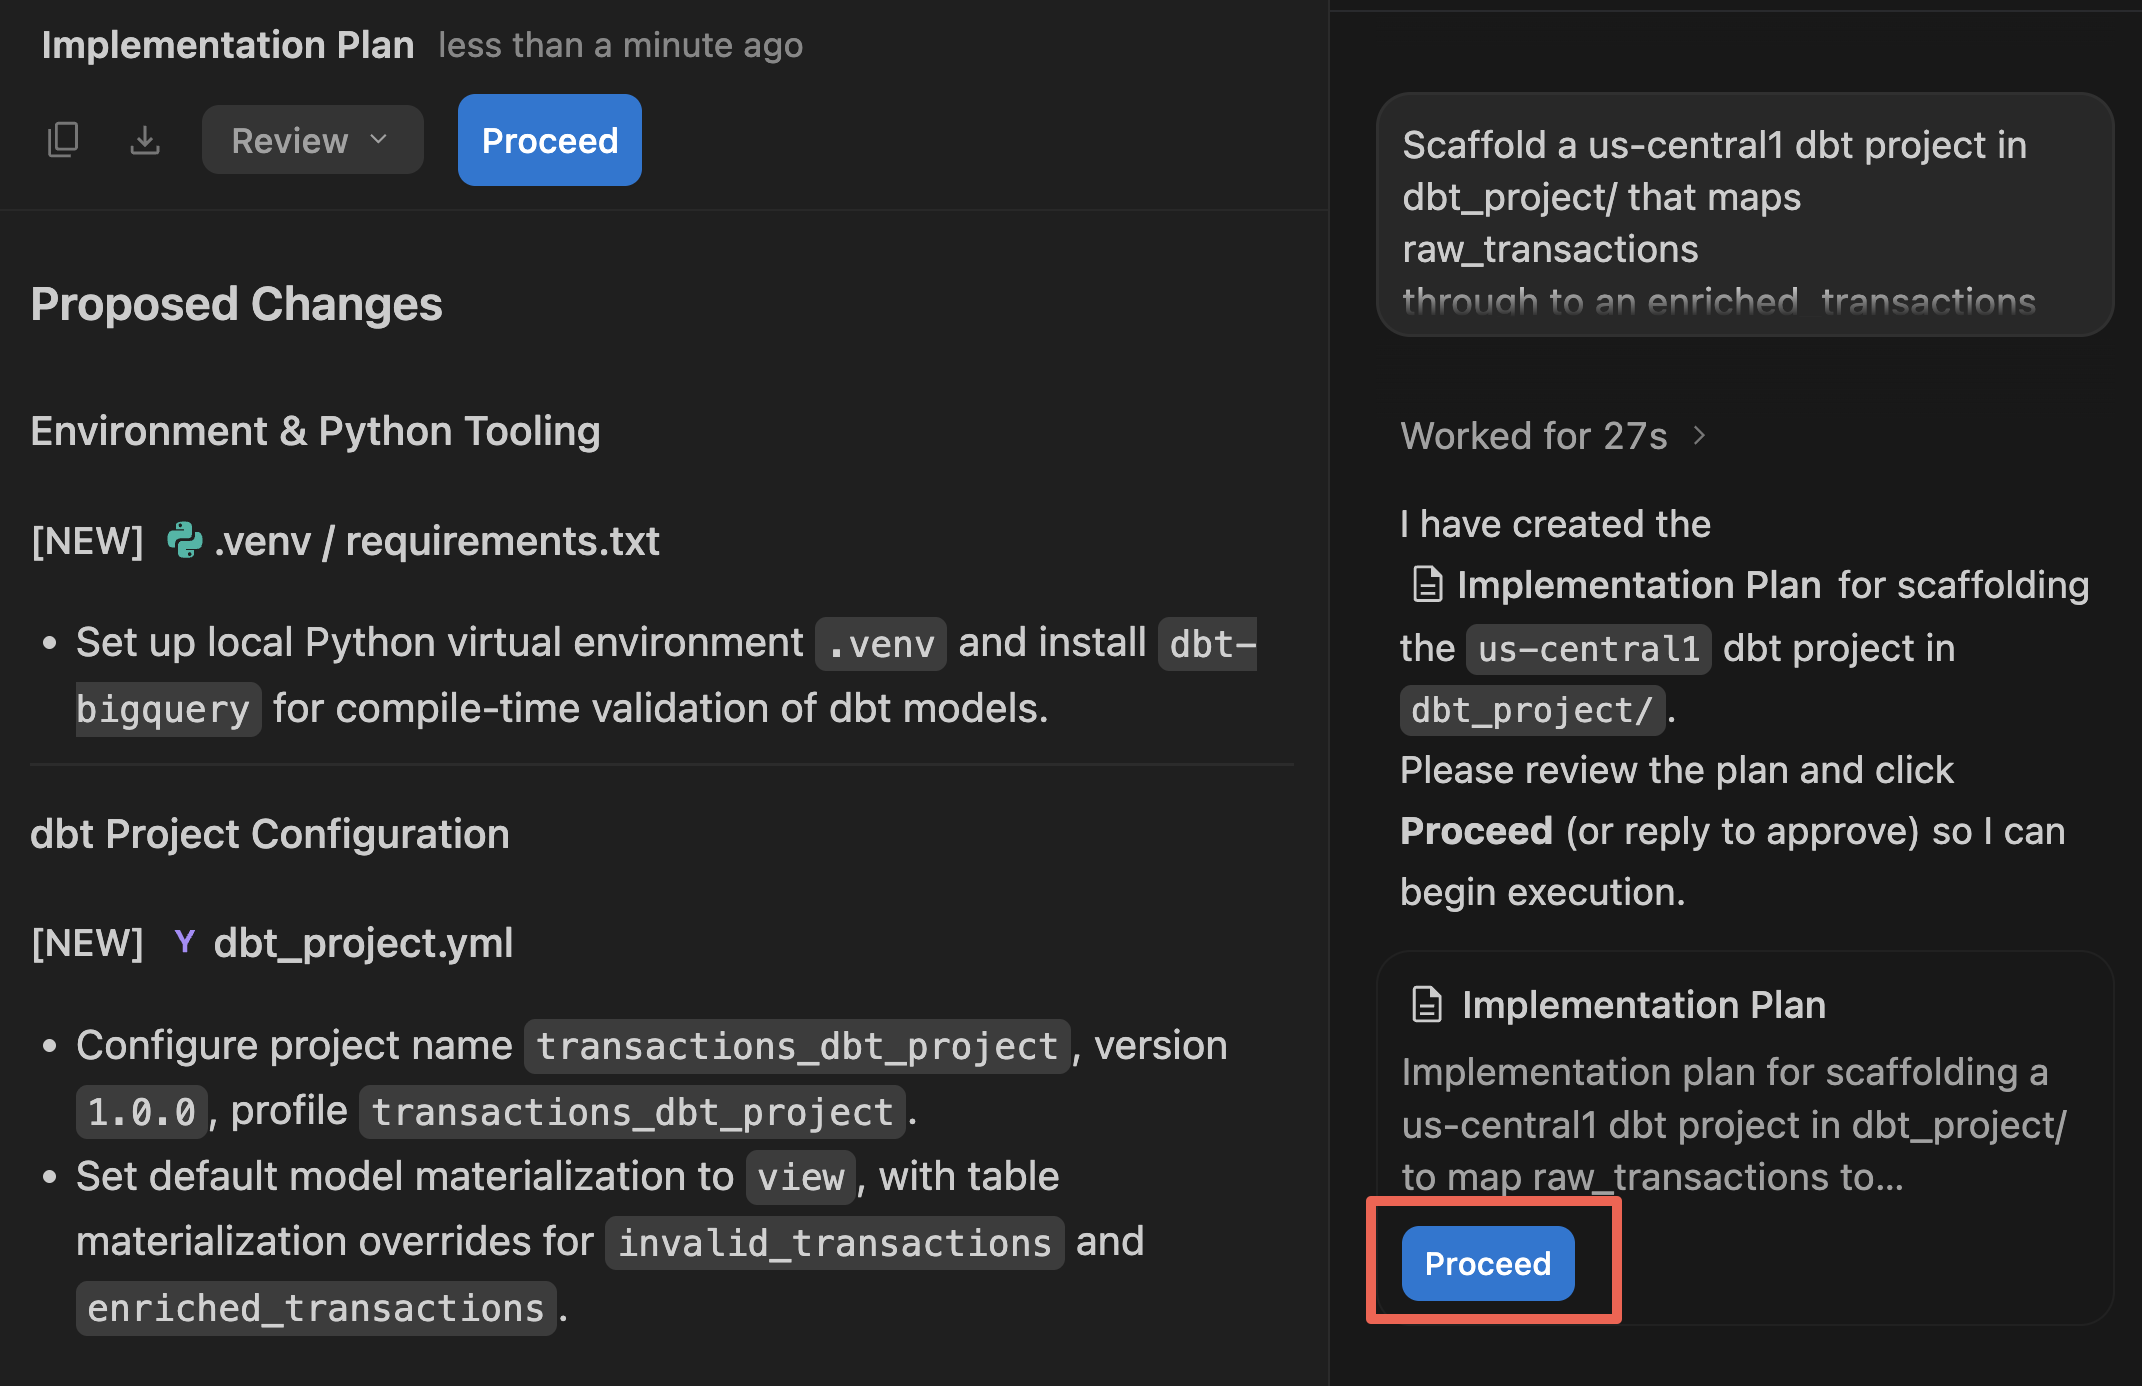
Scaffold a us-central1 dbt project in dbt_project/ that maps raw_transactions
through to an enriched_transactions model in dataset transactions_dataset_evals.

Deduplicate by transaction_id in staging. Quarantine null IDs to an invalid_transactions model.
Join the valid staging records with dim_payers and dim_payees for the enriched_transactions model,
preserving the historical `is_fraud` label column, and finally add a transaction uniqueness test.

Create an implementation plan first.
- 代理将在主编辑器窗格中显示实施方案制品。查看建议的文件结构和 SQL 逻辑。
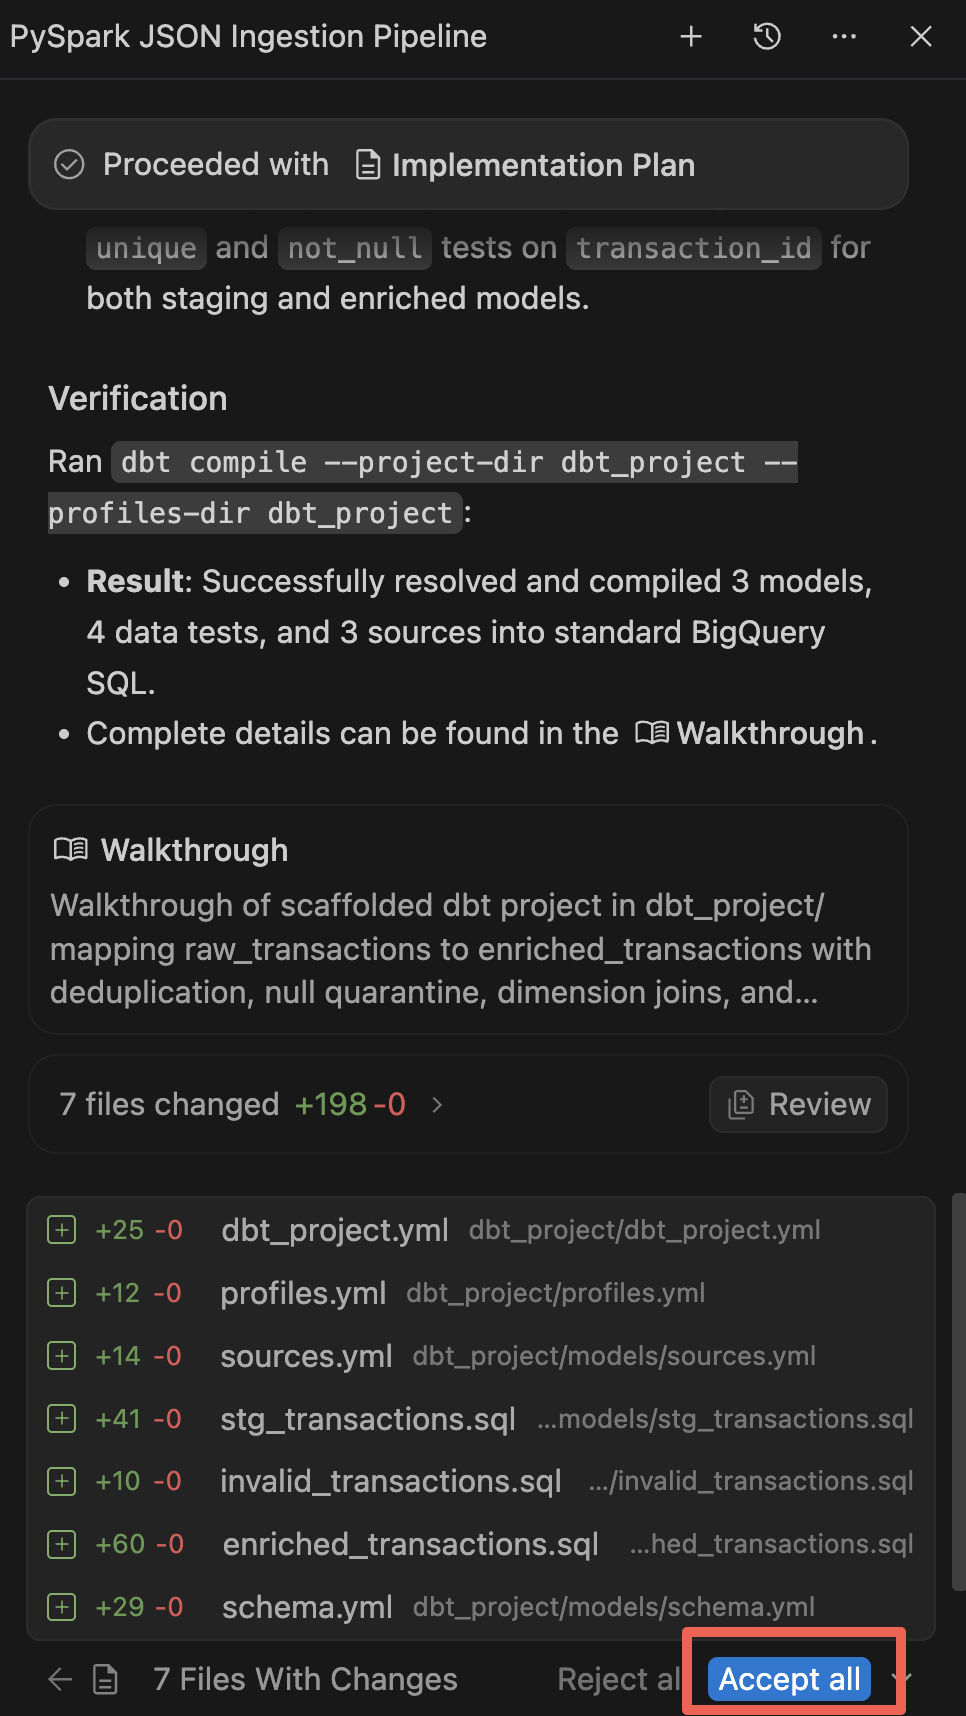
- 点击继续(然后点击全部接受),以允许智能体在您的工作区中生成文件。
- 生成完成后,代理会显示一个导览,其中总结了新组件。如果系统提示,请接受所有更改。
构建和测试
虽然代理会自动运行 dbt compile 以确保生成的 SQL 在语法上有效,但您现在会将这些视图和表具体化到 BigQuery 中,并运行数据质量测试以进行本地验证。(注意:在本实验的后续环节中,您将自动执行此 dbt 步骤,作为端到端 Airflow DAG 的一部分)。
- 在最左侧的活动栏中,点击探索器图标(或按
Cmd/Ctrl+Shift+E)。 - 展开
dbt_project->models以检查生成的 SQL 模型。点击enriched_transactions.sql以在编辑器中打开并查看转化和欺诈特征逻辑。 - 在文件资源管理器中,右键点击
dbt_project文件夹,然后选择在集成终端中打开。这会自动打开一个终端窗格,该窗格直接设置为所需的dbt_project工作目录。 - 如果您尚未安装
dbt,请在dbt_project/之外(在您的主目录或工作区根目录中)创建一个虚拟环境,然后安装 BigQuery 适配器:
python3 -m venv ~/.venv/dbt
source ~/.venv/dbt/bin/activate
pip install dbt-bigquery
- 运行 dbt 模型及其关联的数据质量测试:
dbt build
- 观看终端输出。dbt 将编译 SQL,在 BigQuery 中具体化暂存表和丰富表,并执行数据测试。
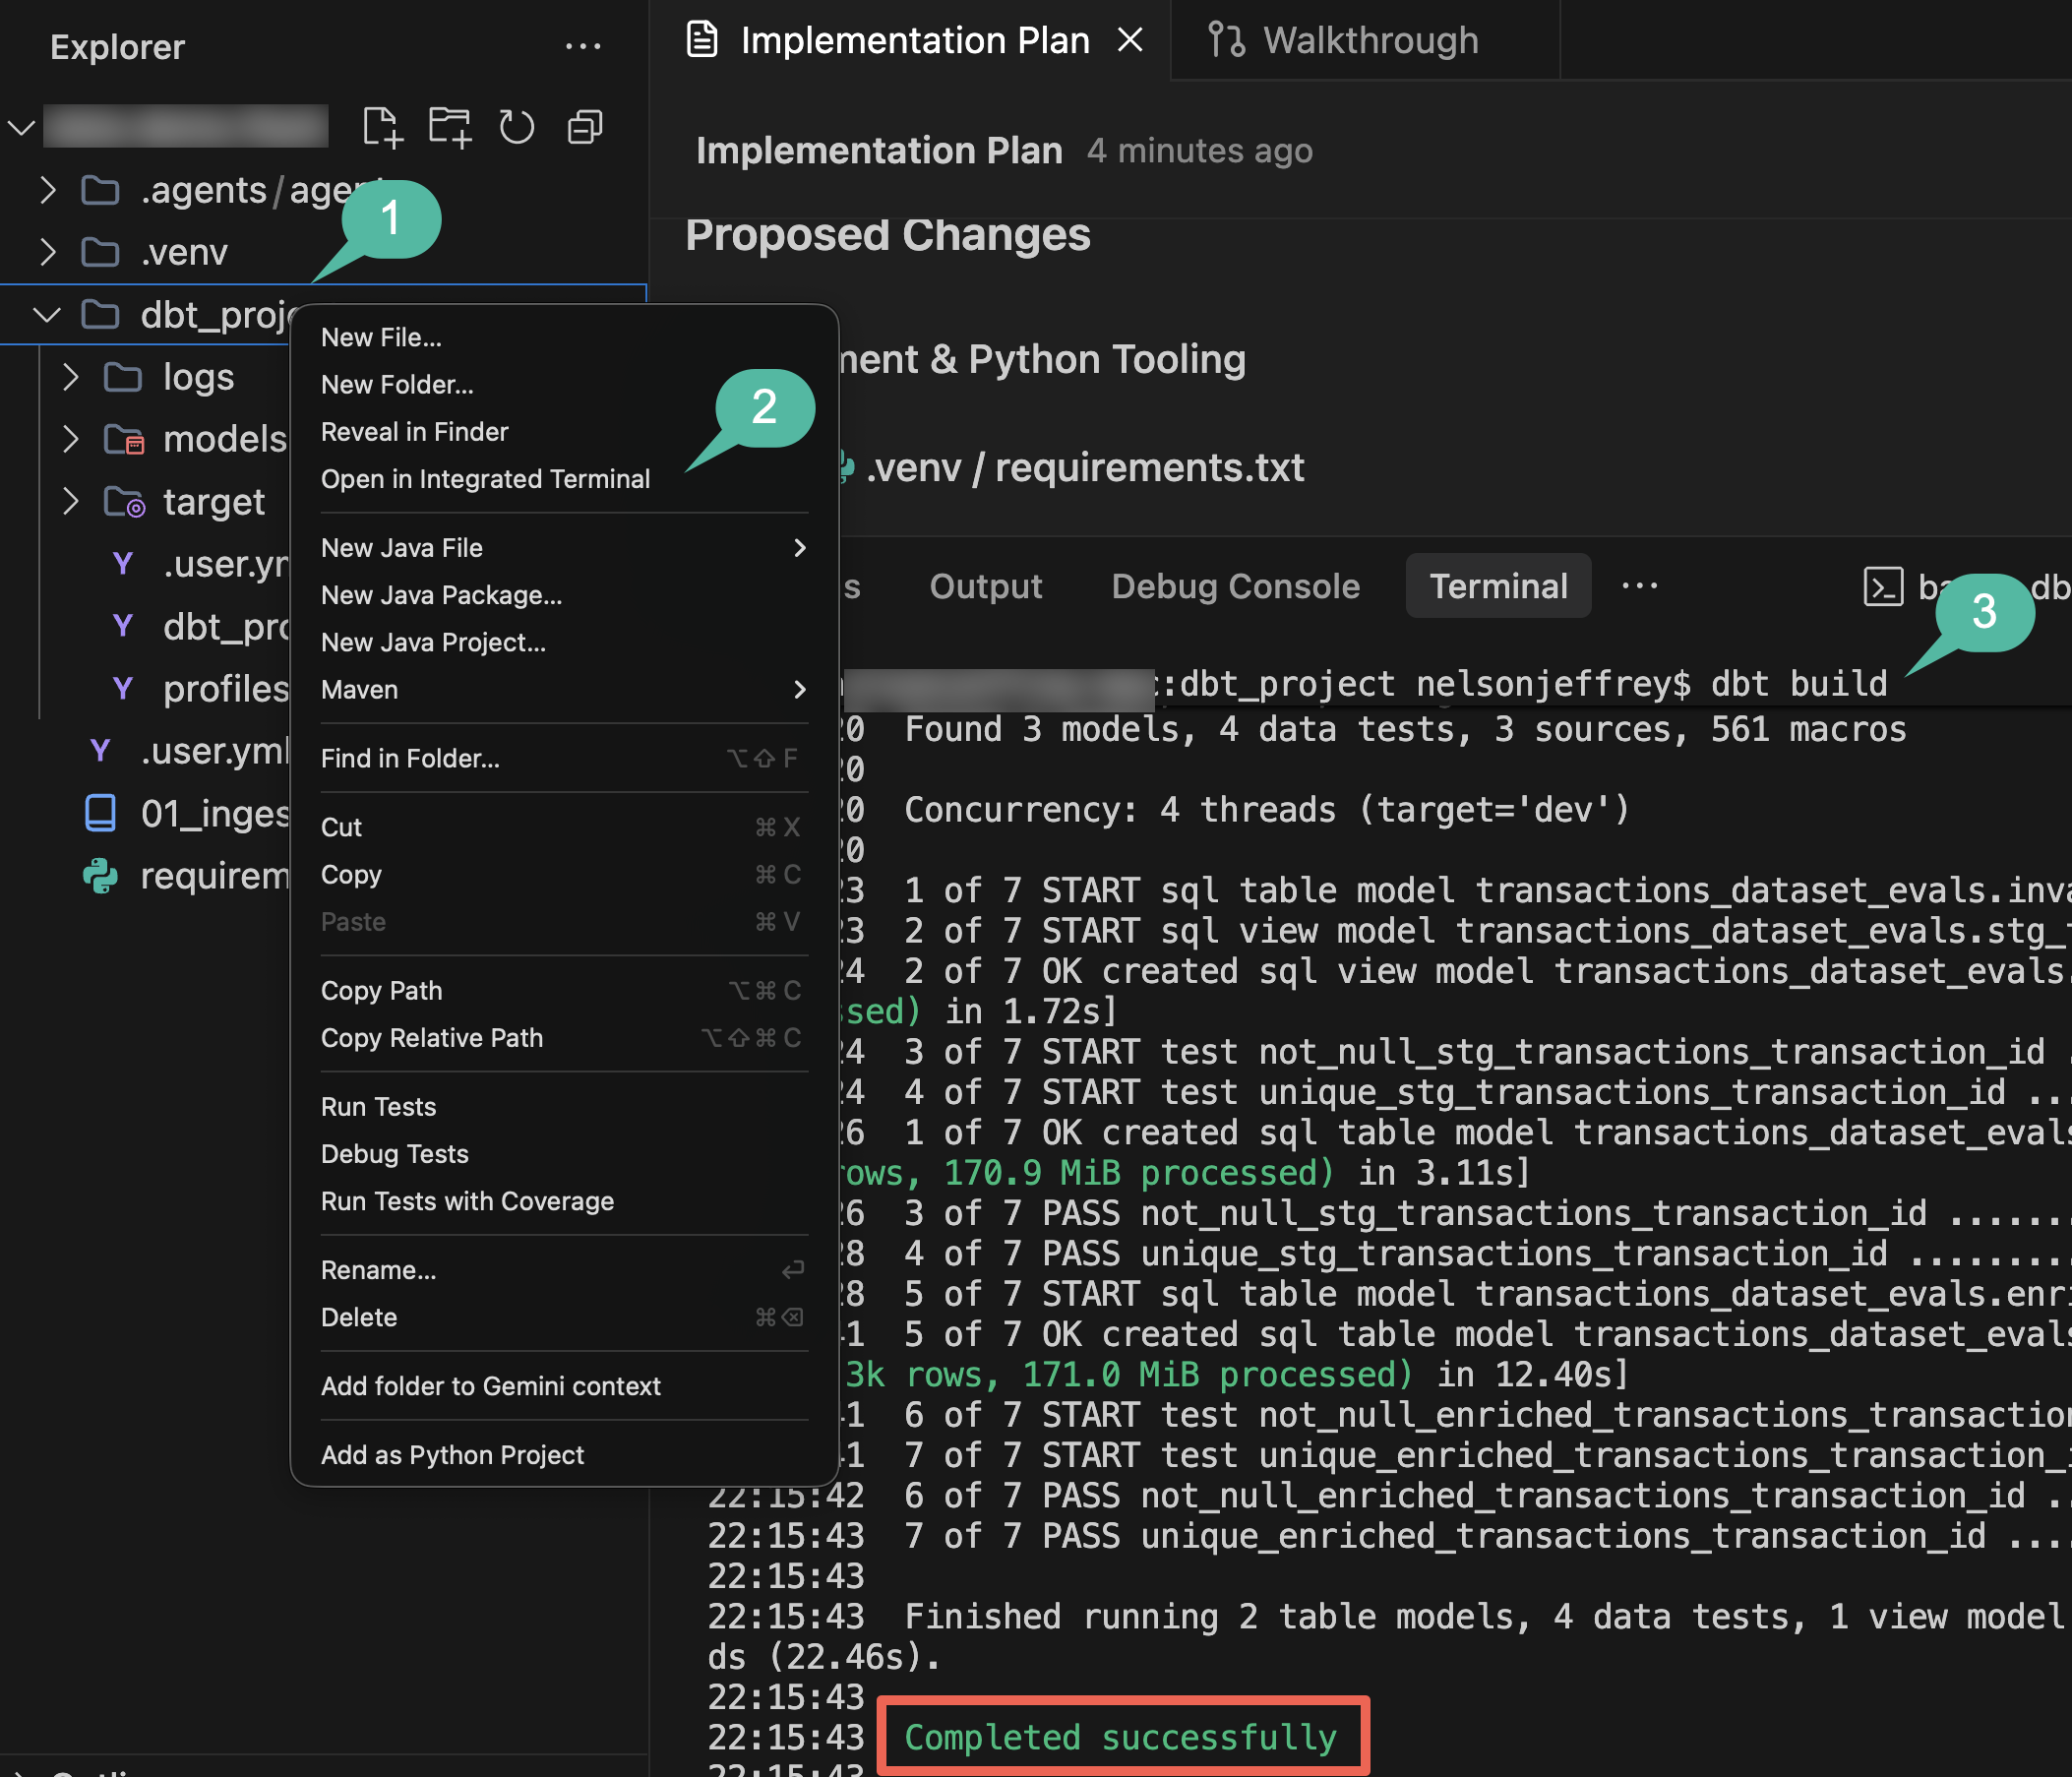
- 构建完成后,关闭终端窗格,以便为剩余步骤腾出屏幕空间。
本部分总结:您使用代理生成了一个 dbt 项目,运行了数据质量测试,并将原始记录转换为暂存和丰富型 BigQuery 表。
5. 使用随机森林训练分布式欺诈检测模型
在 BigQuery 中实现交易数据丰富后,您将构建一个机器学习模型来对欺诈性事件进行分类。随机森林是一种集成学习方法,非常适合表格分类数据。在 Spark Serverless 上运行 RandomForestClassifier 可在工作节点之间分配模型训练,而无需您管理基础设施。
在此步骤中,您将使用智能体生成 Spark ML 训练流水线。
生成机器学习训练笔记本
- 打开智能客服聊天窗格。
- 提供以下提示来设计模型训练序列(请记得将
${PROJECT_ID}替换为您的有效项目 ID):
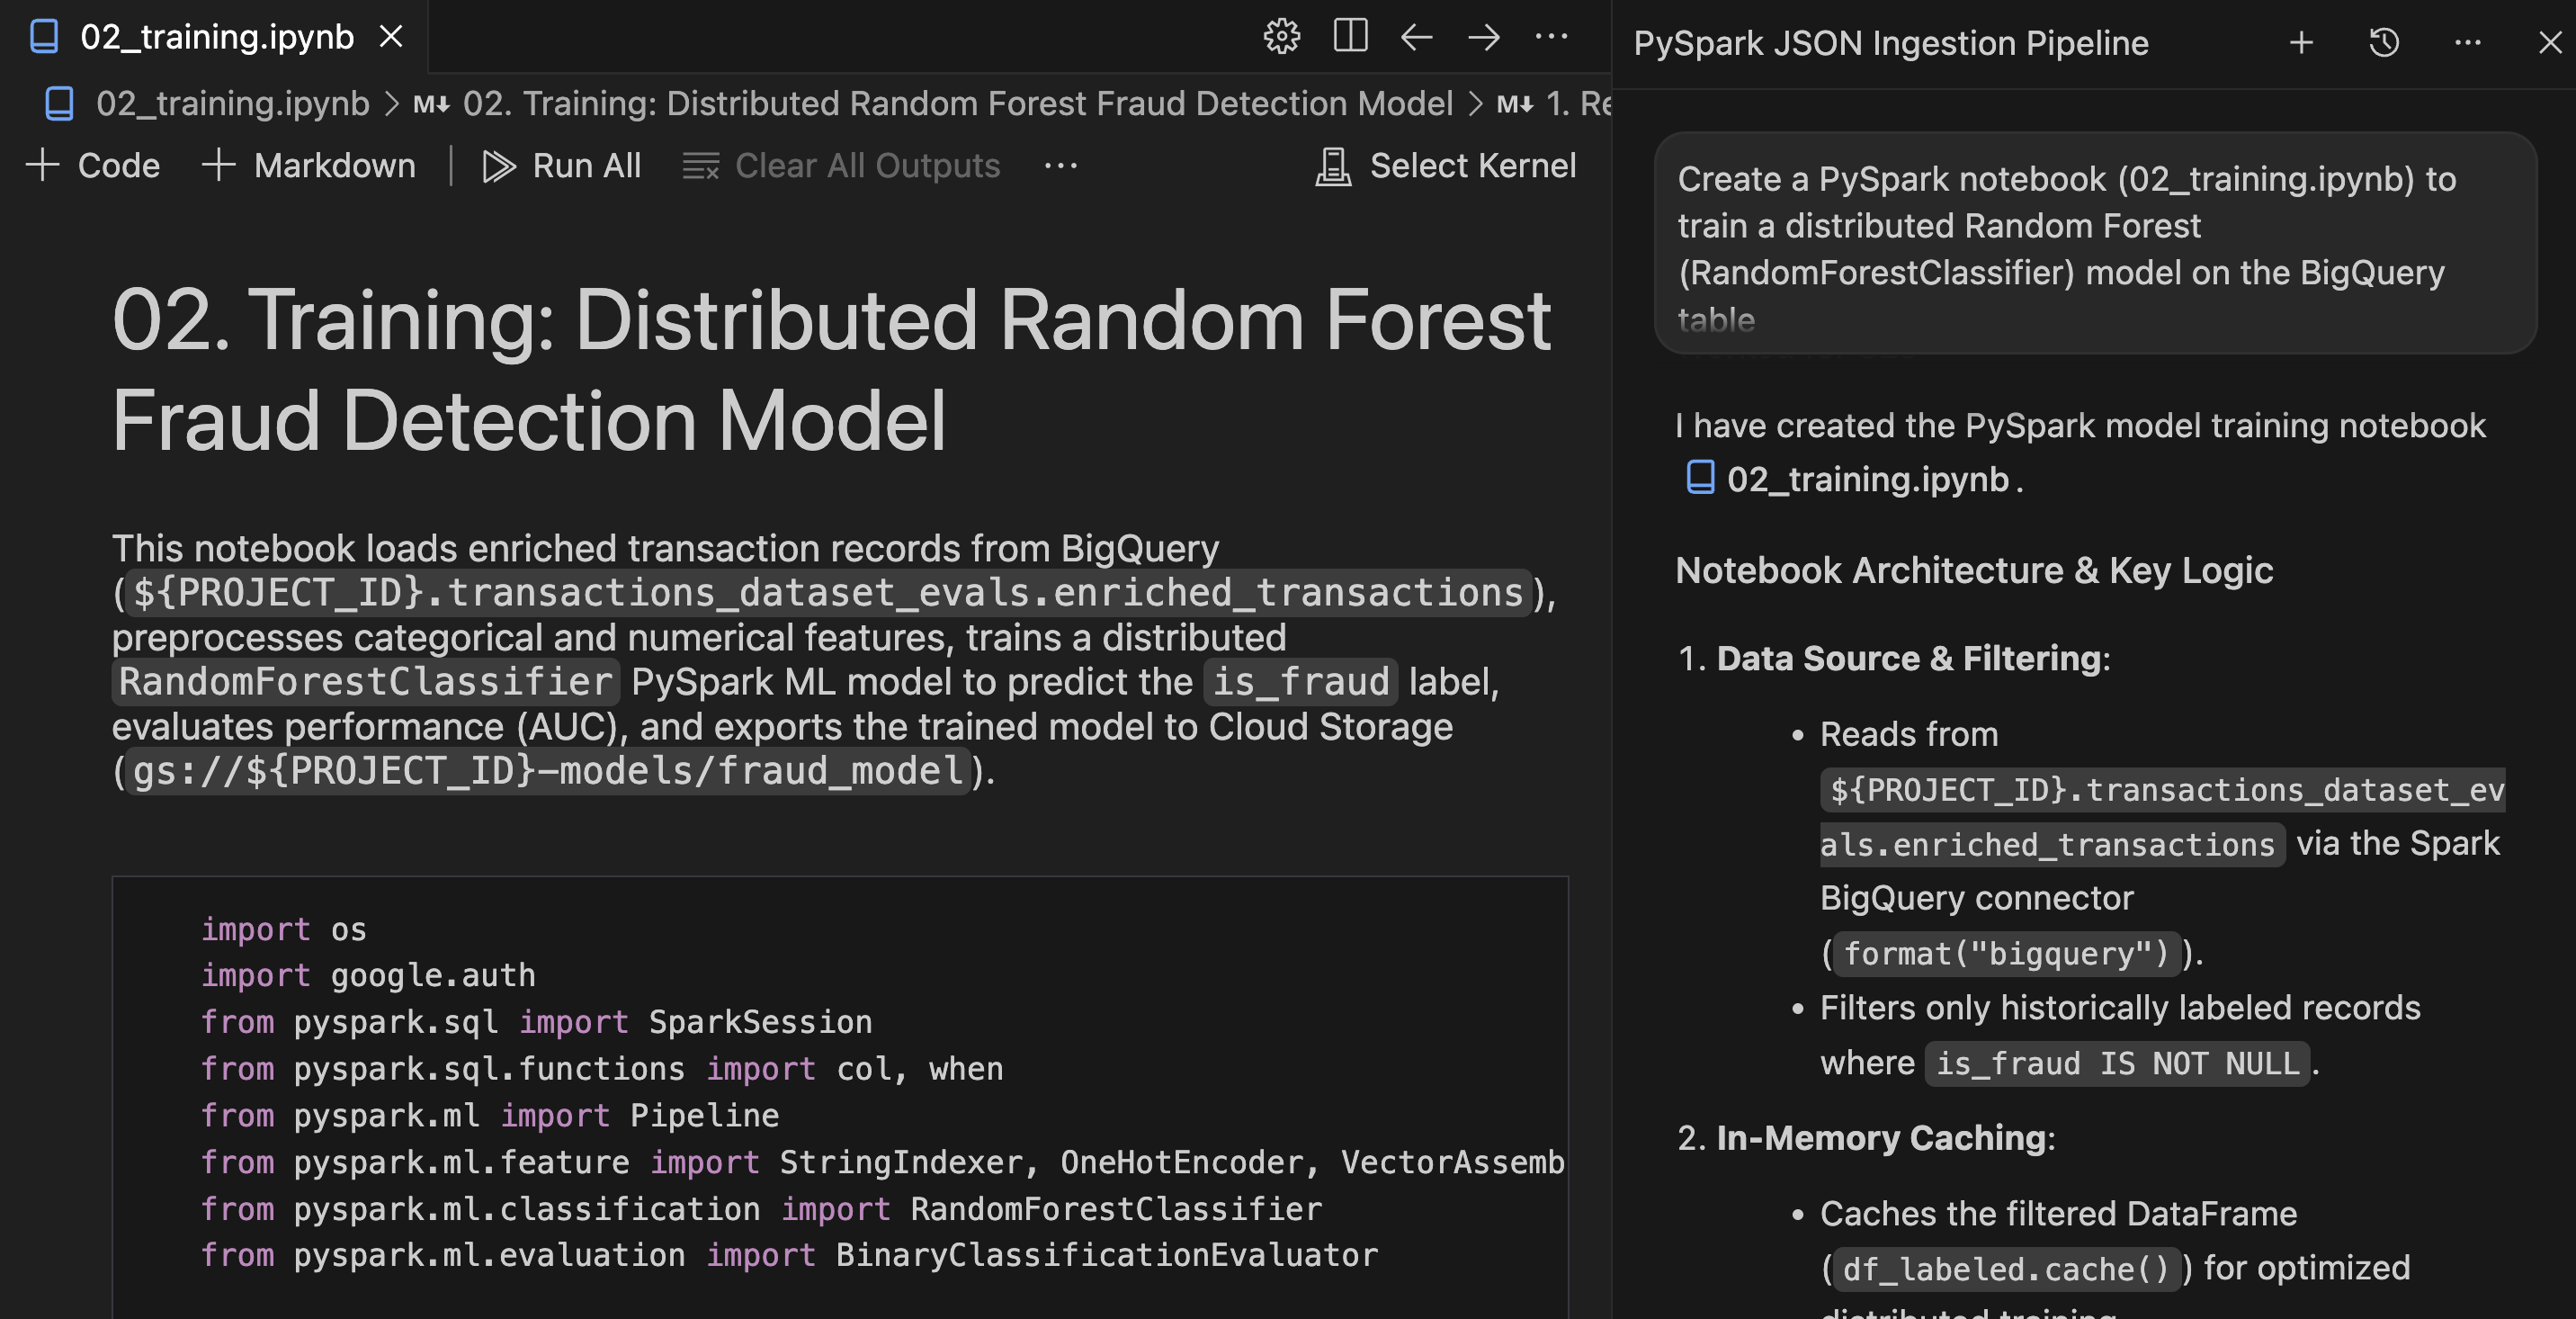
Create a PySpark notebook (02_training.ipynb) to train a distributed Random Forest
(RandomForestClassifier) model on the BigQuery table
`transactions_dataset_evals`.`enriched_transactions`, predicting the `is_fraud` label.
Train only on historically labeled records where `is_fraud` is not null.

One-hot encode categorical strings, scale amounts, cache the dataset in memory,
evaluate AUC, and save the evaluated model to gs://${PROJECT_ID}-models/fraud_model.
- 查看代理的方案或生成的代码,然后点击继续 / 全部接受,将
notebooks/02_training.ipynb保存到您的工作区。
查看并执行笔记本
- 在编辑器中打开
notebooks/02_training.ipynb。 - 查看 PySpark ML 流水线阶段,了解特征编码、向量组装和随机森林分类逻辑。
- 点击 IDE 的笔记本工具栏中的全部运行。
- 当选择内核下拉选择器打开时,选择 Serverless Spark 上的 fraud-pipeline-runtime。
验证
执行完成后,确认模型已正确训练和导出:
- 查看笔记本底部的评估单元格输出,验证报告的 ROC 曲线下面积 (AUC) 得分。
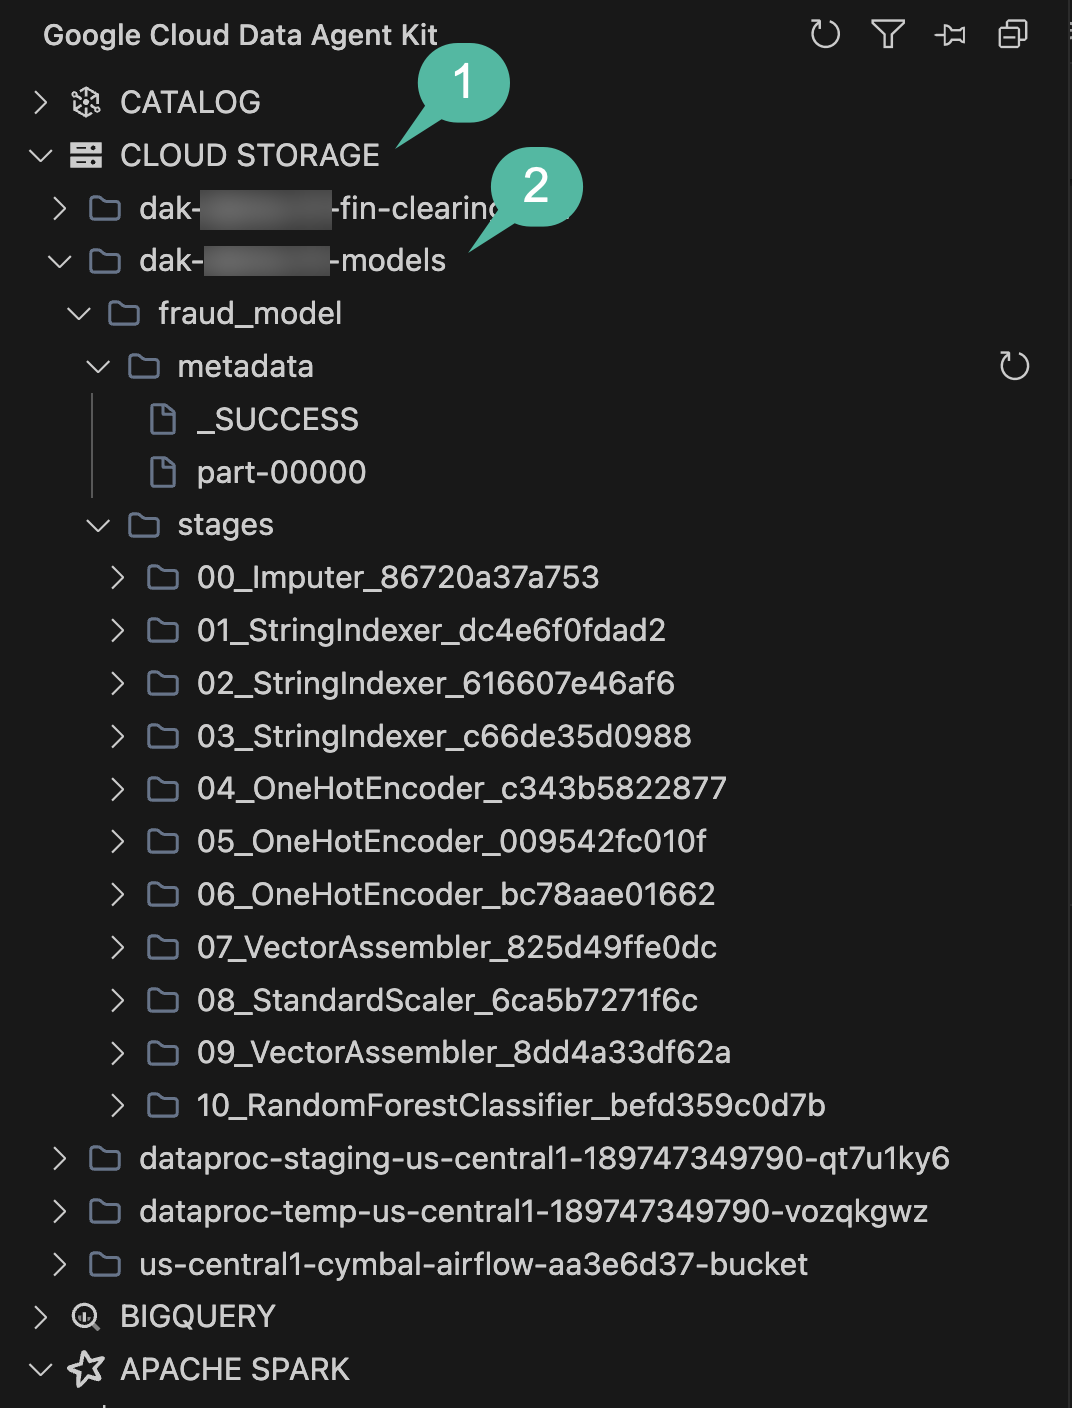
- 为确保模型制品已成功保存到 GCS,请展开 Data Agent Kit 边栏中的存储资源管理器窗格。
- 找到以
-models结尾的水桶(与您的有效项目 ID 相关联),展开该水桶,然后向下钻取以验证fraud_model目录及其流水线阶段是否存在。
本部分回顾:您使用代理创建了 PySpark ML 训练流水线,在经过丰富处理的 BigQuery 表上训练了随机森林模型,并将该模型导出到了 Cloud Storage。
6. 批量推理和 Cloud Spanner 写入
借助存储在 Cloud Storage 中的经过训练的预测模型,您将对通过 BigQuery 流入的新交易运行批量推理。高风险交易需要路由到运营系统,以便合规团队进行审核。Cloud Spanner 为此审核队列提供可扩缩的事务型数据库。
生成批量推理笔记本
使用代理创建连接 BigQuery、Cloud Storage 和 Cloud Spanner 的推理笔记本:
- 打开智能客服聊天窗格。
- 提供以下提示:
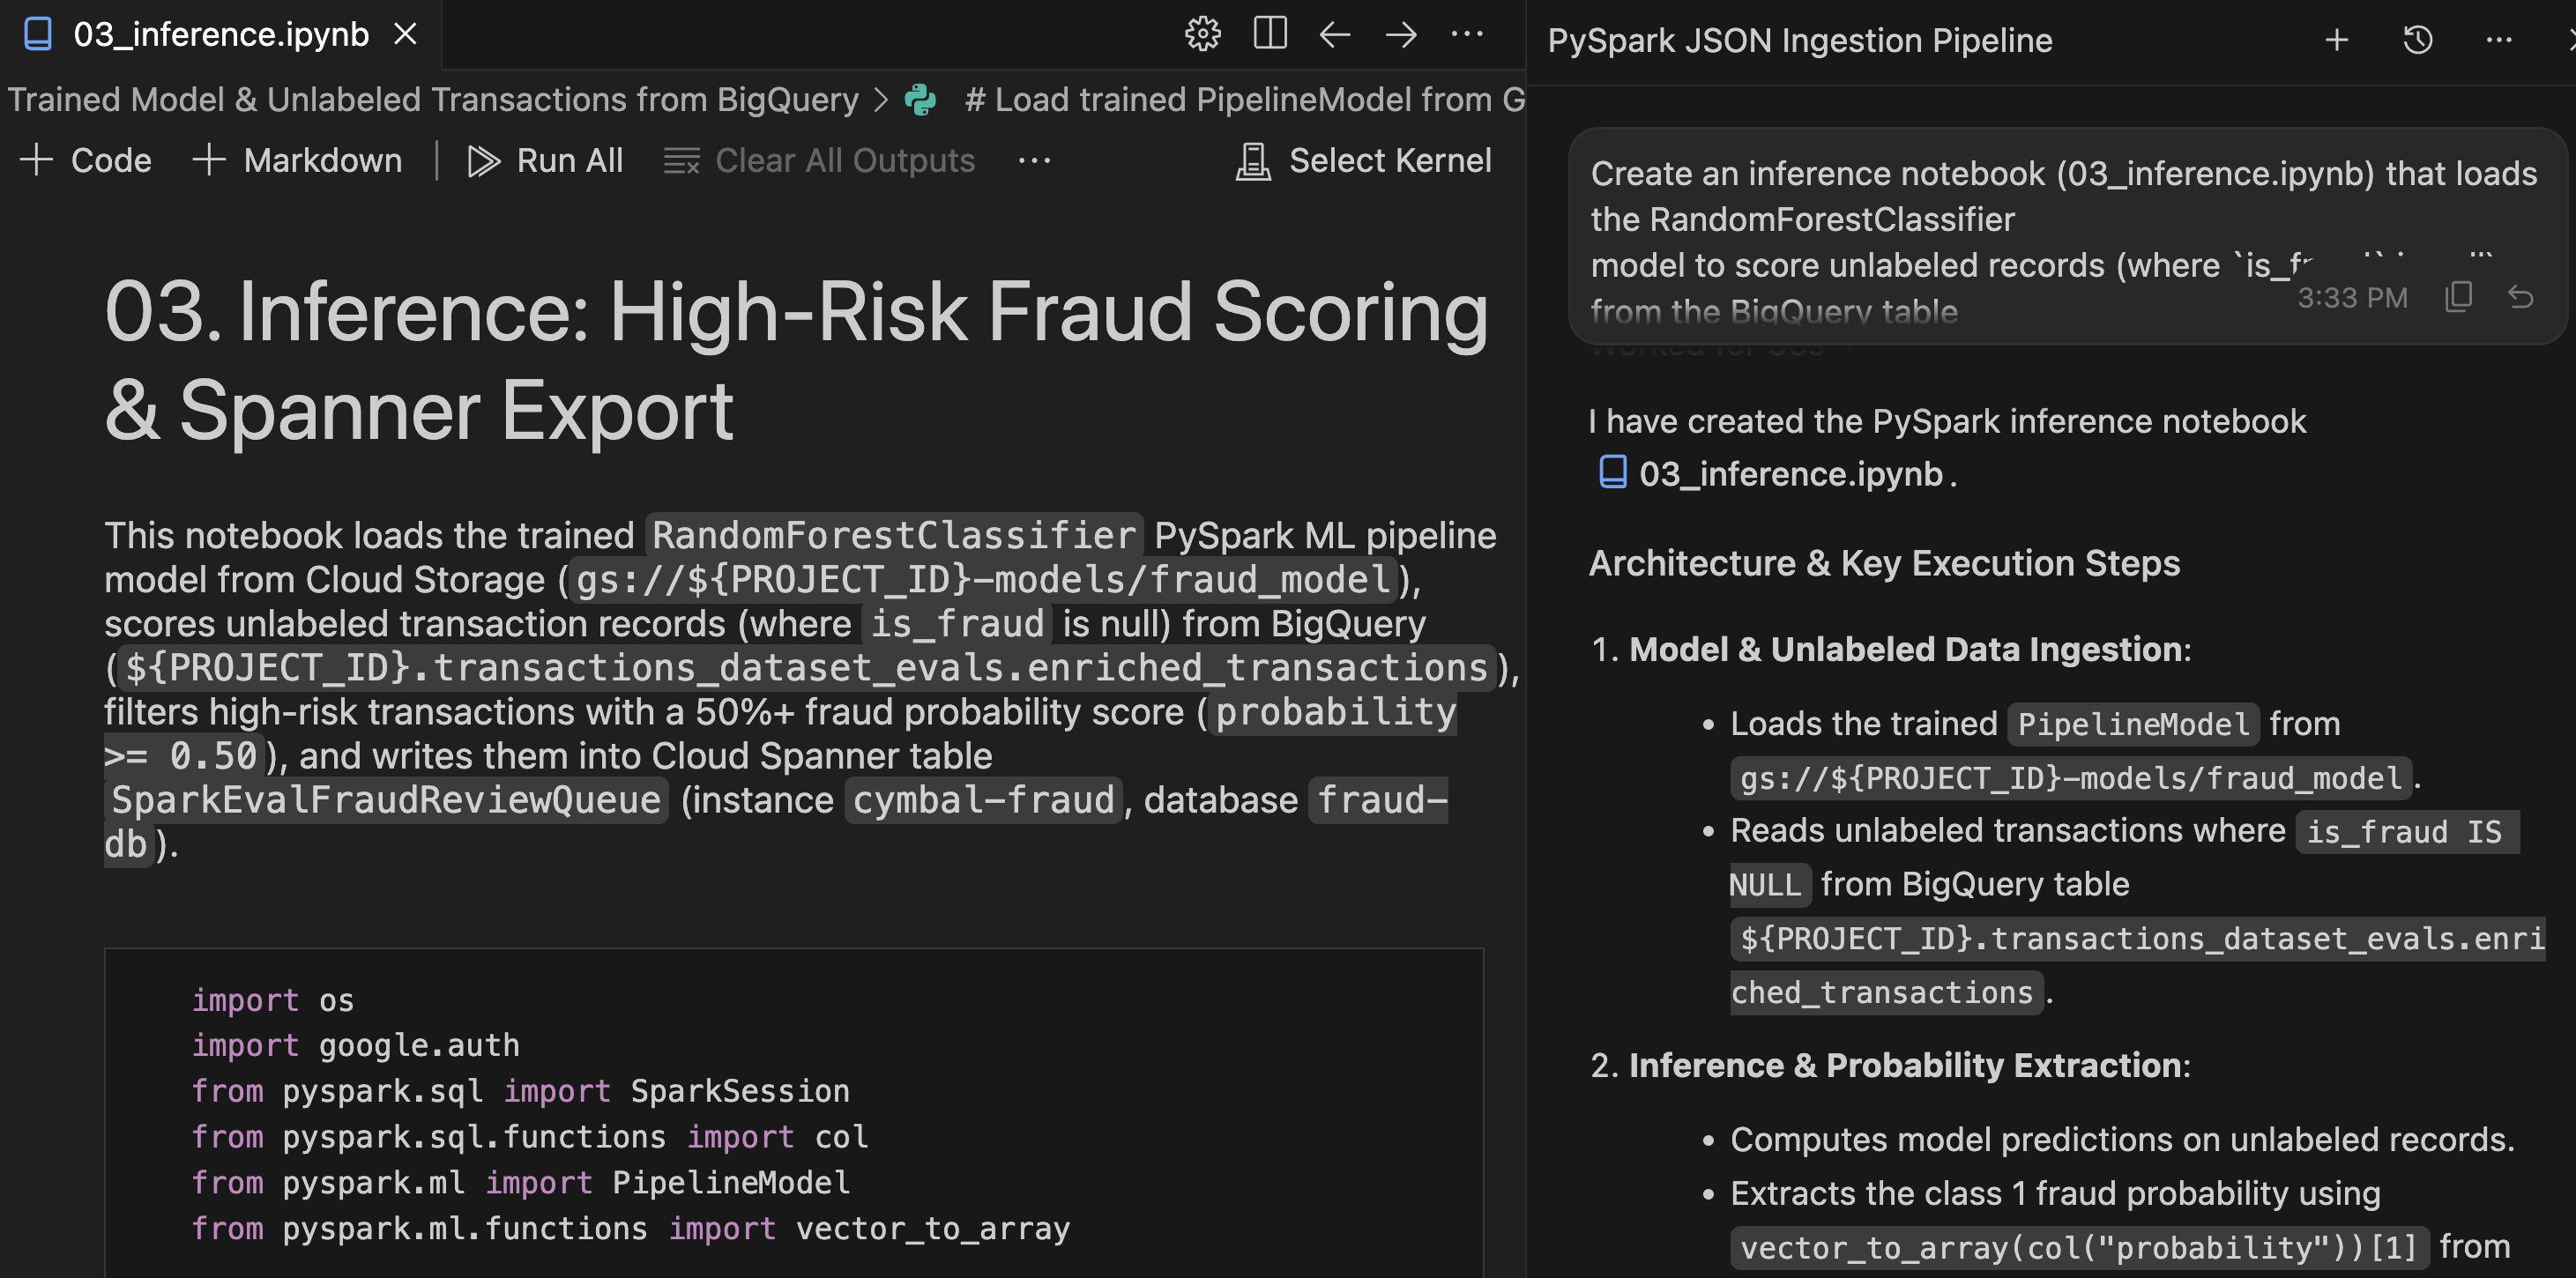
Create an inference notebook (03_inference.ipynb) that loads the RandomForestClassifier
model to score unlabeled records (where `is_fraud` is null) from the BigQuery table
`transactions_dataset_evals`.`enriched_transactions`.

Filter for high-risk transactions with a 50%+ fraud probability score (probability >= 0.50)
and write them to the Cloud Spanner table SparkEvalFraudReviewQueue in the cymbal-fraud instance
under fraud-db.
- 接受生成的笔记本,将
notebooks/03_inference.ipynb保存到工作区。
查看并执行笔记本
- 在编辑器中打开新生成的
notebooks/03_inference.ipynb。 - 查看 PySpark 推理序列:
- 依赖项:无服务器运行时模板提供 Spark 执行所需的
cloud-spannerJAR 依赖项。 - 数据格式设置:脚本会在写入之前舍弃复杂的 Spark ML 向量列(例如原始特征和概率),以匹配 Spanner 表架构。
- Spanner 连接器:它使用
.format("cloud-spanner")写入标记的行,以直接附加到审核队列。
- 依赖项:无服务器运行时模板提供 Spark 执行所需的
- 点击 IDE 的笔记本工具栏中的全部运行。
- 当系统提示您选择内核时,请选择 fraud-pipeline-runtime on Serverless Spark。
验证
推理笔记本处理完毕后,您可以在 IDE 中直接查询 Spanner 运营数据库:
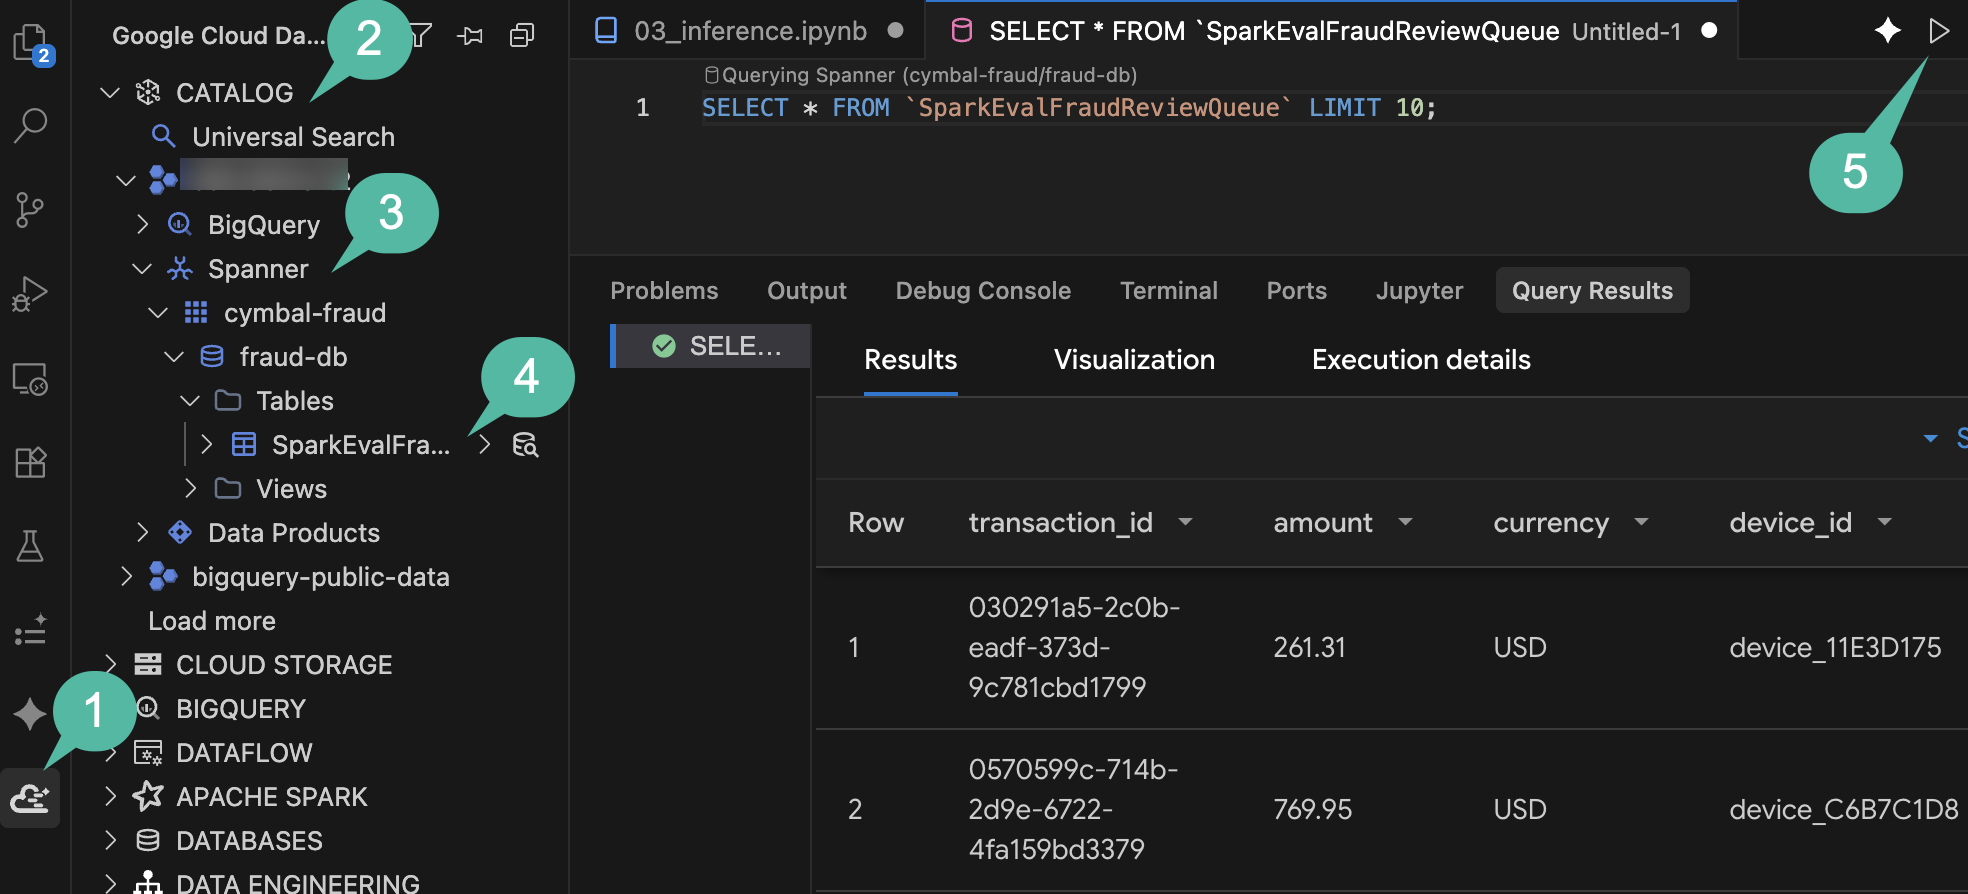
- 在 IDE 活动栏中,打开 Google Cloud Data Agent Kit 面板。
- 展开目录部分。
- 展开您的项目 ID,然后展开 Spanner。
- 依次前往
cymbal-fraud->fraud-db->Tables->SparkEvalFraudReviewQueue。 - 右键点击该表,然后选择查询表,接着执行查询:
SELECT *
FROM `SparkEvalFraudReviewQueue`
LIMIT 100;
- 在下方的查询结果窗格中,您应该会看到新插入的行,这些行表示标记为需要人工审核的高风险交易。
部分总结:您使用代理创建了批次推理笔记本,使用训练好的模型对未标记的 BigQuery 记录进行了评分,并将高风险交易直接写入 Cloud Spanner。
7. 使用 Managed Airflow 进行框架搭建和编排
您的流水线目前包含多个离散步骤:一个注入笔记本、一个 dbt 转换项目和一个批量推理笔记本。为了让此工作流可用于生产环境,您需要将它们拼接成一个预定依赖关系图。
Managed Service for Apache Airflow(以前称为 Cloud Composer)可为此工作流提供托管式编排引擎。Data Agent Kit 包含一项 Orchestration Pipelines 功能,可将声明式 YAML 流水线定义直接转换为 Airflow DAG。
定义流水线
使用代理生成编排流水线配置:
- 在智能体对话中,提供以下提示(请记得替换
${PROJECT_ID}):
Initialize and define an orchestration pipeline (fraud_analysis_pipeline) triggering
the ingestion notebook, dbt project, and inference notebook in sequential order.
For Dataproc Serverless engine configs in us-central1, use resourceProfile.inline
(defining properties with spark.jars: "gs://spark-lib/spanner/spark-3.5-spanner-1.4.0.jar"
for inference) rather than resourceProfile.path or overrides.

Set the schedule interval to run daily at midnight, and use
gs://${PROJECT_ID}-airflow-artifacts for artifact storage.
查看 DAG 配置
Data Agent Kit 编排器使用声明式 YAML 配置来定义流水线并将其部署到 Apache Airflow,从而允许通过 CI/CD 对定义进行版本控制和部署。
在 IDE 探索器窗格中,查看代理在工作区根目录中生成的两个流水线文件:
deployment.yaml:打开此文件。此文件用作您的环境注册表。它将逻辑dev流水线映射到cymbal-airflow环境,设置执行区域 (us-central1),并定义用于暂存已编译 DAG 和依赖项的artifact_storage存储分区。fraud_analysis_pipeline.yaml:打开此文件。这定义了执行图。它指定了触发器时间表 (interval: '0 0 * * *'),并按顺序执行actions代码块下的三个步骤:- 在 Dataproc Serverless 上运行的
01_ingestion.ipynb的提取notebook操作。 - 以
dbt_project目录为目标的转换pipeline操作,具有指向提取步骤的dependsOn依赖项。 - 针对
03_inference.ipynb的推理notebook操作,具有指向 dbt 步骤的dependsOn依赖项,用于捆绑 Spanner JAR 属性。
- 在 Dataproc Serverless 上运行的
- 代理还会将这些生成的制品汇总到编辑器窗格的 Walkthrough(演练)标签页中,其中会列出执行的配置和验证。
交互式 DAG 配置
Data Agent Kit 会将流水线配置呈现为交互式可视化图表,以便检查和修改 Airflow DAG 属性。
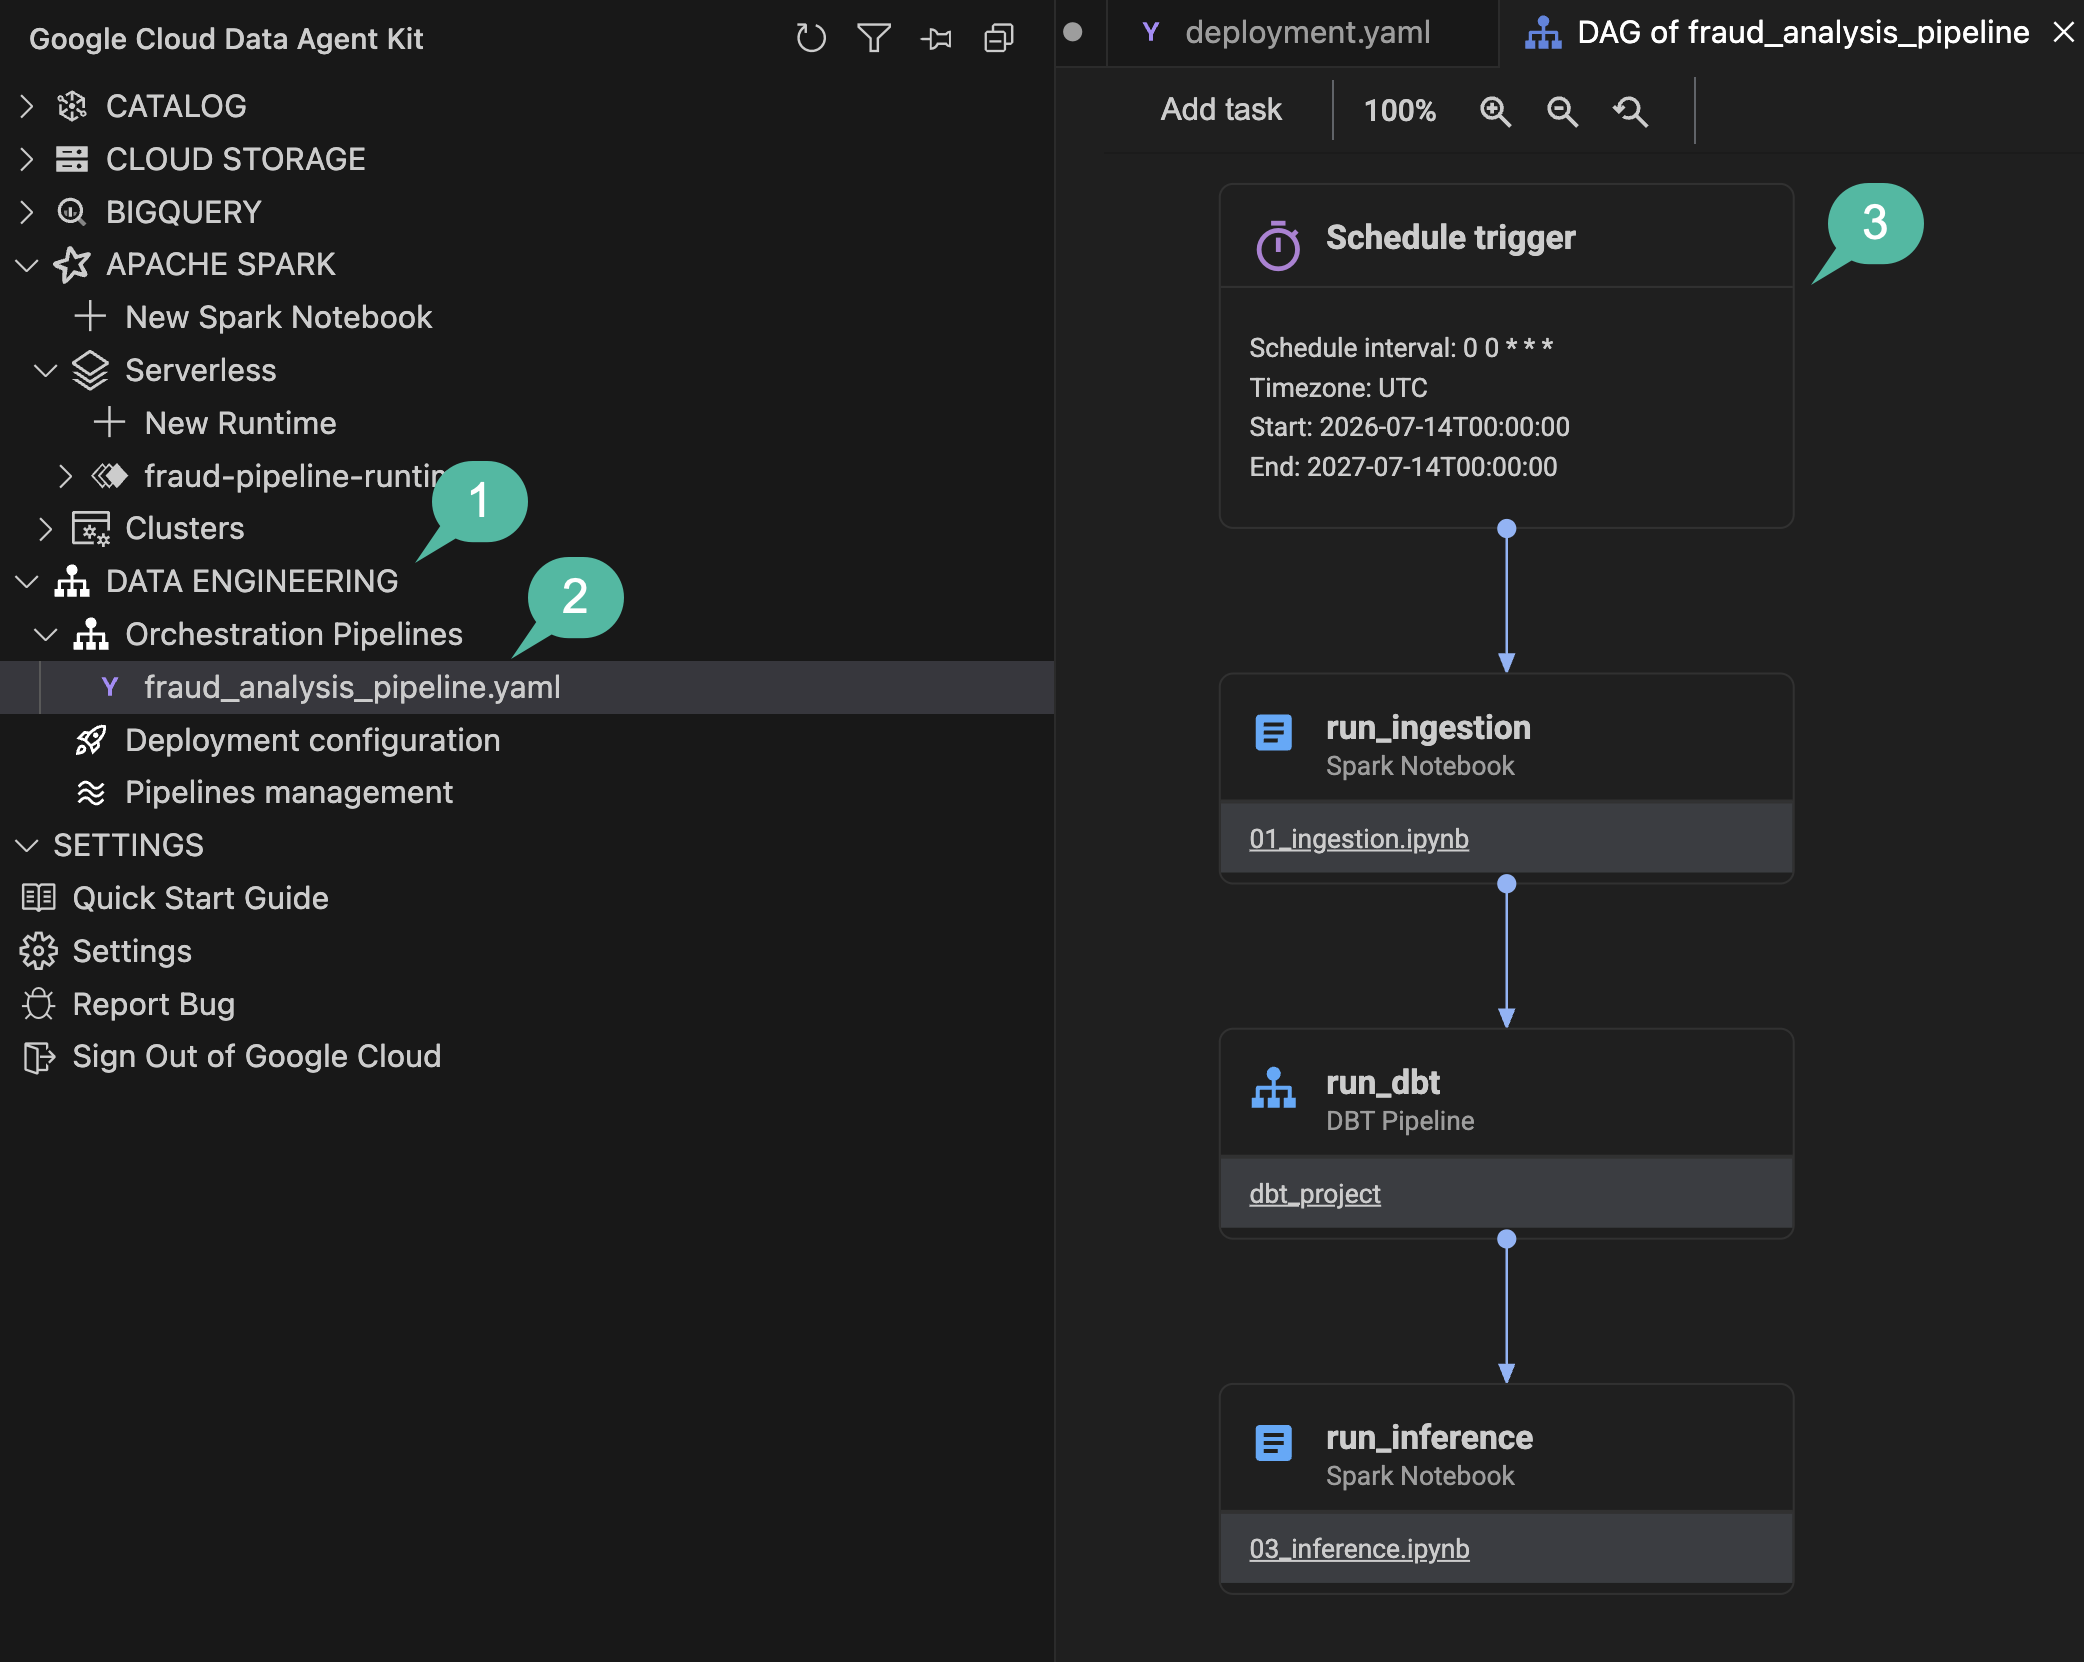
- 在 IDE 活动栏中,打开 Google Cloud Data Agent Kit 面板。
- 在
DATA ENGINEERING下,展开Orchestration Pipelines。 - 点击
fraud_analysis_pipeline.yaml以在主编辑器中打开可视化 DAG 画布。
- 点击顶部的
Schedule trigger节点。右侧会打开一个配置弹出式菜单,其中显示已解析的 Cron 字符串 (0 0 * * *),并允许您调整回填和追赶等参数。 - 点击任一笔记本任务节点(例如提取或推理步骤)。弹出式菜单会更新,以显示具体的 Dataproc Serverless 执行映射和连接器属性。
- 请注意节点块内的笔记本文件名超链接(例如
01_ingestion.ipynb)。点击该链接即可直接在编辑器中打开笔记本。 - 在左侧边栏中的“Orchestration Pipelines”下方,点击
Deployment configuration。此视图显示了目标dev环境集群和输出 GCS 存储分区制品。
部分总结:您使用代理生成了编排流水线配置,在交互式可视化画布中定义了提取、dbt 和推理任务之间的依赖关系。
8. 部署、执行和监控
在本地定义 DAG 后,您将连接到设置期间预配的 Managed Airflow 环境并部署流水线。
配置 Managed Service for Apache Airflow
在部署之前,请在 Data Agent Kit 设置中配置调度程序连接,以便扩展程序以您的 Managed Airflow 环境为目标:
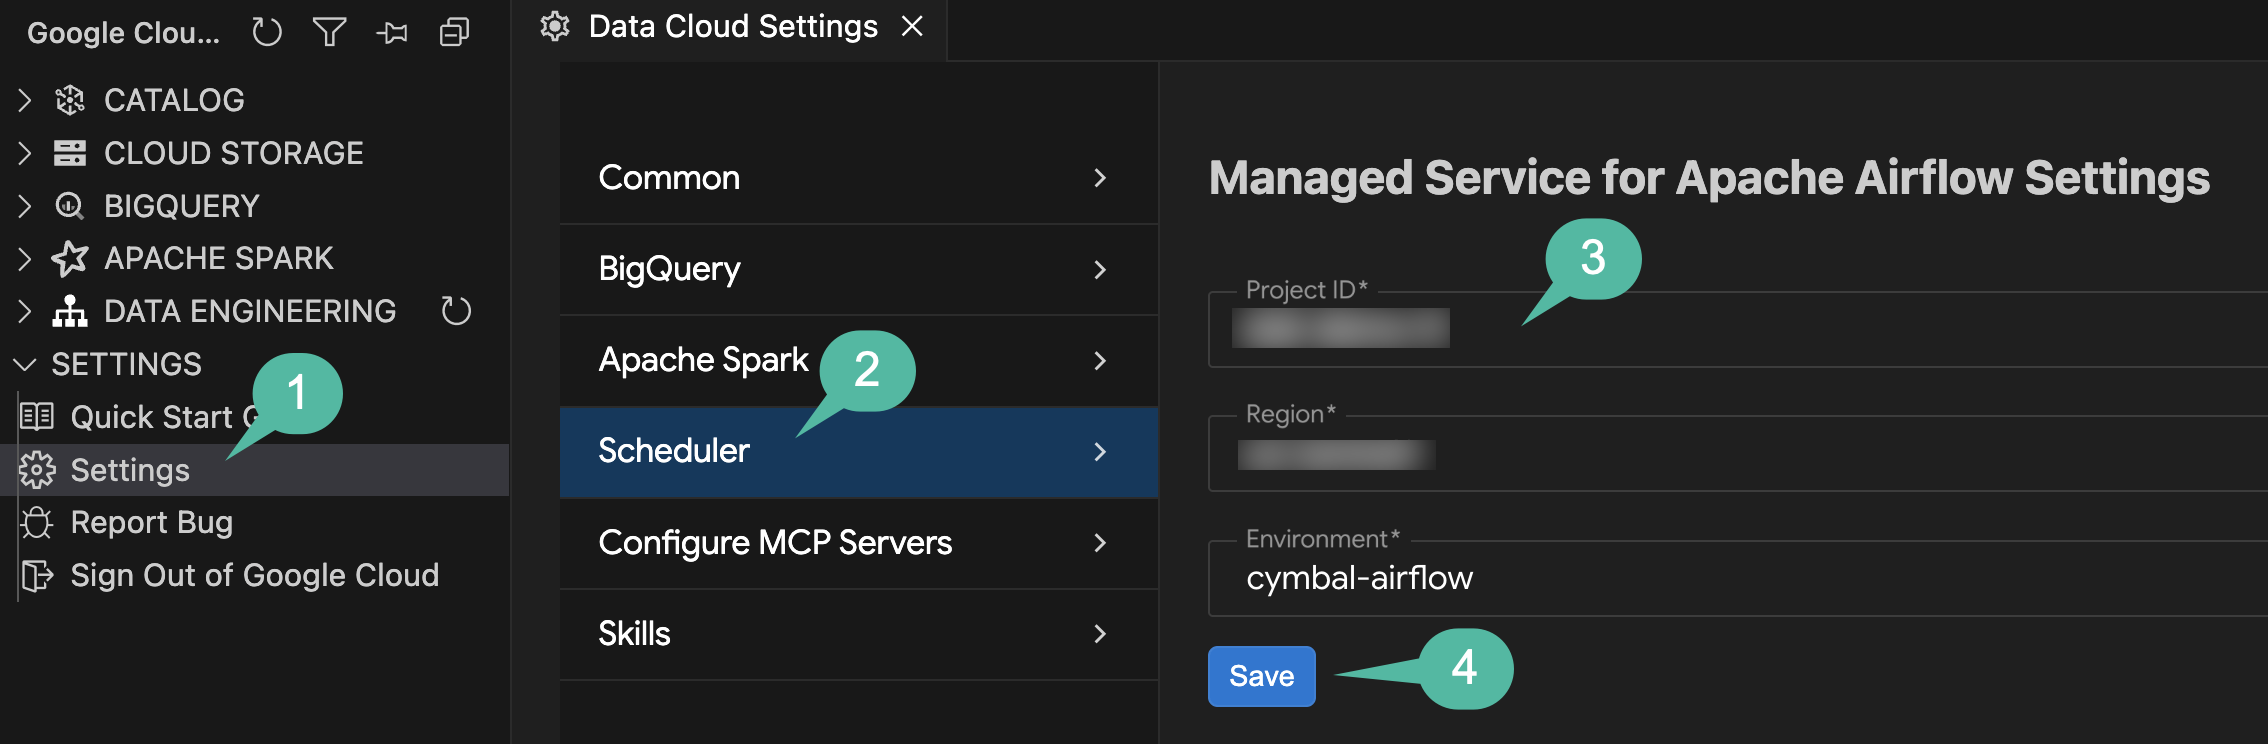
- 在 IDE 活动栏中,打开 Google Cloud Data Agent Kit 面板。
- 在
SETTINGS下,点击设置。 - 从左侧菜单中选择调度程序。
- 配置设置:
- 项目 ID:选择您的有效项目 ID。
- 区域:选择
us-central1。 - 环境:选择
cymbal-airflow。
- 点击保存。
部署 DAG
现在,您将直接从可视化画布将配置的流水线部署到 Managed Airflow 环境:
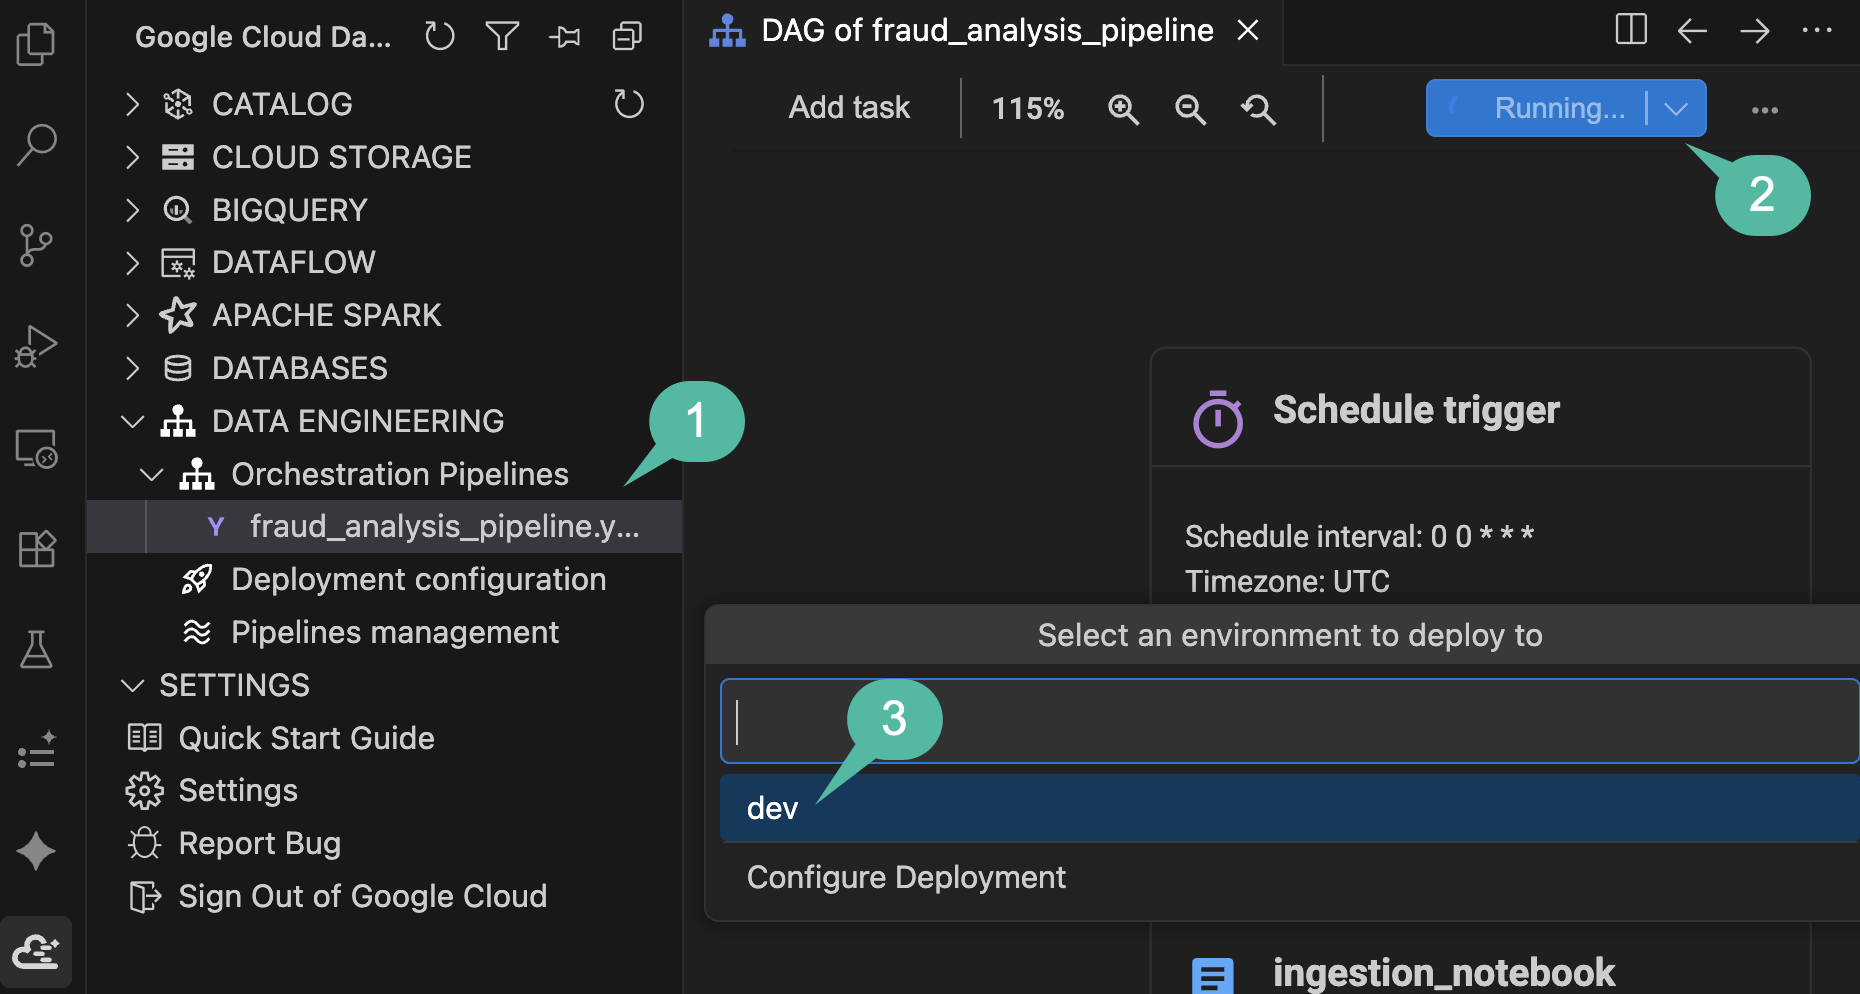
- 在 Google Cloud Data Agent Kit 边栏中,依次展开
DATA ENGINEERING>Orchestration Pipelines,然后点击fraud_analysis_pipeline.yaml以打开可视化 DAG 画布。 - 在画布工具栏的右上角,点击蓝色运行流水线按钮。
- 在环境下拉选择器中,选择
dev。 - 观察底部状态区域 (
Running pipeline: Building pipeline locally...) 中的进度通知。该扩展程序会自动编译您的 DAG、打包笔记本和 dbt 资源,并将它们上传到您的 Managed Airflow 环境的 GCS 存储分区(此过程大约需要 3-4 分钟才能完成)。
监控运行
本地编译完成后,系统会显示一条弹出式通知,确认 Triggered a new run for pipeline... successfully,然后监控实时执行情况:
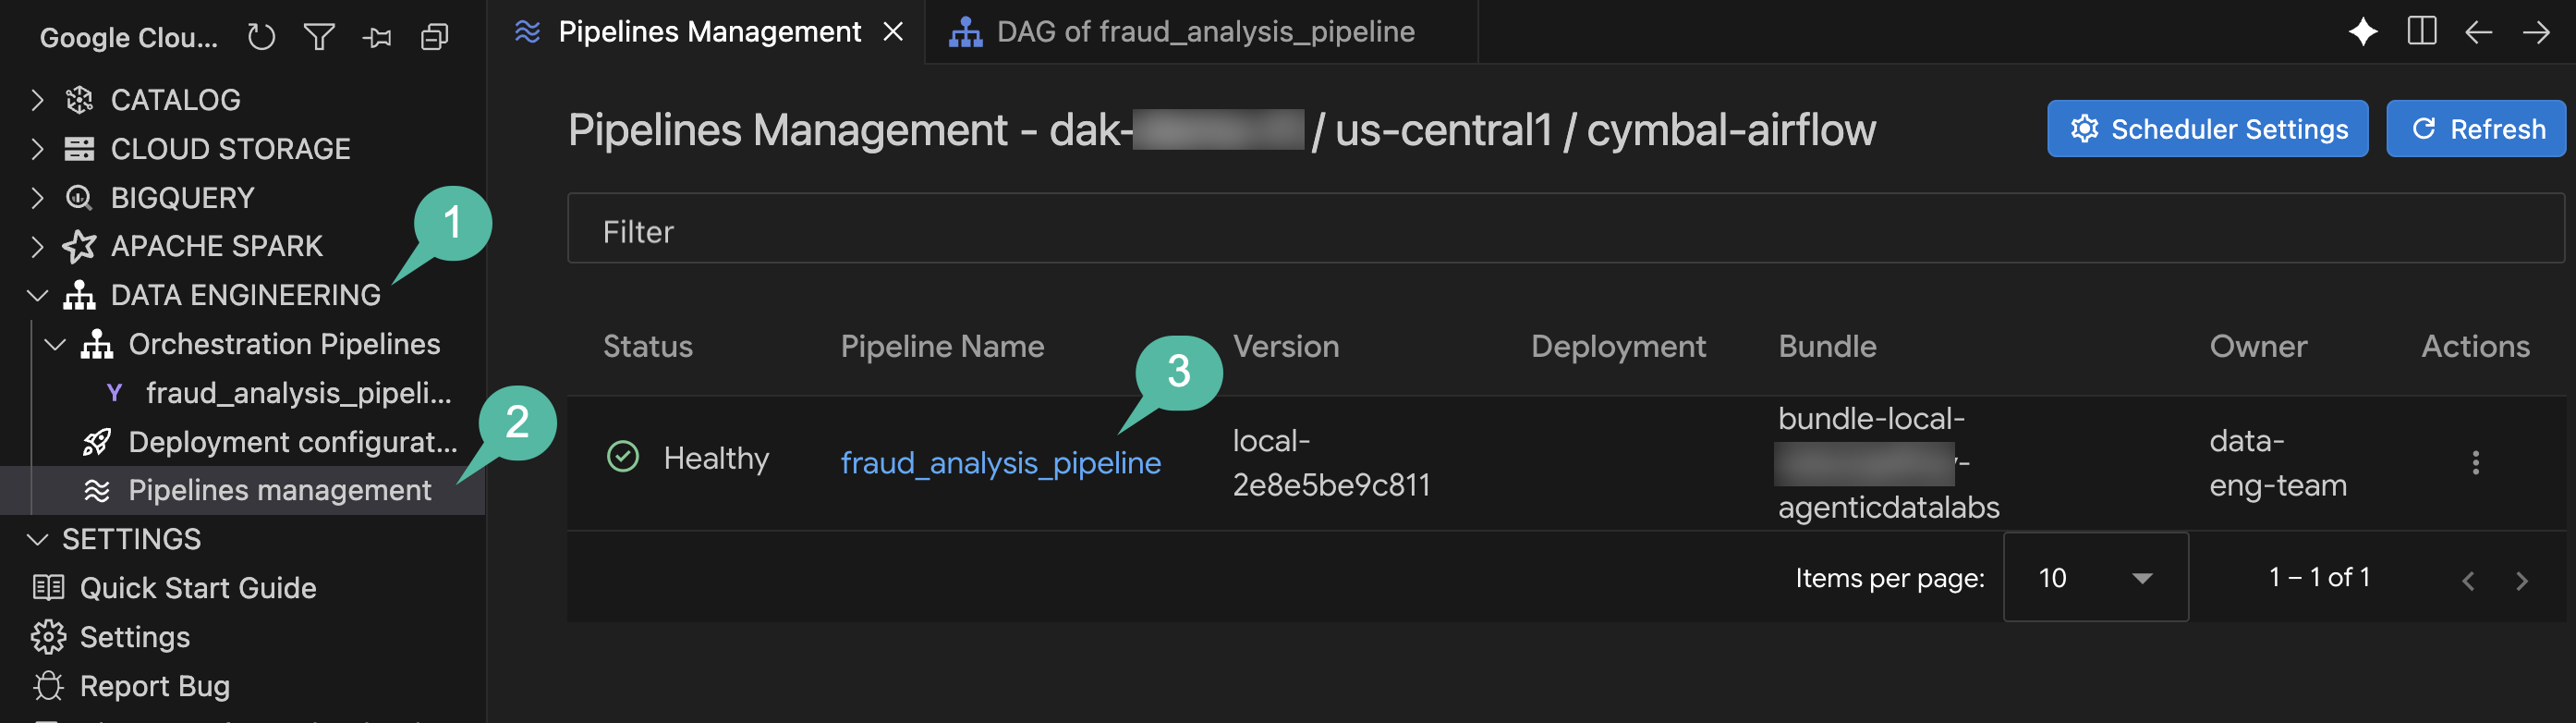
- 在 Google Cloud Data Agent Kit 边栏中,依次展开
DATA ENGINEERING>Orchestration Pipelines。 - 点击流水线管理。
- 在“流水线管理”表格中,点击
fraud_analysis_pipeline以打开其执行历史记录。
- 在执行历史记录视图中,从日历中选择正在进行的跑步活动。
- 随着执行在每个流水线任务(提取、dbt 转换和推理)中推进,状态指示器会更新,任务时长会填充。点击任意任务即可检查其实时执行输出和 Airflow DAG 日志。
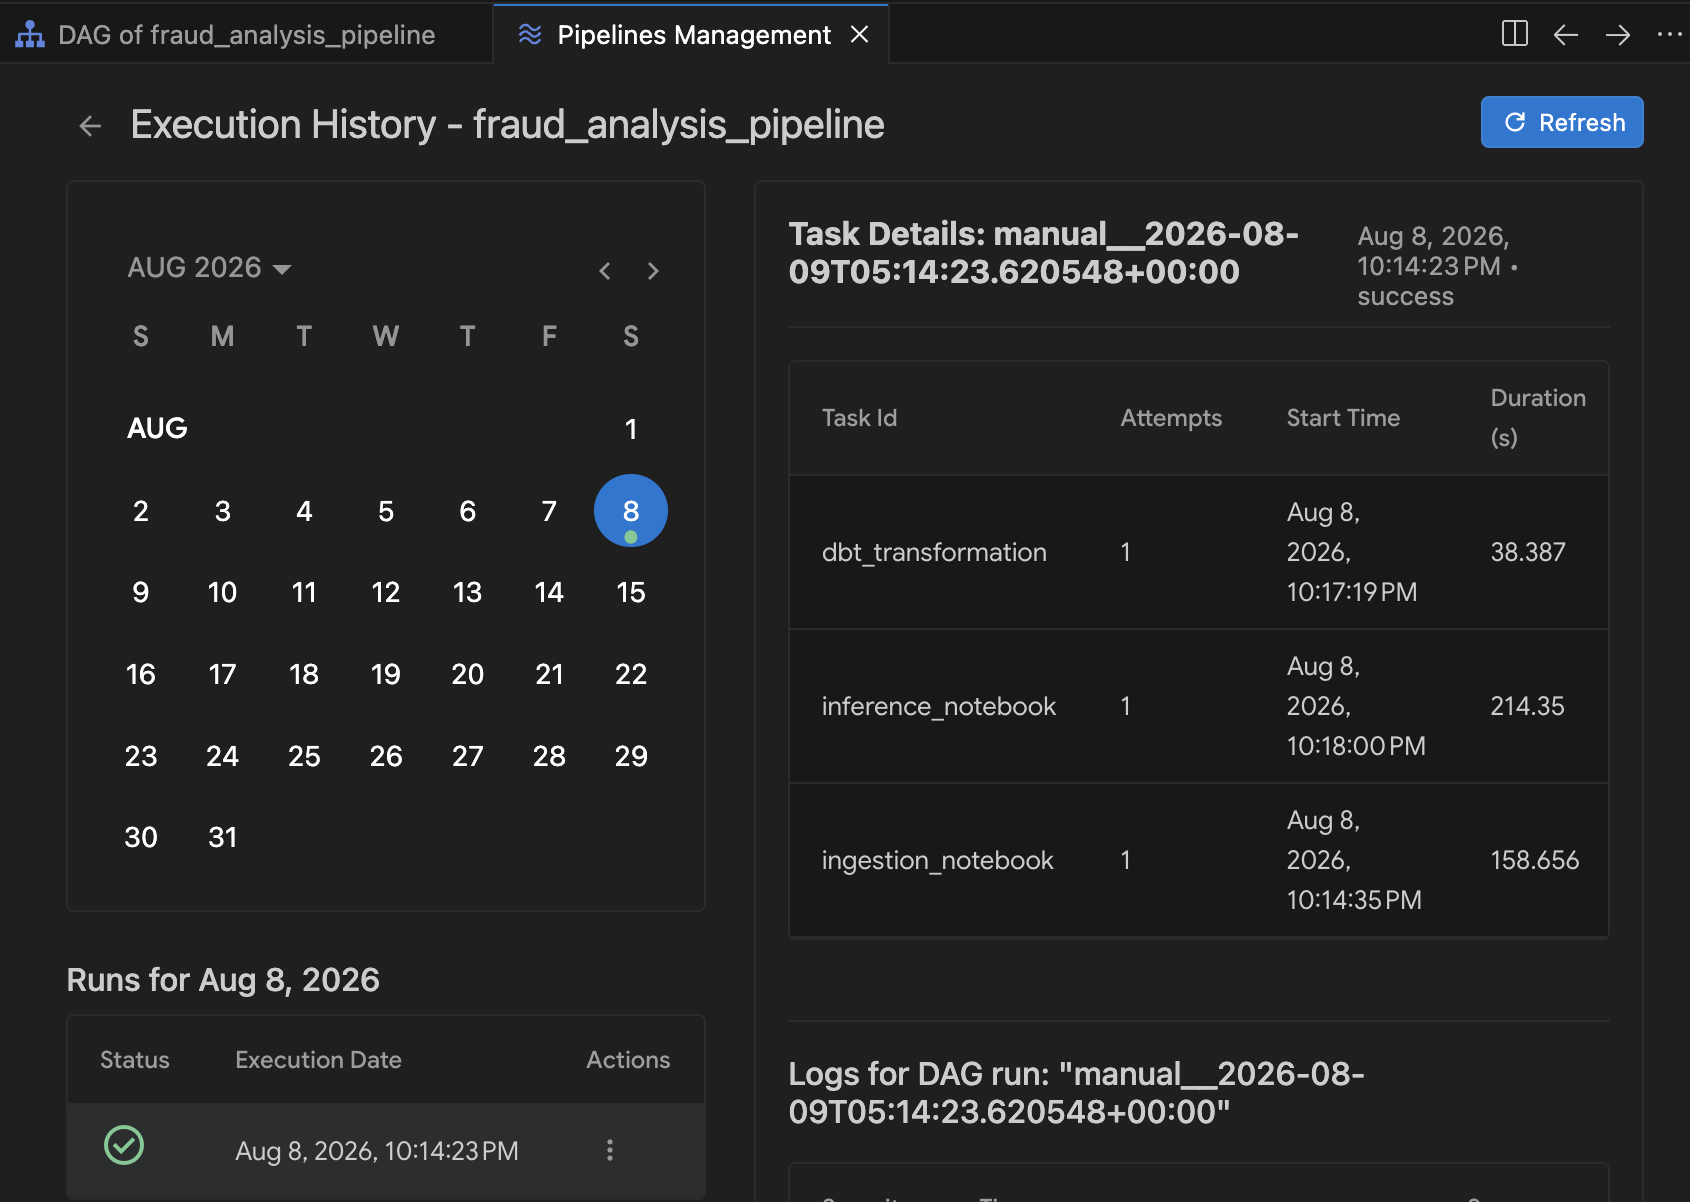
本部分总结:您配置了 Airflow 调度程序连接,将端到端分析流水线部署到托管 Airflow,并监控了实时执行情况,验证了从原始日志到最终 Cloud Spanner 预测的整个系统。
9. 清理
为避免系统因本 Codelab 中使用的资源而持续向您的 Google Cloud 项目收取费用,请使用自动化脚本拆除环境。
- 在终端面板(或 Cloud Shell)中,前往脚本目录并执行以下命令:
cd ~/devrel-demos/codelabs/agentic-data-labs/data-science/scripts
chmod +x teardown.sh
./teardown.sh
- 脚本将列出计划删除的所有资源,并提示您进行确认:
- Managed Airflow 环境 (
cymbal-airflow) - Cloud Spanner 实例 (
cymbal-fraud) - BigQuery 数据集 (
transactions_dataset_evals) - Cloud Storage 存储分区(
gs://${PROJECT_ID}-fin-clearing-raw和gs://${PROJECT_ID}-models) - Worker Service Account (
composer-worker-sa)
- Managed Airflow 环境 (
- 请输入
y进行确认。拆解脚本将移除所有已配置的 GCP 服务并清理本地文件。
10. 恭喜!
您已在 Antigravity IDE 中与 Google Cloud Data Agent Kit 结对编程,构建了一个端到端的欺诈检测流水线,该流水线涵盖 Cloud Storage、BigQuery、Managed Service for Apache Spark (Spark Serverless)、dbt、Cloud Spanner 和 Managed Service for Apache Airflow。
您完成的任务
- 📥 使用 Managed Service for Apache Spark 和 Data Agent Kit 将原始交易日志提取到 BigQuery 表中。
- 🧹 通过创建包含数据质量测试的 dbt 项目,对数据进行去重和归一化处理。
- 🤖 使用
RandomForestClassifier训练了分布式随机森林模型,并将训练后的模型导出到 Cloud Storage。 - ⚡ 对传入的交易执行了批量推理,并将高风险记录路由到 Cloud Spanner 以供审核。
- 🔄 使用 Managed Service for Apache Airflow 和 IDE 的可视化 DAG 管理工具,将工作流编排、部署和监控为已调度的 Airflow DAG。
主要概念
概念 | 要点回顾 |
在 IDE 中使用自然语言进行结对编程,以生成 PySpark Notebook、配置 dbt 模型和定义 Airflow DAG | |
可伸缩的表格存储空间,适用于分析型 SQL、dbt 转换和机器学习训练 | |
以无服务器方式执行分布式 PySpark 数据加载和随机森林 ML 训练 | |
将批量 Spark 推理预测结果直接写入运营数据库审核队列 | |
YAML DAG 声明 | 在 IDE 中以交互式 Airflow 可视化图表的形式呈现声明式流水线定义 |
可视化 DAG 管理 | 在 IDE 中检查流水线依赖项、部署到Managed Airflow 并监控实时任务执行历史记录 |
后续步骤
- 探索 Google Cloud Data Agent Kit 文档
- 详细了解 Managed Service for Apache Spark
- 详细了解 Managed Service for Apache Airflow
- 使用 Antigravity IDE 构建自己的多服务流水线