

1. نظرة عامة
في هذا الدرس التطبيقي حول الترميز، ستنشئ تطبيقًا قابلاً للتوسّع للبحث في قاعدة المعرفة. بدلاً من إدارة مسار ETL معقّد باستخدام نصوص برمجية وحلقات تكرار بلغة Python لإنشاء تضمينات المتّجهات، ستستخدم AlloyDB AI لمعالجة إنشاء التضمينات بشكلٍ أصلي داخل قاعدة البيانات باستخدام أمر SQL واحد.
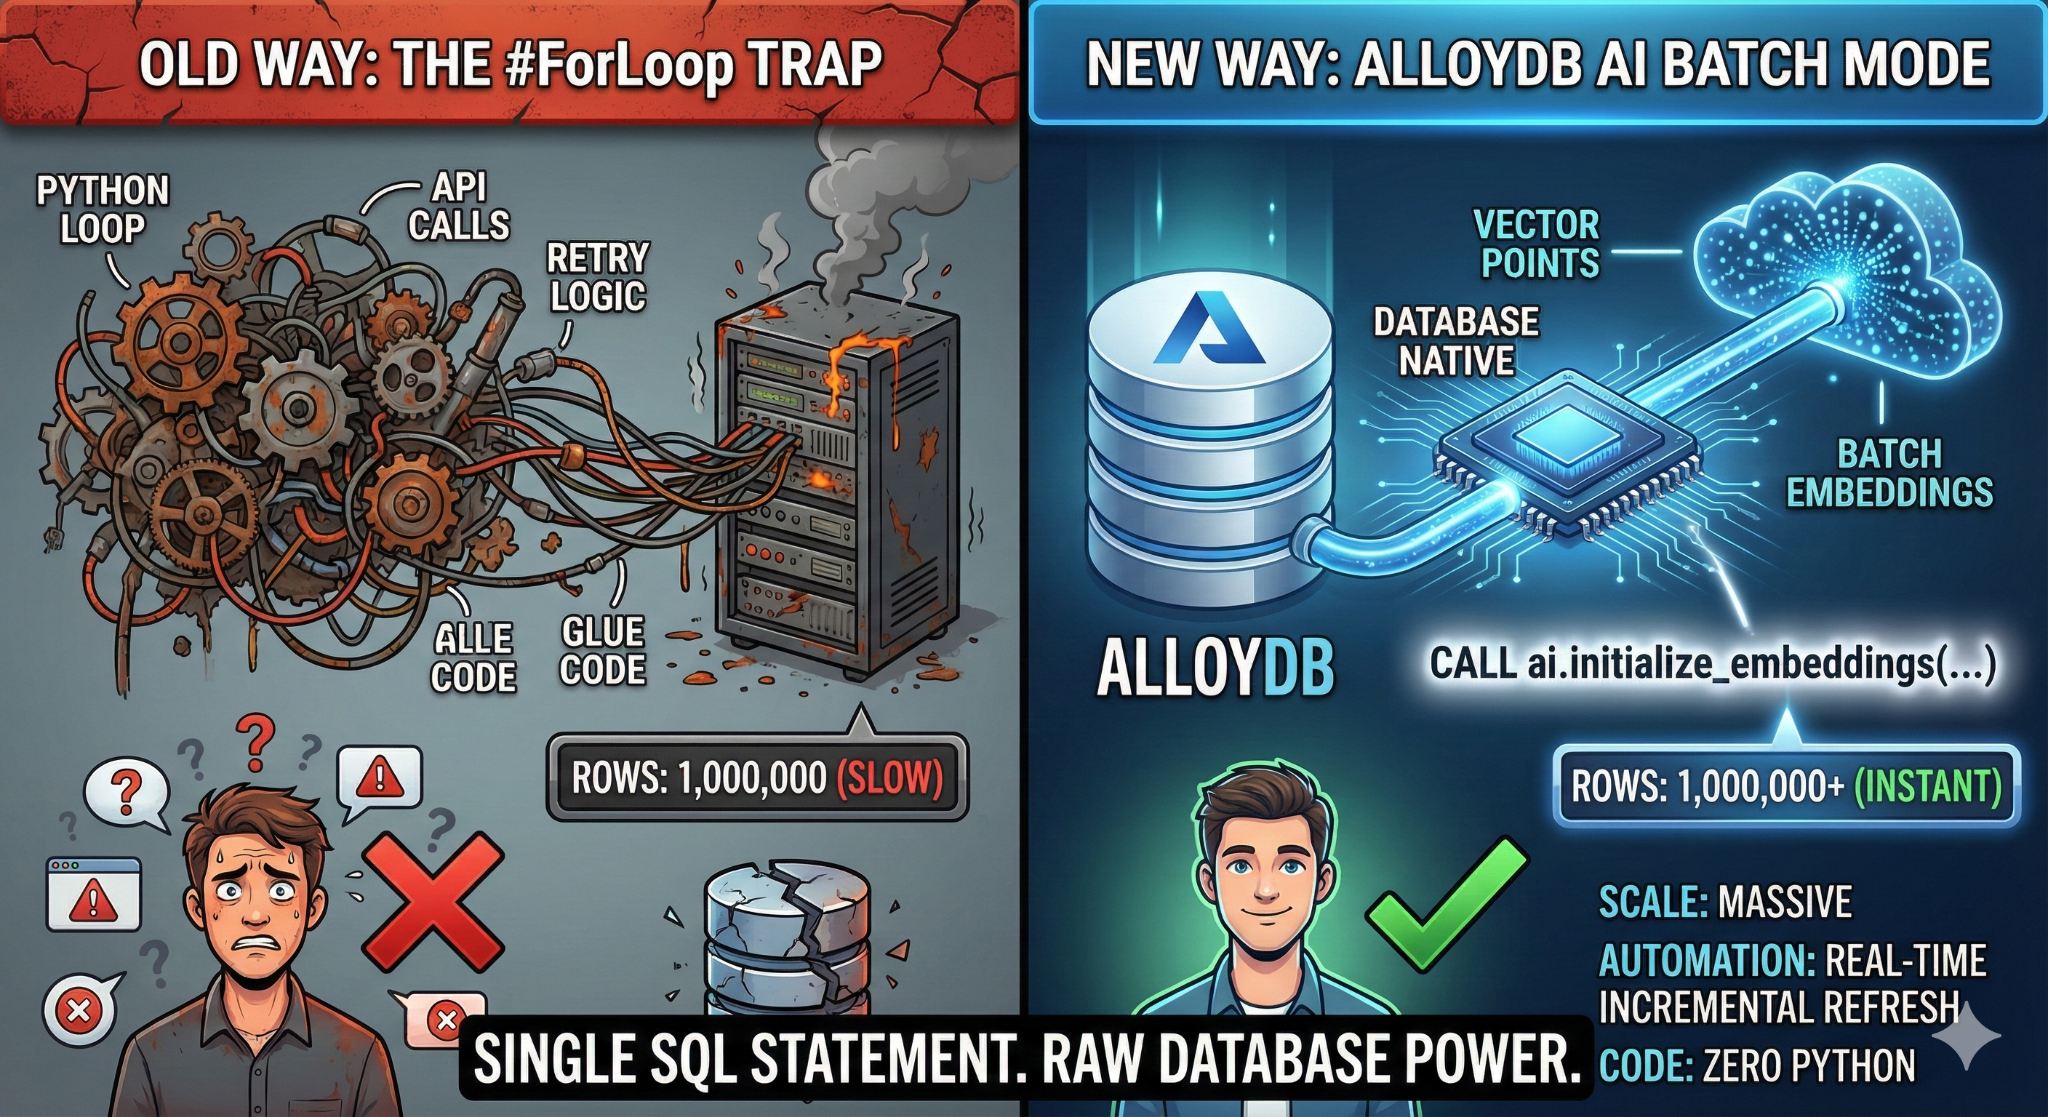
ما ستقوم بإنشائه
تطبيق قاعدة بيانات "قابل للبحث" عالي الأداء.
أهداف الدورة التعليمية
ستتعرّف على كيفية:
- توفير مجموعة AlloyDB وتفعيل إضافات الذكاء الاصطناعي
- إنشاء بيانات اصطناعية (أكثر من 50,000 صف) باستخدام SQL
- تعبئة تضمينات المتجهات لمجموعة البيانات بأكملها باستخدام المعالجة على دفعات
- إعداد مشغّلات تزايدية في الوقت الفعلي لتضمين البيانات الجديدة تلقائيًا
- أجرِ بحثًا مختلطًا (فلاتر المتجهات وفلاتر SQL) عن "Flexing Context".
المتطلبات
2. قبل البدء
إنشاء مشروع
- في Google Cloud Console، في صفحة "أداة اختيار المشاريع"، اختَر مشروعًا على Google Cloud أو أنشِئه.
- تأكَّد من تفعيل الفوترة لمشروعك على السحابة الإلكترونية. كيفية التحقّق من تفعيل الفوترة في مشروع
- ستستخدم Cloud Shell، وهي بيئة سطر أوامر تعمل في Google Cloud. انقر على "تفعيل Cloud Shell" في أعلى وحدة تحكّم Google Cloud.
- بعد الاتصال بـ Cloud Shell، تأكَّد من أنّه تمت مصادقتك وأنّ المشروع مضبوط على رقم تعريف مشروعك باستخدام الأمر التالي:
gcloud auth list
- نفِّذ الأمر التالي في Cloud Shell للتأكّد من أنّ أمر gcloud يتعرّف على مشروعك.
gcloud config list project
- إذا لم يتم ضبط مشروعك، استخدِم الأمر التالي لضبطه:
gcloud config set project <YOUR_PROJECT_ID>
- تفعيل واجهات برمجة التطبيقات المطلوبة: اتّبِع الرابط وفعِّل واجهات برمجة التطبيقات.
يمكنك بدلاً من ذلك استخدام أمر gcloud لإجراء ذلك. يُرجى الرجوع إلى المستندات للاطّلاع على أوامر gcloud واستخدامها.
gcloud services enable \
  alloydb.googleapis.com \
  compute.googleapis.com \
  cloudresourcemanager.googleapis.com \
  servicenetworking.googleapis.com \
  aiplatform.googleapis.com
المشاكل الشائعة وتحديد المشاكل وحلّها
متلازمة "المشروع الشبح" | لقد شغّلت |
The Billing Barricade | لقد فعّلت المشروع، ولكن نسيت حساب الفوترة. AlloyDB هو محرّك عالي الأداء، ولن يبدأ العمل إذا كان "خزان الوقود" (الفوترة) فارغًا. |
تأخّر انتشار واجهة برمجة التطبيقات | لقد نقرت على "تفعيل واجهات برمجة التطبيقات"، ولكن لا يزال سطر الأوامر يعرض |
Quota Quags | إذا كنت تستخدم حسابًا تجريبيًا جديدًا، قد تبلغ حصة إقليمية لمثيلات AlloyDB. إذا تعذّر تنفيذ " |
وكيل خدمة "مخفي" | في بعض الأحيان، لا يتم منح وكيل خدمة AlloyDB دور |
3- إعداد قاعدة البيانات
في هذا التمرين المعملي، سنستخدم AlloyDB كقاعدة بيانات لبيانات الاختبار. ويستخدم مجموعات للاحتفاظ بجميع الموارد، مثل قواعد البيانات والسجلّات. تحتوي كل مجموعة على مثيل أساسي يوفّر نقطة وصول إلى البيانات. ستحتوي الجداول على البيانات الفعلية.
لننشئ مجموعة ومثيل وجدول في AlloyDB حيث سيتم تحميل مجموعة البيانات الاختبارية.
- انقر على الزر أو انسخ الرابط أدناه إلى المتصفّح الذي سجّلت الدخول من خلاله إلى حساب مستخدم Google Cloud Console.
- بعد اكتمال هذه الخطوة، سيتم استنساخ المستودع إلى محرِّر Cloud Shell على جهازك وستتمكّن من تنفيذ الأمر أدناه من مجلد المشروع (من المهم التأكّد من أنّك في دليل المشروع):
sh run.sh
- الآن، استخدِم واجهة المستخدم (بالنقر على الرابط في الوحدة الطرفية أو النقر على رابط "المعاينة على الويب" في الوحدة الطرفية).
- أدخِل تفاصيل رقم تعريف المشروع وأسماء المجموعات والمثيلات للبدء.
- يمكنك تناول القهوة أثناء ظهور السجلّات، ويمكنك الاطّلاع على كيفية تنفيذ ذلك وراء الكواليس هنا. قد يستغرق ذلك من 10 إلى 15 دقيقة تقريبًا.
المشاكل الشائعة وتحديد المشاكل وحلّها
مشكلة "الصبر" | مجموعات قواعد البيانات هي بنية أساسية ثقيلة. إذا أعدت تحميل الصفحة أو أنهيت جلسة Cloud Shell لأنّها "تبدو عالقة"، قد ينتهي بك الأمر مع مثيل "شبح" تم توفيره جزئيًا ويستحيل حذفه بدون تدخّل يدوي. |
عدم تطابق المنطقة | إذا فعّلت واجهات برمجة التطبيقات في |
مجموعات Zombie | إذا سبق لك استخدام الاسم نفسه لمجموعة ولم تحذفها، قد يشير النص البرمجي إلى أنّ اسم المجموعة متوفّر حاليًا. يجب أن تكون أسماء المجموعات فريدة داخل المشروع. |
مهلة Cloud Shell | إذا استغرقت استراحة القهوة 30 دقيقة، قد ينتقل Cloud Shell إلى وضع السكون ويقطع عملية |
4. توفير المخطط
في هذه الخطوة، سنتناول ما يلي:
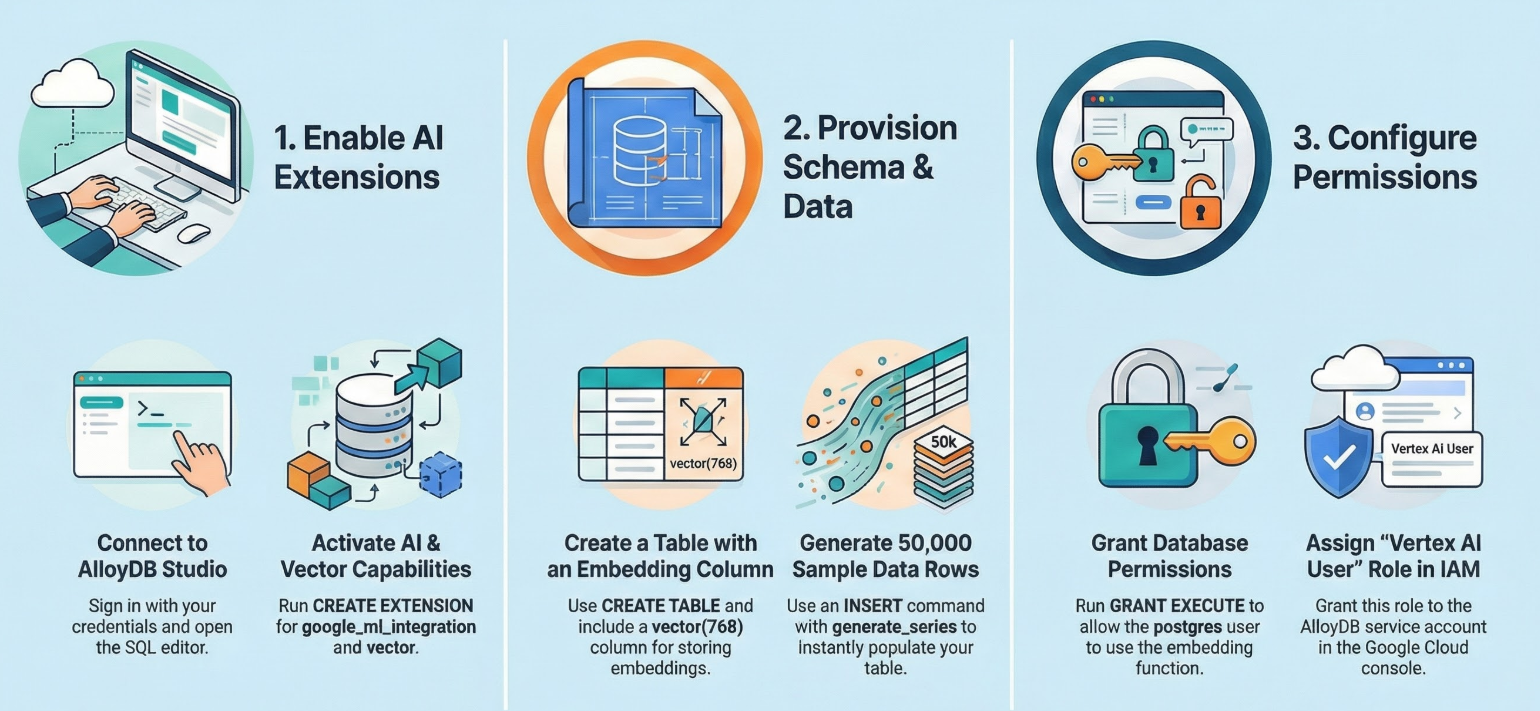
بعد تشغيل مجموعة AlloyDB ومثيلها، انتقِل إلى محرِّر SQL في AlloyDB Studio لتفعيل إضافات الذكاء الاصطناعي وتوفير المخطّط.
قد تحتاج إلى الانتظار حتى يكتمل إنشاء المثيل. بعد ذلك، سجِّل الدخول إلى AlloyDB باستخدام بيانات الاعتماد التي أنشأتها عند إنشاء المجموعة. استخدِم البيانات التالية للمصادقة على PostgreSQL:
- اسم المستخدم : "
postgres" - قاعدة البيانات : "
postgres" - كلمة المرور : "
alloydb" (أو أي كلمة مرور تم ضبطها في وقت الإنشاء)
بعد المصادقة بنجاح في AlloyDB Studio، يتم إدخال أوامر SQL في "المحرِّر". يمكنك إضافة نوافذ متعددة في "محرِّر الإعلانات" باستخدام علامة الجمع على يسار النافذة الأخيرة.
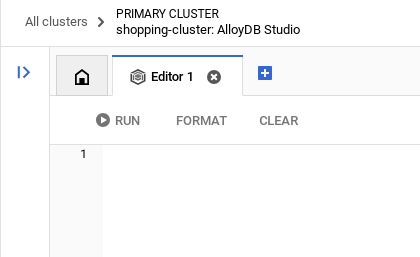
ستُدخل أوامر AlloyDB في نوافذ المحرِّر، باستخدام خيارات "تشغيل" (Run) و"تنسيق" (Format) و"محو" (Clear) حسب الحاجة.
تفعيل الإضافات
لإنشاء هذا التطبيق، سنستخدم الإضافتَين pgvector وgoogle_ml_integration. تتيح لك إضافة pgvector تخزين تضمينات المتّجهات والبحث فيها. توفّر الإضافة google_ml_integration دوال يمكنك استخدامها للوصول إلى نقاط نهاية التوقّعات في Vertex AI للحصول على توقّعات في SQL. فعِّل هذه الإضافات من خلال تشغيل لغات تعريف البيانات (DDL) التالية:
CREATE EXTENSION IF NOT EXISTS google_ml_integration CASCADE;
CREATE EXTENSION IF NOT EXISTS vector;
إنشاء جدول
نحتاج إلى مجموعة بيانات لتوضيح المقياس. بدلاً من استيراد ملف CSV، سننشئ 50,000 صف من "مقالات المساعدة" الاصطناعية على الفور باستخدام SQL.
يمكنك إنشاء جدول باستخدام عبارة DDL التالية في AlloyDB Studio:
-- 1. Create the table
CREATE TABLE help_articles (
    id SERIAL PRIMARY KEY,
    title TEXT,
    category TEXT,
    product_version TEXT,
    content_body TEXT,
    embedding vector(768) -- Dimension for text-embedding-005
);

-- 2. Generate 50,000 rows of synthetic data
INSERT INTO help_articles (title, category, product_version, content_body)
SELECT
    'Help Article ' || i,
    CASE
        WHEN i % 3 = 0 THEN 'Billing'
        WHEN i % 3 = 1 THEN 'Technical'
        ELSE 'General'
    END,
    CASE
        WHEN i % 2 = 0 THEN '2.0'
        ELSE '1.0'
    END,
    'This article covers common issues regarding ' ||
    CASE
        WHEN i % 3 = 0 THEN 'payment failures, invoice disputes, and credit card updates.'
        WHEN i % 3 = 1 THEN 'connection timeouts, latency issues, and API errors.'
        ELSE 'account profile settings, password resets, and user roles.'
    END
FROM generate_series(1, 50000) AS i;
سيسمح عمود item_vector بتخزين قيم المتجهات للنص.
التحقّق من البيانات:
SELECT count(*) FROM help_articles;
-- Output: 50000
تفعيل علامات قواعد البيانات
انتقِل إلى وحدة التحكّم في إعدادات المثيل، وانقر على "تعديل المثيل الأساسي"، ثم انتقِل إلى "الإعدادات المتقدّمة" وانقر على "إضافة علامات قاعدة البيانات".
إذا لم تكن كذلك، أدخِلها في القائمة المنسدلة "العلامات" واضبطها على "تفعيل" وعدِّل المثيل.
إذا لم تكن كذلك، أدخِلها في القائمة المنسدلة "العلامات" واضبطها على "تفعيل" وعدِّل المثيل.
خطوات ضبط علامات قواعد البيانات:
- في وحدة تحكّم Google Cloud، انتقِل إلى صفحة "المجموعات العنقودية".
- انقر على مجموعة في عمود اسم المورد.
- في صفحة نظرة عامة، انتقِل إلى المثيلات في المجموعة، واختَر مثيلاً، ثم انقر على تعديل.
- إضافة علامة قاعدة بيانات إلى مثيلك أو تعديلها أو حذفها:
إضافة علامة
- لإضافة علامة قاعدة بيانات إلى المثيل، انقر على "إضافة علامة".
- اختَر علامة من قائمة "علامة قاعدة بيانات جديدة".
- أدخِل قيمة للعَلم.
- انقر على "تم".
- انقر على تعديل المثيل.
- تأكَّد من أنّ إضافة google_ml_integration هي الإصدار 1.5.2 أو إصدار أحدث:
للتحقّق من إصدار الإضافة، استخدِم الأمر التالي:
SELECT extversion FROM pg_extension WHERE extname = 'google_ml_integration';
إذا كنت بحاجة إلى تحديث الإضافة إلى إصدار أعلى، استخدِم الأمر:
ALTER EXTENSION google_ml_integration UPDATE;
منح الإذن
- للسماح لمستخدم بإدارة عملية إنشاء التضمينات تلقائيًا، امنحه أذونات INSERT وUPDATE وDELETE في الجدولَين google_ml.embed_gen_progress وgoogle_ml.embed_gen_settings:
GRANT INSERT, UPDATE, DELETE ON google_ml.embed_gen_progress TO postgres;
"postgres" هو USER_NAME الذي يتم منح الأذونات له.
- نفِّذ العبارة التالية لمنح إذن التنفيذ على دالة "التضمين":
GRANT EXECUTE ON FUNCTION embedding TO postgres;
منح دور مستخدم Vertex AI لحساب خدمة AlloyDB
من وحدة تحكّم Google Cloud IAM، امنح حساب خدمة AlloyDB (الذي يبدو على النحو التالي: service-<<PROJECT_NUMBER>>@gcp-sa-alloydb.iam.gserviceaccount.com) إذن الوصول إلى الدور "مستخدم Vertex AI". سيحتوي PROJECT_NUMBER على رقم مشروعك.
بدلاً من ذلك، يمكنك تشغيل الأمر التالي من Cloud Shell Terminal:
PROJECT_ID=$(gcloud config get-value project)


gcloud projects add-iam-policy-binding $PROJECT_ID \
  --member="serviceAccount:service-$(gcloud projects describe $PROJECT_ID --format="value(projectNumber)")@gcp-sa-alloydb.iam.gserviceaccount.com" \
--role="roles/aiplatform.user"
المشاكل الشائعة وتحديد المشاكل وحلّها
حلقة "نسيان كلمة المرور" | إذا استخدمت إعداد "One Click" (نقرة واحدة) ولم تتمكّن من تذكُّر كلمة المرور، انتقِل إلى صفحة المعلومات الأساسية للمثيل في وحدة التحكّم وانقر على "Edit" (تعديل) لإعادة ضبط كلمة مرور |
خطأ "لم يتم العثور على الإضافة" | إذا تعذّر تنفيذ |
5- إنشاء المتّجهات "بخطوة واحدة"
هذا هو جوهر التمرين العملي. بدلاً من كتابة حلقة Python لمعالجة هذه الصفوف البالغ عددها 50,000، سنستخدم الدالة ai.initialize_embeddings.
ينفّذ هذا الأمر الواحد إجراءَين:
- تعبئة جميع الصفوف الحالية.
- إنشاء مشغّل لتضمين الصفوف المستقبلية تلقائيًا
نفِّذ عبارة SQL التالية من محرِّر طلبات البحث في AlloyDB
CALL ai.initialize_embeddings(
  model_id => 'text-embedding-005',
  table_name => 'help_articles',
  content_column => 'content_body',
  embedding_column => 'embedding',
  incremental_refresh_mode => 'transactional'
);
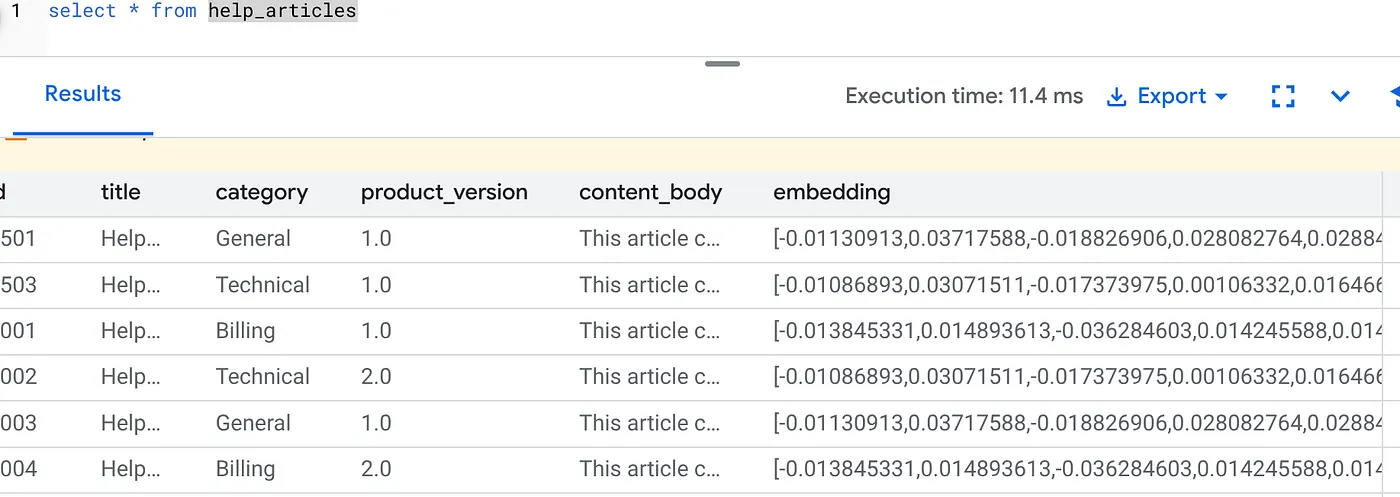
التحقّق من التضمينات
تأكَّد من ملء عمود embedding الآن:
SELECT id, left(content_body, 30), substring(embedding::text, 1, 30) as vector_partial
FROM help_articles;
من المفترض أن تظهر لك نتيجة مشابهة لما يلي:
ما الذي حدث للتو؟
- التعبئة التلقائية على نطاق واسع: تفحص هذه الميزة تلقائيًا صفوفك الحالية البالغ عددها 50,000 صف وتنشئ عمليات تضمين من خلال Vertex AI.
- التشغيل الآلي: من خلال ضبط incremental_refresh_mode => 'transactional'، يضبط AlloyDB المشغّلات الداخلية تلقائيًا. سيتم إنشاء تضمين لأي صف جديد يتم إدراجه في help_articles على الفور.
- يمكنك اختياريًا ضبط incremental_refresh_mode => ‘None' حتى تتمكّن من الحصول على العبارة لإجراء تعديلات مجمّعة واستدعاء ai.refresh_embeddings() يدويًا لتعديل تضمينات جميع الصفوف.
لقد استبدلت للتو قائمة انتظار Kafka، وعامل Python، ونص نقل البيانات بـ 6 أسطر من SQL. في ما يلي المستندات الرسمية المفصّلة لجميع السمات.
اختبار المشغّلات في الوقت الفعلي
لنتأكّد من أنّ عملية التشغيل الآلي "Zero Loop" تعمل مع البيانات الجديدة.
- إدراج صف جديد:
INSERT INTO help_articles (title, category, product_version, content_body)
VALUES ('New Scaling Guide', 'Technical', '2.0', 'How to scale AlloyDB to millions of transactions.');
- التحقّق على الفور:
SELECT embedding FROM help_articles WHERE title = 'New Scaling Guide';
النتيجة:
من المفترض أن يظهر لك المتجه الذي تم إنشاؤه على الفور بدون تشغيل أي نص برمجي خارجي.
حجم دفعة الضبط
في الوقت الحالي، يضبط AlloyDB حجم الدفعة تلقائيًا على 50. على الرغم من أنّ الإعدادات التلقائية تعمل بشكل رائع، لا يزال AlloyDB يمنح المستخدمين إمكانية التحكّم في ضبط الإعدادات المثالية للنموذج ومجموعة البيانات الفريدة.
CALL ai.initialize_embeddings(
  model_id => 'text-embedding-005',
  table_name => 'help_articles',
  content_column => 'content_body',
  embedding_column => 'embedding',
  incremental_refresh_mode => 'transactional',
  batch_size => 20
);
ومع ذلك، يجب أن يكون المستخدمون على دراية بحدود الحصص التي يمكن أن تحدّ من الأداء. لمراجعة حصص AlloyDB المقترَحة، يُرجى الاطّلاع على قسم "قبل البدء" في المستندات.
المشاكل الشائعة وتحديد المشاكل وحلّها
فجوة نشر "إدارة الهوية وإمكانية الوصول" | لقد نفّذت أمر إدارة الهوية وإمكانية الوصول (IAM) في |
عدم تطابق أبعاد المتّجهات | تم ضبط الجدول |
6. البحث السياقي المرن
الآن، سنُجري بحثًا مختلطًا. نجمع بين الفهم الدلالي (المتّجه) ومنطق النشاط التجاري (فلاتر SQL).
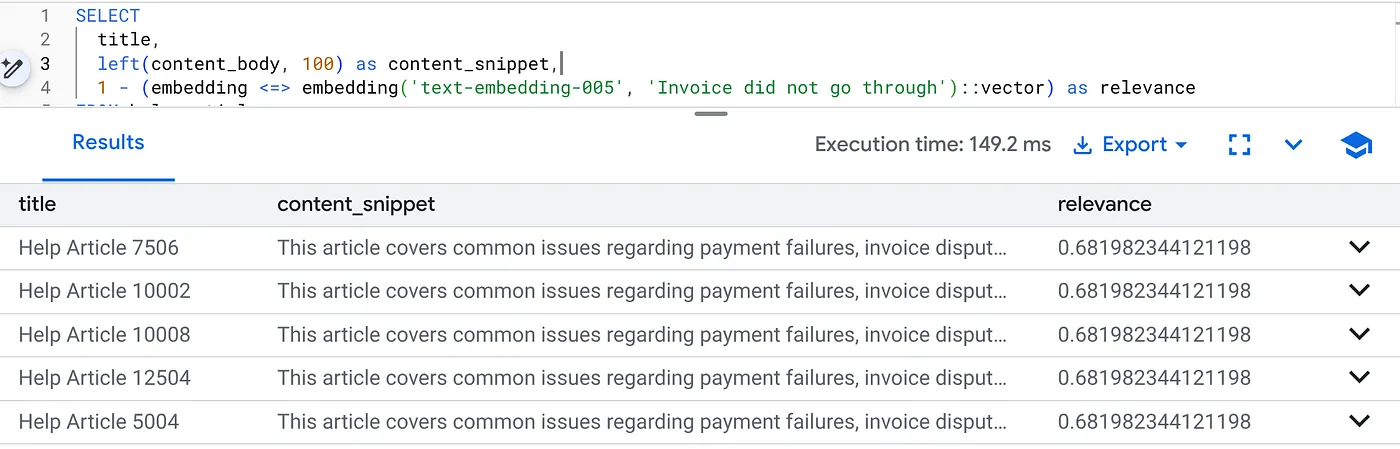
يمكنك تنفيذ طلب البحث هذا للعثور على مشاكل الفوترة المتعلّقة بالإصدار 2.0 من المنتج تحديدًا:
SELECT
  title,
  left(content_body, 100) as content_snippet,
  1 - (embedding <=> embedding('text-embedding-005', 'Invoice did not go through')::vector) as relevance
FROM help_articles
WHERE category = 'Billing'  -- Hard SQL Filter
  AND product_version = '2.0' -- Hard SQL Filter
ORDER BY relevance DESC
LIMIT 5;
هذه لعبة "سياق مرن". يتم "تعديل" البحث لفهم قصد المستخدم ("مشاكل الفوترة") مع الالتزام بالقيود الصارمة للنشاط التجاري (الإصدار 2.0).
أهمية هذه الميزة للشركات الناشئة وعمليات نقل البيانات
- عدم تراكم ديون البنية الأساسية: لم يتم إنشاء قاعدة بيانات متّجهات منفصلة (Pinecone/Milvus). لم تكتب مهمة ETL منفصلة. كل ذلك في Postgres.
- التعديلات في الوقت الفعلي: باستخدام وضع "المعاملات"، لن يصبح فهرس "بحث Google" قديمًا أبدًا. بمجرد إدخال البيانات، تصبح جاهزة للاستخدام في المتجهات.
- قابلية التوسّع: يستند AlloyDB إلى بنية Google الأساسية. ويمكنه إنشاء ملايين المتجهات بشكل مجمّع بسرعة أكبر من أي وقت مضى باستخدام نص Python البرمجي.
المشاكل الشائعة وتحديد المشاكل وحلّها
مشكلة في أداء الإنتاج | المشكلة: سريع لـ 50,000 صف. بطيء جدًا لمليون صف إذا لم يكن فلتر الفئات انتقائيًا بما يكفي.الحل:أضِف فهرس متّجهات: بالنسبة إلى نطاق الإنتاج، يجب إنشاء فهرس:CREATE INDEX ON help_articles USING hnsw (embedding vector_cosine_ops);التحقّق من استخدام الفهرس: شغِّل |
كارثة "عدم تطابق النماذج" | المشكلة: تم إعداد العمود باستخدام text-embedding-005 في إجراء CALL. إذا استخدمت عن طريق الخطأ نموذجًا مختلفًا (مثل text-embedding-004 أو نموذج OSS) في دالة طلب البحث SELECT embedding('model-name', ...)، قد تتطابق الأبعاد (768)، ولكن مساحة المتجه ستكون مختلفة تمامًا. يتم تنفيذ طلب البحث بدون خطأ، ولكن النتائج غير ذات صلة على الإطلاق (نتائج مدى الصلة بالموضوع غير صحيحة). تحديد المشاكل وحلّها:تأكَّد من أنّ model_id في ai.initialize_embeddings يتطابق مع model_id في طلب البحث SELECT تمامًا. |
نتيجة "فارغة بدون إشعار" (الفلترة الزائدة) | المشكلة: البحث المختلط هو عملية "AND". يتطلّب ذلك مطابقة دلالية ومطابقة SQL.إذا بحث مستخدم عن "مساعدة بشأن الفوترة"، ولكنّ عمود
|
4. أخطاء الأذونات/الحصص (الخطأ 500) | المشكلة:تُجري الدالة
|
5- التضمينات الفارغة | المشكلة:إذا أدخلت بيانات قبل إعداد النموذج بالكامل أو إذا تعذّر على العامل في الخلفية إكمال العملية، قد تحتوي بعض الصفوف على
|
7. تَنظيم
بعد الانتهاء من هذا التمرين، لا تنسَ حذف مجموعة AlloyDB ومثيلها.
من المفترض أن يؤدي ذلك إلى تنظيف المجموعة مع مثيلاتها.
8. تهانينا
لقد نجحت في إنشاء تطبيق بحث في قاعدة المعرفة قابل للتوسّع. بدلاً من إدارة مسار ETL معقّد باستخدام نصوص برمجية وحلقات تكرار في Python لإنشاء تضمينات المتّجهات، استخدمت AlloyDB AI لمعالجة إنشاء التضمينات بشكلٍ أصلي داخل قاعدة البيانات باستخدام أمر SQL واحد.
المواضيع التي تناولناها
- لقد أوقفنا "حلقة Python For" لمعالجة البيانات.
- لقد أنشأنا 50,000 متجه باستخدام أمر SQL واحد.
- لقد جعلنا عملية إنشاء المتجهات المستقبلية تلقائية باستخدام المشغّلات.
- أجرينا بحثًا مختلطًا.
الخطوات التالية
- جرِّب ذلك باستخدام مجموعة البيانات الخاصة بك.
- استكشِف مستندات AlloyDB AI.
- يمكنك الاطّلاع على الموقع الإلكتروني Code Vipassana لمزيد من ورش العمل.