

۱. نمای کلی
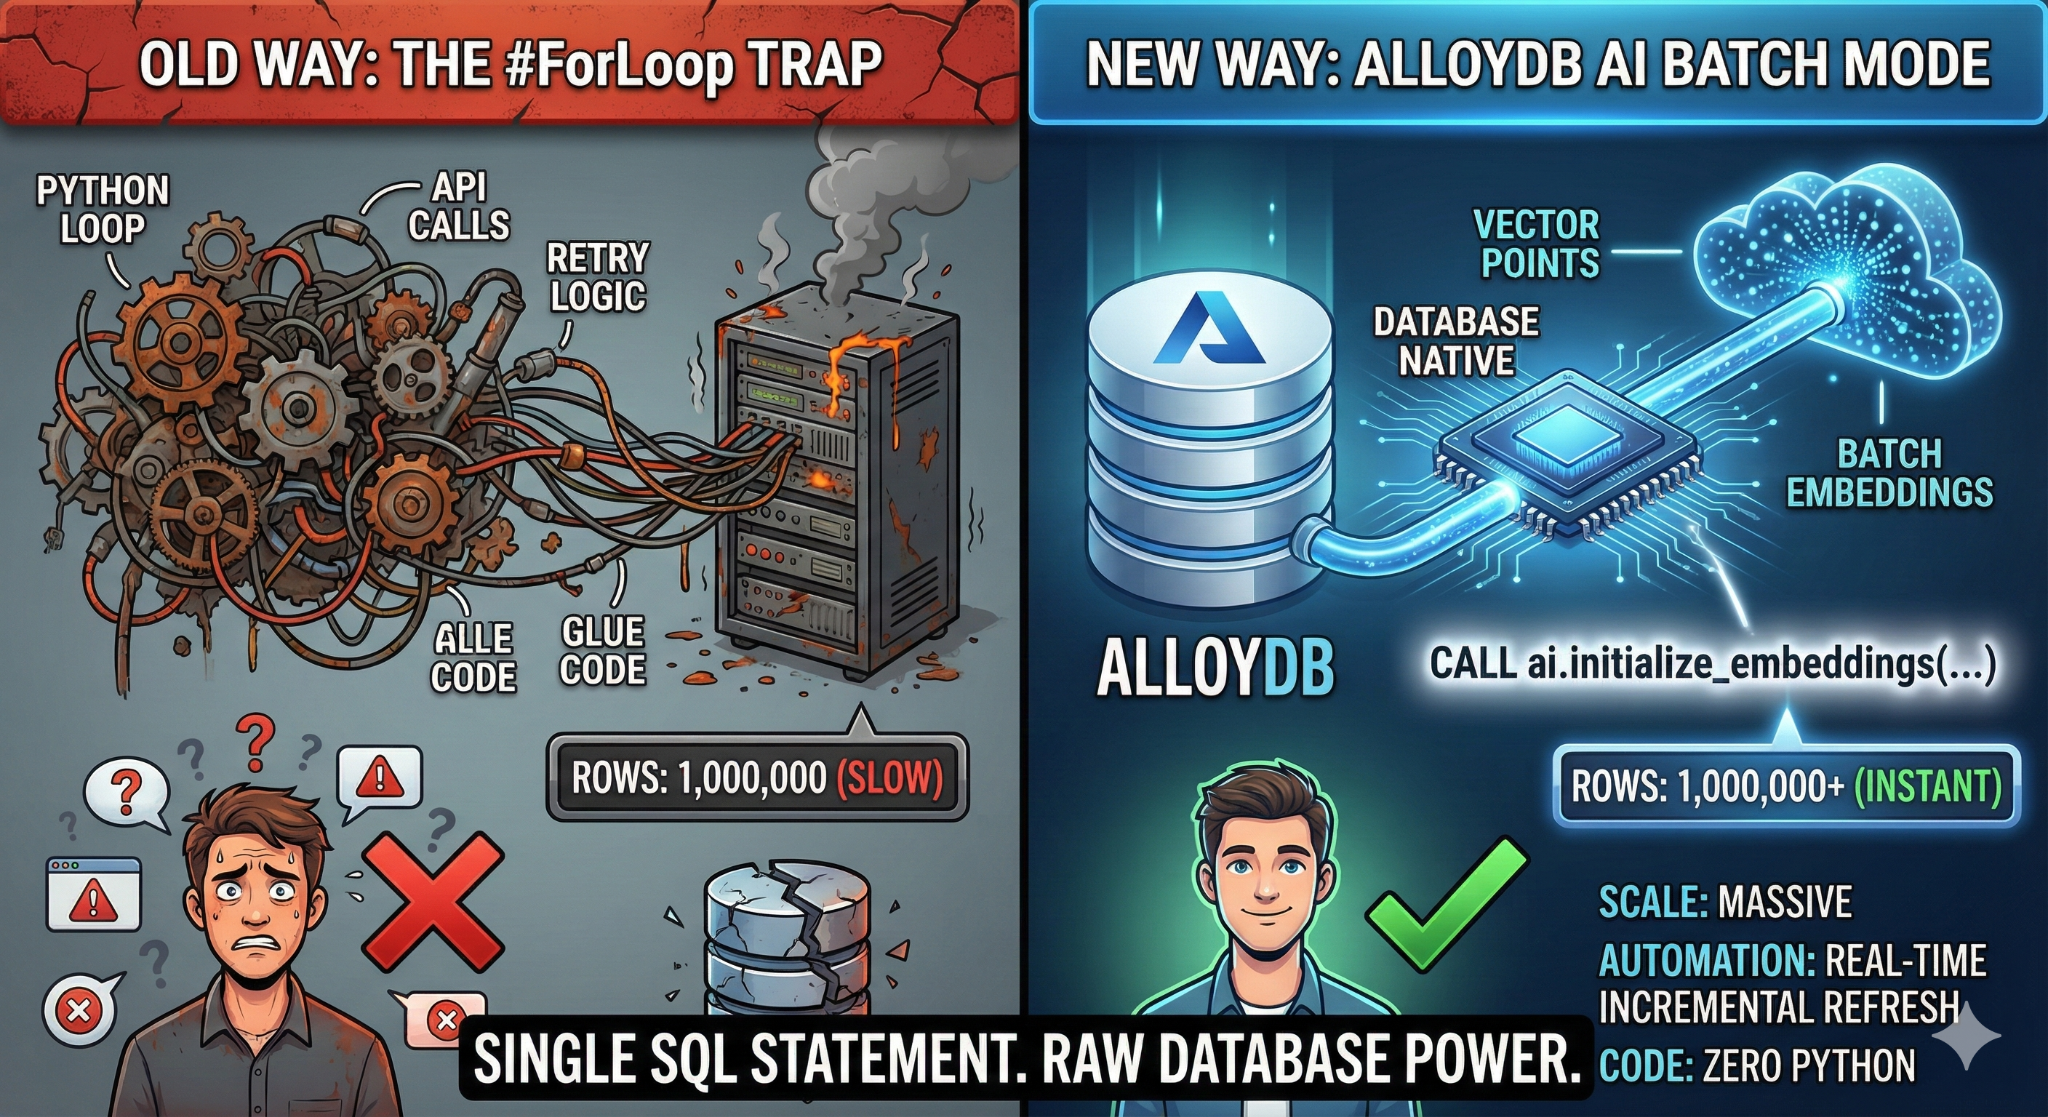
در این codelab، یک برنامه جستجوی مقیاسپذیر «پایگاه دانش» خواهید ساخت. بهجای مدیریت کردن خط لوله پیچیده ETL با دستورگانها و حلقههای Python برای تولید کردن جاسازیهای برداری، از AlloyDB AI برای مدیریت کردن تولید جاسازی بهصورت بومی در پایگاه داده بااستفاده از یک فرمان SQL استفاده خواهید کرد.
آنچه خواهید ساخت
برنامه پایگاه داده پایگاه دانش «قابلجستجو» با عملکرد بالا.
آنچه خواهید آموخت
با روش انجام این کارها آشنا خواهید شد:
- یک خوشه AlloyDB را آماده کنید و افزونههای هوش مصنوعی را فعال کنید.
- بااستفاده از SQL، دادههای مصنوعی (بیشاز ۵۰٬۰۰۰ ردیف) تولید کنید.
- جاسازیهای برداری را برای کل مجموعه داده بااستفاده از پردازش دستهای تکمیل کنید.
- راهاندازهای افزایشی همزمان را راهاندازی کنید تا دادههای جدید بهطور خودکار جاسازی شوند.
- جستجوی ترکیبی (بردار + فیلترهای SQL) را برای «Flexing Context» انجام دهید.
الزامات
۲. قبلاز شروع
ایجاد کردن پروژه
- در کنسول Google Cloud، در صفحه انتخابگر پروژه، یک پروژه Google Cloud را انتخاب یا ایجاد کنید.
- مطمئن شوید که صورتحساب برای پروژه Cloud شما فعال است. با نحوه بررسی فعال بودن صورتحساب در پروژهآشنا شوید.
- از Cloud Shell استفاده خواهید کرد که محیط خط فرمانی است که در Google Cloud اجرا میشود. روی «فعالسازی Cloud Shell» در بالای کنسول Google Cloud کلیک کنید.
- پساز اتصال به Cloud Shell، بااستفاده از فرمان زیر بررسی میکنید که ازقبل اصالتسنجی شدهاید و پروژه روی شناسه پروژه شما تنظیم شده است:
gcloud auth list
- فرمان زیر را در Cloud Shell اجرا کنید تا مطمئن شوید فرمان gcloud پروژه شما را میشناسد.
gcloud config list project
- اگر پروژهتان تنظیم نشده است، از فرمان زیر برای تنظیم آن استفاده کنید:
gcloud config set project <YOUR_PROJECT_ID>
- میاناهای برنامهسازی کاربردی موردنیاز را فعال کنید: پیوند را دنبال کنید و میاناهای برنامهسازی کاربردی را فعال کنید.
یا میتوانید از فرمان gcloud برای این کار استفاده کنید. برای فرمانها و کاربرد gcloud، به اسناد مراجعه کنید.
gcloud services enable \
  alloydb.googleapis.com \
  compute.googleapis.com \
  cloudresourcemanager.googleapis.com \
  servicenetworking.googleapis.com \
  aiplatform.googleapis.com
مشکلات احتمالی و عیبیابی
سندروم «پروژه شبح» |
|
The Billing Barricade | پروژه را فعال کردهاید، اما حساب صورتحساب را فراموش کردهاید. AlloyDB موتور با عملکرد بالا است؛ اگر «مخزن سوخت» (صورتحساب) خالی باشد، شروع نمیشود. |
تأخیر انتشار میانای برنامهسازی کاربردی | روی «فعال کردن میاناهای برنامهسازی کاربردی» کلیک کردید، اما خط فرمان همچنان |
سهمیه Quags | اگر از حساب آزمایشی کاملاً جدیدی استفاده میکنید، ممکن است به سهمیه منطقهای برای نمونههای AlloyDB برسید. اگر |
«Hidden» Service Agent | گاهی اوقات نقش |
۳. راهاندازی پایگاه داده
در این آزمایشگاه، از AlloyDB بهعنوان پایگاه داده برای دادههای آزمایشی استفاده خواهیم کرد. این سرویس از خوشهها برای نگهداری همه منابع، مانند پایگاههای داده و گزارشها، استفاده میکند. هر خوشه یک نمونه اصلی دارد که نقطه دسترسی به دادهها را فراهم میکند. جدولها دادههای واقعی را نگه میدارند.
بیایید خوشه، نمونه، و جدول AlloyDB را که مجموعه داده آزمایشی در آن بار خواهد شد ایجاد کنیم.
- روی دکمه کلیک کنید یا پیوند زیر را در مرورگری که کاربر «کنسول Google Cloud» در آن به سیستم وارد شده است کپی کنید.
- پساز تکمیل این مرحله، مخزن در ویرایشگر پوسته ابری محلی شما شبیهسازی میشود و میتوانید فرمان زیر را از داخل پوشه پروژه اجرا کنید (مهم است که مطمئن شوید در فهرست راهنمای پروژه هستید):
sh run.sh
- اکنون از واسط کاربر استفاده کنید (با کلیک کردن روی پیوند در پایانه یا کلیک کردن روی پیوند «پیشنمایش در وب» در پایانه.
- برای شروع، جزئیات مربوط به شناسه پروژه، خوشه، و نامهای نمونه را وارد کنید.
- تا گزارشها پیمایش میشوند، بروید و قهوهای بنوشید و در اینجا درباره نحوه انجام این کار در پشت صحنه بخوانید. ممکن است حدود ۱۰ تا ۱۵ دقیقه طول بکشد.
مشکلات احتمالی و عیبیابی
مشکل «صبر» | خوشههای پایگاه داده زیرساختهای سنگینی هستند. اگر صفحه را بازآورید یا جلسه Cloud Shell را بهدلیل «گیر کردن» ببندید، ممکن است با یک نمونه «شبح» مواجه شوید که بهطور ناقص تأمین شده است و حذف آن بدون دخالت دستی غیرممکن است. |
منطقه مطابقت ندارد | اگر میاناهای برنامهسازی کاربردی را در |
خوشههای زامبی | اگر قبلاً از همین نام برای خوشهای استفاده کردهاید و آن را حذف نکردهاید، ممکن است متن بگوید نام خوشه ازقبل وجود دارد. نامهای خوشه باید در پروژه منحصربهفرد باشند. |
مهلت Cloud Shell | اگر استراحت قهوه شما ۳۰ دقیقه طول بکشد، Cloud Shell ممکن است به حالت خواب برود و فرایند |
۴. آمادهسازی طرحواره
در این مرحله، موارد زیر را پوشش خواهیم داد:
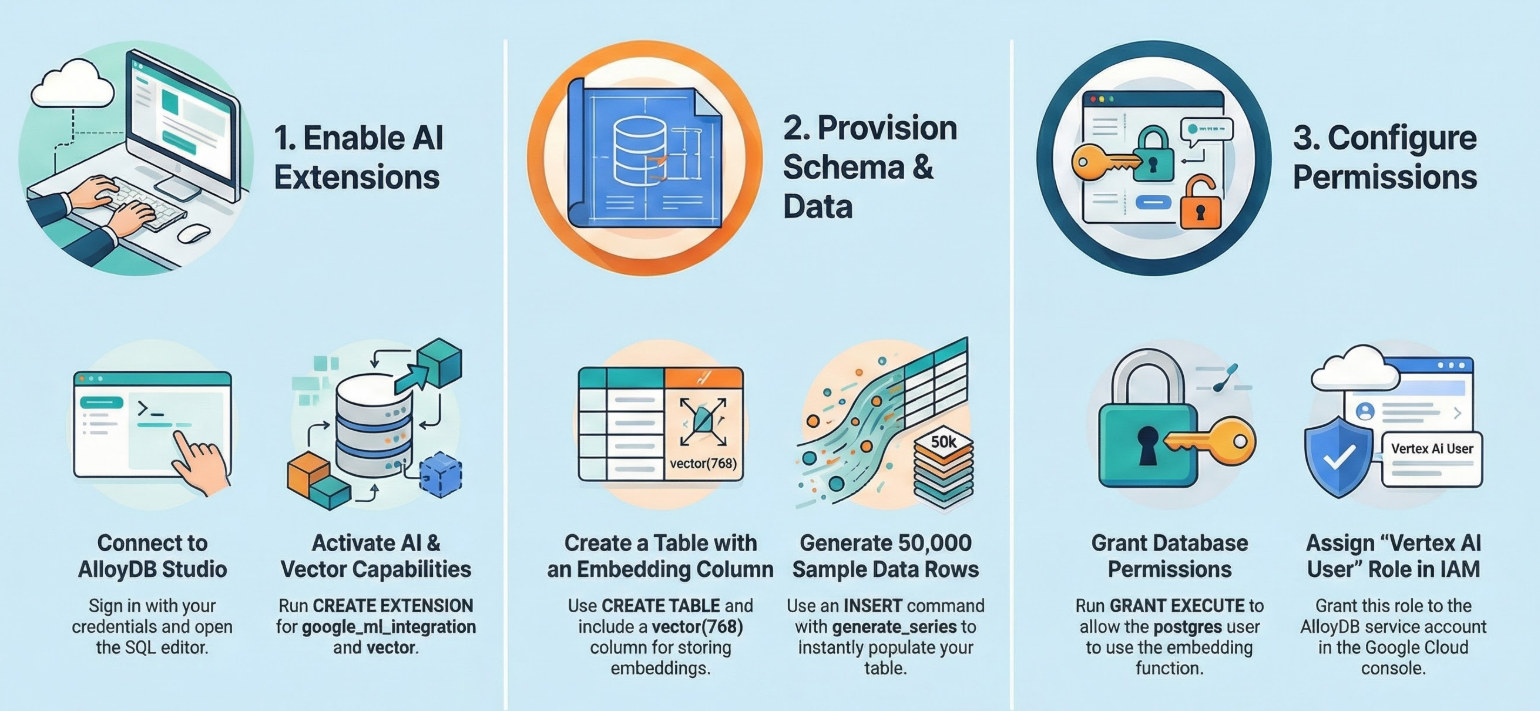
وقتی خوشه و نمونه AlloyDB شما درحال اجرا بود، به ویرایشگر SQL در AlloyDB Studio بروید تا افزونههای هوش مصنوعی را فعال کنید و طرحواره را فراهم کنید.
ممکن است لازم باشد منتظر بمانید تا ایجاد نمونه شما بهپایان برسد. پساز آماده شدن، بااستفاده از اطلاعات اعتباری که هنگام ایجاد خوشه ایجاد کردید، به سیستم AlloyDB وارد شوید. از دادههای زیر برای اصالتسنجی در PostgreSQL استفاده کنید:
- نام کاربری: «
postgres» - پایگاه داده : «
postgres» - گذرواژه: «
alloydb» (یا هر چیزی که در زمان ایجاد تنظیم کردهاید)
پساز اینکه باموفقیت در AlloyDB Studio اصالتسنجی شدید، فرمانهای SQL در «ویرایشگر» وارد میشوند. بااستفاده از علامت جمع در سمت چپ آخرین پنجره، میتوانید چندین پنجره «ویرایشگر» اضافه کنید.
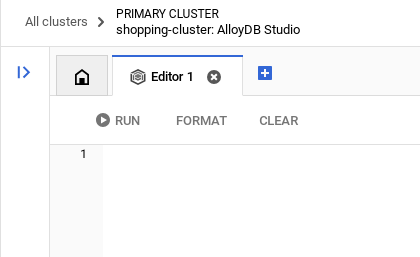
فرمانهای AlloyDB را در پنجرههای ویرایشگر وارد خواهید کرد و درصورت لزوم از گزینههای «اجرا»، «قالببندی»، و «پاک کردن» استفاده خواهید کرد.
فعال کردن افزونهها
برای ساختن این برنامه، از افزونههای pgvector و google_ml_integration استفاده خواهیم کرد. افزونه pgvector به شما امکان میدهد جاسازیهای برداری را ذخیره و جستجو کنید. افزونه google_ml_integration توابعی را ارائه میدهد که برای دسترسی به نقطههای پایانی پیشبینی Vertex AI جهت دریافت پیشبینیها در SQL استفاده میکنید. با اجرای DDLهای زیر، این افزونهها را فعال کنید:
CREATE EXTENSION IF NOT EXISTS google_ml_integration CASCADE;
CREATE EXTENSION IF NOT EXISTS vector;
ایجاد جدول
برای نشان دادن مقیاس به مجموعه داده نیاز داریم. بهجای وارد کردن CSV، فوراً ۵۰٬۰۰۰ ردیف «مقاله راهنما» مصنوعی بااستفاده از SQL تولید خواهیم کرد.
میتوانید بااستفاده از عبارت DDL زیر در AlloyDB Studio جدولی ایجاد کنید:
-- 1. Create the table
CREATE TABLE help_articles (
    id SERIAL PRIMARY KEY,
    title TEXT,
    category TEXT,
    product_version TEXT,
    content_body TEXT,
    embedding vector(768) -- Dimension for text-embedding-005
);

-- 2. Generate 50,000 rows of synthetic data
INSERT INTO help_articles (title, category, product_version, content_body)
SELECT
    'Help Article ' || i,
    CASE
        WHEN i % 3 = 0 THEN 'Billing'
        WHEN i % 3 = 1 THEN 'Technical'
        ELSE 'General'
    END,
    CASE
        WHEN i % 2 = 0 THEN '2.0'
        ELSE '1.0'
    END,
    'This article covers common issues regarding ' ||
    CASE
        WHEN i % 3 = 0 THEN 'payment failures, invoice disputes, and credit card updates.'
        WHEN i % 3 = 1 THEN 'connection timeouts, latency issues, and API errors.'
        ELSE 'account profile settings, password resets, and user roles.'
    END
FROM generate_series(1, 50000) AS i;
ستون item_vector امکان ذخیره مقادیر برداری نوشتار را فراهم میکند.
درستیسنجی دادهها:
SELECT count(*) FROM help_articles;
-- Output: 50000
فعال کردن پرچمهای پایگاه داده
به کنسول پیکربندی «نمونه» بروید، روی «ویرایش اصلی» کلیک کنید، به «پیکربندی پیشرفته» بروید و روی «افزودن پرچمهای پایگاه داده» کلیک کنید.
اگر نه، آن را در منو کرکرهای پرچمها وارد کنید و آن را روی «روشن» تنظیم کنید و نمونه را بهروز کنید.
- مطمئن شوید که پرچم google_ml_integration.enable_faster_embedding_generation روی روشن تنظیم شده باشد:
اگر نه، آن را در منو کرکرهای پرچمها وارد کنید و آن را روی «روشن» تنظیم کنید و نمونه را بهروز کنید.
مراحل پیکربندی پرچمهای پایگاه داده:
- در کنسول Google Cloud، به صفحه «خوشهها» بروید.
- روی خوشهای در ستون نام منبع کلیک کنید.
- در صفحه نمای کلی، به نمونهها در خوشهتان بروید، نمونهای را انتخاب کنید، و سپس روی ویرایش کلیک کنید.
- پرچم پایگاه داده را به نمونهتان اضافه کنید، آن را اصلاح کنید، یا حذف کنید:
افزودن پرچم
- برای افزودن پرچم پایگاه داده به نمونهتان، روی «افزودن پرچم» کلیک کنید.
- پرچمی را از فهرست پرچم پایگاه داده جدید انتخاب کنید.
- مقداری برای پرچم ارائه دهید.
- روی «تمام» کلیک کنید.
- روی بهروزرسانی نمونه کلیک کنید.
- بررسی کنید که افزونه google_ml_integration نسخه ۱.۵.۲ یا بالاتر باشد:
برای بررسی نسخه افزونه با فرمان زیر:
SELECT extversion FROM pg_extension WHERE extname = 'google_ml_integration';
اگر لازم است افزونه را به نسخه بالاتر بهروز کنید، از این فرمان استفاده کنید:
ALTER EXTENSION google_ml_integration UPDATE;
اعطا کردن اجازه
- برای اینکه به کاربر اجازه دهید تولید جاسازی خودکار را مدیریت کند، اجازههای INSERT، UPDATE، و DELETE را در جدولهای google_ml.embed_gen_progress و google_ml.embed_gen_settings اعطا کنید:
GRANT INSERT, UPDATE, DELETE ON google_ml.embed_gen_progress TO postgres;
«postgres» نام کاربریای است که اجازهها به آن اعطا شده است.
- دستور زیر را اجرا کنید تا اجرای تابع «جاسازی» را اعطا کنید:
GRANT EXECUTE ON FUNCTION embedding TO postgres;
اعطا کردن «نقش کاربر Vertex AI» به حساب سرویس AlloyDB
از کنسول Google Cloud IAM، به حساب سرویس AlloyDB (که شبیه این است: service-<<PROJECT_NUMBER>>@gcp-sa-alloydb.iam.gserviceaccount.com) دسترسی به نقش «کاربر Vertex AI» را اعطا کنید. PROJECT_NUMBER شماره پروژه شما را خواهد داشت.
یا میتوانید فرمان زیر را از «پایانه Cloud Shell» اجرا کنید:
PROJECT_ID=$(gcloud config get-value project)


gcloud projects add-iam-policy-binding $PROJECT_ID \
  --member="serviceAccount:service-$(gcloud projects describe $PROJECT_ID --format="value(projectNumber)")@gcp-sa-alloydb.iam.gserviceaccount.com" \
--role="roles/aiplatform.user"
مشکلات احتمالی و عیبیابی
حلقه «فراموشی گذرواژه» | اگر از راهاندازی «One Click» استفاده کردهاید و گذرواژهتان را بهخاطر نمیآورید، به صفحه اطلاعات پایه «نمونه» در کنسول بروید و برای بازنشانی گذرواژه |
خطای «افزونه پیدا نشد» | اگر |
۵. تولید بردار «تکمرحلهای»
این هسته آزمایشگاه است. بهجای نوشتن حلقه Python برای پردازش این ۵۰٬۰۰۰ ردیف، از تابع ai.initialize_embeddings استفاده خواهیم کرد.
این فرمان واحد دو کار انجام میدهد:
- همه ردیفهای موجود را تکمیل میکند.
- راهاندازی ایجاد میکند تا ردیفهای آینده را بهطور خودکار جاسازی کند.
عبارت SQL زیر را از «ویرایشگر پُرسمان AlloyDB» اجرا کنید
CALL ai.initialize_embeddings(
  model_id => 'text-embedding-005',
  table_name => 'help_articles',
  content_column => 'content_body',
  embedding_column => 'embedding',
  incremental_refresh_mode => 'transactional'
);
تأیید جاسازیها
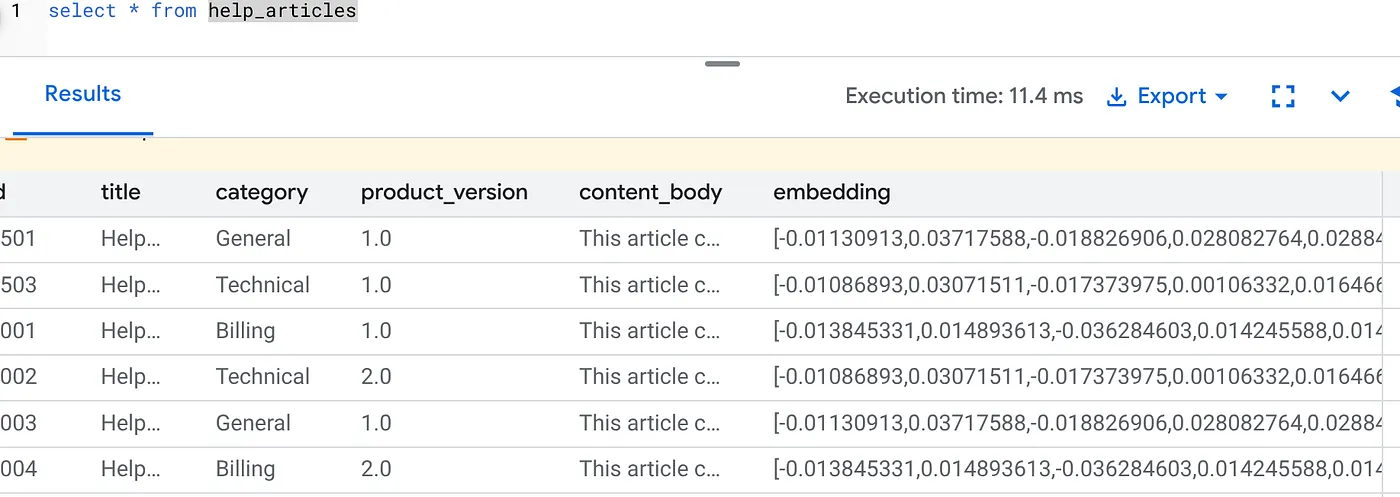
بررسی کنید که ستون embedding اکنون پر شده باشد:
SELECT id, left(content_body, 30), substring(embedding::text, 1, 30) as vector_partial
FROM help_articles;
باید نتیجهای مشابه تصویر زیر ببینید:
چه اتفاقی افتاد؟
- Backfill at Scale: It automatically sweeps through your existing 50,000 rows and generates embeddings via Vertex AI.
- خودکارسازی: با تنظیم incremental_refresh_mode => 'transactional'، AlloyDB بهطور خودکار راهاندازهای داخلی را راهاندازی میکند. هر ردیف جدیدی که در help_articles درج شود، جاسازی آن فوراً تولید خواهد شد.
- میتوانید بهطور اختیاری incremental_refresh_mode => ‘None' را تنظیم کنید تا فقط بتوانید عبارت را برای انجام بهروزرسانیهای انبوه دریافت کنید و بهطور دستی ai.refresh_embeddings() را برای بهروزرسانی جاسازیهای همه ردیفها فراخوانی کنید.
شما بهتازگی یک صف Kafka، یک کارگر Python، و یک اسکریپت انتقال را با ۶ خط SQL جایگزین کردید. در اینجا اسناد رسمی دقیق برای همه مشخصهها ارائه شده است.
آزمایش راهانداز همزمان
بیایید درستیسنجی کنیم که خودکارسازی «Zero Loop» برای دادههای جدید کار میکند.
- درج ردیف جدید:
INSERT INTO help_articles (title, category, product_version, content_body)
VALUES ('New Scaling Guide', 'Technical', '2.0', 'How to scale AlloyDB to millions of transactions.');
- فوراً بررسی کنید:
SELECT embedding FROM help_articles WHERE title = 'New Scaling Guide';
نتیجه:
باید ببینید که بردار فوراً بدون اجرای هیچ اسکریپت خارجی تولید میشود.
اندازه دسته تنظیم
درحالحاضر AlloyDB بهطور پیشفرض اندازه دسته را روی ۵۰ تنظیم میکند. درحالیکه تنظیمات پیشفرض بهخوبی کار میکنند، AlloyDB همچنان به کاربران این امکان را میدهد که پیکربندی ایدهآل را برای مدل و مجموعه داده منحصربهفرد خود تنظیم کنند.
CALL ai.initialize_embeddings(
  model_id => 'text-embedding-005',
  table_name => 'help_articles',
  content_column => 'content_body',
  embedding_column => 'embedding',
  incremental_refresh_mode => 'transactional',
  batch_size => 20
);
بااینحال، کاربران باید از محدودیتهای سهمیه که میتواند عملکرد را محدود کند آگاه باشند. برای بررسی سهمیههای توصیهشده AlloyDB، به بخش «قبلاز شروع» در اسناد مراجعه کنید.
مشکلات احتمالی و عیبیابی
شکاف انتشار IAM | فرمان |
عدم تطابق ابعاد بردار | جدول |
۶. جستجوی بافتاری Flexing
اکنون جستجوی ترکیبی انجام میدهیم. ما درک معنایی (Vector) را با منطق کسبوکار (SQL Filters) ترکیب میکنیم.
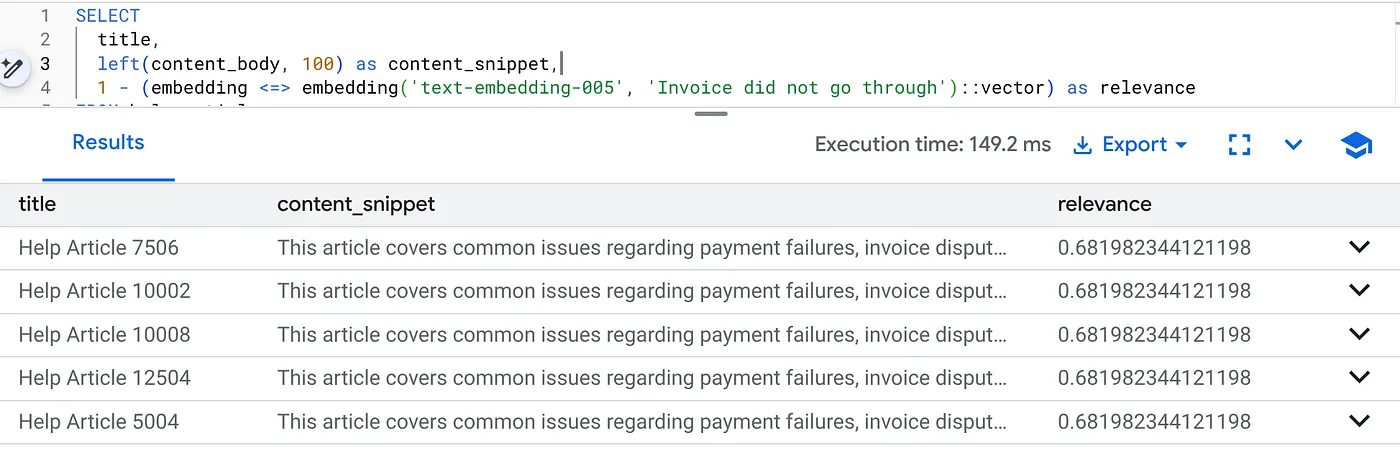
این پُرسمان را برای پیدا کردن مشکلات صورتحساب بهطور خاص برای «نسخه محصول ۲.۰» اجرا کنید:
SELECT
  title,
  left(content_body, 100) as content_snippet,
  1 - (embedding <=> embedding('text-embedding-005', 'Invoice did not go through')::vector) as relevance
FROM help_articles
WHERE category = 'Billing'  -- Hard SQL Filter
  AND product_version = '2.0' -- Hard SQL Filter
ORDER BY relevance DESC
LIMIT 5;
این Flexing Context است. جستجو برای درک قصد کاربر («مشکلات صورتحساب») «انعطافپذیر» است، درحالیکه محدودیتهای سختگیرانه کسبوکار (نسخه ۲.۰) را رعایت میکند.
چرا این گزینه برای استارتاپها و انتقالها بهترین است
- بدهی زیرساخت صفر: شما یک Vector DB جداگانه (Pinecone/Milvus) راهاندازی نکردید. تکلیف ETL جداگانهای ننوشتید. همه چیز در Postgres است.
- بهروزرسانیهای همزمان: بااستفاده از حالت «تراکنشی»، نمایه جستجوی شما هرگز قدیمی نمیشود. بهمحض اینکه دادهها ثبت شوند، آماده برداری شدن هستند.
- مقیاس: AlloyDB بر روی زیرساخت Google ساخته شده است. این مدل میتواند تولید انبوه میلیونها بردار را سریعتر از آنچه اسکریپت Python شما قادر به انجام آن است مدیریت کند.
مشکلات احتمالی و عیبیابی
نکته مهم درباره عملکرد تولید | مشکل: برای ۵۰٬۰۰۰ ردیف سریع است. برای ۱ میلیون ردیف بسیار کند است اگر فیلتر دسته بهاندازه کافی گزینشی نباشد.راهحل:افزودن نمایه برداری: برای مقیاس تولید، باید نمایهای ایجاد کنید:CREATE INDEX ON help_articles USING hnsw (embedding vector_cosine_ops);تأیید استفاده از نمایه: |
فاجعه «عدم تطابق مدل» | مشکل: ستون را بااستفاده از text-embedding-005 در رویه CALL مقداردهی اولیه کردهاید. اگر بهطور تصادفی از مدل دیگری (مثلاً text-embedding-004 یا مدل OSS) در تابع پُرسمان SELECT embedding('model-name', ...) استفاده کنید، ممکن است ابعاد مطابقت داشته باشند (۷۶۸)، اما فضای برداری کاملاً متفاوت خواهد بود. پُرسمان بدون خطا اجرا میشود، اما نتایج کاملاً نامربوط هستند (امتیازهای ارتباط بیارزش). عیبیابی:مطمئن شوید model_id در ai.initialize_embeddings دقیقاً با model_id در پُرسمان SELECT شما مطابقت داشته باشد. |
نتیجه «خالی بیصدا» (فیلتر کردن بیشازحد) | مشکل: جستجوی ترکیبی عملیات «AND» است. این کار به تطابق معنایی و تطابق SQL نیاز دارد. اگر کاربری «راهنمای صورتحساب» را جستجو کند اما ستون
|
۴. خطاهای اجازه/سهمیه (خطای ۵۰۰) | مشکل:تابع
|
۵. جاسازیهای تهی | مشکل:اگر دادهها را قبلاز مقداردهی اولیه کامل مدل درج کنید یا اگر کارگر پسزمینه ناموفق باشد، ممکن است برخیاز ردیفها در ستون
|
۷. مرتبسازی
وقتی این آزمایشگاه تمام شد، فراموش نکنید که خوشه و نمونه alloyDB را حذف کنید.
این کار باید خوشه را بههمراه نمونه(های) آن پاکسازی کند.
۸. تبریک میگوییم
باموفقیت یک برنامه جستجوی «پایگاه دانش» مقیاسپذیر ساختهاید. بهجای مدیریت کردن یک خط لوله ETL پیچیده با دستورگانهای Python و حلقهها برای تولید جاسازیهای برداری، از AlloyDB AI برای مدیریت کردن تولید جاسازی بهصورت بومی در پایگاه داده بااستفاده از یک فرمان SQL واحد استفاده کردید.
آنچه پوشش دادیم
- ما «Python For-Loop» را برای پردازش دادهها ازبین بردیم.
- ما ۵۰٬۰۰۰ بردار را با یک فرمان SQL تولید کردیم.
- تولید بردار آینده را با راهاندازها خودکار کردیم.
- «جستجوی ترکیبی» انجام دادیم.
مراحل بعدی
- این کار را با مجموعه داده خودتان امتحان کنید.
- مستندات AlloyDB AI را کاوش کنید.
- برای کارگاههای بیشتر، به وبسایت Code Vipassana مراجعه کنید.