

1. Обзор
В этой практической работе вы создадите масштабируемое приложение для поиска по базе знаний. Вместо того чтобы управлять сложным конвейером ETL со скриптами и циклами Python для создания векторных представлений, вы будете использовать AlloyDB AI, чтобы генерировать представления прямо в базе данных с помощью одной команды SQL.
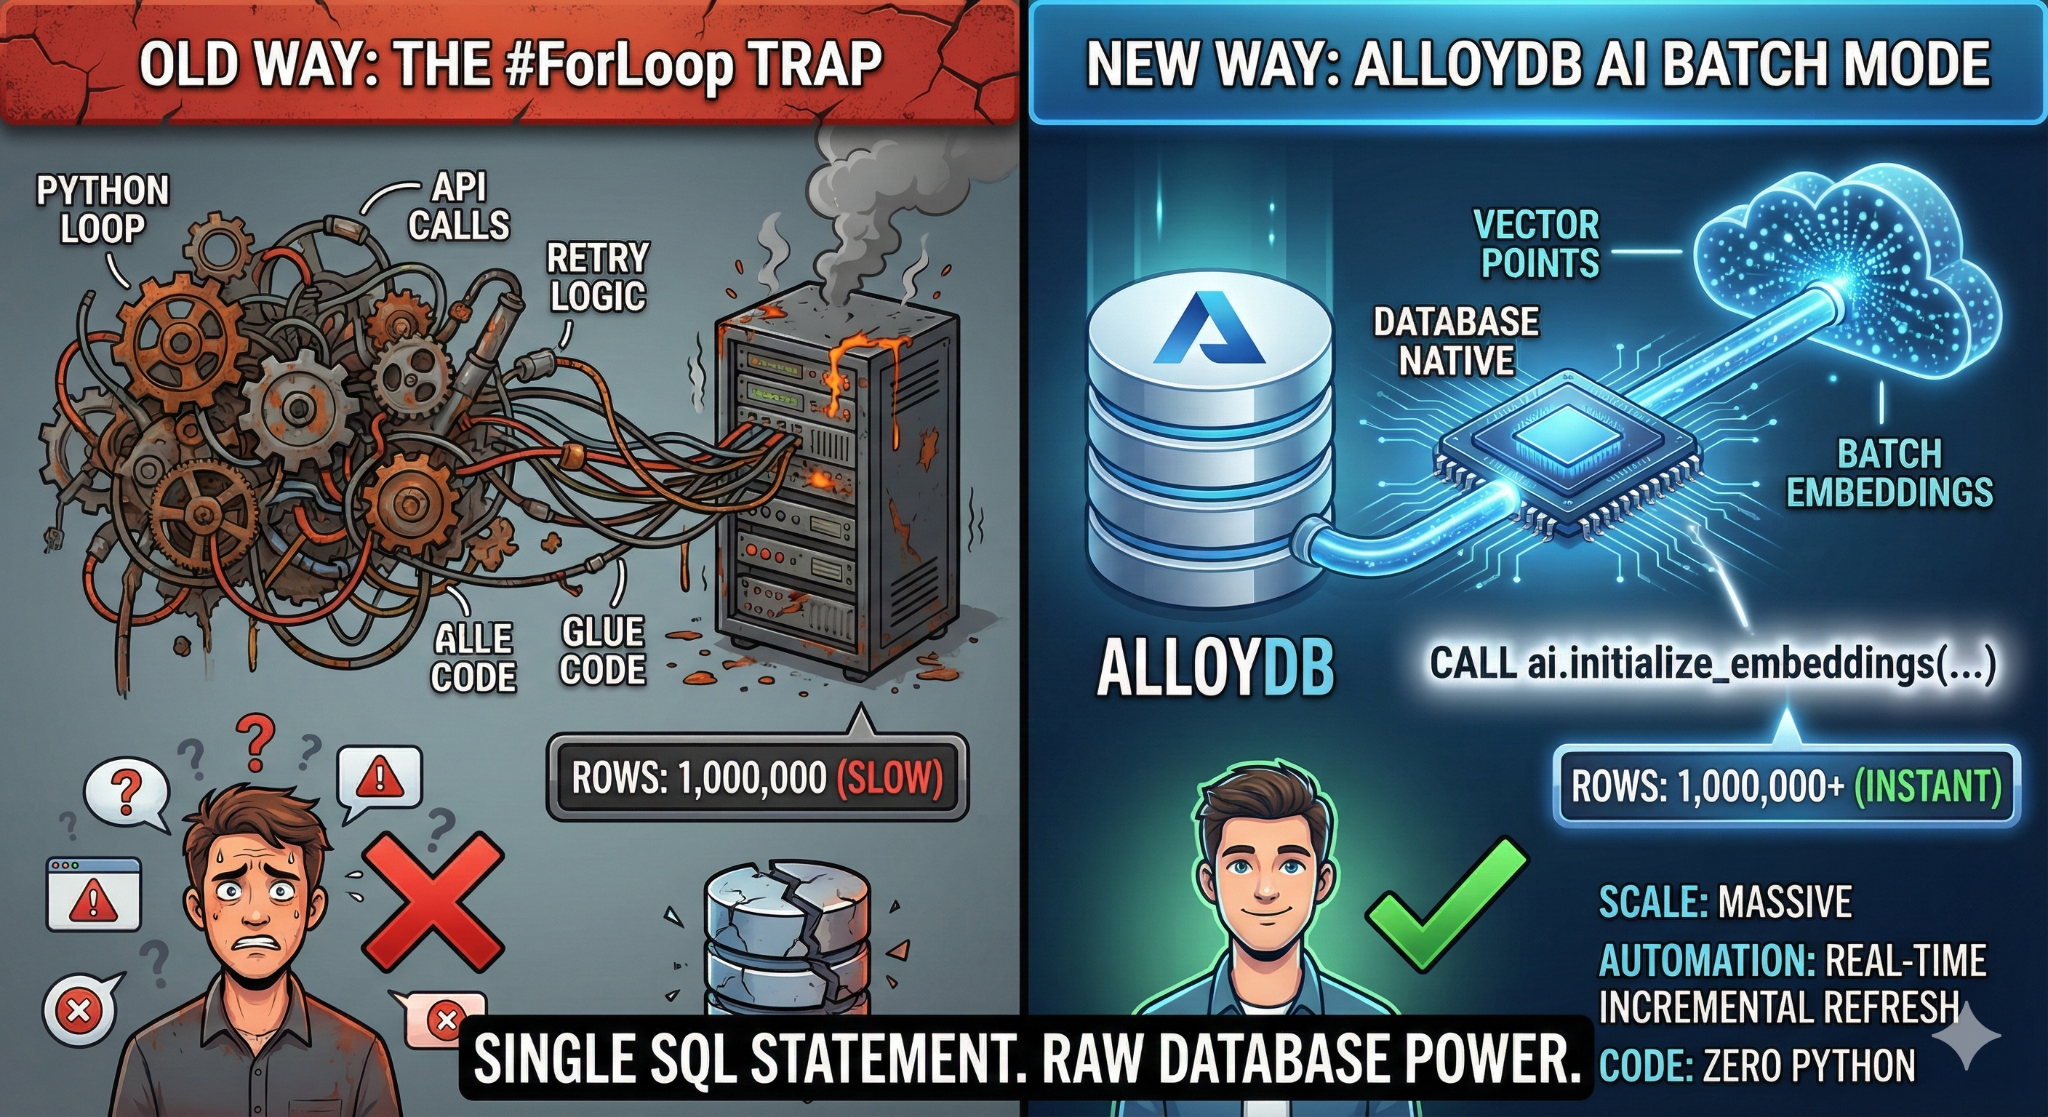
Что вы создадите
Высокопроизводительное приложение базы данных с возможностью поиска.
Что вы узнаете
Вы научитесь:
- Подготовка кластера AlloyDB и включение расширений ИИ.
- Сгенерируйте синтетические данные (более 50 000 строк) с помощью SQL.
- Заполните векторные эмбеддинги для всего набора данных с помощью пакетной обработки.
- Настройте триггеры добавочного обновления в реальном времени, чтобы автоматически встраивать новые данные.
- Выполните гибридный поиск (векторный поиск + SQL-фильтры) по запросу "Flexing Context".
Требования
2. Подготовка
Как создать проект
- В консоли Google Cloud на странице выбора проекта выберите или создайте проект Google Cloud.
- Убедитесь, что для вашего облачного проекта включены платежные функции. Подробнее о том, как проверить, включены ли платежные функции для проекта…
- Вы будете использовать Cloud Shell – среду командной строки, работающую в Google Cloud. В верхней части консоли Google Cloud нажмите "Активировать Cloud Shell".
- После подключения к Cloud Shell убедитесь, что вы уже прошли аутентификацию и что в качестве проекта указан идентификатор вашего проекта. Для этого используйте следующую команду:
gcloud auth list
- Чтобы убедиться, что команда gcloud распознает ваш проект, выполните в Cloud Shell следующую команду:
gcloud config list project
- Если проект не задан, используйте следующую команду:
gcloud config set project <YOUR_PROJECT_ID>
- Включите необходимые API. Для этого перейдите по ссылке.
Вы также можете использовать для этого команду gcloud. Информацию о командах gcloud и их использовании можно найти в документации.
gcloud services enable \
  alloydb.googleapis.com \
  compute.googleapis.com \
  cloudresourcemanager.googleapis.com \
  servicenetworking.googleapis.com \
  aiplatform.googleapis.com
Подводные камни и устранение неполадок
Синдром "призрачного проекта" | Вы запустили |
The Billing Barricade | Вы включили проект, но забыли платежный аккаунт. AlloyDB – это высокопроизводительный движок, который не запустится, если "топливный бак" (платежный аккаунт) пуст. |
Задержка распространения API | Вы нажали "Включить API", но в командной строке по-прежнему отображается |
Quota Quags | Если вы используете новый пробный аккаунт, то можете столкнуться с региональной квотой на экземпляры AlloyDB. Если |
"Скрытый" агент сервиса | Иногда агенту сервиса AlloyDB не назначается автоматически роль |
3. Настройка базы данных
В этой лабораторной работе мы будем использовать AlloyDB в качестве базы данных для тестовых данных. Для хранения всех ресурсов, таких как базы данных и журналы, используются кластеры. В каждом кластере есть основной экземпляр, который предоставляет точку доступа к данным. Таблицы будут содержать фактические данные.
Давайте создадим кластер, экземпляр и таблицу AlloyDB, куда будет загружен тестовый набор данных.
- Нажмите кнопку или скопируйте ссылку ниже в браузер, в котором вы вошли в аккаунт пользователя Google Cloud Console.
- После этого репозиторий будет клонирован в локальный редактор Cloud Shell, и вы сможете выполнить приведенную ниже команду из папки проекта (убедитесь, что вы находитесь в каталоге проекта):
sh run.sh
- Теперь используйте пользовательский интерфейс (нажмите на ссылку в терминале или на ссылку "Предварительный просмотр в интернете" в терминале).
- Чтобы начать, укажите идентификатор проекта, а также названия кластера и экземпляра.
- Пока идет прокрутка журналов, вы можете выпить кофе и почитать о том, как это происходит за кулисами. Это может занять 10–15 минут.
Подводные камни и устранение неполадок
Проблема с терпением | Кластеры баз данных – это тяжелая инфраструктура. Если вы обновите страницу или закроете сеанс Cloud Shell, потому что вам кажется, что он завис, вы можете получить "призрачный" экземпляр, который частично инициализирован и который невозможно удалить без вмешательства вручную. |
Несоответствие региона | Если вы включили API в |
Кластеры-зомби | Если вы ранее использовали то же название для кластера и не удалили его, скрипт может сообщить, что название кластера уже существует. Названия кластеров в рамках проекта должны быть уникальными. |
Тайм-аут Cloud Shell | Если ваш перерыв на кофе длится 30 минут, Cloud Shell может перейти в спящий режим и отключить процесс |
4. Инициализация схемы
На этом шаге мы рассмотрим следующие темы:
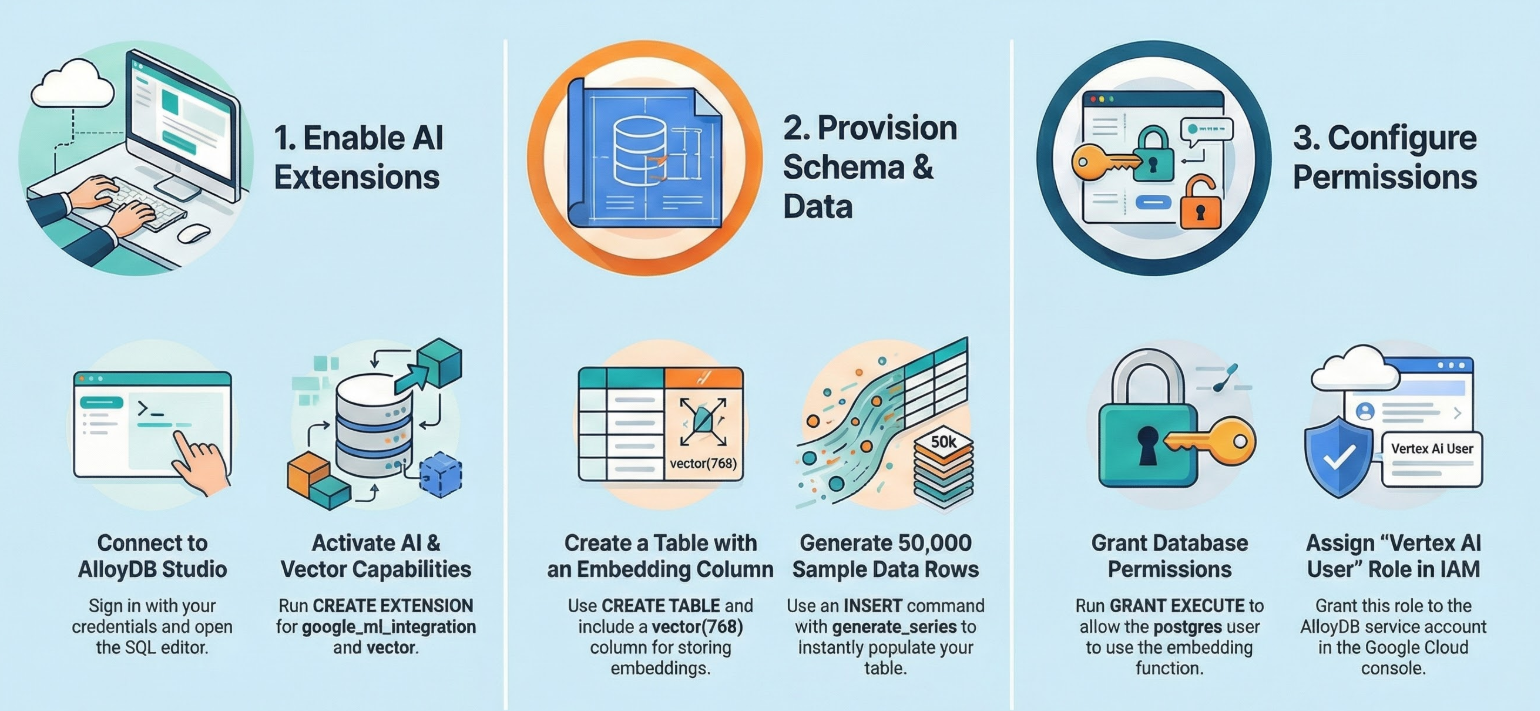
После запуска кластера и экземпляра AlloyDB перейдите в редактор SQL AlloyDB Studio, чтобы включить расширения ИИ и подготовить схему.
Возможно, вам придется подождать, пока завершится создание экземпляра. После этого войдите в AlloyDB, используя учетные данные, которые вы создали при создании кластера. Для аутентификации в PostgreSQL используйте следующие данные:
- Имя пользователя : "
postgres" - База данных : "
postgres" - Пароль : "
alloydb" (или тот, который вы задали при создании).
После успешной аутентификации в AlloyDB Studio команды SQL вводятся в редакторе. Чтобы добавить окно Редактора, нажмите на значок плюса справа от последнего окна.
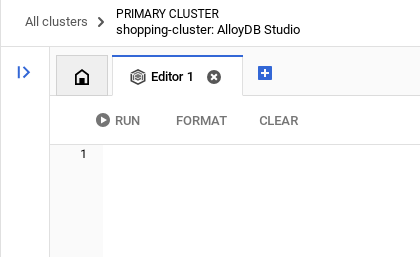
Вы будете вводить команды для AlloyDB в окнах редактора, используя по мере необходимости параметры Run (Выполнить), Format (Форматировать) и Clear (Очистить).
Включить расширения
Для создания этого приложения мы будем использовать расширения pgvector и google_ml_integration. Расширение pgvector позволяет хранить векторные встраивания и выполнять поиск по ним. Расширение google_ml_integration предоставляет функции, которые вы используете для доступа к конечным точкам прогнозирования Vertex AI, чтобы получать прогнозы в SQL. Включите эти расширения, выполнив следующие DDL-запросы:
CREATE EXTENSION IF NOT EXISTS google_ml_integration CASCADE;
CREATE EXTENSION IF NOT EXISTS vector;
Создать таблицу
Нам нужен набор данных, чтобы продемонстрировать масштаб. Вместо импорта CSV-файла мы сгенерируем 50 000 строк синтетических справочных статей с помощью SQL.
Вы можете создать таблицу, используя приведенную ниже инструкцию DDL в AlloyDB Studio:
-- 1. Create the table
CREATE TABLE help_articles (
    id SERIAL PRIMARY KEY,
    title TEXT,
    category TEXT,
    product_version TEXT,
    content_body TEXT,
    embedding vector(768) -- Dimension for text-embedding-005
);

-- 2. Generate 50,000 rows of synthetic data
INSERT INTO help_articles (title, category, product_version, content_body)
SELECT
    'Help Article ' || i,
    CASE
        WHEN i % 3 = 0 THEN 'Billing'
        WHEN i % 3 = 1 THEN 'Technical'
        ELSE 'General'
    END,
    CASE
        WHEN i % 2 = 0 THEN '2.0'
        ELSE '1.0'
    END,
    'This article covers common issues regarding ' ||
    CASE
        WHEN i % 3 = 0 THEN 'payment failures, invoice disputes, and credit card updates.'
        WHEN i % 3 = 1 THEN 'connection timeouts, latency issues, and API errors.'
        ELSE 'account profile settings, password resets, and user roles.'
    END
FROM generate_series(1, 50000) AS i;
В столбце item_vector будут храниться векторные значения текста.
Проверьте данные:
SELECT count(*) FROM help_articles;
-- Output: 50000
Включить флаги базы данных
Перейдите в консоль Instance configuration (Конфигурация экземпляра), нажмите Edit Primary (Изменить основной), перейдите в Advanced Configuration (Расширенная конфигурация) и нажмите Add Database Flags (Добавить флаги базы данных).
Если нет, введите его в раскрывающемся списке флагов, установите значение "ВКЛ." и обновите экземпляр.
Если нет, введите его в раскрывающемся списке флагов, установите значение "ВКЛ." и обновите экземпляр.
Как настроить параметры базы данных
- В консоли Google Cloud перейдите на страницу Clusters (Кластеры).
- Нажмите на кластер в столбце Название ресурса.
- На странице Overview (Обзор) перейдите в раздел Instances (Экземпляры) в кластере, выберите экземпляр и нажмите Edit (Изменить).
- Добавьте, измените или удалите флаг базы данных из своего экземпляра:
Как добавить флаг
- Чтобы добавить флаг базы данных в экземпляр, нажмите "Добавить флаг".
- Выберите пометку из списка "Новая пометка базы данных".
- Укажите значение для пометки.
- Нажмите "Готово".
- Нажмите Update instance (Обновить экземпляр).
- Убедитесь, что расширение google_ml_integration имеет версию 1.5.2 или выше:
Чтобы проверить версию расширения, выполните следующую команду:
SELECT extversion FROM pg_extension WHERE extname = 'google_ml_integration';
Если вам нужно обновить расширение до более новой версии, используйте следующую команду:
ALTER EXTENSION google_ml_integration UPDATE;
Предоставить право доступа
- Чтобы разрешить пользователю управлять автоматическим созданием эмбеддингов, предоставьте разрешения INSERT, UPDATE и DELETE для таблиц google_ml.embed_gen_progress и google_ml.embed_gen_settings:
GRANT INSERT, UPDATE, DELETE ON google_ml.embed_gen_progress TO postgres;
postgres – это имя пользователя (USER_NAME), которому предоставляются разрешения.
- Выполните следующую инструкцию, чтобы разрешить выполнение функции embedding:
GRANT EXECUTE ON FUNCTION embedding TO postgres;
Предоставьте роль пользователя Vertex AI сервисному аккаунту AlloyDB
В консоли Google Cloud IAM предоставьте сервисному аккаунту AlloyDB (он выглядит так: service-<<PROJECT_NUMBER>>@gcp-sa-alloydb.iam.gserviceaccount.com) доступ к роли Vertex AI User. PROJECT_NUMBER – номер вашего проекта.
Вы также можете выполнить следующую команду в терминале Cloud Shell:
PROJECT_ID=$(gcloud config get-value project)


gcloud projects add-iam-policy-binding $PROJECT_ID \
  --member="serviceAccount:service-$(gcloud projects describe $PROJECT_ID --format="value(projectNumber)")@gcp-sa-alloydb.iam.gserviceaccount.com" \
--role="roles/aiplatform.user"
Подводные камни и устранение неполадок
Забытый пароль | Если вы использовали настройку в один клик и не помните пароль, перейдите на страницу с основной информацией об экземпляре в консоли и нажмите "Изменить", чтобы сбросить пароль |
Ошибка "Расширение не найдено" | Если |
5. Генерация векторов за один шаг
Это основа лаборатории. Вместо того чтобы писать цикл Python для обработки этих 50 000 строк, мы будем использовать функцию ai.initialize_embeddings.
Эта команда выполняет два действия:
- Заполняет все существующие строки.
- Создает триггер для автоматического встраивания будущих строк.
Выполните приведенную ниже инструкцию SQL в редакторе запросов AlloyDB.
CALL ai.initialize_embeddings(
  model_id => 'text-embedding-005',
  table_name => 'help_articles',
  content_column => 'content_body',
  embedding_column => 'embedding',
  incremental_refresh_mode => 'transactional'
);
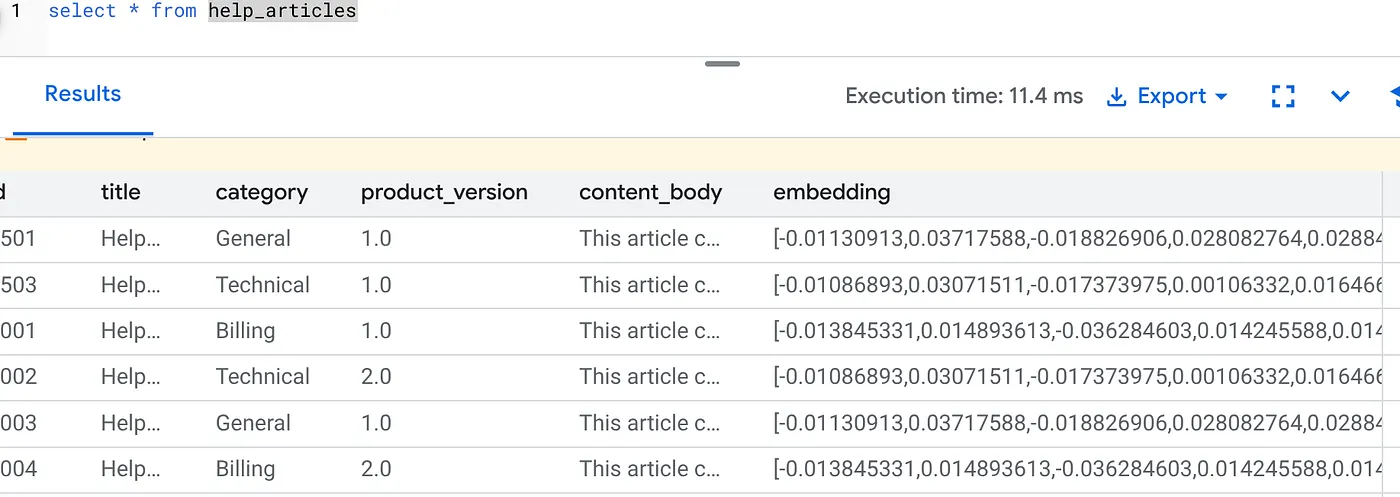
Проверьте эмбеддинги
Убедитесь, что столбец embedding заполнен.
SELECT id, left(content_body, 30), substring(embedding::text, 1, 30) as vector_partial
FROM help_articles;
Вы должны увидеть результат, похожий на приведенный ниже:
Что произошло?
- Массовое заполнение. Расширение автоматически просматривает 50 000 существующих строк и генерирует эмбеддинги с помощью Vertex AI.
- Автоматизация. Если задать incremental_refresh_mode => 'transactional', AlloyDB автоматически настроит внутренние триггеры. Для любой новой строки, вставленной в help_articles, эмбеддинг будет сгенерирован мгновенно.
- Вы можете задать incremental_refresh_mode => ‘None', чтобы получить инструкцию для массового обновления и вручную вызвать ai.refresh_embeddings() для обновления эмбеддингов всех строк.
Вы только что заменили очередь Kafka, обработчик Python и скрипт миграции шестью строками SQL. Подробную информацию обо всех атрибутах можно найти в официальной документации.
Тест триггера в реальном времени
Давайте проверим, работает ли автоматизация Zero Loop для новых данных.
- Чтобы вставить новую строку:
INSERT INTO help_articles (title, category, product_version, content_body)
VALUES ('New Scaling Guide', 'Technical', '2.0', 'How to scale AlloyDB to millions of transactions.');
- Проверить немедленно
SELECT embedding FROM help_articles WHERE title = 'New Scaling Guide';
Результат
Вы увидите, что вектор сгенерирован мгновенно без запуска внешнего скрипта.
Размер пакета для настройки
В настоящее время в AlloyDB по умолчанию используется размер пакета, равный 50. Хотя настройки по умолчанию отлично работают, AlloyDB по-прежнему дает пользователям возможность настраивать идеальную конфигурацию для вашей уникальной модели и набора данных.
CALL ai.initialize_embeddings(
  model_id => 'text-embedding-005',
  table_name => 'help_articles',
  content_column => 'content_body',
  embedding_column => 'embedding',
  incremental_refresh_mode => 'transactional',
  batch_size => 20
);
Однако пользователям необходимо учитывать квоты, которые могут ограничивать производительность. Рекомендуемые квоты AlloyDB приведены в разделе "Подготовка" документации.
Подводные камни и устранение неполадок
Задержка распространения IAM | Вы выполнили команду IAM |
Несоответствие размерности вектора | Для таблицы |
6. Гибкий контекстный поиск
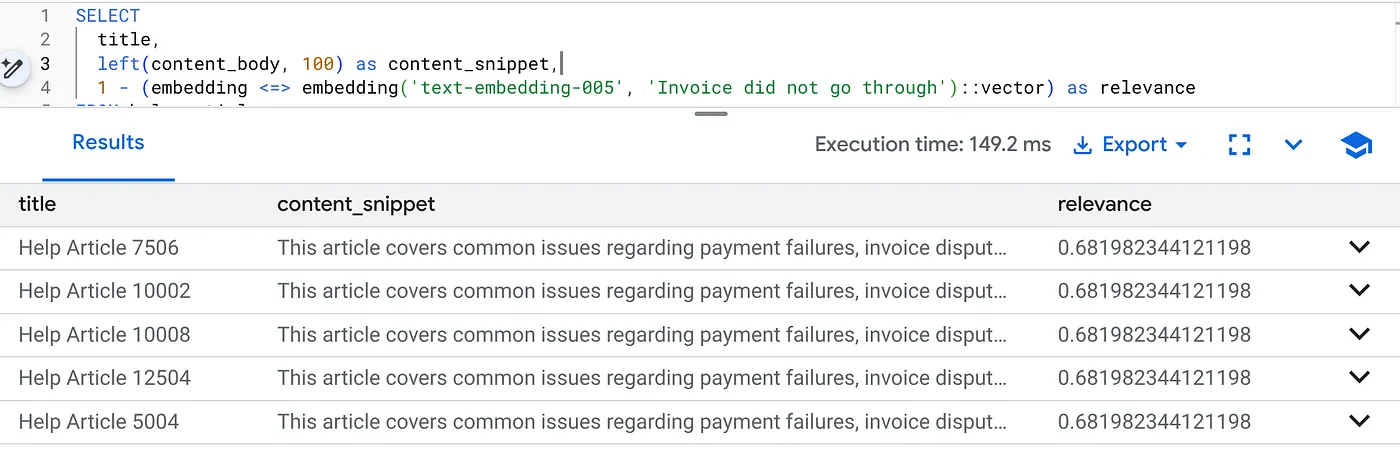
Теперь мы выполняем гибридный поиск. Мы объединяем семантическое понимание (вектор) с бизнес-логикой (фильтры SQL).
Чтобы найти проблемы с оплатой, связанные с версией продукта 2.0, выполните следующий запрос:
SELECT
  title,
  left(content_body, 100) as content_snippet,
  1 - (embedding <=> embedding('text-embedding-005', 'Invoice did not go through')::vector) as relevance
FROM help_articles
WHERE category = 'Billing'  -- Hard SQL Filter
  AND product_version = '2.0' -- Hard SQL Filter
ORDER BY relevance DESC
LIMIT 5;
Это Flexing Context. Поиск "подстраивается", чтобы понять намерение пользователя ("проблемы с оплатой"), соблюдая при этом жесткие бизнес-ограничения (версия 2.0).
Почему это выгодно для стартапов и переноса данных
- Нулевой долг по инфраструктуре: вам не пришлось создавать отдельную векторную базу данных (Pinecone/Milvus). Вы не написали отдельное задание ETL. Все это в Postgres.
- Обновление в реальном времени. В режиме транзакций индекс поиска всегда актуален. Данные готовы к векторизации сразу после фиксации.
- Масштабируемость. AlloyDB создана на базе инфраструктуры Google. Он может обрабатывать массовую генерацию миллионов векторов быстрее, чем ваш скрипт Python.
Подводные камни и устранение неполадок
Проблемы с производительностью в рабочей среде | Проблема: быстро работает только для 50 000 строк. Очень медленно для 1 миллиона строк, если фильтрация категорий недостаточно избирательна.Решение: добавьте векторный индекс. Для масштабирования рабочей версии необходимо создать индекс: CREATE INDEX ON help_articles USING hnsw (embedding vector_cosine_ops); Проверьте использование индекса. Запустите |
Катастрофа "Несоответствие модели" | Проблема: вы инициализировали столбец, используя text-embedding-005 в процедуре CALL. Если вы случайно используете другую модель (например, text-embedding-004 или модель OSS) в функции запроса SELECT embedding('model-name', ...), размерности могут совпадать (768), но векторное пространство будет совершенно другим. Запрос выполняется без ошибок, но результаты совершенно нерелевантны (оценки релевантности мусорные). Устранение неполадок. Убедитесь, что model_id в ai.initialize_embeddings точно соответствует model_id в вашем запросе SELECT. |
Пустой результат (чрезмерная фильтрация) | Проблема: гибридный поиск – это операция "И". Для этого требуется семантическое соответствие И соответствие SQL.Если пользователь ищет "Помощь с оплатой", но в столбце
|
4. Ошибки, связанные с разрешениями и квотами (ошибка 500) | Проблема. Функция
|
5. Нулевые представления | Проблема. Если вы вставите данные до полной инициализации модели или если фоновый рабочий процесс завершится ошибкой, в некоторых строках в столбце
|
7. Организовать
После завершения лабораторной работы не забудьте удалить кластер и экземпляр AlloyDB.
Кластер и его экземпляры будут удалены.
8. Поздравляю!
Вы успешно создали масштабируемое приложение для поиска по базе знаний. Вместо того чтобы управлять сложным конвейером ETL со скриптами и циклами Python для создания векторных представлений, вы использовали AlloyDB AI, чтобы генерировать представления прямо в базе данных с помощью одной команды SQL.
Что мы обсудили
- Мы убрали цикл for в Python для обработки данных.
- Мы сгенерировали 50 000 векторов с помощью одной команды SQL.
- Мы автоматизировали генерацию векторов с помощью триггеров.
- Мы выполнили гибридный поиск.
Дальнейшие действия
- Попробуйте сделать это со своим набором данных.
- Изучите документацию по AlloyDB AI.
- Другие семинары можно найти на сайте Code Vipassana.