

1. Übersicht
In der anspruchsvollen Welt regulierter, geschäftskritischer Branchen stehen Unternehmen vor einem großen Paradoxon: Wie können Sie modernste KI zur Optimierung der Produktion einsetzen, wenn Ihre Cybersicherheitsrichtlinien vorschreiben, dass Ihre Daten niemals mit dem öffentlichen Internet in Berührung kommen dürfen? Intranets und das öffentliche Internet sind strikt voneinander getrennt und kommen nie miteinander in Berührung. Die moderne Fertigung benötigt dringend prädiktive KI, um katastrophale Geräteausfälle zu verhindern und den Ertrag zu optimieren. Das Senden sensibler Telemetrielogs, patentierter Legierungsrezepturen oder ERP-Daten an eine öffentliche Cloud-API ist jedoch in der Praxis nicht möglich. Wenn die Daten also nicht in die Cloud gelangen können, muss die Cloud zu den Daten kommen.
In diesem Codelab bringen wir die fortschrittlichsten Daten- und KI-Tools von Google Cloud mit Gemma 4 und AlloyDB Omni direkt in isolierte, hochsichere Umgebungen.
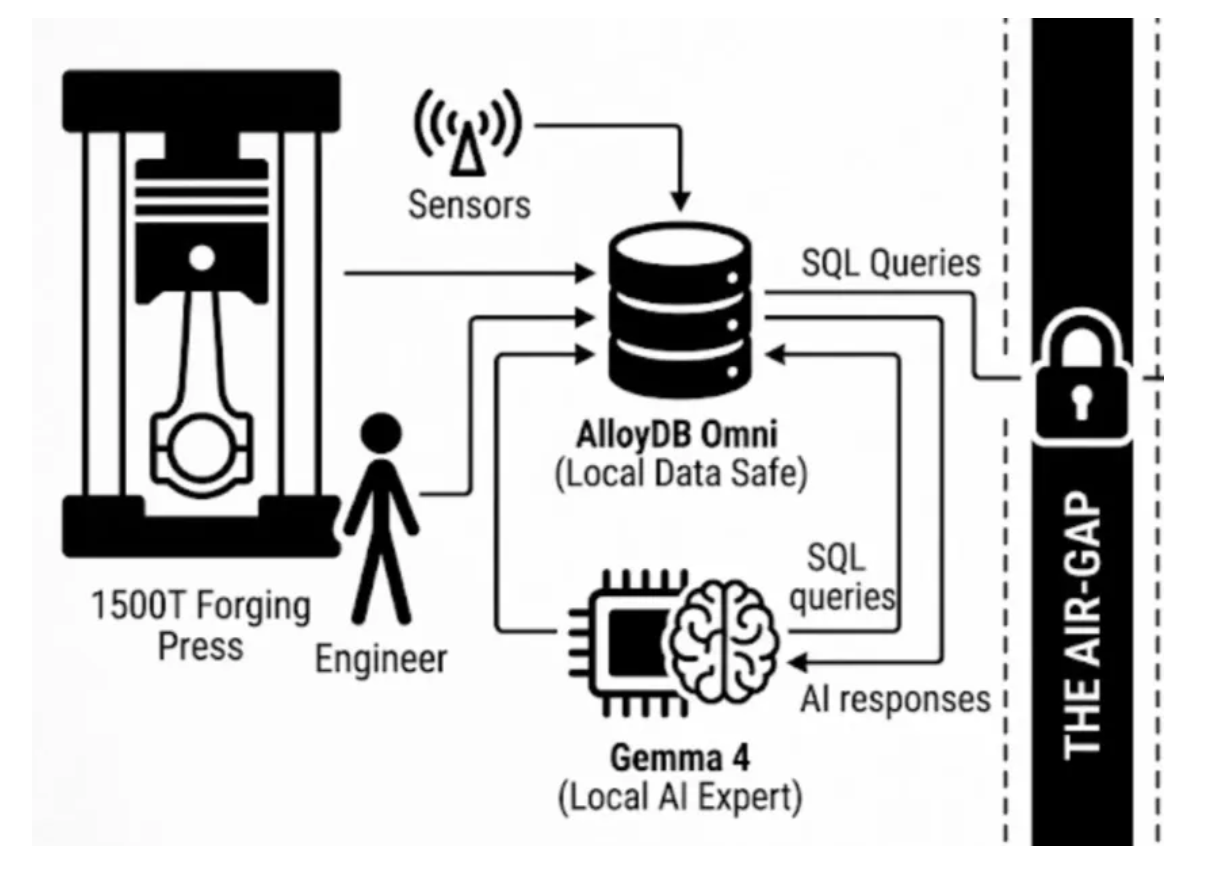
AlloyDB Omni: Der ultimative Datensafe
Stellen Sie sich AlloyDB Omni als einen leistungsstarken Tresor vor. Es handelt sich um eine containerisierte Datenbank auf Unternehmensniveau, die Sie herunterladen und vollständig in Ihrem eigenen sicheren Intranet ausführen.
- Nahtlose Integration: Es stellt eine direkte Verbindung zu den Fertigungssensoren (z. B. VIM oder schwere Presse) und lokalen ERP-Systemen (z. B. Oracle R12) her.
- KI-fähiger Speicher: Es werden streng geheime Prozessblätter mithilfe von Vektoreinbettungen für die KI-Suche (pgvector) sicher gespeichert.
- Leistung: AlloyDB ist bei umfangreichen transaktionalen Arbeitslasten und analytischer KI‑Verarbeitung deutlich schneller als Standard-PostgreSQL.
Lokale KI-Experten: Gemma, TimesFM, TabFM
Anstatt Remote-APIs zu verwenden, können Sie Modelle mit offenen Gewichtungen herunterladen und nativ auf Ihrer lokalen Hardware ausführen, ohne dass API-Daten verloren gehen.
- Gemma: Das LLM mit offenen Gewichtungen von Google fungiert als Ihr F&E-Experte. Es kann historische Logs sicher lesen oder komplexe, patentierte Legierungsrezepturen analysieren, um mechanische Eigenschaften vorherzusagen.
- TimesFM (The Numerical Forecaster): Da LLMs manchmal Zahlen halluzinieren können, ist für schwere Maschinen ein dediziertes Zeitreihen-Foundation-Model erforderlich. TimesFM prognostiziert langfristige numerische Horizonte (bis zu 16.000 Datenpunkte) genau und liest Vibrations- und Temperaturprotokolle, um genaue Kurven für Geräteausfälle vorherzusagen – vollständig offline.
- TabFM (The Tabular Reasoner): Während LLMs Text und TimesFM numerische Trends verarbeiten, ist TabFM auf das Schlussfolgern über strukturierte Tabellendaten spezialisiert. Sie können es sicher lokal ausführen, um komplexe Analysen durchzuführen und Fragen direkt aus dichten, mehrspaltigen ERP- oder CRM-Daten zu beantworten, ohne komplexe SQL-Joins schreiben zu müssen.
Anwendungsfall
Vorausschauende Instandhaltung einer 1.500-Tonnen-Schmiedepresse:
Ungeplante Ausfallzeiten dieser riesigen Maschinen führen zu Produktionsstopps, was zu enormen Zeitverlusten und dem Verlust wichtiger Materialien führt. Umgekehrt werden bei der planmäßigen Wartung oft teure Teile zu früh ausgetauscht, was Budget verschwendet. Wir müssen von der reaktiven zur vorausschauenden Instandhaltung übergehen, ohne den Air Gap zu beeinträchtigen.
Lerninhalte
In diesem Codelab:
- Sie verwenden AlloyDB Omni, um Vibrations- und Temperatursensordaten lokal sicher zu erfassen. Sie können weitere Parameter hinzufügen, um die Daten realistischer und nützlicher zu machen.
- Sie lernen, wie Sie mit Gemma Trends anhand von historischen Fehlerlogs analysieren.
- Sie erstellen ein System, das Ausfälle vorhersagt und automatisch Arbeitsaufträge für die Anlagenverwaltung in Ihrem ERP-System simuliert.
Wir verwenden Docker, um sowohl das lokale LLM als auch AlloyDB Omni bereitzustellen. Der Vorteil dieses Ansatzes ist seine Einfachheit: AlloyDB Omni kann seinen eigenen internen ML-Agent-Prozess automatisch verwalten.
Voraussetzungen
- Grundkenntnisse in SQL
- Eine Standard-Linux-VM (z.B. Ubuntu 22.04) oder ein lokaler Computer (macOS/Windows) mit installiertem Docker.
2. Lokales LLM (Gemma 4) starten
Wir verwenden Ollama, um Gemma lokal zu hosten. Erstellen Sie ein Dockerfile, um die Ollama-Instanz zu konfigurieren:
- Führen Sie auf Ihrem lokalen Computer die folgenden Befehle nacheinander in einem Terminal aus:
mkdir -p gemma4-ollama && cd gemma4-ollama
cat << 'EOF' > Dockerfile
FROM ollama/ollama:latest
ENV OLLAMA_HOST=0.0.0.0:8080
ENV OLLAMA_MODELS=/root/.ollama
ENV MODEL=gemma4:e2b
RUN ollama serve & sleep 5 && ollama pull $MODEL
ENTRYPOINT ["ollama", "serve"]
EOF
- Erstellen Sie den Container und führen Sie ihn im Hostnetzwerk aus:
docker build -t gemma4-local .

docker run --network host -d -p 8080:8080 --name gemma4-ollama-instance gemma4-local
- Sie können sie mit dem folgenden Befehl testen:
curl -X POST http://localhost:8080/api/generate -d '{
  "model": "gemma4:e2b",
  "prompt": "Hello! Explain Gemma 4 in a few sentences."
}'
3. AlloyDB Omni installieren und starten
Starten Sie als Nächstes den AlloyDB Omni-Datenbankcontainer, ebenfalls im Hostnetzwerk:
docker run -d \
  --name my-omni \
  --network host \
  -e POSTGRES_PASSWORD=omni \
  gcr.io/alloydb-omni/alloydbomni:18
Wenn das AlloyDB Omni-Image in Ihrem Google Cloud-Projekt nicht gefunden werden konnte, versuchen Sie, sich zu authentifizieren, indem Sie den folgenden Befehl ausführen, bevor Sie den obigen „docker run“-Befehl ausführen:
gcloud auth login
Versuchen Sie nach Abschluss der Authentifizierung noch einmal, den Befehl „docker run“ auszuführen.
4. Internen ML-Agenten aktivieren
Standardmäßig sind die ML-Integrationsfunktionen von AlloyDB Omni deaktiviert. Wir müssen die Datei „postgresql.conf“ im Container ändern, um den internen ML-Agent-Prozess und die KI-Abfrage-Engine zu aktivieren.
Führen Sie diesen einzelnen Befehl aus, um die erforderlichen Flags anzuhängen:
docker exec -it my-omni sh -c "cat << EOF >> /var/lib/postgresql/data/postgresql.conf
omni_enable_ml_agent_process = 'on'
google_ml_integration.enable_model_support = 'on'
google_ml_integration.enable_ai_query_engine = 'on'
EOF"
Starten Sie den Container neu, um die Änderungen zu übernehmen:
docker restart my-omni
Sie können mit dem Testen von Abfragen beginnen, indem Sie psql mit dem folgenden Befehl starten:
docker exec -it my-omni psql -U postgres
5. KI an das lokale LLM weiterleiten
Nachdem Sie über psql (docker exec -it my-omni psql -U postgres) eine Verbindung zur Datenbank hergestellt haben, können Sie Ihr lokales, netzunabhängiges Modell registrieren. Anstatt eine Anfrage an das Internet zu senden, leiten Sie die model_request_url an Ihren lokalen Ollama-Server weiter, der auf Port 8080 ausgeführt wird.
Führen Sie die folgenden SQL-Anweisungen über die psql-Eingabeaufforderung im Terminal aus:
CREATE EXTENSION IF NOT EXISTS google_ml_integration CASCADE;

CALL google_ml.create_model(
    model_id => 'gemma4:e2b',
    model_request_url => 'http://localhost:8080/api/generate',
    model_provider => 'custom',
    model_type => 'generic'
);
Sie können jetzt Vorhersagen sicher in SQL aufrufen:
SELECT google_ml.predict_row(
    'gemma4:e2b',
    '{"model": "gemma4:e2b", "prompt": "Why is the sky blue?", "stream": false}'
)->'response';
Ausgabe:
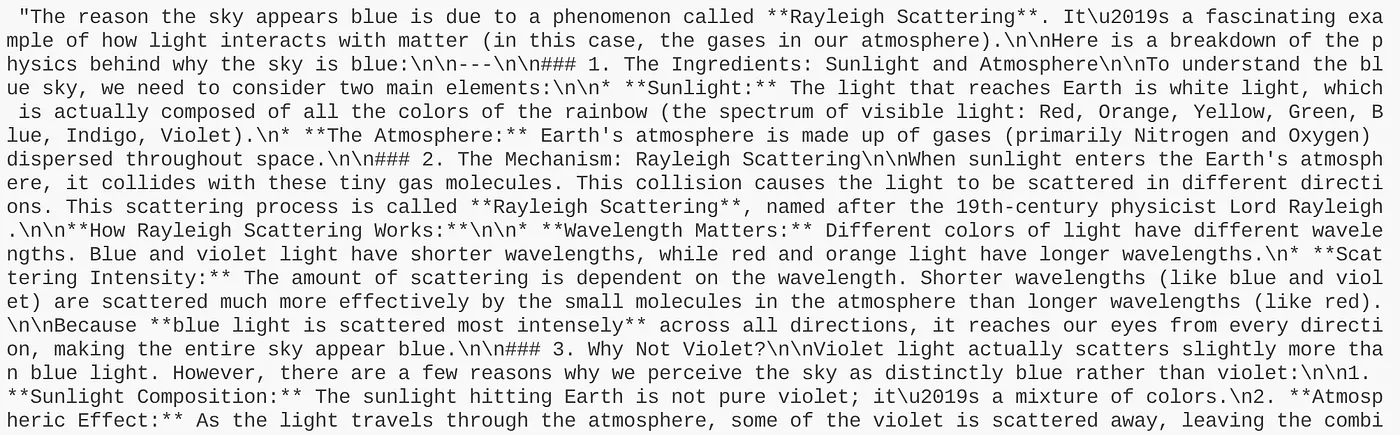
Nachdem wir das Modell mit einem allgemeinen Testfall getestet haben, können wir nun die Daten für unseren Anwendungsfall einbeziehen.
6. Schema erstellen und Daten aufnehmen
Jetzt erstellen wir das Schema und die Daten, die für die Demonstration erforderlich sind.
Führen Sie die folgenden SQL-Anweisungen über die psql-Eingabeaufforderung im Terminal aus:
-- ==============================================================================
-- 1. Setup the Schema for the 1500T Forging Press
-- ==============================================================================
CREATE TABLE IF NOT EXISTS forging_press_logs (
    log_id SERIAL PRIMARY KEY,
    timestamp TIMESTAMP NOT NULL DEFAULT NOW(),
    cycle_id VARCHAR(50) NOT NULL,
    hyd_pressure_bar NUMERIC(5,2),
    oil_temp_c NUMERIC(5,2),
    vib_z_rms NUMERIC(5,2)
);

-- Clean up any existing data if running multiple times
TRUNCATE TABLE forging_press_logs;

-- ==============================================================================
-- 2. Generate 1,000 Records of Simulated Data
-- ==============================================================================
-- 99% of data is 'Normal'
INSERT INTO forging_press_logs (cycle_id, hyd_pressure_bar, oil_temp_c, vib_z_rms)
SELECT
    'C-' || LPAD(i::text, 5, '0'),
    280.0 + (random() * 10 - 5), -- Pressure around 280
    42.0 + (random() * 5),       -- Temp around 42-47
    1.8 + (random() * 0.5)       -- Vib Z around 1.8-2.3
FROM generate_series(1, 990) AS i;

-- 1% of data is 'Anomalous' (Hydraulic pressure drop & vibration spike)
INSERT INTO forging_press_logs (cycle_id, hyd_pressure_bar, oil_temp_c, vib_z_rms)
SELECT
    'C-' || LPAD((990 + i)::text, 5, '0'),
    250.0 + (random() * 5),      -- Pressure dropping
    55.0 + (random() * 5),       -- Temp rising
    5.0 + (random() * 1.5)       -- High vibration
FROM generate_series(1, 10) AS i;

-- ==============================================================================
-- 3. Run the AI Prediction via AlloyDB Omni
-- ==============================================================================
-- Ensure the model is registered (assuming 'gemma4:e2b' is running locally on port 8080)
CREATE EXTENSION IF NOT EXISTS google_ml_integration CASCADE;

DO $$
BEGIN
    CALL google_ml.create_model(
        model_id => 'gemma4:e2b',
        model_request_url => 'http://localhost:8080/api/generate',
        model_provider => 'custom',
        model_type => 'generic'
    );
EXCEPTION WHEN OTHERS THEN
    -- Ignore error if model already exists
END $$;

-- Query the most recent 5 potentially anomalous records and ask Gemma for an analysis
SELECT
    cycle_id,
    hyd_pressure_bar,
    vib_z_rms,
    google_ml.predict_row(
        model_id => 'gemma4:e2b',
        request_body => json_build_object(
            'model', 'gemma4:e2b',
            'stream', false,
            'prompt', 'You are an industrial engineer. Analyze this sensor data from a 1500T forging press: Pressure=' || hyd_pressure_bar || ' bar, Vibration=' || vib_z_rms || ' mm/s. Normal pressure is ~280 bar and normal vibration is ~2.0 mm/s. Does this indicate a hydraulic failure? Answer in one short sentence.'
        )
    )->>'response' AS ai_analysis
FROM
    forging_press_logs
WHERE
    hyd_pressure_bar < 260 OR vib_z_rms > 4.5
ORDER BY
    timestamp DESC
LIMIT 5;
Wenn Sie die obigen Anweisungen nacheinander ausführen, sollten Sie folgendes Ergebnis erhalten:
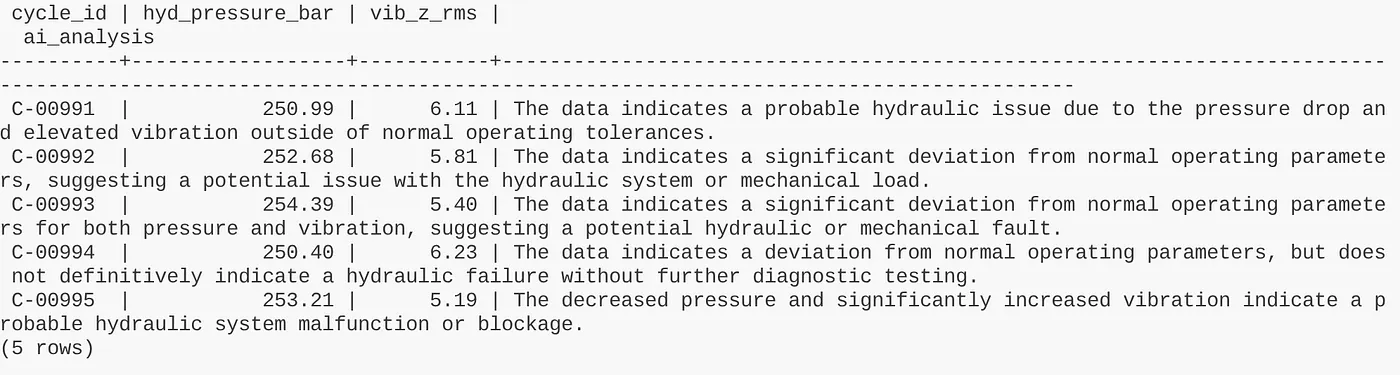
Nachdem die Daten nun bereit sind, können wir das Dashboard für die vorausschauende Instandhaltung erstellen.
7. Livestreaming-Dashboard erstellen
Um diese Architektur zu visualisieren, können Sie sie ganz einfach mit einem Python Flask-Dashboard verbinden, einer Webanwendung.
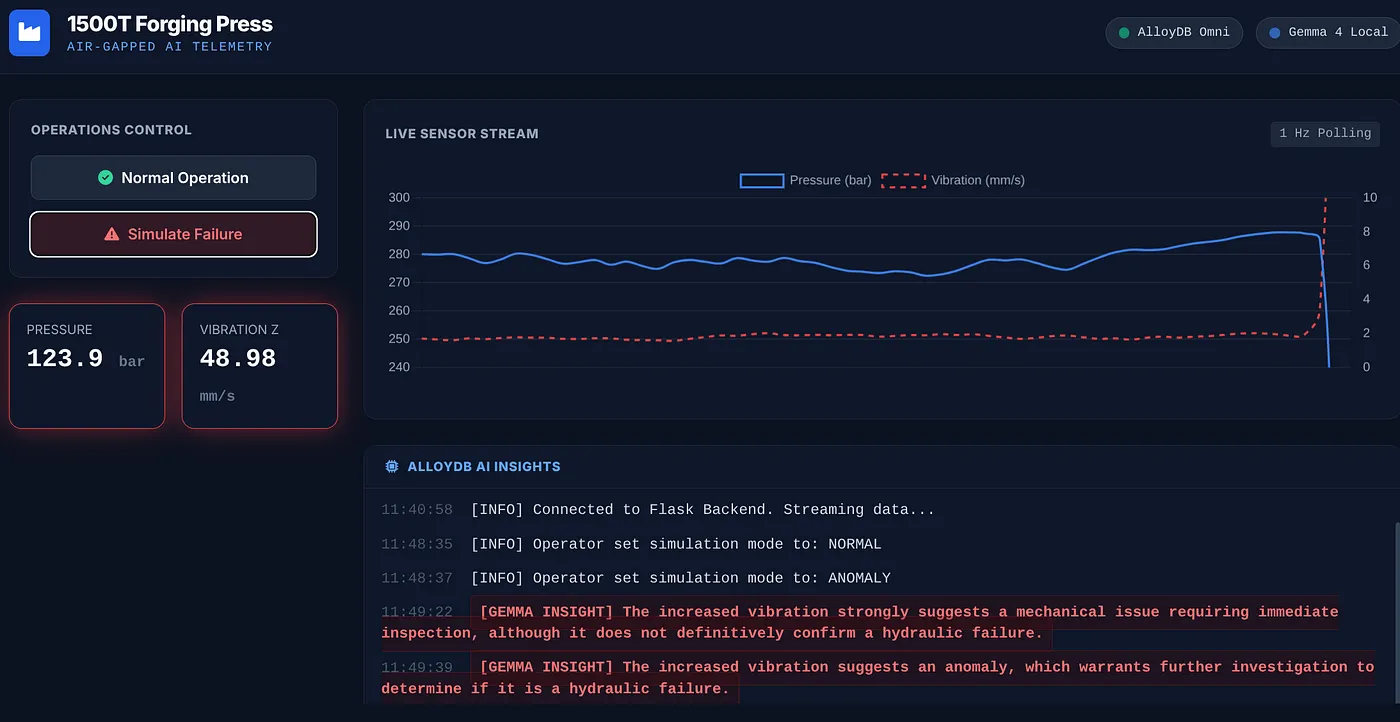
Anstatt SQL-Abfragen manuell auszuführen, streamt ein einfaches Flask-Backend die Live-Sensortelemetrie an ein HTML-Dashboard. Im Normalbetrieb werden im Dashboard einfach die Diagramme dargestellt.
Wenn das Backend jedoch eine Anomalie erkennt (z.B. Druckabfall), löst der Python-Code sofort die Funktion google_ml.predict_row() in AlloyDB aus. AlloyDB leitet den Kontext nahtlos an Ihr lokales Gemma-Modell weiter und die Diagnoseinformationen der KI werden in Echtzeit auf dem Dashboard angezeigt.
💡 Codelab-Tipp: Wenn Sie den Datenbankcontainer verlassen und zur Befehlszeile des Hosts zurückkehren möchten, geben Sie \q ein und drücken Sie die Eingabetaste (oder öffnen Sie einen neuen Terminal-Tab). Führen Sie dann die folgenden Flask-Anwendungsbefehle aus.
Gehen Sie dazu so vor:
- Rufen Sie Ihre Entwicklungsumgebung oder Ihren Code-Editor auf und öffnen Sie das Terminal.
- Führen Sie den folgenden Befehl aus:
pip install flask psycopg2-binary
- Klonen Sie das Code-Repository in Ihr Projektverzeichnis, indem Sie den folgenden Befehl in Ihrem Cloud Shell-Terminal ausführen:
git clone https://github.com/AbiramiSukumaran/gemma4-alloydb-omni-demo
- Wechseln Sie zum Projektordner:
cd gemma4-alloydb-omni-demo
- Führen Sie die Anwendung aus:
python3 app.py
Öffnen Sie den Webbrowser oder klicken Sie auf den Link zur Anwendung, die auf Ihrem Localhost ausgeführt wird.
Was das Live-Dashboard darstellt
Die Flask-Anwendung dient als Echtzeit-Monitoring-Dashboard für die 1.500-Tonnen-Schmiedepresse und visualisiert, wie ein vollständig offline, mit Air Gap betriebenes System die vorausschauende Instandhaltung handhabt:
- Kontinuierlicher Telemetrie-Stream: Das Dashboard stellt Echtzeit-Logs für Vibration (mm/s) und Hydraulikdruck (bar) dar, die dynamisch aktualisiert werden, um den aktiven Betrieb in der Fabrik zu simulieren.
- Datenbankanomalien in Echtzeit: Wenn ein Sensor unter den Schwellenwert fällt (z.B. Druck unter 260 bar), kennzeichnet das Python-Backend das Ereignis und ruft sofort die Funktion
google_ml.predict_row()in AlloyDB Omni auf. - Lokalisierte KI-Diagnose: AlloyDB Omni leitet den Echtzeitkontext an Ihr lokales Gemma 4-Modell weiter. Gemma fungiert als lokaler Industrieexperte, analysiert die Telemetriedaten und gibt eine Diagnosebenachrichtigung (z.B. „Warnung: Druckabfall und starke Vibrationen deuten auf einen potenziellen Ausfall der Hydraulikdichtung hin“) direkt auf dem Dashboard aus.
- Keine Datenlecks: Alle Berechnungen, Datenbanken, Diagramme und KI-Schlussfolgerungen werden vollständig auf Ihrem lokalen Host ausgeführt, ohne dass eine Internetverbindung erforderlich ist.
8. Weg zur Produktion
Wenn Sie diese Architektur von einem lokalen Prototyp auf eine produktionsreife Bereitstellung in der Fertigung skalieren möchten, ohne die Sicherheit durch Air Gap zu beeinträchtigen, können Sie zwischen zwei standardmäßigen lokalen Installationspfaden wählen:
Produktions-VMs und Bare-Metal-VMs (nicht containerisiert):
Für Umgebungen, in denen die Containerisierung nicht bevorzugt wird oder in denen die Sicherheitsrichtlinie eine tiefe Integration in das Host-Betriebssystem erfordert, können Sie die Bereitstellung mit dem offiziellen AlloyDB Omni-RPM-Paket vornehmen. Mit dem AlloyDB Omni Red Hat RPM-Orchestrator bietet diese Bereitstellung eine geringe Latenz, SELinux-Compliance und automatisierte Hochverfügbarkeit (HA) direkt auf Ihren lokalen RHEL- oder Rocky Linux-VMs – und das vollständig offline.
Produktions-Kubernetes und Hochverfügbarkeit:
Wenn Ihre Fabrikinfrastruktur lokale Orchestrierung verwendet, können Sie AlloyDB Omni in Kubernetes bereitstellen . Mit dem offiziellen AlloyDB Omni Kubernetes-Operator können Sie einen robusten Datenbankcluster mit synchronen Stand-by-Replikaten, automatisierten lokalen Sicherungen und dedizierten Lesezugriff-Endpunkten deklarativ bereitstellen.
9. Glückwunsch!
In der Rüstungsindustrie und anderen Branchen mit Air Gap müssen sich Unternehmen nicht mehr zwischen strenger Sicherheit und technologischer Innovation entscheiden. Durch die Bereitstellung von containerisierten Datenbanken, spezialisierten Proxy-Modellen und KI mit offenen Gewichtungen auf souveräner Hardware können Sie Ihre Produktionsstätte in ein intelligentes, vorausschauendes Kraftpaket verwandeln – und gleichzeitig Ihre digitale Festung vollständig intakt halten.