

1. Descripción general
En el mundo de alto riesgo de las industrias reguladas y de misión crítica, las organizaciones se enfrentan a una paradoja enorme: ¿Cómo adoptar la IA de vanguardia para optimizar la producción cuando las políticas de seguridad cibernética exigen que los datos nunca entren en contacto con el Internet público? Las intranets y el Internet público están estrictamente separados y nunca se tocan. Si bien la fabricación moderna necesita con urgencia la IA predictiva para evitar fallas catastróficas en los equipos y optimizar el rendimiento, enviar registros de telemetría sensibles, recetas de aleaciones patentadas o datos de ERP a una API de nube pública es, en la práctica, algo inviable. Por lo tanto, si los datos no pueden ir a la nube, la nube debe ir a los datos.
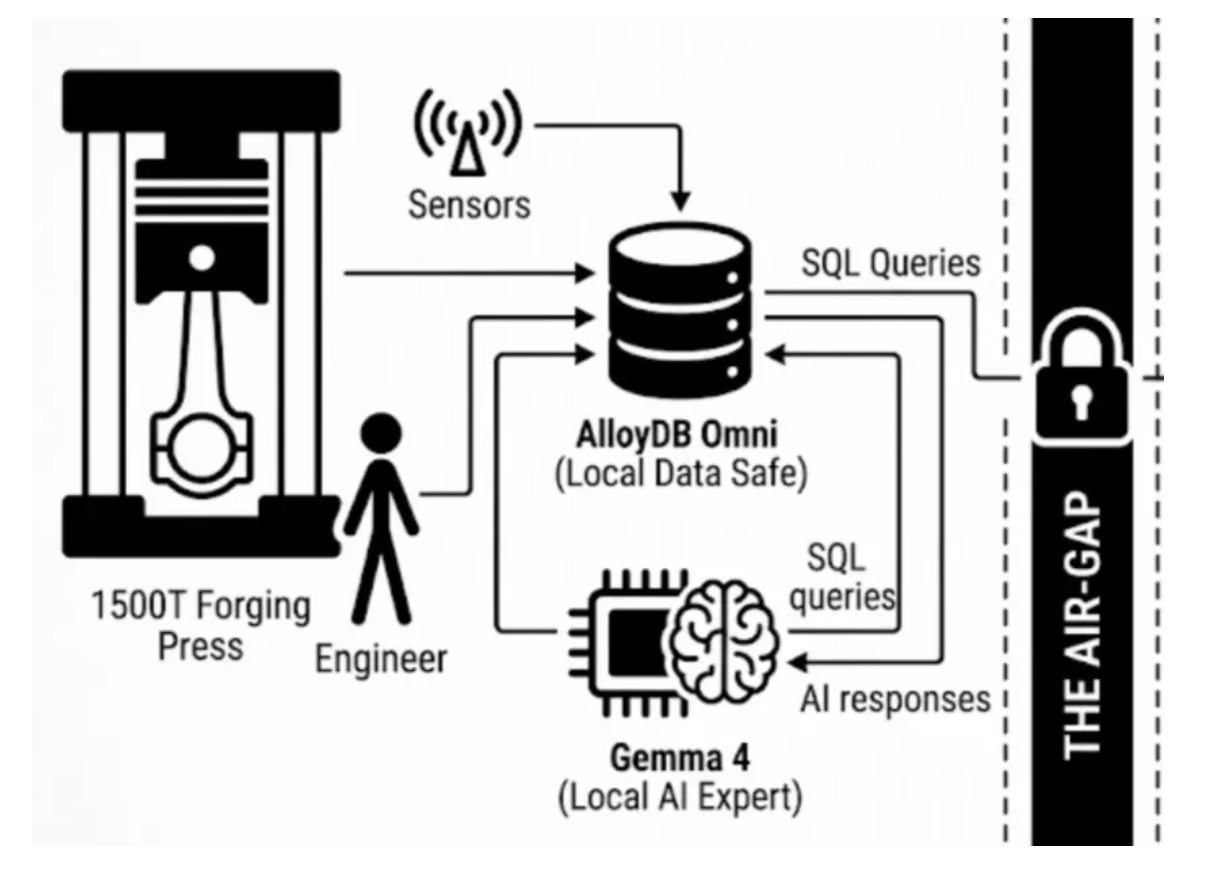
En este codelab, llevaremos las herramientas de IA y datos más avanzadas de Google Cloud directamente a entornos desconectados y altamente seguros con Gemma 4 y AlloyDB Omni.
AlloyDB Omni: La caja fuerte de datos definitiva
Piensa en AlloyDB Omni como una bóveda de alto rendimiento. Es una base de datos de nivel empresarial alojada en contenedores que descargas y ejecutas por completo en tu propia intranet segura.
- Integración perfecta: Se conecta directamente a los sensores de fabricación (como un VIM o una prensa pesada) y a los ERP locales (como Oracle R12).
- Almacenamiento listo para la IA: Almacena de forma segura hojas de procesos ultrasecretas con embeddings de vectores para la búsqueda con IA (pgvector).
- Rendimiento: Supera drásticamente a PostgreSQL estándar tanto para cargas de trabajo transaccionales pesadas como para el procesamiento con IA analítico.
Expertos de IA locales: Gemma, TimesFM y TabFM
En lugar de usar APIs remotas, puedes descargar modelos de pesos abiertos y ejecutarlos de forma nativa en tu hardware local sin filtraciones de APIs.
- Gemma: El LLM de pesos abiertos de Google actúa como tu experto en I+D. Puede leer de forma segura registros históricos o analizar recetas de aleaciones complejas y patentadas para predecir propiedades mecánicas.
- TimesFM (el pronosticador numérico): Debido a que los LLM a veces pueden alucinar números, la maquinaria pesada requiere un modelo de base de series temporales dedicado. TimesFM predice con exactitud horizontes numéricos a largo plazo (hasta 16,000 datos) y lee registros de vibración y temperatura para prever curvas exactas de fallas de equipos, todo sin conexión.
- TabFM (el razonador tabular): Mientras que los LLM manejan texto y TimesFM maneja tendencias numéricas, TabFM se especializa en razonar sobre datos de tablas estructuradas. Puedes ejecutarlo de forma segura de manera local para realizar análisis complejos y responder preguntas directamente a partir de datos densos de ERP o CRM de varias columnas sin necesidad de escribir combinaciones en SQL complejas.
Caso de uso
Mantenimiento predictivo en una prensa de forjado de 1,500 toneladas:
El tiempo de inactividad no planificado en esta maquinaria masiva detiene la producción, lo que desperdicia mucho tiempo y materiales fundamentales. Por el contrario, el mantenimiento programado suele reemplazar piezas costosas demasiado pronto, lo que desperdicia el presupuesto. Necesitamos pasar del mantenimiento reactivo al predictivo sin romper el aislamiento físico.
Qué aprenderás
En este codelab:
- Usarás AlloyDB Omni para capturar de forma segura los datos de los sensores de vibración y temperatura de forma local. Puedes agregar más parámetros para que sea más realista y útil.
- Aprenderás a usar Gemma para analizar las tendencias en comparación con los registros de fallas históricos.
- Crearás un sistema que prediga fallas y active de forma simulada órdenes de trabajo de administración de activos en tu ERP automáticamente.
Usamos Docker para aprovisionar tanto el LLM local como AlloyDB Omni. Lo mejor de este enfoque es su simplicidad: AlloyDB Omni puede administrar automáticamente su propio proceso interno de ML-Agent.
Requisitos
- Conocimientos básicos de SQL
- Una VM de Linux estándar (p. ej., Ubuntu 22.04) o una máquina local (macOS o Windows) con Docker instalado
2. Inicia el LLM local (Gemma 4)
Usaremos Ollama para alojar Gemma de forma local. Crea un Dockerfile para configurar la instancia de Ollama:
- En tu máquina local, ejecuta los siguientes comandos en una terminal, uno por uno:
mkdir -p gemma4-ollama && cd gemma4-ollama
cat << 'EOF' > Dockerfile
FROM ollama/ollama:latest
ENV OLLAMA_HOST=0.0.0.0:8080
ENV OLLAMA_MODELS=/root/.ollama
ENV MODEL=gemma4:e2b
RUN ollama serve & sleep 5 && ollama pull $MODEL
ENTRYPOINT ["ollama", "serve"]
EOF
- Compila y ejecuta el contenedor en la red del host:
docker build -t gemma4-local .

docker run --network host -d -p 8080:8080 --name gemma4-ollama-instance gemma4-local
- Puedes probarlo con el siguiente comando:
curl -X POST http://localhost:8080/api/generate -d '{
  "model": "gemma4:e2b",
  "prompt": "Hello! Explain Gemma 4 in a few sentences."
}'
3. Instala e inicia AlloyDB Omni
A continuación, inicia el contenedor de la base de datos de AlloyDB Omni, también en la red del host:
docker run -d \
  --name my-omni \
  --network host \
  -e POSTGRES_PASSWORD=omni \
  gcr.io/alloydb-omni/alloydbomni:18
Si no se pudo encontrar la imagen de AlloyDB Omni de tu proyecto de Google Cloud, intenta autenticarte ejecutando el comando antes de ejecutar el comando docker run anterior:
gcloud auth login
Una vez que se complete la autenticación, intenta ejecutar el comando docker run de nuevo.
4. Habilita el agente de AA interno
De forma predeterminada, las funciones de integración de AA de AlloyDB Omni están desactivadas. Necesitamos modificar el archivo postgresql.conf dentro del contenedor para habilitar el proceso interno de ML-Agent y el motor de consultas de IA.
Ejecuta este comando único para agregar las marcas necesarias:
docker exec -it my-omni sh -c "cat << EOF >> /var/lib/postgresql/data/postgresql.conf
omni_enable_ml_agent_process = 'on'
google_ml_integration.enable_model_support = 'on'
google_ml_integration.enable_ai_query_engine = 'on'
EOF"
Reinicia el contenedor para aplicar los cambios:
docker restart my-omni
Para comenzar a probar las consultas, inicia psql con el siguiente comando:
docker exec -it my-omni psql -U postgres
5. Enruta la IA al LLM local
Una vez que te conectes a la base de datos a través de psql (docker exec -it my-omni psql -U postgres), podrás registrar tu modelo local sin conexión. En lugar de llamar a Internet, enruta la model_request_url a tu servidor local de Ollama que se ejecuta en el puerto 8080.
Ejecuta las siguientes sentencias de SQL desde el mensaje de psql en la terminal:
CREATE EXTENSION IF NOT EXISTS google_ml_integration CASCADE;

CALL google_ml.create_model(
    model_id => 'gemma4:e2b',
    model_request_url => 'http://localhost:8080/api/generate',
    model_provider => 'custom',
    model_type => 'generic'
);
Ahora puedes invocar predicciones de forma segura desde SQL:
SELECT google_ml.predict_row(
    'gemma4:e2b',
    '{"model": "gemma4:e2b", "prompt": "Why is the sky blue?", "stream": false}'
)->'response';
Resultado:
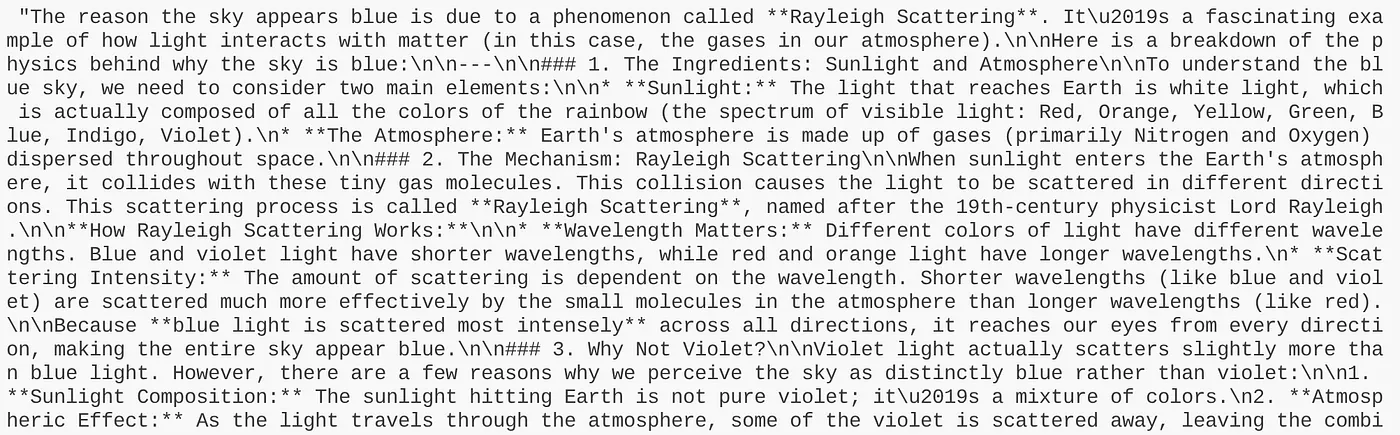
Ahora que lo probamos en un caso de prueba genérico, incorporemos los datos de nuestro caso de uso.
6. Crea un esquema y transfiere datos
Ahora, desarrollemos nuestro caso de uso creando el esquema y los datos necesarios para la demostración.
Ejecuta las siguientes sentencias de SQL desde el mensaje de psql en la terminal:
-- ==============================================================================
-- 1. Setup the Schema for the 1500T Forging Press
-- ==============================================================================
CREATE TABLE IF NOT EXISTS forging_press_logs (
    log_id SERIAL PRIMARY KEY,
    timestamp TIMESTAMP NOT NULL DEFAULT NOW(),
    cycle_id VARCHAR(50) NOT NULL,
    hyd_pressure_bar NUMERIC(5,2),
    oil_temp_c NUMERIC(5,2),
    vib_z_rms NUMERIC(5,2)
);

-- Clean up any existing data if running multiple times
TRUNCATE TABLE forging_press_logs;

-- ==============================================================================
-- 2. Generate 1,000 Records of Simulated Data
-- ==============================================================================
-- 99% of data is 'Normal'
INSERT INTO forging_press_logs (cycle_id, hyd_pressure_bar, oil_temp_c, vib_z_rms)
SELECT
    'C-' || LPAD(i::text, 5, '0'),
    280.0 + (random() * 10 - 5), -- Pressure around 280
    42.0 + (random() * 5),       -- Temp around 42-47
    1.8 + (random() * 0.5)       -- Vib Z around 1.8-2.3
FROM generate_series(1, 990) AS i;

-- 1% of data is 'Anomalous' (Hydraulic pressure drop & vibration spike)
INSERT INTO forging_press_logs (cycle_id, hyd_pressure_bar, oil_temp_c, vib_z_rms)
SELECT
    'C-' || LPAD((990 + i)::text, 5, '0'),
    250.0 + (random() * 5),      -- Pressure dropping
    55.0 + (random() * 5),       -- Temp rising
    5.0 + (random() * 1.5)       -- High vibration
FROM generate_series(1, 10) AS i;

-- ==============================================================================
-- 3. Run the AI Prediction via AlloyDB Omni
-- ==============================================================================
-- Ensure the model is registered (assuming 'gemma4:e2b' is running locally on port 8080)
CREATE EXTENSION IF NOT EXISTS google_ml_integration CASCADE;

DO $$
BEGIN
    CALL google_ml.create_model(
        model_id => 'gemma4:e2b',
        model_request_url => 'http://localhost:8080/api/generate',
        model_provider => 'custom',
        model_type => 'generic'
    );
EXCEPTION WHEN OTHERS THEN
    -- Ignore error if model already exists
END $$;

-- Query the most recent 5 potentially anomalous records and ask Gemma for an analysis
SELECT
    cycle_id,
    hyd_pressure_bar,
    vib_z_rms,
    google_ml.predict_row(
        model_id => 'gemma4:e2b',
        request_body => json_build_object(
            'model', 'gemma4:e2b',
            'stream', false,
            'prompt', 'You are an industrial engineer. Analyze this sensor data from a 1500T forging press: Pressure=' || hyd_pressure_bar || ' bar, Vibration=' || vib_z_rms || ' mm/s. Normal pressure is ~280 bar and normal vibration is ~2.0 mm/s. Does this indicate a hydraulic failure? Answer in one short sentence.'
        )
    )->>'response' AS ai_analysis
FROM
    forging_press_logs
WHERE
    hyd_pressure_bar < 260 OR vib_z_rms > 4.5
ORDER BY
    timestamp DESC
LIMIT 5;
Si ejecutas las declaraciones anteriores una por una, deberías obtener el siguiente resultado:
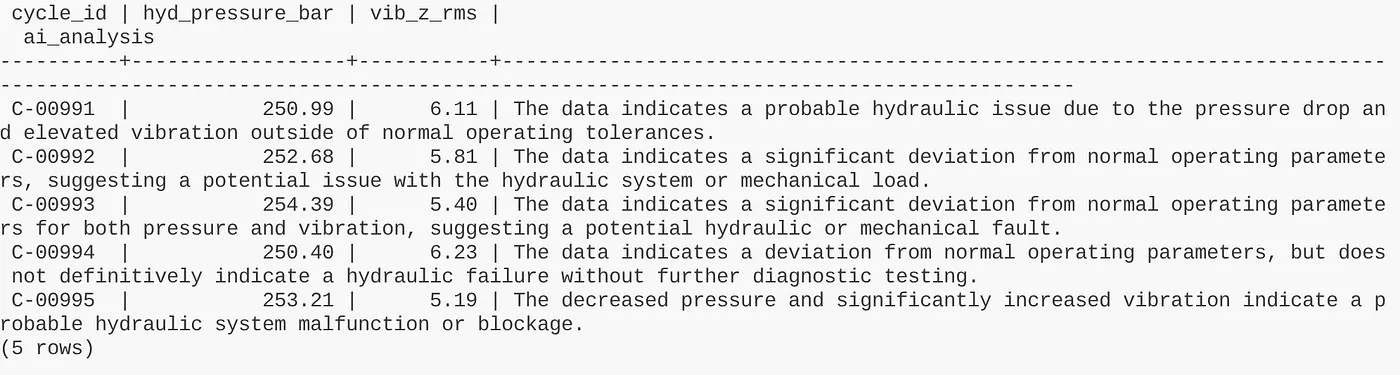
Ahora que tenemos nuestros datos listos, pasemos a compilar el panel de mantenimiento predictivo.
7. Crea un panel de transmisión en vivo
Para visualizar realmente esta arquitectura, puedes conectarla con facilidad a un panel de Flask de Python, que es una aplicación web.
En lugar de ejecutar consultas en SQL de forma manual, un backend de Flask ligero transmite la telemetría del sensor en vivo a un panel de HTML. Durante las operaciones normales, el panel simplemente traza los gráficos.
Sin embargo, cuando el backend detecta una anomalía (p.ej., caídas de presión), el código de Python activa de forma instantánea la función google_ml.predict_row() dentro de AlloyDB. AlloyDB reenvía sin problemas el contexto a tu modelo de Gemma local, y las estadísticas de diagnóstico de la IA aparecen en el panel en tiempo real.
💡 Sugerencia del codelab: Para salir del contenedor de la base de datos y volver a la línea de comandos del host, escribe \q y presiona Intro (o abre una nueva pestaña de la terminal). Luego, ejecuta los comandos de la aplicación de Flask que se indican a continuación.
Para hacer lo siguiente:
- Ve a tu entorno de desarrollo o editor de código y abre la terminal.
- Ejecuta el siguiente comando:
pip install flask psycopg2-binary
- Ejecuta el siguiente comando en la terminal de Cloud Shell para clonar el repositorio de código en el directorio de tu proyecto:
git clone https://github.com/AbiramiSukumaran/gemma4-alloydb-omni-demo
- Navega a la carpeta del proyecto:
cd gemma4-alloydb-omni-demo
- Ejecuta la aplicación:
python3 app.py
Abre el navegador web o haz clic en el vínculo a la app que se ejecuta en tu localhost.
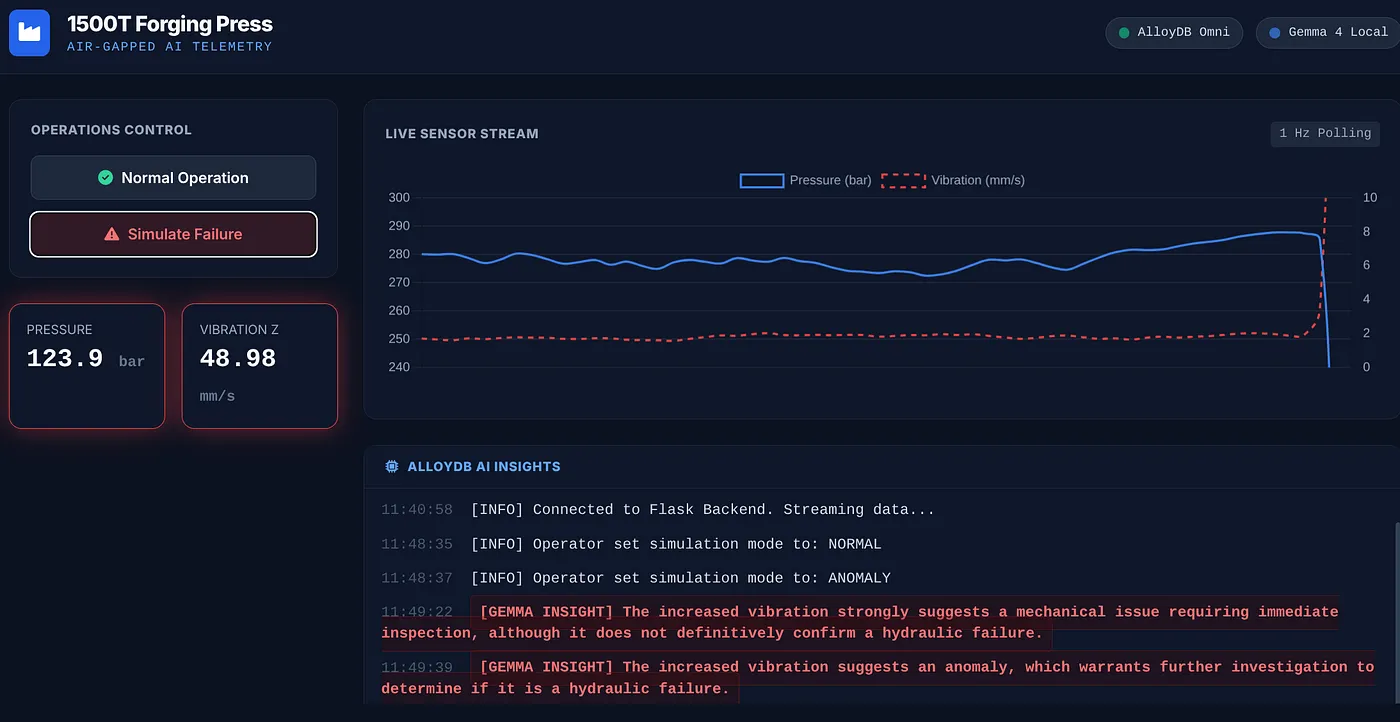
Qué representa el panel de transmisiones en vivo
La aplicación de Flask actúa como un panel de supervisión en tiempo real para la prensa de forjado de 1, 500 toneladas, lo que permite visualizar cómo un sistema completamente sin conexión y aislado maneja el mantenimiento predictivo:
- Transmisión continua de telemetría: El panel traza registros de vibración (mm/s) y presión hidráulica (bar) en tiempo real, que se actualizan de forma dinámica para simular las operaciones activas de la fábrica.
- Anomalías de la base de datos sobre la marcha: Cuando un sensor cae por debajo del umbral (p.ej., la presión cae por debajo de 260 bar), el backend de Python marca el evento y llama de inmediato a la función
google_ml.predict_row()dentro de AlloyDB Omni. - Diagnóstico de IA localizado: AlloyDB Omni reenvía el contexto en tiempo real a tu modelo local de Gemma 4. Gemma actúa como un experto industrial local, analiza la telemetría y muestra una alerta de diagnóstico (p.ej., "Advertencia: La caída de presión y la alta vibración indican una posible falla del sello hidráulico") directamente en el panel.
- Cero filtraciones: Todos los cálculos, las bases de datos, los gráficos y el razonamiento de la IA se ejecutan por completo en tu host local sin necesidad de conectividad a Internet.
8. Ruta a la producción
Para escalar esta arquitectura de un prototipo local a una implementación de planta de producción sin sacrificar la seguridad de aislamiento físico, puedes elegir entre dos pistas de instalación locales estándar:
VMs de producción y equipos físicos (sin contenedores):
En entornos en los que no se prefiere la creación de contenedores o en los que la política de seguridad requiere una integración profunda con el sistema operativo host, puedes implementar con el paquete oficial de RPM de AlloyDB Omni. Con la ayuda del organizador de RPM de Red Hat de AlloyDB Omni, esta implementación ofrece un rendimiento de baja latencia, cumplimiento de SELinux y alta disponibilidad (HA) automatizada directamente en tus VMs locales de RHEL o Rocky Linux, todo de forma sin conexión.
Kubernetes de producción y alta disponibilidad:
Si la infraestructura de tu fábrica utiliza la organización local, puedes implementar AlloyDB Omni en Kubernetes . Con el operador oficial de AlloyDB Omni para Kubernetes, puedes implementar de forma declarativa un clúster de base de datos sólido con réplicas en espera síncronas, copias de seguridad locales automatizadas y extremos de solo lectura dedicados.
9. ¡Felicitaciones!
Para la fabricación de defensa y las industrias con aislamiento físico, la elección ya no es entre una seguridad estricta y la innovación tecnológica. Si implementas bases de datos en contenedores, modelos de proxy especializados y una IA de pesos abiertos en hardware soberano, puedes convertir tu fábrica en un centro de operaciones inteligente y predictivo, todo mientras mantienes tu foso digital completamente intacto.