

۱. نمای کلی
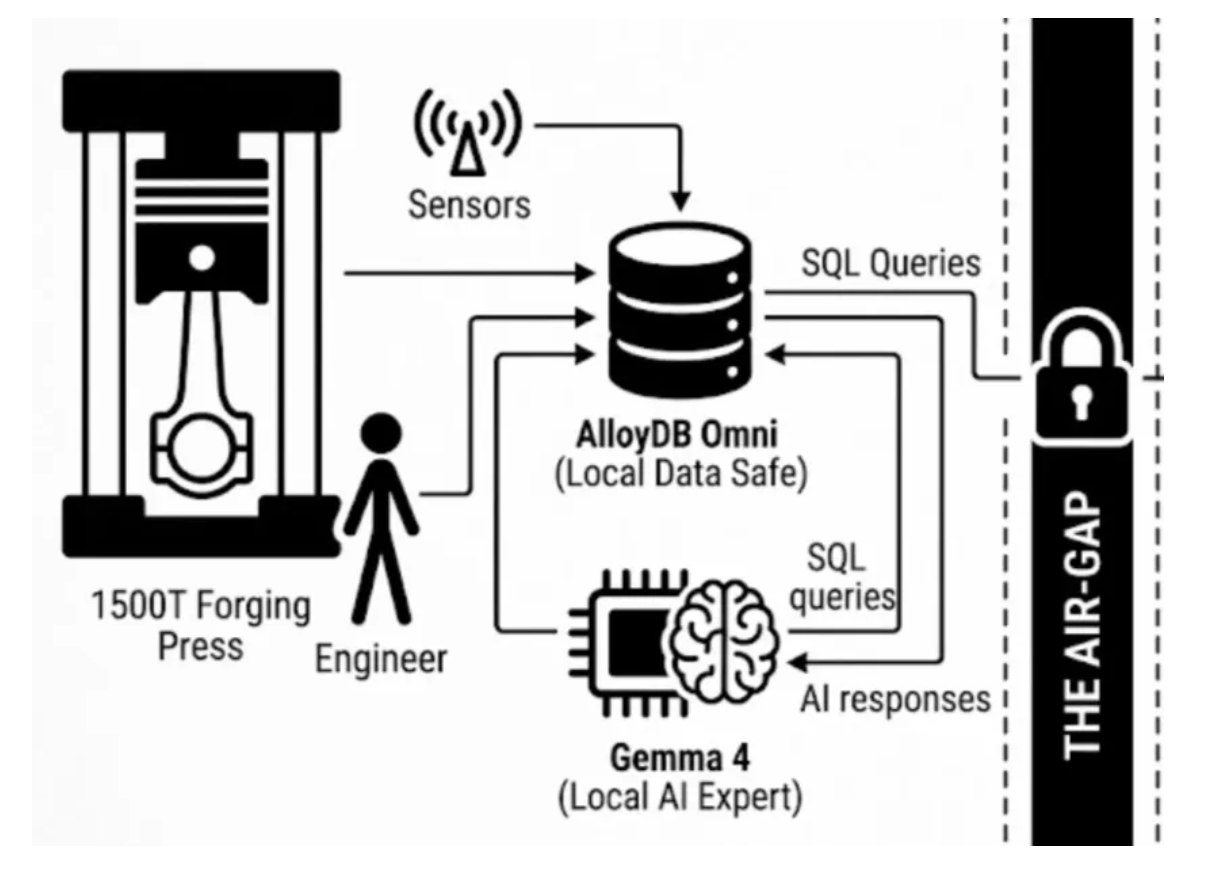
در دنیای پرمخاطره صنایع تحت نظارت و مأموریتمحور، سازمانها با تناقض بزرگی مواجه هستند: چگونه میتوان از هوش مصنوعی پیشرفته برای بهینهسازی تولید استفاده کرد، درحالیکه خطمشیهای امنیت سایبری شما حکم میکنند که دادههایتان هرگز نباید با اینترنت عمومی تماس داشته باشند؟ اینترانتها و اینترنت عمومی کاملاً از هم جدا هستند و هرگز با هم تلاقی ندارند. درحالیکه تولید مدرن بهشدت به هوش مصنوعی پیشبینیکننده برای جلوگیری از خرابیهای فاجعهبار تجهیزات و بهینهسازی بازده نیاز دارد، ارسال گزارشهای حساس دورسنجی، دستورالعملهای آلیاژ ثبتشده، یا دادههای ERP به یک API ابری عمومی در عمل غیرممکن است. بنابراین، اگر دادهها نمیتوانند به فضای ابری بروند، فضای ابری باید به دادهها بیاید.
در این codelab، پیشرفتهترین ابزارهای هوش مصنوعی و داده Google Cloud را با Gemma 4 و AlloyDB Omni مستقیماً به محیطهای بسیار امن و قطعشده میآوریم.
AlloyDB Omni: نهایت امنیت دادهها
AlloyDB Omni را بهعنوان یک گاوصندوق با عملکرد بالا درنظر بگیرید. این پایگاه دادهای کانتینری در سطح سازمانی است که آن را بارگیری میکنید و کاملاً در اینترانت امن خودتان اجرا میکنید.
- ادغام یکپارچه: مستقیماً به حسگرهای تولید (مانند VIM یا پرس سنگین) و ERPهای محلی (مانند Oracle R12) متصل میشود.
- فضای ذخیرهسازی آماده برای هوش مصنوعی: این فضا برگههای فرایند کاملاً محرمانه را بااستفاده از جاسازیهای برداری برای جستجوی هوش مصنوعی (pgvector) بهطور ایمن ذخیره میکند.
- عملکرد: این پایگاه داده بهطور چشمگیری از PostgreSQL استاندارد برای بارهای کاری تراکنشی سنگین و پردازش هوش مصنوعی تحلیلی بهتر عمل میکند.
کارشناسان هوش مصنوعی محلی: Gemma، TimesFM، TabFM
بهجای استفاده از میاناهای برنامهسازی کاربردی ازراهدور، میتوانید مدلهای با وزن باز را بارگیری کنید و آنها را بهصورت بومی در سختافزار محلی خود بدون هیچگونه نشت میانای برنامهسازی کاربردی اجرا کنید.
- Gemma: مدل زبانی بزرگ با وزنهای باز Google بهعنوان کارشناس تحقیق و توسعه شما عمل میکند. این مدل میتواند بهطور ایمن گزارشهای تاریخی را بخواند یا دستورالعملهای پیچیده آلیاژهای ثبتشده را تجزیه و تحلیل کند تا خواص مکانیکی را پیشبینی کند.
- TimesFM (پیشبینیکننده عددی): ازآنجاییکه مدلهای زبانی بزرگ گاهی اوقات میتوانند اعداد را توهم کنند، ماشینآلات سنگین به یک «مدل پایه سری زمانی» اختصاصی نیاز دارند. TimesFM افقهای عددی بلندمدت (تا ۱۶٬۰۰۰ نقطه داده) را بهطور دقیق پیشبینی میکند و گزارشهای لرزش و دما را برای پیشبینی دقیق منحنیهای خرابی تجهیزات میخواند — کاملاً آفلاین.
- TabFM (استدلالگر جدولی): درحالیکه مدلهای زبانی بزرگ نوشتار را مدیریت میکنند و TimesFM روندهای عددی را مدیریت میکند، TabFM در استدلال روی دادههای جدول ساختاریافته تخصص دارد. میتوانید آن را بهطور ایمن در محل اجرا کنید تا تحلیلهای پیچیده انجام دهید و مستقیماً از دادههای متراکم و چندستونی ERP یا CRM به سؤالات پاسخ دهید، بدون اینکه نیازی به نوشتن پیوندهای پیچیده SQL باشد.
مورد استفاده
نگهداری پیشبینانه در پرس آهنگری ۱۵۰۰ تنی:
زمان ازکارافتادگی برنامهریزینشده در این ماشینآلات عظیم تولید را متوقف میکند و زمان بسیار زیاد و مواد حیاتی را هدر میدهد. برعکس، تعمیر و نگهداری زمانبندیشده اغلب قطعات گرانقیمت را خیلی زود تعویض میکند و بودجه را هدر میدهد. باید بدون شکستن شکاف هوا، از تعمیر و نگهداری واکنشی به تعمیر و نگهداری پیشبینیکننده برویم.
آنچه خواهید آموخت
در این codelab:
- از AlloyDB Omni برای ضبط ایمن دادههای حسگر لرزش و دما بهصورت محلی استفاده خواهید کرد، میتوانید پارامترهای بیشتری اضافه کنید تا آن را واقعیتر و مفیدتر کنید.
- یاد خواهید گرفت که چگونه از Gemma برای تجزیهوتحلیل روندها درمقابل گزارشهای خرابی گذشته استفاده کنید.
- سیستمی خواهید ساخت که خرابیها را پیشبینی میکند و بهطور خودکار دستورات کاری «مدیریت دارایی» را در ERP شما بهصورت آزمایشی راهاندازی میکند.
ما برای تأمین LLM محلی و AlloyDB Omni به Docker متکی هستیم. زیبایی این رویکرد در سادگی آن است: AlloyDB Omni میتواند بهطور خودکار فرایند ML-Agent داخلی خود را مدیریت کند.
الزامات
- آشنایی اولیه با SQL.
- یک VM استاندارد Linux (مثلاً Ubuntu 22.04) یا یک ماشین محلی (macOS/Windows) که Docker در آن نصب شده باشد.
۲. شروع کردن «مدل زبانی بزرگ محلی» (Gemma 4)
از Ollama برای میزبانی محلی Gemma استفاده خواهیم کرد. برای پیکربندی نمونه Ollama، یک Dockerfile ایجاد کنید:
- از دستگاه محلیتان، فرمانهای زیر را یکییکی در پایانه اجرا کنید:
mkdir -p gemma4-ollama && cd gemma4-ollama
cat << 'EOF' > Dockerfile
FROM ollama/ollama:latest
ENV OLLAMA_HOST=0.0.0.0:8080
ENV OLLAMA_MODELS=/root/.ollama
ENV MODEL=gemma4:e2b
RUN ollama serve & sleep 5 && ollama pull $MODEL
ENTRYPOINT ["ollama", "serve"]
EOF
- محتوی را در شبکه میزبان بسازید و اجرا کنید:
docker build -t gemma4-local .

docker run --network host -d -p 8080:8080 --name gemma4-ollama-instance gemma4-local
- میتوانید آن را بااستفاده از این فرمان آزمایش کنید:
curl -X POST http://localhost:8080/api/generate -d '{
  "model": "gemma4:e2b",
  "prompt": "Hello! Explain Gemma 4 in a few sentences."
}'
۳. نصب و راهاندازی AlloyDB Omni
سپس، محفظه پایگاه داده AlloyDB Omni را، همچنین در شبکه میزبان، راهاندازی کنید:
docker run -d \
  --name my-omni \
  --network host \
  -e POSTGRES_PASSWORD=omni \
  gcr.io/alloydb-omni/alloydbomni:18
اگر نتوانست تصویر AlloyDB Omni را از پروژه Google Cloud شما پیدا کند، قبلاز اجرای فرمان docker run در بالا، با اجرای فرمان زیر اصالتسنجی کنید:
gcloud auth login
پساز تکمیل اصالتسنجی، فرمان docker run را دوباره اجرا کنید.
۴. فعال کردن «عامل یادگیری ماشین داخلی»
بهطور پیشفرض، ویژگیهای ادغام یادگیری ماشین AlloyDB Omni خاموش است. باید فایل postgresql.conf را در محفظه اصلاح کنیم تا فرایند داخلی ML-Agent و موتور پُرسمان هوش مصنوعی فعال شود.
این فرمان تکی را برای افزودن پرچمهای لازم اجرا کنید:
docker exec -it my-omni sh -c "cat << EOF >> /var/lib/postgresql/data/postgresql.conf
omni_enable_ml_agent_process = 'on'
google_ml_integration.enable_model_support = 'on'
google_ml_integration.enable_ai_query_engine = 'on'
EOF"
برای اعمال تغییرات، محفظه را بازراهاندازی کنید:
docker restart my-omni
میتوانید با شروع psql بااستفاده از فرمان زیر، آزمایش پُرسمانها را شروع کنید:
docker exec -it my-omni psql -U postgres
۵. هدایت کردن هوش مصنوعی به مدل زبانی بزرگ محلی
پساز اتصال به پایگاه داده ازطریق psql (docker exec -it my-omni psql -U postgres)، میتوانید مدل محلی و غیرمتصل به شبکه خود را ثبت کنید. بهجای فراخوانی اینترنت، model_request_url را به سرور Ollama محلی خود که روی درگاه ۸۰۸۰ اجرا میشود هدایت کنید.
عبارتهای SQL زیر را از پیامواره psql در پایانه اجرا کنید:
CREATE EXTENSION IF NOT EXISTS google_ml_integration CASCADE;

CALL google_ml.create_model(
    model_id => 'gemma4:e2b',
    model_request_url => 'http://localhost:8080/api/generate',
    model_provider => 'custom',
    model_type => 'generic'
);
اکنون میتوانید پیشبینیها را بهطور ایمن از داخل SQL فراخوانی کنید:
SELECT google_ml.predict_row(
    'gemma4:e2b',
    '{"model": "gemma4:e2b", "prompt": "Why is the sky blue?", "stream": false}'
)->'response';
خروجی:
اکنون که آن را در یک چارچوب تست عمومی آزمایش کردهایم، بیایید دادههای مورد استفاده خود را وارد تصویر کنیم.
۶. ایجاد طرحواره و دریافت دادهها
اکنون بیایید با ایجاد طرحواره و دادههای لازم برای نمایش، مورد استفادهمان را بسازیم.
عبارتهای SQL زیر را از پیامواره psql در پایانه اجرا کنید:
-- ==============================================================================
-- 1. Setup the Schema for the 1500T Forging Press
-- ==============================================================================
CREATE TABLE IF NOT EXISTS forging_press_logs (
    log_id SERIAL PRIMARY KEY,
    timestamp TIMESTAMP NOT NULL DEFAULT NOW(),
    cycle_id VARCHAR(50) NOT NULL,
    hyd_pressure_bar NUMERIC(5,2),
    oil_temp_c NUMERIC(5,2),
    vib_z_rms NUMERIC(5,2)
);

-- Clean up any existing data if running multiple times
TRUNCATE TABLE forging_press_logs;

-- ==============================================================================
-- 2. Generate 1,000 Records of Simulated Data
-- ==============================================================================
-- 99% of data is 'Normal'
INSERT INTO forging_press_logs (cycle_id, hyd_pressure_bar, oil_temp_c, vib_z_rms)
SELECT
    'C-' || LPAD(i::text, 5, '0'),
    280.0 + (random() * 10 - 5), -- Pressure around 280
    42.0 + (random() * 5),       -- Temp around 42-47
    1.8 + (random() * 0.5)       -- Vib Z around 1.8-2.3
FROM generate_series(1, 990) AS i;

-- 1% of data is 'Anomalous' (Hydraulic pressure drop & vibration spike)
INSERT INTO forging_press_logs (cycle_id, hyd_pressure_bar, oil_temp_c, vib_z_rms)
SELECT
    'C-' || LPAD((990 + i)::text, 5, '0'),
    250.0 + (random() * 5),      -- Pressure dropping
    55.0 + (random() * 5),       -- Temp rising
    5.0 + (random() * 1.5)       -- High vibration
FROM generate_series(1, 10) AS i;

-- ==============================================================================
-- 3. Run the AI Prediction via AlloyDB Omni
-- ==============================================================================
-- Ensure the model is registered (assuming 'gemma4:e2b' is running locally on port 8080)
CREATE EXTENSION IF NOT EXISTS google_ml_integration CASCADE;

DO $$
BEGIN
    CALL google_ml.create_model(
        model_id => 'gemma4:e2b',
        model_request_url => 'http://localhost:8080/api/generate',
        model_provider => 'custom',
        model_type => 'generic'
    );
EXCEPTION WHEN OTHERS THEN
    -- Ignore error if model already exists
END $$;

-- Query the most recent 5 potentially anomalous records and ask Gemma for an analysis
SELECT
    cycle_id,
    hyd_pressure_bar,
    vib_z_rms,
    google_ml.predict_row(
        model_id => 'gemma4:e2b',
        request_body => json_build_object(
            'model', 'gemma4:e2b',
            'stream', false,
            'prompt', 'You are an industrial engineer. Analyze this sensor data from a 1500T forging press: Pressure=' || hyd_pressure_bar || ' bar, Vibration=' || vib_z_rms || ' mm/s. Normal pressure is ~280 bar and normal vibration is ~2.0 mm/s. Does this indicate a hydraulic failure? Answer in one short sentence.'
        )
    )->>'response' AS ai_analysis
FROM
    forging_press_logs
WHERE
    hyd_pressure_bar < 260 OR vib_z_rms > 4.5
ORDER BY
    timestamp DESC
LIMIT 5;
اجرای دستورات بالا بهصورت یکبهیک باید به نتیجه ما در اینجا منجر شود:
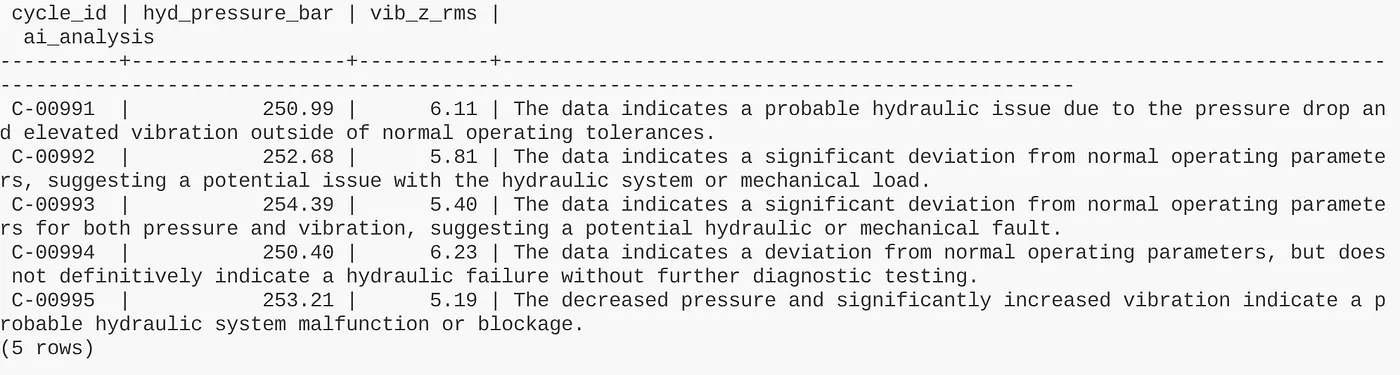
اکنون که دادههایمان آماده است، بیایید به ساخت داشبورد نگهداری پیشبینانه برویم!
۷. ساختن داشبورد جاریسازی زنده
برای تجسم واقعی این معماری، میتوانید بهراحتی آن را به داشبورد Python Flask که یک برنامه وب است متصل کنید.
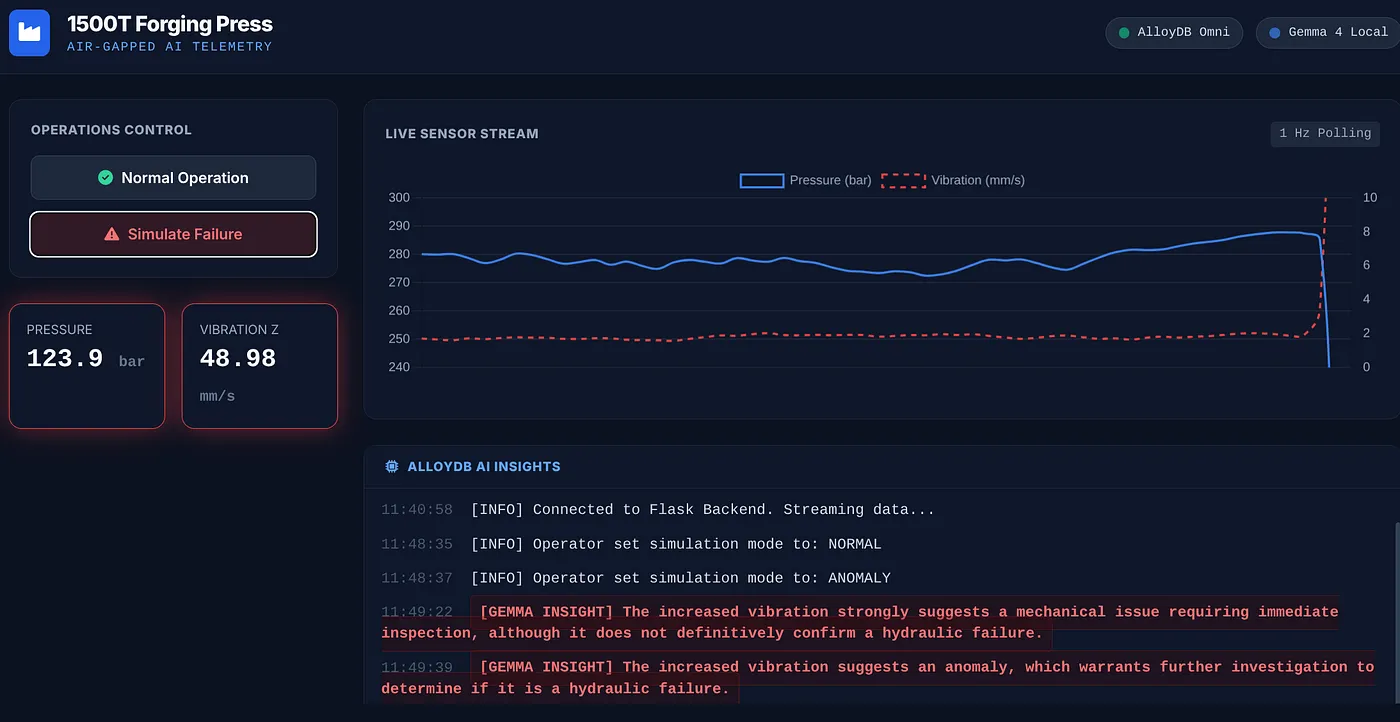
بهجای اجرای دستی پُرسمانهای SQL، یک پسای سبک Flask تلهمتری حسگر زنده را به داشبورد HTML جاریسازی میکند. درطول عملیات عادی، داشبورد فقط نمودارها را ترسیم میکند.
اما وقتی پسرانه ناهنجاریای را شناسایی میکند (مثلاً افت فشار)، کد Python فوراً تابع google_ml.predict_row() را در AlloyDB راهاندازی میکند. AlloyDB بهطور یکپارچه بافت را به مدل Gemma محلی شما ارسال میکند و اطلاعات آماری تشخیصی هوش مصنوعی بهطور همزمان در داشبورد چشمک میزند.
💡 نکته Codelab: برای خروج از محفظه پایگاه داده و بازگشت به خط فرمان میزبان، \q را تایپ کنید و کلید Enter را فشار دهید (یا برگه پایانه جدیدی باز کنید). سپس، فرمانهای برنامه Flask زیر را اجرا کنید.
برای انجام این کار:
- به محیط توسعه نرمافزار / ویرایشگر کد بروید و پایانه را باز کنید
- فرمان زیر را اجرا کنید
pip install flask psycopg2-binary
- با اجرای فرمان زیر در «پایانه Cloud Shell»، مخزن کد را در فهرست راهنمای پروژهتان شبیهسازی کنید:
git clone https://github.com/AbiramiSukumaran/gemma4-alloydb-omni-demo
- به پوشه پروژه بروید:
cd gemma4-alloydb-omni-demo
- برنامه را اجرا کنید:
python3 app.py
مرورگر وب را باز کنید یا روی پیوند برنامه درحال اجرا در میزبان محلیتان کلیک کنید.
داشبورد جاریسازی زنده چه چیزی را نشان میدهد
برنامه Flask بهعنوان داشبورد پایش همزمان برای «پرس آهنگری ۱۵۰۰ تنی» عمل میکند و نحوه مدیریت نگهداری پیشبینانه توسط یک سیستم کاملاً آفلاین و ایزوله را تجسم میکند:
- جاریسازی پیوسته دورسنجی: داشبورد گزارشهای بیدرنگ لرزش (میلیمتر بر ثانیه) و فشار هیدرولیک (بار) را ترسیم میکند و بهطور پویا بهروز میشود تا عملیات فعال کف کارخانه را شبیهسازی کند.
- ناهنجاریهای پایگاه داده درلحظه: وقتی حسگری به زیر آستانه میرسد (مثلاً فشار به زیر ۲۶۰ بار میرسد)، پسای Python رویداد را پرچمگذاری میکند و بلافاصله تابع
google_ml.predict_row()را در AlloyDB Omni فراخوانی میکند. - تشخیصهای هوش مصنوعی محلیشده: AlloyDB Omni بافت همزمان را به مدل Gemma 4 محلی شما ارسال میکند. Gemma بهعنوان یک کارشناس صنعتی در محل عمل میکند، تلهمتری را تجزیهوتحلیل میکند و یک هشدار تشخیصی (مثلاً «هشدار: افت فشار و لرزش بالا نشاندهنده خرابی احتمالی آببند هیدرولیک است») را مستقیماً روی داشبورد چاپ میکند.
- بدون نشت: همه محاسبات، پایگاههای داده، نمودارها، و استدلالهای هوش مصنوعی کاملاً در میزبان محلی شما اجرا میشوند و به اتصال اینترنت نیاز ندارند.
۸. مسیر تولید
برای مقیاسبندی این معماری از یک نمونه اولیه محلی به یک استقرار در سطح کارخانه بدون بهخطر انداختن امنیت ایزوله، میتوانید از بین دو مسیر نصب استاندارد و محلی انتخاب کنید:
ماشینهای مجازی تولید و Bare-Metal (غیرمحتوی):
برای محیطهایی که کانتینرسازی ترجیح داده نمیشود یا محیطهایی که ادغام عمیق با سیستمعامل میزبان طبق خطمشی امنیتی الزامی است، میتوانید بااستفاده از بسته رسمی AlloyDB Omni RPM استقرار کنید. این استقرار با کمک هماهنگکننده AlloyDB Omni Red Hat RPM، عملکرد با تأخیر کم، مطابقت با SELinux، و «دسترسیپذیری بالا» (HA) خودکار را مستقیماً به ماشینهای مجازی RHEL یا Rocky Linux محلی شما بهصورت کاملاً آفلاین میآورد.
تولید Kubernetes و HA:
اگر زیرساخت کارخانه شما از هماهنگسازی محلی استفاده میکند، میتوانید AlloyDB Omni را در Kubernetes مستقر کنید . بااستفاده از AlloyDB Omni Kubernetes Operator رسمی، میتوانید بهصورت اعلانی یک خوشه پایگاه داده قوی با نسخههای کپی آمادهبهکار همگام، پشتیبانگیریهای محلی خودکار، و نقاط پایانی فقط خواندنی اختصاصی مستقر کنید.
۹. تبریک!
برای تولیدات دفاعی و صنایع ایزوله، دیگر انتخاب بین امنیت سختگیرانه و نوآوری فناوری نیست. با استقرار پایگاههای داده کانتینری، مدلهای پراکسی تخصصی، و هوش مصنوعی با وزن باز روی سختافزار مستقل، میتوانید کف کارخانه خود را به یک نیروگاه هوشمند و پیشبینیکننده تبدیل کنید — همه اینها درحالیکه خندق دیجیتال خود را کاملاً دستنخورده نگه میدارید.