

1. खास जानकारी
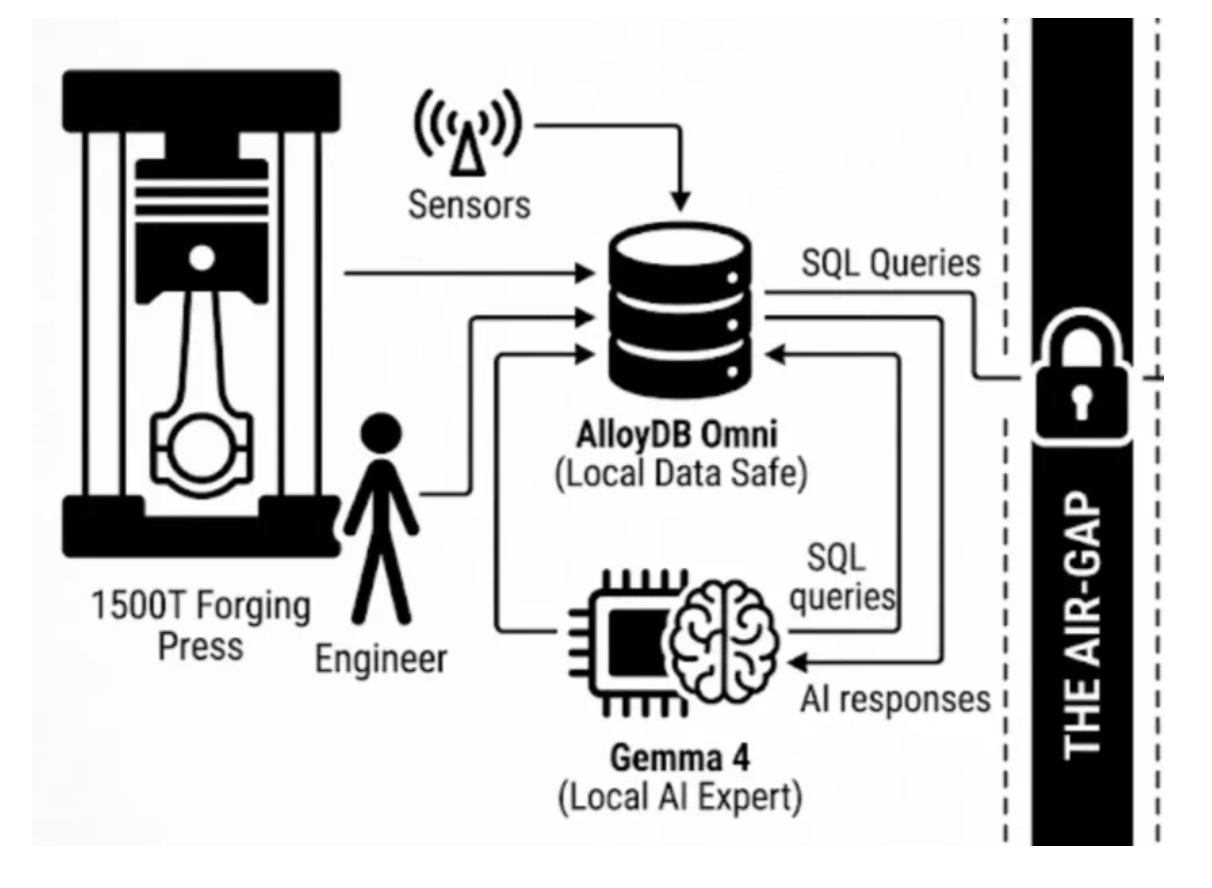
नियमों के तहत काम करने वाली और मिशन-क्रिटिकल इंडस्ट्री में, संगठनों को एक बड़ी चुनौती का सामना करना पड़ता है: जब आपकी साइबर सुरक्षा नीतियां यह तय करती हैं कि आपका डेटा कभी भी सार्वजनिक इंटरनेट से कनेक्ट नहीं हो सकता, तो प्रोडक्शन को ऑप्टिमाइज़ करने के लिए, एआई की बेहतरीन टेक्नोलॉजी को कैसे अपनाया जाए? इंट्रानेट और सार्वजनिक इंटरनेट को पूरी तरह से अलग रखा जाता है. ये कभी भी एक-दूसरे से नहीं जुड़ते. आज के समय में, मैन्युफ़ैक्चरिंग सेक्टर को प्रेडिक्टिव एआई की बहुत ज़रूरत है. इससे उपकरणों को खराब होने से बचाया जा सकता है और प्रॉडक्ट की क्वालिटी को बेहतर बनाया जा सकता है. हालांकि, संवेदनशील टेलीमेट्री लॉग, पेटेंट किए गए अलॉय की रेसिपी या ईआरपी डेटा को किसी पब्लिक क्लाउड एपीआई को भेजना, आम तौर पर सही नहीं माना जाता. इसलिए, अगर डेटा को क्लाउड पर नहीं भेजा जा सकता, तो क्लाउड को डेटा के पास आना होगा.
इस कोडलैब में, हम Google Cloud के सबसे बेहतर डेटा और एआई टूल को सीधे तौर पर Gemma 4 और AlloyDB Omni के साथ, डिसकनेक्ट किए गए और बेहद सुरक्षित एनवायरमेंट में लाएंगे.
AlloyDB Omni: डेटा को सुरक्षित रखने का बेहतरीन तरीका
AlloyDB Omni को बेहतरीन परफ़ॉर्मेंस वाली तिजोरी की तरह समझें. यह कंटेनर में मौजूद, एंटरप्राइज़-ग्रेड का डेटाबेस है. इसे डाउनलोड करके, पूरी तरह से अपने सुरक्षित इंट्रानेट पर चलाया जा सकता है.
- आसान इंटिग्रेशन: यह सीधे तौर पर मैन्युफ़ैक्चरिंग सेंसर (जैसे, वीआईएम या हैवी प्रेस) और लोकल ईआरपी (जैसे, Oracle R12) से कनेक्ट होता है.
- एआई के लिए तैयार स्टोरेज: यह एआई सर्च (pgvector) के लिए वेक्टर एंबेडिंग का इस्तेमाल करके, टॉप-सीक्रेट प्रोसेस शीट को सुरक्षित तरीके से सेव करता है.
- परफ़ॉर्मेंस: यह स्टैंडर्ड PostgreSQL की तुलना में, ज़्यादा ट्रांज़ैक्शनल वर्कलोड और एआई की मदद से डेटा प्रोसेस करने की सुविधा, दोनों के लिए बेहतर परफ़ॉर्म करता है.
लोकल एआई एक्सपर्ट: Gemma, TimesFM, TabFM
रिमोट एपीआई इस्तेमाल करने के बजाय, ओपन-वेट्स मॉडल डाउनलोड किए जा सकते हैं. साथ ही, उन्हें अपने लोकल हार्डवेयर पर नेटिव तौर पर चलाया जा सकता है. इससे एपीआई लीक होने का खतरा नहीं रहता.
- Gemma: Google का ओपन-वेट्स एलएलएम, आपके रिसर्च और डेवलपमेंट एक्सपर्ट के तौर पर काम करता है. यह पुराने लॉग को सुरक्षित तरीके से पढ़ सकता है. इसके अलावा, यह पेटेंट किए गए मिश्र धातु के जटिल फ़ॉर्मूले का विश्लेषण करके, मैकेनिकल प्रॉपर्टी का अनुमान लगा सकता है.
- TimesFM (The Numerical Forecaster): एलएलएम कभी-कभी गलत नंबर जनरेट कर सकते हैं. इसलिए, भारी-भरकम मशीनरी के लिए, टाइम-सीरीज़ फ़ाउंडेशन मॉडल की ज़रूरत होती है. TimesFM, लंबे समय के लिए सटीक अनुमान लगाता है. यह 16,000 डेटा पॉइंट तक के लिए अनुमान लगा सकता है. यह वाइब्रेशन और तापमान के लॉग को पढ़कर, उपकरण के खराब होने के सटीक कर्व का अनुमान लगाता है. यह पूरी तरह से ऑफ़लाइन काम करता है.
- TabFM (टेबलर रीज़नर): एलएलएम टेक्स्ट को हैंडल करते हैं और TimesFM न्यूमेरिकल ट्रेंड को हैंडल करता है. वहीं, TabFM स्ट्रक्चर्ड टेबल डेटा के बारे में तर्क करने में माहिर है. इसे कंपनी की इमारत में सुरक्षित तरीके से चलाया जा सकता है, ताकि मुश्किल विश्लेषण किए जा सकें. साथ ही, मुश्किल एसक्यूएल जॉइन लिखे बिना, कई कॉलम वाले ईआरपी या सीआरएम डेटा से सीधे सवालों के जवाब दिए जा सकें.
इस्तेमाल का उदाहरण
1,500 टन की फ़ोर्जिंग प्रेस पर प्रिडिक्टिव मेंटेनेंस:
इस विशाल मशीनरी के अचानक बंद होने से प्रोडक्शन रुक जाता है. इससे काफ़ी समय और ज़रूरी मटीरियल बर्बाद होता है. इसके उलट, शेड्यूल किए गए रखरखाव में अक्सर महंगे पुर्ज़ों को बहुत जल्दी बदल दिया जाता है. इससे बजट बर्बाद होता है. हमें एयर-गैप को तोड़े बिना, समस्या होने पर उसे ठीक करने के बजाय, समस्या होने से पहले ही उसे ठीक करने की रणनीति अपनानी होगी.
आपको क्या सीखने को मिलेगा
इस कोडलैब में:
- आपको AlloyDB Omni का इस्तेमाल करके, वाइब्रेशन और तापमान मापने वाले सेंसर के डेटा को स्थानीय तौर पर सुरक्षित तरीके से कैप्चर करना होगा. इसे ज़्यादा रियलिस्टिक और काम का बनाने के लिए, इसमें ज़्यादा पैरामीटर जोड़े जा सकते हैं.
- आपको Gemma का इस्तेमाल करके, गड़बड़ियों के पुराने लॉग के आधार पर रुझानों का विश्लेषण करना सिखाया जाएगा.
- आपको एक ऐसा सिस्टम बनाना होगा जो गड़बड़ियों का अनुमान लगाए और आपके ईआरपी में, ऐसेट मैनेजमेंट के वर्क ऑर्डर को अपने-आप मॉक-ट्रिगर करे.
हम लोकल एलएलएम और AlloyDB Omni, दोनों को उपलब्ध कराने के लिए Docker का इस्तेमाल करते हैं. इस तरीके की सबसे अच्छी बात यह है कि यह आसान है: AlloyDB Omni, अपनी इंटरनल एमएल-एजेंट प्रोसेस को अपने-आप मैनेज कर सकता है.
ज़रूरी शर्तें
- एसक्यूएल की बुनियादी जानकारी.
- एक स्टैंडर्ड Linux वीएम (जैसे, Ubuntu 22.04) या Docker इंस्टॉल किया गया कोई लोकल मशीन (macOS/Windows).
2. लोकल एलएलएम (Gemma 4) को चालू करना
हम Gemma को स्थानीय तौर पर होस्ट करने के लिए, Ollama का इस्तेमाल करेंगे. Ollama इंस्टेंस को कॉन्फ़िगर करने के लिए, Dockerfile बनाएं:
- अपनी लोकल मशीन से, टर्मिनल में ये कमांड एक-एक करके चलाएं:
mkdir -p gemma4-ollama && cd gemma4-ollama
cat << 'EOF' > Dockerfile
FROM ollama/ollama:latest
ENV OLLAMA_HOST=0.0.0.0:8080
ENV OLLAMA_MODELS=/root/.ollama
ENV MODEL=gemma4:e2b
RUN ollama serve & sleep 5 && ollama pull $MODEL
ENTRYPOINT ["ollama", "serve"]
EOF
- होस्ट नेटवर्क पर कंटेनर बनाएं और चलाएं:
docker build -t gemma4-local .

docker run --network host -d -p 8080:8080 --name gemma4-ollama-instance gemma4-local
- इस कमांड का इस्तेमाल करके, इसकी जांच की जा सकती है:
curl -X POST http://localhost:8080/api/generate -d '{
  "model": "gemma4:e2b",
  "prompt": "Hello! Explain Gemma 4 in a few sentences."
}'
3. AlloyDB Omni को इंस्टॉल करना और शुरू करना
इसके बाद, AlloyDB Omni डेटाबेस कंटेनर को होस्ट नेटवर्क पर भी स्पिन अप करें:
docker run -d \
  --name my-omni \
  --network host \
  -e POSTGRES_PASSWORD=omni \
  gcr.io/alloydb-omni/alloydbomni:18
अगर आपके Google Cloud प्रोजेक्ट में AlloyDB Omni की इमेज नहीं मिलती है, तो ऊपर दिए गए docker run कमांड को चलाने से पहले, यह कमांड चलाकर पुष्टि करने की कोशिश करें:
gcloud auth login
पुष्टि होने के बाद, docker run कमांड को फिर से चलाएं.
4. इंटरनल एमएल-एजेंट को चालू करना
डिफ़ॉल्ट रूप से, AlloyDB Omni में मशीन लर्निंग इंटिग्रेशन की सुविधाएं बंद होती हैं. हमें कंटेनर में मौजूद postgresql.conf फ़ाइल में बदलाव करना होगा, ताकि इंटरनल मशीन लर्निंग-एजेंट प्रोसेस और एआई क्वेरी इंजन को चालू किया जा सके.
ज़रूरी फ़्लैग जोड़ने के लिए, यह कमांड चलाएं:
docker exec -it my-omni sh -c "cat << EOF >> /var/lib/postgresql/data/postgresql.conf
omni_enable_ml_agent_process = 'on'
google_ml_integration.enable_model_support = 'on'
google_ml_integration.enable_ai_query_engine = 'on'
EOF"
बदलावों को लागू करने के लिए, कंटेनर को रीस्टार्ट करें:
docker restart my-omni
इस कमांड का इस्तेमाल करके psql शुरू करके, क्वेरी की जांच की जा सकती है:
docker exec -it my-omni psql -U postgres
5. एआई को लोकल एलएलएम पर रूट करना
psql (docker exec -it my-omni psql -U postgres) के ज़रिए डेटाबेस से कनेक्ट होने के बाद, अपने लोकल, ऑफ़-ग्रिड मॉडल को रजिस्टर किया जा सकता है. इंटरनेट को कॉल करने के बजाय, model_request_url को पोर्ट 8080 पर चल रहे अपने लोकल Ollama सर्वर पर रूट करें.
टर्मिनल में psql प्रॉम्प्ट से, ये एसक्यूएल स्टेटमेंट चलाएं:
CREATE EXTENSION IF NOT EXISTS google_ml_integration CASCADE;

CALL google_ml.create_model(
    model_id => 'gemma4:e2b',
    model_request_url => 'http://localhost:8080/api/generate',
    model_provider => 'custom',
    model_type => 'generic'
);
अब एसक्यूएल से अनुमानों को सुरक्षित तरीके से शुरू किया जा सकता है:
SELECT google_ml.predict_row(
    'gemma4:e2b',
    '{"model": "gemma4:e2b", "prompt": "Why is the sky blue?", "stream": false}'
)->'response';
आउटपुट:
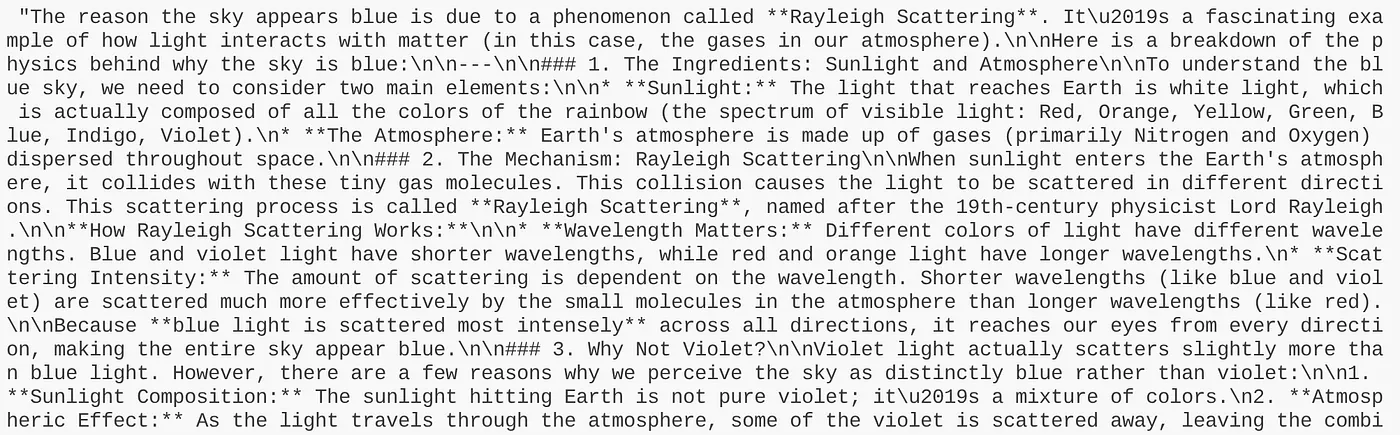
अब हमने सामान्य टेस्ट केस पर इसकी जांच कर ली है. चलिए, अब अपने इस्तेमाल के उदाहरण का डेटा शामिल करते हैं.
6. स्कीमा बनाना और डेटा डालना
अब हम स्कीमा और डेटा बनाकर, अपने इस्तेमाल के उदाहरण को बेहतर बनाते हैं.
टर्मिनल में psql प्रॉम्प्ट से, ये एसक्यूएल स्टेटमेंट चलाएं:
-- ==============================================================================
-- 1. Setup the Schema for the 1500T Forging Press
-- ==============================================================================
CREATE TABLE IF NOT EXISTS forging_press_logs (
    log_id SERIAL PRIMARY KEY,
    timestamp TIMESTAMP NOT NULL DEFAULT NOW(),
    cycle_id VARCHAR(50) NOT NULL,
    hyd_pressure_bar NUMERIC(5,2),
    oil_temp_c NUMERIC(5,2),
    vib_z_rms NUMERIC(5,2)
);

-- Clean up any existing data if running multiple times
TRUNCATE TABLE forging_press_logs;

-- ==============================================================================
-- 2. Generate 1,000 Records of Simulated Data
-- ==============================================================================
-- 99% of data is 'Normal'
INSERT INTO forging_press_logs (cycle_id, hyd_pressure_bar, oil_temp_c, vib_z_rms)
SELECT
    'C-' || LPAD(i::text, 5, '0'),
    280.0 + (random() * 10 - 5), -- Pressure around 280
    42.0 + (random() * 5),       -- Temp around 42-47
    1.8 + (random() * 0.5)       -- Vib Z around 1.8-2.3
FROM generate_series(1, 990) AS i;

-- 1% of data is 'Anomalous' (Hydraulic pressure drop & vibration spike)
INSERT INTO forging_press_logs (cycle_id, hyd_pressure_bar, oil_temp_c, vib_z_rms)
SELECT
    'C-' || LPAD((990 + i)::text, 5, '0'),
    250.0 + (random() * 5),      -- Pressure dropping
    55.0 + (random() * 5),       -- Temp rising
    5.0 + (random() * 1.5)       -- High vibration
FROM generate_series(1, 10) AS i;

-- ==============================================================================
-- 3. Run the AI Prediction via AlloyDB Omni
-- ==============================================================================
-- Ensure the model is registered (assuming 'gemma4:e2b' is running locally on port 8080)
CREATE EXTENSION IF NOT EXISTS google_ml_integration CASCADE;

DO $$
BEGIN
    CALL google_ml.create_model(
        model_id => 'gemma4:e2b',
        model_request_url => 'http://localhost:8080/api/generate',
        model_provider => 'custom',
        model_type => 'generic'
    );
EXCEPTION WHEN OTHERS THEN
    -- Ignore error if model already exists
END $$;

-- Query the most recent 5 potentially anomalous records and ask Gemma for an analysis
SELECT
    cycle_id,
    hyd_pressure_bar,
    vib_z_rms,
    google_ml.predict_row(
        model_id => 'gemma4:e2b',
        request_body => json_build_object(
            'model', 'gemma4:e2b',
            'stream', false,
            'prompt', 'You are an industrial engineer. Analyze this sensor data from a 1500T forging press: Pressure=' || hyd_pressure_bar || ' bar, Vibration=' || vib_z_rms || ' mm/s. Normal pressure is ~280 bar and normal vibration is ~2.0 mm/s. Does this indicate a hydraulic failure? Answer in one short sentence.'
        )
    )->>'response' AS ai_analysis
FROM
    forging_press_logs
WHERE
    hyd_pressure_bar < 260 OR vib_z_rms > 4.5
ORDER BY
    timestamp DESC
LIMIT 5;
ऊपर दिए गए स्टेटमेंट को एक-एक करके चलाने पर, हमें यह नतीजा मिलेगा:
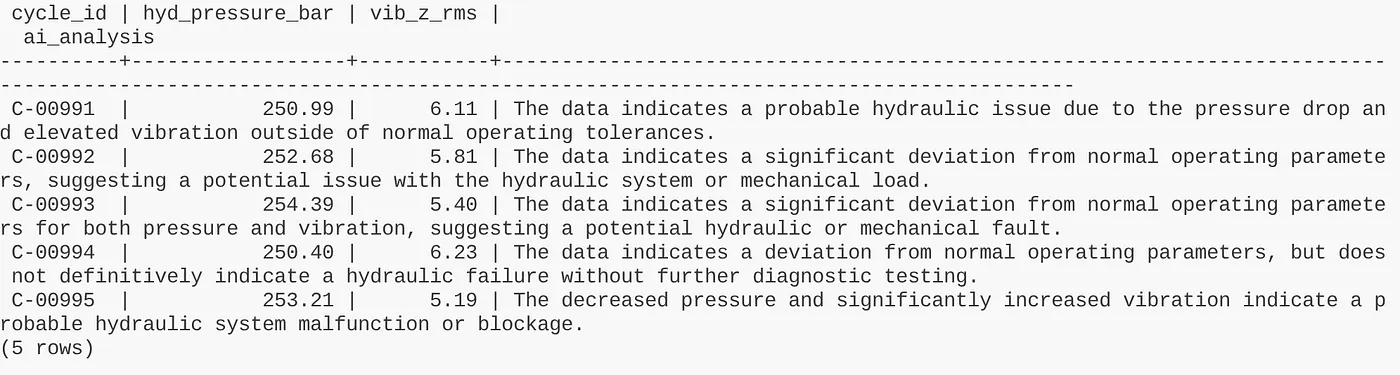
अब हमारे पास डेटा तैयार है. चलिए, प्रिडिक्टिव मेंटेनेंस डैशबोर्ड बनाते हैं!
7. लाइव स्ट्रीमिंग डैशबोर्ड बनाना
इस आर्किटेक्चर को बेहतर तरीके से समझने के लिए, इसे Python Flask डैशबोर्ड से आसानी से कनेक्ट किया जा सकता है. यह एक वेब ऐप्लिकेशन है.
एसक्यूएल क्वेरी को मैन्युअल तरीके से चलाने के बजाय, एक लाइटवेट Flask बैकएंड, लाइव सेंसर टेलीमेट्री को एचटीएमएल डैशबोर्ड पर स्ट्रीम करता है. सामान्य कार्रवाइयों के दौरान, डैशबोर्ड सिर्फ़ ग्राफ़ दिखाता है.
हालांकि, जब बैकएंड को किसी गड़बड़ी का पता चलता है (जैसे, दबाव में गिरावट), तो Python कोड, AlloyDB में google_ml.predict_row() फ़ंक्शन को तुरंत ट्रिगर करता है. AlloyDB, कॉन्टेक्स्ट को आपके लोकल Gemma मॉडल पर आसानी से फ़ॉरवर्ड करता है. इसके बाद, एआई की डाइग्नोस्टिक इनसाइट, डैशबोर्ड पर रीयल-टाइम में दिखती है.
💡 कोडलैब के लिए सलाह: डेटाबेस कंटेनर से बाहर निकलने और अपनी होस्ट कमांड लाइन पर वापस जाने के लिए, \q टाइप करें और Enter दबाएं (या नया टर्मिनल टैब खोलें). इसके बाद, Flask ऐप्लिकेशन के लिए यहां दिए गए कमांड चलाएं.
ऐसा करने के लिए:
- अपने डेवलपमेंट एनवायरमेंट / कोड एडिटर पर जाएं और टर्मिनल खोलें
- यह निर्देश चलाएं
pip install flask psycopg2-binary
- अपने Cloud Shell टर्मिनल में यह कमांड चलाकर, अपनी प्रोजेक्ट डायरेक्ट्री में कोड रेपो को क्लोन करें:
git clone https://github.com/AbiramiSukumaran/gemma4-alloydb-omni-demo
- प्रोजेक्ट फ़ोल्डर में जाएं:
cd gemma4-alloydb-omni-demo
- ऐप्लिकेशन चलाएं:
python3 app.py
वेब ब्राउज़र खोलें या अपने लोकलहोस्ट में चल रहे ऐप्लिकेशन के लिंक पर क्लिक करें.
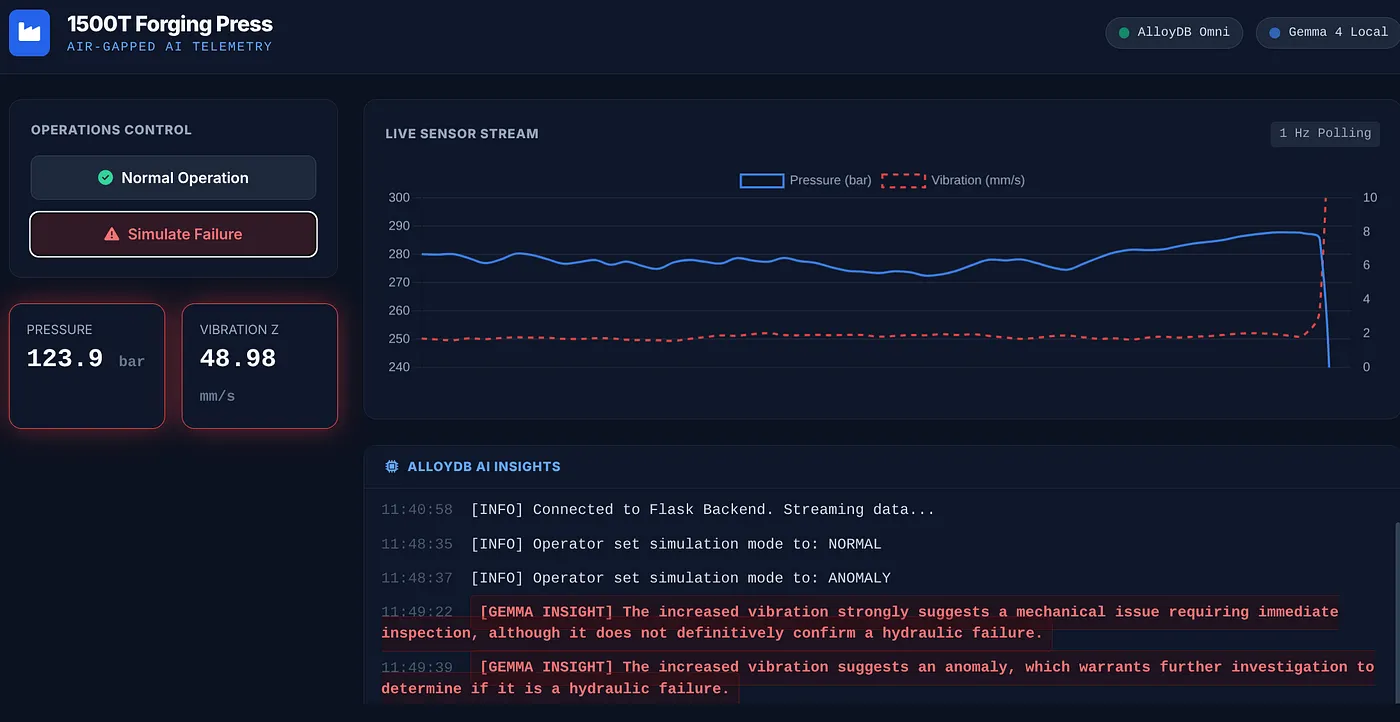
लाइव डैशबोर्ड में क्या दिखता है
Flask ऐप्लिकेशन, 1,500 टन की फ़ोर्जिंग प्रेस के लिए रीयल-टाइम मॉनिटरिंग डैशबोर्ड के तौर पर काम करता है. इससे यह पता चलता है कि पूरी तरह से ऑफ़लाइन और एयर-गैप वाला सिस्टम, प्रिडिक्टिव मेंटेनेंस को कैसे मैनेज करता है:
- लगातार टेलीमेट्री स्ट्रीम: डैशबोर्ड, रीयल-टाइम वाइब्रेशन (मि॰मी॰/से॰) और हाइड्रॉलिक प्रेशर (बार) लॉग को प्लॉट करता है. साथ ही, फ़ैक्ट्री फ़्लोर के चालू ऑपरेशन को सिम्युलेट करने के लिए, डाइनैमिक तौर पर अपडेट करता है.
- डेटाबेस में रीयल-टाइम में अनियमितताओं का पता लगाना: जब कोई सेंसर थ्रेशोल्ड से नीचे चला जाता है (उदाहरण के लिए, दबाव 260 बार से कम हो जाता है), तो Python बैकएंड इवेंट को फ़्लैग करता है. साथ ही, AlloyDB Omni में मौजूद
google_ml.predict_row()फ़ंक्शन को तुरंत कॉल करता है. - लोकल एआई डाइग्नोस्टिक्स: AlloyDB Omni, रीयल-टाइम कॉन्टेक्स्ट को आपके लोकल Gemma 4 मॉडल पर फ़ॉरवर्ड करता है. Gemma, कंपनी की इमारत में इंडस्ट्रियल एक्सपर्ट के तौर पर काम करता है. यह टेलीमेट्री का विश्लेषण करता है और गड़बड़ी की जानकारी देने वाली सूचनाएं या चेतावनी (जैसे, "चेतावनी: प्रेशर में गिरावट और ज़्यादा वाइब्रेशन से पता चलता है कि हाइड्रॉलिक सील में गड़बड़ी हो सकती है") सीधे डैशबोर्ड पर दिखाता है.
- डेटा लीक होने का कोई खतरा नहीं: सभी कैलकुलेशन, डेटाबेस, ग्राफ़, और एआई रीज़निंग पूरी तरह से आपके लोकल होस्ट पर काम करते हैं. इसके लिए, इंटरनेट कनेक्शन की ज़रूरत नहीं होती.
8. प्रोडक्शन तक का सफ़र
इस आर्किटेक्चर को स्थानीय प्रोटोटाइप से प्रोडक्शन-ग्रेड फ़ैक्ट्री फ़्लोर डिप्लॉयमेंट तक स्केल करने के लिए, एयर-गैप वाली सुरक्षा पर कोई असर डाले बिना, आपके पास दो स्टैंडर्ड, कंपनी की इमारत में इंस्टॉलेशन ट्रैक में से किसी एक को चुनने का विकल्प होता है:
प्रोडक्शन वीएम और बेयर-मेटल (नॉन-कंटेनराइज़्ड):
ऐसे एनवायरमेंट जहां कंटेनर का इस्तेमाल नहीं किया जाता या जहां सुरक्षा नीति के तहत, होस्ट ऑपरेटिंग सिस्टम के साथ डीप इंटिग्रेशन की ज़रूरत होती है वहां आधिकारिक AlloyDB Omni RPM पैकेज का इस्तेमाल करके डिप्लॉय किया जा सकता है. AlloyDB Omni Red Hat RPM ऑर्केस्ट्रेटर की मदद से, यह डिप्लॉयमेंट कम इंतज़ार के समय वाली परफ़ॉर्मेंस, SELinux के नियमों का पालन, और ऑटोमेटेड ज़्यादा अपटाइम (एचए) की सुविधा सीधे आपके लोकल आरएचईएल या Rocky Linux वीएम पर उपलब्ध कराता है. यह पूरी तरह से ऑफ़लाइन काम करता है.
Production Kubernetes और HA:
अगर आपकी फ़ैक्ट्री के इन्फ़्रास्ट्रक्चर में लोकल ऑर्केस्ट्रेशन का इस्तेमाल किया जाता है, तो AlloyDB Omni को Kubernetes पर डिप्लॉय किया जा सकता है . AlloyDB Omni Kubernetes Operator का इस्तेमाल करके, एक मज़बूत डेटाबेस क्लस्टर को डिक्लेरेटिव तरीके से डिप्लॉय किया जा सकता है. इसमें सिंक्रोनस स्टैंडबाय रेप्लिका, अपने-आप होने वाले लोकल बैकअप, और सिर्फ़ पढ़ने के लिए इस्तेमाल किए जाने वाले एंडपॉइंट शामिल हैं.
9. बधाई हो!
डिफ़ेंस मैन्युफ़ैक्चरिंग और एयर-गैप वाली अन्य इंडस्ट्री के लिए, अब सुरक्षा और तकनीकी इनोवेशन के बीच किसी एक को चुनने की ज़रूरत नहीं है. सॉवरेन हार्डवेयर पर कंटेनराइज़्ड डेटाबेस, खास प्रॉक्सी मॉडल, और ओपन-वेट एआई को डिप्लॉय करके, अपनी फ़ैक्ट्री को एक इंटेलिजेंट और प्रिडिक्टिव पावरहाउस में बदला जा सकता है. साथ ही, अपने डिजिटल डेटा को पूरी तरह से सुरक्षित रखा जा सकता है.