

1. Panoramica
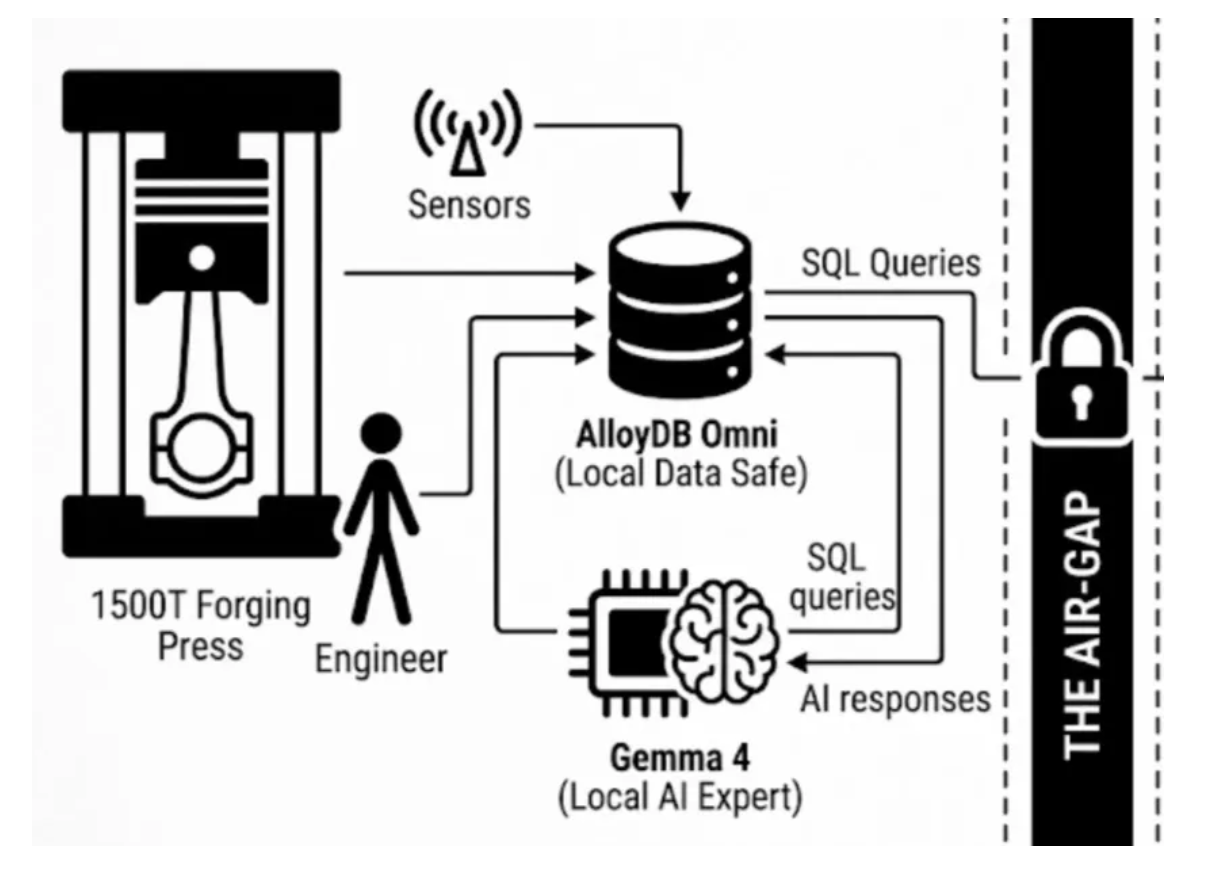
Nel mondo ad alto rischio dei settori regolamentati e mission-critical, le organizzazioni si trovano di fronte a un enorme paradosso: come adottare l'AI all'avanguardia per ottimizzare la produzione quando le policy di sicurezza informatica impongono che i dati non possano mai entrare in contatto con l'internet pubblico? Le intranet e la rete internet pubblica sono rigorosamente separate e non entrano mai in contatto. Sebbene la produzione moderna abbia un disperato bisogno di AI predittiva per prevenire guasti catastrofici alle apparecchiature e ottimizzare il rendimento, l'invio di log di telemetria sensibili, formule di leghe brevettate o dati ERP a un'API cloud pubblica è, in pratica, un'operazione impossibile. Quindi, se i dati non possono andare nel cloud, il cloud deve andare ai dati.
In questo codelab, porteremo gli strumenti di dati e AI più avanzati di Google Cloud direttamente in ambienti disconnessi e altamente sicuri con Gemma 4 e AlloyDB Omni.
AlloyDB Omni: la cassaforte dei dati definitiva
Pensa ad AlloyDB Omni come a un caveau ad alte prestazioni. Si tratta di un database containerizzato di livello enterprise che scarichi ed esegui interamente sulla tua intranet sicura.
- Integrazione perfetta: si connette direttamente ai sensori di produzione (come un VIM o una pressa pesante) e agli ERP locali (come Oracle R12).
- Spazio di archiviazione pronto per l'AI: archivia in modo sicuro i fogli di processo top secret utilizzando i vector embedding per la ricerca AI (pgvector).
- Prestazioni: supera drasticamente PostgreSQL standard sia per i workload transazionali pesanti sia per l'elaborazione con l'AI analitica.
Esperti AI locali: Gemma, TimesFM, TabFM
Anziché utilizzare API remote, puoi scaricare modelli con pesi aperti ed eseguirli in modo nativo sul tuo hardware locale senza alcuna perdita di dati tramite API.
- Gemma: l'LLM con pesi aperti di Google funge da esperto di ricerca e sviluppo. Può leggere in modo sicuro i log storici o analizzare formule complesse di leghe brevettate per prevedere le proprietà meccaniche.
- TimesFM (The Numerical Forecaster): poiché gli LLM a volte possono allucinare i numeri, i macchinari pesanti richiedono un modello di base di serie temporali dedicato. TimesFM prevede con precisione orizzonti numerici a lungo termine (fino a 16.000 punti dati), leggendo i log di vibrazione e temperatura per prevedere le curve esatte di guasto delle apparecchiature, interamente offline.
- TabFM (The Tabular Reasoner): mentre gli LLM gestiscono il testo e TimesFM gestisce le tendenze numeriche, TabFM è specializzato nel ragionamento sui dati delle tabelle strutturate. Puoi eseguirlo in modo sicuro on-premise per eseguire analisi complesse e rispondere alle domande direttamente da dati ERP o CRM densi e su più colonne, senza dover scrivere join SQL complessi.
Caso d'uso
Manutenzione predittiva su una pressa per forgiatura da 1500 tonnellate:
I tempi di inattività non pianificati di questi enormi macchinari interrompono la produzione, con un enorme spreco di tempo e materiali critici. Al contrario, la manutenzione programmata spesso sostituisce parti costose troppo presto, sprecando budget. Dobbiamo passare dalla manutenzione reattiva a quella predittiva senza interrompere l'air gap.
Obiettivi didattici
In questo codelab:
- Utilizzerai AlloyDB Omni per acquisire in modo sicuro i dati dei sensori di vibrazione e temperatura localmente. Puoi aggiungere altri parametri per renderlo più realistico e utile.
- Imparerai a utilizzare Gemma per analizzare le tendenze rispetto ai log degli errori storici.
- Creerai un sistema che prevede i guasti e attiva automaticamente ordini di lavoro di gestione degli asset simulati nel tuo ERP.
Utilizziamo Docker per eseguire il provisioning sia dell'LLM locale sia di AlloyDB Omni. La bellezza di questo approccio sta nella sua semplicità: AlloyDB Omni può gestire automaticamente il proprio processo interno di ML-Agent.
Requisiti
- Conoscenza di base di SQL.
- Una VM Linux standard (ad es. Ubuntu 22.04) o una macchina locale (macOS/Windows) con Docker installato.
2. Avvia l'LLM locale (Gemma 4)
Utilizzeremo Ollama per ospitare Gemma localmente. Crea un Dockerfile per configurare l'istanza Ollama:
- Dalla tua macchina locale, esegui i seguenti comandi in un terminale, uno alla volta:
mkdir -p gemma4-ollama && cd gemma4-ollama
cat << 'EOF' > Dockerfile
FROM ollama/ollama:latest
ENV OLLAMA_HOST=0.0.0.0:8080
ENV OLLAMA_MODELS=/root/.ollama
ENV MODEL=gemma4:e2b
RUN ollama serve & sleep 5 && ollama pull $MODEL
ENTRYPOINT ["ollama", "serve"]
EOF
- Crea ed esegui il container sulla rete host:
docker build -t gemma4-local .

docker run --network host -d -p 8080:8080 --name gemma4-ollama-instance gemma4-local
- Puoi testarlo utilizzando il comando:
curl -X POST http://localhost:8080/api/generate -d '{
  "model": "gemma4:e2b",
  "prompt": "Hello! Explain Gemma 4 in a few sentences."
}'
3. Installa e avvia AlloyDB Omni
Successivamente, avvia il container del database AlloyDB Omni, sempre sulla rete host:
docker run -d \
  --name my-omni \
  --network host \
  -e POSTGRES_PASSWORD=omni \
  gcr.io/alloydb-omni/alloydbomni:18
Se non è stato possibile trovare l'immagine AlloyDB Omni dal tuo progetto Google Cloud, prova a eseguire l'autenticazione eseguendo il comando prima di eseguire il comando docker run riportato sopra:
gcloud auth login
Una volta completata l'autenticazione, prova a eseguire nuovamente il comando docker run.
4. Attiva l'agente ML interno
Per impostazione predefinita, le funzionalità di integrazione del ML di AlloyDB Omni sono disattivate. Dobbiamo modificare il file postgresql.conf all'interno del container per abilitare il processo ML-Agent interno e il motore di query AI.
Esegui questo singolo comando per aggiungere i flag necessari:
docker exec -it my-omni sh -c "cat << EOF >> /var/lib/postgresql/data/postgresql.conf
omni_enable_ml_agent_process = 'on'
google_ml_integration.enable_model_support = 'on'
google_ml_integration.enable_ai_query_engine = 'on'
EOF"
Riavvia il container per applicare le modifiche:
docker restart my-omni
Puoi iniziare a testare le query avviando psql con il comando:
docker exec -it my-omni psql -U postgres
5. Instrada l'AI all'LLM locale
Una volta stabilita la connessione al database tramite psql (docker exec -it my-omni psql -U postgres), puoi registrare il tuo modello locale, off-grid. Anziché chiamare internet, indirizza model_request_url al tuo server Ollama locale in esecuzione sulla porta 8080.
Esegui le seguenti istruzioni SQL dal prompt psql nel terminale:
CREATE EXTENSION IF NOT EXISTS google_ml_integration CASCADE;

CALL google_ml.create_model(
    model_id => 'gemma4:e2b',
    model_request_url => 'http://localhost:8080/api/generate',
    model_provider => 'custom',
    model_type => 'generic'
);
Ora puoi richiamare le previsioni in modo sicuro da SQL:
SELECT google_ml.predict_row(
    'gemma4:e2b',
    '{"model": "gemma4:e2b", "prompt": "Why is the sky blue?", "stream": false}'
)->'response';
Output:
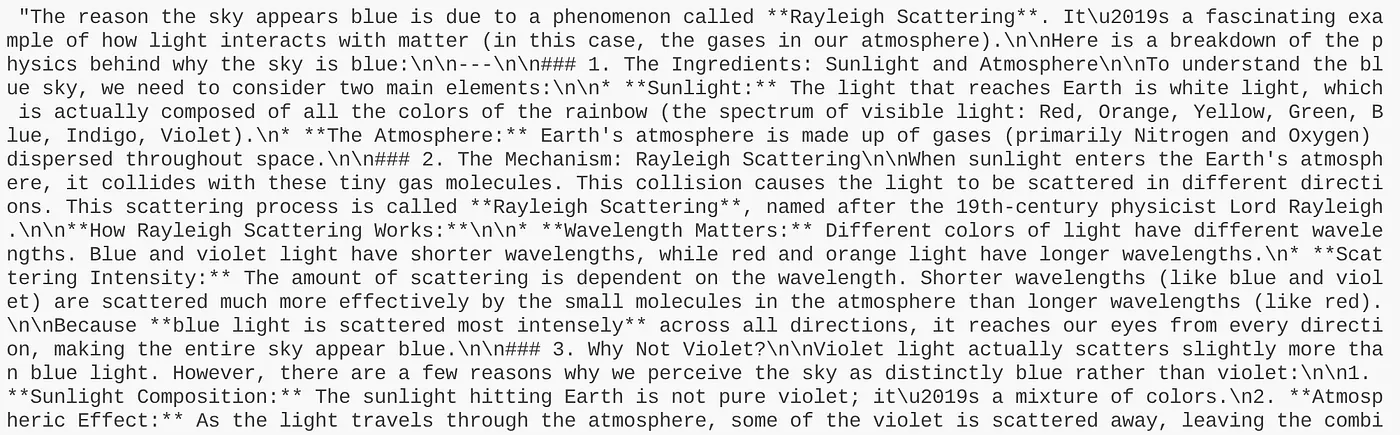
Ora che l'abbiamo testato su uno scenario di test generico, inseriamo i dati del nostro caso d'uso.
6. Crea lo schema e importa i dati
Ora sviluppiamo il nostro caso d'uso creando lo schema e i dati necessari per la dimostrazione.
Esegui le seguenti istruzioni SQL dal prompt psql nel terminale:
-- ==============================================================================
-- 1. Setup the Schema for the 1500T Forging Press
-- ==============================================================================
CREATE TABLE IF NOT EXISTS forging_press_logs (
    log_id SERIAL PRIMARY KEY,
    timestamp TIMESTAMP NOT NULL DEFAULT NOW(),
    cycle_id VARCHAR(50) NOT NULL,
    hyd_pressure_bar NUMERIC(5,2),
    oil_temp_c NUMERIC(5,2),
    vib_z_rms NUMERIC(5,2)
);

-- Clean up any existing data if running multiple times
TRUNCATE TABLE forging_press_logs;

-- ==============================================================================
-- 2. Generate 1,000 Records of Simulated Data
-- ==============================================================================
-- 99% of data is 'Normal'
INSERT INTO forging_press_logs (cycle_id, hyd_pressure_bar, oil_temp_c, vib_z_rms)
SELECT
    'C-' || LPAD(i::text, 5, '0'),
    280.0 + (random() * 10 - 5), -- Pressure around 280
    42.0 + (random() * 5),       -- Temp around 42-47
    1.8 + (random() * 0.5)       -- Vib Z around 1.8-2.3
FROM generate_series(1, 990) AS i;

-- 1% of data is 'Anomalous' (Hydraulic pressure drop & vibration spike)
INSERT INTO forging_press_logs (cycle_id, hyd_pressure_bar, oil_temp_c, vib_z_rms)
SELECT
    'C-' || LPAD((990 + i)::text, 5, '0'),
    250.0 + (random() * 5),      -- Pressure dropping
    55.0 + (random() * 5),       -- Temp rising
    5.0 + (random() * 1.5)       -- High vibration
FROM generate_series(1, 10) AS i;

-- ==============================================================================
-- 3. Run the AI Prediction via AlloyDB Omni
-- ==============================================================================
-- Ensure the model is registered (assuming 'gemma4:e2b' is running locally on port 8080)
CREATE EXTENSION IF NOT EXISTS google_ml_integration CASCADE;

DO $$
BEGIN
    CALL google_ml.create_model(
        model_id => 'gemma4:e2b',
        model_request_url => 'http://localhost:8080/api/generate',
        model_provider => 'custom',
        model_type => 'generic'
    );
EXCEPTION WHEN OTHERS THEN
    -- Ignore error if model already exists
END $$;

-- Query the most recent 5 potentially anomalous records and ask Gemma for an analysis
SELECT
    cycle_id,
    hyd_pressure_bar,
    vib_z_rms,
    google_ml.predict_row(
        model_id => 'gemma4:e2b',
        request_body => json_build_object(
            'model', 'gemma4:e2b',
            'stream', false,
            'prompt', 'You are an industrial engineer. Analyze this sensor data from a 1500T forging press: Pressure=' || hyd_pressure_bar || ' bar, Vibration=' || vib_z_rms || ' mm/s. Normal pressure is ~280 bar and normal vibration is ~2.0 mm/s. Does this indicate a hydraulic failure? Answer in one short sentence.'
        )
    )->>'response' AS ai_analysis
FROM
    forging_press_logs
WHERE
    hyd_pressure_bar < 260 OR vib_z_rms > 4.5
ORDER BY
    timestamp DESC
LIMIT 5;
L'esecuzione delle istruzioni precedenti una per una dovrebbe portare al seguente risultato:
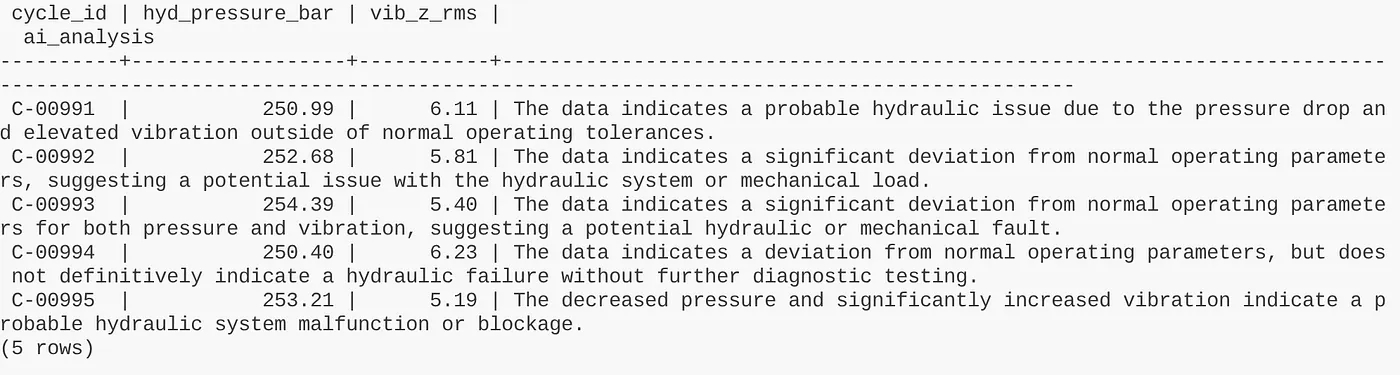
Ora che i dati sono pronti, passiamo alla creazione della dashboard di manutenzione predittiva.
7. Creazione di una dashboard di live streaming
Per visualizzare davvero questa architettura, puoi collegarla facilmente a una dashboard Python Flask, che è un'applicazione web.
Anziché eseguire manualmente le query SQL, un backend Flask leggero trasmette la telemetria dei sensori in tempo reale a una dashboard HTML. Durante le normali operazioni, la dashboard traccia semplicemente i grafici.
Tuttavia, quando il backend rileva un'anomalia (ad esempio, un calo di pressione), il codice Python attiva immediatamente la funzione google_ml.predict_row() all'interno di AlloyDB. AlloyDB inoltra senza problemi il contesto al tuo modello Gemma locale e l'insight diagnostico dell'AI lampeggia sulla dashboard in tempo reale.
💡 Suggerimento per il codelab: per uscire dal container del database e tornare alla riga di comando dell'host, digita \q e premi Invio (oppure apri una nuova scheda del terminale). Quindi, procedi con l'esecuzione dei comandi dell'applicazione Flask riportati di seguito.
Per
- Vai al tuo ambiente di sviluppo / editor di codice e apri il terminale
- Esegui questo comando:
pip install flask psycopg2-binary
- Clona il repository di codice nella directory del progetto eseguendo questo comando nel terminale Cloud Shell:
git clone https://github.com/AbiramiSukumaran/gemma4-alloydb-omni-demo
- Vai alla cartella del progetto:
cd gemma4-alloydb-omni-demo
- Esegui l'applicazione:
python3 app.py
Apri il browser web o fai clic sul link all'app in esecuzione nel tuo localhost.
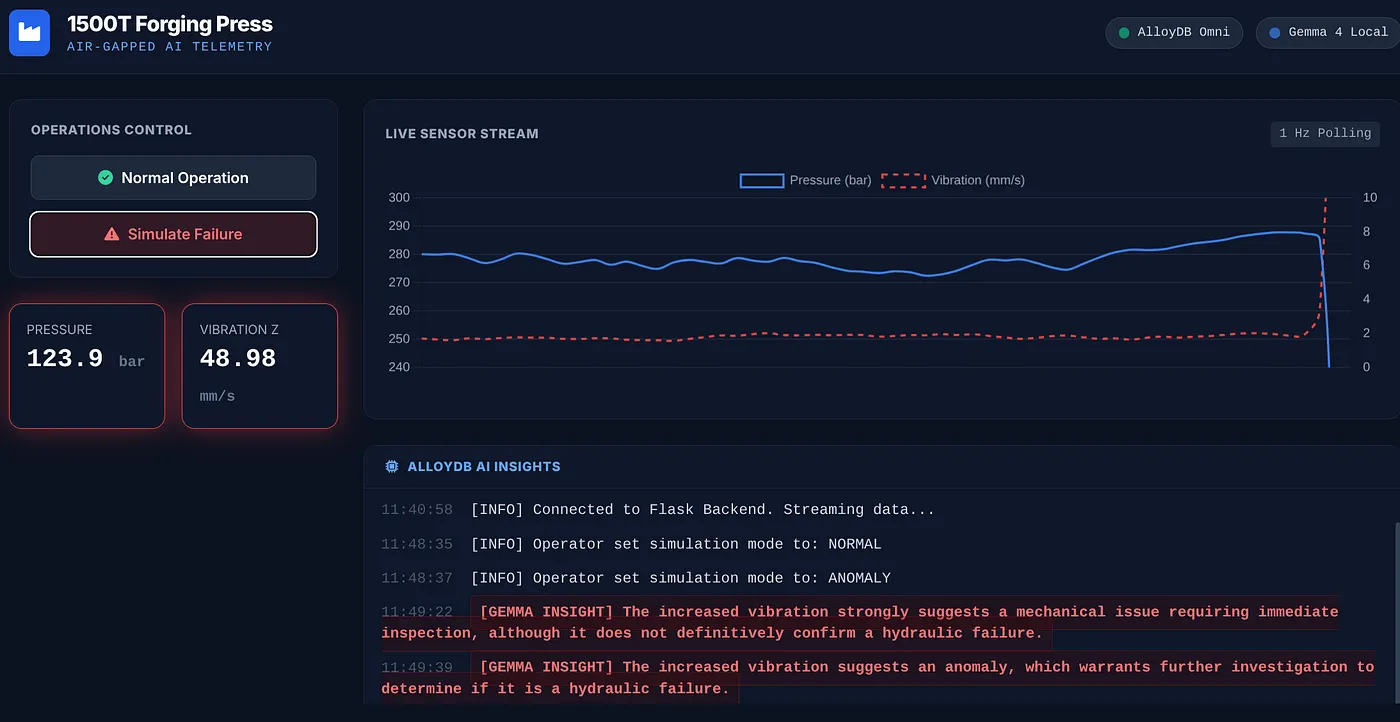
Cosa rappresenta la dashboard live
L'applicazione Flask funge da dashboard di monitoraggio in tempo reale per la pressa per forgiatura da 1500 tonnellate, visualizzando il modo in cui un sistema completamente offline con air gap gestisce la manutenzione predittiva:
- Flusso di telemetria continuo: la dashboard traccia i log delle vibrazioni (mm/s) e della pressione idraulica (bar) in tempo reale, aggiornandosi dinamicamente per simulare le operazioni attive in fabbrica.
- Anomalie del database in tempo reale: quando un sensore scende al di sotto della soglia (ad esempio, la pressione scende al di sotto di 260 bar), il backend Python segnala l'evento e chiama immediatamente la funzione
google_ml.predict_row()all'interno di AlloyDB Omni. - Diagnostica AI localizzata: AlloyDB Omni inoltra il contesto in tempo reale al modello Gemma 4 locale. Gemma agisce come un esperto industriale on-premise, analizzando la telemetria e stampando un avviso di diagnostica (ad es. "Avviso: il calo di pressione e le vibrazioni elevate indicano un potenziale guasto della guarnizione idraulica") direttamente sulla dashboard.
- Zero Leakage: tutti i calcoli, i database, i grafici e il ragionamento dell'AI vengono eseguiti interamente sul tuo host locale senza richiedere la connessione a internet.
8. Percorso verso la produzione
Per scalare questa architettura da un prototipo locale a un deployment in fabbrica di livello di produzione senza sacrificare la sicurezza con air gap, puoi scegliere tra due percorsi di installazione on-premise standard:
VM di produzione e bare metal (non containerizzate):
Per gli ambienti in cui la containerizzazione non è preferita o in cui l'integrazione profonda con il sistema operativo host è richiesta dalla policy di sicurezza, puoi eseguire il deployment utilizzando il pacchetto RPM ufficiale di AlloyDB Omni. Con l'assistenza dell'orchestratore RPM Red Hat di AlloyDB Omni, questo deployment offre prestazioni a bassa latenza, conformità a SELinux e alta affidabilità (HA) automatizzata direttamente alle tue VM RHEL o Rocky Linux locali, completamente offline.
Kubernetes in produzione e HA:
Se l'infrastruttura della tua fabbrica utilizza l'orchestrazione locale, puoi eseguire il deployment di AlloyDB Omni su Kubernetes . Utilizzando l'operatore Kubernetes AlloyDB Omni ufficiale, puoi eseguire il deployment in modo dichiarativo di un cluster di database robusto con repliche in standby sincrone, backup locali automatici ed endpoint di sola lettura dedicati.
9. Complimenti!
Per la produzione nel settore della difesa e per i settori con air gap, la scelta non è più tra una sicurezza rigorosa e l'innovazione tecnologica. Eseguendo il deployment di database containerizzati, modelli proxy specializzati e AI con pesi aperti su hardware sovrano, puoi trasformare la tua fabbrica in un centro di potenza intelligente e predittivo, mantenendo al contempo completamente intatto il tuo fossato digitale.