

1. 概要
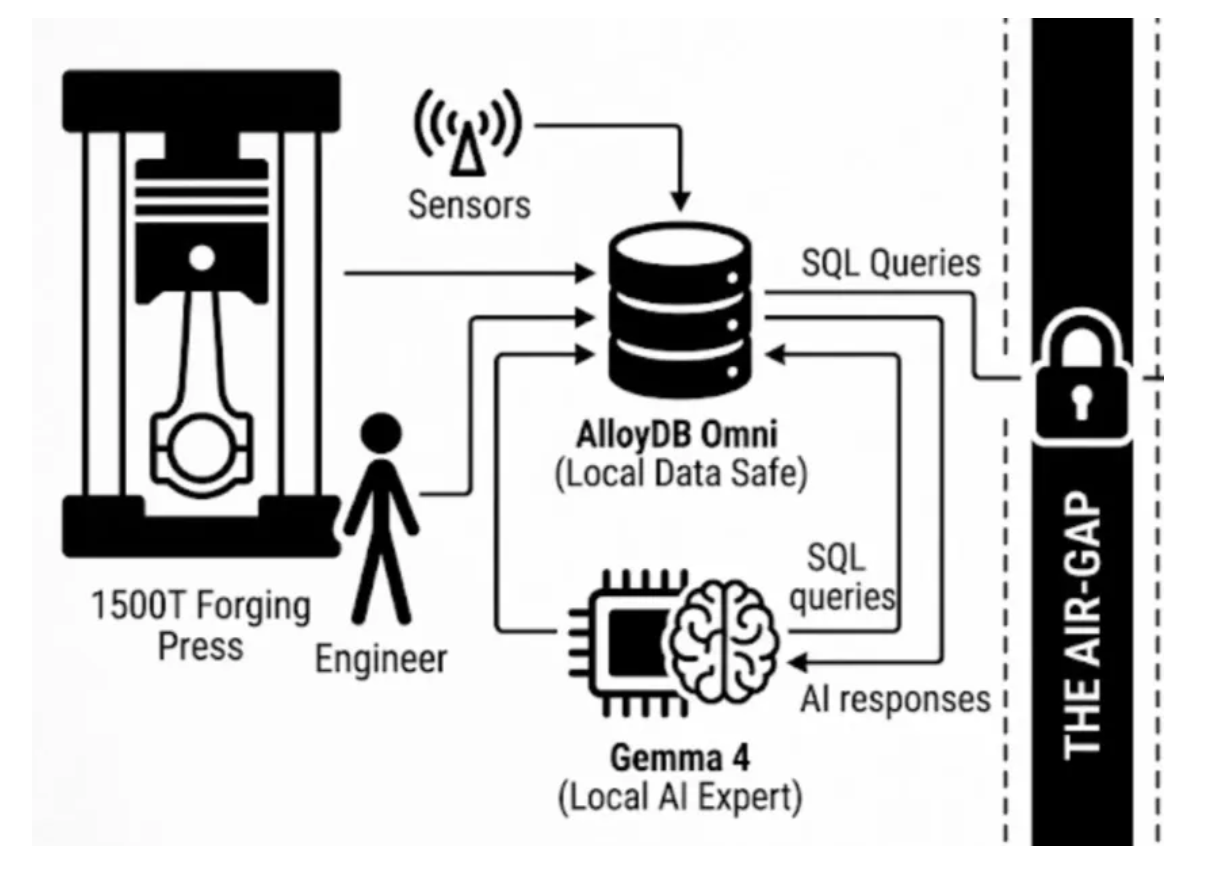
規制が厳しく、ミッション クリティカルな業界では、組織は大きな矛盾に直面しています。サイバーセキュリティ ポリシーでデータが公共のインターネットに接続できないことが義務付けられている場合、最先端の AI を導入して本番環境を最適化するにはどうすればよいでしょうか。イントラネットと公共のインターネットは厳密に分離されており、接触することはありません。現代の製造業では、致命的な機器の故障を防ぎ、歩留まりを最適化するために、予測 AI が切実に求められています。しかし、機密性の高いテレメトリー ログ、特許取得済みの合金レシピ、ERP データをパブリック クラウド API に送信することは、実際には不可能です。つまり、データをクラウドに移行できない場合は、クラウドをデータに移行する必要があります。
この Codelab では、Gemma 4 と AlloyDB Omni を使用して、Google Cloud の最先端のデータツールと AI ツールを、接続されていない安全性の高い環境に直接導入します。
AlloyDB Omni: 究極のデータ金庫
AlloyDB Omni は、高性能な金庫のようなものです。これは、コンテナ化されたエンタープライズ グレードのデータベースであり、ダウンロードして、独自の安全なイントラネット上で完全に実行できます。
- シームレスな統合: 製造センサー(VIM や大型プレスなど)やローカル ERP(Oracle R12 など)に直接接続します。
- AI 対応ストレージ: AI 検索(pgvector)用のベクトル エンベディングを使用して、極秘のプロセスシートを安全に保存します。
- パフォーマンス: 重いトランザクション ワークロードと分析 AI 処理の両方で、標準の PostgreSQL を大幅に上回るパフォーマンスを発揮します。
ローカル AI エキスパート: Gemma、TimesFM、TabFM
リモート API を使用する代わりに、オープンウェイト モデルをダウンロードしてローカル ハードウェアでネイティブに実行することで、API の漏洩をゼロにできます。
- Gemma: Google のオープン ウェイト LLM が研究開発の専門家として機能します。過去のログを安全に読み取ったり、複雑な特許取得済みの合金レシピを分析して機械的特性を予測したりできます。
- TimesFM(数値予測ツール): LLM は数値をハルシネーションすることがあるため、重機には専用の時系列基盤モデルが必要です。TimesFM は、長期的な数値ホライズン(最大 16,000 のデータポイント)を正確に予測し、振動と温度のログを読み取って、機器の故障曲線を正確に予測します。これはすべてオフラインで行われます。
- TabFM(表形式推論ツール): LLM がテキストを処理し、TimesFM が数値の傾向を処理するのに対し、TabFM は構造化された表形式データの推論に特化しています。オンプレミスで安全に実行して、複雑な分析を行い、複雑な SQL 結合を記述することなく、高密度の複数列の ERP または CRM データから直接質問に回答できます。
ユースケース
1,500 トン鍛造プレスの予測メンテナンス:
この巨大な機械で計画外のダウンタイムが発生すると、生産が停止し、膨大な時間と重要な材料が無駄になります。逆に、定期メンテナンスでは高価な部品を早すぎるタイミングで交換することが多く、予算の無駄遣いにつながります。エアギャップを維持したまま、事後対応型のメンテナンスから予測メンテナンスに移行する必要があります。
学習内容
この Codelab では次のことを学習しました。
- AlloyDB Omni を使用して、振動センサーと温度センサーのデータをローカルで安全にキャプチャします。パラメータを追加して、より現実的で有用なものにすることもできます。
- Gemma を使用して、過去の障害ログの傾向を分析する方法を学びます。
- 障害を予測し、ERP でアセット管理の作業指示を自動的にモックトリガーするシステムを構築します。
ローカル LLM と AlloyDB Omni の両方をプロビジョニングするために Docker を使用します。このアプローチの利点は、そのシンプルさにあります。AlloyDB Omni は、独自の内部 ML-Agent プロセスを自動的に管理できます。
要件
- SQL に関する基本的な知識。
- 標準の Linux VM(Ubuntu 22.04 など)または Docker がインストールされたローカルマシン(macOS/Windows)。
2. ローカル LLM(Gemma 4)を起動する
Ollama を使用して Gemma をローカルでホストします。Ollama インスタンスを構成する Dockerfile を作成します。
- ローカルマシンから、ターミナルで次のコマンドを 1 つずつ実行します。
mkdir -p gemma4-ollama && cd gemma4-ollama
cat << 'EOF' > Dockerfile
FROM ollama/ollama:latest
ENV OLLAMA_HOST=0.0.0.0:8080
ENV OLLAMA_MODELS=/root/.ollama
ENV MODEL=gemma4:e2b
RUN ollama serve & sleep 5 && ollama pull $MODEL
ENTRYPOINT ["ollama", "serve"]
EOF
- ホスト ネットワークでコンテナをビルドして実行します。
docker build -t gemma4-local .

docker run --network host -d -p 8080:8080 --name gemma4-ollama-instance gemma4-local
- 次のコマンドを使用してテストできます。
curl -X POST http://localhost:8080/api/generate -d '{
  "model": "gemma4:e2b",
  "prompt": "Hello! Explain Gemma 4 in a few sentences."
}'
3. AlloyDB Omni をインストールして起動する
次に、AlloyDB Omni データベース コンテナをホスト ネットワーク上で起動します。
docker run -d \
  --name my-omni \
  --network host \
  -e POSTGRES_PASSWORD=omni \
  gcr.io/alloydb-omni/alloydbomni:18
Google Cloud プロジェクトから AlloyDB Omni イメージが見つからない場合は、上記の docker run コマンドを実行する前に、次のコマンドを実行して認証を試してください。
gcloud auth login
認証が完了したら、docker run コマンドをもう一度実行してみてください。
4. 内部 ML-Agent を有効にする
デフォルトでは、AlloyDB Omni の ML 統合機能はオフになっています。内部の ML-Agent プロセスと AI クエリエンジンを有効にするには、コンテナ内の postgresql.conf ファイルを変更する必要があります。
次のコマンドを実行して、必要なフラグを追加します。
docker exec -it my-omni sh -c "cat << EOF >> /var/lib/postgresql/data/postgresql.conf
omni_enable_ml_agent_process = 'on'
google_ml_integration.enable_model_support = 'on'
google_ml_integration.enable_ai_query_engine = 'on'
EOF"
コンテナを再起動して変更を適用します。
docker restart my-omni
次のコマンドを使用して psql を起動すると、クエリのテストを開始できます。
docker exec -it my-omni psql -U postgres
5. AI をローカル LLM にルーティングする
psql(docker exec -it my-omni psql -U postgres)を介してデータベースに接続したら、ローカルのオフグリッド モデルを登録できます。インターネットに呼び出す代わりに、model_request_url をポート 8080 で実行されているローカル Ollama サーバーにルーティングします。
ターミナルの psql プロンプトから次の SQL ステートメントを実行します。
CREATE EXTENSION IF NOT EXISTS google_ml_integration CASCADE;

CALL google_ml.create_model(
    model_id => 'gemma4:e2b',
    model_request_url => 'http://localhost:8080/api/generate',
    model_provider => 'custom',
    model_type => 'generic'
);
SQL 内から予測を安全に呼び出せるようになりました。
SELECT google_ml.predict_row(
    'gemma4:e2b',
    '{"model": "gemma4:e2b", "prompt": "Why is the sky blue?", "stream": false}'
)->'response';
出力:
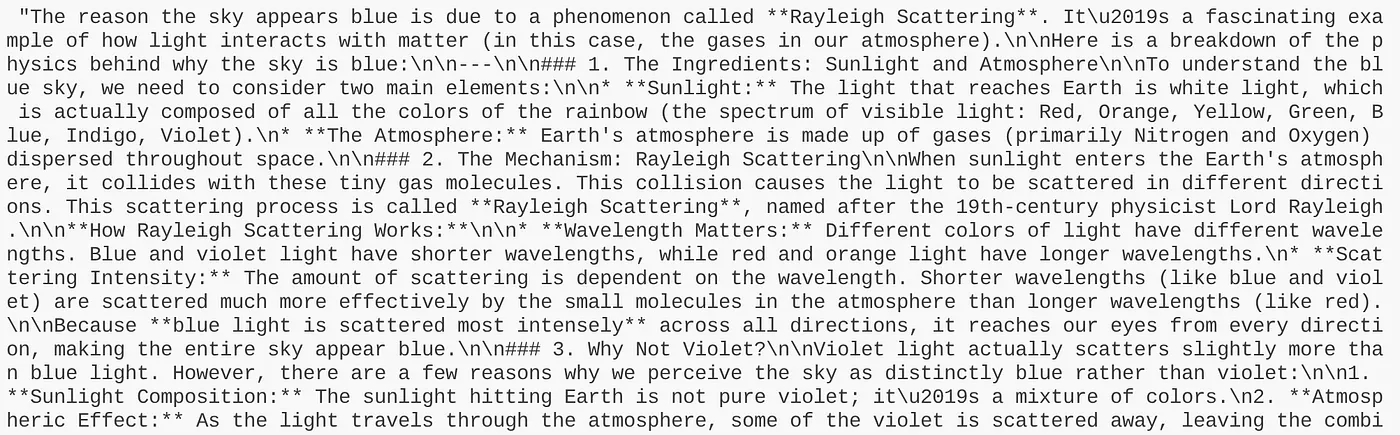
一般的なテストケースでテストしたので、次はユースケースのデータを追加しましょう。
6. スキーマを作成してデータを取り込む
次に、デモに必要なスキーマとデータを作成して、ユースケースを構築しましょう。
ターミナルの psql プロンプトから次の SQL ステートメントを実行します。
-- ==============================================================================
-- 1. Setup the Schema for the 1500T Forging Press
-- ==============================================================================
CREATE TABLE IF NOT EXISTS forging_press_logs (
    log_id SERIAL PRIMARY KEY,
    timestamp TIMESTAMP NOT NULL DEFAULT NOW(),
    cycle_id VARCHAR(50) NOT NULL,
    hyd_pressure_bar NUMERIC(5,2),
    oil_temp_c NUMERIC(5,2),
    vib_z_rms NUMERIC(5,2)
);

-- Clean up any existing data if running multiple times
TRUNCATE TABLE forging_press_logs;

-- ==============================================================================
-- 2. Generate 1,000 Records of Simulated Data
-- ==============================================================================
-- 99% of data is 'Normal'
INSERT INTO forging_press_logs (cycle_id, hyd_pressure_bar, oil_temp_c, vib_z_rms)
SELECT
    'C-' || LPAD(i::text, 5, '0'),
    280.0 + (random() * 10 - 5), -- Pressure around 280
    42.0 + (random() * 5),       -- Temp around 42-47
    1.8 + (random() * 0.5)       -- Vib Z around 1.8-2.3
FROM generate_series(1, 990) AS i;

-- 1% of data is 'Anomalous' (Hydraulic pressure drop & vibration spike)
INSERT INTO forging_press_logs (cycle_id, hyd_pressure_bar, oil_temp_c, vib_z_rms)
SELECT
    'C-' || LPAD((990 + i)::text, 5, '0'),
    250.0 + (random() * 5),      -- Pressure dropping
    55.0 + (random() * 5),       -- Temp rising
    5.0 + (random() * 1.5)       -- High vibration
FROM generate_series(1, 10) AS i;

-- ==============================================================================
-- 3. Run the AI Prediction via AlloyDB Omni
-- ==============================================================================
-- Ensure the model is registered (assuming 'gemma4:e2b' is running locally on port 8080)
CREATE EXTENSION IF NOT EXISTS google_ml_integration CASCADE;

DO $$
BEGIN
    CALL google_ml.create_model(
        model_id => 'gemma4:e2b',
        model_request_url => 'http://localhost:8080/api/generate',
        model_provider => 'custom',
        model_type => 'generic'
    );
EXCEPTION WHEN OTHERS THEN
    -- Ignore error if model already exists
END $$;

-- Query the most recent 5 potentially anomalous records and ask Gemma for an analysis
SELECT
    cycle_id,
    hyd_pressure_bar,
    vib_z_rms,
    google_ml.predict_row(
        model_id => 'gemma4:e2b',
        request_body => json_build_object(
            'model', 'gemma4:e2b',
            'stream', false,
            'prompt', 'You are an industrial engineer. Analyze this sensor data from a 1500T forging press: Pressure=' || hyd_pressure_bar || ' bar, Vibration=' || vib_z_rms || ' mm/s. Normal pressure is ~280 bar and normal vibration is ~2.0 mm/s. Does this indicate a hydraulic failure? Answer in one short sentence.'
        )
    )->>'response' AS ai_analysis
FROM
    forging_press_logs
WHERE
    hyd_pressure_bar < 260 OR vib_z_rms > 4.5
ORDER BY
    timestamp DESC
LIMIT 5;
上記のステートメントを 1 つずつ実行すると、次のような結果になります。
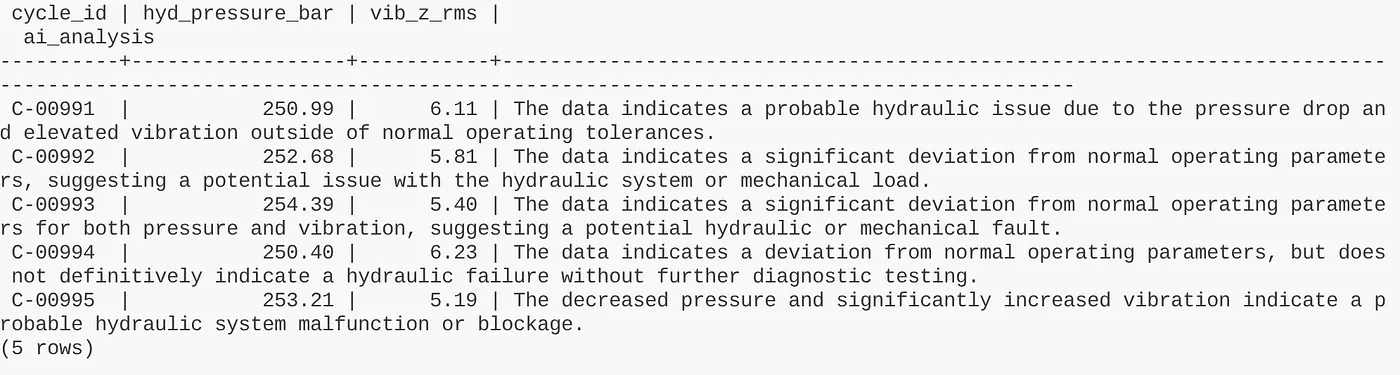
データの準備ができたので、予測メンテナンス ダッシュボードの構築に進みましょう。
7. ライブ ストリーミング ダッシュボードの構築
このアーキテクチャを実際に可視化するには、ウェブ アプリケーションである Python Flask ダッシュボードに簡単に接続できます。
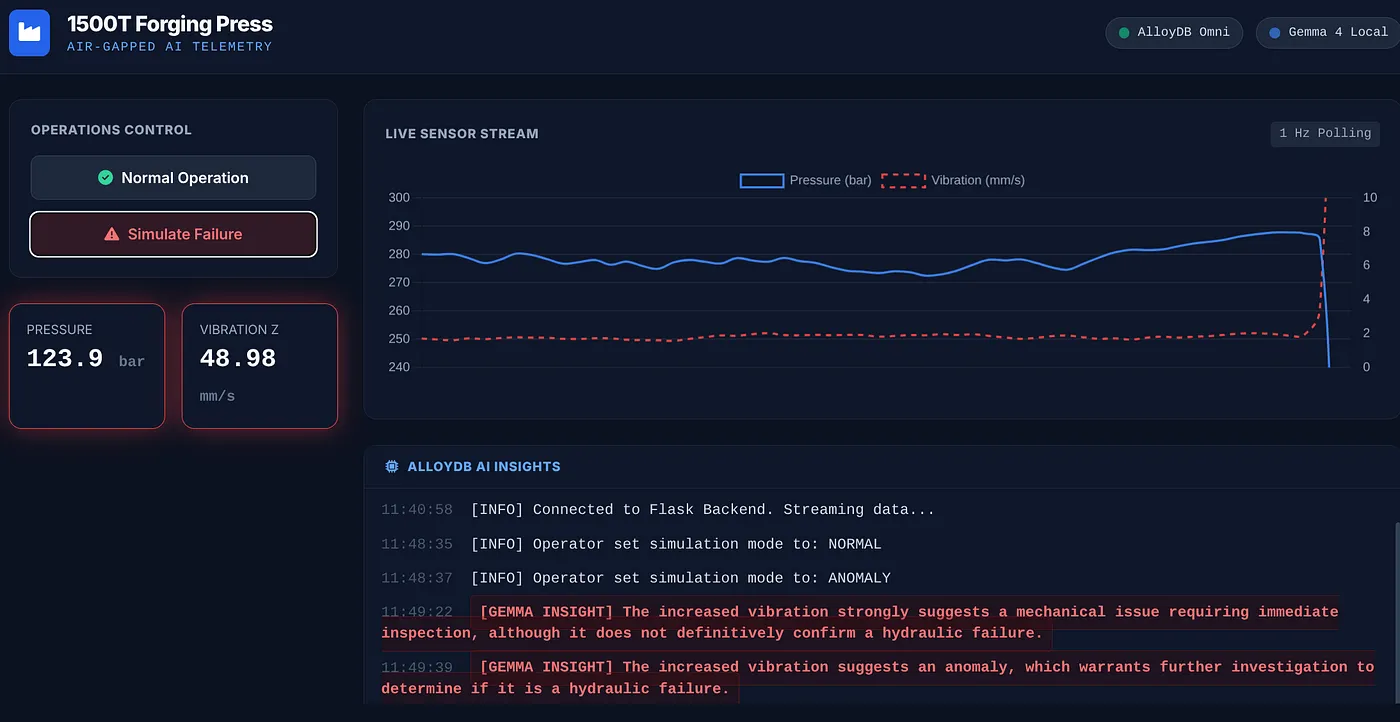
SQL クエリを手動で実行する代わりに、軽量の Flask バックエンドがライブ センサー テレメトリーを HTML ダッシュボードにストリーミングします。通常のオペレーションでは、ダッシュボードはグラフをプロットするだけです。
しかし、バックエンドが異常(圧力低下など)を検出すると、Python コードが AlloyDB 内の google_ml.predict_row() 関数を即座にトリガーします。AlloyDB はコンテキストをローカルの Gemma モデルにシームレスに転送し、AI の診断的インサイトがダッシュボードにリアルタイムで表示されます。
💡 Codelab のヒント: データベース コンテナを終了してホストのコマンドラインに戻るには、「\q」と入力して Enter キーを押します(または、新しいターミナルタブを開きます)。次に、以下の Flask アプリケーション コマンドを実行します。
手順は次のとおりです。
- 開発環境 / コードエディタに移動してターミナルを開きます。
- 次のコマンドを実行します。
pip install flask psycopg2-binary
- Cloud Shell ターミナルで次のコマンドを実行して、プロジェクト ディレクトリにコードリポジトリのクローンを作成します。
git clone https://github.com/AbiramiSukumaran/gemma4-alloydb-omni-demo
- プロジェクト フォルダに移動します。
cd gemma4-alloydb-omni-demo
- アプリケーションを実行します。
python3 app.py
ウェブブラウザを開くか、localhost で実行されているアプリへのリンクをクリックします。
ライブ ダッシュボードに表示される内容
Flask アプリケーションは、1,500 トン鍛造プレスのリアルタイム モニタリング ダッシュボードとして機能し、完全にオフラインのエアギャップ システムが予測メンテナンスをどのように処理するかを可視化します。
- 継続的なテレメトリー ストリーム: ダッシュボードには、リアルタイムの振動(mm/s)と油圧(bar)のログがプロットされ、動的に更新されて、アクティブな工場フロアのオペレーションがシミュレートされます。
- オンザフライのデータベース異常: センサーがしきい値を下回ると(例: 圧力が 260 bar を下回る)、Python バックエンドがイベントにフラグを付け、AlloyDB Omni 内の
google_ml.predict_row()関数を直ちに呼び出します。 - ローカライズされた AI 診断: AlloyDB Omni は、リアルタイムのコンテキストをローカルの Gemma 4 モデルに転送します。Gemma はオンプレミスの産業エキスパートとして機能し、テレメトリーを分析して、診断アラート(例: 「警告: 圧力低下と高振動は、油圧シールの故障の可能性を示しています」)をダッシュボードに直接出力します。
- 情報漏洩ゼロ: すべての計算、データベース、グラフ、AI 推論は、インターネット接続を必要とせず、ローカルホスト上で完全に実行されます。
8. 本番環境へのパス
エアギャップ セキュリティを犠牲にすることなく、このアーキテクチャをローカル プロトタイプから本番環境グレードの工場フロア デプロイにスケールするには、次の 2 つの標準的なオンプレミス インストール トラックから選択できます。
プロダクション VM とベアメタル(コンテナ化されていない):
コンテナ化が推奨されない環境や、セキュリティ ポリシーによりホスト オペレーティング システムとの緊密な統合が必要な環境では、公式の AlloyDB Omni RPM パッケージを使用してデプロイできます。AlloyDB Omni Red Hat RPM オーケストレーターの支援により、このデプロイでは、低レイテンシのパフォーマンス、SELinux コンプライアンス、自動化された高可用性(HA)を、完全にオフラインでローカルの RHEL または Rocky Linux VM に直接提供します。
本番環境の Kubernetes と HA:
工場のインフラストラクチャでローカル オーケストレーションを使用している場合は、AlloyDB Omni を Kubernetes にデプロイできます。公式の AlloyDB Omni Kubernetes Operator を使用すると、同期スタンバイ レプリカ、自動ローカル バックアップ、専用の読み取り専用エンドポイントを備えた堅牢なデータベース クラスタを宣言的にデプロイできます。
9. 完了
防衛製造業やエアギャップのある業界では、厳格なセキュリティと技術革新のどちらかを選択する必要はなくなりました。コンテナ化されたデータベース、専用のプロキシモデル、オープンウェイト AI を主権ハードウェアにデプロイすることで、デジタル モートを完全に維持しながら、工場をインテリジェントで予測的なパワーハウスに変えることができます。