

1. 개요
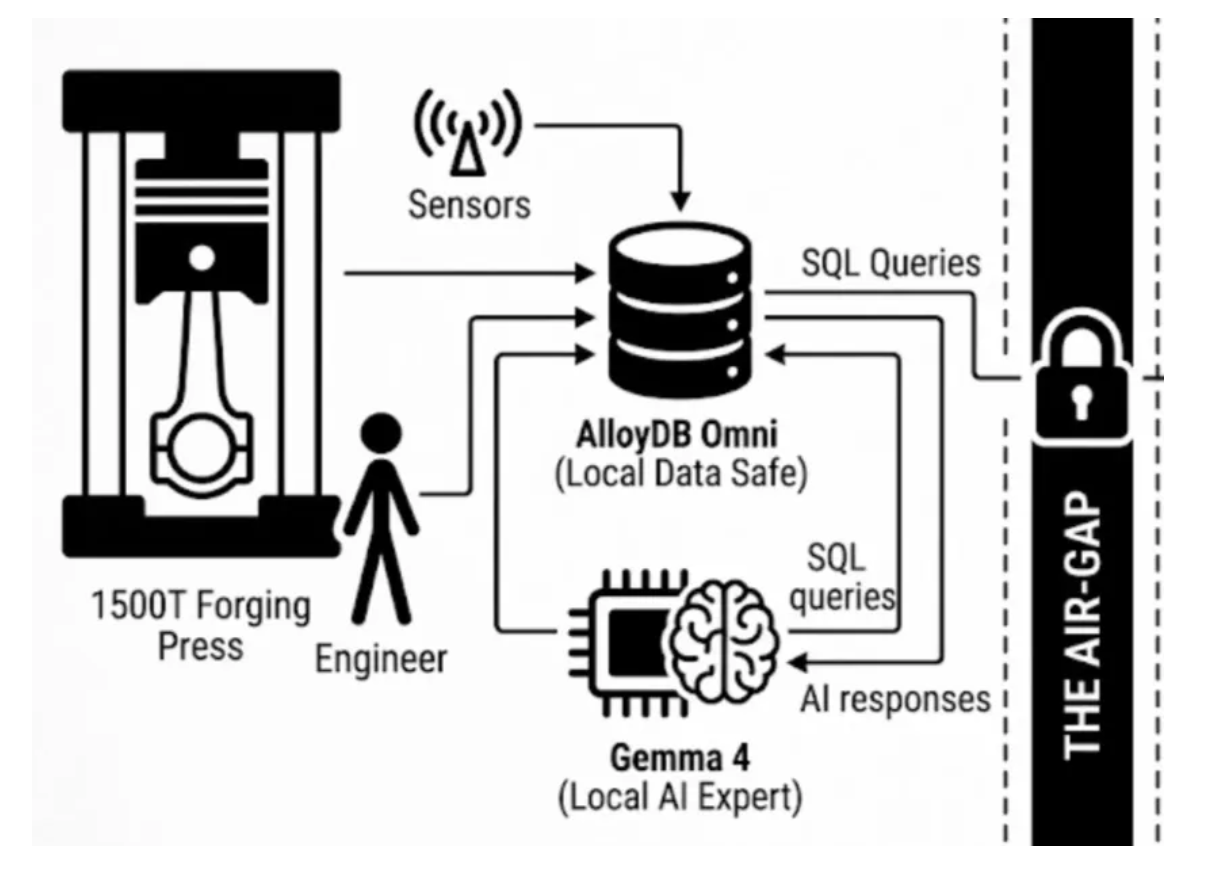
규제가 엄격하고 미션 크리티컬한 산업에서는 조직이 큰 모순에 직면합니다. 사이버 보안 정책에 따라 데이터가 공개 인터넷에 절대 노출되지 않아야 하는 경우 최첨단 AI를 도입하여 프로덕션을 최적화하려면 어떻게 해야 할까요? 인트라넷과 공개 인터넷은 엄격하게 분리되어 있으며 서로 연결되지 않습니다. 현대 제조업에서는 치명적인 장비 고장을 방지하고 수율을 최적화하기 위해 예측 AI가 절실히 필요하지만, 민감한 텔레메트리 로그, 특허받은 합금 레시피 또는 ERP 데이터를 퍼블릭 클라우드 API로 전송하는 것은 실제로 불가능합니다. 데이터가 클라우드로 이동할 수 없다면 클라우드가 데이터로 이동해야 합니다.
이 Codelab에서는 Gemma 4와 AlloyDB Omni를 사용하여 Google Cloud의 최첨단 데이터 및 AI 도구를 연결이 끊긴 안전한 환경에 직접 가져옵니다.
AlloyDB Omni: 최고의 데이터 금고
AlloyDB Omni를 고성능 금고라고 생각해 보세요. 이는 자체 보안 인트라넷에서 완전히 다운로드하고 실행하는 컨테이너화된 엔터프라이즈급 데이터베이스입니다.
- 원활한 통합: 제조 센서 (예: VIM 또는 대형 프레스) 및 로컬 ERP (예: Oracle R12)에 직접 연결됩니다.
- AI 지원 스토리지: AI 검색을 위한 벡터 임베딩 (pgvector)을 사용하여 일급 기밀 공정 시트를 안전하게 저장합니다.
- 성능: 대규모 트랜잭션 워크로드와 분석 AI 처리 모두에서 표준 PostgreSQL보다 훨씬 뛰어난 성능을 발휘합니다.
로컬 AI 전문가: Gemma, TimesFM, TabFM
원격 API를 사용하는 대신 가중치 공개 모델을 다운로드하여 API 유출 없이 로컬 하드웨어에서 기본적으로 실행할 수 있습니다.
- Gemma: Google의 개방형 가중치 LLM이 R&D 전문가 역할을 합니다. 과거 로그를 안전하게 읽거나 복잡한 특허 합금 레시피를 분석하여 기계적 특성을 예측할 수 있습니다.
- TimesFM (수치 예측 모델): LLM은 때때로 숫자를 할루시네이션할 수 있으므로 중장비에는 전용 시계열 파운데이션 모델이 필요합니다. TimesFM은 진동 및 온도 로그를 읽어 정확한 장비 고장 곡선을 예측함으로써 장기적인 수치 범위 (최대 16,000개의 데이터 포인트)를 정확하게 예측합니다. 이 모든 작업은 오프라인에서 이루어집니다.
- TabFM (테이블 형식 추론 모델): LLM은 텍스트를 처리하고 TimesFM은 수치 추세를 처리하는 반면, TabFM은 정형 테이블 데이터에 대한 추론을 전문으로 합니다. 온프레미스에서 안전하게 실행하여 복잡한 SQL 조인을 작성할 필요 없이 밀도가 높은 다중 열 ERP 또는 CRM 데이터에서 직접 복잡한 분석을 수행하고 질문에 답할 수 있습니다.
사용 사례
1,500톤 단조 프레스의 예측 유지보수:
이 거대한 기계가 계획되지 않은 다운타임으로 인해 중단되면 생산이 중단되어 막대한 시간과 중요한 자재가 낭비됩니다. 반대로 정기 유지보수는 고가의 부품을 너무 일찍 교체하여 예산을 낭비하는 경우가 많습니다. 에어 갭을 깨지 않고 사후 대응에서 예측 유지보수로 전환해야 합니다.
학습할 내용
이 Codelab에서 알아본 내용은 다음과 같습니다.
- AlloyDB Omni를 사용하여 진동 및 온도 센서 데이터를 로컬에서 안전하게 캡처하고, 더 많은 매개변수를 추가하여 더 현실적이고 유용하게 만들 수 있습니다.
- Gemma를 사용하여 이전 실패 로그의 추세를 분석하는 방법을 알아봅니다.
- 장애를 예측하고 ERP에서 자산 관리 작업 오더를 자동으로 모의 트리거하는 시스템을 빌드합니다.
로컬 LLM과 AlloyDB Omni를 모두 프로비저닝하기 위해 Docker를 사용합니다. 이 접근 방식의 장점은 단순성입니다. AlloyDB Omni는 자체 내부 ML-Agent 프로세스를 자동으로 관리할 수 있습니다.
요구사항
- SQL에 관한 기본 지식
- 표준 Linux VM (예: Ubuntu 22.04) 또는 Docker가 설치된 로컬 머신 (macOS/Windows)
2. 로컬 LLM (Gemma 4) 시작하기
Ollama를 사용하여 Gemma를 로컬에서 호스팅합니다. Ollama 인스턴스를 구성하는 Dockerfile을 만듭니다.
- 로컬 머신의 터미널에서 다음 명령어를 하나씩 실행합니다.
mkdir -p gemma4-ollama && cd gemma4-ollama
cat << 'EOF' > Dockerfile
FROM ollama/ollama:latest
ENV OLLAMA_HOST=0.0.0.0:8080
ENV OLLAMA_MODELS=/root/.ollama
ENV MODEL=gemma4:e2b
RUN ollama serve & sleep 5 && ollama pull $MODEL
ENTRYPOINT ["ollama", "serve"]
EOF
- 호스트 네트워크에서 컨테이너를 빌드하고 실행합니다.
docker build -t gemma4-local .

docker run --network host -d -p 8080:8080 --name gemma4-ollama-instance gemma4-local
- 다음 명령어를 사용하여 테스트할 수 있습니다.
curl -X POST http://localhost:8080/api/generate -d '{
  "model": "gemma4:e2b",
  "prompt": "Hello! Explain Gemma 4 in a few sentences."
}'
3. AlloyDB Omni 설치 및 시작
다음으로 호스트 네트워크에서 AlloyDB Omni 데이터베이스 컨테이너를 가동합니다.
docker run -d \
  --name my-omni \
  --network host \
  -e POSTGRES_PASSWORD=omni \
  gcr.io/alloydb-omni/alloydbomni:18
Google Cloud 프로젝트에서 AlloyDB Omni 이미지를 찾을 수 없는 경우 위의 docker run 명령어를 실행하기 전에 다음 명령어를 실행하여 인증을 시도합니다.
gcloud auth login
인증이 완료되면 docker run 명령어를 다시 실행해 보세요.
4. 내부 ML 에이전트 사용 설정
기본적으로 AlloyDB Omni의 ML 통합 기능은 사용 중지되어 있습니다. 내부 ML 에이전트 프로세스와 AI 쿼리 엔진을 사용 설정하려면 컨테이너 내의 postgresql.conf 파일을 수정해야 합니다.
다음 단일 명령어를 실행하여 필요한 플래그를 추가합니다.
docker exec -it my-omni sh -c "cat << EOF >> /var/lib/postgresql/data/postgresql.conf
omni_enable_ml_agent_process = 'on'
google_ml_integration.enable_model_support = 'on'
google_ml_integration.enable_ai_query_engine = 'on'
EOF"
컨테이너를 다시 시작하여 변경사항을 적용합니다.
docker restart my-omni
다음 명령어를 사용하여 psql을 시작하여 쿼리 테스트를 시작할 수 있습니다.
docker exec -it my-omni psql -U postgres
5. AI를 로컬 LLM으로 라우팅
psql (docker exec -it my-omni psql -U postgres)을 통해 데이터베이스에 연결되면 로컬 오프그리드 모델을 등록할 수 있습니다. 인터넷을 호출하는 대신 model_request_url을 포트 8080에서 실행되는 로컬 Ollama 서버로 라우팅합니다.
터미널의 psql 프롬프트에서 다음 SQL 문을 실행합니다.
CREATE EXTENSION IF NOT EXISTS google_ml_integration CASCADE;

CALL google_ml.create_model(
    model_id => 'gemma4:e2b',
    model_request_url => 'http://localhost:8080/api/generate',
    model_provider => 'custom',
    model_type => 'generic'
);
이제 SQL 내에서 예측을 안전하게 호출할 수 있습니다.
SELECT google_ml.predict_row(
    'gemma4:e2b',
    '{"model": "gemma4:e2b", "prompt": "Why is the sky blue?", "stream": false}'
)->'response';
출력:
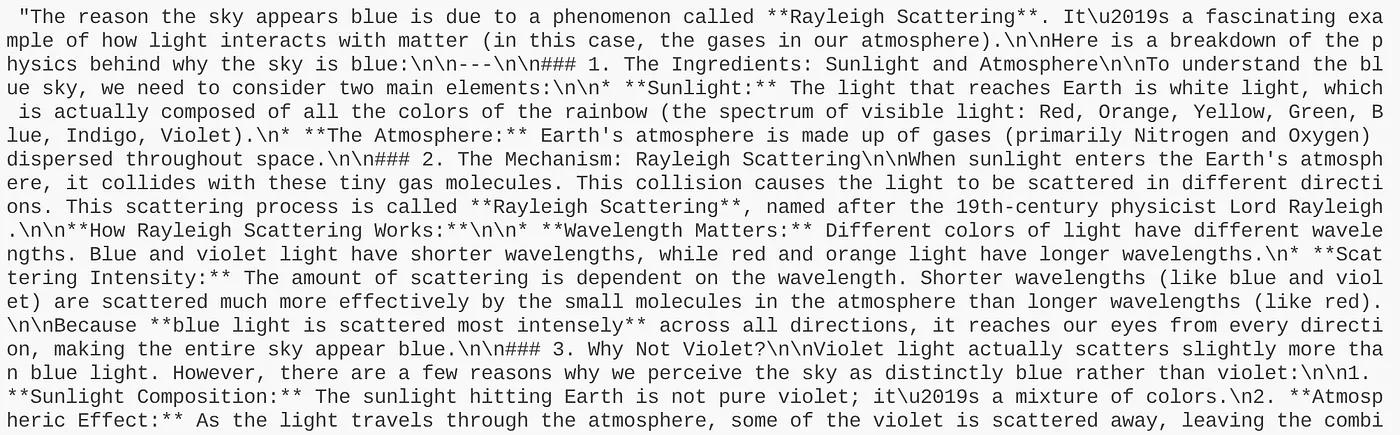
일반적인 테스트 사례에서 테스트를 마쳤으니 이제 사용 사례 데이터를 가져오겠습니다.
6. 스키마 만들기 및 데이터 수집
이제 시연에 필요한 스키마와 데이터를 만들어 사용 사례를 구축해 보겠습니다.
터미널의 psql 프롬프트에서 다음 SQL 문을 실행합니다.
-- ==============================================================================
-- 1. Setup the Schema for the 1500T Forging Press
-- ==============================================================================
CREATE TABLE IF NOT EXISTS forging_press_logs (
    log_id SERIAL PRIMARY KEY,
    timestamp TIMESTAMP NOT NULL DEFAULT NOW(),
    cycle_id VARCHAR(50) NOT NULL,
    hyd_pressure_bar NUMERIC(5,2),
    oil_temp_c NUMERIC(5,2),
    vib_z_rms NUMERIC(5,2)
);

-- Clean up any existing data if running multiple times
TRUNCATE TABLE forging_press_logs;

-- ==============================================================================
-- 2. Generate 1,000 Records of Simulated Data
-- ==============================================================================
-- 99% of data is 'Normal'
INSERT INTO forging_press_logs (cycle_id, hyd_pressure_bar, oil_temp_c, vib_z_rms)
SELECT
    'C-' || LPAD(i::text, 5, '0'),
    280.0 + (random() * 10 - 5), -- Pressure around 280
    42.0 + (random() * 5),       -- Temp around 42-47
    1.8 + (random() * 0.5)       -- Vib Z around 1.8-2.3
FROM generate_series(1, 990) AS i;

-- 1% of data is 'Anomalous' (Hydraulic pressure drop & vibration spike)
INSERT INTO forging_press_logs (cycle_id, hyd_pressure_bar, oil_temp_c, vib_z_rms)
SELECT
    'C-' || LPAD((990 + i)::text, 5, '0'),
    250.0 + (random() * 5),      -- Pressure dropping
    55.0 + (random() * 5),       -- Temp rising
    5.0 + (random() * 1.5)       -- High vibration
FROM generate_series(1, 10) AS i;

-- ==============================================================================
-- 3. Run the AI Prediction via AlloyDB Omni
-- ==============================================================================
-- Ensure the model is registered (assuming 'gemma4:e2b' is running locally on port 8080)
CREATE EXTENSION IF NOT EXISTS google_ml_integration CASCADE;

DO $$
BEGIN
    CALL google_ml.create_model(
        model_id => 'gemma4:e2b',
        model_request_url => 'http://localhost:8080/api/generate',
        model_provider => 'custom',
        model_type => 'generic'
    );
EXCEPTION WHEN OTHERS THEN
    -- Ignore error if model already exists
END $$;

-- Query the most recent 5 potentially anomalous records and ask Gemma for an analysis
SELECT
    cycle_id,
    hyd_pressure_bar,
    vib_z_rms,
    google_ml.predict_row(
        model_id => 'gemma4:e2b',
        request_body => json_build_object(
            'model', 'gemma4:e2b',
            'stream', false,
            'prompt', 'You are an industrial engineer. Analyze this sensor data from a 1500T forging press: Pressure=' || hyd_pressure_bar || ' bar, Vibration=' || vib_z_rms || ' mm/s. Normal pressure is ~280 bar and normal vibration is ~2.0 mm/s. Does this indicate a hydraulic failure? Answer in one short sentence.'
        )
    )->>'response' AS ai_analysis
FROM
    forging_press_logs
WHERE
    hyd_pressure_bar < 260 OR vib_z_rms > 4.5
ORDER BY
    timestamp DESC
LIMIT 5;
위의 문을 하나씩 실행하면 다음과 같은 결과가 표시됩니다.
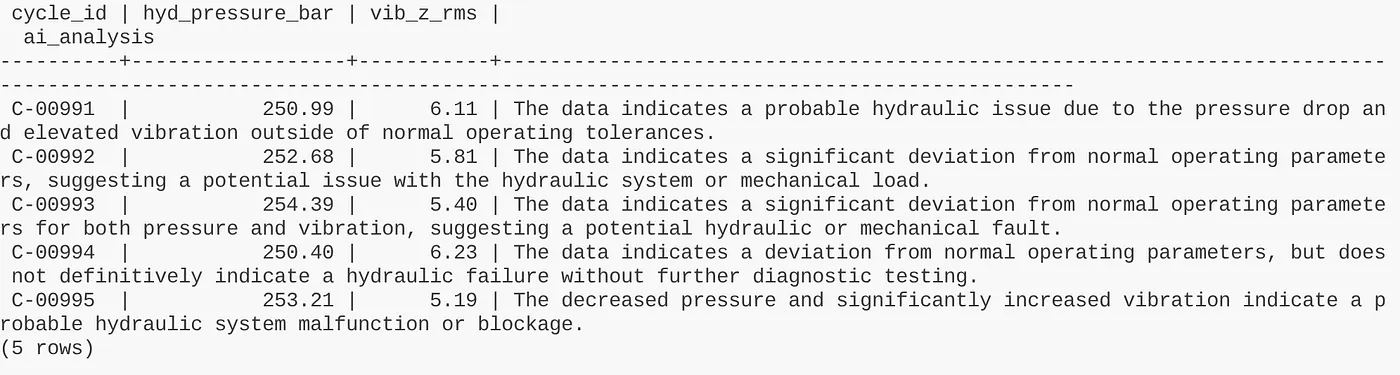
이제 데이터가 준비되었으니 예측 유지보수 대시보드를 빌드해 보겠습니다.
7. 라이브 스트리밍 대시보드 빌드
이 아키텍처를 시각화하려면 웹 애플리케이션인 Python Flask 대시보드에 쉽게 연결하면 됩니다.
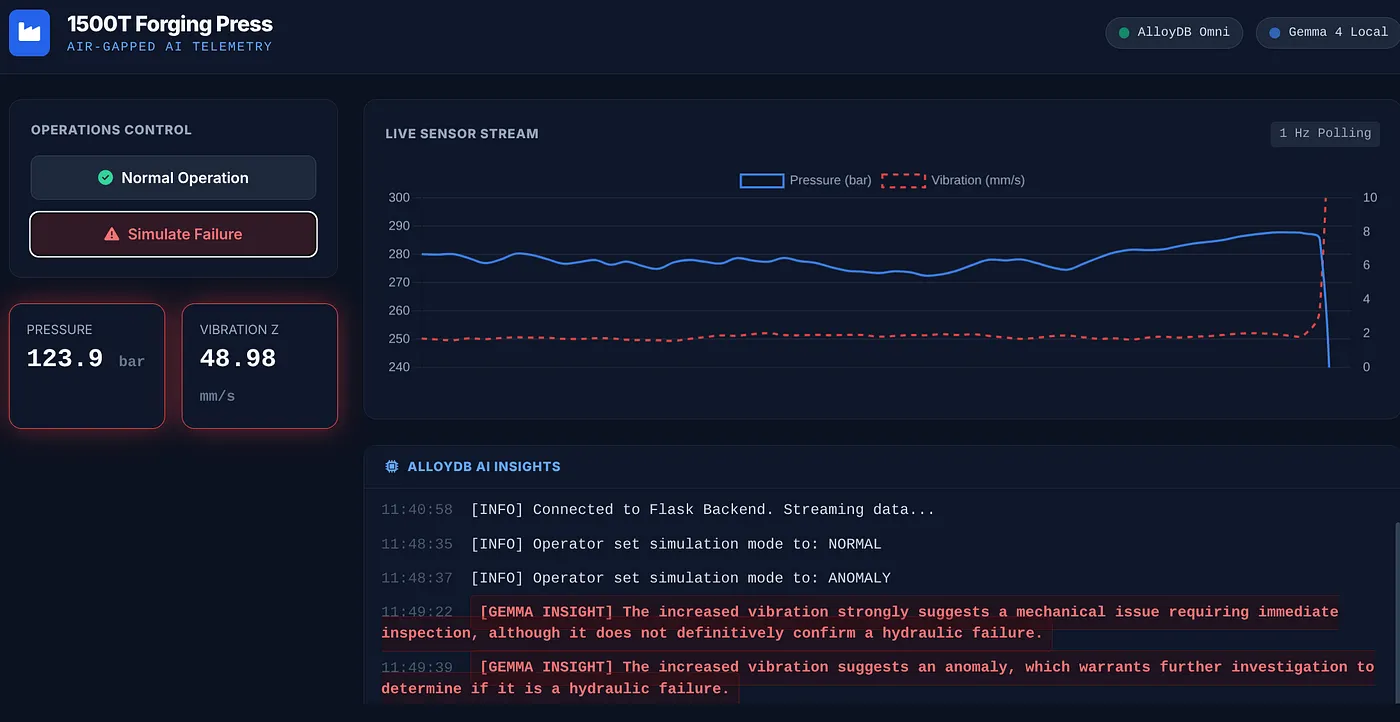
SQL 쿼리를 수동으로 실행하는 대신 가벼운 Flask 백엔드가 실시간 센서 원격 분석을 HTML 대시보드로 스트리밍합니다. 정상 작동 중에는 대시보드에 그래프가 표시됩니다.
하지만 백엔드에서 이상치 (예: 압력 강하)를 감지하면 Python 코드가 AlloyDB 내에서 google_ml.predict_row() 함수를 즉시 트리거합니다. AlloyDB는 컨텍스트를 로컬 Gemma 모델로 원활하게 전달하고 AI의 진단 통계가 대시보드에 실시간으로 표시됩니다.
💡 Codelab 도움말: 데이터베이스 컨테이너를 종료하고 호스트 명령줄로 돌아가려면 \q를 입력하고 Enter 키를 누릅니다 (또는 새 터미널 탭을 엽니다). 그런 다음 아래의 Flask 애플리케이션 명령어를 실행합니다.
방법은 다음과 같습니다.
- 개발 환경 / 코드 편집기로 이동하여 터미널을 엽니다.
- 다음 명령어를 실행합니다.
pip install flask psycopg2-binary
- Cloud Shell 터미널에서 다음 명령어를 실행하여 프로젝트 디렉터리에 코드 저장소를 클론합니다.
git clone https://github.com/AbiramiSukumaran/gemma4-alloydb-omni-demo
- 프로젝트 폴더로 이동합니다.
cd gemma4-alloydb-omni-demo
- 애플리케이션을 실행합니다.
python3 app.py
웹브라우저를 열거나 localhost에서 실행 중인 앱의 링크를 클릭합니다.
라이브 대시보드의 의미
Flask 애플리케이션은 1, 500톤 단조 프레스의 실시간 모니터링 대시보드 역할을 하며, 완전히 오프라인 상태인 에어 갭 적용 시스템이 예측 유지보수를 처리하는 방식을 시각화합니다.
- 지속적인 원격 분석 스트림: 대시보드는 실시간 진동 (mm/s) 및 유압 (bar) 로그를 표시하며, 활성 공장 현장 작업을 시뮬레이션하기 위해 동적으로 업데이트됩니다.
- 즉각적인 데이터베이스 이상치: 센서가 기준점 아래로 떨어지면 (예: 압력이 260bar 미만으로 떨어짐) Python 백엔드가 이벤트를 플래그 지정하고 AlloyDB Omni 내에서
google_ml.predict_row()함수를 즉시 호출합니다. - 현지화된 AI 진단: AlloyDB Omni가 실시간 컨텍스트를 로컬 Gemma 4 모델로 전달합니다. Gemma는 온프레미스 산업 전문가 역할을 하며 원격 분석을 분석하고 대시보드에 직접 진단 알림 (예: '경고: 압력 강하 및 높은 진동은 유압 씰 고장 가능성을 나타냅니다')을 출력합니다.
- 유출 없음: 모든 연산, 데이터베이스, 그래프, AI 추론이 로컬 호스트에서 완전히 실행되므로 인터넷 연결이 필요하지 않습니다.
8. 프로덕션 경로
에어 갭 보안을 유지하면서 이 아키텍처를 로컬 프로토타입에서 프로덕션급 공장 현장 배포로 확장하려면 다음 두 가지 표준 온프레미스 설치 트랙 중에서 선택할 수 있습니다.
프로덕션 VM 및 베어메탈 (컨테이너화되지 않음):
컨테이너화가 선호되지 않거나 보안 정책에 따라 호스트 운영체제와의 긴밀한 통합이 필요한 환경에서는 공식 AlloyDB Omni RPM 패키지를 사용하여 배포할 수 있습니다. AlloyDB Omni Red Hat RPM 조정자의 지원을 받는 이 배포는 지연 시간이 짧은 성능, SELinux 규정 준수, 자동화된 고가용성 (HA)을 로컬 RHEL 또는 Rocky Linux VM에 완전히 오프라인으로 직접 제공합니다.
프로덕션 Kubernetes 및 HA:
공장 인프라에서 로컬 조정을 사용하는 경우 Kubernetes에 AlloyDB Omni를 배포할 수 있습니다 . 공식 AlloyDB Omni Kubernetes Operator를 사용하면 동기식 대기 복제본, 자동화된 로컬 백업, 전용 읽기 전용 엔드포인트를 갖춘 강력한 데이터베이스 클러스터를 선언적으로 배포할 수 있습니다.
9. 수고하셨습니다
방위 제조업과 같은 에어 갭 적용 산업에서는 더 이상 엄격한 보안과 기술 혁신 중 하나를 선택할 필요가 없습니다. 컨테이너화된 데이터베이스, 특화된 프록시 모델, 개방형 가중치 AI를 주권 하드웨어에 배포하면 공장 현장을 지능적이고 예측 가능한 강력한 환경으로 전환하는 동시에 디지털 경계를 완벽하게 유지할 수 있습니다.