

1. Przegląd
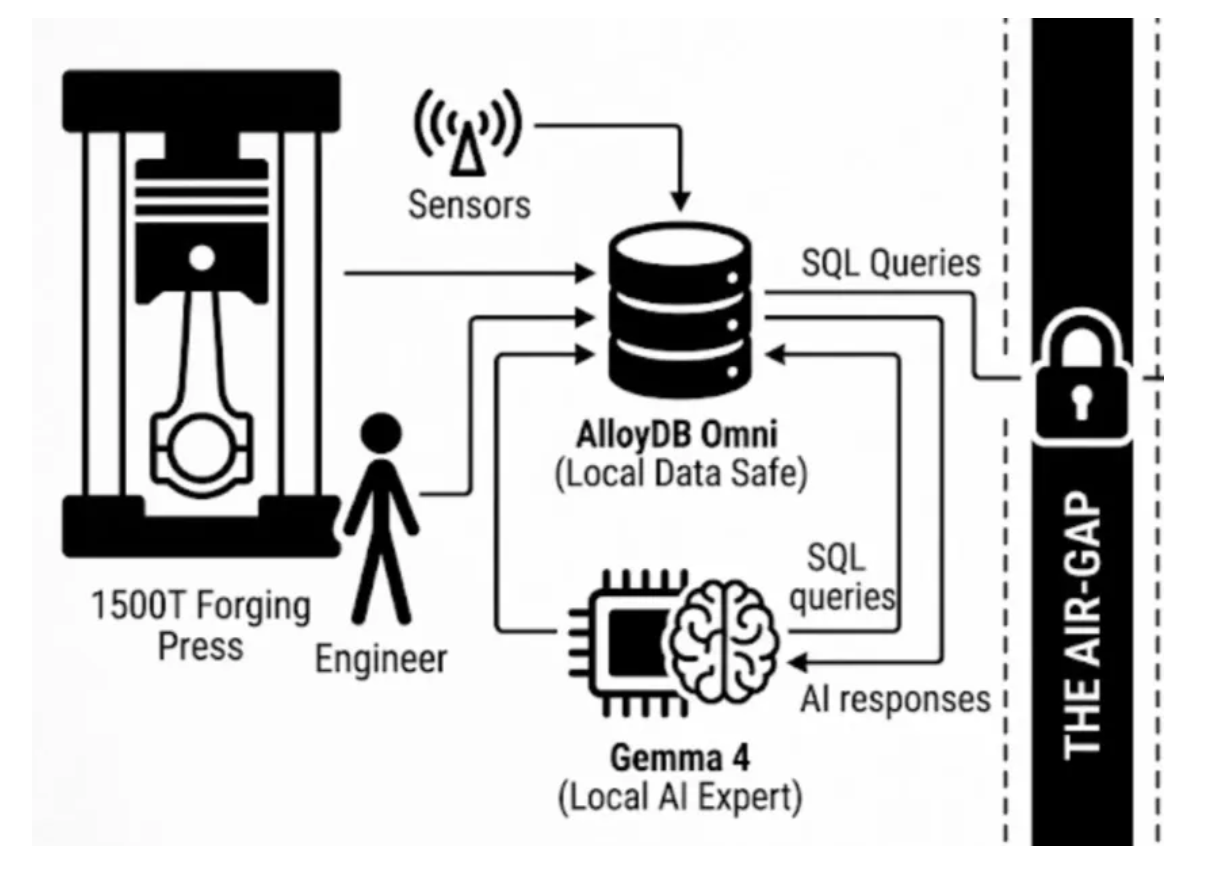
W świecie regulowanych, kluczowych branż organizacje stoją przed ogromnym paradoksem: jak wdrożyć najnowocześniejszą AI, aby zoptymalizować produkcję, gdy zasady cyberbezpieczeństwa wymagają, aby dane nigdy nie były przesyłane przez publiczny internet? Intranety i publiczny internet są ściśle odseparowane i nigdy się nie łączą. Nowoczesna produkcja bardzo potrzebuje sztucznej inteligencji do prognozowania, aby zapobiegać katastrofalnym awariom sprzętu i optymalizować wydajność, ale wysyłanie poufnych dzienników telemetrycznych, opatentowanych receptur stopów czy danych ERP do Cloud APIs chmury publicznej jest w praktyce niemożliwe. Jeśli więc dane nie mogą trafić do chmury, chmura musi trafić do danych.
W tym ćwiczeniu z programowania przeniesiemy najbardziej zaawansowane narzędzia Google Cloud do obsługi danych i AI bezpośrednio do odłączonych, wysoce bezpiecznych środowisk z Gemma 4 i AlloyDB Omni.
AlloyDB Omni: najwyższy poziom bezpieczeństwa danych
AlloyDB Omni można porównać do bardzo wydajnego skarbca. Jest to skonteneryzowana baza danych klasy korporacyjnej, którą można pobrać i uruchomić w całości we własnym bezpiecznym intranecie.
- Płynna integracja: łączy się bezpośrednio z czujnikami produkcyjnymi (takimi jak VIM lub ciężka prasa) i lokalnymi systemami ERP (takimi jak Oracle R12).
- Pamięć masowa gotowa na AI: bezpiecznie przechowuje ściśle tajne arkusze procesów, używając wektorów dystrybucyjnych do wyszukiwania AI (pgvector).
- Wydajność: znacznie przewyższa standardową wersję PostgreSQL zarówno w przypadku dużych zbiorów zadań transakcyjnych, jak i przetwarzania analitycznego przez AI.
Lokalni eksperci AI: Gemma, TimesFM, TabFM
Zamiast korzystać ze zdalnych interfejsów API, możesz pobrać modele z otwartymi wagami i uruchamiać je natywnie na sprzęcie lokalnym bez ryzyka wycieku danych przez interfejs API.
- Gemma LLM Google z otwartymi wagami działa jako ekspert ds. badań i rozwoju. Może bezpiecznie odczytywać logi historyczne lub analizować złożone, opatentowane przepisy na stopy, aby przewidywać właściwości mechaniczne.
- TimesFM (The Numerical Forecaster): ponieważ LLM mogą czasami halucynować liczby, ciężkie maszyny wymagają specjalnego modelu podstawowego do ciągów czasowych. TimesFM dokładnie prognozuje długoterminowe horyzonty liczbowe (do 16 000 punktów danych), odczytując logi dotyczące wibracji i temperatury, aby prognozować dokładne krzywe awarii sprzętu – całkowicie offline.
- TabFM (The Tabular Reasoner): LLM obsługują tekst, a TimesFM trendy liczbowe, natomiast TabFM specjalizuje się w rozumowaniu na podstawie uporządkowanych danych tabelarycznych. Możesz go bezpiecznie uruchamiać lokalnie, aby przeprowadzać złożone analizy i odpowiadać na pytania bezpośrednio na podstawie gęstych, wielokolumnowych danych ERP lub CRM bez konieczności pisania złożonych złączeń SQL.
Przypadek użycia
Konserwacja predykcyjna prasy kuźniczej o nacisku 1500 ton:
Nieplanowane przestoje tych ogromnych maszyn wstrzymują produkcję, co powoduje marnowanie czasu i ważnych materiałów. Z kolei zaplanowana konserwacja często powoduje zbyt wczesną wymianę drogich części, co prowadzi do marnowania budżetu. Musimy przejść od konserwacji reaktywnej do konserwacji predykcyjnej bez naruszania odcięcia od sieci zewnętrznych.
Czego się nauczysz
W tym ćwiczeniu:
- Użyjesz AlloyDB Omni do bezpiecznego przechwytywania danych z czujników wibracji i temperatury lokalnie. Możesz dodać więcej parametrów, aby zwiększyć realizm i przydatność.
- Dowiesz się, jak używać Gemmy do analizowania trendów na podstawie historycznych logów błędów.
- Utworzysz system, który przewiduje awarie i automatycznie wyzwala próbne zlecenia pracy związane z zarządzaniem zasobami w systemie ERP.
Do obsługi lokalnego LLM i AlloyDB Omni używamy Dockera. Zaletą tego podejścia jest jego prostota: AlloyDB Omni może automatycznie zarządzać własnym wewnętrznym procesem ML-Agent.
Wymagania
- podstawowa znajomość SQL;
- standardowa maszyna wirtualna z systemem Linux (np. Ubuntu 22.04) lub komputer lokalny (macOS/Windows) z zainstalowanym Dockerem;
2. Uruchamianie lokalnego LLM (Gemma 4)
Do hostowania Gemmy lokalnie użyjemy Ollama. Utwórz plik Dockerfile, aby skonfigurować instancję Ollama:
- Na komputerze lokalnym uruchom w terminalu kolejno te polecenia:
mkdir -p gemma4-ollama && cd gemma4-ollama
cat << 'EOF' > Dockerfile
FROM ollama/ollama:latest
ENV OLLAMA_HOST=0.0.0.0:8080
ENV OLLAMA_MODELS=/root/.ollama
ENV MODEL=gemma4:e2b
RUN ollama serve & sleep 5 && ollama pull $MODEL
ENTRYPOINT ["ollama", "serve"]
EOF
- Skompiluj i uruchom kontener w sieci hosta:
docker build -t gemma4-local .

docker run --network host -d -p 8080:8080 --name gemma4-ollama-instance gemma4-local
- Możesz to przetestować za pomocą polecenia:
curl -X POST http://localhost:8080/api/generate -d '{
  "model": "gemma4:e2b",
  "prompt": "Hello! Explain Gemma 4 in a few sentences."
}'
3. Instalowanie i uruchamianie AlloyDB Omni
Następnie uruchom kontener bazy danych AlloyDB Omni, również w sieci hosta:
docker run -d \
  --name my-omni \
  --network host \
  -e POSTGRES_PASSWORD=omni \
  gcr.io/alloydb-omni/alloydbomni:18
Jeśli nie udało się znaleźć obrazu AlloyDB Omni z projektu w chmurze Google, spróbuj przeprowadzić uwierzytelnianie, uruchamiając polecenie przed wykonaniem powyższego polecenia docker run:
gcloud auth login
Po zakończeniu uwierzytelniania spróbuj ponownie uruchomić polecenie docker run.
4. Włączanie wewnętrznego agenta ML
Domyślnie funkcje integracji AlloyDB Omni z systemami uczącymi się są wyłączone. Aby włączyć wewnętrzny proces ML-Agent i mechanizm zapytań AI, musimy zmodyfikować plik postgresql.conf w kontenerze.
Uruchom to polecenie, aby dołączyć niezbędne flagi:
docker exec -it my-omni sh -c "cat << EOF >> /var/lib/postgresql/data/postgresql.conf
omni_enable_ml_agent_process = 'on'
google_ml_integration.enable_model_support = 'on'
google_ml_integration.enable_ai_query_engine = 'on'
EOF"
Uruchom ponownie kontener, aby zastosować zmiany:
docker restart my-omni
Możesz zacząć testować zapytania, uruchamiając psql za pomocą polecenia:
docker exec -it my-omni psql -U postgres
5. Przekierowywanie AI do lokalnego modelu LLM
Po połączeniu się z bazą danych za pomocą psql (docker exec -it my-omni psql -U postgres) możesz zarejestrować lokalny model offline. Zamiast wywoływać internet, przekieruj model_request_url na lokalny serwer Ollama działający na porcie 8080.
Uruchom te instrukcje SQL w wierszu poleceń psql w terminalu:
CREATE EXTENSION IF NOT EXISTS google_ml_integration CASCADE;

CALL google_ml.create_model(
    model_id => 'gemma4:e2b',
    model_request_url => 'http://localhost:8080/api/generate',
    model_provider => 'custom',
    model_type => 'generic'
);
Teraz możesz bezpiecznie wywoływać prognozy z poziomu SQL:
SELECT google_ml.predict_row(
    'gemma4:e2b',
    '{"model": "gemma4:e2b", "prompt": "Why is the sky blue?", "stream": false}'
)->'response';
Dane wyjściowe:
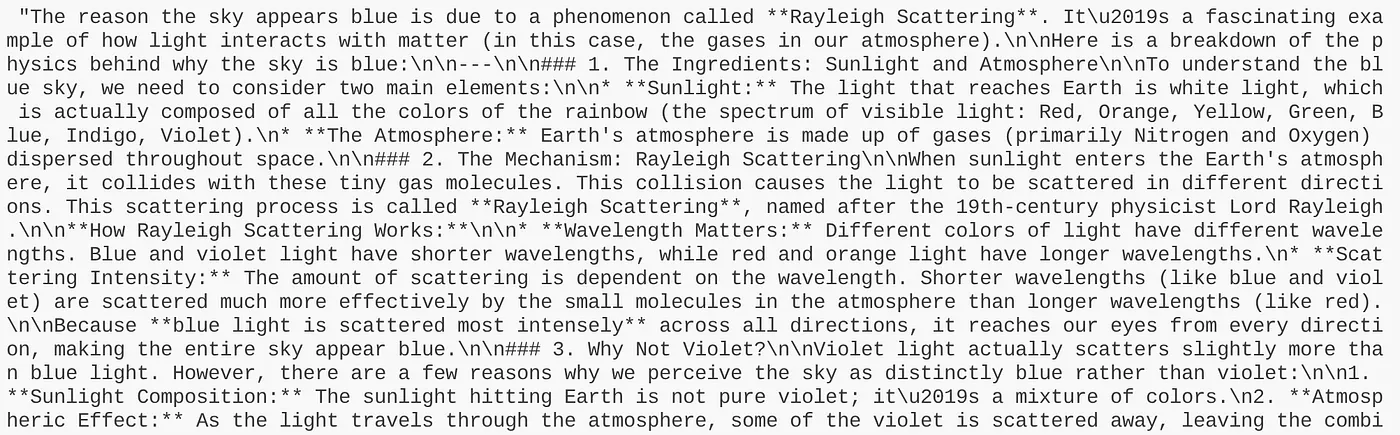
Teraz, gdy przetestowaliśmy to na ogólnym elemencie testowania, przejdźmy do danych naszego przypadku użycia.
6. Tworzenie schematu i pozyskiwanie danych
Teraz rozbudujmy nasz przypadek użycia, tworząc schemat i dane wymagane do demonstracji.
Uruchom te instrukcje SQL w wierszu poleceń psql w terminalu:
-- ==============================================================================
-- 1. Setup the Schema for the 1500T Forging Press
-- ==============================================================================
CREATE TABLE IF NOT EXISTS forging_press_logs (
    log_id SERIAL PRIMARY KEY,
    timestamp TIMESTAMP NOT NULL DEFAULT NOW(),
    cycle_id VARCHAR(50) NOT NULL,
    hyd_pressure_bar NUMERIC(5,2),
    oil_temp_c NUMERIC(5,2),
    vib_z_rms NUMERIC(5,2)
);

-- Clean up any existing data if running multiple times
TRUNCATE TABLE forging_press_logs;

-- ==============================================================================
-- 2. Generate 1,000 Records of Simulated Data
-- ==============================================================================
-- 99% of data is 'Normal'
INSERT INTO forging_press_logs (cycle_id, hyd_pressure_bar, oil_temp_c, vib_z_rms)
SELECT
    'C-' || LPAD(i::text, 5, '0'),
    280.0 + (random() * 10 - 5), -- Pressure around 280
    42.0 + (random() * 5),       -- Temp around 42-47
    1.8 + (random() * 0.5)       -- Vib Z around 1.8-2.3
FROM generate_series(1, 990) AS i;

-- 1% of data is 'Anomalous' (Hydraulic pressure drop & vibration spike)
INSERT INTO forging_press_logs (cycle_id, hyd_pressure_bar, oil_temp_c, vib_z_rms)
SELECT
    'C-' || LPAD((990 + i)::text, 5, '0'),
    250.0 + (random() * 5),      -- Pressure dropping
    55.0 + (random() * 5),       -- Temp rising
    5.0 + (random() * 1.5)       -- High vibration
FROM generate_series(1, 10) AS i;

-- ==============================================================================
-- 3. Run the AI Prediction via AlloyDB Omni
-- ==============================================================================
-- Ensure the model is registered (assuming 'gemma4:e2b' is running locally on port 8080)
CREATE EXTENSION IF NOT EXISTS google_ml_integration CASCADE;

DO $$
BEGIN
    CALL google_ml.create_model(
        model_id => 'gemma4:e2b',
        model_request_url => 'http://localhost:8080/api/generate',
        model_provider => 'custom',
        model_type => 'generic'
    );
EXCEPTION WHEN OTHERS THEN
    -- Ignore error if model already exists
END $$;

-- Query the most recent 5 potentially anomalous records and ask Gemma for an analysis
SELECT
    cycle_id,
    hyd_pressure_bar,
    vib_z_rms,
    google_ml.predict_row(
        model_id => 'gemma4:e2b',
        request_body => json_build_object(
            'model', 'gemma4:e2b',
            'stream', false,
            'prompt', 'You are an industrial engineer. Analyze this sensor data from a 1500T forging press: Pressure=' || hyd_pressure_bar || ' bar, Vibration=' || vib_z_rms || ' mm/s. Normal pressure is ~280 bar and normal vibration is ~2.0 mm/s. Does this indicate a hydraulic failure? Answer in one short sentence.'
        )
    )->>'response' AS ai_analysis
FROM
    forging_press_logs
WHERE
    hyd_pressure_bar < 260 OR vib_z_rms > 4.5
ORDER BY
    timestamp DESC
LIMIT 5;
Uruchomienie powyższych instrukcji jedna po drugiej powinno dać taki wynik:
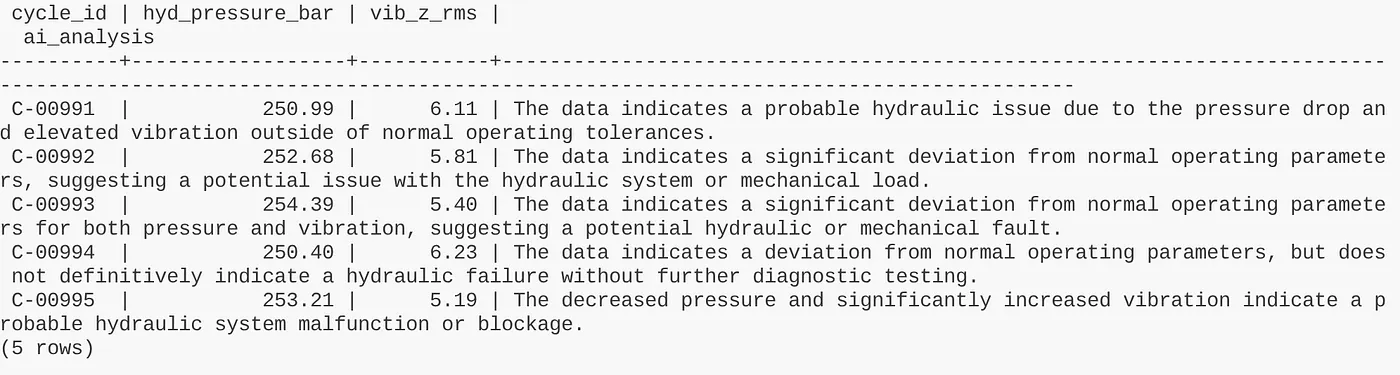
Mamy już gotowe dane, więc możemy przejść do tworzenia panelu konserwacji predykcyjnej.
7. Tworzenie panelu transmisji na żywo
Aby zwizualizować tę architekturę, możesz łatwo połączyć ją z panelem Flask w języku Python, który jest aplikacją internetową.
Zamiast ręcznie uruchamiać zapytania SQL, lekki backend Flask przesyła strumieniowo dane telemetryczne z czujników na żywo do panelu HTML. Podczas normalnego działania panel po prostu wyświetla wykresy.
Gdy jednak backend wykryje anomalię (np. spadek ciśnienia), kod w Pythonie natychmiast wywołuje funkcję google_ml.predict_row() w AlloyDB. AlloyDB bezproblemowo przekazuje kontekst do lokalnego modelu Gemma, a statystyki diagnostyczne AI pojawiają się na panelu w czasie rzeczywistym.
💡 Wskazówka dotycząca programu ćwiczeń: aby wyjść z kontenera bazy danych i wrócić do wiersza poleceń hosta, wpisz \q i naciśnij Enter (lub otwórz nową kartę terminala). Następnie uruchom poniższe polecenia aplikacji Flask.
Aby to zrobić:
- Przejdź do środowiska programistycznego lub edytora kodu i otwórz terminal.
- Uruchom to polecenie:
pip install flask psycopg2-binary
- Sklonuj repozytorium kodu w katalogu projektu, uruchamiając w terminalu Cloud Shell to polecenie:
git clone https://github.com/AbiramiSukumaran/gemma4-alloydb-omni-demo
- Przejdź do folderu projektu:
cd gemma4-alloydb-omni-demo
- Uruchom aplikację:
python3 app.py
Otwórz przeglądarkę lub kliknij link do aplikacji działającej na lokalnym hoście.
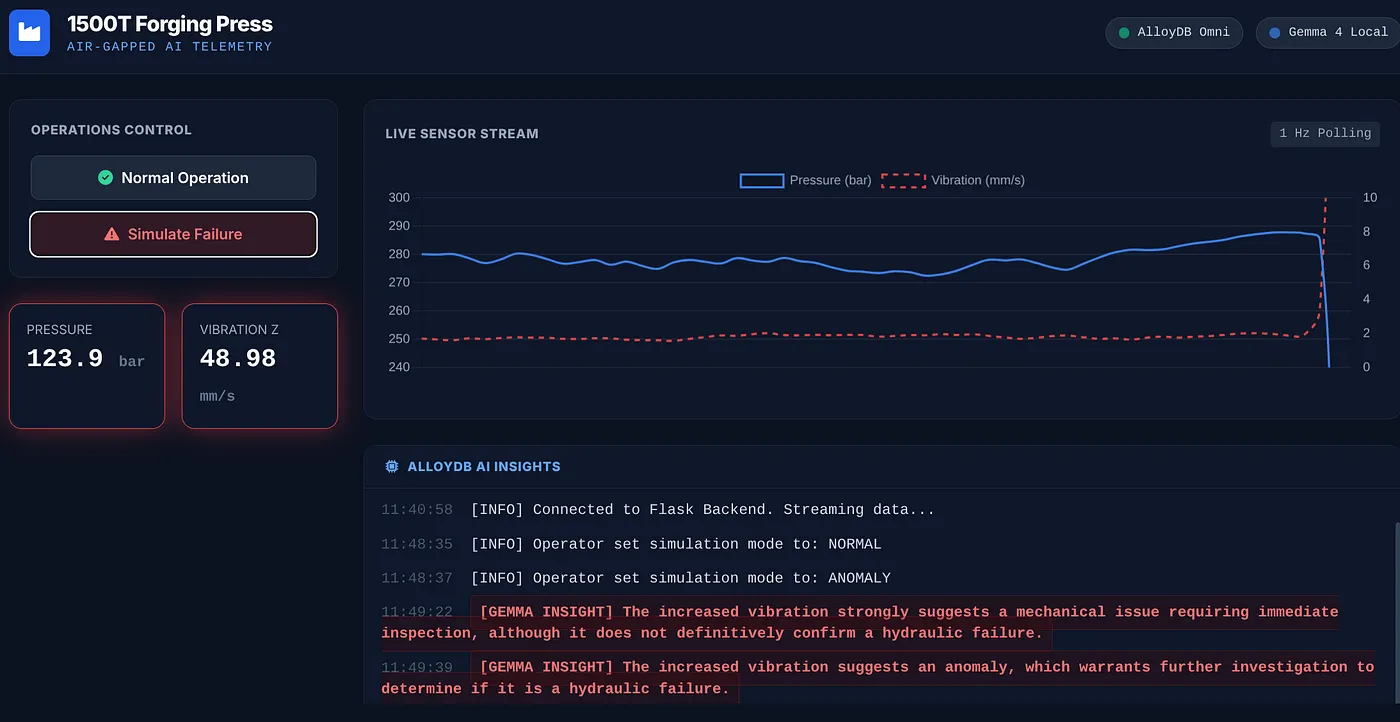
Co przedstawia panel transmisji na żywo
Aplikacja Flask działa jako panel monitorowania w czasie rzeczywistym dla prasy kuźniczej o nacisku 1500 ton, wizualizując, jak całkowicie odcięty od sieci zewnętrznych system offline obsługuje konserwację prognozowaną:
- Ciągły strumień danych telemetrycznych: panel wyświetla w czasie rzeczywistym logi dotyczące wibracji (mm/s) i ciśnienia hydraulicznego (bar), które są aktualizowane dynamicznie, aby symulować aktywne operacje na hali fabrycznej.
- Anomalie w bazie danych na bieżąco: gdy czujnik spadnie poniżej progu (np. ciśnienie spadnie poniżej 260 barów), backend Pythona oznaczy zdarzenie i natychmiast wywoła funkcję
google_ml.predict_row()w AlloyDB Omni. - Zlokalizowana diagnostyka AI: AlloyDB Omni przekazuje kontekst w czasie rzeczywistym do lokalnego modelu Gemma 4. Gemma działa jako lokalny ekspert przemysłowy, analizując dane telemetryczne i wyświetlając alert diagnostyczny (np. „Ostrzeżenie: spadek ciśnienia i silne wibracje wskazują na potencjalną awarię uszczelnienia hydraulicznego”) bezpośrednio w panelu.
- Zero wycieków: wszystkie obliczenia, bazy danych, wykresy i wnioskowanie AI są wykonywane całkowicie na lokalnym hoście bez konieczności połączenia z internetem.
8. Ścieżka do środowiska produkcyjnego
Aby przeskalować tę architekturę z lokalnego prototypu do wdrożenia na poziomie produkcyjnym w fabryce bez utraty bezpieczeństwa odcięcia od sieci zewnętrznych, możesz wybrać jedną z 2 standardowych ścieżek instalacji lokalnej:
Produkcyjne maszyny wirtualne i sprzęt klienta (niekonteneryzowane):
W środowiskach, w których konteneryzacja nie jest preferowana lub w których zasady bezpieczeństwa wymagają głębokiej integracji z systemem operacyjnym hosta, możesz wdrożyć AlloyDB Omni za pomocą oficjalnego pakietu RPM. To wdrożenie, wspomagane przez aranżer AlloyDB Omni Red Hat RPM, zapewnia niskie opóźnienia, zgodność z SELinux i automatyczną wysoką dostępność bezpośrednio na lokalnych maszynach wirtualnych RHEL lub Rocky Linux całkowicie offline.
Kubernetes w środowisku produkcyjnym i wysoka dostępność:
Jeśli infrastruktura fabryki korzysta z lokalnej orkiestracji, możesz wdrożyć AlloyDB Omni w Kubernetes . Korzystając z oficjalnego operatora AlloyDB Omni Kubernetes, możesz deklaratywnie wdrożyć solidny klaster bazy danych z synchronicznymi replikami rezerwowymi, automatycznymi lokalnymi kopiami zapasowymi i dedykowanymi punktami końcowymi tylko do odczytu.
9. Gratulacje!
W przypadku produkcji obronnej i podobnych branż odciętych od sieci zewnętrznych nie trzeba już wybierać między rygorystycznymi zabezpieczeniami a innowacjami technologicznymi. Wdrażając skonteneryzowane bazy danych, wyspecjalizowane modele proxy i AI z otwartymi wagami na suwerennym sprzęcie, możesz przekształcić swoją fabrykę w inteligentne, predykcyjne centrum – zachowując przy tym pełną kontrolę nad danymi.