

1. Visão geral
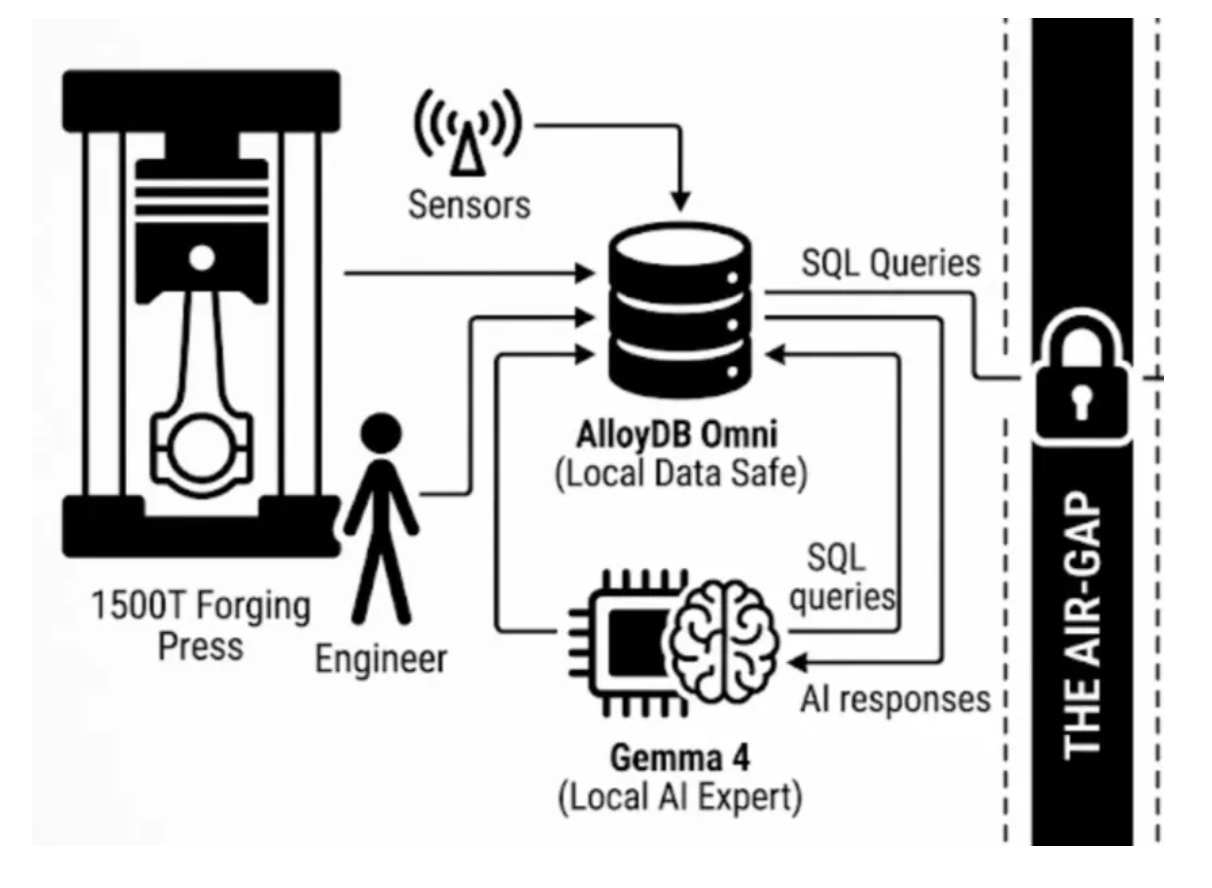
No mundo de alto risco das indústrias regulamentadas e de missão crítica, as organizações enfrentam um grande paradoxo: como adotar a IA de ponta para otimizar a produção quando as políticas de segurança cibernética exigem que os dados nunca entrem em contato com a Internet pública? As intranets e a Internet pública são estritamente separadas e nunca se tocam. Embora a manufatura moderna precise desesperadamente de IA preditiva para evitar falhas catastróficas de equipamentos e otimizar o rendimento, o envio de registros de telemetria sensíveis, receitas de ligas patenteadas ou dados de ERP para uma API de nuvem pública é, na prática, inviável. Portanto, se os dados não podem ir para a nuvem, a nuvem precisa ir até os dados.
Neste codelab, vamos levar as ferramentas de dados e IA mais avançadas do Google Cloud diretamente para ambientes desconectados e altamente seguros com o Gemma 4 e o AlloyDB Omni.
AlloyDB Omni: o melhor cofre de dados
Pense no AlloyDB Omni como um cofre de alto desempenho. É um banco de dados em contêiner de nível empresarial que você baixa e executa inteiramente na sua própria intranet segura.
- Integração total: ele se conecta diretamente aos sensores de fabricação (como um VIM ou uma prensa pesada) e aos ERPs locais (como o Oracle R12).
- Armazenamento pronto para IA: armazena com segurança planilhas de processos ultrassecretas usando embeddings de vetor para pesquisa com IA (pgvector).
- Desempenho: ele supera drasticamente o PostgreSQL padrão em cargas de trabalho transacionais pesadas e no processamento analítico de IA.
IAs especialistas locais: Gemma, TimesFM, TabFM
Em vez de usar APIs remotas, você pode baixar modelos de pesos abertos e executá-los nativamente no hardware local sem vazamento de API.
- Gemma: o LLM de pesos abertos do Google atua como seu especialista em P&D. Ele pode ler registros históricos com segurança ou analisar receitas de ligas complexas e patenteadas para prever propriedades mecânicas.
- TimesFM (The Numerical Forecaster): como os LLMs às vezes podem alucinar números, o maquinário pesado requer um modelo de fundação de séries temporais dedicado. O TimesFM prevê com precisão horizontes numéricos de longo prazo (até 16.000 pontos de dados), lendo registros de vibração e temperatura para prever curvas exatas de falha de equipamentos, tudo totalmente off-line.
- TabFM (The Tabular Reasoner): enquanto os LLMs processam texto e o TimesFM processa tendências numéricas, o TabFM é especializado em raciocinar sobre dados de tabelas estruturadas. Você pode executá-lo de forma segura no local para realizar análises complexas e responder a perguntas diretamente de dados densos de ERP ou CRM com várias colunas, sem precisar escrever junções SQL complexas.
Caso de uso
Manutenção preditiva em uma prensa de forjamento de 1.500 toneladas:
O tempo de inatividade não planejado nessas máquinas enormes interrompe a produção, desperdiçando muito tempo e materiais essenciais. Por outro lado, a manutenção programada geralmente substitui peças caras antes do tempo, desperdiçando orçamento. Precisamos passar da manutenção reativa para a preditiva sem quebrar o isolamento físico.
O que você vai aprender
Neste codelab você aprendeu como:
- Você vai usar o AlloyDB Omni para capturar dados de sensores de vibração e temperatura de forma segura e local. É possível adicionar mais parâmetros para tornar o processo mais realista e útil.
- Você vai aprender a usar o Gemma para analisar as tendências em relação aos registros de falhas históricos.
- Você vai criar um sistema que prevê falhas e simula o acionamento de ordens de serviço de gerenciamento de recursos no seu ERP automaticamente.
Usamos o Docker para provisionar o LLM local e o AlloyDB Omni. A beleza dessa abordagem é a simplicidade: o AlloyDB Omni pode gerenciar automaticamente o próprio processo interno do agente de ML.
Requisitos
- Conhecimento básico sobre SQL.
- Uma VM padrão do Linux (por exemplo, Ubuntu 22.04) ou uma máquina local (macOS/Windows) com o Docker instalado.
2. Iniciar o LLM local (Gemma 4)
Vamos usar o Ollama para hospedar o Gemma localmente. Crie um Dockerfile para configurar a instância do Ollama:
- Na máquina local, execute os seguintes comandos em um terminal, um por um:
mkdir -p gemma4-ollama && cd gemma4-ollama
cat << 'EOF' > Dockerfile
FROM ollama/ollama:latest
ENV OLLAMA_HOST=0.0.0.0:8080
ENV OLLAMA_MODELS=/root/.ollama
ENV MODEL=gemma4:e2b
RUN ollama serve & sleep 5 && ollama pull $MODEL
ENTRYPOINT ["ollama", "serve"]
EOF
- Crie e execute o contêiner na rede do host:
docker build -t gemma4-local .

docker run --network host -d -p 8080:8080 --name gemma4-ollama-instance gemma4-local
- Para testar, use o comando:
curl -X POST http://localhost:8080/api/generate -d '{
  "model": "gemma4:e2b",
  "prompt": "Hello! Explain Gemma 4 in a few sentences."
}'
3. Instalar e iniciar o AlloyDB Omni
Em seguida, crie o contêiner do banco de dados do AlloyDB Omni, também na rede do host:
docker run -d \
  --name my-omni \
  --network host \
  -e POSTGRES_PASSWORD=omni \
  gcr.io/alloydb-omni/alloydbomni:18
Se não for possível encontrar a imagem do AlloyDB Omni no seu projeto na nuvem do Google Cloud, tente fazer a autenticação executando o comando antes de executar o comando docker run acima:
gcloud auth login
Depois que a autenticação for concluída, tente executar o comando docker run novamente.
4. Ativar o agente de ML interno
Por padrão, os recursos de integração de ML do AlloyDB Omni estão desativados. Precisamos modificar o arquivo postgresql.conf dentro do contêiner para ativar o processo interno do ML-Agent e o mecanismo de consulta de IA.
Execute este comando único para adicionar as flags necessárias ao final:
docker exec -it my-omni sh -c "cat << EOF >> /var/lib/postgresql/data/postgresql.conf
omni_enable_ml_agent_process = 'on'
google_ml_integration.enable_model_support = 'on'
google_ml_integration.enable_ai_query_engine = 'on'
EOF"
Reinicie o contêiner para aplicar as mudanças:
docker restart my-omni
Para começar a testar consultas, inicie o psql usando o comando:
docker exec -it my-omni psql -U postgres
5. Encaminhar a IA para o LLM local
Depois de se conectar ao banco de dados via psql (docker exec -it my-omni psql -U postgres), você pode registrar seu modelo local e off-grid. Em vez de chamar a Internet, encaminhe o model_request_url para o servidor local do Ollama em execução na porta 8080.
Execute as seguintes instruções SQL no prompt do psql no terminal:
CREATE EXTENSION IF NOT EXISTS google_ml_integration CASCADE;

CALL google_ml.create_model(
    model_id => 'gemma4:e2b',
    model_request_url => 'http://localhost:8080/api/generate',
    model_provider => 'custom',
    model_type => 'generic'
);
Agora é possível invocar previsões com segurança no SQL:
SELECT google_ml.predict_row(
    'gemma4:e2b',
    '{"model": "gemma4:e2b", "prompt": "Why is the sky blue?", "stream": false}'
)->'response';
Saída:
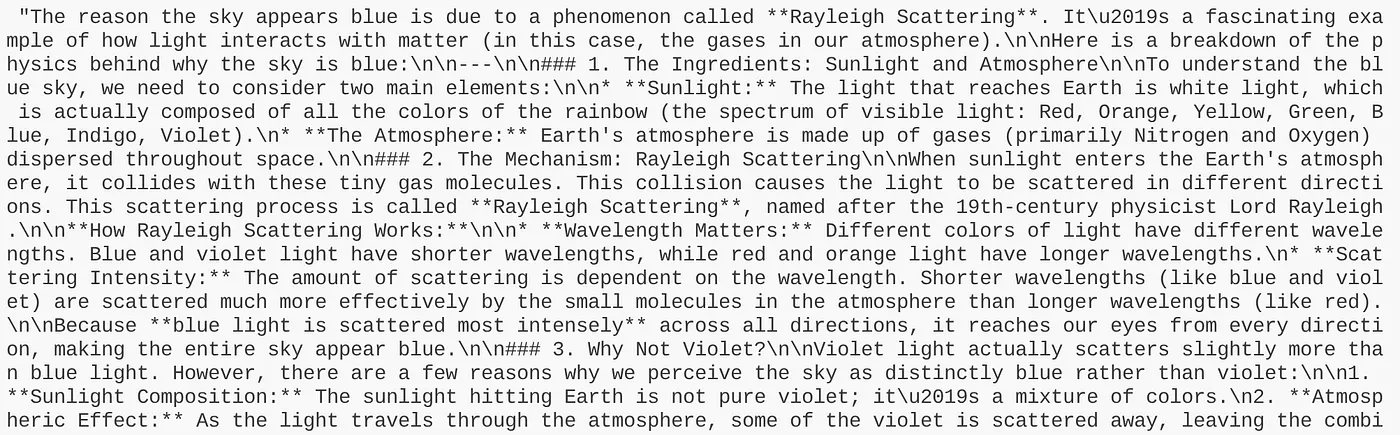
Agora que testamos um caso de teste genérico, vamos usar os dados do nosso caso de uso.
6. Criar esquema e ingerir dados
Agora vamos desenvolver nosso caso de uso criando o esquema e os dados necessários para a demonstração.
Execute as seguintes instruções SQL no prompt do psql no terminal:
-- ==============================================================================
-- 1. Setup the Schema for the 1500T Forging Press
-- ==============================================================================
CREATE TABLE IF NOT EXISTS forging_press_logs (
    log_id SERIAL PRIMARY KEY,
    timestamp TIMESTAMP NOT NULL DEFAULT NOW(),
    cycle_id VARCHAR(50) NOT NULL,
    hyd_pressure_bar NUMERIC(5,2),
    oil_temp_c NUMERIC(5,2),
    vib_z_rms NUMERIC(5,2)
);

-- Clean up any existing data if running multiple times
TRUNCATE TABLE forging_press_logs;

-- ==============================================================================
-- 2. Generate 1,000 Records of Simulated Data
-- ==============================================================================
-- 99% of data is 'Normal'
INSERT INTO forging_press_logs (cycle_id, hyd_pressure_bar, oil_temp_c, vib_z_rms)
SELECT
    'C-' || LPAD(i::text, 5, '0'),
    280.0 + (random() * 10 - 5), -- Pressure around 280
    42.0 + (random() * 5),       -- Temp around 42-47
    1.8 + (random() * 0.5)       -- Vib Z around 1.8-2.3
FROM generate_series(1, 990) AS i;

-- 1% of data is 'Anomalous' (Hydraulic pressure drop & vibration spike)
INSERT INTO forging_press_logs (cycle_id, hyd_pressure_bar, oil_temp_c, vib_z_rms)
SELECT
    'C-' || LPAD((990 + i)::text, 5, '0'),
    250.0 + (random() * 5),      -- Pressure dropping
    55.0 + (random() * 5),       -- Temp rising
    5.0 + (random() * 1.5)       -- High vibration
FROM generate_series(1, 10) AS i;

-- ==============================================================================
-- 3. Run the AI Prediction via AlloyDB Omni
-- ==============================================================================
-- Ensure the model is registered (assuming 'gemma4:e2b' is running locally on port 8080)
CREATE EXTENSION IF NOT EXISTS google_ml_integration CASCADE;

DO $$
BEGIN
    CALL google_ml.create_model(
        model_id => 'gemma4:e2b',
        model_request_url => 'http://localhost:8080/api/generate',
        model_provider => 'custom',
        model_type => 'generic'
    );
EXCEPTION WHEN OTHERS THEN
    -- Ignore error if model already exists
END $$;

-- Query the most recent 5 potentially anomalous records and ask Gemma for an analysis
SELECT
    cycle_id,
    hyd_pressure_bar,
    vib_z_rms,
    google_ml.predict_row(
        model_id => 'gemma4:e2b',
        request_body => json_build_object(
            'model', 'gemma4:e2b',
            'stream', false,
            'prompt', 'You are an industrial engineer. Analyze this sensor data from a 1500T forging press: Pressure=' || hyd_pressure_bar || ' bar, Vibration=' || vib_z_rms || ' mm/s. Normal pressure is ~280 bar and normal vibration is ~2.0 mm/s. Does this indicate a hydraulic failure? Answer in one short sentence.'
        )
    )->>'response' AS ai_analysis
FROM
    forging_press_logs
WHERE
    hyd_pressure_bar < 260 OR vib_z_rms > 4.5
ORDER BY
    timestamp DESC
LIMIT 5;
A execução das instruções acima, uma por uma, deve levar ao seguinte resultado:
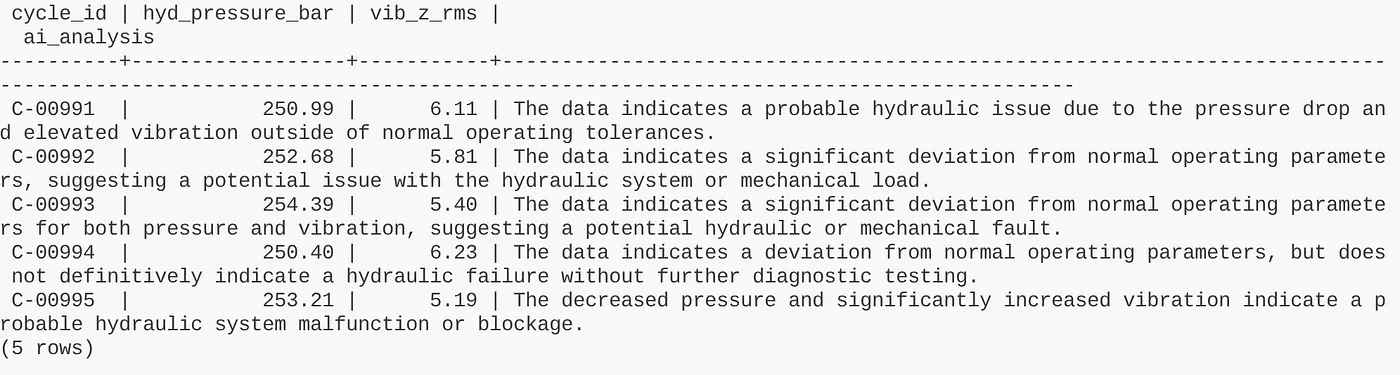
Agora que os dados estão prontos, vamos criar o painel de manutenção preditiva.
7. Como criar um painel de transmissão ao vivo
Para visualizar essa arquitetura, você pode conectá-la facilmente a um painel do Python Flask, que é um aplicativo da web.
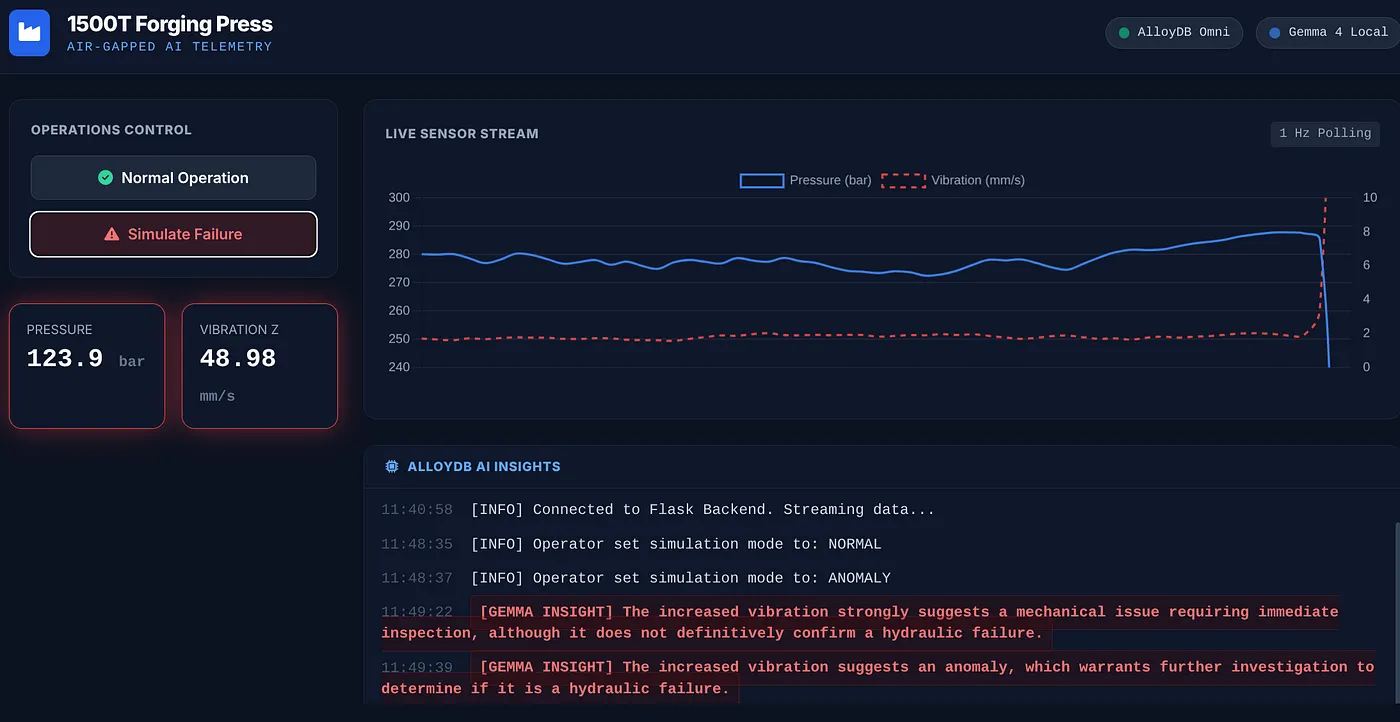
Em vez de executar consultas SQL manualmente, um back-end leve do Flask transmite a telemetria do sensor em tempo real para um painel HTML. Durante as operações normais, o painel simplesmente plota os gráficos.
No entanto, quando o back-end detecta uma anomalia (por exemplo, quedas de pressão), o código Python aciona instantaneamente a função google_ml.predict_row() no AlloyDB. O AlloyDB encaminha o contexto para o modelo local do Gemma, e o insight de diagnóstico da IA aparece no painel em tempo real.
💡 Dica do codelab: para sair do contêiner do banco de dados e voltar à linha de comando do host, digite \q e pressione Enter (ou abra uma nova guia do terminal). Em seguida, execute os comandos do aplicativo Flask abaixo.
Para fazer isto:
- Acesse o ambiente de desenvolvimento / editor de código e abra o terminal.
- Execute este comando:
pip install flask psycopg2-binary
- Clone o repositório de código no diretório do projeto executando o seguinte comando no terminal do Cloud Shell:
git clone https://github.com/AbiramiSukumaran/gemma4-alloydb-omni-demo
- Acesse a pasta do projeto:
cd gemma4-alloydb-omni-demo
- Execute o aplicativo:
python3 app.py
Abra o navegador da Web ou clique no link para o app em execução no host local.
O que o painel da transmissão ao vivo representa
O aplicativo Flask funciona como um painel de monitoramento em tempo real para a prensa de forjamento de 1.500 toneladas, mostrando como um sistema totalmente off-line e com isolamento físico lida com a manutenção preditiva:
- Fluxo de telemetria contínuo: o painel mostra registros de vibração (mm/s) e pressão hidráulica (bar) em tempo real, atualizando-se dinamicamente para simular operações ativas no chão de fábrica.
- Anomalias no banco de dados em tempo real: quando um sensor fica abaixo do limite (por exemplo, a pressão cai abaixo de 260 bar), o back-end do Python sinaliza o evento e chama imediatamente a função
google_ml.predict_row()no AlloyDB Omni. - Diagnóstico de IA localizado: o AlloyDB Omni encaminha o contexto em tempo real para o modelo Gemma 4 local. O Gemma atua como um especialista industrial no local, analisando a telemetria e imprimindo um alerta de diagnóstico (por exemplo, "Aviso: a queda de pressão e a alta vibração indicam uma possível falha na vedação hidráulica") diretamente no painel.
- Zero vazamento: todos os cálculos, bancos de dados, gráficos e raciocínios de IA são executados inteiramente no host local, sem necessidade de conexão com a Internet.
8. Caminho para a produção
Para escalonar essa arquitetura de um protótipo local para uma implantação de fábrica de nível de produção sem sacrificar a segurança com isolamento físico, escolha entre duas opções de instalação padrão no local:
VMs de produção e bare metal (não conteinerizadas):
Para ambientes em que a conteinerização não é preferida ou em que a integração profunda com o sistema operacional host é exigida pela política de segurança, é possível implantar usando o pacote RPM oficial do AlloyDB Omni. Com a ajuda do orquestrador RPM do AlloyDB Omni Red Hat, essa implantação oferece desempenho de baixa latência, conformidade com o SELinux e alta disponibilidade (HA) automatizada diretamente para suas VMs locais do RHEL ou do Rocky Linux, totalmente off-line.
Kubernetes de produção e alta disponibilidade:
Se a infraestrutura da fábrica usar orquestração local, implante o AlloyDB Omni no Kubernetes . Usando o operador oficial do AlloyDB Omni no Kubernetes, é possível implantar de forma declarativa um cluster de banco de dados robusto com réplicas em espera síncronas, backups locais automatizados e endpoints dedicados somente leitura.
9. Parabéns!
Para a fabricação de defesa e esses setores com isolamento físico, a escolha não é mais entre segurança rigorosa e inovação tecnológica. Ao implantar bancos de dados em contêineres, modelos de proxy especializados e IA de pesos abertos em hardware soberano, é possível transformar sua fábrica em uma potência inteligente e preditiva, mantendo seu fosso digital completamente intacto.