

1. Tổng quan
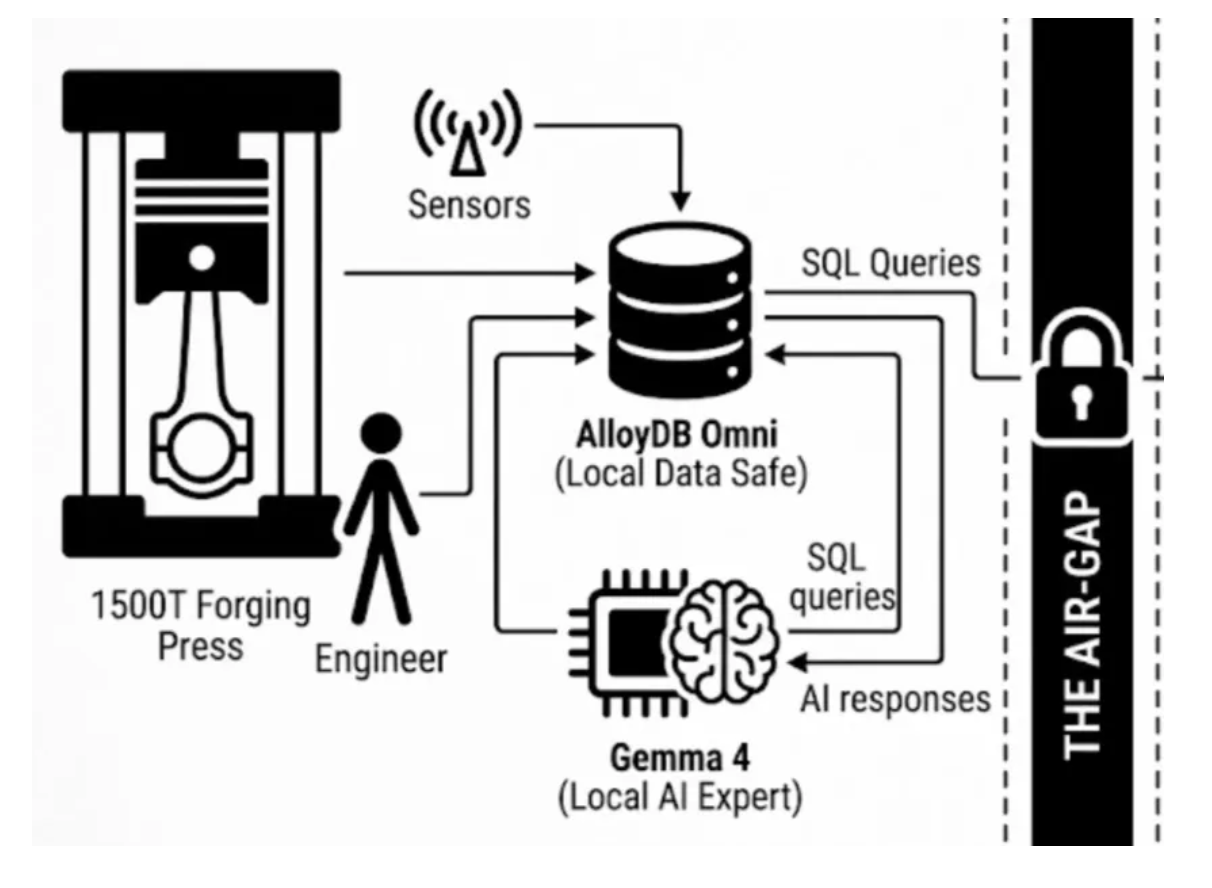
Trong thế giới đầy rủi ro của các ngành được quản lý và có vai trò quan trọng, các tổ chức phải đối mặt với một nghịch lý lớn: Làm thế nào để áp dụng AI tiên tiến nhằm tối ưu hoá hoạt động sản xuất khi các chính sách bảo mật mạng yêu cầu dữ liệu của bạn không bao giờ được tiếp xúc với Internet công cộng? Mạng nội bộ và Internet công cộng được tách biệt nghiêm ngặt và không bao giờ tiếp xúc với nhau. Mặc dù ngành sản xuất hiện đại rất cần AI dự đoán để ngăn chặn các sự cố thiết bị nghiêm trọng và tối ưu hoá sản lượng, nhưng việc gửi nhật ký đo từ xa nhạy cảm, công thức hợp kim được cấp bằng sáng chế hoặc dữ liệu ERP đến một Cloud APIs công khai là điều không thể thực hiện được. Vì vậy, nếu dữ liệu không thể chuyển lên đám mây, thì đám mây phải đến với dữ liệu.
Trong lớp học lập trình này, chúng ta sẽ đưa các công cụ AI và dữ liệu tiên tiến nhất của Google Cloud vào thẳng các môi trường không kết nối và có độ bảo mật cao bằng Gemma 4 và AlloyDB Omni.
AlloyDB Omni: Kho dữ liệu tối ưu
Hãy coi AlloyDB Omni như một kho lưu trữ hiệu suất cao. Đây là một cơ sở dữ liệu cấp doanh nghiệp, được đóng gói trong vùng chứa mà bạn tải xuống và chạy hoàn toàn trên mạng nội bộ bảo mật của riêng mình.
- Tích hợp liền mạch: Kết nối trực tiếp với các cảm biến sản xuất (như VIM hoặc máy ép hạng nặng) và ERP cục bộ (như Oracle R12).
- Bộ nhớ hỗ trợ AI: Lưu trữ an toàn các bảng quy trình tối mật bằng cách sử dụng các vectơ nhúng cho tính năng tìm kiếm bằng AI (pgvector).
- Hiệu suất: AlloyDB vượt trội hơn hẳn so với PostgreSQL tiêu chuẩn cho cả khối lượng công việc giao dịch nặng và xử lý phân tích bằng AI.
Chuyên gia AI cục bộ: Gemma, TimesFM, TabFM
Thay vì sử dụng API từ xa, bạn có thể tải các mô hình có trọng số mở xuống và chạy chúng ngay trên phần cứng cục bộ mà không lo rò rỉ dữ liệu qua API.
- Gemma: Mô hình ngôn ngữ lớn (LLM) có trọng số mở của Google đóng vai trò là chuyên gia nghiên cứu và phát triển (R&D). Mô hình này có thể đọc nhật ký trước đây một cách an toàn hoặc phân tích các công thức hợp kim phức tạp, đã được cấp bằng sáng chế để dự đoán các đặc tính cơ học.
- TimesFM (Công cụ dự báo số): Vì LLM đôi khi có thể tạo ra số liệu ảo, nên máy móc hạng nặng cần có một Mô hình nền tảng chuỗi thời gian chuyên dụng. TimesFM dự đoán chính xác các khoảng thời gian dài (lên đến 16.000 điểm dữ liệu), đọc nhật ký độ rung và nhiệt độ để dự báo chính xác đường cong hỏng hóc của thiết bị — hoàn toàn không cần kết nối mạng.
- TabFM (The Tabular Reasoner): Trong khi LLM xử lý văn bản và TimesFM xử lý xu hướng số, TabFM chuyên suy luận về dữ liệu bảng có cấu trúc. Bạn có thể chạy công cụ này một cách an toàn tại cơ sở để thực hiện các phép phân tích phức tạp và trả lời các câu hỏi trực tiếp từ dữ liệu ERP hoặc CRM dày đặc, nhiều cột mà không cần viết các phép nối SQL phức tạp.
Trường hợp sử dụng
Bảo trì có dự đoán trên máy dập rèn 1.500 tấn:
Thời gian ngừng hoạt động ngoài kế hoạch của máy móc khổng lồ này khiến hoạt động sản xuất bị đình trệ, gây lãng phí rất nhiều thời gian và nguyên liệu quan trọng. Ngược lại, việc bảo trì theo lịch thường thay thế các bộ phận đắt tiền quá sớm, gây lãng phí ngân sách. Chúng ta cần chuyển từ bảo trì phản ứng sang bảo trì dự đoán mà không làm hỏng khoảng cách không khí.
Kiến thức bạn sẽ học được
Trong lớp học lập trình này:
- Bạn sẽ sử dụng AlloyDB Omni để thu thập dữ liệu cảm biến nhiệt độ và độ rung một cách an toàn trên thiết bị. Bạn có thể thêm nhiều tham số khác để dữ liệu này trở nên thực tế và hữu ích hơn.
- Bạn sẽ tìm hiểu cách sử dụng Gemma để phân tích xu hướng dựa trên nhật ký lỗi trước đây.
- Bạn sẽ xây dựng một hệ thống dự đoán lỗi và tự động kích hoạt lệnh công việc giả định trong hệ thống ERP của bạn.
Chúng tôi dựa vào Docker để cung cấp cả LLM cục bộ và AlloyDB Omni. Ưu điểm của phương pháp này là sự đơn giản: AlloyDB Omni có thể tự động quản lý quy trình ML-Agent nội bộ của riêng mình.
Yêu cầu
- Hiểu biết cơ bản về SQL.
- Một máy ảo Linux tiêu chuẩn (ví dụ: Ubuntu 22.04) hoặc một máy cục bộ (macOS/Windows) đã cài đặt Docker.
2. Khởi động LLM cục bộ (Gemma 4)
Chúng ta sẽ sử dụng Ollama để lưu trữ Gemma trên máy cục bộ. Tạo một tệp Docker để định cấu hình thực thể Ollama:
- Trên máy cục bộ, hãy chạy lần lượt từng lệnh sau trong cửa sổ dòng lệnh:
mkdir -p gemma4-ollama && cd gemma4-ollama
cat << 'EOF' > Dockerfile
FROM ollama/ollama:latest
ENV OLLAMA_HOST=0.0.0.0:8080
ENV OLLAMA_MODELS=/root/.ollama
ENV MODEL=gemma4:e2b
RUN ollama serve & sleep 5 && ollama pull $MODEL
ENTRYPOINT ["ollama", "serve"]
EOF
- Tạo và chạy vùng chứa trên mạng lưu trữ:
docker build -t gemma4-local .

docker run --network host -d -p 8080:8080 --name gemma4-ollama-instance gemma4-local
- Bạn có thể kiểm thử bằng lệnh:
curl -X POST http://localhost:8080/api/generate -d '{
  "model": "gemma4:e2b",
  "prompt": "Hello! Explain Gemma 4 in a few sentences."
}'
3. Cài đặt và khởi động AlloyDB Omni
Tiếp theo, hãy khởi động vùng chứa cơ sở dữ liệu AlloyDB Omni, cũng trên mạng lưu trữ:
docker run -d \
  --name my-omni \
  --network host \
  -e POSTGRES_PASSWORD=omni \
  gcr.io/alloydb-omni/alloydbomni:18
Nếu không tìm thấy hình ảnh AlloyDB Omni trong dự án trên đám mây của Google Cloud, hãy thử xác thực bằng cách chạy lệnh trước khi thực thi lệnh chạy docker ở trên:
gcloud auth login
Sau khi xác thực xong, hãy thử chạy lại lệnh docker run.
4. Bật ML-Agent nội bộ
Theo mặc định, các tính năng tích hợp học máy của AlloyDB Omni sẽ bị tắt. Chúng ta cần sửa đổi tệp postgresql.conf bên trong vùng chứa để bật quy trình ML-Agent nội bộ và công cụ truy vấn AI.
Thực thi lệnh duy nhất này để thêm các cờ cần thiết:
docker exec -it my-omni sh -c "cat << EOF >> /var/lib/postgresql/data/postgresql.conf
omni_enable_ml_agent_process = 'on'
google_ml_integration.enable_model_support = 'on'
google_ml_integration.enable_ai_query_engine = 'on'
EOF"
Khởi động lại vùng chứa để áp dụng các thay đổi:
docker restart my-omni
Bạn có thể bắt đầu kiểm thử truy vấn bằng cách khởi động psql bằng lệnh:
docker exec -it my-omni psql -U postgres
5. Định tuyến AI đến LLM cục bộ
Sau khi kết nối với cơ sở dữ liệu qua psql (docker exec -it my-omni psql -U postgres), bạn có thể đăng ký mô hình cục bộ, không kết nối mạng. Thay vì gọi ra Internet, hãy định tuyến model_request_url đến máy chủ Ollama cục bộ đang chạy trên cổng 8080.
Chạy các câu lệnh SQL sau từ lời nhắc psql trong dòng lệnh:
CREATE EXTENSION IF NOT EXISTS google_ml_integration CASCADE;

CALL google_ml.create_model(
    model_id => 'gemma4:e2b',
    model_request_url => 'http://localhost:8080/api/generate',
    model_provider => 'custom',
    model_type => 'generic'
);
Giờ đây, bạn có thể gọi thông tin dự đoán một cách an toàn từ trong SQL:
SELECT google_ml.predict_row(
    'gemma4:e2b',
    '{"model": "gemma4:e2b", "prompt": "Why is the sky blue?", "stream": false}'
)->'response';
Kết quả:
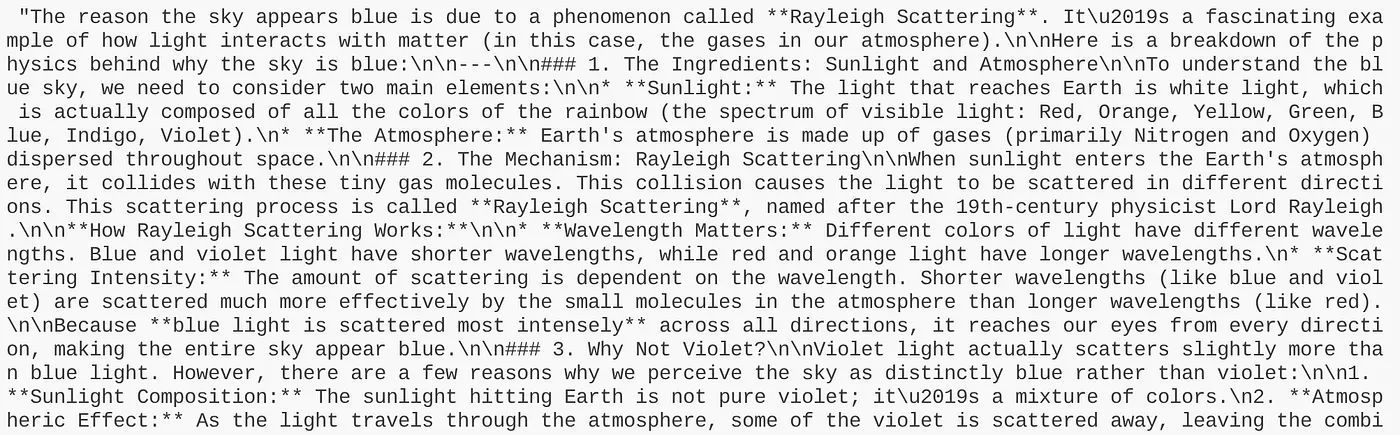
Bây giờ, sau khi đã thử nghiệm trên một trường hợp kiểm thử chung, hãy đưa dữ liệu trường hợp sử dụng của chúng ta vào.
6. Tạo giản đồ và nhập dữ liệu
Bây giờ, hãy xây dựng trường hợp sử dụng bằng cách tạo giản đồ và dữ liệu cần thiết để minh hoạ.
Chạy các câu lệnh SQL sau từ lời nhắc psql trong dòng lệnh:
-- ==============================================================================
-- 1. Setup the Schema for the 1500T Forging Press
-- ==============================================================================
CREATE TABLE IF NOT EXISTS forging_press_logs (
    log_id SERIAL PRIMARY KEY,
    timestamp TIMESTAMP NOT NULL DEFAULT NOW(),
    cycle_id VARCHAR(50) NOT NULL,
    hyd_pressure_bar NUMERIC(5,2),
    oil_temp_c NUMERIC(5,2),
    vib_z_rms NUMERIC(5,2)
);

-- Clean up any existing data if running multiple times
TRUNCATE TABLE forging_press_logs;

-- ==============================================================================
-- 2. Generate 1,000 Records of Simulated Data
-- ==============================================================================
-- 99% of data is 'Normal'
INSERT INTO forging_press_logs (cycle_id, hyd_pressure_bar, oil_temp_c, vib_z_rms)
SELECT
    'C-' || LPAD(i::text, 5, '0'),
    280.0 + (random() * 10 - 5), -- Pressure around 280
    42.0 + (random() * 5),       -- Temp around 42-47
    1.8 + (random() * 0.5)       -- Vib Z around 1.8-2.3
FROM generate_series(1, 990) AS i;

-- 1% of data is 'Anomalous' (Hydraulic pressure drop & vibration spike)
INSERT INTO forging_press_logs (cycle_id, hyd_pressure_bar, oil_temp_c, vib_z_rms)
SELECT
    'C-' || LPAD((990 + i)::text, 5, '0'),
    250.0 + (random() * 5),      -- Pressure dropping
    55.0 + (random() * 5),       -- Temp rising
    5.0 + (random() * 1.5)       -- High vibration
FROM generate_series(1, 10) AS i;

-- ==============================================================================
-- 3. Run the AI Prediction via AlloyDB Omni
-- ==============================================================================
-- Ensure the model is registered (assuming 'gemma4:e2b' is running locally on port 8080)
CREATE EXTENSION IF NOT EXISTS google_ml_integration CASCADE;

DO $$
BEGIN
    CALL google_ml.create_model(
        model_id => 'gemma4:e2b',
        model_request_url => 'http://localhost:8080/api/generate',
        model_provider => 'custom',
        model_type => 'generic'
    );
EXCEPTION WHEN OTHERS THEN
    -- Ignore error if model already exists
END $$;

-- Query the most recent 5 potentially anomalous records and ask Gemma for an analysis
SELECT
    cycle_id,
    hyd_pressure_bar,
    vib_z_rms,
    google_ml.predict_row(
        model_id => 'gemma4:e2b',
        request_body => json_build_object(
            'model', 'gemma4:e2b',
            'stream', false,
            'prompt', 'You are an industrial engineer. Analyze this sensor data from a 1500T forging press: Pressure=' || hyd_pressure_bar || ' bar, Vibration=' || vib_z_rms || ' mm/s. Normal pressure is ~280 bar and normal vibration is ~2.0 mm/s. Does this indicate a hydraulic failure? Answer in one short sentence.'
        )
    )->>'response' AS ai_analysis
FROM
    forging_press_logs
WHERE
    hyd_pressure_bar < 260 OR vib_z_rms > 4.5
ORDER BY
    timestamp DESC
LIMIT 5;
Việc chạy từng câu lệnh trên sẽ dẫn đến kết quả sau:
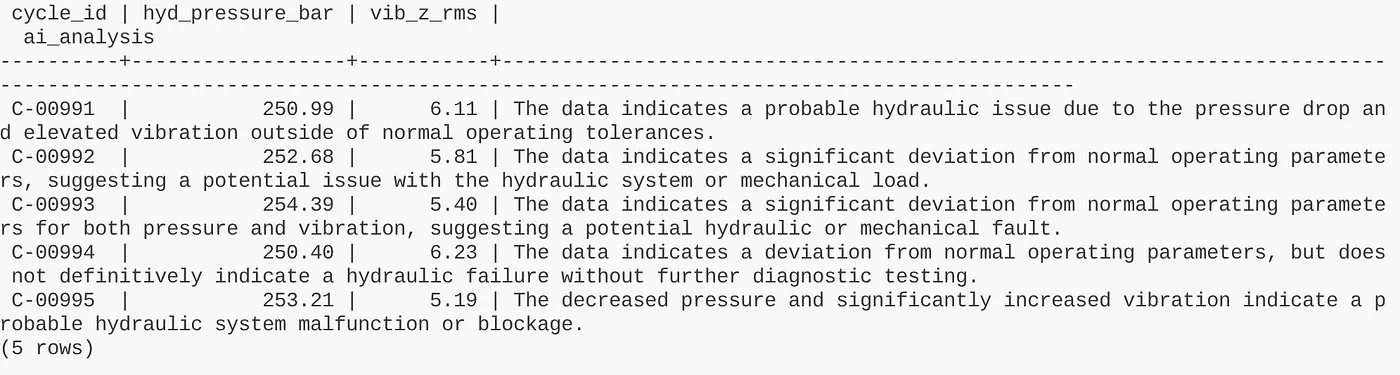
Giờ đây, khi đã có dữ liệu, hãy chuyển sang bước xây dựng trang tổng quan về bảo trì dự đoán!
7. Xây dựng trang tổng quan về sự kiện phát trực tiếp
Để thực sự hình dung cấu trúc này, bạn có thể dễ dàng kết nối cấu trúc này với một trang tổng quan Python Flask, tức là một ứng dụng web.
Thay vì chạy truy vấn SQL theo cách thủ công, một phần phụ trợ Flask gọn nhẹ sẽ truyền dữ liệu đo từ xa của cảm biến trực tiếp đến một trang tổng quan HTML. Trong các hoạt động thông thường, trang tổng quan chỉ vẽ biểu đồ.
Tuy nhiên, khi phần phụ trợ phát hiện thấy điểm bất thường (ví dụ: áp suất giảm), mã Python sẽ kích hoạt ngay hàm google_ml.predict_row() bên trong AlloyDB. AlloyDB chuyển tiếp liền mạch bối cảnh đến mô hình Gemma cục bộ của bạn và thông tin chẩn đoán chi tiết của AI sẽ nhấp nháy trên trang tổng quan theo thời gian thực.
💡 Mẹo cho lớp học lập trình: Để thoát khỏi vùng chứa cơ sở dữ liệu và quay lại dòng lệnh của máy chủ lưu trữ, hãy nhập \q rồi nhấn phím Enter (hoặc mở một thẻ dòng lệnh mới). Sau đó, hãy tiếp tục chạy các lệnh của ứng dụng Flask bên dưới.
Để thực hiện việc này:
- Chuyển đến môi trường phát triển / trình soạn thảo mã rồi mở cửa sổ dòng lệnh
- Chạy lệnh sau
pip install flask psycopg2-binary
- Sao chép kho lưu trữ mã trong thư mục dự án bằng cách chạy lệnh sau trong Cloud Shell Terminal:
git clone https://github.com/AbiramiSukumaran/gemma4-alloydb-omni-demo
- Chuyển đến thư mục dự án:
cd gemma4-alloydb-omni-demo
- Chạy ứng dụng:
python3 app.py
Mở trình duyệt web hoặc nhấp vào đường liên kết đến ứng dụng đang chạy trong máy chủ cục bộ của bạn.
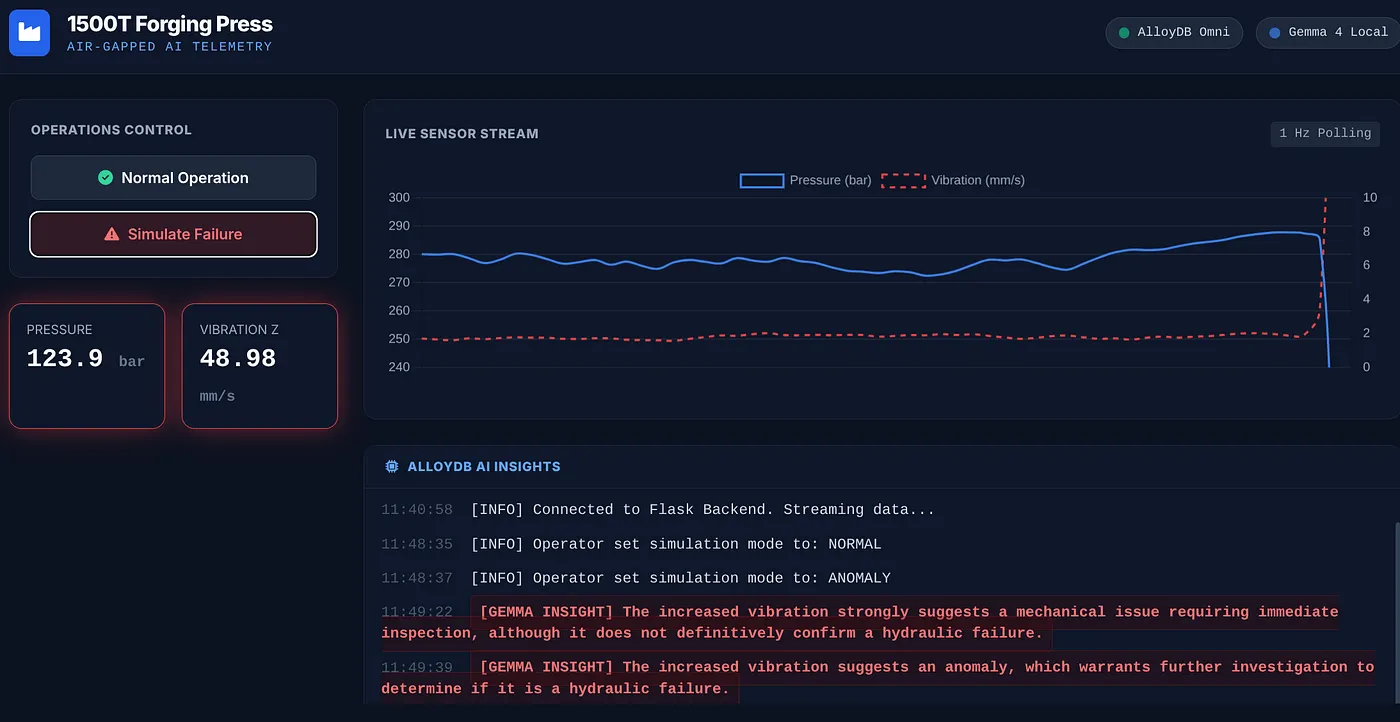
Ý nghĩa của trang tổng quan sự kiện trực tiếp
Ứng dụng Flask đóng vai trò là trang tổng quan giám sát theo thời gian thực cho Máy ép rèn 1.500 tấn, trực quan hoá cách một hệ thống hoàn toàn không có kết nối mạng, không có kết nối mạng xử lý hoạt động bảo trì dự đoán:
- Luồng dữ liệu đo từ xa liên tục: Trang tổng quan vẽ biểu đồ nhật ký độ rung (mm/s) và áp suất thuỷ lực (bar) theo thời gian thực, cập nhật linh động để mô phỏng các hoạt động thực tế tại nhà máy.
- Điểm bất thường trong cơ sở dữ liệu tức thời: Khi một cảm biến giảm xuống dưới ngưỡng (ví dụ: áp suất giảm xuống dưới 260 bar), phần phụ trợ Python sẽ gắn cờ sự kiện và gọi ngay hàm
google_ml.predict_row()bên trong AlloyDB Omni. - Chẩn đoán AI cục bộ: AlloyDB Omni chuyển tiếp bối cảnh theo thời gian thực đến mô hình Gemma 4 cục bộ của bạn. Gemma đóng vai trò là một chuyên gia công nghiệp tại chỗ, phân tích dữ liệu đo từ xa và in cảnh báo chẩn đoán (ví dụ: "Cảnh báo: Áp suất giảm và độ rung cao cho thấy có thể có lỗi phớt thuỷ lực") ngay trên trang tổng quan.
- Không rò rỉ dữ liệu: Mọi hoạt động tính toán, cơ sở dữ liệu, biểu đồ và suy luận AI đều được thực hiện hoàn toàn trên máy chủ cục bộ của bạn mà không cần kết nối Internet.
8. Lộ trình phát hành công khai
Để mở rộng quy mô kiến trúc này từ một nguyên mẫu cục bộ thành một mô hình triển khai tại nhà máy cấp sản xuất mà không làm mất đi tính bảo mật của môi trường tách biệt, bạn có thể chọn một trong hai quy trình cài đặt tiêu chuẩn tại chỗ:
Máy ảo chính thức và máy chủ vật lý (không được đóng gói):
Đối với những môi trường không ưu tiên việc đóng gói hoặc những môi trường mà chính sách bảo mật yêu cầu tích hợp sâu với hệ điều hành lưu trữ, bạn có thể triển khai bằng gói RPM chính thức của AlloyDB Omni. Được hỗ trợ bởi trình điều phối AlloyDB Omni Red Hat RPM, quy trình triển khai này mang lại hiệu suất có độ trễ thấp, tuân thủ SELinux và tính năng Tự động hoá có độ sẵn sàng cao (HA) trực tiếp cho các máy ảo RHEL hoặc Rocky Linux cục bộ của bạn hoàn toàn ngoại tuyến.
Kubernetes và HA trong môi trường thực tế:
Nếu cơ sở hạ tầng của nhà máy sử dụng tính năng điều phối cục bộ, bạn có thể triển khai AlloyDB Omni trên Kubernetes . Bằng cách sử dụng AlloyDB Omni Kubernetes Operator chính thức, bạn có thể khai báo triển khai một cụm cơ sở dữ liệu mạnh mẽ với các bản sao dự phòng đồng bộ, bản sao lưu cục bộ tự động và các điểm cuối chỉ có thể đọc chuyên dụng.
9. Xin chúc mừng!
Đối với ngành sản xuất quốc phòng và các ngành biệt lập tương tự, lựa chọn không còn là giữa bảo mật nghiêm ngặt và đổi mới công nghệ. Bằng cách triển khai cơ sở dữ liệu trong vùng chứa, mô hình proxy chuyên biệt và AI có trọng số mở trên phần cứng có chủ quyền, bạn có thể biến nhà máy của mình thành một trung tâm thông minh, có khả năng dự đoán — đồng thời giữ nguyên vẹn hào kỹ thuật số của mình.