

1. 概览
在受到严格监管、任务关键型行业的高风险世界中,组织面临着一个巨大的悖论:当网络安全政策规定数据绝不能接触公共互联网时,如何采用尖端 AI 来优化生产?内网和公共互联网严格隔离,绝不相交。虽然现代制造业迫切需要预测性 AI 来防止灾难性的设备故障并优化产量,但将敏感的遥测日志、专利合金配方或 ERP 数据发送到公有云 API 在实践中是行不通的。因此,如果数据无法上云,云就必须下沉到数据所在的位置。
在本 Codelab 中,我们将借助 Gemma 4 和 AlloyDB Omni,将 Google Cloud 最先进的数据和 AI 工具直接引入断网、高度安全的环境中。
AlloyDB Omni:终极数据保险箱
不妨将 AlloyDB Omni 想象成一个高性能保险库。它是一个容器化的企业级数据库,您可以下载该数据库并完全在自己的安全内网中运行。
- 无缝集成:它直接连接到制造传感器(如 VIM 或重型压力机)和本地 ERP(如 Oracle R12)。
- AI-Ready 存储:使用向量嵌入 (pgvector) 安全存储绝密工艺单,以便进行 AI 搜索。
- 性能:在处理繁重的事务型工作负载和分析型 AI 处理方面,其性能远超标准 PostgreSQL。
本地 AI 专家:Gemma、TimesFM、TabFM
您无需使用远程 API,而是可以下载开放权重模型,并在本地硬件上原生运行这些模型,从而实现零 API 泄露。
- Gemma:Google 的开放权重 LLM,可充当您的研发专家。它能安全地读取历史日志,或分析复杂的专利合金配方,从而预测机械性能。
- TimesFM(数值预测器):由于 LLM 有时可能会产生数字幻觉,因此重型机械需要专用的时序基础模型。TimesFM 可准确预测长期数值范围(最多 16,000 个数据点),通过读取振动和温度日志来预测确切的设备故障曲线,且完全离线运行。
- TabFM(表格推理器):LLM 负责处理文本,TimesFM 负责处理数值趋势,而 TabFM 则专门负责对结构化表格数据进行推理。您可以在本地安全地运行该模型,直接根据密集的多列 ERP 或 CRM 数据执行复杂分析并回答问题,而无需编写复杂的 SQL 联接。
使用场景
1500 吨锻压机的预测性维护:
这些大型机械的意外停机不仅会导致生产中断,还会浪费大量时间和关键材料。相反,定期维护往往会过早更换昂贵的部件,从而浪费预算。我们需要在不破坏网闸隔离的情况下,从被动维护转向预测性维护。
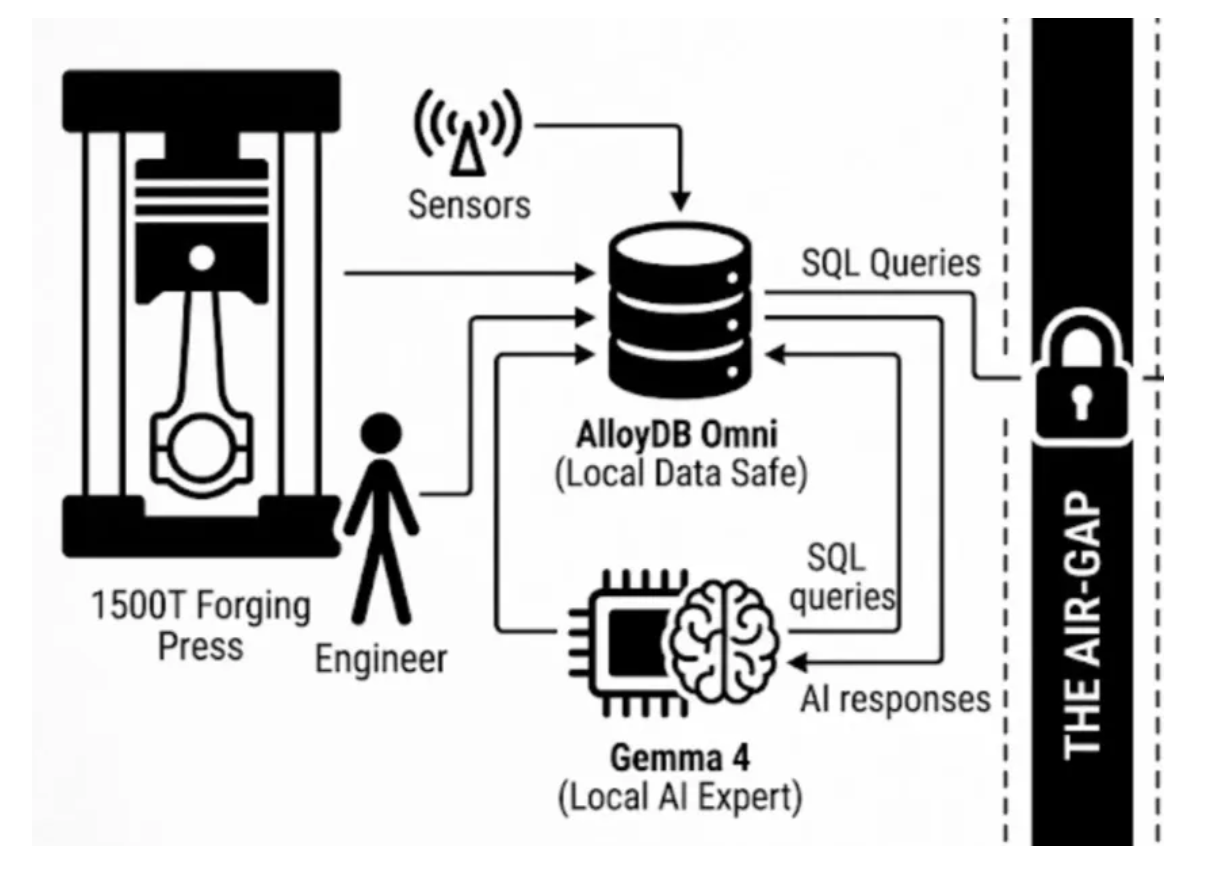
学习内容
在此 Codelab 中:
- 您将使用 AlloyDB Omni 在本地安全地捕获振动和温度传感器数据,还可以添加更多参数,使其更贴近实际且更实用。
- 您将学习如何使用 Gemma 分析历史故障日志中的趋势。
- 您将构建一个系统,该系统可预测故障并在 ERP 中自动模拟触发资产管理工作单。
我们将使用 Docker 来预配本地 LLM 和 AlloyDB Omni。这种方法的优势在于简单:AlloyDB Omni 可以自动管理自己的内部 ML-Agent 进程。
要求
- 基本熟悉 SQL。
- 标准 Linux 虚拟机(例如 Ubuntu 22.04)或安装了 Docker 的本地机器 (macOS/Windows)。
2. 启动本地 LLM (Gemma 4)
我们将使用 Ollama 在本地托管 Gemma。创建一个 Dockerfile 来配置 Ollama 实例:
- 在本地机器上,在终端中逐一运行以下命令:
mkdir -p gemma4-ollama && cd gemma4-ollama
cat << 'EOF' > Dockerfile
FROM ollama/ollama:latest
ENV OLLAMA_HOST=0.0.0.0:8080
ENV OLLAMA_MODELS=/root/.ollama
ENV MODEL=gemma4:e2b
RUN ollama serve & sleep 5 && ollama pull $MODEL
ENTRYPOINT ["ollama", "serve"]
EOF
- 在主机网络上构建并运行容器:
docker build -t gemma4-local .

docker run --network host -d -p 8080:8080 --name gemma4-ollama-instance gemma4-local
- 您可以使用以下命令进行测试:
curl -X POST http://localhost:8080/api/generate -d '{
  "model": "gemma4:e2b",
  "prompt": "Hello! Explain Gemma 4 in a few sentences."
}'
3. 安装并启动 AlloyDB Omni
接下来,在主机网络上启动 AlloyDB Omni 数据库容器:
docker run -d \
  --name my-omni \
  --network host \
  -e POSTGRES_PASSWORD=omni \
  gcr.io/alloydb-omni/alloydbomni:18
如果系统无法从您的 Google Cloud 项目中找到 AlloyDB Omni 映像,请尝试在执行上述 docker run 命令之前运行以下命令进行身份验证:
gcloud auth login
完成身份验证后,请尝试再次运行 docker run 命令。
4. 启用内部 ML-Agent
默认情况下,AlloyDB Omni 的机器学习集成功能处于关闭状态。我们需要修改容器内的 postgresql.conf 文件,以启用内部 ML-Agent 进程和 AI 查询引擎。
执行以下单条命令,以附加必要的标志:
docker exec -it my-omni sh -c "cat << EOF >> /var/lib/postgresql/data/postgresql.conf
omni_enable_ml_agent_process = 'on'
google_ml_integration.enable_model_support = 'on'
google_ml_integration.enable_ai_query_engine = 'on'
EOF"
重启容器以应用更改:
docker restart my-omni
您可以使用以下命令启动 psql,开始测试查询:
docker exec -it my-omni psql -U postgres
5. 将 AI 路由到本地 LLM
通过 psql (docker exec -it my-omni psql -U postgres) 连接到数据库后,您就可以注册本地离线模型了。将 model_request_url 路由到在 8080 端口上运行的本地 Ollama 服务器,而不是调用互联网。
在终端的 psql 提示符处运行以下 SQL 语句:
CREATE EXTENSION IF NOT EXISTS google_ml_integration CASCADE;

CALL google_ml.create_model(
    model_id => 'gemma4:e2b',
    model_request_url => 'http://localhost:8080/api/generate',
    model_provider => 'custom',
    model_type => 'generic'
);
现在,您可以在 SQL 中安全地调用预测:
SELECT google_ml.predict_row(
    'gemma4:e2b',
    '{"model": "gemma4:e2b", "prompt": "Why is the sky blue?", "stream": false}'
)->'response';
输出:
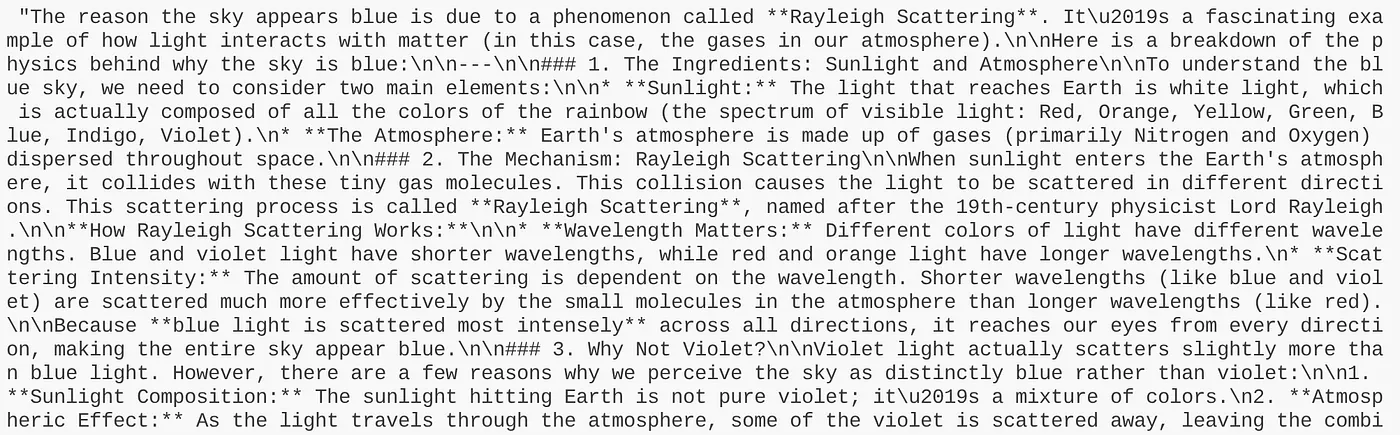
现在,我们已经在一个通用测试用例上进行了测试,接下来让我们将用例数据纳入其中。
6. 创建架构并注入数据
现在,我们来创建演示所需的架构和数据,进一步完善我们的应用场景。
在终端的 psql 提示符处运行以下 SQL 语句:
-- ==============================================================================
-- 1. Setup the Schema for the 1500T Forging Press
-- ==============================================================================
CREATE TABLE IF NOT EXISTS forging_press_logs (
    log_id SERIAL PRIMARY KEY,
    timestamp TIMESTAMP NOT NULL DEFAULT NOW(),
    cycle_id VARCHAR(50) NOT NULL,
    hyd_pressure_bar NUMERIC(5,2),
    oil_temp_c NUMERIC(5,2),
    vib_z_rms NUMERIC(5,2)
);

-- Clean up any existing data if running multiple times
TRUNCATE TABLE forging_press_logs;

-- ==============================================================================
-- 2. Generate 1,000 Records of Simulated Data
-- ==============================================================================
-- 99% of data is 'Normal'
INSERT INTO forging_press_logs (cycle_id, hyd_pressure_bar, oil_temp_c, vib_z_rms)
SELECT
    'C-' || LPAD(i::text, 5, '0'),
    280.0 + (random() * 10 - 5), -- Pressure around 280
    42.0 + (random() * 5),       -- Temp around 42-47
    1.8 + (random() * 0.5)       -- Vib Z around 1.8-2.3
FROM generate_series(1, 990) AS i;

-- 1% of data is 'Anomalous' (Hydraulic pressure drop & vibration spike)
INSERT INTO forging_press_logs (cycle_id, hyd_pressure_bar, oil_temp_c, vib_z_rms)
SELECT
    'C-' || LPAD((990 + i)::text, 5, '0'),
    250.0 + (random() * 5),      -- Pressure dropping
    55.0 + (random() * 5),       -- Temp rising
    5.0 + (random() * 1.5)       -- High vibration
FROM generate_series(1, 10) AS i;

-- ==============================================================================
-- 3. Run the AI Prediction via AlloyDB Omni
-- ==============================================================================
-- Ensure the model is registered (assuming 'gemma4:e2b' is running locally on port 8080)
CREATE EXTENSION IF NOT EXISTS google_ml_integration CASCADE;

DO $$
BEGIN
    CALL google_ml.create_model(
        model_id => 'gemma4:e2b',
        model_request_url => 'http://localhost:8080/api/generate',
        model_provider => 'custom',
        model_type => 'generic'
    );
EXCEPTION WHEN OTHERS THEN
    -- Ignore error if model already exists
END $$;

-- Query the most recent 5 potentially anomalous records and ask Gemma for an analysis
SELECT
    cycle_id,
    hyd_pressure_bar,
    vib_z_rms,
    google_ml.predict_row(
        model_id => 'gemma4:e2b',
        request_body => json_build_object(
            'model', 'gemma4:e2b',
            'stream', false,
            'prompt', 'You are an industrial engineer. Analyze this sensor data from a 1500T forging press: Pressure=' || hyd_pressure_bar || ' bar, Vibration=' || vib_z_rms || ' mm/s. Normal pressure is ~280 bar and normal vibration is ~2.0 mm/s. Does this indicate a hydraulic failure? Answer in one short sentence.'
        )
    )->>'response' AS ai_analysis
FROM
    forging_press_logs
WHERE
    hyd_pressure_bar < 260 OR vib_z_rms > 4.5
ORDER BY
    timestamp DESC
LIMIT 5;
逐一运行上述语句应该会得到以下结果:
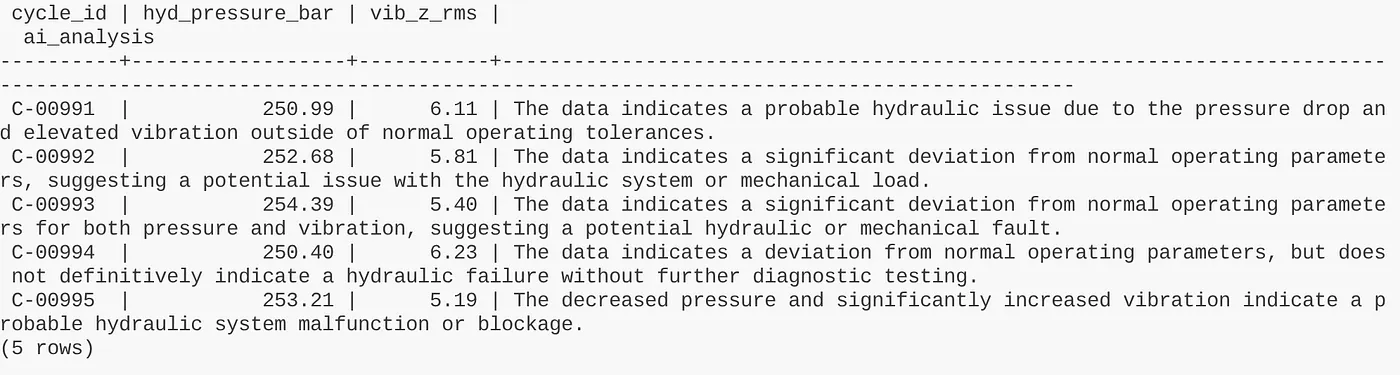
现在,数据已准备就绪,接下来我们来构建预测性维护信息中心!
7. 构建直播信息中心
为了真正直观地呈现此架构,您可以轻松地将其连接到 Python Flask 信息中心(一个 Web 应用)。
轻量级 Flask 后端会将实时传感器遥测数据流式传输到 HTML 信息中心,而无需手动运行 SQL 查询。在正常运行期间,信息中心只会绘制图表。
但当后端检测到异常(例如压力下降)时,Python 代码会立即触发 AlloyDB 中的 google_ml.predict_row() 函数。AlloyDB 会将上下文无缝转发给本地 Gemma 模型,AI 的诊断分析会实时显示在信息中心内。
💡 Codelab 提示:如需退出数据库容器并返回主机命令行,请输入 \q,然后按 Enter 键(或打开新的终端标签页)。然后,继续运行以下 Flask 应用命令。
为此,请执行以下操作:
- 前往开发环境 / 代码编辑器,然后打开终端
- 运行以下命令
pip install flask psycopg2-binary
- 在 Cloud Shell 终端中运行以下命令,在项目目录中克隆代码库:
git clone https://github.com/AbiramiSukumaran/gemma4-alloydb-omni-demo
- 进入项目文件夹:
cd gemma4-alloydb-omni-demo
- 运行应用:
python3 app.py
打开网络浏览器,或点击指向在 localhost 中运行的应用的链接。
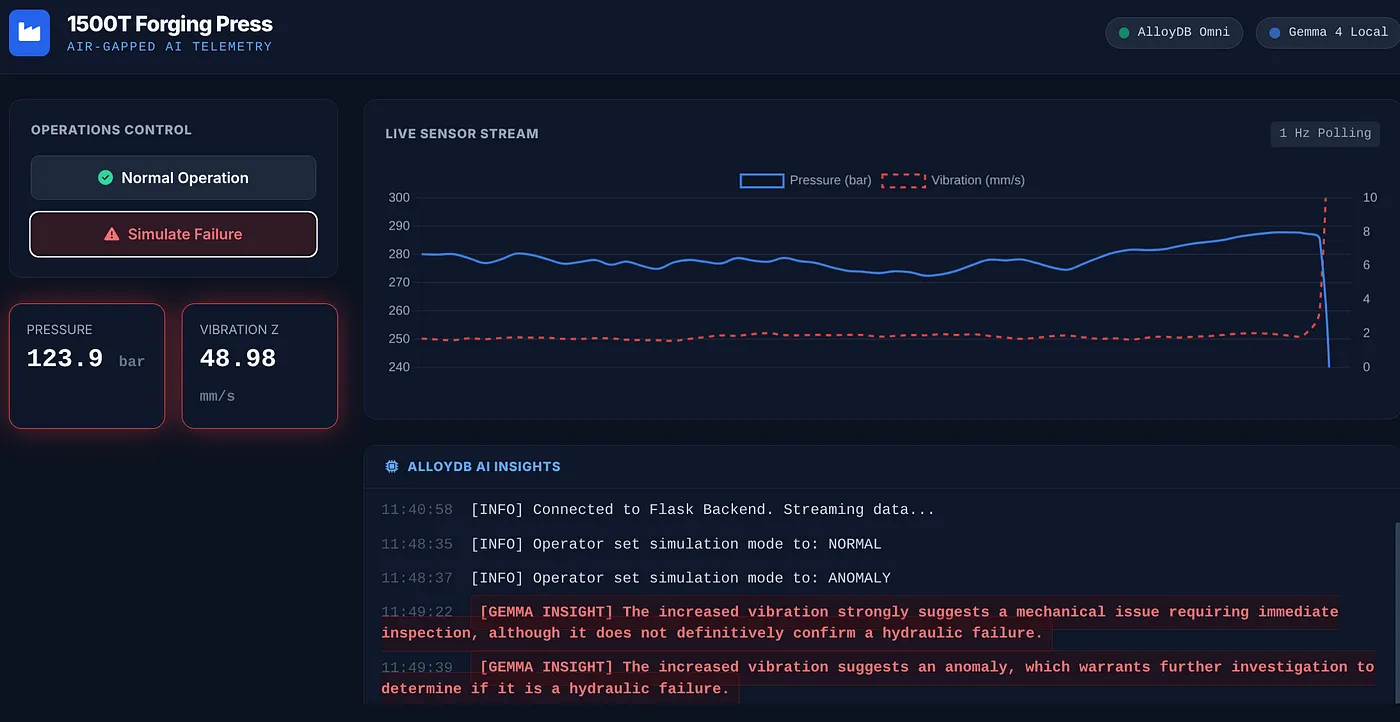
直播信息中心代表什么
Flask 应用充当 1500 吨锻压机的实时监控信息中心,直观展示完全离线、经过网闸隔离的系统如何处理预测性维护:
- 持续遥测流:信息中心会绘制实时振动 (mm/s) 和液压 (bar) 日志,并动态更新以模拟活跃的工厂车间运营。
- 实时数据库异常:当传感器读数低于阈值(例如压力低于 260 bar)时,Python 后端会标记该事件,并立即调用 AlloyDB Omni 中的
google_ml.predict_row()函数。 - 本地化 AI 诊断:AlloyDB Omni 会将实时上下文转发到本地 Gemma 4 模型。Gemma 充当本地工业专家,分析遥测数据并直接在信息中心打印诊断提醒(例如,“警告:压力下降和高振动表明可能存在液压密封故障”)。
- 零泄露:所有计算、数据库、图表和 AI 推理均完全在本地主机上执行,无需连接互联网。
8. 投产路径
如需将此架构从本地原型扩展到生产级工厂车间部署,同时不牺牲经过网闸隔离的安全性,您可以从以下两种标准本地安装路径中进行选择:
生产环境虚拟机和裸金属(非容器化):
对于不首选容器化或安全政策要求与宿主机操作系统深度集成的环境,您可以使用官方 AlloyDB Omni RPM 软件包进行部署。在 AlloyDB Omni Red Hat RPM Orchestrator 的协助下,此部署可直接在本地 RHEL 或 Rocky Linux 虚拟机上实现低延迟性能、SELinux 合规性和自动化高可用性 (HA),且完全离线。
生产环境 Kubernetes 和高可用性:
如果您的工厂基础设施使用本地编排,则可以在 Kubernetes 上部署 AlloyDB Omni。利用官方 AlloyDB Omni Kubernetes Operator,您可以以声明方式部署一个强大的数据库集群,该集群具有同步备用副本、自动本地备份和专用只读端点。
9. 恭喜!
对于国防制造和经过网闸隔离的行业,无需再在严格的安全性和技术创新之间做出选择。通过在主权硬件上部署容器化数据库、专用代理模型和开放权重 AI,您可以将工厂车间转变为智能、预测性的强大系统,同时保持数字护城河完全完好无损。