

1. 總覽
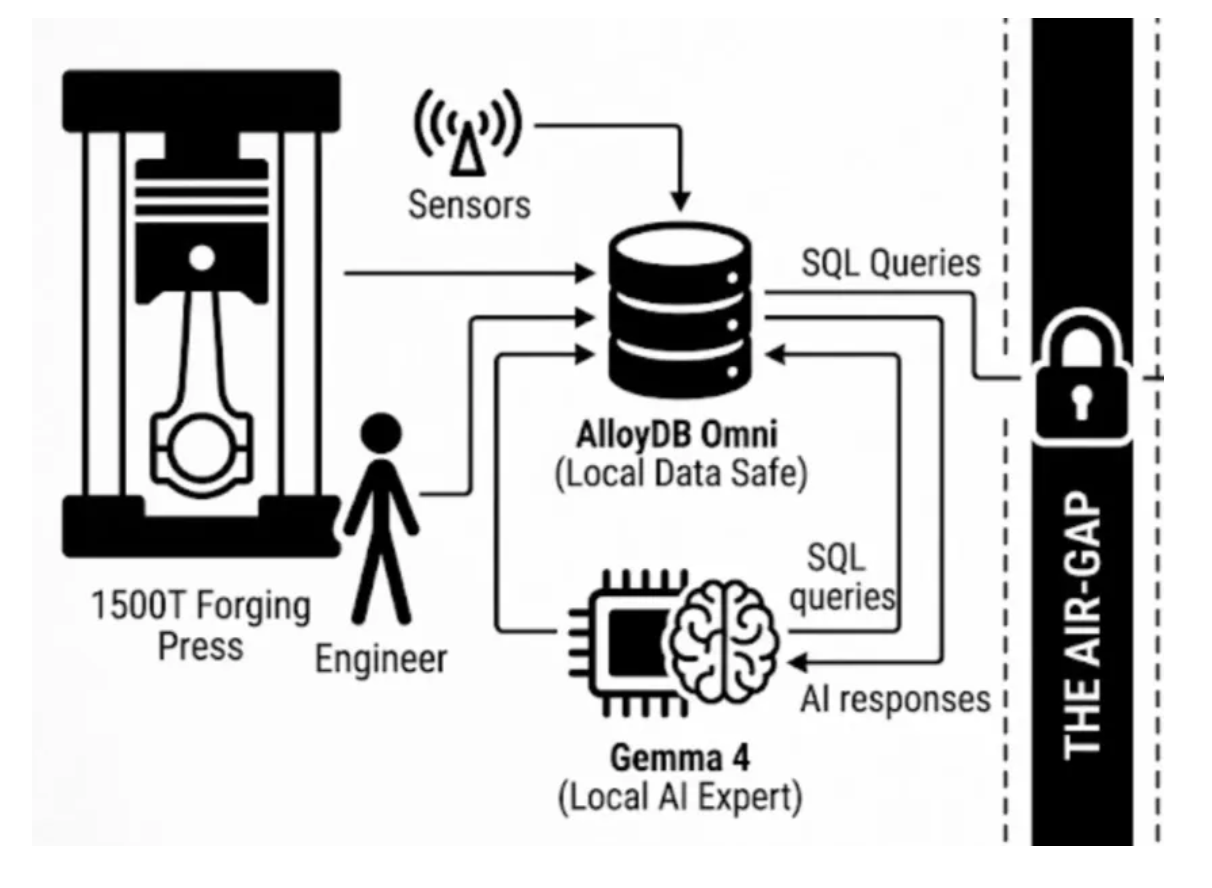
在受監管的重要產業中,組織面臨著巨大的矛盾:如果網路安全政策規定資料絕不能接觸公用網際網路,該如何採用先進的 AI 技術來最佳化生產流程?內部網路和公開網際網路嚴格區隔,絕不互通。雖然現代製造業迫切需要預測性 AI 來防止災難性的設備故障並提高產量,但將敏感的遙測記錄、專利合金配方或 ERP 資料傳送至公有雲 API,在實務上是不可行的。因此,如果資料無法上雲端,雲端就必須來到資料所在位置。
在本程式碼實驗室中,我們將使用 Gemma 4 和 AlloyDB Omni,直接將 Google Cloud 最先進的資料和 AI 工具,導入未連線的高度安全環境。
AlloyDB Omni:終極資料保險箱
AlloyDB Omni 就像高效能金庫,這是一款容器化企業級資料庫,可完全在您自己的安全內部網路下載及執行。
- 完美整合:直接連結製造感應器 (例如 VIM 或重型壓機) 和本機 ERP (例如 Oracle R12)。
- AI 專用儲存空間:使用向量嵌入 (pgvector) 安全儲存機密製程表,供 AI 搜尋。
- 效能:無論是繁重的交易工作負載,還是分析型 AI 處理作業,效能都大幅超越標準 PostgreSQL。
本機 AI 專家:Gemma、TimesFM、TabFM
您可以下載開放權重模型,並在本機硬體上執行,不必使用遠端 API,因此不會有 API 外洩的問題。
- Gemma:Google 的開放權重 LLM,可做為研發專家。這項工具可安全讀取歷來記錄,或分析複雜的專利合金配方,預測機械性質。
- TimesFM (數值預測模型):LLM 有時會產生幻覺,因此重型機械需要專用的時間序列基礎模型。TimesFM 可準確預測長期數值範圍 (最多 16,000 個資料點),讀取震動和溫度記錄,預測確切的設備故障曲線,而且完全不需連上網路。
- TabFM (表格推論模型):LLM 負責處理文字,TimesFM 負責處理數值趨勢,TabFM 則專門推論結構化表格資料。您可以在地端部署環境安全執行這項功能,直接從密集的多欄 ERP 或 CRM 資料執行複雜分析並回答問題,不必編寫複雜的 SQL join。
用途
1500 噸鍛壓機的預測性維護:
如果這類大型機具意外停機,生產作業就會中斷,浪費大量時間和重要材料。相反地,定期維護往往會過早更換昂貴零件,浪費預算。我們需要從被動維護轉為預測性維護,同時不破壞實體隔離。
課程內容
在本程式碼實驗室中:
- 您將使用 AlloyDB Omni,在本機安全擷取震動和溫度感應器資料,並可新增更多參數,讓資料更貼近實際情況且更實用。
- 您將瞭解如何使用 Gemma 分析歷來故障記錄的趨勢。
- 您將建構一個系統,用於預測故障,並在 ERP 中自動模擬觸發資產管理工作訂單。
我們使用 Docker 佈建本機 LLM 和 AlloyDB Omni。這個方法的好處在於簡單:AlloyDB Omni 可以自動管理內部的 ML-Agent 程序。
需求條件
- 對 SQL 有基本瞭解。
- 標準 Linux VM (例如 Ubuntu 22.04) 或已安裝 Docker 的本機電腦 (macOS/Windows)。
2. 啟動本機 LLM (Gemma 4)
我們將使用 Ollama 在本機託管 Gemma。建立 Dockerfile 來設定 Ollama 執行個體:
- 在本機電腦的終端機中,依序執行下列指令:
mkdir -p gemma4-ollama && cd gemma4-ollama
cat << 'EOF' > Dockerfile
FROM ollama/ollama:latest
ENV OLLAMA_HOST=0.0.0.0:8080
ENV OLLAMA_MODELS=/root/.ollama
ENV MODEL=gemma4:e2b
RUN ollama serve & sleep 5 && ollama pull $MODEL
ENTRYPOINT ["ollama", "serve"]
EOF
- 在主機網路上建構並執行容器:
docker build -t gemma4-local .

docker run --network host -d -p 8080:8080 --name gemma4-ollama-instance gemma4-local
- 您可以使用下列指令進行測試:
curl -X POST http://localhost:8080/api/generate -d '{
  "model": "gemma4:e2b",
  "prompt": "Hello! Explain Gemma 4 in a few sentences."
}'
3. 安裝並啟動 AlloyDB Omni
接著,在主機網路上啟動 AlloyDB Omni 資料庫容器:
docker run -d \
  --name my-omni \
  --network host \
  -e POSTGRES_PASSWORD=omni \
  gcr.io/alloydb-omni/alloydbomni:18
如果系統在 Google Cloud 雲端專案中找不到 AlloyDB Omni 映像檔,請先執行下列指令進行驗證,再執行上述 docker run 指令:
gcloud auth login
驗證完成後,請再次嘗試執行 docker run 指令。
4. 啟用內部 ML-Agent
根據預設,AlloyDB Omni 的機器學習整合功能為關閉狀態。我們需要修改容器內的 postgresql.conf 檔案,啟用內部機器學習代理程式程序和 AI 查詢引擎。
執行下列指令,附加必要旗標:
docker exec -it my-omni sh -c "cat << EOF >> /var/lib/postgresql/data/postgresql.conf
omni_enable_ml_agent_process = 'on'
google_ml_integration.enable_model_support = 'on'
google_ml_integration.enable_ai_query_engine = 'on'
EOF"
重新啟動容器,以套用變更:
docker restart my-omni
您可以使用下列指令啟動 psql,開始測試查詢:
docker exec -it my-omni psql -U postgres
5. 將 AI 轉送至本機 LLM
透過 psql (docker exec -it my-omni psql -U postgres) 連線至資料庫後,即可註冊本機離網模型。請將 model_request_url 轉送至在通訊埠 8080 執行的本機 Ollama 伺服器,而非呼叫網際網路。
在終端機的 psql 提示中,執行下列 SQL 陳述式:
CREATE EXTENSION IF NOT EXISTS google_ml_integration CASCADE;

CALL google_ml.create_model(
    model_id => 'gemma4:e2b',
    model_request_url => 'http://localhost:8080/api/generate',
    model_provider => 'custom',
    model_type => 'generic'
);
現在,您可以直接在 SQL 中安全地叫用預測功能:
SELECT google_ml.predict_row(
    'gemma4:e2b',
    '{"model": "gemma4:e2b", "prompt": "Why is the sky blue?", "stream": false}'
)->'response';
輸出內容:
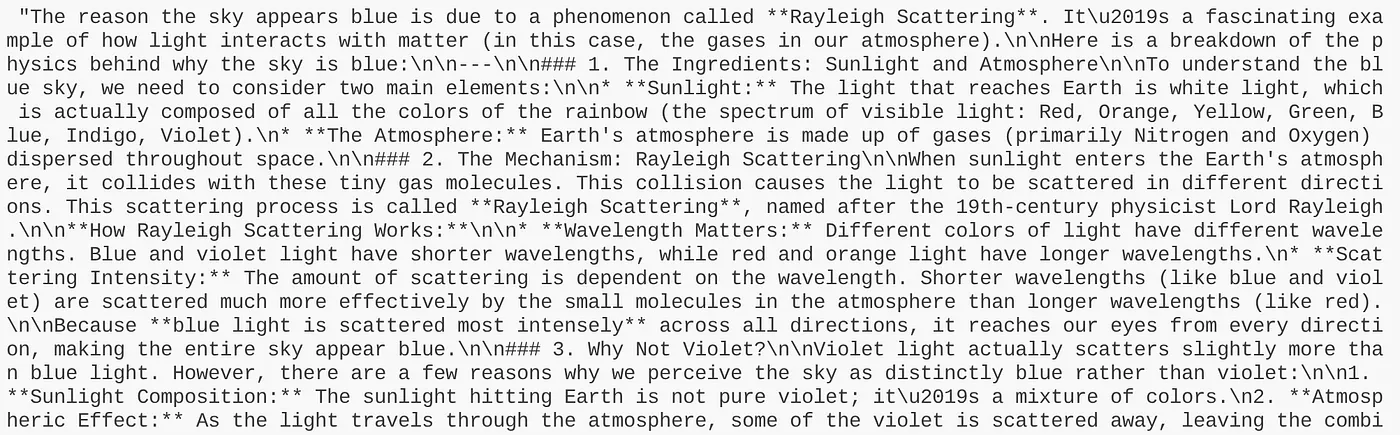
我們已在一般測試案例中測試過,現在來看看實際應用案例資料。
6. 建立結構定義並擷取資料
現在,我們來建立示範所需的結構定義和資料,進一步擴充應用實例。
在終端機的 psql 提示中,執行下列 SQL 陳述式:
-- ==============================================================================
-- 1. Setup the Schema for the 1500T Forging Press
-- ==============================================================================
CREATE TABLE IF NOT EXISTS forging_press_logs (
    log_id SERIAL PRIMARY KEY,
    timestamp TIMESTAMP NOT NULL DEFAULT NOW(),
    cycle_id VARCHAR(50) NOT NULL,
    hyd_pressure_bar NUMERIC(5,2),
    oil_temp_c NUMERIC(5,2),
    vib_z_rms NUMERIC(5,2)
);

-- Clean up any existing data if running multiple times
TRUNCATE TABLE forging_press_logs;

-- ==============================================================================
-- 2. Generate 1,000 Records of Simulated Data
-- ==============================================================================
-- 99% of data is 'Normal'
INSERT INTO forging_press_logs (cycle_id, hyd_pressure_bar, oil_temp_c, vib_z_rms)
SELECT
    'C-' || LPAD(i::text, 5, '0'),
    280.0 + (random() * 10 - 5), -- Pressure around 280
    42.0 + (random() * 5),       -- Temp around 42-47
    1.8 + (random() * 0.5)       -- Vib Z around 1.8-2.3
FROM generate_series(1, 990) AS i;

-- 1% of data is 'Anomalous' (Hydraulic pressure drop & vibration spike)
INSERT INTO forging_press_logs (cycle_id, hyd_pressure_bar, oil_temp_c, vib_z_rms)
SELECT
    'C-' || LPAD((990 + i)::text, 5, '0'),
    250.0 + (random() * 5),      -- Pressure dropping
    55.0 + (random() * 5),       -- Temp rising
    5.0 + (random() * 1.5)       -- High vibration
FROM generate_series(1, 10) AS i;

-- ==============================================================================
-- 3. Run the AI Prediction via AlloyDB Omni
-- ==============================================================================
-- Ensure the model is registered (assuming 'gemma4:e2b' is running locally on port 8080)
CREATE EXTENSION IF NOT EXISTS google_ml_integration CASCADE;

DO $$
BEGIN
    CALL google_ml.create_model(
        model_id => 'gemma4:e2b',
        model_request_url => 'http://localhost:8080/api/generate',
        model_provider => 'custom',
        model_type => 'generic'
    );
EXCEPTION WHEN OTHERS THEN
    -- Ignore error if model already exists
END $$;

-- Query the most recent 5 potentially anomalous records and ask Gemma for an analysis
SELECT
    cycle_id,
    hyd_pressure_bar,
    vib_z_rms,
    google_ml.predict_row(
        model_id => 'gemma4:e2b',
        request_body => json_build_object(
            'model', 'gemma4:e2b',
            'stream', false,
            'prompt', 'You are an industrial engineer. Analyze this sensor data from a 1500T forging press: Pressure=' || hyd_pressure_bar || ' bar, Vibration=' || vib_z_rms || ' mm/s. Normal pressure is ~280 bar and normal vibration is ~2.0 mm/s. Does this indicate a hydraulic failure? Answer in one short sentence.'
        )
    )->>'response' AS ai_analysis
FROM
    forging_press_logs
WHERE
    hyd_pressure_bar < 260 OR vib_z_rms > 4.5
ORDER BY
    timestamp DESC
LIMIT 5;
逐一執行上述陳述式後,應會得到以下結果:
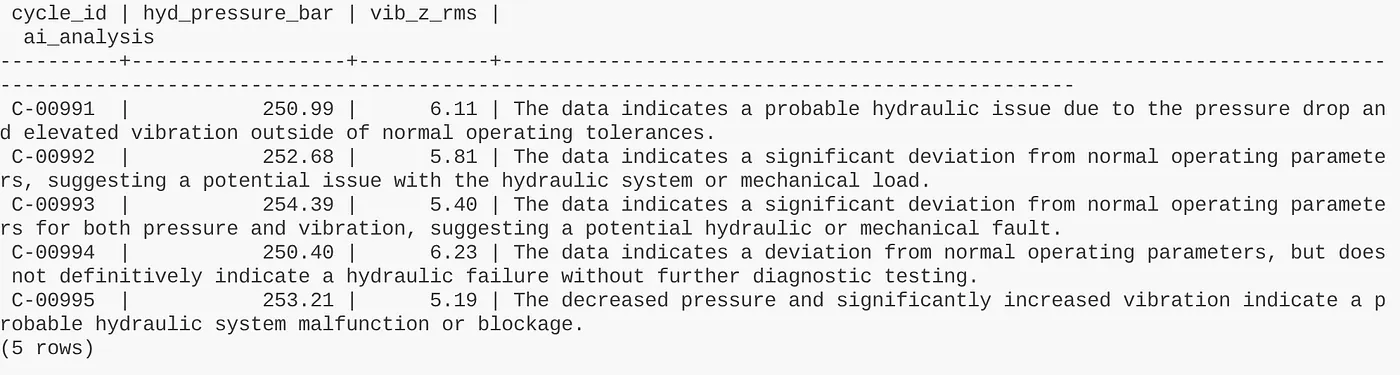
資料準備就緒後,就可以開始建構預測性維護資訊主頁了!
7. 建構直播資訊主頁
如要真正以視覺化方式呈現這個架構,您可以輕鬆將其連結至 Python Flask 資訊主頁,這是一個網頁應用程式。
輕量 Flask 後端會將即時感應器遙測資料串流至 HTML 資訊主頁,不必手動執行 SQL 查詢。正常運作時,資訊主頁只會繪製圖表。
但如果後端偵測到異常狀況 (例如壓力下降),Python 程式碼就會立即觸發 AlloyDB 中的 google_ml.predict_row() 函式。AlloyDB 會將脈絡資訊順暢轉送至本機 Gemma 模型,AI 的診斷洞察資訊也會即時顯示在資訊主頁上。
💡 程式碼實驗室提示:如要退出資料庫容器並返回主機指令列,請輸入 \q 並按下 Enter 鍵 (或開啟新的終端機分頁)。接著,請執行下方的 Flask 應用程式指令。
步驟如下:
- 前往開發環境 / 程式碼編輯器,然後開啟終端機
- 執行下列指令
pip install flask psycopg2-binary
- 在 Cloud Shell 終端機執行下列指令,將程式碼存放區複製到專案目錄:
git clone https://github.com/AbiramiSukumaran/gemma4-alloydb-omni-demo
- 前往專案資料夾:
cd gemma4-alloydb-omni-demo
- 執行應用程式:
python3 app.py
開啟網路瀏覽器,或點選連結,前往在 localhost 執行的應用程式。
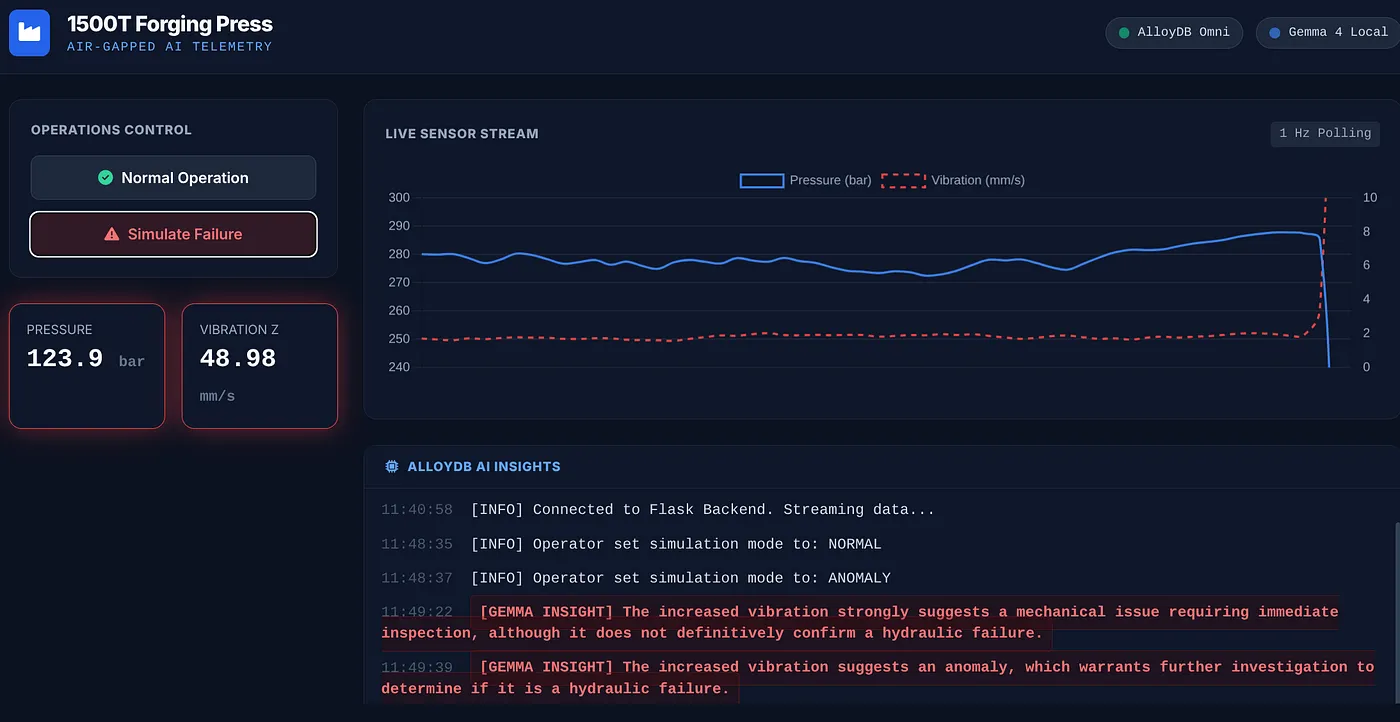
直播資訊主頁代表的意義
Flask 應用程式是 1500 噸鍛壓機的即時監控資訊主頁,可視覺化呈現完全離線、實體隔離的系統如何處理預測性維護:
- 持續遙測串流:資訊主頁會繪製即時震動 (mm/s) 和液壓 (bar) 記錄,並動態更新,模擬實際廠區作業。
- 即時資料庫異常狀況:當感應器數值低於門檻 (例如壓力低於 260 bar),Python 後端會標記事件,並立即呼叫 AlloyDB Omni 內的
google_ml.predict_row()函式。 - 本機 AI 診斷:AlloyDB Omni 會將即時情境轉送至本機 Gemma 4 模型。Gemma 扮演地端部署工業專家的角色,分析遙測資料,並直接在資訊主頁上顯示診斷快訊 (例如「警告:壓力下降和高震動表示液壓密封可能故障」)。
- 零外洩:所有運算、資料庫、圖表和 AI 推論作業,完全在本機主機上執行,不需網際網路連線。
8. 正式版群組路徑
如要將這個架構從本機原型擴充至正式環境等級的工廠部署,同時不犧牲實體隔離安全性,可以選擇兩種標準地端部署安裝方式:
正式環境 VM 和裸機 (非容器化):
如果環境不適合容器化,或安全性政策要求與主機作業系統深度整合,您可以使用官方 AlloyDB Omni RPM 套件部署。在 AlloyDB Omni Red Hat RPM 自動調度管理工具的協助下,這項部署作業可直接在本機 RHEL 或 Rocky Linux VM 上,提供低延遲效能、SELinux 法規遵循和自動化高可用性 (HA),而且完全離線。
正式環境 Kubernetes 和高可用性:
如果工廠基礎架構採用本機自動調度管理,您可以在 Kubernetes 部署 AlloyDB Omni。使用官方 AlloyDB Omni Kubernetes Operator,您就能以宣告方式部署強大的資料庫叢集,並具備同步待命副本、自動本機備份和專屬唯讀端點。
9. 恭喜!
對於國防製造業和這類實體隔離產業,不必再在嚴格安全性和技術創新之間取捨。在主權硬體上部署容器化資料庫、專用 Proxy 模型和開放權重 AI,就能將工廠廠房轉變為智慧型預測中心,同時完整保留數位護城河。