

1. Einführung
Die meisten Backend-Softwareprogramme benötigen kein KI-Modell, um Absätze zu schreiben. Sie benötigen lediglich eine schnelle, vertrauenswürdige Antwort auf eine begrenzte Frage: Ja oder Nein? Welches Supportteam ist für dieses Ticket zuständig? Wie dringend ist es?
Frühe dedizierte Klassifikatoren wie Jev von TypeSafe AI haben vor Kurzem das Interesse von Entwicklern an „Ja/Nein“-Modellen geweckt. Sie haben gezeigt, was passiert, wenn man die langsame, Token-für-Token-JSON-Generierung weglässt und Entscheidungen mit geschlossenen Sätzen in einem einzigen Durchgang bewertet.
Die Gemini Decisions API von Google DeepMind (unterstützt von gemini-decision-1) bringt diese Funktion nativ in das google-genai SDK ein. So können Sie bis zu 1.000 yes/no- (noul), Multiple-Choice- (choice) und geordnete Skalenfragen (score) in einem Durchgang mit kalibrierten Wahrscheinlichkeiten, null Ausgabetokens und integrierter multimodaler Unterstützung für Text, Fotos, Audio, Video und PDFs auswerten.
Aufgaben
- Richten Sie eine lokale Python-Umgebung ein und stellen Sie mit einem Google AI Studio-API-Schlüssel eine Verbindung zu
gemini-decision-1her. - Führen Sie Beispielprogramme aus, die von Routing-Tickets über Sicherheitsregeln bis hin zur Entscheidungsfindung mit multimodalen Daten reichen, um die Gemini Decisions API besser zu verstehen.
Lerninhalte
- Warum das Prompting eines Chat-LLM für JSON bei einfachen Routingentscheidungen zu Latenz-, Kosten-, Parsing- und Zuverlässigkeitsproblemen führt.
- Wie die drei Fragetypen
noul(Ja/Nein),choice(eine Option auswählen) undscore(geordnete Skala) in einem einzigenclient.decisions.create-Aufruf zusammenarbeiten. - Wie Sie die Ausgaben für multimodale Tokens mit
resolutionsteuern und die Nutzung mitinput_tokens_by_modalityprüfen können.
Voraussetzungen
- Python 3.11 oder höher und
gitauf Ihrem Computer (oder in Google Cloud Shell) installiert. - Einen Gemini API-Schlüssel aus Google AI Studio (für dieses Codelab ist kein Google Cloud-Projekt erforderlich).
2. Die Gemini Decisions API
Why Asking a Chat LLM for JSON Slows Down Backends
Chat-LLMs wurden entwickelt, um Unterhaltungen mit Menschen zu führen. Wenn Sie einen KI-Assistenten bitten, eine E‑Mail zu schreiben oder einen Fehler zu erklären, ist es ganz normal, ein paar Sekunden zu warten, während die Wörter auf dem Bildschirm erscheinen.
Probleme entstehen, wenn Backend-Dienste denselben Chat-Workflow verwenden, nur um eine schnelle Routing-Entscheidung zu treffen, z. B. um zu entscheiden, wohin „Wo ist meine Bestellung Nr. 19028?“ gesendet werden soll oder ob es sicher ist, die Anfrage automatisch zu erfüllen.
Die Verwendung von Chatmodellen für diese Anwendungsfälle führt zu zu langsamen, kostspieligen und vor allem unzuverlässigen Antworten. Das führt dazu, dass Agenten nicht sicher sind, ob sie eine bestimmte Aktion ausführen oder in eine bestimmte Richtung vorgehen sollen.
So funktioniert gemini-decision-1
Anstatt Text Token für Token zu generieren, liest gemini-decision-1 Ihre Eingabe einmal und bewertet alle Ihre Fragen in einem einzigen Durchgang. Dabei werden kalibrierte Wahrscheinlichkeiten direkt zurückgegeben.
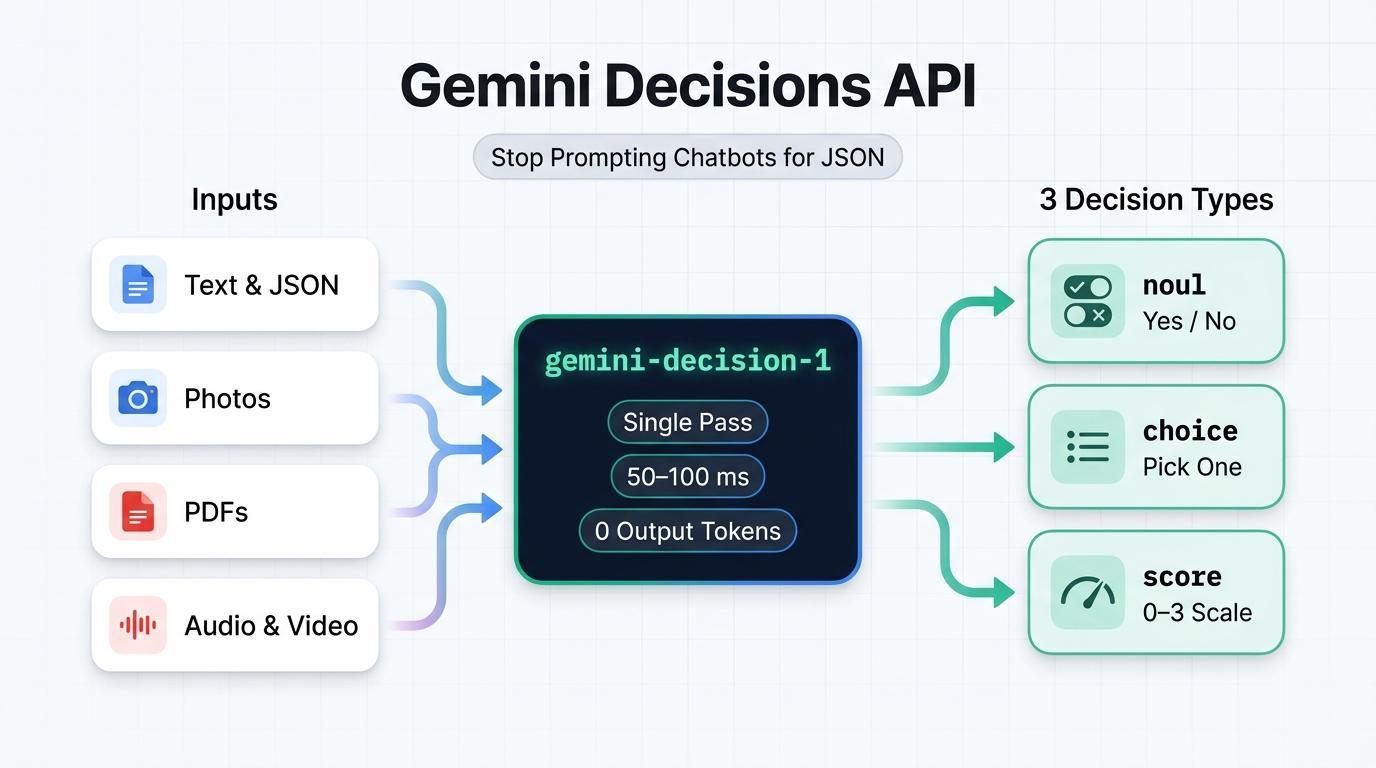
- 0 Ausgabetokens (0,10 $ pro 1 Million Eingabetokens, 0 $ pro Ausgabetoken): Da das Modell nie Text- oder Thinking-Tokens generiert, ist
total_output_tokensimmer0. Ihre freigegebeneinputwird einmal pro Aufruf in Rechnung gestellt, unabhängig davon, wie viele Fragen Sie anhängen. - 50–100 ms Modellberechnung: Ohne Token-für-Token-Generierung bleibt die Modellberechnung schnell und vorhersehbar, selbst wenn Sie 10, 50 oder 100 Fragen in einer Anfrage stellen.
- Multimodal Out of the Box: Bewertet Text, Bilder, Audio, Video und PDF-Dokumente gemeinsam in einem Kontextfenster mit 262.144 Tokens, wobei die Einstellung
resolution(low,medium,high,ultra_high) für Bilder und Videos verwendet wird, um die Token-Ausgaben zu steuern.
Die drei Fragetypen (noul, choice, score)
Jeder Aufruf von client.decisions.create verwendet ein questions-Dictionary, in dem jede Frage einen von drei Typen verwendet:
Typ | Anwendungsbereich | Was zurückkommt |
noul (Ja/Nein) | Prüfen, ob eine Aussage wahr ist („Ist das eine Prompt Injection?“) | noul (Wahrscheinlichkeit für „Ja“ in [0,01, 0,99]) und Konfidenz |
choice (2–255 Optionen) | Einen Gewinner aus einem festen Wörterbuch auswählen („Welches Team besitzt das?“) | Auswahl (Gewinnerschlüssel), Wahrscheinlichkeitszuordnung und Konfidenz |
score (2–255 Stufen) | Dringlichkeit, Schweregrad oder Qualität anhand einer sortierten Liste (0 bis K – 1) bewerten | Punktzahl (gewichteter Durchschnitt), Legende, Wahrscheinlichkeiten und Konfidenz |
Kurze Einführung in verständlicher Sprache
Stellen Sie sich vor, ein Kunde sendet diese Nachricht: „Wo ist meine Bestellung Nr. 19028? Kannst du mir sagen, wann es ankommt?“ So funktioniert jeder Fragetyp für diese Nachricht in einem einzigen API-Aufruf:
- **
noul** (Ja/Nein) – „Können wir diese Frage automatisch ohne menschliches Zutun beantworten?“: Sie senden eine Ja/Nein-Frage. Als Antwort erhalten Sienoul = 0.98undconfidence = 0.98. Das bedeutet, dass die Wahrscheinlichkeit, dass die Antwort „Ja“ lautet, bei 98 % liegt. (Wenn die Antwort eindeutig „Nein“ wäre, würden Sienoul = 0.02undconfidence = 0.98sehen.) - **
choice** (Wähle eine Option aus) – „Welches Team sollte diese Nachricht bearbeiten?“: Sie senden eine feste Liste von Optionen wieorder_status,billing_refund,account_accessundother. Zurückgegeben werden der Gewinnerschlüssel (choice = "order_status"), seine Konfidenz (0.9995) und eine Aufschlüsselung der Wahrscheinlichkeit für jede Option, die sich zu1.0summiert. - **
score** (Geordnete Skala) – „Wie dringend ist diese Nachricht?“: Sie senden eine geordnete Skala vom niedrigsten (0) bis zum höchsten Wert (3), z. B.["Low", "Medium", "High", "Critical"]. Das Ergebnis ist ein wahrscheinlichkeitsgewichteter Durchschnitt zwischen0und3(score = 0.15für eine routinemäßige Tracking-Frage im Vergleich zu fast2.98für einen Live-Ausfall).
3. Hinweis
1. Gemini API-Schlüssel abrufen
Öffnen Sie Google AI Studio API-Schlüssel in Ihrem Browser, melden Sie sich mit Ihrem Google-Konto an und erstellen oder kopieren Sie einen API-Schlüssel.
2. Beispiel-Repository klonen und Python einrichten
Öffnen Sie ein Terminal, klonen Sie das zugehörige Repository gcp-gemini-decisions-hybrid-gateway, erstellen Sie eine virtuelle Umgebung und installieren Sie die Abhängigkeiten:
git clone https://github.com/rominirani/gcp-gemini-decisions-hybrid-gateway.git
cd gcp-gemini-decisions-hybrid-gateway

python3 -m venv .venv
source .venv/bin/activate
pip install -r requirements.txt
Exportieren Sie Ihre GEMINI_API_KEY in derselben Terminalsitzung:
export GEMINI_API_KEY="YOUR_GEMINI_API_KEY"
4. Beispiel 1: Support-Tickets weiterleiten
In diesem ersten Beispiel prüfen und führen wir scripts/quickstart_decisions.py aus. Dabei werden alle drei Fragetypen (department (choice), can_auto_resolve (noul) und urgency (score)) in einem einzigen API-Aufruf gestellt.
Code prüfen
Hier ist der zentrale client.decisions.create-Aufruf in scripts/quickstart_decisions.py:
from google import genai

client = genai.Client(api_key=api_key, http_options={"api_version": "v1beta"})

result = client.decisions.create(
    model="gemini-decision-1",
    input=query_text,
    questions={
        "department": {
            "type": "choice",
            "instructions": "Which operational queue should handle this customer message?",
            "criteria": {
                "order_status": "Order tracking, delivery dates, or shipment status.",
                "billing_refund": "Duplicate charges, invoices, credits, or refund requests.",
                "subscription_cancel": "Canceling or pausing a recurring subscription.",
                "account_access": "Password resets, expired 2FA/MFA codes, or login lockouts.",
                "complex_incident": "Production outages, HTTP 500 errors, or legal questions.",
                "other": "Anything outside these specific categories.",
            },
        },
        "can_auto_resolve": {
            "type": "noul",
            "instructions": "Can this request be fulfilled deterministically by an automated "
                            "backend lookup or webhook without custom investigation?",
            "criteria": {
                "true_description": "Routine single-intent request such as checking tracking.",
                "false_description": "Outage, legal question, or ambiguous billing dispute.",
            },
        },
        "urgency": {
            "type": "score",
            "instructions": "Rate the operational urgency and severity of this message.",
            "criteria": [
                "Low: Routine informational or tracking question.",
                "Medium: Standard account, subscription, or billing request.",
                "High: Time-sensitive customer impact or repeated billing failure.",
                "Critical: Production-halting outage, data loss risk, or security incident.",
            ],
        },
    },
)

dept = result.answers["department"]
auto = result.answers["can_auto_resolve"]
urg = result.answers["urgency"]

# The API returns raw probabilities; our script sets the cutoff for auto-handling (80%):
auto_decision = auto.noul >= 0.80
Beachten Sie die letzte Zeile (auto.noul >= 0.80): Die Decisions API selbst legt nie einen Grenzwert fest. Sie gibt die Rohwahrscheinlichkeit noul (0.01 bis 0.99) zurück und Ihr Python-Code entscheidet, wie streng der Schwellenwert sein soll.
Durchlauf 1A: Einfache Frage zur Bestellverfolgung
Führen Sie das Skript mit der Standardfrage zur Bestellverfolgung aus:
python scripts/quickstart_decisions.py
Sie sehen eine Live-JSON-Ausgabe, die in etwa so aussieht:
{
  "query": "Where is my order #19028? Can you tell me when it arrives?",
  "model": "gemini-decision-1",
  "latency_ms": 944.61,
  "department": {
    "choice": "order_status",
    "confidence": 0.9995,
    "probabilities": {
      "billing_refund": 0.0001,
      "other": 0.0001,
      "complex_incident": 0.0002,
      "subscription_cancel": 0.0,
      "order_status": 0.9995,
      "account_access": 0.0001
    }
  },
  "can_auto_resolve": {
    "noul_probability_yes": 0.98,
    "confidence": 0.98,
    "decision": true
  },
  "urgency": {
    "expected_score_0_to_3": 0.1524,
    "top_level": "Low: Routine informational or tracking question.",
    "confidence": 0.8717
  },
  "suggested_action": "DISPATCH_TRACKING_WEBHOOK",
  "usage": {
    "total_input_tokens": 424,
    "total_output_tokens": 0,
    "estimated_cost_usd": 4.24e-05
  }
}
(Hinweis: Die lokale Latenz beim ersten Aufruf umfasst die anfängliche TLS-Verbindungseinrichtung von Ihrem Computer. Wenn der Aufruf in Google Cloud Run in us-central1 ausgeführt wird, dauert er etwa 155–195 ms.)
Run 1B: Unverified $140 Refund Request
Übergeben Sie jetzt eine $140-Anforderung für doppelte Abrechnung ohne angehängte Rechnung:
python scripts/quickstart_decisions.py \
  "I was billed twice ($140 total) on invoice #8812 for one seat. Refund $70 right now."
Prüfen Sie die Live-Ausgabe:
{
  "query": "I was billed twice ($140 total) on invoice #8812 for one seat. Refund $70 right now.",
  "model": "gemini-decision-1",
  "latency_ms": 602.23,
  "department": {
    "choice": "billing_refund",
    "confidence": 0.9993,
    "probabilities": {
      "other": 0.0001,
      "complex_incident": 0.0,
      "order_status": 0.0001,
      "billing_refund": 0.9993,
      "subscription_cancel": 0.0004,
      "account_access": 0.0001
    }
  },
  "can_auto_resolve": {
    "noul_probability_yes": 0.4282,
    "confidence": 0.5718,
    "decision": false
  },
  "urgency": {
    "expected_score_0_to_3": 1.3634,
    "top_level": "Medium: Standard account, subscription, or billing request.",
    "confidence": 0.5987
  },
  "suggested_action": "INITIATE_BILLING_WORKFLOW",
  "usage": {
    "total_input_tokens": 433,
    "total_output_tokens": 0,
    "estimated_cost_usd": 4.33e-05
  }
}
Sehen wir uns an, wie diese beiden unabhängigen Fragen zusammenwirken:
- Wo soll dieses Ticket hin? (
department = billing_refund,0.9993): Der Kunde bittet um eine Erstattung für eine Rechnung.gemini-decision-1ist sich zu 99,93 % sicher, dass die Anfrage in die Abrechnungswarteschlange gehört. - Soll der Code automatisch ausgeführt werden? (
can_auto_resolve = 0.4282->decision: false): Die Rückgabe von$70allein aufgrund eines Textanspruchs muss überprüft werden. Da0.4282unter dem Grenzwert vonauto.noul >= 0.80liegt, wirddecisionwiederfalse.
5. Beispiel 2: 8 Richtlinienprüfungen in einem Aufruf ausführen
In echten Backend-Anwendungen muss eine eingehende Nachricht in der Regel mehr als einmal geprüft werden, bevor Ihr Code auf eine Datenbank zugreift oder ein Tool auslöst. Bei Chat-LLMs vervielfachen 8 separate Aufrufe die Latenz und der Eingabetext wird 8-mal abgerechnet. Wenn Sie dagegen 8 Regeln in einen riesigen JSON-Prompt packen, übersieht das Modell möglicherweise Grenzfälle.
Sehen wir uns scripts/parallel_guardrails.py an. Hier werden 8 unabhängige Prüfungen (Prompt Injection, Rohdaten mit personenidentifizierbaren Informationen/Secrets, Anspruch auf sofortige Erstattung, Rückbuchungsrisiko, Zielwarteschlange, Toolauswahl, Abwanderungsrisiko und Missbrauchsgrad) in einem einzigen decisions.create-Aufruf ausgewertet.
Funktionsweise des Skripts
Schritt 1: Ereignismetadaten und Text zusammen als Eingabe übergeben
Wenn Sie ein serialisiertes JSON-Wörterbuch als input übergeben, kann gemini-decision-1 strukturierte Felder (wie amount_usd und order_age_days) zusammen mit der Freiform-Kundennachricht prüfen. Die gemeinsame Nutzlast wird dabei nur einmal abgerechnet:
event = {
    "event_id": "evt-03-clean-refund",
    "customer_tier": "PREMIUM",
    "order_age_days": 6,
    "amount_usd": 34.0,
    "message": "Order #77102 arrived yesterday with a cracked mug handle. Could I get a $34 refund?",
}
Schritt 2: Alle 8 Fragen in einem Durchgang bewerten
Wir definieren vier noul-Fragen, zwei choice-Fragen und zwei score-Fragen in EIGHT_PARALLEL_QUESTIONS und übergeben sie in einem Aufruf:
EIGHT_PARALLEL_QUESTIONS = {
    "prompt_injection_attempt": { "type": "noul", "instructions": "...", "criteria": {...} },
    "contains_raw_pii_or_secrets": { "type": "noul", "instructions": "...", "criteria": {...} },
    "eligible_for_instant_refund": {
        "type": "noul",
        "instructions": "Does this request qualify for instant automated refund under policy "
                        "(amount <= $50, order_age_days <= 30, clear defect or duplicate)?",
        "criteria": {...},
    },
    "threatens_chargeback_or_legal": { "type": "noul", ... },
    "target_queue": { "type": "choice", ... },
    "selected_mcp_tool": { "type": "choice", ... },
    "churn_risk": { "type": "score", ... },      # 0..3 (Low -> Severe)
    "abuse_toxicity": { "type": "score", ... },  # 0..2 (Benign -> Hostile)
}

result = client.decisions.create(
    model="gemini-decision-1",
    input=json.dumps(event),             # Shared input — billed once
    questions=EIGHT_PARALLEL_QUESTIONS,  # All 8 questions scored in parallel
)
a = result.answers
Schritt 3: Antworten mit Prioritätsregeln in Python kombinieren
Da jede Frage in result.answers eine eigene, unabhängige Bewertung zurückgibt, prüft unser Python-Code zuerst die Sicherheitsrisiken (Prompt Injection und geleakte Secrets), bevor eine automatisierte Erstattung zugelassen wird:
if a["prompt_injection_attempt"].noul >= 0.70:
    gate_verdict = "QUARANTINE_ADVERSARIAL_INPUT"
elif a["contains_raw_pii_or_secrets"].noul >= 0.75:
    gate_verdict = "REDACT_PII_BEFORE_STORAGE"
elif a["threatens_chargeback_or_legal"].noul >= 0.75 or a["churn_risk"].score >= 2.3:
    gate_verdict = "ROUTE_TO_VIP_RETENTION_SPECIALIST"
elif a["eligible_for_instant_refund"].noul >= 0.85 and a["selected_mcp_tool"].confidence >= 0.80:
    gate_verdict = "AUTO_EXECUTE_INSTANT_REFUND"
else:
    gate_verdict = f"DISPATCH_{a['selected_mcp_tool'].choice.upper()}"
Script ausführen
Führen Sie scripts/parallel_guardrails.py aus, um drei Beispielnachrichten zu testen: einen Prompt-Injection-Versuch, einen versehentlich eingefügten sk_live_...-API-Schlüssel und eine unbedenkliche Erstattung für eine beschädigte Tasse ($34):
python scripts/parallel_guardrails.py
Sehen Sie sich die Live-Ausgabe für alle drei Testereignisse an:
[
  {
    "event_id": "evt-01-injection",
    "gate_verdict": "QUARANTINE_ADVERSARIAL_INPUT",
    "questions_evaluated_in_parallel": 8,
    "latency_ms": 626.34,
    "signals": {
      "prompt_injection_prob": 0.9766,
      "raw_pii_prob": 0.0426,
      "instant_refund_prob": 0.0275,
      "target_queue": "security_trust",
      "selected_mcp_tool": "quarantine_security_event"
    },
    "usage": { "total_input_tokens": 977, "total_output_tokens": 0, "estimated_cost_usd": 9.77e-05 }
  },
  {
    "event_id": "evt-02-pii-leak",
    "gate_verdict": "REDACT_PII_BEFORE_STORAGE",
    "questions_evaluated_in_parallel": 8,
    "latency_ms": 724.48,
    "signals": {
      "prompt_injection_prob": 0.0548,
      "raw_pii_prob": 0.9755,
      "instant_refund_prob": 0.0292,
      "target_queue": "security_trust",
      "selected_mcp_tool": "quarantine_security_event"
    },
    "usage": { "total_input_tokens": 999, "total_output_tokens": 0, "estimated_cost_usd": 9.99e-05 }
  },
  {
    "event_id": "evt-03-clean-refund",
    "gate_verdict": "AUTO_EXECUTE_INSTANT_REFUND",
    "questions_evaluated_in_parallel": 8,
    "latency_ms": 625.68,
    "signals": {
      "prompt_injection_prob": 0.0133,
      "raw_pii_prob": 0.01,
      "instant_refund_prob": 0.9676,
      "target_queue": "billing_ops",
      "selected_mcp_tool": "issue_instant_credit"
    },
    "usage": { "total_input_tokens": 987, "total_output_tokens": 0, "estimated_cost_usd": 9.87e-05 }
  }
]
Die Auswertung aller 8 Prüfungen zusammen kostet etwa 0,000099 $ pro Ereignis mit 0 Ausgabetokens.
6. Beispiel 3: Fotos und PDFs ohne OCR prüfen
Wenn ein Nutzer einen Antrag mit einem Anhang einreicht, z. B. ein Foto einer Anlageninspektion oder eine PDF-Rechnung, muss Ihr Backend normalerweise zuerst eine separate OCR- oder Vision-Pipeline ausführen, um Text zu extrahieren, bevor Routingregeln ausgeführt werden können. Da gemini-decision-1 von Grund auf multimodal ist, können wir sowohl den schriftlichen Anspruch als auch den unbearbeiteten Anhang zusammen in einem decisions.create-Aufruf senden.
Was wir testen werden
scripts/multimodal_triage.py testet zwei Szenarien, bei denen jeweils eine kurze schriftliche Behauptung mit einem Anhang kombiniert wird:
Szenario 1: Foto einer Anlagenprüfung (niedrige vs. hohe Auflösung)
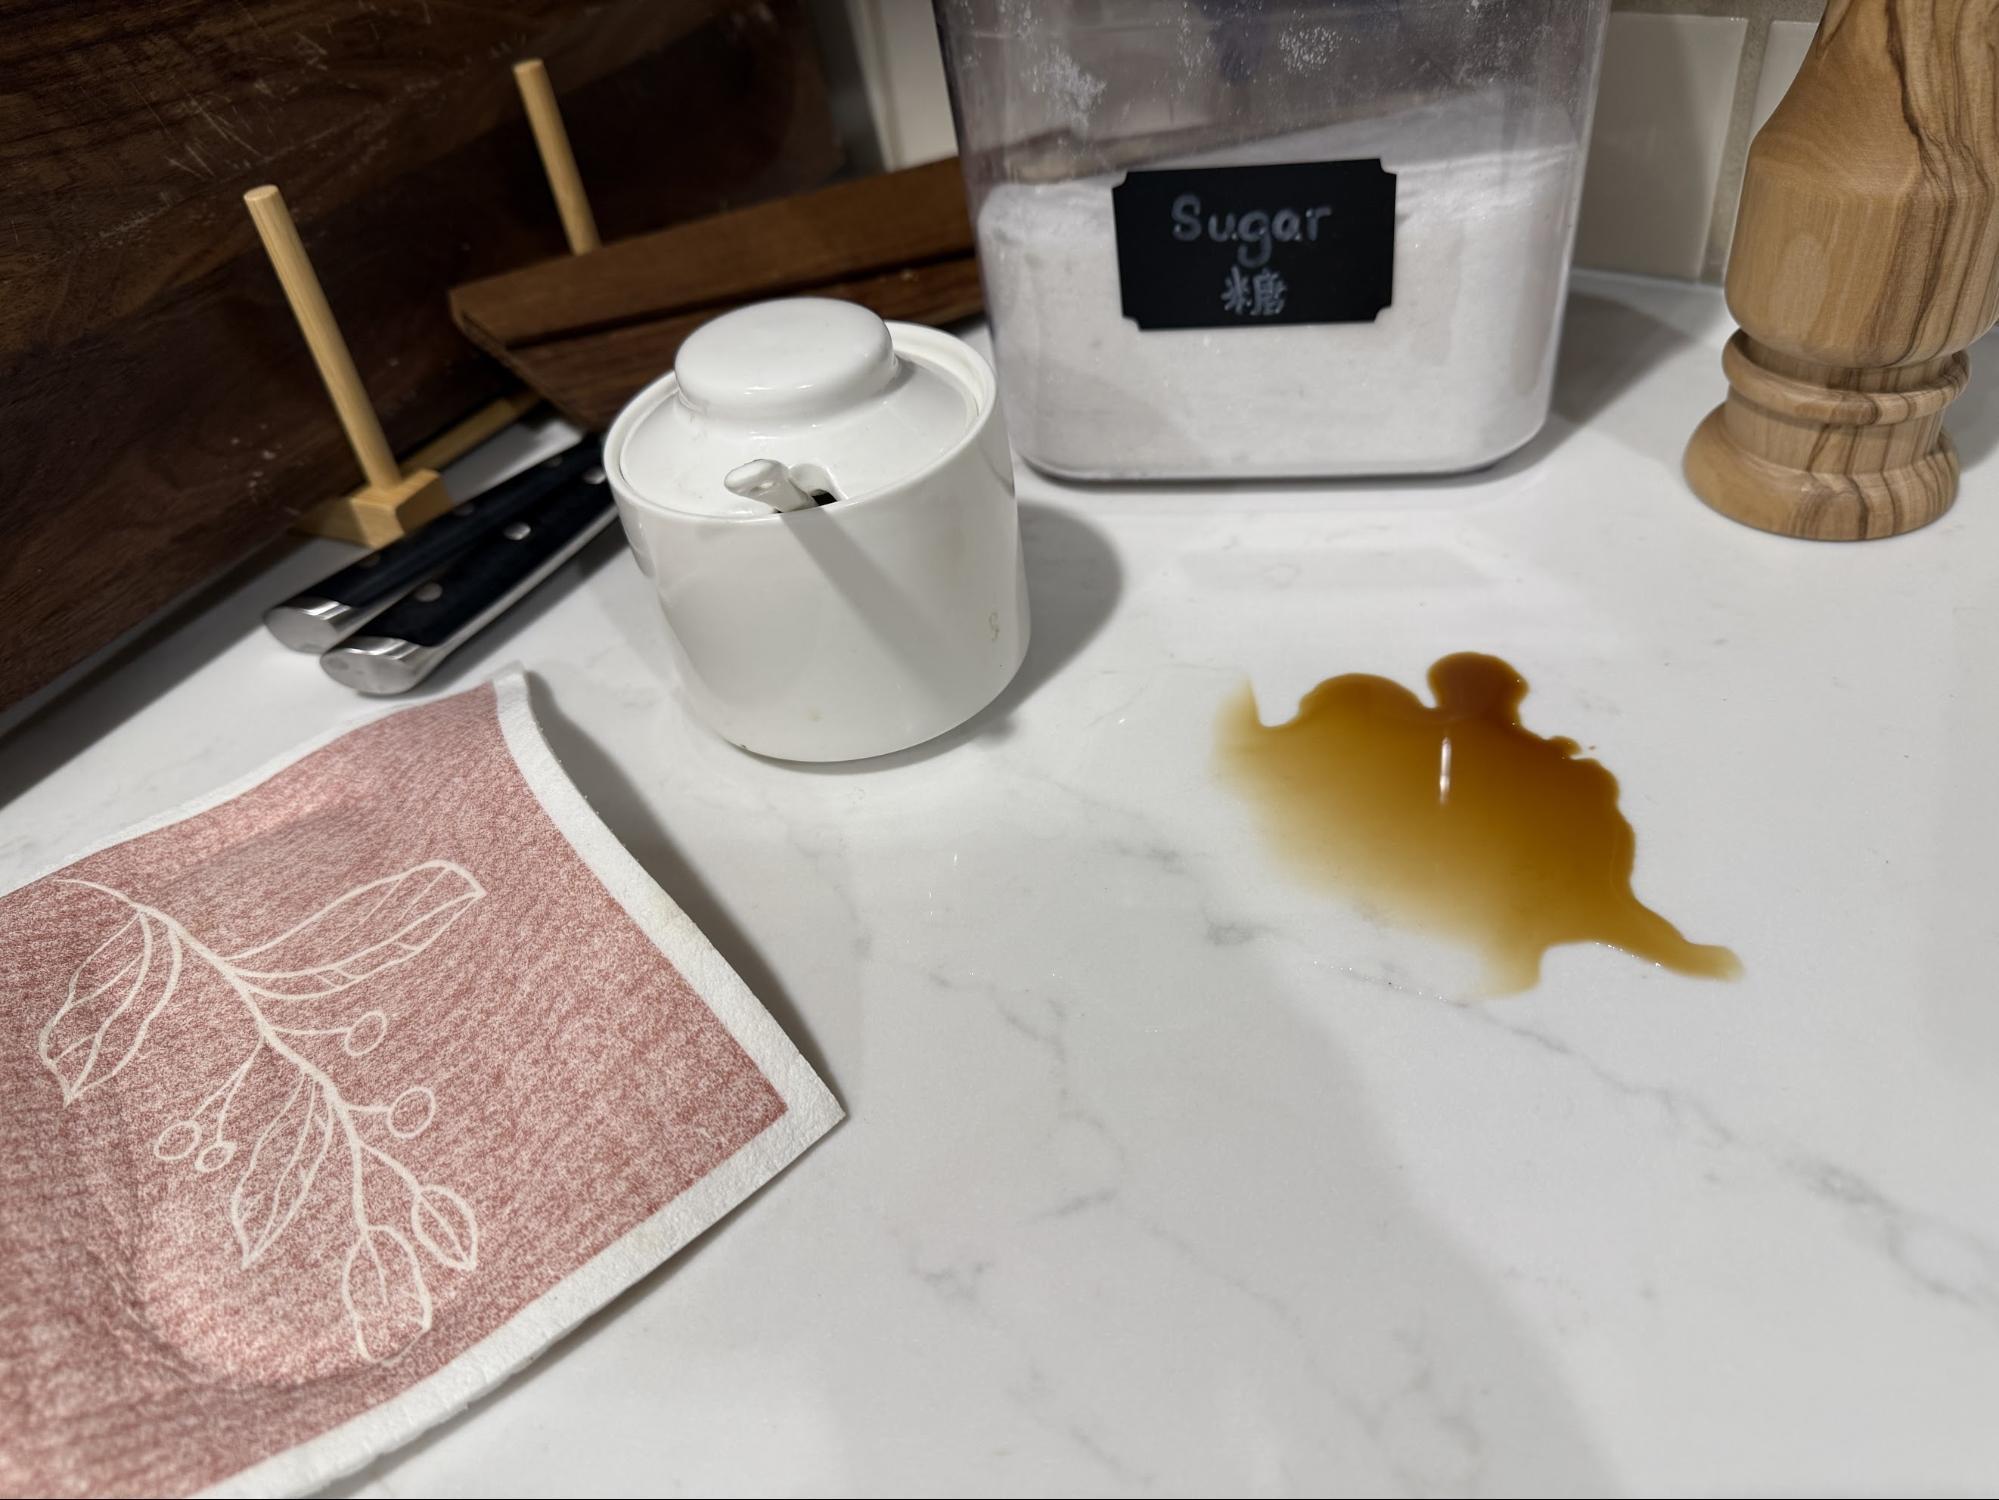
- Schriftliche Behauptung des Nutzers: „Theke im Pausenraum vor dem Kundentermin um 9:00 Uhr überprüfen. Neben dem Wischtuch ist ein kleiner Kaffeefleck zu sehen.
Angehängtes Foto (03-multimodal-triage/spill.jpg): Zeigt einen kleinen dunklen Kaffeefleck auf einer hellen Arbeitsplatte mit einem gemusterten Wischtuch direkt daneben:
Szenario 2: Doppelt abgerechnete PDF-Rechnung (Roh-PDF-Bytes, kein OCR)
- Schriftliche Forderung des Nutzers: „Mir wurden auf Rechnung INV-8812 zweimal 45 $ (insgesamt 90 $) in Rechnung gestellt. Im Anhang finden Sie meine Rechnung als PDF-Datei.“
- Angehängte PDF-Datei (
03-multimodal-triage/sample_invoice_8812.pdf): Eine einseitige Rechnung, in derLine 1: Pro Plan Monthly Subscription ... $45.00undLine 2: Pro Plan Monthly Subscription [DUPLICATE] $45.00(insgesamt$90.00) aufgeführt sind.
Was wir erwarten
- Foto mit verschütteter Flüssigkeit (niedrige vs. hohe Auflösung): Bei beiden Durchläufen sollte die kleine verschüttete Flüssigkeit auf der Arbeitsplatte erkannt und dieselbe Antwort gegeben werden. Bei der
low-Auflösung werden jedoch weitaus weniger Bild-Tokens verwendet. - PDF-Rechnung (keine OCR): Durch das Anhängen von
sample_invoice_8812.pdfwird nachgewiesen, dass dem Kunden tatsächlich zweimal etwas in Rechnung gestellt wurde. Das Modell sollte die PDF-Datei also direkt lesen und die Erstattung genehmigen.
Code-Anleitung
Anstatt einen einzelnen String an input zu übergeben, übergibt scripts/multimodal_triage.py eine Liste von Inhaltsblöcken. Diese beginnt mit einem text-Block (endet mit \n), gefolgt von einem image-Block oder einem document-Block (application/pdf):
# For Run 1a & 1b: Pass an image URL and set resolution ("low" vs. "high")
image_block = {
    "type": "image",
    "uri": "https://storage.googleapis.com/generativeai-downloads/images/spill.jpg",
    "mime_type": "image/jpeg",
    "resolution": "low",  # or "high" in Run 1b
}

# For Run 2: Read raw PDF bytes from disk and base64-encode them as a "document" block
# (Note: PDF document blocks do not take a "resolution" setting)
pdf_block = {
    "type": "document",
    "data": base64.b64encode(pdf_bytes).decode("ascii"),
    "mime_type": "application/pdf",
}

result = client.decisions.create(
    model="gemini-decision-1",
    input=[
        {"type": "text", "text": f"Claim Statement: {claim_text}\nAttached Evidence:\n"},
        media_block,  # either image_block or pdf_block
    ],
    questions=MULTIMODAL_QUESTIONS,
)
Um die Tokennutzung zwischen resolution="low" und resolution="high" zu vergleichen, liest das Script auch result.usage.input_tokens_by_modality, wodurch Eingabetokens in "text" und "image" aufgeteilt werden.
Script ausführen und Ergebnisse prüfen
python scripts/multimodal_triage.py
Prüfen Sie die Live-JSON-Ausgabe für alle drei Ausführungen:
[
  {
    "experiment": "1a_photo_resolution_low",
    "resolution": "low",
    "evidence_supports_claim_prob": 0.9532,
    "disposition": "local_cleanup_or_self_service",
    "disposition_confidence": 0.9863,
    "severity_expected_0_to_3": 1.0319,
    "tokens_by_modality": { "text": 441, "image": 266 },
    "total_input_tokens": 707,
    "total_output_tokens": 0,
    "estimated_cost_usd": 7.07e-05
  },
  {
    "experiment": "1b_photo_resolution_high",
    "resolution": "high",
    "evidence_supports_claim_prob": 0.9154,
    "disposition": "local_cleanup_or_self_service",
    "disposition_confidence": 0.9825,
    "severity_expected_0_to_3": 1.0471,
    "tokens_by_modality": { "text": 441, "image": 1064 },
    "total_input_tokens": 1505,
    "total_output_tokens": 0,
    "estimated_cost_usd": 0.0001505
  },
  {
    "experiment": "2_pdf_duplicate_invoice_zero_ocr",
    "resolution": null,
    "latency_ms": 676.98,
    "evidence_supports_claim_prob": 0.9578,
    "disposition": "automated_credit_or_replacement",
    "disposition_confidence": 0.9367,
    "severity_expected_0_to_3": 1.9849,
    "tokens_by_modality": { "text": 587, "image": 520 },
    "total_input_tokens": 1107,
    "total_output_tokens": 0,
    "estimated_cost_usd": 0.0001107
  }
]
Zwei kurze Erkenntnisse aus der Ausgabe:
low-Auflösung wurden viermal weniger Bild-Tokens verwendet (266 statt 1. 064): Beide Durchläufe lieferten genau dieselbe Antwort (local_cleanup_or_self_servicemit einer Konfidenz von über 98 %). Verwenden Sie"high"oder"ultra_high"für sehr kleinen Text oder Kleingedrucktes.- Die PDF-Rechnung hat die Erstattung mit null OCR genehmigt: Mit angehängtem
sample_invoice_8812.pdfistevidence_supports_claim_probauf0.9578gesprungen und das Modell hatautomated_credit_or_replacementin ca. 677 ms ausgewählt.
7. Glückwunsch
Glückwunsch! Sie haben die Gemini Decisions API (
gemini-decision-1
) in Python, um Support-Tickets mit kalibrierten Wahrscheinlichkeiten weiterzuleiten, acht unabhängige Sicherheits- und Richtlinien-Guardrails in einem einzigen Durchlauf auszuführen und Fotos und PDF-Rechnungen ohne separaten OCR-Schritt zu überprüfen – alles mit null Ausgabetokens.
Wenn Sie bereit sind, sich weiter einzuarbeiten, sehen Sie sich die zusätzlichen Ordner im zugehörigen Repository an, darunter 02-hybrid-gateway/ (Bereitstellung eines schnellen Cloud Run-Dienstes, der komplexe Tickets an gemini-3.8-flash übergibt) und 06-adk-workflows/ (Kombination der Decisions API mit Google ADK 2.0-Workflows).
Referenzdokumente
- Offizieller Beitrag zur Veröffentlichung: Making quick work of bounded choices with the Gemini Decisions API
- Entwicklerdokumentation: Gemini Decisions API Guide (Google AI for Developers)
- Interaktiver Playground: Gemini Decision 1 in Google AI Studio ausprobieren
- Beispielcode-Repository: https://github.com/rominirani/gcp-gemini-decisions-hybrid-gateway