

1. Introducción
La mayoría del software de backend no necesita un modelo de IA para escribir párrafos, solo necesita una respuesta rápida y confiable a una pregunta limitada: ¿Sí o no? ¿Qué equipo de asistencia al cliente es responsable de este ticket? ¿Qué tan urgente es?
Los primeros clasificadores dedicados, como Jev de TypeSafe AI, despertaron recientemente el interés de los desarrolladores en los modelos de "sí/no" al mostrar lo que sucede cuando se descarta la generación lenta de JSON token por token y se puntúan las decisiones de conjunto cerrado en una sola pasada.
La API de Gemini Decisions de Google DeepMind (con la tecnología de gemini-decision-1) incorpora esta capacidad de forma nativa en el SDK de google-genai, lo que te permite evaluar hasta 1,000 preguntas de tipo yes/no (noul), opción múltiple (choice) y escala ordenada (score) en una sola pasada con probabilidades calibradas, cero tokens de salida y compatibilidad multimodal integrada para texto, fotos, audio, video y PDFs.
Actividades
- Configurar un entorno de Python local y conectarse a
gemini-decision-1con una clave de API de Google AI Studio - Ejecuta programas de ejemplo que van desde el enrutamiento de tickets, las reglas de seguridad y la toma de decisiones con datos multimodales, que te ayudarán a comprender la API de Gemini Decisions.
Qué aprenderás
- Por qué enviar instrucciones a un LLM de chat para que genere JSON crea problemas de latencia, costo, análisis y confianza en las decisiones de enrutamiento simples.
- Cómo funcionan juntos los tres tipos de preguntas:
noul(sí/no),choice(elegir una opción) yscore(escala ordenada), en una sola llamada aclient.decisions.create. - Cómo controlar el gasto de tokens multimodales con
resolutiony, además, inspeccionar el uso coninput_tokens_by_modality
Requisitos
- Python 3.11 o una versión posterior y
gitinstalados en tu máquina (o Google Cloud Shell) - Una clave de API de Gemini de Google AI Studio (no se necesita configurar un proyecto de Google Cloud para este codelab)
2. Información sobre la API de Gemini Decisions
Why Asking a Chat LLM for JSON Slows Down Backends
Los LLM de chat se crearon para tener conversaciones con personas. Cuando le pides a un asistente que escriba un correo electrónico o explique un error, esperar unos segundos mientras las palabras aparecen en la pantalla se siente completamente natural.
Los problemas comienzan cuando los servicios de backend usan ese mismo flujo de trabajo de chat solo para tomar una decisión rápida de enrutamiento, como decidir dónde enviar "¿Dónde está mi pedido n° 19028?" o si es seguro completarlo automáticamente.
El uso de modelos de Chat para estos casos de uso genera respuestas demasiado lentas, costosas y, lo que es más importante, frágiles, lo que genera una confianza poco confiable a la hora de realizar una acción determinada o avanzar en una dirección específica para los agentes.
Cómo funciona gemini-decision-1
En lugar de generar texto token por token, gemini-decision-1 lee tu entrada una vez y califica todas tus preguntas en una sola pasada, devolviendo probabilidades calibradas directamente.
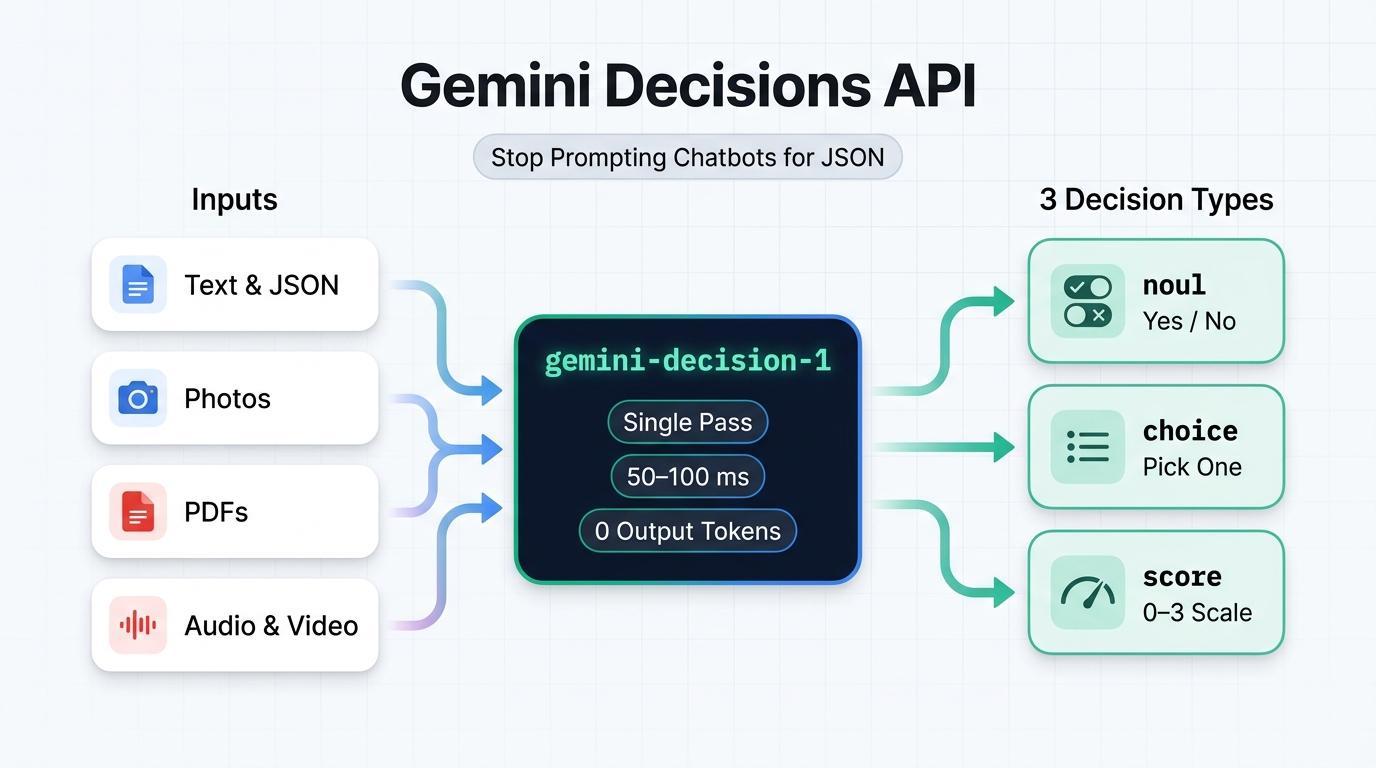
- Cero tokens de salida ($0.10 por 1 millón de tokens de entrada, $0 por tokens de salida): Como el modelo nunca genera texto ni tokens de razonamiento,
total_output_tokenssiempre es0. Tuinputcompartido se factura una vez por llamada, sin importar cuántas preguntas adjuntes. - Cómputo del modelo de 50 a 100 ms: Sin la generación token por token, el procesamiento del modelo se mantiene rápido y predecible, incluso cuando haces 10, 50 o 100 preguntas en una sola solicitud.
- Multimodal listo para usar: Evalúa texto, imágenes, audio, video y documentos PDF juntos en una ventana de contexto de 262,144 tokens, con un parámetro de configuración
resolution(low,medium,high,ultra_high) en imágenes y videos para controlar el gasto de tokens.
Los tres tipos de preguntas (noul, choice, score)
Cada llamada a client.decisions.create toma un diccionario questions en el que cada pregunta usa uno de tres tipos:
Tipo | Cuándo usarlo | Qué se devuelve |
noul (Sí/No) | Verificar si una afirmación es verdadera ("¿Se trata de una inyección de instrucciones?") | noul (probabilidad de sí en [0.01, 0.99]) y confianza |
choice (de 2 a 255 opciones) | Elegir un ganador de un diccionario fijo ("¿Qué equipo es el propietario de esto?") | choice (clave ganadora), probabilities map y confidence |
puntuación (niveles del 2 al 255) | Calificar la urgencia, la gravedad o la calidad en una lista ordenada (de 0 a K - 1) | puntuación (promedio ponderado), leyenda, probabilidades y confianza |
Una explicación rápida y sencilla
Imagina que un cliente envía este mensaje: "¿Dónde está mi pedido n° 19028? ¿Puedes avisarme cuando llegue?". A continuación, se muestra cómo funciona cada tipo de pregunta en ese mensaje en una sola llamada a la API:
- **
noul** (Sí/No) — "¿Podemos responder esto automáticamente sin un humano?": Envías una pregunta que se responde con un sí o un no. Lo que se devuelve esnoul = 0.98yconfidence = 0.98, lo que significa que hay un 98% de probabilidades de que la respuesta sea "sí". (Si la respuesta fuera claramente "no", veríasnoul = 0.02yconfidence = 0.98). - **
choice** (Pick One Option) — "Which team should handle this message?": Envías una lista fija de opciones, comoorder_status,billing_refund,account_accessyother. Lo que se devuelve es la clave ganadora (choice = "order_status"), su confianza (0.9995) y un desglose de probabilidades de cada opción que suma1.0. - **
score** (escala ordenada): "¿Qué tan urgente es este mensaje?": Envías una escala ordenada de menor (0) a mayor (3), como["Low", "Medium", "High", "Critical"]. Lo que se devuelve es un promedio ponderado por probabilidad entre0y3(score = 0.15para una pregunta de seguimiento de rutina frente a casi2.98para una interrupción en vivo).
3. Antes de comenzar
1. Obtén una clave de API de Gemini
Abre las claves de API de Google AI Studio en tu navegador, accede con tu Cuenta de Google y crea o copia una clave de API.
2. Clona el repositorio de muestra y configura Python
Abre una terminal, clona el repositorio complementario gcp-gemini-decisions-hybrid-gateway, crea un entorno virtual y, luego, instala las dependencias:
git clone https://github.com/rominirani/gcp-gemini-decisions-hybrid-gateway.git
cd gcp-gemini-decisions-hybrid-gateway

python3 -m venv .venv
source .venv/bin/activate
pip install -r requirements.txt
Exporta tu GEMINI_API_KEY en la misma sesión de terminal:
export GEMINI_API_KEY="YOUR_GEMINI_API_KEY"
4. Ejemplo 1: Enrutamiento de tickets de asistencia
En este primer ejemplo, inspeccionaremos y ejecutaremos scripts/quickstart_decisions.py, que hace los tres tipos de preguntas (department [choice], can_auto_resolve [noul] y urgency [score]) en una sola llamada a la API.
Inspecciona el código
Esta es la llamada principal a client.decisions.create dentro de scripts/quickstart_decisions.py:
from google import genai

client = genai.Client(api_key=api_key, http_options={"api_version": "v1beta"})

result = client.decisions.create(
    model="gemini-decision-1",
    input=query_text,
    questions={
        "department": {
            "type": "choice",
            "instructions": "Which operational queue should handle this customer message?",
            "criteria": {
                "order_status": "Order tracking, delivery dates, or shipment status.",
                "billing_refund": "Duplicate charges, invoices, credits, or refund requests.",
                "subscription_cancel": "Canceling or pausing a recurring subscription.",
                "account_access": "Password resets, expired 2FA/MFA codes, or login lockouts.",
                "complex_incident": "Production outages, HTTP 500 errors, or legal questions.",
                "other": "Anything outside these specific categories.",
            },
        },
        "can_auto_resolve": {
            "type": "noul",
            "instructions": "Can this request be fulfilled deterministically by an automated "
                            "backend lookup or webhook without custom investigation?",
            "criteria": {
                "true_description": "Routine single-intent request such as checking tracking.",
                "false_description": "Outage, legal question, or ambiguous billing dispute.",
            },
        },
        "urgency": {
            "type": "score",
            "instructions": "Rate the operational urgency and severity of this message.",
            "criteria": [
                "Low: Routine informational or tracking question.",
                "Medium: Standard account, subscription, or billing request.",
                "High: Time-sensitive customer impact or repeated billing failure.",
                "Critical: Production-halting outage, data loss risk, or security incident.",
            ],
        },
    },
)

dept = result.answers["department"]
auto = result.answers["can_auto_resolve"]
urg = result.answers["urgency"]

# The API returns raw probabilities; our script sets the cutoff for auto-handling (80%):
auto_decision = auto.noul >= 0.80
Observa la última línea (auto.noul >= 0.80): la API de Decisions nunca codifica un límite de forma fija, sino que devuelve la probabilidad noul sin procesar (de 0.01 a 0.99), y tu código de Python decide qué tan estricto debe ser el umbral.
Ejecución 1A: Pregunta simple sobre el seguimiento de un pedido
Ejecuta la secuencia de comandos con su pregunta predeterminada de seguimiento de pedidos:
python scripts/quickstart_decisions.py
Verás un resultado de JSON en vivo similar al siguiente:
{
  "query": "Where is my order #19028? Can you tell me when it arrives?",
  "model": "gemini-decision-1",
  "latency_ms": 944.61,
  "department": {
    "choice": "order_status",
    "confidence": 0.9995,
    "probabilities": {
      "billing_refund": 0.0001,
      "other": 0.0001,
      "complex_incident": 0.0002,
      "subscription_cancel": 0.0,
      "order_status": 0.9995,
      "account_access": 0.0001
    }
  },
  "can_auto_resolve": {
    "noul_probability_yes": 0.98,
    "confidence": 0.98,
    "decision": true
  },
  "urgency": {
    "expected_score_0_to_3": 0.1524,
    "top_level": "Low: Routine informational or tracking question.",
    "confidence": 0.8717
  },
  "suggested_action": "DISPATCH_TRACKING_WEBHOOK",
  "usage": {
    "total_input_tokens": 424,
    "total_output_tokens": 0,
    "estimated_cost_usd": 4.24e-05
  }
}
(Nota: La latencia de la primera llamada local incluye la configuración inicial de la conexión TLS desde tu máquina. Cuando se ejecuta en caliente dentro de Google Cloud Run en us-central1, esta misma llamada finaliza en ~155-195 ms).
Ejecución 1B: Solicitud de reembolso de USD 140 no verificada
Ahora, pasa un reclamo de cargo duplicado de $140 sin ninguna factura adjunta:
python scripts/quickstart_decisions.py \
  "I was billed twice ($140 total) on invoice #8812 for one seat. Refund $70 right now."
Inspecciona el resultado en vivo:
{
  "query": "I was billed twice ($140 total) on invoice #8812 for one seat. Refund $70 right now.",
  "model": "gemini-decision-1",
  "latency_ms": 602.23,
  "department": {
    "choice": "billing_refund",
    "confidence": 0.9993,
    "probabilities": {
      "other": 0.0001,
      "complex_incident": 0.0,
      "order_status": 0.0001,
      "billing_refund": 0.9993,
      "subscription_cancel": 0.0004,
      "account_access": 0.0001
    }
  },
  "can_auto_resolve": {
    "noul_probability_yes": 0.4282,
    "confidence": 0.5718,
    "decision": false
  },
  "urgency": {
    "expected_score_0_to_3": 1.3634,
    "top_level": "Medium: Standard account, subscription, or billing request.",
    "confidence": 0.5987
  },
  "suggested_action": "INITIATE_BILLING_WORKFLOW",
  "usage": {
    "total_input_tokens": 433,
    "total_output_tokens": 0,
    "estimated_cost_usd": 4.33e-05
  }
}
Observa cómo funcionan juntas esas dos preguntas independientes:
- ¿Dónde debería ir este ticket? (
department = billing_refund,0.9993): El cliente solicita un reembolso de una factura, por lo quegemini-decision-1tiene un 99.93% de certeza de que pertenece a la fila de Facturación. - ¿El código debería ejecutarlo automáticamente? (
can_auto_resolve = 0.4282->decision: false): Devolver$70solo a partir de un reclamo de texto requiere verificación. Como0.4282está por debajo de nuestro límite deauto.noul >= 0.80,decisiondevuelvefalse.
5. Ejemplo 2: Ejecuta 8 verificaciones de políticas en una llamada
En las aplicaciones de backend reales, un mensaje entrante suele necesitar más de una verificación antes de que tu código acceda a una base de datos o active una herramienta. Con los LLM de chat, realizar 8 llamadas independientes multiplica la latencia y factura el texto de entrada 8 veces, mientras que incluir 8 reglas en una instrucción JSON gigante hace que el modelo pase por alto los casos extremos.
Inspeccionemos scripts/parallel_guardrails.py, que evalúa 8 verificaciones independientes (inyección de instrucciones, IIP/secretos sin procesar, elegibilidad para recibir un reembolso instantáneo, amenazas de devolución del cargo, cola de destino, selección de herramientas, riesgo de deserción y nivel de abuso) en una llamada de decisions.create.
Cómo funciona la secuencia de comandos
Paso 1: Pasa los metadatos del evento y el texto juntos como entrada
Pasar un diccionario JSON serializado como input permite que gemini-decision-1 verifique los campos estructurados (como amount_usd y order_age_days) junto con el mensaje de formato libre del cliente, lo que factura la carga útil compartida solo una vez:
event = {
    "event_id": "evt-03-clean-refund",
    "customer_tier": "PREMIUM",
    "order_age_days": 6,
    "amount_usd": 34.0,
    "message": "Order #77102 arrived yesterday with a cracked mug handle. Could I get a $34 refund?",
}
Paso 2: Califica las 8 preguntas en una sola pasada
Definimos 4 preguntas de noul, 2 de choice y 2 de score en EIGHT_PARALLEL_QUESTIONS y las pasamos en una llamada:
EIGHT_PARALLEL_QUESTIONS = {
    "prompt_injection_attempt": { "type": "noul", "instructions": "...", "criteria": {...} },
    "contains_raw_pii_or_secrets": { "type": "noul", "instructions": "...", "criteria": {...} },
    "eligible_for_instant_refund": {
        "type": "noul",
        "instructions": "Does this request qualify for instant automated refund under policy "
                        "(amount <= $50, order_age_days <= 30, clear defect or duplicate)?",
        "criteria": {...},
    },
    "threatens_chargeback_or_legal": { "type": "noul", ... },
    "target_queue": { "type": "choice", ... },
    "selected_mcp_tool": { "type": "choice", ... },
    "churn_risk": { "type": "score", ... },      # 0..3 (Low -> Severe)
    "abuse_toxicity": { "type": "score", ... },  # 0..2 (Benign -> Hostile)
}

result = client.decisions.create(
    model="gemini-decision-1",
    input=json.dumps(event),             # Shared input — billed once
    questions=EIGHT_PARALLEL_QUESTIONS,  # All 8 questions scored in parallel
)
a = result.answers
Paso 3: Combina las respuestas con las reglas de prioridad en Python
Como cada pregunta devuelve su propia puntuación independiente dentro de result.answers, nuestro código de Python verifica primero los riesgos de seguridad (inserción de instrucciones y secretos filtrados) antes de permitir cualquier reembolso automatizado:
if a["prompt_injection_attempt"].noul >= 0.70:
    gate_verdict = "QUARANTINE_ADVERSARIAL_INPUT"
elif a["contains_raw_pii_or_secrets"].noul >= 0.75:
    gate_verdict = "REDACT_PII_BEFORE_STORAGE"
elif a["threatens_chargeback_or_legal"].noul >= 0.75 or a["churn_risk"].score >= 2.3:
    gate_verdict = "ROUTE_TO_VIP_RETENTION_SPECIALIST"
elif a["eligible_for_instant_refund"].noul >= 0.85 and a["selected_mcp_tool"].confidence >= 0.80:
    gate_verdict = "AUTO_EXECUTE_INSTANT_REFUND"
else:
    gate_verdict = f"DISPATCH_{a['selected_mcp_tool'].choice.upper()}"
Ejecuta la secuencia de comandos
Ejecuta scripts/parallel_guardrails.py para probar tres mensajes de ejemplo: un intento de inserción de instrucciones, una clave de API de sk_live_... pegada por accidente y un reembolso de taza dañada de $34 limpio:
python scripts/parallel_guardrails.py
Revisa el resultado en vivo de los tres eventos de prueba:
[
  {
    "event_id": "evt-01-injection",
    "gate_verdict": "QUARANTINE_ADVERSARIAL_INPUT",
    "questions_evaluated_in_parallel": 8,
    "latency_ms": 626.34,
    "signals": {
      "prompt_injection_prob": 0.9766,
      "raw_pii_prob": 0.0426,
      "instant_refund_prob": 0.0275,
      "target_queue": "security_trust",
      "selected_mcp_tool": "quarantine_security_event"
    },
    "usage": { "total_input_tokens": 977, "total_output_tokens": 0, "estimated_cost_usd": 9.77e-05 }
  },
  {
    "event_id": "evt-02-pii-leak",
    "gate_verdict": "REDACT_PII_BEFORE_STORAGE",
    "questions_evaluated_in_parallel": 8,
    "latency_ms": 724.48,
    "signals": {
      "prompt_injection_prob": 0.0548,
      "raw_pii_prob": 0.9755,
      "instant_refund_prob": 0.0292,
      "target_queue": "security_trust",
      "selected_mcp_tool": "quarantine_security_event"
    },
    "usage": { "total_input_tokens": 999, "total_output_tokens": 0, "estimated_cost_usd": 9.99e-05 }
  },
  {
    "event_id": "evt-03-clean-refund",
    "gate_verdict": "AUTO_EXECUTE_INSTANT_REFUND",
    "questions_evaluated_in_parallel": 8,
    "latency_ms": 625.68,
    "signals": {
      "prompt_injection_prob": 0.0133,
      "raw_pii_prob": 0.01,
      "instant_refund_prob": 0.9676,
      "target_queue": "billing_ops",
      "selected_mcp_tool": "issue_instant_credit"
    },
    "usage": { "total_input_tokens": 987, "total_output_tokens": 0, "estimated_cost_usd": 9.87e-05 }
  }
]
La evaluación de las 8 verificaciones juntas cuesta aproximadamente USD 0.000099 por evento con 0 tokens de salida.
6. Ejemplo 3: Cómo verificar fotos y archivos PDF sin OCR
Normalmente, cuando un usuario envía un reclamo con un archivo adjunto, como una foto de la inspección de una instalación o una factura en PDF, tu backend debe ejecutar primero una canalización de OCR o de visión independiente solo para extraer el texto antes de que se puedan ejecutar las reglas de enrutamiento. Como gemini-decision-1 es multimodal de forma nativa, podemos enviar tanto el reclamo escrito como el archivo adjunto sin procesar en una llamada de decisions.create.
Qué probaremos
scripts/multimodal_triage.py prueba dos situaciones, cada una de las cuales vincula una reclamación escrita breve con un archivo adjunto:
Situación 1: Foto de inspección de la instalación (resolución baja frente a alta)
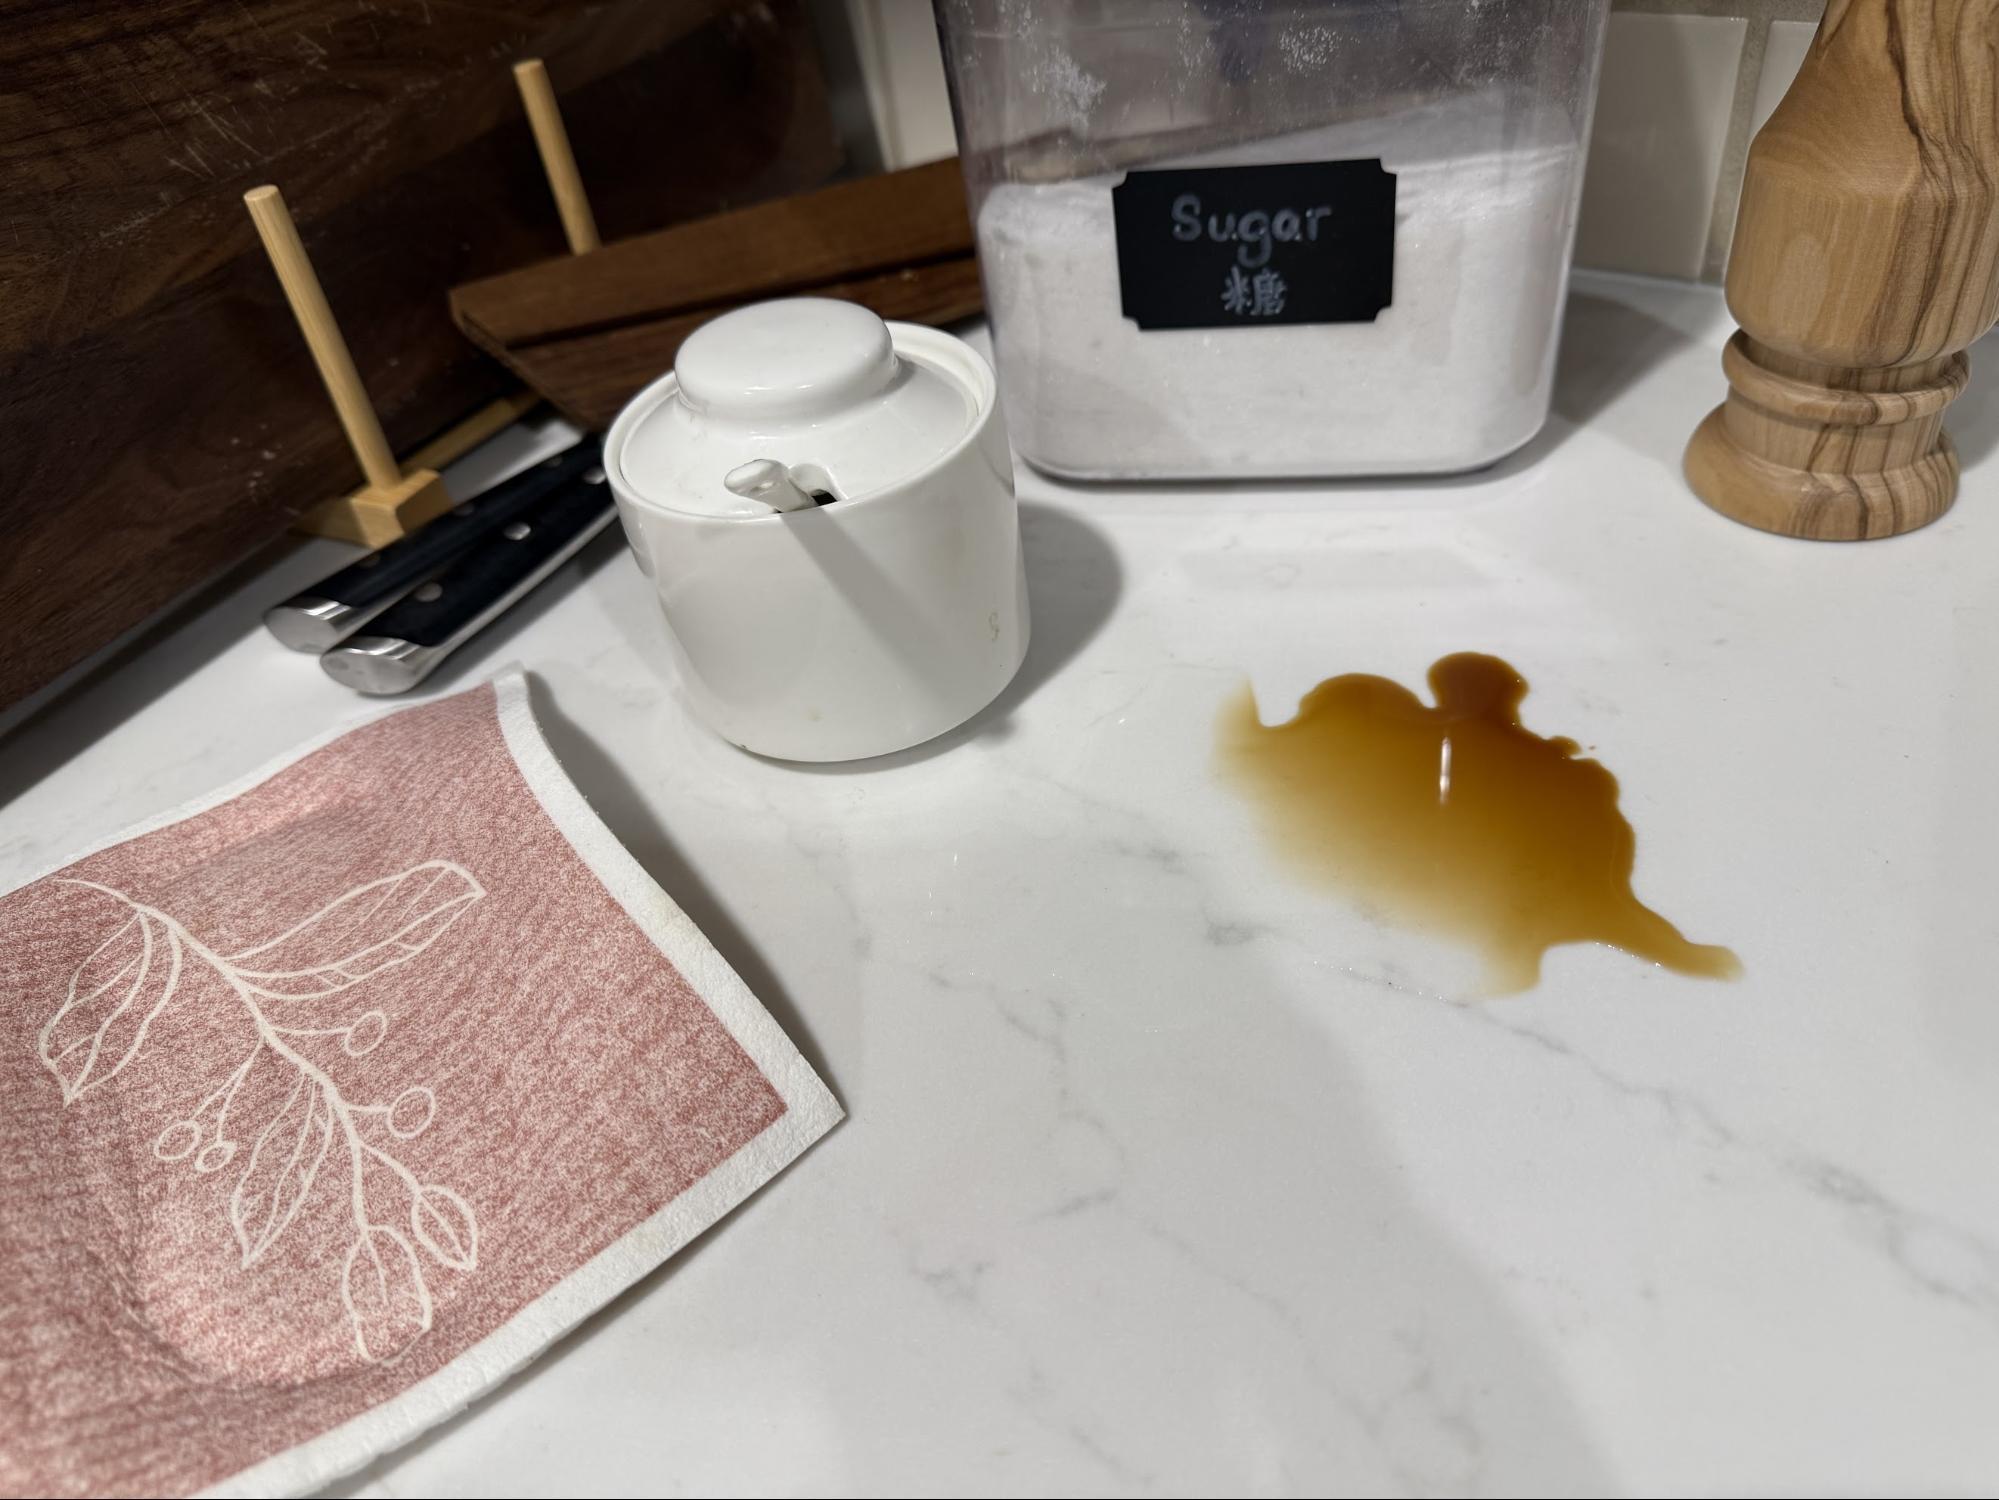
- Reclamo escrito del usuario: "Revisar el mostrador de la sala de descanso antes de la reunión con el cliente de las 9:00 a.m. Se detectó un pequeño derrame de café junto al paño de limpieza".
Foto adjunta (03-multimodal-triage/spill.jpg): Muestra un pequeño derrame de café oscuro sobre una mesada clara con un paño de limpieza estampado justo al lado:
Situación 2: Factura en PDF duplicada (bytes de PDF sin procesar, sin OCR)
- Reclamo escrito del usuario: "Se me cobraron USD 45 dos veces (USD 90 en total) en la factura INV-8812. Adjunto mi factura en formato PDF".
- PDF adjunto (
03-multimodal-triage/sample_invoice_8812.pdf): Una factura de 1 página en la que se detallanLine 1: Pro Plan Monthly Subscription ... $45.00yLine 2: Pro Plan Monthly Subscription [DUPLICATE] $45.00($90.00en total).
Qué esperamos ver
- Foto de derrame (baja resolución frente a alta resolución): Ambas ejecuciones deberían detectar el pequeño derrame en la encimera y dar la misma respuesta, aunque la resolución
lowusa muchos menos tokens de imagen. - Factura en PDF (sin OCR): Adjuntar
sample_invoice_8812.pdfdemuestra que realmente se le facturó dos veces al cliente, por lo que el modelo debería leer el PDF directamente y aprobar el reembolso.
Revisa el código
En lugar de pasar una sola cadena a input, scripts/multimodal_triage.py pasa una lista de bloques de contenido, que comienza con un bloque text (que termina en \n), seguido de un bloque image o un bloque document (application/pdf):
# For Run 1a & 1b: Pass an image URL and set resolution ("low" vs. "high")
image_block = {
    "type": "image",
    "uri": "https://storage.googleapis.com/generativeai-downloads/images/spill.jpg",
    "mime_type": "image/jpeg",
    "resolution": "low",  # or "high" in Run 1b
}

# For Run 2: Read raw PDF bytes from disk and base64-encode them as a "document" block
# (Note: PDF document blocks do not take a "resolution" setting)
pdf_block = {
    "type": "document",
    "data": base64.b64encode(pdf_bytes).decode("ascii"),
    "mime_type": "application/pdf",
}

result = client.decisions.create(
    model="gemini-decision-1",
    input=[
        {"type": "text", "text": f"Claim Statement: {claim_text}\nAttached Evidence:\n"},
        media_block,  # either image_block or pdf_block
    ],
    questions=MULTIMODAL_QUESTIONS,
)
Para comparar el uso de tokens entre resolution="low" y resolution="high", la secuencia de comandos también lee result.usage.input_tokens_by_modality, que divide los tokens de entrada en "text" y "image".
Ejecuta la secuencia de comandos y verifica los resultados
python scripts/multimodal_triage.py
Inspecciona el resultado JSON en vivo en las tres ejecuciones:
[
  {
    "experiment": "1a_photo_resolution_low",
    "resolution": "low",
    "evidence_supports_claim_prob": 0.9532,
    "disposition": "local_cleanup_or_self_service",
    "disposition_confidence": 0.9863,
    "severity_expected_0_to_3": 1.0319,
    "tokens_by_modality": { "text": 441, "image": 266 },
    "total_input_tokens": 707,
    "total_output_tokens": 0,
    "estimated_cost_usd": 7.07e-05
  },
  {
    "experiment": "1b_photo_resolution_high",
    "resolution": "high",
    "evidence_supports_claim_prob": 0.9154,
    "disposition": "local_cleanup_or_self_service",
    "disposition_confidence": 0.9825,
    "severity_expected_0_to_3": 1.0471,
    "tokens_by_modality": { "text": 441, "image": 1064 },
    "total_input_tokens": 1505,
    "total_output_tokens": 0,
    "estimated_cost_usd": 0.0001505
  },
  {
    "experiment": "2_pdf_duplicate_invoice_zero_ocr",
    "resolution": null,
    "latency_ms": 676.98,
    "evidence_supports_claim_prob": 0.9578,
    "disposition": "automated_credit_or_replacement",
    "disposition_confidence": 0.9367,
    "severity_expected_0_to_3": 1.9849,
    "tokens_by_modality": { "text": 587, "image": 520 },
    "total_input_tokens": 1107,
    "total_output_tokens": 0,
    "estimated_cost_usd": 0.0001107
  }
]
Dos conclusiones rápidas del resultado:
- La resolución
lowusó 4 veces menos tokens de imagen (266 frente a 1,064): Ambas ejecuciones dieron exactamente la misma respuesta (local_cleanup_or_self_servicecon un nivel de confianza superior al 98%). Guarda"high"o"ultra_high"para texto pequeño o letra chica. - La factura en PDF aprobó el reembolso sin OCR: Con
sample_invoice_8812.pdfadjunto,evidence_supports_claim_probsaltó a0.9578y el modelo seleccionóautomated_credit_or_replacementen ~677 ms.
7. Felicitaciones
¡Felicitaciones! Usaste la API de Gemini Decisions (
gemini-decision-1
) en Python para enrutar tickets de asistencia con probabilidades calibradas, ejecutar 8 barreras de seguridad y políticas independientes en un solo paso, y verificar fotos y facturas en PDF sin un paso de OCR separado, todo con cero tokens de salida.
Cuando tengas todo listo para avanzar, consulta las carpetas adicionales en el repositorio complementario, incluidas 02-hybrid-gateway/ (implementa un servicio rápido de Cloud Run que entrega tickets complejos a gemini-3.8-flash) y 06-adk-workflows/ (combina la API de Decisions con los flujos de trabajo de Google ADK 2.0).
Documentos de referencia
- Publicación oficial del lanzamiento: Agiliza el trabajo de las opciones limitadas con la API de Gemini Decisions
- Documentación para desarrolladores: Guía de la API de Gemini Decisions (IA de Google para desarrolladores)
- Entorno de pruebas interactivo: Prueba Gemini Decision 1 en Google AI Studio
- Repositorio de código de muestra: https://github.com/rominirani/gcp-gemini-decisions-hybrid-gateway