

1. Introduction
La plupart des logiciels de backend n'ont pas vraiment besoin d'un modèle d'IA pour écrire des paragraphes. Ils ont simplement besoin d'une réponse rapide et fiable à une question limitée : Oui ou non ? Quelle équipe d'assistance est responsable de cette demande ? Est-ce urgent ?
Les premiers classificateurs dédiés, tels que Jev de TypeSafe AI, ont récemment suscité l'intérêt des développeurs pour les modèles "oui/non" en montrant ce qui se passe lorsque vous abandonnez la génération JSON lente, jeton par jeton, et que vous évaluez les décisions d'un ensemble fermé en une seule passe.
L'API Gemini Decisions de Google DeepMind (basée sur gemini-decision-1) intègre cette fonctionnalité de manière native dans le SDK google-genai. Vous pouvez ainsi évaluer jusqu'à 1 000 questions de type yes/no (noul), à choix multiples (choice) et à échelle ordonnée (score) en une seule fois, avec des probabilités calibrées, zéro jeton de sortie et une compatibilité multimodale intégrée pour le texte, les photos, l'audio, la vidéo et les PDF.
Objectifs de l'atelier
- Configurez un environnement Python local et connectez-vous à
gemini-decision-1à l'aide d'une clé API Google AI Studio. - Exécutez des exemples de programmes allant du routage des tickets aux règles de sécurité et à la prise de décision basée sur des données multimodales, qui vous aideront à comprendre l'API Gemini Decisions.
Points abordés
- Pourquoi l'envoi d'un prompt à un LLM de chat pour obtenir du JSON crée des problèmes de latence, de coût, d'analyse et de confiance pour les décisions de routage simples.
- Comment les trois types de questions :
noul(oui/non),choice(choisir une option) etscore(échelle ordonnée) fonctionnent ensemble dans un seul appelclient.decisions.create. - Contrôler la dépense de jetons multimodaux à l'aide de
resolutionet inspecter l'utilisation avecinput_tokens_by_modality.
Prérequis
- Python 3.11 ou version ultérieure et
gitinstallés sur votre machine (ou Google Cloud Shell). - Une clé API Gemini de Google AI Studio (aucune configuration de projet Google Cloud n'est requise pour cet atelier de programmation).
2. Comprendre l'API Gemini Decisions
Why Asking a Chat LLM for JSON Slows Down Backends
Les LLM de chat ont été conçus pour discuter avec des personnes. Lorsque vous demandez à un assistant de rédiger un e-mail ou d'expliquer un bug, il est tout à fait naturel d'attendre quelques secondes pendant que les mots s'affichent à l'écran.
Les problèmes commencent lorsque les services de backend utilisent ce même workflow de chat simplement pour prendre une décision de routage rapide, par exemple pour décider où envoyer "Où est ma commande n° 19028 ?" ou s'il est sûr de la traiter automatiquement.
L'utilisation de modèles de chat pour ces cas d'utilisation entraîne des réponses trop lentes, coûteuses et, surtout, fragiles, ce qui se traduit par un manque de fiabilité dans la prise d'une certaine mesure ou dans la poursuite d'une direction spécifique pour les agents.
Fonctionnement de gemini-decision-1
Au lieu de générer du texte jeton par jeton, gemini-decision-1 lit votre entrée une fois et évalue toutes vos questions en un seul passage, en renvoyant directement des probabilités calibrées.
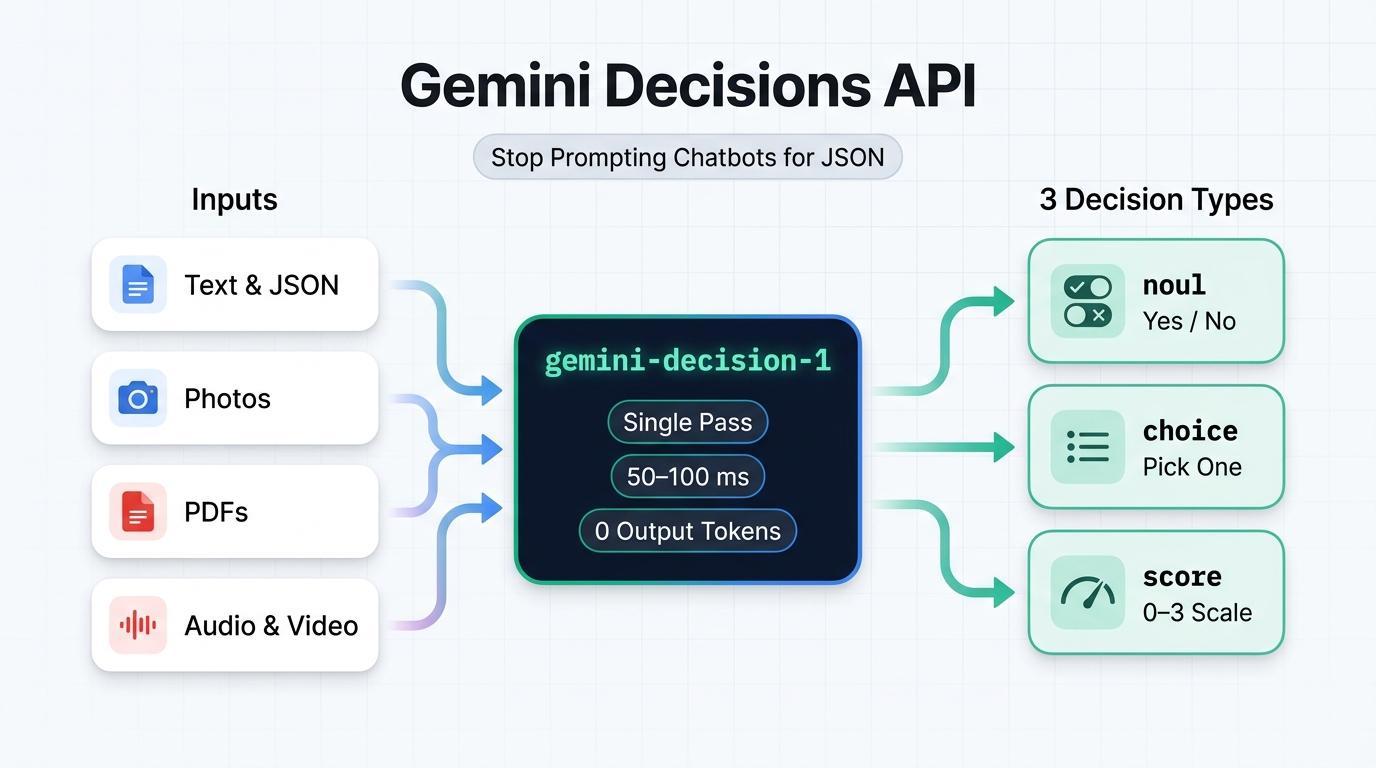
- Zéro jeton de sortie (0,10 $ par million de jetons d'entrée, 0 $ par jeton de sortie) : comme le modèle ne génère jamais de jetons de texte ou de raisonnement,
total_output_tokensest toujours égal à0. Votreinputpartagé est facturé une fois par appel, quel que soit le nombre de questions que vous joignez. - Calcul du modèle en 50 à 100 ms : sans génération jeton par jeton, le calcul du modèle reste rapide et prévisible, même si vous posez 10, 50 ou 100 questions dans une seule requête.
- Multimodalité prête à l'emploi : évaluez ensemble du texte, des images, de l'audio, de la vidéo et des documents PDF dans une fenêtre de contexte de 262 144 jetons, avec un paramètre
resolution(low,medium,high,ultra_high) sur les images et les vidéos pour contrôler la consommation de jetons.
Les trois types de questions (noul, choix, score)
Chaque appel à client.decisions.create utilise un dictionnaire questions dans lequel chaque question utilise l'un des trois types suivants :
Type | Quand l'utiliser ? | What Comes Back |
noul (Oui/Non) | Vérifier si une affirmation est vraie ("S'agit-il d'une injection de prompt ?") | noul (probabilité de "oui" dans [0,01, 0,99]) et confiance |
choix (2 à 255 options) | Choisir un gagnant dans un dictionnaire fixe ("À quelle équipe appartient cet élément ?") | choix (clé gagnante), carte des probabilités et confiance |
score (2 à 255 niveaux) | Évaluer l'urgence, la gravité ou la qualité sur une liste ordonnée (0 à K - 1) | score (moyenne pondérée), légende, probabilités et confiance |
A Quick Plain-English Walkthrough
Imaginons qu'un client envoie le message suivant : "Où se trouve ma commande n° 19028 ? Pouvez-vous me dire quand il arrivera ?" Voici comment chaque type de question fonctionne sur ce message dans un seul appel d'API :
- **
noul** (Oui/Non) : "Pouvons-nous répondre automatiquement sans intervention humaine ?" Vous envoyez une question fermée. La réponse estnoul = 0.98etconfidence = 0.98, ce qui signifie qu'il y a 98 % de chances que la réponse soit "oui". (Si la réponse était clairement "non", vous verrieznoul = 0.02etconfidence = 0.98.) - **
choice** (Sélectionnez une option) — "Quelle équipe doit traiter ce message ?" : Vous envoyez une liste fixe d'options, commeorder_status,billing_refund,account_accessetother. La réponse renvoie la clé gagnante (choice = "order_status"), son niveau de confiance (0.9995) et une répartition des probabilités pour chaque option, dont la somme est égale à1.0. - **
score** (Échelle ordonnée) : "Quel est le degré d'urgence de ce message ?" Vous envoyez une échelle ordonnée de la valeur la plus faible (0) à la plus élevée (3), par exemple["Low", "Medium", "High", "Critical"]. Le résultat est une moyenne pondérée par la probabilité entre0et3(score = 0.15pour une question de suivi de routine, contre près de2.98pour une panne en cours).
3. Avant de commencer
1. Obtenir une clé API Gemini
Ouvrez Clés API Google AI Studio dans votre navigateur, connectez-vous avec votre compte Google, puis créez ou copiez une clé API.
2. Cloner l'exemple de dépôt et configurer Python
Ouvrez un terminal, clonez le dépôt associé gcp-gemini-decisions-hybrid-gateway, créez un environnement virtuel et installez les dépendances :
git clone https://github.com/rominirani/gcp-gemini-decisions-hybrid-gateway.git
cd gcp-gemini-decisions-hybrid-gateway

python3 -m venv .venv
source .venv/bin/activate
pip install -r requirements.txt
Exportez votre GEMINI_API_KEY dans la même session de terminal :
export GEMINI_API_KEY="YOUR_GEMINI_API_KEY"
4. Exemple 1 : Routage des demandes d'assistance
Dans ce premier exemple, nous allons inspecter et exécuter scripts/quickstart_decisions.py, qui pose les trois types de questions (department (choice), can_auto_resolve (noul) et urgency (score)) en un seul appel d'API.
Inspecter le code
Voici l'appel client.decisions.create principal dans scripts/quickstart_decisions.py :
from google import genai

client = genai.Client(api_key=api_key, http_options={"api_version": "v1beta"})

result = client.decisions.create(
    model="gemini-decision-1",
    input=query_text,
    questions={
        "department": {
            "type": "choice",
            "instructions": "Which operational queue should handle this customer message?",
            "criteria": {
                "order_status": "Order tracking, delivery dates, or shipment status.",
                "billing_refund": "Duplicate charges, invoices, credits, or refund requests.",
                "subscription_cancel": "Canceling or pausing a recurring subscription.",
                "account_access": "Password resets, expired 2FA/MFA codes, or login lockouts.",
                "complex_incident": "Production outages, HTTP 500 errors, or legal questions.",
                "other": "Anything outside these specific categories.",
            },
        },
        "can_auto_resolve": {
            "type": "noul",
            "instructions": "Can this request be fulfilled deterministically by an automated "
                            "backend lookup or webhook without custom investigation?",
            "criteria": {
                "true_description": "Routine single-intent request such as checking tracking.",
                "false_description": "Outage, legal question, or ambiguous billing dispute.",
            },
        },
        "urgency": {
            "type": "score",
            "instructions": "Rate the operational urgency and severity of this message.",
            "criteria": [
                "Low: Routine informational or tracking question.",
                "Medium: Standard account, subscription, or billing request.",
                "High: Time-sensitive customer impact or repeated billing failure.",
                "Critical: Production-halting outage, data loss risk, or security incident.",
            ],
        },
    },
)

dept = result.answers["department"]
auto = result.answers["can_auto_resolve"]
urg = result.answers["urgency"]

# The API returns raw probabilities; our script sets the cutoff for auto-handling (80%):
auto_decision = auto.noul >= 0.80
Notez la dernière ligne (auto.noul >= 0.80) : l'API Decisions elle-même ne code jamais de seuil en dur. Elle renvoie la probabilité noul brute (de 0.01 à 0.99), et votre code Python décide du niveau de rigueur du seuil.
Exécution 1A : Question simple sur le suivi d'une commande
Exécutez le script avec sa question par défaut sur le suivi des commandes :
python scripts/quickstart_decisions.py
Vous verrez une sortie JSON en direct semblable à celle-ci :
{
  "query": "Where is my order #19028? Can you tell me when it arrives?",
  "model": "gemini-decision-1",
  "latency_ms": 944.61,
  "department": {
    "choice": "order_status",
    "confidence": 0.9995,
    "probabilities": {
      "billing_refund": 0.0001,
      "other": 0.0001,
      "complex_incident": 0.0002,
      "subscription_cancel": 0.0,
      "order_status": 0.9995,
      "account_access": 0.0001
    }
  },
  "can_auto_resolve": {
    "noul_probability_yes": 0.98,
    "confidence": 0.98,
    "decision": true
  },
  "urgency": {
    "expected_score_0_to_3": 0.1524,
    "top_level": "Low: Routine informational or tracking question.",
    "confidence": 0.8717
  },
  "suggested_action": "DISPATCH_TRACKING_WEBHOOK",
  "usage": {
    "total_input_tokens": 424,
    "total_output_tokens": 0,
    "estimated_cost_usd": 4.24e-05
  }
}
(Remarque : La latence locale du premier appel inclut la configuration initiale de la connexion TLS depuis votre machine. Lorsqu'il est exécuté à chaud dans Google Cloud Run dans us-central1, ce même appel se termine en environ 155 à 195 ms.)
Exécution 1B : Demande de remboursement non validée de 140 $
Transmettez maintenant une réclamation pour débit en double $140 sans facture jointe :
python scripts/quickstart_decisions.py \
  "I was billed twice ($140 total) on invoice #8812 for one seat. Refund $70 right now."
Inspectez le résultat en direct :
{
  "query": "I was billed twice ($140 total) on invoice #8812 for one seat. Refund $70 right now.",
  "model": "gemini-decision-1",
  "latency_ms": 602.23,
  "department": {
    "choice": "billing_refund",
    "confidence": 0.9993,
    "probabilities": {
      "other": 0.0001,
      "complex_incident": 0.0,
      "order_status": 0.0001,
      "billing_refund": 0.9993,
      "subscription_cancel": 0.0004,
      "account_access": 0.0001
    }
  },
  "can_auto_resolve": {
    "noul_probability_yes": 0.4282,
    "confidence": 0.5718,
    "decision": false
  },
  "urgency": {
    "expected_score_0_to_3": 1.3634,
    "top_level": "Medium: Standard account, subscription, or billing request.",
    "confidence": 0.5987
  },
  "suggested_action": "INITIATE_BILLING_WORKFLOW",
  "usage": {
    "total_input_tokens": 433,
    "total_output_tokens": 0,
    "estimated_cost_usd": 4.33e-05
  }
}
Voyons comment ces deux questions indépendantes fonctionnent ensemble :
- Où cette demande doit-elle être envoyée ? (
department = billing_refund,0.9993) : le client demande le remboursement d'une facture.gemini-decision-1est donc sûr à 99, 93 % que la demande appartient à la file d'attente "Facturation". - Le code doit-il l'exécuter automatiquement ? (
can_auto_resolve = 0.4282->decision: false) : Le retour de$70à partir d'une réclamation textuelle seule nécessite une vérification. Comme0.4282est inférieur à notre seuil deauto.noul >= 0.80,decisionrenvoiefalse.
5. Exemple 2 : Exécuter huit vérifications de règles en un seul appel
Dans les applications de backend réelles, un message entrant nécessite généralement plusieurs vérifications avant que votre code n'accède à une base de données ou ne déclenche un outil. Avec les LLM de chat, effectuer huit appels distincts multiplie votre latence et vous facture huit fois votre texte d'entrée. En revanche, si vous insérez huit règles dans un seul prompt JSON géant, le modèle risque de passer à côté des cas limites.
Examinons scripts/parallel_guardrails.py, qui évalue huit vérifications indépendantes (injection de prompt, informations permettant d'identifier l'utilisateur/secrets bruts, éligibilité au remboursement instantané, menaces de rétrofacturation, file d'attente cible, sélection d'outils, risque de désabonnement et niveau d'abus) dans un seul appel decisions.create.
Fonctionnement du script
Étape 1 : Transmettez les métadonnées d'événement et le texte ensemble en tant qu'entrée
La transmission d'un dictionnaire JSON sérialisé en tant que input permet à gemini-decision-1 de vérifier les champs structurés (comme amount_usd et order_age_days) en plus du message client au format libre, en ne facturant qu'une seule fois la charge utile partagée :
event = {
    "event_id": "evt-03-clean-refund",
    "customer_tier": "PREMIUM",
    "order_age_days": 6,
    "amount_usd": 34.0,
    "message": "Order #77102 arrived yesterday with a cracked mug handle. Could I get a $34 refund?",
}
Étape 2 : Évaluez les huit questions en une seule fois
Nous définissons quatre questions noul, deux questions choice et deux questions score dans EIGHT_PARALLEL_QUESTIONS, et nous les transmettons en un seul appel :
EIGHT_PARALLEL_QUESTIONS = {
    "prompt_injection_attempt": { "type": "noul", "instructions": "...", "criteria": {...} },
    "contains_raw_pii_or_secrets": { "type": "noul", "instructions": "...", "criteria": {...} },
    "eligible_for_instant_refund": {
        "type": "noul",
        "instructions": "Does this request qualify for instant automated refund under policy "
                        "(amount <= $50, order_age_days <= 30, clear defect or duplicate)?",
        "criteria": {...},
    },
    "threatens_chargeback_or_legal": { "type": "noul", ... },
    "target_queue": { "type": "choice", ... },
    "selected_mcp_tool": { "type": "choice", ... },
    "churn_risk": { "type": "score", ... },      # 0..3 (Low -> Severe)
    "abuse_toxicity": { "type": "score", ... },  # 0..2 (Benign -> Hostile)
}

result = client.decisions.create(
    model="gemini-decision-1",
    input=json.dumps(event),             # Shared input — billed once
    questions=EIGHT_PARALLEL_QUESTIONS,  # All 8 questions scored in parallel
)
a = result.answers
Étape 3 : Combinez les réponses avec les règles de priorité en Python
Comme chaque question renvoie son propre score indépendant dans result.answers, notre code Python vérifie d'abord les risques de sécurité (injection de prompt et fuite de secrets) avant d'autoriser un remboursement automatisé :
if a["prompt_injection_attempt"].noul >= 0.70:
    gate_verdict = "QUARANTINE_ADVERSARIAL_INPUT"
elif a["contains_raw_pii_or_secrets"].noul >= 0.75:
    gate_verdict = "REDACT_PII_BEFORE_STORAGE"
elif a["threatens_chargeback_or_legal"].noul >= 0.75 or a["churn_risk"].score >= 2.3:
    gate_verdict = "ROUTE_TO_VIP_RETENTION_SPECIALIST"
elif a["eligible_for_instant_refund"].noul >= 0.85 and a["selected_mcp_tool"].confidence >= 0.80:
    gate_verdict = "AUTO_EXECUTE_INSTANT_REFUND"
else:
    gate_verdict = f"DISPATCH_{a['selected_mcp_tool'].choice.upper()}"
Exécuter le script
Exécutez scripts/parallel_guardrails.py pour tester trois exemples de messages : une tentative d'injection de prompt, une clé API sk_live_... collée accidentellement et un remboursement de mug endommagé $34 propre :
python scripts/parallel_guardrails.py
Examinez le résultat en direct des trois événements de test :
[
  {
    "event_id": "evt-01-injection",
    "gate_verdict": "QUARANTINE_ADVERSARIAL_INPUT",
    "questions_evaluated_in_parallel": 8,
    "latency_ms": 626.34,
    "signals": {
      "prompt_injection_prob": 0.9766,
      "raw_pii_prob": 0.0426,
      "instant_refund_prob": 0.0275,
      "target_queue": "security_trust",
      "selected_mcp_tool": "quarantine_security_event"
    },
    "usage": { "total_input_tokens": 977, "total_output_tokens": 0, "estimated_cost_usd": 9.77e-05 }
  },
  {
    "event_id": "evt-02-pii-leak",
    "gate_verdict": "REDACT_PII_BEFORE_STORAGE",
    "questions_evaluated_in_parallel": 8,
    "latency_ms": 724.48,
    "signals": {
      "prompt_injection_prob": 0.0548,
      "raw_pii_prob": 0.9755,
      "instant_refund_prob": 0.0292,
      "target_queue": "security_trust",
      "selected_mcp_tool": "quarantine_security_event"
    },
    "usage": { "total_input_tokens": 999, "total_output_tokens": 0, "estimated_cost_usd": 9.99e-05 }
  },
  {
    "event_id": "evt-03-clean-refund",
    "gate_verdict": "AUTO_EXECUTE_INSTANT_REFUND",
    "questions_evaluated_in_parallel": 8,
    "latency_ms": 625.68,
    "signals": {
      "prompt_injection_prob": 0.0133,
      "raw_pii_prob": 0.01,
      "instant_refund_prob": 0.9676,
      "target_queue": "billing_ops",
      "selected_mcp_tool": "issue_instant_credit"
    },
    "usage": { "total_input_tokens": 987, "total_output_tokens": 0, "estimated_cost_usd": 9.87e-05 }
  }
]
L'évaluation des huit vérifications coûte environ 0,000099 $ par événement avec 0 jeton de sortie.
6. Exemple 3 : Vérifier des photos et des PDF sans OCR
Normalement, lorsqu'un utilisateur envoie une réclamation avec une pièce jointe (par exemple, une photo d'inspection d'un établissement ou une facture au format PDF), votre backend doit d'abord exécuter un pipeline d'OCR ou de vision distinct pour extraire le texte avant que les règles de routage ne puissent s'exécuter. Comme gemini-decision-1 est nativement multimodal, nous pouvons envoyer à la fois la réclamation écrite et la pièce jointe brute dans un seul appel decisions.create.
Ce que nous allons tester
scripts/multimodal_triage.py teste deux scénarios, chacun associant une courte affirmation écrite à une pièce jointe :
Scénario 1 : Photo d'inspection des locaux (basse résolution vs haute résolution)
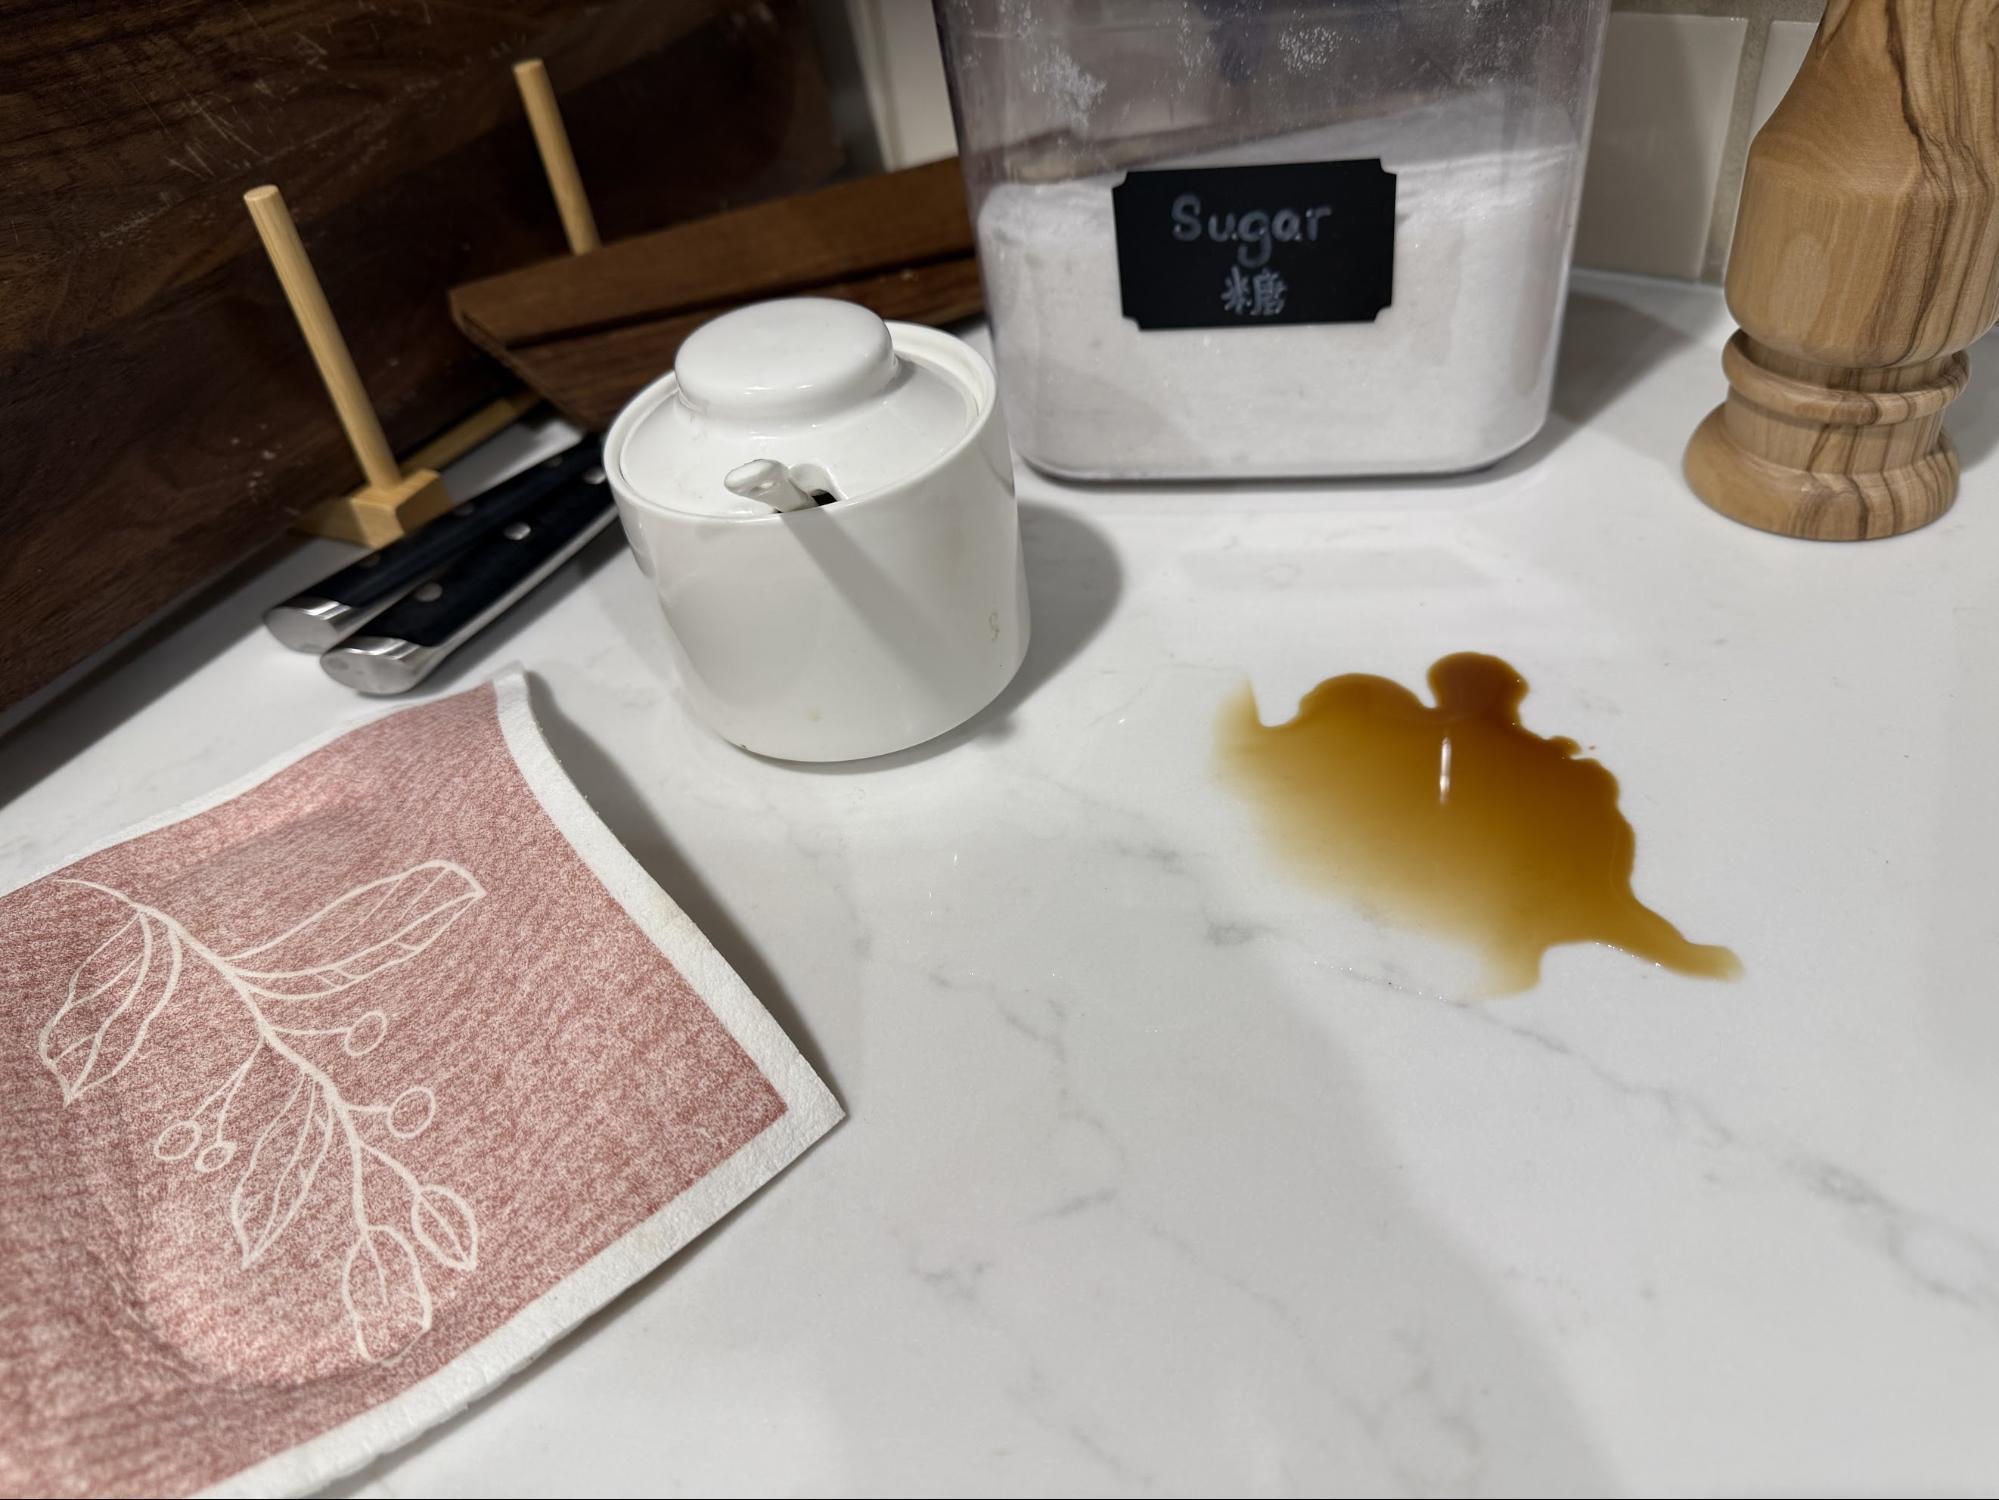
- Réclamation écrite de l'utilisateur : "Vérification du comptoir de la salle de pause avant la réunion client de 9h. Petite tache de café repérée à côté du chiffon."
Photo jointe (03-multimodal-triage/spill.jpg) : montre une petite tache de café sombre sur un comptoir clair, avec un chiffon à motifs juste à côté :
Scénario 2 : Facture PDF facturée en double (octets PDF bruts, sans OCR)
- Réclamation écrite de l'utilisateur : "J'ai été facturé deux fois 45 € (90 € au total) sur la facture INV-8812. Vous trouverez ma facture au format PDF en pièce jointe."
- PDF joint (
03-multimodal-triage/sample_invoice_8812.pdf) : facture d'une page listantLine 1: Pro Plan Monthly Subscription ... $45.00etLine 2: Pro Plan Monthly Subscription [DUPLICATE] $45.00($90.00au total).
Ce que nous attendons
- Photo de déversement (basse résolution vs haute résolution) : les deux exécutions doivent repérer le petit déversement sur le comptoir et donner la même réponse, tandis que la résolution
lowutilise beaucoup moins de jetons d'image. - Facture PDF (sans OCR) : la pièce jointe
sample_invoice_8812.pdfprouve que le client a bien été facturé deux fois. Le modèle doit donc lire le PDF directement et approuver le remboursement.
Examinez le code
Au lieu de transmettre une seule chaîne à input, scripts/multimodal_triage.py transmet une liste de blocs de contenu, en commençant par un bloc text (se terminant par \n), suivi d'un bloc image ou d'un bloc document (application/pdf) :
# For Run 1a & 1b: Pass an image URL and set resolution ("low" vs. "high")
image_block = {
    "type": "image",
    "uri": "https://storage.googleapis.com/generativeai-downloads/images/spill.jpg",
    "mime_type": "image/jpeg",
    "resolution": "low",  # or "high" in Run 1b
}

# For Run 2: Read raw PDF bytes from disk and base64-encode them as a "document" block
# (Note: PDF document blocks do not take a "resolution" setting)
pdf_block = {
    "type": "document",
    "data": base64.b64encode(pdf_bytes).decode("ascii"),
    "mime_type": "application/pdf",
}

result = client.decisions.create(
    model="gemini-decision-1",
    input=[
        {"type": "text", "text": f"Claim Statement: {claim_text}\nAttached Evidence:\n"},
        media_block,  # either image_block or pdf_block
    ],
    questions=MULTIMODAL_QUESTIONS,
)
Pour comparer l'utilisation des jetons entre resolution="low" et resolution="high", le script lit également result.usage.input_tokens_by_modality, qui divise les jetons d'entrée en "text" et "image".
Exécuter le script et vérifier les résultats
python scripts/multimodal_triage.py
Inspectez la sortie JSON en direct pour les trois exécutions :
[
  {
    "experiment": "1a_photo_resolution_low",
    "resolution": "low",
    "evidence_supports_claim_prob": 0.9532,
    "disposition": "local_cleanup_or_self_service",
    "disposition_confidence": 0.9863,
    "severity_expected_0_to_3": 1.0319,
    "tokens_by_modality": { "text": 441, "image": 266 },
    "total_input_tokens": 707,
    "total_output_tokens": 0,
    "estimated_cost_usd": 7.07e-05
  },
  {
    "experiment": "1b_photo_resolution_high",
    "resolution": "high",
    "evidence_supports_claim_prob": 0.9154,
    "disposition": "local_cleanup_or_self_service",
    "disposition_confidence": 0.9825,
    "severity_expected_0_to_3": 1.0471,
    "tokens_by_modality": { "text": 441, "image": 1064 },
    "total_input_tokens": 1505,
    "total_output_tokens": 0,
    "estimated_cost_usd": 0.0001505
  },
  {
    "experiment": "2_pdf_duplicate_invoice_zero_ocr",
    "resolution": null,
    "latency_ms": 676.98,
    "evidence_supports_claim_prob": 0.9578,
    "disposition": "automated_credit_or_replacement",
    "disposition_confidence": 0.9367,
    "severity_expected_0_to_3": 1.9849,
    "tokens_by_modality": { "text": 587, "image": 520 },
    "total_input_tokens": 1107,
    "total_output_tokens": 0,
    "estimated_cost_usd": 0.0001107
  }
]
Deux conclusions rapides à tirer de la sortie :
- La résolution
lowa utilisé quatre fois moins de jetons d'image (266 contre 1 064) : les deux exécutions ont donné exactement la même réponse (local_cleanup_or_self_serviceavec un niveau de confiance supérieur à 98 %). Réservez"high"ou"ultra_high"pour les petits caractères ou les mentions légales. - La facture PDF a approuvé le remboursement sans OCR : avec
sample_invoice_8812.pdfen pièce jointe,evidence_supports_claim_probest passé à0.9578et le modèle a sélectionnéautomated_credit_or_replacementen environ 677 ms.
7. Félicitations
Félicitations ! Vous avez utilisé l'API Gemini Decisions (
gemini-decision-1
) en Python pour acheminer les demandes d'assistance avec des probabilités calibrées, exécuter huit garde-fous indépendants de sécurité et de règles en une seule passe, et vérifier les photos et les factures PDF sans étape d'OCR distincte, le tout avec zéro jeton de sortie.
Lorsque vous serez prêt à aller plus loin, consultez les autres dossiers du dépôt associé, y compris 02-hybrid-gateway/ (déploiement d'un service Cloud Run rapide qui transmet les tickets complexes à gemini-3.8-flash) et 06-adk-workflows/ (combinaison de l'API Decisions avec les workflows Google ADK 2.0).
Documents de référence
- Article de lancement officiel : Making quick work of bounded choices with the Gemini Decisions API
- Documentation pour les développeurs : Guide de l'API Gemini Decisions (Google AI for Developers)
- Playground interactif : Essayez Gemini Decision 1 dans Google AI Studio
- Dépôt d'exemples de code : https://github.com/rominirani/gcp-gemini-decisions-hybrid-gateway