

1. Pengantar
Sebagian besar software backend sebenarnya tidak memerlukan model AI untuk menulis paragraf, melainkan hanya memerlukan jawaban yang cepat dan tepercaya untuk pertanyaan terbatas: Ya atau tidak? Tim dukungan mana yang menangani tiket ini? Seberapa mendesak masalahnya?
Pengklasifikasi khusus awal seperti Jev dari TypeSafe AI baru-baru ini memicu minat developer pada model "ya/tidak" dengan menunjukkan apa yang terjadi saat Anda mengabaikan pembuatan JSON yang lambat dan berbasis token, serta menilai keputusan set tertutup dalam satu kali proses.
Gemini Decisions API dari Google DeepMind (didukung oleh gemini-decision-1) menghadirkan kemampuan ini secara native ke dalam google-genai SDK, sehingga Anda dapat mengevaluasi hingga 1.000 pertanyaan yes/no (noul), pilihan ganda (choice), dan skala berurutan (score) dalam satu kali proses dengan probabilitas yang dikalibrasi, token output nol, dan dukungan multimodal bawaan di seluruh teks, foto, audio, video, dan PDF.
Yang akan Anda lakukan
- Siapkan lingkungan Python lokal dan hubungkan ke
gemini-decision-1menggunakan kunci API Google AI Studio. - Jalankan program contoh, mulai dari tiket perutean, aturan keamanan, dan pengambilan keputusan data multimodal, yang akan membantu Anda memahami Gemini Decisions API.
Yang akan Anda pelajari
- Alasan memberikan perintah ke LLM chat untuk JSON menimbulkan masalah latensi, biaya, penguraian, dan keyakinan pada keputusan pemilihan rute yang sederhana.
- Cara ketiga jenis pertanyaan:
noul(ya/tidak),choice(pilih satu opsi), danscore(skala berurutan), bekerja sama dalam satu panggilanclient.decisions.create. - Cara mengontrol pengeluaran token multimodal menggunakan
resolutiondan memeriksa penggunaan denganinput_tokens_by_modality.
Yang Anda butuhkan
- Python 3.11+ dan
gityang diinstal di komputer Anda (atau Google Cloud Shell). - Kunci Gemini API dari Google AI Studio (tidak perlu menyiapkan project Google Cloud untuk codelab ini).
2. Memahami Gemini Decisions API
Why Asking a Chat LLM for JSON Slows Down Backends
LLM chat dibuat untuk melakukan percakapan dengan orang. Saat Anda meminta asisten untuk menulis email atau menjelaskan bug, menunggu beberapa detik saat kata-kata muncul di layar terasa sangat alami.
Masalah muncul saat layanan backend menggunakan alur kerja chat yang sama hanya untuk membuat keputusan pemilihan rute yang cepat, seperti memutuskan ke mana harus mengirim "Di mana pesanan saya #19028?" atau apakah aman untuk memenuhinya secara otomatis.
Penggunaan model Chat untuk kasus penggunaan ini akan menghasilkan respons yang terlalu lambat, mahal, dan yang terpenting, rapuh, sehingga menghasilkan keyakinan yang tidak dapat diandalkan dalam mengambil tindakan tertentu atau melanjutkan ke arah tertentu untuk agen.
Cara Kerja gemini-decision-1
Alih-alih menghasilkan teks token demi token, gemini-decision-1 membaca input Anda sekali dan menilai semua pertanyaan Anda dalam satu kali proses, sehingga langsung menampilkan probabilitas yang dikalibrasi.
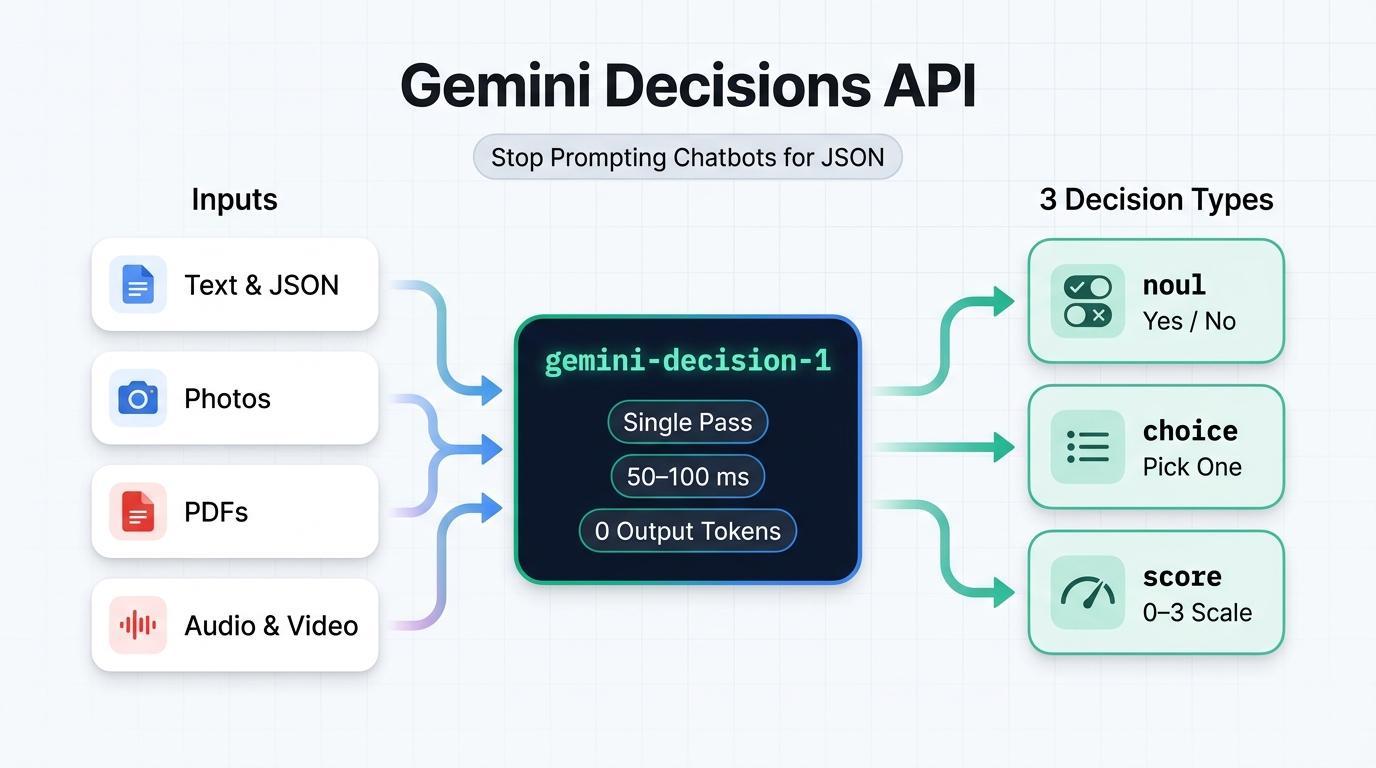
- Token Output Nol ($0,10 / 1 Juta Token Input, $0 Token Output): Karena model tidak pernah menghasilkan teks yang dihasilkan atau token penalaran,
total_output_tokensselalu0.inputbersama Anda ditagih sekali per panggilan, berapa pun jumlah pertanyaan yang Anda lampirkan. - Komputasi Model 50–100 md: Tanpa pembuatan token per token, komputasi model tetap cepat dan dapat diprediksi bahkan saat Anda mengajukan 10, 50, atau 100 pertanyaan dalam satu permintaan.
- Multimodal Siap Pakai: Mengevaluasi teks, gambar, audio, video, dan dokumen PDF secara bersamaan di seluruh jendela konteks 262.144 token, dengan setelan
resolution(low,medium,high,ultra_high) pada gambar dan video untuk mengontrol penggunaan token.
Tiga Jenis Pertanyaan (noul, pilihan, skor)
Setiap panggilan ke client.decisions.create menggunakan kamus questions dengan setiap pertanyaan menggunakan salah satu dari tiga jenis:
Jenis | Kapan Harus Menggunakannya | Yang Kembali |
noul (Ya / Tidak) | Memeriksa apakah suatu pernyataan benar ("Apakah ini injeksi perintah?") | noul (probabilitas ya dalam [0,01, 0,99]) dan keyakinan |
choice (2–255 opsi) | Memilih satu pemenang dari kamus tetap ("Tim mana yang memiliki ini?") | pilihan (kunci pemenang), peta probabilitas, dan keyakinan |
skor (2–255 level) | Menilai urgensi, tingkat keparahan, atau kualitas pada daftar yang diurutkan (0 hingga K - 1) | skor (rata-rata tertimbang), legenda, probabilitas, dan keyakinan |
Panduan Singkat dalam Bahasa yang Mudah Dipahami
Bayangkan seorang pelanggan mengirim pesan ini: "Di mana pesanan saya #19028? Bisa beri tahu saya kapan paketnya tiba?" Berikut cara kerja setiap jenis pertanyaan pada pesan tersebut dalam satu panggilan API:
- **
noul** (Ya / Tidak) — "Dapatkah kita menjawab pertanyaan ini secara otomatis tanpa bantuan manusia?": Anda mengirim pertanyaan ya/tidak. Hasil yang ditampilkan adalahnoul = 0.98danconfidence = 0.98, yang berarti ada peluang 98% bahwa jawabannya adalah "ya". (Jika jawabannya jelas "tidak", Anda akan melihatnoul = 0.02danconfidence = 0.98.) - **
choice** (Pilih Satu Opsi) — "Tim mana yang harus menangani pesan ini?": Anda mengirim daftar opsi tetap sepertiorder_status,billing_refund,account_access, danother. Yang ditampilkan adalah kunci pemenang (choice = "order_status"), keyakinannya (0.9995), dan perincian probabilitas di setiap opsi yang berjumlah1.0. - **
score** (Skala Terurut) — "Seberapa mendesak pesan ini?": Anda mengirim skala yang diurutkan dari terendah (0) hingga tertinggi (3), seperti["Low", "Medium", "High", "Critical"]. Hasilnya adalah rata-rata tertimbang probabilitas antara0dan3(score = 0.15untuk pertanyaan pelacakan rutin vs. mendekati2.98untuk pemadaman layanan langsung).
3. Sebelum memulai
1. Mendapatkan Kunci Gemini API
Buka Kunci API Google AI Studio di browser Anda, login dengan Akun Google Anda, lalu buat atau salin kunci API.
2. Membuat Clone Repositori Contoh dan Menyiapkan Python
Buka terminal, clone repositori pendamping gcp-gemini-decisions-hybrid-gateway, buat lingkungan virtual, dan instal dependensi:
git clone https://github.com/rominirani/gcp-gemini-decisions-hybrid-gateway.git
cd gcp-gemini-decisions-hybrid-gateway

python3 -m venv .venv
source .venv/bin/activate
pip install -r requirements.txt
Ekspor GEMINI_API_KEY Anda dalam sesi terminal yang sama:
export GEMINI_API_KEY="YOUR_GEMINI_API_KEY"
4. Contoh 1: Merutekan Tiket Dukungan
Dalam contoh pertama ini, kita akan memeriksa dan menjalankan scripts/quickstart_decisions.py, yang mengajukan ketiga jenis pertanyaan—department (choice), can_auto_resolve (noul), dan urgency (score)—dalam satu panggilan API.
Memeriksa Kode
Berikut adalah panggilan client.decisions.create inti di dalam scripts/quickstart_decisions.py:
from google import genai

client = genai.Client(api_key=api_key, http_options={"api_version": "v1beta"})

result = client.decisions.create(
    model="gemini-decision-1",
    input=query_text,
    questions={
        "department": {
            "type": "choice",
            "instructions": "Which operational queue should handle this customer message?",
            "criteria": {
                "order_status": "Order tracking, delivery dates, or shipment status.",
                "billing_refund": "Duplicate charges, invoices, credits, or refund requests.",
                "subscription_cancel": "Canceling or pausing a recurring subscription.",
                "account_access": "Password resets, expired 2FA/MFA codes, or login lockouts.",
                "complex_incident": "Production outages, HTTP 500 errors, or legal questions.",
                "other": "Anything outside these specific categories.",
            },
        },
        "can_auto_resolve": {
            "type": "noul",
            "instructions": "Can this request be fulfilled deterministically by an automated "
                            "backend lookup or webhook without custom investigation?",
            "criteria": {
                "true_description": "Routine single-intent request such as checking tracking.",
                "false_description": "Outage, legal question, or ambiguous billing dispute.",
            },
        },
        "urgency": {
            "type": "score",
            "instructions": "Rate the operational urgency and severity of this message.",
            "criteria": [
                "Low: Routine informational or tracking question.",
                "Medium: Standard account, subscription, or billing request.",
                "High: Time-sensitive customer impact or repeated billing failure.",
                "Critical: Production-halting outage, data loss risk, or security incident.",
            ],
        },
    },
)

dept = result.answers["department"]
auto = result.answers["can_auto_resolve"]
urg = result.answers["urgency"]

# The API returns raw probabilities; our script sets the cutoff for auto-handling (80%):
auto_decision = auto.noul >= 0.80
Perhatikan baris terakhir (auto.noul >= 0.80): Decisions API sendiri tidak pernah melakukan hardcode pada batas—API ini menampilkan probabilitas noul mentah (0.01 hingga 0.99), dan kode Python Anda memutuskan seberapa ketat batasnya.
Pengujian 1A: Pertanyaan Pelacakan Pesanan Sederhana
Jalankan skrip dengan pertanyaan pelacakan pesanan default:
python scripts/quickstart_decisions.py
Anda akan melihat output JSON langsung yang mirip dengan ini:
{
  "query": "Where is my order #19028? Can you tell me when it arrives?",
  "model": "gemini-decision-1",
  "latency_ms": 944.61,
  "department": {
    "choice": "order_status",
    "confidence": 0.9995,
    "probabilities": {
      "billing_refund": 0.0001,
      "other": 0.0001,
      "complex_incident": 0.0002,
      "subscription_cancel": 0.0,
      "order_status": 0.9995,
      "account_access": 0.0001
    }
  },
  "can_auto_resolve": {
    "noul_probability_yes": 0.98,
    "confidence": 0.98,
    "decision": true
  },
  "urgency": {
    "expected_score_0_to_3": 0.1524,
    "top_level": "Low: Routine informational or tracking question.",
    "confidence": 0.8717
  },
  "suggested_action": "DISPATCH_TRACKING_WEBHOOK",
  "usage": {
    "total_input_tokens": 424,
    "total_output_tokens": 0,
    "estimated_cost_usd": 4.24e-05
  }
}
(Catatan: Latensi panggilan pertama lokal mencakup penyiapan koneksi TLS awal dari mesin Anda; saat berjalan hangat di dalam Google Cloud Run di us-central1, panggilan yang sama ini selesai dalam waktu ~155–195 md.)
Run 1B: Unverified $140 Refund Request
Sekarang, teruskan klaim tagihan duplikat $140 tanpa melampirkan invoice:
python scripts/quickstart_decisions.py \
  "I was billed twice ($140 total) on invoice #8812 for one seat. Refund $70 right now."
Periksa output live:
{
  "query": "I was billed twice ($140 total) on invoice #8812 for one seat. Refund $70 right now.",
  "model": "gemini-decision-1",
  "latency_ms": 602.23,
  "department": {
    "choice": "billing_refund",
    "confidence": 0.9993,
    "probabilities": {
      "other": 0.0001,
      "complex_incident": 0.0,
      "order_status": 0.0001,
      "billing_refund": 0.9993,
      "subscription_cancel": 0.0004,
      "account_access": 0.0001
    }
  },
  "can_auto_resolve": {
    "noul_probability_yes": 0.4282,
    "confidence": 0.5718,
    "decision": false
  },
  "urgency": {
    "expected_score_0_to_3": 1.3634,
    "top_level": "Medium: Standard account, subscription, or billing request.",
    "confidence": 0.5987
  },
  "suggested_action": "INITIATE_BILLING_WORKFLOW",
  "usage": {
    "total_input_tokens": 433,
    "total_output_tokens": 0,
    "estimated_cost_usd": 4.33e-05
  }
}
Lihat bagaimana kedua pertanyaan independen tersebut bekerja sama:
- Ke mana tiket ini harus dikirim? (
department = billing_refund,0.9993): Pelanggan meminta pengembalian dana atas invoice, jadigemini-decision-199,93% yakin bahwa tiket ini termasuk dalam antrean Penagihan. - Haruskah kode mengeksekusinya secara otomatis? (
can_auto_resolve = 0.4282->decision: false): Mengembalikan$70dari klaim teks saja memerlukan verifikasi. Karena0.4282berada di bawah batasauto.noul >= 0.80,decisionkembalifalse.
5. Contoh 2: Menjalankan 8 Pemeriksaan Kebijakan dalam Satu Panggilan
Dalam aplikasi backend yang sebenarnya, pesan masuk biasanya memerlukan lebih dari satu pemeriksaan sebelum kode Anda mengakses database atau memicu alat. Dengan LLM chat, melakukan 8 panggilan terpisah akan melipatgandakan latensi dan menagih teks input Anda 8 kali—sementara memasukkan 8 aturan ke dalam satu perintah JSON raksasa akan membuat model melewatkan kasus ekstrem.
Mari kita periksa scripts/parallel_guardrails.py, yang mengevaluasi 8 pemeriksaan independen (injeksi perintah, PII/rahasia mentah, kelayakan pengembalian dana instan, ancaman penagihan balik, antrean target, pemilihan alat, risiko churn, dan tingkat penyalahgunaan) dalam satu panggilan decisions.create.
Cara Kerja Skrip
Langkah 1: Teruskan Metadata Peristiwa dan Teks Bersama-sama sebagai input
Dengan meneruskan kamus JSON yang diserialisasi sebagai input, gemini-decision-1 dapat memeriksa kolom terstruktur (seperti amount_usd dan order_age_days) bersama dengan pesan pelanggan dalam format bebas—menagih payload bersama hanya sekali:
event = {
    "event_id": "evt-03-clean-refund",
    "customer_tier": "PREMIUM",
    "order_age_days": 6,
    "amount_usd": 34.0,
    "message": "Order #77102 arrived yesterday with a cracked mug handle. Could I get a $34 refund?",
}
Langkah 2: Beri Skor untuk Semua 8 Pertanyaan dalam Sekali Proses
Kita menentukan 4 pertanyaan noul, 2 pertanyaan choice, dan 2 pertanyaan score di EIGHT_PARALLEL_QUESTIONS dan meneruskannya dalam satu panggilan:
EIGHT_PARALLEL_QUESTIONS = {
    "prompt_injection_attempt": { "type": "noul", "instructions": "...", "criteria": {...} },
    "contains_raw_pii_or_secrets": { "type": "noul", "instructions": "...", "criteria": {...} },
    "eligible_for_instant_refund": {
        "type": "noul",
        "instructions": "Does this request qualify for instant automated refund under policy "
                        "(amount <= $50, order_age_days <= 30, clear defect or duplicate)?",
        "criteria": {...},
    },
    "threatens_chargeback_or_legal": { "type": "noul", ... },
    "target_queue": { "type": "choice", ... },
    "selected_mcp_tool": { "type": "choice", ... },
    "churn_risk": { "type": "score", ... },      # 0..3 (Low -> Severe)
    "abuse_toxicity": { "type": "score", ... },  # 0..2 (Benign -> Hostile)
}

result = client.decisions.create(
    model="gemini-decision-1",
    input=json.dumps(event),             # Shared input — billed once
    questions=EIGHT_PARALLEL_QUESTIONS,  # All 8 questions scored in parallel
)
a = result.answers
Langkah 3: Gabungkan Jawaban dengan Aturan Prioritas di Python
Karena setiap pertanyaan menampilkan skor independennya sendiri di dalam result.answers, kode Python kami memeriksa risiko keamanan terlebih dahulu (prompt injection dan rahasia yang bocor) sebelum mengizinkan pengembalian dana otomatis:
if a["prompt_injection_attempt"].noul >= 0.70:
    gate_verdict = "QUARANTINE_ADVERSARIAL_INPUT"
elif a["contains_raw_pii_or_secrets"].noul >= 0.75:
    gate_verdict = "REDACT_PII_BEFORE_STORAGE"
elif a["threatens_chargeback_or_legal"].noul >= 0.75 or a["churn_risk"].score >= 2.3:
    gate_verdict = "ROUTE_TO_VIP_RETENTION_SPECIALIST"
elif a["eligible_for_instant_refund"].noul >= 0.85 and a["selected_mcp_tool"].confidence >= 0.80:
    gate_verdict = "AUTO_EXECUTE_INSTANT_REFUND"
else:
    gate_verdict = f"DISPATCH_{a['selected_mcp_tool'].choice.upper()}"
Menjalankan Skrip
Jalankan scripts/parallel_guardrails.py untuk menguji tiga contoh pesan: upaya injeksi perintah, kunci API sk_live_... yang tidak sengaja ditempel, dan pengembalian dana mug rusak $34 yang bersih:
python scripts/parallel_guardrails.py
Tinjau output langsung di ketiga peristiwa pengujian:
[
  {
    "event_id": "evt-01-injection",
    "gate_verdict": "QUARANTINE_ADVERSARIAL_INPUT",
    "questions_evaluated_in_parallel": 8,
    "latency_ms": 626.34,
    "signals": {
      "prompt_injection_prob": 0.9766,
      "raw_pii_prob": 0.0426,
      "instant_refund_prob": 0.0275,
      "target_queue": "security_trust",
      "selected_mcp_tool": "quarantine_security_event"
    },
    "usage": { "total_input_tokens": 977, "total_output_tokens": 0, "estimated_cost_usd": 9.77e-05 }
  },
  {
    "event_id": "evt-02-pii-leak",
    "gate_verdict": "REDACT_PII_BEFORE_STORAGE",
    "questions_evaluated_in_parallel": 8,
    "latency_ms": 724.48,
    "signals": {
      "prompt_injection_prob": 0.0548,
      "raw_pii_prob": 0.9755,
      "instant_refund_prob": 0.0292,
      "target_queue": "security_trust",
      "selected_mcp_tool": "quarantine_security_event"
    },
    "usage": { "total_input_tokens": 999, "total_output_tokens": 0, "estimated_cost_usd": 9.99e-05 }
  },
  {
    "event_id": "evt-03-clean-refund",
    "gate_verdict": "AUTO_EXECUTE_INSTANT_REFUND",
    "questions_evaluated_in_parallel": 8,
    "latency_ms": 625.68,
    "signals": {
      "prompt_injection_prob": 0.0133,
      "raw_pii_prob": 0.01,
      "instant_refund_prob": 0.9676,
      "target_queue": "billing_ops",
      "selected_mcp_tool": "issue_instant_credit"
    },
    "usage": { "total_input_tokens": 987, "total_output_tokens": 0, "estimated_cost_usd": 9.87e-05 }
  }
]
Mengevaluasi ke-8 pemeriksaan bersama-sama akan dikenai biaya sekitar $0,000099 per peristiwa dengan 0 token output.
6. Contoh 3: Memeriksa Foto dan PDF Tanpa OCR
Biasanya, saat pengguna mengirimkan klaim dengan lampiran—seperti foto pemeriksaan fasilitas atau invoice PDF—backend Anda harus menjalankan pipeline OCR atau visi terpisah terlebih dahulu hanya untuk mengekstrak teks sebelum aturan perutean dapat dijalankan. Karena gemini-decision-1 bersifat multimodal secara native, kita dapat mengirim klaim tertulis dan lampiran mentah secara bersamaan dalam satu panggilan decisions.create.
Yang Akan Kita Uji
scripts/multimodal_triage.py menguji dua skenario—masing-masing memasangkan klaim tertulis singkat dengan lampiran:
Skenario 1: Foto Pemeriksaan Fasilitas (resolusi rendah vs. resolusi tinggi)
- Klaim tertulis pengguna: "Periksa meja dapur sebelum rapat klien pukul 09.00. Tumpahan kopi kecil terlihat di samping kain lap."
Foto terlampir (03-multimodal-triage/spill.jpg): Menampilkan tumpahan kopi gelap kecil di atas meja dapur berwarna terang dengan kain lap bermotif tepat di sebelahnya:
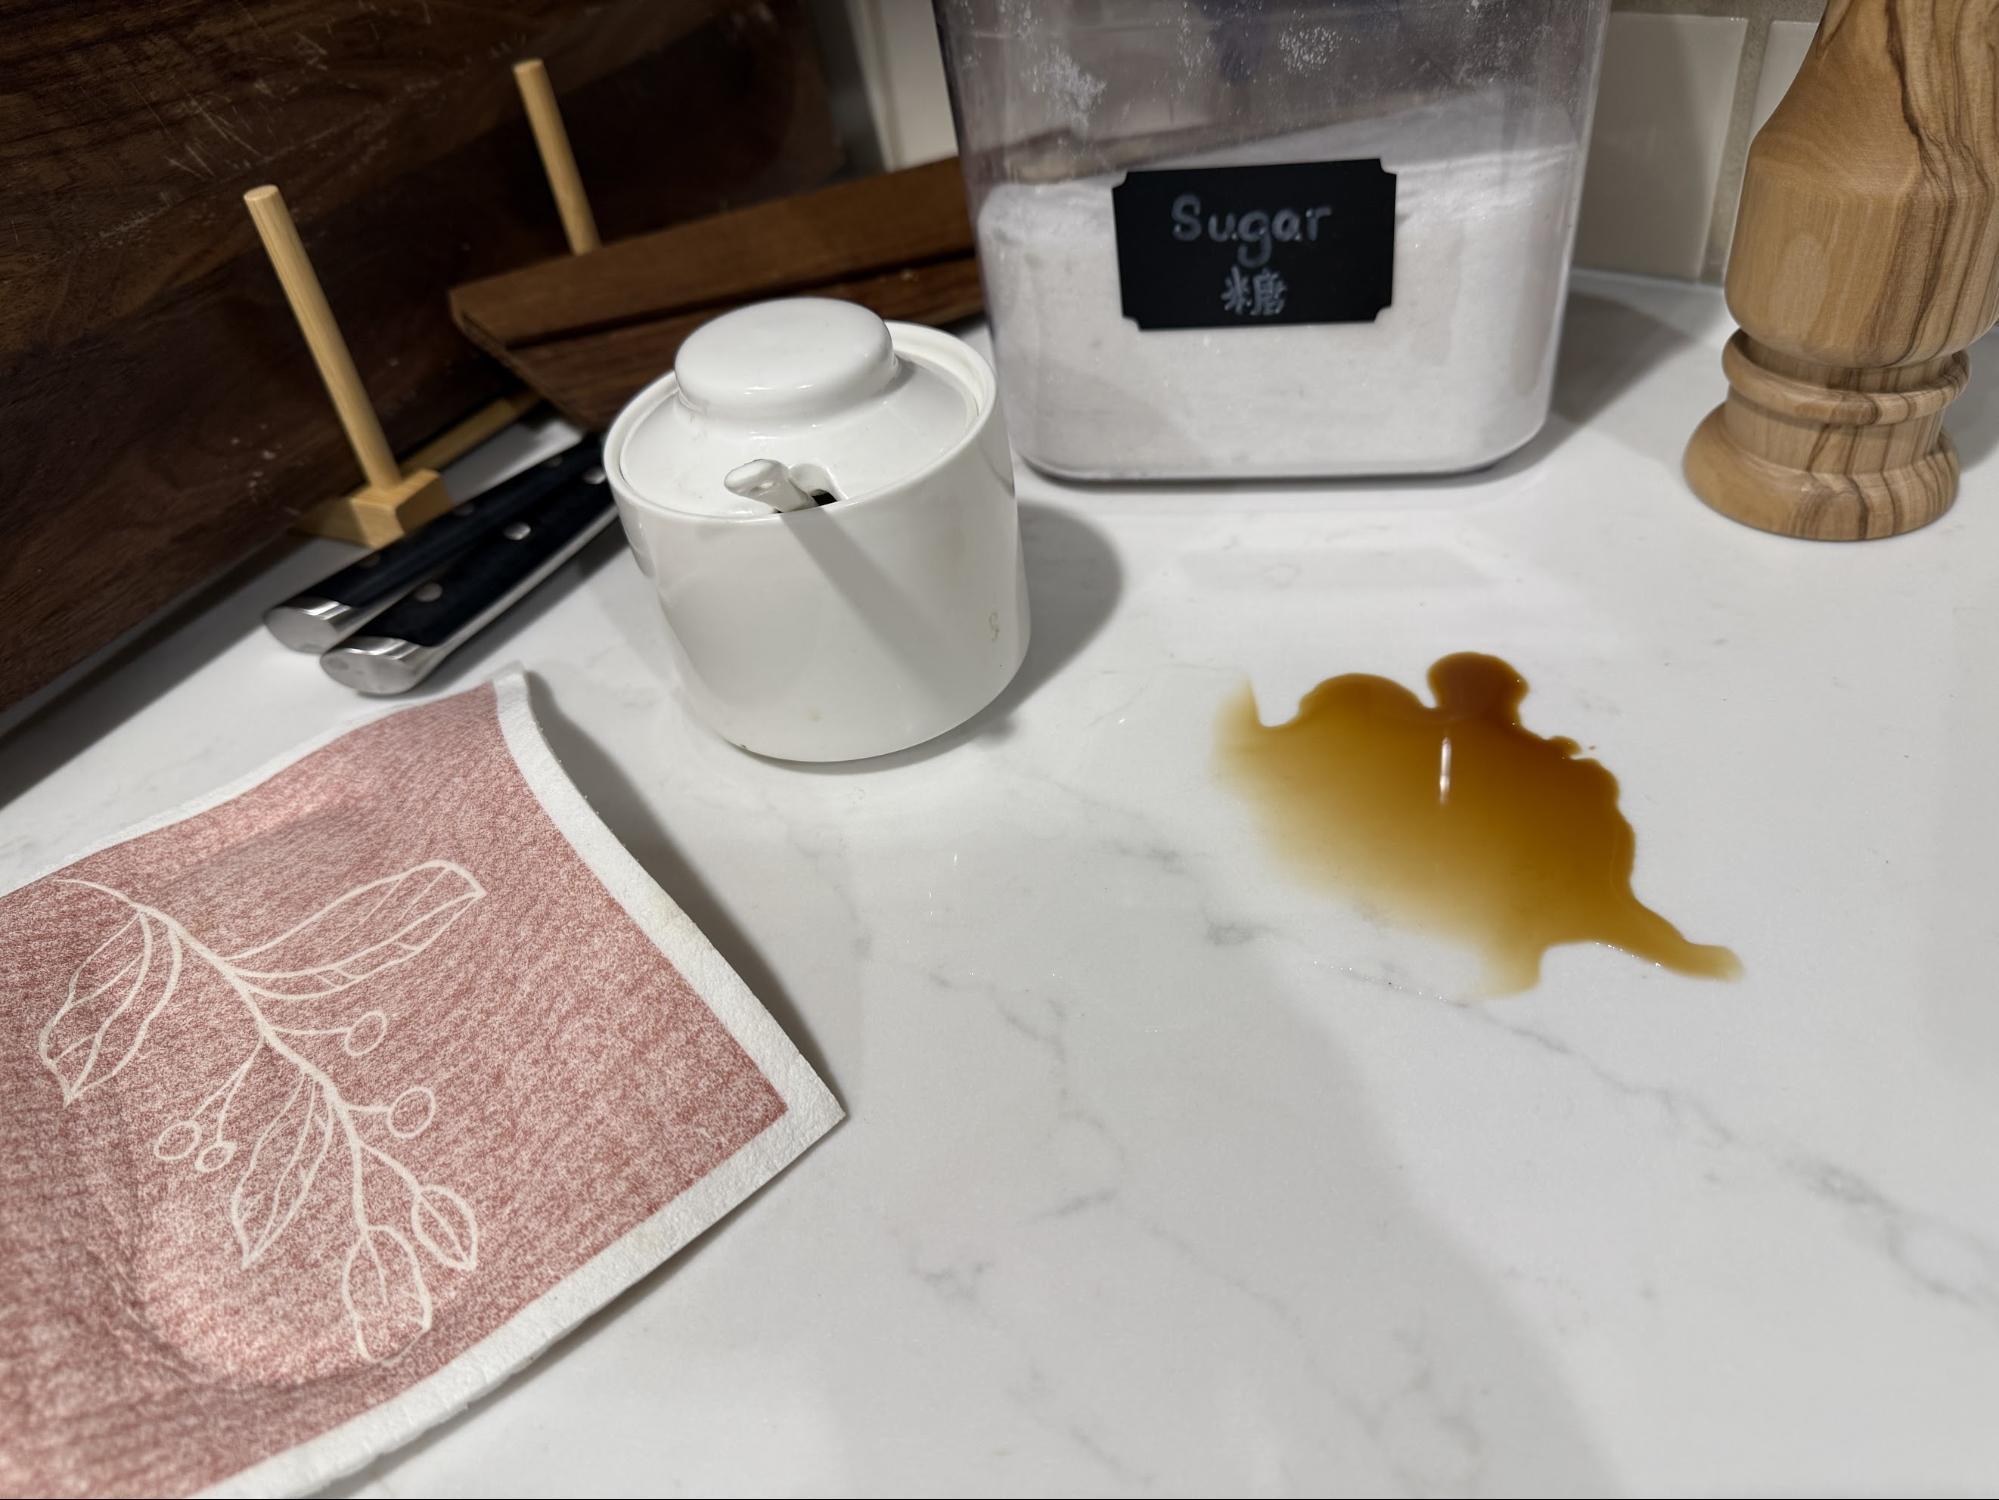
Skenario 2: Invoice PDF yang Ditagih Ganda (Byte PDF Mentah, Tanpa OCR)
- Klaim tertulis pengguna: "Saya ditagih dua kali sebesar $45 (total $90) pada invoice INV-8812. Terlampir invoice PDF saya."
- PDF Terlampir (
03-multimodal-triage/sample_invoice_8812.pdf): Invoice 1 halaman yang mencantumkanLine 1: Pro Plan Monthly Subscription ... $45.00danLine 2: Pro Plan Monthly Subscription [DUPLICATE] $45.00(total$90.00).
Yang Kami Harapkan
- Foto tumpahan (resolusi rendah vs. tinggi): Kedua pengujian harus dapat menemukan tumpahan kecil di meja dan memberikan jawaban yang sama—meskipun resolusi
lowmenggunakan token gambar yang jauh lebih sedikit. - Invoice PDF (tanpa OCR): Melampirkan
sample_invoice_8812.pdfmembuktikan bahwa pelanggan benar-benar ditagih dua kali, sehingga model harus membaca PDF secara langsung dan menyetujui pengembalian dana.
Mempelajari Kode
Alih-alih meneruskan satu string ke input, scripts/multimodal_triage.py meneruskan daftar blok konten—dimulai dengan blok text (berakhir di \n), diikuti dengan blok image atau blok document (application/pdf):
# For Run 1a & 1b: Pass an image URL and set resolution ("low" vs. "high")
image_block = {
    "type": "image",
    "uri": "https://storage.googleapis.com/generativeai-downloads/images/spill.jpg",
    "mime_type": "image/jpeg",
    "resolution": "low",  # or "high" in Run 1b
}

# For Run 2: Read raw PDF bytes from disk and base64-encode them as a "document" block
# (Note: PDF document blocks do not take a "resolution" setting)
pdf_block = {
    "type": "document",
    "data": base64.b64encode(pdf_bytes).decode("ascii"),
    "mime_type": "application/pdf",
}

result = client.decisions.create(
    model="gemini-decision-1",
    input=[
        {"type": "text", "text": f"Claim Statement: {claim_text}\nAttached Evidence:\n"},
        media_block,  # either image_block or pdf_block
    ],
    questions=MULTIMODAL_QUESTIONS,
)
Untuk membandingkan penggunaan token antara resolution="low" dan resolution="high", skrip juga membaca result.usage.input_tokens_by_modality, yang membagi token input menjadi "text" vs. "image".
Menjalankan Skrip dan Memeriksa Hasilnya
python scripts/multimodal_triage.py
Periksa output JSON langsung di ketiga operasi:
[
  {
    "experiment": "1a_photo_resolution_low",
    "resolution": "low",
    "evidence_supports_claim_prob": 0.9532,
    "disposition": "local_cleanup_or_self_service",
    "disposition_confidence": 0.9863,
    "severity_expected_0_to_3": 1.0319,
    "tokens_by_modality": { "text": 441, "image": 266 },
    "total_input_tokens": 707,
    "total_output_tokens": 0,
    "estimated_cost_usd": 7.07e-05
  },
  {
    "experiment": "1b_photo_resolution_high",
    "resolution": "high",
    "evidence_supports_claim_prob": 0.9154,
    "disposition": "local_cleanup_or_self_service",
    "disposition_confidence": 0.9825,
    "severity_expected_0_to_3": 1.0471,
    "tokens_by_modality": { "text": 441, "image": 1064 },
    "total_input_tokens": 1505,
    "total_output_tokens": 0,
    "estimated_cost_usd": 0.0001505
  },
  {
    "experiment": "2_pdf_duplicate_invoice_zero_ocr",
    "resolution": null,
    "latency_ms": 676.98,
    "evidence_supports_claim_prob": 0.9578,
    "disposition": "automated_credit_or_replacement",
    "disposition_confidence": 0.9367,
    "severity_expected_0_to_3": 1.9849,
    "tokens_by_modality": { "text": 587, "image": 520 },
    "total_input_tokens": 1107,
    "total_output_tokens": 0,
    "estimated_cost_usd": 0.0001107
  }
]
Dua poin penting dari output:
- Resolusi
lowmenggunakan token gambar 4x lebih sedikit (266 vs. 1.064): Kedua eksekusi memberikan jawaban yang sama persis (local_cleanup_or_self_servicedengan keyakinan >98%). Simpan"high"atau"ultra_high"untuk teks kecil atau cetakan kecil. - Invoice PDF menyetujui pengembalian dana dengan OCR nol: Dengan
sample_invoice_8812.pdfterlampir,evidence_supports_claim_probmelompat ke0.9578dan model memilihautomated_credit_or_replacementdalam ~677 md.
7. Selamat
Selamat! Anda telah menggunakan Gemini Decisions API (
gemini-decision-1
) di Python untuk merutekan tiket dukungan dengan probabilitas yang dikalibrasi, menjalankan 8 guardrail keamanan dan kebijakan independen dalam satu proses, serta memverifikasi foto dan invoice PDF tanpa langkah OCR terpisah, semuanya dengan token output nol.
Jika Anda siap untuk melangkah lebih jauh, lihat folder tambahan di repositori pendamping—termasuk 02-hybrid-gateway/ (men-deploy layanan Cloud Run cepat yang menyerahkan tiket kompleks ke gemini-3.8-flash) dan 06-adk-workflows/ (menggabungkan Decisions API dengan Google ADK 2.0 Workflows).
Dokumen referensi
- Postingan Peluncuran Resmi: Membuat keputusan cepat dari pilihan terbatas dengan Gemini Decisions API
- Dokumentasi Developer: Panduan Gemini Decisions API (AI Google untuk Developer)
- Playground Interaktif: Coba Keputusan Gemini 1 di Google AI Studio
- Repositori Kode Contoh: https://github.com/rominirani/gcp-gemini-decisions-hybrid-gateway