

1. Introduzione
La maggior parte dei software di backend non ha bisogno di un modello di AI per scrivere paragrafi, ma solo di una risposta rapida e affidabile a una domanda limitata: Sì o no? Quale team di assistenza è responsabile di questo ticket? Quanto è urgente?
I primi classificatori dedicati, come Jev di TypeSafe AI, hanno recentemente suscitato l'interesse degli sviluppatori per i modelli "sì/no", mostrando cosa succede quando si abbandona la lenta generazione di JSON token per token e si valutano le decisioni a set chiuso in un unico passaggio.
L'API Gemini Decisions di Google DeepMind (basata su gemini-decision-1) porta questa funzionalità in modo nativo nell'SDK google-genai, consentendoti di valutare fino a 1000 domande yes/no (noul), a scelta multipla (choice) e con scala ordinata (score) in un unico passaggio con probabilità calibrate, zero token di output e supporto multimodale integrato per testo, foto, audio, video e PDF.
Attività previste
- Configura un ambiente Python locale e connettiti a
gemini-decision-1utilizzando una chiave API di Google AI Studio. - Esegui programmi di esempio che vanno dal routing dei ticket alle regole di sicurezza e al processo decisionale basato su dati multimodali, che ti aiuteranno a comprendere l'API Gemini Decisions.
Cosa imparerai a fare
- Perché l'utilizzo di prompt per un LLM di chat per JSON crea problemi di latenza, costi, analisi e affidabilità su semplici decisioni di routing.
- Come i tre tipi di domande:
noul(sì/no),choice(scegli un'opzione) escore(scala ordinata), interagiscono in una singola chiamataclient.decisions.create. - Come controllare la spesa per i token multimodali utilizzando
resolutione ispezionare l'utilizzo coninput_tokens_by_modality.
Che cosa ti serve
- Python 3.11+ e
gitinstallati sulla tua macchina (o su Google Cloud Shell). - Una chiave API Gemini di Google AI Studio (per questo codelab non è necessaria la configurazione di un progetto Google Cloud).
2. Informazioni sull'API Gemini Decisions
Why Asking a Chat LLM for JSON Slows Down Backends
Gli LLM di chat sono stati creati per conversare con le persone. Quando chiedi a un assistente di scrivere un'email o di spiegare un bug, aspettare qualche secondo mentre le parole scorrono sullo schermo sembra del tutto naturale.
I problemi iniziano quando i servizi di backend utilizzano lo stesso workflow di chat solo per prendere una rapida decisione di routing, ad esempio decidere dove inviare "Dov'è il mio ordine n. 19028?" o se è sicuro evaderlo automaticamente.
L'utilizzo di modelli di chat per questi casi d'uso comporta risposte troppo lente, costose e, soprattutto, fragili, il che si traduce in una fiducia inaffidabile nell'intraprendere una determinata azione o nel procedere in una direzione specifica per gli agenti.
Come funziona gemini-decision-1
Anziché generare testo token per token, gemini-decision-1 legge l'input una volta e valuta tutte le domande in un unico passaggio, restituendo direttamente le probabilità calibrate.
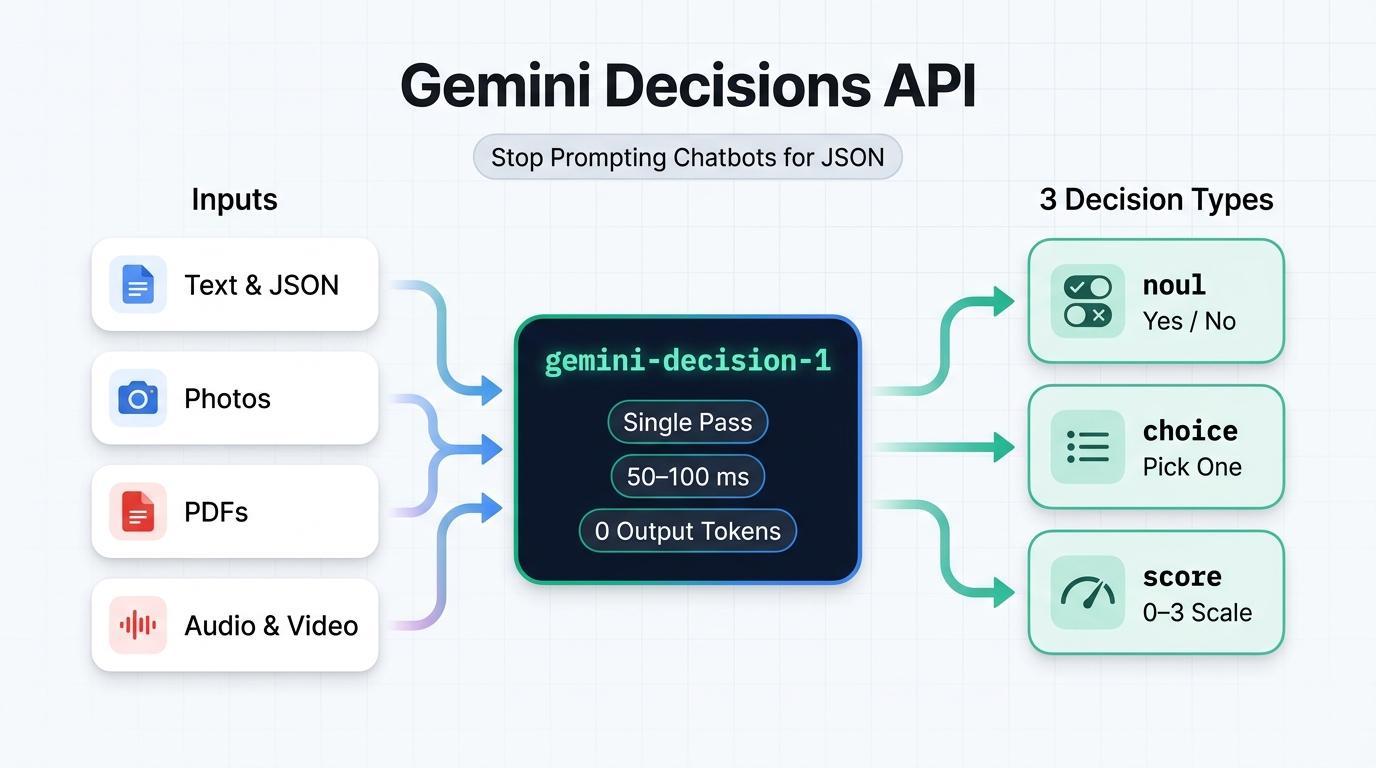
- Zero token di output (0,10 $ / 1 milione di token di input, 0 $ di token di output): poiché il modello non genera mai token di testo o di ragionamento,
total_output_tokensè sempre0. Il tuoinputcondiviso viene fatturato una volta per chiamata, indipendentemente dal numero di domande allegate. - Calcolo del modello in 50-100 ms: senza la generazione token per token, il calcolo del modello rimane rapido e prevedibile anche quando poni 10, 50 o 100 domande in un'unica richiesta.
- Multimodalità integrata: valuta testo, immagini, audio, video e documenti PDF insieme in una finestra di contesto di 262.144 token, con un'impostazione
resolution(low,medium,high,ultra_high) su immagini e video per controllare la spesa dei token.
I tre tipi di domande (noul, choice, score)
Ogni chiamata a client.decisions.create accetta un dizionario questions in cui ogni domanda utilizza uno dei tre tipi:
Tipo | Quando utilizzarle | What Comes Back |
noul (Yes / No) | Verificare se un'affermazione è vera ("Si tratta di un prompt injection?") | noul (probabilità di sì in [0,01, 0,99]) e confidenza |
choice (2–255 options) | Scegli un vincitore da un dizionario fisso ("Quale team possiede questo?") | scelta (chiave vincente), mappa delle probabilità e confidenza |
punteggio (2-255 livelli) | Valutare l'urgenza, la gravità o la qualità in un elenco ordinato (da 0 a K - 1) | punteggio (media ponderata), legenda, probabilità e confidenza |
A Quick Plain-English Walkthrough
Immagina che un cliente invii questo messaggio: "Dov'è il mio ordine n. 19028? Puoi dirmi quando arriva?" Ecco come funziona ogni tipo di domanda su quel messaggio in una singola chiamata API:
- **
noul** (Sì/No) - "Possiamo rispondere automaticamente senza l'intervento di un essere umano?": Invii una domanda con risposta sì/no. Vengono restituitinoul = 0.98econfidence = 0.98, il che significa che esiste una probabilità del 98% che la risposta sia "sì". (Se la risposta fosse chiaramente "no", vedrestinoul = 0.02econfidence = 0.98.) - **
choice** (Scegli un'opzione) - "Quale team deve gestire questo messaggio?": Invia un elenco fisso di opzioni comeorder_status,billing_refund,account_accesseother. Viene restituita la chiave vincente (choice = "order_status"), la sua confidenza (0.9995) e una suddivisione della probabilità tra tutte le opzioni che sommate danno1.0. - **
score** (Ordered Scale) — "How urgent is this message?": Invia una scala ordinata dal valore più basso (0) a quello più alto (3), ad esempio["Low", "Medium", "High", "Critical"]. Il risultato è una media ponderata in base alla probabilità tra0e3(score = 0.15per una domanda di monitoraggio di routine rispetto a quasi2.98per un'interruzione in tempo reale).
3. Prima di iniziare
1. Ottieni una chiave API Gemini
Apri le chiavi API di Google AI Studio nel browser, accedi con il tuo Account Google e crea o copia una chiave API.
2. Clona il repository di esempio e configura Python
Apri un terminale, clona il repository associato gcp-gemini-decisions-hybrid-gateway, crea un ambiente virtuale e installa le dipendenze:
git clone https://github.com/rominirani/gcp-gemini-decisions-hybrid-gateway.git
cd gcp-gemini-decisions-hybrid-gateway

python3 -m venv .venv
source .venv/bin/activate
pip install -r requirements.txt
Esporta il tuo GEMINI_API_KEY nella stessa sessione del terminale:
export GEMINI_API_KEY="YOUR_GEMINI_API_KEY"
4. Esempio 1: routing dei ticket di assistenza
In questo primo esempio, esamineremo ed eseguiremo scripts/quickstart_decisions.py, che pone tutti e tre i tipi di domande, department (choice), can_auto_resolve (noul) e urgency (score), in un'unica chiamata API.
Ispeziona il codice
Ecco la chiamata client.decisions.create principale all'interno di scripts/quickstart_decisions.py:
from google import genai

client = genai.Client(api_key=api_key, http_options={"api_version": "v1beta"})

result = client.decisions.create(
    model="gemini-decision-1",
    input=query_text,
    questions={
        "department": {
            "type": "choice",
            "instructions": "Which operational queue should handle this customer message?",
            "criteria": {
                "order_status": "Order tracking, delivery dates, or shipment status.",
                "billing_refund": "Duplicate charges, invoices, credits, or refund requests.",
                "subscription_cancel": "Canceling or pausing a recurring subscription.",
                "account_access": "Password resets, expired 2FA/MFA codes, or login lockouts.",
                "complex_incident": "Production outages, HTTP 500 errors, or legal questions.",
                "other": "Anything outside these specific categories.",
            },
        },
        "can_auto_resolve": {
            "type": "noul",
            "instructions": "Can this request be fulfilled deterministically by an automated "
                            "backend lookup or webhook without custom investigation?",
            "criteria": {
                "true_description": "Routine single-intent request such as checking tracking.",
                "false_description": "Outage, legal question, or ambiguous billing dispute.",
            },
        },
        "urgency": {
            "type": "score",
            "instructions": "Rate the operational urgency and severity of this message.",
            "criteria": [
                "Low: Routine informational or tracking question.",
                "Medium: Standard account, subscription, or billing request.",
                "High: Time-sensitive customer impact or repeated billing failure.",
                "Critical: Production-halting outage, data loss risk, or security incident.",
            ],
        },
    },
)

dept = result.answers["department"]
auto = result.answers["can_auto_resolve"]
urg = result.answers["urgency"]

# The API returns raw probabilities; our script sets the cutoff for auto-handling (80%):
auto_decision = auto.noul >= 0.80
Nota l'ultima riga (auto.noul >= 0.80): l'API Decisions non imposta mai un limite come hardcoded, ma restituisce la probabilità noul non elaborata (da 0.01 a 0.99) e il tuo codice Python decide quanto deve essere rigorosa la soglia.
Esecuzione 1A: domanda semplice sul monitoraggio degli ordini
Esegui lo script con la domanda predefinita per il monitoraggio degli ordini:
python scripts/quickstart_decisions.py
Vedrai un output JSON in tempo reale simile al seguente:
{
  "query": "Where is my order #19028? Can you tell me when it arrives?",
  "model": "gemini-decision-1",
  "latency_ms": 944.61,
  "department": {
    "choice": "order_status",
    "confidence": 0.9995,
    "probabilities": {
      "billing_refund": 0.0001,
      "other": 0.0001,
      "complex_incident": 0.0002,
      "subscription_cancel": 0.0,
      "order_status": 0.9995,
      "account_access": 0.0001
    }
  },
  "can_auto_resolve": {
    "noul_probability_yes": 0.98,
    "confidence": 0.98,
    "decision": true
  },
  "urgency": {
    "expected_score_0_to_3": 0.1524,
    "top_level": "Low: Routine informational or tracking question.",
    "confidence": 0.8717
  },
  "suggested_action": "DISPATCH_TRACKING_WEBHOOK",
  "usage": {
    "total_input_tokens": 424,
    "total_output_tokens": 0,
    "estimated_cost_usd": 4.24e-05
  }
}
(Nota: la latenza della prima chiamata locale include la configurazione iniziale della connessione TLS dalla tua macchina; se eseguita in modalità warm all'interno di Google Cloud Run in us-central1, questa stessa chiamata termina in circa 155-195 ms.)
Run 1B: Unverified $140 Refund Request
Ora passa un reclamo per addebito duplicato $140 senza alcuna fattura allegata:
python scripts/quickstart_decisions.py \
  "I was billed twice ($140 total) on invoice #8812 for one seat. Refund $70 right now."
Esamina l'output in tempo reale:
{
  "query": "I was billed twice ($140 total) on invoice #8812 for one seat. Refund $70 right now.",
  "model": "gemini-decision-1",
  "latency_ms": 602.23,
  "department": {
    "choice": "billing_refund",
    "confidence": 0.9993,
    "probabilities": {
      "other": 0.0001,
      "complex_incident": 0.0,
      "order_status": 0.0001,
      "billing_refund": 0.9993,
      "subscription_cancel": 0.0004,
      "account_access": 0.0001
    }
  },
  "can_auto_resolve": {
    "noul_probability_yes": 0.4282,
    "confidence": 0.5718,
    "decision": false
  },
  "urgency": {
    "expected_score_0_to_3": 1.3634,
    "top_level": "Medium: Standard account, subscription, or billing request.",
    "confidence": 0.5987
  },
  "suggested_action": "INITIATE_BILLING_WORKFLOW",
  "usage": {
    "total_input_tokens": 433,
    "total_output_tokens": 0,
    "estimated_cost_usd": 4.33e-05
  }
}
Vediamo come interagiscono queste due domande indipendenti:
- Dove deve essere inviato questo ticket? (
department = billing_refund,0.9993): il cliente chiede un rimborso su una fattura, quindigemini-decision-1è sicuro al 99,93% che appartenga alla coda Fatturazione. - Il codice deve essere eseguito automaticamente? (
can_auto_resolve = 0.4282->decision: false): la restituzione di$70da una sola affermazione di testo richiede una verifica. Poiché0.4282è inferiore al nostro limite diauto.noul >= 0.80,decisionrestituiscefalse.
5. Esempio 2: esecuzione di 8 controlli delle policy in un'unica chiamata
Nelle applicazioni di backend reali, un messaggio in arrivo di solito richiede più di un controllo prima che il codice tocchi un database o attivi uno strumento. Con gli LLM di chat, effettuare 8 chiamate separate moltiplica la latenza e addebita il testo di input 8 volte, mentre inserire 8 regole in un unico prompt JSON gigante fa sì che il modello non rilevi i casi limite.
Esaminiamo scripts/parallel_guardrails.py, che valuta 8 controlli indipendenti (prompt injection, PII/secret non elaborati, idoneità al rimborso immediato, minacce di storno di addebito, coda di destinazione, selezione dello strumento, rischio di abbandono e livello di abuso) in una chiamata decisions.create.
Come funziona lo script
Passaggio 1: passa i metadati dell'evento e il testo insieme come input
Il passaggio di un dizionario JSON serializzato come input consente a gemini-decision-1 di controllare i campi strutturati (come amount_usd e order_age_days) insieme al messaggio del cliente in formato libero, fatturando il payload condiviso una sola volta:
event = {
    "event_id": "evt-03-clean-refund",
    "customer_tier": "PREMIUM",
    "order_age_days": 6,
    "amount_usd": 34.0,
    "message": "Order #77102 arrived yesterday with a cracked mug handle. Could I get a $34 refund?",
}
Passaggio 2: valuta tutte e 8 le domande in un'unica sessione
Definiamo 4 domande noul, 2 domande choice e 2 domande score in EIGHT_PARALLEL_QUESTIONS e le passiamo in un'unica chiamata:
EIGHT_PARALLEL_QUESTIONS = {
    "prompt_injection_attempt": { "type": "noul", "instructions": "...", "criteria": {...} },
    "contains_raw_pii_or_secrets": { "type": "noul", "instructions": "...", "criteria": {...} },
    "eligible_for_instant_refund": {
        "type": "noul",
        "instructions": "Does this request qualify for instant automated refund under policy "
                        "(amount <= $50, order_age_days <= 30, clear defect or duplicate)?",
        "criteria": {...},
    },
    "threatens_chargeback_or_legal": { "type": "noul", ... },
    "target_queue": { "type": "choice", ... },
    "selected_mcp_tool": { "type": "choice", ... },
    "churn_risk": { "type": "score", ... },      # 0..3 (Low -> Severe)
    "abuse_toxicity": { "type": "score", ... },  # 0..2 (Benign -> Hostile)
}

result = client.decisions.create(
    model="gemini-decision-1",
    input=json.dumps(event),             # Shared input — billed once
    questions=EIGHT_PARALLEL_QUESTIONS,  # All 8 questions scored in parallel
)
a = result.answers
Passaggio 3: combina le risposte con le regole di priorità in Python
Poiché ogni domanda restituisce un punteggio indipendente all'interno di result.answers, il nostro codice Python controlla prima i rischi per la sicurezza (prompt injection e secret divulgati) prima di consentire qualsiasi rimborso automatico:
if a["prompt_injection_attempt"].noul >= 0.70:
    gate_verdict = "QUARANTINE_ADVERSARIAL_INPUT"
elif a["contains_raw_pii_or_secrets"].noul >= 0.75:
    gate_verdict = "REDACT_PII_BEFORE_STORAGE"
elif a["threatens_chargeback_or_legal"].noul >= 0.75 or a["churn_risk"].score >= 2.3:
    gate_verdict = "ROUTE_TO_VIP_RETENTION_SPECIALIST"
elif a["eligible_for_instant_refund"].noul >= 0.85 and a["selected_mcp_tool"].confidence >= 0.80:
    gate_verdict = "AUTO_EXECUTE_INSTANT_REFUND"
else:
    gate_verdict = f"DISPATCH_{a['selected_mcp_tool'].choice.upper()}"
Esegui lo script
Esegui scripts/parallel_guardrails.py per testare tre messaggi di esempio: un tentativo di prompt injection, una chiave API sk_live_... incollata per errore e un rimborso per una tazza danneggiata $34:
python scripts/parallel_guardrails.py
Esamina l'output in tempo reale di tutti e tre gli eventi di test:
[
  {
    "event_id": "evt-01-injection",
    "gate_verdict": "QUARANTINE_ADVERSARIAL_INPUT",
    "questions_evaluated_in_parallel": 8,
    "latency_ms": 626.34,
    "signals": {
      "prompt_injection_prob": 0.9766,
      "raw_pii_prob": 0.0426,
      "instant_refund_prob": 0.0275,
      "target_queue": "security_trust",
      "selected_mcp_tool": "quarantine_security_event"
    },
    "usage": { "total_input_tokens": 977, "total_output_tokens": 0, "estimated_cost_usd": 9.77e-05 }
  },
  {
    "event_id": "evt-02-pii-leak",
    "gate_verdict": "REDACT_PII_BEFORE_STORAGE",
    "questions_evaluated_in_parallel": 8,
    "latency_ms": 724.48,
    "signals": {
      "prompt_injection_prob": 0.0548,
      "raw_pii_prob": 0.9755,
      "instant_refund_prob": 0.0292,
      "target_queue": "security_trust",
      "selected_mcp_tool": "quarantine_security_event"
    },
    "usage": { "total_input_tokens": 999, "total_output_tokens": 0, "estimated_cost_usd": 9.99e-05 }
  },
  {
    "event_id": "evt-03-clean-refund",
    "gate_verdict": "AUTO_EXECUTE_INSTANT_REFUND",
    "questions_evaluated_in_parallel": 8,
    "latency_ms": 625.68,
    "signals": {
      "prompt_injection_prob": 0.0133,
      "raw_pii_prob": 0.01,
      "instant_refund_prob": 0.9676,
      "target_queue": "billing_ops",
      "selected_mcp_tool": "issue_instant_credit"
    },
    "usage": { "total_input_tokens": 987, "total_output_tokens": 0, "estimated_cost_usd": 9.87e-05 }
  }
]
La valutazione di tutti gli 8 controlli insieme costa circa 0,000099 $ per evento con 0 token di output.
6. Esempio 3: controllo di foto e PDF senza OCR
Normalmente, quando un utente invia un reclamo con un allegato, ad esempio una foto dell'ispezione di una struttura o una fattura in formato PDF, il tuo backend deve prima eseguire una pipeline OCR o di visione artificiale separata solo per estrarre il testo prima che possano essere eseguite le regole di instradamento. Poiché gemini-decision-1 è nativamente multimodale, possiamo inviare sia la richiesta scritta sia l'allegato non elaborato in un'unica chiamata decisions.create.
Cosa testeremo
scripts/multimodal_triage.py testa due scenari, ciascuno dei quali associa una breve affermazione scritta a un allegato:
Scenario 1: foto dell'ispezione della struttura (bassa vs alta risoluzione)
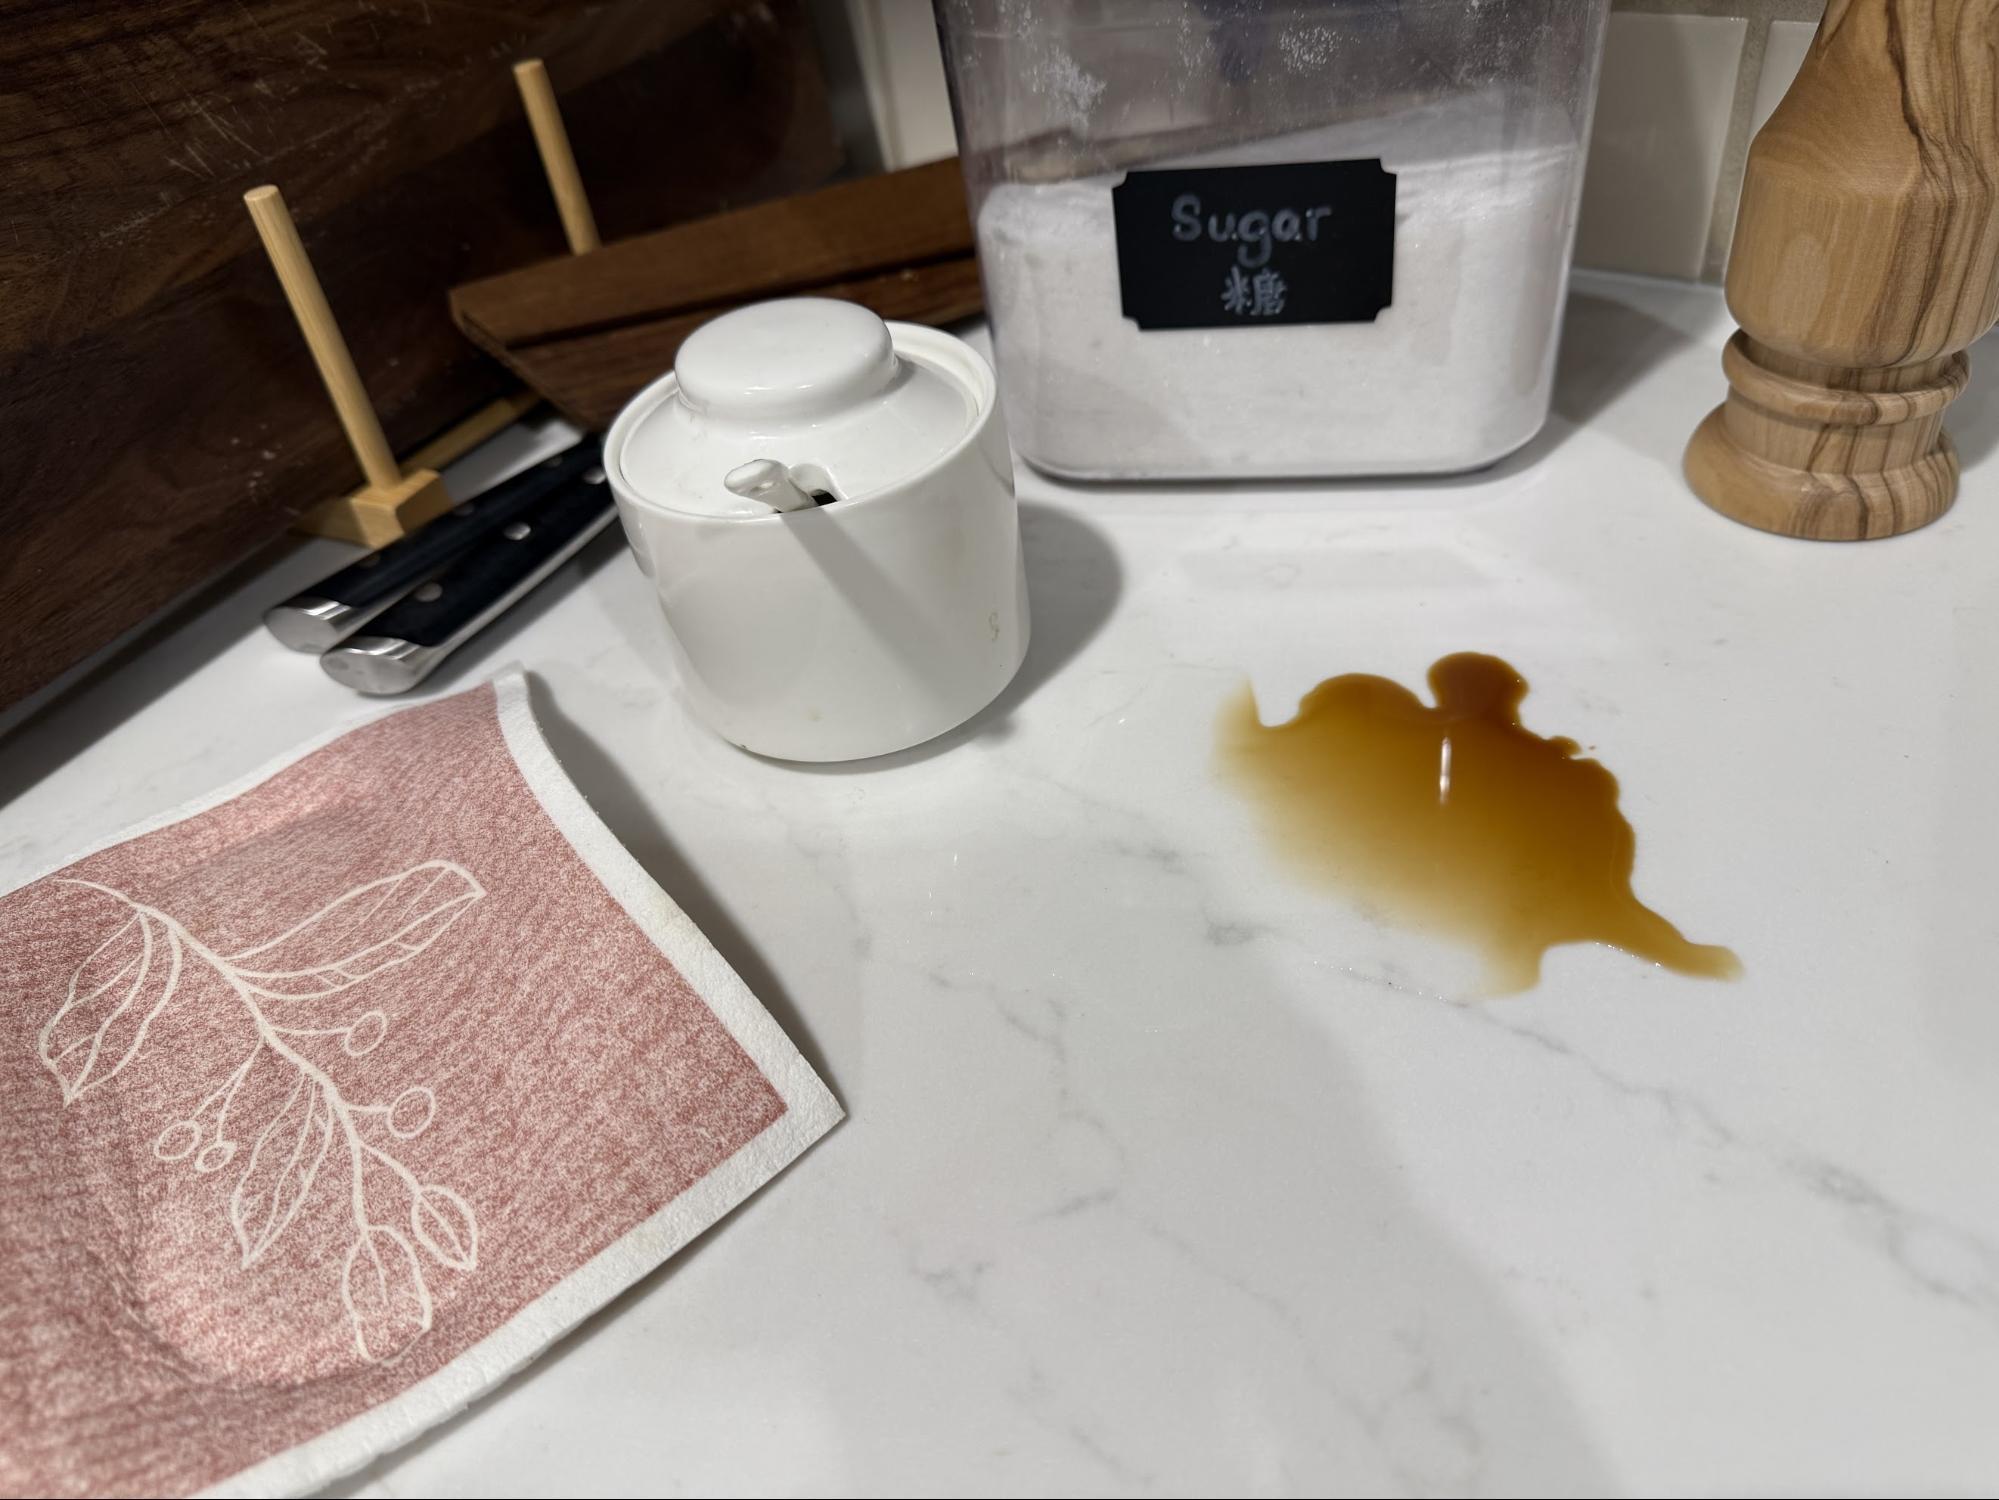
- Reclamo scritto dell'utente: "Controllo del bancone della sala relax prima della riunione con il cliente delle 09:00. Piccola macchia di caffè vicino al panno per la pulizia."
Foto allegata (03-multimodal-triage/spill.jpg): mostra una piccola macchia di caffè scuro su un bancone chiaro con un panno per pulire con un motivo proprio accanto:
Scenario 2: fattura PDF con fatturazione duplicata (byte PDF non elaborati, zero OCR)
- Reclamo scritto dell'utente: "Mi sono stati addebitati due volte 45 $ (90 $ in totale) sulla fattura INV-8812. In allegato trovi la mia fattura in formato PDF."
- PDF allegato (
03-multimodal-triage/sample_invoice_8812.pdf): una fattura di una pagina che elencaLine 1: Pro Plan Monthly Subscription ... $45.00eLine 2: Pro Plan Monthly Subscription [DUPLICATE] $45.00($90.00in totale).
What We Expect to See
- Foto di una fuoriuscita (bassa vs alta risoluzione): entrambe le esecuzioni dovrebbero individuare la piccola fuoriuscita sul bancone e dare la stessa risposta, anche se la risoluzione
lowutilizza molti meno token di immagine. - Fattura in formato PDF (senza OCR): l'allegato
sample_invoice_8812.pdfdimostra che al cliente sono stati effettivamente addebitati due importi, quindi il modello deve leggere direttamente il PDF e approvare il rimborso.
Analisi del codice
Anziché passare una singola stringa a input, scripts/multimodal_triage.py passa un elenco di blocchi di contenuti, a partire da un blocco text (che termina con \n), seguito da un blocco image o da un blocco document (application/pdf):
# For Run 1a & 1b: Pass an image URL and set resolution ("low" vs. "high")
image_block = {
    "type": "image",
    "uri": "https://storage.googleapis.com/generativeai-downloads/images/spill.jpg",
    "mime_type": "image/jpeg",
    "resolution": "low",  # or "high" in Run 1b
}

# For Run 2: Read raw PDF bytes from disk and base64-encode them as a "document" block
# (Note: PDF document blocks do not take a "resolution" setting)
pdf_block = {
    "type": "document",
    "data": base64.b64encode(pdf_bytes).decode("ascii"),
    "mime_type": "application/pdf",
}

result = client.decisions.create(
    model="gemini-decision-1",
    input=[
        {"type": "text", "text": f"Claim Statement: {claim_text}\nAttached Evidence:\n"},
        media_block,  # either image_block or pdf_block
    ],
    questions=MULTIMODAL_QUESTIONS,
)
Per confrontare l'utilizzo dei token tra resolution="low" e resolution="high", lo script legge anche result.usage.input_tokens_by_modality, che suddivide i token di input in "text" e "image".
Esegui lo script e controlla i risultati
python scripts/multimodal_triage.py
Controlla l'output JSON in tempo reale in tutte e tre le esecuzioni:
[
  {
    "experiment": "1a_photo_resolution_low",
    "resolution": "low",
    "evidence_supports_claim_prob": 0.9532,
    "disposition": "local_cleanup_or_self_service",
    "disposition_confidence": 0.9863,
    "severity_expected_0_to_3": 1.0319,
    "tokens_by_modality": { "text": 441, "image": 266 },
    "total_input_tokens": 707,
    "total_output_tokens": 0,
    "estimated_cost_usd": 7.07e-05
  },
  {
    "experiment": "1b_photo_resolution_high",
    "resolution": "high",
    "evidence_supports_claim_prob": 0.9154,
    "disposition": "local_cleanup_or_self_service",
    "disposition_confidence": 0.9825,
    "severity_expected_0_to_3": 1.0471,
    "tokens_by_modality": { "text": 441, "image": 1064 },
    "total_input_tokens": 1505,
    "total_output_tokens": 0,
    "estimated_cost_usd": 0.0001505
  },
  {
    "experiment": "2_pdf_duplicate_invoice_zero_ocr",
    "resolution": null,
    "latency_ms": 676.98,
    "evidence_supports_claim_prob": 0.9578,
    "disposition": "automated_credit_or_replacement",
    "disposition_confidence": 0.9367,
    "severity_expected_0_to_3": 1.9849,
    "tokens_by_modality": { "text": 587, "image": 520 },
    "total_input_tokens": 1107,
    "total_output_tokens": 0,
    "estimated_cost_usd": 0.0001107
  }
]
Due considerazioni rapide sull'output:
- La risoluzione
lowha utilizzato un numero di token di immagine 4 volte inferiore (266 rispetto a 1064): entrambe le esecuzioni hanno fornito la stessa risposta (local_cleanup_or_self_servicecon un livello di confidenza superiore al 98%). Riserva"high"o"ultra_high"per il testo di piccole dimensioni o le note legali. - La fattura in PDF ha approvato il rimborso con OCR pari a zero: con
sample_invoice_8812.pdfallegato,evidence_supports_claim_probè passato a0.9578e il modello ha selezionatoautomated_credit_or_replacementin circa 677 ms.
7. Complimenti
Complimenti! Hai utilizzato l'API Gemini Decisions (
gemini-decision-1
) in Python per instradare i ticket di assistenza con probabilità calibrate, eseguire 8 guardrail indipendenti di sicurezza e policy in un unico passaggio e verificare foto e fatture PDF senza un passaggio OCR separato, il tutto con zero token di output.
Quando vuoi andare oltre, dai un'occhiata alle cartelle aggiuntive nel repository associato, tra cui 02-hybrid-gateway/ (deployment di un servizio Cloud Run rapido che trasferisce i ticket complessi a gemini-3.8-flash) e 06-adk-workflows/ (combinazione dell'API Decisions con i workflow di Google ADK 2.0).
Documenti di riferimento
- Post di lancio ufficiale: Semplifica le scelte limitate con l'API Gemini Decisions
- Documentazione per lo sviluppo: Guida all'API Gemini Decisions (Google AI for Developers)
- Playground interattivo: prova Gemini Decision 1 in Google AI Studio
- Repository di codice campione: https://github.com/rominirani/gcp-gemini-decisions-hybrid-gateway