

1. Introdução
A maioria dos softwares de back-end não precisa de um modelo de IA para escrever parágrafos, mas sim de uma resposta rápida e confiável para uma pergunta limitada: sim ou não? Qual equipe de suporte é responsável por este tíquete? É urgente?
Os primeiros classificadores dedicados, como o Jev da TypeSafe AI, despertaram recentemente o interesse dos desenvolvedores em modelos de "sim/não", mostrando o que acontece quando você descarta a geração lenta de JSON token por token e pontua decisões de conjunto fechado em uma única passagem.
A API Gemini Decisions do Google DeepMind (com tecnologia do gemini-decision-1) traz esse recurso de forma nativa para o SDK do google-genai, permitindo que você avalie até 1.000 perguntas de yes/no (noul), múltipla escolha (choice) e escala ordenada (score) em uma única passagem com probabilidades calibradas, zero tokens de saída e suporte multimodal integrado para texto, fotos, áudio, vídeo e PDFs.
O que você aprenderá
- Configure um ambiente Python local e conecte-se ao
gemini-decision-1usando uma chave de API do Google AI Studio. - Execute programas de exemplo que vão de roteamento de tíquetes e regras de segurança a tomada de decisões com dados multimodais, que vão ajudar você a entender a API Gemini Decisions.
O que você vai aprender
- Por que pedir um JSON a um LLM de chat cria problemas de latência, custo, análise e confiança em decisões de roteamento simples.
- Como os três tipos de pergunta:
noul(sim/não),choice(escolha uma opção) escore(escala ordenada) funcionam juntos em uma única chamadaclient.decisions.create. - Como controlar o gasto de tokens multimodais usando
resolutione inspecionar o uso cominput_tokens_by_modality.
O que é necessário
- Python 3.11+ e
gitinstalados na sua máquina (ou no Google Cloud Shell). - Uma chave da API Gemini do Google AI Studio (não é necessário configurar um projeto do Google Cloud para este codelab).
2. Noções básicas sobre a API Gemini Decisions
Por que pedir JSON a um LLM de chat deixa os back-ends mais lentos (em inglês)
Os LLMs de chat foram criados para conversar com pessoas. Quando você pede para um assistente escrever um e-mail ou explicar um bug, esperar alguns segundos enquanto as palavras aparecem na tela é algo totalmente natural.
Os problemas começam quando os serviços de back-end usam esse mesmo fluxo de trabalho de chat apenas para tomar uma decisão rápida de roteamento, como decidir para onde enviar "Onde está meu pedido nº 19028?" ou se é seguro atender automaticamente.
O uso de modelos de chat para esses casos resulta em respostas muito lentas, caras e, o mais importante, frágeis, o que resulta em uma confiança não confiável na tomada de uma determinada ação ou no prosseguimento em uma direção específica para os agentes.
Como o gemini-decision-1 funciona
Em vez de gerar texto token por token, o gemini-decision-1 lê sua entrada uma vez e pontua todas as perguntas em uma única passagem, retornando probabilidades calibradas diretamente.
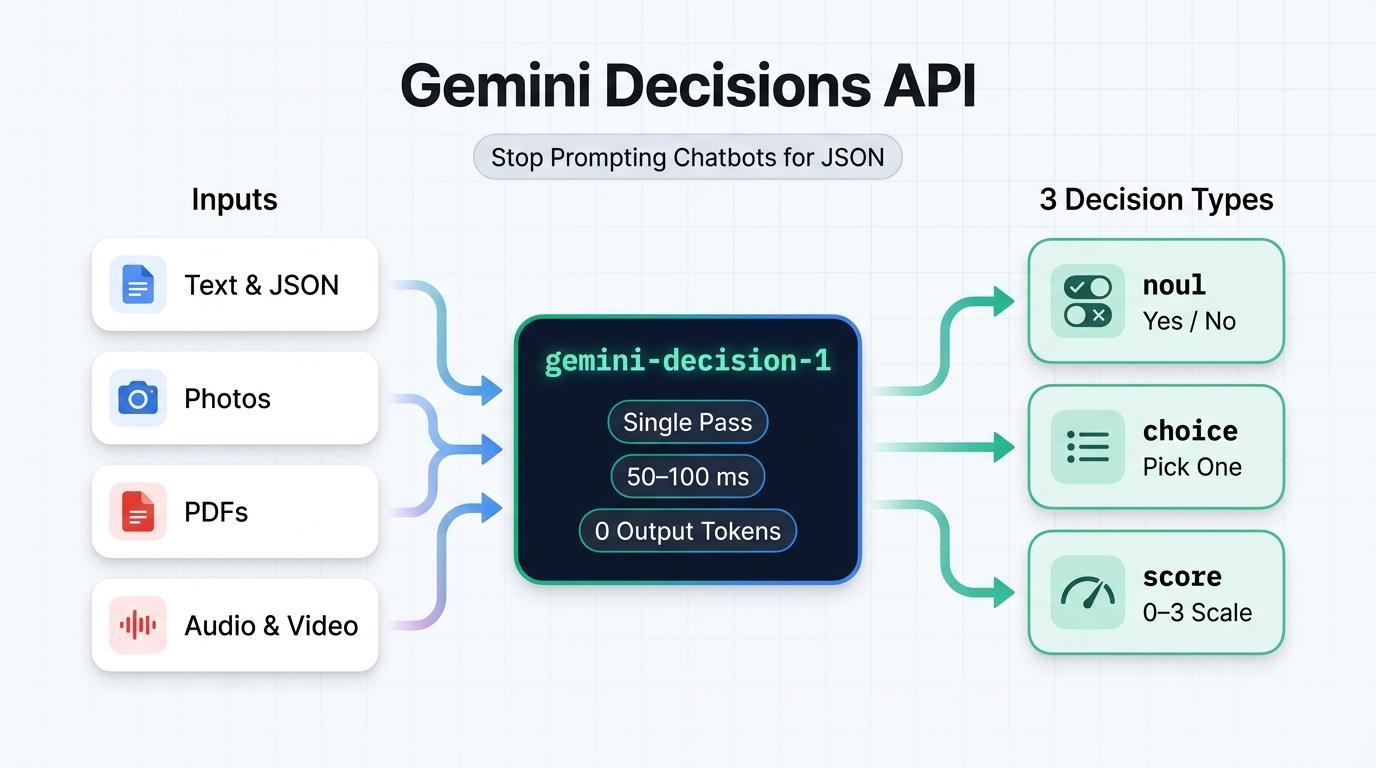
- Zero tokens de saída (US$ 0,10 / 1 milhão de tokens de entrada, US$ 0 de tokens de saída): como o modelo nunca gera texto gerado ou tokens de raciocínio,
total_output_tokensé sempre0. Oinputcompartilhado é cobrado uma vez por chamada, não importa quantas perguntas você anexe. - Computação de modelo de 50 a 100 ms: sem a geração token por token, a computação de modelo permanece rápida e previsível, mesmo que você faça 10, 50 ou 100 perguntas em uma única solicitação.
- Multimodalidade pronta para uso: avalia textos, imagens, áudios, vídeos e documentos PDF juntos em uma janela de contexto de 262.144 tokens, com uma configuração
resolution(low,medium,high,ultra_high) em imagens e vídeos para controlar o gasto de tokens.
Os três tipos de pergunta (noul, choice, score)
Cada chamada para client.decisions.create usa um dicionário questions em que cada pergunta usa um dos três tipos:
Tipo | Quando usar | O que volta |
noul (Sim / Não) | Verificar se uma declaração é verdadeira ("Isso é uma injeção de comando?") | noul (probabilidade de sim em [0,01, 0,99]) e confiança |
escolha (2 a 255 opções) | Escolher um vencedor de um dicionário fixo ("Qual equipe é responsável por isso?") | escolha (chave vencedora), mapa de probabilidades e confiança |
pontuação (2 a 255 níveis) | Classificar a urgência, a gravidade ou a qualidade em uma lista ordenada (0 a K - 1) | pontuação (média ponderada), legenda, probabilidades e confiança |
Um guia rápido em linguagem simples
Imagine que um cliente envie esta mensagem: "Onde está meu pedido nº 19028? Você pode me avisar quando ele chegar?" Veja como cada tipo de pergunta funciona nessa mensagem em uma única chamada de API:
- **
noul** (Sim / Não) — "Podemos responder a isso automaticamente sem um humano?": Você envia uma pergunta de sim/não. O que é retornado énoul = 0.98econfidence = 0.98, o que significa que há 98% de chance de a resposta ser "sim". Se a resposta fosse claramente "não", você verianoul = 0.02econfidence = 0.98. - **
choice** (Escolha uma opção) — "Qual equipe deve lidar com esta mensagem?": Você envia uma lista fixa de opções, comoorder_status,billing_refund,account_accesseother. O que é retornado é a chave vencedora (choice = "order_status"), a confiança dela (0.9995) e um detalhamento de probabilidade em todas as opções que somam1.0. - **
score** (escala ordenada) — "Qual é a urgência desta mensagem?": Você envia uma escala ordenada do menor (0) para o maior (3), como["Low", "Medium", "High", "Critical"]. O que é retornado é uma média ponderada pela probabilidade entre0e3(score = 0.15para uma pergunta de rastreamento de rotina x quase2.98para uma interrupção em tempo real).
3. Antes de começar
1. Gerar uma chave de API Gemini
Abra as chaves de API do Google AI Studio no navegador, faça login com sua Conta do Google e crie ou copie uma chave de API.
2. Clonar o repositório de amostra e configurar o Python
Abra um terminal, clone o repositório complementar gcp-gemini-decisions-hybrid-gateway, crie um ambiente virtual e instale as dependências:
git clone https://github.com/rominirani/gcp-gemini-decisions-hybrid-gateway.git
cd gcp-gemini-decisions-hybrid-gateway

python3 -m venv .venv
source .venv/bin/activate
pip install -r requirements.txt
Exporte o GEMINI_API_KEY na mesma sessão do terminal:
export GEMINI_API_KEY="YOUR_GEMINI_API_KEY"
4. Exemplo 1: encaminhamento de tíquetes de suporte
Neste primeiro exemplo, vamos inspecionar e executar scripts/quickstart_decisions.py, que faz os três tipos de perguntas (department [choice], can_auto_resolve [noul] e urgency [score]) em uma única chamada de API.
Inspecionar o código
Esta é a chamada principal de client.decisions.create dentro de scripts/quickstart_decisions.py:
from google import genai

client = genai.Client(api_key=api_key, http_options={"api_version": "v1beta"})

result = client.decisions.create(
    model="gemini-decision-1",
    input=query_text,
    questions={
        "department": {
            "type": "choice",
            "instructions": "Which operational queue should handle this customer message?",
            "criteria": {
                "order_status": "Order tracking, delivery dates, or shipment status.",
                "billing_refund": "Duplicate charges, invoices, credits, or refund requests.",
                "subscription_cancel": "Canceling or pausing a recurring subscription.",
                "account_access": "Password resets, expired 2FA/MFA codes, or login lockouts.",
                "complex_incident": "Production outages, HTTP 500 errors, or legal questions.",
                "other": "Anything outside these specific categories.",
            },
        },
        "can_auto_resolve": {
            "type": "noul",
            "instructions": "Can this request be fulfilled deterministically by an automated "
                            "backend lookup or webhook without custom investigation?",
            "criteria": {
                "true_description": "Routine single-intent request such as checking tracking.",
                "false_description": "Outage, legal question, or ambiguous billing dispute.",
            },
        },
        "urgency": {
            "type": "score",
            "instructions": "Rate the operational urgency and severity of this message.",
            "criteria": [
                "Low: Routine informational or tracking question.",
                "Medium: Standard account, subscription, or billing request.",
                "High: Time-sensitive customer impact or repeated billing failure.",
                "Critical: Production-halting outage, data loss risk, or security incident.",
            ],
        },
    },
)

dept = result.answers["department"]
auto = result.answers["can_auto_resolve"]
urg = result.answers["urgency"]

# The API returns raw probabilities; our script sets the cutoff for auto-handling (80%):
auto_decision = auto.noul >= 0.80
Observe a última linha (auto.noul >= 0.80): a API Decisions nunca codifica um limite. Ela retorna a probabilidade bruta de noul (0.01 a 0.99), e seu código Python decide o nível de rigor do limite.
Execução 1A: pergunta simples sobre rastreamento de pedidos
Execute o script com a pergunta padrão de acompanhamento de pedidos:
python scripts/quickstart_decisions.py
Você vai ver uma saída JSON em tempo real semelhante a esta:
{
  "query": "Where is my order #19028? Can you tell me when it arrives?",
  "model": "gemini-decision-1",
  "latency_ms": 944.61,
  "department": {
    "choice": "order_status",
    "confidence": 0.9995,
    "probabilities": {
      "billing_refund": 0.0001,
      "other": 0.0001,
      "complex_incident": 0.0002,
      "subscription_cancel": 0.0,
      "order_status": 0.9995,
      "account_access": 0.0001
    }
  },
  "can_auto_resolve": {
    "noul_probability_yes": 0.98,
    "confidence": 0.98,
    "decision": true
  },
  "urgency": {
    "expected_score_0_to_3": 0.1524,
    "top_level": "Low: Routine informational or tracking question.",
    "confidence": 0.8717
  },
  "suggested_action": "DISPATCH_TRACKING_WEBHOOK",
  "usage": {
    "total_input_tokens": 424,
    "total_output_tokens": 0,
    "estimated_cost_usd": 4.24e-05
  }
}
(Observação: a latência da primeira chamada local inclui a configuração inicial da conexão TLS na sua máquina. Quando executada em um ambiente quente no Google Cloud Run em us-central1, essa mesma chamada é concluída em cerca de 155 a 195 ms.)
Execução 1B: solicitação de reembolso de US $140 não verificada
Agora, envie uma reivindicação de cobrança duplicada de $140 sem nenhuma fatura anexada:
python scripts/quickstart_decisions.py \
  "I was billed twice ($140 total) on invoice #8812 for one seat. Refund $70 right now."
Inspecione a saída ao vivo:
{
  "query": "I was billed twice ($140 total) on invoice #8812 for one seat. Refund $70 right now.",
  "model": "gemini-decision-1",
  "latency_ms": 602.23,
  "department": {
    "choice": "billing_refund",
    "confidence": 0.9993,
    "probabilities": {
      "other": 0.0001,
      "complex_incident": 0.0,
      "order_status": 0.0001,
      "billing_refund": 0.9993,
      "subscription_cancel": 0.0004,
      "account_access": 0.0001
    }
  },
  "can_auto_resolve": {
    "noul_probability_yes": 0.4282,
    "confidence": 0.5718,
    "decision": false
  },
  "urgency": {
    "expected_score_0_to_3": 1.3634,
    "top_level": "Medium: Standard account, subscription, or billing request.",
    "confidence": 0.5987
  },
  "suggested_action": "INITIATE_BILLING_WORKFLOW",
  "usage": {
    "total_input_tokens": 433,
    "total_output_tokens": 0,
    "estimated_cost_usd": 4.33e-05
  }
}
Veja como essas duas perguntas independentes funcionam juntas:
- Para onde este tíquete deve ser enviado? (
department = billing_refund,0.9993): o cliente está pedindo o reembolso de uma fatura.Portanto, ogemini-decision-1tem 99,93% de certeza de que o caso pertence à fila de faturamento. - O código deve ser executado automaticamente? (
can_auto_resolve = 0.4282->decision: false): Devolver$70de uma reivindicação de texto por si só precisa de verificação. Como0.4282está abaixo do limite deauto.noul >= 0.80,decisionvolta parafalse.
5. Exemplo 2: executar oito verificações de política em uma chamada
Em aplicativos de back-end reais, uma mensagem recebida geralmente precisa de mais de uma verificação antes que o código toque em um banco de dados ou acione uma ferramenta. Com LLMs de chat, fazer 8 chamadas separadas multiplica a latência e cobra o texto de entrada 8 vezes. Por outro lado, colocar 8 regras em um único comando JSON gigante faz com que o modelo perca casos extremos.
Vamos inspecionar scripts/parallel_guardrails.py, que avalia 8 verificações independentes (injeção de comandos, PIIs/secrets brutos, qualificação para reembolso instantâneo, ameaças de estorno, fila de destino, seleção de ferramentas, risco de desistência e nível de abuso) em uma chamada decisions.create.
Como o script funciona
Etapa 1: transmitir os metadados do evento e o texto juntos como entrada
Transmitir um dicionário JSON serializado como input permite que o gemini-decision-1 verifique campos estruturados (como amount_usd e order_age_days) junto com a mensagem de formato livre do cliente, cobrando o payload compartilhado apenas uma vez:
event = {
    "event_id": "evt-03-clean-refund",
    "customer_tier": "PREMIUM",
    "order_age_days": 6,
    "amount_usd": 34.0,
    "message": "Order #77102 arrived yesterday with a cracked mug handle. Could I get a $34 refund?",
}
Etapa 2: pontuar as 8 perguntas de uma só vez
Definimos 4 perguntas noul, 2 perguntas choice e 2 perguntas score em EIGHT_PARALLEL_QUESTIONS e as transmitimos em uma chamada:
EIGHT_PARALLEL_QUESTIONS = {
    "prompt_injection_attempt": { "type": "noul", "instructions": "...", "criteria": {...} },
    "contains_raw_pii_or_secrets": { "type": "noul", "instructions": "...", "criteria": {...} },
    "eligible_for_instant_refund": {
        "type": "noul",
        "instructions": "Does this request qualify for instant automated refund under policy "
                        "(amount <= $50, order_age_days <= 30, clear defect or duplicate)?",
        "criteria": {...},
    },
    "threatens_chargeback_or_legal": { "type": "noul", ... },
    "target_queue": { "type": "choice", ... },
    "selected_mcp_tool": { "type": "choice", ... },
    "churn_risk": { "type": "score", ... },      # 0..3 (Low -> Severe)
    "abuse_toxicity": { "type": "score", ... },  # 0..2 (Benign -> Hostile)
}

result = client.decisions.create(
    model="gemini-decision-1",
    input=json.dumps(event),             # Shared input — billed once
    questions=EIGHT_PARALLEL_QUESTIONS,  # All 8 questions scored in parallel
)
a = result.answers
Etapa 3: combinar respostas com regras de prioridade em Python
Como cada pergunta retorna uma pontuação independente dentro de result.answers, nosso código Python verifica primeiro os riscos de segurança (injeção de comandos e vazamento de secrets) antes de permitir qualquer reembolso automatizado:
if a["prompt_injection_attempt"].noul >= 0.70:
    gate_verdict = "QUARANTINE_ADVERSARIAL_INPUT"
elif a["contains_raw_pii_or_secrets"].noul >= 0.75:
    gate_verdict = "REDACT_PII_BEFORE_STORAGE"
elif a["threatens_chargeback_or_legal"].noul >= 0.75 or a["churn_risk"].score >= 2.3:
    gate_verdict = "ROUTE_TO_VIP_RETENTION_SPECIALIST"
elif a["eligible_for_instant_refund"].noul >= 0.85 and a["selected_mcp_tool"].confidence >= 0.80:
    gate_verdict = "AUTO_EXECUTE_INSTANT_REFUND"
else:
    gate_verdict = f"DISPATCH_{a['selected_mcp_tool'].choice.upper()}"
Executar o script
Execute scripts/parallel_guardrails.py para testar três mensagens de exemplo: uma tentativa de injeção de comando, uma chave de API sk_live_... colada acidentalmente e um reembolso de caneca danificada $34 limpo:
python scripts/parallel_guardrails.py
Analise a saída em tempo real dos três eventos de teste:
[
  {
    "event_id": "evt-01-injection",
    "gate_verdict": "QUARANTINE_ADVERSARIAL_INPUT",
    "questions_evaluated_in_parallel": 8,
    "latency_ms": 626.34,
    "signals": {
      "prompt_injection_prob": 0.9766,
      "raw_pii_prob": 0.0426,
      "instant_refund_prob": 0.0275,
      "target_queue": "security_trust",
      "selected_mcp_tool": "quarantine_security_event"
    },
    "usage": { "total_input_tokens": 977, "total_output_tokens": 0, "estimated_cost_usd": 9.77e-05 }
  },
  {
    "event_id": "evt-02-pii-leak",
    "gate_verdict": "REDACT_PII_BEFORE_STORAGE",
    "questions_evaluated_in_parallel": 8,
    "latency_ms": 724.48,
    "signals": {
      "prompt_injection_prob": 0.0548,
      "raw_pii_prob": 0.9755,
      "instant_refund_prob": 0.0292,
      "target_queue": "security_trust",
      "selected_mcp_tool": "quarantine_security_event"
    },
    "usage": { "total_input_tokens": 999, "total_output_tokens": 0, "estimated_cost_usd": 9.99e-05 }
  },
  {
    "event_id": "evt-03-clean-refund",
    "gate_verdict": "AUTO_EXECUTE_INSTANT_REFUND",
    "questions_evaluated_in_parallel": 8,
    "latency_ms": 625.68,
    "signals": {
      "prompt_injection_prob": 0.0133,
      "raw_pii_prob": 0.01,
      "instant_refund_prob": 0.9676,
      "target_queue": "billing_ops",
      "selected_mcp_tool": "issue_instant_credit"
    },
    "usage": { "total_input_tokens": 987, "total_output_tokens": 0, "estimated_cost_usd": 9.87e-05 }
  }
]
Avaliar as 8 verificações juntas custa cerca de US$ 0,000099 por evento com 0 token de saída.
6. Exemplo 3: verificar fotos e PDFs sem OCR
Normalmente, quando um usuário envia uma solicitação com um anexo, como uma foto de inspeção de instalações ou uma fatura em PDF, seu back-end precisa executar um pipeline de OCR ou de visão separado para extrair o texto antes que as regras de rota possam ser executadas. Como o gemini-decision-1 é multimodal por natureza, podemos enviar a declaração escrita e o anexo bruto juntos em uma chamada decisions.create.
O que vamos testar
scripts/multimodal_triage.py testa dois cenários, cada um combinando uma declaração curta por escrito com um anexo:
Cenário 1: foto de inspeção de instalações (baixa x alta resolução)
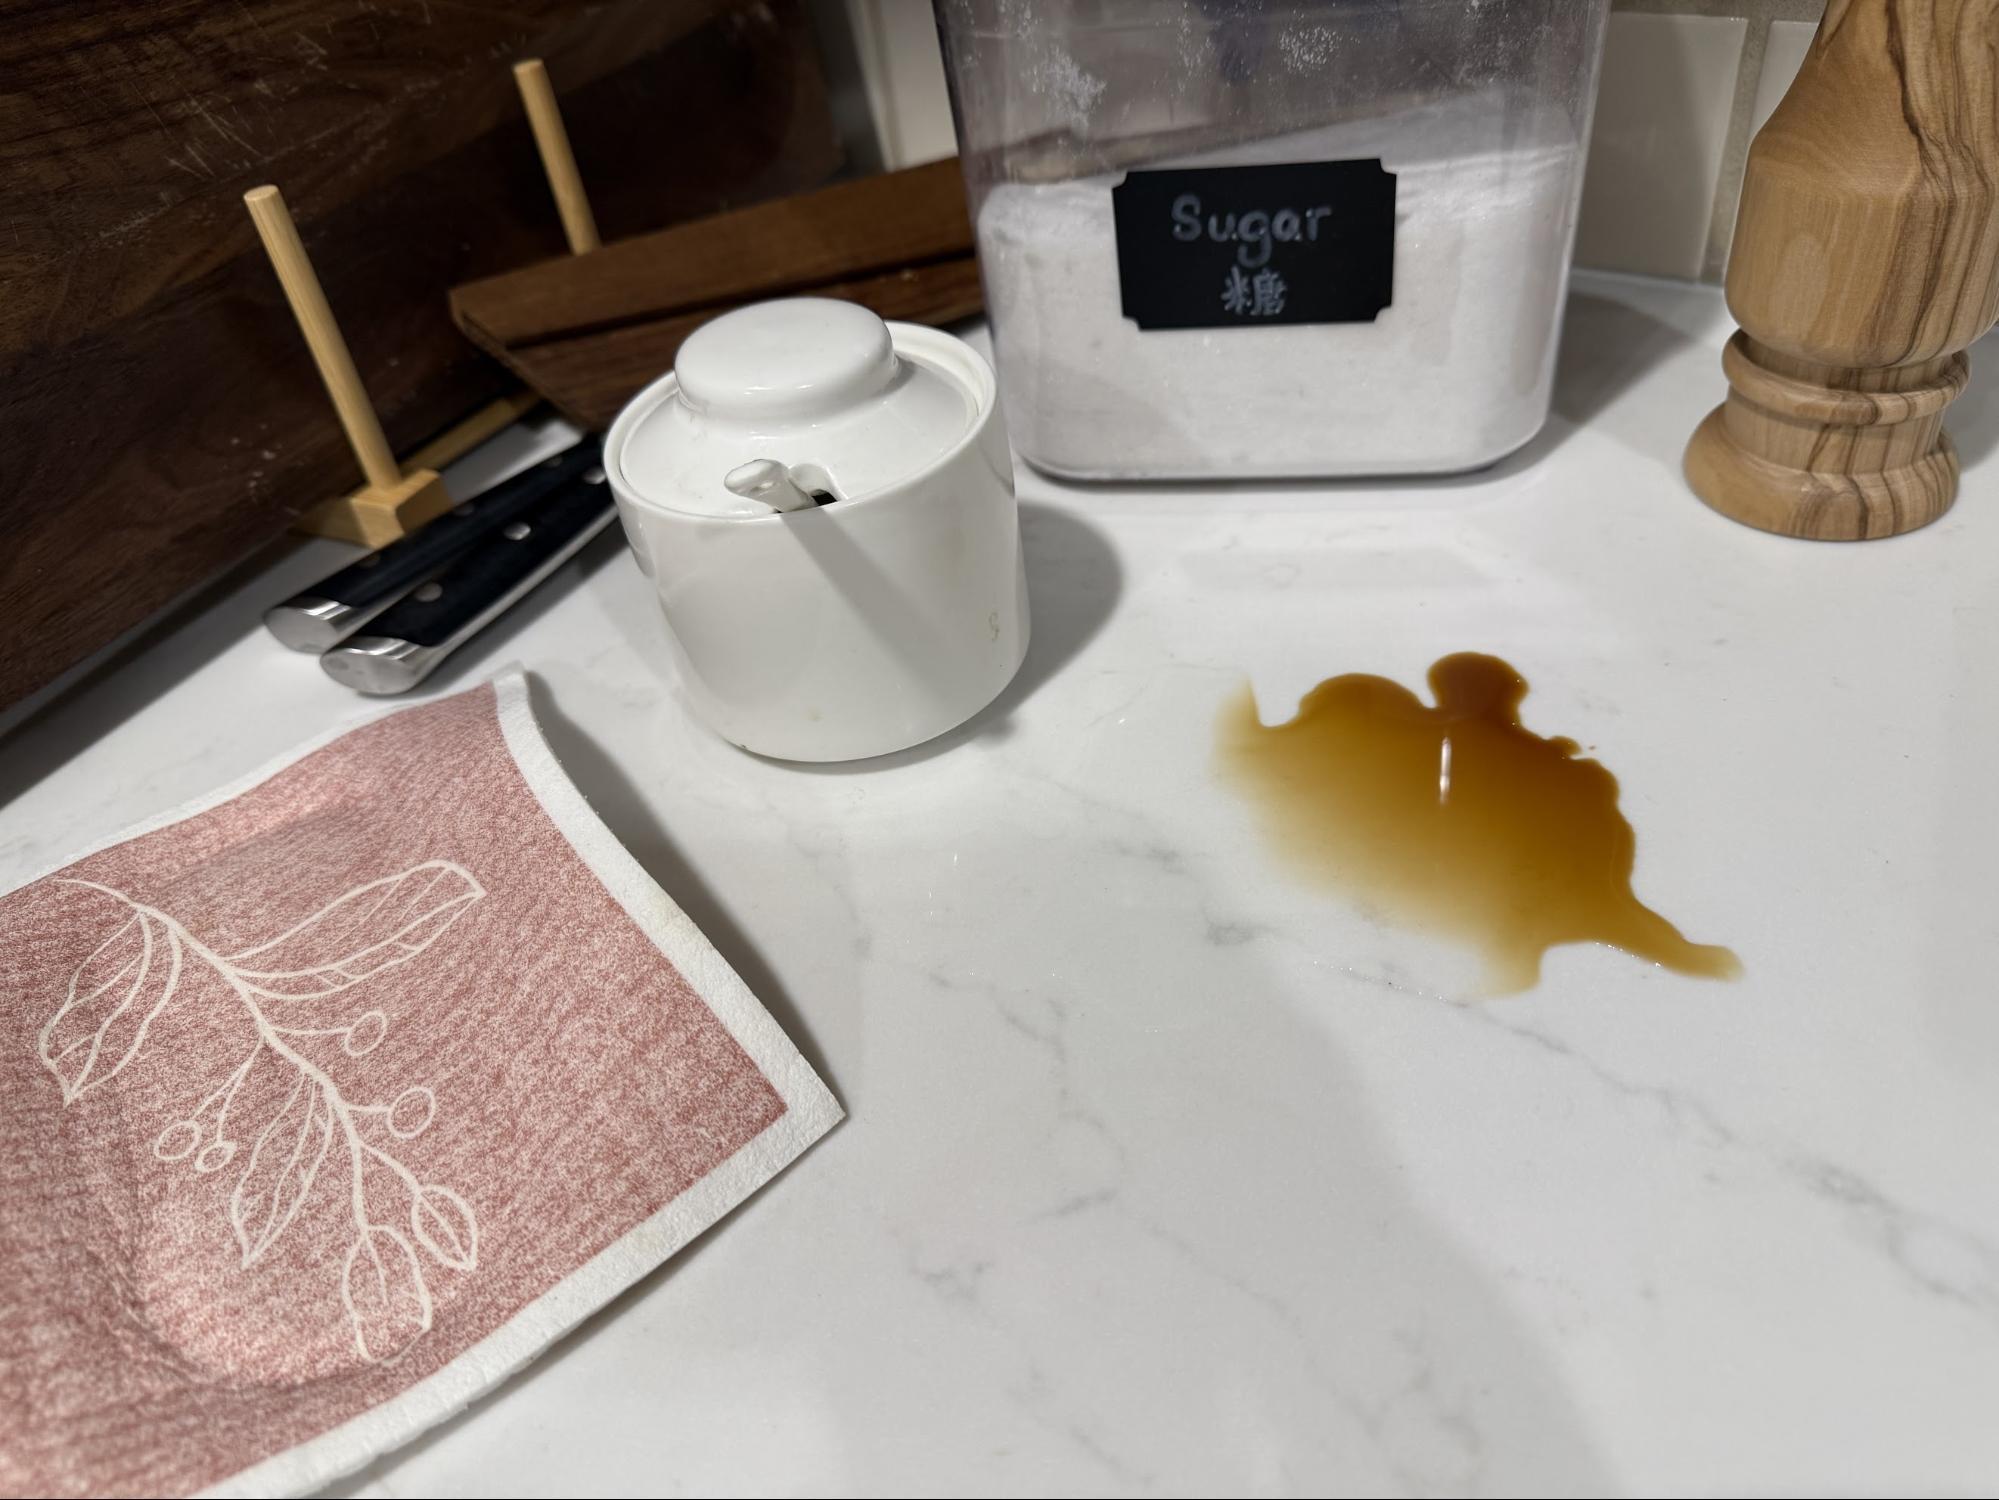
- Reclamação por escrito do usuário: "Verificar o balcão da copa antes da reunião com o cliente às 9h. Café derramado ao lado do pano de limpeza."
Foto anexada (03-multimodal-triage/spill.jpg): mostra uma pequena mancha de café em um balcão claro com um pano de limpeza estampado ao lado:
Cenário 2: fatura em PDF com cobrança duplicada (bytes de PDF brutos, zero OCR)
- Reclamação por escrito do usuário: "Fui cobrado duas vezes no valor de US $45 (total de US$ 90) na fatura INV-8812. Em anexo, está minha fatura em PDF."
- PDF em anexo (
03-multimodal-triage/sample_invoice_8812.pdf): uma fatura de uma página que listaLine 1: Pro Plan Monthly Subscription ... $45.00eLine 2: Pro Plan Monthly Subscription [DUPLICATE] $45.00($90.00no total).
O que esperamos ver
- Foto de derramamento (baixa x alta resolução): as duas execuções devem identificar o pequeno derramamento no balcão e dar a mesma resposta, mas a resolução
lowusa muito menos tokens de imagem. - Fatura em PDF (sem OCR): anexar
sample_invoice_8812.pdfcomprova que o cliente realmente foi cobrado duas vezes. Portanto, o modelo deve ler o PDF diretamente e aprovar o reembolso.
Analisar o código
Em vez de transmitir uma única string para input, scripts/multimodal_triage.py transmite uma lista de blocos de conteúdo, começando com um bloco text (terminando em \n), seguido por um bloco image ou um bloco document (application/pdf):
# For Run 1a & 1b: Pass an image URL and set resolution ("low" vs. "high")
image_block = {
    "type": "image",
    "uri": "https://storage.googleapis.com/generativeai-downloads/images/spill.jpg",
    "mime_type": "image/jpeg",
    "resolution": "low",  # or "high" in Run 1b
}

# For Run 2: Read raw PDF bytes from disk and base64-encode them as a "document" block
# (Note: PDF document blocks do not take a "resolution" setting)
pdf_block = {
    "type": "document",
    "data": base64.b64encode(pdf_bytes).decode("ascii"),
    "mime_type": "application/pdf",
}

result = client.decisions.create(
    model="gemini-decision-1",
    input=[
        {"type": "text", "text": f"Claim Statement: {claim_text}\nAttached Evidence:\n"},
        media_block,  # either image_block or pdf_block
    ],
    questions=MULTIMODAL_QUESTIONS,
)
Para comparar o uso de tokens entre resolution="low" e resolution="high", o script também lê result.usage.input_tokens_by_modality, que divide os tokens de entrada em "text" e "image".
Executar o script e conferir os resultados
python scripts/multimodal_triage.py
Inspecione a saída JSON em tempo real nas três execuções:
[
  {
    "experiment": "1a_photo_resolution_low",
    "resolution": "low",
    "evidence_supports_claim_prob": 0.9532,
    "disposition": "local_cleanup_or_self_service",
    "disposition_confidence": 0.9863,
    "severity_expected_0_to_3": 1.0319,
    "tokens_by_modality": { "text": 441, "image": 266 },
    "total_input_tokens": 707,
    "total_output_tokens": 0,
    "estimated_cost_usd": 7.07e-05
  },
  {
    "experiment": "1b_photo_resolution_high",
    "resolution": "high",
    "evidence_supports_claim_prob": 0.9154,
    "disposition": "local_cleanup_or_self_service",
    "disposition_confidence": 0.9825,
    "severity_expected_0_to_3": 1.0471,
    "tokens_by_modality": { "text": 441, "image": 1064 },
    "total_input_tokens": 1505,
    "total_output_tokens": 0,
    "estimated_cost_usd": 0.0001505
  },
  {
    "experiment": "2_pdf_duplicate_invoice_zero_ocr",
    "resolution": null,
    "latency_ms": 676.98,
    "evidence_supports_claim_prob": 0.9578,
    "disposition": "automated_credit_or_replacement",
    "disposition_confidence": 0.9367,
    "severity_expected_0_to_3": 1.9849,
    "tokens_by_modality": { "text": 587, "image": 520 },
    "total_input_tokens": 1107,
    "total_output_tokens": 0,
    "estimated_cost_usd": 0.0001107
  }
]
Duas conclusões rápidas da saída:
lowA resolução usou 4 vezes menos tokens de imagem (266 em vez de 1. 064): as duas execuções deram exatamente a mesma resposta (local_cleanup_or_self_servicecom >98% de confiança). Reserve"high"ou"ultra_high"para textos pequenos ou letras miúdas.- A fatura em PDF aprovou o reembolso com zero OCR: com o
sample_invoice_8812.pdfanexado, oevidence_supports_claim_probSequência para o0.9578, e o modelo selecionou oautomated_credit_or_replacementem cerca de 677 ms.
7. Parabéns
Parabéns! Você usou a API Gemini Decisions (
gemini-decision-1
) em Python para encaminhar tíquetes de suporte com probabilidades calibradas, executar oito proteções independentes de segurança e política em uma única passagem e verificar fotos e faturas em PDF sem uma etapa de OCR separada, tudo com zero token de saída.
Quando estiver tudo pronto para continuar, confira as outras pastas no repositório complementar, incluindo 02-hybrid-gateway/ (implantação de um serviço rápido do Cloud Run que transfere tickets complexos para o gemini-3.8-flash) e 06-adk-workflows/ (combinação da API Decisions com os fluxos de trabalho do Google ADK 2.0).
Documentos de referência
- Postagem oficial de lançamento: Como agilizar escolhas limitadas com a API Gemini Decisions
- Documentação para desenvolvedores: Guia da API Gemini Decisions (IA do Google para desenvolvedores)
- Playground interativo: teste o Gemini Decision 1 no Google AI Studio
- Repositório de exemplo de código: https://github.com/rominirani/gcp-gemini-decisions-hybrid-gateway