

1. Введение
Большинству серверных программ не нужна ИИ-модель, чтобы писать абзацы текста. Им нужен быстрый и надежный ответ на конкретный вопрос: да или нет? Какая служба поддержки отвечает за этот запрос? Насколько это срочно?
Ранние специализированные классификаторы, такие как Jev от TypeSafe AI, недавно вызвали интерес разработчиков к моделям "да/нет", показав, что происходит, когда вы отказываетесь от медленной генерации JSON по токенам и оцениваете решения с закрытым набором за один проход.
Gemini Decisions API от Google DeepMind на основе gemini-decision-1 добавляет эту возможность в SDK google-genai. Вы можете оценивать до 1000 вопросов типа yes/no (noul), с несколькими вариантами ответа (choice) и с упорядоченной шкалой (score) за один проход с калиброванными вероятностями, нулевыми выходными токенами и встроенной мультимодальной поддержкой текста, фотографий, аудио, видео и PDF.
Что вам предстоит сделать
- Настройте локальную среду Python и подключитесь к
gemini-decision-1с помощью ключа API Google AI Studio. - Запустите примеры программ, которые помогут вам понять, как работает Gemini Decisions API. Они выполняют разные задачи, например маршрутизацию запросов, проверку правил безопасности и принятие решений на основе мультимодальных данных.
Что вы узнаете
- Почему запрос к LLM для чата на получение JSON создает задержки, затраты, проблемы с синтаксическим анализом и уверенностью при принятии простых решений о маршрутизации.
- Как три типа вопросов:
noul(да/нет),choice(выбор одного варианта) иscore(упорядоченная шкала) – работают вместе в одном вызовеclient.decisions.create. - Как контролировать расход мультимодальных токенов с помощью
resolutionи проверять использование с помощьюinput_tokens_by_modality.
Что вам понадобится
- Python 3.11+ и
git, установленные на вашем компьютере (или в Google Cloud Shell). - Ключ Gemini API из Google AI Studio (для этой практической работы не нужно настраивать проект Google Cloud).
2. Общие сведения о Gemini Decisions API
Почему запросы к LLM-чату для получения JSON замедляют работу бэкенда
Большие языковые модели для чатов созданы для общения с людьми. Когда вы просите помощника написать электронное письмо или объяснить ошибку, подождать несколько секунд, пока слова появляются на экране, кажется вполне естественным.
Проблемы начинаются, когда бэкенд-службы используют тот же рабочий процесс чата, чтобы быстро принять решение о маршрутизации, например решить, куда отправить "Где мой заказ № 19028?" или безопасно ли выполнить его автоматически.
Использование моделей Chat в этих случаях приводит к слишком медленным, дорогостоящим и, что наиболее важно, хрупким ответам, что приводит к ненадежной уверенности в принятии определенных действий или движении в определенном направлении для агентов.
Как работает gemini-decision-1
Вместо того чтобы генерировать текст токен за токеном, gemini-decision-1 считывает входные данные один раз и оценивает все вопросы за один проход, напрямую возвращая откалиброванные вероятности.
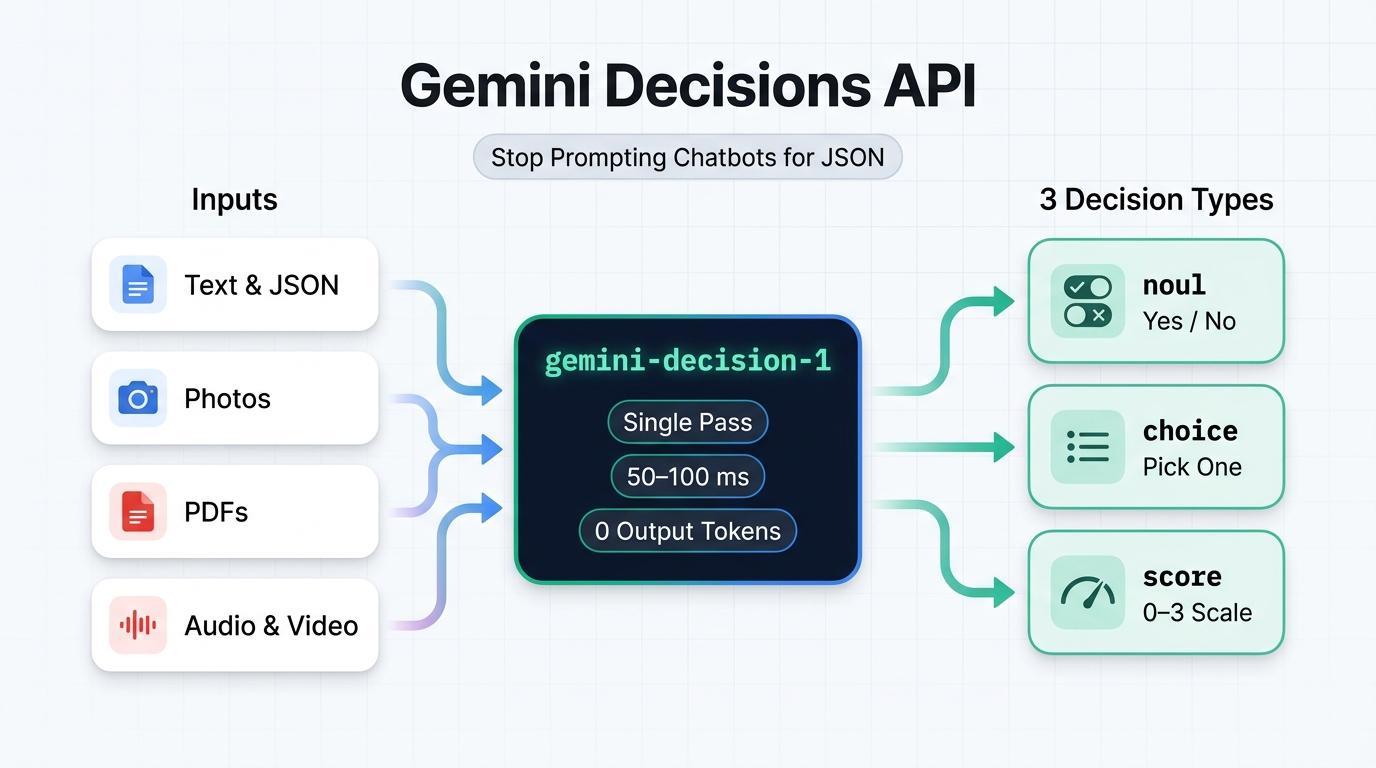
- Нулевое количество токенов вывода (0,10 доллара США за 1 миллион токенов ввода, 0 долларов США за токены вывода). Поскольку модель никогда не генерирует текст или токены мышления,
total_output_tokensвсегда равно0. Плата за общийinputвзимается один раз за звонок, независимо от того, сколько вопросов вы прикрепите. - Вычисления модели за 50–100 мс. Без посимвольной генерации вычисления модели остаются быстрыми и предсказуемыми, даже если вы задаете 10, 50 или 100 вопросов в одном запросе.
- Мультимодальность. Модель может одновременно обрабатывать текст, изображения, аудио, видео и PDF-документы в окне контекста размером 262 144 токена. Для изображений и видео можно задать параметр
resolution(low,medium,high,ultra_high), чтобы контролировать расход токенов.
Три типа вопросов (noul, choice, score)
Каждый вызов client.decisions.create принимает словарь questions, в котором каждый вопрос относится к одному из трех типов:
Тип | Когда использовать | What Comes Back |
noul (Yes / No) | Проверить, верно ли утверждение ("Это внедрение запроса?"). | noul (вероятность "да" в диапазоне [0,01, 0,99]) и confidence |
choice (от 2 до 255 вариантов) | Выбрать один правильный ответ из фиксированного словаря ("Какой команде это принадлежит?") | выбор (ключ-победитель), карта вероятностей и достоверность |
score (2–255 levels) | Оценка срочности, серьезности или качества по упорядоченному списку (от 0 до K - 1) | оценка (средневзвешенная), легенда, вероятности и достоверность |
Краткое руководство на простом языке
Представьте, что клиент отправляет такое сообщение: "Где мой заказ № 19028? Сообщи, когда он прибудет". Вот как работает каждый тип вопроса в этом сообщении при одном вызове API:
- **
noul** (Да/Нет) – "Можно ли ответить на это автоматически, без участия человека?": Вы отправляете вопрос, на который можно ответить "да" или "нет". Возвращаются значенияnoul = 0.98иconfidence = 0.98, что означает, что вероятность ответа "да" составляет 98 %. (Если бы ответ был "нет", вы бы увиделиnoul = 0.02иconfidence = 0.98.) - **
choice** (Pick One Option) — "Which team should handle this message?": Вы отправляете фиксированный список вариантов, напримерorder_status,billing_refund,account_accessиother. Возвращается ключ-победитель (choice = "order_status"), его достоверность (0.9995) и разбивка вероятности по каждому варианту, сумма которых равна1.0. - **
score** (Ordered Scale) — "How urgent is this message?": Вы отправляете упорядоченную шкалу от самого низкого (0) до самого высокого (3), например["Low", "Medium", "High", "Critical"]. В результате вы получите средневзвешенное значение между0и3(score = 0.15для обычного вопроса и около2.98для сбоя в работе).
3. Подготовка
1. Получите ключ Gemini API
Откройте Google AI Studio API Keys в браузере, войдите в аккаунт Google и создайте или скопируйте ключ API.
2. Клонирование репозитория с примерами и настройка Python
Откройте терминал, клонируйте сопутствующий репозиторий gcp-gemini-decisions-hybrid-gateway, создайте виртуальную среду и установите зависимости:
git clone https://github.com/rominirani/gcp-gemini-decisions-hybrid-gateway.git
cd gcp-gemini-decisions-hybrid-gateway

python3 -m venv .venv
source .venv/bin/activate
pip install -r requirements.txt
Экспортируйте GEMINI_API_KEY в том же сеансе терминала:
export GEMINI_API_KEY="YOUR_GEMINI_API_KEY"
4. Пример 1. Маршрутизация запросов в службу поддержки
В первом примере мы рассмотрим и запустим scripts/quickstart_decisions.py, который задает все три типа вопросов – department (choice), can_auto_resolve (noul) и urgency (score) – в одном вызове API.
Проверка кода
Ниже приведен основной вызов client.decisions.create внутри scripts/quickstart_decisions.py:
from google import genai

client = genai.Client(api_key=api_key, http_options={"api_version": "v1beta"})

result = client.decisions.create(
    model="gemini-decision-1",
    input=query_text,
    questions={
        "department": {
            "type": "choice",
            "instructions": "Which operational queue should handle this customer message?",
            "criteria": {
                "order_status": "Order tracking, delivery dates, or shipment status.",
                "billing_refund": "Duplicate charges, invoices, credits, or refund requests.",
                "subscription_cancel": "Canceling or pausing a recurring subscription.",
                "account_access": "Password resets, expired 2FA/MFA codes, or login lockouts.",
                "complex_incident": "Production outages, HTTP 500 errors, or legal questions.",
                "other": "Anything outside these specific categories.",
            },
        },
        "can_auto_resolve": {
            "type": "noul",
            "instructions": "Can this request be fulfilled deterministically by an automated "
                            "backend lookup or webhook without custom investigation?",
            "criteria": {
                "true_description": "Routine single-intent request such as checking tracking.",
                "false_description": "Outage, legal question, or ambiguous billing dispute.",
            },
        },
        "urgency": {
            "type": "score",
            "instructions": "Rate the operational urgency and severity of this message.",
            "criteria": [
                "Low: Routine informational or tracking question.",
                "Medium: Standard account, subscription, or billing request.",
                "High: Time-sensitive customer impact or repeated billing failure.",
                "Critical: Production-halting outage, data loss risk, or security incident.",
            ],
        },
    },
)

dept = result.answers["department"]
auto = result.answers["can_auto_resolve"]
urg = result.answers["urgency"]

# The API returns raw probabilities; our script sets the cutoff for auto-handling (80%):
auto_decision = auto.noul >= 0.80
Обратите внимание на последнюю строку (auto.noul >= 0.80): Decisions API никогда не задает пороговое значение в коде. Он возвращает необработанную вероятность noul (от 0.01 до 0.99), а ваш код Python определяет, насколько строгим должен быть порог.
Запуск 1A: простой вопрос об отслеживании заказа
Запустите скрипт с вопросом по умолчанию для отслеживания заказов:
python scripts/quickstart_decisions.py
Вы увидите вывод JSON, похожий на следующий:
{
  "query": "Where is my order #19028? Can you tell me when it arrives?",
  "model": "gemini-decision-1",
  "latency_ms": 944.61,
  "department": {
    "choice": "order_status",
    "confidence": 0.9995,
    "probabilities": {
      "billing_refund": 0.0001,
      "other": 0.0001,
      "complex_incident": 0.0002,
      "subscription_cancel": 0.0,
      "order_status": 0.9995,
      "account_access": 0.0001
    }
  },
  "can_auto_resolve": {
    "noul_probability_yes": 0.98,
    "confidence": 0.98,
    "decision": true
  },
  "urgency": {
    "expected_score_0_to_3": 0.1524,
    "top_level": "Low: Routine informational or tracking question.",
    "confidence": 0.8717
  },
  "suggested_action": "DISPATCH_TRACKING_WEBHOOK",
  "usage": {
    "total_input_tokens": 424,
    "total_output_tokens": 0,
    "estimated_cost_usd": 4.24e-05
  }
}
Примечание. Задержка при первом локальном вызове включает время на установку TLS-подключения с вашего компьютера. При запуске в Google Cloud Run в регионе us-central1 этот же вызов выполняется за 155–195 мс.
Run 1B: Unverified $140 Refund Request
Теперь передайте претензию $140 о дублирующемся платеже без прикрепленного счета:
python scripts/quickstart_decisions.py \
  "I was billed twice ($140 total) on invoice #8812 for one seat. Refund $70 right now."
Проверьте выходные данные:
{
  "query": "I was billed twice ($140 total) on invoice #8812 for one seat. Refund $70 right now.",
  "model": "gemini-decision-1",
  "latency_ms": 602.23,
  "department": {
    "choice": "billing_refund",
    "confidence": 0.9993,
    "probabilities": {
      "other": 0.0001,
      "complex_incident": 0.0,
      "order_status": 0.0001,
      "billing_refund": 0.9993,
      "subscription_cancel": 0.0004,
      "account_access": 0.0001
    }
  },
  "can_auto_resolve": {
    "noul_probability_yes": 0.4282,
    "confidence": 0.5718,
    "decision": false
  },
  "urgency": {
    "expected_score_0_to_3": 1.3634,
    "top_level": "Medium: Standard account, subscription, or billing request.",
    "confidence": 0.5987
  },
  "suggested_action": "INITIATE_BILLING_WORKFLOW",
  "usage": {
    "total_input_tokens": 433,
    "total_output_tokens": 0,
    "estimated_cost_usd": 4.33e-05
  }
}
Посмотрите, как эти два независимых вопроса работают вместе:
- Куда отправить этот запрос? (
department = billing_refund,0.9993): клиент просит вернуть средства по счету, поэтомуgemini-decision-1на 99,93 % уверен, что запрос относится к категории "Оплата". - Должен ли код выполняться автоматически? (
can_auto_resolve = 0.4282->decision: false): Возврат$70только на основании текстовой заявки требует проверки. Поскольку0.4282ниже порогового значенияauto.noul >= 0.80,decisionвозвращаетfalse.
5. Пример 2. Выполнение восьми проверок правил в одном вызове
В реальных серверных приложениях входящее сообщение обычно проходит несколько проверок, прежде чем код обратится к базе данных или запустит инструмент. Если вы используете LLM для чата, то восемь отдельных вызовов увеличат задержку и стоимость входного текста в восемь раз. А если вы добавите восемь правил в один гигантский запрос JSON, модель может пропустить пограничные случаи.
Давайте рассмотрим scripts/parallel_guardrails.py, который оценивает 8 независимых проверок (внедрение запроса, необработанные PII/секреты, право на мгновенный возврат средств, угрозы возвратного платежа, целевая очередь, выбор инструмента, риск оттока и уровень злоупотреблений) за один вызов decisions.create.
Принцип работы скрипта
Шаг 1. Передайте метаданные события и текст вместе в качестве входных данных
Передача сериализованного словаря JSON в качестве input позволяет gemini-decision-1 проверять структурированные поля (например, amount_usd и order_age_days) вместе с сообщением клиента в свободной форме, при этом плата за общую полезную нагрузку взимается только один раз:
event = {
    "event_id": "evt-03-clean-refund",
    "customer_tier": "PREMIUM",
    "order_age_days": 6,
    "amount_usd": 34.0,
    "message": "Order #77102 arrived yesterday with a cracked mug handle. Could I get a $34 refund?",
}
Шаг 2. Оцените все восемь вопросов за один проход
Мы определяем четыре вопроса noul, два вопроса choice и два вопроса score в EIGHT_PARALLEL_QUESTIONS и передаем их в одном вызове:
EIGHT_PARALLEL_QUESTIONS = {
    "prompt_injection_attempt": { "type": "noul", "instructions": "...", "criteria": {...} },
    "contains_raw_pii_or_secrets": { "type": "noul", "instructions": "...", "criteria": {...} },
    "eligible_for_instant_refund": {
        "type": "noul",
        "instructions": "Does this request qualify for instant automated refund under policy "
                        "(amount <= $50, order_age_days <= 30, clear defect or duplicate)?",
        "criteria": {...},
    },
    "threatens_chargeback_or_legal": { "type": "noul", ... },
    "target_queue": { "type": "choice", ... },
    "selected_mcp_tool": { "type": "choice", ... },
    "churn_risk": { "type": "score", ... },      # 0..3 (Low -> Severe)
    "abuse_toxicity": { "type": "score", ... },  # 0..2 (Benign -> Hostile)
}

result = client.decisions.create(
    model="gemini-decision-1",
    input=json.dumps(event),             # Shared input — billed once
    questions=EIGHT_PARALLEL_QUESTIONS,  # All 8 questions scored in parallel
)
a = result.answers
Шаг 3. Объедините ответы с правилами приоритета в Python
Поскольку каждый вопрос возвращает свою независимую оценку в result.answers, наш код Python сначала проверяет риски безопасности (внедрение запроса и утечка секретов), прежде чем разрешить автоматический возврат средств:
if a["prompt_injection_attempt"].noul >= 0.70:
    gate_verdict = "QUARANTINE_ADVERSARIAL_INPUT"
elif a["contains_raw_pii_or_secrets"].noul >= 0.75:
    gate_verdict = "REDACT_PII_BEFORE_STORAGE"
elif a["threatens_chargeback_or_legal"].noul >= 0.75 or a["churn_risk"].score >= 2.3:
    gate_verdict = "ROUTE_TO_VIP_RETENTION_SPECIALIST"
elif a["eligible_for_instant_refund"].noul >= 0.85 and a["selected_mcp_tool"].confidence >= 0.80:
    gate_verdict = "AUTO_EXECUTE_INSTANT_REFUND"
else:
    gate_verdict = f"DISPATCH_{a['selected_mcp_tool'].choice.upper()}"
Запустите скрипт
Выполните scripts/parallel_guardrails.py, чтобы протестировать три примера сообщений: попытку внедрения запроса, случайно вставленный ключ API sk_live_... и чистый запрос на возврат средств за поврежденную кружку $34.
python scripts/parallel_guardrails.py
Проверьте выходные данные для всех трех тестовых событий:
[
  {
    "event_id": "evt-01-injection",
    "gate_verdict": "QUARANTINE_ADVERSARIAL_INPUT",
    "questions_evaluated_in_parallel": 8,
    "latency_ms": 626.34,
    "signals": {
      "prompt_injection_prob": 0.9766,
      "raw_pii_prob": 0.0426,
      "instant_refund_prob": 0.0275,
      "target_queue": "security_trust",
      "selected_mcp_tool": "quarantine_security_event"
    },
    "usage": { "total_input_tokens": 977, "total_output_tokens": 0, "estimated_cost_usd": 9.77e-05 }
  },
  {
    "event_id": "evt-02-pii-leak",
    "gate_verdict": "REDACT_PII_BEFORE_STORAGE",
    "questions_evaluated_in_parallel": 8,
    "latency_ms": 724.48,
    "signals": {
      "prompt_injection_prob": 0.0548,
      "raw_pii_prob": 0.9755,
      "instant_refund_prob": 0.0292,
      "target_queue": "security_trust",
      "selected_mcp_tool": "quarantine_security_event"
    },
    "usage": { "total_input_tokens": 999, "total_output_tokens": 0, "estimated_cost_usd": 9.99e-05 }
  },
  {
    "event_id": "evt-03-clean-refund",
    "gate_verdict": "AUTO_EXECUTE_INSTANT_REFUND",
    "questions_evaluated_in_parallel": 8,
    "latency_ms": 625.68,
    "signals": {
      "prompt_injection_prob": 0.0133,
      "raw_pii_prob": 0.01,
      "instant_refund_prob": 0.9676,
      "target_queue": "billing_ops",
      "selected_mcp_tool": "issue_instant_credit"
    },
    "usage": { "total_input_tokens": 987, "total_output_tokens": 0, "estimated_cost_usd": 9.87e-05 }
  }
]
Оценка всех восьми проверок вместе стоит примерно 0,000099 доллара США за событие с 0 выходных токенов.
6. Пример 3. Проверка фотографий и PDF-файлов без OCR
Обычно, когда пользователь отправляет заявку с прикрепленным файлом, например фотографией проверки объекта или счетом в формате PDF, серверная часть должна сначала запустить отдельный конвейер OCR или компьютерного зрения, чтобы извлечь текст, прежде чем можно будет запустить правила маршрутизации. Поскольку gemini-decision-1 – мультимодальная модель, мы можем отправить и письменную претензию, и необработанное вложение в одном вызове decisions.create.
Что мы будем тестировать
scripts/multimodal_triage.py тестирует два сценария, в каждом из которых короткое письменное утверждение сочетается с прикрепленным файлом:
Сценарий 1. Фотография проверки объекта (низкое и высокое разрешение)
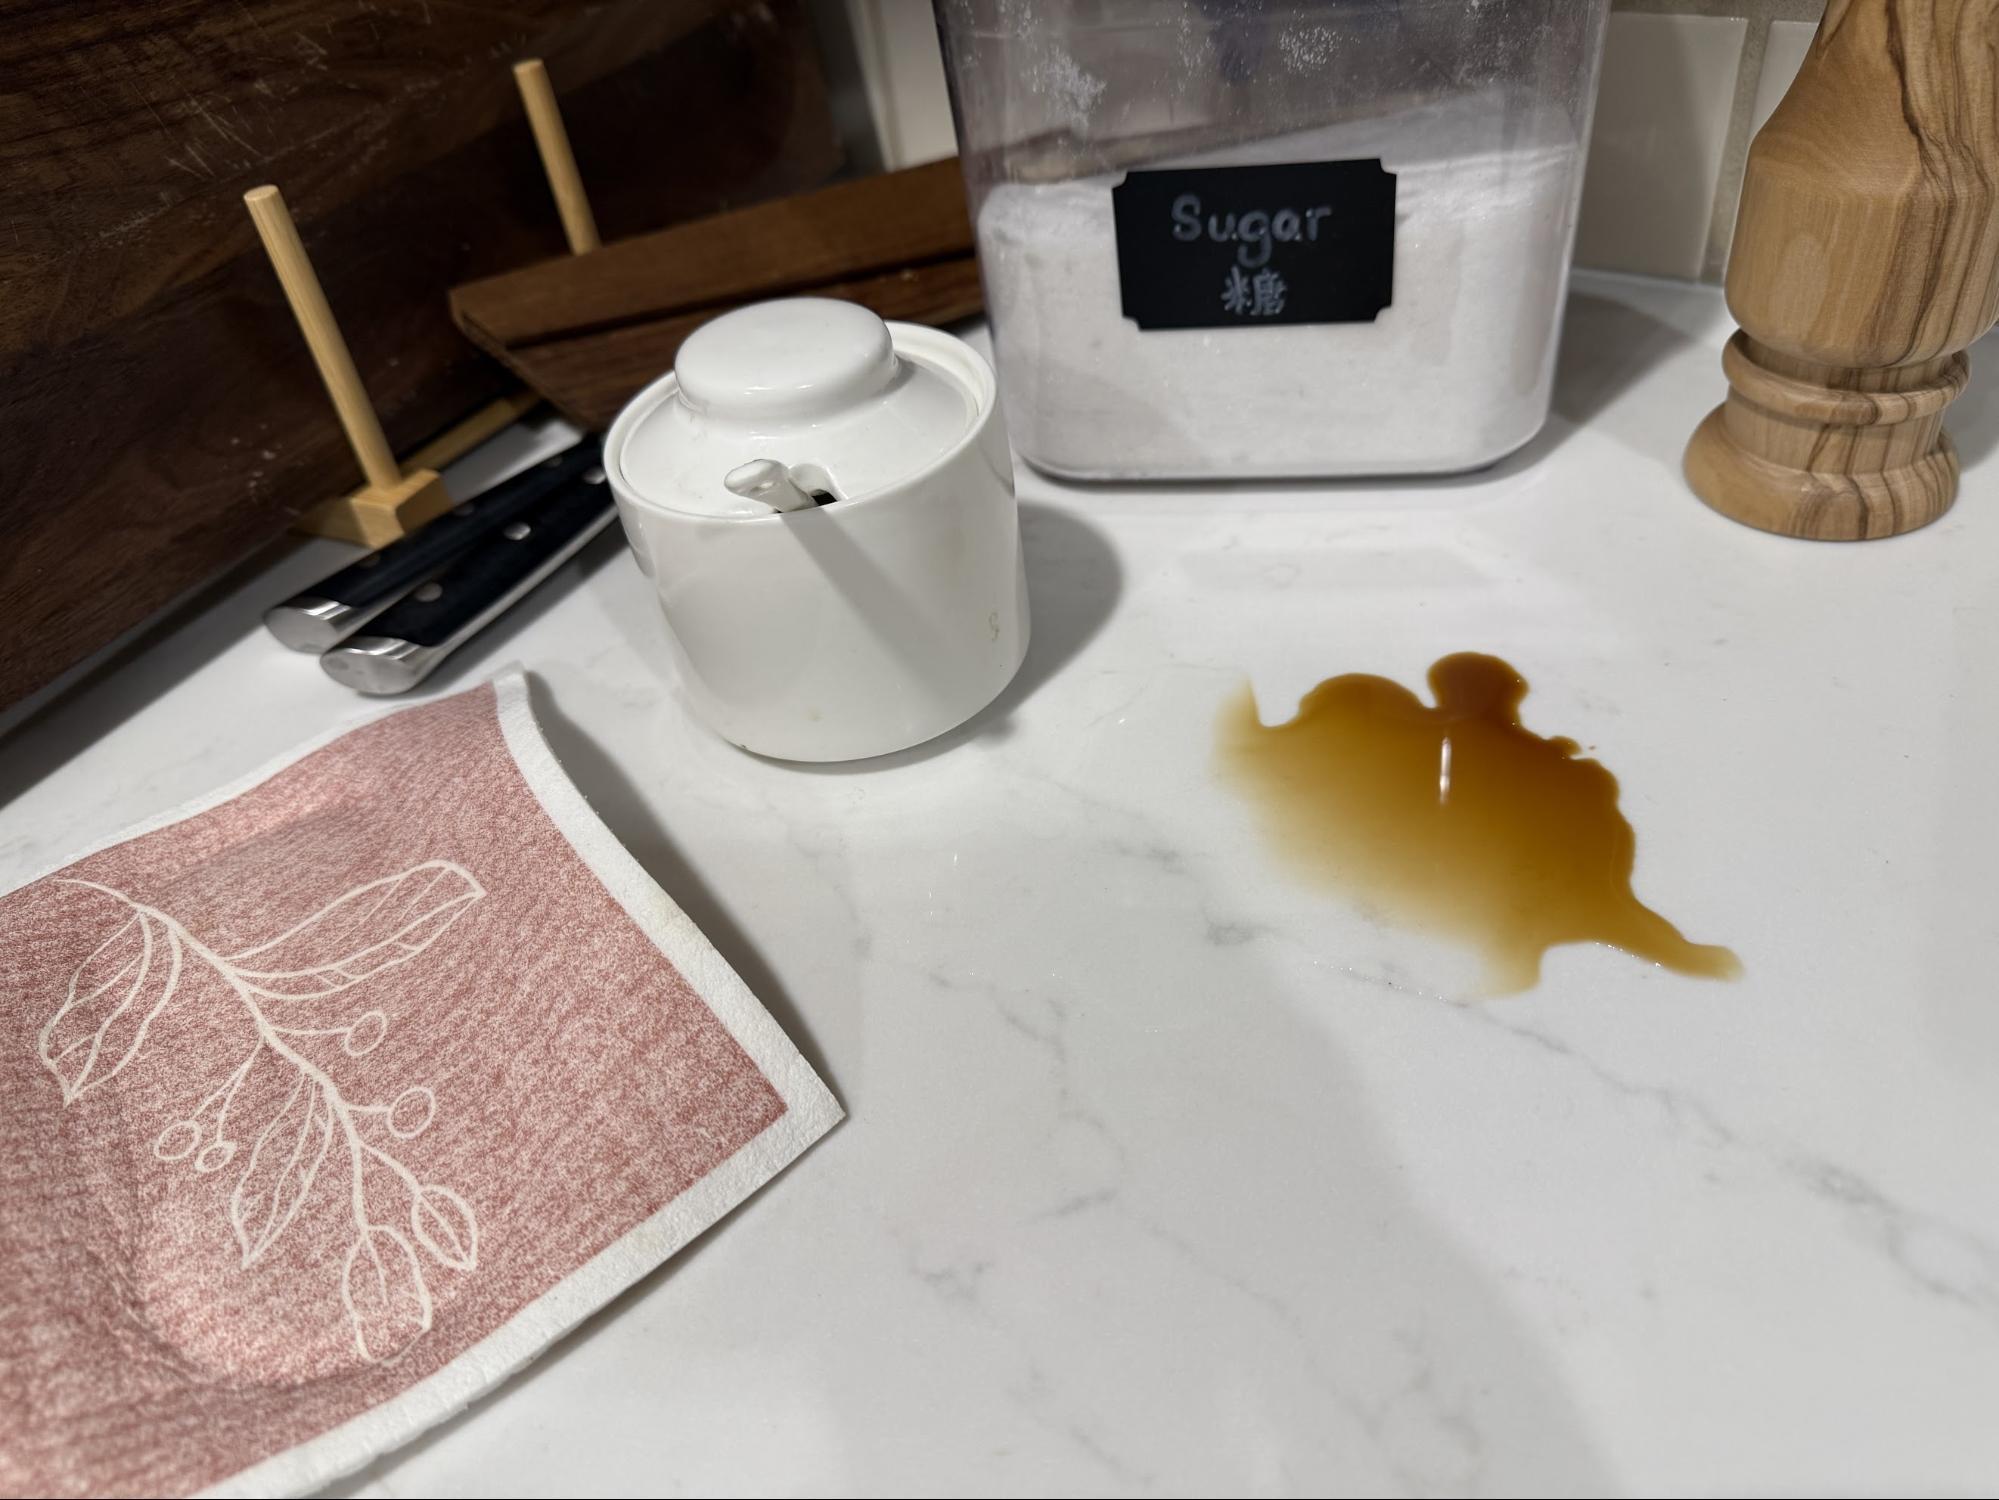
- Письменное заявление пользователя: "Проверка стойки в комнате отдыха перед встречей с клиентом в 9:00. Рядом с тряпкой видно небольшое пятно от кофе.
Прикрепленное фото (03-multimodal-triage/spill.jpg): на светлой столешнице видно небольшое темное пятно от кофе, а рядом лежит тряпка с узором.
Сценарий 2. Повторно выставленный счет в формате PDF (необработанные байты PDF, без OCR)
- Письменная претензия пользователя: "С меня дважды списали по 45 долларов США (всего 90 долларов США) по счету INV-8812. Счет в формате PDF прикреплен к письму".
- Прикрепленный PDF-файл (
03-multimodal-triage/sample_invoice_8812.pdf). Одностраничный счет, в котором указаныLine 1: Pro Plan Monthly Subscription ... $45.00иLine 2: Pro Plan Monthly Subscription [DUPLICATE] $45.00(всего$90.00).
Что мы ожидаем увидеть
- Фотография с пролитой жидкостью (низкое и высокое разрешение). В обоих случаях модель должна заметить небольшое пятно на столешнице и дать одинаковый ответ, но при разрешении
lowиспользуется гораздо меньше токенов изображения. - Счет в формате PDF (без OCR). Прикрепленный файл
sample_invoice_8812.pdfдоказывает, что с клиента действительно дважды списали средства, поэтому модель должна прочитать PDF-файл и одобрить возврат средств.
Разбор кода
Вместо того чтобы передавать в input одну строку, scripts/multimodal_triage.py передает список блоков контента, начиная с блока text (заканчивается на \n), за которым следует блок image или document (application/pdf):
# For Run 1a & 1b: Pass an image URL and set resolution ("low" vs. "high")
image_block = {
    "type": "image",
    "uri": "https://storage.googleapis.com/generativeai-downloads/images/spill.jpg",
    "mime_type": "image/jpeg",
    "resolution": "low",  # or "high" in Run 1b
}

# For Run 2: Read raw PDF bytes from disk and base64-encode them as a "document" block
# (Note: PDF document blocks do not take a "resolution" setting)
pdf_block = {
    "type": "document",
    "data": base64.b64encode(pdf_bytes).decode("ascii"),
    "mime_type": "application/pdf",
}

result = client.decisions.create(
    model="gemini-decision-1",
    input=[
        {"type": "text", "text": f"Claim Statement: {claim_text}\nAttached Evidence:\n"},
        media_block,  # either image_block or pdf_block
    ],
    questions=MULTIMODAL_QUESTIONS,
)
Чтобы сравнить использование токенов между resolution="low" и resolution="high", скрипт также считывает result.usage.input_tokens_by_modality, который разделяет входные токены на "text" и "image".
Как запустить скрипт и проверить результаты
python scripts/multimodal_triage.py
Проверьте выходные данные JSON для всех трех запусков:
[
  {
    "experiment": "1a_photo_resolution_low",
    "resolution": "low",
    "evidence_supports_claim_prob": 0.9532,
    "disposition": "local_cleanup_or_self_service",
    "disposition_confidence": 0.9863,
    "severity_expected_0_to_3": 1.0319,
    "tokens_by_modality": { "text": 441, "image": 266 },
    "total_input_tokens": 707,
    "total_output_tokens": 0,
    "estimated_cost_usd": 7.07e-05
  },
  {
    "experiment": "1b_photo_resolution_high",
    "resolution": "high",
    "evidence_supports_claim_prob": 0.9154,
    "disposition": "local_cleanup_or_self_service",
    "disposition_confidence": 0.9825,
    "severity_expected_0_to_3": 1.0471,
    "tokens_by_modality": { "text": 441, "image": 1064 },
    "total_input_tokens": 1505,
    "total_output_tokens": 0,
    "estimated_cost_usd": 0.0001505
  },
  {
    "experiment": "2_pdf_duplicate_invoice_zero_ocr",
    "resolution": null,
    "latency_ms": 676.98,
    "evidence_supports_claim_prob": 0.9578,
    "disposition": "automated_credit_or_replacement",
    "disposition_confidence": 0.9367,
    "severity_expected_0_to_3": 1.9849,
    "tokens_by_modality": { "text": 587, "image": 520 },
    "total_input_tokens": 1107,
    "total_output_tokens": 0,
    "estimated_cost_usd": 0.0001107
  }
]
Вот два вывода, которые можно сделать на основе этих данных:
lowиспользовалось в четыре раза меньше токенов изображений (266 вместо 1064). В обоих случаях был получен один и тот же ответ (local_cleanup_or_self_serviceс достоверностью >98 %)."high"или"ultra_high"– для мелкого шрифта.- Счет в формате PDF подтвердил возврат средств без OCR. С прикрепленным файлом
sample_invoice_8812.pdfevidence_supports_claim_probперешел к0.9578, и модель выбралаautomated_credit_or_replacementпримерно за 677 мс.
7. Поздравляю!
Поздравляем! Вы использовали Gemini Decisions API (
gemini-decision-1
) на Python, чтобы маршрутизировать запросы в службу поддержки с калиброванными вероятностями, запускать восемь независимых проверок безопасности и соблюдения правил за один проход и проверять фотографии и счета в формате PDF без отдельного шага OCR – и все это с нулевым количеством выходных токенов.
Когда вы будете готовы двигаться дальше, ознакомьтесь с дополнительными папками в сопутствующем репозитории, включая 02-hybrid-gateway/ (развертывание быстрого сервиса Cloud Run, который передает сложные запросы в gemini-3.8-flash) и 06-adk-workflows/ (объединение Decisions API с Google ADK 2.0 Workflows).
Справочная документация
- Официальная запись о запуске: Быстрое принятие решений в ограниченных условиях с помощью Gemini Decisions API
- Документация для разработчиков: руководство по Gemini Decisions API (Google ИИ для разработчиков)
- Интерактивная среда: попробуйте Gemini Decision 1 в Google AI Studio.
- Репозиторий образцов кода: https://github.com/rominirani/gcp-gemini-decisions-hybrid-gateway