

1. บทนำ
ซอฟต์แวร์แบ็กเอนด์ส่วนใหญ่ไม่จำเป็นต้องใช้โมเดล AI เพื่อเขียนย่อหน้า แต่ต้องการคำตอบที่รวดเร็วและเชื่อถือได้สำหรับคำถามที่มีขอบเขต เช่น ใช่หรือไม่ใช่ ทีมสนับสนุนใดเป็นเจ้าของคำขอแจ้งปัญหานี้ เร่งด่วนเพียงใด
ตัวแยกประเภทเฉพาะรุ่นแรกๆ เช่น Jev ของ TypeSafe AI เพิ่งจุดประกายความสนใจของนักพัฒนาซอฟต์แวร์ในโมเดล "ใช่/ไม่ใช่" โดยแสดงให้เห็นว่าจะเกิดอะไรขึ้นเมื่อคุณเลิกใช้การสร้าง JSON แบบทีละโทเค็นที่ช้า และให้คะแนนการตัดสินใจแบบชุดปิดในการส่งผ่านครั้งเดียว
Gemini Decisions API ของ Google DeepMind (ขับเคลื่อนโดย gemini-decision-1) นำความสามารถนี้มาไว้ใน google-genai SDK โดยตรง ซึ่งช่วยให้คุณประเมินคำถามแบบyes/no (noul) หลายตัวเลือก (choice) และแบบสเกลเรียงลำดับ (score) ได้สูงสุด 1,000 ข้อในครั้งเดียว พร้อมความน่าจะเป็นที่ปรับเทียบแล้ว โทเค็นเอาต์พุตเป็นศูนย์ และการรองรับมัลติโมดัลในตัวสำหรับข้อความ รูปภาพ เสียง วิดีโอ และ PDF
สิ่งที่คุณจะได้ทำ
- ตั้งค่าสภาพแวดล้อม Python ในเครื่องและเชื่อมต่อกับ
gemini-decision-1โดยใช้คีย์ API ของ Google AI Studio - เรียกใช้โปรแกรมตัวอย่างตั้งแต่การกำหนดเส้นทางทิกเก็ต กฎความปลอดภัย และการตัดสินใจเกี่ยวกับข้อมูลแบบหลายโมดัล ซึ่งจะช่วยให้คุณเข้าใจ Gemini Decisions API
สิ่งที่คุณจะได้เรียนรู้
- เหตุใดการใช้พรอมต์ LLM ของแชทสำหรับ JSON จึงทำให้เกิดปัญหาเกี่ยวกับเวลาในการตอบสนอง ต้นทุน การแยกวิเคราะห์ และความเชื่อมั่นในการตัดสินใจกำหนดเส้นทางที่ง่ายๆ
- วิธีที่คำถาม 3 ประเภท ได้แก่
noul(ใช่/ไม่ใช่)choice(เลือก 1 ตัวเลือก) และscore(สเกลแบบเรียงลำดับ) ทำงานร่วมกันในการเรียกclient.decisions.createครั้งเดียว - วิธีควบคุมการใช้โทเค็นแบบหลายโมดัลโดยใช้
resolutionและตรวจสอบการใช้งานด้วยinput_tokens_by_modality
สิ่งที่ต้องมี
- Python 3.11 ขึ้นไปและ
gitที่ติดตั้งในเครื่อง (หรือ Google Cloud Shell) - คีย์ Gemini API จาก Google AI Studio (ไม่จำเป็นต้องตั้งค่าโปรเจ็กต์ Google Cloud สำหรับ Codelab นี้)
2. ทำความเข้าใจ Gemini Decisions API
Why Asking a Chat LLM for JSON Slows Down Backends
LLM สำหรับแชทสร้างขึ้นเพื่อสนทนากับผู้คน เมื่อคุณขอให้ผู้ช่วยเขียนอีเมลหรืออธิบายข้อบกพร่อง การรอ 2-3 วินาทีขณะที่คำต่างๆ ปรากฏขึ้นบนหน้าจอจะให้ความรู้สึกที่เป็นธรรมชาติอย่างสมบูรณ์
ปัญหาจะเริ่มขึ้นเมื่อบริการแบ็กเอนด์ใช้เวิร์กโฟลว์แชทเดียวกันนั้นเพื่อตัดสินใจกำหนดเส้นทางอย่างรวดเร็ว เช่น การตัดสินใจว่าจะส่ง "คำสั่งซื้อ #19028 ของฉันอยู่ที่ไหน" ไปที่ใด หรือจะดำเนินการตามคำสั่งซื้อโดยอัตโนมัติได้อย่างปลอดภัยหรือไม่
การใช้โมเดล Chat สำหรับกรณีการใช้งานเหล่านี้ส่งผลให้การตอบกลับช้าเกินไป มีค่าใช้จ่ายสูง และที่สำคัญที่สุดคือไม่เสถียร ซึ่งส่งผลให้ความเชื่อมั่นในการดำเนินการบางอย่างหรือการดำเนินการในทิศทางที่เฉพาะเจาะจงสำหรับ Agent ไม่น่าเชื่อถือ
วิธีการทำงานของ gemini-decision-1
gemini-decision-1 จะอ่านอินพุตของคุณเพียงครั้งเดียวและให้คะแนนคำถามทั้งหมดในครั้งเดียว โดยแสดงผลความน่าจะเป็นที่ปรับเทียบแล้วโดยตรง แทนที่จะสร้างข้อความที่สร้างขึ้นทีละโทเค็น
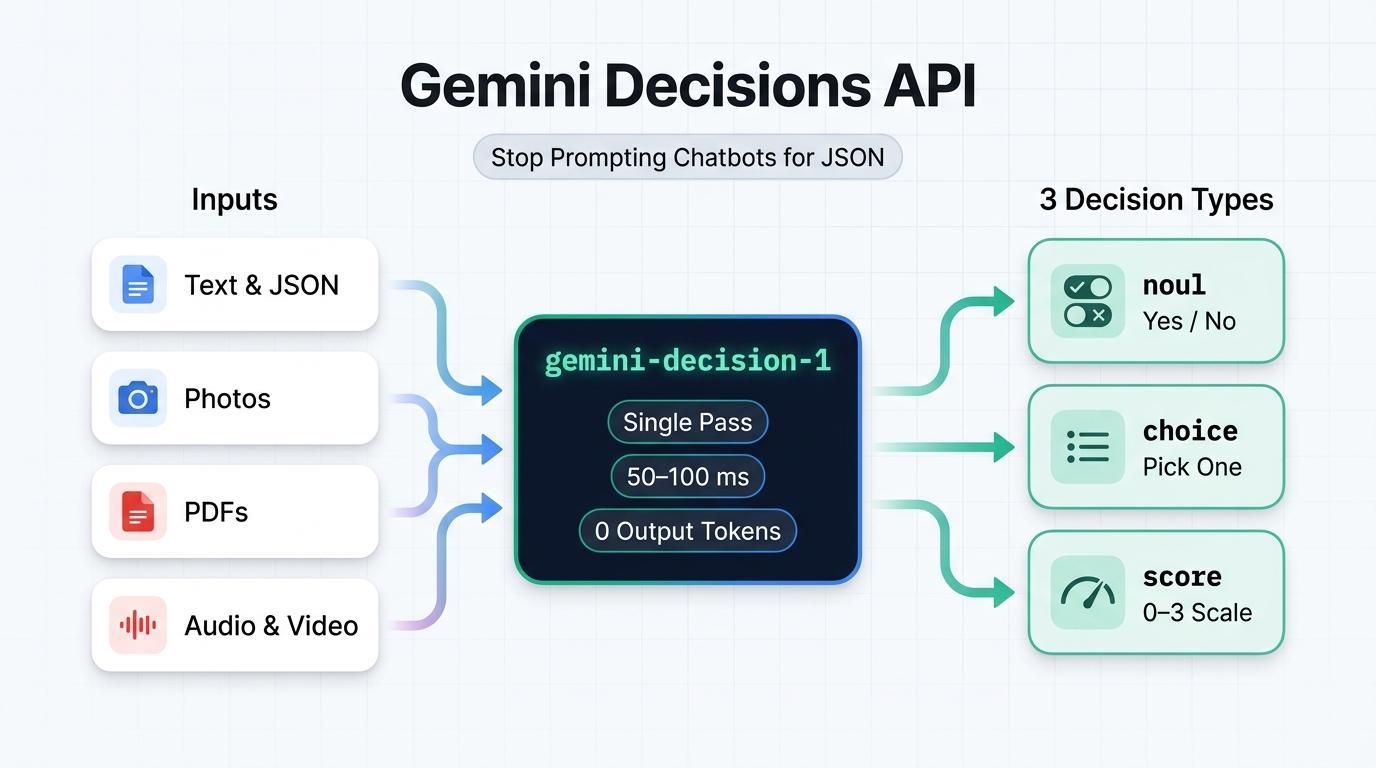
- โทเค็นเอาต์พุตเป็น 0 ($0.10 / โทเค็นอินพุต 1 ล้านรายการ, โทเค็นเอาต์พุต $0): เนื่องจากโมเดลไม่เคยสร้างข้อความที่สร้างขึ้นหรือโทเค็นการคิด
total_output_tokensจึงเป็น0เสมอ ระบบจะเรียกเก็บเงินค่าinputที่แชร์ 1 ครั้งต่อการโทร ไม่ว่าคุณจะแนบคำถามกี่ข้อก็ตาม - การประมวลผลโมเดล 50-100 มิลลิวินาที: การประมวลผลโมเดลจะรวดเร็วและคาดการณ์ได้แม้ว่าคุณจะถามคำถาม 10, 50 หรือ 100 ข้อในคำขอเดียว โดยไม่ต้องสร้างทีละโทเค็น
- Multimodal Out of the Box: ประเมินข้อความ รูปภาพ เสียง วิดีโอ และเอกสาร PDF ร่วมกันในหน้าต่างบริบทขนาด 262,144 โทเค็น โดยมีการตั้งค่า
resolution(low,medium,high,ultra_high) สำหรับรูปภาพและวิดีโอเพื่อควบคุมการใช้โทเค็น
คำถามสามประเภท (คำตอบ, ตัวเลือก, คะแนน)
การเรียกใช้ client.decisions.create ทุกครั้งจะใช้พจนานุกรม questions โดยที่คำถามแต่ละข้อจะใช้ประเภทใดประเภทหนึ่งจาก 3 ประเภทต่อไปนี้
ประเภท | กรณีที่ควรใช้ | What Comes Back |
noul (ใช่/ไม่) | ตรวจสอบว่าข้อความเป็นจริงหรือไม่ ("นี่เป็นการแทรกพรอมต์ใช่ไหม") | noul (ความน่าจะเป็นของ "ใช่" ใน [0.01, 0.99]) และความเชื่อมั่น |
choice (2-255 ตัวเลือก) | เลือกผู้ชนะ 1 รายจากพจนานุกรมที่กำหนด ("ทีมใดเป็นเจ้าของสิ่งนี้") | ตัวเลือก (คีย์ที่ชนะ) แผนที่ความน่าจะเป็น และความเชื่อมั่น |
คะแนน (2-255 ระดับ) | ให้คะแนนความเร่งด่วน ความรุนแรง หรือคุณภาพในรายการตามลำดับ (0 ถึง K - 1) | คะแนน (ค่าเฉลี่ยถ่วงน้ำหนัก) คำอธิบาย ความน่าจะเป็น และความเชื่อมั่น |
คำแนะนำแบบทีละขั้นเกี่ยวกับภาษาอังกฤษแบบง่ายๆ
สมมติว่าลูกค้าส่งข้อความนี้มา "คำสั่งซื้อ #19028 ของฉันอยู่ที่ไหน ช่วยบอกหน่อยได้ไหมว่าพัสดุจะมาถึงเมื่อไร" ต่อไปนี้คือวิธีการทำงานของคำถามแต่ละประเภทในข้อความนั้นในการเรียก API ครั้งเดียว
- **
noul** (ใช่/ไม่ใช่) — "เราสามารถตอบคำถามนี้โดยอัตโนมัติโดยไม่ต้องใช้เจ้าหน้าที่ได้ไหม": คุณส่งคำถามแบบใช่/ไม่ใช่ ผลลัพธ์ที่ได้คือnoul = 0.98และconfidence = 0.98ซึ่งหมายความว่ามีโอกาส 98% ที่คำตอบจะเป็น "ใช่" (หากคำตอบคือ "ไม่" อย่างชัดเจน คุณจะเห็นnoul = 0.02และconfidence = 0.98) - **
choice** (เลือก 1 ตัวเลือก) — "ทีมใดควรจัดการข้อความนี้": คุณส่งรายการตัวเลือกที่กำหนดไว้ เช่นorder_status,billing_refund,account_accessและotherสิ่งที่แสดงผลกลับมาคือคีย์ที่ชนะ (choice = "order_status") ความเชื่อมั่น (0.9995) และรายละเอียดความน่าจะเป็นในทุกตัวเลือกที่รวมกันเป็น1.0 - **
score** (มาตราส่วนแบบเรียงลำดับ) — "ข้อความนี้ด่วนแค่ไหน": คุณส่งสเกลที่เรียงลำดับจากต่ำสุด (0) ไปสูงสุด (3) เช่น["Low", "Medium", "High", "Critical"]สิ่งที่ได้กลับมาคือค่าเฉลี่ยถ่วงน้ำหนักความน่าจะเป็นระหว่าง0ถึง3(score = 0.15สำหรับคำถามเกี่ยวกับการติดตามตามปกติ เทียบกับเกือบ2.98สำหรับการหยุดทำงานแบบเรียลไทม์)
3. ก่อนเริ่มต้น
1. รับคีย์ Gemini API
เปิดคีย์ API ของ Google AI Studio ในเบราว์เซอร์ ลงชื่อเข้าใช้ด้วยบัญชี Google แล้วสร้างหรือคัดลอกคีย์ API
2. โคลนที่เก็บตัวอย่างและตั้งค่า Python
เปิดเทอร์มินัล โคลนที่เก็บที่ใช้ร่วมกัน gcp-gemini-decisions-hybrid-gateway สร้างสภาพแวดล้อมเสมือนจริง และติดตั้งทรัพยากร Dependency ดังนี้
git clone https://github.com/rominirani/gcp-gemini-decisions-hybrid-gateway.git
cd gcp-gemini-decisions-hybrid-gateway

python3 -m venv .venv
source .venv/bin/activate
pip install -r requirements.txt
ส่งออก GEMINI_API_KEY ในเซสชันเทอร์มินัลเดียวกันโดยทำดังนี้
export GEMINI_API_KEY="YOUR_GEMINI_API_KEY"
4. ตัวอย่างที่ 1: การกำหนดเส้นทางคำขอแจ้งปัญหา
ในตัวอย่างแรกนี้ เราจะตรวจสอบและเรียกใช้ scripts/quickstart_decisions.py ซึ่งจะถามคำถามทั้ง 3 ประเภท ได้แก่ department (choice), can_auto_resolve (noul) และ urgency (score) ในการเรียก API ครั้งเดียว
ตรวจสอบโค้ด
ต่อไปนี้คือการเรียกใช้ client.decisions.create หลักภายใน scripts/quickstart_decisions.py
from google import genai

client = genai.Client(api_key=api_key, http_options={"api_version": "v1beta"})

result = client.decisions.create(
    model="gemini-decision-1",
    input=query_text,
    questions={
        "department": {
            "type": "choice",
            "instructions": "Which operational queue should handle this customer message?",
            "criteria": {
                "order_status": "Order tracking, delivery dates, or shipment status.",
                "billing_refund": "Duplicate charges, invoices, credits, or refund requests.",
                "subscription_cancel": "Canceling or pausing a recurring subscription.",
                "account_access": "Password resets, expired 2FA/MFA codes, or login lockouts.",
                "complex_incident": "Production outages, HTTP 500 errors, or legal questions.",
                "other": "Anything outside these specific categories.",
            },
        },
        "can_auto_resolve": {
            "type": "noul",
            "instructions": "Can this request be fulfilled deterministically by an automated "
                            "backend lookup or webhook without custom investigation?",
            "criteria": {
                "true_description": "Routine single-intent request such as checking tracking.",
                "false_description": "Outage, legal question, or ambiguous billing dispute.",
            },
        },
        "urgency": {
            "type": "score",
            "instructions": "Rate the operational urgency and severity of this message.",
            "criteria": [
                "Low: Routine informational or tracking question.",
                "Medium: Standard account, subscription, or billing request.",
                "High: Time-sensitive customer impact or repeated billing failure.",
                "Critical: Production-halting outage, data loss risk, or security incident.",
            ],
        },
    },
)

dept = result.answers["department"]
auto = result.answers["can_auto_resolve"]
urg = result.answers["urgency"]

# The API returns raw probabilities; our script sets the cutoff for auto-handling (80%):
auto_decision = auto.noul >= 0.80
โปรดสังเกตบรรทัดสุดท้าย (auto.noul >= 0.80) ว่า Decisions API เองไม่เคยฮาร์ดโค้ดจุดตัด แต่จะแสดงผลความน่าจะเป็นของ noul แบบดิบ (0.01 ถึง 0.99) และโค้ด Python ของคุณจะตัดสินว่าเกณฑ์ควรเข้มงวดเพียงใด
การเรียกใช้ 1A: คำถามง่ายๆ เกี่ยวกับการติดตามคำสั่งซื้อ
เรียกใช้สคริปต์ที่มีคำถามเกี่ยวกับการติดตามคำสั่งซื้อเริ่มต้น ดังนี้
python scripts/quickstart_decisions.py
คุณจะเห็นเอาต์พุต JSON แบบเรียลไทม์ที่คล้ายกับตัวอย่างนี้
{
  "query": "Where is my order #19028? Can you tell me when it arrives?",
  "model": "gemini-decision-1",
  "latency_ms": 944.61,
  "department": {
    "choice": "order_status",
    "confidence": 0.9995,
    "probabilities": {
      "billing_refund": 0.0001,
      "other": 0.0001,
      "complex_incident": 0.0002,
      "subscription_cancel": 0.0,
      "order_status": 0.9995,
      "account_access": 0.0001
    }
  },
  "can_auto_resolve": {
    "noul_probability_yes": 0.98,
    "confidence": 0.98,
    "decision": true
  },
  "urgency": {
    "expected_score_0_to_3": 0.1524,
    "top_level": "Low: Routine informational or tracking question.",
    "confidence": 0.8717
  },
  "suggested_action": "DISPATCH_TRACKING_WEBHOOK",
  "usage": {
    "total_input_tokens": 424,
    "total_output_tokens": 0,
    "estimated_cost_usd": 4.24e-05
  }
}
(หมายเหตุ: เวลาในการตอบสนองของการเรียกครั้งแรกในเครื่องรวมถึงการตั้งค่าการเชื่อมต่อ TLS เริ่มต้นจากเครื่องของคุณ เมื่อเรียกใช้แบบอุ่นเครื่องภายใน Google Cloud Run ใน us-central1 การเรียกเดียวกันนี้จะเสร็จสิ้นในเวลาประมาณ 155-195 มิลลิวินาที)
การดำเนินการ 1B: คำขอคืนเงิน $140 ที่ไม่ได้รับการยืนยัน
ตอนนี้ให้ส่งต่อการอ้างสิทธิ์การเรียกเก็บเงินซ้ำของ $140 โดยไม่ต้องแนบใบแจ้งหนี้ใดๆ ดังนี้
python scripts/quickstart_decisions.py \
  "I was billed twice ($140 total) on invoice #8812 for one seat. Refund $70 right now."
ตรวจสอบเอาต์พุตแบบเรียลไทม์
{
  "query": "I was billed twice ($140 total) on invoice #8812 for one seat. Refund $70 right now.",
  "model": "gemini-decision-1",
  "latency_ms": 602.23,
  "department": {
    "choice": "billing_refund",
    "confidence": 0.9993,
    "probabilities": {
      "other": 0.0001,
      "complex_incident": 0.0,
      "order_status": 0.0001,
      "billing_refund": 0.9993,
      "subscription_cancel": 0.0004,
      "account_access": 0.0001
    }
  },
  "can_auto_resolve": {
    "noul_probability_yes": 0.4282,
    "confidence": 0.5718,
    "decision": false
  },
  "urgency": {
    "expected_score_0_to_3": 1.3634,
    "top_level": "Medium: Standard account, subscription, or billing request.",
    "confidence": 0.5987
  },
  "suggested_action": "INITIATE_BILLING_WORKFLOW",
  "usage": {
    "total_input_tokens": 433,
    "total_output_tokens": 0,
    "estimated_cost_usd": 4.33e-05
  }
}
ลองดูวิธีที่คำถาม 2 ข้อที่แยกกันนี้ทำงานร่วมกัน
- ควรส่งคำขอแจ้งปัญหานี้ไปที่ใด (
department = billing_refund,0.9993): ลูกค้าขอเงินคืนสำหรับใบแจ้งหนี้ ดังนั้นgemini-decision-1จึงมั่นใจ 99.93% ว่าควรอยู่ในคิวการเรียกเก็บเงิน - โค้ดควรเรียกใช้โดยอัตโนมัติไหม (
can_auto_resolve = 0.4282->decision: false): การส่งคืน$70จากการอ้างสิทธิ์ข้อความเพียงอย่างเดียวต้องมีการยืนยัน เนื่องจาก0.4282ต่ำกว่าเกณฑ์auto.noul >= 0.80decisionจึงกลับมาfalse
5. ตัวอย่างที่ 2: การตรวจสอบนโยบาย 8 รายการในการเรียกใช้ครั้งเดียว
ในแอปพลิเคชันแบ็กเอนด์จริง ข้อความขาเข้ามักจะต้องมีการตรวจสอบมากกว่า 1 ครั้งก่อนที่โค้ดจะเข้าถึงฐานข้อมูลหรือทริกเกอร์เครื่องมือ เมื่อใช้ LLM สำหรับแชท การเรียกใช้ 8 ครั้งแยกกันจะเพิ่มเวลาในการตอบสนองและเรียกเก็บเงินค่าข้อความอินพุต 8 ครั้ง ในขณะที่การยัดกฎ 8 ข้อลงในพรอมต์ JSON ขนาดใหญ่รายการเดียวจะทำให้โมเดลพลาดกรณีที่ผิดปกติ
มาตรวจสอบ scripts/parallel_guardrails.py ซึ่งจะประเมินการตรวจสอบอิสระ 8 รายการ (การแทรกพรอมต์, PII/ข้อมูลลับดิบ, สิทธิ์รับเงินคืนทันที, ภัยคุกคามจากการปฏิเสธการชำระเงิน, คิวเป้าหมาย, การเลือกเครื่องมือ, ความเสี่ยงในการเลิกใช้งาน และระดับการละเมิด) ในการเรียก decisions.create ครั้งเดียว
วิธีการทำงานของสคริปต์
ขั้นตอนที่ 1: ส่งข้อมูลเมตาของเหตุการณ์และข้อความร่วมกันเป็นอินพุต
การส่งพจนานุกรม JSON ที่เรียงลำดับเป็น input ช่วยให้ gemini-decision-1 ตรวจสอบฟิลด์ที่มีโครงสร้าง (เช่น amount_usd และ order_age_days) ควบคู่ไปกับข้อความของลูกค้าแบบรูปแบบอิสระได้ โดยจะเรียกเก็บเงินสำหรับเพย์โหลดที่แชร์เพียงครั้งเดียว ดังนี้
event = {
    "event_id": "evt-03-clean-refund",
    "customer_tier": "PREMIUM",
    "order_age_days": 6,
    "amount_usd": 34.0,
    "message": "Order #77102 arrived yesterday with a cracked mug handle. Could I get a $34 refund?",
}
ขั้นตอนที่ 2: ให้คะแนนคำถามทั้ง 8 ข้อในครั้งเดียว
เรากำหนดคำถาม noul 4 ข้อ, คำถาม choice 2 ข้อ และคำถาม score 2 ข้อใน EIGHT_PARALLEL_QUESTIONS และส่งคำถามเหล่านั้นในการเรียกใช้ครั้งเดียว ดังนี้
EIGHT_PARALLEL_QUESTIONS = {
    "prompt_injection_attempt": { "type": "noul", "instructions": "...", "criteria": {...} },
    "contains_raw_pii_or_secrets": { "type": "noul", "instructions": "...", "criteria": {...} },
    "eligible_for_instant_refund": {
        "type": "noul",
        "instructions": "Does this request qualify for instant automated refund under policy "
                        "(amount <= $50, order_age_days <= 30, clear defect or duplicate)?",
        "criteria": {...},
    },
    "threatens_chargeback_or_legal": { "type": "noul", ... },
    "target_queue": { "type": "choice", ... },
    "selected_mcp_tool": { "type": "choice", ... },
    "churn_risk": { "type": "score", ... },      # 0..3 (Low -> Severe)
    "abuse_toxicity": { "type": "score", ... },  # 0..2 (Benign -> Hostile)
}

result = client.decisions.create(
    model="gemini-decision-1",
    input=json.dumps(event),             # Shared input — billed once
    questions=EIGHT_PARALLEL_QUESTIONS,  # All 8 questions scored in parallel
)
a = result.answers
ขั้นตอนที่ 3: รวมคำตอบเข้ากับกฎลำดับความสำคัญใน Python
เนื่องจากคำถามแต่ละข้อจะแสดงผลคะแนนของตัวเองแยกกันภายใน result.answers โค้ด Python ของเราจึงตรวจสอบความเสี่ยงด้านความปลอดภัยก่อน (การแทรกพรอมต์และข้อมูลลับที่รั่วไหล) ก่อนที่จะอนุญาตให้คืนเงินอัตโนมัติ ดังนี้
if a["prompt_injection_attempt"].noul >= 0.70:
    gate_verdict = "QUARANTINE_ADVERSARIAL_INPUT"
elif a["contains_raw_pii_or_secrets"].noul >= 0.75:
    gate_verdict = "REDACT_PII_BEFORE_STORAGE"
elif a["threatens_chargeback_or_legal"].noul >= 0.75 or a["churn_risk"].score >= 2.3:
    gate_verdict = "ROUTE_TO_VIP_RETENTION_SPECIALIST"
elif a["eligible_for_instant_refund"].noul >= 0.85 and a["selected_mcp_tool"].confidence >= 0.80:
    gate_verdict = "AUTO_EXECUTE_INSTANT_REFUND"
else:
    gate_verdict = f"DISPATCH_{a['selected_mcp_tool'].choice.upper()}"
เรียกใช้สคริปต์
เรียกใช้ scripts/parallel_guardrails.py เพื่อทดสอบข้อความตัวอย่าง 3 รายการ ได้แก่ ความพยายามในการแทรกพรอมต์ คีย์ API sk_live_... ที่วางโดยไม่ตั้งใจ และการคืนเงินสำหรับแก้วที่เสียหาย $34 ที่ไม่มีปัญหา
python scripts/parallel_guardrails.py
ตรวจสอบเอาต์พุตแบบสดในเหตุการณ์ทดสอบทั้ง 3 รายการ ดังนี้
[
  {
    "event_id": "evt-01-injection",
    "gate_verdict": "QUARANTINE_ADVERSARIAL_INPUT",
    "questions_evaluated_in_parallel": 8,
    "latency_ms": 626.34,
    "signals": {
      "prompt_injection_prob": 0.9766,
      "raw_pii_prob": 0.0426,
      "instant_refund_prob": 0.0275,
      "target_queue": "security_trust",
      "selected_mcp_tool": "quarantine_security_event"
    },
    "usage": { "total_input_tokens": 977, "total_output_tokens": 0, "estimated_cost_usd": 9.77e-05 }
  },
  {
    "event_id": "evt-02-pii-leak",
    "gate_verdict": "REDACT_PII_BEFORE_STORAGE",
    "questions_evaluated_in_parallel": 8,
    "latency_ms": 724.48,
    "signals": {
      "prompt_injection_prob": 0.0548,
      "raw_pii_prob": 0.9755,
      "instant_refund_prob": 0.0292,
      "target_queue": "security_trust",
      "selected_mcp_tool": "quarantine_security_event"
    },
    "usage": { "total_input_tokens": 999, "total_output_tokens": 0, "estimated_cost_usd": 9.99e-05 }
  },
  {
    "event_id": "evt-03-clean-refund",
    "gate_verdict": "AUTO_EXECUTE_INSTANT_REFUND",
    "questions_evaluated_in_parallel": 8,
    "latency_ms": 625.68,
    "signals": {
      "prompt_injection_prob": 0.0133,
      "raw_pii_prob": 0.01,
      "instant_refund_prob": 0.9676,
      "target_queue": "billing_ops",
      "selected_mcp_tool": "issue_instant_credit"
    },
    "usage": { "total_input_tokens": 987, "total_output_tokens": 0, "estimated_cost_usd": 9.87e-05 }
  }
]
การประเมินการตรวจสอบทั้ง 8 รายการร่วมกันมีค่าใช้จ่ายประมาณ $0.000099 ต่อเหตุการณ์ โดยมีโทเค็นเอาต์พุต 0 รายการ
6. ตัวอย่างที่ 3: การตรวจสอบรูปภาพและ PDF โดยไม่มี OCR
โดยปกติแล้ว เมื่อผู้ใช้ส่งการเคลมพร้อมไฟล์แนบ เช่น รูปภาพการตรวจสอบสถานที่หรือใบแจ้งหนี้ PDF แบ็กเอนด์ของคุณจะต้องเรียกใช้ไปป์ไลน์ OCR หรือวิชันแยกต่างหากก่อนเพื่อดึงข้อความก่อนที่กฎการกำหนดเส้นทางจะทำงานได้ เนื่องจาก gemini-decision-1 มีความสามารถในการประมวลผลข้อมูลหลายรูปแบบอยู่ในตัว เราจึงส่งทั้งการอ้างสิทธิ์ที่เป็นลายลักษณ์อักษรและไฟล์แนบดิบพร้อมกันในการเรียกใช้ decisions.create ครั้งเดียวได้
สิ่งที่เราจะทดสอบ
scripts/multimodal_triage.py ทดสอบ 2 สถานการณ์ โดยแต่ละสถานการณ์จะจับคู่คำกล่าวอ้างสั้นๆ ที่เขียนขึ้นกับไฟล์แนบ ดังนี้
สถานการณ์ที่ 1: รูปภาพการตรวจสอบพื้นที่ทำงาน (ความละเอียดต่ำเทียบกับความละเอียดสูง)
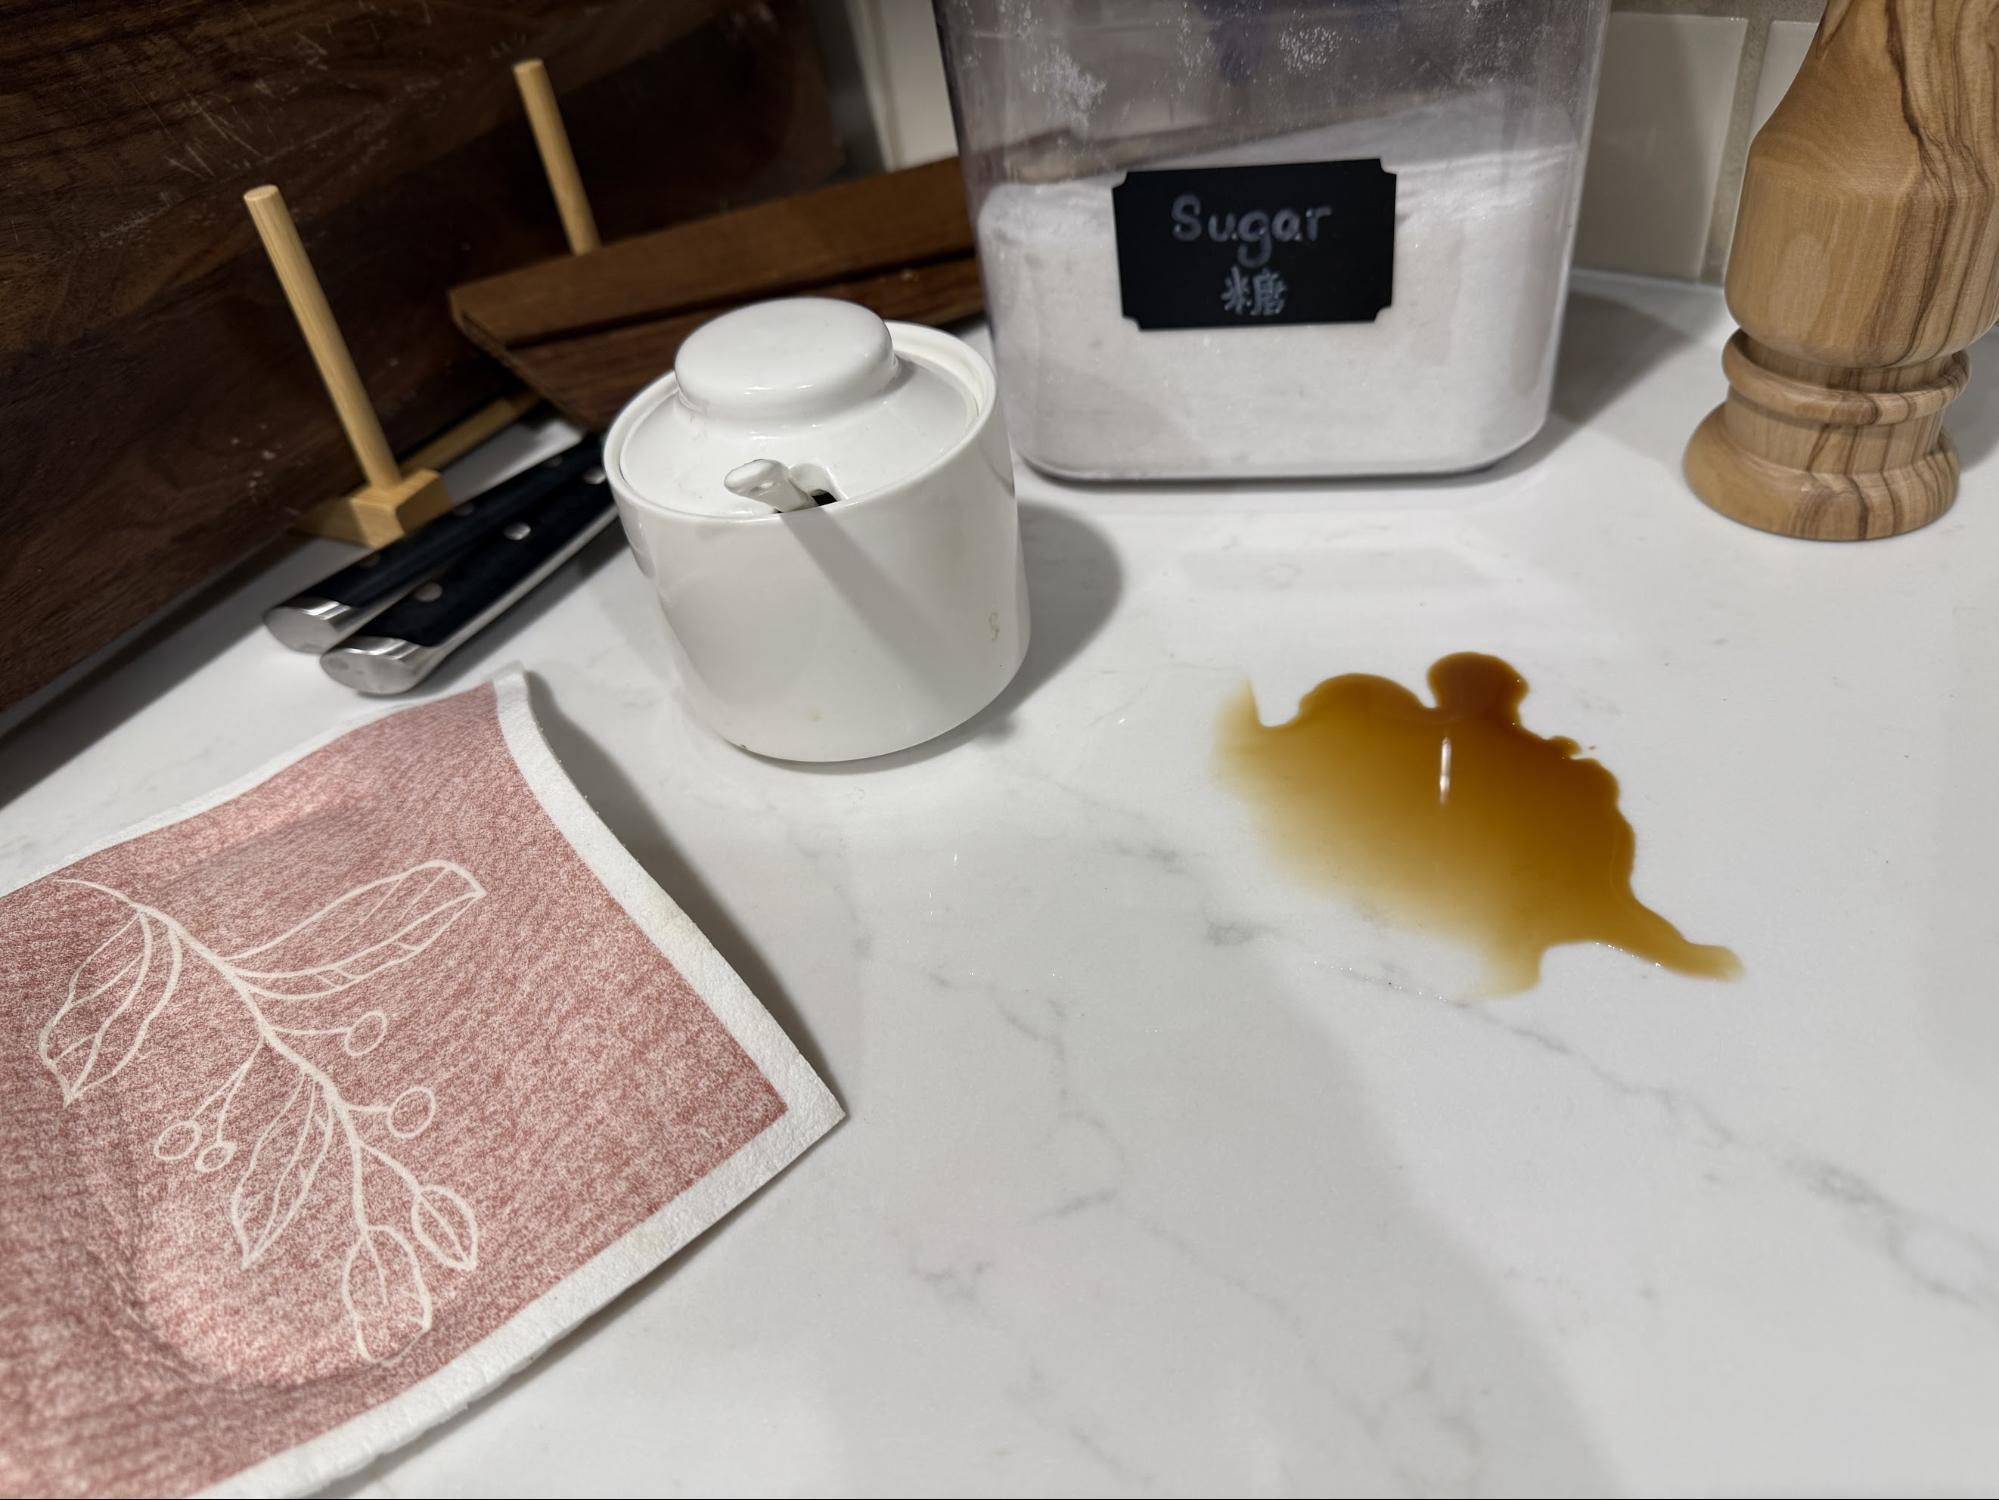
- คำกล่าวอ้างที่เป็นลายลักษณ์อักษรของผู้ใช้: "ตรวจสอบเคาน์เตอร์ในห้องพักก่อนการประชุมกับลูกค้าเวลา 9:00 น. พบกาแฟหกเล็กน้อยข้างผ้าเช็ด"
รูปภาพที่แนบมา (03-multimodal-triage/spill.jpg): แสดงคราบกาแฟสีเข้มเล็กน้อยบนเคาน์เตอร์สีอ่อน โดยมีผ้าเช็ดลายตารางอยู่ข้างๆ
สถานการณ์ที่ 2: ใบแจ้งหนี้ PDF ที่เรียกเก็บเงินซ้ำ (ไบต์ PDF ดิบ, ไม่มี OCR)
- คำกล่าวอ้างเป็นลายลักษณ์อักษรของผู้ใช้: "ฉันถูกเรียกเก็บเงิน $45 ซ้ำ 2 ครั้ง (รวมเป็น $90) ในใบแจ้งหนี้ INV-8812 ฉันแนบใบแจ้งหนี้ PDF มาด้วย"
- PDF ที่แนบมา (
03-multimodal-triage/sample_invoice_8812.pdf): ใบแจ้งหนี้ 1 หน้าที่แสดงรายการLine 1: Pro Plan Monthly Subscription ... $45.00และLine 2: Pro Plan Monthly Subscription [DUPLICATE] $45.00(รวม$90.00)
สิ่งที่เราคาดหวังว่าจะได้เห็น
- รูปภาพน้ำหก (ความละเอียดต่ำเทียบกับความละเอียดสูง): การเรียกใช้ทั้ง 2 ครั้งควรตรวจพบน้ำหกเล็กน้อยบนเคาน์เตอร์และให้คำตอบเดียวกัน แม้ว่าความละเอียด
lowจะใช้โทเค็นรูปภาพน้อยกว่ามากก็ตาม - ใบแจ้งหนี้ PDF (ไม่มี OCR): การแนบ
sample_invoice_8812.pdfเป็นการพิสูจน์ว่าลูกค้าถูกเรียกเก็บเงิน 2 ครั้งจริงๆ ดังนั้นโมเดลควรอ่าน PDF โดยตรงและอนุมัติการคืนเงิน
ดูโค้ด
แทนที่จะส่งสตริงเดียวไปยัง input scripts/multimodal_triage.py จะส่งรายการบล็อกเนื้อหา โดยเริ่มจากบล็อก text (ลงท้ายด้วย \n) ตามด้วยบล็อก image หรือบล็อก document (application/pdf) ดังนี้
# For Run 1a & 1b: Pass an image URL and set resolution ("low" vs. "high")
image_block = {
    "type": "image",
    "uri": "https://storage.googleapis.com/generativeai-downloads/images/spill.jpg",
    "mime_type": "image/jpeg",
    "resolution": "low",  # or "high" in Run 1b
}

# For Run 2: Read raw PDF bytes from disk and base64-encode them as a "document" block
# (Note: PDF document blocks do not take a "resolution" setting)
pdf_block = {
    "type": "document",
    "data": base64.b64encode(pdf_bytes).decode("ascii"),
    "mime_type": "application/pdf",
}

result = client.decisions.create(
    model="gemini-decision-1",
    input=[
        {"type": "text", "text": f"Claim Statement: {claim_text}\nAttached Evidence:\n"},
        media_block,  # either image_block or pdf_block
    ],
    questions=MULTIMODAL_QUESTIONS,
)
หากต้องการเปรียบเทียบการใช้งานโทเค็นระหว่าง resolution="low" กับ resolution="high" สคริปต์จะอ่าน result.usage.input_tokens_by_modality ด้วย ซึ่งจะแยกโทเค็นอินพุตออกเป็น "text" กับ "image"
เรียกใช้สคริปต์และตรวจสอบผลลัพธ์
python scripts/multimodal_triage.py
ตรวจสอบเอาต์พุต JSON แบบเรียลไทม์ในการเรียกใช้ทั้ง 3 ครั้ง ดังนี้
[
  {
    "experiment": "1a_photo_resolution_low",
    "resolution": "low",
    "evidence_supports_claim_prob": 0.9532,
    "disposition": "local_cleanup_or_self_service",
    "disposition_confidence": 0.9863,
    "severity_expected_0_to_3": 1.0319,
    "tokens_by_modality": { "text": 441, "image": 266 },
    "total_input_tokens": 707,
    "total_output_tokens": 0,
    "estimated_cost_usd": 7.07e-05
  },
  {
    "experiment": "1b_photo_resolution_high",
    "resolution": "high",
    "evidence_supports_claim_prob": 0.9154,
    "disposition": "local_cleanup_or_self_service",
    "disposition_confidence": 0.9825,
    "severity_expected_0_to_3": 1.0471,
    "tokens_by_modality": { "text": 441, "image": 1064 },
    "total_input_tokens": 1505,
    "total_output_tokens": 0,
    "estimated_cost_usd": 0.0001505
  },
  {
    "experiment": "2_pdf_duplicate_invoice_zero_ocr",
    "resolution": null,
    "latency_ms": 676.98,
    "evidence_supports_claim_prob": 0.9578,
    "disposition": "automated_credit_or_replacement",
    "disposition_confidence": 0.9367,
    "severity_expected_0_to_3": 1.9849,
    "tokens_by_modality": { "text": 587, "image": 520 },
    "total_input_tokens": 1107,
    "total_output_tokens": 0,
    "estimated_cost_usd": 0.0001107
  }
]
สาระสำคัญ 2 ประการจากผลลัพธ์ที่ได้มีดังนี้
lowความละเอียดใช้โทเค็นรูปภาพน้อยลง 4 เท่า (266 เทียบกับ 1,064): การเรียกใช้ทั้ง 2 ครั้งให้คำตอบเหมือนกันทุกประการ (local_cleanup_or_self_serviceที่ความเชื่อมั่น >98%) ใช้การซูม"high"หรือ"ultra_high"สำหรับข้อความขนาดเล็กหรือตัวพิมพ์เล็ก- ใบแจ้งหนี้ PDF อนุมัติการคืนเงินโดยไม่มี OCR: เมื่อแนบ
sample_invoice_8812.pdfแล้วevidence_supports_claim_probจะข้ามไปที่0.9578และโมเดลจะเลือกautomated_credit_or_replacementในเวลาประมาณ 677 มิลลิวินาที
7. ขอแสดงความยินดี
ยินดีด้วย คุณได้ใช้ Gemini Decisions API (
gemini-decision-1
) ใน Python เพื่อกำหนดเส้นทางคำขอแจ้งปัญหาด้วยความน่าจะเป็นที่ปรับเทียบแล้ว เรียกใช้การป้องกันด้านความปลอดภัยและนโยบายแบบอิสระ 8 รายการในการส่งครั้งเดียว และยืนยันรูปภาพและใบแจ้งหนี้ PDF โดยไม่ต้องมีขั้นตอน OCR แยกต่างหาก ทั้งหมดนี้ทำได้โดยไม่มีโทเค็นเอาต์พุต
เมื่อพร้อมที่จะดำเนินการต่อแล้ว ให้ดูโฟลเดอร์เพิ่มเติมในที่เก็บที่ใช้ร่วมกัน ซึ่งรวมถึง 02-hybrid-gateway/ (การติดตั้งใช้งานบริการ Cloud Run ที่รวดเร็วซึ่งส่งต่อตั๋วที่ซับซ้อนไปยัง gemini-3.8-flash) และ 06-adk-workflows/ (การรวม Decisions API เข้ากับเวิร์กโฟลว์ Google ADK 2.0)
เอกสารอ้างอิง
- โพสต์การเปิดตัวอย่างเป็นทางการ: การตัดสินใจอย่างรวดเร็วเกี่ยวกับตัวเลือกที่มีขอบเขตด้วย Gemini Decisions API
- เอกสารประกอบสำหรับนักพัฒนาซอฟต์แวร์: คู่มือ Gemini Decisions API (Google AI สำหรับนักพัฒนาซอฟต์แวร์)
- Interactive Playground: ลองใช้ Gemini Decision 1 ใน Google AI Studio
- ที่เก็บโค้ดตัวอย่าง: https://github.com/rominirani/gcp-gemini-decisions-hybrid-gateway