

1. Giới thiệu
Hầu hết phần mềm phụ trợ không thực sự cần mô hình AI để viết đoạn văn, mà chỉ cần một câu trả lời nhanh, đáng tin cậy cho một câu hỏi có giới hạn: Có hay không? Nhóm hỗ trợ nào sở hữu phiếu yêu cầu này? Mức độ khẩn cấp như thế nào?
Các bộ phân loại chuyên dụng ban đầu như Jev của TypeSafe AI gần đây đã thu hút sự quan tâm của nhà phát triển đối với các mô hình "có/không" bằng cách cho thấy điều gì xảy ra khi bạn bỏ qua quá trình tạo JSON chậm, từng mã thông báo và chấm điểm các quyết định theo tập hợp đóng trong một lượt duy nhất.
Gemini Decisions API của Google DeepMind (dựa trên gemini-decision-1) tích hợp sẵn tính năng này vào SDK google-genai, cho phép bạn đánh giá tối đa 1.000 câu hỏi yes/no (noul), trắc nghiệm (choice) và thang đo thứ tự (score) trong một lần với xác suất được hiệu chỉnh, không có mã thông báo đầu ra và hỗ trợ đa phương thức tích hợp sẵn cho văn bản, ảnh, âm thanh, video và tệp PDF.
Bạn sẽ thực hiện
- Thiết lập môi trường Python cục bộ và kết nối với
gemini-decision-1bằng khoá API của Google AI Studio. - Chạy các chương trình mẫu từ việc định tuyến phiếu yêu cầu hỗ trợ, quy tắc an toàn và ra quyết định dựa trên dữ liệu đa thức, giúp bạn hiểu rõ Gemini Decisions API.
Kiến thức bạn sẽ học được
- Tại sao việc đặt câu lệnh cho LLM trò chuyện để tạo JSON lại gây ra các vấn đề về độ trễ, chi phí, phân tích cú pháp và độ tin cậy đối với các quyết định định tuyến đơn giản.
- Cách 3 loại câu hỏi:
noul(có/không),choice(chọn một phương án) vàscore(thang đo có thứ tự) hoạt động cùng nhau trong một lệnh gọiclient.decisions.createduy nhất. - Cách kiểm soát mức chi tiêu mã thông báo đa thức bằng
resolutionvà kiểm tra mức sử dụng bằnginput_tokens_by_modality.
Bạn cần có
- Python 3.11 trở lên và
gitđược cài đặt trên máy của bạn (hoặc Google Cloud Shell). - Khoá Gemini API từ Google AI Studio (bạn không cần thiết lập dự án Google Cloud cho lớp học lập trình này).
2. Tìm hiểu về Gemini Decisions API
Tại sao việc yêu cầu LLM trò chuyện cung cấp JSON lại làm chậm phần phụ trợ
LLM trò chuyện được xây dựng để trò chuyện với con người. Khi bạn yêu cầu trợ lý viết email hoặc giải thích lỗi, việc chờ vài giây trong khi các từ xuất hiện trên màn hình là hoàn toàn tự nhiên.
Vấn đề bắt đầu khi các dịch vụ phụ trợ sử dụng cùng một quy trình trò chuyện đó chỉ để đưa ra quyết định định tuyến nhanh chóng, chẳng hạn như quyết định nơi gửi "Đơn đặt hàng #19028 của tôi ở đâu?" hoặc liệu có an toàn để thực hiện tự động hay không.
Việc sử dụng mô hình Chat cho những trường hợp này khiến câu trả lời quá chậm, tốn kém và quan trọng nhất là không ổn định, dẫn đến việc các nhân viên hỗ trợ không đủ tin tưởng để thực hiện một hành động nhất định hoặc tiến hành theo một hướng cụ thể.
Cách hoạt động của gemini-decision-1
Thay vì tạo văn bản do AI tạo theo từng mã thông báo, gemini-decision-1 đọc thông tin đầu vào của bạn một lần và chấm điểm tất cả câu hỏi của bạn trong một lần duy nhất, trả về xác suất đã hiệu chỉnh trực tiếp.
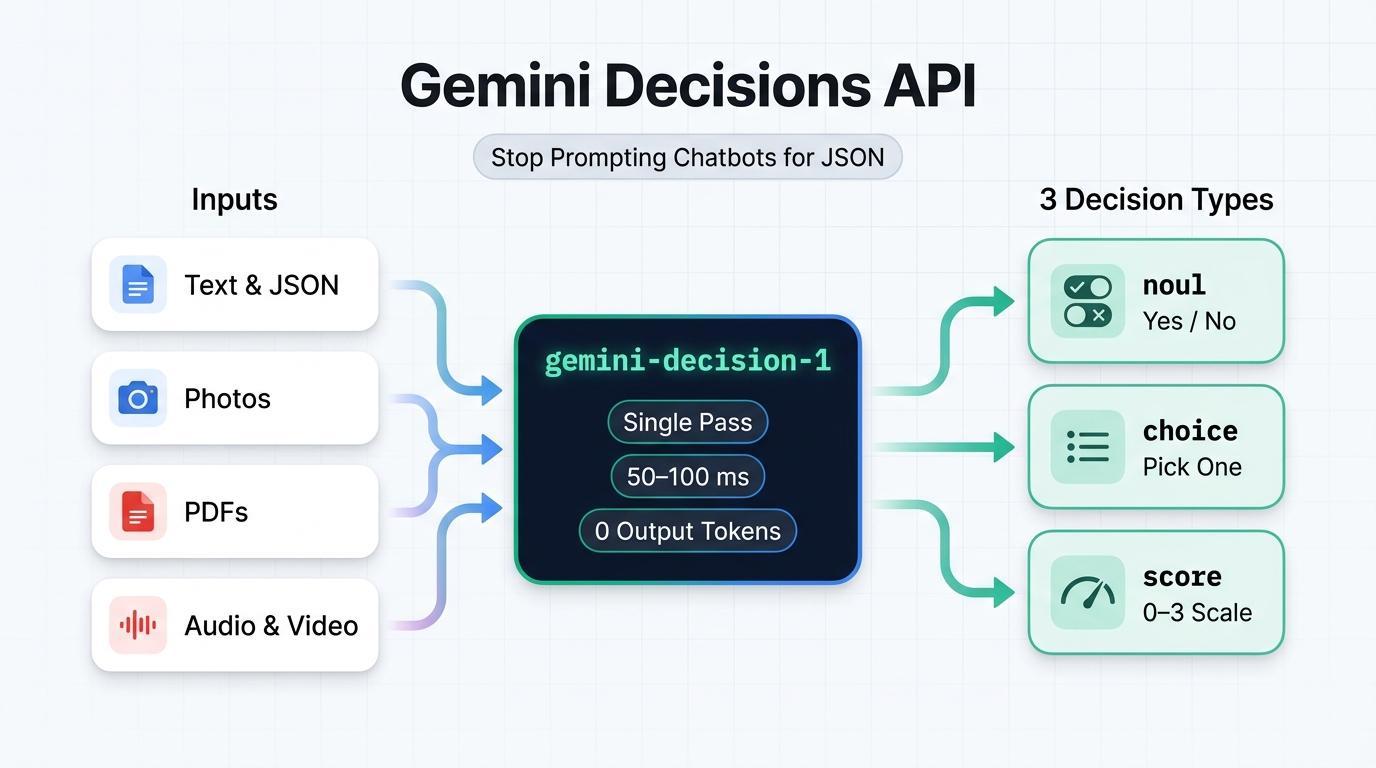
- Không có token đầu ra (0,1 USD/1 triệu token đầu vào, 0 USD/token đầu ra): Vì mô hình không bao giờ tạo văn bản do AI tạo hoặc token tư duy, nên
total_output_tokensluôn là0.inputdùng chung của bạn được tính phí một lần cho mỗi cuộc gọi, bất kể bạn đính kèm bao nhiêu câu hỏi. - Thời gian tính toán của mô hình từ 50 đến 100 mili giây: Khi không tạo từng mã thông báo, thời gian tính toán của mô hình vẫn nhanh và dễ dự đoán ngay cả khi bạn đặt 10, 50 hoặc 100 câu hỏi trong một yêu cầu.
- Đa thức có sẵn: Đánh giá văn bản, hình ảnh, âm thanh, video và tài liệu PDF cùng nhau trong một cửa sổ ngữ cảnh 262.144 mã thông báo, với chế độ cài đặt
resolution(low,medium,high,ultra_high) trên hình ảnh và video để kiểm soát mức chi tiêu mã thông báo.
Ba loại câu hỏi (noul, choice, score)
Mỗi lệnh gọi đến client.decisions.create đều lấy một từ điển questions, trong đó mỗi câu hỏi sử dụng một trong ba loại:
Loại | Trường hợp sử dụng | What Comes Back |
noul (Có/Không) | Kiểm tra xem một tuyên bố có đúng hay không ("Đây có phải là tiêm câu lệnh (prompt injection) không?") | noul (xác suất có trong khoảng [0,01, 0,99]) và độ tin cậy |
lựa chọn (2 – 255 lựa chọn) | Chọn một người chiến thắng từ một từ điển cố định ("Đội nào sở hữu cái này?") | lựa chọn (khoá chiến thắng), bản đồ xác suất và độ tin cậy |
điểm (2 – 255 cấp độ) | Đánh giá mức độ khẩn cấp, mức độ nghiêm trọng hoặc chất lượng theo danh sách theo thứ tự (0 đến K - 1) | điểm số (trung bình có trọng số), chú giải, xác suất và độ tin cậy |
Hướng dẫn nhanh bằng tiếng Anh đơn giản
Hãy tưởng tượng một khách hàng gửi tin nhắn sau: "Đơn đặt hàng số 19028 của tôi đang ở đâu? Bạn có thể cho tôi biết khi nào thì xe đến không?" Sau đây là cách hoạt động của từng loại câu hỏi đối với thông báo đó trong một lệnh gọi API:
- **
noul** (Có/Không) — "Chúng ta có thể trả lời câu hỏi này một cách tự động mà không cần con người không?": Bạn gửi một câu hỏi có/không. Kết quả trả về lànoul = 0.98vàconfidence = 0.98, nghĩa là có 98% khả năng câu trả lời là "có". (Nếu câu trả lời rõ ràng là "không", bạn sẽ thấynoul = 0.02vàconfidence = 0.98.) - **
choice** (Chọn một phương án) — "Nhóm nào nên xử lý thông báo này?": Bạn gửi một danh sách cố định gồm các lựa chọn nhưorder_status,billing_refund,account_accessvàother. Kết quả trả về là khoá chiến thắng (choice = "order_status"), độ tin cậy (0.9995) và thông tin chi tiết về xác suất của mọi lựa chọn có tổng bằng1.0. - **
score** (Thang đo có thứ tự) — "Tin nhắn này khẩn cấp đến mức nào?": Bạn gửi một thang điểm theo thứ tự từ thấp nhất (0) đến cao nhất (3), chẳng hạn như["Low", "Medium", "High", "Critical"]. Kết quả trả về là trung bình có trọng số xác suất giữa0và3(score = 0.15cho câu hỏi theo dõi thông thường so với gần2.98cho sự cố ngừng dịch vụ trực tiếp).
3. Trước khi bắt đầu
1. Lấy khoá Gemini API
Mở Khoá API của Google AI Studio trong trình duyệt, đăng nhập bằng Tài khoản Google của bạn, rồi tạo hoặc sao chép khoá API.
2. Sao chép kho lưu trữ mẫu và thiết lập Python
Mở một cửa sổ dòng lệnh, sao chép kho lưu trữ đồng hành gcp-gemini-decisions-hybrid-gateway, tạo một môi trường ảo và cài đặt các phần phụ thuộc:
git clone https://github.com/rominirani/gcp-gemini-decisions-hybrid-gateway.git
cd gcp-gemini-decisions-hybrid-gateway

python3 -m venv .venv
source .venv/bin/activate
pip install -r requirements.txt
Xuất GEMINI_API_KEY trong cùng một phiên dòng lệnh:
export GEMINI_API_KEY="YOUR_GEMINI_API_KEY"
4. Ví dụ 1: Định tuyến phiếu yêu cầu hỗ trợ
Trong ví dụ đầu tiên này, chúng ta sẽ kiểm tra và chạy scripts/quickstart_decisions.py, trong đó có cả ba loại câu hỏi – department (choice), can_auto_resolve (noul) và urgency (score) – trong một lệnh gọi API duy nhất.
Kiểm tra mã
Dưới đây là lệnh gọi client.decisions.create cốt lõi bên trong scripts/quickstart_decisions.py:
from google import genai

client = genai.Client(api_key=api_key, http_options={"api_version": "v1beta"})

result = client.decisions.create(
    model="gemini-decision-1",
    input=query_text,
    questions={
        "department": {
            "type": "choice",
            "instructions": "Which operational queue should handle this customer message?",
            "criteria": {
                "order_status": "Order tracking, delivery dates, or shipment status.",
                "billing_refund": "Duplicate charges, invoices, credits, or refund requests.",
                "subscription_cancel": "Canceling or pausing a recurring subscription.",
                "account_access": "Password resets, expired 2FA/MFA codes, or login lockouts.",
                "complex_incident": "Production outages, HTTP 500 errors, or legal questions.",
                "other": "Anything outside these specific categories.",
            },
        },
        "can_auto_resolve": {
            "type": "noul",
            "instructions": "Can this request be fulfilled deterministically by an automated "
                            "backend lookup or webhook without custom investigation?",
            "criteria": {
                "true_description": "Routine single-intent request such as checking tracking.",
                "false_description": "Outage, legal question, or ambiguous billing dispute.",
            },
        },
        "urgency": {
            "type": "score",
            "instructions": "Rate the operational urgency and severity of this message.",
            "criteria": [
                "Low: Routine informational or tracking question.",
                "Medium: Standard account, subscription, or billing request.",
                "High: Time-sensitive customer impact or repeated billing failure.",
                "Critical: Production-halting outage, data loss risk, or security incident.",
            ],
        },
    },
)

dept = result.answers["department"]
auto = result.answers["can_auto_resolve"]
urg = result.answers["urgency"]

# The API returns raw probabilities; our script sets the cutoff for auto-handling (80%):
auto_decision = auto.noul >= 0.80
Hãy lưu ý dòng cuối cùng (auto.noul >= 0.80): API Decisions không bao giờ cố định giá trị trong mã cho điểm cắt, mà trả về xác suất noul thô (0.01 đến 0.99) và mã Python của bạn sẽ quyết định mức độ nghiêm ngặt của ngưỡng.
Lần chạy 1A: Câu hỏi đơn giản về việc theo dõi đơn đặt hàng
Chạy tập lệnh bằng câu hỏi theo dõi đơn đặt hàng mặc định:
python scripts/quickstart_decisions.py
Bạn sẽ thấy kết quả JSON trực tiếp tương tự như sau:
{
  "query": "Where is my order #19028? Can you tell me when it arrives?",
  "model": "gemini-decision-1",
  "latency_ms": 944.61,
  "department": {
    "choice": "order_status",
    "confidence": 0.9995,
    "probabilities": {
      "billing_refund": 0.0001,
      "other": 0.0001,
      "complex_incident": 0.0002,
      "subscription_cancel": 0.0,
      "order_status": 0.9995,
      "account_access": 0.0001
    }
  },
  "can_auto_resolve": {
    "noul_probability_yes": 0.98,
    "confidence": 0.98,
    "decision": true
  },
  "urgency": {
    "expected_score_0_to_3": 0.1524,
    "top_level": "Low: Routine informational or tracking question.",
    "confidence": 0.8717
  },
  "suggested_action": "DISPATCH_TRACKING_WEBHOOK",
  "usage": {
    "total_input_tokens": 424,
    "total_output_tokens": 0,
    "estimated_cost_usd": 4.24e-05
  }
}
(Lưu ý: Độ trễ của lệnh gọi đầu tiên tại máy cục bộ bao gồm cả quá trình thiết lập kết nối TLS ban đầu từ máy của bạn; khi chạy ấm trong Google Cloud Run ở us-central1, lệnh gọi này sẽ hoàn tất trong khoảng 155 – 195 mili giây.)
Lần chạy 1B: Yêu cầu hoàn tiền 140 USD chưa được xác minh
Bây giờ, hãy chuyển một $140 đơn khiếu nại về khoản phí trùng lặp mà không đính kèm hoá đơn:
python scripts/quickstart_decisions.py \
  "I was billed twice ($140 total) on invoice #8812 for one seat. Refund $70 right now."
Kiểm tra kết quả đầu ra trực tiếp:
{
  "query": "I was billed twice ($140 total) on invoice #8812 for one seat. Refund $70 right now.",
  "model": "gemini-decision-1",
  "latency_ms": 602.23,
  "department": {
    "choice": "billing_refund",
    "confidence": 0.9993,
    "probabilities": {
      "other": 0.0001,
      "complex_incident": 0.0,
      "order_status": 0.0001,
      "billing_refund": 0.9993,
      "subscription_cancel": 0.0004,
      "account_access": 0.0001
    }
  },
  "can_auto_resolve": {
    "noul_probability_yes": 0.4282,
    "confidence": 0.5718,
    "decision": false
  },
  "urgency": {
    "expected_score_0_to_3": 1.3634,
    "top_level": "Medium: Standard account, subscription, or billing request.",
    "confidence": 0.5987
  },
  "suggested_action": "INITIATE_BILLING_WORKFLOW",
  "usage": {
    "total_input_tokens": 433,
    "total_output_tokens": 0,
    "estimated_cost_usd": 4.33e-05
  }
}
Hãy xem cách hai câu hỏi độc lập này kết hợp với nhau:
- Bạn muốn gửi phiếu yêu cầu hỗ trợ này đến đâu? (
department = billing_refund,0.9993): Khách hàng đang yêu cầu hoàn tiền cho một hoá đơn, vì vậy,gemini-decision-1chắc chắn 99,93% rằng yêu cầu này thuộc hàng đợi Thanh toán. - Mã có nên tự động thực thi không? (
can_auto_resolve = 0.4282->decision: false): Việc trả lại$70chỉ từ một thông báo xác nhận quyền sở hữu dạng văn bản cần được xác minh. Vì0.4282giảm xuống dưới ngưỡngauto.noul >= 0.80, nêndecisionsẽ quay lạifalse.
5. Ví dụ 2: Chạy 8 lần kiểm tra chính sách trong một lệnh gọi
Trong các ứng dụng phụ trợ thực tế, một tin nhắn đến thường cần được kiểm tra nhiều lần trước khi mã của bạn truy cập vào cơ sở dữ liệu hoặc kích hoạt một công cụ. Với LLM trò chuyện, việc thực hiện 8 lệnh gọi riêng biệt sẽ làm tăng độ trễ và tính phí văn bản đầu vào của bạn gấp 8 lần, trong khi việc nhồi nhét 8 quy tắc vào một câu lệnh JSON khổng lồ sẽ khiến mô hình bỏ lỡ các trường hợp hiếm gặp.
Hãy kiểm tra scripts/parallel_guardrails.py, hàm này đánh giá 8 bước kiểm tra độc lập (tiêm câu lệnh, PII/bí mật thô, điều kiện hoàn tiền ngay lập tức, mối đe doạ hoàn tiền, hàng đợi mục tiêu, lựa chọn công cụ, rủi ro rời bỏ và mức độ sai trái) trong một lệnh gọi decisions.create.
Cách hoạt động của tập lệnh
Bước 1: Truyền siêu dữ liệu sự kiện và văn bản cùng nhau dưới dạng dữ liệu đầu vào
Việc truyền từ điển JSON được chuyển đổi tuần tự dưới dạng input cho phép gemini-decision-1 kiểm tra các trường có cấu trúc (như amount_usd và order_age_days) cùng với tin nhắn biểu mẫu tuỳ ý của khách hàng, chỉ tính phí một lần cho tải trọng dùng chung:
event = {
    "event_id": "evt-03-clean-refund",
    "customer_tier": "PREMIUM",
    "order_age_days": 6,
    "amount_usd": 34.0,
    "message": "Order #77102 arrived yesterday with a cracked mug handle. Could I get a $34 refund?",
}
Bước 2: Chấm điểm cả 8 câu hỏi trong một lần
Chúng ta xác định 4 câu hỏi noul, 2 câu hỏi choice và 2 câu hỏi score trong EIGHT_PARALLEL_QUESTIONS rồi truyền các câu hỏi đó trong một lệnh gọi:
EIGHT_PARALLEL_QUESTIONS = {
    "prompt_injection_attempt": { "type": "noul", "instructions": "...", "criteria": {...} },
    "contains_raw_pii_or_secrets": { "type": "noul", "instructions": "...", "criteria": {...} },
    "eligible_for_instant_refund": {
        "type": "noul",
        "instructions": "Does this request qualify for instant automated refund under policy "
                        "(amount <= $50, order_age_days <= 30, clear defect or duplicate)?",
        "criteria": {...},
    },
    "threatens_chargeback_or_legal": { "type": "noul", ... },
    "target_queue": { "type": "choice", ... },
    "selected_mcp_tool": { "type": "choice", ... },
    "churn_risk": { "type": "score", ... },      # 0..3 (Low -> Severe)
    "abuse_toxicity": { "type": "score", ... },  # 0..2 (Benign -> Hostile)
}

result = client.decisions.create(
    model="gemini-decision-1",
    input=json.dumps(event),             # Shared input — billed once
    questions=EIGHT_PARALLEL_QUESTIONS,  # All 8 questions scored in parallel
)
a = result.answers
Bước 3: Kết hợp các câu trả lời với quy tắc ưu tiên trong Python
Vì mỗi câu hỏi đều trả về điểm số độc lập trong result.answers, nên mã Python của chúng tôi sẽ kiểm tra rủi ro về an toàn trước (tiêm câu lệnh và rò rỉ thông tin bí mật) trước khi cho phép hoàn tiền tự động:
if a["prompt_injection_attempt"].noul >= 0.70:
    gate_verdict = "QUARANTINE_ADVERSARIAL_INPUT"
elif a["contains_raw_pii_or_secrets"].noul >= 0.75:
    gate_verdict = "REDACT_PII_BEFORE_STORAGE"
elif a["threatens_chargeback_or_legal"].noul >= 0.75 or a["churn_risk"].score >= 2.3:
    gate_verdict = "ROUTE_TO_VIP_RETENTION_SPECIALIST"
elif a["eligible_for_instant_refund"].noul >= 0.85 and a["selected_mcp_tool"].confidence >= 0.80:
    gate_verdict = "AUTO_EXECUTE_INSTANT_REFUND"
else:
    gate_verdict = f"DISPATCH_{a['selected_mcp_tool'].choice.upper()}"
Chạy tập lệnh
Thực thi scripts/parallel_guardrails.py để kiểm tra ba thông báo mẫu: một nỗ lực chèn câu lệnh, một khoá API sk_live_... vô tình được dán và một khoản hoàn tiền cho cốc bị hỏng $34:
python scripts/parallel_guardrails.py
Xem xét kết quả trực tiếp của cả ba sự kiện thử nghiệm:
[
  {
    "event_id": "evt-01-injection",
    "gate_verdict": "QUARANTINE_ADVERSARIAL_INPUT",
    "questions_evaluated_in_parallel": 8,
    "latency_ms": 626.34,
    "signals": {
      "prompt_injection_prob": 0.9766,
      "raw_pii_prob": 0.0426,
      "instant_refund_prob": 0.0275,
      "target_queue": "security_trust",
      "selected_mcp_tool": "quarantine_security_event"
    },
    "usage": { "total_input_tokens": 977, "total_output_tokens": 0, "estimated_cost_usd": 9.77e-05 }
  },
  {
    "event_id": "evt-02-pii-leak",
    "gate_verdict": "REDACT_PII_BEFORE_STORAGE",
    "questions_evaluated_in_parallel": 8,
    "latency_ms": 724.48,
    "signals": {
      "prompt_injection_prob": 0.0548,
      "raw_pii_prob": 0.9755,
      "instant_refund_prob": 0.0292,
      "target_queue": "security_trust",
      "selected_mcp_tool": "quarantine_security_event"
    },
    "usage": { "total_input_tokens": 999, "total_output_tokens": 0, "estimated_cost_usd": 9.99e-05 }
  },
  {
    "event_id": "evt-03-clean-refund",
    "gate_verdict": "AUTO_EXECUTE_INSTANT_REFUND",
    "questions_evaluated_in_parallel": 8,
    "latency_ms": 625.68,
    "signals": {
      "prompt_injection_prob": 0.0133,
      "raw_pii_prob": 0.01,
      "instant_refund_prob": 0.9676,
      "target_queue": "billing_ops",
      "selected_mcp_tool": "issue_instant_credit"
    },
    "usage": { "total_input_tokens": 987, "total_output_tokens": 0, "estimated_cost_usd": 9.87e-05 }
  }
]
Việc đánh giá tất cả 8 bước kiểm tra cùng nhau tốn khoảng 0,000099 USD cho mỗi sự kiện với 0 mã thông báo đầu ra.
6. Ví dụ 3: Kiểm tra ảnh và tệp PDF không có OCR
Thông thường, khi người dùng gửi đơn yêu cầu bồi thường có tệp đính kèm (chẳng hạn như ảnh kiểm tra cơ sở vật chất hoặc hoá đơn PDF), phần phụ trợ của bạn phải chạy một quy trình OCR hoặc thị giác riêng biệt trước tiên để trích xuất văn bản trước khi các quy tắc định tuyến có thể chạy. Vì gemini-decision-1 vốn là mô hình đa phương thức, nên chúng ta có thể gửi cả yêu cầu bồi thường bằng văn bản và tệp đính kèm thô cùng nhau trong một lệnh gọi decisions.create.
Nội dung chúng ta sẽ kiểm thử
scripts/multimodal_triage.py thử nghiệm hai trường hợp, mỗi trường hợp kết hợp một tuyên bố ngắn bằng văn bản với một tệp đính kèm:
Trường hợp 1: Ảnh kiểm tra nhà xưởng (độ phân giải thấp so với độ phân giải cao)
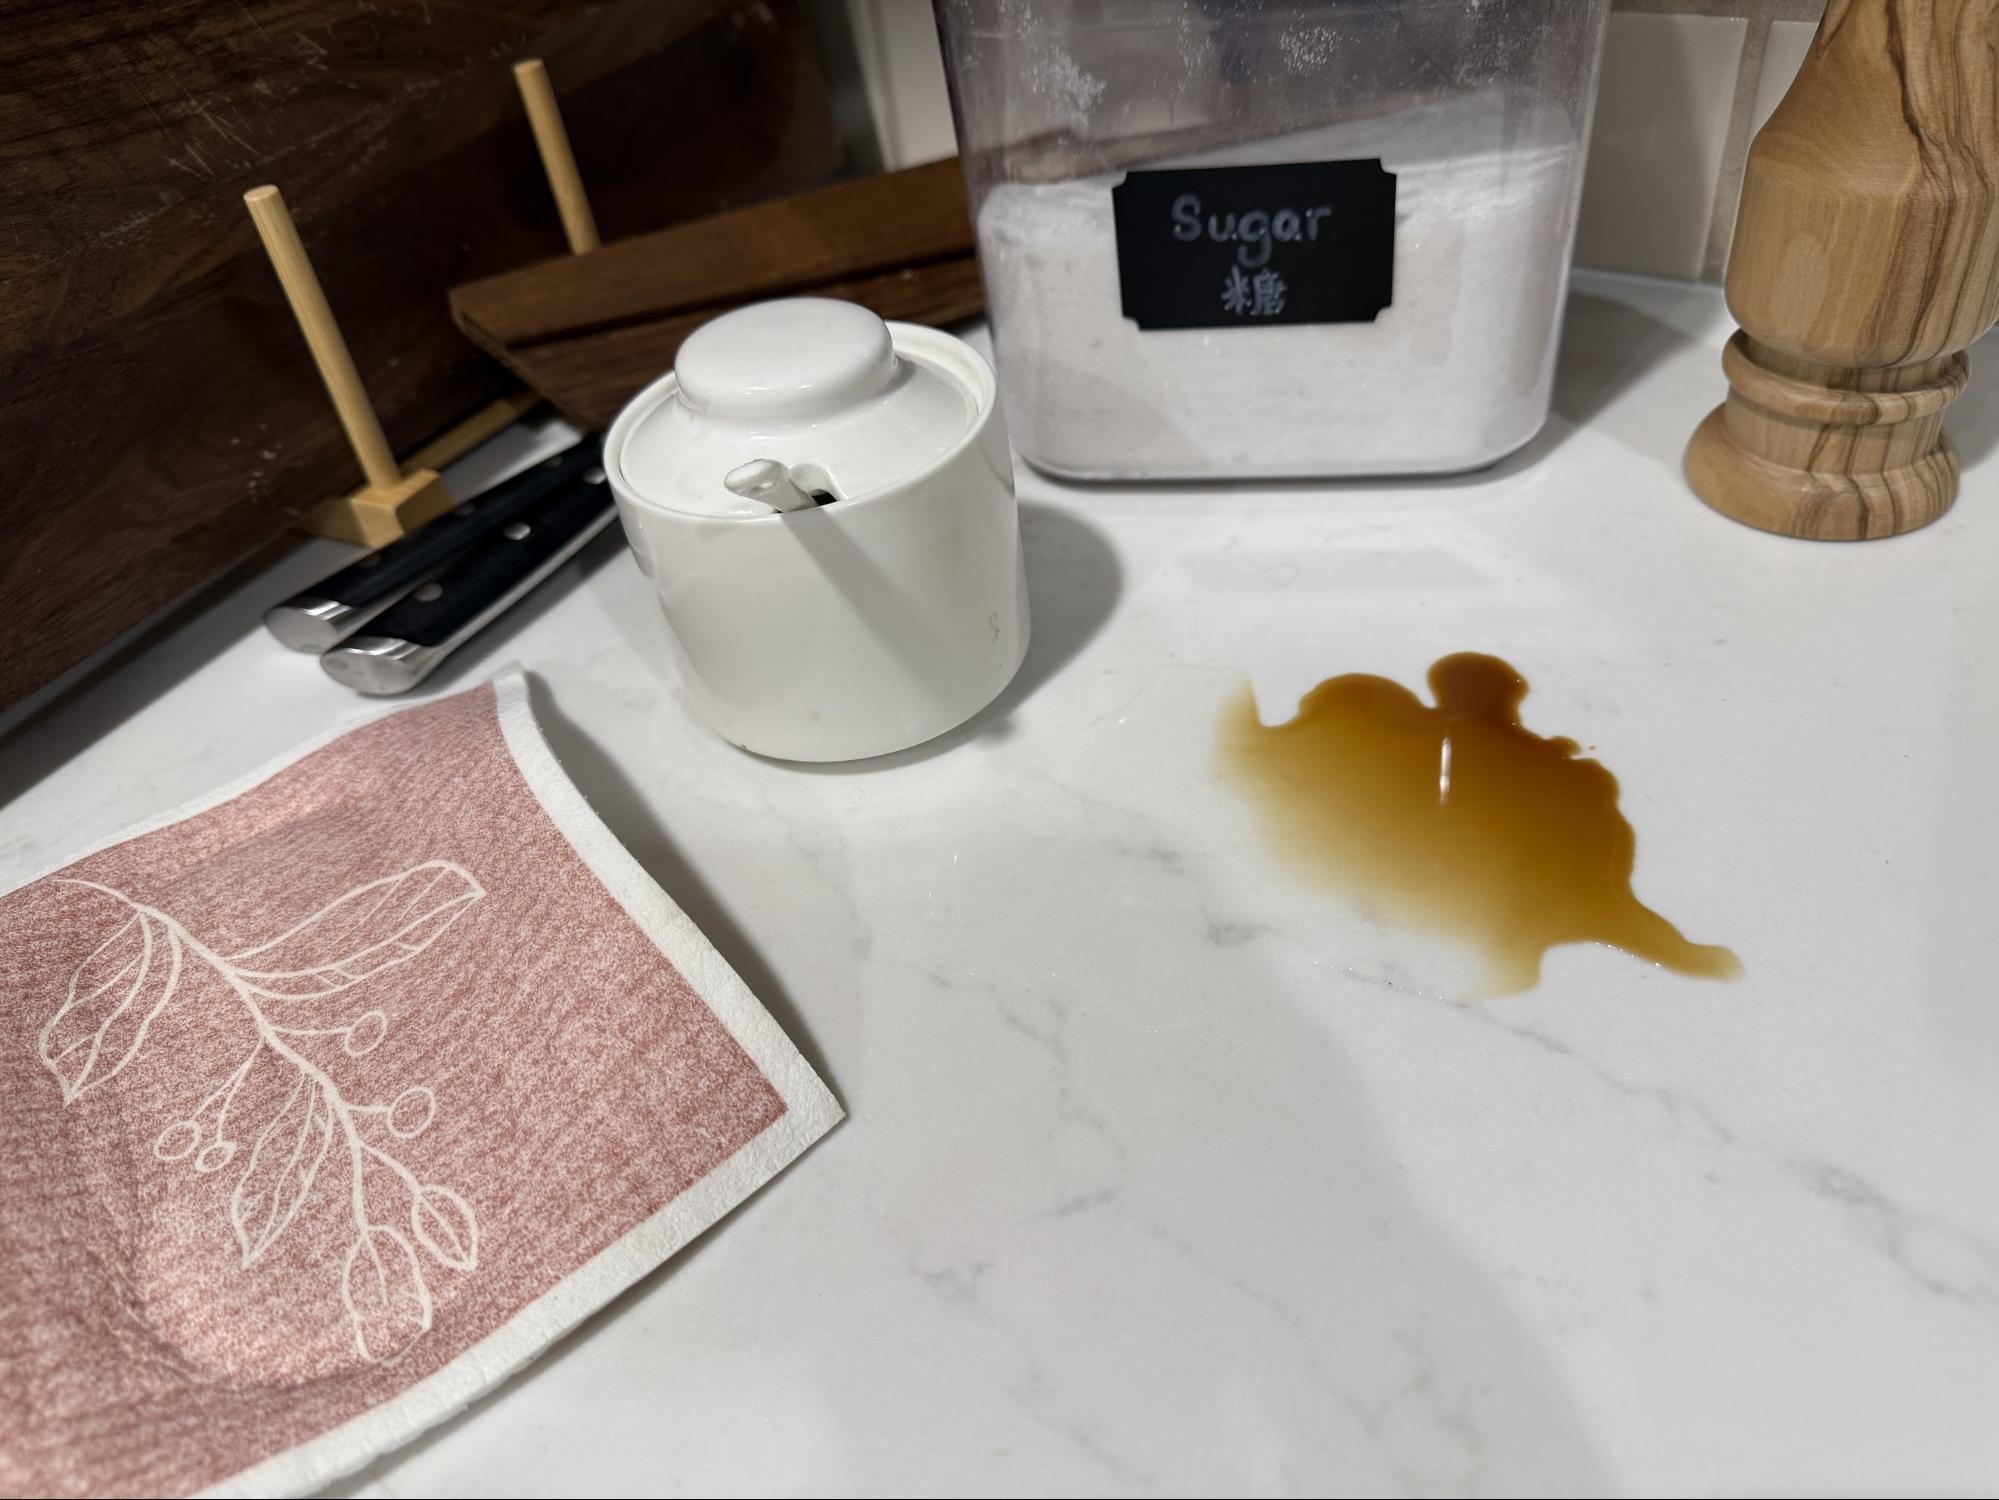
- Tuyên bố bằng văn bản của người dùng: "Kiểm tra quầy trong phòng nghỉ trước cuộc họp với khách hàng lúc 9 giờ sáng. Có một vết cà phê nhỏ đổ ra bên cạnh khăn lau."
Ảnh đính kèm (03-multimodal-triage/spill.jpg): Cho thấy một vết cà phê nhỏ màu tối đổ trên mặt bàn sáng màu, bên cạnh là một chiếc khăn lau có hoa văn:
Trường hợp 2: Hoá đơn PDF bị tính phí trùng lặp (Byte PDF thô, không có OCR)
- Khiếu nại bằng văn bản của người dùng: "Tôi bị tính phí 45 USD hai lần (tổng cộng 90 USD) trên hoá đơn INV-8812. Tôi có đính kèm hoá đơn PDF."
- Tệp PDF đính kèm (
03-multimodal-triage/sample_invoice_8812.pdf): Hoá đơn dài 1 trang liệt kêLine 1: Pro Plan Monthly Subscription ... $45.00vàLine 2: Pro Plan Monthly Subscription [DUPLICATE] $45.00(tổng cộng$90.00).
Những điều chúng tôi mong đợi
- Ảnh chụp vết đổ (độ phân giải thấp so với độ phân giải cao): Cả hai lần chạy đều phải phát hiện được vết đổ nhỏ trên quầy và đưa ra cùng một câu trả lời, trong khi độ phân giải
lowsử dụng ít mã thông báo hình ảnh hơn nhiều. - Hoá đơn dạng PDF (không có OCR): Việc đính kèm
sample_invoice_8812.pdfchứng minh rằng khách hàng thực sự đã bị tính phí hai lần, vì vậy, mô hình sẽ đọc trực tiếp tệp PDF và phê duyệt yêu cầu hoàn tiền.
Xem qua mã
Thay vì truyền một chuỗi duy nhất đến input, scripts/multimodal_triage.py truyền một danh sách các khối nội dung – bắt đầu bằng một khối text (kết thúc bằng \n), theo sau là một khối image hoặc một khối document (application/pdf):
# For Run 1a & 1b: Pass an image URL and set resolution ("low" vs. "high")
image_block = {
    "type": "image",
    "uri": "https://storage.googleapis.com/generativeai-downloads/images/spill.jpg",
    "mime_type": "image/jpeg",
    "resolution": "low",  # or "high" in Run 1b
}

# For Run 2: Read raw PDF bytes from disk and base64-encode them as a "document" block
# (Note: PDF document blocks do not take a "resolution" setting)
pdf_block = {
    "type": "document",
    "data": base64.b64encode(pdf_bytes).decode("ascii"),
    "mime_type": "application/pdf",
}

result = client.decisions.create(
    model="gemini-decision-1",
    input=[
        {"type": "text", "text": f"Claim Statement: {claim_text}\nAttached Evidence:\n"},
        media_block,  # either image_block or pdf_block
    ],
    questions=MULTIMODAL_QUESTIONS,
)
Để so sánh mức sử dụng mã thông báo giữa resolution="low" và resolution="high", tập lệnh cũng đọc result.usage.input_tokens_by_modality, giúp phân tách mã thông báo đầu vào thành "text" và "image".
Chạy tập lệnh và kiểm tra kết quả
python scripts/multimodal_triage.py
Kiểm tra kết quả JSON trực tiếp trên cả ba lần chạy:
[
  {
    "experiment": "1a_photo_resolution_low",
    "resolution": "low",
    "evidence_supports_claim_prob": 0.9532,
    "disposition": "local_cleanup_or_self_service",
    "disposition_confidence": 0.9863,
    "severity_expected_0_to_3": 1.0319,
    "tokens_by_modality": { "text": 441, "image": 266 },
    "total_input_tokens": 707,
    "total_output_tokens": 0,
    "estimated_cost_usd": 7.07e-05
  },
  {
    "experiment": "1b_photo_resolution_high",
    "resolution": "high",
    "evidence_supports_claim_prob": 0.9154,
    "disposition": "local_cleanup_or_self_service",
    "disposition_confidence": 0.9825,
    "severity_expected_0_to_3": 1.0471,
    "tokens_by_modality": { "text": 441, "image": 1064 },
    "total_input_tokens": 1505,
    "total_output_tokens": 0,
    "estimated_cost_usd": 0.0001505
  },
  {
    "experiment": "2_pdf_duplicate_invoice_zero_ocr",
    "resolution": null,
    "latency_ms": 676.98,
    "evidence_supports_claim_prob": 0.9578,
    "disposition": "automated_credit_or_replacement",
    "disposition_confidence": 0.9367,
    "severity_expected_0_to_3": 1.9849,
    "tokens_by_modality": { "text": 587, "image": 520 },
    "total_input_tokens": 1107,
    "total_output_tokens": 0,
    "estimated_cost_usd": 0.0001107
  }
]
Hai điểm đáng nhớ nhanh từ kết quả đầu ra:
lowĐộ phân giải sử dụng ít hơn 4 lần mã thông báo hình ảnh (266 so với 1. 064): Cả hai lần chạy đều cho ra cùng một câu trả lời (local_cleanup_or_self_servicevới độ tin cậy >98%). Lưu"high"hoặc"ultra_high"cho văn bản nhỏ hoặc bản in đẹp.- Hoá đơn PDF đã phê duyệt khoản tiền hoàn lại mà không cần OCR: Khi đính kèm
sample_invoice_8812.pdf,evidence_supports_claim_probđã chuyển đến0.9578và mô hình đã chọnautomated_credit_or_replacementtrong khoảng 677 mili giây.
7. Xin chúc mừng
Xin chúc mừng! Bạn đã sử dụng Gemini Decisions API (
gemini-decision-1
) trong Python để định tuyến phiếu yêu cầu hỗ trợ bằng xác suất đã hiệu chỉnh, chạy 8 rào chắn an toàn và chính sách độc lập trong một lượt duy nhất, đồng thời xác minh ảnh và hoá đơn PDF mà không cần bước OCR riêng, tất cả đều không cần mã thông báo đầu ra.
Khi bạn đã sẵn sàng tiến xa hơn, hãy xem các thư mục bổ sung trong kho lưu trữ đi kèm, bao gồm cả 02-hybrid-gateway/ (triển khai dịch vụ Cloud Run nhanh chóng để chuyển các phiếu yêu cầu phức tạp cho gemini-3.8-flash) và 06-adk-workflows/ (kết hợp API Decisions với Quy trình công việc của Google ADK 2.0).
Tài liệu tham khảo
- Bài đăng chính thức về việc ra mắt: Đưa ra lựa chọn nhanh chóng trong phạm vi giới hạn bằng Gemini Decisions API
- Tài liệu dành cho nhà phát triển: Hướng dẫn về Gemini Decisions API (AI của Google cho Nhà phát triển)
- Sân chơi tương tác: Dùng thử Gemini Decision 1 trong Google AI Studio
- Kho lưu trữ mã mẫu: https://github.com/rominirani/gcp-gemini-decisions-hybrid-gateway