

১. ভূমিকা
আধুনিক এন্টারপ্রাইজ ডেটা ক্লাউডে, যেখানে ডেটা বিভিন্ন ফিজিক্যাল স্টোরেজ সিস্টেম জুড়ে থাকে, সেখানে ফ্র্যাগমেন্টেড নিরাপত্তার একটি বিশাল আর্কিটেকচারাল চ্যালেঞ্জ রয়েছে।
আপনি কীভাবে নিশ্চিত করবেন যে সংবেদনশীল ডেটা (যেমন আর্থিক লেনদেনের পরিমাণ) ধারাবাহিকভাবে সুরক্ষিত থাকে যখন ডেটা শারীরিকভাবে ওপেন-সোর্স ফর্ম্যাটে যেমন Parquet-এ Google Cloud storage-এ স্টোর করা হয় এবং একাধিক বিভিন্ন ইঞ্জিন যেমন BigQuery SQL বা Apache Spark দ্বারা কোয়েরি করা হয়?
এই কোডল্যাবে, আপনি একটি পরিচালিত ডেটা লেকহাউস আর্কিটেকচার তৈরি করবেন যা Apache Iceberg টেবিল, BigQuery এবং Knowledge Catalog ব্যবহার করে এইসব সমস্যার সমাধান করে। আপনি জিরো-ট্রাস্ট নিরাপত্তা নীতি এবং বিভিন্ন কম্পিউট ইঞ্জিন জুড়ে কীভাবে সেগুলি ডাইনামিকভাবে এনফোর্স করা হয় তা নির্ধারণ করতে ইনফ্রাস্ট্রাকচার অ্যাজ কোড (IaC) ব্যবহার করবেন।
পূর্বশর্ত
- বিলিং চালু করা আছে এমন একটি Google Cloud প্রোজেক্ট।
- SQL, IAM ও Cloud Storage-এর ধারণা সম্পর্কে প্রাথমিক জ্ঞান।
আপনি কী শিখবেন
- কীভাবে BigQuery-তে Apache Iceberg-এর জন্য Google Cloud Lakehouse টেবিল তৈরি করতে হয় যেখানে Cloud Storage নেটিভভাবে ডেটা হোল্ড করে।
- কলাম-লেভেল নিরাপত্তা ও ডেটা মাস্কিংয়ের জন্য নীতি ট্যাগ ব্যবহার করে কীভাবে সেন্ট্রালাইজড ডেটা নীতি প্রয়োগ করতে হয়।
- ক্লাউড রিসোর্স কানেকশন ব্যবহার করে কীভাবে লজিক্যাল ডেটা অ্যাক্সেস থেকে ফিজিক্যাল স্টোরেজ অ্যাক্সেস ডিকাপল করবেন।
- ওপেন-সোর্স ইঞ্জিন যাতে গভর্নেন্স বাইপাস করতে না পারে তা নিশ্চিত করতে, Apache Spark-এর জন্য ম্যানেজ করা পরিষেবা ব্যবহার করে কীভাবে জিরো-ট্রাস্ট কম্পিউট ডেলিগেশন এনফোর্স করা যায়।
- ডেটা লিনেজ কীভাবে অটোমেটিক ভিজ্যুয়ালাইজ করবেন।
আর্কিটেকচার ওভারভিউ: Iceberg-এ ইউনিভার্সাল গভর্নেন্স
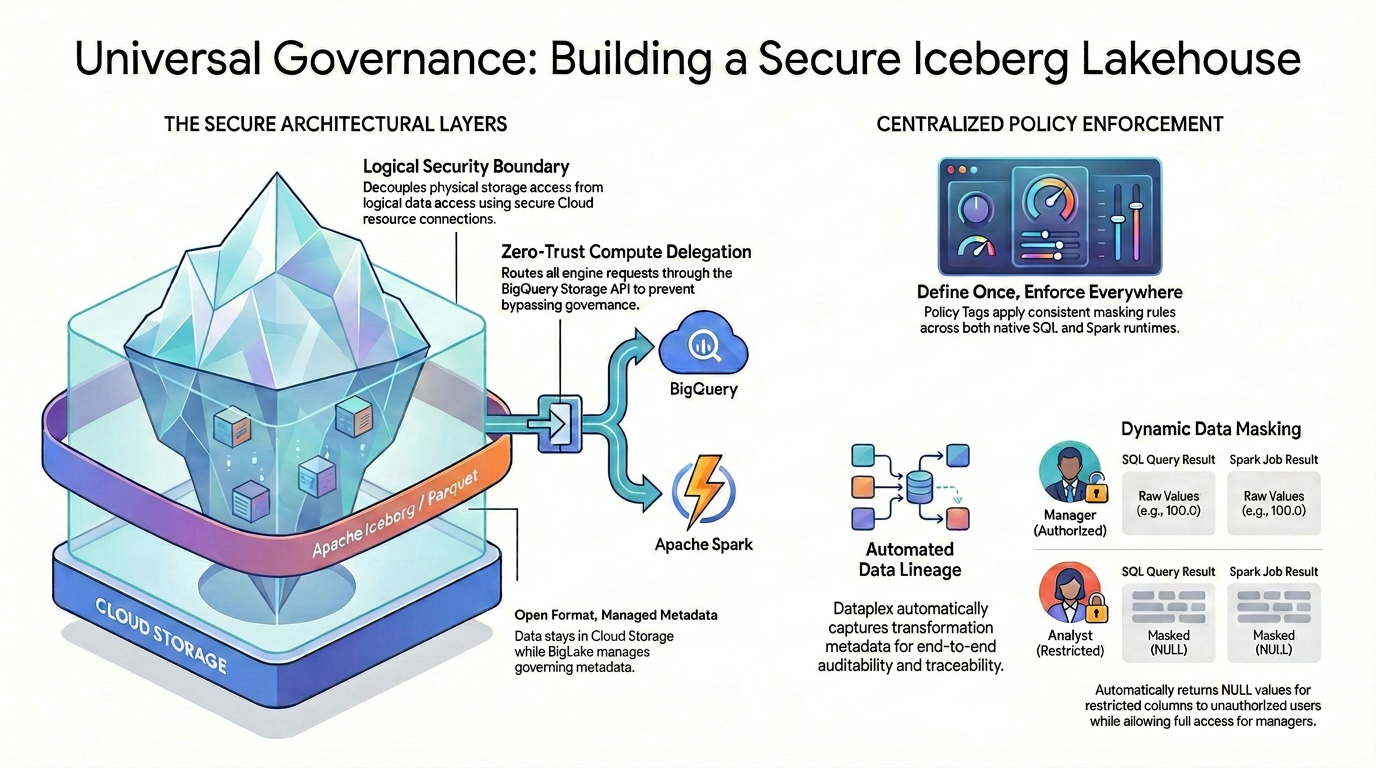
ওপেন-সোর্স ডেটা ফর্ম্যাটে ফাইন-গ্রেনড অ্যাক্সেস কন্ট্রোল (যেমন কলাম-লেভেল নিরাপত্তা ও ডেটা মাস্কিং) অর্জন করতে, আপনাকে অবশ্যই একটি কঠোর এবং ইউনিফায়েড নিরাপত্তা আর্কিটেকচার তৈরি করতে হবে।
ডায়াগ্রামে যেমন দেখানো হয়েছে, এই পরিচালিত লেকহাউস প্যাটার্ন ফ্র্যাগমেন্টেড নিরাপত্তা সংক্রান্ত চ্যালেঞ্জের সমাধান করতে দুটি প্রধান স্তম্ভের উপর নির্ভর করে:
🛡️ সুরক্ষিত আর্কিটেকচারাল লেয়ার (বাঁদিকে)
ব্যবহারকারী বা এক্সটার্নাল ইঞ্জিনকে সরাসরি Cloud Storage অ্যাক্সেস করার অনুমতি দেওয়ার পরিবর্তে—যা শুধুমাত্র ব্রড বাকেট-লেভেল নিরাপত্তা প্রদান করে: আপনি একটি নিরাপদ ভিত্তি তৈরি করেন।
- ওপেন ফর্ম্যাট, ম্যানেজ করা মেটাডেটা: ওপেন Apache Iceberg (Parquet) ফর্ম্যাট ব্যবহার করে ডেটা ফিজিক্যালি Cloud Storage-এ থাকে, যেখানে Lakehouse নির্বিঘ্নে গভর্নিং মেটাডেটা ম্যানেজ করে।
- লজিক্যাল নিরাপত্তা বাউন্ডারি: আপনি একটি নিরাপদ ক্লাউড রিসোর্স কানেকশন ব্যবহার করে লজিক্যাল ডেটা অ্যাক্সেস থেকে ফিজিক্যাল স্টোরেজ অ্যাক্সেস ডিকাপল করেন। ব্যবহারকারীদের কখনই র GCS ফাইলে সরাসরি ফিজিক্যাল IAM অ্যাক্সেস দেওয়া হয় না।
- জিরো-ট্রাস্ট কম্পিউট ডেলিগেশন: কোনও এক্সিকিউশন ইঞ্জিন যাতে গভর্নেন্স সংক্রান্ত নিয়ম এড়িয়ে যেতে না পারে তা নিশ্চিত করতে, ডেটা রিড করার সব অনুরোধ BigQuery Storage API-এর মাধ্যমে কঠোরভাবে রুট করা হয়। কোয়েরি নেটিভ BigQuery SQL বা ওপেন-সোর্স Apache Spark থেকে তৈরি হলেও এটি প্রযোজ্য।
🎯 সেন্ট্রালাইজড নীতি এনফোর্সমেন্ট (ডানদিকে)
নিরাপদ ফাউন্ডেশন সহ, নলেজ ক্যাটালগ গভর্নেন্সের জন্য ইউনিফায়েড ব্রেন হিসেবে কাজ করে:
- একবার নির্ধারণ করুন, সব জায়গায় প্রয়োগ করুন: আপনি নলেজ ক্যাটালগে আপনার নীতি ট্যাগ একবারই নির্ধারণ করেন এবং আর্কিটেকচারটি সমস্ত সমর্থিত এক্সিকিউশন রানটাইম জুড়ে সর্বজনীনভাবে সামঞ্জস্যপূর্ণ মাস্কিং নিয়ম প্রয়োগ করে।
- ডায়নামিক ডেটা মাস্কিং: ডেটা কোয়েরি করা হলে, সিস্টেম ব্যবহারকারীর পরিচয় তৎক্ষণাৎ মূল্যায়ন করে। অনুমোদিত ব্যবহারকারীরা SQL এবং Spark, দুটিতেই র, আনমাস্ক করা ভ্যালু (যেমন, ১০০.০) দেখতে পাবেন, তবে সীমাবদ্ধ ব্যবহারকারীরা দুটি ইঞ্জিনের ক্ষেত্রেই সীমাবদ্ধ কলামের জন্য অটোমেটিক মাস্ক করা NULL ভ্যালু পাবেন।
- অটোমেটেড ডেটা লিনেজ: ডেটা ফ্লো ও ট্রান্সফর্ম হওয়ার সাথে সাথে, নলেজ ক্যাটালগ অটোমেটিক ট্রান্সফর্মেশন মেটাডেটা ক্যাপচার করে, কাস্টম লগিং কোডের প্রয়োজন ছাড়াই বিল্ট-ইন এন্ড-টু-এন্ড অডিটেবিলিটি ও ট্রেসেবিলিটি প্রদান করে।
২. সেট-আপ ও প্রয়োজনীয়তা
Cloud Shell চালু করুন
আপনার ল্যাপটপ থেকে Google Cloud রিমোটলি অপারেট করা গেলেও, এই কোডল্যাবে আপনি Google Cloud Shell ব্যবহার করবেন, এটি হল ক্লাউডে চলা একটি কমান্ড লাইন এনভায়রনমেন্ট।
Google Cloud Console থেকে, উপরে ডানদিকের টুলবারে Cloud Shell আইকনে ক্লিক করুন:
এনভায়রনমেন্টে প্রভিশন ও কানেক্ট করতে মাত্র কয়েক মুহূর্ত সময় লাগতে পারে। এটি সম্পূর্ণ হয়ে গেলে, আপনি এইরকম কিছু দেখতে পাবেন:
আপনার প্রয়োজনীয় সব ডেভেলপমেন্ট টুল এই ভার্চুয়াল মেশিনে লোড করা আছে। এটি একটি স্থায়ী 5GB হোম ডিরেক্টরি অফার করে এবং Google Cloud-এ চলে, যা নেটওয়ার্ক পারফর্ম্যান্স এবং যাচাইকরণকে ব্যাপকভাবে উন্নত করে। এই কোডল্যাবে আপনার সমস্ত কাজ একটি ব্রাউজারের মধ্যে করা যেতে পারে। আপনাকে কিছু ইনস্টল করতে হবে না।
এনভায়রনমেন্ট শুরু করা
Cloud Shell খুলুন এবং আপনার প্রোজেক্ট ভেরিয়েবল সেট করুন যাতে সব কমান্ড সঠিক ইনফ্রাস্ট্রাকচারকে টার্গেট করে।
export PROJECT_ID=$(gcloud config get-value project)
export REGION="us-central1"
export ICEBERG_BUCKET="iceberg-retail-demo-${PROJECT_ID}"
export DATASET_ID="lakehouse_retail_demo"
export CONN_NAME="iceberg-bq-conn-demo"
তারপর আমাদের দুই ব্যক্তির পরিচয় নির্ধারণ করুন।
export USER_ANALYST="retail-analyst-demo"
export EMAIL_ANALYST="${USER_ANALYST}@${PROJECT_ID}.iam.gserviceaccount.com"

export USER_MANAGER="retail-manager-demo"
export EMAIL_MANAGER="${USER_MANAGER}@${PROJECT_ID}.iam.gserviceaccount.com"
export CURRENT_USER=$(gcloud config get-value account)
API চালু করুন
প্রয়োজনীয় Google Cloud পরিষেবা চালু করুন।
gcloud services enable \
  bigquery.googleapis.com \
  bigqueryconnection.googleapis.com \
  datacatalog.googleapis.com \
  bigquerydatapolicy.googleapis.com \
  datalineage.googleapis.com \
  dataplex.googleapis.com \
  dataproc.googleapis.com \
  storage-component.googleapis.com
Codelab সোর্স কোড ডাউনলোড করুন
আপনার Cloud Shell-এ বিশৃঙ্খলা এড়াতে, আপনি Google Cloud DevRel রিপোজিটরি থেকে এই কোডল্যাবের জন্য শুধুমাত্র প্রয়োজনীয় Python স্ক্রিপ্ট ডাউনলোড করতে একটি স্পার্স চেকআউট করবেন।
# Shallow clone without full history
git clone --depth 1 --filter=blob:none --sparse https://github.com/GoogleCloudPlatform/devrel-demos.git
cd devrel-demos

# Download only the specific folder
git sparse-checkout set data-analytics/governed-lakehouse
cd data-analytics/governed-lakehouse
স্টোরেজ তৈরি করুন
অত্যন্ত সুরক্ষিতভাবে পরিচালিত Iceberg ডেটা রাখার জন্য বাকেট তৈরি করুন।
gcloud storage buckets create gs://${ICEBERG_BUCKET} --location=${REGION}
পরিচয় ও নিরাপত্তা সংক্রান্ত তথ্য প্রস্তুত করা
ক্লাউড রিসোর্স কানেকশন কনফিগার করুন। এটিই একমাত্র এন্টিটি যার কাছে র আইসবার্গ ফাইল পড়ার জন্য স্থায়ী ফিজিক্যাল IAM কী আছে।
# Create the BigQuery connection
bq mk --connection \
    --connection_type=CLOUD_RESOURCE \
    --location=${REGION} \
    ${CONN_NAME}

# Retrieve the connection's automatically generated Service Account
export BQ_CONN_SVC_ACCT=$(bq show --format=json --connection ${REGION}.${CONN_NAME} \
    | jq -r '.cloudResource.serviceAccountId')

# Grant Storage Object Admin to the connection for the Iceberg bucket
gcloud storage buckets add-iam-policy-binding gs://${ICEBERG_BUCKET} \
    --member="serviceAccount:${BQ_CONN_SVC_ACCT}" \
    --role="roles/storage.objectAdmin" \
    --quiet
এরপর, ব্যবহারকারীর পারসোনা সেট-আপ করুন। ব্যবহারকারীদের লজিক্যাল অ্যাক্সেস দেওয়া হয়, ফিজিক্যাল স্টোরেজ অ্যাক্সেস নয়। IAM প্রোপাগেশন বিলম্বের কারণে হওয়া সমস্যা এড়াতে, আপনি প্রথমে অ্যাকাউন্ট তৈরি করবেন, কয়েক সেকেন্ড অপেক্ষা করবেন এবং তারপরে তাদের ভূমিকা অ্যাসাইন করবেন।
echo "Creating Service Accounts..."
for USER in "${USER_ANALYST}" "${USER_MANAGER}"; do
    gcloud iam service-accounts create ${USER} --display-name="Lakehouse ${USER}"
done

echo "⏳ Waiting 15 seconds for IAM propagation..."
sleep 15

echo "Granting IAM Roles to Service Accounts..."
for USER in "${USER_ANALYST}" "${USER_MANAGER}"; do
    EMAIL="${USER}@${PROJECT_ID}.iam.gserviceaccount.com"

    # Allow Cloud Shell to impersonate them for testing
    gcloud iam service-accounts add-iam-policy-binding ${EMAIL} \
        --member="user:${CURRENT_USER}" \
        --role="roles/iam.serviceAccountTokenCreator" \
        --quiet

    # Allow logical viewing of the catalog, querying, and running Dataproc jobs
    for ROLE in "roles/datacatalog.viewer" "roles/bigquery.dataViewer" "roles/bigquery.user" "roles/bigquery.connectionUser" "roles/serviceusage.serviceUsageConsumer" "roles/dataproc.worker"; do
        gcloud projects add-iam-policy-binding ${PROJECT_ID} \
            --member="serviceAccount:${EMAIL}" \
            --role="${ROLE}" \
            --quiet
    done
done

# Grant the Manager data creation rights
gcloud projects add-iam-policy-binding ${PROJECT_ID} \
    --member="serviceAccount:${EMAIL_MANAGER}" \
    --role="roles/bigquery.dataEditor" \
    --quiet

echo "✅ Identity and Security setup completed!"
৩. Lakehouse-এর মাধ্যমে নেটিভ Iceberg টেবিল তৈরি করা
ম্যানেজ করা Iceberg টেবিল তৈরি করতে আপনি Lakehouse-এর নেটিভ ক্ষমতা ব্যবহার করবেন।
BigQuery ডেটাসেট তৈরি করুন
প্রথমে, আমাদের Iceberg টেবিলগুলি লজিক্যালি গ্রুপ করতে একটি BigQuery ডেটাসেট তৈরি করুন।
echo "Creating BigQuery Dataset..."
bq mk --location=${REGION} --dataset ${PROJECT_ID}:${DATASET_ID}
Iceberg টেবিল তৈরি করুন
এরপর, টেবিল তৈরি করতে নিম্নলিখিত কমান্ড রান করুন। OPTIONS ব্লকটি লক্ষ্য করুন যেখানে আমরা table_format = 'ICEBERG' নির্দিষ্ট করি এবং এটিকে সরাসরি আমাদের Cloud Storage বাকেট এবং কানেকশনে ম্যাপ করি।
echo "Creating Iceberg tables..."

# Inventory table
bq query --use_legacy_sql=false \
"CREATE OR REPLACE TABLE \`${PROJECT_ID}.${DATASET_ID}.inventory\` (
    product_id INT64,
    product_name STRING,
    stock_count INT64
)
WITH CONNECTION \`${REGION}.${CONN_NAME}\`
OPTIONS (
    file_format = 'PARQUET',
    table_format = 'ICEBERG',
    storage_uri = 'gs://${ICEBERG_BUCKET}/inventory/'
);"

# Transactions table
bq query --use_legacy_sql=false \
"CREATE OR REPLACE TABLE \`${PROJECT_ID}.${DATASET_ID}.transactions\` (
    id INT64,
    item STRING,
    amount FLOAT64,
    transaction_date DATE
)
WITH CONNECTION \`${REGION}.${CONN_NAME}\`
OPTIONS (
    file_format = 'PARQUET',
    table_format = 'ICEBERG',
    storage_uri = 'gs://${ICEBERG_BUCKET}/transactions/'
);"
ডেটা দিয়ে টেবিল পূরণ করা
শেষে, নতুন তৈরি করা আইসবার্গ টেবিলে স্যাম্পেল ডেটা যোগ করুন।
echo "Inserting data into Iceberg tables..."

# Insert into Inventory table
bq query --use_legacy_sql=false \
"INSERT INTO \`${PROJECT_ID}.${DATASET_ID}.inventory\` (product_id, product_name, stock_count)
VALUES (101, 'Widget A', 500), (102, 'Widget B', 250), (103, 'Widget C', 800);"

# Insert into Transactions table
bq query --use_legacy_sql=false \
"INSERT INTO \`${PROJECT_ID}.${DATASET_ID}.transactions\` (id, item, amount, transaction_date)
VALUES
    (1, 'Widget A', 100.0, DATE '2024-01-01'),
    (2, 'Widget B', 150.0, DATE '2024-01-02'),
    (3, 'Widget C', 50.0, DATE '2024-01-03');"
আপনার কাছে এখন দুটি সম্পূর্ণ কার্যকরী Iceberg টেবিল আছে। Lakehouse মেটাডেটা ম্যানেজ করে, তবে ফিজিক্যাল Parquet ফাইল আপনার GCS বাকেটে নিরাপদে থাকে!
ETL পাইপলাইন সিমুলেট করা
বাস্তব পরিস্থিতিতে, ব্যবসায়িক রিপোর্টিংয়ের জন্য প্রায়ই র ডেটা এগ্রিগেট করে সামারি টেবিলে দেখানো হয়। ডেটা ইঞ্জিনিয়ার হিসেবে কাজ করে আমাদের ট্রানজ্যাকশনের কাঁচা ডেটা থেকে দৈনিক বিক্রির সারসংক্ষেপ টেবিল তৈরি করা যাক।
(মনে রাখবেন: এই ধাপটি এখনই সম্পূর্ণ করুন যাতে Google Cloud ব্যাকগ্রাউন্ড মেটাডেটা প্রসেস করার জন্য পর্যাপ্ত সময় পায়। এটি কেন গুরুত্বপূর্ণ তা আপনি পরে কোডল্যাবে জানতে পারবেন!)
echo "Creating transactions summary table..."
bq query --use_legacy_sql=false \
"CREATE TABLE \`${PROJECT_ID}.${DATASET_ID}.transactions_summary\` AS
 SELECT transaction_date, SUM(amount) as total_sales, COUNT(id) as transaction_count
 FROM \`${PROJECT_ID}.${DATASET_ID}.transactions\`
 GROUP BY transaction_date;"
৪. কেন্দ্রীভূত শাসন: Python ব্যবহার করে নীতি নির্ধারণ করুন
প্রোডাকশন এনভায়রনমেন্টে, UI-এর মাধ্যমে পরিচালনা সংক্রান্ত নীতি কনফিগার করা স্কেল ও বজায় রাখা কঠিন। পরিবর্তে, কোড (IaC) হিসেবে ইনফ্রাস্ট্রাকচার ব্যবহার করার জন্য বিশেষভাবে সাজেস্ট করা হয়।
এই বিভাগে, আপনি Google Cloud Python SDK ব্যবহার করে প্রোগ্রাম্যাটিকভাবে আপনার জিরো-ট্রাস্ট গভর্নেন্স রুল ধাপে ধাপে তৈরি ও এনফোর্স করবেন।
Python এনভায়রনমেন্ট সেট-আপ করা
প্রথমে, লাইব্রেরি সংক্রান্ত দ্বন্দ্ব এড়াতে এবং প্রয়োজনীয় Google Cloud SDK ইনস্টল করতে একটি আইসোলেটেড Python এনভায়রনমেন্ট (venv) সেট-আপ করা যাক।
Cloud Shell-এ নিম্নলিখিত কমান্ড রান করুন:
# Create and activate a virtual environment
python3 -m venv lakehouse_env
source lakehouse_env/bin/activate

# Install required Knowledge Catalog and BigQuery governance libraries
pip install google-cloud-datacatalog google-cloud-bigquery-datapolicies google-cloud-bigquery --quiet

echo "✅ Python environment is ready!"
ট্যাক্সোনমি ও নীতি ট্যাগ তৈরি করা
ট্যাক্সোনমি হল একটি লজিক্যাল কন্টেনার এবং নীতি ট্যাগ হল নির্দিষ্ট লেবেল যা আপনি আমাদের সংবেদনশীল কলামে অ্যাটাচ করবেন। কলাম-লেভেল নিরাপত্তা এনফোর্স করতে, প্রথমে আপনার একটি লজিক্যাল কন্টেনার (একটি ট্যাক্সোনমি) এবং একটি নির্দিষ্ট লেবেল (একটি নীতি ট্যাগ) প্রয়োজন।
আপনি 1_create_taxonomy.py-এর ভিতরে দেখলে, নিম্নলিখিত মূল যুক্তি দেখতে পাবেন:
# Create Taxonomy with Fine-Grained Access Control enabled
taxonomy = datacatalog_v1.Taxonomy(
    display_name="BusinessCritical",
    activated_policy_types=[datacatalog_v1.Taxonomy.PolicyType.FINE_GRAINED_ACCESS_CONTROL]
)
created_taxonomy = client.create_taxonomy(parent=parent, taxonomy=taxonomy)

# Create Policy Tag inside the Taxonomy
policy_tag = datacatalog_v1.PolicyTag(display_name="RestrictedFinancial")
created_policy_tag = client.create_policy_tag(parent=created_taxonomy.name, policy_tag=policy_tag)
FINE_GRAINED_ACCESS_CONTROL নীতির ধরন স্পষ্টভাবে সেট করার মাধ্যমে, আপনি একটি স্ট্যান্ডার্ড মেটাডেটা ট্যাগকে একটি কঠোর জিরো-ট্রাস্ট নিরাপত্তা সীমানায় রূপান্তর করেন। এই ট্যাগ সহ যেকোনও কলাম ডিফল্ট হিসেবে সব ব্যবহারকারীর অ্যাক্সেস প্রত্যাখ্যান করবে।
রিসোর্স তৈরি করতে স্ক্রিপ্ট রান করুন:
python 1_create_taxonomy.py
মাস্কিং রুল (ডেটা নীতি) কনফিগার করুন
এখন, আপনি নির্ধারণ করেন যে বিশেষাধিকার ছাড়া কেউ ট্যাগ করা কলামে কোয়েরি করলে কী হবে। আপনি একটি ডেটা নীতি তৈরি করবেন যা ভ্যালুকে NULL হিসেবে ফেরত দিতে বাধ্য করে এবং এই নিয়মটি অ্যানালিস্ট পারসোনা-এর সাথে অ্যাটাচ করবেন।
2_create_masking.py-এর মধ্যে, স্ক্রিপ্টটি আপনার তৈরি করা নীতি ট্যাগ আইডি ডাইনামিকভাবে খুঁজে বের করে এবং একটি ডেটা নীতি প্রয়োগ করে:
# Define a Masking Policy that always returns NULL
data_policy = bigquery_datapolicies_v1.DataPolicy(
    data_policy_id="mask_financial_null",
    policy_tag=policy_tag_id,
    data_policy_type=bigquery_datapolicies_v1.DataPolicy.DataPolicyType.DATA_MASKING_POLICY,
    data_masking_policy=bigquery_datapolicies_v1.DataMaskingPolicy(
        predefined_expression=bigquery_datapolicies_v1.DataMaskingPolicy.PredefinedExpression.ALWAYS_NULL
    )
)

# ... (Policy creation code) ...

# Bind the Masked Reader role to the Analyst
iam_policy.bindings.add(
    role="roles/bigquerydatapolicy.maskedReader",
    members=[f"serviceAccount:{analyst_email}"]
)
এই কোড প্রোগ্রাম্যাটিক্যালি এমন একটি নিয়ম তৈরি করে যা অন্তর্নিহিত ভ্যালুকে NULL হিসেবে ফেরত দিতে বাধ্য করে। এটি তারপরে maskedReader IAM ভূমিকাটি বিশেষভাবে Analyst পার্সোনাতে অ্যাসাইন করে, যাতে তারা শুধুমাত্র ডেটার মাস্ক করা ভার্সন দেখতে পায়।
মাস্কিং সংক্রান্ত নিয়ম কনফিগার করতে স্ক্রিপ্ট রান করুন:
python 2_create_masking.py
ফাইন-গ্রেনড অ্যাক্সেস মঞ্জুর করা
আমাদের জিরো-ট্রাস্ট সেট-আপের কারণে, এই মুহূর্তে কেউ ট্যাগ করা কলাম পড়তে পারবেন না। আপনাকে অবশ্যই ম্যানেজার এবং আপনার ব্যক্তিগত অ্যাকাউন্টে অ্যাক্সেস দিতে হবে।
3_grant_access.py-এর মধ্যে, আপনি নীতি ট্যাগের IAM নীতি পরিবর্তন করেন:
# Grant original data read access
iam_policy.bindings.add(
    role="roles/datacatalog.categoryFineGrainedReader",
    members=[f"serviceAccount:{manager_email}", f"user:{current_user}"]
)
client.set_iam_policy(request=iam_policy_pb2.SetIamPolicyRequest(resource=policy_tag_id, policy=iam_policy))
categoryFineGrainedReader ভূমিকা যোগ করলে, এই নির্দিষ্ট প্রিন্সিপাল মাস্কিং নিয়ম বাইপাস করতে এবং র, আনমাস্ক করা ডেটা পড়তে পারে।
অ্যাক্সেস দিতে স্ক্রিপ্ট চালান:
python 3_grant_access.py
BigQuery টেবিলে পলিসি ট্যাগ অ্যাটাচ করা
শেষে, আপনাকে অবশ্যই এই লজিক্যাল নীতি ট্যাগটি আমাদের ফিজিক্যাল Iceberg টেবিল স্কিমাতে অ্যাটাচ করতে হবে।
4_attach_tag.py-কে ঘিরে সেরা কিছু স্মৃতি দেখুন। স্ক্রিপ্টটি BigQuery টেবিল স্কিমা নিয়ে আসে, ফিল্ডের মাধ্যমে ইটারেট করে এবং বিশেষভাবে amount কলামে ট্যাগটি অ্যাটাচ করে:
new_schema =[]
for field in table.schema:
    if field.name == 'amount':
        # Wrap the Policy Tag ID and attach it to the column
        policy_tags_list = bigquery.PolicyTagList(names=[policy_tag_id])
        new_field = bigquery.SchemaField(
            name=field.name, field_type=field.field_type, mode=field.mode,
            description=field.description, policy_tags=policy_tags_list
        )
        new_schema.append(new_field)
    else:
        new_schema.append(field)

# Update the table schema in BigQuery
table.schema = new_schema
client.update_table(table, ["schema"])
এই স্কিমা আপডেট প্রয়োগ করা হলে, Lakehouse সাথে সাথে আমাদের নলেজ ক্যাটালগ লজিক্যাল ট্যাগকে আপনার Cloud Storage বাকেটে স্টোর করা ফিজিক্যাল Parquet ফাইলের সাথে যুক্ত করে।
টেবিল স্কিমা আপডেট করতে স্ক্রিপ্ট রান করুন:
python 4_attach_tag.py
৫. নলেজ ক্যাটালগ নীতি যাচাই করুন
আমাদের কেন্দ্রীভূত শাসন কাজ করে কিনা তা পরীক্ষা করার সময় এসেছে। আপনি দুটি ভিন্ন ইঞ্জিনে এটি পরীক্ষা করবেন যাতে প্রমাণ করা যায় যে নলেজ ক্যাটালগ নীতি সর্বজনীনভাবে প্রয়োগ করা হয়েছে।
BigQuery নেটিভ SQL ব্যবহার করে যাচাই করুন
প্রথমে, আপনি Cloud Shell ব্যবহার করে আমাদের দুই ব্যক্তির পরিচয় গ্রহণ করবেন এবং BigQuery-এর নেটিভ SQL ইঞ্জিন ব্যবহার করে টেবিল কোয়েরি করবেন।
ম্যানেজার (বিশেষাধিকার প্রাপ্ত ব্যবহারকারী) হিসেবে পরীক্ষা করুন:
# Impersonate the manager
gcloud config set auth/impersonate_service_account ${EMAIL_MANAGER}

# Query the transactions table
bq query --use_legacy_sql=false "SELECT * FROM \`${PROJECT_ID}.${DATASET_ID}.transactions\`"
ম্যানেজারের কাছে ফাইন-গ্রেনড রিডার ভূমিকা আছে, তাই এটি কাঁচা পরিমাণের মান দেখাবে
+----+----------+--------+------------------+
| id |   item   | amount | transaction_date |
+----+----------+--------+------------------+
|  1 | Widget A |  100.0 |       2024-01-01 |
|  3 | Widget C |   50.0 |       2024-01-03 |
|  2 | Widget B |  150.0 |       2024-01-02 |
+----+----------+--------+------------------+
বিশ্লেষক (সীমাবদ্ধ ব্যবহারকারী) হিসেবে পরীক্ষা করুন:
gcloud config set auth/impersonate_service_account ${EMAIL_ANALYST}

bq query --use_legacy_sql=false "SELECT * FROM \`${PROJECT_ID}.${DATASET_ID}.transactions\`"
Knowledge Catalog মাস্কিং নিয়মের কারণে, প্রতিটি সারির জন্য অ্যামাউন্ট কলাম NULL হিসেবে রিটার্ন করে।
+----+----------+--------+------------------+
| id |   item   | amount | transaction_date |
+----+----------+--------+------------------+
|  1 | Widget A |   NULL |       2024-01-01 |
|  3 | Widget C |   NULL |       2024-01-03 |
|  2 | Widget B |   NULL |       2024-01-02 |
+----+----------+--------+------------------+
আপনার পরিচয় ফিরিয়ে আনুন
আপনার অ্যাডমিন ব্যবহারকারীতে ফিরে যেতে আপনার Cloud Shell যাচাইকরণ অবস্থা পরিষ্কার করুন।
# Unset impersonation
gcloud config unset auth/impersonate_service_account
Apache Spark (কম্পিউট ডেলিগেশন) ব্যবহার করে যাচাই করুন
কোনও ডেটা সায়েন্টিস্ট এই টেবিল পড়ার জন্য Apache Spark ব্যবহার করলে কী হবে? Spark যদি সরাসরি ফিজিক্যাল GCS Parquet ফাইল পড়ে, তাহলে নলেজ ক্যাটালগ মাস্কিং সংক্রান্ত নিয়ম সম্পূর্ণভাবে বাইপাস করা হয়, কারণ ক্লাউড স্টোরেজ শুধুমাত্র বাকেট-লেভেল অনুমতি বুঝতে পারে।
এটি প্রতিরোধ করতে, আপনি Spark-BigQuery কানেক্টর ব্যবহার করে কম্পিউট ডেলিগেশন এনফোর্স করেন। এই কানেক্টর একটি সুরক্ষিত ব্রিজ হিসেবে কাজ করে, BigQuery Storage API-এর মাধ্যমে Spark রিড অনুরোধ রাউট করে যাতে Spark ক্লাস্টারে কোনও ডেটা পাঠানোর আগে নলেজ ক্যাটালগ পরিচালনার নিয়মগুলি ডাইনামিকভাবে মূল্যায়ন করা হয়।
আপনার ডাউনলোড করা read_transactions.py স্ক্রিপ্টের মূল লজিকটি দেখুন:
# Reading data via Compute Delegation (Knowledge Catalog policies are applied dynamically here)
df = spark.read \
    .format("bigquery") \
    .option("table", f"{project_id}.{dataset_id}.{table_name}") \
    .load()

print("\n=== 📊 Data Preview ===")
df.show(truncate=False)
লক্ষ্য করুন যে আমরা Spark-কে Iceberg ফাইলের gs:// পাথে পয়েন্ট করছি না। .format("bigquery") উল্লেখ করার মাধ্যমে, BigQuery Storage API রিড করার অনুরোধ ইন্টারসেপ্ট করে, Spark জব রান করা ব্যবহারকারীর পরিচয় চেক করে, Knowledge Catalog মাস্কিং নিয়ম প্রয়োগ করে এবং শুধুমাত্র অনুমোদিত ডেটা Spark DataFrame-এ ফেরত পাঠায়।
আপনার Cloud Storage বাকেটে এই PySpark স্ক্রিপ্ট আপলোড করুন যাতে ম্যানেজ করা Apache Spark এটি অ্যাক্সেস করতে পারে:
# Upload script to GCS
gsutil cp read_transactions.py gs://${ICEBERG_BUCKET}/scripts/read_transactions.py
ম্যানেজার হিসেবে Spark চালান:
আপনি ম্যানেজ করা Apache Spark ব্যবহার করবেন। এই ম্যানেজ করা পরিষেবা আপনাকে ডেডিকেটেড ক্লাস্টার প্রভিশন, কনফিগার বা ম্যানেজ করার প্রয়োজন ছাড়াই সরাসরি Spark ওয়ার্কলোড রান করতে দেয়।
echo "🚀 Submitting Managed Apache Spark Job as [MANAGER]..."
gcloud dataproc batches submit pyspark gs://${ICEBERG_BUCKET}/scripts/read_transactions.py \
    --project=${PROJECT_ID} \
    --region=${REGION} \
    --service-account=${EMAIL_MANAGER} \
    --version=2.3 \
    -- ${PROJECT_ID} ${DATASET_ID} \
    --format="value(name)"
টার্মিনালে জব আউটপুট লগ দেখুন। ম্যানেজারের কাছে ফাইন-গ্রেনড রিডার রোল থাকার কারণে, Spark সফলভাবে কাঁচা, আনমাস্ক করা পরিমাণ পুনরুদ্ধার করে।
=== 📊 Data Preview ===
+---+--------+------+-------------------+
|id |item    |amount|transaction_date   |
+---+--------+------+-------------------+
|1  |Widget A|100.0 |2024-01-01         |
|2  |Widget B|150.0 |2024-01-02         |
|3  |Widget C|50.0  |2024-01-03         |
+---+--------+------+-------------------+
অ্যানালিস্ট হিসেবে Spark রান করুন:
এখন, ঠিক একই Spark জব জমা দিন, তবে এবার অ্যানালিস্ট পারসোনা ছদ্মবেশে।
echo "🚀 Submitting Managed Apache Spark Job as [ANALYST]..."
gcloud dataproc batches submit pyspark gs://${ICEBERG_BUCKET}/scripts/read_transactions.py \
    --project=${PROJECT_ID} \
    --region=${REGION} \
    --service-account=${EMAIL_ANALYST} \
    --version=2.3 \
    -- ${PROJECT_ID} ${DATASET_ID} \
    --format="value(name)"
লগ আবার চেক করুন। বিশ্লেষক ঠিক একই Spark কোড রান করলেও, BigQuery Storage API অনুরোধটি ইন্টারসেপ্ট করে এবং নলেজ ক্যাটালগ নীতি এনফোর্স করে। অ্যানালিস্টের Spark DataFrame-এ পরিমাণের জন্য null দেখাচ্ছে!
=== 📊 Data Preview ===
+---+--------+------+-------------------+
|id |item    |amount|transaction_date   |
+---+--------+------+-------------------+
|1  |Widget A|null  |2024-01-01         |
|2  |Widget B|null  |2024-01-02         |
|3  |Widget C|null  |2024-01-03         |
+---+--------+------+-------------------+
আর্কিটেকচারাল ট্রেড-অফ: BigQuery SQL বনাম Spark
আপনি প্রমাণ করে দিলেন যে ইঞ্জিন যাই হোক না কেন, ফলাফল একই হয়! নলেজ ক্যাটালগ নীতি এনফোর্স করা হয়েছে। কিন্তু প্রোডাকশনে, আপনার কোনটি ব্যবহার করা উচিত?
- BigQuery SQL: SQL-এর মতো ইঞ্জিন ব্যবহার করে এমন ওয়ার্কফ্লোর জন্য দারুণ এবং সরাসরি কম্পিউটেশন রান করে। এটি দ্রুত অ্যানালিটিক্স ও বিজনেস ইন্টেলিজেন্সের জন্য আদর্শ।
- Apache Spark: Python ব্যবহার করার কারণে আরও জটিল ওয়ার্কলোড ম্যানেজ করতে পারে, যার ফলে এটি উন্নত মেশিন লার্নিং পাইপলাইন বা পুরনো Hadoop কোডের জন্য উপযুক্ত।
মূল বক্তব্য: যে ইঞ্জিনই ব্যবহার করা হোক না কেন, কম্পিউট ডেলিগেশন এনফোর্স করার মাধ্যমে, সেন্ট্রালাইজড জিরো-ট্রাস্ট গভর্নেন্স লেয়ারকে কখনই বাইপাস করা যাবে না!
৬. অটোমেটেড ডেটা লিনেজ
যেকোনও এন্টারপ্রাইজ ডেটা আর্কিটেকচারে, আপনার ডেটা ঠিক কোথা থেকে আসে এবং কীভাবে এটি পরিবর্তন করা হয়েছে তা জানা, সম্মতি, ডিবাগিং এবং বিশ্বাস প্রতিষ্ঠার জন্য অত্যন্ত গুরুত্বপূর্ণ। এই ধারণাটি ডেটা লিনেজ নামে পরিচিত। এটি এই ধরনের মৌলিক প্রশ্নের উত্তর দেয়: "কোনও ম্যানেজার যদি দৈনিক বিক্রির রিপোর্ট দেখেন, তাহলে সেই সংখ্যাগুলি গণনা করার জন্য কোন র টেবিল ব্যবহার করা হয়েছিল?"
সাধারণত, এই লাইফসাইকেল ট্র্যাক করার জন্য ডেটা ইঞ্জিনিয়ারদের ম্যানুয়ালি কাস্টম লগিং কোড লিখতে হয় বা SQL স্ক্রিপ্ট পার্স করার জন্য জটিল থার্ড-পার্টি টুল ব্যবহার করতে হয়। তবে, একটি পরিচালিত Google Cloud Lakehouse-এ, এই ট্র্যাকিং বিল্ট-ইন এবং সম্পূর্ণ হ্যান্ডস-অফ।
কোডল্যাবে আগে র ট্রানজ্যাকশন টেবিল থেকে আপনি যে transactions_summary টেবিল তৈরি করেছিলেন, সেটি মনে আছে? BigQuery যখন সেই CREATE TABLE AS SELECT স্টেটমেন্টটি এক্সিকিউট করে, তখন কম্পিউট ইঞ্জিন অটোমেটিক ট্রান্সফর্মেশন মেটাডেটা ক্যাপচার করে এবং এটি নলেজ ক্যাটালগে পাঠায়। ফলাফল দেখা যাক।
বংশতালিকা ভিজ্যুয়ালাইজ করুন
- Google Cloud Console-এ, Knowledge Catalog > Search-এ নেভিগেট করুন।
- সার্চ বারে
lakehouse_retail_demo.transactionsটাইপ করে টেবিলে ক্লিক করুন। - বংশানুক্রম ট্যাবে ক্লিক করুন।
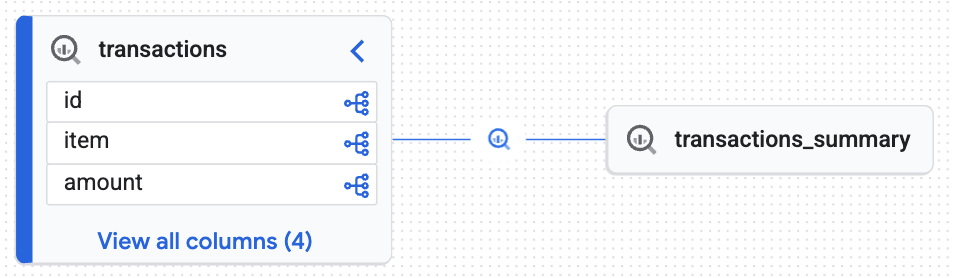
আপনি নলেজ ইঞ্জিনের মাধ্যমে তৈরি করা একটি ইন্টার্যাক্টিভ গ্রাফ দেখতে পাবেন যা প্রমাণ করে যে টার্গেট টেবিল (transactions_summary) র-গভর্নড Iceberg টেবিল (transactions) থেকে নেওয়া হয়েছে। আপনি ডেটা অডিটিংয়ের জন্য প্রয়োজনীয় এন্ড-টু-এন্ড ট্রেসেবিলিটি অর্জন করেছেন।
৭. অপ্রয়োজনীয়গুলি মুছুন
এই কোডল্যাবে ব্যবহৃত রিসোর্সের জন্য আপনার Google Cloud অ্যাকাউন্টে চার্জ এড়াতে, এই ধাপগুলি অনুসরণ করুন।
নলেজ ক্যাটালগ গভর্নেন্স রিসোর্স সরিয়ে দিন
BigQuery ডেটাসেট বা Cloud Storage বাকেট মুছে ফেলার আগে, আপনাকে অবশ্যই লজিক্যাল গভর্নেন্স নিয়মগুলি সরাতে হবে। আপনি যদি রিপোজিটরি থেকে cleanup_governance.py স্ক্রিপ্টের ভিতরে দেখেন, তাহলে আপনি নিম্নলিখিত টিয়ারডাউন সিকোয়েন্স দেখতে পাবেন:
# 1. Delete Data Policy
data_policy_name = f"{parent_loc}/dataPolicies/mask_financial_null"
dp_client.delete_data_policy(name=data_policy_name)

# 2. Find and Delete Taxonomy (This auto-deletes child Policy Tags)
taxonomies = catalog_client.list_taxonomies(parent=parent_loc)
taxonomy_id = next((t.name for t in taxonomies if t.display_name == "BusinessCritical"), None)
catalog_client.delete_taxonomy(name=taxonomy_id)
এখানে ক্রমটি গুরুত্বপূর্ণ। স্ক্রিপ্টটি প্রথমে ডেটা নীতি (মাস্কিং নিয়ম) মুছে দেয় কারণ এটি নীতি ট্যাগের উপর নির্ভর করে। নীতিটি সরিয়ে দেওয়া হলে, মূল ট্যাক্সোনমি মুছে দেওয়ার ফলে অটোমেটিক ক্যাসকেড হবে এবং রিসোর্স ডিপেন্ডেন্সি সংক্রান্ত সমস্যা ট্রিগার না করেই সব অন্তর্নিহিত নীতি ট্যাগ মুছে যাবে।
Python ক্লিনআপ স্ক্রিপ্ট রান করুন:
python cleanup_governance.py
পরিচয়, স্টোরেজ ও কম্পিউট অ্যাসেট সরিয়ে দেওয়া
এখন যেহেতু গভর্নেন্স লেয়ারটি আলাদা করা হয়েছে, আপনি নিরাপদে BigQuery টেবিল, Cloud Storage বাকেট, পরিষেবা অ্যাকাউন্ট এবং লোকাল Python এনভায়রনমেন্ট মুছে ফেলতে পারবেন।
আপনার Cloud Shell-এ নিম্নলিখিত কম্প্রিহেনসিভ ক্লিনআপ ব্লক কপি করে রান করুন:
echo "Deleting Service Accounts and Impersonation Bindings..."
export CURRENT_USER=$(gcloud config get-value account)

for USER in "${USER_ANALYST}" "${USER_MANAGER}"; do
    EMAIL="${USER}@${PROJECT_ID}.iam.gserviceaccount.com"

    # Remove impersonation binding
    gcloud iam service-accounts remove-iam-policy-binding ${EMAIL} \
        --member="user:${CURRENT_USER}" \
        --role="roles/iam.serviceAccountTokenCreator" \
        --quiet > /dev/null 2>&1

    # Delete the Service Account
    gcloud iam service-accounts delete ${EMAIL} --quiet
done

echo "Removing BigQuery Dataset and Tables..."
bq rm -f ${DATASET_ID}.transactions_summary
bq rm -f ${DATASET_ID}.transactions
bq rm -f ${DATASET_ID}.inventory
bq rm -f -d ${DATASET_ID}

echo "Removing BigQuery Cloud Resource Connection..."
bq rm --connection --location=${REGION} ${CONN_NAME}

echo "Removing Iceberg Cloud Storage Bucket..."
gcloud storage rm --recursive gs://${ICEBERG_BUCKET} --quiet

echo "Removing Auto-generated Dataproc Staging & Temp Buckets..."
for BUCKET in $(gcloud storage ls | grep -E "gs://dataproc-(staging|temp)-${REGION}"); do
    gcloud storage rm --recursive $BUCKET --quiet
done

echo "Deactivating and removing the local Python environment..."
deactivate
cd ../..
rm -rf devrel-demos

echo "✅ Clean up completed successfully!"
এইসব ধাপ সম্পূর্ণ করার মাধ্যমে, আপনি নিশ্চিত করেছেন যে আপনার প্রোজেক্টে কোনও অনাথ রিসোর্স বা লুকানো নীতি নেই।
৮. অভিনন্দন!
আপনি সম্পূর্ণভাবে পরিচালিত, খুঁজে নেওয়ার যোগ্য ডেটা লেকহাউস প্রয়োগ করেছেন।
আপনি জেনেছেন যে:
- নেটিভ Iceberg ইন্টিগ্রেশন: Lakehouse, Cloud Storage-এ ফিজিক্যাল ফাইল নিরাপদে স্টোর করার সময় নেটিভভাবে ওপেন-সোর্স Iceberg টেবিল ম্যানেজ করতে পারে।
- নিরাপত্তার জন্য কম্পিউট ডেলিগেশন: BigQuery Storage API-এর মাধ্যমে কোয়েরি রাউট করে, আপনি ফিজিক্যাল ফাইলের উপর ফাইন-গ্রেনড ডায়নামিক মাস্কিং এনফোর্স করেছেন যা নেটিভভাবে আংশিক অ্যাক্সেস সীমাবদ্ধ করতে পারে না।
- ইঞ্জিন-অ্যাগনস্টিক গভর্নেন্স: নীতি ট্যাগ আপনাকে একবার নিয়ম নির্ধারণ করতে এবং নেটিভ SQL বা Apache Spark রানটাইমের মাধ্যমে কোয়েরি করা হোক না কেন, সেগুলি সর্বজনীনভাবে প্রয়োগ করতে দেয়।
- ডেটা খুঁজে নেওয়ার যোগ্যতা: নলেজ ইঞ্জিন অটোমেটিক ডেটা লিনেজ ট্র্যাক করে, যা এন্টারপ্রাইজ অডিটেবিলিটির জন্য প্রয়োজনীয়।
এর পরে কী হবে?
- উন্নত অ্যাক্সেস কন্ট্রোল এক্সপ্লোর করুন: আরও জটিল নিরাপত্তা পরিস্থিতি প্রয়োগ করতে, অতিরিক্ত ফিচার সহ Lakehouse কাস্টমাইজ করা সংক্রান্ত অফিসিয়াল ডকুমেন্টেশন পর্যালোচনা করুন।
- GenAI-এর জন্য আনস্ট্রাকচার্ড ডেটা ম্যানেজ করুন: অবজেক্ট টেবিল এক্সপ্লোর করুন। এই একই Secure bridge প্যাটার্ন Cloud Storage-এ আনস্ট্রাকচার্ড ফাইলের (PDF, ছবি) ক্ষেত্রেও ব্যবহার করুন, যাতে Gemini Enterprise Agent Engine ও RAG পাইপলাইনের জন্য সুরক্ষিত, নিয়ন্ত্রিত ডেটা ফাউন্ডেশন তৈরি করা যায়।