

۱. مقدمه
در Data Cloud سازمانی مدرن، که دادهها در سیستمهای ذخیرهسازی فیزیکی مختلفی قرار دارند، چالش معماری عظیمی از امنیت تکهتکه وجود دارد.
چگونه اطمینان حاصل میکنید که دادههای حساس (مانند مبالغ تراکنشهای مالی) بهطور مداوم محافظت میشوند، وقتی دادهها بهصورت فیزیکی در قالبهای متنباز مانند Parquet در فضای ذخیرهسازی Google Cloud ذخیره میشوند و توسط چندین موتور مختلف مانند BigQuery SQL یا Apache Spark پرسوجو میشوند؟
در این codelab، یک معماری «لیکهاوس تحت حاکمیت داده» خواهید ساخت که این مشکلات را بااستفاده از جدولهای Apache Iceberg، BigQuery، و Knowledge Catalog حل میکند. از «زیرساخت بهعنوان کد» (IaC) برای تعریف خطمشیهای امنیتی اعتماد صفر و نحوه اعمال پویای آنها در موتورهای محاسباتی مختلف استفاده خواهید کرد.
پیشنیازها
- پروژه Google Cloud با صورتحساب فعالشده.
- درک اولیه از مفاهیم SQL، IAM، و Cloud Storage.
آنچه خواهید آموخت
- نحوه ایجاد جدولهای Google Cloud Lakehouse برای Apache Iceberg در BigQuery که در آن «فضای ذخیرهسازی ابری» بهطور بومی دادهها را نگهداری میکند.
- نحوه اعمال خطمشیهای متمرکز داده بااستفاده از برچسبهای خطمشی برای امنیت در سطح ستون و ماسکگذاری دادهها.
- نحوه جدا کردن دسترسی به فضای ذخیرهسازی فیزیکی از دسترسی به دادههای منطقی بااستفاده از اتصال منابع Cloud.
- نحوه اعمال واگذاری محاسبات «اعتماد صفر» بااستفاده از سرویس مدیریتشده برای Apache Spark برای اطمینان از اینکه موتورهای متنباز نمیتوانند حاکمیت را دور بزنند.
- نحوه دیداریسازی تبار داده خودکارشده.
نمای کلی معماری: حاکمیت جهانی در Iceberg
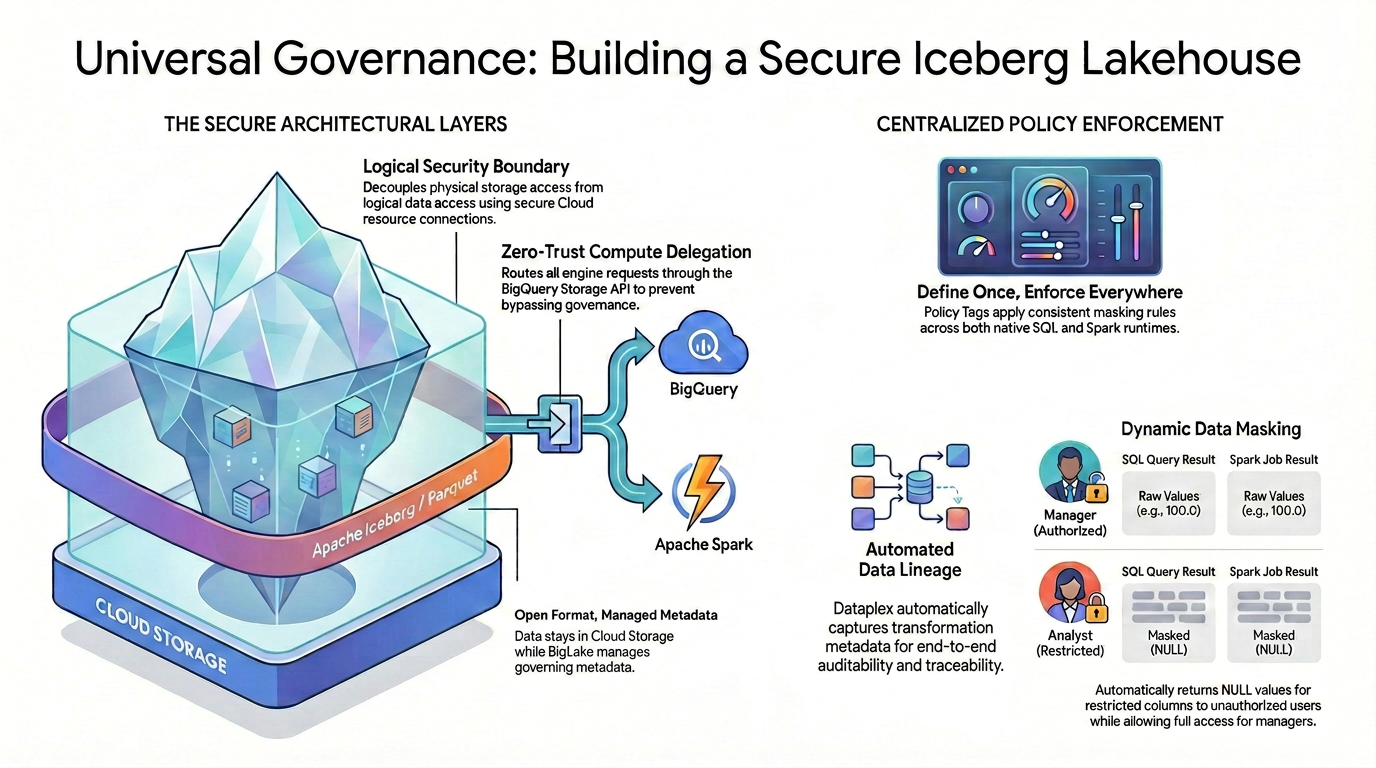
برای دستیابی به کنترل دسترسی دقیق (مانند امنیت در سطح ستون و ماسکگذاری دادهها) در قالبهای داده متنباز، باید معماری امنیتی سختگیرانه و یکپارچهای ایجاد کنید.
همانطور که در نمودار نشان داده شده است، این الگوی دریاچه داده تحت نظارت برای حل چالش امنیت تکهتکه بر دو ستون اصلی تکیه دارد:
🛡️ لایههای معماری امن (سمت راست)
بهجای اینکه به کاربران یا موتورهای خارجی اجازه دهید مستقیماً به Cloud Storage دسترسی داشته باشند (که فقط از امنیت گسترده در سطح دسته پشتیبانی میکند)، شما یک پایه امن میسازید.
- قالب باز، فراداده مدیریتشده: دادهها بهطور فیزیکی بااستفاده از قالب باز Apache Iceberg (Parquet) در «فضای ذخیرهسازی ابری» باقی میمانند، درحالیکه Lakehouse فراداده حاکم را بهطور یکپارچه مدیریت میکند.
- مرز امنیتی منطقی: دسترسی به فضای ذخیرهسازی فیزیکی را بااستفاده از اتصال امن منابع Cloud از دسترسی به دادههای منطقی جدا میکنید. کاربران نهایی هرگز دسترسی فیزیکی مستقیم IAM به فایلهای خام GCS ندارند.
- واگذاری محاسبات با رویکرد اعتماد صفر: برای اطمینان از اینکه هیچ موتور اجرایی نمیتواند قوانین حاکمیت را دور بزند، همه درخواستهای خواندن دادهها بهطور دقیق ازطریق BigQuery Storage API هدایت میشوند. این امر صرفنظر از اینکه پُرسمان از BigQuery SQL بومی یا Apache Spark متنباز منشأ گرفته باشد اعمال میشود.
🎯 اجرای متمرکز خطمشی (راست)
با وجود زیرساخت امن، Knowledge Catalog بهعنوان مغز یکپارچه برای حاکمیت عمل میکند:
- یکبار تعریف کنید، همهجا اجرا کنید: «برچسبهای خطمشی» خود را فقط یکبار در Knowledge Catalog تعریف میکنید و معماری قوانین ماسکگذاری یکپارچه را بهطور جهانی در همه زمانهای اجرای پشتیبانیشده اعمال میکند.
- پوشاندن پویای دادهها: وقتی دادهها پُرسمان میشوند، سیستم هویت کاربر را در همان لحظه ارزیابی میکند. درحالیکه کاربران مجاز مقادیر خام و بدون ماسک (مثلاً ۱۰۰٫۰) را در SQL و Spark خواهند دید، کاربران محدودشده بهطور خودکار مقادیر NULL ماسکشده را برای ستونهای محدودشده در هر دو موتور دریافت خواهند کرد.
- تبار داده خودکارسازیشده: با جریان یافتن و تبدیل شدن دادهها، Knowledge Catalog بهطور خودکار فراداده تبدیل را ضبط میکند و قابلیت حسابرسی و ردیابی سرتاسر داخلی را بدون نیاز به کد ثبت سفارشی ارائه میدهد.
۲. راهاندازی و الزامات
راهاندازی Cloud Shell
درحالیکه Google Cloud را میتوان از راه دور از رایانه کیفی شما اجرا کرد، در این codelab از Google Cloud Shell استفاده خواهید کرد که یک محیط خط فرمان است که در Cloud اجرا میشود.
از کنسول Google Cloud، روی نماد Cloud Shell در نوار ابزار بالا سمت چپ کلیک کنید:
تأمین و اتصال به محیط فقط چند لحظه طول میکشد. وقتی تمام شد، باید چیزی شبیه به این ببینید:
این ماشین مجازی با همه ابزارهای توسعهای که نیاز دارید بارگیری شده است. این ابزار یک دایرکتوری خانگی ۵ گیگابایتی دائمی ارائه میدهد و در Google Cloud اجرا میشود که عملکرد شبکه و اصالتسنجی را بهطور قابلتوجهی بهبود میبخشد. همه کارهای شما در این codelab میتواند در مرورگر انجام شود. نیازی نیست چیزی نصب کنید.
مقداردهی اولیه محیط
Cloud Shell را باز کنید و متغیرهای پروژهتان را تنظیم کنید تا مطمئن شوید همه فرمانها زیرساخت درست را هدف قرار میدهند.
export PROJECT_ID=$(gcloud config get-value project)
export REGION="us-central1"
export ICEBERG_BUCKET="iceberg-retail-demo-${PROJECT_ID}"
export DATASET_ID="lakehouse_retail_demo"
export CONN_NAME="iceberg-bq-conn-demo"
سپس دو شخصیت خود را تعریف کنید.
export USER_ANALYST="retail-analyst-demo"
export EMAIL_ANALYST="${USER_ANALYST}@${PROJECT_ID}.iam.gserviceaccount.com"

export USER_MANAGER="retail-manager-demo"
export EMAIL_MANAGER="${USER_MANAGER}@${PROJECT_ID}.iam.gserviceaccount.com"
export CURRENT_USER=$(gcloud config get-value account)
فعال کردن میاناهای برنامهسازی کاربردی
سرویسهای Google Cloud لازم را فعال کنید.
gcloud services enable \
  bigquery.googleapis.com \
  bigqueryconnection.googleapis.com \
  datacatalog.googleapis.com \
  bigquerydatapolicy.googleapis.com \
  datalineage.googleapis.com \
  dataplex.googleapis.com \
  dataproc.googleapis.com \
  storage-component.googleapis.com
بارگیری کد منبع Codelab
برای جلوگیری از شلوغ شدن Cloud Shell، یک تسویهحساب پراکنده انجام خواهید داد تا فقط اسکریپتهای Python لازم برای این codelab را از مخزن Google Cloud DevRel بارگیری کنید.
# Shallow clone without full history
git clone --depth 1 --filter=blob:none --sparse https://github.com/GoogleCloudPlatform/devrel-demos.git
cd devrel-demos

# Download only the specific folder
git sparse-checkout set data-analytics/governed-lakehouse
cd data-analytics/governed-lakehouse
ایجاد فضای ذخیرهسازی
ایجاد کردن دسته برای نگهداری دادههای Iceberg تحت نظارت بسیار امن.
gcloud storage buckets create gs://${ICEBERG_BUCKET} --location=${REGION}
آمادهسازی هویتها و امنیت
اتصال منبع ابری را پیکربندی کنید. این تنها موجودیتی است که کلیدهای فیزیکی دائمی IAM را برای خواندن فایلهای خام Iceberg نگه میدارد.
# Create the BigQuery connection
bq mk --connection \
    --connection_type=CLOUD_RESOURCE \
    --location=${REGION} \
    ${CONN_NAME}

# Retrieve the connection's automatically generated Service Account
export BQ_CONN_SVC_ACCT=$(bq show --format=json --connection ${REGION}.${CONN_NAME} \
    | jq -r '.cloudResource.serviceAccountId')

# Grant Storage Object Admin to the connection for the Iceberg bucket
gcloud storage buckets add-iam-policy-binding gs://${ICEBERG_BUCKET} \
    --member="serviceAccount:${BQ_CONN_SVC_ACCT}" \
    --role="roles/storage.objectAdmin" \
    --quiet
سپس، شخصیتهای کاربر را تنظیم کنید. به کاربران دسترسی منطقی داده میشود، نه دسترسی به فضای ذخیرهسازی فیزیکی. برای جلوگیری از خطاهای ناشی از تأخیر انتشار IAM، ابتدا حسابها را ایجاد میکنید، چند ثانیه صبر میکنید، و سپس نقشهای آنها را اختصاص میدهید.
echo "Creating Service Accounts..."
for USER in "${USER_ANALYST}" "${USER_MANAGER}"; do
    gcloud iam service-accounts create ${USER} --display-name="Lakehouse ${USER}"
done

echo "⏳ Waiting 15 seconds for IAM propagation..."
sleep 15

echo "Granting IAM Roles to Service Accounts..."
for USER in "${USER_ANALYST}" "${USER_MANAGER}"; do
    EMAIL="${USER}@${PROJECT_ID}.iam.gserviceaccount.com"

    # Allow Cloud Shell to impersonate them for testing
    gcloud iam service-accounts add-iam-policy-binding ${EMAIL} \
        --member="user:${CURRENT_USER}" \
        --role="roles/iam.serviceAccountTokenCreator" \
        --quiet

    # Allow logical viewing of the catalog, querying, and running Dataproc jobs
    for ROLE in "roles/datacatalog.viewer" "roles/bigquery.dataViewer" "roles/bigquery.user" "roles/bigquery.connectionUser" "roles/serviceusage.serviceUsageConsumer" "roles/dataproc.worker"; do
        gcloud projects add-iam-policy-binding ${PROJECT_ID} \
            --member="serviceAccount:${EMAIL}" \
            --role="${ROLE}" \
            --quiet
    done
done

# Grant the Manager data creation rights
gcloud projects add-iam-policy-binding ${PROJECT_ID} \
    --member="serviceAccount:${EMAIL_MANAGER}" \
    --role="roles/bigquery.dataEditor" \
    --quiet

echo "✅ Identity and Security setup completed!"
۳. ایجاد جدولهای Iceberg بومی ازطریق Lakehouse
از قابلیتهای بومی Lakehouse برای ایجاد جدولهای Iceberg مدیریتشده استفاده خواهید کرد.
ایجاد مجموعه دادههای BigQuery
ابتدا، یک مجموعه داده BigQuery ایجاد کنید تا جدولهای Iceberg ما را بهطور منطقی گروهبندی کند.
echo "Creating BigQuery Dataset..."
bq mk --location=${REGION} --dataset ${PROJECT_ID}:${DATASET_ID}
ایجاد جدولهای Iceberg
سپس، فرمانهای زیر را برای ایجاد جدولها اجرا کنید. به بلوک OPTIONS توجه کنید که در آن table_format = 'ICEBERG' را مشخص میکنیم و آن را مستقیماً به مخزن Cloud Storage و اتصالمان نگاشت میکنیم.
echo "Creating Iceberg tables..."

# Inventory table
bq query --use_legacy_sql=false \
"CREATE OR REPLACE TABLE \`${PROJECT_ID}.${DATASET_ID}.inventory\` (
    product_id INT64,
    product_name STRING,
    stock_count INT64
)
WITH CONNECTION \`${REGION}.${CONN_NAME}\`
OPTIONS (
    file_format = 'PARQUET',
    table_format = 'ICEBERG',
    storage_uri = 'gs://${ICEBERG_BUCKET}/inventory/'
);"

# Transactions table
bq query --use_legacy_sql=false \
"CREATE OR REPLACE TABLE \`${PROJECT_ID}.${DATASET_ID}.transactions\` (
    id INT64,
    item STRING,
    amount FLOAT64,
    transaction_date DATE
)
WITH CONNECTION \`${REGION}.${CONN_NAME}\`
OPTIONS (
    file_format = 'PARQUET',
    table_format = 'ICEBERG',
    storage_uri = 'gs://${ICEBERG_BUCKET}/transactions/'
);"
پر کردن جدولها با داده
درنهایت، دادههای نمونه را در جدولهای Iceberg جدیداً ایجادشده درج کنید.
echo "Inserting data into Iceberg tables..."

# Insert into Inventory table
bq query --use_legacy_sql=false \
"INSERT INTO \`${PROJECT_ID}.${DATASET_ID}.inventory\` (product_id, product_name, stock_count)
VALUES (101, 'Widget A', 500), (102, 'Widget B', 250), (103, 'Widget C', 800);"

# Insert into Transactions table
bq query --use_legacy_sql=false \
"INSERT INTO \`${PROJECT_ID}.${DATASET_ID}.transactions\` (id, item, amount, transaction_date)
VALUES
    (1, 'Widget A', 100.0, DATE '2024-01-01'),
    (2, 'Widget B', 150.0, DATE '2024-01-02'),
    (3, 'Widget C', 50.0, DATE '2024-01-03');"
اکنون دو جدول Iceberg با عملکرد کامل دارید. Lakehouse فراداده را مدیریت میکند، اما فایلهای Parquet فیزیکی بهطور ایمن در سطل GCS شما قرار دارند!
شبیهسازی خط لوله ETL
در سناریوهای دنیای واقعی، دادههای خام اغلب برای گزارشدهی کسبوکار در جدولهای خلاصه جمعآوری میشوند. بیایید بهعنوان مهندس داده عمل کنیم و از دادههای تراکنشهای خاممان جدول خلاصه فروش روزانه ایجاد کنیم.
(توجه: این مرحله را اکنون اجرا کنید تا Google Cloud زمان کافی برای پردازش فراداده پسزمینه داشته باشد. در ادامه codelab متوجه خواهید شد که چرا این موضوع مهم است!)
echo "Creating transactions summary table..."
bq query --use_legacy_sql=false \
"CREATE TABLE \`${PROJECT_ID}.${DATASET_ID}.transactions_summary\` AS
 SELECT transaction_date, SUM(amount) as total_sales, COUNT(id) as transaction_count
 FROM \`${PROJECT_ID}.${DATASET_ID}.transactions\`
 GROUP BY transaction_date;"
۴. حاکمیت متمرکز: تعریف کردن خطمشیها بااستفاده از Python
در محیط تولید، پیکربندی خطمشیهای حاکمیتی ازطریق میانای کاربر برای مقیاسبندی و نگهداری دشوار است. درعوض، اکیداً توصیه میشود از «زیرساخت بهعنوان کد» (IaC) استفاده کنید.
در این بخش، از Google Cloud Python SDK برای ایجاد و اعمال گامبهگام قوانین حاکمیت «اعتماد صفر» بهصورت برنامهنویسیشده استفاده خواهید کرد.
راهاندازی محیط Python
ابتدا، بیایید یک محیط Python مجزا (venv) راهاندازی کنیم تا از تداخل کتابخانهها جلوگیری شود و «کیتهای توسعه نرمافزار» (SDK) لازم Google Cloud را نصب کنیم.
فرمانهای زیر را در Cloud Shell اجرا کنید:
# Create and activate a virtual environment
python3 -m venv lakehouse_env
source lakehouse_env/bin/activate

# Install required Knowledge Catalog and BigQuery governance libraries
pip install google-cloud-datacatalog google-cloud-bigquery-datapolicies google-cloud-bigquery --quiet

echo "✅ Python environment is ready!"
ایجاد برچسب ردهبندی و خطمشی
ردهبندی یک محفظه منطقی است و برچسب خطمشی برچسب خاصی است که به ستون حساس ما پیوست میکنید. برای اعمال امنیت در سطح ستون، ابتدا به یک محفظه منطقی (یک طبقهبندی) و یک برچسب خاص (یک برچسب خطمشی) نیاز دارید.
اگر به داخل 1_create_taxonomy.py نگاه کنید، منطق اصلی زیر را خواهید دید:
# Create Taxonomy with Fine-Grained Access Control enabled
taxonomy = datacatalog_v1.Taxonomy(
    display_name="BusinessCritical",
    activated_policy_types=[datacatalog_v1.Taxonomy.PolicyType.FINE_GRAINED_ACCESS_CONTROL]
)
created_taxonomy = client.create_taxonomy(parent=parent, taxonomy=taxonomy)

# Create Policy Tag inside the Taxonomy
policy_tag = datacatalog_v1.PolicyTag(display_name="RestrictedFinancial")
created_policy_tag = client.create_policy_tag(parent=created_taxonomy.name, policy_tag=policy_tag)
با تنظیم صریح نوع خطمشی FINE_GRAINED_ACCESS_CONTROL، برچسب فراداده استاندارد را به مرز امنیتی سختگیرانه اعتماد صفر تبدیل میکنید. هر ستونی که این برچسب را داشته باشد بهطور پیشفرض دسترسی همه کاربران را رد میکند.
برای ایجاد منابع، اسکریپت را اجرا کنید:
python 1_create_taxonomy.py
پیکربندی قانون پوشاندن (خطمشی داده)
اکنون، شما تعریف میکنید که وقتی فردی بدون امتیاز ستون برچسبگذاریشده را پُرسمان میکند چه اتفاقی میافتد. خطمشی دادهای ایجاد خواهید کرد که مقدار را مجبور میکند بهعنوان NULL برگردد و این قانون را به شخصیت تحلیلگر پیوست میکنید.
درون 2_create_masking.py، اسکریپت بهطور پویا «شناسه برچسب خطمشی» را که بهتازگی ایجاد کردهاید جستجو میکند و خطمشی داده را اعمال میکند:
# Define a Masking Policy that always returns NULL
data_policy = bigquery_datapolicies_v1.DataPolicy(
    data_policy_id="mask_financial_null",
    policy_tag=policy_tag_id,
    data_policy_type=bigquery_datapolicies_v1.DataPolicy.DataPolicyType.DATA_MASKING_POLICY,
    data_masking_policy=bigquery_datapolicies_v1.DataMaskingPolicy(
        predefined_expression=bigquery_datapolicies_v1.DataMaskingPolicy.PredefinedExpression.ALWAYS_NULL
    )
)

# ... (Policy creation code) ...

# Bind the Masked Reader role to the Analyst
iam_policy.bindings.add(
    role="roles/bigquerydatapolicy.maskedReader",
    members=[f"serviceAccount:{analyst_email}"]
)
این کد بهصورت برنامهنویسیشده قانونی ایجاد میکند که مقادیر زیربنایی را مجبور میکند بهعنوان NULL برگردانده شوند. سپس نقش IAM maskedReader را بهطور خاص به شخصیت «تحلیلگر» اختصاص میدهد تا اطمینان حاصل شود که آنها فقط نسخه ماسکشده دادهها را میبینند.
دستورگان را برای پیکربندی قانون ماسکگذاری اجرا کنید:
python 2_create_masking.py
اعطای دسترسی دقیق
بهدلیل راهاندازی اعتماد صفر ما، درحالحاضر هیچکس نمیتواند ستون برچسبگذاریشده را بخواند. باید صریحاً به مدیر و حساب شخصیتان اجازه دسترسی بدهید.
در 3_grant_access.py، خطمشی IAM خود «برچسب خطمشی» را اصلاح میکنید:
# Grant original data read access
iam_policy.bindings.add(
    role="roles/datacatalog.categoryFineGrainedReader",
    members=[f"serviceAccount:{manager_email}", f"user:{current_user}"]
)
client.set_iam_policy(request=iam_policy_pb2.SetIamPolicyRequest(resource=policy_tag_id, policy=iam_policy))
افزودن نقش categoryFineGrainedReader به این مدیران خاص اجازه میدهد قوانین ماسکگذاری را دور بزنند و دادههای خام و ماسکگذارینشده را بخوانند.
برای اعطای دسترسی، متن را اجرا کنید:
python 3_grant_access.py
پیوست کردن برچسب خطمشی به جدول BigQuery
درنهایت، باید این «برچسب خطمشی» منطقی را به طرحواره جدول Iceberg فیزیکی ما پیوست کنید.
نگاهی به 4_attach_tag.py بیندازید. این متن طرح جدول BigQuery را واکشی میکند، فیلدها را تکرار میکند، و برچسب را بهطور خاص به ستون amount پیوست میکند:
new_schema =[]
for field in table.schema:
    if field.name == 'amount':
        # Wrap the Policy Tag ID and attach it to the column
        policy_tags_list = bigquery.PolicyTagList(names=[policy_tag_id])
        new_field = bigquery.SchemaField(
            name=field.name, field_type=field.field_type, mode=field.mode,
            description=field.description, policy_tags=policy_tags_list
        )
        new_schema.append(new_field)
    else:
        new_schema.append(field)

# Update the table schema in BigQuery
table.schema = new_schema
client.update_table(table, ["schema"])
وقتی این بهروزرسانی طرحواره اعمال میشود، Lakehouse فوراً برچسبهای منطقی «کاتالوگ دانش» ما را به فایلهای Parquet فیزیکی ذخیرهشده در فضای ذخیرهسازی Cloud Storage شما متصل میکند.
برای بهروزرسانی طرحواره جدول، اسکریپت را اجرا کنید:
python 4_attach_tag.py
۵. درستیسنجی کردن خطمشیهای کاتالوگ دانش
وقت آن است که ببینیم آیا حاکمیت متمرکز ما کار میکند یا نه. این را در دو موتور مختلف آزمایش خواهید کرد تا ثابت کنید که خطمشیهای Knowledge Catalog بهطور جهانی اجرا میشوند.
درستیسنجی بااستفاده از SQL بومی BigQuery
ابتدا، از Cloud Shell برای فرض کردن هویت دو شخصیتمان استفاده خواهید کرد و جدول را بااستفاده از موتور SQL بومی BigQuery پُرسمان خواهید کرد.
آزمایش بهعنوان «مدیر» (کاربر دارای امتیاز):
# Impersonate the manager
gcloud config set auth/impersonate_service_account ${EMAIL_MANAGER}

# Query the transactions table
bq query --use_legacy_sql=false "SELECT * FROM \`${PROJECT_ID}.${DATASET_ID}.transactions\`"
ازآنجاییکه مدیر نقش «خواننده با جزئیات دقیق» را دارد، مقادیر مبلغ خام را نشان خواهد داد
+----+----------+--------+------------------+
| id |   item   | amount | transaction_date |
+----+----------+--------+------------------+
|  1 | Widget A |  100.0 |       2024-01-01 |
|  3 | Widget C |   50.0 |       2024-01-03 |
|  2 | Widget B |  150.0 |       2024-01-02 |
+----+----------+--------+------------------+
آزمایش بهعنوان تحلیلگر (کاربر محدودشده):
gcloud config set auth/impersonate_service_account ${EMAIL_ANALYST}

bq query --use_legacy_sql=false "SELECT * FROM \`${PROJECT_ID}.${DATASET_ID}.transactions\`"
بهدلیل قانون ماسکگذاری Knowledge Catalog، ستون مقدار برای هر ردیف بهصورت NULL برگردانده میشود.
+----+----------+--------+------------------+
| id |   item   | amount | transaction_date |
+----+----------+--------+------------------+
|  1 | Widget A |   NULL |       2024-01-01 |
|  3 | Widget C |   NULL |       2024-01-03 |
|  2 | Widget B |   NULL |       2024-01-02 |
+----+----------+--------+------------------+
بازیابی هویت
وضعیت اصالتسنجی Cloud Shell را پاک کنید تا به کاربر سرپرست برگردید.
# Unset impersonation
gcloud config unset auth/impersonate_service_account
درستیسنجی بااستفاده از Apache Spark (واگذاری محاسبات)
اگر یک «متخصص علم داده» از Apache Spark برای خواندن این جدول استفاده کند چه میشود؟ اگر Spark فایلهای فیزیکی GCS Parquet را مستقیماً بخواند، قوانین پوشاندن Knowledge Catalog کاملاً نادیده گرفته میشود زیرا Cloud Storage فقط اجازههای سطح مخزن را درک میکند.
برای جلوگیری از این اتفاق، واگذاری محاسبات را بااستفاده از رابط Spark-BigQuery اعمال میکنید. این متصلکننده بهعنوان یک پل امن عمل میکند و درخواستهای خواندن Spark را ازطریق BigQuery Storage API هدایت میکند تا قوانین حاکمیت Knowledge Catalog قبلاز ارسال هرگونه داده به خوشه Spark بهصورت پویا ارزیابی شوند.
به منطق اصلی در اسکریپت read_transactions.py که بارگیری کردید نگاهی بیندازید:
# Reading data via Compute Delegation (Knowledge Catalog policies are applied dynamically here)
df = spark.read \
    .format("bigquery") \
    .option("table", f"{project_id}.{dataset_id}.{table_name}") \
    .load()

print("\n=== 📊 Data Preview ===")
df.show(truncate=False)
توجه داشته باشید که Spark را به مسیر gs:// فایلهای Iceberg هدایت نمیکنیم. با مشخص کردن .format("bigquery")، BigQuery Storage API درخواست خواندن را رهگیری میکند، هویت کاربری را که کار Spark را اجرا میکند بررسی میکند، قوانین پوشاندن Knowledge Catalog را اعمال میکند، و فقط دادههای مجاز را به Spark DataFrame برمیگرداند.
این اسکریپت PySpark را در مخزن Cloud Storage خود بارگذاری کنید تا Managed Apache Spark بتواند به آن دسترسی داشته باشد:
# Upload script to GCS
gsutil cp read_transactions.py gs://${ICEBERG_BUCKET}/scripts/read_transactions.py
Spark را بهعنوان مدیر اجرا کنید:
از Managed Apache Spark استفاده خواهید کرد. این سرویس مدیریتشده به شما امکان میدهد حجمهای کاری Spark را مستقیماً بدون نیاز به تأمین، پیکربندی، یا مدیریت خوشههای اختصاصی اجرا کنید.
echo "🚀 Submitting Managed Apache Spark Job as [MANAGER]..."
gcloud dataproc batches submit pyspark gs://${ICEBERG_BUCKET}/scripts/read_transactions.py \
    --project=${PROJECT_ID} \
    --region=${REGION} \
    --service-account=${EMAIL_MANAGER} \
    --version=2.3 \
    -- ${PROJECT_ID} ${DATASET_ID} \
    --format="value(name)"
گزارشهای خروجی کار را در پایانه ببینید. چون مدیر نقش «خواننده با جزئیات دقیق» را دارد، Spark باموفقیت مبالغ خام و بدون ماسک را بازیابی میکند.
=== 📊 Data Preview ===
+---+--------+------+-------------------+
|id |item    |amount|transaction_date   |
+---+--------+------+-------------------+
|1  |Widget A|100.0 |2024-01-01         |
|2  |Widget B|150.0 |2024-01-02         |
|3  |Widget C|50.0  |2024-01-03         |
+---+--------+------+-------------------+
Spark را بهعنوان تحلیلگر اجرا کنید:
اکنون، دقیقاً همان کار Spark را ارسال کنید، اما اینبار خود را بهجای شخصیت تحلیلگر جا بزنید.
echo "🚀 Submitting Managed Apache Spark Job as [ANALYST]..."
gcloud dataproc batches submit pyspark gs://${ICEBERG_BUCKET}/scripts/read_transactions.py \
    --project=${PROJECT_ID} \
    --region=${REGION} \
    --service-account=${EMAIL_ANALYST} \
    --version=2.3 \
    -- ${PROJECT_ID} ${DATASET_ID} \
    --format="value(name)"
گزارشها را دوباره بررسی کنید. بااینکه تحلیلگر دقیقاً همان کد Spark را اجرا کرد، BigQuery Storage API درخواست را رهگیری کرد و خطمشی Knowledge Catalog را اعمال کرد. Spark DataFrame تحلیلگر null را برای مبالغ نمایش میدهد!
=== 📊 Data Preview ===
+---+--------+------+-------------------+
|id |item    |amount|transaction_date   |
+---+--------+------+-------------------+
|1  |Widget A|null  |2024-01-01         |
|2  |Widget B|null  |2024-01-02         |
|3  |Widget C|null  |2024-01-03         |
+---+--------+------+-------------------+
موازنههای معماری: BigQuery SQL درمقابل Spark
شما ثابت کردید که نتیجه بدون توجه به موتور یکسان است! خطمشی «کاتالوگ دانش» باموفقیت اجرا شد. اما در تولید، از کدامیک باید استفاده کنید؟
- BigQuery SQL: برای گردشهای کاری که SQL موتور مطلوب است و محاسبات را مستقیماً در محل اجرا میکند عالی است. این مدل برای تجزیهوتحلیل سریع و هوش تجاری ایدهآل است.
- Apache Spark: بااستفاده از Python، امکان حجمهای کاری پیچیدهتر را فراهم میکند و آن را برای خطوط لوله پیشرفته «یادگیری ماشین» یا کد Hadoop قدیمی مناسب میسازد.
نکته کلیدی: مهم نیست از کدام موتور استفاده میشود، با اعمال واگذاری محاسبات، لایه حاکمیت متمرکز با اعتماد صفر هرگز قابلدور زدن نیست!
۶. تبار داده خودکارسازیشده
در هر معماری داده سازمانی، دانستن دقیق اینکه دادههای شما از کجا میآیند و چگونه تغییر کردهاند برای رعایت مقررات، اشکالزدایی، و ایجاد اعتماد بسیار مهم است. این مفهوم بهعنوان تبار داده شناخته میشود. این ویژگی به سؤالات اساسی پاسخ میدهد، مثلاً: «اگر مدیری درحال بررسی گزارش فروش روزانه است، از کدام جدولهای خام برای محاسبه آن اعداد استفاده شده است؟»
بهطور سنتی، ردیابی این چرخه حیات مستلزم آن است که مهندسان داده بهصورت دستی کد ثبت سفارشی بنویسند یا از ابزارهای پیچیده شخص ثالث برای تجزیه دستورگانهای SQL استفاده کنند. اما در یک Google Cloud Lakehouse تحت حاکمیت، این ردیابی بهصورت داخلی و کاملاً خودکار انجام میشود.
جدول transactions_summary را که قبلاً در codelab از جدول تراکنشهای خام ایجاد کردید بهخاطر دارید؟ وقتی BigQuery آن عبارت CREATE TABLE AS SELECT را اجرا کرد، موتور محاسباتی بهطور خودکار فراداده تبدیل را ضبط کرد و آن را به Knowledge Catalog ارسال کرد. بیایید نتیجه را ببینیم.
دیداریسازی تبار
- در Google Cloud Console، به کاتالوگ دانش > جستجو بروید.
lakehouse_retail_demo.transactionsرا در نوار جستجو تایپ کنید و روی جدول کلیک کنید.- روی برگه تبار کلیک کنید.
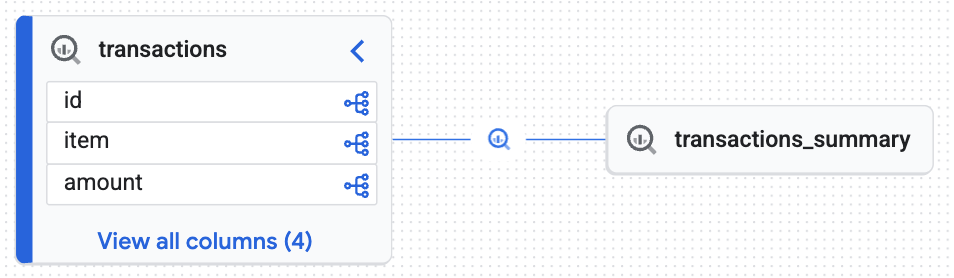
نمودار تعاملی تولیدشده توسط Knowledge Engine را خواهید دید که ثابت میکند جدول هدف (transactions_summary) از جدول Iceberg تحتنظارت خام (transactions) مشتق شده است. شما به قابلیت ردیابی سرتاسری که برای ممیزی دادهها ضروری است دست یافتهاید.
۷. مرتبسازی
برای جلوگیری از کسر هزینه از حساب Google Cloud شما بابت منابع استفادهشده در این codelab، این مراحل را دنبال کنید.
برداشتن منابع حاکمیتی Knowledge Catalog
قبلاز حذف مجموعه داده BigQuery یا سطل Cloud Storage، باید قوانین حاکمیت منطقی را بردارید. اگر به داخل اسکریپت cleanup_governance.py از مخزن نگاه کنید، توالی جداسازی زیر را خواهید دید:
# 1. Delete Data Policy
data_policy_name = f"{parent_loc}/dataPolicies/mask_financial_null"
dp_client.delete_data_policy(name=data_policy_name)

# 2. Find and Delete Taxonomy (This auto-deletes child Policy Tags)
taxonomies = catalog_client.list_taxonomies(parent=parent_loc)
taxonomy_id = next((t.name for t in taxonomies if t.display_name == "BusinessCritical"), None)
catalog_client.delete_taxonomy(name=taxonomy_id)
ترتیب در اینجا بسیار مهم است. این دستور ابتدا «خطمشی داده» (قانون پوشاندن) را حذف میکند زیرا به «برچسب خطمشی» متکی است. پساز برداشته شدن خطمشی، حذف «ردهبندی» اصلی بهطور خودکار بهصورت آبشاری انجام میشود و همه «برچسبهای خطمشی» زیرین را بدون ایجاد خطاهای وابستگی منابع حذف میکند.
اسکریپت پاکسازی Python را اجرا کنید:
python cleanup_governance.py
برداشتن هویتها، فضای ذخیرهسازی، و داراییهای محاسباتی
اکنون که لایه حاکمیت جدا شده است، میتوانید بهطور ایمن جدولهای BigQuery، دستههای Cloud Storage، «حسابهای سرویس»، و محیط Python محلی را حذف کنید.
بلوک پاکسازی جامع زیر را در Cloud Shell خود کپی و اجرا کنید:
echo "Deleting Service Accounts and Impersonation Bindings..."
export CURRENT_USER=$(gcloud config get-value account)

for USER in "${USER_ANALYST}" "${USER_MANAGER}"; do
    EMAIL="${USER}@${PROJECT_ID}.iam.gserviceaccount.com"

    # Remove impersonation binding
    gcloud iam service-accounts remove-iam-policy-binding ${EMAIL} \
        --member="user:${CURRENT_USER}" \
        --role="roles/iam.serviceAccountTokenCreator" \
        --quiet > /dev/null 2>&1

    # Delete the Service Account
    gcloud iam service-accounts delete ${EMAIL} --quiet
done

echo "Removing BigQuery Dataset and Tables..."
bq rm -f ${DATASET_ID}.transactions_summary
bq rm -f ${DATASET_ID}.transactions
bq rm -f ${DATASET_ID}.inventory
bq rm -f -d ${DATASET_ID}

echo "Removing BigQuery Cloud Resource Connection..."
bq rm --connection --location=${REGION} ${CONN_NAME}

echo "Removing Iceberg Cloud Storage Bucket..."
gcloud storage rm --recursive gs://${ICEBERG_BUCKET} --quiet

echo "Removing Auto-generated Dataproc Staging & Temp Buckets..."
for BUCKET in $(gcloud storage ls | grep -E "gs://dataproc-(staging|temp)-${REGION}"); do
    gcloud storage rm --recursive $BUCKET --quiet
done

echo "Deactivating and removing the local Python environment..."
deactivate
cd ../..
rm -rf devrel-demos

echo "✅ Clean up completed successfully!"
با تکمیل این مراحل، مطمئن شدهاید که هیچ منبع یتیم یا خطمشی پنهانی در پروژهتان باقی نمانده است.
۸. تبریک!
یک Data Lakehouse کاملاً تحت نظارت و قابلکشف را باموفقیت پیادهسازی کردهاید.
یاد گرفتید که:
- ادغام Iceberg بومی: Lakehouse میتواند جدولهای Iceberg متنباز را بهطور بومی مدیریت کند و درعینحال فایلهای فیزیکی را بهطور ایمن در «فضای ذخیرهسازی ابری» ذخیره کند.
- محاسبه واگذاری برای امنیت: با مسیریابی پُرسمانها ازطریق BigQuery Storage API، پوشاندن پویای دقیق را روی فایلهای فیزیکی اعمال کردید که بهطور پیشفرض نمیتوانند دسترسی جزئی را محدود کنند.
- حاکمیت مستقل از موتور: «برچسبهای خطمشی» به شما امکان میدهد قوانین را یکبار تعریف کنید و آنها را بهطور جهانی اعمال کنید، چه ازطریق SQL بومی و چه ازطریق زمانهای اجرای Apache Spark پُرسمان شوند.
- قابلیت کشف داده: Knowledge Engine بهطور خودکار تبار دادهها را ردیابی کرد و قابلیت حسابرسی ضروری سازمانی را فراهم کرد.
بعد چه باید کرد؟
- کاوش کنترل دسترسی پیشرفته: برای پیادهسازی سناریوهای امنیتی پیچیدهتر، اسناد رسمی مربوط به سفارشیسازی Lakehouse با ویژگیهای اضافی را مرور کنید.
- مدیریت دادههای بدون ساختار برای هوش مصنوعی زایا: جدولهای شیء را کاوش کنید. این الگوی پل امن دقیق را به فایلهای بدون ساختار (PDF، تصویر) در Cloud Storage گسترش دهید و یک پایه داده امن و تحت نظارت برای Gemini Enterprise Agent Engine و خطوط لوله RAG ایجاد کنید.