

1. Введение
В современном корпоративном облаке данных, где данные хранятся в различных физических системах хранения, существует огромная архитектурная проблема фрагментированной безопасности.
Как обеспечить единообразную защиту конфиденциальных данных (например, сумм финансовых транзакций), если они физически хранятся в форматах с открытым исходным кодом, таких как Parquet, в Google Cloud Storage и запрашиваются несколькими разными системами, такими как BigQuery SQL или Apache Spark?
В этой практической работе вы создадите управляемую архитектуру озера-хранилища данных, которая решает эти проблемы с помощью таблиц Apache Iceberg, BigQuery и Knowledge Catalog. Вы будете использовать инфраструктуру как код (IaC) для определения политик безопасности с нулевым доверием и того, как они динамически применяются в различных вычислительных системах.
Требования
- Проект Google Cloud с включенными платежными функциями.
- Базовое понимание концепций SQL, IAM и Cloud Storage.
Что вы узнаете
- Как создавать таблицы Google Cloud Lakehouse для Apache Iceberg в BigQuery, где данные хранятся в Cloud Storage.
- Как применять централизованные политики данных с помощью тегов политик для безопасности на уровне столбцов и деидентификации данных.
- Как отделить доступ к физическому хранилищу от доступа к логическим данным с помощью подключения к облачному ресурсу.
- Как принудительно использовать делегирование вычислений с нулевым доверием с помощью управляемого сервиса для Apache Spark, чтобы механизмы с открытым исходным кодом не могли обходить управление.
- Как визуализировать автоматизированное происхождение данных.
Обзор архитектуры: универсальное управление в Iceberg
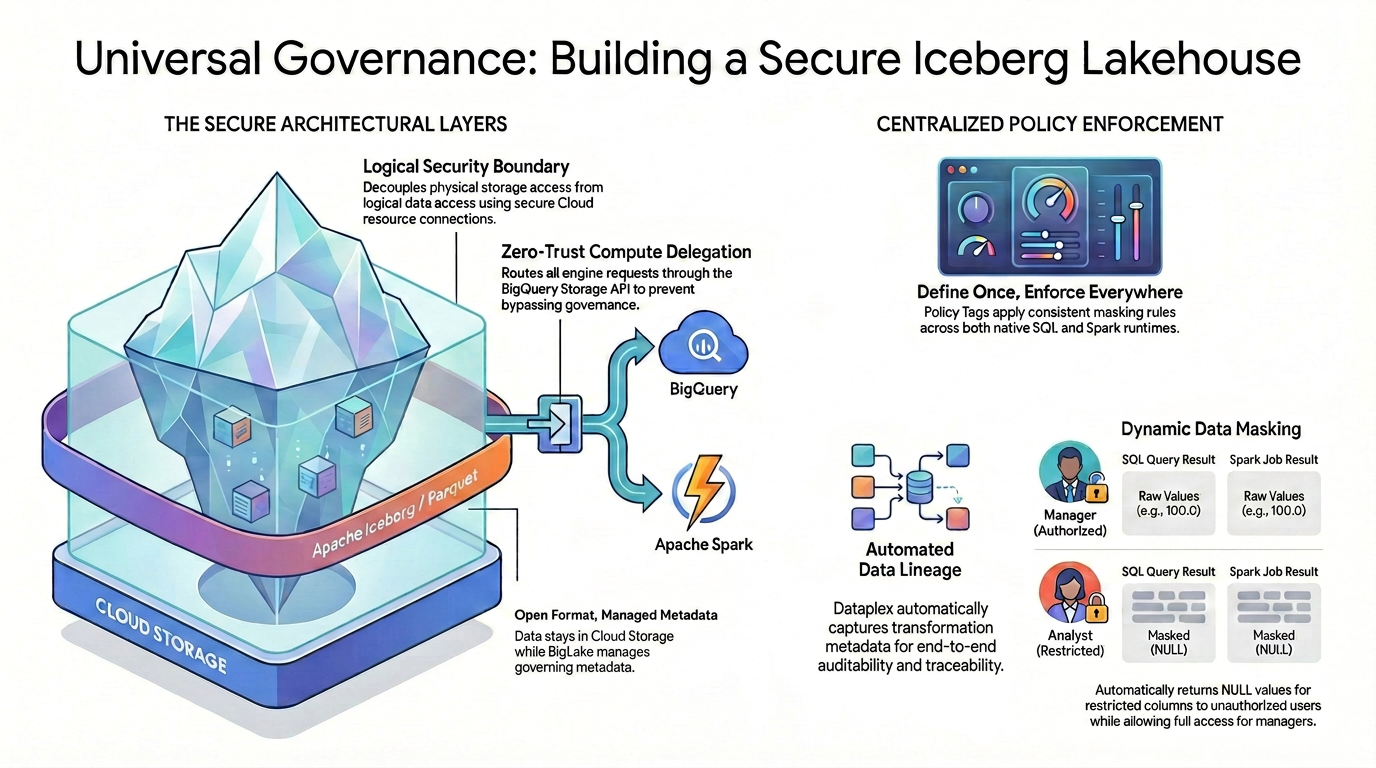
Чтобы обеспечить детальный контроль доступа (например, безопасность на уровне столбцов и деидентификацию данных) к форматам данных с открытым исходным кодом, необходимо создать строгую и унифицированную архитектуру безопасности.
Как показано на схеме, этот шаблон управляемого хранилища данных опирается на два основных принципа, позволяющих решить проблему фрагментированной безопасности:
🛡️ Уровни безопасности архитектуры (слева)
Вместо того чтобы разрешать пользователям или внешним системам напрямую обращаться к Cloud Storage, где поддерживается только безопасность на уровне сегментов, вы создаете безопасную основу.
- Открытый формат, управляемые метаданные. Данные физически остаются в Cloud Storage в открытом формате Apache Iceberg (Parquet), а Lakehouse управляет метаданными.
- Логическая граница безопасности. Вы разделяете доступ к физическому хранилищу и логический доступ к данным, используя защищенное подключение к ресурсу Cloud. Конечные пользователи никогда не получают прямого физического доступа IAM к необработанным файлам GCS.
- Делегирование вычислений с нулевым доверием. Чтобы ни один механизм выполнения не мог обойти правила управления, все запросы на чтение данных строго маршрутизируются через BigQuery Storage API. Это относится как к запросам, созданным в BigQuery SQL, так и к запросам, созданным в Apache Spark с открытым исходным кодом.
🎯 Централизованное применение правил (правильно)
Каталог знаний – это единый центр управления, который обеспечивает:
- Определите один раз, применяйте везде. Вы определяете теги политики в Knowledge Catalog только один раз, и архитектура применяет согласованные правила маскирования ко всем поддерживаемым средам выполнения.
- Динамическое маскирование данных. При запросе данных система на лету оценивает личность пользователя. Авторизованные пользователи будут видеть необработанные, незамаскированные значения (например, 100.0) как в SQL, так и в Spark, а пользователи с ограниченным доступом будут автоматически получать замаскированные значения NULL для столбцов с ограниченным доступом в обеих системах.
- Автоматизированное отслеживание происхождения данных. По мере передачи и преобразования данных Knowledge Catalog автоматически собирает метаданные преобразования, обеспечивая встроенную сквозную возможность аудита и отслеживания без необходимости в пользовательском коде ведения журнала.
2. Настройка и требования
Запустите Cloud Shell
Хотя Google Cloud можно управлять удаленно с ноутбука, в этой практической работе вы будете использовать Google Cloud Shell – среду командной строки, работающую в облаке.
В консоли Google Cloud нажмите на значок Cloud Shell на панели инструментов в правом верхнем углу.
Подготовка и подключение к среде займет всего несколько минут. После завершения вы увидите примерно следующее:
На этой виртуальной машине установлены все необходимые инструменты разработки. Она предлагает постоянный домашний каталог объемом 5 ГБ и работает на платформе Google Cloud, что значительно повышает производительность сети и аутентификацию. Все действия в рамках этой практической работы можно выполнить в браузере. Ничего устанавливать не нужно.
Инициализация среды
Откройте Cloud Shell и задайте переменные проекта, чтобы все команды были направлены на нужную инфраструктуру.
export PROJECT_ID=$(gcloud config get-value project)
export REGION="us-central1"
export ICEBERG_BUCKET="iceberg-retail-demo-${PROJECT_ID}"
export DATASET_ID="lakehouse_retail_demo"
export CONN_NAME="iceberg-bq-conn-demo"
Затем определите двух персонажей.
export USER_ANALYST="retail-analyst-demo"
export EMAIL_ANALYST="${USER_ANALYST}@${PROJECT_ID}.iam.gserviceaccount.com"

export USER_MANAGER="retail-manager-demo"
export EMAIL_MANAGER="${USER_MANAGER}@${PROJECT_ID}.iam.gserviceaccount.com"
export CURRENT_USER=$(gcloud config get-value account)
Как включить API
Включите необходимые сервисы Google Cloud.
gcloud services enable \
  bigquery.googleapis.com \
  bigqueryconnection.googleapis.com \
  datacatalog.googleapis.com \
  bigquerydatapolicy.googleapis.com \
  datalineage.googleapis.com \
  dataplex.googleapis.com \
  dataproc.googleapis.com \
  storage-component.googleapis.com
Скачайте исходный код практической работы
Чтобы не загромождать Cloud Shell, вы выполните разреженное извлечение и скачаете из репозитория Google Cloud DevRel только скрипты Python, необходимые для этой практической работы.
# Shallow clone without full history
git clone --depth 1 --filter=blob:none --sparse https://github.com/GoogleCloudPlatform/devrel-demos.git
cd devrel-demos

# Download only the specific folder
git sparse-checkout set data-analytics/governed-lakehouse
cd data-analytics/governed-lakehouse
Создание хранилища
Создайте сегмент для хранения управляемых данных Iceberg с высоким уровнем защиты.
gcloud storage buckets create gs://${ICEBERG_BUCKET} --location=${REGION}
Как подготовить идентификационную информацию и настроить безопасность
Настройте подключение к ресурсу Google Cloud. Это единственный объект, у которого есть постоянные физические ключи IAM для чтения необработанных файлов Iceberg.
# Create the BigQuery connection
bq mk --connection \
    --connection_type=CLOUD_RESOURCE \
    --location=${REGION} \
    ${CONN_NAME}

# Retrieve the connection's automatically generated Service Account
export BQ_CONN_SVC_ACCT=$(bq show --format=json --connection ${REGION}.${CONN_NAME} \
    | jq -r '.cloudResource.serviceAccountId')

# Grant Storage Object Admin to the connection for the Iceberg bucket
gcloud storage buckets add-iam-policy-binding gs://${ICEBERG_BUCKET} \
    --member="serviceAccount:${BQ_CONN_SVC_ACCT}" \
    --role="roles/storage.objectAdmin" \
    --quiet
Затем настройте персонажи пользователей. Пользователям предоставляется логический доступ, а не доступ к физическому хранилищу. Чтобы избежать ошибок, связанных с задержками распространения IAM, сначала создайте аккаунты, подождите несколько секунд, а затем назначьте им роли.
echo "Creating Service Accounts..."
for USER in "${USER_ANALYST}" "${USER_MANAGER}"; do
    gcloud iam service-accounts create ${USER} --display-name="Lakehouse ${USER}"
done

echo "⏳ Waiting 15 seconds for IAM propagation..."
sleep 15

echo "Granting IAM Roles to Service Accounts..."
for USER in "${USER_ANALYST}" "${USER_MANAGER}"; do
    EMAIL="${USER}@${PROJECT_ID}.iam.gserviceaccount.com"

    # Allow Cloud Shell to impersonate them for testing
    gcloud iam service-accounts add-iam-policy-binding ${EMAIL} \
        --member="user:${CURRENT_USER}" \
        --role="roles/iam.serviceAccountTokenCreator" \
        --quiet

    # Allow logical viewing of the catalog, querying, and running Dataproc jobs
    for ROLE in "roles/datacatalog.viewer" "roles/bigquery.dataViewer" "roles/bigquery.user" "roles/bigquery.connectionUser" "roles/serviceusage.serviceUsageConsumer" "roles/dataproc.worker"; do
        gcloud projects add-iam-policy-binding ${PROJECT_ID} \
            --member="serviceAccount:${EMAIL}" \
            --role="${ROLE}" \
            --quiet
    done
done

# Grant the Manager data creation rights
gcloud projects add-iam-policy-binding ${PROJECT_ID} \
    --member="serviceAccount:${EMAIL_MANAGER}" \
    --role="roles/bigquery.dataEditor" \
    --quiet

echo "✅ Identity and Security setup completed!"
3. Создание нативных таблиц Iceberg с помощью Lakehouse
Для создания управляемых таблиц Iceberg вы будете использовать встроенные возможности Lakehouse.
Как создать набор данных BigQuery
Сначала создайте набор данных BigQuery, чтобы логически сгруппировать таблицы Iceberg.
echo "Creating BigQuery Dataset..."
bq mk --location=${REGION} --dataset ${PROJECT_ID}:${DATASET_ID}
Как создать таблицы Iceberg
Затем выполните следующие команды, чтобы создать таблицы. Обратите внимание на блок OPTIONS, в котором мы указываем table_format = 'ICEBERG' и сопоставляем его непосредственно с сегментом Cloud Storage и подключением.
echo "Creating Iceberg tables..."

# Inventory table
bq query --use_legacy_sql=false \
"CREATE OR REPLACE TABLE \`${PROJECT_ID}.${DATASET_ID}.inventory\` (
    product_id INT64,
    product_name STRING,
    stock_count INT64
)
WITH CONNECTION \`${REGION}.${CONN_NAME}\`
OPTIONS (
    file_format = 'PARQUET',
    table_format = 'ICEBERG',
    storage_uri = 'gs://${ICEBERG_BUCKET}/inventory/'
);"

# Transactions table
bq query --use_legacy_sql=false \
"CREATE OR REPLACE TABLE \`${PROJECT_ID}.${DATASET_ID}.transactions\` (
    id INT64,
    item STRING,
    amount FLOAT64,
    transaction_date DATE
)
WITH CONNECTION \`${REGION}.${CONN_NAME}\`
OPTIONS (
    file_format = 'PARQUET',
    table_format = 'ICEBERG',
    storage_uri = 'gs://${ICEBERG_BUCKET}/transactions/'
);"
Заполните таблицы данными
Наконец, вставьте примеры данных в новые таблицы Iceberg.
echo "Inserting data into Iceberg tables..."

# Insert into Inventory table
bq query --use_legacy_sql=false \
"INSERT INTO \`${PROJECT_ID}.${DATASET_ID}.inventory\` (product_id, product_name, stock_count)
VALUES (101, 'Widget A', 500), (102, 'Widget B', 250), (103, 'Widget C', 800);"

# Insert into Transactions table
bq query --use_legacy_sql=false \
"INSERT INTO \`${PROJECT_ID}.${DATASET_ID}.transactions\` (id, item, amount, transaction_date)
VALUES
    (1, 'Widget A', 100.0, DATE '2024-01-01'),
    (2, 'Widget B', 150.0, DATE '2024-01-02'),
    (3, 'Widget C', 50.0, DATE '2024-01-03');"
Теперь у вас есть две полностью функционирующие таблицы Iceberg. Lakehouse управляет метаданными, но физические файлы Parquet надежно хранятся в вашем сегменте GCS.
Моделирование конвейера ETL
В реальном сценарии первичные данные часто агрегируются в сводные таблицы для бизнес-отчётности. Давайте представим, что мы инженеры данных, и создадим сводную таблицу ежедневных продаж на основе необработанных данных о транзакциях.
Примечание. Выполните этот шаг сейчас, чтобы у Google Cloud было достаточно времени для обработки фоновых метаданных. Позже вы узнаете, почему это важно.
echo "Creating transactions summary table..."
bq query --use_legacy_sql=false \
"CREATE TABLE \`${PROJECT_ID}.${DATASET_ID}.transactions_summary\` AS
 SELECT transaction_date, SUM(amount) as total_sales, COUNT(id) as transaction_count
 FROM \`${PROJECT_ID}.${DATASET_ID}.transactions\`
 GROUP BY transaction_date;"
4. Централизованное управление: определение правил с помощью Python
В рабочей среде настраивать правила управления через интерфейс сложно, поскольку это не позволяет масштабировать и поддерживать их. Вместо этого настоятельно рекомендуется использовать инфраструктуру как код (IaC).
В этом разделе вы будете использовать Google Cloud Python SDK, чтобы программно создавать и применять правила управления нулевым доверием.
Как настроить среду Python
Сначала настроим изолированную среду Python (venv), чтобы избежать конфликтов библиотек, и установим необходимые Google Cloud SDK.
Выполните в Cloud Shell следующие команды:
# Create and activate a virtual environment
python3 -m venv lakehouse_env
source lakehouse_env/bin/activate

# Install required Knowledge Catalog and BigQuery governance libraries
pip install google-cloud-datacatalog google-cloud-bigquery-datapolicies google-cloud-bigquery --quiet

echo "✅ Python environment is ready!"
Создание таксономии и тега политики
Таксономия – это логический контейнер, а тег политики – это конкретный ярлык, который вы прикрепите к столбцу с конфиденциальными данными. Чтобы обеспечить безопасность на уровне столбцов, сначала необходимо создать логический контейнер (таксономию) и специальный ярлык (тег политики).
Если вы посмотрите на код 1_create_taxonomy.py, то увидите следующую логику:
# Create Taxonomy with Fine-Grained Access Control enabled
taxonomy = datacatalog_v1.Taxonomy(
    display_name="BusinessCritical",
    activated_policy_types=[datacatalog_v1.Taxonomy.PolicyType.FINE_GRAINED_ACCESS_CONTROL]
)
created_taxonomy = client.create_taxonomy(parent=parent, taxonomy=taxonomy)

# Create Policy Tag inside the Taxonomy
policy_tag = datacatalog_v1.PolicyTag(display_name="RestrictedFinancial")
created_policy_tag = client.create_policy_tag(parent=created_taxonomy.name, policy_tag=policy_tag)
Явно задав тип правила FINE_GRAINED_ACCESS_CONTROL, вы преобразуете стандартный тег метаданных в строгую границу безопасности с нулевым доверием. По умолчанию доступ к столбцам с этим тегом будет запрещен для всех пользователей.
Запустите скрипт, чтобы создать ресурсы:
python 1_create_taxonomy.py
Настройте правило деидентифицирования (правило в отношении данных)
Теперь вы определяете, что происходит, когда кто-то без привилегий запрашивает столбец с тегами. Вы создадите правило в отношении данных, которое принудительно возвращает значение NULL, и прикрепите это правило к персонажу аналитика.
Внутри 2_create_masking.py скрипт динамически ищет идентификатор тега политики, который вы только что создали, и применяет политику данных:
# Define a Masking Policy that always returns NULL
data_policy = bigquery_datapolicies_v1.DataPolicy(
    data_policy_id="mask_financial_null",
    policy_tag=policy_tag_id,
    data_policy_type=bigquery_datapolicies_v1.DataPolicy.DataPolicyType.DATA_MASKING_POLICY,
    data_masking_policy=bigquery_datapolicies_v1.DataMaskingPolicy(
        predefined_expression=bigquery_datapolicies_v1.DataMaskingPolicy.PredefinedExpression.ALWAYS_NULL
    )
)

# ... (Policy creation code) ...

# Bind the Masked Reader role to the Analyst
iam_policy.bindings.add(
    role="roles/bigquerydatapolicy.maskedReader",
    members=[f"serviceAccount:{analyst_email}"]
)
Этот код программно создает правило, которое принудительно возвращает базовые значения как NULL. Затем она назначает роль IAM maskedReader специально для аналитика, чтобы он видел только маскированную версию данных.
Запустите скрипт, чтобы настроить правило маскирования:
python 2_create_masking.py
Предоставление детализированного доступа
Поскольку у нас настроена модель нулевого доверия, сейчас никто не может прочитать помеченный тегом столбец. Вам нужно явно предоставить доступ управляющему и личному аккаунту.
В 3_grant_access.py вы изменяете политику IAM самого тега политики:
# Grant original data read access
iam_policy.bindings.add(
    role="roles/datacatalog.categoryFineGrainedReader",
    members=[f"serviceAccount:{manager_email}", f"user:{current_user}"]
)
client.set_iam_policy(request=iam_policy_pb2.SetIamPolicyRequest(resource=policy_tag_id, policy=iam_policy))
Добавление роли categoryFineGrainedReader позволяет этим конкретным участникам обходить правила маскирования и читать необработанные, немаскированные данные.
Выполните скрипт, чтобы предоставить доступ:
python 3_grant_access.py
Как прикрепить тег политики к таблице BigQuery
Наконец, вам нужно прикрепить этот логический тег политики к физической схеме таблицы Iceberg.
Посмотрите на 4_attach_tag.py. Скрипт получает схему таблицы BigQuery, перебирает поля и прикрепляет тег к столбцу amount:
new_schema =[]
for field in table.schema:
    if field.name == 'amount':
        # Wrap the Policy Tag ID and attach it to the column
        policy_tags_list = bigquery.PolicyTagList(names=[policy_tag_id])
        new_field = bigquery.SchemaField(
            name=field.name, field_type=field.field_type, mode=field.mode,
            description=field.description, policy_tags=policy_tags_list
        )
        new_schema.append(new_field)
    else:
        new_schema.append(field)

# Update the table schema in BigQuery
table.schema = new_schema
client.update_table(table, ["schema"])
Когда это обновление схемы применяется, Lakehouse мгновенно связывает логические теги Knowledge Catalog с физическими файлами Parquet, хранящимися в сегменте Cloud Storage.
Запустите скрипт, чтобы обновить схему таблицы:
python 4_attach_tag.py
5. Проверьте правила Каталога знаний
Пришло время проверить, работает ли наше централизованное управление. Вы протестируете это на двух разных движках, чтобы доказать, что правила Knowledge Catalog применяются повсеместно.
Проверка с помощью нативного SQL в BigQuery
Сначала вы будете использовать Cloud Shell, чтобы принять идентификационные данные двух наших персонажей и запросить таблицу с помощью собственного механизма SQL BigQuery.
Тестирование в роли менеджера (пользователя с расширенными правами)
# Impersonate the manager
gcloud config set auth/impersonate_service_account ${EMAIL_MANAGER}

# Query the transactions table
bq query --use_legacy_sql=false "SELECT * FROM \`${PROJECT_ID}.${DATASET_ID}.transactions\`"
Поскольку у менеджера есть роль Fine-Grained Reader, он увидит точные значения сумм.
+----+----------+--------+------------------+
| id |   item   | amount | transaction_date |
+----+----------+--------+------------------+
|  1 | Widget A |  100.0 |       2024-01-01 |
|  3 | Widget C |   50.0 |       2024-01-03 |
|  2 | Widget B |  150.0 |       2024-01-02 |
+----+----------+--------+------------------+
Тестирование в роли аналитика (пользователя с ограниченным доступом):
gcloud config set auth/impersonate_service_account ${EMAIL_ANALYST}

bq query --use_legacy_sql=false "SELECT * FROM \`${PROJECT_ID}.${DATASET_ID}.transactions\`"
Из-за правила маскировки Knowledge Catalog столбец amount возвращает NULL для каждой строки.
+----+----------+--------+------------------+
| id |   item   | amount | transaction_date |
+----+----------+--------+------------------+
|  1 | Widget A |   NULL |       2024-01-01 |
|  3 | Widget C |   NULL |       2024-01-03 |
|  2 | Widget B |   NULL |       2024-01-02 |
+----+----------+--------+------------------+
Восстановление личных данных
Очистите состояние аутентификации Cloud Shell, чтобы вернуться к пользователю с правами администратора.
# Unset impersonation
gcloud config unset auth/impersonate_service_account
Проверка с помощью Apache Spark (делегирование вычислений)
Что если специалист по обработке данных использует Apache Spark для чтения этой таблицы? Если Spark считывает физические файлы Parquet в GCS напрямую, правила маскирования Knowledge Catalog полностью игнорируются, поскольку Cloud Storage распознает только разрешения на уровне сегмента.
Чтобы предотвратить это, вы принудительно применяете делегирование вычислений с помощью коннектора Spark-BigQuery. Этот коннектор выступает в качестве безопасного моста, направляя запросы на чтение Spark через BigQuery Storage API, чтобы правила управления Knowledge Catalog динамически оценивались до отправки каких-либо данных в кластер Spark.
Рассмотрим основную логику скачанного скрипта read_transactions.py:
# Reading data via Compute Delegation (Knowledge Catalog policies are applied dynamically here)
df = spark.read \
    .format("bigquery") \
    .option("table", f"{project_id}.{dataset_id}.{table_name}") \
    .load()

print("\n=== 📊 Data Preview ===")
df.show(truncate=False)
Обратите внимание, что мы не указываем Spark путь gs:// к файлам Iceberg. Если указать .format("bigquery"), BigQuery Storage API перехватит запрос на чтение, проверит личность пользователя, выполняющего задание Spark, применит правила маскирования Knowledge Catalog и вернет в Spark DataFrame только разрешенные данные.
Загрузите этот скрипт PySpark в сегмент Cloud Storage, чтобы управляемый Apache Spark мог получить к нему доступ:
# Upload script to GCS
gsutil cp read_transactions.py gs://${ICEBERG_BUCKET}/scripts/read_transactions.py
Запустите Spark от имени менеджера:
Вы будете использовать управляемый сервис Apache Spark. Этот управляемый сервис позволяет запускать рабочие нагрузки Spark напрямую, без необходимости выделять, настраивать или управлять выделенными кластерами.
echo "🚀 Submitting Managed Apache Spark Job as [MANAGER]..."
gcloud dataproc batches submit pyspark gs://${ICEBERG_BUCKET}/scripts/read_transactions.py \
    --project=${PROJECT_ID} \
    --region=${REGION} \
    --service-account=${EMAIL_MANAGER} \
    --version=2.3 \
    -- ${PROJECT_ID} ${DATASET_ID} \
    --format="value(name)"
Посмотрите журналы выходных данных задания в терминале. Поскольку у менеджера есть роль Fine-Grained Reader, Spark успешно извлекает необработанные, немаскированные суммы.
=== 📊 Data Preview ===
+---+--------+------+-------------------+
|id |item    |amount|transaction_date   |
+---+--------+------+-------------------+
|1  |Widget A|100.0 |2024-01-01         |
|2  |Widget B|150.0 |2024-01-02         |
|3  |Widget C|50.0  |2024-01-03         |
+---+--------+------+-------------------+
Запустите Spark от имени аналитика:
Теперь отправьте то же самое задание Spark, но от имени аналитика.
echo "🚀 Submitting Managed Apache Spark Job as [ANALYST]..."
gcloud dataproc batches submit pyspark gs://${ICEBERG_BUCKET}/scripts/read_transactions.py \
    --project=${PROJECT_ID} \
    --region=${REGION} \
    --service-account=${EMAIL_ANALYST} \
    --version=2.3 \
    -- ${PROJECT_ID} ${DATASET_ID} \
    --format="value(name)"
Проверьте журналы ещё раз. Несмотря на то, что аналитик запустил тот же код Spark, BigQuery Storage API перехватил запрос и применил правило Knowledge Catalog. В Spark DataFrame аналитика отображается null для сумм!
=== 📊 Data Preview ===
+---+--------+------+-------------------+
|id |item    |amount|transaction_date   |
+---+--------+------+-------------------+
|1  |Widget A|null  |2024-01-01         |
|2  |Widget B|null  |2024-01-02         |
|3  |Widget C|null  |2024-01-03         |
+---+--------+------+-------------------+
Архитектурные компромиссы: BigQuery SQL и Spark
Вы только что доказали, что результат одинаков независимо от движка! Правило каталога знаний успешно применено. Но что использовать в рабочей версии?
- BigQuery SQL. Отлично подходит для рабочих процессов, в которых SQL является предпочтительным движком и выполняет вычисления непосредственно на месте. Она идеально подходит для быстрой аналитики и бизнес-аналитики.
- Apache Spark. Позволяет выполнять более сложные рабочие нагрузки за счет использования Python, что делает его хорошо подходящим для продвинутых конвейеров машинного обучения или устаревшего кода Hadoop.
Главный вывод. Независимо от того, какой движок используется, принудительное делегирование вычислений гарантирует, что централизованный уровень управления нулевым доверием никогда не будет обойден.
6. Автоматизированная линия данных
В любой корпоративной архитектуре данных точное знание того, откуда поступают данные и как они были изменены, имеет решающее значение для соблюдения нормативных требований, отладки и установления доверия. Эта концепция называется происхождением данных. Она отвечает на фундаментальные вопросы, например: "Если менеджер смотрит на ежедневный отчет о продажах, какие необработанные таблицы использовались для расчета этих цифр?"
Обычно для отслеживания этого жизненного цикла инженерам по обработке данных приходится вручную писать код для ведения журналов или использовать сложные сторонние инструменты для анализа скриптов SQL. Однако в управляемом озере-хранилище Google Cloud это отслеживание встроено и полностью автоматизировано.
Помните таблицу transactions_summary, которую вы создали из таблицы необработанных транзакций ранее в этой практической работе? Когда BigQuery выполнил эту инструкцию CREATE TABLE AS SELECT, Compute Engine автоматически зафиксировал метаданные преобразования и отправил их в Knowledge Catalog. Посмотрим, что получилось.
Визуализация происхождения
- В консоли Google Cloud перейдите в раздел Knowledge Catalog > Search (Каталог знаний > Поиск).
- Введите
lakehouse_retail_demo.transactionsв строке поиска и нажмите на таблицу. - Перейдите на вкладку Происхождение.
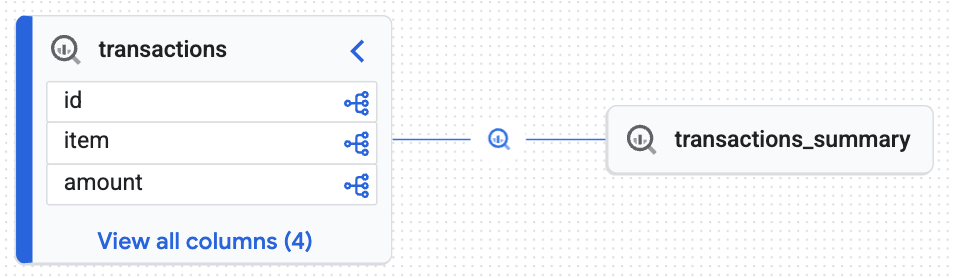
Вы увидите интерактивную диаграмму, созданную Knowledge Engine, которая доказывает, что целевая таблица (transactions_summary) была получена из необработанной управляемой таблицы Iceberg (transactions). Вы достигли сквозной прослеживаемости, необходимой для аудита данных.
7. Организовать
Чтобы избежать списания средств с вашего аккаунта Google Cloud за ресурсы, используемые в этой практической работе, выполните следующие действия.
Как удалить ресурсы управления каталогом знаний
Прежде чем удалять набор данных BigQuery или сегмент Cloud Storage, необходимо удалить логические правила управления. Если вы посмотрите на скрипт cleanup_governance.py из репозитория, то увидите следующую последовательность действий:
# 1. Delete Data Policy
data_policy_name = f"{parent_loc}/dataPolicies/mask_financial_null"
dp_client.delete_data_policy(name=data_policy_name)

# 2. Find and Delete Taxonomy (This auto-deletes child Policy Tags)
taxonomies = catalog_client.list_taxonomies(parent=parent_loc)
taxonomy_id = next((t.name for t in taxonomies if t.display_name == "BusinessCritical"), None)
catalog_client.delete_taxonomy(name=taxonomy_id)
Порядок вызова команд в данном случае очень важен. Сначала скрипт удаляет правила защиты данных (правило маскирования), поскольку оно зависит от тега политики. После удаления политики удаление родительской таксономии автоматически приведет к удалению всех базовых тегов политики без возникновения ошибок зависимости ресурсов.
Запустите скрипт очистки Python:
python cleanup_governance.py
Как удалить идентификационные данные, хранилище и вычислительные ресурсы
Теперь, когда уровень управления отключен, вы можете безопасно удалить таблицы BigQuery, сегменты Cloud Storage, сервисные аккаунты и локальную среду Python.
Скопируйте и запустите в Cloud Shell следующий блок кода:
echo "Deleting Service Accounts and Impersonation Bindings..."
export CURRENT_USER=$(gcloud config get-value account)

for USER in "${USER_ANALYST}" "${USER_MANAGER}"; do
    EMAIL="${USER}@${PROJECT_ID}.iam.gserviceaccount.com"

    # Remove impersonation binding
    gcloud iam service-accounts remove-iam-policy-binding ${EMAIL} \
        --member="user:${CURRENT_USER}" \
        --role="roles/iam.serviceAccountTokenCreator" \
        --quiet > /dev/null 2>&1

    # Delete the Service Account
    gcloud iam service-accounts delete ${EMAIL} --quiet
done

echo "Removing BigQuery Dataset and Tables..."
bq rm -f ${DATASET_ID}.transactions_summary
bq rm -f ${DATASET_ID}.transactions
bq rm -f ${DATASET_ID}.inventory
bq rm -f -d ${DATASET_ID}

echo "Removing BigQuery Cloud Resource Connection..."
bq rm --connection --location=${REGION} ${CONN_NAME}

echo "Removing Iceberg Cloud Storage Bucket..."
gcloud storage rm --recursive gs://${ICEBERG_BUCKET} --quiet

echo "Removing Auto-generated Dataproc Staging & Temp Buckets..."
for BUCKET in $(gcloud storage ls | grep -E "gs://dataproc-(staging|temp)-${REGION}"); do
    gcloud storage rm --recursive $BUCKET --quiet
done

echo "Deactivating and removing the local Python environment..."
deactivate
cd ../..
rm -rf devrel-demos

echo "✅ Clean up completed successfully!"
Выполнив эти действия, вы убедитесь, что в вашем проекте не осталось потерянных ресурсов или скрытых правил.
8. Поздравляем!
Вы успешно внедрили полностью управляемое и доступное для поиска хранилище Data Lakehouse.
Вы узнали, что:
- Встроенная интеграция с Iceberg. Lakehouse может управлять таблицами Iceberg с открытым исходным кодом, безопасно храня физические файлы в Cloud Storage.
- Делегирование вычислений для обеспечения безопасности. Направляя запросы через BigQuery Storage API, вы применили точное динамическое маскирование к физическим файлам, которые изначально не могут ограничивать частичный доступ.
- Управление, не зависящее от системы. Теги политики позволяют определить правила один раз и применять их повсеместно, независимо от того, запрашиваются ли они через нативные среды выполнения SQL или Apache Spark.
- Обнаруживаемость данных. Knowledge Engine автоматически отслеживает происхождение данных, обеспечивая необходимую для предприятия возможность аудита.
Что дальше?
- Изучите расширенные возможности контроля доступа. Чтобы реализовать более сложные сценарии безопасности, ознакомьтесь с официальной документацией по настройке Lakehouse с дополнительными функциями.
- Управление неструктурированными данными для генеративного ИИ. Узнайте больше об объектных таблицах. Расширьте этот шаблон безопасного моста на неструктурированные файлы (PDF, изображения) в Cloud Storage, создав безопасную управляемую основу данных для Gemini Enterprise Agent Engine и конвейеров RAG.