

1. はじめに
この Codelab では、GitHub リポジトリに含まれるソースコードの要約を生成し、そのプログラミング言語を識別する手順を紹介します。そのために、BigQuery でホストされるリモート関数として Vertex AI の大規模言語モデル(text-bison)を使用し、テキストを生成します。GitHub の Archive プロジェクトのおかげで、Google BigQuery 一般公開データセットに含まれるオープンソースの GitHub リポジトリの数はいまや、完全スナップショットで 280 万件以上にのぼります。使用されるサービスのリストは次のとおりです。
- BigQuery ML
- Vertex AI PaLM API
作成するアプリの概要
作成する内容
- モデルを格納する BigQuery データセット
- Vertex AI PaLM API をリモート関数としてホストする BigQuery モデル
- BigQuery と Vertex AI 間の接続を確立するための外部接続
2. 必要なもの
3. 始める前に
- Google Cloud コンソールのプロジェクト選択ページで、Google Cloud プロジェクトを選択または作成します。
- Cloud プロジェクトに対して課金が有効になっていることを確認します。詳しくは、プロジェクトで課金が有効になっているかどうかを確認する方法をご覧ください。
- 必要な API(BigQuery API、Vertex AI API、BigQuery Connection API)がすべて有効になっていることを確認します。
- Cloud Shell(Google Cloud で動作するコマンドライン環境)を使用します。この環境には bq がプリロードされています。gcloud コマンドとその使用方法については、ドキュメントをご覧ください。
Cloud コンソールで、[Cloud Shell をアクティブにする] をクリックします。

プロジェクトが設定されていない場合は、次のコマンドを使用して設定します。
gcloud config set project <YOUR_PROJECT_ID>
- ブラウザに https://console.cloud.google.com/bigquery と入力して、BigQuery コンソールに直接移動します。
4. データの準備
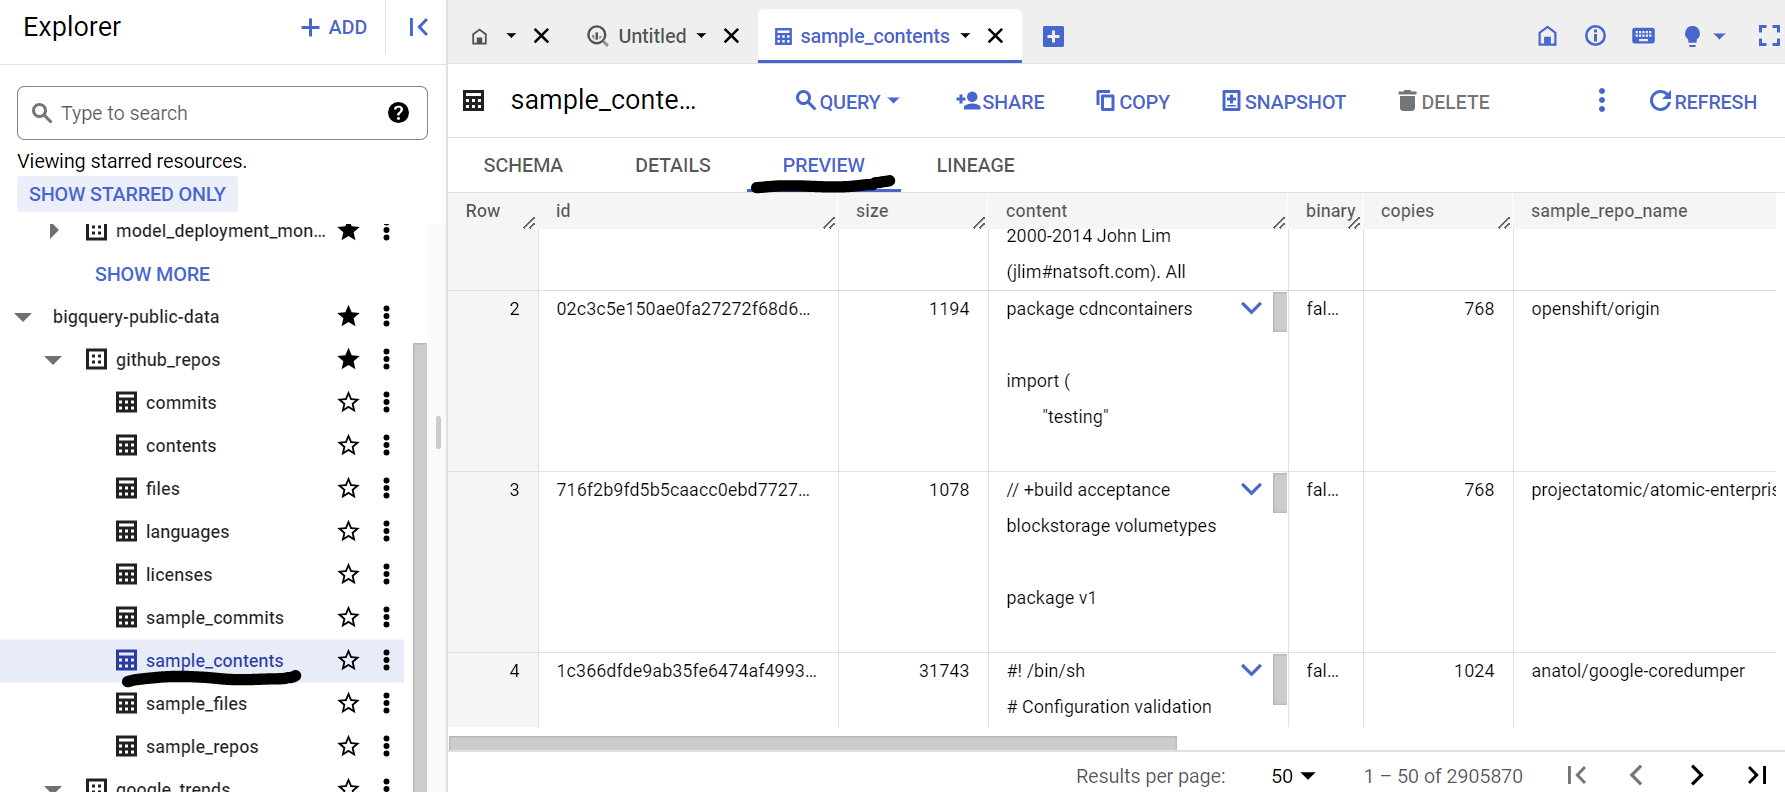
このユースケースでは、Google BigQuery 一般公開データセットから、github_repos データセットのソースコード コンテンツを使用します。これを使用するには、BigQuery コンソールで「github_repos」を検索して、Enter キーを押します。検索結果として表示されたデータセットの横にあるスターをクリックします。続けて、[スター付きのみを表示] をクリックして、一般公開データセットのみを表示します。

データセットのテーブルを開いて、スキーマとデータ プレビューを表示します。ここでは、contents テーブルに含まれる全データのサンプル(10%)のみを含む sample_contents を使用します。データのプレビューは次のとおりです。
5. BigQuery データセットを作成する
BigQuery データセットはテーブルのコレクションです。データセット内のすべてのテーブルは、同じデータのロケーションに保存されます。また、アクセス制御をカスタマイズして、データセットとそのテーブルへのアクセスを制限することも可能です。
「US」リージョン(またはご希望のリージョン)にデータセットを作成して、bq_llm という名前を付けます。
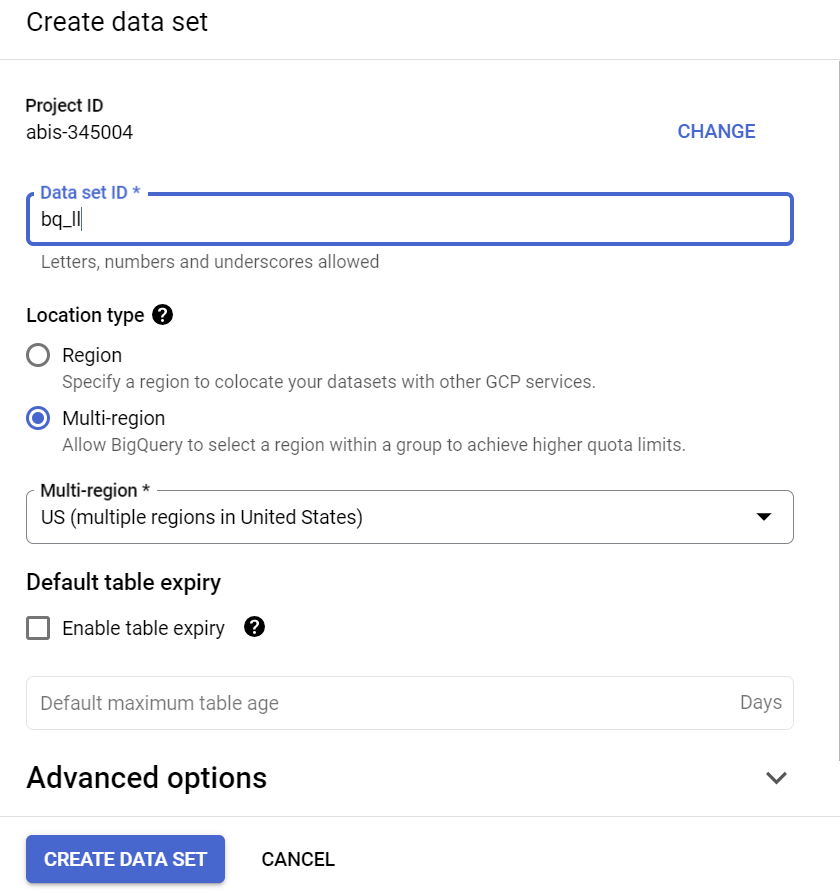
このデータセットには、次のステップで作成する ML モデルが格納されます。通常、ML アプリケーションで使用するデータもこのデータセットのテーブルに保存しますが、このユースケースではデータが BigQuery の一般公開データセットにすでに存在するため、必要に応じて新しく作成したデータセットから直接参照します。CSV など任意の形式で保存してある独自データセットに対してこのプロジェクトを実行したい場合は、Cloud Shell ターミナルで以下のコマンドを実行して、対象のデータを BigQuery データセットのテーブルに読み込みます。
bq load --source_format=CSV --skip_leading_rows=1 bq_llm.table_to_hold_your_data \
./your_file.csv \ text:string,label:string
6. 外部接続の作成
外部接続を作成し(BigQuery Connection API がまだ有効になっていない場合は有効にします)、接続の構成情報を参照してサービス アカウント ID を書き留めます。
- BigQuery コンソールの左側の [エクスプローラ] ペインで [+ 追加] ボタンをクリックし、表示された一般的なソースの中から、[外部データソースへの接続] をクリックします。
- 接続タイプとして [BigLake とリモート関数] を選択し、[接続 ID] に「llm-conn」と指定します

- 接続を作成したら、接続の構成情報を参照して、生成されたサービス アカウントを書き留めます
7. 権限を付与する
このステップでは、Vertex AI サービスにアクセスする権限をサービス アカウントに付与します。
IAM を開き、外部接続の作成後にコピーしたサービス アカウントをプリンシパルとして追加して、[Vertex AI ユーザー] ロールを選択します。

8. リモート ML モデルを作成する
ホストされる Vertex AI 大規模言語モデルを表すリモートモデルを作成します。
CREATE OR REPLACE MODEL bq_llm.llm_model
  REMOTE WITH CONNECTION `us.llm-conn`
  OPTIONS (remote_service_type = 'CLOUD_AI_LARGE_LANGUAGE_MODEL_V1');
このステートメントは、データセット bq_llm に llm_model というモデルを作成します。このモデルは、Vertex AI の CLOUD_AI_LARGE_LANGUAGE_MODEL_V1 API をリモート関数として利用します。完了まで数秒かかることがあります。
9. ML モデルを使用してテキストを生成する
モデルを作成したら、そのモデルを使用してテキストを生成、要約、分類します。
SELECT
  ml_generate_text_result['predictions'][0]['content'] AS generated_text,
  ml_generate_text_result['predictions'][0]['safetyAttributes']
    AS safety_attributes,
  * EXCEPT (ml_generate_text_result)
FROM
  ML.GENERATE_TEXT(
    MODEL `bq_llm.llm_model`,
    (
  SELECT
        CONCAT('Can you read the code in the following text and generate a summary for what the code is doing and what language it is written in:', content)
        AS prompt from `bigquery-public-data.github_repos.sample_contents`
          limit 5
    ),
    STRUCT(
      0.2 AS temperature,
      100 AS max_output_tokens));
**説明:
ml_generate_text_result** は、テキスト生成モデルから返される JSON 形式のレスポンスで、コンテンツ(content)と安全性属性(safetyAttributes)の両方が含まれます。content は、生成されたテキストの結果 b を表します。safetyAttributes は、調整可能なしきい値を持つ Vertex AI Palm API に付属のコンテンツ フィルタを表します。このフィルタを使って、大規模言語モデルからの想定外の予期せぬレスポンスを除外することができます。具体的には、安全性のしきい値に収まらないレスポンスはブロックされます。
ML.GENERATE_TEXT は、BigQuery 内で使用する構造で、Vertex AI LLM にアクセスしてテキスト生成処理を実行します。
CONCAT は、PROMPT 文とデータベース レコードを連結します
github_repos はデータセット名です。sample_contents は、このプロンプト設計で使用するデータを含むテーブルの名前です。
temperature は、レスポンスのランダム性を制御するプロンプト パラメータです。この値が小さいほど、関連度が高くなります。
Max_output_tokens は、レスポンスに含める単語の数です
クエリのレスポンスは次のようになります。

10. クエリ結果をフラット化する
結果をフラット化し、クエリ内で JSON を明示的にデコードせずに済ませるには、以下のように記述します。
SELECT *
FROM
  ML.GENERATE_TEXT(
    MODEL `bq_llm.llm_model`,
    (
  SELECT
        CONCAT('Can you read the code in the following text and generate a summary for what the code is doing and what language it is written in:', content)
        AS prompt from `bigquery-public-data.github_repos.sample_contents`
          limit 5
        ),
    STRUCT(
      0.2 AS temperature,
      100 AS max_output_tokens,
      TRUE AS flatten_json_output));
**説明:
**flatten_json_output** はブール値で、true に設定すると、JSON のレスポンスから平坦でわかりやすいテキストが抽出されて返されます。
クエリのレスポンスは次のようになります。

11. クリーンアップ
この投稿で使用したリソースについて、Google Cloud アカウントに課金されないようにするには、次の手順を行います。
- Google Cloud コンソールで、[リソースの管理] ページに移動します。
- プロジェクト リストで、削除するプロジェクトを選択し、[削除] をクリックします。
- ダイアログでプロジェクト ID を入力し、[シャットダウン] をクリックしてプロジェクトを削除します。
12. 完了
おめでとうございます!プログラムで Vertex AI テキスト生成 LLM を使用して、SQL クエリのみを使って、独自データに対してテキスト分析を実行することができました。使用可能なモデルの詳細については、Vertex AI LLM プロダクトのドキュメントをご覧ください。