

1. Einführung
Über 80% der Unternehmensdaten liegen in unstrukturierten Formaten vor, z. B. in technischen Handbüchern im PDF-Format, Standardarbeitsanweisungen, Compliance-Zertifikaten und Geräteschemata, die in Cloud Storage gespeichert sind. Da in herkömmlichen Katalogen nur relationale Tabellenschemas indexiert werden, bleiben diese Dokumente „Dark Data“: Sie sind für die Unternehmenssuche nicht sichtbar, nicht mit strukturierten Inventartabellen verbunden und nicht auf Einhaltung von Vorschriften geprüft.
Wenn ein Prüfer oder KI-Agent fragt: „Für welche Hardware-SKUs ist eine UL-153-Sicherheitszertifizierung erforderlich und welche thermischen Gefahrenstufen haben sie?“, kann ein Katalog, in dem nur SQL-Tabellen indexiert sind, diese Frage nicht beantworten. Die Fakten sind in unstrukturierten PDFs in Cloud Storage enthalten.
Architekturlösung: Multimodale Metadaten als Code
In diesem Codelab erstellen Sie eine End-to-End-Pipeline für Metadata-as-Code in Google Cloud, mit der unstrukturierte PDF-Handbücher in Cloud Storage mithilfe der Gemini Enterprise Agent Platform (Google GenAI SDK, google-genai) in schemabezogene Knowledge Catalog-Assets umgewandelt werden:
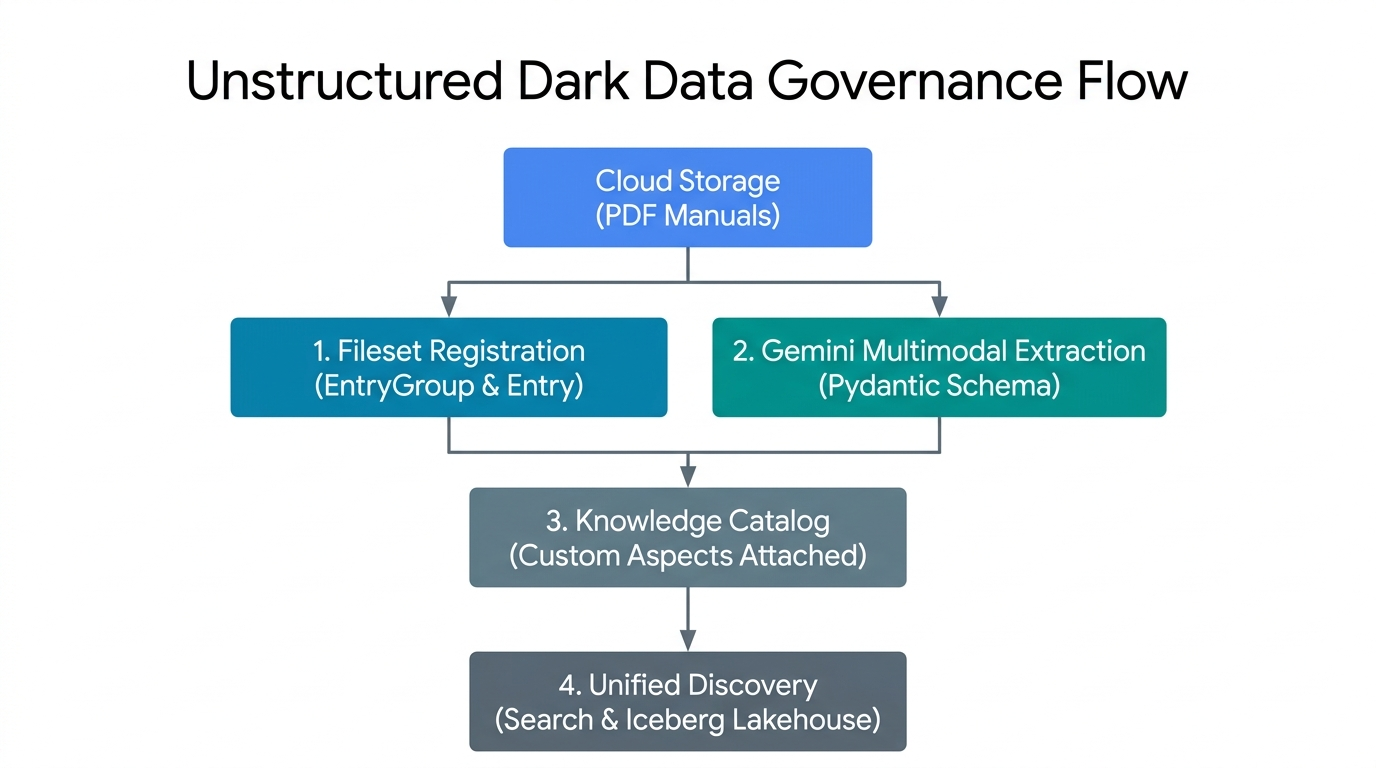
- Fileset Registration (
EntryGroupundEntry): Gruppiert unstrukturierte PDFs in Cloud Storage in verwaltete logische Fileset-Einträge im Knowledge Catalog. - Gemini Multimodal Extraction (Pydantic-Schema): Ruft die Gemini Enterprise Agent Platform für rohe PDF-Bytes mit deterministischer
response_schema-Validierung auf. - Control Plane Aspect Binding: Die validierten JSON-Nutzlasten für Betrieb und Compliance werden als stark typisierte
Aspect-Instanzen an den Katalogeintrag angehängt. - Unified Catalog Discovery: Die unstrukturierten PDF-Dateisätze und die daraus extrahierten Metadaten sind über
SearchEntriesRequestauffindbar.
Wichtige Konzepte: Primitive der Knowledge Catalog-Steuerungsebene
Angenommen, Ihr Team speichert Hunderte von Produktanleitungen im PDF-Format in Cloud Storage. Damit diese Dateien im Knowledge Catalog leicht zu finden und zu prüfen sind, können Sie sich die fünf Bausteine wie das Organisieren von Papierhandbüchern in einem Büroschrank vorstellen:
EntryGroup(Ein verschlossener Schrank für ein Team): Ein Schrank mit Schloss. Nur Teammitglieder mit Berechtigung (roles/dataplex.entryCreator) können Ordner darin platzieren. Sie müssen alle Ordner aus dem Schrank entfernen, bevor Sie den Schrank selbst entfernen können.EntryType(Label für eine Ordnerkategorie): Ein Label, das Nutzern mitteilt, welche Art von Asset ein Ordner darstellt, z. B. „Sammlung von PDF-Handbüchern“ anstelle von „Datenbanktabelle“.Entry(Ein Dateiverzeichnis mit einem Speicherlink): Der Katalogordner für Ihre PDF-Handbücher. Anstelle von schweren Papierkopien enthält der Ordner eine Standortkarte, die auf den genauen Cloud Storage-Bucket (gs://...) verweist, in dem sich die eigentlichen PDF-Dateien befinden.AspectType(Leere Checkliste): Ein wiederverwendbares leeres Formular mit vorgedruckten Kästchen (z. B. eine Sicherheitscheckliste, in deroperational_hazard_levelals Text undconfidence_scoreals Zahl zwischen0.0und1.0angegeben werden muss). Sie erstellen dieses leere Formular einmal und verwenden es für Tausende von Ordnern wieder.Aspect(Eine ausgefüllte Checkliste, die an einen Ordner angehängt ist): Nachdem die Gemini Enterprise Agent Platform das PDF-Handbuch gelesen und die Lücken ausgefüllt hat, wird die ausgefüllte Checkliste an den OrdnerEntryangehängt. Da jede Checkliste einen eigenen Schlüssel (aspect_keys) hat, können das Entwicklungsteam und das Rechtsteam jeweils ihre eigene Checkliste an denselben Ordner anhängen, ohne die Arbeit des anderen zu überschreiben.
Alle fünf regionalen Ressourcen befinden sich unter projects/{project}/locations/{location}/:
Primitive und relativer Pfad | Rolle in Knowledge Catalog | Lösch- und IAM-Regel |
| Logischer Container, in dem Einträge gruppiert und der Teamzugriff gesteuert wird ( | Muss vor dem Löschen keine untergeordneten |
| Kategoriedefinition für eine Klasse von Assets ( | Löschen Sie den Typ erst, wenn alle Einträge, die ihn verwenden, entfernt wurden. |
| Katalogdatensatz, der einen physischen Cloud Storage-URI ( | Befindet sich in einem |
| Wiederverwendbare Schemavorlage, in der typisierte | Wird einmal pro Region erstellt und für alle Einträge freigegeben. |
| Validierte JSON-Metadaten, die mit einem | Aktualisiert mit |
Aufgaben
Mit den Begleitskripts in codelabs/metadata-as-code-lab führen Sie eine 7-stufige Pipeline aus und prüfen sie:
schemas.py– Duale Pydantic-BaseModel-Schemas (DarkDataExtractedMetadataundDocumentGovernanceMetadata), die 1:1 mit Knowledge Catalog -AspectType-Vorlagen gekoppelt sind.step2_provision.py: Idempotente Bereitstellung benutzerdefinierterEntryGroup-,EntryType- undAspectType-Blaupausen.step3_register_fileset.py: Hochladen vonLUM-LIG-DES-8G8J_manual.pdfin Cloud Storage und Registrierung als verwaltetes FilesetEntry.step4_extract_metadata.py: Dynamische Ermittlung des Flaggschiff-Gemini-Modells und multimodale PDF-Extraktion mitgoogle-genai.step5_attach_aspects.py,step6_search_catalog.pyundstep7_verify_assertions.py: Chirurgische Aspektanhänge, exponentielle Backoff-Katalogsuche und End-to-End-Assertionen der Steuerungsebene.
Voraussetzungen und benötigte Informationen
- Ein Google Cloud-Projekt mit aktivierter Abrechnung und Google Cloud Shell (mit vorinstallierten
gcloud,git,python3undpip). - IAM-Berechtigungen zum Verwalten von Knowledge Catalog-Ressourcen (
roles/dataplex.admin), zum Bereitstellen von Cloud Storage-Buckets und -Objekten (roles/storage.admin) und zum Aufrufen der Gemini Enterprise Agent Platform (roles/aiplatform.user). - Ein Webbrowser wie Google Chrome.
2. Einrichtung und Anforderungen
Begleitendes Repository in Cloud Shell klonen
Öffnen Sie die Google Cloud Console, starten Sie Cloud Shell und führen Sie einen Sparse Checkout von codelabs/metadata-as-code-lab aus. Dieser umfasst das Beispiel-PDF-Handbuch für Ingenieure (LUM-LIG-DES-8G8J_manual.pdf) und alle Python-Skripts:
git clone --branch main --depth 1 --filter=blob:none --sparse \
  https://github.com/GoogleCloudPlatform/devrel-demos.git
cd devrel-demos
git sparse-checkout set codelabs/metadata-as-code-lab
cd codelabs/metadata-as-code-lab
ls -la
Umgebungsvariablen konfigurieren
Legen Sie Ihre Projekt-ID, den Standort der regionalen Steuerungsebene und den Ziel-Cloud Storage-Bucket in Cloud Shell fest:
export PROJECT_ID="${PROJECT_ID:-$(gcloud config get-value project)}"
gcloud config set project $PROJECT_ID

export REGION="us-central1"
export BUCKET_NAME="${PROJECT_ID}-dark-data-manuals"
export GEMINI_LOCATION="global"

echo "Configured Project ID        : $PROJECT_ID"
echo "Knowledge Catalog Region     : $REGION"
echo "Gemini Endpoint Location     : $GEMINI_LOCATION"
echo "Target Cloud Storage Bucket  : $BUCKET_NAME"
APIs aktivieren und Abhängigkeiten installieren
Aktivieren Sie die erforderlichen Google Cloud-APIs und installieren Sie die Python-Abhängigkeiten (google-genai, google-cloud-dataplex, pydantic und pandas) aus requirements.txt:
gcloud services enable \
  dataplex.googleapis.com \
  storage.googleapis.com \
  aiplatform.googleapis.com \
  --quiet
python3 -m pip install --upgrade --quiet --user --break-system-packages -r requirements.txt
3. Pydantic-Schemas und Aspektvorlagen definieren
schemas.py definiert zwei sich ergänzende Verträge, die die clientseitige Pydantic-Validierung mit serverseitigen Knowledge Catalog -VorlagenAspectType kombinieren:
DarkDataExtractedMetadata: Betriebsbezogene Attribute, die aus dem PDF extrahiert wurden (Dokumenttitel, Domänenontologie, Gefahrenstufe, Herkunft von Erstellung/Version, Zusammenfassung und Konfidenzwert für die Extraktion).DocumentGovernanceMetadata: Einhaltung regulatorischer Anforderungen (UL-153, FCC Part 15, CE-LVD, RoHS), Verantwortlicher, Aufbewahrungsrichtlinie und ein Referenztabellen-ID-String (lakehouse_cross_ref_table) zum Verknüpfen des PDF-Handbuchs mit nachgelagerten Inventartabellen.
schemas.py prüfen
Zuerst werden mit DarkDataExtractedMetadata Pydantic-Field-Einschränkungen (ge=0.0, le=1.0, d. h. größer/kleiner als oder gleich, für confidence_score) die JSON-Ausgabe der Gemini Enterprise Agent Platform eingeschränkt:
class DarkDataExtractedMetadata(BaseModel):
    document_title: str = Field(
        description="Official document title or product model name extracted from the PDF manual."
    )
    # ... domain_ontology, operational_hazard_level, author_provenance ...
    version_provenance: str = Field(
        description="Document version, revision code, or publication standard identifier."
    )
    # ... document_summary ...
    confidence_score: float = Field(
        ge=0.0,
        le=1.0,
        description="AI extraction confidence metric between 0.0 and 1.0.",
    )
Zweitens: extracted_aspect_template spiegelt genau diese Feldnamen wider und ordnet die Python-Typen str und float den string- und double-record_fields von Knowledge Catalog zu. Im AspectType.MetadataTemplate-Protobuf-Vertrag muss für jedes Feld in record_fields eine eindeutige, streng positive, 1-basierte Ganzzahl index (1 bis 7) deklariert werden. Wenn index ausgelassen oder dupliziert wird, schlägt create_aspect_type mit 400 INVALID_ARGUMENT fehl:
extracted_aspect_template = {
    "name": "DarkDataExtractedMetadata",
    "type": "record",
    "record_fields": [
        {
            "name": "document_title",
            "type": "string",
            "index": 1,
            "annotations": {"description": "Official document title or product model name."},
        },
        # ... fields 2 through 6 (string) ...
        {
            "name": "confidence_score",
            "type": "double",
            "index": 7,
            # ... annotations ...
        },
    ],
}
Schemamodul validieren
Führen Sie schemas.py aus, um die Konfiguration Ihrer Umgebung zu überprüfen und beide Schemas zu kompilieren:
python3 schemas.py
Configured Project ID         : your-project-id
Knowledge Catalog Region      : us-central1
Gemini Endpoint Location      : global
Governed Fileset Storage URI  :
  gs://your-project-id-dark-data-manuals/sop-pdfs/LUM-LIG-DES-8G8J_manual.pdf
Target Fileset Entry ID       : sop-manuals-fileset-lum8g8j
✓ Defined DarkDataExtractedMetadata and DocumentGovernanceMetadata
  Pydantic schemas.
✓ Prepared Knowledge Catalog AspectType metadata templates.
4. Namespaces und benutzerdefinierte Aspekttypen bereitstellen
Bevor Sie Dateisatz-Einträge registrieren oder Metadaten anhängen, stellt step2_provision.py drei Steuerungsebenenressourcen in Knowledge Catalog bereit:
EntryGroup:dark-data-fileset-groupEntryType:unstructured-pdf-filesetAspectTypeBlueprints:dark-data-extracted-metadataunddocument-governance-aspect
Idempotente Bereitstellung in step2_provision.py
Jeder Erstellungsaufruf in step2_provision.py umschließt den Vorgang mit langer Ausführungszeit (op.result()) in einem try / except AlreadyExists-Block, damit das Skript sicher noch einmal ausgeführt werden kann, ohne dass ein Fehler bei vorhandenen Ressourcen auftritt:
# Provision AspectType 1: dark-data-extracted-metadata
try:
    at1_op = catalog_client.create_aspect_type(
        parent=parent_location,
        aspect_type_id=EXTRACTED_ASPECT_TYPE_ID,
        aspect_type=AspectType(
            name=extracted_aspect_type_name,
            display_name="Dark Data Multimodal Extracted Metadata",
            # ... description ...
            metadata_template=extracted_aspect_template,
        ),
    )
    if hasattr(at1_op, "result"):
        at1_op.result()
    print(f"Created AspectType: {extracted_aspect_type_name}")
except AlreadyExists:
    print(f"AspectType already exists; retrieving live resource: {extracted_aspect_type_name}")

live_extracted_aspect_type = catalog_client.get_aspect_type(name=extracted_aspect_type_name)
Sobald metadata_template=extracted_aspect_template registriert ist, erzwingt Knowledge Catalog das Schema an der API-Grenze. Alle nachfolgenden update_entry()-Aufrufe, bei denen ein String an confidence_score (double) übergeben wird, werden abgelehnt.
Führen Sie step2_provision.py aus
Führen Sie das Bereitstellungsskript aus und prüfen Sie, ob die benutzerdefinierten Aspekttypen in Ihrer Region registriert sind:
python3 step2_provision.py
gcloud dataplex aspect-types list --location=$REGION
Created EntryGroup:
  projects/your-project-id/locations/us-central1/entryGroups/
  dark-data-fileset-group
Created EntryType :
  projects/your-project-id/locations/us-central1/entryTypes/
  unstructured-pdf-fileset
Created AspectType:
  projects/your-project-id/locations/us-central1/aspectTypes/
  dark-data-extracted-metadata
Created AspectType:
  projects/your-project-id/locations/us-central1/aspectTypes/
  document-governance-aspect
✓ All Knowledge Catalog namespaces and AspectType blueprints are active.
5. Einträge für unstrukturierte Dateigruppen registrieren
Anstatt den Katalog mit Millionen isolierter Dateiverweise zu überladen, gruppiert Knowledge Catalog zugehörige Dokumente in Cloud Storage (gs://YOUR_BUCKET/sop-pdfs/*.pdf) in logischen Dateisatzeinträgen – entweder über automatisierte Discovery-Scans (DataScanServiceClient) oder die direkte programmatische Registrierung (CatalogServiceClient.create_entry).
So wird der Speicherort des step3_register_fileset.py dem Katalog zugeordnet
step3_register_fileset.py lädt LUM-LIG-DES-8G8J_manual.pdf in gs://${BUCKET_NAME}/sop-pdfs/LUM-LIG-DES-8G8J_manual.pdf hoch und registriert die verwalteten Entry:
fully_qualified_fileset_uri = f"gcs:{BUCKET_NAME}"
fileset_entry_spec = Entry(
    name=fileset_entry_name,
    entry_type=entry_type_resource_name,
    fully_qualified_name=fully_qualified_fileset_uri,
    entry_source=EntrySource(
        resource=VIRTUAL_STORAGE_URI,
        system="Cloud Storage",
        platform="Google Cloud",
        display_name="LUM-LIG-DES-8G8J Unstructured SOP & Technical Manual Fileset",
        # ... description ...
        location=REGION,
    ),
)

create_entry_op = catalog_client.create_entry(
    parent=entry_group_resource_name,
    entry_id=FILESET_ENTRY_ID,
    entry=fileset_entry_spec,
)
Beachten Sie die unterschiedlichen Rollen der beiden URI-Felder auf Entry:
fully_qualified_name=fully_qualified_fileset_uri(f"gcs:{BUCKET_NAME}"): Verwendet das kanonischegcs:{bucket_name}-FQN-Schema, das für den Knowledge Catalog erforderlich ist, um den logischen Katalogeintrag mit dem zugrunde liegenden Cloud Storage-Bucket zu verknüpfen.entry_source.resource=VIRTUAL_STORAGE_URI: Speichert den physischengs://-Objekt-URI, der von nachgelagerten Extraktions-Workern geprüft wird.
Führen Sie step3_register_fileset.py aus
python3 step3_register_fileset.py
Created Cloud Storage bucket:
  gs://your-project-id-dark-data-manuals in us-central1
Uploaded unstructured PDF manual to:
  gs://your-project-id-dark-data-manuals/sop-pdfs/LUM-LIG-DES-8G8J_manual.pdf
Registered governed Fileset Entry:
  projects/your-project-id/locations/us-central1/entryGroups/
  dark-data-fileset-group/entries/sop-manuals-fileset-lum8g8j
  -> Fully Qualified Name : gcs:your-project-id-dark-data-manuals
  -> Physical Resource URI:
  gs://your-project-id-dark-data-manuals/sop-pdfs/LUM-LIG-DES-8G8J_manual.pdf
  -> Source System        : Cloud Storage
6. Dokumentmetadaten mit Gemini extrahieren
step4_extract_metadata.py liest die Roh-PDF-Bytes und ruft die Gemini Enterprise Agent Platform (genai_client.models.generate_content) mit zwei wichtigen Mustern auf:
1. Dynamische Erkennung von Flaggschiffmodellen
Anstatt anfällige Modellversionsstrings fest zu codieren, fragt das Script genai_client.models.list() ab und sortiert aktive Kandidaten nach (is_ga_channel, semantic_version_tuple), um das neueste allgemein verfügbare flash-Modell auszuwählen:
genai_client = genai.Client(
    vertexai=True,
    project=PROJECT_ID,
    location=GEMINI_LOCATION,
)

for model_obj in genai_client.models.list():
    raw_id = (model_obj.name or "").split("/")[-1]
    # Filter to flagship Gemini Flash models (version >= 3.0) and prioritize GA over preview
    ...
    discovered_candidates.append((is_ga_channel, ver_tuple, raw_id))

discovered_candidates.sort(key=lambda item: (item[0], item[1]), reverse=True)
2. Schema-constrained multimodal extraction (Part.from_bytes + response_schema)
Wenn Sie response_mime_type="application/json" und response_schema=DarkDataExtractedMetadata (gefolgt von DocumentGovernanceMetadata) übergeben, wird die Tokencodecierung direkt auf das Pydantic-JSON-Schema beschränkt:
with open(LOCAL_PDF_PATH, "rb") as pdf_file:
    raw_pdf_bytes = pdf_file.read()

extraction_response = genai_client.models.generate_content(
    model=candidate_model,
    contents=[
        types.Part.from_bytes(data=raw_pdf_bytes, mime_type="application/pdf"),
        extraction_prompt,
    ],
    config=types.GenerateContentConfig(
        response_mime_type="application/json",
        response_schema=DarkDataExtractedMetadata,
        temperature=0.1,
    ),
)

extracted_dark_data = json.loads(extraction_response.text)
validated_extraction = DarkDataExtractedMetadata(**extracted_dark_data)
Führen Sie step4_extract_metadata.py aus
python3 step4_extract_metadata.py
Dynamically discovered active GA model currency :
  gemini-3.8-flash (version (3, 8))
Loaded unstructured PDF manual at: LUM-LIG-DES-8G8J_manual.pdf
Read unstructured PDF document (1184 bytes).
  Executing multimodal extraction with gemini-3.8-flash...
✓ Multimodal extraction completed using model: gemini-3.8-flash
✓ Governance classification completed using model: gemini-3.8-flash

--- Extracted Multimodal Operational Metadata ---
Extracted Attribute    Multimodal Value
document_title    LUM-LIG-DES-8G8J Contemporary Linen Desk Lamp
domain_ontology    Electrical Hardware & Lighting Systems
operational_hazard_level    MEDIUM
author_provenance    Global Hardware Safety & Lighting Systems Engin
version_provenance    Rev 4.2
document_summary    This document outlines standard operating proce
confidence_score    0.99

--- Extracted Governance & Inventory Cross-Reference Metadata ---
Governance Attribute    Classification Value
compliance_classifications    UL-153 Portable Luminaires, FCC Part 15, CE-LVD
stewardship_owner    Global Hardware Safety & Lighting Systems Engin
retention_policy    10-Year Active Product Lifecycle Archival
lakehouse_cross_ref_table    lakehouse.your-project-id.retail_hardware
governance_status    VERIFIED_PRODUCTION
7. Bestätigte Aspekte an Katalogeinträge anhängen
step5_attach_aspects.py bindet die validierten JSON-Payloads (extracted_metadata.json und governance_metadata.json) über catalog_client.update_entry() an den sop-manuals-fileset-lum8g8j-Eintrag.
Mutation des chirurgischen Aspekts in step5_attach_aspects.py
extracted_aspect_key = f"{PROJECT_ID}.{REGION}.{EXTRACTED_ASPECT_TYPE_ID}"
governance_aspect_key = f"{PROJECT_ID}.{REGION}.{GOVERNANCE_ASPECT_TYPE_ID}"

updated_entry_payload = Entry(
    name=fileset_entry_name,
    entry_type=entry_type_resource_name,
    fully_qualified_name=fully_qualified_fileset_uri,
    aspects={
        extracted_aspect_key: Aspect(
            aspect_type=extracted_aspect_type_name,
            data=extracted_data,
        ),
        governance_aspect_key: Aspect(
            aspect_type=governance_aspect_type_name,
            data=governance_data,
        ),
    },
)

update_op = catalog_client.update_entry(
    request=dataplex_v1.UpdateEntryRequest(
        entry=updated_entry_payload,
        update_mask={"paths": ["aspects"]},
        aspect_keys=[extracted_aspect_key, governance_aspect_key],
    )
)
Wenn Sie beide update_mask={"paths": ["aspects"]}- und aspect_keys=[extracted_aspect_key, governance_aspect_key]-Bereiche übergeben, wird die Mutation streng auf diese beiden Aspektschlüssel beschränkt. entry_source und alle Aspekte, die anderen Teams gehören, bleiben unverändert.
Führen Sie step5_attach_aspects.py aus
python3 step5_attach_aspects.py
Successfully bound 2 Aspect(s) to Entry:
  projects/your-project-id/locations/us-central1/entryGroups/
  dark-data-fileset-group/entries/sop-manuals-fileset-lum8g8j

=== Live Attached Aspect: document-governance-aspect ===
Catalog Field    Authoritative Stored Value
compliance_classifications    UL-153 Portable Luminaires, FCC Part 15, CE-LVD
stewardship_owner    Global Hardware Safety & Lighting Systems Engin
retention_policy    10-Year Active Product Lifecycle Archival
lakehouse_cross_ref_table    lakehouse.your-project-id.retail_hardware
governance_status    VERIFIED_PRODUCTION

=== Live Attached Aspect: dark-data-extracted-metadata ===
Catalog Field    Authoritative Stored Value
document_title    LUM-LIG-DES-8G8J Contemporary Linen Desk Lamp
domain_ontology    Electrical Hardware & Lighting Systems
operational_hazard_level    MEDIUM
author_provenance    Global Hardware Safety & Lighting Systems Engin
version_provenance    Rev 4.2
document_summary    This document outlines standard operating proce
confidence_score    0.99
Dual-Track-Überprüfung
- Track 1 (CLI-Überprüfung): Sehen Sie sich den Eintrag mit allen zugehörigen Aspekten über
gcloudan:gcloud dataplex entries describe sop-manuals-fileset-lum8g8j \ --entry-group=dark-data-fileset-group \ --location=$REGION \ --view=ALL - Track 2 (Console UI Inspection):
- Öffnen Sie die Knowledge Catalog Search Console, suchen Sie nach LUM-LIG-DES-8G8J Unstructured SOP & Technical Manual Fileset (
sop-manuals-fileset-lum8g8j) und wählen Sie den entsprechenden Eintrag aus den Ergebnissen aus. - Prüfen Sie unter Optionale Tags und Aspekte, ob sowohl Dark Data Multimodal Extracted Metadata als auch Document Governance & Inventory Cross-Reference Aspect die extrahierte Gefahrenstufe (
MEDIUM), die Compliance-Codes (UL-153, FCC Part 15, CE-LVD, RoHS) und den Querverweistabellenstring (lakehouse_cross_ref_table) enthalten.
- Öffnen Sie die Knowledge Catalog Search Console, suchen Sie nach LUM-LIG-DES-8G8J Unstructured SOP & Technical Manual Fileset (
8. Gesteuerte Dark Data im Katalog abfragen
Sobald benutzerdefinierte Aspekte angehängt sind, können unstrukturierte PDF-Handbücher in Cloud Storage über die Knowledge Catalog-Suche (catalog_client.search_entries()) gefunden werden.
Umfrage zu search_entries() in step6_search_catalog.py
step6_search_catalog.py-Umfragen search_entries() mit exponentiellem Backoff und liest die kanonischen Aspektschlüssel über .endswith():
search_query = f"entrygroup={entry_group_resource_name} name:{FILESET_ENTRY_ID}"

while elapsed_seconds < max_wait_seconds:
    catalog_search_results = list(
        catalog_client.search_entries(
            request=dataplex_v1.SearchEntriesRequest(
                name=parent_location,
                query=search_query,
            )
        )
    )
    if catalog_search_results:
        break
    backoff_seconds = min(5 * (2 ** attempt), 30)
    time.sleep(backoff_seconds)
    ...

for k, asp in detailed_entry.aspects.items():
    if k.endswith(f".{REGION}.{EXTRACTED_ASPECT_TYPE_ID}"):
        print(f"    Domain Ontology     : {asp.data.get('domain_ontology')}")
        print(f"    Hazard Level        : {asp.data.get('operational_hazard_level')}")
    elif k.endswith(f".{REGION}.{GOVERNANCE_ASPECT_TYPE_ID}"):
        print(f"    Compliance Codes    : {asp.data.get('compliance_classifications')}")
        print(f"    Lakehouse Join Table: {asp.data.get('lakehouse_cross_ref_table')}")
Führen Sie step6_search_catalog.py aus
python3 step6_search_catalog.py
Executing Knowledge Catalog search query:
  'entrygroup=projects/your-project-id/locations/us-central1/entryGroups/
  dark-data-fileset-group name:sop-manuals-fileset-lum8g8j'...

✓ Discovered 1 governed asset(s) in Knowledge Catalog:

[1] Entry Resource Name :
    projects/your-project-id/locations/us-central1/entryGroups/
    dark-data-fileset-group/entries/sop-manuals-fileset-lum8g8j
    Fully Qualified Name: gcs:your-project-id-dark-data-manuals
    Entry Type :
    projects/your-project-id/locations/us-central1/entryTypes/
    unstructured-pdf-fileset
    Physical Storage URI:
    gs://your-project-id-dark-data-manuals/sop-pdfs/LUM-LIG-DES-8G8J_manual.pdf
    Domain Ontology     : Electrical Hardware & Lighting Systems
    Hazard Level        : MEDIUM
    Compliance Codes    : UL-153 Portable Luminaires, FCC Part 15, CE-LVD, RoHS
    Lakehouse Join Table:
    lakehouse.your-project-id.retail_hardware.luminaire_sku_inventory_iceberg
Dual-Track-Überprüfung
- Track 1 (CLI Search): Suchindex direkt über
gcloudabfragen:gcloud dataplex entries search "name:sop-manuals-fileset-lum8g8j" --project=$PROJECT_ID - Track 2 (Console-UI-Suche in natürlicher Sprache)
- :
- Öffnen Sie die Knowledge Catalog Search Console und suchen Sie nach
LUM-LIG-DES-8G8JoderUL-153. - Sehen Sie sich an, wie Knowledge Catalog den verwalteten Cloud Storage-Dateisatzeintrag für PDF-Dateien und die zugehörigen Metadatenaspekte anzeigt.
- Öffnen Sie die Knowledge Catalog Search Console und suchen Sie nach
9. Ende-zu-Ende-Governance-Behauptungen überprüfen
step7_verify_assertions.py führt deterministische Zusicherungen für Live-Antworten der Knowledge Catalog-Steuerungsebene aus, um zu prüfen, ob die EntryGroup, EntryType, beide benutzerdefinierten AspectType-Blaupausen, die gebundenen EntryView.ALL-Aspekt-Nutzlasten (confidence_score-Grenzen und lakehouse_cross_ref_table-String) und die Suche nach dem Suchindex erfolgreich sind:
verify_eg = catalog_client.get_entry_group(name=entry_group_resource_name)
assert verify_eg.name == entry_group_resource_name, "EntryGroup resource name mismatch."

verify_entry = catalog_client.get_entry(
    request=dataplex_v1.GetEntryRequest(
        name=fileset_entry_name,
        view=dataplex_v1.EntryView.ALL,
    )
)
bound_extracted = next(
    (
        asp for k, asp in verify_entry.aspects.items()
        if k.endswith(f".{REGION}.{EXTRACTED_ASPECT_TYPE_ID}")
    ),
    None,
)
bound_governance = next(
    (
        asp for k, asp in verify_entry.aspects.items()
        if k.endswith(f".{REGION}.{GOVERNANCE_ASPECT_TYPE_ID}")
    ),
    None,
)

assert bound_extracted is not None, f"Aspect '{EXTRACTED_ASPECT_TYPE_ID}' not found on live Entry."
assert bound_governance is not None, (
    f"Aspect '{GOVERNANCE_ASPECT_TYPE_ID}' not found on live Entry."
)
assert (
    bound_extracted.data.get("document_title") == expected_extraction["document_title"]
), "Extracted title mismatch."
assert (
    0.0 <= float(bound_extracted.data.get("confidence_score", -1.0)) <= 1.0
), "Invalid confidence score in catalog."
assert (
    "lakehouse" in str(bound_governance.data.get("lakehouse_cross_ref_table", "")).lower()
), "Missing Lakehouse cross-reference."
...
assert len(search_results) >= 1, "Expected at least 1 search result in Knowledge Catalog."
Führen Sie step7_verify_assertions.py aus
python3 step7_verify_assertions.py && echo "Verification exit code: $?"
Running substantive end-to-end verification assertions...
✓ All 5 substantive verification assertions passed
  against live Google Cloud control plane state!
Verification exit code: 0
10. Ereignisgesteuerte Pipeline entwerfen
Die interaktive Ausführung von Python-Skripts in Cloud Shell ist zwar ideal für die Entwicklung und das Testen Ihrer Governance-Verträge, in Unternehmensumgebungen gehen jedoch täglich Tausende von neuen oder überarbeiteten technischen Handbüchern im PDF-Format, Compliance-Zertifikaten von Lieferanten und SOP-Dokumenten aus ERP-, PLM- und Anbieterportalen ein. Wenn Batch-Skripts manuell ausgeführt werden, entstehen schnell Lücken in der Governance zwischen dem Hochladen von Dokumenten und der Katalogindexierung.
In der Produktion operationalisieren Plattformteams den Code, den Sie in den Schritten 4 und 5 ausgeführt haben, als ereignisgesteuerte Pipeline ohne manuellen Eingriff:
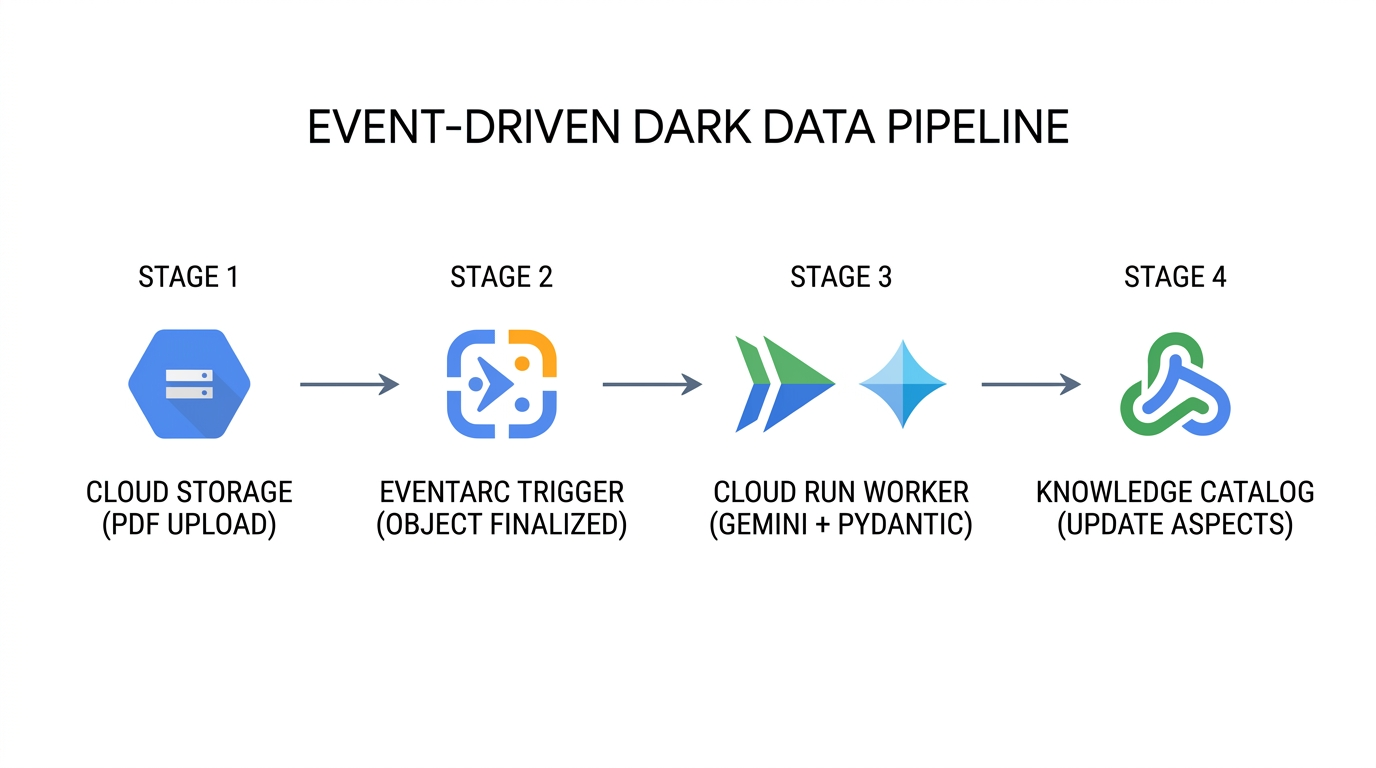
- Kontinuierliches Erfassen von Dokumenten (
Cloud Storage→Eventarc): Immer wenn ein neues PDF-Handbuch hochgeladen oder eine neue Version ein vorhandenes Objekt in Cloud Storage überschreibt, gibt der Bucket eingoogle.cloud.storage.object.v1.finalized-CloudEvent mit der Bucket-ID, dem Objektpfad und der Objektgenerierungsnummer aus. - Stateless Multimodal Extraction (
Eventarc→Cloud Run→Gemini Enterprise Agent Platform): Eventarc leitet das CloudEvent an einen serverlosen Cloud Run-Worker weiter, derschemas.py,step4_extract_metadata.pyundstep5_attach_aspects.pyenthält. Der Worker streamt die PDF-Bytes an die Gemini Enterprise Agent Platform mitresponse_schema, wodurch sichergestellt wird, dass jedes extrahierte AttributDarkDataExtractedMetadataundDocumentGovernanceMetadataentspricht. - Surgical Control Plane Update (
Cloud Run→Knowledge Catalog): Der Worker löst das übergeordnete FilesetEntryauf und führtcatalog_client.update_entry()mitupdate_mask={"paths": ["aspects"]}und explizitemaspect_keysaus. Auch wenn die Verarbeitung von Dutzenden von Dokumenten gleichzeitig abgeschlossen wird, werden bei jeder Mutation nur die zugehörigen Aspektschlüssel aktualisiert. - Confidence-Gated Steward Quarantine: Wenn bei der Überprüfung einer alten PDF-Datei eine Extraktion
confidence_scoreunter Ihrem Betriebsschwellenwert (z. B.< 0.85) erfolgt, legt der Workergovernance_status = "PENDING_STEWARD_REVIEW"für den angehängten Aspekt fest, damit Datenverantwortliche Knowledge Catalog nach Assets mit geringer Konfidenz abfragen können, die eine manuelle Überprüfung erfordern.
So wenden Unternehmen dieses Muster in der Produktion an
Anwendungsfall in Unternehmen | Funktionsweise von „Metadata-as-Code“ in der Praxis | Auswirkungen auf das Geschäft und den Betrieb |
Automatisierte behördliche Prüfungen und Rückrufbereitschaft | Compliance-Systeme führen unstrukturierte PDF-Sicherheitsaspekte ( | Wenn ein Standard wie |
Grounded AI Agents und RAG-Vorfilterung | Bevor ein RAG-Agent (Retrieval-Augmented Generation) auf der Gemini Enterprise Agent Platform die Frage eines Außendiensttechnikers beantwortet, werden Knowledge Catalog-Einträge nach | Verhindert, dass KI-Assistenten halluzinieren oder veraltete technische Entwürfe, abgelaufene Standardarbeitsanweisungen oder nicht überprüfte Handbücher von Drittanbietern zitieren. |
Gleichzeitige Anreicherung durch mehrere Teams | Mehrere unabhängige Pipelines reichern dasselbe Fileset | Da |
CI/CD-Schemaentwicklung über GitOps | Plattformteams speichern | Dadurch wird ein Schemadrift zwischen dem Code zum Extrahieren von Anwendungen und der Knowledge Catalog-Steuerungsebene in den Projekten |
11. Umgebung bereinigen
In Knowledge Catalog können übergeordnete Container und Schemavorlagen nicht gelöscht werden, solange untergeordnete Einträge noch darauf verweisen. Mit cleanup.py werden Ressourcen in streng umgekehrter Abhängigkeitsreihenfolge gelöscht (Entry → EntryGroup → EntryType → AspectTypes → Cloud Storage-Bucket-Objekte → temporäre JSON-Dateien):
# 1. Delete Fileset Entry first
catalog_client.delete_entry(name=target_entry_path)

# 2. Delete EntryGroup container
del_eg_op = catalog_client.delete_entry_group(name=target_eg_path)
if hasattr(del_eg_op, "result"):
    del_eg_op.result()

# 3. Delete EntryType and Custom AspectTypes
del_et_op = catalog_client.delete_entry_type(name=target_et_path)
if hasattr(del_et_op, "result"):
    del_et_op.result()
for aspect_id_val in (EXTRACTED_ASPECT_TYPE_ID, GOVERNANCE_ASPECT_TYPE_ID):
    target_at_path = f"{active_parent}/aspectTypes/{aspect_id_val}"
    del_at_op = catalog_client.delete_aspect_type(name=target_at_path)
    if hasattr(del_at_op, "result"):
        del_at_op.result()
Führen Sie cleanup.py aus
python3 cleanup.py
Starting reverse-dependency resource cleanup in Knowledge Catalog...
Deleted Fileset Entry:
  projects/your-project-id/locations/us-central1/entryGroups/
  dark-data-fileset-group/entries/sop-manuals-fileset-lum8g8j
Deleted EntryGroup   :
  projects/your-project-id/locations/us-central1/entryGroups/
  dark-data-fileset-group
Deleted EntryType    :
  projects/your-project-id/locations/us-central1/entryTypes/
  unstructured-pdf-fileset
Deleted AspectType   :
  projects/your-project-id/locations/us-central1/aspectTypes/
  dark-data-extracted-metadata
Deleted AspectType   :
  projects/your-project-id/locations/us-central1/aspectTypes/
  document-governance-aspect
Deleted Cloud Storage object :
  gs://your-project-id-dark-data-manuals/sop-pdfs/LUM-LIG-DES-8G8J_manual.pdf
Deleted Cloud Storage bucket : gs://your-project-id-dark-data-manuals
Removed local temporary file : extracted_metadata.json
Removed local temporary file : governance_metadata.json
✓ Standalone teardown complete. Environment cleanly reset.
Geklontes Repository-Verzeichnis entfernen
Nachdem cleanup.py die Cloud-Ressourcen gelöscht hat, kehren Sie zu Ihrem Basisverzeichnis zurück und entfernen Sie den geklonten devrel-demos-Repository-Ordner aus Cloud Shell:
cd ~
rm -rf ~/devrel-demos
12. Glückwunsch!
Sie haben eine End-to-End-Governance-Pipeline für Metadata-as-Code erstellt und überprüft, die unstrukturierte PDFs in Cloud Storage mithilfe der Gemini Enterprise Agent Platform in auffindbare, schemabezogene Knowledge Catalog-Assets umwandelt.
Nächste Schritte
- Mit Terraform automatisieren:
google_dataplex_aspect_type- undgoogle_dataplex_entry_group-Ressourcen deklarativ in CI/CD-Pipelines verwalten. - Eventarc + Cloud Run-Worker bereitstellen: Containerisieren Sie
step4_extract_metadata.pyundstep5_attach_aspects.pyin einem ereignisgesteuerten Cloud Run-Dienst. - Downstream-Inventarabgleich in BigQuery: Exportieren Sie die extrahierten Governance-Metadaten (
lakehouse_cross_ref_table), um Compliance-Attribute für unstrukturierte Dokumente mit strukturierten SKU-Inventartabellen zu verknüpfen.