

1. Introducción
Más del 80% de los datos empresariales se encuentran en formatos no estructurados: manuales de ingeniería en PDF, procedimientos operativos estándar (SOP), certificados de cumplimiento y esquemas de equipos almacenados en Cloud Storage. Dado que los catálogos tradicionales solo indexan esquemas de tablas relacionales, estos documentos siguen siendo "datos oscuros": invisibles para la búsqueda empresarial, desconectados de las tablas de inventario estructuradas y no verificados para el cumplimiento de las reglamentaciones.
Cuando un auditor o un agente de IA pregunta "¿Qué SKU de hardware requieren la certificación de seguridad UL-153 y cuáles son sus niveles de riesgo térmico?", un catálogo que solo indexa tablas de SQL no puede responder. Los hechos están bloqueados dentro de archivos PDF no estructurados en Cloud Storage.
Solución de arquitectura: Metadatos como código multimodales
En este codelab, compilarás una canalización de metadatos como código de extremo a extremo en Google Cloud que convierte los manuales en PDF no estructurados de Cloud Storage en recursos de Knowledge Catalog con esquema aplicado a través de Gemini Enterprise Agent Platform (SDK de GenAI de Google, google-genai):
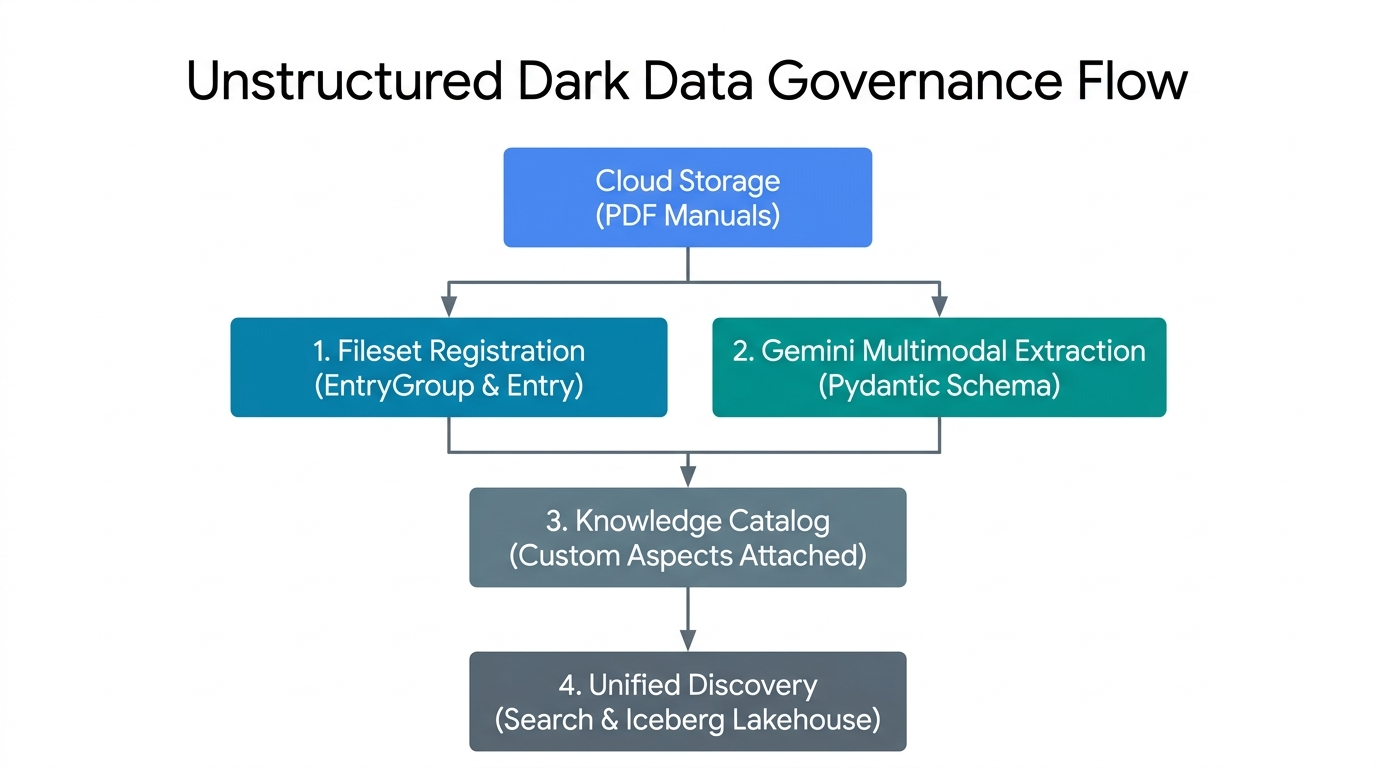
- Registro de conjunto de archivos (
EntryGroupyEntry): Agrupa los archivos PDF no estructurados en Cloud Storage en entradas de conjunto de archivos lógicos controlados en Knowledge Catalog. - Extracción multimodal de Gemini (esquema de Pydantic): Invoca Gemini Enterprise Agent Platform en bytes de PDF sin procesar con validación determinística de
response_schema. - Control Plane Aspect Binding: Vincula las cargas útiles de JSON operativas y de cumplimiento validadas como instancias
Aspectcon escritura segura en la entrada del catálogo. - Descubrimiento unificado del catálogo: Permite que los conjuntos de datos de PDF no estructurados y sus metadatos extraídos se puedan descubrir a través de
SearchEntriesRequest.
Conceptos clave: Primitivas del plano de control de Knowledge Catalog
Imagina que tu equipo almacena cientos de manuales de productos en PDF en Cloud Storage. Para que esos archivos sean fáciles de encontrar y consultar en Knowledge Catalog, piensa en los cinco componentes básicos como si estuvieras organizando manuales en papel en un archivador de oficina:
EntryGroup(un armario cerrado con llave para un equipo): Un armario con una cerradura. Solo los compañeros de equipo con permiso (roles/dataplex.entryCreator) pueden colocar carpetas dentro. Debes vaciar todas las carpetas del gabinete antes de poder quitarlo.EntryType(Etiqueta de categoría de carpeta): Es una etiqueta que les indica a las personas qué tipo de recurso representa una carpeta, por ejemplo, "Colección de manuales en PDF" en lugar de "Tabla de base de datos".Entry(una carpeta de archivos con un vínculo de almacenamiento): Es la carpeta del catálogo de tus manuales en PDF. En lugar de contener copias en papel pesadas, la carpeta contiene una tarjeta de ubicación que apunta al bucket exacto de Cloud Storage (gs://...) donde se encuentran los archivos PDF reales.AspectType(Un formulario de lista de verificación en blanco): Es un formulario en blanco reutilizable con casillas preimpresas (por ejemplo, una "Lista de verificación de seguridad" que solicitaoperational_hazard_levelcomo texto yconfidence_scorecomo un número del0.0al1.0). Creas este formulario en blanco una vez y lo reutilizas en miles de carpetas.Aspect(Una lista de verificación completa adjunta a una carpeta): Después de que Gemini Enterprise Agent Platform lee el manual en PDF y completa los espacios en blanco, esa lista de verificación completada se adjunta a la carpetaEntry. Como cada lista de verificación tiene su propia clave (aspect_keys), el equipo de ingeniería y el equipo legal pueden adjuntar sus propias listas de verificación a la misma carpeta sin sobrescribir el trabajo del otro.
Los cinco recursos regionales se encuentran en projects/{project}/locations/{location}/:
Ruta de acceso primitiva y relativa | Rol en Knowledge Catalog | Regla de eliminación y de IAM |
| Es un contenedor lógico que agrupa entradas y controla el acceso del equipo ( | Antes de borrarlo, no debe contener recursos |
| Es la definición de categoría para una clase de recursos ( | Solo se debe borrar después de que se quiten todas las entradas que usen este tipo. |
| Registro del catálogo que vincula un URI físico de Cloud Storage ( | Se encuentra dentro de un |
| Es una plantilla de esquema reutilizable que define | Se crea una vez por región y se comparte entre las entradas. |
| Son metadatos JSON validados que coinciden con un | Se actualizó con |
Qué compilarás
Con las secuencias de comandos complementarias en codelabs/metadata-as-code-lab, ejecutarás e inspeccionarás una canalización de 7 etapas:
schemas.py: Esquemas deBaseModelPydantic duales (DarkDataExtractedMetadatayDocumentGovernanceMetadata) vinculados 1:1 con plantillas de Knowledge CatalogAspectType.step2_provision.py: Aprovisionamiento idempotente de planos personalizados deEntryGroup,EntryTypeyAspectType.step3_register_fileset.py: Es la carga deLUM-LIG-DES-8G8J_manual.pdfen Cloud Storage y el registro como un conjunto de archivosEntrygobernado.step4_extract_metadata.py: Descubrimiento dinámico del modelo insignia de Gemini y extracción multimodal de PDFs congoogle-genai.step5_attach_aspects.py,step6_search_catalog.pyystep7_verify_assertions.py: Adjunto de aspectos quirúrgicos, búsqueda de catálogo con retroceso exponencial y aserciones de plano de control de extremo a extremo.
Requisitos previos y lo que necesitarás
- Un proyecto de Google Cloud con la facturación habilitada y Google Cloud Shell (preinstalado con
gcloud,git,python3ypip). - Permisos de IAM para administrar recursos de Knowledge Catalog (
roles/dataplex.admin), aprovisionar buckets y objetos de Cloud Storage (roles/storage.admin) y llamar a Gemini Enterprise Agent Platform (roles/aiplatform.user). - Un navegador web, como Google Chrome
2. Configuración y requisitos
Clona el repositorio complementario en Cloud Shell
Abre la consola de Google Cloud, inicia Cloud Shell y realiza una extracción dispersa de codelabs/metadata-as-code-lab, que incluye el manual de ingeniería de PDF de muestra (LUM-LIG-DES-8G8J_manual.pdf) y todos los secuencias de comandos de Python:
git clone --branch main --depth 1 --filter=blob:none --sparse \
  https://github.com/GoogleCloudPlatform/devrel-demos.git
cd devrel-demos
git sparse-checkout set codelabs/metadata-as-code-lab
cd codelabs/metadata-as-code-lab
ls -la
Configure las variables de entorno
Establece tu ID del proyecto, la ubicación del plano de control regional y el bucket de Cloud Storage de destino en Cloud Shell:
export PROJECT_ID="${PROJECT_ID:-$(gcloud config get-value project)}"
gcloud config set project $PROJECT_ID

export REGION="us-central1"
export BUCKET_NAME="${PROJECT_ID}-dark-data-manuals"
export GEMINI_LOCATION="global"

echo "Configured Project ID        : $PROJECT_ID"
echo "Knowledge Catalog Region     : $REGION"
echo "Gemini Endpoint Location     : $GEMINI_LOCATION"
echo "Target Cloud Storage Bucket  : $BUCKET_NAME"
Habilita las APIs e instala las dependencias
Habilita las APIs de Google Cloud requeridas y, luego, instala las dependencias de Python (google-genai, google-cloud-dataplex, pydantic y pandas) desde requirements.txt:
gcloud services enable \
  dataplex.googleapis.com \
  storage.googleapis.com \
  aiplatform.googleapis.com \
  --quiet
python3 -m pip install --upgrade --quiet --user --break-system-packages -r requirements.txt
3. Define esquemas de Pydantic y plantillas de aspectos
schemas.py define dos contratos complementarios que combinan la validación de Pydantic del cliente con las plantillas de Knowledge Catalog AspectType del servidor:
DarkDataExtractedMetadata: Son los atributos operativos extraídos del PDF (título del documento, ontología del dominio, nivel de riesgo de seguridad, procedencia de la creación o la versión, resumen ejecutivo y puntuación de confianza de la extracción).DocumentGovernanceMetadata: Códigos de cumplimiento de reglamentaciones (UL-153, FCC Part 15, CE-LVD, RoHS), propietario de la administración, política de retención y una cadena de identificador de tabla de referencia (lakehouse_cross_ref_table) para vincular el manual en PDF a las tablas de inventario posteriores.
Inspeccionar schemas.py
Primero, DarkDataExtractedMetadata usa restricciones de Field de Pydantic (ge=0.0, le=1.0, lo que significa mayor o menor que o igual a, en confidence_score) para restringir el resultado JSON de Gemini Enterprise Agent Platform:
class DarkDataExtractedMetadata(BaseModel):
    document_title: str = Field(
        description="Official document title or product model name extracted from the PDF manual."
    )
    # ... domain_ontology, operational_hazard_level, author_provenance ...
    version_provenance: str = Field(
        description="Document version, revision code, or publication standard identifier."
    )
    # ... document_summary ...
    confidence_score: float = Field(
        ge=0.0,
        le=1.0,
        description="AI extraction confidence metric between 0.0 and 1.0.",
    )
En segundo lugar, extracted_aspect_template refleja esos nombres de campo exactos y asigna los tipos str y float de Python a string y double record_fields de Knowledge Catalog. Ten en cuenta que el contrato de protobuf AspectType.MetadataTemplate requiere que cada campo de record_fields declare un número entero index único, estrictamente positivo y basado en 1 (de 1 a 7). Si se omite o duplica index, create_aspect_type fallará con 400 INVALID_ARGUMENT:
extracted_aspect_template = {
    "name": "DarkDataExtractedMetadata",
    "type": "record",
    "record_fields": [
        {
            "name": "document_title",
            "type": "string",
            "index": 1,
            "annotations": {"description": "Official document title or product model name."},
        },
        # ... fields 2 through 6 (string) ...
        {
            "name": "confidence_score",
            "type": "double",
            "index": 7,
            # ... annotations ...
        },
    ],
}
Valida el módulo de esquema
Ejecuta schemas.py para verificar la configuración de tu entorno y compilar ambos esquemas:
python3 schemas.py
Configured Project ID         : your-project-id
Knowledge Catalog Region      : us-central1
Gemini Endpoint Location      : global
Governed Fileset Storage URI  :
  gs://your-project-id-dark-data-manuals/sop-pdfs/LUM-LIG-DES-8G8J_manual.pdf
Target Fileset Entry ID       : sop-manuals-fileset-lum8g8j
✓ Defined DarkDataExtractedMetadata and DocumentGovernanceMetadata
  Pydantic schemas.
✓ Prepared Knowledge Catalog AspectType metadata templates.
4. Aprovisiona espacios de nombres y tipos de aspectos personalizados
Antes de registrar entradas de conjuntos de archivos o adjuntar metadatos, step2_provision.py aprovisiona tres recursos del plano de control en Knowledge Catalog:
EntryGroup:dark-data-fileset-groupEntryType:unstructured-pdf-filesetAspectTypeBlueprints:dark-data-extracted-metadataydocument-governance-aspect
Aprovisionamiento idempotente en step2_provision.py
Cada llamada de creación en step2_provision.py encapsula la operación de larga duración (op.result()) en un bloque try / except AlreadyExists para que la secuencia de comandos se pueda volver a ejecutar de forma segura sin fallar en los recursos existentes:
# Provision AspectType 1: dark-data-extracted-metadata
try:
    at1_op = catalog_client.create_aspect_type(
        parent=parent_location,
        aspect_type_id=EXTRACTED_ASPECT_TYPE_ID,
        aspect_type=AspectType(
            name=extracted_aspect_type_name,
            display_name="Dark Data Multimodal Extracted Metadata",
            # ... description ...
            metadata_template=extracted_aspect_template,
        ),
    )
    if hasattr(at1_op, "result"):
        at1_op.result()
    print(f"Created AspectType: {extracted_aspect_type_name}")
except AlreadyExists:
    print(f"AspectType already exists; retrieving live resource: {extracted_aspect_type_name}")

live_extracted_aspect_type = catalog_client.get_aspect_type(name=extracted_aspect_type_name)
Una vez que se registra metadata_template=extracted_aspect_template, Knowledge Catalog aplica el esquema en el límite de la API, por lo que se rechaza cualquier llamada posterior a update_entry() que pase una cadena a confidence_score (double).
Ejecuta step2_provision.py
Ejecuta la secuencia de comandos de aprovisionamiento y confirma que los tipos de aspectos personalizados estén registrados en tu región:
python3 step2_provision.py
gcloud dataplex aspect-types list --location=$REGION
Created EntryGroup:
  projects/your-project-id/locations/us-central1/entryGroups/
  dark-data-fileset-group
Created EntryType :
  projects/your-project-id/locations/us-central1/entryTypes/
  unstructured-pdf-fileset
Created AspectType:
  projects/your-project-id/locations/us-central1/aspectTypes/
  dark-data-extracted-metadata
Created AspectType:
  projects/your-project-id/locations/us-central1/aspectTypes/
  document-governance-aspect
✓ All Knowledge Catalog namespaces and AspectType blueprints are active.
5. Registra entradas de conjuntos de archivos no estructurados
En lugar de saturar el catálogo con millones de punteros de archivos aislados, Knowledge Catalog agrupa los documentos relacionados en Cloud Storage (gs://YOUR_BUCKET/sop-pdfs/*.pdf) en entradas de conjunto de archivos lógicas, ya sea a través de análisis de descubrimiento automatizados (DataScanServiceClient) o registros programáticos directos (CatalogServiceClient.create_entry).
Cómo step3_register_fileset.py asigna el almacenamiento del mapa al catálogo
step3_register_fileset.py sube LUM-LIG-DES-8G8J_manual.pdf a gs://${BUCKET_NAME}/sop-pdfs/LUM-LIG-DES-8G8J_manual.pdf y registra el Entry gobernado:
fully_qualified_fileset_uri = f"gcs:{BUCKET_NAME}"
fileset_entry_spec = Entry(
    name=fileset_entry_name,
    entry_type=entry_type_resource_name,
    fully_qualified_name=fully_qualified_fileset_uri,
    entry_source=EntrySource(
        resource=VIRTUAL_STORAGE_URI,
        system="Cloud Storage",
        platform="Google Cloud",
        display_name="LUM-LIG-DES-8G8J Unstructured SOP & Technical Manual Fileset",
        # ... description ...
        location=REGION,
    ),
)

create_entry_op = catalog_client.create_entry(
    parent=entry_group_resource_name,
    entry_id=FILESET_ENTRY_ID,
    entry=fileset_entry_spec,
)
Observa los distintos roles de los dos campos de URI en Entry:
fully_qualified_name=fully_qualified_fileset_uri(f"gcs:{BUCKET_NAME}"): Usa el esquema canónico de FQN degcs:{bucket_name}que requiere Knowledge Catalog para correlacionar la entrada del catálogo lógico con el bucket subyacente de Cloud Storage.entry_source.resource=VIRTUAL_STORAGE_URI: Almacena el URI del objetogs://físico que inspeccionan los trabajadores de extracción de nivel inferior.
Ejecuta step3_register_fileset.py
python3 step3_register_fileset.py
Created Cloud Storage bucket:
  gs://your-project-id-dark-data-manuals in us-central1
Uploaded unstructured PDF manual to:
  gs://your-project-id-dark-data-manuals/sop-pdfs/LUM-LIG-DES-8G8J_manual.pdf
Registered governed Fileset Entry:
  projects/your-project-id/locations/us-central1/entryGroups/
  dark-data-fileset-group/entries/sop-manuals-fileset-lum8g8j
  -> Fully Qualified Name : gcs:your-project-id-dark-data-manuals
  -> Physical Resource URI:
  gs://your-project-id-dark-data-manuals/sop-pdfs/LUM-LIG-DES-8G8J_manual.pdf
  -> Source System        : Cloud Storage
6. Cómo extraer metadatos de documentos con Gemini
step4_extract_metadata.py lee los bytes sin procesar del PDF y, luego, invoca Gemini Enterprise Agent Platform (genai_client.models.generate_content) con dos patrones clave:
1. Descubrimiento dinámico de modelos insignia
En lugar de codificar de forma rígida cadenas de versiones de modelos frágiles, la secuencia de comandos consulta genai_client.models.list() y ordena los candidatos activos por (is_ga_channel, semantic_version_tuple) para elegir el modelo flash más reciente con disponibilidad general (DG):
genai_client = genai.Client(
    vertexai=True,
    project=PROJECT_ID,
    location=GEMINI_LOCATION,
)

for model_obj in genai_client.models.list():
    raw_id = (model_obj.name or "").split("/")[-1]
    # Filter to flagship Gemini Flash models (version >= 3.0) and prioritize GA over preview
    ...
    discovered_candidates.append((is_ga_channel, ver_tuple, raw_id))

discovered_candidates.sort(key=lambda item: (item[0], item[1]), reverse=True)
2. Extracción multimodal restringida por esquema (Part.from_bytes + response_schema)
Pasar response_mime_type="application/json" y response_schema=DarkDataExtractedMetadata (seguido de DocumentGovernanceMetadata) restringe la decodificación del token directamente al esquema JSON de Pydantic:
with open(LOCAL_PDF_PATH, "rb") as pdf_file:
    raw_pdf_bytes = pdf_file.read()

extraction_response = genai_client.models.generate_content(
    model=candidate_model,
    contents=[
        types.Part.from_bytes(data=raw_pdf_bytes, mime_type="application/pdf"),
        extraction_prompt,
    ],
    config=types.GenerateContentConfig(
        response_mime_type="application/json",
        response_schema=DarkDataExtractedMetadata,
        temperature=0.1,
    ),
)

extracted_dark_data = json.loads(extraction_response.text)
validated_extraction = DarkDataExtractedMetadata(**extracted_dark_data)
Ejecuta step4_extract_metadata.py
python3 step4_extract_metadata.py
Dynamically discovered active GA model currency :
  gemini-3.8-flash (version (3, 8))
Loaded unstructured PDF manual at: LUM-LIG-DES-8G8J_manual.pdf
Read unstructured PDF document (1184 bytes).
  Executing multimodal extraction with gemini-3.8-flash...
✓ Multimodal extraction completed using model: gemini-3.8-flash
✓ Governance classification completed using model: gemini-3.8-flash

--- Extracted Multimodal Operational Metadata ---
Extracted Attribute    Multimodal Value
document_title    LUM-LIG-DES-8G8J Contemporary Linen Desk Lamp
domain_ontology    Electrical Hardware & Lighting Systems
operational_hazard_level    MEDIUM
author_provenance    Global Hardware Safety & Lighting Systems Engin
version_provenance    Rev 4.2
document_summary    This document outlines standard operating proce
confidence_score    0.99

--- Extracted Governance & Inventory Cross-Reference Metadata ---
Governance Attribute    Classification Value
compliance_classifications    UL-153 Portable Luminaires, FCC Part 15, CE-LVD
stewardship_owner    Global Hardware Safety & Lighting Systems Engin
retention_policy    10-Year Active Product Lifecycle Archival
lakehouse_cross_ref_table    lakehouse.your-project-id.retail_hardware
governance_status    VERIFIED_PRODUCTION
7. Adjunta aspectos validados a las entradas del catálogo
step5_attach_aspects.py vincula las cargas útiles de JSON validadas (extracted_metadata.json y governance_metadata.json) a la entrada sop-manuals-fileset-lum8g8j a través de catalog_client.update_entry().
Mutación del aspecto quirúrgico en step5_attach_aspects.py
extracted_aspect_key = f"{PROJECT_ID}.{REGION}.{EXTRACTED_ASPECT_TYPE_ID}"
governance_aspect_key = f"{PROJECT_ID}.{REGION}.{GOVERNANCE_ASPECT_TYPE_ID}"

updated_entry_payload = Entry(
    name=fileset_entry_name,
    entry_type=entry_type_resource_name,
    fully_qualified_name=fully_qualified_fileset_uri,
    aspects={
        extracted_aspect_key: Aspect(
            aspect_type=extracted_aspect_type_name,
            data=extracted_data,
        ),
        governance_aspect_key: Aspect(
            aspect_type=governance_aspect_type_name,
            data=governance_data,
        ),
    },
)

update_op = catalog_client.update_entry(
    request=dataplex_v1.UpdateEntryRequest(
        entry=updated_entry_payload,
        update_mask={"paths": ["aspects"]},
        aspect_keys=[extracted_aspect_key, governance_aspect_key],
    )
)
Si se pasan ambos alcances update_mask={"paths": ["aspects"]} y aspect_keys=[extracted_aspect_key, governance_aspect_key], la mutación se limita estrictamente a estas dos claves de aspecto, lo que deja entry_source y cualquier aspecto que pertenezca a otros equipos sin modificar.
Ejecuta step5_attach_aspects.py
python3 step5_attach_aspects.py
Successfully bound 2 Aspect(s) to Entry:
  projects/your-project-id/locations/us-central1/entryGroups/
  dark-data-fileset-group/entries/sop-manuals-fileset-lum8g8j

=== Live Attached Aspect: document-governance-aspect ===
Catalog Field    Authoritative Stored Value
compliance_classifications    UL-153 Portable Luminaires, FCC Part 15, CE-LVD
stewardship_owner    Global Hardware Safety & Lighting Systems Engin
retention_policy    10-Year Active Product Lifecycle Archival
lakehouse_cross_ref_table    lakehouse.your-project-id.retail_hardware
governance_status    VERIFIED_PRODUCTION

=== Live Attached Aspect: dark-data-extracted-metadata ===
Catalog Field    Authoritative Stored Value
document_title    LUM-LIG-DES-8G8J Contemporary Linen Desk Lamp
domain_ontology    Electrical Hardware & Lighting Systems
operational_hazard_level    MEDIUM
author_provenance    Global Hardware Safety & Lighting Systems Engin
version_provenance    Rev 4.2
document_summary    This document outlines standard operating proce
confidence_score    0.99
Verificación de doble vía
- Pista 1 (verificación de la CLI): Inspecciona la entrada con todos los aspectos adjuntos a través de
gcloud:gcloud dataplex entries describe sop-manuals-fileset-lum8g8j \ --entry-group=dark-data-fileset-group \ --location=$REGION \ --view=ALL - Pista 2 (inspección de la IU de la consola):
- Abre la consola de búsqueda de Knowledge Catalog, busca LUM-LIG-DES-8G8J Unstructured SOP & Technical Manual Fileset (
sop-manuals-fileset-lum8g8j) y selecciona la entrada coincidente en los resultados. - En Etiquetas y aspectos opcionales, verifica que tanto Dark Data Multimodal Extracted Metadata como Document Governance & Inventory Cross-Reference Aspect muestren el nivel de riesgo extraído (
MEDIUM), los códigos de cumplimiento (UL-153, FCC Part 15, CE-LVD, RoHS) y la cadena de la tabla de referencias cruzadas (lakehouse_cross_ref_table).
- Abre la consola de búsqueda de Knowledge Catalog, busca LUM-LIG-DES-8G8J Unstructured SOP & Technical Manual Fileset (
8. Consulta datos oscuros gobernados en el catálogo
Una vez que se adjuntan los aspectos personalizados, los manuales en PDF no estructurados en Cloud Storage se pueden detectar a través de la búsqueda de Knowledge Catalog (catalog_client.search_entries()).
Sondeo search_entries() en step6_search_catalog.py
step6_search_catalog.py sondea search_entries() con retirada exponencial y lee las claves de aspectos canonizadas a través de .endswith():
search_query = f"entrygroup={entry_group_resource_name} name:{FILESET_ENTRY_ID}"

while elapsed_seconds < max_wait_seconds:
    catalog_search_results = list(
        catalog_client.search_entries(
            request=dataplex_v1.SearchEntriesRequest(
                name=parent_location,
                query=search_query,
            )
        )
    )
    if catalog_search_results:
        break
    backoff_seconds = min(5 * (2 ** attempt), 30)
    time.sleep(backoff_seconds)
    ...

for k, asp in detailed_entry.aspects.items():
    if k.endswith(f".{REGION}.{EXTRACTED_ASPECT_TYPE_ID}"):
        print(f"    Domain Ontology     : {asp.data.get('domain_ontology')}")
        print(f"    Hazard Level        : {asp.data.get('operational_hazard_level')}")
    elif k.endswith(f".{REGION}.{GOVERNANCE_ASPECT_TYPE_ID}"):
        print(f"    Compliance Codes    : {asp.data.get('compliance_classifications')}")
        print(f"    Lakehouse Join Table: {asp.data.get('lakehouse_cross_ref_table')}")
Ejecuta step6_search_catalog.py
python3 step6_search_catalog.py
Executing Knowledge Catalog search query:
  'entrygroup=projects/your-project-id/locations/us-central1/entryGroups/
  dark-data-fileset-group name:sop-manuals-fileset-lum8g8j'...

✓ Discovered 1 governed asset(s) in Knowledge Catalog:

[1] Entry Resource Name :
    projects/your-project-id/locations/us-central1/entryGroups/
    dark-data-fileset-group/entries/sop-manuals-fileset-lum8g8j
    Fully Qualified Name: gcs:your-project-id-dark-data-manuals
    Entry Type :
    projects/your-project-id/locations/us-central1/entryTypes/
    unstructured-pdf-fileset
    Physical Storage URI:
    gs://your-project-id-dark-data-manuals/sop-pdfs/LUM-LIG-DES-8G8J_manual.pdf
    Domain Ontology     : Electrical Hardware & Lighting Systems
    Hazard Level        : MEDIUM
    Compliance Codes    : UL-153 Portable Luminaires, FCC Part 15, CE-LVD, RoHS
    Lakehouse Join Table:
    lakehouse.your-project-id.retail_hardware.luminaire_sku_inventory_iceberg
Verificación de doble vía
- Pista 1 (búsqueda con la CLI): Consulta el índice de búsqueda directamente a través de
gcloud:gcloud dataplex entries search "name:sop-manuals-fileset-lum8g8j" --project=$PROJECT_ID - Pista 2 (búsqueda en lenguaje natural en la IU de la consola):
- Abre la Search Console de Knowledge Catalog y busca
LUM-LIG-DES-8G8JoUL-153. - Observa cómo Knowledge Catalog muestra la entrada gobernada del conjunto de archivos PDF de Cloud Storage y sus aspectos de metadatos adjuntos.
- Abre la Search Console de Knowledge Catalog y busca
9. Verifica las aserciones de administración integral
step7_verify_assertions.py ejecuta aserciones determinísticas en las respuestas del plano de control de Knowledge Catalog en vivo para verificar que EntryGroup, EntryType, ambos planos personalizados de AspectType, las cargas útiles del aspecto EntryView.ALL vinculadas (límites de confidence_score y cadena de lakehouse_cross_ref_table) y el descubrimiento del índice de búsqueda se realicen correctamente:
verify_eg = catalog_client.get_entry_group(name=entry_group_resource_name)
assert verify_eg.name == entry_group_resource_name, "EntryGroup resource name mismatch."

verify_entry = catalog_client.get_entry(
    request=dataplex_v1.GetEntryRequest(
        name=fileset_entry_name,
        view=dataplex_v1.EntryView.ALL,
    )
)
bound_extracted = next(
    (
        asp for k, asp in verify_entry.aspects.items()
        if k.endswith(f".{REGION}.{EXTRACTED_ASPECT_TYPE_ID}")
    ),
    None,
)
bound_governance = next(
    (
        asp for k, asp in verify_entry.aspects.items()
        if k.endswith(f".{REGION}.{GOVERNANCE_ASPECT_TYPE_ID}")
    ),
    None,
)

assert bound_extracted is not None, f"Aspect '{EXTRACTED_ASPECT_TYPE_ID}' not found on live Entry."
assert bound_governance is not None, (
    f"Aspect '{GOVERNANCE_ASPECT_TYPE_ID}' not found on live Entry."
)
assert (
    bound_extracted.data.get("document_title") == expected_extraction["document_title"]
), "Extracted title mismatch."
assert (
    0.0 <= float(bound_extracted.data.get("confidence_score", -1.0)) <= 1.0
), "Invalid confidence score in catalog."
assert (
    "lakehouse" in str(bound_governance.data.get("lakehouse_cross_ref_table", "")).lower()
), "Missing Lakehouse cross-reference."
...
assert len(search_results) >= 1, "Expected at least 1 search result in Knowledge Catalog."
Ejecuta step7_verify_assertions.py
python3 step7_verify_assertions.py && echo "Verification exit code: $?"
Running substantive end-to-end verification assertions...
✓ All 5 substantive verification assertions passed
  against live Google Cloud control plane state!
Verification exit code: 0
10. Diseña una canalización controlada por eventos
Si bien ejecutar de forma interactiva secuencias de comandos de Python en Cloud Shell es ideal para compilar y probar tus contratos de administración, los entornos empresariales reciben miles de manuales de ingeniería en PDF, certificados de cumplimiento de proveedores y documentos de SOP nuevos o revisados a diario desde los portales de ERP, administración del ciclo de vida del producto (PLM) y proveedores. Ejecutar manualmente los scripts por lotes crea rápidamente puntos ciegos de control entre la carga de documentos y la indexación del catálogo.
En producción, los equipos de la plataforma operativizan el código exacto que ejecutaste en los pasos 4 y 5 como una canalización sin intervención y basada en eventos:
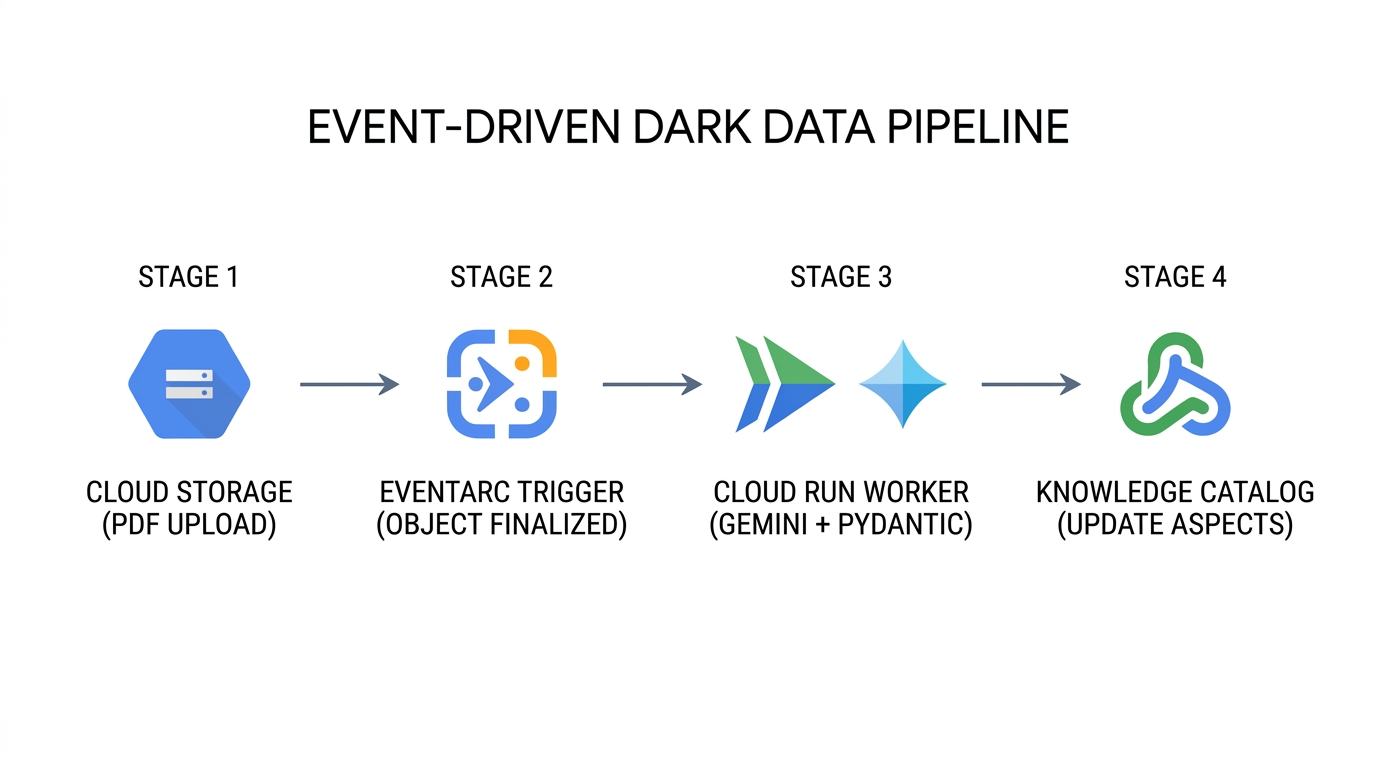
- Ingesta continua de documentos (
Cloud Storage→Eventarc): Cada vez que se sube un nuevo manual en PDF o una nueva revisión sobrescribe un objeto existente en Cloud Storage, el bucket emite un CloudEvent degoogle.cloud.storage.object.v1.finalizedque contiene el identificador del bucket, la ruta de acceso del objeto y el número de generación del objeto. - Extracción multimodal sin estado (
Eventarc→Cloud Run→Gemini Enterprise Agent Platform): Eventarc enruta el CloudEvent a un paquete de trabajadores Cloud Run sin servidoresschemas.py,step4_extract_metadata.pyystep5_attach_aspects.py. El trabajador transmite los bytes del PDF a Gemini Enterprise Agent Platform conresponse_schemaaplicado, lo que garantiza que cada atributo extraído cumpla conDarkDataExtractedMetadatayDocumentGovernanceMetadata. - Actualización quirúrgica del plano de control (
Cloud Run→Knowledge Catalog): El trabajador resuelve el Fileset principalEntryy ejecutacatalog_client.update_entry()conupdate_mask={"paths": ["aspects"]}yaspect_keysexplícitos. Incluso si docenas de documentos terminan de procesarse de forma simultánea, cada mutación actualiza solo las claves de aspecto designadas. - Aislamiento de administradores con puerta de confianza: Si un PDF heredado escaneado genera una extracción
confidence_scorepor debajo del umbral operativo (por ejemplo,< 0.85), el trabajador establecegovernance_status = "PENDING_STEWARD_REVIEW"en el aspecto adjunto para que los administradores de datos puedan consultar Knowledge Catalog en busca de recursos con baja confianza que requieran una revisión humana.
Cómo las empresas aplican este patrón en producción
Caso de uso empresarial | Cómo funciona Metadata-as-Code en la práctica | Impacto operativo y comercial |
Auditorías reglamentarias automatizadas y preparación para retiros | Los sistemas de cumplimiento unen aspectos de seguridad de PDF no estructurados ( | Cuando se actualiza un estándar, como |
Agentes de IA fundamentados y prefiltrado de RAG | Antes de que un agente de generación mejorada por recuperación (RAG) en Gemini Enterprise Agent Platform responda la pregunta de un ingeniero de campo, filtra las entradas del Knowledge Catalog por | Evita que los asistentes de IA alucinen o citen borradores de ingeniería obsoletos, POE vencidos o manuales de terceros no verificados. |
Enriquecimiento simultáneo de varios equipos | Varias canalizaciones independientes enriquecen el mismo conjunto de archivos | Dado que los permisos de |
Evolución del esquema de CI/CD a través de GitOps | Los equipos de la plataforma almacenan | Elimina la desviación del esquema entre el código de extracción de la aplicación y el plano de control de Knowledge Catalog en los proyectos |
11. Limpia tu entorno
En Knowledge Catalog, no se pueden borrar los contenedores principales ni las plantillas de esquema mientras las entradas secundarias sigan haciendo referencia a ellos. cleanup.py borra los recursos en orden inverso estricto de dependencia (Entry → EntryGroup → EntryType → AspectTypes → objetos del bucket de Cloud Storage → archivos JSON temporales):
# 1. Delete Fileset Entry first
catalog_client.delete_entry(name=target_entry_path)

# 2. Delete EntryGroup container
del_eg_op = catalog_client.delete_entry_group(name=target_eg_path)
if hasattr(del_eg_op, "result"):
    del_eg_op.result()

# 3. Delete EntryType and Custom AspectTypes
del_et_op = catalog_client.delete_entry_type(name=target_et_path)
if hasattr(del_et_op, "result"):
    del_et_op.result()
for aspect_id_val in (EXTRACTED_ASPECT_TYPE_ID, GOVERNANCE_ASPECT_TYPE_ID):
    target_at_path = f"{active_parent}/aspectTypes/{aspect_id_val}"
    del_at_op = catalog_client.delete_aspect_type(name=target_at_path)
    if hasattr(del_at_op, "result"):
        del_at_op.result()
Ejecuta cleanup.py
python3 cleanup.py
Starting reverse-dependency resource cleanup in Knowledge Catalog...
Deleted Fileset Entry:
  projects/your-project-id/locations/us-central1/entryGroups/
  dark-data-fileset-group/entries/sop-manuals-fileset-lum8g8j
Deleted EntryGroup   :
  projects/your-project-id/locations/us-central1/entryGroups/
  dark-data-fileset-group
Deleted EntryType    :
  projects/your-project-id/locations/us-central1/entryTypes/
  unstructured-pdf-fileset
Deleted AspectType   :
  projects/your-project-id/locations/us-central1/aspectTypes/
  dark-data-extracted-metadata
Deleted AspectType   :
  projects/your-project-id/locations/us-central1/aspectTypes/
  document-governance-aspect
Deleted Cloud Storage object :
  gs://your-project-id-dark-data-manuals/sop-pdfs/LUM-LIG-DES-8G8J_manual.pdf
Deleted Cloud Storage bucket : gs://your-project-id-dark-data-manuals
Removed local temporary file : extracted_metadata.json
Removed local temporary file : governance_metadata.json
✓ Standalone teardown complete. Environment cleanly reset.
Quita el directorio del repositorio clonado
Después de que cleanup.py termine de borrar los recursos de la nube, vuelve a tu directorio principal y quita la carpeta del repositorio devrel-demos clonado de Cloud Shell:
cd ~
rm -rf ~/devrel-demos
12. ¡Felicitaciones!
Creaste y verificaste una canalización de administración de metadatos como código de extremo a extremo que convierte los PDFs no estructurados en Cloud Storage en recursos detectables y con esquema aplicado de Knowledge Catalog con Gemini Enterprise Agent Platform.
Próximos pasos
- Automatiza con Terraform: Administra los recursos de
google_dataplex_aspect_typeygoogle_dataplex_entry_groupde forma declarativa en las canalizaciones de CI/CD. - Implementa Eventarc y Cloud Run Workers: Coloca
step4_extract_metadata.pyystep5_attach_aspects.pyen contenedores para crear un servicio de Cloud Run controlado por eventos. - Combinaciones de inventario posteriores en BigQuery: Exporta los metadatos de administración extraídos (
lakehouse_cross_ref_table) para combinar los atributos de cumplimiento de documentos no estructurados con las tablas de inventario de SKU estructuradas.
Documentos de referencia
- Repositorio de muestras complementarias (
codelabs/metadata-as-code-lab) - Descripción general de Knowledge Catalog
- Administra entradas y tipos de aspectos personalizados en Knowledge Catalog
- Documentación del SDK de IA generativa de Google (
google-genai) - Salidas estructuradas con esquemas de Gemini y Pydantic